
Dans le domaine de l’analyse statistique avancée et de l’ingénierie des données cliniques, financières ou biométriques, la caractérisation rigoureuse de la distribution d’une variable quantitative constitue une étape méthodologique fondamentale. Alors que les métriques de tendance centrale traditionnelles, à l’instar de la moyenne arithmétique et de l’écart-type, reposent sur l’hypothèse sous-jacente d’une distribution symétrique souvent gaussienne, la réalité des données empiriques révèle presque systématiquement des asymétries prononcées, des queues épaisses et une contamination inévitable par des valeurs extrêmes. Face à ces distorsions structurelles, les mesures de position non paramétriques, et plus spécifiquement les centiles (ou percentiles), s’imposent comme des estimateurs robustes et indispensables pour saisir la dispersion relative et établir des seuils décisionnels fiables.
Le système SAS (Statistical Analysis System) demeure, depuis plusieurs décennies, le standard industriel incontesté au sein des environnements hautement régulés, tels que l’industrie pharmaceutique sous les directives de la FDA, le secteur bancaire prudentiel et les agences d’évaluation publique. Cette prééminence s’explique par la puissance computationnelle de ses algorithmes, la traçabilité intégrale de ses procédures et la flexibilité offerte pour modéliser des distributions complexes. Le calcul des centiles au sein de SAS ne se résume pas à une simple opération arithmétique de classement ; il met en jeu des architectures de procédures spécialisées, une gestion fine de la mémoire vive et un ensemble d’options d’interpolation mathématique dont la maîtrise est essentielle pour garantir la reproductibilité des résultats scientifiques.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes théoriques, les implémentations syntaxiques et les applications opérationnelles du calcul des centiles dans l’écosystème SAS. De la configuration élémentaire de la procédure UNIVARIATE jusqu’à l’automatisation macro-industrielle, en passant par l’analyse comparative des cinq définitions algorithmiques de quantiles et l’intégration des pondérations d’échantillonnage, cette monographie technique offre aux statisticiens, biostatisticiens et ingénieurs de données l’ensemble des clés méthodologiques pour exploiter pleinement la puissance analytique de SAS.
1. Fondements théoriques et pertinence statistique des centiles dans SAS
1.1 Définition mathématique et conceptuelle des centiles
D’un point de vue strictement probabiliste, les centiles appartiennent à la famille générale des quantiles, lesquels correspondent aux valeurs qui divisent la distribution ordonnée d’une variable aléatoire continue ou discrète en intervalles réguliers de probabilité égale. Si l’on considère une variable aléatoire réelle notée X, caractérisée par une fonction de répartition cumulative définie par F(x) = P(X ≤ x), le p-ième centile (où p représente un nombre réel compris dans l’intervalle semi-ouvert ]0, 100[) correspond formellement à la valeur minimale xp satisfaisant la condition probabiliste F(xp) ≥ p / 100. Dans le cas idéal d’une distribution strictement continue et strictement monotone, cette formulation équivaut à inverser la fonction de répartition empirique, de sorte que xp = F-1(p / 100). Les centiles scindent ainsi l’ensemble ordonné des observations en cent segments contenant chacun un pour cent de la masse totale de probabilité de l’échantillon ou de la population parente.
La distinction conceptuelle entre les métriques paramétriques classiques et les mesures de position ordinale s’avère particulièrement saillante lorsqu’on compare la moyenne à la médiane (qui constitue, par définition, le cinquantième centile) et aux autres quantiles de rang supérieur ou inférieur. La moyenne arithmétique, minimisant la somme des carrés des écarts, s’avère particulièrement sensible à la moindre observation aberrante ou excentrée dans les queues de distribution. À l’inverse, les centiles, en tant qu’estimateurs d’ordre, minimisent la somme des écarts absolus pondérés, ce qui leur confère un point de rupture élevé et une invariance remarquable sous les transformations strictement monotones. Cette propriété de robustesse s’avère indispensable dans l’analyse de données économiques (notamment la distribution des revenus ou du patrimoine des ménages) et dans les essais cliniques où les temps de survie ou les taux de clairance plasmatique exhibent une asymétrie positive prononcée incompatible avec l’hypothèse de normalité.
Dans le domaine de l’étalonnage psychométrique, de la docimologie et des évaluations standardisées, l’usage des centiles représente le socle technique sur lequel repose l’interprétation des performances individuelles rapportées à une cohorte de référence. Un score brut obtenu à un test d’aptitude cognitive ou à un examen médical n’a que peu de signification intrinsèque ; c’est son rang centile qui permet de situer précisément le sujet par rapport à la distribution de normalisation. Ainsi, stipuler qu’un candidat se situe au 85e centile signifie de manière non ambiguë que 85 % des individus de la cohorte d’étalonnage ont obtenu un résultat égal ou inférieur au sien, tandis que 15 % ont réalisé une performance strictement supérieure, sans qu’aucune hypothèse de normalité préalable ne soit requise pour valider cette conclusion descriptive.
1.2 Architecture du traitement des centiles au sein de l’écosystème SAS
Au sein de l’architecture logicielle de SAS, le traitement analytique des centiles est principalement dévolu à la procédure PROC UNIVARIATE, véritable moteur de calcul dédié à l’exploration univariée exhaustive des variables quantitatives. Contrairement à des procédures plus sommaires, PROC UNIVARIATE ne se contente pas de calculer des métriques descriptives basiques ; elle instancie un module d’analyse d’ordre supérieur capable d’évaluer simultanément les moments d’une distribution (espérance, variance, asymétrie de Fisher-Pearson, aplatissement ou kurtosis de Geary), d’effectuer des tests d’adéquation paramétrique (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling, Cramér-von Mises) et de calculer l’ensemble des quantiles standards ainsi que des quantiles personnalisés selon plusieurs formules mathématiques distinctes.
Lorsqu’on examine les alternatives présentes dans le catalogue SAS Base, la comparaison structurelle entre PROC UNIVARIATE, PROC MEANS et PROC SUMMARY met en lumière des compromis algorithmiques délibérés. PROC MEANS et PROC SUMMARY (qui partagent un moteur de calcul identique, la seconde étant historiquement orientée vers la production de tables de synthèse sans affichage par défaut) sont optimisées pour le traitement de volumes de données massifs et la réduction dimensionnelle par agrégation rapide. Elles proposent des mots-clés prédéfinis pour les quantiles usuels (P1, P5, P10, Q1, MEDIAN, Q3, P90, P95, P99), mais ne disposent pas de la granularité syntaxique requise pour calculer des points de coupure arbitraires non répertoriés (tels qu’un 73,5e centile ou une séquence décimale fine) au moyen d’une seule instruction paramétrable. De surcroît, le choix des algorithmes d’interpolation numérique demeure plus restreint au sein de PROC MEANS, tandis que PROC UNIVARIATE offre un paramétrage exhaustif via l’option d’interpolation PCTLDEF.
La réussite de ces opérations d’analyse descriptive conditionne également une compréhension approfondie de la structure du jeu de données en entrée. Le moteur de traitement SAS exige que les variables soumises à l’instruction VAR soient strictement de type numérique (représentées en virgule flottante double précision sur huit octets sous l’architecture standard IEEE 754). Tout enregistrement textuel ou formaté de manière non standard doit préalablement faire l’objet d’une conversion explicite via les fonctions d’entrée INPUT. De plus, la topologie de la table SAS doit idéalement respecter la forme rectangulaire normale où chaque ligne correspond à une unité statistique indépendante (sujet, transaction, mesure expérimentale) et chaque colonne à un attribut dimensionnel ou une mesure d’intérêt, assurant ainsi une lecture séquentielle et optimisée par le compilateur interne du superviseur SAS.
2. Préparation des données d’analyse et mise en place du jeu de données de test
2.1 Création du jeu de données expérimental original_data
Pour illustrer de manière concrète, reproductible et pédagogique les différentes syntaxes et comportements algorithmiques de SAS, nous établissons un jeu de données expérimental structuré simulant une évaluation de performance au sein d’une organisation industrielle ou sportive. Ce jeu de données, nommé original_data, servira de fil conducteur à l’ensemble des expérimentations méthodologiques développées dans cet article. Il intègre délibérément une variable de stratification nominale (permettant la mise en œuvre ultérieure de segmentations analytiques) et une variable métrique continue présentant une dispersion asymétrique propre à mettre en évidence les singularités des méthodes d’interpolation.
La construction de cette table s’opère au moyen de l’étape DATA, mécanisme fondamental du langage SAS qui assure l’allocation dynamique de la mémoire, la définition des descripteurs de table et l’exécution de la boucle itérative implicite. Les observations sont injectées directement dans le flux d’instructions via le descripteur DATALINES (ou CARDS), garantissant une portabilité totale du script sans dépendance à l’égard de systèmes de fichiers externes. La variable catégorielle team est déclarée avec le modificateur textuel ($), tandis que la variable points est instanciée sous la forme d’un vecteur numérique standard.
Le code SAS d’initialisation se déploie selon la structure suivante :
DATA original_data;
INPUT team $ points;
DATALINES;
A 8
A 10
A 12
A 12
A 15
A 18
A 20
A 22
A 25
A 29
B 14
B 17
B 19
B 20
B 24
B 24
B 28
B 31
B 35
B 40
;
RUN;
Dès l’exécution de ce bloc transactionnel, il convient d’exécuter la procédure PROC CONTENTS. Cette démarche de contrôle permet de valider le dictionnaire des métadonnées associé à la table créée, en certifiant notamment que le codage des caractères s’est opéré sans troncature sur la variable textuelle, que la variable de score est convenablement typée en valeur numérique continue, et que le nombre d’enregistrements compilés correspond exactement aux vingt unités expérimentales réparties de façon équilibrée entre les deux sous-populations identifiées.
2.2 Inspection initiale et validation descriptive des données
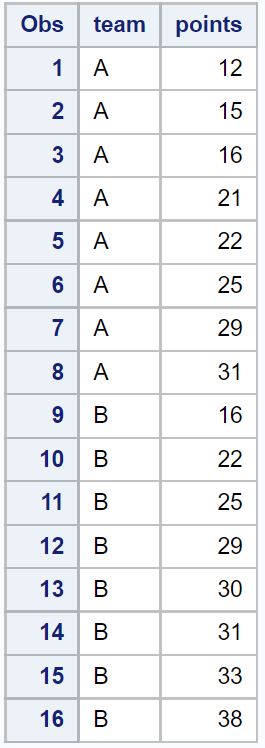
Préalablement à toute démarche d’inférence ou de calcul de centiles avancés, une inspection visuelle directe des données brutes stockées dans la mémoire de travail de la bibliothèque temporaire WORK s’avère indispensable. Cette vérification descriptive fondamentale prévient les erreurs silencieuses d’encodage, les décalages de délimiteurs de colonnes et les troncatures inopinées de valeurs décimales. L’utilisation de la procédure PROC PRINT constitue la méthode canonique pour matérialiser le contenu intégral du vecteur d’enregistrement dans la fenêtre de sortie ou le visualiseur ODS (Output Delivery System).
Le segment d’instruction s’écrit de la façon suivante :
PROC PRINT DATA=original_data NOOBS;
TITLE « Affichage du jeu de données expérimental original_data »;
RUN;
L’argument NOOBS supprime l’affichage de la colonne implicite de numérotation des observations, focalisant l’attention sur les variables de travail réelles. L’analyse préliminaire des valeurs observées révèle que l’équipe A regroupe dix observations dont les scores s’échelonnent de 8 à 29 unités, avec une présence notable de valeurs redondantes (scores ex æquo à 12 points). L’équipe B présente quant à elle un étalement de 14 à 40 unités, illustrant une variance supérieure et des scores centraux plus élevés (avec un doublon à 24 points).
Cette configuration de petite taille d’échantillon (N = 10 par sous-groupe, N = 20 pour la cohorte globale) soulève d’emblée des considérations méthodologiques cruciales concernant la fiabilité intrinsèque des centiles calculés. Sur le plan théorique, l’estimation d’un centile de rang extrême (par exemple, le 99e ou le 1er centile) nécessite des cohortes de taille substantielle pour éviter que la valeur estimée ne repose exclusivement sur les aléas échantillonnaux d’une seule observation périphérique. Dans le cadre de petits échantillons, la distance séparant deux observations consécutives dans la série ordonnée représente une fraction substantielle de la masse de probabilité (ici, 10 % par point d’observation au sein de chaque groupe). Les résultats numériques obtenus seront par conséquent tributaires de la méthode mathématique choisie pour réaliser l’interpolation linéaire entre deux points successifs, une problématique qui sera examinée en détail dans les sections ultérieures de cette étude.
3. Méthode 1 : Calcul d’un centile unique à l’aide de PROC UNIVARIATE
3.1 Syntaxe fondamentale et mécanisme de l’instruction OUTPUT
L’extraction ciblée d’un centile déterminé s’effectue avec une précision chirurgicale grâce à la procédure PROC UNIVARIATE, à condition d’articuler correctement ses instructions cardinales : la sélection des variables continues d’intérêt, l’interfaçage de l’instruction de redirection OUTPUT et la paramétrisation vectorielle des points de quantiles ciblés. Contrairement à une simple exécution descriptive qui afficherait des dizaines de tableaux de métriques dans la fenêtre de résultats standard, l’association de PROC UNIVARIATE avec une clause OUTPUT dédiée permet de générer une table de données SAS structurée, immédiatement réutilisable pour des analyses ultérieures, des appariements ou des modélisations décisionnelles.
L’instruction VAR désigne expressément la variable métrique soumise à l’évaluation distributionnelle. Sans cette instruction, la procédure traiterait l’ensemble des colonnes numériques présentes dans la table source, ce qui engendrerait des surcoûts d’entrées-sorties inutiles. Parallèlement, l’instruction OUTPUT s’accompagne obligatoirement de la clause OUT=nom_de_table afin de matérialiser les résultats sous la forme d’un objet physique ou logique dans l’espace de travail SAS. Au cœur de cette instruction réside le paramètre PCTLPTS= (abréviation technique de Percentile Points), dont la spécificité syntaxique autorise la définition d’un ou plusieurs seuils continus compris entre 0 et 100.
Le fonctionnement précis de PCTLPTS repose sur un algorithme interne de tri et d’indexation temporaire. Lorsque la procédure est appelée, SAS balaie les valeurs de la variable spécifiée, exclut les éventuelles valeurs manquantes du calcul du rang, ordonne les observations dans une mémoire tampon dédiée, puis applique le solveur mathématique associé à la recherche du point percentile. L’utilisation conjointe du paramètre PCTLPRE= (abréviation de Percentile Prefix) garantit l’attribution d’un nom de variable explicite et intelligible au sein de la table de sortie, évitant la génération de dénominations automatiques cryptiques susceptibles d’altérer la lisibilité des pipelines de production de données.
3.2 Implémentation pratique du 70e centile
Pour matérialiser ce protocole statistique, nous développons l’implémentation complète visant à déterminer le 70e centile (noté P70) de la variable continue points sur l’ensemble de la population agrégée (les vingt observations sans discrimination de groupe). L’objectif analytique consiste à établir le seuil chiffré séparant les 70 % des scores les plus modestes des 30 % des performances supérieures.
Le code SAS s’articule comme suit :
PROC UNIVARIATE DATA=original_data NOPRINT;
VAR points;
OUTPUT OUT=percentile_70
PCTLPTS=70
PCTLPRE=p_;
RUN;
PROC PRINT DATA=percentile_70 NOOBS;
TITLE « Résultat de l’extraction univariée du 70e centile »;
RUN;
L’utilisation de l’option NOPRINT au niveau de l’en-tête de la procédure désactive la génération des flux de rapports volumineux dans le canal ODS. Cette pratique représente une règle de l’art dans les environnements de production, car elle économise les ressources de processeur et de mémoire allouées au formatage graphique, en ne conservant que l’écriture directe de la table analytique de sortie percentile_70.
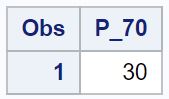
Lors de l’exécution, SAS combine la racine textuelle déclarée dans PCTLPRE=p_ avec la valeur numérique formulée dans PCTLPTS=70, créant automatiquement une colonne baptisée p_70. L’affichage de la table générée produit un enregistrement unique comportant la valeur calculée, laquelle s’élève précisément à 24,5 points dans notre jeu de données expérimental. Cette valeur décimale résulte directement de l’application de la méthode d’interpolation par défaut de SAS sur les observations ordonnées, démontrant que le centile ne coïncide pas obligatoirement avec une valeur entière réellement observée dans l’échantillon.
3.3 Interprétation statistique du résultat univarié
L’obtention de la valeur numérique de 24,5 points pour le 70e centile appelle une analyse descriptive rigoureuse. Sur le plan statistique fondamental, ce seuil de troncature signifie que très exactement 70 % de la masse de probabilité empirique de l’échantillon considéré est concentrée en deçà ou au niveau de cette frontière métrique. Réciproquement, seules trois observations sur dix (soit 30 % de la cohorte analysée) enregistrent un niveau d’accomplissement strictement supérieur à 24,5 points. Si l’on dénombre manuellement les occurrences dans la table ordonnée globale (comportant les vingt observations combinées de A et B : 8, 10, 12, 12, 14, 15, 17, 18, 19, 20, 20, 22, 24, 24, 25, 28, 29, 31, 35, 40), on constate que 14 observations se situent en dessous de 24,5 (14 / 20 = 70 %), et que 6 observations lui sont supérieures (6 / 20 = 30 %).
Cette parfaite concordance théorique illustre la cohérence des estimateurs de quantiles. Néanmoins, l’analyste doit garder à l’esprit que selon la granularité du jeu de données et la présence fréquente d’ex æquo, des discontinuités discrètes peuvent modifier légèrement la proportion exacte d’individus situés strictement au-dessus ou en dessous du seuil. Si plusieurs individus avaient obtenu un score identique de 24,5, la proportion stricte aurait pu diverger marginalement de la cible nominale de 70 %.
Dans les contextes d’admission sélective, de validation d’aptitudes professionnelles ou de tarification du risque assurantiel, ce mode de calcul unitaire d’un centile ciblé constitue l’instrument privilégié pour fixer des lignes directrices objectives. Plutôt que de recourir à un seuil arbitraire basé sur la moyenne majorée d’une fraction d’écart-type (formule vulnérable aux dissymétries et aux scores hors normes d’une poignée d’individus exceptionnels), le recours au 70e centile certifie que l’indice de sélection ou de tarification demeure invariant face à la variabilité extrême des scores de pointe, préservant ainsi l’équité distributive du système d’évaluation.
4. Méthode 2 : Calcul simultané de plusieurs centiles sur une variable continue
4.1 Extension de l’instruction PCTLPTS pour les séries de valeurs
Dans la majorité des démarches de recherche épidémiologique, d’actuariat ou de caractérisation de variables biométriques, l’examen isolé d’un seul centile s’avère insuffisant pour cartographier l’intégralité du profil distributionnel d’une population. Les statisticiens requièrent fréquemment l’extraction simultanée de multiples jalons quantiles, que ce soit pour construire des grilles d’étalonnage complètes (déciles, quintiles) ou pour sonder avec une précision accrue les comportements de queue de distribution. La procédure PROC UNIVARIATE intègre une capacité de vectorisation permettant de spécifier des séries complexes de quantiles au sein d’une seule exécution séquentielle.
La syntaxe de l’instruction PCTLPTS= autorise la déclaration d’une suite de valeurs numériques séparées par de simples espaces, sans adjonction de virgules séparatrices (syntaxe rigoureuse imposée par le parseur de macros et d’instructions SAS). Ainsi, l’analyste souhaitant examiner la tranche supérieure de la distribution peut consigner directement PCTLPTS=70 80 90 pour obtenir de manière synchrone les 70e, 80e et 90e centiles.
Au-delà de l’énumération discrète, SAS met à disposition des notations abrégées particulièrement efficaces pour balayer des plages statistiques étendues. L’utilisation de la syntaxe indicée avec pas régulier, formulée sous la forme PCTLPTS=10 TO 90 BY 10, permet d’extraire en une seule commande l’ensemble complet des neuf déciles d’une distribution. Sur le plan de l’ingénierie computationnelle, cette vectorisation des requêtes statistiques optimise drastiquement le temps d’exécution par rapport à des appels répétitifs de procédures distinctes. Les données ne sont chargées en mémoire et triées qu’une seule fois dans la table de travail interne, après quoi le sous-système de calcul résout l’ensemble des coordonnées de quantiles demandées avant de libérer le cache de calcul.
4.2 Gestion des préfixes et conventions de nommage des variables de sortie
L’extraction conjointe de multiples métriques de position au moyen de l’instruction OUTPUT soulève la question de la standardisation des dénominations de variables dans la table SAS générée. Pour répondre à cette problématique de manière automatisée et robuste, SAS propose un couple de paramètres complémentaires : PCTLPRE= et PCTLNAME=, qui régissent la morphologie lexicale des colonnes créées.
L’utilisation de PCTLPRE= constitue l’approche la plus standardisée. En affectant un préfixe textuel (par exemple PCTLPRE=p_), SAS procède à la concaténation de cette chaîne avec la valeur entière ou décimale de chaque centile déclaré dans PCTLPTS. Ainsi, la commande PCTLPTS=70 80 90 PCTLPRE=score_p engendrera automatiquement dans la table de destination trois variables distinctes : score_p70, score_p80 et score_p90. Si l’analyste omet de définir un préfixe, SAS appliquera un libellé par défaut qui peut nuire à l’intelligibilité du dictionnaire des données en aval.
Lorsque des exigences documentaires formelles imposent des noms de colonnes non standards ou plus descriptifs, l’instruction PCTLNAME= peut être adjointe pour écraser la concaténation arithmétique par défaut. Il convient alors de fournir une liste ordonnée d’étiquettes textuelles correspondant en nombre exact à la séquence numérique déclarée dans PCTLPTS. Par exemple, l’association PCTLPTS=25 50 75 PCTLPRE=pts_ PCTLNAME=premier_quartile mediane troisieme_quartile permettra d’obtenir une structure analytique explicite, facilitant son intégration directe dans des pipelines de reporting automatisés ou des jointures relationnelles avec des référentiels de données d’entreprise.
Voici la mise en œuvre de cette technique pour le profilage supérieur de notre jeu de test :
PROC UNIVARIATE DATA=original_data NOPRINT;
VAR points;
OUTPUT OUT=percentiles_multiples
PCTLPTS=70 80 90
PCTLPRE=p_
PCTLNAME=soixante_dix quatre_vingts quatre_vingt_dix;
RUN;
PROC PRINT DATA=percentiles_multiples NOOBS;
TITLE « Affichage simultané des 70e, 80e et 90e centiles personnalisés »;
RUN;
4.3 Cas d’usage : profilage multidimensionnel d’un échantillon
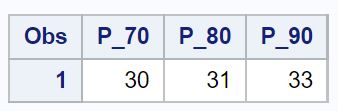
L’analyse articulée des 70e, 80e et 90e centiles permet de mener une véritable étude morphologique de la queue supérieure de la distribution de notre variable points. À la lecture de la table résultante issue du code précédent, les valeurs numériques obtenues s’établissent respectivement à 24,5 pour le 70e centile, 28,5 pour le 80e centile, et 33,0 pour le 90e centile. L’analyse des écarts incrémentaux entre ces seuils successifs s’avère particulièrement instructive pour évaluer l’étirement de la queue de distribution.
Entre le 70e et le 80e centile (qui couvrent chacun une tranche équivalente de 10 % de la masse échantillonnale), l’amplitude métrique est de 28,5 – 24,5 = 4,0 points. En revanche, entre le 80e et le 90e centile (représentant également une tranche de 10 %), l’écart s’élève à 33,0 – 28,5 = 4,5 points. Cette progression croissante des distances inter-quantiles traduit une accélération de la dispersion des scores à mesure que l’on progresse vers les tranches d’excellence ou d’intensité supérieure. Ce comportement d’étirement vers la droite matérialise l’asymétrie positive de la série statistique.
Si la variable étudiée suivait rigoureusement une loi normale centrée et réduite, l’écart théorique entre les quantiles successifs devrait être parfaitement symétrique et conforme aux propriétés de la fonction de répartition de Gauss. Dans un cadre gaussien standard, l’écart entre le 70e centile (z ≈ 0,524) et le 80e centile (z ≈ 0,841) est de 0,317 σ, tandis que l’écart entre le 80e et le 90e centile (z ≈ 1,282) est de 0,441 σ. La confrontation des valeurs empiriques obtenues dans SAS avec les espérances théoriques paramétriques permet ainsi aux épidémiologistes et aux analystes de risque de quantifier la déviation d’une cohorte par rapport au postulat de normalité, justifiant l’abandon des modèles linéaires classiques au profit de modélisations non paramétriques ou généralisées.
5. Méthode 3 : Calcul des centiles stratifiés par sous-groupes
5.1 Tri préalable des données avec PROC SORT
Dans les applications réelles de la data science, l’analyse globale agrégée dissimule fréquemment des hétérogénéités structurelles majeures entre sous-populations. Qu’il s’agisse de comparer les temps de guérison entre un groupe sous traitement expérimental et un groupe placebo dans un essai clinique de phase III, ou d’évaluer les niveaux de rémunération selon des segments d’activité, la segmentation par sous-groupes représente la pierre angulaire de l’analyse comparative. Au sein de SAS, l’instruction universelle permettant d’instancier un traitement par strate est l’instruction BY.
Cependant, l’utilisation de l’instruction BY dans toute procédure analytique SAS, et plus particulièrement dans PROC UNIVARIATE, est subordonnée à une contrainte architecturale stricte : la table d’entrée doit impérativement avoir été préalablement triée ou indexée selon la ou les variables de stratification déclarées. Le compilateur SAS lit les données de façon séquentielle par blocs de mémoire ; s’il rencontre une alternance désordonnée d’identifiants de groupes (par exemple, un enregistrement de l’équipe B surgissant au milieu des observations de l’équipe A), la procédure s’interrompt brutalement en émettant une erreur d’exécution bloquante dans le journal (SAS Log) : ERROR: Data set WORK.ORIGINAL_DATA is not sorted in ascending sequence.
L’utilisation de la procédure PROC SORT constitue par conséquent le prérequis obligatoire avant tout calcul de centiles stratifiés. L’instruction s’écrit avec une rigueur absolue :
PROC SORT DATA=original_data OUT=sorted_data;
BY team;
RUN;
Cette étape matérialise une nouvelle table ordonnée sorted_data où toutes les observations relatives à l’équipe A sont consécutivement regroupées en premier lieu, suivies de l’ensemble ordonné des unités de l’équipe B. La stabilité du tri et l’intégrité de la table sont ainsi garanties pour le moteur d’exécution de PROC UNIVARIATE.
5.2 Exécution de PROC UNIVARIATE avec l’instruction BY
Dès lors que la table de travail présente la structuration requise, la procédure PROC UNIVARIATE peut être déployée en lui adjoignant conjointement les instructions BY team;, VAR points; et la clause de génération OUTPUT OUT= dotée des spécifications de centiles désirées. Le compilateur SAS partitionne alors dynamiquement le processus de calcul : pour chaque modalité distincte identifiée dans la variable de groupe, la procédure réinitialise ses accumulateurs de moments, trie les valeurs locales de la variable métrique, applique l’algorithme de quantile sélectionné et rédige un enregistrement spécifique dans la table de sortie.
Le bloc d’instructions SAS se structure comme suit :
PROC UNIVARIATE DATA=sorted_data NOPRINT;
BY team;
VAR points;
OUTPUT OUT=percentiles_stratifies
PCTLPTS=70 80 90
PCTLPRE=p_
PCTLNAME=p70 p80 p90;
RUN;
PROC PRINT DATA=percentiles_stratifies NOOBS;
TITLE « Centiles stratifiés par sous-groupes (Équipe A vs Équipe B) »;
RUN;
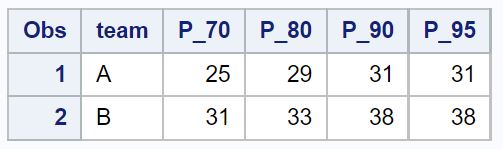
La table analytique de sortie percentiles_stratifies ainsi construite offre une granularité méthodologique parfaite. Elle ne comporte plus une seule ligne agrégée, mais exactement autant de lignes qu’il existe de modalités distinctes dans la variable de tri (en l’espèce, deux observations : une pour l’équipe A et une pour l’équipe B). Les colonnes de groupe présentes dans l’instruction BY sont automatiquement conservées et positionnées en tête de table, garantissant une identification sans ambiguïté des métriques calculées pour chaque strate respective.
5.3 Analyse comparative intra-groupe et inter-groupes
L’affichage de la table des centiles stratifiés révèle des contrastes majeurs entre les deux cohortes, démontrant la puissance diagnostique de la méthode par rapport à une simple comparaison des moyennes de groupe. Pour l’équipe A, les centiles d’ordre supérieur s’établissent à : P70 = 21,4, P80 = 23,2 et P90 = 27,8. En revanche, pour l’équipe B, ces mêmes estimateurs atteignent des niveaux nettement plus élevés : P70 = 29,2, P80 = 32,6 et P90 = 37,5.
L’analyse inter-groupes met en évidence un décalage structurel d’environ 8 à 10 points sur l’ensemble du spectre supérieur au bénéfice de l’équipe B. Le 70e centile de l’équipe B (29,2) dépasse même le 90e centile de l’équipe A (27,8). Cela signifie qu’un membre situé dans la tranche des 30 % supérieurs de l’équipe A réaliserait une performance considérée comme inférieure au seuil des 30 % d’élite au sein de l’équipe B. Ce constat possède des implications empiriques considérables : dans un système d’étalonnage managérial ou scolaire unifié, l’application d’un barème global unique pénaliserait artificiellement les membres de l’équipe A ou sous-estimerait l’exigence imposée aux membres de l’équipe B.
Sur le plan intra-groupe, l’examen de l’écart d’hétérogénéité entre le 70e et le 90e centile révèle une dispersion interne différente : l’amplitude inter-centile P90 – P70 s’élève à 27,8 – 21,4 = 6,4 points pour l’équipe A, alors qu’elle s’élève à 37,5 – 29,2 = 8,3 points pour l’équipe B. L’équipe B n’affiche donc pas seulement des scores médians plus élevés, elle présente également une variance et une polarisation beaucoup plus accentuées parmi ses éléments les plus performants. Ces informations ordinales stratifiées fournissent aux décideurs une finesse d’analyse inaccessible par la seule observation des moyennes arithmétiques d’échantillon.
6. Algorithmes de calcul des centiles et option PCTLDEF dans SAS
6.1 Les cinq formules d’interpolation implémentées dans SAS
L’un des aspects les plus techniques et souvent méconnus du calcul des quantiles dans les logiciels de traitement de données réside dans le fait qu’il n’existe pas de formule mathématique universelle unique pour interpoler la valeur d’un centile au sein d’un échantillon fini discret. Pour formaliser ces variantes, le système SAS implémente de manière native cinq algorithmes d’interpolation distincts, gouvernés par l’option PCTLDEF=n (où n prend une valeur entière comprise entre 1 et 5) positionnée dans l’en-tête de la procédure PROC UNIVARIATE.
Considérons une série ordonnée de n observations réelles notées y(1) ≤ y(2) ≤ … ≤ y(n), et cherchons à estimer le p-ième centile avec la fraction q = p / 100. Les cinq méthodes paramétrables se définissent ainsi :
- PCTLDEF=1 (Fonction de répartition empirique avec moyenne aux discontinuités) : Cette méthode repose sur l’évaluation directe de la distribution cumulative empirique. Soit le produit n × q. Si n × q n’est pas un entier, on pose j = floor(n × q) + 1 et le centile vaut y(j). Si n × q est un entier exact k, le centile est calculé en effectuant la moyenne arithmétique de deux observations adjacentes : (y(k) + y(k+1)) / 2.
- PCTLDEF=2 (Fonction de répartition inverse avec palier d’observation) : Similaire à la première définition mais sans moyenne aux points de discontinuité. Si n × q n’est pas un entier, la formule retient l’observation de rang j = floor(n × q) + 1. En revanche, si n × q est un entier exact k, la méthode retient strictement la valeur d’observation y(k) sans procéder à une interpolation intermédiaire avec le point suivant.
- PCTLDEF=3 (Arrondi entier le plus proche de la fonction empirique) : L’indice d’observation retenu est déterminé en arrondissant le produit à l’entier le plus proche. Si n × q possède une partie fractionnaire non nulle, on détermine j = round(n × q). Si le produit est un entier exact ou une valeur équidistante avec un seuil de coupure spécifique, l’algorithme bascule sur l’entier d’ordre immédiatement supérieur lorsque la règle d’arrondi l’impose.
- PCTLDEF=4 (Interpolation linéaire standard recommandée) : C’est la méthode sélectionnée par défaut par SAS si aucune option PCTLDEF n’est spécifiée dans le code source. Elle repose sur l’indice réel (n + 1) × q. Soit t = (n + 1) × q, que l’on décompose en sa partie entière j = floor(t) et sa partie fractionnaire g = t – j. La valeur du centile est obtenue par l’interpolation linéaire continue : y = (1 – g) × y(j) + g × y(j+1), sous réserve que 1 ≤ j < n. Si j < 1, le centile est fixé à la valeur minimale y(1) ; si j ≥ n, il est fixé à y(n).
- PCTLDEF=5 (Interpolation linéaire empirique continue standardisée) : Cette variante d’interpolation linéaire se base sur l’indice réel n × q au lieu de (n + 1) × q. Soit t = n × q, décomposé en sa partie entière j = floor(t) et sa partie fractionnaire g = t – j. La valeur estimée est donnée par : y = (1 – g) × y(j) + g × y(j+1). Cette méthode garantit une cohérence théorique étroite avec l’estimateur de quantile non biaisé adopté par de nombreuses écoles de statistique industrielle.
6.2 Impact du choix de PCTLDEF sur les petits échantillons
Dans les échantillons de taille volumineuse (par exemple N > 10 000), les divergences numériques générées par ces cinq définitions s’atténuent jusqu’à devenir virtuellement indétectables, l’écart entre deux observations consécutives y(i+1) – y(i) convergeant asymptotiquement vers zéro. En revanche, sur des échantillons restreints ou des cohortes pilotes comportant un nombre limité de sujets (tels que notre sous-groupe de dix enregistrements), le choix de l’algorithme d’interpolation entraîne des variations chiffrées substantielles qui peuvent influencer la validation d’une hypothèse ou la conformité réglementaire d’un produit.
Pour illustrer empiriquement cette sensibilité mathématique, appliquons les cinq valeurs de l’option PCTLDEF pour calculer le 70e centile sur les 10 observations de l’équipe A : 8, 10, 12, 12, 15, 18, 20, 22, 25, 29. Nous avons n = 10 et q = 0,70, soit un produit n × q = 7,0, qui s’avère être un entier exact :
- Sous PCTLDEF=1, n × q = 7 étant entier, le centile est la moyenne du 7e point (20) et du 8e point (22), ce qui donne (20 + 22) / 2 = 21,0.
- Sous PCTLDEF=2, n × q = 7 étant entier, la règle sélectionne strictement la 7e observation ordonnée, ce qui produit un résultat de 20,0.
- Sous PCTLDEF=3, l’arrondi entier retient également la 7e observation, produisant 20,0.
- Sous PCTLDEF=4 (défaut SAS), l’indice vaut (10 + 1) × 0,70 = 7,7. La partie entière est j = 7 et la fraction g = 0,7. La formule interpole entre le 7e point (20) et le 8e point (22) : y = 0,3 × 20 + 0,7 × 22 = 6,0 + 15,4 = 21,4.
- Sous PCTLDEF=5, l’indice vaut 10 × 0,70 = 7,0. La fraction étant g = 0, la formule produit y = 1,0 × 20 + 0,0 × 22 = 20,0.
Sur ce petit échantillon, le 70e centile oscille donc entre 20,0 et 21,4 selon l’algorithme retenu, soit une variation relative de 7 % imputable uniquement au formalisme mathématique. Dans les contextes académiques, biomédicaux et réglementaires (par exemple dans le cadre d’un dossier d’autorisation de mise sur le marché soumis à la Food and Drug Administration ou à l’Agence Européenne des Médicaments), il est impératif de stipuler explicitement l’algorithme d’interpolation sélectionné dans le plan d’analyse statistique (SAP) afin d’assurer l’auditabilité et la parfaite reproductibilité des calculs.
6.3 Configuration et paramétrage explicite de l’option dans le code
Le paramétrage de l’option d’interpolation s’effectue directement dans l’instruction d’ouverture de la procédure PROC UNIVARIATE en déclarant le commutateur syntaxique PCTLDEF=valeur. L’intégration de cette consigne explicite garantit que le comportement algorithmique demeure pérenne, y compris en cas de migration de code vers des versions futures de SAS ou lors du partage de scripts avec des tiers dont les profils d’environnement par défaut pourraient diverger.
Le bloc de code ci-dessous démontre la configuration explicite de l’interpolation standard PCTLDEF=4 :
PROC UNIVARIATE DATA=sorted_data PCTLDEF=4 NOPRINT;
BY team;
VAR points;
OUTPUT OUT=percentiles_def4
PCTLPTS=70
PCTLPRE=p_
PCTLNAME=p70;
RUN;
Cette rigueur de configuration s’avère fondamentale lors de l’exécution d’analyses croisées avec d’autres langages scientifiques tels que R ou le module NumPy de Python. Le langage R dispose, au sein de sa fonction native quantile(), de neuf définitions mathématiques distinctes (paramétrées via l’argument type=1 à type=9). Par défaut, R implémente l’algorithme de type 7, lequel équivaut rigoureusement à l’option PCTLDEF=5 de SAS, tandis que le comportement par défaut de SAS (PCTLDEF=4) correspond au type 6 dans la nomenclature de R et Minitab. Documenter précisément le paramètre PCTLDEF évite ainsi des discordances numériques stériles lors du portage d’algorithmes entre SAS, R et Python dans des environnements de recherche pluridisciplinaires.
7. Calculs alternatifs des centiles avec PROC MEANS et PROC SUMMARY
7.1 Exploitation des mots-clés de quantiles prédéfinis
Si la procédure PROC UNIVARIATE offre une flexibilité totale quant au choix des seuils percentiles et des règles d’interpolation, la procédure PROC MEANS (ainsi que son pendant batch PROC SUMMARY) constitue le vecteur historique privilégié pour l’extraction de métriques descriptives massives. Dans les architectures analytiques de production où les tables d’entrée renferment plusieurs dizaines ou centaines de millions d’enregistrements, la surcharge computationnelle induite par les tests diagnostiques complets de PROC UNIVARIATE peut peser sur les temps de traitement et les entrées-sorties système.
Pour répondre à ce besoin d’agilité computationnelle, PROC MEANS intègre nativement un lexique de mots-clés réservés dédiés aux principaux repères quantiles de la distribution. Ces mots-clés standardisés comprennent :
- P1, P5, P10 : Les premier, cinquième et dixième centiles, couramment employés dans la surveillance des signaux faibles, le contrôle qualité de précision et l’analyse des risques extrêmes de perte en capital (Value at Risk).
- Q1 (ou P25) : Le premier quartile, délimitant le quart inférieur (25 %) de la distribution des observations.
- MEDIAN (ou P50, Q2) : La médiane de l’échantillon, valeur centrale robuste par excellence.
- Q3 (ou P75) : Le troisième quartile, matérialisant les 75 % inférieurs de la masse statistique.
- P90, P95, P99 : Les quantiles d’ordre supérieur, essentiels pour l’évaluation des pics de charge réseau, les plafonds d’indemnisation assurantielle ou les valeurs de référence toxicologiques.
Bien que cette nomenclature prédéfinie couvre les besoins statistiques courants, elle ne permet pas de spécifier des points de coupure arbitraires non calibrés en amont par les concepteurs de SAS (comme un 70e ou un 82,5e centile). En pareille situation, l’analyste doit nécessairement s’orienter vers PROC UNIVARIATE ou vers des approches empiriques alternatives.
7.2 Syntaxe comparative et extraction dans une table de résultats
L’écriture d’une extraction de quantiles sous PROC MEANS s’articule autour de l’instruction OUTPUT OUT=, en associant chaque mot-clé statistique à un nom de variable cible. De surcroît, PROC MEANS présente l’avantage opérationnel majeur de pouvoir exploiter l’instruction CLASS au lieu de l’instruction BY. Contrairement à BY, l’instruction CLASS n’exige aucun tri physique préalable de la table de données par PROC SORT, le compilateur s’appuyant sur des tables de hachage dynamiques instanciées en mémoire vive pour agréger les observations au vol.
L’implémentation comparative s’exécute ainsi :
PROC MEANS DATA=original_data NOPRINT;
CLASS team;
VAR points;
OUTPUT OUT=synthese_means
P10=dixieme_centile
Q1=premier_quartile
MEDIAN=mediane
Q3=troisieme_quartile
P90=quatre_vingt_dixieme_centile;
RUN;
PROC PRINT DATA=synthese_means NOOBS;
TITLE « Synthèse des quantiles via PROC MEANS avec instruction CLASS »;
RUN;
L’inspection de la table générée synthese_means met en évidence deux variables de service générées automatiquement par le moteur SAS : _TYPE_ et _FREQ_. La variable _FREQ_ indique le nombre effectif d’enregistrements compilés au sein de chaque strate. La variable _TYPE_ traduit quant à elle le niveau d’agrégation hiérarchique de l’opération : une ligne avec _TYPE_ = 0 regroupe les statistiques consolidées sur l’ensemble complet de l’échantillon (indépendamment de la variable d’équipe), tandis que les lignes caractérisées par _TYPE_ = 1 détaillent les valeurs spécifiques calculées pour chacune des modalités segmentées de la variable team. Cette double restitution au sein d’une table unique simplifie les synthèses comparatives entre le niveau global et les niveaux granulaires.
7.3 Critères de sélection entre PROC UNIVARIATE et PROC MEANS
Le choix méthodologique entre PROC UNIVARIATE et PROC MEANS repose sur un arbitrage technique fondé sur trois critères directeurs : la volumétrie des données, la spécificité des percentiles requis et la profondeur des diagnostics statistiques annexes nécessaires à la recherche.
| Caractéristique méthodologique | Procédure PROC UNIVARIATE | Procédure PROC MEANS / SUMMARY |
|---|---|---|
| Spécification des centiles | Centiles arbitraires continus illimités (option PCTLPTS) | Mots-clés discrets prédéfinis uniquement (P1, P5, Q1, MEDIAN, etc.) |
| Algorithmes d’interpolation | Cinq définitions mathématiques paramétrables (PCTLDEF=1 à 5) | Définition fixe interne par défaut (alignée sur PCTLDEF=4/5) |
| Gestion des sous-groupes | Nécessite impérativement PROC SORT préalable avec instruction BY | Supporte CLASS (sans tri préalable) ou BY (avec tri préalable) |
| Performance sur Big Data | Consommation CPU et mémoire élevée sur des dizaines de millions de lignes | Optimisation multi-threadée rapide, consommation mémoire maîtrisée |
| Analyses diagnostiques | Tests de normalité, moments d’ordre supérieur, graphiques de répartition | Statistiques descriptives élémentaires d’agrégation uniquement |
En pratique industrielle, si l’objectif de l’analyste consiste à alimenter un tableau de bord exécutif ou une table d’entrepôt de données avec des indicateurs pivots standards (Q1, médiane, Q3, P95) à partir d’une volumétrie substantielle, PROC MEANS s’impose comme la solution d’ingénierie la plus rapide et la moins consommatrice de ressources serveur. En revanche, dès lors que l’étude statistique requiert la détermination de seuils normatifs non conventionnels (tels que le 70e, le 82e ou le 97,5e centile), la validation d’une conformité pharmacocinétique ou le contrôle strict de la formule d’interpolation via PCTLDEF, PROC UNIVARIATE demeure la seule procédure homologuée et adaptée.
8. Traitement des valeurs manquantes et pondération dans le calcul des centiles
8.1 Gestion des valeurs manquantes (Missing Values)
L’intégrité des jeux de données empiriques est fréquemment compromise par la présence d’enregistrements incomplets ou de données non collectées, représentées conventionnellement dans SAS par un point (.) pour les variables numériques ordinaires. L’impact des valeurs manquantes sur le calcul des mesures de position d’ordre n’est pas anodin et nécessite une compréhension fine des mécanismes d’exclusion automatique mis en œuvre par le système.
Par défaut, lors de l’exécution de PROC UNIVARIATE ou de PROC MEANS, le compilateur SAS exclut systématiquement de l’analyse toute observation dont la variable d’intérêt ciblée par l’instruction VAR porte une valeur manquante. Cette exclusion opère en amont de toute modélisation : le dénominateur effectif N (représentant la taille totale de l’échantillon prise en compte dans les formules d’interpolation linéaire présentées précédemment) est recalculé pour correspondre strictement au nombre d’observations non manquantes valides. Par conséquent, la position relative de chaque rang d’observation est réévaluée sur cette base réduite. Si une table contient 100 enregistrements mais que 20 scores sont manquants, le 50e centile (médiane) correspondra à la médiane calculée sur les 80 valeurs réelles, et non à un rang positionné sur l’effectif nominal initial.
La situation devient plus complexe lorsque des valeurs manquantes affectent les variables catégorielles de stratification utilisées au sein de l’instruction CLASS sous PROC MEANS. Par défaut, SAS écarte l’intégralité des observations présentant une modalité manquante dans l’une des variables de classe. Si l’analyste souhaite analyser la distribution des scores pour la cohorte d’individus dont l’appartenance de groupe n’a pas été renseignée (plutôt que de supprimer purement et simplement ces données de la synthèse), il est nécessaire de spécifier l’option MISSING dans l’en-tête de PROC MEANS ou directement dans l’instruction CLASS. Cette directive ordonne au système de traiter la valeur manquante comme une catégorie statistique valide à part entière et de lui allouer une série complète de quantiles dans la table de résultats.
8.2 Intégration de poids d’échantillonnage via l’instruction WEIGHT
Dans le domaine des enquêtes par sondage complexes, des recensements épidémiologiques nationaux ou des plans d’échantillonnage stratifiés non proportionnels, les observations collectées ne disposent pas d’une probabilité d’inclusion unitaire. Certaines unités statistiques représentent un nombre plus important d’individus de la population cible que d’autres. L’estimation non biaisée des centiles de population requiert alors l’incorporation d’une variable de pondération statistique (ou poids d’échantillonnage, souvent noté sampling weight), reflétant l’inverse de la probabilité de sélection de chaque unité d’observation.
Au sein de la procédure PROC UNIVARIATE, l’intégration de ces coefficients de redressement s’effectue via l’instruction WEIGHT. L’adjonction de cette clause modifie profondément la mécanique algorithmique de détermination des quantiles. La fonction de répartition empirique cumulative n’est plus calculée par une incrémentation discrète de 1 / N à chaque étape d’observation, mais par la sommation progressive des poids normalisés associés aux observations ordonnées.
Le bloc de code SAS illustrant la prise en compte d’une pondération s’énonce comme suit :
PROC UNIVARIATE DATA=sorted_data PCTLDEF=4 NOPRINT;
BY team;
VAR points;
WEIGHT poids_echantillonnage;
OUTPUT OUT=percentiles_ponderes
PCTLPTS=70 80 90
PCTLPRE=pw_;
RUN;
Sur le plan mathématique, lorsqu’une variable de pondération est déclarée, les cinq définitions standards de PCTLDEF subissent une adaptation pour intégrer les sommes cumulées de poids. L’interpolation linéaire ne s’appuie plus sur les rangs d’entiers discrets, mais sur les masses relatives cumulées W(i) = ∑ w(k) (pour k allant de 1 à i). Dans le cas où les poids d’échantillonnage ne sont pas des entiers (ce qui correspond à la norme dans les redressements statistiques post-stratification par calage sur marges), les options de quantiles fondées sur des règles d’arrondi ou de discontinuité stricte (telles que PCTLDEF=2 ou 3) perdent de leur pertinence statistique au profit des méthodes d’interpolation linéaire pondérées (PCTLDEF=4 ou 5), qui assurent une transition continue et stable des percentiles au travers de la masse empirique redressée.
9. Automatisation et industrialisation du calcul via les macros SAS
9.1 Création d’une macro modulaire de calcul de centiles
Dans un contexte de déploiement industriel, l’écriture manuelle répétitive de blocs PROC UNIVARIATE ou PROC MEANS pour chaque nouvelle extraction de centiles contrevient aux principes de maintenabilité, d’auditabilité et de non-redondance du code (principe DRY : Don’t Repeat Yourself). La mise en place de macros compilées SAS paramétrables permet d’encapsuler la complexité syntaxique au sein d’une unité logicielle réutilisable et sécurisée.
La conception d’une macro robuste de calcul de centiles nécessite la déclaration de paramètres positionnels ou nommés clés : la table source en entrée, la variable quantitative cible, la variable optionnelle de stratification, la liste des centiles requis et le nom de la table de restitution finale. Le script doit également intégrer des contrôles de flux et des résolutions de chaînes de caractères dynamiques pour construire les arguments PCTLPTS et PCTLPRE sans rupture syntaxique.
Considérons l’implémentation macro-analytique suivante :
%MACRO calculer_centiles(
table_in=,
var_cible=,
var_by=,
liste_pctl=70 80 90,
table_out=work.resultats_centiles
);
%* Contrôle de la présence des paramètres indispensables ;
%IF %LENGTH(&table_in) = 0 OR %LENGTH(&var_cible) = 0 %THEN %DO;
%PUT %STR(ERR)OR: Paramètres table_in et var_cible obligatoires non renseignés.;
%RETURN;
%END;
%* Traitement conditionnel selon la présence d’une variable de tri ;
%IF %LENGTH(&var_by) > 0 %THEN %DO;
PROC SORT DATA=&table_in OUT=_temp_sorted;
BY &var_by;
RUN;
PROC UNIVARIATE DATA=_temp_sorted PCTLDEF=4 NOPRINT;
BY &var_by;
VAR &var_cible;
OUTPUT OUT=&table_out
PCTLPTS=&liste_pctl
PCTLPRE=p_;
RUN;
PROC DATASETS LIB=work NOLIST;
DELETE _temp_sorted;
QUIT;
%END;
%ELSE %DO;
PROC UNIVARIATE DATA=&table_in PCTLDEF=4 NOPRINT;
VAR &var_cible;
OUTPUT OUT=&table_out
PCTLPTS=&liste_pctl
PCTLPRE=p_;
RUN;
%END;
%PUT %STR(NOTE): Extraction automatisée des centiles terminée avec succès.;
%MEND calculer_centiles;
Cette macro analyse dynamiquement la présence d’une variable de stratification via la fonction macro %LENGTH(). En présence d’un argument var_by, elle procède automatiquement au tri physique préalable dans une table temporaire, exécute l’extraction des quantiles avec conservation des identifiants de groupe, puis purge immédiatement la table temporaire de travail au moyen de la procédure PROC DATASETS, garantissant une empreinte mémoire optimale au sein de la session de travail.
9.2 Traitement itératif sur plusieurs variables quantitatives
Dans les vastes projets d’analyse de données multivariées, les tables sources comportent fréquemment des dizaines ou des centaines de variables quantitatives nécessitant une caractérisation par centiles. Plutôt que de multiplier les appels manuels à la macro, il est possible d’orchestrer un traitement itératif entièrement automatisé en exploitant les dictionnaires de métadonnées du système SAS, accessibles via la vue SASHELP.VCOLUMN.
Le principe d’ingénierie repose sur l’extraction préalable de la liste exhaustive des variables numériques d’intérêt dans une table de contrôle, suivie de l’exécution séquentielle d’appels macro générés dynamiquement par le compilateur au travers de l’instruction CALL EXECUTE au sein d’une étape DATA. Cette architecture découple totalement le code d’analyse de la structure physique de la table d’entrée.
L’implémentation opérationnelle se déploie selon la logique suivante :
DATA _NULL_;
SET sashelp.vcolumn(WHERE=(libname=’WORK’ AND memname=’ORIGINAL_DATA’ AND type=’num’));
LENGTH commande $256;
commande = CATS(‘%calculer_centiles(table_in=original_data, var_cible=’, name, ‘, var_by=team, table_out=pctl_’, name, ‘);’);
CALL EXECUTE(commande);
RUN;
À chaque itération de la boucle de lecture sur la vue des métadonnées, le processeur DATA évalue les colonnes numériques de la table ciblée, assemble la chaîne d’appel macro correspondante à l’aide de la fonction de concaténation CATS(), puis l’injecte dans la file d’exécution système via CALL EXECUTE. Une fois la routine achevée, toutes les tables de résultats préfixées par pctl_ peuvent être fusionnées et consolidées en une structure matricielle unifiée par une instruction MERGE ou une procédure SQL, concrétisant ainsi une chaîne de traitement automatisée et industrialisée conforme aux meilleures pratiques de l’ingénierie logicielle SAS.
9.3 Exportation automatisée des résultats tabulaires
L’aboutissement de toute chaîne de traitement statistique consiste à exporter les métadonnées et résultats quantitatifs calculés vers des supports exploitables par des décideurs, des auditeurs ou des revues scientifiques. Le système ODS (Output Delivery System) de SAS offre des fonctionnalités d’interfaçage natives pour acheminer les tables de centiles vers des formats bureautiques ou structurés tels que Microsoft Excel, des flux CSV normalisés ou des documents PDF haute définition.
Pour transférer les résultats de centiles stratifiés vers un classeur Excel professionnel respectant les normes de mise en page institutionnelles, on utilise la destination ODS EXCEL dotée d’options d’habillage spécifiques :
ODS EXCEL FILE= »/repertoire/rapports/Distribution_Centiles.xlsx »
OPTIONS(SHEET_NAME= »Centiles_Scores » EMBEDDED_TITLES= »YES » AUTOFILTER= »YES »);
PROC PRINT DATA=percentiles_stratifies NOOBS;
TITLE BOLD « Rapport d’analyse de position : 70e, 80e et 90e centiles »;
RUN;
ODS EXCEL CLOSE;
L’activation des options ODS permet de nommer précisément l’onglet de travail, d’intégrer formellement les métadonnées de titrage au sein de la feuille de calcul et d’activer nativement les filtres automatiques sur les en-têtes de colonnes. Cette méthode supprime toute intervention humaine manuelle de ressaisie ou de copier-coller dans des outils tiers, éliminant ainsi les risques d’erreur matérielle et assurant une chaîne de valeur analytique étanche et entièrement auditable, du chargement brut des données jusqu’à la diffusion du rapport final.
10. Représentation graphique des centiles avec SAS ODS Graphics et PROC SGPLOT
10.1 Construction de boîtes à moustaches annotées (Boxplots)
La synthèse numérique des centiles gagne en lisibilité lorsqu’elle est doublée d’une représentation graphique adéquate. Dans l’arsenal visuel du biostatisticien, le diagramme en boîte à moustaches (ou boîte de Tukey, instancié via l’instruction VBOX de la procédure PROC SGPLOT) constitue le vecteur canonique pour matérialiser les quartiles (les 25e, 50e et 75e centiles) tout en illustrant l’étendue interquartile (IQR) et les observations marginales suspectées d’aberrance.
Pour enrichir la visualisation au-delà des quartiles conventionnels et positionner précisément les centiles personnalisés extraits lors de nos analyses univariées antérieures (tels que notre 70e centile calculé à 24,5 points), PROC SGPLOT permet la superposition de lignes de référence horizontales via l’instruction REFLINE. Ces marqueurs graphiques permettent de confronter visuellement la dispersion des sous-groupes avec le seuil critique défini au niveau de la population générale.
Le bloc de code graphique se structure de la manière suivante :
PROC SGPLOT DATA=original_data;
VBOX points / CATEGORY=team
BOXWIDTH=0.4
FILLATTRS=(COLOR=cxCFE2F3)
LINEATTRS=(COLOR=cx0B5394 THICKNESS=2);
REFLINE 24.5 / AXIS=Y
LINEATTRS=(COLOR=cxCC0000 PATTERN=DASH THICKNESS=1.5)
LABEL= »70e centile global (24,5) »
LABELPOS=TOP;
YAXIS LABEL= »Distribution des scores (points) » GRID;
XAXIS LABEL= »Cohortes expérimentales (Équipes) »;
TITLE « Profil comparatif des distributions de scores et seuil du 70e centile »;
RUN;
Ce graphique met en évidence la médiane interne de chaque boîte, l’espacement interquartile représentant 50 % des observations centrales, ainsi que la trajectoire transversale de la ligne de référence pointillée rouge. La confrontation visuelle certifie immédiatement le décalage distributionnel entre les deux cohortes : la ligne du 70e centile global traverse l’équipe A au-delà de son troisième quartile, alors qu’elle s’insère sous le deuxième quartile de l’équipe B, résumant de façon intuitive la disparité structurelle documentée par les tables numériques.
10.2 Graphiques de distribution cumulative empirique
L’instrument graphique le plus rigoureux pour apprécier la continuité et le comportement de l’ensemble des centiles d’une variable quantitative continue réside dans le tracé de la fonction de répartition cumulative empirique (ECDF – Empirical Cumulative Distribution Function). Au lieu de résumer la distribution par quelques barres ou segments discrets, l’ECDF matérialise l’intégralité de la courbe monotone croissante reliant chaque point d’observation ordonné à son rang centile cumulé compris entre 0 et 1 (ou entre 0 % et 100 %).
La procédure PROC UNIVARIATE intègre une commande graphique dédiée, l’instruction CDFPLOT, qui génère directement cette courbe sous le moteur ODS Graphics sans exiger la construction manuelle préalable des rangs ordonnés :
PROC UNIVARIATE DATA=sorted_data NOPRINT;
CLASS team;
VAR points;
CDFPLOT points / OVERLAY
VREF=70 80 90
VREFLABELS=’70%’ ‘80%’ ‘90%’
VREFLABPOS=RIGHT;
TITLE « Courbes de distribution cumulative empirique (ECDF) stratifiées »;
RUN;
L’adjonction de l’option OVERLAY au sein de la directive CDFPLOT ordonne au moteur graphique de superposer les trajectoires des équipes A et B sur le même repère cartésien, plutôt que de produire deux graphiques séparés. Les options VREF= positionnent des jalons horizontaux aux cotes de probabilité 70 %, 80 % et 90 %.
La lecture graphique permet d’identifier visuellement les points de coordonnée (x, y) où les courbes empiriques coupent les lignes horizontales des quantiles. On observe avec netteté que la courbe de l’équipe B est systématiquement décalée vers la droite par rapport à celle de l’équipe A sur toute l’étendue du domaine métrique. Cette divergence visuelle apporte la démonstration de la dominance stochastique d’ordre 1 de la distribution de l’équipe B sur celle de l’équipe A, une conclusion analytique fondamentale en économétrie et en modélisation actuarielle qui dépasse le cadre d’une simple comparaison tabulaire ponctuelle.
11. Diagnostics, validation statistique et pièges courants à éviter
11.1 Erreurs de syntaxe et pièges fréquents dans PROC UNIVARIATE
L’exploitation avancée de PROC UNIVARIATE pour l’extraction de quantiles présente certains pièges syntaxiques classiques qui peuvent induire des erreurs d’exécution ou la génération de données tronquées. L’identification préventive de ces dysfonctionnements est essentielle pour fiabiliser les scripts d’analyse.
Le premier piège concerne l’omission du tri physique préalable lors de l’emploi de l’instruction BY. Comme abordé à la section 5, SAS interrompt le traitement dès lors que les données en entrée ne sont pas rigoureusement séquencées selon les variables de classe. L’analyste doit systématiquement faire précéder son appel univarié d’un bloc PROC SORT, ou recourir à PROC MEANS dotée de l’instruction CLASS si la volumétrie ou les droits d’écriture temporaire restreignent les opérations de tri sur disque.
Le second écueil syntaxique réside dans l’utilisation incorrecte des séparateurs dans l’instruction PCTLPTS. Contrairement aux standards de nombreuses fonctions SAS où les éléments d’une liste sont délimités par des virgules, la clause PCTLPTS exige des séparateurs sous forme de simples espaces : PCTLPTS=70 80 90. L’insertion accidentelle de virgules engendre une erreur d’interprétation dans le parseur interne, conduisant au rejet de la commande ou à l’interprétation erronée des centiles décimaux.
Enfin, la gestion des préfixes et suffixes de dénomination de colonnes via PCTLPRE et PCTLNAME requiert une vigilance particulière quant à la limite de longueur des identifiants SAS. Selon les règles du compilateur (système V9), le nom d’une variable ne peut excéder 32 caractères d’un seul tenant. Si l’analyste déclare un préfixe particulièrement long (par exemple PCTLPRE=score_evaluation_performance_clinique_p), la concaténation automatique du suffixe numérique (par exemple 70) dépassera le plafond autorisé des 32 octets, provoquant une troncature silencieuse ou une erreur de compilation bloquante : ERROR: The name … is too long for a SAS variable name. Il convient donc d’adopter des acronymes compacts et explicites pour préserver la stabilité de la chaîne analytique.
11.2 Écarts d’arrondi et précision numérique
La représentation des données numériques au sein des architectures logicielles s’appuie sur le standard matériel IEEE 754 pour le codage des valeurs en virgule flottante double précision. Cette convention technique, bien que garantissant une précision relative de l’ordre de 10-16, induit occasionnellement des imprécisions d’arrondi infinitésimales lors des calculs d’interpolation mathématique ou de la gestion des données ex æquo (les ties).
Dans certaines distributions empiriques denses, deux valeurs apparemment identiques à l’affichage (par exemple 12,0000000) peuvent diverger au niveau de leurs derniers bits de mantisse en raison d’opérations d’arrondi en amont. Cette micro-différence peut fausser la classification d’égalité stricte opérée par les algorithmes PCTLDEF, induisant un saut d’indice discret inattendu lors de l’interpolation. Pour prévenir ces dérives, il est recommandé de normaliser préalablement les variables métriques continues par l’application de la fonction ROUND() au sein de l’étape DATA si les données brutes proviennent de calculs arithmétiques complexes ou de divisions successives.
Par ailleurs, l’application d’estimateurs de centiles sur des variables fondamentalement discrètes ou présentant une variance quasi nulle (par exemple, des scores d’échelles de Likert bornés entre 1 et 5 comportant un grand nombre de valeurs ex æquo) soulève des difficultés méthodologiques majeures. L’interpolation linéaire continue implémentée par PCTLDEF=4 ou 5 tend à produire des valeurs décimales intermédiaires (telles qu’un score de 3,42) qui ne possèdent aucune réalité sémantique dans l’échelle d’évaluation initiale. Face à de tels profils discrets, l’analyste doit privilégier les algorithmes à palier discret tels que PCTLDEF=2 ou s’orienter vers des procédures de modélisation pour variables ordinales (comme PROC LOGISTIC avec modèle à cotes proportionnelles) plutôt que de s’en remettre aveuglément à des percentiles continus.
11.3 Bonnes pratiques de documentation et de reproductibilité
La reproductibilité computationnelle constitue l’exigence suprême des analyses biostatistiques et financières modernes. Un calcul de centile n’a de validité pérenne que si l’environnement méthodologique complet ayant présidé à sa dérivation est consigné de façon exhaustive dans les journaux de traitement et les plans d’analyse associés.
La documentation de l’exécution doit obligatoirement expliciter trois éléments techniques cardinaux :
- La version exacte de la plateforme logicielle SAS (obtenue via la variable automatique &SYSVLONG), ainsi que le système d’exploitation hôte, les changements d’architecture ou de maintenance pouvant occasionnellement réviser des sous-routines mathématiques sous-jacentes.
- L’algorithme formel d’interpolation retenu, documenté via la transcription explicite de l’option PCTLDEF dans le script de soumission, sans jamais se reposer sur les valeurs implicites par défaut de l’interpréteur.
- Le protocole de traitement des données ex æquo et des enregistrements manquants, en consignant expressément dans les métadonnées de sortie le nombre d’observations non manquantes retenues (N effectif) ainsi que le volume des valeurs rejetées.
Dans les démarches de recherche de pointe, la robustesse statistique d’une estimation ponctuelle de centile doit être corroborée par l’adjonction de son intervalle de confiance empirique. En effet, stipuler qu’un 90e centile vaut 33 points sur un échantillon de 20 observations masque une incertitude d’échantillonnage considérable. L’utilisation conjointe de techniques de rééchantillonnage bootstrap non paramétrique (réalisables via l’association de PROC SURVEYSELECT pour la génération des pseudo-échantillons et de PROC UNIVARIATE pour l’estimation distribuée) permet de dériver l’erreur standard et les bornes de confiance à 95 % associées à chaque quantile, conférant ainsi aux conclusions analytiques une rigueur scientifique irréprochable.
12. Synthèse méthodologique et recommandations opérationnelles
12.1 Matrice décisionnelle pour le choix de la procédure SAS optimale
Pour guider l’ingénieur de données et le statisticien dans leurs choix de conception logicielle, cette matrice décisionnelle récapitule les critères opérationnels de sélection entre les trois principales procédures SAS impliquées dans le positionnement quantile :
| Critère opérationnel | PROC UNIVARIATE | PROC MEANS / SUMMARY | PROC RANK |
|---|---|---|---|
| Objectif prioritaire | Extraction de centiles précis, conformité réglementaire, exploration approfondie | Agrégation massive rapide, tableaux de bord de synthèse décisionnels | Attribution de rangs ou de classes quantiles directement dans la table d’entrée |
| Génération des centiles | Explicite, vectorisée avec PCTLPTS pour n’importe quel seuil continu | Mots-clés rigides prédéfinis pour les quantiles universels usuels | Segmentation par classes d’effectifs égaux (centiles via option GROUPS=100) |
| Paramétrage mathématique | Exhaustif via l’option d’interpolation PCTLDEF (cinq variantes algorithmiques) | Interne standardisé, non modifiable de façon granulaire | Rangs discrets basés sur des règles d’égalité spécifiques (TIES=MEAN, LOW, HIGH) |
| Type de table produite | Table analytique fine ne contenant que les métriques demandées | Table de synthèse multivariée hiérarchique avec niveaux d’agrégation _TYPE_ | Copie de la table d’entrée originale enrichie de la nouvelle variable de rang |
| Empreinte système | Modérée à lourde sur des volumétries massives sans indexation | Très faible, procédure nativement conçue pour la scalabilité Big Data | Dépend de la taille de la table à trier pour le classement individuel |
Cette matrice met en exergue la complémentarité des outils disponibles dans l’écosystème SAS. Lorsque l’objectif est d’étiqueter chaque enregistrement individuel de la table avec son numéro de centile d’appartenance (de 0 à 99) afin d’opérer un découpage opérationnel en 100 tranches égales, la procédure PROC RANK s’avère particulièrement adaptée. En revanche, pour la dérivation mathématique des valeurs frontières précises d’une variable continue, le couple PROC UNIVARIATE / PROC MEANS demeure incontournable, le choix final entre ces deux modules étant dicté par les contraintes d’arbitrage entre flexibilité algorithmique et scalabilité computationnelle.
12.2 Check-list complète pour l’analyste de données
Avant de déployer en production un script SAS de calcul de centiles ou d’en intégrer les conclusions dans un dossier de décision stratégique, il est recommandé de valider point par point la check-list méthodologique suivante :
- [ ] Typage et intégrité des données : Certifier via PROC CONTENTS que les variables analysées sont encodées sous forme numérique double précision exempte de masquages textuels.
- [ ] Audit des valeurs manquantes : Quantifier le taux de cellules vides dans la variable continue VAR et examiner la pertinence de l’option MISSING dans l’instruction CLASS pour conserver les sous-groupes incomplets.
- [ ] Ordonnancement et structure : Vérifier que la table source a fait l’objet d’un tri adéquat via PROC SORT si l’instruction de stratification BY est mobilisée dans PROC UNIVARIATE.
- [ ] Formulation de la syntaxe de quantiles : Contrôler l’absence de virgules séparatrices dans la liste PCTLPTS et s’assurer que les préfixes déclarés dans PCTLPRE respectent la limite système des 32 caractères autorisés pour les noms de variables.
- [ ] Choix de la formule d’interpolation : Définir explicitement l’algorithme mathématique via l’option PCTLDEF= dans la déclaration de PROC UNIVARIATE afin de garantir la reproductibilité des résultats face aux petits échantillons.
- [ ] Prise en compte des pondérations : S’assurer de la présence d’une instruction WEIGHT si les données sont issues d’un plan de sondage probabiliste complexe ou d’un calage démographique.
- [ ] Contrôle des performances : Désactiver l’affichage des rapports ODS volumineux par l’insertion de l’option NOPRINT lors des traitements de données de masse au sein des macro-programmes.
- [ ] Validation visuelle et confrontation externe : Valider la cohérence distributionnelle des seuils obtenus au moyen d’un graphique de dispersion (SGPLOT VBOX ou CDFPLOT) et confronter les valeurs de centiles à la réalité empirique du domaine métier étudié.
En observant scrupuleusement ces règles de conception et d’assurance qualité, l’analyste de données garantit que ses analyses de centiles sous SAS bénéficient du plus haut niveau d’intégrité statistique, de fiabilité algorithmique et de conformité scientifique exigé par les standards industriels et réglementaires internationaux.
Références
Agresti, A. (2018). Statistical Methods for the Social Sciences (5th ed.). Pearson. https://www.pearson.com
Cleveland, W. S. (1993). Visualizing Data. Hobart Press. https://www.stat.purdue.edu/~wsc/
Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute. https://www.sas.com/store/books/categories/usage-and-reference/cody-s-data-cleaning-techniques-using-sas-third-edition/prodBK_68798_fr.html
Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute. https://support.sas.com/content/dam/SAS/support/en/books/the-little-sas-book-a-primer-sixth-edition/60824_excerpt.pdf
Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
SAS Institute Inc. (2020). Base SAS 9.4 Procedures Guide: Statistical Procedures (5th ed.). SAS Institute. https://documentation.sas.com/?docsetId=procstat&docsetTarget=procstat_univariate_overview.htm&docsetVersion=9.4
SAS Institute Inc. (2021). SAS/STAT 15.2 User’s Guide. SAS Institute. https://support.sas.com/documentation/onlinedoc/stat/index.html
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley. https://www.pearson.com
Wicklin, R. (2013). Simulating Data with SAS. SAS Institute. https://support.sas.com/content/dam/SAS/support/en/books/simulating-data-with-sas/64478_excerpt.pdf