
Dans le paysage des sciences humaines et cognitives, la recherche empirique repose de manière fondamentale sur notre capacité à discerner si une variation observée entre deux conditions expérimentales reflète une véritable dynamique sous-jacente ou s’il s’agit d’une simple fluctuation stochastique. L’évaluation rigoureuse des interventions cliniques, des protocoles d’apprentissage ou des manipulations neurocognitives impose l’usage d’outils d’inférence statistique capables de modéliser avec précision l’incertitude inhérente aux mesures comportementales. Depuis plus d’un siècle, le paradigme des tests de signification d’hypothèse nulle domine cette démarche, fournissant un cadre décisionnel quantifié pour guider l’interprétation des données de laboratoire et de terrain.
Au cœur de cette pratique se trouve le test de comparaison de moyennes pour deux échantillons indépendants, historiquement dominé par le classique test t de Student. Cependant, les hypothèses sous-jacentes à ce modèle canonique — notamment le postulat strict d’homogénéité des variances ou homoscédasticité — sont très fréquemment violées dans les contextes réels de recherche en psychologie. Les disparités individuelles face à une pathologie, l’asymétrie des effets thérapeutiques ou les contingences logistiques conduisant à des effectifs inégaux génèrent régulièrement des données hétéroscédastiques. Face à cette réalité méthodologique, l’utilisation aveugle du test de Student expose les chercheurs à des distorsions sévères du taux d’erreur de première espèce ou à des pertes substantielles de puissance statistique.
Le présent article propose une analyse approfondie et exhaustive du test t de Welch, une adaptation mathématique robuste conçue spécifiquement pour pallier l’inégalité des variances intergroupes sans sacrifier la validité inférentielle. À travers une déconstruction formelle de ses équations, une exploration comparative de ses performances et des démonstrations pratiques issues de la psychologie clinique, cognitive et neuropsychologique, nous mettrons en lumière les raisons empiriques pour lesquelles cette approche s’impose désormais comme le standard analytique moderne dans les sciences du comportement.
1. Introduction aux tests de comparaison de moyennes en psychologie expérimentale
1.1 La nécessité de comparer deux échantillons indépendants en sciences du comportement
L’expérimentation en psychologie scientifique s’articule quasi systématiquement autour de la comparaison contrôlée de groupes d’individus soumis à des conditions distinctes. Qu’il s’agisse d’évaluer l’efficacité d’une nouvelle psychothérapie cognitivo-comportementale contre un groupe placebo, de mesurer l’impact de l’induction d’une émotion négative sur le rappel mnésique ou d’analyser les temps de réponse attentionnels entre des sujets neurotypiques et des individus présentant un trouble du déficit de l’attention, le chercheur doit isoler l’effet causal de sa variable indépendante. Cette démarche nécessite de confronter les distributions empiriques issues de deux sous-populations distinctes afin de déterminer si le centre de gravité de leurs scores respectifs diffère au-delà des variations aléatoires.
La difficulté majeure de cette entreprise réside dans la variabilité interindividuelle naturelle. Contrairement aux sciences physiques où les constantes fondamentales stabilisent les mesures, la recherche comportementale capture des réponses intrinsèquement bruitées, modulées par l’histoire d’apprentissage, la génétique, la fatigue momentanée ou la motivation intrinsèque des participants. Quantifier l’erreur d’échantillonnage constitue donc le cœur du défi statistique : la différence brute observée entre la moyenne du groupe expérimental et celle du groupe contrôle découle-t-elle d’un impact réel du protocole ou de l’agrégation fortuite de particularités individuelles lors de la constitution des cohortes ?
Les origines méthodologiques de cette inférence remontent à l’institutionnalisation de la psychologie différentielle et cognitive au début du vingtième siècle. La formalisation de la démarche hypothético-déductive a imposé le calcul systématique d’une probabilité d’erreur conditionnelle, formalisée par la p-valeur sous l’hypothèse nulle d’équivalence absolue. Dans ce cadre, la comparaison de deux échantillons indépendants constitue la pierre angulaire à partir de laquelle s’érigent les théories psychologiques, exigeant des estimateurs mathématiques une fidélité absolue vis-à-vis des postulats distributionnels des phénomènes investigués.
1.2 Le dilemme fondamental : test t de Student versus test t de Welch
Historiquement, l’outil statistique de prédilection pour répondre à cette exigence a été formulé par William Sealy Gosset en 1908, sous le pseudonyme académique de Student. Travaillant au sein de la brasserie Guinness, Gosset a révolutionné l’inférence pour les petits échantillons en introduisant la distribution t, permettant de compenser l’incertitude liée à l’estimation de l’écart-type de la population à partir d’un nombre restreint d’observations. Néanmoins, l’élégante construction mathématique du test t de Student repose sur une contrainte structurelle majeure : l’égalité stricte des variances au sein des deux populations mères, une condition technique désignée sous le terme d’homoscédasticité.
Trois décennies plus tard, en 1938 et 1947, le statisticien britannique Bernard Lewis Welch s’est attaqué de front à la vulnérabilité intrinsèque de la méthode de Student face au problème de Behrens-Fisher, à savoir la comparaison de moyennes issues de populations normales dont les variances sont inconnues et potentiellement inégales. Welch a formalisé une solution approchée novatrice en redéfinissant le calcul de l’erreur type et en ajustant de manière dynamique les degrés de liberté de la statistique de test. Cette avancée théorique a donné naissance au test t de Welch, souvent qualifié de test t à variances inégales.
La persistance historique de l’arbitrage entre la méthode de Student et l’ajustement de Welch cristallise les tensions entre orthodoxie pédagogique et rigueur méthodologique. Alors que les manuels de statistiques ont longtemps perpétué l’enseignement d’un protocole conditionnel complexe fondé sur la primauté de Student, la recherche contemporaine en psychométrie et méthodologie quantitative opère un virage paradigmatique. Les preuves computationnelles accumulées démontrent avec constance que le test de Welch protège efficacement les conclusions scientifiques sans requérir le sacrifice arbitraire de l’homoscédasticité, invitant la communauté scientifique à repenser ses pratiques analytiques fondamentales.
1.3 Objectifs pédagogiques et structure de l’analyse
L’objectif central de cet article est de dissiper les ambiguïtés techniques et méthodologiques entourant l’application du test t de Welch dans le champ de la psychologie et des sciences sociales. Trop souvent perçu comme une simple option logicielle secondaire ou un correctif d’urgence à n’activer qu’en cas d’anomalie flagrante, le test de Welch mérite d’être appréhendé dans toute sa finesse mathématique, ses conditions empiriques de supériorité et ses répercussions directes sur l’interprétation des résultats de laboratoire.
Pour atteindre cette clarté conceptuelle, notre analyse se déploiera de façon méthodique. Nous examinerons dans un premier temps les fondements algébriques de la statistique de Welch et l’approximation de Welch-Satterthwaite régissant ses degrés de liberté non entiers. Par la suite, une confrontation directe entre le modèle de Student et celui de Welch mettra en relief la mécanique des erreurs de type I et de la puissance d’analyse. Nous explorerons ensuite les causes réelles de l’hétéroscédasticité dans la pratique psychologique avant d’établir un arbre décisionnel rationnel guidant le chercheur.
Enfin, afin d’ancrer ces développements théoriques dans la réalité concrète de la recherche, nous détaillerons trois exemples empiriques complets issus de problématiques psychologiques contemporaines, suivis de guides d’implémentation opérationnels sous les environnements R, SPSS et Python. L’analyse se conclura par des recommandations formelles d’écriture académique conformes aux normes éditoriales les plus strictes de l’American Psychological Association.
2. Fondements théoriques et formulation mathématique du test t de Welch
2.1 La statistique de test t de Welch : déconstruction de la formule
Pour mesurer la divergence entre deux groupes indépendants sans contraindre leurs dispersions respectives à l’identité, le test t de Welch redéfinit l’estimation de l’erreur type sous-jacente à la différence des moyennes. Soient deux échantillons aléatoires et indépendants de tailles respectives $n_1$ et $n_2$, issus de populations normales de moyennes théoriques $\mu_1$ et $\mu_2$, et de variances théoriques $\sigma_1^2$ et $\sigma_2^2$. Les moyennes d’échantillon sont notées $\bar{X}_1$ et $\bar{X}_2$, et les variances d’échantillon sans biais sont désignées par $s_1^2$ et $s_2^2$.
La statistique $t$ de Welch s’exprime par le ratio suivant :
$$t = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}}$$
Le numérateur représente l’amplitude brute de la divergence empirique entre les deux conditions expérimentales. Le dénominateur quantifie quant à lui l’erreur type de cette différence de moyennes. La spécificité cruciale de cette écriture réside dans le fait que chaque échantillon contribue à l’erreur type globale de manière strictement proportionnelle à sa propre variance empirique divisée par son effectif respectif.
Ce traitement contraste formellement avec le dénominateur du test t de Student traditionnel. Dans ce dernier, les données sont analysées sous le postulat que $\sigma_1^2 = \sigma_2^2 = \sigma^2$. En conséquence, Student calcule une variance combinée pondérée, notée $s_p^2$ (pooled variance), formulée ainsi :
$$s_p^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
Et l’erreur type du test de Student devient :
$$SE_{\text{Student}} = \sqrt{s_p^2 \left(\frac{1}{n_1} + \frac{1}{n_2}\right)}$$
En refusant cette agrégation artificielle, Welch préserve l’intégrité de l’information apportée par chaque groupe. L’erreur type de Welch ne dilue pas la forte variabilité d’un sous-groupe dans la stabilité d’un autre, éliminant d’emblée la principale faille structurelle du modèle classique.
2.2 L’approximation de Welch-Satterthwaite pour les degrés de liberté
L’abandon de la mise en commun des variances engendre une complexité mathématique majeure : la somme de deux distributions du chi-carré indépendantes divisées par leurs degrés de liberté respectifs ne suit plus exactement une loi du chi-carré lorsque les variances sous-jacentes sont inégales. Dès lors, le dénominateur de la statistique de Welch n’obéit plus à la distribution requise pour que le ratio $t$ suive de façon exacte une loi de Student standard. Pour résoudre cette aporie mathématique, Welch a mobilisé les principes d’approximation des moments développés par F. E. Satterthwaite en 1946.
L’approximation de Welch-Satterthwaite permet d’ajuster les degrés de liberté, désignés par la lettre grecque $\nu$ (nu) ou couramment notés $df$, afin que la distribution d’échantillonnage de la statistique se rapproche au plus près d’une distribution $t$ théorique. La formule explicite de ces degrés de liberté ajustés s’écrit :
$$\nu = \frac{\left( \frac{s_1^2}{n_1} + \frac{s_2^2}{n_2} \right)^2}{\frac{\left(\frac{s_1^2}{n_1}\right)^2}{n_1 – 1} + \frac{\left(\frac{s_2^2}{n_2}\right)^2}{n_2 – 1}}$$
L’une des propriétés les plus frappantes de cette équation réside dans la production quasi systématique de degrés de liberté non entiers, comportant des valeurs décimales (par exemple, $\nu = 34,72$). Ce phénomène, qui déconcerte fréquemment les néophytes de la recherche expérimentale, est parfaitement naturel : il traduit l’ajustement continu de la forme de la distribution théorique pour refléter l’asymétrie informationnelle générée par la disparité des variances et des effectifs.
Sur le plan analytique, la valeur de $\nu$ est rigoureusement bornée :
$$\min(n_1 – 1, n_2 – 1) le \nu le n_1 + n_2 – 2$$
Lorsque les ratios des variances d’échantillon divisées par leurs effectifs respectifs ($s_1^2/n_1$ et $s_2^2/n_2$) s’écartent drastiquement de l’unité, $\nu$ chute vers sa borne inférieure. Cette réduction drastique des degrés de liberté alourdit les queues de la distribution de référence, ce qui a pour effet direct d’augmenter la valeur critique requise pour rejeter l’hypothèse nulle. Le test incorpore ainsi mécaniquement l’incertitude liée à l’hétérogénéité des données.
2.3 Propriétés asymptotiques et comportement de la distribution d’échantillonnage
L’étude asymptotique de la statistique de Welch révèle sa remarquable stabilité face aux configurations expérimentales complexes. Sous l’effet du théorème central limite, lorsque les tailles d’échantillons $n_1$ et $n_2$ progressent vers l’infini, la distribution empirique des moyennes $\bar{X}_1$ et $\bar{X}_2$ converge vers des lois normales de variances $\sigma_1^2/n_1$ et $\sigma_2^2/n_2$. Parallèlement, en vertu de la loi faible des grands nombres, les variances d’échantillon $s_1^2$ et $s_2^2$ convergent en probabilité vers leurs cibles paramétriques $\sigma_1^2$ et $\sigma_2^2$.
Par conséquent, la statistique $t$ de Welch converge en loi vers une distribution normale centrée réduite $\mathcal{N}(0, 1)$ lorsque les effectifs tendent vers l’infini, confirmant la robustesse asymptotique de l’inférence indépendamment des variances réelles :
$$t_{\text{Welch}} x\rightarrow{\mathcal{D}} \mathcal{N}(0, 1) \quad \text{quand} \quad n_1, n_2 to \infty$$
Cependant, la supériorité opérationnelle de l’ajustement de Welch se manifeste surtout à des tailles d’échantillons finies, voire restreintes. Les travaux computationnels de simulation de Monte Carlo démontrent que même lorsque les effectifs sont modestes ($n_i in [10, 30]$) et les ratios de variance substantiels ($\sigma_1^2 / \sigma_2^2 ge 4$), la fonction de répartition empirique de la statistique de Welch calque la distribution $t(\nu)$ avec une marge de divergence négligeable dans les queues distributionnelles, là où se décident précisément les seuils critiques du rejet de $H_0$.
3. Test t de Student versus Test t de Welch : étude comparative détaillée
3.1 Divergences méthodologiques au niveau des postulats
L’architecture de l’inférence paramétrique classique impose un ensemble d’exigences théoriques qui garantissent la validité mathématique des conclusions formulées. Le test t de Student et le test t de Welch partagent deux postulats essentiels : le recueil d’observations strictement indépendantes au sein de chaque échantillon ainsi qu’entre les groupes, et l’appartenance des distributions parentes à une loi normale. Néanmoins, leurs trajectoires conceptuelles divergent radicalement quant à la tolérance structurelle de la dispersion.
Le test de Student exige l’homoscédasticité absolue ($\sigma_1^2 = \sigma_2^2$). Ce postulat n’est pas un simple détail technique, mais la condition sine qua non permettant d’isoler la variance combinée $s_p^2$ comme estimateur sans biais et exhaustif de la dispersion populationnelle unique. Dès l’instant où cette égalité est rompue, la structure probabiliste du test s’effondre.
À l’inverse, le test t de Welch traite l’hétéroscédasticité non pas comme une violation pathologique d’une règle sacro-sainte, mais comme une condition probabiliste naturelle et fréquente. En modélisant directement deux paramètres de dispersion distincts ($\sigma_1^2 ne \sigma_2^2$), Welch libère le protocole expérimental d’une contrainte souvent intenable en sciences empiriques. Cette souplesse s’avère particulièrement salvatrice lorsque les données associent des effectifs asymétriques à des dispersions inégales, configuration au sein de laquelle l’approche de Student génère de profondes altérations inférentielles.
3.2 Contraste mathématique : variance combinée contre variances séparées
Pour mesurer les répercussions empiriques de la divergence entre Student et Welch, analysons les mécanismes internes de la variance combinée $s_p^2$. Dans le test de Student, la formule de $s_p^2$ pondère chaque variance d’échantillon par ses degrés de liberté respectifs ($n_i – 1$). Cette opération confère une influence prépondérante à l’échantillon disposant du volume d’observations le plus imposant :
$$s_p^2 = \left(\frac{n_1 – 1}{n_1 + n_2 – 2}\right) s_1^2 + \left(\frac{n_2 – 1}{n_1 + n_2 – 2}\right) s_2^2$$
Si l’échantillon le plus vaste ($n_1 gg n_2$) présente également la plus faible variabilité ($s_1^2 ll s_2^2$), $s_p^2$ sous-estimera l’incertitude réelle pesant sur la mesure du groupe restreint. En conséquence, l’erreur type combinée sera artificiellement comprimée, conduisant à une valeur de statistique $t$ artificiellement gonflée.
Inversement, le calcul des variances séparées mis en œuvre par Welch découple totalement l’estimation de l’erreur type :
$$SE_{\text{Welch}} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
Chaque groupe génère son propre terme de variance d’échantillonnage. Ce découplage impacte directement la construction de l’intervalle de confiance pour la différence de moyennes théoriques $(\mu_1 – \mu_2)$ :
$$IC_{1-\alpha} = (\bar{X}_1 – \bar{X}_2) \pm t^*_{\nu, 1-alpha/2} \cdot \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
Grâce à cette formulation, la précision affichée par l’intervalle de confiance reflète fidèlement la qualité métrologique individuelle de chaque échantillon, interdisant aux effectifs massifs d’un groupe d’étouffer arbitrairement le bruit expérimental d’un second groupe plus volatile.
3.3 Contrôle de l’erreur de type I et puissance statistique
L’évaluation comparative de deux tests statistiques repose sur leur capacité à respecter le seuil de signification nominal $\alpha$ (contrôle des faux positifs ou erreur de type I) tout en maximisant la probabilité de rejeter une hypothèse nulle fausse (puissance statistique $1 – \beta$). Sur ces deux dimensions fondamentales, le test de Welch surpasse systématiquement le test de Student dès lors que les données s’écartent de l’idéal théorique de l’homoscédasticité.
Lorsque les variances sont inégales et que les effectifs diffèrent, le taux de faux positifs du test t de Student subit de graves distorsions :
- Dans l’association négative (le groupe au plus faible effectif affiche la plus grande variance), le taux d’erreur de type I réel subit un gonflement dramatique, atteignant couramment 15 % à 30 % pour un seuil visé à 5 % ($p < 0,05$). Le chercheur conclut alors à tort à l’existence d’un effet expérimental.
- Dans l’association positive (le groupe au plus grand effectif affiche la plus grande variance), le test de Student devient hyper-conservateur, avec un taux de faux positifs réel tombant souvent sous la barre de 1 % ou 2 %. Bien que cela semble sécurisant à première vue, cette dérive entraîne une chute dévastatrice de la puissance statistique, rendant l’expérience incapable de détecter un phénomène pourtant réel (hausse de l’erreur de type II).
À l’opposé, le test t de Welch maintient le taux d’erreur de première espèce remarquablement stable, ancré au seuil nominal fixé par l’expérimentateur (généralement $\alpha = 0,05$), quelles que soient la disparité des effectifs et l’ampleur du ratio de variance. De surcroît, les simulations indiquent que dans l’éventualité où l’hypothèse d’homoscédasticité serait rigoureusement respectée dans la population, la perte de puissance statistique encourue par l’adoption préventive du test de Welch par rapport au test de Student est virtuellement nulle (de l’ordre de quelques millièmes de point de puissance). L’argument du prétendu coût statistique de Welch relève donc d’un mythe inférentiel.
4. La réalité de l’hétéroscédasticité dans la recherche psychologique
4.1 Origines fréquentes des variances inégales en psychologie
L’illusion d’une dispersion uniforme des comportements humains au sein de groupes soumis à des conditions différentes résiste rarement à l’épreuve de la clinique et de l’expérimentation. L’hétéroscédasticité n’est pas une anomalie expérimentale accidentelle en psychologie ; elle découle directement de la complexité dynamique des processus cognitifs, émotionnels et biologiques étudiés.
La première cause réside dans l’hétérogénéité structurelle des réponses pathologiques. Dans les protocoles de psychologie clinique ou de neuropsychologie, le groupe contrôle est généralement constitué d’individus sains manifestant un niveau d’adaptation homogène et des scores stables sur les échelles d’évaluation clinique. En revanche, le groupe clinique (patients souffrant de dépression majeure, de schizophrénie ou de lésions cérébrales focales) présente des profils symptomatiques hautement polymorphes. Cette variabilité interindividuelle idiosyncrasique entraîne une dispersion des scores considérablement plus vaste que celle observée au sein du groupe témoin.
La deuxième source émane des propriétés psychométriques des outils d’évaluation eux-mêmes. De nombreuses échelles d’auto-évaluation ou tests de performance cognitive génèrent des effets de plancher ou de plafond. Par exemple, lors de l’administration d’une tâche de mémoire facile à des jeunes adultes et à des personnes âgées, le groupe jeune peut saturer le haut de l’échelle avec des scores très regroupés (variance faible), tandis que le groupe âgé présentera une trajectoire éclatée, oscillant de performances parfaites à des effondrements mnésiques marqués (variance forte).
Enfin, la nature même de l’intervention psychologique induit régulièrement de l’hétérogénéité. Certaines thérapeutiques ou manipulations attentionnelles ne bénéficient qu’à une sous-fraction d’individus sensibles, transformant une population initialement homogène en un ensemble hétéroclite composé de répondeurs rapides, de répondeurs modérés et de non-répondeurs.
4.2 Le péril des effectifs inégaux combinés aux variances hétérogènes
L’asymétrie des effectifs constitue la norme plutôt que l’exception dans la recherche appliquée. Les abandons en cours d’étude (attrition différentielle fréquente dans les protocoles longitudinaux ou psychothérapeutiques), les contraintes logistiques d’accès aux populations cliniques rares ou la non-conformité de certaines passations créent presque systématiquement des déséquilibres d’effectifs ($n_1 ne n_2$). Lorsque ce phénomène de déséquilibre se superpose à l’inégalité des variances, le modèle statistique classique de Student devient caduc.
Considérons le tableau comparatif des conséquences méthodologiques de cette interaction pernicieuse :
- Configuration à association négative ($n_{\text{petit}}$ avec $s_{\text{grand}}^2$) : Biais méthodologique libéral. L’erreur type de Student est sous-estimée. La statistique $t$ est artificiellement dilatée, produisant des p-valeurs faussement significatives et une prolifération de fausses découvertes scientifiques impossibles à répliquer.
- Configuration à association positive ($n_{\text{grand}}$ avec $s_{\text{grand}}^2$) : Biais méthodologique conservateur. L’erreur type de Student est surestimée. La statistique $t$ est comprimée, occultant des effets comportementaux cruciaux en raison d’une puissance expérimentale anéantie.
Ces déséquilibres ne sont pas marginaux. Une analyse de la littérature en psychologie sociale et clinique révèle que plus de la moitié des études publiées font état de tailles d’échantillons asymétriques associées à des écarts-types dont le ratio dépasse couramment la proportion de 1 à 1,5, voire 1 à 2, zone au sein de laquelle le test de Student échoue à maintenir ses garanties nominales.
4.3 Les limites méthodologiques des tests d’homogénéité préliminaires
Pendant plusieurs décennies, la formation universitaire a enseigné une approche décisionnelle séquentielle conditionnelle : appliquer en premier lieu un test d’égalité des variances (tel que le test de Levene ou le test de Bartlett), puis, si et seulement si ce test préliminaire s’avère statistiquement significatif ($p < 0,05$), abandonner le test de Student au profit de l’ajustement de Welch. Bien que séduisante de prime abord, cette stratégie en deux étapes est unanimement réprouvée par les statisticiens contemporains pour des raisons méthodologiques majeures.
La première défaillance tient au manque chronique de puissance statistique du test de Levene sur de petits échantillons. Lorsque $n_1$ et $n_2$ sont restreints (ce qui constitue paradoxalement la situation où le test de Student est le plus fragile face à l’hétérogénéité), le test de Levene échoue très fréquemment à détecter des écarts de variance pourtant substantiels. Le chercheur conserve alors l’hypothèse d’homoscédasticité à tort et applique un test de Student hautement biaisé.
À l’opposé, face à de grands échantillons ($N > 500$), le test de Levene devient hypersensible et détecte des différences triviales de dispersion sans aucune portée pratique, forçant l’abandon du modèle de Student alors même que son impact sur l’erreur type aurait été parfaitement négligeable.
Le second écueil, plus grave encore, relève du conditionnement analytique. Conditionner le choix d’un test inférentiel aux résultats d’un autre test statistique sur le même jeu de données modifie la distribution d’échantillonnage de l’estimateur final. Cette cascade probabiliste altère le taux global d’erreur de type I d’une manière totalement imprévisible, introduisant un biais de sélection analytique délétère pour la reproductibilité scientifique.
5. Quand utiliser le test t de Welch : critères décisionnels et organigramme
5.1 Organigramme décisionnel pour la comparaison de deux moyennes indépendantes
Pour assurer une démarche d’analyse quantitative rigoureuse tout en neutralisant les écueils du conditionnement préalable, le chercheur doit adopter un protocole analytique structuré. Cet organigramme repose sur l’évaluation des postulats structurants des données expérimentales :
Le processus décisionnel s’articule en trois phases successives :
- Phase 1 : Vérification absolue de l’indépendance des observations. Le chercheur s’assure qu’aucune structure hiérarchique, temporelle ou dyadique ne lie les scores des deux groupes. Si cette indépendance fait défaut (ex. : pré-test et post-test sur les mêmes sujets), l’arbre décisionnel s’oriente impérativement vers les modèles appariés ou les régressions à effets mixtes.
- Phase 2 : Évaluation des caractéristiques distributionnelles et de la taille d’échantillon. Examen des diagrammes de normalité et des indices de forme. Si les échantillons sont de grande taille ($N ge 30$ par cellule), le théorème central limite garantit la quasi-normalité des moyennes d’échantillonnage. Pour les échantillons réduits, la normalité doit être raisonnablement approchée.
- Phase 3 : Sélection directe du modèle paramétrique. Au vu des risques documentés sur les tests préliminaires, l’orientation systématique vers le test t de Welch s’impose dès cette étape comme l’option rationnelle dominante.
5.2 L’argument contemporain pour une utilisation systématique par défaut
L’accumulation de preuves statistiques robustes a conduit d’éminents méthodologistes, à l’instar de Marie Delacre, Daniël Lakens et Christophe Leys dans leur article séminal publié en 2017, à préconiser l’abandon définitif du test de Student au profit de l’usage universel et par défaut du test t de Welch pour la comparaison de deux échantillons indépendants.
Cette recommandation s’appuie sur une démonstration mathématique sans équivoque :
- Lorsque l’homoscédasticité est strictement respectée ($\sigma_1^2 = \sigma_2^2$), le test de Welch affiche une puissance statistique quasiment indiscernable de celle du test t de Student optimal. Le coût lié à la perte mineure de degrés de liberté via l’ajustement de Welch-Satterthwaite est dérisoire, de l’ordre de quelques millièmes sur la p-valeur finale.
- Dès que l’homoscédasticité fait défaut ($\sigma_1^2 ne \sigma_2^2$), le test de Welch contrôle impeccablement le taux nominal de fausses alarmes ($\alpha = 0,05$), là où le test de Student peut dériver vers l’invalidation pure et simple des conclusions de l’étude.
Adopter le test de Welch comme procédure par défaut simplifie considérablement les flux de travail analytiques, élimine la pratique néfaste des tests d’homogénéité préliminaires et referme un degré de liberté de l’expérimentateur (researcher degrees of freedom) souvent exploité de façon inconsciente pour sélectionner l’analyse produisant le résultat le plus séduisant.
5.3 Situations spécifiques où le test t de Welch n’est pas approprié
Bien que le test t de Welch s’avère exceptionnellement robuste face aux disparités de variance, il ne constitue pas une panacée universelle affranchie de toute condition de validité. Il existe des configurations expérimentales précises où son déploiement méthodologique s’avère illégitime ou insuffisant.
En premier lieu, le test de Welch pour échantillons indépendants est formellement inopérant face à des plans factoriels intra-sujets ou à des mesures répétées dans le temps. La covariance existant entre les mesures successives d’un même individu exige une prise en compte mathématique explicite via le test t pour échantillons appariés ou les analyses de variance à mesures répétées. Tenter d’appliquer un test de Welch indépendant sur des données appariées détruirait l’information liée à la variabilité intra-individuelle et biaiserait l’estimation de l’erreur type.
En deuxième lieu, lorsque l’échantillon présente une taille très restreinte (par exemple $n < 15$ par cellule) combinée à une déviation sévère de la normalité (distributions fortement asymétriques ou bimodales), les approximations asymptotiques de Welch cessent d’être fiables. Dans ce scénario, le recours aux tests de randomisation exacte, aux méthodes de rééchantillonnage par bootstrap ou aux tests non paramétriques sur les rangs (test de Mann-Whitney-Wilcoxon ou test de Brunner-Munzel) s’avère impératif.
Enfin, lorsque le dessein de recherche implique la comparaison conjointe de trois groupes ou plus, le test t de Welch bivarié ne peut être multiplié sans provoquer une inflation dramatique de l’erreur de type I par le problème des comparaisons multiples. Le chercheur doit alors basculer vers l’analyse de variance robuste d’Ashton et Welch (ANOVA de Welch) complétée par des procédures de comparaisons post-hoc adaptées comme la méthode de Games-Howell.
6. Vérification des postulats préalables à l’application du test de Welch
6.1 Le postulat d’indépendance des observations
Le postulat d’indépendance des observations constitue la condition méthodologique la plus critique et la moins négociable de l’inférence statistique. Contrairement aux violations de variance ou de normalité pour lesquelles des correctifs mathématiques efficaces existent, la violation du postulat d’indépendance corrompt de manière irréversible le calcul probabiliste, invalidant formellement l’estimation des erreurs types.
Dans un protocole expérimental rigoureux, l’indépendance signifie que la réponse, le score ou le comportement de n’importe quel participant n’exerce aucune influence directe ou indirecte sur les performances des autres sujets composant l’échantillon. Cette exigence impose une randomisation stricte lors de l’assignation des participants aux groupes et un recueil isolé des données.
Dans la pratique de la recherche comportementale, les violations insidieuses de cette hypothèse sont malheureusement légion. On observe fréquemment des situations de dépendance cachée lorsque des passations sont administrées de manière collective en classe, créant une corrélation intra-classe attribuable à l’ambiance de la salle ou à la personnalité spécifique de l’enseignant. De même, les études portant sur des dyades (couples, interactions parent-enfant) ou des équipes de travail violent structurellement l’indépendance si les individus sont traités comme des unités d’échantillonnage autonomes. Dans ces cas de figure, l’adoption du test de Welch ne protège en rien le chercheur ; la modélisation multiniveau ou hiérarchique devient la seule réponse analytique valide.
6.2 Le postulat de normalité et le théorème central limite
La dérivation formelle de la statistique de Welch repose sur le postulat théorique selon lequel les deux échantillons proviennent de populations sous-jacentes distribuées conformément à la loi de Laplace-Gauss (loi normale). Néanmoins, dans l’exercice concret de la recherche empirique, la distribution des variables psychologiques (temps de latence, scores de dépression, échelles d’attitudes) s’écarte régulièrement de cette cloche théorique immaculée.
L’évaluation de la normalité doit privilégier une démarche intégrative, combinant diagnostics visuels qualitatifs et indicateurs quantitatifs formels. Les diagrammes quantile-quantile (Q-Q plots) constituent le moyen d’inspection le plus instructif : un alignement satisfaisant des observations empiriques le long de la bissectrice théorique témoigne d’une normalité acceptable. Les histogrammes de fréquence et les boîtes à moustaches permettent de repérer d’éventuelles asymétries ou structures bimodales.
Sur le plan formel, le test de normalité de Shapiro-Wilk offre une quantification probabiliste de la déviation gaussienne, à condition de l’interpréter avec discernement compte tenu de sa propre sensibilité à la taille de l’échantillon. L’analyse des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) fournit des balises concrètes : des indices d’asymétrie compris dans l’intervalle $[-1, +1]$ et d’aplatissement dans $[-2, +2]$ sont traditionnellement considérés comme des déviations bénignes ne menaçant pas la validité inférentielle.
Il convient de rappeler avec force le rôle protecteur conféré par le théorème central limite : dès lors que la taille de chaque groupe atteint ou dépasse 30 individus ($n_i ge 30$), la distribution de la moyenne d’échantillonnage tend inéluctablement vers la normalité, rendant le test de Welch extrêmement résilient face aux imperfections distributionnelles modérées des données brutes.
6.3 Résistance du test t de Welch aux violations modérées de la normalité
D’abondantes recherches fondées sur des protocoles de simulation numérique ont exploré le comportement du test t de Welch en conditions d’entorse conjointe à la normalité et à l’homoscédasticité. Les conclusions méthodologiques attestent que le test de Welch présente une remarquable robustesse intrinsèque aux distributions modérément asymétriques ou présentant un aplatissement non gaussien, surpassant de manière décisive le test de Student classique sur ces terrains complexes.
Toutefois, la présence de valeurs aberrantes (outliers) sévères demeure un facteur de déstabilisation majeur pour toute méthode paramétrique, Welch y compris. Une valeur extrême et atypique exerce un double effet délétère : elle tire arbitrairement la moyenne empirique de son groupe vers l’extrémité de l’échelle, tout en dilatant considérablement la variance d’échantillon $s^2$. Le chercheur doit impérativement identifier ces observations incongrues via l’inspection des scores standardisés ($z$-scores supérieurs en valeur absolue à 3 ou 3,29) et l’examen de l’écart interquartile.
Face à des données manifestant des valeurs extrêmes avérées sans erreur de saisie identifiable, deux stratégies méthodologiques d’appoint s’offrent au chercheur :
- L’application d’une transformation mathématique stabilisatrice de la variable dépendante (par exemple une transformation logarithmique $log(X)$ pour des distributions étirées vers la droite ou une transformation racine carrée $\sqrt{X}$ pour des données de comptage).
- L’emploi de méthodes d’inférence non paramétriques robustes, à l’instar du test de Yuen fondé sur la comparaison de moyennes tronquées (trimmed means) avec variance de Welch, ou l’estimation d’intervalles de confiance par rééchantillonnage avec remplacement (bootstrap percentile ajusté BCa).
7. Exemple pratique 1 : Étude de l’impact du stress induit sur les fonctions exécutives
7.1 Cadre théorique, protocole expérimental et hypothèses opérationnelles
Afin d’illustrer la mécanique opératoire et le calcul du test t de Welch, considérons une recherche expérimentale en psychologie cognitive et neuroendocrinienne. L’objectif de cette étude est d’examiner dans quelle mesure un stress psychosocial aigu altère les processus d’inhibition cognitive et de flexibilité mentale, composantes maîtresses des fonctions exécutives frontales.
Le protocole expérimental s’appuie sur une assignation aléatoire de 63 étudiants universitaires à deux conditions indépendantes :
- Condition Stress Aigu : Les participants sont soumis au Trier Social Stress Test (TSST), un paradigme validé comprenant une épreuve de prise de parole en public improvisée devant un jury neutre et inexpressif, suivie immédiatement d’une tâche d’arithmétique mentale chronométrée sous pression sociale.
- Condition Contrôle : Les participants effectuent une tâche neutre de lecture silencieuse d’articles encyclopédiques de complexité linguistique équivalente, dans une ambiance bienveillante et sans contrainte temporelle.
À l’issue de l’induction expérimentale, l’ensemble des participants réalise une épreuve informatisée standardisée du Wisconsin Card Sorting Test (WCST). La variable dépendante retenue est le score global de flexibilité exécutive, standardisé sur une échelle continue de performance allant de 0 à 100 points, où des scores élevés traduisent une excellente capacité d’adaptation aux changements de règles. L’hypothèse opérationnelle postule que le stress aigu provoque une détérioration de la flexibilité cognitive, s’accompagnant d’une instabilité comportementale marquée et d’une variabilité interindividuelle nettement accrue sous l’effet des réactions différentielles de l’axe hypothalamo-hypophyso-surrénalien.
7.2 Statistiques descriptives et identification de l’hétérogénéité
Le recueil des données expérimentales produit les résultats descriptifs synthétisés ci-dessous :
- Groupe Contrôle ($j = 1$) : Effectif $n_1 = 35$, Moyenne empirique $\bar{X}_1 = 82,40$, Écart-type empirique $s_1 = 6,20$, Variance empirique $s_1^2 = 38,44$.
- Groupe Stress ($j = 2$) : Effectif $n_2 = 28$, Moyenne empirique $\bar{X}_2 = 73,10$, Écart-type empirique $s_2 = 14,80$, Variance empirique $s_2^2 = 219,04$.
L’inspection descriptive de ces paramètres révèle une configuration expérimentale typique et hautement périlleuse pour l’inférence classique :
Les effectifs sont asymétriques ($n_1 = 35$ contre $n_2 = 28$). Plus critique encore, la dispersion observée au sein du groupe stress est massivement plus ample que celle du groupe contrôle. Le ratio empirique des variances s’élève à :
$$\text{Ratio de variance} = \frac{s_2^2}{s_1^2} = \frac{219,04}{38,44} \approx 5,70$$
La variance du groupe stress surpasse ainsi de près de six fois celle du groupe contrôle. Cette configuration correspond précisément au schéma d’association négative décrit dans notre analyse théorique : le groupe à l’effectif le plus faible ($n = 28$) héberge la variance de loin la plus considérable. L’application du test t de Student traditionnel dans ce contexte sous-estimerait gravement l’erreur type combinée et produirait un gonflement substantiel de l’erreur de type I. Le déploiement du test t de Welch s’impose ici pour préserver la rigueur de l’inférence.
7.3 Calcul pas à pas de la statistique de test et des degrés de liberté
Procédons au calcul manuel détaillé étape par étape de la statistique de Welch et de ses degrés de liberté ajustés.
Étape 1 : Calcul de la différence de moyennes
$$\Delta \bar{X} = \bar{X}_1 – \bar{X}_2 = 82,40 – 73,10 = 9,30$$
Étape 2 : Calcul des variances d’échantillonnage individuelles
Pour le groupe contrôle :
$$\frac{s_1^2}{n_1} = \frac{38,44}{35} \approx 1,0983$$
Pour le groupe stress :
$$\frac{s_2^2}{n_2} = \frac{219,04}{28} \approx 7,8229$$
Étape 3 : Calcul de l’erreur type de Welch au dénominateur
$$SE_{\text{Welch}} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}} = \sqrt{1,0983 + 7,8229} = \sqrt{8,9212} \approx 2,9868$$
Étape 4 : Détermination de la statistique t de Welch
$$t = \frac{\bar{X}_1 – \bar{X}_2}{SE_{\text{Welch}}} = \frac{9,30}{2,9868} \approx 3,114$$
Étape 5 : Résolution manuelle des degrés de liberté ajustés ($\nu$)
Rappelons la formule de Welch-Satterthwaite :
$$\nu = \frac{\left( \frac{s_1^2}{n_1} + \frac{s_2^2}{n_2} \right)^2}{\frac{\left(\frac{s_1^2}{n_1}\right)^2}{n_1 – 1} + \frac{\left(\frac{s_2^2}{n_2}\right)^2}{n_2 – 1}}$$
Calculons le numérateur :
$$\left(1,0983 + 7,8229\right)^2 = (8,9212)^2 \approx 79,5878$$
Calculons le dénominateur :
Terme pour le groupe contrôle :
$$\frac{(1,0983)^2}{35 – 1} = \frac{1,2063}{34} \approx 0,03548$$
Terme pour le groupe stress :
$$\frac{(7,8229)^2}{28 – 1} = \frac{61,1978}{27} \approx 2,26659$$
Somme des termes au dénominateur :
$$0,03548 + 2,26659 = 2,30207$$
Nous obtenons ainsi la valeur des degrés de liberté ajustés :
$$\nu = \frac{79,5878}{2,30207} \approx 34,57$$
Notons avec quel impact l’inégalité des variances réduit le nombre de degrés de liberté : sous un modèle de Student classique, le chercheur aurait comptabilisé $n_1 + n_2 – 2 = 35 + 28 – 2 = 61$ degrés de liberté. Welch ramène cette valeur à $df = 34,57$, pénalisant de manière proportionnée l’incertitude liée à la variance élevée du petit groupe.
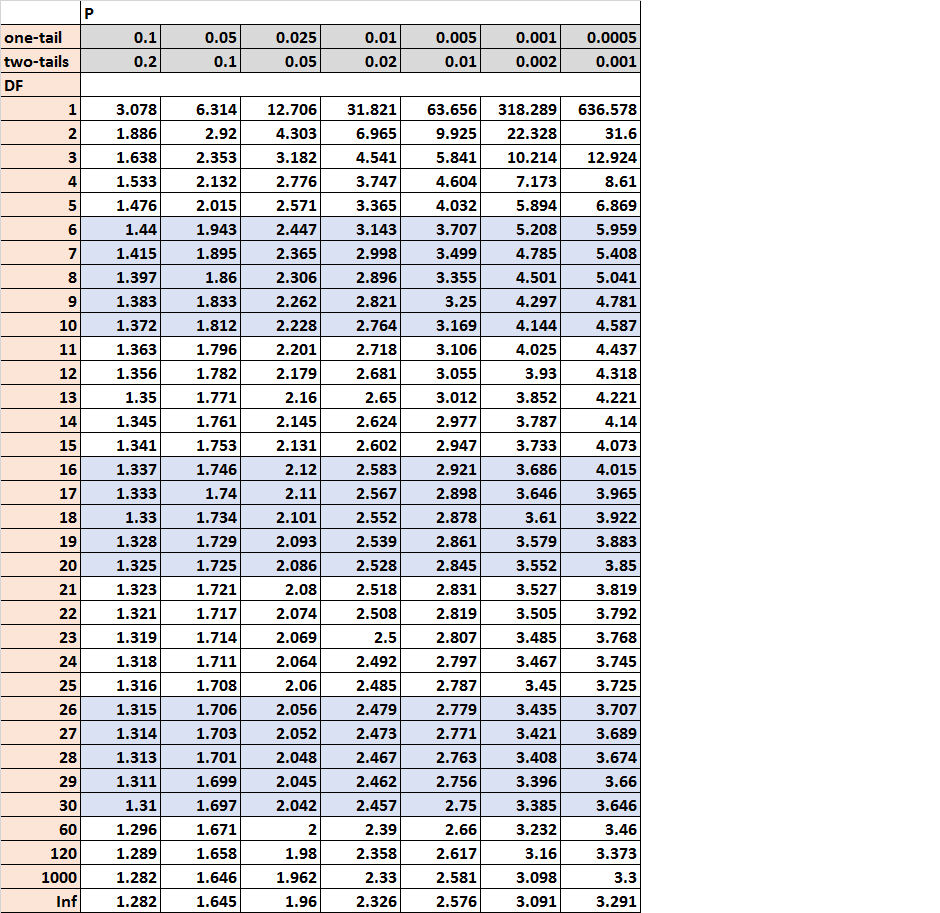
En consultant une table de distribution $t$ ou en utilisant une fonction de distribution sous logiciel pour $t = 3,114$ avec $df = 34,57$ pour un test bilatéral :
$$p = 0,00369$$
Puisque la probabilité critique calculée ($p \approx 0,0037$) demeure largement inférieure au seuil conventionnel de signification fixé à $\alpha = 0,05$, nous rejetons formellement l’hypothèse nulle d’équivalence des moyennes. L’expérimentation démontre de manière empiriquement robuste que l’induction d’un stress aigu provoque une baisse statistiquement significative des capacités de flexibilité exécutive des participants.
8. Exemple pratique 2 : Comparaison de deux psychothérapies pour le trouble panique
8.1 Contexte clinique et design de l’essai contrôlé randomisé
Considérons à présent un cadre de recherche issu de la psychologie clinique et de la psychiatrie interventionnelle. Un essai contrôlé randomisé bicentrique a été mené afin de comparer l’efficacité relative de deux protocoles d’intervention thérapeutique structurés chez des patients diagnostiqués avec un trouble panique avec agoraphobie, conformément aux critères diagnostiques du DSM-5.
Les participants éligibles ont été randomisés au sein de deux bras thérapeutiques menés en séances hebdomadaires sur une durée de 12 semaines :
- Bras Expérimental (TCC) : Protocole de Thérapie Cognitivo-Comportementale standardisée ciblant l’exposition intéroceptive aux sensations physiques de panique, la restructuration cognitive des pensées catastrophiques et la désensibilisation in vivo face aux évitements agoraphobiques.
- Bras Comparateur Actif (Soutien) : Psychothérapie non directive d’écoute active et de soutien émotionnel, garantissant un temps de contact thérapeutique identique sans intégration des composantes techniques d’exposition ou de restructuration.
La variable dépendante principale d’efficacité est mesurée à l’issue des 12 semaines via l’échelle clinique de sévérité du trouble panique (Panic Disorder Severity Scale, PDSS), administrée par des évaluateurs indépendants maintenus en aveugle de l’assignation des patients. L’échelle PDSS s’échelonne de 0 à 28 points, les scores faibles traduisant une rémission clinique complète.
En conformité avec la réalité des essais cliniques de terrain, l’attrition a frappé de manière inégale les deux cohortes de l’étude : la thérapie de soutien a enregistré un taux de décrochage précoce supérieur en raison d’un désengagement motivationnel de certains participants face à l’absence de tâches ciblées, générant des effectifs terminaux asymétriques à l’analyse en fin de traitement.
8.2 Analyse empirique des données et calculs inférentiels
Les scores de sévérité PDSS recueillis post-intervention auprès des participants ayant complété l’intégralité du protocole se présentent comme suit :
- Groupe Thérapie Cognitivo-Comportementale (TCC) : $n_{\text{TCC}} = 45$, Moyenne $\bar{X}_1 = 6,80$, Écart-type $s_1 = 3,10$, Variance $s_1^2 = 9,61$.
- Groupe Psychothérapie de Soutien : $n_{\text{Soutien}} = 32$, Moyenne $\bar{X}_2 = 11,40$, Écart-type $s_2 = 5,33$, Variance $s_2^2 = 28,41$.
Une première analyse de dispersion révèle une disparité manifeste : la variance observée sous thérapie de soutien ($s_2^2 = 28,41$) est près de trois fois supérieure à celle observée sous TCC ($s_1^2 = 9,61$). Un test de Levene préliminaire exécuté sur ces données confirme la faillite de l’hypothèse d’homoscédasticité : $F(1, 75) = 10,48, p = 0,0018$. L’emploi du test de Student conventionnel est formellement révoqué.
Résolvons l’inférence par le test t de Welch :
Différence de moyennes observée :
$$\bar{X}_{\text{TCC}} – \bar{X}_{\text{Soutien}} = 6,80 – 11,40 = -4,60$$
Erreurs types individuelles des groupes :
$$\frac{s_1^2}{n_1} = \frac{9,61}{45} \approx 0,2136$$
$$\frac{s_2^2}{n_2} = \frac{28,41}{32} \approx 0,8878$$
Erreur type de Welch :
$$SE_{\text{Welch}} = \sqrt{0,2136 + 0,8878} = \sqrt{1,1014} \approx 1,0495$$
Statistique de test de Welch :
$$t = \frac{-4,60}{1,0495} \approx -4,383$$
Calcul des degrés de liberté de Welch-Satterthwaite :
Numérateur :
$$(0,2136 + 0,8878)^2 = (1,1014)^2 \approx 1,2131$$
Dénominateur :
$$\frac{(0,2136)^2}{44} + \frac{(0,8878)^2}{31} = \frac{0,04563}{44} + \frac{0,78819}{31} \approx 0,001037 + 0,025425 = 0,026462$$
Degrés de liberté :
$$\nu = \frac{1,2131}{0,026462} \approx 45,84$$
Pour $t = -4,383$ et $df = 45,84$, la p-valeur bilatérale associée est :
$$p = 0,000067 \quad (p < 0,001)$$
Le calcul met en évidence une supériorité hautement significative de la TCC dans la réduction des scores de panique par rapport à la thérapie de soutien.
8.3 Interprétation clinique et portée des résultats thérapeutiques
L’apport d’une modélisation rigoureuse via le test de Welch dépasse le simple verdict dichotomique de significativité statistique ($p < 0,05$) pour éclairer la clinique des interventions psychothérapeutiques. La différence moyenne observée de 4,60 points sur l’échelle PDSS franchit largement le seuil minimal de différence cliniquement significative (MCID), généralement estimé à 2,5 points pour cet instrument.
Cependant, l’enseignement le plus remarquable réside dans la lecture croisée des variances d’échantillon. La faible dispersion constatée au sein du groupe TCC ($s_1 = 3,10$) atteste d’une efficacité thérapeutique homogène et constante : la quasi-totalité des patients engagés dans le protocole structuré bénéficie d’une rémission symptomatique stable. À l’inverse, l’importante variabilité propre au groupe de soutien ($s_2 = 5,33$) démontre un profil de réponse erratique : si quelques patients s’améliorent spontanément par le simple étayage bienveillant, un nombre substantiel d’individus stagne ou s’aggrave au cours du suivi.
En employant le test t de Welch, le chercheur clinicien garantit que l’incertitude et la forte dispersion inhérentes au groupe de soutien n’ont pas contaminé l’estimation de l’efficacité relative de la prise en charge active, offrant aux décideurs de santé publique des conclusions méthodologiquement irréprochables.
9. Exemple pratique 3 : Effet de la privation de sommeil sur le temps de réaction en neuropsychologie
9.1 Protocole en laboratoire du sommeil et recueil chronométrique
Notre troisième illustration empirique s’ancre dans le champ de la neuropsychologie expérimentale et des neurosciences comportementales. Cette investigation s’intéresse aux répercussions d’une privation totale de sommeil sur la vigilance tonique et la vitesse de traitement psychomoteur.
Quarante volontaires sains ont été hébergés au sein d’une unité de recherche clinique sur le sommeil et répartis de manière aléatoire en deux cohortes de taille rigoureusement égale :
- Condition Sommeil Normal : Les sujets bénéficient d’une nuit de sommeil surveillée par polysomnographie d’une durée standard de 8 heures consécutives.
- Condition Privation Totale : Les sujets sont maintenus en état de veille continue sous surveillance médicale constante pendant une période ininterrompue de 24 heures, dans des conditions d’éclairage tamisé uniforme et sans accès à des stimulants psychotropes (caféine bannie).
Le lendemain matin à 08h00, l’ensemble des participants réalise l’épreuve informatisée standardisée du Psychomotor Vigilance Task (PVT). Cette tâche impose de réagir le plus promptement possible à l’apparition aléatoire d’un compteur numérique milliseconde sur un moniteur visuel, sur une durée continue de 10 minutes. La variable dépendante analysée correspond au temps de réaction moyen mesuré en millisecondes (ms).
La littérature neuropsychologique documente un phénomène cognitif bien particulier lors de la privation de sommeil : la manifestation intermittente de « microsommeils » corticaux involontaires d’une durée de quelques centaines de millisecondes. Ces intrusions soudaines n’affectent pas tous les essais de manière homogène mais déclenchent une instabilité attentionnelle profonde (« state instability »), caractérisée par l’apparition conjointe de réponses préservées et de ralentissements massifs des temps de réaction.
9.2 Calcul statistique et gestion des degrés de liberté fractionnaires
L’extraction des données chronométriques des deux groupes produit les paramètres descriptifs suivants :
- Groupe Reposé : $n_1 = 20$, Moyenne $\bar{X}_1 = 242,50\text{ ms}$, Écart-type $s_1 = 25,00\text{ ms}$, Variance $s_1^2 = 625,00$.
- Groupe Privé de Sommeil : $n_2 = 20$, Moyenne $\bar{X}_2 = 318,80\text{ ms}$, Écart-type $s_2 = 78,00\text{ ms}$, Variance $s_2^2 = 6084,00$.
Cet exemple illustre une fausse croyance solidement enracinée chez de nombreux praticiens : l’illusion selon laquelle l’égalité stricte des effectifs ($n_1 = n_2 = 20$) vaccinerait le test de Student contre l’inégalité des variances. Bien qu’il soit mathématiquement exact que des effectifs symétriques protègent le taux d’erreur de première espèce face à des écarts modérés d’hétéroscédasticité, un ratio de variance atteignant ici $6084 / 625 \approx 9,73$ fausse la distribution d’échantillonnage théorique de Student. En pareil cas, l’ajustement de Welch s’avère indispensable pour recalibrer les degrés de liberté réels de la distribution.
Exécutons les étapes calculatoires :
Différence de moyennes observée :
$$\bar{X}_1 – \bar{X}_2 = 242,50 – 318,80 = -76,30\text{ ms}$$
Erreurs types individuelles des groupes :
$$\frac{s_1^2}{n_1} = \frac{625,00}{20} = 31,25$$
$$\frac{s_2^2}{n_2} = \frac{6084,00}{20} = 304,20$$
Erreur type de Welch :
$$SE_{\text{Welch}} = \sqrt{31,25 + 304,20} = \sqrt{335,45} \approx 18,315\text{ ms}$$
Statistique de test de Welch :
$$t = \frac{-76,30}{18,315} \approx -4,166$$
Ajustement des degrés de liberté de Welch-Satterthwaite :
Numérateur :
$$(31,25 + 304,20)^2 = (335,45)^2 \approx 112526,70$$
Dénominateur :
$$\frac{(31,25)^2}{19} + \frac{(304,20)^2}{19} = \frac{976,5625}{19} + \frac{92537,64}{19} \approx 51,398 + 4870,402 = 4921,800$$
Degrés de liberté :
$$\nu = \frac{112526,70}{4921,800} \approx 22,86$$
Constatons l’ampleur de la correction : alors qu’un test de Student standard aurait prétendu disposer de $20 + 20 – 2 = 38$ degrés de liberté, l’ajustement de Welch-Satterthwaite réduit ce capital à seulement $\nu = 22,86$. Cette contraction de près de 40 % des degrés de liberté compense directement l’instabilité induite par l’immense variance du groupe privé de sommeil.
Sous une distribution $t$ avec $df = 22,86$, la valeur $t = -4,166$ correspond à une p-valeur de :
$$p = 0,00037$$
La dégradation des temps de réaction sous l’effet de la privation de sommeil est indiscutablement avérée.
9.3 Synthèse cognitive des résultats neuropsychologiques
L’application de l’ajustement de Welch trouve ici une résonance conceptuelle directe avec les théories actuelles de la régulation de la vigilance. L’élévation de l’écart-type de 25 ms à 78 ms chez les individus privés de sommeil reflète la défaillance des mécanismes attentionnels top-down sous-tendus par le réseau fronto-pariétal. Le cerveau privé de sommeil ne bascule pas dans un ralentissement monotone et régulier ; il oscille de manière chaotique entre des moments d’effort compensatoire préservé et des effondrements attentionnels sévères causés par les microsommeils.
Si le chercheur avait naïvement appliqué un test de Student en se reposant sur la symétrie des effectifs ($n_1 = n_2 = 20$), il aurait calculé des intervalles de confiance artificiellement resserrés autour de la différence de moyennes en surestimant les degrés de liberté, dissimulant l’ampleur de la volatilité comportementale. L’approche de Welch assure une estimation fidèle du phénomène neuropsychologique, fournissant des éléments quantitatifs tangibles pour l’évaluation des risques en ergonomie du travail et sécurité opérationnelle (postes de sécurité, transport aérien et ferroviaire, gardes médicales).
10. Implémentation du test t de Welch dans les logiciels statistiques majeurs
10.1 Mise en œuvre dans l’environnement R
L’environnement de programmation statistique R constitue la plateforme par excellence pour l’analyse des données de recherche en psychologie. Fait particulièrement révélateur de la reconnaissance académique de sa robustesse, le test t de Welch est implémenté comme le réglage natif par défaut de la fonction fondamentale t.test().
Lorsqu’un chercheur exécute une comparaison bivariée indépendante sous R sans spécifier d’argument additionnel relatif à la dispersion, le système applique automatiquement l’ajustement de Welch. La syntaxe opérationnelle se déploie comme suit :
Pour des vecteurs numériques indépendants ou une formule de régression :
resultat <- t.test(score ~ groupe, data = mon_dataframe, var.equal = FALSE)
print(resultat)
La sortie textuelle renvoyée par la console R affiche explicitement l’en-tête « Welch Two Sample t-test », confirmant la neutralisation de la mise en commun des variances. L’utilisateur y trouvera la statistique $t$, la p-valeur bilatérale, l’intervalle de confiance à 95 % pour la différence de moyennes et, fait distinctif majeur, les degrés de liberté ajustés sous forme décimale (par exemple df = 34.571).
Pour forcer l’usage du test de Student classique obsolète, l’analyste devrait inscrire explicitement var.equal = TRUE. Le choix des concepteurs du noyau de R d’inverser ce paradigme témoigne de la suprématie méthodologique reconnue du test de Welch.
10.2 Exécution sous IBM SPSS Statistics
Le progiciel IBM SPSS Statistics demeure largement répandu dans les laboratoires de psychologie universitaire et hospitalière. Contrairement à R, la manipulation sous SPSS requiert une vigilance méthodologique accrue lors de la lecture des tables de résultats.
L’accès à la procédure s’opère via le cheminement classique des menus :
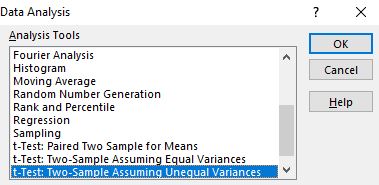
Analyser > Comparer les moyennes > Test T pour échantillons indépendants
Dans la boîte de dialogue, le chercheur transfère la variable continue d’intérêt dans le champ « Variables de test » et la variable dichotomique catégorielle dans le champ « Variable de regroupement », en définissant les valeurs numériques assignées aux deux sous-groupes.
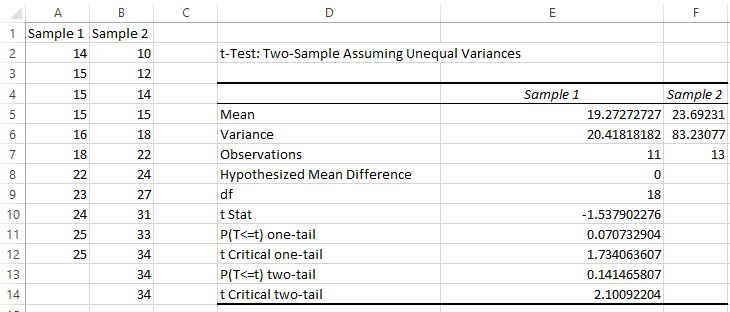
Le tableau de sortie généré par SPSS présente deux lignes de résultats inférentiels juxtaposées au sein du bloc « Test d’échantillons indépendants » :
- La ligne supérieure, intitulée « Hypothèse de variances égales », correspond au test t de Student standard.
- La ligne inférieure, explicitement nommée « Hypothèse de variances inégales », présente les résultats du test t de Welch.
L’erreur méthodologique la plus fréquente sous SPSS consiste à poser son regard sur le bloc liminaire « Test de Levene sur l’égalité des variances » et à n’opter pour la seconde ligne que si la valeur de signification $p$ de Levene est inférieure à 0,05. Conformément aux démonstrations scientifiques exposées précédemment, le chercheur doit désormais court-circuiter cette lecture conditionnelle et retenir directement et systématiquement les valeurs rapportées sur la ligne « Hypothèse de variances inégales », où figurent la statistique $t$ de Welch et ses degrés de liberté ajustés non entiers.
10.3 Exécution sous Python (bibliothèques SciPy et Pingouin) et JASP
Avec l’essor de la science des données et de l’intelligence artificielle, Python est devenu un langage incontournable pour l’analyse computationnelle en neurosciences et sciences du comportement. Deux bibliothèques majeures permettent de déployer le test de Welch avec aisance : SciPy et Pingouin.
Au sein de la bibliothèque scientifique de référence SciPy, le module statistique offre la fonction ttest_ind. Par défaut, cette fonction applique l’ancienne formule de Student. Pour enclencher la correction de Welch, le chercheur doit expressément activer le paramètre logique equal_var=False :
from scipy import stats
stats.ttest_ind(groupe_1, groupe_2, equal_var=False)
Cette commande retourne un objet structuré contenant la statistique $t$ calculée sans agrégation des variances ainsi que la p-valeur exacte correspondante.
Pour les psychologues désireux d’obtenir un compte-rendu académique enrichi incluant directement les tailles d’effet, la bibliothèque spécialisée Pingouin offre une syntaxe particulièrement fluide :
import pingouin as pg
pg.ttest(groupe_1, groupe_2, correction=True)
L’argument correction=True (actif par défaut dans la fonction) ordonne le calcul immédiat de l’approximation de Welch, produisant un tableau Pandas détaillé comprenant les degrés de liberté décimaux, la p-valeur, l’intervalle de confiance, la taille d’effet standardisée ($g$ de Hedges) ainsi que la puissance statistique a posteriori et le facteur de Bayes.
Pour les utilisateurs réfractaires au code informatique recherchant une alternative libre et élégante à SPSS, le logiciel open-source JASP constitue l’environnement d’élection. Dans l’interface conviviale de JASP, il suffit de cocher l’option « Welch » sous l’onglet des tests t indépendants pour obtenir des tableaux au format APA dynamique prêts pour publication.
11. Tailles d’effet, intervalles de confiance et normes de rédaction APA
11.1 Calcul de la taille d’effet adaptée en contexte hétéroscédastique
La publication scientifique moderne ne saurait se cantonner à la simple formulation d’une dichotomie binaire significative/non-significative fondée sur la p-valeur. L’American Psychological Association prescrit la quantification systématique de la magnitude pratique de l’effet observé via le calcul de tailles d’effet standardisées assorties de leurs intervalles de confiance.
Néanmoins, la formule traditionnelle du $d$ de Cohen pose une difficulté mathématique directe en présence d’hétéroscédasticité. Sa formulation canonique standardise en effet la différence brute de moyennes en la divisant par l’écart-type combiné $s_p$ issu du modèle de Student :
$$d_{\text{Cohen}} = \frac{\bar{X}_1 – \bar{X}_2}{s_p}$$
Si les variances des populations mères sont inégales, $s_p$ n’a aucune légitimité théorique, conduisant à une sous-estimation ou surestimation de la taille d’effet réelle. Face à des variances divergentes, le chercheur doit sélectionner un standardisateur plus adapté :
1. Le Delta de Glass ($\Delta$) : Recommandé lorsque l’un des groupes constitue une condition contrôle pure face à un groupe clinique ou expérimental perturbé. Glass préconise de standardiser la différence de moyennes exclusivement par l’écart-type du groupe contrôle ($s_{\text{contrôle}}$), considéré comme l’étalon stable de variabilité non altéré par l’intervention :
$$\Delta_{\text{Glass}} = \frac{\bar{X}_{\text{\exp}} – \bar{X}_{\text{contrôle}}}{s_{\text{contrôle}}}$$
2. Le $d$ de Cohen non pondéré ($d_{\text{Welch}}$ ou $d_{\text{average}}$) : Si aucune condition ne fait office de contrôle absolu, une alternative robuste consiste à diviser la différence par la moyenne quadratique directe des deux écarts-types individuels sans pondération par les effectifs :
$$s_{\text{avg}} = \sqrt{\frac{s_1^2 + s_2^2}{2}} implies d = \frac{\bar{X}_1 – \bar{X}_2}{s_{\text{avg}}}$$
3. Le $g$ de Hedges ajusté : Pour les échantillons restreints ($N < 30$), le $d$ empirique présente un biais positif systématique qu’il convient de corriger via le coefficient correcteur de Hedges $J \approx 1 – \frac{3}{4(df) – 1}$ appliqué aux degrés de liberté ajustés de Welch.
11.2 Construction et interprétation des intervalles de confiance de Welch
L’intervalle de confiance pour la différence entre deux moyennes indépendantes constitue l’outil analytique le plus informatif de l’inférence moderne. Contrairement à la p-valeur qui se limite à jauger la compatibilité des données avec l’hypothèse d’une absence stricte d’effet, l’intervalle de confiance délimite la plage de valeurs plausibles au sein de laquelle réside la véritable différence paramétrique $(\mu_1 – \mu_2)$, tout en communiquant intuitivement la précision de la mesure.
En contexte hétéroscédastique, la borne inférieure ($LL$) et la borne supérieure ($UL$) de l’intervalle de confiance à $100(1-\alpha)%$ s’obtiennent par la relation :
$$IC_{1-\alpha} = (\bar{X}_1 – \bar{X}_2) \pm t^*_{\nu, 1-alpha/2} \cdot \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
Où $t^*_{\nu, 1-alpha/2}$ désigne la valeur critique issue de la distribution $t$ pour les degrés de liberté décimaux de Welch $\nu$ calculés par l’équation de Welch-Satterthwaite. L’avantage primordial de cette formulation réside dans son asymétrie protectrice : si un groupe présente une grande imprécision méthodologique ($s^2/n$ imposant), l’intervalle de confiance s’élargit immédiatement pour refléter cette incertitude, empêchant le chercheur de professer des conclusions péremptoires quant à l’exactitude de l’estimation.
L’interprétation de l’intervalle de confiance s’articule autour de deux critères cardinaux :
- L’inclusion ou l’exclusion du zéro : si la valeur zéro est exclue des bornes de l’intervalle à 95 %, l’effet est déclaré statistiquement significatif au seuil $\alpha = 0,05$.
- La portée clinique ou théorique des bornes : un intervalle de confiance dont la borne inférieure frôle le seuil de significativité pratique renseigne le clinicien sur le fait que, dans le scénario le plus défavorable compatible avec les données, l’efficacité de l’intervention pourrait s’avérer négligeable.
11.3 Rédaction des résultats selon les standards académiques de l’APA (7e édition)
Les normes de publication de l’American Psychological Association (APA, 7e édition) fixent des règles précises pour la transcription des résultats d’un test t de Welch. Deux impératifs formels méritent une attention particulière : mentionner explicitement le recours à la méthode de Welch et rapporter les degrés de liberté sans arrondir la partie décimale.
Le gabarit syntaxique formel de rédaction se décline ainsi :
« Un test t de Welch pour échantillons indépendants a révélé que les participants soumis à la condition A (M = …, SD = …) ont obtenu des scores significativement plus élevés que ceux assignés à la condition B (M = …, SD = …), t(df_décimal) = valeur_t, p = valeur_p, 95% IC [borne_inf, borne_sup], d = taille_effet. »
Illustrons cette transposition à travers la rédaction académique des résultats obtenus lors de notre exemple pratique 1 sur le stress et la flexibilité cognitive :
« Afin d’examiner l’impact du stress aigu sur la flexibilité exécutive, un test t de Welch pour échantillons indépendants a été conduit sur les scores au WCST, compte tenu de l’inégalité marquée des variances entre les conditions. Les résultats indiquent une détérioration statistiquement significative des performances cognitives dans le groupe stress aigu (M = 73,10, SD = 14,80) par rapport au groupe contrôle (M = 82,40, SD = 6,20), t(34,57) = 3,11, p = 0,004, 95% IC [3,23, 15,37]. La taille d’effet standardisée ajustée selon la formule du Delta de Glass s’avère substantielle (Δ = 1,50), témoignant d’un fléchissement exécutif d’ampleur majeure induit par le stress psychosocial. »
De même, pour notre étude clinique sur le trouble panique (Exemple 2) :
« L’analyse comparative de la sévérité symptomatique post-thérapeutique démontre une supériorité hautement significative de la TCC (M = 6,80, SD = 3,10) sur la psychothérapie de soutien (M = 11,40, SD = 5,33), test t de Welch t(45,84) = -4,38, p < 0,001, 95% IC [-6,71, -2,49], d_Welch = -1,06. »
12. Erreurs méthodologiques courantes, controverses et recommandations finales
12.1 Le piège de la stratégie conditionnelle en deux étapes
L’erreur méthodologique la plus enracinée dans la communauté des chercheurs en sciences humaines demeure la dépendance envers la stratégie décisionnelle conditionnelle en deux étapes. Cette procédure, perpétuée par d’anciens manuels pédagogiques, prescrit de tester l’égalité des variances via le test de Levene (étape 1) pour décider ensuite de la mobilisation du test de Student ou de Welch (étape 2).
Cette approche est mathématiquement déficiente pour trois raisons prouvées :
- Instabilité du taux global d’erreur de type I : En conditionnant le second test statistique au verdict probabiliste du premier sur le même échantillon, le chercheur crée une dépendance stochastique qui modifie la loi d’échantillonnage finale. Les simulations computationnelles démontrent que cette cascade peut porter le taux d’erreur de première espèce effectif à des niveaux inacceptables (dépassant fréquemment 8 % à 10 % pour un seuil nominal théorique visé à 5 %).
- Manque de puissance chronique sur petits échantillons : Lorsque les effectifs sont modestes, le test de Levene échoue régulièrement à rejeter l’hypothèse nulle d’homogénéité en présence de variances pourtant fortement dissemblables, poussant l’analyste vers le test de Student dans la configuration où il est précisément le plus vulnérable aux distorsions.
- Sur-sensibilité sur grands échantillons : Pour des cohortes imposantes, le test préliminaire détectera des déviations infimes et totalement inoffensives de variances, contraignant le chercheur à des adaptations superflues.
Le consensus méthodologique international appelle aujourd’hui à l’abandon pur et simple de cette approche séquentielle en deux temps au profit du recours direct et systématique au test t de Welch.
12.2 Confusions conceptuelles fréquentes parmi les chercheurs
L’assimilation incomplète des fondements du test t de Welch alimente plusieurs idées reçues récurrentes au sein des équipes de recherche comportementale :
Première idée fausse : « Le test de Welch n’est utile que si les tailles d’échantillons sont différentes. »
S’il est exact que l’impact d’une hétérogénéité modérée des variances est partiellement amorti sur le taux d’erreur de type I lorsque $n_1 = n_2$, cette protection s’effondre face à de forts contrastes de dispersion (comme démontré dans notre exemple neuropsychologique de privation de sommeil). De plus, l’intervalle de confiance calculé par Student demeure sous-optimal même à effectifs égaux, justifiant l’application de Welch en toutes circonstances de divergence de variances.
Deuxième idée fausse : « Le test de Welch résout les problèmes de non-normalité. »
Le test de Welch a été conçu pour traiter l’hétérogénéité des variances, non la violation drastique de la distribution gaussienne. Bien qu’il fasse preuve d’une tolérance remarquable face à des asymétries modérées grâce au théorème central limite dès que les effectifs sont suffisants, il ne dispense nullement le chercheur de diagnostiquer la distribution de ses données et de recourir à des méthodes non paramétriques (Mann-Whitney ou Brunner-Munzel) ou à des modèles de troncation (test de Yuen) face à des distributions fortement anormales sur de petits effectifs.
Troisième idée fausse : « Les degrés de liberté décimaux constituent une anomalie de calcul. »
L’obtention de valeurs de degrés de liberté non entières ($df = 34,57$) est fréquemment perçue par les étudiants comme le signe d’une défaillance logicielle. Il s’agit au contraire du témoignage direct de l’élégance de l’approximation de Satterthwaite, qui ajuste la forme théorique de la distribution $t$ pour coller à la réalité physique des incertitudes de mesure des sous-populations.
12.3 Guide récapitulatif des bonnes pratiques pour la recherche comportementale
Afin de maximiser la reproductibilité scientifique et la robustesse analytique des travaux publiés dans le domaine des sciences psychologiques, cognitives et médicales, nous formulons les recommandations méthodologiques suivantes :
- Faire du test t de Welch le choix par défaut : Dans tout protocole comparant deux échantillons indépendants continus, privilégiez d’emblée le test t de Welch sans recourir à un test préalable d’homogénéité des variances. Cette décision ne vous coûtera pratiquement aucune puissance statistique si les variances sont égales et vous préservera de graves dérives d’inférence si elles sont hétérogènes.
- Inspecter rigoureusement la distribution des variables : Avant toute analyse, examinez les Q-Q plots et les histogrammes de chaque groupe pour identifier d’éventuelles valeurs aberrantes ou des asymétries majeures incompatibles avec l’inférence paramétrique sur petits échantillons.
- Rapporter les paramètres avec transparence : Mentionnez explicitement le nom du test (« test t de Welch pour échantillons indépendants »), conservez les degrés de liberté décimaux originaux sans les tronquer arbitrairement, et précisez la valeur exacte de la probabilité critique $p$.
- Intégrer systématiquement les métriques de magnitude : Ne réduisez pas vos conclusions à la p-valeur. Associez chaque test de Welch à l’intervalle de confiance à 95 % de la différence de moyennes et à une taille d’effet standardisée adaptée à l’hétéroscédasticité (Delta de Glass ou $d$ de Cohen non pondéré).
- Privilégier la réplication et la transparence des données brutes : Déposez vos données brutes et vos scripts d’analyse reproductibles (scripts R ou syntaxe SPSS/Python) sur des plateformes d’Open Science (telles que l’Open Science Framework), permettant à la communauté scientifique de vérifier la solidité de vos modélisations quantitatives.
Références
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. Frontiers in Psychology, 8, Article 846. https://doi.org/10.3389/fpsyg.2017.00846
- Glass, G. V. (1976). Primary, secondary, and meta-analysis of research. Educational Researcher, 5(10), 3-8. https://doi.org/10.3102/0013189X005010003
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107-128. https://doi.org/10.3102/10769986006002107
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Levene, H. (1960). Robust tests for equality of variances. Dans I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Dir.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 278-292). Stanford University Press.
- Ruxton, G. D. (2006). The unequal variance t-test is underused in alternative to Student’s t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688-690. https://doi.org/10.1093/beheco/ark016
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110-114. https://doi.org/10.2307/3002019
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1938). The significance of the difference between two means when the population variances are unequal. Biometrika, 29(3/4), 350-362. https://doi.org/10.1093/biomet/29.3-4.350
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28-35. https://doi.org/10.1093/biomet/34.1-2.28
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3e éd.). Academic Press.
- Yuen, K. K. (1974). The two-sample trimmed t for unequal population variances. Biometrika, 61(1), 165-170. https://doi.org/10.1093/biomet/61.1.165