
L’analyse inférentielle bivariée constitue l’un des piliers méthodologiques fondamentaux de la recherche quantitative contemporaine, traversant aussi bien les sciences biomédicales, les sciences du comportement, l’économétrie que l’ingénierie des données. Au cœur de cette architecture d’évaluation empirique se trouve le test t pour deux échantillons indépendants, conçu originellement pour déterminer si deux moyennes observées au sein de populations distinctes diffèrent de manière statistiquement significative ou si cette divergence apparente relève d’une simple fluctuation d’échantillonnage aléatoire. Bien que son principe conceptuel repose sur une élégante simplicité mathématique, son application opérationnelle dans des écosystèmes d’analyse de données exige une rigueur absolue, tant sur le plan du diagnostic des postulats théoriques que sur celui de la maîtrise algorithmique des progiciels spécialisés.
Le système SAS (Statistical Analysis System) s’est imposé comme la référence absolue au sein des institutions de recherche académique, des agences de régulation du médicament comme la FDA et des industries de pointe grâce à sa robustesse computationnelle sans compromis, sa reproductibilité analytique et la richesse de ses sorties tabulaires et graphiques. La procédure PROC TTEST de SAS offre une infrastructure complète permettant non seulement d’exécuter le calcul canonique de Student, mais également d’ajuster automatiquement les estimations en présence de variances inégales par l’approximation de Welch-Satterthwaite, d’évaluer la conformité des données et de quantifier précisément la magnitude des effets observés.
Ce guide exhaustif a été conçu pour accompagner le chercheur, le statisticien et l’analyste de données dans chaque étape de la mise en œuvre d’un test t pour deux échantillons indépendants sous SAS. À travers une décomposition systématique des fondements épistémologiques, des conditions d’application, des protocoles de programmation, des diagnostics d’homoscédasticité et de normalité, jusqu’à la restitution finale des conclusions selon les exigences formelles des normes APA 7, ce traité fournit une feuille de route complète et rigoureuse pour transformer des données brutes en inférences scientifiques irréprochables.
1. Fondements théoriques et épistémologiques du test t pour deux échantillons indépendants
1.1 Définition et objectifs statistiques du test d’hypothèse bivarié
Le test t pour deux échantillons indépendants est une procédure d’inférence statistique paramétrique dont l’objectif premier réside dans la comparaison des espérances mathématiques issues de deux populations distinctes, mutuellement exclusives et n’exerçant aucune influence réciproque l’une sur l’autre. Dans la démarche scientifique hypothético-déductive, ce test permet de statuer sur la véracité empirique d’un effet présumé produit par une variable indépendante catégorielle dichotomique sur une variable dépendante mesurée sur une échelle d’intervalle ou de rapport continue. Il s’agit d’extraire une conclusion généralisable à l’échelle populationnelle à partir des variations observées sur des sous-groupes restreints d’échantillonnage.
La mécanique inférentielle s’articule autour de la confrontation rigoureuse entre deux énoncés mathématiques antagonistes. L’hypothèse nulle, traditionnellement désignée sous le symbole H0, postule l’égalité parfaite des moyennes populationnelles, indiquant que la différence constatée entre les deux groupes est strictement nulle (mu1 – mu2 = 0) et attribuable uniquement au hasard d’échantillonnage. En opposition, l’hypothèse alternative, notée H1, formalise l’existence d’une divergence réelle entre les paramètres. Cette hypothèse alternative peut être bilatérale ou non directionnelle (mu1 distinct de mu2), ce qui représente la norme méthodologique prudente dans l’exploration scientifique, ou unilatérale (mu1 supérieur à mu2 ou mu1 inférieur à mu2) lorsqu’une orientation causale univoque est justifiée par un cadre théorique solide préalable.
L’application empirique de cette modélisation prédomine dans les protocoles de recherche quasi-expérimentaux et expérimentaux menés dans les sciences médicales, la psychologie et la sociologie quantitative. Par exemple, l’évaluation de l’efficacité d’un principe actif comparativement à un placebo repose intégralement sur ce dispositif comparatif. Il est impératif d’établir une distinction formelle entre cette configuration d’échantillons indépendants et celle des échantillons appariés ou répétés. Dans les échantillons indépendants, chaque unité statistique ne contribue qu’à une seule modalité du facteur d’exposition, garantissant l’absence de covariance intrinsèque entre les mesures, contrairement aux devis pré-test et post-test où le même sujet fournit des observations corrélées dans le temps.
1.2 Modélisation probabiliste de la statistique de Student
L’édifice mathématique du test t repose sur la distribution de probabilité découverte par William Sealy Gosset en 1908 sous le pseudonyme de Student. La statistique t représente un ratio standardisé évaluant la distance entre les moyennes empiriques observées rapportée à la variabilité inhérente aux mesures d’échantillonnage. Le numérateur de cette fraction calcule la divergence brute entre les moyennes des deux groupes, tandis que le dénominateur incarne l’erreur type de la différence de ces moyennes, laquelle quantifie l’imprécision estimée de la mesure due à la fluctuation d’échantillonnage.
Sous l’hypothèse nulle d’absence de différence, ce ratio suit théoriquement une distribution t de Student caractérisée par son paramètre fondamental : les degrés de liberté. Pour deux échantillons indépendants respectant le principe de variances homogènes, ces degrés de liberté correspondent à la somme des effectifs des deux sous-groupes diminuée du nombre de paramètres moyens estimés simultanément, soit n1 + n2 – 2. Cette allocation des degrés de liberté reflète la quantité d’informations indépendantes résiduelles disponibles pour estimer la variance d’erreur non biaisée au sein des populations mères.
La distribution t de Student présente une forme en cloche symétrique centrée sur zéro, mais se distingue de la distribution normale standard de Gauss par des queues de distribution nettement plus épaisses et lourdes, conséquence directe de l’incertitude introduite par l’estimation simultanée de la variance populationnelle à partir d’échantillons restreints. Lorsque la taille globale de l’échantillon s’accroît et tend vers l’infini, la distribution t subit un comportement asymptotique convergent, ses queues s’affinant progressivement jusqu’à se superposer parfaitement avec la courbe de Gauss. La statistique de test est particulièrement sensible aux fluctuations de l’effectif : pour une même amplitude de différence observée entre les moyennes, une augmentation de la taille d’échantillon réduit considérablement l’erreur type au dénominateur, propulsant la valeur t calculée vers des zones de rejet critiques.
1.3 Le contrôle de l’erreur d’échantillonnage et seuils de décision
Toute prise de décision inférentielle s’opère dans un contexte probabiliste contraint par deux risques d’erreur fondamentaux théorisés par Jerzy Neyman et Egon Pearson. Le chercheur doit fixer a priori, avant même toute inspection exploratoire des données, le niveau de risque de première espèce, désigné par la lettre grecque alpha. Ce seuil, conventionnellement établi à 0,05 ou 5 % dans les publications académiques, délimite la probabilité maximale tolérée de rejeter à tort l’hypothèse nulle alors que celle-ci est fondamentalement vraie dans la réalité empirique, commettant ainsi un faux positif théorique.
Le second risque, l’erreur de deuxième espèce désignée par bêta, représente la probabilité d’échouer à rejeter l’hypothèse nulle alors qu’une différence tangible existe effectivement entre les populations. Le complémentaire de ce risque (1 – bêta) définit la puissance statistique du test, c’est-à-dire sa propension à détecter un effet réel lorsqu’il existe. L’arbitrage entre ces deux risques s’effectue au moyen de la valeur p calculée par les algorithmes de Student sous SAS, qui quantifie la probabilité exacte d’observer une statistique de test au moins aussi extrême que celle obtenue dans l’échantillon, sous la condition stricte que H0 soit rigoureusement exacte.
La décision statistique formelle s’établit selon la règle binaire : si la valeur p est strictement inférieure au seuil alpha prédéterminé, l’hypothèse nulle est rejetée en faveur de l’hypothèse alternative, et la différence observée est déclarée statistiquement significative. Cependant, il est épistémologiquement impératif de ne jamais confondre significativité statistique et pertinence substantielle, pratique ou clinique. Dans le cadre de cohortes très volumineuses, des différences microscopiques d’aucune portée pratique peuvent franchir les seuils de significativité statistique en raison d’une puissance computationnelle démesurée, obligeant le statisticien à dissocier rigoureusement la probabilité d’erreur de la magnitude opérationnelle de l’effet mesuré.
2. Les postulats statistiques fondamentaux et leurs implications analytiques
2.1 Postulat d’indépendance des observations
Le postulat d’indépendance des observations constitue la condition mathématique la plus intransigeante du test t pour deux échantillons indépendants. Il stipule que la valeur mesurée sur une unité expérimentale donnée ne doit être conditionnée, influencée ou corrélée en aucune manière par la valeur enregistrée sur une autre unité, qu’elle appartienne au même groupe ou au groupe opposé. La structure probabiliste de la distribution t s’effondre en cas de violation de ce postulat, car l’estimation de l’erreur type repose sur l’orthogonalité totale des vecteurs de données collectés.
La satisfaction de cette exigence fondamentale repose intégralement sur la qualité de l’échantillonnage probabiliste et les protocoles de randomisation employés lors de l’assignation des sujets aux conditions expérimentales. Des défaillances méthodologiques récurrentes, telles que l’échantillonnage en grappes non contrôlé, le recrutement de membres issus d’une même cellule familiale, l’interaction sociale des participants au sein d’un laboratoire ou la répétition de mesures longitudinales traitées abusivement comme des observations indépendantes, introduisent des corrélations résiduelles systématiques.
Les conséquences d’une autocorrélation positive entre les observations s’avèrent désastreuses pour la validité interne des conclusions : elle provoque une sous-estimation artificielle massive de la variance d’échantillonnage et de l’erreur type, gonflant démesurément la statistique t et multipliant de manière exponentielle le taux réel d’erreur de type I bien au-delà du seuil nominal de 5 %. Les mesures préventives s’avèrent exclusivement méthodologiques et expérimentales ; aucune manipulation algébrique a posteriori dans SAS ne peut compenser la perte d’indépendance au sein d’un jeu de données mal recueilli, imposant sinon le recours à des modèles mixtes hiérarchiques.
2.2 Postulat de normalité distributionnelle
Le modèle sous-jacent au test t classique postule formellement que la variable dépendante d’intérêt suit une distribution gaussienne normale au sein de chacune des deux populations sous-jacentes. Cette condition garantit que la distribution d’échantillonnage de la différence des moyennes se conforme strictement au modèle de Student pour n’importe quel effectif d’échantillonnage fini. La vérification de cette caractéristique nécessite l’examen attentif des fonctions de densité conditionnelles générées au sein de chaque groupe expérimental séparément.
Le rôle modérateur du théorème central limite permet toutefois d’atténuer la rigueur de cette exigence lorsque la taille des échantillons s’accroît. En vertu de ce théorème, dès lors que les effectifs atteignent ou dépassent une trentaine d’observations par groupe (n1 et n2 supérieurs à 30), la distribution d’échantillonnage des moyennes converge de manière autonome vers une forme normale, conférant au test t une remarquable robustesse intrinsèque face aux déviations modérées de la normalité. Dans cette configuration asymptotique, les inférences produites demeurent fiables malgré des distributions empiriques imparfaites.
En revanche, dans le cadre d’échantillons de taille réduite (n < 20 par groupe), la sensibilité du test aux asymétries prononcées (skewness) et aux aplatissements excessifs (kurtosis) devient critique. Les distributions présentant des queues particulièrement lourdes ou des structures multimodales perturbent l’estimation de l’erreur type et altèrent le contrôle nominal du risque alpha. Si les distributions leptokurtiques tendent à restreindre indûment la puissance du test, les asymétries sévères décalent l’espérance de la statistique t, rendant caduque la déduction probabiliste issue des tables conventionnelles et justifiant des transformations de variables ou des tests non paramétriques.
2.3 Postulat d’homogénéité des variances (homoscédasticité)
Le postulat d’homoscédasticité suppose que les variances de la variable d’intérêt au sein des deux populations comparées sont strictement identiques, quand bien même leurs moyennes respectives différeraient (sigma1 au carré = sigma2 au carré = sigma au carré). Cette hypothèse de variance commune autorise l’analyste à combiner les variances des deux échantillons en une estimation conjointe et unique, optimisant ainsi la précision du dénominateur de la statistique t en mobilisant l’intégralité des observations pour capturer l’ampleur du bruit de mesure résiduel.
La vulnérabilité du test t standard de Student devient particulièrement aiguë lorsque la violation de l’homoscédasticité s’associe à un déséquilibre numérique entre les groupes (n1 distinct de n2). Ce phénomène génère le problème classique des variances directes et inverses. Lorsque le groupe possédant l’effectif le plus restreint présente la variance la plus élevée, l’erreur type conjointe est sous-estimée, ce qui entraîne une inflation dramatique de l’erreur de type I (rejets intempestifs de l’hypothèse nulle). Inversement, si le groupe le plus volumineux présente la plus grande variance, l’erreur type est surestimée, comprimant la statistique t et augmentant considérablement l’erreur de type II (perte de puissance statistique sévère).
Face à ce comportement instable du modèle canonique, la statistique moderne a développé des critères de décision permettant d’arbitrer entre l’approche classique de Student à variance combinée (pooled variance) et l’ajustement de Welch-Satterthwaite, spécialement conçu pour fonctionner sous hétéroscédasticité. Ce choix conditionnel constitue l’une des forces majeures de l’environnement SAS, qui fournit systématiquement les deux résolutions au sein de ses sorties synthétiques, permettant à l’analyste de basculer vers la modélisation la plus intègre au regard des propriétés géométriques de ses données.
3. Préparation et structuration des données expérimentales dans SAS
3.1 Création du jeu de données via l’étape DATA
L’organisation optimale des données constitue le prérequis absolu à toute exploitation statistique sous SAS. L’architecture logicielle requiert que les données soient structurées au format long univarié : chaque ligne doit correspondre à une observation individuelle unique, tandis que les colonnes matérialisent les différentes variables descriptives et quantitatives associées à cette unité. Le test t pour échantillons indépendants nécessite au minimum deux colonnes fondamentales : une variable de classification dichotomique identifiant l’appartenance au groupe expérimental et une variable continue enregistrant le score ou la mesure d’intérêt.
L’étape DATA représente le mécanisme canonique permettant de compiler, structurer et charger des données brutes en mémoire opérationnelle. Au sein de cette étape, l’instruction INPUT instancie la liste des variables à lire, en précisant par un symbole dollar ($) les variables alphanumériques désignant les catégories d’exposition, tandis que les variables dépourvues de ce caractère sont automatiquement instanciées en variables numériques réelles à double précision. L’instruction DATALINES permet de juxtaposer directement les enregistrements dans le flux programmatique.
Considérons l’instruction programmatique suivante, illustrant la déclaration d’une table analytique dédiée à l’évaluation comparative des performances cognitives entre deux groupes de sujets soumis à des environnements d’apprentissage différenciés :
data test_cognitif;
input Groupe $ Score_Memoire;
datalines;
Controle 68.5
Controle 72.1
Controle 65.4
Controle 70.8
Controle 69.2
Controle 74.3
Controle 67.9
Controle 71.0
Experimental 78.4
Experimental 81.2
Experimental 75.9
Experimental 83.1
Experimental 79.5
Experimental 82.0
Experimental 77.8
Experimental 84.6
;
run;
3.2 Validation de l’intégrité et typage des variables
Préalablement à l’appel de toute procédure inférentielle, une validation méticuleuse des métadonnées de la table s’impose afin de prévenir toute altération des estimations résultant d’un mauvais typage des variables ou de la présence silencieuse de valeurs erronées. La procédure proc contents data=test_cognitif; run; constitue l’outil de diagnostic privilégié pour contrôler les attributs de stockage, confirmant que la variable dépendante est bien répertoriée comme numérique (Type: Num) et que le facteur d’exposition correspond à une variable de chaîne (Type: Char) ou numérique formatée.
Le traitement des valeurs manquantes requiert une vigilance méthodologique aiguë. SAS traite par défaut les données numériques absentes au moyen d’un point standard (.) et les variables de caractères par une chaîne vide. Lors de l’exécution d’un test t, SAS applique automatiquement une exclusion observationnelle univariée (listwise deletion) : toute ligne présentant une valeur manquante soit sur la variable de classification, soit sur la variable d’intérêt est intégralement évincée du calcul. Il incombe à l’analyste de quantifier la prévalence de ces omissions afin de s’assurer qu’elles ne traduisent pas un biais d’attrition non aléatoire susceptible de fausser les estimations.
L’enrichissement syntaxique des données comprend également la standardisation des étiquettes descriptives et le recodage éventuel des catégories. L’attribution d’étiquettes formelles via l’instruction LABEL permet de clarifier les sorties générées par SAS, facilitant ainsi leur transposition directe vers des publications académiques ou des rapports d’audit statistique :
data test_cognitif;
set test_cognitif;
label Groupe = « Condition Expérimentale d’Étude »
Score_Memoire = « Score d’Évaluation Mémorielle (0-100) »;
run;
3.3 Exemple d’implémentation de données empiriques comparatives
L’analyse empirique dans les environnements de production ou les plateformes modernes comme SAS Studio exige une organisation rigoureuse du code source, articulée autour de bibliothèques pérennes et d’une traçabilité intégrale des transformations de données. Afin de contextualiser notre propos, considérons une étude clinique comparant la pression artérielle systolique (exprimée en millimètres de mercure, mmHg) entre deux cohortes de patients hypertendus assignés soit à une monothérapie conventionnelle, soit à une bithérapie novatrice.
La structuration du jeu de données dans la bibliothèque de travail SAS s’opère par une étape DATA rigoureusement balisée. Il convient de vérifier systématiquement que la variable de classification ne comporte strictement que deux niveaux distincts. Si un facteur d’exposition présente par inadvertance trois modalités (par exemple en raison d’une faute de frappe orthographique créant une troisième catégorie parasite), l’exécution de la procédure échouera immédiatement, SAS bloquant l’inférence par un message d’erreur stipulant que le facteur de groupement doit posséder exactement deux niveaux.
L’examen de l’équilibre des effectifs entre les groupes doit être mené dès l’étape descriptive à l’aide de la procédure proc freq data=hypertension; tables Traitement; run;. Si un équilibre parfait des effectifs maximise la robustesse statistique face aux violations de l’homoscédasticité, la présence de plans déséquilibrés constitue une situation empirique récurrente qu’il s’agira de traiter méthodologiquement par les ajustements appropriés lors de la phase inférentielle sous PROC TTEST.
4. La syntaxe fondamentale et les options avancées de PROC TTEST dans SAS
4.1 Structure syntaxique standard de la procédure PROC TTEST
La procédure PROC TTEST constitue le moteur computationnel dédié à l’évaluation des différences de moyennes au sein de l’environnement SAS. Sa conception syntaxique obéit à une logique déclarative modulaire alliant concision et puissance fonctionnelle. L’appel de base de la procédure s’effectue par l’instruction proc ttest data=nom_de_table;, qui spécifie le jeu de données SAS sur lequel opérer l’inférence comparative.
L’architecture interne de la procédure repose sur la conjonction obligatoire de deux instructions secondaires indispensables pour orchestrer une comparaison à deux échantillons indépendants :
- CLASS : Cette instruction identifie la variable indépendante de classification. Elle spécifie le facteur binaire qui segmente la population en deux sous-échantillons mutuellement exclusifs. Cette variable peut être soit de nature alphanumérique, soit numérique.
- VAR : Cette instruction définit la variable dépendante continue dont les moyennes empiriques doivent être comparées à travers les deux modalités définies par l’instruction CLASS. Si cette instruction est omise, SAS tentera d’exécuter l’analyse sur l’ensemble des variables numériques présentes dans la table source, ce qui peut s’avérer inutilement lourd et inapproprié.
L’exécution de la procédure s’achève formellement par l’instruction RUN;, qui déclenche l’exécution des calculs matriciels et la restitution des résultats analytiques dans la fenêtre de sortie ODS (Output Delivery System). Un exemple canonique se formalise ainsi :
proc ttest data=test_cognitif;
class Groupe;
var Score_Memoire;
run;
4.2 Paramétrage des intervalles de confiance et niveaux alpha
Par défaut, la procédure PROC TTEST opère au seuil de confiance classique de 95 %, correspondant à une marge d’erreur nominale alpha de 0,05. Toutefois, selon les exigences spécifiques des protocoles de recherche ou la sévérité des pénalités requises face aux faux positifs (notamment lors d’analyses multiples ou d’essais cliniques confirmatoires), il est fréquemment requis de moduler ce paramètre de précision.
Cette personnalisation s’effectue directement dans l’en-tête de la procédure via l’option ALPHA=. En spécifiant par exemple proc ttest data=test_cognitif alpha=0.01;, l’utilisateur ordonne à SAS de recalibrer l’ensemble des intervalles de confiance estimés au niveau de confiance de 99 %. Ces intervalles englobent non seulement les moyennes individuelles estimées au sein de chaque sous-groupe, mais également leurs écarts types respectifs, ainsi que la différence brute calculée entre les deux moyennes de populations.
L’évaluation des intervalles de confiance de la différence moyenne présente une valeur herméneutique bien supérieure à la simple valeur p. L’examen des bornes inférieure et supérieure permet d’apprécier la précision intrinsèque de l’estimation de l’effet expérimental : un intervalle excessivement large, bien que statistiquement significatif (n’englobant pas le zéro), signalera une faible précision due à une taille d’échantillon trop modeste ou à une variabilité résiduelle considérable, invitant le chercheur à une prudente réserve lors de l’extrapolation clinique ou théorique.
4.3 Gestion des options directionnelles et alternatives d’hypothèse
L’inférence bilatérale constitue le paramétrage natif de PROC TTEST, évaluant l’hypothèse nulle d’égalité stricte face à une hypothèse alternative d’hétérogénéité sans considération du sens de la déviation. Néanmoins, lorsque des fondements théoriques inaltérables ou des nécessités réglementaires prédisent expressément qu’un traitement ne peut que majorer une réponse physiologique ou qu’une intervention ne peut qu’abaisser un niveau de toxicité, la mobilisation d’un test unilatéral (one-sided test) s’avère méthodologiquement recevable.
L’instruction SIDES= implantée dans l’en-tête de la procédure offre une flexibilité totale dans l’orientation mathématique de l’hypothèse alternative :
- SIDES=2 : Spécification bilatérale par défaut (H1: mu1 – mu2 distinct de 0).
- SIDES=U (Upper) : Hypothèse alternative unilatérale supérieure postulant que la moyenne du premier groupe excède celle du second groupe (H1: mu1 – mu2 > 0).
- SIDES=L (Lower) : Hypothèse alternative unilatérale inférieure stipulant que la moyenne du premier groupe est inférieure à celle du second groupe (H1: mu1 – mu2 < 0).
Cette réorientation modifie radicalement le calcul de la probabilité critique, en reportant l’intégralité du risque alpha de rejet sur une seule queue de la distribution théorique de Student. Il en résulte un abaissement du seuil critique absolu requis pour proclamer la significativité, ce qui amplifie la puissance statistique du test pour détecter l’effet dans la direction anticipée. Toutefois, cette approche est à manier avec une circonspection extrême : si la différence observée s’oriente dans le sens inverse de l’hypothèse unilatérale formulée, l’analyste se trouve dans l’obligation formelle de rejeter toute significativité, quelle que soit la magnitude empirique de l’écart constaté.
5. Diagnostic de l’homogénéité des variances : Le test de Folded F
5.1 Mécanisme computationnel du ratio de variance dans SAS
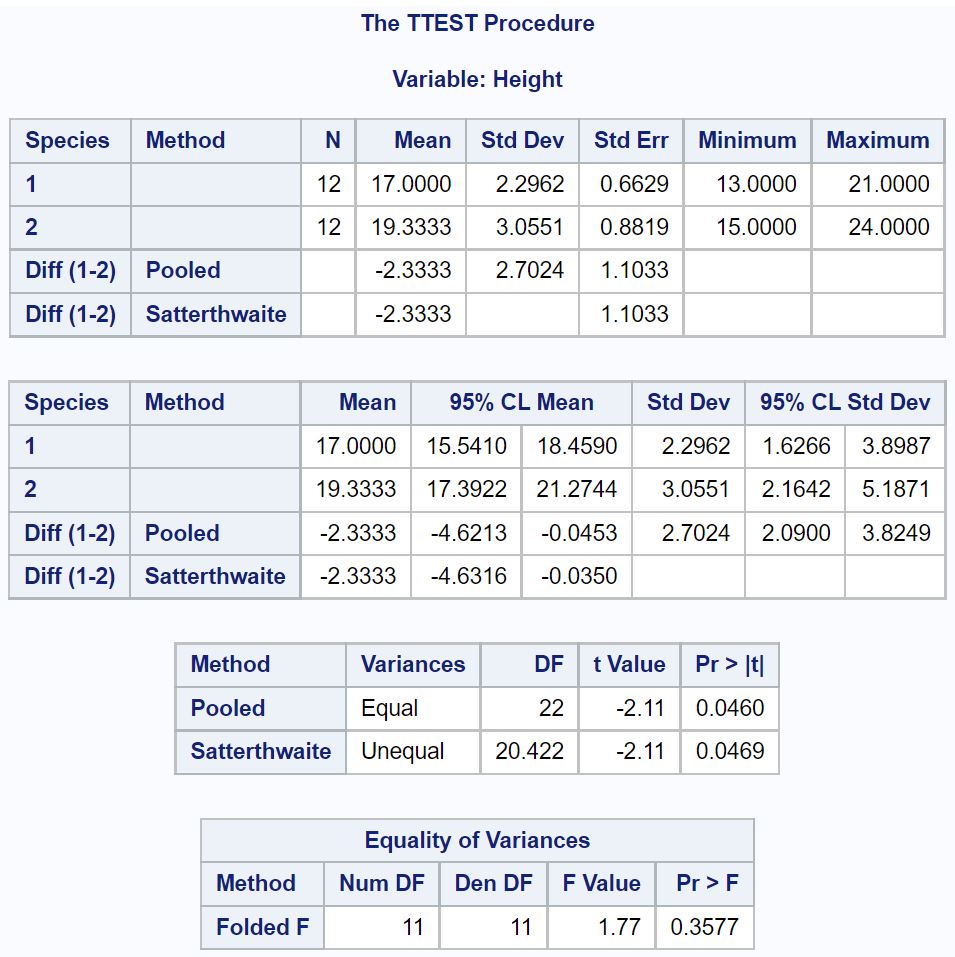
L’exécution de la procédure PROC TTEST génère automatiquement, en annexe du test des moyennes proprement dit, une section diagnostique fondamentale intitulée « Equality of Variances ». Le moteur de calcul de SAS implémente à cet endroit le test de Folded F (ou statistique F pliée), conçu pour tester l’hypothèse nulle d’homogénéité parfaite des variances populationnelles (H0: sigma1 au carré = sigma2 au carré) contre l’hypothèse alternative de leur inégalité substantielle (H1: sigma1 au carré distinct de sigma2 au carré).
La mécanique calculatoire de cette statistique pliée se distingue par une standardisation méthodique évitant les fractions inférieures à l’unité. SAS identifie les variances non biaisées estimées dans chacun des deux sous-échantillons (s1 au carré et s2 au carré) et calcule systématiquement le ratio en positionnant la variance la plus élevée au numérateur et la variance la plus faible au dénominateur : F_plié = max(s1^2, s2^2) / min(s1^2, s2^2).
En conséquence de cette sélection séquentielle de la plus grande variance au numérateur, la valeur empirique du ratio F obtenu est structurellement supérieure ou égale à 1,0. Les degrés de liberté associés à cette statistique, désignés dans la sortie SAS par les colonnes « Num DF » (degrés de liberté du numérateur) et « Den DF » (degrés de liberté du dénominateur), correspondent respectivement à la taille du groupe possédant la plus forte variance amputée d’une unité (n – 1) et à la taille du groupe présentant la variance la plus faible diminuée d’une unité.
5.2 Interprétation des résultats du test d’égalité des variances
L’examen du tableau d’égalité des variances délivre une information décisionnelle pivot qui conditionne le choix de la méthode d’inférence principale. SAS produit une probabilité critique bilatérale, libellée sous l’expression « Pr > F ». Cette métrique quantifie la probabilité exacte d’observer un déséquilibre de variance d’une telle magnitude sous l’hypothèse où les populations d’origine partageraient une dispersion strictement identique.
La règle décisionnelle s’applique selon les canons usuels de la déduction statistique :
- Maintien de l’homoscédasticité (Pr > F >= 0,05) : L’écart entre les variances d’échantillons est jugé imputable aux simples aléas de l’échantillonnage. L’hypothèse de variances égales n’est pas rejetée. L’analyste doit impérativement lire et interpréter la ligne de résultats étiquetée Pooled dans le tableau principal des tests t.
- Constat formel d’hétéroscédasticité (Pr > F < 0,05) : La divergence entre les variances des deux groupes est trop marquée pour être expliquée par le hasard. L’hypothèse d’homogénéité est formellement rejetée. L’analyste se trouve dans l’obligation méthodologique de rejeter la ligne standard et de basculer exclusivement son interprétation sur la ligne ajustée intitulée Satterthwaite.
Cette étape d’aiguillage constitue un point de passage obligatoire pour garantir la robustesse des déductions inférentielles, prévenant l’inflation incontrôlée du risque d’erreur de première espèce liée aux violations d’homogénéité.
5.3 Limites intrinsèques et sensibilité du test de variance aux écarts de normalité
En dépit de son intégration systématique et automatisée au sein des sorties PROC TTEST, le test d’égalité des variances basé sur le ratio F classique souffre d’une fragilité théorique bien documentée dans la littérature statistique : son extrême vulnérabilité face aux violations du postulat de normalité distributionnelle. La distribution du rapport de deux variances estimées dépend de manière critique de l’absence totale d’aplatissement excessif au sein des données mères.
Si la variable dépendante s’écarte même modérément d’une distribution gaussienne — notamment en présence de distributions leptokurtiques caractérisées par des queues lourdes ou des pointes centrales effilées — la distribution du ratio empirique s’éloigne drastiquement de la loi théorique de Fisher-Snedecor. Il en résulte un rejet erroné systématique de l’hypothèse d’homoscédasticité, le test F interprétant la lourdeur des queues de distribution comme une différence de variance, conduisant à tort le praticien vers des corrections d’hétéroscédasticité non requises.
Cette lacune épistémologique a conduit de nombreux méthodologistes à recommander l’usage de tests diagnostiques plus robustes et moins sensibles aux déviations de normalité, au premier rang desquels figure le test de Levene (ou sa variante fondée sur la médiane, le test de Brown-Forsythe). Bien que PROC TTEST n’intègre pas directement le test de Levene dans son tableau récapitulatif par défaut, celui-ci peut être très aisément sollicité sous SAS via la procédure ANOVA ou GLM au moyen de la syntaxe proc glm; class Groupe; model Score = Groupe; means Groupe / hovtest=levene; run;, fournissant un arbitrage bien plus imperméable aux asymétries sous-jacentes.
6. Interprétation de la méthode de Student classique : Approche des variances combinées (Pooled)
6.1 Formule mathématique de la variance combinée (Pooled Variance)
Lorsque le diagnostic d’homogénéité des variances valide la présomption de dispersion équivalente entre les populations, l’approche de Student standard basée sur la variance combinée (dénommée méthode « Pooled » dans SAS) représente la modalité analytique optimale sur le plan de l’efficience statistique. Cette approche exploite pleinement l’ensemble de l’information disponible en agrégeant les sommes des carrés des écarts observées dans chaque groupe.
La formule mathématique de la variance combinée (sp au carré) s’exprime comme une moyenne pondérée des variances d’échantillons individuelles (s1 au carré et s2 au carré), où les coefficients de pondération correspondent précisément à leurs degrés de liberté respectifs :
sp^2 = [ (n1 – 1) * s1^2 + (n2 – 1) * s2^2 ] / (n1 + n2 – 2)
L’erreur type de la différence des moyennes se calcule ensuite directement à partir de cette estimation unique et conjointe : SE_diff = racine_carree[ sp^2 * ( (1 / n1) + (1 / n2) ) ]. Cette mutualisation confère à l’estimation de l’erreur type une stabilité maximale. Les degrés de liberté globaux alloués au test s’élèvent ainsi à n1 + n2 – 2. Lorsque l’homoscédasticité est strictement respectée, cette méthode offre la puissance statistique la plus élevée pour déceler un écart réel, minimisant l’erreur de deuxième espèce face à toute autre modalité computationnelle.
6.2 Lecture méthodique du tableau ‘t Tests’ de SAS
Le tableau intitulé « t Tests » constitue le cœur opérationnel de l’output généré par PROC TTEST. Ce tableau présente une structure matricielle compartimentée en deux lignes distinctes étiquetées « Pooled » et « Satterthwaite ». Lorsque l’homogénéité des variances a été préalablement confirmée, l’analyste isole rigoureusement la ligne Pooled et procède à la lecture séquentielle de ses composantes scalaires.
La première colonne d’intérêt est intitulée « Method », indiquant la méthode de variance appliquée (Pooled). Vient ensuite la colonne « Variances », rappelant le postulat sous-jacent (Equal). La colonne « DF » rapporte les degrés de liberté théoriques, calculés selon la formule n1 + n2 – 2. L’analyste relève ensuite dans la colonne « t Value » la valeur empirique de la statistique de Student calculée par SAS. Le signe de cette valeur t dépend simplement de l’ordre algébrique de soustraction défini par SAS, qui procède par défaut selon l’ordre alphanumérique des modalités de la variable CLASS.
L’aboutissement de la démarche inférentielle réside dans la lecture de la colonne « Pr > |t| », qui rapporte la probabilité critique bilatérale associée à la statistique t pour les degrés de liberté spécifiés. Si cette p-valeur s’affiche sous un seuil strictement inférieur à 0,05 (par exemple t = 4,28, DF = 14, Pr > |t| = 0,0007), le chercheur est formellement autorisé à rejeter l’hypothèse nulle H0 au seuil alpha de 5 %, concluant avec un haut niveau de confiance statistique à l’existence d’une différence systématique entre les moyennes des deux populations étudiées.
6.3 Intervalles de confiance de la différence moyenne Pooled
L’interprétation de la significativité statistique via la p-valeur doit impérativement être consolidée par l’analyse des intervalles de confiance de la différence moyenne, répertoriés dans le tableau supérieur intitulé « Differences ». SAS y calcule l’estimation ponctuelle brute de l’écart entre les moyennes d’échantillons (Mean), flanquée de sa borne inférieure (Lower CL Mean) et de sa borne supérieure (Upper CL Mean), calibrées au seuil spécifié (par défaut à 95 %).
La règle herméneutique de l’intervalle de confiance est d’une grande limpidité géométrique : il existe une relation de dualité parfaite entre le test d’hypothèse bilatéral au seuil alpha et l’intervalle de confiance à 100*(1 – alpha) %. Dès lors que la valeur zéro est totalement exclue de l’intervalle de confiance (par exemple si l’intervalle s’étend de +3,42 à +12,18), cela équivaut mathématiquement au rejet strict de l’hypothèse nulle d’égalité des moyennes au seuil de 5 % (p < 0,05). À l’inverse, si l’intervalle chevauche le zéro en englobant des valeurs à la fois négatives et positives (par exemple de -1,54 à +4,82), l’hypothèse d’absence d’effet ne peut en aucun cas être écartée.
Au-delà de cette décision binaire, l’intervalle de confiance apporte une information substantielle inestimable sur la précision du dispositif expérimental. La largeur totale de l’intervalle reflète la marge d’erreur inhérente à l’échantillonnage : une amplitude restreinte garantit que la véritable différence populationnelle est circonscrite avec une excellente précision, tandis qu’un intervalle excessivement vaste souligne l’incertitude entourant l’estimation, indiquant que de futures réplications pourraient enregistrer des ampleurs d’effets substantiellement discordantes.
7. Traitement de l’hétéroscédasticité : La méthode de Welch-Satterthwaite
7.1 L’approximation des degrés de liberté de Satterthwaite
Lorsque le test de Folded F (ou tout autre diagnostic d’homoscédasticité) révèle une divergence significative entre les variances des deux groupes, l’usage de la méthode Pooled devient caduque et expose l’analyste à de graves erreurs de décision, particulièrement en présence d’échantillons de tailles inégales. Pour surmonter cette impasse méthodologique, l’ingénierie statistique recourt à la correction élaborée par Bernard Lewis Welch et popularisée par Franklin E. Satterthwaite.
La méthode de Welch-Satterthwaite abandonne le principe d’une variance combinée. L’erreur type de la différence n’est plus calculée sur la base d’un sp commun, mais s’obtient par la sommation directe des variances d’échantillons divisées chacune par leur propre taille d’échantillon : SE_Welch = racine_carree[ (s1^2 / n1) + (s2^2 / n2) ]. Cette dissociation immunise la statistique de test contre le risque de sous-estimation ou de surestimation de la dispersion globale.
Toutefois, le ratio t ainsi calculé ne suit plus rigoureusement une distribution de Student standard pourvue des degrés de liberté entiers n1 + n2 – 2. Satterthwaite a établi une approximation analytique sophistiquée permettant d’estimer des degrés de liberté effectifs ajustés. La formule calcule une valeur fractionnaire continue reposant sur la pondération complexe des variances et des effectifs :
DF_Satterthwaite = [ ( (s1^2 / n1) + (s2^2 / n2) )^2 ] / [ ( (s1^2 / n1)^2 / (n1 – 1) ) + ( (s2^2 / n2)^2 / (n2 – 1) ) ]
Cette correction a pour effet géométrique systématique de réduire le nombre de degrés de liberté disponibles. En abaissant cette valeur par rapport au total n1 + n2 – 2, la procédure épaissit les queues de la distribution de référence, ce qui majore mécaniquement les valeurs critiques requises pour déclarer la significativité et préserve ainsi rigoureusement le taux d’erreur de première espèce au niveau nominal désiré de 5 %.
7.2 Lecture de la ligne ‘Satterthwaite’ dans les résultats SAS
Dans l’environnement de sortie de PROC TTEST, l’exploitation des résultats sous hétéroscédasticité implique une focalisation exclusive sur la ligne inférieure du tableau « t Tests », expressément étiquetée « Satterthwaite ». L’analyste y observe immédiatement une divergence méthodologique majeure par rapport aux standards de Student classiques.
Dans la colonne « DF », les degrés de liberté ne se présentent plus sous la forme d’un nombre entier naturel, mais sous un format décimal fractionnaire (par exemple DF = 9,3421). Cette valeur non entière découle directement de l’application de l’équation de Welch-Satterthwaite aux données d’échantillon. La statistique t ajustée est consignée dans la colonne adjacente, calculée avec le dénominateur de Welch.
L’arbitrage inférentiel s’opère en observant la valeur « Pr > |t| » alignée sur cette même rangée Satterthwaite. Il n’est pas rare de constater des divergences décisionnelles notables entre la ligne Pooled et la ligne Satterthwaite, en particulier lors d’études comportant un groupe restreint à forte variabilité opposé à un groupe étendu à faible dispersion. Dans une telle situation, la ligne Pooled affichera fréquemment une significativité trompeuse (p < 0,05) engendrée par une erreur type artificiellement comprimée, alors que la ligne Satterthwaite rétablira la réalité inférentielle en fournissant une p-valeur non significative (p > 0,05), épargnant au chercheur la publication d’un résultat artefactuel.
7.3 Robustesse et prévalence moderne de l’approche de Welch
Au cours des dernières décennies, un courant méthodologique influent au sein de la statistique appliquée et de la psychométrie a profondément remis en cause la pertinence du protocole de décision séquentiel traditionnel en deux étapes (qui consiste à tester d’abord l’homoscédasticité via le test F, puis à choisir entre Pooled et Satterthwaite). Des statisticiens de renom soulignent que le test préliminaire d’homoscédasticité manque cruellement de puissance sur les petits échantillons et présente une sensibilité excessive sur les larges cohortes, introduisant un biais de conditionnalité analytique qui altère le comportement global de l’inférence.
Face à ces écueils, de nombreux consensus scientifiques contemporains préconisent l’adoption systématique et inconditionnelle du test t de Welch (la méthode de Satterthwaite) comme procédure d’analyse par défaut pour la comparaison de deux moyennes indépendantes. Cette recommandation s’appuie sur le comportement asymptotique optimal de la statistique de Welch : lorsque les variances empiriques sont réellement égales, le test de Welch fournit des résultats virtuellement indiscernables de ceux du test de Student standard, sans aucune perte significative de puissance statistique. En revanche, lorsque les variances s’avèrent inégales, il garantit un contrôle parfait de l’erreur de première espèce, éliminant ainsi toute dépendance envers un test d’homoscédasticité préliminaire imparfait.
Dans la pratique analytique sous SAS, bien que PROC TTEST persiste à afficher les deux estimations côte à côte pour des raisons de conformité historique et de flexibilité réglementaire, le chercheur contemporain gagne en rigueur et en reproductibilité à déclarer a priori dans son plan d’analyse statistique le recours préférentiel à la méthode de Satterthwaite pour l’ensemble de ses tests bivariés.
8. Évaluation rigoureuse des postulats distributionnels via PROC UNIVARIATE
8.1 Syntaxe de vérification de la normalité conditionnelle
La validité des inférences issues de PROC TTEST repose sur la satisfaction du postulat de normalité distributionnelle de la variable d’intérêt au sein de chaque niveau du facteur de classification. La procédure SAS la plus adaptée, la plus exhaustive et la plus robuste pour conduire cet examen diagnostique approfondi est incontestablement la procédure PROC UNIVARIATE. Elle déploie un spectre complet d’indicateurs descriptifs de forme, de tests statistiques d’ajustement formels et de graphiques exploratoires.
Pour auditer la normalité conditionnelle séparément pour chaque sous-groupe expérimental, la syntaxe SAS requiert l’adjonction de l’option NORMAL dans l’en-tête de la procédure ainsi que l’utilisation de l’instruction CLASS (ou alternativement d’une instruction BY conditionnée par un tri préalable via PROC SORT). L’instruction standard se structure comme suit :
proc univariate data=test_cognitif normal;
class Groupe;
var Score_Memoire;
run;
Cette commande génère une ventilation complète des sorties statistiques segmentées pour chaque modalité du facteur Groupe, permettant à l’analyste de dissocier scrupuleusement la distribution de l’échantillon de contrôle de celle du groupe expérimental, prévenant ainsi l’erreur fréquente consistant à évaluer la normalité globale sur l’échantillon agrégé sans distinction des sous-populations.
8.2 Interprétation des tests statistiques de normalité
L’activation de l’option NORMAL dans PROC UNIVARIATE déclenche la production d’un tableau synthétique intitulé « Tests for Normality ». SAS y implémente simultanément quatre tests formels d’adéquation à la loi normale, accompagnés de leur statistique empirique respective et de leur p-valeur bilatérale associée. L’hypothèse nulle conjointe de ces tests stipule que l’échantillon analysé est issu d’une population parente distribuée selon une loi gaussienne normale.
Le test de référence pour les échantillons de taille restreinte à modérée (n < 50 voire n < 200) demeure la statistique W de Shapiro-Wilk. Ce test quantifie la corrélation entre les quantiles observés et les scores théoriques normaux ; une valeur W proche de 1,0 atteste d’une adéquation parfaite. Si la probabilité critique étiquetée « Pr < W » est supérieure au seuil critique de 0,05, l’hypothèse de normalité est conservée. En revanche, une valeur p inférieure à 0,05 oblige l’analyste à rejeter formellement l’hypothèse de normalité pour le groupe concerné.
Pour des cohortes plus massives (n >= 200), SAS fournit le test de Kolmogorov-Smirnov avec correction de Lilliefors (indiqué par la statistique D), ainsi que les tests de Cramér-von Mises (statistique W-Sq) et d’Anderson-Darling (statistique A-Sq). Le test d’Anderson-Darling s’avère particulièrement pertinent en recherche quantitative en raison de sa sensibilité accrue aux anomalies localisées dans les queues de distribution, zone d’inflexion où les violations de normalité s’avèrent les plus préjudiciables pour la stabilité de l’erreur type de Student.
8.3 Analyse descriptive des indices de Skewness et Kurtosis
Bien que les tests formels d’adéquation soient indispensables, ils présentent un écueil méthodologique symétrique à celui rencontré lors du test des variances : sur de très grands échantillons, ils tendent à rejeter l’hypothèse nulle pour des écarts infinitésimaux sans gravité analytique, tandis que sur de très faibles effectifs, ils manquent de puissance pour déceler des asymétries problématiques. Dès lors, l’examen direct des coefficients d’asymétrie (Skewness) et d’aplatissement (Kurtosis) documentés dans le premier tableau « Moments » de PROC UNIVARIATE s’impose comme une démarche complémentaire impérative.
Le coefficient d’asymétrie de Fisher (Skewness) évalue la symétrie de la distribution autour de son espérance :
- Une valeur nulle caractérise une symétrie parfaite.
- Un indice positif reflète un étirement de la queue de distribution vers la droite (distribution asymétrique positive, typique des données de temps de réaction ou de revenus).
- Un indice négatif matérialise un étirement vers la gauche (asymétrie négative).
Le coefficient d’aplatissement (Kurtosis standardisé de Pearson, où SAS soustrait automatiquement 3 pour fixer la normale théorique à zéro) renseigne sur l’épaisseur des queues : une valeur positive indique une distribution leptokurtique aux queues épaisses et à forte concentration centrale, tandis qu’une valeur négative dénote une distribution platykurtique aux queues tronquées.
Dans la littérature méthodologique contemporaine, une distribution est généralement considérée comme acceptable pour l’application d’un test t paramétrique dès lors que la valeur absolue du Skewness demeure inférieure à 2,0 et que le Kurtosis absolu ne dépasse pas le seuil de 7,0 (certains auteurs plus conservateurs préconisant une plage d’acceptabilité comprise entre -1,0 et +1,0 pour les faibles effectifs). Tout dépassement substantiel de ces seuils signale des déviations pathologiques nécessitant soit une transformation mathématique des échelles, soit le recours aux méthodes non paramétriques.
9. Exploration graphique et diagnostics visuels avec SAS ODS Graphics
9.1 Activation et exploitation du système ODS Graphics
L’exploration analytique ne saurait se restreindre à la seule lecture d’indices tabulaires ; le diagnostic visuel de la forme des distributions constitue une composante indissociable de toute évaluation statistique rigoureuse. L’infrastructure graphique native de SAS, ODS Graphics (Output Delivery System Graphics), permet d’engendrer automatiquement des représentations visuelles haute résolution directement intégrées aux procédures d’analyse.
Pour activer cette fonctionnalité globale, l’instruction ods graphics on; doit être exécutée préalablement dans la session SAS. Dès lors que cette option est active, la simple invocation de la procédure PROC TTEST déclenche la production spontanée d’un panneau graphique intégré comprenant des diagrammes en boîte à moustaches comparatifs, des estimations de densités nucléaires empiriques et théoriques, ainsi que des graphiques de concordance quantile-quantile.
La fermeture de l’environnement graphique en fin d’exécution s’opère par l’instruction ods graphics off;. Les analystes peuvent personnaliser le format vectoriel de restitution (PDF, PNG, SVG) ainsi que les thèmes typographiques à l’aide de l’instruction ods listing ou ods html, garantissant l’obtention immédiate de visualisations graphiques directement insérables au sein d’articles scientifiques ou de protocoles cliniques conformes aux standards éditoriaux les plus exigeants.
9.2 Analyse des diagrammes en boîte à moustaches et d’intervalles
Le premier ensemble graphique généré par PROC TTEST juxtapose des diagrammes en boîte à moustaches côte à côte (Side-by-side Box Plots) pour chacun des deux groupes expérimentaux. Cette représentation synthétise les propriétés structurales non paramétriques des échantillons : la barre transversale matérialise la médiane, les bordures inférieure et supérieure de la boîte délimitent respectivement le premier et le troisième quartile (l’écart interquartile regroupant les 50 % centraux des observations), tandis que les moustaches illustrent les valeurs adjacentes délimitées par 1,5 fois l’étendue interquartile.
L’examen simultané des boîtes permet d’opérer un double diagnostic immédiat :
- Vérification visuelle de l’homoscédasticité : Des boîtes et des moustaches présentant des longueurs approximativement équivalentes d’un groupe à l’autre attestent visuellement d’une bonne homogénéité des variances intra-groupes. À l’inverse, une boîte deux à trois fois plus étendue que sa comparse signale graphiquement une situation d’hétéroscédasticité criante qui conforte le recours à la méthode de Satterthwaite.
- Identification des valeurs aberrantes univariées (outliers) : Les observations individuelles franchissant les moustaches sont isolées par des symboles discrets. Ces données extrêmes doivent être minutieusement examinées, car elles exercent un effet de levier disproportionné sur le calcul de la moyenne arithmétique et gonflent dramatiquement la variance d’échantillonnage.
Parallèlement, SAS superpose à l’intérieur de chaque boîte un marqueur spécifique (généralement un losange ou un point plein) désignant l’emplacement de la moyenne empirique arithmétique, entouré de ses barres d’erreur type. La distance verticale séparant ce marqueur de la médiane centrale offre une première estimation visuelle du degré d’asymétrie interne de la distribution.
9.3 Diagrammes quantile-quantile (Q-Q plots) et courbes de densité
Le panneau graphique de diagnostic délivré par SAS ODS inclut un diagramme quantile-quantile (Q-Q Plot) conditionnel pour chaque niveau du facteur CLASS. Le Q-Q plot représente l’outil qualitatif le plus puissant pour juger de la conformité d’un échantillon empirique à la loi normale théorique. L’axe des ordonnées reporte les quantiles des données empiriques observées, tandis que l’axe des abscisses porte les quantiles théoriques issus d’une distribution gaussienne idéale de même espérance et de même variance.
Si la variable dépendante est distribuée normalement au sein du groupe, les points d’échantillonnage s’alignent avec précision le long de la ligne diagonale de référence tracée par SAS. Tout décrochage morphologique systématique par rapport à cette diagonale fournit un diagnostic étiologique immédiat de la nature de la violation :
- Inflexion sigmoïde en forme de ‘S’ : Révèle des queues de distribution beaucoup plus lourdes que celles d’une loi normale (présence d’observations extrêmes aux deux extrémités, distribution leptokurtique).
- Courbure convexe ou concave unilatérale : Traduit une asymétrie marquée (skewness), la distribution s’étirant préférentiellement vers les valeurs positives ou négatives.
En complément des diagrammes Q-Q, SAS projette des histogrammes sur lesquels sont superposées deux courbes de densité distinctes : une courbe continue traçant la fonction de densité gaussienne paramétrique idéale, et une courbe en pointillés représentant la densité nucléaire empirique non paramétrique (kernel density estimation). La concordance visuelle étroite entre ces deux tracés achève d’établir la validité de l’ancrage paramétrique du test de Student.
10. Quantification de l’ampleur de l’effet : d de Cohen et métriques associées
10.1 Formulation théorique et calcul du d de Cohen
Dans l’épistémologie contemporaine des sciences quantitatives, la publication exclusive d’une valeur p et de la statistique de test associée est jugée notoirement insuffisante pour fonder une conclusion scientifique complète. Une p-valeur très faible atteste du rejet de l’hypothèse nulle selon laquelle la différence observée serait attribuable au seul hasard, mais elle n’apporte aucune information quantifiable sur la magnitude réelle ou la force substantielle de cette divergence. Pour combler cette béance descriptive, la quantification de la taille de l’effet (effect size) s’impose comme une exigence méthodologique absolue.
Le d de Jacob Cohen constitue la métrique standardisée par excellence pour la comparaison de deux moyennes indépendantes. Il exprime la distance brute séparant les moyennes des deux groupes en unités d’écart type combiné :
d = (Moyenne_1 – Moyenne_2) / s_pooled
Cette standardisation métrique libère l’indice de toute dépendance vis-à-vis de l’unité de mesure initiale (qu’il s’agisse de milligrammes, de scores psychométriques ou de secondes), conférant au d de Cohen un statut d’indice universel permettant la comparaison inter-études et l’intégration directe au sein d’analyses méta-analytiques formalisées.
Dans les versions contemporaines de SAS (à partir de la version 9.4m1), la procédure PROC TTEST intègre désormais nativement le calcul des tailles d’effet en spécifiant l’option PLOTS(SHOWHOOD)=ALL ou via l’option DIST=NORMAL associée à des instructions avancées. Alternativement, le d de Cohen peut être programmé avec une élégante simplicité à l’aide d’une courte macro SAS ou extrait directement des tables descriptives générées par l’instruction ODS OUTPUT.
10.2 Interprétation des seuils conventionnels et contextuels
Dans son ouvrage séminal de 1988, Jacob Cohen a proposé des balises interprétatives conventionnelles pour guider le chercheur dans l’appréciation heuristique de la magnitude du d calculé :
- Effet faible (d = 0,20) : La différence entre les groupes est modeste et demeure difficilement perceptible à l’œil nu sans instruments de mesure fins. Elle correspond à un taux de chevauchement (distribution overlapping) d’environ 85 % entre les populations.
- Effet moyen (d = 0,50) : La magnitude de la divergence devient visible et perceptible au niveau observationnel brut. Les distributions partagent environ 67 % de variance commune.
- Effet fort (d = 0,80 et au-delà) : L’effet expérimental s’avère massif ; les deux distributions se séparent de manière substantielle, avec un taux de recouvrement plongeant sous la barre des 53 %.
Cependant, les méthodologistes actuels mettent expressément en garde la communauté scientifique contre l’application aveugle et décontextualisée de ces balises rigides. La qualification d’un effet doit impérativement s’apprécier à la lumière du champ d’application disciplinaire. En épidémiologie préventive ou en cardiologie, un d de Cohen de 0,15 résultant d’un traitement médicamenteux peut représenter une avancée médicale colossale à l’échelle d’une population nationale en sauvant des milliers de vies, alors qu’en psychologie de laboratoire ou en ergonomie cognitive, un d inférieur à 0,40 peut être jugé méthodologiquement négligeable et dénué d’application concrète.
10.3 Autres indicateurs de variance expliquée et corrections
Bien que le d de Cohen jouisse d’une hégémonie d’usage, il présente une propriété mathématique qui impose une vigilance particulière : sur de très petits échantillons (N total < 20), la statistique d a tendance à surestimer systématiquement la taille d’effet réelle au sein de la population. Pour pallier ce biais d’échantillonnage, la correction formulée par Larry Hedges s’avère particulièrement recommandée.
Le g de Hedges applique au d de Cohen un coefficient correcteur non biaisé fondé sur la fonction Gamma, approximé par la formule suivante : g = d * [ 1 – (3 / (4 * DF – 1)) ]. Pour les grands échantillons, la différence entre d et g devient infinitésimale, mais pour les faibles cohortes expérimentales, le recours au g de Hedges garantit une estimation rigoureusement non biaisée de la taille d’effet populationnelle.
D’autres métriques évaluant le pourcentage de variance expliquée complètent ce dispositif analytique, notamment le coefficient de corrélation ponctuelle bisériale (r de Pearson associé au test t) ou le coefficient êta-carré (eta^2). Ce dernier exprime la proportion exacte de la variance totale de la variable continue qui est attribuable à l’appartenance au groupe expérimental :
eta^2 = t^2 / (t^2 + DF)
L’estimation conjointe de l’intervalle de confiance à 95 % associé à cette taille d’effet standardisée parachève la démarche, reflétant l’incertitude d’échantillonnage entourant la magnitude de l’impact mesuré.
11. Procédures alternatives et non paramétriques en cas de violation des postulats
11.1 Test de Wilcoxon-Mann-Whitney avec PROC NPAR1WAY
Lorsque l’analyse distributionnelle menée sous PROC UNIVARIATE révèle des violations rédhibitoires des postulats de normalité — telles que la présence de fortes asymétries associées à de très petits échantillons (n < 15 par groupe) ou la présence avérée de valeurs aberrantes impossibles à évincer légitimement —, le test t paramétrique perd toute validité inférentielle. Dans cette conjoncture, la procédure non paramétrique canonique de substitution est le test des sommes de rangs de Wilcoxon, mathématiquement équivalent au test U de Mann-Whitney.
Le test de Wilcoxon-Mann-Whitney contourne le postulat de normalité en substituant aux valeurs numériques continues brutes leur rang ordinal séquentiel au sein de l’échantillon agrégé. L’algorithme ne compare plus des moyennes arithmétiques sensibles aux valeurs extrêmes, mais évalue si la distribution des rangs d’un groupe tend stochastiquement à excéder celle de l’autre groupe. Si les formes des distributions des deux populations sont approximativement identiques, le test permet de statuer sur l’égalité formelle des médianes.
Sous SAS, cette analyse non paramétrique s’exécute avec une extrême fluidité grâce à la procédure PROC NPAR1WAY, comme l’illustre la syntaxe canonique suivante :
proc npar1way data=test_cognitif wilcoxon;
class Groupe;
var Score_Memoire;
run;
La sortie produite par SAS fournit la somme des rangs pour chaque groupe, le score z asymptotique normal standardisé ainsi que la probabilité exacte bilatérale calculée par permutations combinatoires (particulièrement précieuse sur de faibles effectifs), offrant une parade méthodologique imperméable aux déviations de normalité.
11.2 Transformations mathématiques préalables des données
Une alternative élégante au passage vers le non-paramétrique consiste à appliquer une transformation mathématique continue à la variable dépendante brute au sein de l’étape DATA, dans le but explicite de rapprocher sa distribution de la loi normale et de stabiliser ses variances entre les groupes. Cette approche préserve le cadre de modélisation paramétrique et autorise le maintien de la procédure PROC TTEST classique.
Le choix de la fonction de transformation dépend directement de la nature géométrique de l’asymétrie décelée :
- Transformation logarithmique (Log10 ou Log népérien LN) : Constitue le traitement de référence pour corriger les asymétries positives prononcées où les données s’étirent le long d’une longue queue droite (données de concentrations biologiques, durées, métriques financières).
- Transformation par racine carrée (SQRT) : Particulièrement adaptée aux données de comptage discrets présentant une distribution de Poisson où la variance s’avère proportionnelle à la moyenne.
- Transformation inverse ou réciproque (1 / X) : Traitement puissant destiné à corriger les asymétries positives extrêmes, comprimant drastiquement les valeurs excessivement élevées.
Considérons l’implémentation d’une transformation logarithmique sous SAS :
data donnees_transformees;
set test_cognitif;
Log_Score = log(Score_Memoire);
run;
proc ttest data=donnees_transformees;
class Groupe;
var Log_Score;
run;
Il importe toutefois de souligner la complexité herméneutique induite par ce procédé : le test statistique s’applique formellement sur l’échelle transformée. Lors de la restitution des résultats, la rétro-transformation de la différence des moyennes logarithmiques vers l’échelle originelle par la fonction exponentielle ne fournit pas une différence arithmétique de moyennes, mais le rapport géométrique des moyennes d’origine (Ratio of Geometric Means), imposant une contextualisation soignée dans le rapport de recherche.
11.3 Approches par rééchantillonnage et méthodes de permutation (Bootstrap)
Lorsque la structure des données défie à la fois les distributions paramétriques classiques et les schémas de transformations analytiques simples, les approches contemporaines par rééchantillonnage computationnel (Bootstrap) ou par tests de permutation constituent la réponse méthodologique la plus avancée. Le bootstrap empirique ne formule aucun postulat quant à la distribution mère des données ; il exploite l’échantillon empirique observé comme une pseudo-population théorique.
Le principe computationnel consiste à générer de manière itérative un nombre massif de sous-échantillons (par exemple B = 10 000 répliques) par tirage aléatoire avec remise au sein de chaque groupe, de calculer la différence empirique des moyennes pour chacune de ces itérations, et de construire ainsi une distribution d’échantillonnage empirique directe de l’estimateur. Les intervalles de confiance non paramétriques (notamment par la méthode des percentiles ou la méthode BCa corrigée des biais et accélérations) s’extraient directement des fractiles de cette distribution simulée.
Sous SAS, ces procédures de rééchantillonnage s’exécutent avec une remarquable efficacité grâce à la combinaison de la procédure PROC SURVEYSELECT (pour l’extraction aléatoire répétée des répliques) et de l’environnement matriciel SAS/IML. Cette approche computationnelle offre une robustesse inférentielle inégalée pour traiter des dispositifs expérimentaux atypiques, tout en autorisant l’estimation conjointe des intervalles de confiance de la taille de l’effet d de Cohen sans recourir aux distributions d’échantillonnage non centrales théoriques.
12. Restitution académique et communication des résultats selon les normes APA 7
12.1 Directives formelles de rédaction de la septième édition de l’APA
La transmission formelle des résultats au sein de la communauté scientifique internationale obéit à des standards typographiques et rédactionnels rigoureusement codifiés par l’American Psychological Association dans sa septième édition (APA 7). Le respect scrupuleux de ces directives garantit la lisibilité, l’intégrité déontologique et la reproductibilité directe des analyses inférentielles conduites sous SAS.
Les conventions APA 7 imposent des règles typographiques strictes :
- Toutes les lettres symbolisant des paramètres statistiques ou des métriques inférentielles doivent impérativement être formatées en italique : t, p, d, M (moyenne), SD (écart type), F, df. En revanche, les chiffres, les parenthèses et les opérateurs arithmétiques demeurent en typographie romaine droite.
- La restitution de la statistique de Student doit mentionner obligatoirement entre parenthèses la valeur exacte des degrés de liberté associés : t(14) = 4,28. Dans le cas d’un test de Welch-Satterthwaite, les degrés de liberté décimaux fractionnaires doivent être rapportés avec précision, généralement arrondis à une ou deux décimales : t(9,34) = 3,89.
- La valeur p doit être rapportée avec sa valeur décimale exacte à deux ou trois décimales (par exemple p = ,024 ou p = ,001), et non plus sous forme de simples inégalités globales (p < ,05), sauf lorsque la valeur calculée par SAS est strictement inférieure à un millième, auquel cas elle est formulée ainsi : p < ,001. La lettre zéro précédant la virgule décimale est traditionnellement omise en langue anglaise mais peut être maintenue en langue française selon les chartes institutionnelles.
- L’adjonction systématique d’une mesure de taille d’effet standardisée (typiquement le d de Cohen ou le g de Hedges) accompagnée de son intervalle de confiance à 95 % est devenue une obligation formelle dans la restitution académique contemporaine.
12.2 Exemples concrets de rédaction pour les cas Pooled et Satterthwaite
La formulation narrative des résultats doit allier concision littéraire et exhaustivité analytique, intégrant harmonieusement les indicateurs de tendance centrale, de dispersion et les statistiques inférentielles. Voici deux modèles narratifs de référence calibrés pour les publications universitaires :
Cas 1 : Test t de Student classique avec variances homogènes (Méthode Pooled) :
« Un test t de Student pour deux échantillons indépendants a été conduit afin de déterminer l’impact de la condition d’apprentissage sur les scores mémoriels. Le test d’égalité des variances de Folded F n’a révélé aucune violation significative de l’homoscédasticité, F(7, 7) = 1,18, p = ,823. Les analyses indiquent que les participants exposés à la condition expérimentale ont obtenu des performances cognitives moyennes significativement supérieures (M = 80,28, SD = 3,01) à celles des participants de la condition de contrôle (M = 69,96, SD = 2,78), t(14) = 7,13, p < ,001, différence moyenne = 10,32, IC à 95 % [7,22, 13,42]. L’ampleur de cet effet expérimental est considérée comme particulièrement élevée selon les critères conventionnels, d de Cohen = 3,56, IC à 95 % [2,02, 5,08]. »
Cas 2 : Test t de Welch consécutif à une violation d’homoscédasticité (Méthode Satterthwaite) :
« L’évaluation comparative de la pression artérielle systolique résiduelle a mis en évidence une hétérogénéité significative des variances entre les deux protocoles thérapeutiques, F(18, 14) = 3,45, p = ,018. En conséquence, l’ajustement robuste de Welch-Satterthwaite a été mobilisé pour l’inférence statistique. Les patients sous bithérapie présentent une réduction moyenne de la pression systolique significativement plus marquée (M = 124,5 mmHg, SD = 4,2) comparativement à ceux soumis à la monothérapie standard (M = 138,2 mmHg, SD = 8,9), t(19,82) = -5,64, p < ,001, différence brute = -13,70 mmHg, IC à 95 % [-18,77, -8,63]. Cette divergence reflète une taille d’effet substantielle, g de Hedges = -1,88, IC à 95 % [-2,67, -1,07]. »
12.3 Conception de tableaux synthétiques conformes aux standards universitaires
L’intégration de tableaux récapitulatifs obéit à des normes graphiques strictes édictées par l’APA : l’usage des lignes verticales de séparation y est formellement banni, la structure devant reposer exclusivement sur trois lignes horizontales principales (une bordure supérieure, une ligne séparant l’en-tête du corps des données, et une bordure inférieure finale de fermeture).
Pour des comparaisons multiples ou des études incluant plusieurs variables dépendantes consécutives, la présentation tabulaire offre une clarté optimale. Le tableau doit juxtaposer horizontalement : la désignation claire de la variable, les effectifs (n), les moyennes (M) et les écarts types (SD) pour chacun des deux groupes d’étude, la valeur de la statistique de test (t), les degrés de liberté (df), la probabilité critique exacte (p) ainsi que la taille d’effet standardisée (d de Cohen) et ses bornes d’intervalle de confiance.
Toute abréviation présente dans la table doit être explicitée dans une note de bas de tableau rigoureusement articulée. Si des tests de Welch ont été exécutés pour certaines variables en raison d’hétéroscédasticités diagnostiquées, la note de tableau doit stipuler clairement : « *Note.* Les degrés de liberté fractionnaires indiquent l’application de la correction de Welch-Satterthwaite en présence de variances inégales. » L’exportation directe des données SAS vers ces formats éditables s’opère avec une grande fluidité grâce à l’utilisation de l’instruction ODS RTF ou ODS TAGSETS.RTF, qui convertit nativement les tableaux générés par SAS en objets de traitement de texte modifiables, garantissant un gain d’efficience et une fidélité absolue dans la chaîne de production scientifique.
Références
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
Cressie, N. A. C., & Whitford, H. J. (1986). How to use the two-sample t-test. Biometrical Journal, 28(2), 131–148. https://doi.org/10.1002/bimj.4710280202
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.2307/1164588
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student’s t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
SAS Institute Inc. (2023). SAS/STAT 15.3 user’s guide: The TTEST procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510