
Dans le paysage méthodologique de la psychologie expérimentale et des neurosciences cognitives, l’analyse de la variance à mesures répétées (communément désignée sous l’acronyme ANOVA intra-sujets) constitue l’un des outils d’inférence statistique les plus fréquemment mobilisés. Qu’il s’agisse d’évaluer l’efficacité différentielle d’une prise en charge psychothérapeutique au fil du temps, de mesurer les temps de réaction face à des stimuli émotionnels variés ou d’observer la cinétique d’apprentissage moteur au cours de sessions successives, ce paradigme expérimental offre une puissance statistique substantielle en permettant à chaque participant d’agir comme son propre témoin. Néanmoins, cette économie méthodologique s’accompagne d’une exigence théorique fondamentale : le respect des postulats sous-jacents au modèle linéaire généralisé univarié.
Parmi ces conditions d’application, la sphéricité occupe une place à la fois prépondérante et fréquemment mécomprise. Contrairement aux plans factoriels inter-sujets où l’indépendance des observations et l’homogénéité des variances d’erreur (homoscédasticité) suffisent à garantir l’exactitude de la distribution de Fisher-Snedecor, les plans intra-sujets induisent une corrélation inhérente entre les mesures répétées prélevées sur une même unité expérimentale. Lorsque cette structure de corrélation dévie d’un schéma mathématique précis, les distributions théoriques du ratio F deviennent erronées, augmentant considérablement le risque d’aboutir à des conclusions scientifiques fallacieuses. C’est précisément pour sonder cette exigence que le test de sphéricité de Mauchly a été développé et intégré systématiquement dans les logiciels d’analyse statistique contemporains.
Le présent article propose une exploration approfondie, à la fois théorique, mathématique et empirique, du test de sphéricité de Mauchly. Destiné aux chercheurs, doctorants et praticiens des sciences comportementales, ce guide vise à démystifier les fondements algébriques du test, à exposer les mécanismes sous-jacents aux distorsions inférentielles consécutives à sa violation, et à détailler l’ensemble des procédures d’ajustement et des alternatives modernes à disposition du méthodologue. À travers un exemple concret entièrement documenté en psychologie clinique, nous examinerons pas à pas la trajectoire analytique complète, depuis l’extraction de la matrice de variance-covariance jusqu’à la prise de décision méthodologique éclairée et la rédaction rigoureuse des résultats selon les normes académiques internationales.
1. Introduction au test de sphéricité de Mauchly en psychologie expérimentale
1.1 Origine historique et contextualisation statistique
L’acte de naissance du test de sphéricité remonte à l’année 1940, lorsque le physicien et statisticien américain John William Mauchly publie dans les colonnes des Annals of Mathematical Statistics son article princeps intitulé « A Significance Test for Sphericity of a Normal n-Variate Distribution ». Bien avant de devenir l’un des pionniers de l’informatique moderne à travers la conception de l’ENIAC, Mauchly s’est intéressé à la géométrie analytique des distributions multinormales et à l’évaluation des propriétés structurelles des matrices de variance-covariance. À cette époque, le problème posé relevait de la statistique mathématique pure : comment vérifier si un échantillon multidimensionnel d’observations corrélées dérive d’une population parente dont les axes principaux de dispersion possèdent une variance identique dans toutes les directions orthogonales de l’espace euclidien ?
La migration de cette formulation matricielle abstraite vers l’arsenal des sciences comportementales et biomédicales s’est opérée au cours des décennies 1950 et 1960. Avec l’essor des plans expérimentaux sophistiqués théorisés par Ronald Fisher, les psychologues ont rapidement perçu l’intérêt d’administrer plusieurs conditions expérimentales successives à un même groupe d’individus. Cependant, les pionniers de la psychométrie se sont heurtés à un écueil analytique majeur : l’application non critique de l’ANOVA univariée classique à ces données longitudinales entraînait des taux anormaux de rejet de l’hypothèse nulle. Les travaux fondamentaux de George Box en 1954, suivis de ceux de Samuel Greenhouse et Seymour Geisser en 1958, ont mis en lumière que la validité du ratio de variance était intrinsèquement conditionnée par les propriétés algébriques de la matrice de dispersion intra-sujets, propulsant les travaux de Mauchly au centre des préoccupations méthodologiques de la psychologie empirique.
Dès lors, l’évaluation des matrices de variance-covariance intra-sujets n’a plus été perçue comme une simple coquetterie technique, mais comme un impératif de rigueur scientifique. Dans les protocoles de psychologie cognitive et clinique, où l’on enregistre couramment l’évolution de marqueurs cognitifs, physiologiques ou affectifs à travers de multiples sessions d’évaluation, le test de Mauchly est devenu l’algorithme standard implémenté par défaut dans les environnements computationnels pour certifier la validité des inférences déduites des contrastes temporels ou factoriels.
1.2 Importance critique dans les plans à mesures répétées
La spécificité des protocoles longitudinaux et intra-sujets en psychologie réside dans la partition de la variabilité totale. Contrairement aux devis transversaux où la variance inter-individuelle vient systématiquement alimenter le dénominateur du test statistique (carré moyen de l’erreur), le plan à mesures répétées permet d’isoler mathématiquement cette variance attribuable aux particularités stables des participants. En soustrayant cet effet « sujet » du terme d’erreur résiduelle, le chercheur maximise la sensibilité de son dispositif expérimental, augmentant de façon drastique la probabilité de détecter des effets réels de faible ou moyenne amplitude, tels qu’un gain mnésique ténu ou une variation subtile de l’activité électrodermale.
Néanmoins, cet avantage statistique majeur se paie d’un coût structural : les observations recueillies sur une même unité expérimentale partagent une dépendance stochastique intrinsèque. Un individu affichant une anxiété basale élevée lors de la première passation aura une forte probabilité probabiliste de maintenir un niveau relatif élevé lors des passations subséquentes par rapport à ses pairs. Dès lors que l’on manipule un facteur expérimental comportant trois modalités ou davantage, la structure de covariance reliant ces moments de mesure devient complexe. Il devient illusoire de postuler une indépendance des erreurs, et c’est à ce niveau précis qu’intervient la sphéricité comme critère de régularité géométrique.
Le test de Mauchly joue ainsi un rôle de sentinelle méthodologique incontournable préalablement à toute interprétation des effets omnibus ou des interactions intra-sujets au sein de l’ANOVA. Si la géométrie des dispersions s’avère non sphérique, l’estimateur de l’erreur résiduelle univariée est structurellement biaisé à la baisse, ce qui gonfle mécaniquement la valeur calculée de la statistique F. Sans le filtrage préventif assuré par le test de Mauchly, les chercheurs s’exposeraient à déclarer significatives des différences de traitement qui ne sont en réalité que des artefacts imputables à la corrélation différentielle entre les niveaux d’administration des variables indépendantes.
1.3 Positionnement par rapport aux autres postulats statistiques
Pour appréhender correctement la fonction diagnostique du test de Mauchly, il convient de le situer au sein de l’arborescence des conditions d’application du modèle linéaire général. Une confusion fréquente dans la littérature psychologique consiste à assimiler la sphéricité à l’homogénéité des variances (homoscédasticité) telle qu’évaluée par les tests de Levene ou de Bartlett. L’homoscédasticité classique concerne l’égalité des variances de la variable dépendante entre des groupes d’individus indépendants et distincts. En revanche, la sphéricité s’applique de manière exclusive aux comparaisons intra-individuelles et concerne la stabilité de la variance des différences calculées entre les multiples conditions expérimentales appliquées à une même cohorte.
De surcroît, la sphéricité doit être soigneusement distinguée du postulat d’indépendance des résidus. Dans les plans inter-sujets, l’indépendance des observations individuelles est une condition fondamentale dont la violation ruine l’inférence univariée. Dans un plan à mesures répétées, l’interdépendance des scores d’un même sujet au fil du temps est explicitement reconnue et intégrée dans le modèle mathématique. Le postulat ne porte donc plus sur l’indépendance mutuelle des scores bruts, mais sur la conformité de leur matrice de dépendance à un patron particulier où chaque paire de conditions présente la même variance d’écart.
Il existe par conséquent une hiérarchie séquentielle rigoureuse dans la vérification des postulats menant à l’inférence statistique valide dans les designs intra-sujets. En premier lieu se trouve l’indépendance des unités expérimentales entre elles (les sujets ne doivent pas s’influencer mutuellement). En deuxième lieu intervient la normalité multidimensionnelle des distributions conditionnelles au sein de la population parente. Ce n’est qu’une fois ces deux piliers conceptuels posés que s’articule le troisième verrou : l’évaluation de la structure de covariance via le test de sphéricité de Mauchly. Si ce dernier est transgressé, le chercheur ne doit pas nécessairement abandonner le paradigme univarié, mais ajuster les degrés de liberté théoriques ou basculer vers des méthodes multivariées appropriées.
2. Le concept fondamental de sphéricité : cadre théorique et mathématique
2.1 Définition rigoureuse de la condition de sphéricité
Sur le plan mathématique, la sphéricité ne requiert aucunement que les variances des conditions expérimentales d’origine soient identiques, ni même que toutes les covariances entre paires de conditions soient égales. La condition de sphéricité, formellement conceptualisée par Huynh et Feldt ainsi que par Rouanet et Lépine au début des années 1970, exige une propriété plus accessible mais stricte : la variance de la différence entre n’importe quelle paire de modalités du facteur intra-sujets doit être rigoureusement constante. Si l’on désigne par Yj et Yk deux conditions distinctes mesurées chez un ensemble de participants, la condition de sphéricité impose que :
Var(Yj – Yk) = constante, pour tout j différent de k.
En développant l’expression de la variance d’une différence de deux variables aléatoires dépendantes, cette égalité peut être transcrite en fonction des variances individuelles et de la covariance qui les lie :
Var(Yj – Yk) = Var(Yj) + Var(Yk) – 2 * Cov(Yj, Yk).
Cette formulation analytique montre avec clarté pourquoi la sphéricité est une condition moins restrictive que l’égalité conjointe de toutes les variances et de toutes les covariances. Si une condition expérimentale présente une variance intrinsèque plus élevée, la sphéricité peut néanmoins être préservée si les covariances unissant cette condition aux autres augmentent proportionnellement de manière à maintenir invariant le terme résultant. Algébriquement, lorsqu’on applique un ensemble de (k – 1) contrastes orthogonaux normalisés à la matrice de covariance de départ, la matrice résultante doit posséder une forme diagonale où tous les éléments de la diagonale principale sont identiques et où tous les éléments hors diagonale s’annulent. C’est l’exacte satisfaction de cette propriété spectrale qui garantit que la statistique univariée F suit rigoureusement une distribution théorique de Fisher avec (k – 1) et (k – 1)(N – 1) degrés de liberté.
2.2 Distinction entre symétrie composée et sphéricité
L’une des ambiguïtés les plus récurrentes de la littérature statistique appliquée réside dans la confusion entre la symétrie composée (compound symmetry) et la sphéricité. La symétrie composée représente un cas particulier, particulièrement contraignant, de la structure de dispersion. Une matrice de variance-covariance empirique respecte la symétrie composée si et seulement si deux conditions sont simultanément remplies : d’une part, toutes les variances sur la diagonale principale sont strictement identiques (homoscédasticité parfaite entre les sessions : σ12 = σ22 = … = σk2 = σ2), et d’autre part, toutes les covariances hors diagonale sont rigoureusement égales (σjk = σcov pour tout j distinct de k).
Il est aisé de démontrer mathématiquement que la symétrie composée constitue une condition suffisante pour assurer la sphéricité. En effet, si Var(Yj) = σ2 pour tout j et que Cov(Yj, Yk) = σcov pour tout couple (j, k), alors l’application directe de la formule de la variance d’une différence donne :
Var(Yj – Yk) = σ2 + σ2 – 2 * σcov = 2 * (σ2 – σcov) = constante.
Néanmoins, la symétrie composée n’est aucunement une condition nécessaire. Il est mathématiquement tout à fait possible qu’une matrice de variance-covariance présente des variances marginales hétérogènes le long de sa diagonale et des covariances disparates hors de sa diagonale, tout en satisfaisant rigoureusement la condition d’égalité des variances des différences de paires. Ainsi, l’ensemble des matrices possédant la propriété de symétrie composée forme un sous-ensemble strict de l’ensemble plus vaste des matrices satisfaisant le postulat de sphéricité. C’est cette généralité algébrique qui rend la sphéricité centrale : l’ANOVA intra-sujets n’exige pas la rigidité de la symétrie composée, mais s’accommode parfaitement de la sphéricité au sens large.
2.3 Cas particulier des plans à deux niveaux de mesure
Une propriété théorique fondamentale, souvent négligée par les praticiens débutants, concerne le comportement des plans factoriels intra-sujets ne comportant que deux conditions expérimentales (k = 2). Qu’il s’agisse d’un pré-test comparé à un post-test, ou de la confrontation de deux blocs de stimuli (congruents versus incongruents dans une tâche de Stroop), la condition de sphéricité ne peut tout simplement jamais être violée.
La démonstration de cette propriété repose sur une logique arithmétique immédiate. Lorsque k = 2, le nombre total de différences appariées possibles entre deux modalités est donné par la formule combinatoire k(k – 1) / 2. Pour k = 2, nous obtenons :
2 * (2 – 1) / 2 = 1 paire unique.
Puisqu’il n’existe qu’une seule et unique variance de différence possible au sein du plan expérimental, à savoir Var(Y1 – Y2), la notion même de comparaison d’homogénéité entre plusieurs variances de différences devient mathématiquement sans objet. Une valeur unique est, par définition tautologique, égale à elle-même. Dès lors, toute violation de la sphéricité est conceptuellement impossible dans les plans à deux niveaux de mesure.
C’est pourquoi les logiciels d’analyse statistique tels qu’IBM SPSS, JASP ou les paquets spécialisés de R ne génèrent aucun résultat pour le test de Mauchly lorsqu’un facteur ne possède que deux modalités : la boîte de dialogue ou l’objet de sortie affiche un point d’interrogation, une valeur vide ou une mention textuelle d’inapplicabilité. Le test de sphéricité de Mauchly ne commence à déployer sa pertinence diagnostique et méthodologique qu’à partir du moment où le facteur intra-sujets comprend au minimum k ≥ 3 niveaux, engendrant au moins trois variances de différences susceptibles de différer mutuellement.
3. Les postulats de l’ANOVA à mesures répétées et les risques de violation
3.1 Panorama des hypothèses de l’ANOVA intra-sujets
L’analyse de variance à mesures répétées s’inscrit dans l’architecture probabiliste des modèles linéaires généraux. Sa puissance explicative repose sur un faisceau d’hypothèses distributionnelles et structurelles que le chercheur doit obligatoirement inventorier. En premier lieu figure l’exigence de multinormalité des données : le vecteur des variables dépendantes mesurées à travers les k conditions doit suivre conjointement une loi normale multidimensionnelle au sein de chaque population parente. Cette condition garantit la distributivité conjointe des sommes de carrés et l’adéquation des lois théoriques associées aux termes de résidus.
En second lieu se trouve l’indépendance de l’échantillonnage entre les sujets. Si les observations recueillies chez un même individu sont par essence corrélées, le protocole expérimental doit assurer que le comportement ou le score de n’importe quel participant n’exerce aucune influence directe ou indirecte sur les performances d’un autre participant de la cohorte. Ce principe récuse toute forme de contagion inter-individuelle, de passation collective non contrôlée ou de structure hiérarchique nichée non prise en compte par le modèle mathématique.
Enfin, au-delà de la normalité et de l’échantillonnage aléatoire, l’ANOVA intra-sujets requiert la stabilité temporelle ou structurelle des covariances au sein de la matrice de données. Cette propriété se décline en l’absence d’effets résiduels asymétriques (effets de report ou carryover effects) entre les conditions expérimentales, généralement contrôlés par des techniques de contrebalancement ou de carré latin, et s’incarne formellement dans le respect du postulat de sphéricité de la matrice de covariance résiduelle.
3.2 Mécanismes de distorsion du ratio F
Pour comprendre la catastrophe statistique provoquée par une violation de la sphéricité, il faut disséquer l’équation fondamentale qui détermine le test de la significativité de l’effet intra-sujets. La statistique F de Fisher correspond au rapport entre le carré moyen de l’effet factoriel (MSeffet) et le carré moyen de l’interaction de cet effet avec les sujets, qui sert d’erreur résiduelle (MSerreur) :
F = MSeffet / MSerreur.
Sous l’hypothèse nulle d’absence d’effet du traitement et sous la condition stricte de sphéricité, ce ratio suit exactement une loi F paramétrée par ν1 = (k – 1) degrés de liberté au numérateur et ν2 = (k – 1)(N – 1) degrés de liberté au dénominateur. La construction mathématique de cette loi suppose que les variances d’erreur associées à chacun des contrastes orthogonaux constitutifs de l’espace intra-sujets soient rigoureusement homogènes.
En cas de non-respect avéré de la sphéricité, cette égalité spectrale se brise. L’estimateur composite du carré moyen de l’erreur, qui calcule une moyenne arithmétique globale des variances de résidus associées aux différents contrastes, cesse de constituer une estimation non biaisée de la variabilité locale propre à chaque écart. De manière plus critique, les corrélations hétérogènes entre les niveaux d’évaluation entraînent une distorsion qui comprime le terme d’erreur global (MSerreur). En présence de covariances fortement variables, le dénominateur de la fraction diminue de manière anormale, ce qui provoque une augmentation artificielle et infondée de la valeur numérique du ratio F calculé. L’analyste se trouve alors face à une statistique F empirique très élevée qui ne reflète pas une divergence systématique entre les moyennes expérimentales, mais une pathologie géométrique de la matrice d’erreur résiduelle.
3.3 Inflation du taux d’erreur de première espèce (alpha)
La conséquence directe et immédiate de l’élévation artificielle du ratio F est la dérive incontrôlée du risque d’erreur de première espèce, universellement désigné par la lettre grecque α. En psychologie comme dans l’ensemble des sciences empiriques, le seuil de significativité conventionnel est fixé à α = 0,05, signifiant que le chercheur accepte un risque maximal de 5 % de rejeter l’hypothèse nulle alors qu’elle est vérifiée dans la population parente. Or, dès lors que la matrice de variance-covariance s’éloigne significativement de la sphéricité, les valeurs critiques tabulées de la distribution de Fisher théorique cessent d’être valables.
Les études de simulation de Monte-Carlo menées depuis les travaux séminaux de Box (1954) démontrent sans équivoque que lorsque la violation de la sphéricité devient sévère, le taux d’erreur de première espèce empirique diverge considérablement du seuil nominal de 0,05. Dans des situations d’hétérogénéité marquée des variances des différences, le risque réel de fausse découverte peut grimper à 0,10, 0,15, voire excéder 0,25 pour des plans expérimentaux complexes impliquant un grand nombre de mesures répétées. En d’autres termes, un expérimentateur peut avoir plus d’une chance sur quatre de déclarer un traitement clinique ou une manipulation cognitive statistiquement significatif alors qu’aucun effet réel n’existe dans la population générale.
Cette vulnérabilité mathématique représente une menace majeure pour la robustesse et la réplicabilité des résultats en psychologie expérimentale. Dans le contexte contemporain de la crise de la reproductibilité, où la communauté scientifique exige une transparence accrue et une solidité méthodologique sans faille, négliger l’évaluation de la sphéricité et omettre d’appliquer les corrections correctives appropriées revient à injecter massivement des faux positifs dans le corpus académique publié.
4. Formulation théorique et hypothèses statistiques du test de Mauchly
4.1 Énoncé formel des hypothèses nulle et alternative
Le test élaboré par John W. Mauchly en 1940 a été spécifiquement conçu pour évaluer la conformité statistique d’une matrice de variance-covariance empirique au postulat de sphéricité. Comme tout test d’inférence d’adéquation, il repose sur la confrontation formelle de deux hypothèses statistiques mutuellement exclusives. L’hypothèse nulle, notée H0, postule que la matrice de variance-covariance de la population, une fois projetée sur un ensemble orthonormal de contrastes intra-sujets, possède une structure parfaitement sphérique :
H0 : Σtransformée = σ2 I(k – 1),
où Σtransformée désigne la matrice de covariance réduite de dimension (k – 1) × (k – 1), σ2 représente une constante scalaire positive correspondant à la variance commune de tous les contrastes normalisés, et I(k – 1) symbolise la matrice identité d’ordre (k – 1). Sous cette hypothèse nulle, toutes les variances des différences de paires sont identiques au sein de la population parente, ce qui valide l’emploi direct des valeurs critiques de l’ANOVA univariée sans ajustement.
À l’opposé, l’hypothèse alternative, notée H1, pose la négation de cette égalité structurelle :
H1 : Σtransformée ≠ σ2 I(k – 1).
Le rejet de l’hypothèse nulle consacre le fait que la matrice de dispersion empirique présente une hétérogénéité des variances de contrastes ou des corrélations non nulles entre contrastes orthogonaux qui ne peut raisonnablement être imputée aux seules fluctuations d’échantillonnage aléatoire. Ce rejet interdit formellement au chercheur d’interpréter le ratio F standard et déclenche immédiatement l’obligation méthodologique de modifier le pipeline d’analyse des données par l’application de coefficients de correction d’epsilon ou par le recours à des modélisations alternatives.
4.2 Structure de la statistique W de Mauchly
Pour quantifier l’écart séparant la matrice observée de l’idéal de sphéricité, Mauchly a développé un critère statistique d’une grande élégance géométrique, désigné par la lettre W. Cette statistique repose sur le rapport entre la moyenne géométrique et la moyenne arithmétique des valeurs propres (λ1, λ2, …, λp) extraites de la matrice de covariance transformée de dimension p = (k – 1) :
W = [ ∏i = 1p λi ] / [ (1 / p) * ∑i = 1p λi ]p.
Cette formulation spectrale peut également s’exprimer directement à partir des invariants scalaires fondamentaux de la matrice transformée, à savoir son déterminant et sa trace. Le numérateur du rapport correspond en effet au déterminant de la matrice (qui est égal au produit des valeurs propres), tandis que la somme des valeurs propres au dénominateur est strictement équivalente à la trace de la matrice :
W = |Σtransformée| / [ (1 / p) * tr(Σtransformée) ]p.
En vertu de l’inégalité arithmético-géométrique classique de Cauchy, la moyenne géométrique d’un ensemble de nombres réels strictement positifs est toujours inférieure ou égale à leur moyenne arithmétique, l’égalité n’étant atteinte que dans le cas unique où tous les nombres sont strictement identiques. Par conséquent, la statistique W de Mauchly est mathématiquement confinée dans l’intervalle fermé :
0 ≤ W ≤ 1.
L’interprétation intuitive de la métrique est immédiate : lorsque la matrice est parfaitement sphérique, toutes ses valeurs propres sont rigoureusement identiques (λ1 = λ2 = … = λp = σ2), ce qui conduit à une valeur de W exactement égale à 1. Inversement, plus la matrice s’éloigne de la condition de sphéricité — c’est-à-dire plus les valeurs propres divergent, révélant une dispersion prépondérante selon certains axes et restreinte selon d’autres —, plus la statistique W décroît pour se rapprocher de 0.
4.3 Approximation asymptotique par la loi du Chi-deux
La statistique W brute ne suit pas une distribution d’échantillonnage élémentaire directement tabulable sous forme analytique simple. Afin de déterminer si la déviation observée de W par rapport à sa valeur théorique idéale de 1 est statistiquement significative pour une taille d’échantillon N donnée, Mauchly et ses continuateurs ont établi une transformation logarithmique asymptotique permettant de relier W à la distribution continue bien connue du Chi-deux (χ2).
La transformation repose sur l’application du logarithme naturel à la statistique W. Puisque 0 < W ≤ 1, le terme ln(W) est toujours négatif ou nul. En multipliant cette valeur par un facteur d’échelle approprié dépendant du nombre de degrés de liberté résiduels et d’un paramètre de correction de convergence développé par Bartlett, on obtient une quantité distribuée de façon asymptotique selon une loi du Chi-deux. Le nombre de degrés de liberté associé à cette statistique est fonction directe du nombre de conditions intra-sujets k et correspond au nombre d’éléments indépendants nécessaires pour spécifier la sphéricité dans la matrice transformée :
ddl = [ k * (k – 1) / 2 ] – 1.
Pour un facteur comprenant k = 3 modalités, le calcul des degrés de liberté produit : [3 * (3 – 1) / 2] – 1 = [6 / 2] – 1 = 3 – 1 = 2 ddl. Pour un facteur à k = 4 modalités, nous obtenons : [4 * 3 / 2] – 1 = 6 – 1 = 5 ddl. Il convient de souligner que cette approximation par le Chi-deux est une propriété asymptotique. Elle exige un échantillon de taille suffisante (généralement N > 20 participants) et un strict respect du postulat de normalité multivariée pour maintenir sa fidélité probabiliste.
5. Calcul mathématique approfondi de la statistique de Mauchly
5.1 Transformation orthonormale de la matrice de covariance
L’exécution computationnelle du test de Mauchly ne s’effectue pas directement sur la matrice empirique de variance-covariance d’origine S d’ordre k × k, car celle-ci intègre la variabilité du niveau moyen global entre les sujets. La première étape analytique consiste à éliminer cette dimension inter-sujets en appliquant à la matrice S une matrice de contrastes orthogonaux normalisés, notée C, de dimensions (k – 1) × k.
Chaque ligne du vecteur de contrastes ci doit satisfaire deux critères stricts d’orthonormalité : d’une part, la somme des coefficients de chaque ligne doit être rigoureusement nulle (∑j = 1k cij = 0), ce qui garantit qu’il s’agit d’un contraste intra-sujets éliminant la constante ; d’autre part, la somme des carrés des coefficients de chaque ligne doit être égale à l’unité (∑j = 1k cij2 = 1), et le produit scalaire entre deux lignes distinctes doit s’annuler (∑j = 1k cij * cmj = 0 pour tout i ≠ m). Une matrice classique répondant à ces conditions est la matrice de contrastes de Helmert normalisée.
À l’aide de cette matrice de projection C, on calcule la matrice de covariance transformée, notée Σ~ (ou S~ au niveau de l’échantillon), de dimension (k – 1) × (k – 1) :
S~ = C * S * CT,
où CT désigne la transposée de la matrice de contrastes C. Si l’hypothèse de sphéricité est rigoureusement vérifiée au sein de la population parente, la matrice théorique résultante Σ~ est une matrice scalaire parfaite, dont les éléments diagonaux sont tous égaux à la même constante et dont les termes extradiagonaux sont strictement nuls.
5.2 Dérivation analytique de la statistique W
Une fois obtenue la matrice transformée d’échantillon S~ d’ordre p = (k – 1), le calcul analytique de la statistique W fait intervenir l’algèbre des opérateurs spectraux. Nous devons extraire simultanément deux scalaires cardinaux : le déterminant |S~| et la trace tr(S~).
Le déterminant d’une matrice carrée mesure le volume géométrique de l’ellipsoïde de dispersion défini par les contrastes dans l’espace euclidien à p dimensions. Si la matrice est singulière ou si un contraste est une combinaison linéaire parfaite des autres, ce déterminant s’annule. Dans le cas général d’une matrice définie positive, le déterminant est calculé par la sommation alternée des cofacteurs ou par le produit des valeurs propres réelles issues de la décomposition spectrale :
det(S~) = |S~| = ∏i = 1p λi.
La trace de la matrice est obtenue par la sommation arithmétique simple de ses éléments diagonaux, ce qui équivaut également à la somme de ses valeurs propres :
tr(S~) = ∑i = 1p s~ii = ∑i = 1p λi.
La formulation algébrique canonique de la statistique de Mauchly W s’écrit alors de façon condensée sans recourir obligatoirement au calcul explicite des valeurs propres individuelles :
W = det(S~) / [ (1 / (k – 1)) * tr(S~) ](k – 1).
Cette expression met en lumière que le dénominateur représente le volume sphérique idéal qu’occuperait la dispersion si la variance totale (tr(S~)) était distribuée de manière parfaitement équitable et isotrope le long des (k – 1) dimensions orthogonales. Le numérateur quantifiant le volume effectif occupé par les données, le ratio W exprime directement la proportion de volume conservée par rapport à une sphère parfaite.
5.3 Formule de correction pour la statistique du Chi-deux
Pour convertir la quantité scalaire W en une statistique d’inférence suivant une distribution théorique connue, il est impératif d’ajuster le logarithme naturel par le facteur multiplicatif de Bartlett. Ce paramètre ajuste la convergence de la statistique vers une loi du Chi-deux pour des échantillons de taille finie N. Posons p = k – 1, la dimension de l’espace des contrastes, et n = N – 1, les degrés de liberté associés aux participants. Le terme multiplicateur correctif, traditionnellement désigné par d, se formule comme suit :
d = 1 – [ (2 * p2 + p + 2) / (6 * p * n) ].
En substituant p par (k – 1) et n par (N – 1), nous obtenons l’expression développée complète du coefficient d’ajustement :
d = 1 – [ (2 * (k – 1)2 + (k – 1) + 2) / (6 * (k – 1) * (N – 1)) ] = 1 – [ (2 * k2 – 3 * k + 3) / (6 * (k – 1) * (N – 1)) ].
À partir de ce facteur correctif d, la statistique asymptotique du Chi-deux ajusté, notée χ2Mauchly, est obtenue par la formule finale :
χ2 = – n * d * ln(W) = – ( (N – 1) – [ (2 * k2 – 3 * k + 3) / (6 * (k – 1)) ] ) * ln(W).
Cette valeur empirique de Chi-deux est ensuite comparée à la fonction de distribution cumulative inverse de la loi du χ2 paramétrée par ddl = [k(k – 1) / 2] – 1 degrés de liberté. La probabilité critique associée (valeur p) correspond à la surface située dans la queue supérieure de la distribution au-delà de la valeur observée :
p = P( Χ2ddl ≥ χ2observé ).
6. Exemple pratique complet : protocole expérimental en psychologie
6.1 Présentation du cas clinique : évaluation de l’anxiété sous thérapie
Afin de concrétiser l’ensemble de cette mécanique computationnelle, considérons une étude clinique contrôlée menée au sein d’un service de psychopathologie expérimentale. L’équipe de recherche s’intéresse à l’efficacité d’un protocole novateur de thérapie cognitive basée sur la pleine conscience (MBCT) administré à une cohorte de patients répondant aux critères diagnostiques du trouble panique avec agoraphobie. L’échantillon expérimental se compose de N = 15 participants adultes suivis de manière longitudinale.
L’indicateur clinique retenu comme variable dépendante continue est le score global obtenu à l’Inventaire d’Anxiété de Beck (BAI – Beck Anxiety Inventory), une échelle psychométrique standardisée dont le score varie continûment de 0 à 63 points, un score élevé dénotant une symptomatologie anxieuse sévère. Chaque participant est évalué à trois reprises successives au cours de sa trajectoire thérapeutique :
- Temps 1 (T1) : Évaluation basale pré-thérapeutique, mesurée une semaine avant le début des ateliers.
- Temps 2 (T2) : Évaluation intermédiaire à mi-parcours, recueillie précisément après la quatrième semaine de traitement.
- Temps 3 (T3) : Évaluation terminale post-thérapeutique, administrée à l’issue du cycle complet de huit semaines d’intervention.
Le plan expérimental retenu constitue un schéma univarié à mesures répétées à un facteur : le facteur Temps, qui comporte k = 3 modalités ordonnées. Avant de calculer le modèle ANOVA standard pour déterminer si l’intervention induit une décrue statistiquement significative de l’anxiété, il est méthodologiquement impératif de soumettre la matrice des données empiriques au test de sphéricité de Mauchly.
6.2 Données brutes et calcul des différences appariées
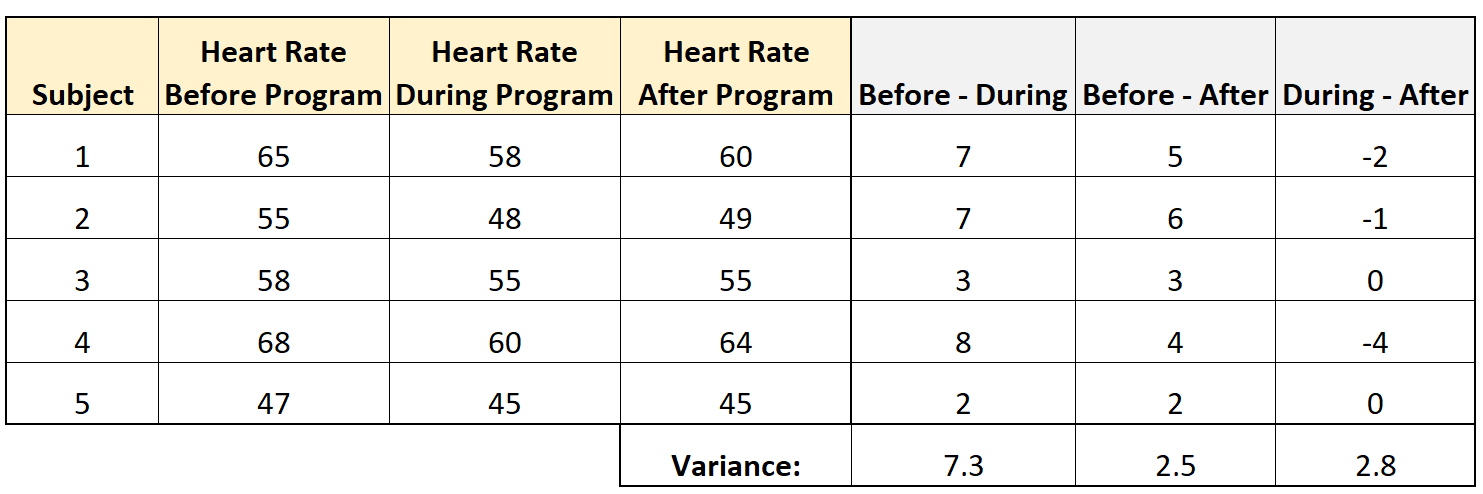
Le protocole a permis de recueillir les observations individuelles consignées dans le tableau suivant pour les 15 participants. Pour illustrer la définition matricielle de la sphéricité, nous avons également calculé de façon exhaustive les trois séries de différences appariées possibles pour chaque individu : (T1 – T2), (T1 – T3) et (T2 – T3).
| Sujet | T1 (Pré) | T2 (Mi) | T3 (Post) | Diff (T1 – T2) | Diff (T1 – T3) | Diff (T2 – T3) |
|---|---|---|---|---|---|---|
| S01 | 34 | 26 | 18 | 8 | 16 | 8 |
| S02 | 29 | 24 | 15 | 5 | 14 | 9 |
| S03 | 36 | 31 | 22 | 5 | 14 | 9 |
| S04 | 32 | 25 | 14 | 7 | 18 | 11 |
| S05 | 41 | 35 | 20 | 6 | 21 | 15 |
| S06 | 27 | 21 | 17 | 6 | 10 | 4 |
| S07 | 38 | 30 | 25 | 8 | 13 | 5 |
| S08 | 30 | 23 | 19 | 7 | 11 | 4 |
| S09 | 35 | 28 | 16 | 7 | 19 | 12 |
| S10 | 33 | 27 | 18 | 6 | 15 | 9 |
| S11 | 44 | 36 | 21 | 8 | 23 | 15 |
| S12 | 28 | 20 | 12 | 8 | 16 | 8 |
| S13 | 31 | 24 | 19 | 7 | 12 | 5 |
| S14 | 37 | 32 | 24 | 5 | 13 | 8 |
| S15 | 39 | 31 | 16 | 8 | 23 | 15 |
L’examen des statistiques descriptives fondamentales révèle une diminution constante de la tendance centrale du score d’anxiété : la moyenne au Temps 1 s’établit à M1 = 34,267 points (ET1 = 5,147), celle au Temps 2 passe à M2 = 27,533 points (ET2 = 4,794), et celle au Temps 3 décroît jusqu’à M3 = 17,733 points (ET3 = 3,751). Mais l’indicateur crucial pour la sphéricité réside dans l’analyse de la dispersion des colonnes de différences :
- Moyenne de (T1 – T2) = 6,733 ; Variance de (T1 – T2) : s2diff(1-2) = 1,352.
- Moyenne de (T1 – T3) = 16,533 ; Variance de (T1 – T3) : s2diff(1-3) = 17,410.
- Moyenne de (T2 – T3) = 9,800 ; Variance de (T2 – T3) : s2diff(2-3) = 14,886.
Une simple inspection visuelle préliminaire de ces variances de différences met immédiatement en évidence une disparité flagrante : la variance de la différence entre le début et la fin de l’intervention (17,410) est près de treize fois supérieure à la variance observée entre le pré-test et le mi-parcours (1,352). Une telle hétérogénéité suggère a priori une violation manifeste de la sphéricité.
6.3 Établissement de la matrice de variance-covariance empirique
Pour formaliser rigoureusement le calcul, établissons la matrice symétrique d’échantillon S d’ordre 3 × 3. Les éléments diagonaux représentent les variances empiriques non biaisées de chaque condition temporelle, calculées avec la division par (N – 1) = 14 :
s11 = Var(T1) = 26,495 ;
s22 = Var(T2) = 22,981 ;
s33 = Var(T3) = 14,067.
Les éléments hors diagonale représentent les covariances empiriques calculées entre les trois paires de sessions à partir de la formule canonique Cov(X, Y) = [ ∑ (X – Mx)(Y – My) ] / (N – 1) :
s12 = s21 = Cov(T1, T2) = 24,062 ;
s13 = s31 = Cov(T1, T3) = 11,576 ;
s23 = s32 = Cov(T2, T3) = 11,081.
La matrice de variance-covariance empirique S s’assemble ainsi comme suit :
[ 26,495 24,062 11,576 ]
[ 24,062 22,981 11,081 ]
[ 11,576 11,081 14,067 ]
Nous pouvons vérifier l’exactitude de nos calculs par la relation algébrique Var(Yj – Yk) = sjj + skk – 2 * sjk :
Var(T1 – T2) = 26,495 + 22,981 – (2 * 24,062) = 49,476 – 48,124 = 1,352.
Var(T1 – T3) = 26,495 + 14,067 – (2 * 11,576) = 40,562 – 23,152 = 17,410.
Var(T2 – T3) = 22,981 + 14,067 – (2 * 11,081) = 37,048 – 22,162 = 14,886.
Les égalités coïncident parfaitement avec les calculs obtenus directement sur les scores de différence individuels, fournissant le matériau nécessaire pour la mise en œuvre matricielle du test de Mauchly.
7. Réalisation du test de Mauchly pas à pas sur les données de l’exemple
7.1 Application des contrastes et transformation matricielle
Pour un facteur à k = 3 modalités, l’espace des contrastes intra-sujets est de dimension (k – 1) = 2. Nous construisons une matrice de contrastes orthonormale C d’ordre 2 × 3 en appliquant la décomposition de Helmert normalisée :
Ligne 1 (comparant le niveau 1 au niveau 2) : c1 = [ 1 / √2, -1 / √2, 0 ] ≈ [ 0,707107, -0,707107, 0 ].
Ligne 2 (comparant la moyenne des niveaux 1 et 2 au niveau 3) : c2 = [ 1 / √6, 1 / √6, -2 / √6 ] ≈ [ 0,408248, 0,408248, -0,816497 ].
On constate que pour chaque ligne, la somme des coefficients est nulle et la somme de leurs carrés est égale à 1. De surcroît, le produit scalaire des deux lignes donne : (1/√12) – (1/√12) + 0 = 0. La matrice est donc parfaitement orthonormale. Procédons au calcul de la matrice transformée S~ = C * S * CT de dimension 2 × 2 :
Commençons par le produit intermédiaire M = C * S :
Ligne 1 de M = [ 0,707107 * (26,495 – 24,062), 0,707107 * (24,062 – 22,981), 0,707107 * (11,576 – 11,081) ]
= [ 0,707107 * 2,433, 0,707107 * 1,081, 0,707107 * 0,495 ]
= [ 1,7204, 0,7644, 0,3500 ].
Ligne 2 de M = [ 0,408248 * 26,495 + 0,408248 * 24,062 – 0,816497 * 11,576, 0,408248 * 24,062 + 0,408248 * 22,981 – 0,816497 * 11,081, 0,408248 * 11,576 + 0,408248 * 11,081 – 0,816497 * 14,067 ]
= [ 10,8165 + 9,8233 – 9,4518, 9,8233 + 9,3819 – 9,0476, 4,7259 + 4,5238 – 11,4856 ]
= [ 11,1880, 10,1576, -2,2359 ].
Calculons maintenant la matrice finale S~ = M * CT :
Élément (1,1) : s~11 = 1,7204 * 0,707107 – 0,7644 * 0,707107 + 0 = 1,2165 – 0,5405 = 0,6760 (soit exactement Var(T1 – T2) / 2 = 1,352 / 2 = 0,676).
Élément (1,2) : s~12 = 1,7204 * 0,408248 + 0,7644 * 0,408248 – 0,3500 * 0,816497 = 0,7023 + 0,3121 – 0,2858 = 0,7286.
Élément (2,1) : s~21 = 0,7286 (par symétrie).
Élément (2,2) : s~22 = 11,1880 * 0,408248 + 10,1576 * 0,408248 – (-2,2359) * 0,816497 = 4,5675 + 4,1468 + 1,8256 = 10,5399.
La matrice réduite de covariance transformée S~ est donc :
[ 0,6760 0,7286 ]
[ 0,7286 10,5399 ]
Pour en extraire les valeurs propres λ, nous résolvons l’équation caractéristique det(S~ – λ I) = 0 :
(0,6760 – λ)(10,5399 – λ) – (0,7286)2 = 0
λ2 – 11,2159 λ + 7,1250 – 0,5309 = 0
λ2 – 11,2159 λ + 6,5941 = 0.
Le discriminant est Δ = (-11,2159)2 – 4 * 1 * 6,5941 = 125,7964 – 26,3764 = 99,4200 (√Δ ≈ 9,97096).
Les deux valeurs propres sont donc :
λ1 = (11,2159 + 9,97096) / 2 = 10,5934 ;
λ2 = (11,2159 – 9,97096) / 2 = 0,6225.
7.2 Obtention de la statistique W et conversion en Chi-deux
Nous disposons désormais des quantités nécessaires pour dériver analytiquement le déterminant et la trace de S~ :
det(S~) = λ1 * λ2 = 10,5934 * 0,6225 ≈ 6,5941 ;
tr(S~) = λ1 + λ2 = 10,5934 + 0,6225 = 11,2159.
Appliquons la formule canonique de la statistique W de Mauchly pour p = k – 1 = 2 :
W = det(S~) / [ (1 / 2) * tr(S~) ]2
W = 6,5941 / [ 11,2159 / 2 ]2
W = 6,5941 / [ 5,60795 ]2
W = 6,5941 / 31,4491 ≈ 0,20967.
La statistique W obtenue (0,210) est particulièrement basse, s’éloignant massivement de la valeur idéale de 1, ce qui traduit une déformation considérable de la structure d’erreur. Procédons à sa conversion en Chi-deux asymptotique en calculant le facteur multiplicateur de Bartlett d avec k = 3 et N = 15 (degrés de liberté résiduels n = 14) :
d = 1 – [ (2 * k2 – 3 * k + 3) / (6 * (k – 1) * (N – 1)) ]
d = 1 – [ (2 * 32 – 3 * 3 + 3) / (6 * (3 – 1) * (15 – 1)) ]
d = 1 – [ (18 – 9 + 3) / (6 * 2 * 14) ]
d = 1 – [ 12 / 168 ]
d = 1 – 0,071429 = 0,928571.
Calculons à présent la statistique empirique du Chi-deux :
ln(W) = ln(0,20967) ≈ -1,56223 ;
χ2 = – n * d * ln(W)
χ2 = – 14 * 0,928571 * (-1,56223)
χ2 = – 13,0000 * (-1,56223) ≈ 20,309.
Le nombre de degrés de liberté associé est déterminé par la formule :
ddl = [ k * (k – 1) / 2 ] – 1 = [ 3 * 2 / 2 ] – 1 = 3 – 1 = 2.
7.3 Calcul de la valeur p exacte
Pour déterminer la significativité statistique de ce résultat, nous confrontons la valeur empirique χ2 = 20,309 à la loi de distribution théorique du Chi-deux à 2 degrés de liberté. Rappelons que la valeur critique tabulée pour α = 0,05 avec 2 ddl est de 5,991, et que la valeur critique pour α = 0,001 est de 13,816.
La probabilité d’excéder une valeur de 20,309 sous une loi du χ2 à 2 degrés de liberté s’obtient analytiquement par la fonction de survie exponentielle :
P(Χ2(2) ≥ 20,309) = exp(-20,309 / 2) = exp(-10,1545) ≈ 0,0000388.
La probabilité critique exacte s’élève donc à p = 3,88 × 10⁻⁵, soit p < 0,001. Ce résultat empirique étant immensément inférieur au seuil conventionnel fixé à α = 0,05, le chercheur se trouve dans l’obligation formelle de rejeter l’hypothèse nulle de sphéricité.
8. Interprétation statistique et décision méthodologique
8.1 Cas du maintien de l’hypothèse nulle (p ≥ 0,05)
Dans l’éventualité où la probabilité critique calculée à l’issue du test de Mauchly demeure supérieure ou égale au seuil de signification conventionnel (p ≥ 0,05), l’analyste méthodologique ne dispose pas de preuves statistiques suffisantes pour affirmer que les données violent l’exigence de sphéricité. Dans cette configuration favorable, la conclusion technique autorise le chercheur à considérer que la matrice de variance-covariance de la population ne dévie pas de façon inacceptable de l’isotropie requise.
Cette non-significativité délivre une autorisation formelle à interpréter directement les sorties du tableau univarié d’analyse de variance sans avoir à altérer la métrique de référence. Les degrés de liberté théoriques non modifiés, à savoir ν1 = (k – 1) pour le numérateur et ν2 = (k – 1)(N – 1) pour le dénominateur de l’effet, sont alors pleinement conservés pour dériver la valeur critique de l’effet omnibus.
Sur le plan rédactionnel, la transcription académique conforme aux normes de l’American Psychological Association (APA 7e édition) impose de stipuler l’intégrité de la condition préalablement au rapport du ratio F : « Le test de sphéricité de Mauchly n’a révélé aucune violation significative de la condition de sphéricité, W = 0,94, χ2(2) = 0,82, p = 0,664. Par conséquent, les résultats de l’ANOVA à mesures répétées sont rapportés sans correction des degrés de liberté : F(2, 28) = 14,35, p < 0,001, ηp2 = 0,51. » Une telle transparence atteste du parcours de vérification des prérequis inférentiels.
8.2 Cas du rejet de l’hypothèse nulle (p < 0,05)
Dès lors que la probabilité p s’avère strictement inférieure à 0,05, comme c’est très nettement le cas dans notre exemple clinique (p < 0,001), le diagnostic est sans équivoque : la matrice de variance-covariance viole le postulat de sphéricité. L’hypothèse nulle d’égalité des variances des différences est catégoriquement rejetée. Maintenir une démarche univariée non corrigée dans un tel scénario constitue une faute méthodologique avérée, car la distribution théorique de la statistique F standard ne protège plus le cadre inférentiel contre l’inflation du risque d’erreur de type I.
La conséquence méthodologique directe est l’interdiction d’interpréter le ratio F nominal sous les degrés de liberté théoriques standards (k – 1) et (k – 1)(N – 1). L’expérimentateur doit alors bifurquer obligatoirement vers l’une des deux voies de sauvetage mathématique validées par la littérature :
- La voie univariée ajustée : Conserver l’ANOVA univariée classique mais en réduisant drastiquement les degrés de liberté au numérateur et au dénominateur par un coefficient multiplicateur d’aplatissement (l’indice ε), ce qui augmente la valeur seuil du F critique nécessaire pour atteindre la significativité.
- La voie multivariée : Abandonner l’approche univariée au profit d’une analyse de variance multivariée (MANOVA intra-sujets) qui ne présuppose nullement la sphéricité de la matrice de covariance.
8.3 Interprétation contextuelle dans l’exemple clinique
L’application rigoureuse du test de Mauchly à notre jeu de données sur l’anxiété (W = 0,210, χ2(2) = 20,309, p < 0,001) documente une distorsion structurelle sévère de la matrice de dispersion. D’un point de vue clinique et méthodologique, ce rejet massif n’est pas un accident aléatoire, mais le reflet fidèle des trajectoires individuelles de rémission au sein de la cohorte.
En observant de près les données descriptives établies en section 6.2, nous constatons que la variance de la différence (T1 – T2) est extrêmement faible (s2 = 1,352). Cela signifie que tous les patients ont réagi de manière remarquablement homogène au cours des quatre premières semaines de thérapie, diminuant chacun leur score de façon presque uniforme (les écarts individuels tournant tous autour de 5 à 8 points de baisse). En revanche, entre le début et la huitième semaine (T1 – T3), la variance de la différence explose pour atteindre 17,410 points. Cette disparité traduit une divergence clinique marquée : certains patients ont bénéficié d’une baisse thérapeutique spectaculaire (diminution de 21 à 23 points pour S05, S11, S15), tandis que d’autres ont plafonné dans leur progression (baisse modeste de 10 à 13 points pour S06, S07, S14).
Cette hétérogénéité des patrons d’évolution au cours du temps crée mécaniquement une disparité des covariances qui brise la sphéricité. Si nous ignorions ce diagnostic posé par le test de Mauchly, le modèle de calcul de l’ANOVA sous-estimerait sévèrement la variance d’erreur résiduelle lors du contraste global, gonflant le F empirique. L’évaluation de l’effet thérapeutique exige donc impérativement l’application des facteurs correctifs d’epsilon développés dans la section suivante.
9. Procédures de correction en cas de violation de la sphéricité
9.1 Le coefficient Epsilon de Greenhouse-Geisser
Lorsqu’une violation de la sphéricité est actée par le test de Mauchly, la stratégie corrective prédominante consiste à maintenir le cadre de l’ANOVA univariée tout en modifiant la distribution d’échantillonnage théorique par l’application d’un facteur correctif scalaire, universellement désigné par l’indice ε (epsilon). Cet indice a été mathématiquement formalisé par Samuel Greenhouse et Seymour Geisser dans leur publication phare de 1959. Le principe fondamental consiste à multiplier à la fois les degrés de liberté du numérateur (ν1 = k – 1) et les degrés de liberté du dénominateur (ν2 = (k – 1)(N – 1)) par la valeur estimée de l’epsilon, notée ε^GG :
ddlajusté 1 = ε^GG * (k – 1) ;
ddlajusté 2 = ε^GG * (k – 1) * (N – 1).
Sur le plan mathématique, l’estimateur de Greenhouse-Geisser se calcule directement à partir des éléments de la matrice de variance-covariance transformée ou empirique :
ε^GG = [ tr(S~) ]2 / [ (k – 1) * tr(S~2) ] = [ ( ∑i = 1p λi )2 ] / [ p * ∑i = 1p λi2 ].
Le coefficient ε varie rigoureusement entre une borne théorique inférieure égale à 1 / (k – 1) et une borne supérieure maximale de 1,0 (représentant la sphéricité parfaite). L’estimateur de Greenhouse-Geisser possède un caractère documenté : il est intrinsèquement conservateur. Des simulations approfondies ont démontré qu’il a tendance à sous-estimer l’epsilon réel de la population, particulièrement dans les échantillons de taille modeste. Pour cette raison, la recommandation méthodologique prévalente préconise son emploi prioritaire lorsque l’estimation empirique de l’epsilon se situe en deçà de 0,75 (ε^GG < 0,75), situation dans laquelle une pénalisation substantielle des degrés de liberté s’avère indispensable pour neutraliser le risque de faux positifs.
9.2 Le coefficient Epsilon de Huynh-Feldt
Pour remédier au conservatisme excessif de la procédure de Greenhouse-Geisser — susceptible d’augmenter indûment le taux d’erreur de seconde espèce (β) et de masquer des effets expérimentaux réels —, Huynh et Feldt ont proposé en 1976 un estimateur alternatif ajusté. L’epsilon de Huynh-Feldt, noté ε~HF, introduit une correction algébrique prenant explicitement en compte la taille de l’échantillon N et le nombre de niveaux du facteur intra-sujets k :
ε~HF = [ N * (k – 1) * ε^GG – 2 ] / [ (k – 1) * ( (N – 1) – (k – 1) * ε^GG ) ].
Par construction algébrique, le coefficient de Huynh-Feldt est systématiquement supérieur ou égal à celui de Greenhouse-Geisser (ε~HF ≥ ε^GG), ce qui préserve davantage la puissance statistique du test univarié. Cependant, cette formule mathématique présente une singularité : dans certaines configurations d’échantillonnage où la sphéricité est quasi-parfaite, le calcul peut produire une valeur strictement supérieure à 1,0. Dans ce cas, les logiciels d’analyse appliquent un plafonnement automatique, ramenant la valeur rapportée à 1,000.
La règle empirique généralement admise en psychologie quantitative, formulée à l’origine par Girden (1992), stipule que le chercheur doit sélectionner préférentiellement l’epsilon de Huynh-Feldt dès lors que l’estimation initiale de Greenhouse-Geisser excède le seuil de 0,75 (ε^GG > 0,75). Ce seuil garantit que l’on ne pénalise pas inutilement le test lorsque la matrice de données ne s’écarte que modérément des réquisitions théoriques.
9.3 La borne inférieure (Lower-Bound Epsilon)
La borne inférieure théorique, désignée sous le terme anglo-saxon de Lower-Bound Epsilon, représente la correction la plus sévère qu’il soit mathématiquement possible d’appliquer à un jeu de données sans violer les lois d’invariance des formes quadratiques. Définie à l’origine par Geisser et Greenhouse (1958), cette quantité scalaire est strictement fonction du nombre de niveaux k du facteur intra-sujets :
εlower = 1 / (k – 1).
Pour un design expérimental comportant k = 3 modalités temporelles, la borne inférieure absolue s’établit exactement à 1 / (3 – 1) = 1 / 2 = 0,500. Si le protocole intégrait k = 5 modalités, la borne chuterait à 1 / 4 = 0,250. Cette valeur modélise la pire violation envisageable, dans laquelle l’ensemble de la variabilité résiduelle se trouve totalement concentrée sur une seule dimension orthogonale, les autres dimensions présentant une variance nulle.
En pratique contemporaine, la borne inférieure n’est presque jamais utilisée comme paramètre d’ajustement effectif dans les analyses de routine, en raison de son conservatisme. Elle conserve toutefois une valeur heuristique et décisionnelle : si un ratio F calculé demeure statistiquement significatif après l’application de la correction par la borne inférieure — c’est-à-dire en divisant les degrés de liberté par (k – 1) —, le chercheur a la certitude absolue que l’effet expérimental est robuste et indiscutable, quelle que soit la sévérité de la violation de la sphéricité au sein de la population parente.
10. Mise en œuvre du test de Mauchly dans les logiciels statistiques majeurs
10.1 Exécution et lecture des sorties dans IBM SPSS Statistics
Dans l’environnement IBM SPSS Statistics, l’évaluation de la sphéricité est intégrée de manière native et automatisée au sein de la procédure du Modèle Linéaire Généralisé (GLM). Pour déclencher l’analyse à partir des données de notre exemple clinique, l’utilisateur suit la séquence de navigation classique : Analyser > Modèle linéaire général > Mesures répétées… Dans la boîte de dialogue initiale, l’expérimentateur nomme le facteur intra-sujets (par exemple « Temps »), spécifie son nombre de niveaux (3), clique sur Ajouter, puis sur Définir pour associer les trois variables de la matrice (T1, T2, T3) aux modalités du facteur.
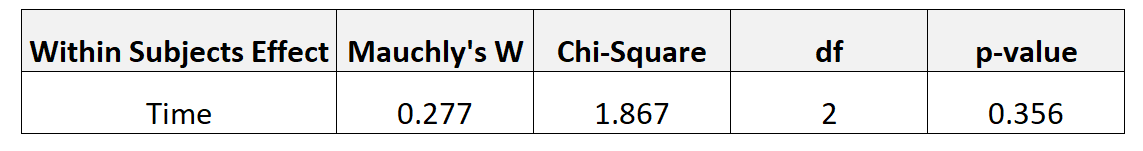
L’exécution de la commande génère une séquence de tableaux normalisés dans la fenêtre d’affichage des résultats (Output). Le tableau pivot d’intérêt s’intitule précisément « Mauchly’s Test of Sphericity ». Ce tableau fournit pour chaque effet intra-sujets :
- La valeur numérique de la statistique W de Mauchly (colonne Mauchly’s W).
- La statistique de test convertie sous distribution asymptotique (colonne Approx. Chi-Square).
- Le nombre de degrés de liberté associés (colonne df).
- La probabilité critique bilatérale exacte (colonne Sig.).
- Les estimations des coefficients correctifs d’aplatissement (colonnes Epsilon : Greenhouse-Geisser, Huynh-Feldt et Lower-bound).
Dans la table consécutive intitulée « Tests of Within-Subjects Effects », SPSS présente simultanément quatre lignes de calcul pour chaque terme d’effet : la première ligne (Sphericity Assumed) rapporte le test F non corrigé ; la deuxième ligne (Greenhouse-Geisser) applique la correction d’epsilon conservatrice ; la troisième ligne (Huynh-Feldt) présente le test ajusté moins conservateur ; enfin, la quatrième ligne (Lower-bound) affiche le test à sévérité maximale. La lecture du tableau consiste à vérifier la significativité de Mauchly dans la première table : si Sig. < 0,05, l’expérimentateur ignore la ligne « Sphericity Assumed » et se réfère impérativement à la ligne correspondant à l’epsilon sélectionné.
10.2 Implémentation sous R
Au sein de l’écosystème open-source R, plusieurs packages méthodologiques permettent de calculer avec exactitude le test de Mauchly et d’automatiser les corrections associées. L’approche la plus intuitive et standardisée repose sur l’utilisation combinée des bibliothèques rstatix et car. Avec rstatix, les données étant structurées au format long (une colonne identifiant le participant, une colonne temporelle et une colonne pour le score BAI), la commande anova_test() exécute l’ensemble du pipeline computationnel de façon transparente :
L’appel de la fonction produit un objet complet incluant le sous-élément mauchly qui extrait la statistique W, la valeur du Chi-deux et la probabilité critique, ainsi qu’un tableau récapitulatif des corrections d’epsilon (get_anova_table()) ajustant automatiquement les degrés de liberté si p < 0,05.
Pour les chercheurs préférant l’approche matricielle multivariée native, la fonction Anova() du package car, développée par John Fox, fournit une modélisation basée sur l’ajustement d’un modèle linéaire multivarié via la commande lm() appliquée à une matrice d’observations au format large. En spécifiant l’argument idata pour définir la structure intra-sujets et en exécutant summary(modele, multivariate=FALSE), R édite le résultat du test de Mauchly ainsi que les valeurs numériques exactes de ε^GG et ε~HF. Cette implémentation offre une souplesse algorithmique permettant d’extraire par programmation les scalaires nécessaires pour les réinjecter dans des pipelines de calcul personnalisés ou des visualisations graphiques avancées.
10.3 Procédure sous JASP et Jamovi
Les logiciels statistiques graphiques de dernière génération que sont JASP et Jamovi — largement plébiscités dans les départements universitaires de psychologie pour leur ergonomie et leur adhésion rigoureuse aux standards de l’Open Science — ont particulièrement simplifié le diagnostic de la sphéricité. Sous Jamovi, l’accès s’effectue via le menu supérieur Analyses > ANOVA > Repeated Measures ANOVA. Dès lors que l’utilisateur définit son facteur intra-sujets et assigne les colonnes de variables continues correspondantes, il lui suffit de dérouler l’onglet latéral intitulé Assumption Checks (Vérification des postulats) et de cocher la case Sphericity tests.
Instantanément, le moteur computationnel (qui s’appuie sur le moteur d’exécution de R) génère un tableau au format académique APA affichant la statistique de Mauchly, le χ2, les degrés de liberté et la p-valeur. Simultanément, sous la section Sphericity Corrections du panneau principal, l’utilisateur peut sélectionner les boutons radio None, Greenhouse-Geisser ou Huynh-Feldt. Le tableau de l’ANOVA ajuste ses colonnes de degrés de liberté (df), de carré moyen (Mean Square) et de valeur critique (p) en direct, offrant une interface interactive et prévenant les erreurs de saisie manuelle courantes dans les environnements logiciels plus anciens.
Sous JASP, la démarche est rigoureusement symétrique : le module Repeated Measures ANOVA intègre dans sa section d’options diagnostiques la commande Sphericity tests ainsi que les options de correction dynamique. L’exportation des tableaux se fait directement en format LaTeX ou Markdown prêt pour l’intégration dans un manuscrit scientifique.
11. Limites méthodologiques et controverses autour du test de Mauchly
11.1 Sensibilité extrême à la taille de l’échantillon
En dépit de son omniprésence dans les logiciels commerciaux, le test de sphéricité de Mauchly fait l’objet de réserves méthodologiques substantielles au sein de la communauté des statisticiens appliqués. La principale faiblesse de ce test d’hypothèse réside dans sa dépendance mécanique vis-à-vis de la taille de l’échantillon (N), une caractéristique commune à la quasi-totalité des tests d’adéquation basés sur le rejet d’une hypothèse nulle.
Dans les études impliquant des cohortes de grande taille (par exemple en épidémiologie psychiatrique ou dans les recherches comportementales en ligne où N excède couramment 200 à 500 participants), la puissance statistique du test de Mauchly devient disproportionnée. Le test devient alors capable de détecter des déviations infimes et triviales par rapport à la sphéricité parfaite — des micro-asymétries n’ayant aucun impact substantiel sur la distribution réelle du ratio F de l’ANOVA. Le chercheur se voit alors contraint d’appliquer des corrections pénalisantes d’epsilon alors que le modèle linéaire univarié standard aurait parfaitement conservé sa robustesse.
À l’inverse, dans les protocoles de psychologie cognitive expérimentale ou d’imagerie cérébrale fonctionnelle (IRMf) où les échantillons sont réduits pour des raisons logistiques ou financières (souvent compris entre 10 et 18 sujets), le test de Mauchly souffre d’une sous-puissance statistique préoccupante. Le risque de commettre une erreur de type II (ne pas rejeter l’hypothèse nulle de sphéricité alors que la population parente présente une non-sphéricité marquée) devient alors critique. Le chercheur conserve faussement la lecture de l’ANOVA univariée non corrigée, s’exposant directement à l’inflation clandestine du taux de fausses découvertes (α).
11.2 Dépendance critique au postulat de normalité
Une seconde vulnérabilité majeure du test de Mauchly réside dans son hyper-sensibilité au respect de la multinormalité. L’approximation asymptotique par la distribution du Chi-deux et la dérivation analytique de la statistique W reposent sur le postulat que les résidus suivent conjointement une loi normale multidimensionnelle exempte d’aplatissement anormal ou d’asymétrie marquée.
Lorsque les données empiriques s’écartent de la normalité — par exemple en présence de distributions leptokurtiques fréquentes dans les mesures de temps de réaction, ou de distributions asymétriques consécutives à des effets de plancher ou de plafond sur des échelles cliniques —, le test de Mauchly produit des taux anormaux de rejet de l’hypothèse nulle, même lorsque la matrice de variance-covariance sous-jacente est parfaitement sphérique. Le test tend à confondre une déviance d’aplatissement (kurtosis) avec une violation géométrique de la sphéricité. C’est pourquoi plusieurs méthodologues (notamment Keselman et ses collaborateurs) insistent sur la nécessité d’éprouver la normalité des contrastes avant de prêter une confiance aveugle au verdict du test de Mauchly.
11.3 Le débat sur l’automatisation des corrections systématiques
Face à ces limites chroniques, un débat méthodologique vigoureux anime la littérature statistique depuis plusieurs décennies. Des auteurs influents, à l’instar de Scott Maxwell et Harold Delaney dans leur ouvrage de référence Designing Experiments and Analyzing Data, remettent ouvertement en question l’intérêt de recourir au test de Mauchly comme procédure conditionnelle préalable à l’analyse.
L’argumentation repose sur le problème bien connu des « tests séquentiels à deux étapes » (two-stage testing). Le fait de conditionner l’application d’une correction statistique au résultat d’un pré-test formel dont la puissance fluctue en fonction de la taille d’échantillon introduit une incertitude supplémentaire dans le processus inférentiel global. Cette chaîne décisionnelle altère le contrôle rigoureux du taux d’erreur final de la recherche. Si le pré-test de Mauchly échoue par manque de puissance sur un petit échantillon, l’analyste utilise l’ANOVA standard et génère un faux positif. S’il sur-réagit sur un grand échantillon, l’analyste pénalise indûment sa puissance.
En conséquence, une proportion croissante de méthodologues recommande d’abandonner purement et simplement le test de Mauchly pour adopter une stratégie d’ajustement systématique inconditionnelle. Selon cette perspective pragmatique, le chercheur applique par défaut la correction de Greenhouse-Geisser ou de Huynh-Feldt à tous les plans à mesures répétées à k ≥ 3 niveaux, sans chercher à savoir si le test de Mauchly franchit ou non le seuil de 0,05. Si les données s’avèrent sphériques, la valeur calculée de l’epsilon sera très proche de 1,0 et l’ajustement sur les degrés de liberté sera négligeable, n’altérant en rien la décision finale. Si les données s’avèrent hétérogènes, la protection contre l’erreur de type I est instantanément et automatiquement garantie.
12. Alternatives contemporaines au test de Mauchly et à l’ANOVA classique
12.1 L’approche multivariée (MANOVA intra-sujets)
La première alternative méthodologique à l’ANOVA univariée à mesures répétées et à ses dilemmes de sphéricité consiste à opter pour l’approche multivariée, couramment appelée MANOVA intra-sujets. Au lieu de combiner l’ensemble des mesures répétées au sein d’une unique variable dépendante traitée de manière scalaire, l’approche multivariée traite les (k – 1) contrastes orthogonaux formés sur les temps de mesure comme un vecteur simultané de variables dépendantes interdépendantes.
L’évaluation statistique globale s’appuie alors sur les critères multivariés classiques que sont le Lambda de Wilks, la Trace de Pillai, la Trace de Hotelling-Lawley ou la Plus Grande Racine de Roy. L’avantage fondamental et décisif de cette approche réside dans son immunité totale face au postulat de sphéricité. Par construction mathématique, la MANOVA n’exige aucune régularité des variances des différences : elle estime librement et sans contrainte l’intégralité des variances et covariances de la matrice de dispersion.
Cependant, cette libération méthodologique a un coût en termes de puissance statistique. Lorsque la taille de l’échantillon N est modeste et que le postulat de sphéricité n’est que marginalement enfreint dans la population, l’ANOVA univariée (même corrigée par l’epsilon) s’avère systématiquement plus puissante pour détecter des effets subtils que la MANOVA. De plus, la MANOVA exige impérativement que le nombre de participants soit strictement supérieur au nombre de conditions intra-sujets (N > k), une condition d’existence mathématique qui interdit son emploi dans les petits protocoles expérimentaux hautement répétés (par exemple en psychophysique où k peut valoir 12 et N seulement 8).
12.2 Les modèles linéaires mixtes (LMM / Modèles multiniveaux)
L’évolution computationnelle des vingt dernières années a propulsé les Modèles Linéaires Mixtes (Linear Mixed Models – LMM), également qualifiés de modèles hiérarchiques ou multiniveaux, au rang de nouvelle référence pour le traitement des données répétées en psychologie. Modélisant simultanément des effets fixes (l’impact moyen des facteurs expérimentaux au niveau du groupe) et des effets aléatoires (la variabilité individuelle des ordonnées à l’origine et des pentes d’évolution), les LMM transcendent les limitations historiques de l’ANOVA de Fisher.
Dans le cadre des LMM, la sphéricité cesse d’être une contrainte imposée par le modèle mathématique pour devenir une simple option parmi un vaste éventail de structures de covariance résiduelle modélisables explicitement. Le chercheur peut instruire le logiciel statistique de tester et de comparer différentes géométries matricielles :
- La structure autorégressive d’ordre 1 (AR(1)) : Postulant que deux moments de mesure rapprochés dans le temps sont plus fortement corrélés que deux moments éloignés, un patron fréquent en psychologie longitudinale que l’ANOVA classique est incapable de traiter adéquatement.
- La structure Toeplitz ou hétérogène : Permettant aux variances de différer à chaque session tout en contraignant les corrélations selon leur décalage temporel.
- La structure non structurée (Unstructured – UN) : Estimant de façon totalement libre et indépendante chaque variance et chaque covariance, éliminant tout risque d’erreur d’ajustement lié à la forme de la matrice.
De surcroît, les Modèles Linéaires Mixtes offrent une tolérance remarquable envers les données manquantes. Alors que l’ANOVA à mesures répétées classique impose la suppression listwise impitoyable de tout participant ayant manqué une seule session d’évaluation (amputant fréquemment la taille finale des cohortes cliniques), les LMM conservent l’intégralité des données disponibles sous le postulat que les données sont manquantes au hasard (MAR – Missing At Random).
12.3 Guide décisionnel pour le chercheur en psychologie
Pour s’orienter avec rigueur face à ces multiples trajectoires analytiques, le chercheur en psychologie expérimentale et clinique peut mobiliser un arbre décisionnel séquentiel fondé sur la structure de ses données et le respect des critères de diagnostic :
- Étape 1 : Vérification préliminaire du design. Le facteur intra-sujets comprend-il k = 2 modalités ? Si oui, le test de sphéricité de Mauchly est inapplicable et le postulat est garanti par construction ; procédez directement à l’ANOVA univariée standard. Si k ≥ 3, passez à l’étape suivante.
- Étape 2 : Évaluation des données manquantes et de la complexité temporelle. Le protocole présente-t-il des données manquantes entre les sessions ou des intervalles d’administration irréguliers ? Si oui, délaissez l’ANOVA classique et orientez-vous directement vers les Modèles Linéaires Mixtes (LMM). Si le jeu de données est équilibré et complet, l’approche ANOVA reste envisageable.
- Étape 3 : Évaluation du test de Mauchly. Si le test de Mauchly s’avère non significatif (p ≥ 0,05) et que la taille d’échantillon est adéquate (N ≥ 20), rapportez l’ANOVA univariée non corrigée (Sphericity Assumed).
- Étape 4 : Gestion de la violation de la sphéricité (p < 0,05). Si la sphéricité est rejetée :
- Examinez la valeur de l’indice de Greenhouse-Geisser (ε^GG).
- Si ε^GG < 0,75, rapportez impérativement l’ANOVA univariée avec les degrés de liberté corrigés selon Greenhouse-Geisser.
- Si ε^GG ≥ 0,75, rapportez l’ANOVA univariée avec les degrés de liberté corrigés selon Huynh-Feldt pour préserver la puissance statistique.
- Si l’échantillon est large (N > k + 10) et que les violations sont manifestes, vérifiez la cohérence des conclusions avec la MANOVA intra-sujets (Trace de Pillai ou Lambda de Wilks).
En adoptant cette rigueur séquentielle, le chercheur s’assure non seulement d’une totale conformité méthodologique avec les standards contemporains de la publication scientifique internationale, mais préserve également ses inférences contre les dérives pernicieuses des faux positifs et des fausses alertes qui altèrent l’avancement de la psychologie empirique.
Références
- Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, II. Effects of inequality of variance and of correlation between errors in the two-way classification. The Annals of Mathematical Statistics, 25(3), 484–498. https://doi.org/10.1214/aoms/1177728717
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Geisser, S., & Greenhouse, S. W. (1958). An extension of Box’s results on the use of the F distribution in multivariate analysis. The Annals of Mathematical Statistics, 29(3), 885–891. https://doi.org/10.1214/aoms/1177706545
- Girden, E. R. (1992). ANOVA: Repeated measures. SAGE Publications. https://doi.org/10.4135/9781412983419
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1970). Conditions under which mean square ratios in repeated measurements designs have true F-distributions. Journal of the American Statistical Association, 65(332), 1582–1589. https://doi.org/10.1080/01621459.1970.10481187
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731885
- Maxwell, S. E., & Delaney, H. D. (2004). Designing experiments and analyzing data: A model comparison perspective (2nd ed.). Lawrence Erlbaum Associates.
- Rouanet, H., & Lépine, D. (1970). Comparison between treatments in a repeated-measurement design: ANOVA and multivariate methods. British Journal of Mathematical and Statistical Psychology, 23(2), 147–163. https://doi.org/10.1111/j.2044-8317.1970.tb00441.x
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.