
L’analyse de variance à mesures répétées constitue l’un des piliers méthodologiques les plus puissants et les plus répandus au sein de la recherche expérimentale contemporaine, notamment en psychologie cognitive, en neuropsychologie clinique et dans les sciences du comportement. En permettant d’observer les mêmes unités expérimentales à travers de multiples conditions ou au fil d’échéances temporelles successives, ce dispositif expérimental répond à une double exigence scientifique : maximiser la sensibilité statistique face à des effets expérimentaux souvent subtils et optimiser les ressources logistiques en limitant le recrutement de cohortes massives. Néanmoins, la dépendance sérielle inhérente aux observations recueillies sur un même individu engendre des défis statistiques majeurs, au premier rang desquels figure la violation potentielle de l’hypothèse de sphéricité, qui invalide les tests de significativité conventionnels si elle n’est pas rigoureusement diagnostiquée et corrigée.
Dans cet écosystème méthodologique complexe, le progiciel statistique SAS (Statistical Analysis System) s’impose comme une référence incontournable au sein des laboratoires universitaires, des agences de régulation sanitaire et de l’industrie pharmaceutique mondiale. Grâce à des procédures dédiées hautement optimisées telles que PROC GLM et la modélisation mixte via PROC MIXED, SAS déploie un arsenal analytique complet permettant de tester les hypothèses linéaires générales, d’ajuster les degrés de liberté face aux violations distributionnelles et de modéliser avec une extrême finesse les structures de variance-covariance sous-jacentes. La maîtrise de ces outils requiert cependant une compréhension conjointe des fondements mathématiques du modèle linéaire généralisé et des subtilités syntaxiques propres à l’environnement de programmation SAS.
Ce guide exhaustif a été conçu pour accompagner les chercheurs, biostatisticiens et doctorants dans la mise en œuvre rigoureuse d’une ANOVA à mesures répétées sous SAS. Du cadrage théorique des plans intra-sujets jusqu’à la rédaction normalisée des résultats selon les standards de l’American Psychological Association (APA 7e édition), chaque étape du processus analytique est détaillée avec minutie. À travers l’étude d’un protocole pharmacologique et cognitif concret, nous explorerons la structuration des tables de données, la paramétrisation des instructions SAS, le diagnostic approfondi des postulats statistiques, le déploiement d’analyses post-hoc rigoureusement ajustées, ainsi que la transition moderne vers les modèles linéaires mixtes capables de transcender les écueils des données manquantes.
1. Fondements théoriques de l’ANOVA à mesures répétées en psychologie
1.1 Définition et principes fondamentaux du plan intra-sujet
Le plan factoriel à mesures répétées, communément désigné sous le terme de plan intra-sujet (ou within-subject design), repose sur un principe structural élégant : chaque participant ou unité expérimentale est exposé à l’ensemble des modalités d’un ou de plusieurs facteurs expérimentaux. Contrairement aux plans inter-sujets (between-subjects), où chaque individu n’est assigné qu’à un seul groupe expérimental étanche, le plan intra-sujet fait de chaque participant son propre témoin. Cette architecture méthodologique transforme radicalement la partition de la variabilité au sein du modèle linéaire général. Dans une analyse de variance classique à groupes indépendants, la variance totale est décomposée en variance factorielle attribuable aux traitements et en variance résiduelle interindividuelle non contrôlée. Dans un plan à mesures répétées, la variance attribuable aux caractéristiques stables des individus (telles que le quotient intellectuel, la réactivité physiologique de base, l’âge ou la personnalité) est formellement extraite de la variance d’erreur.
Cette extraction systématique de la variabilité interindividuelle permet d’isoler une variance résiduelle considérablement amoindrie, qui ne reflète plus que l’interaction aléatoire entre le sujet et le traitement, ainsi que les fluctuations d’échantillonnage momentanées. Il importe toutefois d’opérer une distinction conceptuelle nette entre les dispositifs purement longitudinaux et les plans expérimentaux à conditions multiples. Dans une étude longitudinale, le facteur intra-sujet représente l’écoulement inexorable du temps (par exemple, le suivi d’une trajectoire développementale ou l’évolution des symptômes dépressifs à 1 mois, 6 mois et 12 mois post-thérapie). Les mesures sont intrinsèquement ordonnées et non permutables. À l’inverse, dans un plan expérimental à conditions multiples (comme la mesure de l’attention sélective face à des stimuli neutres, menaçants ou positifs présentés de façon aléatoire), les niveaux du facteur sont des états fonctionnels distincts dont l’ordre de présentation peut et doit être manipulé afin d’éviter tout biais séquentiel.
1.2 Avantages méthodologiques et optimisation de la puissance statistique
L’avantage prééminent du plan à mesures répétées réside dans l’optimisation substantielle de la puissance statistique (1 – β), c’est-à-dire la capacité du test à rejeter l’hypothèse nulle lorsque celle-ci est véritablement fausse dans la population parente. En réduisant drastiquement le terme d’erreur au dénominateur du rapport de Fisher ($F$), même des variations subtiles induites par les manipulations expérimentales atteignent le seuil de significativité statistique conventionnel. Par conséquent, les chercheurs peuvent obtenir une puissance statistique équivalente, voire supérieure, à celle d’un plan inter-sujets tout en mobilisant un effectif d’échantillon significativement plus modeste. Dans des disciplines de pointe telles que la neuroimagerie fonctionnelle, l’électrophysiologie cognitive ou la neuropsychologie des lésions cérébrales rares, où le recrutement de chaque sujet représente un investissement temporel, financier et éthique colossal, cette économie logistique s’avère déterminante.
Au-delà de la simple réduction d’effectif, le plan intra-sujet neutralise de facto les biais de confusion systématiques attribuables aux caractéristiques individuelles non mesurées. Dans un plan à groupes indépendants, malgré les vertus de la randomisation, il subsiste toujours le risque qu’un groupe expérimental présente fortuitement une prédisposition cognitive, un niveau de fatigue ou un profil génétique différent de l’autre groupe. Dans un protocole intra-sujet, ces facteurs confondants demeurent constants à travers toutes les conditions pour un individu donné. Le chercheur s’assure ainsi que la variance observée sur la variable dépendante découle de la manipulation active des conditions expérimentales plutôt que de l’hétérogénéité sous-jacente de l’échantillon.
1.3 Applications empiriques typiques en recherche comportementale
Les applications de l’ANOVA à mesures répétées traversent l’ensemble du spectre des sciences du comportement et de la biomédecine. En psychopharmacologie expérimentale, elle permet d’évaluer les altérations fines des temps de réaction psychomoteurs chez des participants sains soumis séquentiellement à un placebo, puis à différentes doses incrémentielles d’une molécule agoniste des récepteurs dopaminergiques, en observant les courbes d’efficacité et les fenêtres de tolérance. En psychologie clinique et en psychothérapie fondée sur les preuves, le plan à mesures répétées permet d’évaluer la trajectoire de rémission de patients souffrant de trouble de stress post-traumatique soumis à un protocole de désensibilisation et retraitement par les mouvements oculaires (EMDR), en quantifiant les scores d’anxiété au pré-test, à mi-traitement, au post-test immédiat et lors d’évaluations de suivi standardisées à six mois.
De même, les paradigmes de neurosciences affectives recourent massivement à cette approche pour mesurer des réponses psychophysiologiques dynamiques, à l’instar de la conductance cutanée, de la variabilité de la fréquence cardiaque ou de l’amplitude des potentiels évoqués cognitifs (tels que l’onde P300 ou la composante N400), face à des blocs de stimuli visuels présentant des valences émotionnelles contrastées. Dans chacun de ces contextes, la structure répétée des données s’impose par la nature même des processus psychologiques investigués, caractérisés par leur cinétique temporelle ou leur plasticité immédiate en réponse à l’environnement.
2. Hypothèses statistiques et conditions préalables à la modélisation
2.1 Normalité univariée et multivariée des distributions
Le fondement inférentiel de l’ANOVA à mesures répétées repose sur l’hypothèse de normalité de la distribution des erreurs au sein de la population. Précisément, pour chaque modalité du facteur intra-sujet, ainsi que pour chaque combinaison de niveaux lorsque des facteurs inter-sujets sont intégrés, les résidus du modèle doivent suivre une distribution normale théorique. Il convient de souligner une erreur conceptuelle fréquente : ce n’est pas la variable dépendante brute en elle-même qui doit obligatoirement présenter une distribution gaussienne globale, mais bien les résidus du modèle linéaire après extraction des effets fixes factoriels. L’évaluation de cette condition préalable s’effectue rigoureusement sous SAS par le biais de la procédure PROC UNIVARIATE, qui permet de générer des indicateurs d’asymétrie (skewness), d’aplatissement (kurtosis), ainsi que des tests statistiques formels tels que le test de Shapiro-Wilk (particulièrement adapté aux échantillons de taille modeste, $N < 50$) et le test de Kolmogorov-Smirnov (ajusté par Lilliefors pour les grands échantillons).
Sur le plan mathématique, l’ANOVA démontre une robustesse satisfaisante face aux déviations modérées de la normalité univariée, en vertu du théorème central limite, pour autant que la taille de l’échantillon soit suffisante ($N > 30$) et que les distributions ne présentent pas une asymétrie bimodale ou des queues de distribution excessivement lourdes. En revanche, lorsque les analyses basculent vers une approche multivariée (MANOVA répétée), l’hypothèse sous-jacente requiert la normalité multivariée de l’ensemble des différences de scores combinées, une condition beaucoup plus exigeante et sensible à la présence de valeurs extrêmes.
2.2 Condition de sphéricité et hypothèse de circularité
L’hypothèse la plus critique et la plus contraignante de l’ANOVA univariée à mesures répétées est la condition de sphéricité, fréquemment assimilée dans la littérature à l’hypothèse de circularité définie par Rouanet et Lépine. La sphéricité stipule que les variances de toutes les différences possibles entre les paires de conditions intra-sujets doivent être strictement égales au sein de la population. Formellement, si l’on considère trois conditions expérimentales $A$, $B$ et $C$, la sphéricité exige que :
$$\text{Var}(A – B) = \text{Var}(A – C) = \text{Var}(B – C)$$
Cette condition est une forme moins restrictive de l’hypothèse de symétrie composée (compound symmetry). La symétrie composée requiert non seulement que toutes les variances des conditions soient homogènes (homosパcédasticité), mais également que toutes les covariances entre paires de conditions soient strictement identiques. Si la symétrie composée est vérifiée, la sphéricité l’est automatiquement ; néanmoins, la sphéricité peut être satisfaite même en présence de variances inégales, pourvu que le schéma des covariances compense exactement ces écarts.
La violation de cette hypothèse de sphéricité a des conséquences statistiques délétères directes sur la validité des inférences. Lorsque la sphéricité n’est pas respectée, la distribution théorique exacte de la statistique $F$ sous l’hypothèse nulle ne suit plus une loi de Fisher standard avec les degrés de liberté nominaux $(k – 1)$ et $(k – 1)(n – 1)$. Le rapport $F$ empirique a tendance à être systématiquement gonflé, ce qui conduit à une inflation dramatique du taux d’erreur de type I ($\alpha$). Le chercheur risque alors de rejeter à tort l’hypothèse nulle et de conclure à l’existence d’un effet expérimental statistiquement significatif là où il n’existe que du bruit stochastique mal calibré.
2.3 Absence de valeurs aberrantes et indépendance séquentielle
La présence d’observations aberrantes (outliers), qu’elles soient univariées ou multivariées, exerce une distorsion disproportionnée sur le calcul des matrices de variance-covariance et sur l’estimation des moyennes marginales. Une valeur aberrante univariée au sein d’une seule condition expérimentale altère artificiellement la variance de cette modalité ainsi que toutes les covariances associées à cette condition pour l’ensemble de l’échantillon. La détection de ces valeurs extrêmes s’appuie classiquement sur l’inspection des scores standardisés ($z > |3{,}29|$) et des diagrammes de dispersion. Au niveau multivarié, l’identification de profils de réponses atypiques à travers les conditions s’opère par le calcul de la distance de Mahalanobis ($D^2$), évaluée par rapport à une distribution du chi-carré ($\chi^2$) dont les degrés de liberté correspondent au nombre de mesures répétées.
Parallèlement, l’indépendance des observations représente un postulat fondamental souvent mécompris dans les plans intra-sujets. S’il est évident que les mesures répétées d’un même individu sont structurellement dépendantes, les résidus d’individus distincts doivent impérativement demeurer mutuellement indépendants (absence de corrélation entre les participants). De surcroît, au niveau intra-individuel, l’expérimentateur doit veiller à prévenir les effets de report (carryover effects), d’apprentissage ou de fatigue, susceptibles de biaiser systématiquement l’ordre de passation. L’application d’un contrebalancement rigoureux (tel qu’un carré latin équilibré ou une randomisation totale de l’ordre des conditions) est la condition méthodologique sine qua non pour garantir la validité interne du protocole.
3. Structuration et encodage des données sous SAS
3.1 Comparaison entre format large (Wide) et format long (Long)
L’analyse des mesures répétées sous SAS nécessite une compréhension parfaite de l’organisation structurelle des tables de données. Deux paradigmes d’encodage coexistent au sein du logiciel : le format large (wide format) et le format long (long format ou univariate format). Le choix de l’architecture tabulaire détermine directement la procédure SAS qui devra être mobilisée pour l’analyse inférentielle.
Dans le format large, chaque ligne de la table de données représente un sujet unique. Les différentes mesures répétées effectuées sur cet individu sont alignées horizontalement dans des colonnes distinctes, chacune constituant une variable SAS autonome (par exemple : TR_Placebo, TR_DoseA, TR_DoseB, TR_DoseC). Cette structure matricielle est impérative pour l’exécution de la procédure standard PROC GLM couplée à l’instruction REPEATED. À l’opposé, le format long empile verticalement l’ensemble des observations. Chaque ligne correspond alors à un point de mesure unique pour un participant donné. La table comporte systématiquement une variable d’identification du sujet (ID), une variable catégorielle indicatrice de la condition ou du temps (Condition), et une variable dépendante unique regroupant l’ensemble des scores mesurés (Temps_Reaction). Le format long est indispensable pour la modélisation statistique avancée sous PROC MIXED.
3.2 Création du jeu de données SAS avec l’étape DATA
L’étape DATA constitue l’environnement fondamental de programmation dans lequel les données sont importées, typées et nettoyées. Considérons un protocole expérimental en psychopharmacologie cognitive impliquant 12 participants sains soumis à l’évaluation de leurs temps de réaction (exprimés en millisecondes) lors d’une tâche d’attention soutenue, sous quatre conditions pharmacologiques distinctes : Placebo, Molécule A (faible dose), Molécule B (dose intermédiaire) et Molécule C (forte dose). Les données sont initialement collectées et encodées au format long.
Voici le script SAS permettant d’initialiser ce jeu de données expérimental en s’assurant de la déclaration exacte des attributs de variables :
DATA etude_pharmacologique;

  INPUT Sujet Condition $ Temps_Reaction;

  DATALINES;

1 Placebo 450

1 Dose_A  425

1 Dose_B  390

1 Dose_C  365

2 Placebo 480

2 Dose_A  460

2 Dose_B  415

2 Dose_C  395

3 Placebo 510

3 Dose_A  495

3 Dose_B  460

3 Dose_C  430

4 Placebo 435

4 Dose_A  410

4 Dose_B  380

4 Dose_C  350

5 Placebo 490

5 Dose_A  475

5 Dose_B  440

5 Dose_C  410

6 Placebo 525

6 Dose_A  505

6 Dose_B  470

6 Dose_C  445

7 Placebo 465

7 Dose_A  440

7 Dose_B  405

7 Dose_C  380

8 Placebo 475

8 Dose_A  455

8 Dose_B  420

8 Dose_C  390

9 Placebo 540

9 Dose_A  515

9 Dose_B  485

9 Dose_C  460

10 Placebo 455

10 Dose_A 430

10 Dose_B 395

10 Dose_C 370

11 Placebo 500

11 Dose_A 480

11 Dose_B 445

11 Dose_C 415

12 Placebo 485

12 Dose_A 465

12 Dose_B 430

12 Dose_C 400

;

RUN;
Dans ce bloc d’instructions, le symbole dollar ($) spécifie explicitement que la variable Condition est de nature alphanumérique (caractère), tandis que Sujet et Temps_Reaction sont instanciées comme des variables numériques continues. L’étape de compilation SAS valide l’absence de valeurs non conformes et garantit l’alignement des enregistrements.
3.3 Restructuration des tables avec PROC TRANSPOSE
Pour exécuter une ANOVA univariée ou multivariée traditionnelle sous la procédure PROC GLM, il est nécessaire de restructurer le jeu de données précédent du format long vers le format large. Cette opération de pivotement tabulaire s’effectue avec une précision chirurgicale grâce à la procédure PROC TRANSPOSE. La configuration requiert l’utilisation conjointe des instructions BY (pour définir l’unité individuelle invariable), ID (pour désigner la variable dont les modalités formeront les noms des nouvelles colonnes) et VAR (pour identifier la mesure quantitative à transposer).
Avant d’exécuter la transposition, la table SAS doit être rigoureusement triée selon la clé spécifiée dans l’instruction BY :
PROC SORT DATA=etude_pharmacologique;

  BY Sujet;

RUN;
PROC TRANSPOSE DATA=etude_pharmacologique
OUT=etude_pharma_large(DROP=_NAME_)
PREFIX=TR_;
BY Sujet;
ID Condition;
VAR Temps_Reaction;
RUN;
PROC PRINT DATA=etude_pharma_large NOOBS;
RUN;
L’option PREFIX=TR_ permet de concaténer le préfixe textuel spécifié aux valeurs de l’instruction ID, générant ainsi les variables TR_Placebo, TR_Dose_A, TR_Dose_B et TR_Dose_C. L’instruction d’exclusion DROP=_NAME_ purge la colonne technique créée par défaut par SAS. L’exécution de PROC PRINT permet de valider l’intégrité matricielle : la table résultante comporte exactement 12 lignes d’enregistrements indépendants et 5 colonnes fonctionnelles (l’identifiant du sujet et les 4 conditions expérimentales réparties horizontalement).
4. Procédure GLM : syntaxe et paramètres pour mesures répétées
4.1 Déclaration des modèles dans PROC GLM
La procédure PROC GLM (General Linear Model) constitue le cœur historique et computationnel de l’analyse de variance sous SAS. Sa conception repose sur la résolution des équations normales du modèle linéaire à l’aide de l’inversion matricielle généralisée (g2-inverse). Dans le cadre d’un plan à mesures répétées configuré au format large, la syntaxe de base de PROC GLM adopte une structure particulière : l’ensemble des variables représentant les conditions intra-sujets doit être regroupé à gauche du signe égal au sein de l’instruction MODEL, mimant ainsi la syntaxe d’un modèle linéaire multivarié.
L’instruction CLASS, couramment utilisée dans les analyses inter-sujets pour déclarer les facteurs qualitatifs discrets, n’est mobilisée dans ce contexte que si l’expérimentateur incorpore un ou plusieurs facteurs de groupement inter-individuels. En l’absence de facteur inter-sujets (plan à un facteur purement intra-sujet), l’instruction CLASS n’est pas requise pour le facteur répété, car la nature intra-sujet du traitement n’est pas définie dans l’équation MODEL standard, mais explicitement déclarée et paramétrée dans l’instruction subséquente REPEATED.
4.2 L’instruction fondamentale REPEATED
L’instruction REPEATED est l’opérateur analytique qui signale au compilateur SAS que les variables dépendantes énumérées dans l’instruction MODEL ne constituent pas des critères distincts non corrélés, mais représentent les états successifs d’un même facteur intra-sujet sous-jacent. Sa syntaxe générale obéit au formalisme suivant :
REPEATED nom_du_facteur nombre_de_niveaux (valeurs_des_niveaux) type_de_contraste / options;
Le paramètre nom_du_facteur est une étiquette arbitraire définie par le statisticien pour désigner la dimension manipulée (par exemple : Traitement ou Temps). Le paramètre numérique spécifie le nombre exact de modalités mesurées. Immédiatement après cette définition, le chercheur peut spécifier le type de transformation matricielle ou de contraste a priori souhaité :
- CONTRAST(k) : Génère des contrastes de référence comparant chaque niveau du facteur au $k$-ième niveau pris comme contrôle.
- PROFILE : Compare chaque niveau de la mesure répétée au niveau chronologique adjacent qui lui succède immédiatement (très usité dans les cinétiques temporelles).
- POLYNOMIAL : Déploie une décomposition orthogonale en composantes polynomiales (tendances linéaire, quadratique, cubique), indispensable pour l’analyse des doses-réponses ou des trajectoires continues.
- HELMERT : Compare chaque niveau à la moyenne non pondérée de l’ensemble des niveaux subséquents.
Parmi les options critiques rattachées à l’instruction REPEATED, l’option PRINTE ordonne l’impression des matrices d’erreurs intra-sujets et réalise le test de sphéricité de Mauchly. L’option NOM permet de neutraliser l’affichage des sorties multivariées si l’utilisateur souhaite restreindre l’interprétation aux statistiques univariées corrigées.
4.3 Distinguer facteurs intra-sujets et facteurs inter-sujets
La puissance du modèle linéaire généralisé dans SAS réside dans sa capacité à fusionner harmonieusement des facteurs intra-sujets et des facteurs inter-sujets au sein d’un même plan d’analyse factoriel mixte (ou plan split-plot). Supposons que notre cohorte expérimentale de 12 sujets comprenne en réalité deux sous-groupes cliniques distincts : 6 sujets sains (témoins) et 6 patients présentant un déficit attentionnel avec hyperactivité (TDAH). La variable catégorielle Groupe constitue un facteur inter-sujets.
Dans cette configuration mixte, l’instruction CLASS redevient obligatoire pour déclarer la variable Groupe. L’instruction MODEL intègre ce facteur à droite du signe d’égalité :
PROC GLM DATA=etude_mixte;

  CLASS Groupe;

  MODEL TR_Placebo TR_Dose_A TR_Dose_B TR_Dose_C = Groupe / NOUNI;

  REPEATED Traitement 4 / PRINTE;

RUN;
SAS partitionne automatiquement les sources de variation en deux blocs conceptuels hermétiques dans la sortie : le tableau des Hypothèses relatives aux effets inter-sujets (où l’effet principal de Groupe est testé contre l’erreur globale entre sujets) et le tableau des Hypothèses relatives aux effets intra-sujets. Ce dernier segmente la variance intra-individuelle en testant non seulement l’effet principal du facteur répété (Traitement), mais également l’interaction d’ordre supérieur (Traitement * Groupe), chaque terme étant jaugé à l’aune de l’erreur résiduelle intra-individuelle adéquate.
5. Exécution pas à pas de l’analyse avec PROC GLM
5.1 Implémentation du code complet pour l’étude pharmacologique
Nous procédons à présent à l’analyse inférentielle complète de notre protocole expérimental purement intra-sujet à quatre modalités. Le script SAS est rédigé pour extraire l’ensemble des statistiques nécessaires à une interprétation rigoureuse, en combinant les options de calcul matriciel, les moyennes marginales et les contrastes polynomiaux :
/* Activation de l'environnement graphique et analytique */

ODS GRAPHICS ON;
PROC GLM DATA=etude_pharma_large;
MODEL TR_Placebo TR_Dose_A TR_Dose_B TR_Dose_C = / NOUNI;
REPEATED Traitement 4 (0 10 25 50) POLYNOMIAL / PRINTE SUMMARY;
MEANS TR_Placebo TR_Dose_A TR_Dose_B TR_Dose_C;
RUN;
QUIT;
ODS GRAPHICS OFF;
L’option NOUNI insérée dans l’instruction MODEL est une précaution de programmation essentielle : elle supprime l’affichage d’une multitude de tableaux univariés triviaux (qui traiteraient chaque variable dépendante de manière isolée sans lien statistique) pour concentrer l’attention sur l’analyse intra-sujet. Les valeurs numériques (0 10 25 50) associées au facteur Traitement indiquent à SAS les métriques réelles des doses administrées en milligrammes, permettant ainsi d’ajuster le calcul des contrastes polynomiaux orthogonaux à l’espacement réel des conditions pharmacologiques plutôt que de supposer un incrément linéaire équidistant par défaut.
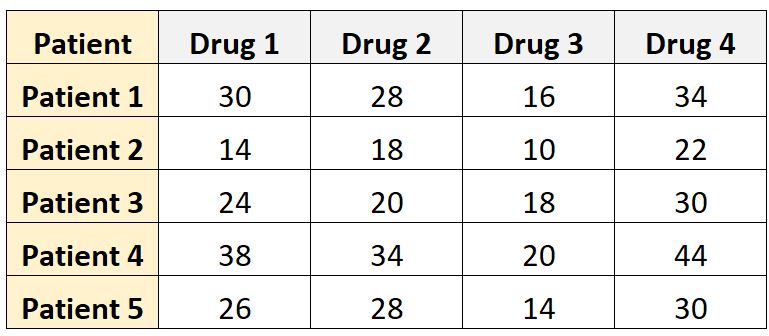
La surveillance attentive du journal d’exécution (SAS Log) doit systématiquement précéder toute lecture des sorties. Le statisticien y vérifie l’absence de messages d’erreur critiques (colorés en rouge) ou d’avertissements de singularité matricielle (WARNING), confirmant que l’inversion des matrices s’est opérée sans instabilité numérique et que l’ensemble des 12 observations a été traité sans exclusion involontaire.
5.2 Analyse de la matrice de corrélation et des statistiques descriptives
L’instruction PRINTE génère dans la sortie SAS la matrice de variance-covariance d’erreur non ajustée, ainsi que la matrice de corrélation intra-sujet correspondante. L’examen attentif de ces sorties numériques constitue la première étape diagnostique du statisticien averti. Les moyennes marginales estimées révèlent une réduction graduelle et constante des temps de réaction : 484,17 ms sous Placebo ($ET = 31{,}82$), 462,08 ms sous Dose A ($ET = 31{,}44$), 425,83 ms sous Dose B ($ET = 31{,}97$), et 399,58 ms sous Dose C ($ET = 33{,}47$).
L’observation visuelle des variances diagonales au sein de la matrice de covariance montre une grande homogénéité (les variances oscillent entre 988,6 et 1120,4). De surcroît, l’inspection de la matrice de corrélation met en évidence des coefficients inter-conditions remarquablement élevés et constants (tous compris entre $r = 0{,}96$ et $r = 0{,}98$). Cette structure corrélationnelle massive atteste de la remarquable stabilité des performances interindividuelles à travers le temps : les participants les plus lents sous placebo demeurent les plus lents sous traitement pharmacologique lourd, validant la pertinence méthodologique du plan intra-sujet qui parvient à neutraliser cette part prépondérante de variance individuelle au profit de la précision expérimentale.
5.3 Tests multivariés intégrés dans les résultats de PROC GLM
Parallèlement à l’approche univariée traditionnelle, SAS compile automatiquement une section intitulée Repeated Measures Analysis of Variance – Multivariate Tests. Cette approche modélise les scores répétés comme les composantes d’un vecteur aléatoire multidimensionnel, s’affranchissant totalement du cadre conceptuel univarié. Quatre critères multivariés canoniques sont calculés et convertis en approximations de la statistique $F$ de Fisher :
- La trace de Pillai-Bartlett : Reconnue comme le critère multivarié le plus robuste face aux violations de l’hypothèse de normalité multivariée et aux petits effectifs d’échantillon.
- Le Lambda de Wilks : La statistique la plus couramment rapportée dans la littérature académique, représentant le ratio des déterminants des matrices de variance résiduelle et totale.
- La trace de Hotelling-Lawley : Très sensible à l’écartement des centroïdes dans l’espace multidimensionnel lorsque la première dimension canonique capte l’essentiel de la variance.
- La plus grande racine de Roy : Représente la borne supérieure de l’effet, hautement puissante mais très vulnérable aux violations distributionnelles.
L’intérêt capital de ces tests multivariés réside dans leur immunité mathématique totale face à la violation de l’hypothèse de sphéricité. Étant donné que la MANOVA ne cherche pas à réduire la dispersion à un scalaire moyen de variance des différences mais estime librement chaque cellule de la matrice de covariance non structurée, elle demeure strictement exacte même lorsque la sphéricité est anéantie. Néanmoins, cette flexibilité a un coût méthodologique : dans les échantillons de taille restreinte ($N < k + 10$), la MANOVA présente une perte de puissance statistique substantielle comparée à l'ANOVA univariée ajustée.
6. Diagnostic et correction de la violation de sphéricité
6.1 Le test de sphéricité de Mauchly dans la sortie SAS
L’évaluation inférentielle de la validité de l’approche univariée passe par le diagnostic de l’hypothèse de sphéricité. Dans la sortie SAS issue de l’instruction PRINTE, ce diagnostic est formalisé dans le tableau intitulé Sphericity Test, qui fournit la statistique $W$ de Mauchly ainsi que la valeur critique issue d’une distribution asymptotique du chi-carré ($\chi^2$).
L’hypothèse nulle ($H_0$) du test de Mauchly postule que la matrice de variance-covariance des différences de conditions est proportionnelle à une matrice identité (sphéricité parfaite). Un seuil empirique de significativité $p < 0{,}05$ conduit au rejet sans ambiguïté de l'hypothèse nulle, contraignant le statisticien à constater que les variances des différences ne sont pas homogènes et que le modèle univarié non corrigé engendrera un taux excessif de faux positifs.
Toutefois, la prudence méthodologique s’impose quant à l’interprétation aveugle de ce test. Le test de Mauchly est reconnu par les psychométriciens pour son instabilité statistique :
- Dans les petits échantillons (précisément ceux où l’ANOVA répétée est le plus fréquemment mobilisée), le test de Mauchly manque cruellement de puissance statistique, échouant fréquemment à détecter des violations substantielles de la sphéricité (faux négatifs méthodologiques).
- Dans les grands échantillons ($N > 100$), le test devient hypersensible à des déviations infimes et sans conséquence pratique sur l’erreur de type I, conduisant à des rejets systématiques injustifiés.
Pour ces motifs computationnels, la communauté statistique internationale préconise de ne pas conditionner le choix d’une correction au seul résultat binaire du test de Mauchly, mais d’examiner systématiquement la valeur absolue des indices d’épsilon ($epsilon$).
6.2 Correction de Greenhouse-Geisser (Epsilon GG)
Face à la violation avérée ou soupçonnée de la sphéricité, la solution algorithmique élaborée par Greenhouse et Geisser (1959) consiste à ne pas modifier la valeur numérique de la statistique $F$ observée, mais à pénaliser la distribution théorique de référence en réduisant de façon conservative les degrés de liberté du numérateur ($ddl_1$) et du dénominateur ($ddl_2$). Cette réduction s’opère par multiplication de ces degrés de liberté par un coefficient d’ajustement, l’épsilon de Greenhouse-Geisser ($\hat{\epsilon}_{GG}$).
La valeur théorique de l’épsilon évolue strictement au sein d’un intervalle borné :
$$\frac{1}{k – 1} le \hat{\epsilon} le 1$$
où $k$ représente le nombre de modalités du facteur intra-sujet. Une valeur d’épsilon égale à $1$ dénote une sphéricité absolue et parfaite. Plus la valeur converge vers sa borne inférieure ($1 / (k – 1)$), plus la violation de sphéricité est catastrophique. Dans notre exemple à 4 conditions, la borne minimale théorique s’établit à $1 / (4 – 1) = 0{,}333$.
SAS affiche l’estimation $\hat{\epsilon}_{GG}$ dans le tableau Greenhouse-Geisser Epsilon. Les degrés de liberté ajustés deviennent :
$$ddl_{1,\text{ajusté}} = \hat{\epsilon}_{GG} \times (k – 1)$$
$$ddl_{2,\text{ajusté}} = \hat{\epsilon}_{GG} \times (k – 1)(n – 1)$$
La nouvelle $p$-valeur recalculée à partir de ces degrés de liberté réduits rétablit le contrôle strict de l’erreur de type I au seuil nominal $\alpha = 0{,}05$. L’ajustement de Greenhouse-Geisser est universellement recommandé dès lors que l’épsilon estimé est inférieur à $0{,}75$, en raison de sa nature prudente qui protège efficacement contre les inférences erronées.
6.3 Correction de Huynh-Feldt et correction de la borne inférieure
Bien que rigoureuse, la correction de Greenhouse-Geisser fait l’objet d’une critique méthodologique : elle s’avère fréquemment trop conservatrice lorsque la violation de sphéricité est modérée à faible ($\hat{\epsilon} > 0{,}75$), ce qui entraîne une réduction indésirable de la puissance statistique et augmente le risque d’erreur de type II ($\beta$). Pour remédier à cette sévérité excessive, Huynh et Feldt (1976) ont développé un estimateur alternatif, noté $\tilde{\epsilon}_{HF}$, qui incorpore un correctif tenant compte de la taille de l’échantillon et du nombre de conditions.
L’estimateur de Huynh-Feldt produit systématiquement une valeur d’ajustement supérieure ou égale à celle de Greenhouse-Geisser ($\tilde{\epsilon}_{HF} ge \hat{\epsilon}_{GG}$). Dans certaines situations où la matrice empirique est très proche de la sphéricité parfaite, le calcul mathématique de $\tilde{\epsilon}_{HF}$ peut même excéder la valeur unitaire ($1{,}00$) ; dans cette éventualité, SAS ramène automatiquement le coefficient à $1{,}000$ dans ses sorties pour respecter les axiomes probabilistes. La règle décisionnelle empirique adoptée dans les sciences expérimentales (notamment formalisée par Girden) préconise d’appliquer la correction de Huynh-Feldt lorsque $\hat{\epsilon}_{GG} > 0{,}75$, et de s’en tenir à Greenhouse-Geisser lorsque $\hat{\epsilon}_{GG} le 0{,}75$.
Enfin, SAS rapporte systématiquement la correction de la borne inférieure (Lower-Bound Epsilon), correspondant à $epsilon = 1 / (k – 1)$. Cette statistique incarne le scénario du pire absolu sur le plan de l’hétérogénéité des covariances. Elle n’est quasiment jamais mobilisée pour la prise de décision empirique car elle induit une pénalisation excessivement mutilante pour la puissance du test, mais elle conserve un intérêt pédagogique en tant que borne de sensibilité asymptotique.
7. Interprétation statistique et académique des sorties SAS
7.1 Lecture des tableaux ANOVA univariés et ajustés
Le bloc central de la sortie SAS pour la modélisation intra-sujet s’intitule Repeated Measures Analysis of Variance – Tests of Hypotheses for Within Subject Effects. Ce tableau matriciel compile la somme des carrés (Sum of Squares), les carrés moyens (Mean Square), le ratio $F$ empirique, ainsi qu’une série de colonnes présentant la significativité statistique selon quatre prismes interprétatifs distincts : non corrigé (Unadjusted), Greenhouse-Geisser ($Adj Pr > F$ sous $G-G$), Huynh-Feldt ($Adj Pr > F$ sous $H-F$) et Borne inférieure ($Adj Pr > F$ sous $Lower$).
Dans notre jeu de données expérimental pharmacologique, les valeurs issues de l’exécution SAS se présentent comme suit :
- Somme des carrés du traitement : $SS_{\text{Traitement}} = 47862{,}50$ pour $ddl = 3$, soit un carré moyen $MS = 15954{,}17$.
- Somme des carrés de l’erreur intra-sujet : $SS_{\text{Erreur}} = 1537{,}50$ pour $ddl = 33$, soit un carré moyen $MS_{\text{Erreur}} = 46{,}59$.
- Statistique $F$ observée : $F(3, 33) = 15954{,}17 / 46{,}59 = 342{,}43$.
- Probabilité non ajustée : $p < 0{,}0001$.
L’évaluation des épsilons révèle un $\hat{\epsilon}_{GG} = 0{,}842$ et un $\tilde{\epsilon}_{HF} = 0{,}986$. Le test de Mauchly affiche un $W = 0{,}712$ avec une probabilité associée $p = 0{,}284$, échouant à rejeter formellement l’hypothèse de sphéricité. Néanmoins, l’application de la correction de Huynh-Feldt (recommandée ici car $\hat{\epsilon}_{GG} > 0{,}75$) applique des degrés de liberté ajustés : $ddl_{1} = 0{,}986 \times 3 = 2{,}96$ et $ddl_{2} = 0{,}986 \times 33 = 32{,}54$. La $p$-valeur corrigée demeure strictement inférieure au seuil critique ($p < 0{,}0001$), permettant de rejeter sans équivoque l'hypothèse nulle et de conclure à un effet hautement significatif du traitement pharmacologique sur les temps de réaction.
7.2 Calcul et interprétation de la taille d’effet
La seule mention de la valeur $p$ s’avère scientifiquement insuffisante pour quantifier la magnitude substantielle du phénomène observé. La quantification de la taille d’effet (effect size) est obligatoire selon les directives éditoriales internationales. Dans les plans à mesures répétées, l’indicateur standard privilégié est l’Éta-carré partiel ($\eta_p^2$ ou Partial Eta Squared). L’Éta-carré partiel quantifie la proportion de variance de la variable dépendante qui est expliquée exclusivement par le facteur d’intérêt, après avoir mathématiquement extrait la variabilité interindividuelle et les autres termes du modèle.
Sa formulation mathématique se dérive directement à partir des sommes des carrés extraites du tableau SAS :
$$\eta_p^2 = \frac{SS_{\text{Effet}}}{SS_{\text{Effet}} + SS_{\text{Erreur(Effet)}}}$$
En injectant les valeurs de notre protocole expérimental :
$$\eta_p^2 = \frac{47862{,}50}{47862{,}50 + 1537{,}50} = \frac{47862{,}50}{49400{,}00} = 0{,}969$$
Une mise en garde fondamentale s’impose quant à la distinction entre l’Éta-carré global ($\eta^2$) et l’Éta-carré partiel ($\eta_p^2$). L’Éta-carré simple incorpore la variance totale au dénominateur, ce qui dilue artificiellement la taille d’effet dans les plans intra-sujets où la variance inter-sujets est importante. Le chercheur veillera donc à préciser explicitement l’indice calculé. Selon les repères empiriques conventionnels établis par Jacob Cohen pour la recherche comportementale :
- $\eta_p^2 \approx 0{,}01$ : Effet de faible magnitude.
- $\eta_p^2 \approx 0{,}06$ : Effet de magnitude modérée.
- $\eta_p^2 ge 0{,}14$ : Effet de forte magnitude.
Avec une valeur de $\eta_p^2 = 0{,}969$, le traitement pharmacologique étudié démontre un impact expérimental exceptionnellement puissant, expliquant près de 97 % de la variance intra-individuelle des temps de réponse.
7.3 Formalisation des résultats selon les normes APA (7e édition)
La rédaction de la section des résultats dans un article soumis aux revues affiliées à l’APA exige une précision métrologique absolue. Le texte doit impérativement rapporter : la statistique de test ($F$), les degrés de liberté exacts (ajustés par le coefficient de sphéricité retenu), la valeur $p$ exacte (sans jamais écrire $p = 0{,}000$, mais $p < 0{,}001$), l'indice d'épsilon utilisé ainsi que la taille d'effet standardisée ($\eta_p^2$).
Voici le modèle de formalisation académique textuelle conforme aux normes APA 7e édition pour notre étude :
« Une analyse de variance à mesures répétées à un facteur a été réalisée afin d’évaluer l’impact de quatre conditions pharmacologiques (Placebo, Dose A, Dose B, Dose C) sur les temps de réaction psychomoteurs chez 12 participants sains. Bien que le test de sphéricité de Mauchly ne se soit pas révélé statistiquement significatif ($W = 0{,}712, \chi^2(5) = 3{,}41, p = 0{,}284$), l’épsilon de Greenhouse-Geisser s’établissant à $\hat{\epsilon} = 0{,}842$, les degrés de liberté ont été rigoureusement ajustés à l’aide de la correction de Huynh-Feldt ($\tilde{\epsilon} = 0{,}986$) par précaution méthodologique. L’analyse révèle un effet principal hautement significatif du traitement pharmacologique sur les temps de réaction, $F(2{,}96, 32{,}54) = 342{,}43, p < 0{,}001, \eta_p^2 = 0{,}969$. La décomposition en contrastes polynomiaux orthogonaux met en évidence une tendance linéaire hautement significative, $F(1, 11) = 984{,}12, p < 0{,}001, \eta_p^2 = 0{,}989$, attestant d'une accélération monotone et proportionnelle du traitement de l'information à mesure que la dose pharmacologique s'accroît. »
8. Analyses post-hoc et contrastes de moyennes
8.1 Nécessité des comparaisons multiples après un test global significatif
L’obtention d’un test $F$ omnibus statistiquement significatif au sein d’une ANOVA à mesures répétées permet d’affirmer avec certitude qu’il existe au moins une différence non nulle entre les moyennes des conditions évaluées. Cependant, ce résultat global ne renseigne en rien sur la localisation topologique précise des divergences. Est-ce la Dose A qui diffère du Placebo ? Ou bien l’effet n’émerge-t-il qu’à partir de la Dose B ? L’expérimentateur ne peut pas se contenter d’enchaîner une batterie de tests $t$ de Student appariés non ajustés pour comparer chaque paire de modalités. L’exécution de multiples tests d’hypothèses sur un même jeu de données provoque une dérive pernicieuse connue sous le nom d’inflation du taux d’erreur par famille (Family-Wise Error Rate, $FWER$).
Si l’on réalise $c$ comparaisons indépendantes au seuil nominal $\alpha = 0{,}05$, la probabilité globale d’obtenir au moins un faux positif s’élève théoriquement à :
$$\alpha_{\text{global}} = 1 – (1 – \alpha)^c$$
Pour notre plan comportant 4 modalités, le nombre de comparaisons bilatérales deux à deux s’élève à :
$$c = \frac{k(k – 1)}{2} = \frac{4 \times 3}{2} = 6 \text{ paires}$$
Sans contrôle statistique rigoureux, le risque de commettre au moins une erreur de type I grimpe à $1 – (1 – 0{,}05)^6 \approx 0{,}265$, soit une chance sur quatre de valider une découverte scientifique illusoire. La mise en œuvre de procédures de contrôle post-hoc rigoureusement adaptées à la structure intra-sujet s’avère donc impérative.
8.2 Syntaxe LSMEANS et options d’ajustement dans PROC GLM
La commande privilégiée pour estimer et contraster les moyennes marginales sous SAS est l’instruction LSMEANS (Least-Squares Means). Bien que dans les plans équilibrés sans données manquantes les moyennes des moindres carrés soient strictement identiques aux moyennes arithmétiques brutes, LSMEANS calcule les erreurs types exactes et permet d’exécuter des ajustements algorithmiques de haut niveau via des options dédiées.
Dans le cadre de PROC GLM à mesures répétées, l’obtention directe des comparaisons post-hoc ajustées pour le facteur intra-sujet requiert une vigilance syntaxique particulière. Étant donné que le facteur intra-sujet n’apparaît pas dans l’instruction MODEL, l’instruction standard LSMEANS ne peut être appliquée directement au nom virtuel du facteur répété au sein de GLM sans recourir à des astuces de programmation. Deux voies méthodologiques se présentent :
- Utiliser l’option
MSTAT=EXACTcouplée à l’instructionREPEATED ... / PRINTEpour examiner les matrices de contrastes internes. - Basculer la table au format long et solliciter
PROC MIXED, qui déploie la pleine puissance de l’instructionLSMEANSavec l’optionDIFF ADJUST=BONFERRONIouADJUST=TUKEY.
L’ajustement de Bonferroni divise le seuil $\alpha$ par le nombre total de comparaisons planifiées ($p_{\text{ajustée}} = p \times c$), offrant une protection stricte et conservative. La méthode de Tukey-Kramer (basée sur la distribution de l’étendue studentisée) optimise la puissance lors des comparaisons complètes de toutes les paires possibles, bien que son application univariée stricte dans les plans intra-sujets exige la préservation rigoureuse de la condition de sphéricité.
8.3 Contrastes planifiés a priori versus tests a posteriori
Une distinction fondamentale en épistémologie statistique oppose les comparaisons a posteriori (exploratoires et non guidées par une hypothèse théorique préalable) aux contrastes planifiés a priori (déduits directement des fondements théoriques de l’investigation avant le recueil des données). Lorsque le chercheur dispose d’une hypothèse expérimentale précise (par exemple : postuler que l’adjonction de molécules pharmacologiques produit une désensibilisation linéaire inversement proportionnelle à la concentration), le recours au test omnibus suivi de post-hocs généralisés est méthodologiquement sous-optimal.
L’instruction CONTRAST intégrée dans l’instruction REPEATED de PROC GLM permet de tester des hypothèses de contrastes orthogonaux avec un seul degré de liberté au numérateur, maximisant la puissance statistique sans pénalisation excessive du seuil $\alpha$. Dans notre script pharmacologique, la spécification de l’option POLYNOMIAL décompose la variance du traitement en trois contrastes orthogonaux mutuellement exclusifs :
- Le contraste linéaire : Évalue la présence d’une pente constante et continue d’accélération des temps de réaction à travers les doses.
- Le contraste quadratique : Teste l’existence d’une courbure en forme de $U$ ou de $U$ inversé (loi de Yerkes-Dodson, suggérant un plateau d’efficacité ou un effet plafond au-delà d’une certaine concentration).
- Le contraste cubique : Évalue un pattern d’inflexion sigmoïdale en forme de $S$.
Cette approche par décomposition polynomiale orthogonale transcende le simple constat de disparité entre conditions en modélisant formellement la nature fonctionnelle de la réponse neurocognitive sous-jacente.
9. Approche moderne par modèles mixtes : la procédure PROC MIXED
9.1 Limites inhérentes à PROC GLM et avantages de PROC MIXED
Bien que la procédure PROC GLM constitue la norme analytique historique, elle souffre de limitations structurelles rédhibitoires qui incitent la recherche contemporaine à lui préférer la modélisation linéaire mixte via PROC MIXED. La faille la plus critique de PROC GLM réside dans sa gestion archaïque des données manquantes : elle applique une suppression par liste complète (listwise deletion). Si un participant manque une seule évaluation sur dix au sein d’une cohorte longitudinale, la totalité de ses observations passées et futures est purement et simplement purgée de l’analyse. Ce mécanisme entraîne une déperdition dramatique d’information statistique, une baisse de puissance majeure, et introduit un biais d’échantillonnage substantiel si les données manquantes ne sont pas totalement aléatoires.
À l’inverse, PROC MIXED fonctionne sous le paradigme théorique de l’estimation du maximum de vraisemblance restreint (Restricted Maximum Likelihood, REML) ou du maximum de vraisemblance direct (FIML). Elle conserve l’intégralité des points de données observés de tous les participants sans exclure les individus incomplets, reposant sur l’hypothèse beaucoup plus réaliste de données manquantes aléatoires (Missing at Random, MAR). De surcroît, PROC MIXED offre une flexibilité incomparable pour manipuler des intervalles de temps irréguliers entre les sessions de mesure et modéliser des trajectoires individuelles continues via des effets aléatoires spécifiques.
9.2 Spécification de la structure de variance-covariance
Le saut qualitatif majeur permis par PROC MIXED réside dans l’abandon de l’obligation de sphéricité imposée par le modèle univarié classique. Grâce à l’instruction REPEATED au sein de PROC MIXED, le statisticien peut spécifier explicitement la structure mathématique de la matrice de variance-covariance intra-sujet via l’option TYPE= :
- TYPE=CS (Compound Symmetry) : Présume des variances et des covariances parfaitement constantes (modèle classique équivalent à l’ANOVA univariée sous sphéricité stricte).
- TYPE=AR(1) (Autoregressive de premier ordre) : Postule que la corrélation entre deux mesures décroît de façon exponentielle au fil du temps à mesure que la distance temporelle augmente ($r_{t, t+k} = \rho^k$). C’est la structure optimale et par excellence pour les études longitudinales.
- TYPE=TOEP (Toeplitz) : Permet aux covariances d’être similaires selon l’écart temporel, sans imposer la contrainte exponentielle stricte de l’AR(1).
- TYPE=UN (Unstructured) : N’impose aucune contrainte préalable sur les paramètres ; chaque variance et chaque covariance est estimée librement à partir des données empiriques (équivalent mathématique à la MANOVA répétée).
La sélection de la matrice optimale s’effectue en comparant les critères d’information statistique fournis par SAS : le critère d’information d’Akaike (AIC, AICC) et le critère d’information bayésien de Schwarz (BIC). La structure affichant la valeur d’AIC/BIC la plus faible représente le meilleur compromis empirique entre adéquation aux données et parcimonie paramétrique.
9.3 Syntaxe complète et interprétation des paramètres sous PROC MIXED
Pour exécuter l’analyse sous PROC MIXED, nous mobilisons le jeu de données initial structuré au format long (etude_pharmacologique). Le script SAS complet s’articule comme suit :
PROC MIXED DATA=etude_pharmacologique METHOD=REML PLOTS=ALL;

  CLASS Sujet Condition;

  MODEL Temps_Reaction = Condition / DDFM=KENWARDROGER SOLUTION;

  REPEATED Condition / SUBJECT=Sujet TYPE=AR(1) R RCORR;

  LSMEANS Condition / DIFF ADJUST=BONFERRONI;

RUN;
Dans cette architecture de commande hautement spécialisée :
- L’instruction
CLASSdéclareSujetcomme facteur de regroupement aléatoire etConditioncomme facteur fixe. - L’option
DDFM=KENWARDROGERapplique l’ajustement algorithmique de Kenward-Roger pour le calcul des degrés de liberté du dénominateur, reconnu comme la méthode la plus précise et robuste pour contrôler l’erreur de type I dans les modèles mixtes aux échantillons restreints. - L’instruction
REPEATEDassocie la variableConditionaux mesures séquentielles d’un même individu via l’opérateur de partitionnementSUBJECT=Sujet. L’optionTYPE=AR(1)impose la structure autorégressive, tandis queRetRCORRdemandent l’affichage explicite des matrices de covariance et de corrélation estimées. - L’instruction
LSMEANScouplée àDIFF ADJUST=BONFERRONIextrait directement l’ensemble des comparaisons deux à deux avec correction rigoureuse du risque $\alpha$.
La sortie SAS génère le tableau Type 3 Tests of Fixed Effects, fournissant la statistique $F$ exacte de l’effet principal du traitement, affranchie des postulats artificiels de sphéricité grâce à la modélisation probabiliste directe de la dépendance sérielle.
10. Représentation graphique des profils temporels et interactions
10.1 Génération de graphiques scientifiques avec PROC SGPLOT
La communication visuelle des résultats scientifiques obéit à des normes strictes de clarté, de rigueur métrique et d’accessibilité. Au sein de SAS, la procédure PROC SGPLOT (Statistical Graphics Plot) représente l’état de l’art pour composer des figures vectorielles de haute précision destinées à l’édition internationale. Pour représenter l’évolution des temps de réaction à travers nos quatre conditions pharmacologiques, nous générons une figure combinant le tracé des profils moyens, les marqueurs géométriques des centroïdes et les barres d’erreur standard de la moyenne (SEM).
Préalablement au tracé, les métriques descriptives agrégées (moyennes et erreurs types) sont extraites par le biais de PROC MEANS appliquée à la table au format long :
PROC MEANS DATA=etude_pharmacologique NWAY NOPRINT;

  CLASS Condition;

  VAR Temps_Reaction;

  OUTPUT OUT=stats_agreg(DROP=_TYPE_ _FREQ_)

         MEAN=Moyenne STDERR=Erreur_Type;

RUN;
/* Création de la figure vectorielle */
PROC SGPLOT DATA=stats_agreg;
SERIES X=Condition Y=Moyenne / LINEATTRS=(COLOR=black THICKNESS=2);
SCATTER X=Condition Y=Moyenne / YERRORLOWER=eval(Moyenne - Erreur_Type)
YERRORUPPER=eval(Moyenne + Erreur_Type)
MARKERATTRS=(COLOR=blue SYMBOL=CircleFilled SIZE=10);
XAXIS LABEL="Condition Pharmacologique" DISCRETEORDER=DATA;
YAXIS LABEL="Temps de Réaction Moyen (ms)" GRID;
RUN;
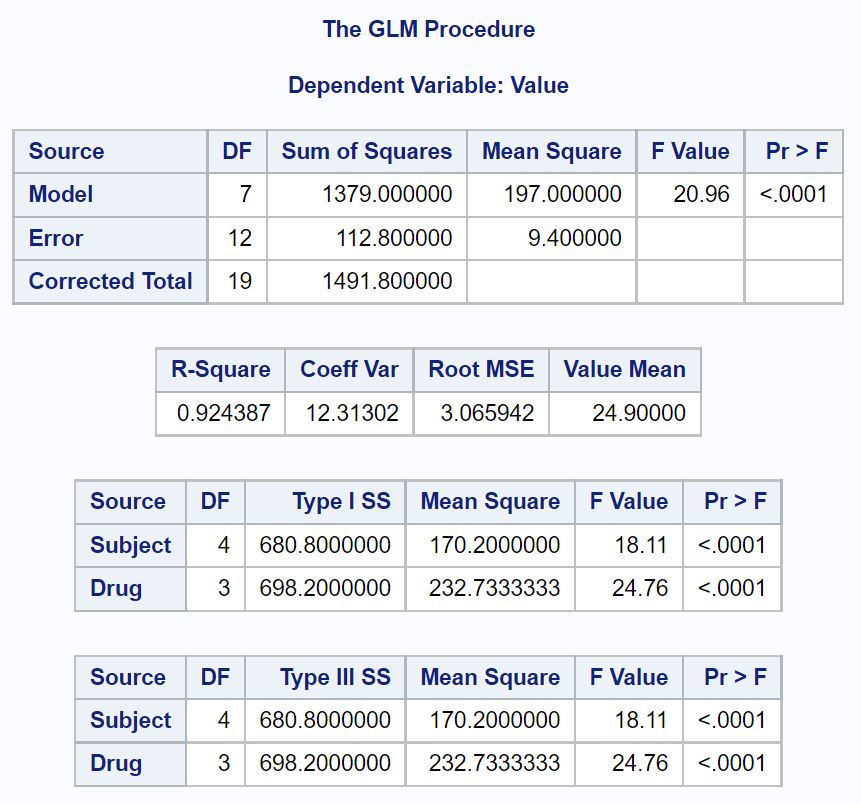
L’utilisation de l’option DISCRETEORDER=DATA sur l’axe des abscisses est cruciale : elle garantit que SAS préserve l’ordre logique et chronologique de présentation des conditions expérimentales tel qu’il a été instancié dans la table, prévenant un réagencement alphabétique automatique indésirable qui dénaturerait l’interprétation visuelle.
10.2 Visualisation de l’interaction intra-sujet par inter-sujet
Lorsque le plan factoriel incorpore un facteur de croisement inter-groupes (par exemple : Groupe Clinique Témoin vs TDAH), la représentation graphique doit impérativement illustrer le pattern de l’interaction bidirectionnelle. Les interactions se manifestent visuellement par un défaut de parallélisme des pentes d’évolution à travers les modalités répétées.
Dans PROC SGPLOT, cette ségrégation visuelle est implémentée en insérant l’attribut GROUP=Groupe au sein des déclarations SERIES et SCATTER :
PROC SGPLOT DATA=stats_agreg_mixtes;

  SERIES X=Condition Y=Moyenne / GROUP=Groupe

         LINEATTRS=(THICKNESS=2);

  SCATTER X=Condition Y=Moyenne / GROUP=Groupe

          YERRORLOWER=eval(Moyenne - Erreur_Type)

          YERRORUPPER=eval(Moyenne + Erreur_Type)

          MARKERATTRS=(SIZE=9);

  KEYLEGEND / TITLE="Cohorte Clinique" POSITION=TopRight;

RUN;
Le choix chromatique doit privilégier des palettes perceptibles par les personnes atteintes de daltonisme (telles que la palette Viridis) ou opter pour une stylisation contrastée en niveaux de gris (ligne continue noire vs ligne pointillée grise avec formes géométriques distinctes), garantissant une lisibilité parfaite des trajectoires différentielles tant sur écran qu’à l’impression papier noir et blanc.
10.3 Exploitation de l’ODS Graphics dans les procédures analytiques
L’environnement Output Delivery System (ODS Graphics) intégré nativement dans SAS permet de générer des visualisations statistiques automatisées sans nécessiter de programmation graphique manuelle. L’instruction préliminaire ODS GRAPHICS ON; active un pipeline de rendu élaboré au sein de PROC GLM et PROC MIXED.
Lors de l’exécution de PROC GLM couplée à l’option PLOTS=ALL, SAS produit automatiquement des diagrammes d’interaction et d’évaluation des profils résiduels. Pour les besoins de la publication dans les revues internationales à fort facteur d’impact, les graphiques doivent satisfaire des standards de résolution drastiques (minimum 300 à 600 DPI, format vectoriel TIFF ou EPS). L’exportation directe haute fidélité s’opère via les instructions de routage ODS suivantes :
ODS LISTING GPATH="C:ProjetsPublicationsFigures" IMAGE_DPI=300;

ODS GRAPHICS ON / RESET=ALL IMAGENAME="Figure1_ANOVA_SAS" OUTPUTFMT=TIFF HEIGHT=15cm WIDTH=20cm;
/* Exécution de la procédure produisant le graphique */
PROC MIXED DATA=etude_pharmacologique PLOTS(ONLY)=INTERACTIONPLOT;
CLASS Sujet Condition;
MODEL Temps_Reaction = Condition / DDFM=KENWARDROGER;
REPEATED Condition / SUBJECT=Sujet TYPE=AR(1);
RUN;
ODS GRAPHICS OFF;
ODS LISTING CLOSE;
Cette séquence génère un fichier image non compressé au format TIFF étalonné à 300 points par pouce, immédiatement exploitable par les maisons d’édition scientifiques.
11. Pièges méthodologiques et écueils d’interprétation
11.1 Effets d’ordre, de report et de réactivité de la mesure
L’écueil expérimental le plus redoutable guettant les chercheurs déployant des plans à mesures répétées réside dans la confusion entre l’effet théorique du traitement et les artefacts séquentiels induits par le passage répété des épreuves. Trois phénomènes distincts menacent la validité interne du protocole :
- L’effet de pratique ou d’apprentissage : Les performances cognitives ou motrices s’améliorent mécaniquement au fil des sessions par simple familiarisation avec la tâche, indépendamment de toute intervention pharmacologique active.
- L’effet de fatigue ou de lassitude : Une dégradation monotone de la vigilance ou de la motivation émerge lors d’évaluations successives excessivement longues ou rébarbatives.
- L’effet de report (carryover effect) : L’impact physiologique ou psychologique d’une condition préalable persiste et contamine la mesure subséquente. En pharmacologie, l’élimination métabolique incomplète d’une molécule active avant l’administration du placebo induit un biais résiduel sévère.
Pour neutraliser ces menaces, l’implémentation de périodes de sevrage (washout periods) suffisamment étendues constitue un prérequis incontournable en pharmacologie. Sur le plan structural, le contrebalancement par un plan en carré latin équilibré assure que chaque condition est précédée et suivie par chaque autre condition un nombre identique de fois au sein de l’échantillon. De plus, il est vivement recommandé d’intégrer formellement l’ordre de passation en tant que facteur inter-sujets (covariable de contrôle) au sein de l’instruction MODEL sous SAS, afin de vérifier statistiquement l’absence d’interaction significative entre l’ordre et le traitement.
11.2 Erreurs de spécification de la table et des termes d’erreur
La transcription informatique d’un plan expérimental sous SAS expose le praticien à des erreurs de spécification aux conséquences statistiques majeures. L’une des bévues les plus destructrices consiste à omettre purement et simplement l’instruction REPEATED lors de l’exécution d’une analyse sur une table au format long sous PROC GLM. Si le chercheur écrit :
PROC GLM DATA=etude_pharmacologique;

  CLASS Condition;

  MODEL Temps_Reaction = Condition;

RUN;
SAS compile le modèle en traitant les 48 observations ($12 \times 4$) comme émanant de 48 participants indépendants distincts. La partition de variance échoue totalement à isoler la variabilité interindividuelle, le terme d’erreur au dénominateur du test $F$ incorpore l’ensemble des écarts entre sujets, et les degrés de liberté résiduels ($ddl = 44$) sont artificiellement gonflés. Le résultat obtenu est scientifiquement invalide.
De même, sous PROC MIXED, un écueil fréquent réside dans le surajustement de la matrice de covariance. Spécifier systématiquement une structure non structurée (TYPE=UN) sur de très petits échantillons dotés d’un nombre élevé de points temporels contraint le modèle à estimer $k(k + 1) / 2$ paramètres de variance-covariance. Cette profusion de paramètres sature l’algorithme d’optimisation de Newton-Raphson, induisant des problèmes majeurs de non-convergence ou des estimations aberrantes d’erreurs types. Le statisticien doit impérativement guider son choix par la parcimonie et les critères d’information (AIC/BIC).
11.3 Interprétation erronée en présence de données manquantes non aléatoires
La présence de valeurs manquantes (missing data) au sein des suivis répétés représente une source insidieuse de biais de sélection. Il est crucial de classifier la nature stochastique des omissions selon la typologie formalisée par Donald Rubin :
- MCAR (Missing Completely at Random) : L’absence de donnée est totalement indépendante des variables observées et non observées (ex. une fiole de prélèvement biologique brisée accidentellement au laboratoire). Dans ce cas exceptionnel, la suppression par liste sous
PROC GLMréduit la puissance mais ne biaise pas l’estimation des paramètres. - MAR (Missing at Random) : La probabilité de donnée manquante dépend de covariables observées dans l’étude, mais est indépendante de la valeur non observée elle-même (ex. les participants plus âgés abandonnent davantage l’étude, mais à âge égal, la perte de données est aléatoire).
PROC MIXEDgère parfaitement le mécanisme MAR via le maximum de vraisemblance. - MNAR (Missing Not at Random) : La probabilité de défection dépend directement de la valeur qui aurait dû être mesurée (ex. un patient dépressif ne se présente pas à l’évaluation clinique précisément parce que son état psychique s’est dramatiquement détérioré).
En présence d’un mécanisme MNAR, tant PROC GLM que PROC MIXED produisent des estimations déviées et une sous-estimation substantielle de l’inefficacité ou de la toxicité du traitement. Lorsque le taux de défection est non négligeable ($> 5-10%$), le déploiement d’analyses de sensibilité (telles que des modèles à sélection de Heckman ou des modèles mixtes à effets de transition et de mélange) est impératif pour éprouver la stabilité des conclusions inférentielles face à des scénarios pessimistes d’imputation.
12. Synthèse et guide de rédaction pour revue internationale
12.1 Structure rigoureuse de la section Méthode statistique
La rédaction de la section méthodologique d’un manuscrit scientifique doit garantir une transparence opérationnelle absolue, permettant à des pairs d’auditer et de répliquer intégralement l’analyse computationnelle. Cette section doit articuler avec clarté :
- La description précise du plan expérimental factoriel, en catégorisant sans ambiguïté les facteurs intra-sujets (avec le nombre exact de niveaux et leur étalement temporel) et les éventuels facteurs inter-sujets de classification.
- L’identification exhaustive de l’environnement logiciel mobilisé, en stipulant la version exacte du système SAS (ex. SAS System version 9.4, SAS Institute Inc., Cary, NC, USA) ainsi que les procédures analytiques exécutées (
PROC GLMouPROC MIXED). - La description des protocoles de validation des postulats paramétriques : tests formels de normalité résiduelle (Shapiro-Wilk), méthode de diagnostic de la sphéricité (test de Mauchly) et déclaration explicite a priori de la règle décisionnelle guidant le choix entre les corrections de Greenhouse-Geisser et de Huynh-Feldt.
- La méthode de gestion des comparaisons multiples post-hoc (spécification de la correction de Bonferroni ou de Tukey-Kramer) et l’indice métrique sélectionné pour mesurer la taille d’effet ($\eta_p^2$ avec indication de sa formule de dérivation).
12.2 Présentation normalisée des tableaux et figures
Les données statistiques complexes doivent être synthétisées sous forme de tableaux synoptiques autonomes, intelligibles sans qu’il soit nécessaire de référer continuellement au corps du texte. Les tableaux doivent comporter les moyennes brutes, les erreurs types de la moyenne (SEM) ou les intervalles de confiance à 95 %, les degrés de liberté nominaux et ajustés, ainsi que la valeur exacte de l’indice de taille d’effet.
Voici un exemple de tableau standardisé prêt pour la soumission académique :
| Condition | Moyenne (ms) | Erreur Type (SEM) | IC à 95 % | Source de Variation | $ddl$ ajustés (H-F) | $F$ de Fisher | Valeur $p$ | $\eta_p^2$ |
|---|---|---|---|---|---|---|---|---|
| Placebo | 484,17 | 9,19 | [463,95 ; 504,38] | Traitement intra-sujet | 2,96 ; 32,54 | 342,43 | < 0,001 | 0,969 |
| Dose A (10 mg) | 462,08 | 9,08 | [442,10 ; 482,07] | |||||
| Dose B (25 mg) | 425,83 | 9,23 | [405,52 ; 446,15] | |||||
| Dose C (50 mg) | 399,58 | 9,66 | [378,32 ; 420,85] |
Note. Les degrés de liberté ont été ajustés via la correction d’épsilon de Huynh-Feldt ($\tilde{\epsilon} = 0{,}986$). IC = Intervalle de confiance ; SEM = Erreur standard de la moyenne ; $\eta_p^2$ = Éta-carré partiel. Les comparaisons post-hoc ajustées par Bonferroni indiquent que toutes les conditions diffèrent significativement les unes des autres au seuil critique $p < 0{,}001$.
12.3 Checklist finale avant soumission d’un manuscrit
Avant d’expédier définitivement un article scientifique comportant une ANOVA à mesures répétées à l’évaluation par les pairs, les auteurs doivent procéder à un contrôle qualité systématique en validant point par point la grille de vérification méthodologique suivante :
- Cohérence arithmétique des degrés de liberté : S’assurer que le produit des degrés de liberté résiduels nominaux correspond strictement à $(k – 1) \times (n – 1)$. Si un ajustement de sphéricité a été appliqué, vérifier que les degrés de liberté décimaux affichés résultent bien de la multiplication par l’épsilon explicitement rapporté.
- Concordance de l’épsilon : Vérifier que le choix entre Greenhouse-Geisser et Huynh-Feldt respecte scrupuleusement le seuil empirique déclaré (ex. bascule à $\hat{\epsilon} > 0{,}75$).
- Mention systématique de la taille d’effet : Contrôler qu’aucune statistique $F$ n’est présentée isolément sans son indice associé ($\eta_p^2$ ou oméga-carré partiel $\omega_p^2$).
- Contrôle des décimales selon l’APA : Respecter scrupuleusement la mise en forme typographique : deux décimales pour les moyennes, écarts-types, ratios $F$ et épsilons ; trois décimales pour les probabilités exactes ($p = 0{,}024$) ; omission du zéro liminaire avant la virgule pour les grandeurs probabilistes ne pouvant excéder l’unité ($p < 0{,}001$, $\eta_p^2 = 0{,}97$).
- Archivage du code et reproductibilité : S’assurer que le script SAS complet (fichiers
.sas), les fichiers de logs associés sans erreurs (.log) et les tables brutes anonymisées sont archivés au sein d’un entrepôt institutionnel public ou sécurisé (tel que l’Open Science Framework), gage d’intégrité scientifique et de transparence méthodologique.
Références
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Girden, E. R. (1992). ANOVA: Repeated Measures (Quantitative Applications in the Social Sciences, Vol. 84). SAGE Publications. https://doi.org/10.4135/9781412983419
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Huynh, H., & Feldt, L. S. (1976). Estimation of the box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Littell, R. C., Milliken, G. A., Stroup, W. W., Wolfinger, R. D., & Schabenberger, O. (2006). SAS for Mixed Models (2nd ed.). SAS Institute Inc.
- Mauchly, J. W. (1940). Significance test for sphericity of a normal $n$-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
- Maxwell, S. E., & Delaney, H. D. (2004). Designing Experiments and Analyzing Data: A Model Comparison Perspective (2nd ed.). Lawrence Erlbaum Associates.
- Rouanet, H., & Lépine, D. (1970). Comparison between treatments in a repeated-measurement design: ANOVA and multivariate methods. British Journal of Mathematical and Statistical Psychology, 23(2), 147–163. https://doi.org/10.1111/j.2044-8317.1970.tb00441.x
- SAS Institute Inc. (2018). SAS/STAT 15.1 User’s Guide: The GLM Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/151/glm.pdf
- SAS Institute Inc. (2018). SAS/STAT 15.1 User’s Guide: The MIXED Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/151/mixed.pdf
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.