
La rédaction de la section des résultats dans un article empirique constitue l’un des exercices les plus délicats et déterminants de la communication scientifique. En psychologie, en neurosciences cognitives, en sciences de l’éducation et en médecine comportementale, l’analyse de variance à mesures répétées (souvent désignée sous le terme d’ANOVA intra-sujet) représente un outil statistique d’une puissance considérable. Ce modèle permet de tester l’évolution de variables dépendantes continues chez les mêmes participants à travers différents moments d’évaluation ou sous diverses conditions expérimentales. Néanmoins, la sophistication mathématique de ce test impose des contraintes strictes lors de la restitution textuelle et tabulaire des données.
Trop souvent, les manuscrits soumis aux comités de lecture pèchent par omission : degrés de liberté résiduels oubliés, confusion autour des corrections appliquées en cas de violation des postulats fondamentaux, méconnaissance des conventions d’écriture des tailles d’effet ou encore imprécision dans la description des comparaisons multiples. Le respect scrupuleux des normes édictées par l’American Psychological Association (APA), actuellement dans sa septième édition, ne relève pas d’un simple formalisme esthétique ou éditorial. Il s’agit du garant indispensable de la transparence méthodologique, de la rigueur inférentielle et de la reproductibilité universelle des découvertes scientifiques.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, doctorants et analystes de données dans la maîtrise absolue de la rédaction des résultats issus d’une ANOVA à mesures répétées. De la formulation des tests diagnostiques préalables à la dissection minutieuse des effets d’interaction au sein de plans factoriels complexes, chaque étape sera détaillée avec le plus haut degré d’exigence académique. En suivant ces directives, vous offrirez à vos évaluateurs et lecteurs une lecture fluide, irréprochable sur le plan formel, et pleinement conforme aux standards contemporains de la science ouverte.
1. Introduction aux exigences de rédaction d’une ANOVA à mesures répétées
1.1 Fondements méthodologiques et contextualisation de l’analyse
Le devis de recherche à mesures répétées, également qualifié de plan intra-sujet (within-subjects design), repose sur un principe fondamental : chaque participant est exposé à l’ensemble des niveaux d’une ou plusieurs variables indépendantes qualitatives. Ce protocole se distingue radicalement des plans à échantillons indépendants (between-subjects design), où chaque individu n’est assigné qu’à un seul groupe expérimental ou à une condition unique. D’un point de vue statistique, le principal avantage de cette approche réside dans la réduction drastique de la variance d’erreur. En utilisant chaque participant comme son propre témoin, la variabilité interindividuelle stable (liée par exemple à la personnalité, au quotient intellectuel, au patrimoine génétique ou au statut socio-économique) est isolée mathématiquement et retirée du terme d’erreur résiduel. Cette particularité confère à l’ANOVA à mesures répétées une puissance statistique substantiellement supérieure pour détecter des effets réels, même avec des effectifs d’échantillons modérés.
Pour le rédacteur scientifique, cette configuration implique une identification rigoureuse de la nature des variables en jeu. La variable dépendante doit obligatoirement être quantitative et mesurée sur une échelle d’intervalle ou de rapport continue. Les variables indépendantes intra-sujets, quant à elles, représentent soit des passages temporels ordonnés (par exemple : pré-test, post-test immédiat et suivi à six mois), soit des manipulations expérimentales distinctes (par exemple : exposition séquentielle à des stimuli émotionnels neutres, positifs et négatifs). La rédaction du manuscrit doit refléter cette structure sans la moindre ambiguïté dès les premières lignes de la section des résultats. Une parfaite cohérence doit exister entre les hypothèses opérationnelles formulées dans l’introduction et la structure séquentielle de l’analyse statistique rapportée, évitant ainsi l’impression délétère d’une pêche aux données non planifiée.
1.2 Objectifs de communication scientifique et transparence
La communication des analyses statistiques ne doit jamais être conçue comme un simple inventaire de valeurs numériques déconnectées de leur portée épistémologique. L’objectif cardinal est de permettre au lecteur d’évaluer de manière critique la solidité de la démarche inférentielle et de reconstituer, si nécessaire, les calculs effectués. Dans le contexte actuel de la crise de la reproductibilité en sciences humaines et biomédicales, les comités de rédaction et les évaluateurs pairs exigent une transparence totale quant à la chaîne de traitement analytique. Cela signifie qu’il ne suffit plus d’affirmer qu’un test s’est révélé « statistiquement significatif » ; il est impératif de documenter chaque étape décisionnelle ayant conduit à cette conclusion.
L’alignement sur les préconisations du manuel de style de l’APA (7e édition) fournit un cadre normatif reconnu internationalement, garantissant une transmission uniforme de l’information. Cette standardisation implique la communication exhaustive de la distribution des données, des diagnostics de postulats, des paramètres du modèle omnibus, des tailles d’effet standardisées accompagnées de leurs intervalles de confiance, ainsi que des ajustements appliqués lors des tests post-hoc. Rédiger cette section avec clarté protège le chercheur contre les biais de publication et démontre que les choix analytiques ont été guidés par des critères méthodologiques objectifs plutôt que par une quête effrénée de résultats favorables aux hypothèses de départ.
2. Vérification et rapportage des postulats statistiques
2.1 Évaluation et documentation de la normalité de la distribution
L’analyse de variance à mesures répétées requiert la normalité de la distribution de la variable dépendante à chaque niveau du facteur intra-sujet ou, plus rigoureusement encore, la normalité des résidus du modèle linéaire général. Dans votre manuscrit, la vérification de ce postulat ne doit pas être traitée de façon désinvolte par une simple affirmation générique. Il convient d’exposer formellement la méthode de détection employée. Le test de normalité de Shapiro-Wilk est particulièrement recommandé lorsque les échantillons sont de taille petite à modérée (N < 50), en raison de sa puissance supérieure comparativement au test de Kolmogorov-Smirnov corrigé par Lilliefors.
Cependant, l’interprétation des tests d’hypothèse formels pour la normalité doit toujours être complétée par une inspection visuelle qualitative, notamment au moyen de diagrammes quantiles-quantiles (Q-Q plots), ainsi que par le calcul des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Un rapport académique modèle précisera ces indices statistiques. Si les coefficients standardisés se situent dans un intervalle acceptable (classiquement entre -2 et +2 pour l’asymétrie et l’aplatissement), le texte doit le mentionner clairement. En cas de déviations mineures par rapport à la courbe de Gauss, il est parfaitement légitime d’invoquer la robustesse intrinsèque du modèle d’ANOVA face aux entorses modérées à la normalité, à condition que les effectifs soient équilibrés et que le théorème central limite puisse raisonnablement s’appliquer. Une phrase type pourra s’énoncer ainsi : « L’examen des diagrammes Q-Q et les tests de Shapiro-Wilk ont confirmé la normalité des distributions pour l’ensemble des conditions expérimentales (toutes les valeurs de p > ,05), à l’exception d’une légère asymétrie au temps T3 qui demeure toutefois dans les tolérances admises par le modèle (skewness = 0,64). »
2.2 Le postulat critique de sphéricité et le test de Mauchly
Contrairement à l’ANOVA pour groupes indépendants qui postule l’homogénéité des variances (homoscédasticité), l’ANOVA à mesures répétées repose sur une hypothèse beaucoup plus restrictive et complexe : la sphéricité. La sphéricité stipule que les variances des différences calculées entre toutes les combinaisons possibles de paires de conditions intra-sujets doivent être égales dans la population parente. Ce postulat constitue une version assouplie de la symétrie composée, laquelle exigeait à la fois l’égalité des variances pour chaque condition et l’égalité des covariances entre toutes les paires de conditions. Lorsque la variable indépendante ne comporte que deux modalités, le postulat de sphéricité est automatiquement satisfait par définition mathématique, car il n’existe qu’une seule variance de différence. Dès lors que le facteur comprend trois modalités ou davantage, la vérification devient obligatoire.
Le test canonique utilisé pour évaluer cette condition est le test de sphéricité de Mauchly. Dans le manuscrit, il est impératif de rapporter la statistique de Mauchly (notée W), la valeur du khi-deux associée ($\chi^2$), ses degrés de liberté et la probabilité critique correspondante. Si le résultat s’avère non significatif (p > ,05), le postulat de sphéricité est considéré comme respecté, autorisant l’usage direct des degrés de liberté standards du test F omnibus. Vous formulerez ce constat de la manière suivante : « Le test de sphéricité de Mauchly a indiqué que le postulat d’égalité des variances des différences n’était pas violé pour l’effet principal de la condition, W = 0,92, $\chi^2$(2) = 2,45, p = ,294. » Cette déclaration textuelle pose les bases d’une lecture sereine des paramètres inférentiels non ajustés qui suivront immédiatement.
2.3 Traitement des valeurs aberrantes intra-sujets
La présence de valeurs extrêmes ou aberrantes (outliers) au sein de données répétées peut fausser de manière disproportionnée le calcul des moyennes conditionnelles, gonfler artificiellement les variances résiduelles et induire des violations sévères de sphéricité. L’identification de ces observations atypiques doit être menée à l’aide de critères statistiques rigoureusement documentés. Deux approches complémentaires sont classiquement retenues : la détection univariée par standardisation des scores (identification des valeurs dont les scores z dépassent le seuil critique absolu de 3,29, correspondant à un seuil de probabilité bilatéral de p < ,001) et l’analyse multivariée via le calcul de la distance de Mahalanobis ou des résidus studentisés pour chaque sujet sur l’ensemble de son profil de réponses.
Dans la rédaction de votre article, toute suppression ou modification d’une donnée brute doit être justifiée de façon transparente. Le chercheur doit déclarer explicitement si des données ont été retirées, winsorisées ou transformées (par exemple par transformation logarithmique ou racine carrée). De plus, il est hautement souhaitable de rapporter une brève analyse de sensibilité précisant si l’exclusion des valeurs aberrantes modifie la significativité ou la magnitude des effets observés. Le standard de rédaction exige d’indiquer l’impact précis sur la taille de l’échantillon analysé : « L’inspection des résidus standardisés a révélé une valeur aberrante univariée (|z| = 3,82) lors de la seconde session de mesure. Ce participant a été exclu des analyses ultérieures, ramenant l’échantillon final à N = 44. Une analyse de sensibilité incluant ce cas atypique a produit des conclusions inférentielles identiques. »
3. Structure générale du paragraphe de résultats selon les normes APA
3.1 L’architecture séquentielle standardisée
L’agencement des phrases au sein du paragraphe de résultats obéit à une logique séquentielle immuable, conçue pour guider le lecteur de la question de recherche vers la conclusion empirique la plus fine. Déroger à cet ordre logique engendre une surcharge cognitive préjudiciable à la bonne compréhension de votre travail. Le paragraphe standardisé se compose invariablement de quatre blocs distincts :
- L’énoncé contextuel : Une courte phrase introductive rappelant l’objectif de l’analyse, identifiant précisément la variable dépendante ainsi que le ou les facteurs intra-sujets testés.
- Les statistiques descriptives de base : La communication des moyennes et des indices de dispersion associés à chaque condition, permettant d’apprécier la tendance empirique avant tout test inférentiel.
- Le test omnibus : La présentation des résultats de l’ANOVA globale, incluant la statistique F, les degrés de liberté inter-conditions et résiduels, la valeur exacte de la probabilité critique p, et la taille d’effet.
- La décomposition analytique : L’exposition des comparaisons par paires ou tests post-hoc avec leurs corrections d’erreur de type I respectives, venant expliciter la localisation exacte des différences mises au jour par le test omnibus.
3.2 Règles typographiques et conventions de notation
Les directives stylistiques de l’APA imposent une discipline typographique rigoureuse. L’une des erreurs les plus fréquentes réside dans l’omission de la mise en italique des symboles statistiques. Selon la norme, toute lettre latine désignant une statistique d’échantillon ou un paramètre mathématique doit systématiquement figurer en italique : M (moyenne), SD (écart-type, standard deviation), SE (erreur standard), F (statistique de Fisher-Snedecor), t (statistique de Student), p (valeur de probabilité), N (taille totale de l’échantillon) et n (sous-effectif). En revanche, les lettres grecques, telles que l’éta-carré partiel ($\eta_p^2$), l’epsilon ($epsilon$) ou le khi-deux ($\chi^2$), ne doivent jamais être mises en italique, de même que les indices textuels placés en indice (subscript).
En ce qui concerne l’arrondissement numérique, la règle d’or de l’APA 7e édition prescrit l’usage de deux décimales pour l’immense majorité des grandeurs statistiques (moyennes, écarts-types, valeurs de F, intervalles de confiance et tailles d’effet). La valeur de p constitue la principale exception : elle doit impérativement être rapportée avec trois décimales. Une autre convention essentielle concerne l’omission du zéro initial devant la virgule ou le point décimal. Lorsque la statistique ne peut théoriquement pas dépasser la valeur absolue de 1 (ce qui est le cas des probabilités p, des coefficients de corrélation r et des proportions), le zéro précédant le séparateur décimal doit être supprimé. En typographie francophone soignée, on écrira p = ,024 plutôt que p = 0,024. Enfin, des espaces insécables doivent entourer les opérateurs mathématiques d’égalité ou d’inégalité (=, <, >) pour éviter les ruptures de ligne inesthétiques.
3.3 Choix du registre discursif et objectivité scientifique
Le registre rédactionnel de la section des résultats se caractérise par une sobriété absolue et une neutralité stylistique exemplaire. Les résultats statistiques doivent être décrits comme des faits d’observation émanant d’un échantillon donné, ce qui justifie l’emploi préférentiel du passé simple ou du passé composé pour relater les opérations effectuées (« Une ANOVA à mesures répétées a été conduite… », « Les analyses ont révélé un effet principal significatif… »). Bien que l’usage traditionnel de la voix passive demeure largement toléré et fréquent dans les revues médicales et comportementales, l’APA encourage également l’emploi d’une forme active modérée (« Nous avons observé une diminution… »), à condition de ne pas verser dans un style subjectif ou familier.
L’écueil stylistique majeur consiste à glisser subrepticement de la constatation empirique brute vers l’interprétation théorique. La section des résultats doit formuler ce que les chiffres démontrent mathématiquement, et rien de plus. Les explications causales approfondies, la confrontation avec les modèles théoriques de la littérature ou les justifications psychologiques des comportements observés doivent être rigoureusement réservées à la section « Discussion ». Confondre le constat statistique (« les scores de rappel étaient significativement plus élevés en condition A qu’en condition B ») et l’inférence théorique (« cela prouve que la condition A optimise le fonctionnement exécutif du lobe frontal ») affaiblit considérablement la crédibilité d’un manuscrit soumis pour publication.
4. Présentation détaillée des statistiques descriptives
4.1 Mesures de tendance centrale et de dispersion par condition
L’interprétation d’un test inférentiel s’avère totalement stérile pour le lecteur si elle n’est pas précédée ou accompagnée d’une description quantitative précise du comportement des variables au sein de chaque condition. Avant même d’annoncer la valeur du test F, le texte doit communiquer les mesures de tendance centrale et de variabilité associées à chaque niveau de la variable intra-sujet. Pour des données continues distribuées normalement, le couple moyenne et écart-type demeure le standard universel. Il est formellement déconseillé de rapporter les moyennes de manière isolée sans mentionner leur indice de dispersion.
L’intégration textuelle de ces paramètres doit respecter la syntaxe APA : M = X,XX, SD = X,XX. Par exemple, pour une étude mesurant la performance mnésique sur trois intervalles temporels, on rédigera : « Les scores moyens de rappel mnésique ont diminué entre la phase initiale (M = 18,42, SD = 2,15), la session intermédiaire à 24 heures (M = 14,30, SD = 2,89) et la session différée à sept jours (M = 11,05, SD = 3,42). » Dans l’éventualité où certaines distributions présenteraient une asymétrie marquée ayant justifié l’usage de statistiques non paramétriques ou de transformations de données, il convient de substituer ou d’adjoindre aux moyennes le couple médiane et intervalle interquartile (Méd = X,XX, IQR = X,XX). Enfin, si des données manquent ponctuellement à certains temps de mesure, le nombre effectif de participants inclus pour chaque modalité (noté n) doit être explicitement précisé.
4.2 Intervalles de confiance pour mesures répétées
La présentation des intervalles de confiance (IC) constitue une exigence centrale des standards APA, fournissant une indication directe de la précision de l’estimation des paramètres de population. Néanmoins, l’application directe des formules classiques de l’intervalle de confiance aux devis à mesures répétées soulève une aporie méthodologique majeure documentée par Loftus et Masson (1994). Les intervalles de confiance standards calculés indépendamment pour chaque condition reflètent à la fois la variance intra-sujet et la variance interindividuelle. Or, dans une ANOVA intra-sujet, la variance inter-sujets est mathématiquement éliminée du terme d’erreur utilisé pour tester les hypothèses. L’affichage d’intervalles de confiance conventionnels donne une fausse impression de chevauchement important des conditions, dissimulant la significativité statistique réelle de l’effet intra-individuel.
Pour remédier à cette distorsion, il est hautement recommandé d’appliquer la correction de normalisation des données proposée par Cousineau (2005) et ajustée par Morey (2008), couramment appelée « correction de Cousineau-Morey ». Cette procédure retire la moyenne globale de chaque sujet avant de calculer la variance spécifique à chaque condition, puis applique un facteur d’ajustement dépendant du nombre de mesures répétées. Dans votre manuscrit, la mention de cette correction doit être formulée sans détour : « Les intervalles de confiance à 95 % ont été ajustés pour mesures répétées selon la méthode de Cousineau-Morey afin d’éliminer la variance interindividuelle. » La notation textuelle standardisée s’écrit sous la forme suivante : IC à 95 % [limite inférieure, limite supérieure]. Par exemple : « Au temps initial, le niveau d’anxiété s’établissait à M = 45,20, SD = 6,10, IC à 95 % [43,12, 47,28]. »
5. Rédaction du test omnibus et intégration des paramètres d’inférence
5.1 Décomposition de la notation F et degrés de liberté
Le test F omnibus représente le pivot inférentiel de l’ANOVA à mesures répétées, évaluant si au moins une condition diffère significativement des autres à travers la partition de la somme des carrés. La formulation académique d’un résultat d’ANOVA répond à une syntaxe canonique extrêmement précise : F(degrés de liberté de l’effet, degrés de liberté de l’erreur) = valeur de F. Tout chercheur se doit de comprendre parfaitement l’origine de ces deux degrés de liberté (ddl) afin d’éviter les erreurs grossières d’écriture.
Le premier chiffre entre parenthèses correspond au degré de liberté du facteur intra-sujet ($ddl_{\text{effet}}$). Il est égal au nombre de conditions ($k$) moins 1 ($k – 1$). Si votre expérience évalue les participants à travers quatre temps de mesure, ce premier ddl sera égal à 3. Le second chiffre représente le degré de liberté du terme d’erreur résiduel spécifique au facteur ($ddl_{\text{erreur}}$). Dans un plan intra-sujet simple à un facteur sans données manquantes, il est égal au produit du nombre de conditions moins un par le nombre de participants ($N$) moins un, soit $(k – 1) \times (N – 1)$. Pour un échantillon de 30 participants mesurés à quatre reprises, le degré de liberté résiduel sera donc de $(4 – 1) \times (30 – 1) = 3 \times 29 = 87$. Le rapport s’écrira ainsi : F(3, 87) = 14,62. L’omission du second degré de liberté constitue un motif fréquent de rejet partiel lors de l’évaluation technique des manuscrits, car elle prive l’évaluateur de la possibilité de vérifier la taille effective de l’échantillon d’erreur.
5.2 Rapportage précis de la valeur de p
L’American Psychological Association a banni depuis plusieurs éditions l’usage des seuils arbitraires et dichotomiques pour rapporter la significativité statistique. Les formulations archaïques telles que « p < ,05 », « p = NS » (non significatif) ou l’affirmation laconique selon laquelle « le test est significatif » sans mention numérique sont expressément proscrites. Les auteurs doivent fournir la valeur de p exacte calculée par le logiciel d’analyse statistique, arrondie à trois décimales (par exemple : p = ,038 ou p = ,412).
Une règle fondamentale concerne le seuil plancher généré par la plupart des logiciels (SPSS, R, Jamovi, Prism), qui affichent fréquemment la mention trompeuse « p = ,000 ». En probabilités continues, une valeur de p n’est jamais rigoureusement égale à zéro absolu. Il est strictement interdit d’écrire p = ,000 dans un article scientifique. Dans cette situation, la convention impose d’indiquer que la probabilité est inférieure à un millième, sous la forme : p < ,001. En cas de non-rejet de l’hypothèse nulle, il convient de rapporter la valeur exacte (ex. : p = ,184) et de proscrire absolument les expressions du type « tendance à la significativité » lorsque p se situe entre ,05 et ,10. Une telle formulation masque mal une incompréhension de la théorie des tests d’hypothèse de Neyman-Pearson, où la décision statistique doit demeurer binaire par rapport au seuil alpha prédéterminé.
6. Procédure de rédaction en cas de violation de la sphéricité
6.1 Critères de sélection entre Greenhouse-Geisser et Huynh-Feldt
Lorsque le test de Mauchly se révèle statistiquement significatif (p < ,05), le postulat de sphéricité est formellement violé. L’impact de cette violation sur le modèle d’ANOVA standard est délétère : le taux d’erreur de type I réel devient substantiellement supérieur au seuil nominal alpha fixé à 5 %, ce qui conduit à rejeter l’hypothèse nulle beaucoup trop fréquemment et à identifier des effets illusoires. Pour préserver l’intégrité de la décision statistique sans recourir obligatoirement à des modèles mixtes complexes ou à une MANOVA (analyse de variance multivariée), il est indispensable d’appliquer une correction aux degrés de liberté du test F. Cette correction consiste à multiplier le numérateur et le dénominateur des degrés de liberté par un coefficient d’ajustement, l’epsilon ($epsilon$), dont la valeur théorique oscille entre une borne inférieure ($1 / (k – 1)$) et 1 (situation de sphéricité parfaite).
Deux corrections dominent la pratique scientifique contemporaine : la correction de Greenhouse-Geisser et celle de Huynh-Feldt. Le choix entre ces deux approches n’est pas discrétionnaire et doit suivre l’algorithme décisionnel validé par la littérature méthodologique (Girden, 1992) :
- Si l’indice epsilon estimé de Greenhouse-Geisser ($\hat{\epsilon}$) est strictement inférieur à 0,75, la correction de Greenhouse-Geisser doit être retenue. Cette procédure est relativement conservatrice et contrôle parfaitement l’inflation du risque alpha lorsque la non-sphéricité est substantielle.
- Si l’indice epsilon estimé de Greenhouse-Geisser ($\hat{\epsilon}$) est supérieur ou égal à 0,75, il est recommandé d’adopter la correction de Huynh-Feldt. En présence d’une violation modérée, Greenhouse-Geisser tend à pénaliser excessivement la puissance du test, tandis que Huynh-Feldt offre un ajustement plus équilibré et moins biaisé vers le faux négatif.
- La correction de la borne inférieure (lower-bound epsilon), qui applique la pénalité maximale mathématiquement possible, est jugée excessivement conservatrice pour un usage empirique standard et ne doit généralement pas être utilisée, sauf en cas d’exploration délibérément ultra-prudente.
6.2 Ajustement des degrés de liberté dans la phrase de rapport
L’application d’un facteur de correction $epsilon$ inférieur à 1 a pour conséquence mécanique directe de transformer les degrés de liberté entiers en nombres fractionnaires comprenant des décimales. L’erreur la plus commune chez les étudiants et chercheurs novices consiste à arrondir ces degrés de liberté à des nombres entiers. Les normes APA stipulent formellement que les degrés de liberté corrigés doivent être rapportés avec deux décimales.
Considérons un plan d’expérience comportant quatre modalités temporelles mesurées sur 25 participants. Les degrés de liberté non corrigés sont de 3 et 72. Si le test de Mauchly indique une rupture de sphéricité et que le logiciel calcule un epsilon de Greenhouse-Geisser $\hat{\epsilon} = 0,68$, les nouveaux degrés de liberté ajustés deviennent : $3 \times 0,68 = 2,04$ pour l’effet, et $72 \times 0,68 = 48,96$ pour l’erreur résiduelle. La phrase de résultats doit impérativement spécifier la procédure appliquée, les valeurs de Mauchly préalables, et présenter les nouveaux ddl décimaux. Le texte s’articulera comme suit : « Le postulat de sphéricité ayant été violé d’après le test de Mauchly, W = 0,62, $\chi^2$(5) = 18,40, p = ,003, et l’estimation de l’epsilon étant inférieure à 0,75 ($\hat{\epsilon} = 0,68$), les degrés de liberté ont été corrigés selon la méthode de Greenhouse-Geisser. L’effet principal du temps s’est avéré statistiquement significatif, F(2,04, 48,96) = 8,74, p < ,001, $\eta_p^2$ = ,27. »
7. Calcul, sélection et présentation de la taille d’effet
7.1 Distinction cruciale entre éta-carré partiel et éta-carré généralisé
Rapporter la significativité statistique d’une ANOVA à mesures répétées sans lui adjoindre une estimation de la magnitude de l’effet constitue un manquement direct aux exigences fondamentales de l’APA. La taille d’effet permet d’apprécier la pertinence pratique d’un phénomène indépendamment de la taille de l’échantillon. Dans les analyses de variance, la famille des indices d’éta-carré est universellement employée, mais une confusion tenace persiste quant au choix de la métrique appropriée entre l’éta-carré partiel ($\eta_p^2$) et l’éta-carré généralisé ($\eta_G^2$).
L’éta-carré partiel représente la proportion de variance de la variable dépendante expliquée par le facteur intra-sujet, après avoir extrait l’influence des autres facteurs et des différences interindividuelles stables :
$\eta_p^2 = \frac{SS_{\text{effet}}}{SS_{\text{effet}} + SS_{\text{erreur}}}$
Cette statistique est fournie par défaut par la majorité des logiciels commerciaux, notamment SPSS. Son calcul est direct et son interprétation intuitive au sein d’une étude fermée. Toutefois, comme l’ont démontré Olejnik et Algina (2003) ainsi que Bakeman (2005), l’éta-carré partiel présente l’inconvénient majeur de gonfler artificiellement la taille d’effet dans les devis à mesures répétées comparativement aux devis inter-sujets, car la variance interindividuelle est retirée du dénominateur. Cela rend les comparaisons inter-études et les synthèses méta-analytiques hautement biaisées.
L’éta-carré généralisé ($\eta_G^2$) a été développé précisément pour résoudre cette incompatibilité. Il réintègre dans son dénominateur la variance globale liée aux sujets, permettant de comparer directement les tailles d’effet issues de devis intra-sujets et de devis inter-sujets. Bien que l’éta-carré partiel demeure la métrique la plus couramment rencontrée dans la littérature, le consensus moderne en psychologie expérimentale et en neurosciences recommande fortement l’intégration de l’éta-carré généralisé, ou à tout le moins une déclaration limpide de l’indice retenu. L’écriture APA respecte la forme suivante : $\eta_p^2$ = ,14 (ou $\eta_G^2$ = ,08). Conformément à la règle des grandeurs bornées à 1, le zéro initial doit être omis.
7.2 Interprétation sémantique de l’amplitude de l’effet
L’attribution d’un qualificatif verbal (« petit », « moyen », « grand ») à une taille d’effet s’appuie traditionnellement sur les repères conventionnels proposés par Jacob Cohen (1988). Pour l’éta-carré partiel ($\eta_p^2$), les seuils heuristiques admis s’établissent comme suit :
- Effet de faible amplitude : $\eta_p^2 \approx 0,01$ (environ 1 % de la variance résiduelle expliquée) ;
- Effet de moyenne amplitude : $\eta_p^2 \approx 0,06$ (environ 6 % de la variance résiduelle expliquée) ;
- Effet de forte amplitude : $\eta_p^2 ge 0,14$ (14 % ou plus de la variance résiduelle expliquée).
Il importe toutefois de mettre en garde les rédacteurs contre une application aveugle, rigide et décontextualisée de ces frontières théoriques. Dans de nombreux domaines cliniques, pharmacologiques ou cognitifs, un effet dont l’amplitude est formellement qualifiée de « petite » selon les critères de Cohen peut revêtir une importance pratique ou thérapeutique monumentale (par exemple, un ralentissement ténu mais systématique du déclin cognitif dans une pathologie neurodégénérative). À l’inverse, dans un contexte de laboratoire ultra-contrôlé mesurant des temps de réaction simples, un grand effet peut n’avoir qu’une portée théorique marginale. Le rapport textuel doit articuler la significativité statistique ($p$) avec la magnitude mathématique ($\eta_p^2$) et contextualiser judicieusement cette valeur au regard de la littérature spécialisée du domaine d’investigation.
8. Rapportage des analyses post-hoc et comparaisons multiples
8.1 Justification du recours aux tests complémentaires
Le test F omnibus d’une ANOVA à mesures répétées présente une limite intrinsèque inhérente à sa nature globale : lorsque le facteur étudié comporte trois modalités ou plus, un résultat statistiquement significatif indique simplement qu’au moins deux des moyennes conditionnelles diffèrent de façon non aléatoire dans la population. Il ne renseigne en aucune manière sur les paires précises de conditions entre lesquelles se situent ces divergences. L’analyste se trouve alors dans l’obligation de poursuivre son exploration statistique par des comparaisons multiples par paires (tests post-hoc) ou par des contrastes planifiés prédéfinis théoriquement.
Cependant, la multiplication des tests statistiques au sein d’un même jeu de données expose l’expérimentateur au redoutable problème de l’inflation de l’erreur de type I globale (familywise error rate). Si l’on effectue $c$ comparaisons indépendantes au seuil $\alpha = 0,05$, la probabilité cumulée de commettre au moins une erreur de type I (faux positif) s’élève à :
$\alpha_{\text{cumulé}} = 1 – (1 – \alpha)^c$
Pour un facteur à quatre modalités impliquant six comparaisons de paires ($4 \times 3 / 2 = 6$), le risque d’erreur cumulé atteint $1 – (0,95)^6 \approx 26,5 %$, soit plus d’une chance sur quatre d’affirmer à tort l’existence d’une différence significative. Tout rapport de recherche sérieux doit donc formuler explicitement la nécessité de procéder à des ajustements stricts du seuil de décision statistique pour préserver la validité nominale de l’inférence.
8.2 Sélection et documentation des méthodes d’ajustement
Plusieurs stratégies de contrôle de l’erreur de type I coexistent dans l’arsenal méthodologique contemporain. La rédaction de la section des résultats doit impérativement déclarer et justifier la technique de correction retenue :
- La méthode de Bonferroni : Approche classique consistant à diviser le seuil alpha par le nombre de comparaisons effectuées ($\alpha_{\text{ajusté}} = \alpha / c$) ou, de façon équivalente sur les logiciels statistiques, à multiplier la valeur de p brute par le nombre de comparaisons ($p_{\text{adj}} = p \times c$). Bien que simple et rigoureuse, la correction de Bonferroni devient excessivement conservative lorsque le nombre de paires augmente, réduisant drastiquement la puissance statistique.
- La procédure séquentielle de Holm-Bonferroni : Alternative largement supérieure sur le plan de la puissance statistique qui contrôle strictement le risque d’erreur de type I global sans introduire le conservatisme excessif de Bonferroni. Les valeurs de p brutes sont triées par ordre croissant et comparées à des seuils graduellement dégressifs. Sa mention textuelle est hautement appréciée des relecteurs méthodologistes.
- Le test Tukey HSD adapté aux mesures répétées : Spécifiquement calibré pour les comparaisons exhaustives par paires, il est fréquemment utilisé mais requiert des formulations matricielles appropriées dans les logiciels (comme Jamovi ou le package emmeans sous R) pour intégrer correctement la variance d’erreur intra-sujet.
- Le taux de fausses découvertes (Benjamini-Hochberg / FDR) : Généralement privilégié dans les plans massifs comportant des dizaines de comparaisons répétées (comme en imagerie cérébrale ou en génomique), il contrôle la proportion de faux positifs parmi les résultats déclarés significatifs plutôt que l’erreur globale par famille.
8.3 Rédaction formelle des comparaisons par paires
La présentation textuelle des comparaisons post-hoc doit obéir à un formalisme chirurgical. Chaque comparaison pertinente doit être documentée avec la statistique de test associée (généralement un test t de Student pour échantillons appariés, noté t avec ses degrés de liberté), la différence moyenne brute ($M_{\text{diff}}$) accompagnée de son intervalle de confiance ajusté, la valeur de p corrigée ($p_{\text{adj}}$ ou $p_{\text{bonf}}$), et la taille d’effet spécifique de la comparaison, représentée par le d de Cohen pour mesures répétées.
Une attention particulière doit être portée au calcul du d de Cohen intra-sujet. L’analyste doit préciser s’il rapporte le $d_z$ (calculé sur la base de l’écart-type de la différence) ou le $d_{\text{av}}$ (utilisant la moyenne des écarts-types des deux conditions, recommandé par Lakens, 2013). La phrase modèle type s’articulera de la manière suivante : « Des analyses post-hoc menées avec ajustement de Bonferroni ont mis en évidence une diminution statistiquement significative des scores d’anxiété entre le pré-test et le post-test immédiat, $M_{\text{diff}} = 7,35$, IC à 95 % [4,12, 10,58], t(29) = 4,68, $p_{\text{adj}}$ < ,001, $d_z$ = 0,85, ainsi qu’entre le pré-test et le suivi à un mois, $M_{\text{diff}} = 5,20$, IC à 95 % [1,85, 8,55], t(29) = 3,18, $p_{\text{adj}}$ = ,011, $d_z$ = 0,58. En revanche, aucune divergence significative n’a été détectée entre le post-test et le suivi, $M_{\text{diff}} = -2,15$, IC à 95 % [-5,20, 0,90], t(29) = -1,44, $p_{\text{adj}}$ = ,478, $d_z$ = 0,26. »
9. ANOVA à mesures répétées factorielle (plans mixtes ou multifactoriels)
9.1 Présentation des effets principaux multiples
Les dispositifs expérimentaux en sciences humaines et médicales dépassent fréquemment le cadre du facteur unique pour explorer l’action conjointe de plusieurs variables indépendantes. On rencontre couramment des plans factoriels entièrement à mesures répétées (par exemple, 2 × 3 intra-sujets, où chaque participant passe les six combinaisons expérimentales) ou des plans factoriels mixtes (split-plot ANOVA), comportant à la fois un facteur inter-sujets (ex. : Groupe Clinique vs Groupe Témoin) et un facteur intra-sujet (ex. : Temps 1, Temps 2, Temps 3). Lors de la rédaction, la règle maîtresse est de dissocier rigoureusement les effets principaux avant d’aborder l’effet d’interaction.
Le rapport textuel doit exposer chaque effet principal de façon séquentielle et indépendante. Pour chaque facteur, vous devez consigner les statistiques descriptives marginales (moyennes et écarts-types regroupés à travers les niveaux de l’autre facteur), le test F correspondant avec ses propres degrés de liberté d’effet et d’erreur, le niveau d’ajustement éventuel de sphéricité propre à ce facteur, la probabilité exacte et la taille d’effet ($\eta_p^2$). Il importe de veiller scrupuleusement à ne pas mélanger les termes d’erreur résiduelle : dans un plan factoriel intra-sujet, chaque effet principal possède sa propre somme des carrés résiduelle et donc ses propres degrés de liberté d’erreur dans la table d’ANOVA. Un exemple de restitution textuelle ordonnée se lira : « L’ANOVA factorielle à mesures répétées 2 × 3 a révélé un effet principal statistiquement significatif de la charge cognitive, F(1, 40) = 28,34, p < ,001, $\eta_p^2$ = ,41, les temps de réaction étant globalement plus longs sous forte charge (M = 645 ms, SD = 58) que sous faible charge (M = 512 ms, SD = 44). L’effet principal de la modalité sensorielle s’est également avéré significatif, F(2, 80) = 12,18, p < ,001, $\eta_p^2$ = ,23. »
9.2 Rapportage statistique de l’interaction
L’effet d’interaction constitue bien souvent le cœur théorique de l’investigation empirique. Il répond à la question de savoir si l’impact d’un facteur intra-sujet sur la variable dépendante varie en fonction des modalités du second facteur. Sur le plan géométrique, l’existence d’une interaction significative traduit une absence de parallélisme entre les profils de réponse à travers les conditions. Dans le corps du texte, l’interaction s’écrit formellement en intercalant le symbole de multiplication entre les noms des facteurs (par exemple : « Effet d’interaction Temps × Groupe » ou « Interaction Charge × Modalité »).
Lorsque le test F indique une interaction statistiquement significative, il est méthodologiquement incorrect de s’arrêter à ce constat ou de sur-interpréter les effets principaux isolés, car ceux-ci se trouvent mathématiquement conditionnés par le croisement des variables. Le rédacteur a le devoir d’exposer la décomposition de l’interaction par l’analyse des « effets principaux simples » (simple main effects). Cette démarche consiste à tester l’effet d’un premier facteur à chaque niveau séparé du second facteur. Par exemple, si l’interaction Temps × Traitement s’avère significative, le texte détaillera l’effet du Traitement au Temps 1, puis au Temps 2, et enfin au Temps 3, en précisant les statistiques F ou t correspondantes et les corrections d’erreur alpha associées. Une décomposition modèle s’énoncera ainsi : « L’interaction Temps × Groupe s’est révélée statistiquement significative, F(2, 76) = 7,89, p < ,001, $\eta_p^2$ = ,17. La décomposition des effets simples a montré que les deux groupes ne différaient pas avant intervention au pré-test, F(1, 38) = 0,12, p = ,731, $\eta_p^2$ = ,003. En revanche, le groupe expérimental présentait des performances de mémorisation significativement supérieures à celles du groupe témoin lors du post-test immédiat, F(1, 38) = 14,56, p < ,001, $\eta_p^2$ = ,28, et cette supériorité s’est maintenue lors du suivi à trois mois, F(1, 38) = 9,42, p = ,004, $\eta_p^2$ = ,20. »
10. Visualisation des données et intégration des figures et tableaux
10.1 Conception de tableaux récapitulatifs selon le format APA
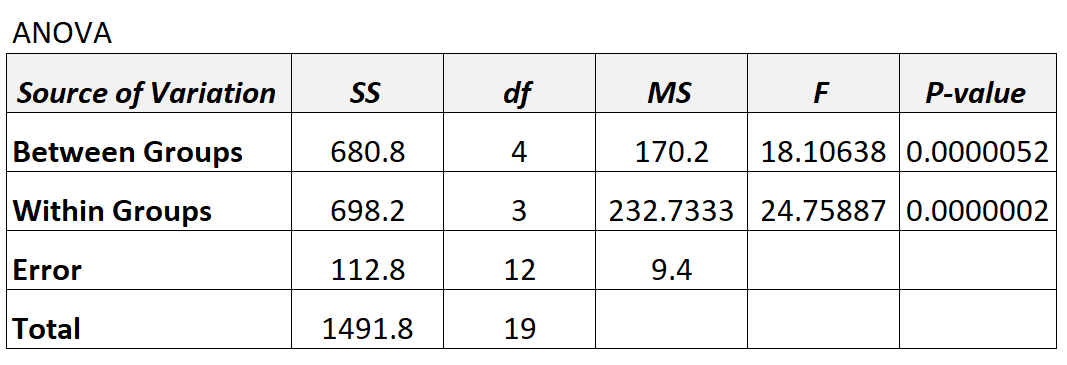
L’intégration d’un tableau récapitulatif d’ANOVA s’avère hautement pertinente dès lors que le protocole comprend des facteurs multiples ou des décompositions complexes de contrastes. Selon les normes rigoureuses de l’APA (7e édition), la typographie d’un tableau scientifique doit être épurée à l’extrême. L’usage de lignes verticales est formellement banni. Seules trois bordures horizontales principales doivent structurer le tableau : une bordure au-dessus du tableau délimitant l’en-tête, une bordure sous la rangée d’en-tête séparant les libellés des données numériques, et une bordure inférieure fermant le corps du tableau au-dessus des notes.
Le tableau doit comporter des colonnes standardisées : la source de variation (Source), la somme des carrés (SS), les degrés de liberté (ddl ou df), le carré moyen (MS), la valeur de F, la valeur exacte de p et l’estimation de la taille d’effet ($\eta_p^2$). Le titre du tableau se place obligatoirement au-dessus du corps de celui-ci, en italique après la mention « Tableau X » en gras. Sous le tableau, une section dédiée aux notes clarifie les abréviations et fournit les précisions méthodologiques indispensables. Une cohérence arithmétique absolue doit régner entre les données chiffrées rapportées dans le texte courant et celles figurant dans le tableau. L’exemple suivant illustre l’organisation textuelle attendue :
Tableau 1
Tableau récapitulatif de l’ANOVA à mesures répétées pour la performance attentionnelle
- En-têtes de colonnes : Source | SS | ddl | MS | F | p | $\eta_p^2$
- Ligne Facteur Intra : Temps | 458,24 | 2 | 229,12 | 16,84 | < ,001 | ,32
- Ligne Erreur Intra : Erreur(Temps) | 979,50 | 72 | 13,60 | — | — | —
Note. N = 37. Les degrés de liberté et les carrés moyens reflètent les données non corrigées, la sphéricité ayant été confirmée par le test de Mauchly (p = ,418).
10.2 Graphiques de profil temporel et représentation de la variance
En présence de mesures répétées, la représentation graphique de prédilection demeure le graphique linéaire de profil temporel (line plot), enrichi des marqueurs des moyennes pour chaque condition. Ce format permet d’apprécier d’un coup d’œil la trajectoire intra-individuelle des participants à travers les temps de mesure ou l’inflexion des profils en cas d’interaction factorielle. Cependant, le point le plus névralgique de la figure réside dans la nature des barres d’erreur apposées sur les moyennes.
Trop d’articles omettent d’indiquer la nature exacte de leurs barres d’erreur, ce qui constitue une faute scientifique majeure. La légende de la figure doit obligatoirement mentionner s’il s’agit d’écarts-types (SD), d’erreurs standards de la moyenne (SEM) ou d’intervalles de confiance à 95 % (IC à 95 %). De surcroît, conformément à ce qui a été développé à la section 4.2, l’insertion de barres d’erreur classiques issues de la variance brute interindividuelle induit en erreur quant à la significativité statistique de la comparaison intra-sujet. Les figures destinées aux revues de premier rang doivent arborer des barres d’erreur ajustées pour mesures répétées (intervalles de Cousineau-Morey ou barres d’erreur de Loftus-Masson). La légende située sous la figure explicitera ce choix méthodologique de façon limpide : « Figure 1. Évolution du score de fluidité verbale à travers les trois sessions de mesure. Les points représentent les moyennes conditionnelles et les barres d’erreur figurent les intervalles de confiance à 95 % calculés avec la correction de Cousineau-Morey pour mesures répétées. »
11. Études de cas concrètes et modèles de phrases réutilisables
11.1 Modèle 1 : ANOVA à un facteur sans violation de sphéricité
Contexte expérimental : Un chercheur en psychopharmacologie cognitive évalue l’impact de trois dosages différents d’une molécule nootropique (Placebo, Dose Faible : 10 mg, Dose Forte : 30 mg) sur le temps de réaction (en millisecondes) lors d’une tâche d’attention soutenue. L’échantillon comprend 30 participants sains soumis aux trois conditions dans un ordre contrebalancé selon un carré latin.
Paragraphe modèle prêt à l’emploi :
« Une analyse de variance (ANOVA) à mesures répétées à un facteur intra-sujet a été menée afin d’évaluer l’effet du dosage pharmacologique (Placebo vs 10 mg vs 30 mg) sur les temps de réaction des participants. L’examen des diagrammes de dispersion et les tests de Shapiro-Wilk ont confirmé la normalité des distributions pour l’ensemble des conditions expérimentales (toutes les valeurs de p > ,05). Le test de sphéricité de Mauchly a indiqué que le postulat d’égalité des variances des différences était respecté, W = 0,96, $\chi^2$(2) = 1,12, p = ,571. Les analyses ont mis en évidence un effet principal statistiquement significatif du dosage, F(2, 58) = 14,25, p < ,001, $\eta_p^2$ = ,33. Les temps de réaction moyens s’établissaient respectivement à 485 ms (SD = 42, IC à 95 % [469, 501]) pour la condition Placebo, à 452 ms (SD = 38, IC à 95 % [438, 466]) pour la dose de 10 mg, et à 421 ms (SD = 35, IC à 95 % [408, 434]) pour la dose de 30 mg. Les comparaisons par paires post-hoc ajustées selon la méthode de Bonferroni ont démontré que la dose de 10 mg induisait une accélération significative des temps de réaction par rapport au placebo, $M_{\text{diff}} = -33,00$ ms, IC à 95 % [-52,45, -13,55], t(29) = -3,88, $p_{\text{adj}}$ = ,002, $d_z$ = 0,71. De même, la dose de 30 mg réduisait significativement les temps de réponse comparativement au placebo, $M_{\text{diff}} = -64,00$ ms, IC à 95 % [-86,10, -41,90], t(29) = -6,62, $p_{\text{adj}}$ < ,001, $d_z$ = 1,21, et comparativement à la dose intermédiaire de 10 mg, $M_{\text{diff}} = -31,00$ ms, IC à 95 % [-51,80, -10,20], t(29) = -3,41, $p_{\text{adj}}$ = ,006, $d_z$ = 0,62. Ces résultats confirment une amélioration dose-dépendante de la vitesse de traitement attentionnel. »
Commentaire analytique : Ce paragraphe intègre l’intégralité de la chaîne décisionnelle. Les ddl du test omnibus sont des entiers parfaits (2 et 58) car le test de Mauchly n’a pas révélé de rupture de sphéricité ($p = ,571$). La taille d’effet ($\eta_p^2 = ,33$) témoigne d’un effet robuste, et les comparaisons post-hoc fournissent systématiquement la statistique $t$, l’intervalle de confiance de la différence, la probabilité corrigée et la taille d’effet appariée ($d_z$).
11.2 Modèle 2 : ANOVA avec violation de sphéricité (correction appliquée)
Contexte expérimental : Une équipe de neurobiologie clinique suit l’évolution des marqueurs sériques du stress (cortisol salivaire, en nmol/L) chez 42 patients souffrant de trouble anxieux généralisé, mesurés à quatre moments successifs d’un protocole d’exposition standardisé : Ligne de base (T0), Anticipation (T1), Exposition aiguë (T2) et Récupération (T3).
Paragraphe modèle prêt à l’emploi :
« Afin d’examiner la dynamique neuroendocrine au cours du protocole expérimental, une ANOVA à mesures répétées à un facteur a été réalisée sur les concentrations salivaires de cortisol à travers les quatre temps d’évaluation (T0, T1, T2, T3). L’évaluation des postulats a révélé une violation significative du postulat de sphéricité d’après le test de Mauchly, W = 0,54, $\chi^2$(5) = 24,85, p < ,001. L’indice d’ajustement epsilon de Greenhouse-Geisser s’établissant à une valeur strictement inférieure à 0,75 ($\hat{\epsilon} = 0,67$), les degrés de liberté ont été corrigés en appliquant l’algorithme de Greenhouse-Geisser. L’analyse a révélé une modulation statistiquement significative des niveaux de cortisol à travers le temps, F(2,01, 82,41) = 22,78, p < ,001, $\eta_p^2$ = ,36. Les concentrations moyennes de cortisol salivaire s’élevaient respectivement à 12,40 nmol/L (SD = 3,10) à T0, à 16,85 nmol/L (SD = 4,25) à T1, à 24,60 nmol/L (SD = 5,80) à T2, pour redescendre à 14,10 nmol/L (SD = 3,45) à T3. Les comparaisons par paires post-hoc ajustées selon la méthode séquentielle de Holm ont mis en lumière une élévation significative du cortisol entre la phase de base et l’anticipation, $M_{\text{diff}} = 4,45$, IC à 95 % [2,80, 6,10], t(41) = 5,45, $p_{\text{adj}}$ < ,001, $d_z$ = 0,84, suivie d’une accentuation majeure lors de l’exposition aiguë, $M_{\text{diff}} = 7,75$, IC à 95 % [5,50, 10,00], t(41) = 6,98, $p_{\text{adj}}$ < ,001, $d_z$ = 1,08. La phase de récupération a été marquée par une décrue significative des taux sériques comparativement au pic d’exposition, $M_{\text{diff}} = -10,50$, IC à 95 % [-12,85, -8,15], t(41) = -9,05, $p_{\text{adj}}$ < ,001, $d_z$ = 1,40, bien que la concentration à T3 demeure marginalement supérieure au niveau basal de repos, $M_{\text{diff}} = 1,70$, IC à 95 % [0,35, 3,05], t(41) = 2,54, $p_{\text{adj}}$ = ,044, $d_z$ = 0,39. »
Commentaire analytique : L’exemplarité de ce paragraphe réside dans la manipulation impeccable des degrés de liberté non entiers : $3 \times 0,67 = 2,01$ et $123 \times 0,67 = 82,41$. Le choix exclusif de Greenhouse-Geisser est dûment motivé par le seuil mathématique $\hat{\epsilon} < 0,75$. L’usage de la procédure séquentielle de Holm offre une rigueur supérieure à Bonferroni.
11.3 Modèle 3 : Plan factoriel à mesures répétées avec interaction
Contexte expérimental : Une recherche en psycholinguistique examine la vitesse de lecture (mots par minute) selon un plan factoriel entièrement intra-sujet 2 × 2 croisant le Type de Texte (Narratif vs Explicatif) et la Modalité d’Affichage (Support Papier vs Écran Numérique) chez 35 étudiants universitaires.
Paragraphe modèle prêt à l’emploi :
« Une ANOVA factorielle à mesures répétées 2 (Type de Texte : Narratif vs Explicatif) × 2 (Modalité d’Affichage : Papier vs Écran) a été appliquée aux indices de vitesse de lecture. Les deux facteurs ne comportant que deux modalités, le postulat de sphéricité était automatiquement satisfait par définition. L’effet principal du Type de Texte s’est avéré statistiquement significatif, F(1, 34) = 45,60, p < ,001, $\eta_p^2$ = ,57, indiquant que les textes narratifs étaient lus globalement plus rapidement (M = 265 mots/min, SD = 32) que les textes explicatifs (M = 210 mots/min, SD = 28). En revanche, l’effet principal de la Modalité d’Affichage n’a pas atteint le seuil de significativité statistique, F(1, 34) = 2,15, p = ,152, $\eta_p^2$ = ,06, la vitesse moyenne sur papier (M = 241 mots/min, SD = 36) n’étant pas significativement différente de celle sur écran (M = 234 mots/min, SD = 38).
Toutefois, ces effets principaux étaient qualifiés par une interaction statistiquement significative entre le Type de Texte et la Modalité d’Affichage, F(1, 34) = 11,84, p = ,002, $\eta_p^2$ = ,26. L’analyse des effets simples a été entreprise pour décomposer ce patron d’interaction. Pour les textes narratifs simples, le support de lecture n’exerçait aucun effet détectable sur la vitesse, F(1, 34) = 0,85, p = ,363, $\eta_p^2$ = ,02 (Papier : M = 267, SD = 31 ; Écran : M = 263, SD = 34). À l’inverse, pour les textes explicatifs complexes nécessitant un traitement cognitif approfondi, la vitesse de lecture était significativement supérieure sur support papier comparativement à l’écran numérique, F(1, 34) = 16,42, p < ,001, $\eta_p^2$ = ,33 (Papier : M = 224, SD = 26 ; Écran : M = 196, SD = 29). Ce ralentissement spécifique sur écran corrobore l’hypothèse d’une surcharge cognitive accrue induite par les terminaux numériques lors du traitement textuel dense. »
Commentaire analytique : L’architecture narrative structure parfaitement la transition de l’effet d’interaction vers sa décomposition en effets simples conditionnels. Notez que pour un plan 2 × 2, les degrés de liberté sont tous à 1 au numérateur et que les tests d’effets simples utilisent l’erreur résiduelle appropriée. La formulation articule l’invariance sur le narratif avec la divergence significative sur l’explicatif.
12. Erreurs récurrentes, pièges à éviter et liste de vérification finale
12.1 Les écueils fréquents lors de la soumission scientifique
L’analyse minutieuse des rapports d’évaluation par les pairs (peer review) révèle une récurrence frappante des mêmes fautes méthodologiques et stylistiques dans le rapport des ANOVA intra-sujets. L’inventaire de ces écueils constitue un rempart indispensable pour sécuriser la recevabilité de vos manuscrits :
- Le rapport incomplet des degrés de liberté : Mentionner uniquement le ddl de l’effet sous la forme tronquée « F(2) = 5,43 » au lieu de « F(2, 48) = 5,43 ». Cette omission prive le lecteur de la connaissance du dénominateur d’erreur résiduelle.
- La confusion entre variance inter-sujets et intra-sujet sur les graphiques : Représenter des barres d’erreur basées sur l’écart-type standard non corrigé pour des mesures répétées, masquant ainsi la significativité réelle des contrastes intra-individuels.
- L’omission de l’ajustement en présence d’une sphéricité violée : Conserver des degrés de liberté entiers lorsque le test de Mauchly est significatif, conduisant à une inflation massive de faux positifs non régulée.
- L’affirmation fallacieuse d’une équivalence en cas de non-significativité : Conclure à l’absence totale d’effet ou à l’égalité stricte des conditions au seul motif que p > ,05. Le non-rejet de l’hypothèse nulle n’équivaut jamais à la preuve de l’hypothèse nulle. Seules des procédures d’équivalence formelle (comme le protocole TOST – Two One-Sided Tests) permettent de conclure à l’invariance.
- Le recalcul erroné de l’éta-carré partiel : Utiliser des formules manuelles inadaptées ou mélanger sans précaution les sorties d’éta-carré ordinaire et partiel fournies par des logiciels distincts.
12.2 Checklist de validation finale pour manuscrits en psychologie
Avant d’apposer votre signature sur la version définitive de votre manuscrit ou de téléverser votre fichier sur la plateforme éditoriale d’une revue, soumettez scrupuleusement votre section des résultats à la grille d’audit méthodologique suivante :
- [ ] Vérification de la matrice des postulats : Le test de normalité (Shapiro-Wilk ou Q-Q plot) et le test de sphéricité de Mauchly sont-ils textuellement documentés avec leurs valeurs numériques exactes ?
- [ ] Cohérence de la correction de sphéricité : En cas de Mauchly significatif ($p < ,05$), la valeur de l’epsilon ($\hat{\epsilon}$) a-t-elle dicté le choix exclusif entre Greenhouse-Geisser ($\hat{\epsilon} < 0,75$) et Huynh-Feldt ($\hat{\epsilon} ge 0,75$) ? Les degrés de liberté de l’effet et de l’erreur affichent-ils leurs deux décimales corrigées ?
- [ ] Conformité absolue de la syntaxe APA : Tous les symboles statistiques latins (M, SD, F, p, t, N) sont-ils rigoureusement mis en italique ? Les lettres grecques ($\eta_p^2$, $epsilon$, $\chi^2$) demeurent-elles en typographie droite standard ?
- [ ] Gestion décimale et zéros initiaux : Les valeurs de M, SD, F et $\eta_p^2$ comportent-elles deux décimales ? Les probabilités p disposent-elles de trois décimales ? Le zéro initial a-t-il été omis pour les probabilités ($p = ,024$) et tailles d’effet ($\eta_p^2 = ,15$) ?
- [ ] Interdiction du seuil plancher nul : Aucune mention du type « p = ,000 » ne figure-t-elle dans le texte ou les tableaux, celle-ci ayant été systématiquement remplacée par « p < ,001 » ?
- [ ] Exhaustivité descriptive : Chaque condition expérimentale dispose-t-elle de sa moyenne, de son écart-type et idéalement de son intervalle de confiance à 95 % ajusté pour mesures répétées (Cousineau-Morey) ?
- [ ] Rigueur de la décomposition analytique : L’analyse omnibus significative est-elle immédiatement suivie de tests post-hoc justifiés, dont la méthode de correction du risque alpha (Bonferroni, Holm, Tukey) est formellement nommée et accompagnée des tailles d’effet spécifiques ($d$ de Cohen) ?
- [ ] Neutralité discursive : Le registre rédactionnel s’en tient-il à la description objective des paramètres statistiques constatés au passé, en différant toute spéculation théorique ou déduction causale abusive vers la section « Discussion » ?
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cousineau, D. (2005). Confidence intervals in within-subject designs: A simpler solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Girden, E. R. (1992). ANOVA: Repeated measures. SAGE Publications. https://doi.org/10.4135/9781412983419
Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.2307/1164736
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Loftus, G. R., & Masson, M. E. J. (1994). Using confidence intervals in within-subject designs. Psychonomic Bulletin & Review, 1(4), 476–490. https://doi.org/10.3758/BF03210951
Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
Maxwell, S. E., & Delaney, H. D. (2004). Designing experiments and analyzing data: A model comparison perspective (2nd ed.). Lawrence Erlbaum Associates.
Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434