
Dans le domaine de l’analyse statistique et de la recherche quantitative, la caractérisation d’une distribution ne peut jamais se limiter à ses seules mesures de tendance centrale. Si la moyenne arithmétique offre un point d’ancrage fondamental pour situer le centre de gravité d’une série de données, elle demeure intrinsèquement aveugle aux fluctuations, à la dispersion et à l’hétérogénéité des observations. C’est précisément dans cette brèche méthodologique que s’impose l’écart-type (ou déviation standard), métrique cardinale permettant d’évaluer la variabilité empirique au sein d’une population ou d’un échantillon. Dans des disciplines aussi exigeantes que la biométrie, l’épidémiologie, la psychométrie ou l’économétrie, maîtriser l’estimation de cette dispersion constitue le socle indispensable à toute inférence statistique valide.
Le système SAS (Statistical Analysis System) s’est établi depuis plusieurs décennies comme l’un des environnements de référence pour le traitement de données volumineuses et l’exécution d’analyses statistiques certifiées. Réputé pour sa robustesse algorithmique, sa conformité aux exigences réglementaires internationales et sa gestion rigoureuse des structures de données complexes, SAS propose un éventail d’outils hautement optimisés pour dériver des statistiques descriptives univariées et multivariées. Parmi ces outils, la procédure PROC MEANS occupe une place prépondérante en raison de sa flexibilité conceptuelle, de sa rapidité d’exécution et de son intégration transparente dans les chaînes de traitement automatisées.
Ce guide exhaustif a pour vocation d’explorer en profondeur les fondements théoriques, les mécanismes logiciels et les applications pratiques du calcul de l’écart-type sous SAS. À travers l’examen détaillé de trois architectures syntaxiques représentatives — ciblant une variable isolée, un ensemble complet de métriques continues, puis une stratification rigoureuse par sous-groupes expérimentaux —, nous détaillerons l’ensemble des considérations méthodologiques, computationnelles et interprétatives indispensables au chercheur et au data analyst contemporain.
1. Fondements théoriques de l’écart-type et pertinence en recherche quantitative
1.1 Définition mathématique et conceptuelle de la dispersion
L’écart-type constitue la mesure de dispersion absolue la plus universellement employée dans les sciences empiriques. D’un point de vue strictement formel, il est défini comme la racine carrée de la variance empirique. Cette opération d’extraction de la racine carrée n’est pas un simple artifice calculatoire : elle possède une justification dimensionnelle cruciale. Alors que la variance exprime la dispersion en unités au carré des grandeurs observées — ce qui interdit toute comparaison directe avec la métrique initiale —, l’écart-type rétablit l’échelle originale du phénomène mesuré. Si une cohorte est évaluée sur une échelle de pression artérielle mesurée en millimètres de mercure (mmHg), la variance s’exprimera en mmHg², tandis que l’écart-type s’exprimera en mmHg, autorisant une interprétation clinique immédiate de l’amplitude moyenne des déviations par rapport au centre de gravité.
Sur le plan conceptuel, l’écart-type quantifie la densité des observations autour de la moyenne arithmétique. Mathématiquement, pour une variable quantitative discrète ou continue dont les valeurs individuelles sont notées $x_i$ et dont la moyenne arithmétique est désignée par $\mu$ pour une population ou $\bar{x}$ pour un échantillon, l’écart-type synthétise la distance euclidienne multidimensionnelle reliant le vecteur des observations au vecteur central formé par la constante de la moyenne. Plus cette distance globale est ténue, plus l’échantillon présente une structure homogène ; inversement, une déviation standard élevée témoigne d’une grande dispersion des scores, traduisant la présence de profils individuels hétéroclites ou de fluctuations d’échantillonnage significatives.
Dans le cadre de l’hypothèse d’une distribution normale (ou gaussienne), l’écart-type acquiert des propriétés géométriques et probabilistes fondamentales régies par la règle empirique des trois sigmas. Dans ce cadre théorique spécifique, la fonction de densité de probabilité présente des points d’inflexion situés exactement à une distance d’un écart-type de part et d’autre de l’espérance mathématique. Par conséquent, environ 68,27 % de la masse de probabilité se situe dans l’intervalle délimité par la moyenne plus ou moins un écart-type. Cet intervalle s’étend à approximativement 95,45 % pour deux écarts-types, et à 99,73 % pour trois écarts-types. Cette géométrie rigide confère à l’écart-type un statut d’étalon universel pour cartographier la plausibilité statistique d’une observation empirique.
1.2 Rôle fondamental de l’écart-type en psychométrie et sciences comportementales
Dans les sciences comportementales et la psychométrie contemporaine, la mesure de la variabilité interindividuelle constitue le cœur battant de la modélisation des traits latents. Les instruments d’évaluation standardisés — qu’il s’agisse d’épreuves cognitives, de questionnaires de personnalité ou d’inventaires neuropsychologiques — ne génèrent que des scores bruts dépourvus de signification intrinsèque absolue. Un score brut isolé ne prend sens que lorsqu’il est rapporté à la distribution des scores observés au sein d’un échantillon normatif représentatif. L’écart-type agit alors comme l’unité de mesure psychométrique standard indispensable à toute procédure de normalisation.
La transformation de scores bruts en notes centrées réduites (les fameux scores z) repose explicitement sur le centrage par la moyenne suivi d’une standardisation par l’écart-type. Ce mécanisme permet de convertir des échelles arbitraires en une distribution commune de moyenne nulle et d’écart-type unitaire. De même, les échelles dérivées couramment exploitées dans les bilans cliniques, telles que les scores T (moyenne de 50, écart-type de 10) ou les indices de quotient intellectuel standardisés (moyenne de 100, écart-type de 15), reposent toutes sur un ancrage linéaire strict adossé à l’écart-type. Sans une estimation rigoureuse de la déviation standard, la comparaison transdisciplinaire ou inter-instruments devient méthodologiquement invalide.
Au-delà de la standardisation, l’écart-type intervient directement dans l’évaluation de la métrologie de la mesure, notamment via la dérivation de l’erreur standard de mesure (souvent désignée par l’acronyme anglais SEM pour Standard Error of Measurement). Formellement calculée en multipliant l’écart-type de l’échantillon par la racine carrée du complément à un du coefficient de fidélité de l’instrument, la SEM quantifie l’incertitude entourant le score observé d’un sujet individuel. Dans le diagnostic neuropsychologique de haute précision, c’est l’écart-type qui permet de délimiter les intervalles de confiance au sein desquels fluctue le véritable niveau de performance d’un patient, distinguant ainsi une réelle détérioration cognitive d’un simple aléa de passation.
Enfin, l’écart-type s’avère déterminant dans la détection des profils cliniques atypiques ou d’excellence. Dans les classifications nosographiques actuelles, l’identification d’un déficit fonctionnel ou d’un trouble spécifique des apprentissages nécessite fréquemment de démontrer que le sujet se situe à plus de 1,5 ou 2 écarts-types sous la moyenne de son groupe de référence d’âge et de niveau socioculturel. À l’inverse, l’identification du haut potentiel intellectuel requiert traditionnellement un franchissement du seuil situé à deux écarts-types au-dessus de la norme populationnelle. La déviation standard n’est donc pas un simple indicateur descriptif passif, mais un puissant opérateur décisionnel dans les protocoles diagnostiques.
1.3 Distinctions critiques entre écart-type d’échantillon et de population
L’une des pierres d’angle de l’inférence statistique réside dans la séparation épistémologique stricte entre le paramètre populationnel et son estimateur d’échantillon. Lorsque l’investigateur dispose de l’exhaustivité des observations constituant un univers théorique fini, l’écart-type de la population — conventionnellement formalisé par la lettre grecque $\sigma$ (sigma) — se calcule en divisant la somme des carrés des écarts à la moyenne par l’effectif total $N$. Dans cette situation idéale mais rarissime en recherche empirique, la moyenne populationnelle $\mu$ est parfaitement connue, et l’estimation ne souffre d’aucune incertitude stochastique.
Dans la quasi-totalité des contextes scientifiques réels, l’analyste ne manipule qu’un sous-ensemble fini d’observations : un échantillon de taille $n$ extrait d’une population parente infinie ou inaccessible. Si l’on appliquait naïvement la même formule en divisant la somme des déviations quadratiques par $n$, l’estimateur ainsi obtenu sous-estimerait systématiquement la véritable variabilité de la population. Ce biais d’échantillonnage s’explique par le fait que les observations d’un échantillon tendent naturellement à se regrouper plus étroitement autour de leur propre moyenne d’échantillon $\bar{x}$ qu’autour de la moyenne théorique $\mu$. Ce phénomène mathématique nécessite l’introduction de la célèbre correction de Bessel, consistant à substituer au dénominateur la valeur $n – 1$ en lieu et place de l’effectif brut $n$.
Ce dénominateur ajusté $n – 1$ correspond conceptuellement au nombre de degrés de liberté (degrees of freedom) résiduels du système. Ayant déjà immobilisé un degré de liberté pour estimer la moyenne arithmétique de l’échantillon, seules $n – 1$ déviations indépendantes sont désormais libres de varier. L’estimateur corrigé, conventionnellement noté $s$, possède la propriété mathématique d’être sans biais (ou asymptotiquement non biaisé pour la variance), garantissant que son espérance mathématique converge exactement vers le paramètre $\sigma$ de la population. Les conséquences pratiques de cette distinction sont particulièrement exacerbées sur les échantillons restreints : pour un groupe de $n = 5$ individus, omettre la correction de Bessel induit une sous-estimation systématique de 20 % de la variance empirique, faussant drastiquement les tests d’hypothèses subséquents.
Au sein du système SAS, l’architecture logicielle a été dès son origine conçue pour la rigueur statistique appliquée. Par conséquent, les procédures univariées — au premier rang desquelles figure PROC MEANS — adoptent par défaut le dénominateur $n – 1$ pour dériver l’écart-type empirique. SAS qualifie implicitement cette statistique de STD (pour Standard Deviation), réservant un identifiant distinct (tel que VARDEF=N) pour les rares cas où l’utilisateur souhaiterait expressément forcer une division par l’effectif total de l’échantillon. Cette conformité par défaut aux canons de l’inférence garantit la validité méthodologique des sorties produites sans exiger d’interventions manuelles complexes de la part du chercheur.
2. Présentation de l’environnement SAS et de la procédure PROC MEANS
2.1 Architecture fondamentale et syntaxe de PROC MEANS
Au cœur de l’écosystème de programmation SAS, la procédure PROC MEANS constitue l’épine dorsale du calcul de statistiques descriptives pour les variables quantitatives continues. Conçue pour combiner puissance analytique et économie de code, elle offre une interface modulaire hautement paramétrable. La structure la plus élémentaire de cette procédure repose sur une déclaration d’appel pointant vers la table de données cible via l’option DATA=, complétée par un bloc d’instructions délimitant le périmètre des calculs et s’achevant impérativement par l’instruction de clôture RUN;. Cette compacité syntaxique dissimule un moteur d’optimisation vectoriel particulièrement sophistiqué, capable de traiter des téraoctets de données sans compromettre la fluidité du système hôte.
Par défaut, l’exécution brute d’un appel à PROC MEANS sans spécification de mots-clés statistiques génère un ensemble figé de cinq indicateurs standards : l’effectif valide ($N$), la moyenne arithmétique ($MEAN$), l’écart-type ($STD DEV$), la valeur minimale ($MIN$) et la valeur maximale ($MAX$). Toutefois, dans le cadre de protocoles d’analyse ciblés ou de publications hautement normées, le chercheur souhaite fréquemment restreindre l’affichage à une métrique exclusive pour épurer ses rapports d’analyse. SAS autorise cette modularité en permettant l’inscription directe de spécificateurs statistiques au sein de la ligne de commande principale de la procédure. L’adjonction explicite du mot-clé STD intime ainsi à l’interpréteur l’ordre de masquer les autres indicateurs pour focaliser l’évaluation uniquement sur l’écart-type.
L’organisation interne de PROC MEANS s’articule autour d’instructions secondaires majeures. L’instruction VAR circonscrit les variables numériques soumises au calcul, prévenant ainsi l’analyse accidentelle d’identifiants numériques ou de métadonnées non pertinentes. L’instruction CLASS permet d’opérer des partitions catégorielles directes en mémoire sans exiger de pré-tri des enregistrements, tandis que l’instruction OUTPUT réoriente les métriques condensées vers de nouvelles tables physiques. En matière d’efficience computationnelle, PROC MEANS surpasse nombre d’outils concurrents grâce à sa gestion optimisée des flux de données séquentielles, ce qui en fait l’instrument de prédilection pour le traitement de volumétries massives rencontrées dans les cohortes épidémiologiques contemporaines.
2.2 Comparaison entre PROC MEANS et PROC UNIVARIATE
L’utilisateur confronté à l’analyse de dispersion sous SAS s’interroge régulièrement sur le choix optimal à opérer entre la procédure PROC MEANS et sa consœur PROC UNIVARIATE. Bien que toutes deux partagent des algorithmes de calcul identiques pour dériver les moments statistiques élémentaires, leurs finalités analytiques et leur niveau de granularité divergent profondément. PROC MEANS a été forgée dans une optique de synthèse, d’agrégation rapide et de production de rapports compacts. Elle excelle dans la restitution épurée de tableaux condensés, particulièrement lorsqu’un grand nombre de variables doivent être synthétisées simultanément ou ventilées selon des grilles factorielles complexes.
À l’opposé, PROC UNIVARIATE se présente comme un moteur de diagnostic statistique microscopique. Dès son invocation élémentaire, elle déploie une panoplie exhaustive d’indicateurs : moments d’ordre supérieur incluant l’asymétrie empirique (skewness) et l’aplatissement (kurtosis), quantiles détaillés du premier au centième centile, modes multiples, et identification formelle des valeurs extrêmes les plus saillantes situées aux deux bornes de la distribution. En outre, PROC UNIVARIATE intègre nativement des tests formels d’adéquation distributionnelle — tels que les tests de Shapiro-Wilk, de Kolmogorov-Smirnov, de Cramer-von Mises ou d’Anderson-Darling — permettant de vérifier rigoureusement l’hypothèse de normalité qui conditionne l’interprétation géométrique de l’écart-type.
Le choix entre ces deux procédures s’articule donc autour des exigences du protocole empirique. Dans une phase exploratoire inaugurale visant à vérifier la conformité distributionnelle d’un score ou à repérer la présence de valeurs aberrantes susceptibles de gonfler artificiellement la dispersion, PROC UNIVARIATE s’avère irremplaçable. Une fois ces vérifications formelles complétées et les hypothèses structurelles assainies, PROC MEANS s’impose pour l’ensemble des analyses descriptives de routine, la confection de tables synthétiques pour publication académique, et la dérivation programmatique d’indicateurs de variabilité destinés à être injectés dans des macros statistiques en aval.
2.3 Précision numérique et algorithmes de calcul sous SAS
L’estimation rigoureuse de la dispersion statistique constitue un défi informatique souvent sous-estimé en matière de calcul en virgule flottante. L’implémentation naïve de la formule de la variance, fréquemment désignée sous l’appellation d’algorithme en une passe (calculant simultanément la somme des valeurs et la somme des valeurs au carré via la formule développée), est notoirement vulnérable aux phénomènes de perte d’importance ou de dérive numérique. Lorsque les observations présentent des magnitudes élevées combinées à des variations relatives infimes, la soustraction de deux grands nombres flottants quasi-identiques entraîne une annulation catastrophique, générant parfois des variances mathématiquement négatives sur des machines opérant en précision limitée.
Pour prévenir ces écueils arithmétiques, le moteur sous-jacent de SAS met en œuvre des algorithmes à deux passes hautement perfectionnés, affiliés aux méthodes stables de Welford et de Neely. Lors du premier balayage de la table physique, SAS procède à l’évaluation robuste de la moyenne arithmétique en cumulant les grandeurs via une représentation interne en virgule flottante double précision conforme aux spécifications de la norme internationale IEEE 754. Ce mode de représentation alloue 64 bits à chaque valeur numérique, octroyant une mantisse de 53 bits garantissant une précision relative d’environ 15 à 17 chiffres décimaux significatifs. Lors de la seconde passe, les déviations individuelles par rapport à cette moyenne stabilisée sont élevées au carré puis sommées, annihilant tout risque d’instabilité numérique.
Au niveau de l’interface utilisateur, la maîtrise de cette précision s’articule autour de l’option de contrôle d’affichage MAXDEC=. Dans sa configuration usine, PROC MEANS ajuste dynamiquement le nombre de décimales affichées dans la fenêtre de résultats pour préserver la lisibilité de la grille tabulaire, arrondissant parfois les métriques à quatre ou sept décimales. L’adjonction de l’option MAXDEC=2 intime au système l’ordre de formater les écarts-types avec un strict calibrage à deux chiffres après la virgule, standard communément exigé dans les revues internationales de psychologie et de médecine. Il importe toutefois de souligner que cette option gouverne exclusivement l’affichage cosmétique : la précision des valeurs enregistrées au sein des tables dérivées demeure quant à elle intégrale et non altérée par le formateur visuel.
3. Préparation et initialisation du jeu de données expérimental
3.1 Création du jeu de données via l’étape DATA
Pour illustrer concrètement l’ensemble des fonctionnalités de calcul de dispersion sous SAS, nous construisons un jeu de données expérimental structuré, issu du champ des performances sportives professionnelles. Cette thématique présente l’avantage d’intégrer des variables continues aux dynamiques contrastées ainsi qu’un facteur de classification catégoriel binaire. L’instanciation de cette cohorte s’opère par l’intermédiaire de l’étape fondamentale DATA, mécanisme déclaratif par excellence du langage SAS permettant la lecture, la transformation et l’allocation en mémoire vive des tables d’analyse.
L’étape débute par l’instruction DATA work.my_data;, qui commande la création d’une table temporaire logée dans la bibliothèque de travail par défaut WORK. La structuration des colonnes s’effectue ensuite par l’instruction INPUT, laquelle explicite la topologie des champs : la variable textuelle d’appartenance de groupe est signalée par l’opérateur dollar team $, immédiatement suivie par les deux variables quantitatives continues de performance, respectivement baptisées points et rebounds. Cette séquence d’entrée informe l’interpréteur qu’il doit analyser séquentiellement chaque ligne d’enregistrement en dissociant la composante nominale des métriques arithmétiques.
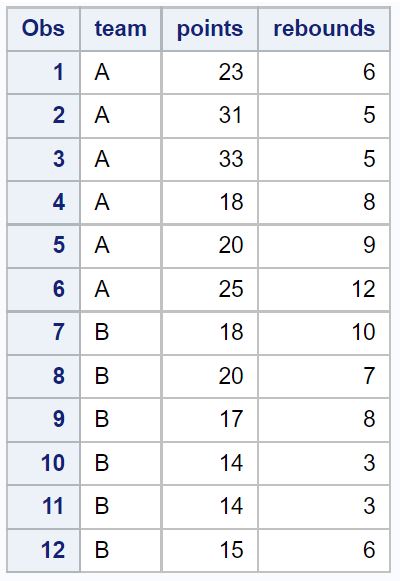
L’injection effective des données empiriques se concrétise au moyen du mot-clé DATALINES; (ou de son équivalent historique CARDS;), placé juste en amont du bloc des enregistrements unitaires. L’échantillon retenu comprend 12 observations complètes réparties symétriquement entre deux formations concurrentes, désignées par les modalités ‘A’ et ‘B’. Chaque ligne encapsule la contribution chiffrée d’un athlète donné au cours d’une phase de compétition standardisée :
data my_data;
input team $ points rebounds;
datalines;
A 12 8
A 15 8
A 19 10
A 24 5
A 25 7
A 25 10
B 10 12
B 15 4
B 20 5
B 25 7
B 29 8
B 37 9
;
run;
3.2 Typage des variables et cohérence métrique
La distinction opérée lors de l’étape INPUT entre variables de nature caractère et variables de nature numérique conditionne l’ensemble des traitements analytiques ultérieurs. Sous SAS, il n’existe que deux types fondamentaux de variables : les chaînes alphanumériques et les nombres flottants à double précision. La variable team relève impérativement de la première catégorie en vertu de son rôle de facteur de stratification nominal. Tenter d’exécuter des procédures de dispersion univariée sur une telle métrique provoquerait un arrêt immédiat du compilateur avec émission d’une notification d’incompatibilité de type au sein du journal d’exécution.
Inversement, les métriques points et rebounds relèvent du niveau de mesure à intervalle ou de rapport selon la taxonomie classique de Stevens. Dans le cadre de modélisations comportementales ou sportives, ces variables possèdent une origine non arbitraire (le zéro absolu représentant l’absence totale de l’action motrice évaluée) et une unité constante. Elles satisfont donc pleinement aux prérequis mathématiques imposés par le calcul des moments statistiques du second ordre. Toute confusion lors du typage initial, telle que l’omission accidentelle du symbole dollar après le libellé team, conduirait SAS à tenter de parser les caractères alphabétiques sous forme numérique, convertissant immédiatement les modalités ‘A’ et ‘B’ en valeurs manquantes désignées par des points système.
De surcroît, la vérification de l’encodage des modalités alphanumériques constitue un impératif méthodologique souvent négligé. Le compilateur SAS se caractérise par une sensibilité stricte à la casse (case-sensitivity) lors du traitement des valeurs textuelles au sein des procédures d’analyse. Par conséquent, une modalité saisie par inadvertance sous la forme ‘a’ minuscule serait traitée comme une entité factorielle distincte de la modalité ‘A’ majuscule par l’instruction CLASS. Dans le jeu de données formulé ci-dessus, l’homogénéité typographique stricte des libellés garantit une partition binaire parfaitement étanche et équilibrée, associant six unités d’observation à chacune des deux équipes en lice.
3.3 Validation de l’intégrité des données à l’aide de PROC PRINT
Préalablement à toute démarche de modélisation ou d’estimation statistique, l’application rigoureuse des standards de reproductibilité scientifique exige de valider l’intégrité structurelle de la table SAS nouvellement matérialisée. Cette démarche d’assurance qualité logicielle repose prioritairement sur l’invocation de la procédure PROC PRINT, couplée à un examen attentif des messages consignés dans le journal d’exécution (le SAS Log). Ce balayage initial vise à neutraliser d’éventuels décalages d’indexation, erreurs d’alignement de colonnes ou troncatures accidentelles de variables.
L’exécution de la séquence minimale suivante permet d’imprimer l’intégralité du contenu de la table de travail :
proc print data=my_data noobs;
run;
L’adjonction de l’option NOOBS (abréviation de No Observations) neutralise l’affichage par défaut de la colonne d’index numérique générée par SAS, délivrant une lecture épurée des colonnes d’intérêt. La sortie tabulaire générée permet de constater sans ambiguïté la concordance parfaite des 12 observations réparties sur les trois colonnes team, points et rebounds. La consultation parallèle du Log doit impérativement attester que l’étape DATA a généré exactement 12 observations avec 3 variables, sans émettre le moindre avertissement relatif à des données invalides (Invalid data note). Une fois cette chaîne d’intégrité formellement validée, le chercheur dispose d’une base robuste pour aborder les calculs de dispersion.
4. Exemple 1 : Calcul de l’écart-type d’une seule variable quantitative
4.1 Implémentation de l’instruction VAR pour une métrique ciblée
Dans la conduite courante des analyses empiriques, l’attention du chercheur se focalise fréquemment sur un indicateur primaire spécifique dont il convient de cerner isolément la variabilité. Pour parvenir à cette focalisation sans saturer les sorties statistiques par des informations périphériques, la procédure PROC MEANS intègre l’instruction VAR (abréviation de Variables). L’emploi de cette instruction agit comme un filtre sélectif au niveau de la phase de chargement des vecteurs en mémoire vive, en enjoignant formellement à SAS de restreindre le calcul des moments statistiques à la seule variable quantitative déclarée.
Pour calculer exclusivement l’écart-type de la variable points au sein de notre cohorte globale, la formulation syntaxique optimale se condense de la manière suivante :
proc means data=my_data std;
var points;
run;
D’un point de vue programmatique, cette syntaxe associe deux commandes hautement spécifiques. D’une part, l’argument std accolé à la déclaration proc means surcharge le comportement par défaut de la procédure, en substituant le rapport quinquennal standardisé (N, Mean, Std Dev, Min, Max) par un affichage restreint à la seule déviation standard empirique. D’autre part, l’instruction var points; isole cette dimension d’intérêt. Ce ciblage s’accompagne d’un gain computationnel notable sur de très vastes entrepôts de données, le moteur de traitement ignorant purement et simplement la colonne rebounds lors de ses passes de calcul en mémoire, évitant tout balayage disque superflu.
4.2 Analyse du rapport SAS généré
L’exécution de cette requête produit un tableau de résultats extrêmement sobre au sein de l’interface ODS (Output Delivery System) de SAS. Ce tableau comporte un en-tête structuré rappelant le nom de la procédure, le nom de la table analysée, ainsi que la variable ciblée. La colonne principale, intitulée de manière explicite Std Dev, affiche la valeur calculée pour la série des 12 observations constituant la cohorte générale :
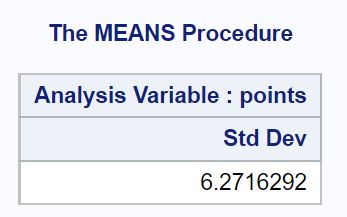
La valeur d’écart-type restituée par le moteur SAS s’établit exactement à 6,2716292 (valeur arrondie par défaut à 6,2716 selon les paramètres d’affichage du système). Pour comprendre l’origine arithmétique rigoureuse de cette grandeur, il convient d’expliciter le traitement sous-jacent opéré par la procédure. SAS a dans un premier temps additionné l’ensemble des 12 scores de la variable points (aboutissant à une somme empirique de 246) pour établir la moyenne arithmétique de l’échantillon à $\bar{x} = 246 / 12 = 20,50$. Dans un second temps, chaque score individuel a été soustrait de cette moyenne, élevé au carré, puis l’ensemble de ces déviations quadratiques a été sommé, produisant une somme des carrés des écarts (désignée sous le sigle CSS pour Corrected Sum of Squares) égale à 432,50.
Conformément aux principes de l’estimateur sans biais décrits précédemment, SAS divise ensuite cette somme des carrés par le nombre de degrés de liberté résiduels, soit $n – 1 = 12 – 1 = 11$. Cette opération engendre une variance empirique d’échantillon de $s^2 = 432,50 / 11 \approx 39,31818$. L’extraction de la racine carrée de cette variance livre précisément la valeur $s = \sqrt{39,31818} \approx 6,2716$. Le rapprochement de cet écart-type avec l’étendue brute observée au sein de l’échantillon — où les scores oscillent entre une valeur plancher de 10 points et un plafond de 37 points, matérialisant une amplitude absolue de 27 unités — valide la cohérence distributionnelle du résultat : la dispersion d’environ 6,27 unités traduit fidèlement la densité relative des performances individuelles autour du point d’équilibre central.
4.3 Interprétation contextuelle et inférentielle de la valeur
Sur le plan de l’interprétation substantielle dans le domaine de la performance sportive, un écart-type de 6,27 points associé à une moyenne de 20,50 points éclaire d’un jour nouveau le profil global de la cohorte étudiée. Pour contextualiser rigoureusement cette valeur absolue, l’analyste fait fréquemment appel à un indicateur adimensionnel de dispersion relative : le coefficient de variation (CV). Ce dernier s’obtient en divisant l’écart-type par la moyenne arithmétique, le résultat étant traditionnellement exprimé sous forme de pourcentage :
CV = (s / x̄) * 100 = (6,2716 / 20,50) * 100 ≈ 30,59 %
Un coefficient de variation avoisinant les 30 % caractérise une variabilité modérée à forte selon les standards usuels de la psychologie différentielle et de la physiologie de l’effort. Cette amplitude indique que le groupe global ne présente pas un comportement monolithique ou hautement homogène : il coexiste au sein de cet effectif des profils offensifs très contrastés, allant de marqueurs occasionnels à des contributeurs majeurs franchissant allègrement la trentaine d’unités. Sous l’hypothèse de travail d’une quasi-normalité de la distribution, on peut en déduire qu’environ deux tiers des joueurs composant ce collectif réalisent des performances comprises approximativement entre 14,23 points (20,50 – 6,27) et 26,77 points (20,50 + 6,27).
Du point de vue de l’inférence statistique, la magnitude de cet écart-type conditionne directement la précision avec laquelle la moyenne de la population sous-jacente peut être estimée. L’erreur standard de la moyenne (SEM), qui gouverne la largeur de l’intervalle de confiance à 95 %, découle directement de la division de cet écart-type empirique par la racine carrée de l’effectif : $SEM = 6,2716 / \sqrt{12} \approx 1,81$. Un écart-type modérément élevé sur un effectif aussi restreint signale au chercheur que la puissance statistique de ses tests d’hypothèses ultérieurs sera limitée, incitant à la prudence avant de généraliser les conclusions tirées de cet échantillon.
5. Exemple 2 : Calcul simultané de l’écart-type pour toutes les variables numériques
5.1 Exécution globale sans spécification de l’instruction VAR
Dans la phase inaugurale du traitement de grands jeux de données — qu’il s’agisse de batteries d’épreuves psychométriques, de panels biochimiques ou de cohortes multidimensionnelles —, la saisie manuelle de chaque identifiant de variable au sein de l’instruction VAR devient fastidieuse et propice aux omissions. Les concepteurs de SAS ont intégré cette contrainte ergonomique en dotant la procédure PROC MEANS d’un mécanisme de sélection contextuelle automatique : lorsqu’aucune instruction VAR n’est soumise par l’analyste, la procédure opère un balayage exhaustif de la table active et intègre d’office toutes les colonnes répondant aux critères du typage numérique.
L’implémentation de cette stratégie d’analyse globale s’exprime dans une sobriété syntaxique absolue :
proc means data=my_data std;
run;
Face à cette commande condensée, le moteur SAS analyse le dictionnaire interne de la table my_data. Il identifie immédiatement que la variable team est stockée sous un format alphanumérique et l’exclut silencieusement du pipeline de calcul mathématique, sans interrompre la chaîne d’exécution ni saturer le journal d’anomalies. Simultanément, il capture l’ensemble des grandeurs quantitatives éligibles — en l’occurrence, les variables points et rebounds — et leur applique de façon vectorisée le calcul de la déviation standard. Cette démarche exploratoire globale s’avère particulièrement productive pour établir rapidement le profil de variabilité d’une matrice empirique complexe.
5.2 Comparaison multidimensionnelle des résultats
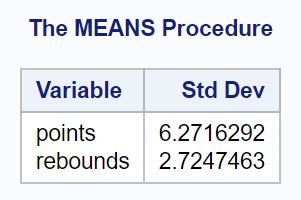
L’exécution de cette requête conjointe produit un rapport structuré présentant les métriques de dispersion pour l’ensemble des colonnes continues détectées. La table de sortie délivrée par l’environnement SAS se présente sous la forme suivante :
Variable : points | Std Dev : 6,2716292
Variable : rebounds | Std Dev : 2,3299304
L’analyse simultanée de ces deux valeurs met immédiatement en lumière des disparités structurelles profondes entre les dimensions investiguées. Si la variable points affiche une déviation standard de 6,27 unités, la variable rebounds présente quant à elle une dispersion absolue bien plus contenue, chiffrée à environ 2,33 unités. À première vue, un investigateur non averti pourrait hâtivement conclure que la performance relative aux rebonds est nettement plus stable et homogène que la performance relative au marquage de points.
Toutefois, une telle comparaison brute entre des variables possédant des échelles de mesure distinctes relève d’une erreur méthodologique classique. La moyenne des rebonds au sein de cette cohorte s’établissant à 7,92 unités (avec une somme globale de 95 rebonds), l’évaluation de sa variabilité relative via le coefficient de variation livre une perspective sensiblement différente :
CV_rebounds = (2,3299 / 7,9167) * 100 ≈ 29,43 %
La confrontation du coefficient de variation de la variable rebounds (29,43 %) avec celui précédemment dérivé pour la variable points (30,59 %) révèle en réalité une proximité frappante de leur niveau de dispersion intrinsèque. En termes relatifs, la variabilité interindividuelle des athlètes est quasiment identique sur les deux dimensions motrices. Cet exemple met en exergue l’impératif absolu de ne jamais interpréter un écart-type de façon isolée, particulièrement lors de balayages multivariés où des indicateurs construits sur des amplitudes métriques hétérogènes sont juxtaposés au sein d’un même tableau de bord.
5.3 Considérations d’optimisation pour de grands volumes de données
Bien que la commande unifiée PROC MEANS DATA=… STD; RUN; séduise par sa concision, son application sans discernement à des bases de données volumineuses renfermant des centaines ou des milliers de colonnes numériques soulève des problématiques majeures d’optimisation matérielle. Dans les entrepôts de données massives rencontrés en bio-informatique ou en analyse comportementale du Web, une telle instruction contraint le serveur SAS à allouer des structures de mémoire tampon substantielles pour chaque vecteur de données, générant des goulets d’étranglement au niveau de la bande passante entrées/sorties (I/O) et du temps processeur alloué.
Pour prévenir la dégradation des performances lors du traitement de très grandes tables, il est vivement recommandé d’intégrer des clauses de filtrage préventives au niveau de la table source. L’utilisation des options de sélection d’ensemble de données KEEP= ou DROP= directement dans la déclaration d’appel permet de restreindre le périmètre d’accès physique aux seuls champs pertinents pour l’investigation, déchargeant ainsi la mémoire vive des métadonnées superflues :
proc means data=my_data(keep=points rebounds) std;
run;
De surcroît, lorsque les jeux de données dépassent la capacité d’adressage de la mémoire physique disponible, SAS met en œuvre un mécanisme de pagination vers le disque temporaire (SAS Work Utility files). Ce basculement peut démultiplier le temps d’exécution d’un calcul de dispersion globale. Dans ces environnements contraints, la surveillance rigoureuse des options système telles que MEMSIZE (plafond de mémoire vive allouable) et UTILLOC (emplacement des fichiers d’échange temporaires) devient indispensable pour garantir que le calcul simultané des écarts-types sur des millions d’enregistrements s’exécute avec une efficience maximale.
6. Exemple 3 : Calcul de l’écart-type ventilé par sous-groupes
6.1 Implémentation de l’instruction CLASS pour la stratification
L’immense majorité des plans de recherche en sciences quantitatives ne se satisfait pas d’une analyse globale indifférenciée ; la comparaison intergroupes — qu’il s’agisse de comparer un groupe témoin et un groupe expérimental, des sous-populations cliniques ou des cohortes d’entraînement distinctes — constitue l’objectif scientifique prioritaire. Pour réaliser une telle stratification sous SAS, la procédure PROC MEANS propose l’instruction CLASS. Cette commande intime au logiciel l’ordre de partitionner l’espace d’échantillonnage selon les modalités d’une ou plusieurs variables de catégorisation.
La mise en œuvre conjointe de la stratification factorielle et du calcul de dispersion multivarié s’articule selon l’instruction suivante :
proc means data=my_data std;
class team;
var points rebounds;
run;
D’un point de vue structurel, l’instruction CLASS team; indique à SAS que la variable team doit servir d’axe de segmentation. Contrairement à d’autres approches procédurales qui requièrent un ordonnancement physique préalable des lignes d’enregistrements, l’instruction CLASS mobilise des structures d’indexation internes en mémoire vive (tables de hachage) pour regrouper dynamiquement les flux d’observations. Les variables désignées dans l’instruction VAR sont ensuite évaluées indépendamment au sein de chaque strate factorielle délimitée par les modalités ‘A’ et ‘B’.
6.2 Comparaison de la variabilité intra-groupe entre les équipes A et B
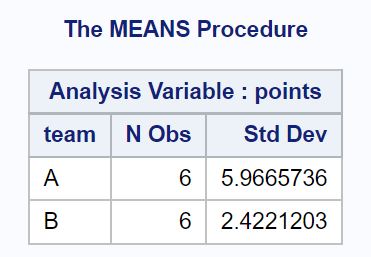
L’exécution de cette syntaxe stratifiée transforme la structure du rapport émis par SAS, produisant une table hiérarchisée où chaque modalité factorielle fait l’objet d’un bilan distinct. Le tableau de sortie délivre les estimations de dispersion suivantes :
Équipe A :
– Variable points : N Obs = 6 | Std Dev = 5,6391489
– Variable rebounds : N Obs = 6 | Std Dev = 1,9663842
Équipe B :
– Variable points : N Obs = 6 | Std Dev = 9,6090235
– Variable rebounds : N Obs = 6 | Std Dev = 2,9439203
L’examen minutieux de cette désagrégation factorielle fait émerger des divergences méthodologiques et pratiques de premier plan. Si l’on observe la variable points, l’écart-type de l’équipe A s’élève à 5,64, tandis que celui de l’équipe B bondit à 9,61. Cette asymétrie de dispersion est particulièrement prononcée : la variabilité intra-groupe des scores de marquage est près de 70 % plus volatile au sein de la seconde formation qu’au sein de la première. Une inspection contextuelle des scores bruts confirme cette observation empirique : au sein de l’équipe A, les points s’échelonnent de manière compacte entre 12 et 25 unités, alors que l’équipe B présente une dispersion étirée allant d’un minimum de 10 à un score extrême de 37.
Sur le plan de l’interprétation sportive ou comportementale, ces écarts-types différentiels révèlent des organisations fonctionnelles opposées. L’équipe A se caractérise par un modèle de distribution des responsabilités offensives hautement collectivisé, où chaque participant contribue de façon modérée mais régulière. L’équipe B, à l’inverse, présente le profil type d’un groupe polarisé autour d’un contributeur vedette atypique conjugué à des acteurs marginaux, induisant une hétérogénéité marquée. La même dynamique s’observe d’ailleurs sur la dimension des rebonds, où l’écart-type de l’équipe B (2,94) dépasse notablement celui de l’équipe A (1,97). L’instruction CLASS met ainsi en lumière une réalité distributionnelle que l’analyse non segmentée masquait totalement derrière la moyenne globale.
6.3 Évaluation méthodologique de l’homoscédasticité
Au-delà de la description morphologique des groupes, la mise en évidence d’écarts-types sous-groupes contrastés constitue une étape diagnostique incontournable pour la statistique inférentielle. La quasi-totalité des modèles linéaires généraux paramétriques classiques — à l’instar du test t de Student pour échantillons indépendants ou de l’analyse de variance unifactorielle (ANOVA) — repose sur le postulat fondamental d’homoscédasticité, c’est-à-dire l’égalité stricte des variances au sein des populations dont sont issus les différents groupes comparés ($\sigma_A^2 = \sigma_B^2$).
La confrontation directe des déviations standards d’échantillon obtenues sous PROC MEANS fournit un premier signal d’alarme quant à la validité de ce postulat. Dans le cas présent, le rapport de variance entre les deux équipes pour la métrique points est substantiel :
F_ratio = s_B^2 / s_A^2 = (9,6090)^2 / (5,6391)^2 = 92,333 / 31,800 ≈ 2,90
Bien que sur un échantillon restreint de six observations par strate ce ratio puisse ne pas atteindre le seuil de signification statistique formel, il indique une hétéroscédasticité manifeste qui menacerait l’intégrité inférentielle d’un test paramétrique standard. L’application d’un test t classique dans de telles conditions risquerait de fausser le taux d’erreur de première espèce ($\alpha$), conduisant à rejeter abusivement l’hypothèse nulle d’égalité des moyennes. L’identification précoce de cette divergence de variabilité via PROC MEANS enjoint donc le chercheur à bifurquer méthodologiquement vers des alternatives robustes, telles que la correction de Satterthwaite ou le test d’égalisation de Welch sous PROC TTEST, ou à envisager des modélisations semi-paramétriques.
7. Instruction CLASS versus instruction BY : analyse comparative sous SAS
7.1 Mécanismes opérationnels de l’instruction BY
Au sein de l’architecture SAS, la stratification d’une analyse descriptive ne repose pas exclusivement sur l’instruction CLASS ; elle peut également être opérée par l’instruction concurrente BY. Bien que leur finalité statistique soit en apparence analogue — produire des indicateurs ventilés selon les niveaux d’un facteur —, leurs mécanismes logiciels sous-jacents divergent fondamentalement. La contrainte opérationnelle primordiale de l’instruction BY réside dans son exigence absolue d’un agencement préalable des données : la table cible doit impérativement être triée selon les variables de regroupement avant tout traitement descriptif.
Pour exécuter un calcul d’écart-type via cette approche, l’analyste doit préalablement invoquer la procédure d’ordonnancement PROC SORT, créant un pipeline en deux étapes séquentielles :
proc sort data=my_data out=my_data_sorted;
by team;
run;
proc means data=my_data_sorted std;
by team;
var points rebounds;
run;
Dans ce schéma, SAS traite le flux de données de manière partitionnée. Lorsque PROC MEANS rencontre la commande by team;, elle ne crée pas une table unique segmentée en interne ; elle instancie un cycle d’analyse indépendant pour chaque bloc d’enregistrements homogènes rencontrés successivement. Sur le plan de la présentation des résultats, cette approche génère des tableaux de synthèse physiquement séparés pour chaque modalité du facteur, isolant l’équipe A et l’équipe B au sein de sections de rapport étanches dotées de leurs propres en-têtes.
7.2 Critères d’arbitrage computationnel entre CLASS et BY
L’arbitrage entre CLASS et BY représente une décision technique majeure pour les concepteurs de pipelines d’analyse industrielle sous SAS. Cet arbitrage s’articule principalement autour de la gestion des ressources matérielles, au premier rang desquelles figurent la mémoire vive (RAM) et le temps processeur alloué aux opérations d’entrées/sorties disque.
L’instruction CLASS présente l’immense commodité de s’abstraire de toute phase de pré-tri. Elle se charge d’accumuler les totaux partiels en mémoire vive via des tables d’adressage direct. Cependant, cette flexibilité possède une contrepartie sévère : si la variable de stratification possède une cardinalité élevée (par exemple un identifiant patient comprenant des centaines de milliers de modalités distinctes) ou si l’on croise de multiples facteurs de classification, la structure de hachage interne peut saturer la mémoire allouée au processus SAS. Dans de telles circonstances, l’exécution s’interrompt avec une erreur critique d’épuisement mémoire (Out of memory).
À l’inverse, l’instruction BY présente une empreinte mémoire infinitésimale et constante, quelle que soit la volumétrie de la table ou le nombre de strates. Puisque les données sont physiquement pré-ordonnées, SAS ne conserve en mémoire vive que les informations relatives au groupe en cours de traitement, purgeant ses registres dès qu’il bascule sur la modalité suivante. De plus, dans les architectures d’entreprise contemporaines comme SAS Viya ou sur des bases relationnelles intégrant des index préexistants, la séquence PROC SORT préalable devient inutile si un index clustered existe déjà sur la variable cible. En conclusion, l’instruction CLASS doit être privilégiée pour les regroupements à faible cardinalité et la production de rapports condensés, tandis que l’instruction BY demeure le standard incontestable pour les traitements massifs à haute densité d’échantillonnage.
7.3 Gestion des interactions factorielles multiples
Dans les plans expérimentaux sophistiqués, le partitionnement s’opère rarement sur un seul facteur isolé ; il requiert fréquemment de croiser de multiples dimensions catégorielles (par exemple, évaluer la dispersion selon le traitement, le sexe et la tranche d’âge au sein d’un plan factoriel complet). L’instruction CLASS excelle dans cette modélisation combinatoire grâce à l’adjonction d’instructions de contrôle structurel telles que TYPES et WAYS.
Par défaut, lorsque plusieurs variables sont déclarées au sein de l’instruction CLASS, SAS peut dériver l’ensemble des combinaisons factorielles possibles (effets principaux, interactions d’ordre 1, interactions d’ordre 2, jusqu’au total général). L’option WAYS permet de restreindre précisément la dérivation des écarts-types à un niveau d’agrégation déterminé. En déclarant ways 2;, l’analyste intime à PROC MEANS l’ordre de ne calculer la dispersion que pour les cellules croisées issues de l’intersection de deux facteurs, ignorant les totaux marginaux univariés.
Cette maîtrise de la combinatoire factorielle s’avère particulièrement précieuse dans la recherche comportementale pour isoler des sous-groupes hautement spécifiques présentant des anomalies de dispersion. Les sorties tabulaires croisées permettent de détecter instantanément des effets d’interaction sur la variabilité (par exemple, lorsqu’un traitement pharmacologique stabilise les scores de dispersion chez les sujets masculins tout en amplifiant l’hétérogénéité chez les sujets féminins), offrant une granularité descriptive d’une richesse incomparable.
8. Gestion des valeurs manquantes et impact sur l’estimation de l’écart-type
8.1 Traitement par défaut des données manquantes dans PROC MEANS
Dans toute investigation scientifique empirique, l’incomplétude des observations constitue une réalité inévitable, résultant d’abandons en cours d’étude, de défaillances instrumentales ou de non-réponses sélectives à certains items de mesure. La manière dont un environnement statistique appréhende ces absences conditionne directement la justesse mathématique de ses estimations de variabilité. Sous SAS, les valeurs manquantes sont matérialisées par un point isolé (‘.’) pour les grandeurs numériques et par un espace vide (‘ ‘) pour les variables alphanumériques.
Au sein de la procédure PROC MEANS, le traitement par défaut des valeurs manquantes numériques obéit au principe de l’exclusion par observation univariée (pairwise deletion ou analyse variable par variable). Lorsque plusieurs colonnes sont déclarées dans l’instruction VAR, l’absence d’une mesure sur l’une d’entre elles pour un sujet donné n’entraîne nullement son exclusion automatique des calculs conduits sur les autres variables. Pour chaque métrique quantitative, SAS évalue de manière totalement indépendante l’effectif valide effectif ($N$).
Ce mécanisme dynamique de calcul met automatiquement à jour les degrés de liberté résiduels ($n – 1$) associés à chaque estimation de dispersion. Si sur une cohorte initiale de 100 individus, la variable points comporte 10 valeurs manquantes tandis que la variable rebounds n’en comporte aucune, la déviation standard de la première sera dérivée sur un dénominateur de $90 – 1 = 89$, tandis que celle de la seconde reposera sur un dénominateur de $100 – 1 = 99$. Cette flexibilité opérationnelle préserve un niveau de puissance statistique maximal pour chaque variable, mais exige une vigilance extrême de la part du chercheur, les écarts-types ainsi juxtaposés ne reposant plus rigoureusement sur le même échantillon d’individus sous-jacent.
8.2 Utilisation de l’option MISSING dans l’instruction CLASS
Une divergence comportementale majeure s’observe lorsque des valeurs manquantes affectent non plus les métriques d’analyse quantitatives, mais la variable de stratification catégorielle assignée au sein de l’instruction CLASS. Dans sa configuration usine, la procédure PROC MEANS applique une règle d’exclusion stricte : tout enregistrement présentant une valeur manquante au niveau de sa variable de classification est purement et simplement banni de l’ensemble du rapport statistique, ses mesures continues associées étant ignorées tant au niveau des strates qu’au niveau des agrégations globales.
Cette censure par défaut peut induire de redoutables biais d’attrition, masquant au chercheur la présence d’une fraction substantielle de son échantillon. Pour désactiver cette élimination passive, SAS propose l’option systématique MISSING, à insérer directement dans l’instruction d’ouverture de la procédure :
proc means data=my_data std missing;
class team;
var points rebounds;
run;
L’adjonction de ce paramètre modifie radicalement le comportement du système. Désormais, les observations dépourvues d’assignation d’équipe (valeur textuelle vide) ne sont plus évincées ; elles sont au contraire rassemblées au sein d’une strate factorielle indépendante explicitement désignée par un libellé manquant au sein du rapport de sortie. Cette fonctionnalité est cruciale pour le diagnostic épidémiologique et observationnel : elle permet de quantifier la dispersion spécifique des sujets non répondeurs et de vérifier si ce sous-groupe se distingue par une volatilité comportementale accrue, transformant une lacune de recueil en opportunité d’investigation méthodologique.
8.3 Sensibilité de l’écart-type aux valeurs extrêmes et discordantes
L’une des vulnérabilités structurelles les plus sévères de l’écart-type réside dans sa sensibilité disproportionnée aux observations atypiques ou discordantes (couramment qualifiées d’outliers). Cette hypersensibilité trouve son fondement direct dans l’architecture mathématique de l’indicateur : la mise au carré systématique des déviations individuelles ($ (x_i – bar{x})^2 $). Lorsqu’une observation se situe à une distance prononcée du barycentre de la distribution, son élévation à la puissance deux engendre une valeur quadratique gigantesque qui s’arroge un poids démesuré au sein de la somme totale des carrés.
Dans un tel scénario, l’introduction d’un unique score contaminé (provenant par exemple d’une erreur de frappe saisissant un score de 370 au lieu de 37 points) provoque une inflation artificielle spectaculaire de l’écart-type, annihilant sa représentativité en tant qu’indice de la dispersion typique des données. Pour se prémunir contre ces distorsions dévastatrices en recherche appliquée, le chercheur doit combiner l’usage de PROC MEANS avec des mesures de dispersion robustes dites non paramétriques. Parmi ces alternatives figurent l’écart interquartile ($IQR = Q_3 – Q_1$), insensible aux dérives situées aux extrémités de la distribution, et la déviation absolue médiane (MAD).
SAS permet d’ailleurs de solliciter directement l’écart interquartile au sein de la même commande PROC MEANS en renseignant le mot-clé QRANGE aux côtés de l’indicateur STD. La comparaison conjointe de la déviation standard et de l’intervalle interquartile constitue un excellent baromètre exploratoire : une divergence marquée entre un écart-type démesurément étiré et un QRANGE resserré signale invariablement la présence d’observations aberrantes nécessitant un examen approfondi via des procédures de détection d’anomalies univariées ou multivariées.
9. Extraction et enregistrement programmatique des résultats de dispersion
9.1 Création de tables SAS dérivées avec l’instruction OUTPUT
Si la visualisation des indicateurs de dispersion sur l’interface graphique satisfait le besoin ponctuel d’exploration, le travail du biostatisticien et du data scientist implique presque systématiquement de réinjecter ces grandeurs dans des chaînes de traitement automatisées. Qu’il s’agisse de standardiser des variables au sein d’une étape DATA ultérieure, d’élaborer des critères de normalisation ou de construire des graphiques personnalisés, la persistance des écarts-types calculés au sein de nouvelles tables SAS physiques constitue un passage obligé.
Le vecteur privilégié pour orchestrer cette exportation programmatique réside dans l’instruction OUTPUT de la procédure PROC MEANS. Cette instruction d’une puissance remarquable offre une liberté totale de renommage et de sélection des indicateurs extraits :
proc means data=my_data noprint;
class team;
var points rebounds;
output out=work.dispersion_synthese
std(points)=ecart_type_pts
std(rebounds)=ecart_type_reb
mean(points)=moyenne_pts
mean(rebounds)=moyenne_reb;
run;
L’adjonction de l’option générale NOPRINT ordonne à la procédure d’annihiler la production visuelle de rapports au sein du visualiseur de résultats, allouant l’intégralité des cycles processeur à la cristallisation ultra-rapide de la nouvelle table work.dispersion_synthese. La syntaxe std(points)=ecart_type_pts illustre la précision du mécanisme : elle assigne spécifiquement l’écart-type de la variable points à une nouvelle colonne baptisée avec clarté, tout en permettant de capturer conjointement d’autres métriques telles que les moyennes arithmétiques.
La table SAS ainsi matérialisée hérite automatiquement de variables techniques créées par le moteur logiciel, notamment les colonnes _TYPE_ et _FREQ_. La métrique _TYPE_ code sous une forme binaire ou entière le niveau d’agrégation hiérarchique de la ligne (identifiant si l’enregistrement représente une modalité factorielle isolée de l’instruction CLASS ou l’agrégation totale consolidée de l’échantillon global), tandis que _FREQ_ consigne le volume exact d’observations ayant concouru à l’estimation statistique. La manipulation experte de cette table dérivée permet d’alimenter directement des calculs de scores centrés réduits ou des calibrages algorithmiques.
9.2 Interception des sorties tabulaires via le système ODS (Output Delivery System)
Parallèlement à l’instruction OUTPUT historique, SAS dispose d’un framework d’interception d’une grande modernité : l’architecture ODS (Output Delivery System). Ce système abstrait complètement la séparation entre la logique d’analyse mathématique et la restitution typographique des objets de données. Sous ODS, chaque fragment de résultat produit par une procédure correspond à un composant tabulaire unifié baptisé Table Object, identifiable par un nom immuable au sein du dictionnaire des procédures.
Pour capturer textuellement le tableau des statistiques descriptives généré par PROC MEANS sans reconfigurer l’instruction OUTPUT, il suffit d’intercepter le composant générique Summary via l’instruction ODS OUTPUT :
ods output Summary=work.table_ods_means;
proc means data=my_data std;
class team;
var points;
run;
ods output close;
Cette approche d’interception ODS garantit que la table créée reflète rigoureusement la topologie exacte et les formats d’affichage du tableau visible à l’écran. Elle s’avère particulièrement adaptée pour alimenter des pipelines de reporting automatisé vers des destinations bureautiques variées telles que des classeurs Excel structurés (via ODS EXCEL), des rapports textuels normalisés (via ODS CSV) ou des publications scientifiques prêtes pour impression typographique (via ODS PDF). L’homogénéité de cette passerelle ODS consolide la traçabilité des résultats de dispersion dans les environnements soumis à de strictes contraintes d’auditabilité.
9.3 Intégration dans des macros SAS pour l’automatisation de la recherche
Dans les centres de recherche clinique et les départements d’analytique prédictive, le calcul de la dispersion univariée n’est fréquemment qu’un maillon intermédiaire destiné à alimenter des règles décisionnelles automatisées. La dynamique d’exclusion de sujets déviant de plus de deux ou trois écarts-types de la norme exige d’encapsuler la valeur calculée de la déviation standard au sein d’une variable macro globale réutilisable à la volée dans des étapes logiques ultérieures.
Cette jonction entre les statistiques procédurales et l’environnement de programmation macro SAS s’opère couramment au moyen de la routine CALL SYMPUTX dans une étape DATA consécutive à l’extraction de la déviation standard :
proc means data=my_data noprint;
var points;
output out=work.temp_std std=std_points;
run;
data _null_;
set work.temp_std;
call symputx(‘g_ecart_type_pts’, std_points, ‘G’);
run;
La commande call symputx(‘g_ecart_type_pts’, std_points, ‘G’); extrait la valeur arithmétique de la variable std_points présente dans la table temporaire, la convertit en chaîne textuelle épurée de tout blanc typographique résiduel, et la stocke au sein d’une macro-variable d’envergure globale nommée g_ecart_type_pts. Dès lors, cette variable macro devient accessible depuis n’importe quel segment du code SAS en invoquant le préfixe &g_ecart_type_pts. Le chercheur peut ainsi implémenter des seuils d’exclusion dynamiques, filtrant par exemple les individus dont la performance dépasse un seuil calculé programmatiquement, sécurisant ainsi l’industrialisation des chaînes de prétraitement expérimental.
10. Procédures SAS alternatives pour le calcul de l’écart-type
10.1 Approche approfondie avec PROC UNIVARIATE
Bien que la procédure PROC MEANS s’illustre par sa compacité, l’investigateur statisticien a régulièrement besoin de recourir à la procédure PROC UNIVARIATE pour adosser son estimation de l’écart-type à un cadre inférentiel élargi. Alors que PROC MEANS se borne à délivrer une estimation ponctuelle du paramètre empirique $s$, PROC UNIVARIATE autorise notamment la construction d’intervalles de confiance probabilistes entourant la véritable déviation standard de la population parente $\sigma$.
L’implémentation de cette procédure dédiée à l’analyse univariée approfondie s’effectue via la séquence suivante :
proc univariate data=my_data cibasic;
var points;
run;
L’adjonction de l’option CIBASIC sollicite expressément le calcul d’intervalles de confiance bilatéraux au seuil de confiance de 95 % pour les trois paramètres cardinaux de la distribution : la moyenne théorique $\mu$, la variance théorique $\sigma^2$, et précisément l’écart-type théorique $\sigma$. Pour ce dernier, la dérivation mathématique sous-jacente ne fait plus intervenir la distribution de Student, mais s’appuie sur la loi du Khi-deux ($\chi^2$) à $n – 1$ degrés de liberté, en vertu du théorème stipulant que la quantité $(n-1)s^2 / \sigma^2$ suit asymptotiquement cette loi de probabilité. L’analyste obtient ainsi un encadrement rigoureux de la variabilité réelle de son phénomène, palliant l’insuffisance intrinsèque de l’estimation ponctuelle isolée sur des cohortes réduites.
10.2 Agrégation de données condensées via PROC SUMMARY
L’examen des outils d’agrégation sous SAS serait incomplet sans évoquer la procédure PROC SUMMARY. D’un point de vue strict d’architecture logicielle et de compilateur système, PROC SUMMARY et PROC MEANS partagent exactement le même noyau d’exécution et les mêmes algorithmes de calcul vectoriel. La distinction fondamentale qui sépare ces deux entités relève uniquement de leur comportement d’affichage par défaut.
Historiquement conçue pour l’agrégation batch silencieuse, la procédure PROC SUMMARY désactive nativement l’émission de tableaux visuels dans la fenêtre de sortie. Si l’on exécute proc summary data=my_data std; var points; run;, le système réalise bien les calculs mathématiques en mémoire, mais ne produit absolument aucune trace graphique, attendant expressément une instruction OUTPUT pour déverser ses métriques condensées dans une table d’archivage. Dans les scripts d’exploitation industrielle et les environnements de production à haute performance où la génération de flux HTML ou PDF consomme des ressources périphériques inutiles, PROC SUMMARY constitue la norme syntaxique universelle pour extraire des écarts-types à grande échelle de façon silencieuse et optimale.
10.3 Calcul de dispersion au moyen du langage SQL sous PROC SQL
L’écosystème SAS intègre un compilateur complet du standard ANSI SQL à travers la puissante procédure PROC SQL. Cette interface s’avère particulièrement séduisante pour les data analysts et ingénieurs de données habitués à manipuler des environnements de bases de données relationnelles et souhaitant s’affranchir de la syntaxe procédurale conventionnelle de SAS. PROC SQL dispose de ses propres fonctions d’agrégation vectorielle, parmi lesquelles la fonction STD() (ou son équivalent formel STDDEV()).
L’extraction de l’écart-type stratifié par équipe s’exprime alors dans une élégance déclarative familière :
proc sql;
select team,
std(points) as ecart_type_points format=6.2,
std(rebounds) as ecart_type_rebounds format=6.2
from my_data
group by team;
quit;
Dans cette requête déclarative, la clause GROUP BY team opère la partition factorielle de façon analogue à l’instruction CLASS, tandis que la fonction scalaire d’agrégation STD() dérive rigoureusement la déviation standard d’échantillon corrigée par Bessel ($n – 1$). L’adjonction de modificateurs de formatage tels que FORMAT=6.2 assure une présentation immédiate calibrée à deux décimales. Cette méthode SQL unifiée présente l’avantage majeur de pouvoir combiner au sein d’une unique requête des opérations de jointure complexe de tables distantes et le calcul immédiat d’indices de dispersion, éliminant le besoin de chaîner plusieurs étapes DATA et procédures MEANS successives.
11. Pratiques recommandées pour la présentation scientifique de l’écart-type
11.1 Conformité aux normes de l’American Psychological Association (APA)
La rigueur du calcul mathématique sous SAS doit impérativement se prolonger par une conformité irréprochable aux standards de rédaction scientifique internationale lors de la phase de valorisation éditoriale. Dans les revues affiliées aux sciences comportementales, à l’éducation, à la psychométrie et à la médecine sociale, les préconisations stylistiques formulées par l’American Psychological Association (APA 7th edition) font figure d’autorité absolue.
Sur le plan de la typographie textuelle, l’écart-type doit impérativement être consigné par l’abréviation latine en lettre majuscule et mise en italique : SD (pour Standard Deviation). Dans les synthèses narratives intégrées au corps du texte scientifique, la présentation de la moyenne arithmétique — désignée par la majuscule italique M — doit systématiquement être couplée à l’écart-type, les deux métriques étant séparées par une virgule et insérées au sein d’un bloc parenthétique rigide :
(M = 20,50, SD = 6,27) pour l’ensemble de la cohorte sportive.
Lorsque la restitution concerne une comparaison stratifiée entre sous-groupes, la mise en forme textuelle doit refléter fidèlement les grandeurs dérivées sous SAS :
Les athlètes de l’équipe A ont présenté un niveau de marquage modéré mais homogène (M = 19,50, SD = 5,64), tandis que les athlètes de l’équipe B ont exhibé des performances plus dispersées (M = 21,50, SD = 9,61).
Concernant la conservation des décimales, la règle empirique de l’APA préconise de limiter l’affichage à deux chiffres après la virgule pour les moments descriptifs standards, sauf si la sensibilité de l’instrumentation métrique justifie une résolution accrue. Dans les tableaux récapitulatifs formels de statistiques descriptives, les colonnes abritant les moyennes et les déviations standards doivent être clairement étiquetées M et SD, l’ensemble des valeurs étant rigoureusement aligné sur le séparateur décimal pour préserver la lisibilité de la structure d’ensemble.
11.2 Représentation graphique de la dispersion sous SAS
Si la restitution tabulaire de l’écart-type demeure indispensable, la communication visuelle de la variabilité améliore drastiquement l’assimilation cognitive des disparités distributionnelles. Le sous-système graphique moderne de SAS, incarné par la procédure PROC SGPLOT, permet de construire des représentations visuelles hautement professionnelles matérialisant directement l’écart-type sous forme d’intervalles d’erreur ou d’enveloppes morphologiques.
Une première approche classique consiste à édifier un diagramme en barres ou en points enrichi de barres d’erreur représentant explicitement l’écart-type de part et d’autre de la moyenne arithmétique :
proc sgplot data=my_data;
vbar team / response=points stat=mean limitstat=stddev limits=both
fillattrs=(color=CX4A90E2) capshape=bracket;
yaxis label= »Moyenne des points marqués (+/- 1 SD) »;
xaxis label= »Formation sportive »;
run;
L’argument clé limitstat=stddev combiné à limits=both commande à la procédure d’adjoindre des segments d’erreur verticaux matérialisant l’étendue exacte couverte par la déviation standard empirique. Cependant, la visualisation scientifique contemporaine tend à privilégier l’usage des boîtes à moustaches schématiques (boxplots) via l’instruction VBOX. Bien que le boxplot repose nativement sur des métriques non paramétriques (médiane et quartiles), l’instruction vbox points / category=team display=(caps mean); permet de superposer un repère visuel spécifique (tel qu’un losange central) figurant la moyenne arithmétique. Cette superposition conjointe confronte visuellement la dispersion paramétrique (écart-type) à la dispersion ordinale (intervalle interquartile), permettant au lecteur d’identifier instantanément toute asymétrie distributionnelle au sein de la cohorte.
11.3 Erreurs d’interprétation fréquentes à éviter
La dissémination des résultats statistiques dans les revues académiques est régulièrement compromise par des méconnaissances conceptuelles entourant la nature de l’écart-type. La méprise la plus répandue et la plus pernicieuse consiste à confondre méthodologiquement l’écart-type (Standard Deviation – SD) et l’erreur standard de la moyenne (Standard Error of the Mean – SEM). Alors que l’écart-type est un indice purement descriptif quantifiant la variabilité naturelle et irréductible existant entre les individus constituant un échantillon, l’erreur standard est un indicateur inférentiel mesurant l’incertitude théorique entourant l’estimation de la moyenne populationnelle. La SEM étant mécaniquement égale à l’écart-type divisé par la racine carrée de l’effectif ($SEM = s / \sqrt{n}$), elle présente une amplitude systématiquement bien inférieure à celle du SD. Certains auteurs cèdent parfois à la tentation méthodologique contestable de reporter la SEM en lieu et place du SD dans leurs tableaux de synthèse, dans le but cosmétique de donner l’illusion d’une dispersion artificielle minime autour de leurs mesures.
Une seconde dérive interprétative réside dans l’application aveugle de l’écart-type à des distributions qui dévient radicalement du modèle gaussien. Dans le cas de distributions fortement asymétriques (telles que des distributions de revenus, des délais de survie ou des consommations de soins présentant un étirement prononcé vers la droite) ou de profils bimodaux, la moyenne arithmétique et l’écart-type perdent leur pertinence descriptive. Afficher une moyenne de 10 jours associée à un écart-type de 15 jours sur une distribution strictement positive peut induire l’illusion absurde qu’une fraction des observations se situe en territoire négatif ($M – SD = -5$), ce qui est matériellement impossible. Dans de telles configurations morphologiques, l’analyste doit impérativement reléguer l’écart-type au second plan pour adopter le couple robuste formé par la médiane et l’écart interquartile.
Enfin, une erreur récurrente consiste à déduire la normalité d’une distribution sur le fondement exclusif de la production d’un écart-type fini. Tout échantillon quantitatif composé d’au moins deux valeurs non identiques permet l’évaluation arithmétique d’une déviation standard finie, indépendamment de la forme véritable de la fonction de densité sous-jacente. L’existence calculatoire d’un écart-type ne valide en rien l’application de la règle des trois sigmas ni l’exécution sans précaution de tests d’hypothèses paramétriques linéaires.
12. Synthèse méthodologique et arbre décisionnel pour l’analyse sous SAS
12.1 Récapitulatif des trois approches présentées
L’exploration détaillée des trois syntaxes opérationnelles sous la procédure PROC MEANS fournit au praticien de la donnée un éventail de solutions adaptées à chaque phase du cycle de recherche quantitative. Le premier exemple, mobilisant l’instruction restrictive VAR couplée au sélecteur STD, incarne l’approche ciblée par excellence : elle permet d’interroger isolément la variabilité d’une métrique primaire sans distraire l’analyste par des dimensions accessoires, tout en réduisant l’empreinte computationnelle sur le système hôte.
Le second exemple, exploitant le comportement par défaut de balayage multidimensionnel sans spécification de variables, représente l’outil exploratoire fondamental lors de la prise en main d’une nouvelle base empirique. Il permet d’extraire instantanément un panorama complet de la dispersion à travers l’ensemble des colonnes numériques, autorisant des comparaisons d’amplitudes relatives au moyen du coefficient de variation et amorçant la phase d’assurance qualité des instruments de mesure.
Enfin, le troisième exemple, matérialisé par l’adjonction de l’instruction de partitionnement CLASS, hisse l’analyse descriptive au niveau de l’évaluation factorielle comparative. Cette approche met en relief la dispersion intra-groupe, dévoile d’éventuelles dynamiques hétéroscédastiques susceptibles de violer les postulats des tests inférentiels, et jette les fondations d’une interprétation différentielle rigoureuse des sous-populations composant la cohorte.
12.2 Matrice décisionnelle pour le choix de la procédure SAS
Face à la richesse des procédures univariées disponibles au sein de la boîte à outils SAS, l’analyste gagne à s’appuyer sur une matrice décisionnelle claire régie par la nature des données, les objectifs de recherche et l’infrastructure matérielle déployée :
- Objectif de synthèse compacte ou production de tables descriptives destinées à publication : Le choix préférentiel doit incontestablement se porter sur PROC MEANS (ou PROC SUMMARY avec option PRINT). Sa compacité syntaxique, sa compatibilité native avec l’instruction CLASS et sa vitesse d’exécution en font l’instrument de référence pour la production de statistiques descriptives univariées.
- Diagnostic approfondi, évaluation formelle de la normalité et modélisation probabiliste : L’orientation méthodologique impose d’invoquer PROC UNIVARIATE. Elle seule délivre les tests formels d’adéquation (Shapiro-Wilk, Anderson-Darling), les intervalles de confiance rigoureux du Khi-deux pour l’écart-type de population via l’option CIBASIC, et la cartographie des quantiles extrêmes.
- Traitement de tables massives dépassant les capacités d’adressage de la mémoire vive : L’arbitrage computationnel dicte d’associer la procédure PROC SORT à une invocation de PROC MEANS articulée autour de l’instruction BY, ou d’exploiter PROC SUMMARY en tâche de fond silencieuse pour éviter toute saturation de la mémoire vive.
- Environnements transactionnels et intégration au sein de bases relationnelles unifiées : La syntaxe déclarative de PROC SQL employant la fonction d’agrégation STD() avec clause GROUP BY représente la solution la plus modulaire et ergonomique pour les profils transversaux data science/SQL.
12.3 Perspectives d’approfondissement statistique
L’évaluation rigoureuse de la déviation standard univariée ne marque pas l’aboutissement de la démarche d’analyse quantitative, mais constitue le socle indispensable sur lequel s’édifient des méthodologies statistiques d’un niveau d’abstraction supérieur. Dans la continuité de la caractérisation univariée de la dispersion, la transition vers les espaces multidimensionnels s’opère par l’estimation des matrices de variance-covariance sous la procédure PROC CORR. L’écart-type individuel de chaque variable y alimente les éléments diagonaux de la matrice, permettant de standardiser les covariances pour dériver les coefficients de corrélation linéaire de Pearson.
Au-delà de la modélisation corrélationnelle, le concept d’écart-type acquiert un rôle déterminant dans le cadre des modèles de régression linéaire sous la procédure PROC REG. L’écart-type des résidus empiriques (souvent qualifié d’erreur standard de la régression ou de racine du carré moyen de l’erreur, Root MSE) constitue le baromètre par excellence de la qualité d’ajustement du modèle théorique, quantifiant l’amplitude moyenne avec laquelle les observations réelles s’écartent de l’hyperplan de prédiction mathématique.
Enfin, dans les protocoles longitudinaux ou hiérarchiques impliquant des mesures répétées dans le temps ou des individus emboîtés au sein de structures collectives (telles que des élèves au sein d’écoles, ou des patients au sein de centres hospitaliers), la dispersion ne peut plus être modélisée de manière globale. L’analyse exige alors de faire appel aux modèles linéaires mixtes sous la procédure PROC MIXED ou PROC GLIMMIX, permettant de décomposer rigoureusement l’écart-type total en une composante de variance intra-individuelle et une composante de variance inter-individuelle. La maîtrise préalable du calcul élémentaire de la dispersion sous PROC MEANS représente ainsi le marchepied technique indispensable pour appréhender avec rigueur toute l’étendue de l’édifice statistique contemporain sous SAS.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cody, R. (2018). Learning SAS by example: A programmer’s guide (2nd ed.). SAS Institute.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute.
- Howell, D. C. (2016). Fundamental statistics for the behavioral sciences (9th ed.). Cengage Learning.
- SAS Institute Inc. (2023). Base SAS 9.4 procedures guide: Statistical procedures (5th ed.). SAS Institute. https://documentation.sas.com
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Wicklin, R. (2013). Simulating data with SAS. SAS Institute.