
Dans l’arsenal des méthodes quantitatives appliquées aux sciences humaines, biomédicales et comportementales, l’analyse des données catégorielles longitudinales occupe une place prépondérante et singulière. Lorsqu’un chercheur évalue les mêmes sujets à travers plusieurs conditions expérimentales ou à différents points dans le temps, et que la variable dépendante mesurée est strictement binaire (succès ou échec, rémission ou rechute, présence ou absence d’un comportement), les postulats classiques des modèles paramétriques continus s’effondrent. Les approches traditionnelles telles que l’analyse de variance à mesures répétées (ANOVA) présupposent en effet la normalité de la distribution des résidus et l’homogénéité des variances-covariances, des conditions structurellement incompatibles avec des distributions de Bernoulli. Face à ce défi méthodologique, les statisticiens ont développé des alternatives non paramétriques robustes adaptées aux structures de données appariées.
Le test Q de Cochran s’impose précisément comme la référence méthodologique fondamentale pour traiter ces configurations expérimentales à mesures répétées portant sur des réponses dichotomiques. Conçu initialement pour étendre l’analyse de deux conditions corrélées à un nombre arbitraire de conditions expérimentales, ce test permet d’éprouver l’hypothèse selon laquelle les proportions marginales observées demeurent statistiquement invariantes à travers l’ensemble des modalités évaluées. Son élégance repose sur sa capacité à contrôler la variabilité interindividuelle en utilisant chaque sujet comme son propre témoin, neutralisant ainsi les facteurs de confusion liés aux différences idiosyncrasiques qui polluent fréquemment les recherches empiriques.
Le présent article propose une exploration exhaustive, théorique et appliquée du test Q de Cochran. Conçu à la fois comme un traité méthodologique approfondi et un manuel opératoire destiné aux chercheurs, psychologues cliniciens et analystes de données, ce document examine la genèse de l’outil, ses fondements mathématiques rigoureux, ses hypothèses sous-jacentes, ses procédures de calcul manuel pas à pas, ainsi que son implémentation logicielle contemporaine sous R, SPSS et Python. Enfin, une attention minutieuse est accordée aux pièges méthodologiques usuels, aux stratégies de corrections post-hoc pour comparaisons multiples et aux normes de publication académique les plus récentes édictées par l’American Psychological Association (APA).
1. Fondements conceptuels et historique du test Q de Cochran
1.1 Origine statistique et contribution de William Gemmell Cochran
L’émergence du test Q de Cochran s’inscrit au cœur d’une période charnière de l’histoire de la statistique moderne, marquée par la volonté de formaliser l’inférence non paramétrique pour répondre aux exigences concrètes de l’expérimentation biologique, agricole et psychologique. En 1950, le statisticien d’origine écossaise William Gemmell Cochran publie dans la revue Biometrika un article séminal intitulé « The Comparison of Percentages in Matched Samples ». Dans ce travail pionnier, Cochran identifie une lacune majeure dans les outils analytiques de l’époque : alors que les plans factoriels en blocs aléatoires complets se généralisent sous l’impulsion des travaux de Ronald Fisher, les chercheurs restent démunis lorsque les variables d’intérêt ne sont pas continues mais qualitatives et binaires.
À cette époque, les praticiens recouraient fréquemment à des approximations risquées, consistant soit à appliquer une analyse de variance paramétrique sur des scores codés en 0 et 1, soit à découper artificiellement leurs protocoles en séries de comparaisons bivariées au détriment du contrôle de l’erreur globale. Cochran démontre que l’application naïve des techniques d’analyse de la variance sur des variables de Bernoulli viole non seulement le postulat de normalité, mais induit également une hétéroscédasticité intrinsèque puisque la variance d’une variable binaire dépend directement de sa moyenne. Sa contribution réside dans la dérivation d’une statistique d’inférence élégante, conditionnée par le nombre total de succès obtenus par chaque sujet, permettant d’évaluer l’effet du traitement tout en éliminant analytiquement l’effet perturbateur des blocs individuels.
Ce développement a constitué une étape fondamentale dans la transition vers une inférence robuste sur données qualitatives. En introduisant une statistique dont la distribution asymptotique converge vers une loi du Chi-deux sous l’hypothèse nulle, Cochran a fourni aux chercheurs une méthode mathématiquement rigoureuse, épargnée par les postulats distributionnels restrictifs des modèles linéaires gaussiens. L’impact de cet article de 1950 a résonné bien au-delà de l’agronomie et de la biométrie, devenant rapidement un pilier de la méthodologie en psychologie expérimentale, en sociologie quantitative et en recherche clinique.
1.2 Définition formelle du test Q de Cochran
D’un point de vue formel, le test Q de Cochran est une procédure d’inférence statistique non paramétrique conçue pour comparer la distribution d’une variable qualitative dichotomique à travers k échantillons appariés, où k est supérieur ou égal à deux. Il s’applique spécifiquement aux plans expérimentaux intra-sujets (mesures répétées) ou aux plans à blocs complets où chaque unité expérimentale (le sujet, le patient ou le groupe apparié) est exposée à l’ensemble des k conditions de traitement, ou évaluée à travers k instants temporels distincts.
L’objectif fondamental du test est de déterminer s’il existe une différence statistiquement significative entre les proportions de « succès » observées dans les différentes conditions. Le codage de la variable dépendante s’opère conventionnellement sous la forme d’un indicateur binaire où la valeur 1 dénote l’apparition de l’événement d’intérêt (tel que la réussite à une tâche, la présence d’une symptomatologie ou l’adhésion à une proposition) et la valeur 0 dénote l’absence de cet événement (échec, absence de symptôme, rejet). Le test évalue si la probabilité sous-jacente d’observer un succès varie en fonction de la modalité expérimentale sous contrôle strict de l’hétérogénéité des sujets.
Sur le plan mathématique, le test Q de Cochran constitue l’extension directe du test de McNemar au cas où le facteur intra-sujet comporte plus de deux modalités (k > 2). Alors que le test de McNemar est restreint à la comparaison de deux proportions corrélées (par exemple, un design pré-test versus post-test), le test Q de Cochran généralise cette logique à une matrice rectangulaire de dimensions b × k, où b représente le nombre de blocs ou d’individus et k le nombre de conditions. Tout comme le test de McNemar neutralise l’effet des paires concordantes pour focaliser son calcul sur les paires discordantes, le test de Cochran neutralise l’impact des sujets présentant des réponses uniformes (ceux ayant obtenu 0 à toutes les conditions ou 1 à toutes les conditions) pour baser son inférence exclusivement sur la variabilité intra-individuelle informative.
1.3 Pertinence épistémologique en recherche psychologique
Dans le domaine de la psychologie scientifique et de la psychopathologie, la nature des phénomènes observés impose fréquemment le recours à des indicateurs dichotomiques. Les critères diagnostiques du Manuel diagnostique et statistique des troubles mentaux (DSM) ou de la Classification internationale des maladies (CIM) fonctionnent fondamentalement selon une logique de seuil de présence ou d’absence. Lorsqu’une équipe de recherche évalue l’efficacité d’un protocole psychothérapeutique à travers différentes phases temporelles (pré-traitement, mi-parcours, post-traitement immédiat et suivi à six mois), la variable clinique d’intérêt est fréquemment formalisée sous la forme d’une rémission symptomatique binaire. Le test Q de Cochran constitue ici l’outil électif pour établir si la proportion de patients atteignant le critère de rémission évolue de manière significative au fil du temps.
Au-delà de la clinique, la psychologie cognitive et la neuropsychologie mobilisent intensivement ce test dans les paradigmes d’attention, de perception et de mémorisation. Dans les protocoles de rappel ou de reconnaissance indicée, la performance à un item lors de présentations successives sous différentes conditions de charge cognitive ou d’interférence est par nature binaire (item correctement rappelé versus non rappelé). Le chercheur cherche alors à savoir si la manipulation des conditions d’encodage mnésique modifie significativement le taux de réussite globale au sein d’une même cohorte de participants.
Sur le plan épistémologique, la pertinence du test Q de Cochran réside dans son adéquation parfaite avec la structure répétée des protocoles de psychologie expérimentale. Les individus diffèrent considérablement quant à leurs aptitudes cognitives basales, leurs traits de personnalité ou leur sensibilité aux stimuli. En contrôlant intrinsèquement cette variance interindividuelle résiduelle, le test Q de Cochran isole l’effet pur de la manipulation expérimentale. Il protège le chercheur contre les biais d’inférence résultant d’une surévaluation de la variabilité non contrôlée, tout en respectant l’échelle de mesure authentique des instruments psychométriques binaires.
2. Hypothèses statistiques et cadre décisionnel
2.1 Formulation de l’hypothèse nulle (H0)
Toute démarche d’inférence statistique formelle repose sur la spécification précise de l’hypothèse nulle, notée H0, qui incarne le postulat d’absence d’effet ou d’équivalence entre les conditions évaluées. Dans le cadre conceptuel du test Q de Cochran, l’hypothèse nulle postule que l’efficacité ou la probabilité de succès associée à chacun des k traitements est rigoureusement identique au sein de la population parente dont est extrait l’échantillon d’observation. Cela implique que l’assignation d’un sujet à l’une ou l’autre des conditions expérimentales n’exerce aucune influence systématique sur la probabilité d’occurrence de la modalité 1 de la variable dépendante.
Sur le plan mathématique et probabiliste, si l’on désigne par P(Tj = 1) la probabilité marginale qu’une observation choisie aléatoirement présente un succès sous la condition expérimentale j (avec j variant de 1 à k), l’hypothèse nulle s’énonce formellement comme suit :
H0 : P(T1 = 1) = P(T2 = 1) = P(T3 = 1) = … = P(Tk = 1) = p
Cette formulation probabiliste souligne que, sous H0, les variations observées entre les totaux marginaux de chaque colonne de la matrice de données ne sont imputables qu’aux fluctuations d’échantillonnage aléatoire. L’hypothèse nulle spécifie également que le facteur temps, le facteur traitement ou le facteur méthodologique n’induit aucune transition directionnelle globale des états 0 vers 1 ou des états 1 vers 0 au niveau de l’ensemble de la structure expérimentale.
2.2 Formulation de l’hypothèse alternative (H1 ou HA)
L’hypothèse alternative, conventionnellement désignée par H1 ou HA, représente la négation logique de l’hypothèse nulle. Dans le cadre du test de Cochran, elle postule qu’il existe au moins une paire de conditions pour laquelle les probabilités de succès sous-jacentes diffèrent de manière significative au sein de la population. Elle s’exprime sous la forme générale suivante :
H1 : Il existe au moins une paire d’indices (j, j’) telle que P(Tj = 1) ≠ P(Tj’ = 1) pour j ≠ j’
Il est fondamental de souligner le caractère omnibus et intrinsèquement non directionnel du test Q de Cochran. À l’instar du test F de l’analyse de variance ou du test du Chi-deux d’indépendance, le test de Cochran teste une hypothèse globale. Un résultat statistiquement significatif autorisant le rejet de H0 n’indique en aucune manière quelle condition expérimentale se distingue des autres, ni si une trajectoire temporelle spécifique (telle qu’une amélioration monotone continue) s’est produite. Le rejet de H0 informe simplement le statisticien que les données observées sont hautement incompatibles avec l’hypothèse d’une homogénéité parfaite des proportions marginales.
Par conséquent, l’acceptation de l’hypothèse alternative engendre obligatoirement la nécessité de déployer des analyses secondaires a posteriori, qualifiées de tests post-hoc. Ces procédures spécifiques ont pour fonction d’analyser les cellules de contraste pour identifier avec précision les sous-ensembles de conditions à l’origine de la divergence statistique omnibus, tout en neutralisant l’inflation corollaire du risque d’erreur de première espèce.
2.3 Seuil de significativité et erreurs d’inférence
La prise de décision statistique dans le cadre du test Q de Cochran s’articule autour de la théorie classique des tests d’hypothèses formalisée par Neyman et Pearson. Le chercheur doit fixer a priori un seuil de significativité, désigné par la lettre grecque α, qui délimite la probabilité maximale tolérée de commettre une erreur de première espèce (rejeter l’hypothèse nulle alors qu’elle est en réalité vraie dans la population). Dans les publications en psychologie et en sciences médicales, ce risque est conventionnellement arrêté à α = 0,05, ou à des niveaux plus conservateurs tels que α = 0,01 ou α = 0,001 lors d’études confirmatoires à haute criticité méthodologique.
Symétriquement, l’erreur de deuxième espèce, quantifiée par β, correspond à la probabilité d’échouer à rejeter l’hypothèse nulle alors qu’il existe une différence substantielle entre les traitements. La puissance statistique du test, définie par 1 − β, traduit la capacité de l’outil à détecter une non-homogénéité réelle des proportions. La puissance du test Q de Cochran est étroitement tributaire du nombre de sujets inclus dans l’échantillon, du nombre de conditions comparées, de la magnitude de l’effet réel au sein de la population, mais également de la proportion de profils de réponses discriminants. Une taille d’échantillon réduite couplée à une forte concordance des réponses à travers les conditions dégrade considérablement la puissance, augmentant le risque d’erreur de type II.
La règle de décision statistique opérationnelle repose sur la comparaison directe entre la statistique observée Qobs calculée sur les données empiriques et une valeur critique théorique extraite de la distribution du Chi-deux au seuil α choisi, ou, de façon équivalente dans les logiciels statistiques modernes, sur l’évaluation de la probabilité critique asymptotique (la p-valeur). Si la p-valeur est strictement inférieure au seuil α, l’analyste rejette formellement H0 au profit de l’hypothèse alternative. Dans le cas contraire, si la p-valeur excède le seuil α, le chercheur conclut à l’absence de preuve suffisante pour affirmer l’hétérogénéité des proportions, maintenant l’hypothèse de travail nulle.
3. Postulats et conditions d’application méthodologiques
3.1 Nature binaire et codage de la variable dépendante
Le postulat architectural fondamental conditionnant la validité du test Q de Cochran réside dans la nature strictement dichotomique de la variable dépendante mesurée. Chaque observation collectée au croisement d’un sujet individuel i et d’une condition j doit impérativement relever d’une alternative exclusive, modélisée par une variable de Bernoulli prenant ses valeurs dans l’ensemble discret {0, 1}. Tout écart par rapport à cette échelle binaire stricte rend la formule algébrique de Cochran caduque et fausse irrémédiablement l’estimation de la variance d’échantillonnage.
Dans la pratique de la recherche, il est fréquent que les psychologues recueillent des données ordinales via des échelles de type Likert en cinq ou sept points, ou des scores quantitatifs continus issus de tests psychométriques. Le test Q de Cochran ne peut en aucun cas être appliqué directement sur de telles échelles continues ou polyatomiques. Pour utiliser ce test dans un tel contexte, les chercheurs procèdent fréquemment à une dichotomisation préalable en appliquant un score seuil (par exemple, convertir des scores d’anxiété en 0 = « sous le seuil clinique » et 1 = « au-dessus du seuil clinique »).
Il convient toutefois d’alerter le méthodologiste sur la sensibilité critique du test aux seuils de catégorisation artificielle. La dichotomisation d’une variable originellement continue entraîne inévitablement une perte substantielle d’information statistique, réduit la variance observable et peut, selon l’emplacement arbitraire du point de césure, introduire des biais de classification ou masquer des effets non linéaires subtils. L’usage du test Q de Cochran doit être réservé aux variables pour lesquelles le caractère binaire est intrinsèque au phénomène étudié (survie/décès, rappel réussi/oubli, présence/absence d’un critère clinique strict) ou méthodologiquement inévitable.
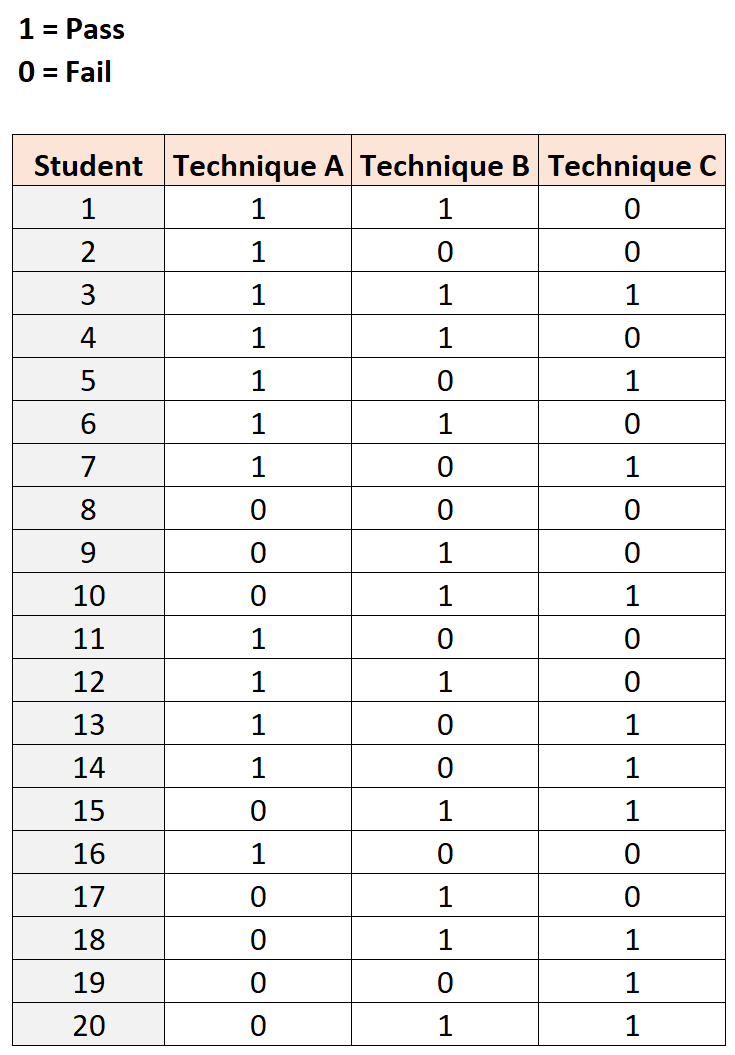
3.2 Structure des données en blocs aléatoires complets
Le second prérequis méthodologique concerne l’agencement structural des données, qui doit correspondre rigoureusement à un plan en blocs aléatoires complets. Dans la terminologie de l’expérimentation factorielle, un bloc représente l’unité source d’appariement. Dans la vaste majorité des applications psychologiques, chaque bloc correspond à un participant individuel unique évalué successivement sous toutes les conditions (plan intra-sujet pur). Cependant, un bloc peut également désigner un groupe homogène d’individus distincts préalablement appariés sur des variables de contrôle majeures (par exemple, des triplés monozygotes ou des patients appariés sur l’âge, le quotient intellectuel et la sévérité initiale du trouble).
Ce plan requiert une complétude absolue : chaque sujet ou bloc doit impérativement posséder une observation valide pour chacune des k conditions expérimentales. La présence de valeurs manquantes (données incomplètes sur un temps de mesure spécifique) pose une difficulté majeure car la structure matricielle de Cochran impose un croisement exhaustif. Dans les implémentations standards, tout sujet présentant une valeur manquante sur l’une quelconque des colonnes est automatiquement évincé de l’analyse (procédure d’exclusion par liste complète ou listwise deletion), ce qui peut dégrader significativement la puissance statistique et introduire des biais si l’attrition n’est pas complètement aléatoire.
Par ailleurs, si les mesures répétées au sein d’un même bloc sont structurellement dépendantes (c’est l’essence même de l’appariement), le modèle postule en contrepartie une indépendance mutuelle totale entre les différents blocs de sujets. La réponse fournie par le sujet A ne doit en aucun cas être influencée par celle du sujet B. Ce postulat d’indépendance inter-blocs exclut l’analyse de données recueillies dans des contextes d’interactions de groupe ou de dyades non contrôlées sans ajustements multiniveaux préalables.
3.3 Exigences relatives à la taille de l’échantillon et critères asymptotiques
La statistique Q développée par William Cochran ne possède pas de distribution exacte élémentaire pour les échantillons de taille finie ; son inférence repose sur une convergence asymptotique vers la loi théorique du Chi-deux. Dès lors, la validité des p-valeurs obtenues est subordonnée au respect de règles dimensionnelles minimales concernant la taille de l’échantillon de blocs b et le nombre de traitements k.
Une règle empirique largement acceptée dans la littérature statistique (formulée notamment par Patil en 1975 et consolidée par Siegel et Castellan en 1988) stipule que l’approximation par la loi du Chi-deux demeure fiable et robuste sous réserve que le produit du nombre de blocs (sujets) b et du nombre de conditions k soit supérieur ou égal à 24, avec un minimum absolu de k ≥ 3 conditions (pour k = 2, le test exact binomial de McNemar s’applique directement sans approximation continue) :
b × k ≥ 24
Cependant, cette condition purement arithmétique s’avère insuffisante si l’on ne prend pas en considération la distribution intrinsèque des données à l’intérieur des lignes. Un phénomène capital et fréquemment négligé réside dans l’influence délétère des lignes uniformes. Un participant qui obtient un score de 0 à travers l’ensemble des k conditions, ou inversement qui présente un score de 1 à chaque mesure, apporte une information sur la performance globale moyenne mais ne fournit absolument aucune variance intra-individuelle différentielle pour juger de la supériorité d’un traitement sur un autre.
Sur le plan computationnel, ces sujets aux profils uniformes s’annulent purement et simplement dans le calcul de la statistique de Cochran. Par conséquent, la taille de l’échantillon effectif utile ne correspond pas au nombre brut d’individus recrutés b, mais exclusivement au nombre de sujets dits « discriminants » ou « discordants », c’est-à-dire ceux ayant présenté des réponses hétérogènes (au moins un succès et au moins un échec parmi leurs mesures). Si une cohorte comprend 100 participants mais que 85 d’entre eux présentent des profils uniformes, la puissance réelle du test équivaut à celle d’un micro-échantillon de 15 sujets, ce qui fragilise l’approximation par le Chi-deux et expose l’étude à un risque sévère d’erreur de type II.
4. Dérivation mathématique et calcul pas à pas de la statistique Q
4.1 Notation matricielle et variables marginales
Pour appréhender rigoureusement la mécanique interne du test, il convient de formaliser le recueil des données sous la forme d’une matrice rectangulaire d’observations binaires, notée X, comprenant b lignes (représentant les blocs ou participants individuels, indexés par i = 1, 2, …, b) et k colonnes (représentant les modalités expérimentales ou conditions de mesure répétées, indexées par j = 1, 2, …, k).
Chaque élément Xij de la matrice prend impérativement la valeur 0 ou 1 :
Xij ∈ {0, 1}
À partir de cette matrice fondamentale, deux séries de totaux marginaux essentiels doivent être calculées :
- Le total marginal de la colonne j, désigné par Cj (ou X.j), correspond à la somme arithmétique de l’ensemble des réponses binaires enregistrées pour la condition j à travers l’ensemble des b participants. Ce total reflète directement le nombre brut de succès générés par le traitement j :
Cj = Σi=1…b Xij
- Le total marginal de la ligne i, désigné par Ri (ou Xi.), correspond à la somme arithmétique des réponses binaires données par le sujet i à travers l’ensemble des k conditions. Ce score individuel peut varier de 0 (échec complet sous toutes les modalités) à k (succès universel) :
Ri = Σj=1…k Xij
- Le grand total d’échantillon, noté N, représente la somme globale de l’ensemble des succès présents dans toute la matrice. Il s’obtient indifféremment en sommant les totaux marginaux de colonnes ou les totaux marginaux de lignes :
N = Σj=1…k Cj = Σi=1…b Ri
4.2 Formule canonique de la statistique de test Q
La statistique Q élaborée par Cochran mesure le degré de dispersion des sommes marginales de colonnes (Cj) autour de leur moyenne théorique, standardisée par une estimation sans biais de la variance intra-sujet conditionnelle. La formule canonique s’exprime de la manière suivante :
Q = [ (k − 1) × ( k × Σj=1…k (Cj)2 − (Σj=1…k Cj)2 ) ] / [ k × Σi=1…b Ri − Σi=1…b (Ri)2 ]
Cette expression algébrique mérite une analyse structurale fine pour en comprendre les propriétés mathématiques :
Le numérateur quantifie la variabilité inter-traitements. Le terme Σ (Cj)2 calcule la somme des carrés des totaux de colonnes. En lui soustrayant le carré de la somme globale divisé implicitement par k, ce calcul isole la déviation quadratique brute des performances relatives aux différentes conditions. Plus les traitements induisent des pourcentages de succès dissemblables, plus les valeurs Cj s’écartent les unes des autres, et plus ce numérateur croît en amplitude. Le facteur multiplicateur (k − 1) intervient comme un coefficient d’échelle lié aux degrés de liberté du plan expérimental.
Le dénominateur agit comme un terme de normalisation de la variance d’erreur. Il intègre directement les totaux marginaux de lignes Ri et la somme de leurs carrés (Ri)2. Remarquons que la quantité Ri × k − (Ri)2 peut se réécrire algébriquement sous la forme Ri × (k − Ri). Cette décomposition démontre mathématiquement l’élimination des profils uniformes : si un sujet possède un total de ligne Ri = 0, le produit 0 × (k − 0) égale 0. De même, si un sujet réussit toutes les épreuves, Ri = k, le produit k × (k − k) égale également 0. Ces sujets ne contribuent en rien à la valeur du dénominateur, illustrant la neutralisation rigoureuse de la variance non informative liée aux sujets invariants.
4.3 Distribution d’échantillonnage et degrés de liberté
Sous la condition que l’hypothèse nulle H0 soit rigoureusement vraie dans la population et que les critères asymptotiques de taille d’échantillon soient satisfaits, la distribution d’échantillonnage de la statistique Q converge vers une distribution théorique connue : la loi du Chi-deux (χ²). Le paramètre fondamental régissant cette distribution est son nombre de degrés de liberté (noté ddl ou df pour degrees of freedom).
Le nombre de degrés de liberté de la statistique Q dépend exclusivement du nombre de conditions expérimentales ou de traitements comparés, et non du nombre de participants inclus dans l’échantillon. Il est défini par la relation :
ddl = k − 1
Cette propriété découle du fait que la statistique évalue la dispersion de k totaux de colonnes qui sont liés par une contrainte linéaire stricte : leur somme totale est obligatoirement égale à N. Une fois que (k − 1) totaux de colonnes sont fixés, le k-ième total est mathématiquement déterminé. La zone de rejet de l’hypothèse nulle se situe exclusivement dans la queue supérieure de la distribution du Chi-deux, car toute disparité entre les conditions se traduit par des écarts quadratiques positifs, conduisant à une valeur de Q systématiquement positive ou nulle.
L’inférence s’effectue en comparant la valeur empirique Q calculée à la valeur critique χ²critique lue dans les tables statistiques pour ddl = k − 1 au niveau de confiance (1 − α). Si Q ≥ χ²critique, la p-valeur associée est inférieure à α, commandant le rejet formel de H0.
5. Exemple pratique appliqué à la psychologie cognitive
5.1 Cadre de l’étude : Évaluation de trois techniques de révision
Pour illustrer concrètement la mise en œuvre empirique et le calcul de la statistique de Cochran, considérons une recherche expérimentale menée en psychologie cognitive de l’éducation. Un groupe de chercheurs s’intéresse à l’impact comparatif de trois techniques distinctes d’apprentissage mnésique sur la capacité de rétention d’informations complexes chez de jeunes adultes.
Le protocole sélectionné suit un plan intra-sujet complet à mesures répétées. Un échantillon de 12 étudiants universitaires (b = 12 participants) est recruté. Chaque étudiant est soumis successivement, à intervalles d’une semaine d’intervalle et selon un ordre de passation contrebalancé pour neutraliser tout effet de report ou d’apprentissage séquentiel, à trois méthodes d’encodage distinctes appliquées à des listes de vocabulaire technique de difficulté linguistique strictement équivalente :
- Condition 1 (C1) : Répétition par cœur passive. L’étudiant relit la liste de termes et leurs définitions de façon linéaire et continue pendant 30 minutes.
- Condition 2 (C2) : Méthode d’imagerie mentale visuelle. L’étudiant applique la technique des loci, en associant mentalement chaque terme à une image visuelle dynamique au sein d’un environnement spatial familier.
- Condition 3 (C3) : Pratique de récupération espacée (Testing effect). L’étudiant s’auto-évalue activement à l’aide de cartes mémoires (flashcards) selon un intervalle de temps croissant.
Le critère d’évaluation principal, mesuré exactement 48 heures après chaque phase d’apprentissage, est une variable dépendante binaire : la réussite ou l’échec à un test de rappel libre critérié. Le seuil de réussite (codé 1) est fixé à l’évocation exacte d’au moins 80 % des concepts de la liste. Une performance strictement inférieure à 80 % est enregistrée comme un échec (codé 0). Les chercheurs souhaitent déterminer si le taux de succès au test de rappel diffère significativement selon la méthode de révision employée.
5.2 Tableau des données brutes et calculs intermédiaires
Les observations expérimentales recueillies auprès des 12 participants sont colligées dans la matrice ci-dessous. Nous procédons immédiatement au calcul des sommes marginales de lignes Ri, de leurs carrés (Ri)2, ainsi que des sommes marginales de colonnes Cj et de leurs carrés (Cj)2.
| Participant (i) | Méthode 1 : Répétition (C1) | Méthode 2 : Imagerie (C2) | Méthode 3 : Récupération (C3) | Total Ligne (Ri) | (Ri)2 |
|---|---|---|---|---|---|
| Sujet 1 | 0 | 1 | 1 | 2 | 4 |
| Sujet 2 | 1 | 1 | 1 | 3 | 9 |
| Sujet 3 | 0 | 0 | 1 | 1 | 1 |
| Sujet 4 | 0 | 1 | 1 | 2 | 4 |
| Sujet 5 | 0 | 0 | 0 | 0 | 0 |
| Sujet 6 | 1 | 0 | 1 | 2 | 4 |
| Sujet 7 | 0 | 1 | 1 | 2 | 4 |
| Sujet 8 | 0 | 0 | 1 | 1 | 1 |
| Sujet 9 | 1 | 1 | 1 | 3 | 9 |
| Sujet 10 | 0 | 1 | 1 | 2 | 4 |
| Sujet 11 | 0 | 0 | 0 | 0 | 0 |
| Sujet 12 | 0 | 1 | 1 | 2 | 4 |
| Total Colonne (Cj) | C1 = 3 | C2 = 7 | C3 = 11 | Σ Ri = 21 | Σ (Ri)2 = 44 |
| (Cj)2 | 32 = 9 | 72 = 49 | 112 = 121 | Σ (Cj)2 = 179 | |
Une observation attentive du tableau révèle les caractéristiques fondamentales du traitement par blocs :
Les sujets 2 et 9 présentent des profils uniformes de réussite totale (Ri = 3). Pour ces sujets, la contribution au terme de variance du dénominateur est k × Ri − (Ri)2 = 3(3) − 32 = 9 − 9 = 0. De même, les sujets 5 et 11 présentent des profils d’échec total (Ri = 0), générant une contribution de 3(0) − 02 = 0. Ces quatre sujets sont donc mathématiquement informatifs pour les proportions marginales globales, mais s’annulent quant au calcul du dénominateur discriminant de Cochran. Les 8 autres participants constituent les blocs discriminants portant l’inférence comparative.
5.3 Résolution numérique et interprétation du résultat
Munis des valeurs intermédiaires calculées dans la matrice, nous disposons des paramètres quantitatifs suivants :
- Nombre de traitements (colonnes) : k = 3
- Nombre de blocs (participants) : b = 12
- Totaux marginaux de colonnes : C1 = 3, C2 = 7, C3 = 11
- Somme des totaux de colonnes : Σ Cj = 3 + 7 + 11 = 21
- Somme des carrés des totaux de colonnes : Σ (Cj)2 = 9 + 49 + 121 = 179
- Somme des totaux de lignes : Σ Ri = 21
- Somme des carrés des totaux de lignes : Σ (Ri)2 = 44
Introduisons ces scalaires dans la formule canonique de Cochran :
Q = [ (3 − 1) × ( 3 × 179 − (21)2 ) ] / [ 3 × 21 − 44 ]
Décomposons le calcul de manière séquentielle :
Au numérateur :
- (k − 1) = 3 − 1 = 2
- 3 × Σ (Cj)2 = 3 × 179 = 537
- (Σ Cj)2 = (21)2 = 441
- Différence quadratique = 537 − 441 = 96
- Numérateur total = 2 × 96 = 192
Au dénominateur :
- k × Σ Ri = 3 × 21 = 63
- Σ (Ri)2 = 44
- Dénominateur total = 63 − 44 = 19
Nous obtenons la valeur empirique de la statistique Q :
Q = 192 / 19 ≈ 10,105
Déterminons à présent le seuil critique théorique. Le nombre de degrés de liberté est :
ddl = k − 1 = 3 − 1 = 2
En consultant la table de distribution théorique du Chi-deux pour ddl = 2 au seuil de significativité conventionnel α = 0,05, nous constatons que la valeur critique seuil est :
χ²critique (2 ; 0,05) = 5,991
Puisque notre statistique calculée Q = 10,105 est strictement supérieure à la valeur critique seuil de 5,991 (ce qui correspond sous ordinateur à une probabilité critique exacte de p = 0,0064), la règle de décision nous impose de rejeter catégoriquement l’hypothèse nulle H0 au risque de 5 %.
Sur le plan substantiel, cette conclusion statistique permet aux chercheurs d’affirmer que les trois techniques d’encodage mnésique ne produisent pas les mêmes proportions de mémorisation réussie chez les étudiants. Les taux de succès marginaux observés (25 % pour la répétition simple, 58,3 % pour l’imagerie visuelle et 91,7 % pour la récupération espacée) traduisent une hétérogénéité qui ne peut être attribuée aux seules fluctuations de l’échantillonnage aléatoire.
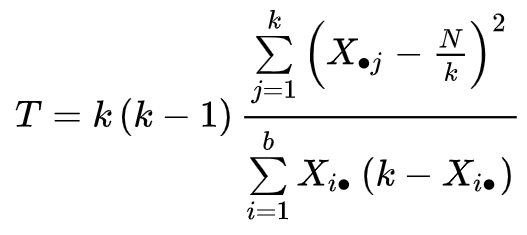
6. Analyses post-hoc et ajustements pour comparaisons multiples
6.1 Nécessité de tests de contrastes après rejet de l’hypothèse nulle
L’aboutissement à un résultat statistiquement significatif au terme de l’exécution du test Q de Cochran soulève une contrainte d’interprétation inhérente à la famille des tests d’hypothèses omnibus. Si le rejet de l’hypothèse nulle permet de certifier que l’ensemble des proportions observées ne provient pas d’une population homogène, il ne permet en aucun cas de situer la localisation empirique des différences. La performance sous la condition de récupération espacée est-elle statistiquement supérieure à celle de la répétition mécanique ? L’imagerie mentale surpasse-t-elle la répétition passive de façon significative ? La différence observée entre l’imagerie mentale et la récupération espacée atteint-elle le seuil de décision statistique, ou s’agit-il d’un simple écart d’échantillonnage ?
Pour répondre à ces interrogations spécifiques, le chercheur doit procéder à des contrastes ou comparaisons multiples a posteriori (tests post-hoc). Toutefois, l’exécution non régulée d’une série de tests d’hypothèses secondaires engendre un écueil méthodologique bien documenté : l’inflation du taux d’erreur de première espèce par famille d’hypothèses (Family-Wise Error Rate, FWER). Si un chercheur réalise m tests bivariés indépendants, chacun fixé individuellement au seuil nominal α = 0,05, la probabilité cumulée de déclarer à tort au moins une comparaison faussement significative s’élève à :
αglobal = 1 − (1 − α)m
Pour trois conditions expérimentales, le nombre de comparaisons deux à deux possibles est calculé par la formule des combinaisons : m = k(k − 1) / 2 = 3(2)/2 = 3 comparaisons. Le risque global de commettre au moins une fausse découverte s’élève alors à 1 − (1 − 0,05)3 = 1 − 0,953 ≈ 0,143, soit plus de 14 %, un niveau de risque inacceptable dans un cadre scientifique rigoureux. Le recours à des protocoles de contrôle et de correction de l’erreur globale est donc une obligation absolue.
6.2 Utilisation du test de McNemar par paires
La méthodologie standard recommandée par les statisticiens pour opérer les comparaisons post-hoc consécutives au test Q de Cochran repose sur l’exécution d’une série de tests de McNemar appliqués par paires d’échantillons appariés. Pour chaque paire de modalités de traitement (Tj versus Tj’), l’analyste extrait de la matrice originale les deux colonnes d’intérêt et construit un sous-tableau de contingence croisé bivarié d’ordre 2 × 2.
Dans un tel tableau de contingence, les participants sont classés selon leurs schémas de réponse croisés :
- Cellule a : Sujets présentant un succès (1) sous la condition j et un succès (1) sous la condition j’.
- Cellule b : Sujets présentant un succès (1) sous la condition j et un échec (0) sous la condition j’.
- Cellule c : Sujets présentant un échec (0) sous la condition j et un succès (1) sous la condition j’.
- Cellule d : Sujets présentant un échec (0) sous la condition j et un échec (0) sous la condition j’.
La logique mathématique de McNemar stipule que les cellules concordantes (a et d) n’apportent aucun pouvoir discriminant quant à la supériorité d’une méthode sur l’autre, puisque le statut du sujet demeure inchangé. L’inférence bivariée repose donc exclusivement sur les fréquences observées dans les cellules discordantes (b et c). Lorsque l’effectif des cellules discordantes est suffisant (b + c ≥ 10), la statistique de McNemar avec correction de continuité d’Edwards s’exprime par :
χ²McNemar = (|b − c| − 1)2 / (b + c)
Cette statistique suit asymptotiquement une loi du Chi-deux à un degré de liberté (ddl = 1). Lorsque le total des paires discordantes est faible (b + c < 10), ce qui se produit régulièrement dans les petits échantillons de recherche clinique, il est impératif d’abandonner l’approximation asymptotique du Chi-deux au profit du calcul exact de la probabilité cumulée issu de la distribution binomiale de paramètres n = b + c et probabilité théorique de succès p = 0,5.
6.3 Procédures de contrôle du taux d’erreur par famille
Afin de neutraliser l’inflation de l’erreur de première espèce lors de l’application de multiples tests de McNemar, plusieurs procédures mathématiques d’ajustement du seuil α ou des p-valeurs sont envisageables :
La correction canonique de Bonferroni représente l’approche la plus classique et conservatrice. Elle consiste à diviser le seuil nominal α par le nombre total de comparaisons planifiées m :
αajusté = α / m
Dans le cadre de notre étude portant sur trois conditions de révision (m = 3 comparaisons : C1 vs C2, C1 vs C3, C2 vs C3), le seuil de décision pour chaque comparaison individuelle devient αajusté = 0,05 / 3 ≈ 0,0167. Si la p-valeur calculée pour une paire donnée est strictement inférieure à 0,0167, la divergence est déclarée significative. Bien que robuste, la correction de Bonferroni est souvent critiquée pour son hyper-conservatisme, qui engendre une réduction notable de la puissance statistique et accroît le risque d’erreur de deuxième espèce (β).
La procédure séquentielle descendante de Holm-Bonferroni (ou test de Holm) constitue une alternative mathématiquement supérieure car uniformément plus puissante que la méthode de Bonferroni standard, tout en maintenant un contrôle parfait de l’erreur de type I globale. La démarche s’opère selon l’algorithme suivant :
- Classer les m p-valeurs non ajustées obtenues par ordre croissant : p(1) ≤ p(2) ≤ … ≤ p(m).
- Associer à chaque p-valeur d’indice k un seuil d’évaluation dynamique donné par α / (m − k + 1).
- Évaluer la plus petite p-valeur : si p(1) < α / m, le rejet de l’hypothèse d’équivalence est acté pour cette paire, et l’on progresse vers la suivante.
- Dès qu’une p-valeur échoue à satisfaire son critère local, le processus d’inférence est immédiatement interrompu et l’ensemble des hypothèses restantes est conservé.
Le contrôle du taux de fausses découvertes (False Discovery Rate – FDR), théorisé par Benjamini et Hochberg (1995), constitue une troisième voie de choix dans les études exploratoires impliquant un nombre élevé de conditions expérimentales (par exemple dans le cadre de protocoles psychophysiologiques avec k ≥ 5). Au lieu de verrouiller hermétiquement la probabilité de commettre une seule erreur de type I, le FDR module la proportion attendue de fausses découvertes parmi l’ensemble des résultats déclarés significatifs, offrant un compromis optimal entre sensibilité et spécificité empirique.
7. Positionnement comparatif au sein de la boîte à outils statistique
7.1 Cochran versus McNemar : La transition du bivarié au multivarié
L’articulation théorique entre le test de McNemar et le test Q de Cochran relève d’une relation d’inclusion formelle. Le test de McNemar (développé en 1947 par Quinn McNemar) a été conçu spécifiquement pour le traitement de deux échantillons appariés évaluant une variable dépendante binaire (cas k = 2). Le test Q de Cochran constitue son extension matricielle rigoureuse pour toute configuration où le nombre de conditions de mesures répétées est supérieur ou égal à deux (k ≥ 2).
Sur le plan formel, lorsque l’on applique la formule de la statistique Q de Cochran à un ensemble de données ne comportant strictement que deux modalités (k = 2), la statistique Q obtenue est mathématiquement identique, à l’arrondi près, à la statistique du Chi-deux de McNemar calculée sans correction de continuité :
Pour k = 2 : QCochran = χ²McNemar (sans continuité) = (b − c)2 / (b + c)
Le grand danger méthodologique consisterait à scinder un protocole comportant k > 2 conditions en une collection de tests de McNemar isolés dès la première étape d’analyse. Une telle stratégie fragmentaire prive le statisticien d’une estimation globale et robuste de la variance résiduelle inter-traitements, accroît drastiquement le risque d’erreur d’inférence globale et fragmente l’évaluation de la cohérence de l’effet expérimental. Le test Q de Cochran s’impose impérativement comme l’étape omnibus indispensable avant tout examen bivarié ciblé.
7.2 Cochran versus Friedman : Variable qualitative dichotomique versus ordinale
Une analogie structurelle étroite lie le test Q de Cochran au test de Friedman. Tous deux sont des tests non paramétriques destinés aux plans expérimentaux à mesures répétées ou en blocs aléatoires complets. La frontière conceptuelle qui les sépare tient exclusivement à la nature métrique de la variable dépendante recueillie.
Le test de Friedman s’applique aux variables quantitatives continues violant les postulats de normalité ou aux variables qualitatives ordinales (scores sur échelles d’attitudes, rangs de classement, scores fonctionnels gradués). Sa mécanique computationnelle repose sur la transformation préalable des données brutes de chaque bloc en rangs ordonnés intra-individuels (de 1 à k), neutralisant ainsi l’échelle de mesure originale.
À l’inverse, le test de Cochran a été mathématiquement calibré pour des variables strictement binaires {0, 1}. Il est remarquable de noter que si l’on injectait directement une matrice de données binaires dans l’algorithme computationnel du test de Friedman, et que la formule d’ajustement pour ex æquo (liens de rangs) était rigoureusement implémentée, la statistique du test de Friedman corrigée pour les ex æquo deviendrait numériquement identique à la statistique Q de Cochran. Le test Q de Cochran peut donc être théoriquement conceptualisé comme un cas particulier dégénéré du test de rangs de Friedman restreint aux données de Bernoulli pures.
7.3 Cochran versus ANOVA à mesures répétées et modèles logistiques mixtes
Pendant de nombreuses décennies, les chercheurs ont parfois utilisé l’ANOVA à mesures répétées classique pour analyser des variables dichotomiques, en s’appuyant sur l’argument de la robustesse relative du modèle linéaire généralisé. Cette pratique est aujourd’hui unanimement condamnée par les méthodologistes. L’application d’une ANOVA gaussienne sur une variable binaire viole violemment le postulat de normalité des résidus et induit une violation intrinsèque de l’hypothèse de sphéricité (homogénéité des variances des différences de traitement). Plus critique encore, le modèle linéaire peut prédire des probabilités de succès théoriques absurdes, inférieures à 0 ou supérieures à 1.
En alternative contemporaine au test Q de Cochran, les modèles linéaires généralisés mixtes (GLMM pour Generalized Linear Mixed Models) — et singulièrement la régression logistique mixte — constituent l’approche paramétrique moderne de référence. Un modèle logistique mixte traite adéquatement la variable dépendante binaire en modélisant le logit de la probabilité de succès en fonction des effets fixes du traitement et des effets aléatoires assignés aux sujets individuels.
Le tableau analytique suivant synthétise les propriétés respectives du test Q de Cochran et des modèles logistiques mixtes :
| Critère méthodologique | Test Q de Cochran | Régression logistique mixte (GLMM) |
|---|---|---|
| Paradigme inférentiel | Non paramétrique (asymptotique Chi-deux) | Paramétrique (maximum de vraisemblance) |
| Complexité computationnelle | Très faible, calculable manuellement | Élevée, requiert des algorithmes d’optimisation numérique |
| Prise en compte des covariables continues | Impossible (purement bivarié/blocs) | Excellente (ajustement possible pour âge, sévérité, etc.) |
| Gestion des données manquantes | Élimination par liste complète (listwise deletion) | Flexible sous l’hypothèse MAR (Missing at Random) |
| Taille d’échantillon requise | Fonctionne sur petits échantillons (b × k ≥ 24) | Nécessite des échantillons plus volumineux pour converger |
Le test Q de Cochran conserve une pertinence de premier ordre en recherche fondamentale en raison de sa simplicité conceptuelle, de son absence totale de postulats distributionnels sur la distribution des effets aléatoires des participants, et de son interprétabilité immédiate dans les plans expérimentaux équilibrés sans données manquantes.
8. Implémentation pas à pas sous le logiciel R
8.1 Structuration et mise en forme des données matricielles
L’environnement statistique et programmatique R offre une grande flexibilité pour l’exécution du test Q de Cochran et de ses extensions post-hoc. Selon le package sélectionné, l’agencement structural des données dans le tableau (data.frame ou tibble) doit adopter soit le format large (wide format), soit le format long (long format).
Dans le format large, chaque ligne correspond à un sujet unique et chaque colonne représente une condition expérimentale mesurée, reproduisant exactement la structure de la matrice mathématique classique. Ce format est particulièrement intuitif pour l’inspection visuelle immédiate des profils individuels et pour la saisie manuelle initiale des données d’expérimentation. Les variables doivent être rigoureusement encodées sous forme numérique binaire (vecteurs d’entiers 0 et 1) :
donnees_large <- data.frame(
Sujet = paste0(« S », 1:12),
C1 = c(0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0),
C2 = c(1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 1),
C3 = c(1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 0, 1)
)
Dans le format long, chaque ligne unitaire correspond à une mesure unique, de sorte qu’un même sujet est répété sur k lignes successives. Ce format inclut trois colonnes fondamentales : l’identifiant du sujet (facteur), la modalité de la condition expérimentale (facteur à k niveaux), et la réponse comportementale dichotomique obtenue (0 ou 1). La conversion du format large vers le format long s’effectue aisément via la fonction pivot_longer() du package tidyr :
library(tidyr)
donnees_long <- pivot_longer(
donnees_large,
cols = c(« C1 », « C2 », « C3 »),
names_to = « Condition »,
values_to = « Reponse »
)
8.2 Exécution avec les packages spécialisés (nonpar, RVAideMemoire, descr)
Plusieurs librairies R permettent de calculer instantanément la statistique de Cochran. L’une des implémentations les plus réputées dans la communauté biomédicale et psychométrique francophone réside dans le package RVAideMemoire développé par Maxime Hervé, qui fournit la fonction canonique cochran.qtest().
L’appel de la fonction sur des données structurées au format long s’exécute via la syntaxe de formule standard reliant la variable binaire, le facteur intra-sujet et le facteur de blocage :
library(RVAideMemoire)
cochran.qtest(Reponse ~ Condition | Sujet, data = donnees_long)
L’affichage console renvoie les résultats d’inférence sous une forme normalisée :
Cochran’s Q test
Reponse by Condition, block = Sujet
Q = 10.105, df = 2, p-value = 0.006392
Alternativement, le package descr propose la commande CochranQTest() qui accepte directement en entrée une matrice ou un tableau de données rectangulaire au format large ne contenant que les colonnes expérimentales (en excluant le vecteur identifiant) :
library(descr)
CochranQTest(donnees_large[, c(« C1 », « C2 », « C3 »)])
Les métriques extraites corroborent rigoureusement les calculs manuels menés à la section 5 : la statistique Q s’établit précisément à 10,105 pour deux degrés de liberté, générant une p-valeur asymptotique de 0,006392.
8.3 Automatisation des tests post-hoc et visualisations graphiques
Le package RVAideMemoire offre une commande complémentaire dédiée à l’automatisation des comparaisons multiples par paires avec ajustement du risque d’erreur globale : la fonction pairwise.mcnemar.test(), ou de façon intégrée, la fonction pairwise.mcnemar.test() combinée avec l’argument d’ajustement séquentiel :
pairwise.mcnemar.test(
x = donnees_long$Reponse,
g = donnees_long$Condition,
b = donnees_long$Sujet,
p.adjust.method = « holm »
)
Cette commande génère une matrice symétrique de p-valeurs corrigées selon la méthode de Holm-Bonferroni, permettant d’identifier immédiatement quelles paires de conditions présentent des contrastes statistiquement significatifs au seuil de 5 %.
Sur le plan de la communication scientifique, la restitution graphique de l’évolution des proportions marginales gagne à être réalisée sous l’environnement ggplot2. Il est particulièrement recommandé d’adjoindre aux taux de succès ponctuels observés leurs intervalles de confiance respectifs calculés selon la méthode de Wilson pour proportions appariées (Wilson score interval), méthode nettement plus robuste que l’intervalle classique de Wald sur petits échantillons :
library(ggplot2)
# Calcul des proportions et intervalles marginaux
# Visualisation sous forme de barplot ou de nuage de points avec lignes de tendance
Une telle visualisation met immédiatement en exergue la progression des pourcentages de réussite (25 % → 58,3 % → 91,7 %), offrant au lecteur une appréhension visuelle limpide de la structure fonctionnelle de l’effet expérimental.
9. Mise en œuvre pratique sous IBM SPSS Statistics
9.1 Codage et préparation du fichier d’analyse SPSS
Le logiciel commercial IBM SPSS Statistics demeure un standard largement répandu au sein des laboratoires universitaires et des centres hospitaliers de recherche clinique. La bonne conduite du test Q de Cochran sous cet environnement nécessite une rigueur stricte dès l’étape de structuration du fichier de données (.sav).
Dans SPSS, la structure des données pour les mesures répétées doit obligatoirement être configurée en format large (une ligne par sujet d’étude). Chaque condition expérimentale évaluée au cours du protocole doit constituer une colonne distincte dans l’éditeur de données. Dans l’onglet Vue des variables (Variable View), le chercheur doit renseigner les paramètres suivants :
- Type : Définir la variable comme « Numérique » (Numeric).
- Largeur et décimales : Largeur standard de 8 avec 0 décimale (les données étant entières).
- Valeurs (Value Labels) : Il est essentiel de documenter précisément l’étiquetage binaire : assigner la valeur 0 pour « Échec » (ou Absence) et la valeur 1 pour « Succès » (ou Présence).
- Mesure : Attribuer le statut métrique « Nominal » ou « Ordinal » (bien que SPSS calcule la statistique de Cochran sur des variables numériques catégorielles).
Une vigilance particulière doit être portée à la gestion des données manquantes. Par défaut, les procédures de tests non paramétriques pour échantillons reliés sous SPSS appliquent une exclusion par liste complète (listwise deletion). Si un participant ne possède pas d’observation valide pour l’une des colonnes de traitement, la totalité de son dossier d’observation est rejetée de l’analyse globale. L’analyste doit vérifier au préalable le tableau récapitulatif des fréquences pour s’assurer que le nombre de cas valides (N) correspond bien à la taille d’échantillon anticipée.
9.2 Navigation dans les menus d’analyse non paramétrique
L’accès au test Q de Cochran s’effectue au sein de l’architecture logicielle de SPSS selon deux cheminements distincts : l’interface moderne des tests non paramétriques assistés ou la boîte de dialogue héritée (Legacy Dialogs), cette dernière demeurant privilégiée par les analystes pour sa simplicité et son ergonomie directe.
Pour utiliser la boîte de dialogue héritée, suivez la séquence de navigation suivante :
- Dérouler le menu principal supérieur : Analyse (Analyze).
- Sélectionner le sous-menu : Tests non paramétriques (Nonparametric Tests).
- Choisir l’option : Boîtes de dialogue héritées (Legacy Dialogs).
- Cliquer sur la commande : K échantillons appariés… (K Related Samples…).
Une nouvelle fenêtre interactive se déploie à l’écran. Dans le panneau de gauche contenant la liste de l’ensemble des variables du fichier, sélectionnez les k variables binaires représentant vos conditions expérimentales répétées (par exemple Methode1, Methode2, Methode3) et transférez-les à l’aide de la flèche centrale dans l’encadré de droite intitulé Variables de test : (Test Variables:).
Au bas de la fenêtre, dans la section intitulée Type de test (Test Type), le logiciel propose par défaut le test de Friedman. Il est impératif de décocher la case « Friedman » et de cocher explicitement la case « Q de Cochran » (Cochran’s Q). Enfin, cliquez sur le bouton Options… pour activer la demande de statistiques descriptives (moyennes, quartiles) si souhaité, puis validez la procédure en cliquant sur le bouton OK.
9.3 Lecture critique des tableaux de résultats SPSS
L’exécution de la procédure génère instantanément dans la fenêtre de sortie (SPSS Viewer) deux tableaux synthétiques consécutifs :
Le tableau des fréquences (Frequencies) : Ce premier tableau dresse l’état des lieux descriptif des observations enregistrées. Pour chacune des conditions soumises au test, SPSS récapitule la distribution des effectifs observés, scindée en deux lignes distinctes : le nombre de participants ayant obtenu la modalité 0 (échec) et le nombre de participants ayant obtenu la modalité 1 (succès). L’analyste doit inspecter minutieusement ces effectifs pour vérifier les pourcentages bruts de réussite par condition et s’assurer qu’aucune anomalie de codage n’est intervenue.
Le tableau des statistiques de test (Test Statistics) : Ce tableau fournit les grandeurs inférentielles décisives pour l’arbitrage de l’hypothèse nulle :
- N : Le nombre de participants valides inclus dans l’analyse globale (par exemple N = 12).
- Q de Cochran (Cochran’s Q) : La valeur numérique exacte de la statistique de test calculée par l’algorithme (dans notre exemple : 10,105).
- ddl (df) : Le nombre de degrés de liberté associé, équivalant strictement à k − 1 (dans notre exemple : 2).
- Signification asymptotique (Asymp. Sig.) : La p-valeur bilatérale associée à la distribution du Chi-deux. La mention d’une valeur telle que « .006 » indique que la probabilité d’obtenir une telle dispersion par pur hasard d’échantillonnage est de 6 pour 1000.
Si la mention Asymp. Sig. est inférieure au seuil α = 0,05, SPSS autorise formellement à rejeter l’hypothèse nulle. Toutefois, SPSS ne réalise pas automatiquement, dans cette boîte de dialogue classique, les tests post-hoc de McNemar par paires avec ajustement. L’analyste doit exécuter manuellement ces tests secondaires en naviguant dans Analyse > Tests non paramétriques > Boîtes de dialogue héritées > Deux échantillons appariés…, en sélectionnant le test de McNemar pour chaque doublet de conditions, puis en ajustant manuellement à la calculatrice le seuil α selon la règle de Bonferroni ou de Holm.
10. Calculs avancés sous Python avec SciPy et Statsmodels
10.1 Préparation des DataFrames avec la bibliothèque Pandas
Dans l’écosystème open-source Python dédié à la science des données et à la recherche quantitative, la manipulation et la structuration préalable des matrices d’observations reposent principalement sur la bibliothèque Pandas. La configuration optimale pour administrer le test Q de Cochran consiste à construire un objet DataFrame où chaque colonne encapsule les observations binaires d’une condition d’évaluation.
L’initialisation programmatique du jeu de données s’opère comme suit :
import pandas as pd
import numpy as np
# Définition de la matrice des résultats binaires (12 participants x 3 conditions)
donnees = {
‘Repetition’: [0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0],
‘Imagerie’: [1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 1],
‘Recuperation’: [1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 0, 1]
}
df = pd.DataFrame(donnees)
Avant d’exécuter l’inférence, une étape de validation méthodologique des données est nécessaire. Il s’agit de vérifier le typage strict des données (qui doivent être coercibles en entiers int64) et l’absence de valeurs aberrantes (toute valeur différente de 0 et 1 doit lever une exception). De surcroît, le calcul préliminaire de la variabilité intra-ligne permet d’isoler en amont les profils invariants afin d’évaluer la taille réelle de l’échantillon effectif :
# Identification des lignes discordantes (utiles pour Cochran)
sommes_lignes = df.sum(axis=1)
nb_conditions = df.shape[1]
lignes_discriminantes = df[(sommes_lignes > 0) & (sommes_lignes < nb_conditions)]
print(f »Nombre de sujets effectifs discriminants : {len(lignes_discriminantes)} sur {len(df)} »)
10.2 Exécution du test via statsmodels.sandbox.stats.runs
Bien que la bibliothèque scientifique SciPy standard héberge un vaste assortiment de tests d’hypothèses dans son module scipy.stats, le test Q de Cochran est hébergé au sein du package spécialisé statsmodels, plus précisément dans le sous-module d’analyse non paramétrique statsmodels.sandbox.stats.runs via la fonction cochrans_q.
L’exécution de la routine s’effectue en transmettant la matrice brute (sous forme de DataFrame Pandas ou de matrice NumPy bidimensionnelle) :
from statsmodels.sandbox.stats.runs import cochrans_q
# Exécution du test de Cochran
statistique_q, p_valeur = cochrans_q(df)
print(f »Statistique Q de Cochran : {statistique_q:.4f} »)
print(f »Degrés de liberté : {df.shape[1] – 1} »)
print(f »P-valeur asymptotique : {p_valeur:.6f} »)
L’exécution de ces lignes de code produit en sortie un tuple renvoyant exactement les valeurs théoriques dérivées analytiquement : statistique_q = 10.1053 et p_valeur = 0.006392.
Pour des impératifs de contrôle qualité ou lors du déploiement d’environnements de production allégés ne supportant pas l’importation de bibliothèques volumineuses, il est aisé d’écrire une fonction pure NumPy reproduisant fidèlement la formule algébrique :
def calcul_manuel_cochran(matrice):
X = np.asarray(matrice)
b, k = X.shape
C_j = np.sum(X, axis=0)
R_i = np.sum(X, axis=1)
numerateur = (k – 1) * (k * np.sum(C_j**2) – (np.sum(C_j))**2)
denominateur = k * np.sum(R_i) – np.sum(R_i**2)
q_stat = numerateur / denominateur
from scipy.stats import chi2
p_val = chi2.sf(q_stat, df=k-1)
return q_stat, p_val
10.3 Visualisation et post-traitement des résultats sous Python
Pour parachever l’analyse sous Python, l’implémentation de tests de McNemar par paires avec ajustement séquentiel de Holm-Bonferroni peut être construite à l’aide des fonctions mcnemar de statsmodels.stats.contingency_tables et multipletests de statsmodels.stats.multitest :
from itertools import combinations
from statsmodels.stats.contingency_tables import mcnemar
from statsmodels.stats.multitest import multipletests
conditions = df.columns
p_valeurs_brutes = []
comparaisons = []
for c1, c2 in combinations(conditions, 2):
table_croisee = pd.crosstab(df[c1], df[c2])
res = mcnemar(table_croisee, exact=True)
p_valeurs_brutes.append(res.pvalue)
comparaisons.append(f »{c1} vs {c2} »)
rejet, p_ajustees, _, _ = multipletests(p_valeurs_brutes, alpha=0.05, method=’holm’)
resultats_posthoc = pd.DataFrame({
‘Comparaison’: comparaisons,
‘P_brute’: p_valeurs_brutes,
‘P_ajustee_Holm’: p_ajustees,
‘Significatif’: rejet
})
Enfin, la modélisation graphique des taux de succès marginaux s’effectue élégamment à l’aide des bibliothèques matplotlib et seaborn. La réalisation d’un graphique à barres annoté avec les pourcentages d’adhésion ou de réussite et les barres d’erreur fournit un support visuel direct et synthétique pour les restitutions scientifiques et rapports de laboratoire.
11. Limites méthodologiques, pièges fréquents et controverses
11.1 Le paradoxe des lignes invariables et la perte d’information
L’une des vulnérabilités conceptuelles majeures du test Q de Cochran — fréquemment qualifiée de « paradoxe des lignes invariables » dans la littérature méthodologique — réside dans son insensibilité mathématique structurelle aux sujets présentant des réponses uniformes. Comme démontré lors de la dérivation algébrique de la formule canonique, tout individu obtenant un score de 0 sous toutes les modalités (aucun succès) ou un score de 1 sous toutes les modalités (succès systématique) génère une variance intra-sujet nulle.
Ce postulat computationnel entraîne une conséquence fondamentale : ces participants n’exercent aucune influence sur la statistique de décision du test. Si une étude clinique recrute un échantillon de 200 patients pour comparer trois molécules thérapeutiques, mais que 180 d’entre eux présentent une résistance pharmacologique totale (0 partout) et que les 20 autres manifestent des profils de réponse différentiels, le test Q de Cochran fonctionnera avec une puissance statistique limitée aux 20 sujets informatifs, ignorant totalement les 90 % restants de l’effectif recruté.
Cette particularité impose aux chercheurs une distinction critique entre l’absence d’effet statistique et le manque d’observables discriminants. Dans les cohortes caractérisées par un taux massif de succès faciles (effet de plafond) ou un taux écrasant d’échecs insurmontables (effet de plancher), l’analyste risque d’échouer à rejeter l’hypothèse nulle en raison d’une déflation sévère de la puissance du test, et non parce que les traitements sont réellement équivalents. Avant de conclure à l’interchangeabilité de plusieurs dispositifs expérimentaux, la proportion de blocs non discriminants doit impérativement faire l’objet d’un examen descriptif approfondi.
11.2 Confusion entre plans indépendants et plans appariés
Une confusion récurrente observée dans les publications scientifiques consiste en l’application erronée du test du Chi-deux d’indépendance de Pearson en lieu et place du test Q de Cochran sur des données longitudinales appariées, ou inversement, l’application du test de Cochran sur des groupes indépendants.
L’utilisation du test du Chi-deux classique d’homogénéité ou d’indépendance sur des mesures répétées constitue une faute méthodologique majeure : ce test présuppose fondamentalement l’indépendance stochastique absolue de l’ensemble des observations du tableau de contingence. Or, lorsqu’un même sujet fournit plusieurs réponses au cours du protocole, les observations sont corrélées par essence. L’application du Chi-deux d’indépendance dans un plan apparié surestime dramatiquement l’erreur type d’échantillonnage, aboutit à un nombre erroné de degrés de liberté et fausse le taux d’erreur de première espèce.
À l’inverse, appliquer le test de Cochran à des données issues de k groupes d’individus distincts et indépendants n’a aucun sens mathématique, puisque le concept même de total marginal de ligne Ri repose sur le couplage fonctionnel des réponses d’un bloc homogène. L’analyste doit impérativement cartographier l’architecture de son protocole : des sujets distincts sous chaque condition imposent le test du Chi-deux de Pearson ou la régression logistique binaire standard ; les mêmes sujets évalués sous toutes les conditions imposent le test Q de Cochran ou les modèles mixtes.
11.3 Dichotomisation abusive de variables psychologiques continues
Un autre piège épistémologique réside dans la pratique de la dichotomisation artificielle de variables initialement continues ou ordinales pour forcer l’adéquation des données aux prérequis du test Q de Cochran. En psychopathologie et en psychométrie, il est courant de convertir des scores issus d’inventaires d’anxiété (comme le STAI) ou de dépression (comme le BDI) en variables binaires à l’aide d’un point de césure théorique (par exemple : score ≥ 16 = « Dépressif », score < 16 = « Non dépressif »).
Bien que cette procédure permette l’application formelle du test de Cochran, la littérature statistique contemporaine (MacCallum et al., 2002) a largement démontré le coût méthodologique élevé de la dichotomisation :
- Une perte massive de puissance statistique, équivalant fréquemment à l’élimination pure et simple d’un tiers des sujets recrutés.
- La suppression de toute distinction clinique entre les patients proches du seuil (par exemple, des scores de 15 versus 16 se retrouvent dans deux catégories opposées) et ceux aux extrémités (un score de 17 est assimilé à un score de 40).
- L’augmentation du risque de faux positifs ou de fausses conclusions d’invariance en présence de distributions asymétriques.
Lorsque les instruments de mesure délivrent des scores continus ou polytomiques, il est préférable de préserver la richesse de l’échelle d’origine en employant l’ANOVA à mesures répétées non paramétrique de Friedman, ou, plus optimalement, un modèle linéaire mixte gaussien ou un modèle à effets mixtes cumulatif (modèle logit ordinal mixte), plutôt que d’opérer une binarisation artificielle dans le seul dessein d’utiliser le test de Cochran.
12. Normes de rédaction et communication scientifique selon l’APA
12.1 Règles formelles de présentation des résultats selon la 7e édition de l’APA
La restitution académique des résultats inférentiels issus d’un test Q de Cochran doit se conformer aux standards typographiques et méthodologiques édictés par le manuel de publication de l’American Psychological Association (7e édition). La transparence scientifique exige la communication d’un ensemble structuré d’indicateurs quantitatifs permettant au lecteur d’évaluer la rigueur de l’inférence.
Le formalisme d’énonciation de la statistique Q dans le corps du texte suit des règles d’agencement strictes :
- La lettre identifiant le test, Q, doit être mise en forme en italique majuscule.
- Les degrés de liberté (k − 1) doivent figurer immédiatement entre parenthèses sans espace après la lettre : Q(ddl).
- La taille de l’échantillon valide d’analyse (N) peut être mentionnée entre parenthèses ou spécifiée dans la structure de la phrase.
- La valeur empirique calculée pour la statistique doit être rapportée avec deux ou trois décimales de précision.
- La probabilité critique (p-valeur) doit être libellée en italique minuscule (p) et rapportée avec exactitude (ex. : p = ,006), sans préfixer le zéro avant la virgule dans la tradition anglo-saxonne pure, ou avec le zéro selon les conventions de rédaction francophones adoptées (ex. : p = 0,006). Les formulations vagues du type « p < 0,05 » doivent être proscrites au profit de la valeur exacte, sauf si celle-ci est inférieure à un millième, auquel cas la mention « p < 0,001 » s’impose.
Au-delà de la métrique d’inférence, la communication scientifique selon l’APA impose de fournir systématiquement les statistiques descriptives complètes : les fréquences absolues de succès ainsi que les pourcentages marginaux observés pour chacune des k conditions. De surcroît, la description des analyses secondaires doit documenter avec clarté la procédure post-hoc appliquée (par exemple, tests de McNemar par paires), la méthode de correction de l’erreur par famille retenue (Bonferroni, Holm) et les seuils d’arbitrage corrigés qui en découlent.
12.2 Exemples concrets de paragraphes de résultats pour articles empiriques
Afin de guider la rédaction d’articles scientifiques ou de thèses de doctorat, voici deux modèles formels d’intégration textuelle de résultats d’analyses.
Exemple 1 : Cas d’un résultat statistiquement significatif (rejet de l’hypothèse nulle) :
« Un test Q de Cochran a été conduit afin de déterminer si le taux d’étudiants atteignant le critère de mémorisation réussie (rappel ≥ 80 %) différait significativement en fonction de la technique de révision adoptée (répétition mécanique passive, imagerie mentale visuelle et récupération espacée). Les pourcentages de réussite marginaux observés s’établissent respectivement à 25,0 % (n = 3) pour la répétition, 58,3 % (n = 7) pour l’imagerie visuelle et 91,7 % (n = 11) pour la récupération espacée. L’analyse omnibus révèle une différence statistiquement significative entre les trois conditions d’apprentissage, Q(2) = 10,11, p = 0,006.
Des analyses post-hoc par paires ont été consécutivement réalisées à l’aide de tests exacts de McNemar, en appliquant une correction séquentielle de Holm pour contrôler l’inflation de l’erreur de première espèce par famille (α global = 0,05). La technique de récupération espacée s’avère significativement plus efficace que la simple répétition mécanique (p corrigé = 0,021). En revanche, après ajustement, les contrastes entre la répétition et l’imagerie mentale (p corrigé = 0,180) ainsi qu’entre l’imagerie mentale et la récupération espacée (p corrigé = 0,180) n’atteignent pas le seuil de significativité statistique, bien qu’une tendance clinique favorable à la récupération espacée soit manifeste. »
Exemple 2 : Cas d’un résultat non significatif (maintien de l’hypothèse nulle) :
« Afin d’évaluer l’impact de trois interfaces utilisateur distinctes sur l’occurrence d’erreurs de navigation critiques lors de la réalisation d’une tâche d’évaluation cognitive assistée, un test Q de Cochran a été appliqué aux données binaires recueillies auprès des 25 participants de la cohorte. Les proportions de participants ayant commis au moins une erreur de navigation s’élèvent à 32,0 % (n = 8) sous l’interface classique, 28,0 % (n = 7) sous l’interface tactile et 20,0 % (n = 5) sous l’interface adaptative. Les résultats de l’analyse n’indiquent aucune divergence statistiquement significative des taux d’erreur entre les trois environnements numériques, Q(2) = 1,17, p = 0,558. Ces données soutiennent l’hypothèse nulle d’équivalence fonctionnelle des trois interfaces ergonomiques quant à l’induction d’erreurs opérationnelles. »
Pour parachever la clarté de la restitution, l’insertion d’un tableau synthétique récapitulatif est recommandée dans la section des résultats :
| Condition expérimentale | Succès (n) | Échecs (n) | Proportion de succès (%) | Statistique omnibus |
|---|---|---|---|---|
| Méthode 1 : Répétition | 3 | 9 | 25,0 % |
Q(2) = 10,11 p = 0,006 |
| Méthode 2 : Imagerie | 7 | 5 | 58,3 % | |
| Méthode 3 : Récupération | 11 | 1 | 91,7 % |
12.3 Interprétation substantive et portée clinique des résultats
L’aboutissement d’une recherche quantitative ne saurait se confiner à la simple déclaration d’une significativité statistique formalisée par une p-valeur inférieure à 0,05. L’American Psychological Association insiste particulièrement sur la dissociation fondamentale entre significativité statistique et portée clinique ou substantive. Dans un vaste échantillon comptant des centaines de blocs, un écart de réussite minime de 2 ou 3 % entre des conditions peut atteindre le seuil de rejet de H0 tout en restant parfaitement négligeable sur le plan applicatif ou médical.
Pour quantifier l’ampleur du phénomène au-delà de l’effet de taille de l’échantillon, le calcul d’une mesure de taille d’effet s’avère indispensable. Dans le cadre du test Q de Cochran, plusieurs métriques peuvent être mobilisées. L’une des plus adaptées consiste en l’utilisation du V de Cramér adapté aux plans en blocs ou d’un coefficient de concordance η² dérivé de l’analogie avec le test de Friedman :
η2Q = Q / [ b × (k − 1) ]
Ce coefficient varie théoriquement entre 0 et 1, quantifiant la proportion de variance d’adhésion attribuable au facteur de traitement sous contrôle des blocs. Dans notre étude cognitive numérique, le calcul renvoie : η²Q = 10,105 / [12 × (3 − 1)] = 10,105 / 24 ≈ 0,421. Cette valeur traduit un effet substantiel de très forte intensité selon les critères d’évaluation conventionnels (un η² > 0,14 caractérisant un effet d’ampleur majeure).
Sur le plan translationnel et éthique, le chercheur doit articuler ses conclusions autour de la réalité du terrain clinique ou pédagogique. L’identification d’une technique de récupération espacée générant 91,7 % de succès comparativement à 25 % pour la méthode traditionnelle fournit une base probante justifiant des recommandations pédagogiques directes en milieu éducatif. La dissémination scientifique doit allier rigueur computationnelle, restitution des intervalles d’incertitude et mise en perspective écologique des implications cliniques pour les praticiens.
Références
- Agresti, A. (2002). Categorical data analysis (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289-300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cochran, W. G. (1950). The comparison of percentages in matched samples. Biometrika, 37(3/4), 256-266. https://doi.org/10.2307/2332378
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675-701. https://doi.org/10.1080/01621459.1937.10503522
- Hervé, M. (2020). RVAideMemoire: Testing and plotting procedures for biostatistics (R package version 0.9-79). https://cran.r-project.org/package=RVAideMemoire
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65-70. https://www.jstor.org/stable/4615733
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19-40. https://doi.org/10.1037/1082-989X.7.1.19
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153-157. https://doi.org/10.1007/BF02295996
- Patil, K. D. (1975). Cochran’s Q test: Exact distribution. Journal of the American Statistical Association, 70(349), 186-189. https://doi.org/10.1080/01621459.1975.10480283
- Siegel, S., & Castellan, N. J. (1988). Nonparametric statistics for the behavioral sciences (2nd ed.). McGraw-Hill.