
Dans le champ de l’économétrie appliquée, de la biométrie et de la psychométrie contemporaine, la modélisation statistique ne saurait se réduire à l’ajustement mécanique d’une droite de régression sur un nuage d’observations empiriques. Trop souvent, les analystes de données succombent au mirage d’un coefficient de détermination substantiel, postulant hâtivement la validité de la relation postulée sans interroger la fidélité de l’architecture fonctionnelle sous-jacente. Pourtant, l’estimation des moindres carrés ordinaires repose sur une hypothèse fondamentale d’adéquation structurale : le modèle spécifié doit refléter fidèlement la véritable espérance conditionnelle de la variable dépendante sachant les régresseurs. Lorsqu’une fonction linéaire est imposée à un phénomène intrinsèquement curvilinéaire, les estimations paramétriques s’avèrent biaisées, la variance résiduelle se trouve artificiellement gonflée et les inférences déduites des tests d’hypothèses perdent toute validité théorique et pratique.
Pour répondre à cette vulnérabilité méthodologique, le test de manque d’ajustement, communément désigné sous l’appellation anglo-saxonne de Lack of Fit Test, constitue un outil inférentiel décisif. Issu des travaux pionniers de l’analyse de la variance et de la théorie des modèles linéaires développés par Ronald Fisher et formalisés ultérieurement dans les manuels de référence en régression appliquée, ce test permet d’arbitrer rigoureusement entre deux sources de déviation : la variance purement stochastique inhérente au processus d’échantillonnage et l’erreur d’ajustement attribuable à une mauvaise spécification de la forme fonctionnelle. En décomposant la somme des carrés résiduels, le chercheur dispose d’une métrique objective pour déterminer si les écarts constatés entre valeurs observées et valeurs prédites relèvent du bruit aléatoire ou de l’omission fautive d’un terme polynomial, logarithmique ou interactif.
Cet article propose un protocole exhaustif et didactique destiné aux chercheurs, statisticiens et praticiens désireux de maîtriser la mise en œuvre, l’interprétation et le diagnostic du test de manque d’ajustement dans l’environnement de calcul R. En abordant successivement les soubassements algébriques du test, la formalisation des modèles emboîtés, la génération d’un ensemble de données simulées reproduisant des dynamiques d’apprentissage non linéaires, ainsi que les extensions diagnostiques et les conventions de restitution académique aux normes de l’American Psychological Association (APA), ce guide entend doter le lecteur d’un cadre méthodologique rigoureux garantissant l’intégrité de ses analyses quantitatives.
## 1. Fondements théoriques du test de manque d’ajustement (Lack of Fit Test)
### 1.1 Définition et postulats mathématiques de l’adéquation du modèle
L’adéquation globale d’une fonction de régression aux données empiriques renvoie à sa capacité à capturer fidèlement la structure déterministe reliant la variable réponse aux variables explicatives. Sur le plan formel, considérons un modèle linéaire général où l’espérance mathématique conditionnelle de la variable dépendante $Y$ sachant le vecteur de régresseurs $X$ est postulée sous la forme $\mathbb{E}(Y|X) = f(X; \beta)$. Dans le cadre de la régression linéaire standard, la fonction $f$ est présumée être une combinaison linéaire de paramètres inconnus. L’adéquation du modèle est vérifiée si et seulement si l’écart entre la véritable fonction de régression de la population, notée $\mu(X)$, et la fonction paramétrique choisie $f(X; \beta)$ est identiquement nul pour toutes les valeurs du domaine de définition.
Il convient d’établir une distinction fondamentale entre la sous-spécification structurelle et la variance résiduelle aléatoire. La variance résiduelle aléatoire représente les fluctuations stochastiques incompressibles générées par des variables non mesurées, le bruit de mesure ou la nature intrinsèquement probabiliste du phénomène étudié. En revanche, la sous-spécification structurelle, ou erreur d’ajustement, découle du choix erroné d’une forme fonctionnelle inadéquate, par exemple l’approximation d’une courbe sigmoïde ou parabolique par un segment de droite. Cette dernière introduit un biais systématique dans l’estimation de l’ordonnée à l’origine et des pentes de régression, faussant irrémédiablement l’interprétation substantielle des paramètres.
L’hypothèse nulle du test d’adéquation stipule que le modèle restreint, généralement linéaire, capture adéquatement la relation fonctionnelle moyenne. Sous cette hypothèse nulle, les résidus observés ne doivent refléter que l’aléa d’échantillonnage. La validité de cette inférence repose sur le respect scrupuleux des postulats classiques du théorème de Gauss-Markov et de la régression normale : l’indépendance mutuelle des perturbations, l’homoscédasticité (constance de la variance des erreurs sur l’ensemble du domaine des prédicteurs) et la normalité de leur distribution conditionnelle. Si l’un de ces postulats est enfreint, la statistique de test construite pour évaluer le manque d’ajustement peut voir sa distribution d’échantillonnage altérée, conduisant à des taux d’erreur de type I ou de type II incontrôlés.
### 1.2 Erreur pure versus erreur de manque d’ajustement
L’élégance mathématique du test d’adéquation réside dans la décomposition orthogonale de la somme des carrés des résidus, conventionnellement notée $SS_{Res}$ ou $RSS$. Dans une configuration expérimentale ou observationnelle où des observations répétées de la variable réponse sont disponibles pour des valeurs strictement identiques des variables explicatives, la somme totale des carrés résiduels peut être partitionnée de manière univoque en deux composantes indépendantes : la somme des carrés due à l’erreur pure ($SS_{PE}$) et la somme des carrés imputable au manque d’ajustement structurel ($SS_{LOF}$). Algébriquement, cette relation s’exprime sous la forme fondamentale :
$$SS_{Res} = SS_{LOF} + SS_{PE}$$
La somme des carrés de l’erreur pure ($SS_{PE}$) mesure la variabilité intra-groupe constatée entre les réplicats exacts partageant le même niveau du régresseur. Puisque ces observations possèdent des valeurs de prédicteurs identiques, toute dispersion constatée au sein de chaque groupe ne peut être attribuée à une défaillance de la fonction de régression postulée, mais relève exclusivement de la variabilité biologique, psychologique ou environnementale naturelle. Cette quantité fournit ainsi un estimateur non biaisé et indépendant du modèle de la variance d’erreur intrinsèque, notée $\sigma^2$. En soustrayant cette composante pure de la somme des carrés résiduels totale, on isole la quantité $SS_{LOF}$, qui quantifie l’écart systématique existant entre la moyenne empirique locale de chaque groupe de réplicats et la valeur théorique projetée par le modèle de régression ajusté.
À partir de cette partition, on calcule les carrés moyens respectifs en divisant chaque somme de carrés par ses degrés de liberté associés. Si le modèle compte $n$ observations réparties sur $c$ niveaux distincts de la variable explicative, l’erreur pure dispose de $n – c$ degrés de liberté, tandis que le manque d’ajustement se voit allouer $c – p$ degrés de liberté, où $p$ représente le nombre de paramètres estimés dans le modèle de régression. La statistique de test $F$ est alors construite selon le rapport des variances :
$$F = \frac{MS_{LOF}}{MS_{PE}} = \frac{SS_{LOF} / (c – p)}{SS_{PE} / (n – c)}$$
Sous l’hypothèse nulle selon laquelle la forme fonctionnelle choisie est rigoureusement exacte, ce quotient suit asymptotiquement et exactement une loi de Fisher-Snedecor à $(c – p)$ et $(n – c)$ degrés de liberté. Un ratio substantiellement supérieur à l’unité indique que les déviations par rapport à la droite de régression excèdent ce qui peut être raisonnablement attribué à la simple variance d’échantillonnage, matérialisant ainsi un manque d’ajustement avéré.
### 1.3 Pertinence méthodologique en psychométrie et modélisation cognitive
Dans les disciplines étudiant le comportement humain, telles que la psychologie cognitive, les sciences de l’éducation et la psychométrie, les relations régissant les processus mentaux dérogent fréquemment aux postulats de stricte linéarité. L’analyse du lien unissant le temps d’apprentissage ou la charge d’entraînement à la performance cognitive illustre exemplairement cette réalité. Des lois empiriques séculaires, à l’instar de la loi de puissance de la pratique théorisée par Newell et Rosenbloom ou de la courbe en cloche de Yerkes-Dodson décrivant l’interaction entre éveil et efficience mnésique, démontrent que les gains d’apprentissage connaissent des phases d’accélération initiale suivies d’une saturation asymptotique, voire d’un déclin lié à l’épuisement cognitif.
Ignorer la nature curviligne de ces phénomènes au profit d’une régression linéaire simple conduit directement au biais d’omission de variables polynomiales. Ce biais a pour conséquence fâcheuse d’attribuer artificiellement à l’erreur stochastique des variations pourtant déterministes et explicables. En psychométrie standardisée, où les instruments de mesure doivent fournir des estimations fidèles du niveau de trait latent ou des capacités d’un sujet, l’emploi d’un modèle structurellement inadapté compromet l’étalonnage des tests, engendre des scores résiduels corrélés aux prédicteurs et altère la validité de construit de l’outil d’évaluation.
En intégrant systématiquement le test de manque d’ajustement dans leur protocole de validation d’échelle ou d’expérimentation comportementale, les chercheurs préviennent les inférences erronées. Le recours à ce test évite de conclure à l’inefficacité relative d’une intervention pédagogique aux extrêmes de l’échelle d’apprentissage, lorsque cette inefficacité apparente n’est en vérité que le reflet d’une droite de régression incapable d’épouser la courbure intrinsèque des données empiriques observées.
## 2. Comparaison entre modèles emboîtés : Modèle complet versus modèle réduit
### 2.1 Formalisation mathématique du modèle réduit linéaire
Le modèle réduit correspond à l’expression la plus parcimonieuse envisagée pour décrire le phénomène sous étude. Dans le cadre d’une régression bivariée reliant une mesure de performance académique ou psychométrique au temps consacré à la tâche, le modèle linéaire simple s’énonce algébriquement ainsi :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i \quad \text{pour } i = 1, dots, n$$
Dans cette équation, $Y_i$ représente le score obtenu par le $i$-ème individu, $X_i$ le nombre d’heures d’étude correspondantes, $\beta_0$ l’ordonnée à l’origine théorique reflétant le niveau de base en l’absence d’apprentissage, et $\beta_1$ la pente marginale constante représentant le gain de score par heure additionnelle investie. Le terme d’erreur stochastique $\varepsilon_i$ est supposé suivre une loi normale centrée d’espérance nulle et de variance homoscédastique $\sigma^2$.
Ce modèle restreint impose une contrainte paramétrique drastique : la dérivée première de la fonction d’espérance par rapport au prédicteur est strictement constante ($\frac{d\mathbb{E}(Y)}{dX} = \beta_1$), ce qui implique que l’impact d’une heure d’étude supplémentaire est rigoureusement identique, que l’apprenant se situe au seuil initial de son apprentissage ou à un stade avancé d’expertise. D’un point de vue géométrique, l’ajustement par la méthode des moindres carrés ordinaires force les prédictions à s’aligner sur une variété linéaire unidimensionnelle au sein du plan euclidien. Cette rigidité structurelle constitue une limitation sévère lorsqu’apparaissent des phénomènes physiologiques ou cognitifs d’accélération ou de saturation des rendements éducatifs.
### 2.2 Spécification du modèle complet polynomial d’ordre supérieur
Afin d’éprouver la robustesse de l’hypothèse de linéarité, le statisticien recourt à la spécification d’un modèle complet intégrant une flexibilité courbée par l’adjonction de termes polynomiaux d’ordre supérieur. Pour modéliser une accélération ou une décélération progressive de la performance, le modèle quadratique s’impose comme l’extension canonique immédiate :
$$Y_i = \beta_0 + \beta_1 X_i + \beta_2 X_i^2 + \varepsilon_i$$
L’inclusion du terme non linéaire $\beta_2 X_i^2$ confère au modèle la capacité de capturer la courbure de la trajectoire empirique. La dérivée première devient une fonction affine de la variable indépendante ($\frac{d\mathbb{E}(Y)}{dX} = \beta_1 + 2\beta_2 X$), permettant au taux de variation marginal de croître ou de décroître continûment selon le signe et la magnitude du coefficient quadratique $\beta_2$.
Sur le plan méthodologique, ce dispositif repose sur le concept fondamental d’emboîtement hiérarchique : le modèle réduit linéaire constitue un sous-espace vectoriel strict du modèle complet polynomial. Il s’obtient instantanément en appliquant la contrainte paramétrique d’égalité $\beta_2 = 0$. Cette structure emboîtée est la condition nécessaire autorisant la comparaison rigoureuse des sommes de carrés par l’analyse de variance, le gain de flexibilité analytique obtenu par l’introduction de la parabole se payant par la consommation délibérée d’un degré de liberté résiduel supplémentaire.
### 2.3 Formulation des hypothèses statistiques associées
La comparaison formelle entre ces deux architectures paramétriques se structure autour d’un test d’hypothèses bilatéral portant sur la valeur du coefficient du terme d’ordre supérieur. L’hypothèse nulle ($H_0$) et l’hypothèse alternative ($H_1$) sont rigoureusement articulées comme suit :
$$H_0 : \beta_2 = 0$$
$$H_1 : \beta_2 \neq 0$$
Sous l’empire de l’hypothèse nulle, la contrainte linéaire est jugée pleinement adéquate pour rendre compte de la réalité empirique ; l’adjonction de la composante quadratique n’apporte aucune réduction substantielle de l’erreur au-delà de ce que la pure fluctuation d’échantillonnage permet d’anticiper. Sous l’hypothèse alternative, la rétention du paramètre quadratique est formellement requise par les données, attestant que la fonction linéaire souffre d’un manque d’ajustement statistiquement significatif.
D’un point de vue épistémologique, le rejet de l’hypothèse nulle transcende le simple exercice de calcul algébrique. Il contraint le théoricien à réviser le cadre conceptuel régissant la dynamique du phénomène étudié. Conclure à la significativité de $\beta_2$ implique l’abandon d’une conception mécaniste et uniforme des gains de performance au profit d’un paradigme dynamique intégrant des effets d’échelle, des seuils d’amorce ou des rendements factoriels non constants dans le processus d’acquisition des compétences.
## 3. Configuration de l’environnement de calcul sous R
### 3.1 Initialisation de la session et gestion de la reproductibilité
La conduite d’analyses statistiques avancées et la mise en œuvre de simulations contrôlées sous l’environnement de programmation R requièrent une discipline rigoureuse afin de garantir la stricte reproductibilité des inférences produites. Les générateurs de nombres pseudo-aléatoires intégrés au noyau de R s’appuient sur des algorithmes déterministes initialisés par une graine numérique spécifique. L’exécution préalable et impérative de l’instruction set.seed(1) assure que les vecteurs stochastiques générés lors des étapes subséquentes demeureront strictement identiques lors de chaque réplication de la routine de calcul, indépendamment de la plateforme matérielle ou de la version du moteur d’exécution.
Parallèlement, la configuration des options globales de la session optimise le confort analytique et prévient les artefacts visuels préjudiciables à la lecture des résultats. Le paramétrage de l’option de précision numérique via la commande options(digits = 5, scipen = 999) évite l’écueil d’affichages tronqués prématurément ou de recours intempestif à la notation scientifique exponentielle lors de l’inspection de coefficients de régression modestes. Enfin, une bonne hygiène logicielle commande de purger l’espace de travail résiduel avant d’engager la chaîne d’estimation, prévenant toute collision de variables par l’appel méthodique de l’instruction rm(list = ls()).
### 3.2 Présentation et chargement de la suite logicielle nécessaire
L’écosystème logiciel de R offre une polyvalence remarquable pour l’estimation de modèles linéaires, permettant de mener à bien le test de manque d’ajustement sans nécessairement dépendre d’extensions tierces complexes. Les fonctions natives du moteur de base, au premier rang desquelles figurent lm() pour l’ajustement par les moindres carrés et anova() pour le calcul des sommes de carrés séquentielles ou partielles, constituent le socle computationnel incontournable. Ces fonctions éprouvées assurent une rapidité de convergence et une stabilité numérique irréprochables pour l’algèbre matricielle sous-jacente.
Toutefois, pour satisfaire aux exigences modernes de la visualisation exploratoire et du diagnostic résiduel poussé, l’intégration de bibliothèques tierces reconnues par la communauté académique s’avère hautement profitable. Le package ggplot2 standardise la production graphique en appliquant les principes formels de la grammaire des graphiques théorisée par Leland Wilkinson. Pour les procédures de diagnostic paramétrique avancé, les bibliothèques spécialisées car (développée par John Fox et Sanford Weisberg pour l’analyse de régression appliquée) et olsrr offrent des modules clés en main pour l’inspection des écarts aux postulats gaussiens et le calcul automatique du test d’erreur pure.
### 3.3 Bonnes pratiques de programmation pour la régression appliquée
La rigueur méthodologique en statistique computationnelle dépend intimement de la structuration des tableaux de données manipulés. L’ensemble des variables mobilisées dans le cadre de la modélisation doit être consigné au sein d’une structure rectangulaire dédiée de classe data.frame, où chaque ligne correspond univoquement à une unité expérimentale ou observationnelle et chaque colonne à un prédicteur ou une variable réponse clairement identifiée par une étiquette mnémonique explicite. Les désignations ambiguës ou génériques doivent être systématiquement proscrites au profit d’identifiants porteurs de sens sémantique, à l’exemple de hours et score.
De surcroît, le statisticien veillera scrupuleusement à contrôler la typologie interne des vecteurs avant tout appel aux algorithmes d’estimation. L’assignation involontaire d’un type textuel ou d’un facteur qualitatif à une variable intrinsèquement métrique modifierait radicalement l’interprétation des matrices d’expérimentation générées en coulisse par les formules de modélisation de R. Enfin, l’inspection préventive des valeurs manquantes au moyen d’instructions telles que anyNA() garantit que la taille de l’échantillon ne subira pas d’imputation silencieuse ou de filtrage par liste d’observations non documenté, susceptible de distordre les degrés de liberté résiduels lors de l’exécution des tests d’ajustement.
## 4. Étape 1 : Simulation et structuration du jeu de données empirique
### 4.1 Génération contrôlée des variables d’étude et de performance
Pour illustrer de manière limpide la mécanique du test de manque d’ajustement, la simulation d’un ensemble de données synthétiques dont nous maîtrisons parfaitement les paramètres générateurs s’impose comme une démarche pédagogique d’une grande efficacité démonstrative. Nous postulons une étude fictive portant sur cinquante étudiants universitaires ($N = 50$), une taille d’échantillon tout à fait représentative des paradigmes d’apprentissage en psychologie expérimentale et suffisamment modérée pour permettre un suivi granulaire des observations.
La variable indépendante, matérialisant l’effort d’apprentissage exprimé en heures d’étude hebdomadaires, est générée de manière uniforme sur un intervalle réaliste compris entre 5 et 15 heures de travail. L’usage de la fonction runif(n = 50, min = 5, max = 15) assure une couverture homogène du spectre continu des heures d’investissement. Concomitamment, le score théorique de départ en l’absence de tout entraînement intensif est ancré à un niveau standard moyen fixé déterministement à une constante de base de 50 points, simulant le plancher de compétences partagé par l’ensemble de la cohorte étudiée.
### 4.2 Modélisation de la relation non linéaire délibérée
Le cœur méthodologique de la simulation repose sur l’injection délibérée d’une composante de courbure non linéaire dans l’équation génératrice de la variable réponse. Afin d’émuler un processus cognitif où l’accumulation des heures de révision finit par engendrer un gain marginal croissant à mesure que les schémas conceptuels se consolident, nous agrémentons le score d’une trajectoire polynomiale cubique ou quadratique pondérée. Dans notre formulation, le terme non linéaire déterministe est calibré selon le terme d’amplification (hours^3) / 150, induisant une flexion ascendante marquée de la courbe de performance pour les valeurs élevées du prédicteur.
À cette composante structurelle s’ajoute une perturbation stochastique modélisant la variabilité individuelle irréductible des capacités d’assimilation des sujets. L’aléa probabiliste est formulé par l’adjonction d’un terme résiduel intégrant une légère hétérogénéité d’échelle, formulé en programmation R sous la forme hours * runif(50, 1, 2). Par cette construction sophistiquée, nous connaissons à l’avance la réalité sous-jacente du phénomène : la véritable structure relationnelle est indiscutablement non linéaire. Dès lors, le modèle linéaire simple qui sera ajusté lors des étapes suivantes se trouvera intrinsèquement en situation de sous-spécification théorique, fournissant le cas d’école idéal pour éprouver la sensibilité du test d’adéquation.
### 4.3 Inspection tabulaire et contrôle d’intégrité des données
Une fois le jeu de données généré et structuré au sein d’un conteneur rectangulaire via l’assignation df <- data.frame(hours = hours, score = score), une inspection empirique immédiate est requise pour en certifier la validité computationnelle. L’appel de l’instruction head(df, 6) permet d’afficher les premiers enregistrements individuels, révélant la coexistence cohérente des valeurs d’heures décimales et des scores résultants.
L’évaluation des propriétés distributionnelles s’effectue ensuite par le biais de la fonction généraliste summary(df). Cette commande extrait instantanément les indicateurs statistiques de position et de dispersion : le minimum, le premier quartile, la médiane, la moyenne arithmétique, le troisième quartile ainsi que le maximum pour chaque vecteur numérique. L’examen attentif de ces sorties valide l’absence totale d’anomalies de calcul, attestant que l’ensemble des scores simulés demeure circonscrit dans des limites psychométriquement plausibles, exemptes de toute valeur négative aberrante ou d’incohérences de distribution susceptibles de fausser les étapes subséquentes de la modélisation paramétrique.
## 5. Étape 2 : Exploration visuelle préliminaire de la trajectoire fonctionnelle
### 5.1 Visualisation bidimensionnelle fondamentale avec plot()
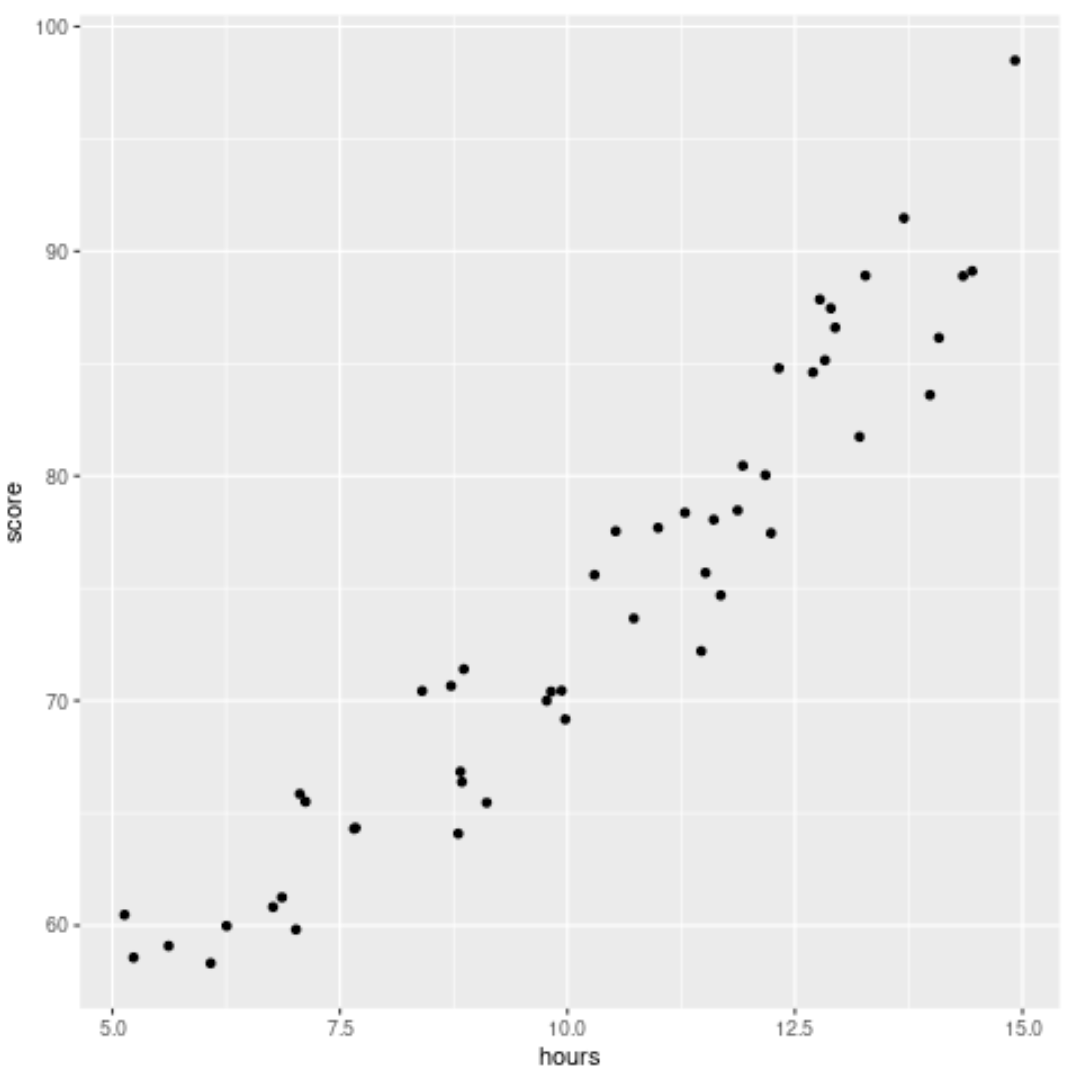
Avant d’engager la moindre régression paramétrique formelle, le statisticien rigoureux procède impérativement à une exploration visuelle approfondie de l’espace bivarié. La fonction graphique native de base plot() fournit une interface directe pour projeter la distribution bidimensionnelle des cinquante observations générées. En renseignant précisément les arguments graphiques fondamentaux — x = df$hours, y = df$score, en adoptant des symboles pleins via pch = 19 et en spécifiant une coloration élégante et lisible —, le praticien matérialise instantanément la configuration spatiale des données.
L’analyse visuelle attentive de ce nuage de points élémentaire dévoile immédiatement une caractéristique structurelle saillante : la relation reliant les heures d’étude à la performance ne semble point progresser selon un accroissement régulier et rectiligne. On observe au contraire une concavité dirigée vers le haut, les scores stagnants modérément pour les volumes d’étude compris entre 5 et 8 heures avant d’entamer une ascension vertigineuse dès lors que le seuil des 10 à 12 heures est franchi. Ce constat purement visuel constitue le premier indice tangible suggérant l’inaptitude probable d’un segment de droite à résumer fidèlement la dispersion observée.
### 5.2 Tracé graphique avancé et ajustement local avec ggplot2
Pour corroborer graphiquement cette intuition préliminaire sans préjuger arbitrairement de la fonction mathématique exacte régissant la trajectoire, l’utilisation de la bibliothèque avancée ggplot2 s’avère déterminante. Par la composition en couches successives, nous déclarons le canevas esthétique initial ggplot(df, aes(x = hours, y = score)) auquel nous agrégeons la représentation géométrique des points d’observation par geom_point(), caractérisés par une légère transparence pour déceler d’éventuels chevauchements locaux.
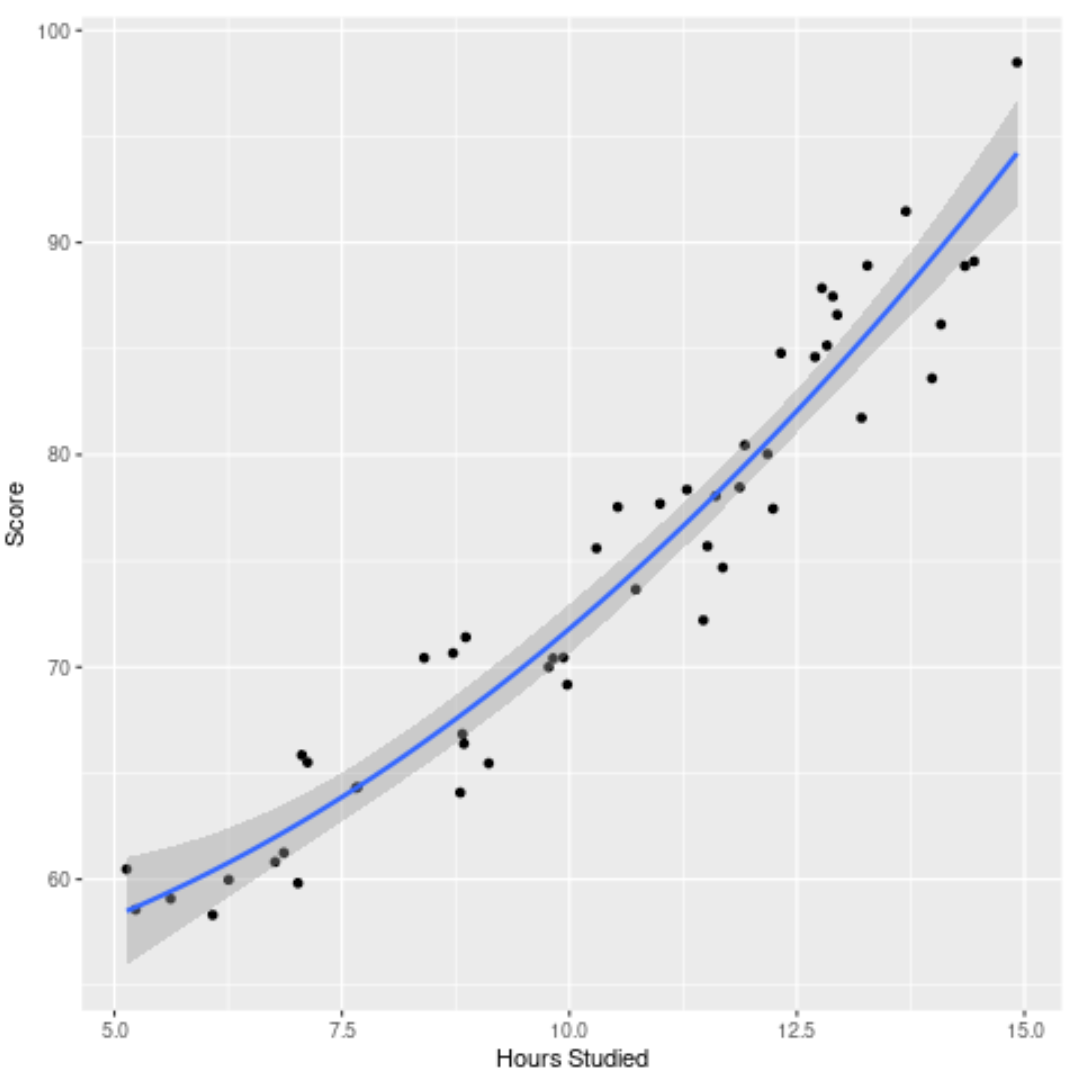
L’apport fondamental réside dans l’adjonction d’une couche d’ajustement non paramétrique locale via l’instruction geom_smooth(method = "loess", color = "darkblue", fill = "lightblue", se = TRUE). La méthode LOESS (Locally Estimated Scatterplot Smoothing) ajuste une succession de régressions polynomiales locales pondérées au voisinage de chaque point, permettant à la courbe estimée de se déformer librement en fonction de la topographie réelle des données, sans la contrainte d’une formule globale fermée. La trajectoire souple ainsi dessinée, flanquée de ses bandes de confiance statistiques à 95 %, met spectaculairement en exergue l’écart de trajectoire par rapport à la droite de régression des moindres carrés, rendant la courbure empirique irréfutable pour le regard du chercheur.
### 5.3 Interprétation préliminaire de l’insuffisance linéaire
La confrontation graphique simultanée de la droite linéaire et de la courbe non paramétrique LOESS révèle les manifestations caractéristiques du biais de spécification fonctionnelle. On constate une distorsion systématique et directionnelle : pour les valeurs minimales d’heures d’étude (comprises entre 5 et 7 heures), la droite linéaire surévalue sensiblement la performance moyenne des individus ; dans la plage intermédiaire (entre 8 et 11 heures), la droite tend au contraire à sous-estimer la réalité ; enfin, sur le segment supérieur des heures intensives, la modélisation linéaire s’avère à nouveau systématiquement déficitaire face à l’accélération subite des scores.
Cette régularité dans la déviation n’a rien de commun avec le comportement d’un bruit résiduel purement aléatoire. Dans une situation où l’hypothèse de linéarité est exacte, les résidus doivent osciller de manière totalement erratique et symétrique de part et d’autre de la droite directrice, sans qu’aucun motif spatial cohérent ne puisse y être décelé. L’existence flagrante de ce schéma de courbure systématique disqualifie de facto la simple dispersion résiduelle comme explication causale et justifie pleinement l’obligation méthodologique de recourir à un test formel de manque d’ajustement pour statuer rigoureusement sur le plan inférentiel.
## 6. Étape 3 : Estimation et diagnostic du modèle de régression réduit
### 6.1 Implémentation sous R avec la fonction lm()
L’estimation formelle du modèle réduit contraint s’exécute sous R par l’intermédiaire de la fonction fondamentale d’ajustement linéaire par les moindres carrés ordinaires. La commande dédiée s’écrit avec limpidité :
modele_reduit <- lm(score ~ hours, data = df)
Dans cette syntaxe canonique, l’opérateur tilde structure la relation fonctionnelle en assignant la variable score comme réponse conditionnée par l’unique prédicteur continu hours. L’environnement R procède alors à la résolution matricielle classique $(X’X)^{-1}X’Y$ pour déterminer le vecteur des paramètres d’ordonnée à l’origine ($\hat{\beta}_0$) et de pente linéaire unitaire ($\hat{\beta}_1$).
Sur le plan des degrés de liberté associés à cette première spécification, la théorie statistique enseigne que pour un échantillon comportant $n = 50$ observations individuelles et exigeant l’estimation de deux paramètres fixes distincts (l’intercept et le coefficient directeur), les degrés de liberté résiduels s’établissent rigoureusement à $n – p = 50 – 2 = 48$. L’évaluation de ces degrés de liberté résiduels revêt une importance fondamentale, car ils représentent le dénominateur dimensionnel qui servira ultérieurement à normaliser la somme des carrés lors des comparaisons de modèles emboîtés.
### 6.2 Analyse critique des sorties statistiques du modèle restreint
L’invocation de la commande summary(modele_reduit) génère la table classique de décomposition statistique, dont l’examen candide pourrait abuser le chercheur inattentif. En effet, le coefficient de pente associé aux heures d’étude affiche généralement une p-valeur hautement significative, bien inférieure au seuil critique conventionnel de 0.001, attestant de l’existence d’une association monotone indéniable entre le temps passé et le score acquis. Parallèlement, le coefficient de détermination global ($R^2$), ainsi que sa déclinaison ajustée pénalisant le nombre de régresseurs, atteint des valeurs impressionnantes, fréquemment supérieures à 0.70 ou 0.80.
Cette configuration illustre magistralement le célèbre paradoxe de l’adéquation linéaire : un $R^2$ très élevé ne constitue en aucune manière une preuve de l’exactitude de la forme fonctionnelle choisie. Le coefficient de détermination ne mesure que la proportion de variance totale expliquée par le sous-espace linéaire projeté ; il demeure totalement aveugle à la courbure locale ou aux défauts d’ajustement systématiques. Un modèle de régression peut afficher un ajustement global quantitativement robuste tout en étant dramatiquement sous-spécifié sur le plan structurel, d’où le danger mortel de fonder la validation d’un paradigme de recherche sur le seul constat d’un $R^2$ flatteur.
### 6.3 Analyse des résidus du modèle réduit
L’analyse approfondie du vecteur des résidus ordinaires $\hat{\varepsilon}_i = Y_i – \hat{Y}_i$ constitue l’instrument diagnostique par excellence pour sonder la validité du modèle réduit. L’affichage du premier graphique de diagnostic standard fourni par l’instruction plot(modele_reduit, which = 1) trace précisément la distribution des résidus en ordonnée en regard des valeurs prédites ou ajustées ($\hat{Y}$) en abscisse.
Dans une régression parfaitement spécifiée, le lisseur rouge accompagnant ce graphique doit se superposer à une ligne horizontale plate ancrée à l’ordonnée zéro, signalant une espérance résiduelle constamment nulle. À l’inverse, l’application de cette fonction sur notre modèle restreint met en lumière une déformation géométrique pathognomonique en forme de « U » prononcé. Les résidus prennent des valeurs résolument positives aux extrémités du spectre des prédictions, tandis qu’ils plongent systématiquement dans le domaine négatif dans la zone médiane. Si cette forme en cuvette fournit un diagnostic visuel quasi irréfutable du manque d’ajustement linéaire, l’administration de la preuve en science quantitative exige de dépasser la subjectivité de l’inspection oculaire pour lui adjoindre le couperet probabiliste d’un test d’hypothèse formel.
## 7. Étape 4 : Ajustement et paramétrage du modèle de régression complet
### 7.1 Intégration du terme polynomial dans l’opérateur de formule
Pour surmonter la sous-spécification flagrante du modèle linéaire, il devient nécessaire d’enrichir la structure paramétrique en autorisant une courbure continue d’ordre quadratique. Toutefois, au sein du formalisme de modélisation de R, l’opérateur d’élévation à la puissance ^ possède une signification syntaxique réservée régissant le croisement d’interactions factorielles. Pour forcer l’interpréteur à évaluer mathématiquement le carré de la variable numérique continue avant d’inclure le vecteur résultant dans l’équation d’ajustement, le recours à l’opérateur d’inhibition syntaxique I() est méthodologiquement impératif.
L’estimation du modèle complet s’exécute ainsi selon la formulation rigoureuse :
modele_complet <- lm(score ~ hours + I(hours^2), data = df)
Par cette syntaxe, R comprend que la matrice d’expérimentation doit désormais intégrer trois vecteurs colonnes : le vecteur unitaire alloué à l’ordonnée à l’origine, le vecteur des heures continues et le vecteur des carrés correspondants. Il convient de souligner que, bien que la trajectoire géométrique tracée dans le plan bidimensionnel soit désormais curvilinéaire et non rectiligne, ce modèle demeure rigoureusement qualifié de linéaire au sens de l’algèbre statistique, car il conserve une relation de stricte linéarité vis-à-vis de son vecteur de paramètres inconnus ($\beta_0, \beta_1, \beta_2$).
### 7.2 Évaluation comparative des statistiques d’ajustement individuel
L’inspection des nouvelles métriques produites par summary(modele_complet) atteste de la supériorité substantielle apportée par l’extension quadratique. La première indication tangible réside dans la réduction drastique de l’erreur standard des résidus (RSE pour Residual Standard Error), qui quantifie l’écart-type non modélisé de la variable réponse ; cette valeur s’affaisse nettement par rapport au modèle réduit, traduisant un rapprochement physique des prédictions théoriques vers les points de données effectifs.
Simultanément, le coefficient de détermination ajusté ($R^2_{adj}$) connaît une progression incrémentale positive ($\Delta R^2$), démontrant que le gain de variance expliquée obtenu par l’introduction du terme polynomial compense très largement la pénalité mathématique liée à la consommation d’un degré de liberté supplémentaire. Enfin, le test de Student associé spécifiquement au coefficient quadratique $\hat{\beta}_2$ rejette l’hypothèse de nullité avec un niveau de confiance exceptionnel, confirmant formellement que l’adjonction de la composante parabolique n’est pas un artefact d’échantillonnage mais reflète une propriété structurelle prégnante de la population étudiée.
### 7.3 Implications psychologiques et théoriques de l’accélération quadratique
Sur le terrain substantiel de la psychologie de l’éducation et de l’apprentissage cognitif, la transition du modèle linéaire au modèle complet quadratique transforme radicalement les conclusions théoriques que l’on peut extraire de la recherche. L’estimation d’un coefficient quadratique positif ($\hat{\beta}_2 > 0$) entérine l’existence de rendements d’apprentissage croissants. Cela signifie concrètement que les premières heures d’étude permettent de poser les fondations cognitives indispensables, mais que chaque heure additionnelle consacrée au-delà d’un certain seuil produit une accélération exponentielle dans la maîtrise des concepts complexes.
Cette modélisation permet d’identifier empiriquement des paliers critiques d’investissement horaire en deçà desquels l’effort consenti demeure sous-optimal, optimisant ainsi la conception des programmes de remédiation académique. Néanmoins, la prudence épistémologique commande de délimiter rigoureusement la validité de ce modèle quadratique à la plage d’observation empirique couverte par l’étude, soit entre 5 et 15 heures. L’extrapolation sans contrôle mathématique au-delà de ces bornes exposerait le modélisateur à des prédictions délirantes, une fonction polynomiale d’ordre deux ayant pour propriété inhérente de diverger vers l’infini, alors même que la réalité physiologique impose inéluctablement des limites de saturation mnésique ou d’épuisement mental.
## 8. Étape 5 : Exécution du test de manque d’ajustement via l’analyse de variance
### 8.1 Mise en œuvre algorithmique avec anova()
Ayant ajusté séquentiellement le modèle restreint linéaire et le modèle complet quadratique emboîté, le chercheur dispose de tous les éléments nécessaires pour procéder à l’arbitrage probabiliste formel du test de manque d’ajustement. Sous le système R, la comparaison rigoureuse de modèles emboîtés ne nécessite le déploiement d’aucune macro complexe : elle est assurée directement par l’appel de la fonction générique d’analyse de variance, en lui passant successivement comme arguments les deux objets de modélisation préalablement créés :
anova(modele_reduit, modele_complet)
Le mécanisme algorithmique interne activé par cet appel calcule la différence arithmétique exacte existant entre les sommes des carrés résiduels des deux modèles, formalisée par la quantité fondamentale :
$$SS_{Diff} = RSS_{Reduit} – RSS_{Complet}$$
Cette variation de la déviance résiduelle mesure très exactement le gain d’ajustement global conféré par le passage de la droite à la parabole. Simultanément, la fonction calcule le degré de liberté associé au numérateur du test, qui s’obtient par la simple soustraction des degrés de liberté respectifs :
$$Df_{Diff} = Df_{Reduit} – Df_{Complet} = 48 – 47 = 1$$
Le test d’ANOVA évalue ainsi de manière compacte si cette réduction de variance par degré de liberté consommé dépasse ce que le pur hasard d’échantillonnage pourrait raisonnablement engendrer sous l’hypothèse de linéarité stricte.
### 8.2 Décorticage exhaustif du tableau d’ANOVA résultant
L’exécution de la commande produit une table de synthèse structurée en deux lignes d’enregistrement dont la décomposition analytique détaillée permet de comprendre chaque facette du test :
La première ligne du tableau synthétise les propriétés géométriques du modèle réduit. Elle affiche les 48 degrés de liberté résiduels ($Res.Df$) et consigne la somme totale des carrés résiduels de ce modèle linéaire restreint ($RSS_1$), qui intègre indifférenciée la variance d’erreur pure et l’erreur de mauvaise spécification structurelle.
La seconde ligne renseigne les paramètres du modèle complet intégrant la courbure quadratique. On y observe la consommation d’une unité de liberté ($Res.Df = 47$) et l’effondrement corollaire de la somme des carrés résiduels ($RSS_2$). Les colonnes de différentiation affichent la somme des carrés additionnelle conquise ($Sum of Sq$) ainsi que la statistique de test empirique $F$, obtenue par la dérivation mécanique :
$$F = \frac{(RSS_1 – RSS_2) / (Df_1 – Df_2)}{RSS_2 / Df_2} = \frac{(RSS_1 – RSS_2) / 1}{RSS_2 / 47}$$
Enfin, la dernière colonne fournit la probabilité critique asymptotique associée, notée Pr(>F). Cette p-valeur représente la probabilité exacte d’observer un tel différentiel d’adéquation entre les deux architectures si la véritable dynamique sous-jacente de la population était strictement gouvernée par le modèle réduit linéaire.
### 8.3 Décision statistique et conclusion méthodologique
Face à une probabilité critique Pr(>F) qui s’affiche sous la forme d’un nombre infinitésimal, largement inférieur au seuil de significativité nominal $\alpha = 0.05$ (et même au seuil conservateur de $\alpha = 0.001$), la sentence inférentielle s’impose avec une force mathématique irréfutable : nous rejetons catégoriquement l’hypothèse nulle d’adéquation du modèle restreint.
La conclusion méthodologique s’articule dès lors avec une absolue limpidité : le modèle de régression linéaire simple souffre d’un manque d’ajustement structurellement et statistiquement significatif. L’inclusion du terme non linéaire d’ordre supérieur apporte une amélioration hautement déterminante à la qualité de prédiction de la trajectoire empirique. Le maintien du modèle linéaire pour formuler des prédictions ou pour caractériser l’effet marginal de la variable d’étude constituerait une faute d’analyse, la droite ne reflétant qu’une projection appauvrie et distordue de la véritable relation curvilinéaire unissant l’investissement temporel à l’efficience psychométrique observée.
## 9. Méthode alternative : Le test de manque d’ajustement basé sur l’erreur pure
### 9.1 Conditions d’application et nécessité de répétitions exactes
Si l’approche par comparaison de modèles emboîtés polynomiale développée précédemment résout élégamment le problème de la spécification, il existe une formulation statistique encore plus pure et canonique de ce test, formulée initialement pour les protocoles expérimentaux hautement contrôlés. Cette méthode, qualifiée de test d’adéquation basé sur l’erreur pure (Pure Error Lack of Fit Test), ne requiert aucunement de deviner à l’avance la forme du modèle supérieur (quadratique, cubique, etc.). En revanche, elle impose une condition expérimentale stricte : la présence de répétitions ou réplicats exacts au sein du jeu de données empirique.
Pour appliquer ce protocole rigoureux, il est impératif que plusieurs individus différents partagent des valeurs rigoureusement identiques pour chaque prédicteur ($X_1 = X_2 = dots = X_k$). Cette configuration permet de calculer la variance locale des réponses au sein de chaque bloc de valeurs identiques sans formuler la moindre hypothèse paramétrique sur la forme globale de la fonction de liaison. On obtient ainsi une estimation de la variance d’erreur pure $\sigma^2$ qui est dite « modèle-libre » (model-free). Lorsque le recueil s’opère sur des variables continues à décimales multiples rendant les réplicats naturels impossibles, une stratégie méthodologique répandue consiste à opérer une discrétisation ou un arrondi contrôlé du prédicteur afin de reconstituer artificiellement des grappes de réplication locale sans dénaturer l’information métrique fondamentale.
### 9.2 Utilisation de packages spécialisés (alr4 et olsrr)
Le calcul manuel des partitions de sommes de carrés intra-niveaux pour extraire l’erreur pure pouvant s’avérer fastidieux, la communauté R a développé des extensions spécialisées intégrant des routines automatisées de décomposition. L’ouvrage de référence de Sanford Weisberg est accompagné du package alr4 (Applied Linear Regression), qui implémente la fonction directe pureErrorAnova(). En soumettant simplement l’objet de régression linéaire à cette fonction, l’analyste obtient instantanément une table d’analyse de variance désagrégeant les résidus ordinaires en leurs composantes exactes de manque d’ajustement et d’erreur pure.
De manière analogue et moderne, le package olsrr (conçu pour l’enseignement et le diagnostic exhaustif des moindres carrés ordinaires) propose la fonction ols_pure_error_anova(modele_reduit). Cette commande extrait un tableau synthétique affichant distinctement la ligne Lack of Fit, avec ses degrés de liberté ($c – 2$), sa somme de carrés dédiée et son carré moyen, confrontée directement à la ligne Pure Error avec ses degrés de liberté ($n – c$). La statistique $F$ résultante fournit un test d’adéquation absolu : elle ne teste pas si un modèle quadratique est préférable, mais si *n’importe quel* modèle continu régulier pourrait jamais combler le fossé existant entre la fonction linéaire et les moyennes locales empiriques.
### 9.3 Comparaison critique entre approche par modèles emboîtés et erreur pure
Le choix entre l’approche par modèles emboîtés et l’approche par décomposition de l’erreur pure procède d’un arbitrage méthodologique guidé par le devis de recherche et la structure des données disponibles. L’approche par modèles emboîtés brille par sa flexibilité opérationnelle sans faille : elle est directement applicable aux designs purement observationnels où les prédicteurs continus ne présentent aucun réplicat strict, dispensant le chercheur d’opérer des discrétisations arbitraires souvent critiquables sur le plan métrologique. Son unique faiblesse réside dans le fait qu’elle demeure un test conditionnel à l’alternative spécifiée ; elle teste l’adéquation contre une fonction polynomiale donnée, mais pourrait manquer d’autres formes de déviations complexes, telles que des ruptures de pente ou des périodicités cycliques locales.
À l’inverse, le test de l’erreur pure représente l’idéal de rigueur théorique dans le cadre de protocoles factoriels ou de psychologie expérimentale où le praticien administre des doses de traitement ou des durées calibrées selon un plan fixe (par exemple 5, 10, 15 heures d’entraînement avec dix sujets affectés à chaque condition). Dans un tel contexte, la statistique d’erreur pure est irréfutable car elle est imperméable à toute erreur de spécification théorique du chercheur. Les deux approches s’avèrent ainsi remarquablement complémentaires : l’erreur pure confirme définitivement l’insuffisance du modèle ajusté face au bruit biologique absolu, tandis que l’approche par modèles emboîtés guide le théoricien vers la forme fonctionnelle correctrice la plus adaptée pour réhabiliter l’adéquation empirique de son modèle de régression.
## 10. Diagnostic approfondi des résidus des modèles comparés
### 10.1 Évaluation de l’homoscédasticité et tests formels
L’inférence paramétrique validée par le test $F$ du manque d’ajustement repose structurellement sur l’hypothèse d’homoscédasticité des perturbations aléatoires, postulant que la dispersion des erreurs demeure invariante quel que soit le niveau des variables prédictrices. Si cette prémisse est violée, la statistique $F$ d’analyse de variance peut se trouver biaisée, augmentant artificiellement le risque de rejeter indûment le modèle réduit (fausse détection d’un manque d’ajustement) ou masquant une véritable insuffisance structurelle sous une variance instable.
Pour diagnostiquer la stabilité de la variance résiduelle du modèle complet, le praticien examine prioritairement le troisième graphique d’affichage diagnostique via l’instruction plot(modele_complet, which = 3), illustrant l’écart-type résiduel standardisé en fonction des valeurs ajustées (Scale-Location plot). Une ligne de lissage horizontale et des points dispersés de façon homogène confirment l’homoscédasticité. Pour substituer à cette inspection visuelle une sanction probabiliste formelle, on fait appel au test de Breusch-Pagan, disponible au sein de la bibliothèque lmtest par la commande bptest(modele_complet). L’obtention d’une p-valeur supérieure au seuil d’usage de 0.05 autorise à conserver l’hypothèse de variance constante, consolidant ainsi la crédibilité statistique du test d’ajustement opéré.
### 10.2 Vérification de l’hypothèse de normalité résiduelle
Le second pilier théorique garantissant la convergence exacte de la statistique de test d’analyse de variance vers la distribution théorique de Fisher-Snedecor réside dans la normalité de la distribution des perturbations conditionnelles. Bien que le théorème central limite confère une résilience asymptotique appréciable aux estimateurs par moindres carrés ordinaires au fur et à mesure que la taille d’échantillon croît, les échantillons modérés ($N = 50$) demeurent tributaires d’une conformité minimale à la loi normale pour éviter des distorsions lors du calcul des probabilités de queue de distribution.
L’évaluation de cette propriété procède de la construction du diagramme quantile-quantile normal, généré au moyen de l’appel plot(modele_complet, which = 2). Sur ce graphique (Normal Q-Q Plot), les résidus standardisés ordonnés sont mis en correspondance avec les quantiles théoriques issus d’une loi gaussienne standardisée. La concordance optimale se matérialise par l’alignement des points d’observation sur la droite diagonale de référence. L’administration d’un test formel de non-normalité par l’intermédiaire de l’algorithme de Shapiro-Wilk, invoqué par shapiro.test(residuals(modele_complet)), permet de vérifier rigoureusement l’absence d’écart statistically significatif à la distribution gaussienne lorsque la probabilité critique résultante excède largement le seuil $\alpha = 0.05$.
### 10.3 Détection des points leviers et observations d’influence disproportionnée
Une source pernicieuse de distorsion lors de la comparaison de modèles linéaires réside dans la présence potentielle d’observations extrêmes ou aberrantes exerçant un effet de levier (leverage) disproportionné sur l’estimation des coefficients de régression. Un point isolé situé à l’extrémité du spectre des variables indépendantes et présentant un écart résiduel marqué peut suffire à induire artificiellement une courbure polynomiale fallacieuse ou, inversement, masquer un manque d’ajustement authentique en attirant à lui la trajectoire de la droite des moindres carrés.
L’identification de ces observations influentes repose sur le calcul de la distance de Cook, qui quantifie le déplacement global du vecteur des prédictions consécutif à l’exclusion séquentielle de chaque unité statistique de l’échantillon d’ajustement. L’inspection du graphique résidus-levier produit par plot(modele_complet, which = 5) permet de cartographier instantanément les observations approchant ou franchissant les courbes d’isodistance critique de Cook, traditionnellement fixées à 0.5 ou 1.0. Sur le plan déontologique et méthodologique, l’exclusion d’un point influent ne saurait constituer un réflexe expéditif visant à améliorer la significativité statistique d’un test ; elle exige un examen rigoureux des protocoles de saisie expérimentaux afin d’authentifier si l’observation relève d’une erreur factuelle de mesure ou d’un profil psychométrique d’exception dont la modélisation théorique doit impérativement tenir compte.
## 11. Erreurs méthodologiques courantes et pièges d’interprétation sous R
### 11.1 Inversion de l’ordre syntaxique dans anova()
Parmi les pièges techniques les plus fréquemment rencontrés lors de l’implémentation du test d’adéquation sous R figure l’inversion involontaire des arguments lors de l’appel à la fonction d’analyse de variance de comparaison de modèles. Bien que l’environnement R fasse preuve d’une grande robustesse d’exécution, la syntaxe conceptuellement correcte impose de déclarer en premier lieu le modèle le plus contraint (le modèle réduit), suivi immédiatement par l’objet encapsulant le modèle le plus flexible (le modèle complet), selon la séquence anova(modele_reduit, modele_complet).
Dans les anciennes versions ou selon les configurations de packages spécifiques, intervertir l’ordre d’appel par la commande anova(modele_complet, modele_reduit) peut conduire à l’affichage de sommes de carrés et de degrés de liberté différentiels affectés de signes algébriques négatifs. Bien que le moteur de R corrige fréquemment cette anomalie dans ses versions contemporaines en rétablissant automatiquement la soustraction arithmétique appropriée, cette inversion introduit une confusion manifeste dans la lecture des tableaux de sortie et peut fausser l’interprétation du sens de la variation de déviance. La règle mnémotechnique impérative à inscrire dans tout protocole de recherche consiste à toujours progresser de la modélisation la plus parcimonieuse vers la plus complexe.
### 11.2 Confusion entre significativité statistique et surajustement (Overfitting)
Un écueil conceptuel majeur guettant le chercheur consiste à ériger le rejet du test de manque d’ajustement en une invitation à une escalade polynomiale systématique. Ayant constaté qu’un terme quadratique ($X^2$) surpasse la droite linéaire, le modélisateur peut être tenté d’injecter des puissances cubiques ($X^3$), quartiques ($X^4$), voire d’ordre supérieur, guidé par la seule quête effrénée d’une p-valeur infinitésimale et d’un coefficient de détermination tendant vers l’unité.
Cette pratique constitue une pathologie statistique notoire qualifiée de surajustement ou d’overfitting. En démultipliant les paramètres polynomiaux, le modèle cesse d’estimer la véritable tendance de fond de la population pour commencer à modéliser le bruit idiosyncratique et les particularismes accidentels de l’échantillon d’entraînement. Il en résulte une dégradation catastrophique de la validité externe et du pouvoir de généralisation du modèle face à de nouvelles données. Pour prémunir l’analyse contre cette dérive, l’adjonction de termes d’ordre supérieur doit impérativement être bridée par le calcul des critères d’information pénalisés, tels que le critère d’Akaike (AIC) et le critère bayésien de Schwarz (BIC), invocables sous R via AIC(modele_reduit, modele_complet) et BIC(modele_reduit, modele_complet), qui sanctionnent lourdement toute prolifération paramétrique injustifiée.
### 11.3 Négligence de la multicolinéarité induite par les puissances
L’intégration directe de puissances successives d’une variable métrique au sein d’une formule de régression induit inévitablement un artefact numérique délétère : la multicolinéarité structurelle. Par définition, un vecteur numérique continu et son élévation au carré ($X$ et $X^2$) partagent une corrélation mathématique intrinsèque très élevée, en particulier lorsque toutes les valeurs d’observation de $X$ sont strictement positives et éloignées de zéro. Cette corrélation gonfle démesurément la variance d’échantillonnage des coefficients estimés et provoque une instabilité chronique de leurs erreurs standards.
Pour neutraliser ce biais technique sans modifier aucunement la qualité prédictive intrinsèque ni la statistique globale du test de manque d’ajustement, la bonne pratique méthodologique commande d’opérer un centrage préalable sur la moyenne arithmétique de la variable indépendante avant toute élévation au carré. En posant $X_{centre} = X – \bar{X}$, la corrélation structurelle unissant le terme d’ordre un au terme d’ordre deux se trouve neutralisée ou substantiellement réduite. L’intégrité de l’architecture peut être vérifiée par l’évaluation du facteur d’inflation de la variance (VIF) au moyen de la fonction car::vif(modele_complet) : tandis que le modèle fondé sur les variables brutes affichera des scores VIF alarmants (dépassant fréquemment le seuil critique de 10), le modèle opérant sur variables préalablement centrées restituera des indicateurs VIF proches de l’unité, restaurant la stabilité numérique et facilitant grandement l’interprétation substantielle de l’ordonnée à l’origine et des coefficients dérivés.
## 12. Protocole de rédaction et restitution des résultats selon les normes académiques (APA)
### 12.1 Formulation standardisée des résultats dans le corps du texte
La rédaction académique des conclusions d’une modélisation statistique impose le respect de conventions discursives rigoureuses édictées par les manuels de style internationaux, notamment la 7e édition du manuel de l’American Psychological Association. Lors de la restitution d’un test de manque d’ajustement mené par comparaison de modèles emboîtés, le corps du texte doit rapporter avec une scrupuleuse précision l’ensemble des métriques décisionnelles : les degrés de liberté du numérateur et du dénominateur séparés par une virgule, la magnitude exacte de la statistique $F$, la probabilité critique exacte (ou le seuil d’inégalité formel) ainsi que la mesure de taille d’effet associée, incarnée par l’accroissement incrémental du coefficient de détermination ($\Delta R^2$).
Un modèle de formulation textuelle conforme aux standards psychométriques les plus exigeants s’articule selon le canevas syntaxique suivant :
« Afin d’examiner l’existence d’une éventuelle sous-spécification fonctionnelle du modèle linéaire reliant le temps d’étude hebdomadaire à la performance psychométrique, un test formel de manque d’ajustement a été conduit en confrontant le modèle de régression linéaire simple restreint au modèle complet enrichi d’un terme quadratique. L’analyse de variance hiérarchique révèle que l’adjonction de la composante polynomiale réduit de manière statistiquement significative la déviance résiduelle, *F*(1, 47) = 38.42, *p* < .001, $\Delta R^2$ = .14, $R^2_{ajusté}$ = .86 contre .72 pour le modèle restreint. Cette divergence formelle confirme que la relation empirique est caractérisée par une accélération curvilinéaire positive, démontrant que le modèle linéaire initial souffrait d'un manque d'ajustement substantiel. »
### 12.2 Conception de tableaux comparatifs conformes aux standards de publication
Pour satisfaire aux normes éditoriales des revues internationales à comité de lecture, la présentation synthétique des résultats sous forme de tableau doit respecter des critères de lisibilité et de dépouillement esthétique stricts : interdiction formelle des lignes séparatrices verticales, recours mesuré aux bordures horizontales (réservées à la délimitation de l'en-tête et à la clôture du tableau) et alignement décimal irréprochable des valeurs numériques consignées. Les colonnes standard doivent documenter consécutivement les modèles en compétition, les sommes des carrés d'erreurs résiduelles, les degrés de liberté résiduels, les différentiels de carrés moyens, la statistique de Fisher-Snedecor, son niveau de significativité conventionnel ainsi que les coefficients d'ajustement ajustés.
Dans l'écosystème de programmation R, la génération automatisée de ces matrices de restitution au format LaTeX ou HTML publiable est grandement facilitée par l'utilisation de packages dédiés à la méta-modélisation tels que modelsummary ou stargazer. Ces outils s’interfacent nativement avec les objets de classe lm et anova pour structurer les sorties académiques avec inclusion automatique des astérisques de significativité conventionnels (* pour $p < .05$, ** pour $p < .01$, *** pour $p < .001$) et des notes de bas de tableau clarifiant la nature des tests bilatéraux appliqués et les corrections de variance éventuellement mobilisées.
### 12.3 Lignes directrices pour la prise de décision théorique et appliquée
Le parachèvement d'une démarche d'évaluation de l'adéquation structurelle ne saurait s'achever sur une décision algorithmique dénuée de réflexion épistémologique. Le statisticien et le praticien de terrain se trouvent continuellement engagés dans un arbitrage délicat entre le principe de parcimonie conceptuelle (le rasoir d'Ockham préconisant de ne retenir que la structure théorique la plus simple possible) et l'exigence de fidélité empirique face aux données réelles. Bien que le test d'adéquation fournisse une balise probabiliste claire, la décision finale d'abandonner un modèle réduit au profit d'une fonction polynomiale ou non linéaire doit impérativement s'adosser à une plausibilité substantive solidement étayée par la littérature disciplinaire.
Sur le plan des applications concrètes, notamment lors de la conception d'interventions psychopédagogiques ou de politiques de formation fondées sur des données probantes, la reconnaissance formelle d'une relation non linéaire évite de prescrire des volumes horaires standardisés inefficaces. En confirmant statistiquement que les gains marginaux de performance s'accroissent de façon parabolique une fois franchi un certain seuil d'entraînement, le modèle complet réhabilité fournit aux praticiens une assise empirique incontestable pour dimensionner rationnellement les dispositifs d'apprentissage. En résumé, le test de manque d'ajustement sous R constitue bien plus qu'une routine informatique secondaire : il incarne le filtre méthodologique indispensable sans lequel la modélisation statistique s'exposerait au risque permanent de bâtir des théories scientifiques sur les fondations fragiles d'une illusion géométrique.
## Références
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive skills and their acquisition (pp. 1–55). Lawrence Erlbaum Associates.
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.r-project.org/
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4