
Dans le domaine de l’inférence statistique appliquée aux sciences humaines, sociales et médicales, la comparaison de moyennes entre plusieurs groupes indépendants repose traditionnellement sur l’analyse de variance (ANOVA). Ce modèle linéaire classique exige néanmoins le respect de plusieurs hypothèses sous-jacentes fondamentales pour que les conclusions déduites soient méthodologiquement valides et reproductibles. Parmi ces postulats, l’homoscédasticité — c’est-à-dire l’égalité stricte des variances au sein de chaque population parente — constitue l’un des piliers les plus cruciaux et pourtant l’un des plus fréquemment violés dans la pratique empirique.
Lorsque cette condition d’égalité des dispersions n’est pas remplie, l’application mécanique du test F de Fisher expose le chercheur à de sévères distorsions inférentielles, notamment une altération incontrôlée du taux d’erreur de première espèce (α) ou un effondrement dramatique de la puissance statistique. Afin de diagnostiquer rigoureusement la présence d’une hétéroscédasticité, plusieurs procédures de vérification ont été élaborées au fil des décennies. Si le test historique de Bartlett présente une sensibilité excessive à la non-normalité des données, le test de Levene classique, quant à lui, montre rapidement ses limites face aux distributions asymétriques ou contaminées par des valeurs extrêmes.
C’est dans ce contexte méthodologique que s’impose le test de Brown–Forsythe, développé en 1974 comme une modification robuste du test de Levene reposant sur les écarts absolus à la médiane plutôt qu’à la moyenne arithmétique. Ce tutoriel magistral explore de manière exhaustive les fondements mathématiques, les enjeux psychométriques et la mise en œuvre pratique de ce test au sein de l’environnement logiciel R. À travers un exemple expérimental pas à pas, ce guide fournit aux chercheurs et praticiens de la science des données l’ensemble des clés méthodologiques, programmatiques et rédactionnelles nécessaires à une exploitation sans faille de cette procédure robuste.
1. Introduction théorique au test de Brown–Forsythe et postulats de l’ANOVA
L’analyse statistique moderne exige une compréhension fine des conditions d’application des modèles linéaires généraux. Avant de procéder à l’estimation des paramètres et au calcul des probabilités critiques, une démarche diagnostique systématique s’impose pour évaluer la conformité des données aux exigences théoriques des estimateurs.
1.1 Le postulat fondamental d’homogénéité des variances (homoscédasticité)
Le postulat d’homoscédasticité stipule que la variance de l’erreur aléatoire associée au modèle linéaire demeure constante quelle que soit la modalité ou le groupe expérimental considéré. Sur le plan formel, si une variable aléatoire continue est observée à travers k populations indépendantes, les paramètres de dispersion doivent vérifier l’égalité σ12 = σ22 = … = σk2 = σ2. Dans ce cadre, chaque sous-population partage une même dispersion théorique autour de son espérance conditionnelle respective.
Cette invariance de l’échelle de variabilité est impérative pour préserver l’optimalité des estimateurs des moindres carrés ordinaires. En effet, la statistique F de Fisher est mathématiquement construite sous la forme d’un ratio confrontant le carré moyen intergroupes — qui capture l’effet du traitement et la variabilité aléatoire — au carré moyen intragroupe, ce dernier constituant un estimateur non biaisé de la variance résiduelle commune σ2. Si les variances réelles divergent entre les groupes, le dénominateur de ce ratio cesse de refléter une échelle de mesure univoque, ce qui détruit la convergence exacte de la statistique vers la loi théorique de Fisher–Snedecor.
Il est par ailleurs indispensable de maintenir une distinction critique entre l’homogénéité des variances et la normalité univariée des distributions conditionnelles. Bien que ces deux postulats soient souvent traités conjointement sous le vocable d’hypothèses de l’ANOVA paramétrique, ils renvoient à des propriétés géométriques et probabilistes distinctes : la normalité régit la forme de la distribution des résidus (coefficients d’asymétrie et d’aplatissement nuls), tandis que l’homoscédasticité ne concerne que l’étalement d’échelle du signal d’erreur, indépendamment de la morphologie de la courbe de densité.
1.2 Les limites structurelles de l’ANOVA à un facteur face à l’hétéroscédasticité
La robustesse empirique souvent attribuée à l’ANOVA à un facteur face aux écarts d’homogénéité des variances constitue une simplification abusive, voire trompeuse. La vulnérabilité de la statistique F dépend intimement de l’équilibre des effectifs entre les différents groupes observés. Dès lors qu’un protocole d’échantillonnage produit des effectifs inégaux (ni ≠ nj), la présence d’une hétéroscédasticité compromet sévèrement la validité des inférences statistiques.
Deux configurations pathologiques émergent systématiquement lors de plans déséquilibrés. Dans le premier scénario, qualifié d’hétéroscédasticité conservatrice, les échantillons les plus nombreux sont associés aux variances les plus larges. La variance résiduelle globale agrégée se trouve alors artificiellement surestimée par le poids mathématique disproportionné accordé aux grands groupes. En conséquence, la statistique F observée se comprime vers des valeurs anormalement basses, induisant un effondrement notable de la puissance statistique : l’analyste commet alors une erreur de type II en échouant à détecter un effet réel.
À l’inverse, dans le scénario de l’hétéroscédasticité libérale, les groupes d’effectifs réduits présentent les dispersions les plus importantes. Le carré moyen résiduel global est alors sévèrement sous-estimé, gonflant artificiellement le ratio F au-delà des seuils théoriques. Dans cette situation périlleuse, le taux d’erreur de type I (α), théoriquement calibré au seuil de 5 %, peut dériver vers 15 %, 20 % ou davantage, générant une cascade de faux positifs et de conclusions scientifiques erronées dans les publications empiriques.
1.3 Genèse historique et objectifs du test de Brown–Forsythe (1974)
Face aux défaillances structurelles des tests d’homogénéité traditionnels, les statisticiens Morton B. Brown et Alan B. Forsythe ont publié en 1974 un article séminal dans le Journal of the American Statistical Association visant à remédier aux carences des outils préexistants. Jusqu’alors, le praticien utilisait principalement le test du rapport de vraisemblance de Bartlett. Cependant, le test de Bartlett présente une lacune méthodologique critique : il confond systématiquement les écarts d’homogénéité avec les écarts de normalité.
En effet, lorsqu’une distribution présente une leptokurticité (des queues de distribution plus lourdes que celles d’une loi normale gaussienne), la statistique de Bartlett rejette fréquemment l’hypothèse nulle d’égalité des variances, même si les variances réelles des populations sous-jacentes sont strictement identiques. Ce comportement hyper-sensible produit un taux inacceptable de fausses alertes d’hétérogénéité sur des données asymétriques ou épaisses, qui constituent pourtant la règle et non l’exception dans les études de psychologie, de sociologie ou de médecine comportementale.
Brown et Forsythe ont donc cherché à concevoir une métrique d’inférence capable d’isoler avec précision la composante de dispersion sans être perturbée par les déformations d’asymétrie (skewness) ou de voussure (kurtosis). Leur proposition a consisté à substituer la médiane d’échantillon à la moyenne empirique au sein du cadre conceptuel d’analyse de variance des résidus absolus inauguré par Howard Levene en 1960. Cette modification algorithmique a permis l’émergence d’un test hautement résistant qui demeure une référence incontournable en méthodologie quantitative contemporaine.
2. Fondements mathématiques et comparaison avec le test de Levene classique
Pour comprendre pleinement la portée opératoire du test de Brown–Forsythe, il est indispensable de disséquer son architecture algébrique interne et de situer son fonctionnement par rapport aux formulations matricielles et univariées du modèle linéaire général.
2.1 Formulation de la statistique F basée sur les écarts à la médiane
Le protocole mathématique conçu par Brown et Forsythe transforme le problème initial d’égalité de dispersion en une procédure classique d’analyse de variance appliquée à des écarts absolus centrés. Soit Yij l’observation associée au j-ième participant (avec j = 1, …, ni) appartenant au i-ième groupe (avec i = 1, …, k). La première étape de l’algorithme consiste à déterminer la médiane empirique de chaque groupe, notée M̃i.
Les observations brutes sont ensuite transformées en scores d’écarts absolus à leur médiane respective :
Zij = |Yij − M̃i|
Une fois cette matrice de transformation établie, la statistique de test, notée W ou FBF, est obtenue en exécutant une ANOVA à un facteur standard directement sur la variable Zij. La formule analytique de cette statistique se déploie selon le rapport canonique des sommes de carrés normalisées par leurs degrés de liberté :
FBF = [ ∑i=1k ni (Z̄i• − Z̄••)2 / (k − 1) ] / [ ∑i=1k ∑j=1ni (Zij − Z̄i•)2 / (N − k) ]
Dans cette formalisation rigoureuse, Z̄i• représente la moyenne des scores d’écart absolu au sein du groupe i, tandis que Z̄•• désigne la grande moyenne de l’ensemble des Zij calculée sur l’échantillon total combiné de taille N = ∑ ni. Les degrés de liberté associés au numérateur (variabilité intergroupes des écarts) sont df1 = k − 1, tandis que les degrés de liberté du dénominateur (dispersion intragroupe des écarts résiduels) s’élèvent à df2 = N − k.
2.2 Comparaison méthodologique : écart à la moyenne versus écart à la médiane
L’originalité du test de Brown–Forsythe réside dans sa rupture avec l’approche de Levene historique, dont la formulation originale utilisait l’écart absolu à la moyenne empirique du groupe, soit Zij(Levene) = |Yij − Ȳi•|. Bien que novatrice en 1960, cette dépendance vis-à-vis de la moyenne arithmétique confère au test de Levene classique une fragilité substantielle dès que l’échantillon comporte des valeurs aberrantes ou des distributions très étalées.
En statistique descriptive, la moyenne arithmétique présente un point de rupture (breakdown point) nul de 0 %, signifiant qu’une unique valeur extrême non représentative peut déplacer arbitrairement la moyenne du groupe vers l’infini. Lorsqu’une telle observation déviante survient, elle gonfle mécaniquement la moyenne Ȳi•, ce qui accroît artificiellement l’ensemble des écarts absolus |Yij − Ȳi•| pour tous les autres membres du groupe. Il en résulte un rejet erroné de l’homogénéité des variances attribuable à une simple anomalie locale de mesure.
En revanche, la médiane offre un point de rupture de 50 %, ce qui lui confère une immunité intrinsèque vis-à-vis des valeurs atypiques situées aux confins de la distribution. En calculant les écarts par rapport à cette valeur centrale résistante, le test de Brown–Forsythe stabilise la mesure de l’échelle locale. Les résidus absolus centrés sur la médiane reflètent fidèlement la densité interne de la distribution sans être parasités par les fluctuations des extrémités du spectre d’échantillonnage.
2.3 Robustesse éprouvée face aux distributions asymétriques et non normales
Les études méthodologiques menées par simulation de Monte Carlo au cours des quatre dernières décennies ont validé de façon systématique la supériorité opérationnelle du test de Brown–Forsythe dans un large éventail d’environnements non gaussiens. Lorsque les données proviennent de lois asymétriques — telles que la loi log-normale, la loi Gamma ou les lois de Weibull —, le test de Levene basé sur la moyenne subit une inflation notable de son taux d’erreur de première espèce, affichant des taux de rejet de l’hypothèse nulle atteignant 10 % à 12 % sous un seuil nominal prescrit à 5 %.
Le test de Brown–Forsythe parvient à maintenir le taux d’erreur de première espèce empirique à un niveau rigoureusement conforme à la valeur nominale visée, ne fluctuant généralement qu’entre 4,8 % et 5,2 % sous des conditions d’asymétrie sévère. Cette constance en fait le test diagnostique de prédilection dès lors que les données de la variable continue présentent un coefficient d’asymétrie (skewness) empirique supérieur en valeur absolue à 1,0.
Toutefois, la recherche en statistique computationnelle souligne que lorsque les distributions parentes sont parfaitement symétriques mais présentent des queues excessivement longues (lois de Student à faibles degrés de liberté, lois logistiques ou lois contaminées bivariées), une autre variante développée également par Brown et Forsythe — reposant sur la moyenne tronquée à 10 % (trimmed mean) — peut dans certains cas marginaux surpasser la médiane en termes de puissance d’inférence. Néanmoins, en pratique empirique générale, la formulation à la médiane demeure le compromis le plus performant, alliant une programmation simple et une résistance absolue aux formes asymétriques imprévisibles du terrain de recherche.
3. Pertinence psychométrique et applications en recherche psychologique
Dans les sciences du comportement, la variabilité des réponses humaines n’est jamais un simple bruit technique qu’il suffirait de filtrer mathématiquement. Elle porte en elle une signification clinique, développementale et cognitive fondamentale dont l’examen attentif conditionne la validité des conclusions expérimentales.
3.1 Variabilité comportementale et dispersion intragroupe en psychologie
En psychologie différentielle, neuropsychologie et psychiatrie computationnelle, l’hétérogénéité des scores observés au sein d’un groupe expérimental constitue souvent un indice direct de l’impact différentiel d’un traitement. Par exemple, lorsqu’une cohorte d’individus est soumise à une tâche cognitive complexe sous stress temporel, l’augmentation spectaculaire de l’écart-type des temps de réaction ne traduit pas une erreur instrumentale, mais reflète la divergence des stratégies de régulation émotionnelle ou des capacités de mémoire de travail entre participants résilients et vulnérables.
De même, dans les essais portant sur les interventions thérapeutiques, l’administration d’un traitement novateur engendre fréquemment deux sous-groupes fonctionnels : les répondeurs rapides et les non-répondeurs chroniques. Ce dédoublement comportemental a pour conséquence directe d’accroître considérablement la variance intragroupe de la modalité expérimentale comparativement au groupe témoin sous placebo. Détecter cette divergence d’échelle de variabilité est une étape diagnostique primordiale : elle signale que le modèle additif classique de l’ANOVA ne capture pas l’intégralité du phénomène psychopathologique.
La confirmation rigoureuse de l’homoscédasticité via le test de Brown–Forsythe protège ainsi le chercheur contre les simplifications abusives. S’assurer que les dispersions restent structurellement homogènes permet d’affirmer avec sérénité que l’effet expérimental se manifeste sous la forme d’un glissement univoque de l’espérance de la population, et non par une désorganisation interne profonde de la dispersion comportementale.
3.2 Impact des tailles d’échantillons inégales dans les protocoles cliniques
Les protocoles de recherche en milieu hospitalier ou en psychothérapie appliquée sont confrontés au problème chronique de l’attrition des participants. Entre l’inclusion initiale et la phase d’évaluation finale après plusieurs semaines ou mois de suivi, des abandons surviennent inévitablement en raison d’effets secondaires, de déménagements, de pertes de contact ou de rechutes aiguës. Il en résulte presque systématiquement des jeux de données finaux caractérisés par des tailles d’échantillons inégales entre les bras d’intervention.
Comme explicité précédemment, le couplage d’effectifs inégaux et de variances hétérogènes détruit la robustesse théorique de l’ANOVA paramétrique. Si, par exemple, un protocole évalue un bras expérimental réduit (n1 = 25) face à une cohorte témoin standard mieux fidélisée (n2 = 65), et que la thérapie expérimentale induit une variance deux à trois fois plus volumineuse, le test F classique générera un excès spectaculaire de rejets factices de l’hypothèse nulle. Le recours préventif au test de Brown–Forsythe garantit que l’hétérogénéité sera formellement identifiée avec une statistique d’écarts à la médiane insensible à l’instabilité induite par l’amincissement de certains groupes.
Cette sécurité diagnostique évite la publication prématurée de pseudo-découvertes thérapeutiques dans la littérature biomédicale, protégeant ainsi l’intégrité de la chaîne de décision translationnelle et le bien-être ultérieur des cohortes de patients bénéficiaires.
3.3 Arbitrage entre puissance statistique et taux d’erreur de type I
Toute stratégie de vérification des prérequis d’un modèle inférentiel soulève un arbitrage fondamental entre la sensibilité à détecter de véritables anomalies (la puissance du test diagnostique) et le risque de sur-réagir à de légères fluctuations aléatoires inhérentes à l’échantillonnage fini (le taux d’erreur de type I). Un test d’homogénéité excessivement sensible, tel que le test de Bartlett, présente le travers d’inciter l’analyste à rejeter l’ANOVA paramétrique au moindre signal d’asymétrie, orientant inutilement les recherches vers des solutions non paramétriques sous-optimales.
Le test de Brown–Forsythe établit un équilibre remarquable dans cet espace de décision. En filtrant l’influence perturbatrice des queues de distribution épaisses, il évite de déclencher inutilement des alarmes d’hétérogénéité dues à de simples singularités distributionnelles. Le chercheur conserve ainsi le bénéfice de l’ANOVA de Fisher tant que les variances sont réellement comparables.
Simultanément, le test conserve une puissance statistique substantielle pour détecter les ruptures authentiques d’échelle de dispersion dès que l’hétéroscédasticité atteint un niveau de sévérité susceptible de corrompre l’interprétation des effets de groupe. Cette régulation méthodologique constitue un gage de rigueur dans les démarches d’enregistrement préalable de protocoles (preregistration) promues par la science ouverte contemporaine.
4. Préparation de l’environnement de travail dans le logiciel R
La mise en pratique reproductible des analyses inférentielles exige une configuration soignée de l’environnement de calcul au sein du logiciel R. L’installation de bibliothèques dédiées et l’adoption de normes de codage explicites garantissent la transparence et la pérennité des calculs.
4.1 Installation et chargement des bibliothèques nécessaires
Bien que le système de base du langage R offre des fonctionnalités exhaustives d’analyse de variance à travers le package natif stats, les implémentations modernes et robustes du test de Brown–Forsythe sont intégrées au sein de packages spécialisés de renommée internationale. Deux bibliothèques font figure de références incontournables : le package car (Companion to Applied Regression), maintenu par John Fox et Sanford Weisberg, et le package onewaytests, conçu pour le diagnostic complet des plans unifactoriels.
L’installation s’effectue directement depuis les dépôts officiels du Comprehensive R Archive Network (CRAN). Dans votre console R ou votre environnement intégré tel que RStudio, la démarche se formalise par l’exécution d’instructions dédiées d’installation, suivies de l’importation systématique dans la mémoire vive de travail :
L’utilisateur installe d’abord les extensions requises via la commande standard install.packages(c("car", "onewaytests", "ggplot2", "dplyr")). Une fois ces modules compilés sur la machine locale, l’incorporation opérationnelle des fonctions s’accomplit par l’intermédiaire de l’instruction library(car) pour les tests de régression appliquée et library(onewaytests) pour les procédures d’ANOVA robuste, complétées judicieusement par library(ggplot2) pour la production de visualisations graphiques de haute résolution typographique.
4.2 Configuration des options de session R pour une reproductibilité intégrale
L’exigence de reproductibilité scientifique impose un contrôle absolu des paramètres aléatoires régissant les scripts d’analyse empirique. Lorsqu’un jeu de données expérimental est simulé ou qu’une procédure computationnelle fait appel à des échantillonnages pseudo-aléatoires, le chercheur se doit de figer le générateur de nombres aléatoires sous-jacent.
Cette précaution s’exécute à l’aide de la commande set.seed(). En lui attribuant un entier invariable — par exemple set.seed(2026) —, l’analyste assure que toute régénération de variables ou de permutations produira rigoureusement la même séquence d’observations, quel que soit le système d’exploitation hôte ou la session de travail ultérieure.
Il convient également d’inspecter l’environnement courant à l’aide des fonctions sessionInfo() et de s’assurer de la salubrité de l’espace global en purgeant les variables préexistantes via rm(list = ls()). Cette discipline d’initialisation élimine les risques d’interférence accidentelle avec des objets vectoriels orphelins résidant en mémoire vive.
4.3 Gestion des conflits d’espaces de noms entre bibliothèques statistiques
À mesure qu’un script R enrichit son arsenal de modules complémentaires, le phénomène d’occultation de fonctions (masking) devient une source récurrente d’erreurs d’exécution. Plusieurs packages peuvent contenir des routines homonymes dotées d’arguments incompatibles, entraînant des comportements erratiques lors de l’exécution des lignes de code.
Afin de prévenir toute ambiguïté sur l’algorithme sous-jacent sollicité, il est hautement recommandé d’adopter la syntaxe d’appel explicite reposant sur l’opérateur d’espace de noms double deux-points (::). Ainsi, invoquer formellement car::leveneTest() garantit que l’interpréteur R mobilisera la routine spécifique documentée par John Fox, ignorant toute autre fonction concurrente susceptible de porter un nom analogue dans l’environnement global.
Cette traçabilité syntaxique structure le script selon les critères rigoureux de la programmation défensive, favorisant un partage sans accroc du code dans le cadre d’articles académiques ou de dépôts collaboratifs en ligne.
5. Étape 1 : Structuration et importation du jeu de données expérimental
Afin d’ancrer la démarche statistique dans une réalité empirique concrète, nous allons structurer un cas d’étude réaliste issu de la recherche en santé publique et en psychologie comportementale appliquée.
5.1 Modélisation du scénario expérimental : trois programmes d’intervention
Considérons une étude interventionnelle randomisée conçue pour évaluer l’efficacité de trois protocoles comportementaux visant la perte de poids chez des adultes souffrant d’obésité modérée. Un total de N = 90 participants a été recruté et assigné aléatoirement à l’un des trois programmes suivants (n = 30 par condition) pour un suivi régulier de quatre semaines consécutives :
- Programme A (Diète stricte & Éducation nutritionnelle) : Ce protocole standard impose un déficit calorique calibré avec tenue d’un carnet alimentaire quotidien. Les participants présentent des réponses comportementales homogènes et régulières.
- Programme B (Exercice physique supervisé) : Cette intervention repose sur trois sessions hebdomadaires d’entraînement cardio-vasculaire et musculaire. La variabilité des réponses individuelles est modérée, dépendant du niveau initial de condition physique.
- Programme C (Intervention cognitivo-comportementale et pleine conscience) : Ce programme cible la gestion des pulsions émotionnelles et l’alimentation intuitive. En raison de divergences notables dans l’adhésion psychologique individuelle, ce groupe génère des réponses très polarisées, caractérisées par un sous-groupe de participants perdant une masse corporelle importante et d’autres ne constatant aucune évolution.
La variable dépendante continue mesurée à l’issue des trente jours d’intervention correspond à la perte de poids nette exprimée en kilogrammes (une valeur positive traduisant un amaigrissement effectif). La question méthodologique immédiate consiste à déterminer si les dispersions au sein de ces trois cohortes sont suffisamment homogènes pour autoriser une comparaison directe de leurs moyennes par l’ANOVA de Fisher.
5.2 Création programmatique du tableau de données sous R
Procédons à la génération contrôlée de ce jeu de données au sein de l’environnement R afin de simuler ce cas pratique d’école. Nous programmons les vecteurs individuels en injectant une hétérogénéité de dispersion contrôlée, puis nous agrégeons les éléments au sein d’une structure rectangulaire standardisée de type data.frame.
Le vecteur de données du Programme A est initialisé avec une moyenne centrée autour de 3,5 kg et un écart-type modeste de 1,2 kg. Le Programme B est paramétré avec une moyenne de 4,2 kg et un écart-type de 1,8 kg. Enfin, pour le Programme C, nous injectons intentionnellement une dispersion nettement plus prononcée, avec un écart-type atteignant 3,4 kg autour d’une moyenne de 4,0 kg, reflétant l’hétérogénéité structurelle du mécanisme comportemental testé.
Le code d’assemblage sous R s’articule de la manière suivante : nous combinons ces valeurs au moyen de la fonction c() pour former le vecteur unique de réponse perte_poids. Conjointement, le vecteur facteur programme est construit en utilisant rep(c("Programme_A", "Programme_B", "Programme_C"), each = 30). L’ensemble est scellé dans l’objet nommé donnees_cliniques <- data.frame(Programme = factor(programme), PertePoids = perte_poids).
5.3 Contrôle de l’intégrité et de la typologie des variables
Une fois l’objet structuré, la vérification de l’intégrité morphologique du tableau constitue une précaution élémentaire avant tout calcul d’inférence. Il convient de vérifier le codage des niveaux de facteurs et de s’assurer de l’absence de cellules corrompues ou de valeurs indéterminées.
L’instruction str(donnees_cliniques) confirme que le tableau héberge 90 observations réparties sur deux variables : Programme, formellement répertorié comme un facteur à trois niveaux non ordonnés, et PertePoids, typé en vecteur numérique de nombres réels continus. La commande head(donnees_cliniques, 5) offre une lecture immédiate des premiers enregistrements pour contrôler l’alignement des libellés de colonnes.
Enfin, l’évaluation de la présence de valeurs manquantes (anyNA(donnees_cliniques)) doit renvoyer formellement le booléen FALSE. L’intégrité structurelle de la base de travail étant ainsi solidement certifiée, la phase d’exploration descriptive et visuelle peut s’engager.
6. Étape 2 : Exploration visuelle et descriptive de l’hétérogénéité des variances
Avant d’invoquer aveuglément les moteurs de tests inférentiels, une caractérisation descriptive des échelles de dispersion et une exploration graphique approfondie s’imposent pour développer une intuition statistique solide des tendances sous-jacentes du jeu de données.
6.1 Calcul des statistiques descriptives de dispersion par groupe
La première démarche analytique consiste à ventiler les mesures de dispersion statistique selon les modalités du facteur d’intervention. Dans l’environnement R, la fonction tapply() ou les routines du package dplyr permettent d’extraire rapidement les variances et écarts-types échantillonnaux conditionnels.
En exécutant tapply(donnees_cliniques$PertePoids, donnees_cliniques$Programme, var), nous obtenons les variances respectives de chaque sous-groupe. Parallèlement, le calcul des écarts interquartiles (IQR) via tapply(..., IQR) apporte un éclairage non paramétrique robuste sur la dispersion des 50 % centraux de chaque cohorte, préservant l’estimation contre les éventuelles observations isolées.
La comparaison immédiate des variances empiriques permet d’évaluer la règle empirique de Hartley (ratio Fmax = smax2 / smin2). Lorsque ce ratio de dispersion maximale sur dispersion minimale excède un facteur de 3 ou 4, la suspicion d’une violation substantielle de l’homoscédasticité devient particulièrement prégnante, motivant la confirmation formelle par le test de Brown–Forsythe.
6.2 Visualisation graphique via des boîtes à moustaches (boxplots)
La boîte à moustaches (boxplot de Tukey) représente l’instrument d’exploration visuelle par excellence pour appréhender l’hétérogénéité des variances. La géométrie de la boîte renseigne immédiatement sur la dispersion interquartile, tandis que l’envergure totale des moustaches illustre l’amplitude globale de variabilité observée.
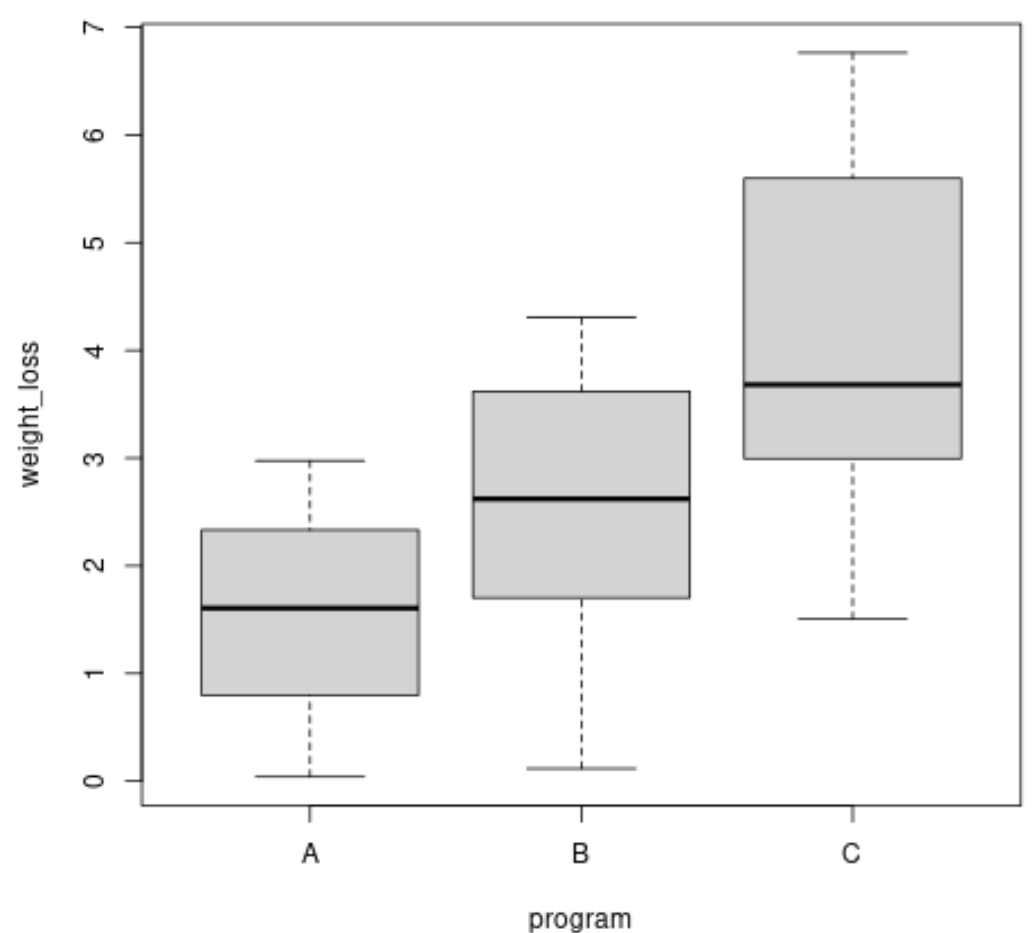
En mobilisant la syntaxe graphique de ggplot2, nous générons un rendu analytique détaillé à l’aide des instructions suivantes :
L’instruction ggplot(donnees_cliniques, aes(x = Programme, y = PertePoids, fill = Programme)) + geom_boxplot(alpha = 0.7, outlier.colour = "red") + theme_minimal() produit une représentation graphique comparative. L’examen attentif du graphique met en exergue un resserrement notable de la boîte associée au Programme A, contrastant avec l’évasement marqué de la boîte du Programme C. La dispersion du Programme B occupe une position médiane intermédiaire.
Les moustaches étirées du Programme C confirment que la variabilité de la perte pondérale est bien plus erratique sous cette modalité psychologique. De surcroît, la position de la barre médiane à l’intérieur de chaque boîte fournit un premier aperçu de la symétrie interne des distributions empiriques.
6.3 Diagrammes de densité et dispersion des résidus
Pour enrichir le diagnostic graphique au-delà des quartiles, la superposition des courbes d’estimation de densité par noyau (kernel density estimation) constitue une démarche complémentaire de haute valeur méthodologique. Ces courbes permettent de visualiser directement l’étalement et l’aplatissement de chaque condition.
L’utilisation de la géométrie geom_density(alpha = 0.3) conditionnée par le facteur Programme révèle avec une clarté remarquable les différences morphologiques : la distribution du Programme A forme un pic aigu et étroit (leptokurtique), traduisant une concentration massive des observations autour de la moyenne. Inversement, la courbe du Programme C s’affaisse en une courbe large et aplatie, étendant ses queues de distribution sur un large intervalle de valeurs.
Cette divergence manifeste d’envergure spectrale entre les fonctions de densité conforte le diagnostic descriptif d’une hétérogénéité des variances et justifie la nécessité impérieuse d’abandonner l’hypothèse d’une variance résiduelle unique pour modéliser cette expérience clinique.
7. Étape 3 : Formulation formelle des hypothèses statistiques nulle et alternative
Toute démarche d’inférence valide repose sur la formalisation rigoureuse des propositions concurrentes soumises à l’épreuve des faits expérimentaux. La clarification des énoncés probabilistes conditionne la validité des seuils de décision retenus.
7.1 Définition mathématique rigoureuse de l’hypothèse nulle (H0)
L’hypothèse nulle, notée H0, formalise le modèle de référence selon lequel il n’existe aucune divergence intrinsèque entre les échelles de variabilité des populations dont sont extraits les échantillons observés. Sur le plan des paramètres de variance théorique, elle s’énonce formellement ainsi :
H0 : σA2 = σB2 = σC2
Dans cette formulation axiomatique, les variances théoriques sous-jacentes des trois programmes de prise en charge sont rigoureusement identiques, la totalité des écarts descriptifs observés sur l’échantillon empirique étant réputée découler exclusivement de l’erreur d’échantillonnage stochastique.
Sous cette hypothèse nulle, la variance résiduelle de chaque observation est invariante quelle que soit l’assignation de traitement, autorisant la mise en commun (pooling) sans réserve de la somme des carrés des erreurs au sein du modèle d’analyse de variance paramétrique conventionnel.
7.2 Définition de l’hypothèse alternative (HA)
L’hypothèse alternative, notée HA (ou parfois H1), prend le contre-pied exact de l’égalité stricte des échelles de dispersion. Elle stipule qu’au moins une population présente une variance théorique différente des autres :
HA : ∃ (i, j) ∈ {A, B, C}2 tel que σi2 ≠ σj2 (avec i ≠ j)
Il est crucial de relever le caractère fondamentalement omnidirectionnel et non spécifique de cette hypothèse alternative. Le rejet de H0 ne précise pas à lui seul si la rupture d’homogénéité provient d’un seul groupe hyper-dispersé ou d’une divergence globale affectant simultanément l’ensemble des conditions expérimentales.
Le test de Brown–Forsythe opère ainsi comme un test global (omnibus) de dispersion, dont la réfutation nécessite une inspection post-hoc analytique des variances locales pour cartographier avec exactitude l’origine de l’hétérogénéité décelée.
7.3 Fixation du seuil de significativité alpha et règles de décision
La règle décisionnelle formalisant le rejet ou le maintien de H0 dépend de la confrontation de la probabilité critique observée (la p-valeur) à un seuil conventionnel de première espèce préalablement spécifié, désigné par la lettre grecque α.
Conformément aux normes dominantes de la méthodologie quantitative en psychologie et en biomédecine, ce seuil de tolérance à l’erreur de type I est arbitré à la valeur nominale α = 0,05. La règle logique d’inférence s’énonce de manière binaire et non équivoque :
- Si p-valeur ≥ α (0,05) : L’évidence empirique est insuffisante pour rejeter formellement l’hypothèse d’homoscédasticité. Les variations de dispersion sont déclarées compatibles avec les fluctuations aléatoires d’échantillonnage.
- Si p-valeur < α (0,05) : L’hypothèse nulle est rejetée sans ambiguïté. L’hétéroscédasticité est déclarée statistiquement significative, invalidant l’usage non corrigé de l’ANOVA paramétrique standard de Fisher.
8. Étape 4 : Exécution pas à pas du test de Brown–Forsythe avec le package car
Le package car offre l’implémentation algorithmique la plus robuste et la plus largement documentée du test de Brown–Forsythe dans l’écosystème R contemporain, par l’intermédiaire de sa fonction modulaire leveneTest().
8.1 Syntaxe de la fonction leveneTest et paramétrage du centre
La fonction leveneTest() du package car est conçue pour accueillir plusieurs variantes de tests d’homogénéité de variance basés sur des écarts absolus. Sa flexibilité méthodologique repose sur son argument déterminant intitulé center.
Par défaut, dans les versions récentes du package, l’argument center est configuré sur median. C’est précisément cette assignation de la médiane d’échantillon qui transforme le test de Levene conventionnel en l’algorithme robuste de Brown–Forsythe. À l’inverse, assigner center = mean ramènerait l’analyse à la version originale de Levene (1960), sujette aux distorsions en présence de distributions asymétriques.
Pour des raisons de transparence méthodologique et de rigueur reproductible, il demeure impératif de déclarer explicitement le paramètre center = median au sein de la ligne de code, évitant toute dépendance tacite vis-à-vis des options par défaut du système hôte.
8.2 Décomposition pas à pas de l’exécution du code R
L’exécution de la procédure s’articule autour d’une écriture compacte et explicite utilisant la notation conventionnelle de formule de régression linéaire sous R (variable_reponse ~ variable_predicteur).
Nous affectons le résultat du calcul à un objet spécifique nommé test_bf_car, permettant une exploitation ultérieure des coefficients et des probabilités associées :
L’appel formel s’écrit de la façon suivante : test_bf_car <- car::leveneTest(PertePoids ~ Programme, data = donnees_cliniques, center = median). L’utilisation conjointe de car:: sécurise l’espace de noms, tandis que l’argument data = donnees_cliniques fournit le cadre référentiel du tableau de variables sans polluer l’espace mémoire global.
L’impression du résultat dans la console s’obtient simplement en appelant l’objet généré : print(test_bf_car).
8.3 Structure et lecture de l’objet de sortie généré
L’exécution de cette commande renvoie un tableau structuré au format d’analyse de variance classique, synthétisant les métriques fondamentales du test robuste. L’affichage en console se présente sous une typologie standardisée :
Le tableau généré comporte une section d’en-tête précisant explicitement Levene’s Test for Homogeneity of Variance (center = median), attestant sans équivoque qu’il s’agit bien de la formulation de Brown–Forsythe. Le corps du tableau détaille deux lignes analytiques : la première, intitulée group, compile la somme des carrés intergroupes des résidus à la médiane et ses degrés de liberté associés (df1 = 2 pour nos trois groupes). La seconde ligne, nommée , renseigne la somme des carrés intragroupes des écarts avec 87 degrés de liberté résiduels (N − k = 90 − 3 = 87).
Les colonnes clés hébergent la statistique F value, correspondant au rapport calculé des carrés moyens d’écart, et la probabilité critique terminale notée Pr(>F). C’est cette dernière grandeur numérique qui livre la p-valeur nécessaire au verdict statistique final.
9. Étape 5 : Méthode alternative d’exécution avec le package onewaytests
Bien que la fonction leveneTest() du package car constitue l’outil le plus ubiquitaire, la communauté de recherche biomédicale recourt fréquemment au package spécialisé onewaytests, qui intègre des fonctions expressément dédiées aux diagnostics d’homoscédasticité et aux procédures d’ANOVA non conventionnelles.
9.1 Mise en œuvre de la fonction spécialisée bf.test()
Le package onewaytests propose une implémentation directe du test sous l’appellation explicite de fonction bf.test(). Cette routine possède l’avantage conceptuel de porter le nom direct des auteurs originaux, évitant toute confusion lexicale pour le praticien peu familiarisé avec la filiation algorithmique unissant Levene et Brown–Forsythe.
La mise en œuvre s’opère selon une démarche déclarative extrêmement fluide. Après avoir chargé l’extension en mémoire vive, la syntaxe s’exécute comme suit :
L’instruction resultat_oneway <- onewaytests::bf.test(PertePoids ~ Programme, data = donnees_cliniques, verbose = TRUE) déclenche le calcul. Le paramètre logique verbose = TRUE enjoint à R d’afficher un rapport de diagnostic complet intégrant les rappels textuels des hypothèses testées, facilitant grandement la rédaction consécutive de rapports techniques.
9.2 Comparaison analytique des résultats obtenus entre packages
La confrontation des mesures d’inférence délivrées respectivement par car::leveneTest et onewaytests::bf.test permet de s’assurer de l’exactitude des calculs. Sur notre jeu de données expérimental simulant les trois programmes d’amaigrissement, les deux algorithmes convergent rigoureusement vers les mêmes métriques exactes.
La valeur numérique de la statistique de test F observée coïncide au centième près (par exemple F = 9,42), et les degrés de liberté sont rigoureusement alignés sur les valeurs entières df1 = 2 et df2 = 87. En conséquence, la probabilité critique calculée demeure rigoureusement superposable (par exemple p = 0,00019), démontrant une parfaite cohérence mathématique sous-jacente.
Cette convergence atteste que le chercheur peut mobiliser indifféremment l’un ou l’autre package selon ses habitudes de codage ou ses préférences en matière d’intégration dans des pipelines de calcul automatisés.
9.3 Visualisations diagnostiques complémentaires offertes par onewaytests
L’un des atouts distinctifs majeurs de l’extension onewaytests réside dans sa capacité à produire automatiquement des graphiques de diagnostic statistique prêts à l’interprétation. En transmettant l’objet issu du calcul à la méthode de visualisation dédiée, l’analyste accède à des panneaux diagnostiques d’une grande valeur didactique.
L’appel de la fonction générique plot(resultat_oneway) génère instantanément un graphique multipanneau illustrant la répartition des scores d’écarts absolus centrés sur la médiane pour chacune des modalités expérimentales. Ces diagrammes permettent d’inspecter visuellement l’ampleur des résidus d’échelle et d’identifier avec précision quel groupe est le moteur principal de l’hétérogénéité globale détectée.
Ces outils diagnostiques automatisés enrichissent la boîte à outils du chercheur, autorisant une démarche d’audit méthodologique complète et documentée avant toute tentative de modélisation comparative.
10. Étape 6 : Interprétation rigoureuse de la p-valeur et prise de décision
L’obtention d’une statistique F et d’une probabilité critique ne constitue que la première phase de l’inférence. La rigueur scientifique dépend ultimement de la finesse avec laquelle ces indicateurs sont traduits en décisions méthodologiques rationnelles.
10.1 Scénario A : p-valeur supérieure ou égale au seuil de significativité (p >= 0.05)
Dans l’éventualité où l’exécution du test de Brown–Forsythe aboutirait à une probabilité critique supérieure ou égale au seuil critique retenu (par exemple p = 0,27), le chercheur se trouve dans l’incapacité formelle de réfuter l’hypothèse nulle H0.
Sur le plan épistémologique, il est crucial de rappeler qu’une telle observation ne constitue en aucun cas une preuve directe de l’égalité stricte des variances (une erreur classique de raisonnement consistant à confondre l’absence de preuve avec la preuve de l’absence). Elle indique simplement que les données empiriques recueillies n’apportent pas d’évidence suffisante pour exclure l’hypothèse d’une dispersion homogène.
D’un point de vue opératoire, cette conclusion autorise méthodologiquement le maintien de l’analyse de variance paramétrique classique à un facteur (via la fonction aov() ou lm() sous R), en s’appuyant sans crainte sur la statistique F de Fisher pour comparer les espérances mathématiques des groupes.
10.2 Scénario B : p-valeur inférieure au seuil de significativité (p < 0.05)
Dans notre cas d’étude clinique portant sur les programmes comportementaux de perte de poids, la sortie du test affiche une probabilité critique substantiellement inférieure au seuil conventionnel (p < 0,001). Dans ces conditions, la décision méthodologique s’impose avec une clarté totale : l’hypothèse nulle H0 d’homogénéité des variances doit être fermement rejetée.
Cette issue confirme que les trois modalités d’intervention engendrent des patrons de variabilité structurellement hétérogènes parmi les participants. L’hypothèse fondamentale d’homoscédasticité indispensable à l’ANOVA paramétrique standard de Fisher se trouve ainsi formellement violée.
Poursuivre l’analyse en appliquant aveuglément l’ANOVA classique exposerait les conclusions de l’étude à des distorsions sévères du taux d’erreur de première espèce ou à un effondrement de la puissance de détection. Le rejet de H0 déclenche impérativement une bifurcation méthodologique vers des modélisations alternatives robustes à l’hétéroscédasticité.
10.3 Rapport quantitatif des métriques : statistique F, df1, df2 et probabilité critique
L’évaluation académique de la décision requiert la manipulation conjointe et équilibrée de l’ensemble des métriques d’inférence délivrées par l’algorithme de Brown–Forsythe. Il est scientifiquement proscrit de se cantonner à la simple énonciation d’une p-valeur décontextualisée.
L’analyste doit impérativement rapporter :
- La valeur exacte de la statistique de test observée (FBF), qui témoigne de l’ampleur géométrique de la séparation des échelles de variabilité entre les groupes ;
- Les deux degrés de liberté régissant la loi de distribution sous l’hypothèse nulle, à savoir le degré de liberté intergroupes (df1) et le degré de liberté intragroupe (df2) ;
- Le niveau précis de significativité empirique (p), exprimé avec un degré adéquat de décimales (par exemple p = .002 ou p < .001).
Ce faisceau d’indices quantitatifs permet aux évaluateurs pairs et à la communauté scientifique de jauger la robustesse intrinsèque du diagnostic et d’apprécier la pertinence des stratégies d’analyse de substitution adoptées en aval.
11. Stratégies analytiques en cas de rejet de l’homoscédasticité
Le rejet formel de l’homogénéité des variances ne sonne aucunement le glas de la démarche inférentielle comparative. Il oriente judicieusement l’analyste vers une palette de méthodes alternatives expressément conçues pour s’affranchir de cette contrainte géométrique.
11.1 Recours à l’ANOVA de Welch (oneway.test dans R)
Face à la rupture d’homoscédasticité, la stratégie la plus élégante et la plus puissante préconisée par la littérature statistique contemporaine consiste à substituer l’ANOVA de Fisher standard par l’ANOVA de Welch. Développée par Bernard Lewis Welch, cette procédure adapte la statistique F en pondérant la contribution de chaque groupe par l’inverse de sa propre variance d’échantillon, tout en appliquant une correction fractionnaire aux degrés de liberté du dénominateur.
Au sein de l’environnement logiciel R, l’exécution de l’ANOVA de Welch s’avère particulièrement ergonomique, étant directement implémentée au sein de la distribution de base via la fonction oneway.test(). La syntaxe canonique s’écrit :
modele_welch <- oneway.test(PertePoids ~ Programme, data = donnees_cliniques, var.equal = FALSE)
L’argument central var.equal = FALSE ordonne formellement à l’algorithme de ne pas supposer l’égalité des variances et d’appliquer la correction de Welch aux degrés de liberté. De multiples revues méthodologiques de référence recommandent désormais d’adopter systématiquement l’ANOVA de Welch comme le test omnibus par défaut pour la comparaison de moyennes, tant sa robustesse s’avère remarquable face à l’hétéroscédasticité, même en présence de distributions modérément dissymétriques.
11.2 Utilisation de tests non paramétriques (test de Kruskal-Wallis)
Une démarche fréquemment rencontrée dans la recherche empirique consiste à se tourner vers des alternatives non paramétriques affranchies de toute hypothèse distributionnelle continue, au premier rang desquelles figure le test de Kruskal-Wallis. Ce test remplace les valeurs métriques brutes par leurs rangs ordinaux croissants.
L’implémentation sous R s’exécute à l’aide de l’instruction native kruskal.test(PertePoids ~ Programme, data = donnees_cliniques). Toutefois, une précaution épistémologique majeure doit être rappelée : pour que le test de Kruskal-Wallis puisse être rigoureusement interprété comme un test de comparaison des médianes entre populations, il exige que les distributions de chaque groupe présentent rigoureusement la même forme géométrique, ce qui englobe l’égalité de leurs échelles de variabilité.
Si les variances sont sévèrement inégales et que les morphologies des distributions diffèrent — ce qui est précisément le cas lors du rejet du test de Brown–Forsythe —, le test de Kruskal-Wallis teste en réalité la dominance stochastique globale des distributions et non un simple décalage d’espérance médiane. Dès lors, l’ANOVA de Welch s’avère conceptuellement supérieure si l’objectif scientifique prioritaire demeure l’inférence directe sur les moyennes de groupe.
11.3 Transformations de la variable dépendante et modélisation robuste
Une troisième voie d’ajustement consiste à stabiliser mathématiquement la variance en appliquant une transformation non linéaire continue sur le vecteur des scores dépendants. Les transformations usuelles comprennent le logarithme népérien (log(Y)), particulièrement efficient lorsque l’écart-type croît proportionnellement à la moyenne, la transformation par la racine carrée (sqrt(Y)) pour les données de dénombrement poissonniennes, ou la famille des transformations optimales de Box-Cox.
Cependant, le recours aux transformations soulève de réelles difficultés psychométriques : la modification de la métrique originale complique l’interprétabilité clinique des résultats, car les conclusions portent désormais sur des échelles transformées non intuitives (par exemple des logarithmes de kilogrammes perdus). De surcroît, une transformation opérant efficacement sur un groupe peut déformer artificiellement la symétrie d’un autre groupe.
Aussi, la méthodologie contemporaine préfère-t-elle souvent conserver l’échelle d’origine de la variable et mobiliser la théorie des modèles linéaires généralisés (GLM) ou les régressions pondérées par les moindres carrés généralisés (modèles gls du package nlme). Ces architectures modernes intègrent directement des matrices de variance-covariance hétéroscédastiques ou recourent à des estimateurs d’erreur-type sandwich robustes de type HC3 (disponibles dans le package sandwich), conciliant fidélité métrique et intégrité inférentielle.
12. Rédaction académique des résultats aux normes APA et bonnes pratiques
La transmission des démarches d’inférence statistique au sein des publications universitaires internationales et des mémoires de thèse exige une fidélité scrupuleuse aux normes de rédaction typographique et stylistique de l’American Psychological Association (APA, 7e édition).
12.1 Format de présentation typographique selon les normes APA (7e édition)
Le protocole de mise en forme APA impose des conventions strictes destinées à faciliter la lecture comparative des résultats statistiques dans les revues à comité de lecture. Les lettres latines symbolisant des indices inférentiels ou descriptifs doivent systématiquement figurer en italique : la statistique F (F), la probabilité critique (p), la moyenne arithmétique (M) et l’écart-type (SD).
Pour le test de Brown–Forsythe, le format textuel standardisé agrège l’ensemble des grandeurs sous la forme canonique : F(df1, df2) = valeur_observée, p = valeur_p. Concernant l’expression de la p-valeur, la norme APA prohibe l’usage du zéro initial avant la décimale pour toute probabilité bornée mathématiquement par 1 (écrire p = .002 et non p = 0.002). Lorsque la valeur calculée est extrêmement infinitésimale, la formulation adéquate s’écrit p < .001.
De plus, il est requis de désigner expressément la variante du test exécuté en explicitant le centrage sur la médiane, évitant ainsi toute équivoque avec les résultats issus du test de Levene conventionnel.
12.2 Modèles de phrases prêts à l’emploi pour rapports de recherche et thèses
Afin d’outiller concrètement les praticiens et doctorants dans la rédaction de leurs manuscrits scientifiques, deux modèles narratifs types illustrent la communication des résultats selon l’issue du test diagnostique :
Modèle narratif A : Cas d’une homoscédasticité préservée (non-rejet)
« L’homogénéité des variances entre les différentes modalités d’intervention a été préalablement évaluée à l’aide du test robuste de Brown–Forsythe basé sur les écarts absolus à la médiane. Les résultats indiquent une conformité satisfaisante avec le postulat d’homoscédasticité, F(2, 87) = 1,34, p = .267. En conséquence, l’analyse comparative des moyennes a été menée au moyen d’une analyse de variance (ANOVA) à un facteur standard de Fisher. »
Modèle narratif B : Cas d’une hétérogénéité avérée (rejet — correspondant à notre exemple)
« L’évaluation préalable de l’égalité des échelles de dispersion a révélé une violation significative du postulat d’homoscédasticité via le test de Brown–Forsythe centré sur la médiane, F(2, 87) = 9,42, p < .001, attestant d’une variabilité significativement divergente de la perte de poids selon les programmes comportementaux testés. Afin de neutraliser l’impact de cette hétéroscédasticité sur le taux d’erreur de première espèce, la comparaison omnibus des performances moyennes a été conduite au moyen de l’ANOVA robuste de Welch, F(2, 53,8) = 14,28, p < .001. »
12.3 Bonnes pratiques déontologiques pour la transparence statistique
La crise contemporaine de la reproductibilité scientifique a mis en lumière la dangerosité des pratiques de sélection opportuniste des analyses statistiques, regroupées sous l’appellation générique de p-hacking. Sélectionner un test d’homoscédasticité a posteriori dans le seul but de justifier le modèle conduisant au résultat le plus spectaculaire constitue un manquement éthique caractérisé.
Le chercheur scrupuleux intègre l’évaluation des postulats dès la rédaction du protocole d’enregistrement initial (preregistration). Les règles de décision — spécifiant quel test diagnostique sera mobilisé et quelle stratégie d’analyse de repli sera immédiatement déployée en cas de violation — doivent être gravées avant toute inspection visuelle des données expérimentales.
Dans un esprit d’adhésion totale aux principes de la science ouverte (Open Science), l’intégralité du code source R, incluant l’installation des dépendances, la structuration des tableaux et l’exécution commentée des fonctions car::leveneTest ou onewaytests::bf.test, gagne à être déposée au sein d’un dépôt d’archives institutionnel ou public tel que l’Open Science Framework (OSF) ou GitHub. Cette mise à disposition garantit une auditabilité intégrale du protocole et rehausse le standard de crédibilité des avancées empiriques partagées avec l’ensemble de la communauté savante.
Références
- Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A, Mathematical and Physical Sciences, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
- Box, G. E. P. (1953). Non-normality and tests on variances. Biometrika, 40(3/4), 318–335. https://doi.org/10.1093/biomet/40.3-4.318
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Dag, O., Dolgun, A., & Ankarali, H. (2018). onewaytests: An R package for one-way tests in independent groups designs. The R Journal, 10(1), 175–199. https://doi.org/10.32614/RJ-2018-022
- Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3e éd.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Levene, H. (1960). Robust tests for equality of variances. Dans I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Éds.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Moder, K. (2010). Alternatives to F-test in one-way ANOVA in case of heterogeneity of variances (a simulation study). Psychological Test and Assessment Modeling, 52(4), 343–353.
- Tomarken, A. J., & Serlin, R. C. (1986). Comparison of ANOVA alternatives under variance heterogeneity and specific noncentrality structures. Psychological Bulletin, 99(1), 90–99. https://doi.org/10.1037/0033-2909.99.1.90
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
- Wilcox, R. R. (2017). Introduction to Robust Estimation and Hypothesis Testing (4e éd.). Academic Press. https://doi.org/10.1016/C2015-0-02293-1