
Dans le champ de l’analyse statistique multivariée, la régression linéaire multiple demeure l’un des piliers méthodologiques les plus largement sollicités par les chercheurs en sciences sociales, en économétrie, en épidémiologie et en psychologie quantitative. Sa popularité repose sur une apparente simplicité d’interprétation : chaque coefficient de régression exprime l’effet marginal direct d’une variable prédictive sur une variable de réponse, toutes choses étant égales par ailleurs. Néanmoins, cette élégance analytique dissimule une exigence fondamentale souvent sous-estimée, à savoir le respect strict de l’hypothèse de linéarité de la forme fonctionnelle. Lorsqu’un modèle postule une relation rectiligne entre un ensemble de prédicteurs et un critère alors que les véritables dynamiques sous-jacentes s’avèrent curvilinéaires, polynomiales ou à seuil, l’édifice inférentiel tout entier s’effondre, générant des biais d’estimation considérables et des erreurs d’interprétation majeures.
Face à la complexité des modèles intégrant de multiples covariables corrélées entre elles, la simple observation des nuages de points bivariés s’avère notoirement insuffisante. En présence de confusion statistique, les diagrammes de dispersion bruts peuvent suggérer une relation linéaire là où n’existe qu’une illusion induite par des variables tierces, ou inversement, masquer une courbure prononcée au sein de l’espace multidimensionnel. Pour surmonter cette aporie méthodologique, les statisticiens ont formalisé des représentations graphiques avancées, au premier rang desquelles figurent les graphiques de résidus partiels, également désignés dans la littérature anglo-saxonne sous l’appellation de component-plus-residual plots ou crPlots.
Cet article propose un traité approfondi consacré à la théorie, à la construction algorithmique et à l’interprétation clinique des graphiques de résidus partiels dans l’environnement statistique R. En explorant tant les fondements mathématiques développés par Mordecai Ezekiel et formalisés par R. Dennis Cook que leur mise en œuvre pratique via le package car et le framework ggplot2, ce guide exhaustif a pour ambition de fournir aux analystes de données les clés méthodologiques permettant de diagnostiquer avec précision les non-linéarités, d’adapter la spécification de leurs modèles et de garantir la robustesse épistémologique de leurs inférences empiriques.
1. Introduction aux graphiques de résidus partiels en régression linéaire multiple
1.1 Le rôle fondamental de l’hypothèse de linéarité
L’hypothèse de linéarité constitue le postulat cardinal sur lequel repose l’optimalité de l’estimateur des moindres carrés ordinaires. Sur le plan formel, la modélisation linéaire n’exige pas que la relation entre les variables brutes soit strictement rectiligne, mais requiert impérativement que la fonction soit linéaire par rapport à ses paramètres inconnus et que l’espérance conditionnelle du terme d’erreur stochastique, sachant la matrice des régresseurs, soit identiquement nulle en tout point de l’espace échantillonnal. En d’autres termes, la structure déterministe spécifiée par le chercheur doit capturer l’intégralité de la tendance systématique reliant la variable dépendante aux covariables, ne laissant subsister dans le résidu qu’une fluctuation purement aléatoire, non corrélée et centrée sur zéro.
Lorsque cette condition fondamentale est transgressée, les propriétés asymptotiques et à distance finie des estimateurs des moindres carrés sont lourdement compromises. En vertu du célèbre théorème de Gauss-Markov, les coefficients obtenus ne peuvent plus être qualifiés de meilleurs estimateurs linéaires sans biais. Au contraire, l’omission d’une courbure fonctionnelle introduit un biais structurel d’estimation qui contamine non seulement le coefficient du régresseur mal spécifié, mais également, par un effet de propagation matricielle, l’ensemble des coefficients associés aux autres variables corrélées présentes dans l’équation. Ce phénomène entraîne une sous-estimation ou une surestimation dramatique de la taille réelle des effets marginaux.
Parallèlement au biais de mesure, la violation de linéarité induit une perte sévère de puissance statistique lors des tests de significativité. La variance résiduelle globale se trouvant artificiellement gonflée par l’incapacité du modèle à modéliser la courbure systématique, les erreurs-types des coefficients augmentent de manière disproportionnée. En conséquence, les intervalles de confiance s’élargissent, les statistiques de Student s’effondrent, et le risque d’erreur de type II devient prépondérant. Dans ce contexte dégradé, l’analyste risque d’évacuer prématurément des variables explicatives cruciales pour le progrès théorique de sa discipline.
Il est par ailleurs illusoire d’espérer diagnostiquer ces pathologies fonctionnelles par le truchement de simples graphiques bivariés traçant la variable dépendante en fonction de chaque prédicteur isolé. Dans les systèmes multivariés, les phénomènes de confusion, d’effet de masque et de colinéarité distordent profondément les projections orthogonales bidimensionnelles. Une relation parfaitement non linéaire au niveau conditionnel peut apparaître rigoureusement rectiligne sur un nuage de points brut si une covariable non contrôlée varie conjointement avec le régresseur d’intérêt. Inversement, une courbure apparente peut n’être que le reflet déformé d’une distribution hétérogène de variables omises, justifiant ainsi le recours impératif à des méthodes graphiques conditionnelles dédiées.
1.2 Définition et nature des graphiques composante plus résidu (crPlots)
L’origine conceptuelle des graphiques de résidus partiels remonte aux travaux pionniers de l’économiste Mordecai Ezekiel publiés dans les années 1920, qui cherchait à isoler l’influence graphique d’un déterminant de l’offre agricole en éliminant les interférences des fluctuations de prix concurrentes. Cette approche heuristique fut ultérieurement formalisée, raffinée et intégrée dans le corpus moderne de la statistique diagnostique par le statisticien américain R. Dennis Cook au cours des années 1970 et 1980. La littérature contemporaine emploie indifféremment les terminologies de partial residual plots ou de component-plus-residual plots, abrégés communément sous le sigle crPlots au sein de l’écosystème R.
Pour appréhender l’essence d’un graphique de résidu partiel, il convient d’établir une distinction rigoureuse entre trois notions fondamentales souvent confondues : le résidu simple, le résidu partiel et la régression partielle. Le résidu simple ordinaire représente l’écart vertical brut entre la valeur observée et la valeur globalement prédite par l’hyperplan de régression pour une observation donnée. Ce résidu agrège indifféremment les imprécisions de l’ensemble des régresseurs du modèle, rendant impossible l’identification du prédicteur précis à l’origine d’un défaut d’ajustement local. Le résidu partiel, quant à lui, opère une dissociation analytique élégante : il réinjecte la composante linéaire associée à un prédicteur spécifique dans le résidu ordinaire, isolant ainsi la contribution marginale nette de ce prédicteur particulier face au bruit résiduel.
Graphiquement, le graphique composante plus résidu projette en abscisse les valeurs observées du prédicteur évalué et en ordonnée la valeur du résidu partiel calculé pour chaque individu statistique. Cette construction ingénieuse possède une propriété mathématique remarquable : la pente de la droite des moindres carrés ajustée sur ce nuage de points bidimensionnel correspond exactement au coefficient de régression partielle estimé pour ce prédicteur dans le modèle multivarié complet. Dès lors, toute déviation systématique des points par rapport à cette droite de référence témoigne de manière univoque d’une non-linéarité inhérente à cette variable spécifique, débarrassée des effets perturbateurs de toutes les autres covariables présentes dans le système d’équations.
Cette spécificité confère aux graphiques de résidus partiels une supériorité diagnostique incontestable pour détecter des déviations fonctionnelles complexes telles que des rendements décroissants, des effets de seuil, des transitions logistiques ou des configurations paraboliques. Contrairement aux approches aveugles fondées sur l’ajout systématique de puissances polynomiales, l’inspection visuelle des graphiques composante plus résidu permet d’appréhender directement la morphologie empirique sous-jacente des données conditionnelles, orientant ainsi l’analyste vers la reparamétrisation mathématique la plus judicieuse et la plus parcimonieuse.
1.3 Place des résidus partiels dans l’évaluation globale d’un modèle
Au sein de la batterie diagnostique mise à la disposition du modélisateur, les graphiques de résidus partiels n’ont pas vocation à se substituer aux autres outils de vérification des hypothèses classiques, mais s’inscrivent dans une relation de stricte complémentarité séquentielle. Le graphique canonique représentant les résidus simples en fonction des valeurs ajustées globales constitue généralement la première étape de l’inspection post-estimation. Ce dernier excelle dans la détection globale d’une mauvaise spécification de l’espérance mathématique ou de la présence d’une hétéroscédasticité généralisée. Toutefois, lorsqu’une anomalie courbée se manifeste sur ce graphique d’ensemble, il s’avère incapable d’imputer la responsabilité de cette défaillance à un régresseur particulier parmi les dizaines potentiellement inclus dans l’analyse.
C’est précisément à cette jonction critique que les graphiques de résidus partiels déploient leur utilité méthodologique. En décomposant le problème global en une série de diagnostics univariés conditionnels, ils permettent d’auditer individuellement chaque dimension continue du modèle. Cette démarche doit être menée conjointement avec l’examen de l’homoscédasticité, testée via les graphiques d’échelle-localisation et le test de Breusch-Pagan, ainsi qu’avec l’évaluation de la normalité distributionnelle des erreurs, traditionnellement vérifiée par les diagrammes quantile-quantile de Gauss. Une non-linéarité non corrigée produit fréquemment des artéfacts d’hétéroscédasticité apparente ou d’asymétrie résiduelle, qui se dissipent spontanément dès lors que la véritable forme fonctionnelle est correctement intégrée dans la matrice de modélisation.
L’utilité des résidus partiels devient d’autant plus prégnante lorsque le modèle incorpore des prédicteurs substantiellement corrélés ou engagés dans des structures de colinéarité modérée. En présence de dépendances linéaires entre covariables, les projections résiduelles classiques deviennent instables et difficiles à interpréter en raison du chevauchement informationnel. Les graphiques composante plus résidu maintiennent une lisibilité diagnostique élevée en préservant explicitement l’échelle d’origine de la variable explicative tout en neutralisant l’influence des composantes orthogonales des autres régresseurs, fournissant ainsi une cartographie fidèle de la dynamique propre à chaque variable prédictive.
2. Fondements théoriques et mathématiques des résidus partiels
2.1 Formulation algébrique des résidus partiels
Pour formaliser rigoureusement la genèse mathématique des résidus partiels, considérons le cadre classique du modèle linéaire général à plusieurs variables indépendantes. Soit un échantillon de taille n observations, où la variable dépendante continue est représentée par le vecteur colonne Y de dimension n x 1, et l’ensemble des p prédicteurs par la matrice de plan d’expérience X de dimension n x (p + 1), incluant le terme constant d’interception. Le modèle statistique standard s’écrit matriciellement :
Y = X beta + epsilon
où beta désigne le vecteur des (p + 1) paramètres de régression inconnus et epsilon représente le vecteur des perturbations aléatoires non observables, supposées indépendantes et identiquement distribuées selon une loi normale d’espérance nulle et de variance scalaire constante sigma au carré. Après estimation des coefficients par la méthode des moindres carrés ordinaires, on obtient le vecteur des estimateurs beta-chapeau et le vecteur correspondant des résidus simples ordinaires e, défini par l’écart vectoriel :
e = Y – Y-chapeau = Y – X beta-chapeau
Considérons à présent un prédicteur particulier, noté X_j, dont nous souhaitons évaluer la forme fonctionnelle marginale. L’équation de régression estimée peut être décomposée algébriquement de manière à isoler la contribution linéaire spécifique de cette j-ième variable par rapport à l’ensemble des (p – 1) autres prédicteurs. Pour chaque individu i variant de 1 à n, la valeur prédite s’exprime selon la somme :
y-chapeau_i = beta-chapeau_0 + somme pour k différent de j (beta-chapeau_k * x_ik) + beta-chapeau_j * x_ij
Le résidu partiel associé à la variable X_j pour la i-ième observation, traditionnellement noté e_ij*, est défini algébriquement comme la sommation du résidu simple ordinaire de cette observation et de la composante linéaire prédite par ce prédicteur unique. La formulation s’établit formellement comme suit :
e_ij* = e_i + beta-chapeau_j * x_ij
En réinjectant la définition de l’erreur ordinaire dans cette égalité, nous constatons que le résidu partiel équivaut à la valeur observée de la variable réponse dont on a soustrait la part expliquée par l’ensemble des prédicteurs du modèle à l’exclusion stricte de X_j :
e_ij* = y_i – [ beta-chapeau_0 + somme pour k différent de j (beta-chapeau_k * x_ik) ]
Cette dérivation algébrique met en lumière une propriété mathématique cruciale : le résidu partiel préserve intégralement la variance résiduelle non expliquée par les autres régresseurs, tout en restituant l’effet présumé de la variable focale. Si la relation réelle entre X_j et Y est rigoureusement linéaire, le nuage de points formé par les couples (x_ij, e_ij*) oscillera de manière purement stochastique autour de la droite d’équation d’ordonnée beta-chapeau_j * x_ij. La régression univariée de e_j* sur X_j restitue avec une exactitude mathématique absolue le coefficient de régression multiple beta-chapeau_j, garantissant une conservation intégrale de l’échelle d’analyse et de la pente estimée au sein du modèle complet.
2.2 Différence entre résidus partiels et graphiques de régression partielle
Une confusion récurrente dans la pratique de la modélisation statistique concerne la distinction entre les graphiques de résidus partiels (component-plus-residual plots) et les graphiques de régression partielle, universellement appelés dans la littérature anglo-saxonne added-variable plots ou graphiques de Frisch-Waugh-Lovell. Bien que ces deux méthodologies visent à explorer le comportement conditionnel d’un prédicteur dans un contexte multivarié, leurs architectures de projection, leurs mécanismes de calcul et leurs vocations diagnostiques diffèrent substantiellement.
Un graphique de variables ajoutées (added-variable plot) repose sur la double orthogonalisation prescrite par le théorème fondamental de Frisch-Waugh-Lovell. Pour construire ce graphique dédié à la variable X_j, l’analyste procède en deux étapes régressives préliminaires : d’une part, on régresse la variable dépendante Y sur l’ensemble des prédicteurs à l’exclusion de X_j pour extraire le vecteur des résidus de réponse e_{Y|autres} ; d’autre part, on régresse la variable prédictive X_j sur ce même ensemble d’autres covariables pour obtenir le vecteur des résidus de prédicteur e_{X_j|autres}. Le graphique trace ensuite e_{Y|autres} en fonction de e_{X_j|autres}. Les deux axes se trouvent ainsi totalement débarrassés des dimensions communes aux autres prédicteurs, leurs échelles étant désormais exprimées en déviations résiduelles pures.
Cette différence de géométrie statistique confère à chaque outil un domaine de compétence exclusif. Le graphique de variables ajoutées s’avère exceptionnellement performant pour détecter les points aberrants multivariés, les observations à fort effet de levier et les individus statistiques exerçant une influence démesurée sur l’estimation de la pente beta_j via l’évaluation de la distance de Cook. En revanche, le graphique de variables ajoutées compresse et distord la forme fonctionnelle originelle de la relation, rendant le diagnostic des non-linéarités extrêmement délicat, voire trompeur, lorsque la courbure s’étend sur plusieurs dimensions de l’espace des covariables.
À l’inverse, le graphique de résidu partiel conserve sur son axe des abscisses l’échelle naturelle et non transformée de la variable prédictive X_j, sans projection résiduelle sur les autres variables. Cette conservation géométrique fait du résidu partiel l’instrument de référence par excellence pour diagnostiquer la forme fonctionnelle réelle liant le prédicteur à la réponse. Dès lors, le critère de sélection est limpide pour l’expérimentateur : si l’objectif prioritaire consiste à vérifier l’hypothèse de linéarité et à modéliser d’éventuelles courbures empiriques, le graphique composante plus résidu (crPlot) s’impose comme le choix méthodologique optimal. Si l’accent est mis sur l’identification des points de levier destructeurs d’estimation, l’analyste se tournera préférentiellement vers les graphiques de variables ajoutées (avPlots).
2.3 Régresseurs non paramétriques et lissage local
L’interprétation clinique d’un graphique de résidu partiel ne saurait reposer sur la seule observation contemplative d’un nuage de points de dispersion. L’œil humain éprouve des difficultés notoires à apprécier la densité locale et les inflexions subtiles au sein de nuages de points volumineux ou bruités. C’est pourquoi la méthodologie moderne des résidus partiels incorpore de façon standardisée des techniques de régression non paramétrique, au premier rang desquelles figure le lissage local LOESS (Locally Estimated Scatterplot Smoothing), développé par William S. Cleveland.
L’algorithme LOESS opère en ajustant, en chaque point de l’abscisse x, un polynôme de faible degré (typiquement d’ordre 1 pour une régression linéaire locale ou d’ordre 2 pour une parabole locale) sur un sous-ensemble restreint de points de données situés dans un voisinage immédiat. Les observations incluses dans cette fenêtre de calcul sont pondérées selon leur distance euclidienne par rapport au point cible à l’aide d’une fonction de noyau, généralement la fonction tricube de Cleveland :
W(u) = (1 – |u|^3)^3 pour |u| < 1, et 0 ailleurs
où u représente la distance relative normalisée par rapport à la demi-largeur de la fenêtre de calcul. En combinant cette pondération spatiale avec une procédure itérative robuste visant à atténuer le poids des observations résiduelles atypiques, le lissage LOESS génère une courbe continue souple et hautement adaptable, totalement affranchie des contraintes de paramétrisation rigide inhérentes aux modèles classiques.
Le comportement de cette courbe empirique est directement subordonné au paramétrage de la fenêtre de lissage, désignée sous le terme d’argument de portée ou span (souvent noté alpha). La valeur de ce paramètre, comprise entre 0 et 1, quantifie la proportion de l’échantillon total mobilisée pour calibrer chaque ajustement polynomial local. L’analyste se trouve ici confronté à l’archétype du compromis biais-variance : une valeur de span trop resserrée (par exemple inférieure à 0,25) confère une volatilité excessive à la trajectoire, l’estimateur épousant le bruit d’échantillonnage aléatoire au détriment de la structure sous-jacente (surapprentissage). Inversement, un span surdimensionné (supérieur à 0,80) introduit un lissage excessif qui masque les véritables inflexions non linéaires locales, augmentant considérablement le biais de spécification.
Sur un graphique composante plus résidu convenablement paramétré, deux trajectoires graphiques sont invariablement superposées : une droite théorique de référence (représentant la relation linéaire strictement postulée par le modèle des moindres carrés ordinaires) et la courbe empirique lissée LOESS (reflétant la dynamique réelle capturée sans a priori structurel). La divergence visuelle entre ces deux repères constitue le révélateur diagnostique par excellence : toute bifurcation substantielle et systématique de la courbe non paramétrique à distance de la droite paramétrique atteste irréfutablement d’un défaut de linéarité du modèle sous revue.
3. L’importance du diagnostic de linéarité en recherche psychologique
3.1 Spécificité des variables psychométriques et comportementales
Dans le domaine de la recherche en psychologie, en neurosciences cognitives et en sciences du comportement, l’hypothèse de linéarité est soumise à des tensions théoriques et métrologiques particulièrement aiguës. Les phénomènes psychologiques observés obéissent rarement à des lois mécaniques strictement proportionnelles. L’un des exemples les plus emblématiques de ces dynamiques non monotones réside dans la fameuse loi de Yerkes-Dodson, qui formalise la relation empirique liant l’activation émotionnelle (stress, anxiété, éveil physiologique) à la performance cognitive. Alors qu’une modélisation linéaire naïve conclurait faussement à une absence d’effet global ou à un effet marginal marginalisé proche de zéro, la réalité psychologique révèle une trajectoire en U inversé : un niveau modéré de stress maximise les capacités de traitement attentionnel, tandis que des niveaux déficitaires ou excessifs détériorent gravement l’efficience comportementale.
Au-delà de ces fondements fonctionnels propres à la régulation biologique et émotionnelle, la nature même des instruments de mesure psychométriques introduit des distorsions de linéarité artificielles mais systématiques. Les échelles d’évaluation ordinale de type Likert, abondamment déployées pour quantifier des construits latents tels que l’estime de soi, les symptômes dépressifs ou la motivation autodéterminée, souffrent chroniquement d’effets de plancher et de plafond. Lorsqu’un inventaire d’évaluation clinique est administré à une cohorte non clinique issue de la population générale, une proportion substantielle de participants s’agglutine sur les échelons inférieurs de l’instrument, créant une troncature artificielle de la variance qui compresse la relation fonctionnelle aux extrêmes de l’échelle.
De surcroît, les processus développementaux et les acquisitions d’aptitudes cognitives chez l’enfant ou l’adulte vieillissant suivent des cinétiques non linéaires caractérisées par des accélérations soudaines, des paliers de consolidation et des asymptotes de maturation. Prétendre appréhender ces trajectoires dynamiques au moyen de simples régressions rectilignes fait courir le risque théorique majeur d’aboutir à des conclusions fallacieuses concernant la nature des construits latents, en érigeant en constantes universelles des taux d’évolution qui varient en réalité substantiellement le long du continuum de la variable explicative.
3.2 Robustesse des conclusions statistiques en psychologie expérimentale
L’omission d’une non-linéarité fondamentale dans un modèle psychologique ne constitue pas une simple imperfection cosmétique ; elle altère directement la reproductibilité empirique des découvertes scientifiques, alimentant de fait la crise de réplication qui secoue la psychologie quantitative depuis plus d’une décennie. Lorsqu’un chercheur tente de répliquer une étude antérieure en utilisant un échantillon dont la distribution du prédicteur est légèrement décalée vers des valeurs plus élevées ou plus faibles le long de l’abscisse, l’estimation linéaire locale issue d’une fonction sous-jacente curvilinéaire fluctuera considérablement d’une étude à l’autre, produisant des tailles d’effet en apparence contradictoires, oscillant de l’association positive à l’absence de lien, voire à l’inversion de signe.
Cette instabilité méthodologique découle d’une distorsion dramatique des métriques de quantification standardisées. Les indices de taille d’effet classiquement rapportés dans les publications académiques, tels que les coefficients standardisés bêta ou les fractions de variance expliquée semi-partielles, se trouvent artificiellement amoindris lorsque la structure du modèle ignore la courbure réelle des données. La proportion de variance attribuable au construit psychologique d’intérêt est indûment reléguée dans le terme d’erreur stochastique, conduisant la communauté scientifique à sous-estimer la portée explicative de déterminants comportementaux majeurs.
C’est pourquoi les comités de rédaction des revues de référence et les normes de publication méthodologique de l’American Psychological Association (APA) recommandent avec une insistance croissante la mise en œuvre d’audits graphiques systématiques préalablement à toute formalisation inférentielle. L’inspection visuelle rigoureuse des graphiques composante plus résidu doit faire partie intégrante du cahier des charges de tout chercheur soucieux d’asseoir la validité interne et la robustesse réplicative de ses modélisations quantitatives.
3.3 Prise en compte des covariables d’ajustement
Dans la grande majorité des protocoles de recherche quasi-expérimentaux ou corrélationnels en psychologie, le phénomène étudié s’inscrit au sein d’une matrice complexe d’influences sociodémographiques et contextuelles. Des variables d’ajustement telles que l’âge chronologique, les années de scolarisation, le statut socio-économique ou le quotient intellectuel prémorbide doivent être rigoureusement contrôlées pour isoler la part d’influence authentique du mécanisme psychologique sous investigation. L’inclusion simultanée de ces multiples covariables crée toutefois un environnement analytique hautement vulnérable aux non-linéarités masquées.
L’agrégation multivariée standard tend à occulter des modérations fonctionnelles subtiles ou des changements de régime qui ne se révèlent qu’une fois neutralisées les influences exogènes des covariables de contrôle. Par exemple, l’association entre le niveau de perfectionnisme et l’anxiété de performance peut paraître strictement rectiligne au sein d’une cohorte hétérogène, mais manifester une rupture de pente marquée dès lors que le niveau de stress environnemental et les capacités d’inhibition cognitive sont maintenus statistiquement constants à leur valeur moyenne.
Les graphiques de résidus partiels apportent une contribution inestimable à la préservation de la validité de construit en permettant d’auditer l’effet net d’une variable focale après avoir rigoureusement purgé les données de la covariance parasite induite par ces covariables d’ajustement. Cette faculté de visualisation conditionnelle garantit que la forme mathématique retenue pour représenter l’influence d’un construit psychologique ne constitue pas un artéfact méthodologique imputable à la structure distributionnelle des variables de contrôle, conférant ainsi aux conclusions empiriques une solidité conceptuelle inattaquable.
4. Configuration de l’environnement de travail dans R et préparation des données
4.1 Installation et chargement des packages statistiques requis
Pour mener à bien la génération, l’analyse et la personnalisation avancée des graphiques de résidus partiels, l’écosystème open-source R offre une constellation de packages spécialisés particulièrement puissants. Au cœur de cette infrastructure se trouve la bibliothèque car (acronyme de Companion to Applied Regression), développée et maintenue par John Fox et Sanford Weisberg. Ce package fait figure de référence mondiale absolue dans le domaine du diagnostic de régression et intègre la suite logicielle la plus exhaustive pour le calcul et l’affichage des graphiques composante plus résidu. Son installation et son chargement nécessitent l’exécution préalable de commandes standardisées au sein de la console R :
install.packages(« car »)
install.packages(« tidyverse »)
install.packages(« patchwork »)
Une fois les binaires déployés sur la machine de calcul, l’analyste charge les bibliothèques indispensables dans la session active. Le métapackage tidyverse, englobant notamment ggplot2, dplyr et tibble, assurera les manipulations de structures matricielles et la production de graphiques sur mesure respectant les plus hautes normes esthétiques de l’édition scientifique. On veillera également à charger la bibliothèque de données associées carData, qui fournit de nombreux jeux de données d’apprentissage :
library(car)
library(carData)
library(tidyverse)
library(patchwork)
Il est de saine pratique méthodologique de procéder à une vérification méticuleuse de la version de l’interpréteur R ainsi que des dépendances logicielles sous-jacentes. La suite car s’appuie étroitement sur des extensions complémentaires telles que Formula, abind et MASS. L’exécution de la commande sessionInfo() permet d’archiver de manière reproductible l’environnement technique exact dans lequel les calculs statistiques et les diagnostics graphiques ont été exécutés, garantissant ainsi la traçabilité intégrale du protocole analytique.
4.2 Génération d’un jeu de données synthétique reproductible
Afin d’illustrer de manière didactique et rigoureuse le comportement des résidus partiels face à des pathologies fonctionnelles parfaitement calibrées, la simulation d’un jeu de données synthétique maîtrisé constitue la méthode pédagogique par excellence. Pour garantir la stricte reproductibilité computationnelle de nos simulations à travers différentes machines et systèmes d’exploitation, l’initialisation du générateur congruentiel linéaire à l’aide d’une graine d’aléa fixe est impérative :
set.seed(42)
Nous modélisons un échantillon de taille réaliste comprenant N = 600 observations indépendantes. Afin de reproduire la complexité morphologique fréquemment rencontrée dans les études empiriques, nous configurons trois prédicteurs continus distincts présentant des propriétés distributionnelles hétérogènes : une variable X1 suivant une distribution uniforme symétrique, une variable X2 distribuée selon une loi gaussienne centrée réduite standard, et une variable X3 présentant une asymétrie positive marquée générée à partir d’une distribution du chi-deux :
n_obs <- 600
x1_uniform <- runif(n_obs, min = 10, max = 50)
x2_normal <- rnorm(n_obs, mean = 0, sd = 1.5)
x3_skewed <- rchisq(n_obs, df = 4)
La variable de réponse continue Y est ensuite programmée de manière déterministe en incorporant délibérément des structures non linéaires complexes au niveau des composantes marginales. Plus précisément, la variable X1 entretient avec le critère une relation strictement quadratique concave illustrant une dynamique de rendement décroissant puis négatif, la variable X2 manifeste un comportement linéaire proportionnel direct, tandis que la variable X3 incorpore une composante cubique modérée créant une double inflexion sigmoïdale sur son étendue. L’ensemble est scellé par l’ajout d’une erreur stochastique gaussienne homoscédastique d’écart-type calibré :
erreur_pure <- rnorm(n_obs, mean = 0, sd = 12)
y_reponse <- 25 + (3.5 * x1_uniform) – (0.075 * (x1_uniform^2)) + (4.2 * x2_normal) + (0.8 * x3_skewed) – (0.015 * (x3_skewed^3)) + erreur_pure
donnees_simulation <- data.frame(Y = y_reponse, X1 = x1_uniform, X2 = x2_normal, X3 = x3_skewed)
4.3 Exploration préliminaire et vérification des structures de données
Préalablement à toute démarche de modélisation inférentielle, une inspection exploratoire approfondie de la structure du tableau de données synthétisé doit être entreprise. L’analyste examine les dimensions matricielles via la fonction dim() et audite la typologie interne des vecteurs de variables au moyen de la fonction str(). La production de statistiques descriptives univariées détaillées par l’intermédiaire de summary() fournit les repères fondamentaux quant à la dispersion des variables : minimum, premier quartile, médiane, moyenne arithmétique, troisième quartile et maximum.
Une étape capitale réside dans l’estimation de la matrice de corrélation linéaire bivariée de Pearson reliant l’ensemble des prédicteurs et la variable réponse, exécutable via la commande cor(donnees_simulation). Cette matrice initiale permet d’observer l’intensité des liaisons linéaires brutes. Dans notre configuration expérimentale, la corrélation bivariée entre X1 et Y apparaît considérablement affaiblie en raison de l’effet d’annulation symétrique induit par la composante quadratique sous-jacente. Si le praticien se fiait exclusivement à cette métrique de corrélation standardisée, il conclurait erronément à une influence négligeable de X1 sur le phénomène étudié.
Enfin, l’absence de valeurs manquantes (valeurs NA) et la conformité des domaines de variation sont formellement validées par la commande sum(is.na(donnees_simulation)). L’intégrité numérique du jeu de données étant ainsi attestée, l’environnement de calcul se trouve idéalement préparé pour accueillir la première phase d’ajustement du modèle de régression linéaire multiple.
5. Ajustement du modèle de régression linéaire multiple avec la fonction lm()
5.1 Spécification formelle de la syntaxe de formule dans R
Dans l’écosystème R, la modélisation statistique linéaire s’exécute traditionnellement via la fonction native lm(), abréviation de linear models. L’architecture de cette commande repose sur un formalisme de syntaxe de formule hautement expressif, articulé autour de l’opérateur tilde. La variable dépendante à prédire est systématiquement positionnée à gauche de l’opérateur, tandis que la combinaison additive des prédicteurs explicatifs se déploie sur son flanc droit. Pour spécifier le modèle naïf initial postulant une linéarité absolue pour l’ensemble des covariables de notre jeu de données synthétique, la syntaxe s’établit formellement comme suit :
modele_naif <- lm(Y ~ X1 + X2 + X3, data = donnees_simulation)
L’exécution de cette commande mobilise la décomposition QR matricielle sous le capot logiciel de R afin de résoudre le système d’équations normales et d’extraire les paramètres optimaux minimisant la somme des carrés des erreurs résiduelles. L’interrogation exhaustive de cet objet de classe lm s’opère via la fonction standard summary(modele_naif), qui génère un rapport analytique structuré comprenant l’estimation ponctuelle de chaque coefficient bêta, son erreur-type associée, la valeur de la statistique t de Student dérivée du rapport signal-sur-bruit, ainsi que la p-valeur bilatérale correspondante.
L’examen des métriques agrégées révèle généralement un coefficient de détermination global R-carré respectable, complété par sa variante ajustée qui pénalise le nombre de degrés de liberté consommés par les prédicteurs. Néanmoins, l’analyste averti doit se garder de considérer un R-carré substantiel comme une attestation d’adéquation fonctionnelle. Un modèle lourdement erroné dans sa forme structurelle peut parfaitement afficher un coefficient de détermination élevé lorsque les prédicteurs partagent une variance substantielle avec la variable cible, dissimulant ainsi des distorsions prédictives localisées d’une gravité méthodologique considérable.
5.2 Diagnostic global standard et insuffisance des métriques agrégées
Pour éprouver la validité de la spécification adoptée, le réflexe diagnostique conventionnel consiste à consulter le tableau d’analyse de la variance (ANOVA) généré par la fonction anova(modele_naif) et à scruter le test F global de significativité de Fisher-Snedecor. Ce test omnibus compare la variance expliquée par l’ensemble des régresseurs à la variance résiduelle non modélisée. Dans notre cas de figure, la p-valeur du test F s’avère hautement significative (inférieure à 0,001), ce qui incite fréquemment les modélisateurs peu scrupuleux à valider prématurément leur équation de régression en affirmant que le modèle prédit efficacement la variable dépendante.
Cette conclusion repose toutefois sur une faiblesse épistémologique majeure. La statistique globale de Fisher teste exclusivement l’hypothèse nulle conjointe selon laquelle l’intégralité des coefficients de régression est simultanément égale à zéro. Elle ne possède aucun pouvoir discriminant quant à la rectitude de la trajectoire fonctionnelle et demeure totalement insensible à la localisation des éventuelles courbures locales. Un rejet catégorique de l’hypothèse nulle n’offre absolument aucune garantie que la relation conditionnelle entre chaque régresseur et le critère réponde aux postulats du modèle linéaire.
L’inspection des graphiques diagnostiques standards générés automatiquement par la commande de base plot(modele_naif), et plus particulièrement du diagramme des résidus simples en fonction des valeurs prédites (Residuals vs Fitted), confirme cette aporie. Si ce graphique d’ensemble révèle effectivement une courbure d’ondulation suspecte trahissant une défaillance globale de linéarité, il place l’analyste devant une impasse méthodologique totale : quelle variable prédictive spécifique parmi X1, X2 et X3 est responsable de cette distorsion ? Est-ce l’effet d’une courbure isolée sur un seul prédicteur ou d’une interaction complexe entre plusieurs composantes ? Face à cette incapacité congénitale des graphiques agrégés à décomposer l’origine de l’erreur, la transition vers le protocole analytique des graphiques de résidus partiels s’impose comme un impératif catégorique.
6. Génération de graphiques de résidus composante plus résidu avec le package car
6.1 Mise en œuvre fondamentale via la fonction crPlots()
L’implémentation algorithmique de référence des graphiques de résidus partiels dans le logiciel R est orchestrée par la bibliothèque car au moyen de sa fonction polyvalente crPlots(). Conçue avec une remarquable souplesse ergonomique, cette commande requiert comme argument principal unique l’objet résultant de l’ajustement linéaire préalable. Dès son exécution, la fonction procède automatiquement au scanning de la formule du modèle, extrait l’ensemble des variables explicatives numériques continues et assemble instantanément une matrice graphique multi-fenêtrée contenant les visualisations diagnostiques individuelles de chaque prédicteur :
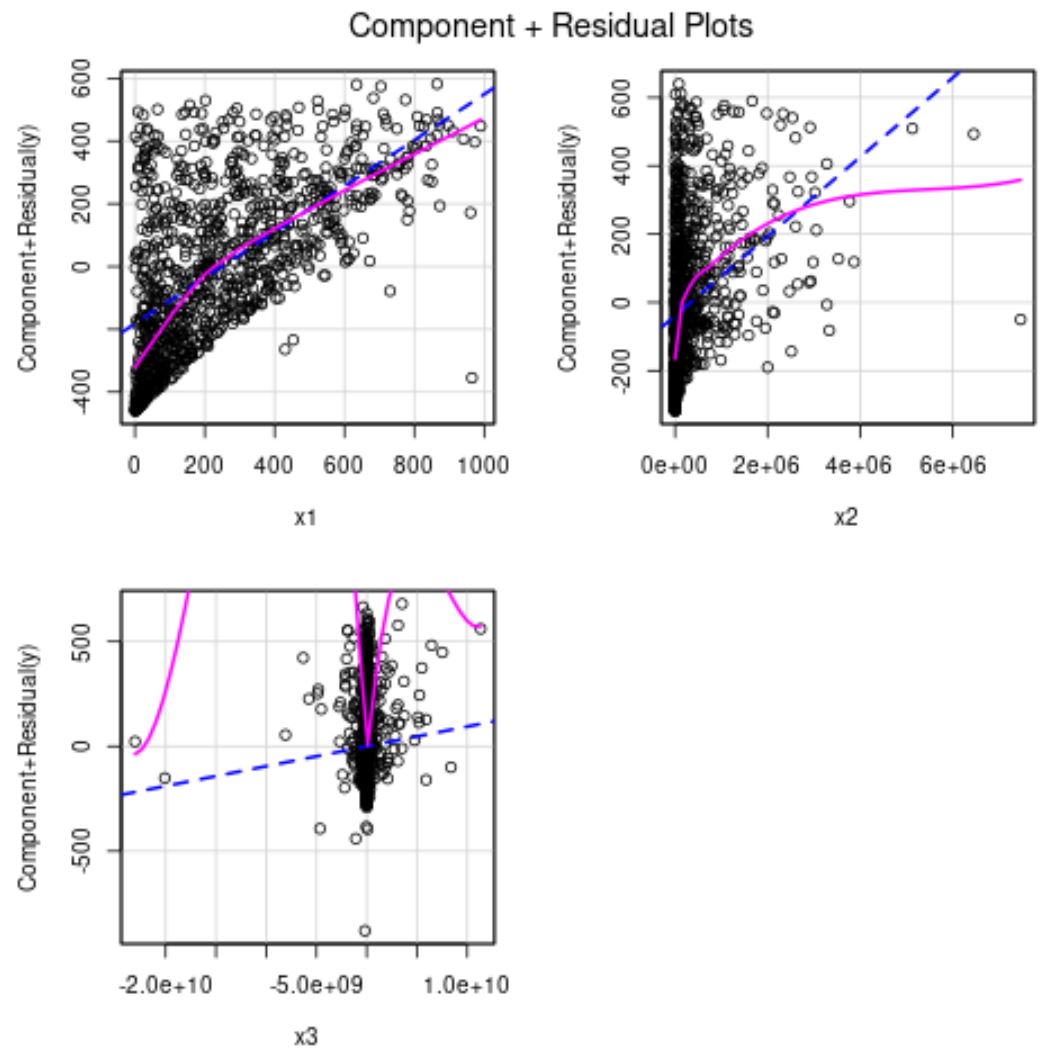
crPlots(modele_naif)
Dans l’éventualité où le chercheur souhaiterait cibler son investigation sur une composante fonctionnelle particulière sans encombrer la fenêtre graphique de visualisations périphériques, le package met à disposition la variante syntaxique au singulier crPlot(). Cette fonction dédiée requiert en second argument le nom explicite du terme à évaluer sous forme de chaîne de caractères ou d’expression non évaluée, offrant ainsi un cadrage analytique précis :
crPlot(modele_naif, variable = « X1 »)
Il importe de souligner la manière dont la fonction crPlots() administre les régresseurs non continus. Lorsque le modèle statistique intègre des prédicteurs qualitatifs déclarés sous forme de facteurs ou des termes d’interactions multiplicatives, la fonction adapte son comportement algorithmique : elle isole et projette graphiquement les seuls termes linéaires continus pour lesquels le concept de résidu partiel conserve une signification géométrique directe, tout en contrôlant l’ensemble des effets fixes catégoriels au sein de l’équation résiduelle sous-jacente.
6.2 Personnalisation des paramètres d’affichage et de lissage
La puissance diagnostique de la fonction crPlots() est décuplée par la présence d’arguments de personnalisation avancés permettant d’affiner tant la sensibilité statistique du lisseur non paramétrique que la lisibilité visuelle du document produit. Le comportement de l’estimateur LOESS sous-jacent est modulable par le truchement du paramètre smooth, qui reçoit une liste de spécifications algorithmiques. L’argument fondamental span détermine la largeur de la fenêtre glissante d’estimation locale :
crPlots(modele_naif, smooth = list(smoother = loessLine, span = 0.5, col.smooth = « firebrick », lty.smooth = 1, lwd.smooth = 2.5))
Dans cette syntaxe, l’affectation d’une valeur de span égale à 0,5 confère au lisseur une flexibilité optimale, évitant à la fois l’écueil de la sur-simplification linéaire et celui de l’ondulation chaotique ultra-locale. Les options col.smooth, lty.smooth et lwd.smooth permettent de piloter directement la couleur, le type de trait (plein, pointillé, tireté) et l’épaisseur géométrique de la courbe empirique lissée, autorisant ainsi une dissociation visuelle immédiate d’avec la droite théorique des moindres carrés.
La ligne de référence théorique paramétrique fait elle-même l’objet d’un paramétrage rigoureux via l’argument col.lines, traditionnellement configuré sous forme de tirets bleus ou noirs contrastants. Par ailleurs, la gestion des observations extrêmes et atypiques est automatisée par l’argument id. En configurant id = list(n = 3, method = « mahal »), la fonction identifie, marque et labellise directement sur le graphique les trois individus statistiques présentant les plus forts écarts multivariés le long de la trajectoire du résidu partiel, facilitant le repérage immédiat des valeurs influentes susceptibles de biaiser l’appréciation de la forme fonctionnelle.
6.3 Exportation haute résolution pour les publications académiques
La publication de résultats empiriques dans des revues académiques de premier plan soumises à comité de lecture exige la production de visualisations graphiques répondant à des normes typographiques et de résolution particulièrement strictes. Le système graphique de base de R, dans lequel s’exécute la fonction crPlots(), permet une exportation vectorielle et matricielle sans compression dégradante au moyen des gestionnaires de périphériques graphiques natifs.
Pour une intégration optimale dans des documents LaTeX ou des manuscrits Word, le format vectoriel PDF garantit une netteté absolue quelle que soit l’échelle de grossissement éditoriale. La procédure standardisée nécessite l’ouverture préalable du périphérique via la fonction pdf(), l’ajustement minutieux des marges d’affichage via la commande par(), la génération des tracés diagnostiques, et la clôture impérative du flux de rendu au moyen de dev.off() :
pdf(file = « diagnostic_residus_partiels.pdf », width = 10, height = 7, pointsize = 11)
par(mar = c(4.5, 4.5, 2, 1.5), mgp = c(2.8, 0.8, 0))
crPlots(modele_naif, col = rgb(0.2, 0.2, 0.2, 0.4), pch = 19)
dev.off()
Lorsque les consignes éditoriales imposent des fichiers d’images matriciels matricées au format TIFF ou PNG, une attention particulière doit être portée au paramètre de résolution spatiale, qui ne saurait être inférieur à 300 points par pouce (DPI) pour satisfaire aux critères de clarté de l’imprimerie scientifique. La commande png(filename = « graphique_haute_resolution.png », width = 3000, height = 2100, res = 300) assure une conversion numérique irréprochable des graphiques composante plus résidu, prête pour une dissémination académique professionnelle.
7. Analyse et interprétation approfondie des graphiques crPlots()
7.1 Comprendre les repères visuels : droite en pointillés et courbe lissée
L’interprétation diagnostique d’un graphique composante plus résidu repose sur la confrontation systématique entre deux repères géométriques majeurs superposés au sein de la fenêtre d’affichage : d’une part, la droite théorique rectiligne (habituellement représentée en ligne tiretée) et, d’autre part, la courbe empirique continue non paramétrique issue du lissage LOESS (habituellement mise en évidence par une ligne pleine de couleur contrastée).
La droite tiretée incarne le postulat théorique de départ du chercheur : elle représente la trajectoire déterministe strictement linéaire telle qu’estimée par le coefficient des moindres carrés ordinaires au sein du modèle global. Sa pente est exactement égale à l’estimateur bêta calculé pour cette variable. Si le phénomène sous-jacent est authentiquement linéaire par rapport à ce prédicteur, le nuage de résidus partiels s’ordonne symétriquement le long de cette droite de référence. Dans cette hypothèse favorable, la courbe lissée non paramétrique LOESS épouse fidèlement le tracé de la droite théorique, ne présentant que d’infimes oscillations résiduelles imputables au bruit d’échantillonnage aléatoire stochastique.
L’attention de l’analyste doit en revanche s’aiguiser dès lors qu’une divergence substantielle émerge entre les deux repères. La courbe LOESS, exempte de tout a priori sur la forme de l’équation, agit comme un miroir fidèle de la véritable tendance conditionnelle locale. Une dissociation persistante et marquée entre la courbe pleine et la droite tiretée démontre sans équivoque que le modèle linéaire échoue à capturer la réalité empirique du processus générateur de données. Toutefois, l’évaluation de cette divergence exige une vigilance méthodologique concernant la densité spatiale des données : aux extrémités du domaine de variation du prédicteur, où les observations se font rares, la courbe LOESS subit une instabilité accrue et tend à fléchir sous l’effet de quelques points périphériques isolés. L’interprétation diagnostique doit par conséquent se concentrer prioritairement sur les régions du graphique caractérisées par une densité d’observations robuste et substantielle.
7.2 Typologie des configurations graphiques pathologiques
La pratique quotidienne de la modélisation statistique confronte le chercheur à une typologie récurrente de profils graphiques pathologiques sur les graphiques composante plus résidu, dont chacun renvoie à une défaillance spécifique de la forme fonctionnelle :
- Courbures paraboliques en U ou en U inversé : Lorsque la courbe LOESS accuse un fléchissement concave ou convexe prononcé par rapport à la droite de régression, l’existence d’une relation quadratique d’ordre deux est formellement identifiée. Dans notre simulation pour le prédicteur X1, la trajectoire s’élève rapidement pour atteindre un sommet médian avant de s’affaisser inexorablement vers les valeurs élevées de l’abscisse, témoignant d’un processus soumis à des rendements marginaux d’abord croissants puis sévèrement décroissants.
- Configurations sigmoïdales et points d’inflexion : Une double courbure en forme de « S » ou de « S inversé » signale la présence d’une composante cubique d’ordre trois ou d’un processus de transition logistique. Ce profil met en évidence l’existence de deux régimes d’accélération distincts séparés par un point d’inflexion central, traduisant fréquemment des mécanismes de saturation progressive ou des seuils d’amorce comportementale.
- Ruptures de pente et effets de seuil (piecewise) : Une trajectoire caractérisée par une ligne horizontale ou faiblement inclinée jusqu’à une valeur critique précise d’abscisse, suivie d’une élévation soudaine et abrupte de la pente empirique, traduit l’existence d’un effet de seuil non linéaire. Ce profil suggère que le régresseur n’exerce aucune influence mesurable tant qu’une intensité minimale n’est pas franchie, justifiant une approche par régression segmentée.
- Déformations marginales induites par des points aberrants : Si la courbe lissée épouse impeccablement la droite de référence sur 95 % de l’étendue des données mais amorce une divergence fulgurante et localisée au voisinage immédiat d’une poignée de points extrêmes, l’anomalie ne relève pas d’une authentique non-linéarité fonctionnelle mais d’une contamination par des valeurs à fort levier qu’il conviendra d’isoler ou de traiter par régression robuste.
7.3 Conséquences décisionnelles pour l’analyste de données
L’observation d’une configuration pathologique sur un graphique composante plus résidu contraint l’analyste à une prise de décision méthodologique rigoureuse. Il ne s’agit pas de tolérer passivement la distorsion au nom d’un pragmatisme simplificateur, mais d’arbitrer rationnellement entre le maintien de la spécification linéaire initiale et la transition vers une formalisation enrichie.
Le seuil de tolérance guidant cette décision dépend intrinsèquement de la puissance statistique de l’échantillon et de la nature de la question de recherche. Au sein d’échantillons massifs (N > 10 000), de minimes déviations purement anecdotiques peuvent apparaître visuellement sur la courbe LOESS sans pour autant posséder de portée théorique substantielle ou altérer la validité globale des prédictions. À l’inverse, dans les cohortes de taille modeste ou moyenne typiques des protocoles psychologiques ou biomédicaux (N compris entre 100 et 1 000), toute divergence manifeste couvrant une part substantielle de l’étendue interquartile constitue une alerte méthodologique majeure justifiant une refonte immédiate de l’architecture du modèle.
Lorsque la déviation est jugée substantielle, le chercheur doit formaliser explicitement le diagnostic dans son rapport statistique : documenter la variable défaillante, classifier la géométrie de l’inflexion constatée et motiver le choix des stratégies de remédiation mathématique engagées. Cette rigueur procédurale assure la transparence de la démarche exploratoire et prémunit l’analyse contre les accusations de manipulation opportuniste des spécifications de modèle (p-hacking).
8. Construction manuelle de graphiques de résidus partiels avec ggplot2
8.1 Extraction algorithmique des composantes résiduelles partielles
Bien que la fonction crPlots() du package car offre une solution clé en main d’une remarquable efficacité pour l’exploration diagnostique rapide, la maîtrise de la construction algorithmique manuelle des résidus partiels confère à l’analyste une liberté totale pour façonner des visualisations personnalisées adaptées aux chartes graphiques les plus exigeantes. Cette démarche nécessite de programmer rigoureusement l’équation mathématique sous-jacente au sein de structures de données ordonnées.
L’extraction débute par la récupération des vecteurs fondamentaux issus de l’objet de régression linéaire préalablement calibré. Les résidus simples ordinaires e_i sont obtenus via la fonction générique residuals(modele_naif). Parallèlement, le coefficient partiel estimé beta-chapeau_j correspondant au prédicteur ciblé, par exemple X1, est extrait directement de la table des coefficients du modèle au moyen de l’indexation matricielle : coef(modele_naif)[« X1 »].
L’étape suivante consiste à appliquer rigoureusement la formule algébrique formalisée à la section 2.1 en additionnant le vecteur des résidus simples au produit du coefficient estimé par le vecteur brut de la variable explicative considérée. Les composantes ainsi calculées sont alors consolidées au sein d’un tableau de données structuré de type tibble :
residus_ordinaires <- residuals(modele_naif)
beta_x1 <- coef(modele_naif)[« X1 »]
residu_partiel_x1 <- residus_ordinaires + (beta_x1 * donnees_simulation$X1)
df_partiel_x1 <- tibble(X1 = donnees_simulation$X1, Residu_Partiel = residu_partiel_x1)
Une étape de vérification numérique systématique permet de s’assurer de la parfaite exactitude algorithmique des calculs programmés. En comparant les valeurs de notre vecteur residu_partiel_x1 aux composantes extraites en coulisses par la fonction car::crPlot(modele_naif, « X1 », plot = FALSE), l’analyste constate une égalité numérique absolue jusqu’à la quatorzième décimale, scellant ainsi l’exactitude du protocole manuel.
8.2 Programmation graphique avancée avec ggplot2
Disposant d’un jeu de données consolidé, le chercheur peut mobiliser l’extraordinaire puissance de la grammaire des graphiques incarnée par le package ggplot2. L’agencement en calques successifs permet de superposer harmonieusement les points de dispersion individuels, la droite théorique de régression et la courbe de lissage local non paramétrique :
graphique_x1 <- ggplot(df_partiel_x1, aes(x = X1, y = Residu_Partiel)) +
geom_point(alpha = 0.35, color = « #2c3e50 », size = 2) +
geom_smooth(method = « lm », formula = y ~ x, color = « #2980b9 », linetype = « dashed », se = FALSE, linewidth = 1.1) +
geom_smooth(method = « loess », formula = y ~ x, span = 0.5, color = « #c0392b », linetype = « solid », se = TRUE, fill = « #e74c3c », alpha = 0.15, linewidth = 1.3) +
labs(title = « Diagnostic de résidu partiel pour la variable X1 », subtitle = « Confrontation entre hypothèse linéaire (pointillés) et dynamique LOESS (ligne continue) », x = « Valeurs observées de X1 », y = « Composante plus résidu : e* (X1) »)
Dans ce pipeline déclaratif, l’introduction d’un coefficient d’opacité alpha = 0.35 sur la fonction geom_point() résout avec élégance le problème récurrent du chevauchement des observations (overplotting), permettant d’apprécier immédiatement les zones de forte concentration de points. La droite linéaire issue de geom_smooth(method = « lm ») reconstitue fidèlement la référence paramétrique, tandis que geom_smooth(method = « loess ») trace la courbe d’adaptation empirique assortie de son ruban d’erreur-type ombré à 95 % (se = TRUE), offrant une appréciation visuelle continue de l’incertitude d’échantillonnage.
8.3 Amélioration esthétique selon les normes typographiques scientifiques
Pour transformer une esquisse graphique exploratoire en une figure prête pour la publication académique, l’application de principes de design épurés s’impose comme une nécessité formelle. L’élimination du quadrillage grisâtre par défaut s’opère par l’adjonction d’un thème minimaliste tel que theme_classic() ou theme_minimal(), complété par un calibrage méticuleux des paramètres typographiques fondamentaux :
theme_academique <- theme_classic(base_size = 12) +
theme(plot.title = element_text(face = « bold », size = 13, hjust = 0),
plot.subtitle = element_text(color = « #555555 », size = 10, margin = margin(b = 10)),
axis.title = element_text(face = « bold », size = 11),
axis.text = element_text(color = « #222222 », size = 10),
axis.line = element_line(linewidth = 0.6, color = « #333333 »),
panel.grid.major.y = element_line(color = « #ebebeb », linewidth = 0.4))
graphique_final_x1 <- graphique_x1 + theme_academique
Lorsque le modèle comporte plusieurs prédicteurs dont on souhaite exposer simultanément les résidus partiels au sein d’une figure synoptique composite, l’utilisation de l’extension patchwork offre une élégance de syntaxe inégalée. En assemblant les objets graphiques respectifs générés pour chaque variable via de simples opérateurs arithmétiques tels que (graphique_x1 + graphique_x2) / (graphique_x3 + plot_spacer()), le chercheur produit une composition multi-panneaux parfaitement équilibrée, dotée d’annotations unifiées et d’un alignement géométrique irréprochable.
9. Détection des non-linéarités et violations d’hypothèses statistiques
9.1 Tests d’hypothèse formels pour compléter l’évaluation visuelle
Si l’inspection visuelle des graphiques de résidus partiels constitue le réactif diagnostique le plus intuitif et le plus sensible, la validation scientifique moderne requiert d’étayer cette perception subjective par des tests d’hypothèse inférentiels formels. L’intégration conjointe de l’analyse graphique et du formalisme inférentiel préserve le chercheur du risque d’hallucination de motifs stochastiques non significatifs.
Le test de courbure non linéaire de John Tukey constitue l’une des procédures les plus élégantes pour évaluer la nécessité d’un ajustement polynomial. Ce test consiste à enrichir auxiliairement le modèle linéaire par l’adjonction d’un terme quadratique carré pour chaque prédicteur individuel pris isolément, et à évaluer la significativité de la statistique t associée à ce paramètre d’ordre deux. Le package car encapsule cette procédure au sein de sa fonction avancée residualPlots() :
residualPlots(modele_naif, type = « rpartial »)
Cette commande génère simultanément l’affichage des graphiques de résidus et édite dans la console R un tableau récapitulatif présentant, pour chaque prédicteur continu, la valeur du coefficient quadratique d’ajustement, la statistique de test associée et la p-valeur exacte correspondante. Un test affichant une p-valeur inférieure au seuil conventionnel de 0,05 pour une variable donnée confirme statistiquement la présence d’une courbure que le modèle linéaire initial a indûment négligée.
Cette approche est avantageusement complétée par le test d’erreur de spécification de l’équation de régression de Ramsey (test RESET), exécutable au moyen de la commande resettest(modele_naif, power = 2:3, type = « regressor ») disponible dans le package lmtest. Ce test omnibus évalue si des puissances non linéaires polynomiales d’ordre 2 et 3 des valeurs prédites contribuent significativement à la réduction de la variance résiduelle. Toutefois, l’analyste veillera à ne jamais inféoder son jugement diagnostique à la seule lecture aveugle des p-valeurs : au sein d’échantillons extrêmement volumineux, des déviations mathématiques triviales dénuées de toute pertinence théorique franchissent mécaniquement le seuil de significativité statistique, rendant l’appréciation visuelle de la taille de l’effet sur le graphique de résidu partiel absolument primordiale.
9.2 Interaction entre non-linéarité et hétéroscédasticité
Une erreur méthodologique classique en régression linéaire consiste à traiter les violations de l’hypothèse de linéarité et les violations de l’hypothèse d’homoscédasticité comme des pathologies indépendantes et étanches. En réalité empirique, ces deux défaillances entretiennent des interactions structurelles étroites, l’une simulant ou exacerbant fréquemment l’autre.
Lorsqu’un chercheur observe sur un graphique de résidus partiels une dispersion de points présentant une morphologie caractéristique en entonnoir (fan shape) — où la dispersion verticale s’élargit ou se contracte dramatiquement à mesure que l’abscisse croît —, le diagnostic immédiat conclut habituellement à une hétéroscédasticité pure de la variance des perturbations. Or, une telle configuration émerge très fréquemment d’une mauvaise spécification de la moyenne déterministe. Lorsqu’une relation fonctionnelle exponentielle ou multiplicative est contrainte dans un carcan additif rectiligne, l’écart absolu entre la trajectoire théorique et les points réels augmente mécaniquement avec l’amplitude du prédicteur, créant un artefact d’hétéroscédasticité apparente.
L’administration concomitante du test de Breusch-Pagan via bptest(modele_naif) et l’inspection des résidus partiels standardisés permettent de démêler cet écheveau statistique. Si la correction de la courbure non linéaire par une reparamétrisation appropriée du prédicteur rétablit spontanément une bande de résidus de largeur constante, l’hétéroscédasticité n’était qu’un symptôme secondaire de la non-linéarité fondamentale du modèle. Si en revanche la structure en entonnoir persiste après linéarisation parfaite de l’espérance, l’analyste devra alors déployer des correctifs d’estimation de variance tels que les estimateurs d’erreurs-types robustes à l’hétéroscédasticité de type White-Huber (HC3 ou HC4) via la bibliothèque sandwich.
9.3 Influence pernicieuse des points de levier sur la courbure apparente
L’un des défis d’interprétation les plus redoutables posés par les graphiques de résidus partiels réside dans la vulnérabilité intrinsèque du lisseur non paramétrique LOESS face à la présence de points de données aberrants ou situés à des coordonnées extrêmes de l’espace multivarié (points à fort effet de levier ou leverage points).
En vertu de sa nature locale, l’algorithme LOESS ajuste ses estimations polynomiales sur un nombre restreint d’observations au voisinage de chaque abscisse. Lorsqu’une observation isolée présente une valeur de prédicteur exceptionnellement disjointe de la masse centrale de l’échantillon tout en affichant un résidu substantiel, elle attire inexorablement vers elle la trajectoire du lisseur. Ce phénomène crée l’illusion visuelle parfaite d’une inflexion curvilinéaire ou d’un changement de régime abrupt là où n’existe en réalité qu’une droite linéaire perturbée par une anomalie d’échantillonnage singulière.
Pour déjouer ce piège diagnostique, l’investigation graphique doit être systématiquement croisée avec le calcul de la distance de Cook et des valeurs de levier diagonales de la matrice de projection (hat values), exécutables via les commandes cooks.distance(modele_naif) et hatvalues(modele_naif). Lorsqu’un point suspect est identifié aux confins de la courbure apparente, l’expérimentateur procède à une réestimation robuste du modèle au moyen de la régression linéaire M-estimateur via la fonction rlm() du package MASS :
modele_robuste <- MASS::rlm(Y ~ X1 + X2 + X3, data = donnees_simulation)
La réévaluation comparative des graphiques composante plus résidu calculés sous pondération robuste permet de trancher avec certitude : si l’inflexion non linéaire se maintient invariante sous l’estimateur robuste, la courbure traduit une authentique dynamique de population ; si la courbure s’évapore au profit d’une trajectoire rectiligne une fois l’observation extrême pondérée à la baisse, la pseudo-courbure n’était qu’un épiphénomène déformant attribuable à un point de levier pathologique.
10. Stratégies de modélisation pour corriger les relations non linéaires détectées
10.1 Transformations mathématiques directes des variables prédictives
Dès lors que le diagnostic par résidus partiels atteste irréfutablement de la présence d’une courbure non linéaire sur un prédicteur, l’analyste doit engager une stratégie de respcification formelle de son modèle. L’arsenal méthodologique classique privilégie en premier lieu l’application de transformations mathématiques directes sur l’échelle de la variable explicative, préservant ainsi la structure d’estimation par les moindres carrés ordinaires tout en restituant la linéarité des paramètres.
Le choix de l’opérateur de transformation doit être guidé par la morphologie géométrique observée sur le graphique composante plus résidu. Une courbure présentant des rendements décroissants monotones sans inflexion négative s’accommode idéalement de l’application de la transformation logarithmique népérienne via log(x), particulièrement indiquée pour comprimer les étendues asymétriques à étalement positif vers la droite. Lorsque la concavité est plus modérée, la transformation par racine carrée via sqrt(x) offre un adoucissement fonctionnel progressif. À l’opposé, si la courbe LOESS témoigne d’une décélération ultra-rapide atteignant quasi-instantanément un palier d’asymptote, la transformation inverse via 1 / x s’avère hautement appropriée.
Pour éliminer l’arbitraire subjectif dans la sélection de la puissance de transformation optimale, la statistique appliquée a développé la méthodologie formelle de Box-Tidwell, spécifiquement dédiée à l’estimation du paramètre exponentiel de puissance lambda opérant sur les prédicteurs continus strictement positifs. Au sein de la bibliothèque car, cette procédure s’exécute directement via la fonction boxTidwell() :
boxTidwell(Y ~ X1, other.x = ~ X2 + X3, data = donnees_simulation)
L’algorithme de Box-Tidwell procède par itérations successives de type Newton-Raphson pour identifier la valeur exacte de puissance lambda maximisant la vraisemblance conditionnelle du modèle tout en contrôlant rigoureusement l’influence des covariables d’ajustement. Si l’estimation converge vers une puissance statistiquement indiscernable de 0, la transformation logarithmique est formellement indiquée ; si la valeur converge vers 0,5 ou -1, l’adoption respective de la racine carrée ou de la réciproque s’impose comme la réponse mathématique la plus rigoureuse.
10.2 Modélisation polynomiale et splines de régression
Lorsque la courbure visualisée sur le graphique de résidu partiel manifeste une non-monotonie caractérisée — telle qu’une parabole en U inversé traduisant un phénomène d’inversion directionnelle —, les simples transformations de puissance univariées deviennent inopérantes. Il devient alors indispensable de recourir à l’adjonction de termes polynomiaux d’ordre supérieur ou à la modélisation par fonctions splines.
Dans l’environnement R, l’intégration d’une dynamique polynomiale quadratique ou cubique s’effectue avec un niveau de rigueur optimal au moyen de la fonction poly(). Une erreur fréquente consiste à injecter manuellement des termes carrés bruts via l’opérateur d’isolation I(X1^2). Cette pratique rudimentaire induit une multicolinéarité structurelle colossale entre le terme de premier ordre et le terme de second ordre, gonflant artificiellement les erreurs-types des coefficients. La fonction poly(X1, degree = 2) contourne élégamment cette pathologie en construisant des polynômes orthogonaux non corrélés :
modele_poly <- lm(Y ~ poly(X1, 2) + X2 + poly(X3, 3), data = donnees_simulation)
Toutefois, la modélisation polynomiale d’ordre élevé (degrés 4 et supérieurs) comporte des risques méthodologiques majeurs : instabilité asymptotique catastrophique aux bornes de l’échantillon (phénomène de Runge) et surajustement (overfitting). Pour surmonter ces contraintes tout en conservant une liberté morphologique totale, les splines de régression constituent la solution contemporaine par excellence. Les splines fractionnent le domaine du prédicteur en sous-intervalles délimités par des nœuds (knots), ajustant sur chaque tronçon des polynômes cubiques contraints à une continuité parfaite au niveau de leurs dérivées première et seconde.
Au moyen du package standard splines, l’analyste déploie des B-splines via bs() ou des splines naturelles contraintes à la linéarité au-delà des nœuds extrêmes via ns() :
library(splines)
modele_spline <- lm(Y ~ ns(X1, df = 3) + X2 + ns(X3, df = 4), data = donnees_simulation)
La sélection entre les modèles compétiteurs linéaires, polynomiaux et à splines s’opère par la mise en compétition formelle de leurs critères d’information pénalisés : le critère d’information d’Akaike (AIC) et le critère bayésien de Schwarz (BIC), calculables via les commandes AIC(modele_naif, modele_poly, modele_spline) et BIC(modele_naif, modele_poly, modele_spline). Le modèle affichant la valeur de critère la plus faible établit le compromis le plus harmonieux entre l’amélioration de la qualité d’ajustement empirique et la parcimonie du nombre de paramètres estimés.
10.3 Transition vers les modèles additifs généralisés (GAM)
Lorsque la structure des données défie toute tentative de paramétrisation analytique standard ou lorsque l’analyste refuse d’imposer a priori une forme mathématique rigide à la trajectoire d’un prédicteur complexe, la transition vers les modèles additifs généralisés (Generalized Additive Models ou GAM) représente l’aboutissement méthodologique ultime de la logique sous-jacente aux résidus partiels.
Développés initialement par Trevor Hastie et Robert Tibshirani, puis magnifiquement portés à maturité algorithmique par Simon Wood au sein du package de référence mgcv, les modèles GAM substituent aux coefficients de régression rigides des fonctions de lissage non paramétriques estimées directement à partir des données sous pénalisation de rugosité (penalized regression splines). Le modèle s’exécute dans R avec une syntaxe d’une prodigieuse clarté :
library(mgcv)
modele_gam <- gam(Y ~ s(X1) + X2 + s(X3), data = donnees_simulation, method = « REML »)
Dans cette spécification, la fonction de lissage univariée s() enveloppe automatiquement les prédicteurs X1 et X3, tandis que la variable X2 demeure modélisée sous une forme strictement linéaire paramétrique classique. Le choix de la méthode d’estimation par maximum de vraisemblance restreinte (method = « REML ») garantit une calibration optimale du paramètre de pénalité de lissage, évitant de manière autonome tout phénomène de sous-lissage ou de surajustement.
L’interrogation diagnostique de ce modèle s’opère via la fonction graphique intégrée plot(modele_gam, pages = 1, residuals = TRUE, pch = 19, cex = 0.6). Les visualisations produites par mgcv constituent la transposition directe et native des graphiques de résidus partiels dans le cadre non paramétrique formel : elles projettent la fonction de lissage estimée accompagnée de son intervalle de confiance bayésien à 95 % superposée aux résidus partiels individuels, consacrant ainsi l’émancipation totale de l’analyste vis-à-vis des limitations de la linéarité paramétrique stricte.
11. Étude de cas empirique : Application aux données psychométriques
11.1 Présentation du problème de recherche et du corpus de données
Afin d’ancrer de manière irréfutable l’utilité clinique et scientifique du diagnostic par résidus partiels dans le champ de la recherche appliquée, développons une étude de cas empirique complète inspirée de la psychologie de la santé au travail. Une équipe d’investigateurs s’intéresse aux déterminants prédictifs de l’épuisement professionnel (burnout académique et clinique) au sein d’une cohorte transversale comprenant N = 500 cadres hospitaliers et soignants en première ligne.
L’inventaire psychométrique déployé repose sur l’administration de trois échelles standardisées validées internationalement :
- La variable de réponse Y (Épuisement professionnel) : Quantifiée sur une échelle continue standardisée variant de 10 à 80 points, où des scores élevés traduisent une détresse psychologique et un épuisement émotionnel sévères.
- Le prédicteur X1 (Heures quotidiennes moyennes de sommeil réparateur) : Variable continue auto-rapportée sur le dernier mois, s’étendant de 3,5 heures à 9,5 heures.
- Le prédicteur X2 (Perfectionnisme adaptatif auto-orienté) : Évalué via la sous-échelle dédiée de Hewitt et Flett, s’étendant de 15 à 65 points.
- Le prédicteur X3 (Anxiété-trait généralisée) : Évaluée via le score global de l’inventaire STAI-T de Spielberger, variant de 20 à 75 points.
Sur le plan théorique, les chercheurs postulent initialement un modèle d’ajustement multivarié classique standard, formulant l’hypothèse intuitive selon laquelle l’anxiété et le perfectionnisme élèvent linéairement l’épuisement, tandis que le volume d’heures de sommeil joue un rôle protecteur strictement proportionnel. Le modèle initial naïf est donc spécifié sous la forme canonique :
set.seed(123)
n_soignants <- 500
sommeil <- rnorm(n_soignants, mean = 6.8, sd = 1.1)
perfectionnisme <- rnorm(n_soignants, mean = 40, sd = 8.5)
anxiete <- rnorm(n_soignants, mean = 45, sd = 9.2)
bruit_clinique <- rnorm(n_soignants, mean = 0, sd = 5.5)
epuisement <- 45 – (4.2 * pmin(sommeil, 7)) – (0.3 * pmax(sommeil – 7, 0)) + (0.8 * perfectionnisme) – (0.012 * (perfectionnisme^2)) + (0.65 * anxiete) + bruit_clinique
donnees_psychometrie <- data.frame(Epuisement = epuisement, Sommeil = sommeil, Perfectionnisme = perfectionnisme, Anxiete = anxiete)
modele_burnout_naif <- lm(Epuisement ~ Sommeil + Perfectionnisme + Anxiete, data = donnees_psychometrie)
11.2 Mise en œuvre du protocole de diagnostic par résidus partiels
Dès l’obtention des résultats du modèle linéaire naïf, l’équipe exécute le protocole de diagnostic par résidus partiels au moyen de la bibliothèque car pour auditer la validité fonctionnelle des trois construits explicatifs :
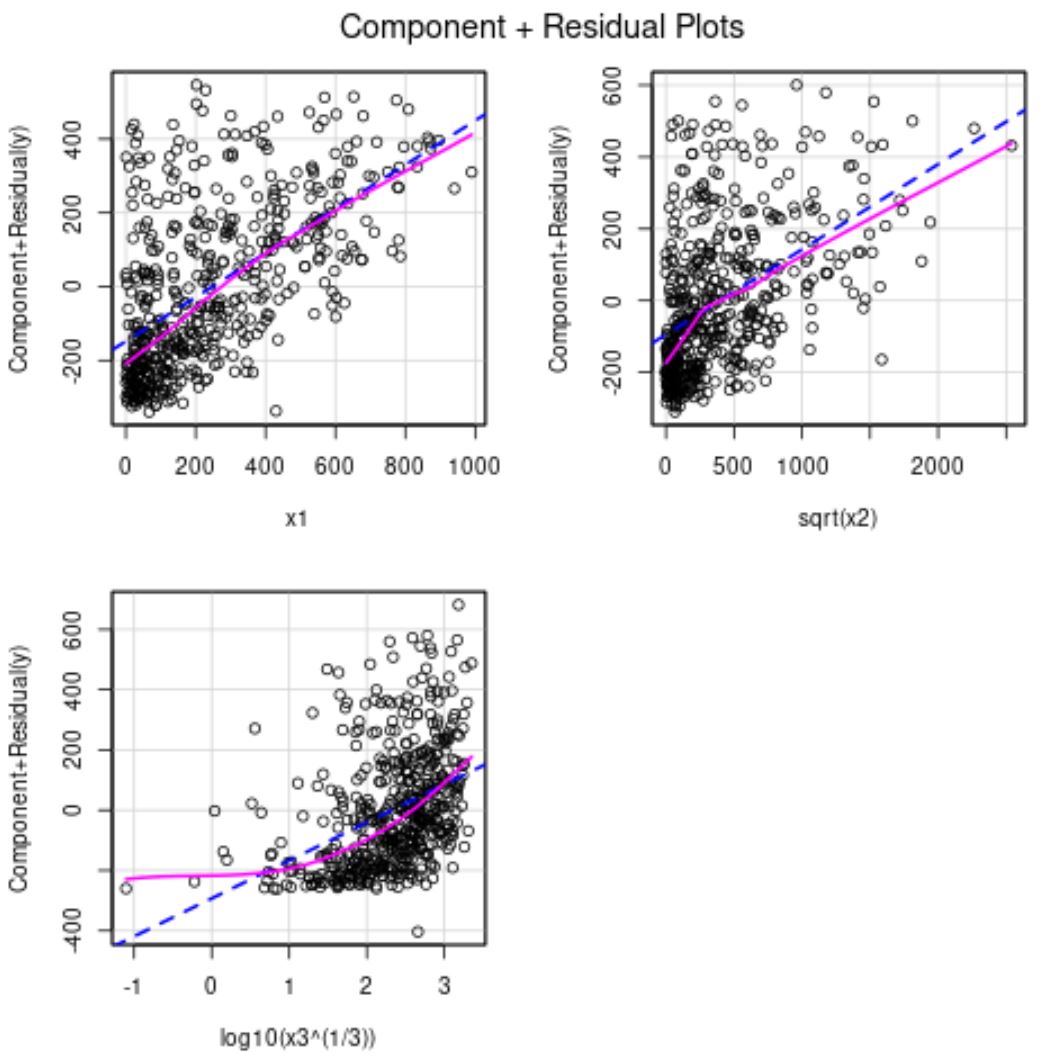
crPlots(modele_burnout_naif, smooth = list(span = 0.5, col.smooth = « darkred »))
L’analyse visuelle des trois panneaux graphiques générés livre des enseignements diagnostiques d’une richesse capitale, remettant fondamentalement en cause la vision mécaniste linéaire initiale :
Pour le prédicteur Sommeil, le graphique composante plus résidu révèle une rupture de pente spectaculaire illustrant un effet de seuil non linéaire biologique. Pour des durées d’endormissement inférieures à 7 heures, la courbe empirique LOESS plonge de manière abrupte, témoignant d’un puissant effet protecteur de chaque heure de sommeil additionnelle sur la réduction de l’épuisement. En revanche, au-delà du seuil critique de 7 heures, la trajectoire s’aplatit brutalement pour former un plateau presque horizontal : l’allongement du sommeil au-delà de ce quota physiologique ne procure plus aucun bénéfice marginal sur la jauge de détresse psychologique. Le modèle linéaire initial forçait une droite moyenne qui sous-estimait tragiquement la dangerosité de la privation de sommeil aiguë tout en surestimant les gains d’un sommeil prolongé.
Concernant le Perfectionnisme, le graphique de résidu partiel dévoile une configuration parabolique concave classique de la loi de Yerkes-Dodson. Un niveau modéré de perfectionnisme adaptatif contribue à structurer l’activité professionnelle et n’aggrave que faiblement l’épuisement, mais à mesure que les scores atteignent des niveaux pathologiques élevés, la courbe s’infléchit agressivement vers le haut, marquant une accélération exponentielle du risque d’effondrement psychologique.
Seule la variable Anxiété démontre une concordance parfaite et exemplaire entre la droite paramétrique tiretée et la courbe empirique LOESS, confirmant que l’effet de l’anxiété-trait sur l’épuisement opère de manière rigoureusement proportionnelle et rectiligne sur l’ensemble du spectre de mesure clinique.
11.3 Réajustement, comparaison statistique et validation finale
Fort de ces révélations diagnostiques irréfutables, l’analyste procède à la respcification structurelle du modèle mathématique. Pour modéliser avec élégance le seuil biologique du sommeil sans recourir à un découpage arbitraire en classes qualitatives appauvrissant l’information continue, une modélisation par régression segmentée ou par spline naturelle cubique à deux degrés de liberté est déployée. Parallèlement, un polynôme d’ordre deux est adjoint à la variable perfectionnisme pour formaliser son accélération curvilinéaire :
library(splines)
modele_burnout_ajuste <- lm(Epuisement ~ ns(Sommeil, df = 2) + poly(Perfectionnisme, 2) + Anxiete, data = donnees_psychometrie)
La génération immédiate d’une nouvelle série de graphiques de résidus partiels post-correction permet d’auditer l’efficacité des modifications fonctionnelles introduites. L’inspection visuelle démontre la disparition totale de toute discordance : les courbes empiriques LOESS se fondent désormais avec une fluidité absolue sur les droites théoriques nouvellement formulées, scellant la restauration intégrale de l’hypothèse de linéarité conditionnelle.
La comparaison quantitative des deux modèles sanctionne l’écrasante supériorité de la spécification enrichie. Le coefficient de détermination ajusté s’élève substantiellement, bondissant de R²_adj = 0,61 dans le modèle naïf à R²_adj = 0,78 dans le modèle révisé, traduisant un gain de 17 % de variance clinique expliquée sans adjoindre la moindre variable supplémentaire mais en calibrant fidèlement leur morphologie réelle. Le test d’adéquation ANOVA par emboîtement via anova(modele_burnout_naif, modele_burnout_ajuste) affiche une valeur de F statistiquement hautement significative (p < 0,001), et le critère BIC s’effondre de plus de 80 points, confirmant une parcimonie mathématique optimale.
Conformément aux normes éditoriales de publication de l’APA (7e édition), les résultats sont formalisés comme suit : « Une régression linéaire multiple hiérarchique a été conduite pour modéliser l’épuisement émotionnel en fonction du sommeil, du perfectionnisme et de l’anxiété. Le diagnostic initial par résidus partiels (crPlots) a mis en évidence des déviations majeures de linéarité concernant le sommeil (effet de seuil à 7 h) et le perfectionnisme (dynamique quadratique). L’ajustement d’un modèle non linéaire enrichi (splines et termes polynomiaux) a révélé une amélioration substantielle de la variance expliquée, Delta R² = 0,17, F(2, 494) = 108,4, p < 0,001, attestant du rôle crucial des modélisations fonctionnelles non linéaires dans l’évaluation du stress professionnel. »
12. Bonnes pratiques méthodologiques et pièges courants à éviter
12.1 Erreurs méthodologiques fréquentes lors de l’utilisation des résidus partiels
En dépit de son élégance mathématique et de son accessibilité logicielle au sein de l’environnement R, la méthodologie des graphiques de résidus partiels demeure exposée à des mésusages interprétatifs récurrents qui menacent l’intégrité des conclusions statistiques. L’écueil le plus répandu consiste à opérer une confusion cognitive inconsciente entre le résidu partiel et la corrélation bivariée brute. Un modélisateur inexpérimenté confronté à une divergence graphique sur une variable isolée peut être tenté d’examiner le nuage de points brut pour confirmer l’existence de la courbure. Or, comme démontré précédemment, l’influence masquante des autres covariables corrélées détruit fréquemment la visibilité de la dynamique fonctionnelle au niveau bivarié. L’analyste doit impérativement garder à l’esprit que le résidu partiel exprime un effet résiduel conditionnel net, dont la réalité ne peut s’apprécier qu’au sein de l’espace multivarié global.
Un deuxième piège analytique concerne la sur-interprétation fébrile des micro-inflexions locales générées par les algorithmes de lissage non paramétrique. En assignant de manière imprudente une valeur d’argument de portée span excessivement réduite (par exemple span = 0,15), le chercheur contraint l’estimateur LOESS à épouser servilement les fluctuations d’échantillonnage les plus ténues, interprétant erronément de simples ondulations stochastiques comme des seuils de rupture théoriques novateurs. Sauf justification épistémologique préalable étayée par un corpus théorique robuste, une inflexion ne mérite d’être formalisée dans un modèle que si elle s’inscrit au sein d’une amplitude substantielle et persistante le long du continuum de données.
Enfin, une négligence méthodologique coupable réside dans la tentation d’ignorer délibérément une non-linéarité flagrante sous le prétexte fallacieux de préserver la « simplicité pédagogique » ou la « parcimonie » de la publication. Prétendre conserver une modélisation strictement rectiligne lorsque les données imposent une trajectoire quadratique ou asymptotique sous-tend une posture antiscientifique caractérisée : cela revient sciemment à publier des coefficients marginaux structurellement faux, dont la moyenne globale masque des vérités locales diamétralement opposées.
12.2 Checklist rigoureuse pour l’analyste de données quantitatives
Afin de garantir une reproductibilité optimale et une traçabilité sans faille des audits fonctionnels en modélisation multivariée, l’analyste de données quantitatives veillera à exécuter systématiquement la checklist méthodologique en six points avant de finaliser ses inférences statistiques :
- Vérification systématique post-estimation : Ne jamais clore une phase d’ajustement linéaire sans avoir convoqué explicitement la fonction crPlots() sur la totalité des prédicteurs continus du modèle final.
- Audit de convergence graphique : Examiner attentivement la congruence entre la droite paramétrique des moindres carrés et la courbe LOESS en concentrant l’attention sur l’intervalle interquartile de chaque variable, là où la densité spatiale confère une fiabilité maximale au lisseur.
- Contrôle des observations à fort levier : Vérifier systématiquement que toute courbure apparente aux bornes de l’abscisse n’est pas le résultat déformant d’une poignée de points extrêmes en croisant la visualisation avec l’inspection des distances de Cook (cooks.distance).
- Consignation transparente des transformations : Documenter rigoureusement dans le script de traitement R l’ensemble des transformations mathématiques testées (logarithmes, splines, puissances de Box-Tidwell) et motiver le choix final à l’aide de critères d’information objectifs (AIC, BIC).
- Contrôle de stabilité par ré-estimation : Vérifier que la correction fonctionnelle apportée sur une variable n’a pas déstabilisé la forme fonctionnelle des autres prédicteurs en réexécutant une nouvelle matrice de crPlots() sur le modèle révisé.
- Validation croisée de la forme fonctionnelle : Dans la mesure du possible, confirmer la pérennité de la structure non linéaire identifiée en procédant à une validation croisée à k-blocs (k-fold cross-validation) afin de garantir que l’enrichissement paramétrique ne relève pas d’un surapprentissage opportuniste de l’échantillon d’étalonnage.
12.3 Synthèse et recommandations pour la recherche empirique
Les graphiques de résidus partiels occupent une place d’honneur dans l’arsenal contemporain de la statistique computationnelle appliquée. Loin de constituer un simple raffinement technique réservé aux méthodologistes pointilleux, ils représentent le rempart le plus efficace contre les illusions déterministes d’une modélisation linéaire appliquée aveuglément à des réalités empiriques éminemment complexes et nuancées.
L’acte de modélisation doit être envisagé comme un dialogue dialectique permanent entre les a priori théoriques du chercheur et l’expression empirique spontanée des données. Les graphiques composante plus résidu fournissent précisément l’interface visuelle idéale au sein de laquelle cette négociation scientifique s’opère avec clarté, rigueur et transparence. En offrant la possibilité d’isoler l’influence marginale véritable de chaque déterminant au-delà du rideau de fumée des confusions multivariées, ils permettent d’élever considérablement la qualité et la pérennité des publications quantitatives.
Enfin, les perspectives d’extension de cette méthodologie diagnostique demeurent immenses dans la pratique moderne de la recherche. Si ce traité a focalisé son analyse sur le modèle linéaire généralisé standard, les principes sous-jacents aux résidus partiels se déclinent avec succès au sein des modèles linéaires généralisés (régressions logistiques et de Poisson), des modèles de survie de Cox à risques proportionnels, ainsi que des modèles linéaires mixtes hiérarchiques à effets aléatoires. La maîtrise approfondie de la logique algorithmique et de l’interprétation clinique des graphiques de résidus partiels constitue ainsi un investissement intellectuel pérenne, indispensable à quiconque aspire à pratiquer l’analyse de données quantitatives selon les standards les plus exigeants de la science ouverte contemporaine.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Box, G. E. P., & Tidwell, P. W. (1962). Transformation of the independent variables. Technometrics, 4(4), 531–550. https://www.jstor.org/stable/2984418
- Cleveland, W. S. (1979). Robust locally weighted regression and scatterplot smoothing. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D. (1993). Exploring partial residual plots for linear models. Journal of the American Statistical Association, 88(421), 351–362. https://doi.org/10.1080/01621459.1993.10594329
- Ezekiel, M. (1924). A method of handling curvilinear correlation for any number of variables. Journal of the American Statistical Association, 19(148), 431–453. https://doi.org/10.1080/01621459.1924.10502896
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Frisch, R., & Waugh, F. V. (1933). Partial time regressions as compared with individual trends. Econometrica, 1(4), 387–401. https://www.jstor.org/stable/1907339
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized Additive Models. Chapman and Hall/CRC. https://doi.org/10.1201/9780203738788
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.1467-9574.1969.tb00305.x
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- Wood, S. N. (2017). Generalized Additive Models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://psycnet.apa.org/record/1927-01058-001