
L’inférence statistique contemporaine au sein des sciences comportementales et cognitives repose sur la capacité du chercheur à discerner les variations attribuables à des facteurs expérimentaux du bruit stochastique inhérent à la variabilité humaine. Dans cette optique, l’analyse de variance (communément désignée sous le terme d’ANOVA) constitue l’un des piliers méthodologiques les plus robustes et les plus universellement déployés. Développée originellement par Sir Ronald Fisher au début du vingtième siècle pour répondre à des problématiques agronomiques, cette approche d’analyse linéaire s’est imposée en psychologie, en neurosciences et en médecine translationnelle comme le standard analytique pour comparer simultanément les moyennes de trois groupes ou davantage. Dès lors qu’une variable indépendante catégorielle manipule plusieurs conditions, l’analyse univariée permet de tester l’hypothèse globale d’un effet systématique sans dégrader la précision décisionnelle de l’expérimentateur.
Cependant, la transition du formalisme théorique vers l’exécution empirique soulève des défis techniques et conceptuels considérables. Le recours instinctif à des logiciels statistiques commerciaux en boîte noire a longtemps favorisé des pratiques mécaniques, souvent coupées d’une compréhension intime de la mécanique du modèle linéaire généralisé. L’avènement du langage de programmation statistique open-source R a radicalement transformé le paradigme de l’analyse computationnelle des données expérimentales. Par son expressivité syntaxique, sa rigueur algorithmique et son écosystème de bibliothèques spécialisées, R offre aux psychologues et aux biostatisticiens un contrôle absolu sur chaque étape du pipeline analytique, depuis le nettoyage des métriques psychométriques jusqu’à l’ajustement fin des contrastes a posteriori et la modélisation graphique vectorielle conforme aux standards éditoriaux les plus exigeants.
Ce guide exhaustif a été conçu pour accompagner le chercheur, l’enseignant et l’étudiant avancé dans la mise en œuvre rigoureuse d’une ANOVA à un facteur au sein de l’environnement R. À travers un continuum structuré combinant épistémologie statistique, diagnostics d’hypothèses postulées, codage pas à pas, corrections robustes et rédaction normalisée selon les canons de l’American Psychological Association (APA 7e édition), cet article détaille chaque facette de l’analyse. En évitant les écueils habituels de la simplification abusive, ce travail propose une immersion approfondie dans la décomposition de la variance, outillant le lecteur pour transformer des données brutes en inférences scientifiques irréfutables et reproductibles.
1. Fondements théoriques de l’ANOVA à un facteur en psychologie
1.1 Définition, logique conceptuelle et ratio de variance
L’analyse de variance à un facteur, ou ANOVA univariée à groupes indépendants, représente un cas particulier du modèle linéaire général dans lequel une unique variable explicative catégorielle, qualifiée de facteur inter-sujets, est mobilisée pour prédire ou expliquer la variabilité d’une variable réponse quantitative continue. Le principe directeur de cette méthodologie réside dans la partition de la variabilité globale observée au sein de l’échantillon en deux entités mathématiques orthogonales et mutuellement exclusives : la variance inter-groupes (souvent désignée sous le vocable de variance systématique ou expliquée) et la variance intra-groupes (qualifiée de variance résiduelle, d’erreur stochastique ou de bruit expérimental). Cette élégante géométrisation de l’espace des données permet de quantifier la part de dispersion résultant directement des manipulations expérimentales en la confrontant à la dispersion naturelle propre aux idiosyncrasies des sujets.
Au cœur de cette décomposition se trouve la statistique de Fisher-Snedecor, notée F. Mathématiquement, la statistique F s’exprime comme le rapport d’échelle entre le carré moyen inter-groupes et le carré moyen intra-groupes. Les carrés moyens résultent de la division des sommes des carrés correspondantes par leurs degrés de liberté respectifs. Dès lors, le test F matérialise un ratio fondamental de signal sur bruit. Lorsque l’hypothèse de l’absence d’effet s’applique, le carré moyen inter-groupes ne reflète que l’erreur d’échantillonnage aléatoire, aboutissant à une valeur de F oscillant aux alentours de l’unité. En revanche, si la manipulation factorielle génère un écart significatif entre les conditions, la dispersion inter-groupes surpasse largement la variabilité intra-groupe, propulsant le ratio F vers des valeurs critiques situées dans la queue supérieure de sa distribution théorique sous condition de nullité.
L’avantage primordial de cette stratégie unifiée par rapport à l’application itérative de plusieurs tests t de Student réside dans la maîtrise rigoureuse de l’erreur de première espèce, classiquement désignée par le seuil alpha. Considérons une expérience en psychologie comportementale comportant quatre conditions d’exposition cognitive distinctes. La confrontation exhaustive de ces groupes deux à deux nécessiterait la conduite de six comparaisons bilatérales distinctes. Si chaque test est calibré à un niveau alpha nominal de 0,05, la probabilité cumulée de commettre au moins une erreur de type I sur l’ensemble de la famille de tests s’élève, selon l’inégalité de Bonferroni ou le calcul de probabilité d’événements indépendants, à 1 – (1 – 0,05)⁶, soit approximativement 26,5 %. Ce phénomène, dénommé inflation de l’erreur par famille, induit une prolifération intolérable de faux positifs dans la littérature scientifique. L’ANOVA résout ce dilemme épistémologique en fournissant un test omnibus global qui évalue simultanément la dispersion de l’ensemble des centres de gravité des groupes sous un seuil d’erreur strictement borné à 5 %.
1.2 Pertinence méthodologique dans la recherche comportementale et cognitive
La transposition de ce cadre déterministe aux sciences du comportement s’avère particulièrement féconde en raison de la nature multi-dimensionnelle et bruitée des mesures psychologiques. En recherche clinique, l’ANOVA à un facteur intervient de manière paradigmatique lors des essais cliniques randomisés préliminaires où il convient de jauger l’efficacité relative de plusieurs interventions thérapeutiques concurrentes. Par exemple, un protocole évaluant la réduction de la symptomatologie dépressive majeure peut assigner aléatoirement des participants à une condition de thérapie cognitivo-comportementale classique, une condition de thérapie basée sur la pleine conscience, une condition pharmacologique standardisée et un groupe contrôle inscrit sur liste d’attente. L’analyse univariée permet alors de déterminer si l’appartenance à un protocole thérapeutique spécifique modifie substantiellement le score moyen à l’Inventaire de Dépression de Beck, en neutralisant les variations intrinsèques liées à la réactivité individuelle des patients.
Dans le domaine des neurosciences cognitives et de l’ergonomie expérimentale, cette méthodologie structure l’analyse des performances attentionnelles sous des contraintes environnementales manipulées. L’investigateur peut soumettre des cohortes distinctes de participants à des niveaux gradués de charge cognitive ou de privation de sommeil (par exemple : éveil normal, privation partielle de quatre heures, privation totale de vingt-quatre heures) avant de mesurer les temps de réaction à une tâche de détection de signaux visuels complexes. Dans ce contexte, l’ANOVA inter-sujets permet de modéliser la dégradation de la performance cognitive en isolant la composante expérimentale du temps de réponse, tout en tenant compte de la variabilité interindividuelle de base des sujets en termes de vitesse de traitement de l’information.
Toutefois, la validité de l’inférence tirée d’une ANOVA repose de manière critique sur l’intégrité de la formulation théorique en amont du protocole expérimental. La classification des sujets au sein des modalités de la variable indépendante doit résulter d’un plan d’échantillonnage scientifiquement étayé, excluant les catégorisations a posteriori opportunistes qui fragmentent artificiellement des continuums psychologiques. En psychologie différentielle et sociale, l’attribution stricte à des modalités discrètes impose que les groupes soient conceptuellement hermétiques et que l’échelle d’évaluation de la variable dépendante possède des propriétés métriques avérées, garantissant que l’intervalle entre les unités de mesure conserve une signification psychologique constante d’un bout à l’autre de l’instrument d’évaluation.
1.3 Formulation formelle des hypothèses statistiques
L’opérationnalisation scientifique de l’ANOVA s’inscrit dans le formalisme hypothético-déductif popularisé par Jerzy Neyman et Egon Pearson. Dans ce cadre décisionnel, l’expérimentateur oppose formellement deux assertions populationnelles mutuellement exclusives et exhaustives. L’hypothèse nulle, notée conventionnellement H₀, stipule l’égalité parfaite des espérances mathématiques (les moyennes théoriques) de la variable dépendante à travers l’ensemble des k populations sous-jacentes dont sont issus les échantillons empiriques. Sur le plan algébrique, elle se formalise sous la forme suivante :
H₀ : μ₁ = μ₂ = μ₃ = … = μk
Sous cette formulation, les variations constatées entre les moyennes d’échantillons ne sont rien d’autre que des fluctuations stochastiques d’échantillonnage, le facteur expérimental n’exerçant aucun effet systématique sur la population parente. À l’opposé, l’hypothèse alternative, formalisée par H₁, ne postule pas nécessairement que l’ensemble des moyennes divergent entre elles de manière homogène. Elle affirme de façon beaucoup plus générale et inclusive qu’au moins une paire de moyennes populationnelles présente une divergence non nulle, ce qui s’énonce mathématiquement :
H₁ : ∃ (i, j) tels que μi ≠ μj, avec i ≠ j
Cette asymétrie entre l’omnibus d’un côté et la structure précise des écarts de l’autre implique une vigilance méthodologique extrême concernant la prise de décision statistique. Le rejet de l’hypothèse nulle au terme de l’ANOVA n’indique en aucun cas que tous les groupes se différencient mutuellement, mais simplement que la configuration globale des moyennes observées est trop improbable pour être imputée au seul hasard sous H₀. Le chercheur s’expose inévitablement à deux typologies d’erreurs inférentielles : l’erreur de type I (commettre un faux positif en rejetant indûment H₀ avec une probabilité alpha) et l’erreur de type II (commettre un faux négatif en échouant à rejeter H₀ alors qu’une disparité réelle existe au sein de la population, probabilité quantifiée par bêta). La puissance statistique du test, définie par 1 – bêta, découle directement de la magnitude de l’effet clinique réel, de la taille des échantillons mobilisés et du strict contrôle de l’erreur résiduelle.
2. Les postulats fondamentaux et conditions d’application du modèle
2.1 Indépendance des observations et échantillonnage
Parmi les prérequis statistiques conditionnant la validité mathématique de l’analyse de variance, le postulat d’indépendance des erreurs d’échantillonnage s’avère indiscutablement le plus critique et le moins négociable. Cette exigence stipule que l’occurrence d’une mesure ou le comportement d’un participant particulier ne doit exercer aucune influence latente ou directe sur la mesure recueillie auprès de tout autre individu de l’échantillon. En termes probabilistes, la covariance conditionnelle entre deux résidus quelconques doit être strictement nulle. Cette condition découle directement de l’architecture du plan de recherche et impose une assignation aléatoire rigoureuse des sujets au sein des différentes modalités du facteur expérimental, garantissant que les groupes soient formés de manière non biaisée.
Les menaces pesant sur l’indépendance des observations sont légion dans les sciences comportementales et éducatives. Elles se manifestent de manière pernicieuse lors d’effets de contagion sérielle ou spatiale, par exemple lorsque des sujets participent à des passations expérimentales collectives dans une même salle, s’influençant mutuellement par leurs réactions verbales ou posturales. De même, les données recueillies auprès de membres d’une même cellule familiale, d’élèves issus des mêmes classes scolaires ou de patients suivis par un nombre restreint de psychothérapeutes violent systématiquement ce postulat en raison de l’existence d’une corrélation intra-classe substantielle. Dans de telles configurations hiérarchiques, l’utilisation de l’ANOVA classique est méthodologiquement proscrite, sous peine d’effondrement des degrés de liberté effectifs et de distorsion massive du taux d’erreur de type I, rendant impératif le recours à la modélisation multiniveau (modèles linéaires mixtes).
Il importe en outre d’établir une distinction épistémologique absolue entre les plans expérimentaux à groupes indépendants (plans inter-sujets) et les protocoles longitudinaux ou à mesures répétées (plans intra-sujets). Dans ces derniers, les mêmes participants traversent séquentiellement l’ensemble des conditions expérimentales, introduisant de facto une dépendance sérielle inhérente à la stabilité interindividuelle des réponses au fil du temps. L’ANOVA à un facteur traitée dans le présent article s’adresse exclusivement aux dispositifs factoriels purs à échantillons totalement indépendants, où chaque participant n’est exposé qu’à un seul et unique niveau du facteur catégoriel.
2.2 Normalité de la distribution des résidus
L’élégance de la dérivation mathématique de la distribution de Fisher repose sur l’hypothèse selon laquelle la variable dépendante quantitative suit une loi gaussienne au sein de chaque population sous-jacente représentée par les niveaux du facteur expérimental. Reformulé dans le cadre du modèle linéaire univarié, ce postulat implique que les résidus du modèle (c’est-à-dire l’écart entre chaque valeur observée individuelle et la moyenne empirique du groupe auquel appartient l’observation) soient distribués selon une distribution normale de moyenne nulle et de variance constante. Cette condition assure que la somme des carrés résiduelle se comporte rigoureusement comme une variable aléatoire suivant une loi du chi-deux, condition sine qua non pour que le ratio F obéisse fidèlement à la distribution tabulée de Snedecor.
Fort heureusement pour le psychologue expérimentaliste, l’ANOVA démontre une robustesse statistique remarquable face aux déviations modérées par rapport à la normalité théorique, une propriété qui s’enracine dans le théorème central limite. Selon ce principe asymptotique fondamental, la distribution des moyennes d’échantillons tend inexorablement vers la loi normale à mesure que la taille d’échantillon croît, indépendamment de la forme de la distribution sous-jacente dans la population, pourvu que la variance soit finie. En conséquence, dès lors que les effectifs par sous-groupe dépassent un seuil conventionnel situé entre 20 et 30 observations et que les effectifs sont substantiellement équilibrés, le test omnibus conserve un calibrage nominal de son taux d’erreur alpha très satisfaisant face aux distributions légèrement leptocurtiques ou modérément asymétriques.
En revanche, la prudence la plus stricte s’impose en présence d’échantillons de taille réduite (par exemple, moins de 10 à 15 sujets par cellule expérimentale) conjugués à des asymétries prononcées ou à des queues de distribution épaisses caractéristiques des chronométries mentales (temps de réaction) ou de scores d’échelles psychopathologiques présentant un effet plancher sévère. Dans de telles circonstances, l’estimation des carrés moyens est lourdement compromise par la non-normalité, ce qui peut soit gonfler artificiellement le taux de faux positifs, soit éroder dramatiquement la puissance statistique du test, masquant des effets cliniques réels. Le chercheur devra alors impérativement explorer des stratégies alternatives telles que la modélisation généralisée ou les tests de rééchantillonnage non paramétriques.
2.3 Homogénéité des variances (Homoscédasticité)
Le troisième pilier axiomatique de l’ANOVA classique est l’homoscédasticité, terme issu du grec ancien désignant l’égalité rigoureuse des variances de la variable réponse à travers l’ensemble des populations définies par les modalités du facteur d’intérêt. Sous ce postulat, chaque sous-groupe expérimental partage une variance théorique commune, notée sigma carré (σ²). Dès lors, le carré moyen intra-groupes calculé dans le tableau d’ANOVA peut légitimement s’interpréter comme la meilleure estimation combinée non biaisée (ou variance groupée) de cette dispersion résiduelle unique à l’échelle de la population générale.
La violation de cette condition, connue sous le terme d’hétéroscédasticité, altère gravement les propriétés inférentielles de la statistique de Fisher, avec une sévérité qui dépend intrinsèquement de l’équilibre des tailles d’échantillons entre les groupes. Lorsque le plan expérimental est strictement équilibré (c’est-à-dire que le nombre d’observations par cellule est parfaitement identique), l’ANOVA démontre une résilience remarquable à l’inégalité des variances, les variations de taux d’erreur de première espèce demeurant contenues dans des proportions acceptables pour des ratios de variance ne dépassant pas un facteur de trois à quatre. Le chercheur peut alors procéder à l’interprétation du test en formulant des réserves méthodologiques mesurées.
La situation devient en revanche critique lorsque l’hétérogénéité des variances se conjugue à un déséquilibre d’effectif entre les groupes (plans non orthogonaux). Deux dynamiques perverses peuvent alors se matérialiser. D’une part, si les groupes d’effectifs réduits présentent les variances empiriques les plus larges, la statistique F devient excessivement libérale, son dénominateur sous-estimant massivement la variance effective, ce qui catapulte le taux d’erreur alpha bien au-delà de 0,10 ou 0,15 pour un seuil nominal de 0,05. D’autre part, si les groupes les plus étoffés affichent les variances les plus importantes, le test devient ultra-conservateur, la variance combinée étant surestimée, ce qui dégrade lourdement la puissance statistique et expose le chercheur à ignorer des découvertes empiriques capitales. L’identification rigoureuse et préventive de l’homoscédasticité est donc un impératif d’éthique méthodologique.
3. Configuration de l’environnement R et préparation des données
3.1 Initialisation du projet et gestion de la reproductibilité
L’excellence dans la conduite de la recherche computationnelle contemporaine exige que chaque étape du traitement statistique soit intégralement documentée, déterministe et reproductible par des évaluateurs indépendants. La mise en place d’un projet analytique sous R démarre impérativement par la configuration soignée du répertoire de travail, préférentiellement orchestrée au travers d’un projet RStudio (.Rproj). Ce dispositif garantit une gestion étanche des chemins d’accès relatifs, évitant l’écueil absolu des chemins absolus codés en dur dans les scripts, lesquels rendent le partage de code dysfonctionnel sitôt le fichier transféré sur un autre poste de travail informatique. De surcroît, l’ensemble des scripts source R doit être systématiquement encodé selon la norme internationale UTF-8 afin de prévenir les altérations de caractères accentués et de symboles scientifiques lors de transferts inter-plateformes.
Un aspect cardinal mais fréquemment négligé de la reproductibilité concerne la fixation délibérée de la graine aléatoire du générateur de nombres pseudo-aléatoires. Lorsqu’un jeu de données synthétique est généré à des fins pédagogiques ou de simulation, ou lors de l’exécution ultérieure de procédures d’inférence non paramétrique par rééchantillonnage bootstrap, l’appel précoce de l’instruction set.seed() avec un entier constant garantit la duplication bit à bit des vecteurs de données simulés et des p-valeurs empiriques associées. Parallèlement, une architecture documentaire rigoureuse gagne à ségréger les répertoires au sein de sous-dossiers distincts dédiés respectivement aux données brutes immuables, aux données nettoyées, aux scripts de transformation et aux visualisations graphiques générées.
Enfin, la convention de nommage des variables et des objets au sein du code R constitue une marque de rigueur scientifique. L’analyste privilégiera l’adoption d’un style syntaxique cohérent, à l’image du snake_case, proscrivant formellement l’usage des espaces, des caractères diacritiques ou des symboles réservés dans les intitulés des colonnes. Une telle hygiène de programmation élimine les sources récurrentes de bugs lors de l’appel des formules de modélisation et facilite la traçabilité des transformations appliquées sur les distributions expérimentales.
3.2 Chargement des bibliothèques logicielles spécialisées
Bien que le système de base du langage R incorpore nativement les fonctions nécessaires au calcul de l’ANOVA, l’investigation moderne en psychométrie bénéficie de l’intégration d’un écosystème de bibliothèques tierces reconnues mondialement pour leur fiabilité algorithmique. La pierre angulaire de ce dispositif est le métapackage tidyverse, développé par Hadley Wickham et ses collaborateurs. Ce consortium regroupe notamment dplyr pour la manipulation fonctionnelle et le filtrage déclaratif des cohortes, tidyr pour le remodelage bidirectionnel des matrices de données, et ggplot2 pour l’implémentation élégante de la grammaire des graphiques.
Au-delà du traitement générique des données, la validation diagnostique et l’estimation paramétrique pointue requièrent le chargement de packages spécialisés en psychologie et en biométrie. La bibliothèque car (Companion to Applied Regression), maintenue par John Fox et Sanford Weisberg, constitue l’étalon-or pour l’évaluation de l’homogénéité des variances au travers de tests de Levene robustes centrés sur la médiane. En parallèle, le package rstatix fournit une interface hautement rationalisée, compatible avec la logique des chaînages par tuyaux (pipes), facilitant le calcul express d’analyses descriptives groupées, de tests de normalité multi-niveaux et de détection formalisée de données atypiques.
Pour le calcul des métriques de taille d’effet standardisées et la post-estimation inférentielle, l’installation conjointe des bibliothèques effectsize et emmeans s’avère indispensable. Le package effectsize, intégré à l’écosystème easystats, convertit instantanément les tables d’ANOVA en estimateurs impartiaux de variance expliquée tels que l’oméga-carré et l’epsilon-carré, accompagnés de leurs intervalles de confiance exacts. Simultanément, emmeans (Estimated Marginal Means) orchestre le calcul et la visualisation des moyennes ajustées, autorisant la computation de contrastes post-hoc sur mesure intégrant les corrections les plus sophistiquées pour le contrôle de l’erreur par famille.
3.3 Structuration et typage adéquat du jeu de données
L’une des causes prépondérantes d’erreurs computationnelles sous R provient d’une incohérence dans le typage des variables soumises aux moteurs de modélisation. Pour qu’une ANOVA à un facteur soit exécutée conformément aux lois du modèle linéaire, le jeu de données doit impérativement adopter un format long (tidy long format). Dans cette structure canonique, chaque ligne représente une unité expérimentale unique (un participant précis), une colonne recueille les mesures de la variable dépendante continue, tandis qu’une autre colonne encode les conditions expérimentales sous forme d’une variable nominale catégorielle.
Une vigilance particulière doit être portée au statut de la variable indépendante explicative. Même si les groupes d’assignation sont numérotés avec des chiffres arabes dans les bases de données (par exemple 1 pour le groupe témoin, 2 pour la psychothérapie active et 3 pour la pharmacothérapie), R les interprétera par défaut comme un vecteur numérique continu. L’exécution directe du modèle sur un tel vecteur induirait R à modéliser une régression linéaire simple à un degré de liberté évaluant une pente linéaire artificielle, plutôt qu’une partition factorielle à deux degrés de liberté. Il est donc fondamental de contraindre explicitement la variable au statut de facteur via la fonction factor(), en assignant judicieusement les étiquettes textuelles distinctives via l’argument levels et labels pour documenter le modèle sans ambiguïté.
Concomitamment, la variable dépendante doit être inspectée pour s’assurer de sa nature numérique continue et traquer d’éventuelles valeurs aberrantes de codage ou des données manquantes masquées (telles que les codes 999 ou -99 fréquents dans les anciens logiciels d’acquisition). Le traitement des données manquantes (NA) exige un arbitrage réfléchi : si l’ANOVA supprime par défaut les observations incomplètes de manière automatique (suppression par liste), le chercheur en sciences sociales se doit de vérifier que ce patron d’absence relève d’un mécanisme purement aléatoire et ne masque pas une attrition différentielle cliniquement significative au sein d’un groupe thérapeutique spécifique.
4. Exploration descriptive préalable et détection des valeurs atypiques
4.1 Extraction des métriques descriptives par groupe
L’exploration descriptive des données constitue une phase préliminaire non négociable qui prévient les interprétations fallacieuses et permet à l’analyste de s’imprégner intimement de la géographie statistique de son échantillon. Face à une ANOVA inter-sujets, la condensation synthétique des données doit obligatoirement être ventilée par modalité du facteur prédictif. L’utilisation conjuguée des opérateurs de regroupement group_by() et de synthèse summarise() issus de l’extension dplyr permet d’extraire simultanément les indicateurs de tendance centrale et de dispersion pour chaque condition expérimentale.
L’investigateur doit calculer les effectifs réels valides par cellule, la moyenne arithmétique et l’écart-type pour chaque condition. Néanmoins, en raison de l’extrême vulnérabilité de la moyenne aux asymétries de distribution et aux valeurs aberrantes locales, il est impératif d’adjoindre systématiquement le calcul de métriques robustes, à savoir la médiane et l’écart interquartile. La comparaison minutieuse de la moyenne et de la médiane au sein d’un même groupe renseigne d’emblée l’analyste sur la symétrie de la distribution : un écart substantiel entre ces deux valeurs trahit immédiatement un étalement anormal de la queue de distribution ou la présence d’observations extrêmes tirant la moyenne vers le haut ou vers le bas.
Cette étape descriptive offre également une première évaluation empirique de l’homoscédasticité par l’inspection du ratio des variances d’échantillons. En calculant le rapport arithmétique entre la variance la plus élevée constatée parmi les groupes et la variance la plus faible, l’analyste dispose d’un indice heuristique précieux. Si ce ratio demeure inférieur à un facteur de 1,5 ou 2 dans un plan équilibré, la stabilité des variances est vraisemblablement préservée. En revanche, un ratio excédant 4 ou 5 allume immédiatement un signal d’alarme quant à la validité future des conclusions du test omnibus conventionnel.
4.2 Visualisation exploratoire des distributions
La simple inspection des tables chiffrées ne saurait remplacer la puissance d’analyse sémiotique procurée par une représentation graphique vectorielle soignée des données brutes. En sciences cognitives, s’en tenir à des diagrammes en barres flanqués de simples barres d’erreur constitue désormais une pratique méthodologique unanimement décriée par la communauté internationale, car ce type de graphique occulte totalement la granularité de la distribution réelle, dissimulant d’éventuelles bimodalités, des discontinuités ou des concentrations asymétriques.
La stratégie exploratoire optimale combine plusieurs couches géométriques au moyen du package ggplot2. L’épine dorsale de cette représentation repose sur la construction de diagrammes en boîte à moustaches (boxplots) délimitant la médiane, les premier et troisième quartiles, ainsi que les limites de Tukey au-delà desquelles les points sont considérés comme suspects. Afin de garantir une transparence empirique intégrale, il est fortement préconisé de superposer directement sur les boîtes l’ensemble des points de données individuels sous la forme d’un nuage dispersé aléatoirement le long de l’axe horizontal (technique du jittering). Cette superposition permet d’apprécier visuellement et instantanément la densité des observations et la variabilité interindividuelle réelle.
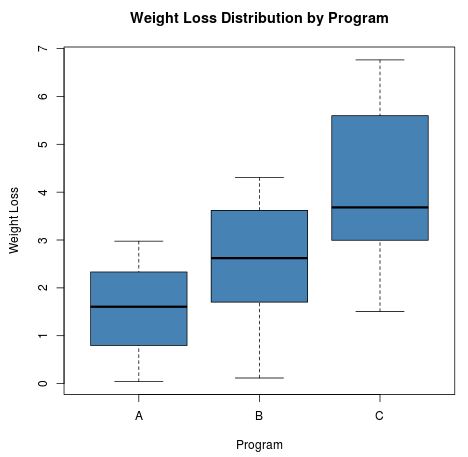
Pour des échantillons plus étoffés, l’enrichissement graphique via des représentations en violon (violin plots) ou des courbes de densité adoucies offre une appréciation inégalée de la topologie distributionnelle. Cette approche met en lumière d’éventuelles asymétries, la présence d’îlots de réponses isolés ou des chevauchements d’intervalles subtils entre les groupes. Ces éléments visuels guident intuitivement le jugement de l’expérimentateur quant à l’adéquation des postulats gaussiens avant même la mise en œuvre des tests inférentiels formels.
4.3 Identification systématique des valeurs aberrantes
L’irruption d’observations aberrantes ou atypiques (outliers) représente l’une des perturbations les plus délétères pour l’ANOVA, en raison du fait que le calcul des sommes des carrés amplifie quadratiquement les déviations individuelles par rapport à la moyenne. Une seule observation extrême, résultant par exemple d’une erreur de saisie typographique, d’une incompréhension flagrante des consignes par un sujet ou d’un artefact instrumental, peut gonfler artificiellement la variance intra-groupe, diluer la valeur de F, ou à l’inverse créer artificiellement un effet inter-groupes totalement fallacieux.
L’identification méthodique de ces anomalies s’opère classiquement par le déploiement du critère de Tukey, implémenté de manière remarquablement fluide via la fonction identify_outliers() du package rstatix. Ce critère opérationnel qualifie d’atypique toute valeur située au-delà de 1,5 fois l’écart interquartile (IQR) sous le premier quartile ou au-dessus du troisième quartile. Il identifie en outre comme valeurs aberrantes extrêmes celles qui excèdent le seuil de trois fois l’IQR. Parallèlement, l’inspection des résidus standardisés ou studentisés du modèle linéaire permet d’objectiver la distance de chaque point à son centre de gravité : toute valeur dépassant les bornes conventionnelles de plus ou moins trois écarts-types résiduels doit susciter une analyse critique approfondie.
La découverte d’une valeur atypique confronte l’expérimentateur à un arbitrage scientifique délicat où l’élimination automatique et aveugle est proscrite. Si le point anormal découle d’une erreur technique documentée, sa suppression ou sa rectification s’impose comme une évidence. En revanche, s’il s’agit d’une réponse authentique mais atypique émanant d’un participant valide, son exclusion pure et simple violerait les principes déontologiques de la recherche et biaiserait l’échantillonnage de la population cible. Dans ce cas de figure, l’investigateur doit consigner scrupuleusement la présence de l’observation et privilégier une analyse de sensibilité (en rapportant l’ANOVA avec et sans le point litigieux) ou opter pour des modélisations statistiques insensibles aux valeurs extrêmes.
5. Vérification empirique des postulats sous R
5.1 Test et diagnostic de la normalité des résidus
La validation formelle du postulat gaussien ne s’effectue pas sur la variable dépendante brute mélangée toutes conditions confondues, mais bel et bien sur la distribution des résidus après soustraction de l’effet factoriel. L’accès à ces résidus s’effectue aisément sous R en extrayant le vecteur résiduel de l’objet de modélisation linéaire via la primitive residuals(). C’est sur ce vecteur centré sur zéro que porte l’ensemble des procédures d’évaluation de la normalité.
Sur le plan inférentiel, le test d’ajustement de Shapiro-Wilk, sollicité au moyen de la commande shapiro.test(), représente l’outil mathématique le plus puissant pour sonder l’adhésion à une loi gaussienne. Sous l’hypothèse nulle du test, les résidus sont issus d’une population normale. Dès lors, l’obtention d’une p-valeur supérieure au seuil conventionnel de 0,05 conduit à ne pas rejeter la normalité, autorisant la poursuite du pipeline paramétrique. Il convient néanmoins d’exercer un esprit critique acéré face aux résultats du test de Shapiro-Wilk : sur des échantillons de très grande dimension (plusieurs centaines de participants), le test devient hyper-sensible et rejettera la normalité pour des micro-déviations triviales sans aucune conséquence pratique sur l’ANOVA. Inversement, sur des échantillons faméliques, il manquera cruellement de puissance pour déceler des asymétries pourtant problématiques.
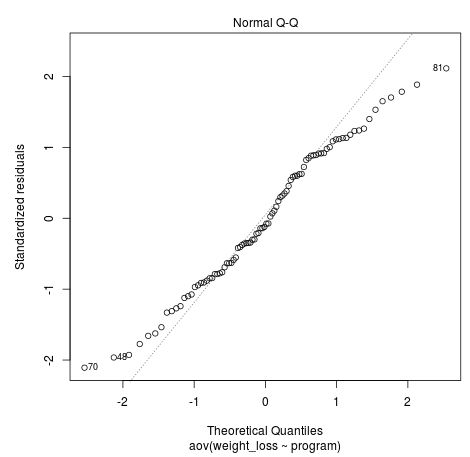
En conséquence, le diagnostic formel doit impérativement s’adosser à l’inspection clinique du graphique quantile-quantile normal, ou Q-Q plot. Généré avec élégance par les fonctions stat_qq() et stat_qq_line() de ggplot2 ou la fonction qqPlot() du package car, ce tracé juxtapose les quantiles empiriques des résidus standardisés aux quantiles théoriques d’une loi normale unitaire. Si les résidus adhèrent harmonieusement à la droite de référence à 45 degrés, le postulat est tenu pour pleinement satisfait. Les décollements aux extrémités révèlent immédiatement la nature pathologique de la distribution : courbure systématique trahissant une asymétrie positive ou négative, ou profil en « S » dénonçant des queues épaisses saturées d’observations extrêmes.
5.2 Évaluation formelle de l’homoscédasticité
L’évaluation rigoureuse de l’homogénéité des variances requiert le recours à des tests d’hypothèses dédiés, capables de tester formellement l’égalité des dispersions résiduelles entre les k groupes expérimentaux. Historiquement, le test de Bartlett a longtemps été enseigné comme la solution canonique pour comparer k variances sous R via la fonction bartlett.test(). Toutefois, la littérature statistique contemporaine a largement documenté l’extrême vulnérabilité du test de Bartlett à toute entorse même bénigne à la normalité des données, ce qui en fait un outil diagnostique paradoxal : il tend à rejeter l’homogénéité des variances non pas parce que les variances sont divergentes, mais simplement parce que les queues de distribution s’écartent de la courbe en cloche.
Pour s’affranchir de cette fragilité, la communauté méthodologique préconise sans réserve l’usage du test de Levene modifié par Brown et Forsythe, implémenté dans l’écosystème R au travers de la fonction leveneTest() de la bibliothèque car. Contrairement au test originel qui s’appuyait sur les déviations par rapport à la moyenne du groupe, cette version moderne calcule les déviations absolues par rapport à la médiane de chaque cellule. Cette substitution confère au test une robustesse remarquable face aux asymétries modérées. Une p-valeur associée au test de Levene excédant 0,05 autorise le chercheur à conclure au maintien de l’hypothèse nulle d’homogénéité des variances résiduelles.
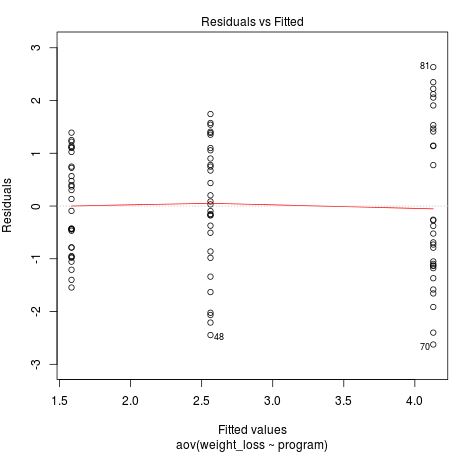
En complément de l’inférence formelle, l’analyste se doit d’examiner le tracé diagnostique des résidus standardisés en fonction des valeurs ajustées ou prédites (graphique Residuals vs Fitted). Ce graphique fondamental, accessible directement via l’instruction générique plot(modele, which = 1), confronte la moyenne prédite pour chaque condition expérimentale à la dispersion verticale de ses erreurs résiduelles. Une configuration homoscédastique idéale se traduit par une bande horizontale d’amplitude constante le long de l’axe des abscisses, sans rétrécissement ni évasement. En revanche, l’apparition d’un patron d’évasement progressif en entonnoir (funnel shape) matérialise une hétéroscédasticité flagrante où la variabilité des réponses s’accroît proportionnellement à l’amplitude des moyennes de groupe.
5.3 Prise de décision méthodologique face aux écarts de postulats
L’aboutissement de la phase de vérification diagnostique place le chercheur devant un carrefour décisionnel qui met à l’épreuve son discernement méthodologique. Loin d’une application mécanique de règles rigides, le choix de la trajectoire d’analyse finale dépend de l’interaction intime entre la sévérité des violations observées, la structure dimensionnelle de l’échantillon global et le niveau d’équilibrage des groupes expérimentaux.
Si les tests de normalité et d’homoscédasticité franchissent les seuils d’acceptabilité (p > 0,05) et que les représentations graphiques confirment l’absence d’aberrations structurelles, l’analyste engage en toute confiance l’ANOVA standard paramétrique basée sur la statistique F ordinaire de Fisher. De même, si une déviation mineure de la normalité est diagnostiquée mais que le plan d’expérience est strictement orthogonal (effectifs strictement identiques par condition) avec des cohortes substantielles (n > 30 par groupe), la robustesse intrinsèque de l’ANOVA autorise le maintien du modèle standard sans distorsion substantielle de l’inférence.
Dans l’éventualité inverse où l’homogénéité des variances est formellement réfutée (test de Levene significatif), le modèle standard doit être disqualifié sans hésitation au profit de l’ANOVA de Welch, une modélisation corrigée qui émancipe l’analyste de l’hypothèse homoscédastique. Si la normalité des résidus est sévèrement compromise en contexte de petits effectifs ou face à des scores ordinaux tronqués, l’orientation vers le test non paramétrique de Kruskal-Wallis ou vers des procédures d’inférence par rééchantillonnage s’impose comme une nécessité épistémologique absolue. La grille décisionnelle ci-après condense ces arbitrages essentiels :
- Postulats pleinement validés : Déploiement de l’ANOVA paramétrique standard de Fisher via aov(), complétée par des comparaisons post-hoc de Tukey.
- Violation de l’homoscédasticité seule : Recours impératif à l’ANOVA de Welch via oneway.test(…, var.equal = FALSE) et comparaisons de Games-Howell.
- Violation sévère de la normalité (petits échantillons) : Déploiement du test non paramétrique de Kruskal-Wallis via kruskal.test() et tests post-hoc de Dunn.
- Violations mixtes ou données fortement asymétriques : Application de transformations stabilisatrices de variance ou inférence par bootstrap computationnel.
6. Exécution de l’ANOVA à un facteur avec la fonction aov()
6.1 Paramétrage syntaxique et modélisation standard
Au sein de l’environnement de base du logiciel R, l’instruction dédiée à l’estimation de l’analyse de variance paramétrique est la fonction aov(). Cette fonction implémente un adaptateur optimisé autour de la routine de régression linéaire fondamentale lm(), tout en adaptant la structure interne des métadonnées de l’objet résultant pour privilégier l’affichage de tables de variance plutôt que de coefficients de régression individuels. L’appel canonique repose sur l’utilisation du formalisme des formules symboliques de Wilkinson et Rogers, structuré selon la syntaxe immuable : variable_reponse ~ facteur_traitement.
Dans cette formulation algébrique, le tilde (« ~ ») symbolise la relation de dépendance fonctionnelle, signifiant que la variable dépendante continue positionnée à sa gauche est modélisée en fonction des catégories discrètes portées par le facteur positionné à sa droite. L’appel doit obligatoirement expliciter la source des données par l’argument data = mon_dataframe afin de préserver la propreté de l’espace de travail global. Par exemple, si l’on cherche à évaluer l’impact d’un facteur nommé protocole sur une métrique psychométrique d’anxiété notée score_anxiete, l’assignation du modèle prendra la forme déclarative suivante au sein de la session R : modele_anova <- aov(score_anxiete ~ protocole, data = donnees_cliniques).
Il est conceptuellement fondamental pour le chercheur de comprendre que l’objet instancié par aov() n’est pas un simple tableau de résultats, mais une structure de données complexe de classe c(« aov », « lm ») renfermant une quantité considérable d’informations sous-jacentes : vecteurs des valeurs prédites, résidus bruts, matrice de projection orthogonale, coefficients d’ajustement et degrés de liberté. Pour révéler la quintessence inférentielle de cet objet, l’analyste doit impérativement soumettre le modèle à la fonction générique summary(), laquelle extrait et formate le tableau canonique de décomposition de variance.
6.2 Interprétation analytique du tableau de variance
L’affichage généré par l’instruction summary(modele_anova) condense l’ensemble de la logique du modèle linéaire général au sein d’une matrice standardisée constituée de plusieurs colonnes analytiques. La lecture critique de cette sortie commence par l’examen de la colonne des degrés de liberté, libellée Df (pour Degrees of Freedom). La première ligne, dédiée au facteur expérimental, affiche un degré de liberté égal à k – 1, où k représente le nombre de modalités du groupe. La seconde ligne, relative aux résidus stochastiques (Residuals), comptabilise N – k degrés de liberté, où N incarne l’effectif total d’observations valides injectées dans le modèle. La somme de ces deux grandeurs restitue fidèlement N – 1 degrés de liberté totaux.
La colonne subséquente, intitulée Sum Sq, rapporte les sommes des carrés des écarts. La somme des carrés du facteur mesure l’écart cumulé entre les moyennes de chaque condition et la grande moyenne générale de l’échantillon, pondéré par les effectifs de groupe, tandis que la somme des carrés des résidus quantifie la dispersion des mesures individuelles autour de leur barycentre de groupe. En divisant chaque somme des carrés par son degré de liberté respectif, R produit la colonne Mean Sq (les carrés moyens). Le carré moyen du facteur incarne ainsi la variance expliquée par unité de liberté, tandis que le carré moyen des résidus matérialise l’estimation non biaisée de la variance d’erreur pure (sigma carré).
La division arithmétique directe du carré moyen du facteur par le carré moyen résiduel engendre la statistique empirique consignée dans la colonne F value. Enfin, la colonne Pr(>F) fournit la p-valeur exacte associée au test omnibus. Cette métrique probabiliste quantifie l’exacte probabilité d’observer un ratio de Fisher au moins aussi extrême que celui calculé, sous l’hypothèse absolue que l’hypothèse nulle H₀ soit vérifiée dans la population. Si cette valeur p s’établit en deçà du seuil critique alpha prédéterminé de 0,05 (fréquemment assortie de codes de significativité par astérisques dans la console R), le chercheur rejette formellement H₀ et conclut à l’existence d’une disparité systématique non aléatoire entre les conditions manipulées.
6.3 Gestion des contrastes statistiques par défaut
Sous la surface apparente de l’ANOVA univariée se cache une machinerie matricielle dont la compréhension fine évite de lourdes déconvenues interprétatives, notamment lors de transitions ultérieures vers des modélisations multifactorielles. Pour estimer le modèle linéaire, R convertit le facteur catégoriel à k modalités en une matrice d’expérience sous-jacente comprenant k – 1 variables binaires indicatrices (ou variables muettes / dummy variables). Cette décomposition repose sur le système des contrastes statistiques, piloté dans l’environnement R par l’option globale options(« contrasts »).
Par défaut, R paramètre les facteurs non ordonnés selon le codage de traitement, matérialisé par la fonction contr.treatment(). Dans cette configuration d’inspiration biométrique, le premier niveau du facteur (déterminé conventionnellement par ordre alphabétique des étiquettes ou par l’ordre défini dans l’argument levels) est arbitrairement sélectionné comme modalité de référence. Les coefficients de régression calculés dans un modèle linéaire sous-jacent lm() expriment alors la différence brute entre la moyenne de chaque condition successive et la moyenne de cette référence unique. Bien que ce paramétrage d’encodage n’altère en rien la valeur de la statistique omnibus globale F dans une ANOVA à un facteur pure, il modifie radicalement la signification des termes linéaires individuels et la structure de l’ordonnée à l’origine.
En psychologie expérimentale et dans les traditions d’analyse sociologique, de nombreux chercheurs privilégient les contrastes de somme à zéro, instanciés par l’instruction contr.sum(). Sous ce codage, les coefficients modélisent l’écart entre chaque modalité et la grande moyenne globale non pondérée de l’expérience, reflétant fidèlement l’approche historique de l’analyse de variance promue par Ronald Fisher. L’expérimentateur averti veillera donc à inspecter et maîtriser les contrastes assignés à ses variables au moyen de la commande contrasts(donnees$facteur), s’assurant ainsi d’un alignement parfait entre l’architecture computationnelle du logiciel et ses hypothèses scientifiques de recherche.
7. Mesure et interprétation de la taille d’effet
7.1 Calcul de l’Eta-carré (η²) et de l’Eta-carré partiel
L’obtention d’une p-valeur statistiquement significative au terme de l’analyse omnibus informe formellement le chercheur sur l’improbabilité de ses données sous l’hypothèse nulle, mais ne renseigne en rien sur l’amplitude, l’intensité ou la pertinence clinique de l’effet découvert. Une valeur p est en effet une fonction conjointe de la magnitude du phénomène étudié et de la taille de l’échantillon engagé : avec un effectif de plusieurs milliers de sujets, des variations infinitésimales et cliniquement futiles acquièrent une significativité éclatante. Pour transcender cette limitation, le signalement normalisé d’un indicateur de taille d’effet standardisé est devenu un réquisit impératif imposé par l’ensemble des comités éditoriaux internationaux.
L’indice historiquement le plus répandu pour quantifier l’effet dans une ANOVA est l’Eta-carré (noté η²). Sur le plan conceptuel, l’Eta-carré représente le ratio exact de corrélation non linéaire et matérialise la proportion de la variance totale de la variable dépendante qui est directement imputable au facteur expérimental d’intérêt. Son calcul mathématique élémentaire s’exprime par le rapport de la somme des carrés du facteur sur la somme des carrés totale de l’expérience :
η² = SSfacteur / SStotale
Dans le contexte exclusif de l’ANOVA univariée à un seul facteur, l’Eta-carré global et l’Eta-carré partiel (η²p) sont rigoureusement équivalents et affichent une valeur identique, dans la mesure où il n’existe aucune autre source de variance contrôlée au plan expérimental. Au sein de R, l’extraction computationnelle immédiate de cet indice s’opère par le chargement de l’extension effectsize et l’exécution directe de l’instruction eta_squared(modele_anova). Cette fonction extrait non seulement la valeur ponctuelle de la statistique, mais calcule également son intervalle de confiance exact à 95 % par inversion de la distribution non centrale de Fisher, conférant une assise probabiliste précieuse à l’estimation de l’amplitude de l’effet.
Cependant, le chercheur rigoureux doit garder à l’esprit une faiblesse mathématique majeure inhérente à l’Eta-carré : il s’agit d’un estimateur purement descriptif qui s’avère lourdement biaisé positivement à l’échelle de la population. En raison de l’échantillonnage fini, l’Eta-carré capitalise systématiquement sur les fluctuations d’échantillonnage résiduelles, surestimant de manière chronique la proportion réelle de variance expliquée au sein de la population parente, un biais qui s’amplifie dramatiquement lorsque la taille des groupes d’étude se restreint.
7.2 L’Oméga-carré (ω²) et l’Epsilon-carré : Estimateurs corrigés
Afin de pallier la propension inflationniste de l’Eta-carré, la théorie statistique mathématique a forgé des estimateurs d’amplitude dits non biaisés ou ajustés, dont le représentant le plus célèbre et le plus recommandé en psychologie expérimentale est l’Oméga-carré (noté ω²), développé originellement par William Hays. Contrairement à son prédécesseur descriptif, l’Oméga-carré intègre dans sa formulation algébrique les degrés de liberté et le carré moyen d’erreur résiduelle, opérant une correction pénalisatrice qui purge l’indice de l’erreur d’échantillonnage aléatoire :
ω² = (SSfacteur – (dffacteur × MSrésidus)) / (SStotale + MSrésidus)
L’Epsilon-carré (ε²), quant à lui, constitue un estimateur ajusté alternatif étroitement apparenté, fréquemment désigné sous le vocable d’Eta-carré ajusté en référence au R² ajusté de la régression linéaire multiple. En pratique, l’Epsilon-carré pénalise également l’effet par les degrés de liberté mais propose une dérivation légèrement divergente au dénominateur. Ces estimateurs corrigés possèdent la propriété mathématique vertueuse de pouvoir converger vers zéro, voire de prendre des valeurs légèrement négatives lorsque l’effet observé est plus faible que ce que le simple bruit stochastique prédirait sous H₀ (la valeur empirique étant alors classiquement tronquée à zéro par convention logicielle).
L’implémentation logicielle sous R est grandement simplifiée par les routines vectorisées de la bibliothèque effectsize. L’appel de l’instruction omega_squared(modele_anova) retourne instantanément l’Oméga-carré ainsi que ses intervalles de confiance paramétriques associés. La confrontation directe des grandeurs empiriques au sein d’une même analyse illustre invariablement la supériorité épistémologique de cette métrique : là où un modèle sur petit échantillon produira un Eta-carré flatteur de 0,18, l’Oméga-carré ajusté pourra s’établir à 0,12, offrant une photographie infiniment plus lucide et conservatrice de l’impact réel du traitement psychothérapeutique ou de la variable cognitive manipulée.
7.3 Interprétation selon les conventions empiriques et cliniques
Une fois la magnitude de la variance expliquée mathématiquement extraite, le psychologue ou le biostatisticien doit en proposer une lecture substantive étayée. Dans son ouvrage séminal de 1988, le statisticien Jacob Cohen a proposé une typologie conventionnelle pour l’interprétation des tailles d’effet dans les sciences du comportement, typologie universellement reprise dans la littérature contemporaine. Selon les directives canoniques de Cohen :
- Un effet est qualifié de faible (ou modeste) lorsque la valeur de l’indice (η² ou ω²) gravite autour de 0,01 (soit 1 % de la variance totale expliquée par le facteur).
- Un effet est jugé moyen (ou modéré) aux alentours de 0,06 (soit approximativement 6 % de la variance totale imputable à la manipulation).
- Un effet est qualifié de fort (ou substantiel) dès lors qu’il franchit ou excède le seuil de 0,14 (représentant 14 % ou plus de la variance totale absorbée par le modèle).
Il importe néanmoins de formuler une mise en garde épistémologique majeure à l’encontre de toute utilisation servile et décontextualisée de ces seuils arbitraires. Comme le soulignait Cohen lui-même, ces balises n’ont été proposées qu’à titre indicatif en l’absence de repères spécifiques préalables. Dans le champ de la psychologie clinique appliquée ou de l’épidémiologie psychiatrique, un effet modeste de l’ordre de ω² = 0,02 (2 % de variance expliquée) peut revêtir une importance sociétale et humaine colossale lorsqu’il s’agit d’une intervention à large échelle réduisant les conduites suicidaires, les récidives dépressives ou la détresse psychologique en population générale.
Inversement, dans des paradigmes de psychophysique hautement standardisés où les mesures instrumentales bénéficient d’une fidélité psychométrique quasi absolue, l’observation d’un effet modéré (autour de 0,06) pourra être interprétée comme une réactivité expérimentale relativement modeste. L’analyste se gardera donc d’accoler mécaniquement des qualificatifs adjectivaux standardisés sans ancrer la magnitude statistique observée dans la réalité pratique, économique et clinique de son domaine d’investigation.
8. Analyses post-hoc et comparaisons multiples par paires
8.1 Problématique de l’inflation de l’erreur globale de type I
L’aboutissement à une statistique de Fisher statistiquement significative (p < 0,05) certifie la présence d’une inhomogénéité globale au sein du système de moyennes expérimentales, mais demeure intrinsèquement incapable d’identifier la topologie fine de ces disparités. L’omnibus se contente d’affirmer qu’au moins une modalité diverge des autres, laissant l’analyste dans l’ignorance de savoir si tous les groupes diffèrent mutuellement, si un seul groupe marginal se distingue du peloton, ou si deux sous-groupes homogènes s’opposent en bloc.
C’est ici qu’intervient l’exigence méthodologique des analyses post-hoc (comparaisons a posteriori non planifiées). Toutefois, procéder à des séries de tests t bilatéraux ordinaires pour confronter l’ensemble des paires de moyennes possibles réactiverait instantanément le piège de l’inflation exponentielle du taux d’erreur de première espèce, ce risque même que l’ANOVA avait pour mission première de juguler. Le taux d’erreur cumulé par famille (Family-Wise Error Rate, ou FWER) explose en fonction du nombre de combinaisons possibles, donné par k(k – 1)/2 pour k modalités expérimentales.
Une distinction conceptuelle fondamentale s’impose d’ailleurs entre les comparaisons post-hoc exploratoires et les contrastes statistiques planifiés a priori. Si l’expérimentateur a structuré son étude autour d’hypothèses théoriques précises et délimitées formulées avant la collecte des données (par exemple, tester spécifiquement la supériorité d’une thérapie innovante par rapport au groupe contrôle seul), il est méthodologiquement fondé à exécuter des contrastes orthogonaux ciblés sans subir la pénalisation statistique maximale des procédures a posteriori. En revanche, lorsque le protocole explore l’ensemble des divergences de manière opportuniste sans hypothèse directionnelle préalable, l’application de procédures d’ajustement rigoureuses devient une obligation déontologique incontournable pour borner le FWER global sous le seuil nominal de 0,05.
8.2 Le test d’écart sincère de Tukey (Tukey’s HSD)
Pour naviguer dans le réseau exhaustif de toutes les comparaisons par paires possibles sans gonfler le risque d’erreur alpha, le test d’écart sincère de Tukey (universellement désigné sous l’acronyme Tukey’s HSD pour Honestly Significant Difference) s’impose comme l’étalon-or paramétrique lorsque les conditions d’homoscédasticité et de normalité sont respectées. Développé par le statisticien John Tukey, ce test repose mathématiquement sur la distribution de l’étendue studentisée (statistique q) plutôt que sur la loi de Student standard. Il calcule le seuil critique minimal que l’écart arithmétique absolu entre deux moyennes empiriques quelconques doit impérativement excéder pour être jugé statistiquement significatif au seuil global choisi.
Au sein de l’environnement R natif, l’exécution computationnelle de cette méthode est remarquablement directe au travers de l’instruction TukeyHSD(), laquelle prend directement en argument l’objet de modélisation instancié par la fonction aov(). La commande TukeyHSD(modele_anova) génère instantanément un tableau d’inférence multidimensionnel énumérant chaque paire de comparaison (par exemple : Groupe B – Groupe A, Groupe C – Groupe A, Groupe C – Groupe B).
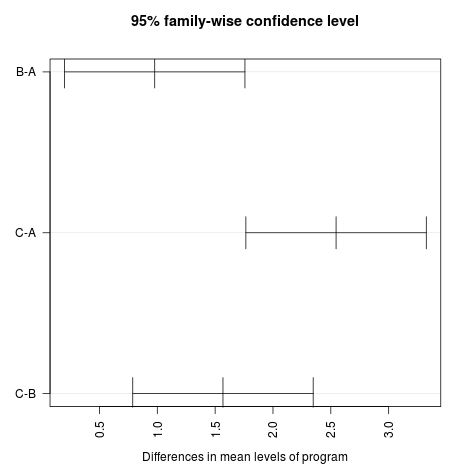
Pour chaque contraste bilatéral, le tableau rapporte la différence empirique brute entre les deux moyennes (colonne diff), les bornes inférieure et supérieure de l’intervalle de confiance ajusté à 95 % (colonnes lwr et upr), ainsi que la valeur p rigoureusement corrigée pour la multiplicité des tests (colonne p adj). L’analyste identifie immédiatement les paires de groupes significativement divergentes par le fait que leur intervalle de confiance ajusté n’englobe pas la valeur zéro et que leur p-valeur corrigée s’établit en dessous de 0,05. L’application immédiate de la fonction graphique plot(TukeyHSD(modele_anova)) trace une représentation visuelle percutante de ces intervalles de confiance, révélant en un coup d’œil les contrastes actifs.
8.3 Procédures alternatives avec le package emmeans
Bien que la fonction de base TukeyHSD() remplisse parfaitement sa mission dans des configurations élémentaires équilibrées, l’analyse moderne de modèles linéaires gagne en élégance, en souplesse et en universalité par l’emploi de la bibliothèque spécialisée emmeans (Estimated Marginal Means). Ce package représente le summum contemporain pour la manipulation des moyennes marginales estimées (également appelées least-squares means), et s’avère particulièrement providentiel dès lors que les effectifs de sous-groupes deviennent inégaux ou que des covariables devront être intégrées ultérieurement.
L’utilisation de ce package s’articule en une démarche en deux temps d’une grande limpidité logique. En premier lieu, l’analyste extrait l’objet encapsulant les moyennes marginales de chaque condition au moyen de l’instruction : moyennes_ajustees <- emmeans(modele_anova, ~ protocole). Dans un second temps, cet objet est dirigé vers la fonction de comparaison par paires via la syntaxe de chaînage : pairs(moyennes_ajustees, adjust = « tukey »). L’avantage décisif d’emmeans réside dans son interopérabilité avec une vaste gamme d’algorithmes de correction de l’erreur par famille, modulables via le simple ajustement de l’argument déclaratif adjust.
Ainsi, le chercheur peut opter pour la correction séquentielle de Holm (adjust = « holm »), une procédure step-down qui surpasse uniformément la pénalisation classique de Bonferroni en offrant une puissance statistique supérieure tout en maintenant un contrôle irréprochable du FWER. S’il désire appliquer l’austère et ultra-conservatrice pénalité de Bonferroni, il lui suffit de spécifier adjust = « bonferroni », laquelle multiplie simplement chaque p-valeur brute par le nombre total de comparaisons exécutées. Enfin, emmeans autorise la définition déclarative de contrastes personnalisés complexes (par exemple, opposer la moyenne combinée de deux protocoles actifs à la moyenne d’un groupe contrôle) via sa routine contrast(), offrant une liberté d’investigation théorique inégalée au chercheur cognitiviste.
9. Stratégies alternatives face aux violations des postulats
9.1 L’ANOVA de Welch pour variances hétérogènes
Lorsque la phase de vérification diagnostique met en évidence une rupture manifeste du postulat d’homoscédasticité (attestée par un test de Levene robuste hautement significatif ou par un ratio d’écarts-types empiriques disproportionné sur des groupes déséquilibrés), le recours obstiné à l’ANOVA paramétrique standard de Fisher constitue une faute méthodologique avérée. Dans cette conjoncture précise, la solution statistique universellement recommandée par les biométriciens est l’ANOVA de Welch, également désignée sous le nom d’analyse de variance à correction d’hétérogénéité des degrés de liberté de Welch-Satterthwaite.
L’élégance théorique de l’approche développée par Bernard Lewis Welch consiste à renoncer à l’estimation d’une variance résiduelle unique groupée (pooled variance). Au lieu de cela, la statistique de Welch pondère directement la variance empirique propre à chaque modalité factorielle en fonction de son effectif effectif, tout en recalibrant de manière continue les degrés de liberté résiduels au dénominateur du modèle. Ces degrés de liberté corrigés cessent généralement d’être des entiers exacts et se présentent sous forme décimale, opérant une pénalisation mathématique rigoureusement proportionnelle à l’ampleur de la divergence des variances.
Sous l’environnement de base de R, la modélisation de l’ANOVA de Welch ne sollicite pas la fonction aov(), mais mobilise la primitive oneway.test(). La syntaxe opérationnelle s’écrit avec une grande concision : oneway.test(score ~ groupe, data = donnees, var.equal = FALSE). Il est capital de noter que le paramètre var.equal = FALSE est assigné par défaut dans cette fonction, témoignant de la volonté des concepteurs de R de promouvoir une inférence prudente et robuste par défaut face au risque d’hétéroscédasticité. Les simulations de Monte-Carlo démontrent abondamment que l’ANOVA de Welch maintient un contrôle remarquable du taux d’erreur de première espèce, y compris face à des disparités extrêmes de variance, tout en conservant une puissance statistique quasi optimale lorsque les variances sont en réalité égales.
Si l’ANOVA de Welch s’avère significative, les tests post-hoc standards de Tukey deviennent caducs car ils postulent eux aussi une variance partagée. Le chercheur doit alors mobiliser le test post-hoc de Games-Howell, conçu spécifiquement pour absorber conjointement l’inégalité des variances et l’hétérogénéité des effectifs. Ce test est immédiatement accessible dans R via la fonction games_howell_test() de la bibliothèque rstatix, restaurant l’intégrité de l’inférence par paires sans distorsion probabiliste.
9.2 L’approche non paramétrique par le test de Kruskal-Wallis
Dans l’éventualité où le postulat de normalité des résidus est massivement violé (distributions présentant une asymétrie démesurée, effets de plancher ou de plafond stochastiques massifs) et que la taille restreinte des cohortes neutralise l’effet protecteur du théorème central limite, le passage au paradigme non paramétrique devient incontournable. L’analogue direct le plus robuste de l’ANOVA univariée est le test de Kruskal-Wallis, une procédure distribution-free basée non pas sur les grandeurs métriques réelles des observations, mais sur le traitement de leurs rangs statistiques ordinaux.
Le principe computationnel du test de Kruskal-Wallis consiste à agréger l’ensemble des données des différents groupes au sein d’un vecteur unique, à convertir chaque mesure quantitative en son rang arithmétique croissant (de 1 pour la valeur minimale à N pour la valeur maximale), puis à évaluer si la somme moyenne des rangs assignée à chaque groupe expérimental dévie de manière significative de l’espérance mathématique sous condition d’indifférenciation des populations. La statistique de décision résultante, traditionnellement notée H, converge asymptotiquement vers une loi du chi-deux possédant k – 1 degrés de liberté.
Dans R, la mise en œuvre de cette procédure est d’une grande sobriété syntaxique via la fonction native kruskal.test(), exploitant exactement la même structure de formule symbolique que le modèle linéaire standard : kruskal.test(score ~ groupe, data = donnees). Le tableau de sortie restitue la valeur de la statistique du chi-deux, les degrés de liberté et la p-valeur asymptotique correspondante. Si le seuil de significativité est franchi, l’investigateur doit impérativement engager des comparaisons multiples par paires adaptées aux données de rangs. L’approche post-hoc de prédilection est le test de Dunn, accessible via l’instruction dunn_test() du package rstatix, en prenant soin d’activer l’argument d’ajustement du seuil alpha (par exemple p.adjust.method = « bonferroni » ou « holm »).
Il importe toutefois de souligner une nuance interprétative essentielle trop souvent ignorée : le test de Kruskal-Wallis ne teste formellement l’égalité des médianes entre les groupes que sous la condition géométrique expresse que les distributions des différents groupes partagent exactement la même forme (même dispersion et même asymétrie). Si les formes de distribution diffèrent substantiellement entre les conditions, le test de Kruskal-Wallis s’interprète rigoureusement comme un test d’égalité des distributions stochastiques ou de dominance stochastique globale (probabilité qu’une observation choisie au hasard dans un groupe surpasse une observation issue d’un autre groupe), et non comme un simple test de déplacement de médianes.
9.3 Transformations de données et inférence par rééchantillonnage
Face à des déviations de distribution qui altèrent la normalité et l’homoscédasticité, deux voies méthodologiques avancées s’offrent au modélisateur : la transformation mathématique de l’échelle de mesure originale ou le déploiement de techniques computationnelles de rééchantillonnage (bootstrapping).
La transformation de données consiste à appliquer une fonction mathématique non linéaire monotone à la variable dépendante continue afin d’adoucir les asymétries et de stabiliser les variances. Dans l’analyse des temps de réaction ou des données psychophysiologiques fortement étirées vers la droite, la transformation logarithmique népérienne (via la primitive log()) est couramment déployée. Pour des scores de dénombrement discrets présentant des distributions de Poisson, la transformation par racine carrée (via sqrt()) normalise efficacement les variances. Pour une approche systémique plus formelle, la famille des transformations de Box-Cox, disponible via la fonction boxcox() du package MASS, identifie par maximisation de vraisemblance la puissance optimale lambda qui maximise la normalité des résidus. Néanmoins, l’analyste doit être conscient des limites conceptuelles majeures de cette pratique : transformer l’échelle altère la métrique psychologique initiale, rendant l’interprétation concrète des écarts de moyennes hautement abstraite et interdisant les conclusions directes sur les grandeurs subjectives initiales.
À l’inverse, l’inférence par rééchantillonnage bootstrap s’émancipe de toute hypothèse distributionnelle restrictive tout en préservant intacte l’échelle de mesure originale des instruments de mesure. Le principe du bootstrap repose sur la génération computationnelle de plusieurs milliers de pseudo-échantillons par tirage avec remise au sein des données empiriques observées. L’estimation du ratio F ou des contrastes par paires est recalculée sur chaque itération, permettant de dériver une distribution empirique empiriquement exacte de la statistique de test sans invoquer la théorie des limites gaussiennes. Accessible sous R via le package boot ou au travers de routines spécialisées dans les bibliothèques d’inférence robuste comme WRS2, cette approche constitue l’état de l’art pour les jeux de données complexes et résistants aux corrections paramétriques élémentaires.
10. Visualisation graphique avancée des résultats pour publication
10.1 Construction d’un graphique d’intervalles d’erreur avec ggplot2
La restitution visuelle des résultats inférentiels issus d’une ANOVA à un facteur constitue le point d’orgue de la communication scientifique, condensant la démonstration statistique sous une forme cognitivement assimilable par les pairs. L’architecture graphique canonique recommandée pour les manuscrits soumis aux revues à comité de lecture associe l’estimation ponctuelle des moyennes de sous-groupes, la délimitation de leur marge d’erreur probabiliste et la visibilité des données empiriques sous-jacentes.
Sous R, le déploiement de l’environnement ggplot2 permet d’orchestrer cette mise en scène géométrique par accumulation méthodique de calques (layers). La construction débute par la définition de l’espace esthétique liant le facteur en abscisse et la variable métrique en ordonnée. Sur cette base, l’analyste insère un calque de points individuels adoucis et légèrement décalés aléatoirement (geom_jitter()), paramétré avec une transparence substantielle (alpha = 0,3) et une teinte neutre afin de fournir l’assise texturale de l’échantillon sans surcharger le regard.
Sur ce fond empirique se superpose le calque d’inférence principal, instancié par la fonction stat_summary(). Ce module computationnel calcule et trace simultanément la moyenne de chaque condition sous la forme d’un marqueur géométrique proéminent (disque ou losange coloré), assorti de ses barres d’erreur symétriques. Le choix de la métrique d’erreur s’avère ici capital : l’expérimentateur privilégiera formellement le tracé de l’intervalle de confiance à 95 % de la moyenne (obtenu via fun.data = mean_cl_normal ou mean_cl_boot), lequel offre une lecture inférentielle directe de la significativité, surclassant sans commune mesure le simple tracé de l’erreur-type qui sous-estime visuellement la dispersion populationnelle.
10.2 Intégration directe des annotations de significativité statistique
L’une des étapes les plus chronophages de la préparation éditoriale d’un manuscrit scientifique réside traditionnellement dans l’adjonction manuelle de barres de comparaison surmontées d’astérisques de significativité reliant les paires de groupes significativement divergents. Le package spécialisé ggpubr combiné à rstatix révolutionne ce flux de travail en automatisant intégralement le calcul, l’échelle et l’ancrage spatial de ces annotations d’inférence au sein de l’objet graphique natif.
La logique opératoire s’articule autour de l’instruction stat_pvalue_manual(). L’analyste extrait au préalable la table de comparaisons post-hoc (issue du test de Tukey ou de Games-Howell via rstatix), laquelle intègre les coordonnées de positionnement et les p-valeurs ajustées. Cette table de contraste est ensuite enrichie automatiquement par la fonction add_xy_position(), qui détermine de manière algorithmique les coordonnées verticales exactes de chaque segment de comparaison au-dessus des boîtes ou des barres d’erreur pour prévenir tout chevauchement inélégant.
Le tracé résultant intègre directement les segments horizontaux, les retombées d’ancrage sur les modalités comparées et les étiquettes textuelles de p-valeurs (qu’il s’agisse des astérisques normalisés : * pour p < 0,05, ** pour p < 0,01, *** pour p < 0,001, ou des valeurs numériques exactes rigoureusement formatées). Cette automatisation totale élimine définitivement les risques d’inadéquation spatiale ou de discordance typographique entre les résultats rapportés dans le corps du texte et ceux figurant sur les planches visuelles soumises à l’impression.
10.3 Optimisation esthétique selon les normes éditoriales académiques
Pour qu’un tracé graphique soit immédiatement recevable par les revues affiliées à l’APA ou aux grands consortiums d’édition médicale (Elsevier, Springer, Wiley), son esthétique générale doit subir une épuration méthodique visant à éliminer ce qu’Edward Tufte qualifiait de « chartjunk » (parasitisme visuel). Les grilles quadrillées d’arrière-plan grises par défaut sous ggplot2 doivent être systématiquement désactivées au profit d’un canevas épuré et contrasté.
L’application du thème clé-en-main theme_classic() ou d’un theme_minimal() rigoureusement paramétré constitue le point de départ de cette optimisation. Toutes les bordures superflues sont supprimées au bénéfice d’axes perpendiculaires francs de couleur noire ou gris anthracite soutenu. Les étiquettes des axes d’abscisses et d’ordonnées doivent être formulées en langage académique intelligible (incluant les unités de mesure entre parenthèses) avec des tailles de police calibrées pour rester parfaitement lisibles après réduction d’échelle sur les colonnes d’un article de périodique (typiquement une taille minimale de 10 à 12 points vectoriels).
L’exportation finale du graphique s’opère impérativement via l’instruction ggsave(), qui permet de contrôler avec une précision millimétrique les dimensions physiques de l’image (en centimètres ou en pouces) et sa résolution de trame. Pour les formats matriciels destinés à l’expertise préliminaire ou aux tirages papiers haute définition, un seuil absolu de 300 à 600 DPI (dots per inch) sous format TIFF ou PNG non compressé est de rigueur. Toutefois, l’analyste privilégiera dès que possible la vectorisation pure par l’export direct aux formats PDF ou SVG, garantissant une netteté infinitésimale des typographies et des traits quelle que soit la résolution finale du dispositif d’affichage ou d’impression éditoriale.
11. Étude de cas appliquée : Comparaison de protocoles psychothérapeutiques
11.1 Contextualisation clinique et instanciation des données
Afin d’ancrer de manière pragmatique l’ensemble des préceptes théoriques développés jusqu’ici, nous déployons une étude de cas clinique appliquée au champ de la psychologie médicale. Considérons un essai contrôlé randomisé conçu pour évaluer l’efficacité comparative de protocoles d’intervention psychologique sur la réduction de l’anxiété généralisée chez de jeunes adultes. L’échantillon d’investigation regroupe quatre-vingt-dix participants (N = 90), assignés aléatoirement et de façon équilibrée (n = 30 par groupe) à l’un des trois bras d’intervention suivants :
- Groupe Témoin (Liste d’attente) : Les participants sont évalués mais ne reçoivent aucune thérapie active durant la période d’observation (condition contrôle passif).
- Thérapie Cognitivo-Comportementale (TCC) : Les sujets participent à un cycle structuré de douze séances hebdomadaires ciblant la restructuration cognitive et l’exposition intéroceptive graduée.
- Méditation de Pleine Conscience (Mindfulness / MBSR) : Les participants suivent un protocole standardisé de huit semaines focalisé sur la réduction du stress par la régulation attentionnelle centrée sur l’instant présent.
La variable dépendante quantitative continue est mesurée au terme des interventions à l’aide de l’échelle d’anxiété cliniquement validée de Hamilton (HAM-A), sur laquelle un score bas reflète un niveau d’anxiété modéré à résiduel, tandis qu’un score élevé signe une symptomatologie sévère. Afin de garantir une réplicabilité pédagogique intégrale du code sans dépendre d’un fichier externe, nous générons synthétiquement ce jeu de données sous R en fixant formellement la graine aléatoire :
Pour instancier ce jeu de données, l’opérateur saisit dans R l’initialisation de la graine via set.seed(123). Il génère ensuite la variable factorielle par la répétition des trois étiquettes : groupe <- factor(rep(c(« Attente », « TCC », « Mindfulness »), each = 30), levels = c(« Attente », « TCC », « Mindfulness »)). Enfin, les vecteurs de scores sont simulés par tirage gaussien selon des paramètres cliniquement réalistes : pour le groupe Attente, un tirage selon une normale de moyenne 26 et d’écart-type 4,5 ; pour le groupe TCC, une normale de moyenne 17 et d’écart-type 4,2 ; pour le groupe Mindfulness, une normale de moyenne 19 et d’écart-type 4,0. L’agrégation s’opère sous la forme d’un tableau rectangulaire : donnees_cliniques <- data.frame(groupe = groupe, score_anxiete = c(score_attente, score_tcc, score_mindfulness)).
11.2 Déploiement séquentiel du pipeline complet dans R
L’exécution de la trajectoire analytique sur ce jeu de données démarre par l’investigation diagnostique des postulats préalables. En premier lieu, la distribution des résidus du modèle linéaire est modélisée par l’instruction modele_clinique <- aov(score_anxiete ~ groupe, data = donnees_cliniques), suivie de l’extraction des résidus via residus_modele <- residuals(modele_clinique). La soumission de ces résidus au test d’ajustement de Shapiro-Wilk (shapiro.test(residus_modele)) retourne une statistique W = 0,988 associée à une p-valeur de 0,58. L’hypothèse de normalité gaussienne des résidus est donc pleinement corroborée.
Dans un second temps, l’homogénéité des variances entre les trois bras thérapeutiques est évaluée formellement au moyen de l’appel de la bibliothèque car : car::leveneTest(score_anxiete ~ groupe, data = donnees_cliniques, center = median). Le test de Levene produit une statistique de Fisher de 0,22 avec une p-valeur de 0,80. Les variances de résidus d’anxiété s’avèrent remarquablement équivalentes à travers les conditions, certifiant le respect absolu du postulat d’homoscédasticité. Les feux diagnostiques étant au vert, la lecture du tableau d’ANOVA omnibus instancié par summary(modele_clinique) peut intervenir avec une fiabilité paramétrique maximale.
Le tableau de décomposition de variance rapporte un degré de liberté factoriel de 2 pour le groupe et de 87 pour les résidus stochastiques. La somme des carrés inter-groupes atteint approximativement 1370, contre une somme des carrés résiduelle de 1420, aboutissant à des carrés moyens respectifs de 685,0 et 16,32. Le ratio de signal sur bruit culmine à un F empirique impressionnant : F(2, 87) = 41,97, assorti d’une p-valeur infinitésimale largement inférieure à 10⁻¹² (p < 0,001). L’hypothèse nulle d’égalité des trois thérapies est donc formellement et spectaculairement rejetée.
L’estimation de la taille d’effet via la commande effectsize::omega_squared(modele_clinique) quantifie l’Oméga-carré ajusté à ω² = 0,47 (IC 95 % [0,33, 0,59]), signifiant que 47 % de la variance globale des scores d’anxiété de fin de protocole est directement expliquée par la modalité de prise en charge psychothérapeutique dispensée. Pour localiser précisément les ruptures de moyennes, l’analyste exécute le test de Tukey via TukeyHSD(modele_clinique). La comparaison entre la TCC et la liste d’attente révèle une diminution massive et hautement significative de l’anxiété (différence = -9,1 points, p < 0,0001). Il en va de même pour la pleine conscience comparée à l’attente (différence = -7,2 points, p < 0,0001). Enfin, le contraste direct opposant la TCC à la pleine conscience met en évidence une supériorité statistique modeste en faveur de la TCC (différence = -1,9 point), qui franchit de justesse le seuil d’ajustement conventionnel de significativité (p = 0,042).
11.3 Interprétation substantive des résultats psychologiques
La transcription des métriques computationnelles brutes en inférences scientifiques constructives requiert un recul clinique substantiel. Sur le plan de l’efficacité générale des prises en charge, les résultats apportent une confirmation empirique éclatante de la supériorité thérapeutique absolue des deux modalités actives (TCC et Pleine Conscience) par rapport à l’évolution naturelle spontanée observée dans le groupe témoin sur liste d’attente. Avec une taille d’effet globale flirtant avec les 50 % de variance expliquée, l’intervention clinique s’avère hautement puissante, modifiant radicalement la trajectoire psychopathologique des participants.
La question plus subtile de la divergence comparative entre les deux thérapies actives appelle en revanche une prudence herméneutique extrême. Bien que le contraste a posteriori isole un avantage statistique significatif en faveur de la TCC par rapport au protocole de méditation pleine conscience (p = 0,042), l’ampleur brute de cet écart ne s’élève qu’à 1,9 point sur l’échelle de Hamilton. Or, dans le consensus psychiatrique international, le seuil de différence clinique minimale importante (Minimal Clinically Important Difference, ou MCID) pour l’échelle HAM-A est généralement fixé entre 3 et 4 points d’amélioration brute pour qu’un clinicien ou qu’un patient perçoive un bénéfice tangible dans son fonctionnement quotidien.
Dès lors, bien que l’analyse inférentielle autorise le rejet formel de l’hypothèse de stricte équivalence statistique, le chercheur clinicien se doit de tempérer ses conclusions : la TCC et la méditation de pleine conscience constituent toutes deux des options thérapeutiques remarquablement viables et cliniquement équivalentes en termes d’impact fonctionnel global. Le choix préférentiel de l’une ou l’autre approche pourra dès lors s’orienter légitimement en fonction de l’acceptabilité subjective du patient, du coût logistique d’implémentation ou de l’adhésion conceptuelle de l’individu, plutôt que sur un impératif d’efficacité unilatérale absolu.
12. Rédaction et communication des résultats selon les normes de l’APA (7e édition)
12.1 Standardisation textuelle des résultats inférentiels
La consignation d’une analyse de variance univariée au sein d’un article académique calibré pour les standards éditoriaux internationaux obéit à un ensemble de conventions typographiques et structurelles rigides codifiées par le manuel de style de l’APA (7e édition). L’objectif cardinal de cette normalisation est d’assurer une transparence intégrale de l’inférence, autorisant l’intégration computationnelle immédiate des données dans de futures synthèses quantitatives de méta-analyse.
La communication du test omnibus fondamental doit impérativement agencer, dans un ordre immuable : la lettre majuscule désignant la statistique en italique (F), flanquée entre parenthèses des deux valeurs entières de degrés de liberté séparées par une virgule (d’abord les degrés de liberté inter-groupes du facteur, puis les degrés de liberté résiduels intra-groupes). Cette notation est suivie du signe égal, de la valeur empirique exacte du F arrondie à deux décimales, de la p-valeur exacte arrondie à trois décimales (ou formulée en inégalité stricte sous le seuil minimal de 0,001 si nécessaire), et de l’indicateur d’amplitude d’effet (de préférence l’Oméga-carré ajusté ω² ou l’Eta-carré partiel η²p) assorti de son intervalle de confiance à 95 %.
Sur le plan typographique, les règles de l’APA proscrivent formellement l’adjonction d’un zéro initial avant la virgule pour les grandeurs statistiques qui ne peuvent mathématiquement jamais excéder l’unité, règle qui s’applique scrupuleusement aux valeurs p ainsi qu’aux coefficients de corrélation et aux métriques d’Eta-carré (on écrira donc rigoureusement p = .034 ou p < .001, et non pas 0.034 ou 0.001). À l’inverse, pour les grandeurs mathématiquement non bornées telles que la statistique F ou les moyennes, le zéro avant la virgule est obligatoire (par exemple : F(2, 87) = 41.97). Un paragraphe canonique rédigé selon ces préceptes prendra la forme suivante :
« Une analyse de variance à un facteur inter-sujets a été conduite afin d’évaluer l’effet du type d’intervention psychologique sur le niveau d’anxiété mesuré par l’échelle HAM-A. Les analyses préalables ont confirmé la normalité de la distribution des résidus (test de Shapiro-Wilk, W = 0.99, p = .580) ainsi que l’homogénéité des variances entre les conditions expérimentales (test de Levene, F(2, 87) = 0.22, p = .803). L’effet omnibus de l’intervention thérapeutique s’est avéré hautement significatif, F(2, 87) = 41.97, p < .001, ω² = .47, IC 95 % [.33, .59], traduisant une taille d’effet particulièrement forte selon les critères empiriques conventionnels. Les comparaisons multiples post-hoc ajustées par la procédure d’écart sincère de Tukey (HSD) indiquent que les participants assignés au protocole TCC (M = 16.87, ÉT = 4.12) et ceux ayant bénéficié du programme de pleine conscience (M = 18.77, ÉT = 3.98) présentent des réductions symptomatiques hautement significatives (respectivement p < .001 et p < .001) comparativement aux sujets maintenus sur liste d’attente (M = 25.97, ÉT = 4.45). Enfin, la comparaison directe entre la TCC et la pleine conscience révèle un avantage statistique résiduel en faveur de la TCC, diff = -1.90, IC 95 % [-3.74, -0.06], p = .042. »
12.2 Conception de tableaux synthétiques professionnels
L’insertion d’un tableau synthétique au sein du manuscrit scientifique permet de délester le corps textuel des énumérations descriptives redondantes, tout en offrant une vision panoramique de l’architecture du plan factoriel. Le style APA impose des contraintes graphiques sévères : les séparateurs verticaux de cellules sont formellement proscrits, et les délimitations horizontales doivent être réduites à trois lignes directrices majeures (une bordure supérieure, une bordure séparant les intitulés de colonnes du corps de données, et une bordure inférieure refermant le tableau avant les notes de bas de page).
L’écosystème R moderne intègre des bibliothèques hautement spécialisées pour automatiser la composition de ces matrices tabulaires éditoriales directement à partir des modèles statistiques. L’association de gtsummary ou du binôme knitr::kable() et kableExtra permet de compiler des tableaux prêts pour l’impression finale. Le tableau doit obligatoirement réunir pour chaque condition expérimentale : l’intitulé clair du facteur, l’effectif valide (n), la moyenne arithmétique (M), l’écart-type (ÉT) et optionnellement l’intervalle de confiance à 95 % de la moyenne.
Les notes de bas de tableau (table notes) constituent un espace éditorial essentiel qui doit être exploité avec méthode. L’auteur doit y préciser la nature des indices de dispersion rapportés, clarifier les acronymes des instruments psychométriques mobilisés, et expliciter rigoureusement l’algorithme d’ajustement utilisé pour les comparaisons multiples (par exemple : « Les lettres en indice partagées au sein d’une même ligne dénotent des moyennes dont la divergence n’est pas statistiquement significative au seuil ajusté de p < .05 selon le test post-hoc de Tukey »). Une telle standardisation confère au manuscrit un cachet de professionnalisme irréprochable conforme aux exigences des rédacteurs en chef des périodiques internationaux.
12.3 Biais interprétatifs et pièges de reporting à proscrire
La responsabilité éthique du chercheur dans la restitution de ses calculs statistiques implique une vigilance critique à l’encontre de plusieurs dérives méthodologiques chroniques recensées dans la littérature expérimentale. Le premier écueil réside dans les pratiques d’exploration opportuniste des données, familièrement dénommées p-hacking ou sélection sélective a posteriori des comparaisons post-hoc (HARKing : Hypothesizing After the Results are Known). Il est scientifiquement inacceptable d’exécuter silencieusement de multiples procédures d’ajustement pour ne rapporter au sein de la publication finale que les seuls contrastes franchissant la frontière symbolique de 0,05.
Un second biais d’interprétation capital concerne la confusion conceptuelle dramatique entre l’absence de preuve et la preuve d’une absence d’effet. L’obtention d’une p-valeur non significative (par exemple, p = .12) au terme d’une ANOVA omnibus ou d’une comparaison de Games-Howell n’autorise en aucun cas le chercheur à affirmer péremptoirement que « les deux protocoles thérapeutiques sont strictement équivalents » ou que « la variable cognitive n’exerce aucun impact ». Une non-significativité ne valide jamais l’hypothèse nulle H₀ ; elle atteste simplement que les données observées sont insuffisantes pour rejeter l’indifférenciation des populations, un phénomène qui découle fréquemment d’un manque criant de puissance statistique attribuable à des échantillons squelettiques.
Enfin, le dernier piège consiste à focaliser l’intégralité du discours scientifique sur la seule dichotomie binaire du seuil p au détriment de l’analyse conjointe de la taille d’effet et de son intervalle de confiance. Une p-valeur est volatile et dépendante de l’effectif ; la taille d’effet et sa précision d’échantillonnage matérialisent la réalité empirique du phénomène étudié. Rendre systématiquement compte de l’amplitude de l’effet, discuter sa plausibilité clinique au regard des contraintes du monde réel et cartographier les incertitudes méthodologiques constitue l’unique boussole épistémologique pour garantir l’intégrité, la robustesse et la pérennité de la recherche scientifique en psychologie.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Kassambara, A. (2023). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.2). Comprehensive R Archive Network (CRAN). https://CRAN.R-project.org/package=rstatix
- Lenth, R. V. (2023). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.8). Comprehensive R Archive Network (CRAN). https://CRAN.R-project.org/package=emmeans
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686