
Dans le paysage contemporain de la recherche quantitative en sciences humaines, sociales et comportementales, l’analyse des données expérimentales requiert une rigueur méthodologique sans faille. Parmi l’éventail des approches inférentielles paramétriques à la disposition des chercheurs et des analystes, l’analyse de variance univariée à un facteur — communément désignée sous l’acronyme international ANOVA (Analysis of Variance) — occupe une position cardinale. Conçue initialement par le statisticien et généticien britannique Sir Ronald Aylmer Fisher dans les années 1920, cette technique permet de comparer simultanément les moyennes empiriques obtenues dans trois conditions expérimentales ou plus, afin de déterminer si les fluctuations observées résultent de véritables effets des traitements ou d’une simple variabilité d’échantillonnage aléatoire.
Bien que des progiciels spécialisés et coûteux tels que SPSS, SAS, Stata ou des environnements de programmation comme R et Python soient fréquemment mobilisés dans les laboratoires universitaires, Microsoft Excel demeure un vecteur incontournable pour le traitement statistique des données. Grâce à son module intégré nommé l’Utilitaire d’analyse (Analysis ToolPak), le tableur permet de déployer une modélisation inférentielle complète, allant de la génération automatique des tableaux descriptifs jusqu’au calcul précis des rapports de variance de Fisher-Snedecor. Néanmoins, l’obtention mécanique d’une feuille de résultats sous Excel ne constitue que la première étape d’un processus scientifique rigoureux : la plus grande valeur ajoutée du chercheur réside dans sa capacité à décoder, interpréter, contextualiser et restituer ces métriques conformément aux exigences académiques les plus strictes.
Ce guide exhaustif a été pensé pour offrir une formation complète et approfondie à l’interprétation des résultats d’une ANOVA à un facteur issue de Microsoft Excel. Destiné aux étudiants de master, aux doctorants, aux chercheurs en psychologie clinique, cognitive et organisationnelle, ainsi qu’aux professionnels de l’analyse décisionnelle, cet ouvrage décompose chaque composante du tableau de sortie, explicite les fondements mathématiques sous-jacents, détaille la vérification des postulats de distribution, formalise le calcul de la taille de l’effet clinique et guide la mise en œuvre des comparaisons multiples post-hoc jusqu’à la rédaction finale selon les normes typographiques de l’American Psychological Association (APA, 7e édition).
1. Introduction à l’ANOVA à un facteur et ses applications en psychologie
1.1 Définition conceptuelle de l’analyse de variance univariée
L’analyse de variance à un facteur, ou ANOVA univariée à plan simple inter-sujets, est un test statistique paramétrique destiné à éprouver l’hypothèse de l’égalité de plusieurs moyennes de populations gaussiennes. Lorsqu’un investigateur souhaite déterminer si une variable indépendante catégorielle comportant au moins trois modalités distinctes (facteur k ≥ 3) exerce une influence mesurable sur une variable dépendante continue, l’ANOVA s’impose comme l’outil privilégié. Le principe directeur de cette méthode repose sur une décomposition élégante de la variance totale observée au sein de l’échantillon global en deux entités additives et indépendantes : la variance intergroupes (dite expliquée ou systématique) et la variance intragroupe (dite résiduelle ou erreur de mesure).
D’un point de vue théorique, il pourrait sembler intuitif de multiplier les tests t de Student pour échantillons indépendants afin de comparer deux à deux chacune des modalités du protocole (par exemple, le groupe A contre le groupe B, puis B contre C, puis A contre C). Une telle démarche s’avère toutefois scientifiquement erronée en raison de ce que la théorie des probabilités nomme l’inflation de l’erreur de première espèce, ou risque α global. Pour un ensemble de m comparaisons indépendantes conduites à un seuil nominal α = 0,05, la probabilité cumulée de rejeter à tort au moins une hypothèse nulle vraie correspond à l’expression 1 – (1 – α)m. Ainsi, dans une expérimentation impliquant seulement quatre groupes — générant 6 comparaisons binaires distinctes —, le risque réel d’erreur de type I s’élève à 1 – (0,95)6 ≈ 0,265, soit plus de 26,5 %. L’ANOVA préserve l’intégrité de la décision inférentielle en testant globalement l’effet du facteur sous un seuil d’erreur strictement contrôlé.
Dans l’architecture de la recherche quantitative, l’analyse de variance univariée ne se borne pas à un calcul algorithmique ; elle matérialise une modélisation linéaire générale où chaque score individuel est conceptualisé comme la somme d’une moyenne générale, de l’effet propre au traitement expérimental auquel le participant a été assigné, et d’une perturbation résiduelle aléatoire inhérente à la nature humaine et aux imperfections instrumentales. Cette formalisation confère à l’ANOVA une puissance descriptive et prédictive majeure pour valider empiriquement des cadres théoriques dans les domaines de la psychométrie, des neurosciences comportementales et de l’épidémiologie clinique.
1.2 Cas d’usage typiques en recherche psychologique et comportementale
Les protocoles de recherche en psychologie clinique constituent un terreau particulièrement propice à l’utilisation de l’ANOVA à un facteur. Imaginons une étude d’intervention clinique conçue pour évaluer l’efficacité différentielle de trois démarches psychothérapeutiques distinctes appliquées à la prise en charge du trouble d’anxiété généralisée (TAG). Un chercheur constitue, via une assignation aléatoire rigoureuse, trois cohortes de patients : le premier groupe bénéficie d’une thérapie cognitivo-comportementale (TCC) standardisée, le deuxième suit une intervention basée sur la réduction du stress par la pleine conscience (MBSR), tandis que le troisième constitue un groupe témoin placé sur une liste d’attente active recevant un soutien empathique non directif. La variable dépendante est constituée par le score obtenu à l’échelle d’anxiété de Hamilton (HAM-A) après douze semaines d’intervention. L’ANOVA permet de déterminer si la dispersion des moyennes observées entre ces trois prises en charge dépasse ce que l’on attendrait de la simple variation interindividuelle entre les patients.
Un autre cas paradigmatique relève de la psychologie cognitive et expérimentale de l’apprentissage. Supposons qu’un laboratoire cherche à mesurer l’impact de différents modes d’encodage pédagogique sur la rétention mnésique à long terme. Soixante participants sont aléatoirement répartis entre trois conditions de mémorisation d’un corpus lexical complexe : un encodage superficiel basé sur les caractéristiques visuelles et typographiques des mots, un encodage acoustique focalisé sur la rime et la phonologie, et un encodage sémantique profond axé sur l’intégration contextuelle et la conceptualisation. La mesure continue correspond au nombre d’items correctement restitués lors d’une tâche de rappel libre différé de quarante-huit heures. L’analyse de variance permet de quantifier précisément dans quelle mesure le niveau d’élaboration cognitive influence la performance mémorielle globale.
Enfin, en psychologie du travail et des organisations, l’ANOVA univariée est couramment mobilisée pour comparer les niveaux de stress perçu ou d’épuisement professionnel (mesurés par des instruments psychométriques validés comme le Maslach Burnout Inventory) selon diverses modalités d’aménagement du temps et de l’espace de travail : télétravail exclusif, formule hybride flexible, ou travail en présentiel continu en bureau paysager. Dans l’ensemble de ces contextes expérimentaux ou quasi-expérimentaux, l’ANOVA offre une méthodologie robuste pour extraire le signal expérimental au milieu du bruit inhérent à la subjectivité humaine.
1.3 Formulation formelle des hypothèses statistiques
Toute démarche d’inférence statistique structurée exige la formulation rigoureuse et a priori d’un couple d’hypothèses antagonistes, mutuellement exclusives et collectivement exhaustives : l’hypothèse nulle (notée H0) et l’hypothèse alternative (notée H1). Ces propositions conditionnent l’ensemble de la mécanique du test de Fisher et définissent le cadre épistémologique dans lequel s’inscrira le chercheur au terme de ses calculs sous Excel.
L’hypothèse nulle postule formellement l’égalité stricte des moyennes des populations mères dont sont issus les différents échantillons expérimentaux. Si nous considérons une expérimentation comportant k conditions, l’hypothèse nulle s’écrit mathématiquement :
H0 : μ1 = μ2 = μ3 = … = μk
Sous H0, la variable indépendante manipulée par le chercheur n’exerce aucun effet sur la variable dépendante. Autrement dit, les variations observées entre les moyennes d’échantillons ne sont que des artéfacts attribuables à l’erreur d’échantillonnage et aux fluctuations stochastiques naturelles.
À l’inverse, l’hypothèse alternative ne soutient pas nécessairement que toutes les moyennes sont différentes les unes des autres de façon bilatérale, mais affirme qu’au moins l’une d’entre elles dévie significativement des autres. Sa formulation canonique s’exprime comme suit :
H1 : Il existe au moins une paire d’indices (i, j) telle que μi ≠ μj (avec i ≠ j)
Cette distinction conceptuelle est fondamentale : le rejet formel de H0 au profit de H1 constitue un test omnibus. Il signale l’existence d’un effet global statistiquement fiable, mais demeure incapable d’indiquer de façon intrinsèque quelles sont les conditions précises qui s’écartent les unes des autres. La décision de rejeter H0 est assujettie à un seuil de risque d’erreur alpha préalablement consenti par la communauté scientifique, fixé de manière conventionnelle à α = 0,05 (ou α = 0,01 dans les protocoles biomédicaux à haute criticité).
2. Conditions d’application et vérification des postulats avant l’analyse
2.1 Postulat de normalité des distributions résiduelles
En tant qu’outil paramétrique, l’ANOVA repose sur des hypothèses distributionnelles strictes que le praticien se doit de vérifier scrupuleusement avant d’accorder le moindre crédit inférentiel aux résultats générés par Microsoft Excel. Le premier de ces prérequis stipule que les scores de la variable dépendante doivent être distribués normalement au sein de chaque population parente, ce qui équivaut à exiger que les résidus du modèle (les écarts individuels par rapport à la moyenne de leur groupe respectif) suivent une loi normale d’espérance nulle et de variance σ2.
Pour diagnostiquer cette normalité sous Excel en l’absence de tests formels automatisés comme celui de Shapiro-Wilk ou de Kolmogorov-Smirnov, le chercheur doit recourir à des indicateurs graphiques et numériques. L’examen des histogrammes de distribution générés via l’outil graphique d’Excel permet de visualiser l’allure générale de la courbe (recherche d’une cloche symétrique et mésokurtique). De manière plus rigoureuse, la création d’un diagramme quantile-quantile (Q-Q plot) — réalisable en traçant les quantiles observés en ordonnée contre les quantiles théoriques d’une distribution normale standard en abscisse — offre un contrôle visuel direct : les points empiriques doivent s’aligner de manière rectiligne le long de la bissectrice.
Il convient néanmoins de souligner que le test F de Fisher possède une robustesse remarquable face aux déviations modérées de la normalité, en vertu du théorème central limite, pour autant que la taille d’échantillon soit substantielle (généralement N ≥ 30 par groupe) et que les distributions ne présentent pas une asymétrie (skewness) ou un aplatissement (kurtosis) excessifs. Si la distribution s’avère sévèrement asymétrique, bimodale ou polluée par des valeurs extrêmes irréductibles, une transformation mathématique des données (logarithmique, racine carrée ou inverse) ou l’abandon de l’ANOVA au profit d’un test non paramétrique s’impose.
2.2 Homogénéité des variances (Homoscédasticité)
Le second postulat indispensable à la validité de l’ANOVA est l’homogénéité des variances intra-groupes, techniquement désignée sous le terme d’homoscédasticité. Cette condition exige que la dispersion des scores autour de leur moyenne de groupe soit statistiquement équivalente à travers l’ensemble des conditions expérimentales :
σ12 = σ22 = … = σk2 = σ2
La violation de cette hypothèse — l’hétéroscédasticité — induit des distorsions graves sur la distribution théorique du ratio F calculé par Excel. Lorsque les variances sont inégales et que les effectifs des groupes sont asymétriques, l’erreur de première espèce (α) est massivement biaisée : si le groupe possédant la plus petite variance présente l’effectif le plus restreint, le test devient excessivement libéral, générant des faux positifs en série ; inversement, si le plus grand échantillon présente la plus grande variance, le test devient trop conservateur, érodant sévèrement la puissance statistique.
Bien qu’Excel n’intègre pas nativement le test de Levene ou de Bartlett dans son Utilitaire d’analyse, le chercheur peut opérer une première vérification empirique via la règle heuristique du ratio de variance maximale (parfois appelée règle empirique de Hartley). Elle consiste à diviser la plus grande variance observée parmi les groupes par la plus petite. Si ce ratio demeure inférieur à 3 (ou 4 pour des tailles d’échantillon parfaitement équilibrées), l’hétéroscédasticité est généralement jugée tolérable pour l’ANOVA standard. Dans le cas contraire, ou si les effectifs sont grandement disparates, il convient de migrer vers des alternatives comme la correction de Welch ou le test non paramétrique de Kruskal-Wallis.
2.3 Indépendance rigoureuse des observations
Le postulat d’indépendance des observations est, sans conteste, le plus critique de tous les prérequis mathématiques de l’analyse de variance à un facteur. Il exige que le score attribué à un participant donné soit totalement indépendant et déconnecté des scores de tous les autres participants de l’étude. Contrairement aux postulats de normalité et d’homoscédasticité pour lesquels le test F manifeste une relative tolérance, la moindre violation de l’indépendance résiduelle invalide irrémédiablement les inférences probabilistes.
Cette condition engage directement la qualité du plan d’échantillonnage et le contrôle méthodologique exercé par l’expérimentateur lors du recueil des données. Des biais majeurs d’interdépendance surgissent typiquement lorsque des participants interagissent verbalement durant une tâche cognitive, lorsque des élèves sont évalués collectivement par classes entières (effet de grappe ou de contagion sociale), ou lorsque les mêmes sujets sont mesurés de manière répétée à différents moments sans recourir au protocole spécifique de l’ANOVA à mesures répétées. Dans ce dernier cas, la présence d’une covariance intra-sujet non modélisée viole les fondements de l’ANOVA inter-sujets standard disponible par défaut dans l’Utilitaire d’analyse univarié d’Excel.
Pour garantir l’indépendance, l’assignation aléatoire stricte des participants aux modalités expérimentales, l’isolation physique ou psychologique des sujets lors de la passation des épreuves et le respect d’une standardisation rigoureuse des protocoles expérimentaux sont des impératifs méthodologiques absolus. L’absence de corrélation sérielle entre les résidus doit être préservée pour que les degrés de liberté mobilisés dans les calculs d’Excel reflètent véritablement la quantité d’information indépendante apportée par les données.
3. Configuration technique de l’Utilitaire d’analyse dans Excel
3.1 Vérification et activation du complément Analysis ToolPak
L’Utilitaire d’analyse (Analysis ToolPak) est une extension logicielle développée par Microsoft qui enrichit Excel d’un ensemble complet de fonctions de modélisation mathématique, financière et statistique avancée. Cependant, dans la configuration d’usine du logiciel, ce module complémentaire n’est pas systématiquement activé par défaut dans le ruban principal de l’interface utilisateur. Son initialisation requiert une manipulation préliminaire simple mais essentielle.
Pour activer ce module sous les versions modernes de Microsoft Excel pour Windows (Excel 2016, 2019, 2021 et Microsoft 365), la procédure s’articule comme suit :
- Cliquez sur l’onglet Fichier situé dans le coin supérieur gauche du ruban, puis sélectionnez la rubrique Options en bas du menu contextuel.
- Dans la fenêtre des Options d’Excel qui apparaît à l’écran, cliquez sur la catégorie Compléments dans le volet de navigation vertical de gauche.
- Localisez le menu déroulant nommé Gérer : au bas de la boîte de dialogue, assurez-vous que l’option Compléments Excel est active, puis cliquez sur le bouton Atteindre….
- Une boîte de dialogue surgissante liste les extensions disponibles. Cochez explicitement la case intitulée Utilitaire d’analyse (veillez à ne pas confondre avec l’Utilitaire d’analyse – VBA si vous ne programmez pas de macros automatisées).
- Validez la sélection en cliquant sur le bouton OK.
Sous macOS, la navigation diffère légèrement : il convient d’accéder au menu Outils dans la barre supérieure des menus du système d’exploitation, de cliquer sur Compléments Excel…, puis de cocher l’option équivalente Analysis ToolPak avant de valider. Une fois cette étape franchie, Excel charge le moteur de calcul statistique en mémoire vive et l’intègre définitivement à votre environnement de travail jusqu’à désactivation délibérée.
3.2 Présentation de l’interface du module d’analyse de données
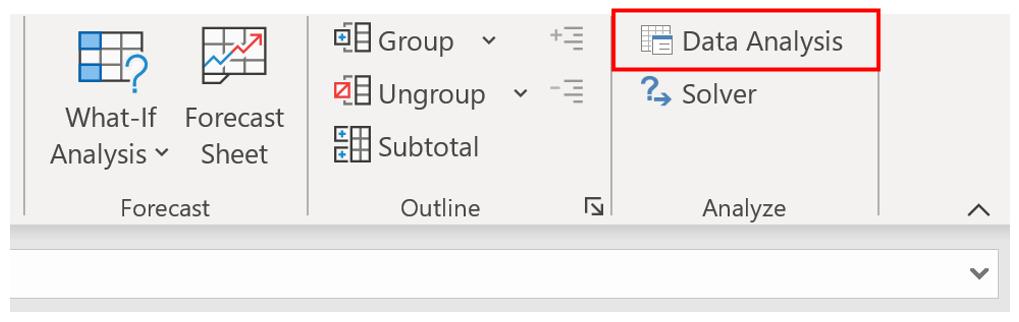
Une fois l’extension activée avec succès, une nouvelle commande apparaît dans l’arborescence du logiciel. Rendez-vous dans l’onglet Données du ruban principal : à l’extrémité droite de cette barre d’outils, au sein du groupe fonctionnel dénommé Analyse, trône désormais le bouton Utilitaire d’analyse (ou parfois simplement libellé Analyse de données selon les versions linguistiques).
En cliquant sur ce bouton, une fenêtre modale s’ouvre, présentant une liste alphabétique exhaustive d’outils statistiques paramétriques et descriptifs. Pour l’objet qui nous occupe, trois entrées distinctes font référence à l’analyse de variance, ce qui exige une vigilance conceptuelle rigoureuse lors de la sélection :
- Anova : un facteur (Anova: Single Factor) : correspond au modèle univarié classique inter-sujets avec un seul facteur expérimental comportant plusieurs modalités. C’est l’outil que nous étudierons en détail.
- Anova : deux facteurs avec répétition : dédié aux plans factoriels croisés où chaque cellule expérimentale comprend plusieurs observations (participants distincts mesurés sous des combinaisons de deux variables indépendantes).
- Anova : deux facteurs sans répétition : mobilisé pour les plans factoriels sans réplication ou, par extension statistique, pour l’ANOVA à un facteur à mesures répétées (intra-sujets).
La sélection de l’outil Anova : un facteur fait éclore la boîte de dialogue paramétrique principale du test. Cette interface épurée concentre l’ensemble des réglages nécessaires à la définition des plages de données sources, du mode de structuration géométrique des variables, de l’inclusion des en-têtes textuels, de la fixation du seuil α, et de la destination spatiale des résultats calculés.
4. Organisation et structuration des données expérimentales sous Excel
4.1 Formatage matriciel adapté à l’Utilitaire d’analyse
Contrairement aux bases de données statistiques utilisées sous SPSS ou R — qui privilégient le format dit « long » où chaque ligne matérialise une observation unique et où des colonnes d’index identifient l’appartenance aux groupes expérimentaux —, l’Utilitaire d’analyse d’Excel exige une disposition spatiale spécifique, généralement configurée selon le format « large ».
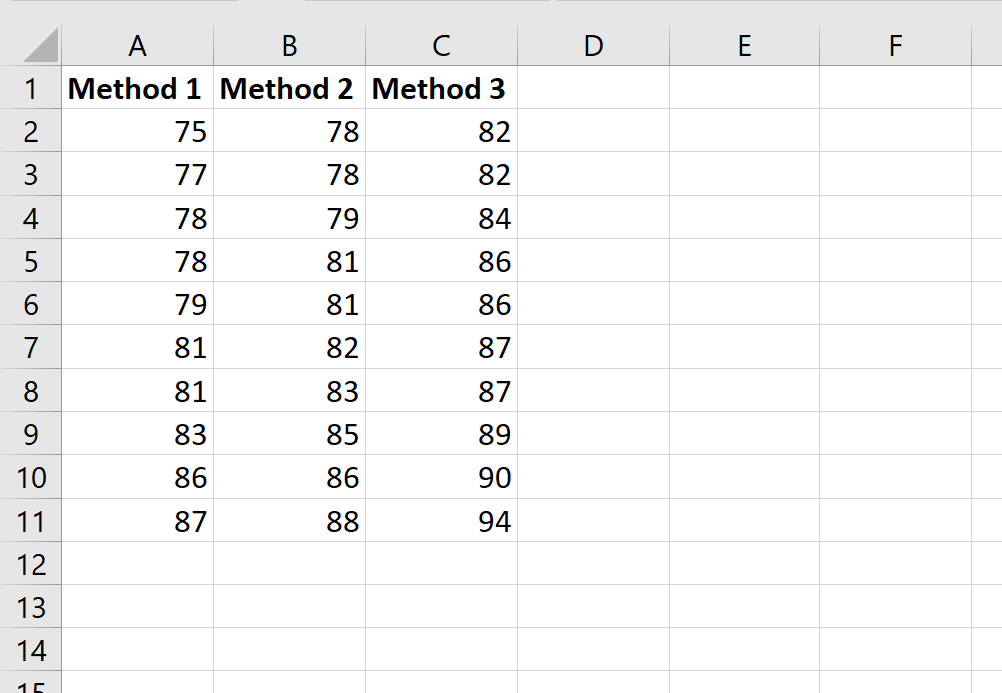
Pour configurer un jeu de données expérimental optimal sous Excel en vue d’une ANOVA à un facteur, la structure recommandée consiste à dédier une colonne unique à chaque modalité de la variable indépendante :
- Ligne 1 (En-têtes descriptifs) : inscrivez le libellé textuel clair de chaque groupe expérimental (par exemple,
TCC_Standarden colonne A,Pleine_Conscienceen colonne B, etGroupe_Controleen colonne C). Ces intitulés seront directement reconnus et repris par l’algorithme d’Excel pour étiqueter automatiquement le tableau de sortie. - Lignes 2 et suivantes (Observations continues) : saisissez verticalement les scores numériques bruts enregistrés pour chaque participant assigné à la condition correspondante. L’alignement doit être exempt de tout caractère alphanumérique parasite, de symboles monétaires ou d’unités de mesure collées aux chiffres, lesquels empêcheraient Excel d’interpréter le contenu cellulaire comme un nombre réel en virgule flottante.
Bien que l’interface permette de structurer les données par lignes horizontales plutôt que par colonnes verticales en modifiant le bouton radio correspondant (Groupé par Lignes), la disposition par colonnes demeure le standard ergonomique universel. Cette présentation facilite l’audit visuel, l’application de filtres et l’extension éventuelle des séries d’observations sans altérer la cohérence spatiale de la feuille de calcul.
4.2 Gestion des données manquantes et des valeurs aberrantes
Dans les protocoles réels de recherche en sciences humaines, l’obtention d’échantillons parfaitement équilibrés et dépourvus d’aspérités est rare. Des participants abandonnent le protocole en cours de route (perdus de vue), refusent de répondre à certains sous-tests ou présentent des anomalies comportementales massives. L’analyste doit impérativement arbitrer ces situations avant d’exécuter la procédure statistique.
En ce qui concerne les plans non équilibrés — c’est-à-dire les situations où le nombre d’observations diffère d’un groupe à l’autre (par exemple, n1 = 25, n2 = 22, n3 = 27) —, l’Utilitaire d’analyse d’Excel gère nativement cette disparité. Dans la colonne du groupe présentant moins de participants, il suffit de laisser les cellules inférieures totalement vides. Il ne faut surtout pas y inscrire la valeur zéro (« 0 »), car Excel comptabiliserait ce chiffre comme un score empirique réel, ce qui fausserait dramatiquement les moyennes et écraserait les variances du groupe concerné.
Le traitement des valeurs aberrantes (outliers) exige une justification méthodologique transparente. L’application de la méthode statistique de Tukey, basée sur l’intervalle interquartile (IQR), permet d’objectiver l’identification de ces points déviants :
- Calcul du premier quartile (Q1) et du troisième quartile (Q3) pour chaque modalité via les fonctions
=QUARTILE.EXCLURE(plage; 1)et=QUARTILE.EXCLURE(plage; 3). - Détermination de l’intervalle interquartile : IQR = Q3 – Q1.
- Identification des valeurs aberrantes situées en dehors des bornes [Q1 – 1,5 × IQR ; Q3 + 1,5 × IQR].
Si une valeur anormale résulte d’une erreur matérielle de saisie ou d’un dysfonctionnement instrumental avéré, sa suppression ou sa correction est légitime. En revanche, si la valeur reflète une variabilité humaine authentique mais extrême, son exclusion doit faire l’objet d’une analyse de sensibilité comparant les résultats avec et sans le point litigieux.
5. Paramétrage et exécution pas à pas du test ANOVA dans Excel
5.1 Sélection des plages d’entrée et regroupement des variables
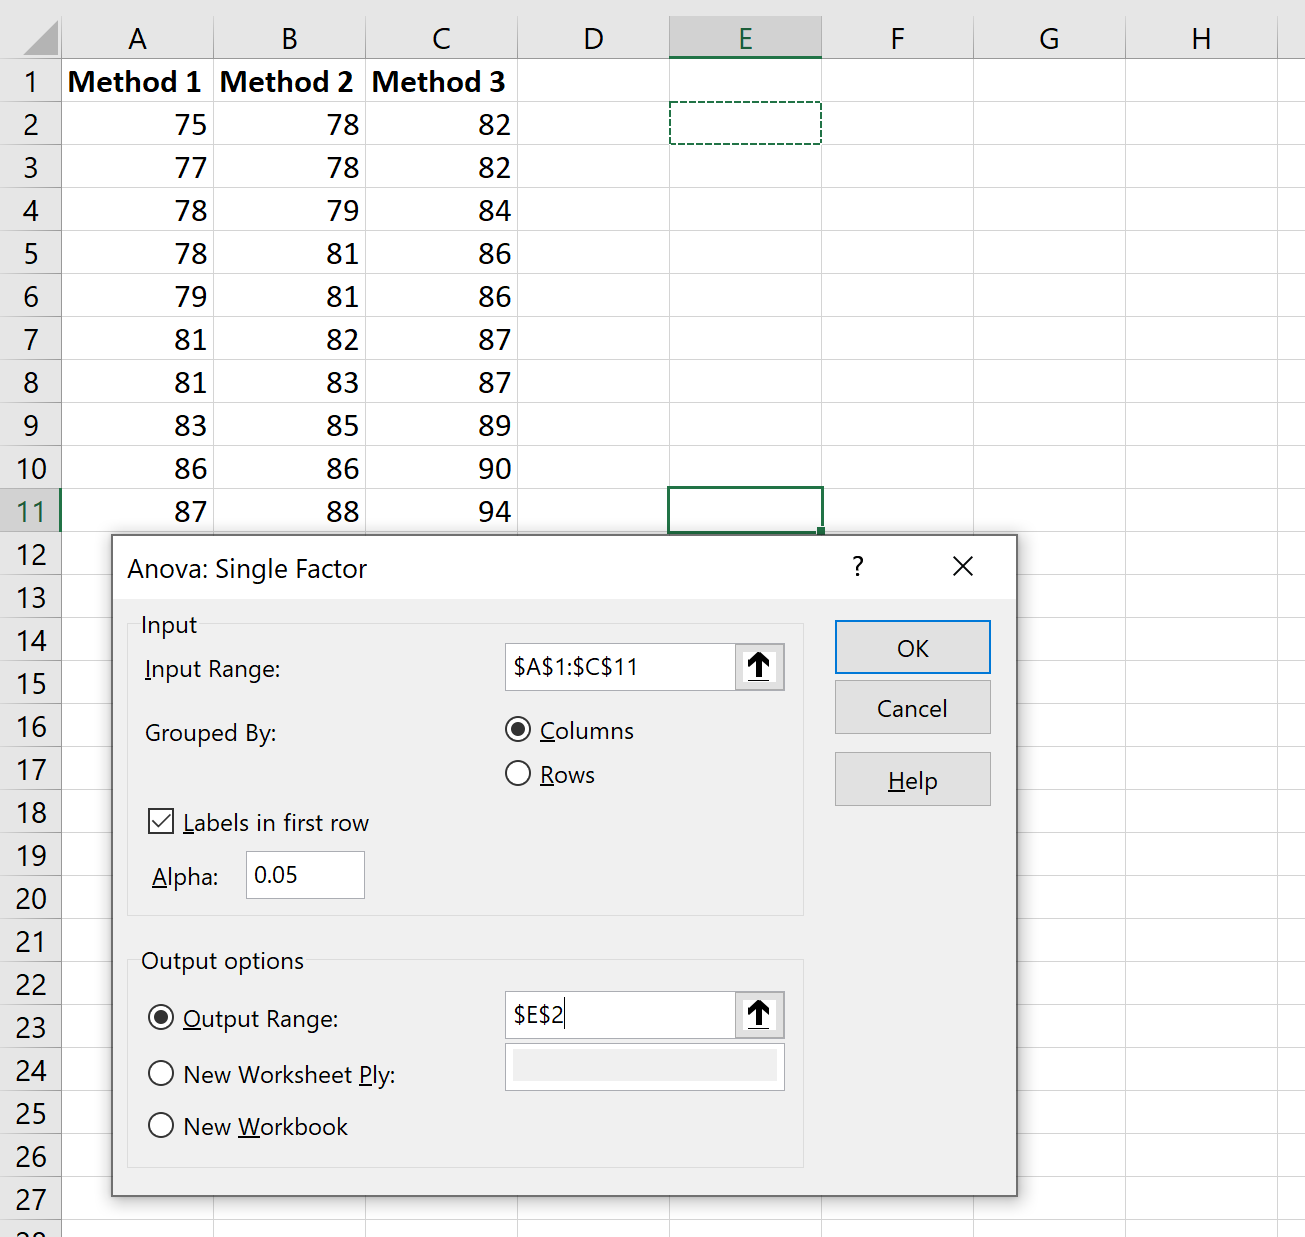
Dès que la matrice de données est convenablement assainie et organisée dans la grille de calcul, l’exécution opérationnelle du test dans Excel peut être engagée. Pour ce faire, lancez l’interface en cliquant sur Données > Utilitaire d’analyse > Anova : un facteur, puis cliquez sur OK.
La première section de la boîte de dialogue concerne la définition de la Plage d’entrée :
- Cliquez sur le sélecteur de plage situé à l’extrémité droite du champ de saisie, puis sélectionnez à l’aide du curseur de la souris le rectangle complet comprenant les données. Si vos trois modalités occupent les colonnes A, B et C de la première à la vingt-sixième ligne, la chaîne de référence doit afficher formellement
$A$1:$C$26. - Dans la section Groupé par, assurez-vous que le bouton radio Colonnes est activé, ce qui correspond à la topologie matricielle standard décrite précédemment.
- Cochez impérativement la case à cocher intitulée Intitulés en première ligne si votre sélection inclut effectivement les étiquettes textuelles de la ligne 1. L’omission de cette coche lorsque des textes sont présents générera une erreur fatale signalant la présence de données non numériques dans la plage d’entrée. Inversement, cocher cette case sans avoir sélectionné d’en-tête amputera mécaniquement la première observation de votre premier groupe, faussant l’intégralité du calcul.
Assurez-vous qu’aucune colonne vide intercalaire ne figure à l’intérieur de la plage sélectionnée. Si vous avez disposé des calculs intermédiaires ou laissé des espaces entre vos colonnes de données, l’Utilitaire d’analyse générera un message d’erreur bloquant ou produira un tableau d’analyse corrompu par des groupes fantômes à effectif nul.
5.2 Réglage du seuil alpha et configuration des options de sortie
La deuxième partie de la configuration paramétrique requiert la fixation du niveau de risque statistique et le ciblage géographique de la restitution des résultats :
- Le champ Alpha : Par défaut, Excel initialise cette valeur à
0,05, ce qui correspond au seuil conventionnel de 5 % de risque d’erreur de première espèce admis par la communauté scientifique. Si votre protocole expérimental requiert un contrôle plus strict (par exemple en recherche clinique interventionnelle de phase III où l’on privilégie α = 0,01), saisissez manuellement la valeur désirée dans cette case. Ce paramètre n’altère pas la valeur du F calculé ni la p-valeur, mais modifie directement le seuil de la valeur critique F qui sera inscrite dans le tableau de sortie final. - Options de sortie : Trois modalités géographiques sont proposées à l’utilisateur :
- Plage de sortie : permet d’implanter les tableaux générés au sein de la feuille de calcul active, à partir d’une cellule d’ancrage spécifique (par exemple
$E$2). Veillez à réserver un espace vierge suffisant en dessous et à droite de cette cellule pour éviter l’écrasement de données préexistantes. - Nouvelle feuille de calcul : génère un nouvel onglet au sein du classeur courant et y dépose l’ensemble des résultats statistiques. C’est l’option recommandée pour préserver la lisibilité de la feuille de données brutes.
- Nouveau classeur : exporte les sorties statistiques vers un fichier Excel totalement distinct, pratique pour isoler les synthèses d’analyses destinées à l’archivage ou au partage documentaire.
- Plage de sortie : permet d’implanter les tableaux générés au sein de la feuille de calcul active, à partir d’une cellule d’ancrage spécifique (par exemple
Une fois ces paramètres validés en cliquant sur le bouton OK, l’algorithme d’Excel exécute instantanément la décomposition matricielle de la variance et produit deux tableaux statistiques successifs : le tableau RÉSUMÉ (statistiques descriptives intra-groupes) et le tableau ANOVA (statistiques inférentielles du modèle). Il est fortement conseillé de figer les valeurs calculées ou de verrouiller la feuille de calcul générée pour prévenir toute altération accidentelle des formules statiques injectées par l’outil.
6. Décryptage du tableau RÉSUMÉ (SUMMARY) : Statistiques descriptives
6.1 Interprétation des effectifs (Nombre) et des totaux (Somme)
Le premier composant graphique produit par l’Utilitaire d’analyse est le tableau descriptif intitulé RÉSUMÉ. Bien que son statut soit préliminaire à la prise de décision inférentielle, son examen minutieux constitue une étape d’audit empirique incontournable pour le chercheur soucieux de garantir la traçabilité de ses analyses.
La première colonne quantitative, intitulée Nombre (ou Count dans les versions anglophones), renseigne l’effectif valide nj pris en compte pour chaque modalité expérimentale :
- Elle permet de valider instantanément la concordance entre le nombre théorique de sujets recrutés dans le protocole et le volume effectif de données numériques traitées par le moteur de calcul. Une divergence inattendue dans ces effectifs révèle immédiatement une omission de saisie, un décalage de sélection de plage ou la présence non identifiée d’une valeur non numérique au sein de la matrice.
- Ce diagnostic renseigne sur la symétrie du plan d’expérience : un plan est dit équilibré lorsque n1 = n2 = … = nk, conférant au test F une robustesse maximale face aux écarts modérés à l’homoscédasticité. Si les effectifs sont inégaux (plan non équilibré), le chercheur est averti qu’il devra surveiller de très près la proximité des variances estimées.
La colonne adjacente, nommée Somme, présente l’agrégation arithmétique brute de l’ensemble des scores enregistrés au sein de chaque groupe (∑ Xij). Bien que cette métrique brute ne possède pas de signification clinique intrinsèque directe en raison de sa dépendance à la taille d’échantillon, elle sert de socle algorithmique intermédiaire au calcul des sommes de carrés globales.
6.2 Analyse critique des Moyennes de groupe
La troisième colonne du tableau descriptif présente la métrique centrale la plus fondamentale pour la communication scientifique : la Moyenne arithmétique empirique de chaque condition expérimentale, calculée selon la formulation conventionnelle :
X̄j = (∑ Xij) / nj
L’observation de ces valeurs fournit une première lecture directe de la direction et de l’intensité apparente des effets expérimentaux induits par les modalités de la variable indépendante :
- Dans le cadre d’une expérimentation pédagogique portant sur l’efficacité de méthodes d’apprentissage, si le groupe « Encodage Sémantique » affiche une moyenne de 18,4 mots retenus, tandis que les groupes « Acoustique » et « Superficiel » plafonnent respectivement à 13,2 et 9,6 mots, la trajectoire des performances semble confirmer la supériorité de la profondeur de traitement théorique.
- Cependant, le chercheur doit se garder de toute conclusion hâtive à ce stade de l’analyse. Une divergence entre des moyennes descriptives ne constitue en aucun cas la preuve formelle d’une différence systématique dans la population générale. Ces variations peuvent résulter purement du bruit d’échantillonnage aléatoire. Seul le verdict probabiliste du tableau inférentiel permettra d’affirmer si cette hiérarchie des moyennes est statistiquement robuste.
Il est par ailleurs fondamental de relier ces moyennes empiriques à l’échelle de mesure clinique ou psychométrique initiale pour juger de leur plausibilité théorique et détecter d’éventuels effets de plafond (scores saturés au maximum de l’échelle) ou de plancher (scores concentrés au minimum technique), susceptibles de biaiser la distribution résiduelle.
6.3 Évaluation de la dispersion intra-groupe par la Variance
La quatrième et dernière colonne du tableau descriptif renseigne la Variance empirique corrigée (notée sj2) au sein de chaque modalité, calculée à l’aide de l’estimateur sans biais divisé par les degrés de liberté résiduels propres au groupe (nj – 1) :
sj2 = ∑ (Xij – X̄j)2 / (nj – 1)
Cette mesure capture l’ampleur de la dispersion individuelle des réponses autour de la moyenne respective de chaque traitement. Son interprétation apporte des indications capitales :
- Conversion en écart-type : La variance étant exprimée dans le carré de l’unité de mesure initiale, il est recommandé de calculer mentalement ou par formule adjacente sa racine carrée (
=RACINE(cellule_variance)) pour obtenir l’écart-type sj, directement commensurable à la moyenne et indispensable aux normes de rédaction académiques. - Diagnostic heuristique de l’homogénéité : En inspectant visuellement les variances des différents groupes, le chercheur peut contrôler le respect du postulat d’homoscédasticité. Si l’une des variances calculées par Excel s’avère quadruple ou quintuple par rapport à une autre (par exemple s12 = 4,2 et s22 = 22,8), le postulat d’égalité des variances est manifestement compromis, ce qui impose la plus grande prudence quant à la lecture de la statistique F globale.
- Identification de sous-populations cliniques : Une variance anormalement boursouflée au sein d’un groupe thérapeutique indique souvent qu’une fraction des patients a remarquablement réagi au traitement (répondeurs) alors qu’une autre fraction a manifesté une résistance clinique complète, révélant une possible variable modératrice non contrôlée.
7. Décomposition de la variance : Analyse des colonnes Somme des carrés et Degrés de liberté
7.1 Origine et signification de la Somme des carrés (SS)
Le second tableau d’Excel, intitulé formellement ANOVA, constitue le cœur inférentiel de la procédure. Sa première colonne de données numériques, intitulée Somme des carrés (notée fréquemment SS pour l’anglais Sum of Squares), concrétise la géométrie fondamentale de la décomposition de la variance introduite par Fisher.
La théorie statistique démontre l’identité mathématique fondamentale suivante, selon laquelle la variabilité totale observée dans l’expérience est la résultante additive parfaite de deux sources de variation orthogonales :
SSTotale = SSEntre_groupes + SSÀ_l’intérieur_des_groupes
Chacune de ces composantes remplit un rôle conceptuel spécifique dans l’équation globale :
- Entre groupes (SS Between / Variation intergroupes) : Cette ligne quantifie la part de la variabilité totale attribuable aux différences qui séparent les moyennes de chaque modalité de la moyenne générale (Grand Mean) de l’ensemble de l’échantillon. Elle matérialise l’effet direct de la variable indépendante manipulée par l’expérimentateur, additionné de l’erreur d’échantillonnage entre les groupes. Plus cette grandeur est élevée, plus le traitement expérimental a généré une différenciation marquée entre les conditions.
- À l’intérieur des groupes (SS Within / Variation intragroupe ou d’Erreur) : Cette ligne agrège les déviations quadratiques individuelles de chaque sujet par rapport à la moyenne de son propre sous-groupe. Cette variation résiduelle ne peut en aucun cas être expliquée par l’effet du traitement, puisque tous les sujets d’une modalité donnée ont reçu une intervention rigoureusement identique. Elle représente donc le réceptacle des différences interindividuelles, de l’hétérogénéité génétique et cognitive, des fluctuations attentionnelles transitoires et des erreurs imprévisibles de mesure.
- Total (SS Total) : Elle représente la dispersion globale brute de l’ensemble des observations prises indistinctement autour de la moyenne arithmétique globale de l’expérimentation.
7.2 Calcul et attribution des Degrés de liberté (ddl)
La deuxième colonne quantitative du tableau d’analyse est titrée Degrés de liberté (notée ddl en français, ou df pour Degrees of Freedom). Les degrés de liberté désignent le nombre de valeurs indépendantes pouvant varier librement lors de l’estimation d’un paramètre statistique au sein d’une distribution mathématique.
Dans l’architecture de l’ANOVA à un facteur générée par Excel, ces valeurs sont rigoureusement déterminées selon des relations algébriques directes fondées sur le nombre de groupes k et le volume total d’observations N :
- Degrés de liberté intergroupes (Ligne Entre groupes) : Ils sont mathématiquement égaux au nombre total de modalités de traitement moins une unité, soit ddlinter = k – 1. Pour une étude portant sur trois approches psychothérapeutiques distinctes, cette valeur sera systématiquement de 3 – 1 = 2.
- Degrés de liberté intragroupe (Ligne À l’intérieur des groupes) : Ils correspondent à la somme des degrés de liberté propres à chaque groupe, ce qui équivaut à la taille globale de l’échantillon délestée du nombre total de groupes, soit ddlintra = N – k. Si notre étude mobilise 60 participants répartis sur trois groupes, nous obtiendrons 60 – 3 = 57 degrés de liberté résiduels.
- Degrés de liberté totaux (Ligne Total) : Ils reflètent l’ensemble des observations disponibles diminué de l’estimation de la moyenne globale, soit ddltotal = N – 1 (dans notre exemple, 60 – 1 = 59). L’additivité des degrés de liberté est totale : ddltotal = ddlinter + ddlintra (2 + 57 = 59).
Ces paramètres géométriques exercent une influence déterminante : ils vont dicter la forme mathématique exacte de la distribution de probabilité théorique du F sous l’hypothèse nulle et définiront la précision de la puissance statistique du test.
7.3 Détermination des Moyennes des carrés (MS)
La troisième colonne du tableau d’analyse d’Excel s’intitule Moyenne des carrés (notée MS pour l’anglais Mean Square). Bien que le vocable statistique francophone utilise le terme « moyenne », il s’agit sur le plan opératoire de variances d’échantillonnage estimées.
Ces valeurs ne sont pas le fruit d’une nouvelle mesure brute, mais résultent de la division mathématique stricte de chaque somme des carrés par son degré de liberté correspondant :
- Carré moyen intergroupes (MS Between) : Calculé par la formule MSinter = SSinter / ddlinter. Cette métrique quantifie l’estimation de la variance entre les groupes. Sous l’hypothèse alternative (H1), cette quantité reflète simultanément la variance d’erreur aléatoire naturelle plus la variance systématique induite par l’efficacité différentielle des traitements.
- Carré moyen intragroupe (MS Within ou MSE pour Mean Squared Error) : Calculé par l’opération MSintra = SSintra / ddlintra. Cette valeur constitue l’estimateur non biaisé par excellence de la variance de la population générale (σ2), représentant le bruit de fond expérimental pur exempt de tout effet de groupe. Elle est l’équivalent pondéré des variances individuelles observées dans le tableau RÉSUMÉ précédent.
La ligne « Total » ne comporte jamais de valeur sous la colonne Moyenne des carrés dans Excel : cela s’explique par le fait que la variance totale n’est pas la simple somme arithmétique des deux variances estimées, mais correspond à une moyenne pondérée globale qui n’a pas d’utilité opérationnelle pour le calcul de la statistique de test de Fisher.
8. Évaluation de la statistique de test : Le ratio F empirique versus la valeur critique
8.1 Mécanisme mathématique et conceptuel du test F de Snedecor
La quatrième colonne du tableau ANOVA d’Excel délivre la métrique décisionnelle fondamentale du test : la statistique notée simplement F. Également connue sous le nom de rapport de Fisher-Snedecor, cette grandeur scalaire incarne la concrétisation ultime du raisonnement de l’analyse de variance.
Le mécanisme mathématique qui régit le calcul de F est d’une grande simplicité opératoire :
F = MSinter / MSintra = Variance systématique / Variance d’erreur
Ce ratio confronte directement l’estimation de la variabilité induite par la manipulation expérimentale à l’estimation du bruit de fond aléatoire interindividuel. La logique conceptuelle sous-jacente s’articule comme suit :
- Si l’hypothèse nulle (H0) est rigoureusement vraie dans la réalité, il n’existe aucun effet de traitement. Par conséquent, les différences constatées entre les moyennes de groupe ne traduisent que le bruit d’échantillonnage ordinaire. Dans ces conditions, le numérateur (MSinter) et le dénominateur (MSintra) constituent deux estimateurs indépendants d’une seule et même quantité fondamentale (σ2). Le rapport de deux variances équivalentes tendant naturellement vers l’unité, la statistique F attendue sous H0 présente une espérance mathématique proche de 1.
- Si, en revanche, l’hypothèse alternative (H1) se vérifie, le numérateur est gonflé par l’effet systématique du traitement (σ2 + nσ2traitement). Il devient substantiellement supérieur au dénominateur, propulsant le ratio F à des valeurs très au-delà de 1 (par exemple, F = 5,42 ou F = 18,90).
La distribution d’échantillonnage théorique de cette statistique sous l’hypothèse nulle n’est pas symétrique : bornée à gauche par zéro (une variance étant toujours positive), la courbe du test F présente une asymétrie positive prononcée avec un étirement prononcé de sa queue vers la droite.
8.2 Confrontation avec la Valeur critique pour F
À l’extrémité droite du tableau ANOVA, Excel génère une colonne désignée sous l’intitulé Valeur critique pour F (ou F critical). Cette grandeur correspond à la valeur seuil théorique que la statistique F empirique doit impérativement dépasser pour autoriser le rejet de l’hypothèse nulle au niveau de risque alpha choisi par l’opérateur (généralement 0,05).
La valeur critique dépend exclusivement de trois paramètres stricts : le seuil d’erreur α consenti, les degrés de liberté du numérateur (ddlinter) et les degrés de liberté du dénominateur (ddlintra). Dans les ouvrages de référence classiques, cette valeur était fastidieusement recherchée dans les tables imprimées de la loi de Snedecor. Excel automatise rigoureusement cette quête en exécutant en arrière-plan l’équivalent de sa fonction native =LOI.F.INVERSE.N(alpha; ddl_inter; ddl_intra).
La règle de décision inférentielle se structure de façon binaire et sans ambiguïté :
- Scénario de rejet (Effet statistiquement significatif) : Si Fcalculé > Fcritique, la statistique expérimentale se projette profondément dans la région critique de rejet située dans la queue droite de la distribution théorique. Le chercheur conclut formellement au rejet de l’hypothèse nulle (H0) et valide l’hypothèse d’une différence systématique entre les conditions.
- Scénario de non-rejet (Absence d’effet statistiquement fiable) : Si Fcalculé ≤ Fcritique, la valeur observée reste confinée dans la zone de plausibilité stochastique attendue sous l’hypothèse nulle. Les données empiriques ne fournissent pas de preuves suffisantes pour affirmer que les traitements induisent des moyennes différenciées dans la population d’origine.
9. Interprétation probabiliste : La p-valeur (P-value) et la décision statistique
9.1 Définition rigoureuse de la p-valeur générée par Excel
Encadrée entre la statistique F empirique et la valeur critique, l’avant-dernière colonne du tableau inférentiel d’Excel s’intitule Probabilité (communément abrégée en p-valeur ou p-value). Cette composante constitue la mesure probabiliste contemporaine la plus mobilisée dans les publications scientifiques internationales pour étayer la décision inférentielle.
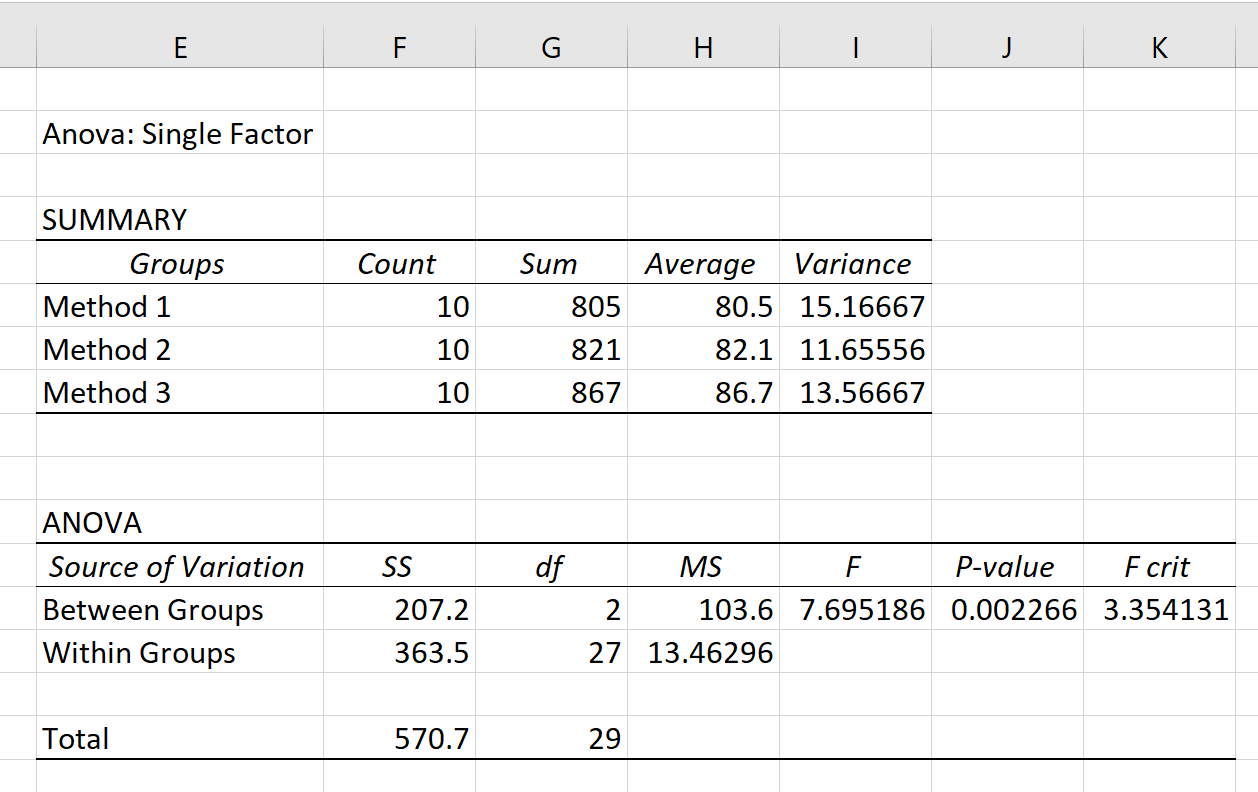
La p-valeur représente mathématiquement l’intégrale de la fonction de densité de Fisher-Snedecor calculée depuis la valeur de la statistique F obtenue jusqu’à l’infini positif. En termes épistémologiques précis, elle quantifie la probabilité exacte d’observer, sous l’hypothèse que l’hypothèse nulle (H0) soit rigoureusement vraie, une statistique F au moins aussi extrême ou disproportionnée que celle calculée à partir de vos données d’échantillon.
Il importe de déconstruire avec force les contresens épistémologiques récurrents qui pullulent dans la littérature profane :
- La p-valeur ne mesure absolument pas la probabilité que l’hypothèse nulle soit vraie dans l’absolu : P(Données | H0) ≠ P(H0 | Données).
- La p-valeur n’indique pas la probabilité que les résultats observés soient le fruit du hasard pur, ni la probabilité d’erreur commise en cas de réplication du protocole expérimental.
- Un affichage typographique sous Excel arborant la notation scientifique — par exemple
2,45E-05— ne doit pas désarçonner l’analyste : il s’agit simplement de l’écriture exponentielle signifiant 2,45 × 10⁻⁵, soit une probabilité infime de 0,0000245, signalant une divergence spectaculaire par rapport aux prédictions de l’hypothèse nulle.
9.2 Seuils décisionnels et formulation de la conclusion inférentielle
L’interprétation inférentielle formelle de la p-valeur découle de sa confrontation directe avec le seuil critique conventionnel α préalablement entériné lors du paramétrage de l’outil (typiquement α = 0,05) :
- Si p < 0,05 : Le résultat est qualifié de statistiquement significatif. L’occurrence des données empiriques recueillies sous l’empire de l’hypothèse nulle étant hautement improbable (moins d’une chance sur vingt), le consensus méthodologique impose le rejet de H0 au profit de l’hypothèse alternative H1. L’expérimentateur affirme avec un risque d’erreur contrôlé que le facteur expérimental influe sur la variable dépendante.
- Gradations académiques courantes : Dans les standards de communication de la recherche, il est d’usage de moduler la qualification du résultat : p < 0,05 est dit significatif ; p < 0,01 est qualifié de hautement significatif ; et p < 0,001 est désigné comme très hautement significatif.
- Si p ≥ 0,05 : Le résultat n’est pas statistiquement significatif. Les variations intergroupes observées demeurent parfaitement compatibles avec les fluctuations d’échantillonnage attendues sous l’hypothèse nulle. On conclut formellement au « non-rejet » de H0.
Une vigilance épistémologique stricte s’impose face aux résultats qualifiés de « marginaux » ou « tendanciels » (par exemple, p = 0,064). Selon les règles strictes de l’inférence neyman-peirsonienne, une probabilité supérieure à 0,05, fût-ce d’un millième, impose le maintien de l’hypothèse nulle. Tenter de décrire une telle situation par des contorsions stylistiques du type « tendance marquée vers la significativité » constitue un abus d’interprétation méthodologique que les comités de lecture académiques rejettent quasi systématiquement.
10. Quantification de la pertinence clinique : Calcul de la taille de l’effet dans Excel
10.1 Calcul et portée de l’Êta-carré (Eta-squared, η²)
Une faiblesse structurelle majeure de la seule p-valeur réside dans son insolente dépendance à la taille de l’échantillon global N. Avec un effectif monumental de plusieurs milliers de sujets, la moindre variation infinitésimale et dénuée de toute pertinence pratique entre deux moyennes atteindra un seuil de significativité statistique éclatant (p < 0,001). Inversement, un protocole pilote mobilisant un effectif restreint peut masquer un effet thérapeutique massif sous une p-valeur supérieure à 0,05 faute de puissance suffisante. Pour dissocier la significativité statistique de la portée clinique ou pratique d’une intervention, le calcul de la taille de l’effet est désormais rendu obligatoire par la quasi-totalité des revues scientifiques.
L’indice standard d’amplitude d’effet le plus couramment associé à l’ANOVA à un facteur est l’Êta-carré (η²). Il s’interprète exactement comme un coefficient de détermination (R²) dans le cadre d’une régression linéaire : il quantifie la proportion de la variance totale des scores qui est directement expliquée ou prédite par l’appartenance aux différents groupes expérimentaux.
L’Utilitaire d’analyse d’Excel ne délivre pas nativement cette statistique au sein de son tableau automatisé. Néanmoins, sa détermination manuelle immédiate s’effectue via une formule élémentaire mobilisant les composantes de la colonne Somme des carrés :
η² = SSEntre_groupes / SSTotal
Directement sous votre tableau ANOVA dans Excel, vous pouvez sélectionner une cellule libre et saisir l’équation suivante : =B13/B15 (en supposant que la cellule B13 héberge la SS intergroupes et B15 la SS totale). L’indice ainsi calculé varie entre 0 et 1 (ou entre 0 % et 100 %). Pour interpréter la magnitude de cette statistique en psychologie et sciences du comportement, les balises conventionnelles établies par Jacob Cohen font figure d’étalon universel :
- Effet de faible amplitude : η² ≈ 0,01 (le facteur n’explique que 1 % de la variance globale).
- Effet de moyenne amplitude : η² ≈ 0,06 (le traitement explique environ 6 % de la variabilité des réponses).
- Effet de forte amplitude : η² ≥ 0,14 (au moins 14 % de la variance totale est attribuable aux conditions d’intervention, témoignant d’une pertinence clinique majeure).
10.2 Introduction à l’Êta-carré partiel et à l’Oméga-carré
Dans le cadre strict de l’ANOVA univariée à un seul facteur inter-sujets, l’Êta-carré ordinaire (η²) et l’Êta-carré partiel (ηp²) sont mathématiquement identiques, la variance totale ne comportant qu’une seule source explicative systématique. Ce n’est que dans les plans factoriels complexes à deux facteurs ou plus que l’Êta-carré partiel isole la variance propre au facteur en neutralisant l’influence des autres prédicteurs.
Toutefois, l’Êta-carré souffre d’un biais systématique bien documenté : en tant qu’estimateur strictement descriptif calculé sur l’échantillon empirique, il a une propension mécanique à surestimer la véritable proportion de variance expliquée dans la population générale, un biais particulièrement virulent lorsque les tailles d’échantillon sont modestes (par exemple n < 20 par groupe).
Pour corriger cette distorsion, de nombreux méthodologistes préconisent le recours à l’Oméga-carré (ω²), qui constitue un estimateur non biaisé ajusté par les degrés de liberté et le carré moyen de l’erreur résiduelle. Son calcul s’opère dans Excel via la formule algorithmique suivante :
ω² = [SSinter – (ddlinter × MSintra)] / [SStotal + MSintra]
L’implantation de cette syntaxe arithmétique directement sous le tableau de sortie d’Excel — par exemple =(B13-(C13*D14))/(B15+D14) — confère à votre rapport une qualité psychométrique accrue. Les seuils d’interprétation de Cohen s’appliquent de manière symétrique à l’Oméga-carré (ω² = 0,01 pour faible, 0,06 pour moyen, et 0,14 pour fort), offrant une vision réaliste et reproductible de l’efficacité thérapeutique ou expérimentale investiguée.
11. Stratégie d’analyse post-hoc : Localiser les contrastes significatifs après Excel
11.1 Nécessité absolue des tests de comparaison multiple
L’obtention d’un ratio de Fisher statistiquement significatif (p < 0,05) au sein du tableau ANOVA d’Excel scelle le rejet formel de l’hypothèse nulle globale. Vous disposez désormais de la certitude statistique que les populations mères ne partagent pas toutes la même moyenne. Cependant, une limite structurelle rédhibitoire se profile : l’ANOVA est un test global (dit omnibus), incapable par essence de désigner la localisation exacte des divergences observées.
Si votre recherche évalue trois méthodes thérapeutiques (TCC, MBSR et Contrôle), le rejet de H0 soulève des interrogations cliniques précises :
- La thérapie cognitive (TCC) surpasse-t-elle significativement le groupe témoin de contrôle ?
- L’approche basée sur la pleine conscience (MBSR) procure-t-elle des bénéfices distincts de la liste d’attente ?
- Existe-t-il une supériorité cliniquement démontrable entre la TCC et la MBSR prises en comparaison directe ?
L’Utilitaire d’analyse d’Excel ne propose nativement aucun module de tests post-hoc dédiés à l’instar de Tukey, Scheffé ou Bonferroni. Devant cette carence algorithmique, certains utilisateurs commettent l’erreur d’exécuter des tests t de Student ordinaires entre chaque paire sans précaution. Comme explicité au chapitre 1, cette multiplication non régulée des contrastes fait exploser le taux global d’erreur de type I. Il appartient donc au chercheur de mettre en œuvre manuellement dans sa feuille de calcul une procédure d’ajustement rigoureuse pour garantir la validité des contrastes multiples.
11.2 Application manuelle de la correction de Bonferroni sous Excel
Parmi les stratégies de régulation du risque d’erreur globale lors de comparaisons multiples, la procédure d’ajustement de Bonferroni s’impose comme la plus simple, la plus intuitive et la plus facilement intégrable au sein d’une feuille de calcul Microsoft Excel. Elle repose sur l’inégalité de Boole pour recalculer le seuil de décision α individuel en fonction du nombre total de comparaisons planifiées ou post-hoc.
Le protocole opératoire pour déployer la correction de Bonferroni sous Excel s’articule comme suit :
- Décompte du nombre de paires possibles : Pour k groupes, le volume total de comparaisons binaires distinctes s’obtient par la formule combinatoire c = [k × (k – 1)] / 2. Pour trois groupes, nous obtenons c = [3 × 2] / 2 = 3 comparaisons (Groupe 1 vs 2, Groupe 1 vs 3, et Groupe 2 vs 3).
- Calcul du seuil alpha corrigé : Le chercheur redéfinit le seuil de rejet individuel αajusté en divisant le risque global consenti (typiquement 0,05) par le nombre total de comparaisons : αajusté = α / c. Dans notre exemple à trois conditions, le seuil de décision devient : αajusté = 0,05 / 3 ≈ 0,0167.
- Exécution des tests t sous Excel : Utilisez la fonction intégrée
=TEST.T.N(matrice1; matrice2; 2; 2)pour chaque paire de colonnes. Les deux derniers arguments de la fonction stipulent respectivement un test bilatéral (argument2) et une hypothèse de variances homogènes (argument2, correspondant au t-test de Student basé sur la variance résiduelle poolée). - Règle de décision : Pour qu’une comparaison par paire soit déclarée statistiquement significative, sa p-valeur calculée par
TEST.T.Ndoit être strictement inférieure au nouveau seuil αajusté (0,0167) et non plus au seuil standard de 0,05.
Bien que Bonferroni présente l’avantage d’une clarté conceptuelle absolue, sa limite réside dans son caractère ultra-conservateur dès que le nombre de modalités s’accroît, augmentant mécaniquement le risque d’erreur de seconde espèce (β) en occultant de réelles divergences cliniques.
11.3 Approche alternative : Le test HSD de Tukey via formules Excel
Pour surmonter le conservatisme excessif de Bonferroni, le test de la plus petite différence significative honnête de Tukey (Tukey’s Honest Significant Difference ou HSD) représente l’étalon d’excellence pour l’ensemble des comparaisons par paires dans un plan d’ANOVA équilibré. Ce test s’appuie sur la loi de l’étendue studentisée (Studentized Range Distribution, notée q).
Pour implémenter le critère HSD de Tukey au sein d’Excel, il convient de déterminer la valeur critique de différence absolue minimale que doit atteindre l’écart entre deux moyennes empiriques pour être proclamé statistiquement signifiant. L’équation mathématique du seuil HSD est la suivante :
HSD = qcritique × √ (MSintra / n)
Où :
- qcritique est la valeur théorique de l’étendue studentisée pour un risque α = 0,05, paramétrée sur le nombre total de groupes k et les degrés de liberté intragroupe de l’ANOVA (ddlintra). Cette valeur est extraite d’une table statistique standard de l’étendue studentisée de Tukey.
- MSintra (ou MSE) est la moyenne des carrés intragroupe extraite directement de la colonne D du tableau ANOVA d’Excel.
- n est la taille d’échantillon uniforme par groupe (si le plan est légèrement déséquilibré, on utilise la moyenne harmonique des effectifs).
Une fois la constante numérique HSD calculée dans une cellule d’Excel — par exemple =q_valeur * RACINE(cellule_MS_intra / cellule_n) —, l’analyste dresse une matrice des différences absolues des moyennes empiriques via la syntaxe =ABS(Moyenne_A - Moyenne_B). Toute paire dont la différence arithmétique absolue surpasse le seuil HSD est formellement déclarée significativement disjointe à α = 0,05, permettant d’isoler avec précision les sous-groupes homogènes au sein du collectif expérimental.
12. Restitution académique et rédaction des résultats selon les normes APA
12.1 Syntaxe formelle de présentation des paramètres inférentiels
La communication publique des résultats au sein d’un mémoire universitaire, d’une thèse de doctorat ou d’un manuscrit soumis à une revue internationale à comité de lecture affiliée aux neurosciences ou à la psychologie obéit aux normes typographiques prescrites par l’American Psychological Association (manuel de style APA, 7e édition).
La transcription narrative standard d’un test ANOVA univarié mobilise une syntaxe canonique codifiée, qui condense l’ensemble des données décisionnelles au sein d’une parenthèse statistique insérée directement à l’issue de l’affirmation scientifique :
F(ddlinter, ddlintra) = valeur_F, p = valeur_p, η² = valeur_effet
Les conventions typographiques et d’arrondi de l’APA 7e édition imposent des règles formelles strictes :
- Les lettres symbolisant les statistiques inférentielles (F, p, t) ainsi que la taille d’effet (η²) doivent être systématiquement composées en caractères italiques.
- La statistique F empirique et la taille d’effet (η² ou ω²) sont invariablement arrondies à deux décimales après la virgule (par exemple : F(2, 57) = 6,48 ; η² = ,19).
- Règle du zéro initial : Conformément aux prescriptions de l’APA, si une métrique statistique ne peut mathématiquement jamais excéder la valeur absolue de 1 — ce qui est rigoureusement le cas des probabilités (p) et des proportions de variance comme l’Êta-carré (η²) —, le zéro initial précédant la virgule ou le point décimal doit être délibérément omis dans la rédaction typographique anglophone standard (ex. p = ,003 et non p = 0,003 ; η² = ,18 et non η² = 0,18). Dans un manuscrit universitaire rédigé en langue française, l’usage autorise le maintien du zéro (p = 0,003), mais les publications anglophones internationales appliquent sans exception la règle d’omission du zéro.
- Si la p-valeur générée par Excel s’avère infinitésimale (par exemple sous la forme
1,12E-07), il ne faut jamais rédiger p = 0,000, formulation mathématiquement absurde car une probabilité continue n’est jamais rigoureusement nulle. Il convient de transcrire formellement l’inégalité : p < ,001.
Exemple canonique de rédaction textuelle :
« Une analyse de variance univariée (ANOVA) à un facteur a été réalisée afin d’évaluer l’impact des modalités thérapeutiques sur les scores de dépression mesurés à l’inventaire de Beck. L’analyse révèle un effet principal statistiquement significatif du protocole de prise en charge, F(2, 57) = 7,24, p = ,002, η² = ,20. Les comparaisons post-hoc conduites avec la correction de Bonferroni indiquent que le groupe soumis à la thérapie cognitivo-comportementale (M = 12,40, ET = 3,12) présente un niveau d’anxiété résiduelle significativement inférieur au groupe placé sur liste d’attente (M = 18,95, ET = 4,05, p < ,001). En revanche, la différence observée entre le protocole de pleine conscience (M = 14,80, ET = 3,88) et la prise en charge TCC ne franchit pas le seuil de significativité statistique ajusté (p = ,112). »
12.2 Conception de tableaux et graphiques scientifiques conformes aux standards APA
La clarté de la restitution des résultats repose fréquemment sur la mise en page de tableaux synthétiques et de représentations graphiques épurées, conçus selon l’esthétique minimaliste propre aux standards académiques.
Pour formater un tableau descriptif et inférentiel selon les normes APA au départ des données produites par Excel :
- Bannissement absolu des quadrillages verticaux : Un tableau aux normes APA ne contient aucune ligne verticale de séparation cellulaire. Seules trois lignes horizontales épaisses sont tolérées : une bordure supérieure délimitant le haut du tableau, une bordure séparant la rangée des en-têtes de colonnes de la première ligne de données, et une bordure inférieure fermant le tableau avant les notes de bas de page.
- Typographie épurée : Intégrez le numéro du tableau en gras sur une ligne dédiée (ex. Tableau 1), suivi sur la ligne immédiatement inférieure du titre descriptif rédigé en italique (ex. Statistiques descriptives et analyse de variance des scores mnésiques selon le mode d’encodage).
- Notes explicatives de bas de tableau : Sous la bordure horizontale inférieure, insérez une section débutant par le mot Note. en italique. Explicitez-y la signification des abréviations mobilisées (M = moyenne, ET = écart-type, IC = intervalle de confiance), et indiquez les seuils de significativité des astérisques s’ils sont utilisés (* p < ,05. ** p < ,01. *** p < ,001).
Sur le plan graphique, l’analyste évitera les diagrammes circulaires (« camemberts ») ou les effets 3D artificiels proposés par défaut dans les menus grand public d’Excel. La figure de référence consiste en un diagramme en barres ou un graphique en nuage de points avec lignes directrices représentant les moyennes de chaque condition, surmontées impérativement de barres d’erreur matérialisant l’intervalle de confiance à 95 % (calculé par la fonction =INTERVALLE.CONFIANCE.T) ou l’erreur standard de la moyenne (SEM). L’axe des ordonnées doit débuter à une valeur théoriquement justifiée et comporter des graduations explicites sans surcharges ornementales.
12.3 Pièges récurrents et recommandations de bonne pratique pour les chercheurs
L’interprétation et la restitution de l’ANOVA sous Excel recèlent plusieurs écueils méthodologiques dans lesquels les praticiens débutants trébuchent fréquemment. L’identification préventive de ces travers garantit l’intégrité de la communication scientifique :
- Confondre non-significativité et preuve d’équivalence : L’obtention d’une p-valeur supérieure à 0,05 (p ≥ ,05) ne prouve absolument pas que les moyennes des populations sont strictement égales. Elle atteste uniquement que les données disponibles ne permettent pas de rejeter l’hypothèse nulle avec une confiance suffisante. L’absence de preuve d’un effet n’est pas la preuve de l’absence d’effet. Pour statuer sur l’équivalence de deux interventions, des tests d’équivalence spécifiques (comme la procédure TOST — Two One-Sided Tests) doivent être convoqués.
- Omettre la vérification préalable des hypothèses : Conduire aveuglément l’Utilitaire d’analyse sans avoir investigué l’homogénéité des variances ou la présence de points extrêmes aberrants relève d’une négligence statistique susceptible de conduire à des conclusions totalement erronées, en particulier en présence de petits échantillons déséquilibrés.
- L’hypnose de la seule p-valeur : Focaliser son argumentation scientifique exclusivement sur le fait que la probabilité franchit ou non la frontière artificielle de ,05 sans quantifier l’amplitude réelle de l’effet (η² ou ω²) prive le lecteur de la dimension pratique et clinique de la recherche. Un effet cliniquement dérisoire peut être très « significatif » dans un grand échantillon, tandis qu’un effet thérapeutique majeur peut échapper au seuil de significativité faute de participants suffisants.
- Pérennité et reproductibilité des classeurs : L’Utilitaire d’analyse d’Excel présente la particularité technique d’injecter des valeurs calculées statiques et non des formules dynamiques reliées aux données sources dans ses tableaux de sortie. Par conséquent, si vous modifiez ultérieurement une observation au sein de votre matrice brute, le tableau ANOVA préalablement généré ne s’actualisera aucunement ! Il est capital de réexécuter l’analyse à chaque modification des données et d’archiver méthodiquement une copie figée et horodatée du classeur source pour assurer la traçabilité intégrale de la chaîne de traitement empirique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Hartley, H. O. (1950). The use of range in analysis of variance. Biometrika, 37(3/4), 271-280. https://doi.org/10.2307/2332378
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434-447. https://doi.org/10.1037/1082-989X.8.4.434
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99-114. https://doi.org/10.2307/3001913