
Dans l’écosystème de la recherche empirique contemporaine, et tout particulièrement au sein des sciences psychologiques, de la psychiatrie expérimentale et des neurosciences comportementales, l’analyse de variance — universellement désignée sous l’acronyme ANOVA (Analysis of Variance) — constitue l’un des piliers méthodologiques les plus fondamentaux. Conçue à l’origine par le statisticien et généticien britannique Sir Ronald Aylmer Fisher dans les années 1920, cette technique inférentielle a révolutionné la modélisation statistique en permettant aux chercheurs de dépasser la simple confrontation binaire de deux échantillons pour analyser simultanément des dispositifs expérimentaux complexes impliquant de multiples conditions, groupes cliniques ou niveaux de traitement. Au cœur de cette architecture mathématique élégante repose une dialectique étroite entre deux indicateurs canoniques : la statistique F (ou valeur F) et la probabilité critique associée, la p-valeur.
Pourtant, malgré leur omniprésence dans la littérature scientifique révisée par les pairs, la valeur F et la p-valeur demeurent paradoxalement entourées de confusions conceptuelles majeures, d’erreurs d’interprétation récurrentes et d’usages mécaniques déconnectés de leur logique probabiliste sous-jacente. Trop souvent, les analystes de données et les cliniciens réduisent l’évaluation statistique à une quête binaire dictée par un seuil arbitraire, concluant à un prétendu triomphe dès que le chiffre magique de 0,05 est franchi, sans appréhender ce que le ratio de variance révèle structurellement quant à la dynamique des données observées. Une telle approche instrumentale occulte la nature intrinsèque du modèle linéaire général, ignore les conséquences des violations des postulats et méconnaît les limites inhérentes au cadre fréquentiste classique.
Ce guide encyclopédique et méthodologique a pour ambition de démystifier, déconstruire et réhabiliter la pleine compréhension conceptuelle, mathématique et pratique de la valeur F et de la p-valeur dans le cadre de l’ANOVA univariée et multivariée. À travers un parcours pédagogique et technique exhaustif, nous explorerons les fondations théoriques de la partition de la variance, la mécanique décisionnelle du ratio de Fisher-Snedecor, les règles rigoureuses d’interprétation des tableaux de résultats, la complémentarité impérative avec les mesures de taille d’effet, ainsi que les protocoles de rédaction conformes aux standards académiques les plus rigoureux, notamment ceux de l’American Psychological Association (APA 7e édition).
1. Fondements théoriques de l’ANOVA dans la recherche quantitative en psychologie
1.1 Rôle et utilité de l’analyse de variance face aux comparaisons multiples
Pour appréhender l’utilité première de l’analyse de variance, il est indispensable d’examiner le problème épistémologique et probabiliste que soulève la comparaison de plus de deux moyennes d’échantillons au moyen de tests classiques de Student (test t). Imaginons un chercheur en psychopathologie comparant l’efficacité de trois modalités d’intervention pour des épisodes dépressifs majeurs : une thérapie cognitive et comportementale (TCC), une thérapie interpersonnelle (TIP) et une condition de contrôle sur liste d’attente. Si ce chercheur choisissait de réaliser des tests t bilatéraux pour comparer chaque paire possible (TCC contre Contrôle, TIP contre Contrôle, TCC contre TIP), il effectuerait un total de trois comparaisons indépendantes ou semi-dépendantes.
Le danger majeur de cette démarche réside dans le phénomène d’inflation de l’erreur de type I globale, souvent désignée sous le terme de taux d’erreur par famille (familywise error rate). Si chaque test individuel est conduit avec un seuil de signification nominal α fixé à 0,05, la probabilité de ne commettre aucune erreur de type I sur les trois tests — en supposant l’indépendance statistique — correspond à (1 − 0,05)3 = 0,953 ≈ 0,857. Par voie de conséquence, la probabilité cumulée de déclarer à tort au moins une différence significative alors que toutes les moyennes de population sont rigoureusement identiques s’élève à 1 − 0,857 = 0,143, soit un risque de 14,3 %, bien supérieur au seuil nominal initial de 5 %. Dès lors que le nombre de groupes k augmente, le nombre de comparaisons bilatérales par paires s’élève à C = k(k − 1) / 2. Pour une étude psychométrique comparant 5 groupes diagnostiques, 10 tests t seraient nécessaires, propulsant le taux d’erreur de type I global à 1 − (0,95)10 ≈ 40,1 %.
L’ANOVA résout magistralement cette aporie méthodologique en proposant un test global unique, qualifié d’omnibus. Au lieu de disséquer prématurément les données en paires isolées, l’analyse de variance teste en une seule et même opération mathématique l’hypothèse générale selon laquelle toutes les moyennes de population sous-jacentes sont mutuellement indiscernables. Cette évaluation globale protège intégralement le taux d’erreur α nominal tout en tirant parti de l’ensemble des données d’échantillonnage pour quantifier l’erreur de mesure non contrôlée. Dans les devis expérimentaux factoriels et les études quasi-expérimentales courantes en psychométrie, ce contrôle s’avère indispensable pour garantir la validité interne des conclusions inférentielles.
1.2 Formulation formelle des hypothèses nulle (H0) et alternative (HA)
Sur le plan mathématique, l’analyse de variance univariée à un facteur inter-sujets évalue une confrontation formelle entre deux hypothèses mutuellement exclusives et conjointement exhaustives. L’hypothèse nulle, canoniquement notée H0, postule l’invariance absolue des paramètres moyens de la variable dépendante au sein des k populations d’intérêt dont sont issus les échantillons expérimentaux. Elle s’écrit formellement :
H0 : μ1 = μ2 = μ3 = … = μk
Cette égalité parfaite signifie que l’appartenance à un groupe de traitement, à une catégorie nosologique ou à une modalité expérimentale particulière n’exerce aucune influence différentielle systématique sur le score moyen de la variable dépendante. L’ensemble des k sous-populations partage une seule et même moyenne générale parente, notée μ.
À l’inverse, l’hypothèse alternative, notée H1 ou HA, ne postule nullement que toutes les moyennes de population diffèrent mutuellement les unes des autres d’une manière ordonnée ou homogène. Elle affirme de façon beaucoup plus générale et non directionnelle qu’il existe au moins une paire de moyennes divergente, ou qu’au moins une population présente une espérance mathématique distincte des autres :
H1 : ∃ (i, j) tel que μi ≠ μj (avec i ≠ j)
Il est critique de souligner la nature omnibus de cette formalisation. L’hypothèse alternative d’une ANOVA ne fournit aucune indication vectorielle ou directionnelle spécifique quant à la localisation précise, au sens arithmétique ou à l’amplitude de l’écart. Un résultat significatif rejetant H0 valide uniquement la présence d’une hétérogénéité structurelle au sein du vecteur des moyennes, ce qui exige des investigations a posteriori (contrastes ou tests post-hoc) pour déterminer quels sous-groupes spécifiques diffèrent significativement les uns des autres.
1.3 Postulats statistiques sous-jacents au modèle linéaire général
En tant qu’émanation directe du modèle linéaire général (GLM), l’ANOVA repose sur une équation linéaire structurelle décrivant chaque observation individuelle Yij (le score du i-ième sujet au sein du j-ième groupe) comme la résultante de paramètres additifs :
Yij = μ + αj + εij
Dans cette formalisation, μ représente la constante correspondant à la moyenne globale non pondérée, αj figure l’effet systématique du j-ième niveau du traitement (avec la contrainte ∑αj = 0 dans un modèle à effets fixes équilibré), et εij incarne le terme d’erreur résiduelle aléatoire associé à l’individu. Pour que l’inférence par le test F de Fisher conserve sa validité mathématique exacte, trois postulats probabilistes fondamentaux doivent être satisfaits au regard de ces résidus εij :
- La normalité des résidus : Pour chaque condition expérimentale j, les erreurs résiduelles εij doivent suivre une distribution normale de moyenne nulle, soit εij ~ N(0, σ2). Ce postulat concerne spécifiquement les résidus du modèle et non l’agrégation brute de la variable dépendante sans différentiation des groupes.
- L’homogénéité des variances (homoscédasticité) : La variance de l’erreur aléatoire σ2 doit être rigoureusement identique au sein de l’ensemble des k populations de traitement, c’est-à-dire σ12 = σ22 = … = σk2 = σ2. Cette condition est couramment évaluée à l’aide du test d’homogénéité des variances de Levene ou du test de Brown-Forsythe.
- L’indépendance stricte des observations : Les termes d’erreur εij doivent être mutuellement indépendants et non corrélés (Cov(εij, εi’j’) = 0 pour tout (i, j) ≠ (i’, j’)). Ce postulat d’indépendance, garanti principalement par une randomisation scrupuleuse lors de l’assignation des sujets et par un échantillonnage probabiliste, constitue le garant le plus sensible et le plus inaltérable de la validité de l’inférence.
2. La décomposition de la variance : Sommes des carrés et carrés moyens
2.1 Partition de la variation totale : Modèle et résidus
L’élégance fondamentale de l’analyse de variance réside dans sa capacité arithmétique à décomposer la quantité globale d’incertitude et de dispersion observée au sein d’un ensemble de données en sous-composantes additives parfaitement indépendantes. Cette quantification s’opère par le calcul des sommes des carrés des écarts (Sum of Squares ou SS). La variation totale présente dans l’échantillon global, agrégée sur l’ensemble des N participants sans distinction de groupe, est mesurée par la Somme des Carrés Totale (SST ou SSTotal) :
SSTotal = ∑j=1k ∑i=1nj (Yij − Ȳ..)2
où Yij désigne le score d’un individu donné et Ȳ.. représente la moyenne générale (grand mean) de l’ensemble de l’échantillon. Cette somme totale des déviations quadratiques quantifie l’entropie brute du jeu de données.
La puissance du théorème de décomposition orthogonale réside dans l’égalité algébrique démontrée par Fisher, selon laquelle cette dispersion totale se partitionne exactement en deux éléments mutuellement exclusifs :
SSTotal = SSInter + SSIntra (ou SSModel + SSResidual)
La Somme des Carrés Intergroupes (SSBetween ou SSTreatment) capture la part de la variabilité totale qui peut être attribuée directement aux fluctuations des moyennes des sous-groupes expérimentaux autour de la grande moyenne générale :
SSBetween = ∑j=1k nj (Ȳ.j − Ȳ..)2
où Ȳ.j correspond à la moyenne empirique observée au sein du groupe j et nj désigne l’effectif dudit groupe. Cette grandeur isole la variabilité expliquée par le facteur d’intérêt ou le protocole de manipulation expérimentale.
À l’inverse, la Somme des Carrés Intragroupes (SSWithin ou SSError) quantifie la dispersion des individus à l’intérieur même de leur propre condition expérimentale, c’est-à-dire l’écart entre le score de chaque participant et la moyenne de son sous-groupe d’appartenance :
SSWithin = ∑j=1k ∑i=1nj (Yij − Ȳ.j)2
Puisque chaque individu à l’intérieur d’un groupe j a été exposé à une condition expérimentale strictement identique, toute divergence constatée entre son score personnel et la moyenne de son groupe ne peut résulter du traitement lui-même. SSWithin incarne donc formellement la variation résiduelle non contrôlée, associant la variabilité biologique individuelle, les traits idiosyncrasiques stables, les bruits de mesure psychométrique et l’erreur d’échantillonnage aléatoire.
2.2 Rôle crucial des degrés de liberté (df)
Les sommes des carrés représentent des grandeurs cumulatives dépendantes du nombre d’observations sommées. Pour transformer ces grandeurs brutes en estimateurs de variance non biaisés, il est impératif de les rapporter à leurs dimensions d’échantillonnage théoriques respectives, désignées sous le vocable de degrés de liberté (degrees of freedom, notés df). Un degré de liberté correspond géométriquement au nombre d’informations indépendantes restant libres de varier lors de l’estimation d’un paramètre mathématique après imposition de contraintes linéaires.
La répartition des degrés de liberté obéit à la même règle d’additivité stricte que les sommes des carrés :
dfTotal = dfBetween + dfWithin
Pour un échantillon total constitué de N sujets répartis à travers k groupes :
- Les degrés de liberté totaux s’établissent à dfTotal = N − 1, reflétant la seule contrainte arithmétique liée à l’estimation de la moyenne générale Ȳ...
- Les degrés de liberté intergroupes (ou du traitement) correspondent à dfBetween = k − 1. Cette valeur traduit le fait que si l’on connaît la moyenne générale et les moyennes de (k − 1) groupes, la k-ième moyenne de groupe est obligatoirement déterminée.
- Les degrés de liberté intragroupes (ou de l’erreur) correspondent à dfWithin = N − k. Ce résultat découle de la somme des degrés de liberté alloués à chaque groupe individuel, soit ∑(nj − 1) = ∑nj − k = N − k, puisque l’estimation de chaque moyenne de groupe Ȳ.j impose une contrainte arithmétique sur la variabilité résiduelle de ses membres.
L’attribution de ces degrés de liberté joue un rôle déterminant dans la précision inférentielle : plus dfWithin est étendu (ce qui correspond à de grands effectifs expérimentaux N), plus l’estimation de l’erreur de mesure aléatoire gagne en stabilité asymptotique, conférant au modèle une sensibilité accrue pour détecter les effets expérimentaux authentiques.
2.3 Passage des sommes des carrés aux carrés moyens (MS)
Une somme des carrés ne constitue pas en elle-même une variance. Pour parvenir à une mesure standardisée de la dispersion qui soit indépendante de la taille de l’échantillon ou du nombre de groupes comparés, chaque somme des carrés doit être divisée par son degré de liberté correspondant. Les quantités résultantes sont désignées sous le terme de Carrés Moyens (Mean Squares, ou MS).
Le Carré Moyen Intergroupes — ou Carré Moyen du Traitement (MST ou MSBetween) — s’obtient par la formule :
MSBetween = SSBetween / dfBetween = SSBetween / (k − 1)
Sur le plan de l’espérance mathématique, MSBetween modélise simultanément deux entités distinctes : la variance de l’erreur aléatoire pure (σ2) augmentée d’un terme proportionnel à la véritable divergence systématique séparant les moyennes de traitement au sein de la population parente (∑ nj αj2 / (k − 1)) :
E[MSBetween] = σ2 + [ ∑ nj αj2 / (k − 1) ]
Parallèlement, le Carré Moyen Intragroupes — ou Carré Moyen de l’Erreur (MSE ou MSWithin) — est défini par le rapport :
MSWithin = SSWithin / dfWithin = SSWithin / (N − k)
L’espérance mathématique de MSWithin correspond rigoureusement à la variance de l’erreur aléatoire de la population :
E[MSWithin] = σ2
Il apparaît ainsi que MSWithin constitue un estimateur non biaisé du bruit expérimental pur et des fluctuations stochastiques individuelles. Cette dissociation fondamentale des espérances mathématiques constitue le socle sur lequel s’érige la construction du test de Fisher.
3. Anatomie et calcul mathématique de la statistique F (F-Value)
3.1 Le ratio de variance comme cœur de la statistique F
La statistique F, baptisée ainsi par George Snedecor en hommage aux travaux pionniers de Ronald Fisher, est fondamentalement un ratio de deux variances indépendantes. Dans le cadre de l’ANOVA, elle formalise la confrontation directe entre la variabilité systématique observée entre les groupes expérimentaux et la variabilité aléatoire observée à l’intérieur de ces mêmes groupes :
F = MSBetween / MSWithin = MST / MSE
Cette fraction établit une confrontation structurelle d’une clarté théorique remarquable :
F = (Variance systématique due au traitement + Variance résiduelle aléatoire) / (Variance résiduelle aléatoire)
Si l’hypothèse nulle H0 est rigoureusement vraie dans la population parente, l’effet spécifique du traitement est nul (αj = 0 pour tout j). Dans cette circonstance théorique, le terme traduisant la déviation systématique s’annule dans l’espérance mathématique du numérateur, de sorte que E[MSBetween] = σ2. Le ratio F devient dès lors la confrontation d’un estimateur de σ2 avec un autre estimateur indépendant de σ2 :
F ≈ σ2 / σ2 ≈ 1
Sous l’hypothèse nulle, la valeur attendue (ou espérance théorique) de la variable aléatoire F n’est pas strictement égale à 1 pour des échantillons finis, mais s’établit exactement à E[F] = dfWithin / (dfWithin − 2) pour dfWithin > 2. Dès lors que l’effectif global N devient raisonnablement important, ce ratio converge asymptotiquement vers l’unité. Tout écart systématique substantiel au-delà de 1 suggère que le numérateur contient une composante de variance excédentaire qui ne peut être raisonnablement attribuée au seul hasard de l’échantillonnage.
3.2 Sensibilité du ratio F à l’effet expérimental
La sensibilité expérimentale de la valeur F repose sur le comportement asymétrique de ses composantes face aux interventions du chercheur. Lorsqu’une manipulation expérimentale en psychologie — qu’il s’agisse de l’administration d’un psychotrope, d’un paradigme de remédiation cognitive ou d’une induction émotionnelle — exerce un impact réel et robuste sur le comportement ou la cognition, elle déplace les centroïdes des groupes expérimentaux les uns par rapport aux autres. Cet éloignement des moyennes élargit la dispersion des Ȳ.j autour de la grande moyenne générale Ȳ.., entraînant une élévation mathématique directe de la somme des carrés intergroupes (SSBetween), et par conséquent du carré moyen intergroupes (MSBetween).
Pendant que le numérateur réagit dynamiquement à la présence d’un effet expérimental systématique, le dénominateur (MSWithin) demeure structurellement invariant face à l’effet de groupe. Parce qu’il est calculé exclusivement à partir des déviations des individus par rapport à la moyenne de leur propre condition expérimentale, MSWithin isole le bruit stochastique inhérent à la population. Si le modèle expérimental est bien conçu et que le traitement s’applique de manière homogène à l’ensemble des membres d’un groupe donné, le traitement déplace la moyenne du groupe sans nécessairement modifier la dispersion interne des participants autour de cette nouvelle moyenne.
Ainsi, plus l’effet provoqué par la manipulation psychologique est puissant, plus le numérateur s’accroît relativement au dénominateur stabilisé, propulsant le ratio F vers des valeurs nettement supérieures à 1. Inversement, une valeur F proche de 1 — voire inférieure à 1 — indique sans ambiguïté que la variation séparant les différents groupes expérimentaux est d’un ordre de grandeur rigoureusement comparable ou inférieur au bruit de fond d’échantillonnage, invalidant empiriquement toute prétention à avoir provoqué une différenciation clinique ou comportementale réelle.
3.3 Distribution d’échantillonnage théorique de Fisher-Snedecor
Pour statuer sur le caractère exceptionnel ou banal d’un ratio F empirique, le statisticien recourt à la distribution théorique d’échantillonnage de Fisher-Snedecor. Cette loi de probabilité continue modélise rigoureusement le comportement mathématique qu’adopterait le ratio de deux variables aléatoires indépendantes distribuées selon des lois du Khi-deux (χ2), chacune rapportée à ses degrés de liberté respectifs.
La loi de Fisher-Snedecor est gouvernée par des propriétés géométriques et mathématiques immuables qui dictent l’interprétation des données :
- Un domaine de définition unilatéralement positif : La distribution de F est définie exclusivement sur l’intervalle semi-ouvert [0, +∞[. Étant le rapport de deux sommes de déviations quadratiques — par définition strictement positives ou nulles — affectées de degrés de liberté strictement positifs, une valeur F ne peut jamais être négative.
- Une asymétrie positive marquée : La densité de probabilité présente un étalement asymétrique vers la droite (positive skewness). La masse principale de la distribution se concentre autour des valeurs proches de l’unité, tandis qu’une queue de distribution décroissante s’étend de manière asymptotique vers l’infini positif.
- Un paramétrage bidimensionnel par les degrés de liberté : La distribution de F ne constitue pas une courbe unique, mais une famille infinie de distributions univoquement déterminées par un couple ordonné de paramètres : les degrés de liberté du numérateur (notés ν1 ou df1 = dfBetween) et les degrés de liberté du dénominateur (notés ν2 ou df2 = dfWithin). La notation standard s’écrit F(df1, df2).
À mesure que les degrés de liberté du dénominateur (df2) s’accroissent — traduisant une augmentation substantielle de la taille d’échantillon totale N —, la variance de la distribution d’échantillonnage se contracte, réduisant l’épaisseur de la queue droite. Sous l’effet des grands effectifs, la valeur critique requise pour rejeter l’hypothèse nulle diminue, rendant le test capable d’isoler des déviations systématiques plus fines avec une précision accrue.
4. Comprendre et interpréter conceptuellement la p-valeur (P-Value)
4.1 Définition probabiliste exacte de la p-valeur
Aucun concept en inférence statistique n’a suscité autant d’aphorismes réducteurs, de quiproquos théoriques et de distorsions méthodologiques que la p-valeur (ou probabilité critique). Définie avec une rigueur mathématique stricte, la p-valeur associée à une statistique F observée (Fobs) représente la probabilité conditionnelle d’obtenir, par simple fluctuation d’échantillonnage aléatoire, une valeur de F au moins aussi extrême ou plus extrême que celle effectivement mesurée dans l’échantillon, sous l’assomption formelle que l’hypothèse nulle H0 soit parfaitement exacte au sein de la population parente :
p-valeur = P(F ≥ Fobs | H0 est vraie)
Sur le plan géométrique et probabiliste, la p-valeur s’incarne de manière univoque comme la surface continue située sous la fonction de densité de la loi théorique de Fisher-Snedecor F(df1, df2), délimitée à sa gauche par l’abscisse correspondant à la valeur empirique Fobs et s’étendant à sa droite vers l’infini asymptotique positif :
p-valeur = ∫Fobs+∞ f(u; df1, df2) du
Il est indispensable de préciser avec insistance ce que la p-valeur n’est pas. Elle ne constitue en aucun cas la probabilité que l’hypothèse nulle soit vraie, ni la probabilité que l’hypothèse alternative soit fausse, c’est-à-dire que p ≠ P(H0 | Données). Dans le paradigme fréquentiste de Fisher, Neyman et Pearson, les hypothèses statistiques ne sont pas des variables aléatoires dotées de lois de probabilité ; elles représentent des états de la nature fixés, soit ontologiquement vrais, soit ontologiquement faux. La p-valeur quantifie exclusivement la compatibilité ou la conformité stochastique relative entre les données empiriques observées et le modèle théorique sous-jacent incarné par H0.
4.2 Seuils de signification alpha et convention de rejet
L’utilisation décisionnelle de la p-valeur s’articule historiquement autour de la fixation a priori d’un seuil de signification critique, conventionnellement désigné par la lettre grecque α (alpha). Établi avant tout recueil et toute manipulation computationnelle des données, ce seuil représente le niveau maximal toléré de risque de commettre une erreur de type I, à savoir rejeter l’hypothèse nulle d’égalité des moyennes alors qu’elle est pourtant biologiquement ou psychologiquement vraie dans la population globale.
Par convention historique séculaire — popularisée par Fisher dans ses tables numériques initiales —, les seuils α standards sont universellement fixés à 0,05 (5 % de risque d’erreur de faux positif) ou à 0,01 (1 % de risque, privilégié dans les contextes biomédicaux exigeant une prudence accrue). La règle décisionnelle s’applique de façon déterministe :
- Si p ≤ α : Les données empiriques sont jugées insuffisamment compatibles avec le modèle probabiliste de H0. Le chercheur rejette formellement l’hypothèse nulle au seuil α et conclut à l’existence d’une différence statistiquement significative entre au moins deux moyennes de traitement au sein de la population.
- Si p > α : La discordance observée entre les moyennes d’échantillons et l’égalité parfaite postulée par H0 demeure compatible avec les fluctuations aléatoires prévisibles dues à l’échantillonnage. Le chercheur échoue à rejeter H0.
Ce second scénario impose une nuance conceptuelle cardinale : ne pas être en mesure de rejeter l’hypothèse nulle ne prouve nullement la véracité de H0. Une p-valeur supérieure à 0,05 signifie simplement que l’échantillon analysé n’apporte pas une évidence statistique suffisante pour écarter l’hypothèse nulle d’invariance. La formule consacrée dans l’épistémologie analytique rappelle avec force que l’absence de preuve d’une différence ne saurait constituer la preuve scientifique d’une absence de différence (absence of evidence is not evidence of absence).
4.3 P-valeur bilatérale vs unilatérale dans le cadre du test F
Une ambiguïté persistante traverse fréquemment l’esprit des apprentis statisticiens quant à la dimensionalité directionnelle de l’ANOVA : le test F doit-il être interprété comme unilatéral (one-tailed) ou bilatéral (two-tailed) ? L’apparent paradoxe réside dans le fait que l’hypothèse testée par l’ANOVA est intrinsèquement bilatérale (non directionnelle), alors que le calcul probabiliste de la p-valeur sur la distribution de Fisher est toujours strictement unilatéral à droite.
Ce phénomène s’explique par la construction mathématique même de la statistique F. En calculant les sommes des carrés intergroupes (SSBetween), chaque déviation d’une moyenne de groupe par rapport à la grande moyenne (Ȳ.j − Ȳ..) est rigoureusement élevée au carré. Cette opération quadratique annihile tout signe arithmétique négatif : qu’un groupe performe très au-dessus de la moyenne ou très en dessous, l’écart quadratique est invariablement positif. Dès lors, toute forme de déviation systématique entre les groupes — quelle que soit sa direction spatiale — a pour conséquence mathématique inévitable de faire croître le numérateur MSBetween, et donc de déplacer la statistique F observée vers la queue supérieure (droite) de sa distribution théorique.
Ainsi, dans une ANOVA à un facteur comparant deux groupes, la statistique F calculée est rigoureusement identique au carré du test t de Student correspondant (F = t2). L’intégration bilatérale des deux queues extrêmes de la distribution symétrique en cloche de Student se trouve comprimée et projetée exclusivement au sein de l’unique queue supérieure droite de la loi asymétrique de Fisher-Snedecor. En conséquence, les logiciels de traitement de données statistiques (tels que SPSS, R, JASP ou SAS) affichent systématiquement une probabilité critique correspondant à la surface unilatérale droite. Toute tentative manuelle de multiplier cette p-valeur par deux relève d’une méconnaissance mathématique totale de l’architecture du modèle linéaire.
5. Lecture et déconstruction pas-à-pas du tableau récapitulatif de l’ANOVA
5.1 Structure matricielle standard du tableau d’ANOVA
L’ensemble des opérations calculatoires sous-tendant la décomposition de la variance et l’estimation inférentielle de l’ANOVA est conventionnellement synthétisé sous la forme d’un tableau matriciel standardisé, désigné sous le terme de table d’ANOVA. Cette structure matricielle se compose d’un jeu de colonnes formalisées croisant les différentes sources de variation identifiées par le modèle linéaire.
Les colonnes canoniques d’un tableau d’ANOVA classique sont organisées selon la logique computationnelle séquentielle suivante :
- Source de variation (Source) : Identifie l’origine structurelle de la dispersion décomposée. Pour une ANOVA univariée à un facteur, elle isole la composante intergroupes (généralement désignée par le nom du facteur expérimental ou le terme Treatment / Between), la composante intragroupes (désignée par Error, Residuals ou Within), et la variation totale combinée (Total).
- Somme des carrés (Sum of Squares, SS) : Reporte les déviations quadratiques cumulées calculées pour chaque source de variation respective (SSTreatment, SSError, SSTotal).
- Degrés de liberté (df) : Quantifie le nombre de dimensions statistiques indépendantes allouées à chaque source (dfTreatment = k − 1, dfError = N − k, dfTotal = N − 1).
- Carré moyen (Mean Square, MS) : Présente la variance ajustée obtenue par la division stricte de la somme des carrés de la ligne par son degré de liberté correspondant (MS = SS / df). Notons que la ligne Total ne comporte conventionnellement pas de valeur de Carré Moyen, cette grandeur globale n’intervenant pas dans le calcul inférentiel du test F.
- Valeur F (F-value ou F-ratio) : Exprime le ratio obtenu en divisant le carré moyen du traitement par le carré moyen de l’erreur résiduelle (F = MSTreatment / MSError). Cette statistique apparaît exclusivement sur la ligne dédiée au facteur expérimental.
- Signification statistique (p-value ou Sig. ou Pr(>F)) : Renseigne la probabilité critique exacte associée à la valeur F pour le couple de degrés de liberté (dfTreatment, dfError) sous l’hypothèse nulle théorique.
5.2 Vérification de la cohérence interne des calculs
L’un des avantages remarquables du formalisme mathématique de l’analyse de variance réside dans sa traçabilité arithmétique parfaite. Un examinateur critique, un réviseur d’article scientifique ou un clinicien doit être en mesure d’auditer l’intégrité interne de n’importe quel tableau récapitulatif d’ANOVA en vérifiant trois équations fondamentales d’additivité et de cohérence.
La première règle concerne la conservation de l’énergie de dispersion, formalisée par l’additivité totale des sommes des carrés :
SSTotal = SSBetween + SSWithin
Toute discordance numérique à ce niveau trahit soit une omission de covariables, soit une erreur de calcul computationnelle majeure.
La deuxième règle impose la stricte additivité des degrés de liberté de l’échantillonnage :
dfTotal = dfBetween + dfWithin
Cette égalité permet de reconstituer instantanément la taille totale de l’échantillon ayant servi à l’investigation empirique (N = dfTotal + 1) ainsi que le nombre de conditions expérimentales étudiées (k = dfBetween + 1).
Enfin, la troisième vérification impose le recalcul manuel du ratio de variance pour s’assurer de l’exactitude de la valeur F reportée dans les publications académiques :
F = (SSBetween / dfBetween) / (SSWithin / dfWithin)
Cette démarche de vérification permet d’immuniser l’analyste contre les erreurs typographiques ou les hallucinations logicielles occasionnelles.
5.3 Analyse guidée à partir d’un exemple empirique chiffré
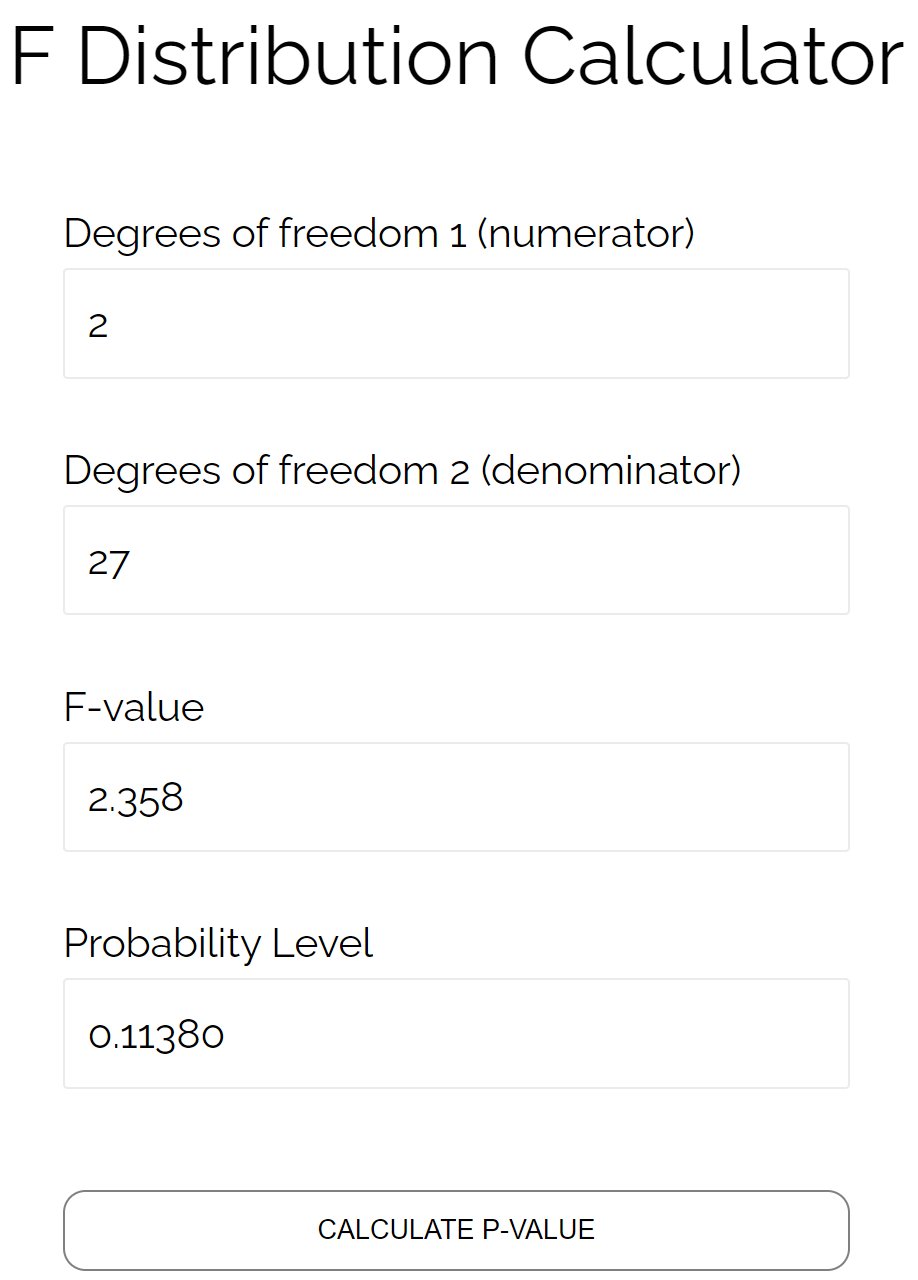
Afin de concrétiser cette mécanique de lecture, examinons un cas clinique concret issu d’une étude d’ergonomie cognitive comparant l’impact de trois interfaces d’utilisabilité logicielle (Interface Classique, Interface Adaptative, Interface Épurée) sur le temps de complétion d’une tâche d’évaluation diagnostique. Trente neuropsychologues (N = 30) ont été aléatoirement répartis au sein de ces trois conditions (n1 = 10, n2 = 10, n3 = 10). Les données brutes issues de l’expérimentation ont produit les paramètres intermédiaires résumés dans le tableau suivant :
| Source de variation | Somme des Carrés (SS) | Degrés de liberté (df) | Carré Moyen (MS) | Valeur F | p-valeur (Sig.) |
|---|---|---|---|---|---|
| Interface (Intergroupes) | 192,200 | 2 | 96,100 | 2,358 | 0,1138 |
| Erreur (Intragroupes) | 1100,600 | 27 | 40,763 | – | – |
| Total | 1292,800 | 29 | – | – | – |
La déconstruction analytique de ce tableau s’opère de façon transparente :
- Les degrés de liberté du traitement sont vérifiés par dfBetween = k − 1 = 3 − 1 = 2. Les degrés de liberté résiduels correspondent à dfWithin = N − k = 30 − 3 = 27. La somme 2 + 27 = 29 valide l’effectif global N = 30 (dfTotal = 29).
- Le carré moyen intergroupes s’élève à MSBetween = 192,200 / 2 = 96,100. Le carré moyen résiduel de l’erreur s’établit à MSWithin = 1100,600 / 27 ≈ 40,763.
- La confrontation de ces deux grandeurs génère la statistique F empirique : F(2, 27) = 96,100 / 40,763 = 2,3575 (arrondi conventionnellement à 2,358).
- L’intégration sous la fonction de densité de Fisher F(2, 27) au-delà de l’abscisse 2,358 livre une surface probabiliste égale à 0,1138.
Sur le plan décisionnel, en adoptant le seuil de signification standard α = 0,05, nous constatons que la p-valeur obtenue (0,1138) est strictement supérieure au seuil critique de 0,05. Par conséquent, les données empiriques ne fournissent pas d’évidence statistique suffisante pour rejeter l’hypothèse nulle. Le chercheur conclut formellement qu’il n’existe pas de différence statistiquement significative entre les trois interfaces logicielles quant au temps de complétion de la tâche au sein de cette population d’échantillonnage.
6. Mécanique décisionnelle statistique : Décoder le couple F et p
6.1 Cas de figure 1 : F élevé et p-valeur inférieure au seuil alpha
Le premier scénario — fréquemment espéré par les chercheurs lors de la phase de recueil de données — correspond à l’émergence d’une statistique F substantiellement supérieure à l’unité, couplée à une p-valeur strictement inférieure au seuil conventionnel nominal fixé a priori (par exemple F(3, 116) = 14,82 ; p < 0,001).
Sur le plan de l’architecture mathématique, cette configuration indique que la variabilité moyenne enregistrée entre les centroïdes des groupes expérimentaux dépasse de façon prépondérante la variabilité moyenne attendue par l’effet du seul bruit de mesure stochastique au sein des unités d’observation. La statistique F empirique a franchi le seuil critique (Fcrit) déterminé par la loi d’échantillonnage de Fisher-Snedecor pour les degrés de liberté considérés. La probabilité d’obtenir une telle dispersion par le simple fait d’un échantillonnage aléatoire dans une population où l’ensemble des moyennes serait strictement identique est infime (inférieure à un millième dans notre exemple).
La conclusion méthodologique opérationnelle s’impose : le chercheur rejette catégoriquement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. Dans le cadre des sciences comportementales ou cliniques, cette configuration valide statistiquement l’existence d’une modulation causale ou différentielle induite par le facteur expérimental. La démonstration de cette hétérogénéité générale constitue le prérequis méthodologique impératif autorisant le chercheur à engager des procédures de décomposition fine, à travers l’investigation ciblée des comparaisons post-hoc ou l’examen des contrastes planifiés.
6.2 Cas de figure 2 : F faible et p-valeur supérieure au seuil alpha
Le second scénario décisionnel se caractérise par l’obtention d’une statistique F d’amplitude modeste — typiquement oscillant entre 0 et 2 — invariablement accompagnée d’une p-valeur s’élevant au-dessus du seuil α standard (par exemple F(2, 42) = 0,87 ; p = 0,426).
Cette situation traduit l’impuissance du modèle expérimental à discerner la moindre dynamique systématique au travers du voile des fluctuations aléatoires. Le numérateur MSBetween s’avère comparable, voire inférieur, au dénominateur résiduel MSWithin. Une valeur F inférieure à l’unité (F < 1) possède d’ailleurs une signification méthodologique particulièrement éloquente : elle indique formellement que la variabilité existant entre les différents groupes expérimentaux est littéralement plus faible que la dispersion naturelle existant entre des participants soumis à un traitement rigoureusement identique. Dans cette conjoncture, la probabilité que les déviations observées résultent de la pure contingence du tirage au sort d’échantillonnage est extrêmement substantielle.
Sur le plan épistémologique, l’analyste doit formuler sa sentence avec une circonspection rigoureuse : les données ne permettent pas de rejeter l’hypothèse nulle. Cette incapacité méthodologique à rejeter H0 ne constitue en aucun cas une démonstration que l’intervention n’a exercé aucun impact absolu. Une telle issue statistique peut émaner soit d’une absence réelle d’effet psychologique dans le monde physique, soit d’un devis expérimental affecté d’un manque criant de puissance statistique (échantillons trop restreints), soit de la présence d’instruments psychométriques entachés d’une erreur de mesure colossale venue saturer artificiellement le dénominateur de variance.
6.3 Cas atypiques : F modéré et valeurs p marginales
Le troisième scénario confronte le chercheur à l’une des zones d’inconfort les plus débattues de la méthodologie quantitative : la situation où la valeur F franchit modérément le niveau unitaire tout en générant une p-valeur située dans une zone grise intermédiaire, typiquement comprise entre 0,051 et 0,099 (par exemple F(2, 57) = 2,68 ; p = 0,077).
Dans la littérature empirique passée, ce type d’occurrence était fréquemment qualifié d’effet « tendanciel », de « tendance vers la significativité » (trend towards significance), ou de « significativité marginale ». Les méthodologistes contemporains et les comités éditoriaux des revues scientifiques de premier rang dénoncent aujourd’hui fermement ces formulations euphémiques comme des violations de la logique de décision statistique. Le paradigme de décision binaire élaboré par Neyman et Pearson n’admet aucun continuum ontologique : un résultat est soit conforme au rejet de H0 au seuil critique délimité a priori (α = 0,05), soit non conforme. L’étiquetage d’un résultat en tant que « tendance » traduit souvent un biais de confirmation de l’auteur tentant de surinterpréter un résultat statistiquement non fondé.
Ces situations de frontière constituent le terreau le plus propice aux pratiques de manipulation statistique douteuses (connues sous le terme générique de p-hacking) : retrait sélectif de participants sous couvert de détection de valeurs aberrantes, ajout post-hoc de sujets jusqu’à ce que la p-valeur descende miraculeusement sous la barre des 0,05, ou réorganisation opportune des groupes. Face à une p-valeur marginale, l’intégrité méthodologique exige de conclure au non-rejet de l’hypothèse nulle, tout en discutant avec transparence de la magnitude de la taille d’effet observée et en appelant formellement à une réplication empirique sur un échantillon calibré a priori pour garantir une puissance adéquate.
7. Taille d’effet et magnitude : Pourquoi la valeur F et la p-valeur ne suffisent pas
7.1 Différenciation entre significativité statistique et pertinence clinique
L’une des dérives les plus pernicieuses de la recherche quantitative contemporaine consiste à confondre la significativité statistique — mesurée par le couple F et p — avec la magnitude, la portée théorique ou la pertinence clinique pratique d’un phénomène comportemental. La statistique F et la p-valeur sont des indices d’évidence inférentielle, et non des mesures directes de la force substantielle d’une relation.
Cette limitation découle d’une propriété fondamentale du modèle linéaire général : la sensibilité mathématique extrême de la p-valeur à la taille globale de l’échantillon N. À mesure que N s’accroît et tend vers de très grands effectifs (par exemple dans le cadre d’études épidémiologiques ou de cohortes massives regroupant des dizaines de milliers d’individus), le dénominateur des degrés de liberté de l’erreur s’élève dramatiquement, provoquant une contraction spectaculaire de l’erreur type. Dans ces conditions, la puissance statistique du test devient gigantesque, conférant à l’ANOVA la capacité d’isoler des écarts minuscules et totalement dénués de sens pratique comme étant « hautement significatifs » (p < 0,001).
À l’inverse, une intervention psychologique thérapeutique majeure, susceptible de soulager durablement des souffrances cliniques aiguës, peut produire un ratio F associé à une p-valeur de 0,08 — et donc être jugée statistiquement non significative — simplement parce que l’investigateur n’a pu recruter qu’un échantillon limité de patients rares. La valeur F et la p-valeur ne révèlent rien de l’amplitude absolue de la divergence observée. C’est pourquoi la communauté statistique internationale, unie derrière les recommandations de l’APA et de la Société Américaine de Statistique (ASA), impose désormais d’assortir obligatoirement tout résultat inférentiel d’un indice standardisé de taille d’effet (effect size).
7.2 Indicateurs d’association : L’Éta-carré (η²) et l’Éta-carré partiel (η²p)
Parmi les métriques standardisées de taille d’effet dédiées à l’ANOVA, la famille des indices η2 (Éta-carré) occupe une position centrale. L’Éta-carré classique (η2) constitue une mesure descriptive de proportion de variance expliquée par le facteur expérimental au sein de l’échantillon considéré. Il s’apparente directement au coefficient de détermination multiple (R2) de la régression linéaire et se calcule comme le ratio de la Somme des Carrés du Traitement sur la Somme des Carrés Totale :
η2 = SSTreatment / SSTotal
Cet indicateur varie strictement entre 0 et 1 (ou entre 0 % et 100 %). Un η2 de 0,15 signifie formellement que 15 % de la variabilité globale observée sur la variable dépendante est directement attribuable à l’appartenance des sujets aux différents groupes expérimentaux.
Toutefois, dans les devis factoriels complexes combinant plusieurs variables indépendantes (par exemple une ANOVA à deux facteurs de type Traitement × Genre), l’Éta-carré classique souffre d’un défaut structurel : sa magnitude diminue mécaniquement à chaque fois qu’un nouveau facteur est incorporé dans l’équation, car ce nouveau facteur vient alourdir la Somme des Carrés Totale au dénominateur. Pour pallier cet écueil, les chercheurs emploient l’Éta-carré partiel (ηp2), qui neutralise l’impact des autres facteurs pour rapporter la variance de l’effet d’intérêt uniquement à la somme de cet effet et de l’erreur résiduelle :
ηp2 = SSTreatment / (SSTreatment + SSError)
Dans le cadre strict d’une ANOVA univariée à un seul facteur inter-sujets, SSTotal se réduisant par définition à SSTreatment + SSError, l’Éta-carré simple et l’Éta-carré partiel sont strictement identiques (η2 = ηp2). Cependant, ces deux estimateurs partagent un défaut mathématique inhérent : ils reposent exclusivement sur les grandeurs d’échantillons sans corriger les degrés de liberté, ce qui leur confère un biais systématique d’optimisme consistant à surestimer la réelle part de variance expliquée au niveau de la population globale.
7.3 Indicateurs non biaisés : L’Oméga-carré (ω²) et le d de Cohen équivalent
Pour remédier au biais de surestimation inhérent à l’η2 — particulièrement saillant lorsque les effectifs d’échantillonnage sont modestes (N < 50) —, William Hays a élaboré l’Oméga-carré (ω2). Cet estimateur ajuste la métrique en intégrant les degrés de liberté et en substituant le carré moyen de l’erreur à la dispersion empirique brute, offrant un reflet considérablement plus fidèle et non biaisé de la variance véritablement expliquée dans la population théorique :
ω2 = [ SSTreatment − (dfTreatment × MSError) ] / [ SSTotal + MSError ]
Si la statistique F calculée est inférieure à 1, le numérateur de l’équation devient arithmétiquement négatif ; par convention standardisée, l’ω2 est alors ramené à zéro, ce qui traduit l’incapacité absolue du facteur à expliquer la moindre parcelle de variance au niveau populationnel.
Pour guider l’interprétation heuristique de ces métriques, Jacob Cohen (1988) a forgé des grilles de lecture universelles, devenues la référence incontournable en psychologie et en sciences comportementales :
- Effet de faible amplitude (small effect) : η2 ou ω2 ≈ 0,01 (le facteur explique environ 1 % de la variance totale).
- Effet d’amplitude modérée (medium effect) : η2 ou ω2 ≈ 0,06 (le facteur explique environ 6 % de la variance totale).
- Effet de forte amplitude (large effect) : η2 ou ω2 ≥ 0,14 (le facteur explique au moins 14 % de la variance globale).
Dans les contextes cliniques où la variable dépendante correspond à un score continu d’évaluation diagnostique, les chercheurs convertissent fréquemment ces indices de variance globale en mesures de contraste standardisé de type d de Cohen (d équivalent) afin de quantifier précisément le décalage séparant deux moyennes ciblées en unités d’écart-type résiduel commun (√MSError). L’intégration simultanée du triplet canonique — valeur F (évidence du signal), p-valeur (probabilité stochastique conditionnelle) et taille d’effet standardisée (magnitude de l’impact réel) — constitue la condition sine qua non d’une analyse quantitative intègre et méthodologiquement irréprochable.
8. Procédure consécutive au test F : L’exploration post-hoc
8.1 Limites inhérentes au résultat omnibus du test F
L’obtention d’une statistique F hautement significative — par exemple F(3, 76) = 8,45, p < 0,0001 — représente un accomplissement analytique fondamental, mais ce résultat est intrinsèquement incomplet. De par sa nature de test omnibus, l’ANOVA opère comme un détecteur global d’hétérogénéité : elle affirme avec une certitude statistique éprouvée que le modèle d’égalité parfaite des k moyennes de population doit être rejeté, mais elle est structurellement muette quant à la topologie fine de cette divergence.
Cette incapacité de localisation pose un dilemme opérationnel majeur. Face à un devis expérimental comparant quatre modalités thérapeutiques (μ1, μ2, μ3, μ4), le rejet de H0 peut provenir d’une multitude de configurations sous-jacentes distinctes : le groupe 1 peut être supérieur à tous les autres sans qu’aucun autre groupe ne diffère entre eux ; les groupes 1 et 2 peuvent être équivalents mais surpasser radicalement les groupes 3 et 4 réunis ; ou encore, un unique groupe atypique peut créer à lui seul l’illusion d’une différenciation généralisée.
Arrêter la démarche inférentielle à la seule publication du résultat F et de sa p-valeur expose le chercheur à des contresens analytiques majeurs. L’investigateur risquerait d’attribuer une efficacité clinique à une modalité d’intervention précise alors même que la divergence statistique globale est portée par un contraste entièrement distinct. Par conséquent, la significativité omnibus du test F ne constitue jamais l’aboutissement de l’analyse, mais l’autorisation méthodologique d’engager la deuxième phase de l’exploration inférentielle : les procédures d’analyses par paires et de décompositions post-hoc.
8.2 Principaux tests post-hoc et ajustements du seuil de significativité
Dès lors que le chercheur entreprend de comparer les moyennes deux à deux consécutivement au test omnibus, il est à nouveau confronté au péril de l’inflation de l’erreur de type I globale décrit dans la première section de ce guide. Pour comparer toutes les paires possibles sans corrompre le seuil α nominal, la statistique moderne offre un arsenal de tests post-hoc intégrant des ajustements probabilistes sophistiqués.
Le choix du protocole d’ajustement dépend de la structure du devis expérimental et du niveau de conservatisme requis :
- Le test HSD de Tukey (Honestly Significant Difference) : Considéré comme le standard d’excellence pour l’exploration systématique de l’ensemble de toutes les comparaisons par paires possibles, notamment lorsque les effectifs des groupes sont équilibrés. Fondé sur la distribution de l’amplitude studentisée (Studentized Range Distribution, q), le test de Tukey maintient rigoureusement l’erreur par famille à α = 0,05 tout en offrant une puissance statistique nettement supérieure aux ajustements arithmétiques simplistes.
- La correction de Bonferroni : Méthode universelle d’une grande rigueur mathématique, applicable à n’importe quel ensemble de m comparaisons spécifiques prévues ou exploratoires. Elle consiste à diviser le seuil nominal par le nombre exact de tests exécutés (αajusté = α / m). Bien qu’extrêmement robuste pour prévenir les faux positifs, la procédure de Bonferroni devient excessivement conservatrice dès que le nombre de comparaisons s’accroît, induisant une perte substantielle de puissance statistique au détriment de la détection d’effets réels (inflation de l’erreur de type II).
- La procédure de Scheffé : Le protocole le plus conservateur et le plus flexible du modèle linéaire. Il autorise l’exploration post-hoc sans restriction non seulement des comparaisons par paires simples, mais également de l’ensemble infini des contrastes complexes possibles (par exemple, la moyenne des groupes 1 et 2 comparée à la moyenne des groupes 3 et 4). En contrepartie de cette immunité mathématique totale, le seuil de significativité critique est fortement réhaussé, exigeant des différences empiriques massives pour atteindre le rejet de H0.
8.3 Contrastes orthogonaux et hypothèses a priori
Une alternative méthodologiquement supérieure à l’exploration post-hoc aveugle réside dans la formulation d’hypothèses planifiées a priori, concrétisées à travers la technique des contrastes orthogonaux. Dans une démarche scientifique rigoureusement hypothético-déductive, le chercheur n’attend pas de contempler ses tableaux de données empiriques pour deviner quelles moyennes méritent d’être confrontées. Ses hypothèses cliniques fondamentales — dérivées de la théorie psychologique ou des études précliniques — dictent d’emblée des comparaisons ciblées et circonscrites.
Un contraste s’exprime sous la forme d’une combinaison linéaire des moyennes de groupes :
L = ∑ cj Ȳ.j avec la contrainte impérative ∑ cj = 0
où les coefficients cj sont des pondérations numériques assignées à chaque modalité expérimentale pour refléter la comparaison souhaitée. Deux contrastes définis par les vecteurs de coefficients c1j et c2j sont qualifiés d’orthogonaux si la somme du produit de leurs coefficients respectifs est rigoureusement nulle (∑ c1j c2j = 0 pour des effectifs équilibrés). Un facteur comportant k groupes autorise l’extraction d’exactement (k − 1) contrastes orthogonaux parfaitement indépendants.
L’avantage méthodologique de cette approche est double. D’une part, sur le plan de la décomposition de la variance, les sommes des carrés associées à chaque contraste orthogonal partitionnent exactement la somme des carrés intergroupes globale (SSBetween = SSContraste 1 + SSContraste 2 + … + SSContraste k−1), chaque contraste n’accaparant qu’un seul degré de liberté (df = 1). D’autre part, sur le plan inférentiel, les contrastes a priori planifiés théoriquement bénéficient d’une puissance statistique considérablement supérieure à celle des tests post-hoc conventionnels, tout en dispensant l’analyste des pénalités d’ajustement conservatrices liées à l’exploration exhaustive non guidée.
9. Impact des violations des postulats sur la valeur F et la p-valeur
9.1 Robustesse du test F face à la non-normalité
L’un des atouts historiques ayant scellé la prééminence de l’ANOVA dans les sciences appliquées repose sur la propriété de robustesse empirique remarquable de la statistique F de Fisher face aux déviations modérées du postulat de normalité des distributions résiduelles. Cette résilience théorique est intimement liée aux propriétés asymptotiques formalisées par le Théorème Central Limite (TCL) : dès lors que la taille des échantillons au sein de chaque cellule atteint un volume raisonnable (couramment n ≥ 20 à 30 sujets par condition), la distribution d’échantillonnage des moyennes marginales converge inexorablement vers une forme normale, indépendamment de la morphologie de la population parente sous-jacente.
Néanmoins, cette tolérance opérationnelle trouve ses limites critiques dès lors que les distributions empiriques manifestent une asymétrie extrême (skewness sévère), un aplatissement prononcé (kurtosis lourd) ou une structure manifestement multimodale, particulièrement en présence de petits échantillons (n < 10). Dans ces circonstances défavorables, la forme mathématique réelle de la statistique de test dévie de la loi théorique de Fisher-Snedecor, conduisant à des distorsions notables de la p-valeur affichée par les logiciels, augmentant le risque d’erreurs d’inférence.
Face à une rupture caractérisée de la normalité confirmée par l’inspection conjointe des graphiques quantiles-quantiles (Q-Q plots) et des tests d’adéquation (tels que le test de Shapiro-Wilk), l’analyste dispose de voies de contournement rigoureuses :
- L’application de transformations mathématiques non linéaires stabilisatrices appliquées à la variable dépendante brute (logarithmique, racine carrée ou transformation de Box-Cox).
- Le recours à l’inférence non paramétrique par rangs, notamment matérialisée par le test de Kruskal-Wallis, qui s’affranchit totalement de toute hypothèse distributionnelle sur la population continue.
- L’adoption des méthodes modernes de rééchantillonnage non paramétrique (bootstrapping résiduel et tests de permutation), qui génèrent empiriquement la distribution d’échantillonnage empirique de la statistique F sans dépendre d’hypothèses gaussiennes préétablies.
9.2 Conséquences de l’hétéroscédasticité (variances inégales)
Si l’ANOVA résiste admirablement aux déviations de normalité, elle se montre en revanche d’une vulnérabilité critique face à la violation du postulat d’homogénéité des variances (hétéroscédasticité), en particulier lorsque les effectifs au sein des différents groupes expérimentaux sont asymétriques (devis non équilibré). L’interaction entre disparité des variances et disparité des effectifs produit des altérations majeures sur le comportement stochastique du ratio F :
- L’association directe ou positive (les grands échantillons possèdent les plus grandes variances) : Le dénominateur de l’erreur MSWithin — calculé comme une moyenne pondérée des variances individuelles de groupe — se trouve artificiellement surévalué, tiré vers le haut par les données pléthoriques des grands groupes instables. Le ratio F qui en résulte est systématiquement comprimé vers le bas, gonflant artificiellement la p-valeur. Le test devient alors excessivement conservateur, augmentant l’occurrence d’erreurs de type II (faux négatifs).
- L’association inverse ou négative (les petits échantillons possèdent les plus grandes variances) : Cette configuration constitue le scénario le plus désastreux en méthodologie quantitative. Le dénominateur MSWithin est artificiellement sous-estimé, car dominé par les petits écarts des grands groupes. Le ratio F résultant subit une inflation mathématique artificielle spectaculaire, réduisant la p-valeur à des niveaux trompeusement microscopiques. Le taux réel d’erreur de type I peut alors s’envoler jusqu’à 20 % ou 30 % pour un seuil α théoriquement programmé à 5 %, inondant la littérature de pseudo-découvertes scientifiques reproductibles par personne.
Lorsque le test de Levene rejette sans équivoque l’hypothèse d’homogénéité des variances (p < 0,05) en contexte d’échantillons inégaux, l’ANOVA classique de Fisher doit être catégoriquement récusée au profit de corrections d’hétéroscédasticité éprouvées : le test d’ANOVA robuste de Welch (qui ajuste à la fois la statistique F et applique une décote spécifique sur les degrés de liberté résiduels) ou le test de Brown-Forsythe. Le test F de Welch est aujourd’hui préconisé par de nombreux méthodologistes comme le test par défaut en analyse de variance à un facteur, tant sa robustesse théorique surpasse celle du test de Fisher classique sans induire la moindre perte de puissance statistique lorsque les variances sont parfaitement égales.
9.3 Dépendance des données et observations appariées
Le troisième postulat fondamental du modèle linéaire — l’indépendance stricte des résidus d’observation — est le garant le plus absolu et le plus sensible de l’architecture mathématique de l’analyse de variance. Toute forme de dépendance structurelle non contrôlée entre les observations — qu’elle découle de mesures répétées longitudinales sur les mêmes individus, d’un regroupement en grappes (clustering hiérarchique au sein d’écoles, de services hospitaliers ou de fratries) ou de contaminations d’influence sociale au sein de groupes thérapeutiques — détruit irrémédiablement la validité de l’estimateur de l’erreur résiduelle MSWithin.
Lorsqu’une corrélation positive sous-jacente relie les observations à l’insu de l’analyste, la variance résiduelle empirique calculée est dramatiquement sous-évaluée comparativement à la variance réelle d’un échantillonnage véritablement indépendant. Le dénominateur du ratio F s’effondre, provoquant une explosion incontrôlable du taux d’erreur de type I global. Dans de telles circonstances, l’application d’une ANOVA à plan factoriel inter-sujets standard constitue une faute méthodologique grave.
La remédiation requiert l’alignement strict du modèle statistique sur le design méthodologique de recueil :
- L’utilisation d’une ANOVA à mesures répétées (Within-Subjects ANOVA), dont l’équation décompose spécifiquement la variance inter-sujets globale pour l’isoler de la variance de l’erreur résiduelle réelle, tout en validant le postulat corollaire de circularité ou de sphéricité de la matrice des covariances au moyen du test de sphéricité de Mauchly. Si ce postulat de sphéricité est violé, des corrections d’ajustement des degrés de liberté — à l’instar des protocoles de Greenhouse-Geisser ou de Huynh-Feldt — sont impérativement appliquées au test F pour rétablir l’exactitude de la p-valeur.
- L’adoption des Modèles Linéaires Mixtes (LMM) ou de la modélisation multiniveau (Hierarchical Linear Modeling), qui intègrent explicitement les structures d’autocorrélation résiduelle et traitent avec élégance les données manquantes sans imposer les hypothèses rigides de sphéricité.
10. Erreurs courantes d’interprétation de F et de la p-valeur
10.1 Confusions conceptuelles récurrentes chez les praticiens
L’acculturation hâtive aux logiciels statistiques presse-bouton a engendré la diffusion massive d’erreurs de raisonnement au sein des publications universitaires et professionnelles. Il est primordial de cataloguer ces distorsions conceptuelles majeures pour les éradiquer des pratiques d’interprétation :
- Le sophisme bayésien inverse (The Inverse Probability Fallacy) : Croire qu’une valeur de p = 0,03 atteste que l’hypothèse nulle n’a que 3 % de chances d’être vraie, ou de manière symétrique, que l’hypothèse de recherche dispose de 97 % de probabilité de véracité. La p-valeur évalue P(Données | H0) et ne quantifie d’aucune manière P(H0 | Données). Calculer la probabilité rétrospective d’une hypothèse exige l’incorporation de probabilités a priori par le truchement du théorème de Bayes.
- Le mythe de la réplicabilité directe : Présumer qu’une statistique F massive associée à une p-valeur de p = 0,001 garantit que toute réplication exacte du protocole expérimental aura 99,9 % de chances d’aboutir à une redécouverte significative. Les travaux pionniers de Geoff Cumming ont démontré que la p-valeur présente une instabilité stochastique majeure d’un échantillon à l’autre (concept du p-dance) ; elle ne renseigne en rien la puissance de réplication d’une étude.
- La réification mécanique du seuil : Postuler une césure méthodologique radicale entre deux résultats séparés d’un millième de dispersion, par exemple déclarer triomphalement un effet clinique prouvé pour F = 4,02 (p = 0,049) tout en disqualifiant comme inexistant et caduc un résultat affichant F = 3,98 (p = 0,051). La fonction de perte épistémologique est continue ; la discontinuité provient exclusivement d’une convention sociologique d’arbitrage.
10.2 Négligence de la puissance statistique et des petits échantillons
Une pathologie analytique fréquente au sein des laboratoires consiste à concevoir des protocoles de recherche quantitative reposant sur des échantillons d’une étroitesse structurelle (par exemple n = 8 participants par groupe clinique), puis à conclure de manière péremptoire à l’inutilité d’une thérapeutique au motif que « l’analyse d’ANOVA n’a révélé aucun effet statistiquement significatif (p > 0,05) ». Ce travers témoigne d’une méconnaissance de la théorie de la puissance statistique (1 − β) modélisée par Neyman et Pearson.
Lorsqu’un échantillon global N est réduit, l’erreur type d’échantillonnage s’accroît considérablement, ce qui a pour conséquence d’augmenter substantiellement la valeur critique F requise pour rejeter H0. Dans un devis expérimental souffrant d’une sous-puissance caractérisée — où la puissance statistique plafonne par exemple à 20 % pour détecter un effet modéré réel —, l’investigateur a littéralement 4 chances sur 5 de manquer l’effet psychologique bien réel qu’il tente de mettre au jour. L’échec du test F à atteindre le seuil de significativité est alors un artefact direct d’un échantillonnage indigent.
Pour prévenir cette défaillance méthodologique, tout protocole d’ANOVA doit obligatoirement être précédé d’une analyse de puissance a priori calibrée au moyen d’outils dédiés (tels que le logiciel standardisé G*Power). Cette procédure permet de déterminer avec précision le nombre minimal d’observations N indispensable pour garantir la détection, à un niveau de puissance cible contractuel (conventionnellement 1 − β = 0,80 ou 0,90), d’une taille d’effet minimale jugée cliniquement ou théoriquement significative au regard de l’état de l’art.
10.3 Interprétation isolée sans vérification des moyennes brutes
Une tentation réductionniste majeure chez l’analyste débutant consiste à sauter directement à la dernière colonne du tableau d’ANOVA (la case affichant la p-valeur), à s’exclamer de son passage sous le seuil critique, et à rédiger l’interprétation des résultats sans avoir contemplé scrupuleusement l’anatomie descriptive des moyennes empiriques brutes et des écarts-types au moyen de visualisations graphiques adaptées.
Cette cécité analytique expose à des erreurs monumentales :
- La confusion directionnelle : Le test F étant structurellement omnibus et non directionnel, une valeur F hautement significative peut être déclenchée par un profil de données diamétralement inverse aux prédictions du chercheur. Dans une étude d’ergonomie, une nouvelle thérapie peut provoquer une aggravation massive de la symptomatologie comparativement au groupe témoin ; le test F sera significatif, mais l’effet clinique s’avère délétère.
- La distorsion par valeurs extrêmes isolées (outliers) : La présence au sein d’un échantillon modeste d’un participant unique présentant un score aberrant (par exemple dû à une erreur d’encodage ou à un profil clinique atypique) suffit à faire exploser mathématiquement la somme des carrés intergroupes ou intragroupes, générant artificiellement un résultat hautement significatif ou, au contraire, neutralisant un effet authentique par saturation de l’erreur résiduelle.
L’inférence par le couple F et p ne possède aucun sens méthodologique en apesanteur. Elle ne s’éclaire et ne s’enrichit qu’en articulation étroite avec une description méticuleuse des distributions observées, l’examen de l’homogénéité des variances et la visualisation rigoureuse des moyennes empiriques et de leurs intervalles de confiance.
11. Étude de cas appliquée : Évaluation d’interventions psychologiques
11.1 Contexte expérimental et modélisation des données cliniques
Pour ancrer l’ensemble des théorèmes, équations et principes décisionnels articulés jusqu’ici au sein de la réalité de la pratique de recherche, concevons une étude clinique randomisée contrôlée en psychopathologie cognitive. Une équipe hospitalo-universitaire se propose d’évaluer l’efficacité différentielle de deux approches psychothérapeutiques ciblées sur la réduction de l’anxiété généralisée, comparativement à une condition de contrôle active.
Le protocole retient un devis expérimental univarié à un facteur inter-sujets comportant k = 3 modalités d’intervention assignées aléatoirement à l’inclusion :
- Groupe 1 (TCC Standard) : Protocole manuelisé de Thérapie Cognitive et Comportementale axé sur la restructuration cognitive et l’exposition (n1 = 15).
- Groupe 2 (Pleine Conscience / MBSR) : Programme de Réduction du Stress Basée sur la Pleine Conscience focalisé sur la régulation attentionnelle (n2 = 15).
- Groupe 3 (Groupe Contrôle Actif) : Groupe de parole et de soutien psychoéducatif non directif (n3 = 15).
La variable dépendante retenue (Y) correspond au score d’anxiété évalué au terme des 8 semaines du protocole standardisé au moyen de l’échelle clinique d’anxiété de Hamilton (HAM-A, score continu de sévérité). L’échantillon totalise un effectif équilibré de N = 45 patients cliniquement diagnostiqués. Le tableau ci-dessous récapitule les statistiques descriptives empiriques recueillies à l’issue de l’expérimentation :
| Modalité d’intervention | Effectif (n) | Moyenne empirique (Ȳ) | Écart-type empirique (s) | Variance empirique (s2) |
|---|---|---|---|---|
| 1. TCC Standard | 15 | 14,20 | 3,12 | 9,734 |
| 2. Pleine Conscience (MBSR) | 15 | 16,80 | 3,45 | 11,903 |
| 3. Contrôle Actif | 15 | 22,40 | 3,82 | 14,592 |
| Total de l’échantillon | 45 | 17,80 (Ȳ..) | 4,91 | 24,109 |
11.2 Génération et décryptage analytique de la table d’ANOVA
Procédons désormais à la dérivation computationnelle pas-à-pas de l’ensemble des grandeurs matricielles de l’analyse de variance à partir de ces données empiriques :
Calcul de la Somme des Carrés Intergroupes (SSBetween) :
SSBetween = 15 × (14,20 − 17,80)2 + 15 × (16,80 − 17,80)2 + 15 × (22,40 − 17,80)2
SSBetween = 15 × (−3,60)2 + 15 × (−1,00)2 + 15 × (4,60)2
SSBetween = 15 × 12,96 + 15 × 1,00 + 15 × 21,16 = 194,40 + 15,00 + 317,40 = 526,80
Calcul de la Somme des Carrés Intragroupes (SSWithin) :
Puisque pour chaque groupe la somme des déviations quadratiques s’exprime par SSj = (nj − 1) × sj2 :
SSWithin = (15 − 1) × 9,734 + (15 − 1) × 11,903 + (15 − 1) × 14,592
SSWithin = 14 × (9,734 + 11,903 + 14,592) = 14 × 36,229 = 507,206
Calcul de la Somme des Carrés Totale (SSTotal) :
SSTotal = SSBetween + SSWithin = 526,80 + 507,206 = 1034,006
Détermination des Degrés de Liberté :
- dfBetween = k − 1 = 3 − 1 = 2
- dfWithin = N − k = 45 − 3 = 42
- dfTotal = N − 1 = 45 − 1 = 44 (Contrôle : 2 + 42 = 44)
Dérivation des Carrés Moyens (MS) et du Ratio F :
MSBetween = SSBetween / dfBetween = 526,80 / 2 = 263,40
MSWithin = SSWithin / dfWithin = 507,206 / 42 = 12,076
Fobs = MSBetween / MSWithin = 263,40 / 12,076 = 21,811
La synthèse canonique s’ordonne ainsi dans le tableau d’ANOVA définitif :
| Source de variation | SS | df | MS | F | p-valeur |
|---|---|---|---|---|---|
| Modalité Thérapeutique | 526,800 | 2 | 263,400 | 21,811 | < 0,0001 |
| Erreur Résiduelle | 507,206 | 42 | 12,076 | – | – |
| Total | 1034,006 | 44 | – | – | – |
Au regard de la table théorique de Fisher pour ν1 = 2 et ν2 = 42 degrés de liberté, la valeur critique requise au seuil nominal α = 0,05 est d’environ Fcrit ≈ 3,22. La statistique empirique observée (F = 21,811) surpasse massivement ce seuil. La probabilité critique intégrée exacte s’établit à p = 2,86 × 10⁻⁷, soit une valeur conventionnellement rapportée sous la forme p < 0,001. L’hypothèse nulle d’égalité des scores d’anxiété moyens post-intervention est catégoriquement rejetée.
11.3 Interprétation clinique approfondie et articulation des résultats
L’obtention d’un ratio F omnibus hautement significatif autorise l’analyste à quantifier sans attendre la taille d’effet correspondante. En appliquant la formule de l’Éta-carré partiel et de l’Oméga-carré non biaisé :
ηp2 = 526,80 / 1034,006 = 0,509
ω2 = [ 526,80 − (2 × 12,076) ] / [ 1034,006 + 12,076 ] = (526,80 − 24,152) / 1046,082 = 502,648 / 1046,082 = 0,480
Selon la nomenclature de Cohen, nous faisons face à un effet d’une amplitude spectaculaire : près de la moitié de la variance globale des scores d’anxiété de Hamilton au sein de cette cohorte (48,0 % après correction non biaisée) est directement imputable au type d’intervention thérapeutique administré.
Pour autant, à cette étape du diagnostic statistique, nous ignorons encore si la TCC se démarque significativement de la Pleine Conscience, ou si le test omnibus est exclusivement propulsé par la faillite relative du Groupe Contrôle. L’application séquentielle du test post-hoc HSD de Tukey (avec un seuil α global maintenu à 0,05) apporte l’élucidation définitive :
- Contrôle Actif (M = 22,40) vs TCC (M = 14,20) : Différence de moyenne = 8,20 points, q = 9,14, p < 0,001. La TCC réduit significativement et massivement la symptomatologie anxieuse par rapport au contrôle (taille d’effet équivalente d = 2,36).
- Contrôle Actif (M = 22,40) vs Pleine Conscience (M = 16,80) : Différence de moyenne = 5,60 points, q = 6,24, p < 0,001. La méditation de pleine conscience démontre une supériorité hautement significative face au contrôle actif (d = 1,61).
- Pleine Conscience (M = 16,80) vs TCC (M = 14,20) : Différence de moyenne = 2,60 points, q = 2,90, p = 0,113. Bien que la TCC produise un score moyen numériquement inférieur de 2,60 points à celui de la Pleine Conscience, cet écart ne franchit pas le seuil de signification statistique ajusté.
L’intégration clinique globale est d’une grande limpidité pratique : les deux modalités psychothérapeutiques actives (TCC et MBSR) manifestent une efficacité thérapeutique indiscutable face à une intervention de parole non structurée, tout en ne révélant pas, à ce stade d’échantillonnage, de différenciation statistique probante quant à leur supériorité mutuelle dans la réduction de l’anxiété clinique mesurée par l’échelle de Hamilton.
12. Normes de rédaction académique et rapport des résultats selon l’APA
12.1 Syntaxe formelle selon les directives de l’APA (7e édition)
La communication scientifique des résultats d’une analyse de variance obéit à des standards typographiques et syntaxiques rigoureusement codifiés par l’American Psychological Association au sein du manuel officiel de publication (APA 7e édition). Tout manquement à ces conventions formelles expose le manuscrit à des retours de révision immédiats de la part des éditeurs de revues scientifiques internationales.
Les règles cardinales d’écriture typographique selon les normes APA se déclinent comme suit :
- Mise en italique exclusive des symboles statistiques : Toutes les lettres latines désignant des statistiques de test ou des paramètres d’échantillonnage doivent impérativement être formatées en italique (par exemple F, p, t, N, n, M, SD). À l’inverse, les lettres grecques désignant les tailles d’effet ou les paramètres de population (η2, ηp2, ω2, α, μ) ainsi que les indices en sous-critique (sauf s’ils correspondent à des variables symboliques) demeurent strictement en typographie romaine droite.
- Structure parenthétique des degrés de liberté : La statistique F est immédiatement suivie de ses degrés de liberté présentés entre parenthèses, sans espace après la virgule les séparant : F(dfBetween, dfWithin).
- Formatage décimal et zéro initial : Les valeurs de F, de moyennes et d’écarts-types s’arrondissent conventionnellement à deux décimales après la virgule (ou trois si une précision fine est requise). Concernant la p-valeur, celle-ci étant bornée théoriquement par construction entre 0 et 1, le zéro initial doit obligatoirement être omis selon les standards nord-américains anglophones (ex. p = .034 et non p = 0.034 ; en rédaction académique francophone, l’écriture p = 0,034 est admise, mais l’usage international proscrit le préfixe zéro). Si la p-valeur descend sous le seuil du millième affichable par les logiciels (souvent codée .000 dans SPSS), il est formellement interdit de consigner p = 0,000 — une probabilité continue n’étant jamais rigoureusement nulle — et obligatoire d’écrire p < ,001.
- Intégration indissociable de la taille d’effet : Aucune statistique F ne doit être rapportée de manière isolée sans être immédiatement couplée à un estimateur de taille d’effet standardisé (ηp2 ou ω2) arrondi à deux ou trois décimales.
Le patron d’assemblage syntaxique universel selon l’APA s’énonce ainsi :
F(dfnumérateur, dfdénominateur) = [valeur de F], p = [valeur exacte de p], ηp2 = [valeur de la taille d’effet]
12.2 Exemples de formulations textuelles de résultats significatifs et non significatifs
Pour illustrer la transposition pratique de ces exigences formelles au sein du corps de texte d’une section « Résultats » d’un article empirique, examinons deux gabarits rédactionnels modèles adaptés de nos cas cliniques.
Modèle de rédaction pour un résultat omnibus significatif avec post-hoc :
« Une analyse de variance (ANOVA) univariée à un facteur inter-sujets a été réalisée afin d’évaluer l’impact de la modalité thérapeutique sur les scores de sévérité de l’anxiété mesurés par l’échelle de Hamilton (HAM-A) après huit semaines d’intervention. L’analyse révèle un effet principal hautement significatif du facteur thérapeutique, F(2, 42) = 21,81, p < ,001, ηp2 = ,51, ω2 = ,48, indiquant qu’environ 48 % de la variance des scores d’anxiété dans la population est expliquée par le type d’intervention. Les comparaisons post-hoc conduites au moyen de la procédure HSD de Tukey (α = ,05) démontrent que les participants ayant bénéficié de la TCC (M = 14,20, SD = 3,12) et ceux ayant suivi le programme de pleine conscience MBSR (M = 16,80, SD = 3,45) présentent tous deux des niveaux d’anxiété significativement inférieurs à ceux des participants de la condition contrôle active (M = 22,40, SD = 3,82 ; p < ,001 respectivement). En revanche, la différence observée entre le protocole TCC et le protocole MBSR n’atteint pas le seuil de signification statistique conventionnel (différence moyenne = 2,60, p = ,113). »
Modèle de rédaction pour un résultat non significatif :
« Une analyse de variance univariée à un facteur a été conduite pour comparer l’efficacité de trois interfaces logicielles sur le temps de complétion de la tâche diagnostique (en secondes). Les analyses préliminaires ont confirmé la satisfaction des postulats de normalité des résidus (test de Shapiro-Wilk, p > ,20) et d’homoscédasticité (test de Levene, F(2, 27) = 0,45, p = ,642). Le test omnibus d’ANOVA indique que les temps moyens de complétion ne diffèrent pas significativement selon l’interface utilisée, F(2, 27) = 2,36, p = ,114, ηp2 = ,15. Ces données ne permettent pas de rejeter l’hypothèse nulle d’égalité des moyennes, suggérant que les modifications d’ergonomie visuelle testées n’induisent pas de variation substantielle de la vitesse d’exécution chez les praticiens expérimentés. »
12.3 Représentation graphique professionnelle des résultats de l’ANOVA
Dans la restitution académique des modèles linéaires, la mise en forme graphique ne constitue pas une simple illustration décorative, mais un dispositif d’inférence visuelle soumis aux mêmes exigences d’exactitude mathématique que le texte analytique. La publication d’un résultat d’ANOVA impose des standards graphiques stricts régis par les normes internationales de publication.
Les deux représentations graphiques préférentielles sont le diagramme de profils de moyennes (mean plots connectés ou isolés) et le diagramme en barres standardisé (bar charts), bien que la science ouverte contemporaine encourage de plus en plus l’usage de graphiques de dispersion combinés (tels que les violin plots ou les graphiques raincloud intégrant la visualisation brute de chaque point de donnée individuel superposé au centroïde de groupe).
L’élément technique le plus capital réside dans l’incorporation systématique et explicite de barres d’erreur (error bars) associées à chaque moyenne de groupe. Le chercheur doit impérativement spécifier dans la légende de la figure la métrique mathématique incarnée par ces barres d’erreur, ces dernières pouvant traduire :
- L’écart-type d’échantillon (± 1 SD) : Indique la dispersion descriptive des individus au sein de chaque groupe, mais ne renseigne pas directement sur l’incertitude inférentielle de l’estimation de la moyenne.
- L’erreur standard de la moyenne (± 1 SEM) : Mesure la précision de l’échantillonnage de la moyenne empirique (calculée par s / √n). C’est le choix conventionnel le plus fréquent dans les publications biomédicales.
- L’intervalle de confiance à 95 % (95 % CI) : Représente l’horizon inférentiel d’excellence selon l’APA. L’absence de chevauchement visuel entre les intervalles de confiance à 95 % de deux groupes indépendants signale immédiatement une différenciation statistiquement significative au seuil nominal de 5 %.
La légende sous-jacente doit être rédigée avec une autonomie informative totale, intégrant l’identification explicite de la variable dépendante sur l’axe des ordonnées (avec ses unités psychométriques), les dénominations non tronquées des facteurs sur l’axe des abscisses, et la mention formelle du niveau de signification des contrastes post-hoc (couramment symbolisé par des barres horizontales surmontées d’astérisques : * p < ,05 ; ** p < ,01 ; *** p < ,001 ; ns = non significatif). Cette articulation graphique et inférentielle garantit une transparence méthodologique absolue, scellant l’intégrité de la restitution scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://hdl.handle.net/2440/15227
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2017). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434-447. https://doi.org/10.1037/1082-989X.8.4.434
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129-133. https://doi.org/10.1080/00031305.2016.1154108