
L’analyse de la variance, universellement désignée sous l’acronyme ANOVA, constitue l’un des piliers méthodologiques et inférentiels les plus déterminants de la recherche quantitative moderne, particulièrement au sein des sciences psychologiques, des neurosciences cognitives et des sciences du comportement. Développée originellement pour démêler les contributions relatives de divers facteurs environnementaux et génétiques dans des contextes agronomiques, cette approche a profondément transformé la manière dont les chercheurs examinent les différences entre groupes d’intervention. Plutôt que de restreindre l’investigation empirique à une comparaison binaire et fragmentée des moyennes d’échantillons, l’ANOVA propose une démarche holistique consistant à partitionner la variabilité globale observée au sein d’un ensemble de données en composantes distinctes, attribuables à des sources théoriquement identifiables et à des processus stochastiques résiduels.
Au cœur de cette architecture mathématique et conceptuelle réside la dialectique fondamentale entre deux entités statistiques distinctes mais indissociables : la variation inter-groupe (between-group variation) et la variation intra-groupe (within-group variation). Cette dichotomie fondamentale incarne, d’un point de vue épistémologique, la tension classique entre le signal systématique induit par une manipulation expérimentale et le bruit de fond inhérent à toute mesure du vivant. Comprendre intimement les propriétés mathématiques, les hypothèses sous-jacentes et les dynamiques relationnelles qui unissent ces deux sources de dispersion s’avère indispensable pour quiconque souhaite concevoir des protocoles expérimentaux rigoureux, interpréter adéquatement les résultats d’interventions thérapeutiques ou éducatives, et éviter les écueils interprétatifs fréquents associés à la seule lecture mécaniste d’une valeur de probabilité.
Le présent article propose une exploration exhaustive et approfondie de la dynamique unissant et opposant la variation intra-groupe et la variation inter-groupe dans le cadre de l’analyse de variance univariée et de ses extensions factorielles. À travers une analyse rigoureuse combinant formalisation algébrique, justification conceptuelle, décomposition géométrique et illustrations cliniques appliquées à la psychologie, nous mettrons en lumière le fonctionnement interne du ratio de Fisher-Snedecor, les conditions de validité requises pour son emploi légitime, ainsi que les stratégies expérimentales contemporaines destinées à maximiser la puissance de détection des effets psychologiques tout en préservant l’intégrité de la démarche scientifique.
1. Introduction aux principes fondamentaux de l’ANOVA et partition de la variance
1.1 Origine conceptuelle et utilité de l’ANOVA en recherche psychologique
L’émergence de l’analyse de variance est intrinsèquement liée aux contributions magistrales du statisticien et généticien britannique Ronald Aylmer Fisher au début des années 1920. Confronté à la complexité des données agronomiques collectées à la station expérimentale de Rothamsted, Fisher prit conscience des limites inhérentes aux méthodes d’inférence de son époque, alors dominées par les comparaisons bilatérales dérivées du test t de Student. Dans les sciences du comportement, cette prise de conscience s’est traduite par une révolution paradigmatique : les phénomènes psychologiques, qu’il s’agisse de la réactivité émotionnelle, des capacités mnésiques ou des changements d’attitudes, ne se manifestent jamais sous la forme d’effets purs et isolés au sein de systèmes déterministes fermés. Ils se déploient au contraire dans un environnement probabiliste saturé de variabilité.
L’utilité méthodologique première de l’ANOVA en psychologie réside dans sa capacité à juguler l’inflation exponentielle du taux d’erreur de premier type (erreur de type I), classiquement désignée par la lettre grecque alpha ($\alpha$). Lorsqu’un protocole expérimental vise à comparer l’efficacité de plusieurs modalités d’intervention — par exemple, une psychothérapie cognitivo-comportementale classique, une thérapie basée sur la pleine conscience, une intervention pharmacologique et un groupe contrôle sous placebo —, le recours à des tests t d’échantillons indépendants successifs conduirait à une prolifération de tests d’hypothèses. Le taux global d’erreur par famille de comparaisons ($FWER$, pour Family-Wise Error Rate) augmente selon la formule probabiliste fondamentale :
$$FWER = 1 – (1 – \alpha)^c$$
où $c$ représente le nombre total de comparaisons binaires possibles, calculé par la combinaison $c = \frac{k(k – 1)}{2}$ pour $k$ groupes. Pour quatre groupes, six tests distincts seraient requis, portant le risque réel d’observer au moins un faux positif à près de 26,5 % si le seuil nominal initial est établi à 5 %. L’ANOVA univariée résout cette impasse computationnelle en proposant un test unique et global, qualifié d’omnibus, qui examine simultanément l’ensemble des conditions expérimentales tout en maintenant le risque de rejet erroné de l’hypothèse nulle au niveau $\alpha$ désiré.
Au-delà de cette sécurité algorithmique, l’ANOVA opère un basculement conceptuel décisif : elle substitue à la simple observation statique des moyennes empiriques une modélisation dynamique de la dispersion des scores. En psychologie, une moyenne d’échantillon ne constitue jamais une entité autonome auto-suffisante ; elle n’acquiert de sens que lorsqu’elle est rapportée à la structure de variance sous-jacente qui l’engendre. L’ANOVA formalise cette dialectique en démontrant que l’information contenue dans les écarts entre les moyennes peut être calibrée avec exactitude par l’analyse de la dispersion résiduelle présente au sein des groupes observés.
1.2 Définition des hypothèses statistiques nulle et alternative
Toute démarche d’inférence via l’analyse de variance repose sur la formulation explicite et mutuellement exclusive de deux hypothèses statistiques fondamentales portant sur les paramètres des populations parentes. L’hypothèse nulle, notée conventionnellement $H_0$, postule une égalité stricte et absolue des espérances mathématiques des populations associées à chacune des $k$ conditions expérimentales investiguées :
$$H_0 : \mu_1 = \mu_2 = dots = \mu_k$$
Sur le plan épistémologique, $H_0$ postule l’absence totale d’effet systématique induit par la variable indépendante manipulée ou catégorisée. Dans l’espace paramétrique de la recherche clinique, cela revient à affirmer que les différentes modalités de traitement ne génèrent aucune altération distincte du comportement moyen des individus, et que les légères divergences constatées entre les moyennes d’échantillons résultent uniquement des fluctuations d’échantillonnage aléatoires.
À l’inverse, l’hypothèse alternative, notée $H_1$, ne stipule pas nécessairement que toutes les moyennes de populations diffèrent les unes des autres de manière symétrique ou ordonnée. Elle se définit formellement par la négation logique de l’hypothèse nulle, formulée comme l’existence d’au moins une paire de groupes pour laquelle les espérances mathématiques ne sont pas identiques :
$$H_1 : \exists (j, j’) \quad \text{tel que} \quad \mu_j \neq \mu_{j’} \quad \text{pour} \quad j \neq j’$$
Cette asymétrie structurale entre $H_0$ et $H_1$ porte des implications majeures pour la déduction scientifique. Le rejet statistique de l’hypothèse nulle consécutif à un test omnibus significatif autorise le chercheur à inférer qu’une manipulation a produit un impact mesurable dans la population étudiée, mais ne fournit aucune indication précise sur la localisation spatiale ou directionnelle de cette divergence. Le test omnibus ne permet pas d’établir, à ce stade, si l’ensemble des groupes se détache uniformément ou si l’effet repose exclusivement sur une condition marginale déviante. Cette indétermination impose le déploiement ultérieur d’analyses plus granulaires, articulées autour de contrastes planifiés a priori ou de procédures de comparaisons multiples post-hoc.
1.3 Le principe fondamental de décomposition de la somme des carrés totale
L’architecture de l’ANOVA repose intégralement sur une propriété géométrique remarquable de la dispersion quadratique : l’additivité exacte des sommes de carrés d’écarts. Soit une observation individuelle $Y_{ij}$ désignant le score obtenu par le $i$-ème participant ($i = 1, dots, n_j$) assigné au $j$-ème groupe ($j = 1, dots, k$). La déviation totale de ce score individuel par rapport à la moyenne générale de l’ensemble de l’échantillon, appelée grand-moyenne et notée $\bar{Y}_{bulletbullet}$, peut être partitionnée de manière tautologique par l’insertion de la moyenne locale du groupe d’appartenance, notée $\bar{Y}_{bullet j}$ :
$$(Y_{ij} – \bar{Y}_{bulletbullet}) = (\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet}) + (Y_{ij} – \bar{Y}_{bullet j})$$
En élevant chacun des membres de cette identité au carré et en sommant sur l’ensemble exhaustif des individus et des groupes expérimentaux, les termes croisés issus du double produit vectoriel s’annulent rigoureusement en raison des propriétés de centrage de la moyenne arithmétique ($\sum (Y_{ij} – \bar{Y}_{bullet j}) = 0$). Cette orthogonalité algébrique conduit à l’équation maîtresse de la partition de la variabilité :
$$SS_{total} = SS_{between} + SS_{within}$$
où $SS_{total}$ représente la somme des carrés totale des déviations, mesurant la quantité intégrale d’information ou d’incertitude dispersée au sein de la base de données. La composante $SS_{between}$ (somme des carrés inter-groupes) quantifie la dispersion des moyennes de sous-groupes autour de la grand-moyenne, tandis que $SS_{within}$ (somme des carrés intra-groupes, fréquemment baptisée somme des carrés résiduelle ou de l’erreur) agrège les déviations des individus par rapport à la moyenne spécifique de leur condition de rattachement.
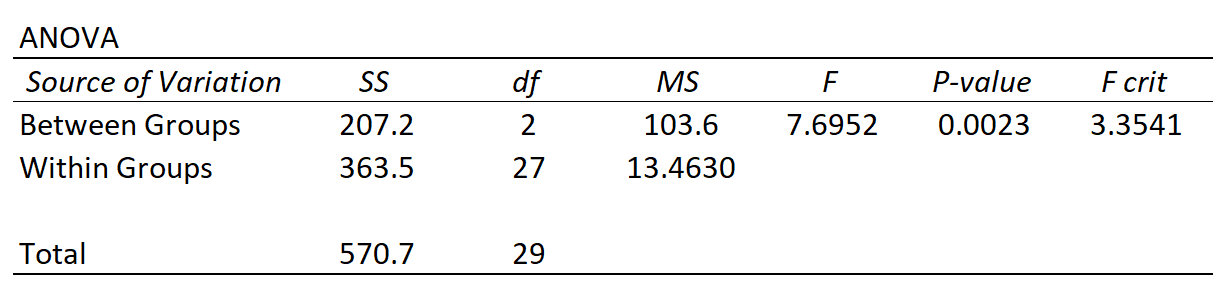
D’un point de vue géométrique, cette décomposition vectorielle équivaut à projeter le vecteur des observations d’un espace euclidien de dimension $N$ sur deux sous-espaces linéaires orthogonaux distincts. Le premier sous-espace, de dimension $k – 1$, capture les déplacements engendrés par la variable indépendante, tandis que le second sous-espace, de dimension $N – k$, héberge les fluctuations stochastiques individuelles. Cette indépendance géométrique et statistique constitue le fondement d’après lequel les variances associées pourront être valablement comparées sous forme d’un ratio sans induire de covariance résiduelle non contrôlée.
2. Fondements théoriques de la variation inter-groupe
2.1 Nature de la variance inter-groupe
La variation inter-groupe, ou dispersion entre les conditions expérimentales, constitue le réceptacle métrique principal de l’effet d’une intervention en psychologie. Elle cristallise l’amplitude selon laquelle les barycentres des distributions empiriques de chaque modalité s’écartent du centre de gravité global de l’expérience. Lorsqu’un protocole soumet des sujets à des conditions cognitives distinctes — comme des charges de travail de mémoire de travail induisant des contraintes faibles, moyennes ou saturées —, l’objectif théorique est d’induire un déplacement systématique des performances entre ces groupes.
Cette variabilité capture la réactivité différentielle du système psychologique aux stimuli imposés par le protocole. Toutefois, il convient d’opérer une distinction rigoureuse entre l’effet théorique pur de la manipulation et l’estimation statistique de la variance inter-groupe. Même en situation de laboratoire hautement contrôlée, les moyennes de deux groupes de participants ne seront presque jamais strictement équivalentes au centième de décimale près, quand bien même la variable indépendante n’exercerait aucun impact réel. La variance inter-groupe observée reflète donc une entité composite, intégrant simultanément l’effet systématique du traitement et une part inévitable d’erreur d’échantillonnage.
Sur le plan de la modélisation des variables latentes en psychologie différentielle, la variation inter-groupe incarne l’hétérogénéité introduite délibérément par le chercheur afin de rompre l’équipotentialité des sujets. Elle traduit le degré de différenciation comportementale provoqué par le facteur expérimental : plus les conditions imposées activent des mécanismes neurocognitifs divergents, plus la distance séparant les moyennes des groupes s’élargit, augmentant proportionnellement la magnitude de la variance inter-groupe brute.
2.2 Sources systématiques et non systématiques de la dispersion inter-groupe
La somme des carrés inter-groupes ne constitue pas un baromètre univoque de l’efficacité d’un traitement. Sa valeur observée est le produit de deux classes distinctes de déterminants environnementaux et statistiques : les sources systématiques et les sources non systématiques. La source systématique principale, idéalement exclusive, correspond à l’impact direct du facteur expérimental fixé par l’investigateur. Dans une étude portant sur le conditionnement de la peur, il s’agit de la contingence temporelle effective établie entre le stimulus conditionné et le stimulus inconditionné.
Cependant, des sources systématiques parasites, qualifiées de variables confondantes ou d’artefacts méthodologiques, peuvent se greffer à la manipulation et biaiser l’estimation de la variance inter-groupe. Si les participants affectés à un groupe d’apprentissage actif bénéficient fortuitement d’un encadrement par un tuteur plus charismatique ou expérimenté que ceux du groupe magistral, l’écart observé entre les moyennes reflétera l’agrégation de l’effet pédagogique nominal et de l’effet confondant lié aux compétences interpersonnelles du formateur. La variance inter-groupe s’en trouve artificiellement gonflée, attribuant à tort à la méthode didactique ce qui relève d’une disparité contextuelle non modélisée.
Parallèlement, la source non systématique omniprésente découle de l’erreur d’échantillonnage. En vertu des fluctuations aléatoires inhérentes à la sélection d’échantillons finis au sein d’une population parente infinie, les moyennes d’échantillons oscillent naturellement autour de la moyenne réelle $\mu$. Cette fluctuation produit une dispersion inter-groupe basale, purement stochastique, qui persiste rigoureusement même lorsque le traitement appliqué possède une efficacité strictement nulle. L’un des défis majeurs de l’inférence sera d’isoler la part attribuable à l’action expérimentale de celle résultant de cette dérive probabiliste passive.
2.3 Conséquences théoriques d’une variation inter-groupe prédominante
L’émergence d’une variation inter-groupe substantielle par rapport à la variance de fond constitue l’indice cardinal de l’existence d’un phénomène psychologique d’ampleur clinique ou fondamentale notable. Lorsque la dispersion entre les modalités surpasse nettement la dispersion présente au sein de chaque modalité, les distributions empiriques des différents groupes se dissocient spatialement le long de l’axe de la variable dépendante. Ce phénomène d’éloignement structurel des densités de probabilité implique que la majorité des participants d’un groupe donné adoptent des comportements qualitativement et quantitativement distincts de ceux des participants assignés aux autres conditions.
Sur le plan de la reproductibilité scientifique, la dominance de la variance inter-groupe accroît drastiquement la robustesse des inférences formulées. Les études affichant de larges déviations entre conditions sont statistiquement plus résistantes aux légères instabilités d’échantillonnage lors des tentatives de réplication directe dans des laboratoires indépendants. L’effet observé transcende alors les bruits de mesure locaux et démontre une transférabilité supérieure.
Enfin, cette prédominance conditionne de manière déterminante la puissance statistique ($1 – \beta$) du devis expérimental. Une variation inter-groupe élevée élève mécaniquement la valeur du paramètre de non-centralité de la distribution de test sous l’hypothèse alternative. Elle réduit le risque de commettre une erreur de type II — consistant à conclure faussement à l’absence d’effet d’une thérapeutique active — et autorise des déductions assertives sans exiger des effectifs démesurés, allégeant ainsi le coût logistique et éthique du recrutement de participants humains.
3. Fondements théoriques de la variation intra-groupe
3.1 Caractérisation de l’erreur résiduelle et de la variance intra-groupe
Tandis que la variance inter-groupe traduit les divergences macroscopiques entre les conditions, la variation intra-groupe (within-group variation) explore la granularité interne de chaque échantillon. Elle se définit formellement comme la mesure de l’éloignement des scores individuels par rapport à la moyenne spécifique du groupe auquel chaque participant a été assigné. En termes opérationnels, elle répond à une interrogation scientifique fondamentale : pourquoi deux individus identiques sur le plan expérimental, soumis aux mêmes instructions, placés dans un environnement physique identique et recevant un traitement thérapeutique strictement similaire, manifestent-ils des scores d’anxiété ou des temps de réaction dissemblables ?
Dans l’édifice mathématique de l’ANOVA, la variance intra-groupe assume le statut conceptuel d’estimateur non biaisé de la variance de l’erreur dans la population, notée $\sigma^2$. Contrairement à l’appellation populaire d' »erreur », ce terme ne désigne pas une méprise ou une bévue calculatoire de l’expérimentateur, mais l’ensemble des variations imprédictibles et non modélisées par le devis expérimental. La variance intra-groupe est postulée comme un invariant structurel sous l’hypothèse d’homogénéité des variances (homoscédasticité) : elle est supposée refléter la variabilité biologique, cognitive et comportementale intrinsèque de la population étudiée, indépendamment des manipulations imposées par le protocole.
Elle sert ainsi de mètre étalon universel au sein du modèle d’analyse de variance. Sans étalon de mesure résiduel, il est rigoureusement impossible d’évaluer la portée d’un écart de moyennes. Une différence de dix millisecondes dans une tâche de chronométrie mentale peut représenter un effet colossal si la dispersion interne des sujets ne dépasse pas deux millisecondes, tandis qu’une différence de quinze points sur une échelle de dépression demeure négligeable si les fluctuations individuelles intra-groupes s’étendent sur cinquante points.
3.2 Origines de la variabilité individuelle en psychologie
La psychologie se distingue des sciences physiques par l’extrême hétérogénéité spontanée de son matériau d’étude. Les sources sous-tendant la variance intra-groupe sont multiples et s’articulent en strates écologiques complexes. La première strate, et de loin la plus vaste, regroupe les différences interindividuelles préexistantes non contrôlées. Les participants qui franchissent la porte d’un laboratoire diffèrent quant à leurs prédispositions génétiques, leurs trajectoires neurobiologiques, leurs traits de personnalité stables (comme le névrosisme ou l’extraversion), leurs capacités intellectuelles générales, ainsi que leur état motivationnel et émotionnel transitoire au moment précis de l’expérimentation.
La deuxième source de variabilité interne découle directement des limites de la mesure psychométrique. Les outils d’évaluation employés — échelles d’auto-évaluation de type Likert, chronomètres numériques, capteurs électrodermaux ou électroencéphalographiques — sont tous entachés d’une marge d’imprécision instrumentale. L’erreur de mesure aléatoire, modélisée dans le cadre de la théorie classique des tests, s’additionne aux véritables fluctuations comportementales et étire artificiellement la variance observée au sein de chaque échantillon.
S’y ajoutent les micro-variations environnementales ponctuelles survenant durant l’administration des épreuves : de fugaces fluctuations de la température de la pièce, un bruit de couloir distracteur, une intonation imperceptiblement modifiée de l’expérimentateur lors de la lecture des consignes, ou une baisse soudaine de vigilance du participant liée à son rythme circadien. Enfin, des interactions d’ordre supérieur non incluses dans le modèle, comme la réaction idiosyncrasique et imprévisible d’un sujet spécifique à un stimulus donné, viennent saturer cette somme de carrés intra-groupes, complexifiant l’isolement du signal expérimental principal.
3.3 Impact d’une variance résiduelle excessive sur la détection des effets
La présence d’une variance intra-groupe hypertrophiée exerce une action délétère directe sur les capacités inférentielles de l’analyse statistique en dégradant drastiquement le rapport signal sur bruit ($SNR$). Dans l’analogie informationnelle sous-tendant l’ANOVA, la somme des carrés inter-groupes représente l’émission du signal communicatif pertinent, tandis que la somme des carrés résiduelle intra-groupe constitue le bruit thermique parasite brouillant le canal de transmission. Si le bruit résiduel s’amplifie de manière excessive, il noie littéralement le signal émis par le traitement, rendant sa distinction statistique impossible.
Cette saturation par le bruit engendre une chute critique de la puissance d’analyse, augmentant substantiellement la probabilité de commettre une erreur de type II (décision erronée de non-rejet de l’hypothèse nulle en présence d’un effet réel dans la population parente). En recherche clinique, ce phénomène peut entraîner l’abandon prématuré de protocoles thérapeutiques pourtant novateurs et potentiellement salvateurs, simplement parce que l’hétérogénéité incontrôlée des patients recrutés ou la piètre fidélité des instruments de mesure aura masqué l’efficacité réelle de la molécule ou de la prise en charge psychologique.
Face à ce risque méthodologique, l’ingénierie expérimentale déploie des stratégies proactives destinées à juguler la variance d’erreur. Celles-ci comprennent la standardisation stricte des protocoles d’administration en double-aveugle, le recours à des instruments psychométriques validés affichant une cohérence interne rigoureuse (coefficients alpha de Cronbach ou oméga de McDonald élevés), l’adoption de critères d’inclusion et d’exclusion homogénéogènes pour les cohortes de sujets, ainsi que l’utilisation de devis à mesures répétées ou l’inclusion de covariables pertinentes via l’analyse de covariance (ANCOVA).
4. Formulation mathématique et calcul de la somme des carrés inter-groupes
4.1 Dérivation algébrique de la somme des carrés inter-groupes
La formalisation rigoureuse de la somme des carrés inter-groupes, universellement abrégée $SS_{between}$ ou $SS_{inter}$, s’appuie sur la pondération des écarts observés entre la moyenne de chaque condition spécifique et la grand-moyenne calculée sur l’ensemble de l’échantillon. Soit $k$ le nombre de modalités de la variable indépendante, $n_j$ l’effectif associé au $j$-ème groupe ($j = 1, dots, k$), et $N = \sum_{j=1}^k n_j$ l’effectif total agrégé. La moyenne du groupe $j$ est définie par :
$$\bar{Y}_{bullet j} = \frac{1}{n_j} \sum_{i=1}^{n_j} Y_{ij}$$
et la grand-moyenne s’exprime comme :
$$\bar{Y}_{bulletbullet} = \frac{1}{N} \sum_{j=1}^k \sum_{i=1}^{n_j} Y_{ij} = \frac{1}{N} \sum_{j=1}^k n_j \bar{Y}_{bullet j}$$
La somme des carrés inter-groupes représente la somme, sur tous les individus de l’expérience, du carré de l’écart entre la moyenne de leur groupe et la grand-moyenne. Puisque chaque individu d’un groupe $j$ partage la même déviation $(\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})$, la sommation sur l’indice $i$ se réduit à une simple multiplication par l’effectif du groupe $n_j$ :
$$SS_{between} = \sum_{j=1}^k \sum_{i=1}^{n_j} (\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})^2 = \sum_{j=1}^k n_j (\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})^2$$
Dans les contextes de protocoles expérimentaux équilibrés, où chaque groupe possède un effectif rigoureusement égal ($n_1 = n_2 = dots = n_k = n$), cette équation se simplifie sous la forme élégante :
$$SS_{between} = n \sum_{j=1}^k (\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})^2$$
Pour optimiser l’efficacité computationnelle et limiter les erreurs d’arrondis consécutives à des soustractions itératives de moyennes décimales, les statisticiens emploient la formule de calcul rapide équivalente, fondée sur les totaux marginaux $T_j = \sum_{i=1}^{n_j} Y_{ij}$ et le grand total $G = \sum_{j=1}^k T_j$ :
$$SS_{between} = \sum_{j=1}^k \frac{T_j^2}{n_j} – \frac{G^2}{N}$$
Cette identité computationnelle met en relief le principe selon lequel la variance inter-groupe reflète l’excédent quadratique produit par les totaux de groupes normalisés par leurs effectifs respectifs par rapport au terme de correction global $\frac{G^2}{N}$.
4.2 Comportement de la somme des carrés inter-groupes sous l’hypothèse nulle
L’étude mathématique du comportement de $SS_{between}$ sous la stricte validité de l’hypothèse nulle ($H_0 : \mu_1 = dots = \mu_k = \mu$) révèle des régularités probabilistes déterminantes. Lorsque le traitement n’exerce aucune influence différentielle, les variables aléatoires $\bar{Y}_{bullet j}$ sont distribuées de manière indépendante selon des lois normales d’espérance commune $\mu$ et de variance $\frac{\sigma^2}{n_j}$, en postulant la normalité des populations sous-jacentes. Par conséquent, la quantité normalisée associée aux écarts de moyennes adopte une structure canonique :
$$\sum_{j=1}^k \frac{n_j (\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})^2}{\sigma^2} \sim \chi^2(k – 1)$$
Cette relation démontre que la quantité $\frac{SS_{between}}{\sigma^2}$ suit rigoureusement une loi du chi deux ($\chi^2$) à $k – 1$ degrés de liberté sous $H_0$. L’espérance mathématique de la somme des carrés inter-groupes sous cette condition s’établit alors formellement comme :
$$\mathbb{E}[SS_{between} mid H_0] = (k – 1)\sigma^2$$
Cette dérivation met en évidence un fait fondamental : la somme des carrés inter-groupes n’est jamais égale à zéro en moyenne, même lorsque le traitement est totalement inerte. Sa magnitude moyenne attendue dépend directement de la variance d’erreur fondamentale $\sigma^2$ pondérée par la dimensionnalité du modèle ($k – 1$). Par ailleurs, l’augmentation de la taille d’échantillon $n$ n’élève pas artificiellement l’espérance de ce terme sous $H_0$, car la variance d’échantillonnage de la moyenne décroît au rythme exact de $\frac{1}{n}$, annulant le multiplicateur $n_j$ présent au numérateur.
4.3 Interprétation quantitative du paramètre de non-centralité
Dès lors que l’hypothèse nulle est enfreinte ($H_1$ vérifiée) et que des divergences réelles existent entre les moyennes de populations ($\mu_j \neq \mu$), la distribution de $\frac{SS_{between}}{\sigma^2}$ s’écarte de la loi du chi deux centrale pour se conformer à une distribution du chi deux non centrale, notée $\chi^2(k – 1, \lambda)$. Le paramètre de non-centralité, conventionnellement désigné par la lettre grecque lambda ($lambda$), quantifie l’ampleur exacte de la déviation paramétrique dans la population :
$$\lambda = \sum_{j=1}^k \frac{n_j (\mu_j – \bar{\mu})^2}{\sigma^2}$$
où $\bar{\mu} = \frac{1}{N} \sum_{j=1}^k n_j \mu_j$ représente la grand-moyenne paramétrique des populations. L’espérance mathématique conditionnelle de $SS_{between}$ sous l’hypothèse alternative intègre dès lors ce paramètre déterministe fondamental :
$$\mathbb{E}[SS_{between} mid H_1] = (k – 1)\sigma^2 + \sum_{j=1}^k n_j (\mu_j – \bar{\mu})^2 = (k – 1)\sigma^2 + \lambda \sigma^2$$
Cette formalisation établit un lien direct entre la taille de l’échantillon, la magnitude de l’effet théorique et la distribution asymptotique du test. Elle montre sans ambiguïté que la somme des carrés inter-groupes s’amplifie linéairement sous $H_1$ en fonction directe de la taille d’échantillon $n_j$. Le paramètre $lambda$ forme ainsi le pivot calculatoire essentiel pour les analyses de puissance statistique a priori (notamment via des algorithmes logiciels standardisés comme G*Power), permettant de déterminer la taille d’échantillon minimale nécessaire pour garantir la détection d’un écart donné entre populations avec un niveau d’assurance spécifié.
5. Formulation mathématique et calcul de la somme des carrés intra-groupes
5.1 Formulation formelle de la somme des carrés des écarts individuels
La somme des carrés intra-groupes, désignée indifféremment par les notations $SS_{within}$, $SS_{intra}$ ou $SS_{error}$, constitue l’opérateur d’agrégation de la dispersion interne à chaque modalité. Mathématiquement, elle se définit comme la sommation double des écarts quadratiques calculés entre chaque score individuel $Y_{ij}$ et la moyenne empirique de son groupe d’assignation respectif $\bar{Y}_{bullet j}$ :
$$SS_{within} = \sum_{j=1}^k \sum_{i=1}^{n_j} (Y_{ij} – \bar{Y}_{bullet j})^2$$
Une propriété fondamentale de cette formule réside dans sa structure de décomposition locale. Soit $SS_j = \sum_{i=1}^{n_j} (Y_{ij} – \bar{Y}_{bullet j})^2$ la somme des carrés des déviations calculée isolément au sein du sous-échantillon $j$. L’expression générale s’écrit comme l’addition arithmétique simple de ces composantes locales indépendantes :
$$SS_{within} = SS_1 + SS_2 + dots + SS_k = \sum_{j=1}^k SS_j$$
Cette propriété algorithmique met en lumière l’insensibilité structurelle absolue de $SS_{within}$ aux différences qui séparent les moyennes des différents groupes. Si l’on ajoute une constante arbitraire $C$ à l’ensemble des observations d’une modalité spécifique — déplaçant arbitrairement sa moyenne $\bar{Y}_{bullet j}$ —, la quantité $(Y_{ij} + C) – (\bar{Y}_{bullet j} + C) = Y_{ij} – \bar{Y}_{bullet j}$ demeure scrupuleusement inchangée. La somme des carrés intra-groupes est par essence aveugle aux effets inter-groupes : elle ne quantifie que les instabilités locales internes.
Pour le calcul opérationnel manuel ou automatisé sans calcul intermédiaire des moyennes de groupes, on utilise l’identité computationnelle dérivée :
$$SS_{within} = \sum_{j=1}^k \sum_{i=1}^{n_j} Y_{ij}^2 – \sum_{j=1}^k \frac{T_j^2}{n_j}$$
où la somme totale des carrés de l’ensemble des scores bruts est allégée de la somme des carrés des totaux de groupes divisés par leurs effectifs respectifs, garantissant l’additivité exacte avec l’expression rapide de $SS_{between}$ explicitée précédemment.
5.2 Estimation sans biais de la variance d’erreur de la population
L’estimation rigoureuse du paramètre de variance résiduelle $\sigma^2$ dans la population constitue le rôle dévolu à la somme des carrés intra-groupes. Au sein d’un échantillon unique $j$, la variance d’échantillon non biaisée s’exprime traditionnellement selon la formule de Bessel par $s_j^2 = \frac{SS_j}{n_j – 1}$. Chacune de ces variances locales constitue un estimateur convergent et non biaisé de la variance théorique commune $\sigma^2$, sous le postulat d’homogénéité des variances.
En agrégeant l’ensemble de ces informations parcellaires, l’ANOVA opère une mise en commun (pooling) optimale de la variance. La somme des carrés intra-groupes pondérée par ses degrés de liberté résiduels ($N – k$) définit le carré moyen intra-groupe $MS_{within}$ :
$$MS_{within} = \frac{SS_{within}}{N – k} = \frac{\sum_{j=1}^k (n_j – 1)s_j^2}{\sum_{j=1}^k (n_j – 1)}$$
L’espérance mathématique de cette quantité révèle sa nature d’estimateur sans biais :
$$\mathbb{E}[MS_{within}] = \sigma^2$$
Cette propriété d’invariance est remarquable : que l’hypothèse nulle $H_0$ soit scrupuleusement respectée ou qu’elle soit massivement violée par des effets de traitement monumentaux, $\mathbb{E}[MS_{within}]$ converge toujours vers la variance d’erreur pure $\sigma^2$. Cette stabilité fournit à l’analyse un ancrage paramétrique invariant, garantissant que le dénominateur de la statistique de test reflète exclusivement le niveau d’incertitude stochastique du modèle.
5.3 Sensibilité aux valeurs aberrantes et contamination des distributions
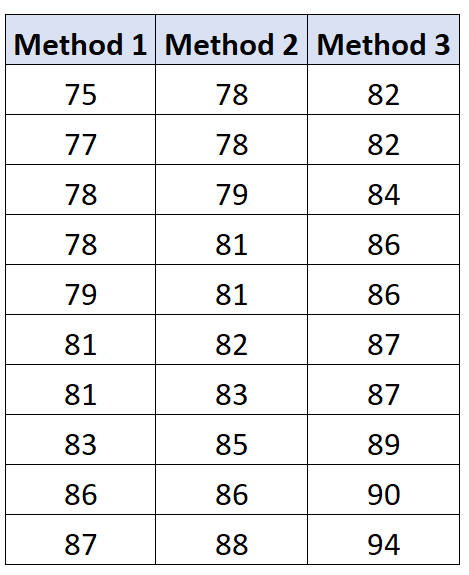
En dépit de ses propriétés algébriques élégantes, le calcul de la somme des carrés intra-groupes présente une vulnérabilité critique face aux données extrêmes non représentatives (valeurs aberrantes ou outliers). En raison de l’élévation quadratique des écarts $(Y_{ij} – \bar{Y}_{bullet j})^2$, un individu affichant une observation déviant significativement de la moyenne de son groupe exercera une influence disproportionnée sur la magnitude finale de $SS_{within}$.
Si un patient participant à un essai clinique rapporte, en raison d’un traumatisme aigu indépendant de l’expérimentation, un score d’anxiété situé à quatre écarts-types au-dessus de la moyenne locale, cette déviation unitaire s’élèvera à seize fois la variance typique d’un score standard. Cette anomalie engendre une dilatation artificielle immédiate de la somme des carrés d’erreur de son groupe, contaminant la somme globale $SS_{within}$. Il en résulte une inflation du dénominateur du test F, provoquant un affaiblissement drastique de la statistique de test globale et risquant d’étouffer un effet de traitement pourtant authentique au niveau des moyennes.
Cette sensibilité s’observe également en présence d’asymétries distributionnelles prononcées ou de distributions leptokurtiques au sein d’une seule modalité expérimentale. Les procédures diagnostiques contemporaines imposent dès lors un examen pré-analytique attentif de la distribution des résidus au moyen de représentations graphiques dédiées (boîtes à moustaches, graphiques quantile-quantile des résidus) et d’indices quantitatifs d’influence (distance de Cook, leviers), afin de neutraliser ou d’ajuster les scores distordants avant l’inférence finale.
6. Le rôle des degrés de liberté et le calcul des carrés moyens
6.1 Partitionnement des degrés de liberté du modèle linéaire
Les sommes de carrés brutes ($SS$) constituent des mesures dimensionnelles extensives dont la magnitude s’amplifie mécaniquement au fur et à mesure que le nombre d’observations s’accroît. Pour permettre une comparaison statistique et convertir ces sommes quadratiques en densités de variance exploitables, il est indispensable de les rapporter à leurs degrés de liberté ($df$) respectifs. Le partitionnement additif qui caractérise les sommes de carrés régit avec la même rigueur arithmétique la décomposition des degrés de liberté :
$$df_{total} = df_{between} + df_{within}$$
Les degrés de liberté totaux sont définis par $df_{total} = N – 1$. La perte d’une unité de liberté découle de la contrainte imposée par l’estimation de la grand-moyenne empirique $\bar{Y}_{bulletbullet}$ à partir des $N$ observations : sitôt que $N – 1$ scores sont assignés, la dernière valeur est arithmétiquement déterminée pour que la somme des déviations s’annule.
Pour la composante inter-groupes, les degrés de liberté sont indexés sur le nombre de conditions expérimentales moins une unité, soit :
$$df_{between} = k – 1$$
Cette restriction traduit le fait que l’on manipule $k$ moyennes de sous-groupes assujetties à la contrainte de recomposer la grand-moyenne globale. Concernant la composante intra-groupe, chaque modalité $j$ dispose de $n_j – 1$ degrés de liberté pour exprimer ses variations internes autour de sa moyenne locale. En sommant ces dimensions sur l’ensemble des $k$ groupes, on obtient :
$$df_{within} = \sum_{j=1}^k (n_j – 1) = N – k$$
L’égalité sommative fondamentale se vérifie immédiatement : $(k – 1) + (N – k) = N – 1$. Sur le plan géométrique, ces degrés de liberté spécifient la dimension euclidienne exacte des sous-espaces orthogonaux sur lesquels la variabilité brute du système est projetée.
6.2 Transformation des sommes de carrés en carrés moyens
La transformation d’une somme de carrés en carré moyen (Mean Square, couramment abrégé $MS$) correspond à une opération de normalisation dimensionnelle. Le carré moyen est obtenu par le quotient direct de la somme des carrés par son degré de liberté associé, opérant ainsi la transition conceptuelle d’une énergie globale de dispersion vers une variance statistique par dimension de liberté :
$$MS_{between} = \frac{SS_{between}}{df_{between}} = \frac{SS_{between}}{k – 1}$$
$$MS_{within} = \frac{SS_{within}}{df_{within}} = \frac{SS_{within}}{N – k}$$
Il est impératif d’insister sur une divergence conceptuelle fondamentale : si les sommes de carrés sont strictement additives ($SS_{total} = SS_{between} + SS_{within}$), les carrés moyens ne possèdent jamais cette propriété d’additivité arithmétique. Le carré moyen total $MS_{total} = \frac{SS_{total}}{N – 1}$ n’est en aucun cas équivalent à la somme algébrique de $MS_{between}$ et de $MS_{within}$ :
$$MS_{total} \neq MS_{between} + MS_{within}$$
Cette non-additivité illustre la nature des carrés moyens : ils constituent des variances échantillonnales indépendantes dimensionnées pour évaluer des hypothèses spécifiques et ne représentent pas des fragments d’un volume cumulatif. Le carré moyen inter-groupe ($MS_{between}$) mesure la variance observée entre les centres de gravité des conditions, tandis que le carré moyen intra-groupe ($MS_{within}$) capture la variance moyenne régnant au cœur des cellules de l’expérience.
6.3 Espérances mathématiques des carrés moyens
L’examen des espérances mathématiques associées à chacun des deux carrés moyens constitue l’étape théorique clé permettant de justifier logiquement la construction du test de Fisher. En développant les variables aléatoires sous-jacentes selon le modèle linéaire général univarié élémentaire ($Y_{ij} = \mu + \alpha_j + \varepsilon_{ij}$, où $\alpha_j = \mu_j – \mu$ représente l’effet fixe de la condition expérimentale et $\varepsilon_{ij} \sim \mathcal{N}(0, \sigma^2)$ l’erreur résiduelle), les moments d’ordre un des carrés moyens se formalisent comme suit :
$$\mathbb{E}[MS_{within}] = \sigma^2$$
$$\mathbb{E}[MS_{between}] = \sigma^2 + \frac{\sum_{j=1}^k n_j \alpha_j^2}{k – 1} = \sigma^2 + \frac{\sum_{j=1}^k n_j (\mu_j – \mu)^2}{k – 1}$$
Cette formalisation met à nu l’asymétrie structurelle des deux grandeurs. L’espérance du carré moyen intra-groupe est invariante et contient un terme unique : la variance pure de l’erreur $\sigma^2$. En revanche, l’espérance du carré moyen inter-groupe combine une somme composite de deux entités distinctes :
- D’une part, la variance d’erreur pure $\sigma^2$, présente à l’identique de celle de $MS_{within}$ ;
- D’autre part, un terme quadratique strict traduisant la dispersion des véritables effets différentiels du traitement pondérés par la taille des échantillons, désigné par $\frac{\sum n_j \alpha_j^2}{k – 1}$.
De cette démonstration découle une conclusion décisive : si l’hypothèse nulle $H_0$ est rigoureusement exacte, l’effet spécifique de chaque traitement est nul ($\alpha_1 = \alpha_2 = dots = \alpha_k = 0$). Dans cette circonstance théorique stricte, le second terme s’annule intégralement, et l’espérance de $MS_{between}$ devient parfaitement identique à celle de $MS_{within}$ :
$$\mathbb{E}[MS_{between} mid H_0] = \sigma^2 = \mathbb{E}[MS_{within} mid H_0]$$
Les deux carrés moyens représentent alors deux estimateurs concurrents, orthogonaux et convergents du même paramètre populationnel $\sigma^2$. En revanche, si des effets de traitement existent ($H_1$), l’espérance mathématique de $MS_{between}$ surpasse obligatoirement $\sigma^2$, excédant la valeur moyenne de $MS_{within}$.
7. Le ratio F de Fisher-Snedecor : Mécanisme de comparaison des variances
7.1 Construction structurelle de la statistique de test F
La statistique d’épreuve de l’ANOVA, nommée ratio $F$ en hommage aux travaux pionniers de Ronald Fisher formalisés ultérieurement par George Snedecor, s’érige directement sur la confrontation des espérances mathématiques préalablement établies. Elle se structure sous la forme d’un quotient strict confrontant le carré moyen inter-groupe au carré moyen intra-groupe :
$$F = \frac{MS_{between}}{MS_{within}}$$
Cette statistique incarne la traduction opérationnelle d’un rapport signal sur bruit. Le numérateur ($MS_{between}$) agrège l’ensemble des variations décelables entre les groupes, englobant l’expression potentielle de la manipulation expérimentale combinée au bruit d’échantillonnage inévitable. Le dénominateur ($MS_{within}$) fait office de ligne de base et quantifie exclusivement la magnitude de l’aléa résiduel. En divisant le numérateur par ce calibrateur, l’ANOVA neutralise la composante d’erreur attendue :
$$F = \frac{\text{Signal expérimental potentiel} + \text{Bruit de fond résiduel}}{\text{Bruit de fond résiduel}}$$
D’un point de vue distributionnel, dès lors que les observations individuelles sont indépendantes et distribuées selon une loi normale d’égale variance, la variable $F$ se compose du quotient de deux variables chi deux indépendantes divisées par leurs degrés de liberté respectifs :
$$F = \frac{\frac{\chi^2(k – 1)}{k – 1}}{\frac{\chi^2(N – k)}{N – k}}$$
Cette configuration confère au ratio $F$ une distribution de probabilité théorique continue bien caractérisée : la loi de Fisher-Snedecor, paramétrée de façon univoque par la paire ordonnée de ses degrés de liberté $(df_1, df_2) = (k – 1, N – k)$.
7.2 Comportement distributionnel selon la validité de l’hypothèse nulle
La forme géométrique de la distribution $F$ et la position qu’y occupe la statistique empirique calculée dépendent de la véracité de l’hypothèse théorique testée. Sous l’égide exclusive de l’hypothèse nulle ($H_0$), puisque le numérateur et le dénominateur convergent vers la même espérance mathématique $\sigma^2$, le ratio $F$ évolue sur une distribution centrale asymétrique positive, dont l’espérance mathématique se stabilise légèrement au-dessus de l’unité pour des degrés de liberté résiduels finis :
$$\mathbb{E}[F mid H_0] = \frac{df_2}{df_2 – 2} \quad \text{pour} \quad df_2 > 2$$
Lorsque la taille globale de l’échantillon s’élève, cette espérance tend asymptotiquement vers $1,00$. Obtenir une valeur empirique de $F$ gravitant autour de l’unité indique que les divergences observées entre les conditions expérimentales s’expliquent intégralement par les simples aléas du rééchantillonnage de l’erreur résiduelle.
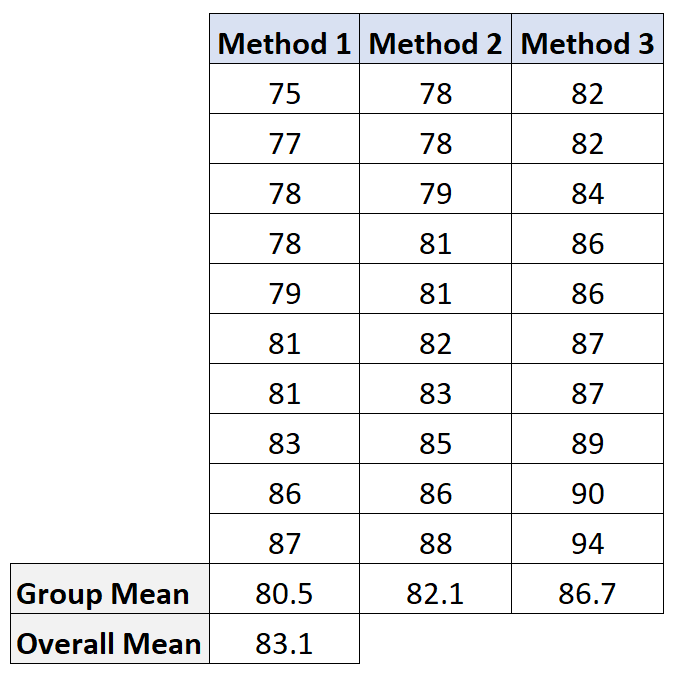
À l’inverse, dès lors qu’un traitement psychologique induit des déviations significatives de moyennes ($H_1$), le numérateur $MS_{between}$ s’accroît par l’adjonction de l’énergie systématique de l’effet ($\sum n_j \alpha_j^2$). La statistique $F$ s’extrait alors du régime central pour se projeter sous une distribution $F$ non centrale ($F(df_1, df_2, \lambda)$). Sa trajectoire se décale vers les valeurs positives élevées de l’abscisse. Le test statistique de l’ANOVA est structurellement unilatéral à droite : seule une concentration anormale de densité dans la queue supérieure de la distribution (au-delà du quantile critique $F_{critique}$ défini pour un seuil $\alpha$ donné) justifie le rejet formel de l’hypothèse nulle.
7.3 Dynamique d’ajustement du ratio F face aux variations d’échantillonnage
La statistique $F$ constitue un système dynamique extrêmement sensible aux modifications dimensionnelles du protocole expérimental. Deux leviers distincts régulent son amplitude : la modification des effectifs ($N$) et la compression de la variabilité résiduelle ($MS_{within}$). L’impact d’une augmentation de la taille d’échantillon globale sur la robustesse du dénominateur s’exprime à travers la loi des grands nombres : plus $N$ est vaste, plus $df_{within} = N – k$ s’élève, rétrécissant l’erreur-type de l’estimation de $\sigma^2$. Cette stabilisation supprime les instabilités extrêmes de la statistique causées par d’éventuelles sous-estimations fortuites de l’erreur résiduelle.
Cependant, la dynamique la plus puissante réside dans l’effet multiplicateur induit par l’optimisation méthodologique. Puisque la statistique $F$ repose sur une division, toute réduction proportionnelle de la variance intra-groupe produit une élévation inversement proportionnelle du ratio de Fisher :
$$F propto \frac{1}{MS_{within}}$$
Diviser la variance résiduelle par deux par un contrôle expérimental rigoureux équivaut rigoureusement, en termes d’amplification de la statistique $F$, à doubler l’amplitude de l’effet d’écart des moyennes au numérateur. À l’inverse, face à des déviations de moyennes modestes, une dispersion intra-groupe anarchique comprime irrémédiablement le ratio en deçà des seuils critiques de significativité, neutralisant la détection des effets expérimentaux.
8. Interprétation statistique et décisionnelle du ratio de variance
8.1 Articulation entre statistique F et calcul de la valeur p
La transition de la statistique descriptive d’échantillon vers l’inférence décisionnelle s’opère par l’intermédiaire de la valeur de probabilité empirique, universellement désignée par la valeur p (p-value). Formellement, la valeur p ne mesure aucunement la probabilité que l’hypothèse nulle soit vraie dans l’absolu — écueil interprétatif ubiquitaire dans les publications biomédicales et psychologiques —, ni la probabilité que les données aient été générées par un pur hasard. Elle quantifie précisément la probabilité d’obtenir, sous l’hypothèse formelle que $H_0$ soit rigoureusement exacte dans la population, une statistique $F$ au moins aussi extrême que la valeur empiriquement observée sur l’échantillon ($F_{obs}$) :
$$p = P(F(df_1, df_2) \geq F_{obs} mid H_0)$$
Cette probabilité correspond à l’intégrale définie de la fonction de densité de probabilité de Fisher-Snedecor, bornée à gauche par $F_{obs}$ et s’étendant à l’infini positif :
$$p = \int_{F_{obs}}^{\infty} f(F; df_1, df_2) , dF$$
La règle décisionnelle formalisée dans le paradigme neyman-pearsonien prescrit de comparer ce calcul continu au seuil de significativité conventionnel nominal $\alpha$, traditionnellement fixé à $0,05$ ou $0,01$ a priori. Si $p \leq \alpha$, l’investigateur prend la décision standardisée de rejeter l’hypothèse nulle au profit de l’hypothèse alternative ; la divergence observée entre les moyennes est déclarée statistiquement significative. Cependant, confondre ce seuil décisionnel binaire avec l’importance clinique ou substantielle d’un résultat constitue une erreur méthodologique majeure. Un ratio $F$ associé à un $p < 0,001$ peut masquer une différence comportementale dérisoire si l'échantillon analysé comporte des milliers d'observations, conférant au test une hyper-sensibilité aux déviations triviales.
8.2 Quantification de la taille de l’effet à partir des composantes de variance
Pour affranchir l’évaluation de la pertinence empirique de la contingence exclusive de la taille de l’échantillon, la communauté scientifique impose désormais la déclaration systématique des indices standardisés de taille d’effet (effect size). En analyse de variance, ces métriques se fondent directement sur la partition des sommes de carrés pour exprimer la part relative de variance expliquée par le facteur expérimental. L’indicateur le plus immédiat est l’êta-carré ($\eta^2$), défini par le ratio :
$$\eta^2 = \frac{SS_{between}}{SS_{total}}$$
Cet indice décrit scrupuleusement la proportion de la variabilité totale des scores qui est imputable aux différences existant entre les conditions expérimentales au sein de l’échantillon analysé. Toutefois, $\eta^2$ constitue un estimateur descriptif systématiquement biaisé vers le haut : il surestime l’impact réel du traitement dans la population globale, particulièrement au sein de protocoles employant des effectifs modestes.
Pour remédier à cette distorsion asymptotique, Ronald Fisher et ses successeurs ont développé l’oméga-carré ($\omega^2$), un estimateur ajusté qui corrige le biais d’échantillonnage en incorporant le carré moyen résiduel au numérateur et au dénominateur :
$$\omega^2 = \frac{SS_{between} – (k – 1)MS_{within}}{SS_{total} + MS_{within}}$$
L’oméga-carré fournit une approximation remarquablement plus fidèle et non biaisée de la véritable proportion de variance expliquée dans la population parente. Dans les devis factoriels complexes à plusieurs variables indépendantes, les chercheurs recourent fréquemment à l’êta-carré partiel ($\eta_p^2$), qui isole la variance associée à un facteur spécifique en soustrayant préalablement l’influence des autres prédicteurs de l’équation :
$$\eta_p^2 = \frac{SS_{facteur}}{SS_{facteur} + SS_{error}}$$
Pour interpréter ces magnitudes en psychologie, les conventions proposées par Jacob Cohen demeurent la référence canonique : un effet est qualifié de faible pour un $\eta^2$ (ou $\omega^2$) d’environ $0,01$ ($1,%$ de variance expliquée), de moyen ou modéré autour de $0,06$ ($6,%$ de variance expliquée), et de fort au-delà de $0,14$ ($14,%$ de variance expliquée ou plus).
8.3 Limites inhérentes à l’évaluation globale de la variance
En dépit de son élégance formelle, l’ANOVA globale comporte une limitation structurelle intrinsèque : son caractère omnibus unilatéral. Une issue statistiquement significative autorise l’inférence péremptoire qu’au moins deux groupes de l’expérience proviennent de populations aux espérances distinctes, mais demeure structurellement incapable d’identifier la topographie de cette divergence. Le test omnibus ne permet pas de discerner si la condition A surpasse la condition B, si la condition C se détache unilatéralement du binôme A-B, ou si les trois conditions divergent en gradins réguliers.
Toute tentative d’inférence spécifique des contrastes bilatéraux requiert le déploiement de méthodologies d’analyse subséquentes. Deux approches complémentaires dominent la littérature statistique :
- Les contrastes planifiés ou orthogonaux, formulés a priori sur la base d’hypothèses théoriques déductives préalablement à la collecte des données, qui permettent de scinder $SS_{between}$ en composantes à $1$ degré de liberté sans pénalisation statistique sévère ;
- Les tests de comparaisons multiples post-hoc, appliqués de manière exploratoire a posteriori sur l’ensemble des paires possibles.
Ces procédures post-hoc — telles que la méthode HSD de Tukey (Honestly Significant Difference), adaptée aux comparaisons exhaustives par paires sous homoscédasticité, la correction conservatrice de Bonferroni, ou le test robuste de Scheffé dédié aux contrastes complexes non planifiés — appliquent des pénalités correctives rigoureuses sur la valeur critique du ratio afin de maintenir le taux d’erreur par famille ($FWER$) au niveau nominal $\alpha$, jugulant ainsi le risque de surinterpréter des bruits résiduels locaux.
9. Exemple empirique détaillé en psychologie : Impact des méthodes pédagogiques
9.1 Présentation du devis de recherche et des données brutes
Pour ancrer l’ensemble des dérivations théoriques exposées dans un cadre pratique représentatif, concevons une expérimentation appliquée en psychologie de l’éducation. Un laboratoire s’intéresse à l’efficacité différentielle de trois protocoles distincts d’enseignement de la remédiation cognitive auprès d’étudiants manifestant des blocages d’apprentissage en méthodologie statistique. Trois conditions indépendantes sont explorées :
- Groupe 1 : Méthode magistrale traditionnelle ($k_1$) — enseignement passif fondé sur l’écoute magistrale et la lecture linéaire de manuels ;
- Groupe 2 : Pédagogie active collaborative ($k_2$) — travail en petits groupes interactifs, études de cas cliniques et résolution de problèmes appliqués ;
- Groupe 3 : Apprentissage immersif assisté par le multimédia interactif ($k_3$) — modules informatisés adaptatifs, simulations visuelles et rétroaction algorithmique immédiate.
Quinze participants ($N = 15$) sont assignés de manière rigoureusement aléatoire aux trois conditions expérimentales, aboutissant à un plan expérimental équilibré comprenant $n_1 = n_2 = n_3 = 5$ étudiants par groupe. Au terme d’un cycle de formation de quatre semaines, les capacités de conceptualisation statistique et de raisonnement inférentiel sont évaluées au moyen d’une épreuve standardisée notée de $0$ à $20$. Les scores bruts obtenus par chaque individu ($Y_{ij}$) se structurent comme suit :
- Groupe 1 (Traditionnel) : $8$, $10$, $9$, $7$, $11$
- Groupe 2 (Actif) : $13$, $15$, $12$, $14$, $16$
- Groupe 3 (Immersif) : $15$, $17$, $18$, $14$, $16$
L’inspection des totaux de groupe ($T_j$) et des moyennes conditionnelles associées ($\bar{Y}_{bullet j}$) fournit les premières métriques de centralité empirique :
- Pour le Groupe 1 : $T_1 = 8 + 10 + 9 + 7 + 11 = 45$ ; moyenne $\bar{Y}_{bullet 1} = \frac{45}{5} = 9,00$
- Pour le Groupe 2 : $T_2 = 13 + 15 + 12 + 14 + 16 = 70$ ; moyenne $\bar{Y}_{bullet 2} = \frac{70}{5} = 14,00$
- Pour le Groupe 3 : $T_3 = 15 + 17 + 18 + 14 + 16 = 80$ ; moyenne $\bar{Y}_{bullet 3} = \frac{80}{5} = 16,00$
Le grand total de l’expérience ($G$) et la grand-moyenne correspondante ($\bar{Y}_{bulletbullet}$) s’établissent dès lors à :
$$G = T_1 + T_2 + T_3 = 45 + 70 + 80 = 195$$
$$\bar{Y}_{bulletbullet} = \frac{G}{N} = \frac{195}{15} = 13,00$$
9.2 Décomposition pas à pas des sommes de carrés et degrés de liberté
Procédons à l’isolation méthodique manuelle des composantes quadratiques du devis afin d’expliciter le mécanisme arithmétique de l’ANOVA. Calculons initialement la somme des carrés inter-groupes ($SS_{between}$), mesurant la dispersion pondérée des moyennes de conditions autour de la grand-moyenne ($\bar{Y}_{bulletbullet} = 13,00$) :
$$SS_{between} = \sum_{j=1}^3 n_j (\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})^2$$
$$SS_{between} = 5 \times (9 – 13)^2 + 5 \times (14 – 13)^2 + 5 \times (16 – 13)^2$$
$$SS_{between} = 5 \times (-4)^2 + 5 \times (1)^2 + 5 \times (3)^2$$
$$SS_{between} = 5 \times 16 + 5 \times 1 + 5 \times 9 = 80 + 5 + 45 = 130,00$$
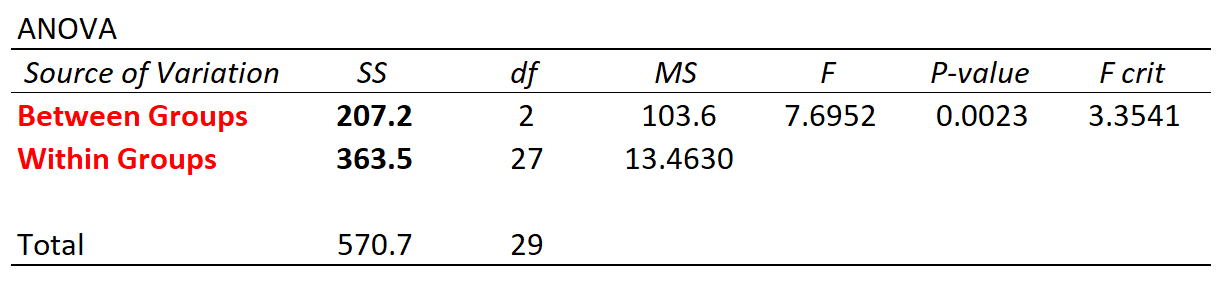
Calculons ensuite pas à pas la somme des carrés intra-groupes ($SS_{within}$), qui exige la sommation des déviations quadratiques des participants au sein de leur modalité d’assignation respective :
Pour le Groupe 1 ($\bar{Y}_{bullet 1} = 9,00$) :
$$SS_1 = (8 – 9)^2 + (10 – 9)^2 + (9 – 9)^2 + (7 – 9)^2 + (11 – 9)^2 = (-1)^2 + (1)^2 + (0)^2 + (-2)^2 + (2)^2 = 1 + 1 + 0 + 4 + 4 = 10,00$$
Pour le Groupe 2 ($\bar{Y}_{bullet 2} = 14,00$) :
$$SS_2 = (13 – 14)^2 + (15 – 14)^2 + (12 – 14)^2 + (14 – 14)^2 + (16 – 14)^2 = (-1)^2 + (1)^2 + (-2)^2 + (0)^2 + (2)^2 = 1 + 1 + 4 + 0 + 4 = 10,00$$
Pour le Groupe 3 ($\bar{Y}_{bullet 3} = 16,00$) :
$$SS_3 = (15 – 16)^2 + (17 – 16)^2 + (18 – 16)^2 + (14 – 16)^2 + (16 – 16)^2 = (-1)^2 + (1)^2 + (2)^2 + (-2)^2 + (0)^2 = 1 + 1 + 4 + 4 + 0 = 10,00$$
L’agrégation des variances locales produit la somme des carrés résiduelle globale :
$$SS_{within} = SS_1 + SS_2 + SS_3 = 10,00 + 10,00 + 10,00 = 30,00$$
Par application du principe fondamental d’additivité, la somme des carrés totale s’obtient instantanément :
$$SS_{total} = SS_{between} + SS_{within} = 130,00 + 30,00 = 160,00$$
Les degrés de liberté associés se partitionnent comme suit :
- $df_{between} = k – 1 = 3 – 1 = 2$
- $df_{within} = N – k = 15 – 3 = 12$
- $df_{total} = N – 1 = 15 – 1 = 14$
La normalisation des sommes de carrés par leurs degrés de liberté respectifs génère les carrés moyens correspondants :
$$MS_{between} = \frac{SS_{between}}{df_{between}} = \frac{130,00}{2} = 65,00$$
$$MS_{within} = \frac{SS_{within}}{df_{within}} = \frac{30,00}{12} = 2,50$$
Nous pouvons désormais consigner ces résultats calculatoires dans le tableau canonique de l’ANOVA :
Tableau récapitulatif canonique de l’ANOVA :
- Source Inter-groupes : Somme des carrés ($SS$) = $130,00$ | Degrés de liberté ($df$) = $2$ | Carré moyen ($MS$) = $65,00$ | Ratio $F$ = $26,00$
- Source Intra-groupes (Erreur) : Somme des carrés ($SS$) = $30,00$ | Degrés de liberté ($df$) = $12$ | Carré moyen ($MS$) = $2,50$
- Source Totale : Somme des carrés ($SS$) = $160,00$ | Degrés de liberté ($df$) = $14$
9.3 Décision statistique, calcul d’effet et conclusion clinique
La statistique de test s’obtient en confrontant le carré moyen inter-groupe au carré moyen intra-groupe :
$$F = \frac{MS_{between}}{MS_{within}} = \frac{65,00}{2,50} = 26,00$$
En consultant les tables de la distribution théorique de Fisher-Snedecor pour les degrés de liberté critiques $(df_1 = 2, df_2 = 12)$, la valeur seuil pour un niveau de risque conventionnel fixé à $\alpha = 0,05$ est de $F_{critique}(2, 12) = 3,89$. Pour un seuil hautement conservateur fixé à $\alpha = 0,001$, le seuil s’établit à $F_{critique}(2, 12) = 12,97$. La statistique calculée empiriquement ($F_{obs} = 26,00$) surpasse largement la valeur critique au seuil de $0,001$ ($26,00 > 12,97$). La valeur $p$ exacte associée à cette statistique est de $p = 0,000041$ ($p < 0,001$). L'hypothèse nulle d'égalité des espérances mathématiques des trois méthodes pédagogiques est donc rejetée sans ambiguïté.
Procédons à l’estimation de la taille de l’effet pour qualifier l’ampleur substantielle de cette dissociation pédagogique. L’êta-carré de l’échantillon s’élève à :
$$\eta^2 = \frac{SS_{between}}{SS_{total}} = \frac{130,00}{160,00} = 0,8125$$
L’estimation non biaisée dans la population au moyen de l’oméga-carré confirme la robustesse de l’effet :
$$\omega^2 = \frac{SS_{between} – (k – 1)MS_{within}}{SS_{total} + MS_{within}} = \frac{130,00 – (2 \times 2,50)}{160,00 + 2,50} = \frac{130,00 – 5,00}{162,50} = \frac{125,00}{162,50} \approx 0,7692$$
Près de $77,%$ de la variance des performances d’acquisition conceptuelle dans la population parente s’avère explicable par le type de méthode pédagogique employée, ce qui dénote un impact majeur selon les critères de Cohen ($\omega^2 > 0,14$).
Conformément aux normes rédactionnelles de l’American Psychological Association (APA 7e édition), ce résultat empirique se formalise de la manière suivante :
« Une analyse de variance univariée à un facteur indépendant a révélé un effet statistiquement significatif de la méthode pédagogique sur les performances d’acquisition méthodologique des étudiants, $F(2, 12) = 26,00$, $p < 0,001$, $\omega^2 = 0,77$. Des analyses complémentaires de comparaisons multiples post-hoc au moyen du test HSD de Tukey indiquent que les étudiants soumis à l'apprentissage interactif immersif ($M = 16,00$, $ET = 1,58$) et ceux affectés à la pédagogie active ($M = 14,00$, $ET = 1,58$) ont obtenu des scores significativement supérieurs à ceux du groupe d'enseignement magistral traditionnel ($M = 9,00$, $ET = 1,58$, $p < 0,001$). En revanche, la différence observée entre la pédagogie active et l'apprentissage immersif ne franchit pas le seuil de significativité statistique ($p = 0,113$). »
10. Facteurs influençant les composantes de la variance intra-groupe et inter-groupe
10.1 Optimisation expérimentale de la variance inter-groupe
La maximisation rationnelle de la variance inter-groupe représente le premier pilier de l’ingénierie méthodologique en sciences du comportement. Si l’investigateur applique des manipulations expérimentales trop timorées ou subtiles — par exemple, en comparant deux doses infinitésimales d’un psychotrope ou deux formulations sémantiquement proches d’une consigne d’amorçage cognitif —, les moyennes des sous-groupes divergeront à peine, comprimant la somme des carrés inter-groupes ($SS_{between}$). L’optimisation impose l’emploi de contrastes théoriques francs et robustes, capables de mobiliser pleinement les circuits neurocognitifs ou les processus affectifs ciblés.
Cette démarche exige une sélection rigoureuse de conditions contrastées et cliniquement pertinentes. Plutôt que d’étudier un continuum indistinct de variations paramétriques mineures, le chercheur a intérêt à opposer des modalités représentant des ruptures conceptuelles claires (par exemple, une privation totale de sommeil versus une nuit de sommeil physiologique standard). Une telle accentuation accroît structurellement l’écart $(\bar{Y}_{bullet j} – \bar{Y}_{bulletbullet})$, conférant au numérateur du ratio $F$ une magnitude propre à surpasser l’aléa résiduel.
Parallèlement, cette quête d’amplification du signal expérimental impose de neutraliser activement les biais réactifs humains susceptibles d’étouffer les écarts entre groupes. Les phénomènes d’attentes de l’expérimentateur (effet Pygmalion) ou la désirabilité sociale chez les participants peuvent uniformiser artificiellement les comportements des sujets d’un groupe à l’autre. Le recours systématique à des protocoles en double aveugle — où ni le participant ni le psychologue évaluateur ne connaissent l’assignation de la condition — permet de préserver l’authenticité des écarts induits par la variable indépendante.
10.2 Stratégies méthodologiques pour réduire la variance intra-groupe
Si l’optimisation de la variance inter-groupe cherche à élever le signal, la compression méthodique de la variance intra-groupe ($MS_{within}$) a pour visée de réduire le bruit de fond. Plusieurs leviers complémentaires permettent d’atteindre cet objectif :
- Standardisation stricte des protocoles : La rédaction de scripts directifs et immuables pour les expérimentateurs, l’automatisation intégrale de la passation des tests sur support numérique et l’insonorisation des cabines d’expérimentation concourent à éliminer les sources d’interférence environnementales qui gonflent artificiellement la somme des carrés résiduelle ;
- Fidélité psychométrique des instruments : L’emploi d’instruments de mesure validés affichant une haute fidélité test-retest et une consistance interne élevée ($\alpha > 0,85$) minimise la variance d’erreur instrumentale $\sigma^2_e$ incorporée dans les scores individuels ;
- Homogénéisation a priori des cohortes : La définition de critères d’inclusion et d’exclusion précis, ou l’utilisation de techniques d’appariement méthodique sur des variables morphologiques, cognitives ou sociodémographiques clés, permet de stabiliser les distributions au sein de chaque modalité ;
- Inclusion de covariables (ANCOVA) : Lorsqu’une variable continue préexistante (comme l’âge, le quotient intellectuel ou le score d’anxiété initial pré-thérapeutique) est corrélée à la variable dépendante, son intégration comme covariable permet de soustraire mathématiquement sa part explicative de la somme des carrés résiduelle intra-groupe, abaissant le dénominateur du test $F$ sans altérer l’intégrité de la variance de traitement.
10.3 Équilibre entre validité interne et validité écologique
L’optimisation conjointe des variances pose un dilemme épistémologique classique en méthodologie de la recherche : la tension dialectique entre la validité interne et la validité écologique. Pousser à l’extrême la réduction de la variance intra-groupe en sur-sélectionnant des cohortes ultra-homogènes (par exemple, en restreignant exclusivement les recrutements à des étudiants universitaires de sexe masculin âgés de 20 ans, exempts de tout passif médical) produit un environnement hautement aseptisé.
Dans ce contexte artificiel, la variance intra-groupe se trouve drastiquement comprimée, garantissant un ratio $F$ élevé et une validité interne robuste : l’investigateur peut attester sans conteste que la variable manipulée est la cause de la différence observée. Cependant, cette pureté méthodologique compromet sévèrement la validité écologique et la généralisabilité des conclusions. Les dynamiques psychologiques identifiées au sein d’un échantillon aussi restreint risquent de ne plus opérer de manière comparable lorsqu’elles sont confrontées à la complexité et à l’hétérogénéité biologique du monde clinique réel.
Une appréciation qualitative équilibrée de la variance résiduelle s’avère donc indispensable. En sciences appliquées, accepter une fraction incompressible de variance intra-groupe constitue le prix méthodologique nécessaire pour garantir que les interventions évaluées conservent leur pertinence fonctionnelle dans des environnements naturels complexes.
11. Violations des postulats statistiques et implications pour la variance
11.1 Non-respect du postulat de normalité des distributions résiduelles
L’édifice mathématique garantissant que le ratio $F$ suit précisément la loi de Fisher-Snedecor repose sur une série de postulats distributionnels formulés sur les résidus du modèle :
$$\varepsilon_{ij} = (Y_{ij} – \mu_j) \overset{\text{iid}}{\sim} \mathcal{N}(0, \sigma^2)$$
Le premier de ces postulats stipule que les résidus se distribuent selon une loi normale au sein de chaque sous-population parente. En pratique clinique, les données psychologiques s’écartent fréquemment de cette symétrie idéale, exhibant des asymétries positives marquées (comme pour les temps de réaction ou les concentrations plasmatiques de cortisol) ou des aplatissements non gaussiens.
Fort heureusement, l’ANOVA démontre une robustesse statistique remarquable face aux déviations modérées de normalité, un phénomène explicable par l’action du théorème central limite : sitôt que les tailles d’échantillons atteignent des seuils raisonnables ($n_j \geq 20$ à $30$ observations par cellule), la distribution des moyennes de sous-groupes converge asymptotiquement vers une loi normale, préservant la validité nominale du test d’hypothèse.
Néanmoins, des violations sévères de ce postulat — notamment la présence de distributions hautement leptokurtiques ou bimodales — déstabilisent l’estimation de la somme des carrés résiduelle, distordant les probabilités critiques réelles. Pour identifier ces anomalies en amont de l’analyse, les chercheurs déploient des diagnostics visuels fins (diagrammes quantile-quantile des résidus, ou Q-Q plots) doublés de tests d’adéquation formels comme le test de Shapiro-Wilk ou de Kolmogorov-Smirnov avec correction de Lilliefors. En présence d’asymétries incompatibles avec le modèle, le recours à des transformations mathématiques stabilisatrices (logarithmiques, racine carrée) ou à des alternatives non paramétriques (test de Kruskal-Wallis) s’impose.
11.2 Hétéroscédasticité et rupture du postulat d’homogénéité des variances
Le postulat d’homoscédasticité, prescrivant l’égalité des variances intra-groupes dans les populations parentes ($\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2 = \sigma^2$), constitue une condition fondamentale de l’ANOVA classique. Lorsque ce postulat est invalidé, la situation relève de l’hétéroscédasticité. Cette rupture altère directement le dénominateur du ratio $F$ : l’opération d’agrégation d’une variance résiduelle unique $MS_{within}$ n’a plus de sens physique si les différents groupes proviennent de populations possédant des dispersions intrinsèques discordantes.
Les conséquences méthodologiques de l’hétéroscédasticité sont asymétriques et dépendent étroitement de l’équilibre des effectifs :
- Plans équilibrés ($n_1 = n_2 = dots = n_k$) : L’ANOVA conserve une relative robustesse face à des hétérogénéités modérées de variance (ratio de la variance maximale sur la variance minimale inférieur à 3 ou 4), le taux nominal d’erreur de premier type demeurant proche de 5 % ;
- Plans déséquilibrés — Appariement direct : Si les effectifs les plus vastes sont associés aux variances locales les plus larges, la variance résiduelle $MS_{within}$ est artificiellement surestimée par le poids des grands groupes, comprimant indûment le ratio $F$ et rendant le test excessivement conservateur (perte de puissance statistique) ;
- Plans déséquilibrés — Appariement inverse : Si les effectifs les plus faibles coïncident avec les variances locales les plus fortes, $MS_{within}$ est sous-estimé, provoquant une inflation incontrôlée des faux positifs (le taux d’erreur de type I réel pouvant grimper au-delà de 20 ou 30 % pour un seuil nominal de 5 %).
Pour statuer sur l’homogénéité des variances, l’investigateur emploie des tests formels tels que le test de Levene (calculé sur les déviations absolues par rapport à la médiane pour accroître sa robustesse face à la non-normalité) ou le test de Bartlett. En cas de rejet de l’homoscédasticité, il est impératif d’abandonner l’ANOVA classique de Fisher au profit de procédures robustes intégrant une correction des degrés de liberté, comme le test de Welch ou le test de Brown-Forsythe, qui pondèrent spécifiquement la contribution de chaque cellule en fonction de sa variance propre.
11.3 Non-indépendance des observations au sein des groupes
De l’ensemble des conditions requises pour la validité de l’ANOVA, le postulat d’indépendance statistique des erreurs résiduelles ($operatorname{Cov}(\varepsilon_{ij}, \varepsilon_{i’j’}) = 0$) est de loin le plus intransigeant et le moins tolérant à l’approximation. Contrairement aux entorses à la normalité ou à l’homogénéité des variances — pour lesquelles des corrections algébriques simples existent —, une violation de l’indépendance invalide structurellement l’ensemble de la distribution de référence du ratio $F$.
Cette non-indépendance se manifeste fréquemment en recherche appliquée lorsque les participants partagent un contexte social ou spatial commun : étudiants testés au sein de classes scolaires partagées, patients traités par le même psychothérapeute en thérapie de groupe, ou mesures répétées dans le temps sur un même individu sans modélisation de la dépendance sérielle. Ce phénomène engendre une dépendance positive entre observations, quantifiée statistiquement par le coefficient de corrélation intra-classe ($ICC$, ou $rho$) :
$$ICC = \frac{\sigma_{cluster}^2}{\sigma_{cluster}^2 + \sigma_{residuelle}^2}$$
Même une corrélation intra-classe d’apparence modeste ($\rho \approx 0,05$) exerce des ravages majeurs sur l’estimation des variances. Elle induit une sous-estimation substantielle de la variance intra-groupe $MS_{within}$ : les individus d’une même grappe se ressemblant davantage que des individus prélevés au hasard, la dispersion apparente au sein des échantillons rétrécit artificiellement. Il en découle une explosion exponentielle des faux positifs, l’erreur de type I pouvant atteindre 40 à 50 % sans que le chercheur n’en ait conscience.
Face à des structures de données emboîtées ou groupées (clustered data), le cadre univarié standard de l’ANOVA doit impérativement être abandonné au profit des modèles linéaires mixtes ou des analyses multiniveaux (Hierarchical Linear Modeling, HLM), capables d’isoler explicitement la variance attributable aux groupes de niveau supérieur et de préserver l’intégrité de l’inférence.
12. Prolongements avancés : De l’ANOVA unidirectionnelle aux modèles factoriels et mixtes
12.1 Partition de la variance dans les modèles factoriels à deux voies
L’extension naturelle de l’analyse univariée simple à un facteur réside dans l’ANOVA factorielle, qui examine simultanément l’impact de deux variables indépendantes (Facteur $A$ à $p$ niveaux et Facteur $B$ à $q$ niveaux) ainsi que leur terme conjoint d’interaction ($A \times B$). Dans cette architecture, le principe fondamental de partitionnement de la variance s’étend en divisant la somme des carrés inter-groupes globale en sous-composantes orthogonales indépendantes :
$$SS_{total} = SS_A + SS_B + SS_{AB} + SS_{within}$$
La composante $SS_A$ isole la variabilité liée à l’effet principal du facteur $A$ (pondéré sur les niveaux de $B$), $SS_B$ quantifie l’effet principal du facteur $B$ (pondéré sur les niveaux de $A$), et $SS_{AB}$ mesure l’énergie propre à l’interaction statistique. L’interaction capture l’ampleur selon laquelle l’effet du traitement $A$ change de direction ou d’amplitude en fonction du niveau spécifique du facteur $B$.
Malgré cette complexification structurelle du numérateur, le carré moyen intra-groupe d’erreur ($MS_{within} = \frac{SS_{within}}{N – pq}$) demeure le calibrateur invariant de référence pour l’ensemble des tests de significativité. Trois ratios de Fisher distincts sont ainsi dérivés :
$$F_A = \frac{MS_A}{MS_{within}}, \quad F_B = \frac{MS_B}{MS_{within}}, \quad F_{AB} = \frac{MS_{AB}}{MS_{within}}$$
L’émergence d’une interaction statistiquement significative module la portée des effets principaux. En psychologie cognitive, constater qu’un traitement pharmacologique ($A$) améliore la mémoire de travail uniquement chez les individus soumis à un stress intense ($B_1$) mais produit une dégradation chez les sujets non stressés ($B_2$) démontre que l’effet principal agrégé du médicament masquerait la réalité fonctionnelle du phénomène.
12.2 Mesures répétées et isolation de la variabilité interindividuelle
Dans les plans à mesures répétées (within-subjects designs), chaque participant est soumis successivement à l’ensemble des modalités de la variable expérimentale, opérant ainsi comme son propre témoin. Ce dispositif méthodologique modifie en profondeur la partition de la variabilité en opérant une extraction chirurgicale de la variance interindividuelle stable hors du dénominateur d’erreur.
Dans un tel plan, la somme des carrés intra-groupe brute est scindée en deux sous-espaces orthogonaux :
- Une composante attribuable aux différences systématiques stables entre participants ($SS_{sujets}$), liée au fait que certains individus affichent globalement des performances supérieures aux autres sur l’ensemble des conditions ;
- Une composante résiduelle d’erreur pure ($SS_{erreur} = SS_{sujets \times traitement}$).
La formule de décomposition prend alors la forme :
$$SS_{total} = SS_{traitement} + SS_{sujets} + SS_{erreur}$$
Puisque la variance stable des participants ($SS_{sujets}$) est retirée du dénominateur du test de Fisher, la statistique d’épreuve devient :
$$F = \frac{MS_{traitement}}{MS_{erreur}}$$
Cette extraction confère aux devis à mesures répétées une puissance statistique considérablement accrue par rapport aux protocoles à groupes indépendants, car l’hétérogénéité individuelle basale n’entre plus en concurrence avec le signal expérimental. Cette sensibilité supérieure s’accompagne toutefois d’une contrainte paramétrique additionnelle : le respect du postulat de sphéricité de Mauchly, exigeant l’égalité stricte des variances des différences calculées entre toutes les paires possibles de conditions répétées. Lorsque ce postulat est enfreint, des corrections correctives appliquées aux degrés de liberté (Greenhouse-Geisser ou Huynh-Feldt) sont requises pour préserver l’intégrité de la valeur p.
12.3 Intégration au sein du modèle linéaire généralisé
L’étape ultime de la compréhension conceptuelle de l’analyse de variance réside dans la reconnaissance de son équivalence mathématique absolue avec la régression linéaire multiple au sein de la théorie unifiée du modèle linéaire généralisé (General Linear Model, GLM). L’ANOVA ne constitue aucunement une méthodologie empirique autonome ou isolée ; elle incarne un cas particulier de modèle de régression linéaire appliqué à des prédicteurs catégoriels codés sous forme de variables muettes (dummy coding) ou de contrastes polynomiaux orthogonaux.
Considérons une ANOVA à trois groupes. En définissant deux variables binaires indicatrices $X_1$ et $X_2$, l’équation de régression s’exprime comme suit :
$$Y_i = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + \varepsilon_i$$
Dans cette formulation, l’ordonnée à l’origine $\beta_0$ modélise l’espérance du groupe de référence, tandis que les coefficients de régression partiels $\beta_1$ et $\beta_2$ mesurent l’écart des moyennes respectives des autres groupes par rapport à cette base. Le test $F$ de l’ANOVA testant $H_0 : \mu_1 = \mu_2 = \mu_3$ équivaut rigoureusement au test de significativité globale du coefficient de détermination multiple $R^2$ de la régression linéaire évaluant $H_0 : \beta_1 = \beta_2 = 0$ :
$$F = \frac{\frac{R^2}{k – 1}}{\frac{1 – R^2}{N – k}} = \frac{MS_{between}}{MS_{within}}$$
Cette identité structurelle met en lumière l’universalité de la décomposition de la variance. Que l’on formule une problématique empirique en termes de contrastes de moyennes discrètes ou de modélisation de surfaces de régression continues, le chercheur manipule systématiquement la même partition fondamentale entre l’espace vectoriel des prédictions systématiques et l’espace vectoriel des résidus stochastiques. Maîtriser les interactions unissant et opposant la variation intra-groupe et la variation inter-groupe offre ainsi une clé d’accès conceptuelle directe à l’ensemble des méthodes statistiques contemporaines de la modélisation du comportement.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysis-for-the-Behavioral-Sciences/Cohen/p/book/9780805802832
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://digital.library.adelaide.edu.au/dspace/handle/2440/15227
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning. https://www.cengage.com/c/statistical-methods-for-psychology-8e-howell/9781111835484/
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall. https://www.pearson.com/en-us/subject-catalog/p/design-and-analysis-a-researchers-handbook/P200000003390/9780135159415
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2017). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Rutherford, A. (2011). ANOVA and ANCOVA: A GLM approach (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118491683
- Snedecor, G. W., & Cochran, W. G. (1989). Statistical methods (8th ed.). Iowa State University Press. https://www.wiley.com/en-us/Statistical+Methods%2C+8th+Edition-p-9780813815619
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/using-multivariate-statistics/P200000003395/9780134790541