
La régression linéaire par les moindres carrés ordinaires (MCO) constitue depuis plus d’un siècle la clé de voûte de l’analyse quantitative dans les sciences empiriques, et tout particulièrement au sein de la psychologie, de l’économétrie et de l’épidémiologie comportementale. Conçue comme un dispositif formel permettant d’isoler des associations fonctionnelles, de tester des hypothèses déductives et de prédire des grandeurs continues à partir d’un ensemble de covariables, la méthode séduit par son apparente simplicité calculatoire et l’élégance interprétative de ses coefficients standardisés. Pourtant, l’attribution d’une signification scientifique robuste aux estimations paramétriques ne découle pas spontanément de l’exécution d’un algorithme matriciel ; elle est conditionnée par le respect rigoureux d’un ensemble d’axiomes fondamentaux régissant la nature du processus générateur de données sous-jacent.
Dans la pratique de la recherche contemporaine, une proportion substantielle d’analyses publiées applique la modélisation linéaire comme une simple procédure algorithmique « boîte noire », reléguant l’évaluation des postulats théoriques à un examen superficiel, voire à une omission délibérée. Cette dérive méthodologique expose l’édifice inférentiel à des vulnérabilités systémiques majeures. Lorsque les conditions d’application de la régression linéaire sont compromises, les propriétés fondamentales des estimateurs — au premier rang desquelles figurent la non-biaisitude, la convergence et l’efficacité asymptotique — s’effondrent, transformant des inférences statistiques prétendument robustes en artéfacts computationnels dénués de validité écologique ou nomologique.
Cet article propose une déconstruction épistémologique, mathématique et méthodologique exhaustive des quatre postulats classiques de la régression linéaire : la linéarité structurelle de la fonction de régression, l’indépendance conditionnelle des résidus, l’homoscédasticité de leur variance et la normalité de leur distribution. Pour chaque postulat, nous examinerons les fondements formels, les mécanismes spécifiques par lesquels leur violation corrompt les conclusions scientifiques, la panoplie des protocoles diagnostiques graphiques et inférentiels, ainsi que les stratégies thérapeutiques les plus avancées — depuis les transformations fonctionnelles jusqu’aux modèles additifs généralisés, hiérarchiques et robustes. L’objectif est de fournir aux chercheurs une feuille de route sans compromis pour garantir l’intégrité de l’inférence statistique dans l’étude des phénomènes complexes.
1. Fondements épistémologiques et importance des postulats en régression linéaire
1.1 Le rôle fondamental de la régression linéaire dans la recherche comportementale
La modélisation paramétrique des relations causales et prédictives occupe une place centrale dans les sciences du comportement. Qu’il s’agisse de mesurer l’impact de l’exposition à un stress chronique sur les performances en mémoire de travail, ou de modéliser la dynamique liant le sentiment d’auto-efficacité à l’engagement académique, le recours à la régression linéaire permet de formaliser mathématiquement des conjectures théoriques complexes en isolant l’effet partiel de chaque variable indépendante tout en neutralisant statistiquement l’influence de variables de confusion. L’intérêt méthodologique de cette approche repose sur sa capacité à fournir une métrique intelligible du changement espéré de la variable dépendante pour chaque incrément unitaire d’un régresseur donné, autorisant ainsi des comparaisons d’ampleur d’effet standardisées indispensables à l’élaboration de théories cumulatives.
Cette commodité analytique est cependant conditionnée par les impératifs du cadre mathématique formalisé par le théorème de Gauss-Markov. Ce dernier établit que, sous un ensemble strict de conditions idéalisées, l’estimateur des moindres carrés ordinaires possède le statut optimal d’estimateur linéaire sans biais de variance minimale, désigné par l’acronyme BLUE (Best Linear Unbiased Estimator). La démonstration mathématique de ce statut ne relève pas de la convenance empirique, mais d’une déduction déterministe : dès lors que l’un des maillons axiomatiques fait défaut, l’optimalité s’évanouit. L’estimateur peut demeurer linéaire, mais il perd soit son absence de biais, soit son efficacité statistique, privant le chercheur de la garantie que les paramètres estimés convergent vers les véritables valeurs populationnelles à un rythme d’échantillonnage optimal.
Il importe ici de tracer une démarcation épistémologique stricte entre la modélisation exploratoire et l’inférence statistique confirmatoire formelle. En phase exploratoire, un modèle linéaire peut être mobilisé comme une approximation heuristique de premier ordre, utile pour cartographier les régularités brutes d’un jeu de données sans prétention à l’établissement de lois universelles. En revanche, dès lors que le chercheur bascule dans l’inférence formelle — testant la significativité statistique d’un coefficient $\beta$, construisant un intervalle de confiance ou affirmant la plausibilité d’un mécanisme causal —, la vérification des postulats cesse d’être une précaution facultative pour devenir la condition sine qua non de la validité interne du protocole. Enfreindre ces principes revient à construire des édifices déductifs sur des sables mouvants analytiques, où les grandeurs obtenues ne reflètent plus la réalité empirique, mais les distorsions inhérentes à une spécification inadéquate.
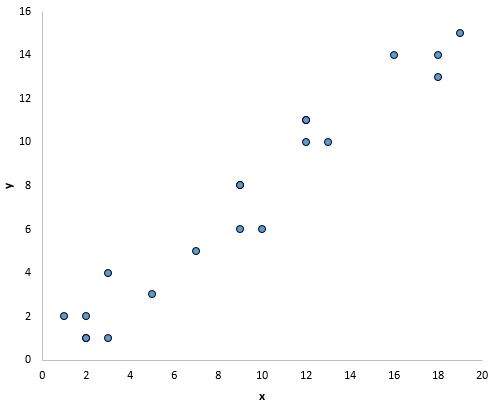
1.2 La typologie des erreurs statistiques résultant de postulats non vérifiés
L’inobservation des conditions sous-jacentes à la régression des moindres carrés induit une cascade de dérèglements statistiques qui compromettent systématiquement les tests d’hypothèses conventionnels. Le premier dérèglement concerne l’inflation dramatique du taux d’erreur de type I ($\alpha$). Dans des conditions standards, le chercheur tolère un risque nominal de 5 % de rejeter à tort l’hypothèse nulle d’absence d’effet. Toutefois, en présence de violations structurelles, telles que l’autocorrélation positive des résidus ou une forte hétéroscédasticité combinée à des distributions déséquilibrées des prédicteurs, le taux d’erreur de type I effectif peut grimper à 20 %, 40 %, voire au-delà de 70 %. Le chercheur conclut alors avec une certitude fallacieuse à l’existence d’effets psychologiques novateurs qui ne sont en vérité que des artefacts d’échantillonnage amplifiés par un modèle erroné.
Conjointement à cette inflation du faux positif, les violations méthodologiques entraînent fréquemment une dégradation sévère de la puissance statistique, augmentant de manière critique le risque d’erreur de type II ($\beta$). Lorsqu’un modèle souffre d’inefficacité due à une variance résiduelle mal calibrée ou à une non-linéarité fondamentale non prise en compte, les erreurs types des coefficients se trouvent artificiellement gonflées par rapport à ce que permettrait un modèle correctement spécifié. Par conséquent, des effets réels, subtils mais cliniquement cruciaux, sont masqués : le test statistique échoue à franchir le seuil conventionnel de significativité, conduisant au rejet injustifié d’hypothèses théoriques pourtant valides. L’outil analytique se transforme ainsi en un instrument myope, incapable de distinguer les signaux substantiels du bruit stochastique résiduel.
À un niveau plus fondamental, l’estimation des erreurs types et le calcul consécutif des intervalles de confiance se trouvent structurellement biaisés. La formule analytique standard de la matrice de variance-covariance des estimateurs MCO suppose expressément la constance de la variance et l’indépendance conditionnelle. Si ces postulats s’effondrent, les estimateurs de variance conventionnels ne convergent plus vers les vrais paramètres de dispersion. Les intervalles de confiance à 95 % affichés par les logiciels d’analyse ne couvrent plus 95 % des réalisations de l’échantillonnage, mais parfois moins de 80 %. Cette fragilité rejaillit directement sur la crise de la reproductibilité scientifique en psychométrie et sciences du comportement : des cohortes entières de résultats publiés échouent aux tentatives de réplication indépendante simplement parce que leurs inférences initiales reposaient sur des variances résiduelles mal modélisées.
1.3 Aperçu structurel des quatre conditions requises pour une estimation sans biais
Afin de prémunir le processus inférentiel contre ces dérives, la modélisation par régression linéaire exige la satisfaction conjointe de quatre piliers axiomatiques. Le premier est la linéarité structurelle de la relation, postulant que l’espérance conditionnelle de la variable critère sachant les prédicteurs est une fonction linéaire des paramètres inconnus du modèle. Cette condition garantit que la forme fonctionnelle choisie rend fidèlement compte de la géométrie de l’association, interdisant toute déviation systématique sous forme de courbures, d’asymptotes ou de seuils d’activation non paramétrés. Si ce postulat est transgressé, les coefficients bêtas obtenus ne représentent que de simples moyennes pondérées de pentes variables à travers le continuum des prédicteurs, vidant la modélisation de sa précision prédictive.
Le deuxième pilier concerne l’indépendance stochastique des termes d’erreur résiduels. Ce postulat exige que l’erreur associée à une observation spécifique ne partage aucune corrélation avec l’erreur d’une quelconque autre observation de l’échantillon. Cette indépendance conditionnelle est fréquemment violée dans les protocoles comportementaux impliquant des mesures répétées dans le temps, des dispositifs en grappes (tels que des élèves regroupés au sein de classes, ou des patients suivis par un même thérapeute) ou des dynamiques spatiales et relationnelles. L’absence de corrélation sérielle ou hiérarchique est impérative : sans elle, le modèle s’illusionne sur la quantité réelle d’informations indépendantes contenues dans l’échantillon, générant des degrés de liberté fictifs.
Le troisième pilier est l’homogénéité de la variance conditionnelle des erreurs, formellement désignée sous le terme d’homoscédasticité. Elle stipule que la dispersion des résidus doit demeurer parfaitement constante, quelle que soit la valeur prise par les variables prédictives ou les valeurs ajustées issues du modèle. Enfin, le quatrième pilier requiert que la distribution des résidus conditionnels suive une loi normale (gaussienne). Alors que les trois premiers postulats sont rigoureusement nécessaires pour garantir l’absence de biais et l’efficacité optimale des coefficients au sens du théorème de Gauss-Markov, le postulat de normalité résiduelle conditionne l’exactitude des tests inférentiels ($t$ de Student et $F$ de Fisher) à taille d’échantillon finie. Comprendre l’interaction intime entre ces quatre piliers constitue le prérequis absolu à toute pratique analytique responsable.
2. Premier postulat : La linéarité de la relation structurelle
2.1 Définition mathématique et conceptuelle de la linéarité des paramètres
Dans l’architecture de la régression linéaire, l’intitulé « linéaire » est fréquemment l’objet d’une confusion conceptuelle majeure parmi les praticiens. Il est crucial d’établir une distinction épistémologique stricte entre la linéarité par rapport aux variables explicatives et la linéarité par rapport aux paramètres du modèle. La méthode des moindres carrés ordinaires n’exige nullement que la relation entre la variable dépendante $Y$ et un prédicteur $X$ soit représentée par une ligne droite dans l’espace euclidien. En revanche, elle impose que l’équation reliant la variable dépendante aux coefficients inconnus $\beta$ soit strictement linéaire en ces paramètres. Ainsi, un modèle formulé comme $Y_i = \beta_0 + \beta_1 X_i + \beta_2 X_i^2 + \varepsilon_i$ est formellement un modèle linéaire au sens des MCO, bien que la trajectoire géométrique résultante soit parabolique.
Sur le plan formel, la condition de linéarité structurelle s’exprime à travers l’hypothèse d’espérance conditionnelle nulle des perturbations stochastiques :
$$E(\varepsilon_i mid X_{i1}, X_{i2}, dots, X_{ik}) = 0$$
Cette équation fondamentale stipule que pour toute combinaison donnée des valeurs des prédicteurs, la moyenne théorique des termes d’erreur résiduels est égale à zéro. En termes géométriques et substantiels, cela implique que la fonction déterministe $f(X) = X\beta$ capte l’intégralité du patron systématique liant les variables indépendantes au critère, ne laissant dans le terme résiduel $\varepsilon_i$ qu’une composante aléatoire non structurée, de moyenne nulle, assimilable à un bruit blanc pur.
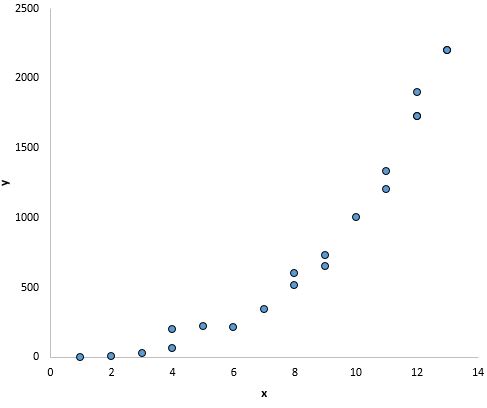
Si la spécification du modèle est erronée — par exemple si la véritable relation sous-jacente est une fonction exponentielle ou sigmoïde alors que le chercheur impose une pente linéaire brute —, l’espérance conditionnelle des erreurs dévie de zéro et devient elle-même fonction de $X$. Les conséquences mathématiques sur les estimateurs MCO sont désastreuses : les coefficients $\hat{\beta}$ deviennent structurellement biaisés et non convergents. Augmenter indéfiniment la taille de l’échantillon $N$ ne résout en rien cette tare, car l’estimateur converge asymptotiquement vers une valeur théorique fausse, fixée par la déformation de l’approximation linéaire. Dans le champ des sciences comportementales, cette défaillance se traduit par une incapacité radicale à modéliser des phénomènes omniprésents tels que les seuils critiques d’activation cognitive, les rendements décroissants des apprentissages ou les dynamiques d’épuisement émotionnel.
2.2 Manifestations concrètes de la non-linéarité en sciences psychologiques
Les réalités phénoménologiques explorées par la psychologie et la psychiatrie empirique se plient rarement à des architectures strictement linéaires. L’un des exemples canoniques les plus illustres est incarné par la loi de Yerkes-Dodson, qui formalise la relation empirique entre le niveau d’éveil physiologique (ou l’anxiété) et l’efficacité de la performance cognitive sous la forme d’une courbe en U inversé. À de faibles niveaux d’activation, la performance est médiocre en raison d’un manque d’engagement attentionnel ; elle atteint un pic optimal à un niveau d’éveil modéré, puis s’effondre consécutivement à une anxiété excessive et à la saturation des ressources attentionnelles. Tenter de capturer cette dynamique via une régression linéaire simple produira un coefficient global $\beta$ potentiellement proche de zéro, incitant fallacieusement le chercheur à conclure à l’absence d’association entre stress et cognition.
De même, les protocoles d’évaluation clinique se heurtent systématiquement à des effets de saturation fonctionnelle et à des limites de mesurabilité. Les échelles standardisées mesurant des construits tels que la symptomatologie dépressive ou la détresse traumatique présentent des seuils de plancher et de plafond notables. L’accroissement d’un stresseur environnemental n’exerce plus le même effet différentiel chez un individu sévèrement traumatisé dont le score clinique plafonne déjà au sommet de l’échelle, comparativement à un individu modérément exposé. La relation sous-jacente adopte alors une forme asymptotique ou sigmoïdale caractéristique, rebelle à toute simplification par un gradient linéaire continu.
Enfin, les processus psychophysiques fondamentaux et les courbes d’apprentissage individuel illustrent cette non-linéarité omniprésente. Qu’il s’agisse de la loi de Weber-Fechner relative à la perception sensorielle ou des dynamiques de consolidation mnésique au fil des essais expérimentaux, le taux de progression cognitive est typiquement logarithmique : les gains initiaux sont spectaculaires avant d’atteindre un plateau de consolidation. Lorsque de telles dynamiques sont contraintes au sein d’un cadre linéaire additif sans transformations préalables, les résidus du modèle accumulent des distorsions prédictives massives, qui masquent fréquemment des interactions multiplicatives complexes entre les prédicteurs.
3. Protocoles de diagnostic pour évaluer l’hypothèse de linéarité
3.1 Diagnostics graphiques des relations bivariées et multivariées
L’évaluation empirique du postulat de linéarité repose en première instance sur une panoplie d’inspections graphiques rigoureuses, bien plus informatives que l’examen isolé de métriques globales comme le $R^2$. Pour les relations bivariées, la construction de nuages de points enrichis d’un lissage non paramétrique par régression locale pondérée, couramment désignée sous le nom de lissage LOESS (Locally Estimated Scatterplot Smoothing), constitue le premier réflexe méthodologique. En ajustant localement des polynômes de bas degré sans imposer de contrainte paramétrique globale, la courbe LOESS permet d’épouser fidèlement les oscillations des données et d’exposer immédiatement à l’œil nu d’éventuelles inflexions quadratiques, courbures exponentielles ou saturations sigmoïdes.
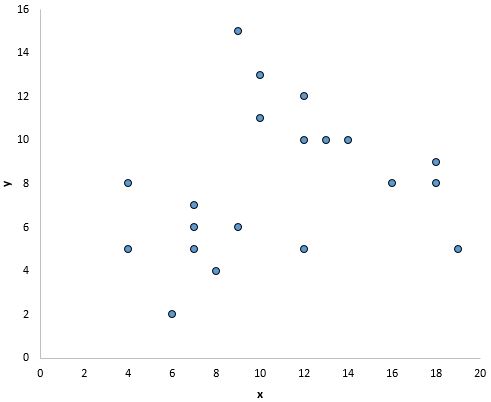
Dans un contexte multivarié, où les relations entre variables sont conditionnées par la présence simultanée de multiples régresseurs, les diagrammes de dispersion simples deviennent insuffisants. L’outil diagnostique cardinal est alors le graphique des résidus en fonction des valeurs ajustées (Residuals vs Fitted plot). Dans un modèle satisfaisant rigoureusement au postulat de linéarité, le nuage des résidus ordinaires ou studentisés doit se répartir de façon aléatoire et isotrope au sein d’une bande horizontale d’épaisseur constante, centrée sur la ligne d’ordonnée zéro. Si le lissage LOESS appliqué à ce graphique résiduel trace une trajectoire parabolique en U, une sinusoïde ou une courbure concave marquée, la présence d’une misspecification non linéaire est établie de manière indubitable.
Pour démasquer quel régresseur individuel est responsable de la courbure observée au sein d’un modèle multidimensionnel, le recours aux graphiques de résidus partiels, également appelés diagrammes de variables ajoutées (Added-Variable Plots ou Component-plus-Residual Plots), est impératif. En reportant sur l’axe des ordonnées le résidu de la variable dépendante régressée sur tous les prédicteurs à l’exception d’un prédicteur $X_j$, contre le résidu de ce même $X_j$ régressé sur tous les autres prédicteurs, ce dispositif isole la relation marginale univoque entre $X_j$ et $Y$. Si la tendance observée dans ce plan partiel dévie de la rectitude, elle indique avec précision la composante du modèle nécessitant une correction structurelle.
3.2 Tests d’hypothèses statistiques pour confirmer la spécification fonctionnelle
Bien que l’inspection graphique demeure irremplaçable, elle gagne à être corroborée par des tests d’hypothèses formels visant à réfuter statistiquement l’adéquation de la forme fonctionnelle linéaire. Parmi ces procédures, le test RESET de Ramsey (Regression Equation Specification Error Test) occupe une position prééminente dans la littérature économétrique et psychométrique. Ce test repose sur une intuition élégante : si la forme fonctionnelle linéaire est parfaitement spécifiée, l’adjonction de puissances supérieures des valeurs prédites (généralement $\hat{Y}^2$, $\hat{Y}^3$ et $\hat{Y}^4$) au modèle de base ne devrait apporter aucun pouvoir explicatif additionnel statistiquement significatif.
Le test RESET évalue formellement l’hypothèse nulle $H_0 : \gamma_1 = \gamma_2 = dots = \gamma_k = 0$ au sein de la régression auxiliaire :
$$Y_i = X_i\beta + \sum_{p=2}^{m} \gamma_{p-1} \hat{Y}_i^p + u_i$$
au moyen d’une statistique de test $F$ de Fisher. Un rejet de l’hypothèse nulle ($p < 0{,}05$) signale de manière formelle qu'une part systématique de la variance n'a pas été captée par les termes linéaires initiaux, indiquant l'omission de composantes d'ordre supérieur ou d'effets d'interaction structurels.
Une démarche complémentaire consiste à comparer directement des modèles emboîtés par le test du rapport de vraisemblance (Likelihood Ratio Test, LRT) ou par le test $F$ de changement de $R^2$. Le chercheur spécifie explicitement un modèle concurrent enrichi de termes polynomiaux (par exemple quadratiques) ou logarithmiques, et évalue si l’amélioration de l’ajustement global dépasse substantiellement celle attendue sous les simples fluctuations de l’échantillonnage. Il convient toutefois de manier ces tests formels avec un discernement critique : sur des échantillons de très grande taille ($N > 10,000$), des déviations minuscules et théoriquement négligeables par rapport à la linéarité atteindront le seuil de significativité statistique conventionnel, risquant de conduire à une complexification inutile du modèle sans gain écologique mesurable.
4. Stratégies méthodologiques face à la violation de la linéarité
4.1 Transformations mathématiques des variables indépendantes et dépendantes
Face à une déviation attestée du postulat de linéarité, la transformation mathématique des variables constitue la réponse méthodologique la plus classique, permettant de rétablir la linéarité des paramètres sans quitter le cadre élégant des moindres carrés. Lorsque les phénomènes sous-jacents suivent des lois de croissance exponentielle ou de rendements marginaux décroissants, l’application d’une fonction logarithmique (népérienne ou décimale) s’avère hautement féconde. La modélisation log-linéaire ou log-log permet d’absorber les relations multiplicatives et de linéariser des dynamiques asymétriques, récurrentes dans l’étude des latences cognitives ou des niveaux de revenus dans les enquêtes sociopsychologiques.
Afin de systématiser le choix de la transformation optimale sans recourir à des tâtonnements subjectifs, la famille de transformations de Box-Cox fournit un cadre d’estimation paramétrique rigoureux pour les variables strictement positives :
$$y^{(\lambda)} = \begin{\cases} \dfrac{y^\lambda – 1}{\lambda}, &a\mp; \text{si } \lambda \neq 0 \ln(y), &a\mp; \text{si } \lambda = 0 \end{\cases}$$
Par une procédure d’estimation par maximum de vraisemblance, l’algorithme identifie la valeur optimale du paramètre $lambda$ qui maximise la normalité et la linéarité des résidus du modèle ajusté. Lorsque $\lambda = 0{,}5$, la transformation équivaut fonctionnellement à une racine carrée, particulièrement efficiente pour linéariser les données de comptage ou les fréquences comportementales rares ; lorsque $lambda = -1$, elle correspond à une transformation inverse, traditionnellement assignée aux chronométries et temps de réaction où l’on modélise préférentiellement la vitesse plutôt que la durée brute.
Ces manœuvres mathématiques soulèvent cependant des défis herméneutiques majeurs. L’interprétation intuitive des coefficients de régression sur des échelles transformées exige une gymnastique mentale qui obscurcit fréquemment la communication scientifique. Un coefficient $\beta$ obtenu dans un modèle log-linéaire ne renvoie plus à une augmentation absolue en unités métriques brutes de la variable dépendante par unité de $X$, mais à une variation relative en pourcentage (élasticité ou semi-élasticité). En psychométrie clinique, cela peut altérer la signification directe de scores normés sur des échelles diagnostiques étalonnées, contraignant le chercheur à opérer des rétrotractions non linéaires complexes pour restituer la pertinence clinique de ses conclusions.
4.2 Recours à des architectures de modélisation non linéaires alternatives
Lorsque les transformations univariées de variables s’avèrent impuissantes à capturer des géométries empiriques complexes, le chercheur doit se tourner vers des architectures de modélisation plus sophistiquées. L’adjonction de termes polynomiaux orthogonaux représente l’extension la plus directe, autorisant la prise en compte de dynamiques quadratiques (en U) ou cubiques (en S). L’utilisation de polynômes orthogonaux est ici primordiale afin de circonscrire l’inflation désastreuse de la multicolinéarité qui découle inévitablement de l’élévation d’un prédicteur brut au carré ou au cube.
Pour une flexibilité accrue sans postuler a priori une forme géométrique rigide, les Modèles Additifs Généralisés (Generalized Additive Models, GAM) constituent l’apogée contemporaine de l’approche semi-paramétrique. Formalisés initialement par Trevor Hastie et Robert Tibshirani, les GAM remplacent le prédicteur linéaire standard $\sum \beta_j X_j$ par une somme de fonctions de lissage non paramétriques lisses :
$$E(Y) = \beta_0 + \sum_{j=1}^p s_j(X_j)$$
où chaque $s_j(\cdot)$ est une fonction spline pénalisée estimée directement à partir des données via une validation croisée généralisée (GCV). Cette modélisation offre une capacité d’ajustement sans égale face aux processus d’adaptation biologique ou aux fluctuations émotionnelles non monotones, tout en préservant l’additivité et l’interprétabilité des effets marginaux de chaque prédicteur individuel.
Enfin, lorsque la théorie psychologique suggère l’existence d’une rupture structurelle nette ou d’un point de bascule développemental, la régression segmentée (piecewise linear regression) s’impose comme l’outil électif. Elle permet d’estimer des pentes distinctes de part et d’autre d’un ou plusieurs seuils critiques (breakpoints ou knots), identifiés soit théoriquement, soit par optimisation algorithmique. Dans des cadres plus contraignants encore, la modélisation non linéaire paramétrique directe — ajustant par moindres carrés non linéaires des fonctions logistiques, de Gompertz ou de Michaelis-Menten — permet d’ancrer formellement les paramètres estimés dans des lois biophysiques ou cognitives établies, offrant une supériorité épistémique indéniable sur l’ajustement polynomial empirique brut.
5. Deuxième postulat : L’indépendance conditionnelle des erreurs
5.1 Fondements théoriques de l’absence d’autocorrélation résiduelle
Le deuxième pilier indispensable à l’édifice des moindres carrés ordinaires stipule l’indépendance conditionnelle des termes d’erreur résiduels. Sur le plan de la théorie des probabilités, ce postulat requiert que la covariance stochastique entre deux erreurs quelconques associées à des observations différentes soit rigoureusement nulle :
$$\mathrm{Cov}(\varepsilon_i, \varepsilon_j mid X) = 0 \quad \forall ; i \neq j$$
En d’autres termes, la connaissance de l’amplitude ou de la direction de la déviation résiduelle d’une unité expérimentale donnée ne doit conférer absolument aucune information prédictive sur l’erreur résiduelle observée pour une autre unité de l’échantillon. Cette hypothèse assure que chaque ligne de la matrice des données apporte une contribution informationnelle entièrement autonome et non redondante à l’estimation des coefficients.
Lorsque cette indépendance est violée — une condition génériquement désignée sous le terme d’autocorrélation ou de corrélation sérielle/spatiale —, les conséquences mathématiques sur l’inférence statistique sont dévastatrices. Il est capital de noter que les coefficients de régression $\hat{\beta}$ eux-mêmes conservent techniquement leur propriété de non-biaisitude : ils continuent d’estimer les grandeurs moyennes réelles de la population si la forme fonctionnelle est correcte. En revanche, ils perdent irrévocablement leur statut de variance minimale ; ils ne sont plus BLUE. L’estimateur MCO devient particulièrement inefficace, fluctuant de façon chaotique d’un échantillon à un autre comparativement à des estimateurs intégrant explicitement la matrice de corrélation des erreurs.
Le dommage le plus pernicieux infligé par la dépendance résiduelle réside dans la sous-estimation dramatique de la variance des estimateurs par les formules de calcul usuelles. Dans la quasi-totalité des contextes comportementaux, les corrélations résiduelles sont positives. Les MCO traitent alors des observations redondantes comme si elles représentaient des entités d’information totalement indépendantes. La formule analytique de l’erreur type des coefficients s’effondre artificiellement, affichant des valeurs qui peuvent être sous-évaluées d’un facteur 2, 3 ou 5. Les statistiques $t$ de Student calculées par le ratio $\hat{\beta} / \mathrm{SE}(\hat{\beta})$ explosent de manière artificielle, catapultant les valeurs de $p$ sous les seuils de significativité conventionnels et déclenchant une prolifération massive de faux positifs méthodologiques.
5.2 Sources communes de dépendance des observations en psychologie
La recherche comportementale et neuropsychologique est, par essence, particulièrement vulnérable aux violations de l’indépendance conditionnelle en raison de la nature écologique de ses terrains d’investigation. La première source manifeste de dépendance réside dans les protocoles à mesures répétées et les devis longitudinaux. Lorsqu’un même participant est soumis à de multiples vagues d’évaluation à travers le temps — qu’il s’agisse de mesurer la trajectoire de déclin exécutif sur cinq ans ou d’évaluer la réponse neurocognitive à différents dosages d’une molécule psychoactive —, les résidus associés à cet individu partagent inévitablement des composantes stables non observées (traits génétiques, résilience, histoire développementale), générant une forte autocorrélation intra-sujet.
Une deuxième source majeure relève des structures hiérarchiques ou données en grappes (clustered data). Dans les sciences de l’éducation et la psychologie organisationnelle, les individus ne sont jamais échantillonnés dans un vide social : les élèves sont imbriqués dans des classes, elles-mêmes nichées au sein d’établissements scolaires partageant des climats pédagogiques et des compositions socio-économiques spécifiques ; de même, les salariés sont groupés dans des équipes opérationnelles sous la tutelle de mêmes managers. Les résidus de participants appartenant à une même grappe manifestent une ressemblance systématique induite par l’exposition à un environnement contextuel partagé, brisant irrémédiablement l’indépendance stochastique postulée par la régression conventionnelle.
Enfin, l’avènement des méthodologies de collecte numérique en temps réel, telles que l’évaluation écologique momentanée (Ecological Momentary Assessment, EMA) ou le journal de bord quotidien sur smartphone, expose les analystes à des séries temporelles individuelles denses. Dans ce cadre micro-longitudinal, où un participant répond à des auto-évaluations émotionnelles plusieurs fois par jour pendant des semaines, l’erreur résiduelle à l’instant $t$ est structurellement conditionnée par l’erreur à l’instant $t-1$ (effet de carry-over ou inertie émotionnelle). De même, les plans d’échantillonnage par réseau social ou méthode « boule de neige » génèrent une interdépendance relationnelle diffuse qui viole l’autonomie informationnelle des observations.
6. Techniques diagnostiques de l’indépendance des résidus
6.1 Outils statistiques d’évaluation de l’autocorrélation
Pour statuer rigoureusement sur la validité de l’indépendance conditionnelle, le statisticien dispose d’un ensemble d’outils analytiques adaptés aux diverses topologies de dépendance. Dans le cadre classique des données ordonnées temporellement ou séquentiellement, la statistique de Durbin-Watson ($d$) demeure la procédure historique de référence. Conçue spécifiquement pour identifier une autocorrélation de premier ordre de type autorégressif AR(1), elle est définie par le quotient de la somme des carrés des différences successives des résidus par la somme des carrés résiduels globaux :
$$d = \frac{\sum_{i=2}^n (e_i – e_{i-1})^2}{\sum_{i=1}^n e_i^2} \approx 2(1 – \hat{\rho})$$
où $\hat{\rho}$ représente le coefficient d’autocorrélation empirique des résidus. Une valeur de $d$ oscillant étroitement autour de 2 signale l’absence d’autocorrélation sérielle ; une valeur chutant vers 0 trahit une autocorrélation positive sévère, tandis qu’une valeur tendant vers 4 dénonce une autocorrélation négative.
Le test de Durbin-Watson présente toutefois des limites notables : il ne teste que la dépendance d’ordre 1 et devient invalide si le modèle intègre une valeur retardée de la variable dépendante parmi ses prédicteurs. Pour pallier ces carences, le test de Breusch-Godfrey (test du multiplicateur de Lagrange) s’impose comme une alternative bien plus robuste et polyvalente. Ce test autorise la détection d’autocorrélations d’ordres arbitrairement supérieurs, $\mathrm{AR}(p)$, et s’adapte sans distorsion à la présence de variables endogènes retardées, évaluant formellement la significativité globale de la régression auxiliaire des résidus courants sur l’ensemble des résidus antérieurs jusqu’au décalage $p$.
Face à des données hiérarchisées ou groupées spatialement plutôt que temporelles, l’évaluation de la dépendance passe impérativement par le calcul du coefficient de corrélation intraclasse (Intraclass Correlation Coefficient, ICC). Dérivé d’un modèle d’analyse de variance à effets aléatoires ou modèle sans prédicteur (null model), l’ICC quantifie la proportion de la variance résiduelle totale qui est imputable à l’appartenance aux grappes :
$$\mathrm{ICC} = \frac{\tau_{00}}{\tau_{00} + \sigma^2}$$
où $\tau_{00}$ est la variance inter-groupes et $\sigma^2$ la variance intra-groupe. Même une valeur d’ICC modeste (par exemple 0,05, indiquant que seulement 5 % de la variance réside au niveau du groupe) suffit à gonfler massivement le taux d’erreur de type I si une régression MCO standard est déployée sans ajustement hiérarchique.
6.2 Diagnostics graphiques pour détecter la structure de dépendance
La confirmation analytique de l’autocorrélation ne saurait faire l’économie de visualisations graphiques ciblées, indispensables pour identifier la forme géométrique précise prise par l’interdépendance. Lorsque les données disposent d’un ordonnancement séquentiel, le tracé de la fonction d’autocorrélation empirique (ACF) et de la fonction d’autocorrélation partielle (PACF) constitue le dispositif de diagnostic de pointe. L’ACF représente graphiquement le coefficient de corrélation entre les résidus $e_t$ et leurs valeurs décalées $e_{t-k}$ pour une succession de décalages temporels (lags $k = 1, 2, 3, dots$). La présence de barres verticales excédant les limites en pointillé des intervalles de confiance à 95 % établit de façon spectaculaire la persistance d’une mémoire stochastique résiduelle.
Un autre outil visuel éminemment intuitif est le graphique séquentiel des résidus ordonnés dans le temps ou selon l’axe de collecte (Residuals Sequence Plot). Dans ce plan, les résidus sont reportés sur l’axe des ordonnées tandis que l’index chronologique de l’observation occupe l’axe des abscisses, les points successifs étant reliés par un trait continu. Sous l’hypothèse nulle d’indépendance conditionnelle, le graphique doit ressembler à un tracé chaotique oscillant de façon erratique et rapide autour de zéro. À l’inverse, l’existence d’une autocorrélation positive se matérialise par de longues vagues de résidus positifs consécutifs, suivies de lentes dérives sous la ligne zéro, formant des cycles et ondulations trahissant une inertie systémique des perturbations.
Dans les contextes de données nichées en grappes, le diagnostic graphique passe par l’inspection des boîtes à moustaches (boxplots) ou des diagrammes de dispersion des résidus stratifiés par unité d’échantillonnage de niveau 2 (par exemple par classe, école ou clinique). Si l’indépendance conditionnelle était respectée, les médianes résiduelles de chaque grappe devraient toutes s’aligner sur le zéro global avec des dispersions uniformes. L’observation fréquente de décalages verticaux marqués entre les grappes — certaines affichant une moyenne résiduelle systématiquement positive et d’autres systématiquement négative — apporte la preuve tangible que le modèle ignore une source majeure de variance écologique partagée, invalidant l’hypothèse de covariance nulle.
7. Résolution des violations d’indépendance : modèles multi-niveaux et temporels
7.1 Implémentation de modèles linéaires mixtes et hiérarchiques (HLM)
Face à des structures de données en grappes ou longitudinales transgressant frontalement l’indépendance stochastique, la modélisation linéaire mixte (Linear Mixed Models, LMM), également connue sous le nom de modélisation multiniveau ou hiérarchique (HLM), s’affirme comme le paradigme méthodologique de référence. Dépassant radicalement les limites des moindres carrés ordinaires, cette architecture statistique procède à une décomposition rigoureuse de la variance totale en composantes intra-sujet (ou intra-grappe) et inter-sujets (ou inter-grappes), évitant à la fois l’agrégation abusive (qui détruit l’hétérogénéité individuelle) et la désagrégation naïve (qui invente des degrés de liberté fictifs).
Dans sa formalisation canonique, le modèle mixte distingue explicitement les effets fixes ($\gamma$), qui décrivent l’association moyenne populationnelle entre les prédicteurs et le critère, des effets aléatoires ($u$), qui capturent les déviations idiosyncratiques spécifiques à chaque cluster. Ainsi, pour une observation individuelle $i$ imbriquée au sein d’une grappe $j$, l’équation s’articule :
$$Y_{ij} = \beta_{0j} + \beta_{1j} X_{ij} + \varepsilon_{ij}$$
avec des coefficients de niveau 2 modélisés comme :
$$\beta_{0j} = \gamma_{00} + u_{0j}, \quad \beta_{1j} = \gamma_{10} + u_{1j}$$
où $u_{0j}$ représente l’interception aléatoire (permettant à chaque grappe d’avoir son propre niveau de départ) et $u_{1j}$ représente la pente aléatoire (autorisant l’impact du prédicteur $X$ à varier librement selon l’environnement de la grappe). Les résidus de niveau 1, $\varepsilon_{ij}$, sont désormais délestés de la variance de groupe et recouvrent leur indépendance stochastique.
L’avantage épistémique des modèles mixtes pour les plans expérimentaux à mesures répétées et protocoles écologiques (EMA) est incommensurable. Non seulement ils neutralisent le biais sur les erreurs types induit par l’autocorrélation intra-sujet, mais ils acceptent avec une souplesse remarquable les données manquantes aléatoires (MAR) et les décalages d’intervalles temporels entre mesures, deux fléaux empiriques qui rendaient traditionnellement caduques les approches par analyse de variance à mesures répétées (ANOVA-RM).
7.2 Estimation avec erreurs types robustes et modélisation de séries temporelles
Lorsque la structure hiérarchique n’est pas au cœur de la conjecture théorique du chercheur et fonctionne simplement comme une nuisance d’échantillonnage, ou lorsque le nombre de grappes est très élevé sans nécessiter d’effets aléatoires explicites, l’estimation des erreurs types ajustées pour le regroupement (cluster-robust standard errors, CRSE) offre une solution élégante. Dérivée des travaux de Liang et Zeger sur les équations d’estimation généralisées (GEE) et de la matrice sandwich de Huber-White, cette technique conserve les coefficients bêtas estimés par les MCO conventionnels, mais recalcule la matrice asymptotique de variance-covariance en sommant directement les covariances croisées des résidus à l’intérieur de chaque grappe empirique, rétablissant la validité nominale des tests d’hypothèses.
Pour les données temporelles pures présentant une autocorrélation persistante combinée à une hétérogénéité résiduelle, l’estimateur de Newey-West constitue le remède non paramétrique par excellence. Cet estimateur corrige la matrice de variance en intégrant une pondération de Bartlett décroissante sur les covariances décalées jusqu’à un certain horizon temporel $L$, garantissant que les erreurs types résultantes demeurent convergentes tant face à l’hétéroscédasticité qu’à l’autocorrélation (propriété HAC : Heteroscedasticity and Autocorrelation Consistent). Le chercheur peut alors continuer d’interpréter ses coefficients MCO usuels en s’appuyant sur des statistiques $t$ corrigées pour l’interdépendance sérielle.
Enfin, lorsque la dépendance temporelle reflète un processus endogène complexe, le chercheur doit abandonner les MCO au profit de modèles autorégressifs intégrés à moyenne mobile (ARIMA) ou spécifier des structures de covariance des erreurs paramétrées — telles que les processus autorégressifs continus CAR(1) ou les matrices de Toeplitz — au sein de modèles par moindres carrés généralisés (GLS). En psychodynamique moderne, cette approche culmine dans les modèles d’équations différentielles stochastiques et les modèles d’état-espace, qui permettent de désintriquer le signal autorégressif substantiel (l’inertie psychologique) de l’erreur de mesure purement stochastique.
8. Troisième postulat : L’homoscédasticité de la variance d’erreur
8.1 Définition mathématique et implications de la variance constante
Le troisième postulat fondamental conditionnant la performance de la régression linéaire des moindres carrés réside dans l’homogénéité de la dispersion des perturbations, concept désigné dans la littérature sous le terme d’homoscédasticité. Formellement, cette condition impose que la variance conditionnelle des termes d’erreur résiduels demeure strictement invariante et égale à une constante finie positive, notée $\sigma^2$, quel que soit le point considéré dans l’espace multidimensionnel défini par les variables explicatives :
$$\mathrm{Var}(\varepsilon_i mid X_{i1}, X_{i2}, dots, X_{ik}) = \sigma^2 \quad \forall ; i = 1, dots, n$$
Sous forme matricielle condensée, la matrice de variance-covariance des erreurs s’écrit alors $\mathbf{\Sigma} = \sigma^2 \mathbf{I}_n$, où $\mathbf{I}_n$ représente la matrice identité de dimension $n \times n$. Cette spécification garantit que chaque observation empirique est affectée de la même précision stochastique intrinsèque.
Lorsque cette stabilité est rompue — situation qualifiée d’hétéroscédasticité —, la variance de l’erreur devient une fonction non constante des régresseurs, notée $\sigma_i^2 = f(X_i)$. Les répercussions de cette pathologie sur les estimateurs des moindres carrés ordinaires doivent être appréhendées avec une précision chirurgicale. À l’instar de ce qui prévaut lors de violations de l’indépendance, l’hétéroscédasticité n’introduit aucun biais intrinsèque dans les estimateurs ponctuels des coefficients $\hat{\beta}$ : les valeurs des pentes estimées continuent de converger asymptotiquement vers les paramètres réels de la population. L’intégrité de la prédiction moyenne n’est donc pas systématiquement faussée à grande échelle.
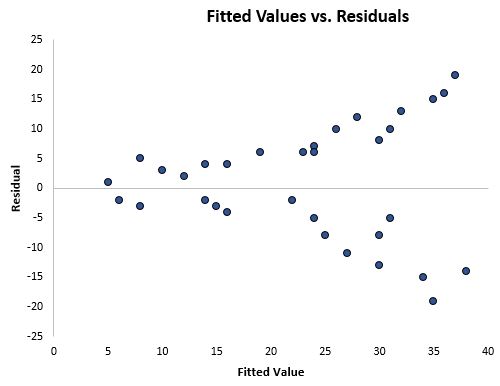
Cependant, l’hétéroscédasticité pulvérise le statut BLUE garanti par le théorème de Gauss-Markov. Les estimateurs MCO perdent leur efficacité : ils cessent d’être les plus précis parmi la classe des estimateurs linéaires sans biais, ce qui signifie qu’ils manifestent une variabilité d’échantillonnage inutilement large. Plus grave encore, l’hétéroscédasticité corrompt de façon fatale l’estimateur classique de la matrice de variance-covariance des coefficients $\hat{\beta}$. Les erreurs types standards produites par les logiciels conventionnels deviennent mathématiquement fausses, déformant simultanément les statistiques $t$ de Student individuelles et les tests $F$ de Fisher omnibus. Enfin, sur le plan clinique appliqué, l’hétéroscédasticité rend les intervalles de prévision individuels fallacieux : prédire le niveau d’adaptation d’un patient avec une marge d’erreur uniforme calculée sur tout l’échantillon devient aberrant si la dispersion des résidus est en réalité trois fois plus large pour les scores extrêmes que pour les scores moyens.
8.2 Origines fréquentes de l’hétéroscédasticité dans les données comportementales
L’émergence de l’hétéroscédasticité dans les jeux de données expérimentaux et corrélationnels en sciences humaines découle directement de mécanismes psychologiques et cognitifs bien documentés. L’un des vecteurs les plus répandus est l’instabilité de la performance cognitive aux âges extrêmes ou sous conditions de fatigue intense. Alors que des adultes jeunes et reposés manifestent une variabilité de temps de réaction très resserrée autour de leur moyenne individuelle, des enfants en développement, des personnes âgées ou des sujets privés de sommeil présentent une variance intra- et interindividuelle spectaculairement accrue. Dès lors que l’âge ou la charge cognitive est introduit comme prédicteur continu, l’enveloppe résiduelle s’évase inévitablement au fur et à mesure que l’on progresse le long de l’axe des abscisses.
Un mécanisme inverse, mais tout aussi générateur d’hétéroscédasticité, concerne les effets d’apprentissage et de consolidation procédurale. Au cours des premières sessions d’une tâche motrice ou intellectuelle novatrice, les participants exhibent une dispersion de performance considérable, liée à des écarts majeurs de styles cognitifs et d’habiletés initiales. Au fur et à mesure de la répétition des blocs expérimentaux, la variance résiduelle se contracte drastiquement sous l’effet de l’automatisation comportementale. Le modèle de régression linéaire appliqué à ce type de suivi temporel verra ses résidus se comprimer progressivement, dessinant un entonnoir inversé incompatible avec l’hypothèse de dispersion constante.
Par ailleurs, les artefacts d’échelles psychométriques dotées d’effets de seuil (plancher ou plafond) induisent mécaniquement de l’hétéroscédasticité conditionnelle. Chez les sujets se situant au voisinage du plancher d’une échelle d’anxiété (score proche de zéro), l’erreur résiduelle ne peut s’exprimer que dans une direction strictement positive et avec une amplitude comprimée par la borne de l’instrument, tandis qu’au centre de l’échelle, les résidus oscillent avec une liberté bidirectionnelle maximale. Enfin, l’hétéroscédasticité trahit très souvent l’omission d’une interaction fondamentale au sein du modèle théorique : si l’effet de $X_1$ sur $Y$ dépend en réalité de la valeur d’un trait modérateur $X_2$ non mesuré ou non intégré à l’équation, cette variabilité conditionnelle inexpliquée sera absorbée par le terme d’erreur résiduel, qui verra sa dispersion osciller systématiquement selon les niveaux de $X_1$.
9. Approches diagnostiques pour identifier l’hétéroscédasticité
9.1 Examens visuels des résidus standardisés et studentisés
La recherche méthodique de l’hétéroscédasticité s’ouvre impérativement par une inspection graphique approfondie, conçue pour révéler la géométrie spatiale de la dispersion des résidus. Bien que le graphique des résidus bruts contre les valeurs ajustées offre de premiers indices, l’outil visuel le plus sensible et recommandé est le graphique d’échelle-localisation (Scale-Location plot ou Spread-Location plot). Ce diagnostic reporte sur l’axe des ordonnées la racine carrée des résidus standardisés absolus, $\sqrt{|e_i^*|}$, en fonction des valeurs prédites $\hat{Y}_i$ sur l’axe des abscisses. L’application de la transformation racine carrée stabilise les fluctuations stochastiques et replie la distribution résiduelle sur un domaine strictement positif, facilitant grandement la détection des dérives de dispersion.
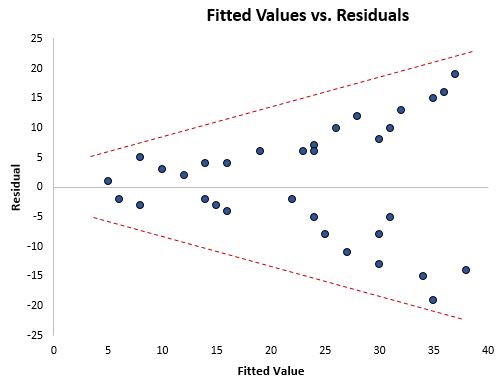
Dans une configuration d’homoscédasticité idéale, le nuage de points du graphique d’échelle-localisation doit se déployer de manière uniforme et homogène, tandis que la courbe de lissage LOESS superposée doit adopter une horizontalité parfaite. L’apparition d’un patron conique, en éventail ou en entonnoir — où les points s’écartent massivement de l’axe au fur et à mesure que $\hat{Y}$ s’élève — constitue la signature visuelle incontestable d’une hétéroscédasticité croissante. De manière analogue, un resserrement progressif des points dénonce une hétéroscédasticité décroissante, souvent liée à des saturations instrumentales de mesure.
Il est tout aussi fondamental d’inspecter la dispersion des résidus le long de l’axe de chaque régresseur individuel pris isolément. Cette étape permet d’isoler si l’instabilité de la variance est diffuse à travers l’espace prédictif global ou si elle est spécifiquement indexée sur une covariable clinique ou démographique particulière. Enfin, l’analyste doit impérativement examiner la présence de valeurs aberrantes (outliers) et d’observations à fort levier (high-leverage points) : une poignée de points extrêmes situés aux marges de la distribution peut artificiellement faire exploser l’estimation locale de la variance, mimant un patron d’hétéroscédasticité globale qui disparaît dès que ces singularités sont convenablement modélisées.
9.2 Batterie de tests formels d’hétéroscédasticité
Pour dépasser l’appréciation visuelle et asseoir le diagnostic sur une démonstration probante, la littérature économétrique et statistique a conçu une série de tests d’hypothèses formels. Le test de référence le plus largement implémenté est le test de Breusch-Pagan, enrichi par les contributions de Koenker pour relâcher la stricte contrainte de normalité. Le test de Breusch-Pagan évalue si les carrés des résidus standardisés peuvent être prédits linéairement par l’ensemble ou une fraction des variables indépendantes via une régression auxiliaire :
$$e_i^2 = \gamma_0 + \gamma_1 X_{i1} + dots + \gamma_k X_{ik} + \nu_i$$
L’hypothèse nulle stipule l’homogénéité globale ($H_0 : \gamma_1 = dots = \gamma_k = 0$). La statistique de test, régie asymptotiquement par une loi du $\chi^2$ à $k$ degrés de liberté sous $H_0$, conduit en cas de rejet ($p < 0{,}05$) à la réfutation catégorique de l'homoscédasticité linéaire.
Le test de Breusch-Pagan présente néanmoins une vulnérabilité : il teste exclusivement une dérive linéaire de la variance. Si la relation entre les régresseurs et la dispersion résiduelle adopte une forme non linéaire complexe, le test peut échouer à détecter l’hétéroscédasticité. Pour remédier à cette restriction, Halbert White a développé le test général de White, souvent considéré comme le standard absolu de la robustesse diagnostique. Le test de White exécute une régression auxiliaire des résidus au carré sur toutes les variables indépendantes initiales, leurs puissances au carré ($X_j^2$), ainsi que l’ensemble de leurs produits croisés ou interactions d’ordre 2 ($X_j X_l$). Dépourvu de toute supposition quant à la structure géométrique de l’hétéroscédasticité, le test de White offre une puissance de détection omnidirectionnelle remarquable.
Dans des contextes où les participants sont répartis entre des conditions discrètes ou des groupes naturels présentant des tailles asymétriques, le test de Goldfeld-Quandt constitue une alternative paramétrique élégante. En ordonnant l’échantillon selon les valeurs d’une covariable clé et en comparant le ratio des variances résiduelles issues de deux sous-échantillons extrêmes (après avoir éliminé un segment central neutre), le test produit une statistique régie de façon exacte par une loi de Fisher-Snedecor $F$. Toutefois, le chercheur doit garder à l’esprit que l’ensemble de ces tests formels souffre d’une hypersensibilité chronique aux échantillons massifs : pour de très grands effectifs, un test de White rejettera quasi systématiquement l’hypothèse nulle pour des instabilités de variance dénuées de tout impact pragmatique sur l’inférence.
10. Traitements et modélisations robustes face à l’hétéroscédasticité
10.1 Estimation par moindres carrés pondérés (WLS) et généralisés (GLS)
Lorsque la structure de l’hétéroscédasticité est formellement documentée ou déductible d’un principe biophysique, la méthode des moindres carrés pondérés (Weighted Least Squares, WLS), cas particulier de l’estimation par moindres carrés généralisés (GLS), constitue l’intervention mathématique la plus rigoureuse pour restaurer l’optimalité statistique. Le principe directeur de l’estimation WLS consiste à rééquilibrer le rôle de chaque observation au sein de la fonction de perte : au lieu de minimiser la somme simple des carrés des résidus, l’algorithme attribue à chaque résidu un coefficient de pondération $w_i$ inversement proportionnel à la variance résiduelle conditionnelle locale :
$$w_i = \frac{1}{\sigma_i^2}$$
Les observations caractérisées par une imprécision majeure (large dispersion) reçoivent ainsi un poids affaibli dans l’ajustement du modèle, tandis que les observations d’une précision chirurgicale (faible dispersion) guident prioritairement la fixation des paramètres.
Sur le plan formel, cette procédure équivaut à normaliser les équations originales en divisant chaque terme par son écart-type conditionnel $\sigma_i$. Le modèle transformé :
$$\frac{Y_i}{\sigma_i} = \beta_0 \frac{1}{\sigma_i} + \beta_1 \frac{X_{i1}}{\sigma_i} + dots + \beta_k \frac{X_{ik}}{\sigma_i} + \frac{\varepsilon_i}{\sigma_i}$$
satisfait désormais scrupuleusement au critère d’homoscédasticité, puisque $\mathrm{Var}(\varepsilon_i / \sigma_i) = 1$. L’estimateur WLS qui en résulte retrouve intégralement son statut d’estimateur de variance minimale (BLUE) au sens du théorème de Gauss-Markov, surpassant sans équivoque l’efficience des MCO ordinaires.
La mise en œuvre pratique des moindres carrés pondérés se heurte cependant à une difficulté empirique fondamentale : les véritables variances populationnelles $\sigma_i^2$ sont rarement connues a priori. Le chercheur est alors contraint de recourir aux moindres carrés pondérés réalisables (Feasible Generalized Least Squares, FGLS). Cette démarche itérative implique d’estimer en premier lieu un modèle MCO conventionnel, d’extraire les résidus empiriques au carré, puis de régresser leur logarithme naturel $\ln(e_i^2)$ sur les prédicteurs pour modéliser analytiquement la fonction de variance. Les valeurs prédites exponentiées issues de cette régression auxiliaire servent ensuite de pondérations $w_i$ pour l’ajustement final du modèle WLS. Cette technique exige toutefois une modélisation exacte de la fonction de variance, sous peine d’introduire de nouveaux biais d’estimation sur de petits échantillons.
10.2 Erreurs types robustes et approches non paramétriques
Face aux écueils de la spécification explicite de la fonction de variance requise par les WLS, la méthodologie contemporaine privilégie très largement le recours aux matrices d’erreurs types robustes à l’hétéroscédasticité (Heteroscedasticity-Consistent standard errors, HC). Développée initialement par Eicker et formalisée par Halbert White dans un article séminal de 1980, l’approche repose sur un estimateur « sandwich » de la matrice asymptotique de variance des coefficients. Au lieu d’assumer $\mathbf{\Sigma} = \sigma^2 \mathbf{I}$, l’estimateur de White (désigné sous l’acronyme HC0) utilise la matrice diagonale empirique des résidus au carré pour encapsuler l’hétérogénéité locale sans faire d’hypothèse fonctionnelle restrictive.
Bien que l’estimateur HC0 soit asymptotiquement convergent, des recherches subséquentes ont démontré qu’il manifeste un biais sévère à la baisse au sein d’échantillons de taille modeste ($N < 250$), amplifiant le risque d'erreur de type I. Une série de corrections successives a été proposée pour ajuster les résidus par les valeurs de levier $h_{ii}$ (éléments diagonaux de la matrice de projection hat) :
- HC1 : Applique un ajustement élémentaire par les degrés de liberté, en multipliant par $\sqrt{n / (n – k – 1)}$.
- HC2 : Divise chaque résidu au carré par $(1 – h_{ii})$, corrigeant de façon optimale le biais d’échantillon fini sous homoscédasticité.
- HC3 : Divise les résidus par $(1 – h_{ii})^2$, ce qui pénalise plus agressivement les points de fort levier et émule les performances d’une procédure jackknife.
- HC4 : Introduit un facteur de pénalisation exponentiel $\delta_i = \min(4, n h_{ii} / (k + 1))$ pour maintenir l’intégrité inférentielle même en présence de valeurs aberrantes extrêmes.
Sur la base de simulations computationnelles extensives, les méthodologistes de renom, à l’instar de Long et Ervin, recommandent de bannir formellement l’utilisation des erreurs types MCO par défaut au profit de l’utilisation systématique de la correction HC3 (ou HC4 sur très petits échantillons), assurant ainsi une stabilité sans faille des publications empiriques évaluées par les pairs.
Enfin, les méthodes d’inférence non paramétrique offrent une protection complémentaire remarquable sans supposer de loi mathématique sous-jacente. Le rééchantillonnage par bootstrap sauvage (wild bootstrap), formalisé par Wu et perfectionné par Mammen, est expressément conçu pour les contextes d’hétéroscédasticité sévère. En perturbant de façon aléatoire les résidus observés par des tirages issus d’une distribution à deux points de moyenne nulle et de variance unitaire (telle que la distribution de Rademacher), le wild bootstrap génère des distributions d’échantillonnage empiriques d’une fidélité exceptionnelle pour les intervalles de confiance, garantissant des inférences valides même lorsque les approximations asymptotiques de White échouent.
11. Quatrième postulat : La normalité de la distribution des erreurs
11.1 Clarification conceptuelle de la normalité requise
Le quatrième postulat classique de la régression linéaire stipule que les termes d’erreur résiduels conditionnels sont distribués selon une loi normale univariée de moyenne nulle et de variance constante $\sigma^2$ :
$$\varepsilon_i mid X \sim \mathcal{N}(0, \sigma^2)$$
Ce postulat est sans conteste celui qui suscite les confusions conceptuelles les plus persistantes au sein de la communauté des chercheurs en sciences humaines. Il est impératif de dissiper un contresens méthodologique récurrent : la méthode de régression linéaire n’exige en aucun cas que la variable dépendante $Y$ brute, ni les prédicteurs $X$, soient normalement distribués. Exiger la normalité univariée d’une variable binaire, d’une échelle catégorielle ou d’un prédicteur démographique bimodal relève d’une erreur d’appréciation catégorique. Seule compte la distribution des perturbations stochastiques résiduelles une fois que la structure déterministe du modèle a été soustraite.
Sur le plan de l’architecture mathématique, la normalité résiduelle conditionne l’exactitude de la dérivation des distributions des statistiques inférentielles fondamentales. C’est précisément l’hypothèse de gaussianité des erreurs qui autorise la démonstration rigoureuse que le ratio des estimateurs divisé par leur erreur type suit une distribution exacte $t$ de Student à $n – k – 1$ degrés de liberté, et que le ratio des variances pour tester le modèle global s’ajuste strictement à une loi $F$ de Fisher-Snedecor. En l’absence de normalité résiduelle, ces distributions formelles cessent d’être exactes à taille d’échantillon finie.
Cependant, l’importance relative de ce postulat est puissamment régie par les mécanismes asymptotiques décrits par le théorème central limite (TCL). En vertu du TCL et des théorèmes d’invariance de Slutsky, dès lors que la taille de l’échantillon devient modérément volumineuse (typiquement lorsque $N > 100$ ou $N > 200$, pourvu qu’il n’y ait pas de points aberrants écrasants), la distribution d’échantillonnage des coefficients $\hat{\beta}$ converge asymptotiquement vers une loi normale multivariée, même si les résidus individuels du processus physique sous-jacent manifestent une asymétrie substantielle ou un aplatissement non gaussien. Ainsi, la régression par moindres carrés s’avère particulièrement robuste aux violations de normalité sur grands échantillons pour l’estimation de l’effet moyen. En revanche, le chercheur doit maintenir une vigilance absolue si son objectif consiste à établir des intervalles de prévision individuels pour des cas cliniques uniques : dans ce cas, le TCL n’exerce aucune protection, et l’absence de normalité résiduelle détruit directement la couverture probabiliste des marges prédictives individuelles.
11.2 Outils de détection des déviations par rapport à la normalité
L’évaluation empirique de la normalité des résidus s’appuie sur une convergence d’indices quantitatifs et de diagnostics visuels haute résolution. L’instrument graphique par excellence est le diagramme quantile-quantile normal (Normal Q-Q Plot). Ce graphique confronte les quantiles empiriques ordonnés des résidus standardisés du modèle aux quantiles théoriques attendus d’une loi normale standard. Si le postulat est scrupuleusement respecté, l’ensemble des points d’échantillonnage doit s’aligner de façon continue le long de la ligne diagonale de référence bissectrice à 45 degrés.
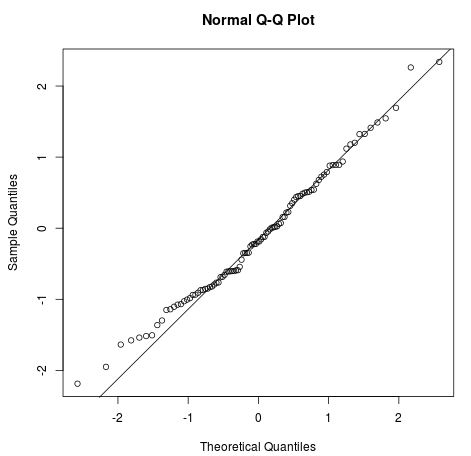
Les déviations caractéristiques par rapport à cette diagonale fournissent un diagnostic clinique immédiat de la nature de l’anomalie distributionnelle :
- Une courbure convexe générale ou une trajectoire en arc au-dessus ou en dessous de la droite signale une asymétrie structurelle (skewness positive ou négative).
- Une configuration sigmoïde en forme de « S », où les points dévient vers le bas à l’extrémité gauche et vers le haut à l’extrémité droite, trahit des queues de distribution épaisses (heavy-tailed ou distribution leptokurtique), indiquant une probabilité d’occurrences extrêmes bien supérieure à celle postulée par le modèle gaussien.
- Une déviation inverse dénonce une distribution platykurtique aux queues tronquées. L’insertion d’enveloppes de confiance simulées par rééchantillonnage bootstrap à 95 % autour de la droite de référence est vivement recommandée pour distinguer les fluctuations d’échantillonnage bénignes des distorsions structurelles avérées.
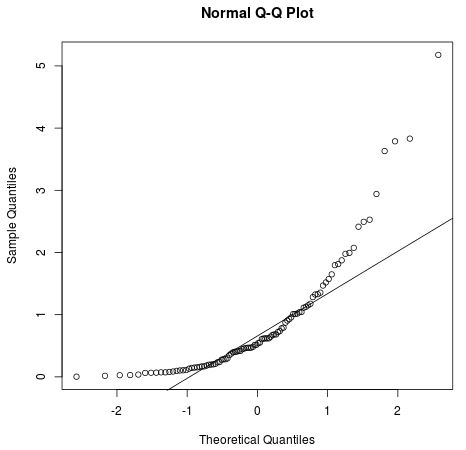
Cette analyse visuelle gagne à être complétée par l’examen d’histogrammes enrichis d’une estimation de densité par noyau (KDE) et par le calcul des coefficients de forme : le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement ou d’excès de kurtosis (où une valeur normale idéale équivaut à 0). Des règles empiriques courantes suggèrent qu’une valeur absolue d’asymétrie excédant 2 ou un excès de kurtosis surpassant 7 signale une déformation critique susceptible de menacer l’inférence.
Enfin, la batterie des tests d’ajustement formels comprend le test de Shapiro-Wilk, reconnu comme le test le plus puissant pour les échantillons restreints ou intermédiaires ($N 1,000$), ils rejetteront systématiquement l’hypothèse de normalité au moindre frémissement de skewness, conduisant l’analyste inexpérimenté à une panique méthodologique injustifiée alors même que le théorème central limite garantit une inférence asymptotique irréprochable.
11.3 Remèdes et modélisations adaptées aux résidus asymétriques ou leptokurtiques
Lorsque les résidus manifestent des violations distributionnelles massives au sein d’échantillons de taille insuffisante pour bénéficier de la protection asymptotique du TCL, ou lorsque la prédiction clinique exige la préservation d’intervalles individuels calibrés, des alternatives paramétriques et non paramétriques performantes doivent être mobilisées. Le premier recours méthodologique est la régression quantile, conceptualisée par Roger Koenker. Contrairement aux moindres carrés qui modélisent exclusivement l’espérance conditionnelle moyenne via une minimisation de la somme des carrés résiduels $L_2$, la régression quantile médiane minimise la somme des déviations absolues $L_1$ :
$$\min_{\beta} \sum_{i=1}^n |Y_i – X_i beta|$$
Cette propriété confère à l’estimateur une insensibilité totale aux valeurs aberrantes extrêmes et aux asymétries de queue, offrant une description robuste de la tendance centrale d’échelles de sévérité clinique lourdement asymétriques.
Une alternative élégante repose sur le déploiement des Modèles Linéaires Généralisés (Generalized Linear Models, GLM), formalisés par Nelder et Wedderburn. Dès lors que la variable de réponse est intrinsèquement non négative, asymétrique positive et dotée d’une variance qui croît avec la moyenne (comme les temps de réaction ou les coûts de soins psychiatriques), l’ajustement d’un GLM à loi Gamma ou loi Inverse-Gaussienne, couplé à une fonction de lien logarithmique, constitue la démarche de modélisation naturelle. Le modèle intègre nativement l’asymétrie sans nécessiter de transformations artificielles de la variable dépendante qui déformeraient l’échelle de mesure clinique.
Pour contrer les résidus leptokurtiques pollués par des observations atypiques issues de processus d’échantillonnage contaminés, les techniques de régression robuste par M-estimateurs (notamment l’estimateur de Huber ou la fonction bi-carrée de Tukey) apportent une résilience remarquable. Ces algorithmes opèrent une pénalisation progressive ou une annulation totale du poids accordé aux observations présentant des résidus de forte magnitude, assurant la convergence des coefficients vers les paramètres dominants de la population. Enfin, pour l’inférence de confiance sans assomption de distribution, le recours au bootstrap avec correction d’asymétrie et accélération (BCa bootstrap) autorise la dérivation d’intervalles de confiance empiriques d’une exactitude irréprochable, s’ajustant dynamiquement aux irrégularités morphologiques des résidus observés.
12. Synthèse intégrative, flux méthodologique et reporting académique
12.1 Arbre de décision opérationnel pour l’évaluation séquentielle des postulats
L’évaluation des quatre postulats ne saurait être appréhendée comme une succession d’inspections disjointes et indépendantes. Dans la réalité empirique, les violations interagissent et s’induisent mutuellement de façon pernicieuse. Par exemple, une spécification erronée de la forme fonctionnelle (violation du postulat de linéarité) engendre inévitablement des vagues de résidus ordonnés qui imitent fidèlement un patron d’autocorrélation temporelle ou génèrent une fausse hétéroscédasticité le long de la courbe d’inflexion. Dès lors, l’application aveugle d’un remède contre l’hétéroscédasticité sur un modèle structurellement non linéaire constitue une aberration analytique qui ne résout en rien la cause première de la défaillance.
Pour guider le praticien à travers ce labyrinthe inférentiel, un ordre chronologique d’investigation séquentielle s’impose avec force :
- Phase 1 : Validation prioritaire de la linéarité structurelle. Avant toute autre considération, le chercheur doit examiner le graphique des résidus en fonction des valeurs ajustées et exécuter le test RESET de Ramsey. Si la linéarité des paramètres fait défaut, elle doit être résolue immédiatement par l’intégration de termes polynomiaux, de splines de lissage ou de transformations de Box-Cox. Tenter d’évaluer la variance ou la normalité sur un modèle dont la structure déterministe est viciée s’avère totalement stérile.
- Phase 2 : Évaluation de l’indépendance conditionnelle. Une fois la géométrie de la fonction clarifiée, l’analyste doit contrôler l’indépendance stochastique par l’inspection de l’ICC (pour les données imbriquées) et des statistiques de Durbin-Watson / Breusch-Godfrey (pour les suivis séquentiels). Toute dépendance identifiée impose une transition immédiate vers les modèles linéaires hiérarchiques (LMM/HLM) ou la correction des erreurs types par cluster-robustesse.
- Phase 3 : Examen de l’homoscédasticité. Sur les résidus conditionnels issus du modèle géométriquement ajusté et décorrélé, l’analyste applique le graphique d’échelle-localisation et le test de White ou Breusch-Pagan. La présence d’hétéroscédasticité oriente l’inférence vers l’utilisation standardisée des estimateurs de type HC3/HC4 ou vers l’implémentation de moindres carrés pondérés (WLS) si la fonction de dispersion est paramétrable.
- Phase 4 : Diagnostic final de la distribution de normalité. En dernière instance, la morphologie distributionnelle des résidus est évaluée via le Q-Q plot et les coefficients d’asymétrie et d’aplatissement. Sur les cohortes de grande taille, le chercheur s’appuie sereinement sur le théorème central limite pour l’interprétation des moyennes, tandis que pour les échantillons restreints manifestant une non-normalité tenace, la bascule vers la régression quantile ou l’inférence par bootstrap BCa scelle l’intégrité de la publication.
12.2 Normes de publication et de transparence scientifique selon l’APA
L’élévation des exigences méthodologiques au sein de la communauté scientifique internationale a conduit les instances éditoriales, sous l’égide de l’American Psychological Association (APA 7e édition) et du consortium JARS (Journal Article Reporting Standards), à formuler des directives strictes de transparence pour les analyses par régression. Il n’est désormais plus acceptable de confiner le compte-rendu analytique à un simple tableau alignant des coefficients $\beta$, des valeurs $p$ et un $R^2$ global, en omettant la documentation explicite de l’audit des postulats qui valide ces résultats.
Le manuscrit empirique rigoureux doit documenter méthodiquement chaque étape du protocole diagnostique dans la section relative à l’analyse des données :
- Mentionner explicitement les contrôles visuels opérés (présence de graphiques de résidus et Q-Q plots archivés en matériel supplémentaire accessible).
- Rapporter les statistiques inférentielles associées aux tests de spécification fonctionnelle (RESET de Ramsey), d’indépendance sérielle/hiérarchique (statistique $d$, Breusch-Godfrey, ou coefficient ICC avec mention du nombre précis de grappes) et d’homoscédasticité (test de Breusch-Pagan ou White avec degrés de liberté et valeur $p$).
- Fournir une justification théorique et empirique impérative pour toute transformation de variable entreprise (par exemple, justification du paramètre $lambda$ de Box-Cox) ou pour le recours à des matrices de variance-covariance robustes (spécification formelle de l’estimateur HC mobilisé, typiquement HC3 ou sandwich par grappes).
Enfin, la véritable garantie de la reproductibilité scientifique réside dans la mise à disposition des scripts analytiques complets et documentés au sein de répertoires ouverts pérennes (tels que l’Open Science Framework, OSF, ou Zenodo). Que les calculs aient été orchestrés sous l’environnement R (via des packages spécialisés comme car, sandwich, lmme4, mgcv), en Python (statsmodels, scikit-learn), ou au sein d’interfaces logicielles comme JASP ou Jamovi, le partage du code exécutable permet à la communauté des pairs de reproduire intégralement la chaîne de traitement, assurant l’éradication progressive des inférences statistiques fragiles au profit d’une science cumulative et réplicable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409–428. https://doi.org/10.2307/2332388
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman & Hall/CRC.
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Liang, K. Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703–708. https://doi.org/10.2307/1913610
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.