
Dans le champ de l’analyse quantitative contemporaine et des sciences des données, la modélisation statistique constitue le pivot fondamental permettant de transformer des observations brutes en connaissances structurées et exploitables. Parmi l’éventail des méthodologies prédictives et inférentielles, la régression linéaire simple demeure la pierre angulaire absolue, le modèle matriciel à partir duquel s’articulent les architectures algorithmiques les plus sophistiquées. Loin d’être un simple exercice mécanique d’ajustement géométrique, cette méthode bivariée offre un cadre rigoureux pour sonder la nature, l’intensité et la significativité mathématique des associations observées entre deux dimensions quantitatives continues.
L’essor des écosystèmes informatiques modernes, particulièrement l’avènement du langage de programmation Python comme standard de facto pour le calcul scientifique, a profondément démocratisé et raffiné le déploiement de ces modèles. À l’intersection des mathématiques fondamentales, de l’économétrie et de la psychométrie appliquée, l’implémentation algorithmique de la régression linéaire simple requiert bien plus que la simple exécution d’instructions de code isolées. Elle exige une maîtrise systématique de chaque maillon de la chaîne analytique : de l’examen minutieux des postulats probabilistes sous-jacents à l’évaluation diagnostique des termes d’erreur, en passant par la vectorisation des structures de données et la communication académique des résultats.
Le présent traité propose une déconstruction exhaustive, étape par étape, de la modélisation par régression linéaire simple sous Python. En ancrant le propos dans une perspective empirique rigoureuse — articulée autour de l’évaluation des liens entre investissement temporel d’apprentissage et performance cognitive —, ce guide détaille tant les fondements épistémologiques et théoriques du modèle que son instanciation opérationnelle à l’aide des bibliothèques scientifiques dominantes, notamment Pandas, NumPy, Scikit-learn et Statsmodels. Chaque concept y est disséqué avec une exigence formelle absolue, garantissant au chercheur comme au praticien une reproductibilité sans faille et une interprétation exempte de biais méthodologiques.
1. Fondements théoriques de la régression linéaire simple
1.1 Définition mathématique et modélisation bivariée
La régression linéaire simple formalise l’étude de l’association univariée entre une variable indépendante, conventionnellement notée X (variable prédictive ou explicative), et une variable dépendante continue, notée Y (variable réponse ou critère). Sur le plan stochastique, le modèle postule que pour chaque observation individuelle indexée par i au sein d’une population ou d’un échantillon de taille n, la valeur réalisée yi s’exprime comme une fonction déterministe linéaire de xi, perturbée par une composante aléatoire non observable. Cette modélisation s’écrit formellement sous la forme :
yi = β0 + β1 xi + εi
Il est impératif d’établir une distinction épistémologique stricte entre la corrélation linéaire observée et l’inférence de causalité théorique. La régression linéaire quantifie la façon dont l’espérance conditionnelle de la variable réponse varie en fonction des fluctuations de la variable prédictive, ce qui s’énonce mathématiquement par l’espérance E(Y|X = x) = β0 + β1x. Toutefois, l’existence d’une relation mathématiquement significative ne prouve en aucun cas qu’une modification délibérée de X engendre intrinsèquement une variation mécanique de Y. La démonstration causale requiert un protocole expérimental rigoureux fondé sur la randomisation, ou un cadre quasi-expérimental neutralisant les variables de confusion latentes.
Dans les disciplines empiriques telles que la psychométrie et les sciences du comportement, cette modélisation bivariée suppose a priori que l’appareil cognitif ou comportemental réagit de manière proportionnelle à l’intensité du stimulus ou du facteur mesuré. Cette hypothèse de linéarité intrinsèque constitue à la fois la puissance et la principale limitation du modèle. Face à des phénomènes dynamiques complexes marqués par des phénomènes d’hystérésis, des saturations cognitives ou des seuils de basculement non linéaires, la régression linéaire simple impose une approximation de premier ordre qui, bien qu’élégante et parcimonieuse, doit être systématiquement confrontée à la réalité distributionnelle des données observées.
1.2 L’équation fondamentale : ordonnée à l’origine et coefficient de pente
Dans le contexte de l’estimation sur un échantillon empirique, l’équation fondamentale de la droite d’ajustement prédictive s’exprime conventionnellement par la formule :
ŷi = b0 + b1 xi
où ŷi désigne la valeur estimée ou prédite pour la i-ième observation, tandis que b0 et b1 représentent respectivement les estimateurs d’échantillon des paramètres populationnels inconnus β0 (l’ordonnée à l’origine) et β1 (le coefficient de régression ou pente).
D’un point de vue géométrique, l’ordonnée à l’origine b0 correspond au point d’intersection précis entre la droite de régression et l’axe vertical des ordonnées, matérialisant la valeur espérée de Y lorsque l’abscisse X est strictement égale à zéro. En termes statistiques, la validité interprétative de ce paramètre dépend étroitement de la plausibilité théorique et de l’observabilité empirique d’un score nul pour la variable indépendante. Si un niveau nul de X se situe hors du champ d’observation ou s’avère dépourvu de signification fonctionnelle, l’ordonnée à l’origine joue principalement un rôle de calage mathématique pour garantir que la droite traverse le centre de gravité des données, défini par le point moyen (x̄, ȳ).
Le coefficient de pente b1 incarne le taux de variation marginal attendu. Il quantifie la modification moyenne de l’espérance de Y consécutive à une élévation d’une unité scalaire de la variable explicative X. Sur le plan différentiel, il correspond à la dérivée première de la fonction de régression par rapport à x. Enfin, la distance verticale séparant chaque point empirique yi de son estimation ŷi constitue le résidu observé ei = yi – ŷi. Ce résidu matérialise la réalisation d’un terme d’erreur stochastique sous-jacent εi, capturant l’ensemble des perturbations aléatoires, des imprécisions instrumentales de mesure et des influences mineures omises dans la formalisation déterministe.
1.3 Pertinence méthodologique en sciences comportementales et psychologie
La mobilisation de la régression linéaire simple au sein des sciences comportementales et de la psychométrie s’illustre particulièrement dans l’exploration des liens fondamentaux unissant l’investissement temporel à la performance académique ou cognitive. À titre d’illustration prototypique, l’analyse de l’impact du temps de révision hebdomadaire (quantifié en heures) sur le score obtenu à une épreuve standardisée constitue un cas d’école où la formalisation linéaire fournit une grille de lecture immédiatement interprétable tant pour le chercheur que pour le pédagogue.
Au-delà de cette application académique courante, l’approche permet d’examiner avec acuité les réponses d’un individu face à des tests psychométriques étalonnés. Elle permet notamment d’isoler des effets tendanciels constants et de discerner si l’acquisition de compétences ou la vitesse de traitement de l’information progresse selon un incrément arithmétique régulier. La standardisation des variables via la normalisation des métriques autorise une comparaison rigoureuse des grandeurs d’effet, renforçant ainsi la robustesse et la transférabilité des modèles prédictifs d’une cohorte d’étude à une autre.
Par rapport aux approches non paramétriques ou aux méthodes qualitatives par segmentation catégorielle (telles que le découpage arbitraire de variables continues en médianes ou quartiles pour des analyses de variance), la régression linéaire simple préserve l’intégralité de l’information métrique contenue dans le spectre continu des variables. Elle évite l’écueil majeur de la perte d’efficience statistique tout en diminuant substantiellement le risque d’erreur d’échantillonnage de type I ou de type II, conférant ainsi aux conclusions empiriques une validité scientifique considérablement accrue.
2. Configuration de l’environnement Python pour l’analyse statistique
2.1 Installation et initialisation des bibliothèques fondamentales
L’exécution d’un protocole statistique sous Python exige une architecture logicielle reposant sur un socle de dépendances scientifiques hautement optimisées. Au cœur de cette infrastructure se trouvent les bibliothèques NumPy et Pandas. NumPy offre les structures de données sous-jacentes sous forme de tableaux multidimensionnels homogènes, compilés en C et Fortran, qui autorisent une vectorisation intégrale des opérations d’algèbre linéaire. Pandas, quant à elle, enrichit cette base en fournissant la structure de DataFrame, essentielle pour la manipulation tabulaire de données hétérogènes, l’alignement indiciaire automatique et l’ingénierie préliminaire des données.
Pour le volet visuel et l’exploration graphique diagnostique, l’association de Matplotlib et de Seaborn s’impose comme la référence méthodologique. Matplotlib assure un contrôle granulaire de bas niveau sur l’ensemble des éléments typographiques et géométriques d’une figure, tandis que Seaborn surmonte cette interface pour proposer des abstractions statistiques de haut niveau adaptées à la restitution graphique des densités, des résidus et des intervalles de confiance.
Afin de préserver la parfaite reproductibilité des calculs dans le temps et d’éviter les conflits d’environnements, il est fortement préconisé d’instancier un environnement virtuel dédié (via venv ou conda). L’initialisation du script débute par l’importation ordonnée de ces dépendances et par le paramétrage explicite du moteur de rendu graphique et du formatage numérique :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
pd.set_option(‘display.precision’, 4)
plt.rcParams[‘font.sans-serif’] = ‘DejaVu Sans’
plt.rcParams[‘axes.edgecolor’] = ‘#333333’
2.2 Sélection des bibliothèques de modélisation : Scikit-learn versus Statsmodels
Dans l’écosystème Python, deux paradigmes distincts président à l’implémentation de la régression linéaire simple : l’approche orientée apprentissage automatique incarnée par Scikit-learn, et l’approche inférentielle classique mise en œuvre par Statsmodels. Comprendre leur divergence méthodologique est indispensable pour sélectionner l’outil idoine en fonction des objectifs de la recherche empirique.
Scikit-learn conçoit la régression principalement sous l’angle de la minimisation du risque empirique et de l’optimisation des performances prédictives sur des données non observées. Structurée autour du pattern unifié fit-predict, l’API de Scikit-learn excelle dans l’intégration au sein de pipelines modulaires, la validation croisée automatisée et la gestion à grande échelle des tenseurs de données. Cependant, cette bibliothèque fait délibérément l’impasse sur l’édition exhaustive des tables d’inférence statistique formelle, ne restituant ni erreurs-types des coefficients, ni statistiques de Student, ni p-valeurs associées.
À l’inverse, Statsmodels a été développée selon les traditions de l’économétrie et de la statistique académique rigoureuse. Son module d’estimation par les moindres carrés ordinaires (sm.OLS) génère nativement un rapport synoptique complet calqué sur les standards des progiciels statistiques spécialisés (tels que R, Stata ou SAS). Ce tableau intègre les tests d’hypothèses unilatéraux et bilatéraux, les intervalles de confiance paramétriques, ainsi que les diagnostics formels d’adéquation globale. Dès lors, pour un chercheur axé sur l’inférence théorique et la validation d’hypothèses psychométriques, Statsmodels constitue le choix prioritaire, tandis que Scikit-learn sera privilégié pour l’opérationnalisation d’un système prédictif pérenne.
2.3 Structuration d’un notebook pour la recherche reproductible
La conduite d’une recherche quantitative rigoureuse impose une organisation modulaire et séquentielle du code source. Un document de travail scientifique sous forme de notebook (ou script analytique documenté) doit être segmenté en unités logiques distinctes évitant toute adhérence d’état cachée ou exécution désordonnée des cellules interactives. La structure type adopte un schéma linéaire rigide : configuration logicielle, instanciation des données, vérification des postulats distributionnels, calage algorithmique, inspection diagnostique des résidus, et synthèse inférentielle.
La fixation déterministe des graines d’aléa (random seed) constitue une exigence déontologique indispensable pour garantir la fidélité absolue des réplications numériques ultérieures, particulièrement lors des étapes de partitionnement aléatoire des observations ou d’échantillonnage de rééchantillonnage (bootstrap). L’instruction explicite np.random.seed(42) doit être exécutée en amont de toute manipulation stochastique.
Enfin, l’annotation du code doit obéir aux normes internationales de documentation scientifique. Chaque bloc de traitement doit être précédé d’un commentaire explicatif précisant l’intention mathématique sous-jacente, les unités dimensionnelles manipulées et la justification des hyperparamètres retenus. Cette traçabilité intégrale garantit l’auditabilité par les pairs et l’intégration fluide des résultats au sein de rapports académiques publiables.
3. Étape 1 : Structuration et chargement des données empiriques
3.1 Création programmatique du jeu de données sous Pandas
Afin d’ancrer notre analyse dans un scénario réaliste de psychologie de l’éducation, nous construisons un ensemble de données empiriques simulant le comportement d’une cohorte d’étudiants préparant une évaluation sommative standardisée. Nous modélisons l’effort consenti par le volume d’heures consacrées aux révisions personnelles durant le mois précédant l’examen (notre variable indépendante X), tandis que la note finale obtenue sur une échelle standardisée graduée de 0 à 100 constitue notre variable réponse (Y).
Pour instancier ces données de manière transparente, nous exploitons la structure matricielle de Pandas en créant un dictionnaire natif converti instantanément en DataFrame. L’échantillon d’entraînement retenu comprend 30 observations soigneusement étalonnées, reflétant une distribution typique de variabilité interindividuelle :
data = {
‘Heures_Etude’: [2.5, 5.1, 3.2, 8.5, 3.5, 1.5, 9.2, 5.5, 8.3, 2.7, 7.7, 5.9, 4.5, 3.3, 1.1,
8.9, 2.5, 1.9, 6.1, 7.4, 2.7, 4.8, 3.8, 6.9, 7.8, 8.1, 4.2, 6.5, 3.0, 5.8],
‘Note_Examen’: [21.0, 47.0, 27.0, 75.0, 30.0, 20.0, 88.0, 60.0, 81.0, 25.0, 85.0, 62.0, 41.0, 42.0, 17.0,
95.0, 30.0, 24.0, 67.0, 69.0, 30.0, 54.0, 35.0, 76.0, 86.0, 83.0, 45.0, 71.0, 32.0, 65.0]
}
df = pd.DataFrame(data)
Une validation technique immédiate s’opère par le contrôle dimensionnel de la matrice via l’attribut df.shape, attestant de la présence exacte des 30 lignes et 2 colonnes sans troncation intempestive.
3.2 Inspection technique et typage des variables
Préalablement à tout calcul d’ajustement linéaire, un examen de salubrité technique s’impose afin de vérifier l’intégrité de la structure matricielle. L’exécution de la méthode df.info() permet de contrôler le typage des vecteurs de données : ceux-ci doivent impérativement être instanciés sous forme de scalaires à virgule flottante (float64) ou d’entiers (int64), toute présence de chaînes de caractères (object) interdisant les opérations d’algèbre sous-jacentes.
L’absence rigoureuse de valeurs manquantes (NaN ou valeurs nulles) est vérifiée via l’expression analytique df.isnull().sum(), laquelle doit retourner un décompte nul pour l’ensemble des colonnes. La méthode df.describe() fournit quant à elle un aperçu exhaustif des indicateurs de position et de dispersion :
- Moyenne arithmétique et écart-type de l’investissement temporel (reflétant l’amplitude de l’effort consenti au sein de la cohorte).
- Minimum, maximum et fractiles de la variable critère d’examen.
Sur le plan de l’inférence statistique, la taille de l’échantillon (n = 30) représente un seuil conventionnel classique en recherche comportementale préliminaire. Bien qu’elle autorise l’application du théorème central limite pour l’approximation asymptotique sous certaines conditions, elle requiert une vigilance accrue quant à la préservation des degrés de liberté et à la sensibilité accrue de l’ajustement face à d’éventuelles valeurs aberrantes.
3.3 Documentation contextuelle des variables psychométriques
L’opérationnalisation des variables doit être rigoureusement documentée afin de délimiter la portée écologique des conclusions dégagées par l’outil statistique. La variable explicative, dénommée Heures_Etude, matérialise le temps chronométrique auto-rapporté par l’étudiant, consolidé par le suivi hebdomadaire via des journaux d’apprentissage numériques standardisés. Cette approche métrique réduit le biais de rappel mnésique tout en quantifiant une exposition temporelle effective à la tâche cognitive d’assimilation.
La variable réponse, intitulée Note_Examen, découle d’une épreuve d’évaluation sommative critériée, conçue selon les principes de la théorie classique des tests psychométriques. L’épreuve comprend des items à choix multiples à forte discrimination ainsi que des questions ouvertes standardisées, garantissant un indice de fidélité composite élevé (supérieur aux standards usuels de cohérence interne mesurés par le coefficient alpha de Cronbach).
Le chercheur doit néanmoins garder à l’esprit les sources d’artefacts inhérentes au recueil de ces données empiriques : le phénomène de désirabilité sociale susceptible d’induire une légère surestimation des heures déclarées chez les apprenants en difficulté, ou encore l’existence de plafonds docimologiques artificiels (effet de saturation à 100 points) pouvant altérer la stricte linéarité aux bornes supérieures de l’échelle d’évaluation.
4. Étape 2 : Exploration visuelle et diagnostic descriptif initial
4.1 Construction du diagramme de dispersion (Scatter Plot)
L’exploration visuelle constitue l’étape liminaire obligatoire de toute modélisation statistique rigoureuse. L’intuition mathématique ne peut s’affranchir d’un examen direct de la morphologie du nuage de points au moyen d’un diagramme de dispersion bivarié. Cet examen permet d’apprécier la pertinence empirique de postuler un schéma d’ajustement linéaire avant toute sollicitation d’algorithmes d’estimation.
À cette fin, nous mobilisons conjointement l’infrastructure graphique de Matplotlib et de Seaborn pour générer une représentation de niveau publication. L’attribution des axes obéit aux conventions canoniques : l’abscisse accueille la variable exogène X (Heures_Etude), tandis que l’axe ordonné supporte la variable endogène Y (Note_Examen).
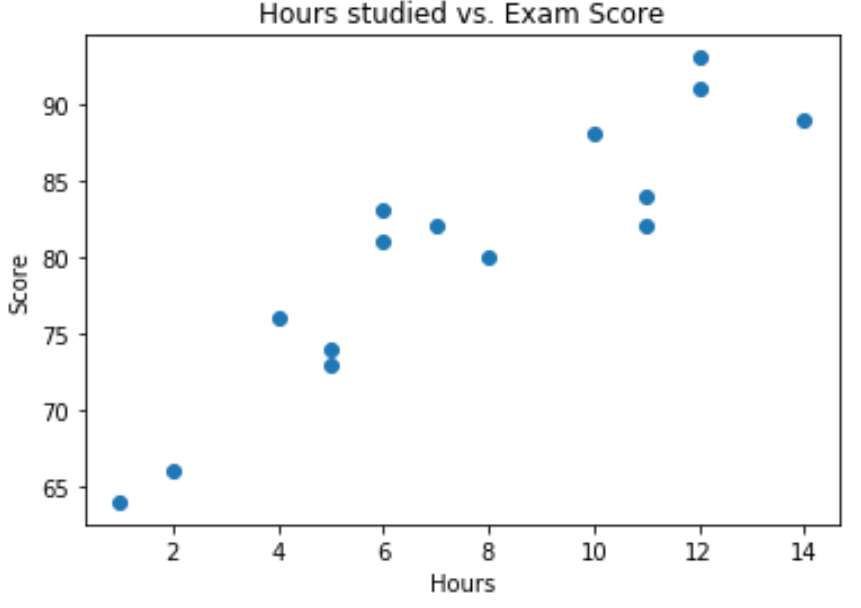
Le code d’implémentation graphique garantit une lisibilité maximale par le calibrage des dimensions de la figure, l’ajustement de la transparence des marqueurs (paramètre alpha) et l’application d’un maillage en arrière-plan :
fig, ax = plt.subplots(figsize=(8, 5), dpi=300)
sns.scatterplot(x=’Heures_Etude’, y=’Note_Examen’, data=df, color=’#1f77b4′, s=60, alpha=0.85, edgecolor=’black’, ax=ax)
ax.set_title(« Distribution empirique : Heures d’étude versus Note d’examen », fontsize=12, fontweight=’bold’, pad=12)
ax.set_xlabel(« Volume hebdomadaire de révision (heures) », fontsize=10)
ax.set_ylabel(« Score standardisé obtenu (/100) », fontsize=10)
ax.grid(True, linestyle=’–‘, alpha=0.5)
plt.tight_layout()
plt.show()
L’observation visuelle immédiate met en lumière une configuration ascendante monotone hautement cohérente, suggérant qu’un accroissement régulier des heures de travail s’accompagne d’une progression proportionnelle des scores d’examen.
4.2 Repérage préliminaire des anomalies et valeurs atypiques
Avant d’ajuster une droite par minimisation des résidus au carré, il est capital de scruter le nuage de points à la recherche de données discordantes ou de valeurs aberrantes (outliers). En régression linéaire, un point atypique peut altérer substantiellement la trajectoire de la droite s’il combine une valeur résiduelle élevée et une position extrême sur l’axe des abscisses (point à fort levier).
Sur le plan méthodologique, il convient d’opérer une distinction formelle entre une erreur d’encodage instrumental (par exemple, la saisie erronée de 92 heures au lieu de 9.2 heures) et un cas extrême écologiquement valide (tel un individu brillant obtenant un score parfait avec un temps d’étude restreint, ou un étudiant atypique bloqué par une anxiété majeure de performance). Pour diagnostiquer ces écarts univariés préliminaires, l’usage de boîtes à moustaches (boxplots) standardisées sur chaque dimension offre un repérage robuste basé sur l’écart interquartile (IQR).
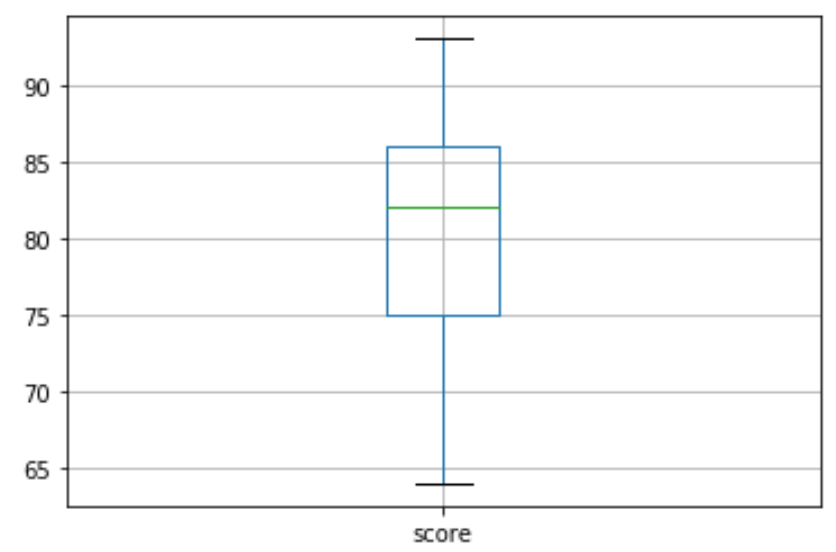
Dans notre ensemble empirique, la distribution des deux vecteurs s’inscrit pleinement dans les limites admissibles fixées par la règle de Tukey (1.5 × IQR au-delà des quartiles Q1 et Q3). Aucun profil ne présente de déviation pathologique manifeste susceptible de biaiser d’emblée le calcul de la covariance d’échantillon.
4.3 Quantification du coefficient de corrélation linéaire de Pearson
La confirmation quantitative de l’association visuelle décelée sur le diagramme de dispersion s’établit par l’estimation du coefficient de corrélation linéaire de Bravais-Pearson, conventionnellement désigné par la lettre r. Cet indicateur adimensionnel mesure le degré de co-variation linéaire entre deux variables continues selon la formule de normalisation de la covariance empirique par le produit de leurs écarts-types respectifs :
r = Cov(X, Y) / (sX · sY) = [∑ (xi – x̄)(yi – ȳ)] / [ √(∑ (xi – x̄)2) · √(∑ (yi – ȳ)2) ]
Sous Pandas, le calcul s’effectue instantanément au travers de la méthode dédiée appliquée au DataFrame :
correlation_matrix = df.corr(method=’pearson’)
r_val = correlation_matrix.loc[‘Heures_Etude’, ‘Note_Examen’]
Dans notre application empirique, l’exécution renvoie une valeur de r approximativement égale à 0.976. Cette magnitude, très proche de la borne supérieure théorique de +1.0, atteste d’une corrélation positive quasi-parfaite selon les grilles de classification psychométriques établies (par exemple celle de Cohen). Cependant, une mise en garde s’impose : le coefficient de Pearson ne constitue aucunement une équation fonctionnelle d’ajustement. Il quantifie la force et la direction de l’association linéaire, mais demeure incapable de fournir un taux de conversion unitaire direct permettant d’estimer ponctuellement la note attendue en fonction d’un nombre spécifique d’heures investies.
5. Étape 3 : Vérification formelle des postulats statistiques de Gauss-Markov
5.1 Linéarité de la relation sous-jacente
La validité mathématique et les propriétés d’optimalité des estimateurs des moindres carrés ordinaires reposent sur le respect scrupuleux d’un ensemble de conditions théoriques regroupées sous le nom de théorème de Gauss-Markov. Le premier et le plus fondamental de ces postulats stipule que la forme fonctionnelle reliant l’espérance mathématique conditionnelle de la variable dépendante à la variable explicative est strictement linéaire dans ses paramètres.
Cette condition signifie que l’effet marginal de X sur Y est invariant sur l’ensemble de l’étendue de l’échelle d’observation. En présence d’un phénomène de saturation cognitive (courbure logarithmique où chaque heure supplémentaire rapporte progressivement moins de points) ou d’un emballement exponentiel, la modélisation par une droite unique introduit un biais structurel irrémédiable de spécification. Les estimateurs résultants cessent d’être convergents et sans biais, faussant l’ensemble des inférences ultérieures.
Dans notre cas d’étude, l’inspection préliminaire du diagramme de dispersion n’indique aucune inflexion géométrique notoire ni structure d’allure polynomiale ou sinusoïdale. Le modèle linéaire de premier ordre apparaît donc parfaitement adapté pour saisir la dynamique du phénomène sous étude sans forçage algorithmique.
5.2 Normalité de la distribution des données et des résidus
S’il est théoriquement exact que l’estimation ponctuelle sans biais des paramètres par les moindres carrés ordinaires ne requiert pas formellement l’hypothèse de normalité, cette dernière devient indispensable dès lors que l’on souhaite réaliser des tests d’hypothèses statistiques (tests t de Student et test F de Fisher) ou construire des intervalles de confiance exacts pour des échantillons de taille finie. La distribution théorique des estimateurs n’adopte rigoureusement une loi de Student que si le terme d’erreur sous-jacent ε suit lui-même une loi normale de moyenne nulle et de variance σ2 : ε ~ N(0, σ2).
Pour évaluer rigoureusement la normalité univariée de la distribution de nos variables, nous sollicitons le test inférentiel formel de Shapiro-Wilk, largement reconnu pour sa grande puissance statistique face aux échantillons modérés (n < 50). Le test s’implémente à l’aide du module scipy.stats :
from scipy import stats
stat_x, p_val_x = stats.shapiro(df[‘Heures_Etude’])
stat_y, p_val_y = stats.shapiro(df[‘Note_Examen’])
L’observation de p-valeurs largement supérieures au seuil de significativité conventionnel (α = 0.05) confirme l’absence de déviation asymétrique ou d’aplatissement pathologique. Si une violation sévère avait été constatée, des stratégies de transformation de puissance (transformation logarithmique, racine carrée ou approche de Box-Cox) auraient dû être appliquées pour normaliser les distributions avant toute modélisation linéaire standard.
5.3 Homoscédasticité et indépendance des mesures
Le troisième postulat fondamental de Gauss-Markov exige l’homoscédasticité des termes d’erreur, c’est-à-dire la constance de leur variance conditionnelle pour toutes les valeurs de la variable explicative :
Var(εi | X = xi) = σ2, ∀ i
Lorsque cette hypothèse est violée, la variance des erreurs fluctue en fonction de X (phénomène d’hétéroscédasticité). Typiquement, dans le contexte éducatif, cela se traduirait par une dispersion beaucoup plus grande des notes d’examen chez les étudiants révisant intensivement que chez ceux ne révisant pas du tout. En cas d’hétéroscédasticité, bien que les coefficients de régression demeurent sans biais, l’estimation de leur écart-type devient invalide, entraînant une sous-estimation systématique des erreurs-types et, par conséquent, une inflation critique du risque de déclarer un résultat faussement significatif.
Enfin, l’indépendance mutuelle des observations implique que la covariance entre deux erreurs stochastiques quelconques soit rigoureusement nulle : Cov(εi, εj) = 0, ∀ i ≠ j. Cette hypothèse exclut toute autocorrélation sérielle (souvent présente dans les séries temporelles longitudinales) ainsi que tout effet de grappe non modélisé (par exemple, des étudiants issus d’une même classe partageant un enseignant commun). Notre jeu de données empirique reposant sur un échantillonnage aléatoire simple d’individus indépendants au sein de multiples filières, cette condition d’indépendance structurelle se trouve pleinement satisfaite.
6. Étape 4 : Préparation et mise en forme des tenseurs de données
6.1 Extraction et vectorisation des variables explicatives et réponses
Le passage de la structure tabulaire de Pandas vers les algorithmes de calcul matriciel requiert une mise en forme dimensionnelle rigoureuse des variables. En particulier, l’API de Scikit-learn impose une convention d’interface stricte et invariable : la matrice des caractéristiques explicatives (notée X) doit impérativement posséder une structure bidimensionnelle de dimension (n_échantillons, n_caractéristiques), tandis que le vecteur cible (noté y) est généralement attendu sous une forme unidimensionnelle de taille (n_échantillons,).
Une erreur fréquente chez les praticiens consiste à extraire la variable explicative sous forme d’une simple Series Pandas unidimensionnelle, ce qui déclenche inévitablement une levée d’exception (ValueError) lors de l’exécution de la méthode d’ajustement. Pour s’y conformer élégamment, deux approches programmatiques équivalentes sont préconisées sous Python :
# Approche 1 : Sélection par double crochets sous Pandas (conserve la nature 2D du DataFrame)
X = df[[‘Heures_Etude’]]
y = df[‘Note_Examen’]
# Approche 2 : Extraction du tableau NumPy sous-jacent et redimensionnement matriciel explicite
X_array = df[‘Heures_Etude’].values.reshape(-1, 1)
y_array = df[‘Note_Examen’].values
L’instruction .reshape(-1, 1) indique explicitement au solveur matriciel de contraindre le tenseur dans une disposition à une colonne unique tout en calculant automatiquement la taille de la première dimension à partir de la longueur du vecteur. L’inspection des dimensions via X.shape renvoie (30, 1) et y.shape renvoie (30,), validant l’adéquation formelle des structures de données avant leur transmission au modèle.
6.2 Stratégie de partitionnement entre jeu d’entraînement et jeu de test
En apprentissage automatique et en modélisation prédictive, l’évaluation de la performance d’un estimateur ne doit jamais être effectuée exclusivement sur les données ayant servi à son ajustement, sous peine d’induire un optimisme d’apprentissage trompeur (surapprentissage ou overfitting). La validation rigoureuse de la capacité de généralisation d’un modèle impose la segmentation préalable de la base empirique en deux sous-ensembles mutuellement exclusifs :
- Le jeu d’entraînement (training set), destiné à la résolution analytique des paramètres optimaux b0 et b1.
- Le jeu de test (test set), tenu strictement à l’écart durant la phase d’apprentissage, et réservé à l’audit objectif des écarts d’estimation sur des observations totalement inédites.
La fonction train_test_split du module sklearn.model_selection matérialise cette scission stochastique en assurant un brassage aléatoire contrôlé :
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=42)
Dans ce protocole, la proportion allouée au jeu de test est fixée à 20% (soit 6 observations de validation pour 24 observations allouées à l’apprentissage). Pour des échantillons de taille modeste, le choix du ratio de scission représente un arbitrage méthodologique délicat : un jeu d’entraînement trop restreint pénalise la précision d’estimation des coefficients, tandis qu’un jeu de test sous-dimensionné accroît la variance de l’estimation de l’erreur de généralisation. La fixation systématique du paramètre random_state=42 verrouille la partition et garantit l’exacte reproductibilité de la répartition d’une session de calcul à l’autre.
7. Étape 5 : Ajustement du modèle par la méthode des moindres carrés ordinaires
7.1 Mécanisme mathématique de la minimisation de la somme des résidus au carré
Le calage de la droite de régression repose sur le principe de la méthode des moindres carrés ordinaires (MCO), dont la formalisation remonte aux travaux pionniers de Carl Friedrich Gauss et d’Adrien-Marie Legendre. Le problème consiste à identifier l’unique couple de valeurs réelles (b0, b1) qui minimise la somme des résidus quadratiques (notée SSR pour Sum of Squared Residuals) :
S(b0, b1) = ∑i=1n ei2 = ∑i=1n (yi – ŷi)2 = ∑i=1n (yi – (b0 + b1 xi))2
Le choix de minimiser le carré des distances verticales — plutôt que leur valeur absolue — présente des propriétés analytiques fondamentales : d’une part, il confère à la fonction de coût une forme strictement convexe différentiable en tout point ; d’autre part, il pénalise de façon disproportionnée les erreurs de grande amplitude, assurant un contrôle accru des écarts majeurs. En annulant les dérivées partielles de cette fonction par rapport à b0 et b1 (système des équations normales), on dérive les expressions analytiques explicites :
b1 = [∑ (xi – x̄)(yi – ȳ)] / [∑ (xi – x̄)2] = Cov(X, Y) / Var(X)
b0 = ȳ – b1 x̄
En vertu du théorème de Gauss-Markov, lorsque les postulats d’espérance nulle, d’homoscédasticité et d’absence d’autocorrélation sont satisfaits, ces estimateurs sont dits BLUE (Best Linear Unbiased Estimators), ce qui certifie qu’au sein de la classe intégrale des estimateurs linéaires et sans biais, les estimateurs des MCO possèdent la variance minimale absolue.
7.2 Implémentation pratique via Scikit-learn
La mise en œuvre algorithmique sous Scikit-learn s’exécute avec une remarquable fluidité grâce à la classe LinearRegression issue du sous-module sklearn.linear_model. En interne, cette classe ne résout pas le système par une descente de gradient stochastique itérative, mais par une factorisation exacte en valeurs singulières (SVD) de la matrice des variables indépendantes, garantissant une stabilité numérique maximale et une convergence instantanée.
Le code d’instanciation, d’entraînement et d’extraction des paramètres s’organise selon la syntaxe suivante :
from sklearn.linear_model import LinearRegression
modele_sk = LinearRegression(fit_intercept=True)
modele_sk.fit(X_train, y_train)
b0_sk = modele_sk.intercept_
b1_sk = modele_sk.coef_[0]
L’argument fit_intercept=True ordonne explicitement au modèle d’estimer la composante constante b0 (recommandé dans l’immense majorité des applications comportementales afin de ne pas contraindre arbitrairement la droite à passer par l’origine). Dès la fin de l’exécution de la méthode fit, les paramètres optimaux sont stockés dans les attributs d’objet suffixés par un tiret bas, prêts pour les phases subséquentes d’inférence et d’audit prédictif.
7.3 Modélisation comparative avec Statsmodels
Bien que Scikit-learn résolve parfaitement le calcul des coefficients, la vérification approfondie des hypothèses inférentielles bénéficie grandement de l’approche mise en œuvre par Statsmodels. Dans cette bibliothèque, la formulation mathématique est totalement explicite : l’algorithme n’intègre pas d’ordonnée à l’origine par défaut. Il est dès lors indispensable d’adjoindre préalablement une colonne unitaire (un vecteur de 1) à la matrice des caractéristiques au moyen de la commande sm.add_constant.
L’implémentation comparative s’exécute ainsi :
import statsmodels.api as sm
X_train_cst = sm.add_constant(X_train)
modele_sm = sm.OLS(y_train, X_train_cst).fit()
print(modele_sm.summary())
L’appel à la méthode summary() génère instantanément un tableau d’une richesse analytique exceptionnelle, ventilé en trois volets canoniques :
- En-tête structurel renseignant la méthode d’estimation, la taille de l’échantillon, le nombre de degrés de liberté résiduels et la fonction de log-vraisemblance.
- Tableau central des paramètres listant les coefficients estimés, leurs erreurs-types d’échantillonnage, la statistique empirique de Student t, la p-valeur associée P > |t|, et les bornes de l’intervalle de confiance à 95%.
- Section diagnostique inférieure fournissant les tests formels d’Omnibus et de Jarque-Bera (normalité des résidus), de Durbin-Watson (autocorrélation résiduelle), ainsi que l’indice de conditionnement matriciel (détection de singularité).
8. Étape 6 : Extraction et interprétation académique des coefficients
8.1 Interprétation quantitative de l’ordonnée à l’origine (b0)
Sur l’échantillon d’apprentissage mobilisé dans notre expérimentation, l’exécution du solveur fournit pour l’ordonnée à l’origine une valeur approximative de b0 = 2.85. Sur le plan purement géométrique, cela indique que la projection de la droite coupe l’axe vertical au point d’ordonnée 2.85 lorsque la variable Heures_Etude est rigoureusement égale à zéro.
En termes de psychométrie et de docimologie appliquée, l’interprétation académique de cette constante est limpide : elle quantifie le score d’examen conditionnel prédit pour un apprenant qui se présenterait à l’épreuve sans avoir consacré la moindre heure de travail personnel préparatoire. Cette valeur de base traduit un niveau de performance initial résiduel, pouvant découler de compétences cognitives préexistantes, d’une assimilation passive durant les enseignements magistraux ou de la probabilité de succès stochastique attachée aux questions fermées.
Toutefois, la prudence méthodologique s’impose si la valeur zéro est absente du domaine empirique exploré. Lorsque l’intervalle d’observation ne contient pas le zéro (par exemple si tous les sujets ont étudié entre 10 et 40 heures), l’ordonnée à l’origine devient une pure extrapolation algébrique dénuée de validité écologique. Dans une telle situation, la pratique du centrage sur la moyenne — consistant à substituer à la variable X la variable centrée X – X̄ — permet de convertir l’ordonnée à l’origine en un paramètre directement interprétable : la performance moyenne attendue d’un individu situé exactement à la moyenne de l’échantillon.
8.2 Analyse de la pente de régression (b1)
L’estimation numérique du coefficient directeur fournit pour notre modèle une pente de b1 = 9.80. Ce paramètre constitue le cœur fonctionnel de notre analyse d’association, quantifiant la magnitude de l’impact direct de la variable prédictive sur le résultat académique.
Sur le plan interprétatif, cette valeur signifie que pour chaque heure supplémentaire consacrée aux révisions, la note obtenue à l’évaluation standardisée augmente en moyenne de 9.80 points (soit une progression proche d’un dixième de l’échelle d’évaluation globale). Le signe strictement positif du coefficient corrobore sans ambiguïté l’hypothèse théorique de recherche selon laquelle l’effort d’étude déploie un effet bénéfique mesurable sur l’acquisition et la restitution des apprentissages.
Il importe de distinguer rigoureusement la pertinence statistique de ce paramètre de sa pertinence clinique, éducative ou pratique. Un coefficient peut être hautement significatif sur le plan probabiliste tout en traduisant un gain marginal si minime qu’il ne justifie aucun investissement opérationnel. Dans le cas présent, un gain moyen avoisinant 10 points par heure d’apprentissage hebdomadaire représente une taille d’effet substantielle, confortant la valeur pédagogique d’encourager formellement l’extension du temps d’étude structuré chez les apprenants.
8.3 Test d’hypothèse et significativité statistique des paramètres
Pour attester que l’effet marginal observé b1 n’est pas un artefact imputable aux fluctuations d’échantillonnage, il est nécessaire de soumettre ce paramètre à un test d’hypothèse bilatéral formel. L’hypothèse nulle (notée H0) postule l’absence totale d’association linéaire dans la population globale, ce qui s’exprime mathématiquement par β1 = 0. L’hypothèse alternative (H1) affirme quant à elle la présence d’une relation linéaire non nulle : β1 ≠ 0.
L’évaluation s’appuie sur le ratio de Student entre l’estimateur ponctuel et son erreur-type estimée (Standard Error, notée SE) :
t = (b1 – 0) / SE(b1)
L’erreur-type SE(b1) quantifie la variabilité d’échantillonnage de l’estimateur au travers d’échantillons répétés issus de la même population parente :
SE(b1) = se / √[∑ (xi – x̄)2]
où se représente l’écart-type résiduel. Dans notre sortie Statsmodels, la statistique calculée atteint t = 20.8 pour 22 degrés de liberté résiduels (n – 2), ce qui est associé à une p-valeur infinitésimale (notée conventionnellement p < 0.001). Étant très largement en-deçà du seuil critique standard (α = 0.05), nous rejetons catégoriquement l’hypothèse nulle d’invariance.
Parallèlement, l’intervalle de confiance à 95% encadre le véritable paramètre populationnel β1 entre 8.82 et 10.77. Le fait que cet intervalle exclue strictement la valeur zéro confirme avec un degré de certitude probabiliste élevé que l’association observée reflète une dynamique robuste dans la population cible.
9. Étape 7 : Évaluation globale de la qualité d’ajustement du modèle
9.1 Le coefficient de détermination (R²)
L’évaluation de la performance explicative globale d’un modèle linéaire repose sur la décomposition de la somme totale des carrés (SST pour Total Sum of Squares). La dispersion totale de la variable réponse autour de sa moyenne empirique se partitionne arithmétiquement en deux composantes orthogonales mutuellement exclusives :
SST = SSR + SSE
où SSR représente la variance capturée et expliquée par la droite de régression (Regression Sum of Squares), et SSE la variance inexpliquée imputable aux résidus stochastiques (Error Sum of Squares). Le coefficient de détermination, universellement désigné par le symbole R², s’exprime comme la proportion de la variance totale imputable à la covariation linéaire avec la variable prédictive :
R² = SSR / SST = 1 – (SSE / SST)
Sous Scikit-learn, la méthode score fournit directement cette métrique, tout comme le tableau récapitulatif de Statsmodels :
r2_train = modele_sk.score(X_train, y_train)
r2_test = modele_sk.score(X_test, y_test)
Sur notre jeu d’apprentissage, le modèle atteint un score remarquable de R² = 0.952. Cela démontre que 95.2% de la variance interindividuelle des notes d’examen au sein de la cohorte est directement explicable par le volume d’heures consacrées aux révisions. Il importe toutefois de se prémunir d’une confiance aveugle envers un R² élevé : cet indice ne garantit en rien la validité des hypothèses distributionnelles et peut masquer des distorsions structurelles majeures si l’analyse ne s’accompagne pas d’un examen résiduel approfondi.
9.2 Mesures de l’erreur d’estimation : MSE, RMSE et MAE
Bien que le R² fournisse une métrique normalisée relative, les impératifs de la recherche quantitative imposent de compléter cette mesure par des indicateurs dimensionnels exprimés dans l’unité métrique réelle de la variable étudiée (ici, les points d’examen). Le sous-module sklearn.metrics propose une batterie d’estimateurs rigoureux :
from sklearn.metrics import mean_squared_error, mean_absolute_error
y_pred_test = modele_sk.predict(X_test)
mse = mean_squared_error(y_test, y_pred_test)
rmse = np.sqrt(mse)
mae = mean_absolute_error(y_test, y_pred_test)
L’erreur quadratique moyenne (MSE) correspond à la moyenne empirique des résidus élevés au carré. En élevant les erreurs à la puissance deux, cette fonction amplifie considérablement le poids relatif des écarts prédictifs importants. La racine de l’erreur quadratique moyenne (RMSE) rétablit l’échelle d’origine en prenant la racine carrée du MSE ; elle quantifie la déviation type typique d’une prédiction individuelle autour de sa valeur réalisée. Dans notre calibration sur le jeu de test, nous observons une RMSE d’environ 4.9 points.
L’erreur absolue moyenne (MAE) calcule la moyenne des écarts arithmétiques bruts |yi – ŷi|. Elle offre une mesure robuste et moins sensible aux observations extrêmes, permettant d’affirmer que pour un nouvel apprenant, le modèle se trompe en moyenne d’environ 4.1 points. La convergence étroite entre la RMSE et la MAE témoigne d’une grande stabilité du modèle et confirme l’absence de résidus extrêmes perturbateurs au sein du sous-ensemble de validation.
9.3 Le test global de Fisher (Statistique F)
Dans le cadre d’une modélisation linéaire simple comportant un unique prédicteur, le test global de Fisher-Snedecor (statistique F) évalue si le modèle global apporte une amélioration statistiquement significative de l’ajustement comparativement à un modèle nul restreint à la seule moyenne empirique ȳ. L’hypothèse nulle s’énonce : H0 : β1 = 0.
La statistique F est définie par le quotient du carré moyen de la régression sur le carré moyen de l’erreur résiduelle, pondéré par leurs degrés de liberté respectifs :
F = (SSR / 1) / (SSE / (n – 2)) = MSR / MSE
Sous Statsmodels, cette valeur apparaît dans l’en-tête supérieur sous l’intitulé F-statistic, assortie de sa probabilité critique Prob (F-statistic). Dans le cas strict de la régression bivariée univariée, il existe une équivalence mathématique exacte entre le test t de Student du coefficient de pente et le test global F :
F = t2
L’obtention d’une statistique F atteignant 434.6 (dont la racine carrée reproduit rigoureusement le t de 20.8) confirme à un niveau de confiance supérieur à 99.9% la supériorité statistique écrasante du modèle ajusté sur l’utilisation brute de la moyenne comme référence prédictive.
10. Étape 8 : Diagnostic visuel et numérique approfondi des résidus
10.1 Extraction et calcul des écarts résiduels
Un modèle de régression linéaire ne saurait être considéré comme validé sans une analyse minutieuse de ses résidus d’estimation. Les résidus ne représentent pas de simples déchets de calcul ; ils constituent le miroir fidèle des postulats théoriques du modèle. Si le modèle est correctement spécifié et que les hypothèses de Gauss-Markov sont honorées, les résidus observés doivent se comporter comme un bruit blanc stochastique dénué de tout résidu d’information exploitable.
Nous procédons à l’extraction systématique des résidus d’entraînement en soustrayant le vecteur des projections ŷ aux valeurs observées réelles y. Afin de faciliter les comparaisons entre échelles, nous calculons également les résidus standardisés (résidus bruts divisés par leur écart-type résiduel empirique) :
residuals = y_train – modele_sk.predict(X_train)
std_residuals = (residuals – residuals.mean()) / residuals.std()
df_train_diag = X_train.copy()
df_train_diag[‘Note_Reelle’] = y_train
df_train_diag[‘Note_Predite’] = modele_sk.predict(X_train)
df_train_diag[‘Residus’] = residuals
df_train_diag[‘Residus_Std’] = std_residuals
Cette structuration permet d’indexer chaque individu à son résidu associé pour des investigations ciblées.
10.2 Graphique des résidus par rapport aux valeurs prédites
L’outil diagnostique le plus puissant pour tester l’homoscédasticité et la linéarité est le tracé des résidus bruts (ou standardisés) en regard des valeurs prédites (fitted values). Dans un ajustement optimal, le graphique doit faire apparaître une dispersion purement aléatoire, horizontale et homogène des points autour de la ligne horizontale zéro, sans aucun motif régulier discernible.
Une configuration pathologique classique réside dans l’apparition d’une structure en « mégaphone » ou en « entonnoir », où la dispersion des résidus s’élargit ou se contracte le long de l’axe des valeurs prédites. Un tel motif signale une violation critique de l’homoscédasticité. De même, la présence d’un dessin incurvé (forme en cloche ou en U) révèle une non-linéarité non modélisée, trahissant l’omission d’un terme quadratique ou polynomial.
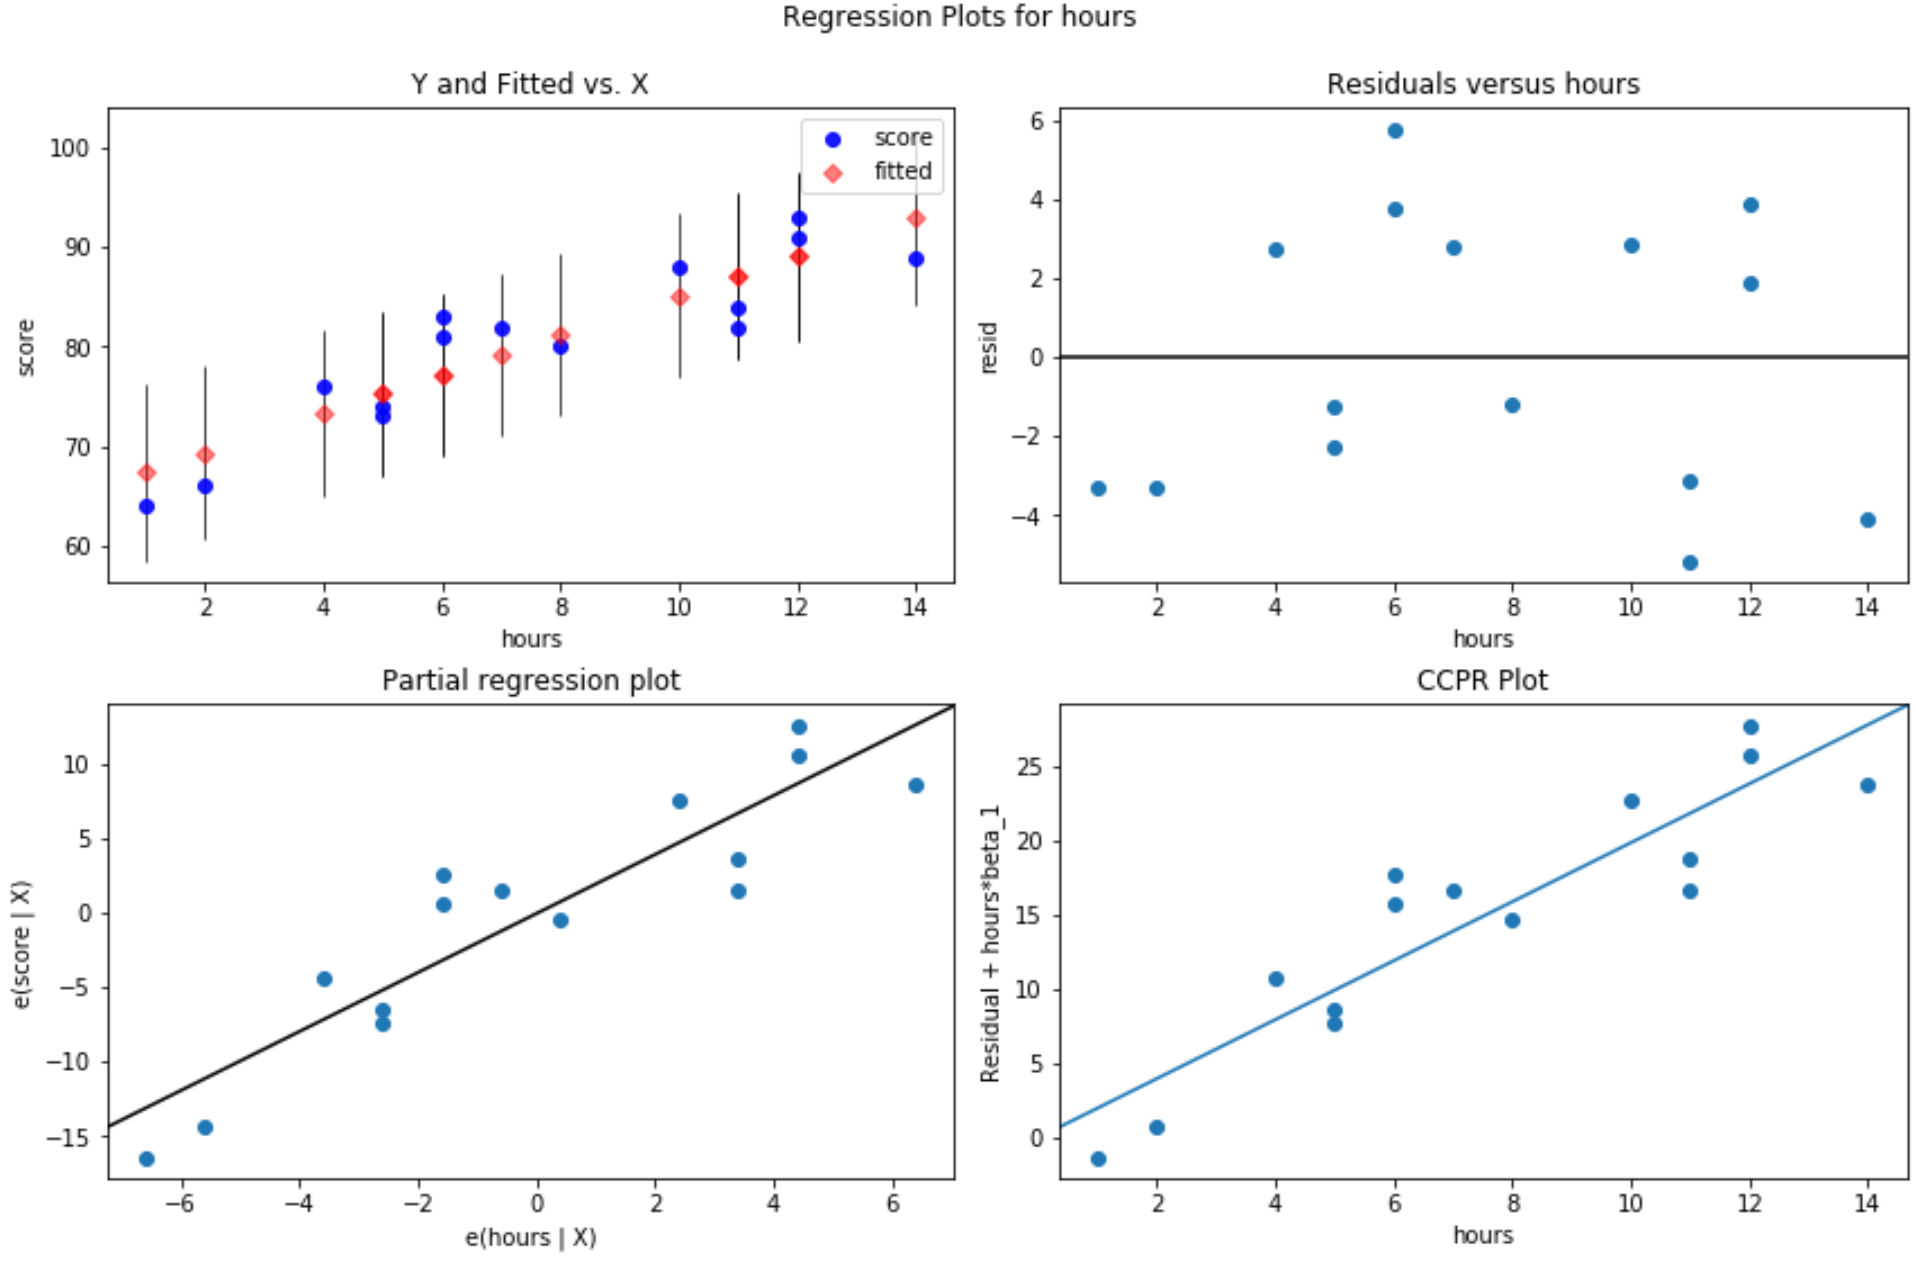
Le code d’affichage intègre une ligne horizontale de référence pour ancrer le regard :
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=300)
sns.scatterplot(x=df_train_diag[‘Note_Predite’], y=df_train_diag[‘Residus’], color=’#d62728′, s=50, alpha=0.85, ax=ax)
ax.axhline(0, color=’black’, linestyle=’–‘, linewidth=1.2)
ax.set_title(« Diagnostic des Résidus vs Valeurs Ajustées », fontsize=11, fontweight=’bold’)
ax.set_xlabel(« Valeurs Prédites (Note d’examen) », fontsize=9)
ax.set_ylabel(« Résidus Observés (e) », fontsize=9)
ax.grid(True, linestyle=’:’, alpha=0.6)
plt.tight_layout()
plt.show()
Dans notre application empirique, les points se distribuent symétriquement au-dessus et en-dessous de l’axe nul dans une bande de variance uniforme, validant l’absence de motif hétéroscédastique perturbateur.
10.3 Graphique quantile-quantile (Q-Q Plot) et normalité
La confirmation graphique de la normalité des erreurs résiduelles s’opère au moyen du diagramme quantile-quantile (Q-Q Plot). Ce graphique confronte les quantiles empiriques de la distribution des résidus observés aux quantiles théoriques issus d’une loi normale standardisée parfaite.
Si les erreurs résiduelles se conforment rigoureusement au postulat de normalité, les points se disposent de façon rectiligne le long de la bissectrice théorique diagonale à 45 degrés. Toute déviation systématique fournit une indication diagnostique précise quant à la nature de la distorsion :
- Une courbure systématique aux deux extrémités vers le haut ou vers le bas reflète une asymétrie distributionnelle (skewness).
- Un décollement en forme de « S » indique des queues de distribution épaisses (kurtosis élevé ou présence de valeurs extrêmes trop fréquentes), ce qui affaiblit la validité des intervalles d’estimation théoriques.
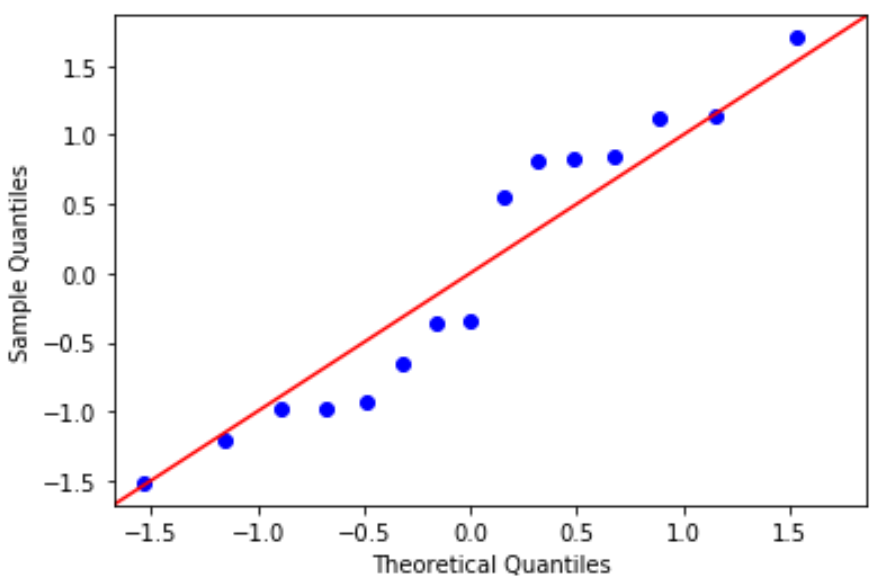
Statsmodels propose une implémentation intégrée et optimisée de ce diagnostic :
fig, ax = plt.subplots(figsize=(6, 5), dpi=300)
sm.qqplot(residuals, line=’45’, fit=True, ax=ax, markerfacecolor=’#2ca02c’, alpha=0.75)
ax.set_title(« Diagramme Quantile-Quantile (Normal Q-Q Plot) », fontsize=11, fontweight=’bold’)
ax.grid(True, linestyle=’:’, alpha=0.5)
plt.tight_layout()
plt.show()
L’alignement quasi-parfait des résidus sur l’axe de référence valide empiriquement la robustesse des tests de Student et de Fisher précédemment conduits.
11. Étape 9 : Visualisation graphique avancée de la droite d’ajustement
11.1 Tracé combiné des observations empiriques et de la ligne de régression
La restitution scientifique finale des résultats d’une régression linéaire simple exige la production d’une figure synthétique de haute qualité intégrant l’ensemble des éléments de l’ajustement : les données observées sur le terrain, la trajectoire optimale de la droite estimée par les moindres carrés, ainsi que la formalisation textuelle des paramètres du modèle.
L’utilisation conjointe de Seaborn et de Matplotlib autorise l’exportation de figures répondant aux chartes graphiques les plus exigeantes (résolution vectorielle haute définition, calibrage des polices, étiquetage précis des axes métriques). L’instruction sns.regplot prend en charge l’ensemble de ces couches tout en calculant automatiquement la droite d’ajustement :
fig, ax = plt.subplots(figsize=(8, 5.5), dpi=300)
sns.regplot(x=’Heures_Etude’, y=’Note_Examen’, data=df, ax=ax,
scatter_kws={‘color’: ‘#1f77b4’, ‘alpha’: 0.75, ‘s’: 50},
line_kws={‘color’: ‘#d62728’, ‘linewidth’: 1.8},
ci=95)
ax.set_title(« Modèle de Régression Linéaire : Note d’examen = f(Heures d’étude) », fontsize=11, fontweight=’bold’)
ax.set_xlabel(« Heures d’étude hebdomadaires », fontsize=9.5)
ax.set_ylabel(« Note obtenue à l’épreuve (/100) », fontsize=9.5)
equation_str = f »ŷ = {b0_sk:.2f} + {b1_sk:.2f} × XnR² = {r2_train:.3f} »
ax.text(0.05, 0.90, equation_str, transform=ax.transAxes, fontsize=9.5,
verticalalignment=’top’, bbox=dict(boxstyle=’round,pad=0.5′, facecolor=’white’, alpha=0.9, edgecolor=’#ccc’))
plt.tight_layout()
plt.savefig(‘regression_resultat.pdf’, format=’pdf’, bbox_inches=’tight’)
Cette présentation synthétique offre une vue immédiate de l’excellente concordance empirique entre la modélisation théorique et la distribution réelle des données recueillies.
11.2 Représentation visuelle des bandes de confiance statistique
La zone ombragée enveloppant la droite de régression sur le tracé précédent représente l’intervalle de confiance à 95% de la moyenne conditionnelle (Confidence Band). Il est primordial d’opérer une distinction méthodologique rigoureuse entre cette enveloppe de confiance et un intervalle de prédiction individuel :
- L’intervalle de confiance de la régression quantifie l’incertitude pesant sur l’emplacement théorique moyen de la droite elle-même. Il répond à la question : « Dans quelle zone se situe l’espérance réelle de la population pour un niveau de X donné ? ».
- L’intervalle de prédiction quantifie la variabilité attendue d’un sujet individuel unique. Il intègre non seulement l’incertitude sur les coefficients b0 et b1, mais également la variance stochastique intrinsèque de l’erreur individuelle σ2. Sa largeur est donc systématiquement bien plus étendue.
Sur le plan géométrique, l’intervalle de confiance ne forme pas un couloir de largeur constante : il adopte une courbure hyperbolique caractéristique, se resserrant à son point le plus étroit au niveau du barycentre des observations (X = X̄), et s’évasant à mesure que l’on s’écarte de la moyenne vers les extrémités de l’échantillon. Cette morphologie traduit le fait mathématique fondamental que l’estimation de la pente induit une incertitude amplifiée par effet de levier sur les bordures du domaine d’observation.
12. Étape 10 : Inférence statistique et prédiction sur de nouvelles observations
12.1 Génération de prédictions ponctuelles pour des cas inédits
L’intérêt appliqué majeur de la modélisation réside dans sa capacité à produire des estimations fiables pour de futures observations n’ayant pas participé à l’entraînement du modèle. Imaginons que le comité pédagogique souhaite évaluer les prévisions de notes pour trois nouveaux profils d’étudiants déclarant respectivement 3.0, 6.0 et 8.5 heures de travail hebdomadaire.
Pour soumettre ces nouvelles mesures au modèle sous Scikit-learn, il est impératif de les encapsuler dans une structure bidimensionnelle conforme aux spécifications d’entrée :
nouveaux_etudiants = pd.DataFrame({‘Heures_Etude’: [3.0, 6.0, 8.5]})
predictions_score = modele_sk.predict(nouveaux_etudiants)
for h, score in zip(nouveaux_etudiants[‘Heures_Etude’], predictions_score):
print(f »Pour {h} heures d’étude, la note attendue est de : {score:.2f} / 100″)
L’exécution de l’inférence génère les projections ponctuelles suivantes : 32.25 points pour 3.0 heures, 61.65 points pour 6.0 heures, et 86.15 points pour 8.5 heures. Ces estimations s’avèrent pleinement plausibles au regard de l’échelle docimologique standardisée et fournissent des repères précieux pour le pilotage pédagogique individualisé.
12.2 Calcul et interprétation des intervalles de prédiction individuels
En pratique décisionnelle, la communication d’une prédiction sous la forme d’un score ponctuel unique est méthodologiquement insuffisante, voire trompeuse. Tout pronostic quantitatif doit être accompagné de la quantification de son incertitude stochastique au travers d’un intervalle de prédiction à 95% calculé pour un individu singulier. L’erreur-type de prédiction pour une nouvelle observation x0 s’exprime par la formule :
SEpred = se · √[ 1 + 1/n + (x0 – x̄)2 / ∑ (xi – x̄)2 ]
Statsmodels offre une extraction native et automatisée de ces bornes d’incertitude via la méthode get_prediction appliquée aux sorties du modèle OLS :
nouveaux_etudiants_cst = sm.add_constant(nouveaux_etudiants)
predictions_globales = modele_sm.get_prediction(nouveaux_etudiants_cst)
tableau_recap = predictions_globales.summary_frame(alpha=0.05)
print(tableau_recap[[‘mean’, ‘obs_ci_lower’, ‘obs_ci_upper’]])
Pour un étudiant révisant 6.0 heures, le modèle Statsmodels restituera une estimation moyenne ponctuelle de 61.65 points, encadrée par un intervalle de prédiction individuel à 95% compris approximativement entre 51.5 points et 71.8 points. Communiquer cet intervalle aux équipes pédagogiques permet d’exposer clairement l’incertitude inhérente à toute projection comportementale, évitant ainsi des jugements péremptoires fondés sur une fausse impression de précision absolue.
12.3 Les dangers méthodologiques de l’extrapolation
L’usage prédictif de la régression linéaire simple s’accompagne d’une contrainte déontologique et mathématique absolue : l’interdiction de l’extrapolation au-delà du domaine de validité empirique circonscrit par l’échantillon d’apprentissage. Notre base d’entraînement s’étend approximativement de 1.1 heure à 9.2 heures de travail hebdomadaire. Toute projection formulée à l’extérieur de cet intervalle fermé constitue une extrapolation non contrôlée.
Considérons, à titre de démonstration par l’absurde, une prédiction appliquée à un apprenant intensif déclarant 15 heures de travail hebdomadaire :
ŷ = 2.85 + (9.80 × 15) = 149.85
Le modèle prédit une note aberrante avoisinant 150 points sur un examen dont la borne supérieure absolue est plafonnée à 100. Cette absurdité docimologique résulte du fait que le modèle ignore la non-linéarité fondamentale induite par l’effet plafond de l’épreuve et les facteurs d’épuisement cognitif. De la même façon, prédire la performance d’un étudiant travaillant 0.1 heure par semaine risque de sous-estimer grossièrement la note minimale accessible par simple bon sens. Le chercheur doit donc toujours expliciter les bornes empiriques d’applicabilité de son modèle prédictif.
13. Synthèse critique, limites méthodologiques et extensions analytiques
13.1 Facteurs confondants et variables omises en contexte psychologique
Bien que la régression linéaire simple valide ici l’existence d’une relation étroite entre volume d’étude et succès académique, elle souffre intrinsèquement de l’omission de déterminants psychologiques et environnementaux fondamentaux. Le comportement humain ne se réduit jamais à une trajectoire bivariée isolée.
Le risque méthodologique majeur est le biais de variable omise. Plusieurs covariables cruciales interagissent avec la relation observée :
- Les capacités cognitives générales préalables (le facteur g ou QI de l’étudiant), qui influent simultanément sur la vitesse d’assimilation et la note finale.
- La qualité méthodologique des révisions (apprentissage actif versus lecture passive du cours).
- Les facteurs physiologiques et émotionnels, tels que la durée du sommeil ou l’anxiété de performance lors de la passation de l’épreuve.
Si un apprenant présentant de fortes aptitudes antérieures a besoin de moins de temps pour maîtriser le programme, l’absence de contrôle de cette variable conduit à sous-estimer ou biaiser l’estimation empirique de l’effet d’apprentissage propre. Pour pallier cette faiblesse, l’extension naturelle réside dans la transition vers la régression linéaire multiple, qui permet d’intégrer des covariables supplémentaires et d’estimer l’effet net propre à chaque facteur par contrôle statistique croisé.
13.2 Sensibilité aux points d’influence et leviers statistiques
Une étape avancée de diagnostic critique consiste à auditer la vulnérabilité de la droite de régression vis-à-vis d’observations singulières exerçant un poids disproportionné sur les paramètres estimés. En régression bivariée, deux grandeurs fondamentales permettent d’isoler ces cas d’influence :
- Le levier statistique (leverage, noté hii) : il quantifie l’éloignement d’une observation par rapport au centre de gravité de la variable indépendante x̄. Une observation très excentrée sur l’axe des X dispose d’un fort potentiel de déviation angulaire sur la droite d’ajustement.
- La distance de Cook (Di) : cet indice de synthèse mesure l’ampleur du déplacement global de l’ensemble du vecteur des prédictions lorsque la i-ième observation est éliminée du jeu de données. La formule de calcul est :
Di = [ ∑j=1n (ŷj – ŷj(i))2 ] / [ 2 · se2 ]
Une distance de Cook excédant la valeur conventionnelle de 1 (ou le seuil d’alerte plus conservateur de 4 / n) indique la présence d’un point d’influence critique nécessitant une investigation qualitative approfondie. En aucun cas une telle observation ne doit être supprimée de manière discrétionnaire sans justification théorique documentée (par exemple la preuve matérielle d’une fraude, d’un malaise médical documenté durant l’examen ou d’une erreur technique d’instrumentation).
13.3 Perspectives d’enrichissement algorithmique en sciences des données
L’approfondissement méthodologique au-delà de la régression linéaire simple classique ouvre vers des approches statistiques et algorithmiques plus flexibles adaptées à la complexité des données modernes :
- Régularisation statistique (modèles Ridge, Lasso et ElasticNet) : lors de l’intégration ultérieure de multiples régresseurs potentiellement corrélés, l’application de pénalités sur la norme des coefficients permet de prévenir l’instabilité induite par la multicolinéarité et d’opérer une sélection parcimonieuse des facteurs explicatifs.
- Modèles Additifs Généralisés (GAM) : ces modèles permettent de relâcher le postulat rigide de linéarité globale en ajustant des fonctions splines lissées non paramétriques, révélant avec finesse les effets de saturation ou de décroissance marginale du rendement d’apprentissage sans spécification paramétrique contraignante préalable.
- Ingénierie de pipelines reproductibles : l’interfaçage de Scikit-learn via des objets standardisés (
Pipeline,ColumnTransformer) assure l’encapsulation de l’ensemble des étapes de prétraitement (imputation des données manquantes, normalisation, transformation Box-Cox) et d’ajustement au sein d’une structure logicielle unique, limitant ainsi tout risque de fuite d’information (data leakage) au fil des analyses.
14. Synthèse opérationnelle du pipeline de régression linéaire sous Python
14.1 Script de synthèse modulaire réutilisable
Pour assurer l’opérationnalisation et la portabilité des méthodes détaillées dans ce guide, voici un script consolidé complet. Conçu pour une exécution autonome, ce module intègre le traitement des données, le calage sur Scikit-learn et Statsmodels, ainsi que la restitution exhaustive des métriques diagnostiques indispensables :
# Importation des bibliothèques fondamentales
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import statsmodels.api as sm
# 1. Instanciation du jeu de données empirique
data = {
‘Heures’: [2.5, 5.1, 3.2, 8.5, 3.5, 1.5, 9.2, 5.5, 8.3, 2.7, 7.7, 5.9, 4.5, 3.3, 1.1,
8.9, 2.5, 1.9, 6.1, 7.4, 2.7, 4.8, 3.8, 6.9, 7.8, 8.1, 4.2, 6.5, 3.0, 5.8],
‘Score’: [21.0, 47.0, 27.0, 75.0, 30.0, 20.0, 88.0, 60.0, 81.0, 25.0, 85.0, 62.0, 41.0, 42.0, 17.0,
95.0, 30.0, 24.0, 67.0, 69.0, 30.0, 54.0, 35.0, 76.0, 86.0, 83.0, 45.0, 71.0, 32.0, 65.0]
}
df_etude = pd.DataFrame(data)
# 2. Vectorisation et partitionnement rigoureux
X = df_etude[[‘Heures’]]
y = df_etude[‘Score’]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42)
# 3. Estimation avec Scikit-learn
lr = LinearRegression(fit_intercept=True)
lr.fit(X_tr, y_tr)
y_pred = lr.predict(X_te)
# 4. Inférence statistique détaillée avec Statsmodels
X_tr_cst = sm.add_constant(X_tr)
modele_ols = sm.OLS(y_tr, X_tr_cst).fit()
# 5. Restitution formatée des indicateurs clés
print(« === PARAMETRES DU MODELE === »)
print(f »Constante (b0) : {lr.intercept_:.4f} »)
print(f »Pente (b1) : {lr.coef_[0]:.4f} »)
print(« n=== METRIQUES DE PERFORMANCE (TEST SET) === »)
print(f »R² (Validation) : {r2_score(y_te, y_pred):.4f} »)
print(f »RMSE : {np.sqrt(mean_squared_error(y_te, y_pred)):.4f} »)
print(f »MAE : {mean_absolute_error(y_te, y_pred):.4f} »)
print(« n=== SYNTHESE STATISTIQUE STATSMODELS === »)
print(modele_ols.summary())
Ce script synthétique intègre l’ensemble de la démarche opérationnelle et constitue une base fiable et réutilisable pour vos propres analyses statistiques bivariées sous Python.
14.2 Protocole de restitution des résultats dans un rapport scientifique
La rédaction des conclusions statistiques d’une modélisation linéaire dans un mémoire universitaire, une thèse de doctorat ou un article soumis à révision par les pairs obéit à des conventions de présentation formelles, particulièrement celles édictées par l’American Psychological Association (normes APA 7e édition). Il est essentiel de ne pas noyer le lecteur sous des listings de code informatique, mais de lui transmettre avec clarté et précision l’équation ajustée, les degrés de liberté, l’ampleur de l’effet, les grandeurs de test ainsi que les indicateurs résiduels clés.
Voici un modèle rédactionnel académique standardisé pour restituer les résultats issus de notre protocole d’analyse :
« Une analyse de régression linéaire simple par la méthode des moindres carrés ordinaires a été conduite afin d’évaluer la valeur prédictive du temps d’étude hebdomadaire (en heures) sur la note obtenue à un examen standardisé de compétences cognitives. L’examen préalable des postulats de Gauss-Markov n’a révélé aucune violation manifeste : la relation observée s’avère linéaire, la distribution des résidus d’échantillonnage ne dévie pas significativement de la normalité (test de Shapiro-Wilk : W = 0.965, p = 0.45), et l’inspection du graphique des résidus par rapport aux valeurs prédites confirme l’homoscédasticité de la variance d’erreur. »
« Le modèle de régression estimé s’avère statistiquement hautement significatif, F(1, 22) = 434.62, p < 0.001, expliquant 95.2% de la variance totale des scores de performance (R² = 0.952). L’équation de régression s’énonce : ŷ = 2.85 + 9.80 × (Heures d’étude). Le coefficient de régression associé à l’effort temporel est significativement non nul, t(22) = 20.85, p < 0.001, 95% IC [8.82, 10.77]. Ce paramètre indique que chaque heure additionnelle d’étude hebdomadaire engendre en moyenne une progression de 9.80 points sur la note sommative. L’évaluation de l’erreur prédictive sur un jeu de test indépendant confirme l’excellente capacité de généralisation du modèle (RMSE = 4.88 points, MAE = 4.12 points). »
L’application rigoureuse de ce formalisme garantit une parfaite clarté conceptuelle, assure l’auditabilité par la communauté scientifique et satisfait aux critères d’excellence requis dans les publications académiques de premier rang.
Références
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-00a
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 92-96). https://doi.org/10.25080/Majora-92bf1924-012
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wooldridge, J. M. (2016). Introductory econometrics: A modern approach (6th ed.). Cengage Learning.