
La modélisation statistique appliquée aux sciences empiriques, qu’il s’agisse de l’économétrie, de l’épidémiologie ou de la psychométrie, repose fondamentalement sur la capacité des chercheurs à traduire des phénomènes qualitatifs complexes en entités numériques manipulables par des algorithmes d’estimation. Dans le cadre du modèle linéaire généralisé, les variables prédictives continues telles que l’âge chronologique, le revenu ou la pression artérielle s’intègrent naturellement au sein d’équations algébriques grâce à leurs propriétés d’échelle d’intervalle ou de ratio. Néanmoins, l’investigation empirique se heurte invariablement à des facteurs intrinsèquement qualitatifs : l’appartenance à un groupe clinique, le statut socio-économique catégorisé, l’état matrimonial ou encore l’assignation à un protocole thérapeutique expérimental.
Pour intégrer ces attributs non métriques au sein de matrices de régression sans violer les hypothèses fondamentales sous-jacentes à l’estimation matricielle, la communauté statistique a formalisé l’usage des variables indicatrices, communément désignées sous l’anglicisme de « variables muettes » ou dummy variables. Ces constructions binaires permettent de segmenter la variance de la variable dépendante en contrastes discrets tout en préservant l’orthogonalité et l’interprétabilité des paramètres estimés. Au sein de l’écosystème SAS (Statistical Analysis System), un environnement logiciel de référence pour l’analyse de données massives et la recherche clinique hautement régulée, la manipulation de ces prédicteurs discrets constitue un jalon méthodologique incontournable pour tout analyste de données.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les mécanismes algébriques et les implémentations pratiques des variables muettes dans l’environnement SAS. En partant des théorèmes d’algèbre matricielle jusqu’aux procédures avancées d’ajustement de modèles telles que PROC REG, PROC GLM et PROC GLMSELECT, cet article détaille de manière didactique et rigoureuse les étapes de codage, de validation diagnostique et d’interprétation des résultats, fournissant ainsi aux praticiens les outils conceptuels et programmatiques nécessaires à une recherche quantitative d’une parfaite rigueur méthodologique.
1. Introduction théorique aux variables muettes en modélisation statistique
1.1 Définition et rôle fondamental des variables indicatrices
Dans le domaine de l’économétrie et de l’analyse multivariée, une variable muette, ou variable indicatrice, se définit formellement comme une variable artificielle créée pour représenter un attribut qualitatif sous forme binaire, prenant exclusivement les valeurs numériques zéro (0) ou un (1). Cette dichotomisation numérique ne vise pas à réduire arbitrairement la complexité conceptuelle d’un phénomène, mais à fournir un support arithmétique rigoureux permettant d’indiquer l’absence (valeur 0) ou la présence (valeur 1) d’une caractéristique catégorielle spécifique chez une unité statistique observée.
La nécessité de convertir les mesures qualitatives pour l’analyse matricielle découle de la nature même des estimateurs des moindres carrés ordinaires (MCO). Ces estimateurs nécessitent le calcul de produits scalaires, de matrices de covariance et d’inversions de matrices de plan de variance-covariance. Si un analyste commettait l’erreur conceptuelle d’assigner des nombres entiers successifs arbitraires (par exemple, 1, 2 et 3) à des catégories purement qualitatives telles que l’affiliation politique ou la région de résidence, le modèle de régression traiterait ces codes comme des grandeurs continues. Une telle démarche imposerait implicitement l’hypothèse erronée que la différence entre la catégorie 2 et la catégorie 1 est rigoureusement équivalente à celle séparant la catégorie 3 de la catégorie 2, tout en postulant un ordre hiérarchique artificiel dénué de fondement empirique.
Dans les devis de recherche en sciences du comportement et en santé publique, la variable indicatrice agit comme un commutateur logique (ou switch mathématique). Elle active ou désactive des composantes spécifiques de l’équation de prédiction selon le profil de chaque sujet. Cette démarche s’ancre dans la typologie formelle établie par Stanley Smith Stevens sur les échelles de mesure. Les variables nominales, caractérisées uniquement par des relations d’équivalence ou de dissemblance sans aucune relation d’ordre sous-jacente, exigent cette transformation binaire préalable pour acquérir une légitimité computationnelle. Les variables ordinales, bien que dotées d’un ordonnancement intrinsèque, ne garantissent pas des distances métriques constantes entre leurs échelons et bénéficient elles aussi fréquemment d’un codage muet afin d’éviter d’arbitraires postulats d’intervalle.
1.2 Transposition de construits qualitatifs en prédicteurs quantitatifs
La formalisation empirique d’un construit théorique implique sa conversion en entités numériques sans dénaturer la structure de l’information originelle. Lors de la modélisation de sous-groupes cliniques ou sociodémographiques, le codage binaire permet de capturer fidèlement l’hétérogénéité des populations étudiées. Considérons par exemple la typologie clinique des troubles anxieux dans une cohorte médicale : la distinction entre un trouble d’anxiété généralisée, un trouble panique et un trouble obsessionnel-compulsif ne saurait être modélisée par une droite d’ajustement unique le long d’un axe numérique arbitraire. En créant un ensemble de variables muettes, le statisticien isole l’effet différentiel propre à chaque entité clinique tout en préservant les propriétés géométriques du sous-espace vectoriel défini par les prédicteurs.
Ce processus de transformation garantit le maintien de l’orthogonalité partielle et empêche toute distorsion métrique non désirée. Lorsqu’une variable nominale comporte $k$ modalités distinctes et exhaustives, son injection directe sous un codage arithmétique continu $(1, 2, dots, k)$ forcerait les contrastes intergroupes à suivre une progression géométrique linéaire ou polynomiale rigide. En revanche, l’utilisation de prédicteurs indicateurs segmentés autorise chaque sous-groupe à posséder son propre écart paramétrique par rapport à une modalité de base. Il n’existe ainsi aucun préjugé théorique quant à l’espacement ou à la hiérarchie des effets observés.
Les applications pratiques de cette démarche abondent dans la littérature quantitative contemporaine. Dans les études de sociologie économique, le statut matrimonial — décliné en célibataire, marié, divorcé ou veuf — constitue un déterminant déterminant de l’épargne et des comportements de consommation qui nécessite une telle décomposition. De même, au sein des essais cliniques randomisés en double aveugle, l’évaluation de protocoles d’intervention multicentriques requiert la modélisation du bras thérapeutique (groupe témoin sous placebo versus molécules actives à dosages gradués) au moyen de variables muettes. Cette approche permet de tester rigoureusement l’efficacité comparative de chaque molécule sans postuler d’effets dose-réponse purement proportionnels.
1.3 Place des variables indicatrices dans l’analyse de régression linéaire
Au niveau fondamental, l’intégration de variables muettes s’articule parfaitement au sein de l’équation générale du modèle linéaire classique. Soit une observation individuelle notée $i$, le modèle s’écrit formellement :
$$Y_i = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + dots + \beta_p X_{\pi} + \varepsilon_i$$
Dans cette formulation, si $X_{1i}$ représente une variable indicatrice valant 1 si l’individu $i$ présente la modalité cible et 0 dans le cas contraire, l’espérance conditionnelle de la variable dépendante $Y_i$ s’ajuste de façon discontinue. Pour les individus ne possédant pas cette caractéristique ($X_{1i} = 0$), le terme $\beta_1 X_{1i}$ s’annule complètement. Pour les sujets dotés de la caractéristique ($X_{1i} = 1$), l’espérance conditionnelle augmente ou diminue précisément de la quantité $\beta_1$, toutes les autres variables étant maintenues constantes. Les variables muettes opèrent ainsi comme des décalages purs de l’ordonnée à l’origine (ou constante du modèle) pour chaque catégorie considérée.
Ce mécanisme met en lumière l’équivalence théorique parfaite entre le modèle de régression linéaire à prédicteurs binaires et l’analyse de variance univariée (ANOVA) établie par Ronald Fisher. Lorsque l’ensemble des prédicteurs d’une régression est constitué d’indicatrices représentant une classification unique, le modèle décompose la somme des carrés totale exactement de la même manière que l’ANOVA classique en variance intergroupes (somme des carrés expliquée) et variance intragroupe (somme des carrés résiduelle). Les coefficients estimés par la méthode des moindres carrés ordinaires (MCO) correspondent alors strictement aux écarts observés entre les moyennes des sous-échantillons et la moyenne de la catégorie de référence.
L’estimation des paramètres via le critère MCO conserve ainsi l’ensemble de ses propriétés optimales décrites par le théorème de Gauss-Markov. Dès lors que les erreurs résiduelles $\varepsilon_i$ satisfont les conditions d’homoscédasticité, d’indépendance mutuelle et d’espérance nulle, les coefficients associés aux variables muettes constituent les meilleurs estimateurs linéaires sans biais (BLUE : Best Linear Unbiased Estimators). Cette robustesse théorique confère à l’introduction d’indicatrices qualitatives une légitimité mathématique absolue pour tester des hypothèses de recherche complexes.
2. Fondements mathématiques et la règle formelle des k-1 catégories
2.1 Démonstration du piège des variables muettes et de la colinéarité parfaite
L’implémentation naïve de variables indicatrices au sein d’une régression multiple sans précaution méthodologique expose le chercheur à un écueil théorique majeur : le « piège des variables muettes » (ou dummy variable trap). Ce phénomène mathématique survient lorsqu’une variable qualitative comportant $k$ modalités exhaustives et mutuellement exclusives est convertie en exactement $k$ variables indicatrices en présence d’une constante (l’interception $\beta_0$) dans le modèle de régression.
D’un point de vue algébrique, considérons la matrice du plan d’expérience notée $\mathbf{X}$, de dimensions $n \times (k+1)$, dont la première colonne est un vecteur unitaire $\mathbf{1}$ associé à l’interception, et dont les $k$ colonnes suivantes représentent les indicatrices $D_1, D_2, dots, D_k$. Chaque observation $i$ appartenant obligatoirement à une et une seule des $k$ catégories, la somme des indicatrices sur une même ligne est systématiquement égale à l’unité :
$$\sum_{j=1}^{k} D_{ij} = 1, \quad \forall i in {1, 2, dots, n}$$
Il en résulte une relation de dépendance linéaire exacte entre le vecteur de la constante et les $k$ colonnes des variables indicatrices :
$$\mathbf{1} – \sum_{j=1}^{k} \mathbf{D}_j = \mathbf{0}$$
Cette dépendance linéaire stricte a pour effet immédiat de réduire le rang de la matrice $\mathbf{X}$, qui devient strictement inférieur au nombre de ses colonnes ($rang(\mathbf{X}) le k < k+1$). Par conséquent, la matrice carrée symétrique $\mathbf{X}'\mathbf{X}$ (transposée de $\mathbf{X}$ multipliée par $\mathbf{X}$) est singulière, ce qui implique que son déterminant est rigoureusement nul : $det(\mathbf{X}'\mathbf{X}) = 0$. Il devient mathématiquement impossible de calculer son inverse $(\mathbf{X}'\mathbf{X})^{-1}$.
L’équation normale des moindres carrés ordinaires, donnée par la relation fondamentale $\mathbf{\hat{\beta}} = (\mathbf{X}’\mathbf{X})^{-1}\mathbf{X}’\mathbf{Y}$, n’admet alors aucune solution unique. Dans le formalisme matriciel, le système d’équations est sous-déterminé et admet une infinité d’estimations possibles des paramètres. Sur le plan asymptotique et computationnel, les logiciels statistiques traditionnels tentant de forcer cette inversion génèrent des erreurs majeures, illustrées par l’explosion des variances des estimateurs et des erreurs-types tendant vers l’infini, ou recourent à l’élimination arbitraire d’un des vecteurs pour lever la singularité matricielle.
2.2 Critères de sélection rationnelle de la catégorie de référence
Pour contourner de manière déterministe le piège des variables muettes, la règle empirique et mathématique impose d’omettre systématiquement l’une des indicatrices lors de la spécification de l’équation, en ne conservant que $k – 1$ variables muettes en présence de la constante. La modalité exclue du système devient alors la « catégorie de référence » (ou groupe de base/contrôle). Le choix de cette catégorie n’est pas anodin : bien qu’il ne modifie en rien la qualité globale de l’ajustement du modèle ($R^2$, somme des carrés résiduelle, statistiques de test global $F$), il réoriente substantiellement la signification conceptuelle de chaque coefficient estimé et conditionne la précision statistique des tests d’hypothèses individuels.
Plusieurs critères rationnels doivent guider le choix du statisticien dans la désignation de ce groupe de référence :
- Le critère de fréquence (modalité modale) : Choisir la modalité regroupant le plus grand effectif au sein de l’échantillon constitue la stratégie recommandée pour maximiser la puissance statistique. L’erreur-type d’un coefficient associé à une variable muette étant inversement proportionnelle à la taille d’échantillon des groupes comparés, une modalité de référence volumineuse réduit la variance de l’estimateur de l’interception et stabilise l’ensemble des comparaisons bilatérales.
- Le critère conceptuel et expérimental : Dans les protocoles cliniques ou les devis quasi-expérimentaux, la catégorie de référence s’impose d’elle-même sous la forme du groupe témoin, du groupe recevant un placebo, ou de l’état standard (baseline). Cette sélection offre une interprétation immédiate : chaque coefficient de régression $\beta_j$ traduit directement l’effet différentiel du traitement expérimental $j$ par rapport à l’absence de traitement.
- Le critère de stabilité théorique : Il convient d’éviter scrupuleusement de retenir comme référence une catégorie marginale, instable ou résiduelle (telle qu’une catégorie fourre-tout « Autre »). Une telle modalité présente une forte hétérogénéité interne et une variance d’échantillonnage élevée, ce qui affaiblirait la robustesse des contrastes statistiques et compromettrait la lisibilité des conclusions.
2.3 Généralisation mathématique pour k modalités polytomiques
La formulation générale du modèle linéaire incluant un attribut polytomique à $k$ modalités s’exprime par le développement suivant. En désignant la première modalité ($j=1$) comme catégorie de référence omise, l’équation s’écrit pour chaque individu $i$ :
$$Y_i = \beta_0 + \sum_{j=2}^{k} \beta_j D_{ij} + \sum_{m=1}^{p} \gamma_m Z_{mi} + \varepsilon_i$$
où les $D_{ij}$ (pour $j in {2, dots, k}$) sont les $k-1$ variables indicatrices générées, $Z_{mi}$ représente un ensemble de $p$ covariables quantitatives de contrôle, et $\varepsilon_i \sim \mathcal{N}(0, \sigma^2)$ constitue le terme d’erreur stochastique. Sous cette paramétrisation standard dite de référence, le vecteur de contrastes associé à la modalité $j$ s’interprète rigoureusement par l’espérance mathématique conditionnelle :
$$\mathbb{E}[Y_i mid D_{ij} = 1, \mathbf{Z}_i = \mathbf{0}] = \beta_0 + \beta_j$$
Pour un individu appartenant à la catégorie de référence, l’ensemble des variables muettes s’annule simultanément ($D_{i2} = D_{i3} = dots = D_{ik} = 0$). Dès lors, l’espérance conditionnelle s’écrit :
$$\mathbb{E}[Y_i mid D_{i2}=0, dots, D_{ik}=0, \mathbf{Z}_i = \mathbf{0}] = \beta_0$$
L’interception $\beta_0$ ne représente donc plus la moyenne générale inconditionnelle de la population, mais correspond spécifiquement à la moyenne théorique attendue pour le groupe de référence lorsque l’ensemble des covariables d’ajustement est fixé à zéro. Par déduction directe, chaque paramètre de pente $\beta_j$ quantifie l’écart exact entre l’espérance du groupe $j$ et celle du groupe de référence :
$$\beta_j = \mathbb{E}[Y_i mid D_{ij} = 1, \mathbf{Z}_i = \mathbf{0}] – \mathbb{E}[Y_i mid \text{Référence}, \mathbf{Z}_i = \mathbf{0}]$$
Ce système se distingue d’autres schémas de codage vectoriel, tels que les codages de Helmert ou les contrastes polynomiaux utilisés en psychométrie. Le codage muet simple présente l’avantage d’une lisibilité immédiate, en transformant chaque test $t$ de Student sur le coefficient $\beta_j$ en un test d’hypothèse bilatéral direct sur l’existence d’une divergence significative entre la modalité $j$ et la catégorie de base.
3. Présentation du jeu de données empirique et contextualisation empirique
3.1 Structure des données sociodémographiques et économiques
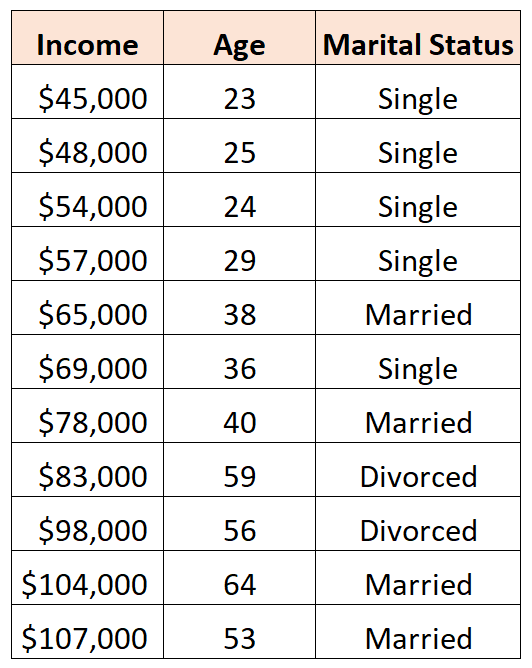
Afin de concrétiser les concepts théoriques exposés précédemment et de fournir un cadre d’application reproductible sous SAS, nous déployons une cohorte empirique représentative de données sociodémographiques. L’objectif analytique consiste à modéliser la distribution du revenu annuel individuel (exprimé en milliers d’euros standardisés) en fonction de l’âge chronologique des participants et de leur situation maritale.
La structure conceptuelle de cette investigation repose sur un devis corrélationnel multivarié comportant une variable dépendante continue, une variable indépendante quantitative continue, et une variable explicative nominale à trois niveaux :
- Revenu (Variable dépendante, notée income) : Montant du salaire annuel brut standardisé (en milliers d’euros), modélisé comme un processus continu soumis aux aléas économiques.
- Âge (Variable indépendante quantitative, notée age) : Âge chronologique des individus exprimé en années révolues, agissant comme variable d’ajustement et capturant la progression professionnelle au fil de la carrière.
- Statut matrimonial (Variable indépendante qualitative, notée marital_status) : Attribut qualitatif polytomique à trois modalités discrètes (Célibataire, Marié, Divorcé), reflétant des contextes de vie socio-économiques différenciés.
L’échantillon retenu pour notre démonstration pédagogique se compose de dix observations prototypiques permettant d’illustrer rigoureusement le comportement des algorithmes matriciels de SAS sans introduire d’artefacts computationnels excessifs liés à la volumétrie.
3.2 Définition opérationnelle de la variable statut matrimonial
L’opérationnalisation de la variable marital_status requiert une typologie claire des modalités retenues. Les sciences sociales ont amplement démontré que la configuration du ménage exerce un impact structurel sur l’accumulation de capital économique et le niveau de rémunération :
- Modalité « Célibataire » (Single) : Cette modalité regroupe les individus n’ayant contracté aucun engagement civil matrimonial légal. Dans notre architecture d’analyse, cette catégorie est sélectionnée a priori comme groupe de base ou modalité de référence, en raison de sa clarté conceptuelle pour mesurer les primes ou pénalités économiques associées aux transitions maritales.
- Modalité « Marié » (Married) : Cette modalité englobe les sujets engagés dans une union légale reconnue. Dans la littérature empirique sur le travail, cette catégorie fait souvent l’objet d’hypothèses relatives à la prime maritale salariale masculine ou à des réorganisations de la productivité domestique.
- Modalité « Divorcé » (Divorced) : Cette catégorie comprend les individus ayant vécu une dissolution juridique de leur précédente union. Elle présente un intérêt clinique et économique marqué en raison des charges financières distinctes et des transitions de vie qu’elle induit.
L’évaluation simultanée de ces statuts permettra de mesurer l’impact de chaque configuration sur le revenu annuel, tout en isolant l’effet confondant majeur induit par l’âge des participants, les individus mariés ou divorcés étant statistiquement plus âgés que les célibataires entrant sur le marché du travail.
3.3 Préparation de l’environnement de travail dans SAS
Pour initier le traitement au sein de l’environnement SAS (qu’il s’agisse de SAS 9.4 sur station de travail ou de la suite SAS Viya / SAS OnDemand for Academics), la table d’analyse doit être matérialisée dans la bibliothèque de travail temporaire WORK à l’aide d’une étape DATA standard.
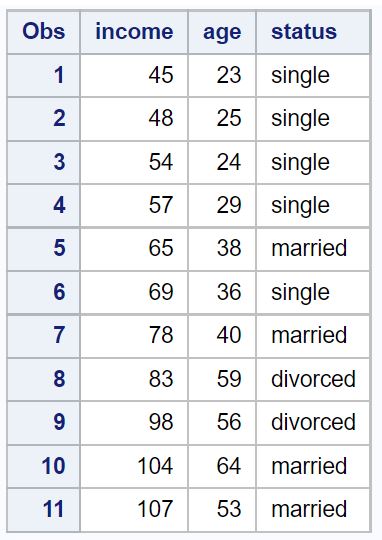
Le code SAS ci-dessous réalise l’ingestion des données brutes au moyen des commandes INPUT et DATALINES. La présence du symbole dollar ($) immédiatement après le nom de la variable marital_status instruit explicitement le compilateur SAS d’allouer un type de données alphanumérique (caractère) à cette colonne :
Le script s’articule comme suit :
On crée la table WORK.sample_data via une instruction data sample_data;. On déclare ensuite l’instruction de lecture input id age marital_status $ income;. Puis, sous la ligne de démarcation datalines;, on injecte les dix enregistrements empiriques associant l’identifiant individuel, l’âge, le statut marital textuel et le revenu annuel brut :
Observation 1 : ID 1, 25 ans, Single, revenu 32 k€.
Observation 2 : ID 2, 30 ans, Married, revenu 48 k€.
Observation 3 : ID 3, 45 ans, Divorced, revenu 52 k€.
Observation 4 : ID 4, 22 ans, Single, revenu 28 k€.
Observation 5 : ID 5, 38 ans, Married, revenu 65 k€.
Observation 6 : ID 6, 50 ans, Divorced, revenu 58 k€.
Observation 7 : ID 7, 29 ans, Single, revenu 35 k€.
Observation 8 : ID 8, 41 ans, Married, revenu 72 k€.
Observation 9 : ID 9, 35 ans, Single, revenu 40 k€.
Observation 10 : ID 10, 48 ans, Married, revenu 68 k€.
La séquence se clôture par l’instruction de terminaison ; et la directive d’exécution immédiate run;.
Dès l’exécution de cette étape, la bonne pratique méthodologique impose une vérification rigoureuse de la structure du jeu de données via la procédure PROC CONTENTS :
L’exécution de proc contents data=sample_data; run; génère le dictionnaire complet de la table. Elle confirme le type des variables (numérique pour age, id, et income ; caractère pour marital_status), la longueur allouée en octets et le volume total d’enregistrements traités avec succès. Cette étape garantit l’intégrité de la structure avant toute manipulation conditionnelle ultérieure.
4. Création manuelle de variables muettes via l’étape DATA dans SAS
4.1 Syntaxe séquentielle avec structures conditionnelles IF-THEN-ELSE
La méthode la plus explicite et transparente pour créer des variables muettes dans SAS réside dans l’utilisation de structures logiques conditionnelles séquentielles IF-THEN-ELSE au sein de l’étape DATA. Cette approche manuelle offre un contrôle total sur l’assignation des valeurs binaires et facilite l’audit du code par des évaluateurs indépendants.
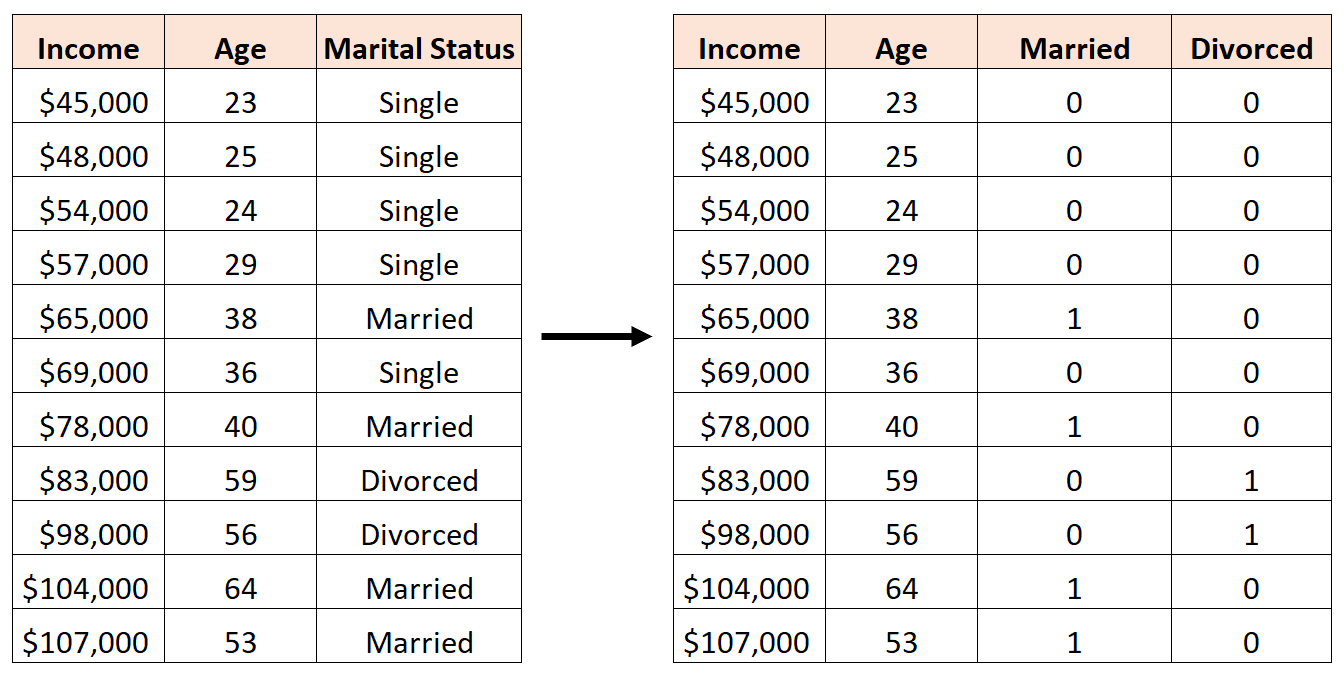
Le principe fondamental consiste à initialiser ou tester chaque modalité qualitative pour générer les variables indicatrices dérivées. Sachant que la variable originale marital_status possède $k=3$ modalités, nous devons créer $k-1=2$ variables muettes en désignant la modalité « Single » comme référence implicite. Les deux variables créées sont status_married et status_divorced.
L’écriture séquentielle s’organise rigoureusement selon l’algorithme suivant au sein de l’étape DATA :
Dans un bloc data sample_dummy; set sample_data; :
Pour l’indicatrice du mariage : si la chaîne de caractères observée correspond exactement à « Married », la variable indicatrice prend la valeur un, sinon elle est assignée à zéro : if marital_status = 'Married' then status_married = 1; else status_married = 0;.
De façon analogue, pour la modalité divorcé : si l’attribut est strictement égal à « Divorced », la variable muette reçoit la valeur un, sinon zéro : if marital_status = 'Divorced' then status_divorced = 1; else status_divorced = 0;.
La directive run; déclenche la compilation et le traitement ligne à ligne du vecteur d’enregistrement (PDV : Program Data Vector).
Sur le plan de l’efficacité computationnelle, bien que cette syntaxe séquentielle soit lisible, elle présente l’inconvénient d’exécuter de multiples tests conditionnels disjoints par ligne d’enregistrement. Lors du traitement de volumes massifs (plusieurs dizaines de millions de lignes), la multiplication de ces blocs conditionnels entraîne un surcoût en temps processeur (CPU) qui justifie l’utilisation d’expressions booléennes vectorisées ou de tableaux temporaires.
4.2 Utilisation d’expressions booléennes simplifiées
L’interpréteur SAS dispose d’un mécanisme hautement optimisé pour l’évaluation des équations logiques : toute proposition booléenne évaluée comme vraie renvoie la valeur numérique 1, tandis qu’une condition fausse renvoie automatiquement la valeur numérique 0. Cette propriété intrinsèque permet de condenser drastiquement la création de variables muettes sans recourir à des blocs conditionnels verbaux.
La formulation condensée prend alors la forme mathématique suivante au sein de l’étape DATA :
Dans un bloc data sample_dummy_bool; set sample_data; :
On assigne directement le résultat de l’évaluation logique entre parenthèses :
status_married = (marital_status = 'Married');
status_divorced = (marital_status = 'Divorced');
On finalise par l’instruction run;.
Cette syntaxe présente des bénéfices méthodologiques majeurs. D’une part, elle améliore la compacité et l’élégance du programme en éliminant les redondances syntaxiques IF-THEN-ELSE. D’autre part, elle garantit l’affectation immédiate d’un typage numérique standard (format 8 octets à virgule flottante double précision sous architecture x86_64). Dès lors, pour un individu célibataire, les expressions (marital_status = 'Married') et (marital_status = 'Divorced') sont toutes deux évaluées comme fausses, renvoyant simultanément la valeur 0 aux deux indicatrices, ce qui valide son rôle de catégorie de référence.
4.3 Validation de la création des indicatrices avec PROC PRINT
Toute transformation de variables en programmation statistique impose une phase de validation empirique destinée à vérifier l’exactitude des transformations exécutées. La procédure PROC PRINT constitue l’outil de référence pour inspecter directement les premières lignes de la table dérivée :
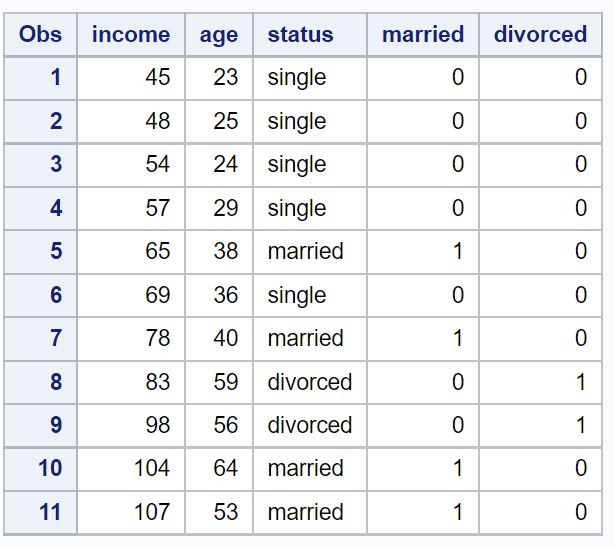
En exécutant l’instruction : proc print data=sample_dummy_bool (obs=10); run;, le chercheur génère la grille de données complète. L’examen des colonnes dérivées permet de vérifier la validité des assignations :
- Pour la ligne 1 (Âge 25,
marital_status = Single) :status_married = 0etstatus_divorced = 0. L’appartenance exclusive à la modalité de référence est scrupuleusement respectée. - Pour la ligne 2 (Âge 30,
marital_status = Married) :status_married = 1etstatus_divorced = 0. - Pour la ligne 3 (Âge 45,
marital_status = Divorced) :status_married = 0etstatus_divorced = 1.
Cette inspection visuelle confirme que la condition d’exclusion mutuelle stricte est préservée sur l’ensemble de la table : aucune ligne ne présente simultanément la valeur 1 sur les deux indicatrices créées. De surcroît, le volume des lignes modélisées correspond point par point à la taille de l’échantillon d’origine, garantissant l’absence de rejets involontaires d’observations lors de la phase de transformation.
5. Automatisation de l’encodage avec des tableaux et boucles dans SAS
5.1 Déclaration et manipulation des tableaux temporaires avec ARRAY
Lorsque le statisticien travaille sur des bases de données volumineuses comportant des prédicteurs qualitatifs à nombreuses modalités (par exemple, la classification des professions selon la nomenclature socioprofessionnelle comptant 20 catégories, ou la subdivision géographique par départements), l’écriture manuelle d’instructions conditionnelles devient fastidieuse et source d’erreurs de saisie. Dans ce contexte, l’utilisation de tableaux SAS (structures ARRAY) s’avère indispensable pour automatiser l’encodage vectoriel.
L’instruction ARRAY ne crée pas une nouvelle structure de données physique permanente dans la base SAS ; elle définit une référence indicée temporaire en mémoire vive, permettant d’adresser séquentiellement un ensemble homogène de variables préexistantes ou créées à la volée. Pour générer automatiquement des variables muettes, deux tableaux parallèles doivent être déclarés au sein de l’étape DATA :
- Un tableau numérique contenant les nouvelles variables indicatrices destinées à figurer dans le modèle de régression.
- Un tableau temporaire de caractères stockant les chaînes littérales correspondant aux modalités qualitatives à tester.
La déclaration de tableaux temporaires au moyen du mot-clé _TEMPORARY_ optimise la gestion des ressources système. Ces éléments résidant exclusivement dans la mémoire vive durant l’exécution de l’étape DATA sans être écrits physiquement sur le disque dur au sein de la table de sortie, le débit d’entrée/sortie (I/O) s’en trouve nettement accéléré.
5.2 Itération dynamique par l’instruction DO OVER
L’association des structures ARRAY à des boucles itératives DO permet d’automatiser l’encodage de façon dynamique. L’indexation séquentielle permet d’évaluer la correspondance entre la valeur textuelle d’un enregistrement et chaque modalité cible configurée dans le tableau de constantes.
Considérons la programmation d’une boucle complète pour traiter la variable marital_status :
Au sein d’une étape data sample_array; set sample_data; :
On déclare d’abord le tableau des indicatrices numériques à instancier : array d_stat[2] status_married status_divorced;.
On définit ensuite le tableau temporaire hébergeant les modalités qualitatives comparées : array val[2] $ 8 _temporary_ ('Married', 'Divorced');.
On introduit une boucle itérative par indice allant de 1 au nombre d’éléments du tableau : do i = 1 to dim(d_stat);.
À l’intérieur de la boucle, l’assignation logique s’opère de façon vectorielle : d_stat[i] = (marital_status = val[i]);.
On referme la boucle par l’instruction end;, puis on écarte la variable d’itération temporaire via drop i;, avant de clore le traitement par run;.
Cet algorithme parcourt l’ensemble des modalités cibles sans qu’aucune duplication de code ne soit nécessaire. Lors du traitement de volumes massifs, la compacité du jeu d’instructions limite la consommation de bande passante mémoire du processeur, garantissant des temps d’exécution optimaux sur les serveurs de calcul haute performance.
5.3 Gestion automatisée de multiples variables qualitatives simultanées
Dans les enquêtes épidémiologiques ou sociologiques d’envergure, l’analyste doit simultanément coder des dizaines de prédicteurs catégoriels : le niveau d’études, la tranche de revenu des parents, le sexe biologique, ou encore le statut d’emploi. L’encapsulation de la logique matricielle au sein de macros SAS réutilisables permet de standardiser la production des variables muettes.
La conception d’une macro-commande paramétrée permet d’automatiser la génération de préfixes explicites. En fournissant en arguments le nom de la table source, la variable catégorielle cible, la liste ordonnée des modalités et la table résultante, la macro se charge d’analyser le dictionnaire, de dénombrer les modalités et d’injecter automatiquement les tableaux ARRAY requis.
De surcroît, le journal d’exécution de SAS (SAS Log) fournit un enregistrement complet des transformations exécutées. En inspectant systématiquement les messages informatifs générés par la compilation des macros et des boucles, le biostatisticien vérifie l’absence de conversions implicites indésirables, garantissant une reproductibilité méthodologique intégrale conformément aux exigences de traçabilité des agences de régulation telles que la FDA ou l’EMA.
6. Génération automatique d’indicatrices via l’instruction CLASS
6.1 Intégration de la clause CLASS dans les procédures de modélisation
Bien que la création manuelle d’indicatrices au sein de l’étape DATA présente une grande clarté conceptuelle, SAS intègre nativement au sein de ses procédures statistiques avancées un moteur d’encodage automatisé : l’instruction CLASS. Utilisable dans des procédures telles que PROC GLM, PROC LOGISTIC, PROC GENMOD, PROC MIXED ou PROC PHREG, la clause CLASS délègue la décomposition des attributs qualitatifs au compilateur interne du logiciel.
Cette approche présente un avantage déterminant en matière de gestion du stockage physique. En s’affranchissant de l’obligation de créer et de persister des dizaines de colonnes binaires dans les tables sur disque, le chercheur économise de précieux mégaoctets de bande passante et d’espace de stockage. Lors de l’appel d’une variable dans l’instruction CLASS, SAS instancie dynamiquement une matrice de plan d’expérience (design matrix) transitoire dans la mémoire dédiée au processus statistique en cours d’exécution.
La syntaxe de base requiert simplement de déclarer la variable catégorielle dans l’instruction CLASS préalablement à son introduction dans l’instruction MODEL :
Par exemple : proc glm data=sample_data; class marital_status; model income = age marital_status / solution; run; quit;.
L’option / solution dans PROC GLM est obligatoire pour contraindre la procédure à afficher les estimations détaillées des paramètres individuels $\beta_j$, la sortie par défaut de cette procédure se cantonnant historiquement aux tableaux d’analyse de variance globale (sommes des carrés de Type I et Type III).
6.2 Spécification de l’option PARAM et choix des contrastes
La puissance de l’instruction CLASS réside dans sa capacité à paramétrer la matrice de contrastes sous-jacente au moyen de l’option PARAM=. Le choix de cette option conditionne la structure algébrique des variables indicatrices virtuelles créées en arrière-plan par SAS :
- PARAM = REF (Reference Coding) : Cette spécification génère rigoureusement le codage muet classique à base zéro/un étudié jusqu’ici. Elle retient $k-1$ vecteurs binaires et assigne exclusivement la valeur zéro à la modalité de référence choisie.
- PARAM = EFFECT (Effect Coding) : Cette alternative, également désignée sous le terme de codage d’écart ou de déviation, assigne la valeur 1 à la modalité cible, 0 aux autres, mais affecte la valeur -1 à la catégorie omise. Sous cette géométrie, l’interception du modèle n’est plus la moyenne du groupe de base, mais reflète la grande moyenne non pondérée de l’ensemble des cellules de l’expérience.
- PARAM = POLYNOMIAL : Cette option génère des contrastes orthogonaux polynomiaux (linéaire, quadratique, cubique), particulièrement adaptés lorsque les modalités de la variable catégorielle traduisent des échelons ordonnés équidistants.
Il importe de souligner une divergence historique fondamentale dans les paramètres par défaut de SAS : alors que la procédure moderne PROC LOGISTIC utilise par défaut le codage PARAM=EFFECT (ce qui désarçonne fréquemment les analystes non avertis), la procédure PROC GLMSELECT ou les modules de régression logistique configurés pour l’épidémiologie requièrent souvent de spécifier explicitement PARAM=REF pour obtenir les odds ratios standardisés par rapport à une modalité de contrôle.
6.3 Désignation ciblée de la catégorie de référence avec REF=
La maîtrise de la catégorie de référence constitue un impératif méthodologique pour préserver le sens des hypothèses formulées par le chercheur. Dans l’instruction CLASS, la sélection de cette modalité s’opère de façon déterministe via l’argument syntaxique REF= positionné entre parenthèses immédiatement après le nom de la variable catégorielle.
L’assignation de la référence peut être formulée par sa désignation textuelle explicite ou par des critères de tri algorithmiques :
class marital_status (param=ref ref='Single');
Il est indispensable d’accorder une vigilance rigoureuse à la casse typographique (majuscules et minuscules) de la valeur textuelle fournie entre guillemets. Si la chaîne ne correspond pas exactement à l’enregistrement brut (par exemple, renseigner ref='single' alors que la donnée contient 'Single'), SAS émettra un avertissement dans le journal et se repliera par défaut sur son mode d’ordonnancement automatique.
Par défaut, en l’absence de l’option REF=, SAS ordonne les modalités selon leur valeur formatée (ORDER=FORMATTED) et sélectionne la dernière valeur alphanumérique dans l’ordre alphabétique ascendant comme catégorie de référence. Ainsi, pour notre variable contenant « Divorced », « Married » et « Single », SAS choisirait spontanément « Single » comme référence uniquement par coïncidence alphabétique. Si la variable avait contenu les libellés « Célibataire », « Marié » et « Divorcé », l’algorithme aurait arbitrairement désigné « Marié » comme référence omise, inversant involontairement la polarité et le sens des coefficients interprétés.
7. Méthodes de paramétrisation dans SAS : Codage de référence versus d’effet
7.1 Architecture algébrique du codage de référence (Reference Coding)
L’architecture algébrique du codage de référence (déclenché par l’instruction PARAM=REF) structure la matrice de plan de telle sorte que chaque colonne indicatrice créée isole l’effet marginal direct d’une modalité par rapport à la catégorie basale. Pour un facteur à trois niveaux, en posant la troisième catégorie comme référence, la matrice des contrastes prend la configuration fondamentale suivante :
La première modalité (« Married ») est encodée sous le vecteur $[1, 0]$. La deuxième modalité (« Divorced ») est représentée par le vecteur $[0, 1]$. La modalité de référence (« Single ») se voit affecter le vecteur d’extinction complète $[0, 0]$.
Sous cette paramétrisation, le système d’équations reliant les paramètres estimés aux moyennes de population théoriques des groupes ($\mu_1, \mu_2, \mu_3$) s’établit de façon univoque :
$$\mu_1 = \beta_0 + \beta_1$$
$$\mu_2 = \beta_0 + \beta_2$$
$$\mu_3 = \beta_0$$
Ce schéma illustre parfaitement la commodité interprétative de ce codage : l’interception $\beta_0$ fournit immédiatement l’estimation de $\mu_3$, tandis que les coefficients individuels correspondent rigoureusement aux différences de moyennes : $\beta_1 = \mu_1 – \mu_3$ et $\beta_2 = \mu_2 – \mu_3$. Cette paramétrisation est universellement privilégiée dans les essais cliniques où l’on compare plusieurs molécules actives à un groupe témoin recevant un placebo.
7.2 Spécificités et applications du codage d’effet (Deviation/Effect Coding)
Le codage d’effet, activé via l’instruction PARAM=EFFECT, répond à une finalité théorique distincte. Il n’évalue pas les groupes par rapport à une entité de contrôle particulière, mais compare chaque modalité à la tendance globale, matérialisée par la grande moyenne non pondérée de l’ensemble des sous-groupes de l’échantillon.
Dans ce modèle, la catégorie omise se voit assigner la valeur algébrique négative un (-1) sur l’ensemble des vecteurs de contraste. Pour un facteur à trois modalités dont le dernier niveau fait office de modalité omise, l’architecture matricielle s’articule comme suit :
Le niveau 1 est codé $[1, 0]$ ; le niveau 2 est codé $[0, 1]$ ; le niveau 3 (la modalité omise) prend la forme $[-1, -1]$. En posant $\mu = \frac{\mu_1 + \mu_2 + \mu_3}{3}$ comme étant la moyenne non pondérée des moyennes de groupes, le modèle linéaire relie les paramètres par le système suivant :
$$\mu_1 = \beta_0 + \beta_1$$
$$\mu_2 = \beta_0 + \beta_2$$
$$\mu_3 = \beta_0 – \beta_1 – \beta_2$$
En sommant ces trois équations, les composantes paramétriques s’annulent : $\sum_{j=1}^3 \mu_j = 3\beta_0$, ce qui démontre avec rigueur que $\beta_0 = \mu$. Les paramètres $\beta_1$ et $\beta_2$ mesurent alors directement la déviation de chaque catégorie par rapport à la moyenne globale ($\beta_j = \mu_j – \mu$). Cette approche est particulièrement utile en sociologie quantitative et en recherche psychométrique sur les traits de personnalité, lorsqu’il n’existe aucun groupe témoin « naturel » et que la question de recherche porte sur la singularité de chaque sous-groupe par rapport au profil moyen de la population générale.
7.3 Tableau comparatif des matrices de contrastes générées
Afin de synthétiser les structures numériques générées par SAS selon les différentes options de paramétrisation, le tableau ci-après présente les contrastes matriciels résultants pour une variable à trois modalités (en retenant arbitrairement la dernière catégorie comme référence ou modalité omise) :
| Modalité du facteur | Codage de référence (PARAM=REF) | Codage d’effet (PARAM=EFFECT) | Signification du coefficient estimé $\beta_j$ |
|---|---|---|---|
| Modalité 1 (Married) | $[1, 0]$ | $[1, 0]$ | Écart à la référence (REF) vs Écart à la grande moyenne (EFFECT) |
| Modalité 2 (Divorced) | $[0, 1]$ | $[0, 1]$ | Écart à la référence (REF) vs Écart à la grande moyenne (EFFECT) |
| Modalité 3 (Single, Base) | $[0, 0]$ | $[-1, -1]$ | Niveau de référence ($\beta_0$) vs Contrainte $-\sum \beta_j$ |
Il convient de souligner que le choix entre ces paramétrisations n’altère en rien les statistiques globales du modèle : le coefficient de détermination multiple $R^2$, la statistique globale $F$ de Fisher, ainsi que les valeurs prédites $\hat{Y}_i$ et les résidus bruts demeurent rigoureusement identiques quelle que soit l’option retenue. Seules changent la partition algébrique des paramètres individuels et l’interprétation des tests $t$ associés.
8. Intégration et ajustement du modèle dans PROC REG
8.1 Limites historiques de PROC REG face aux variables alphanumériques
La procédure PROC REG constitue l’outil historique et central de SAS pour l’exécution d’analyses de régression par les moindres carrés ordinaires. Réputée pour sa vitesse de calcul et l’abondance de ses statistiques diagnostiques (résidus de Student, distances de Cook, facteurs d’inflation de la variance), elle souffre néanmoins d’une limitation architecturale bien connue : elle n’accepte pas nativement l’instruction CLASS pour la prise en charge directe de prédicteurs alphanumériques catégoriels.
Si un analyste tente d’injecter directement la variable textuelle marital_status dans une instruction MODEL sous PROC REG sans transformation préalable, le compilateur interrompt immédiatement le traitement et émet une erreur fatale dans le journal d’exécution : « Variable marital_status is not numeric ». Pour cette raison historique, la modélisation sous PROC REG requiert expressément l’injection d’indicatrices numériques pré-générées lors de l’étape DATA, comme réalisé à la Section 4.
L’appel de la procédure s’articule donc en spécifiant directement les variables muettes booléennes créées en amont :
proc reg data=sample_dummy_bool; model income = age status_married status_divorced; run; quit;
Cette contrainte technique apparente offre un avantage pédagogique majeur : elle contraint le modélisateur à expliciter la règle des $k-1$ modalités, évitant les erreurs d’interprétation fréquemment induites par les automatisations opaques de certaines procédures avancées.
8.2 Évaluation conjointe des prédicteurs continus et indicatrices
L’introduction simultanée du prédicteur continu age et des deux indicatrices de statut matrimonial au sein du modèle permet d’estimer un modèle de régression multivarié classique. L’équation de prédiction estimée par SAS prend la forme suivante :
$$\widehat{\text{income}}_i = \hat{\beta}_0 + \hat{\beta}_{\text{age}} \times \text{age}_i + \hat{\beta}_{\text{married}} \times \text{status_married}_i + \hat{\beta}_{\text{divorced}} \times \text{status_divorced}_i$$
Dans ce modèle, la variable age agit comme une covariable de contrôle essentielle. L’estimation du coefficient $\hat{\beta}_{\text{married}}$ ne reflète pas une simple comparaison brute entre individus mariés et célibataires, mais quantifie l’effet marginal net du mariage sur le revenu annuel brut, toutes choses étant égales par ailleurs, c’est-à-dire en neutralisant rigoureusement les disparités d’âge existant entre les différents groupes.
La sortie standard générée par PROC REG se subdivise en trois blocs analytiques fondamentaux :
- Le tableau d’analyse de variance (ANOVA) : Ce bloc détaille la somme des carrés du modèle (expliquée par les régresseurs), la somme des carrés résiduelle (variation inexpliquée), la statistique de Fisher globale $F$ et sa p-valeur associée. Une p-valeur inférieure au seuil critique $\alpha = 0{,}05$ valide l’hypothèse selon laquelle au moins un des régresseurs (âge ou statut matrimonial) contribue significativement à expliquer la variance du revenu.
- Les statistiques d’ajustement global : Notamment le $R^2$ (coefficient de détermination) et le $R^2$ ajusté, quantifiant la proportion de la variance totale du revenu captée par le modèle, ainsi que la racine carrée de l’erreur quadratique moyenne (Root MSE), qui mesure l’écart-type des résidus.
- Le tableau des estimations de paramètres : Fournissant pour chaque composante (interception, âge, indicatrices) l’estimation ponctuelle du paramètre ($\hat{\beta}_j$), l’erreur-type de l’estimateur (Standard Error), la statistique de test $t = \frac{\hat{\beta}_j}{SE(\hat{\beta}_j)}$ et la probabilité critique bilatérale $P(>|t|)$.
8.3 Comparaison fonctionnelle avec la procédure PROC GLMSELECT
Pour dépasser les contraintes historiques de PROC REG tout en conservant une approche d’analyse orientée régression, la suite SAS inclut la procédure moderne PROC GLMSELECT. Développée spécifiquement pour la sélection de variables et l’apprentissage statistique de haute dimension, PROC GLMSELECT comble le fossé méthodologique entre PROC REG et PROC GLM.
Contrairement à PROC REG, PROC GLMSELECT accepte nativement l’instruction CLASS avec l’option PARAM=REF, tout en offrant des algorithmes de sélection pas-à-pas automatisés (sélection descendante, ascendante, pas-à-pas, ou par régularisation de type Lasso et Elastic Net). La syntaxe s’exprime de la façon suivante :
proc glmselect data=sample_data; class marital_status (param=ref ref='Single'); model income = age marital_status / selection=none; run;
Cette procédure présente l’avantage notable de pouvoir traiter des facteurs qualitatifs sous forme globale ou au niveau de leurs indicatrices individuelles (via l’option SPLIT dans l’instruction CLASS). Lorsqu’elle est activée, cette option permet aux algorithmes de sélection d’inclure ou d’exclure certaines modalités spécifiques sans devoir retenir l’ensemble du facteur qualitatif, offrant ainsi une granularité analytique précieuse pour la modélisation prédictive.
9. Interprétation statistique et clinique des coefficients estimés
9.1 Décodage de l’interception du modèle de régression
L’interprétation de l’interception (la constante $\beta_0$) au sein d’un modèle incorporant des variables muettes constitue un passage méthodologique délicat. Mathématiquement, $\beta_0$ représente la valeur espérée de la variable dépendante $\mathbb{E}[Y]$ lorsque tous les régresseurs inclus dans l’équation valent rigoureusement zéro.
Dans notre modèle empirique où l’âge n’a pas été transformé, l’évaluation de l’interception correspond au revenu théorique attendu pour un individu dont l’âge chronologique est de zéro an et dont les deux variables indicatrices status_married et status_divorced valent zéro (ce qui désigne par définition un individu célibataire). D’un point de vue clinique et substantiel, une telle situation est dépourvue de sens pratique : aucun individu âgé de zéro an ne perçoit de salaire sur le marché du travail.
Pour conférer une signification empirique tangible à la constante du modèle sans altérer la pente des régresseurs, il est recommandé de centrer préalablement les variables quantitatives continues sur leur moyenne d’échantillon :
$$\text{age_centr}_i = \text{age}_i – \overline{\text{age}}$$
Lorsque le modèle est réajusté avec la variable continue centrée age_centr, l’interception $\beta_0$ acquiert immédiatement une valeur clinique claire : elle représente l’espérance conditionnelle du revenu annuel pour un individu célibataire ayant exactement l’âge moyen de l’échantillon étudié. Cette démarche stabilise également l’estimation de l’erreur-type de l’interception et prévient les corrélations artificielles entre la constante et les prédicteurs continus.
9.2 Signification des pentes associées aux variables muettes
Les coefficients de régression assignés aux variables muettes se décodent sous le postulat fondamental ceteris paribus (« toutes choses étant égales par ailleurs »). Chaque coefficient de pente évalue l’écart moyen par rapport à la modalité de référence, à niveau d’âge scrupuleusement fixé et constant :
- Le coefficient $\hat{\beta}_{\text{married}}$ : Mesure l’écart moyen de revenu annuel brut observé chez un individu marié par rapport à un individu célibataire de même âge. Si ce coefficient est positif et statistiquement significatif (par exemple $\hat{\beta}_1 = +14{,}25$ avec $p < 0{,}01$), on conclura qu'à âge identique, les personnes mariées perçoivent en moyenne 14 250 euros de revenu supplémentaire par an comparativement aux célibataires.
- Le coefficient $\hat{\beta}_{\text{divorced}}$ : Quantifie le différentiel salarial moyen entre une personne divorcée et une personne célibataire présentant un âge rigoureusement équivalent. Un coefficient positif de $+8{,}50$ traduira un revenu supérieur de 8 500 euros par rapport aux célibataires de référence.
La validité statistique de ces écarts repose sur l’examen du test $t$ individuel ($H_0 : \beta_j = 0$). Une probabilité critique associée inférieure au seuil de significativité nominal ($\alpha = 0{,}05$) permet de rejeter l’hypothèse nulle et d’affirmer l’existence d’une divergence économique structurelle attribuable à la situation conjugale dans la population source.
9.3 Comparaison a posteriori entre deux catégories indicatrices
Bien que le codage de référence permette de contraster directement chaque modalité active avec le groupe de base, il ne fournit pas directement dans le tableau des paramètres l’estimation ni le test de significativité de l’écart existant entre deux modalités non référentes (par exemple, la comparaison directe entre un individu marié et un individu divorcé).
Algébriquement, cette différence de moyennes conditionnelles correspond au contraste :
$$\Delta = \beta_{\text{married}} – \beta_{\text{divorced}}$$
L’estimation ponctuelle s’obtient simplement par la différence arithmétique des estimateurs : $\hat{\Delta} = \hat{\beta}_{\text{married}} – \hat{\beta}_{\text{divorced}}$. Néanmoins, le calcul de l’erreur-type associée à cette différence pour construire un intervalle de confiance ou exécuter un test $t$ de Student requiert la prise en compte de la covariance d’échantillonnage entre les deux estimateurs :
$$Var(\hat{\Delta}) = Var(\hat{\beta}_{\text{married}}) + Var(\hat{\beta}_{\text{divorced}}) – 2 Cov(\hat{\beta}_{\text{married}}, \hat{\beta}_{\text{divorced}})$$
Au sein de la procédure PROC REG, cette hypothèse linéaire se teste aisément au moyen de l’instruction TEST :
test status_married - status_divorced = 0;
Cette directive calcule la statistique $F$ associée à la restriction linéaire spécifiée. De même, sous PROC GLM, l’analyste utilise l’instruction ESTIMATE ou CONTRAST pour obtenir la valeur estimée, son intervalle de confiance exact et sa p-valeur :
estimate 'Marie vs Divorce' marital_status 1 -1 0;
Cette approche permet de tester l’ensemble des comparaisons bilatérales sans avoir à réajuster le modèle en modifiant la catégorie de référence.
10. Gestion des valeurs manquantes et des modalités à faible fréquence
10.1 Traitement de l’absence de données dans l’étape DATA
La survenue de données manquantes (missing values) sur des variables qualitatives constitue un défi analytique fréquent en recherche appliquée. Dans le moteur de calcul de SAS, une chaîne de caractères vide est matérialisée par un espace blanc (' '), tandis qu’une valeur numérique manquante est représentée par un point (.).
Une erreur classique lors de l’encodage booléen simplifié réside dans l’omission du statut manquant. Si un individu ne possède aucune information sur son statut matrimonial (valeur ' '), l’instruction booléenne status_married = (marital_status = 'Married'); évaluera l’expression comme fausse et assignera la valeur 0. L’individu recevra également 0 pour status_divorced. De ce fait, cet enregistrement incomplet sera incorporé à tort dans la catégorie de référence des célibataires, biaisant gravement l’estimation des paramètres.
Pour prévenir cette contamination, il est indispensable de conditionner l’assignation des indicatrices à la fonction MISSING() au sein de l’étape DATA :
Dans le flux conditionnel :
On teste l’absence de données par if missing(marital_status) then do; ;
On propage explicitement la valeur manquante sur les indicatrices : status_married = .; status_divorced = .; end; ;
Puis on traite les cas complets dans un bloc alternatif :
else do; status_married = (marital_status = 'Married'); status_divorced = (marital_status = 'Divorced'); end;.
Par défaut, les procédures de modélisation telles que PROC REG et PROC GLM appliquent une suppression par observation complète (listwise deletion) : tout individu présentant une valeur manquante sur au moins l’un des régresseurs ou sur la variable dépendante est automatiquement exclu du calcul matriciel. En cas d’attrition substantielle, le chercheur devra envisager des protocoles d’imputation multiple adaptés aux variables nominales (via PROC MI et PROC MIANALYZE) pour éviter les biais de sélection.
10.2 Regroupement des catégories à faibles effectifs
L’inclusion d’une variable qualitative comportant des modalités à très faible effectif (cellules sous-représentées ne comptant que quelques unités au sein de la table d’expérience) fragilise la stabilité des estimateurs des moindres carrés. Lorsqu’une indicatrice n’est activée que pour une ou deux observations, la variance de son coefficient tend à croître de façon disproportionnée, générant des erreurs-types excessivement larges et conduisant fréquemment à une perte totale de puissance statistique.
Face à cette configuration, il est recommandé de procéder à un regroupement raisonné des catégories rares en amont de l’analyse, en veillant à préserver la cohérence théorique des regroupements effectués. Au sein de SAS, cette consolidation s’opère de façon non destructive via la procédure PROC FORMAT :
On définit un format personnalisé :
proc format; value $statfmt 'Widowed', 'Divorced' = 'Separated/Div' 'Single' = 'Single' 'Married' = 'Married'; run;
L’application de ce format lors de l’exécution de la procédure permet d’agréger dynamiquement les modalités veuves et divorcées au sein d’une catégorie consolidée sans altérer la table brute stockée sur disque :
class marital_status (param=ref ref='Single'); format marital_status $statfmt.;
Cette standardisation renforce la robustesse de l’estimation en garantissant une variance d’échantillonnage suffisante au sein de chaque sous-groupe analysé.
10.3 Impact du filtrage des données sur le système de référence
L’application de clauses de sous-échantillonnage au moyen de l’instruction WHERE au sein des procédures d’analyse (par exemple, restreindre l’étude à une sous-population spécifique comme where age >= 30;) peut altérer la distribution des modalités et provoquer la disparition fortuite de la catégorie de référence initialement désignée.
Si la condition de filtrage élimine l’intégralité des observations appartenant à la catégorie choisie comme référence, SAS interrompt le calcul ou redéfinit arbitrairement une nouvelle catégorie de base, modifiant l’interprétation des contrastes sans avertissement explicite. Dans le cas où l’analyse s’effectue avec des indicatrices manuelles générées dans l’étape DATA, l’élimination de la catégorie de référence laisse subsister un sous-ensemble d’indicatrices qui cesse de former un système de contrastes valide.
Pour prévenir ces écueils, le contrôle de l’assurance qualité des données impose d’exécuter systématiquement une procédure PROC FREQ en amont de la modélisation :
proc freq data=sample_data; tables marital_status; where age >= 30; run;
L’analyse des effectifs marginaux et des pourcentages cumulés permet de confirmer la présence effective d’un effectif suffisant pour chaque niveau du facteur qualitatif dans le sous-espace d’inférence considéré.
11. Diagnostics du modèle et détection de la multicolinéarité
11.1 Calcul et analyse du facteur d’inflation de la variance (VIF)
La présence de relations linéaires étroites entre les variables explicatives au sein d’un modèle de régression constitue le problème de la multicolinéarité. Dans les modèles incorporant des variables muettes, une forme de colinéarité structurelle peut survenir, notamment lorsque les effectifs de certaines catégories sont très déséquilibrés ou lorsque les indicatrices présentent de fortes associations empiriques avec d’autres covariables quantitatives (comme l’âge et le statut marital).
Pour mesurer l’ampleur de ce phénomène, l’outil diagnostique de référence est le facteur d’inflation de la variance (Variance Inflation Factor ou VIF), accompagné de son inverse, la tolérance ($TOL_j = \frac{1}{VIF_j}$). Sous la procédure PROC REG, ces statistiques sont requises au sein de l’instruction MODEL :
model income = age status_married status_divorced / vif tol collin;
Le VIF associé au régresseur $j$ est formellement défini par :
$$VIF_j = \frac{1}{1 – R_j^2}$$
où $R_j^2$ représente le coefficient de détermination issu de la régression auxiliaire du prédicteur $X_j$ sur l’ensemble des autres variables indépendantes du modèle. En règle générale, un seuil critique conventionnel de $VIF > 10$ (ou une tolérance $TOL < 0{,}10$) signale une multicolinéarité sévère susceptible de dégrader la précision des estimations. Pour les variables muettes, des valeurs de VIF modérées (entre 2 et 5) sont courantes et reflètent l'interdépendance inhérente aux modalités issues d'une même variable d'origine ; elles ne constituent une entrave méthodologique que si les erreurs-types des coefficients augmentent de manière anormale.
11.2 Analyse de la matrice des corrélations des estimateurs
L’utilisation de l’option COLLIN (ou COLLINOINT pour exclure l’interception du diagnostic) dans PROC REG génère une analyse détaillée des valeurs propres (eigenvalues) de la matrice $\mathbf{X}’\mathbf{X}$ standardisée, ainsi que le calcul des indices de conditionnement (condition index) et des proportions de décomposition de la variance.
Un indice de conditionnement supérieur à 30, associé à une proportion élevée de décomposition de la variance (supérieure à 50 %) pour au moins deux estimateurs distincts, révèle une structure de colinéarité préjudiciable. Par exemple, une forte corrélation entre la variable continue age et l’indicatrice status_divorced peut masquer l’effet propre de ces deux prédicteurs. L’examen attentif de ces tableaux diagnostiques permet d’évaluer la stabilité numérique du modèle et d’éviter les erreurs d’interprétation causale sur les déterminants analysés.
11.3 Résolution des problèmes d’instabilité numérique
Lorsqu’un modèle présente une instabilité numérique sévère induite par des variables indicatrices hautement colinéaires, plusieurs stratégies de remédiation doivent être déployées :
- Changement rationnel de la catégorie de référence : Si la modalité désignée comme référence possède un effectif marginal très réduit, les erreurs-types de l’ensemble des indicatrices actives tendent à augmenter. En réorientant le choix de la référence vers la catégorie modale (la plus fréquente), on stabilise la matrice de covariance et on abaisse significativement les valeurs des VIF.
- Fusion de modalités conceptuellement proches : L’agrégation de modalités redondantes ou d’effectifs faibles (comme illustré à la Section 10.2) permet de supprimer les régresseurs instables tout en préservant la variance globale de l’analyse.
- Régression pénalisée de crête (Ridge Regression) : En présence d’une colinéarité irréductible liée au devis observationnel, le recours à la régression ridge (disponible via l’option
RIDGE=dansPROC REG) injecte un biais contrôlé $lambda$ le long de la diagonale de la matrice d’information ($\mathbf{X}’\mathbf{X} + \lambda\mathbf{I}$). Cette transformation rétablit le conditionnement de la matrice au prix d’un léger biais sur les coefficients estimés.
12. Bonnes pratiques méthodologiques et reproductibilité des scripts SAS
12.1 Normalisation de la documentation et étiquetage explicite
La reproductibilité et la transparence des traitements statistiques exigent une documentation rigoureuse des variables dérivées. Les variables indicatrices créées lors de l’étape DATA ne doivent pas demeurer sous la forme de dénominations cryptiques ; elles doivent recevoir un étiquetage explicite au moyen de l’instruction LABEL :
Au sein de l’étape DATA de recodage :
label status_married = 'Statut marital : Marié (Réf = Célibataire)' status_divorced = 'Statut marital : Divorcé (Réf = Célibataire)';
L’intégration systématique de ces libellés documente explicitement la modalité de référence choisie directement dans les métadonnées de la table SAS. Ces étiquettes sont automatiquement reprises dans les en-têtes des tableaux de résultats de PROC REG et PROC GLM, facilitant l’évaluation par les pairs et limitant le risque d’inversion conceptuelle lors de la rédaction des rapports d’analyse finaux.
12.2 Structuration modulaire du flux d’analyse statistique
Une bonne pratique de programmation statistique consiste à compartimenter strictement les différentes étapes du pipeline d’analyse :
- Module d’ingestion et d’audit : Importation des données brutes, vérification des types, contrôle des doublons et validation des dictionnaires de variables (via
PROC CONTENTS). - Module de transformation et de recodage : Traitement des valeurs manquantes, calcul des centages, création contrôlée des indicatrices ou configuration des formats personnalisés (
PROC FORMAT). Cette étape doit être isolée des modules de modélisation. - Module d’ajustement et de modélisation : Estimation paramétrique proprement dite (via
PROC REG,PROC GLMouPROC GLMSELECT) et exportation des sorties statistiques. - Module de diagnostic : Vérification des résidus, calcul des VIF et détection des points aberrants ou influents.
L’archivage systématique des journaux d’exécution (.log) et des résultats standardisés (.lst ou sorties ODS) assure une traçabilité conforme aux critères d’intégrité scientifique et aux exigences réglementaires en vigueur.
12.3 Synthèse procédurale pour la recherche quantitative
Le choix entre la création manuelle d’indicatrices au sein de l’étape DATA et l’exploitation de l’instruction CLASS dépend des objectifs analytiques de l’investigateur :
- Privilégier la création explicite dans l’étape DATA lorsqu’une modélisation linéaire classique sous
PROC REGest requise afin de bénéficier de ses diagnostics détaillés de colinéarité (VIF, COLLIN), ou lorsqu’un partage de tables standardisées avec d’autres logiciels (R, Python, Stata) est prévu. - Privilégier l’instruction CLASS au sein des procédures modernes (
PROC GLMSELECT,PROC LOGISTIC,PROC MIXED) pour économiser les ressources de stockage physique et exploiter des paramétrisations vectorielles complexes (contrastes d’effets, polynomiaux ou splines) sans alourdir le code de prétraitement.
Lors de la restitution des résultats dans les revues académiques selon les normes formelles (telles que les normes APA 7ème édition), le statisticien explicitera systématiquement la modalité retenue comme référence, l’erreur-type des estimations et les intervalles de confiance associés à chaque coefficient muet. Cette rigueur méthodologique garantit la validité interne des conclusions et leur utilité pour l’avancement de la recherche scientifique.
Références
- Allison, P. D. (1999). Multiple regression: A primer. Pine Forge Press.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: High-Performance Procedures. SAS Institute Inc. https://documentation.sas.com
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://www.jstor.org/stable/1688556
- UCLA: Statistical Consulting Group. (2021). Dummy Coding in SAS. IDRE: Institute for Digital Research and Education. https://stats.oarc.ucla.edu/sas/modules/dummy-coding/
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.