
L’inférence statistique au sein des sciences contemporaines repose sur un postulat fondamental : la capacité d’extraire des conclusions universelles et robustes à partir d’observations empiriques nécessairement finies et soumises aux aléas de l’échantillonnage. Dans le champ de la psychologie clinique, de la neuropsychologie et des sciences comportementales, cette ambition se heurte fréquemment à une réalité méthodologique contraignante. Les chercheurs travaillent régulièrement sur des cohortes d’effectifs restreints, confrontés à la rareté de certains tableaux cliniques, à la lourdeur des protocoles d’intervention ou aux difficultés inhérentes au recrutement de profils psychopathologiques très spécifiques. Lorsque les données recueillies prennent la forme de variables qualitatives discrètes, réparties dans des tableaux de contingence croisant deux modalités binaires, les méthodes asymptotiques traditionnelles montrent rapidement leurs limites mathématiques fondamentales.
Le test du Chi-deux d’indépendance de Karl Pearson, pierre angulaire de l’analyse catégorielle depuis le début du vingtième siècle, constitue une solution élégante mais tributaire d’une condition opérationnelle stricte : il s’appuie sur une loi de probabilité continue théorique qui n’est valide qu’à la limite, lorsque la taille de l’échantillon tend vers l’infini. Dès lors que les effectifs observés ou attendus s’effondrent sous certains seuils critiques, l’approximation continue de cette statistique discrète génère des biais inférentiels majeurs, menant à une distorsion du taux d’erreur de première espèce et à des conclusions scientifiques potentiellement fallacieuses. C’est précisément pour dépasser ces apories calculatoires et conceptuelles que le statisticien et généticien britannique Sir Ronald Aylmer Fisher formalisa, au cours des années 1930, une méthode d’une précision absolue : le test exact de Fisher.
Fondé sur la combinatoire pure et la distribution hypergéométrique, le test exact de Fisher s’affranchit de toute extrapolation asymptotique. En calculant directement la probabilité exacte d’observer une répartition de données donnée — ainsi que des configurations plus extrêmes — sous l’hypothèse nulle d’indépendance conditionnelle aux marges de la table, cette procédure offre un cadre d’une rigueur mathématique irréprochable. Le présent traité propose une exploration exhaustive de cette méthode canonique : de ses racines épistémologiques jusqu’à ses formulations mathématiques rigoureuses, en passant par sa logique computationnelle, ses applications concrètes en psychopathologie clinique et ses prolongements contemporains au sein des paradigmes bayésiens et multidimensionnels.
1. Introduction et fondements épistémologiques du test exact de Fisher
1.1 Origines historiques et travaux de Ronald Fisher
L’acte de naissance du test exact de Fisher s’inscrit au cœur de l’un des ouvrages les plus influents de l’histoire des sciences méthodologiques : The Design of Experiments, publié par Ronald Aylmer Fisher en 1935. Alors en poste à la station agronomique de Rothamsted, Fisher s’efforçait de formaliser les principes de la planification expérimentale, de la randomisation et du test d’hypothèse statistique. C’est dans ce contexte intellectuel foisonnant qu’émergea l’anecdote désormais légendaire de la « dégustation de thé » (the Lady tasting tea). Une collègue de Fisher, la phycologue Muriel Bristol, affirmait être capable de discerner par la seule dégustation si le lait avait été versé dans la tasse avant ou après l’infusion du thé. Loin de rejeter cette allégation ou de se contenter d’un assentiment naïf, Fisher y vit le prétexte idéal pour concevoir un protocole expérimental rigoureux et imperméable au hasard.
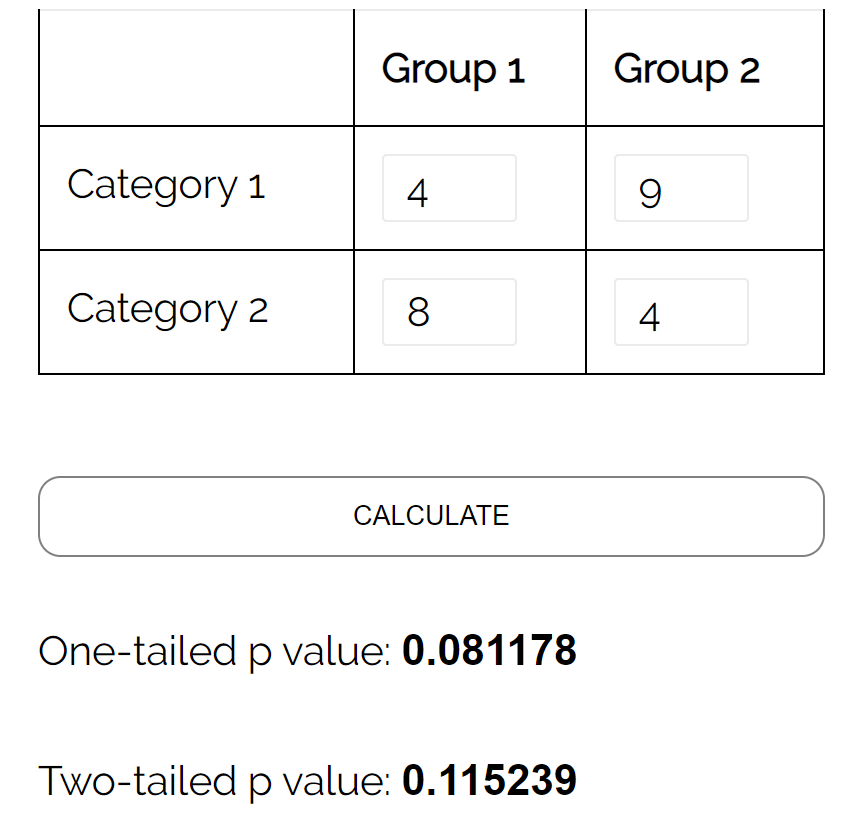
L’expérience fut ainsi conçue : huit tasses de thé furent présentées à la dégustatrice dans un ordre entièrement aléatoire, quatre ayant reçu le lait en premier, et quatre l’infusion de thé. La dégustatrice connaissait la structure globale du protocole — à savoir qu’il y avait exactement quatre tasses de chaque type —, ce qui fixait de facto les totaux marginaux du tableau de contingence résultant. Fisher cherchait à déterminer la probabilité qu’un sujet réussisse à classifier correctement l’ensemble des huit tasses, ou une proportion significative d’entre elles, par simple chance. Les méthodes d’approximation basées sur la loi normale ou la loi du Chi-deux étaient manifestement inopérantes face à un effectif total de huit observations. Fisher élabora donc une dérivation analytique exacte basée sur l’analyse combinatoire, calculant le nombre total de permutations possibles sous l’hypothèse nulle d’une absence totale de discrimination gustative.
Cette formalisation historique permit de consacrer l’inférence exacte dans la statistique moderne. Elle démontrait qu’il n’était point nécessaire d’invoquer un univers asymptotique imaginaire d’échantillons infinis lorsque la combinatoire permettait de cartographier avec une certitude absolue l’intégralité de l’espace échantillonnal. La démarche de Fisher instaurait un standard nouveau : la p-valeur exacte, définie comme la somme des probabilités des événements au moins aussi extrêmes que celui observé sous l’hypothèse d’indépendance. Ce tournant épistémologique marqua la rupture définitive entre les approches purement descriptives du dix-neuvième siècle et l’inférence hypothético-déductive formalisée du vingtième siècle.
1.2 Pertinence méthodologique en psychologie et sciences comportementales
Dans l’écosystème de la recherche en psychologie clinique, en psychiatrie biologique et en neuropsychologie cognitive, les contraintes d’échantillonnage ne relèvent que rarement d’un choix délibéré du chercheur ; elles s’imposent à lui par la nature même des objets d’étude. L’investigation de pathologies à faible prévalence épidémiologique — telles que les troubles dissociatifs de l’identité, les encéphalopathies auto-immunes à manifestations psychiatriques, les syndromes neurodéveloppementaux rares comme le syndrome de Williams ou les séquelles consécutives à des lésions cérébrales focales très circonscrites — interdit le recours aux vastes cohortes couramment mobilisées dans les études sociologiques ou épidémiologiques transversales.
Les chercheurs sont ainsi régulièrement amenés à comparer de petits groupes appariés comprenant entre six et quinze participants par condition expérimentale. L’évaluation de l’efficacité d’un protocole psychothérapeutique novateur dans une unité d’hospitalisation spécialisée, ou la mesure de l’apparition d’un effet secondaire cognitif rare sous une molécule psychotrope, produit presque invariablement des données catégorielles binaires (présence versus absence d’une rémission, amélioration versus stagnation clinique). L’utilisation d’outils statistiques inappropriés dans ce contexte engendre des risques majeurs : d’une part, l’inflation non maîtrisée des faux positifs (erreur de type I), qui conduirait la communauté scientifique à valider des hypothèses d’efficacité thérapeutique infondées ; d’autre part, un déficit dramatique de puissance statistique (erreur de type II) susceptible de faire abandonner des pistes cliniques prometteuses.
Le recours au test exact de Fisher s’avère donc essentiel en méthodologie psychologique pour garantir l’intégrité de l’inférence scientifique. Sa nature déterministe garantit que le risque alpha consenti par l’expérimentateur n’est pas subrepticement altéré par les déformations d’une approximation continue inadaptée. En psychologie de la santé, où les décisions issues de la recherche expérimentale soutiennent l’élaboration de recommandations de bonnes pratiques cliniques et influencent directement le pronostic de patients vulnérables, cette rigueur calculatoire constitue un impératif éthique tout autant qu’un réquisit mathématique.
1.3 Distinction fondamentale entre tests asymptotiques et tests exacts
Pour appréhender la portée du test exact de Fisher, il convient d’expliciter la césure théorique qui sépare les tests asymptotiques des tests exacts. Un test asymptotique repose sur des théorèmes limites — au premier rang desquels figure le théorème central limite formulé dans ses diverses extensions mathématiques. Ces théorèmes stipulent que la distribution d’échantillonnage d’une statistique donnée (comme la somme des écarts quadratiques réduits dans le cas du Chi-deux de Pearson) converge en loi vers une distribution théorique connue et tabulée lorsque la taille de l’échantillon tend vers l’infini mathématique. La validité de la p-valeur issue d’un tel test dépend intrinsèquement de la proximité entre la distribution empirique discrète des données et cette distribution limite continue.
Dans les situations où l’échantillon est restreint, cette convergence en loi ne s’opère pas. La distribution discrète réelle des effectifs de cellules présente des discontinuités fondamentales que la loi continue du Chi-deux (avec un degré de liberté dans une table 2×2) ne parvient pas à lisser adéquatement. L’approximation devient alors poreuse, particulièrement dans les queues de distribution où sont évalués les seuils de significativité critiques (généralement 0,05, 0,01 ou 0,001). Dès lors, le statisticien utilisant un test asymptotique s’expose à manipuler des p-valeurs fictives, dont la valeur nominale sous-estime ou surestime de façon imprévisible la probabilité réelle de commettre une erreur de première espèce.
À l’inverse, un test statistique est qualifié d’« exact » lorsqu’il calcule la distribution d’échantillonnage précise de la statistique de test sous l’hypothèse nulle pour la taille d’échantillon effectivement observée, sans faire appel à aucune hypothèse de convergence vers l’infini. Le test exact de Fisher ne postule aucune fonction de densité continue préexistante : il énumère, de manière purement analytique et combinatoire, l’ensemble des répartitions tabulaires possibles conditionnellement aux marges observées. La p-valeur obtenue n’est pas une approximation dérivée d’une intégrale sous une courbe théorique, mais une somme discrète de probabilités combinatoires réelles. Cette propriété confère au test exact une robustesse absolue face aux violations des critères de validité des tests classiques.
2. Cadre conceptuel et conditions d’application en psychométrie
2.1 Structure et nature des données catégorielles nominales
L’application rigoureuse du test exact de Fisher impose des contraintes structurales strictes relatives à l’échelle de mesure des variables étudiées. Le test est conçu pour analyser l’association entre deux variables qualitatives nominales, chacune étant scindée en deux modalités exclusives et exhaustives, constituant ainsi une matrice de contingence d’ordre 2×2. En psychométrie et en psychopathologie quantitative, ces variables représentent fréquemment des classifications dichotomiques résultant d’opérations d’évaluation standardisées :
- L’assignation des sujets à un statut d’exposition ou d’intervention (ex. : groupe soumis à un protocole de thérapie cognitive basée sur la pleine conscience versus groupe placé sur liste d’attente avec suivi habituel) ;
- Le franchissement d’un seuil diagnostique clinique objectivé par un instrument psychométrique validé (ex. : score au test d’inventaire de dépression de Beck classant les patients en statut de « rémission clinique » versus « persistance de l’épisode dépressif ») ;
- La présence ou l’absence d’une caractéristique neurobiologique ou génétique (ex. : portage de l’allèle court du promoteur du transporteur de la sérotonine 5-HTTLPR versus portage exclusif de l’allèle long).
Un réquisit fondamental réside dans l’indépendance stochastique stricte des unités d’observation. Chaque individu composant l’échantillon global doit être affecté à une et une seule cellule de la matrice de contingence. Cette exigence exclut d’emblée l’analyse de mesures répétées longitudinales réalisées sur les mêmes sujets (comme l’évaluation pré-test et post-test d’une même cohorte de patients), situation qui violerait le postulat d’indépendance inter-observations et nécessiterait le recours au test de McNemar pour données appariées. De même, les observations groupées ou hiérarchisées (élèves au sein de classes thérapeutiques, patients au sein de centres hospitaliers distincts) nécessitent des modélisations mixtes ou des ajustements spécifiques si des effets de grappe sont suspectés.
2.2 La règle des effectifs théoriques réduits (< 5)
Dans la pratique de l’analyse des données catégorielles, la décision de substituer le test exact de Fisher au test du Chi-deux de Pearson est traditionnellement régie par les critères établis par William G. Cochran en 1952 et 1954. La règle empirique classique de Cochran énonce que l’approximation de la distribution du Chi-deux par une loi continue n’est admissible dans une table 2×2 que si l’effectif théorique attendu (c’est-à-dire l’effectif prédit sous l’hypothèse d’indépendance stochastique stricte) de chaque cellule est supérieur ou égal à 5, et que la taille totale de l’échantillon dépasse 20 à 40 individus selon les auteurs.
L’effectif théorique d’une cellule située à l’intersection de la ligne i et de la colonne j est formellement calculé par le produit du total marginal de sa ligne et du total marginal de sa colonne, divisé par l’effectif total observé dans la table :
Eij = (Total Lignei × Total Colonnej) / N
Dès lors qu’une seule cellule de la matrice de contingence 2×2 présente un effectif théorique strictement inférieur à 5 (Eij < 5), l’erreur d’approximation du Chi-deux s’accroît considérablement, provoquant une instabilité marquée de la statistique inférentielle. Dans les situations de recherche clinique où la taille globale de la cohorte est inférieure à 20 sujets, ou lorsque la répartition marginale est très asymétrique (cas d’un phénomène pathologique rare ne touchant qu’une infime fraction des sujets), le test exact de Fisher ne constitue pas seulement une alternative recommandée : il s’impose méthodologiquement comme la seule procédure mathématiquement valide et reconnue par les standards éditoriaux internationaux.
2.3 L’hypothèse des marges conditionnelles fixes
Sur le plan de l’architecture théorique, le test exact de Fisher repose sur une prémisse mathématique spécifique : le conditionnement par rapport aux totaux marginaux observés. Cela signifie que la dérivation de la distribution de probabilité s’effectue en considérant que la somme des éléments de la première ligne, la somme de la seconde ligne, la somme de la première colonne et la somme de la seconde colonne sont des constantes fixées d’avance, invariantes dans l’espace échantillonnal.
Cette hypothèse des « marges fixes » a suscité d’abondants débats épistémologiques dans l’histoire de la biométrie. Dans un plan expérimental idéal — semblable à celui de la dégustation de thé imaginée par Fisher —, l’expérimentateur contrôle délibérément les marges : il décide à l’avance qu’il y aura 4 tasses préparées d’une façon et 4 d’une autre (marge de ligne fixée), et il intime à la dégustatrice de désigner impérativement 4 tasses pour chaque catégorie (marge de colonne fixée). En psychologie clinique, toutefois, ce schéma n’est que partiellement respecté. Dans un essai clinique contrôlé randomisé, l’effectif alloué au groupe expérimental et au groupe témoin est effectivement fixé par le protocole expérimental (marges de lignes fixes), mais le nombre total de patients atteignant la rémission clinique est une variable aléatoire observée a posteriori (marge de colonne libre). Dans une étude épidémiologique observationnelle transversale, les deux marges sont stochastiques et fluctuent librement au gré de l’échantillonnage.
Néanmoins, Fisher a démontré — suivi en cela par des théoriciens de premier plan tels que Jerzy Neyman et Egon Pearson dans leurs travaux sur l’inférence conditionnelle — que le conditionnement sur les marges observées constitue une démarche inférentielle légitime et statistiquement optimale. Les totaux marginaux n’apportent, en eux-mêmes, aucune information substantielle sur l’intensité du lien d’association (le rapport de cotes ou odds ratio) entre les deux facteurs étudiés ; ils ne renseignent que sur les prévalences marginales. Ainsi, en traitant les marges observées comme des statistiques accessoires (ancillary statistics) et en conditionnant l’analyse sur leurs valeurs réalisées, le test de Fisher élimine les paramètres de nuisance inconnus et garantit une inférence parfaitement exacte sur le paramètre d’intérêt fondamental : la dépendance statistique entre les deux attributs cliniques.
3. Formulation formelle des hypothèses statistiques (H0 et H1)
3.1 Hypothèse nulle (H0) d’indépendance
Toute démarche d’inférence décisionnelle débute par l’énoncé explicite et non ambigu de l’hypothèse nulle, notée conventionnellement H0. Dans le cadre canonique du test exact de Fisher appliqué à une table de contingence 2×2, l’hypothèse nulle formalise l’absence totale d’association stochastique entre les deux variables qualitatives nominales au sein de la population parente dont est extrait l’échantillon.
Sur le plan probabiliste, si l’on note p1 la probabilité de succès (ou d’apparition de l’événement clinique cible) au sein de la première population (ex. : les patients recevant l’intervention psychothérapeutique active) et p2 la probabilité de succès au sein de la seconde population (ex. : les patients affectés au groupe témoin sous placebo psychologique), l’hypothèse nulle s’écrit formellement :
H0 : p1 = p2
Cette égalité des proportions fondamentales se traduit de manière équivalente par l’annulation de toute disparité en termes de cotes d’exposition ou de réponse. En mobilisant le concept fondamental de rapport de cotes (Odds Ratio, noté OR ou θ), l’hypothèse nulle équivaut rigoureusement à l’affirmation selon laquelle :
H0 : θ = 1
Sous la perspective de la modélisation psychologique, l’hypothèse nulle pose le postulat déterministe que la répartition observée des effectifs au sein des quatre cases de la table ne reflète aucune efficacité différentielle du traitement ni aucun lien causal ou corrélationnel structurel. Toute déviation par rapport à une répartition strictement proportionnelle des succès et des échecs n’est, selon H0, que la résultante exclusive des fluctuations aléatoires d’échantillonnage inhérentes au tirage probabiliste d’un nombre restreint de sujets.
3.2 Hypothèses alternatives unilatérale et bilatérale (H1)
Face à cette hypothèse de neutralité, le chercheur formule une hypothèse alternative, notée H1, qui représente la théorie scientifique substantielle qu’il entend corroborer à travers le recueil des données. La structure formelle de H1 conditionne directement le mode d’intégration combinatoire des probabilités exactes lors du calcul de la p-valeur du test.
L’hypothèse alternative bilatérale (ou non directionnelle) est privilégiée lorsque la littérature scientifique préalable ou le fondement théorique ne permettent pas d’exclure a priori une direction spécifique de l’effet. Elle postule simplement l’existence d’une divergence entre les deux proportions populationnelles, sans présumer du sens de cette asymétrie :
H1(bilatérale) : p1 ≠ p2 (ou θ ≠ 1)
En psychopathologie interventionnelle, cette formulation s’impose lorsqu’un nouveau dispositif clinique pourrait soit apporter un bénéfice thérapeutique supérieur (p1 > p2), soit au contraire induire un effet iatrogène délétère réduisant les chances de rémission clinique par rapport à l’abstention thérapeutique (p1 < p2).
À l’inverse, l’hypothèse alternative unilatérale (ou directionnelle) postule d’emblée une orientation spécifique du phénomène. Elle se décline en deux variantes mutuellement exclusives selon la prédiction avancée :
H1(unilatérale droite) : p1 > p2 (ou θ > 1)
H1(unilatérale gauche) : p1 < p2 (ou θ < 1)
En méthodologie expérimentale contemporaine, la sélection d’une alternative unilatérale requiert une justification théorique et empirique préalable extrêmement exigeante. Elle doit impérativement faire l’objet d’un préenregistrement (preregistration) au sein d’un registre public d’essais cliniques (tel que ClinicalTrials.gov ou l’Open Science Framework) avant l’initiation du recueil des données. Cette précaution épistémologique prévient tout glissement opportuniste post-hoc consistant à diviser par deux la p-valeur bilatérale obtenue afin de franchir artificiellement le seuil conventionnel de significativité statistique alpha.
3.3 Implications inférentielles du rejet ou du maintien de H0
L’issue calculatoire du test exact de Fisher confronte le chercheur à une alternative binaire d’une haute portée épistémique. Deux décisions s’offrent à l’analyste au terme de la confrontation de la p-valeur empirique exacte au risque d’erreur consenti de première espèce (généralement fixé à α = 0,05) :
Si la p-valeur calculée est strictement inférieure ou égale à α (p ≤ 0,05), l’expérimentateur est fondé à rejeter formellement l’hypothèse nulle H0. Ce rejet autorise la conclusion scientifique selon laquelle les données observées présentent un niveau d’incompatibilité trop élevé avec le modèle du hasard pur conditionnel aux marges. En termes psychologiques, on infère l’existence d’une dépendance statistique significative entre le facteur explicatif (ex. : l’intervention psychothérapeutique) et le critère de jugement clinique (ex. : la guérison du trouble panique). L’attention du chercheur doit alors immédiatement se focaliser sur l’estimation ponctuelle et par intervalle de la taille d’effet mesurée (notamment l’Odds Ratio), afin de dissocier la simple significativité inférentielle de la pertinence clinique clinique pratique.
Si, en revanche, la p-valeur calculée excède le seuil critique (p > 0,05), l’analyste se trouve dans l’incapacité de rejeter H0. Il est impératif, sur le plan épistémologique, de souligner que cette absence de rejet ne constitue en aucun cas une démonstration ou une preuve de la validité de H0. En vertu de l’asymétrie fondamentale de la logique poppérienne de falsification, conclure que p1 = p2 relèverait du sophisme de l’affirmation du conséquent. Dans les études à effectifs réduits pour lesquelles le test de Fisher est expressément requis, le risque d’erreur de type II (noté β) — consistant à échouer à détecter un effet pourtant authentiquement présent dans la population — est mécaniquement très élevé en raison du manque de puissance statistique inhérent aux petits échantillons. L’absence de significativité doit donc être sobrement interprétée comme une indécision des données, nécessitant une réplication sur des cohortes plus substantielles.
4. Anatomie mathématique de la table de contingence 2×2
4.1 Notation matricielle standard (a, b, c, d)
L’opérationnalisation mathématique du test de Fisher repose sur une organisation matricielle rigoureusement standardisée des fréquences conjointes observées. Soit une matrice d’ordre 2×2 croisant deux variables catégorielles dichotomiques. Par convention internationale dans la littérature statistique et psychologique, les effectifs des cellules internes sont désignés par les lettres minuscules de l’alphabet latin : a, b, c et d.
L’affectation conventionnelle de ces cellules obéit généralement à l’ordonnancement structurel suivant :
- Cellule a (Ligne 1, Colonne 1) : Nombre de participants exposés au facteur d’intérêt (ou recevant le traitement expérimental) présentant l’événement cible (succès thérapeutique, rémission, présence du symptôme) ;
- Cellule b (Ligne 1, Colonne 2) : Nombre de participants exposés au facteur d’intérêt ne présentant pas l’événement cible (échec thérapeutique, non-rémission, absence du symptôme) ;
- Cellule c (Ligne 2, Colonne 1) : Nombre de participants non-exposés (ou affectés au groupe témoin/placebo) présentant l’événement cible ;
- Cellule d (Ligne 2, Colonne 2) : Nombre de participants non-exposés ne présentant pas l’événement cible.
Sur le plan des propriétés scalaires, les variables a, b, c, d appartiennent obligatoirement à l’ensemble des entiers naturels ℕ (nombres entiers positifs ou nuls : a, b, c, d ≥ 0). Toute valeur fractionnaire, décimale ou négative est conceptuellement impossible dans ce cadre de comptage exhaustif d’unités d’observation discrètes.
4.2 Rôle et calcul des totaux marginaux et de la taille totale (n)
Les éléments structurants de la matrice de contingence résident dans ses distributions marginales, obtenues par la sommation vectorielle des lignes et des colonnes de la table. Ces totaux marginaux délimitent les frontières de l’espace combinatoire dans lequel s’articule le test exact de Fisher :
- Marge de la première ligne : R1 = a + b (effectif total du groupe expérimental ou exposé) ;
- Marge de la seconde ligne : R2 = c + d (effectif total du groupe témoin ou non-exposé) ;
- Marge de la première colonne : C1 = a + c (nombre total de participants ayant validé l’événement cible à travers l’échantillon global) ;
- Marge de la seconde colonne : C2 = b + d (nombre total de participants n’ayant pas validé l’événement cible) ;
- Taille totale de l’échantillon : n = a + b + c + d = R1 + R2 = C1 + C2.
Une propriété algébrique fondamentale de cette matrice découle de l’hypothèse de fixité conditionnelle des marges : la table 2×2 possède exactement un seul degré de liberté. En effet, dès lors que les quatre totaux marginaux (a+b, c+d, a+c, b+d) ainsi que la taille totale n sont posés comme constants et invariants, la spécification arbitraire de la valeur d’une seule et unique cellule (par exemple la cellule a) détermine de manière rigide et déterministe la valeur numérique des trois autres cellules :
b = (a + b) – a
c = (a + c) – a
d = (c + d) – c = (c + d) – [(a + c) – a] = d
Cette contrainte dimensionnelle unitaire implique que la distribution de probabilité conjointe de la table 2×2 sous conditionnement marginal se réduit mathématiquement à l’étude du comportement de la variable aléatoire univariée représentée par la cellule a.
4.3 Exemples de structures tabulaires typiques en psychologie clinique
Afin d’illustrer la matérialité de cette formalisation au sein des disciplines empiriques du comportement humain, examinons trois configurations matricielles caractéristiques rencontrées dans la littérature spécialisée :
Configuration 1 : Essai d’intervention en psychothérapie brève
Un chercheur évalue l’impact d’un module de thérapie cognitive basée sur l’exposition par réalité virtuelle chez des sujets phobiques sévères (n = 16) :
– Ligne 1 (Réalité virtuelle) : a = 7 (rémission), b = 1 (non-rémission) | Marge R1 = 8
– Ligne 2 (Thérapie conventionnelle in vivo) : c = 2 (rémission), d = 6 (non-rémission) | Marge R2 = 8
– Marges de colonnes : C1 = 9 (rémissions totales), C2 = 7 (échecs totaux) | Total général n = 16.
Configuration 2 : Neuropsychiatrie génétique et vulnérabilité cognitive
Étude de l’expression d’un déficit majeur de l’attention visuo-spatiale chez des patients atteints de microdélétion chromosomique rare (n = 12) :
– Ligne 1 (Porteurs de la délétion) : a = 5 (déficit avéré), b = 1 (fonction préservée) | Marge R1 = 6
– Ligne 2 (Appariés non porteurs) : c = 1 (déficit avéré), d = 5 (fonction préservée) | Marge R2 = 6
– Marges : C1 = 6, C2 = 6 | Total général n = 12.
Configuration 3 : Observance thérapeutique sous alliance clinique renforcée
Mesure du taux d’abandon prématuré (drop-out) au sein d’un protocole de remédiation cognitive pour patients souffrant d’anorexie mentale réfractaire (n = 15) :
– Ligne 1 (Alliance renforcée) : a = 1 (abandon), b = 7 (maintien dans le protocole) | Marge R1 = 8
– Ligne 2 (Prise en charge standard) : c = 5 (abandon), d = 2 (maintien dans le protocole) | Marge R2 = 7
– Marges : C1 = 6, C2 = 9 | Total général n = 15.
Dans chacune de ces configurations réelles, le calcul des effectifs théoriques attendus fait apparaître des cellules inférieures au seuil de 5. L’application du Chi-deux de Pearson standard y produirait des inférences gravement erronées, rendant impératif le traitement par la combinatoire factorielle de Fisher.
5. Dérivation mathématique et formule du test unilatéral
5.1 La formule combinatoire factorielle de Fisher
La dérivation analytique de la probabilité exacte d’une table de contingence 2×2 découle de la théorie combinatoire classique formulée par Pierre-Simon de Laplace et revisitée par Ronald Fisher sous l’angle du conditionnement stochastique. La formule exacte de Fisher calcule la probabilité P d’observer très exactement la distribution interne (a, b, c, d) sachant que les totaux marginaux (a+b), (c+d), (a+c) et (b+d) sont fixés et invariants sous l’hypothèse nulle d’absence d’association.
L’équation maîtresse s’énonce formellement au moyen des factorielles des composantes marginales et cellulaires de la table :
P = [ (a + b)! × (c + d)! × (a + c)! × (b + d)! ] / [ a! × b! × c! × d! × n! ]
Où le point d’exclamation désigne la fonction factorielle standard, définie pour tout entier naturel k par le produit de tous les entiers positifs strictement inférieurs ou égaux à k (avec la convention axiomatique 0! = 1) :
k! = k × (k – 1) × (k – 2) × … × 2 × 1
La structure anatomique de cette fraction factorielle révèle une clarté logique exemplaire :
- Le numérateur : Il est constitué par le produit factoriel des quatre totaux marginaux (a+b)! (c+d)! (a+c)! (b+d)!. Ce terme quantifie le nombre total de permutations ordonnées possibles des partitions marginales fixées par l’expérimentateur ou par la structure de l’échantillonnage ;
- Le dénominateur : Il comprend le produit des factorielles des effectifs des quatre cellules internes (a! b! c! d!), pondéré et multiplié par la factorielle de la taille totale de l’échantillon n!. Le produit des factorielles internes normalise le dénombrement en éliminant les micro-permutations indiscernables d’individus à l’intérieur de chaque catégorie, tandis que n! représente le volume global des permutations sans restriction de l’ensemble des n participants.
Une caractéristique mathématique essentielle de cette formule réside dans son invariance algébrique totale : la valeur de la probabilité P demeure rigoureusement inchangée si l’on transpose la matrice (inversion des lignes et des colonnes) ou si l’on permute la désignation arbitraire des groupes ou des modalités, attestant de la symétrie conceptuelle de la mesure d’association.
5.2 Algorithme de calcul pas à pas d’une configuration spécifique
Pour appréhender la mécanique concrète de cette formule, détaillons le protocole opératoire méthodique nécessaire à l’évaluation d’une table d’observation spécifique. Supposons une table clinique recueillie lors d’une étude préliminaire sur la phobie sociale, présentant les effectifs suivants : a = 3, b = 1, c = 1, d = 4.
Étape 1 : Sommation et établissement des marges
Calculons rigoureusement les totaux marginaux de lignes, de colonnes, et la taille générale de la cohorte :
– Marge ligne 1 : a + b = 3 + 1 = 4
– Marge ligne 2 : c + d = 1 + 4 = 5
– Marge colonne 1 : a + c = 3 + 1 = 4
– Marge colonne 2 : b + d = 1 + 4 = 5
– Taille totale de l’échantillon : n = 4 + 5 = 9.
Étape 2 : Évaluation des factorielles marginales (Numérateur)
Développons les factorielles associées aux quatre marges :
– (a + b)! = 4! = 4 × 3 × 2 × 1 = 24
– (c + d)! = 5! = 5 × 4 × 3 × 2 × 1 = 120
– (a + c)! = 4! = 24
– (b + d)! = 5! = 120
Le numérateur correspond au produit de ces quatre termes :
Numérateur = 24 × 120 × 24 × 120 = 8 294 400.
Étape 3 : Évaluation des factorielles internes et totales (Dénominateur)
Développons les factorielles des cellules internes et de l’effectif n :
– a! = 3! = 3 × 2 × 1 = 6
– b! = 1! = 1
– c! = 1! = 1
– d! = 4! = 4 × 3 × 2 × 1 = 24
– n! = 9! = 9 × 8 × 7 × 6 × 5 × 4 × 3 × 2 × 1 = 362 880
Le dénominateur s’obtient par la multiplication de l’ensemble de ces facteurs :
Dénominateur = 6 × 1 × 1 × 24 × 362 880 = 144 × 362 880 = 52 254 720.
Étape 4 : Calcul de la probabilité exacte ponctuelle
Le quotient arithmétique de ces deux grands nombres fournit la probabilité exacte d’occurrence de cette configuration matricielle précise :
P = 8 294 400 / 52 254 720
En procédant à la simplification de la fraction (division du numérateur et du dénominateur par leur plus grand commun diviseur, 1 658 880) :
P = 5 / 31,5 … ou de façon décimale exacte :
P ≈ 0,15873 (soit une probabilité ponctuelle de 15,87 %).
5.3 Gestion des grands factoriels et limites calculatoires manuelles
Si la démonstration arithmétique manuelle s’avère accessible pour des cohortes n’excédant pas une dizaine d’individus, elle se heurte quasi instantanément à un verrou computationnel infranchissable dès lors que la taille d’échantillon s’accroît modérément. La fonction factorielle présente une cinétique de croissance ultra-exponentielle (formalisée par l’approximation asymptotique de Stirling) :
k! ≈ √(2πk) × (k / e)k
Tandis que 10! = 3 628 800, un effectif de n = 50 participants engendre une valeur de factorielle 50! ≈ 3,04 × 1064, nombre qui surpasse le nombre d’atomes contenus dans notre planète. Dès n = 171, la valeur factorielle dépasse 10308, provoquant le dépassement de capacité (arithmetic overflow) sur la quasi-totalité des architectures processeur standard exploitant le codage en virgule flottante en double précision selon la norme IEEE 754.
Pour surmonter cet écueil sur le plan algorithmique sans altérer la rigueur mathématique du calcul exact, les logiciels statistiques modernes ne calculent jamais directement les factorielles brutes. Ils mobilisent la transformation logarithmique de l’équation en s’appuyant sur la fonction gamma d’Euler, notée Γ(x), dont la propriété analytique fondamentale établit que pour tout entier k, k! = Γ(k + 1). L’équation de Fisher est ainsi réécrite sous forme de somme et de différence de logarithmes népériens de factorielles (fonctions log-gamma ou lgamma) :
ln(P) = ln((a+b)!) + ln((c+d)!) + ln((a+c)!) + ln((b+d)!) – [ ln(a!) + ln(b!) + ln(c!) + ln(d!) + ln(n!) ]
La probabilité finale est ensuite recouvrée par l’exponentiation du résultat scalaire : P = exp(ln(P)). Cette manipulation algébrique garantit une stabilité numérique parfaite, prévenant les erreurs d’arrondi et éliminant tout risque de débordement mémoire, autorisant le traitement exact de tables comportant plusieurs milliers d’observations en quelques fractions de milliseconde.
6. Lien intrinsèque avec la distribution hypergéométrique
6.1 Modélisation du tirage sans remise
L’élégance théorique de la formulation de Fisher réside dans son adéquation conceptuelle avec un modèle stochastique canonique de la théorie des probabilités : la distribution hypergéométrique. Ce modèle régit la probabilité d’obtenir un nombre prédéterminé d’événements de nature spécifique lors d’une suite de tirages successifs réalisés sans remise au sein d’une population finie et close.
L’analogie classique de l’urne permet d’en expliciter intuitivement la dynamique. Considérons une urne scellée contenant un nombre total d’objets égal à n (l’effectif total de l’étude clinique). Dans cette urne, une fraction de ces objets possède une étiquette « Succès thérapeutique » : leur nombre exact est donné par la marge C1 = (a + c). Le reste des objets, d’un effectif égal à C2 = (b + d), porte l’étiquette « Échec ». L’expérimentateur extrait alors aveuglément de l’urne une poignée de boules dont la taille est exactement calibrée sur la marge de la première ligne : R1 = (a + b). Cette poignée représente les patients assignés au traitement expérimental.
Dans un tirage avec remise, chaque élément extrait serait replacé dans l’urne avant le tirage suivant, conservant une probabilité d’extraction rigoureusement constante à chaque essai ; un tel processus relèverait de la loi binomiale. Or, dans un protocole d’échantillonnage clinique, un sujet ne peut appartenir simultanément qu’à une seule condition et ne peut être évalué qu’une unique fois : le tirage s’effectue obligatoirement sans remise. Dès lors, chaque extraction modifie instantanément la composition relative des éléments résiduels dans l’urne. Cette dépendance stochastique séquentielle constitue la signature probabiliste fondamentale de la loi hypergéométrique.
6.2 Paramétrage exact des variables du modèle
L’harmonisation formelle entre la table de contingence 2×2 et les paramètres génériques de la loi hypergéométrique s’opère par une bijection mathématique directe. La distribution hypergéométrique, classiquement notée Hyper(N, K, m), exprime la probabilité d’observer exactement k succès lors de m tirages sans remise au sein d’une population de taille N renfermant K succès initiaux :
P(X = k) = [ C(K, k) × C(N – K, m – k) ] / C(N, m)
Où le terme C(u, v) symbolise le coefficient binomial standard (nombre de combinaisons de v éléments choisis parmi u), défini par :
C(u, v) = u! / [ v! × (u – v)! ]
La transcription des éléments du tableau de contingence de Fisher au sein des paramètres de l’urne hypergéométrique s’établit comme suit :
- Taille de la population globale : N = n (le total général des participants de l’étude) ;
- Nombre total d’éléments favorables dans l’urne : K = a + c (la marge de la colonne des succès cliniques) ;
- Taille de l’échantillon extrait en un tirage : m = a + b (la marge de la ligne du groupe expérimental) ;
- Nombre de succès observés dans l’échantillon : k = a (le contenu effectif de la cellule supérieure gauche).
En substituant ces correspondances fonctionnelles dans la formule combinatoire hypergéométrique, on démontre rigoureusement l’équivalence algébrique absolue :
P(X = a) = [ C(a + c, a) × C(b + d, b) ] / C(n, a + b)
En développant chaque coefficient binomial sous sa forme factorielle explicite, les simplifications algébriques internes reconstituent identiquement la formule de Fisher exposée à la section 5.1 :
P = [ (a + c)! / (a! c!) ] × [ (b + d)! / (b! d!) ] / [ n! / ((a + b)! (c + d)!) ] = [ (a + b)! (c + d)! (a + c)! (b + d)! ] / [ a! b! c! d! n! ]
Le test exact de Fisher n’est donc rien d’autre que l’évaluation analytique de la fonction de masse d’une variable aléatoire hypergéométrique conditionnée par les marges observées.
6.3 Fonction de répartition cumulative (CDF) et calcul unilatéral
Dans la pratique du test d’hypothèse, la probabilité ponctuelle d’observer exactement la table d’intérêt P(X = a) ne suffit pas à construire l’inférence. Le paradigme décisionnel fisherien exige d’estimer la probabilité d’observer un résultat au moins aussi extrême que celui constaté empiriquement, dans le sens prédit par l’hypothèse alternative H1.
Pour une hypothèse alternative unilatérale droite postulant une supériorité du traitement expérimental (impliquant que la cellule a présente une valeur anormalement élevée par rapport à ce que prédirait le simple hasard), la p-valeur unilatérale correspond à la queue de distribution supérieure de la loi hypergéométrique. Elle s’obtient formellement par la sommation cumulative des probabilités ponctuelles associées à toutes les valeurs entières x supérieures ou égales à la valeur observée a, jusqu’à la valeur maximale théoriquement compatible avec les marges :
punilatérale (droite) = P(X ≥ a) = ∑x = amin(a+b, a+c) P(X = x)
La borne supérieure de la sommation est rigoureusement contrainte par le minimum mathématique entre la marge de la ligne 1 (a+b) et la marge de la colonne 1 (a+c), car la cellule a ne peut logiquement surpasser le total d’individus présents dans sa propre ligne ou dans sa propre colonne.
Symétriquement, si l’hypothèse alternative postulait une infériorité thérapeutique (hypothèse unilatérale gauche, suggérant une valeur de a inhabituellement basse), la p-valeur correspondrait à la fonction de répartition cumulative (Cumulative Distribution Function, ou CDF) évaluée au point a :
punilatérale (gauche) = P(X ≤ a) = ∑x = max(0, a – d)a P(X = x)
Où la borne inférieure correspond au maximum arithmétique entre 0 et la valeur (a – d), garantissant qu’aucune cellule ne puisse adopter une valeur strictement négative, ce qui violerait le principe d’intégrité de la table.
7. Détermination de la p-valeur bilatérale et complexités associées
7.1 Pourquoi le simple doublement de la p-valeur est problématique
Si la détermination de la p-valeur dans le cadre d’un test unilatéral découle d’une sommation unidirectionnelle limpide, le calcul de la p-valeur bilatérale (two-sided p-value) confronte le statisticien à une complexité mathématique singulière. Dans le cadre des distributions continues symétriques usuelles (telles que la loi normale centrée réduite de Laplace-Gauss ou la loi de Student), la symétrie géométrique parfaite de la fonction de densité par rapport à l’espérance permet de définir la p-valeur bilatérale par le simple doublement de la p-valeur unilatérale : pbilatérale = 2 × punilatérale.
Appliquer mécaniquement ce procédé à la distribution hypergéométrique constitue une erreur méthodologique majeure. En effet, dès lors que les totaux marginaux du tableau 2×2 sont asymétriques (par exemple lorsque la ligne 1 compte 8 sujets et la ligne 2 compte 15 sujets, ou lorsque le nombre de succès totaux diffère sensiblement du nombre d’échecs), la fonction de masse de la loi hypergéométrique sous-jacente est elle-même intrinsèquement asymétrique. Ses queues de distribution gauche et droite ne possèdent ni la même forme, ni la même étendue, ni la même granularité probabiliste.
En conséquence, doubler la p-valeur unilatérale issue de la queue la plus courte peut conduire à des incohérences formelles aberrantes, telles que l’obtention de p-valeurs artificiellement gonflées pouvant dépasser l’unité (p > 1,0), ce qui contrevient aux axiomes élémentaires de Kolmogorov. De surcroît, cette approche fruste méconnaît la topologie réelle de l’espace échantillonnal en agrégeant un volume de probabilité sur la queue opposée qui ne correspond à aucune configuration de table réellement concevable.
7.2 Méthode standard : somme des probabilités inférieures ou égales
Pour préserver une cohérence mathématique irréprochable face à l’asymétrie hypergéométrique, Ronald Fisher a lui-même proposé une approche rigoureuse, devenue aujourd’hui le standard international par défaut dans l’ensemble des bibliothèques de calcul statistique (implémentée nativement sous R, Python et SAS) : l’approche par ordonnancement des densités de probabilité ponctuelles.
Cette méthode repose sur un principe d’équidistance en probabilité : une table alternative est considérée comme « au moins aussi extrême » ou « plus défavorable » à l’hypothèse nulle que la table observée si et seulement si sa probabilité exacte ponctuelle d’occurrence est inférieure ou égale à celle de la table observée. Le protocole algorithmique s’articule en trois temps :
- On identifie de manière exhaustive toutes les tables de contingence 2×2 admissibles partageant rigoureusement les mêmes marges fixes que la table empirique observée (l’ensemble de ces tables est paramétré de façon biunivoque par la valeur entière de la cellule x, pour x variant de max(0, R1 – C2) à min(R1, C1)) ;
- On calcule la probabilité hypergéométrique exacte ponctuelle P(X = x) pour chacune de ces configurations matricielles réalisables au sein de l’espace échantillonnal ;
- On identifie la probabilité ponctuelle associée à la table empiriquement observée, notée Pobs. La p-valeur bilatérale est alors définie comme la somme intégrale des probabilités de toutes les tables x dont la probabilité propre est inférieure ou égale à Pobs :
pbilatérale (Fisher) = ∑{x : P(X=x) ≤ Pobs} P(X = x)
Cette procédure computationnelle possède l’immense mérite de respecter scrupuleusement la géométrie intrinsèque de la loi discrète : elle agrège l’intégralité de la queue d’observation empirique et intègre, sur la queue opposée, exclusivement les tables dont le niveau de rareté probabiliste égale ou surpasse celui de l’événement observé.
7.3 Méthodes alternatives et critères d’arbitrage
Bien que la méthode de la somme des probabilités inférieures ou égales fasse l’objet d’un consensus très large, la littérature spécialisée répertorie d’autres déclinaisons algorithmiques historiques de la bilatéralité, ce qui peut parfois expliquer de légères disparités numériques d’un logiciel à un autre :
- Le doublement tronqué (Truncated doubling) : Cette variante consiste à multiplier la p-valeur unilatérale de la queue observée par deux, tout en bornant arbitrairement le résultat final à l’unité : p = min(1, 2 × punilatérale). Fréquemment mobilisée dans certains didacticiels simplifiés, cette solution demeure imparfaite sur le plan mathématique car elle postule une symétrie fictive ;
- La distance par rapport à l’espérance mathématique : Cette approche définit la déviation extrême d’une table non pas par sa probabilité ponctuelle, mais par l’écart absolu séparant la cellule a de sa valeur attendue théorique sous l’hypothèse nulle : |x – E[X]| ≥ |a – E[X]|. On somme alors les probabilités des tables satisfaisant cette inégalité métrique. Bien que séduisante car analogue au raisonnement du Chi-deux, cette méthode peut agréger des tables dont la probabilité individuelle est supérieure à la probabilité de la table observée si la distribution présente une forte asymétrie ;
- La p-valeur centrale (Central p-value) : Préconisée par certains statisticiens théoriciens, elle définit la p-valeur bilatérale comme le double de la queue minimale, pondérée par une analyse de centralité.
Dans la recherche contemporaine en psychologie et sciences de la santé, le consensus international (reflété par les directives des comités de lecture des revues indexées à comité de pairs) stipule que la méthode de sommation des tables de probabilités inférieures ou égales — telle qu’exécutée par la fonction standard de calcul exact — doit être adoptée et spécifiée explicitement dans la section méthodologique des manuscrits soumis.
8. Comparaison critique : Test de Fisher vs Test du Chi-deux de Pearson
8.1 Comportement comparatif selon la taille d’échantillon
La mise en concurrence du test exact de Fisher et du test d’indépendance du Chi-deux de Pearson met en lumière les tensions traditionnelles entre exactitude inférentielle et coût de calcul. Sur le plan asymptotique, ces deux procédures sont fondamentalement congruentes : lorsque la taille totale de l’échantillon tend vers des valeurs élevées (par exemple n > 100 ou n > 500) et que toutes les cellules théoriques attendues surpassent largement les critères de Cochran (Eij ≫ 10), les p-valeurs fournies par le Chi-deux de Pearson et par le test de Fisher convergent asymptotiquement vers une quasi-identité numérique.
Cette convergence s’explique mathématiquement par le fait que la loi hypergéométrique, sous l’effet du théorème central limite appliqué aux tirages sans remise au sein de populations finies qui croissent, tend progressivement vers une loi normale multidimensionnelle, dont les formes quadratiques projectives suivent précisément une loi du Chi-deux à 1 degré de liberté. Dès lors, sur des méga-données cliniques ou épidémiologiques, le choix de l’une ou l’autre technique devient indifférent en termes de décision statistique.
Toutefois, en présence d’échantillons clairsemés, ce parallélisme s’effondre. Tandis que le test de Fisher conserve une exactitude inconditionnelle en maintenant rigoureusement le risque alpha au-dessous ou au niveau du seuil nominal consenti (par exemple 5%), le Chi-deux asymptotique adopte un comportement chaotique et imprévisible. Lorsque les effectifs attendus deviennent minimes, la statistique du Chi-deux subit des déformations brutales induites par la division de résidus quadratiques par de très faibles dénominateurs, générant un gonflement artificiel de la valeur du test et conduisant à un rejet abusif de l’hypothèse nulle (sur-rejet ou fausse significativité). Historiquement, la popularité du Chi-deux s’expliquait exclusivement par la simplicité de son calcul algébrique manuel face à la lourdeur dissuasive des factorielles de Fisher ; à l’ère computationnelle contemporaine, cet argument ergonomique est devenu caduc, privant le Chi-deux de toute justification méthodologique sérieuse en contexte de petits effectifs.
8.2 La correction pour continuité de Yates en question
Face à la défaillance bien documentée du Chi-deux asymptotique continu pour modéliser des effectifs discrets réduits, le statisticien britannique Frank Yates proposa, en 1934, une modification corrective de la statistique de Pearson pour les tables 2×2 : la correction pour continuité de Yates. L’objectif théorique de Yates était d’opérer un ajustement géométrique en retranchant la valeur arithmétique 0,5 à la valeur absolue de chaque écart entre effectif observé et effectif attendu avant élévation au carré :
χ2Yates = ∑ [ (|Oij – Eij| – 0,5)2 / Eij ]
Sous sa formulation algébrique équivalente déployée directement sur les cellules brutes d’une table 2×2 :
χ2Yates = [ n × (|ad – bc| – 0,5n)2 ] / [ (a + b)(c + d)(a + c)(b + d) ]
Bien que cette correction ait été quasi systématiquement intégrée dans les didacticiels et les sorties par défaut de logiciels statistiques comme SPSS au cours des décennies passées, elle fait aujourd’hui l’objet de condamnations méthodologiques unanimes dans la littérature biométrique contemporaine. Les travaux approfondis de statisticiens théoriciens de référence ont démontré que la correction de Yates ne constitue pas une approximation adéquate : elle opère une surcorrection systématique. En réduisant drastiquement l’amplitude de la statistique de test, le Chi-deux corrigé de Yates effondre artificiellement la puissance statistique, générant des p-valeurs excessivement conservatrices qui excèdent régulièrement la probabilité exacte dérivée par le test de Fisher lui-même.
Le consensus scientifique actuel en psychométrie et méthodologie clinique est parfaitement explicite : la correction de Yates représente une tentative historiquement datée de sauvetage d’un test asymptotique continu inadapté. Dans toute situation d’analyse catégorielle portant sur de petits effectifs, il convient de rejeter définitivement l’usage de la correction de Yates pour mobiliser directement et sans artifice le test exact de Fisher.
8.3 Puissance statistique et conservatisme du test de Fisher
En dépit de sa perfection mathématique, le test exact de Fisher n’est pas exempt de spécificités comportementales que le chercheur averti doit appréhender, au premier rang desquelles figure le phénomène de conservatisme statistique. Ce conservatisme découle directement de la nature discrète de la distribution hypergéométrique. Contrairement à une distribution continue qui peut épouser n’importe quelle valeur sur l’axe des réels, l’espace d’échantillonnage d’une variable discrète sous marges fixes ne comporte qu’un nombre fini et restreint de configurations possibles.
De ce fait, la fonction de masse ne prend que des valeurs discontinues et échelonnées. Il en résulte que le seuil de rejet effectif réel du test (le taux réel d’erreur de première espèce, noté αréel) est presque invariablement strictement inférieur au seuil nominal consenti par l’expérimentateur (αnominal = 0,05). Par exemple, pour une table d’effectifs réduits, il est fréquent que les p-valeurs immédiatement inférieures au seuil de 0,05 se situent à 0,028 ou 0,031 ; aucune table réalisable ne permet d’atteindre exactement un risque alpha cumulé de 0,050. Cette propriété intrinsèque confère au test exact une prudence inférentielle structurelle : le test de Fisher rejette l’hypothèse nulle moins souvent que ne le permettrait le seuil théorique de 5%, ce qui se traduit inévitablement par une pénalisation relative de sa puissance statistique (probabilité d’identifier un effet réel sous H1).
Pour atténuer ce conservatisme tout en préservant le cadre exact, certains théoriciens préconisent le recours à la mid-p value (p-valeur moyenne). Celle-ci s’obtient en retranchant à la p-valeur exacte standard la moitié de la probabilité ponctuelle de la table observée :
pmid = pstandard – 0,5 × P(Table observée)
La mid-p value rétablit un taux d’erreur de type I moyen rigoureusement calibré sur le seuil alpha nominal et restaure une puissance statistique optimale. Néanmoins, son statut formel n’étant plus strictement exact au sens de Fisher (le risque alpha maximal pouvant très marginalement dépasser 5% pour certaines valeurs spécifiques du paramètre de nuisance), la prudence académique commande, dans les publications biomédicales et psychologiques standard, de rapporter la p-valeur de Fisher classique non modifiée, tout en dimensionnant adéquatement les protocoles expérimentaux par une analyse de puissance a priori prévoyant ce conservatisme.
9. Exemple empirique détaillé en psychologie clinique
9.1 Contexte de recherche : thérapie EMDR et rémission du stress post-traumatique
Pour illustrer de manière tangible l’exécution intégrale du test exact de Fisher, considérons un protocole de recherche clinique interventionnelle conduit au sein d’une unité psychiatrique universitaire spécialisée dans la prise en charge des psychotraumatismes complexes. L’investigation se propose d’évaluer l’efficacité différentielle d’un protocole standardisé de désensibilisation et retraitement par les mouvements oculaires (thérapie EMDR) comparé à une intervention psychothérapeutique active de soutien psychologique non spécifique.
La cohorte d’étude est constituée de patients présentant un diagnostic avéré d’état de stress post-traumatique (ESPT) consécutif à un événement traumatique unique récent. En raison de contraintes déontologiques sévères, de critères d’exclusion psychométriques rigoureux (absence de comorbidités addictives ou dissociatives sévères) et de la durée intensive du suivi, l’échantillon pilote final rassemble un total restreint de n = 14 patients, randomisés avec un ratio d’allocation 1:1 en deux groupes de 7 participants :
- Groupe expérimental : 7 patients bénéficiant de huit séances hebdomadaires d’EMDR ;
- Groupe contrôle : 7 patients bénéficiant de huit séances d’une thérapie de soutien écoute-empathie active.
Le critère de jugement principal est une mesure catégorielle dichotomique standardisée : la rémission diagnostique complète évaluée à trois mois post-traitement par un évaluateur psychiatre indépendant et aveugle de la condition d’assignation, au moyen de l’échelle d’évaluation clinique de l’ESPT administrée par le clinicien (CAPS-5). Les patients sont classifiés en « Rémission » (score CAPS-5 inférieur au seuil clinique pathologique) ou « Non-rémission » (persistance des critères diagnostiques du trouble).
9.2 Construction de la table de contingence des données observées
Au terme des trois mois de suivi post-interventionnel, le recueil exhaustif des statuts cliniques des 14 participants a généré les résultats empiriques bruts suivants :
- Au sein du groupe EMDR (Ligne 1) : 6 patients ont atteint la rémission diagnostique complète (a = 6), tandis qu’un unique patient est resté non-répondeur (b = 1). L’effectif total du groupe est R1 = a + b = 7 ;
- Au sein du groupe Soutien (Ligne 2) : 2 patients ont atteint la rémission (c = 2), tandis que 5 patients ont conservé leur diagnostic d’ESPT (d = 5). L’effectif total du groupe est R2 = c + d = 7.
La sommation des marges de colonnes permet d’établir les totaux catégoriels globaux :
- Nombre total de rémissions cliniques : C1 = a + c = 6 + 2 = 8 ;
- Nombre total de non-rémissions : C2 = b + d = 1 + 5 = 6 ;
- Taille totale de la cohorte : n = R1 + R2 = C1 + C2 = 14.
Avant d’engager toute démarche inférentielle, procédons à la vérification impérative des effectifs théoriques attendus sous l’hypothèse nulle pour s’assurer du bien-fondé méthodologique du test de Fisher :
- Effectif attendu pour la cellule a : E11 = (R1 × C1) / n = (7 × 8) / 14 = 56 / 14 = 4,0 ;
- Effectif attendu pour la cellule b : E12 = (R1 × C2) / n = (7 × 6) / 14 = 42 / 14 = 3,0 ;
- Effectif attendu pour la cellule c : E21 = (R2 × C1) / n = (7 × 8) / 14 = 56 / 14 = 4,0 ;
- Effectif attendu pour la cellule d : E22 = (R2 × C2) / n = (7 × 6) / 14 = 42 / 14 = 3,0.
Le constat est sans appel : l’intégralité des quatre cellules théoriques présente des effectifs strictement inférieurs à 5 (trois et quatre participants attendus par cellule). Le recours au test du Chi-deux de Pearson standard est donc formellement proscrit en vertu des règles de Cochran, le test exact de Fisher s’imposant comme l’unique outil d’analyse valide.
9.3 Calcul arithmétique exhaustif de la formule de Fisher
Engageons le calcul manuel exhaustif des probabilités exactes associées à cette étude clinique. En premier lieu, calculons la probabilité d’occurrence de la configuration empiriquement observée, que nous noterons P(Table 1 : a = 6, b = 1, c = 2, d = 5).
Calcul du numérateur factoriel :
Le numérateur est le produit des factorielles des quatre marges :
Numérateur = (a + b)! × (c + d)! × (a + c)! × (b + d)! = 7! × 7! × 8! × 6!
Développons ces factorielles :
– 7! = 5 040
– 7! = 5 040
– 8! = 40 320
– 6! = 720
Numérateur = 5 040 × 5 040 × 40 320 × 720 ≈ 7,3799657 × 10¹⁴.
Calcul du dénominateur factoriel :
Le dénominateur est le produit des factorielles des cellules internes multiplié par n! :
Dénominateur = a! × b! × c! × d! × n! = 6! × 1! × 2! × 5! × 14!
Développons chaque composante :
– 6! = 720
– 1! = 1
– 2! = 2
– 5! = 120
– 14! = 87 178 291 200
Multiplication interne : 720 × 1 × 2 × 120 = 172 800
Dénominateur = 172 800 × 87 178 291 200 ≈ 1,5064409 × 10¹⁶.
Simplification par fractions successives :
Pour préserver une exactitude sans perte de décimales, exprimons le quotient sous forme simplifiée :
P(6, 1, 2, 5) = [ 7! × 7! × 8! × 6! ] / [ 6! × 1! × 2! × 5! × 14! ]
Simplifions 6! au numérateur et au dénominateur :
= [ 7! × 7! × 8! ] / [ 1 × 2 × 120 × 14! ]
Simplifions 14! par 8!, sachant que 14! / 8! = 14 × 13 × 12 × 11 × 10 × 9 = 2 162 160 :
= [ 7! × 7! ] / [ 240 × 2 162 160 ]
Sachant que 7! = 5 040 et 5 040 / 240 = 21 :
= [ 21 × 5 040 ] / 2 162 160 = 105 840 / 2 162 160
Divisons numérateur et dénominateur par 15 120 :
P(Table observée : 6, 1, 2, 5) = 7 / 143 ≈ 0,048951 (soit 4,90 %).
Identification des tables plus extrêmes dans le sens de H1 :
L’hypothèse d’une supériorité de l’EMDR implique de rechercher les tables présentant une valeur de la cellule a strictement supérieure à 6, sous le respect absolu des marges fixées (R1 = 7, R2 = 7, C1 = 8, C2 = 6). Une seule configuration mathématiquement réalisable satisfait à cette condition : la table où tous les patients du groupe EMDR sont en rémission (a = 7) :
– a = 7, ce qui contraint b = 0 (car R1 = 7) ;
– Ce qui contraint c = 1 (car C1 = a + c = 8) ;
– Ce qui contraint d = 6 (car R2 = c + d = 7 et C2 = b + d = 6).
Cette table extrême s’écrit donc (7, 0, 1, 6).
Calculons la probabilité ponctuelle de cette table plus extrême P(7, 0, 1, 6) :
P(7, 0, 1, 6) = [ 7! × 7! × 8! × 6! ] / [ 7! × 0! × 1! × 6! × 14! ]
Les termes 7! et 6! se simplifient directement au numérateur et au dénominateur (rappelons que 0! = 1) :
= [ 7! × 8! ] / [ 1 × 1 × 14! ] = 7! / [ 14 × 13 × 12 × 11 × 10 × 9 ] = 5 040 / 2 162 160
Divisons numérateur et dénominateur par 5 040 :
P(Table extrême : 7, 0, 1, 6) = 1 / 429 ≈ 0,002331 (soit 0,23 %).
Calcul de la p-valeur unilatérale :
La p-valeur unilatérale correspond à la sommation de la table observée et de la table plus extrême favorable à l’EMDR :
punilatérale = P(6, 1, 2, 5) + P(7, 0, 1, 6) = (7 / 143) + (1 / 429)
Réduisons au même dénominateur (sachant que 143 × 3 = 429) :
punilatérale = (21 / 429) + (1 / 429) = 22 / 429 = 2 / 39 ≈ 0,05128.
Calcul de la p-valeur bilatérale selon la méthode de Fisher :
Pour déterminer la p-valeur bilatérale standard, nous devons identifier toutes les tables potentielles sur la queue opposée (les configurations défavorables à l’EMDR où a ≤ 5) dont la probabilité ponctuelle est inférieure ou égale à P(observée) = 7/143 ≈ 0,048951.
Calculons les probabilités des tables de la queue gauche :
– Pour a = 1 : la table est (1, 6, 7, 0). Par symétrie factorielle avec (7, 0, 1, 6), sa probabilité est strictement égale : P(1, 6, 7, 0) = 1 / 429 ≈ 0,002331. Cette probabilité étant < 0,048951, elle est incluse ;
– Pour a = 2 : la table est (2, 5, 6, 1). Par symétrie factorielle avec (6, 1, 2, 5), sa probabilité est strictement égale : P(2, 5, 6, 1) = 7 / 143 ≈ 0,048951. Cette probabilité étant rigoureusement égale à la probabilité observée, elle est incluse dans la sommation selon le critère P ≤ Pobs ;
– Pour a = 3 : la table est (3, 4, 5, 2). Son calcul fournit : P(3, 4, 5, 2) = 35 / 143 ≈ 0,244755. Cette probabilité excède largement 0,048951 : elle est exclue.
– Pour a = 4 : la table est (4, 3, 4, 3). Sa probabilité est P = 70 / 143 ≈ 0,489510. Exclue.
– Pour a = 5 : la table est (5, 2, 3, 4). Sa probabilité est P = 35 / 143 ≈ 0,244755. Exclue.
La p-valeur bilatérale exacte de Fisher est donc la somme intégrale des quatre tables dont la densité probabiliste est inférieure ou égale à la table observée :
pbilatérale = P(1, 6, 7, 0) + P(2, 5, 6, 1) + P(6, 1, 2, 5) + P(7, 0, 1, 6)
pbilatérale = (1 / 429) + (21 / 429) + (21 / 429) + (1 / 429) = 44 / 429 = 4 / 39 ≈ 0,10256.
9.4 Interprétation clinique et conclusions psychologiques
L’analyse des résultats statistiques fournit des enseignements méthodologiques majeurs :
Si le protocole d’essai clinique avait fait l’objet d’un préenregistrement unilatéral strict (spécifiant a priori l’hypothèse directionnelle d’une supériorité de l’EMDR sur la base de la littérature), la p-valeur unilatérale obtenue (p = 0,0513) échoue de très peu à franchir le seuil critique standard de α = 0,05. Dans le cadre bilatéral conventionnel (recommandé en l’absence de préenregistrement rigide), la p-valeur exacte s’établit à p = 0,1026. En conséquence, au seuil de significativité conventionnel de 5%, le clinicien se trouve dans l’incapacité de rejeter l’hypothèse nulle d’indépendance.
Examinons à présent la taille d’effet mesurée à travers le rapport de cotes empirique (Odds Ratio) :
OR = (a × d) / (b × c) = (6 × 5) / (1 × 2) = 30 / 2 = 15,0
Le rapport des cotes empirique est colossal : la cote de rémission sous EMDR est 15 fois supérieure à celle observée sous thérapie de soutien. Pourtant, malgré cette amplitude clinique spectaculaire (85,7% de rémission contre 28,6%), le test exact de Fisher nous enseigne qu’une telle répartition possède plus de 10% de chances de résulter de simples fluctuations aléatoires d’échantillonnage conditionnel sur une cohorte de seulement 14 sujets. Cet exemple met en lumière la dangerosité des petits effectifs : un effet thérapeutique potentiellement majeur ne parvient pas à atteindre le seuil de significativité statistique conventionnelle en raison d’un manque drastique de puissance statistique. La conclusion de cette recherche pilote ne doit donc pas être le rejet de l’efficacité de l’EMDR, mais la démonstration formelle de la nécessité de déployer un essai clinique à plus grande échelle (par exemple n = 60) pour confirmer l’existence de cette association prometteuse.
10. Implémentation computationnelle dans les logiciels statistiques
10.1 Syntaxe et exécution sous le logiciel libre R
Le langage de programmation et environnement statistique R constitue la plateforme de référence internationale pour le calcul exact, la fonction de Fisher y étant implémentée nativement au sein du paquet de base stats sans requérir de bibliothèque tierce. L’exécution du test requiert en premier lieu la saisie matricielle des données au moyen de la commande matrix() :
Les données de notre essai clinique sur l’ESPT sont ainsi structurées :
donnees_cliniques <- matrix(c(6, 2, 1, 5), nrow = 2, dimnames = list(Traitement = c(« EMDR », « Soutien »), Diagnostic = c(« Remission », « Echec »)))
L’exécution de la procédure bilatérale standard s’effectue via l’instruction :
resultat <- fisher.test(donnees_cliniques, alternative = « two.sided »)
print(resultat)
La sortie console détaillée fournit non seulement la p-valeur exacte (qui retournera rigoureusement la fraction 4/39 soit 0.1026), mais également l’estimation ponctuelle du rapport de cotes conditionnel par la méthode du maximum de vraisemblance conditionnelle (qui peut différer très légèrement de l’Odds Ratio d’échantillon brut ad/bc), ainsi que son intervalle de confiance exact à 95% calculé selon la méthode des distributions non centrales de Fisher. Pour spécifier une alternative unilatérale dans le cadre d’un protocole préenregistré, l’utilisateur paramètre simplement l’argument :
fisher.test(donnees_cliniques, alternative = « greater »)
10.2 Traitement automatisé en Python (scipy.stats)
Dans l’écosystème de la science des données et de l’intelligence artificielle appliquée à la santé mentale sous langage Python, le calcul exact de Fisher est hébergé au sein de l’incontournable bibliothèque scientifique SciPy, plus précisément au sein du sous-module scipy.stats.
Le script d’analyse minimale se structure de la façon suivante :
from scipy.stats import fisher_exact
table_contingence = [[6, 1], [2, 5]]
odds_ratio, p_value = fisher_exact(table_contingence, alternative=’two-sided’)
print(f »Rapport de cotes : {odds_ratio:.4f} »)
print(f »P-valeur exacte bilatérale : {p_value:.5f} »)
Le paramètre alternative accepte trois chaînes de caractères strictement normalisées : ‘two-sided’ pour l’analyse bilatérale standard, ‘greater’ pour tester la supériorité directionnelle de la première cellule (cote du premier groupe supérieure à celle du second), et ‘less’ pour tester son infériorité. Il convient de souligner que, par défaut, la fonction fisher_exact de SciPy renvoie l’Odds Ratio non ajusté de l’échantillon (ad / bc = 15.0), contrairement à R qui estime le paramètre odds ratio conditionnel sous la loi non centrale.
10.3 Procédures guidées sous IBM SPSS Statistics et Jamovi
Pour les cliniciens et chercheurs privilégiant les interfaces graphiques dédiées aux sciences humaines et sociales, les suites logicielles SPSS et Jamovi intègrent des routines hautement ergonomiques :
Procédure sous IBM SPSS Statistics :
1. Dans le menu supérieur, cheminer via : Analyser > Statistiques descriptives > Tableaux croisés ;
2. Assigner la variable prédictive (ex. : Traitement) au champ « Lignes » et la variable de réponse (ex. : Remission) au champ « Colonnes » ;
3. Cliquer sur le sous-menu « Statistiques » et cocher impérativement la case « Chi-deux » ;
4. Ouvrir le bouton spécialisé « Exact » (disponible avec le module Exact Tests de SPSS) et sélectionner l’option « Exact » au lieu de « Asymptotique uniquement » ;
5. Valider l’exécution. Dans la table de résultats intitulée Tests du Chi-deux, localiser la ligne spécifique intitulée Test exact de Fisher (Fisher’s Exact Test). SPSS imprime deux colonnes distinctes : la significativité bilatérale (Exact Sig. (2-sided) = 0,103) et la significativité unilatérale (Exact Sig. (1-sided) = 0,051). Il convient de veiller scrupuleusement à ne pas confondre cette ligne avec la correction de continuité de Yates affichée quelques lignes plus haut.
Procédure sous Jamovi :
Dans l’interface moderne et open-source de Jamovi, le module Fréquences propose l’entrée Tableaux de contingence (Échantillons indépendants). Une fois les variables assignées, dérouler l’onglet « Statistiques » et cocher simplement la case Fisher’s exact test. Jamovi génère instantanément un tableau d’une clarté remarquable, affichant la statistique de test et sa p-valeur exacte bilatérale, tout en permettant de cocher l’estimation de l’Odds Ratio assorti de son intervalle de confiance à 95%.
11. Extensions méthodologiques : Tables r x c et alternatives
11.1 Généralisation de Freeman-Halton pour tables de dimensions supérieures
Le paradigme mathématique du test exact de Fisher ne se cantonne pas aux seules tables binaires 2×2. Dès 1951, les statisticiens G. H. Freeman et J. H. Halton ont formalisé une extension analytique permettant d’appliquer le principe de l’énumération exacte à des tables de contingence de dimensions arbitraires r × c (croisant r lignes et c colonnes). Cette généralisation s’avère indispensable en psychologie lorsque l’on compare plusieurs groupes cliniques (ex. : trois approches thérapeutiques différentes : r = 3) face à une variable de réponse ordinale ou polytomique (ex. : rémission complète, amélioration partielle, aggravation clinique : c = 3).
La formule de Freeman-Halton dérive de la distribution multinomiale hypergéométrique multivariée. La probabilité conjointe exacte d’une matrice d’effectifs cellulaires (nij) sous marges fixes s’exprime par le quotient du produit factoriel de toutes les marges de lignes et de colonnes par le produit factoriel de toutes les cellules internes multiplié par la factorielle totale :
P(nij) = [ (∏i=1r Ri!) × (∏j=1c Cj!) ] / [ n! × (∏i=1r ∏j=1c nij!) ]
Néanmoins, l’application pratique de cette équation sur de grandes tables soulève un problème d’explosion combinatoire colossale. Le nombre de configurations tabulaires compatibles avec des marges multidimensionnelles augmente selon une cinétique combinatoire titanesque, rendant l’énumération exhaustive impossible sur le plan du temps de calcul machine. Pour y remédier, les logiciels comme R implémentent, au-delà d’une certaine taille, une approximation computationnelle de haute précision fondée sur des méthodes de chaînes de Markov Monte-Carlo (MCMC), simulant un échantillon aléatoire de plusieurs millions de tables sous marges contraintes pour approcher asymptotiquement la p-valeur exacte de Freeman-Halton sans biais analytique.
11.2 Le test exact inconditionnel de Barnard
L’une des controverses les plus fascinantes de l’histoire de la statistique inférentielle oppose le conditionnement strict de Fisher à l’approche dite « inconditionnelle », conceptualisée par George Alfred Barnard en 1947. Barnard contestait le postulat fondamental de Fisher selon lequel les marges des tables 2×2 doivent impérativement être traitées comme fixes, particulièrement dans les protocoles d’essais cliniques où le nombre de répondeurs globaux est une variable purement aléatoire non contrôlée.
Dans le test inconditionnel de Barnard, les marges de colonnes sont considérées comme stochastiques et libres d’osciller. L’élimination du paramètre de nuisance (la probabilité commune de succès sous H0, notée π) ne s’effectue pas par conditionnement, mais par une opération de maximisation mathématique : on calcule la p-valeur pour toutes les valeurs possibles de π sur l’intervalle [0, 1] et l’on retient la valeur maximale (scénario du pire pour l’erreur de type I). Barnard a formellement démontré que son test est strictement plus puissant que le test exact de Fisher (il rejette H0 pour des tailles d’échantillon plus faibles sans gonfler le risque alpha au-delà de 5%).
Toutefois, en dépit de cette supériorité théorique en termes de sensibilité statistique, le test de Barnard demeure marginalement utilisé en recherche appliquée. Cette désaffection relative s’explique d’une part par sa complexité algorithmique intrinsèque qui exigeait autrefois des calculs insurmontables, et d’autre part par la rétractation partielle de Barnard lui-même quelques années après sa publication initiale, rallié à la pureté épistémologique du conditionnement auxiliaire de Fisher. Le test inconditionnel de Barnard (ainsi que sa variante de Boschloo) connaît néanmoins un regain d’intérêt notable dans les essais cliniques contemporains de phase I et II sur des thérapies géniques ultra-ciblées où chaque individu compte.
11.3 Perspectives bayésiennes pour l’analyse des petits tableaux
Les limites inhérentes au cadre décisionnel fréquentiste — particulièrement la dépendance artificielle de la p-valeur par rapport à l’intention d’arrêt de l’expérimentateur et son incapacité épistémique fondamentale à quantifier directement l’évidence empirique en faveur de l’hypothèse nulle — ont stimulé l’émergence d’alternatives bayésiennes pour l’analyse des tableaux de contingence clairsemés.
Dans un cadre bayésien, l’incertitude sur les taux de réponse réels p1 et p2 n’est pas traitée comme un paramètre déterministe fixe, mais formalisée par des lois de probabilité a priori. Le modèle probabiliste standard recourt à des distributions Bêta conjuguées (dans le cas binomial) ou à des distributions de Dirichlet (dans le cas multinomial). La mise à jour bayésienne via le théorème de Bayes permet d’obtenir directement la distribution a posteriori du rapport de cotes :
P(θ | Données) ∝ P(Données | θ) × P(θ)
L’arbitrage entre l’hypothèse d’indépendance (H0) et l’hypothèse de dépendance (H1) s’effectue alors au moyen du Facteur de Bayes (noté BF10). Contrairement à la p-valeur de Fisher qui ne fait qu’évaluer la compatibilité des données avec H0, le Facteur de Bayes quantifie le ratio de vraisemblance marginale : il indique précisément dans quelle mesure les observations empiriques rendent l’hypothèse d’une efficacité thérapeutique plus probable que celle de l’équivalence stochastique (par exemple, un BF10 = 8,4 indique que les données sont 8,4 fois plus probables sous le modèle alternatif que sous l’hypothèse d’absence d’effet). Cette modélisation permet d’échapper au conservatisme de la discrétion hypergéométrique tout en fournissant des intervalles de crédibilité d’une interprétation clinique intuitive.
12. Guide de rédaction scientifique et normes APA
12.1 Normes de présentation des résultats selon le format APA 7
La communication scientifique des résultats d’un test exact de Fisher au sein des revues affiliées à l’American Psychological Association (normes APA, 7e édition) obéit à des règles typographiques et structurelles rigoureusement codifiées. Une erreur courante consiste à tenter d’associer un symbole de statistique de test (comme une valeur t, F ou χ2) à l’énoncé du résultat de Fisher ; or, le test de Fisher ne génère aucune statistique scalaire de ce type : il fournit directement et exclusivement une probabilité exacte combinatoire.
Le formalisme textuel conventionnel impose de rapporter la taille totale de l’échantillon N, la direction de l’association observée à l’appui des pourcentages intra-groupes, la spécification explicite du caractère bilatéral ou unilatéral de l’analyse, la p-valeur exacte (écrite avec une minuscule en italique p, sans zéro préliminaire selon les normes anglo-saxonnes si le texte est rédigé en anglais, ou avec le formalisme décimal francophone standard), ainsi que la taille d’effet mesurée assortie de son intervalle de confiance à 95%.
Exemples de phrases modèles conformes aux standards académiques :
Exemple 1 (Résultat non significatif en français académique) :
« Une analyse par le test exact de Fisher (bilatéral) a été menée afin d’évaluer l’association entre le protocole d’intervention psychothérapeutique et la rémission clinique du trouble. Bien que le taux de rémission observé au sein du groupe EMDR (85,7 %, n = 6/7) soit supérieur à celui relevé dans le groupe de soutien (28,6 %, n = 2/7), cette divergence ne franchit pas le seuil de significativité statistique sur cette cohorte pilote restreinte (N = 14, test exact de Fisher : p = ,103, OR = 15,00, IC à 95 % [0,78 ; 288,52]). »
Exemple 2 (Résultat statistiquement significatif en anglais APA 7) :
« A Fisher’s exact test was performed to examine the relationship between genetic polymorphism and cognitive impairment. The proportion of impaired individuals was significantly higher in the deletion carrier group (83.3%) than in the non-carrier group (16.7%), p = .048 (two-tailed), Odds Ratio = 25.00, 95% CI [1.13, 552.84]. »
En ce qui concerne la présentation tabulaire selon les normes APA, le tableau de contingence doit proscrire toute ligne verticale. Il comporte uniquement trois lignes horizontales horizontales majeures (en haut du tableau, sous les en-têtes de colonnes, et au bas du tableau fermant les totaux), en alignant rigoureusement les effectifs bruts et les pourcentages marginaux respectifs entre parenthèses.
12.2 Mesures complémentaires de taille d’effet et précision
La publication scientifique moderne récuse formellement le recours exclusif à la p-valeur comme unique boussole interprétative (mouvement de réforme méthodologique soutenu par l’American Statistical Association). La p-valeur dépendant mécaniquement de la taille d’échantillon, un résultat non significatif ne saurait être assimilé à une absence d’effet clinique, tout comme une p-valeur infime ne démontre pas l’importance substantielle d’une association. Il est donc obligatoire de compléter systématiquement le test exact de Fisher par des métriques de taille d’effet catégorielles standardisées :
- Le rapport de cotes (Odds Ratio, OR) : Mesure symétrique fondamentale, particulièrement adaptée aux études cas-témoins et transversales. Il exprime le rapport entre la cote de succès chez les exposés et la cote de succès chez les non-exposés : OR = (a / b) / (c / d) = (ad) / (bc). Un OR de 1 indique une stricte neutralité d’effet ;
- Le risque relatif (Relative Risk, RR) : Mesure de choix dans les études de cohorte prospectives et les essais randomisés contrôlés. Il rapporte directement la probabilité de survenue de l’événement dans le groupe expérimental sur sa probabilité dans le groupe témoin : RR = [a / (a + b)] / [c / (c + d)]. Bien plus intuitif pour les cliniciens que l’Odds Ratio, il exprime directement la multiplication du risque ou du taux de guérison ;
- La réduction absolue de risque (ARR) ou Différence de Risque : Calculée par |a/(a+b) – c/(c+d)|, elle permet d’estimer directement le nombre de sujets à traiter (Number Needed to Treat, NNT), indicateur pragmatique majeur en santé publique ;
- Le coefficient Phi (φ) : Mesure de corrélation bivariée pour deux variables dichotomiques, mathématiquement équivalente au coefficient r de Pearson calculé sur variables binaires codées 0 et 1. Sa valeur est directement reliée à la statistique du Chi-deux : φ = √(χ2 / n). Pour des tables de dimensions plus amples, on lui substitue le V de Cramér.
Toute mesure de taille d’effet doit obligatoirement être escortée de son intervalle de confiance à 95% (IC 95%). Sur des petits échantillons, ces intervalles de confiance sont fréquemment très larges (comme illustré par l’intervalle [0,78 ; 288,52] de notre exemple clinique), ce qui informe avec pertinence le lecteur sur le haut degré d’incertitude métrologique entourant l’estimation ponctuelle.
12.3 Erreurs fréquentes et recommandations pour les relecteurs
L’évaluation critique d’articles soumis aux revues de psychologie met régulièrement au jour des dérives méthodologiques récurrentes relatives à l’usage du test de Fisher. Les chercheurs et pairs examinateurs doivent porter une vigilance accrue sur les écueils suivants :
- Le double testage conditionnel opportuniste : Certains analystes calculent simultanément le Chi-deux de Pearson standard et le test de Fisher, puis choisissent a posteriori de rapporter la méthode dont la p-valeur est la plus basse ou franchit de justesse le seuil de 0,05. Cette pratique relève du p-hacking et altère gravement l’intégrité scientifique. Le choix de la méthode doit être guidé a priori par l’examen exclusif des effectifs théoriques de Cochran ;
- Le recours unjustified à l’alternative unilatérale post-hoc : Face à une analyse bilatérale retournant une p-valeur de 0,07 ou 0,08, la tentation de transformer arbitrairement l’hypothèse en test unilatéral (divisant la p-valeur pour obtenir 0,035 ou 0,04) constitue une fraude méthodologique lorsqu’elle n’a pas été formellement préenregistrée dans un devis d’étude verrouillé ;
- La confusion sur la nature des observations : Appliquer le test de Fisher sur des mesures appariées (par exemple, le même groupe de 15 patients comparé avant et après thérapie) détruit le fondement d’indépendance inter-observations et génère des inférences mathématiquement invalides. Seul le test de McNemar ou des modèles mixtes logistiques généralisés sont admissibles dans ce cas ;
- La gestion opaque des données manquantes : Dans les cohortes de faible effectif, la perte de vue d’un ou deux participants peut totalement inverser l’issue du test de Fisher. L’analyse de sensibilité (scénarios du pire et du meilleur, imputation conservative) doit être rigoureusement documentée par les auteurs.
En synthèse, le test exact de Fisher s’érige comme l’un des monuments les plus raffinés de l’inférence statistique classique. Alliant la rigueur axiomatique de la combinatoire à une exactitude probabiliste absolue, il constitue l’armature méthodologique irremplaçable pour toute investigation psychologique et clinique contrainte par la rareté de ses observations empiriques.
Références
- Barnard, G. A. (1947). Significance tests for 2×2 tables. Biometrika, 34(1/2), 123–138. https://doi.org/10.2307/2332517
- Cochran, W. G. (1952). The χ2 test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cochran, W. G. (1954). Some methods for strengthening the common χ2 tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Fisher, R. A. (1922). On the interpretation of χ2 from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Fisher, R. A. (1935). The Design of Experiments. Oliver and Boyd.
- Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1/2), 141–149. https://doi.org/10.1093/biomet/38.1-2.141
- Lancaster, H. O. (1961). Significance tests in discrete distributions. Journal of the American Statistical Association, 56(294), 223–234. https://doi.org/10.1080/01621459.1961.10482105
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Yates, F. (1934). Contingency tables involving small numbers and the χ2 test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604