
Dans le champ de la recherche contemporaine en psychologie cognitive, clinique et expérimentale, la modélisation statistique inférentielle constitue la clé de voûte de la validation des hypothèses scientifiques. Qu’il s’agisse de mesurer l’efficacité différentielle de protocoles psychothérapeutiques, d’évaluer l’impact d’un stress aigu sur les capacités de la mémoire de travail ou d’analyser les temps de réaction sous diverses conditions attentionnelles, les chercheurs s’appuient massivement sur des modèles linéaires univariés, au premier rang desquels figure l’analyse de variance (ANOVA). Cependant, la robustesse et la validité interne des inférences tirées de ces modèles reposent sur le respect scrupuleux d’un ensemble de postulats distributionnels fondamentaux. Parmi ces prérequis mathématiques, l’homogénéité des variances intra-groupes — désignée sous le concept d’homoscédasticité — occupe une position aussi critique que souvent négligée lors des phases préliminaires du traitement des données.
L’ignorance ou l’évaluation superficielle de la dispersion des résidus peut entraîner des distorsions méthodologiques sévères, altérant artificiellement le taux d’erreur de première espèce (α) et compromettant la reproductibilité des résultats scientifiques. C’est précisément pour répondre à l’impératif de vérification rigoureuse de cette équi-dispersion qu’ont été développées plusieurs procédures inférentielles dédiées, dont le test de Maurice Stevenson Bartlett constitue le modèle paramétrique historique de référence. Conçu spécifiquement pour sonder l’égalité de plusieurs variances issues d’échantillons indépendants, le test de Bartlett demeure, en raison de ses propriétés mathématiques élégantes et de sa puissance statistique sous conditions idéales, un jalon incontournable de l’économétrie, de la biométrie et de la psychométrie quantitative.
Le présent article propose une analyse exhaustive et approfondie du test de Bartlett pour l’homogénéité des variances. En articulant les fondements théoriques mathématiques, les contextes d’application méthodologique propres à la psychologie empirique, les démonstrations algébriques pas à pas, les codes de mise en œuvre informatique (R, Python, SPSS) et les alternatives robustes face aux violations de postulats, ce guide exhaustif offre aux chercheurs, cliniciens et analystes de données un cadre de référence complet pour évaluer et traiter la structure de dispersion de leurs observations expérimentales.
1. Fondements théoriques et rôle de l’homogénéité des variances en psychologie
1.1 Le postulat d’homoscédasticité dans les modèles inférentiels
Dans l’architecture du modèle linéaire généralisé, le postulat d’homoscédasticité désigne la propriété selon laquelle la variance des termes d’erreur résiduelle demeure constante à travers tous les niveaux ou combinaisons de niveaux de la variable indépendante factorielle. Formellement, si l’on considère un modèle d’analyse de variance à un facteur s’exprimant sous la forme :
Yij = μ + αj + εij
où Yij représente la mesure observée pour le i-ème participant au sein du j-ème groupe de traitement, μ la moyenne générale de la population, αj l’effet spécifique induit par la modalité thérapeutique ou expérimentale j, et εij la composante de l’erreur aléatoire, l’hypothèse d’homoscédasticité impose que :
Var(εij) = σ2 pour tout j ∈ {1, 2, …, k}
Cette condition implique que chaque sous-population théorique partage exactement la même dispersion autour de sa moyenne conditionnelle respective. La validité du test F de Fisher-Snedecor en ANOVA repose structurellement sur cette invariance : le dénominateur du ratio F (le carré moyen résiduel ou intra-groupe) n’est un estimateur sans biais de la variance d’échantillonnage commune que si et seulement si toutes les populations partagent une variance identique σ2.
Lorsque cette prémisse n’est pas respectée — configuration statistique désignée sous le terme d’hétéroscédasticité —, le comportement de la statistique de test se dégrade substantiellement. Dans les plans expérimentaux déséquilibrés, caractérisés par des effectifs inégaux au sein des sous-groupes (n1 ≠ n2 ≠ … ≠ nk), l’hétéroscédasticité produit un dérèglement pernicieux du taux nominal d’erreur de première espèce (α). Si les sous-échantillons de taille réduite sont associés aux variances les plus élevées, le test F devient excessivement libéral, voyant son taux d’erreur de type I réel dépasser largement le seuil nominal de 0,05, conduisant le chercheur à déclarer fallacieusement significatifs des effets purement aléatoires. À l’inverse, si les effectifs les plus massifs concentrent la plus forte dispersion, le test devient artificiellement conservateur, entraînant une chute drastique de la puissance statistique et gonflant l’erreur de seconde espèce (β). Dans le domaine de la recherche comportementale, où les tailles d’effet sont fréquemment modérées et les contraintes de recrutement majeures, une telle distorsion compromet directement l’interprétation des effets principaux et des patrons d’interaction.
1.2 Origine historique et contextualisation du test de Bartlett
Le statisticien britannique Maurice Stevenson Bartlett a introduit ce test d’homogénéité en 1937 au sein d’une publication séminale intitulée « Properties of sufficiency and statistical tests », parue dans les Proceedings of the Royal Society of London. À cette époque charnière, l’école statistique britannique, dynamisée par les travaux de Ronald A. Fisher, Jerzy Neyman et Egon Pearson, cherchait à formaliser rigoureusement les critères d’adéquation et de validité des estimateurs statistiques, notamment via le principe du quotient de vraisemblance (likelihood ratio test).
Bartlett s’est attaqué au problème complexe de la comparaison simultanée de k variances d’échantillons gaussiens indépendants. Alors que le test F classique permettait de comparer le rapport de deux variances empiriques (k = 2), il n’existait pas de cadre général standardisé permettant d’évaluer de manière parcimonieuse l’hypothèse conjointe d’équi-dispersion pour trois groupes ou davantage sans multiplier les comparaisons bivariées, source immédiate d’inflation de l’erreur globale de décision. S’appuyant sur les principes de la théorie des statistiques suffisantes, Bartlett a dérivé un critère statistique basé sur le logarithme du rapport entre la moyenne arithmétique et la moyenne géométrique des variances d’échantillon. Conscient que la statistique brute issue du rapport de vraisemblance présentait un biais d’échantillonnage non négligeable pour des tailles d’échantillons finies, Bartlett a proposé une modification fondamentale : l’introduction d’un facteur de correction analytique, désigné par la constante c, permettant à la statistique d’approcher de façon remarquablement précise une distribution asymptotique du Chi-deux.
Dans les sciences humaines et sociales du milieu du XXe siècle, cette formulation a constitué une avancée majeure, offrant pour la première fois aux psychomètres et psychologues expérimentateurs un algorithme mathématique strict pour légitimer l’emploi des modèles d’ANOVA factoriels et des analyses de covariance (ANCOVA). Bien que l’émergence ultérieure de tests plus robustes aux écarts de distribution ait redéfini son champ d’action privilégié, le test de Bartlett demeure aujourd’hui un étalon théorique pour l’évaluation de la dispersion paramétrique dans la littérature quantitative contemporaine.
1.3 Importance méthodologique dans les protocoles expérimentaux en psychologie
L’évaluation de l’homogénéité des variances dépasse largement le cadre d’une simple formalité calculatoire ; elle touche au cœur de l’épistémologie expérimentale en sciences du comportement. Lorsqu’un chercheur conçoit un essai contrôlé randomisé (ECR) évaluant l’efficacité d’une nouvelle thérapie cognitive et comportementale (TCC) face à une intervention pharmacologique et à un groupe témoin placé sur liste d’attente, il postule implicitement que la variance des scores cliniques après traitement reflète uniquement le bruit de mesure interindividuel résiduel.
Toutefois, une altération de la variance sous un protocole thérapeutique donné constitue souvent en elle-même une donnée clinique hautement informative. Un traitement novateur peut, par exemple, réduire considérablement l’anxiété chez certains patients tout en l’exacerbant chez d’autres en fonction de traits de personnalité sous-jacents, générant ainsi un éclatement de la variance dans le groupe expérimental par rapport au groupe témoin. Le test de Bartlett permet de détecter cette fluctuation systématique de la variabilité intra-groupe, alertant le méthodologiste sur l’existence potentielle de sous-groupes de répondeurs et de non-répondeurs.
En outre, l’homogénéité des variances constitue une garantie indispensable pour attester de l’équivalence métrique des outils psychométriques administrés. Si l’erreur de mesure ou la dispersion des scores sur une échelle d’évaluation de la dépression (telle que le BDI-II ou l’HAM-D) varie considérablement selon les tranches d’âge ou les conditions d’expérimentation, les comparaisons de moyennes brutes perdent leur signification clinique directe. Enfin, sur le plan de la décision statistique formelle, la confirmation de l’homoscédasticité via le test de Bartlett offre la justification analytique nécessaire pour exécuter des contrastes polynomiaux orthogonaux, des comparaisons planifiées a priori ou des procédures de tests post-hoc standards (comme les méthodes de Tukey HSD, Bonferroni ou Scheffé), lesquelles reposent toutes sur l’exploitation sans réserve du carré moyen de l’erreur agrégée.
2. Définition mathématique et formulation des hypothèses statistiques
2.1 Énonciation rigoureuse de l’hypothèse nulle (H0)
La formulation théorique du test d’homogénéité des variances de Bartlett repose sur un cadre de vérification d’hypothèses statistiques unilatéral au niveau de la distribution du Chi-deux, mais intrinsèquement non directionnel quant à la nature des écarts observés entre les populations parentes. L’hypothèse nulle, formellement désignée par H0, postule que les variances théoriques des k populations indépendantes dont sont extraits les échantillons observés sont rigoureusement identiques entre elles.
Mathématiquement, cette égalité conjointe s’énonce comme suit :
H0 : σ12 = σ22 = σ32 = … = σk2 = σ2
Dans cette formalisation, chaque terme σj2 représente le paramètre de variance de la j-ème population (pour j = 1, 2, …, k), tandis que σ2 symbolise la variance commune inconnue qui sous-tend l’ensemble des sous-groupes sous le régime de l’hypothèse nulle. Sur le plan conceptuel, admettre H0 revient à affirmer que les fluctuations numériques observées entre les variances d’échantillon s12, s22, …, sk2 résultent exclusivement de l’erreur d’échantillonnage aléatoire inhérente au tirage des observations, et non de propriétés distributionnelles hétérogènes entre les populations étudiées. L’acceptation (ou le non-rejet) de cette hypothèse valide la possibilité de condenser ces multiples estimations locales en un unique estimateur non biaisé de la dispersion globale : la variance combinée (pooled variance).
2.2 Caractérisation de l’hypothèse alternative (HA)
À l’opposé de cette condition de stricte uniformité, l’hypothèse alternative, traditionnellement notée HA ou H1, correspond à la négation logique de la conjonction postulée par H0. Il est fondamental de souligner que HA n’impose nullement que l’ensemble des k variances diffèrent toutes mutuellement les unes des autres. Il suffit qu’une seule population présente une dispersion divergente par rapport aux autres pour que l’hypothèse d’homogénéité soit formellement rompue.
L’énonciation mathématique s’établit dès lors de la manière suivante :
HA : ∃ (i, j) tel que σi2 ≠ σj2, pour au moins une paire (i, j) avec 1 ≤ i < j ≤ k
Cette structure confère au test de Bartlett une nature de test omnibus. Tout comme le test F de l’ANOVA indique la présence d’une différence de moyenne sans désigner isolément quel groupe se distingue des autres, le test de Bartlett rejette l’homoscédasticité globale dès lors que la divergence statistique globale dépasse le seuil stochastique attendu. Par conséquent, lorsque la décision statistique conduit au rejet formel de H0, le test n’indique pas directement l’identité du ou des groupes atypiques. Le chercheur est alors contraint d’engager des investigations analytiques complémentaires — telles que des comparaisons par paires des variances avec correction de la family-wise error rate ou une inspection diagnostique des résidus standardisés — afin d’isoler la source exacte de l’hétéroscédasticité.
2.3 Types d’échelles et nature des variables admissibles
L’admissibilité des données pour le calcul du test de Bartlett est soumise à des contraintes strictes relatives au niveau de mesure psychométrique des variables analysées, selon la typologie classique formalisée par Stanley Smith Stevens. Le cadre mathématique du test repose sur le calcul des variances empiriques, lesquelles mobilisent des sommes de carrés des écarts à la moyenne arithmétique. Cette opération exige impérativement que la variable dépendante (notée conventionnellement Y) soit une variable continue mesurée sur une échelle d’intervalle ou sur une échelle de rapport.
En psychologie expérimentale et cognitive, cette exigence est satisfaite par des métriques quantitatives réelles telles que les temps de latence motrice mesurés en millisecondes, les concentrations salivaires de cortisol en microgrammes par décilitre, les scores standardisés à des épreuves psychométriques étalonnées (comme les quotients intellectuels ou les échelles de mémoire de Wechsler) ou les indices d’activation hémodynamique en imagerie fonctionnelle. À l’inverse, l’application du test de Bartlett sur des variables purement ordinales brutes — telles que des scores d’items de type Likert en 5 ou 7 points non agrégés, des classements de rangs ou des stades cliniques catégorisés — constitue une faute méthodologique majeure. Pour ces données non métriques, la variance d’échantillon classique perd ses propriétés d’estimation paramétrique, faussant irrémédiablement le calcul logarithmique au cœur du test.
Quant à la variable indépendante (le facteur de groupement X), elle doit impérativement être une variable discrète, catégorielle ou nominale, définissant k ≥ 2 sous-échantillons distincts et mutuellement exclusifs. Si la variable prédictive est elle-même continue, le cadre d’évaluation de l’homogénéité des variances ne relève plus du test de Bartlett, mais des diagnostics de résidus propres à la régression linéaire multiple, tels que les tests de Breusch-Pagan, de White ou de Koenker.
3. Distinction cruciale : Test d’homogénéité vs Test de sphéricité de Bartlett
3.1 Objet et portée du test de sphéricité de Bartlett
Dans la littérature méthodologique en sciences du comportement, une méprise fréquente consiste à confondre deux procédures statistiques distinctes portant le nom du même auteur : le test d’homogénéité des variances de Bartlett et le test de sphéricité de Bartlett. Bien qu’ils partagent une parenté mathématique fondée sur le principe du quotient de vraisemblance et convergent tous deux vers une distribution du Chi-deux, leurs champs d’application respectifs, leurs structures de matrices de données et leurs finalités scientifiques sont fondamentalement divergents.
Le test de sphéricité de Bartlett est exclusivement employé dans le domaine de l’analyse multivariée et de la réduction de dimension, notamment lors de la réalisation d’une Analyse en Composantes Principales (ACP) ou d’une Analyse Factorielle Exploratoire (AFE). Son objet direct est d’évaluer la matrice de corrélation R observée entre p variables quantitatives distinctes mesurées sur un échantillon unique. L’hypothèse nulle sous-jacente postule que la matrice de corrélation empirique est statistiquement indiscernable d’une matrice identité Ip, ce qui équivaut à affirmer que toutes les variables mesurées sont parfaitement orthogonales (indépendantes) et que leurs corrélations croisées sont nulles :
H0, Sphéricité : R = Ip
Dans ce contexte, le rejet de l’hypothèse nulle est impératif pour justifier méthodologiquement la pertinence d’une réduction dimensionnelle : si la matrice est une matrice d’identité, les variables ne partagent aucune variance commune, rendant caduque l’extraction de facteurs latents sous-jacents.
3.2 Objet et portée du test d’homogénéité des variances de Bartlett
À l’opposé diamétral de l’évaluation de matrices de corrélations multivariées, le test d’homogénéité des variances de Bartlett — qui constitue l’objet exclusif du présent article — s’applique strictement à une seule variable dépendante continue observée à travers les modalités d’un facteur inter-sujets. Il n’évalue aucune corrélation entre variables multiples, mais quantifie la stabilité de l’étalement scalaire (la dispersion univariée) d’une mesure unique au sein de sous-groupes indépendants d’individus.
Son cadre mathématique n’opère pas sur les valeurs propres d’une matrice carrée de corrélations ou de covariances, mais confronte directement un vecteur de k variances scalaires [s12, s22, …, sk2] issues de sous-populations expérimentales distinctes. Sa finalité opérationnelle consiste à valider la condition de variance résiduelle constante indispensable à l’exécution d’un modèle linéaire univarié unilatéral ou factoriel. Alors que dans le test de sphéricité, le chercheur espère ardemment rejeter H0 afin de démontrer la factorisabilité de son questionnaire psychologique, dans le test d’homogénéité, le résultat souhaité réside généralement dans le maintien de H0 (p > 0,05), attestant que les variances intra-groupes sont équivalentes et que l’ANOVA classique peut être conduite sans ajustement correctif de ses degrés de liberté.
3.3 Confusion terminologique récurrente et tableau comparatif synthétique
Cette ambiguïté terminologique est accentuée par le fait que de nombreux logiciels de traitement statistique présentent les deux fonctions dans des modules proches ou sous des libellés abrégés. Les chercheurs novices commettent ainsi parfois l’erreur de citer « le test de Bartlett » dans leur section méthodologique sans préciser s’il s’agit de la validation préalable d’une échelle psychométrique (sphéricité) ou de la vérification de l’homoscédasticité d’une ANOVA (homogénéité).
Le tableau comparatif ci-dessous synthétise de manière explicite les lignes de démarcation structurales entre ces deux entités statistiques majeures :
| Critère de différenciation | Test d’homogénéité de Bartlett | Test de sphéricité de Bartlett |
|---|---|---|
| Domaine d’application | Modélisation linéaire univariée (ANOVA, Régression, Tests t indépendants). | Analyse multivariée des données (ACP, Analyse Factorielle Exploratoire). |
| Objet mathématique évalué | Un ensemble de k variances scalaires univariées (s12, …, sk2). | Une matrice carrée de corrélation R de dimension (p × p). |
| Formulation de l’hypothèse nulle (H0) | σ12 = σ22 = … = σk2 (Égalité stricte des variances). | R = Ip (La matrice de corrélation est égale à la matrice identité). |
| Degrés de liberté (df) | df = k – 1 (Nombre de groupes moins un). | df = p(p – 1) / 2 (Nombre de corrélations uniques sous le triangle). |
| Résultat souhaité par le chercheur | Non-rejet de H0 (p > 0,05) pour garantir l’homoscédasticité de l’erreur. | Rejet de H0 (p < 0,05) pour justifier la factorisation des variables. |
| Implémentation standard sous R | stats::bartlett.test(y ~ groupe) |
psych::cortest.bartlett(cor_matrix, n) |
La distinction étant formellement établie, la suite de cette monographie est consacrée exclusivement à l’étude approfondie du test d’homogénéité des variances.
4. Conditions d’application et sensibilité stricte à la normalité
4.1 Le postulat fondamental de distribution normale
Le test d’homogénéité des variances de Bartlett repose sur une condition de validité distributionnelle d’une rigueur absolue : la normalité stricte des populations parentes dont sont extraits les sous-échantillons. Sous le modèle mathématique développé par Bartlett, les observations individuelles doivent obligatoirement suivre une loi normale univariée au sein de chaque groupe :
Yij ~ N(μj, σj2)
Contrairement au test F de l’ANOVA, qui fait preuve d’une robustesse substantielle aux écarts modérés à la normalité lorsque les effectifs d’échantillons sont suffisants et équilibrés en vertu du théorème central limite, le test de Bartlett ne bénéficie d’aucune propriété protectrice similaire. Il est réputé pour sa vulnérabilité extrême aux déviations de la loi normale, et plus spécifiquement aux anomalies affectant l’aplatissement (kurtosis) et l’asymétrie (skewness) de la distribution empirique.
Dans un article polémique devenu un classique de la littérature statistique intitulé « Non-normality and tests on variances », le statisticien George E. P. Box (1953) a formulé une métaphore célèbre pour dénoncer l’extrême sensibilité du test de Bartlett aux entorses de la loi normale. Il écrivait qu’utiliser le test de Bartlett pour vérifier l’homoscédasticité préalable à une ANOVA équivaut à « prendre la mer dans un canot pneumatique pour vérifier si l’océan est suffisamment calme pour qu’un paquebot transatlantique puisse naviguer ». En termes mathématiques, la statistique de Bartlett ne teste pas uniquement l’égalité des variances, elle teste conjointement l’hypothèse composée d’homoscédasticité et de normalité parfaite.
Lorsque la distribution d’une variable présente un kurtosis positif marqué (distribution leptokurtique, caractérisée par des queues épaisses et un pic central prononcé, fréquemment observée lors de l’administration de temps de réaction en neurosciences ou d’échelles d’anxiété en psychiatrie clinique), la variance théorique de la variance d’échantillon est nettement supérieure à celle prédite sous l’hypothèse de Gauss. En conséquence, la statistique du test de Bartlett explose mécaniquement, produisant un nombre exorbitant de faux positifs (rejets indus de H0). Le chercheur en conclura à tort à une hétérogénéité des variances, alors même que les populations partagent rigoureusement la même dispersion mais présentent simplement une forme non gaussienne. Inversement, en présence de distributions platykurtiques (queues légères), le test devient sous-sensible. Par conséquent, l’exécution préalable d’un test rigoureux de normalité au sein de chaque sous-groupe (tel que le test de Shapiro-Wilk pour n < 50 ou le test d’Anderson-Darling) constitue un impératif méthodologique incontournable avant d’accorder le moindre crédit aux conclusions d’un test de Bartlett.
4.2 Indépendance des observations et échantillonnage
Le second pilier théorique garantissant l’adéquation de la distribution d’échantillonnage de Bartlett est l’indépendance statistique absolue des observations, tant à l’intérieur de chaque groupe (indépendance intra-groupe) qu’entre les différents sous-échantillons (indépendance inter-groupes). Cette condition impose que la valeur prise par le participant i dans la condition expérimentale j ne fournisse aucune information prédictive sur la valeur obtenue par le participant i’ dans la même condition ou dans toute condition concurrente :
Cov(εij, εi’j) = 0 pour tout i ≠ i’ et Cov(εij, εi’j’) = 0 pour tout j ≠ j’
Cette exigence disqualifie formellement l’utilisation du test de Bartlett dans tous les protocoles expérimentaux à mesures répétées, les designs en blocs aléatoires complets ou les études longitudinales impliquant un suivi temporel des mêmes sujets (plans pré-test / post-test). Dans de telles configurations, les mesures successives collectées sur une même unité biologique sont positivement corrélées du fait de la variance stable propre au sujet, violant l’hypothèse d’indépendance et nécessitant l’emploi de tests de sphéricité multivariés (comme le test de sphéricité de Mauchly appliqué à la matrice des résidus).
De même, dans les protocoles de psychologie sociale ou organisationnelle où l’échantillonnage est réalisé en grappes hiérarchiques (par exemple, des élèves nichés au sein de classes scolaires, ou des soignants regroupés par établissements hospitaliers), l’erreur résiduelle est soumise à un coefficient de corrélation intra-classe (ρ) non nul. L’application mécanique du test de Bartlett sur des données groupées non décorrélées conduit à une sous-estimation systématique de l’erreur-type de la dispersion et invalide le calcul asymptotique de la statistique de décision.
4.3 Sensibilité aux effectifs échantillonnaux
Le comportement de la statistique de Bartlett est profondément modulé par la taille absolue des effectifs (N total et nj individuels) ainsi que par le ratio d’équilibrage des groupes. Sur le plan théorique, la convergence de la statistique B vers une loi formelle du Chi-deux repose sur une approximation asymptotique. Cette approximation conserve une précision excellente pour des effectifs modérés, à la condition expresse que chaque sous-groupe comporte un effectif minimal suffisant, communément fixé à nj ≥ 5 dans la littérature biométrique contemporaine. Si l’un des groupes descend sous ce seuil critique (par exemple dans des études de cas cliniques rares où nj = 3 ou 4), l’erreur d’approximation de la queue de distribution s’élargit, augmentant le risque d’erreur d’inférence.
Dans les très grands échantillons (N > 1 000 participants), configuration de plus en plus courante à l’ère de la collecte de données en ligne via des plateformes comme Prolific ou Amazon Mechanical Turk, le test de Bartlett développe une puissance statistique colossale. Dans ce scénario, le test tend à rejeter l’hypothèse nulle au seuil de signification de α = 0,05 pour des divergences triviales entre les variances d’échantillons — par exemple, une variance de 10,2 comparée à une variance de 10,6. D’un point de vue clinique ou psychologique, une telle différence de dispersion est rigoureusement négligeable et n’exerce absolument aucun impact délétère sur la validité de l’ANOVA sous-jacente. Le rejet formel de H0 par le test de Bartlett peut alors conduire le chercheur à opter inutilement pour des procédures alternatives complexes, altérant la puissance d’analyse du modèle principal.
5. Formulation mathématique détaillée et algorithme de calcul
5.1 Calcul de la variance combinée globale (pooled variance)
La mécanique calculatoire du test de Maurice Bartlett repose sur une confrontation élégante entre deux façons d’évaluer la dispersion globale de l’échantillon agrégé : une estimation moyenne pondérée arithmétique d’une part, et une estimation moyenne pondérée logarithmique d’autre part. La première étape algorithmique consiste à déterminer l’estimateur sans biais de la variance commune de l’ensemble de l’échantillon sous l’hypothèse nulle H0. Cet estimateur est désigné sous le terme de variance combinée ou pooled sample variance, notée conventionnellement sp2.
Soit k groupes indépendants caractérisés par des effectifs respectifs n1, n2, …, nk. L’effectif total d’observation est défini par :
N = ∑j=1k nj
Pour chaque sous-échantillon j, on calcule sa variance corrigée non biaisée (divisée par ses degrés de liberté locaux nj – 1) :
sj2 = (1 / (nj – 1)) × ∑i=1nj (Yij – Ȳj)2
où Ȳj représente la moyenne empirique observée au sein du groupe j. La variance combinée s’obtient alors en pondérant chaque variance locale par ses degrés de liberté spécifiques, puis en divisant cette somme par le total des degrés de liberté intra-groupes (N – k) :
sp2 = (1 / (N – k)) × ∑j=1k (nj – 1) sj2
Cette quantité sp2 est strictement identique au terme de carré moyen de l’erreur (Mean Square Error, noté MSE ou CMRésiduel) extrait du tableau standard d’une ANOVA à un facteur. Elle constitue la meilleure estimation paramétrique possible de la variabilité résiduelle commune théorique σ2 si l’hypothèse d’homoscédasticité est vérifiée dans la population générale.
5.2 Calcul du numérateur et divergence logarithmique
Une fois la variance combinée sp2 établie, l’étape suivante consiste à quantifier l’écart d’étalement entre cette variance globale de référence et les variances spécifiques de chaque modalité. L’algorithme de Bartlett n’opère pas une simple différence absolue, mais utilise les propriétés de l’entropie statistique et du logarithme népérien (noté ln), directement dérivé du principe du quotient de vraisemblance.
Le numérateur de la statistique — souvent noté M dans la formulation d’origine de Bartlett — correspond à la différence pondérée entre le logarithme de la variance combinée et la somme des logarithmes des variances individuelles :
M = (N – k) ln(sp2) – ∑j=1k (nj – 1) ln(sj2)
Sur le plan mathématique, cette expression peut être réécrite pour faire apparaître explicitement un ratio de moyennes géométriques et arithmétiques :
M = ln [ (sp2)(N – k) / ∏j=1k (sj2)(nj – 1) ]
En vertu de l’inégalité de Jensen et des propriétés élémentaires de la convexité de la fonction logarithme, la moyenne arithmétique d’une série de valeurs positives est toujours supérieure ou égale à leur moyenne géométrique. L’égalité parfaite n’est atteinte que si et seulement si toutes les valeurs individuelles sont rigoureusement identiques entre elles (c’est-à-dire si s12 = s22 = … = sk2 = sp2). Dans cette situation théorique d’identité absolue des variances d’échantillon, la quantité M est strictement égale à zéro. Plus les variances locales divergent les unes des autres, plus le terme de droite décroît par rapport au premier terme, et plus la valeur de M s’accroît positivement. Cette divergence reflète directement le degré de vraisemblance de l’hétérogénéité des données.
5.3 Facteur de correction c et statistique finale de Bartlett
La quantité M définie précédemment constitue le noyau fondamental du test du rapport de vraisemblance. Cependant, pour des échantillons réels de tailles modérées ou inégales, la distribution d’échantillonnage exacte de M s’écarte substantiellement de la loi théorique du Chi-deux, produisant une estimation biaisée de la p-valeur. Le trait de génie de Maurice Bartlett a résidé dans l’élaboration analytique d’un facteur de correction d’échelle, universellement désigné par la constante scalaire c, qui permet de neutraliser ce biais d’échantillonnage fini.
Ce facteur de correction mathématique est rigoureusement défini par la formule suivante :
c = 1 + [ 1 / (3(k – 1)) ] × [ ( ∑j=1k 1 / (nj – 1) ) – 1 / (N – k) ]
Une analyse structurelle de cette équation révèle son fonctionnement stabilisateur :
- Puisque les effectifs nj sont toujours supérieurs à 1 (avec généralement nj ≥ 2 au minimum pour calculer une variance), la quantité entre crochets est toujours strictement positive, ce qui implique que c > 1 de façon systématique.
- Plus les effectifs d’échantillons sont petits, plus les termes 1 / (nj – 1) sont élevés, et plus la constante c s’éloigne de l’unité vers le haut, réduisant proportionnellement la statistique finale pour corriger l’inflation naturelle de l’estimation.
- À l’inverse, lorsque la taille de l’échantillon global N tend vers l’infini (propriété asymptotique), tous les ratios fractionnaires s’effondrent vers zéro, et la valeur de c converge asymptotiquement vers 1.
La statistique finale corrigée du test de Bartlett, communément notée B (ou parfois T ou K2 selon les logiciels), s’obtient alors en divisant la valeur de divergence M par le facteur correctif c :
B = M / c = [ (N – k) ln(sp2) – ∑j=1k (nj – 1) ln(sj2) ] / [ 1 + (1 / (3(k – 1))) × ( ∑j=1k (1 / (nj – 1)) – (1 / (N – k)) ) ]
Grâce à cette pondération correctrice, la statistique B acquiert la propriété mathématique de converger fidèlement vers une loi du Chi-deux à k – 1 degrés de liberté.
6. Distribution d’échantillonnage et règle de décision statistique
6.1 Loi du Chi-deux et degrés de liberté associés
En vertu du théorème du rapport de vraisemblance de Wilks combiné aux corrections d’ordre supérieur de Bartlett, la statistique corrigée B suit asymptotiquement, sous l’hypothèse nulle H0 de variances théoriques rigoureusement identiques, une loi distributionnelle du Chi-deux (χ2) :
B ∼ χ2(df)
Le paramètre central régissant la géométrie de cette loi d’échantillonnage est constitué par ses degrés de liberté (df, pour degrees of freedom). Dans le cadre spécifique du test de Bartlett, ce paramètre est directement déterminé par le nombre total de groupes ou modalités factorielles comparés, sans égard pour le nombre total d’observations individuelles :
df = k – 1
Ce résultat découle directement de la contrainte linéaire imposée par le modèle : ayant calculé la variance combinée sp2 qui agrège les informations des k sous-groupes, le système statistique perd un degré d’indépendance, fixant ainsi le nombre de comparaisons libres de variances à k – 1. Si l’on compare 3 modalités de prise en charge psychothérapeutique, le test sera évalué sur une distribution du χ2 à 3 – 1 = 2 degrés de liberté. Pour 5 conditions expérimentales d’amorçage attentionnel, la distribution de référence sera celle du χ2 à 4 degrés de liberté.
6.2 Seuil de signification critique et p-valeur
La règle formelle d’inférence statistique repose sur la confrontation de la valeur observée du test (Bobs) avec les régions d’acceptation et de rejet déterminées par la table théorique de distribution du χ2. Le chercheur doit au préalable fixer un seuil de risque d’erreur de première espèce, le niveau α, universellement établi à 0,05 (α = 5 %) dans les sciences humaines et sociales, ou à des seuils plus conservateurs (α = 0,01 ou 0,001) lors d’essais cliniques pharmacologiques ou de réplications méthodologiques à haute rigueur.
Pour un risque d’erreur α et un degré de liberté df = k – 1 donnés, la valeur seuil critique χ2critique = χ2(1 – α, k – 1) délimite la frontière au-delà de laquelle la probabilité d’obtenir une telle divergence de dispersion par simple hasard devient inférieure ou égale à α. Parallèlement, l’évaluation moderne privilégie le calcul direct de la p-valeur (probability value), définie comme la surface intégrale sous la courbe de densité de probabilité du χ2 s’étendant depuis la valeur empirique Bobs jusqu’à l’infini positif :
p = P( χ2(k – 1) ≥ Bobs | H0 est vraie )
La p-valeur mesure très précisément la probabilité d’observer un ensemble de variances d’échantillons au moins aussi dispersé que celui constaté dans l’expérience si les populations parentes étaient pourtant caractérisées par des variances rigoureusement équivalentes.
6.3 Règles d’inférence et prise de décision formelle
Le protocole décisionnel final s’exécute selon une alternative binaire rigide :
- Cas 1 : Statistique observée inférieure à la valeur critique (Bobs ≤ χ2critique) ou p-valeur supérieure au seuil nominal (p ≥ α). Dans cette situation, la divergence entre les variances d’échantillons est trop modeste pour rejeter l’hypothèse nulle. Le chercheur conclut au maintien de H0. L’hypothèse d’homoscédasticité est déclarée satisfaite, et les prérequis de dispersion de l’ANOVA univariée classique sont formellement validés. Le chercheur peut légitimement poursuivre son pipeline analytique en utilisant le carré moyen résiduel agrégé pour évaluer la significativité du facteur d’effet et mener ses tests post-hoc standardisés (ex. HSD de Tukey).
- Cas 2 : Statistique observée supérieure à la valeur critique (Bobs > χ2critique) ou p-valeur strictement inférieure au seuil nominal (p < α). Le constat est sans ambiguïté : la divergence de variance observée entre les groupes est trop importante pour être imputable aux seules fluctuations d’échantillonnage. Le chercheur est contraint de rejeter formellement H0 au profit de HA. L’homogénéité des variances est violée (hétéroscédasticité avérée). L’exécution d’une ANOVA paramétrique standard sur ces données brutes devient méthodologiquement invalide et génère un risque majeur de conclusions erronées. Le statisticien doit impérativement réorienter son analyse vers des modèles correctifs robustes.
7. Exemple pratique pas à pas : Expérience de thérapie cognitive en psychologie
7.1 Contexte de l’étude et tableau des données brutes
Afin de concrétiser l’ensemble de ces propositions algébriques et conceptuelles, considérons une recherche clinique standardisée en psychologie de la santé portant sur la réduction de la détresse émotionnelle chez des patients souffrant de trouble d’anxiété généralisée (TAG). Une équipe de cliniciens évalue trois modalités d’intervention distinctes réparties de manière aléatoire sur 30 patients adultes volontaires :
- Groupe 1 : Thérapie Cognitive et Comportementale classique (TCC), ciblant la restructuration cognitive et l’exposition intéroceptive (n1 = 10 participants).
- Groupe 2 : Méditation de Pleine Conscience (Mindfulness-Based Stress Reduction – MBSR), axée sur la régulation de l’attention sans jugement (n2 = 10 participants).
- Groupe 3 : Groupe Contrôle sur liste d’attente active (Témoin), recevant un soutien empathique non directif sans protocole psychothérapeutique formalisé (n3 = 10 participants).
À l’issue des 8 semaines de protocole, chaque participant remplit le score d’état de l’Inventaire d’Anxiété Trait-État de Spielberger (STAI Form Y-1). Les scores s’étalent sur une échelle continue de 20 à 80 points, où des valeurs élevées traduisent une sévérité accrue des symptômes anxieux. La normalité des distributions au sein de chaque condition a été vérifiée préalablement à l’aide de tests de Shapiro-Wilk univariés, concluant sans exception au non-rejet de la loi normale (tous les p > 0,20). Les conditions d’indépendance et de normalité étant consolidées, le chercheur doit à présent valider le postulat d’homogénéité des variances via le test de Bartlett avant de mener son ANOVA.
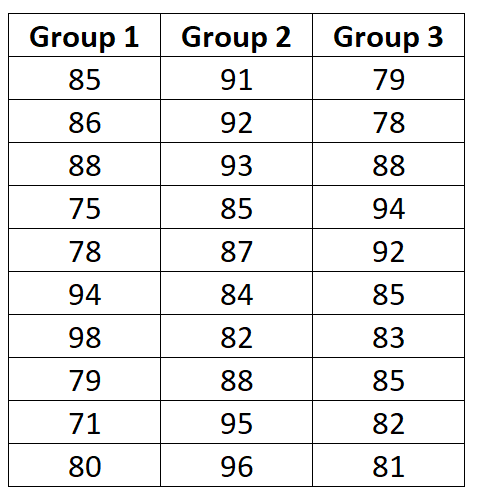
Le tableau des données brutes se présente comme suit pour les 30 participants :
| Participant | Groupe 1 : TCC (Score STAI) | Groupe 2 : Mindfulness (Score STAI) | Groupe 3 : Témoin (Score STAI) |
|---|---|---|---|
| 1 | 34 | 38 | 52 |
| 2 | 31 | 42 | 58 |
| 3 | 37 | 35 | 49 |
| 4 | 35 | 40 | 64 |
| 5 | 29 | 48 | 55 |
| 6 | 38 | 36 | 61 |
| 7 | 32 | 45 | 50 |
| 8 | 36 | 39 | 57 |
| 9 | 30 | 43 | 63 |
| 10 | 33 | 44 | 51 |
7.2 Calcul manuel étape par étape des paramètres descriptifs
Pour exécuter manuellement l’algorithme de Bartlett, calculons pour chaque modalité thérapeutique les grandeurs statistiques descriptives fondamentales : effectifs (nj), sommes des observations (∑Y), moyennes (Ȳ), sommes des carrés des écarts (SSj), variances corrigées (sj2) et logarithmes népériens de ces variances.
Groupe 1 (TCC) :
- Effectif : n1 = 10 ; Degrés de liberté : df1 = n1 – 1 = 9
- Somme des scores : ∑Y1i = 34 + 31 + 37 + 35 + 29 + 38 + 32 + 36 + 30 + 33 = 335
- Moyenne empirique : Ȳ1 = 335 / 10 = 33,50
- Somme des carrés des écarts à la moyenne :
SS1 = (34-33,5)2 + (31-33,5)2 + … + (33-33,5)2
= 0,25 + 6,25 + 12,25 + 2,25 + 20,25 + 20,25 + 2,25 + 6,25 + 12,25 + 0,25 = 82,50 - Variance non biaisée d’échantillon : s12 = SS1 / (n1 – 1) = 82,50 / 9 = 9,1667
- Logarithme népérien de la variance : ln(s12) = ln(9,1667) = 2,2156
Groupe 2 (Mindfulness / MBSR) :
- Effectif : n2 = 10 ; Degrés de liberté : df2 = n2 – 1 = 9
- Somme des scores : ∑Y2i = 38 + 42 + 35 + 40 + 48 + 36 + 45 + 39 + 43 + 44 = 410
- Moyenne empirique : Ȳ2 = 410 / 10 = 41,00
- Somme des carrés des écarts à la moyenne :
SS2 = (38-41)2 + (42-41)2 + … + (44-41)2
= 9 + 1 + 36 + 1 + 49 + 25 + 16 + 4 + 4 + 9 = 154,00 - Variance non biaisée d’échantillon : s22 = SS2 / (n2 – 1) = 154,00 / 9 = 17,1111
- Logarithme népérien de la variance : ln(s22) = ln(17,1111) = 2,8398
Groupe 3 (Témoin) :
- Effectif : n3 = 10 ; Degrés de liberté : df3 = n3 – 1 = 9
- Somme des scores : ∑Y3i = 52 + 58 + 49 + 64 + 55 + 61 + 50 + 57 + 63 + 51 = 540
- Moyenne empirique : Ȳ3 = 540 / 10 = 54,00
- Somme des carrés des écarts à la moyenne :
SS3 = (52-54)2 + (58-54)2 + … + (51-54)2
= 4 + 16 + 25 + 100 + 1 + 49 + 16 + 9 + 81 + 9 = 310,00 - Variance non biaisée d’échantillon : s32 = SS3 / (n3 – 1) = 310,00 / 9 = 34,4444
- Logarithme népérien de la variance : ln(s32) = ln(34,4444) = 3,5394
7.3 Résolution numérique de la statistique de Bartlett
L’observation brute révèle une variabilité croissante : s12 = 9,17, s22 = 17,11 et s32 = 34,44. Le groupe témoin affiche une dispersion presque quatre fois supérieure à celle du groupe sous TCC. Déterminons si cet étalement franchit le seuil de signification statistique.
Étape 1 : Calcul de la taille globale et des degrés de liberté totaux
N = n1 + n2 + n3 = 10 + 10 + 10 = 30
k = 3 groupes
Degrés de liberté résiduels : N – k = 30 – 3 = 27
Étape 2 : Détermination de la variance combinée (sp2)
sp2 = (1 / (N – k)) × [ (n1 – 1)s12 + (n2 – 1)s22 + (n3 – 1)s32 ]
sp2 = (1 / 27) × [ SS1 + SS2 + SS3 ] = (1 / 27) × [ 82,50 + 154,00 + 310,00 ] = 546,50 / 27 ≈ 20,2407
Calculons le logarithme népérien de cette variance agrégée :
ln(sp2) = ln(20,2407) ≈ 3,0077
Étape 3 : Calcul du numérateur de divergence (M)
M = (N – k) ln(sp2) – ∑j=1k (nj – 1) ln(sj2)
Puisque les groupes sont équilibrés (nj – 1 = 9 pour tous les groupes), l’expression se simplifie :
M = 27 × 3,0077 – 9 × [ ln(s12) + ln(s22) + ln(s32) ]
M = 81,2079 – 9 × [ 2,2156 + 2,8398 + 3,5394 ]
M = 81,2079 – 9 × [ 8,5948 ] = 81,2079 – 77,3532 = 3,8547
Étape 4 : Détermination du facteur de correction (c)
c = 1 + [ 1 / (3(k – 1)) ] × [ ∑j=1k (1 / (nj – 1)) – (1 / (N – k)) ]
c = 1 + [ 1 / (3 × 2) ] × [ ( 1/9 + 1/9 + 1/9 ) – 1/27 ]
c = 1 + [ 1 / 6 ] × [ 3/9 – 1/27 ] = 1 + [ 1 / 6 ] × [ 9/27 – 1/27 ]
c = 1 + [ 1 / 6 ] × [ 8/27 ] = 1 + [ 8 / 162 ] = 1 + 0,04938 ≈ 1,0494
Étape 5 : Calcul de la statistique finale corrigée (B)
B = M / c = 3,8547 / 1,0494 ≈ 3,6732
Étape 6 : Décision statistique et interprétation
La statistique corrigée de Bartlett s’élève à Bobs = 3,673. Sous H0, cette valeur suit une loi du χ2 à df = k – 1 = 3 – 1 = 2 degrés de liberté. Consultons les valeurs critiques tabulées pour un risque α = 0,05 :
χ2critique (0,05 ; 2) = 5,991
Puisque la statistique observée est strictement inférieure au seuil critique :
Bobs = 3,673 ≤ 5,991
Le calcul exact de la queue intégrale de probabilité donne une p-valeur de :
p = P( χ2(2) ≥ 3,673 ) ≈ 0,1594
Étant donné que p = 0,159 > 0,05, nous échouons à rejeter l’hypothèse nulle H0. Malgré l’écart apparent entre la variance du groupe TCC (9,17) et celle du groupe témoin (34,44), le test conclut que cette divergence est pleinement compatible avec les fluctuations aléatoires attendues pour des échantillons de taille 10. Le postulat d’homogénéité des variances est empiriquement validé. L’équipe de recherche est donc formellement autorisée à réaliser l’analyse de variance univariée paramétrique conventionnelle sur les scores du STAI.
8. Implémentation du test de Bartlett sous le langage de programmation R
8.1 Utilisation de la fonction native bartlett.test()
Le langage de programmation statistique R constitue l’écosystème de référence pour l’analyse des données de recherche en psychologie. Au sein du package de base stats (chargé par défaut à chaque session), le test de Maurice Bartlett bénéficie d’une implémentation directe et hautement optimisée via la fonction native bartlett.test().
Cette fonction accepte deux formulations syntaxiques principales. La première, la syntaxe par formule (formula notation), représente l’approche la plus standardisée et la plus lisible lors de la manipulation de jeux de données structurés en format long (tidy data). Elle prend la forme générique :
bartlett.test(reponse ~ groupe, data = mon_dataframe)
Dans cette formulation, reponse désigne la variable dépendante continue et groupe la variable indépendante factorielle. La syntaxe alternative permet de passer directement une liste de vecteurs numériques représentant les sous-échantillons distincts :
bartlett.test(list(groupe1, groupe2, groupe3))
L’exécution de la commande sur les données de notre essai clinique en psychologie génère une sortie de console concise mais complète :
Bartlett test of homogeneity of variances
data: score_stai by condition
Bartlett's K-squared = 3.6732, df = 2, p-value = 0.1594
La sortie restitue avec exactitude les paramètres calculés manuellement : la statistique Bartlett's K-squared (qui correspond rigoureusement à la valeur B corrigée de 3,673), les degrés de liberté df = 2, et la probabilité critique asymptotique p-value = 0.1594.
8.2 Pipeline de validation préalable des postulats dans l’écosystème Tidyverse
Dans un cadre de recherche reproductible, l’exécution du test de Bartlett ne doit jamais être isolée, mais intégrée dans un pipeline diagnostique exhaustif orchestré avec l’écosystème tidyverse et les bibliothèques dédiées à l’inférence psychologique comme rstatix. L’architecture de validation débute par la vérification séquentielle de la normalité intra-groupe.
Le script moderne d’analyse se structure selon les étapes suivantes :
Tout d’abord, les données brutes sont organisées sous un tibble propre comprenant l’identifiant des participants, la condition d’appartenance et la mesure observée. Grâce aux fonctions combinées de dplyr, le chercheur génère un tableau récapitulatif détaillé calculant les effectifs, moyennes, variances, coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Dans un second temps, la fonction shapiro_test() issue de rstatix est directement appliquée avec un partitionnement par modalité :
donnees_psy %>% group_by(condition) %>% shapiro_test(score_stai)
Si toutes les p-valeurs de Shapiro-Wilk dépassent 0,05, attestant de la normalité empirique, le test de Bartlett est alors invoqué via le même pipeline méthodologique :
donnees_psy %>% rstatix::bartlett_test(score_stai ~ condition)
Cette intégration fluidifiée garantit que l’analyste ne procède à l’évaluation de Bartlett que si la condition de normalité est préalablement documentée, minimisant ainsi le risque de faux positifs mentionné par George Box.
8.3 Visualisation graphique de la dispersion intra-groupe avec ggplot2
L’inférence statistique ne saurait s’affranchir d’un examen visuel approfondi de la géométrie des dispersions. Le package ggplot2 offre les outils les plus performants pour représenter simultanément la tendance centrale et l’étalement des données à travers les conditions.
Une visualisation optimale conjugue une boîte à moustaches (boxplot) avec un tracé en violon (violin plot) et une superposition de points individuels dispersés (jittering). Alors que les boîtes à moustaches classiques permettent d’apprécier visuellement l’écart interquartile (IQR) — qui constitue une estimation empirique robuste de l’étalement —, les graphiques en violon révèlent la forme intégrale de la densité de probabilité, facilitant la détection conjointe d’un kurtosis atypique ou d’une asymétrie locale.
L’adjonction de barres d’erreur basées sur l’écart-type ou sur les intervalles de confiance à 95 % centrés sur les moyennes offre une confrontation directe entre la dispersion statistique et la variabilité interindividuelle, permettant au clinicien d’illustrer de façon immédiatement intelligible les conclusions issues du test de Bartlett auprès du public académique.
9. Implémentation sous Python (SciPy) et sous SPSS
9.1 Exécution programmatique avec Python et scipy.stats
Dans le domaine des sciences cognitives computationnelles et des neurosciences comportementales, l’environnement de programmation Python s’est imposé comme une plateforme d’analyse majeure. L’exécution du test d’homogénéité de Bartlett s’effectue au moyen de la bibliothèque scientifique de référence SciPy, au sein de son sous-module scipy.stats.
La fonction s’intitule bartlett() et requiert en arguments positionnels les tableaux de données individuels sous forme d’objets NumPy arrays, de séries Pandas ou de listes numériques. La structure d’implémentation standard se développe comme suit :
À partir d’un DataFrame Pandas contenant les colonnes ‘Condition’ et ‘Score’, l’extraction des sous-groupes s’opère via un filtrage booléen rigoureux. Les trois séries numériques sont ensuite transmises directement à la fonction de test :
statistique, p_valeur = scipy.stats.bartlett(groupe_tcc, groupe_mbsr, groupe_temoin)
L’exécution de la commande renvoie un tuple contenant la valeur scalaire de la statistique corrigée et la probabilité critique bilatérale. L’analyste peut alors encapsuler ces retours dans une fonction personnalisée documentant automatiquement le respect du seuil de significativité conventionnel :
print(f"Statistique de Bartlett : {statistique:.4f}")
print(f"p-valeur associée : {p_valeur:.4f}")
La concordance entre l’implémentation Python et l’algorithme manuel démontre une stabilité numérique totale, la valeur de B étant évaluée avec une précision en virgule flottante double (standard IEEE 754).
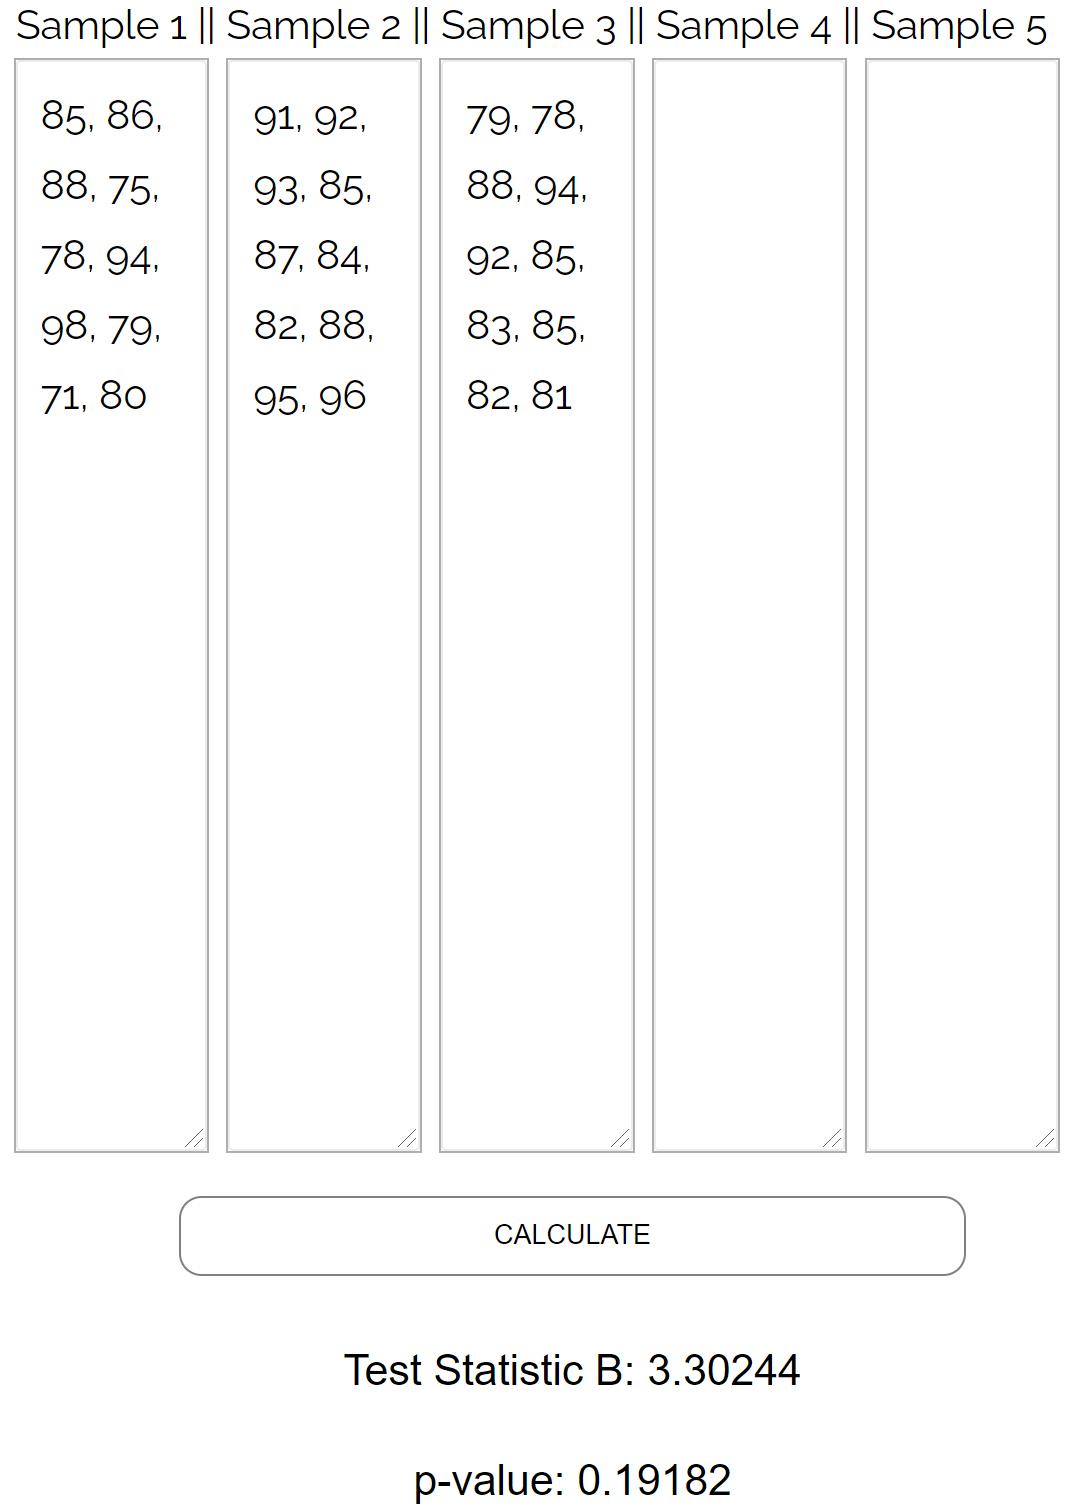
9.2 Procédure pas à pas dans l’interface graphique de SPSS
Le progiciel SPSS (Statistical Package for the Social Sciences, IBM) conserve une diffusion historique massive dans les laboratoires de recherche en psychologie clinique et en sciences de l’éducation. L’accès aux tests d’homogénéité des variances au sein de SPSS est cependant singulier : la commande dédiée au test de Bartlett pour l’homogénéité univariée n’apparaît pas sous un bouton isolé au niveau du menu principal, mais s’inscrit au sein de modules de modélisation analytique ou d’extensions de syntaxe.
Pour exécuter les diagnostics d’homogénéité dans le menu général d’ANOVA :
- Accéder à la barre de menu : Analyser > Comparer les moyennes > ANOVA à un facteur… (ou en version anglaise : Analyze > Compare Means > One-Way ANOVA).
- Insérer la mesure dépendante quantitative dans la boîte Liste des variables dépendantes (Dependent List), et la variable catégorielle définissant les sous-groupes dans la boîte Facteur (Factor).
- Cliquer sur l’onglet Options… situé sur le volet latéral droit.
- Dans la section des statistiques d’adéquation, cocher la case Test d’homogénéité de la variance (Homogeneity of variance test).
Il importe de noter que dans les versions modernes de SPSS, l’activation de cette case génère par défaut le test de Levene (avec ses variantes fondées sur la moyenne et la médiane). Pour forcer explicitement l’édition du test de Maurice Bartlett pour des plans linéaires généraux complexes, le chercheur doit mobiliser la fenêtre d’exécution syntaxique (SPSS Syntax Editor) ou utiliser des scripts macroscopiques basés sur la procédure GLM ou la commande MANOVA, où l’homogénéité de dispersion est documentée via des paramètres d’instruction dédiés (tels que la sous-commande /HOMOGENEITY = BARTLETT).
9.3 Traitement des incohérences mineures entre plateformes logicielles
Lors de projets de réplication internationale en psychologie ouverte (Open Science Framework), les chercheurs constatent occasionnellement de minimes écarts numériques entre les résultats générés par R, Python, SPSS ou SAS sur un même jeu de données. Ces divergences potentielles, bien qu’elles n’altèrent quasiment jamais la décision finale d’inférence, trouvent leur origine dans deux mécanismes algorithmiques bien identifiés :
La première source d’écart relève de la gestion des données manquantes (valeurs NA sous R, NaN sous Python, points de suspension . sous SPSS). Alors que la fonction bartlett.test() sous R élimine par défaut les données incomplètes selon une exclusion univariée stricte (listwise deletion locale), d’autres progiciels peuvent appliquer des pondérations ou exiger l’épuration explicite des vecteurs en amont, modifiant substantiellement les effectifs réels nj pris en compte.
La seconde source provient de la précision machine et des approximations employées lors du calcul du logarithme népérien et du facteur multiplicateur de correction c. Alors que les implémentations modernes sous R et SciPy opèrent en précision double sur 64 bits (garantissant 15 à 17 chiffres significatifs), certaines routines de formats anciens ou logiciels propriétaires appliquent des troncatures intermédiaires à 4 ou 6 décimales au niveau des sommes des carrés ou du logarithme de sp2, provoquant des fluctuations sur la troisième décimale de la statistique finale B. Il est dès lors recommandé d’expliciter le logiciel et la version exacte du package mobilisé lors de la rédaction des rapports de recherche.
10. Conséquences d’une violation de l’homogénéité des variances en ANOVA
10.1 Impact direct sur l’erreur de première espèce et la puissance
La transgression de l’hypothèse d’homoscédasticité au sein d’une analyse de variance ne constitue pas une anomalie bénigne que l’on peut négliger au nom d’une prétendue robustesse aveugle des tests linéaires. Lorsque les variances de population sous-jacentes sont inégales, l’estimateur de la variance combinée sp2 (le carré moyen résiduel) perd sa propriété d’estimateur non biaisé de l’erreur d’échantillonnage locale.
L’impact de cette violation dépend de manière critique de la symétrie des effectifs d’échantillons (l’orthogonalité du plan expérimental) :
- Plans équilibrés (n1 = n2 = … = nk) : Lorsque les tailles de groupes sont strictement identiques, le test F de Fisher conserve une robustesse relative face à des hétérogénéités modérées (par exemple un ratio de variances maximale sur minimale inférieur à 3). La valeur réelle de l’erreur α oscille généralement dans une fourchette acceptable entre 0,05 et 0,07. Néanmoins, dès que les ratios de dispersion excèdent un facteur de 4 ou 5, la probabilité réelle de rejeter fallacieusement H0 augmente sensiblement, même sous effectifs égaux.
- Plans déséquilibrés avec appariement positif (les plus grands groupes ont les plus grandes variances) : Dans cette configuration, la variance combinée sp2 est lourdement dominée par les grands groupes et surestime artificiellement l’erreur résiduelle globale. Le dénominateur du ratio F devient anormalement grand, ce qui abaisse mécaniquement la valeur empirique de F. Le test devient alors excessivement conservateur (α réel < 0,01 pour un seuil nominal de 0,05). Cette situation réduit drastiquement la puissance statistique : le chercheur échouera à mettre en évidence des différences réelles cliniquement capitales entre ses protocoles thérapeutiques.
- Plans déséquilibrés avec appariement négatif (les plus petits groupes ont les plus grandes variances) : Il s’agit du scénario le plus dévastateur sur le plan méthodologique. L’estimateur combiné sp2 est sous-estimé car les petits effectifs contribuent trop faiblement à la pondération globale. Le dénominateur du ratio F s’effondre, gonflant démesurément la valeur de la statistique F. Le taux d’erreur de type I réel explose de manière alarmante, pouvant atteindre 15 %, 20 % ou même 30 % ! Le chercheur déclarera péremptoirement significatives des différences entre moyennes qui ne reflètent que du bruit de fond expérimental.
10.2 Distorsion des tests post-hoc et contrastes planifiés
L’onde de choc méthodologique induite par la violation de l’homoscédasticité ne s’arrête pas au niveau du test omnibus F de l’ANOVA ; elle frappe avec une sévérité accrue les procédures de comparaisons multiples a posteriori (tests post-hoc). La quasi-totalité des tests post-hoc classiques, au premier rang desquels figure le test de différence honnêtement significative de Tukey (Tukey’s HSD), la méthode de Scheffé ou les ajustements de Newman-Keuls, utilisent un estimateur d’erreur standard commun directement dérivé de la variance combinée globale :
SE = √[ (sp2 / 2) × (1/ni + 1/nj) ]
Si l’homogénéité des variances est rompue, cette erreur-type commune devient fictive. Pour une paire de groupes comparant deux modalités caractérisées par des dispersions intrinsèques faibles, l’emploi de sp2 conduit à une surestimation massive de l’erreur standard, empêchant la détection d’une différence réelle entre ces deux niveaux. À l’inverse, lors de la comparaison de deux groupes aux variances réelles très élevées, l’erreur-type combinée sous-estime tragiquement la véritable variabilité locale, déclenchant des faux positifs post-hoc en cascade.
De surcroît, les intervalles de confiance construits autour des différences de moyennes deviennent asymétriquement biaisés ou artificiellement étroits, induisant en erreur les cliniciens sur la précision réelle des effets thérapeutiques estimés et contribuant directement à la crise de reproductibilité des conclusions scientifiques.
10.3 Répercussions sur les méta-analyses et synthèses d’études
Les conséquences d’une hétéroscédasticité ignorée dans les études primaires s’étendent par ricochet jusqu’aux méta-analyses quantitatives qui agrègent l’ensemble des données de la littérature. Dans le cadre d’une synthèse méta-analytique, l’indice d’effet standardisé le plus répandu en psychologie est le d de Cohen ou le g de Hedges. Le calcul du d de Cohen repose structurellement sur la division de la différence des moyennes par l’écart-type combiné :
d = (Ȳ1 – Ȳ2) / spooled
Si la dispersion intra-groupe est soumise à une forte hétérogénéité non contrôlée, la quantification de l’ampleur de l’effet clinique est structurellement faussée. Dans les modèles méta-analytiques à effets fixes ou à effets aléatoires, le poids accordé à chaque étude primaire est inversement proportionnel à sa variance d’échantillonnage (méthode de la pondération par variance inverse, inverse-variance weighting). Une publication dont la variance a été artificiellement compressée ou biaisée par un plan d’ANOVA inadapté recevra un poids disproportionné au sein de la méta-analyse, gauchissant l’estimation globale de l’efficacité d’un traitement à l’échelle internationale.
11. Solutions méthodologiques et alternatives statistiques robustes
11.1 Alternatives paramétriques robustes sans hypothèse d’homogénéité
Lorsque le test de Bartlett est rejeté de manière statistiquement significative (p < α) et que les distributions demeurent approximativement normales, le chercheur ne doit en aucun cas poursuivre avec une ANOVA classique non corrigée. La solution paramétrique de premier choix consiste à basculer vers des modèles spécifiquement conçus pour intégrer des variances locales inégales.
La procédure la plus établie est sans conteste l’ANOVA de Welch (1951). Tout comme le test t de Welch pour deux échantillons indépendants s’est substitué au test t de Student classique de par sa robustesse supérieure, l’ANOVA de Welch s’affranchit totalement du calcul d’une variance combinée sp2 unique. Elle attribue à chaque sous-groupe un coefficient de pondération spécifique wj inversement proportionnel à sa propre variance d’échantillon :
wj = nj / sj2
De plus, l’ANOVA de Welch met en œuvre la correction des degrés de liberté de Welch-Satterthwaite au niveau du dénominateur, ajustant dynamiquement la statistique de décision pour maintenir le taux nominal d’erreur de type I rigoureusement à 0,05, indépendamment du degré d’hétérogénéité des variances et du déséquilibre des effectifs.
Une alternative paramétrique très proche est constituée par le test de Brown-Forsythe (1974), qui utilise une pondération similaire tout en calculant les écarts au sein du dénominateur d’une manière qui le rend particulièrement résilient. Enfin, pour les comparaisons multiples subséquentes, le recours au test post-hoc de Games-Howell — qui combine la logique de Tukey avec l’erreur standard de Welch sans postulat d’homogénéité — s’impose comme la solution méthodologique optimale.
11.2 Transformations mathématiques stabilisatrices de variance
Une stratégie historiquement classique face au rejet du test de Bartlett consiste à tenter de remédier à l’hétéroscédasticité par l’application d’une transformation mathématique non linéaire sur la variable dépendante continue brute. L’objectif est de modifier l’échelle de mesure de telle sorte que la relation entre la moyenne et la variance soit neutralisée.
Les transformations stabilisatrices les plus reconnues incluent :
- La transformation logarithmique : Y* = ln(Y) ou Y* = log10(Y + c). Hautement efficace lorsque l’écart-type est proportionnel à la moyenne du groupe (fréquent pour les temps de latence motrice, les scores d’hormones de stress ou les données d’asymétrie positive marquée).
- La transformation racine carrée : Y* = √Y ou Y* = √(Y + 0,5). Particulièrement appropriée pour des données issues de processus de comptage (distribution de Poisson), comme le nombre d’erreurs commises lors d’une tâche d’attention soutenue.
- La famille de transformations de Box-Cox : Cette approche algorithmique estime par maximum de vraisemblance le paramètre d’exponentiation optimal λ au sein d’une transformation continue de la forme Y* = (Yλ – 1) / λ (pour λ ≠ 0).
Néanmoins, les transformations mathématiques doivent être maniées avec une grande circonspection en psychologie. Le changement d’échelle altère la métrique d’origine : une différence de moyennes calculée sur des échelles logarithmiques ou des racines carrées devient difficilement interprétable en termes cliniques concrets. De plus, une transformation qui stabilise les variances peut parfois induire une asymétrie artificielle sur des distributions initialement équilibrées, déplaçant le problème méthodologique sans le résoudre.
11.3 Approches non paramétriques et ré-échantillonnage
Si la violation de l’homogénéité des variances s’accompagne simultanément d’écarts substantiels à la normalité univariée (données lourdement asymétriques, présence de valeurs aberrantes, bimodalité), les solutions paramétriques même corrigées (Welch) peuvent s’avérer insuffisantes. Le chercheur doit alors mobiliser l’arsenal des statistiques non paramétriques ou des approches par ré-échantillonnage stochastique.
Le test non paramétrique de premier recours pour comparer k groupes indépendants est le test de Kruskal-Wallis. Ce test substitue aux valeurs métriques brutes leurs rangs ordinaux croissants au sein de l’échantillon combiné global. Il convient toutefois de rappeler une vérité fondamentale souvent ignorée : le test de Kruskal-Wallis ne constitue un test pur de comparaison des médianes que si les formes et les dispersions des distributions des groupes sont similaires. Si les variances sont radicalement hétérogènes, le test de Kruskal-Wallis teste une hypothèse mixte stochastique qui peut également voir son taux de faux positifs altéré.
Face à ce défi, les techniques computationnelles de ré-échantillonnage moderne, au premier rang desquelles figure le bootstrapping (ou ré-échantillonnage avec remise), offrent la parade la plus élégante et la plus polyvalente. En générant par simulation informatique plusieurs milliers de sous-échantillons synthétiques (typiquement B = 5 000 à 10 000 itérations bootstrap), le chercheur peut construire des distributions d’échantillonnage empiriques pour les différences de moyennes ou les tailles d’effet sans formuler le moindre postulat théorique sur la normalité ou sur l’homoscédasticité des populations parentes. Les intervalles de confiance bootstrap corrigés des biais et accélérés (BCa) garantissent alors une précision inférentielle irréprochable.
12. Comparaison critique des tests d’homogénéité et recommandations pratiques
12.1 Test de Bartlett vs Test de Levene et Brown-Forsythe
Pour le chercheur en sciences du comportement, le choix de la procédure diagnostique optimale pour évaluer l’homoscédasticité impose un arbitrage minutieux entre puissance statistique et robustesse distributionnelle. Les trois compétiteurs majeurs dans ce domaine sont le test de Maurice Bartlett, le test classique de Howard Levene (1960) et la modification de Morton Brown et Alan Forsythe (1974).
Sur le plan de l’efficacité asymptotique, le test de Bartlett surpasse systématiquement l’ensemble de ses concurrents dès lors que la condition de stricte normalité univariée est parfaitement respectée. Sa puissance statistique — c’est-à-dire sa probabilité de détecter une réelle différence de variance dans la population — est maximale, car il exploite directement la totalité de l’information contenue dans les sommes des carrés via le quotient de vraisemblance paramétrique.
Cependant, cette puissance théorique maximale a pour contrepartie sa fragilité pathologique face aux queues de distribution épaisses. Le test de Levene (1960) a été expressément conçu pour surmonter cette vulnérabilité en transformant le problème de comparaison de variances en une analyse de variance standard exécutée sur les valeurs absolues des écarts à la moyenne empirique : zij = |Yij – Ȳj|. Bien que beaucoup plus robuste que Bartlett, le test original de Levene conserve une légère instabilité face aux distributions fortement asymétriques.
Cette lacune a été définitivement résolue par Brown et Forsythe (1974), qui ont proposé d’utiliser non pas la moyenne arithmétique, mais la médiane empirique du groupe (ou la moyenne tronquée à 10 %) pour calculer les écarts absolus : zij = |Yij – Médianej|. Le test de Brown-Forsythe constitue aujourd’hui la référence empirique universelle pour tester l’égalité des variances lorsque les données s’écartent modérément ou fortement de la courbe de Gauss. En résumé : si la normalité stricte est avérée de manière irréfutable, Bartlett offre la détection la plus aiguisée ; si le moindre doute subsiste sur la forme des queues distributionnelles, Brown-Forsythe doit être préféré sans hésitation.
12.2 Autres alternatives non paramétriques : Test de Fligner-Killeen
Au-delà de la triade Bartlett-Levene-Brown-Forsythe, les méthodologistes disposent d’un autre test non paramétrique particulièrement robuste : le test de Fligner-Killeen (1976). Cette procédure repose sur une transformation par rangs des résidus absolus centrés sur les médianes de chaque modalité, suivie d’une normalisation basée sur les quantiles de la loi normale centrée réduite.
Le test de Fligner-Killeen se distingue par une résistance exceptionnelle face à la présence de valeurs aberrantes extrêmes (outliers) et face à des formes distributionnelles complexes ou tronquées, fréquemment rencontrées dans les études de psychopathologie sévère (par exemple, les scores d’impulsivité chez des patients borderline ou les temps de latence cognitive chez des sujets cérébro-lésés). Dans les études de simulation menées par Conover, Johnson et Johnson (1981), le test de Fligner-Killeen s’est révélé être l’un des outils les plus fiables pour maintenir le taux nominal d’erreur de première espèce sans sacrifier exagérément la puissance statistique sous des distributions très hétérogènes.
12.3 Normes de rédaction académique et reporting APA (7e édition)
L’Association Américaine de Psychologie (American Psychological Association, APA) édicte des normes formelles strictes régissant la communication des résultats quantitatifs au sein des revues scientifiques à comité de lecture. Lors de la restitution d’un test de Bartlett dans un manuscrit selon les directives de l’APA 7e édition, plusieurs éléments typographiques et méthodologiques doivent être obligatoirement intégrés :
- Les lettres et symboles statistiques doivent être formatés en italique (par exemple : B, K2, df, p, F, n).
- Les degrés de liberté doivent être systématiquement précisés entre parenthèses immédiatement après le symbole de la statistique ou présentés dans un libellé clair.
- La valeur numérique de la statistique de test doit être rapportée avec deux ou trois décimales de précision.
- La p-valeur doit être consignée de façon exacte (ex. p = .159) sans zéro initial si elle ne peut excéder 1, ou formulée sous la forme p < .001 lorsqu’elle descend sous cette borne infinitésimale.
- Une justification argumentée de la décision de poursuivre en ANOVA classique ou de basculer vers Welch doit accompagner la présentation numérique.
Modèle d’énoncé académique conforme APA (Cas de non-rejet de H0 – Notre exemple) :
« Préalablement à l’exécution de l’analyse de variance univariée, l’évaluation de la normalité au sein de chaque groupe thérapeutique a confirmé l’adéquation des distributions à la loi de Gauss (tests de Shapiro-Wilk, tous p > .20). L’hypothèse d’homogénéité des variances intra-groupes a été testée et validée à l’aide du test de Maurice Bartlett, B(2) = 3,67, p = .159. La dispersion des scores d’anxiété sur l’échelle STAI ne présentant aucune divergence statistiquement significative entre les conditions TCC (s2 = 9,17), MBSR (s2 = 17,11) et Témoin (s2 = 34,44), le postulat d’homoscédasticité a été retenu, justifiant l’application de l’ANOVA paramétrique standard sur le carré moyen résiduel combiné. »
Modèle d’énoncé académique conforme APA (Cas de rejet de H0) :
« L’hypothèse d’homoscédasticité a été rejetée de manière statistiquement significative par le test de Bartlett, B(2) = 14,82, p < .001, révélant une hétérogénéité marquée des variances résiduelles entre les conditions expérimentales. Face à cette violation du postulat de dispersion dans un plan d’échantillonnage aux effectifs inégaux, l’analyse de variance classique de Fisher a été écartée au profit de l’ANOVA robuste de Welch, FWelch(2, 14.32) = 8,45, p = .004. Les comparaisons par paires ultérieures ont été conduites à l’aide de la procédure post-hoc de Games-Howell afin de préserver le contrôle rigoureux du taux d’erreur de première espèce global. »
Pour guider le chercheur ou l’analyste dans sa démarche quotidienne, l’arbre de décision méthodologique suivant résume la trajectoire analytique à adopter :
- Vérification de la nature de la variable dépendante : Doit être quantitative continue sur échelle d’intervalle ou de rapport. Si ordinale, basculer directement vers les tests non paramétriques (Kruskal-Wallis).
- Vérification de l’indépendance : Observations issues de groupes indépendants sans mesures répétées. Si mesures répétées, utiliser le test de sphéricité de Mauchly.
- Test diagnostique de la normalité intra-groupe (Shapiro-Wilk) :
- Si la normalité est rigoureusement confirmée (p > 0,05 dans tous les groupes) : Appliquer le test de Bartlett. Si Bartlett n’est pas significatif, conduire l’ANOVA standard. Si Bartlett est significatif, conduire l’ANOVA de Welch.
- Si la normalité est violée (asymétrie, kurtosis prononcé, p < 0,05) : Écarter formellement le test de Bartlett. Appliquer le test de Brown-Forsythe (ou Fligner-Killeen). Si l’homogénéité est vérifiée sous Brown-Forsythe, conduire l’ANOVA standard ou une ANOVA sur données transformées. Si l’homogénéité est rejetée, basculer impérativement vers l’ANOVA de Welch ou vers des méthodes non paramétriques / de ré-échantillonnage bootstrap.
En observant scrupuleusement ce protocole décisionnel, les chercheurs en psychologie garantissent à leurs publications un niveau de rigueur méthodologique, de validité statistique et de reproductibilité empirique conforme aux exigences les plus élevées de la communauté scientifique internationale.
Références
- Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A – Mathematical and Physical Sciences, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
- Box, G. E. P. (1953). Non-normality and tests on variances. Biometrika, 40(3/4), 318–335. https://doi.org/10.2307/2333350
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Conover, W. J., Johnson, M. E., & Johnson, M. M. (1981). A comparative study of tests for homogeneity of variances, with applications to the outer continental shelf bidding data. Technometrics, 23(4), 351–361. https://doi.org/10.1080/00401706.1981.10487680
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Fligner, M. A., & Killeen, T. J. (1976). Distribution-free two-sample tests for scale. Journal of the American Statistical Association, 71(353), 210–213. https://doi.org/10.1080/01621459.1976.10481517
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.2307/1164979
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory (Form Y). Consulting Psychologists Press.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579