
Dans le champ de l’analyse quantitative et du calcul stochastique, la modélisation de l’aléa constitue un prérequis indispensable à toute démarche d’inférence scientifique. Qu’il s’agisse d’évaluer la survenue de comportements spécifiques en psychologie cognitive, d’anticiper les fluctuations d’un actif financier ou de quantifier les erreurs de mesure au sein d’une expérience psychophysique, la formalisation mathématique de l’incertitude exige des outils rigoureux, synthétiques et univoques. Parmi ces instruments d’ordonnancement théorique, le tableau de distribution de probabilité occupe une position centrale, servant d’interface cardinale entre la structure abstraite des variables aléatoires discrètes et leur manipulation analytique concrète.
Ce dispositif matriciel n’est pas une simple juxtaposition descriptive de données chiffrées ; il incarne la transcription exhaustive de la loi de probabilité qui régit un phénomène discret. En associant de façon déterministe chaque valeur possible d’une variable à sa mesure de probabilité théorique, le tableau permet d’ancrer l’observation empirique dans le cadre axiomatique de Kolmogorov. L’exhaustivité et l’exclusivité mutuelle qui caractérisent ses cellules offrent aux chercheurs une vision holistique de l’espace échantillonné, rendant possible le calcul direct des moments statistiques primordiaux que sont l’espérance mathématique et la variance.
Le présent article se propose de disséquer de manière exhaustive la nature, les propriétés structurales et les applications pratiques du tableau de distribution de probabilité. À travers une analyse épistémologique et méthodologique rigoureuse, enrichie de modélisations pas à pas, d’exemples empiriques empruntés aux sciences du comportement et d’une exploration systématique des erreurs interprétatives communes, ce guide exhaustif permettra au chercheur, à l’étudiant et au praticien de maîtriser parfaitement cet outil fondateur de la statistique mathématique.
1. Introduction au concept de tableau de distribution de probabilité
1.1 Définition formelle et fondements théoriques
Sur le plan de la théorie formelle des probabilités, un tableau de distribution de probabilité est une configuration matricielle structurée conçue pour décrire de manière intégrale le comportement d’une variable aléatoire discrète. Considérons un espace probabilisé défini par le triplet classique (Ω, ℱ, P), où Ω représente l’univers des événements possibles, ℱ la tribu des événements associés, et P une mesure de probabilité respectant les axiomes canoniques de la théorie de la mesure. Lorsque l’on définit une variable aléatoire discrète X, celle-ci opère comme une fonction mesurable appliquant les éléments de l’espace fondamental Ω sur un sous-ensemble dénombrable ou fini de nombres réels, noté X(Ω) = {x1, x2, …, xk, …}.
Le rôle fondamental de ce tableau est d’offrir une modélisation mathématique achevée des phénomènes expérimentaux où l’incertitude se matérialise sous forme de résultats quantifiables distincts. Contrairement à une description narrative ou à un inventaire brut d’observations parcellaires, le tableau de distribution fixe la loi de probabilité sous-jacente. Il établit une liaison fonctionnelle univoque entre chaque modalité numérique admissible xi et sa probabilité d’occurrence théorique pi = P(X = xi). Cette démarche permet de modéliser le comportement probabiliste du phénomène indépendamment de sa réalisation temporelle immédiate, érigeant la distribution en étalon théorique contre lequel les futures observations empiriques pourront être rigoureusement confrontées.
Une distinction conceptuelle absolue doit être maintenue entre la notion de fréquences relatives observées au terme d’un recueil de données et celle de probabilités théoriques articulées au sein de ce tableau. La fréquence relative d’un événement, calculée comme le quotient de son effectif constaté par la taille totale de l’échantillon empirique N, constitue une variable éminemment fluctuante soumise aux contingences de l’échantillonnage. En revanche, la probabilité consignée dans le tableau de distribution reflète la propension idéale, limite ou déductive, issue soit d’un modèle axiomatique a priori (comme dans les jeux de hasard parfaits), soit d’un processus de convergence asymptotique garanti par la loi des grands nombres. Confondre ces deux statuts épistémologiques conduirait à méconnaître la frontière séparant la statistique purement descriptive de la théorie de la décision sous incertitude.
Dans l’analyse quantitative appliquée aux sciences du comportement, à la psychologie différentielle et à la psychométrie, cette différenciation conceptuelle s’avère critique. Les chercheurs manipulent fréquemment des variables à caractère intrinsèquement discret, telles que le nombre de réponses correctes à une tâche de discrimination perceptive, l’occurrence d’un comportement d’évitement ou le positionnement sur une échelle d’évaluation graduée. La formalisation de ces comportements sous forme d’une distribution de probabilités tabulée confère un ancrage mathématique précis aux hypothèses psychologiques, permettant de substituer à de simples intuitions qualitatives des paramètres quantitatifs stables et comparables d’une population clinique ou expérimentale à une autre.
1.2 Importance méthodologique en analyse statistique
D’un point de vue purement méthodologique, le tableau de distribution de probabilité s’impose comme une étape incontournable de réduction et d’organisation des données théoriques en amont de toute démarche d’inférence statistique et de vérification d’hypothèses. Avant d’engager des procédures d’estimation paramétrique ou de tester des écarts à l’aide de statistiques inférentielles, le chercheur doit obligatoirement expliciter la loi de référence qui régit sa variable d’intérêt. Le tableau offre cette clarification logico-mathématique préalable : en un espace graphique synthétique et condensé, il condense l’intégralité de l’espace des possibles et prévient les dérives interprétatives liées à la dispersion intuitive des données.
Cette condensation analytique engendre une clarté remarquable en autorisant la visualisation directe des poids probabilistes alloués à chaque segment de l’espace événementiel. En consultant les lignes successives du tableau, le praticien repère instantanément les valeurs centrales dotées de la masse de probabilité prépondérante, ainsi que les zones d’extrême rareté statistique reléguées aux extrémités de la distribution. Cette lecture panoramique prévient le biais d’ancrage cognitif fréquent chez l’expérimentateur, lequel consiste à accorder une importance démesurée à des réalisations anecdotiques mais psychologiquement saillantes, au détriment de la dynamique stochastique globale du modèle envisagé.
En outre, la formalisation de la loi de probabilité sous un format tabulaire constitue le socle indispensable sur lequel reposent l’évaluation du risque probabiliste et les modèles de prise de décision rationnelle. Que l’on considère la théorie classique de l’utilité espérée ou des extensions contemporaines telles que la théorie des perspectives développée par Daniel Kahneman et Amos Tversky, toute quantification de l’incertitude décisionnelle exige l’assignation de probabilités explicites à chaque état de la nature envisageable. En fournissant l’inventaire complet et vérifiable de ces grandeurs, le tableau de distribution de probabilité permet de calibrer les fonctions de gain, d’optimiser l’allocation de ressources sous contrainte et de borner formellement les risques de type I et II inhérents aux choix stratégiques ou cliniques.
2. Composantes structurelles d’un tableau de distribution de probabilité
2.1 La variable aléatoire discrète et ses valeurs réalisables
L’ossature architecturale d’un tableau de distribution de probabilité repose avant tout sur la définition exhaustive de la variable aléatoire sous examen, traditionnellement notée par une lettre majuscule de l’alphabet latin, le plus fréquemment X. Cette convention sémiotique rappelle la nature fonctionnelle de l’entité statistique, laquelle transcende toute observation particulière pour incarner le générateur sous-jacent de l’ensemble des événements possibles. Dans la structure matricielle standard, la première colonne (ou la ligne supérieure, selon l’orientation adoptée) est réservée à l’énumération strictement ordonnée des valeurs numériques concrètes que peut effectivement endosser cette variable aléatoire, dénotées par la minuscule indicée correspondante : x1, x2, x3, …, xk.
L’ordonnancement mathématique de ces modalités numériques doit impérativement obéir à une hiérarchie scalaire rigoureuse, généralement croissante, afin de faciliter l’identification ultérieure des fonctions de répartition cumulées et des mesures de position centrale. Chaque modalité xi consignée dans cette première série structurelle représente un point singulier et discret sur l’axe des réels. L’intervalle séparant deux modalités successives peut être fixe, comme dans le cas de comptages unitaires d’événements, ou variable, lorsque les scores attribués résultent de pondérations arbitraires ou de valeurs d’utilité prédéterminées. L’exigence fondamentale demeure toutefois la ponctualité discrète de chaque niveau pris en compte.
De surcroît, deux postulats ensemblistes fondamentaux régissent la constitution de cette série de valeurs : le principe d’exhaustivité et le principe d’exclusivité mutuelle. L’exclusivité mutuelle dicte qu’une même réalisation de l’expérience aléatoire ne peut en aucun cas engendrer deux valeurs distinctes simultanément ; les événements élémentaires générant xi et xj (pour i ≠ j) doivent constituer des ensembles disjoints, c’est-à-dire que leur intersection est strictement vide :
{X = xi} ∩ {X = xj} = ∅
Quant à l’exhaustivité, elle exige que l’union de tous ces événements élémentaires couvre l’intégralité sans résidu de l’univers fondamental Ω. Dans le champ des métriques quantitatives comportementales, ces conditions imposent qu’un protocole expérimental puisse catégoriser chaque comportement cible au sein d’une seule et unique modalité métrique préétablie, qu’il s’agisse de scores à un test d’aptitude, du nombre d’erreurs de frappe ou du total de micro-réveils nocturnes enregistrés chez un sujet d’étude.
2.2 La colonne des probabilités associées
En miroir direct de la colonne des réalisations scalaires, la seconde colonne structurelle matérialise l’assignation stochastique en hébergeant la fonction de masse de probabilité, formellement libellée sous la notation P(X = xi) ou, de façon abrégée mais rigoureuse, p(xi) ou pi. Cette composante associe à chaque point discret de l’espace d’arrivée une mesure de probabilité précise, quantifiant la vraisemblance théorique d’apparition de la modalité associée lors d’une instanciation singulière du processus générateur sous-jacent. L’alignement horizontal strict entre chaque xi et son P(X = xi) correspondant constitue le principe invariant assurant la lisibilité et l’intégrité fonctionnelle de la table.
L’implémentation de cette colonne requiert un respect scrupuleux des normes de précision numérique et des conventions d’arrondi consacrées par la communauté scientifique. Dans la mesure où les probabilités théoriques sont fréquemment issues de fractions rationnelles ou de fonctions combinatoires générant des développements décimaux infinis, le choix du nombre de décimales doit préserver l’équilibre entre représentabilité visuelle et préservation de la masse unitaire globale. En règle générale, la documentation académique prescrit l’utilisation de trois à quatre décimales significatives, tout en proscrivant les arrondis intermédiaires qui pourraient introduire un biais artificiel cumulé lors des calculs d’espérance ou de dispersion.
Le tableau ci-après illustre la disposition canonique bidimensionnelle prescrite par les normes méthodologiques pour consigner la fonction de masse d’une variable aléatoire discrète finie comptant k modalités :
| Valeurs réalisables de la variable (xi) | Probabilité théorique associée P(X = xi) |
|---|---|
| x1 | p1 |
| x2 | p2 |
| x3 | p3 |
| … | … |
| xk | pk |
| Total / Somme théorique | Σ pi = 1,000 |
Cette structure garantit que chaque probabilité est univoquement indexée sur sa réalisation propre, fournissant ainsi une cartographie unifiée prête pour le traitement mathématique déductif.
2.3 Conventions typographiques et notations formelles
L’écriture formelle des probabilités est soumise à un ensemble de règles syntaxiques précises fixées par les standards internationaux de la statistique mathématique (tels que ceux de l’International Statistical Institute et de l’American Psychological Association). La rigueur de cette notation réside dans la dissociation typographique systématique entre la variable aléatoire en tant qu’entité théorique globale et les valeurs particulières qu’elle est susceptible d’adopter au cours d’une épreuve. Par convention invariable, les variables aléatoires sont impérativement composées en majuscules d’imprimerie romaines ou italiques (X, Y, Z), tandis que les réalisations observables, constantes numériques ou indices d’évaluation s’inscrivent invariablement en lettres minuscules (x, y, z ou xi, yj).
La formulation synthétique de l’événement élémentaire s’écrit dès lors sous la forme standardisée {X = xi}, laquelle se lit littéralement : « l’événement consistant en l’attribution par la variable X de la valeur spécifique xi ». La probabilité attachée à cet événement s’exprime par P(X = xi), la lettre P majuscule désignant la mesure probabiliste définie sur la tribu ℱ. L’omission ou la confusion de ces niveaux sémiotiques — par exemple l’usage fautif de P(x) pour caractériser la variable ou de P(X) sans assignation de modalité — engendre des ambiguïtés sémantiques préjudiciables à la clarté démonstrative et invalide la précision de l’énoncé mathématique.
De surcroît, le formalisme calculatoire mobilise des opérateurs normalisés pour régir les manipulations arithmétiques du tableau. L’opérateur de sommation grec Σ (Sigma majuscule) s’accompagne obligatoirement d’indices de bornage définis, spécifiant le domaine de sommation sur l’ensemble fini ou dénombrable des modalités considérées :
∑i=1k P(X = xi)
Dans les publications scientifiques de haut rang, ces notations sont insérées au sein de tables standardisées dont les entêtes doivent expliciter sans ambiguïté la nature des unités physiques ou psychométriques répertoriées, évitant les surcharges de texte inutiles et cantonnant les détails méthodologiques aux notes techniques associées au bas de la table.
3. Propriétés mathématiques fondamentales du tableau
3.1 La contrainte de normalisation : la somme unitaire des probabilités
Pour qu’une configuration tabulaire prétende au statut formel de tableau de distribution de probabilité, elle doit satisfaire sans compromis à la condition d’équilibrage théorique désignée sous le terme d’axiome de normalisation. En vertu du deuxième axiome énoncé par le mathématicien Andreï Kolmogorov dans ses Grundbegriffe der Wahrscheinlichkeitsrechnung (1933), la mesure de probabilité assignée à l’univers des événements Ω est identiquement égale à l’unité. Transposée à l’architecture d’une variable aléatoire discrète déployée en tableau, cette contrainte fondamentale s’exprime mathématiquement par la sommation stricte des probabilités allouées à l’ensemble exhaustif des réalisations élémentaires mutuellement exclusives :
∑i=1k P(X = xi) = 1
Cette sommation unitaire n’est pas un artifice conventionnel ou une commodité graphique ; elle découle de la structure même de la théorie ensembliste sous-jacente. Puisque les événements {X = xi} forment une partition stricte de l’univers Ω, la probabilité de l’union dénombrable de ces événements disjoints équivaut, selon l’axiome de σ-additivité, à la somme arithmétique de leurs probabilités individuelles :
P(Ω) = P(∪i=1k {X = xi}) = ∑i=1k P(X = xi) = 1
Dans la pratique analytique, cette propriété sert de critère de vérification absolu et de mécanisme de contrôle pour détecter les erreurs de modélisation ou l’omission inadmissible de certaines issues expérimentales. Tout tableau présentant une somme des probabilités divergente — qu’elle soit strictement inférieure à un (Σ pi < 1) ou supérieure à un (Σ pi > 1) — est mathématiquement vicié et impropre à l’analyse. Une somme déficitaire révèle invariablement l’occultation d’un ou plusieurs états possibles de la variable, tandis qu’un excédent indique une violation du principe d’exclusivité mutuelle, révélant qu’un événement élémentaire a été comptabilisé de façon redondante au travers de plusieurs modalités concurrentes.
3.2 L’axiome de non-négativité et de bornage unitaire
La seconde condition nécessaire et suffisante qui régit la légitimité probabiliste d’un tableau réside dans le principe de non-négativité et de bornage métrique de chaque cellule. D’après le premier axiome de Kolmogorov, toute probabilité attribuée à un événement quelconque de la tribu ℱ est obligatoirement un nombre réel non négatif. Par voie de conséquence, chaque probabilité P(X = xi) consignée dans la seconde colonne du tableau doit impérativement s’inscrire au sein de l’intervalle fermé [0, 1] du corps des nombres réels :
∀ i ∈ {1, …, k}, 0 ≤ P(X = xi) ≤ 1
Cette délimitation formelle interdit rigoureusement l’émergence de toute valeur stochastique négative, laquelle ne posséderait aucune interprétation sémantique ni géométrique dans le cadre de la théorie des probabilités classique. De la même manière, aucune probabilité individuelle ne saurait excéder la valeur scalaire 1,00, l’unité représentant l’évaluation probabiliste maximale d’un événement qui advient avec une certitude absolue. Les valeurs limites de cet intervalle fermé portent des significations théoriques catégoriques : une modalité xi dotée d’une probabilité rigoureusement nulle P(X = xi) = 0 est qualifiée d’événement quasi-impossible (dans le cadre discret, impossible au sens strict dans le modèle envisagé), ce qui justifie fréquemment son omission pure et simple de la table sans altérer la cohérence du système.
Réciproquement, l’attribution de la probabilité unitaire P(X = xi) = 1 à une modalité spécifique réduirait la variable à une constante déterministe — dite distribution dégénérée —, annulant toute variance et rendant obsolète la structure pluricellulaire du tableau. Dès lors, toute tentative d’introduire des nombres négatifs, des pourcentages excédant 100 % ou des valeurs imaginaires au sein d’une distribution tabulaire relève soit d’une coquille numérique rédhibitoire, soit d’une incompréhension formelle des fondements de la modélisation statistique.
4. Exemple concret et détaillé : analyse pas à pas
4.1 Présentation du cas pratique illustratif
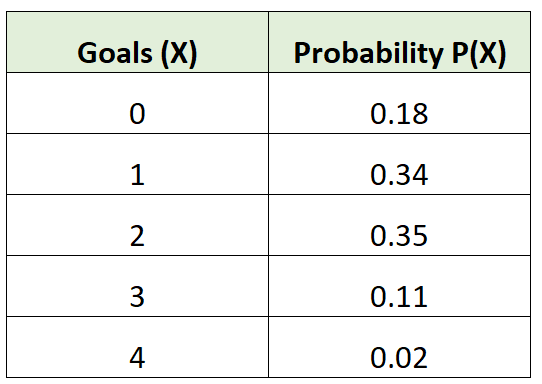
Afin d’ancrer ces considérations axiomatiques dans une dimension concrète et didactique, nous proposons d’analyser en détail un scénario standard modélisant la performance offensive d’une équipe de football professionnel au cours d’une compétition de haut niveau. Dans cet environnement d’observation, les conditions tactiques, psychologiques et environnementales génèrent une variabilité stochastique que l’on peut synthétiser au travers d’une variable aléatoire discrète. Définissons la variable X comme le « nombre total de buts marqués par l’équipe cible au cours d’un match officiel de 90 minutes ».
Sur la base d’une analyse longitudinale conduite sur plusieurs saisons antérieures et adossée à un modèle d’ajustement empirique consolidé, l’espace des réalisations observables a été circonscrit à l’ensemble fini de valeurs entières discrètes : X(Ω) = {0, 1, 2, 3, 4}. Pour les besoins du modèle, la probabilité théorique d’inscrire strictement plus de quatre buts est considérée comme négligeable au seuil de précision retenu, fixant ainsi le domaine de définition de notre variable d’étude. Les attributions probabilistes théoriques assignées à chaque niveau de performance offensive sont établies comme suit :
- Probabilité de ne marquer aucun but : P(X = 0) = 0,18
- Probabilité de marquer exactement un but : P(X = 1) = 0,34
- Probabilité de marquer exactement deux buts : P(X = 2) = 0,35
- Probabilité de marquer exactement trois buts : P(X = 3) = 0,11
- Probabilité de marquer exactement quatre buts : P(X = 4) = 0,02
Ce jeu de données constitue une base empirique et conceptuelle robuste. Il reproduit fidèlement la dynamique observée dans les sports d’équipe à faible taux de score unitaire, tout en conservant une structure arithmétique suffisamment épurée pour autoriser des calculs analytiques explicites.
4.2 Vérification systématique de la validité du tableau
Avant d’engager la moindre exploitation déductive de ces chiffres ou de formuler des prédictions comportementales, il convient d’exécuter un protocole strict de vérification de la conformité axiomatique du tableau de distribution ainsi constitué. Cette démarche d’audit statistique repose sur la vérification conjointe des deux principes fondamentaux détaillés dans la section précédente : la non-négativité unitaire et la complétude de la normalisation.
Premièrement, nous procédons à l’inspection individuelle de chaque terme de masse probabiliste afin de s’assurer de son inclusion stricte dans l’intervalle canonique [0, 1] :
- Pour x = 0 : 0 ≤ 0,18 ≤ 1 (Condition satisfaite)
- Pour x = 1 : 0 ≤ 0,34 ≤ 1 (Condition satisfaite)
- Pour x = 2 : 0 ≤ 0,35 ≤ 1 (Condition satisfaite)
- Pour x = 3 : 0 ≤ 0,11 ≤ 1 (Condition satisfaite)
- Pour x = 4 : 0 ≤ 0,02 ≤ 1 (Condition satisfaite)
Deuxièmement, nous soumettons la série des probabilités à l’opérateur de sommation exhaustif sur l’espace d’arrivée afin de vérifier l’exactitude de la normalisation unitaire :
∑i=04 P(X = xi) = P(X = 0) + P(X = 1) + P(X = 2) + P(X = 3) + P(X = 4)
∑i=04 P(X = xi) = 0,18 + 0,34 + 0,35 + 0,11 + 0,02 = 1,00
La somme arithmétique étant rigoureusement égale à l’unité sans le moindre écart résiduel, et toutes les probabilités individuelles étant intrinsèquement non négatives et inférieures à un, nous pouvons affirmer avec une certitude mathématique irréfutable que ce tableau constitue une représentation valide, complète et rigoureuse de la loi de probabilité de la variable X.
4.3 Interprétation contextuelle des probabilités individuelles et combinées
Dès lors que la validité structurale de la table est formellement certifiée, celle-ci devient un instrument de calcul opérationnel d’une grande puissance analytique. L’exploitation première consiste en la lecture directe des probabilités ponctuelles : par simple consultation de la troisième ligne du tableau, le chercheur ou le stratège sportif déduit que la probabilité d’enregistrer exactement deux réalisations offensives lors d’une confrontation est de 0,35, ce qui équivaut rigoureusement à une proportion de 35 % de chances dans le cadre de ce modèle théorique.
Néanmoins, la puissance opérationnelle du tableau se déploie pleinement lors de la résolution de problèmes probabilistes complexes impliquant des événements composés disjonctifs. En vertu de l’additivité finie des mesures de probabilités sur des ensembles disjoints, la probabilité que l’événement appartienne à un sous-ensemble particulier de réalisations correspond à la sommation directe des probabilités associées aux modalités visées. Supposons que l’on souhaite quantifier la probabilité que l’équipe réussisse une performance positive, c’est-à-dire marquer au moins un but au cours de la rencontre. Cet événement s’exprime sous la forme {X ≥ 1}. Deux démarches de résolution sont envisageables à partir du tableau :
Par sommation directe des états satisfaisant à la condition :
P(X ≥ 1) = P(X = 1) + P(X = 2) + P(X = 3) + P(X = 4)
P(X ≥ 1) = 0,34 + 0,35 + 0,11 + 0,02 = 0,82 (soit 82 %)
Par la méthode du passage à l’événement complémentaire, fréquemment plus économique en calcul lorsque la table compte un nombre élevé de lignes :
P(X ≥ 1) = 1 – P(X = 0) = 1 – 0,18 = 0,82
De façon analogue, si l’on cherche à cerner la probabilité d’un intervalle de performance offensive modérée, défini par l’occurrence de 1 à 3 buts inclus {1 ≤ X ≤ 3}, le calcul s’opère par l’addition sélective des tranches du tableau :
P(1 ≤ X ≤ 3) = P(X = 1) + P(X = 2) + P(X = 3) = 0,34 + 0,35 + 0,11 = 0,80
Le modèle révèle ainsi qu’il existe une probabilité cumulée de 80 % que le score de l’équipe s’inscrive précisément dans cette fourchette opérationnelle, démontrant la souplesse d’interrogation offerte par la table.
5. Calcul et interprétation de l’espérance mathématique
5.1 Formulation algébrique de la moyenne théorique
L’inventaire complet des probabilités au sein d’un tableau permet d’extraire des paramètres synthétiques d’importance majeure, au premier rang desquels figure l’espérance mathématique, communément dénotée E(X) ou symbolisée par la lettre grecque μ. L’espérance représente la moyenne théorique d’une variable aléatoire discrète, pondérée rigoureusement par la structure probabiliste propre au phénomène. D’un point de vue conceptuel, elle n’exprime pas la valeur la plus fréquente (qui correspond au mode statistique), mais bien le barycentre géométrique, ou centre de gravité idéal, de l’ensemble de la distribution de probabilité projetée sur l’axe des nombres réels.
La formulation algébrique canonique de cette moyenne théorique pour une variable aléatoire discrète finie prend la forme de la somme des produits scalaires de chaque modalité réalisable xi par sa probabilité d’apparition respective P(X = xi) :
μ = E(X) = ∑i=1k xi × P(X = xi)
D’un point de vue épistémologique, une césure majeure doit être tracée entre cette espérance théorique E(X) et la moyenne arithmétique empirique, notée traditionnellement x̄, calculée sur un échantillon concret de n observations. Alors que la moyenne de l’échantillon est soumise aux fluctuations inhérentes à la sélection contingente des sujets ou des essais observés, l’espérance mathématique est une constante déterministe rigide inhérente au modèle probabiliste sous-jacent. En vertu du théorème de la loi forte des grands nombres, la moyenne arithmétique empirique d’une suite de variables aléatoires indépendantes et identiquement distribuées converge presque sûrement vers cette espérance théorique à mesure que le nombre d’essais tend vers l’infini :
limn → ∞ (1/n) ∑j=1n Xj = E(X)
L’espérance synthétise donc le rendement théorique à long terme du générateur probabiliste.
5.2 Application numérique pas à pas à l’exemple des buts
Pour matérialiser cette démarche d’intégration arithmétique, appliquons rigoureusement la formule générale aux données de notre tableau de performance offensive exposé précédemment. Le calcul de l’espérance impose d’effectuer le produit individuel de chaque réalisation par sa probabilité attenante, puis de procéder à la sommation systématique des termes intermédiaires :
| Nombre de buts (xi) | Probabilité P(X = xi) | Produit pondéré : xi × P(X = xi) |
|---|---|---|
| 0 | 0,18 | 0 × 0,18 = 0,00 |
| 1 | 0,34 | 1 × 0,34 = 0,34 |
| 2 | 0,35 | 2 × 0,35 = 0,70 |
| 3 | 0,11 | 3 × 0,11 = 0,33 |
| 4 | 0,02 | 4 × 0,02 = 0,08 |
| Espérance mathématique globale E(X) = | 0,00 + 0,34 + 0,70 + 0,33 + 0,08 = 1,45 | |
Le traitement analytique de la table aboutit à une valeur attendue globale de E(X) = 1,45 but par match. L’interprétation de ce résultat exige une mise en garde épistémologique classique : bien que la variable aléatoire X appartienne à l’ensemble discret des entiers naturels non négatifs (♮), son espérance mathématique s’inscrit au sein de l’espace continu des réels (ℝ). Il est matériellement impossible pour l’équipe d’inscrire 1,45 but lors d’une confrontation particulière unique. La valeur 1,45 constitue une abstraction théorique : elle indique que si l’on observait un nombre colossal de rencontres disputées dans des conditions stochastiques parfaitement identiques, le ratio arithmétique total des buts marqués rapporté au nombre de matchs convergerait irrémédiablement vers cette valeur moyenne de 1,45.
5.3 Implications psychologiques et décisionnelles de l’espérance
Dans les sciences de la cognition, du jugement humain et du comportement économique, l’espérance mathématique calculée à partir d’un tableau de distribution constitue le critère normatif traditionnel régissant les paradigmes de décision sous incertitude. Modélisée originellement au XVIIe siècle par Blaise Pascal et Pierre de Fermat, l’évaluation du décideur rationnel postule que tout acteur confronté à des choix stochastiques multiples opte préférentiellement pour l’alternative maximisant l’espérance mathématique de son utilité ou de son gain matériel. Cette grandeur fournit un étalon objectif permettant de transcender les biais de perception immédiate et de rationaliser la confrontation au risque probabiliste.
Cependant, les recherches expérimentales conduites tout au long de la seconde moitié du XXe siècle ont mis en exergue de profondes limites psychologiques associées à l’utilisation brute de l’espérance comme seul indicateur de prédiction comportementale. Des paradoxes empiriques majeurs, tels que le paradoxe de Saint-Pétersbourg conceptualisé par Daniel Bernoulli ou le paradoxe d’Allais, ont démontré que les agents humains ne basent pas leurs choix sur le calcul strict du barycentre probabiliste d’un tableau. Des considérations d’aversion au risque, de sensibilité asymétrique aux pertes par rapport aux gains, ou encore de distorsion cognitive des faibles probabilités introduisent des divergences massives entre la rationalité mathématique incarnée par E(X) et les trajectoires décisionnelles réelles.
En pratique, l’espérance mathématique conserve néanmoins une pertinence diagnostique irremplaçable : elle fournit le point d’ancrage fondamental permettant de mesurer avec exactitude la magnitude du biais cognitif d’un agent. En quantifiant l’écart entre la valeur théoriquement attendue calculable sur le tableau et l’équivalent certain formulé par un sujet dans le cadre d’un protocole d’évaluation des risques, les spécialistes des neurosciences décisionnelles parviennent à modéliser la fonction d’utilité psychologique individuelle avec une finesse inégalée.
6. Mesure de la variabilité : variance et écart-type d’une distribution tabulée
6.1 Dérivation formelle de la variance théorique
Si l’espérance mathématique caractérise l’ancrage central d’une loi de probabilité, elle s’avère manifestement incomplète pour résumer la morphologie globale d’une distribution. Deux variables aléatoires distinctes peuvent présenter une espérance rigoureusement identique tout en déployant des architectures de dispersion radicalement divergentes : l’une concentrant la quasi-totalité de sa masse probabiliste au voisinage immédiat de la moyenne, l’autre dispersant ses poids stochastiques sur des réalisations extrêmement distantes. Pour combler ce déficit informatif, la théorie mathématique adjoint au premier moment un second moment centré dénommé variance, noté Var(X) ou σ².
La variance théorique se définit formellement comme l’espérance mathématique des carrés des écarts des valeurs réalisables par rapport à la moyenne globale μ. Dans le contexte structurel d’un tableau de distribution, son calcul repose sur l’équation générale suivante :
σ² = Var(X) = ∑i=1k (xi – μ)2 × P(X = xi)
Bien que cette formule d’écartement direct reflète fidèlement la géométrie de la dispersion, sa manipulation calculatoire manuelle s’avère particulièrement propice à l’introduction d’erreurs d’arrondi récurrentes lorsque l’espérance μ est un nombre décimal complexe. Dès lors, les statisticiens privilégient universellement une formulation dérivée, rigoureusement équivalente sur le plan algébrique, connue sous le nom de théorème de König-Huygens :
Var(X) = E(X2) – [E(X)]2 = ∑i=1k xi2 × P(X = xi) – μ2
Cette forme opérationnelle découle directement de la linéarité de l’opérateur d’espérance en développant le carré du binôme (X – μ)2 = X2 – 2μX + μ2. Elle simplifie considérablement l’exploitation du tableau de distribution en substituant à l’extraction fastidieuse d’écarts individuels le calcul direct d’une nouvelle colonne de moments bruts du second ordre xi2 × P(X = xi).
6.2 Calcul pratique de l’écart-type
L’utilisation pratique de la variance se heurte toutefois à un écueil interprétatif de taille : par construction mathématique quadratique, l’unité métrique de la variance correspond au carré de l’unité originale de la variable aléatoire. Si la variable modélise des buts marqués, sa variance s’exprime en « buts au carré », entité dénuée de sens physique intuitif. Pour restaurer l’échelle d’observation initiale et autoriser des comparaisons dimensionnelles directes avec la moyenne théorique, les statisticiens opèrent l’extraction de la racine carrée positive de la variance, obtenant ainsi l’écart-type théorique, universellement symbolisé par la lettre grecque minuscule σ :
σ = √Var(X) = √σ²
Procédons à l’application exhaustive et méthodique de la formule de König-Huygens sur le jeu de données relatives à notre équipe sportive, en enrichissant notre démarche d’un calcul pas à pas du moment du second ordre :
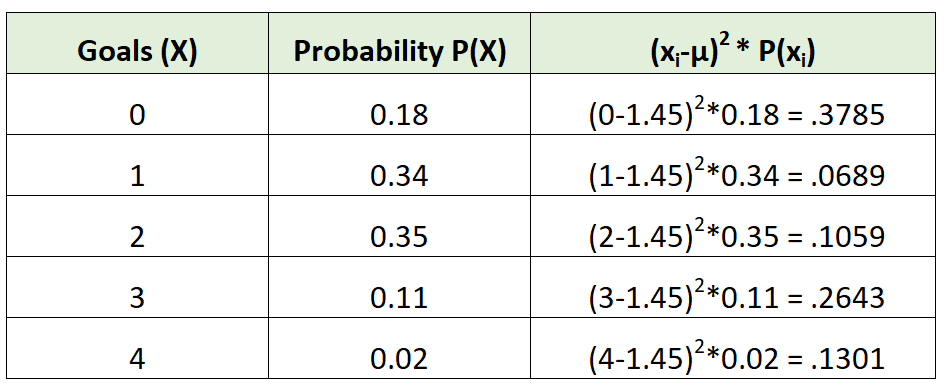
Calcul des composantes du moment d’ordre deux E(X2) :
- Pour x = 0 : 02 × 0,18 = 0 × 0,18 = 0,000
- Pour x = 1 : 12 × 0,34 = 1 × 0,34 = 0,340
- Pour x = 2 : 22 × 0,35 = 4 × 0,35 = 1,400
- Pour x = 3 : 32 × 0,11 = 9 × 0,11 = 0,990
- Pour x = 4 : 42 × 0,02 = 16 × 0,02 = 0,320
Sommation des contributions pour établir E(X2) :
E(X2) = 0,000 + 0,340 + 1,400 + 0,990 + 0,320 = 3,050
Soustraction du carré de l’espérance mathématique (rappel : μ = 1,45) :
Var(X) = E(X2) – [E(X)]2 = 3,050 – (1,45)2
Var(X) = 3,050 – 2,1025 = 0,9475
Extraction finale de l’écart-type σ :
σ = √0,9475 ≈ 0,9734
L’écart-type de notre distribution s’élève donc approximativement à 0,97 but. Cet indicateur dimensionnel atteste que la majorité de la masse de probabilité gravite dans une bande d’environ une unité de part et d’autre de la moyenne de 1,45, quantifiant objectivement la variabilité attendue de la performance sportive au cours d’un match lambda.
6.3 Utilité de la variance dans l’évaluation du risque comportemental
Au-delà de la simple caractérisation descriptive, la variance et l’écart-type dérivés d’un tableau de distribution constituent les indicateurs princeps de l’incertitude perçue et de l’instabilité comportementale au sein des sciences cognitives et sociales. Dans les paradigmes expérimentaux portant sur l’apprentissage par renforcement, un environnement associé à une distribution de récompenses présentant une variance substantielle suscite chez l’individu un état d’imprévisibilité stochastique majeur, mobilisant des structures cérébrales spécifiques telles que l’insula antérieure et l’amygdale, associées au traitement de l’ambiguïté.
À l’inverse, une distribution dont la masse probabiliste est quasi exclusivement confinée à un intervalle étroit — caractérisée par une variance infinitésimale — engendre une régularité comportementale et une stabilisation rapide des règles d’inférence chez le sujet expérimental. La comparaison rigoureuse de profils d’individus ou de cohortes cliniques repose fréquemment sur cette dichotomie : deux patients peuvent présenter un nombre moyen identique de crises d’angoisse par semaine (espérance équivalente), mais présenter des écarts-types profondément disparates. Le premier, caractérisé par un écart-type modéré, subira des manifestations chroniques prévisibles ; le second, soumis à un écart-type élevé, sera confronté à des phases d’accalmie trompeuses alternant brutalement avec des paroxysmes de détresse psychologique aiguë.
Le tableau de distribution de probabilité, en intégrant simultanément la projection de l’espérance et le déploiement de sa variance, confère ainsi au chercheur la capacité d’opérationnaliser le risque sous sa double dimension : le retour moyen attendu et la volatilité structurelle de son actualisation empirique.
7. Distinction fondamentale : distributions discrètes versus distributions continues
7.1 Spécificité exclusive des variables aléatoires discrètes pour les tableaux
Une rigueur méthodologique sans faille exige d’identifier formellement les frontières d’applicabilité du tableau de distribution de probabilité. Cet outil graphique et conceptuel s’adresse de façon quasi exclusive aux variables aléatoires discrètes. Une variable discrète se caractérise mathématiquement par le fait que son ensemble de réalisations possibles — l’espace image X(Ω) — est soit rigoureusement fini, soit au maximum infini dénombrable (pouvant être mis en bijection directe avec l’ensemble des entiers naturels ♮).
C’est cette propriété d’isolement topologique des modalités qui rend techniquement possible la disposition tabulaire : chaque valeur réalisable xi est isolée des autres par un intervalle strictement non nul, autorisant son inscription sur une ligne distincte de la première colonne, face à laquelle on peut faire correspondre une masse de probabilité ponctuelle strictement positive P(X = xi) > 0. Qu’il s’agisse du comptage de stimuli détectés, du relevé du nombre d’enfants par foyer ou du résultat issu du lancer d’un polyèdre régulier, la morphologie discrète garantit que l’accumulation des masses ponctuelles permet de reconstituer l’espace de probabilité total dans sa complétude unitaire.
En revanche, tenter de transposer brutalement la structure simple d’un tableau à un continuum géométrique ou temporel infini se heurte à une impossibilité logique et matérielle. L’infinité non dénombrable des points constituant un intervalle réel quelconque excède irréversiblement toute capacité d’inventaire discret, invalidant de facto l’usage de tables d’assignation ponctuelle directe pour les grandeurs de cette nature.
7.2 Transition vers la fonction de densité de probabilité continue
Lorsque la variable aléatoire sous examen adopte une nature continue — ce qui se produit dès lors que son domaine de définition correspond à un continuum réel indénombrable (un intervalle borné [a, b] ou l’ensemble complet ℝ), comme la mesure d’un temps de réaction chronométrique, d’une pression artérielle ou de la concentration d’un biomarqueur sérique —, la fonction de masse de probabilité perd toute validité opérationnelle. Dans un cadre continu rigoureusement formalisé, la probabilité ponctuelle théorique assignée à n’importe quelle valeur infiniment précise x est rigoureusement nulle :
P(X = x) = 0, ∀ x ∈ ℝ
Cette nullité ponctuelle, qui heurte souvent l’intuition profane, découle de la division de la masse unitaire par une infinité non dénombrable de points constitutifs. Dès lors, le tableau classique est remplacé par une fonction de densité de probabilité, traditionnellement notée f(x). La probabilité n’est plus matérialisée par la hauteur d’un segment sur une grille discrète, mais par l’aire géométrique sous la courbe de la densité délimitée par un intervalle de valeurs [a, b]. Sur le plan formel, la sommation discrète du tableau cède la place à l’intégration continue au sens de Riemann :
P(a ≤ X ≤ b) = ∫ab f(x) dx
L’analogie structurelle demeure intacte : la condition de normalisation unitaire du tableau Σ pi = 1 trouve son pendant continu dans l’exigence d’une surface totale unitaire sous la courbe intégrale :
∫-∞+∞ f(x) dx = 1
Cependant, l’impossibilité de tabuler individuellement chaque point d’une fonction de densité continue requiert l’abandon de la table de masse au profit de tables de répartition cumulative intégrée, telles que les tables historiques de la loi normale centrée réduite 𝒩(0, 1).
7.3 Discrétisation de variables continues en psychométrie
En dépit de cette frontière théorique infranchissable, la pratique empirique des sciences du comportement recourt massivement à un procédé méthodologique d’hybridation : la discrétisation d’une variable continue sous forme de regroupement en classes d’intervalles ordonnés. Face à des mesures intrinsèquement continues — comme le temps de latence avant réponse perceptive mesuré en millisecondes ou le niveau de cortisol salivaire mesuré en microgrammes par décilitre —, le chercheur choisit fréquemment de partitionner l’axe des réels en une série finie d’intervalles contigus et mutuellement exclusifs [ck, ck+1[.
Dès lors que ce partitionnement est opéré, la variable continue originelle est convertie en une variable discrète ordinale ou catégorielle. Il devient parfaitement légitime de consigner ces classes d’intervalles au sein de la colonne de gauche d’un tableau de distribution classique, et de consigner dans la seconde colonne la masse de probabilité intégrée sur chaque tranche :
pk = P(ck ≤ X < ck+1) = ∫ckck+1 f(x) dx
Ce procédé de discrétisation offre un bénéfice indéniable : il permet une communication synthétique des résultats, autorise des tests d’adéquation non paramétriques (tels que le test du Khi-deux d’ajustement) et aligne l’analyse sur les contraintes de formulation de diagnostics cliniques par paliers. Toutefois, ce gain en clarté s’accompagne irrémédiablement d’une perte d’information statistique irréversible, consécutive à l’amalgame de toutes les micro-variations individuelles au sein d’une unique modalité de classe, introduisant un lissage artificiel de la variance sous-jacente.
8. Applications du tableau de distribution en psychologie et sciences cognitives
8.1 Modélisation des décisions face au risque et à l’incertitude
L’un des apports les plus féconds du tableau de distribution de probabilité réside dans la modélisation des processus de choix et d’évaluation probabiliste au sein de la théorie des perspectives, formulée par les psychologues Daniel Kahneman et Amos Tversky (1979). Dans les protocoles de psychologie cognitive expérimentale, les perspectives de choix — communément désignées sous le terme de loteries expérimentales — sont présentées aux participants sous la forme stricte de distributions de probabilités tabulées liant des rétributions monétaires ou symboliques spécifiques à des probabilités discrètes précises d’occurrence.
Le tableau ci-dessous illustre un paradigme expérimental typique de choix sous risque, structurant deux perspectives d’investissement mutuellement exclusives proposées à un panel de sujets :
| Option Risquée A | Option Sécurisée B | ||
|---|---|---|---|
| Gain potentiel (xi) | Probabilité P(X = xi) | Gain potentiel (yj) | Probabilité P(Y = yj) |
| + 1 000 € | 0,50 | + 450 € | 1,00 |
| 0 € | 0,50 | — | — |
| E(A) = 500 € | Σ p = 1,00 | E(B) = 450 € | Σ p = 1,00 |
L’analyse de ces tableaux permet aux chercheurs de disséquer la distorsion cognitive des probabilités opérée par le cerveau humain. Alors que la théorie néo-classique postule le choix systématique de l’Option A (dont l’espérance mathématique de 500 € surpasse les 450 € de l’Option B), les données comportementales révèlent une adhésion massive à l’Option B. Ce phénomène atteste l’existence d’une fonction de pondération subjective des probabilités π(p), au sein de laquelle la certitude (probabilité 1,00) fait l’objet d’une surévaluation psychologique disproportionnée par rapport aux probabilités intermédiaires tabulées.
8.2 Psychométrie et analyse des échelles de réponses discrètes
Dans le domaine de la psychométrie et de la conception des inventaires de personnalité, les tableaux de distribution de probabilité s’avèrent indispensables pour formaliser l’étalonnage des réponses collectées au travers d’échelles de type Likert ordonnées (par exemple, des degrés d’assentiment gradués de 1 = « Pas du tout d’accord » à 5 = « Entièrement d’accord »). Pour chaque item d’un test standardisé, la distribution des réponses de la population normative est consignée sous forme tabulaire, définissant ainsi la loi de probabilité multinomiale régissant le comportement de l’item.
L’examen minutieux de la morphologie de cette table permet d’évaluer la qualité métrologique de l’outil diagnostique. Une distribution asymétrique révélant une concentration massive de probabilité sur les scores extrêmes les plus socialement valorisés (par exemple, P(X = 5) = 0,72 sur un item évaluant l’empathie déclarée) indique la présence critique d’un biais de désirabilité sociale ou d’un effet de plafond. Ce phénomène neutralise le pouvoir discriminant de l’item en réduisant sa variance à un seuil pathologiquement bas. La modélisation tabulaire des probabilités d’adhésion sert ainsi de filtre préalable à l’élaboration des modèles de réponse à l’item (TRI) et à la calibration de profils cliniques différentiels.
8.3 Expérimentations comportementales et tâches d’apprentissage
L’analyse stochastique tabulaire constitue également le cœur méthodologique des paradigmes de conditionnement opérant et des modèles contemporains d’apprentissage par renforcement (reinforcement learning). Dans une tâche comportementale type de type bandit manchot à bras multiples, un animal expérimental ou un volontaire humain est invité à choisir de manière réitérée entre plusieurs stimuli visuels discrets dont l’activation délivre une récompense sous-tendue par des lois de contingence probabiliste préétablies par l’expérimentateur.
Chaque alternative de choix est rigoureusement définie par son propre tableau de distribution de probabilité, assignant à chaque amplitude de récompense (magnitude xi) une probabilité d’occurrence spécifique P(X = xi). Les chercheurs enregistrent la dynamique séquentielle d’ajustement du sujet d’étude afin d’analyser la vitesse à laquelle son système cognitif parvient à inférer, par simple échantillonnage itératif, les paramètres cachés du tableau (notamment l’espérance mathématique de chaque levier). L’introduction soudaine d’inversions de contingence — c’est-à-dire la permutation des tableaux de probabilités associés aux leviers — fournit un outil d’une précision inégalée pour mesurer la flexibilité cognitive et identifier d’éventuels déficits de persévération chez des populations souffrant de lésions préfrontales ou de troubles obsessionnels compulsifs.
9. Modèles théoriques classiques représentables sous forme de tableau
9.1 La distribution de Bernoulli et la distribution binomiale
Parmi l’arsenal des distributions théoriques discrètes, le modèle matriciel le plus élémentaire mais universellement fondamental est la loi de Bernoulli. Cette distribution binaire modélise une expérience aléatoire unique comportant deux issues seulement : le succès (noté par convention 1) et l’échec (noté 0). Si la probabilité d’obtenir un succès est un paramètre fixe noté p, celle de subir un échec équivaut par complémentarité unitaire à q = 1 – p. Le tableau de distribution de Bernoulli adopte alors une forme d’une concision absolue :
| Réalisation de l’épreuve (xi) | Probabilité P(X = xi) |
|---|---|
| 0 (Échec) | 1 – p |
| 1 (Succès) | p |
| Somme unitaire | (1 – p) + p = 1 |
Lorsque cette épreuve binaire est répliquée n fois de façon strictement indépendante et sous des conditions identiques, la somme totale des succès obtenus définit une nouvelle variable aléatoire suivant la prestigieuse loi binomiale, notée ℬ(n, p). Le domaine des réalisations possibles s’étend désormais sur l’ensemble fini {0, 1, 2, …, n}. Chaque ligne du tableau de distribution binomiale est alors formellement complétée par la fonction de masse combinatoire :
P(X = k) = (nk) pk (1 – p)n – k = [ n! / (k! × (n – k)!) ] pk (1 – p)n – k
Dans les laboratoires de psychophysique, ce tableau binomial modélise avec une fidélité remarquable le taux de détection sensorielle correcte sur un bloc de n essais de discrimination subliminale, permettant de certifier si les performances du sujet excèdent statistiquement le niveau de performance attendu par simple chance stochastique.
9.2 La distribution de Poisson pour événements rares
Dans de multiples configurations d’observation comportementale, la variable aléatoire sous examen n’est pas bornée par un nombre fini d’essais préalables, mais résulte d’un processus continu de comptage d’occurrences discontinues émergeant au sein d’une tranche d’espace ou de temps rigoureusement fixe. Lorsque ces événements surviennent de façon mutuellement indépendante avec un taux moyen constant noté λ, la variable aléatoire X est régie par la loi de Poisson, désignée dans la littérature classique sous le nom de loi des événements rares.
La formulation théorique de la fonction de masse de Poisson s’énonce sur un ensemble infini dénombrable de valeurs entières positives (♮) :
P(X = k) = ( λk × e-λ ) / k! pour k ∈ {0, 1, 2, 3, …}
Puisque la structure matérielle d’une table physique ne saurait contenir une infinité de lignes, la transcription d’une loi de Poisson sous forme de tableau de distribution de probabilité impose une procédure méthodique de troncature pragmatique. Le chercheur tabule explicitement les valeurs entières k jusqu’à un seuil supérieur m au-delà duquel la somme résiduelle des probabilités devient infinitésimale (par exemple, inférieure à 10-5). La dernière ligne du tableau consigne alors fréquemment la classe résiduelle semi-ouverte {X ≥ m+1}, assurant ainsi la préservation rigoureuse de la somme unitaire totale. Ce dispositif tabulaire s’avère particulièrement pertinent pour modéliser la fréquence horaire des lapsus verbaux, le nombre de ruptures d’attention lors de tâches de veille prolongée ou la survenue de mutations génétiques ponctuelles au sein d’un contingent cellulaire restreint.
9.3 La distribution discrète uniforme
Le troisième modèle archétypal pouvant être consigné sous forme tabulaire est la distribution discrète uniforme. Sa caractéristique constitutive réside dans l’équiprobabilité stricte : chacune des k valeurs distinctes {x1, x2, …, xk} composant l’espace échantillonné possède rigoureusement la même masse de probabilité d’occurrence, définie invariablement par le ratio inverse du nombre total de modalités :
P(X = xi) = 1 / k ∀ i ∈ {1, …, k}
L’illustration la plus universelle demeure la modélisation du lancer d’un dé cubique équilibré à six faces (k = 6), où chaque face héberge une probabilité ponctuelle exacte de 1/6 (approximativement 0,1667). Au sein des dispositifs expérimentaux rigoureux, le tableau de distribution uniforme sert de modèle de référence pour les procédures de randomisation pure. Lors de la conception de blocs d’essais, l’expérimentateur utilise cette loi théorique pour s’assurer que chaque condition de stimulation apparaît avec une probabilité strictement identique, éliminant ainsi les biais de prévisibilité séquentielle chez le sujet d’étude.
De plus, cette distribution joue un rôle fondamental d’hypothèse nulle (H0) dans les tests d’adéquation statistiques. La comparaison par un test du Khi-deux d’un tableau de fréquences observées contre les cellules d’un tableau uniforme théorique permet d’identifier l’émergence d’une préférence motrice spontanée ou le bris de symétrie décisionnelle dans des contextes d’incertitude absolue.
10. Méthodologie de construction empirique d’un tableau de distribution
10.1 Collecte de données et dénombrement des fréquences absolues
L’édification d’un tableau de distribution de probabilité à partir d’un protocole d’observation concret exige une rigueur méthodologique sans faille dès la phase de collecte empirique. Avant même le recueil du premier point de données, l’expérimentateur doit standardiser de manière exhaustive son protocole d’observation afin d’éradiquer tout facteur de confusion systématique. Les conditions d’administration de la tâche, le calibrage des instruments chronométriques ou psychométriques et les critères stricts de recevabilité des réponses doivent être fixés sans ambiguïté.
La première phase opérationnelle consiste en l’établissement d’une grille de comptage exhaustive répertoriant toutes les occurrences observées pour chaque niveau observable de la variable sous examen. Ce processus de dénombrement débouche sur la constitution de la distribution des fréquences absolues, notées traditionnellement ni, indiquant le nombre exact de fois où la valeur spécifique xi a été matériellement enregistrée au sein de l’échantillon d’étude. La vérification préalable absolue à cette étape consiste à sommer l’ensemble de ces occurrences afin de certifier que leur total arithmétique correspond scrupuleusement à la taille globale de la cohorte d’observation, dénotée N :
∑i=1k ni = N
Toute discordance numérique à ce stade préliminaire révèle un phénomène de double comptage ou l’occultation fautive d’une observation, anomalie qui corromprait l’ensemble des dérivations probabilistes subséquentes.
10.2 Conversion des fréquences relatives en estimations de probabilité
Une fois les fréquences absolues consolidées, le chercheur amorce la transition de la statistique descriptive vers le modèle probabiliste par le calcul des fréquences relatives, notées fi. Celles-ci s’obtiennent par le quotient direct de l’effectif observé pour chaque modalité par l’effectif total échantillonné :
fi = ni / N
Sur le plan épistémologique, la justification mathématique permettant d’assimiler ces proportions observées fi à des estimations valides des probabilités théoriques P(X = xi) procède directement de la loi des grands nombres sous sa variante de Bernoulli. Selon ce théorème de convergence fondamentale, lorsque la taille N de l’échantillon croît vers l’infini, la fréquence relative d’un événement aléatoire converge en probabilité vers sa probabilité théorique sous-jacente intrinsèque :
∀ ε > 0, limN → ∞ P(| fi – P(X = xi) | ≥ ε) = 0
Dans le vocabulaire de la statistique inférentielle, la fréquence relative constitue l’estimateur du maximum de vraisemblance de la probabilité réelle de la population pour une loi multinomiale discrète. Cet estimateur est convergent, sans biais et asymptotiquement normal, ce qui confère une légitimité mathématique totale à son inscription dans la colonne des probabilités sous réserve de disposer d’un échantillon expérimental d’une ampleur statistique suffisante pour minorer la variance d’échantillonnage.
10.3 Audit de conformité et validation formelle
L’étape finale de la construction empirique du tableau réside dans un audit technique méticuleux visant à pallier les distorsions arithmétiques générées par le passage du fini discontinu aux développements décimaux continus. L’obstacle récurrent réside dans l’effet cumulatif des erreurs d’arrondi numérique. Si l’on applique des règles d’arrondi automatique à plusieurs décimales sur un tableau comportant un grand nombre de modalités, la somme arithmétique apparente des probabilités calculées peut fréquemment afficher une valeur légèrement divergente de l’unité parfaite (par exemple 0,9999 ou 1,0002).
Une telle déviance, bien que purement technique, contrevient formellement à l’axiome de normalisation et doit impérativement être rectifiée avant toute diffusion scientifique. Les conventions académiques recommandent soit d’ajuster l’arrondi de la modalité dotée du poids probabiliste prépondérant (dont l’altération marginale présente l’impact relatif le plus faible), soit de consigner les valeurs sous forme de fractions rationnelles exactes (ni / N), préservant ainsi une pureté arithmétique absolue.
Un autre arbitrage méthodologique critique concerne le traitement des modalités théoriquement possibles mais non observées au sein de l’échantillon disponible (fréquence empirique nj = 0). Consigner une probabilité estimée strictement nulle P(X = xj) = 0 reviendrait à affirmer dogmatiquement l’impossibilité physique absolue de cet événement dans la population cible. Dans les architectures probabilistes avancées, les biostatisticiens et informaticiens appliquent dès lors des méthodes de lissage adaptatif (telles que le lissage de Laplace ou l’inférence bayésienne avec loi a priori non informative), lesquelles réallouent une masse de probabilité infinitésimale à ces modalités vacantes, évitant ainsi l’écueil de la certitude absolue prématurée dans les modèles de classification prédictifs.
11. Erreurs courantes, pièges méthodologiques et interprétations erronées
11.1 Non-exhaustivité de l’espace échantillonné et omission de catégories
L’une des dérives les plus dévastatrices au cours de la modélisation sous forme de tableau de distribution de probabilité est le piège de la non-exhaustivité de l’espace échantillonné, se traduisant concrètement par l’omission inadmissible de catégories de réalisations réelles. L’erreur la plus récurrente au sein des travaux de recherche débutants réside dans l’oubli involontaire de la valeur nulle (X = 0). Dans l’analyse de métriques de comptage — comme le relevé du nombre de comportements agressifs d’enfants en milieu scolaire ou l’enregistrement d’erreurs de navigation dans un simulateur —, l’esprit humain tend spontanément à focaliser son attention sur les sujets ayant effectivement extériorisé le comportement, reléguant aux marges de la formalisation les participants n’ayant manifesté aucune occurrence.
La conséquence algébrique de cette occultation est catastrophique : la somme de la colonne des probabilités s’avère déficitaire (Σ pi < 1), ce qui viole frontalement le premier principe de normalisation probabiliste. Si le modélisateur tente de masquer cette défaillance en forçant arbitrairement la normalisation des modalités restantes par une règle proportionnelle, il introduit un biais d’inflation majeur sur l’ensemble des probabilités conditionnelles. Par voie de conséquence, le calcul de l’espérance mathématique théorique E(X) est massivement déporté vers des valeurs excessives, projetant une image trompeuse et artificiellement dramatisée de la prévalence réelle du phénomène au sein de la population générale.
Pour prévenir cet écueil, les standards méthodologiques imposent une cartographie conceptuelle exhaustive de l’ensemble de définition X(Ω) antérieurement à l’insertion du moindre chiffre dans les colonnes du tableau.
11.2 Chevauchement des événements et rupture de l’exclusivité mutuelle
Le revers symétrique de la non-exhaustivité est la rupture de l’exclusivité mutuelle entre les modalités d’une même table. Ce biais méthodologique survient fréquemment lors de l’utilisation de classifications imparfaites ou de libellés ambigus au sein de la première colonne. Considérons un cas pratique où un investigateur évaluant l’adhérence à un protocole clinique partitionnerait sa variable en trois classes nominales : « Adhérence faible », « Adhérence modérée » et « Adhérence forte », tout en associant à ces libellés des seuils de scores présentant des recouvrements géométriques (par exemple, 0 à 10 points, 10 à 20 points, et 20 points ou plus).
Dans un tel scénario, un patient obtenant exactement 10 ou 20 points se trouve simultanément éligible à deux lignes contiguës du tableau. Si ses observations sont intégrées dans les deux compartiments, un phénomène de double comptage contamine la distribution, générant une sommation de probabilités qui excède fatalement l’unité (Σ pi > 1). Sur le plan axiomatique, les événements matérialisés par chaque ligne ne constituent plus une partition de l’univers, puisque l’intersection d’au moins deux cellules s’avère non vide :
{X = xi} ∩ {X = xj} ≠ ∅
Ce manquement dissout la logique fondamentale du calcul des probabilités composées. Pour garantir la robustesse d’un tableau, chaque niveau de la variable doit être défini avec une précision discriminante telle qu’une observation singulière appartienne sans l’ombre d’une équivoque à une seule et unique cellule de la table.
11.3 Biais cognitifs dans la lecture des tableaux de probabilités
Même lorsqu’un tableau de distribution est mathématiquement irréprochable et certifié conforme à tous les axiomes de Kolmogorov, sa lecture par des décideurs, des cliniciens ou des étudiants demeure hautement vulnérable à une constellation de biais cognitifs documentés par la psychologie expérimentale. Le premier de ces écueils est la redoutable illusion du joueur (ou sophisme de Monte-Carlo). Confronté à un tableau modélisant des épreuves indépendantes — par exemple une distribution de Bernoulli avec p = 0,5 —, l’esprit humain tend à projeter une mémoire fallacieuse sur le processus générateur. Si une longue suite d’échecs a été récemment observée, le lecteur intuitif postule une modification temporaire de la loi du tableau, s’imaginant à tort que la probabilité de succès pour la prochaine épreuve s’en trouve mécaniquement majorée pour rétablir une symétrie globale.
Un second biais d’une extrême récurrence est le biais de négligence du taux de base (base-rate neglect). Lorsqu’un praticien examine un tableau de probabilités conjointes ou conditionnelles associées à un test diagnostique, il commet fréquemment l’erreur de focaliser son attention sur la haute probabilité ponctuelle de détection d’une pathologie en cas d’affection réelle (sensibilité P(T+ | M+)), en oblitérant complètement le taux de base de la pathologie dans la distribution marginale globale de la population. Si la maladie est exceptionnellement rare, la probabilité a posteriori qu’un individu testé positif soit véritablement malade demeure minime, fait contre-intuitif que la seule consultation fragmentaire du tableau peine souvent à éclairer chez l’analyste profane.
Enfin, la recherche a identifié une surestimation cognitive systématique des probabilités allouées aux événements extrêmes mais anecdotiques situés aux extrémités de la distribution (les queues de distribution). La présence d’une probabilité résiduelle minuscule telle que P(X = 4) = 0,02 sur notre tableau de buts peut être perçue avec une saillance émotionnelle disproportionnée chez un spectateur passionné, conduisant à des prévisions de score ou à des stratégies de pari totalement déconnectées de la réalité stochastique formellement exprimée par les chiffres.
12. Extension analytique : de la distribution simple au tableau cumulé
12.1 Construction du tableau de distribution cumulative
La puissance d’exploitation d’une loi de probabilité discrète s’accroît considérablement lorsque l’on adjoint à sa fonction de masse une extension analytique fondamentale : la distribution de probabilité cumulative. Sur le plan théorique, cette opération transpose la fonction de masse ponctuelle en ce que l’analyse mathématique désigne sous le terme de fonction de répartition, notée universellement par la lettre majuscule F(x). La fonction de répartition exprime la probabilité formelle que la variable aléatoire X adopte une valeur inférieure ou rigoureusement égale à un seuil réel spécifié x :
F(x) = P(X ≤ x) = ∑xi ≤ x P(X = xi)
La construction concrète du tableau de distribution cumulé s’opère par l’insertion d’une troisième colonne structurelle, disposée à droite de la colonne des probabilités ponctuelles. L’alimentation de cette nouvelle colonne s’effectue par un algorithme d’accumulation séquentielle descendante, ligne par ligne. La première cellule cumulée coïncide nécessairement avec la première probabilité simple :
F(x1) = P(X ≤ x1) = P(X = x1) = p1
Les cellules subséquentes s’obtiennent par la récurrence arithmétique additionnant la probabilité cumulée précédente à la masse de probabilité propre à la ligne courante :
F(xi) = F(xi-1) + P(X = xi)
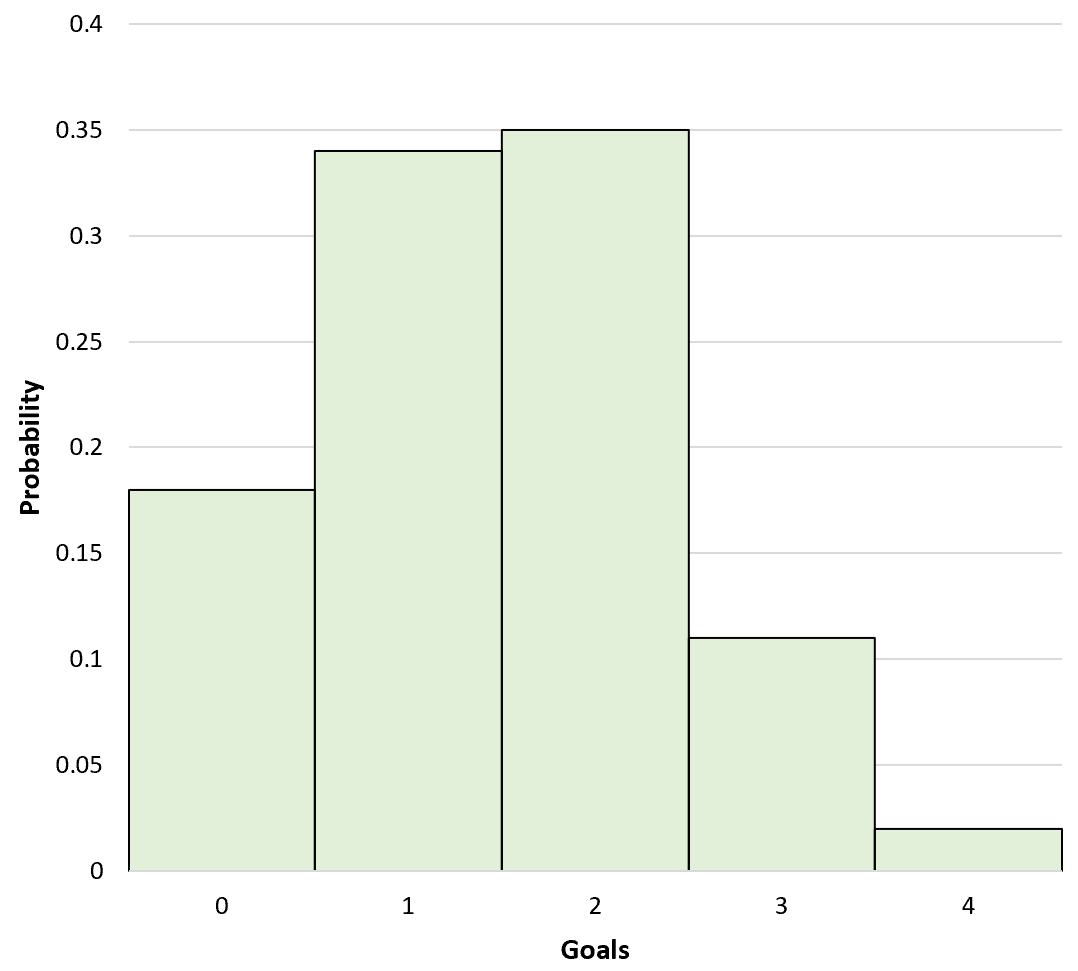
Appliquée aux données de notre modèle de performance offensive, cette procédure algorithmique permet d’ériger le tableau cumulé complet suivant :
| Nombre de buts (xi) | Probabilité ponctuelle P(X = xi) | Probabilité cumulative F(xi) = P(X ≤ xi) |
|---|---|---|
| 0 | 0,18 | F(0) = 0,18 |
| 1 | 0,34 | F(1) = 0,18 + 0,34 = 0,52 |
| 2 | 0,35 | F(2) = 0,52 + 0,35 = 0,87 |
| 3 | 0,11 | F(3) = 0,87 + 0,11 = 0,98 |
| 4 | 0,02 | F(4) = 0,98 + 0,02 = 1,00 |
| Propriété fondamentale vérifiée : convergence monotone vers 1,00 à la borne maximale | ||
Cette structure matricielle enrichie met en évidence la propriété fondamentale de la fonction de répartition pour une variable aléatoire : il s’agit d’une fonction monotone croissante en escalier, dont les bornes asymptotiques sont rigoureusement fixées à 0 en -∞ et à 1 en +∞. La vérification que la dernière cellule cumulée atteint exactement l’unité constitue un contrôle mathématique attestant une fois de plus de l’absence totale de perte de masse probabiliste au long du cheminement calculatoire.
12.2 Interprétation et utilité pratique des probabilités cumulées
L’utilité analytique du tableau cumulé se révèle immédiate lorsqu’il s’agit de répondre à des interrogations opérationnelles relatives à des seuils critiques de tolérance ou d’atteinte d’objectifs, formulation typique des questions soulevées par les décideurs (« Quelle est la probabilité d’obtenir au plus n défaillances ? »). Alors qu’un tableau simple requiert de fastidieuses additions manuelles pour chaque requête, le tableau cumulé permet une lecture directe et instantanée. En consultant la ligne x = 2 de notre tableau d’exemple, on lit immédiatement que F(2) = 0,87, signifiant qu’il y a 87 % de chances que l’équipe marque au maximum deux buts au cours d’une confrontation.
De façon symétrique, le calcul d’un dépassement de seuil — c’est-à-dire la probabilité d’obtenir strictement plus d’un certain nombre d’occurrences P(X > x) — se déduit par une soustraction élémentaire exploitant la complémentarité par rapport à l’unité :
P(X > x) = 1 – P(X ≤ x) = 1 – F(x)
Ainsi, la probabilité d’observer un festival offensif excédant strictement deux buts correspond à :
P(X > 2) = 1 – F(2) = 1 – 0,87 = 0,13 (soit 13 %)
Au-delà de ces calculs directs, la colonne cumulative s’avère indispensable pour dériver les percentiles théoriques et les quantiles d’une distribution discrète. La médiane théorique d’une variable discrète, dénotée Med(X), se définit comme la plus petite valeur xi pour laquelle la probabilité cumulative atteint ou dépasse le seuil fatidique de 0,50 :
Med(X) = min { xi ∈ X(Ω) mid F(xi) ≥ 0,50 }
Dans notre cas d’étude, la consultation du tableau révèle que pour x = 0, F(0) = 0,18 < 0,50, mais que dès le palier x = 1, F(1) = 0,52 ≥ 0,50. La médiane de la distribution s’établit donc formellement à 1 but. Cette métrique offre un complément de lecture capital à l’espérance (μ = 1,45) : elle assure au statisticien qu’au moins 50 % des rencontres enregistreront au maximum 1 but marqué par l’équipe.
Dans le domaine diagnostique et clinique, cette démarche de seuillage cumulé sert à étalonner les zones pathologiques. En fixant un quantile extrême (par exemple le percentile 95, correspondant à F(xi) ≥ 0,95), l’analyste repère instantanément que la modalité x = 3 constitue le point d’inflexion au-delà duquel un comportement s’avère statistiquement rare et cliniquement remarquable (seuil d’alerte), objectivant les décisions d’intervention thérapeutique.
12.3 Transition vers l’analyse multivariée et les tableaux conjoints
L’aboutissement méthodologique de la théorie tabulaire réside dans l’extension de l’analyse univariée vers l’étude simultanée de multiples variables aléatoires discrètes évoluant conjointement au sein d’un même système empirique. Lorsque l’on observe simultanément deux dimensions — par exemple, la variable X matérialisant le nombre de fautes commises par une équipe et la variable Y mesurant le nombre de cartons jaunes sanctionnés —, la structure bidimensionnelle simple cède la place à un tableau de probabilités conjointes à double entrée (matrice bivariée).
Au sein d’une telle table croisée, chaque cellule d’intersection interne correspond à la fonction de masse conjointe, formulée comme la probabilité que la variable X adopte simultanément la modalité xi et que la variable Y endosse la modalité yj :
pij = P(X = xi text{ et } Y = yj) = P(X = xi, Y = yj)
La cohérence axiomatique exige que la sommation de toutes les cellules internes du tableau bivarié soit rigoureusement égale à l’unité :
∑i=1k ∑j=1m P(X = xi, Y = yj) = 1
L’utilité analytique de cette table conjointe est décuplée par la possibilité d’en extraire, par sommation directionnelle, les distributions de probabilités marginales de chaque variable isolée. La probabilité marginale de la ligne xi s’obtient par la sommation horizontale de toutes les colonnes associées, opération qui réalise formellement la marginalisation stochastique :
P(X = xi) = ∑j=1m P(X = xi, Y = yj)
Réciproquement, la probabilité marginale d’une colonne yj s’extrait par la sommation verticale le long de toutes les lignes de la table :
P(Y = yj) = ∑i=1k P(X = xi, Y = yj)
Grâce à cette dérivation marginale, le tableau conjoint devient l’outil suprême d’évaluation de l’indépendance statistique entre deux composantes comportementales. Deux variables aléatoires discrètes X et Y sont mathématiquement indépendantes si et seulement si chaque cellule conjointe interne équivaut strictement au produit arithmétique pur de ses probabilités marginales respectives :
∀ i, j, P(X = xi, Y = yj) = P(X = xi) × P(Y = yj)
La moindre divergence entre la valeur observée au cœur du tableau conjoint et ce produit théorique de marginalisation atteste l’existence d’une dépendance stochastique, pavant la voie au calcul de la covariance théorique Cov(X, Y), du coefficient de corrélation linéaire de Bravais-Pearson et à l’exploration des chaînes de régression probabilistes.
En somme, le tableau de distribution de probabilité, qu’il se déploie sous une forme univariée simple, sous la structure d’une fonction de répartition cumulative ou sous l’architecture multivariée d’une table croisée conjointe, demeure le vecteur par excellence d’élucidation mathématique de l’incertitude. En liant le dénombrement catégoriel à la rigueur de la théorie de la mesure, il transforme la contingence apparente des phénomènes naturels et humains en un système cohérent de lois numériques manipulables, confirmant sa place cardinale au cœur de la boîte à outils méthodologique de la science moderne.
Références
- Allais, M. (1953). Le comportement de l’homme rationnel devant le risque: critique des postulats et axiomes de l’école américaine. Econometrica, 21(4), 503-546. https://doi.org/10.2307/1907921
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bernoulli, D. (1954). Exposition of a new theory on the measurement of risk. Econometrica, 22(1), 23-36. (Ouvrage original publié en 1738 sous le titre Specimen theoriae novae de mensura sortis). https://doi.org/10.2307/1909829
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Thomson Learning.
- Dacunha-Castelle, D., & Duflo, M. (1982). Probabilités et statistiques : Tome 1, Problèmes à temps fixe. Masson.
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263-291. https://doi.org/10.2307/1914185
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Lebart, L., Piron, M., & Morineau, A. (2006). Statistique exploratoire multidimensionnelle : Visualisation et modélisation de données complexes (4e éd.). Dunod.
- Papoulis, A., & Pillai, S. U. (2002). Probability, random variables, and stochastic processes (4th ed.). McGraw-Hill.
- Saporta, G. (2011). Probabilités, analyse des données et statistique (3e éd.). Éditions Technip.
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124-1131. https://doi.org/10.1126/science.185.4157.1124
- Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical statistics with applications (7th ed.). Cengage Learning.