
Dans le vaste champ du traitement quantitatif des données, l’analyse descriptive et l’inférence statistique constituent les deux piliers fondamentaux sur lesquels repose la validité des conclusions scientifiques. Que ce soit au sein des laboratoires de psychologie cognitive, des départements de biométrie, des instituts de sondage ou des directions financières, la réduction de séries numériques massives à des paramètres intelligibles représente une étape analytique incontournable. Cependant, la simplicité apparente des logiciels tableurs modernes, au premier rang desquels figure Microsoft Excel, dissimule fréquemment des subtilités théoriques majeures. Une commande mal choisie, une méconnaissance de l’architecture mathématique sous-jacente ou une confusion conceptuelle élémentaire peuvent induire des distorsions systématiques dans l’estimation de la variabilité des données, compromettant ainsi l’ensemble de la chaîne inférentielle.
Parmi les ambiguïtés les plus récurrentes rencontrées par les analystes et les chercheurs figure la distinction entre deux fonctions de dispersion essentielles : STDEV.P (ou ECARTYPE.PEARSON dans les déclinaisons francophones du logiciel) et STDEV.S (ou ECARTYPE.STANDARD). Bien que ces deux commandes renvoient formellement à la notion intuitive d’écart-type, c’est-à-dire à l’expression de la dispersion moyenne des observations autour de leur centre de gravité arithmétique, elles incarnent deux postulats épistémologiques et mathématiques radicalement divergents. L’une traite l’ensemble des données injectées comme une entité close et autosuffisante représentant l’exhaustivité d’un univers statistique, tandis que l’autre postule que la matrice observée n’est qu’une fraction lacunaire, soumise aux aléas de l’échantillonnage, d’une réalité plus vaste qu’il s’agit d’estimer sans biais.
Ce guide exhaustif se propose d’explorer en profondeur la frontière séparant STDEV.P de STDEV.S. En examinant successivement les fondements de la dispersion en sciences comportementales, l’histoire des implémentations algorithmiques au sein de la suite bureautique de Microsoft, la démonstration formelle de la correction de Bessel et les implications psychométriques du calcul d’indices standardisés, cet article offre aux chercheurs, étudiants et praticiens de la donnée le cadre conceptuel et technique nécessaire pour sécuriser leurs protocoles analytiques et garantir l’intégrité de leurs résultats.
1. Introduction aux mesures de dispersion en statistique et en psychologie empirique
1.1 Rôle de l’écart-type dans l’analyse des données comportementales
Dans l’investigation empirique des conduites humaines, des processus neurocognitifs et des structures de personnalité, la mesure de tendance centrale ne constitue qu’un indicateur parcellaire de la réalité psychologique. Rapporter qu’un groupe de participants soumis à un paradigme d’inhibition cognitive présente un temps de réaction moyen de 450 millisecondes s’avère rigoureusement stérile si cette valeur moyenne ne s’accompagne pas d’une métrique rigoureuse de la dispersion des observations. L’écart-type joue ici un rôle capital : il quantifie la variabilité intra-groupe et inter-individuelle, fournissant une estimation standardisée de l’ampleur avec laquelle les comportements singuliers s’écartent du centre de gravité empirique. En psychologie différentielle comme en neurosciences expérimentales, cette dispersion n’est pas un simple bruit de fond parasite ; elle représente l’expression même de l’hétérogénéité biologique, des stratégies cognitives divergentes et des modulations motivationnelles individuelles.
La nécessité de mesurer rigoureusement la dispersion autour de la moyenne arithmétique répond à l’impératif d’évaluer l’homogénéité des réponses au sein d’une condition expérimentale donnée. Lorsque des psychologues évaluent l’efficacité d’une intervention cognitive ou d’un psychotrope, une réduction significative de l’écart-type post-traitement peut traduire une homogénéisation des performances, indiquant que l’intervention a harmonisé les compétences ou stabilisé les réponses émotionnelles à travers l’échantillon. Inversement, un accroissement de la dispersion signale fréquemment l’émergence d’effets différentiels sous-jacents, où certains profils de patients tirent un bénéfice substantiel du protocole tandis que d’autres manifestent une résistance ou une détérioration symptomatique. Dès lors, l’écart-type transcende le simple statut de résumé numérique pour devenir un instrument de diagnostic théorique.
Sur le plan psychométrique, les implications de cette métrique sont omniprésentes dans l’interprétation des traits latents et des scores aux instruments psychométriques standardisés, à l’image des échelles d’intelligence de Wechsler (American Psychological Association) ou des inventaires de personnalité tels que le NEO-PI. Dans ces contextes, le score brut d’un individu ne possède aucune signification intrinsèque absolue : il n’acquiert sa valeur sémiologique que par rapport à une distribution normée caractérisée par sa moyenne et son écart-type. Toute déviation computationnelle de la dispersion entraîne de facto une distorsion dans le calibrage des rangs centiles, dans le positionnement des seuils diagnostiques et dans l’identification des déficits cognitifs ou des aptitudes exceptionnelles.
Cette réalité impose une distinction critique et permanente entre deux postures analytiques distinctes : la description brute d’un collectif spécifique et la généralisation théorique vers une population cible. Si le statisticien se contente de décrire les données immédiates dont il dispose sans prétendre extrapoler ses conclusions au-delà du périmètre de sa cohorte, la variabilité observée épuise sa propre causalité. En revanche, dès lors que l’ambition méthodologique vise l’inférence, c’est-à-dire l’affirmation que les données recueillies permettent de modéliser le fonctionnement psychologique d’individus non observés, l’évaluation de la dispersion doit intégrer l’incertitude inhérente au prélèvement aléatoire. C’est précisément à cette intersection épistémologique fondamentale que s’enracine la bifurcation entre les différentes approches algorithmiques de l’écart-type.
1.2 Évolution et présence des fonctions de dispersion dans Microsoft Excel
L’utilisation massive de Microsoft Excel comme environnement de calcul dans les laboratoires universitaires, les structures hospitalières et les entreprises a historiquement constitué une source de préoccupations méthodologiques pour les statisticiens professionnels. Durant près de deux décennies, les premières moutures du tableur proposaient une fonction générique désignée sous l’appellation STDEV (ou ECARTYPE dans l’écosystème francophone), dont le comportement mathématique appliquait implicitement la correction d’échantillon sans que l’utilisateur non averti n’en saisisse pleinement les tenants et les aboutissants. Cette absence de clarification explicite au sein de la syntaxe logicielle générait des confusions persistantes, les opérateurs ignorant fréquemment si le résultat retourné reflétait une description exacte des cellules sélectionnées ou une estimation inférentielle de la population parente.
Conscient des limites de sa bibliothèque statistique et soucieux de se conformer aux standards internationaux édictés par les communautés académiques et les organismes de normalisation (tels que l’Organisation internationale de normalisation), Microsoft a procédé, à l’occasion du déploiement d’Excel 2010, à une refonte structurelle majeure de son moteur de calcul. Cette transition s’est traduite par une scission explicite des fonctions de dispersion en deux commandes normées distinctes : STDEV.P (consacrée à la population) et STDEV.S (consacrée à l’échantillon). Cette nomenclature contemporaine, déclinée en français sous les libellés ECARTYPE.PEARSON et ECARTYPE.STANDARD, a été pensée pour aligner le tableur sur les conventions universelles des sciences formelles, en contraignant le praticien à formaliser explicitement son statut de recherche au moment même de l’écriture de sa formule.
Le tableau ci-dessous récapitule cette correspondance terminologique entre les différentes dénominations du logiciel et leur vocation théorique respective :
| Syntaxe Anglaise (Excel moderne) | Syntaxe Française (Excel moderne) | Ancienne Syntaxe (Historique) | Statut Statistique Visé | Dénominateur de la Variance |
|---|---|---|---|---|
| STDEV.P | ECARTYPE.PEARSON | STDEVP / ECARTYPEP | Population exhaustive | N |
| STDEV.S | ECARTYPE.STANDARD | STDEV / ECARTYPE | Échantillon probabiliste | n – 1 |
Cette dichotomie algorithmique ne relève en aucun cas d’une coquetterie de nomenclature ou d’une simple préférence cosmétique. Elle engage directement la validité interne et externe des analyses quantitatives. Dans le cadre de recherches publiées, d’audits financiers ou d’évaluations cliniques, sélectionner la mauvaise commande conduit inéluctablement à fausser les estimations des grandeurs sous-jacentes. La validité scientifique repose sur une adéquation rigoureuse entre le protocole expérimental, la structure d’échantillonnage et l’opérateur mathématique employé. Comprendre cette transition méthodologique constitue le premier pas vers une pratique analytique rigoureuse, exempte des erreurs de calcul qui continuent d’émailler la littérature grise et les applications industrielles non auditées.
2. Fondements conceptuels : la distinction cardinale entre population et échantillon
2.1 La population statistique au sens psychologique et mathématique
Pour appréhender la divergence fonctionnelle entre STDEV.P et STDEV.S, il convient d’expliciter la notion de population statistique, dont la définition outrepasse largement l’acception démographique vulgaire. En théorie des probabilités, une population désigne l’ensemble exhaustif et complet de toutes les entités, observations, scores ou unités expérimentales qui partagent une caractéristique commune spécifiée et sur lesquelles porte la curiosité du chercheur. Cette entité peut être théoriquement infinie — par exemple, l’ensemble des réponses potentielles de tous les êtres humains actuels et à venir face à un stimulus perceptif — ou rigoureusement finie mais parfaitement bornée, telle que la totalité des résidents d’une institution hospitalière spécifique diagnostiqués avec un trouble bipolaire de type I au cours de l’année écoulée.
Sur le plan formel, les propriétés distributionnelles d’une population sont caractérisées par des grandeurs immuables et déterministes qualifiées de paramètres populationnels. La convention statistique internationale, enracinée dans les travaux pionniers de pionniers tels que Karl Pearson et Ronald Fisher, impose d’assigner à ces grandeurs des lettres issues de l’alphabet grec. Ainsi, la moyenne de la population est universellement symbolisée par la lettre μ (mu), tandis que sa variance et son écart-type sont respectivement notés σ² et σ (sigma). Ces notations contrastent catégoriquement avec les statistiques calculées sur des sous-ensembles empiriques, traditionnellement identifiées par des caractères de l’alphabet latin, telles que m ou x̄ pour la moyenne empirique, et s² ou s pour la variance et l’écart-type d’échantillon.
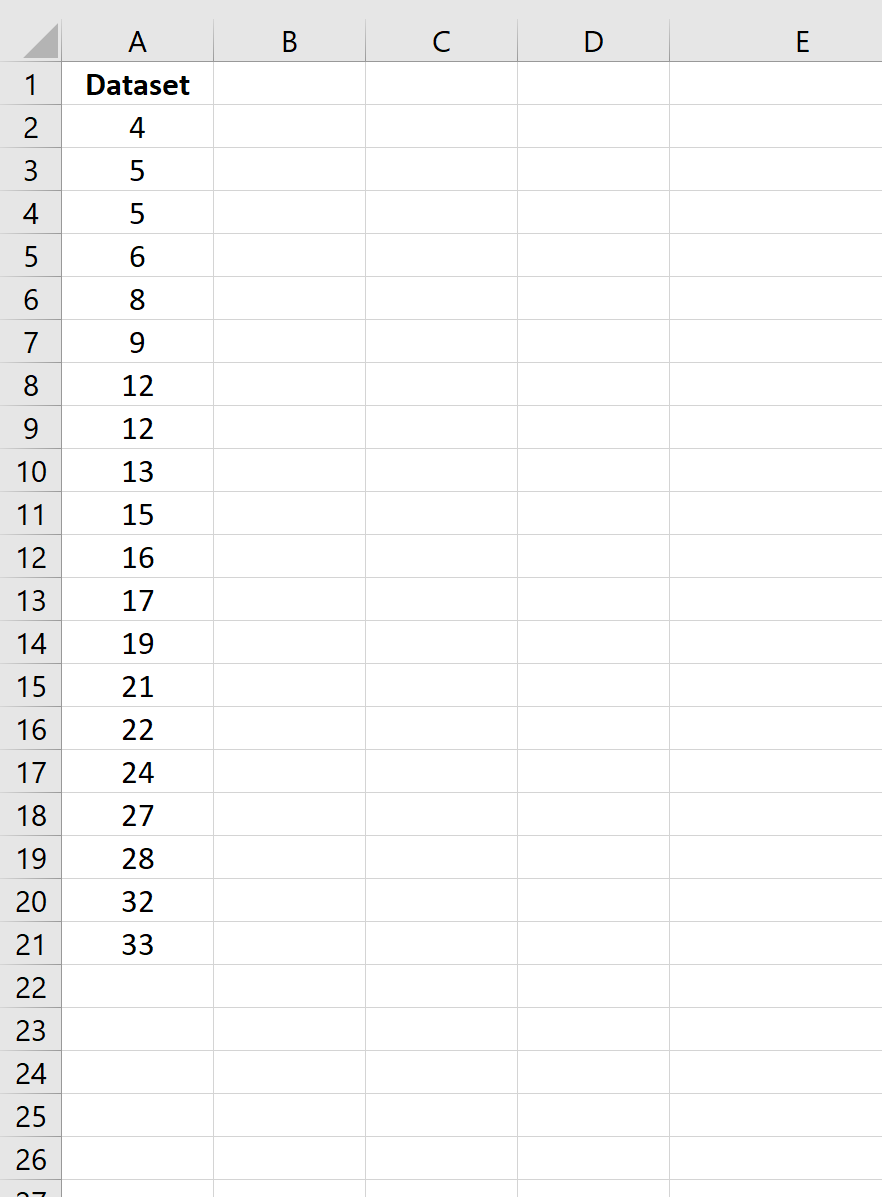
Dans la conduite concrète de la recherche en psychologie cognitive, sociale ou clinique, l’accès direct et intégral à une population parente constitue un événement d’une extrême rareté. Les contraintes matérielles, financières, temporelles et éthiques interdisent d’examiner chaque être humain composant la collectivité cible. Les chercheurs se trouvent donc presque systématiquement confrontés à une asymétrie informationnelle fondamentale : ils désirent énoncer des lois générales s’appliquant à l’ensemble d’une population dont ils ne pourront jamais sonder qu’une frange infime. L’omniscience statistique, qui consisterait à posséder la totalité des points de données réels, relève d’une fiction théorique dans l’immense majorité des applications comportementales.
Il existe néanmoins des configurations expérimentales ou organisationnelles très circonscrites où l’épuisement de la population cible devient effectif. C’est le cas lors d’études institutionnelles closes, où un psychologue du travail se voit confier l’analyse de l’épuisement professionnel au sein d’une entreprise employant exactement quarante-huit collaborateurs, et où l’ensemble des quarante-huit individus a rempli l’inventaire psychométrique de Maslach sans aucune défection. Dans ce scénario précis, les quarante-huit scores ne représentent pas une approximation d’un univers plus grand : ils forment, de manière souveraine, la totalité de la population sous examen. Dès cet instant, le calcul statistique s’affranchit de toute dimension prospective ou prédictive pour se confiner à une description exacte de cette réalité fermée.
2.2 L’échantillon comme fraction représentative pour l’inférence
Face à l’impossibilité pratique d’accéder à l’exhaustivité de la population, la méthode scientifique s’appuie sur le paradigme de l’échantillonnage. Un échantillon se définit comme un sous-ensemble fini d’éléments prélevés de manière raisonnée au sein de la population cible. Ce prélèvement peut s’opérer selon des protocoles probabilistes rigoureux, où chaque unité de la population dispose d’une probabilité d’inclusion connue et non nulle (échantillonnage aléatoire simple, stratifié ou en grappes), ou selon des modalités non-probabilistes (échantillonnage de convenance, par quotas ou boule de neige), particulièrement fréquentes dans les protocoles de psychologie empirique impliquant des cohortes étudiantes ou des volontaires recrutés en ligne.
Cependant, l’acte même d’extraire une fraction représentative introduit dans l’analyse un phénomène inéluctable : la fluctuation d’échantillonnage. Si l’on administre un test de mémoire de travail à vingt individus prélevés au hasard dans la population adulte générale, la moyenne et l’écart-type obtenus pour ce groupe ne seront jamais parfaitement identiques aux paramètres réels μ et σ de ladite population. Si un second groupe de vingt participants est recruté dans des conditions rigoureusement identiques, leurs scores engendreront une moyenne et un écart-type légèrement divergents du premier échantillon. Cette instabilité consubstantielle aux prélèvements aléatoires engendre une incertitude mécanique qui doit être formellement modélisée et neutralisée dans le processus de calcul statistique.
L’inférence statistique a précisément pour mission de bâtir un pont mathématique rigoureux entre les statistiques imparfaites recueillies au niveau local d’un échantillon et les paramètres inobservables de la population globale. Cette extrapolation ne s’apparente nullement à une spéculation hasardeuse ; elle repose sur la théorie des probabilités et sur l’identification d’estimateurs dotés de propriétés formelles optimales. Pour que les données d’un échantillon autorisent une généralisation légitime, les algorithmes de calcul appliqués à ces données doivent intégrer des mécanismes compensateurs capables de neutraliser les biais inhérents à l’observation parcellaire. C’est dans ce cadre théorique que s’impose la nécessité d’un traitement algébrique distinct pour les séries issues de cohortes finies, formalisé par le développement d’estimateurs non biaisés.
3. Analyse mathématique et fonctionnelle de STDEV.P
3.1 Formule mathématique sous-jacente de la variance et de l’écart-type de population
La fonction STDEV.P repose sur l’axiomatique classique de la statistique descriptive déterministe. Elle opère sous le postulat que le vecteur de données fourni à l’algorithme constitue l’intégralité du corpus d’observation possible. Dans ce cadre hermétique, la variance de population, désignée par σ², est définie comme la moyenne arithmétique rigoureuse des déviations quadratiques par rapport à la moyenne de population μ. L’écart-type de population s’obtient alors en extrayant la racine carrée de cette variance :
σ = √ [ ∑(Xi – μ)² / N ]
Dans cette formulation algébrique fondamentale, la variable Xi représente chaque score individuel observé, μ incarne la moyenne arithmétique vraie de l’ensemble de la série, le symbole de sommation ∑ s’étend de l’observation i = 1 jusqu’au dernier élément N, et le dénominateur N correspond à l’effectif total absolu des unités composant la population. Chaque écart individuel à la moyenne (Xi – μ) est élevé au carré, ce qui présente le double avantage théorique d’éliminer les signes négatifs (qui conduiraient à une annulation arithmétique de la somme des écarts) et de pondérer de manière exponentielle les déviations extrêmes par rapport au centre de gravité.
L’élément déterminant de cette équation réside dans la présence du dénominateur N. L’algorithme divise la somme totale des carrés par la taille absolue de la série, sans procéder à la moindre minoration ou ajustement. Cette structure mathématique découle directement du fait que l’analyste se place dans une posture d’omniscience absolue à l’égard de son groupe d’intérêt : aucune incertitude n’affecte la mesure de μ, qui n’est pas une estimation approximative, mais le centre d’inertie exact et exhaustif des observations traitées. Aucune extrapolation vers un ensemble extérieur n’étant postulée, la somme des carrés n’a pas à être réévaluée pour compenser un quelconque déficit d’information.
Du point de vue de la théorie statistique de l’estimation développée au début du XXe siècle, cette formule correspond très exactement à l’estimateur par le maximum de vraisemblance (Wolfram MathWorld) pour l’écart-type d’une distribution normale. L’estimateur par le maximum de vraisemblance privilégie la valeur du paramètre qui maximise la probabilité d’avoir observé la série de données empiriques recueillies. Bien que cet estimateur jouisse de propriétés asymptotiques remarquables et d’une cohérence interne parfaite lorsqu’il est appliqué à une population finie, il présente un défaut substantiel lorsqu’il est détourné pour estimer un paramètre à partir d’un échantillon : il sous-estime systématiquement la variance réelle.
3.2 Syntaxe, arguments et exécution de STDEV.P dans Excel
Dans l’interface opérationnelle de Microsoft Excel, l’appel de cette métrique s’effectue via une syntaxe standardisée. La structure formelle de la commande s’articule comme suit :
=STDEV.P(nombre1; [nombre2]; …) ou, dans sa transcription française officielle : =ECARTYPE.PEARSON(nombre1; [nombre2]; …)
L’argument nombre1 est obligatoire et correspond soit à une valeur numérique isolée, soit à une référence de cellule, soit, plus communément dans les flux d’analyses réels, à une plage matricielle continue ou discontinue (par exemple A2:A150). Excel autorise l’intégration d’arguments facultatifs successifs ([nombre2], etc.), permettant d’agréger jusqu’à 255 plages ou valeurs distinctes au sein d’une unique instruction de calcul. Dès l’exécution de la formule, le processeur logiciel calcule instantanément la moyenne empirique de la plage, détermine les déviations individuelles de chaque cellule, élève ces écarts au carré, additionne l’ensemble et divise cette somme par le décompte total des éléments numériques N, avant d’extraire la racine carrée du quotient.
Le comportement de STDEV.P face aux différents types de données requiert une vigilance technique absolue. Par défaut, la fonction est programmée pour ne prendre en considération que les données purement numériques. Si la plage référencée contient des cellules vides, des chaînes textuelles (telles que des étiquettes ou des annotations qualitatives du type « Absent » ou « Donnée manquante ») ou des valeurs logiques générées par des tests booléens (VRAI ou FAUX), ces entrées sont purement et simplement ignorées par le dénominateur comme par le numérateur. L’effectif N utilisé par la fonction correspond alors exclusivement au résultat retourné par la fonction auxiliaire NB(plage), et non au volume géométrique des cellules sélectionnées fourni par NBVAL(plage).
Cependant, une exception critique existe lorsque des valeurs booléennes ou des représentations textuelles de nombres sont insérées directement sous forme de constantes littérales au sein de la liste des arguments de la fonction (par exemple =STDEV.P(10; 20; VRAI)). Dans ce cas très particulier, Excel convertit silencieusement le booléen VRAI en la valeur numérique 1 (et FAUX en 0), ce qui fausse irrémédiablement le résultat statistique sans déclencher le moindre message d’alerte. Cette particularité algorithmique souligne l’importance d’opérer systématiquement sur des plages de cellules assainies plutôt que par injection d’arguments directs hétéroclites.
4. Analyse mathématique et fonctionnelle de STDEV.S
4.1 Formule mathématique sous-jacente de l’écart-type d’échantillon
Lorsque les données soumises à l’analyse ne constituent qu’un extrait prélevé au sein d’un univers statistique plus large, l’utilisation de la formule classique engendre une erreur structurelle d’estimation. Pour neutraliser cette faille, la science actuarielle et mathématique mobilise l’écart-type d’échantillon, incarné dans Excel par la fonction STDEV.S. L’équation qui régit ce calcul opère une modification qui semble minime en apparence, mais dont la portée théorique est fondamentale : elle substitue au dénominateur N la quantité (n – 1) :
s = √ [ ∑(Xi – x̄)² / (n – 1) ]
Dans ce modèle, s symbolise l’écart-type empirique de l’échantillon, x̄ (ou m) représente la moyenne calculée à partir des seules données observées, Xi figure les valeurs empiriques successives, et n quantifie l’effectif de l’échantillon étudié. La somme des carrés des écarts n’est plus rapportée au nombre total d’observations collectées, mais à ce nombre décrémenté d’une unité arithmétique. Cette minoration intentionnelle du dénominateur produit mécaniquement une élévation de la valeur finale du quotient : pour une même somme de résidus quadratiques, diviser par un nombre inférieur conduit nécessairement à obtenir une variance et un écart-type de magnitude supérieure.
L’introduction du facteur correcteur (n – 1), désigné dans la littérature sous le vocable de correction de Bessel, n’est pas un artifice empirique arbitraire. Elle confère à la variance d’échantillon s² la propriété mathématique d’être un estimateur sans biais de la variance populationnelle inconnue σ². En d’autres termes, si un protocole de recherche était répliqué un nombre infini de fois en prélevant à chaque itération un échantillon aléatoire de taille n au sein d’une même population, l’espérance mathématique des variances d’échantillon calculées avec le diviseur (n – 1) convergerait exactement vers la variance vraie de la population :
E[s²] = σ²
À l’inverse, l’espérance mathématique de la variance calculée via le diviseur non ajusté N demeurerait irrémédiablement inférieure à la cible théorique :
E[s²non corrigée] = [(n – 1) / n] * σ² < σ²
Cette distinction algébrique prend une importance cruciale lorsque les cohortes expérimentales présentent des effectifs réduits. Dans les protocoles de psychologie neuropsychologique ou de résonance magnétique fonctionnelle (IRMf), où les échantillons n’excèdent que rarement une vingtaine de sujets en raison des coûts d’acquisition, l’impact relatif de la soustraction d’une unité au dénominateur est maximal. Plus la taille de l’échantillon est modeste, plus l’estimation de la dispersion requiert cette compensation pour contrebalancer l’amputation informationnelle subie.
4.2 Syntaxe et spécificités techniques de STDEV.S dans Excel
L’exécution de cette logique inférentielle s’effectue dans Excel par le biais de la syntaxe homologuée suivante :
=STDEV.S(nombre1; [nombre2]; …) ou sa correspondance française : =ECARTYPE.STANDARD(nombre1; [nombre2]; …)
Tout comme son homologue dédiée à la population, STDEV.S accepte une série d’arguments pouvant prendre la forme de constantes isolées, de références de cellules ou de structures matricielles complexes. Le comportement de tri des types de données est rigoureusement identique : les cellules contenant des libellés textuels, les cases dépourvues de saisie et les valeurs logiques inscrites au sein des plages sont systématiquement écartées du comptage d’effectif n et du traitement des écarts. Seuls les enregistrements numériques sont pris en compte dans le processus d’itération.
Néanmoins, la mécanique interne de STDEV.S introduit une contrainte fonctionnelle irréductible liée à sa structure algébrique : l’exigence d’un effectif minimal d’au moins deux observations numériques distinctes (n ≥ 2). Si un utilisateur tente d’appliquer la fonction STDEV.S à une cellule isolée ou à une plage matricielle qui ne contient qu’une seule valeur numérique (par exemple une cellule unique contenant le score 100), le dénominateur (n – 1) devient immédiatement nul :
n – 1 = 1 – 1 = 0
La division par zéro étant une opération formellement prohibée par l’arithmétique élémentaire, le moteur de calcul d’Excel suspend son exécution et retourne l’erreur #DIV/0!. Ce comportement logiciel est parfaitement rigoureux sur le plan épistémologique : il est mathématiquement impossible d’évaluer la dispersion d’une mesure unique autour d’elle-même, car un point isolé ne possède aucune variabilité relative. À titre de comparaison, l’application de STDEV.P à une cellule unique ne produit aucune erreur mathématique : avec N = 1 et un écart nul (X1 – μ) = 0, l’opération √(0 / 1) est valide et renvoie systématiquement la valeur 0, matérialisant l’absence de dispersion au sein d’une population monadique.
5. La correction de Bessel : justification théorique et logique statistique
5.1 Pourquoi la moyenne d’un échantillon sous-estime la dispersion réelle
La nécessité de décrémenter le dénominateur d’une unité pour restaurer l’exactitude de l’estimation de la dispersion constitue l’un des principes les plus contre-intuitifs pour l’analyste débutant. Pour comprendre l’origine de ce biais négatif systématique, il convient d’analyser l’interaction mathématique qui s’établit entre les observations empiriques et le centre de dispersion utilisé dans le calcul. La variance théorique d’une population mesure les écarts quadratiques par rapport à la moyenne de population absolue μ. Or, lors du traitement d’un échantillon, cette moyenne vraie demeure totalement inconnue de l’expérimentateur. L’analyste est alors contraint de substituer à ce paramètre inatteignable un substitut empirique : la moyenne d’échantillon x̄.
Or, il s’agit d’une propriété géométrique fondamentale de la moyenne arithmétique : pour n’importe quelle série de nombres réels, la somme des carrés des écarts atteint son minimum absolu précisément lorsqu’elle est calculée par rapport à la moyenne arithmétique de cette série même. Formellement, pour toute constante c ≠ x̄, la relation suivante est invariablement vérifiée :
∑(Xi – x̄)² < ∑(Xi – c)²
Puisque la moyenne empirique x̄ fluctue autour de la moyenne vraie μ et ne coïncide pratiquement jamais avec elle (x̄ ≠ μ), il s’ensuit que la somme des carrés des écarts mesurés par rapport à la moyenne d’échantillon ∑(Xi – x̄)² est mécaniquement et systématiquement inférieure à la somme des carrés qui aurait été obtenue si les écarts avaient pu être mesurés par rapport à la moyenne vraie de la population ∑(Xi – μ)². Les données d’un échantillon se situent, par construction géométrique, toujours plus proches de leur propre centre de gravité que du centre de gravité de la population dont elles proviennent.
Ce resserrement géométrique artificiel engendre une sous-estimation systématique de la dispersion lorsque la formule classique à base de N est appliquée à un échantillon. Si l’on ne procédait à aucun ajustement, l’estimation de la variance souffrirait d’un biais négatif structurel : l’analyste conclurait systématiquement que la réalité sous-jacente est plus homogène et moins volatile qu’elle ne l’est véritablement. La correction de Bessel rétablit l’équilibre. En remplaçant n par (n – 1), on augmente la valeur finale de la variance d’une fraction proportionnelle exacte qui annule rigoureusement ce rétrécissement géométrique, rétablissant ainsi l’exactitude asymptotique de l’estimateur.
5.2 La notion fondamentale de degrés de liberté (ddl)
L’élucidation du diviseur (n – 1) trouve son ancrage le plus élégant dans le concept fondamental de degrés de liberté (généralement abrégé en ddl ou df pour degrees of freedom). Dans la modélisation statistique formalisée par Ronald Fisher (The Royal Society), le nombre de degrés de liberté associé à une série de données caractérise le volume d’informations indépendantes restant disponible après que certaines contraintes arithmétiques ont été imposées sur le système.
Considérons un échantillon composé de n = 5 participants soumis à une tâche de rappel mnésique. Avant toute mesure, le système vectoriel dispose de cinq dimensions de variation totalement libres : chaque participant peut manifester un score tout à fait arbitraire, indépendant de celui de ses pairs. Cependant, pour calculer la variance et l’écart-type de cette cohorte, il est nécessaire de calculer préalablement la moyenne arithmétique x̄ de ces cinq scores. Supposons que cette moyenne s’établisse à x̄ = 12. Dès cet instant, une contrainte arithmétique stricte est imposée à la série : la somme absolue des cinq scores doit impérativement égaler 5 × 12 = 60.
Cette contrainte transforme radicalement la nature informationnelle des observations :
- Le score du premier participant peut varier librement : par exemple X1 = 14.
- Le score du deuxième participant peut varier librement : par exemple X2 = 8.
- Le score du troisième participant peut varier librement : par exemple X3 = 15.
- Le score du quatrième participant peut varier librement : par exemple X4 = 11.
- À cet instant, la somme des quatre premières observations atteint 14 + 8 + 15 + 11 = 48. Pour que la moyenne de l’échantillon demeure égale à 12, le score du cinquième participant ne possède plus aucune liberté de variation : il est arithmétiquement verrouillé à 60 – 48 = 12.
L’acte d’estimer la moyenne empirique à partir de l’échantillon consomme irrévocablement une unité d’information au sein du système. Par conséquent, seules (n – 1) déviations quadratiques sont véritablement libres de fluctuer de manière indépendante. La dernière déviation est entièrement déterminée par la combinaison linéaire des déviations précédentes, car la somme des résidus linéaires par rapport à la moyenne empirique est toujours nulle :
∑(Xi – x̄) = 0
Rapporter la somme des carrés à l’effectif brut n reviendrait à prétendre que l’analyste dispose de n pièces d’information indépendantes pour évaluer la variabilité, ce qui constitue une distorsion logique. La division par le nombre exact de degrés de liberté (n – 1) traduit fidèlement la structure informationnelle sous-jacente du problème, assurant ainsi la parfaite validité des calculs de dispersion et l’adéquation des distributions de probabilité subséquentes (telles que la distribution de Student ou la distribution de Fisher-Snedecor) lors de la conduite des tests d’hypothèses.
6. Comparaison directe : divergence des résultats et comportement asymptotique
6.1 Pourquoi STDEV.P produit systématiquement une valeur inférieure à STDEV.S
L’analyse comparative des formules de STDEV.P et STDEV.S met en lumière une inégalité structurelle : pour n’importe quelle série de données non triviale (c’est-à-dire comportant au moins deux observations distinctes), la valeur calculée par STDEV.P est rigoureusement et systématiquement inférieure à la valeur générée par STDEV.S. Cette hiérarchie arithmétique découle d’une simple analyse comparative des dénominateurs : le numérateur étant rigoureusement identique dans les deux cas (la somme des carrés des déviations à la moyenne empirique), le ratio des deux écarts-types s’exprime sous une forme analytique directe :
STDEV.S = STDEV.P × √ [ N / (N – 1) ]
Étant donné que pour tout entier positif N > 1, le ratio N / (N – 1) est strictement supérieur à 1, sa racine carrée est elle-même supérieure à 1 :
√ [ N / (N – 1) ] > 1 ⇒ STDEV.S > STDEV.P
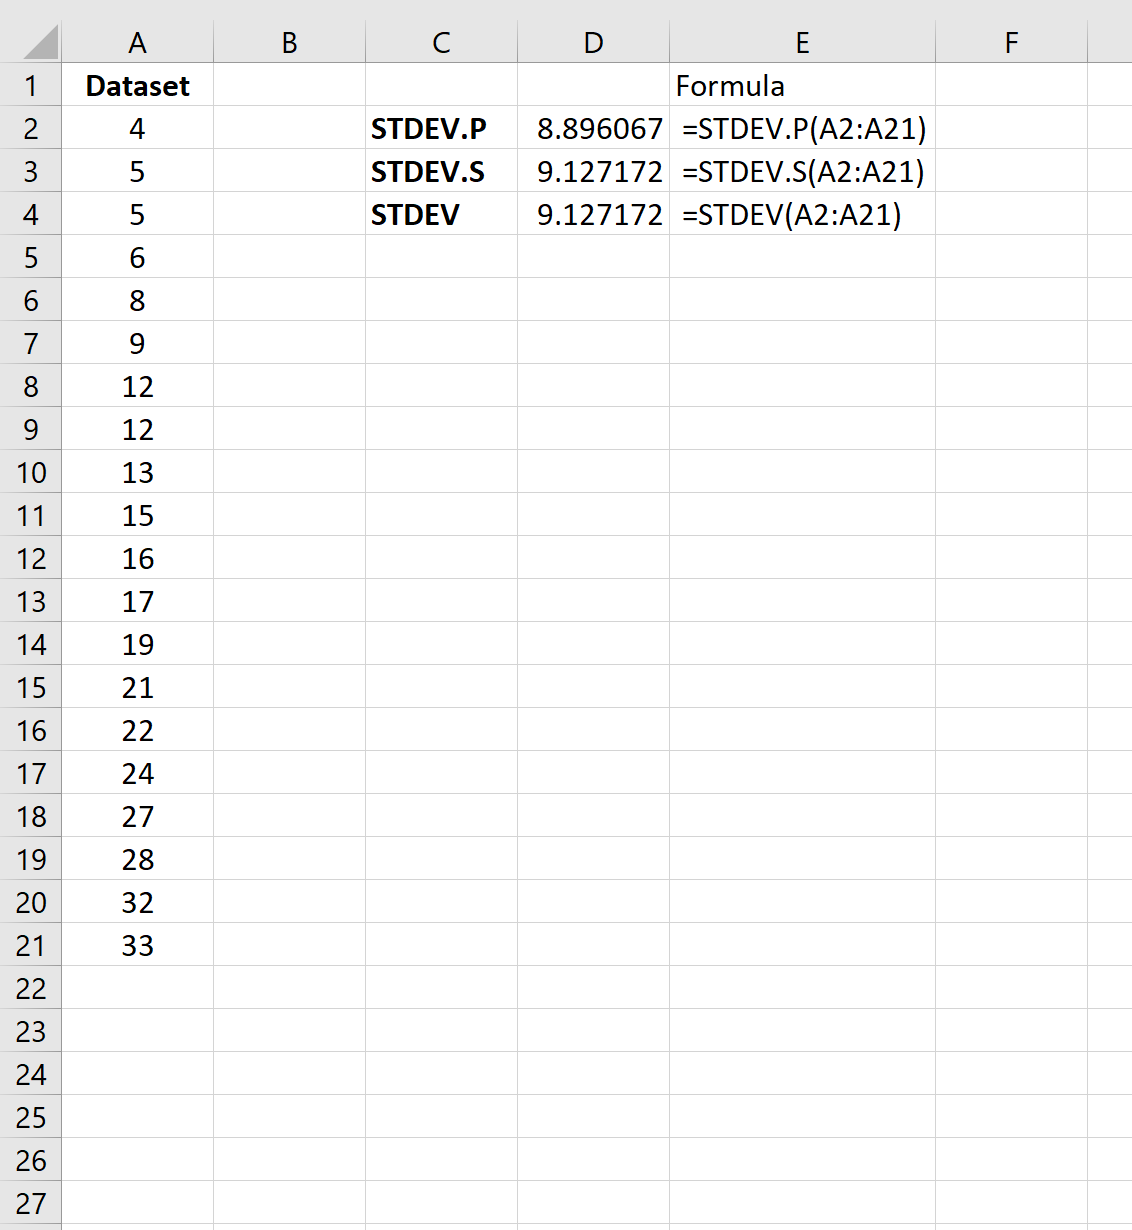
Ce multiplicateur correcteur, √[N / (N – 1)], régit l’amplitude de l’écart relatif existant entre les deux fonctions. Si un analyste commet une erreur de programmation sous Excel en appelant STDEV.P au lieu de STDEV.S pour traiter un échantillon empirique, il induit une minoration artificielle de l’écart-type de sa cohorte. Cette sous-évaluation a des répercussions concrètes : elle rétrécit artificiellement l’amplitude perçue de la dispersion, procure une illusion de précision et masque une portion significative de la variabilité réelle du phénomène étudié.
6.2 Effet de la taille de l’échantillon (N) sur la convergence numérique
L’ampleur du différentiel entre les deux fonctions dépend directement du volume des données analysées. Lorsque la taille de la cohorte est particulièrement ténue, le terme correctif produit un impact proportionnel majeur. Considérons une recherche expérimentale en psychologie clinique portant sur un groupe pilote restreint de n = 5 patients dépressifs. Dans cette situation, le facteur d’ajustement atteint :
√(5 / 4) = √1,25 ≈ 1,1180
L’écart-type d’échantillon STDEV.S s’avère supérieur de 11,80 % à l’écart-type de population STDEV.P. Une distorsion de près de 12 % sur une métrique de variabilité constitue un écart considérable, suffisant pour modifier radicalement la significativité statistique d’un test inférentiel ou le positionnement d’un seuil clinique. En revanche, au fur et à mesure que la taille de l’effectif progresse, le ratio N / (N – 1) se rapproche asymptotiquement de la valeur 1, érodant progressivement le différentiel numérique entre les deux opérateurs.
Le tableau comparatif suivant démontre la convergence asymptotique de ces deux grandeurs à travers différents paliers d’effectifs fréquemment rencontrés dans la pratique de recherche :
| Taille de l’Effectif (N ou n) | Ratio Algébrique [ N / (N – 1) ] | Facteur Multiplicateur √[ N / (N – 1) ] | Divergence Relative (%) | Impact Méthodologique Concret |
|---|---|---|---|---|
| n = 3 | 3 / 2 = 1,5000 | 1,2247 | + 22,47 % | Divergence critique ; distorsion inacceptable |
| n = 5 | 5 / 4 = 1,2500 | 1,1180 | + 11,80 % | Biais massif ; inadéquation méthodologique majeure |
| n = 10 | 10 / 9 = 1,1111 | 1,0541 | + 5,41 % | Divergence notable ; altération visible des scores |
| n = 30 | 30 / 29 = 1,0345 | 1,0171 | + 1,71 % | Divergence modérée ; impact tangible sur les tests limites |
| n = 100 | 100 / 99 = 1,0101 | 1,0050 | + 0,50 % | Divergence résiduelle ; impact marginal |
| n = 500 | 500 / 499 = 1,0020 | 1,0010 | + 0,10 % | Différentiel minime |
| n = 1 000 | 1000 / 999 = 1,0010 | 1,0005 | + 0,05 % | Convergence asymptotique quasi-complète |
| n = 10 000 | 10000 / 9999 = 1,0001 | 1,00005 | < 0,01 % | Identité computationnelle pratique |
Ce comportement asymptotique éclaire une loi fondamentale de la théorie de l’échantillonnage : pour les très grands volumes de données (big data, panels électoraux massifs, cohortes épidémiologiques de plusieurs dizaines de milliers d’individus), l’impact numérique de la correction de Bessel s’atténue jusqu’à devenir imperceptible. Cependant, en psychologie expérimentale et dans les sciences du comportement, où les cohortes dépassent rarement quelques dizaines ou quelques centaines de sujets, l’écart entre STDEV.P et STDEV.S conserve une importance critique. Considérer que cette divergence est négligeable constitue une erreur méthodologique patente dès lors que l’on manipule des cohortes de taille modeste.
7. Rétrocompatibilité et historique : clarification autour de la fonction STDEV classique
7.1 L’ancienne fonction STDEV et son équivalence fonctionnelle
L’exploration des feuilles de calcul générées sous des versions historiques d’Excel met régulièrement en évidence l’emploi d’une fonction ne comportant aucun suffixe explicite : la commande générique =STDEV() (ou =ECARTYPE() dans l’environnement linguistique français). Cette syntaxe historique a constitué la norme opératoire du logiciel depuis ses premières éditions au cours des années 1980 jusqu’à la révision majeure intervenue avec la publication d’Excel 2010. Cette dénomination historique suscite régulièrement des interrogations au sein des équipes d’analystes : quelle équation cette commande historique applique-t-elle véritablement ?
Il existe une équivalence mathématique absolue et indéfectible entre l’ancienne fonction STDEV et la formulation contemporaine STDEV.S :
STDEV ≡ STDEV.S
Dès sa conception initiale, les développeurs de Microsoft avaient arbitré en faveur de l’écart-type d’échantillon comme comportement algorithmique par défaut, intégrant le diviseur (n – 1). L’écart-type de population n’était alors accessible que par l’intermédiaire d’une commande dérivée, STDEVP (ou ECARTYPEP). Néanmoins, cette architecture logicielle induisait une source permanente d’ambiguïté : l’absence de qualification explicite sur la commande principale conduisait d’innombrables utilisateurs à supposer à tort que STDEV renvoyait la métrique de dispersion pure et complète (la population) de leur tableau. Ce déficit de précision terminologique a alimenté durant des années une multitude d’erreurs méthodologiques dans les rapports institutionnels et les mémoires universitaires.
7.2 Bonnes pratiques contemporaines pour l’archivage et le partage de classeurs
Dans un souci scrupuleux de préservation de la rétrocompatibilité, Microsoft maintient active l’ancienne syntaxe STDEV au sein des compilateurs de toutes les éditions actuelles d’Excel, y compris dans l’environnement infonuagique Microsoft 365. L’ouverture d’un classeur conçu il y a plus de quinze ans continuera de renvoyer des résultats arithmétiquement cohérents sans provoquer d’interruption du modèle de calcul. Cependant, cette tolérance logicielle relève du simple impératif industriel et ne saurait justifier la reconduction de ces commandes obsolètes dans les projets de recherche modernes.
L’ensemble des organismes de certification statistique et des comités de lecture scientifique préconise l’abandon total et définitif des fonctions historiques non suffixées. Plusieurs motifs méthodologiques majeurs sous-tendent cette recommandation :
- La clarté épistémologique et la traçabilité de l’intention : L’écriture formelle de
STDEV.Sou deSTDEV.Patteste que l’analyste a sciemment qualifié la nature de son jeu de données, neutralisant tout doute quant à une éventuelle négligence conceptuelle lors de la relecture par les pairs ou de l’audit interne. - La standardisation inter-applicative : Les langages d’analyse de données modernes, à l’instar de R, de Python (bibliothèques pandas, NumPy ou scipy.stats) ou de la syntaxe SQL ANSI, mobilisent des paramètres explicites pour régir le diviseur des degrés de liberté (par exemple l’argument
ddof=1sous NumPy pour l’échantillon versusddof=0pour la population). L’adoption de STDEV.S et STDEV.P favorise une cohérence heuristique immédiate lors de la transposition des classeurs Excel vers ces environnements de programmation scientifique. - La prévention des biais d’interprétation inter-analystes : Au sein d’un laboratoire de recherche ou d’un cabinet d’évaluation psychologique où collaborent des praticiens aux niveaux d’expertise hétérogènes, la présence de la commande historique
STDEVest source de malentendus réguliers, incitant fréquemment des tiers à la modifier de manière inopportune au motif erroné qu’il s’agirait d’un calcul de population.
Par conséquent, les règles de gouvernance des données doivent impérativement proscrire l’usage des anciennes étiquettes et contraindre les équipes de recherche à configurer leurs modèles en exploitant exclusivement les fonctions suffixées introduites depuis 2010.
8. Cas d’usage méthodologiques en psychologie : quand mobiliser STDEV.P ?
8.1 L’étalonnage psychométrique complet d’une population fermée
L’utilisation de la fonction STDEV.P se justifie sur le plan méthodologique dans des configurations empiriques bien circonscrites, caractérisées par l’observation d’un collectif dont les frontières sont totalement étanches et qui constitue en lui-même l’objet d’étude définitif. L’analyste se trouve alors dans un cadre d’observation exhaustive, où aucune extrapolation au-delà des individus effectivement mesurés n’est postulée. Dans ce contexte, toute tentative de mobiliser la correction de Bessel s’avérerait mathématiquement fautive, car elle corrigerait un biais d’échantillonnage… qui n’existe pas.
Un cas concret d’application concerne l’étalonnage interne d’une batterie d’aptitudes cognitives déployée à titre exclusif au sein d’une organisation privée. Imaginons qu’une entreprise multinationale de transport aérien soumette l’intégralité absolue de ses 120 contrôleurs aériens titulaires à une évaluation standardisée de leur vitesse de détection attentionnelle sur écran radar. La direction des ressources humaines n’entend pas généraliser les constats obtenus à l’ensemble des contrôleurs aériens de la planète : l’objectif de l’intervention consiste uniquement à cartographier les performances internes de son propre personnel, afin d’identifier les collaborateurs nécessitant un module de formation complémentaire au sein de cette cohorte fermée.
Dans ce scénario spécifique :
- L’effectif N = 120 englobe 100 % des individus composant la population d’intérêt. Aucun contrôleur n’a été omis, et aucun processus d’échantillonnage probabiliste n’a présidé à la constitution du groupe.
- La moyenne arithmétique calculée à partir des 120 temps de réponse représente la moyenne vraie μ de cette population d’entreprise.
- Pour établir les seuils internes d’alerte (par exemple la fixation d’un repère d’intervention psychologique à un écart-type en deçà de la performance moyenne du collectif), l’ingénieur d’étude doit obligatoirement mobiliser la formule
=STDEV.P(plage_scores).
Un raisonnement analogue s’applique à la psychométrie scolaire ou universitaire lorsque l’objet d’évaluation réside dans l’analyse brute des résultats d’une cohorte académique spécifique. Si un enseignant-chercheur analyse les notes obtenues à un examen terminal par la totalité des 250 étudiants inscrits dans une unité d’enseignement de licence afin d’attribuer des mentions internes selon une distribution de référence, ce groupe constitue une population fermée pour ladite session d’examen. Dès lors que l’on se cantonne à ce cadre descriptif sans chercher à modéliser les promotions futures, STDEV.P s’avère la commande méthodologiquement appropriée.
8.2 Recensements cliniques et bases de données exhaustives
Le second périmètre d’élection de STDEV.P concerne les recensements cliniques, les registres épidémiologiques institutionnels et les banques de données médicales exhaustives. Dans le cadre de la surveillance de la santé publique au sein d’un territoire clos, les agences sanitaires procèdent régulièrement à des extractions recensant l’intégralité des événements survenus sur une temporalité bornée. Il ne s’agit pas ici d’une enquête menée auprès d’un panel de citoyens, mais de l’enregistrement de l’intégralité des admissions hospitalières ou des actes médico-légaux.
Supposons qu’un psychiatre inspecteur étudie la durée moyenne de séjour au sein de l’unique établissement psychiatrique d’un département donné pour tous les patients admis sous le régime des soins sans consentement au cours d’une année civile révolue (du 1er janvier au 31 décembre). Les registres hospitaliers dénombrent exactement 342 admissions. L’ensemble des 342 dossiers cliniques fait l’objet d’une extraction d’information relative au nombre de journées d’hospitalisation :
- La base de données ne souffre d’aucune lacune d’échantillonnage : elle ne constitue pas une estimation sondière, mais la traçabilité complète de l’activité légale et médicale pour le créneau d’observation délimité.
- L’analyse descriptive univariée de la durée de séjour pour ce millésime particulier recourt légitimement à STDEV.P pour fixer la variabilité absolue du phénomène au sein du registre d’archives.
Cependant, une mise en garde méthodologique essentielle s’impose : la légitimité de STDEV.P s’effondre instantanément dès lors que le chercheur bascule d’une posture purement rétrospective vers une posture prédictive ou étiologique. Si le même psychiatre inspecteur utilise ces 342 dossiers pour affirmer que cette durée moyenne et sa dispersion reflètent les durées d’hospitalisation prévisibles pour l’année à venir, ou s’il entend généraliser ses conclusions aux structures hospitalières d’autres départements, les 342 observations perdent leur statut de population close pour devenir un échantillon circonstancié représentatif d’une temporalité ou d’une région géographique. Dès ce basculement inférentiel, l’emploi de STDEV.P devient une faute technique, et l’analyste doit impérativement basculer vers STDEV.S.
9. Cas d’usage méthodologiques en psychologie : quand mobiliser STDEV.S ?
9.1 Protocoles expérimentaux et essais cliniques randomisés
L’administration de la fonction STDEV.S représente la norme d’excellence incontournable dans l’immense majorité des démarches expérimentales conduites en psychologie scientifique, en médecine translationnelle et en neurosciences comportementales. Le cœur épistémologique de ces disciplines repose sur la méthode hypothético-déductive : les données ne sont jamais collectées pour elles-mêmes, mais pour tester la robustesse d’un modèle théorique prétendant à l’universalité ou pour évaluer la transposabilité d’une thérapeutique auprès d’une population clinique globale.
Considérons un essai clinique randomisé contrôlé (ECRC) conçu pour tester l’impact d’une prise en charge issue de la thérapie cognitivo-comportementale (TCC) de troisième vague sur la réduction des ruminations mentales chez des patients présentant un trouble anxieux généralisé (TAG). L’investigateur principal recrute un groupe de 40 participants répondant aux critères diagnostiques internationaux, répartis aléatoirement en un groupe expérimental (TCC) et un groupe témoin sur liste d’attente, à raison de 20 sujets par bras clinique :
- Il est d’une évidence méthodologique totale que ces 20 ou 40 individus ne représentent pas la population exhaustive des sujets souffrant de troubles anxieux. Ils n’en forment qu’un échantillon infinitésimal, sélectionné selon des critères d’inclusion rigoureux au sein d’un bassin de recrutement régional.
- L’ambition ultime du protocole consiste à publier des inférences transposables : l’investigateur cherche à démontrer que le traitement sera statistiquement efficace pour la population clinique parente tout entière.
- Par conséquent, l’évaluation de la dispersion des scores pré et post-interventionnels requiert impérativement un estimateur sans biais de la variabilité populationnelle. L’inscription de la formule
=STDEV.S(plage_groupe_TCC)s’impose alors de manière catégorique.
Un constat rigoureusement identique prévaut dans le champ de la psychologie cognitive expérimentale étudiant les temps de réaction, le traitement de l’information visuelle ou les potentiels évoqués cognitifs. Lorsqu’un laboratoire soumet un panel de 25 étudiants universitaires à un protocole de Stroop ou à une tâche de Simon afin de mesurer le coût temporel de l’inhibition motrice, ces 25 participants agissent comme des médiateurs d’échantillonnage d’un système cognitif universel. L’écart-type de leurs latences de réponse doit impérativement être calculé au moyen de STDEV.S, sans quoi les statistiques de test (comme le t de Student ou le F de Snedecor de l’ANOVA) dérivées de ces mesures souffriraient d’une distorsion de leurs dénominateurs d’erreur standard.
9.2 Enquêtes psychologiques par questionnaire et sondages d’opinion
La recherche par sondage et les protocoles transversaux fondés sur l’administration d’échelles de Likert ou d’inventaires d’attitudes constituent le deuxième grand champ d’application exclusif de STDEV.S. En psychologie sociale ou en sociologie quantitative, la mesure s’opère sur des cohortes d’individus sélectionnées au sein d’une collectivité générale pour explorer des construits latents tels que l’adhésion aux valeurs démocratiques, le niveau d’éco-anxiété ou le degré de précarité perçue.
Imaginons une enquête psychométrique menée auprès d’un échantillon probabiliste de 850 citoyens français, stratifié selon les variables d’âge, de sexe et de catégorie socio-professionnelle, visant à documenter la détresse psychologique ressentie lors d’une crise économique majeure. L’échelle mobilisée produit un indice quantitatif continu variant de 0 à 100 :
- Les 850 répondants ne sauraient en aucun cas épuiser l’univers des 68 millions de citoyens français. Ils n’agissent que comme une miniature probabiliste de la population nationale.
- Chaque calcul de variabilité opéré sur les dimensions de l’échelle a vocation à servir de socle pour la construction d’intervalles de confiance et pour la réalisation de régressions linéaires ou logistiques modélisant les déterminants de l’anxiété.
- L’introduction de la commande
=STDEV.S(plage_reponses)représente une condition absolue de validité pour nourrir ces modèles prédictifs. Recourir à la formule de population sous prétexte que le chiffre de 850 répondants est déjà « volumineux » constituerait un non-sens conceptuel : quelle que soit l’ampleur d’un échantillon, il ne devient une population que s’il correspond formellement à l’intégralité du collectif étudié.
10. Conséquences méthodologiques et psychométriques du mauvais choix de fonction
10.1 Distorsion des tailles d’effet et du d de Cohen
La sélection inappropriée d’un opérateur de dispersion sous Excel ne constitue pas une simple imperfection computationnelle cantonnée aux statistiques descriptives de base. Elle se propage dans l’ensemble de la chaîne des calculs statistiques, contaminant les grandeurs dérivées au premier rang desquelles figurent les mesures de taille d’effet (effect sizes). En psychologie empirique moderne, conformément aux injonctions formelles de l’American Psychological Association (APA Style Guidelines), la simple mention de la significativité statistique (la p-valeur) est jugée insuffisante pour statuer sur la pertinence d’un résultat : le chercheur est tenu de rapporter la magnitude standardisée de l’effet observé, le plus souvent exprimée par le célèbre d de Cohen.
Le d de Cohen caractérise la différence entre deux moyennes empiriques (x̄1 – x̄2), normalisée par l’écart-type combiné ou poolé (spooled) des deux groupes comparés :
d = (x̄1 – x̄2) / spooled
Si un analyste évalue par erreur les écarts-types individuels de ses deux groupes expérimentaux au moyen de la formule de population STDEV.P, les valeurs d’écart-type obtenues seront systématiquement sous-évaluées. Dès lors, l’écart-type combiné spooled qui intègre ces métriques présentera lui aussi une valeur anormalement faible. Le dénominateur de l’équation du d de Cohen se trouvant artificiellement comprimé, le quotient final s’élève de manière mécanique. Le chercheur arrive alors à une conclusion erronée : il surestime artificiellement la taille de l’effet clinique ou expérimental de son protocole.
Les répercussions épistémologiques et éthiques de ce phénomène sont considérables :
- Le risque d’erreur de type I : En surévaluant la magnitude de l’effet, l’investigateur risque de proclamer la découverte d’un phénomène comportemental puissant ou d’un gain thérapeutique majeur qui ne correspond en réalité qu’à une inflation computationnelle de son modèle.
- La crise de la reproductibilité scientifique : Dans le cadre des méta-analyses, les tailles d’effet extraites des publications individuelles sont agrégées pour déterminer l’efficacité globale d’un paradigme. L’injection d’effets artificiellement gonflés par l’usage non documenté de formules de population pollue les banques de données méta-analytiques et contribue directement à la crise de la reproductibilité qui frappe la psychologie empirique contemporaine.
10.2 Altération des scores Z standardisés et des classements diagnostiques
Dans l’exercice quotidien de la neuropsychologie clinique et de la psychométrie d’orientation, la transformation d’un score brut obtenu par un patient en un score standardisé représente la procédure diagnostique centrale. Le score standardisé universel, le score Z, exprime la distance qui sépare la performance brute d’un sujet (X) de la moyenne de sa cohorte de référence (x̄), exprimée en unités d’écart-type :
Z = (X – x̄) / s
Dans les manuels diagnostiques internationaux, à l’instar du DSM-5 (Manuel diagnostique et statistique des troubles mentaux de l’American Psychiatric Association) ou de la CIM-11 (Organisation mondiale de la santé), l’identification des déficiences cognitives majeures ou des troubles spécifiques des apprentissages repose sur des critères standardisés stricts : un profil est typiquement considéré comme pathologique lorsque le score standardisé chute en deçà d’un seuil prédéterminé, généralement fixé à Z ≤ -1,5 ou Z ≤ -2,0 écarts-types sous la moyenne de référence.
Supposons qu’un neuropsychologue évalue un jeune patient sur une épreuve de flexibilité cognitive en confrontant sa performance à un groupe de contrôle composé de n = 15 enfants sains du même âge. Si le praticien utilise Excel pour étalonner son groupe de contrôle et sélectionne par erreur la fonction STDEV.P pour calculer l’écart-type s, la dispersion du groupe témoin sera sous-estimée d’environ 3,5 %. En conséquence :
- Chaque point d’écart brut entre l’enfant évalué et la moyenne du groupe témoin sera divisé par un écart-type artificiellement réduit.
- La valeur absolue du score Z du patient sera donc artificiellement amplifiée : un score réel qui se situerait à Z = -1,95 (n’atteignant pas formellement le seuil pathologique de deux déviations standards) se verra recalculé à Z = -2,02.
- Cette distorsion arithmétique peut suffire à faire franchir au sujet un seuil diagnostique arbitraire, déclenchant potentiellement la prescription de bilans complémentaires invasifs, l’attribution injustifiée d’un diagnostic d’altération neurocognitive ou l’orientation erronée vers une prise en charge spécialisée.
De surcroît, la construction des intervalles de confiance entourant les scores observés se trouve également corrompue. L’erreur type de mesure (ETM = s × √(1 – r), où r désigne la fidélité de l’outil psychométrique) reposant directement sur l’écart-type du groupe d’étalonnage, toute compression de s réduit indûment l’intervalle de confiance, créant une fausse impression de certitude diagnostique autour de mesures psychologiques pourtant intrinsèquement soumises à l’erreur d’échantillonnage.
11. Guide pratique d’implémentation, fonctions alternatives et pièges dans Excel
11.1 Gestion des valeurs textuelles et logiques : STDEVA vs STDEVPA
L’écosystème statistique d’Excel ne se borne pas aux seules commandes STDEV.P et STDEV.S. Il intègre une famille parallèle de fonctions spécialisées portant le suffixe alphabétique « A » : STDEVA et STDEVPA. La présence de ces variantes au sein de la bibliothèque de fonctions engendre régulièrement des méprises chez les analystes qui les confondent avec des versions « avancées » des calculs de dispersion.
La distinction opératoire entre ces deux familles réside exclusivement dans la manière dont le moteur de calcul gère les cellules contenant du texte ou des valeurs logiques au sein de la plage sélectionnée :
- STDEV.S et STDEV.P : Elles ignorent rigoureusement les chaînes de caractères, les cellules sans saisie numérique et les valeurs logiques booléennes (
VRAIouFAUX) hébergées dans la plage matricielle. Le calcul s’exécute exclusivement sur les éléments de type nombre. - STDEVA et STDEVPA : Elles procèdent à une conversion numérique forcée de l’ensemble des éléments non numériques contenus dans la sélection. Une cellule contenant l’expression logique
VRAIest convertie en la valeur 1. Une cellule contenant l’expression logiqueFAUXou n’importe quelle chaîne textuelle (par exemple une annotation qualitative « Non renseigné », « Absent » ou « Refus de réponse ») est silencieusement convertie en la valeur numérique 0.
Le tableau synoptique ci-après synthétise les comportements comparés de ces quatre fonctions majeures :
| Fonction Excel | Vocation Statistique | Dénominateur Appliqué | Traitement du Texte dans la Plage | Traitement des Booléens (VRAI/FAUX) |
|---|---|---|---|---|
| STDEV.S | Échantillon probabiliste | n – 1 | Totalement ignoré | Totalement ignoré |
| STDEV.P | Population exhaustive | N | Totalement ignoré | Totalement ignoré |
| STDEVA | Échantillon composite | n – 1 | Converti en 0 | VRAI = 1 ; FAUX = 0 |
| STDEVPA | Population composite | N | Converti en 0 | VRAI = 1 ; FAUX = 0 |
L’utilisation imprudente de STDEVA ou de STDEVPA dans un contexte d’analyse psychologique ou médicale s’avère particulièrement périlleuse. Supposons qu’une plage de données compile les scores obtenus par 30 participants à un inventaire d’estime de soi s’étalant de 50 à 100 points, et que deux participants aient abandonné la passation, leurs cellules respectives portant la mention textuelle « Abandon ». Si l’analyste exécute par mégarde la commande =STDEVA(plage), le logiciel ne va pas écarter ces deux sujets : il va convertir les deux annotations « Abandon » en deux scores numériques réels de 0.
L’injection artificielle de deux valeurs nulles au sein d’une distribution bornée entre 50 et 100 produira un effondrement brutal de la moyenne arithmétique et une explosion totalement erronée de l’écart-type. Le jeu de données se trouvera irrémédiablement faussé sans qu’aucune notification d’erreur ne soit émise par le logiciel. La règle d’or pour tout analyste de données comportementales consiste donc à proscrire l’usage des fonctions à suffixe « A » pour le calcul de l’écart-type de scores continus, et à privilégier un assainissement préalable strict des matrices de données.
11.2 Structuration dynamique des données et tableaux Excel formels
Pour sécuriser l’implémentation opérationnelle de STDEV.S et STDEV.P dans les projets quantitatifs complexes, il est vivement recommandé d’abandonner l’usage des plages de cellules fixes et figées (telles que C2:C85) au profit des tableaux formels Excel (fonctionnalité « Mettre sous forme de tableau » ou raccourci Ctrl + L / Ctrl + T). L’exploitation des tableaux formels permet de mobiliser les références structurées, dont la flexibilité garantit l’intégrité des calculs statistiques au fil de la collecte expérimentale.
Si une matrice de recherche clinique est modélisée au sein d’un tableau baptisé CohorteClinique comportant une colonne intitulée Score_Anxiete, l’écriture de la commande d’écart-type d’échantillon adopte la forme suivante :
=STDEV.S(CohorteClinique[Score_Anxiete])
Cette méthodologie d’adressage procure des garanties immédiates :
- L’extensibilité dynamique automatique : Dès lors qu’un nouveau patient est inclus dans l’étude et que son score est consigné à la fin de la colonne, la référence structurée englobe instantanément la nouvelle ligne sans qu’aucune modification manuelle de la formule ne soit requise, éliminant tout risque d’omettre des observations lors de l’actualisation de la base.
- La lisibilité documentaire et la prévention des collisions d’adresses : Une formule formulée en langage clair réduit substantiellement les risques de confusion entre différentes colonnes lors de la relecture des modèles d’analyse par d’autres membres de l’équipe de recherche.
Par ailleurs, la modélisation statistique avancée impose fréquemment d’évaluer la dispersion de sous-groupes démographiques sans procéder à un tri manuel fastidieux de la base de données. Dans les versions modernes d’Excel (Microsoft 365 et Office 2021), l’alliance de STDEV.S avec la fonction matricielle FILTRE offre une puissance analytique remarquable. Pour extraire par exemple l’écart-type des scores mnésiques des seuls participants appartenant au groupe d’âge « Senior », la formule se structure de la manière suivante :
=STDEV.S(FILTRE(CohorteClinique[Score_Memoire]; CohorteClinique[Groupe_Age]= »Senior »))
Cette architecture matricielle évalue dynamiquement le prédicat logique et transmet à l’opérateur de dispersion un vecteur contenant exclusivement les observations éligibles, garantissant un cloisonnement parfait des sous-échantillons.
Enfin, l’analyste doit savoir identifier et traiter sans délai les messages d’erreur classiques renvoyés par Excel lors de l’exécution des fonctions de dispersion :
- #DIV/0! : Cette alerte survient quasi-exclusivement avec STDEV.S lorsqu’un filtre ou une sélection matricielle ne contient qu’une seule observation numérique (n = 1) ou est totalement vide. La division par (n – 1) devenant impossible, Excel interrompt le calcul. La parade consiste à sécuriser l’instruction au moyen d’un encapsulateur d’erreur :
=SIREUR(STDEV.S(plage); "Effectif insuffisant"). - #VALEUR! : Ce diagnostic signale qu’une constante non numérique a été directement insérée sous forme de chaîne de caractères au sein des arguments de la fonction sans être logée dans une cellule, ou qu’une formule imbriquée renvoie un type de donnée incompatible avec le traitement arithmétique.
- #NOMBRE! : Cette anomalie, plus rare dans le cadre des fonctions de dispersion, apparaît lorsque des arguments matriciels imbriqués violent les règles fondamentales du domaine de définition arithmétique (par exemple lors de l’interaction avec des calculs matriciels complexes générant des nombres imaginaires).
12. Arbre décisionnel et cadre d’assurance qualité pour l’analyste de données
12.1 Modèle heuristique de décision pour le choix entre STDEV.P et STDEV.S
Afin de prémunir les chercheurs, analystes et auditeurs contre toute incertitude lors de l’affectation de leurs commandes de calcul sous Excel, il est opportun de formaliser le cheminement analytique sous la forme d’un arbre décisionnel séquentiel fondé sur des critères méthodologiques explicites. Le choix de la fonction ne doit jamais relever d’une préférence empirique arbitraire, mais découler d’un diagnostic rigoureux portant sur la nature de la matrice de données et sur les finalités épistémologiques de l’investigation.
Le protocole décisionnel s’articule autour de quatre interrogations fondamentales :
- Interrogation 1 : Quelle est la nature de l’univers d’observation ?
— Option A : Les données saisies dans la feuille de calcul constituent l’intégralité absolue, définitive et exhaustive de tous les éléments qui composent la population d’intérêt (aucun individu non mesuré n’existe dans le périmètre considéré). → Passer à l’interrogation 2.
— Option B : Les données constituent un prélèvement, une fraction, une cohorte ou un ensemble de mesures issu d’un ensemble plus vaste que l’on ne peut pas ou que l’on n’a pas voulu sonder intégralement. → ORIENTATION CATÉGORIQUE VERS STDEV.S (ECARTYPE.STANDARD). - Interrogation 2 : Quelle est la finalité épistémologique de l’analyse ?
— Option A : L’objectif réside strictement dans la description mathématique univariée rétrospective de ce groupe spécifique, sans intention de prédire des comportements futurs, ni d’extrapoler les conclusions à d’autres promotions ou à des contextes géographiques distincts. → ORIENTATION CATÉGORIQUE VERS STDEV.P (ECARTYPE.PEARSON).
— Option B : Bien que l’ensemble du groupe présent ait été mesuré, les données sont mobilisées pour servir de modèle d’inférence, pour projeter des tendances futures ou pour formaliser une loi générale applicable à d’autres cohortes équivalentes. → ORIENTATION CATÉGORIQUE VERS STDEV.S (ECARTYPE.STANDARD). - Interrogation 3 : L’effectif de la cohorte est-il suffisant pour le calcul d’échantillon ?
— Si STDEV.S est requise : L’effectif vérifie-t-il formellement n ≥ 2 ?
— Si n < 2, le calcul d’échantillon est impossible. Il convient d’enrichir la collecte de données ou d’interrompre le calcul pour éviter le crash computationnel#DIV/0!. - Interrogation 4 : La matrice contient-elle des éléments hétérogènes ?
— Examiner si la plage contient des chaînes de caractères résiduelles ou des booléens. Si tel est le cas, proscrire formellement STDEVA/STDEVPA et nettoyer la plage pour soumettre des vecteurs purement numériques à STDEV.S ou STDEV.P.
Ce schéma heuristique peut être résumé sous la forme d’un principe général : « En cas d’hésitation méthodologique, privilégier presque systématiquement STDEV.S ». En effet, dans le contexte des sciences empiriques et de l’ingénierie de la donnée, l’observation d’une population totalement hermétique demeure l’exception, tandis que l’échantillonnage constitue la réalité écrasante des protocoles. Par ailleurs, si un analyste applique par excès de prudence la fonction STDEV.S à une population réelle de taille modérée (par exemple N = 100), l’erreur commise sur l’écart-type n’est que de 0,5 %, ce qui est souvent imperceptible. En revanche, appliquer par erreur STDEV.P à un échantillon pilote restreint de 10 patients génère une distorsion supérieure à 5 %, affectant l’ensemble de la chaîne inférentielle.
12.2 Protocoles de documentation et traçabilité dans les rapports scientifiques
L’assurance qualité dans la modélisation statistique sous Excel exige une transparence documentaire sans faille. Il est fréquent que des auditeurs indépendants, des évaluateurs de revues internationales ou des praticiens cliniques soient confrontés à des mémoires ou rapports présentant des tableaux de synthèse où figure une simple colonne libellée « Écart-type » (SD), sans qu’aucune précision ne soit apportée sur l’équation mathématique mobilisée ou sur la syntaxe logicielle exécutée.
Pour satisfaire aux exigences contemporaines d’intégrité scientifique et d’auditabilité des calculs, plusieurs protocoles de documentation doivent être rigoureusement observés au sein des équipes de recherche :
- Déclaration explicite dans la section Méthodologie : Tout rapport quantitatif doit formaliser expressément le statut assigné aux calculs de variabilité. Il convient de stipuler explicitement : « Les dispersions rapportées correspondent aux écarts-types d’échantillon non biaisés calculés via la fonction STDEV.S de Microsoft Excel, appliquant la correction de Bessel avec (n – 1) degrés de liberté ». Une telle formulation élimine toute ambiguïté lors de l’examen du manuscrit.
- Documentation des feuilles de calcul sources : Dans les classeurs destinés à être archivés ou partagés au sein d’une équipe ou sur des dépôts de science ouverte (à l’image de l’Open Science Framework), les cellules d’en-tête de colonnes dédiées aux métriques de dispersion doivent comporter un commentaire explicatif documentant la formule retenue, la justification de son choix au regard de l’échantillonnage et la conduite tenue à l’égard des données manquantes.
- Standardisation des gabarits institutionnels : Les laboratoires et départements d’évaluation psychologique ont tout intérêt à diffuser des matrices types préconfigurées et verrouillées, où les formules statistiques sont préprogrammées avec les fonctions modernes (
STDEV.SetSTDEV.P), interdisant aux utilisateurs finaux la modification non contrôlée des formules.
En conclusion définitive de cette analyse comparative, le tableau suivant synthétise les propriétés mathématiques, conceptuelles et fonctionnelles qui distinguent les deux commandes fondamentales d’Excel :
| Caractéristique Analytique | STDEV.P (ECARTYPE.PEARSON) | STDEV.S (ECARTYPE.STANDARD) |
|---|---|---|
| Statut statistique ciblé | Population exhaustive et close | Échantillon extrait d’une population |
| Dénominateur de calcul | N (Effectif total absolu) | n – 1 (Degrés de liberté corrigés) |
| Correction de Bessel intégrée | Non (Absence d’ajustement) | Oui (Ajustement non biaisé) |
| Propriété de l’estimateur de variance | Estimateur par le maximum de vraisemblance (Biaisé pour un échantillon) | Estimateur sans biais de la variance populationnelle |
| Valeur relative produite | Systématiquement inférieure à STDEV.S | Systématiquement supérieure à STDEV.P |
| Effectif minimal requis | n ≥ 1 (Renvoie 0 si n = 1) | n ≥ 2 (Renvoie #DIV/0! si n = 1) |
| Cas d’usage méthodologique | Recensements intégraux, cohortes closes, bilans d’archives rétrospectifs | Essais randomisés, recherches cognitives, enquêtes psychométriques, sondages |
| Conséquence d’une mauvaise utilisation | Surévaluation minime de la dispersion si appliqué à une population fermée | Sous-estimation sévère de la variabilité, inflation du d de Cohen, altération des diagnostics Z |
La maîtrise de cette dichotomie fondamentale ne représente pas une simple compétence technique liée au maniement d’un tableur ; elle constitue le garant de la rigueur épistémologique et de la probité scientifique du chercheur et du praticien de la donnée. En articulant lucidement la nature de leurs jeux de données aux propriétés algorithmiques de Microsoft Excel, les professionnels de la psychologie et des sciences quantitatives sécurisent l’ensemble de leurs édifices méthodologiques, assurant à leurs conclusions la solidité et la reproductibilité qu’exige l’avancement de la science.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bessel, F. W. (1816). Untersuchungen über die scheinbare und wahre Bahn des im Jahre 1807 erschienenen grossen Kometen. Königlich-Preussische Akademie der Wissenschaften, 1812–1813, 201–240.
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd.
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Microsoft Support. (2024). Fonction STDEV.S. Support technique Microsoft Office. https://support.microsoft.com/fr-fr/office/fonction-stdev-s-7d69cf97-0c1f-4acf-be27-f3e83904cc23
- Microsoft Support. (2024). Fonction STDEV.P. Support technique Microsoft Office. https://support.microsoft.com/fr-fr/office/fonction-stdev-p-6c9175c4-3996-4460-a070-e33382569688
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71–110. https://doi.org/10.1098/rsta.1894.0003
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.