
Dans le domaine de l’analyse exploratoire des données (Exploratory Data Analysis, EDA), popularisée par le statisticien John Tukey, la première confrontation avec un ensemble d’observations quantitatives constitue un moment critique de la démarche scientifique. L’analyste de données, le psychomètre ou le chercheur en sciences comportementales ne peut pas se contenter d’appliquer aveuglément des modèles inférentiels sophistiqués sans avoir préalablement appréhendé la topographie intime de ses observations. Une telle démarche précipitée exposerait l’investigateur à des erreurs méthodologiques graves, notamment par la violation d’hypothèses paramétriques fondamentales ou par l’aveuglement face à des artéfacts susceptibles de biaiser l’estimation des paramètres populationnels.
Pour guider cette exploration visuelle et quantitative sans rien omettre, la pédagogie des statistiques appliquées a développé des heuristiques mnémotechniques puissantes. Parmi celles-ci, l’acronyme SOCS s’impose comme une référence incontournable au sein de la littérature scientifique et éducative internationale. Articulé autour de quatre dimensions fondamentales — Shape (Forme), Outliers (Valeurs aberrantes), Center (Centre ou tendance centrale) et Spread (Dispersion ou variabilité) —, ce protocole fournit une armature cognitive d’une redoutable efficacité pour décomposer, caractériser et communiquer la structure de n’importe quelle distribution univariée de variables continues ou discrètes.
Ce guide exhaustif a pour ambition d’explorer en profondeur chacune des facettes de l’acronyme SOCS, en combinant les fondements de la statistique mathématique avec les exigences empiriques des sciences psychologiques, sociales et biomédicales. À travers une analyse méticuleuse des concepts théoriques, des critères formels d’identification métrologique, des instruments graphiques dédiés et des implications sur la robustesse inférentielle, cet article offre un manuel de référence destiné aux étudiants, aux chercheurs et aux praticiens soucieux de conférer à leurs analyses descriptives une rigueur méthodologique irréprochable conforme aux standards académiques contemporains.
1. Introduction à l’analyse exploratoire des données et à la mnémotechnique SOCS
1.1 Origine et fondements pédagogiques de l’acronyme SOCS
L’acronyme SOCS trouve son origine dans l’évolution contemporaine de la pédagogie des statistiques, particulièrement au sein du cursus nord-américain Advanced Placement Statistics et des manuels universitaires d’initiation à l’analyse exploratoire. Historiquement, l’enseignement traditionnel des statistiques s’est trop souvent focalisé sur le calcul mécanique de résumés numériques réducteurs, tels que la moyenne arithmétique et l’écart type, sans accorder une importance suffisante à la visualisation globale des jeux de données. Inspiré par les travaux pionniers de John W. Tukey présentés dans son ouvrage séminal de 1977 intitulé Exploratory Data Analysis, l’acronyme SOCS a été formalisé pour opérationnaliser la décomposition qualitative et quantitative d’une distribution empirique.
Le cadre repose sur quatre composantes essentielles : Shape, qui caractérise la silhouette géométrique des données ; Outliers, qui isole et quantifie les points de données situés à une distance anormale de la masse centrale ; Center, qui localise le point d’équilibre ou la valeur typique de l’échantillon ; et Spread, qui mesure l’étendue de la variabilité ou de la dispersion des observations. En tant qu’heuristique systématique, SOCS agit comme un garde-fou cognitif contre les omissions analytiques. Dans l’effervescence de la manipulation de grands jeux de données, les chercheurs novices ont fréquemment tendance à se précipiter sur l’interprétation des indices de tendance centrale en ignorant totalement la forme de la distribution ou la présence d’observations extrêmes susceptibles de dénaturer les conclusions.
L’utilité pédagogique de SOCS réside ainsi dans sa capacité à assurer une transition harmonieuse entre l’intuition visuelle immédiate et la description quantitative formalisée. Lorsqu’un analyste examine un histogramme ou un diagramme de densité, son regard perçoit d’abord une morphologie globale. L’acronyme fournit la structure linguistique et métrologique requise pour traduire cette impression visuelle en une série d’affirmations rigoureuses, vérifiables et reproductibles, soutenues par des métriques appropriées telles que le coefficient d’asymétrie, l’écart interquartile ou la déviation absolue médiane.
1.2 Importance de l’analyse descriptive initiale en sciences psychologiques
Dans les disciplines empiriques étudiant le comportement humain, la cognition ou les manifestations psychopathologiques, les données recueillies présentent rarement la régularité mathématique parfaite des modèles théoriques purs. Les scores obtenus à des échelles de dépression, les temps de réaction mesurés au millième de seconde dans des tâches de discrimination perceptive ou les indices de mémoire de travail présentent presque invariablement des particularités distributionnelles marquées. L’analyse descriptive initiale ne constitue donc pas une simple formalité protocolaire ; elle représente le socle épistémologique sur lequel repose l’ensemble de la validité scientifique de l’étude.
Comprendre la structure sous-jacente des données avant toute inférence permet de détecter précocement les violations directes des postulats régissant les modèles linéaires généraux. La quasi-totalité des tests paramétriques classiques — tels que le test t de Student, l’analyse de variance (ANOVA) ou la régression linéaire ordinaire — reposent sur l’hypothèse de la normalité des résidus et de l’homoscédasticité. Découvrir une asymétrie marquée ou des valeurs aberrantes après avoir exécuté les analyses inférentielles conduit inévitablement à des ajustements post-hoc douteux qui augmentent le risque d’erreurs de type I ou de type II, alimentant ainsi la crise de la reproductibilité qui traverse les sciences comportementales.
De plus, l’inspection initiale selon le protocole SOCS participe directement à la détection d’artefacts expérimentaux ou de biais d’échantillonnage insoupçonnés. Un score aberrant peut signaler un participant inattentif ayant répondu au hasard à un questionnaire informatisé, un problème d’horloge système lors de l’enregistrement d’un temps de réaction, ou encore l’inclusion par inadvertance d’un sujet ne répondant pas aux critères d’inclusion cliniques. Identifier ces particularités dès la phase exploratoire garantit que les décisions méthodologiques ultérieures reposeront sur une connaissance transparente et approfondie de la matière empirique.
1.3 Vue d’ensemble des quatre piliers descriptifs de toute distribution
L’efficacité de la mnémotechnique SOCS repose sur la profonde interdépendance théorique qui lie ses quatre composantes. Il est mathématiquement illusoire de considérer la forme, les valeurs aberrantes, le centre et la dispersion comme des compartiments étanches. Au contraire, la caractérisation de l’un de ces attributs conditionne directement le choix et la pertinence des métriques utilisées pour caractériser les autres. Par exemple, la présence d’une asymétrie prononcée (Shape) rend la moyenne arithmétique (Center) trompeuse et influe mécaniquement sur l’écart type (Spread), tout en rendant les critères classiques d’identification des valeurs aberrantes (Outliers) fondés sur le score Z totalement caducs.
Pour saisir pleinement une distribution, l’analyste doit instaurer une dialectique permanente entre les représentations graphiques et les métriques numériques. Les graphiques seuls, bien qu’indispensables pour appréhender la complexité globale, peuvent souffrir de subjectivité liée aux paramètres de tracé (tels que la largeur des classes d’un histogramme). Inversement, les indices numériques isolés résument les données au prix d’une perte massive d’information, dissimulant potentiellement des bimodalités critiques ou des regroupements inattendus, comme l’illustre de manière magistrale le célèbre quartet d’Anscombe. Les représentations visuelles révèlent la morphologie, tandis que les métriques quantifient précisément cette réalité.
Le protocole SOCS prescrit ainsi une hiérarchie séquentielle logique dans l’examen exploratoire :
l’analyste examine d’abord la forme globale pour évaluer la symétrie et la modalité ; il inspecte ensuite la distribution à la recherche de valeurs aberrantes susceptibles de distordre les calculs ultérieurs ; guidé par ces deux premiers constats, il sélectionne l’indicateur de tendance centrale le plus robuste et le plus représentatif ; enfin, il associe à ce centre la mesure de dispersion mathématiquement et conceptuellement congruente. Cette progression méthodique garantit une cohérence interne absolue dans la rédaction des comptes rendus statistiques.
2. La composante « Shape » (Forme) : Évaluation de la géométrie distributionnelle
2.1 Symétrie et asymétrie : conceptualisation du skewness
L’évaluation de la forme d’une distribution débute invariablement par l’analyse de sa symétrie axiale par rapport à une valeur centrale. Mathématiquement, une distribution continue est dite parfaitement symétrique si sa fonction de densité de probabilité $f(x)$ satisfait la relation $f(c – x) = f(c + x)$ pour tout $x$, où $c$ représente le centre de symétrie. Dans un tel cas, les deux moitiés de la distribution se reflètent de part et d’autre de cet axe, impliquant que la moyenne, la médiane et, si la distribution est unimodale, le mode coïncident rigoureusement au même point.
Lorsque cette équidistance n’est pas respectée, la distribution présente une asymétrie, communément désignée sous le terme anglais de skewness. On distingue fondamentalement deux directions d’asymétrie :
- L’asymétrie positive (ou orientée à droite) : la queue de la distribution s’étire de façon prononcée vers les valeurs élevées de l’axe des abscisses. La masse principale des observations est regroupée à gauche, aux valeurs basses, mais quelques observations très élevées tirent la moyenne arithmétique vers la droite, de sorte que l’on observe typiquement l’ordre hiérarchique : $\text{Mode} < \text{Médiane} < \text{Moyenne}$.
- L’asymétrie négative (ou orientée à gauche) : la queue de distribution s’étend vers les valeurs minimales, tandis que la concentration dominante des données se situe du côté positif. Les valeurs particulièrement faibles tirent la moyenne vers la gauche, générant la relation inverse : $\text{Moyenne} < \text{Médiane} < \text{Mode}$.
Pour quantifier cette caractéristique géométrique au-delà de la simple impression visuelle, la théorie statistique s’appuie principalement sur le coefficient d’asymétrie momentané de Fisher-Pearson ($g_1$), défini pour un échantillon de taille $n$ par la formule normalisée basée sur le troisième moment centré :
$$g_1 = \frac{\frac{1}{n} \sum_{i=1}^{n} (x_i – \bar{x})^3}{\left( \frac{1}{n} \sum_{i=1}^{n} (x_i – \bar{x})^2 \right)^{3/2}}$$
Un coefficient $g_1$ proche de zéro (usuellement situé entre $-0,5$ et $+0,5$) indique une distribution approximativement symétrique. Une valeur supérieure à $+1,0$ ou inférieure à $-1,0$ traduit une asymétrie sévère qui contre-indique formellement l’utilisation aveugle d’indicateurs gaussiens non ajustés.
Dans la pratique de la recherche psychologique, les asymétries positives marquées sont omniprésentes dans la mesure des temps de réaction chronométriques, des durées de fixation oculaire ou des taux de sécrétion de cortisol en réponse au stress. Les processus cognitifs ont un seuil plancher physiologique infranchissable (environ 150 à 200 ms pour une réponse motrice simple), mais aucune limite supérieure théorique stricte, créant inévitablement un allongement de la traîne droite. À l’inverse, l’asymétrie négative se rencontre fréquemment lors de l’administration d’épreuves cognitives trop faciles à une population préservée, provoquant un « effet plafond » où la majorité des individus obtiennent des scores maximaux ou quasi-maximaux.
2.2 Modalité : analyse du nombre de sommets d’une distribution
La seconde caractéristique géométrique critique d’une distribution concerne sa modalité, c’est-à-dire le nombre de pics ou de concentrations locales de densité distincts observables sur l’ensemble de la plage de variation. L’analyse de la modalité permet d’interroger immédiatement l’homogénéité de l’échantillon analysé et d’émettre des hypothèses qualitatives majeures quant à l’existence de processus générateurs multiples.
Une distribution est dite unimodale lorsqu’elle ne présente qu’un seul point d’accumulation principal autour duquel les données se dispersent de manière décroissante. Le cas canonique le plus célèbre est la loi normale (ou courbe de Gauss), mais d’autres lois continues comme la loi Gamma, la loi Log-normale ou la loi exponentielle sont également unimodales. Dans les contextes expérimentaux bien contrôlés où une population homogène est soumise à une tâche standardisée, l’unimodalité représente la structure attendue de la variabilité interindividuelle aléatoire.
À l’opposé, l’émergence d’une distribution bimodale (présentant deux sommets proéminents séparés par une vallée ou un creux de densité) doit immédiatement alerter le chercheur. En sciences comportementales, la bimodalité n’est presque jamais le fruit du pur hasard d’échantillonnage ; elle constitue généralement l’indicateur criant de la superposition non détectée de deux sous-populations sous-jacentes distinctes au sein d’un même échantillon nominalement unique. Par exemple, une distribution bimodale des scores à une tâche d’attention visuo-spatiale peut révéler que les participants ont spontanément adopté deux stratégies cognitives mutuellement exclusives (traitement analytique séquentiel versus traitement holistique global), ou refléter l’inclusion fortuite de sujets présentant des déficits attentionnels non diagnostiqués mélangés à des sujets neurotypiques.
Enfin, les distributions multimodales (comportant trois sommets ou davantage) et les distributions uniformes (dépourvues de pic marqué, où chaque valeur possède une probabilité d’occurrence similaire sur un intervalle donné) posent des défis analytiques considérables. Face à de tels profils, les descripteurs de tendance centrale perdent toute significativité concrète : la moyenne d’une distribution uniforme ou bimodale ne représente en aucun cas un comportement typique, mais se situe paradoxalement dans une région à faible densité d’observations réelles.
2.3 Aplatissement et kurtosis : analyse des queues et du pic
Le troisième aspect de la géométrie distributionnelle est l’aplatissement, traditionnellement conceptualisé sous le terme de kurtosis (du grec kurtos, signifiant bombé ou courbé). Si la métaphore historique décrivait le kurtosis comme la « pointicité » du sommet par rapport aux épaules de la courbe, les travaux contemporains en théorie statistique ont démontré que le kurtosis reflète avant tout le poids relatif des queues de distribution par rapport aux flancs, mesurant ainsi la propension d’un processus à générer des événements rares et extrêmes.
On formalise le coefficient de kurtosis excessif ($g_2$) par le quatrième moment centré et normalisé, diminué de 3 afin que la loi normale serve de référence avec un indice égal à zéro :
$$g_2 = \frac{\frac{1}{n} \sum_{i=1}^{n} (x_i – \bar{x})^4}{\left( \frac{1}{n} \sum_{i=1}^{n} (x_i – \bar{x})^2 \right)^2} – 3$$
Sur la base de cette métrique, trois catégories morphologiques se dégagent nettement :
- Distribution mésocurtique ($g_2 \approx 0$) : la morphologie des queues est équivalente à celle de la loi normale théorique. Les probabilités d’observer des déviations extrêmes diminuent exponentiellement au fur et à mesure que l’on s’éloigne du centre.
- Distribution leptocurtique ($g_2 > 0$) : la distribution possède des queues épaisses (dites heavy tails) et un pic central souvent très aiguisé. Les observations ont tendance à se concentrer massivement autour de la moyenne, tout en présentant simultanément une probabilité non négligeable de produire des valeurs extrêmement éloignées. En neuropsychologie, les scores de récupération fonctionnelle après un accident vasculaire cérébral présentent couramment une leptocurtose : une masse de patients récupère de façon prévisible, mais une fraction minoritaire réalise des récupérations spectaculaires ou subit des déclins dramatiques.
- Distribution platycurtique ($g_2 < 0$) : les queues de distribution sont particulièrement légères et courtes, tandis que le centre apparaît étalé ou aplati. Les valeurs extrêmes sont beaucoup plus rares que dans un cadre gaussien.
Il importe de souligner une distinction conceptuelle fondamentale trop souvent négligée : l’aplatissement n’est pas synonyme de variance. Deux distributions peuvent posséder rigoureusement la même variance tout en affichant des coefficients de kurtosis radicalement opposés. La variance quantifie la dispersion moyenne globale autour du centre, tandis que le kurtosis informe sur la répartition interne de cette dispersion : résulte-t-elle d’écarts modérés constants ou de la combinaison d’une zone centrale très serrée ponctuée d’écarts titanesques ?
3. La composante « Outliers » (Valeurs aberrantes) : Détection et typologie
3.1 Définition conceptuelle et étiologie des données atypiques
Dans la taxonomie SOCS, la lettre O désigne les Outliers, traduits en français par valeurs aberrantes, atypiques ou discordantes. Selon la formulation classique du statisticien Frank Hampel, un outlier est une observation qui s’écarte de manière si prononcée du reste des données qu’elle suscite de légitimes suspicions quant au mécanisme générateur qui l’a produite. La détection de ces entités est capitale car les estimateurs classiques du modèle linéaire sont extrêmement vulnérables à leur présence ; un seul point excessivement divergent suffit à déplacer substantiellement une moyenne ou à inverser la significativité d’un coefficient de corrélation de Pearson.
D’un point de vue étiologique, toutes les valeurs atypiques ne partagent pas la même nature ontologique. Il est impératif d’opérer une distinction rigoureuse entre trois grandes origines :
- Les erreurs de mesure et de saisie : ces artefacts techniques incluent la frappe erronée d’un chiffre (par exemple, enregistrer un âge de 220 ans au lieu de 22 ans), la défaillance d’un capteur physiologique lors d’un protocole d’électroencéphalographie, ou un dysfonctionnement de script informatique tronquant un enregistrement de latence.
- Les artefacts méthodologiques comportementaux : dans les études en psychologie empirique, il s’agit typiquement de participants adoptant des comportements non conformes aux consignes expérimentales. On y retrouve l’effet du désengagement motivationnel (un sujet qui coche systématiquement l’option maximale sur une échelle de Likert en quelques millisecondes sans lire les items), les tentatives délibérées de tricherie, ou la distraction brutale provoquée par un événement extérieur imprévu dans le laboratoire.
- La variabilité naturelle extrême : ces observations n’émanent d’aucune erreur ni d’aucun artéfact, mais incarnent la variabilité intrinsèque, rare mais parfaitement authentique, de la population étudiée. Dans une étude sur le quotient intellectuel ou les compétences en calcul mental, un individu affichant des capacités prodigieuses constituera un outlier statistique tout en représentant une réalité biologique et psychologique de premier ordre qu’il serait scientifiquement désastreux d’ignorer.
3.2 Critères formels d’identification univariée
Pour éviter l’arbitraire consistant à désigner une donnée comme aberrante sur la seule base d’une impression visuelle subjective, la communauté statistique a élaboré des règles de décision mathématiques quantitatives. Parmi celles-ci, deux approches univariées prédominent dans la littérature :
La première est la règle empirique de Tukey, ancrée dans la logique des résumés d’ordre et des quartiles. Cette méthode présente l’immense avantage d’être hautement non-paramétrique et donc totalement insensible aux valeurs extrêmes elles-mêmes. Tukey a défini des « clôtures » (fences) calculées à partir de l’intervalle interquartile ($\text{IQR} = Q_3 – Q_1$) :
- Clôture intérieure inférieure : $Q_1 – 1,5 \times \text{IQR}$
- Clôture intérieure supérieure : $Q_3 + 1,5 \times \text{IQR}$
- Clôture extérieure inférieure : $Q_1 – 3,0 \times \text{IQR}$
- Clôture extérieure supérieure : $Q_3 + 3,0 \times \text{IQR}$
Toute observation comprise entre les clôtures intérieures et extérieures est qualifiée d’atypique modérée (mild outlier) ; toute observation franchissant les clôtures extérieures est désignée comme atypique extrême (extreme outlier).
La seconde approche repose sur l’utilisation des scores standardisés Z. Pour chaque observation $x_i$, le score centré réduit est calculé selon $z_i = (x_i – \bar{x}) / s$, où $\bar{x}$ désigne la moyenne arithmétique et $s$ l’écart type de l’échantillon. Selon les seuils critiques conventionnels établis par David Howell et d’autres méthodologues :
- $|z_i| > 2,5$ est couramment utilisé dans les échantillons de taille modeste ($N < 100$) ;
- $|z_i| > 3,29$ (correspondant à une probabilité bilatérale $p < 0,001$ sous l'hypothèse de normalité) est le standard privilégié pour les échantillons de grande taille.
Toutefois, une limite mathématique majeure affecte le critère du score Z : il souffre du redoutable phénomène de masquage (masking effect). Étant donné que la moyenne et l’écart type sont eux-mêmes violemment gonflés par l’observation aberrante, le score Z de cette dernière s’en trouve artificiellement comprimé, ce qui peut paradoxalement empêcher sa détection formelle dans des distributions asymétriques ou fortement contaminées.
3.3 Stratégies méthodologiques face aux valeurs aberrantes
Une fois les valeurs aberrantes rigoureusement identifiées et répertoriées, le chercheur se trouve confronté à un dilemme épistémologique et déontologique de premier plan : comment traiter ces données ? L’illusion du débutant consiste à procéder à la suppression pure et simple de toutes les observations franchissant les seuils formels. Cette pratique d’amputation arbitraire est scientifiquement toxique : elle réduit artificiellement la variabilité naturelle, tronque les queues de distribution et biaise substantiellement les estimations de taille d’effet, contribuant à la prolifération de résultats faussement positifs dans la littérature.
Trois stratégies méthodologiques légitimes doivent être préférentiellement envisagées :
- La correction ou suppression justifiée par preuve matérielle : Si l’investigateur peut démontrer objectivement que l’observation découle d’une erreur de saisie ou d’un incident matériel documenté dans le cahier de laboratoire, la correction de la valeur (si la source originale est accessible) ou son élimination définitive est pleinement justifiée. La transparence exige que chaque retrait soit explicitement documenté dans la section méthodologique de la publication.
- L’ajustement par winsorisation ou transformation non linéaire : La winsorisation consiste à remplacer la valeur extrême identifiée par la valeur acceptable la plus proche (par exemple, assigner à un score dépassant le 99e centile la valeur exacte de ce centile). Alternativement, l’application d’une fonction mathématique monotone concave — telle que la transformation logarithmique ($ln(x)$ ou $\log_{10}(x)$), racine carrée ($\sqrt{x}$) ou inverse ($1/x$) — permet de comprimer l’échelle des valeurs supérieures sans éliminer un seul individu du corpus de données, rétablissant fréquemment la symétrie et la conformité aux postulats gaussiens.
- La pratique du double rapport (robustness checking) : Considérée comme l’étalon-or de l’intégrité scientifique contemporaine, cette méthode consiste à mener et rapporter l’intégralité des analyses statistiques sous deux conditions parallèles : une première fois avec le jeu de données complet comprenant l’ensemble des outliers authentiques, et une seconde fois après exclusion ou ajustement de ceux-ci. Si les conclusions scientifiques et la significativité des effets demeurent inchangées entre les deux modèles, l’investigateur peut conclure avec confiance à la robustesse absolue de ses résultats face aux perturbations distributionnelles.
4. La composante « Center » (Centre) : Indicateurs de tendance centrale
4.1 La moyenne arithmétique : propriétés et vulnérabilités
Au cœur de la modélisation statistique paramétrique trône la moyenne arithmétique, symbolisée par $\bar{x}$ pour un échantillon et par la lettre grecque $\mu$ pour la population sous-jacente. Définie algébriquement comme la somme de toutes les observations divisée par le nombre total d’unités statistiques de l’échantillon ($\bar{x} = \frac{1}{n}\sum_{i=1}^n x_i$), la moyenne incarne le barycentre ou centre de gravité exact de la distribution. Sur le plan géométrique, si chaque point de données était matérialisé par une masse identique disposée sur une tige graduée infiniment rigide mais de poids nul, la moyenne arithmétique constituerait l’unique point de pivot parfait permettant de maintenir la tige en équilibre horizontal absolu.
Cette définition mathématique confère à la moyenne une propriété théorique d’une importance capitale dans la théorie de l’estimation : elle minimise la somme des carrés des écarts de chaque point par rapport à elle-même, soit :
$$\min_c \sum_{i=1}^{n} (x_i – c)^2 iff c = \bar{x}$$
Cette caractéristique fait de la moyenne l’estimateur sans biais le plus efficace lorsque la population parente suit une loi normale parfaite, maximisant la précision métrologique pour une taille d’échantillon donnée.
Toutefois, cette force algébrique constitue simultanément sa vulnérabilité majeure en analyse descriptive exploratoire. Parce que la somme des écarts non quadratiques doit impérativement s’annuler ($\sum_{i=1}^n (x_i – \bar{x}) = 0$), une seule observation colossale située à l’extrême droite de l’axe contraindra la moyenne à se déplacer vers cette valeur atypique pour compenser l’écart métrique, sans tenir compte du fait que l’immense majorité des observations réside bien plus bas. Dès lors qu’une distribution présente une asymétrie marquée ou des queues lourdes, la moyenne arithmétique cesse d’être une mesure représentative de la « centralité » réelle : elle décrit un individu théorique moyen qui, dans les faits, ne ressemble à aucun membre typique du groupe étudié.
4.2 La médiane : point d’équilibre robuste de la distribution
Face aux fragilités structurelles de la moyenne arithmétique, la médiane s’érige comme le descripteur de tendance centrale par excellence de la statistique non-paramétrique et robuste. Conceptuellement, la médiane est le 50e centile de la distribution ordonnée : elle représente la valeur empirique qui scinde l’échantillon classé par ordre croissant en deux sous-ensembles d’effectifs rigoureusement identiques, de sorte que 50 % des observations lui sont inférieures ou égales et 50 % lui sont supérieures ou égales.
Sur le plan mathématique, la médiane ne minimise pas la somme des carrés des déviations, mais minimise la somme des déviations absolues simples :
$$\min_c \sum_{i=1}^{n} |x_i – c| iff c = \text{Médiane}$$
Cette propriété algorithmique lui confère une insensibilité totale à la magnitude exacte des points situés dans les queues de distribution. Qu’une observation maximale soit située à trois écarts types ou à trois mille écarts types du centre, la position de division ordinale de la médiane demeure absolument inébranlable. Elle constitue donc un indicateur d’une résistance exceptionnelle face aux aberrations numériques unilatérales.
Dans l’architecture du protocole SOCS, l’interprétation conjointe de la moyenne et de la médiane constitue un test heuristique de symétrie d’une redoutable perspicacité :
- Si $\bar{x} \approx \text{Médiane}$, la morphologie centrale de la distribution est virtuellement symétrique.
- Si $\bar{x} > \text{Médiane}$, la distribution est étirée vers les valeurs supérieures par une traîne asymétrique positive.
- Si $\bar{x} < \text{Médiane}$, une traîne d'asymétrie négative tire le centre de gravité vers le bas par rapport au milieu positionnel des observations.
4.3 Le mode : valeur de fréquence maximale
Le troisième indicateur classique de tendance centrale est le mode, défini comme la valeur ou la classe de valeurs dont la fréquence d’occurrence est maximale dans l’échantillon considéré. Dans le cas d’une variable aléatoire discrète ou de scores recueillis sur des échelles ordinales d’attitudes, le mode s’identifie trivialement par l’inspection du dénombrement brut : il s’agit de la modalité numérique recueillant le plus grand nombre absolu d’adhésions de la part des participants.
Pour les variables quantitatives véritablement continues (telles que les coordonnées spatiales, les temps de réponse ou les mesures de potentiels évoqués), la probabilité mathématique d’observer deux fois exactement la même valeur au millionième d’unité près est théoriquement nulle. Dans ce cadre continu, le mode se définit plutôt par l’abscisse correspondant au sommet local maximal de la courbe d’estimation de densité lissée par noyau (KDE). Il désigne l’état du système affichant la plus forte densité locale de probabilité empirique.
Bien que le mode présente l’intérêt unique d’être applicable à tous les niveaux de mesure sans exception — y compris sur les variables strictement nominales et qualitatives où la notion même de moyenne ou de médiane est dépourvue de sens —, il présente d’importantes limites métriques en tant que descripteur unilatéral d’une distribution continue. Il est hautement instable d’un échantillon à un autre lorsqu’il est extrait d’un histogramme dont la largeur de bande varie, et il ignore totalement la structure quantitative des observations situées en dehors du voisinage immédiat de son pic. Son utilité au sein du cadre SOCS réside principalement dans sa mise en contraste avec la moyenne et la médiane pour éclairer la modalité et la complexité structurale exposées dans la section Shape.
5. La composante « Spread » (Dispersion) : Quantifier la variabilité
5.1 Étendue brute et intervalle interquartile (IQR)
La lettre finale de l’acronyme SOCS renvoie au concept indispensable de Spread (dispersion, variabilité ou étendue). Décrire le centre d’une distribution sans quantifier sa variabilité est une faute scientifique caractérisée ; deux distributions de scores psychologiques peuvent présenter une médiane strictement identique de 100 points alors que la première concentre tous ses participants entre 95 et 105, tandis que la seconde disperse ses scores de 20 à 180 points, décrivant deux réalités phénotypiques radicalement dissemblables.
L’indicateur de dispersion le plus spontané et le plus rudimentaire est l’étendue brute (Range), calculée par la simple différence arithmétique entre l’observation maximale et l’observation minimale :
$$\text{Étendue} = X_{\max} – X_{\min}$$
Bien que d’une interprétation intuitive immédiate, l’étendue brute est le descripteur le plus fragile de tout l’arsenal statistique. Reposant exclusivement sur les deux valeurs les plus excentrées de l’échantillon, sa valeur est totalement instable, augmente mécaniquement avec l’augmentation de la taille de l’échantillon et se trouve démesurément amplifiée dès la moindre contamination par une donnée aberrante.
Pour s’affranchir de cette vulnérabilité terminale, l’analyse descriptive non paramétrique privilégie l’intervalle interquartile ($\text{IQR}$, pour Interquartile Range). L’IQR mesure l’étendue spatiale couverte par les 50 % centraux de la distribution ordonnée :
$$\text{IQR} = Q_3 – Q_1$$
Où $Q_1$ désigne le premier quartile (25e centile) et $Q_3$ le troisième quartile (75e centile). En éliminant délibérément de son calcul les 25 % des valeurs les plus basses et les 25 % des valeurs les plus hautes de l’échantillon, l’intervalle interquartile offre une résistance totale aux fluctuations des queues de distribution et aux valeurs aberrantes, fournissant un indicateur stable de l’étalement du cœur compact des observations.
5.2 Variance et écart type : mesures paramétriques standard
Lorsque la distribution présente une symétrie satisfaisante et se prête à l’utilisation de la moyenne comme référence centrale, les mesures de dispersion de référence absolue demeurent la variance et l’écart type. La variance empirique corrigée ($s^2$) exprime la moyenne de la somme des carrés des écarts entre chaque observation individuelle et la moyenne arithmétique globale, ajustée par les degrés de liberté ($n – 1$) pour garantir un estimateur sans biais de la variance de la population :
$$s^2 = \frac{1}{n – 1} \sum_{i=1}^{n} (x_i – \bar{x})^2$$
Cependant, en raison de l’élévation au carré inhérente à sa formulation, la variance est exprimée dans le carré des unités de la variable mesurée (par exemple, des « millisecondes au carré » ou des « points de dépression au carré »), ce qui interdit toute interprétation clinique directe. Pour réintégrer la dispersion dans l’échelle métrique originale du phénomène mesuré, on en extrait la racine carrée positive, définissant ainsi l’écart type (Standard Deviation, noté $s$ pour l’échantillon ou $\sigma$ pour la population) :
$$s = \sqrt{s^2} = \sqrt{\frac{1}{n – 1} \sum_{i=1}^{n} (x_i – \bar{x})^2}$$
Dans le cas spécifique et fondamental d’une distribution approximativement mésocurtique et symétrique (loi normale), l’écart type acquiert une interprétation probabiliste extraordinairement précise formalisée par la règle empirique 68-95-99,7 :
- Environ 68,27 % des observations se situent dans l’intervalle compris entre $\bar{x} – 1s$ et $\bar{x} + 1s$.
- Environ 95,45 % des observations sont contenues dans l’intervalle $[\bar{x} – 2s ; \bar{x} + 2s]$.
- Près de 99,73 % des observations (la quasi-totalité de la population) résident dans l’intervalle $[\bar{x} – 3s ; \bar{x} + 3s]$.
Cette congruence mathématique élégante s’effondre cependant dès que la composante Shape s’éloigne de la gaussianité, soulignant à nouveau l’obligation de synchroniser l’examen du Spread avec l’analyse morphologique préalable.
5.3 Indicateurs de variabilité relative et mesures robustes complémentaires
L’écart type et l’IQR partagent une contrainte métrologique : ce sont des mesures de dispersion absolues, intimement liées à l’unité de mesure et à l’amplitude numérique de la variable étudiée. Lorsque le chercheur souhaite comparer la variabilité d’un groupe mesuré sur des échelles dissemblables (par exemple, comparer la variabilité d’une tâche de mémoire mesurée sur 30 items avec celle d’un test attentionnel chronométré en centaines de millisecondes), les indices absolus deviennent incommensurables. On recourt alors à une métrique adimensionnelle de variabilité relative, le coefficient de variation (CV), défini comme le ratio de l’écart type sur la moyenne arithmétique :
$$\text{CV} = \frac{s}{\bar{x}} \times 100$$
Le CV permet de relativiser l’ampleur des fluctuations observées par rapport au niveau moyen de performance, facilitant la comparaison de la stabilité interindividuelle à travers différents domaines fonctionnels.
Sur le versant de la statistique robuste contemporaine, un autre indicateur surpasse l’IQR en termes de fondement asymptotique : la déviation absolue médiane (Median Absolute Deviation, notée MAD). Formalisée par Hampel en 1974, la MAD est calculée en mesurant la médiane des déviations absolues de chaque observation par rapport à la médiane générale :
$$\text{MAD} = \text{Médiane}\left( |x_i – \text{Médiane}(X)| \right)$$
Pour conférer à la MAD une équivalence asymptotique parfaite avec l’écart type d’une distribution normale, on lui applique généralement un facteur d’ajustement multiplicatif d’environ 1,4826 ($\text{MAD}_{\sigma} = 1,4826 \times \text{MAD}$). Cette métrique offre le blindage statistique le plus robuste disponible contre l’impact destructeur de données aberrantes massives.
Le principe fondamental régissant le traitement du Spread dans l’application de SOCS est la cohérence du couplage métrique. L’analyste rigoureux s’interdit formellement de mélanger des indicateurs de natures épistémologiques divergentes. Il applique systématiquement le couplage paramétrique standard Moyenne / Écart type lorsque la distribution est symétrique et dépourvue d’outliers majeurs, ou le couplage non-paramétrique robuste Médiane / IQR (ou MAD) dès que la distribution présente une asymétrie ou des contaminations extrêmes prononcées.
6. Protocole d’application pas-à-pas de la méthode SOCS
6.1 Phase 1 : Inspection préliminaire et ordonnancement des données
L’implémentation opérationnelle du protocole SOCS ne doit rien laisser à l’improvisation heuristique. Elle s’organise selon un flux procédural séquentiel débutant par une phase de préparation et de vérification méticuleuse de la base de données. Avant de chercher à qualifier la morphologie globale, l’investigateur doit s’assurer de l’intégrité numérique du jeu d’observations.
Cette étape inaugurale consiste à :
- Procéder au tri méthodique des observations par ordre de grandeur croissant, condition préalable absolue pour le calcul des statistiques de rang et des quantiles.
- Conduire un audit systématique des données manquantes (missing data). L’analyste doit recenser le nombre d’omissions, caractériser leur mécanisme générateur potentiel (données manquantes de manière totalement aléatoire [MCAR], aléatoire [MAR] ou non aléatoire [MNAR]) et définir la politique d’exclusion ou d’imputation appropriée.
- Établir immédiatement le résumé à cinq nombres de Tukey (Five-Number Summary), constitué du minimum absolu ($X_{\min}$), du premier quartile ($Q_1$), de la médiane ($Q_2$), du troisième quartile ($Q_3$) et du maximum absolu ($X_{\max}$). Ces cinq jalons positionnels synthétisent instantanément l’architecture squelettique de la série statistique.
6.2 Phase 2 : Analyse conjointe de la forme et détection des anomalies
La seconde phase matérialise le cœur diagnostique de la méthode SOCS en couplant l’évaluation morphologique (Shape) et la traque des entités aberrantes (Outliers). Ces deux dimensions doivent être traitées simultanément car elles s’influencent mutuellement de manière inextricable : une queue de distribution étirée peut être générée par une accumulation diffuse de points asymétriques ou par la présence isolée d’un couple d’outliers extrêmes détachés du corps principal.
L’analyste commence par projeter les données à travers un histogramme soigneusement calibré ou une courbe de densité afin de qualifier visuellement la silhouette : repère-t-on un sommet unique (unimodalité) ou des sommets multiples (multimodalité) ? Observe-t-on une symétrie bilatérale satisfaisante ou une traîne unilatérale orientée vers la droite ou la gauche ? Cette impression morphologique est ensuite immédiatement confrontée aux métriques formelles : calcul du coefficient d’asymétrie de Fisher-Pearson ($g_1$) et du coefficient de kurtosis excessif ($g_2$).
Dans la foulée, l’investigateur applique rigoureusement les barrières quantitatives d’isolement des anomalies. En utilisant les valeurs $Q_1$ et $Q_3$ obtenues à la Phase 1, il calcule l’IQR et trace les clôtures de Tukey ($Q_1 – 1,5 \times \text{IQR}$ et $Q_3 + 1,5 \times \text{IQR}$). Toute observation localisée au-delà de ces bornes est précisément isolée, son identifiant expérimental est noté, et son historique de recueil est audité afin de documenter formellement son étiologie potentielle (erreur matérielle versus variabilité clinique authentique) selon les préceptes développés à la section 3.
6.3 Phase 3 : Sélection justifiée des métriques de centre et de dispersion
La phase conclusive du protocole consiste à arbitrer scientifiquement le choix des paramètres qui seront retenus pour résumer le Centre et le Spread de l’échantillon dans le rapport scientifique final. Cet arbitrage n’est pas libre ou laissé à la discrétion esthétique de l’auteur ; il découle directement de l’arbre de décision alimenté par les conclusions indiscutables des Phases 1 et 2.
L’arbre de décision méthodologique s’articule comme suit :
- Cas de figure A (Distribution symétrique et sans outliers sévères) : Le coefficient d’asymétrie est contenu dans l’intervalle $[-0,5 ; +0,5]$ et aucun point n’excède les clôtures de Tukey. L’analyste privilégie sans réserve le couple paramétrique classique Moyenne arithmétique et Écart type. Ce choix maximise la puissance d’information et s’articule directement avec les modèles linéaires inférentiels ultérieurs.
- Cas de figure B (Distribution fortement asymétrique ou contaminée par des outliers) : Le coefficient $|g_1| > 1,0$ ou des observations dépassent significativement les clôtures extérieures ($3,0 \times \text{IQR}$). L’analyste adopte formellement le couple robuste Médiane et Intervalle Interquartile (ou MAD). Le recours exclusif à la moyenne et à l’écart type est rejeté car ces indicateurs seraient biaisés et non représentatifs du groupe.
Le processus s’achève par la rédaction d’une synthèse textuelle standardisée respectant scrupuleusement la progression chronologique SOCS (Forme $to$ Valeurs aberrantes $to$ Centre $to$ Dispersion), garantissant une transmission intégrale et non distordue de la structure des données aux pairs évaluateurs.
7. Instruments graphiques indispensables pour alimenter l’analyse SOCS
7.1 L’histogramme et l’estimation de densité par noyau (KDE)
Pour matérialiser visuellement la géométrie d’une distribution et alimenter objectivement la composante Shape de SOCS, l’histogramme demeure l’outil graphique fondamental le plus répandu. En partitionnant l’étendue totale des données en classes contiguës (intervalles ou bins) de largeur uniforme et en érigeant au-dessus de chaque classe un rectangle dont la surface est strictement proportionnelle au nombre ou à la densité d’observations qui y tombent, l’histogramme offre une approximation discrète directe de la fonction de densité de probabilité sous-jacente.
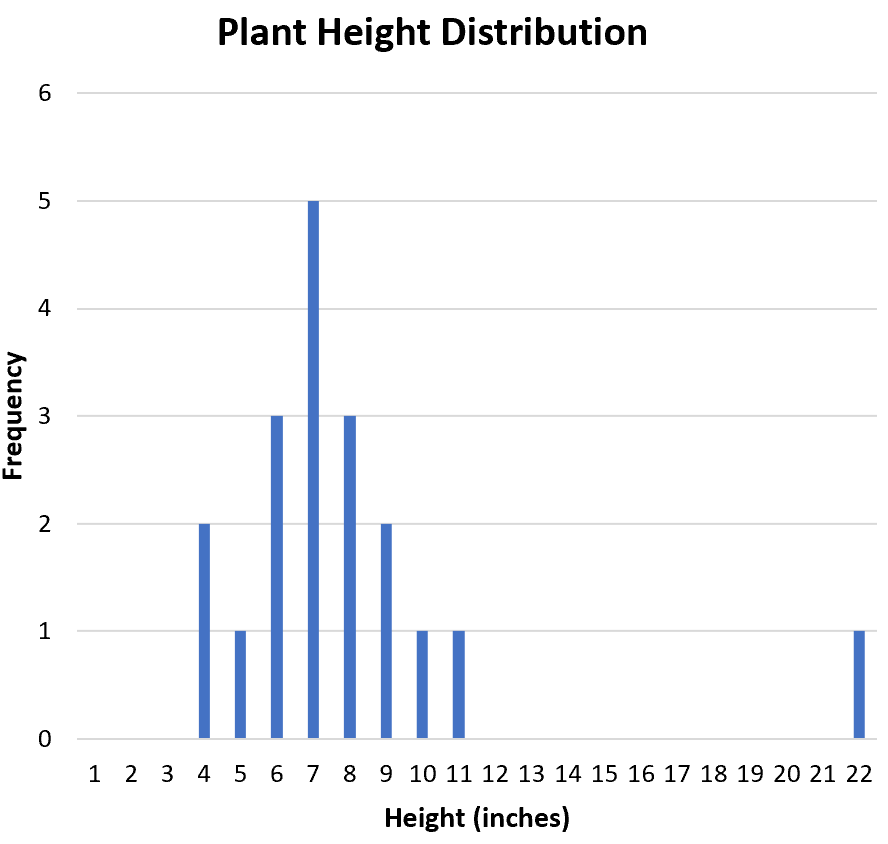
Cependant, l’utilisation rigoureuse de l’histogramme exige une vigilance méthodologique extrême quant au paramétrage de la largeur des classes (bin width). Un découpage comportant un nombre excessif d’intervalles très étroits engendrera une fragmentation visuelle chaotique dominée par le bruit d’échantillonnage aléatoire, masquant les tendances structurelles majeures. À l’inverse, un découpage trop large et grossier lissera artificiellement la distribution, dissimulant une bimodalité critique ou des traînes d’asymétrie réelles. Pour standardiser cette sélection, des algorithmes formels doivent être employés, au premier rang desquels figure la règle de Freedman-Diaconis, particulièrement résiliente face aux outliers :
$$\text{Largeur optimale de classe} = 2 \times \frac{\text{IQR}(X)}{\sqrt[3]{n}}$$
Pour sublimer l’histogramme et s’affranchir du caractère arbitraire du choix de l’origine des classes, la statistique computationnelle contemporaine lui superpose fréquemment l’estimation de densité par noyau (Kernel Density Estimation, KDE). La méthode KDE produit une courbe continue et lisse en plaçant au-dessus de chaque observation individuelle une micro-fonction gaussienne (le noyau) et en sommant l’ensemble de ces contributions le long du continuum métrique. Cette représentation fluide permet de qualifier avec une netteté visuelle supérieure le degré d’asymétrie, l’inclinaison des épaules et l’acuité des pics modaux de la série statistique.
7.2 Le diagramme en boîte à moustaches (Boxplot)
Inventé par John Tukey dans le prolongement de ses travaux sur les résumés d’ordre, le diagramme en boîte à moustaches (Boxplot ou Box-and-Whisker Plot) constitue l’instrument graphique roi pour opérationnaliser simultanément les trois composantes O, C et S de la mnémotechnique. Construit directement à partir du résumé à cinq nombres, il matérialise l’information distributionnelle par une structure géométrique normalisée particulièrement efficiente :
- Le corps de la boîte : Ses bordures inférieure et supérieure représentent respectivement le premier quartile ($Q_1$) et le troisième quartile ($Q_3$). La hauteur totale de la boîte correspond donc exactement à l’intervalle interquartile ($\text{IQR}$), visualisant instantanément la composante Spread.
- La ligne médiane : Tracée à l’intérieur de la boîte, elle identifie avec précision le centre d’équilibre robuste de la distribution (composante Center). Sa position relative dans la boîte éclaire également la forme (Shape) : si la médiane est décentrée vers le bas de la boîte, une asymétrie positive interne est mise en évidence.
- Les moustaches : Traditionnellement selon Tukey, les moustaches s’étendent depuis les quartiles jusqu’aux observations les plus éloignées qui demeurent néanmoins à l’intérieur des clôtures intérieures ($Q_1 – 1,5 \times \text{IQR}$ et $Q_3 + 1,5 \times \text{IQR}$).
- Les points individuels isolés : Toute donnée située au-delà de l’extrémité des moustaches est dessinée sous la forme d’un point ou d’un astérisque distinct, signalant sans la moindre ambiguïté visuelle la présence et le nombre exact de valeurs aberrantes (composante Outliers).
Il existe néanmoins une limite intrinsèque majeure au diagramme en boîte qu’aucun analyste ne doit ignorer : le boxplot standard est totalement aveugle à la multimodalité. Une distribution parfaitement unimodale et une distribution lourdement bimodale présentant des quartiles et des médianes identiques généreront rigoureusement le même tracé en boîte à moustaches. Pour combler cette défaillance de la composante Shape, l’analyste moderne privilégiera souvent le graphique en violon (violin plot), qui greffe une estimation de densité KDE bilatérale autour de la structure interne du boxplot.
7.3 Le graphique quantile-quantile (Q-Q plot) et diagramme branche-et-feuille
Pour pousser au plus haut degré de précision l’évaluation de la composante Shape et vérifier rigoureusement l’adéquation d’un échantillon à un modèle théorique de référence (au premier rang duquel la loi normale), le graphique quantile-quantile (Q-Q plot) représente l’instrument analytique le plus puissant de la statistique inférentielle exploratoire. Le principe sous-jacent repose sur la mise en regard directe des quantiles empiriques ordonnés de l’échantillon observé contre les quantiles théoriques attendus d’une loi gaussienne standardisée de même effectif.
L’interprétation diagnostique d’un Q-Q plot est gouvernée par la topologie de la droite identité à 45 degrés ($y = x$) :
- Si les données proviennent d’une distribution normale, les points d’observation s’alignent rigoureusement le long de la ligne diagonale de référence, ne présentant que de minimes ondulations stochastiques aux extrémités.
- Une courbure en forme de « U » convexe (les points plongent sous la droite au centre et s’élèvent au-dessus aux extrémités) trahit formellement une asymétrie positive prononcée.
- Une courbure concave en forme de « S inversé » (les points forment une sigmoïde traversant la diagonale) dénonce un aplatissement leptocurtique avec des queues de distribution excessivement lourdes.
Pour les échantillons de taille restreinte ($N < 50$), le diagramme branche-et-feuille (Stem-and-Leaf display) conserve une valeur didactique et pratique remarquable. En utilisant les premiers chiffres significatifs d’une valeur comme « branche » (axe des ordonnées) et le dernier chiffre comme « feuille » textuelle horizontale, cet outil hybride combine les vertus visuelles d’un histogramme avec la conservation intégrale de l’information brute individuelle d’origine, permettant une inspection immédiate et sans perte de chaque observation atypique.
8. Étude de cas empirique : Analyse complète d’une distribution de données psychologiques
8.1 Présentation du jeu de données : scores à une tâche d’attention soutenue
Afin d’illustrer la mise en pratique opératoire du protocole SOCS dans des conditions écologiques représentatives des exigences de la recherche expérimentale, considérons une étude menée au sein d’un laboratoire de neuropsychologie cognitive. L’investigateur s’intéresse à l’impact de la fatigue cognitive consécutive à une privation partielle de sommeil chez de jeunes adultes sains. Un échantillon de soixante participants ($N = 60$) a été soumis à une tâche informatisée d’attention soutenue de type Psychomotor Vigilance Task (PVT) d’une durée continue de vingt minutes.
La variable dépendante analysée ici est le temps de réaction moyen aux cibles imprévisibles, recueilli en millisecondes (ms) pour chaque sujet au cours du dernier tiers de l’épreuve. L’objectif de l’investigateur est de conduire une analyse exploratoire exhaustive de cette variable continue afin de statuer sur le profil de la distribution, de repérer d’éventuels profils individuels atypiques, et de déterminer avec certitude si un traitement inférentiel paramétrique classique (par exemple un test t pour échantillons appariés comparé à une condition repos) est méthodologiquement recevable ou s’il convient de se réorienter vers des procédures robustes.
Le jeu de données ordonné (exprimé en millisecondes) se présente ainsi :
320, 332, 345, 350, 358, 362, 365, 370, 372, 378, 381, 385, 390, 392, 395, 401, 404, 408, 412, 415, 418, 420, 422, 424, 425, 425, 428, 430, 432, 435, 438, 440, 442, 445, 448, 452, 455, 460, 465, 470, 475, 482, 490, 498, 510, 525, 535, 550, 565, 580, 595, 612, 630, 655, 680, 710, 745, 790, 1020, 1150.
8.2 Mise en œuvre concrète du protocole SOCS sur l’échantillon
L’application rigoureuse du protocole en trois phases déployé à la section 6 fournit les éléments métriques et morphologiques suivants :
1. Évaluation de la Forme (Shape) : L’inspection conjointe de l’histogramme et du tracé d’estimation de densité par noyau révèle une distribution strictement unimodale dont la silhouette est caractérisée par une déformation asymétrique flagrante. Le sommet principal culmine aux alentours de 420-440 ms, mais la queue de distribution s’étire interminablement vers la droite, s’étendant au-delà de 1000 ms. L’évaluation quantitative confirme cette distorsion visuelle : le coefficient d’asymétrie de Fisher-Pearson s’élève à $g_1 = +2,48$, dénotant une asymétrie positive sévère. Le kurtosis excessif culmine quant à lui à $g_2 = +7,12$, signalant une distribution hautement leptocurtique avec des queues excessivement chargées par rapport à une loi normale.
2. Détection des Valeurs Aberrantes (Outliers) : Pour appliquer la règle de Tukey, établissons les repères quartiles sur la base des rangs ordonnés ($N = 60$) :
- Premier quartile ($Q_1$, 25e centile) : 398 ms
- Médiane ($Q_2$, 50e centile) : 436,5 ms
- Troisième quartile ($Q_3$, 75e centile) : 517,5 ms
- Intervalle interquartile ($\text{IQR} = Q_3 – Q_1$) : $517,5 – 398 = 119,5\text{ ms}$
Calculons les clôtures de décision :
- Clôture intérieure supérieure : $Q_3 + (1,5 \times \text{IQR}) = 517,5 + (1,5 \times 119,5) = 517,5 + 179,25 = 696,75\text{ ms}$
- Clôture extérieure supérieure : $Q_3 + (3,0 \times \text{IQR}) = 517,5 + (3,0 \times 119,5) = 517,5 + 358,5 = 876,0\text{ ms}$
L’analyse des scores révèle que les observations 710 ms, 745 ms et 790 ms dépassent la clôture intérieure : ce sont des outliers modérés. Plus spectaculaire encore, les valeurs 1020 ms et 1150 ms franchissent largement la clôture extérieure des 876 ms : ce sont des outliers extrêmes. L’audit qualitatif de laboratoire indique qu’il ne s’agit pas d’erreurs d’horloge, mais de participants ayant subi des épisodes massifs de microsommeil involontaire au cours de la tâche cognitive.
3. Calcul du Centre (Center) : La confrontation de la moyenne arithmétique et de la médiane illustre de manière saisissante le phénomène de décentrement induit par l’asymétrie et les outliers. La moyenne arithmétique de l’échantillon s’établit à $\bar{x} = 494,2\text{ ms}$. À l’inverse, la médiane des scores se situe à seulement $\text{Médiane} = 436,5\text{ ms}$. La moyenne surestime le centre typique de vigilance de près de 58 millisecondes (un décalage supérieur à un demi-écart type non contaminé), tirée vers le haut par les quelques sujets ayant somnolé.
4. Mesure de la Dispersion (Spread) : L’écart type classique de l’échantillon s’élève à $s = 168,4\text{ ms}$. Cependant, cette valeur est démesurément gonflée par les déviations quadratiques des deux valeurs supérieures supérieures à 1000 ms. Si l’on calcule l’indicateur robuste congruent avec la médiane, l’écart interquartile n’est que de $\text{IQR} = 119,5\text{ ms}$, et la déviation absolue médiane normalisée s’établit à $\text{MAD}_{\sigma} \approx 62,3\text{ ms}$. L’écart type classique dépeint ainsi une image dramatiquement exagérée de la variabilité réelle des participants typiques du groupe.
8.3 Rédaction du compte-rendu narratif selon la grille SOCS
Voici le modèle de paragraphe académique standardisé intégrant avec fluidité et rigueur l’ensemble de la grille SOCS, conforme aux attentes éditoriales des revues internationales de neuropsychologie et de psychologie expérimentale :
« L’examen de la distribution des temps de réaction moyens à la tâche PVT ($N = 60$) met en évidence une morphologie unimodale caractérisée par une asymétrie positive prononcée ($g_1 = +2,48$) ainsi qu’une leptocurtose marquée ($g_2 = +7,12$), la queue de distribution s’étirant de façon substantielle vers les latences élevées (Shape). L’application de la règle des clôtures de Tukey a permis d’isoler cinq observations atypiques supérieures : trois valeurs aberrantes modérées ($710\text{ ms}$, $745\text{ ms}$ et $790\text{ ms}$) et deux valeurs aberrantes extrêmes ($1020\text{ ms}$ et $1150\text{ ms}$), consécutives à des épisodes de microsommeil documentés (Outliers). En raison de cette sévère déviation par rapport au postulat de normalité, les paramètres gaussiens traditionnels s’avèrent fallacieux : la moyenne arithmétique ($\bar{x} = 494,2\text{ ms}$, $s = 168,4\text{ ms}$) est artificiellement tirée vers le haut et ne reflète pas le niveau de performance typique de la cohorte. Le profil d’efficience cognitive est fidèlement capturé par les métriques robustes d’ordre, indiquant une tendance centrale médiane de $436,5\text{ ms}$ (Center) associée à un intervalle interquartile de $119,5\text{ ms}$ [$Q_1 = 398,0\text{ ms}$ ; $Q_3 = 517,5\text{ ms}$] (Spread). En conséquence, les analyses inférentielles comparatives ultérieures reposeront exclusivement sur des modèles non-paramétriques sur rangs ou sur des procédures de rééchantillonnage par bootstrap avec médiane tronquée. »
9. Sensibilité, robustesse et compromis métrologiques
9.1 Le concept de point de rupture des estimateurs
Pour fonder scientifiquement l’arbitrage opéré dans le cadre du protocole SOCS entre statistiques classiques et statistiques non-paramétriques, la théorie statistique s’appuie sur le concept formel de point de rupture (breakdown point), formalisé par Frank Hampel et Peter Rousseeuw au sein du paradigme de la statistique robuste. Le point de rupture quantifie la proportion minimale d’observations arbitrairement aberrantes ou corrompues qu’un estimateur statistique peut tolérer dans un échantillon avant de produire une valeur elle-même infiniment fausse ou dégénérée.
Dans ce cadre métrologique :
- La moyenne arithmétique et l’écart type possèdent un point de rupture de $0$ % (plus formellement $1/n$). Cela signifie qu’il suffit d’une seule et unique observation corrompue parmi dix mille ($x_i to \infty$) pour que la moyenne arithmétique de l’échantillon soit propulsée vers l’infini, anéantissant toute représentativité des $9,999$ observations authentiques restantes.
- À l’opposé, la médiane empirique et la déviation absolue médiane (MAD) affichent un point de rupture maximal de $50$ %. Cela implique qu’il faudrait contaminer ou altérer plus de la moitié absolue de l’ensemble des données d’un échantillon pour contraindre la médiane à basculer vers une valeur arbitraire non maîtrisée. L’intervalle interquartile (IQR) bénéficie pour sa part d’un point de rupture très confortable de $25$ %.
Ce fossé colossal en termes de résistance explique pourquoi l’étape Outliers de la méthode SOCS doit impérativement précéder l’officialisation des étapes Center et Spread. Ignorer un point de rupture nul revient à bâtir l’édifice inférentiel sur des sables mouvants métrologiques.
9.2 Moyennes tronquées et estimateurs M
Si la médiane offre un blindage exceptionnel avec son point de rupture de 50 %, elle présente un revers méthodologique dans les situations où la distribution est quasi-normale : une efficacité statistique asymptotique légèrement inférieure à celle de la moyenne. Pour concilier la robustesse face aux anomalies avec l’efficacité d’estimation des paramètres de population, la méthodologie contemporaine a développé des estimateurs intermédiaires sophistiqués, au premier rang desquels figurent les moyennes tronquées (trimmed means) et les estimateurs M (M-estimators).
La moyenne tronquée à $k$ % consiste à ordonner l’échantillon, à éliminer symétriquement une fraction de $k$ % des observations les plus basses et de $k$ % des observations les plus hautes (les standards internationaux recommandent couramment une troncature bilatérale de 10 % ou 20 %), puis à calculer la moyenne arithmétique sur le sous-ensemble résiduel :
$$\bar{x}_{t(0,20)} = \frac{1}{n – 2g} \sum_{i = g + 1}^{n – g} x_{(i)}$$
Où $g = [0,20 \times n]$. Cette approche élimine d’emblée l’influence destructrice des queues leptocurtiques et des outliers tout en conservant une grande stabilité d’échantillonnage.
Les estimateurs M, introduits par Peter Huber, perfectionnent encore ce principe en n’appliquant pas une découpe brutale en tout-ou-rien. Ils attribuent à chaque observation un coefficient de pondération continu décroissant en fonction de l’éloignement du point par rapport au centre provisoire : les observations centrales reçoivent un poids unitaire plein, tandis que les observations s’aventurant dans les régions périphériques subissent une atténuation progressive de leur poids algébrique dans le calcul final. Dans le cadre d’un rapport SOCS de haut niveau, mentionner une moyenne tronquée à 20 % aux côtés de la médiane permet d’offrir une estimation du Centre d’une élégance méthodologique irréprochable.
9.3 Conséquences sur l’inférence statistique ultérieure
L’omission de l’analyse exploratoire SOCS et l’utilisation aveugle d’indices paramétriques sur des distributions inadaptées entraînent des répercussions désastreuses sur l’ensemble de la chaîne inférentielle ultérieure. Contrairement à une idée reçue tenace issue d’une mauvaise interprétation du théorème central limite, un échantillon modérément grand ($N \approx 50$ à $100$) ne « guérit » pas automatiquement les effets d’une asymétrie sévère combinée à des queues lourdes.
Les principales altérations inférentielles documentées dans la littérature méthodologique incluent :
- La perte massive de puissance statistique : La présence d’outliers et de queues étirées gonfle artificiellement le dénominateur des tests statistiques (la somme des carrés des erreurs et l’erreur standard de la moyenne). En conséquence, les ratios $t$ ou $F$ se trouvent lourdement comprimés, empêchant le chercheur de détecter des effets réels et provoquant une inflation catastrophique du risque d’erreur de type II ($\beta$). Des découvertes scientifiques majeures sont ainsi régulièrement manquées faute d’avoir assaini la dispersion préalable.
- L’inflation pernicieuse de l’erreur de type I ($\alpha$) : Lorsque les distributions comparées présentent des asymétries de formes inégales associées à des variances hétérogènes (hétéroscédasticité), les probabilités critiques de rejet de l’hypothèse nulle ($p$-values) deviennent totalement erratiques, conduisant à affirmer l’existence de différences hautement significatives qui ne sont en réalité que de purs artefacts de forme morphologique.
- La déformation de l’interprétation des tailles d’effet : Le d de Cohen classique utilise l’écart type combiné comme dénominateur de standardisation ($d = (\bar{x}_1 – \bar{x}_2) / s_p$). Si cet écart type est gonflé par des perturbations du Spread, le d de Cohen s’effondre artificiellement, minimisant la portée clinique ou pratique des interventions testées.
Ces dégradations justifient pleinement la décision d’abandonner les modèles linéaires généraux classiques au profit de méthodes de rééchantillonnage par bootstrap, de tests de permutations exacts ou de modélisations linéaires généralisées (GLM) adaptées aux familles non gaussiennes (loi Gamma, loi binomiale négative, distribution de Weibull).
10. Application comparative : Utiliser SOCS pour comparer plusieurs distributions
10.1 Juxtaposition de distributions dans les plans factoriels
Si la mnémotechnique SOCS a été initialement conceptualisée pour disséquer une distribution univariée unique, son potentiel diagnostique s’avère encore plus spectaculaire lorsqu’elle est transposée à la comparaison conjointe de plusieurs groupes au sein de devis factoriels expérimentaux ou quasi-expérimentaux (par exemple, confronter un groupe témoin sain, un groupe clinique recevant une molécule pharmacologique et un groupe clinique sous placebo).
Dans ce contexte multi-groupes, SOCS structure le contraste systématique de chaque dimension :
- Shape comparative : Les morphologies des groupes sont-elles isomorphes ou divergentes ? Découvrir qu’un groupe témoin affiche une distribution parfaitement symétrique alors que le groupe traité présente une distribution bimodale révèle instantanément que l’intervention expérimentale n’a pas décalé l’ensemble de la population de manière uniforme, mais a scindé les sujets en deux sous-groupes fonctionnels (les « répondeurs » thérapeutiques d’un côté, et les « non-répondeurs » de l’autre).
- Outliers comparatifs : Les observations aberrantes sont-elles équitablement réparties ou exclusivement cantonnées à une condition expérimentale spécifique ? Une concentration sélective d’anomalies dans un bras de traitement peut trahir l’émergence d’effets secondaires indésirables ou de réactions de rejet paradoxales chez certains individus ciblés.
- Center et Spread comparatifs : L’analyse simultanée de l’emplacement et de l’échelle permet de diagnostiquer immédiatement les violations d’homoscédasticité. Si l’augmentation de la tendance centrale s’accompagne d’une explosion proportionnelle de la variabilité (Spread), ce phénomène classique d’hétéroscédasticité multiplicative réclamera une transformation stabilisatrice de variance préalable à toute ANOVA.
10.2 Représentations graphiques adaptées à la comparaison multi-groupes
Pour soutenir visuellement la grille comparative SOCS à travers plusieurs cohortes, la statistique moderne déploie des dispositifs d’imagerie hautement synthétiques qui surpassent la simple juxtaposition de multiples histogrammes distincts, cette dernière surchargeant cognitivement le lecteur.
Trois formats graphiques comparatifs s’imposent :
- Les diagrammes en boîte à moustaches côte à côte (Side-by-Side Boxplots) : Alignant les boîtes sur un même axe métrique vertical ou horizontal, ce dispositif offre une lisibilité instantanée des disparités de médiane (Center), de hauteur des boîtes interquartiles (Spread) et d’asymétrie positionnelle des moustaches, tout en projetant immédiatement les identifiants des outliers comparés.
- Les graphiques en violon combinés (Violin-Box Superposition) : En greffant une courbe d’estimation de densité par noyau symétrique bilatérale autour de chaque boîte à moustaches, ce tracé résout la cécité du boxplot face à la multimodalité, permettant de déceler d’un seul coup d’œil si un élargissement du Spread résulte d’un étalement homogène ou d’un dédoublement structurel des sommets (Shape).
- Les densités ridge (Ridgeline Plots) : Particulièrement élégants pour comparer un continuum temporel ou de multiples conditions expérimentales échelonnées, ces graphiques étagent des courbes de densité partiellement transparentes le long d’un axe vertical secondaire, révélant avec une fluidité exceptionnelle le glissement morphologique progressif de la forme et du centre sous l’effet des conditions de test.
10.3 Grille de synthèse comparative structurée selon SOCS
Dans la communication des rapports de recherche factoriels, formaliser la comparaison multi-distributions sous la forme d’un tableau récapitulatif standardisé structuré selon l’armature SOCS confère une transparence et une élégance méthodologique remarquables. Ce dispositif évite la dispersion des chiffres dans de longs paragraphes narratifs confus.
| Groupe expérimental | Shape (Forme & Symétrie) | Outliers (Critère Tukey $1,5\times\text{IQR}$) | Center (Métrique adaptée) | Spread (Dispersion congruente) |
|---|---|---|---|---|
| Groupe Témoin ($n = 45$) | Unimodale, symétrique ($g_1 = +0,12$, $g_2 = -0,21$) | Aucun outlier détecté | Moyenne arithmétique : $52,4\text{ pts}$ | Écart type : $s = 8,1\text{ pts}$ (Étendue : $34\text{ – }69$) |
| Groupe Traitement A ($n = 45$) | Unimodale, asymétrie positive ($g_1 = +1,84$, $g_2 = +3,95$) | Deux outliers supérieurs ($88\text{ pts}$ et $94\text{ pts}$) | Médiane robuste : $61,0\text{ pts}$ (Moyenne : $66,2$) | $\text{IQR} = 12,0\text{ pts}$ ($Q_1=56 ; Q_3=68$) ; $\text{MAD}_{\sigma} = 8,9$ |
| Groupe Traitement B ($n = 45$) | Bimodale marquée (Pics locaux à $45\text{ pts}$ et $78\text{ pts}$) | Aucun outlier isolé | Modes locaux : $45\text{ pts}$ et $78\text{ pts}$ (Médiane : $64,5$) | Écart type : $s = 18,7\text{ pts}$ (Sous-groupes hétérogènes) |
Ce tableau démontre immédiatement que si un chercheur s’était borné à calculer aveuglément les moyennes des Groupes A et B ($66,2$ versus environ $64,5$), il aurait conclu faussement à une équivalence fonctionnelle absolue des deux thérapies, alors que la réalité clinique mise à nu par SOCS révèle que le Traitement A génère un progrès homogène modéré avec deux hyper-répondeurs, tandis que le Traitement B induit une fracture thérapeutique majeure scindant l’échantillon en échec total pour une moitié et succès spectaculaire pour l’autre.
11. Erreurs courantes, écueils conceptuels et pièges d’interprétation
11.1 Confusions sémantiques et d’orientation dans l’asymétrie
L’expérience de l’enseignement des statistiques et l’évaluation par les pairs révèlent une litanie d’erreurs conceptuelles récurrentes lors de l’application pratique du protocole descriptif. La méprise la plus universellement répandue concerne l’orientation sémantique de l’asymétrie (Shape). Les étudiants et les analystes débutants commettent très fréquemment un contresens logique en désignant l’asymétrie par le côté où se trouve la majorité des données ou le sommet de la courbe.
Il convient de rappeler avec force que l’asymétrie est toujours nommée d’après la direction vers laquelle s’étire la queue la plus longue et effilée de la distribution, et non d’après la position du sommet :
- Une distribution dont le pic massif est concentré à gauche avec une queue traînante vers la droite est une asymétrie positive ou orientée à droite (right-skewed).
- Une distribution dont le pic culmine à droite avec une longue queue fuyante vers les valeurs faibles est une asymétrie négative ou orientée à gauche (left-skewed).
Un autre écueil morphologique classique consiste à confondre l’effet plafond ou plancher empirique avec une distribution théorique sous-jacente. L’accumulation de scores maximaux sur une échelle psychologique n’indique pas que le phénomène mesuré est borné dans l’absolu, mais démontre la faillite métrologique de l’instrument d’évaluation, incapable de discriminer les niveaux supérieurs d’aptitude de l’échantillon analysé.
11.2 Utilisation incohérente des couples centre-dispersion
L’hérésie méthodologique la plus tenace observée dans les rapports de recherche empirique réside dans le panachage incohérent des métriques de position et d’échelle. Il n’est pas rare de voir des auteurs rapporter dans une même phrase une médiane associée à un écart type, ou pire encore, une moyenne arithmétique associée à un intervalle interquartile ($\text{IQR}$).
Ce mélange relève d’une profonde incompréhension épistémologique :
- L’écart type mesure les fluctuations quadratiques autour de la moyenne arithmétique ; rapporter un écart type aux côtés d’une médiane est un non-sens mathématique car l’écart type n’a aucun lien fonctionnel avec le point de séparation ordinale à 50 %.
- Inversement, l’intervalle interquartile mesure l’empan séparant le 25e et le 75e centile ordonné ; l’accoler à une moyenne arithmétique constitue une aberration puisque la moyenne ignore totalement les rangs ordinaux des quantiles.
Une autre bévue critique concerne l’interprétation subjective de la forme sans contextualisation par la taille de l’échantillon ($N$). Dans un échantillon minuscule ($N = 15$), l’irrégularité visuelle des barres d’un histogramme n’est presque jamais le reflet d’une véritable multimodalité ou d’une asymétrie populationnelle, mais incarne la volatilité stochastique pure propre aux petits tirages aléatoires. Porter des jugements catégoriques sur la forme sans s’appuyer sur des tests formels d’adéquation (tels que le test de Shapiro-Wilk) constitue un biais cognitif majeur.
11.3 Biais de suppression hâtive des valeurs extrêmes
Le troisième piège méthodologique — et sans doute le plus dangereux sur le plan de l’éthique scientifique — est le réflexe consistant à assimiler tout outlier statistique à une « erreur » devant être éliminée sans délai. Cette tendance délétère découle d’une volonté souvent inconsciente de conformer de force les données réelles aux postulats d’élégance de la courbe de Gauss afin d’obtenir des tests inférentiels artificiellement significatifs.
Supprimer hâtivement un point divergent sans disposer de la moindre preuve empirique ou matérielle démontrant qu’il est issu d’une erreur d’enregistrement ou d’un incident méthodologique caractérisé présente plusieurs conséquences néfastes :
- Cela détruit précisément l’information clinique ou comportementale la plus riche du protocole (le participant atypique qui illustre la variabilité du vivant).
- Cela biaise systématiquement à la baisse l’estimation de la véritable variance populationnelle.
- Cela contrevient frontalement aux exigences d’intégrité de la science ouverte (Open Science), exposant l’auteur à des sanctions pour pratique contestable de recherche (QRP, Questionable Research Practices).
L’attitude scientifique vertueuse exige d’assumer la complexité distributionnelle : un outlier légitime ne se supprime pas ; il s’analyse, se documente, s’ajuste par des procédures mathématiques robustes ou fait l’objet d’un double compte-rendu transparent.
12. Intégration de SOCS dans la communication scientifique et les normes APA
12.1 Standardisation de la section Méthode et Résultats selon l’APA
La communication des analyses statistiques exploratoires est strictement encadrée par les directives internationales du manuel de publication de l’American Psychological Association (APA, 7e édition). Trop souvent, les chercheurs débutants considèrent que la section « Résultats » ne doit débuter qu’avec l’énoncé solennel des tests d’hypothèses ($t$, $F$, $\chi^2$, $p$). Les standards méthodologiques modernes exigent au contraire qu’un paragraphe substantiel soit préalablement consacré à l’analyse descriptive intégrale de chaque variable dépendante continue.
L’intégration de la grille SOCS au sein d’un manuscrit conforme aux normes APA obéit à plusieurs principes directeurs :
- L’exhaustivité narrative : Chaque composante de SOCS doit être abordée de façon concise mais explicite. Les statistiques descriptives doivent être rapportées avec une précision métrologique rigoureuse, usuellement arrondie à deux décimales après la virgule (à l’exception des probabilités $p$, rapportées à trois décimales).
- La contextualisation métrique : L’auteur doit systématiquement rappeler l’unité de mesure physique ou psychométrique accompagnant chaque statistique rapportée ($ms$, points, pourcentages, z-scores) afin de préserver l’intelligibilité clinique du texte.
- La rationalisation des supports : Si l’étude ne comporte qu’une ou deux variables clés, l’analyse SOCS doit être intégrée dans le corps fluide du texte. En revanche, si le protocole implique de multiples échelles ou des devis factoriels complexes, l’auteur doit déporter la synthèse chiffrée vers un tableau normé conforme à l’APA (lignes horizontales épurées, absence de grilles verticales) et enrichir le document d’une figure composite combinant graphiques de densités et boîtes à moustaches.
12.2 Formulations types pour chaque dimension de l’acronyme
Pour faciliter la rédaction académique et garantir une phraséologie irréprochable exempte d’ambiguïtés sémantiques, les gabarits syntaxiques suivants sont recommandés pour la formalisation de chaque composante SOCS dans les revues à comité de lecture francophones :
Pour la composante Shape :
- « L’examen morphologique de la distribution révèle une allure unimodale approximativement symétrique ($g_1 = +0,14$, $g_2 = -0,08$), attestant de la conformité empirique au postulat de normalité univariée. »
- « Les scores indiquent une distribution unimodale caractérisée par une asymétrie positive substantielle ($g_1 = +1,92$) et une leptocurtose marquée ($g_2 = +4,15$), traduisant une traîne d’observations étirée vers les valeurs extrêmes supérieures. »
Pour la composante Outliers :
- « L’application de la règle des clôtures de Tukey ($1,5 \times \text{IQR}$) n’a mis en évidence aucune valeur atypique modérée ou extrême sur l’ensemble de l’échantillon ($N = 120$). »
- « Deux observations discordantes supérieures ont été formellement identifiées au-delà de la clôture externe ($3,0 \times \text{IQR}$) : les cas n° 14 ($X = 142\text{ ms}$) et n° 39 ($X = 158\text{ ms}$). Ces données ont fait l’objet d’une analyse de sensibilité comparée avec et sans inclusion. »
Pour la composante Center :
- « La tendance centrale de la cohorte est quantifiée par la moyenne arithmétique ($M = 104,25$, avec un intervalle de confiance à 95 % compris entre $101,12$ et $107,38$). »
- « Compte tenu de la déviation asymétrique observée, la centralité de l’échantillon est fidèlement résumée par la médiane ($Mdn = 88,50$), la moyenne ($M = 97,30$) surestimant le niveau de performance typique. »
Pour la composante Spread :
- « La variabilité de l’échantillon est caractérisée par un écart type de $s = 14,32$ points (étendue totale : $68\text{ à }139$). »
- « La dispersion non paramétrique est mesurée par un intervalle interquartile de $IQR = 18,00$ points ($Q_1 = 78,50$ ; $Q_3 = 96,50$), associé à une déviation absolue médiane normalisée de $MAD_{\sigma} = 12,45$. »
12.3 De la description exploratoire univariée aux analyses multivariées
L’utilité du protocole SOCS dépasse largement le cadre strict de l’analyse exploratoire univariée ; elle constitue le contrôle qualité préliminaire indispensable conditionnant le succès de l’ensemble des analyses statistiques multivariées avancées. Dans une régression linéaire multiple, une analyse factorielle exploratoire (EFA) ou un modèle d’équations structurelles (SEM), la défaillance d’une seule variable explicative en termes de distribution univariée peut propager des distorsions métrologiques systémiques à travers l’ensemble de la matrice de covariance.
En effet :
- La présence d’un outlier univarié non détecté par SOCS engendre presque mécaniquement des outliers multivariés dévastateurs (détectables par la distance de Mahalanobis), déformant l’hyper-plan de régression et faussant dramatiquement les coefficients de régression standardisés ($\beta$).
- Des asymétries univariées de sens opposés entre deux variables continues compriment mathématiquement le coefficient de corrélation linéaire maximal qu’elles peuvent théoriquement atteindre entre elles, générant une atténuation artificielle de leurs liens de causalité putative au sein des modèles factoriels.
- L’absence d’examen de la modalité peut masquer l’existence de mélanges de distributions latentes, conduisant l’investigateur à modéliser un groupe composite unique au lieu de déployer une analyse de profils latents (Latent Profile Analysis, LPA) ou une modélisation par mélange fini (Finite Mixture Modeling).
En instaurant une discipline analytique irréprochable dès la phase univariée, l’acronyme SOCS s’impose ainsi non pas comme une contrainte pédagogique élémentaire réservée aux étudiants, mais comme le pilier méthodologique transversal garantissant la robustesse, la reproductibilité et la noblesse épistémologique de toute recherche empirique en sciences psychologiques et comportementales.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Hampel, F. R. (1974). The influence curve and its role in robust estimation. Journal of the American Statistical Association, 69(346), 383–393. https://doi.org/10.1080/01621459.1974.10482962
- Howell, D. C. (2016). Statistical methods for psychology (9th ed.). Cengage Learning.
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273–1283. https://doi.org/10.1080/01621459.1993.10476408
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02293-1