
L’analyse exploratoire des données constitue le socle méthodologique indispensable de toute démarche empirique rigoureuse. Popularisée par les travaux séminaux du statisticien John Tukey, cette phase inaugurale ne se limite nullement à une simple formalité technique : elle conditionne la validité des inférences futures en dévoilant la structure fondamentale des variables continues observées. Dans cet écosystème analytique, l’histogramme demeure l’outil de référence absolue pour appréhender la forme géométrique des lois sous-jacentes, diagnostiquer les écarts par rapport à la symétrie théorique et identifier les singularités de distribution qui échappent aux résumés numériques univariés simplifiés.
Au sein des environnements d’analyse statistique avancée, l’environnement SAS (Statistical Analysis System) s’est imposé comme une plateforme standardisée d’une remarquable puissance, notamment au sein des sciences biomédicales, de l’épidémiologie, de l’économétrie et de la recherche comportementale. Grâce à sa procédure historique PROC UNIVARIATE, SAS offre une intégration unique entre la modélisation statistique paramétrique, l’évaluation des moments d’ordre supérieur et la restitution graphique de haute précision. Cet outil va bien au-delà de la simple représentation visuelle en associant systématiquement à chaque graphique un ensemble exhaustif d’indicateurs de localisation, de dispersion et de tests formels d’adéquation distributionnelle.
L’objectif de cet article académique est de fournir un guide technique et conceptuel complet dédié à la construction et à l’optimisation des histogrammes dans SAS. À travers un jeu de données expérimental rigoureusement documenté, nous détaillerons trois implémentations emblématiques : l’histogramme univarié classique enrichi de repères normatifs, le panneau comparatif multipanneau permettant la stratification par sous-groupes, et enfin l’histogramme superposé exploitant les transparences alpha pour la comparaison directe de densités. Chacune de ces approches sera disséquée sous l’angle de sa syntaxe formelle, de ses propriétés statistiques et de ses implications ergonomiques pour la publication scientifique.
1. Introduction à la visualisation des distributions et à la procédure PROC UNIVARIATE dans SAS
1.1 Fondements statistiques de l’histogramme en recherche quantitative
L’inférence statistique moderne repose majoritairement sur des modèles probabilistes dont la robustesse dépend de postulats stricts concernant la distribution des résidus ou des variables analysées. L’évaluation de la normalité constitue la pierre angulaire des analyses univariées et multivariées, qu’il s’agisse du test t de Student, de l’analyse de variance factorielle ou de la régression linéaire généralisée. L’histogramme permet de confronter directement les observations recueillies à une loi théorique par l’agrégation continue des données sous forme de classes contiguës. Cette représentation graphique matérialise la fonction de densité de probabilité empirique en convertissant un ensemble discret d’observations en une surface géométrique dont l’aire totale est proportionnelle à la taille de l’échantillon ou standardisée à l’unité.
La discrétisation d’une variable quantitative continue en intervalles d’amplitudes définies soulève des enjeux statistiques fondamentaux relatifs au biais et à la variance de l’estimation. Si la largeur des classes est excessivement grande, la distribution subit un sur-lissage dissimulant des particularités essentielles telles que la multimodalité ou l’asymétrie locale. Inversement, une granularité trop fine engendre un sous-lissage prononcé où le bruit d’échantillonnage masque la tendance distributionnelle globale. L’histogramme agit ainsi comme un estimateur non paramétrique de densité à fenêtre fixe, précurseur conceptuel des méthodes d’estimation par noyau développées par Emanuel Parzen.
Dans la pratique scientifique, l’inspection visuelle préalable par histogramme empêche des erreurs interprétatives graves. L’observation directe permet de détecter des planchers ou des plafonds de mesure, d’identifier des répartitions bimodalement polarisées témoignant de mélanges de sous-populations non contrôlées, ou encore de constater des traînes épaisses caractéristiques des distributions leptokurtiques. Aucune mesure scalaire, fût-elle le coefficient d’asymétrie de Fisher-Pearson ou le test de Shapiro-Wilk, ne peut remplacer l’intelligibilité spatiale offerte par un histogramme convenablement calibré dans la phase initiale d’exploration des données.
1.2 La procédure PROC UNIVARIATE : syntaxe générale et vocation analytique
Au cœur de l’architecture logicielle de SAS, la procédure PROC UNIVARIATE se distingue par sa triple vocation descriptive, inférentielle et graphique. Contrairement à PROC MEANS qui cible l’agrégation rapide des données au premier et second ordre statistique, PROC UNIVARIATE calcule l’ensemble complet des moments statistiques, englobant la moyenne arithmétique, la variance, l’écart-type, le coefficient de variation, mais surtout les moments centrés d’ordres trois et quatre qui quantifient formellement l’asymétrie (skewness) et l’aplatissement (kurtosis). Elle génère simultanément les quantiles détaillés, les valeurs extrêmes ordonnées et exécute les tests d’hypothèse bilatéraux pour l’emplacement central.
La structure syntaxique standard de la procédure débute par l’instruction formelle d’appel spécifiant la table source via l’option DATA. Vient ensuite l’instruction fondamentale VAR, dont le rôle consiste à déclarer le vecteur des variables quantitatives continues soumises à l’analyse. L’omission de cette instruction inciterait la procédure à traiter indistinctement toutes les colonnes numériques du jeu de données, y compris d’éventuels identifiants codés numériquement, entraînant une surcharge de calcul et une pollution des sorties. C’est l’instruction VAR qui garantit la rigueur du ciblage analytique.
L’intégration de la visualisation graphique s’opère par l’adjonction de l’instruction HISTOGRAM immédiatement après la définition des variables d’analyse. Cette instruction active les routines de calcul géométrique des coordonnées et orchestre la restitution des barres verticales. L’instruction HISTOGRAM accepte une vaste gamme d’options spécialisées après une barre oblique de séparation, permettant d’imposer des contraintes paramétriques, d’ajuster des courbes théoriques ou de contrôler les paramètres de mise à l’échelle métrique. Cette intégration native au sein d’une procédure analytique garantit une cohérence absolue entre les chiffres répertoriés dans les tableaux ODS et la topologie des graphiques produits.
1.3 Distinction méthodologique entre PROC UNIVARIATE, PROC SGPLOT et PROC GCHART
L’environnement SAS offre plusieurs voies pour concevoir des histogrammes, ce qui impose d’établir une démarcation méthodologique claire entre les procédures disponibles. La procédure PROC UNIVARIATE possède une orientation principalement analytique, diagnostique et inférentielle. Lorsqu’elle génère un histogramme, elle le lie intrinsèquement aux tests de conformité distributionnelle, calculant les paramètres du maximum de vraisemblance pour adapter les courbes théoriques (telles que les lois normales, log-normales, exponentielles, de Weibull ou Gamma) sans exiger de pré-calculs de la part du chercheur. Elle est l’outil d’élection pour le statisticien dont le but est d’éprouver des hypothèses théoriques sur la structure des variables.
À l’opposé, la procédure PROC SGPLOT s’inscrit dans la famille moderne des Statistical Graphics (SG) introduite pour standardiser la production de figures selon les concepts de la grammaire des graphiques théorisée par Leland Wilkinson. PROC SGPLOT excelle dans la personnalisation esthétique avancée, la superposition d’éléments visuels hétérogènes (tels que l’association sur un même plan d’un histogramme, d’une estimation par noyau et d’un diagramme en boîte horizontal) et la mise en page modulaire. Sa finalité réside dans la clarté communicative et la mise aux normes de publication, bien qu’elle délègue l’estimation paramétrique complexe à d’autres routines préalables.
Enfin, la procédure PROC GCHART appartient à l’héritage historique de SAS/GRAPH. Fondée sur des moteurs de rendu vectoriels antérieurs à l’avènement du système ODS Graphics moderne, elle nécessite la configuration lourde de déclarations globales d’axes (instructions AXIS) et de motifs (instructions PATTERN). Aujourd’hui considérée comme technologiquement obsolète pour la recherche contemporaine, PROC GCHART souffre d’un manque de flexibilité dans la gestion des résolutions contemporaines et de l’interactivité. L’abandon progressif de cette syntaxe historique au profit de PROC UNIVARIATE et de PROC SGPLOT constitue une évolution majeure vers une programmation plus déclarative, reproductible et robuste.
2. Préparation et structure du jeu de données expérimental
2.1 Définition de l’étape DATA et saisie des observations empiriques
Afin de garantir une reproductibilité parfaite des protocoles présentés tout au long de cette monographie, nous instancions un jeu de données expérimental à l’aide de l’étape DATA canonique de SAS. Ce processus d’initialisation assure la création déterministe d’une table nommée my_data au sein de la bibliothèque de travail temporaire WORK. L’allocation de cette structure matricielle s’appuie sur la combinaison synergique des instructions INPUT et DATALINES, assurant le typage direct et la lecture séquentielle des flux de données brutes intégrés dans le script de traitement.
Le vecteur de variables comprend deux indicateurs numériques continus et un facteur qualitatif de groupement. Lors de la phase de compilation du bloc DATA, le vecteur de données de programme (Program Data Vector, ou PDV) configure les attributs fondamentaux de chaque variable. La syntaxe prévoit une déclaration explicite où le symbole dollar ($) est alloué à la variable catégorielle, stipulant la nature alphanumérique de son encodage et réservant le dimensionnement mémoire adéquat pour la chaîne textuelle, tandis que les métriques d’observation reçoivent le statut de réels en virgule flottante double précision.
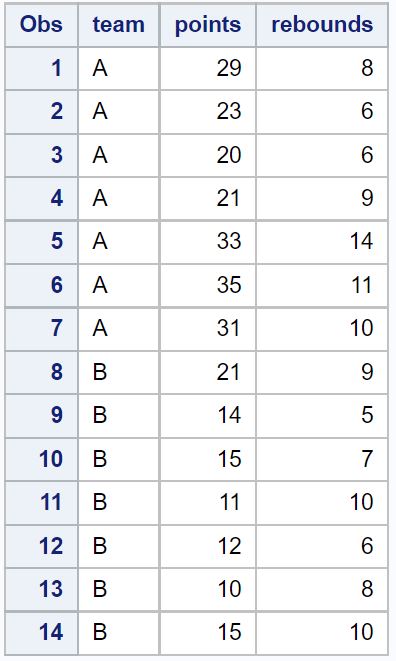
La saisie des observations empiriques s’effectue ligne par ligne au sein du bloc DATALINES. Chaque ligne matérialise une unité statistique élémentaire issue d’une cohorte d’athlètes de haut niveau, pour laquelle nous avons consigné les réalisations offensives et défensives au cours d’une saison sportive rigoureusement monitorée. Cette architecture de données présente l’avantage pédagogique de concilier une structure compacte avec une variance intrinsèque suffisamment marquée pour illustrer avec précision les variations de forme, d’asymétrie et de dispersion bimodale.
2.2 Examen des variables d’étude : points, rebonds et appartenance au groupe
L’architecture matricielle retenue s’articule autour de trois dimensions analytiques complémentaires. La variable principale dépendante, désignée sous l’étiquette points, mesure l’efficacité offensive brute enregistrée par match par chaque athlète. Exprimée sur une échelle d’intervalles continus, cette grandeur présente des fluctuations marquées, allant de performances modestes à des réalisations d’élite. Sur le plan statistique, cette variable sert de réceptacle à l’ensemble de nos investigations sur la normalité empirique, la dispersion interquartile et l’adéquation aux densités paramétriques théoriques.
La seconde variable quantitative, nommée rebounds, quantifie le volume de rebonds captés et fonctionne conceptuellement comme une covariable de performance. Bien que nos démonstrations se focalisent prioritairement sur la variable des points marqués, la présence conjointe des rebonds enrichit la structure du jeu de données, permettant des extensions analytiques vers des tests de corrélation bivariée ou des modélisations de régression linéaire. La variabilité propre de cette covariable reflète les disparités morphologiques et le rôle tactique attribué à chaque profil de joueur au sein du collectif.
Enfin, la variable catégorielle binaire team constitue le facteur de classification inter-sujets par excellence. Répartie équitablement entre deux modalités nominales distinctes (« A » et « B »), elle introduit une partition de l’échantillon global en deux sous-populations d’effectifs maîtrisés. Cette variable de stratification sera mobilisée pour illustrer la segmentation multifenêtre et la comparaison directe par superposition. Elle permet d’éprouver l’homogénéité des variances entre cohortes et d’observer comment les contrastes tactiques entre organisations sportives se répercutent sur la morphologie des histogrammes respectifs.
2.3 Vérification de l’intégrité matricielle avec la procédure PROC PRINT
Avant d’engager toute procédure de modélisation mathématique ou de modélisation graphique, le principe méthodologique de précaution impose une vérification rigoureuse de la cohérence interne du tableau de données. Cette étape élémentaire de contrôle de la qualité des données (data hygiene) prévient la propagation d’erreurs d’assignation typologique ou d’altérations syntaxiques survenues durant l’étape DATA. La procédure PROC PRINT est la commande standard assurant la restitution tabulaire exhaustive des vecteurs enregistrés dans la table WORK.my_data.
L’exécution de la procédure s’effectue par l’appel formel :
proc print data=my_data; run;
Cette commande génère un rapport répertoriant le numéro d’observation (variable automatique _N_) en regard des trois colonnes spécifiées. L’analyste doit contrôler l’absence de cellules vacantes (caractérisées par un point pour les données numériques ou un espace blanc pour les chaînes textuelles), vérifier que le nombre total d’enregistrements correspond exactement au décompte initial prévu, et s’assurer que les valeurs saisies s’inscrivent dans un intervalle de vraisemblance biologique et physique strict.
Parallèlement à l’examen de la sortie visuelle, la consultation méthodique du journal d’exécution (SAS Log) constitue une obligation procédurale incontournable. Le journal consacre l’intégrité de l’exécution en attestant que le jeu de données WORK.my_data a été généré avec le nombre exact d’observations et de variables attendues, sans conversion automatique implicite de variables et sans génération d’avertissements (warnings) ou d’erreurs d’exécution. La validation conjointe de la sortie PROC PRINT et de la propreté du journal d’exécution conditionne le passage aux phases de modélisation graphique univariée.
3. Exemple 1 – Création d’un histogramme univarié simple
3.1 Implémentation du code canonique pour une variable unique
La conception d’un histogramme standardisé pour une variable continue unique requiert l’activation conjointe des instructions PROC UNIVARIATE et HISTOGRAM. Dans sa formulation la plus épurée, le code ne comporte aucun artifice syntaxique complexe, confiant au moteur de calcul de SAS la détermination optimale des paramètres de classe et de mise à l’échelle. L’analyste se contente d’indiquer la table source et de restreindre le champ d’investigation à la métrique offensive via l’instruction VAR.
La syntaxe canonique minimale se déploie selon la structure suivante :
proc univariate data=my_data;
var points;
histogram points;
run;
Dans ce bloc d’instructions, le mot-clé HISTOGRAM prend en argument direct le nom de la variable points. Cette redondance intentionnelle avec l’instruction VAR permet en réalité de dissocier le traitement statistique descriptif général de la génération effective de figures, SAS offrant la possibilité de calculer les moments sur un panier complet de variables tout en restreignant le tracé graphique à une sélection spécifique.
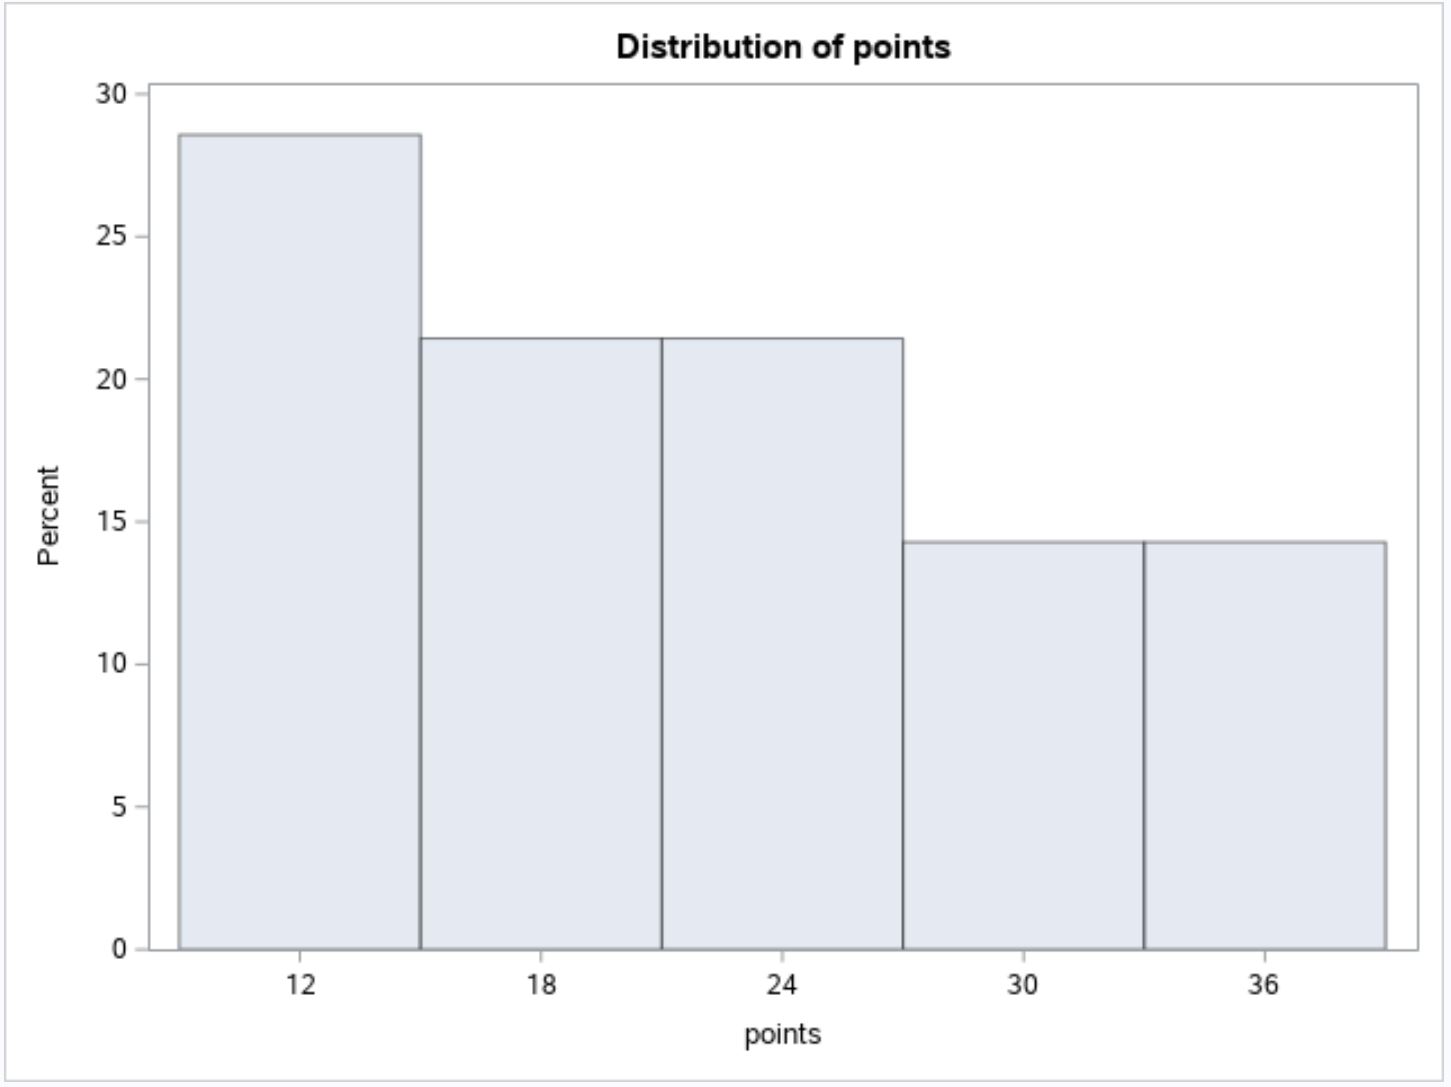
L’exécution séquentielle de cette requête déclenche une double opération au sein du système ODS : la compilation d’une série de tables analytiques décrivant les moments d’échantillonnage et la restitution d’un histogramme haute résolution dans la fenêtre graphique active. Cette figure se compose de rectangles verticaux contigus dont la largeur correspond à l’intervalle de partitionnement automatisé et dont la hauteur traduit l’importance numérique des observations au sein de chaque tranche de valeurs.
3.2 Interprétation métrique des axes et calcul des pourcentages
L’analyse rigoureuse de la sortie graphique produite par l’instruction HISTOGRAM par défaut nécessite une compréhension précise des conventions métriques appliquées aux axes cartésiens. L’axe horizontal (abscisse) structure le domaine de variation de la variable continue analysée. Les valeurs numériques apposées sous l’axe ne représentent pas nécessairement les bornes strictes des intervalles de classe, mais le plus souvent leurs points médians (midpoints), calculés par des algorithmes optimisant la lisibilité visuelle selon des nombres arrondis faciles à appréhender intellectuellement.
L’axe vertical (ordonnée) présente une spécificité déterminante : par défaut, PROC UNIVARIATE n’affiche pas les fréquences absolues brutes (le décompte direct des sujets), mais configure son échelle selon le pourcentage relatif des observations. La hauteur de chaque rectangle exprime formellement le rapport entre l’effectif partiel de la classe considérée et la taille totale de l’échantillon, multiplié par cent. Cette convention de normalisation statistique permet de comparer des distributions issues d’échantillons de tailles différentes sans distorsion d’échelle.
Cette formalisation mathématique de l’ordonnée se traduit par l’équation de densité discrétisée : pour une classe donnée i d’effectif ni au sein d’un échantillon global d’effectif N, l’élévation verticale hi vérifie la relation hi = (ni / N) × 100. La sommation des hauteurs de l’ensemble des rectangles composant l’histogramme converge ainsi exactement vers cent pour cent. Cette configuration garantit une transition conceptuelle naturelle vers les notions de fonction de répartition cumulative et de probabilité empirique d’occurrence.
3.3 Évaluation visuelle de l’asymétrie et de l’aplatissement
Dès l’obtention de l’histogramme univarié simple, l’analyste procède à une lecture morphologique afin de déterminer les caractéristiques de localisation et de dispersion de la série. Le centre de gravité de la distribution se repère visuellement par la zone de concentration maximale des surfaces de barres. Si l’histogramme présente une masse principale décalée vers les valeurs faibles de l’axe horizontal, accompagnée d’un étirement graduel des barres vers la droite, la distribution manifeste une asymétrie positive ou étalement à droite (right-skewed distribution). Inversement, un étirement prononcé vers les faibles valeurs traduira une asymétrie négative.
L’évaluation visuelle porte également sur l’aplatissement ou le caractère pointu de la distribution (kurtosis). Une distribution présentant un pic modal acéré et étroit, entouré de queues de distribution épaisses, sera qualifiée de leptokurtique, suggérant une forte concentration des valeurs autour du mode avec une probabilité accrue de valeurs extrêmes. À l’opposé, une silhouette arrondie, dépourvue de sommet proéminent et s’étendant de manière homogène sur l’intervalle des valeurs, indique une forme platykurtique typique des lois sub-gaussiennes ou uniformes tronquées.
Cette confrontation visuelle entre l’échantillon empirique et le modèle théorique de la cloche de Gauss constitue le premier niveau du diagnostic statistique. Si l’histogramme s’écarte substantiellement de la symétrie spéculaire attendue d’une loi normale, l’analyste sait immédiatement que l’usage de la moyenne arithmétique et de l’écart-type comme résumés synthétiques uniques induira un biais d’interprétation. Cette observation justifie le recours complémentaire à des indicateurs robustes tels que la médiane et l’écart interquartile, tout en orientant le choix des futurs modèles inférentiels vers des méthodes non paramétriques ou des transformations de variables adaptées.
4. Personnalisation technique de l’histogramme univarié simple
4.1 Contrôle des intervalles de classe à l’aide de l’option MIDPOINTS
Bien que les algorithmes automatisés de SAS sélectionnent des fenêtres de partitionnement scientifiquement acceptables, généralement guidées par des variantes de la règle de Sturges ou de la règle de Scott, ces choix par défaut ne correspondent pas toujours aux exigences fines de l’analyste ou aux conventions de reporting d’un domaine disciplinaire spécifique. Dans PROC UNIVARIATE, l’option MIDPOINTS s’avère l’instrument privilégié pour contraindre explicitement la granularité de la discrétisation en fixant manuellement les centres d’intervalles de chaque barre de l’histogramme.
La règle classique de Sturges, modélisée par l’équation k = 1 + log2(N) où k représente le nombre théorique de classes et N la taille d’échantillon, tend à sous-estimer le nombre optimal de tranches lorsque les volumes de données sont modestes ou que les queues de distribution sont asymétriques. En recourant à l’option MIDPOINTS après la barre oblique de l’instruction HISTOGRAM, l’utilisateur peut imposer une séquence numérique explicite à l’aide d’une syntaxe itérative de type :
histogram points / midpoints = 5 to 35 by 5;
Cette déclaration contraint le moteur graphique à centrer ses rectangles sur les valeurs entières 5, 10, 15, 20, 25, 30 et 35, définissant ipso facto des intervalles d’une largeur constante de cinq unités.
L’impact de ce partitionnement contrôlé sur la perception visuelle de la forme distributionnelle est considérable. Un rétrécissement maîtrisé de l’intervalle permet de révéler des singularités locales masquées par le lissage automatisé, telles qu’une légère bimodalité indiquant l’existence de sous-cohortes méconnues. Inversement, un élargissement tempéré élimine les fluctuations d’échantillonnage aléatoires qui fragmentent visuellement les petits effectifs. L’ajustement raisonné des points médians constitue ainsi un arbitrage méthodologique délibéré entre résolution descriptive et stabilité de l’estimation géométrique.
4.2 Superposition théorique d’une courbe de densité normale
L’évaluation visuelle de la normalité franchit un palier de rigueur lorsque l’histogramme empirique est confronté directement à la courbe théorique de la loi de Gauss, ajustée par superposition sur le même plan de coordonnées. PROC UNIVARIATE permet cette comparaison via l’option NORMAL, spécifiée immédiatement à la suite de la commande HISTOGRAM. Cette fonctionnalité convertit un simple graphique de distribution en un outil d’ajustement paramétrique avancé, sans imposer l’écriture de routines mathématiques complexes.
Lorsque l’option NORMAL est stipulée, la procédure estime automatiquement les paramètres de localisation (μ) et d’échelle (σ) de la population parente en mobilisant l’estimateur du maximum de vraisemblance sur les données observées. La moyenne empirique et l’écart-type non biaisé sont alors injectés dans l’équation formelle de la densité normale univariée :
f(x) = (1 / (σ√(2π))) × exp(- (x – μ)2 / (2σ2))
Le profil mathématique ainsi modélisé est tracé sous forme d’une courbe continue superposée aux barres de l’histogramme, dont l’échelle verticale en pourcentage est ajustée pour respecter l’équivalence de surface.
La confrontation directe entre les barres empiriques et l’enveloppe théorique gaussienne permet une lecture analytique immédiate des écarts à la loi normale. Les dépassements verticaux des barres au centre de la cloche dénoncent une leptokurticité manifeste, tandis que l’asymétrie se traduit par un décalage du sommet empirique par rapport à l’axe de symétrie de la courbe continue, accompagné d’une zone où les barres s’écrasent prématurément d’un côté tout en débordant de l’autre. Cette mise en regard visuelle sert de prélude intuitif aux tests d’adéquation formels calculés simultanément dans les tables de sorties statistiques.
4.3 Modification des attributs graphiques des axes et des légendes
La transmission efficace des résultats scientifiques exige un contrôle absolu des éléments paratextuels composant la figure, prévenant toute ambiguïté chez le lecteur académique. L’environnement PROC UNIVARIATE permet de raffiner la typographie, les libellés et les limites dimensionnelles de la scène graphique grâce à des sous-options spécialisées de l’instruction HISTOGRAM, complétées par des instructions déclaratives globales. La suppression des abréviations techniques par défaut au profit d’une nomenclature formelle est un impératif de publication.
L’instruction globale TITLE, positionnée en amont de l’étape de procédure, permet de coiffer la figure d’une dénomination contextualisée, éliminant les titres génériques par défaut de SAS. Au sein de l’instruction HISTOGRAM elle-même, les options VLABEL et HLABEL offrent la liberté de redéfinir intégralement les mentions apposées le long des axes ordonnés et des abscisses. Ainsi, la déclaration hlabel= »Performance Offensive (Points par Match) » confère au graphique une clarté immédiate en explicitant la nature de la métrique et son unité de mesure physique, conformément aux exigences méthodologiques standardisées.
En outre, l’analyste peut moduler l’échelle de l’axe vertical grâce à l’option VSCALE, basculant au besoin de l’échelle des pourcentages vers celle des proportions décimales ou de la densité brute. L’espacement des graduations secondaires et l’insertion de lignes de référence discrètes (à l’aide de l’option HREF ou VREF) permettent d’ancrer le tracé dans un carroyage métrique rigoureux. Cet habillage graphique transforme une sortie statistique brute en un support de communication visuelle conforme aux normes des comités de lecture internationaux, garantissant une transmission non déformée des propriétés distributionnelles du jeu de données.
5. Exemple 2 – Création d’un panneau d’histogrammes comparatifs (Panélisation)
5.1 Emploi de l’instruction CLASS pour la stratification par sous-groupes
L’investigation scientifique ne se limite que rarement à l’étude globale d’une cohorte ; elle requiert le plus souvent l’analyse stratifiée de la distribution en fonction de facteurs qualitatifs inter-groupes. Dans cette perspective, la procédure PROC UNIVARIATE dispose d’un outil de partitionnement puissant : l’instruction CLASS. Lorsqu’une variable catégorielle, telle que notre facteur team, est déclarée via cette commande, la procédure segmente automatiquement l’ensemble des enregistrements en sous-groupes mutuellement exclusifs correspondant à chacune des modalités observées.
L’implémentation de cette segmentation comparative prend la forme syntaxique suivante :
proc univariate data=my_data;
class team;
var points;
histogram points / normal;
run;
Contrairement à une boucle manuelle ou à l’usage maladroit d’une clause BY (qui nécessiterait un tri préalable et fragmenterait la restitution sur plusieurs pages distinctes), l’instruction CLASS instancie un panneau comparatif unifié, souvent désigné sous le terme de diagramme en treillis ou lattice plot.
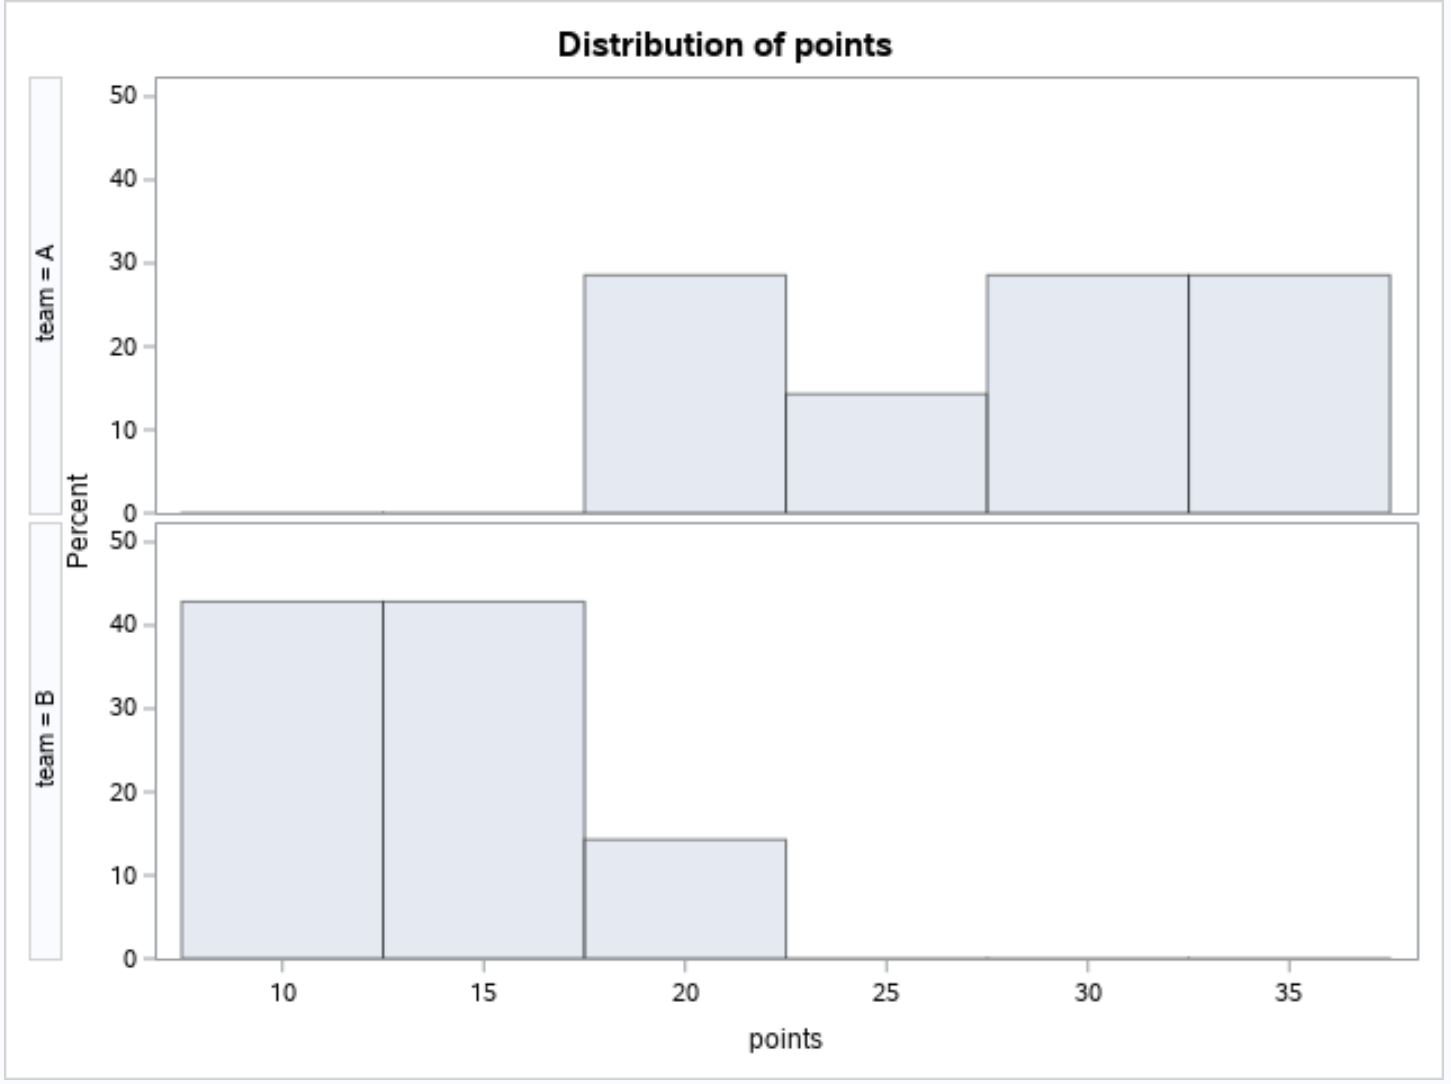
Le moteur graphique ODS configure alors une matrice spatiale unique où chaque sous-groupe se voit assigner une cellule de rendu dédiée au sein du même plan d’observation. Cette synchronisation architecturale permet de maintenir les distributions dans un champ visuel contigu, facilitant les opérations cognitives de mise en relation sans que l’analyste ait à basculer d’une page à l’autre ou à composer laborieusement une mosaïque sous un logiciel d’édition d’images externe.
5.2 Analyse comparative rigoureuse des sous-populations
La restitution multifenêtre des histogrammes pour l’équipe A et l’équipe B permet d’effectuer une comparaison topologique approfondie des sous-populations sans risque de confusion géométrique. L’analyste peut confronter simultanément la position des barycentres (moyennes et médianes respectives) et l’amplitude de dispersion des valeurs. Dans notre configuration expérimentale, l’inspection comparée met en lumière les contrastes tactiques entre les deux entités : une équipe présente une distribution resserrée autour d’un mode central, attestant d’une grande homogénéité de performance, tandis que l’autre expose un étalement bimodal ou fortement dispersé, traduisant une hétérogénéité marquée entre titulaires et remplaçants.
Au-delà de la simple tendance centrale, cette disposition panélisée offre un rôle diagnostique déterminant dans la vérification de l’hypothèse d’homoscedasticité (homogénéité des variances distributionnelles), postulat capital pour la mise en œuvre de modèles comparatifs tels que l’ANOVA à un facteur ou les modèles linéaires à effets mixtes. La simple observation de la largeur de base des histogrammes respectifs permet d’anticiper si le test formel de Levene ou de Bartlett révélera une violation critique de cette condition d’équivariance.
L’évaluation visuelle conjointe des courbes de normalité superposées sur chaque panneau permet également d’apprécier si les écarts à la loi normale sont symétriques ou si l’un des groupes souffre d’une asymétrie idiosyncrasique absente dans l’autre. Par exemple, si l’équipe A respecte rigoureusement une distribution en cloche standardisée alors que l’équipe B déploie une traîne positive prononcée causée par un marqueur d’exception, l’analyste est averti qu’un test t paramétrique classique à deux échantillons indépendants pourrait générer des taux d’erreur de première espèce incontrôlés, orientant alors la démarche inférentielle vers un test de somme des rangs de Wilcoxon-Mann-Whitney.
5.3 Avantages ergonomiques et cognitifs de la décomposition en panneaux
D’un point de vue de l’ergonomie cognitive et des sciences de l’information visuelle, la technique de panélisation (découlant des principes des small multiples théorisés par Edward Tufte) présente des supériorités décisives sur d’autres modes de représentation graphique concurrente. En dissociant physiquement les distributions au sein de fenêtres contiguës mais non entremêlées, elle élimine totalement l’encombrement graphique (clutter) et le phénomène d’occlusion visuelle, inhérents aux représentations où les barres s’entrecroisent au sein d’un repère unique.
Cette clarté d’affichage demeure particulièrement prégnante lorsque le facteur de classification comporte plus de deux catégories. Si la comparaison de deux groupes par superposition reste praticable, l’adjonction d’un troisième, quatrième ou cinquième niveau rend la lecture chaotique en multipliant les couches de couleurs et les intersections géométriques ambiguës. Le treillis conserve quant à lui une lisibilité constante : chaque sous-groupe bénéficie de son propre espace d’expression, respectant la même métrique d’abscisse et d’ordonnée, ce qui favorise les balayages oculaires systématiques de gauche à droite ou de haut en bas.
Dans le contexte des processus d’évaluation par les pairs au sein des revues scientifiques internationales, cette mise en page démontre une rigueur formelle exemplaire. Les évaluateurs peuvent scruter d’un coup d’œil l’intégrité de la structure des données pour chaque modalité factorielle, juger de la pertinence des approximations théoriques et appréhender la répartition des effectifs sans être perturbés par des artifices de rendu tape-à-l’œil. La panélisation via l’instruction CLASS s’impose ainsi comme le standard d’excellence pour le reporting stratifié univarié.
6. Contrôle esthétique et mise en page du panneau comparatif
6.1 Harmonisation des échelles d’axes pour une comparabilité objective
Le piège méthodologique le plus insidieux lors de la création d’affichages multifenêtres réside dans la disjonction involontaire des échelles métriques entre cellules de panneau. Si chaque sous-graphique ajustait de manière opportuniste ses bornes minimales et maximales d’abscisse et d’ordonnée aux valeurs extrêmes propres à chaque groupe, une distorsion cognitive sévère s’introduirait : un écart de dispersion modeste dans un échantillon homogène pourrait sembler visuellement identique, voire supérieur, à une forte dispersion issue d’une cohorte très hétérogène mais compressée par une échelle étendue.
Pour prévenir cette dérive interprétative qui ruinerait la validité de la recherche, PROC UNIVARIATE impose de manière standardisée l’alignement absolu des axes lorsque l’instruction CLASS est mobilisée conjointement avec HISTOGRAM. L’axe des abscisses couvre systématiquement l’étendue commune englobant la valeur minimale globale et la valeur maximale absolue observées sur l’intégralité du jeu de données, assurant que dix unités de points mesurent exactement la même longueur physique sur le panneau supérieur et sur le panneau inférieur.
De même, l’harmonisation de l’ordonnée en pourcentage constitue une exigence fondamentale. Grâce à l’utilisation conjointe des options de contrôle d’échelle verticale, l’analyste contraint SAS à calibrer le sommet de l’axe Y sur le pourcentage le plus élevé parmi l’ensemble des cellules du panneau. Cette standardisation garantit qu’une barre montant à vingt pour cent atteindra une altitude géométrique strictement identique sur chaque cellule, rendant ainsi la comparaison des densités empiriques visuellement irréprochable et scientifiquement objective.
6.2 Configuration de la disposition matricielle : lignes et colonnes
L’optimisation de l’occupation de l’espace graphique requiert un paramétrage réfléchi de l’agencement matriciel des cellules. Par défaut, PROC UNIVARIATE choisit une orientation spatiale automatisée en fonction du ratio d’aspect de la fenêtre active et du nombre de modalités de la variable de classe. Toutefois, l’analyste dispose d’un contrôle direct sur cette topologie grâce aux options structurelles NROWS et NCOLS, à renseigner après la barre oblique de l’instruction HISTOGRAM.
Le choix entre un arrangement en pile verticale (spécification NROWS=2, NCOLS=1 pour deux groupes) ou un étalement en bande horizontale (spécification NROWS=1, NCOLS=2) relève d’un arbitrage analytique précis :
- L’empilement vertical (colonnes superposées) : Cette configuration offre un alignement vertical rigoureux de l’axe des abscisses commun, positionné à la base. Les regards peuvent ainsi descendre directement le long d’une coordonnée précise pour comparer l’altitude relative des barres entre les deux équipes. C’est le format préférentiel pour évaluer les déplacements de la tendance centrale ou des modes respectifs.
- La juxtaposition horizontale (lignes côte à côte) : Cette mise en page met l’accent sur l’axe vertical des pourcentages partagé. Elle s’avère particulièrement pertinente lorsque l’on souhaite intégrer le graphique dans une maquette de manuscrit à double colonne ou focaliser l’attention du lecteur sur les amplitudes relatives des pourcentages maximaux.
Le calibrage délibéré du nombre de lignes et de colonnes préserve ainsi l’équilibre visuel du document final, s’adaptant étroitement aux contraintes géométriques du support de publication cible, qu’il s’agisse d’un rapport technique au format portrait ou d’un diaporama de communication scientifique au format panoramique.
6.3 Édition des en-têtes de sous-groupes et typographie
La qualité de finition d’une figure dépend de la précision de ses éléments d’identification textuelle. Dans un panneau comparatif généré sous PROC UNIVARIATE, chaque cellule est coiffée d’un bandeau ou d’une étiquette signalant le niveau factoriel concerné (par exemple : Team = A). L’analyste dispose de leviers de personnalisation via les options de styles intégrées aux templates ODS et les commandes de formatage SAS, permettant de substituer aux désignations abrégées des formulations complètes et élégantes.
L’instruction FORMAT appliquée en amont de la procédure offre la faculté de recoder à la volée les modalités alphanumériques brutes en intitulés descriptifs sans altérer les structures sous-jacentes du jeu de données (par exemple, afficher « Équipe Professionnelle Alpha » au lieu de « A »). De surcroît, la modulation des attributs typographiques (famille de polices, graisse, corps de caractère et contrastes de teintes) s’orchestre par la modification des styles graphiques ou l’insertion de sous-options déclaratives, garantissant une cohérence formelle avec le corps de texte du document scientifique.
Enfin, la séparation nette entre chaque cellule du treillis s’appuie sur la gestion des bordures et des marges intérieures (cell padding). La suppression des fioritures de remplissage inutiles et la sélection de traits de délimitation discrets évitent la surcharge cognitive dénoncée par les théoriciens de la visualisation de données. Il en résulte un dispositif matriciel épuré où la typographie remplit sa fonction de repérage fonctionnel sans jamais distraire l’observateur des propriétés mathématiques des histogrammes analysés.
7. Exemple 3 – Création d’histogrammes superposés (Option OVERLAY)
7.1 Syntaxe et structure de l’option OVERLAY dans PROC UNIVARIATE
Alors que la panélisation sépare les groupes dans des sous-fenêtres indépendantes, la stratégie graphique de superposition (overlay) regroupe les distributions de plusieurs modalités au sein d’un repère orthonormé unique. Cette approche autorise une confrontation directe et instantanée des formes distributionnelles le long d’un axe horizontal rigoureusement fusionné. Dans la syntaxe de PROC UNIVARIATE, ce comportement s’active en associant l’instruction CLASS à l’option explicite OVERLAY, insérée après la barre oblique de l’instruction HISTOGRAM.
Le code prend la forme structurelle suivante :
proc univariate data=my_data;
class team;
var points;
histogram points / overlay;
run;
À la lecture de cette directive, le processeur graphique modifie radicalement sa cinématique de tracé : au lieu d’instancier autant de graphiques que de modalités factorielles, il projette l’ensemble des rectangles sur un axe d’abscisse et d’ordonnée commun.
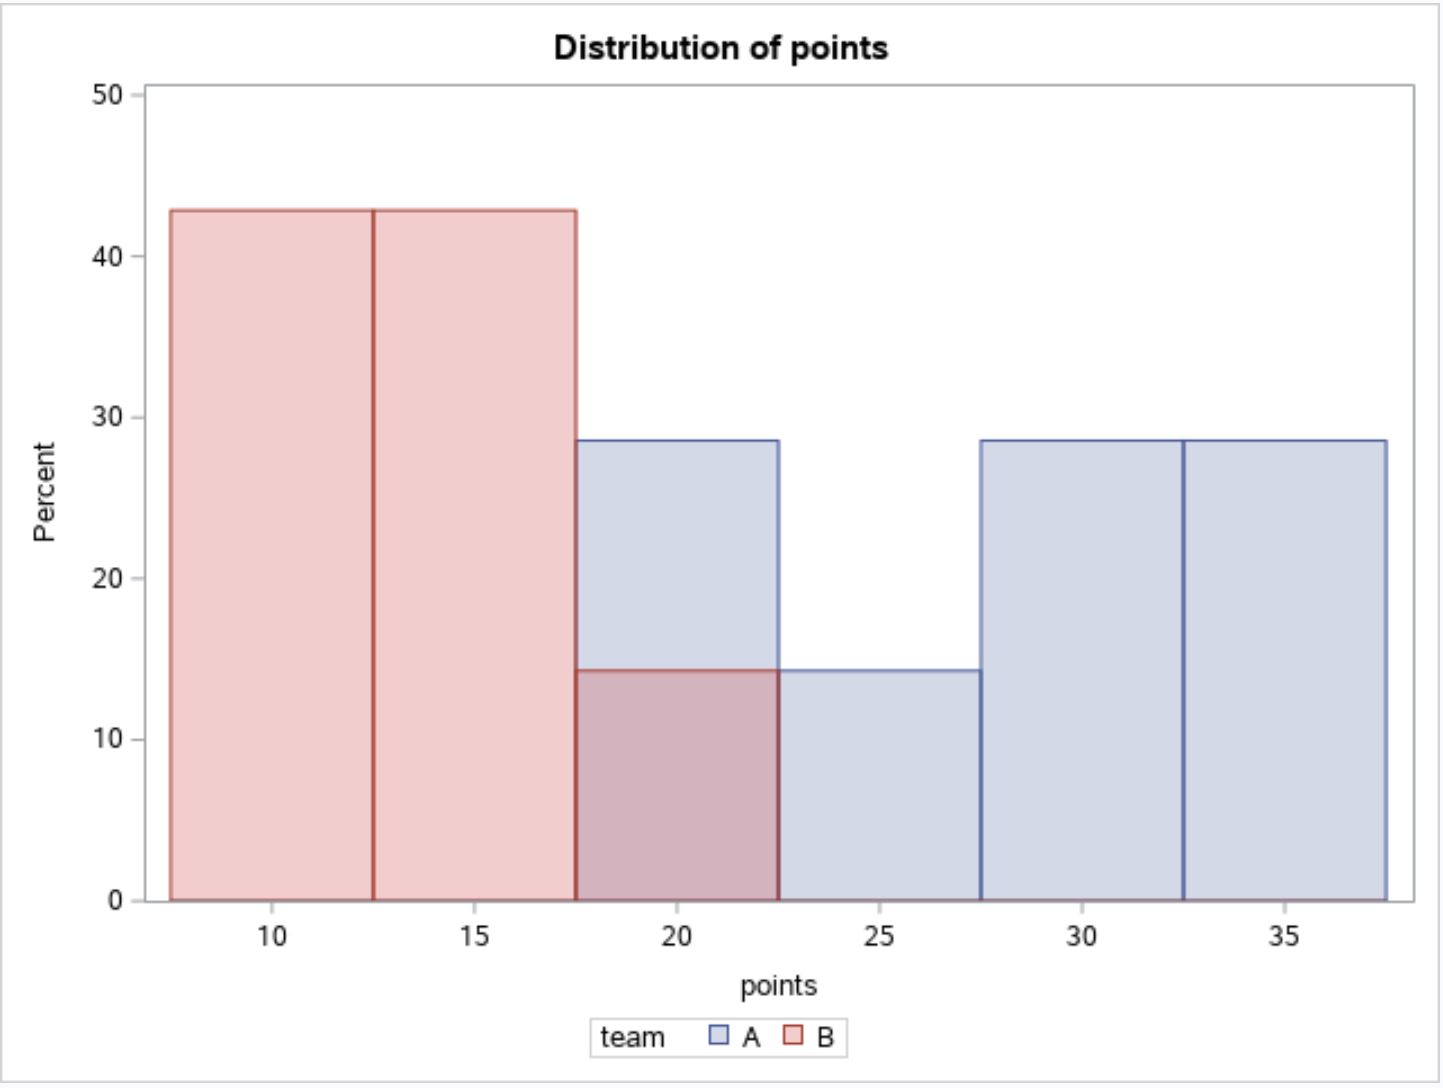
Par défaut, cette opération de fusion géométrique exige une gestion vigilante des conflits de tracé. Lorsque deux barres relatives à deux groupes distincts occupent un même intervalle de valeurs sur l’abscisse, le moteur graphique de SAS doit arbitrer entre le masquage de la barre située à l’arrière-plan ou l’adoption d’un mode de rendu graphique composite. C’est précisément pour lever cette ambiguïté que le recours aux propriétés de transparence alpha et aux codages chromatiques différentiels devient indispensable.
7.2 Gestion de la transparence et de la ségrégation des couleurs
La viabilité cognitive d’un histogramme superposé dépend de la lisibilité des zones d’intersection où les distributions se chevauchent. Si les barres sont rendues sous forme de surfaces totalement opaques, le groupe dessiné en second plan occultera inévitablement les données du premier groupe, induisant une invisibilisation dramatique d’une partie des effectifs. L’introduction d’un indice de transparence (transparency) permet de convertir les surfaces pleines en voiles semi-translucides laissant transparaître les limites sous-jacentes.
Bien que le contrôle fin de la transparence soit nativement plus poussé dans les procédures modernes de la famille SG (comme PROC SGPLOT avec l’option TRANSPARENCY=0.5), PROC UNIVARIATE gère cette problématique via les styles du système ODS Graphics. L’activation de styles graphiques contemporains tels que HTMLBlue ou Statistical alloue automatiquement des teintes contrastées et semi-transparentes aux différentes modalités du facteur de classe, créant par synthèse additive de couleurs une teinte tierce explicite au niveau des segments communs aux deux cohortes.
Pour assurer une conformité avec les critères modernes d’accessibilité scientifique, l’analyste doit veiller à sélectionner des palettes de couleurs adaptées aux lecteurs présentant des déficiences de la vision chromatique (daltonisme). Le recours aux combinaisons universelles (bleu et orange, ou palettes basées sur les normes de Viridis ou de ColorBrewer) doit être privilégié face au traditionnel diptyque rouge-vert. De plus, pour les publications destinées à l’impression monochrome, la différenciation des groupes par l’application de motifs de hachures croisées ou de lignes d’orientation distinctes garantit le maintien d’une séparabilité visuelle absolue, même en l’absence intégrale de couleur.
7.3 Arbitrage méthodologique : superposition vs panélisation
Le choix entre l’option OVERLAY et la panélisation par treillis relève d’un arbitrage méthodologique fondé sur la structure des données et les objectifs de communication de la recherche. La superposition s’avère particulièrement efficace lorsque deux conditions fondamentales sont réunies : premièrement, le facteur de stratification ne doit comporter que deux modalités (k = 2) ; deuxièmement, les distributions des deux groupes doivent présenter un décalage suffisant de leur tendance centrale pour limiter l’ampleur des zones de collision graphique confuse.
Lorsque ces critères sont satisfaits, la superposition offre une puissance de comparaison immédiate inégalée : l’observateur perçoit instantanément la distance séparant les deux modes de distribution, visualisant précisément le point de croisement critique où l’une des sous-populations cesse d’être dominante au profit de l’autre. Cette configuration excelle dans la démonstration d’effets thérapeutiques marqués, où un groupe traité voit sa courbe se décaler univoquement vers les valeurs favorables par rapport à un groupe témoin.
En revanche, dès lors que le nombre de sous-groupes excède deux (k > 2), ou que les distributions se caractérisent par des formes multimodales entrelacées avec des variances très inégales, l’option OVERLAY bascule rapidement dans la surcharge visuelle indéchiffrable. Les mélanges de transparences multiples engendrent des nuances de couleurs confuses et la lecture précise de la hauteur relative des barres devient impossible. Dans une telle conjoncture, la panélisation via l’agencement multifenêtre redevient la méthode de choix, préservant la netteté analytique au détriment mineur d’une immédiateté comparative globale.
8. Analyses statistiques complémentaires associées à PROC UNIVARIATE
8.1 Extraction des paramètres descriptifs fondamentaux
L’immense valeur ajoutée de la procédure PROC UNIVARIATE réside dans son aptitude à fournir un pont analytique entre la représentation spatiale de l’histogramme et un répertoire exhaustif de paramètres statistiques descriptifs compilés au sein de tableaux de résultats standardisés. L’exécution de la procédure calcule automatiquement les paramètres fondamentaux de la tendance centrale : la moyenne arithmétique (estimateur non biaisé du barycentre), la médiane (centile 50 résistant aux perturbations de queue) et le mode (valeur la plus fréquente correspondant à l’apex de l’histogramme).
L’évaluation de la dispersion s’appuie parallèlement sur des métriques scalaires rigoureuses : l’écart-type, la variance de l’échantillon, l’étendue brute et l’écart interquartile (IQR = Q3 – Q1), qui quantifie l’étalement des cinquante pour cent médians de la distribution. Ces valeurs tabulaires fournissent une assise numérique rigide permettant de contextualiser précisément les seuils observés sur les graduations de l’axe des abscisses de l’histogramme.
Plus fondamentalement encore, la procédure calcule les moments statistiques d’ordre trois et quatre standardisés. Le coefficient d’asymétrie empirique (skewness) traduit par une valeur positive un étirement vers la droite, et par une valeur négative une traîne orientée vers la gauche, complétant l’inspection visuelle des queues de l’histogramme. Le coefficient d’aplatissement (kurtosis, rapporté sous forme d’excès par rapport à la valeur gaussienne théorique de 3) mesure l’épaisseur relative des extrémités et la concentration centrale. Ces deux grandeurs numériques valident formellement la qualification typologique établie lors de l’examen visuel du graphique.
8.2 Tests formels d’adéquation à la loi normale
L’inspection purement oculaire d’un histogramme présente une part irréductible de subjectivité dépendant de l’acuité visuelle de l’observateur et des choix de découpage en classes. Pour affranchir l’analyse de ce biais qualitatif, PROC UNIVARIATE intègre des tests d’adéquation formels évaluant l’hypothèse nulle (H0) selon laquelle l’échantillon analysé est issu d’une population parente distribuée selon une loi normale d’espérance et de variance inconnues. Lorsque l’option NORMAL est demandée, ces tests inférentiels sont automatiquement générés.
La procédure calcule et restitue jusqu’à quatre tests statistiques d’adéquation complémentaires au sein de ses sorties synthétiques :
- Le test de Shapiro-Wilk (W) : Méthode privilégiée et reconnue pour sa puissance statistique supérieure sur les échantillons de taille petite à modérée (typiquement N < 50 ou jusqu’à quelques centaines d’unités). Une valeur de W très proche de 1 associée à une p-value supérieure au seuil α = 0,05 conduit à ne pas rejeter la normalité.
- Le test de Kolmogorov-Smirnov (D) : Fondé sur la distance maximale supremum séparant la fonction de répartition empirique de la fonction de répartition cumulative théorique (modifié par la correction de Lilliefors).
- Le test d’Anderson-Darling (A²) : Variante pondérée accordant un poids statistique accru aux écarts intervenant dans les queues de distribution, domaine où les approximations de normalité sont les plus sensibles.
- Le test de Cramér-von Mises (W²) : Calculant l’intégrale quadratique moyenne des écarts entre distribution observée et théorique.
L’analyste scientifique exploite ces résultats selon un principe de complémentarité méthodologique : le test inférentiel apporte la sanction probabiliste rigoureuse sous la forme d’un p-value de décision, tandis que l’histogramme illustre concrètement l’origine morphologique de l’éventuel rejet (asymétrie, bimodalité, ou queues lourdes), guidant le chercheur dans le diagnostic des mesures correctrices à adopter.
8.3 Détection systématique des observations extrêmes et aberrantes
L’un des apports critiques de la procédure PROC UNIVARIATE dans le nettoyage et la validation des données réside dans sa capacité à identifier de manière systématique les observations aberrantes ou singulières (outliers). Dans les sorties tabulaires, la table intitulée Extreme Observations répertorie systématiquement les cinq valeurs les plus basses et les cinq valeurs les plus élevées du vecteur analysé, associant à chaque valeur la référence exacte de son identifiant de ligne (_N_) dans le jeu de données d’origine.
Sur l’histogramme, ces valeurs aberrantes se traduisent visuellement par des barres d’effectif très réduit (parfois limitées à une unité isolée) situées à une distance substantielle du corps principal de la distribution, créant des étendues de vide absolu sur l’axe des abscisses. Cette configuration signale instantanément une rupture de continuité distributionnelle qui mérite une attention soutenue : il peut s’agir d’une erreur matérielle de saisie, d’un dysfonctionnement d’instrumentation de mesure ou, à l’inverse, d’un sujet exceptionnel méritant une analyse clinique individualisée.
La détection de ces extrêmes est également mise en relation avec le tableau des centiles fourni par la procédure, notamment le 95e et le 99e centile pour l’extrémité supérieure, et le 1er et 5e centile pour l’extrémité basse. L’analyste se trouve alors confronté à des choix d’arbitrage statistique : l’exclusion pure et simple de l’observation (si une anomalie de mesure est établie), la conservation en l’état (si l’observation est réelle, imposant l’usage de méthodes non paramétriques robustes), ou encore la transformation par winsorisation ou découpage (trimming) pour stabiliser la variance des futurs modèles prédictifs.
9. Alternative contemporaine : génération d’histogrammes avec PROC SGPLOT
9.1 Syntaxe de l’instruction HISTOGRAM au sein de PROC SGPLOT
En complément de l’approche intégrée de PROC UNIVARIATE, l’écosystème SAS contemporain met à disposition des data scientists la procédure PROC SGPLOT, spécifiquement dédiée à la création graphique modulaire de haute volée. Fondée sur le moteur ODS Graphics, PROC SGPLOT sépare l’évaluation inférentielle de la composition visuelle, offrant une syntaxe fluide et une expressivité esthétique immédiatement accessible pour la production de figures destinées à l’édition papier ou numérique.
La modélisation d’un histogramme sous PROC SGPLOT s’opère par l’appel de l’instruction interne HISTOGRAM. Contrairement à PROC UNIVARIATE où la variable de groupement est instanciée via une instruction CLASS distincte, PROC SGPLOT intègre la gestion des sous-cohortes directement à l’intérieur de l’instruction HISTOGRAM grâce à l’option GROUP. La syntaxe canonique s’articule ainsi :
proc sgplot data=my_data;
histogram points / group=team transparency=0.4 binwidth=5;
run;
Cette formulation concrète permet de fusionner en une ligne d’instruction la sélection de la variable métrique, la déclaration de la segmentation inter-groupes, le paramétrage explicite du niveau de transparence alpha (ici fixé à 40 % pour prévenir les occultations géométriques) et le calibrage direct de la largeur des tranches via l’option BINWIDTH.
La modularité de PROC SGPLOT permet également d’associer des éléments de contrôle typographique d’une grande finesse via des instructions compagnes telles que XAXIS et YAXIS. Ces commandes autorisent la manipulation déterministe des bornes d’affichage, des incréments de grille (grid), des formats d’étiquetage et des titres d’axes sans altérer les propriétés sous-jacentes du jeu de données, conférant ainsi à l’analyste une maîtrise complète sur la géométrie finale de la visualisation.
9.2 Superposition de densités par noyau (Kernel Density Estimation)
L’un des atouts majeurs de la procédure PROC SGPLOT réside dans son aptitude à marier, sur une même scène géométrique, la discrétisation par barres de l’histogramme et l’estimation continue non paramétrique de la densité par la méthode du noyau (Kernel Density Estimation, ou KDE). Contrairement à l’ajustement paramétrique qui contraint a priori la courbe à épouser une silhouette gaussienne fermée, l’estimation par noyau ne formule aucune hypothèse distributionnelle préconçue, épousant organiquement les contours réels des données observées.
L’implémentation de cette technique repose sur l’adjonction de l’instruction DENSITY au bloc de code PROC SGPLOT :
proc sgplot data=my_data;
histogram points / scale=proportion;
density points / type=kernel;
run;
L’instruction DENSITY calcule la densité lissée par l’application d’une fonction de pondération locale (le plus souvent un noyau gaussien ou d’Epanechnikov) centrée sur chaque unité statistique élémentaire. La sommation de ces sous-fonctions produit une enveloppe continue dont l’intégrale est normalisée à l’unité.
L’analyste dispose de leviers de réglage pour affiner ce tracé, notamment en modulant le paramètre de lissage de la fenêtre (bandwidth). Un paramètre étroit révélera des inflections morphologiques locales hypersensibles, tandis qu’un paramètre étendu fournira une tendance macroscopique stabilisée. La superposition conjointe de l’histogramme pour les proportions discrètes et de la courbe KDE continue procure un instrument d’analyse visuelle de premier ordre, réconciliant l’évidence d’échantillonnage direct fournie par les barres et la fluidité prédictive apportée par le modèle non paramétrique lissé.
9.3 Comparaison fonctionnelle entre PROC UNIVARIATE et PROC SGPLOT
Pour arbitrer rationnellement entre PROC UNIVARIATE et PROC SGPLOT lors de la conception d’un protocole d’analyse de données, il convient de dresser un bilan synthétique de leurs forces respectives en fonction des étapes du cycle de vie de la recherche :
- PROC UNIVARIATE (L’outil du diagnostic statistique approfondi) : Elle demeure incontournable lors de la phase exploratoire initiale et de validation des postulats méthodologiques. Sa capacité à lier organiquement en une exécution unique les tableaux complets des moments statistiques, les tests de normalité de Shapiro-Wilk ou d’Anderson-Darling, la détection des centiles extrêmes et la modélisation graphique théorique en fait le compagnon insubstituable du statisticien méthodique. Elle évite la dispersion du code en centralisant inférence et visualisation.
- PROC SGPLOT (Le moteur de publication et d’esthétique graphique) : Elle s’impose dès lors que les hypothèses distributionnelles ont été éprouvées et que l’objectif prioritaire devient la diffusion, la publication dans des revues à fort facteur d’impact ou la présentation exécutive. Grâce à sa grammaire déclarative souple, elle excelle dans la manipulation des palettes de couleurs chromatiques, la gestion fine de la transparence alpha, la création de visualisations hybrides complexes (ex. histogramme couplé à des tracés marginaux ou des densités par noyau) et la standardisation des maquettes de présentation.
En pratique académique avancée, la méthodologie préconise une articulation séquentielle : mobiliser d’abord PROC UNIVARIATE pour vérifier scrupuleusement la propreté des données, diagnostiquer les asymétries et valider la structure des variables, puis exploiter PROC SGPLOT pour élaborer la version finale de la figure avec une précision esthétique et une clarté typographique maximale.
10. Exportation académique et intégration via l’Output Delivery System (ODS)
10.1 Configuration des destinations ODS pour les rapports scientifiques
Dans un flux de travail académique moderne, la génération visuelle d’un histogramme ne constitue que la première phase d’une chaîne de traitement : le chercheur doit être capable d’exporter ses résultats de manière déterministe et reproductible vers des documents formels prêts pour la révision par les pairs. Cette intégration s’opère dans SAS via l’Output Delivery System (ODS), un mécanisme d’encapsulation qui intercepte les flux d’objets graphiques et textuels générés par les procédures pour les diriger vers des destinations spécifiques de restitution.
L’ouverture et la fermeture des canaux ODS obéissent à une logique d’encadrement strict. Pour acheminer une figure vers un fichier PDF vectoriel haute fidélité, un document bureautique RTF éditable ou une page Web interactive HTML5, l’analyste encapsule le bloc de traitement entre des instructions d’ouverture et de clôture dédiées :
ods pdf file= »Distribution_Analysis.pdf » style=Journal;
/* Procédures d’analyse et histogrammes */
ods pdf close;
Cette approche élimine tout recours aux captures d’écran approximatives, garantissant que les graphiques incorporés conservent l’intégralité de leurs coordonnées numériques et de leurs vecteurs de tracé dans le document final.
L’utilisation de styles ODS prédéfinis constitue un levier majeur de conformité éditoriale. Le style Journal, par exemple, dépouille le rendu graphique de tout remplissage chromatique superflu, retenant des échelles de gris sobres, des typographies avec empattement classiques et des contours linéaires précis, répondant aux prérequis stricts des sociétés savantes les plus exigeantes. La fermeture méthodique des flux ODS (via la mention ods _all_ close; ou la fermeture explicite de chaque canal) assure la libération immédiate des buffers système et prévient la corruption des fichiers générés sur le disque de travail.
10.2 Paramétrage de la résolution graphique et des dimensions formelles
L’une des causes majeures de rejet technique lors de la soumission d’articles scientifiques réside dans l’insuffisance de résolution des illustrations fournies. Pour satisfaire aux exigences typographiques des éditeurs académiques majeurs (tels qu’Elsevier, Springer, ou Nature Publishing Group), les graphiques matriciels doivent impérativement présenter une densité minimale de 300 points par pouce (DPI), s’élevant couramment à 600 DPI pour les schémas linéaires complexes. SAS permet d’orchestrer ce calibrage grâce à la déclaration globale ODS GRAPHICS.
L’instruction ODS GRAPHICS accepte un ensemble de commutateurs stratégiques contrôlant la texture dimensionnelle du tracé :
ods graphics on / reset=all imagename= »Histogramme_HD » imagefmt=png dpi=300 width=16cm height=10cm antialias=on;
Dans ce bloc d’instructions, le paramètre DPI=300 force le moteur de rendu à calculer une densité de pixels assurant une netteté absolue à l’impression physique. Les paramètres WIDTH et HEIGHT fixent le calibre géométrique effectif du tracé dans des unités métriques standardisées, éliminant tout étirement anarchique lors de l’incorporation ultérieure de l’image au sein de logiciels de mise en page tels que LaTeX ou Microsoft Word.
L’activation de la fonction d’antialiasing (antialias=on) est capitale : elle applique un filtrage sous-pixel lissant les diagonales, les courbes et les contours de polices, supprimant l’effet d’escalier (pixelation) visible sur les affichages matriciels bruts. Grâce à cette maîtrise de l’infrastructure graphique, l’analyste s’assure que les barres de ses histogrammes, les repères de centiles et les tracés de densités superposés apparaissent avec un piqué de détail parfait, valorisant la qualité globale de la communication scientifique.
10.3 Conformité stylistique aux standards des revues à comité de lecture
L’élaboration d’une illustration destinée à la publication ne se limite pas à des critères techniques de résolution ; elle implique le respect rigoureux des conventions de sémiologie graphique et de sobriété stylistique, à l’image des normes préconisées par l’American Psychological Association (style APA). Cette philosophie repose sur la maximisation du ratio données-encre (data-ink ratio) formulé par Edward Tufte, précepte consistant à éliminer méthodiquement tout artifice de décoration graphique non informatif (chartjunk).
Dans l’architecture SAS, la mise en conformité stylistique se traduit par :
- La neutralisation des arrière-plans colorés : Remplacement systématique des fonds grisés ou chamarrés par des toiles de fond d’une blancheur immaculée, optimisant le contraste chromatique.
- La simplification des grilles de lecture : Suppression des trames de quadrillage horizontales et verticales denses au profit de repères de graduation sobres positionnés uniquement le long des axes principaux.
- L’élimination des effets pseudo-tridimensionnels : Rejet absolu des barres biseautées en fausse perspective 3D, source d’erreurs parallactiques dans l’estimation visuelle de l’amplitude des fréquences.
- L’enrichissement des légendes paratextuelles : Rédaction de libellés autonomes, exhaustifs et explicites intégrant la taille d’échantillon (ex. : N = 20), la mention des unités de mesure physiques et l’explication précise des courbes superposées.
Cette rigueur de conception garantit que la figure fonctionne comme une entité communicative autosuffisante : un lecteur parcourant l’article doit être en mesure de décrypter l’intégralité du message distributionnel, d’en apprécier la portée statistique et d’en vérifier la validité conceptuelle sans avoir à rechercher laborieusement des explications fragmentées au fil des pages du corps de texte.
11. Résolution des anomalies et dépannage lors de l’exécution de PROC UNIVARIATE
11.1 Gestion des données manquantes et impact sur l’histogramme
En recherche appliquée, la complétude parfaite des matrices d’observation relève de l’exception : la présence de données manquantes (missing values) constitue une contingence courante causée par des abandons en cours de protocole, des défaillances techniques de capteurs ou des non-réponses ciblées. Face à cette situation, PROC UNIVARIATE adopte un comportement algorithmique par défaut dont les implications méthodologiques doivent être rigoureusement anticipées par l’analyste.
Lorsqu’une cellule est déclarée manquante pour la variable métrique continue spécifiée dans l’instruction VAR, la procédure applique une exclusion par observation (listwise deletion). L’observation concernée est totalement évincée du calcul des moments, des centiles et de la construction de l’histogramme. La sortie tabulaire génère alors une ligne informative dénombrant explicitement l’effectif des valeurs exclues. Toutefois, si des données sont manquantes sur la variable de stratification instanciée dans l’instruction CLASS, SAS regroupe par défaut ces unités sous une classe orpheline dédiée ou exclut l’enregistrement selon les options globales activées, ce qui peut fausser la comparabilité des effectifs entre sous-groupes.
Sur le plan épistémologique, l’analyste doit impérativement s’interroger sur la nature du mécanisme sous-jacent d’omission : s’agit-il d’une omission complètement aléatoire (Missing Completely at Random, MCAR) ne générant qu’une perte de puissance statistique, ou d’une omission non aléatoire (Missing Not at Random, MNAR) induisant un biais de sélection sévère ? Dans ce dernier cas, l’histogramme produit sera intrinsèquement tronqué. Pour prévenir des distorsions pernicieuses, le recours préalable à l’instruction conditionnelle WHERE permet de filtrer sélectivement les cohortes éligibles :
proc univariate data=my_data;
where points is not missing;
var points;
histogram points;
run;
Cette précaution garantit une transparence totale sur le dénominateur effectif présidant au calcul des fréquences relatives de chaque classe.
11.2 Divergences de syntaxe : mauvaise utilisation des instructions CLASS et BY
L’une des confusions les plus fréquentes chez les praticiens de SAS réside dans l’assimilation erronée de l’instruction CLASS et de l’instruction BY pour la conduite d’analyses stratifiées. Bien que ces deux clauses segmentent l’échantillon en fonction des modalités d’une variable catégorielle, leurs architectures logicielles et leurs modes de restitution visuelle sont fondamentalement dissemblables, conduisant souvent à des blocages d’exécution ou à des résultats graphiques inadaptés.
L’instruction BY exige de manière impérative que la table de données source soit préalablement ordonnée selon la variable de groupement. Si l’utilisateur omet d’exécuter une procédure PROC SORT en amont, SAS interrompt le traitement et inscrit dans le journal (SAS Log) le message d’erreur fatal : ERROR: Data set is not sorted in proper order. En outre, lorsque le tri est exécuté, l’instruction BY scinde l’analyse en autant d’exécutions complètes et indépendantes de la procédure UNIVARIATE qu’il existe de modalités, produisant des séries de graphiques isolés sur des pages distinctes sans axes communs.
À l’inverse, l’instruction CLASS ne réclame aucun tri préalable de la table par PROC SORT. Le moteur logiciel prend en charge en mémoire interne l’allocation des unités aux différents sous-ensembles. Surtout, comme exposé au chapitre 5, CLASS est la seule commande capable de piloter la constitution d’un panneau comparatif unifié (lattice) ou la superposition directe via l’option OVERLAY, en imposant l’harmonisation stricte des échelles métriques. Les programmeurs doivent donc réserver l’instruction BY aux traitements massifs par lots où la mémoire est contrainte, et privilégier systématiquement CLASS pour toute démarche de confrontation graphique univariée.
11.3 Ajustement des distributions fortement tronquées ou dégénérées
Dans la pratique analytique, le statisticien est fréquemment confronté à des distributions atypiques qui mettent en échec les paramètres de tracé standardisés de PROC UNIVARIATE. Le cas le plus emblématique est celui des distributions à inflation de zéros (zero-inflated distributions) ou des métriques présentant une masse d’observations concentrée sur une borne seuil, comme dans les échelles de dépense financière, de consommation médicamenteuse ou de temps d’arrêt machine. Lorsque plus de la moitié de l’échantillon affiche une valeur nulle, l’histogramme présente une première barre démesurée écrasant l’ensemble des tranches supérieures.
Une situation tout aussi problématique découle des variables quasi-dégénérées, dont la variance empirique est extrêmement ténue voire nulle sur un sous-groupe particulier. Dans cette conjoncture, les algorithmes de sélection automatique de la largeur de classe basés sur l’écart-type échouent à délimiter des intervalles cohérents, provoquant des avertissements dans le journal et la génération d’une barre unique étroite occupant toute la hauteur du graphique. Face à ces anomalies, l’analyste doit intervenir directement sur la géométrie de discrétisation.
Plusieurs stratégies de remédiation méthodologique s’imposent :
- Le reparamétrage manuel par MIDPOINTS : Forcer une largeur de classe personnalisée isolant spécifiquement la valeur nulle dans une tranche dédiée, tout en calibrant des intervalles réguliers pour la phase positive de la distribution.
- L’application préalable d’une transformation mathématique : Pour les distributions modérément étalées vers la droite, l’application d’une transformation logarithmique log(x + c) ou par racine carrée permet de stabiliser les variances et de rééquilibrer la silhouette de la variable vers une forme pseudo-gaussienne traitable par l’histogramme standard.
- Le recours aux modèles de Box-Cox : Déterminer la puissance optimale λ pour reconfigurer la métrique continue avant d’engager les étapes de visualisation et d’inférence statistique formelle.
L’anticipation de ces singularités distributionnelles évite la diffusion de graphiques dépourvus de pertinence visuelle et garantit que l’outil descriptif traduit fidèlement la réalité phénoménologique de la mesure.
12. Synthèse méthodologique et arbre décisionnel pour l’analyse visuelle
12.1 Critères de sélection rationnels parmi les trois approches exposées
Au terme de cette exploration technique détaillée des trois grandes approches de modélisation de distributions sous SAS, l’analyste doit disposer d’une matrice décisionnelle claire lui permettant de sélectionner la stratégie graphique la plus performante face à une problématique empirique donnée. Le choix ne doit en aucun cas reposer sur des préférences esthétiques subjectives, mais sur une évaluation rigoureuse de la nature des variables, du volume de données et des objectifs démonstratifs du protocole de recherche.
L’arbre de décision méthodologique peut se formaliser selon les arbitrages suivants :
- L’Histogramme Univarié Simple (Exemple 1) : Doit être sélectionné pour l’investigation préliminaire de cohortes homogènes non stratifiées, ou lorsque l’objectif exclusif consiste à évaluer l’adéquation distributionnelle globale d’une variable dépendante vis-à-vis d’une loi théorique de référence. C’est l’approche à privilégier pour auditer les résidus d’une régression ou vérifier la normalité unitaire d’un biomarqueur.
- Le Panneau Comparatif par Treillis (Exemple 2) : S’impose comme la référence méthodologique absolue dès lors que l’on analyse une variable continue en présence d’un facteur de classification comportant plusieurs modalités (notamment lorsque k ≥ 2). Il garantit une clarté cognitive totale, élimine l’occlusion, prévient la confusion des tracés et permet de vérifier simultanément l’équivariance et l’homogénéité des formes distributionnelles entre sous-groupes.
- L’Histogramme Superposé (Exemple 3) : Est réservé aux confrontations strictes entre deux groupes uniques (k = 2) présentant un étalement de variances comparable mais un déplacement marqué de leur tendance centrale. Son intérêt réside dans la révélation immédiate du seuil de transition et de la magnitude du décalage modal, sous réserve d’exploiter un calibrage maîtrisé de la transparence alpha pour préserver la visibilité des intersections.
L’application rigoureuse de ces règles de décision optimise le temps de développement informatique et garantit une restitution graphique en symbiose parfaite avec les postulats du modèle statistique sous-jacent.
12.2 Tableau récapitulatif des syntaxes et options déterminantes
Afin de fournir un vademecum opérationnel immédiatement mobilisable pour la programmation sous l’environnement SAS, les principales instructions, options et clauses structurantes de la procédure PROC UNIVARIATE sont synthétisées ci-dessous :
- VAR <variable> : Déclare le vecteur des variables quantitatives continues soumises au calcul analytique et à la projection spatiale.
- HISTOGRAM <variable> : Active le moteur de tracé géométrique des barres de distribution discrétisée.
- / NORMAL : Superpose à l’histogramme empirique la courbe de densité théorique de la loi de Gauss calibrée sur les paramètres du maximum de vraisemblance.
- / MIDPOINTS = <liste> : Impose un contrôle manuel absolu sur les bornes médianes et la granularité des intervalles de partitionnement de l’axe horizontal.
- / VSCALE = PERCENT | PROPORTION | DENSITY : Modifie le système de mesure métrique appliqué à l’axe des ordonnées verticales.
- CLASS <variable_cat> : Segmente l’échantillon global en sous-populations selon les modalités d’un facteur qualitatif de groupement.
- / OVERLAY : Fusionne les histogrammes des différentes classes au sein d’un seul repère cartésien au lieu de générer des panneaux séparés.
- / NROWS=n NCOLS=m : Calibre l’architecture spatiale matricielle des cellules lors de la décomposition en panneaux comparatifs.
- ODS GRAPHICS ON / DPI=300 : Configure l’infrastructure de restitution haute résolution pour l’exportation vers les publications académiques.
La maîtrise concertée de cette palette d’instructions permet de couvrir l’intégralité du spectre des besoins de restitution descriptive, depuis le script d’audit rapide jusqu’au dispositif éditorial le plus complexe.
12.3 Perspectives analytiques : de l’histogramme aux modèles multivariés
L’exploration visuelle et inférentielle de la distribution des données à travers les histogrammes de PROC UNIVARIATE ne doit pas être perçue comme un aboutissement analytique en soi, mais comme la phase préparatoire déterminante de l’ensemble de la modélisation statistique ultérieure. Les diagnostics établis lors de cette étape conditionnent la légitimité des choix de paramétrisation appliqués aux modèles plus complexes, qu’il s’agisse de modélisations linéaires multivariées (PROC GLM), de régressions logistiques polytomiques (PROC LOGISTIC) ou de modèles hiérarchiques mixtes à coefficients aléatoires (PROC MIXED).
La découverte d’une asymétrie irrémédiable, de queues lourdes persistantes ou de structures multimodales sur les histogrammes permet au chercheur d’anticiper la violation des postulats gaussiens classiques. Au lieu de subir les distorsions d’une inférence forcée conduisant à des faux positifs ou à des pertes de puissance statistique regrettables, l’analyste peut opter de manière préventive pour les modèles linéaires généralisés (GLM) en sélectionnant une loi de distribution adéquate (Poisson, Binomiale Négative, Gamma ou Tweedie) au sein de PROC GENMOD.
En dernière analyse, la conduite méthodique de visualisations univariées sous SAS incarne les principes contemporains de la science ouverte et de la reproductibilité empirique. En documentant avec une exactitude mathématique la topologie des distributions observées, le chercheur offre à la communauté scientifique une transparence méthodologique totale. L’histogramme univarié, qu’il soit déployé sous sa forme canonique simple, en treillis comparatif multipanneau ou par superposition translucide, confirme ainsi son statut d’instrument fondamental d’investigation statistique et d’aide à la décision scientifique.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472
- SAS Institute Inc. (2021). SAS/STAT 15.2 User’s Guide: The UNIVARIATE Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
- SAS Institute Inc. (2021). SAS 9.4 ODS Graphics: Procedures Guide (6th ed.). SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/base/
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0