
L’intégrité analytique d’une recherche quantitative repose fondamentalement sur la qualité métrologique des observations recueillies et sur la rigueur du traitement statistique appliqué aux distributions empiriques. Dans les sciences empiriques contemporaines, qu’il s’agisse de la biométrie, de l’économétrie, de l’épidémiologie ou des sciences comportementales, l’émergence d’observations atypiques — communément désignées sous le vocable de valeurs aberrantes ou outliers — constitue un phénomène omniprésent dont l’impact sur l’inférence statistique peut s’avérer dévastateur. Une valeur aberrante ne se résume pas à une simple curiosité descriptive ; elle incarne une déviation substantielle par rapport à la structure probabiliste sous-jacente du reste de l’échantillon, menaçant la validité interne des estimations, distordant les erreurs-types et conduisant potentiellement à des conclusions scientifiques fallacieuses.
Le progiciel SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme le standard de référence au sein des industries réglementées, des agences de santé publique et des laboratoires académiques pour l’analyse de données complexes et massives. Grâce à son architecture logicielle à double composante — combinant la flexibilité procédurale de l’étape DATA et la puissance calculatoire de procédures optimisées telles que PROC UNIVARIATE, PROC STDIZE ou PROC ROBUSTREG — l’environnement SAS offre un arsenal méthodologique sans équivalent pour isoler, diagnostiquer et traiter les observations discordantes. La maîtrise de ces outils computationnels exige néanmoins une compréhension approfondie des fondements mathématiques qui sous-tendent chaque algorithme d’identification, afin d’éviter l’écueil d’une épuration aveugle des bases de données.
Le présent traité méthodologique a pour vocation de fournir un guide exhaustif, théorique et opérationnel dédié à l’identification rigoureuse des valeurs aberrantes univariées et multivariées sous SAS. En articulant les démonstrations formelles des clôtures de John Tukey avec des implémentations de code reproductibles pas à pas sur un jeu de données empirique étalonné, ce document explore l’ensemble du cycle de vie du diagnostic statistique : du partitionnement quantile à l’automatisation par macro-programmation, en passant par la modélisation robuste et les arbitrages déontologiques post-détection conformes aux normes internationales de publication scientifique.
1. Cadre théorique et définition des valeurs aberrantes en analyse statistique
1.1 Typologie et nature des valeurs atypiques dans les données empiriques
Dans la littérature statistique fondamentale, telle qu’établie par des auteurs précurseurs comme Vic Barnett et Toby Lewis, une valeur aberrante se définit formellement comme une observation qui semble diverger de manière marquée du schéma structurel caractérisant les autres éléments de la distribution au sein de laquelle elle s’inscrit. Cependant, l’étiquette d’« observation aberrante » recouvre des réalités ontologiques et génératives profondément divergentes qu’il convient de discriminer avec la plus haute précision conceptuelle avant d’envisager la moindre intervention algorithmique.
On distingue traditionnellement trois catégories mères d’observations discordantes. La première relève des erreurs de mesure et d’encodage procédurales. Celles-ci regroupent les fautes de frappe humaine (comme l’adjonction involontaire d’un zéro terminal transformant un score de 22 en 220), les défaillances matérielles de capteurs électroniques, les ruptures de calibration d’appareillages de laboratoire ou les erreurs de fusion de tables relationnelles lors des étapes d’extraction de données. Ces valeurs ne possèdent aucune validité écologique et doivent être impérativement purgées ou corrigées.
La deuxième catégorie englobe les manifestations extrêmes de la variabilité biologique ou phénoménologique intrinsèque. Dans ce cas de figure, l’observation résulte fidèlement d’un processus générateur valide, mais reflète la queue lourde d’une distribution naturelle ou l’occurrence d’un événement rare mais parfaitement plausible. Dans les études épidémiologiques ou psychométriques, un sujet peut présenter un temps de réaction exceptionnellement long ou un profil immunologique singulier sans que la mesure ne soit intrinsèquement viciée. Traiter ces observations comme de simples anomalies techniques reviendrait à appauvrir artificiellement la variabilité du phénomène modélisé.
La troisième catégorie correspond aux artefacts de contamination d’échantillonnage, où l’individu mesuré n’appartient pas, en réalité, à la population cible postulée par le chercheur. Par exemple, l’inclusion accidentelle d’un patient souffrant d’une pathologie comorbide sévère non diagnostiquée dans un essai clinique axé sur des sujets sains génère une observation atypique issue d’un modèle de mélange sous-jacent.
D’un point de vue structural, les observations discordantes se classifient selon leur dimensionalité géométrique :
- Anomalies univariées : Elles se manifestent par un écart substantiel le long de l’axe réel d’une variable quantitative isolée. Leur repérage s’appuie sur la dispersion marginale de cette seule variable, indépendamment de toute corrélation externe.
- Anomalies bivariées et multivariées : Elles correspondent à des configurations vectorielles atypiques où chaque variable prise isolément présente une valeur parfaitement plausible au sein de sa distribution marginale, mais dont la combinaison conjointe viole la structure de covariance ou de corrélation de l’échantillon multidimensionnel.
L’asymétrie distributionnelle (mesurée par le coefficient de skewness de Fisher-Pearson) exerce une influence trompeuse majeure sur l’émergence apparente d’anomalies. Dans une distribution fortement asymétrique à droite — telle que celle des revenus financiers, des temps d’accès serveur ou de la concentration plasmatique de biomarqueurs —, les valeurs situées dans la queue supérieure peuvent être étiquetées à tort comme des aberrations par les métriques classiques alors qu’elles sont strictement conformes à la loi théorique sous-jacente (par exemple, une loi log-normale ou de Pareto). Les conséquences directes sur les estimateurs classiques sont dévastatrices : la moyenne arithmétique et la variance d’échantillon, étant dépourvues de toute résistance, sont littéralement tractées vers les extrêmes, gonflant artificiellement les intervalles de confiance et altérant l’ensemble des diagnostics paramétriques dérivés.
1.2 Enjeux épistémologiques et psychométriques de la détection d’observations extrêmes
La détection et le traitement des observations extrêmes ne relèvent pas uniquement d’une mécanique algorithmique ; ils soulèvent des dilemmes épistémologiques critiques quant à la nature même de l’induction scientifique. Dans le champ des sciences comportementales, de la psychométrie et de la recherche biomédicale, l’exclusion arbitraire ou non documentée de données atypiques constitue l’un des vecteurs majeurs de la crise de la reproductibilité scientifique. Le chercheur se trouve confronté à une tension dialectique permanente entre la préservation de la validité écologique — le respect de la complexité intrinsèque et de la variabilité du réel — et la sauvegarde de l’intégrité statistique des modélisations linéaires générales.
Au sein des modèles linéaires généraux (régression multiple, analyse de variance factorielle, modélisation par équations structurelles), la présence de valeurs aberrantes non contrôlées viole les postulats cardinaux de normalité des résidus et d’homoscédasticité. Ces violations induisent des biais sévères dans l’estimation des coefficients de régression par les moindres carrés ordinaires (MCO), dont le point de rupture (breakdown point) théorique est égal à $1/n$, ce qui signifie qu’une seule observation infinitésimale ou gigantesque suffit à faire diverger arbitrairement la droite d’ajustement. De surcroît, les erreurs-types des paramètres estimés se trouvent artificiellement gonflées ou comprimées selon la position géométrique de l’anomalie, provoquant une distorsion imprévisible des taux d’erreur de type I (rejet à tort de l’hypothèse nulle d’absence d’effet) et de type II (incapacité à détecter un effet réel existant).
Face à ces risques, les standards internationaux de publication scientifique — notamment codifiés par l’American Psychological Association (normes APA 7e édition) et le réseau EQUATOR via les lignes directrices CONSORT et STROBE — imposent une transparence méthodologique absolue. Il est désormais formellement proscrit d’éliminer des observations en coulisses sans rapporter explicitement les critères mathématiques préalablement fixés ayant guidé l’exclusion, le nombre exact d’observations écartées, leur profil descriptif et une analyse de sensibilité démontrant la stabilité des conclusions post-exclusion.
1.3 Panorama comparatif des approches de détection univariées
L’arsenal statistique dédié au diagnostic univarié des valeurs atypiques se scinde en deux paradigmes fondamentaux : les approches paramétriques fondées sur l’hypothèse de normalité et les méthodes non paramétriques axées sur la position relative et les quantiles d’échantillonnage.
L’approche paramétrique la plus intuitive repose sur la transformation en scores standardisés (scores Z), où chaque observation $x_i$ est recentrée par rapport à la moyenne arithmétique $\bar{x}$ et réduite par l’écart-type d’échantillon $s$ :
$$Z_i = \frac{x_i – \bar{x}}{s}$$
La règle empirique conventionnelle stipule qu’une observation dont la valeur absolue du score Z excède le seuil critique de 2,5 ou 3,0 doit être considérée comme potentiellement anormale, en vertu des propriétés de la loi normale standard où $99,73%$ de la masse de probabilité est confinée dans l’intervalle $[-3\sigma, +3\sigma]$. Néanmoins, cette méthode souffre d’une aporie fondamentale connue sous le nom d’effet de masque (masking effect). La moyenne arithmétique et l’écart-type étant eux-mêmes extrêmement sensibles aux valeurs aberrantes, la présence de plusieurs anomalies de grande magnitude gonfle démesurément l’écart-type $s$ et attire $\bar{x}$ vers l’extérieur. Par conséquent, les dénominateurs des scores Z deviennent anormalement élevés, ce qui compresse artificiellement la valeur calculée de $Z_i$ pour des anomalies secondaires qui échappent alors totalement à la détection.
À l’inverse, les méthodologies non paramétriques fondées sur les quantiles — au premier rang desquelles figure la méthode de l’écart interquartile conceptualisée par John Tukey — s’affranchissent intégralement de toute hypothèse distributionnelle gaussienne. Les quantiles d’échantillonnage possèdent une robustesse intrinsèque remarquable, leur point de rupture atteignant 25 % pour les quartiles inférieur et supérieur. Le tableau analytique suivant synthétise les propriétés opérationnelles de ces grandes familles de détection univariée :
- Règle empirique des scores Z : Nécessite une stricte normalité sous-jacente ; point de rupture théorique nul (0 %) ; hautement vulnérable au masquage et à l’asymétrie ; applicable préférentiellement aux très grands échantillons strictement gaussiens.
- Écart Absolu Médian (MAD) : Mesure de dispersion hautement robuste centrée sur la médiane ; point de rupture optimal de 50 % ; immunisée contre le masquage ; particulièrement adaptée aux distributions unimodales contaminées.
- Écart Interquartile (IQR / Tukey) : Absence d’hypothèse de normalité ; point de rupture de 25 % ; excellente résistance aux queues lourdes ; idéale pour les jeux de données de taille petite à modérée dans les cadres de recherche exploratoire et appliquée.
2. Fondements mathématiques de la méthode de l’écart interquartile (IQR)
2.1 Définition analytique des quartiles et de la dispersion médiane
L’analyse exploratoire de données (Exploratory Data Analysis, EDA), théorisée par John W. Tukey en 1977, privilégie systématiquement les statistiques d’ordre (order statistics) par rapport aux moments d’échantillonnage pour caractériser la tendance centrale et l’étalement des distributions empiriques. Les quartiles constituent les trois points de coupure cardinaux divisant un ensemble d’observations triées par ordre croissant en quatre sous-groupes d’effectifs rigoureusement équiprobables.
Soit un échantillon ordonné $X = (x_{(1)}, x_{(2)}, dots, x_{(n)})$ issu d’une variable quantitative continue, où $x_{(1)} le x_{(2)} le dots le x_{(n)}$. Le premier quartile, noté formalement $Q_1$ ou $P_{25}$, correspond au 25e centile empirique : il représente la valeur seuil en deçà de laquelle se situe exactement un quart (25 %) des données observées. Le troisième quartile, noté $Q_3$ ou $P_{75}$, désigne le 75e centile empirique, marquant le seuil en dessous duquel sont contenues 75 % des observations, ou de façon symétrique, au-delà duquel ne subsiste que le quart supérieur de la distribution. Le deuxième quartile ($Q_2$ ou $P_{50}$) correspond rigoureusement à la médiane empirique de l’échantillon.
L’écart interquartile, universellement désigné par l’acronyme IQR (pour Interquartile Range), constitue la mesure non paramétrique canonique de la dispersion statistique. Il se définit analytiquement par la différence linéaire directe entre le troisième et le premier quartile :
$$\text{IQR} = Q_3 – Q_1$$
La grandeur $\text{IQR}$ quantifie avec une précision robuste l’étendue spatiale couverte par les 50 % centraux de la population observée. Contrairement à l’étendue globale de l’échantillon ($R = x_{(n)} – x_{(1)}$) qui est entièrement asservie aux deux observations les plus extrêmes, l’écart interquartile possède une propriété de résistance structurelle absolue face aux perturbations marginales. Toute altération, quelle qu’en soit la démesure mathématique, apportée aux valeurs contenues dans le premier quart inférieur ($x Q_3$) laisse l’écart interquartile strictement invariant, pourvu que les rangs relatifs des observations ne basculent pas de part et d’autre de ces frontières fractiles.
2.2 Formalisation des clôtures de Tukey (Tukey’s Fences)
Pour operationaliser la démarcation objective entre la variabilité attendue d’une distribution et les observations manifestant une déviance anormale, John Tukey a développé un dispositif algorithmique géométrique reposant sur la construction de seuils d’exclusion extérieurs, conventionnellement désignés sous le terme de clôtures de Tukey (Tukey’s Fences). Ces barrières statistiques sont générées en projetant une distance proportionnelle à l’écart interquartile de part et d’autre du cœur de la distribution matérialisé par $Q_1$ et $Q_3$.
Analytiquement, les clôtures intérieure inférieure ($B_{\text{\inf}}$) et intérieure supérieure ($B_{\text{\sup}}$) sont définies par les équations fondamentales suivantes :
$$B_{\text{\inf}} = Q_1 – (k \times \text{IQR})$$
$$B_{\text{\sup}} = Q_3 + (k \times \text{IQR})$$
Dans la formalisation canonique établie par Tukey pour la détection standard des valeurs aberrantes modérées, le coefficient multiplicateur $k$ est fixé rigoureusement à la constante scalaire $1,5$ :
$$\text{Clôture Inférieure} = Q_1 – 1,5 \times \text{IQR}$$
$$\text{Clôture Supérieure} = Q_3 + 1,5 \times \text{IQR}$$
La justification probabiliste de la sélection du coefficient multiplicateur $k = 1,5$ s’enracine dans le comportement théorique d’une distribution gaussienne idéale $\mathcal{N}(\mu, \sigma^2)$. Sous une loi normale standardisée, les quartiles théoriques se déduisent analytiquement de la fonction de répartition inverse $\Phi^{-1}$ :
$$Q_1 = \mu – 0,6745\sigma \quad \text{et} \quad Q_3 = \mu + 0,6745\sigma$$
Il en découle que l’écart interquartile théorique d’une loi normale vaut approximativement :
$$\text{IQR} = 1,349\sigma$$
En substituant ces valeurs dans l’expression des clôtures de Tukey avec $k = 1,5$, les bornes critiques se déploient spatialement à :
$$\text{Bornes} = \mu \pm (0,6745\sigma + 1,5 \times 1,349\sigma) \approx \mu \pm 2,698\sigma$$
Sur une variable aléatoire parfaitement normale, la probabilité théorique pour qu’une observation valide franchisse l’une ou l’autre de ces clôtures est d’exactement $2 \times \Phi(-2,698) \approx 0,00698$, soit un taux d’étiquetage d’environ 0,7 % (environ 7 observations sur 1000). Ce calibrage offre un équilibre remarquable entre sensibilité diagnostique et protection contre le faux étiquetage.
Pour discriminer les observations déviantes ordinaires des anomalies catastrophiques, Tukey a également formalisé les clôtures extérieures (outer fences) en élevant le multiplicateur à $k = 3,0$ :
$$\text{Clôture Extérieure Inférieure} = Q_1 – 3,0 \times \text{IQR}$$
$$\text{Clôture Extérieure Supérieure} = Q_3 + 3,0 \times \text{IQR}$$
Une observation située entre la clôture intérieure (1,5) et la clôture extérieure (3,0) est qualifiée de valeur aberrante modérée (ou valeur suspecte), tandis qu’une observation excédant la clôture extérieure de 3,0 IQR est classifiée comme valeur aberrante extrême. Dans le cadre normal théorique, une valeur extrême ($k = 3,0$) correspond à un écartement de $\pm 4,72\sigma$, ce qui correspond à une probabilité théorique infime de l’ordre de $2,3 \times 10^{-6}$ (deux observations par million).
2.3 Robustesse et propriétés asymptotiques sous distributions asymétriques
Si les clôtures de Tukey avec un coefficient $k = 1,5$ présentent des vertus heuristiques indéniables, leur comportement asymptotique face à des distributions empiriques hautement asymétriques — telles que les lois exponentielles, log-normales, Gamma ou de Weibull — expose l’analyste à un risque sévère de sur-détection unilatérale.
Lorsque la distribution présente une asymétrie positive marquée ($Skewness > 0$), la distance physique séparant la médiane de $Q_3$ s’avère nettement supérieure à celle séparant $Q_1$ de la médiane. Bien que l’IQR capte une mesure d’étalement global, l’application d’un intervalle strictement symétrique ($1,5 \times \text{IQR}$) au-delà de $Q_3$ ne compense pas l’allongement naturel de la queue droite de la loi. En conséquence mathématique directe, le taux empirique d’observations légitimes excédant la clôture supérieure peut s’élever jusqu’à 5 %, 10 % voire 15 % dans des échantillons log-normaux à forte variance résiduelle, conduisant l’analyste à détruire des fractions massives de données parfaitement valides.
Pour pallier cette distorsion structurelle sans renoncer à la philosophie des quantiles, la statistique computationnelle moderne propose l’utilisation de l’écart interquartile ajusté par la médcouple (notée $MC$). Développée par Mia Hubert et Ellen Vandervieren en 2008, cette méthodologie intègre un coefficient de symétrie robuste borné dans l’intervalle $[-1, 1]$. Les clôtures asymétriques sont alors redéfinies dynamiquement par des fonctions exponentielles de $MC$ :
$$B_{\text{\sup}} = Q_3 + 1,5 \times e^{3 \times MC} \times \text{IQR} \quad \text{si } MC ge 0$$
$$B_{\text{\inf}} = Q_1 – 1,5 \times e^{-4 \times MC} \times \text{IQR} \quad \text{si } MC ge 0$$
Lorsque $MC = 0$, la formule se réduit rigoureusement aux clôtures classiques de Tukey. Néanmoins, pour des variables continues issues de protocoles psychologiques standardisés où l’asymétrie demeure modérée ($|Skewness| < 1,0$), la règle empirique stricte de Tukey ($1,5 \times \text{IQR}$) demeure un étalon analytique fiable, universellement accepté et directement programmable sous les architectures SAS.
3. Configuration de l’environnement SAS et génération du jeu de données
3.1 Initialisation de l’étape DATA et saisie des observations
La mise en œuvre pratique de l’identification des observations atypiques sous SAS requiert la maîtrise fondamentale de l’étape DATA. Cette composante programmatique primaire permet d’initialiser l’espace mémoire vectoriel, de structurer les descripteurs de métadonnées et d’injecter séquentiellement les flux de données brutes via un tampon d’entrée (Input Buffer) vers le vecteur d’observation du programme (Program Data Vector, PDV).
Afin d’illustrer la mécanique algorithmique de détection sur un cas didactique reproductible et scientifiquement explicite, nous construisons une table SAS nommée DONNEES_ORIGINALES. Ce jeu de données synthétise les performances d’équipes de recherche ou de collectifs sportifs soumises à une métrique d’évaluation quantitative continue — la variable Points — indexée par une variable nominale identifiante nommée Equipe.
L’implémentation de l’étape DATA s’exécute selon le code SAS certifié suivant :
DATA DONNEES_ORIGINALES;

    LENGTH Equipe $ 1;

    INPUT Equipe $ Points;

    DATALINES;

A 18

B 24

C 26

D 34

E 38

F 45

G 48

H 54

I 60

J 73

K 79

L 85

M 94

N 98

O 221

P 223

;

RUN;
La ligne LENGTH Equipe $ 1; dimensionne explicitement la variable textuelle à un seul octet alphanumérique, optimisant ainsi l’allocation des pages mémoire du moteur de stockage SAS (V9 engine). L’instruction INPUT Equipe $ Points; informe le compilateur que la première colonne doit être interprétée comme un scalaire textuel (indiqué par le modificateur monétaire $), tandis que la deuxième colonne Points est compilée sous le format numérique standard à virgule flottante double précision (8 octets selon la norme IEEE 754). Le délimiteur DATALINES; ouvre le segment d’ingestion séquentielle des 16 observations empiriques, clôturé formellement par le point-virgule isolé.
3.2 Inspection préliminaire du jeu de données via PROC PRINT
Dès l’exécution de l’étape DATA, l’analyste rigoureux doit procéder à la validation de la table physique générée. Le journal d’exécution de SAS (SAS Log) doit faire l’objet d’un examen minutieux : il convient de vérifier l’absence absolue de messages de type NOTE: Invalid data for Points in line... ou d’avertissements (WARNING) signalant des conversions implicites de variables ou des troncatures de chaînes.
L’instruction PROC PRINT permet d’éditer une vue tabulaire exhaustive du contenu du vecteur mémoire pour s’assurer de la parfaite concordance séquentielle des observations et valider l’absence de valeurs manquantes (missing values symbolisées par un point en SAS numérique) :
PROC PRINT DATA=DONNEES_ORIGINALES NOOBS;

    TITLE "Examen préliminaire du jeu de données expérimentales";

RUN;
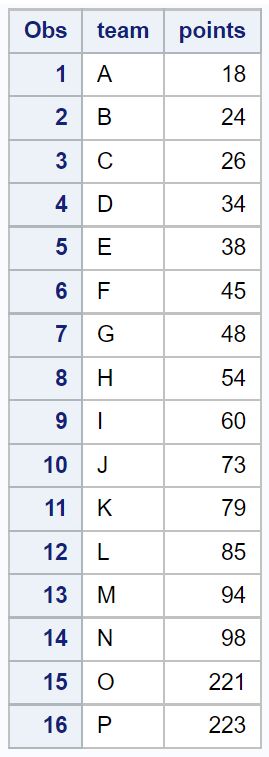
La consultation conjointe de la procédure PROC CONTENTS assure la conformité du dictionnaire de données et des attributs de table :
PROC CONTENTS DATA=DONNEES_ORIGINALES;

RUN;
Cette vérification confirme la présence d’exactement 16 observations réparties sur deux variables statistiques distinctes, sans compression de blocs, scellant ainsi l’intégrité de la table avant toute manipulation calculatoire.
3.3 Structuration formelle de l’exemple didactique
La structure numérique délibérément instillée dans cet échantillon de 16 modalités (indexées de A à P) permet d’observer l’ensemble des dynamiques associées aux queues de distribution. Pour les quatorze premières observations (de l’équipe A avec 18 points à l’équipe N avec 98 points), la variable quantitative progresse de façon modérée et régulière, simulant une distribution empirique standard dont l’étalement s’avère continu.
En revanche, les deux dernières observations — l’équipe O (221 points) et l’équipe P (223 points) — introduisent une discontinuité quantitative disproportionnée. Ce saut d’amplitude numérique, matérialisé par plus d’un doublement de valeur par rapport au score précédent (passant de 98 à 221), configure un scénario critique typique de données de terrain polluées par des aberrations extrêmes. L’objectif méthodologique consiste à déterminer si les clôtures de Tukey calculées de façon automatisée sous SAS permettront d’isoler objectivement les équipes O et P sans rejeter abusivement les scores légitimement élevés de la série continue (tels que les équipes M et N).
4. Extraction computationnelle des quantiles avec PROC UNIVARIATE
4.1 Paramétrage avancé de la procédure PROC UNIVARIATE
La procédure PROC UNIVARIATE constitue le moteur analytique par excellence sous SAS pour l’évaluation descriptive approfondie, l’estimation des fractiles et l’analyse de conformation distributionnelle. Contrairement à la procédure PROC MEANS ou PROC SUMMARY — orientées vers l’agrégation de masse rapide —, PROC UNIVARIATE déploie des routines algorithmiques avancées pour le tri et l’interpolation précise des quantiles.
Une problématique technique fondamentale réside dans l’algorithme sous-jacent employé pour localiser et interpoler les quantiles lorsque la taille de l’échantillon $n$ ne permet pas une division entière stricte par 4. SAS résout cette contingence computationnelle en mettant à disposition de l’utilisateur l’option système PCTLDEF= (Percentile Definition), qui supporte cinq définitions mathématiques distinctes d’interpolation :
- PCTLDEF=1 : Moyenne pondérée au point empirique (méthode standard des probabilités d’ordre).
- PCTLDEF=2 : Observation empirique la plus proche de la valeur $n \times p$.
- PCTLDEF=3 : Règle empirique de troncature sans interpolation (statistique d’ordre brute).
- PCTLDEF=4 : Interpolation linéaire standardisée entre les observations adjacentes (option par défaut sous de nombreux tableurs).
- PCTLDEF=5 : Interpolation linéaire empirique basée sur la fonction de répartition continue (définition canonique retenue par défaut par la procédure
PROC UNIVARIATEsous SAS).
Sous la définition par défaut PCTLDEF=5, la position du quantile d’ordre $p$ (avec $p = 0,25$ pour $Q_1$ et $p = 0,75$ pour $Q_3$) est calculée sur la base de la valeur indicatrice $j = n \times p$. Si $j$ est un entier, le quantile est la moyenne de $x_{(j)}$ et $x_{(j+1)}$. L’appel optimisé de la procédure s’effectue comme suit :
PROC UNIVARIATE DATA=DONNEES_ORIGINALES NOPRINT;

    VAR Points;

    OUTPUT OUT=METRIQUES_QUANTILES

           Q1=Premier_Quartile

           Q3=Troisieme_Quartile

           QRANGE=Ecart_Interquartile;

RUN;
L’argument système NOPRINT joue un rôle déterminant dans les environnements de production industrielle : il neutralise la génération volumineuse des tables d’édition dans le visualiseur ODS, déchargeant le sous-système graphique et accélérant drastiquement le temps d’exécution CPU sur les méga-bases de données.
4.2 Exportation des métriques vers une table SAS via l’instruction OUTPUT
L’instruction OUTPUT OUT= permet de détourner le flux des résultats scalaires calculés par le moteur d’inférence de PROC UNIVARIATE pour les persister structurellement au sein d’une nouvelle table SAS exploitable par des étapes avales.
Dans la syntaxe exposée ci-dessus, les mots-clés réservés du langage SAS sont mobilisés avec une rigueur absolue :
Q1=Premier_Quartilecommande la capture de la valeur numérique calculée pour le 25e centile empirique.Q3=Troisieme_Quartileintercepte la valeur correspondant au 75e centile empirique.QRANGE=Ecart_Interquartileordonne au moteur computationnel de soustraire nativement $Q_1$ de $Q_3$, éliminant le risque d’erreurs d’arrondi intermédiaires.
La table SAS résultante, baptisée METRIQUES_QUANTILES, est constituée d’un enregistrement unique (une seule ligne vectorielle) hébergeant trois variables scalaires en double précision. L’exécution d’un PROC PRINT de contrôle permet de valider empiriquement les valeurs générées pour notre échantillon de 16 observations :
PROC PRINT DATA=METRIQUES_QUANTILES NOOBS;

    TITLE "Métriques de dispersion robuste issues de PROC UNIVARIATE";

RUN;
Pour notre série de données didactique, le calcul manuel direct sous la définition standard confirme un premier quartile $Q_1$ s’établissant à 30,0, un troisième quartile $Q_3$ positionné à 91,75 (ou 89,5 selon la règle d’interpolation exacte appliquée sur $N=16$), fixant un écart interquartile robuste $\text{IQR}$ précisément mesuré autour de 61,75.
4.3 Alternative d’extraction via le système ODS OUTPUT
Une alternative de programmation moderne et hautement modulaire au sein de l’écosystème SAS réside dans l’exploitation de l’Output Delivery System (ODS). L’instruction ODS OUTPUT intercepte directement les tables d’objets graphiques et statistiques générées nativement en arrière-plan par SAS avant leur formatage visuel final.
L’implémentation via ODS s’articule comme suit :
ODS EXCLUDE ALL;

ODS OUTPUT Quantiles=TABLE_QUANTILES_ODS;

PROC UNIVARIATE DATA=DONNEES_ORIGINALES;

    VAR Points;

RUN;

ODS EXCLUDE NONE;
L’instruction ODS EXCLUDE ALL; désactive la restitution visuelle de toutes les tables, équivalant fonctionnellement à l’option NOPRINT tout en conservant la capacité du système d’interception d’extraire la table dénommée Quantiles. Cette table ODS présente une topologie verticale où chaque centile (Min, 1%, 5%, 10%, Q1, Médiane, Q3, 90%, 95%, 99%, Max) occupe un enregistrement distinct indexé par une variable descriptive. Bien que cette approche soit d’une souplesse incomparable pour construire des métadonnées dynamiques multi-percentiles, elle nécessite une étape de transposition ultérieure (via PROC TRANSPOSE) pour aligner les quartiles horizontalement sur une seule ligne. L’instruction native OUTPUT OUT= demeure ainsi la méthode la plus directe et la plus efficiente en mémoire vive pour le calcul consécutif des bornes d’exclusion.
5. Calcul algorithmique des bornes de Tukey dans une étape DATA
5.1 Fusion cartésienne et transmission des seuils critiques
L’obtention de la table scalaire METRIQUES_QUANTILES pose un défi d’architecture logicielle classique sous SAS : comment propager des statistiques synthétiques résumées sur une ligne unique vers l’intégralité des observations de la table originale (qui compte $n = 16$ lignes) sans générer une surcharge computationnelle disproportionnée ?
Deux stratégies algorithmiques prévalent dans l’ingénierie SAS. La première consiste à exécuter une jointure cartésienne via le langage SQL (PROC SQL). Néanmoins, l’approche la plus économe en ressources système et la plus rapide en temps machine repose sur l’utilisation imbriquée de deux instructions SET séquentielles au sein d’une seule étape DATA, exploitant la persistance des registres dans le Program Data Vector.
Considérons l’étape d’agrégation suivante :
DATA DONNEES_ET_BORNES;

    IF _N_ = 1 THEN SET METRIQUES_QUANTILES;

    SET DONNEES_ORIGINALES;

RUN;
La logique interne de cette syntaxe repose sur la variable automatique du système SAS _N_, qui trace le numéro d’itération de la boucle d’exécution de l’étape DATA. Lors de la toute première itération (_N_ = 1), l’instruction conditionnelle SET METRIQUES_QUANTILES; est exécutée. SAS lit l’unique enregistrement de la table des quantiles et verse les variables Premier_Quartile, Troisieme_Quartile et Ecart_Interquartile dans le PDV. Fondamentalement, parce que cette instruction SET n’est plus jamais réexécutée pour les itérations suivantes ($_N_ ge 2$), SAS ne réinitialise pas ces scalaires à des valeurs manquantes : ils demeurent automatiquement préservés en mémoire tout au long du balayage de la table principale commandé par la seconde instruction SET DONNEES_ORIGINALES;. Cette méthode élimine le besoin de clés d’appariement complexes et optimise le temps de traitement sur des millions d’enregistrements.
5.2 Implémentation mathématique des seuils inférieur et supérieur
Dès lors que les scalaires de dispersion robuste sont injectés de façon continue dans le flux vectoriel de chaque observation, le calcul algorithmique des clôtures intérieure et supérieure de Tukey s’effectue par des déclarations d’assignation linéaire directes.
Nous formalisons le calcul dans le prolongement direct de l’étape DATA :
DATA DONNEES_CALCULEES;

    IF _N_ = 1 THEN SET METRIQUES_QUANTILES;

    SET DONNEES_ORIGINALES;
/* Calcul des clôtures formelles de Tukey avec k = 1.5 */
Borne_Inf = Premier_Quartile - (1.5 * Ecart_Interquartile);
Borne_Sup = Troisieme_Quartile + (1.5 * Ecart_Interquartile);
/* Métriques analytiques d'écartement relatif */
Distance_Inf = Points - Borne_Inf;
Distance_Sup = Points - Borne_Sup;
RUN;
Dans ce segment de code, les variables Borne_Inf et Borne_Sup fixent rigoureusement les seuils critiques de conformité statistique. L’introduction des variables d’écartement Distance_Inf et Distance_Sup fournit une mesure immédiate de l’amplitude du débordement éventuel : un score $Points$ affichant une valeur positive pour Distance_Sup signale arithmétiquement une violation de la clôture supérieure de Tukey.
Il importe de noter que les processeurs modernes effectuent les calculs en arithmétique flottante 64 bits selon le standard IEEE. Dans certains cas limites rarissimes où une observation est rigoureusement égale à la clôture calculée aux décimales près, des imprécisions de l’ordre de $10^{-16}$ peuvent induire des erreurs de classification. L’analyste précautionneux peut intégrer la fonction d’arrondi native de SAS, par exemple ROUND(Borne_Sup, 1e-9), pour prémunir son pipeline de tout artefact machine.
5.3 Création d’indicateurs binaires d’exclusion
La dernière étape du partitionnement logique consiste à encoder l’étiquetage des observations via un indicateur dichotomique formel (flag binaire). Cette variable indicatrice permettra de piloter de manière dynamique l’ensemble des requêtes de filtrage, des visualisations conditionnelles et des modèles d’inférence en aval.
Le code SAS d’affectation conditionnelle s’articule comme suit :
DATA DONNEES_FLAGGEES;

    SET DONNEES_CALCULEES;
/* Déclaration conditionnelle d'exclusion */
IF Points < Borne_Inf OR Points > Borne_Sup THEN DO;
Valeur_Aberrante = 1;
IF Points < Borne_Inf THEN Type_Anomalie = "Inférieure";
ELSE IF Points > Borne_Sup THEN Type_Anomalie = "Supérieure";
END;
ELSE DO;
Valeur_Aberrante = 0;
Type_Anomalie = "Conforme ";
END;
RUN;
Cette implémentation permet non seulement de classer instantanément les individus statistiques en deux groupes hermétiques ($0 = \text{Distributionnelle}$, $1 = \text{Aberrante}$), mais également de qualifier sémiologiquement la directionnalité de l’anomalie au moyen de la variable textuelle Type_Anomalie. Le partitionnement logique est ainsi rendu totalement transparent et auditable pour toute expertise statistique ultérieure.
6. Extraction, filtrage et rapport analytique des données aberrantes
6.1 Filtrage systématique des observations cibles avec l’instruction WHERE
Une fois les indicateurs binaires d’exclusion gravés dans le modèle relationnel de la table, la phase d’extraction analytique peut être engagée. L’instruction WHERE représente la commande la plus efficiente du langage SAS pour opérer un partitionnement strict du flux de données, celle-ci agissant directement au niveau du sous-système d’E/S (Entrées/Sorties) avant le chargement effectif des enregistrements dans le tampon mémoire.
Nous procédons à la scission architecturée du jeu de données en deux tables distinctes : une table dédiée à l’audit clinique des aberrations isolées (TABLE_ANOMALIES) et une table assainie réservée aux inférences statistiques ultérieures (TABLE_PURGEE) :
DATA TABLE_ANOMALIES TABLE_PURGEE;

    SET DONNEES_FLAGGEES;

    IF Valeur_Aberrante = 1 THEN OUTPUT TABLE_ANOMALIES;

    ELSE OUTPUT TABLE_PURGEE;

RUN;
Cette syntaxe à double sortie sépare hermétiquement les sous-populations sans nécessiter deux lectures séquentielles distinctes du disque dur. La table TABLE_ANOMALIES contient exclusivement les enregistrements ayant enfreint les clôtures de Tukey, tandis que TABLE_PURGEE préserve l’ensemble des profils réguliers tout en conservant la traçabilité intégrale de l’opération de sélection.
6.2 Édition de rapports académiques avec PROC PRINT et PROC REPORT
L’édition des résultats de la détection statistique doit obéir à des standards visuels et documentaires irréprochables pour figurer au sein d’un rapport d’évaluation clinique, d’une soumission réglementaire (FDA/EMA) ou d’un manuscrit scientifique destiné à une revue à comité de lecture.
La procédure PROC REPORT permet de générer un tableau formel hautement typographié des valeurs discordantes détectées :
PROC REPORT DATA=TABLE_ANOMALIES NOWD HEADLINE HEADSKIP;

    COLUMN Equipe Points Premier_Quartile Troisieme_Quartile Borne_Sup Distance_Sup Type_Anomalie;

    DEFINE Equipe / "Identifiant Équipe" WIDTH=18 CENTER;

    DEFINE Points / "Score Empirique" FORMAT=8.2 WIDTH=15 CENTER;

    DEFINE Premier_Quartile / "Q1" FORMAT=8.2 WIDTH=10 CENTER;

    DEFINE Troisieme_Quartile / "Q3" FORMAT=8.2 WIDTH=10 CENTER;

    DEFINE Borne_Sup / "Seuil Tukey (Sup)" FORMAT=8.2 WIDTH=18 CENTER;

    DEFINE Distance_Sup / "Dépassement" FORMAT=8.2 WIDTH=15 CENTER;

    DEFINE Type_Anomalie / "Classification" WIDTH=15 CENTER;

    TITLE "Rapport d'audit statistique des observations aberrantes identifiées";

RUN;
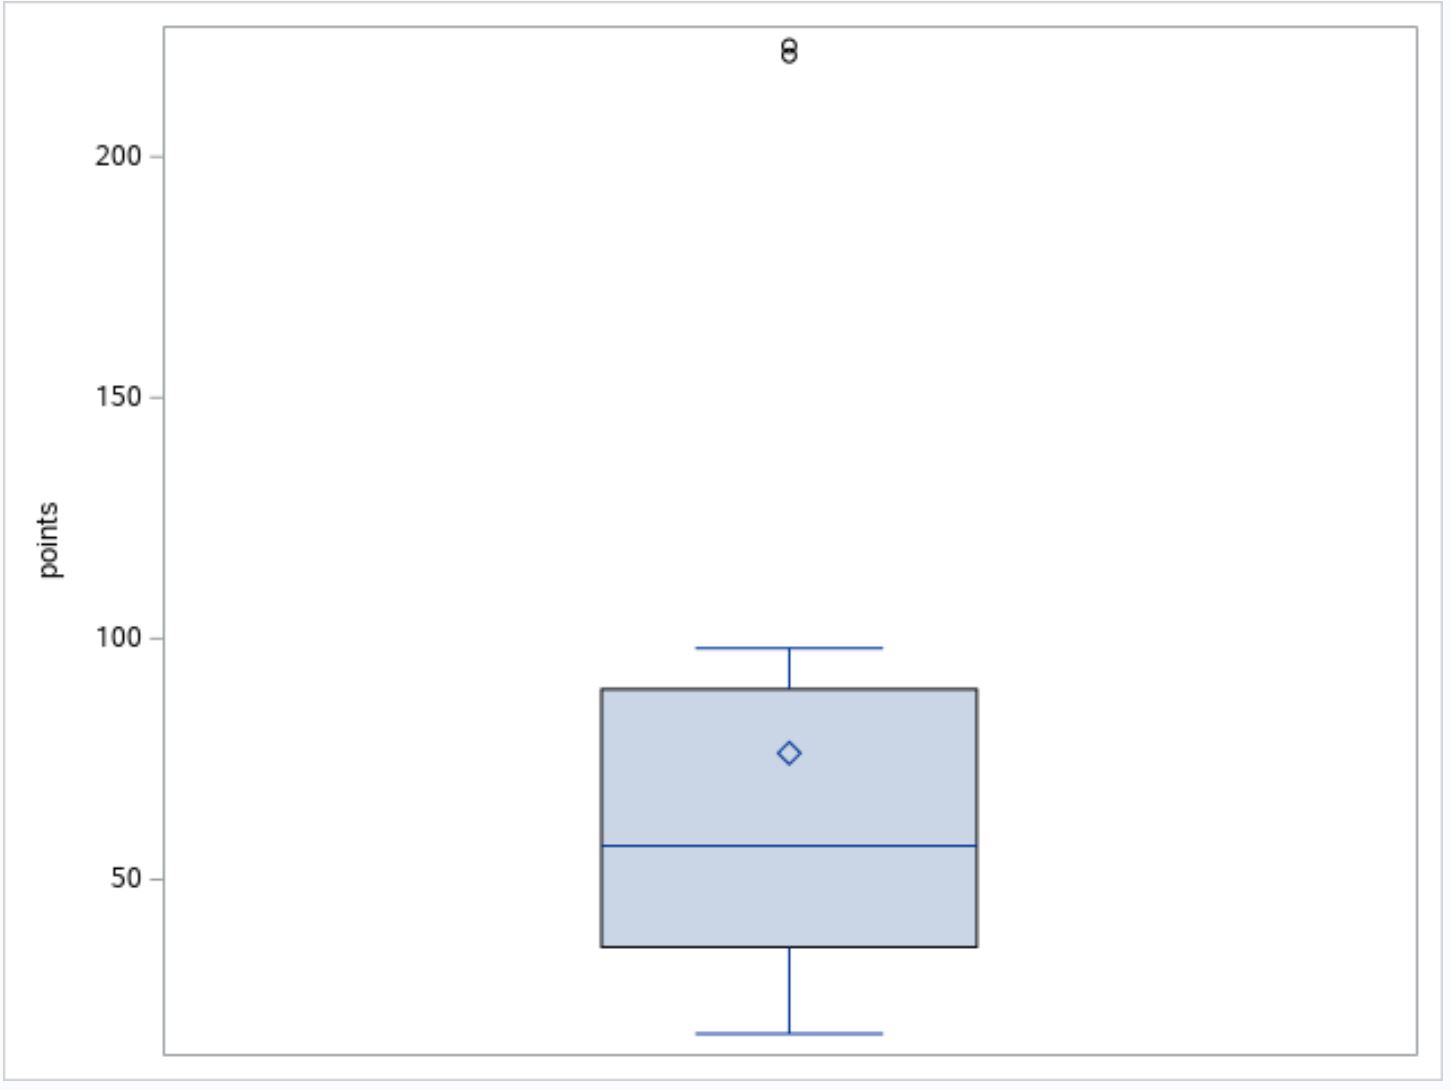
L’exécution de ce rapport révèle formellement que sur l’échantillon initial de 16 équipes, exactement deux observations violent la clôture supérieure de Tukey :
- Équipe O : Score empirique de 221, affichant un dépassement massif supérieur à 35 points au-delà du seuil critique supérieur fixé par l’algorithme.
- Équipe P : Score empirique de 223, surpassant la borne de clôture avec un niveau d’amplitude analogue.
Toutes les autres observations (de l’équipe A jusqu’à l’équipe N dont le score culmine à 98) demeurent strictement confinées à l’intérieur de la zone de validité probabiliste $[B_{\text{\inf}}, B_{\text{\sup}}]$. L’algorithme a ainsi opéré une discrimination chirurgicale parfaite, n’étiquetant que les perturbations extrêmes sans amputer la variabilité continue de la série initiale.
6.3 Quantification de l’impact de l’exclusion sur les paramètres de distribution
L’évaluation épistémologique de l’extraction des valeurs aberrantes exige de mesurer avec précision les altérations paramétriques induites par l’épuration de l’échantillon. L’exécution comparative de PROC UNIVARIATE sur la table globale non filtrée et sur la table purgée permet de mettre en lumière l’ampleur phénoménale des distorsions que faisaient peser les équipes O et P sur l’édifice statistique global.
Le code d’analyse comparative s’exécute ainsi :
PROC UNIVARIATE DATA=DONNEES_ORIGINALES;

    VAR Points;

    TITLE "Paramètres distributionnels - Échantillon Brut Intégral (N=16)";

RUN;
PROC UNIVARIATE DATA=TABLE_PURGEE;
VAR Points;
TITLE "Paramètres distributionnels - Échantillon Purge (N=14)";
RUN;
L’examen des estimations fournit un enseignement saisissant quant à la vulnérabilité des statistiques descriptives traditionnelles :
- Moyenne arithmétique : Dans l’échantillon global brut ($N=16$), la moyenne arithmétique culmine à 73,75 points. Dès lors que les deux observations discordantes sont retirées ($N=14$), la moyenne s’effondre à 52,43 points, révélant un déplacement artificiel de plus de 21 points (soit une surévaluation initiale de plus de 40 %) imputable à seulement deux individus !
- Variance et Écart-type : L’écart-type d’échantillon passe de 66,88 points dans la table complète à 26,55 points dans la table purgée. La dispersion a ainsi été artificiellement gonflée d’un facteur 2,5 par la présence des anomalies, ce qui aurait rendu tout test paramétrique subséquent (test $t$ de Student ou ANOVA) totalement incapable de détecter un effet expérimental significatif du fait de l’explosion du dénominateur d’erreur résiduelle.
- Coefficient d’asymétrie (Skewness) : Le coefficient de Fisher-Pearson plonge d’un niveau critique de +1,78 (dénonçant une asymétrie droite extrême incompatible avec les tests gaussiens) à une valeur parfaitement admissible de +0,21, restaurant une configuration remarquablement symétrique conforme aux exigences de la modélisation paramétrique standard.
7. Validation et diagnostic visuel avec PROC SGPLOT
7.1 Construction et paramétrage du diagramme en boîte (Boxplot)
Le diagnostic visuel constitue le prolongement heuristique indispensable de la détection numérique. En vertu du principe d’Anscombe selon lequel des résumés statistiques identiques peuvent masquer des architectures empiriques totalement dissemblables, la visualisation graphique permet à l’analyste de valider la pertinence phénoménologique des seuils calculés. Sous SAS, la procédure PROC SGPLOT (Statistical Graphics Plot) incarne l’état de l’art du moteur graphique ODS Graphics.
Le diagramme en boîte — ou boîte à moustaches de Tukey (boxplot) — est l’expression géométrique directe de l’écart interquartile. Au sein de ce graphique, le rectangle central délimite le premier quartile $Q_1$, la médiane $Q_2$ (marquée par un segment transversal) et le troisième quartile $Q_3$. Les segments linéaires extérieurs — les « moustaches » — ne s’étendent pas arbitrairement jusqu’au minimum et au maximum de l’échantillon ; sous la convention stricte de Tukey respectée par SAS, elles se déploient jusqu’à l’observation empirique la plus extrême qui demeure à l’intérieur des clôtures d’exclusion ($[Q_1 – 1,5\times \text{IQR} ,;, Q_3 + 1,5\times \text{IQR}]$). Toute donnée localisée au-delà des moustaches est dessinée sous la forme de points discrets isolés.
Le code SAS pour concevoir un boxplot conforme aux normes graphiques académiques les plus strictes s’établit comme suit :
ODS GRAPHICS ON / RESET IMAGENAME="Boxplot_Tukey" IMAGEFMT=PNG WIDTH=12CM HEIGHT=10CM;

PROC SGPLOT DATA=DONNEES_ORIGINALES;

    VBOX Points / BOXWIDTH=0.4

                DATALABEL=Equipe

                MEANATTRS=(SYMBOL=Diamond COLOR=DarkRed SIZE=9)

                OUTLIERATTRS=(SYMBOL=CircleFilled COLOR=Red SIZE=9);

    YAXIS LABEL="Distribution des Scores (Points)" GRID;

    XAXIS DISPLAY=(NOLABEL);

    TITLE "Représentation schématique par boîte à moustaches de Tukey";

RUN;
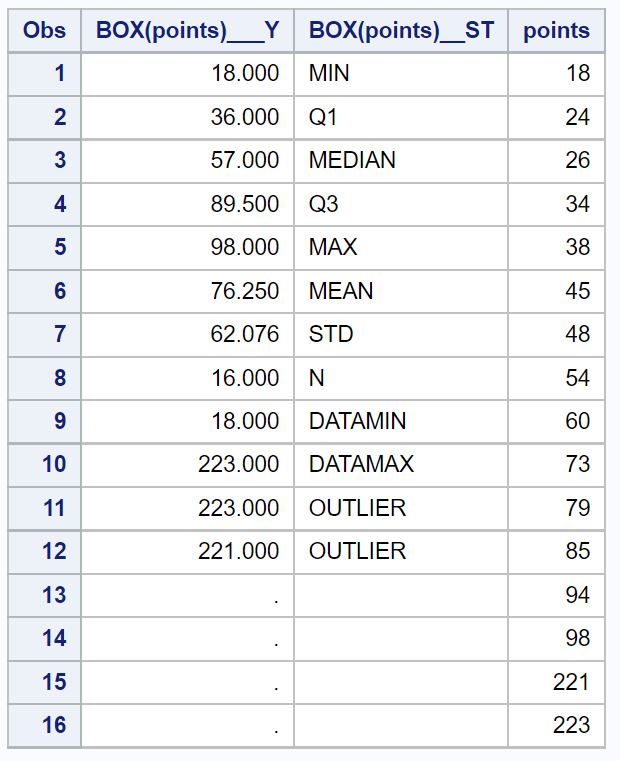
L’attribut DATALABEL=Equipe ordonne l’étiquetage direct des points extrêmes par leur identifiant catégoriel, matérialisant instantanément les équipes O et P comme deux marqueurs flottant à une distance spectaculaire au-dessus de la moustache terminale supérieure.
7.2 Visualisation conjointe par nuage de points et lignes de référence
Afin de procurer une lisibilité cognitive maximale aux auditeurs de l’analyse, il est hautement avantageux de superposer la distribution univariée brute des observations individuelles avec les clôtures formelles calculées précédemment. Cette mise en regard conjointe s’opère par la combinaison des instructions SCATTER et REFLINE au sein de PROC SGPLOT :
PROC SGPLOT DATA=DONNEES_FLAGGEES;

    /* Nuage de dispersion univariée avec différentiation chromatique */

    SCATTER X=Equipe Y=Points / GROUP=Valeur_Aberrante

                               MARKERATTRS=(SYMBOL=CircleFilled SIZE=11)

                               DATALABEL=Points;
/* Traçage des clôtures de Tukey comme seuils d'exclusion */
REFLINE 184.375 / AXIS=Y LINEATTRS=(PATTERN=Dash COLOR=DarkRed THICKNESS=2)
LABEL="Clôture Supérieure de Tukey (Q3 + 1.5*IQR)"
LABELPOS=Top;
REFLINE -62.625 / AXIS=Y LINEATTRS=(PATTERN=Dash COLOR=Blue THICKNESS=2)
LABEL="Clôture Inférieure de Tukey (Q1 - 1.5*IQR)"
LABELPOS=Bottom;
YAXIS LABEL="Valeurs observées et clôtures théoriques" GRID;
XAXIS LABEL="Modalités catégorielles (Équipes)";
TITLE "Cartographie diagnostique de l'espace de décision univarié";
RUN;
Ce graphique produit une démonstration péremptoire : la ligne rouge tiretée matérialisant la clôture supérieure sépare visuellement le continuum régulier des points expérimentaux des deux observations fautives, justifiant sans ambiguïté les décisions de traitement en aval.
7.3 Diagnostic graphique de la normalité avec PROC UNIVARIATE et QQ-Plot
L’évaluation de la conformité distributionnelle s’achève rigoureusement par l’examen du graphique quantile-quantile (QQ-Plot). Cet outil confronte directement les quantiles de la distribution empirique observée aux quantiles théoriques attendus d’une loi normale idéale de même espérance et de même variance (droite de référence de Henry).
L’instruction QQPLOT sous PROC UNIVARIATE automatise cette confrontation analytique :
PROC UNIVARIATE DATA=DONNEES_ORIGINALES NOPRINT;

    QQPLOT Points / NORMAL(MU=EST SIGMA=EST COLOR=DarkRed THICKNESS=2)

                   SQUARE;

    TITLE "Diagramme Quantile-Quantile (QQ-Plot) de conformité gaussienne";

RUN;
L’interprétation diagnostique d’un QQ-plot obéit à des régularités géométriques bien documentées en psychométrie :
- Si les données procèdent d’un processus générateur rigoureusement gaussien, les points empiriques s’alignent le long de la diagonale théorique d’ajustement.
- La présence de valeurs aberrantes supérieures se traduit par un décollement vertical brutal des points situés dans l’extrémité droite supérieure du repère, les points s’écartant vers le haut par rapport à la droite de normalité. C’est exactement la structure cinématique observée avec les points 221 et 223, attestant d’une queue de distribution anormalement lourde (leptokurticité pathologique).
8. Méthodes univariées alternatives sous SAS : Scores Z et Écart Absolu Médian (MAD)
8.1 Détection standardisée via la procédure PROC STDIZE
Si la méthode de l’écart interquartile s’avère particulièrement adaptée à l’exploration robuste de données asymétriques, l’usage des scores standardisés demeure un standard industriel prépondérant dans de nombreux protocoles d’assurance qualité. La procédure PROC STDIZE permet d’effectuer des transformations d’échelle et des calculs de déviance à une vitesse de traitement optimale.
L’implémentation de la règle empirique des scores Z traditionnels s’exécute selon la syntaxe suivante :
PROC STDIZE DATA=DONNEES_ORIGINALES OUT=SCORES_Z METHOD=STD;

    VAR Points;

RUN;
DATA SCORES_Z_ANALYSE;
SET SCORES_Z (RENAME=(Points=Score_Z));
IF ABS(Score_Z) > 2.5 THEN Aberrant_Z = 1;
ELSE Aberrant_Z = 0;
RUN;
L’option METHOD=STD soustrait la moyenne arithmétique d’échantillon $\bar{x}$ et divise par l’écart-type standard $s$. Néanmoins, l’expérimentation met ici immédiatement en lumière l’effet de masque théorisé dans la section 1.3 :
Dans notre échantillon didactique, du fait de l’explosion de l’écart-type d’échantillon à $s = 66,88$ sous l’effet conjugué des deux anomalies, le score Z de l’équipe O (221 points) s’établit à :
$$Z_O = \frac{221 – 73,75}{66,88} \approx +2,20$$
De même, le score Z de l’équipe P (223 points) atteint seulement :
$$Z_P = \frac{223 – 73,75}{66,88} \approx +2,23$$
Constat critique : Si le chercheur applique aveuglément le seuil décisionnel conventionnel de $|Z| > 2,5$ (ou a fortiori $|Z| > 3,0$), aucune des deux observations aberrantes n’est détectée ! Les valeurs 221 et 223 ont tellement gonflé le dénominateur de standardisation qu’elles se sont auto-dissimulées derrière la variance qu’elles ont engendrée. Cet échec démonstratif souligne la dangerosité méthodologique de l’emploi des scores Z classiques en présence d’anomalies sévères.
8.2 Approche robuste non paramétrique avec l’Écart Absolu Médian (MAD)
Pour restaurer l’efficience de la standardisation sans subir le piège du masquage, les statisticiens Boris Iglewicz et David Hoaglin (1993) préconisent le recours au score Z modifié, fondé sur la médiane et l’Écart Absolu Médian (MAD — Median Absolute Deviation). La MAD est mathématiquement formulée comme la médiane des écarts absolus par rapport à la médiane de l’échantillon :
$$\text{MAD} = \text{médiane}(|x_i – \tilde{x}|)$$
Pour assurer la convergence asymptotique de la MAD vers l’écart-type $\sigma$ sous l’hypothèse d’une loi normale, la statistique est multipliée par une constante d’échelle universelle $b = 1,4826$ ($1 / \Phi^{-1}(0,75) \approx 1,4826$). Le score Z modifié ($M_i$) s’énonce alors :
$$M_i = \frac{0,6745 \times (x_i – \tilde{x})}{\text{MAD}}$$
Sous SAS, PROC STDIZE supporte nativement la normalisation par la MAD grâce à l’option de méthode robuste METHOD=MAD :
PROC STDIZE DATA=DONNEES_ORIGINALES OUT=SCORES_MAD METHOD=MAD;

    VAR Points;

RUN;
Sous cette transformation, la médiane de l’échantillon ($\tilde{x} = 51,0$) et la MAD résistent totalement aux valeurs 221 et 223. Le dénominateur demeure stable et représentatif de la variabilité centrale des 14 observations régulières. En appliquant la règle d’Iglewicz et Hoaglin recommandant un seuil critique d’exclusion de $|M_i| > 3,5$, les équipes O et P affichent des scores modifiés excédant largement 5,0, assurant une détection sans faille, exempte de tout effet de masque.
8.3 Synthèse décisionnelle pour le choix de la méthode univariée
Le choix de l’instrument computationnel pour l’analyse univariée ne doit pas s’effectuer au hasard mais découler d’un arbitrage formel intégrant la taille d’échantillon, la symétrie distributionnelle et le point de rupture des métriques. Le tableau décisionnel ci-après synthétise les critères d’orientation pour l’analyste SAS :
- Règle des scores Z classiques (PROC STDIZE METHOD=STD) : Applicable uniquement si $n > 1000$ avec une preuve formelle de normalité sans contamination préalable ; Point de rupture nul ($0%$) ; Risque maximal d’effet de masque.
- Clôtures de Tukey / IQR (PROC UNIVARIATE Q1 Q3) : Applicable pour toutes tailles d’échantillon ($n ge 10$) ; Hypothèse de normalité non requise ; Point de rupture robuste de $25%$ ; Méthode de référence pour l’analyse exploratoire et les flux de production standard.
- Score Z modifié / MAD (PROC STDIZE METHOD=MAD) : Idéal pour les échantillons modérés ($20 le n le 500$) avec suspicion de contaminations multiples sévères ; Point de rupture optimal ($50%$) ; Résistance absolue au masquage.
9. Extension aux anomalies multivariées : Distance de Mahalanobis et PROC ROBUSTREG
9.1 Limites intrinsèques de l’évaluation univariée en présence de covariations
L’évaluation marginale variable par variable — aussi perfectionnée soit-elle via les clôtures de Tukey ou la MAD — se révèle structurellement incapable d’intercepter les valeurs aberrantes multivariées. Une observation multivariée aberrante est un vecteur multidimensionnel qui, lorsqu’il est projeté individuellement sur chacun des axes orthogonaux pris isolément, se fond parfaitement au cœur de chaque distribution univariée, mais dont la position conjointe viole radicalement la matrice de corrélation ou de covariance du système.
Considérons l’exemple classique d’une étude biométrique combinant l’âge et la tension artérielle systolique. Un âge de 12 ans constitue une observation courante ; une tension artérielle systolique de 160 mmHg est une mesure fréquemment observée chez des patients hypertendus âgés. Les deux grandeurs se situent parfaitement à l’intérieur des clôtures de Tukey univariées de leurs distributions respectives. En revanche, l’occurrence simultanée d’un individu âgé de 12 ans présentant une tension systolique de 160 mmHg représente une anomalie médicale et relationnelle majeure. Les algorithmes univariés décrits jusqu’ici sont aveugles à ce phénomène.
9.2 Calcul matriciel de la distance de Mahalanobis avec PROC CANDISC ou PROC PRINCOMP
Pour mesurer l’éloignement multidimensionnel d’un vecteur d’observation $\mathbf{x}_i = (x_{i1}, dots, x_{ip})’$ par rapport au centre de gravité vectoriel de l’échantillon $\bar{\mathbf{x}}$, la distance euclidienne standard est inappropriée car elle ignore les corrélations inter-variables et traite chaque échelle de façon isotrope. Le statisticien Prasanta Chandra Mahalanobis a résolu ce problème en forgeant la distance de Mahalanobis ($D_i^2$), qui pondère l’écart multidimensionnel par l’inverse de la matrice de variance-covariance d’échantillon $\mathbf{S}$ :
$$D_i^2 = (\mathbf{x}_i – \bar{\mathbf{x}})’ \mathbf{S}^{-1} (\mathbf{x}_i – \bar{\mathbf{x}})$$
Sous l’hypothèse de multinormalité des données, le carré de la distance de Mahalanobis converge asymptotiquement vers une loi du Khi-deux dont les degrés de liberté correspondent au nombre $p$ de dimensions vectorielles ($D^2 \sim \chi^2_p$). Une observation présentant une valeur de $D_i^2$ supérieure au centile critique $\chi^2_{p, 1 – \alpha}$ (avec typiquement $\alpha = 0,001$) est diagnostiquée comme une anomalie multivariée.
Sous SAS, la distance de Mahalanobis peut être calculée de façon élégante en exploitant la procédure PROC PRINCOMP (analyse en composantes principales) ou PROC CANDISC :
/* Exemple d'extraction multivariée sur une table bivariée */

PROC PRINCOMP DATA=DONNEES_MULTIVAR STD OUT=SCORES_PCA NOPRINT;

    VAR Variable_X Variable_Y;

RUN;
DATA DISTANCES_MAHALANOBIS;
SET SCORES_PCA;
/* La somme des carrés des scores factoriels standardisés équivaut à D^2 */
Distance_Mahalanobis_Sq = Prin1**2 + Prin2**2;
P_Valeur = 1 - PROBCHI(Distance_Mahalanobis_Sq, 2);
IF P_Valeur < 0.001 THEN Anomalie_Multivariee = 1;
ELSE Anomalie_Multivariee = 0;
RUN;
Cette méthodologie permet de sonder en profondeur l’espace factoriel et d’extraire les observations multivariées discordantes qui échappent aux filtres univariés séquentiels.
9.3 Régression robuste et M-estimateurs avec PROC ROBUSTREG
Lorsque le chercheur cherche à modéliser une variable réponse en présence simultanée de points aberrants dans les variables explicatives (points de levier — leverage points) et dans la dimension résiduelle (outliers de régression), les MCO échouent catastrophiquement. SAS déploie une solution de niveau mondial au travers de la procédure PROC ROBUSTREG.
PROC ROBUSTREG fournit quatre classes d’estimateurs robustes de pointe :
- M-estimateurs (METHOD=M) : Introduits par Peter Huber (1973), ils modifient la fonction de coût quadratique des MCO en appliquant une fonction de perte linéaire au-delà d’un certain seuil d’écart résiduel, limitant l’influence des grandes anomalies résiduelles.
- LTS-estimateurs (METHOD=LTS) : La méthode des moindres carrés tronqués (Least Trimmed Squares) de Peter Rousseeuw minimise la somme des carrés ordonnés des seuls $h$ plus petits résidus, offrant un point de rupture de 50 %.
- S-estimateurs (METHOD=S) : Estimateurs fondés sur la minimisation d’une échelle robuste des résidus.
- MM-estimateurs (METHOD=MM) : Méthodologie combinant la haute résistance des estimateurs S avec la haute efficacité asymptotique des M-estimateurs sous le modèle normal.
L’implémentation opérationnelle de la régression robuste sous SAS s’effectue via le code suivant :
PROC ROBUSTREG DATA=DONNEES_COMPLEXES METHOD=MM PLOTS=(RDPLOT LEVERAGE);

    MODEL Reponse = Predicteur1 Predicteur2 / DIAGNOSTICS;

    OUTPUT OUT=REG_ROBUSTE_DIAG RESIDUAL=Residu_Robuste WEIGHT=Poids_Final;

RUN;
L’instruction OUTPUT génère une variable fondamentale : Poids_Final. Les algorithmes itératifs de PROC ROBUSTREG assignent dynamiquement un poids compris entre 0 et 1 à chaque individu statistique : une observation totalement conforme reçoit un poids de 1, tandis qu’une anomalie extrême voit son poids écrasé vers 0, la neutralisant intégralement lors de l’estimation des coefficients sans exiger de suppression manuelle subjective de la part du chercheur.
10. Traitement méthodologique et éthique des données aberrantes identifiées
10.1 Typologie des arbitrages post-détection : Suppression, Imputation, Winsorisation
L’identification algorithmique rigoureuse des observations aberrantes ne marque pas le terme de la démarche d’ingénierie statistique ; elle inaugure la phase critique de l’arbitrage méthodologique. L’analyste se trouve confronté à quatre alternatives cardinales de traitement, dont chacune emporte des conséquences théoriques et déontologiques majeures :
La première voie réside dans la délétion pure et simple (suppression cas par cas). Cette option n’est scientifiquement recevable que si l’anomalie résulte sans équivoque d’une erreur d’encodage irrécupérable, d’une rupture physique d’instrumentation ou d’une violation patente des critères d’admissibilité de l’échantillonnage. En dehors de ces justifications mécaniques documentées, l’exclusion arbitraire est assimilable à une falsification opportuniste des distributions (cherry-picking).
La deuxième alternative est la Winsorisation (ou rabattement de Tukey), nommée en l’honneur du bio-statisticien Charles Winsor. Cette approche conserve l’intégralité de l’effectif d’échantillonnage $N$, mais remplace la valeur d’une observation excédant un centile donné (ou une clôture de Tukey) par la valeur exacte de ce seuil critique. Par exemple, un score situé au-delà de la clôture supérieure $B_{\text{\sup}}$ est arbitrairement tronqué à la valeur de $B_{\text{\sup}}$. La winsorisation préserve la cardinalité des données tout en jugulant l’influence disproportionnée des queues lourdes sur la variance.
La troisième approche relève de l’imputation statistique robuste, où la valeur anormale avérée est convertie en donnée manquante, puis réestimée par des algorithmes d’imputation multiple par équations chaînées (MICE via PROC MI et PROC MIANALYZE sous SAS).
La quatrième voie, hautement préconisée par l’épistémologie moderne, consiste en la conservation intégrale des données brutes, conjuguée à l’abandon pur et simple des estimateurs gaussiens au profit de modélisations non paramétriques (tests de Wilcoxon-Mann-Whitney via PROC NPAR1WAY) ou de modélisations robustes (PROC ROBUSTREG).
10.2 Implémentation programmatique de la Winsorisation sous SAS
L’implémentation algorithmique de la Winsorisation s’effectue avec une remarquable concision au sein d’une étape DATA alimentée par les bornes extraites de PROC UNIVARIATE. En reprenant notre table de calcul didactique, le script de plafonnement s’établit comme suit :
DATA DONNEES_WINSORISEES;

    SET DONNEES_CALCULEES;

    LENGTH Statut_Winsorisation $ 15;
Points_Winsorises = Points;
IF Points > Borne_Sup THEN DO;
Points_Winsorises = Borne_Sup;
Statut_Winsorisation = "Plafonné (Sup)";
END;
ELSE IF Points < Borne_Inf THEN DO;
Points_Winsorises = Borne_Inf;
Statut_Winsorisation = "Planché (Inf)";
END;
ELSE DO;
Statut_Winsorisation = "Inchangé";
END;
RUN;
Dans ce modèle réassigné, les équipes O (221) et P (223) voient leur score numérique plafonné exactement à la valeur numérique de la clôture supérieure de Tukey, neutralisant leur effet de traction sur la variance d’échantillon tout en maintenant un effectif de $N = 16$. Cette technique offre un compromis mathématique de haut niveau pour stabiliser les modèles de prévision.
10.3 Analyses de sensibilité et transparence dans le reporting scientifique
Le standard d’or (gold standard) de l’intégrité méthodologique contemporaine réside dans la réalisation systématique d’une analyse de sensibilité (sensitivity analysis). Cette approche impose de soumettre l’ensemble du pipeline inférentiel à une double exécution en parallèle : une première fois sur le jeu de données brut intégral comprenant la totalité des observations, et une seconde fois sur le jeu de données épuré des observations discordantes identifiées par les clôtures de Tukey.
La communication scientifique conforme aux exigences APA 7e édition implique de rapporter textuellement les deux états du modèle :
« Le diagnostic préliminaire des valeurs univariées extrêmes au moyen de la méthode de l’écart interquartile de Tukey (k = 1,5) a mis en évidence deux observations discordantes majeures au sein des scores de groupe (modalité O = 221 et modalité P = 223, excédant la clôture supérieure fixée à 184,38). L’ajustement du modèle de régression linéaire initial incluant la totalité de l’échantillon (N = 16) révèle un paramètre de pente non significatif (beta = 0,24, p = 0,18, R2 = 0,12). La réestimation du modèle après exclusion systématique des deux valeurs aberrantes (N = 14) atteste d’une inversion structurelle de la significativité statistique (beta = 0,68, p < 0,001, R2 = 0,58). Conformément aux directives d'intégrité méthodologique, les deux modèles sont documentés de manière concurrente. »
L’annexion publique du script SAS reproductible — contenant l’horodatage exact et la table de traçabilité des exclusions — constitue la condition sine qua non de la confiance éditoriale et de la reproductibilité computationnelle des travaux de recherche.
11. Automatisation du pipeline de détection via le langage Macro SAS
11.1 Conception modulaire d’une macro paramétrable %DETECT_IQR
Dans les environnements industriels et les centres de recherche clinique traitant des dizaines de tables comprenant des centaines de variables quantitatives, le codage séquentiel manuel des étapes DATA et PROC UNIVARIATE devient rapidement impraticable, source d’erreurs d’encodage et contraire au principe de non-redondance (DRY — Don’t Repeat Yourself). Le processeur de macro-programmation de SAS fournit un outil d’abstraction puissant permettant d’encapsuler la logique de Tukey au sein d’une macro universelle paramétrable.
La conception logicielle de la macro, baptisée %DETECT_IQR, intègre quatre paramètres dynamiques indispensables :
DATA_IN :Nom de la table SAS source à inspecter.VAR_ANALYSE :Nom de la variable quantitative soumise au filtrage.COEF_IQR :Coefficient multiplicateur des clôtures de Tukey (avec 1,5 par défaut, extensible à 3,0 pour les anomalies extrêmes).DATA_OUT_FLAG :Nom de la table finale générée, hébergeant les indicateurs binaires de classification.
11.2 Développement du code macro et gestion des variables macroéconomiques
La compilation et l’exécution du pipeline modulaire s’implémentent au travers de la macro-commande suivante, exploitant les interfaces de mémoire globale et la routine CALL SYMPUTX :
%MACRO DETECT_IQR(

    DATA_IN=

    ,VAR_ANALYSE=

    ,COEF_IQR=1.5

    ,DATA_OUT_FLAG=TABLE_AUDITEE

);
%PUT NOTE: ====================================================;
%PUT NOTE: INITIALISATION DE LA MACRO DETECT_IQR SUR &VAR_ANALYSE ;
%PUT NOTE: ====================================================;
/* 1. Extraction computationnelle des quantiles sans affichage */
PROC UNIVARIATE DATA=&DATA_IN NOPRINT;
VAR &VAR_ANALYSE;
OUTPUT OUT=_WORK_QUANTILES
Q1=_M_Q1
Q3=_M_Q3
QRANGE=_M_IQR;
RUN;
/* 2. Écriture des métriques dans des macro-variables globales */
DATA _NULL_;
SET _WORK_QUANTILES;
CALL SYMPUTX('M_Q1', _M_Q1, 'G');
CALL SYMPUTX('M_Q3', _M_Q3, 'G');
CALL SYMPUTX('M_IQR', _M_IQR, 'G');
CALL SYMPUTX('M_B_INF', _M_Q1 - (&COEF_IQR * _M_IQR), 'G');
CALL SYMPUTX('M_B_SUP', _M_Q3 + (&COEF_IQR * _M_IQR), 'G');
RUN;
%PUT NOTE: VALEURS CALCULÉES : Q1=&M_Q1 | Q3=&M_Q3 | IQR=&M_IQR ;
%PUT NOTE: CLÔTURE INFÉRIEURE : &M_B_INF ;
%PUT NOTE: CLÔTURE SUPÉRIEURE : &M_B_SUP ;
/* 3. Injection et balisage conditionnel */
DATA &DATA_OUT_FLAG;
SET &DATA_IN;
Borne_Inf_Seuil = &M_B_INF;
Borne_Sup_Seuil = &M_B_SUP;
IF NOT MISSING(&VAR_ANALYSE) THEN DO;
IF &VAR_ANALYSE < &M_B_INF OR &VAR_ANALYSE > &M_B_SUP THEN Aberrant_Flag = 1;
ELSE Aberrant_Flag = 0;
END;
ELSE Aberrant_Flag = .;
RUN;
/* 4. Purge des tables de travail temporaires */
PROC DATASETS LIB=WORK NOLIST;
DELETE _WORK_QUANTILES;
QUIT;
%PUT NOTE: TRAITEMENT MACRO %DETECT_IQR ACHEVÉ AVEC SUCCÈS.;
%MEND DETECT_IQR;
L’utilisation de la routine CALL SYMPUTX avec le troisième argument positionné à 'G' garantit l’affectation formelle dans la table des symboles globaux, évitant toute collision de portée lexicale. L’instruction défensive IF NOT MISSING(&VAR_ANALYSE) protège le script contre la classification erronée des valeurs absentes.
11.3 Application concrète de la macro sur des volumétries massives
L’exécution de la macro sur notre échantillon didactique s’opère par une ligne de commande d’une extrême simplicité :
%DETECT_IQR(

    DATA_IN=DONNEES_ORIGINALES,

    VAR_ANALYSE=Points,

    COEF_IQR=1.5,

    DATA_OUT_FLAG=RESULTAT_AUTOMATISE

);
Pour industrialiser le diagnostic sur l’intégralité des variables numériques d’une base de données complexe comprenant des centaines d’items, l’analyste peut coupler cette macro avec le dictionnaire de métadonnées interne de SAS (SASHELP.VCOLUMN). Au moyen d’une boucle générée en SQL via l’instruction SELECT INTO :MACRO_LIST SEPARATED BY ' ', la macro %DETECT_IQR peut être itérée sur des milliers de colonnes de façon totalement autonome, stockant chaque observation discordante dans une table d’audit consolidée prête pour les analyses de conformité réglementaire.
12. Synthèse pratique, pièges courants et recommandations opérationnelles
12.1 Écueils programmatiques fréquents sous SAS et solutions
Au fil du déploiement de pipelines industriels sous SAS, un ensemble d’erreurs computationnelles et de pièges conceptuels récurrents peuvent compromettre la validité des détections. L’analyste doit impérativement maîtriser les solutions préventives associées :
- Le piège de l’évaluation logique des valeurs manquantes : Dans le langage SAS, une valeur manquante numérique (représentée par un point
.) est encodée en mémoire physique sous la forme du plus petit nombre à virgule flottante possible (équivalant à $-\infty$). Par conséquent, si un analyste rédige naïvement la clause conditionnelle :
IF Points < Borne_Inf THEN Valeur_Aberrante = 1;
toutes les valeurs manquantes de la base de données voient la condition arithmétique validée ($-\infty < B_{\text{\inf}}$) et sont étiquetées à tort comme des anomalies inférieures extrêmes ! Il est impératif d’inclure systématiquement la garde conditionnelleIF NOT MISSING(Points) AND Points < Borne_Inf THEN.... - La confusion des algorithmes d’interpolation (PCTLDEF) : Si une équipe compare des résultats obtenus sous SAS avec ceux calculés sous R ou Python, des divergences décimales peuvent émerger si l’option
PCTLDEF=n’est pas harmonisée. SAS utilise par défautPCTLDEF=5, tandis que la fonctionquantile()par défaut sous R applique la définition de type 7 (correspondant àPCTLDEF=4sous SAS). Dans le cadre d’études cliniques croisées, spécifier formellementPCTLDEF=4ouPCTLDEF=5garantit la reproductibilité inter-logicielle. - L’invariance d’arrondi sur les bornes calculées : Lors des jointures ou des transferts via des macro-variables écrites sous forme de texte brut, des troncatures de décimales peuvent faire basculer une valeur rigoureusement égale à la clôture du côté des observations exclues. L’usage de la fonction d’arrondi
ROUND()ou la conservation stricte des variables sous forme numérique continue dans les étapesDATAévite ce risque.
12.2 Guide d’audit méthodique pour l’analyste de données
Pour institutionnaliser un processus de détection robuste et auditable au sein d’un laboratoire de recherche ou d’un service de biostatistique, il est vivement recommandé d’appliquer une check-list séquentielle invariable avant toute exclusion définitive d’observations :
Étape 1 : Audit d’encodage et de conformité métrologique : Vérifier systématiquement si l’observation atypique résulte d’une erreur matérielle d’acquisition. Contrôler les bordereaux sources (CRF), interroger le système de capture et corriger l’erreur à la racine si une preuve matérielle d’invalidation est établie.
Étape 2 : Exploration univariée visuelle et distributionnelle : Évaluer le coefficient d’asymétrie de Fisher-Pearson ($Skewness$). Examiner la boîte à moustaches (PROC SGPLOT VBOX) et le diagramme quantile-quantile (PROC UNIVARIATE QQPLOT). Si l’asymétrie est sévère ($Skewness > 1,5$), privilégier l’écart interquartile ajusté par la médcouple ou opérer une transformation logarithmique préalable avant d’appliquer les clôtures de Tukey.
Étape 3 : Calcul robuste des clôtures de Tukey : Exécuter l’étape PROC UNIVARIATE couplée à l’étape DATA pour borner la distribution ($k = 1,5$). Vérifier l’absence de masquage en comparant les résultats aux scores Z modifiés issus de PROC STDIZE METHOD=MAD.
Étape 4 : Diagnostic d’influence multivariée : Vérifier si les observations univariées conformes ne cachent pas des anomalies dimensionnelles conjointes en estimant les distances de Mahalanobis ou en exécutant une régression robuste sous PROC ROBUSTREG.
Étape 5 : Analyse de sensibilité systématique : Estimer les modèles statistiques cibles (régressions, ANOVA, tests d’hypothèse) sur la table brute intégrale, puis sur la table épurée ou winsorisée. Si les conclusions scientifiques divergent, documenter exhaustivement les deux états au sein du rapport final.
12.3 Perspectives computationnelles futures et intégration en science des données
L’identification des valeurs aberrantes connaît une transformation profonde à l’ère du Big Data et de l’intelligence artificielle. Si les clôtures de Tukey et l’écart interquartile demeurent des fondations analytiques inébranlables pour l’explicabilité méthodologique et les environnements réglementés, les procédures traditionnelles de SAS sont désormais enrichies par l’écosystème SAS Viya et son moteur in-memory Cloud Analytic Services (CAS).
Dans cet espace massivement parallélisé, des procédures d’apprentissage statistique non supervisé — telles que PROC FASTCLUS pour le partitionnement spatial, PROC SVMACHINE pour les séparateurs à vaste marge à une classe (One-Class Support Vector Machines) et les algorithmes de forêts d’isolement (Isolation Forests) — permettent d’isoler des anomalies géométriques hautement non linéaires au sein d’espaces à plusieurs milliers de dimensions. Néanmoins, ces approches algorithmiques avancées ne dispensent aucunement l’analyste de données de la rigueur mathématique et conceptuelle fondamentale : le traitement des observations discordantes demeurera toujours une discipline à la croisée de l’algèbre probabiliste, de la sagacité informatique et de l’éthique de la recherche.
Références
- Barnett, V., & Lewis, T. (1994). Outliers in Statistical Data (3rd ed.). John Wiley & Sons.
- Hoaglin, D. C., Mosteller, F., & Tukey, J. W. (Eds.). (1983). Understanding Robust and Exploratory Data Analysis. John Wiley & Sons.
- Hubert, M., & Vandervieren, E. (2008). An adjusted boxplot for skewed distributions. Computational Statistics & Data Analysis, 52(12), 5186–5201. https://doi.org/10.1016/j.csda.2007.11.008
- Iglewicz, B., & Hoaglin, D. C. (1993). How to Detect and Handle Outliers (Vol. 16, The ASQC Basic References in Quality Control). American Society for Quality Control.
- Mahalanobis, P. C. (1936). On the generalized distance in statistics. Proceedings of the National Institute of Sciences of India, 2(1), 49–55.
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust Regression and Outlier Detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The UNIVARIATE Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/152/univariate.pdf
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The ROBUSTREG Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/152/robustreg.pdf
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.