
Dans le champ des sciences humaines, de la biométrie et plus particulièrement de la psychologie différentielle, la quantification des construits latents soulève un défi métrologique fondamental : les données empiriques brutes n’ont pas de signification intrinsèque absolue. Contrairement aux grandeurs physiques telles que la masse ou la longueur, qui disposent d’un zéro absolu et d’unités de mesure stables, une note obtenue à une épreuve neuropsychologique, un inventaire de personnalité ou un test d’efficience intellectuelle est tributaire du nombre d’items, de leur difficulté relative et du système de cotation retenu. Pour donner un sens diagnostique ou comparatif à une performance individuelle, le chercheur ou le praticien doit impérativement transformer ce score brut en une métrique relative, positionnant le sujet au sein d’une distribution de référence standardisée.
Deux piliers mathématiques dominent traditionnellement ces démarches de conversion et d’inférence statistique : le score Z et le score T. Bien que ces termes soient omniprésents dans la littérature scientifique et les manuels d’évaluation clinique, ils recouvrent des réalités conceptuelles et opérationnelles souvent confondues. D’un côté, le score Z incarne la quintessence du modèle gaussien, projetant une observation sur une échelle centrée sur zéro avec une variance unitaire, directement rattachée aux paramètres universels de la population. De l’autre, le score T se manifeste sous une double identité épistémologique : une statistique inférentielle conçue par William Sealy Gosset pour pallier l’ignorance des paramètres populationnels dans les petits échantillons, et une échelle psychométrique standardisée, développée par William A. McCall, offrant une transposition linéaire sans valeur négative.
Le choix judicieux entre ces deux formalismes ne constitue pas une simple coquetterie algorithmique ; il détermine la validité interne des inférences cliniques et la robustesse des conclusions tirées lors des tests d’hypothèses statistiques. Opter pour un cadre inadéquat expose le chercheur au risque d’inflation de l’erreur de type I ou à une sous-estimation systématique de l’incertitude d’échantillonnage. Ce guide doctoral propose une dissection exhaustive des fondements théoriques, des formulations analytiques, des divergences distributionnelles et des règles de décision méthodologiques qui régissent l’usage rigoureux du score Z et du score T dans la pratique contemporaine des sciences du comportement.
1. Fondements théoriques de la standardisation des scores en psychologie et statistiques
1.1 Origine et nécessité de la réduction d’échelle en métrologie psychologique
La psychométrie moderne s’est heurtée, dès sa genèse au début du vingtième siècle, à l’incommensurabilité fondamentale des scores bruts. Lorsqu’un clinicien évalue un patient à travers une batterie comprenant l’inventaire de dépression de Beck, le test de rétention visuelle de Benton et l’échelle de mémoire de Wechsler, il recueille des données numériques dont les échelles de sommation sont mutuellement imperméables. Un score brut de 28 sur un test de mémoire ne possède aucune équivalence fonctionnelle ou sémantique avec un score brut de 28 sur un inventaire d’anxiété. Cette hétérogénéité des métriques interdit toute comparaison intra-individuelle directe des déficits ou des aptitudes, tout comme elle empêche l’agrégation de données multi-sources dans des protocoles de recherche transversaux ou longitudinaux.
La standardisation des scores répond à cet impératif de comparabilité en éliminant les unités de mesure arbitraires. Par une opération d’échelle, les scores bruts sont soustraits de la tendance centrale d’un groupe de référence puis divisés par une mesure de dispersion. Ce processus transforme un score lié aux spécificités de l’instrument en une position relative au sein d’une distribution normative. Sur le plan intra-individuel, cette réduction d’échelle permet de dresser des profils cognitifs ou comportementaux harmonisés, révélant les forces et faiblesses relatives d’un patient sans biais lié au calibrage des instruments. Sur le plan interindividuel, elle autorise la comparaison directe d’individus évalués dans des contextes distincts ou à des époques différentes.
Au-delà de cette commodité pratique, la réduction d’échelle poursuit un objectif épistémologique plus ambitieux : l’harmonisation des distributions empiriques par rapport à des modèles mathématiques théoriques d’inférence. La validité de construit et la fidélité des mesures psychométriques, telles que définies dans les critères de l’American Psychological Association, reposent sur l’hypothèse que la métrique utilisée reflète adéquatement le continuum latent du trait mesuré. En convertissant les observations brutes en scores d’écarts par rapport à la moyenne, la métrologie psychologique garantit que les déviations observées traduisent une véritable variance psychologique et non des artéfacts d’échelle, renforçant ainsi la stabilité des modèles statistiques et la reproductibilité des résultats cliniques.
1.2 La distribution normale standard comme pivot épistémologique
L’édifice de la statistique paramétrique repose sur les propriétés fondamentales de la distribution normale, modélisée initialement par Abraham de Moivre et formalisée par Carl Friedrich Gauss. Cette fonction de densité de probabilité continue est universellement reconnue pour sa géométrie caractéristique en forme de cloche, caractérisée par une symétrie axiale parfaite autour de son espérance mathématique, l’absence de dissymétrie (skewness nulle), et un aplatissement mésokurtique (kurtosis égal à 3, ou un excès de kurtosis égal à 0). Dans sa forme standardisée, où l’espérance mathématique est ramenée à zéro et la variance fixée à l’unité, la distribution normale standard devient l’étalon de référence pour la modélisation probabiliste des phénomènes naturels et comportementaux.
L’application de ce modèle théorique aux sciences de l’esprit s’articule autour de la célèbre loi empirique 68-95-99.7. Selon cette régularité géométrique, environ 68,27 % de la surface sous la courbe se situe dans l’intervalle délimité par plus ou moins un écart-type autour de la moyenne ; 95,45 % de l’aire est comprise dans un intervalle de plus ou moins deux écarts-types, et 99,73 % des observations s’inscrivent à l’intérieur de trois écarts-types. En psychologie différentielle, cette règle permet de traduire immédiatement une déviation métrique en une fréquence probabiliste d’occurrence au sein de la population générale, offrant ainsi un repère précis pour discriminer la variabilité normale des écarts atypiques.
Toutefois, l’adhésion inconditionnelle à la distribution normale standard comporte des limites épistémologiques sévères qu’il convient de ne pas occulter. Dans de nombreuses populations cliniques ou atypiques, les traits étudiés ne suivent nullement une trajectoire gaussienne. Qu’il s’agisse de la symptomatologie psychotique, des conduites addictives ou des troubles de la personnalité, les distributions empiriques manifestent fréquemment une asymétrie positive marquée (effet de plancher chez les sujets sains) ou des profils multimodaux traduisant une hétérogénéité sous-jacente. Forcer l’application de la normalité standard sur de telles données sans ajustement mathématique préalable induit des distorsions diagnostiques substantielles, en surestimant ou sous-estimant la sévérité réelle des troubles mesurés.
1.3 Distinction historique entre le travail de Gosset (Student) et les travaux de Fisher et Pearson
L’histoire de la statistique moderne est marquée par la divergence méthodologique entre les approches applicables aux grands volumes de données et celles requises par les contraintes d’échantillonnage restreint. À la fin du dix-neuvième siècle, Karl Pearson et ses contemporains développent le socle de la biométrie en s’appuyant sur des bases d’échantillonnage massives, où le nombre d’observations se chiffre en milliers. Dans ces conditions de grand nombre, le théorème central limite s’applique de manière optimale : l’écart-type de l’échantillon constitue une approximation quasi parfaite de l’écart-type de la population générale, ce qui justifie l’utilisation inconditionnelle de la statistique z et de la loi normale pour l’estimation et le test d’hypothèses.
Cette certitude méthodologique s’est trouvée ébranlée au début du vingtième siècle par William Sealy Gosset, chimiste et statisticien travaillant pour la brasserie Guinness à Dublin. Confronté à des impératifs expérimentaux agronomiques et brassicoles où les contraintes matérielles imposaient des tailles d’échantillons très faibles (souvent n = 3 ou n = 5), Gosset démontre que l’utilisation mécanique de la loi normale standard induit une sous-estimation systématique de l’incertitude. L’introduction de l’écart-type de l’échantillon en lieu et place de l’écart-type inconnu de la population génère une fluctuation stochastique supplémentaire qui invalide l’usage des valeurs critiques z. Sous le pseudonyme de « Student », il publie en 1908 l’article séminal introduisant la distribution t, spécialement calibrée pour intégrer cette incertitude inhérente aux petits effectifs.
Par la suite, Sir Ronald Aylmer Fisher formalise rigoureusement la théorie mathématique de la distribution de Student, en intégrant le concept fondamental des degrés de liberté et en démontrant la convergence asymptotique de la distribution t vers la loi normale standard lorsque la taille d’échantillon tend vers l’infini. Cette synthèse théorique entre les travaux de Gosset, Pearson et Fisher a structuré l’ensemble des protocoles d’inférence statistique adoptés par les sciences comportementales au cours du vingtième siècle. Elle a instauré une distinction fondamentale entre les méthodologies fondées sur la certitude des paramètres universels et celles, plus réalistes, qui composent avec l’approximation inhérente aux échantillons limités.
2. Définition mathématique et conceptuelle du Score Z
2.1 Formalisation analytique et décomposition des paramètres
Le score Z, fréquemment désigné sous l’appellation de variable centrée réduite, constitue l’expression analytique la plus directe du positionnement d’une valeur observée au regard d’une distribution de référence. Pour une observation individuelle unique désignée par la variable x au sein d’une population caractérisée par une moyenne arithmétique $\mu$ et un écart-type $\sigma$, le score Z univarié s’exprime par la relation mathématique classique :
$$z = \frac{x – \mu}{\sigma}$$
Dans cette formalisation canonique, le numérateur $(x – \mu)$ représente le score centré, c’est-à-dire l’écart absolu et directionnel entre la mesure brute collectée et le centre de gravité de la population. Le dénominateur $\sigma$ joue le rôle d’étalon de mesure unitaire en capturant l’hétérogénéité ou la dispersion globale des observations autour de cette moyenne. L’écart-type $\sigma$ n’est pas une estimation dérivée d’un sous-ensemble expérimental, mais bien le paramètre exact, invariant et exhaustif décrivant la variabilité intégrale de la population parente.
L’analyse vectorielle du score Z révèle une double composante sémantique : le signe arithmétique et l’amplitude scalaire. Un score Z affecté d’un signe positif indique sans ambiguïté que l’observation brute se positionne au-dessus de la moyenne populationnelle, tandis qu’un signe négatif dénote une performance ou un niveau de trait inférieur au barycentre normatif. L’amplitude quantifie la distance exacte qui sépare l’observation du point d’équilibre, exprimée en fractions ou multiples entiers d’écarts-types. Un score de $z = +2{,}00$ signifie ainsi que l’individu se situe rigoureusement à deux unités d’écart-type au-dessus de l’espérance mathématique de la population de référence.
Lorsque la recherche translationnelle ou épidémiologique ne s’intéresse plus à un individu singulier mais à la moyenne d’un groupe d’observations indépendantes de taille $n$, l’expression analytique subit une modification structurelle pour intégrer la variabilité de la moyenne elle-même. La formule d’échantillonnage s’énonce alors selon l’équation :
$$z = \frac{\bar{x} – \mu}{\frac{\sigma}{\sqrt{n}}}$$
Dans ce cadre distributionnel élargi, le terme $\sigma / \sqrt{n}$ correspond à l’erreur type de la moyenne ($SE$). Il reflète l’erreur d’échantillonnage théorique qui découle du prélèvement aléatoire d’un sous-groupe de taille $n$ au sein de la population universelle.
2.2 Propriétés distributionnelles fondamentales du Score Z
La transformation d’un ensemble de scores bruts en scores Z modifie en profondeur les propriétés métriques de la série de données, tout en préservant scrupuleusement son architecture relationnelle interne. Sur le plan algébrique, la moyenne théorique d’une distribution intégrale de scores Z est strictement égale à 0, et sa variance — ainsi que son écart-type — est invariablement égale à 1. Cette propriété découle directement de la linéarité de l’espérance mathématique : la soustraction d’une constante (la moyenne) décale le centre de gravité à zéro, et la division subséquente par une constante scalaire (l’écart-type) comprime ou dilate la dispersion jusqu’à l’obtention d’une variance unitaire.
Une méprise théorique très répandue consiste à postuler que la standardisation par le score Z transforme magiquement une distribution asymétrique en une courbe normale. Cette assertion est mathématiquement erronée. La standardisation en Z est une transformation strictement linéaire de la forme $z = ax + b$, où $a = 1/\sigma$ et $b = -mu/\sigma$. En vertu des théorèmes fondamentaux de l’algèbre vectorielle, les transformations linéaires conservent parfaitement la forme générale de la distribution d’origine, y compris ses coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Si la distribution des scores bruts initiaux présente une forte asymétrie positive, la distribution résultante des scores Z présentera une asymétrie rigoureusement identique, bien que son échelle numérique soit désormais centrée sur zéro.
Cette conservation absolue de la géométrie distributionnelle garantit le respect intégral des distances relatives entre les points de mesure. Deux sujets dont les scores bruts étaient séparés par une différence donnée conserveront cette exactitude d’espacement proportionnel une fois traduits en scores Z. Cette préservation de l’échelle d’intervalle est essentielle en psychométrie, car elle autorise l’application ultérieure de modèles mathématiques sophistiqués sans distordre la morphologie des variations individuelles enregistrées.
2.3 Usage du Score Z en tant que métrique normative universelle
La puissance opérationnelle du score Z réside dans sa capacité à fonctionner comme une passerelle directe entre une mesure continue et une probabilité cumulative, pourvu que la distribution sous-jacente soit conforme au modèle de la loi normale. En exploitant la fonction de répartition de la loi normale centrée réduite, matérialisée par les tables statistiques ou les bibliothèques d’analyse numérique, tout praticien peut convertir instantanément un score Z en un rang percentile. Par exemple, un score de $z = +1{,}00$ correspond mathématiquement au 84,13e percentile, signifiant que l’individu surpasse approximativement 84 % des membres de la population normative. Réciproquement, un score de $z = -1{,}96$ isole précisément les 2,5 % des performances les plus basses de la distribution unilatérale.
Au-delà de son rôle d’étalonnage clinique, le score Z constitue l’un des algorithmes d’identification des valeurs aberrantes ou extrêmes les plus robustes en méthodologie quantitative. Dans les protocoles de nettoyage de données de grande envergure, les observations présentant des scores Z dont la valeur absolue dépasse un seuil d’exclusion prédéfini — conventionnellement $|z| > 3{,}00$ ou $|z| > 3{,}29$ — sont isolées en tant que déviations stochastiques hautement improbables dans un régime gaussien (représentant moins de 0,1 % de probabilité théorique). Cette procédure standardise les protocoles de validation des bases de données en les affranchissant de critères d’exclusion subjectifs.
Enfin, la réduction en scores Z s’avère un préalable indispensable à l’exécution de multiples techniques statistiques multivariées avancées. Dans les modèles de régression linéaire multiple, la standardisation préalable de tous les prédicteurs continus permet d’obtenir des coefficients de régression standardisés (souvent notés $\beta$), dont la magnitude relative peut être directement comparée pour hiérarchiser le pouvoir explicatif de chaque variable. De même, en analyse factorielle exploratoire ou en modélisation par équations structurelles, l’exploitation de matrices de corrélation équivaut méthodologiquement à l’application des calculs sur des données transformées en scores Z, neutralisant ainsi les artéfacts imputables aux écarts d’unités entre les variables latentes et manifestes.
3. Définition mathématique et conceptuelle du Score T
3.1 Formalisation de la statistique t de Student
Dans l’immense majorité des contextes de recherche empirique en psychologie et en neurosciences cognitives, le statisticien est confronté à une aporie ontologique : la variance de la population cible ($\sigma^2$) est une quantité inconnue et inconnaissable. Dès lors qu’il s’avère impossible d’accéder à l’exhaustivité de la population, l’écart-type de référence doit être estimé à partir des données recueillies au sein d’un échantillon fini de taille $n$. C’est précisément à cette jonction épistémologique qu’intervient la formalisation de la statistique t de Student, définie pour le test d’une moyenne d’échantillon $\bar{x}$ face à une moyenne théorique $\mu$ par la formulation suivante :
$$t = \frac{\bar{x} – \mu}{\frac{s}{\sqrt{n}}}$$
Dans cette équation structurelle, le dénominateur ne mobilise plus l’écart-type théorique $\sigma$, mais son estimateur non biaisé calculé sur l’échantillon, universellement désigné par la lettre latine $s$. Le terme $s / \sqrt{n}$ prend l’appellation d’erreur type estimée de la moyenne ($SE$). Contrairement à l’expression homologue du score Z d’échantillonnage, le dénominateur de la statistique t n’est pas une constante fixe préétablie, mais une variable aléatoire à part entière, sujette à des fluctuations d’échantillonnage propres d’un tirage empirique à un autre.
Cette instabilité stochastique du dénominateur est encadrée par la théorie des degrés de liberté ($dl$ ou $\nu$), qui correspond rigoureusement, dans le cadre d’un test sur échantillon unique, à :
$$dl = n – 1$$
Le concept de degrés de liberté quantifie le nombre d’observations indépendantes dont dispose l’analyste une fois que la moyenne de l’échantillon est fixée pour le calcul de la somme des carrés des écarts. Mathématiquement, la perte d’un degré de liberté reflète la contrainte linéaire imposée par le calcul préalable de $\bar{x}$. Ces degrés de liberté régulent directement la morphologie de la fonction de densité probabiliste qui gouverne le comportement de la statistique t, déterminant l’étendue de l’incertitude attachée à l’estimation de la variance.
3.2 Morphologie et dynamique de la distribution t
La distribution t de Student se présente sous une allure générale qui rappelle celle de la loi normale : elle est parfaitement symétrique autour de son espérance mathématique nulle ($E[t] = 0$) et adopte un profil en cloche uni-modal. Néanmoins, son examen mathématique approfondi révèle une divergence géométrique fondamentale : elle présente des queues de distribution notablement plus épaisses que celles de la courbe de Gauss. Ce phénomène morphologique, connu sous le nom de leptokurtose relative ou queues lourdes (heavy tails), reflète la variabilité additionnelle induite par l’estimation simultanée du numérateur (la moyenne) et du dénominateur (l’écart-type).
La densité de probabilité de la loi de Student dépend exclusivement du paramètre des degrés de liberté. Lorsque $dl$ est faible, l’aire sous la courbe située au-delà de deux écarts-types est considérablement plus vaste que l’aire correspondante de la loi normale standard. En conséquence pratique, pour un niveau de confiance fixé (par exemple $\alpha = 0{,}05$), la valeur critique qui délimite le seuil de significativité statistique s’éloigne notablement du centre. Ce comportement d’ajustement dynamique constitue un mécanisme de sécurité mathématique : il compense l’imprécision inhérente à l’échantillon en exigeant des déviations plus amples pour rejeter l’hypothèse nulle, prévenant ainsi une multiplication involontaire des faux positifs.
À mesure que la taille de l’échantillon s’accroît, le paramètre des degrés de liberté tend mathématiquement vers l’infini ($dl to \infty$). Au cours de cette dynamique asymptotique, l’écart-type échantillonnal $s$ converge avec certitude stochastique vers le paramètre universel $\sigma$, conformément à la loi forte des grands nombres. Par conséquent, les queues de la distribution t s’amincissent progressivement, et sa fonction de densité se superpose de manière quasi indistinguable à celle de la loi normale centrée réduite. La loi normale émerge ainsi non pas comme une entité concurrente, mais comme le cas limite absolu de la famille des distributions t de Student lorsque le volume d’information statistique devient parfait.
3.3 Le score T psychométrique linéaire (échelle de McCall)
Il est impératif d’opérer une dissociation sémantique et conceptuelle absolue entre la statistique inférentielle t de Student issue de l’économétrie et de l’agronomie, et l’échelle standardisée T largement utilisée en psychométrie clinique. Cette dernière, introduite au début des années 1920 par le psychologue et statisticien de Columbia William A. McCall, fut baptisée « T » en hommage explicite à son mentor Edward Lee Thorndike. Le score T psychométrique est une transformation linéaire standardisée conçue pour exprimer le profil d’aptitudes ou de personnalité d’un individu selon une métrique standardisée dont l’espérance mathématique est calée à 50 et l’écart-type à 10 :
$$T = 50 + 10 \times z$$
Cette échelle a été adoptée par les inventaires de personnalité de référence mondiale, à l’image du MMPI-2 (Minnesota Multiphasic Personality Inventory), du PAI (Personality Assessment Inventory) ou du BASC (Behavior Assessment System for Children). Le choix de fixer la moyenne à 50 et l’écart-type à 10 procède d’une ergonomie clinique très étudiée. Dans une distribution gaussienne de scores T, un score de 50 matérialise la normalité médiane exacte ; les zones délimitées par 40 et 60 englobent les 68,27 % des individus dits « moyens » ; les scores franchissant le palier de 65 ou 70 (respectivement à 1,5 et 2 écarts-types de la moyenne) signalent l’émergence d’une sévérité symptomatique ou d’un trait psychopathologique significatif.
L’avantage pragmatique majeur de l’échelle de McCall réside dans la neutralisation psychologique des nombres négatifs et des fractions décimales. Un score Z de $-1{,}5$ ou $-2{,}3$ suscite fréquemment des incompréhensions, voire un sentiment d’arbitraire punitif chez les patients, les éducateurs ou les magistrats lors de la restitution d’un bilan psychologique. À l’inverse, l’expression de ces mêmes performances sous la forme d’un score T de 35 ou de 27 présente une échelle graduée positivement (s’étalant le plus souvent de 0 à 100 dans la pratique), exempte de signe arithmétique ambigu. Elle facilite la communication interprofessionnelle sans sacrifier la précision métrologique.
4. La distinction cruciale : variance de la population connue versus inconnue
4.1 L’illusion de la connaissance des paramètres de la population dans les sciences humaines
L’une des dérives épistémologiques les plus manifestes dans l’application des statistiques quantitatives aux comportements humains réside dans la présomption de certitude concernant les paramètres globaux. Dans les sciences dures comme la physique des particules ou la mécanique céleste, certaines constantes universelles permettent de postuler un $\sigma$ universellement invariant sous des conditions d’observation données. À l’opposé, les entités étudiées par la psychologie, la sociologie ou les sciences cognitives sont indissociables du contexte temporel, culturel, démographique et institutionnel dans lequel elles s’expriment.
L’accès réel à la valeur absolue de l’écart-type de la population ($\sigma$) relève d’une exception métrologique rarissime. Elle ne se matérialise que dans des cadres très contraignants : les recensements nationaux exhaustifs administrés par des instituts étatiques (tels que l’INSEE en France ou l’US Census Bureau), ou les standardisations massives d’instruments psychométriques à diffusion planétaire, réétalonnées à intervalles constants sur des cohortes représentatives comptant plusieurs milliers de sujets, stratifiés selon l’âge, le genre et la catégorie socioprofessionnelle. Hors de ces cadres d’exception, toute affirmation postulant la connaissance préalable de $\sigma$ constitue un abus de langage méthodologique.
Le risque épistémologique consiste à opérer une substitution aveugle : attribuer dogmatiquement à un échantillon restreint une variance issue d’une table d’étalonnage obsolète, ou assimiler hâtivement la variabilité d’un groupe expérimental singulier aux normes globales d’un manuel. Lorsque l’expérimentateur décrète qu’il « connaît » l’écart-type de la population sans être en mesure de produire la traçabilité statistique d’un recensement exhaustif, il introduit un biais d’illusion d’exactitude qui vicie l’ensemble des inférences ultérieures.
4.2 Biais d’estimation induit par l’écart-type échantillonnal
L’origine mathématique de l’asymétrie entre les démarches de Gauss et de Student découle de la nature du calcul de la variance à partir d’un échantillon. Si l’on applique naïvement la formule de la variance populationnelle à une série d’observations d’un échantillon fini de taille $n$, en divisant la somme des carrés des écarts par l’effectif total $n$ :
$$\sigma^2_{naïve} = \frac{\sum (x_i – \bar{x})^2}{n}$$
on commet une erreur systématique d’estimation. Les données d’un échantillon ont mathématiquement tendance à se regrouper plus étroitement autour de leur propre moyenne d’échantillon $\bar{x}$ qu’elles ne le feraient autour de la moyenne réelle et inconnue de la population $\mu$. En conséquence incontournable, la variance ainsi calculée sous-estime systématiquement la variance universelle $\sigma^2$.
Pour neutraliser ce biais négatif, il est impératif d’introduire la correction de Bessel, qui consiste à substituer le diviseur $n$ par $(n – 1)$ dans le calcul de la variance d’échantillon sans biais, notée $s^2$ :
$$s^2 = \frac{\sum (x_i – \bar{x})^2}{n – 1}$$
Toutefois, bien que $s^2$ constitue un estimateur sans biais de $\sigma^2$, son extraction sous forme de racine carrée ($s$) demeure un estimateur légèrement biaisé de $\sigma$ pour les distributions normales. Ce déficit de régularité mathématique propage une variabilité stochastique au dénominateur de la statistique de test. Dès lors qu’une variable aléatoire est divisée par une autre variable aléatoire présentant une loi de distribution du chi-deux, le ratio résultant ne peut plus se conformer à la loi normale standard. C’est l’essence même de la dérivation analytique de Gosset : compenser rigoureusement cette propagation d’erreur d’échantillonnage par la géométrie spécifique de la loi t.
4.3 Conséquences méthodologiques de l’inversion des modèles
La confusion entre le modèle Z (réservé aux variances connues ou extrapolées sur des effectifs infinis) et le modèle T (imposé par la variance inconnue) entraîne des conséquences méthodologiques délétères sur les tests d’hypothèses. Si un chercheur applique le test Z en utilisant l’écart-type de son échantillon $s$ comme substitut direct de $\sigma$ sur un petit groupe d’étude (par exemple, $n = 12$), il postule des seuils de décision inadéquats. La valeur critique bilatérale au seuil conventionnel de 5 % pour une loi normale est de $z = 1{,}960$, alors que la valeur critique réelle d’un test t avec 11 degrés de liberté s’élève à $t = 2{,}201$.
En employant abusivement le seuil $1{,}960$, le chercheur gonfle son taux d’erreur de première espèce (l’erreur alpha, c’est-à-dire le rejet indu de l’hypothèse nulle alors qu’elle est vérifiée en réalité). Les résultats déclarés « statistiquement significatifs » ne traduisent alors bien souvent que de banales fluctuations stochastiques d’échantillonnage amplifiées par un modèle inadapté. Ce laxisme méthodologique contribue à la crise de reproductibilité des résultats quantitatifs qui affecte les sciences comportementales.
À l’inverse, l’application d’un modèle ultraconservateur non justifié ou l’introduction de correctifs empiriques approximatifs peut provoquer un effondrement de la puissance statistique (erreur de seconde espèce, ou bêta), conduisant à rejeter des effets cliniques réels par manque de calibrage analytique. Pour contrer ces dérives, les normes de publication méthodologiques de l’American Psychological Association (APA 7e édition) exigent une transparence absolue sur la nature des paramètres de dispersion mobilisés, contraignant les chercheurs à déclarer explicitement le caractère fondé ou estimé de chaque variance rapportée.
5. L’impact de la taille de l’échantillon et le théorème central limite
5.1 Le théorème central limite et le seuil conventionnel de N = 30
Le comportement des statistiques inférentielles est sous-tendu par le théorème central limite (TCL). Selon ce principe probabiliste, quelle que soit la forme de la fonction de distribution de probabilité d’une variable au sein d’une population (qu’elle soit asymétrique, uniforme ou bimodale), la distribution d’échantillonnage des moyennes issues de cette population tendra asymptotiquement vers une loi normale dès lors que la taille des échantillons aléatoires indépendants s’accroît de manière suffisante.
Dans la formation statistique initiale des psychologues et des cliniciens, une heuristique s’est imposée de longue date : le seuil conventionnel de $n = 30$. Les manuels du siècle passé suggéraient de manière empirique qu’à partir de 30 observations, la distribution d’échantillonnage s’était suffisamment rapprochée de la loi normale pour permettre de substituer sans grand danger l’écart-type échantillonnal $s$ à l’écart-type universel $\sigma$, validant de fait le recours simplifié au score Z. Cette simplification opératoire trouvait sa justification pratique à une époque où le calcul manuel s’appuyait sur des tables papier imprimées de la loi normale centrée réduite, évitant ainsi le maniement de volumineuses tables de Student à multiples degrés de liberté.
Dans le champ méthodologique contemporain, cette règle arbitraire du « $n ge 30$ » est formellement invalidée par l’analyse computationnelle moderne. Le rythme de convergence dicté par le théorème central limite dépend intimement du profil de la distribution parente originelle. Lorsque la population d’origine est modérément symétrique et mésokurtique, un effectif de 20 à 30 sujets suffit en effet à obtenir une approximation gaussienne satisfaisante des moyennes d’échantillons. En revanche, si la distribution mère présente une asymétrie marquée (comme les données de temps de réaction ou les concentrations plasmatiques de marqueurs neurobiologiques), un effectif de 100, voire plusieurs centaines d’observations, s’avère indispensable pour neutraliser les déformations distributionnelles et autoriser une convergence valide vers la normalité.
5.2 La zone de convergence entre Z et T pour les grands échantillons
Pour mesurer la dynamique asymptotique qui unifie les métriques Z et T à mesure que l’échantillonnage s’étoffe, il convient de confronter les valeurs critiques bilatérales associées au seuil d’erreur standard de premier ordre $\alpha = 0{,}05$ :
- Pour $n = 5$ ($dl = 4$) : la valeur critique $t$ culmine à 2,776 (contre 1,960 pour Z).
- Pour $n = 15$ ($dl = 14$) : la valeur critique $t$ s’établit à 2,145.
- Pour $n = 30$ ($dl = 29$) : la valeur critique $t$ descend à 2,045.
- Pour $n = 100$ ($dl = 99$) : la valeur critique $t$ rejoint 1,984.
- Pour $n = 1000$ ($dl = 999$) : la valeur critique $t$ s’aligne à 1,962, convergeant avec la constante théorique de Z fixée à 1,960.
Cette confrontation chiffrée démontre qu’à $n = 30$, l’écart entre la valeur critique de la distribution t ($2{,}045$) et celle de la loi normale ($1{,}960$) présente une divergence résiduelle relative de plus de 4,3 %. Bien que cette différence puisse paraître négligeable au regard d’une estimation grossière, elle s’avère décisive pour toute observation située à la lisière du seuil d’exclusion statistique.
D’un point de vue contemporain, avec le traitement automatisé des données par les logiciels spécialisés (tels que Jamovi, JASP, SPSS ou le langage R), la question de la simplification du calcul ne se pose plus. Les environnements d’analyse computational exécutent instantanément les équations de Student sans surcoût de temps ou de mémoire. En conséquence directe, la recommandation méthodologique moderne est universelle : dès lors que l’écart-type de la population n’est pas rigoureusement documenté a priori, il convient de mobiliser systématiquement la distribution t de Student, quel que soit l’effectif de l’échantillon. Cette approche évite tout saut conceptuel ou dérive algorithmique entre petits et grands échantillons.
5.3 Gestion des très petits échantillons (N < 15) en psychologie expérimentale
L’expérimentation en psychologie clinique, en neuropsychologie translationnelle ou dans l’étude des pathologies rares (comme le syndrome de Williams ou les traumatismes cérébraux atypiques) confronte souvent les chercheurs à des micro-échantillons regroupant moins de 15 sujets, parfois moins de 8 individus par condition. Dans ces protocoles très restreints, le test t de Student constitue le seul rempart paramétrique disponible, mais son déploiement exige des précautions d’une rigueur absolue.
À ces niveaux microscopiques d’observation, la robustesse du test t de Student face aux écarts de distribution s’effondre. L’hypothèse de normalité de la distribution parente, dont le test t s’accommode avec une certaine tolérance pour des échantillons de taille modérée (en vertu de sa robustesse intrinsèque), devient une condition de validité sine qua non. Malheureusement, l’évaluation de cette normalité par des tests d’ajustement formels, tels que le test de Shapiro-Wilk ou le test de D’Agostino-Pearson, souffre d’un manque criant de puissance statistique sur les petits effectifs. Ils s’avèrent bien souvent incapables de rejeter l’hypothèse de normalité, même face à des distributions sous-jacentes fortement dysfonctionnelles.
Si la plausibilité de l’hypothèse de normalité est contestée dans un micro-échantillon, le chercheur doit renoncer aux méthodes fondées sur les distributions t ou z. La seule alternative analytique méthodologiquement saine consiste à se tourner vers la modélisation non paramétrique, incarnée par le test de Wilcoxon pour séries appariées ou le test de Mann-Whitney (Wilcoxon rank-sum) pour groupes indépendants. Ces protocoles, qui opèrent sur le rang des observations plutôt que sur leurs valeurs brutes, offrent des garanties de conservation de l’erreur de première espèce indépendantes des caractéristiques distributionnelles des variables étudiées.
6. Arbre décisionnel : critères méthodologiques pour choisir entre Z et T
6.1 Modélisation pas-à-pas de l’arbre de décision
Pour naviguer parmi les critères méthodologiques séparant l’application d’un score ou test Z d’un score ou test T, il est nécessaire de formaliser une structure de choix algorithmique unifiée. Ce cheminement décisionnel séquentiel s’articule autour de trois filtres majeurs, interrogés dans un ordre immuable afin de garantir la rigueur de l’inférence :
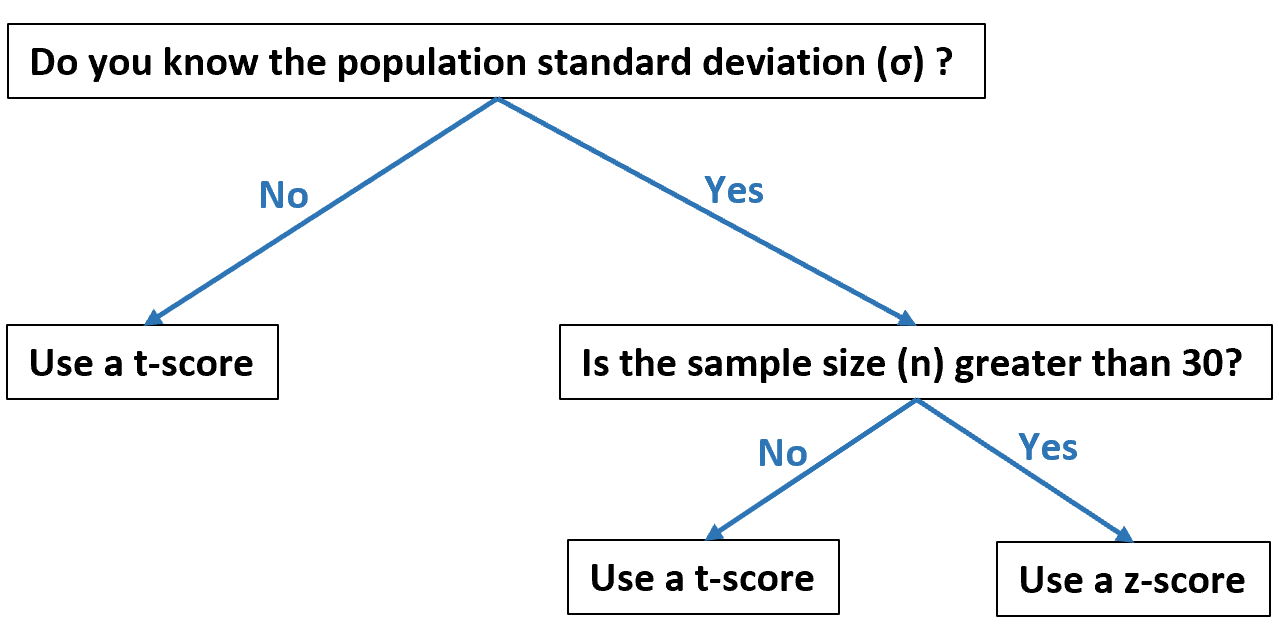
Étape 1 : Le paramètre d’écart-type de la population cible ($\sigma$) est-il formellement et explicitement connu ?
Si la réponse est affirmative, la question de l’effectif d’échantillonnage s’estompe quant au choix du modèle de référence : le chercheur est habilité à employer l’univers distributionnel du Score Z / Test Z. L’incertitude sur la variance étant neutralisée par définition, la loi normale s’impose dès lors que la variable parente présente une distribution normale ou que l’échantillon permet d’invoquer le théorème central limite.
Si la réponse est négative — ce qui constitue la norme dans plus de 98 % des protocoles expérimentaux réels —, l’analyste est immédiatement orienté vers le second niveau de décision.
Étape 2 : Quelle est la configuration de distribution de la variable dépendante au sein de la population ou du groupe d’étude ?
Si l’écart-type universel $\sigma$ est inconnu, l’analyste doit impérativement s’appuyer sur l’estimation $s$ dérivée des données empiriques. Il doit alors évaluer la conformité de la distribution à la loi de Gauss. Deux sous-cas se présentent alors :
- Si la distribution est réputée normale (par validation théorique ou adéquation empirique contrôlée), le Score T / Test t de Student constitue le choix requis, quelle que soit la taille de l’effectif disponible ($n < 30$ ou $n ge 30$).
- Si la distribution diverge manifestement du modèle normal, la prise en compte de la taille d’échantillon devient alors un filtre régulateur décisif.
Étape 3 : Quelle est la taille de l’échantillon disponible ($n$) en présence de distribution non normale et de $\sigma$ inconnu ?
Si la distribution viole l’assomption de normalité mais que la cohorte est massive (par exemple $n > 100$), le théorème central limite garantit une normalisation de la distribution d’échantillonnage des moyennes, autorisant l’usage du Test t (qui convergera numériquement vers Z). En revanche, si la distribution s’éloigne notablement du profil gaussien et que l’effectif est restreint ($n < 30$), l’analyste se trouve dans une impasse paramétrique : les scores Z et T doivent être tous deux écartés au profit de méthodologies d’analyse non paramétriques (comme les tests de rangs de Mann-Whitney ou Kruskal-Wallis) ou de techniques computationnelles de rééchantillonnage (bootstrap robuste).
6.2 Cas limites et zones grises méthodologiques
L’application théorique des modèles statistiques se heurte régulièrement à la nature complexe des données réelles. Parmi les zones d’incertitude les plus fréquentes figure le statut métrologique des échelles de type Likert (par exemple, des items cotés de 1 « Pas du tout d’accord » à 5 « Tout à fait d’accord »), omniprésentes dans les inventaires de personnalité et les sondages d’opinion. Bien qu’elles constituent sur le plan formel des variables ordinales dont l’équidistance des intervalles n’est pas mathématiquement démontrée, la pratique scientifique dominante consiste à sommer ces items pour produire un score continu traité comme une variable d’intervalle.
Cette commodité empirique est acceptable à condition que la distribution du score total obtenu ne présente pas d’asymétrie extrême et que l’échelle comporte un nombre suffisant de gradations. Lorsque les distributions issues de ces échelles d’attitudes présentent une troncature sévère (effet de plafond ou de plancher) ou une configuration bimodale, l’application aveugle des scores Z ou des tests t génère des artéfacts d’inférence. Le praticien doit alors privilégier des modèles à variables latentes ou des régressions ordinales plutôt que de forcer une normalisation non adaptée.
Un autre cas limite concerne les cohortes cliniques caractérisées par une hétérogénéité structurelle, comme les patients souffrant de démences dégénératives à différents stades d’évolution. Dans ces configurations, l’existence de sous-groupes dissimulés fait éclater l’homoscédasticité et la continuité distributionnelle. Tenter de convertir les performances brutes de ces patients sur des tables de scores Z théoriques élaborées sur des sujets sains aboutit souvent à des scores aberrants (par exemple des valeurs de Z inférieures à -5,00). De telles valeurs dépassent le cadre probabiliste standard et perdent leur signification clinique réelle.
6.3 Matrice synthétique de sélection selon le protocole de recherche
Pour clarifier ces arbitrages méthodologiques au quotidien, le tableau synoptique suivant résume les configurations classiques rencontrées par les chercheurs et cliniciens, et indique les métriques adaptées à chaque situation :
| Protocole d’investigation | Paramètre $\sigma$ | Distribution du trait | Taille d’échantillon | Modèle analytique recommandé |
|---|---|---|---|---|
| Évaluation d’un patient individuel par rapport à une batterie neuropsychologique standardisée | Connu (manuel normatif massif) | Présumée normale dans l’étalonnage | $n = 1$ | Score Z (Conversion en percentiles) ou Score T psychométrique |
| Comparaison d’un échantillon clinique unique face à une norme de santé publique nationale | Connu (registre exhaustif) | Normale ou asymptotique | Indifférente ($n ge 1$) | Test Z pour échantillon unique |
| Comparaison d’un échantillon expérimental face à une moyenne de contrôle théorique | Inconnu (estimé par $s$) | Normale | Petite ou grande ($n$ indifférent) | Test t de Student pour échantillon unique |
| Comparaison de deux groupes expérimentaux indépendants (par exemple, traitement vs. placebo) | Inconnu (estimé par $s_1$ et $s_2$) | Normale et variances homogènes | Tout effectif ($n_1, n_2$) | Test t de Student indépendant |
| Comparaison de deux groupes expérimentaux avec hétérogénéité des variances | Inconnu | Normale mais variances inégales | Tout effectif ($n_1, n_2$) | Test t de Welch |
| Comparaison de deux groupes expérimentaux avec violation patente de normalité | Inconnu | Fortement asymétrique | Micro-échantillons ($n < 20$) | Test U de Mann-Whitney (non paramétrique) |
7. Applications pratiques en psychométrie et évaluation neuropsychologique
7.1 Standardisation des bilans cognitifs par le Score Z
Dans l’évaluation neuropsychologique de routine, le score Z s’impose comme la métrique fondamentale pour quantifier les performances cognitives dans les domaines de l’attention, du langage, des fonctions exécutives ou de la mémoire spatiale. Les batteries de tests standardisées, telles que les échelles de Wechsler (WAIS-IV, WISC-V) ou la batterie d’évaluation cognitive de Montréal (MoCA), s’appuient sur des étalonnages normatifs permettant de transformer le score brut d’un patient en un écart standardisé par rapport à son groupe d’âge et de niveau socioculturel de référence.
Le diagnostic neuropsychologique s’appuie sur des seuils statistiques conventionnels de déviation. Une performance comprise entre $z = -1{,}00$ et $z = +1{,}00$ est classifiée comme se situant dans les limites de la normale attendue (délimitant la bande centrale des 68 % de la population). Un score Z descendant sous le seuil critique de $-1{,}50$ déclenche la suspicion d’une fragilité ou d’une atteinte cognitive légère (le score se situant alors au-delà du 93e percentile d’éloignement unilatéral). Dès lors qu’une mesure s’établit en dessous de $-2{,}00$ écarts-types (environ le deuxième percentile), la défaillance est reconnue comme un déficit sévère, confortant le diagnostic de dysfonctionnement neurobiologique ou lésionnel.
Cette homogénéisation des mesures sous la forme de scores Z offre la possibilité de construire des profils cognitifs intra-individuels clairs. En juxtaposant sur un même graphique les scores Z obtenus dans l’empan mnésique, les fonctions exécutives (Trail Making Test) et les aptitudes visuo-constructives, le praticien visualise immédiatement les dissociated profiles. Il identifie les fonctions préservées et les domaines altérés, ce qui permet de guider la rééducation de façon ciblée.
7.2 Exploitation du Score T dans les échelles d’évaluation de la personnalité
Si la neuropsychologie privilégie historiquement le score Z, le domaine de la psychologie de la personnalité et de la psychopathologie clinique a massivement adopté le score T de McCall. Cette préférence s’illustre particulièrement dans le Minnesota Multiphasic Personality Inventory (MMPI), inventaire clinique de référence mondiale depuis plusieurs décennies. Dans la cotation du MMPI-2 et de sa révision MMPI-3, l’ensemble des scores bruts des échelles cliniques (telles que l’hypocondrie, la dépression, l’hystérie, la déviation psychopathique ou la schizophrénie) est systématiquement converti en scores T.
Dans cette métrique, le score T = 50 représente le barycentre précis de la cohorte normative saine. Les seuils de décision clinique sont fixés sur des valeurs repères : un score T franchissant le cap de 65 (situé précisément à 1,5 écart-type au-dessus de la moyenne) définit le seuil de signification clinique. Une note atteignant ou dépassant $T ge 65$ signale que le niveau d’intensité du trait ou du symptôme mesuré n’est rencontré que chez moins de 5 % des individus au sein de la population générale, justifiant ainsi une attention diagnostique approfondie.
Une innovation méthodologique majeure introduite dans le MMPI-2 concerne l’usage des scores T uniformes. Dans les versions initiales, les distributions empiriques des échelles brutes présentaient des degrés de dissymétrie variables. En conséquence, un score T de 65 ne renvoyait pas au même rang percentile d’une échelle à l’autre. Le recours aux scores T uniformisés, corrigés par une méthode polynomiale sur les percentiles réels, a permis d’assurer une parfaite équivalence probabiliste : tout score $T = 65$ sur une échelle uniformisée correspond exactement au 92e percentile cumulé, préservant la fidélité des comparaisons inter-échelles sans distorsion liée à la forme des données d’origine.
7.3 Relations mathématiques et conversions inter-échelles
L’existence conjointe de multiples systèmes de cotation dans les batteries de tests psychologiques impose au praticien de maîtriser les relations d’équivalence algébrique qui unissent ces différentes échelles standardisées. Puisque l’ensemble de ces échelles repose sur des transformations linéaires à partir de la métrique fondamentale du score Z, la conversion d’un système à un autre s’effectue par des équations directes :
$$T = (z \times 10) + 50$$
Réciproquement, pour exprimer un score T sous la forme d’un score Z unitaire :
$$z = \frac{T – 50}{10}$$
Cette relation permet d’intégrer facilement d’autres métriques couramment rencontrées dans l’évaluation psychométrique :
- Le quotient intellectuel standard (Échelles de Wechsler) : calibré sur une moyenne $\mu = 100$ et un écart-type $\sigma = 15$. La formule de liaison est $QI = (z \times 15) + 100$, ou sous sa forme dérivée de T : $QI = ((T – 50) \times 1{,}5) + 100$.
- Les notes standardisées de sous-tests (Wechsler) : calibrées sur une moyenne de 10 et un écart-type de 3. Leur formalisation est $Note = (z \times 3) + 10$.
- Les stens (Standard Ten) : échelle divisée en 10 unités standardisées, centrée sur une moyenne de 5,5 avec un écart-type de 2, fréquemment exploitée dans les inventaires de personnalité en milieu professionnel (comme le test 16PF de Cattell).
- Les stanines (Standard Nines) : découpant la distribution normale en 9 intervalles discrets, centrées sur une moyenne de 5 et un écart-type de 2.
| Rang percentile théorique | Score Z | Score T psychométrique | Quotient Intellectuel (QI) | Note Standard Sous-test | Sten |
|---|---|---|---|---|---|
| 99,9e percentile | +3,00 | 80 | 145 | 19 | 10 |
| 97,7e percentile | +2,00 | 70 | 130 | 16 | 9,5 |
| 84,1e percentile | +1,00 | 60 | 115 | 13 | 7,5 |
| 50,0e percentile | 0,00 | 50 | 100 | 10 | 5,5 |
| 15,9e percentile | -1,00 | 40 | 85 | 7 | 3,5 |
| 2,3e percentile | -2,00 | 30 | 70 | 4 | 1,5 |
| 0,1e percentile | -3,00 | 20 | 55 | 1 | 1,0 |
8. Tests d’hypothèses statistiques : Test Z versus Test t de Student
8.1 Architecture formelle d’un test d’hypothèse univarié
L’inférence statistique univariée repose sur le formalisme probabiliste développé conjointement par Ronald Fisher, Jerzy Neyman et Egon Pearson. Ce cadre méthodologique vise à trancher rigoureusement entre deux propositions exclusives concernant l’état d’un paramètre dans une population :
- L’hypothèse nulle ($H_0$), qui postule l’absence de différence systématique, d’effet de traitement ou de déviation entre le paramètre observé et une valeur de référence théorique ($H_0 : \mu = \mu_0$).
- L’hypothèse alternative ($H_1$), qui postule l’existence d’une différence réelle. Cette hypothèse peut être formulée de manière bilatérale ($H_1 : \mu \neq \mu_0$) ou directionnelle/unilatérale ($H_1 : \mu > \mu_0$ ou $H_1 : \mu < \mu_0$).
Le déroulement opératoire d’un test statistique respecte une séquence standardisée en quatre phases :
- La formulation rigoureuse des hypothèses $H_0$ et $H_1$ et la sélection a priori du seuil d’erreur alpha de première espèce (conventionnellement fixé à $\alpha = 0{,}05$ ou $\alpha = 0{,}01$).
- Le recueil des données et le calcul de la statistique de test empirique observée ($z_{obs}$ ou $t_{obs}$) à partir des métriques d’échantillonnage.
- La détermination de la région critique de rejet, délimitée par la ou les valeurs critiques issues de la distribution théorique appropriée (la loi normale standard pour Z, la loi de Student avec degrés de liberté adaptés pour T).
- La comparaison de la statistique observée à la valeur critique, ou l’évaluation de la p-valeur associée face au seuil $\alpha$, aboutissant au rejet argumenté ou au maintien de l’hypothèse nulle.
8.2 Le Test Z pour échantillon unique face à une norme absolue
L’emploi du test Z pour échantillon unique est restreint à une situation méthodologique bien circonscrite : la confrontation de la moyenne $\bar{x}$ calculée sur un groupe de taille $n$ à une moyenne de référence $\mu_0$, en présupposant que l’écart-type de la population $\sigma$ est documenté de manière certaine. La statistique de test s’exprime selon la formule :
$$z_{obs} = \frac{\bar{x} – \mu_0}{\frac{\sigma}{\sqrt{n}}}$$
L’évaluation probabiliste s’opère par l’intermédiaire de la fonction d’intégration de la loi normale centrée réduite. Pour une hypothèse bilatérale, la p-valeur exacte correspondante est calculée selon l’intégrale :
$$p = 2 \times [1 – \Phi(|z_{obs}|)]$$
où $Phi$ symbolise la fonction de répartition cumulative de la loi normale standard. Si la p-valeur issue de ce calcul est strictement inférieure au seuil $\alpha$ préalablement défini, l’analyste rejette l’hypothèse nulle avec un risque d’erreur contrôlé, concluant que la performance du groupe se distingue significativement de la norme universelle.
Ce protocole s’applique par exemple dans le cadre d’enquêtes épidémiologiques majeures. Supposons qu’une agence de santé publique cherche à savoir si les enfants scolarisés dans une région industrielle exposée aux métaux lourds présentent un fléchissement de leur quotient intellectuel moyen. Si l’échelle de QI utilisée a été calibrée sur une cohorte nationale avec des paramètres fixes connus ($\mu = 100$ et $\sigma = 15$), l’évaluation d’un groupe représentatif de 150 enfants issus de cette zone s’exécute valablement par le test Z, la variance de la population étant issue de l’étalonnage national de référence.
8.3 La famille des tests t pour situations d’échantillonnage réelles
Face à des situations d’investigation où $\sigma$ n’est pas documenté, les chercheurs mobilisent la famille des tests t de Student. Cette boîte à outils analytique se décline en trois variantes principales, adaptées à la structure du protocole expérimental :
1. Le test t pour échantillon unique :
Il confronte la moyenne observée d’un échantillon expérimental $\bar{x}$ à une constante théorique de référence $\mu_0$, la variance étant estimée directement sur le groupe par $s$. La statistique s’exécute avec $dl = n – 1$ selon la formule vue précédemment :
$$t_{obs} = \frac{\bar{x} – \mu_0}{\frac{s}{\sqrt{n}}}$$
2. Le test t de Student pour deux échantillons indépendants :
Ce test évalue si deux moyennes de groupes mutuellement exclusifs ($\bar{x}_1$ et $\bar{x}_2$) présentent un écart statistiquement significatif. Lorsque les deux populations partagent une variance commune (hypothèse d’homoscédasticité), on procède à une estimation mutualisée de la variance (pooled variance, notée $s_p^2$) :
$$s_p^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
La statistique $t$ associée s’énonce alors selon la relation :
$$t = \frac{\bar{x}_1 – \bar{x}_2}{\sqrt{s_p^2 \left(\frac{1}{n_1} + \frac{1}{n_2}\right)}}$$
Ce test dispose de $dl = n_1 + n_2 – 2$ degrés de liberté.
3. Le test t de Welch (correction pour hétéroscédasticité) :
Si les variances des deux groupes divergent notablement (hétéroscédasticité avérée, par exemple via un test de Levene concluant à $p < 0{,}05$) ou si les effectifs $n_1$ et $n_2$ sont inégaux, l’assomption de Student s’effondre. Le test t de Welch s’affranchit de la variance mutualisée et ajuste dynamiquement les degrés de liberté selon la formule d’approximation de Welch-Satterthwaite :
$$dl’ = \frac{\left(\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}\right)^2}{\frac{\left(\frac{s_1^2}{n_1}\right)^2}{n_1 – 1} + \frac{\left(\frac{s_2^2}{n_2}\right)^2}{n_2 – 1}}$$
Cette correction évite une inflation drastique de l’erreur de type I en présence de variances hétérogènes.
4. Le test t pour mesures répétées (échantillons appariés) :
Utilisé lorsqu’un même échantillon de sujets est évalué à deux reprises (protocoles pré-test/post-test ou conditions intra-sujets), ce test modélise directement le vecteur des différences individuelles $D_i = X_{post,i} – X_{pre,i}$. L’analyse revient à exécuter un test t sur échantillon unique appliqué sur la moyenne des différences $\bar{D}$, testant l’hypothèse nulle selon laquelle l’espérance de la différence est nulle ($\mu_D = 0$) :
$$t = \frac{\bar{D} – 0}{\frac{s_D}{\sqrt{n}}}$$
Cette approche neutralise la variance interindividuelle inter-sujets, maximisant la puissance statistique du test.
9. Construction et interprétation des intervalles de confiance
9.1 Intervalles de confiance basés sur le Score Z
L’estimation ponctuelle d’un paramètre (telle que la moyenne d’un échantillon $\bar{x}$) offre une vue incomplète de la réalité statistique, car elle omet de quantifier la marge d’incertitude liée à l’échantillonnage. La construction d’un intervalle de confiance répond à cet impératif en définissant une fourchette de valeurs numériques ayant une probabilité prescrite $(1 – \alpha)$ de contenir la véritable valeur du paramètre de la population étudiée.
Dans la situation théorique où la dispersion de la population $\sigma$ est documentée de manière exhaustive, l’intervalle de confiance bilatéral à $100(1 – \alpha)%$ s’exprime analytiquement selon l’équation :
$$IC_{(1-\alpha)} = \left[ \bar{x} – z_{\text{crit}} \times \frac{\sigma}{\sqrt{n}} ; ; ; \bar{x} + z_{\text{crit}} \times \frac{\sigma}{\sqrt{n}} \right]$$
Pour un niveau de confiance fixé à 95 % ($\alpha = 0{,}05$), la valeur critique issue de la loi normale standard est la constante universelle $z_{\text{crit}} = 1{,}960$. L’étendue de cet intervalle de confiance dépend exclusivement de trois paramètres : le niveau de certitude exigé (qui fixe $z_{\text{crit}}$), l’amplitude de la variabilité populationnelle ($\sigma$), et la taille de l’échantillon ($n$). L’analyste constate ici que la précision augmente de manière inversement proportionnelle à la racine carrée de l’effectif : pour réduire la largeur de l’intervalle de moitié, il est indispensable de quadrupler le nombre d’observations.
L’interprétation de cet intervalle repose sur une modélisation fréquentiste : si l’expérimentateur répétait l’expérience de tirage aléatoire d’échantillons de taille $n$ une infinité de fois dans des conditions identiques, exactement 95 % des intervalles ainsi construits contiendraient la valeur fixe, mais inconnue, de l’espérance mathématique populationnelle $\mu$. L’intervalle de confiance matérialise l’étendue de la variabilité d’échantillonnage sous l’hypothèse de certitude de dispersion.
9.2 Intervalles de confiance basés sur le Score T
Lorsque la variance de la population générale est inconnue — ce qui reflète la réalité quasi intégrale des protocoles de recherche en psychologie clinique —, la construction de l’intervalle de confiance doit intégrer la double incertitude qui affecte à la fois la moyenne $\bar{x}$ et l’écart-type de l’échantillon $s$. L’équation de l’intervalle de confiance bilatéral s’exprime alors à travers la statistique de Student :
$$IC_{(1-\alpha)} = \left[ \bar{x} – t_{\text{crit},dl} \times \frac{s}{\sqrt{n}} ; ; ; \bar{x} + t_{\text{crit},dl} \times \frac{s}{\sqrt{n}} \right]$$
L’incidence du passage de Z à T se manifeste ici par un élargissement mécanique de l’intervalle. Cet étirement de la marge d’erreur résulte de la conjonction de deux facteurs d’amplification mathématique :
- D’une part, l’erreur type estimée ($s/\sqrt{n}$) est elle-même une grandeur stochastique instable, sujette à des fluctuations d’échantillonnage pouvant dépasser $\sigma$.
- D’autre part, la valeur critique $t_{\text{crit},dl}$, conditionnée par les degrés de liberté ($dl = n – 1$), est systématiquement supérieure à son équivalent gaussien $z = 1{,}960$.
Pour un échantillon de très faible ampleur comportant $n = 6$ sujets ($dl = 5$) évalué au seuil de confiance de 95 %, la valeur critique de Student s’établit à $t_{\text{crit}} = 2{,}571$. L’intervalle de confiance résultant est ainsi considérablement plus large que celui que produirait un calcul Z erroné. Cet élargissement de la fourchette d’estimation reflète la prudence statistique requise face à un jeu d’observations restreint, prévenant toute fausse certitude sur la précision de la mesure.
9.3 Interprétation clinique versus inférentielle de l’intervalle
Il est fondamental de distinguer conceptuellement deux applications souvent confondues de l’intervalle de confiance : l’inférence sur le paramètre moyen d’un groupe et l’estimation de la note vraie d’un patient individuel dans un cadre psychométrique. L’intervalle de confiance fondé sur la statistique t encadre l’espérance mathématique d’une population ou d’un groupe d’étude ($\mu$). Il ne saurait en aucun cas être utilisé directement pour quantifier la marge d’imprécision entourant la performance isolée d’une personne singulière.
Dans l’exercice de l’évaluation psychologique individuelle, la métrologie s’appuie sur la théorie classique des tests (TCT), formulée par Charles Spearman. Dans ce modèle théorique, le score brut observé ($X$) d’un sujet est la sommation de son niveau réel sous-jacent (la « note vraie » $V$) et d’une perturbation stochastique aléatoire (l’« erreur de mesure » $E$) :
$$X = V + E$$
Pour encadrer la note vraie d’un patient, le clinicien ne mobilise pas l’erreur type de la moyenne d’échantillonnage, mais l’erreur type de mesure (SEM, pour Standard Error of Measurement), calculée à partir de l’écart-type normatif de l’instrument ($\sigma_X$) et de son coefficient de fidélité ($r_{xx’}$) :
$$SEM = \sigma_X \sqrt{1 – r_{xx’}}$$
L’intervalle d’estimation individuelle autour de la performance du patient s’établit alors conventionnellement en appliquant le score Z de la loi normale (par exemple, $\pm 1{,}96 \times SEM$ pour un seuil bilatéral de 95 %), car les étalonnages psychométriques ont été validés sur de grands échantillons normatifs. Confondre l’erreur type de mesure individuelle et l’erreur type d’échantillonnage d’un groupe constitue une faute méthodologique majeure dans la pratique neuropsychologique.
10. Études de cas pratiques en psychologie clinique et expérimentale
10.1 Étude de cas 1 : Évaluation de l’efficacité d’une thérapie cognitive (Test t)
Pour illustrer l’arbitrage méthodologique en recherche clinique, examinons un protocole évaluant l’efficacité d’une thérapie d’activation comportementale chez des patients présentant un trouble dépressif caractérisé. Une cohorte restreinte de $n = 22$ participants est soumise à l’Inventaire de Dépression de Beck (BDI-II) avant et après un programme d’intervention de 8 semaines. Les variables analysées correspondent aux scores de diminution des symptômes, définis par la différence $D_i = X_{\text{pre},i} – X_{\text{post},i}$.
Le traitement des données empiriques fournit les statistiques d’échantillon suivantes :
- Moyenne observée des réductions de score : $\bar{D} = 7{,}45$ points
- Variance sans biais de l’échantillon : $s_D^2 = 24{,}60$, d’où un écart-type de : $s_D = \sqrt{24{,}60} \approx 4{,}96$ points
- Taille de l’échantillon : $n = 22$, d’où des degrés de liberté s’élevant à : $dl = 22 – 1 = 21$
La question méthodologique se pose : quel modèle probabiliste appliquer pour tester si cette amélioration clinique est significative ? L’écart-type universel de la réduction des scores pour cette thérapie spécifique est par nature inconnu ; les données doivent donc impérativement être traitées par le test t de Student pour mesures appariées, excluant formellement le recours au score Z.
Le calcul de l’erreur type estimée de la moyenne des différences donne :
$$SE = \frac{s_D}{\sqrt{n}} = \frac{4{,}96}{\sqrt{22}} = \frac{4{,}96}{4{,}690} \approx 1{,}058$$
La statistique t empirique observée s’établit ainsi :
$$t_{obs} = \frac{\bar{D} – 0}{SE} = \frac{7{,}45}{1{,}058} \approx 7{,}04$$
La consultation de la table distributionnelle de Student pour $dl = 21$ au seuil bilatéral de $\alpha = 0{,}05$ indique une valeur critique de $t_{\text{crit}} = 2{,}080$. La statistique observée ($t_{obs} = 7{,}04$) dépassant largement le seuil requis, le chercheur rejette formellement l’hypothèse nulle d’absence d’effet ($p < 0{,}001$). L’ampleur de l’effet clinique est ensuite mesurée via le d de Cohen pour mesures appariées :
$$d = \frac{\bar{D}}{s_D} = \frac{7{,}45}{4{,}96} \approx 1{,}50$$
Ce résultat confirme un effet clinique majeur de l’intervention thérapeutique.
10.2 Étude de cas 2 : Dépistage d’un haut potentiel intellectuel (Score Z)
Considérons à présent la démarche diagnostique d’un psychologue clinicien réalisant un bilan psychométrique auprès d’un adolescent de 16 ans au moyen de l’échelle d’intelligence de Wechsler pour adultes (WAIS-IV). À l’issue de la passation des dix subtests obligatoires, l’examinateur calcule la somme des notes standardisées et obtient un score brut composite converti en un Quotient Intellectuel Total (QIT) égal à 132.
Dans ce contexte précis, les paramètres de la distribution de référence sont connus et fixés par l’étalonnage national standardisé de l’éditeur du test :
- Moyenne universelle de l’échelle de QIT : $\mu = 100$
- Écart-type universel de l’échelle : $\sigma = 15$
L’écart-type de référence $\sigma$ étant parfaitement documenté et l’échantillon normatif national de la WAIS-IV ayant été validé sur une cohorte représentative de plusieurs centaines de sujets par tranche d’âge, le clinicien doit employer le modèle du score Z pour positionner la performance de l’adolescent :
$$z = \frac{X – \mu}{\sigma} = \frac{132 – 100}{15} = \frac{32}{15} \approx +2{,}13$$
L’interprétation clinique exploite la fonction de répartition normale. La valeur $z = +2{,}13$ se situe au-delà du seuil classique de normalité ($z ge +2{,}00$), ce qui correspond sur les tables statistiques de la loi normale centrée réduite à un rang percentile unilatéral de 98,34 %. Cette donnée atteste que l’adolescent égale ou dépasse 98,3 % des pairs de son groupe d’âge, satisfaisant ainsi au critère psychométrique formel retenu pour l’identification d’un haut potentiel intellectuel. L’usage du test t serait ici méthodologiquement sans objet, puisque l’évaluation ne porte pas sur l’estimation de la moyenne d’un sous-échantillon expérimental, mais sur le positionnement d’une valeur individuelle par rapport à une métrique populationnelle établie.
10.3 Étude de cas 3 : Comparaison de temps de réaction en neuro-ergonomie (Arbitrage empirique)
Une équipe de neuro-ergonomie évalue l’impact d’une interface de guidage visuel sur la vitesse d’intervention d’opérateurs dans un simulateur de vol. Le protocole recueille la latence motrice de $n = 45$ pilotes face à une alerte critique en cockpit. La latence moyenne d’intervention sous l’interface conventionnelle est documentée dans les manuels aéronautiques à $\mu = 850$ millisecondes.
L’expérimentation avec le nouveau dispositif fournit les paramètres empiriques suivants :
- Moyenne observée : $\bar{x} = 812\text{ ms}$ (soit un gain apparent de 38 ms)
- Écart-type de l’échantillon : $s = 135\text{ ms}$
- Taille de l’échantillon : $n = 45$
Bien que la taille d’échantillon franchisse le seuil empirique de $n = 30$, l’analyste rigoureux refuse l’utilisation mécanique d’un test Z. L’écart-type universel $\sigma$ sous la nouvelle configuration de vol n’est pas connu, et les latences motrices en ergonomie présentent régulièrement une asymétrie positive résiduelle avec une queue de distribution droite étirée par quelques temps de réaction lents.
Le calcul méthodique repose donc sur la statistique t de Student univariée. L’erreur type estimée de la moyenne vaut :
$$SE = \frac{s}{\sqrt{n}} = \frac{135}{\sqrt{45}} = \frac{135}{6{,}708} \approx 20{,}125\text{ ms}$$
La statistique t observée s’établit selon le calcul :
$$t_{obs} = \frac{\bar{x} – \mu}{SE} = \frac{812 – 850}{20{,}125} = \frac{-38}{20{,}125} \approx -1{,}888$$
Pour un test bilatéral avec $dl = 45 – 1 = 44$ degrés de liberté au seuil conventionnel $\alpha = 0{,}05$, la valeur critique est $t_{\text{crit}, 44} = 2{,}015$. La valeur absolue de la statistique empirique observée ($|t_{obs}| = 1{,}888$) s’avère inférieure au seuil d’exclusion requis ($1{,}888 < 2{,}015$), ce qui correspond à une p-valeur de $p = 0{,}065$.
L’intérêt de cet exemple réside dans la confrontation avec le modèle Z. Si l’expérimentateur avait appliqué de manière paresseuse le test Z sous le prétexte fallacieux que $n > 30$, en utilisant le seuil critique théorique fixe de $z = 1{,}960$, la conclusion aurait oscillé dans une zone de flottement méthodologique. Pire encore, pour un seuil unilatéral mal cadré, le résultat aurait été hâtivement déclaré significatif. L’emploi de la distribution t garantit ici le respect des normes d’inférence en retenant à juste titre l’hypothèse nulle au regard des données disponibles.
11. Erreurs courantes, pièges méthodologiques et mauvaises interprétations
11.1 La confusion entre Score T inférentiel et Score T psychométrique
Parmi les erreurs méthodologiques récurrentes dans les départements de psychologie et les centres hospitaliers universitaires, la confusion lexicale et computationnelle entre le t inférentiel (Student) et le T métrique (McCall) figure en première place. Cette situation découle d’une homonymie historique : les deux démarches mobilisent la même lettre majuscule pour désigner deux objets mathématiques totalement distincts.
Dans les environnements logiciels de traitement de données (le projet R, IBM SPSS Statistics, Jamovi ou JASP), cette méprise peut avoir des répercussions fâcheuses :
- D’un côté, l’analyste manipule une statistique de test paramétrique déduite d’un ratio de variance (la statistique t de Student), qui s’exprime typiquement par un nombre restreint pouvant être négatif, nul ou positif (par exemple : $t = -2{,}45$), associé à des degrés de liberté et une p-valeur.
- De l’autre, le psychométricien manipule un score individuel standardisé linéaire d’étalonnage psychométrique, qui s’échelonne sur une échelle strictement positive centrée sur 50, avec un écart-type de 10 (par exemple : $T = 65$).
Pour éviter toute ambiguïté au sein des publications empiriques et des comptes rendus d’évaluation psychologique, il convient d’adopter une graphie typographique stricte, conformément aux préconisations de l’American Psychological Association. La statistique de test de Student doit systématiquement être rapportée en lettre minuscule italique suivie de ses degrés de liberté entre parenthèses : t(21) = 2,45. À l’inverse, l’échelle standardisée de positionnement individuel de McCall doit impérativement être mentionnée en lettre majuscule droite non soulignée : Score T = 65.
11.2 L’utilisation mécanique du Test Z par conformisme logiciel
L’enseignement académique traditionnel a longtemps véhiculé une simplification méthodologique abusive : « Dès que $n ge 30$, l’analyste peut appliquer un test Z même si l’écart-type de la population n’est pas connu ». Cette règle d’or d’un autre temps, héritée des contraintes de l’ère pré-informatique où les tables imprimées de la loi normale s’avéraient plus pratiques à manipuler que celles de Student, est aujourd’hui totalement obsolète.
Appliquer un test Z dès que $n$ franchit le cap de 30 avec un écart-type inconnu estimé par $s$ constitue une approximation inutile. L’ensemble des architectures de calcul statistique modernes, de la fonction de base `t.test()` sous R aux menus de Jamovi ou SPSS, exécutent par défaut l’algorithme exact de la loi t de Student dès lors qu’un écart-type populationnel n’est pas explicitement injecté par l’utilisateur. Forcer manuellement un test Z dans ces conditions revient à dégrader la fidélité de l’inférence en adoptant un modèle qui sous-estime l’incertitude résiduelle d’échantillonnage.
Cette divergence méthodologique engendre souvent des frictions lors de l’apprentissage de la statistique : les étudiants calculant leurs exercices à la main sur la table normale standard obtiennent des p-valeurs ou des intervalles qui ne coïncident pas parfaitement avec les résultats générés par les logiciels professionnels de laboratoire, créant une confusion analytique dommageable.
11.3 La mauvaise interprétation des scores négatifs et des centiles
Dans la pratique clinique, l’interprétation des scores standardisés par les praticiens non statisticiens fait souvent l’objet d’un biais d’évaluation : le réflexe diagnostique négatif. De nombreux intervenants assimilent spontanément un score Z affecté d’un signe négatif (par exemple $z = -0{,}65$) à l’expression d’un déficit fonctionnel ou d’une atteinte cognitive. Cette assimilation témoigne d’une méconnaissance de la logique distributionnelle. Par construction même, 50 % des individus sains issus de la cohorte normative présentent nécessairement un score Z négatif, la médiane d’une loi normale coïncidant avec zéro.
Un score situé à $z = -0{,}65$ correspond environ au 26e percentile de la population générale : bien qu’il se situe dans la moitié inférieure de la distribution, il s’inscrit pleinement dans la zone de variabilité normale (définie par l’intervalle $[-1{,}00 ; +1{,}00]$) et ne témoigne d’aucune altération pathologique.
Une seconde distorsion découle de la transcription hâtive d’un score Z en rang percentile sans vérification préalable de la normalité de la distribution originelle. Si la mesure brute présente une dissymétrie marquée (par exemple, un inventaire de traits dépressifs où la majeure partie des sujets sains obtient un score proche de zéro), l’utilisation des tables de la loi normale pour déduire un percentile à partir d’un score Z calculé induit des décalages probabilistes majeurs pouvant fausser le jugement diagnostique.
Enfin, le clinicien doit se prémunir contre les comparaisons trompeuses de scores Z ou T dérivés d’échantillons normatifs étalonnés à des époques différentes. L’effet Flynn (qui documente une dérive séculaire des scores moyens d’efficience intellectuelle au fil des décennies) démontre qu’une performance brute correspondant à un score $z = 0$ sur une échelle normée en 1980 peut correspondre à un score $z = -0{,}67$ lorsqu’elle est confrontée à une norme contemporaine réactualisée, faussant les conclusions diagnostiques longitudinales.
11.4 L’oubli des hypothèses fondamentales sous-jacentes
L’attention portée au choix entre z et t masque parfois l’omission d’hypothèses plus fondamentales qui conditionnent la validité même des modèles paramétriques. Le non-respect de ces hypothèses préalables fragilise les conclusions des tests d’hypothèses univariés :
- L’hypothèse d’indépendance stochastique des observations : Il s’agit de la condition la plus critique. L’inclusion involontaire de mesures corrélées (par exemple, des données issues de fratries, des évaluations répétées sur un même sujet au sein d’un même échantillon, ou un recrutement en grappes non contrôlé) induit un effondrement de la variance réelle, fausse totalement le calcul de l’erreur type et multiplie artificiellement le taux d’erreur de type I.
- L’hypothèse d’homogénéité des variances (homoscédasticité) : L’application du test t de Student standard à deux groupes de variances inégales, tout particulièrement lorsque les effectifs d’échantillons sont asymétriques ($n_1 ne n_2$), altère la précision des valeurs critiques théoriques. Le recours systématique à la variante de Welch devrait s’imposer comme le standard algorithmique dans toute situation de doute.
- L’absence d’analyse de puissance statistique a priori : Déployer un test t sur un micro-groupe ($n = 8$) sans avoir conduit au préalable une estimation de la puissance via des outils validés (tels que le logiciel open-source G*Power) expose le chercheur au risque d’une étude sans portée, incapable de détecter un effet clinique modéré mais bien réel par manque de puissance analytique.
12. Synthèse comparative et recommandations pour la recherche empirique
12.1 Tableau récapitulatif multidimensionnel des spécificités Z versus T
Afin de structurer les choix méthodologiques du chercheur et du clinicien, le tableau suivant propose une confrontation systématique des propriétés mathématiques, contextes d’application et protocoles de calcul qui caractérisent respectivement le score Z et le score T sous ses deux déclinaisons.
| Dimension analytique | Score / Test Z | Statistique t de Student | Score T psychométrique (McCall) |
|---|---|---|---|
| Rôle fonctionnel principal | Standardisation normative universelle ou test d’inférence face à une variance connue | Test inférentiel d’hypothèses sur des moyennes avec variance inconnue | Échelle psychométrique d’étalonnage pour bilans de personnalité et d’évaluation clinique |
| Paramètre de dispersion mobilisé | Écart-type de la population ($\sigma$) connu et invariant | Écart-type de l’échantillon ($s$) calculé avec correction de Bessel ($n – 1$) | Constante métrique fixée par définition ($\sigma_T = 10$) |
| Moyenne et variance théoriques | $\mu = 0$ et $\sigma^2 = 1$ | $\mu = 0$ et variance fonction des degrés de liberté : $\sigma^2 = dl / (dl – 2)$ pour $dl > 2$ | $\mu_T = 50$ et $\sigma_T^2 = 100$ (Écart-type = 10) |
| Forme de la distribution théorique | Loi normale standard invariante (symétrique, mésokurtique, kurtosis = 3) | Loi t de Student dynamique à queues lourdes (leptokurtique, converge vers Z si $dl to \infty$) | Affine à la distribution sous-jacente (parfaite réplication de l’échelle d’origine) |
| Sensibilité à la taille de l’échantillon | Insensible par postulat (suppose une connaissance absolue ou un effectif infini) | Extrêmement sensible : les valeurs critiques s’adaptent dynamiquement via les $dl$ | Non applicable directement (concerne l’expression de scores individuels) |
| Valeurs critiques types ($\alpha = 0{,}05$, bilatéral) | Constante universelle : 1,960 | Variable : 2,776 ($dl=4$) ; 2,045 ($dl=29$) ; 1,962 ($dl=999$) | Non applicable (interprétation clinique par seuils fixes, typiquement $T ge 65$) |
12.2 Bonnes pratiques rédactionnelles selon les directives de l’APA (7e édition)
La communication scientifique des analyses statistiques doit se conformer aux standards de transparence et de rigueur formelle dictés par le Publication Manual of the American Psychological Association (7e édition). Les directives de l’APA imposent des normes de notation unifiées, conçues pour garantir l’exhaustivité de l’information statistique transmise aux pairs.
Lors de la rédaction d’un rapport de test t de Student, la syntaxe textuelle standardisée requiert la formalisation suivante :
t(degrés de liberté) = valeur de la statistique observée, p = p-valeur exacte, d = indice de taille d’effet.
À titre d’exemple : « L’analyse par test t pour échantillons indépendants révèle une réduction significative des scores d’anxiété dans le groupe d’intervention comparativement au groupe témoin, t(58) = 2,43, p = .018, d = 0,63, IC 95% [0,11, 1,14]. »
Pour un test Z, la formulation retient une structure similaire, en omettant les degrés de liberté :
z = valeur observée, p = p-valeur exacte, intervalle de confiance.
Par exemple : « Le niveau cognitif moyen de l’échantillon d’étude surpasse la norme nationale de référence, z = 2,05, p = .040, IC 95% [0,08, 3,92]. »
L’APA insiste fermement sur trois obligations de présentation :
- Les lettres symbolisant les statistiques de test doivent être typographiées en italique (z, t, p, d, r).
- La p-valeur ne doit jamais être introduite par le chiffre zéro avant le séparateur décimal (écrire p = .018 et non p = 0.018), le paramètre de probabilité ne pouvant excéder l’unité. Les écritures imprécises du type « p < .05 » doivent être proscrites au profit des p-valeurs exactes à trois décimales (sauf si $p < .001$).
- Toute statistique de test univariée rapportée doit obligatoirement être accompagnée de la taille d’effet correspondante (typiquement le d de Cohen ou le g de Hedges corrigé) et de l’intervalle de confiance bilatéral encadrant la mesure de l’effet, fournissant une indication tant de la significativité que de la magnitude de l’observation.
12.3 Perspectives contemporaines : méthodes robustes et rééchantillonnage
L’inférence paramétrique classique fondée sur la dyade des modèles Z et T a été forgée à une époque où le calcul algorithmique automatisé n’existait pas. Dans la pratique scientifique contemporaine, confrontée à des données de neuro-imagerie, de génomique comportementale ou de suivi digital continu, les hypothèses de normalité stricte et de linéarité sont très fréquemment mises à mal.
Pour dépasser l’impasse du dilemme Z/T face à des données réelles complexes, la littérature méthodologique préconise le recours aux approches statistiques computationnelles robustes. Parmi celles-ci, le bootstrapping (ou méthode de rééchantillonnage avec remplacement), conceptualisé par Bradley Efron, s’impose comme une alternative de référence. En tirant plusieurs milliers de sous-échantillons aléatoires au sein de la base de données empirique elle-même, le bootstrap génère une approximation empirique de la distribution d’échantillonnage de la moyenne sans formuler d’assomption restrictive quant à la normalité de la distribution parente ni présumer d’un écart-type théorique fixe.
Parallèlement, la statistique bayésienne propose un dépassement épistémologique du paradigme des tests d’hypothèses traditionnels (NHST). En substituant la recherche de la p-valeur par le calcul du facteur de Bayes ($BF_{10}$), l’analyse bayésienne quantifie directement le degré de vraisemblance relative des données sous l’hypothèse alternative par rapport à l’hypothèse nulle. Cette approche affranchit l’expérimentateur des distorsions liées au seuil d’alpha arbitraire de 5 % et offre une quantification nuancée de l’évidence empirique, garantissant une pratique métrologique plus rigoureuse au service de la psychologie et des sciences du comportement.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- McCall, W. A. (1922). How to measure in education. Macmillan.
- Student [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510