
L’évaluation de la performance des modèles prédictifs constitue l’une des pierres angulaires de l’apprentissage automatique contemporain et de la science des données appliquée. Qu’il s’agisse de déployer un algorithme de détection précoce d’une pathologie neurodégénérative, d’automatiser le tri de requêtes textuelles complexes ou d’identifier des profils psychologiques à risque au sein de vastes cohortes observationnelles, la pertinence diagnostique d’un système inductif ne saurait être jaugée à l’aune de sa seule complexité algorithmique. Trop souvent, la phase critique de validation statistique est réduite à un arbitrage expéditif entre des métriques scalaires génériques, au premier rang desquelles figurent l’exactitude globale (accuracy) et le score F1. Pourtant, le choix délibéré ou inconscient d’une métrique d’évaluation n’est jamais un acte méthodologique neutre : il cristallise une ontologie sous-jacente relative à la nature de l’erreur admissible et conditionne directement l’utilité clinique, économique et éthique des décisions automatisées.
La métrique d’exactitude a longtemps régné en maître incontesté dans la littérature expérimentale en raison de son apparente intuitivité. Présentée de manière quasi instinctive comme le pourcentage d’observations correctement classées par rapport à la taille totale de l’échantillon, elle séduit d’emblée les évaluateurs, les comités d’éthique et les décideurs institutionnels peu rompus aux subtilités de la théorie bayésienne de la décision. Néanmoins, dès lors que l’on quitte les conditions idéalisées des distributions symétriques et parfaitement équilibrées, l’exactitude se transforme fréquemment en un miroir aux alouettes méthodologique. Face à des phénomènes caractérisés par une faible prévalence épidémiologique ou des déséquilibres de classes massifs, un modèle d’une médiocrité absolue peut afficher un taux d’exactitude spectaculairement flatteur tout en échouant systématiquement à déceler le moindre événement d’intérêt réel.
À l’inverse, le score F1 s’érige en rempart contre les distorsions induites par les asymétries distributionnelles en synthétisant, par le biais d’une moyenne harmonique élégante, les notions complémentaires de précision prédictive et de rappel exhaustif. Toutefois, adopter aveuglément le score F1 sans en circonscrire rigoureusement les postulats mathématiques et les zones de cécité constitue une faute méthodologique symétrique tout aussi préjudiciable. Le présent traité propose une déconstruction exhaustive, théorique, formelle et appliquée de cette confrontation paradigmatique. À travers une analyse comparative ancrée dans la statistique inférentielle, l’apprentissage supervisé et les sciences comportementales, nous explorerons les mécanismes intimes de ces indicateurs afin d’équiper le chercheur, le biostatisticien et l’ingénieur des critères d’arbitrage indispensables à une modélisation rigoureuse, transparente et éthiquement responsable.
1. Fondements théoriques de l’évaluation des modèles de classification
1.1 Rôle et importance des métriques de performance
Dans le paradigme de l’apprentissage supervisé, le processus d’induction statistique consiste à ajuster les paramètres internes d’un estimateur de manière à minimiser une fonction de perte empirique définie sur un espace probabiliste d’apprentissage. Cependant, il existe une scission conceptuelle et fonctionnelle majeure entre l’optimisation mathématique continue opérée par les algorithmes de descente de gradient et l’évaluation métrologique finale du modèle. La fonction de perte (telle que l’entropie croisée binaire ou la perte logistique) requiert des propriétés analytiques strictes, notamment la différentiabilité et la convexité locale, afin de guider le calcul des gradients directionnels. À l’opposé, les métriques d’évaluation opérationnelles constituent des fonctions de décision discrètes, non différentiables par nature, conçues pour quantifier la validité écologique, l’efficacité clinique ou la rentabilité industrielle des prédictions finales dans un contexte réel donné.
Cette divergence entre le moteur computationnel de l’algorithme et la grille de lecture métrique impose une vigilance épistémologique absolue. Une métrique quantique ne se limite pas à enregistrer passivement le comportement d’un système : elle oriente rétroactivement les choix d’ingénierie des caractéristiques, la sélection d’hyperparamètres et l’arbitrage des seuils de coupure décisionnels. Choisir un indicateur inadapté à la structure intrinsèque des données équivaut à calibrer un instrument de mesure physique sur une constante dimensionnelle erronée. Les conséquences méthodologiques s’avèrent délétères : publication de résultats fallacieux, réplication expérimentale impossible, biais de confirmation institutionnalisé et déploiement de modèles prédictifs opérationnellement inopérants, voire directement préjudiciables pour les populations évaluées.
1.2 Structure et lecture fondamentale de la matrice de confusion
Toute tentative de formalisation de l’erreur de classification binaire requiert impérativement la projection des prédictions du modèle face à la réalité empirique au sein d’un tableau de contingence standardisé désigné sous le vocable de matrice de confusion. Cette matrice croise les classes réelles observées (l’étalon-or ou ground truth) avec les classes prédites par l’algorithme, segmentant l’univers de discours en quatre quadrants probabilistes exclusifs et exhaustifs. Les concordances diagnostiques s’expriment par le dénombrement des Vrais Positifs (VP) — instances où la condition d’intérêt est effectivement présente et validée comme telle par le classifieur — et des Vrais Négatifs (VN), caractérisant l’absence avérée du phénomène conjointement corroborée par le système.
À l’opposé de ces réussites se déploient les deux modalités d’inférence fautive théorisées par la statistique décisionnelle de Neyman et Pearson. D’une part, les Faux Positifs (FP), également qualifiés d’erreurs de type I ou d’alarmes fallacieuses, désignent les cas où un statut négatif réel se voit attribuer indûment l’étiquette positive. D’autre part, les Faux Négatifs (FN), ou erreurs de type II, correspondent aux défaillances de détection où une entité positive est reléguée au rang de négatif. La normalisation de ces effectifs bruts selon les marges horizontales et verticales de la table conditionne la lecture distributionnelle des prédictions et permet d’isoler l’impact de la prévalence basale sur le comportement intrinsèque de la classification catégorielle.
1.3 Application transversale aux sciences comportementales et à la psychométrie
L’importation de ces formalismes mathématiques au sein des sciences comportementales, de la psychiatrie quantitative et de la psychométrie contemporaine illustre avec acuité la tension entre catégorisation rigide et réalité phénoménologique continue. Lorsqu’un modèle algorithmique est chargé d’inférer un diagnostic psychopathologique — qu’il s’agisse de la dépression majeure, du spectre de l’autisme ou d’un trouble de la personnalité limite —, il tente de superposer une frontière d’arbitrage binaire sur un continuum latent de détresse psychologique ou de traits comportementaux hétérogènes. La sensibilité des taxonomies nosographiques, telles que celles édictées par le DSM-5 ou la CIM-11, est intrinsèquement tributaire de la variabilité des seuils de détection statistique adoptés.
Dans ce contexte disciplinaire particulier, l’alignement des métriques d’évaluation sur la réalité clinique observée relève d’une responsabilité éthique fondamentale. Une erreur d’inférence ne représente pas une simple unité d’entropie résiduelle dans un journal d’exécution informatique ; elle incarne un individu potentiellement soumis à une médication inappropriée ou privé d’un accompagnement thérapeutique salvateur. Le chercheur en psychométrie computationnelle est ainsi contraint de déterminer si son modèle cherche à capturer fidèlement l’amplitude phénoménologique totale d’un syndrome (favorisant l’exhaustivité diagnostique) ou s’il doit garantir une certitude étiologique absolue avant toute assignation catégorielle (privilégiant la pureté de la prédiction positive).
2. Analyse conceptuelle et mathématique de l’Exactitude (Accuracy)
2.1 Formulation mathématique et logique sous-jacente
L’exactitude, universellement désignée dans la littérature anglo-saxonne sous le terme d’accuracy, représente la mesure de proximité globale entre l’ensemble des inférences formulées par un modèle et la distribution réelle des états de la nature. Sur le plan formel, elle se définit comme le ratio arithmétique de la somme des prédictions rigoureusement exactes rapportée à la cardinalité totale de la cohorte d’évaluation. Soit un échantillon composé de $N$ observations individuelles réparties au sein d’un espace binaire, l’équation universelle de l’exactitude s’énonce comme suit :
$$\text{Exactitude} = \frac{\text{VP} + \text{VN}}{\text{VP} + \text{VN} + \text{FP} + \text{FN}} = \frac{\text{VP} + \text{VN}}{N}$$
Cette formulation repose sur une logique d’agrégation symétrique et non pondérée. Chaque observation individuelle, qu’elle appartienne à la modalité positive ou à la modalité négative, contribue rigoureusement à concurrence d’une unité fractionnaire $\frac{1}{N}$ au score final. D’un point de vue probabiliste, l’exactitude modélise l’espérance mathématique qu’une observation $x_i$, extraite de manière aléatoire et uniforme de la distribution conjointe $P(X, Y)$, se voie attribuer par le classifieur $\hat{Y} = f(X)$ une étiquette rigoureusement identique à sa valeur empirique réelle $Y_i$, telle que $P(\hat{Y} = Y)$.
2.2 Avantages opérationnels de la métrique d’exactitude
L’hégémonie historique de l’exactitude dans les rapports d’ingénierie et les protocoles de validation scientifique ne relève pas d’une anomalie aléatoire ; elle procède de vertus cognitives et pratiques manifestes. Le premier avantage réside dans son immédiateté interprétative. Pour un comité d’éthique médicale, une direction d’établissement hospitalier ou des chercheurs transdisciplinaires dépourvus d’expertise approfondie en modélisation stochastique, la notion d’un « taux d’adéquation de 85 % » véhicule une signification intuitive directe et immensément plus accessible que les concepts d’espérance conditionnelle ou de divergence de Kullback-Leibler.
De surcroît, l’exactitude s’aligne harmonieusement avec la conception séculaire du taux de réussite d’une épreuve académique ou psychométrique standardisée, facilitant ainsi l’acculturation des décideurs profanes aux résultats de la recherche. Sur le plan algorithmique et computationnel, son calcul se caractérise par une complexité linéaire $O(N)$ d’une trivialité optimale, ne nécessitant aucune manipulation matricielle sophistiquée, aucune inversion de tenseur ni aucun temps d’exécution prohibitif lors des criblages exploratoires préliminaires ou des procédures d’optimisation d’hyperparamètres sur de gigantesques banques d’apprentissage.
2.3 Hypothèse sous-jacente de symétrie distributionnelle
En dépit de son élégante simplicité arithmétique, l’exactitude porte en son sein un postulat implicite excessivement restrictif que de nombreux praticiens omettent d’interroger : l’hypothèse de symétrie distributionnelle absolue. L’utilisation valide de l’exactitude en tant que critère de performance prédictive exige impérativement que les deux conditions marginales suivantes soient simultanément remplies dans l’univers d’inférence :
- L’équilibre rigoureux des prévalences de classes : La probabilité a priori de rencontrer la classe positive dans l’échantillon d’évaluation doit osciller autour de la parité probabiliste, soit $P(Y=1) \approx P(Y=0) \approx 0{,}50$.
- L’équivalence stricte des coûts de mauvaise classification : La fonction de coût social, clinique ou financier assignée à la commission d’un faux positif doit être rigoureusement identique à celle imputable à la commission d’un faux négatif, soit $\mathcal{C}(\text{FP}) = \mathcal{C}(\text{FN})$.
Dès l’instant où l’une de ces deux conditions axiomatiques est violée — ce qui constitue la norme écrasante dans les études portant sur des données psychologiques, cliniques, biomédicales ou criminologiques —, l’exactitude subit une vulnérabilité épistémologique majeure. En traitant de manière parfaitement indifférenciée le succès sur une classe abondante et le succès sur une classe clairsemée, elle écrase la dynamique interne du tableau de contingence et masque totalement l’incapacité substantielle du modèle à capturer les signaux prédictifs rares mais structurants.
3. Les failles critiques de l’Exactitude : Le paradoxe de l’accuracy
3.1 Mécanisme du paradoxe de l’exactitude face au déséquilibre de classes
Le point de rupture fondamental de la métrique d’exactitude est documenté dans la littérature statistique sous la désignation formalisée de paradoxe de l’exactitude. Ce phénomène émerge de manière inexorable dès lors qu’un algorithme de classification est déployé face à un déséquilibre marqué des effectifs marginaux. Le mécanisme pervers sous-jacent est d’une clarté déconcertante : un estimateur naïf, dit « classifieur trivial », qui se bornerait à ignorer complètement l’ensemble des covariables d’entrée pour prédire systématiquement, et de façon aveugle, l’appartenance de chaque observation à la classe majoritaire, obtiendra une exactitude exactement égale à la prévalence marginale de cette classe dominante au sein du corpus d’évaluation.
Considérons un espace expérimental où la distribution empirique de la variable binaire présente une asymétrie de 95 % pour la modalité négative et de 5 % pour la modalité positive. En formulant l’inférence permanente $\hat{y}_i = 0$ pour toute observation $x_i$, le modèle génère mécaniquement 0 VP, 0 FP, $N \times 0{,}05$ FN, et $N \times 0{,}95$ VN. Son exactitude mathématique globale s’élèvera donc à un insolent 95 %. Pourtant, d’un point de vue scientifique et clinique, ce système est absolument dénué de tout pouvoir discriminant ; son utilité décisionnelle est rigoureusement nulle, voire trompeuse, puisqu’il démontre une incapacité congénitale et totale à isoler la condition d’intérêt. Lors de l’entraînement par descente de gradient stochastique, cette dérive peut figer l’algorithme dans un minimum local d’où il lui est impossible de s’extraire, la surface de perte n’offrant plus de gradient exploitable pour apprendre à reconnaître la classe minoritaire.
3.2 Étude de cas clinique : Diagnostic d’une pathologie psychologique rare
Afin de matérialiser les répercussions tragiques de ce paradoxe, examinons une simulation computationnelle appliquée à l’épidémiologie clinique. Supposons une cohorte de validation longitudinale de 10 000 patients admis en consultation psychiatrique ambulatoire, au sein de laquelle l’objectif est d’entraîner un algorithme de traitement automatique du langage naturel (NLP) sur les comptes rendus cliniques afin de détecter de manière anticipée l’émergence d’un trouble de la personnalité schizotypique sévère. Les relevés épidémiologiques établissent que la prévalence réelle de cette entité nosographique au sein de cette population ambulatoire générale est de 2 %, représentant ainsi une partition clinique de 200 patients affectés et de 9 800 individus indemnes.
Un modèle inductif d’une superficialité crasse, programmé pour prédire de façon invariable l’absence de pathologie pour les 10 000 dossiers, atteindra sans coup férir un taux d’exactitude fulgurant de 98,00 %. Sur la base de cet indicateur trompeur, un comité hospitalier dénué de formation biostatistique avancée pourrait juger ce dispositif hautement fiable et autoriser son déploiement à grande échelle. Les implications éthiques et sanitaires s’avèrent terrifiantes : les 200 patients véritablement atteints par cette affection invalidante constituent 200 faux négatifs critiques, laissés en déshérence thérapeutique sans aucune prise en charge spécialisée, tandis que le système informatique célèbre une réussite de 98 %. Cet écueil illustre à la perfection la dimension profondément fallacieuse et le danger sociétal de l’illusion de performance alimentée par l’exactitude non contextualisée.
3.3 Déconnexion entre validité interne et utilité écologique
Cette vulnérabilité métrologique engendre une rupture irréconciliable entre la validité interne formelle du modèle (sa capacité à minimiser une métrique standard sur un jeu de données spécifique) et sa validité écologique (son efficacité pratique et adaptative au sein d’un écosystème clinique ou comportemental réel). L’exactitude a pour effet d’amplifier les biais d’échantillonnage initiaux. Lorsqu’un chercheur s’en remet à ce critère, il valide implicitement la pérennité immuable de la distribution des classes observée au cours de la collecte préliminaire, interdisant toute robustesse face aux variations de prévalence dans le monde réel.
Dans le cadre des protocoles de recherche longitudinale en sciences du comportement, l’attrition différentielle — le phénomène par lequel certains profils cliniques particuliers décrochent précocement des programmes de suivi thérapeutique — génère des pertes de données massives. L’exactitude s’avère structurellement incapable de rendre compte de cette déperdition et masque les abandons thérapeutiques sous la masse des sujets stables maintenus dans l’étude. Pour pallier ces faillites méthodologiques manifestes, la communauté biomédicale et les comités éditoriaux internationaux formulent désormais l’obligation déontologique de répudier l’exactitude comme unique étalon de mesure lors de l’évaluation des systèmes de classification diagnostique.
4. Décomposition du Score F1 : Précision, Rappel et Moyenne Harmonique
4.1 La Précision : Mesure de la certitude prédictive positive
Face aux apories méthodologiques inhérentes à l’exactitude, la statistique inférentielle moderne a élaboré des métriques désagrégées focalisées sur la qualité décisionnelle au sein de la classe d’intérêt. La première d’entre elles est la précision, également dénommée valeur prédictive positive (VPP) dans le lexique épidémiologique standard. La précision répond à une interrogation opérationnelle spécifique : lorsqu’un modèle affirme qu’une observation donnée présente la modalité positive, quelle est la probabilité que cette déclaration soit rigoureusement conforme à la réalité empirique ? Son expression formelle s’établit par le quotient suivant :
$$\text{Précision} = \frac{\text{VP}}{\text{VP} + \text{FP}}$$
La précision se concentre exclusivement sur la pureté du sous-ensemble des observations labellisées positives par le système. Son dénominateur correspond à l’intégralité des alertes générées, indépendamment de leur pertinence finale. Par conséquent, la précision pénalise sans concession la prolifération des faux positifs (erreurs de type I). Un modèle affichant une haute précision garantit une contamination minimale de ses prédictions positives par des alarmes fallacieuses. Cette métrique devient cruciale dans tous les contextes cliniques ou sociaux où l’assignation indue d’une étiquette diagnostique entraîne une stigmatisation sociale dévastatrice, un enfermement nosographique traumatisant ou le déclenchement d’actes thérapeutiques invasifs et potentiellement iatrogènes.
4.2 Le Rappel (Sensibilité) : Mesure de l’exhaustivité de détection
Le second pilier de cette évaluation désagrégée est le rappel, traditionnellement désigné sous les termes de sensibilité clinique ou de taux de vrais positifs (True Positive Rate, TPR). Le rappel aborde la performance sous un angle diamétralement opposé à celui de la précision en posant la question de l’exhaustivité : parmi l’ensemble des sujets de la population qui présentent véritablement la condition d’intérêt, quelle proportion a été correctement identifiée par le classifieur ? Son équation canonique s’écrit :
$$\text{Rappel} = \frac{\text{VP}}{\text{VP} + \text{FN}}$$
Ici, le dénominateur de la fraction ne dépend plus des choix prédictifs du système, mais de la constitution intrinsèque de la cohorte réelle : il agrège les vrais positifs identifiés et les faux négatifs éludés. Le rappel sanctionne donc avec sévérité les erreurs de type II. Maximiser le rappel revient à minimiser la proportion de cas positifs oubliés ou non diagnostiqués par l’algorithme. Dans le champ des sciences comportementales, cette préoccupation prend une tournure éthique vitale lors de la détection algorithmique du risque suicidaire imminent ou du dépistage de syndromes dépressifs majeurs sévères, contextes où omettre un patient en souffrance (faux négatif) s’avère infiniment plus préjudiciable que d’émettre une alarme de précaution injustifiée.
4.3 Fondement mathématique de la moyenne harmonique
Puisque la précision et le rappel mesurent deux dimensions qualitatives souvent antagonistes, les concepteurs de modèles nécessitent un indicateur synthétique unique capable d’équilibrer ces impératifs contradictoires sans réintroduire les travers pernicieux de l’exactitude. Le score F1 répond à cette exigence par l’application d’une moyenne harmonique entre la précision et le rappel, formalisée par l’équation suivante :
$$\text{Score F1} = 2 \times \frac{\text{Précision} \times \text{Rappel}}{\text{Précision} + \text{Rappel}} = \frac{2 \cdot \text{VP}}{2 \cdot \text{VP} + \text{FP} + \text{FN}}$$
Le choix méthodologique délibéré de la moyenne harmonique, au détriment de la moyenne arithmétique conventionnelle, constitue le fondement épistémologique de l’indicateur. La moyenne harmonique de deux scalaires non nuls est structurellement tirée vers le bas par la valeur minimale du couple. Alors qu’une moyenne arithmétique entre une précision parfaite de 1,00 et un rappel insignifiant de 0,02 concéderait généreusement un score trompeur de 0,51, la moyenne harmonique sanctionne impitoyablement ce déséquilibre extrême en plafonnant le score F1 à un médiocre 0,039. Le score F1 impose ainsi au modèle une exigence de rigueur symétrique : il ne peut afficher un score élevé que s’il excelle simultanément dans la pureté de ses inférences (haute précision) et dans l’exhaustivité de sa détection (haut rappel).
5. Étude comparative par l’exemple : Calculs détaillés sur un échantillon empirique
5.1 Présentation du jeu de données et matrice de confusion observée
Pour dissiper toute abstraction superflue et expliciter la divergence opérationnelle concrète entre l’exactitude et le score F1, mettons en œuvre une démonstration quantitative pas à pas appuyée sur un protocole expérimental simulé. Considérons une recherche psychologique observationnelle menée auprès d’un échantillon stratifié de $N = 400$ adolescents évalués par un algorithme de régression logistique régularisée, dont la tâche est de prédire la survenue d’épisodes de phobie scolaire sévère au cours de l’année scolaire à partir de signaux comportementaux et d’indicateurs psychométriques standardisés.
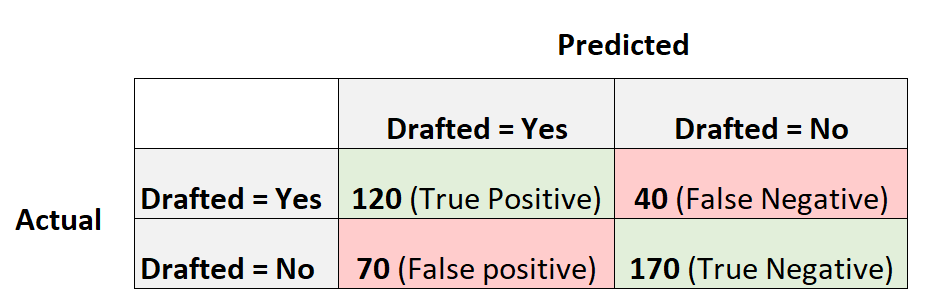
Au terme de la période de suivi clinique, le croisement rigoureux entre les prédictions binaires du modèle et le statut effectif documenté des élèves engendre la matrice de confusion empirique suivante :
- Vrais Positifs (VP) : 120 élèves phobiques ont été correctement identifiés par le modèle algorithmique.
- Faux Positifs (FP) : 70 élèves non affectés ont reçu indûment une prédiction d’occurrence de phobie scolaire.
- Faux Négatifs (FN) : 40 élèves ayant développé une phobie sévère ont été ignorés par le système prédictif.
- Vrais Négatifs (VN) : 170 élèves non affectés ont été validés avec exactitude par le classifieur.
L’inspection des effectifs marginaux confirme la cohérence globale de l’échantillon : la cohorte réelle compte $120 + 40 = 160$ adolescents véritablement phobiques (soit une prévalence de 40,00 %) et $70 + 170 = 240$ sujets asymptomatiques (soit 60,00 % de l’effectif total). De son côté, le modèle a émis au total $120 + 70 = 190$ prédictions d’atteinte phobique contre $40 + 170 = 210$ prédictions d’absence d’affection.
5.2 Calcul pas à pas de l’Exactitude
En application directe des fondements axiomatiques énoncés dans la section précédente, le calcul de l’exactitude globale de ce système s’opère en sommant l’intégralité des concordances diagnostiques et en rapportant cette grandeur au dénominateur total du corpus empirique :
$$\text{Somme des concordances} = \text{VP} + \text{VN} = 120 + 170 = 290$$
L’exactitude brute s’établit par conséquent à :
$$\text{Exactitude} = \frac{290}{400} = 0{,}7250 \quad \text{soit} \quad 72{,}50,%$$
À la lecture brute de cette métrique scalaire, un analyste superficiel pourrait conclure que le classifieur offre une performance respectable en classant convenablement près de trois quarts des sujets évalués. Cependant, ce pourcentage agrégé oblitère totalement la répartition interne des erreurs : il ne permet en rien de discerner si les 110 échecs de classification ($400 – 290$) procèdent d’une sur-détection invalidante (70 fausses alertes) ou d’une cécité thérapeutique dramatique (40 élèves en détresse non secourus). L’exactitude traite ces deux typologies d’échec sur un pied d’égalité arithmétique absolu, annihilant toute possibilité d’évaluation clinique différentielle.
5.3 Calcul pas à pas de la Précision, du Rappel et du Score F1
Procédons à présent à la décomposition fine des performances en isolant les métriques axées sur la classe d’intérêt. La première étape consiste à évaluer la précision prédictive de l’algorithme :
$$\text{Précision} = \frac{\text{VP}}{\text{VP} + \text{FP}} = \frac{120}{120 + 70} = \frac{120}{190} \approx 0{,}6316 \quad \text{soit} \quad 63{,}16,%$$
Ce résultat révèle qu’en réalité, plus d’un tiers des adolescents étiquetés comme « à haut risque de phobie » par l’outil numérique sont des faux positifs, ce qui soulève des interrogations immédiates sur la saturation potentielle des structures de soutien scolaire spécialisées. Évaluons ensuite le rappel clinique :
$$\text{Rappel} = \frac{\text{VP}}{\text{VP} + \text{FN}} = \frac{120}{120 + 40} = \frac{120}{160} = 0{,}7500 \quad \text{soit} \quad 75{,}00,%$$
Le système parvient donc à capter trois quarts des adolescents en détresse, laissant échapper un quart de la population cible sous forme d’erreurs de type II. La synthèse de ces deux grandeurs asymétriques au sein de la moyenne harmonique définit le score F1 standardisé :
$$\text{Score F1} = 2 \times \frac{0{,}6316 \times 0{,}7500}{0{,}6316 + 0{,}7500} = 2 \times \frac{0{,}4737}{1{,}3816} \approx 0{,}6857 \quad \text{soit} \quad 68{,}57,%$$
La confrontation entre l’exactitude globale (72,50 %) et le score F1 (68,57 %) met en exergue un écart négatif de près de quatre points de pourcentage. Cet affaissement reflète la sensibilité punitive du score F1 face au déficit de précision du modèle (63,16 %). En ignorant délibérément le volume massif des 170 vrais négatifs qui venaient gonfler artificiellement l’exactitude, le score F1 livre un diagnostic méthodologique considérablement plus sobre, réaliste et exigeant sur l’efficacité intrinsèque du dispositif d’intervention ciblée.
6. Le compromis fondamental entre Précision et Rappel
6.1 La dynamique d’ajustement du seuil de décision probabiliste
La quasi-totalité des modèles contemporains de classification supervisée — qu’il s’agisse des forêts d’arbres décisionnels, des machines à vecteurs de support à sortie probabiliste ou des réseaux neuronaux profonds équipés d’une couche finale d’activation logistique (softmax ou sigmoid) — n’émettent pas nativement de verdicts catégoriels binaires. Ils calculent une probabilité a posteriori continue $P(Y=1 mid X = x)$, bornée au sein de l’intervalle unitaire $[0, 1]$. La transformation de cette estimation probabiliste en une décision déterministe discrète exige l’application d’un seuil de décision formel, conventionnellement fixé par défaut à $\theta = 0{,}50$.
Or, la fixation arbitraire de ce seuil à $\theta = 0{,}50$ ne constitue en aucun cas un optimum statistique absolu : elle ne fait qu’ancrer un point d’équilibre particulier au sein d’un continuum d’arbitrages. Lorsque l’expérimentateur déplace délibérément ce seuil vers les valeurs supérieures (par exemple $\theta = 0{,}80$), il contraint le modèle à n’attribuer l’étiquette positive qu’aux instances pour lesquelles le système possède une certitude algorithmique écrasante. Cette manœuvre accroît mécaniquement la précision prédictive au prix d’une explosion des faux négatifs, effondrant consécutivement le rappel. À l’inverse, abaisser le seuil vers des valeurs permissives (par exemple $\theta = 0{,}20$) maximise l’exhaustivité de la détection (ascension du rappel) en ouvrant largement la porte aux alarmes fallacieuses (dégradation brutale de la précision). Ce phénomène constitue le compromis structurel précision-rappel, inhérent à toute formalisation géométrique de l’espace de décision.
6.2 Inadéquation de la moyenne arithmétique pour combiner les taux
Pour naviguer méthodologiquement au sein de ce compromis et déterminer le seuil opérationnel optimal, l’agrégation de la précision et du rappel en un indicateur synthétique doit impérativement respecter les propriétés de la topologie de décision. À cet égard, le recours à la moyenne arithmétique simple s’avère conceptuellement invalide et méthodologiquement périlleux. Considérons un modèle pathologique dégénéré qui prédirait systématiquement la classe positive pour la totalité des observations d’un échantillon test. Par définition, un tel système afficherait un rappel parfait de $1{,}00$ ($100,%$), n’ayant commis rigoureusement aucun faux négatif, tout en présentant une précision misérable de $0{,}01$ ($1,%$) du fait d’une prolifération aberrante de faux positifs.
Si l’on mobilisait la moyenne arithmétique pour juger de la pertinence de ce modèle grotesque, on obtiendrait le score suivant :
$$\text{Moyenne arithmétique} = \frac{1{,}00 + 0{,}01}{2} = 0{,}505 \quad (50{,}5,%)$$
Un tel résultat octroierait à un modèle totalement absurde une note supérieure à la moyenne, suggérant une validité opérationnelle modérée. En revanche, le calcul de la moyenne harmonique démasque impitoyablement la carence fondamentale de l’algorithme :
$$\text{Moyenne harmonique (F1)} = 2 \times \frac{1{,}00 \times 0{,}01}{1{,}00 + 0{,}01} = \frac{0{,}02}{1{,}01} \approx 0{,}0198 \quad (1{,}98,%)$$
Le score F1 s’effondre à moins de 2 %, reflétant avec une justesse mathématique irréprochable la nullité pratique de l’inférence. La moyenne harmonique agit ainsi comme un mécanisme de censure statistique qui neutralise toute tentative de sur-optimisation opportuniste d’une métrique au détriment absolu de l’autre.
6.3 Courbes Précision-Rappel (PRC) versus Courbes ROC
Pour s’abstraire de la fixation statique d’un seuil de décision unique lors de la validation comparative de plusieurs architectures algorithmiques, les biostatisticiens font traditionnellement appel aux courbes fonctionnelles globales. Deux écoles s’affrontent régulièrement : celle de la courbe ROC (Receiver Operating Characteristic) couplée à son aire sous-jacente (AUC-ROC), et celle de la courbe Précision-Rappel (PRC) matérialisée par l’AUC-PR. La courbe ROC projette le taux de vrais positifs en fonction du taux de faux positifs ($\text{TFP} = \frac{\text{FP}}{\text{FP} + \text{VN}}$) à travers l’éventail complet des seuils envisageables.
Toutefois, dans les environnements caractérisés par une disproportion massive des classes, la courbe ROC fait preuve d’une indulgence trompeuse. Son axe horizontal intègre en effet le volume des vrais négatifs au dénominateur du TFP. Lorsque la classe négative est ultra-majoritaire, un gonflement substantiel des faux positifs n’induit qu’une variation infinitésimale du ratio $\frac{\text{FP}}{\text{VN} + \text{FP}}$, maintenant artificiellement la courbe ROC dans les quadrants supérieurs et attribuant une AUC-ROC faussement flatteuse (souvent supérieure à 0,90) à des modèles dont l’opérationnalité est pourtant compromise. En revanche, la courbe Précision-Rappel exclut totalement les vrais négatifs de ses équations : l’AUC-PR demeure par conséquent d’une austérité mathématique absolue face au déséquilibre marginal, offrant le baromètre d’évaluation le plus robuste pour les jeux de données psychométriques asymétriques.
7. Conditions optimales d’application de l’Exactitude
7.1 Équilibre strict des distributions marginales
En dépit des critiques méthodologiques rigoureuses qui lui sont légitimement adressées, l’exactitude n’est pas une métrique scientifiquement indéfendable ; elle constitue simplement un indicateur dont la validité inférentielle est conditionnée par des hypothèses distributionnelles strictes. La première de ces conditions réside dans l’existence d’une symétrie marginale absolue, ou du moins excessivement approchée, au sein du protocole d’observation. Lorsque la répartition empirique des étiquettes au sein de la population étudiée se conforme scrupuleusement à un ratio de prévalence de 1:1 ($50,%$ de cas positifs et $50,%$ de cas négatifs), le piège de la trivialité prédictive est mathématiquement neutralisé.
Dans un tel contexte de parité distributionnelle, un classifieur trivial se contentant de prédire mécaniquement la même modalité ne saurait prétendre qu’à une exactitude de 50 %, ce qui équivaut rigoureusement au niveau de l’aléa le plus élémentaire (lancement d’une pièce non biaisée). Toute valeur d’exactitude significativement supérieure à ce plancher stochastique atteste alors d’une véritable extraction d’information discriminante par l’algorithme. Dans ces conditions de stabilité parfaite des priors bayésiens, l’exactitude retrouve son statut d’estimateur non biaisé de l’erreur empirique de généralisation, conférant à chaque pourcentage gagné une interprétabilité directe et scientifiquement irréprochable.
7.2 Symétrie absolue des coûts de mauvaise classification
La seconde condition indispensable à la réhabilitation scientifique de l’exactitude relève de la structure de coût de l’espace décisionnel. Pour que l’exactitude traduise fidèlement la rentabilité fonctionnelle d’un système, l’analyste doit impérativement évoluer dans un cadre où commettre un faux positif engendre des conséquences préjudiciables de magnitude strictement identique à celles résultant d’un faux négatif. En termes formels, la matrice des coûts d’indemnisation ou de perte doit être parfaitement symétrique :
$$\mathcal{C}(\text{FP}) = \mathcal{C}(\text{FN}) \quad \text{et} \quad \mathcal{C}(\text{VP}) = \mathcal{C}(\text{VN}) = 0$$
Cette configuration symétrique se rencontre dans certaines branches de la psychologie différentielle cognitive ou de l’ergonomie comportementale. Considérons, à titre d’illustration, un algorithme chargé de classifier des apprenants adultes selon deux styles d’apprentissage prépondérants strictement neutres sur le plan normatif (par exemple, un profil de traitement préférentiellement visuo-spatial face à un profil de traitement séquentiel-analytique). Dans cette perspective, assigner erronément un profil visuel à un individu analytique ne génère aucun dommage clinique, aucune sanction judiciaire ni aucune séquelle psychologique irréversible : l’erreur n’induit qu’une réorientation mineure d’un module d’auto-formation pédagogique. Dès lors que l’asymétrie punitive est inexistante, l’exactitude demeure l’indicateur d’évaluation le plus synthétique, lisible et légitime.
7.3 Surveillance globale des systèmes automatisés stables
Enfin, l’exactitude s’impose comme un outil de premier choix pour la surveillance macroscopique et le monitoring en flux continu d’architectures décisionnelles matures, opérant sur des environnements statistiques dont la stabilité a été préalablement validée par de longues périodes de contrôle qualité. Dans les tableaux de bord industriels ou hospitaliers destinés aux directions de programmes et aux régulateurs externes, l’exactitude remplit une fonction d’alerte de haut niveau irremplaçable grâce à sa lisibilité universelle.
Dès lors que le jeu de données en production respecte les clauses de symétrie susmentionnées, une érosion brutale de l’exactitude globale (par exemple une chute soudaine de 88 % à 64 % en l’espace d’une semaine) constitue un marqueur diagnostique puissant d’une dérive de concept (concept drift) ou d’une altération technique dans la chaîne d’acquisition des données (dysfonctionnement d’un capteur biométrique, mise à jour défaillante d’une interface de saisie clinique). Dans ce rôle spécifique d’indicateur de veille opérationnelle, l’exactitude combine une efficience computationnelle optimale et une clarté communicative totale pour l’ensemble des parties prenantes non initiées.
8. Conditions méthodologiques imposant l’usage du Score F1
8.1 Présence avérée d’un déséquilibre de classes modéré à sévère
L’abandon irrévocable de l’exactitude au profit d’indicateurs spécialisés devient un impératif méthodologique catégorique dès l’instant où le corpus expérimental présente un déséquilibre de classes modéré à sévère. Selon les standards communément admis en biostatistique quantitative, un déséquilibre est considéré comme méthodologiquement structurant dès que la prévalence marginale de la classe d’intérêt décroît sous la barre des 20 % de la population totale, et devient hautement critique lorsqu’elle passe sous le seuil des 5 % (déséquilibre extrême ou rareté statistique).
Dans ces configurations asymétriques, la métrique d’exactitude subit l’effet de masquage dénoncé dans la section 3. Le score F1, quant à lui, présente la vertu mathématique essentielle de neutraliser entièrement la modalité des vrais négatifs ($\text{VN}$) dans son calcul. En circonscrivant son évaluation stricte au triangle fonctionnel constitué des vrais positifs, des faux positifs et des faux négatifs ($\text{VP}, \text{FP}, \text{FN}$), le score F1 focalise l’ensemble de son pouvoir pénalisant sur la qualité de détection de la classe minoritaire. Il immunise ainsi le chercheur contre le biais de facilité algorithmique et fournit une estimation loyale de l’aptitude du modèle à extraire des régularités significatives au sein de données quantitativement sporadiques.
8.2 Identification de comportements marginaux ou de troubles spécifiques
L’impératif du recours au score F1 s’illustre de manière particulièrement éclatante dans la recherche comportementale consacrée à la psychopathologie aiguë, aux addictions comportementales ou à la détection de vulnérabilités critiques au sein de grandes plateformes numériques. Prenons l’exemple de la veille automatisée menée par des algorithmes d’apprentissage profond sur des forums d’entraide en ligne, ayant pour mandat d’analyser la sémantique textuelle afin d’identifier des signaux faibles d’idéation suicidaire imminente ou de violences intra-familiales.
Au sein d’un corpus englobant des centaines de milliers de publications quotidiennes, les messages matérialisant une détresse vitale immédiate ne représentent souvent qu’une fraction infinitésimale de l’activité globale, typiquement de l’ordre de 0,1 % à 1 % du flux textuel. Évaluer un tel système algorithmique au moyen de l’exactitude relèverait de l’aberration méthodologique la plus coupable, un modèle défaillant n’identifiant rigoureusement aucun individu en danger pouvant se targuer d’un taux d’exactitude de 99,9 %. Seul le score F1 permet ici de contraindre les ingénieurs à maximiser la sensibilité du modèle (pour sauver des vies) tout en veillant à ne pas noyer les équipes d’intervention d’urgence sous des millions de signalements infondés.
8.3 Validation de classifieurs appliqués à des interventions ciblées
Dans les politiques publiques de santé et les interventions psychosociales contemporaines, les ressources humaines, logistiques et financières allouées aux dispositifs de remédiation sont par essence sévèrement limitées. Les effectifs d’éducateurs spécialisés, de psychologues cliniciens en pédopsychiatrie ou de lits d’hospitalisation de crise constituent un goulot d’étranglement structurel qui ne tolère aucun gaspillage institutionnel.
Lorsqu’un modèle prédictif est implémenté pour orchestrer le ciblage d’un programme d’accompagnement psychologique intensif, l’adoption du score F1 s’impose pour aligner la validation mathématique du classifieur sur les capacités d’accueil réelles de l’infrastructure de soin. Le score F1 garantit simultanément deux exigences éthico-économiques fondamentales :
- Le respect de la capacité d’absorption clinique : Grâce à la pénalisation rigoureuse de la précision, l’algorithme limite l’afflux d’individus non cibles (faux positifs), évitant la saturation prématurée des équipes soignantes et l’épuisement professionnel des intervenants.
- La minimisation de la rupture de soins : Grâce à la contrainte exercée sur le rappel, le modèle limite les omissions tragiques (faux négatifs), assurant qu’une proportion acceptable de sujets requérant réellement une prise en charge préventive soit orientée vers les filières appropriées.
9. Évaluation asymétrique des erreurs de type I et II dans l’analyse de décision
9.1 Poids clinique et éthique des Faux Négatifs
Toute réflexion métrologique approfondie relative à l’arbitrage entre l’exactitude et le score F1 débouche inéluctablement sur l’analyse morale et déontologique de la distribution des erreurs. Dans de multiples branches des sciences de la vie et de la psychologie clinique, l’erreur de type II (faux négatif) véhicule une charge éthique, humaine et médico-légale d’une gravité incommensurablement plus élevée que l’erreur de type I. Lorsqu’un algorithme diagnostique échoue à déceler un syndrome mélancolique à haut potentiel suicidaire, une démence fronto-temporale précoce ou un risque avéré de décompensation psychotique, le verdict d’absence de maladie relègue l’individu à un dénuement thérapeutique absolu.
Les conséquences cliniques s’avèrent tragiques : passage à l’acte sans possibilité de contention préventive, séquelles neurologiques irréversibles par défaut d’initiation d’un protocole pharmacologique adapté, détresse intrafamiliale indicible et mise en cause de la responsabilité médico-légale des praticiens ayant accordé une confiance aveugle au système expert. Face à de telles éventualités, la méthodologie scientifique commande d’ériger le rappel en priorité absolue de calibration et de délaisser sans équivoque toute métrique symétrique incapable de formaliser cette asymétrie humaine de l’erreur.
9.2 Poids socio-économique et déontologique des Faux Positifs
Toutefois, il serait intellectuellement malhonnête et cliniquement dangereux de considérer que la commission de faux positifs représente un coût négligeable dans l’écosystème du soin. L’attribution indue d’une pathologie mentale grave ou d’un déficit cognitif à un sujet sain engendre des perturbations iatrogènes profondes. Sur le plan psychologique, l’annonce d’un diagnostic erroné induit une anxiété existentielle majeure, une démoralisation durable et un phénomène d’étiquetage sociologique (stigmatisation nosographique) pouvant altérer durablement l’estime de soi du patient et compromettre ses perspectives socioprofessionnelles.
Sur le versant systémique et économique, un faux positif déclenche l’exécution d’examens complémentaires sophistiqués, onéreux et parfois physiquement délétères (biopsies cérébrales, ponctions lombaires exploratoires, explorations neuro-imageries invasives sous sédation). L’accumulation effrénée de fausses alertes génère en outre un phénomène pernicieux d’accoutumance bien connu des ergonomes sous le vocable de « fatigue des alarmes » (alarm fatigue) : les soignants, submergés de signalements systématiquement infirmés par la clinique, finissent par désactiver ou ignorer l’outil d’aide à la décision, anéantissant ainsi tout bénéfice potentiel de l’intelligence artificielle. Le verrouillage rigoureux de la précision demeure le seul rempart déontologique contre cette dérive.
9.3 Modélisation matricielle de la fonction de coût d’erreur
Pour dépasser les limites de l’évaluation heuristique et réconcilier la statistique avec la praxéologie décisionnelle, la méthode optimale réside dans l’intégration explicite de la matrice de confusion au sein de la théorie bayésienne de la décision. Cette approche postule que chaque quadrant de la matrice de confusion doit se voir assigner un coût économique ou ordinal paramétré, formalisé par une fonction de coût empirique $L(\hat{y}, y)$. Soit la matrice où $C_{FP}$ représente le coût d’une erreur de type I, $C_{FN}$ le coût d’une erreur de type II, et où les concordances exactes bénéficient d’un coût nul ($C_{VP} = C_{VN} = 0$).
La perte espérée globale $\mathbb{E}[L]$ du modèle sur un espace de test s’exprime sous la forme :
$$\mathbb{E}[L] = C_{FP} \cdot P(\text{FP}) + C_{FN} \cdot P(\text{FN}) = C_{FP} \cdot \frac{\text{FP}}{N} + C_{FN} \cdot \frac{\text{FN}}{N}$$
Cette formalisation met en lumière le caractère arbitraire du score F1 standard : en accordant une pondération harmonique égale à la précision et au rappel, le score F1 présuppose implicitement un ratio de coût relatif bien particulier entre les erreurs. Lorsque ce ratio empirique est connu (par exemple si les données d’assurance santé démontrent qu’un non-diagnostic de pathologie coûte en moyenne dix fois plus cher à la collectivité qu’un diagnostic exploratoire erroné, soit $C_{FN} = 10 \times C_{FP}$), la minimisation de la perte espérée devient le complément d’arbitrage indispensable aux métriques scalaires génériques.
10. Au-delà du Score F1 standard : Le Score F-bêta et métriques alternatives
10.1 Paramétrisation de la priorité via le Score F-bêta
Le score F1 traditionnel, bien que remarquablement supérieur à l’exactitude en contexte déséquilibré, souffre d’une rigidité paramétrique : il attribue par conception une importance rigoureusement équipolente à la précision et au rappel. Pour s’affranchir de ce carcan lorsque la réalité opérationnelle exige de privilégier asymétriquement l’une des deux dimensions sans renoncer aux vertus de la moyenne harmonique, les statisticiens ont développé la généralisation du score $F_\beta$ (F-bêta). Sa formulation analytique repose sur l’introduction d’un coefficient de pondération positif $\beta in \mathbb{R}^+$ :
$$F_\beta = (1 + \beta^2) \times \frac{\text{Précision} \times \text{Rappel}}{(\beta^2 \times \text{Précision}) + \text{Rappel}}$$
Le paramètre $\beta$ agit comme un modulateur d’importance relative : il quantifie précisément combien de fois le rappel est jugé plus capital que la précision. Deux instanciations canoniques de cette métrique prédominent dans les protocoles de recherche :
- Le score $F_2$ ($\beta = 2$) : En élevant $\beta$ au carré ($\beta^2 = 4$), cette équation accorde un poids quatre fois plus déterminant au rappel qu’à la précision. Le score $F_2$ s’impose comme l’étalon de référence pour la validation des algorithmes de dépistage épidémiologique de masse ou la détection d’urgences suicidaires, contextes où l’omission d’un individu en détresse constitue l’échec suprême.
- Le score $F_{0{,}5}$ ($\beta = 0{,}5$) : Avec $\beta^2 = 0{,}25$, cette configuration confère une priorité prépondérante à la précision prédictive par rapport au rappel. Elle est privilégiée dans les systèmes de recommandation de traitements hautement invasifs ou dans les applications médicolégales automatisées où la fausse accusation doit être évitée à tout prix.
10.2 Le Coefficient de Corrélation de Matthews (MCC)
Bien que le score F1 surpasse l’exactitude, il fait l’objet d’une contestation méthodologique croissante en bio-informatique computationnelle et en psychométrie quantitative en raison d’une asymétrie résiduelle : il dépend entièrement de la définition arbitraire de la modalité étiquetée comme « positive » et ignore totalement l’effectif des vrais négatifs. Pour pallier cette incomplétude de manière mathématiquement irréprochable, de nombreux biostatisticiens préconisent le recours au Coefficient de Corrélation de Matthews (MCC), défini par la relation suivante :
$$\text{MCC} = \frac{(\text{VP} \times \text{VN}) – (\text{FP} \times \text{FN})}{\sqrt{(\text{VP} + \text{FP})(\text{VP} + \text{FN})(\text{VN} + \text{FP})(\text{VN} + \text{FN})}}$$
Le MCC n’est autre que l’équivalent du coefficient de corrélation phi de Pearson calculé sur un tableau de contingence binaire à deux dimensions. Il intègre de manière holistique les quatre quadrants de la matrice de confusion. Variant harmonieusement au sein de l’intervalle $[-1, +1]$, un score de $+1$ atteste d’une concordance prédictive absolue, $0$ correspond à un niveau d’inférence purement stochastique équivalent au hasard complet, et $-1$ signale une divergence systématique intégrale. Le MCC présente la propriété fondamentale d’être invariant face au renommage ou à l’interversion des classes : définir l’absence ou la présence d’un syndrome comme classe « 1 » n’altère en rien la valeur finale du coefficient, conférant à cet indice une robustesse épistémologique supérieure à celle du score F1.
10.3 Indice Kappa de Cohen et métriques ajustées au hasard
Une autre alternative solidement ancrée dans la tradition de la recherche clinique et de la fidélité inter-juges est le coefficient Kappa de Cohen ($kappa$). Conçu initialement pour quantifier la concordance diagnostique entre deux évaluateurs humains indépendants, le Kappa a été transposé avec succès à l’évaluation des modèles d’apprentissage machine. Son ambition conceptuelle réside dans sa capacité à retrancher systématiquement de la performance observée la part d’exactitude qui aurait pu émerger sous l’effet du seul hasard stochastique :
$$\kappa = \frac{P_o – P_e}{1 – P_e}$$
Où $P_o$ représente la proportion d’exactitude globale observée ($\text{VP} + \text{VN} / N$), et $P_e$ désigne la probabilité théorique de concordance fortuite calculée à partir du produit marginal des distributions réelles et prédites. Toutefois, la rigueur impose de souligner que le Kappa de Cohen fait l’objet de réserves méthodologiques sévères dans des conditions d’asymétrie marginale extrême (le « paradoxe de Kappa » de Feinstein et Cicchetti), situation où un taux d’accord élevé peut paradoxalement générer un score Kappa dérisoire en raison d’une surestimation mécanique de l’accord dû au hasard. Le score F1 et le MCC demeurent de ce fait nettement plus fiables lors de l’évaluation de cohortes fortement déséquilibrées.
11. Protocole expérimental et rigueur méthodologique en apprentissage automatique
11.1 Validation croisée stratifiée pour populations déséquilibrées
L’exactitude d’une métrique d’évaluation dépend en dernier ressort de la validité du schéma d’échantillonnage mis en œuvre au cours du cycle de développement de l’algorithme. Dans un cadre caractérisé par une sous-représentation marquée de la classe clinique d’intérêt, l’application naïve d’une validation croisée standard à $k$ plis (k-fold cross-validation) constitue une faute expérimentale majeure. Une partition purement aléatoire des données expose en effet la recherche au risque d’une hétérogénéité d’attribution, certains plis d’évaluation pouvant ne contenir aucun cas positif, ce qui engendre un effondrement brutal de la variance du score F1 et invalide la convergence de l’apprentissage.
Le chercheur doit impérativement employer la validation croisée stratifiée (Stratified k-Fold). Ce protocole garantit algorithmiquement que chaque pli de découpage préserve avec une rigueur absolue la proportion marginale exacte de la classe positive initialement documentée sur l’intégralité de la cohorte d’origine. Cette précaution neutralise les fluctuations artificielles des métriques entre les différents plis et protège l’expérimentateur contre les risques d’inconsistance prédictive d’une partition à l’autre.
11.2 Techniques de rééquilibrage : Sur-échantillonnage, sous-échantillonnage et SMOTE
Face à la contrainte du déséquilibre marginal, les équipes d’ingénierie statistique déploient fréquemment des stratégies de rééchantillonnage synthétique destinées à restructurer artificiellement l’espace des données d’entraînement. Parmi ces techniques figurent le sous-échantillonnage aléatoire de la classe majoritaire (Random Undersampling), le sur-échantillonnage (Random Oversampling) et les algorithmes d’interpolation géométrique d’instances minoritaires comme la méthode SMOTE (Synthetic Minority Over-sampling Technique).
Si ces approches permettent de contraindre la surface de décision du modèle à accorder une attention accrue à la classe minoritaire durant l’optimisation des gradients, elles exercent un impact colossal et potentiellement pervers sur la structure de la matrice de confusion finale. La manipulation artificielle des priors bayésiens rend l’exactitude mesurée sur les données synthétiques absolument caduque et trompeuse. La rigueur méthodologique impose par conséquent une règle empirique inviolable :
- Les techniques de rééchantillonnage (telles que SMOTE) doivent être appliquées exclusivement sur les plis d’entraînement internes de la validation croisée.
- Le jeu de données de test final (ou chaque pli d’évaluation de la validation croisée) doit demeurer strictement non modifié, vierge de toute synthèse artificielle, afin que les métriques calculées (score F1, rappel, précision) reflètent avec intégrité la performance du modèle face à la prévalence réelle du phénomène naturel sous étude.
11.3 Standardisation du reporting scientifique et transparence empirique
L’écueil récurrent de la littérature consacrée à l’intelligence artificielle réside dans la présentation sélective et complaisante des résultats de modélisation. Nombreux sont les articles qui ne mentionnent que des scores d’exactitude mirifiques ou, à l’inverse, isolent un score F1 maximisé sans contextualiser la précision ou le rappel sous-jacents, privant la communauté scientifique de la possibilité d’évaluer la balance réelle des erreurs décisionnelles.
Pour garantir la reproductibilité et la probité des conclusions scientifiques, les protocoles expérimentaux doivent impérativement s’aligner sur les directives internationales reconnues, à l’instar des déclarations STARD (Standards for Reporting of Diagnostic Accuracy Studies) ou des normes édictées par l’American Psychological Association (APA) pour la psychométrie computationnelle. Les auteurs ont l’obligation déontologique de consigner systématiquement :
- La matrice de confusion brute non normalisée, précisant sans ambiguïté les effectifs absolus de VP, VN, FP et FN.
- Le seuil probabiliste exact $\theta$ retenu pour la prise de décision catégorielle, accompagné de la justification fonctionnelle de son paramétrage.
- L’ensemble du spectre métrologique incluant l’exactitude, la précision, le rappel, la spécificité, le score F1 ainsi que le MCC ou l’AUC-PR, garantissant une transparence totale sur le comportement de l’outil d’inférence.
12. Guide décisionnel complet pour le chercheur et le praticien
12.1 Arbre de décision logique pour l’arbitrage entre métriques
Afin de synthétiser les fondements statistiques et les impératifs épistémologiques discutés tout au long de cette monographie, le choix d’une métrique d’évaluation ne doit plus résulter d’une habitude empirique mais d’une démarche déductive rigoureuse. L’arbre de décision décisionnel suivant formalise les étapes successives d’arbitrage que chaque chercheur ou praticien de la donnée devrait méthodologiquement emprunter :
- Étape 1 : Analyse de la distribution marginale des classes réelles
- La distribution est-elle équilibrée (ratio approximatif compris entre 45:55 et 50:50) ?
- Si Oui : Procéder à l’étape 2.
- Si Non (asymétrie marquée ou prévalence < 20 %) : Rejeter formellement l’exactitude. S’orienter impérativement vers le score F1, le score $F_\beta$ ou le MCC.
- La distribution est-elle équilibrée (ratio approximatif compris entre 45:55 et 50:50) ?
- Étape 2 : Analyse de la symétrie des coûts de l’erreur
- Le coût social, médical ou financier d’un faux positif est-il strictement équivalent à celui d’un faux négatif ($\mathcal{C}(\text{FP}) \approx \mathcal{C}(\text{FN})$) ?
- Si Oui : L’Exactitude globale constitue la métrique de choix, offrant une interprétabilité maximale et une robustesse statistique validée.
- Si Non : Écarter l’exactitude. Procéder à l’étape 3 pour moduler l’asymétrie.
- Le coût social, médical ou financier d’un faux positif est-il strictement équivalent à celui d’un faux négatif ($\mathcal{C}(\text{FP}) \approx \mathcal{C}(\text{FN})$) ?
- Étape 3 : Définition de la priorité clinique ou opérationnelle
- L’exhaustivité de la détection prime-t-elle impérieusement sur la certitude prédictive (minimisation prioritaire des faux négatifs) ? $\rightarrow$ Adopter le Score $F_2$ ou optimiser le Rappel sous contrainte.
- La certitude positive prime-t-elle pour éviter toute stigmatisation ou surcharge (minimisation prioritaire des faux positifs) ? $\rightarrow$ Adopter le Score $F_{0{,}5}$ ou optimiser la Précision sous contrainte.
- Les deux dimensions d’erreur requièrent-elles un compromis harmonique symétrique équilibré ? $\rightarrow$ Adopter le Score F1 standard.
- L’analyse requiert-elle une modélisation invariante intégrant symétriquement la qualité prédictive des vrais négatifs ? $\rightarrow$ Adopter le Coefficient de Corrélation de Matthews (MCC).
12.2 Synthèse comparative globale des forces et vulnérabilités
L’arbitrage entre métriques s’articule autour de compromis méthodologiques inéluctables. Le tableau synthétique suivant structure les axiomes, les prérequis distributionnels, les forces distinctives et les vulnérabilités majeures des deux métriques cardinales examinées dans cet essai, ainsi que de leurs extensions principales :
| Indicateur | Quadrants pris en compte | Hypothèse distributionnelle | Sensibilité au déséquilibre | Cas d’usage préférentiel |
|---|---|---|---|---|
| Exactitude | VP, VN, FP, FN | Parité stricte (50/50) et coûts d’erreur parfaitement symétriques | Vulnérabilité maximale (sujette au paradoxe de l’accuracy) | Surveillance globale de processus industriels équilibrés, classification neutre |
| Score F1 | VP, FP, FN (ignore les VN) | Asymétrie admise, focalisation exclusive sur la classe d’intérêt | Robustesse élevée face au déséquilibre des classes | Recherche clinique, détection de signaux faibles, psychopathologie rare |
| Score F-bêta | VP, FP, FN (ignore les VN) | Asymétrie des coûts d’erreur formellement hiérarchisée | Robustesse élevée, alignement paramétrique sur les priorités | $F_2$ pour urgences suicidaires et dépistage ; $F_{0{,}5}$ pour interventions hautement invasives |
| MCC | VP, VN, FP, FN | Aucune contrainte de parité, invariance au renommage | Résilience optimale absolue sur tous types de matrices | Bio-informatique, génomique, validation méthodologique de haut niveau |
L’analyse comparée de ces structures démontre que la métrique universelle idéale n’existe pas dans l’absolu. Chaque indicateur scalaire agit comme un filtre sélectif : il éclaire certaines propriétés géométriques de la surface de décision tout en reléguant d’autres caractéristiques dans l’ombre. C’est de la conscience lucide de ces angles morts que dépend la clairvoyance méthodologique de l’analyste.
12.3 Perspectives d’avenir : Métriques multidimensionnelles et éthique algorithmique
Au-delà de la confrontation historique entre exactitude et score F1, la modélisation statistique contemporaine fait face à des défis épistémologiques inédits induits par l’essor de l’équité algorithmique (algorithmic fairness). Dans les sciences du comportement appliquées, un classifieur supervisé ne saurait plus être jugé uniquement sur sa performance globale agrégée, qu’elle soit évaluée par le score F1 ou par l’exactitude. Une métrique macroscopique flatteuse peut dissimuler des disparités inacceptables de taux d’erreur entre sous-groupes démographiques, ethniques ou socio-économiques.
De nouvelles contraintes mathématiques émergent pour intégrer l’égalité des chances (Equalized Odds) et la parité prédictive au sein même de la fonction d’évaluation du modèle. Ces avancées imposent d’évaluer le score F1 et l’exactitude de manière stratifiée au sein de chaque strate vulnérable de la population afin d’interdire l’externalisation du coût de l’erreur statistique sur des groupes historiquement marginalisés. Parallèlement, l’essor des données longitudinales issues des technologies portables (smartphones, actimétrie continue) exige le développement de métriques dynamiques capables d’évaluer la précision et le rappel dans leur dynamique temporelle, tenant compte de la détérioration séquentielle du pouvoir prédictif des biomarqueurs comportementaux.
En dernière analyse, le chercheur doit se souvenir que la modélisation mathématique n’est qu’une représentation simplifiée de dynamiques phénoménologiques infiniment complexes. Aucun scalaire d’évaluation — qu’il s’agisse de la simplicité rassurante de l’exactitude ou de la rigueur harmonique du score F1 — ne saurait se substituer au jugement critique du clinicien, à la déontologie du chercheur et à une confrontation systématique des prédictions numériques à la vulnérabilité tangible de l’être humain.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., Lijmer, J. G., Moher, D., Rennie, D., de Vet, H. C. W., Kressel, H. Y., Rifai, N., Golub, R. M., Altman, D. G., Hooft, L., Korevaar, D. A., & Cohen, J. F. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. BMJ, 351, h5528. https://doi.org/10.1136/bmj.h5528
Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: Synthetic minority over-sampling technique. Journal of Artificial Intelligence Research, 16, 321–357. https://doi.org/10.1613/jair.953
Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21(1), Article 6. https://doi.org/10.1186/s12864-019-6413-7
Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. https://doi.org/10.1016/j.patrec.2005.10.010
Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90046-K
Hand, D. J. (2009). Measuring classifier performance: A coherent alternative to the area under the ROC curve. Machine Learning, 77(1), 103–123. https://doi.org/10.1007/s10994-009-5119-5
Matthews, B. W. (1975). Comparison of the predicted and observed secondary structure of T4 phage lysozyme. Biochimica et Biophysica Acta (BBA) – Protein Structure, 405(2), 442–451. https://doi.org/10.1016/0005-2795(75)90109-9
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432
Van Rijsbergen, C. J. (1979). Information retrieval (2nd ed.). Butterworth-Heinemann. http://www.dcs.gla.ac.uk/Keith/Preface.html