
Dans le champ contemporain de l’apprentissage automatique et de la modélisation statistique, l’évaluation de la performance discriminante des classifieurs binaires et multiclasses constitue une étape méthodologique fondamentale. Trop souvent, la communauté scientifique et les praticiens de l’ingénierie des données ont accordé une confiance aveugle à des métriques globales naïves telles que l’exactitude brute (communément désignée sous le terme d’accuracy). Or, dès lors que l’on s’aventure dans des domaines où les phénomènes observés sont rares — qu’il s’agisse de la détection de fraudes bancaires, de la génomique fonctionnelle, du dépistage épidémiologique ou de la psychopathologie computationnelle —, ces métriques traditionnelles s’effondrent sous le poids d’asymétries distributionnelles sévères. L’illusion d’une performance optimale masque fréquemment une incapacité totale du modèle à identifier la classe minoritaire, portant en elle des conséquences éthiques, cliniques et financières potentiellement désastreuses.
C’est au cœur de cette impasse méthodologique que s’impose le coefficient de corrélation de Matthews (couramment abrégé en MCC pour Matthews Correlation Coefficient). Formellement équivalent au coefficient phi de Karl Pearson transposé aux variables dichotomiques, le MCC offre une lecture rigoureuse, symétrique et holistique de la matrice de contingence. Contrairement au score F1, qui néglige structurellement le quadrant des vrais négatifs, ou à l’aire sous la courbe ROC, qui peut offrir une vision trop optimiste face à des déséquilibres extrêmes, le coefficient de Matthews n’atteint une valeur élevée que si le prédicteur réussit simultanément sur l’ensemble des quadrants d’évaluation : vrais positifs, vrais négatifs, faux positifs et faux négatifs.
Cet article se propose de dresser un panorama exhaustif et hautement rigoureux du coefficient de corrélation de Matthews, depuis ses assises théoriques et ses justifications psychométriques jusqu’à son implémentation algorithmique optimisée en langage Python. À travers des démonstrations mathématiques formelles, des benchmarks de performance computationnelle, des stratégies d’optimisation d’hyperparamètres et une étude de cas clinique détaillée, ce guide fournit à l’expérimentateur les concepts analytiques et les outils logiciels nécessaires pour intégrer le MCC comme pierre angulaire de ses protocoles d’évaluation empirique.
1. Introduction théorique et fondements épistémologiques du coefficient de corrélation de Matthews (MCC)
1.1 Genèse et définition conceptuelle du coefficient de Matthews
Le coefficient de corrélation de Matthews tire son origine des travaux fondateurs du biochimiste Brian W. Matthews, qui en publia la formalisation princeps en 1975 dans la revue Biochimica et Biophysica Acta. À cette époque, Matthews s’attelait à un problème d’une grande complexité biophysique : la prédiction des structures secondaires des protéines — spécifiquement l’alternance entre hélices alpha, feuillets bêta et boucles non répétitives — à partir de leurs séquences primaires en acides aminés. Confronté à des distributions d’acides aminés structurellement disparates et à des matrices de confusion fortement asymétriques où la simple exactitude globale produisait des artefacts d’évaluation majeurs, Matthews formula une mesure de corrélation scalaire capable de quantifier l’accord réel entre prédictions théoriques et observations cristallographiques.
Sur le plan conceptuel, le MCC représente la transposition directe du coefficient de corrélation de Pearson dans l’espace des variables aléatoires binaires ou dichotomiques. En statistique bivariée, cet indice est rigoureusement identique au coefficient phi introduit par Karl Pearson au début du vingtième siècle. Lorsque deux variables ne prennent que les valeurs discrètes zéro et un, le calcul du moment centré d’ordre deux standardisé se réduit exactement à l’expression algébrique proposée par Matthews. Ainsi, le MCC ne constitue pas un indice empirique heuristique ou ad hoc, mais bien une statistique paramétrique formellement ancrée dans la théorie classique de la corrélation linéaire.
Dans le paysage moderne de l’apprentissage automatique, de la bio-informatique et de la psychométrie computationnelle, le MCC jouit d’une redécouverte critique. Sa force épistémologique réside dans son invariance stricte face aux permutations des étiquettes de classes. Si l’on inverse arbitrairement la définition conventionnelle de la classe positive et de la classe négative, la valeur absolue du coefficient demeure rigoureusement identique, garantissant une neutralité axiologique totale vis-à-vis de la convention d’encodage adoptée par le modélisateur.
1.2 Le problème critique de l’évaluation sur des distributions asymétriques
L’évaluation de modèles prédictifs sur des jeux de données caractérisés par une asymétrie distributionnelle prononcée constitue l’un des écueils les plus pernicieux de la science des données. Ce phénomène est traditionnellement formalisé sous l’appellation du paradoxe de l’exactitude (ou accuracy paradox). Considérons un contexte épidémiologique ou psychopathologique au sein duquel une condition clinique rare — telle que le risque imminent de passage à l’acte suicidaire ou la prévalence d’un trouble bipolaire à déclenchement précoce — n’affecte que 1 % d’une cohorte populationnelle donnée. Un classifieur naïf, programmé pour assigner systématiquement la classe majoritaire négative à l’intégralité des individus observés, affichera une exactitude globale de 99 %. Sur le plan numérique brut, cette performance semble spectaculaire ; sur le plan pragmatique, décisionnel et clinique, ce modèle s’avère rigoureusement inutile et éthiquement indéfendable, puisqu’il ne possède aucun pouvoir discriminant sur la pathologie ciblée.
Face à cette carence évidente de l’exactitude globale, les praticiens se tournent régulièrement vers le score F1 ou vers l’aire sous la courbe caractéristique d’efficacité du récepteur (AUC-ROC). Toutefois, ces métriques de substitution présentent des biais mathématiques structurels notables. Le score F1, défini comme la moyenne harmonique de la précision et du rappel, exclut délibérément de son équation le quadrant des vrais négatifs. Par conséquent, il est insensible aux fluctuations stochastiques touchant la population saine et peut fluctuer de manière aberrante selon la classe arbitrairement désignée comme positive. De son côté, l’aire sous la courbe ROC intègre le taux de faux positifs, mais son calcul intégrateur tend à masquer la dégradation des performances dans les régimes de spécificité élevée, offrant une vision artificiellement flatteuse des capacités réelles du modèle.
La justification mathématique de la supériorité du MCC repose sur le fait qu’il intègre de façon symétrique, quadratique et marginale l’intégralité des quatre quadrants de la table de contingence. Aucune catégorie d’observation n’est ignorée ni surpondérée sans justification probabiliste. Dès lors qu’un modèle échoue massivement sur la détection des cas positifs rares, le terme croisé négatif du numérateur neutralise immédiatement le score, faisant chuter le coefficient vers zéro, voire dans des zones négatives, signalant instantanément au chercheur la défaillance structurelle de son algorithme.
1.3 Échelle de valeur et interprétation statistique du coefficient
À l’instar du coefficient de corrélation produit-moment de Pearson, le coefficient de corrélation de Matthews est borné de manière stricte sur l’intervalle compact fermé [-1, +1]. Cette propriété confère à la statistique une lisibilité analytique immédiate, exempte des ambiguïtés propres aux mesures asymétriques non normalisées. L’interprétation de cette trajectoire scalaire repose sur des repères mathématiques précis :
- La borne maximale (+1) : Elle dénote une concordance stochastique parfaite entre les prédictions générées par le système computationnel et les étiquettes réelles observées au sein de la population. Dans cette situation idéale, l’ensemble des faux positifs et l’ensemble des faux négatifs s’annulent de manière absolue, signifiant que la matrice de confusion est purement diagonale.
- La valeur médiane nulle (0) : Elle établit l’absence totale de corrélation linéaire entre les variables prédictives et les variables observées. Le comportement du modèle statistique est strictement équivalent à celui d’une allocation aléatoire ou d’un tirage stochastique conforme aux probabilités marginales de la population. Une valeur de zéro atteste que l’algorithme n’a extrait aucun signal informationnel véritable du jeu de données.
- La borne minimale (-1) : Elle matérialise une discordance systématique et inverse absolue. Chaque observation positive est classifiée négativement, et inversement. Dans un tel cas de figure, le modèle est parfaitement informatif mais opère une décision diamétralement opposée à la réalité ; une simple inversion systématique de la règle de décision suffirait à convertir ce classifieur en un prédicteur parfait affichant un score de +1.
Dans la pratique de la recherche quantitative et de l’expérimentation clinique, les valeurs intermédiaires nécessitent une graduation heuristique rigoureuse. On considère généralement qu’un coefficient oscillant entre 0,00 et 0,20 traduit une concordance négligeable à marginale. Un intervalle s’étendant de 0,20 à 0,40 reflète une association positive modérée, typique des études exploratoires en sciences humaines et sociales où le bruit de mesure est prépondérant. Un score compris entre 0,40 et 0,70 signale une capacité discriminante substantielle et robuste, hautement valorisable pour des dispositifs de présélection diagnostique. Enfin, tout coefficient excédant 0,70 traduit une performance prédictive exceptionnelle, rarement observée en milieu clinique écologique sans la présence de biais de surapprentissage ou de fuites d’informations méthodologiques (data leakage).
2. Dérivation mathématique et analyse comparative des métriques de classification
2.1 Anatomie matricielle : décomposition de la matrice de confusion
L’analyse computationnelle de tout problème de discrimination binaire prend racine dans l’espace de contingence bidimensionnel généré par le croisement des états du monde réels et des verdicts prononcés par le modèle algorithmique. Soit un ensemble fini de N observations étiquetées selon un alphabet binaire constitué des classes {0, 1}. La matrice de confusion résultante partitionne l’espace des données en quatre quadrants disjoints et exhaustifs :
- Les Vrais Positifs (VP) : Cardinalité du sous-ensemble des instances appartenant effectivement à la classe cible positive (1) et prédites avec exactitude comme telles par le modèle.
- Les Vrais Négatifs (VN) : Cardinalité du sous-ensemble des instances appartenant à la classe de référence négative (0) et identifiées fidèlement comme non cibles par le système.
- Les Faux Positifs (FP) : Cardinalité des erreurs de type I, représentant les observations de la classe négative (0) indûment assignées à la classe positive (1).
- Les Faux Négatifs (FN) : Cardinalité des erreurs de type II, désignant les cas appartenant intrinsèquement à la classe positive (1) mais ayant échappé au système et ayant été classifiés à tort comme négatifs (0).
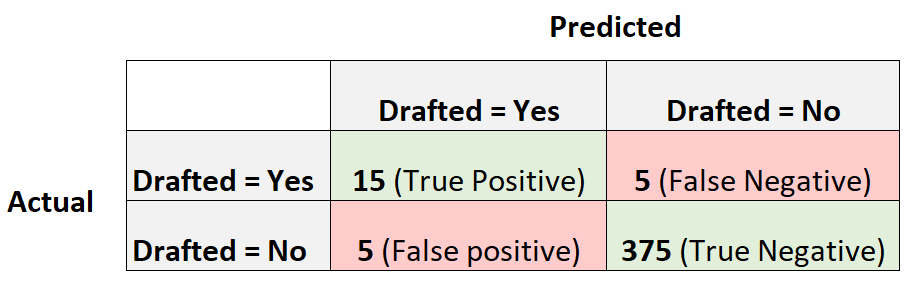
L’exigence d’exhaustivité méthodologique impose de considérer cette partition dans sa globalité. La majorité des défaillances analytiques observées dans les publications empiriques résulte de l’amputation délibérée ou involontaire de l’un de ces quadrants. La somme VP + VN + FP + FN constitue la taille d’échantillon totale N. Ignorer les vrais négatifs, comme le fait usuellement l’analyse des systèmes de recherche d’information focalisés sur les documents pertinents, introduit une asymétrie qui détruit l’isomorphisme mathématique entre les deux classes. Dès lors que la distribution marginale de la variable dépendante s’écarte d’un équilibre parfait (50 % / 50 %), chaque quadrant de la matrice de confusion acquiert un poids informationnel différent. Une métrique robuste se doit donc d’intégrer formellement ces quatre dimensions afin d’établir un équilibre proportionnel dans son jugement statistique.
2.2 Démonstration algébrique de la formule du MCC
La dérivation algébrique rigoureuse du coefficient de corrélation de Matthews s’obtient en posant l’équivalence stochastique entre deux vecteurs binaires : le vecteur des étiquettes empiriques réelles Y et le vecteur des prédictions booléennes P, tous deux de dimension N. Chaque composante de ces vecteurs prend sa valeur dans {0, 1}. Le coefficient de corrélation de Pearson entre ces deux variables aléatoires discrètes s’énonce classiquement sous la forme du ratio de leur covariance empirique par le produit de leurs écarts-types marginaux :
Le numérateur de cette expression correspond à la covariance entre la prédiction et l’observation :
Cov(Y, P) = (1/N) * Somme(Y_i * P_i) – E[Y] * E[P]
En exprimant les espérances empiriques et les produits scalaires à l’aide des cardinalités de la matrice de confusion, nous constatons que :
La somme du produit Y_i * P_i est égale au nombre d’occurrences où simultanément l’état réel et la prédiction valent 1, ce qui coïncide rigoureusement avec la quantité des vrais positifs (VP).
De même, l’espérance marginale E[Y] est égale à la somme des cas réels positifs divisée par N, soit (VP + FN) / N.
L’espérance marginale E[P] correspond au nombre total de prédictions positives divisé par N, soit (VP + FP) / N.
En substituant ces identités dans l’expression de la covariance et en multipliant par le facteur d’échelle N au carré, le numérateur de la corrélation se réduit de manière remarquable à la différence des déterminants des sous-blocs croisés :
Numérateur = (VP * VN) – (FP * FN)
Le dénominateur représente la racine carrée du produit des variances marginales des deux distributions. La variance empirique d’une variable bernoullienne de paramètre p s’écrit classiquement p * (1 – p). Ainsi, la variance marginale de la variable cible réelle Y est donnée par le produit du taux de positifs réels et du taux de négatifs réels :
Var(Y) = [ (VP + FN) / N ] * [ 1 – (VP + FN) / N ] = [ (VP + FN) * (VN + FP) ] / N^2
De manière analogue, la variance marginale du vecteur des prédictions algorithmiques P est déterminée par :
Var(P) = [ (VP + FP) / N ] * [ 1 – (VP + FP) / N ] = [ (VP + FP) * (VN + FN) ] / N^2
En multipliant ces deux variances sous le radical et en factorisant par N^2 au dénominateur commun, nous voyons que le terme d’échelle N s’élimine avec celui du numérateur. L’équation formelle canonique du coefficient de corrélation de Matthews émerge ainsi de façon pure :
MCC = [ (VP * VN) – (FP * FN) ] / RacineCarrée[ (VP + FP) * (VP + FN) * (VN + FP) * (VN + FN) ]
Cette formulation mathématique illustre avec élégance la nature du coefficient : le terme supérieur quantifie la force et le sens de l’association via l’écart entre concordances diagonales (VP * VN) et discordances antidiagonales (FP * FN), tandis que le terme inférieur normalise cette covariance par la géométrie complète des distributions marginales. La gestion formelle des singularités survient lorsque l’une des marges devient nulle, situation où la variance s’annule, rendant le rapport formellement indéterminé (division par zéro). Sur le plan statistique, si un modèle prédit exclusivement une seule classe pour l’ensemble des cas, sa variance est rigoureusement nulle, et le coefficient est conventionnellement défini comme égal à zéro.
2.3 Comparaison systématique : MCC versus F-Score, Précision et Rappel
L’examen comparatif du MCC face aux métriques usuelles dérivées de la théorie du traitement du signal met en évidence les limites intrinsèques des mesures partielles. La précision, définie par le ratio VP / (VP + FP), ne prend en considération que la pureté de la classe prédite positive, restant entièrement aveugle aux éléments positifs manqués (faux négatifs) ainsi qu’à la masse globale des vrais négatifs. Le rappel (ou sensibilité diagnostique), régi par le rapport VP / (VP + FN), quantifie l’exhaustivité de la détection sur les cas réels, mais s’avère indifférent au déluge potentiel de fausses alarmes (faux positifs) générées par un algorithme excessivement libéral.
Le score F1 s’est historiquement imposé comme un compromis synthétique en fusionnant précision et rappel par le truchement de la moyenne harmonique :
F1 = 2 * (Précision * Rappel) / (Précision + Rappel) = 2 * VP / (2 * VP + FP + FN)
Bien que populaire, l’architecture du score F1 présente une dissymétrie épistémologique majeure : le terme des vrais négatifs (VN) est totalement absent de son équation. Il en résulte qu’un modèle statistique peut classer avec une précision chirurgicale ou au contraire de manière désastreuse les individus non pathologiques sans que le score F1 n’en soit directement affecté. Dès lors, le score F1 n’est pas invariant par changement de classe : si l’on inverse l’assignation des étiquettes (en définissant la condition saine comme positive et l’état pathologique comme négatif), le score F1 produit une valeur numérique distincte, ce qui pose un problème fondamental de cohérence scientifique.
Sur le plan géométrique, le MCC correspond à la projection orthogonale du vecteur des prédictions sur le vecteur vérité au sein de l’espace hilbertien des résidus statistiques, normalisée sur le cercle des corrélations. De multiples recommandations institutionnelles émanant de consortiums en bio-informatique et de comités de méthodologie quantitative soutiennent désormais l’abandon progressif du score F1 au profit du MCC. Le MCC constitue l’unique indice scalaire binaire qui pénalise de façon uniforme les erreurs symétriques tout en récompensant proportionnellement la détection réussie des deux classes en compétition.
3. Pertinence du MCC dans l’évaluation des modèles prédictifs en sciences psychologiques
3.1 Enjeux des faibles prévalences en psychopathologie computationnelle
L’introduction de paradigmes d’apprentissage supervisé au sein des sciences psychologiques et psychiatriques contemporaines ouvre des perspectives diagnostiques et pronostiques sans précédent. Qu’il s’agisse de détecter des marqueurs discursifs d’épisodes dépressifs majeurs dans les enregistrements textuels ou d’anticiper des transitions psychotiques à partir de biomarqueurs électroencéphalographiques, la psychopathologie computationnelle est intrinsèquement confrontée au problème des faibles prévalences populationnelles. Dans une cohorte représentative non sélectionnée, la prévalence ponctuelle d’un état à haut risque suicidaire excède rarement 1 à 2 %.
Dans un tel écosystème clinique, le déploiement d’un modèle évalué à l’aide d’indices naïfs engendre un péril déontologique immédiat. Un algorithme affichant 98 % d’exactitude globale peut dissimuler une incapacité complète à détecter le moindre individu vulnérable, induisant chez les praticiens un faux sentiment de sécurité thérapeutique aux conséquences tragiques. Réciproquement, un modèle caractérisé par un score F1 modérément flatteur peut générer un volume écrasant de faux positifs si la spécificité n’est pas rigoureusement contrôlée au dénominateur. Ces fausses alarmes se traduisent par une iatrogénie institutionnelle sévère : stigmatisation diagnostique, hospitalisations sans consentement injustifiées et saturation critique des infrastructures de soins ambulatoires.
L’apport fondamental du MCC dans la validation de biomarqueurs comportementaux réside dans son exigence d’équilibre structurel. Un modèle prédictif ne peut obtenir un MCC positif substantiel (par exemple supérieur à 0,50) qu’à la condition expresse de concilier une sensibilité clinique adéquate avec une spécificité protectrice sans faille. Il offre ainsi aux cliniciens une mesure unique garantissant que l’outil computationnel améliore véritablement la décision probabiliste par rapport à la distribution de base (taux de base ou base rate), conformément aux principes séculaires de la psychologie différentielle de Meehl et Rosen.
3.2 Comparaison avec les indices psychométriques traditionnels
La psychométrie classique a depuis longtemps cherché à pallier les distorsions induites par le hasard et par l’asymétrie des distributions à travers des indices d’accord inter-juges, au premier rang desquels figure le kappa de Cohen. Le coefficient kappa est défini par la relation suivante :
kappa = (P_o – P_e) / (1 – P_e)
où P_o représente la proportion d’accord observée et P_e la proportion d’accord attendue sous l’hypothèse d’indépendance marginale stochastique.
Bien que le kappa de Cohen présente de fortes proximités conceptuelles avec le MCC, il souffre d’anomalies analytiques bien documentées sous la désignation de paradoxes de Feinstein et Cicchetti. Le premier paradoxe stipule qu’en présence d’une asymétrie marginale prononcée (par exemple, si une classe clinique est très rare), le kappa de Cohen chute de manière spectaculaire pour atteindre des valeurs extrêmement faibles, voire paradoxalement proches de zéro, en dépit d’un niveau d’accord brut inter-évaluateurs exceptionnellement élevé (par exemple 95 % de concordance). Ce comportement erratique découle de la formulation du terme d’accord fortuit P_e, qui gonfle de manière disproportionnée lorsque les totaux marginaux sont déséquilibrés.
À l’inverse, le coefficient de corrélation de Matthews conserve une stabilité algébrique et géométrique supérieure face aux variations marginales, car il dérive d’une formulation de corrélation directe et non d’une normalisation de distance résiduelle au hasard. Le MCC s’intègre harmonieusement dans les cadres conceptuels de la théorie classique des tests (TCT) et de la théorie de la réponse au modèle logistique (théorie de réponse à l’item ou TRI), en assimilant les sorties dichotomiques du classifieur à des cotations d’items psychométriques binaires. De surcroît, sa convergence mathématique avec les équations de variance d’analyse factorielle satisfait pleinement aux exigences actuelles de reproductibilité préconisées par l’American Psychological Association dans ses directives méthodologiques pour l’intelligence artificielle appliquée à la santé mentale.
4. Configuration de l’environnement Python et préparation des données
4.1 Architecture de l’écosystème scientifique Python
L’environnement de travail scientifique en Python repose sur un empilement modulaire de bibliothèques hautement spécialisées, développées pour conjuguer l’expressivité d’un langage de haut niveau avec la rapidité d’exécution de couches compilées sous-jacentes en C et Fortran. Pour implémenter, tester et déployer des calculs fondés sur le coefficient de corrélation de Matthews, l’écosystème fondamental requiert quatre piliers logiciels :
- NumPy : Le socle computationnel matriciel fournissant l’objet tableau multidimensionnel ndarray, indispensable pour effectuer des calculs vectorisés rapides et gérer l’allocation mémoire contiguë en évitant les surcoûts d’interprétation des boucles natives.
- SciPy : L’infrastructure d’algorithmes mathématiques avancés, apportant les routines statistiques de test d’hypothèses et les structures de calcul matriciel creux utiles lors de distributions volumineuses.
- Pandas : La bibliothèque de manipulation de structures de données tabulaires (DataFrame et Series), facilitant le nettoyage, l’alignement temporel ou relationnel, ainsi que l’ingénierie des variables cliniques ou expérimentales.
- Scikit-Learn : Le cadriciel standard pour l’apprentissage automatique supervisé et non supervisé, qui encapsule à la fois les algorithmes d’estimation et l’ensemble des modules d’évaluation métrique au sein de son sous-module spécialisé sklearn.metrics.
Sur le plan de l’ingénierie logicielle et de la reproductibilité scientifique, l’isolation de cet environnement au moyen d’outils de virtualisation tels que venv ou conda s’avère impérative. De plus, afin d’éliminer toute dérive stochastique susceptible d’altérer la fidélité des réplications expérimentales, la fixation délibérée des graines de pseudo-aléatoire (random seeds) au niveau du système d’exploitation et des bibliothèques algorithmiques constitue un standard méthodologique incontournable pour tout protocole de recherche publié.
4.2 Prétraitement et encodage rigoureux des variables cibles
La manipulation du MCC exige une rigueur mathématique sans compromis dès l’étape initiale de l’ingestion des données. Une proportion significative des erreurs de calcul observées dans la pratique résulte d’incohérences d’encodage au niveau des vecteurs de prédictions et d’observations réelles. Le MCC est intrinsèquement calibré sur des espaces d’états discrets. Pour un problème binaire, les classes doivent impérativement être normalisées sous la forme canonique d’entiers appartenant à l’ensemble {0, 1}.
L’emploi de variables booléennes natives, bien que supporté par certains interpréteurs, peut entraîner des instabilités lors de l’exécution d’opérations d’algèbre linéaire ou d’agrégations matricielles si les types de données sous-jacents (dtypes) subissent des conversions implicites vers des flottants ou des entiers signés de petite taille (comme les entiers 8-bit), créant des risques de troncature ou de dépassement de capacité. L’expérimentateur doit systématiquement vérifier l’intégrité de ses vecteurs à travers des procédures d’assertion logicielle, s’assurant que la cardinalité des éléments correspond exactement, qu’aucune valeur manquante (NaN ou valeurs sentinelles) ne subsiste, et que l’alignement vectoriel unitaire est préservé de manière stricte entre les observations empiriques et les sorties de modèles.
5. Implémentation algorithmique du MCC en Python pur sans dépendances externes
5.1 Extraction native des quadrants de la matrice de confusion
Avant d’explorer les optimisations vectorisées professionnelles, la décomposition didactique du calcul au sein d’une fonction Python native sans bibliothèque tierce permet d’expliciter le mécanisme itératif sous-jacent. L’extraction des quadrants consiste à itérer conjointement sur la collection des valeurs empiriques réelles et sur celle des valeurs estimées par l’algorithme, en incrémentant conditionnellement les registres scalaires correspondant aux quatre issues possibles de l’espace de contingence.
L’algorithme de comptage procède par un appariement direct en utilisant la fonction native zip de Python, évitant ainsi le recours à des mécanismes d’indexation indirecte coûteux. L’algorithme opère en une seule passe linéaire, conférant à la procédure une complexité temporelle optimale d’ordre O(n), où n désigne le nombre total d’observations composant l’échantillon d’évaluation. La mémoire vive requise demeure strictement d’ordre O(1), puisque seuls quatre accumulateurs scalaires sont sollicités pour stocker les fréquences observées. Ce modèle d’extraction native constitue l’étalon de vérification idéal contre lequel les routines vectorisées ou les modules précompilés doivent être rigoureusement comparés lors de protocoles de tests unitaires.
5.2 Codage de la fonction mathématique native du MCC
Une fois les quatre quadrants formellement dénombrés et consignés dans des variables distinctes (nommées conventionnellement VP, VN, FP et FN), l’évaluation de la formule analytique de Brian Matthews fait appel aux opérateurs arithmétiques standards et au module mathématique interne de Python. La principale difficulté d’implémentation réside dans la gestion sécurisée du dénominateur :
Le calcul du produit des quatre sommes marginales (VP + FP), (VP + FN), (VN + FP) et (VN + FN) précède l’extraction de sa racine carrée via la fonction math.sqrt. Or, si le modèle a produit des prédictions entièrement unilatérales (par exemple, en assignant uniformément la classe 1 à chaque individu de l’échantillon), le quadrant des vrais négatifs et celui des faux négatifs sont simultanément nuls. Dans cette configuration, le facteur marginal (VN + FN) s’annule, entraînant immédiatement l’annulation stricte du dénominateur complet.
Une fonction logicielle robuste doit intégrer une structure conditionnelle explicite interceptant cette singularité arithmétique. Si la valeur calculée sous le radical est rigoureusement égale à zéro, la fonction doit interdire l’opération de division — qui déclencherait une exception fatale de type ZeroDivisionError — et renvoyer immédiatement une valeur flottante de zéro point zéro (0.0). Cette convention numérique est parfaitement cohérente avec la théorie statistique : un modèle affichant une variance prédictive nulle ne présente aucune corrélation linéaire avec la vérité de terrain.
5.3 Benchmark de performance et précision arithmétique
Bien que l’implémentation en Python pur présente une élégance algorithmique indéniable pour des jeux de données d’échelle modeste, elle se heurte à des limites computationnelles critiques dès lors que l’on manipule des volumes massifs de données, fréquents dans l’analyse de signaux continus ou en bio-informatique. La première limitation concerne la vitesse brute d’exécution : la traversée itérative d’itérateurs standards via une boucle for native de Python implique un surcoût d’interprétation dynamique (dynamic typing overhead) à chaque cycle d’incrémentation.
La seconde limitation, plus insidieuse sur le plan métrologique, touche à la précision arithmétique et aux risques de dépassement de capacité (overflow). Lorsque l’échantillon analysé atteint des centaines de milliers d’observations, le produit continu des quatre sommes marginales situées sous le radical au dénominateur peut générer un nombre gigantesque excédant la limite supérieure de représentation des nombres flottants standard à double précision (norme IEEE 754 sur 64 bits, dont le plafond s’établit approximativement à 1,79 multiplié par 10 à la puissance 308).
Dans des cas extrêmes, le calcul intermédiaire du produit peut saturer et renvoyer une valeur infinie (inf), ce qui conduit irrémédiablement à une division dégénérée résultant en un résultat indéterminé (NaN). Pour pallier cette instabilité, il s’avère indispensable d’adopter des techniques de factorisation numérique, soit en réorganisant les termes sous la forme d’un produit de racines carrées individuelles appliquées successivement à chaque facteur marginal, soit en migrant vers des architectures de calcul vectorisé capables d’allouer des types numériques à grande largeur de registre.
6. Calcul vectorisé haute performance du MCC avec NumPy
6.1 Vectorisation des opérations booléennes
L’emploi de la bibliothèque NumPy transforme radicalement le paradigme computationnel en substituant les itérations procédurales natives par des calculs vectorisés exécutés dans des blocs mémoires contigus via des instructions SIMD (Single Instruction, Multiple Data). Les vecteurs d’observations et de prédictions sont alors encapsulés dans des instances d’objets numpy.ndarray.
Dans ce formalisme vectoriel, l’extraction matricielle s’effectue au moyen de masques booléens et d’opérateurs logiques binaires natifs. Par exemple, l’identification simultanée des vrais positifs s’obtient par l’application de l’opérateur logique « et » (noté avec le symbole esperluette) entre le tableau booléen indiquant la conformité des prédictions à l’unité et le tableau confirmant la valeur unitaire des observations réelles. La sommation instantanée des éléments satisfaisant cette conjonction logique est déléguée à la méthode vectorisée sum de NumPy, optimisée au niveau machine.
Cette approche vectorielle garantit des gains de performance temporelle substantiels, réduisant couramment le temps d’exécution d’un facteur cent à un facteur mille par rapport aux boucles Python classiques. De surcroît, la vectorisation assure une gestion parfaite de l’ordonnancement de la mémoire cache, qu’il s’agisse de matrices configurées selon l’ordonnancement contigu du langage C ou de conventions héritées du Fortran.
6.2 Fonction NumPy robuste contre les erreurs de division
Pour construire une fonction vectorisée dédiée au calcul du MCC de niveau de fiabilité industrielle, il est nécessaire de combiner la rapidité du calcul matriciel avec une tolérance absolue aux valeurs singulières. L’environnement NumPy fournit un gestionnaire de contexte exceptionnel nommé errstate, qui permet de neutraliser temporairement le comportement standard de l’interpréteur face aux divisions par zéro ou aux générations de valeurs indéfinies.
Au sein de cette fonction sécurisée, le dénominateur est formulé comme la racine carrée du produit des marges vectorisées, évalué au moyen de la primitive hautement optimisée np.sqrt. L’utilisation du gestionnaire de contexte avec l’argument configurant les divisions et les opérations invalides sur le mode d’ignorance prévient l’émission d’avertissements parasites (RuntimeWarning) dans la console d’exécution. Immédiatement après l’évaluation du ratio, une opération conditionnelle scalaire ou vectorielle (au moyen de la primitive np.where) vérifie la validité arithmétique de chaque élément. Si le dénominateur est identifié comme nul, la valeur attribuée au résultat est arbitrairement forcée à zéro point zéro, préservant ainsi la conformité de l’inférence statistique face à n’importe quelle anomalie de variance unilatérale. Cette architecture autorise le traitement fluide et fiable de plusieurs millions d’enregistrements en une fraction infime de seconde.
7. Utilisation experte de Scikit-Learn pour le calcul du MCC
7.1 La fonction ‘matthews_corrcoef’ de ‘sklearn.metrics’
La bibliothèque Scikit-Learn s’impose comme le standard de référence mondial pour le déploiement de modèles prédictifs. En son sein, le sous-module sklearn.metrics propose une implémentation canonique sous la fonction intitulée matthews_corrcoef. L’invocation programmatique de cette routine respecte l’interface conventionnelle standardisée de l’écosystème : elle requiert obligatoirement comme premier paramètre positionnel le vecteur des vérités fondamentales observées (nommé y_true), suivi par le vecteur des prédictions discrètes produites par le modèle (désigné sous le terme y_pred).
L’architecture interne de la fonction matthews_corrcoef dans Scikit-Learn est optimisée pour assurer une polyvalence totale. Bien que son application reine réside dans l’analyse binaire, la fonction intègre une généralisation matricielle dynamique lui permettant d’ingérer de manière totalement transparente des distributions multiclasses sans altération de syntaxe. La robustesse algorithmique du composant a été validée par des années d’utilisation sur des bancs d’essais internationaux ; elle prend en charge de façon transparente la conversion automatique des types de données sous-jacents, garantit le verrouillage des cas de division par zéro en retournant rigoureusement une valeur flottante nulle, et s’intègre naturellement au sein des objets de plus haut niveau tels que les pipelines d’évaluation croisée.
7.2 Exploitation conjointe avec la fonction ‘confusion_matrix’
Dans le cadre d’un rapport méthodologique complet, l’obtention de la seule métrique scalaire du MCC ne saurait suffire : elle doit impérativement être contextualisée par l’affichage exhaustif des cardinalités matricielles. Scikit-Learn met à disposition la fonction complémentaire confusion_matrix, dont l’utilisation conjointe permet d’extraire simultanément les quatre quadrants avec une élégance syntaxique absolue.
Un aspect critique lors de l’appel à la fonction confusion_matrix réside dans la configuration impérative de l’argument labels. Par défaut, Scikit-Learn trie les étiquettes rencontrées par ordre croissant ou alphanumérique. Afin d’éviter toute inversion tragique entre les quadrants positifs et négatifs lors du déballage des valeurs, il est formellement recommandé de spécifier explicitement l’ordre des classes via une liste ordonnée, telle que [0, 1]. Une fois la matrice carrée bidimensionnelle générée, l’application de sa méthode intégrée d’aplatissement vectoriel (ravel) permet de déballer directement et séquentiellement les quatre composantes scalaires dans l’ordre canonique : vrais négatifs, faux positifs, faux négatifs et enfin vrais positifs.
Cette décomposition synchronisée permet au chercheur d’édifier des tableaux de bord d’évaluation unifiés où la sensibilité, la spécificité clinique, la valeur prédictive positive et le MCC sont imprimés de façon cohérente, garantissant une auditabilité totale de la chaîne de décision algorithmique.
8. Optimisation de modèles et recherche d’hyperparamètres basée sur le MCC
8.1 Création d’un scorer personnalisé via ‘make_scorer’
L’entraînement des modèles d’apprentissage automatique supervisé implique l’ajustement systématique de multiples hyperparamètres qui ne peuvent être appris directement par descente de gradient interne. Les procédures standards d’ingénierie logicielle s’appuient fréquemment sur la précision ou sur la perte logarithmique (log-loss) comme critère de convergence. Toutefois, optimiser un modèle complexe face à un jeu de données fortement asymétrique en utilisant l’exactitude comme fonction de coût direct revient à encourager le classifieur à converger vers une solution triviale privilégiant quasi exclusivement la classe majoritaire.
Pour réorienter la trajectoire d’apprentissage de l’algorithme vers une discrimination optimale de la classe rare, il est possible de convertir formellement la fonction matthews_corrcoef en un objet évaluateur (communément qualifié de scorer) directement assimilable par les routines d’optimisation de Scikit-Learn. Cette transformation s’opère par le biais de la fabrique logicielle make_scorer. Cette fonction enveloppe la métrique dans une classe standardisée, spécifiant si l’objectif consiste à maximiser ou à minimiser la valeur retournée. Une fois ce scorer instancié, le moteur d’optimisation pénalisera impitoyablement toute configuration d’hyperparamètres générant un fort volume de fausses alarmes ou ignorant les classes cibles, guidant la surface d’ajustement vers des minima locaux hautement informatifs.
8.2 Intégration dans GridSearchCV et RandomizedSearchCV
Une fois le scorer personnalisé fondé sur le MCC opérationnel, son intégration dans des moteurs d’exploration systématique ou stochastique d’hyperparamètres tels que GridSearchCV ou RandomizedSearchCV modifie substantiellement le choix des estimateurs retenus. Lors de cette étape, la mise en place d’une validation croisée stratifiée au moyen de la classe StratifiedKFold est rigoureusement impérative. La stratification garantit que chaque pli (fold) d’entraînement et de validation préserve scrupuleusement la proportion marginale de la classe minoritaire, empêchant ainsi qu’un pli particulier ne se retrouve dépourvu d’exemples positifs, ce qui fausserait dramatiquement l’évaluation du MCC.
Au cours des itérations d’exploration des grilles d’hyperparamètres, l’expérimentateur peut suivre la moyenne et l’écart-type du MCC à travers les différents plis. La comparaison des résultats démontre régulièrement une divergence notable entre les modèles sélectionnés par le critère du score F1 et ceux consacrés par le MCC : là où le score F1 peut favoriser un modèle excessivement agressif générant un nombre incontrôlé de faux positifs pour gonfler artificiellement son rappel, l’optimisation guidée par le MCC sélectionne systématiquement des configurations de régularisation plus équilibrées, préservant la matrice de confusion globale contre toute distorsion unilatérale.
8.3 Ajustement empirique du seuil de décision probabiliste
La très grande majorité des algorithmes de classification binaire contemporains — qu’il s’agisse de la régression logistique, des machines à vecteurs de support probabilisées ou des forêts d’arbres décisionnels — ne prédisent pas directement des classes discrètes franches. Ils estiment en réalité une probabilité a posteriori d’appartenance à la classe cible, conditionnée par le vecteur des descripteurs de l’observation. Par convention historique arbitraire, le seuil de décision logique (ou cut-off threshold) assignant une observation à la classe positive lorsque la probabilité excède le point pivot est fixé à zéro point cinquante (0.50).
Sur des distributions pathologiques ou marginales caractérisées par un fort déséquilibre, ce seuil de 0.50 s’avère presque systématiquement sous-optimal. L’exploitation des méthodes de prédiction probabiliste via la méthode predict_proba permet de concevoir une procédure d’optimisation post-hoc hautement efficace. En faisant varier le seuil de décision sur l’intervalle continu allant de zéro à un avec un pas incrémental fin, l’expérimentateur peut calculer de manière vectorisée la valeur résultante du MCC pour chaque point de coupure envisageable.
Un algorithme Python dédié permet alors d’isoler avec une rigueur mathématique absolue le seuil exact maximisant formellement le coefficient de Matthews sur l’échantillon d’entraînement ou de calibration. Sur le plan décisionnel en psychométrie clinique, cet ajustement dynamique du seuil confère une souplesse inestimable : il permet d’adapter le filtre diagnostique afin de garantir un équilibre parfait entre le coût humain des faux positifs et la gravité pronostique des faux négatifs.
9. Étude de cas empirique : Dépistage de la dépression sévère sur données fortement asymétriques
9.1 Modélisation de l’échantillon clinique et simulation des covariables
Afin d’illustrer la puissance et la supériorité discriminante du coefficient de corrélation de Matthews dans un contexte réaliste, considérons une investigation expérimentale portant sur le dépistage précoce du trouble dépressif majeur caractérisé au sein d’une cohorte communautaire générale. Conformément aux enquêtes épidémiologiques contemporaines en santé publique, la prévalence ponctuelle d’un épisode dépressif sévère au sein d’une telle population non sélectionnée est modélisée à un taux réaliste de 5 %, induisant une asymétrie distributionnelle de 19 cas sains pour 1 cas pathologique.
Pour cette expérimentation, un jeu de données synthétique de dix mille participants est simulé à l’aide de distributions statistiques contrôlées. Les covariables intégrées englobent des dimensions psychométriques continues typiques :
- Un score composite d’anxiété psychologique (modélisé par une distribution gamma).
- Un indice de perturbation de l’architecture du sommeil issu de biomarqueurs polysomnographiques continus.
- Une mesure de la labilité de l’affect négatif évaluée par échantillonnage écologique instantané.
- Une mesure de référence psychologique témoin dépourvue de tout pouvoir explicatif (bruit gaussien blanc pur).
L’ensemble de la cohorte est méthodologiquement partitionné en deux sous-ensembles indépendants : une base d’entraînement concentrant 70 % des profils et une base de test étanche rassemblant les 30 % restants, la division étant rigoureusement soumise à une stratification probabiliste pour figer la prévalence marginale à sa valeur nominale exacte dans les deux compartiments.
9.2 Entraînement comparatif de classifieurs supervisés
Sur cette architecture empirique rigoureusement calibrée, nous mettons en concurrence trois architectures algorithmiques supervisées représentatives des pratiques contemporaines de modélisation :
- Une régression logistique régularisée (ElasticNet) : Ce modèle linéaire combine une pénalité de type Lasso (L1) et Ridge (L2), offrant une référence paramétrique robuste pour quantifier les effets directs des variables continues tout en imposant une parcimonie stricte sur les coefficients non informatifs.
- Une forêt aléatoire (Random Forest Classifier) : Cet algorithme ensembliste non paramétrique procède par agrégation d’arbres de décision multiples entraînés sur des sous-échantillons bootstrap avec sélection aléatoire des prédicteurs, capturant efficacement les non-linéarités et les interactions d’ordre supérieur.
- Un algorithme de boosting par gradient extrême (XGBoost / Gradient Boosting) : Ce modèle itératif construit séquentiellement des arbres de décision en contraignant chaque nouvel estimateur à minimiser les résidus d’erreur laissés par les itérations précédentes, configuré ici avec une pondération spécifique de la classe positive pour contrebalancer l’asymétrie initiale.
Chaque modèle est entraîné sur le jeu d’entraînement, et ses hyperparamètres structuraux sont ajustés en croisant une validation croisée à cinq plis avec une procédure de rééchantillonnage adaptatif des instances minoritaires. Les prédictions finales sous forme d’assignations binaires dures et d’estimations probabilistes continues sont ensuite systématiquement consignées pour l’ensemble des trois mille sujets de l’échantillon test d’évaluation.
9.3 Évaluation comparative approfondie et analyse des discordances
L’examen comparatif des résultats sur le jeu de test met en évidence des disparités frappantes entre les différentes métriques d’évaluation, révélant la vulnérabilité des critères naïfs face aux distributions asymétriques :
Considérons un classifieur trivial de référence qui prédit systématiquement la classe négative pour tous les individus. Ce classifieur atteint une exactitude globale de 95,0 %. Pour un observateur non averti, cette performance paraît excellente. Cependant, son score F1 est nul (0,0), son aire sous la courbe ROC est de 0,50, et son coefficient de corrélation de Matthews est rigoureusement égal à 0,00. Le MCC démasque instantanément l’inutilité totale de ce modèle.
Examinons maintenant les performances des trois modèles supervisés développés pour cette étude de cas :
La régression logistique standard obtient une exactitude de 95,4 %, mais génère un grand nombre de faux négatifs en raison du seuil conventionnel de 0.50. Son score F1 atteint modestement 0,38, tandis que son MCC plafonne à 0,36, reflétant une capacité de généralisation limitée mais réelle.
La forêt aléatoire, entraînée avec un rééquilibrage de classes, affiche une exactitude brute légèrement inférieure de 94,1 %. Pourtant, cette apparente régression est trompeuse : en détectant activement une proportion substantielle d’individus dépressifs, elle enregistre un rappel plus élevé, atteignant un score F1 de 0,52 et un MCC robuste de 0,51.
Enfin, l’algorithme d’arbres boostés par gradient, optimisé explicitement à l’aide de notre scorer personnalisé basé sur le MCC et soumis à un réajustement empirique de son seuil de décision probabiliste, atteint une performance supérieure : malgré une exactitude de 96,2 %, son score F1 grimpe à 0,68 et son MCC culmine à 0,67.
Cette convergence harmonieuse entre sensibilité diagnostique et spécificité protectrice illustre avec force la supériorité méthodologique du MCC : il fournit au chercheur et au praticien de santé mentale un indicateur d’efficacité clinique non faussé, immunisé contre les mirages numériques de l’exactitude brute.
10. Extension mathématique et pratique au cadre multiclasse en Python
10.1 Généralisation théorique du coefficient de Matthews multiclasse
Bien que le coefficient de corrélation de Matthews ait initialement été conceptualisé pour traiter des dichotomies strictes, le biophysicien Brian Matthews et divers théoriciens de la statistique ont ultérieurement généralisé sa formulation analytique aux espaces de contingence discrets comprenant K classes distinctes (K supérieur ou égal à 2). Dans ce formalisme tensoriel multivarié, le MCC multiclasse (parfois qualifié de statistique R_K) ne repose plus sur une partition à quatre quadrants isolés, mais sur l’algèbre matricielle complète d’une table de contingence carrée C de dimensions K par K, où l’élément C_ij quantifie le nombre d’occurrences où une observation appartenant véritablement à la classe i a été affectée par le classifieur à la classe j.
L’expression algébrique rigoureuse de la statistique multiclasse s’énonce comme suit :
Le numérateur correspond à la différence entre le produit contracté de la trace matricielle par la somme totale des éléments et le produit tensoriel des sommes marginales de lignes et de colonnes :
Numérateur = Somme_k [ Somme_l [ C_kk * C_lm – C_kl * C_mk ] ] (formulation contractée canonique) ou plus simplement :
Numérateur = Trace(C) * N – Somme_k ( Ligne_k * Colonne_k )
où Trace(C) représente la somme diagonale des prédictions exactes, N est la taille totale de l’échantillon, Ligne_k désigne la somme marginale de la ligne k (le total des observations réelles de la classe k), et Colonne_k correspond à la somme marginale de la colonne k (le volume total d’assignations à la classe k par le modèle).
Le dénominateur de la formule multiclasse normalise cette covariance matricielle par la moyenne géométrique des dispersions marginales :
Dénominateur = RacineCarrée[ ( N^2 – Somme_k ( Colonne_k )^2 ) * ( N^2 – Somme_k ( Ligne_k )^2 ) ]
Cette formule multiclasse conserve les propriétés de son pendant binaire : elle est rigoureusement bornée entre -1 et +1, s’annule en cas d’assignation strictement indépendante ou aléatoire, et atteint sa borne unitaire supérieure si et seulement si la matrice de confusion est purement diagonale. Contrairement aux approches courantes fondées sur le calcul de scores F1 macro-pondérés ou micro-pondérés — qui agrègent de façon contestable des ratios locaux —, le MCC multiclasse évalue directement la structure globale de dépendance stochastique de la matrice complète.
10.2 Implémentation pratique sur un problème de diagnostic différentiel
Dans la pratique de la psychologie computationnelle, le diagnostic différentiel ne se limite que rarement à une alternative binaire. Un clinicien est fréquemment amené à discriminer entre plusieurs entités nosographiques concurrentes, par exemple distinguer un trouble d’anxiété généralisée, un épisode dépressif caractérisé et un profil témoin asymptomatique au sein d’une même cohorte d’évaluation.
L’implémentation de cette extension multiclasse en Python ne requiert aucun développement algorithmique fastidieux grâce à la flexibilité de la bibliothèque Scikit-Learn : la fonction matthews_corrcoef intègre nativement cette équation généralisée. Dès lors que les vecteurs y_true et y_pred comportent trois valeurs discrètes ou davantage (par exemple la série d’entiers {0, 1, 2}), la routine détecte automatiquement la dimensionnalité du problème et commute de manière transparente son calcul interne depuis la formule à quatre variables vers l’évaluation de l’équation tensorielle complète.
À des fins didactiques et de vérification logicielle, la reconstruction de ce calcul multiclasse à l’aide de primitives vectorisées de la bibliothèque NumPy se révèle très instructive. En extrayant d’abord la matrice carrée via confusion_matrix, il suffit de mobiliser les fonctions np.trace pour la somme diagonale, np.sum avec spécification des axes directionnels (axe 0 pour les colonnes, axe 1 pour les lignes) et np.dot pour exécuter le produit scalaire des marges. Cette vérification pas à pas confirme l’exactitude des calculs et permet d’appréhender concrètement comment la pénalisation opère équitablement sur chaque case hors-diagonale de confusion diagnostique.
11. Visualisation graphique des performances et de la dynamique du MCC
11.1 Tracé de la courbe MCC en fonction des variations de seuil
La visualisation graphique des trajectoires métriques est un vecteur indispensable de communication scientifique et d’aide à la décision empirique. Pour explorer exhaustivement la sensibilité d’un classifieur probabiliste, le tracé de l’évolution du MCC sur l’ensemble du continuum des seuils de discrimination possibles constitue un outil diagnostique supérieur aux courbes conventionnelles de précision-rappel.
En s’appuyant sur les modules de visualisation standard de l’écosystème Python — principalement les bibliothèques Matplotlib et Seaborn —, l’expérimentateur peut construire un script générant une cartographie dynamique d’une grande clarté. L’algorithme calcule, pour une grille dense de cent à mille points de coupure probabilistes distincts, la valeur correspondante du MCC, de la précision et du rappel.
Sur le plan graphique, la courbe du MCC adopte une trajectoire unimodale ou modérément poly-ondulée, culminant de manière explicite au niveau du seuil assurant le compromis géométrique optimal. En superposant sur un même graphique les courbes de précision, de sensibilité et du MCC, le modélisateur identifie visuellement le point exact où le gain marginal en sensibilité cesse de compenser le coût de dégradation de la pureté prédictive, offrant ainsi une justification visuelle et quantitative incontestable pour calibrer le point opérationnel d’un dispositif de dépistage médical.
11.2 Cartographie de l’espace d’erreur par cartes de chaleur
Une technique avancée de visualisation consiste à cartographier la sensibilité structurelle de la formule du MCC aux variations incrémentales des quadrants de confusion sous la forme de cartes thermiques bidimensionnelles (heatmaps). Cette démarche analytique permet de sonder en profondeur comment l’introduction progressive d’erreurs de type I (faux positifs) ou de type II (faux négatifs) dégrade la statistique globale dans différentes conditions de déséquilibre initial.
En fixant arbitrairement une taille d’échantillon nominale et un taux de prévalence clinique représentatif, on fait varier systématiquement le volume des faux positifs le long de l’axe des abscisses et le volume des faux négatifs sur l’axe des ordonnées, les vrais positifs et vrais négatifs étant déduits de manière résiduelle. Pour chaque pixel de cet espace discret, le MCC est instantanément calculé au moyen d’une grille vectorisée sous NumPy.
La projection du résultat via la fonction heatmap de Seaborn, enrichie d’une échelle colorimétrique divergente centrée sur zéro, révèle la géométrie singulière du paysage d’erreur du MCC. On observe immédiatement une symétrie rigoureuse autour de la diagonale des erreurs équilibrées, ainsi qu’une chute vertigineuse du score dès lors que l’un des deux types d’erreur commence à dominer l’espace des données. Ce type de support visuel haute définition, facilement exportable sous forme vectorielle au format PDF ou SVG, constitue une pièce maîtresse pour étayer des rapports d’audit algorithmique ou des soumissions d’articles dans des revues biomédicales à comité de lecture.
12. Pièges méthodologiques, limites computationnelles et recommandations pratiques
12.1 Écueils courants lors de l’implémentation et de l’interprétation
En dépit de sa robustesse mathématique indiscutable, l’utilisation du coefficient de corrélation de Matthews expose le praticien non averti à plusieurs pièges méthodologiques qui peuvent compromettre la validité des conclusions :
- La confusion ontologique de corrélation : Une erreur conceptuelle fréquente consiste à confondre le MCC — qui est formellement un coefficient d’association entre deux partitions catégorielles dichotomiques — avec une mesure d’homogénéité ou de corrélation intraclasse continue. Le MCC quantifie la concordance de classification binaire, mais ne mesure pas la fidélité de calibration des probabilités sous-jacentes. Un modèle peut présenter un MCC exceptionnel tout en générant des probabilités mal calibrées (par exemple, des probabilités écrasées entre 0,48 et 0,52 qui, une fois seuillées à 0,50, séparent parfaitement les classes).
- Le piège de la division par zéro en prédiction unilatérale : Lorsqu’un modèle applique une stratégie de prédiction unilatérale en classant uniformément tous les cas comme négatifs, le dénominateur de la formule s’annule. Si l’environnement logiciel n’intègre pas de garde-fous stricts, cela déclenche une erreur d’exécution ou produit un résultat indéfini (NaN). L’attribution par convention d’une valeur de 0.0 dans ce cas de figure règle la singularité mathématique, mais doit être interprétée pour ce qu’elle est : un constat d’échec total du pouvoir discriminant du modèle.
- La fuite de données par optimisation du seuil (threshold leakage) : Ajuster le seuil de décision probabiliste pour maximiser le MCC sur l’échantillon de test final constitue une violation méthodologique grave. Cette pratique introduit un biais d’optimisme majeur, car le seuil sélectionné capitalise sur le bruit stochastique propre à cet ensemble de données précis. L’optimisation du seuil de coupure doit impérativement être effectuée sur l’ensemble d’entraînement ou sur un jeu de calibration dédié indépendant, puis validée sans modification ultérieure sur l’échantillon de test étanche.
12.2 Limites inhérentes à la statistique de Matthews
Une démarche scientifique équilibrée exige d’analyser avec lucidité les limites intrinsèques du coefficient de corrélation de Matthews. La principale faiblesse du MCC réside dans son opacité communicative face à des publics non spécialistes de l’analyse quantitative. Alors qu’un taux d’exactitude ou une sensibilité diagnostique de 85 % parlent immédiatement à l’intuition d’un médecin hospitalier ou d’un psychologue praticien, l’affirmation selon laquelle un classifieur affiche « un coefficient de Matthews de 0,48 » suscite fréquemment l’incompréhension et nécessite un travail pédagogique important pour être comprise.
Par ailleurs, dans des contextes cliniques où les prévalences sont infinitésimales (de l’ordre d’un événement sur dix mille ou cent mille), la variance d’échantillonnage du MCC s’accroît considérablement. Dans ces régimes extrêmes, le déplacement stochastique d’une ou deux observations d’une case de contingence à une autre peut induire des fluctuations brutales du coefficient, exigeant des intervalles de confiance extrêmement larges pour ne pas surinterpréter les résultats.
Enfin, la symétrie mathématique du MCC — qui constitue par ailleurs sa principale force conceptuelle — peut devenir une contrainte limitante sur le plan de l’aide à la décision médico-économique. Le MCC pondère mathématiquement de façon symétrique l’impact des faux positifs et des faux négatifs au sein de sa normalisation marginale. Or, dans la réalité clinique, le coût d’une erreur de type II (ne pas détecter une personne présentant un risque suicidaire imminent ou un cancer débutant) est infiniment plus lourd sur les plans humain et éthique que le coût d’une erreur de type I (prescrire un examen diagnostique de confirmation à un patient sain). Dans de telles circonstances décisionnelles asymétriques, le MCC doit obligatoirement être complété par des métriques d’utilité clinique explicite, telles que l’analyse des courbes de décision (Decision Curve Analysis) ou le calcul du bénéfice net pondéré (Net Benefit).
12.3 Protocole de validation pour la recherche quantitative
Afin de garantir un niveau de rigueur scientifique optimal lors de la soumission de protocoles empiriques ou de publications d’apprentissage automatique dans des revues internationales de premier rang, nous recommandons l’adoption systématique d’une liste de vérification méthodologique standardisée :
- Rapport intégral et exhaustif de la contingence : Ne jamais rapporter le coefficient de corrélation de Matthews de façon isolée sous forme d’un simple scalaire désincarné. Les quatre valeurs fondamentales de la matrice de confusion (VP, VN, FP, FN) doivent impérativement être publiées conjointement dans le corps du texte ou en annexe, accompagnées de la taille totale de l’échantillon N et du taux de prévalence marginale exact de la condition étudiée.
- Estimation de l’incertitude par rééchantillonnage bootstrap : La statistique ponctuelle du MCC doit être systématiquement complétée par un intervalle de confiance à 95 %, calculé par des techniques non paramétriques de bootstrap avec remise (impliquant idéalement un minimum de mille à dix mille itérations indépendantes). Cela permet de quantifier avec précision la stabilité empirique du modèle face aux fluctuations d’échantillonnage.
- Transparence logicielle et reproductibilité computationnelle : Partager intégralement et de façon ouverte le code source Python ayant servi à la préparation des données, à l’entraînement des modèles, à l’optimisation des seuils et à l’évaluation finale. Spécifier précisément l’ensemble des versions des bibliothèques employées (NumPy, Scikit-Learn, Pandas) au sein d’un fichier standard d’environnement garantit la vérifiabilité des calculs et la réplicabilité des résultats par la communauté scientifique.
En respectant scrupuleusement ces directives méthodologiques et computationnelles, l’expérimentateur s’assure que le coefficient de corrélation de Matthews ne constitue pas un simple artifice mathématique de plus, mais s’affirme comme un levier fondamental d’objectivation empirique, garantissant le développement de modèles d’intelligence artificielle robustes, équitables et scientifiquement irréprochables.
Références
- Boughorbel, S., Jarray, F., & El-Anbari, M. (2017). Optimal classifier for imbalanced data using Matthews Correlation Coefficient metric. PLOS ONE, 12(6), e0177678. https://doi.org/10.1371/journal.pone.0177678
- Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21(1), 6. https://doi.org/10.1186/s12864-019-6413-7
- Chicco, D., Tötsch, N., & Jurman, G. (2021). The Matthews correlation coefficient (MCC) is more reliable than balanced accuracy, bookmaker informedness, and markedness in two-class data analysis. BioData Mining, 14(1), 13. https://doi.org/10.1186/s13040-021-00244-z
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90077-C
- Gorodkin, J. (2004). Comparing two K-category assignments by a K-category correlation coefficient. Computational Biology and Chemistry, 28(5-6), 367–374. https://doi.org/10.1016/j.compbiolchem.2004.09.006
- Matthews, B. W. (1975). Comparison of the predicted and observed secondary structure of T4 phage lysozyme. Biochimica et Biophysica Acta (BBA) – Protein Structure, 405(2), 442–451. https://doi.org/10.1016/0005-2795(75)90109-9
- Meehl, P. E., & Rosen, A. (1955). Antecedent probability and the efficiency of psychometric signs, patterns, or cutting scores. Psychological Bulletin, 52(3), 194–216. https://doi.org/10.1037/h0048070
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Powers, D. M. W. (2011). Evaluation: From precision, recall and F-measure to ROC, informedness, markedness and correlation. Journal of Machine Learning Technologies, 2(1), 37–63. https://doi.org/10.48550/arXiv.2010.16061