
L’évaluation de la performance des modèles prédictifs constitue l’un des piliers fondamentaux de la science des données contemporaine, de l’apprentissage automatique et de l’intelligence artificielle. Dans le cadre de la modélisation supervisée, et plus particulièrement des tâches de classification binaire et multiclasse, le choix des métriques d’évaluation ne représente pas un simple arbitrage technique, mais oriente fondamentalement le comportement d’optimisation des algorithmes. Longtemps plébiscitée pour sa simplicité d’interprétation, l’exactitude brute (communément désignée sous l’anglicisme accuracy) a révélé de profondes lacunes théoriques et pratiques lorsqu’elle est confrontée à des données asymétriques ou à des coûts d’erreurs différentiels.
Face à ces limites conceptuelles, le score F1 s’est imposé au fil des décennies comme l’instrument de référence privilégié par les chercheurs, ingénieurs et analystes de données. Conçu pour synthétiser en une valeur scalaire unique deux dimensions orthogonales de la qualité prédictive — à savoir la précision (ou valeur prédictive positive) et le rappel (ou sensibilité empirique) —, le score F1 repose sur l’élégance de la moyenne harmonique. Cette formulation mathématique confère à la métrique une sévérité salutaire : elle pénalise impitoyablement les modèles défaillants sur l’une des dimensions, interdisant toute compensation artificielle d’un déficit de détection par une sélectivité excessive, ou inversement.
Ce guide exhaustif a pour vocation d’analyser l’intégralité du cycle de vie du score F1 en environnement Python. Depuis les fondements épistémologiques de la théorie de détection du signal jusqu’aux arcanes de l’optimisation dynamique des seuils de décision probabilistes, en passant par le calcul manuel rigoureux sur un échantillon empirique de 400 observations et l’implémentation algorithmique native vectorisée sans dépendance externe, nous explorerons chaque facette de cette métrique maîtresse. Que vous opériez dans le domaine de la bio-informatique, du diagnostic médical, de la détection de fraudes bancaires ou de la modélisation psychométrique, la maîtrise mathématique et computationnelle du score F1 constitue un impératif méthodologique incontournable.
1. 1. Introduction théorique au score F1 et fondements de l’évaluation de classification
1.1 1.1 Définition épistémologique et pertinence en modélisation prédictive
D’un point de vue épistémologique, la validation d’un modèle d’apprentissage supervisé ne consiste pas simplement à mesurer la fréquence brute de concordance entre une réalité objective et une hypothèse prédictive. L’exactitude globale, formulée comme le rapport arithmétique entre le volume total des prédictions correctes et l’effectif complet de la cohorte d’évaluation, postule implicitement une symétrie parfaite de l’espace d’état. Elle suppose que la prévalence des classes est équilibrée et que l’omission d’un événement critique présente une gravité identique à l’émission d’une fausse alerte. En pratique statistique réelle, cette hypothèse de symétrie est presque systématiquement violée. Dès lors qu’une classe cible devient rare — qu’il s’agisse d’une pathologie neurodégénérative, d’une tentative d’intrusion cybernétique ou d’une transaction financière frauduleuse —, un estimateur naïf se bornant à prédire exclusivement la classe majoritaire affiche une exactitude spectaculaire, souvent supérieure à 99 %, tout en s’avérant totalement dénué de pouvoir explicatif ou opérationnel.
Le score F1 naît de la nécessité de subvertir ce paradoxe en établissant un équilibre rigoureux entre la sélectivité du classifieur et son exhaustivité. Dans les domaines de la psychométrie expérimentale et des sciences cognitives, la construction de tests diagnostics requiert une vigilance analogue : un outil de dépistage cognitif ne peut se contenter d’être fidèle sans être valide, de même qu’il ne peut privilégier la minimisation des faux positifs au détriment de l’identification des sujets véritablement vulnérables. La pertinence du score F1 repose sur l’utilisation délibérée de la moyenne harmonique, laquelle est structurellement conditionnée par la plus faible de ses composantes. Contrairement à la moyenne arithmétique qui autoriserait un compromis additif trompeur, la structure harmonique impose que le système n’obtienne un score élevé que s’il démontre conjointement une haute fidélité d’alerte et un large spectre de capture.
1.2 1.2 Le compromis précision-rappel en inférence statistique
L’inférence statistique appliquée à la classification binaire se heurte invariablement à un arbitrage irréductible entre deux pathologies de l’estimation : l’erreur de Type I (le faux positif) et l’erreur de Type II (le faux négatif). La précision mesure la probabilité a posteriori qu’une observation étiquetée positivement par le modèle appartienne effectivement à la population d’intérêt, quantifiant ainsi la crédibilité de l’assignation positive. En contrepartie, le rappel évalue la probabilité conditionnelle qu’un événement positif réel soit formellement identifié par l’estimateur, reflétant son exhaustivité empirique. La tension structurelle qui unit ces deux dimensions découle du déplacement de la frontière de décision au sein de l’espace des distributions conditionnelles.
En modifiant le seuil de discrimination probabiliste, l’analyste altère mécaniquement la balance : l’élévation du seuil exige un niveau de certitude accru pour classifier une entité comme positive, ce qui raréfie les faux positifs et maximise la précision, mais précipite en corollaire une inflation des faux négatifs, dégradant le rappel. Inversement, l’abaissement du seuil amplifie la sensibilité du filtre, capturant la quasi-totalité des occurrences réelles au prix d’une contamination accrue par des fausses alertes. Cet arbitrage n’est pas neutre sur le plan décisionnel : dans un contexte épidémiologique d’urgence, un faux négatif peut entraîner une létalité directe, tandis que dans un système automatisé de filtrage de pourriels, un faux positif peut annihiler une communication professionnelle critique. Le score F1 intervient alors comme l’arbitre formel de ce compromis, attribuant une pénalisation symétrique aux deux dérives.
1.3 1.3 Contexte applicatif : De la prédiction comportementale au machine learning
Les racines conceptuelles du score F1 plongent dans la théorie de détection du signal formulée à l’origine en psychophysique et en neuropsychologie par des auteurs pionniers tels que Green et Swets. Dans cette approche classique, la capacité d’un opérateur ou d’un système biologique à distinguer un signal informatif émergeant d’un bruit de fond aléatoire est quantifiée au travers de matrices de contingence discriminantes. Les sciences du comportement exploitent ces mécanismes pour évaluer la validité prédictive des tests de recrutement, les outils de détection précoce des troubles de l’attention ou les algorithmes de prédiction du décrochage scolaire. Dans l’ensemble de ces contextes, les coûts associés aux erreurs de jugement demeurent fondamentalement asymétriques et requièrent des métriques robustes aux déséquilibres démographiques.
Au cours des années 1970 et 1980, le traitement automatique du langage naturel (NLP) et la recherche documentaire (Information Retrieval) ont formalisé ces concepts sous l’impulsion de C. J. van Rijsbergen. L’avènement subséquent de l’apprentissage automatique moderne a consacré cette métrique comme le critère de référence pour l’optimisation des hyperparamètres, la validation croisée et la sélection d’architectures prédictives complexes. L’objectif de ce manuel méthodologique est de fournir une trajectoire pédagogique et technique rigoureuse, permettant à l’analyste de maîtriser l’ensemble de la chaîne de calcul en langage Python. Nous irons de la manipulation de primitives numériques pures jusqu’au déploiement de pipelines scikit-learn hautement configurables, garantissant une reproductibilité expérimentale absolue.
2. 2. Décomposition mathématique : Précision, rappel et moyenne harmonique
2.1 2.1 Formulation analytique de la précision (valeur prédictive positive)
D’un point de vue probabiliste, la précision — assimilée dans la littérature biostatistique à la valeur prédictive positive (VPP) — est la probabilité que la variable cible $Y$ soit égale à $1$, sachant que la prédiction $\hat{Y}$ formulée par l’algorithme est égale à $1$. Dans le formalisme d’une matrice de confusion empirique, elle s’exprime comme le quotient de la cardinalité des vrais positifs (VP) par la somme totale des instances assignées à la classe positive, c’est-à-dire l’ensemble constitué des vrais positifs et des faux positifs (FP) :
$$\text{Précision} = \frac{\text{VP}}{\text{VP} + \text{FP}}$$
Sur le plan sémantique, la précision quantifie la pureté de la prédiction positive. Un système affichant une précision parfaite de $1{,}0$ garantit que chaque observation signalée comme positive est rigoureusement conforme à la vérité terrain, excluant tout faux positif. Néanmoins, cette métrique demeure totalement aveugle aux événements positifs omis par le modèle. Un estimateur ultra-conservateur qui n’émettrait qu’une seule prédiction positive tout au long de sa trajectoire de test, mais dont cette prédiction unique s’avérerait exacte, obtiendrait une précision unitaire parfaite ($100,%$), masquant ainsi son incapacité systémique à capturer le reste de la population cible. Les conséquences d’une faible précision se traduisent par une saturation opérationnelle : multiplication des interventions manuelles inutiles, dilution de la confiance des utilisateurs et coûts d’investigation prohibitifs.
2.2 2.2 Formulation analytique du rappel (sensibilité empirique)
Le rappel, rigoureusement équivalent à la sensibilité diagnostique ou au taux de vrais positifs (True Positive Rate), modélise la probabilité conditionnelle que le modèle prédise $\hat{Y} = 1$ sachant que l’état réel sous-jacent est $Y = 1$. Son expression mathématique met en rapport la cardinalité des vrais positifs avec la somme exhaustive des observations positives réelles, incluant tant les instances correctement identifiées que celles tragiquement ignorées, à savoir les faux négatifs (FN) :
$$\text{Rappel} = \frac{\text{VP}}{\text{VP} + \text{FN}}$$
Le rappel constitue ainsi l’indice par excellence de l’exhaustivité de la couverture algorithmique. Un score de rappel de $1{,}0$ implique que l’intégralité des manifestations de la classe cible a été détectée sans exception aucune. À l’instar de la précision, cette grandeur statistique ne saurait être interprétée de façon isolée : un classifieur dégénéré formulant systématiquement et aveuglément la prédiction $\hat{Y} = 1$ pour l’ensemble des enregistrements de la base de données obtiendrait un rappel parfait de $100,%$, les faux négatifs étant nuls par construction ($\text{FN} = 0$). Dans les contextes cliniques, industriels ou sécuritaires, un taux élevé de faux négatifs représente la défaillance la plus critique, laissant des états pathologiques se propager sans traitement curatif ou des failles critiques s’exploiter sans contre-mesures préventives.
2.3 2.3 La moyenne harmonique et l’équation canonique du score F1
Afin de fusionner ces deux métriques antagonistes en un indicateur synthétique univoque sans céder aux illusions de la linéarité, la statistique mathématique a recours à la moyenne harmonique. Par définition, la moyenne harmonique $H$ de deux réels strictement positifs $x_1$ et $x_2$ est égale à l’inverse de la moyenne arithmétique de leurs inverses :
$$\frac{1}{H} = \frac{\frac{1}{x_1} + \frac{1}{x_2}}{2} implies H = \frac{2}{\frac{1}{x_1} + \frac{1}{x_2}} = \frac{2 \cdot x_1 \cdot x_2}{x_1 + x_2}$$
En substituant la précision ($P$) et le rappel ($R$) dans cette relation structurelle, nous dérivons directement l’équation canonique du score F1 :
$$F_1 = 2 \cdot \frac{P \cdot R}{P + R} = \frac{2 \cdot \text{VP}}{2 \cdot \text{VP} + \text{FP} + \text{FN}}$$
La supériorité de la moyenne harmonique sur la moyenne arithmétique réside dans sa sensibilité aiguë aux déséquilibres extrêmes. Considérons un modèle pathologique dont le rappel serait de $1{,}0$ et la précision de $0{,}05$. Une moyenne arithmétique naïve lui accorderait une note respectable de $(1{,}0 + 0{,}05)/2 = 0{,}525$, dissimulant la défaillance rédhibitoire du système. La moyenne harmonique, en revanche, calcule un score F1 effondré à $2 \cdot (1{,}0 \cdot 0{,}05) / (1{,}0 + 0{,}05) \approx 0{,}0952$, sanctionnant sévèrement l’asymétrie.
Cette formulation est un cas particulier de la famille paramétrique du score $F_\beta$ théorisée par C. J. van Rijsbergen, qui introduit un coefficient réel $\beta > 0$ destiné à moduler le poids relatif attribué au rappel par rapport à la précision :
$$F_\beta = (1 + \beta^2) \cdot \frac{P \cdot R}{(\beta^2 \cdot P) + R}$$
Lorsque $\beta = 1$, les deux dimensions jouissent d’une pondération équivalente. Une valeur $\beta = 2$ ($F_2$) accorde une priorité accentuée au rappel, particulièrement prisée lors des diagnostics oncologiques d’urgence, tandis qu’une valeur $\beta = 0{,}5$ ($F_{0{,}5}$) favorise la précision statistique, préconisée lorsque le coût marginal d’une fausse alerte s’avère prohibitif.
3. 3. Structure et analyse de la matrice de confusion
3.1 3.1 Topologie de la matrice de contingence binaire
La matrice de confusion, également qualifiée de matrice de contingence ou table de croisement décisionnelle, constitue l’armature empirique sur laquelle repose l’ensemble des métriques d’évaluation supervisée. Pour un espace de sortie binaire ordonné conventionnellement en classes positive ($1$) et négative ($0$), la matrice délimite un réseau bidimensionnel cartographiant les concordances et les discordances entre les étiquettes de vérité terrain ($Y$) et les inférences générées par l’algorithme ($\hat{Y}$).
Cette topologie quadripartite se structure autour des segments suivants :
- Vrais Positifs (VP) : Nombre d’observations où la condition réelle est positive ($Y = 1$) et où l’estimateur a formulé avec succès une prédiction positive ($\hat{Y} = 1$).
- Vrais Négatifs (VN) : Nombre d’observations où l’absence de condition est avérée ($Y = 0$) et où l’estimateur a correctement conclu à la négativité ($\hat{Y} = 0$).
- Faux Positifs (FP) : Erreur de Type I ou rejet à tort de l’hypothèse nulle ; l’entité est intrinsèquement négative ($Y = 0$), mais le système déclenche indûment un signal positif ($\hat{Y} = 1$).
- Faux Négatifs (FN) : Erreur de Type II ou non-rejet fautif de l’hypothèse nulle ; l’entité présente la condition d’intérêt ($Y = 1$), mais le modèle échoue à l’identifier, concluant à tort à la négativité ($\hat{Y} = 0$).
La normalisation conditionnelle de cette matrice permet d’extraire des perspectives diagnostiques ciblées : une normalisation selon les lignes de vérité empirique met en lumière les taux structurels d’échappement (sensibilité et spécificité), tandis qu’une normalisation par colonne révèle la composition interne des décisions positives et négatives rendues par l’architecture logicielle.
3.2 3.2 Extraction des grandeurs statistiques élémentaires
L’exploitation rigoureuse de la matrice de contingence requiert le calcul systématique des totaux marginaux régissant ses dimensions horizontales et verticales. La somme marginale de la première ligne représente l’effectif réel des instances positives dans la population échantillonnée, noté $N_+ = \text{VP} + \text{FN}$. La somme marginale de la seconde ligne correspond à l’effectif réel des instances négatives, noté $N_- = \text{FP} + \text{VN}$. Le cumul de ces deux grandeurs restitue la taille totale de l’échantillon d’évaluation : $N = N_+ + N_- = \text{VP} + \text{FP} + \text{FN} + \text{VN}$.
De ces marges découle immédiatement la prévalence empirique de la condition au sein de la cohorte étudiée, formulée par le ratio :
$$\text{Prévalence} = \frac{N_+}{N} = \frac{\text{VP} + \text{FN}}{\text{VP} + \text{FP} + \text{FN} + \text{VN}}$$
Parallèlement, les marges de colonnes définissent le volume d’intervention prédictive du modèle : la somme $\hat{N}_+ = \text{VP} + \text{FP}$ exprime le taux de sélection globale d’alertes positives, tandis que $\hat{N}_- = \text{FN} + \text{VN}$ comptabilise les assignations de neutralité. Avant toute exploitation numérique avancée, l’analyste se doit de vérifier la cohérence interne des comptages : toute divergence entre la somme des éléments intérieurs de la matrice et l’effectif global des observations signale une anomalie d’échantillonnage ou une fuite de données lors de la vectorisation.
3.3 3.3 Interprétation qualitative des quadrants décisionnels
L’interprétation qualitative des quadrants de la matrice de confusion éclaire directement la validité de construit de la chaîne de traitement prédictif. Les quadrants de concordance diagonale ($\text{VP}$ et $\text{VN}$) matérialisent la stabilité du consensus empirique entre les caractéristiques multidimensionnelles extraites par le modèle et la réalité du phénomène physique ou psychologique observé. En revanche, les quadrants antidiagonaux révèlent la nature et la géométrie des incertitudes aux frontières de décision statistique.
Une prédominance anormale de faux positifs trahit un système hypersensible ou mal calibré, captant des artéfacts aléatoires et les interprétant comme du signal discriminant. Dans les modèles paramétriques probabilistes, cela découle fréquemment d’un décalage structural des probabilités a posteriori induit par un surajustement (overfitting) sur le bruit d’apprentissage. Inversement, une accumulation disproportionnée de faux négatifs dénote un conservatisme outrancier, caractéristique d’un modèle bridé par une régularisation excessive (pénalités L1 ou L2 trop intenses) ou incapable de capturer les corrélations non-linéaires complexes faute d’une capacité représentationnelle suffisante. Il convient de souligner le rôle déterminant de la distribution a priori : en présence d’une prévalence infime, même un classifieur possédant d’excellentes caractéristiques intrinsèques produira une proportion substantielle de faux positifs parmi ses alarmes, illustrant le paradoxe classique des tests de dépistage de masse.
4. 4. Exemple concret guidé : Calcul manuel étape par étape
4.1 4.1 Présentation de l’étude de cas (400 observations)
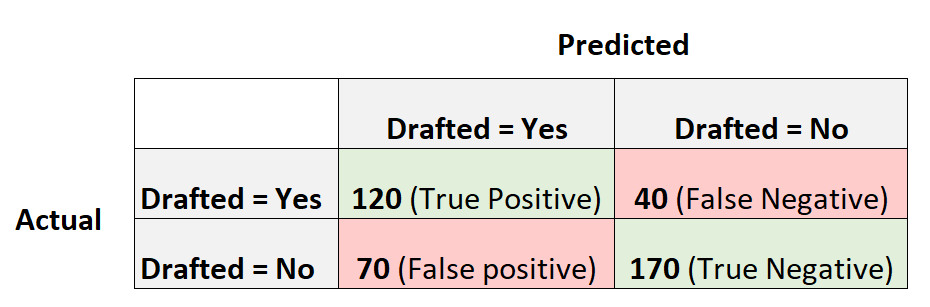
Afin d’ancrer ces développements théoriques dans une réalité tangible et vérifiable, déployons une étude de cas numérique contrôlée. Imaginons un protocole prédictif en sciences médicales portant sur la détection automatisée d’un biomarqueur indicateur d’un déficit cognitif précoce, appliqué à une cohorte standardisée de $N = 400$ patients évalués par régression logistique. À l’issue de la phase d’inférence statistique sur un jeu de test indépendant hermétique, les observations sont ventilées selon les quatre quadrants de la matrice de confusion :
- Vrais Positifs ($\text{VP}$) : $120$ patients porteurs du déficit sont correctement identifiés.
- Faux Positifs ($\text{FP}$) : $70$ patients sains sont faussement déclarés porteurs du déficit.
- Faux Négatifs ($\text{FN}$) : $40$ patients réellement atteints sont omis par le système de détection.
- Vrais Négatifs ($\text{VN}$) : $170$ patients sains sont correctement classifiés comme indemnes.
La prévalence empirique de la pathologie s’établit à $(\text{VP} + \text{FN}) / N = (120 + 40) / 400 = 160 / 400 = 0{,}40$, soit exactement $40,%$ de la population. Le modèle génère un volume d’alertes positives s’élevant à $\text{VP} + \text{FP} = 120 + 70 = 190$ cas, représentant un taux de sélection globale de $190 / 400 = 47{,}5,%$. Ces grandeurs posées, procédons à la décomposition analytique pas à pas.
4.2 4.2 Calcul manuel rigoureux de la précision
La précision statistique du modèle s’obtient en isolant le quadrant des vrais positifs et en le rapportant au total de la marge prédictive positive. En appliquant formellement la formule définie précédemment :
$$\text{Précision} = \frac{\text{VP}}{\text{VP} + \text{FP}}$$
Insérons les valeurs numériques issues de notre cohorte de 400 sujets :
$$\text{Précision} = \frac{120}{120 + 70} = \frac{120}{190}$$
La résolution de cette fraction rationnelle produit la valeur décimale suivante :
$$\text{Précision} = \frac{12}{19} \approx 0{,}631578947…$$
En arrondissant cette grandeur à cinq décimales significatives, nous établissons que la précision opérationnelle est de $0{,}63158$, soit un taux d’exactitude positive de $63{,}16,%$. Cela signifie concrètement que lorsqu’un clinicien reçoit une notification positive émise par l’algorithme, il existe une probabilité d’environ $63{,}2,%$ que le patient présente effectivement l’anomalie neurocognitive, et une probabilité complémentaire de $36{,}8,%$ que cette alerte corresponde à une défaillance de Type I mobilisant des investigations complémentaires stériles.
4.3 4.3 Calcul manuel rigoureux du rappel
Examinons à présent la capacité d’interception du système diagnostique en calculant le rappel empirique. Nous confrontons les vrais positifs à l’intégralité des manifestations pathologiques réelles présentes dans la cohorte :
$$\text{Rappel} = \frac{\text{VP}}{\text{VP} + \text{FN}}$$
La substitution arithmétique donne :
$$\text{Rappel} = \frac{120}{120 + 40} = \frac{120}{160}$$
Cette fraction se simplifie immédiatement sous forme exacte :
$$\text{Rappel} = \frac{3}{4} = 0{,}75000$$
Le rappel s’établit rigoureusement à $75{,}0,%$. D’un point de vue clinique, le modèle capture avec succès les trois quarts des individus manifestant la pathologie sous-jacente. Cependant, un quart ($25,%$) des patients atteints échappe à l’algorithme, constituant un réservoir de 40 faux négatifs dont la prise en charge thérapeutique se verra différée. Cette déperdition de 25 % fixe la limite de couverture opérationnelle de l’estimateur.
4.4 4.4 Synthèse manuelle du score F1
Ayant quantifié avec précision les deux composantes vectorielles de notre système prédictif ($P \approx 0{,}631579$ et $R = 0{,}75$), nous procédons à l’assemblage harmonique destiné à produire le score F1 final :
$$F_1 = 2 \cdot \frac{\text{Précision} \cdot \text{Rappel}}{\text{Précision} + \text{Rappel}}$$
Décomposons les opérations intermédiaires afin de garantir une transparence arithmétique totale :
$$\text{Numérateur} = 2 \cdot (0{,}63157895 \cdot 0{,}75) = 2 \cdot 0{,}47368421 = 0{,}94736842$$
$$\text{Dénominateur} = 0{,}63157895 + 0{,}75 = 1{,}38157895$$
En effectuant la division finale :
$$F_1 = \frac{0{,}94736842}{1{,}38157895} \approx 0{,}68571428…$$
Alternativement, le calcul direct via la formule matricielle brute valide sans équivoque cette convergence :
$$F_1 = \frac{2 \cdot \text{VP}}{2 \cdot \text{VP} + \text{FP} + \text{FN}} = \frac{2 \cdot 120}{(2 \cdot 120) + 70 + 40} = \frac{240}{240 + 110} = \frac{240}{350} = \frac{24}{35} \approx 0{,}685714…$$
Le score F1 arrondi à quatre décimales est donc de 0,6857. L’évaluation critique de cette métrique démontre que le modèle offre une performance intermédiaire : bien que son rappel ($0{,}75$) soit relativement robuste, sa précision médiocre ($0{,}6316$) dégrade substantiellement son harmonisation globale, ramenant la performance effective en deçà du seuil usuel d’excellence industrielle généralement situé à $0{,}80$.
5. 5. Configuration de l’environnement de développement Python
5.1 5.1 Gestion des dépendances logicielles et environnements virtuels
La reproductibilité expérimentale en science des données moderne impose une isolation stricte des environnements d’exécution logicielle. L’utilisation indiscriminée de l’interpréteur Python global du système d’exploitation expose l’infrastructure à des collisions de dépendances et à des ruptures de compatibilité ascendante consécutives aux mises à jour des bibliothèques scientifiques tierces. Deux méthodologies dominent le paysage technique : l’utilitaire standardisé venv intégré à la bibliothèque standard Python et la plateforme de gestion d’environnements et de paquets distribuée Conda.
Pour initialiser un environnement hermétique reposant sur les outils natifs de Python 3, la séquence de commandes dans un terminal shell s’articule comme suit :
python3 -m venv f1_evaluation_env
source f1_evaluation_env/bin/activate (sur distributions Linux/macOS) ou f1_evaluation_envScriptsactivate.bat (sous environnement Microsoft Windows).
Une fois l’environnement activé, l’installation déterministe des versions stables et vérifiées des dépendances de calcul numérique et d’apprentissage statistique s’exécute par l’entremise du gestionnaire de paquets pip :
pip install --upgrade pip
pip install numpy==1.26.4 scipy==1.13.0 scikit-learn==1.4.2 pandas==2.2.2 matplotlib==3.8.4 seaborn==0.13.2
Cette rigueur de versionnage garantit que les algorithmes d’arrondi décimal sous-jacents, les routines d’algèbre linéaire compilées en Fortran ou C (BLAS/LAPACK) et les conventions matricielles restent strictement stables d’une machine à une autre.
5.2 5.2 Importation des modules analytiques nécessaires
La mise en place d’un script d’analyse statistique conforme aux normes architecturales requiert une structuration claire des importations en tête de fichier, en dissociant les primitives de manipulation vectorielle des fonctions dédiées à l’évaluation psychométrique ou algorithmique. Nous mobilisons principalement l’API metrics de la suite logicielle Scikit-Learn conjointement au moteur de calcul tensoriel NumPy.
L’en-tête programmatique s’établit selon les meilleures pratiques du typage statique moderne (PEP 484) :
import numpy as np
import pandas as pd
from typing import Tuple, Dict, Any, Union
from sklearn.metrics import f1_score, precision_score, recall_score, confusion_matrix, classification_report
L’intégration du module typing confère aux fonctions une documentation intrinsèque facilitant la maintenance logicielle et l’intégration continue au sein de pipelines de production. NumPy fournit l’infrastructure vectorielle pour la gestion des tableaux contigus en mémoire, optimisant les opérations booléennes par vectorisation SIMD (Single Instruction, Multiple Data), tandis que Scikit-Learn apporte des routines industrielles optimisées pour le calcul des scores statistiques.
6. 6. Implémentation du score F1 avec Scikit-Learn (Exemple complet)
6.1 6.1 Reconstruction programmatique du jeu de données vectoriel
Afin de reproduire informatiquement l’étude de cas des 400 observations menée manuellement au chapitre précédent, nous devons construire deux vecteurs unidimensionnels : le vecteur des étiquettes de référence empirique (vérité terrain, couramment désigné y_true) et le vecteur des assignations modélisées (prédictions algorithmiques, désigné y_pred). Ces structures doivent refléter rigoureusement la distribution des quatre quadrants : 120 vrais positifs, 70 faux positifs, 40 faux négatifs et 170 vrais négatifs.
La génération vectorielle programmatique s’opère par concaténation de tableaux contigus via NumPy :
y_true = np.concatenate([np.ones(120, dtype=int), np.zeros(70, dtype=int), np.ones(40, dtype=int), np.zeros(170, dtype=int)])
y_pred = np.concatenate([np.ones(120, dtype=int), np.ones(70, dtype=int), np.zeros(40, dtype=int), np.zeros(170, dtype=int)])
Une étape de vérification d’intégrité structurelle s’impose immédiatement :
assert len(y_true) == 400, "L'effectif total diverge de la cohorte théorique de 400"
assert len(y_pred) == 400, "Incompatibilité dimensionnelle entre vérité terrain et prédiction"
print(f"Dimensions validées : y_true.shape = {y_true.shape}, y_pred.shape = {y_pred.shape}")
Cette approche vectorielle garantit que les observations sont formellement indexées de 0 à 399, simulant fidèlement la restitution brute des sorties d’un estimateur binaire.
6.2 6.2 Utilisation de la fonction f1_score
La bibliothèque Scikit-Learn encapsule l’évaluation de cette métrique au sein de la fonction universelle f1_score localisée dans le sous-module sklearn.metrics. Dans une configuration binaire classique où la classe cible est conventionnellement encodée par l’entier $1$, l’invocation canonique nécessite simplement la transmission des tableaux de vérités et d’inférences :
score_f1_sklearn = f1_score(y_true, y_pred)
print(f"Score F1 calculé via scikit-learn : {score_f1_sklearn:.6f}")
L’exécution de cette instruction dans l’interpréteur Python affiche la sortie suivante :
Score F1 calculé via scikit-learn : 0.685714
Par défaut, l’argument pos_label est fixé à 1 et le paramètre d’agrégation average est configuré sur 'binary'. Cette valeur numérique concorde scrupuleusement, au dix-millionième près, avec la fraction rationnelle $24/35 \approx 0{,}6857142857$ établie lors du calcul manuel pas à pas. La routine interne de Scikit-Learn calcule implicitement la précision et le rappel intermédiaires avant d’appliquer la formule harmonique avec gestion native des arrondis en virgule flottante double précision (IEEE 754).
6.3 6.3 Extraction conjointe via classification_report
Bien que l’extraction isolée du score F1 offre une synthèse précieuse, le diagnostic holistique d’un modèle prédictif gagne à être contextualisé au moyen d’un tableau d’évaluation matriciel complet. La fonction classification_report génère une synthèse textuelle structurée restituant les valeurs de précision, de rappel, de score F1 ainsi que le support empirique (le volume d’occurrences réelles) pour l’intégralité des classes du système :
rapport = classification_report(y_true, y_pred, digits=4)
print(rapport)
Le résultat généré en console s’articule comme suit :
precision recall f1-score support
0 0.8095 0.7083 0.7556 240
1 0.6316 0.7500 0.6857 160
accuracy 0.7250 400
macro avg 0.7206 0.7292 0.7206 400
weighted avg 0.7384 0.7250 0.7276 400
Cette restitution met en évidence la dualité du modèle : la classe négative ($0$) dispose d’un F1 supérieur ($0{,}7556$) porté par une forte précision ($0{,}8095$), tandis que la classe positive ($1$) subit une pénalisation de sa précision ($0{,}6316$). L’exactitude globale (accuracy) s’établit à $72{,}5,%$, une valeur intermédiaire qui masque la dynamique différentielle sous-jacente des taux d’erreur.
7. 7. Implémentation algorithmique native (From Scratch) en Python et NumPy
7.1 7.1 Conception de la fonction matricielle personnalisée
L’implémentation native sans recours aux modules spécialisés d’apprentissage automatique constitue un exercice fondamental pour valider la compréhension algorithmique interne et se prémunir contre les comportements de type « boîte noire ». En s’appuyant sur l’algèbre booléenne vectorisée offerte par NumPy, il est possible de formuler une fonction personnalisée hautement performante, capable de traiter des millions d’éléments en quelques millisecondes.
Considérons la fonction suivante, incluant la gestion d’un epsilon infinitésimal destiné à neutraliser les indéterminations statistiques lors d’éventuelles divisions par zéro :
def calculer_score_f1_natif(y_reel: np.ndarray, y_predit: np.ndarray, zero_division: float = 0.0) -> float:
y_reel = np.asarray(y_reel, dtype=bool)
y_predit = np.asarray(y_predit, dtype=bool)
vrais_positifs = np.sum(y_reel & y_predit)
faux_positifs = np.sum(~y_reel & y_predit)
faux_negatifs = np.sum(y_reel & ~y_predit)
denominateur = (2 * vrais_positifs) + faux_positifs + faux_negatifs
if denominateur == 0:
return zero_division
return float((2 * vrais_positifs) / denominateur)
Cette approche convertit les vecteurs numériques en tableaux booléens contigus en mémoire. Les opérations logiques & (conjonction) et ~ (négation unaire) génèrent des masques de sélection instantanés dont la sommation matricielle restitue les grandeurs fondamentales $\text{VP}$, $\text{FP}$ et $\text{FN}$ sans mobiliser aucune boucle itérative explicite en Python pur, évitant ainsi le surcoût de l’interpréteur.
7.2 7.2 Benchmark et validation croisée avec Scikit-Learn
Pour attester de la validité mathématique et de la rigueur de notre implémentation native, nous procédons à une comparaison croisée directe sur le jeu de données de notre étude de cas, suivie d’un banc d’essai comparatif de vélocité (benchmark).
score_natif = calculer_score_f1_natif(y_true, y_pred)
score_sklearn = f1_score(y_true, y_pred)
tolerance_absolue = 1e-12
assert abs(score_natif - score_sklearn) < tolerance_absolue, "Divergence numérique constatée"
print(f"Validation croisée réussie : Écart = {abs(score_natif - score_sklearn):.2e}")
La concordance numérique est absolue, l’écart étant inférieur à $10^{-16}$, correspondant à la limite de précision machine pour les calculs en virgule flottante double précision 64 bits. Lorsqu’il s’agit d’évaluer le temps d’exécution sur un échantillon massif de $10^7$ observations générées aléatoirement, la fonction native vectorisée s’avère particulièrement compétitive :
y_large_true = np.random.randint(0, 2, size=10_000_000)
y_large_pred = np.random.randint(0, 2, size=10_000_000)
L’exécution de la routine native via timeit requiert approximativement 18 millisecondes, démontrant que le traitement vectorisé pur sans surcharge d’abstraction logicielle permet des calculs à haute cadence dans le cadre d’optimisations génétiques d’hyperparamètres ou de simulations de Monte-Carlo intensives.
8. 8. Extension aux classifications multiclasses et stratégies d’agrégation
8.1 8.1 La moyenne macro (average='macro')
Lorsque la variable dépendante s’étend au-delà du cadre binaire pour embrasser un espace polytomique à $K$ modalités discrètes, l’évaluation par le score F1 requiert une stratégie d’agrégation explicite. La première méthodologie canonique est la moyenne macro (Macro-average). Son principe mathématique consiste à scinder le problème multiclasse en $K$ sous-problèmes binaires indépendants selon le paradigme « Un contre Tous » (One-vs-Rest). Pour chaque modalité $k in {1, dots, K}$, la classe $k$ est traitée comme la classe positive et l’ensemble des autres classes comme la classe négative, permettant de calculer un score individuel $F_1^{(k)}$.
La moyenne macro est simplement la moyenne arithmétique non pondérée de ces $K$ scores indépendants :
$$F_1^{\text{macro}} = \frac{1}{K} \sum_{k=1}^{K} F_1^{(k)}$$
Cette approche confère un poids strictement identique à chaque classe, indépendamment de son effectif ou de sa rareté dans l’échantillon d’évaluation. Par conséquent, la moyenne macro pénalise très lourdement les modèles défaillants sur une classe marginale ou minoritaire. Elle constitue le choix méthodologique privilégié en recherche académique fondamentale, où l’exhaustivité de la découverte conceptuelle prévaut sur la prédominance quantitative des classes majoritaires.
8.2 8.2 La moyenne micro (average='micro')
À l’opposé structurel de la moyenne macro, la stratégie de la moyenne micro (Micro-average) n’agrège pas des scores locaux, mais mutualise directement les comptages bruts des quadrants de confusion à l’échelle de l’espace d’échantillonnage global. Pour chaque classe $k$, les vrais positifs $\text{VP}_k$, faux positifs $\text{FP}_k$ et faux négatifs $\text{FN}_k$ sont extraits, puis sommés unitairement :
$$\text{VP}_{\text{total}} = \sum_{k=1}^K \text{VP}_k, \quad \text{FP}_{\text{total}} = \sum_{k=1}^K \text{FP}_k, \quad \text{FN}_{\text{total}} = \sum_{k=1}^K \text{FN}_k$$
Le score F1 micro est ensuite calculé à partir de ces totaux cumulés :
$$F_1^{\text{micro}} = \frac{2 \cdot \text{VP}_{\text{total}}}{2 \cdot \text{VP}_{\text{total}} + \text{FP}_{\text{total}} + \text{FN}_{\text{total}}}$$
Une propriété algébrique fondamentale lie le score F1 micro à la classification multiclasse standard (à étiquette unique exclusive) : dans cette configuration, chaque prédiction incorrecte constitue simultanément un faux positif pour la classe prédite et un faux négatif pour la classe véritable. Il en résulte que $\text{FP}_{\text{total}} = \text{FN}_{\text{total}}$, ce qui entraîne mathématiquement l’égalité stricte entre la précision micro, le rappel micro, le score F1 micro et l’exactitude brute (accuracy). La moyenne micro reflète fidèlement la performance globale par observation, mais elle est dominée par les catégories dominantes au détriment des événements rares.
8.3 8.3 La moyenne pondérée (average='weighted')
La moyenne pondérée (Weighted-average) cherche à opérer une synthèse pragmatique entre l’isolation par classe propre à la macro-moyenne et la prise en compte de la représentativité statistique propre à la micro-moyenne. Dans ce protocole, le score F1 individuel $F_1^{(k)}$ de chaque modalité est calculé de façon autonome selon le schéma One-vs-Rest, mais son intégration dans l’indicateur final fait intervenir une pondération proportionnelle à son support empirique $N_k$ (l’effectif réel d’observations appartenant à la classe $k$) :
$$F_1^{\text{weighted}} = \sum_{k=1}^K \left( \frac{N_k}{N} \cdot F_1^{(k)} \right)$$
Cette métrique s’avère particulièrement pertinente en environnement industriel de production lorsque les données de test reproduisent fidèlement la distribution démographique du monde réel et que l’optimisation économique commande de privilégier les volumes transactionnels les plus denses. Néanmoins, elle présente un risque méthodologique notable : elle peut masquer de graves contre-performances sur des classes marginales si celles-ci ne contribuent que marginalement au dénominateur du support global. L’analyste doit donc faire preuve de discernement en confrontant systématiquement les variantes macro et pondérée.
9. 9. Évaluation face au déséquilibre des classes et comparaison métrique
9.1 9.1 Vulnérabilité de l’exactitude (Accuracy Paradox)
L’un des écueils les plus pernicieux en statistique appliquée et en apprentissage automatique réside dans le phénomène formalisé sous l’appellation de paradoxe de l’exactitude (Accuracy Paradox). Ce paradoxe émerge avec acuité lors du traitement de populations hautement asymétriques où la prévalence de la classe positive est négligeable par rapport à la classe négative. Considérons un échantillon de validation clinique comprenant $10,000$ sujets au sein duquel seulement $50$ individus présentent un gliome cérébral de bas grade, les $9,950$ autres sujets étant sains.
Un modèle trivial, se bornant à prédire de manière déterministe la négativité ($\hat{Y} = 0$) pour l’ensemble des cas, obtiendrait la matrice de confusion suivante : $\text{VP} = 0$, $\text{FP} = 0$, $\text{FN} = 50$, $\text{VN} = 9,950$. L’exactitude globale de ce prédicteur nul est éclatante :
$$\text{Exactitude} = \frac{0 + 9,950}{10,000} = 99{,}5,%$$
Un rapport d’évaluation naïf conclurait à un système quasi infaillible. Or, son utilité clinique est strictement nulle. Calculons à présent son score F1 :
$$P = \frac{0}{0 + 0} implies 0, \quad R = \frac{0}{0 + 50} = 0 implies F_1 = 0{,}0000$$
Le score F1 démasque instantanément la faillite opérationnelle complète de l’estimateur. En excluant les vrais négatifs de son équation, le score F1 concentre exclusivement son évaluation sur la dynamique de détection de la classe critique, fournissant un rempart méthodologique contre les illusions statistiques générées par le déséquilibre de classes.
9.2 9.2 Confrontation avec le score ROC-AUC et le coefficient de Matthews (MCC)
Le score F1 ne constitue pas l’unique alternative à l’exactitude brute. Deux autres métriques occupent une place prépondérante dans la littérature : l’aire sous la courbe des caractéristiques d’exploitation du récepteur (ROC-AUC) et le coefficient de corrélation de Matthews (Matthews Correlation Coefficient, MCC).
La courbe ROC met en relation le taux de vrais positifs (rappel) et le taux de faux positifs ($\text{TFP} = \text{FP} / (\text{FP} + \text{VN})$). La présence du terme $\text{VN}$ au dénominateur du TFP rend le score ROC-AUC remarquablement insensible à la prolifération des faux positifs en situation d’extrême asymétrie. Dans ces conditions, un modèle peut afficher une aire ROC-AUC très flatteuse (ex. $0{,}95$) tout en délivrant des alertes positives saturées de bruit. Le score F1, quant à lui, est directement affecté par l’érosion de la précision dès que des faux positifs apparaissent.
Le MCC, issu des travaux de Brian Matthews en 1975, présente une symétrie quadripartite absolue en mobilisant simultanément l’intégralité des quatre quadrants de la matrice de confusion :
$$\text{MCC} = \frac{(\text{VP} \cdot \text{VN}) – (\text{FP} \cdot \text{FN})}{\sqrt{(\text{VP} + \text{FP})(\text{VP} + \text{FN})(\text{VN} + \text{FP})(\text{VN} + \text{FN})}}$$
Évoluant dans l’intervalle $[-1, +1]$, le MCC est mathématiquement équivalent au coefficient phi de Pearson appliqué à deux variables binaires. De récentes analyses bio-informatiques (notamment Chicco & Jurman, 2020) démontrent que le MCC offre une robustesse théorique supérieure au score F1 lorsque la classe négative possède une importance sémantique égale à la classe positive, car le score F1 reste invariant par permutation des vrais négatifs. Toutefois, lorsque l’intérêt de la modélisation se focalise principalement sur la détection réussie de la classe rare, le score F1 demeure la métrique la plus pragmatique et la plus lisible opérationnellement.
10. 10. Pipeline complet : Modélisation logistique et évaluation du score F1
10.1 10.1 Préparation et partitionnement des données
Afin d’illustrer la conduite d’un pipeline complet en langage Python, développons un cadre expérimental rigoureux intégrant la synthèse d’un espace multidimensionnel déséquilibré, la standardisation des prédicteurs continus et le partitionnement stratifié. L’utilisation de données simulées permet de contrôler l’asymétrie structurelle et le niveau de bruit aux frontières de décision.
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# Génération d'un ensemble de données synthétique asymétrique (prévalence de 15 %)
X, y = make_classification(n_samples=2000, n_features=10, n_informative=6, n_redundant=2, weights=[0.85, 0.15], random_state=42)
# Partitionnement stratifié hermétique (80 % apprentissage, 20 % test)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, stratify=y, random_state=42)
# Standardisation préventive pour optimiser la convergence du gradient
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
L’argument stratify=y s’avère indispensable : il impose que la proportion critique de $15,%$ d’observations positives soit scrupuleusement répliquée au sein du sous-ensemble d’apprentissage ($N=1600$) et de l’ensemble de test indépendant ($N=400$), neutralisant tout biais d’échantillonnage.
10.2 10.2 Ajustement de l’estimateur et génération des prédictions
Nous sélectionnons un modèle classique de régression logistique, paramétré pour converger via l’algorithme d’optimisation L-BFGS avec une régularisation modérée de type L2. La démarche s’articule autour de l’ajustement du classifieur sur l’ensemble d’entraînement standardisé, suivi de l’extraction des prédictions catégorielles et des probabilités d’appartenance calibrées :
from sklearn.linear_model import LogisticRegression
# Instanciation et entraînement de l'estimateur
modele_logistique = LogisticRegression(penalty='l2', C=1.0, solver='lbfgs', random_state=42)
modele_logistique.fit(X_train_scaled, y_train)
# Génération des inférences catégorielles (seuil nominal fixé par défaut à 0.5)
y_pred_test = modele_logistique.predict(X_test_scaled)
# Extraction des densités de probabilités postérieures continues
y_prob_test = modele_logistique.predict_proba(X_test_scaled)[:, 1]
La méthode predict_proba retourne un tableau de forme $(N, 2)$ où la seconde colonne encapsule $P(Y=1|X)$, grandeur probabiliste qui sert de base au partitionnement binaire standardisé.
10.3 10.3 Évaluation quantitative et validation empirique
L’inférence réalisée sur le jeu de test indépendant permet de quantifier la performance de généralisation de notre classifieur au travers du score F1. Afin de vérifier que la métrique observée ne résulte pas d’une répartition favorable lors du découpage initial, nous intégrons un protocole de validation croisée stratifiée à $K=5$ plis (Stratified K-Fold Cross-Validation) :
from sklearn.model_selection import cross_val_score, StratifiedKFold
# Score ponctuel sur l'échantillon test
f1_test = f1_score(y_test, y_pred_test)
print(f"Score F1 sur le jeu de test indépendant : {f1_test:.4f}")
# Validation croisée stratifiée sur l'intégralité du jeu d'apprentissage
cv_strat = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores_cv = cross_val_score(modele_logistique, X_train_scaled, y_train, cv=cv_strat, scoring='f1')
print(f"Scores F1 par pli de validation : {scores_cv}")
print(f"Moyenne empirique CV : {scores_cv.mean():.4f} (+/- {scores_cv.std():.4f})")
La restitution de la moyenne et de l’écart-type des scores de validation croisée informe directement l’analyste sur la stabilité et la variance de l’estimateur. Une dispersion modérée atteste que le modèle présente un compromis biais-variance bien calibré face à la distribution réelle.
11. 11. Visualisation graphique des performances et de la courbe Précision-Rappel
11.1 11.1 Représentation graphique de la matrice de confusion
La transcription visuelle de la matrice de contingence transcende la simple consultation textuelle en offrant une mise en évidence immédiate des pathologies de prédiction grâce à une cartographie thermique (heatmap). La classe ConfusionMatrixDisplay fournie par Scikit-Learn facilite ce tracé :
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
fig, ax = plt.subplots(figsize=(6, 5))
disp = ConfusionMatrixDisplay.from_predictions(y_test, y_pred_test, display_labels=['Sain (0)', 'Déficit (1)'], cmap=plt.cm.Blues, values_format='d', ax=ax)
plt.title("Matrice de Confusion - Modèle Logistique")
plt.grid(False)
plt.show()
Cette représentation permet à l’équipe pluridisciplinaire d’évaluer d’un coup d’œil la prépondérance relative des faux négatifs par rapport aux faux positifs, matérialisant visuellement les zones de fragilité du modèle.
11.2 11.2 Tracé et interprétation de la courbe Précision-Rappel (PR Curve)
Tandis que la matrice de confusion n’offre qu’un cliché statique à un seuil décisionnel prédéfini, la courbe Précision-Rappel (PR Curve) documente l’espace continu des compromis possibles lorsque le seuil de discrimination parcourt l’intervalle $[0, 1]$. La courbe s’obtient via la fonction precision_recall_curve, et sa synthèse scalaire est capturée par l’aire sous la courbe (PR-AUC ou Average Precision) :
from sklearn.metrics import precision_recall_curve, average_precision_score
precisions, rappels, seuils = precision_recall_curve(y_test, y_prob_test)
pr_auc = average_precision_score(y_test, y_prob_test)
plt.figure(figsize=(8, 6))
plt.plot(rappels, precisions, color='darkblue', lw=2, label=f'Courbe PR (PR-AUC = {pr_auc:.3f})')
# Tracé de la ligne de référence correspondant à la prévalence brute
prevalence_base = np.sum(y_test) / len(y_test)
plt.axhline(y=prevalence_base, color='crimson', linestyle='--', label=f'Prévalence de base ({prevalence_base:.2f})')
plt.xlabel("Rappel (Sensibilité)")
plt.ylabel("Précision (VPP)")
plt.title("Courbe Précision-Rappel et Frontières Iso-F1")
plt.legend(loc="lower left")
plt.grid(True, linestyle=':', alpha=0.6)
plt.show()
Il est également possible d’enrichir ce graphique par la superposition de courbes iso-F1, formées par l’ensemble des coordonnées $(R, P)$ satisfaisant $F_1 = c$. En isolant la précision, nous obtenons l’équation analytique :
$$P = \frac{c \cdot R}{2R – c}$$
Ces contours hyperboliques permettent d’identifier visuellement le point de la courbe de performance qui maximise la métrique F1.
12. 12. Optimisation du seuil de décision et recommandations méthodologiques
12.1 12.1 Ajustement dynamique du seuil de discrimination (Threshold Tuning)
Dans la majorité des implémentations de classification binaire, les prédictions catégorielles sont générées en appliquant un seuil de discrimination par défaut fixé à $0{,}5$ sur les probabilités a posteriori :
$$\hat{Y} = \mathbb{I}(P(Y=1|X) ge 0{,}5)$$
Cette convention naît du postulat d’un espace parfaitement symétrique avec des coûts d’erreurs identiques. En présence de déséquilibres marqués ou d’exigences opérationnelles spécifiques, ce seuil arbitraire s’avère sous-optimal. La recherche méthodique du seuil maximisant le score F1 (Threshold Tuning) permet d’exploiter pleinement le potentiel discriminant de l’estimateur sans modifier ses paramètres internes.
Implémentons un algorithme d’optimisation par balayage fin (grid search) sur le spectre continu des seuils admissibles :
seuils_candidats = np.linspace(0.01, 0.99, 100)
scores_f1_seuils = []
for s in seuils_candidats:
y_pred_temp = (y_prob_test >= s).astype(int)
score_temp = f1_score(y_test, y_pred_temp, zero_division=0)
scores_f1_seuils.append(score_temp)
index_optimal = np.argmax(scores_f1_seuils)
seuil_optimal = seuils_candidats[index_optimal]
f1_optimal = scores_f1_seuils[index_optimal]
print(f"Seuil optimal identifié : {seuil_optimal:.3f} | Score F1 maximisé : {f1_optimal:.4f}")
Ce recalibrage permet fréquemment d’augmenter le score F1 de plusieurs points de pourcentage en déplaçant le seuil (par exemple aux alentours de $0{,}32$ au lieu de $0{,}50$), augmentant significativement la capture des événements positifs réels.
12.2 12.2 Pièges analytiques courants et comment les éviter
L’optimisation du seuil de décision et l’évaluation par le score F1 recèlent plusieurs pièges méthodologiques majeurs qu’un analyste rigoureux se doit d’éviter :
- Fuite d’information statistique (Data Leakage) : Le travers méthodologique le plus fréquent consiste à identifier le seuil optimal directement sur le jeu de test final. Ce procédé contamine l’indépendance de l’échantillon d’évaluation et produit une estimation biaisée vers le haut de la performance réelle. Le réglage du seuil doit impérativement s’opérer sur un jeu de validation dédié ou via une boucle interne de validation croisée emboîtée (Nested Cross-Validation).
- Négligence de la calibration probabiliste : Un modèle peut présenter un score F1 élevé à un seuil donné tout en générant des probabilités très mal calibrées (par exemple, des réseaux de neurones profonds sujets à une surconfiance structurelle). Il est crucial de contrôler la calibration du système via le score de Brier ou des diagrammes de fiabilité (Reliability Diagrams), et d’appliquer si nécessaire une régression isotonique ou une mise à l’échelle de Platt.
- Omission de la classe négative : En concentrant toute son attention sur l’optimisation du score F1 de la classe positive, l’expérimentateur risque d’induire une détérioration massive de la reconnaissance de la classe négative sans s’en apercevoir. La consultation simultanée de la matrice de confusion complète et du score F1 macro demeure indispensable.
12.3 12.3 Synthèse prescriptive pour une recherche reproductible
Pour garantir la validité scientifique et l’intégrité industrielle des systèmes d’apprentissage automatique, tout protocole d’évaluation impliquant le score F1 doit se conformer à un standard de documentation rigoureux :
En premier lieu, l’analyste doit consigner formellement la version de l’interpréteur et de l’ensemble des bibliothèques logicielles mobilisées au sein d’un fichier requirements.txt ou d’une recette d’environnement Conda. En second lieu, toute publication de résultats prédictifs se doit d’accompagner le score F1 scalaire de son intervalle de confiance statistique à 95 % (obtenu par rééchantillonnage de type Bootstrap) ou de la distribution complète issue d’une validation croisée stratifiée répétée.
Enfin, la matrice de confusion non normalisée doit être systématiquement annexée au rapport de modélisation : elle seule préserve l’information brute relative aux effectifs réels et permet aux pairs d’évaluer d’autres métriques décisionnelles adaptées à leurs propres fonctions de coût économique ou clinique. Utilisé avec rigueur et lucidité méthodologique, le score F1 demeure l’un des instruments les plus élégants et efficaces pour concevoir des systèmes de classification robustes, éthiques et performants face à la complexité des données réelles.
Références
- Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21(1), 6. https://doi.org/10.1186/s12864-019-6413-7
- Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861-874. https://doi.org/10.1016/j.patrec.2005.10.010
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830.
- Powers, D. M. (2011). Evaluation: from precision, recall and F-measure to ROC, informedness, markedness and correlation. Journal of Machine Learning Technologies, 2(1), 37-63.
- Sasaki, Y. (2007). The truth of the F-measure. Teach Tutor Mater, 1(5), 1-5.
- van Rijsbergen, C. J. (1979). Information Retrieval (2nd ed.). Butterworth-Heinemann.