
Dans le champ contemporain de l’apprentissage automatique, de la bio-statistique et de la psychométrie computationnelle, l’évaluation de la performance prédictive constitue une étape épistémologique déterminante. Trop souvent, les analystes de données et les cliniciens se reposent sur l’exactitude brute — universellement désignée sous le terme anglophone d’accuracy — pour quantifier l’efficacité d’un modèle de classification binaire ou catégorielle. Pourtant, cette métrique globale souffre d’un angle mort méthodologique sévère : elle postule implicitement une répartition homogène des observations entre les différentes classes observées au sein de la population étudiée. Lorsque ce postulat d’équi-répartition s’effondre, l’exactitude standard cesse d’opérer comme un indicateur de compétence diagnostique pour devenir un miroir déformant, dissimulant l’incapacité potentielle d’un algorithme à détecter les phénomènes rares mais cliniquement critiques.
Face à cette aporie mathématique, l’exactitude équilibrée — ou Balanced Accuracy — s’est imposée au fil des deux dernières décennies comme le standard de rigueur pour l’évaluation des classifieurs appliqués à des distributions asymétriques. En calculant la moyenne arithmétique des taux de succès individuels propres à chaque modalité diagnostique, cette métrique confère un poids équivalent à la classe minoritaire et à la classe majoritaire, neutralisant ainsi les artefacts statistiques induits par la prévalence naturelle du phénomène étudié. Qu’il s’agisse de détecter une affection neurodégénérative précoce, de prédire le risque de passage à l’acte suicidaire ou de discriminer des biomarqueurs par imagerie cérébrale, l’exactitude équilibrée offre un cadre d’inférence intègre, indépendant des fluctuations de l’échantillonnage écologique.
Le présent article propose une exploration exhaustive, théorique et opérationnelle de l’exactitude équilibrée. À travers une déconstruction minutieuse de la théorie de la décision statistique, une analyse critique du paradoxe de l’exactitude, la résolution pas-à-pas d’un cas empirique complet issu du milieu universitaire et une comparaison systématique avec les métriques concurrentes, cette contribution académique vise à fournir aux chercheurs, psychométriciens et scientifiques des données les fondements nécessaires pour concevoir des protocoles d’évaluation méthodologiquement inattaquables.
1. 1. Introduction fondamentale à l’exactitude équilibrée (Balanced Accuracy)
1.1 1.1 Définition conceptuelle et émergence historique
L’exactitude équilibrée tire ses origines conceptuelles de la convergence entre la statistique inférentielle classique, la biométrie et les développements modernes de l’apprentissage automatique supervisé. Historiquement, les premiers algorithmes de discrimination linéaire et quadratique, introduits au milieu du XXe siècle par des pionniers tels que Ronald Fisher, évaluaient l’efficacité d’un classifieur à l’aune du taux d’erreur global, c’est-à-dire le ratio entre le nombre total de mauvaises attributions et l’effectif complet de l’échantillon. Toutefois, à mesure que l’informatique a permis le traitement de bases de données massives issues de la génomique, de la détection de fraudes et du diagnostic médical assisté par ordinateur, la communauté scientifique a constaté que cette justesse brute échouait systématiquement à refléter la réalité opérationnelle dès lors que les distributions empiriques présentaient une asymétrie marquée.
Dans un contexte d’asymétrie distributionnelle, un modèle prédictif peut afficher une exactitude globale de 99 % tout en étant rigoureusement incapable d’identifier la moindre occurrence de la classe d’intérêt si cette dernière ne représente que 1 % des cas observés. C’est pour remédier à cette défaillance structurelle que des chercheurs en vision par ordinateur et en bio-informatique, notamment à la suite des travaux fondateurs sur l’analyse des courbes ROC (Receiver Operating Characteristic), ont formalisé l’exactitude équilibrée. Celle-ci redéfinit la justesse non plus comme un ratio d’individus agrégés sans distinction, mais comme la performance moyenne pondérée obtenue indépendamment au sein de chaque strate décisionnelle.
L’introduction formelle de l’exactitude équilibrée dans la littérature méthodologique a ainsi constitué une rupture paradigmatique. En découplant l’évaluation algorithmique de la taille relative des classes d’échantillonnage, elle a instauré un critère standardisé pour les compétitions scientifiques et les bancs d’essai méthodologiques (benchmarks). Les consortiums internationaux d’évaluation algorithmique exigent désormais ce type d’indicateur pour prévenir la publication de modèles artificiellement gonflés par le biais d’écrasement de la classe minoritaire, garantissant une comparabilité authentique des architectures prédictives à travers des corpus hétérogènes.
1.2 1.2 Pertinence en psychologie quantitative et sciences cognitives
Dans le périmètre de la psychométrie quantitative et des sciences cognitives, la pertinence de l’exactitude équilibrée s’avère particulièrement saillante. Les psychopathologies sévères, les anomalies neurodéveloppementales ou les configurations cognitives atypiques présentent, par nature, une faible prévalence dans la population générale comme dans les échantillons non cliniques. Lorsque des chercheurs conçoivent des algorithmes de dépistage précoce du trouble du spectre de l’autisme (TSA), du trouble bipolaire ou des états mentaux à haut risque de transition psychotique, ils se heurtent inévitablement à des cohortes au sein desquelles les participants neurotypiques ou indemnes surpassent numériquement les individus affectés dans des proportions pouvant atteindre un ratio de vingt pour un.
Dans de tels dispositifs de mesure, l’évaluation des temps de réaction chronométriques, des indices de fixation oculaire ou des patterns électroencéphalographiques (EEG) requiert des modèles capables d’isoler des signaux discrets au milieu d’un bruit de fond physiologique prépondérant. Si un modèle de classification comportementale est évalué via l’exactitude naïve, l’optimiseur mathématique privilégiera mécaniquement l’identification correcte du groupe majoritaire au détriment du groupe clinique. En psychologie computationnelle, une telle dérive méthodologique engendre des conséquences éthiques désastreuses : un faux négatif lors d’un dépistage peut priver un patient d’une prise en charge précoce, compromettant l’efficacité des thérapies comportementales et cognitives développementales.
Par ailleurs, l’exactitude équilibrée s’aligne rigoureusement sur les critères contemporains de validité psychométrique, plus spécifiquement la validité relative aux critères (criterion validity). Selon les standards de l’American Educational Research Association (AERA) et de l’American Psychological Association (APA), un instrument d’évaluation doit démontrer une invariance métrique et une sensibilité diagnostique équivalente quel que soit le contexte épidémiologique d’administration. En neutralisant la distorsion causée par la prévalence écologique, l’exactitude équilibrée atteste de la fidélité intrinsèque du test à classifier adéquatement un individu, indépendamment du fait que ce test soit déployé dans une clinique spécialisée à forte concentration de cas ou au sein de la population générale.
1.3 1.3 Vue d’ensemble du cadre d’évaluation binaire
Le cadre décisionnel dans lequel s’enracine l’exactitude équilibrée repose formellement sur une logique dichotomique. Soit une variable aléatoire binaire $Y in {0, 1}$ représentant l’état réel de la nature — où l’état 1 dénote l’existence d’une condition clinique ou d’un trait cible, et l’état 0 son absence — et soit $\hat{Y} in {0, 1}$ l’assignation catégorielle générée par une fonction de décision statistique $f(X)$, conditionnée par un vecteur d’attributs $X$. L’ensemble de la performance d’un tel système est conditionné par la distribution conjointe de ces deux variables discrètes, laquelle reflète à la fois la compétence discriminante du modèle et la prévalence écologique sous-jacente du trait, notée $P(Y=1)$.
La complexité de cette structure réside dans l’interdépendance asymétrique entre la structure probabiliste des données et les règles d’optimisation algorithmique. La plupart des estimateurs statistiques paramétriques ou non paramétriques (tels que la régression logistique, les forêts d’arbres décisionnels ou les réseaux de neurones artificiels) ajustent leurs hyperparamètres internes afin de minimiser une fonction de coût empirique, telle que l’entropie croisée binaire. Lorsque $P(Y=1)$ est marginalement faible, la contribution des instances positives au gradient global de l’erreur devient négligeable face au volume des instances négatives, poussant les frontières de décision à se replier vers l’espace de la classe minoritaire.
Dans ce contexte, l’exactitude équilibrée intervient au niveau du compromis biais-variance (bias-variance tradeoff). Alors que les métriques conventionnelles incitent le modèle à adopter un biais de prédiction structurellement favorable à la classe majoritaire afin de réduire la variance globale de l’erreur empirique, l’exactitude équilibrée force l’analyste à évaluer le système sous l’hypothèse théorique d’un espace des états parfaitement orthogonal. Elle opère ainsi comme un régulateur cognitif et statistique, obligeant le concepteur de l’algorithme à privilégier des architectures dotées d’une réelle capacité de généralisation discriminative, plutôt que des solutions triviales fondées sur l’exploitation statistique de l’asymétrie de base.
2. 2. Le problème du déséquilibre des classes dans la modélisation statistique
2.1 2.1 Mécanismes et origines de la distribution asymétrique
Le problème du déséquilibre des classes (class imbalance problem) survient lorsqu’une disparité quantitative prononcée caractérise la fréquence relative des étiquettes au sein du jeu de données d’apprentissage ou de validation. Sur le plan formel, on considère généralement qu’un déséquilibre se manifeste dès lors que le ratio entre la classe majoritaire et la classe minoritaire dépasse un rapport de 4:1, atteignant fréquemment des ordres de grandeur de 100:1 voire de 1000:1 dans des domaines spécialisés comme la pharmacovigilance ou la détection de mutations génétiques rares associées à des phénotypes cognitifs spécifiques.
Les mécanismes sous-tendant cette asymétrie relèvent de deux typologies causales distinctes : le déséquilibre intrinsèque et le déséquilibre extrinsèque ou induit. Le déséquilibre intrinsèque est inhérent à la biologie ou à la nature phénoménologique de l’objet d’étude. Par exemple, la prévalence vie-entière de la schizophrénie tourne universellement autour de 0,7 % à 1 % ; dès lors, tout échantillon probabiliste représentatif extrait de la population générale reflétera inéluctablement cette rareté épidémiologique fondamentale. Aucune amélioration de la technique de mesure ne peut effacer ce différentiel quantitatif réel sans altérer la représentativité de la cohorte.
À l’opposé, le déséquilibre extrinsèque découle de biais d’échantillonnage, de contraintes de recrutement expérimental ou de défauts dans le protocole de collecte des données. En neurosciences computationnelles, l’acquisition d’images par résonance magnétique fonctionnelle (IRMf) chez des patients en crise maniaque ou chez des enfants souffrant de troubles sévères du comportement est grevée par un taux élevé de données manquantes, d’artefacts de mouvement ou de refus de consentement. Il en résulte des bases de données où les témoins sains sont massivement surreprésentés par rapport aux cas cliniques sévères, introduisant une distorsion purement méthodologique qui vient pervertir la modélisation ultérieure si elle n’est pas rigoureusement modélisée.
2.2 2.2 Le piège de la précision naïve (Accuracy Paradox)
L’écueil le plus redoutable induit par la distribution asymétrique est connu sous l’appellation de paradoxe de l’exactitude (Accuracy Paradox). Cette anomalie théorique et pratique se définit comme la situation paradoxale où un modèle de prédiction doté d’une exactitude globale nettement supérieure à celle de ses concurrents s’avère, en réalité, totalement dépourvu de valeur opérationnelle ou scientifique. Ce phénomène survient lorsqu’un algorithme naïf ou trivial exploite la structure de prévalence en prédisant systématiquement la modalité majoritaire pour l’intégralité des observations soumises à son jugement.
Considérons, à titre d’illustration, une cohorte clinique de 10 000 individus au sein de laquelle on cherche à identifier le risque de récidive d’un épisode dépressif caractérisé à court terme, événement dont la fréquence observée dans cet échantillon est de 2 % (soit 200 individus positifs et 9 800 individus négatifs). Un modèle dit « zéro-information », qui se contenterait d’émettre mécaniquement un pronostic négatif pour chaque patient sans traiter la moindre donnée clinique, atteindrait une exactitude brute remarquable de 98 % (9 800 / 10 000). À l’inverse, un modèle algorithmique hautement sophistiqué, identifiant correctement 160 cas positifs sur 200 (sensibilité de 80 %) mais générant 400 faux positifs au sein de la cohorte négative (spécificité de 95,9 %), présenterait une exactitude globale de 95,6 % [(160 + 9 400) / 10 000].
Si l’analyste se fie aveuglément à l’exactitude naïve, il conclura erronément que le classifieur aveugle surpasse le modèle sophistiqué de plus de deux points de pourcentage. Ce paradoxe crée une illusion statistique dévastatrice : il valide des modèles dégénérés qui n’ont rien appris de la structure latente des prédicteurs psychologiques ou neurocognitifs, tout en disqualifiant des modèles hautement performants pour détecter la condition critique. L’impact sur la reproductibilité scientifique est désastreux, favorisant la publication de scores de performance factices qui s’effondrent dès que l’algorithme est confronté à des cohortes enrichies ou à des milieux écologiques aux ratios de prévalence divergents.
2.3 2.3 Conséquences scientifiques et déontologiques de l’asymétrie
L’usage persistant de métriques sensibles à la prévalence dans des contextes asymétriques génère des répercussions déontologiques et cliniques majeures. Dans le champ de la santé mentale et de l’évaluation diagnostique, tolérer des modèles aveugles à la classe minoritaire conduit directement à un sous-diagnostic systématique. Les personnes affectées par des pathologies rares ou débutantes se voient attribuer une étiquette d’indemnité, ce qui constitue une erreur par omission dont le coût thérapeutique, individuel et social s’avère souvent irréversible. L’omission d’un risque imminent d’autolyse ou la non-reconnaissance d’un déficit cognitif débutant engage la responsabilité éthique directe du chercheur et du praticien.
Sur le versant sociologique et méthodologique, ce dysfonctionnement nourrit ce que l’on qualifie désormais de biais algorithmique systématique. Les sous-groupes démographiques minoritaires — qu’il s’agisse de populations marginalisées sur le plan ethnique, de tranches d’âge pédiatriques ou gériatriques spécifiques, ou de minorités de genre — présentent des effectifs réduits dans les échantillons d’étalonnage psychométrique. Un classifieur optimisé sur l’exactitude globale sacrifiera inéluctablement la précision de ses inférences sur ces populations subsidiaires pour maximiser son taux de réussite sur le groupe de référence dominant, entérinant et amplifiant ainsi des disparités structurelles préexistantes.
Il est donc impératif, pour préserver l’intégrité de l’évaluation en sciences humaines et médicales, d’adopter des métriques formalisées de manière à être mathématiquement invariantes face aux variations de la prévalence marginale. L’exactitude équilibrée répond précisément à cette exigence d’impartialité épistémique en normalisant la contribution de chaque classe, garantissant que l’autorité d’un modèle statistique ne s’édifie jamais sur l’écrasement ou l’invisibilisation des fractions d’échantillons les plus réduites.
3. 3. Déconstruction de la matrice de confusion
3.1 3.1 Les quatre quadrants fondamentaux de la contingence
Toute tentative d’appréhension rigoureuse des métriques de classification doit s’appuyer sur la décomposition exhaustive de la matrice de contingence binaire, communément désignée sous le terme de matrice de confusion. Cette table croisée à double entrée permet de cartographier sans ambiguïté les décisions prononcées par le modèle face à la réalité empirique du terrain (le critère de référence ou gold standard). Elle s’articule autour de quatre quadrants fondamentaux, mutuellement exclusifs et conjointement exhaustifs, constituant la matière première de l’ensemble des inférences statistiques ultérieures.
Le premier quadrant abrite les Vrais Positifs ($VP$), correspondant aux observations pour lesquelles la condition cible était présente et pour lesquelles l’algorithme a effectivement statué en faveur de cette présence. En psychopathologie, il s’agit par exemple d’un adolescent manifestant un trouble dépressif majeur et correctement détecté comme tel par une échelle automatisée. Le deuxième quadrant héberge les Faux Négatifs ($FN$), désignant les cas où la condition est présente dans la réalité mais où le modèle a conclu, à tort, à son absence. Cette omission diagnostique constitue généralement l’erreur la plus coûteuse et la plus dangereuse sur le plan médico-légal et humain.
Le troisième quadrant rassemble les Vrais Négatifs ($VN$), soit l’ensemble des sujets sains chez lesquels le classifieur a validé l’absence de pathologie avec exactitude. Enfin, le quatrième quadrant consigne les Faux Positifs ($FP$), également qualifiés d’erreurs de type I ou de fausses alertes. Dans cette configuration, un sujet exempt du trouble étudié reçoit un verdict algorithmique positif, déclenchant une anxiété indue, des examens complémentaires invasifs ou une stigmatisation diagnostique superflue. La maîtrise de ces quatre grandeurs élémentaires est indispensable, car l’exactitude équilibrée n’est rien d’autre qu’une recombinaison raisonnée et normalisée de ces totaux élémentaires.
3.2 3.2 Alignement structural et normalisation marginale
L’analyse structurale de la matrice de confusion impose de distinguer les totaux marginaux en colonnes des totaux marginaux en lignes. La somme des colonnes traduit la distribution biologique ou écologique réelle au sein de la cohorte étudiée : le total des positifs réels est égal à $P = VP + FN$, tandis que le total des négatifs réels équivaut à $N = VN + FP$. Le ratio $P / (P + N)$ définit très exactement la prévalence empirique de la condition au sein de l’échantillon expérimental. C’est précisément la fluctuation de ce ratio d’une étude à l’autre qui déstabilise les métriques naïves.
La somme des lignes, pour sa part, décrit le comportement décisionnel intrinsèque de l’algorithme : le total des prédictions positives s’élève à $\hat{P} = VP + FP$, et celui des prédictions négatives à $\hat{N} = VN + FN$. Lorsque l’asymétrie entre $P$ et $N$ devient critique, les effectifs bruts inscrits dans les quadrants des négatifs ($VN$ et $FP$) écrasent numériquement ceux des quadrants des positifs ($VP$ et $FN$). Toute opération de sommation directe, telle qu’opérée par l’exactitude classique qui calcule $(VP + VN) / (P + N)$, revient à agréger des entités soumises à des facteurs d’échelle disproportionnés.
Pour neutraliser ce déséquilibre, une normalisation marginale par classe s’avère mathématiquement indispensable. Cette procédure consiste à diviser les grandeurs issues de chaque colonne par leur total marginal respectif avant d’entreprendre toute synthèse d’évaluation. En convertissant les nombres absolus d’occurrences en proportions relatives conditionnelles à l’état réel de l’individu, on transforme la matrice de contingence brute en une matrice de probabilités de transition. Cette normalisation rétablit une symétrie géométrique parfaite au sein de l’espace de décision, permettant de traiter avec une rigueur égale le destin statistique des individus positifs et celui des individus négatifs.
3.3 3.3 Lien opérationnel entre matrice de confusion et théorie de détection du signal
La matrice de confusion n’est pas une simple table comptable ; elle constitue l’expression discrète des postulats de la théorie de la détection du signal (TDS), développée originellement par David Green et John Swets pour la psychophysique et l’analyse sensorielle. La TDS postule que tout système de classification opère dans un environnement bruité au sein duquel il doit distinguer une distribution d’observations représentative du signal plus bruit (l’état positif) d’une distribution concurrente représentative du bruit seul (l’état négatif). Les grandeurs $VP$, $FN$, $VN$ et $FP$ sont les manifestations concrètes de l’intersection entre ces deux densités de probabilité et un critère de réponse interne.
Dans ce cadre psychométrique, deux paramètres cardinaux régissent le comportement de l’observateur ou de l’algorithme : la sensibilité discriminative, synthétisée par l’indice $d’$ (d-prime), et le critère décisionnel, souvent quantifié par le ratio de vraisemblance $\beta$ ou le seuil de coupure $c$. L’indice $d’$ représente la distance standardisée séparant les moyennes des distributions du bruit et du signal. Un système incapable de distinguer le signal du bruit présentera un $d’ = 0$, tandis qu’une discrimination parfaite se traduira par un indice tendant vers l’infini. Le critère $\beta$, en revanche, reflète le conservatisme ou le libéralisme du classifieur : un système libéral multipliera les vrais positifs au prix d’un afflux massif de fausses alarmes ($FP$), tandis qu’un système conservateur minimisera les fausses alarmes en acceptant un taux élevé d’omissions ($FN$).
L’exactitude équilibrée entretient une filiation directe avec cette modélisation psychophysique. Alors que l’exactitude naïve confond arbitrairement la sensibilité intrinsèque de l’outil et le biais décisionnel induit par la prévalence du bruit, l’exactitude équilibrée se focalise sur l’aptitude globale à classifier adéquatement le signal et le bruit sans privilégier la position du critère de réponse imposée par l’asymétrie numérique des événements. Elle offre ainsi une lecture compatible avec l’évaluation des seuils perceptifs et cognitifs humains au sein des protocoles psychophysiques contemporains.
4. 4. Piliers constitutifs : Sensibilité et Spécificité
4.1 4.1 La sensibilité (Taux de vrais positifs / Rappel)
Le premier pilier fondamental sur lequel s’édifie l’exactitude équilibrée est la sensibilité, désignée dans le domaine de la science des données sous le vocable de rappel (recall) ou de taux de vrais positifs (True Positive Rate – TPR). Sur le plan mathématique, elle se définit comme la probabilité conditionnelle que le modèle diagnostique l’état positif sachant que la condition cible est effectivement présente chez le sujet observé :
$$\text{Sensibilité} = P(\hat{Y}=1 mid Y=1) = \frac{VP}{VP + FN}$$
Sur le plan clinique et psychométrique, la sensibilité quantifie la capacité d’échappement minimale de l’instrument d’évaluation. Un test doté d’une sensibilité de 95 % garantit que sur 100 individus véritablement porteurs du trouble cible, 95 seront formellement dépistés et orientés vers les canaux d’intervention appropriés, tandis que seuls 5 individus échapperont à la vigilance de l’algorithme sous forme d’erreurs par faux négatifs. Dans la littérature méthodologique, il convient d’opérer une distinction rigoureuse entre la sensibilité analytique — qui caractérise le seuil physique minimal de détection d’un signal par un appareil de mesure — et la sensibilité diagnostique, qui exprime le rendement de la classification au sein d’une population clinique hétérogène confrontée à des comorbidités diverses.
La sensibilité est influencée par de nombreux facteurs expérimentaux. La sévérité des symptômes, l’homogénéité du phénotype au sein du groupe positif et la fidélité des instruments de recueil conditionnent directement cette grandeur. Dès lors que l’on manipule le seuil de décision d’un modèle statistique, abaisser la sévérité requise pour porter un diagnostic positif maximise la sensibilité. Cependant, cette augmentation ne saurait être interprétée de manière isolée, car elle s’effectue généralement au détriment direct du second pilier de la matrice de contingence : la spécificité.
4.2 4.2 La spécificité (Taux de vrais négatifs)
Le second pilier structural de l’évaluation est la spécificité, désignée symétriquement comme le taux de vrais négatifs (True Negative Rate – TNR). Elle correspond à la probabilité conditionnelle d’obtenir un résultat négatif sachant que le sujet est rigoureusement exempt de la condition ou du trait investigué :
$$\text{Spécificité} = P(\hat{Y}=0 mid Y=0) = \frac{VN}{VN + FP}$$
La spécificité mesure la rigueur avec laquelle le système d’évaluation protège les individus sains contre des désignations nosographiques infondées. En psychométrie de la personnalité et en neuropsychologie clinique, une haute spécificité s’avère impérative pour prévenir le surdiagnostic et la médicalisation abusive de trajectoires développementales normales. Le complémentaire arithmétique de la spécificité, défini par $1 – \text{Spécificité}$, équivaut très exactement au taux de fausses alertes ou taux de faux positifs (False Positive Rate – FPR), qui correspond au ratio $FP / (VN + FP)$.
Dans un contexte d’allocation de ressources thérapeutiques limitées — à l’instar des places disponibles au sein des unités spécialisées de pédopsychiatrie ou des créneaux de remédiation cognitive assistée —, maintenir une spécificité élevée représente une exigence économique et déontologique de premier plan. Un test dont la spécificité est défaillante sature le système de santé d’investigations secondaires superflues et instille chez les individus faussement étiquetés une charge anxiogène susceptible d’induire des effets iatrogènes par étiquetage nosographique.
4.3 4.3 L’antagonisme intrinsèque entre sensibilité et spécificité
Sensibilité et spécificité entretiennent un rapport de tension antagoniste immuable, tributaire du déplacement du seuil décisionnel (désigné par $\theta$). Dès lors qu’un modèle statistique produit un score continu de probabilité a posteriori $P(Y=1 mid X)$, l’expérimentateur doit fixer une coupure $\theta in [0, 1]$ telle que l’assignation catégorielle s’écrive : $\hat{Y} = 1$ si $P(Y=1 mid X) ge \theta$, et $\hat{Y} = 0$ sinon. Si l’on déplace $\theta$ vers zéro, le système adopte un comportement libéral : la sensibilité grimpe inexorablement vers 1,0, mais la spécificité s’effondre consécutivement vers 0,0. Réciproquement, élever $\theta$ vers 1,0 garantit une spécificité absolue au prix d’une cécité presque totale envers les vrais cas positifs.
Ce compromis dynamique est formalisé visuellement le long de la courbe ROC (Receiver Operating Characteristic), qui trace graphiquement la sensibilité en ordonnée en fonction du taux de fausses alertes ($1 – \text{Spécificité}$) en abscisse pour l’ensemble des seuils de décision $\theta$ concevables. Chaque point de cette trajectoire géométrique illustre une transaction statistique spécifique entre détection et fausse alarme. La concavité de la courbe au-dessus de la bissectrice d’équiprobabilité atteste de la puissance discriminative globale du système.
Les stratégies d’équilibrage méthodologique doivent impérativement arbitrer ce compromis en tenant compte de la gravité clinique respective des deux types d’erreurs. Dans une phase de pré-dépistage à large échelle d’une pathologie létale, on tolérera une dégradation contrôlée de la spécificité au bénéfice d’une sensibilité maximale. En revanche, lorsqu’une issue positive déclenche une intervention chirurgicale cérébrale invasive ou un traitement pharmacologique lourd présentant des effets secondaires neurotoxiques, la spécificité devient la priorité absolue. L’exactitude équilibrée intervient précisément au cœur de cette dynamique en offrant une synthèse géométrique qui pénalise tout déséquilibre excessif entre ces deux impératifs contradictoires.
5. 5. Définition mathématique et propriétés de l’exactitude équilibrée
5.1 5.1 La formule fondamentale et sa dérivation
L’exactitude équilibrée (notée formellement $BA$ pour Balanced Accuracy) se définit comme la moyenne arithmétique de la sensibilité et de la spécificité obtenues à un seuil décisionnel discret déterminé. Sa formulation canonique s’énonce selon l’équation fondamentale suivante :
$$\text{Balanced Accuracy} = \frac{\text{Sensibilité} + \text{Spécificité}}{2} = \frac{1}{2} \left( \frac{VP}{VP + FN} + \frac{VN}{VN + FP} \right)$$
Cette expression démontre avec clarté la mécanique d’invariance d’échelle qui la caractérise. En calculant séparément la justesse interne propre à la condition positive ($VP / (VP+FN)$) et la justesse interne propre à la condition négative ($VN / (VN+FP)$), l’équation confère un coefficient de pondération identique de $0,5$ à chacun des deux états du système, sans aucune considération pour le nombre total d’observations composant les strates $P$ et $N$.
Sur le plan géométrique, l’exactitude équilibrée possède une équivalence théorique remarquable avec l’analyse ROC : pour un classifieur discret opérant à un seuil fixe unique, la valeur de la Balanced Accuracy correspond exactement à l’aire sous la courbe (AUC) d’un estimateur ponctuel relié par des segments linéaires aux coordonnées extrêmes $(0,0)$ et $(1,1)$. Cette propriété confère à la métrique une solide légitimité probabiliste, enracinant son interprétation dans le continuum des méthodes d’évaluation non paramétriques de la théorie du signal.
5.2 5.2 Propriétés statistiques remarquables
L’exactitude équilibrée présente un ensemble de propriétés analytiques remarquables qui en facilitent l’interprétation par les praticiens et les chercheurs :
- Comportement face au hasard statistique : Pour un classifieur aléatoire non informatif — c’est-à-dire un modèle qui attribue les étiquettes en tirant à pile ou face selon une loi de Bernoulli, ou un modèle constant prédisant systématiquement la classe majoritaire —, la valeur de la Balanced Accuracy converge rigoureusement vers 0,50 (soit 50 %), indépendamment de l’asymétrie de l’échantillon. Cette caractéristique contraste fortement avec l’exactitude naïve, qui fluctue arbitrairement entre 0,50 et 0,99 en fonction de la prévalence.
- Borne supérieure de discrimination parfaite : Un système de mesure réalisant une classification exempte de toute erreur ($FN = 0$ et $FP = 0$) obtient une sensibilité de 1,0 et une spécificité de 1,0, produisant une exactitude équilibrée maximale de 1,00 (soit 100 %).
- Comportement pour les modèles contre-performants : Lorsque le score d’un modèle s’établit dans l’intervalle $[0,0 ; 0,50[$, cela indique que le classifieur effectue une prédiction pire que le simple hasard statistique, traduisant une inversion pathologique de ses frontières décisionnelles. Une inversion systématique de la règle de décision suffirait théoriquement à transformer ce score déficitaire en une performance supérieure à 0,50.
- Indépendance stricte envers la taille d’échantillon : Contrairement aux mesures d’association comme le Chi-deux de contingence, dont la significativité dépend de l’effectif global $N$, l’exactitude équilibrée demeure invariante si l’on multiplie arbitrairement l’effectif d’une seule classe par un facteur scalaire constant, ce qui en fait une métrique d’évaluation robuste et hautement reproductible.
5.3 5.3 Généralisation au cadre multiclasse
Bien que fréquemment déployée au sein d’architectures décisionnelles binaires, l’exactitude équilibrée se généralise de façon canonique à des espaces catégoriels polytomiques ou multiclasses comportant $K$ catégories distinctes ($K > 2$). Dans un tel dispositif, la matrice de confusion adopte une géométrie dimensionnelle d’ordre $K \times K$, où chaque élément diagonal $C_{ii}$ consigne le volume d’assignations correctes pour la classe $i$, tandis que les éléments extradiagonaux $C_{ij}$ ($i \neq j$) décrivent les diverses modalités de confusion croisée.
La formulation étendue de l’exactitude équilibrée multiclasse repose sur le calcul de la macro-moyenne arithmétique des taux de rappel individuels (c’est-à-dire la sensibilité calculée pour chaque modalité isolée face à l’agrégat des autres classes selon une logique « un contre tous ») :
$$\text{Balanced Accuracy}_{\text{multiclasse}} = \frac{1}{K} \sum_{i=1}^{K} \frac{C_{ii}}{\sum_{j=1}^{K} C_{ij}}$$
Dans cette équation, le terme $\sum_{j=1}^{K} C_{ij}$ représente l’effectif marginal total appartenant originellement à la classe $i$. Cette généralisation macro-moyennée garantit que la capacité du modèle à identifier une classe extrêmement marginale (comme un sous-type rare d’accident vasculaire cérébral ou une variante psychotique atypique) bénéficie d’un coefficient d’influence rigoureusement équivalent ($1/K$) à celui accordé à des catégories hautement prévalentes. Cette approche se distingue radicalement de la micro-moyenne, qui agrège indistinctement les succès globaux et retombe ainsi dans les travers de l’exactitude naïve.
6. 6. Exemple pratique complet : Analyse de cas empirique
6.1 6.1 Présentation du contexte d’étude et de l’échantillon
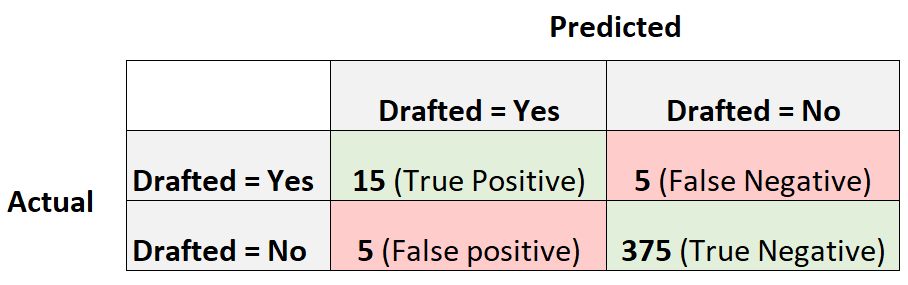
Afin de concrétiser les implications opérationnelles de cette méthodologie, analysons un protocole d’évaluation prédictive appliqué à la psychologie de la performance et aux sciences du sport. Une équipe de chercheurs en sciences du mouvement humain souhaite valider un algorithme basé sur un modèle de régression logistique binaire conçu pour prédire l’accession de jeunes sportifs universitaires d’élite aux ligues sportives professionnelles majeures au terme de leur cursus académique.
Le groupe d’étude comprend un échantillon consécutif de $N = 400$ étudiants-athlètes suivis longitudinalement durant quatre années. Les données d’entrée du modèle intègrent une batterie d’attributs psychométriques et physiologiques standardisés : des indices de résistance mentale (quantifiés par l’inventaire MTQ48), la vitesse de traitement perceptivo-moteur mesurée lors de tâches de temps de réaction de choix, ainsi que des mesures de puissance anaérobie alactique. À l’issue du protocole longitudinal, les données de terrain confirment que seuls 20 athlètes sur les 400 ont effectivement réussi à signer un contrat professionnel, ce qui établit la prévalence écologique du phénomène cible à :
$$\text{Prévalence} = \frac{20}{400} = 0,05 \quad (5,0,%)$$
Nous nous trouvons ainsi confrontés à un problème classique de distribution hautement asymétrique, caractérisé par un ratio de 19:1 entre le groupe majoritaire (380 étudiants-athlètes non sélectionnés) et le groupe minoritaire d’intérêt (20 athlètes recrutés par l’élite). Le recours à la régression logistique est justifié par la nature dichotomique de la variable de sortie et la structure continue des prédicteurs psychométriques standardisés.
6.2 6.2 Données brutes observées de la classification
Au terme de la phase d’apprentissage et de calibrage statistique au seuil probabiliste par défaut de $\theta = 0,50$, le modèle prédictif est appliqué à la cohorte d’évaluation. L’analyse détaillée des assignations catégorielles émises par l’algorithme confrontées aux parcours professionnels réels des 400 sportifs produit la répartition empirique suivante :
- Vrais Positifs ($VP$) = 15 : L’algorithme a correctement diagnostiqué le potentiel professionnel de 15 athlètes qui ont, de fait, intégré avec succès les ligues professionnelles au terme de leur formation.
- Faux Négatifs ($FN$) = 5 : Le modèle a prédit un échec d’insertion pour 5 athlètes qui ont pourtant réussi leur transition vers le sport d’élite. Ces cas constituent des erreurs d’omission psychométrique.
- Vrais Négatifs ($VN$) = 375 : L’algorithme a conclu avec justesse que 375 sportifs ne possédaient pas les caractéristiques requises pour franchir le palier professionnel, confirmant leur maintien dans le circuit amateur.
- Faux Positifs ($FP$) = 5 : Le système a faussement prédit le recrutement de 5 athlètes qui n’ont finalement pas été retenus par les recruteurs professionnels (erreurs par fausse alarme).
6.3 6.3 Représentation formelle sous forme de matrice de contingence
La structuration matricielle standardisée de ces résultats empiriques permet de vérifier scrupuleusement la cohérence des marges et l’exhaustivité de l’échantillon analysé. Le tableau de contingence se configure de la façon suivante :
| Condition Réelle / Prédiction | Prédit Positif ($\hat{Y}=1$) | Prédit Négatif ($\hat{Y}=0$) | Total Réel Marginal |
|---|---|---|---|
| Positif Réel ($Y=1$) | $VP = 15$ | $FN = 5$ | $P = 20$ |
| Négatif Réel ($Y=0$) | $FP = 5$ | $VN = 375$ | $N = 380$ |
| Total Prédit Marginal | $\hat{P} = 20$ | $\hat{N} = 380$ | $N_{\text{total}} = 400$ |
La vérification arithmétique de la complétude confirme que :
$$N_{\text{total}} = VP + FN + FP + VN = 15 + 5 + 5 + 375 = 400$$
Cette formalisation met en relief la structure asymétrique sous-jacente : alors que la marge de la condition positive réelle ne renferme que 20 unités statistiques, la marge de la condition négative en concentre 380. Les conditions nécessaires à l’analyse différentielle des métriques d’exactitude sont désormais parfaitement réunies.
7. 7. Calcul pas-à-pas et comparaison avec l’exactitude classique
7.1 7.1 Calcul arithmétique de la sensibilité et de la spécificité
L’extraction des composantes fondamentales de l’exactitude équilibrée s’effectue par l’évaluation séparée des taux de réussite conditionnels au sein de chaque marge biologique de la matrice empirique :
Premièrement, nous dérivons la sensibilité du protocole de détection des talents sportifs :
$$\text{Sensibilité} = \frac{VP}{VP + FN} = \frac{15}{15 + 5} = \frac{15}{20} = 0,7500 \quad (75,00,%)$$
Sur le plan opérationnel, ce score atteste que l’outil est capable d’identifier avec succès trois quarts de la cohorte d’élite réelle. Un quart des futurs professionnels (25 %) échappe néanmoins à l’algorithme sous forme d’omissions diagnostiques.
Deuxièmement, nous déterminons la spécificité de la décision sur la cohorte des athlètes demeurés amateurs :
$$\text{Spécificité} = \frac{VN}{VN + FP} = \frac{375}{375 + 5} = \frac{375}{380} \approx 0,9868 \quad (98,68,%)$$
Ce niveau remarquable de spécificité prouve que le modèle rejette avec une rigueur exceptionnelle les profils non qualifiés, ne générant qu’un taux marginal de fausses alertes s’élevant à :
$$1 – \text{Spécificité} = \frac{5}{380} \approx 0,0132 \quad (1,32,%)$$
7.2 7.2 Détermination finale de l’exactitude équilibrée
Disposant désormais des deux probabilités conditionnelles normalisées, la détermination finale de l’exactitude équilibrée s’obtient par l’application rigoureuse de la moyenne arithmétique :
$$\text{Balanced Accuracy} = \frac{\text{Sensibilité} + \text{Spécificité}}{2} = \frac{0,7500 + 0,9868}{2} = \frac{1,7368}{2} = 0,8684 \quad (86,84,%)$$
Ce résultat de 86,84 % exprime la performance synthétique du système sur une échelle objective exempte du biais d’échantillonnage. Il illustre de façon transparente le coût statistique induit par les 5 faux négatifs : bien que ces omissions n’affectent que 5 individus sur un effectif total de 400 athlètes, leur localisation au sein de la classe minoritaire pénalise légitimement le score final, signalant aux évaluateurs que la détection du talent nécessite encore des perfectionnements méthodologiques avant d’autoriser un déploiement aveugle du modèle de sélection.
7.3 7.3 Confrontation quantitative avec l’exactitude standard
Calculons à présent, sur les mêmes données empiriques, l’exactitude standard ou naïve ($A_{\text{naïve}}$) telle qu’elle est trop souvent présentée dans les publications non contrôlées :
$$\text{Accuracy}_{\text{naïve}} = \frac{VP + VN}{N_{\text{total}}} = \frac{15 + 375}{400} = \frac{390}{400} = 0,9750 \quad (97,50,%)$$
La confrontation entre ces deux grandeurs met en évidence un décalage substantiel supérieur à 10 points de pourcentage :
$$\Delta = \text{Accuracy}_{\text{naïve}} – \text{Balanced Accuracy} = 97,50,% – 86,84,% = 10,66,%$$
Cette différence illustre parfaitement le mécanisme de dissimulation statistique opéré par l’exactitude classique. Avec un score impressionnant de 97,50 %, un promoteur peu scrupuleux pourrait affirmer que son outil prédictif frôle la perfection diagnostique, masquant opportunément le fait qu’un athlète d’élite potentiel sur quatre (25 %) est purement et simplement ignoré par le système.
Poussons la démonstration méthodologique jusqu’à ses ultimes retranchements théoriques en examinant le comportement d’un classifieur fictif entièrement dégénéré qui prédirait systématiquement l’échec d’accession professionnelle pour la totalité des 400 étudiants-athlètes ($VP = 0$, $FN = 20$, $VN = 380$, $FP = 0$). Un tel système produirait les résultats comparés suivants :
- Exactitude classique du modèle nul : $(0 + 380) / 400 = 0,9500$ (soit 95,00 % de réussite apparente !).
- Sensibilité du modèle nul : $0 / (0 + 20) = 0,0000$ (0,0 %).
- Spécificité du modèle nul : $380 / (380 + 0) = 1,0000$ (100,0 %).
- Exactitude équilibrée du modèle nul : $(0,0000 + 1,0000) / 2 = 0,5000$ (soit 50,00 %).
Cet exemple empirique démontre la supériorité épistémologique de l’exactitude équilibrée : tandis que l’exactitude standard récompense un modèle aveugle par un score quasi parfait de 95 %, l’exactitude équilibrée rétrograde immédiatement l’algorithme défaillant au niveau exact du hasard pur (50,00 %), neutralisant ainsi tout risque de tromperie scientifique.
8. 8. Analyse comparée : Exactitude équilibrée face aux métriques alternatives
8.1 8.1 Confrontation avec le F1-Score
Dans la littérature contemporaine consacrée à l’apprentissage automatique, le F1-Score (ou score de Dice) est couramment présenté comme l’alternative par excellence à l’exactitude naïve pour l’évaluation de données déséquilibrées. Sur le plan structural, le F1-Score représente la moyenne harmonique de la précision (ou valeur prédictive positive, $VPP = VP / (VP + FP)$) et de la sensibilité ($Rappel = VP / (VP + FN)$) :
$$F_1 = 2 \times \frac{\text{Précision} \times \text{Rappel}}{\text{Précision} + \text{Rappel}} = \frac{2 \cdot VP}{2 \cdot VP + FP + FN}$$
Bien que le F1-Score soit très informatif pour évaluer l’efficacité d’un moteur de recherche documentaire ou d’un système de reconnaissance optique, il souffre d’une asymétrie conceptuelle majeure : il ignore totalement le quadrant des vrais négatifs ($VN$). En effet, la variable $VN$ brille par son absence dans la formule du F1-score. Par conséquent, la métrique s’avère particulièrement sensible au choix conventionnel de la classe désignée comme « positive » : inverser l’étiquetage des classes (considérer l’absence de pathologie comme l’événement cible) modifie substantiellement la valeur numérique du F1-Score, ce qui contrevient au principe d’objectivité diagnostique.
À l’opposé, l’exactitude équilibrée traite avec une symétrie mathématique rigoureuse les vrais positifs et les vrais négatifs. Elle s’avère nettement plus robuste et équitable dès lors que l’objectif scientifique consiste non pas uniquement à maximiser la précision des alertes émises, mais à garantir une qualification diagnostique équilibrée des deux versants phénotypiques d’une cohorte clinique. Toutefois, en psychométrie expérimentale, ces deux métriques s’avèrent complémentaires : croiser la Balanced Accuracy et le F1-Score permet d’obtenir un portrait complet de la compétence de discrimination et de la pureté prédictive de l’instrument.
8.2 8.2 Confrontation avec le coefficient de corrélation de Matthews (MCC)
Le coefficient de corrélation de Matthews (Matthews Correlation Coefficient – MCC) est fréquemment considéré par les méthodologistes et statisticiens comme l’une des métriques les plus rigoureuses pour l’analyse des matrices de confusion binaires. Fondé sur la corrélation de Pearson discrète calculée entre les variables binaires observées et prédites, le MCC intègre simultanément l’ensemble des quatre quadrants de contingence :
$$\text{MCC} = \frac{VP \cdot VN – FP \cdot FN}{\sqrt{(VP + FP)(VP + FN)(VN + FP)(VN + FN)}}$$
Le MCC possède d’incontestables vertus théoriques : il oscille sur un intervalle continu borné entre $-1,0$ (désaccord systématique total) et $+1,0$ (concordance absolue), la valeur $0,0$ désignant une performance rigoureusement équivalente à celle d’une assignation aléatoire indépendante. De plus, il est particulièrement sensible aux déséquilibres extrêmes touchant simultanément les deux classes. Cependant, son ergonomie cognitive et son interprétabilité clinique sont notoirement déficientes. Transmettre à un comité de pilotage hospitalier ou à des praticiens de terrain qu’un algorithme de dépistage présente un MCC de $0,42$ s’avère infiniment moins intelligible que de communiquer une exactitude équilibrée de $82,%$.
L’exactitude équilibrée offre ainsi un compromis optimal entre rectitude mathématique et intuitivité opérationnelle. Tout en offrant une résilience comparable à celle du MCC face au paradoxe de l’exactitude, elle conserve une échelle probabiliste bornée sur $[0, 1]$ dont la métrique s’interprète naturellement comme un pourcentage de réussite normalisé, facilitant ainsi le dialogue interdisciplinaire entre biostatisticiens, psychologues cliniciens et décideurs de santé publique.
8.3 8.3 Confrontation avec l’AUC-ROC et la moyenne géométrique (G-Mean)
Une autre alternative de référence est constituée par la moyenne géométrique des taux de réussite individuels, universellement désignée sous l’appellation de G-Mean (Geometric Mean) :
$$\text{G-Mean} = \sqrt{\text{Sensibilité} \times \text{Spécificité}}$$
La G-Mean est spécifiquement paramétrée pour pénaliser les disparités criantes entre sensibilité et spécificité avec une sévérité supérieure à celle de la moyenne arithmétique. Si un algorithme présente une spécificité absolue de $1,0$ mais une sensibilité médiocre de $0,20$, son exactitude équilibrée s’établira à $0,60$ (soit $60,%$) tandis que sa G-Mean chutera drastiquement à $\sqrt{1,0 \times 0,20} \approx 0,447$ (soit $44,7,%$). La moyenne géométrique est donc préconisée lorsqu’un seuil critique minimal doit impérativement être atteint sur chaque modalité sans aucune tolérance pour les compensations asymétriques.
Quant à l’AUC-ROC (aire sous la courbe d’efficacité du récepteur), elle se distingue fondamentalement de l’exactitude équilibrée par son caractère global et continu. Alors que l’AUC-ROC agrège l’intégralité des compromis sensibilité-spécificité possibles sur l’ensemble du continuum des seuils $\theta in [0, 1]$, l’exactitude équilibrée évalue la performance effective du modèle à un seuil décisionnel immuable et concret retenu pour le déploiement opérationnel. L’AUC-ROC informe sur le potentiel discriminant théorique de la fonction de score, mais l’exactitude équilibrée valide la stabilité diagnostique réelle du test entre les mains du praticien confronté à un choix d’action dichotomique.
9. 9. Applications en psychométrie, psychopathologie et neurosciences
9.1 9.1 Évaluation des instruments de dépistage du risque suicidaire
La prédiction du passage à l’acte suicidaire constitue sans doute l’un des défis les plus délicats de la psychiatrie et de la suicidologie computationnelle contemporaines. Dans les cohortes de dépistage en population générale, ou même au sein de cohortes universitaires suivies par les services de médecine préventive, la prévalence annuelle des tentatives de suicide avérées demeure heureusement un événement rare sur le plan quantitatif, oscillant typiquement entre $0,1,%$ et $0,5,%$ des effectifs. Nous sommes ici confrontés à un déséquilibre de classe massif pouvant dépasser un ratio de 500:1.
Dans ce contexte épidémiologique à très haute criticité, l’optimisation des modèles d’apprentissage profond ou de gradient boosting sur l’exactitude classique représenterait une défaillance professionnelle majeure : un modèle assignant à chaque patient un pronostic d’absence totale de risque atteindrait une exactitude insolente de $99,8,%$, tout en laissant mourir sans alerte les $0,2,%$ d’individus en détresse aiguë. Le recours strict à l’exactitude équilibrée contraint l’algorithme à privilégier l’optimisation conjointe du taux d’identification des sujets à risque ($VP$) et de préservation des individus non vulnérables ($VN$).
En forçant le score de performance synthétique à attribuer un poids équivalent à la trajectoire des individus vulnérables, l’exactitude équilibrée garantit un calibrage protecteur. Elle aide les chercheurs à déterminer le seuil décisionnel minimal permettant d’atteindre une sensibilité cliniquement sécurisante (par exemple supérieure à $85,%$) tout en maintenant la spécificité à un niveau suffisant pour ne pas saturer de fausses alertes les cellules d’intervention d’urgence psychosociale, matérialisant ainsi un compromis éthiquement défendable.
9.2 9.2 Diagnostics de troubles du spectre de l’autisme (TSA) et TDAH
L’application de modèles d’intelligence artificielle au dépistage et au diagnostic différentiel du trouble du spectre de l’autisme (TSA) et du trouble du déficit de l’attention avec ou sans hyperactivité (TDAH) repose sur l’intégration de marqueurs hétérogènes : cinématique oculaire lors de scènes sociales, variabilité cardiaque, potentiels évoqués visuels et données volumétriques par résonance magnétique structurelle. Dans la plupart des études de validation neurocognitive, les cohortes cliniques homogènes de patients pédiatriques souffrant de TSA sévère sont structurellement minoritaires face aux groupes témoins neurotypiques.
L’exactitude équilibrée joue ici un rôle de garant épistémologique face aux biais de confirmation et aux distorsions de sélection. En neuro-imagerie fonctionnelle, la tentation est grande de publier des taux d’exactitude spectaculaires qui s’expliquent en réalité par un sur-apprentissage (overfitting) de signatures cérébrales spécifiques au groupe témoin surreprésenté. L’usage de la Balanced Accuracy force les investigateurs à rapporter une mesure qui s’effondre immédiatement si l’algorithme peine à identifier les patterns subtils caractérisant les connectopathies propres aux enfants autistes.
De surcroît, dans les travaux portant sur le TDAH adulte — condition clinique fréquemment sous-évaluée et parasitée par des comorbidités anxio-dépressives —, l’exactitude équilibrée permet de comparer en toute rigueur l’efficacité de nouvelles échelles psychométriques courtes face aux batteries neuropsychologiques d’évaluation des fonctions exécutives. Elle permet d’attester que le pouvoir de discrimination du nouvel outil s’exerce de façon symétrique, sans favoriser la détection des profils typiques au détriment des profils symptomatiques réels mais quantitativement minoritaires.
9.3 9.3 Évaluation des déficits cognitifs débutants (MCI) chez le sujet âgé
Dans le domaine de la neuropsychologie du vieillissement, la détection précoce du déficit cognitif léger (Mild Cognitive Impairment – MCI) constitue la clé de voûte des interventions de remédiation précoce visant à retarder l’entrée dans la démence d’Alzheimer. Au sein d’études longitudinales communautaires suivant des cohortes de seniors autonomes vivant à domicile, la fraction de participants présentant une transition d’un vieillissement physiologique normal vers un état de MCI à un horizon de deux ans oscille généralement entre $5,%$ et $12,%$.
Classifier ces trajectoires cognitives complexes requiert des modèles capables d’isoler des altérations infimes de la mémoire épisodique ou des capacités de flexibilité mentale. L’exactitude équilibrée s’érige en instrument de référence pour calibrer les algorithmes d’analyse automatisée de la voix, de la fluidité verbale sémantique ou des mouvements graphomoteurs sur tablettes tactiles. Grâce à elle, la performance publiée reflète fidèlement la capacité du système à distinguer un déclin débutant réel face à la variance comportementale naturelle propre à l’âge.
Cette rigueur d’évaluation conditionne directement le calibrage des programmes d’entraînement cognitif et de neuroprotection nutritionnelle. En assurant un équilibre objectif entre détection clinique et respect de l’intégrité cognitive normale, l’exactitude équilibrée évite le double écueil de l’angoisse iatrogène infligée aux personnes âgées saines par fausse alerte et de l’abandon thérapeutique des individus s’engageant silencieusement dans un déclin neurocognitif irréversible.
10. 10. Implémentation pratique et reproductibilité méthodologique
10.1 10.1 Implémentation programmatique sous Python
Dans l’écosystème scientifique Python, l’exactitude équilibrée bénéficie d’une implémentation native et hautement optimisée au sein du module metrics de la célèbre bibliothèque scikit-learn. La fonction de référence, désignée par balanced_accuracy_score, accepte en paramètres les étiquettes réelles (vecteur y_true) et les assignations discrètes prédites (vecteur y_pred). Elle prend en charge de façon transparente aussi bien les classifications binaires que les matrices multiclasses complexes.
Une caractéristique avancée de cette fonction réside dans son paramètre optionnel adjusted (défini sur False par défaut). Lorsque ce paramètre est basculé sur True, scikit-learn applique une transformation affine qui normalise le score final de manière à ce qu’une performance aléatoire corresponde exactement à 0,0 et qu’une prédiction parfaite atteigne 1,0, les scores négatifs signalant des prédictions pires que le hasard selon la formule :
$$\text{BA}_{\text{ajustée}} = \frac{\text{BA} – \frac{1}{K}}{1 – \frac{1}{K}}$$
Pour garantir la stabilité empirique de l’estimation, il est impératif d’intégrer le calcul de l’exactitude équilibrée au sein d’une procédure de validation croisée stratifiée (utilisant par exemple la classe StratifiedKFold). Cette stratification assure que chaque pli (fold) de validation conserve rigoureusement la même proportion relative d’événements cliniques rares que le jeu de données initial, éliminant ainsi les variations parasites de variance statistique d’une itération d’apprentissage à l’autre.
10.2 10.2 Implémentation programmatique sous R
Pour les méthodologistes et psychométriciens opérant sous l’environnement statistique R, l’exactitude équilibrée s’évalue via plusieurs paquets de référence. Au sein de l’écosystème moderne tidymodels, le paquet yardstick propose la fonction standardisée bal_accuracy(), laquelle s’articule directement sur des data frames contenant les colonnes de vérité terrain et de verdict algorithmique, facilitant des pipelines d’analyse syntaxiquement fluides et élégants.
Dans l’écosystème classique d’apprentissage automatique articulé autour du paquet caret (Classification And REgression Training), la fonction fondamentale confusionMatrix() calcule et affiche systématiquement l’exactitude équilibrée sous la désignation textuelle « Balanced Accuracy » dans sa sortie standard, aux côtés des intervalles de confiance de l’exactitude globale et des tests de non-information. Cette fonction calcule automatiquement la métrique pour chaque modalité diagnostique en mode multiclasse, offrant un panorama d’évaluation immédiat.
Par ailleurs, la programmation d’une fonction personnalisée en langage R de base ne requiert que deux lignes de code à partir d’un objet de table de contingence classique croisant les prédictions et les étiquettes réelles. Les chercheurs peuvent ensuite aisément modéliser la trajectoire de l’exactitude équilibrée sur l’ensemble du spectre des seuils de discrimination possibles en exploitant les capacités graphiques de bibliothèques telles que ggplot2, visualisant avec une clarté absolue le seuil optimal pour leur cohorte d’étude.
10.3 10.3 Bonnes pratiques de reporting dans les revues académiques
La publication de modèles de classification au sein de revues biomédicales et psychologiques à comité de lecture est désormais encadrée par des exigences déontologiques et méthodologiques standardisées très strictes. Rapporter une exactitude équilibrée de façon isolée, sans fournir son contexte de contingence matricielle, est proscrit par les standards contemporains de la science ouverte et de la reproductibilité expérimentale.
En premier lieu, les auteurs sont tenus de se conformer aux directives internationales de reporting telles que le guide STARD (Standards for Reporting of Diagnostic Accuracy Studies) pour la psychométrie diagnostique ou les recommandations TRIPOD (Transparent Reporting of a multivariable prediction model for Individual Prognosis Or Diagnosis) pour l’apprentissage automatique clinique. Ces protocoles imposent de publier explicitement la matrice de confusion brute non normalisée, permettant à tout évaluateur indépendant de recalculer la sensibilité, la spécificité, les valeurs prédictives positives et négatives, ainsi que l’exactitude équilibrée.
En second lieu, il est méthodologiquement impératif d’assortir systématiquement l’estimation ponctuelle de la Balanced Accuracy de son intervalle de confiance statistique, calculé généralement au niveau de confiance de $95,%$. Dans la mesure où les approximations asymptotiques fondées sur la loi normale peuvent être invalidées par l’extrême asymétrie de la classe minoritaire, le recours à des techniques d’estimation non paramétrique par rééchantillonnage de type bootstrap (idéalement par stratification de 1 000 à 10 000 réplicats) est vivement préconisé. Les chercheurs doivent documenter le code source d’inférence et fixer les graines génératrices de nombres pseudo-aléatoires pour garantir une traçabilité intégrale des résultats publiés.
11. 11. Optimisation du seuil décisionnel et calibrage clinique
11.1 11.1 Ajustement dynamique du seuil de discrimination
La vaste majorité des algorithmes de classification ne génèrent pas directement une catégorie binaire discrète, mais émettent une valeur continue de probabilité prédictive conditionnelle comprise entre $0,0$ et $1,0$. Par convention computationnelle, le seuil de discrimination binaire par défaut est quasi universellement assigné à $\theta = 0,50$. Or, dans un environnement caractérisé par une asymétrie substantielle de la distribution des données, ce seuil arbitraire de 0,50 s’avère presque toujours sous-optimal, conduisant le classifieur à étouffer la détection de la classe minoritaire.
L’optimisation dynamique du seuil décisionnel consiste à faire glisser $\theta$ le long du spectre $[0, 1]$ afin de maximiser un critère objectif prédéfini sur un ensemble de données dédié au réglage des hyperparamètres (l’ensemble de validation). L’indice $J$ de Youden (Youden’s J statistic), formulé historiquement pour la validation des tests diagnostiques, se définit par :
$$J = \text{Sensibilité} + \text{Spécificité} – 1$$
Il existe une relation bijective et linéaire parfaite entre l’indice de Youden et l’exactitude équilibrée :
$$\text{Balanced Accuracy} = \frac{J + 1}{2} iff J = 2 \times \text{Balanced Accuracy} – 1$$
Ainsi, rechercher le seuil décisionnel qui maximise l’indice de Youden le long de la courbe ROC équivaut très exactement à identifier le point opérationnel qui maximise l’exactitude équilibrée. Cette optimisation dynamique permet d’aligner le seuil de basculement non pas sur une convention mathématique arbitraire, mais sur le point de tangence optimal qui réconcilie au plus haut niveau possible la détection du signal et la contention du bruit.
11.2 11.2 Analyse coût-bénéfice des erreurs de prédiction
L’invariance mathématique de l’exactitude équilibrée repose sur l’attribution implicite d’un poids rigoureusement identique aux erreurs par omission (les faux négatifs) et aux erreurs par fausse alarme (les faux positifs). Si cette neutralité constitue un rempart salutaire contre le paradoxe de l’exactitude en phase de modélisation théorique, elle peut s’avérer cliniquement discutable lorsqu’elle est transposée sans nuance dans le champ des décisions médicales réelles.
Dans un contexte d’urgence psychiatrique, le coût humain d’un faux négatif (ne pas hospitaliser un patient présentant une intentionnalité suicidaire imminente, conduisant à un passage à l’acte fatal) surpasse incommensurablement le désagrément généré par un faux positif (retenir sous surveillance pendant 24 heures un individu qui n’avait pas l’intention réelle d’attenter à ses jours). Dans cette situation, une analyse coût-bénéfice formalisée impose de pondérer l’importance relative des erreurs. Les statisticiens peuvent alors recourir à une variante spécialisée : l’exactitude équilibrée pondérée (Weighted Balanced Accuracy) :
$$\text{WBA} = w \cdot \text{Sensibilité} + (1 – w) \cdot \text{Spécificité} \quad \text{a\vec} \quad w in ]0, 1[$$
En modulant le poids $w$ en accord avec les décideurs de santé publique et les représentants des usagers, on recalibre les frontières décisionnelles afin que le modèle statistique reflète fidèlement la hiérarchie des risques cliniques. L’exactitude équilibrée standard ($w = 0,5$) sert alors de socle de référence comparatif attestant de la capacité intrinsèque du modèle avant l’application de toute politique spécifique de gestion du risque.
11.3 11.3 Courbes d’étalonnage et validation de probabilité
Une confusion méthodologique fréquente consiste à postuler qu’un algorithme affichant une excellente exactitude équilibrée fournit nécessairement des estimations probabilistes hautement fiables au niveau individuel. Il s’agit d’une erreur épistémologique fondamentale : la discrimination binaire et le calibrage probabiliste sont deux propriétés statistiques orthogonales. Un modèle peut discriminer impeccablement les classes en ordonnant les scores de probabilité, tout en produisant des valeurs numériques profondément décalées par rapport aux probabilités de survenue réelles.
L’étalonnage des probabilités (probability calibration) doit impérativement être évalué à l’aide de courbes d’étalonnage (ou diagrammes de fiabilité) et quantifié par des métriques d’adéquation probabiliste telles que le score de Brier (Brier Score). Si un réseau de neurones ou une régression logistique souffre d’un sous-étalonnage ou d’un sur-étalonnage consécutif au déséquilibre des classes, il convient d’appliquer des techniques d’ajustement post-hoc avant de trancher sur un seuil discret. Les deux méthodes canoniques de calibrage sont la mise à l’échelle de Platt (Platt Scaling), qui ajuste une transformation logistique sigmoïde univariée sur les sorties du modèle, et la régression isotonique (Isotonic Regression), qui applique une transformation non paramétrique monotone croissante.
Une fois les probabilités convenablement étalonnées, l’application d’un seuil fondé sur la maximisation de l’exactitude équilibrée acquiert une légitimité mathématique totale. Le praticien s’assure ainsi que le modèle ne se contente pas de bien répartir les sujets au sens catégoriel, mais qu’il délivre également une estimation d’incertitude locale sur laquelle le clinicien peut s’appuyer pour affiner son jugement diagnostique en colloque singulier.
12. 12. Limites méthodologiques, controverses et recommandations
12.1 12.1 Situations où l’exactitude équilibrée peut s’avérer trompeuse
Bien qu’infiniment supérieure à l’exactitude naïve pour l’analyse des distributions asymétriques, l’exactitude équilibrée n’est pas exempte d’angles morts méthodologiques et de limites structurelles qu’il convient d’identifier avec lucidité pour prévenir tout mésusage scientifique.
La première vulnérabilité de la métrique se manifeste dans les scénarios où la taille absolue de la classe minoritaire est microscopique en comparaison de l’effectif global. Supposons une cohorte de 10 000 individus renfermant seulement 4 cas cliniques positifs réels ($P = 4$, $N = 9 996$). Si un algorithme identifie correctement 3 de ces cas mais en omet un seul ($VP = 3$, $FN = 1$), sa sensibilité s’établit à 75 %. Toutefois, la perte ou l’ajout accidentel d’une seule observation positive au gré des fluctuations d’échantillonnage fera basculer la sensibilité entre 50 % ($2/4$), 75 % ($3/4$) ou 100 % ($4/4$), entraînant des sauts massifs de plus de 12 points de pourcentage sur l’exactitude équilibrée finale. La métrique devient alors hypersensible et statistiquement volatile.
La seconde limite majeure tient à l’indifférence totale de l’exactitude équilibrée envers la valeur prédictive positive ($VPP$), c’est-à-dire la proportion d’individus véritablement malades parmi ceux étiquetés positifs par le test. Dans un contexte de dépistage de masse en population générale où la prévalence est de 1 pour 1 000, un modèle doté d’une sensibilité remarquable de 90 % et d’une excellente spécificité de 90 % obtiendra une très flatteuse exactitude équilibrée de 90 %. Pourtant, sur 1 000 individus testés (1 malade réel et 999 sujets sains), le modèle identifiera correctement l’unique malade ($VP \approx 1$), mais générera simultanément environ 100 fausses alertes ($FP \approx 100 \times 0,10$). Pour le praticien sur le terrain, cela signifie que 99 % des alertes déclenchées par l’algorithme sont de faux positifs ! L’exactitude équilibrée masque cette réalité pratique quotidienne, ce qui impose de ne jamais l’utiliser de manière exclusive sans l’éclairage indispensable de la VPP.
12.2 12.2 Comparaison critique avec les métriques basées sur l’entropie
Un débat conceptuel récurrent en méthodologie computationnelle oppose les métriques fondées sur un découpage à seuil fixe (comme l’exactitude équilibrée, le F1-Score ou le coefficient de Matthews) aux métriques d’évaluation continues fondées sur la théorie de l’information et l’entropie, au premier rang desquelles figure la perte logistique (Log-Loss ou entropie croisée binaire).
Les tenants de l’approche entropique soutiennent que contraindre la validation d’un modèle statistique au format binaire rigide d’une matrice de confusion à un seuil unique $\theta$ constitue une destruction d’information quantitative. Si un modèle attribue à un individu positif une probabilité prédite de 0,51 et qu’un second modèle lui assigne une probabilité de 0,99, l’exactitude équilibrée les créditera tous deux d’un vrai positif strictly identique ($VP = 1$), ignorant royalement le fait que le second classifieur manifeste une certitude diagnostique infiniment plus solide et reproductible que le premier. L’entropie croisée capture ces nuances de graduation probabiliste de manière continue et sans perte.
Néanmoins, cette critique théorique se heurte à la réalité pragmatique de l’action médicale et clinique : un psychiatre ne peut pas prescrire une fraction continue de traitement pharmacologique, pas plus qu’un comité de probation pénale ne peut libérer partiellement un détenu. L’acte de décision psychologique est ontologiquement discret et dichotomique. Par conséquent, la recommandation méthodologique moderne consiste à combiner ces approches : optimiser les modèles durant la phase d’apprentissage continu à l’aide de fonctions de perte régulières basées sur l’entropie croisée, puis valider et rapporter les performances diagnostiques finales de seuillage à l’aune de l’exactitude équilibrée.
12.3 12.3 Synthèse des recommandations pour les chercheurs et psychologues
Au confluent des considérations mathématiques, psychométriques et éthiques développées tout au long de cet article, il est possible d’énoncer un ensemble de recommandations pragmatiques destinées à guider la pratique des chercheurs en sciences du comportement et des analystes de données :
- Règle empirique de basculement métrique : Dès lors que le ratio entre les classes de votre échantillon excède 4:1 (ou que la classe minoritaire représente moins de 20 % des effectifs totaux), l’exactitude brute doit être formellement bannie comme critère primaire de sélection ou de validation algorithmique. L’exactitude équilibrée doit être instituée par défaut comme la métrique pivot d’évaluation de la justesse de classification.
- Impératif de triangulation multivariée : Aucune métrique unique ne pouvant encapsuler à elle seule la complexité d’une matrice de décision, toute publication scientifique rigoureuse doit trianguler son appréciation en rapportant conjointement un quadruplet métrique harmonisé : la Balanced Accuracy (pour l’efficacité discriminante globale symétrique), le F1-Score ou la VPP (pour la confiance accordée aux alertes positives réelles), le MCC (pour la stabilité de la corrélation globale) et l’AUC-ROC (pour le potentiel discriminant hors seuil).
- Transparence systématique des marges : Ne jamais omettre de consigner au sein du texte principal ou des annexes méthodologiques la matrice de confusion numérique intégrale (les valeurs brutes de $VP$, $FN$, $VN$, $FP$), accompagnée des effectifs marginaux de terrain et des intervalles de confiance obtenus par bootstrap stratifié pour chaque métrique rapportée.
- Intégration du dialogue clinique dans le choix du seuil : Ne pas abandonner le choix du seuil de décision statistique aux seuls automatismes logiciels par défaut. Documenter l’impact de la variation du seuil le long de la courbe ROC et justifier le compromis retenu en fonction du coût clinique et éthique réel des faux négatifs par rapport aux faux positifs pour les populations évaluées.
En adoptant ces standards méthodologiques d’une absolue rigueur, la communauté des psychologues, neuroscientifiques et scientifiques des données contribuera à assainir la littérature computationnelle, garantissant que les promesses d’innovation diagnostique portées par l’intelligence artificielle reposent sur des fondations statistiques transparentes, reproductibles et éthiquement irréprochables.
Références
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association.
- Brodersen, K. H., Ong, C. S., Stephan, K. E., & Buhmann, J. M. (2010). The balanced accuracy and its posterior distribution. In Proceedings of the 20th International Conference on Pattern Recognition (ICPR) (pp. 3121-3124). IEEE. https://doi.org/10.1109/ICPR.2010.764
- Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21(1), Article 6. https://doi.org/10.1186/s12864-019-6413-7
- Collins, G. S., Reitsma, J. B., Altman, D. G., & Moons, K. G. (2015). Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis (TRIPOD): The TRIPOD statement. Annals of Internal Medicine, 162(1), 55-63. https://doi.org/10.7326/M14-0697
- Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861-874. https://doi.org/10.1016/j.patrec.2005.10.010
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- He, H., & Garcia, E. A. (2009). Learning from imbalanced data. IEEE Transactions on Knowledge and Data Engineering, 21(9), 1263-1284. https://doi.org/10.1109/TKDE.2008.239
- Kuhn, M., & Johnson, K. (2013). Applied predictive modeling. Springer. https://doi.org/10.1007/978-1-4614-6849-3
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830.
- Powers, D. M. W. (2011). Evaluation: From precision, recall and F-measure to ROC, informedness, markedness and correlation. Journal of Machine Learning Technologies, 2(1), 37-63.
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32-35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″>https://doi.org/10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3