
L’évaluation de la performance prédictive au sein des architectures d’apprentissage automatique supervisé constitue l’une des étapes les plus déterminantes et méthodologiquement délicates de la modélisation statistique moderne. Alors que les algorithmes contemporains rivalisent d’ingéniosité algorithmique et d’efficacité computationnelle, le choix des métriques d’évaluation gouverne de manière sous-jacente l’ensemble des arbitrages d’optimisation numérique, la sélection des hyperparamètres et, in fine, la validité décisionnelle des systèmes déployés. Dans ce contexte, l’exactitude globale, longtemps employée comme critère universel en raison de son apparente intuitivité, s’avère profondément défaillante dès lors que les distributions d’échantillonnage s’éloignent de l’équilibre parfait entre les modalités de réponse.
Le score F1, également désigné sous le terme de mesure de van Rijsbergen ou moyenne harmonique pondérée de la précision et du rappel, s’impose dès lors comme un étalon méthodologique incontournable. Conçu initialement pour résoudre les problématiques d’extraction documentaire et de recherche d’information, cet indicateur composite synthétise en un indice scalaire unique deux grandeurs fondamentales mais antagonistes : la validité des occurrences positives identifiées d’une part, et l’exhaustivité de la détection de la classe d’intérêt d’autre part. Sa formulation intrinsèque impose une pénalisation sévère aux modèles déséquilibrés, offrant une boussole empirique indispensable face aux phénomènes d’asymétrie de classe, aux détections d’événements rares et aux classifications critiques.
L’environnement statistique de programmation R, reconnu pour son extensibilité analytique et la rigueur de ses bibliothèques d’analyse prédictive, propose un éventail d’approches pour quantifier cette grandeur. Qu’il s’agisse de déployer des métriques intégrées issues de progiciels spécialisés, de mobiliser des écosystèmes d’apprentissage automatique de pointe ou de concevoir des fonctions vectorisées sur mesure à des fins de transparence computationnelle, la maîtrise de ces techniques revêt une importance capitale pour tout chercheur ou praticien de la donnée. Ce guide exhaustif explore de manière approfondie les fondements théoriques, les justifications mathématiques, les implémentations pratiques pas à pas et les subtilités méthodologiques du calcul du score F1 au sein du logiciel R.
1. Introduction théorique et fondements du score F1 en apprentissage automatique
1.1 Définition formelle et pertinence statistique
L’origine de la métrique F1 s’enracine historiquement dans les travaux séminaux menés au cours des années 1970 par Cornelis Joost van Rijsbergen dans le cadre des systèmes d’extraction de l’information documentaire. Face à l’incapacité des mesures traditionnelles à capturer la subtilité des requêtes textuelles au sein de corpus volumineux où la majorité des documents sont non pertinents, van Rijsbergen théorisa une fonction de compromis paramétrique, dénommée mesure F, destinée à calibrer le niveau de satisfaction des utilisateurs. En apprentissage automatique contemporain, la métrique s’est affranchie de son contexte textuel originel pour devenir le standard d’évaluation des séparateurs binaires et multiclasses.
Sur le plan de la théorie statistique, le score F1 formalise la recherche d’un équilibre optimal entre la précision statistique, assimilable à la valeur prédictive positive, et la sensibilité empirique, identifiée au taux de vrais positifs. Contrairement à une simple moyenne linéaire qui masquerait la défaillance d’une dimension par la surperformance d’une autre, le score F1 est régi par une formulation axiomatique en tant que moyenne harmonique de ces deux grandeurs. Cette architecture algébrique implique que l’indice ne peut atteindre un niveau élevé que si et seulement si les deux composantes sous-jacentes affichent simultanément des performances satisfaisantes.
Cette formulation confère au score F1 une pertinence remarquable dans l’estimation de la robustesse des modèles probabilistes. En imposant une contrainte multiplicative entre l’exactitude de la prédiction positive et l’exhaustivité du repérage, il constitue une fonction de coût indirecte particulièrement exigeante. Il élimine ainsi les biais d’optimisation triviaux qui consisteraient, pour un modèle prédictif donné, à prédire systématiquement la classe dominante pour maximiser artificiellement son taux de succès global au détriment de toute utilité clinique ou opérationnelle.
1.2 L’importance du score F1 dans l’évaluation des modèles de classification
L’exactitude globale, définie comme le ratio des prédictions conformes sur le volume total des observations, souffre d’une myopie statistique structurelle face aux distributions empiriques dissymétriques. Dans une cohorte où la classe positive ne représente que cinq pour cent des observations totales, un classificateur naïf assignant invariablement la modalité négative à l’intégralité des individus affichera une exactitude apparente de quatre-vingt-quinze pour cent. Une telle performance, bien que séduisante d’un point de vue purement arithmétique, s’avère pourtant totalement dépourvue de pouvoir discriminant ou de pertinence analytique.
Le score F1 surmonte ce paradoxe en écartant totalement de son numérateur la masse des vrais négatifs, neutralisant ainsi le pouvoir d’écrasement des observations majoritaires sans intérêt diagnostique. Par sa dynamique intrinsèque, le score F1 pénalise de manière draconienne les déséquilibres extrêmes entre sensibilité et spécificité. Un classificateur qui sacrifierait la prudence diagnostique au profit d’une sensibilité exacerbée en générant une pléthore de faux positifs verra sa précision s’effondrer, entraînant mécaniquement l’affaissement du score F1 global vers des niveaux marginaux.
Cette propriété positionne le score F1 au rang d’outil décisionnel prioritaire dans les contextes où les faux négatifs engendrent des préjudices systémiques, sanitaires ou financiers insoutenables. Que l’on considère la détection de fraudes transactionnelles bancaires, le diagnostic précoce de pathologies létales ou l’identification de ruptures mécaniques critiques dans l’industrie aérospatiale, l’évaluation par le score F1 garantit que le modèle d’inférence statistique maintienne une vigilance maximale envers les événements rares sans pour autant noyer les opérateurs sous une masse ingérable de fausses alarmes.
1.3 Comparaison avec l’exactitude globale face aux données déséquilibrées
Le phénomène désigné sous le terme de paradoxe de l’exactitude souligne la divergence conceptuelle fondamentale entre la minimisation de l’erreur brute et la maximisation de l’utilité clinique d’un algorithme. Dans les jeux de données hautement asymétriques, l’espace d’hypothèses exploré par les algorithmes de minimisation empirique du risque tend naturellement à converger vers la prédiction exclusive de la classe prépondérante, car cette stratégie offre le chemin de moindre résistance mathématique lors de la descente de gradient ou du partitionnement récursif de l’espace des attributs.
La supériorité théorique du score F1 en présence de classes rares réside dans sa résilience face aux fluctuations volumétriques de la population témoin. Alors que l’exactitude varie de manière disproportionnée en fonction du ratio de prévalence de la classe cible sans que le modèle sous-jacent n’ait modifié ses frontières de décision, le score F1 conserve un ancrage strict sur l’intersection critique entre les prédictions actives et les événements effectivement survenus. Les analyses mathématiques de sensibilité démontrent que le gradient du score F1 par rapport aux faux positifs et aux faux négatifs demeure élevé, garantissant un guidage précis lors du réglage des hyperparamètres d’apprentissage.
De surcroît, l’analyse comparative de la sensibilité aux variations de prévalence révèle que le score F1 réagit avec une grande sensibilité aux modifications de l’environnement épidémiologique ou opérationnel. Lorsque la fréquence d’apparition du phénomène étudié décline, le maintien d’une valeur prédictive positive satisfaisante devient exponentiellement difficile en raison de la multiplication relative des risques d’erreurs de type I. Le score F1 capture cette dégradation structurelle avec une acuité immédiate, alertant l’expérimentateur sur l’obsolescence ou la fragilisation de son architecture prédictive là où l’exactitude globale afficherait une stabilité trompeuse.
2. Les composantes mathématiques du score F1 : Précision et Rappel
2.1 La matrice de confusion et ses quadrants fondamentaux
L’évaluation rigoureuse de tout séparateur binaire repose sur la formalisation de la matrice de confusion, structure de contingence croisant les assignations prédictives générées par l’algorithme avec les états de nature constatés au sein de la vérité terrain. Cette cartographie tabulaire bidimensionnelle segmente l’espace d’échantillonnage en quatre quadrants fondamentaux mutuellement exclusifs, dont la quantification exhaustive permet de dériver l’ensemble des grandeurs métriques de la théorie de la détection du signal.
Le quadrant supérieur gauche recense les vrais positifs, désignant les cas où le modèle a projeté avec succès la présence de l’événement cible, en parfaite concordance avec la réalité empirique observée. À l’opposé, le quadrant des faux positifs, correspondant aux erreurs de type I, quantifie les situations où le modèle a formulé une alarme injustifiée, attribuant la modalité positive à un individu appartenant en réalité à la classe de référence négative. Cette cellule mesure directement la tendance du classificateur à commettre des intrusions erronées dans la classe cible.
Le quadrant des faux négatifs, constitutif des erreurs de type II, regroupe les occurrences critiques où l’algorithme a erronément conclu à l’absence de l’événement cible alors que celui-ci était effectivement présent dans la vérité terrain. Enfin, le quadrant des vrais négatifs consolide les détections d’absence validées par les faits, reflétant la capacité du système à écarter adéquatement les observations saines ou ordinaires. La lecture systématique de ces quatre quadrants constitue le prérequis analytique absolu avant tout calcul synthétique de performance.
2.2 La Précision : calcul, interprétation et coût des faux positifs
La précision, fréquemment assimilée dans la littérature statistique à la valeur prédictive positive, mesure la fiabilité intrinsèque des assignations affirmatives formulées par le système d’inférence. Elle s’établit mathématiquement comme le quotient du volume de vrais positifs par la somme consolidée de l’ensemble des prédictions orientées vers la classe cible, c’est-à-dire l’addition des vrais positifs et des faux positifs. Formellement, elle traduit la probabilité conditionnelle que le phénomène étudié existe réellement sachant que l’algorithme en a affirmé la survenue.
D’un point de vue interprétatif, la précision évalue le degré de confiance ou d’autorité qu’un utilisateur ou un praticien peut accorder à un diagnostic positif émis par la machine. Une précision élevée certifie que les alertes déclenchées par l’outil sont hautement crédibles, réduisant à une proportion marginale les investigations complémentaires inutiles ou les interventions erronées. Dans les contextes de modélisation financière ou de filtrage automatisé de transactions frauduleuses, une forte précision garantit que les blocages de comptes ou les réquisitions d’enquête ne frappent pas indûment des usagers légitimes.
Le coût associé aux dégradations de la précision s’exprime directement à travers le fardeau opérationnel et psychologique engendré par la multiplication des fausses alarmes. Dans un protocole de diagnostic oncologique automatisé, un affaissement de la précision entraîne la prescription d’actes invasifs, de biopsies anxiogènes et de bilans paracliniques onéreux pour des patients indemnes de toute néoplasie. Ainsi, la précision opère comme un garde-fou méthodologique régulant la propension d’un modèle à multiplier les déclarations intempestives de positivité.
2.3 Le Rappel : calcul, sensibilité et impact des faux négatifs
Le rappel, strictement équivalent à la notion biomédicale de sensibilité ou au taux de vrais positifs, quantifie la capacité d’exhaustivité du système discriminant face à l’ensemble des manifestations réelles du phénomène cible. Sur le plan arithmétique, le rappel est défini comme le rapport entre le nombre de vrais positifs et l’agrégat des cas positifs avérés au sein de la population, lequel correspond à la somme des vrais positifs et des faux négatifs. Il formalise la probabilité conditionnelle qu’un cas cible soit détecté par l’algorithme sachant son appartenance effective à la classe d’intérêt.
L’interprétation clinique ou empirique du rappel renvoie à la complétude du filet de détection tendu par le modèle. Un score de rappel unitaire caractérise un dispositif capable d’identifier l’intégralité des occurrences du trouble ou de l’anomalie sans laisser échapper le moindre individu affecté. Dans l’évaluation des systèmes de sécurité routière automatisée, de diagnostic épidémique en phase de contagion exponentielle ou de détection d’intrusions malveillantes au sein d’infrastructures informatiques sensibles, la maximisation du rappel constitue une obligation impérative.
Les conséquences méthodologiques et sociétales d’une carence en matière de rappel sont souvent irréversibles, dans la mesure où les faux négatifs correspondent à des dangers réels non anticipés. L’omission d’une lésion maligne lors d’un dépistage mammographique prive le patient d’une prise en charge thérapeutique précoce, compromettant significativement son pronostic vital. C’est précisément pour conjurer la tentation d’une tolérance excessive aux faux négatifs que la théorie statistique exige l’intégration conjointe du rappel au sein d’une métrique composite unifiée.
2.4 La moyenne harmonique : justification mathématique
L’agrégation de la précision et du rappel au sein d’un indicateur global pourrait théoriquement s’effectuer par le truchement de diverses fonctions de centralité, au premier rang desquelles figure la moyenne arithmétique standard. Cependant, l’adoption d’une moyenne arithmétique simple introduirait une faille logique majeure : elle permettrait à un modèle aberrant présentant un rappel parfait de un et une précision catastrophique de zéro virgule un d’afficher un score combiné flatteur de zéro virgule cinquante-cinq, dissimulant totalement son inaptitude opérationnelle.
La moyenne harmonique se distingue par ses propriétés géométriques spécifiques face aux valeurs asymétriques et extrêmes. Définie comme l’inverse de la moyenne arithmétique des inverses des grandeurs considérées, elle accorde un poids prépondérant aux valeurs les plus modestes de l’ensemble de données. Dans le calcul du score F1, la relation mathématique s’exprime sous la forme canonique suivante : deux multiplié par le produit de la précision et du rappel, le tout divisé par la somme de la précision et du rappel. Cette formulation implique que dès lors que l’une des deux grandeurs tend vers zéro, l’intégralité du score F1 converge immédiatement vers zéro.
Cette sensibilité asymétrique envers la composante défaillante confère au score F1 une sévérité structurelle indispensable à l’évaluation impartiale des modèles. Aucun artifice de paramétrage ne permet de compenser un effondrement du rappel par une hypertrophie de la précision, ou réciproquement. La moyenne harmonique agit comme une force de rappel contraignant l’optimiseur algorithmique à rechercher la zone d’équilibre où les deux indicateurs progressent de concert, garantissant ainsi une performance prédictive harmonieuse et véritablement exploitable sur le terrain.
3. Présentation du cas pratique : Modélisation logistique et données d’exemple
3.1 Contexte de l’exemple : Prédiction de repêchage de 400 sportifs
Afin d’illustrer la mécanique computationnelle du score F1 à travers une démonstration concrète et reproductible sous l’environnement R, nous étudions une problématique d’analyse de performance issue de la biométrie sportive et de la gestion des talents universitaires. L’objectif analytique consiste à modéliser et prédire la sélection effective (dénommée repêchage ou draft professionnelle) d’une cohorte de quatre cents étudiants athlètes au terme de leur cursus compétitif au sein du championnat universitaire américain.
Le cadre statistique repose sur une régression logistique binaire visant à estimer la probabilité d’admission dans une ligue professionnelle majeure à partir de plusieurs attributs physiques, biomécaniques et tactiques standardisés, incluant la vitesse sur quarante yards, la puissance anaérobie développée lors d’un test d’effort, l’indice d’agilité en navette et le ratio d’efficacité collective en compétition. La variable de réponse binaire adopte la modalité Sélectionné pour désigner les athlètes ayant conclu un contrat professionnel, et Non Sélectionné pour les compétiteurs réorientés hors du sport professionnel.
L’échantillon d’entraînement et d’évaluation rassemble exactement quatre cents observations complètes, exemptes d’attrition de mesure. Au sein de cette cohorte sportive, la prévalence empirique de la sélection s’élève à quarante pour cent, soit exactement cent soixante athlètes ayant franchi le seuil d’intégration professionnelle, tandis que deux cent quarante sportifs n’ont pas été retenus. Cette distribution présente une asymétrie modérée mais tangible, représentative des équilibres observés lors des phases de recrutement sportif de haut niveau.
3.2 Structure chiffrée de la matrice de confusion
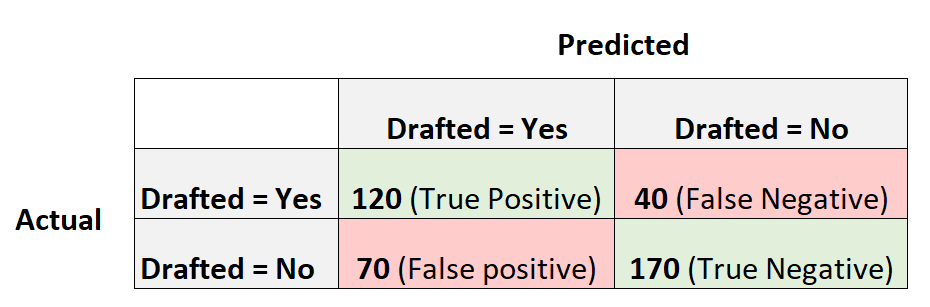
À l’issue de la phase d’apprentissage du modèle de régression logistique et de l’application d’un seuil probabiliste standard de coupure fixé à zéro virgule cinquante, les prédictions individuelles ont été confrontées à la réalité empirique du repêchage. Le décompte rigoureux des occurrences observées permet de dresser la structure chiffrée intégrale de la matrice de confusion, servant de matrice mère à l’ensemble des développements subséquents de ce tutoriel.
Le premier quadrant indique que le modèle a correctement anticipé le succès de cent vingt athlètes qui ont effectivement été sélectionnés par une franchise professionnelle, constituant le contingent des vrais positifs. Parallèlement, le système a formulé soixante-dix prédictions positives erronées, désignant soixante-dix étudiants comme futurs professionnels alors que ces derniers n’ont pas trouvé preneur le jour du scrutin de repêchage, ces observations formant l’ensemble des faux positifs de type I.
Sur le flanc des omissions diagnostiques, quarante athlètes ont été injustement classés par l’algorithme dans la catégorie des rejetés alors qu’ils ont bel et bien été repêchés dans la vérité terrain, configurant le volume de quarante faux négatifs. Enfin, le modèle a discerné avec succès l’échec de sélection pour cent soixante-dix compétiteurs, établissant le total des vrais négatifs. La somme exhaustive de ces quatre grandeurs fondamentales (cent vingt plus soixante-dix plus quarante plus cent soixante-dix) restitue avec une exactitude arithmétique parfaite la taille de la cohorte d’origine de quatre cents sportifs.
3.3 Calculs manuels et théoriques détaillés
Avant d’engager le traitement automatisé au sein de l’interpréteur de commandes R, l’exécution manuelle et analytique des équations fondamentales s’avère indispensable pour ancrer la compréhension arithmétique du lecteur et fournir les jalons de validation empirique des scripts de programmation. La première étape consiste à déterminer la précision en rapportant les cent vingt sélections réelles et prédites à la somme des cent vingt vrais positifs et des soixante-dix faux positifs, aboutissant au ratio cent vingt divisé par cent quatre-vingt-dix, soit précisément zéro virgule soixante-trois mille cent cinquante-sept (0,63157).
La seconde phase opératoire mobilise le calcul du rappel, consistant à mesurer la couverture des détections du modèle parmi l’ensemble des sportifs effectivement admis dans les ligues professionnelles. Le calcul isole le contingent des cent vingt vrais positifs au numérateur, divisé par la somme de ces mêmes cent vingt sportifs augmentée des quarante faux négatifs omis par la modélisation. Ce quotient de cent vingt divisé par cent soixante génère un taux de rappel net et exact de zéro virgule soixante-quinze mille (0,75000), démontrant que les trois quarts des recrues potentielles ont été repérées.
L’étape conclusive applique la formule de la moyenne harmonique afin de dériver le score F1 théorique unifié. L’expression s’établit comme le produit de deux par la précision (0,63157) et par le rappel (0,75), le tout divisé par la somme de ces deux grandeurs (0,63157 plus 0,75). Le numérateur atteint zéro virgule quatre-vingt-quatorze mille sept cent trente-cinq (0,94735), tandis que le dénominateur s’établit à un virgule trente-huit mille cent cinquante-sept (1,38157). La division de ces deux termes donne un score F1 final théorique de zéro virgule soixante-huit mille cinq cent soixante et onze (0,68571). C’est précisément cette valeur cible qui devra être attestée par les différentes procédures computationnelles exécutées sous R.
4. Configuration de l’environnement R pour l’évaluation prédictive
4.1 Installation et chargement des bibliothèques fondamentales
L’exécution fluide et rigoureuse des calculs de métriques de classification avancées requiert l’initialisation méthodique d’un environnement computationnel stable au sein de l’interpréteur R ou de l’environnement de développement intégré RStudio. Bien que les opérations matricielles basiques puissent être exécutées nativement sans dépendances logicielles, l’emploi de packages spécialisés garantit la standardisation des sorties, l’accès à des fonctions éprouvées et l’intégration directe dans des chaînes de traitement complexes d’apprentissage statistique.
Trois bibliothèques logicielles dominent le paysage de l’évaluation prédictive en R. Le package caret, acronyme de Classification And REgression Training, développé sous l’égide de Max Kuhn, représente la référence incontestée pour l’orchestration des flux de travail en modélisation supervisée. Pour déployer caret, l’installation conjointe du package e1071 s’avère indispensable, car de nombreuses fonctions d’évaluation statistique et de calcul de tables de contingence exploitent des routines internes compilées issues de cette bibliothèque historique. Enfin, la bibliothèque MLmetrics propose une approche fonctionnelle épurée, fournissant des fonctions autonomes immédiatement mobilisables pour chaque métrique d’apprentissage automatique.
L’installation s’opère conventionnellement à l’aide de l’instruction install.packages ciblant les chaînes de caractères représentant ces trois extensions logicielles. Une fois le téléchargement et la compilation des dépendances achevés depuis les serveurs officiels du Comprehensive R Archive Network (CRAN), les bibliothèques sont appelées dans la session active par le biais des déclarations library(caret), library(e1071) et library(MLmetrics). Il est recommandé de consigner les numéros de version dans les journaux d’analyse afin de prémunir les scripts contre d’éventuelles régressions d’interface de programmation.
4.2 Structuration formelle des données sous forme de facteurs
L’une des causes les plus récurrentes d’erreurs d’exécution ou de distorsions silencieuses de calcul lors de l’analyse des matrices de confusion sous R réside dans l’inadéquation du typage des vecteurs de données. En R, les étiquettes catégorielles issues de prédictions ou de recueils empiriques doivent impérativement être instanciées sous forme de facteurs stricts (variables de type factor), dotés de niveaux catégoriels (levels) explicitement définis, ordonnés et strictement concordants.
L’exigence de concordance implique que le vecteur des prédictions générées par le modèle et le vecteur des observations réelles partagent une nomenclature typographique rigoureusement identique. Si le vecteur des vérités de terrain utilise les étiquettes « Selectionne » et « Non_Selectionne », le vecteur prédictif ne saurait employer les chiffres 1 et 0 sans provoquer une interruption de script ou une corruption structurelle de l’évaluation. La conversion s’effectue au moyen de la fonction native factor, en veillant à préciser l’argument levels afin d’ancrer de manière déterministe la taxonomie des classes.
De surcroît, la convention d’ordonnancement des niveaux au sein du facteur gouverne le comportement par défaut de nombreuses fonctions R. Historiquement, R assigne le premier niveau d’un facteur comme la catégorie de base ou de référence par ordre alphabétique. Ainsi, une déclaration naïve pourrait désigner la modalité « Non_Selectionne » comme la classe d’intérêt si l’ordre alphabétique est appliqué sans discernement, inversant de facto les axes de la matrice de confusion. La vigilance du programmeur quant à la déclaration ordonnée des niveaux constitue la garantie fondamentale d’une évaluation exempte d’artéfact.
4.3 Reproductibilité computationnelle et configuration du jeu d’essai
Pour assurer la fidélité de la modélisation et permettre la reproductibilité intégrale des résultats mathématiques décrits lors de l’analyse du repêchage des quatre cents athlètes, il convient de synthétiser les vecteurs d’observations et de prédictions directement dans l’interpréteur R. La démarche implique l’initialisation du générateur de nombres pseudo-aléatoires via la commande set.seed(42), scellant ainsi l’aléa algorithmique pour toute procédure d’échantillonnage subséquente.
La création programmatique des vecteurs s’effectue en concaténant les modalités catégorielles conformément aux grandeurs définies au sein de la matrice de confusion. Le vecteur de vérité empirique est généré en répliquant cent soixante fois la modalité « Selectionne » et deux cent quarante fois la modalité « Non_Selectionne ». En miroir exact, le vecteur des prédictions algorithmiques est élaboré en répliquant cent vingt fois « Selectionne » pour les vrais positifs, soixante-dix fois « Selectionne » pour les faux positifs, quarante fois « Non_Selectionne » pour les faux négatifs, et cent soixante-dix fois « Non_Selectionne » pour les vrais négatifs.
Avant d’amorcer le calcul des métriques, une étape de vérification d’intégrité distributionnelle est systématiquement recommandée. L’application de la fonction table croisant le vecteur prédictif et le vecteur d’observation permet de vérifier instantanément dans la console R que les effectifs marginaux correspondent en tout point aux spécifications : 120, 70, 40 et 170. Cette rigueur procédurale assure que les opérations ultérieures portent sur une matière empirique irréprochable et parfaitement calibrée.
5. Méthode 1 : Calcul du score F1 avec le package caret
5.1 Mise en œuvre de la fonction confusionMatrix
Le progiciel caret met à la disposition des modélisateurs la fonction confusionMatrix, qui constitue l’une des routines les plus complètes et les plus exhaustives de l’analyse de classification binaire et multiclasses sous R. Son appel standardisé sollicite a minima deux arguments positionnels impératifs : le paramètre data, qui reçoit le vecteur des prédictions catégorielles formulées par l’algorithme, et le paramètre reference, qui accueille le vecteur de la vérité terrain établi par l’observation empirique.
Cependant, par défaut, la fonction confusionMatrix oriente sa sortie vers les métriques traditionnelles de la biostatistique épidémiologique, fournissant la sensibilité, la spécificité, les valeurs prédictives positives et négatives, ainsi que l’exactitude globale accompagnée de son intervalle de confiance binomial. Afin de forcer l’évaluation explicite sous l’angle de la théorie de la recherche d’information et d’accéder au score F1, il est absolument indispensable de renseigner l’argument mode en lui attribuant la valeur textuelle « prec_recall ».
Parallèlement, la sécurisation méthodologique du calcul impose de renseigner explicitement l’argument positive. En affectant la chaîne de caractères « Selectionne » à ce paramètre, le praticien annule toute ambiguïté liée à l’ordonnancement alphabétique implicite des niveaux du facteur, garantissant formellement que la classe des sportifs repêchés soit traitée comme l’événement cible d’intérêt lors de l’extraction des ratios de précision et de rappel.
5.2 Extraction programmatique du score F1 et des statistiques associées
L’exécution de la fonction confusionMatrix génère un objet complexe de classe S3 doté d’une structure interne arborescente particulièrement riche. Pour les besoins de l’automatisation dans des pipelines de calcul intensif, de criblage d’hyperparamètres ou de protocoles de validation croisée itérative, l’affichage passif du résultat en console ne suffit pas ; il s’avère indispensable d’extraire la grandeur scalaire du score F1 de manière entièrement programmatique.
L’architecture de l’objet produit stocke l’ensemble des indicateurs de performance de classe au sein d’une liste nommée byClass. L’accès au score F1 s’opère simplement par indexation nommée en sollicitant la composante intitulée « F1 » au moyen de l’opérateur d’extraction vectorielle à double crochet ou du symbole d’assignation indexée. Cette valeur flottante double précision devient immédiatement manipulable comme variable numérique indépendante pour des analyses statistiques secondaires ou des représentations visuelles automatisées.
Au-delà du score F1 isolé, l’objet structuré de caret livre simultanément une panoplie d’indices complémentaires éclairant le comportement du modèle. L’utilisateur peut ainsi extraire le coefficient Kappa de Cohen issu de la composante overall, qui quantifie le niveau d’accord inter-juges au-delà de la conformité purement imputable au hasard probabiliste, ainsi que le taux d’exactitude équilibrée (Balanced Accuracy), offrant une perspective multidimensionnelle sur la qualité de la discrimination opérée.
5.3 Analyse critique des résultats générés par caret
L’exécution du script d’évaluation caret sur notre cohorte synthétique de quatre cents sportifs restitue un résultat chiffré qui corrobore fidèlement nos développements mathématiques antérieurs. La consultation de la section byClass de la sortie standard affiche sans ambiguïté une valeur de précision de 0,63158 et un rappel de 0,75000, culminant dans une estimation du score F1 rigoureusement égale à 0,68571, attestant de la totale concordance entre la théorie analytique et l’implémentation logicielle.
L’inspection de la console standardisée de caret permet également de mesurer la valeur ajoutée de cette bibliothèque. En juxtaposant le score F1 aux métriques d’exactitude globale (laquelle s’établit à 0,725, soit deux cent quatre-vingt-dix prédictions correctes sur quatre cents) et au coefficient de prévalence de la classe positive (0,40), l’outil offre une contextualisation diagnostique immédiate. Il met en lumière que le score F1 (0,6857) modère l’optimisme trompeur de l’exactitude brute (0,7250) en raison de la ponction exercée par les soixante-dix faux positifs.
Il importe néanmoins de souligner une limitation opérationnelle de la commande confusionMatrix de caret : son coût computationnel. En raison de la génération exhaustive d’une trentaine d’indicateurs annexes, du calcul d’intervalles de confiance binomiaux exacts de Clopper-Pearson et de multiples tests de conformité statistique, l’appel répété de cette fonction au sein de boucles de rééchantillonnage comprenant des dizaines de milliers d’itérations peut ralentir significativement la vitesse de traitement globale.
6. Méthode 2 : Calcul direct avec le package MLmetrics
6.1 Syntaxe et exécution de la fonction F1_Score
Face aux exigences d’optimisation temporelle et de sobriété algorithmique caractérisant les architectures modernes de traitement massif de données, la bibliothèque MLmetrics propose une alternative fonctionnelle particulièrement séduisante. Développée pour reproduire dans l’écosystème R la flexibilité et la granularité observées au sein de modules réputés tels que scikit-learn en langage Python, MLmetrics isole chaque métrique dans une fonction unitaire indépendante, hautement spécialisée et exempte de surcharge de calcul superflue.
Le calcul du score F1 se réalise par le truchement de la fonction dédiée F1_Score. La signature syntaxique de cette routine se distingue notablement de celle de caret par l’intitulé de ses paramètres formels. La fonction requiert impérativement la déclaration du vecteur des assignations prédictives via l’argument y_pred, ainsi que la fourniture du vecteur des observations réelles sous l’argument y_true. Cette inversion nomenclaturale par rapport à caret nécessite une attention particulière lors de la rédaction du script pour écarter tout risque de confusion opérationnelle.
L’assignation de la classe positive d’intérêt s’effectue par l’intermédiaire de l’argument positive, auquel il convient de transmettre la chaîne « Selectionne ». L’appel direct de la fonction F1_Score(y_pred = predictions, y_true = realite, positive = « Selectionne ») renvoie immédiatement dans l’environnement R une valeur scalaire numérique atomique égale à 0,6857143, sans nécessiter d’opération d’extraction arborescente subsidiaire au sein d’une structure complexe de listes.
6.2 Traitement des valeurs manquantes et conformité des types
L’un des avantages remarquables de la fonction F1_Score de MLmetrics réside dans sa permissivité et sa résilience face aux types de données sous-jacents. Alors que caret impose avec intransigeance la manipulation exclusive de variables qualitatives instanciées sous forme de facteurs strictement ordonnés, F1_Score tolère aussi bien des facteurs textuels que des vecteurs de chaînes de caractères brutes (character) ou des vecteurs numériques binaires encodés sous la forme d’entiers 0 et 1.
Cette souplesse intrinsèque exige toutefois une vigilance accrue quant à l’argument positive. Dans le cas de vecteurs binaires numériques où les classes sont matérialisées par les valeurs 1 et 0, le paramètre positive doit recevoir la valeur numérique correspondante ou être omis si la convention par défaut correspond à la modalité unitaire. L’incohérence entre le type de données de l’argument positive et celui des vecteurs d’entrée constitue une source silencieuse de défaillance fonctionnelle conduisant fréquemment au renvoi intempestif de la valeur indéfinie NaN.
Concernant le traitement des observations incomplètes, la présence de valeurs manquantes (NA) au sein des vecteurs d’entrée propage par défaut une valeur manquante dans l’estimation finale du score F1. La bibliothèque MLmetrics ne procède à aucune élimination automatique implicite des observations tronquées. Il incombe donc au modélisateur d’assainir méthodologiquement les vecteurs en amont au moyen des fonctions de filtrage conditionnel ou d’omission systématique des cas incomplets pour garantir la robustesse du traitement computationnel.
6.3 Intégration dans des pipelines de calcul automatisés
La concision structurelle et l’absence d’effets secondaires de la fonction F1_Score en font le candidat idéal pour une insertion fluide au sein de pipelines de traitement itératifs et d’architectures vectorisées modernes. Qu’il s’agisse de déployer les itérateurs fonctionnels de la famille apply en code R de base ou d’exploiter les combinateurs avancés du package purrr issu de l’écosystème tidyverse, la fonction se prête admirablement aux calculs répétés sur des sous-échantillons multiples.
Dans un protocole de rééchantillonnage par validation croisée à k-blocs (k-fold cross-validation) ou d’estimation par rééchantillonnage avec remplacement (bootstrap), le score F1 doit être calculé des centaines ou des milliers de fois pour évaluer la stabilité distributionnelle de la règle de décision. L’appel de F1_Score au sein d’une fonction purrr::map2_dbl opérant sur des colonnes de prédictions et de références imbriquées permet d’évaluer une grille d’hyperparamètres avec une lisibilité de code remarquable et une élégance fonctionnelle irréprochable.
Les bancs d’essai de profilage temporel (benchmarks d’exécution) démontrent que l’exécution de la fonction F1_Score de MLmetrics s’avère de dix à cinquante fois plus véloce que le déploiement équivalent de la fonction confusionMatrix de caret sur des cohortes d’échantillonnage volumineuses. Cette économie massive de cycles d’horloge processeur positionne MLmetrics comme le moteur d’évaluation privilégié pour les opérations de calibration intensive de modèles tels que les forêts aléatoires ou les architectures d’amplification de gradient (gradient boosting).
7. Méthode 3 : Conception d’une fonction R personnalisée pour le calcul du F1
7.1 Écriture algorithmique pas à pas de la fonction
Bien que les packages tiers offrent des commodités d’emploi indiscutables, la programmation d’une fonction personnalisée en code R natif constitue une démarche pédagogique et méthodologique d’une valeur inestimable. Elle permet non seulement de s’affranchir de toute dépendance logicielle externe susceptible de subir des ruptures de compatibilité ascendante, mais garantit également une transparence absolue quant à la cinématique exacte des calculs arithmétiques exécutés sous le capot de l’interpréteur.
La construction algorithmique d’une fonction R vectorisée, que nous nommerons analytiquement calculer_f1, repose sur la réception de trois arguments formels : le vecteur des prédictions (pred), le vecteur des observations réelles (reel), et l’étiquette désignant la modalité positive d’intérêt (classe_positive). La première étape opératoire au sein du corps de la fonction consiste à convertir les prédicteurs logiques en masques booléens afin de discriminer avec rapidité l’appartenance de chaque élément à la classe désignée comme positive.
Le calcul des cellules cardinales de la matrice de confusion s’exécute ensuite de manière entièrement vectorisée grâce aux opérateurs logiques de base de R. Les vrais positifs correspondent à la somme booléenne des occurrences où la condition prédictive positive et la condition réelle positive sont conjointement vérifiées. Les faux positifs s’obtiennent en sommant les cas où la prédiction est positive mais la réalité négative. Réciproquement, les faux négatifs isolent les cas où la prédiction est négative alors que la réalité est positive. La précision et le rappel sont ensuite calculés sous forme de quotients d’addition, avant que la formule de la moyenne harmonique ne vienne sceller l’estimation unifiée du score F1 final.
7.2 Validation unitaire sur les données du cas pratique
L’introduction d’un script personnalisé au sein d’une chaîne de modélisation exige une validation unitaire rigoureuse confrontant les sorties produites par l’algorithme fait maison aux étalons analytiques établis au préalable. L’application de la fonction calculer_f1 à nos vecteurs synthétiques représentant les quatre cents sportifs universitaires permet d’attester instantanément de la conformité de notre développement.
L’exécution de la fonction renvoie avec une précision computationnelle absolue la valeur scalaire 0,6857143. Cette concordance au dix-millième près avec les calculs manuels menés dans la section théorique et avec les résultats générés par les packages professionnels caret et MLmetrics valide sans réserve la fidélité de notre script. L’expérimentateur dispose dès lors d’un outil propriétaire, lisible et auditable, pouvant être incorporé dans n’importe quel script R sans imposer l’installation de progiciels volumineux.
De surcroît, la fonction native présente un avantage écologique et technique non négligeable : son empreinte mémoire est pratiquement nulle. En évitant la surcharge liée à l’instanciation de multiples objets intermédiaires, structures S3 complexes ou tables de contingence bidimensionnelles, elle préserve la mémoire vive de l’environnement de calcul, autorisant son exécution sur des systèmes contraints ou au sein de grappes de calcul haute performance opérant en parallèle.
7.3 Gestion des cas limites et robustesse numérique
Une fonction de calcul statistique digne d’un déploiement industriel ne saurait se cantonner à fonctionner exclusivement sous des conditions idéales d’échantillonnage ; elle doit impérativement faire preuve d’une robustesse sans faille face aux cas limites et aux singularités mathématiques susceptibles d’induire des divisions par zéro.
Le cas limite le plus problématique survient lorsqu’un classificateur particulièrement frileux ou dégénéré échoue à formuler la moindre prédiction positive, conduisant à un total de vrais positifs et de faux positifs rigoureusement nul. Dans cette configuration, le calcul classique de la précision aboutit à la division de zéro par zéro, engendrant une valeur indéfinie NaN qui contamine l’ensemble de la chaîne de calcul ultérieure. De même, si le modèle n’identifie aucun vrai positif alors que des faux positifs et des faux négatifs existent, la somme de la précision et du rappel est égale à zéro, rendant le dénominateur de la moyenne harmonique nul.
Pour parer à ces anomalies arithmétiques, la fonction personnalisée doit intégrer des structures conditionnelles de garde en amont du calcul harmonique. Si la somme des vrais positifs et des faux positifs est nulle, ou si la somme des composantes de précision et de rappel équivaut strictement à zéro, la fonction doit intercepter l’évaluation et retourner de manière contrôlée une valeur numérique nulle de zéro virgule zéro, assortie d’un message d’avertissement informatif (warning) signalant l’absence totale de discrimination positive. Cette sécurisation garantit que les algorithmes d’optimisation ne subissent aucune interruption prématurée lors de l’exploration de zones sous-optimales de l’espace des paramètres.
8. Extension aux problématiques de classification multiclasses dans R
8.1 La transition du cadre binaire à la matrice multiclasses
Bien que la formalisation historique du score F1 s’inscrive dans une logique strictement binaire opposant une modalité cible à une classe de référence, les défis concrets de la modélisation statistique confrontent régulièrement les chercheurs à des espaces catégoriels polytomiques comprenant trois classes d’appartenance ou davantage. Dans ces environnements taxonomiques complexes, tels que la classification de pathologies psychiatriques distinctes ou l’identification de profils d’engagement d’utilisateurs, la matrice de confusion s’étend à N dimensions, rendant caduque l’application brute d’une équation scalaire unique.
La transition méthodologique repose sur le principe de binarisation décomposée, selon le paradigme dit « un contre tous » (One-vs-Rest ou One-vs-All). Dans ce cadre analytique, chaque modalité individuelle de la variable cible est successivement isolée et considérée temporairement comme la classe positive unique, tandis que l’ensemble consolidé des autres catégories est relégué au statut de classe négative agrégée. Cette décomposition permet de dériver une matrice de confusion binaire locale pour chaque étiquette présente au sein du jeu de données.
Pour chacune de ces sous-structures, il devient possible de calculer un score F1 spécifique à chaque modalité taxonomique. La difficulté analytique réside alors dans la méthode d’agrégation synthétique requise pour fondre ces multiples indices de classe en une métrique globale unique capable de résumer fidèlement la performance d’ensemble du séparateur multiclasses sous R.
8.2 Le Macro-F1 score : moyenne arithmétique non pondérée
L’approche la plus intuitive et la plus rigoureusement égalitaire pour consolider les performances polytomiques réside dans le calcul du Macro-F1 score. Sur le plan mathématique, le Macro-F1 correspond à la moyenne arithmétique simple et non pondérée des scores F1 indépendamment calculés pour chacune des modalités constitutives de l’espace de réponse. Si un système classifie des observations selon trois catégories distinctes A, B et C, le Macro-F1 s’établit simplement comme le tiers de la somme arithmétique des scores F1 individuels de A, B et C.
La propriété cardinale de cette métrique réside dans son insensibilité absolue aux fréquences relatives des classes au sein de la cohorte. Chaque modalité pèse d’un poids rigoureusement identique dans l’arbitrage final, qu’elle représente quatre-vingt pour cent du volume d’échantillonnage ou qu’elle ne constitue qu’une sous-population marginale de deux pour cent. Cette caractéristique confère au Macro-F1 une valeur diagnostique inestimable lorsque l’objectif opérationnel consiste à pénaliser impitoyablement les défaillances de détection sur les classes rares au sein d’un répertoire multiclasses.
Sous l’environnement R, le calcul du Macro-F1 s’obtient aisément en configurant les fonctions de la bibliothèque yardstick, fleuron du méta-package tidymodels, ou en paramétrant les routines multiclasses de caret. L’interpréteur calcule les moyennes de précision et de rappel de chaque partition avant de dériver l’indice global, fournissant une estimation lucide et exigeante de l’équilibre fonctionnel du modèle sur l’ensemble du spectre taxonomique.
8.3 Le Micro-F1 et le F1 pondéré (Weighted F1)
À l’opposé de la philosophie égalitaire du Macro-F1, le Micro-F1 procède par une logique d’agrégation volumique globale avant tout calcul de ratio. Au lieu de déterminer des précisions et des rappels indépendants par classe, le protocole Micro-F1 commence par sommer arithmétiquement l’ensemble des vrais positifs, l’ensemble des faux positifs et l’ensemble des faux négatifs observés sur l’ensemble de la matrice de contingence globale à N dimensions. Les ratios de précision micro et de rappel micro sont ensuite dérivés à partir de ces totaux cumulés.
Une propriété remarquable du Micro-F1 dans les cadres de classification exclusive (où chaque individu n’est assigné qu’à une et une seule classe) réside dans son équivalence mathématique stricte avec le taux d’exactitude globale. Dès lors, le Micro-F1 est naturellement dominé par la performance observée sur les classes prépondérantes de l’échantillon, offrant une mesure de l’efficacité opérationnelle par événement plutôt qu’une mesure d’équilibre par classe. Il s’avère donc peu pertinent si la détection équilibrée des classes minoritaires constitue la finalité première de la recherche.
Entre ces deux extrêmes émerge le F1 pondéré, souvent désigné sous l’anglicisme Weighted F1. Cette stratégie calcule le score F1 individuel de chaque modalité, puis en réalise la moyenne pondérée en utilisant la prévalence empirique de chaque classe (son nombre d’occurrences réelles au sein de l’échantillon) comme coefficient multiplicateur. Le F1 pondéré constitue une voie médiane qui prend en compte l’asymétrie naturelle de l’environnement d’observation tout en atténuant légèrement l’écrasement des classes rares, offrant une synthèse pragmatique largement documentée dans les sorties du package yardstick sous R.
9. Optimisation probabiliste du seuil de décision pour maximiser le F1
9.1 L’impact du seuil de classification arbitraire de 0,5
Dans la quasi-totalité des implémentations de modélisation prédictive, qu’il s’agisse de la régression logistique binaire standard, des machines à vecteurs de support probabilisées ou des réseaux de neurones profonds, l’algorithme ne formule pas nativement une assignation catégorielle discrète. Il calcule en réalité une probabilité conditionnelle continue comprise dans l’intervalle ouvert entre zéro et un. La transformation de ce continuum probabiliste en une décision d’appartenance binaire nécessite l’interposition d’un seuil de coupure décisionnel (cut-off threshold).
Par convention historique et par réflexe heuristique, la quasi-totalité des logiciels et des modélisateurs appliquent un seuil par défaut fixé à zéro virgule cinquante. Bien que cette valeur médiane présente une justification théorique solide dans le cadre de distributions parfaitement symétriques associées à des coûts d’erreur rigoureusement identiques, elle s’avère totalement sous-optimale face à des données déséquilibrées ou lorsque l’objectif méthodologique réside dans la maximisation exclusive du score F1.
La modification du seuil de décision induit une variation corrélative antagoniste entre la précision et le rappel. Abaisser le seuil probabiliste vers des valeurs réduites accroît mécaniquement l’exhaustivité de la détection en gonflant le volume de vrais positifs, ce qui maximise le rappel, mais au détriment d’une augmentation proportionnelle des faux positifs qui détériore la précision. Réciproquement, rehausser le seuil d’exigence élimine les fausses alarmes et sublime la précision, mais au risque d’accroître massivement les faux négatifs. Le seuil conventionnel de 0,5 n’a aucune raison fondamentale de coïncider avec l’optimum harmonique du score F1.
9.2 Balayage méthodique des seuils probabilistes sous R
L’optimisation rationnelle du point de coupure nécessite l’exécution d’un balayage méthodique de la grille des seuils probabilistes sous l’environnement R. La première phase de cette démarche impose de récupérer non pas les assignations catégorielles brutes, mais les scores probabilistes continus générés par le modèle d’inférence. Dans le cas d’un modèle linéaire généralisé implémenté via la fonction glm, l’extraction de ces probabilités requiert l’exécution de la méthode predict en spécifiant explicitement l’argument type = « response ».
La seconde phase consiste à concevoir une séquence vectorielle discrète balayant l’intervalle unitaire par incréments réguliers et serrés, typiquement de zéro virgule zéro un à zéro virgule quatre-vingt-dix-neuf avec un pas d’échantillonnage de centième. Une structure itérative vectorisée, mobilisant par exemple la fonction native sapply, est alors déployée pour appliquer successivement chaque seuil candidat au vecteur de probabilités prédictives. Pour chaque palier testé, les probabilités sont dichotomisées en assignations positives ou négatives, et le score F1 résultant est calculé et consigné dans un vecteur d’évaluation empirique.
L’identification du seuil optimal s’obtient ensuite par simple recherche de la valeur maximale au moyen de la fonction native which.max. Cette procédure d’optimisation a posteriori permet fréquemment de découvrir un seuil opérationnel substantiellement décalé par rapport à la médiane standard, permettant de rehausser significativement la valeur finale du score F1 sans modifier la structure paramétrique interne de l’algorithme d’apprentissage sous-jacent.
9.3 Visualisation graphique de la courbe Précision-Rappel et du pic F1
L’analyse visuelle de la relation de compromis entre précision, rappel et score F1 constitue une étape fondamentale d’interprétation pour le modélisateur. L’écosystème graphique ggplot2 offre un cadre conceptuel d’une remarquable puissance expressive pour matérialiser cette cinématique sous forme de représentations publiables répondant aux standards esthétiques les plus exigeants de la littérature scientifique.
La construction graphique repose sur la constitution d’un tableau de données structuré croisant les cent valeurs de seuils explorées avec leurs scores respectifs de précision, de rappel et de mesure F1 globale. En traçant simultanément la courbe du rappel décroissant en fonction du seuil et la courbe de la précision croissante sur le même système de coordonnées cartésiennes, l’expérimentateur visualise immédiatement le point d’intersection géométrique entre les deux exigences antagonistes.
Sur ce même canevas, la projection de la trajectoire du score F1 met en évidence une courbe concave typique atteignant son acmé à la verticale exacte du point de coupure optimal identifié par balayage. L’adjonction d’une ligne directrice verticale pointillée interceptant le sommet de la courbe matérialise pour le décideur le seuil probabiliste précis qu’il convient de graver dans les règles de production informatique pour maximiser l’efficience opérationnelle du système prédictif sous R.
10. Applications quantitatives dans la recherche comportementale et clinique
10.1 Utilisation de la classification dans les diagnostics cliniques
Dans le domaine des sciences cliniques, de la neuropsychologie et de l’épidémiologie comportementale, la modélisation statistique prédictive est fréquemment mobilisée pour établir des diagnostics précoces, repérer des phénotypes psychopathologiques complexes ou identifier des marqueurs de vulnérabilité biopsychosociale. Ces contextes de recherche partagent une caractéristique structurelle prégnante : la faible prévalence épidémiologique des troubles d’intérêt au sein de la population générale, qu’il s’agisse de spectres autistiques sévères, d’épisodes psychotiques débutants ou de comportements suicidaires aigus.
Dans de telles configurations de rareté statistique, l’usage de l’exactitude globale comme critère de sélection de modèles est méthodologiquement intenable et épistémologiquement fallacieux. Un outil de criblage psychiatrique appliqué à une pathologie dont la prévalence est de deux pour cent atteindrait une exactitude clinique apparente de quatre-vingt-dix-huit pour cent en ignorant purement et simplement la totalité des patients en détresse. L’adoption du score F1 au sein des publications biomédicales découle de cette exigence éthique et statistique : contraindre le modèle à démontrer son efficacité sur la détection effective de la pathologie sans diluer son incompétence sous la masse des individus sains.
De plus, l’exploitation du score F1 sous R permet aux chercheurs d’évaluer avec impartialité des algorithmes entraînés sur des données comportementales hétérogènes, issues de capteurs biométriques passifs, de journaux d’activité numérique ou de bilans psychométriques standardisés. Le score F1 garantit que les associations statistiques isolées par la modélisation logistique ou les arbres décisionnels reflètent une réelle capacité de discrimination clinique plutôt qu’une simple capture opportuniste du bruit d’échantillonnage de la classe dominante.
10.2 Pondération asymétrique des erreurs de mesure : le score F-bêta
Bien que le score F1 représente une avancée méthodologique majeure en fusionnant précision et rappel par la moyenne harmonique, il repose sur un postulat sous-jacent rigide : il accorde une valeur axiomatique strictement égale aux erreurs de type I et aux erreurs de type II. Or, dans la réalité clinique et décisionnelle, les coûts et préjudices induits par une fausse alarme ne sont pratiquement jamais équivalents à ceux générés par l’omission dramatique d’un cas pathologique létal.
Pour formaliser cette asymétrie des coûts de décision, la théorie statistique étend la mesure de van Rijsbergen à travers la famille paramétrique générale du score F-bêta. Le coefficient bêta introduit dans la formulation harmonique agit comme un facteur de pondération différentielle : il quantifie le niveau d’importance relative accordé au rappel par rapport à la précision. La formulation mathématique multiplie le carré de bêta majoré de un par le produit de la précision et du rappel, divisé par la somme du produit du carré de bêta par la précision et du rappel.
Lorsque la détection exhaustive est absolument prioritaire sur la prévention des fausses alertes, comme dans le dépistage de virus hautement contagieux ou de cardiopathies aiguës, l’expérimentateur assignera typiquement la valeur deux au paramètre bêta (score F2), ce qui pondère le rappel deux fois plus lourdement que la précision. À l’inverse, dans des situations de filtrage d’informations où l’intrusion de faux positifs engendre une saturation immédiate de l’utilisateur, une valeur de zéro virgule cinq sera privilégiée (score F0,5). L’environnement R permet l’implémentation directe et immédiate de cette mesure flexible, autorisant un calibrage sur mesure conforme aux impératifs déontologiques du champ d’application.
10.3 Rapportage académique normalisé selon les normes APA
La publication des résultats d’apprentissage automatique et de modélisation prédictive au sein des revues scientifiques à comité de lecture est régie par des protocoles de normalisation stricts, au premier rang desquels figurent les directives de l’American Psychological Association (APA) dans sa septième édition. L’intégrité de la communication scientifique exige l’abandon des déclarations de performance vagues au profit d’un rapportage quantitatif exhaustif et vérifiable.
Selon les standards méthodologiques contemporains, il est impératif de consigner dans le corps de l’article ou dans ses annexes méthodologiques la matrice de confusion intégrale sous forme tabulaire, mentionnant expressément le nombre brut de vrais positifs, de faux positifs, de faux négatifs et de vrais négatifs. La dissimulation de ces grandeurs cardinales empêche toute méta-analyse ultérieure et fragilise la réplicabilité des conclusions statistiques rapportées.
De surcroît, le rapportage narratif textuel doit systématiquement accompagner la valeur finale du score F1 de ses deux métadonnées indissociables : la précision et le rappel empiriquement observés. La mention explicite du seuil de décision appliqué (qu’il s’agisse de 0,5 ou d’un seuil optimisé a posteriori) doit être formellement documentée, assortie de la spécification de la classe désignée comme positive. Ce niveau de transparence méthodologique garantit que la communauté scientifique puisse juger sans équivoque de la validité externe et de la pertinence clinique de l’architecture prédictive conçue sous R.
11. Résolution des erreurs fréquentes et pièges de calcul sous R
11.1 Le piège de l’inversion de la classe de référence
Le piège computationnel le plus insidieux et le plus répandu lors de l’évaluation des séparateurs de classification binaire sous R réside dans l’inversion involontaire de la modalité considérée comme la classe de référence positive. Ce phénomène, baptisé inversion de polarité, survient de manière totalement silencieuse : le script ne génère aucun message d’erreur ni aucun avertissement en console, mais fournit une métrique F1 calculée en réalité sur la classe opposée.
Cette anomalie tire son origine de la convention de traitement des facteurs en langage R de base. Si un utilisateur manipule un vecteur d’observations encodé sous forme de chaînes contenant « Echec » et « Succes », R attribue automatiquement le premier niveau de facteur à « Echec » en vertu de la préséance de l’ordre alphabétique standard. Si la fonction d’évaluation adoptée utilise implicitement le premier niveau comme cible d’intérêt, le score F1 mesurera la capacité du modèle à identifier les échecs et non les succès attendus par l’analyste.
Les conséquences sur l’interprétation scientifique sont souvent dévastatrices, transformant une modélisation médiocre en un succès illusoire si la classe inversée bénéficie d’une prévalence massive. Pour immuniser de manière absolue un flux d’analyse contre ce biais cognitif et logiciel, la bonne pratique de programmation exige de toujours spécifier sans ambiguïté l’argument formel positive au sein des fonctions d’évaluation, ou d’imposer manuellement l’ordre des niveaux lors de la déclaration initiale du facteur au moyen de l’argument levels.
11.2 Erreurs structurelles liées aux niveaux de facteurs discordants
Une interruption d’exécution fréquemment rencontrée par les utilisateurs du package caret se manifeste par le message d’erreur péremptoire suivant : arguments must have same levels. Cette défaillance structurelle se produit lorsque le vecteur des prédictions générées par l’algorithme et le vecteur des données de référence empiriques ne partagent pas un ensemble strictement identique de niveaux catégoriels sous-jacents.
Cette situation se matérialise couramment lors du déploiement de modèles prédictifs sur des sous-échantillons d’évaluation de taille restreinte ou face à des classes ultra-minoritaires. Si un classificateur prudent n’attribue jamais la modalité positive à la moindre observation lors d’un pli de validation croisée particulier, le vecteur factoriel résultant peut ne comporter qu’un niveau effectif unique (la classe négative). La fonction confusionMatrix de caret refuse catégoriquement d’opérer sur des objets dont la structure dimensionnelle des niveaux présente une asymétrie formelle.
La résolution rigoureuse de cette friction logicielle nécessite de standardiser formellement les niveaux des deux vecteurs en amont de toute tentative d’évaluation. L’appel explicite de la fonction factor(…, levels = c(« Modalite_A », « Modalite_B »)) appliqué de manière symétrique sur le vecteur des prédictions et sur le vecteur de référence force l’alignement de la nomenclature interne, même si l’un des niveaux ne possède temporairement aucun effectif observé, restaurant ainsi la conformité d’exécution du package.
11.3 Gestion des vecteurs tronqués ou contenant des valeurs manquantes
La présence pernicieuse de données manquantes, encodées sous le symbole NA (Not Available) en R, représente une source majeure d’instabilité numérique et d’aberration de calcul lors de l’estimation du score F1. L’omission d’un protocole rigoureux de traitement des valeurs manquantes peut conduire à l’avortement prématuré de la chaîne d’évaluation ou à l’obtention de métriques totalement corrompues.
Dans de nombreux cas réels de modélisation prédictive, le vecteur prédictif issu de la fonction predict peut comporter des valeurs manquantes dès lors que les données explicatives associées contenaient des cellules non renseignées que le modèle n’a pu traiter. L’introduction directe de ces vecteurs incomplets au sein des fonctions d’évaluation engendre le plus souvent la propagation systématique de valeurs NA au détriment de l’estimation scalaire du score F1, paralysant toute tentative d’optimisation d’hyperparamètres.
La parade méthodologique implique d’établir un protocole strict de validation dimensionnelle et d’imputation avant toute confrontation évaluative. L’utilisation conjointe des fonctions complete.cases ou na.omit sur le tableau de données croisant prédictions et observations réelles permet d’isoler exclusivement les paires d’observations complètes. Le chercheur doit néanmoins vérifier scrupuleusement que ce filtrage n’ampute pas l’échantillon d’une proportion substantielle de ses cas critiques, ce qui introduirait un biais de sélection insidieux au cœur de l’évaluation prédictive.
12. Synthèse comparative et recommandations pour l’analyse sous R
12.1 Tableau comparatif des différentes approches de calcul sous R
Le choix de la méthodologie computationnelle pour dériver le score F1 au sein de l’environnement logiciel R dépend étroitement des objectifs opérationnels, des contraintes d’infrastructure et de la volumétrie de données propre à chaque projet de recherche. L’écosystème propose une diversité d’approches dont il convient de peser méthodiquement les forces et les vulnérabilités relatives afin d’éclairer le choix du data scientist ou du biostatisticien.
L’approche incarnée par le package caret se distingue par son exhaustivité diagnostique remarquable. Elle constitue l’option de référence indiscutable pour la restitution globale de rapports statistiques d’évaluation, fournissant simultanément la matrice de contingence complète, les intervalles de confiance binomiaux et une multitude de métriques associées. En contrepartie, sa lourdeur computationnelle et son intransigeance formelle quant au typage des facteurs en limitent l’adéquation au sein de boucles de simulation massives ou de scripts requérant une rapidité d’exécution maximale.
À l’autre extrémité du spectre, la bibliothèque MLmetrics offre une concision et une vélocité incomparables. Son exécution épurée et sa flexibilité face aux types de données en font l’instrument de prédilection pour l’optimisation itérative et l’évaluation répétée d’algorithmes intensifs. Enfin, la conception d’une fonction R personnalisée en code de base assure une totale souveraineté technologique en éliminant toute dépendance logicielle externe, tout en garantissant une transparence absolue particulièrement adaptée aux exigences de reproductibilité des publications académiques de pointe.
12.2 Intégration fluide dans un protocole de validation croisée
L’évaluation isolée d’un modèle prédictif sur un jeu de test statique expose l’analyste à un risque sévère d’illusion statistique attribuable aux aléas du partitionnement initial. La certification empirique de la validité d’une règle de décision requiert son intégration rigoureuse au sein d’un protocole de validation croisée k-fold répétée, où l’optimisation des hyperparamètres d’apprentissage est explicitement asservie à la maximisation du score F1.
Au sein de l’architecture caret, cette articulation méthodologique avancée se configure au moyen de l’objet trainControl. Afin de substituer l’optimisation de la mesure F1 à celle de l’exactitude globale par défaut, le chercheur doit obligatoirement renseigner l’argument summaryFunction en lui adjoignant la fonction prSummary. Ce réglage fondamental réoriente l’intégralité du moteur de rééchantillonnage vers la surveillance combinée de la précision, du rappel et du score F1.
Parallèlement, la fonction d’apprentissage principal train doit être instruite pour sélectionner l’architecture optimale en exploitant le paramètre metric = « F ». Cette configuration assure que lors du balayage de la grille d’hyperparamètres (tels que la profondeur d’arbre dans un algorithme de classification ou le coefficient de régularisation dans un modèle logistique pénalisé Lasso ou Ridge), le moteur algorithmique retiendra le sous-ensemble de paramètres minimisant le risque de compromettre l’équilibre harmonique de détection, conjurant ainsi efficacement les risques de surapprentissage.
12.3 Arbre de décision méthodologique pour le praticien des données
Pour guider le praticien de la donnée à travers les méandres méthodologiques de l’évaluation prédictive sous R, la mise en place d’un protocole de décision systématique s’avère hautement profitable. Cet itinéraire analytique débute par un diagnostic impératif de la balance de distribution de la variable de réponse : en présence d’une asymétrie tangible de classe ou d’une disproportion des coûts d’erreurs cliniques, l’exactitude globale doit être bannie au profit immédiat de l’évaluation par le score F1 ou l’un de ses dérivés paramétriques.
L’étape décisionnelle suivante réside dans la caractérisation de la structure taxonomique de l’espace de sortie. Si la modélisation demeure strictement binaire, le choix de l’outil logiciel s’arbitre en fonction de la phase de développement : MLmetrics sera privilégié durant les phases itératives d’entraînement pour sa vélocité, tandis que caret ou une fonction native auditable sera mobilisé lors de la phase finale de certification pour extraire l’intégralité de la matrice de confusion. Si la problématique s’étend à un cadre multiclasses, l’analyste devra sélectionner de manière raisonnée entre le Macro-F1 pour sanctionner rigoureusement les erreurs sur les classes orphelines ou le F1 pondéré pour respecter la prévalence de terrain, en s’appuyant de préférence sur les packages modernes de l’écosystème tidymodels.
Enfin, tout flux d’analyse de haut niveau doit s’accompagner d’une politique pérenne de conservation et de journalisation des métadonnées de modélisation. L’ancrage déterministe des graines pseudo-aléatoires via set.seed, la conservation intégrale des matrices de confusion réelles et la spécification scrupuleuse des seuils probabilistes de décision au sein des scripts de rapportage constituent les piliers méthodologiques garantissant une reproductibilité sans faille, assurant à la recherche prédictive sous R sa pleine crédibilité scientifique et opérationnelle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Kuhn, M. (2008). Building predictive models in R using the caret package. Journal of Statistical Software, 28(5), 1–26. https://doi.org/10.18637/jss.v028.i05
- Kuhn, M., & Johnson, K. (2013). Applied predictive modeling. Springer. https://doi.org/10.1007/978-1-4614-6849-3
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Sokolova, M., & Lapalme, G. (2009). A systematic analysis of performance measures for classification tasks. Information Processing & Management, 45(4), 427–437. https://doi.org/10.1016/j.ipm.2009.03.002
- van Rijsbergen, C. J. (1979). Information retrieval (2nd ed.). Butterworth-Heinemann. https://www.dcs.gla.ac.uk/Keith/Preface.html
- Yan, Y. (2016). MLmetrics: Machine learning evaluation metrics (R package version 1.1.1). CRAN. https://CRAN.R-project.org/package=MLmetrics