
La modélisation mathématique des transitions continues, des probabilités conditionnelles et des dynamiques de saturation constitue l’un des piliers de l’analyse computationnelle moderne. Au cœur de cette démarche se trouve la courbe logistique, communément désignée sous le nom de fonction sigmoïde. Présente aussi bien dans les modèles d’accroissement démographique conçus au XIXe siècle que dans les architectures contemporaines de réseaux de neurones profonds, la sigmoïde opère une transformation non linéaire essentielle : elle comprime un continuum infini de valeurs réelles dans un intervalle strictement borné entre zéro et un. Cette propriété fondamentale en fait l’outil d’élection pour convertir des scores linéaires arbitraires en mesures de probabilité rigoureusement calibrées.
Dans l’écosystème de programmation Python, devenu le standard de facto pour l’ingénierie des données et l’apprentissage automatique, le calcul de la fonction sigmoïde semble à première vue trivial. Une simple ligne de code transcrivant la formule analytique standard semble suffire. Pourtant, la réalité du calcul numérique haute performance impose des exigences bien plus strictes. Entre les phénomènes d’évanescence du gradient, les risques de dépassement de capacité arithmétique (dépassement supérieur ou inférieur en virgule flottante sous la norme IEEE 754), et les impératifs d’accélération vectorielle sur de volumineux ensembles de données, le choix de l’implémentation algorithmique revêt une importance capitale pour la stabilité et l’efficience des systèmes logiciels.
Ce guide exhaustif propose une exploration théorique, algorithmique et pratique du calcul de la fonction sigmoïde en Python. Nous aborderons ses fondements mathématiques rigoureux avant de disséquer ses diverses implémentations, depuis les approches scalaires manuelles via la bibliothèque standard jusqu’aux optimisations bas niveau offertes par SciPy et NumPy. Enfin, nous examinerons son déploiement à grande échelle au sein des cadriciels modernes d’apprentissage profond tels que PyTorch et TensorFlow, en accordant une attention méticuleuse à la stabilité numérique, au profilage des performances et aux cas d’usage industriels réels.
1. Fondements mathématiques et théoriques de la fonction sigmoïde
1.1 Définition formelle et équation logistique standard
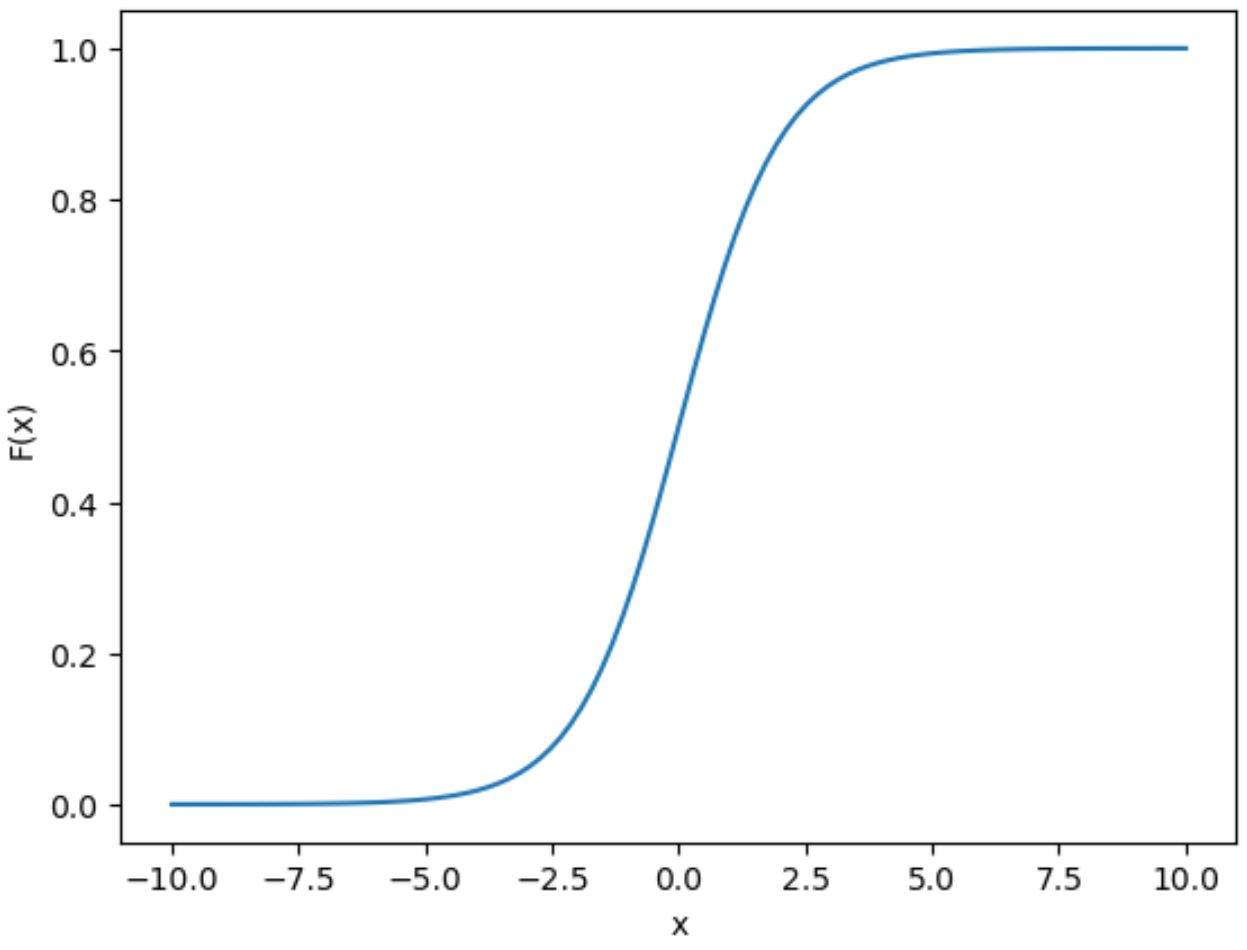
D’un point de vue analytique, la fonction sigmoïde standard, couramment qualifiée de fonction logistique, est une fonction réelle d’une variable réelle définie sur l’ensemble complet des réels $\mathbb{R}$ et à valeurs dans l’intervalle ouvert $]0, 1[$. Son expression analytique canonique est formulée comme suit :
$$F(x) = \frac{1}{1 + e^{-x}} = \frac{e^x}{e^x + 1}$$
Cette expression engendre une courbe caractéristique en forme de « S » (d’où son étymologie issue de la lettre grecque sigma). La transition progressive entre les régimes asymptotiques confère à cette fonction une géométrie d’une grande régularité. L’un des traits structurels les plus déterminants de cette fonction réside dans sa symétrie centrale parfaite autour de son point d’inflexion situé aux coordonnées $(0, 0{,}5)$. Algébriquement, cette propriété se traduit par l’identité remarquable $F(-x) = 1 – F(x)$ pour tout réel $x$. Cette relation d’invariance par rapport au centre de symétrie simplifie grandement les calculs analytiques et les optimisations logicielles.
Il importe de distinguer rigoureusement la fonction logistique d’autres fonctions sigmoïdales classiques appartenant à la même famille topologique. Par exemple, la tangente hyperbolique ($tanh$) projette l’espace réel sur l’intervalle ouvert $]-1, 1[$ et se trouve liée à la logistique standard par la transformation affine $tanh(x) = 2F(2x) – 1$. De même, la fonction arc-tangente ($arctan$) ou la fonction algébrique $x / \sqrt{1 + x^2}$ génèrent des courbes en esse, mais présentent des vitesses de convergence asymptotique polynomiales nettement plus lentes que la convergence exponentielle stricte régie par le terme $e^{-x}$.
1.2 Propriétés analytiques et comportement asymptotique
L’analyse infinitésimale de la fonction logistique révèle des propriétés de régularité remarquables. La fonction est indéfiniment dérivable sur son domaine de définition, ce qui la classe dans l’espace des fonctions lisses $\mathcal{C}^\infty(\mathbb{R})$. Son comportement aux limites constitue le socle de sa robustesse pour la normalisation de grandeurs physiques ou probabilistes :
$$\lim_{x to -\infty} F(x) = 0 \quad \text{et} \quad \lim_{x to +\infty} F(x) = 1$$
Cette convergence asymptotique bilatérale garantit une stricte monotonicité croissante, dans la mesure où sa dérivée première demeure strictement positive pour toute valeur finie de l’argument $x$. Le taux de variation instantané atteint son maximum absolu précisément au point d’inflexion $x = 0$, où la pente de la tangente vaut exactement $0{,}25$. À mesure que l’on s’éloigne de l’origine vers les régions extrêmes du domaine réel, la pente décroît exponentiellement vers zéro, engendrant des plateaux de saturation où la fonction devient quasi insensible aux variations incrémentales de la variable explicative.
Cette dynamique de saturation asymptotique joue un rôle protecteur contre les valeurs aberrantes (outliers) dans les modèles statistiques, en évitant qu’une observation extrême ne déforme excessivement le signal global. En contrepartie, cette même caractéristique pose des défis computationnels majeurs lors de l’application d’algorithmes d’optimisation basés sur le calcul différentiel, en raison de l’écrasement des gradients dans les zones éloignées de l’origine.
1.3 Rôle de la fonction dans la modélisation mathématique et cognitive
Historiquement formulée par le mathématicien belge Pierre-François Verhulst dans ses mémoires publiés entre 1838 et 1845 pour décrire l’accroissement continu des populations confrontées à des ressources limitées, la sigmoïde s’est imposée bien au-delà de l’écologie quantitative. En psychophysique et en sciences cognitives, elle modélise avec fidélité la loi de transition perceptuelle entre l’absence de détection et la perception consciente d’un stimulus sensoriel. Les travaux fondamentaux de Gustav Fechner et les modèles psychophysiques modernes exploitent cette courbe pour décrire la fonction psychométrique, liant l’intensité physique continue d’une stimulation à la fréquence d’activation des potentiels d’action au sein des réseaux neuronaux corticaux.
Dans le domaine de la psychométrie contemporaine et de la docimologie, la sigmoïde logistique constitue la pierre angulaire de la théorie de réponse aux items (modèle de Rasch à un ou plusieurs paramètres). Elle permet d’établir une correspondance mathématiquement cohérente entre une variable latente inobservable (telle que l’aptitude cognitive d’un individu ou l’intensité d’un trait de personnalité) et la probabilité empirique d’observer une réponse positive à une épreuve donnée.
Cette conversion d’une échelle sous-jacente infinie en probabilités d’occurrence strictement comprises entre 0 et 1 fait le pont naturel entre la modélisation théorique des processus décisionnels et la formalisation statistique du choix binaire dans les architectures de calcul modernes.
2. Environnement de développement Python et prérequis techniques
2.1 Configuration de l’interpréteur Python et gestion des dépendances
Pour exécuter et analyser les différentes déclinaisons algorithmiques de la fonction sigmoïde, il est impératif d’établir un environnement d’exécution stable et reproductible. Nous préconisons l’usage de Python en version 3.8 ou supérieure, les versions antérieures ne bénéficiant plus du support de sécurité officiel de la Python Software Foundation et présentant des disparités potentielles dans l’optimisation des bibliothèques C sous-jacentes. L’isolation des dépendances logicielles garantit l’intégrité de l’environnement système et prévient les conflits entre versions binaires compilées.
L’initialisation d’un environnement virtuel standard s’effectue via le terminal à l’aide des commandes fondamentales de l’interpréteur :
python3 -m venv env_sigmoide
source env_sigmoide/bin/activate
Sous les systèmes d’exploitation Windows, l’activation s’opère par le script .env_sigmoideScriptsactivate. Une fois l’environnement isolé activé, il convient de procéder à l’installation des paquets nécessaires au calcul numérique, à la modélisation avancée et au rendu visuel. L’utilisation du gestionnaire de paquets pip permet de déployer de manière déterministe les modules de référence :
pip install –upgrade pip
pip install numpy scipy matplotlib
Il est recommandé de consigner explicitement les versions installées au sein d’un fichier requirements.txt afin de garantir la portabilité stricte des analyses présentées à travers différents systèmes informatiques.
2.2 Présentation de l’écosystème scientifique
Le traitement des calculs mathématiques en Python repose sur une stratification logicielle optimisée, articulée autour de trois piliers principaux :
- Le module standard math : Fourni nativement avec l’interpréteur CPython, il expose directement en Python les fonctions de la bibliothèque mathématique C standard (
libm). Il opère exclusivement sur des types scalaires natifs (flottants et entiers) et ne requiert aucune dépendance tierce. - NumPy (Numerical Python) : Constitue le socle fondamental du calcul scientifique matriciel. En encapsulant des structures de données contiguës en mémoire (
ndarray) écrites en C et Fortran, il autorise l’exécution d’opérations vectorisées hautement parallélisables sans subir le surcoût d’interprétation des boucles Python. - SciPy (Scientific Python) : Bâti au-dessus de NumPy, SciPy regroupe des algorithmes spécialisés pour l’optimisation, l’intégration numérique et les statistiques. Son sous-module
scipy.specialcontient des implémentations de niveau industriel de fonctions transcendantes et spéciales, conçues pour préserver la précision analytique aux limites du domaine de calcul.
2.3 Précision numérique et représentation des nombres à virgule flottante
La mise en œuvre logicielle de fonctions exponentielles nécessite une compréhension rigoureuse du standard de calcul en virgule flottante IEEE 754, implémenté par les types flottants natifs de Python (représentés en double précision sur 64 bits). Dans cette norme, un nombre flottant se compose de trois segments binaires distincts : un bit de signe, 11 bits d’exposant biaisé et 52 bits de fraction (ou mantisse effective), fournissant approximativement 15 à 17 chiffres décimaux significatifs.
L’évaluation numérique de l’expression $e^{-x}$ se heurte à des contraintes physiques fondamentales dictées par l’intervalle dynamique des nombres représentables. En double précision standard, le plus grand exposant positif calculable avant dépassement de capacité (overflow) s’élève à approximativement $\ln(1{,}79769 \times 10^{308}) \approx 709{,}78$. Inversement, toute tentative d’évaluation d’un terme exponentiel négatif dont l’amplitude excède $-745{,}13$ provoque un sous-dépassement arithmétique (underflow), tronquant purement et simplement le résultat à zéro absolu ($0{,}0$).
Par conséquent, l’évaluation naïve de la fonction sigmoïde sur des réels très négatifs (par exemple $x = -1000$) impose le calcul de $e^{-(-1000)} = e^{1000}$, ce qui surpasse instantanément les capacités de la mantisse matérielle et déclenche des exceptions arithmétiques ou la production de valeurs spéciales infinies (inf). La validation rigoureuse des algorithmes requiert donc la mise en place de critères de tolérance relative (rtol) et absolue (atol), garantissant que l’invariance mathématique théorique est respectée au sein des marges de précision machine (la constante $epsilon$ valant approximativement $2{,}22 \times 10^{-16}$).
3. Calcul scalaire élémentaire avec la bibliothèque standard Python
3.1 Implémentation manuelle avec le module math
L’approche la plus intuitive pour évaluer la fonction sigmoïde sans introduire de dépendances externes consiste à mobiliser la fonction exponentielle math.exp présente dans le module standard de Python. Cette fonction fait office de passerelle directe vers la fonction exp() de la bibliothèque standard C du système hôte, garantissant une exécution rapide pour les scalaires individuels.
L’implémentation algorithmique se structure en décomposant scrupuleusement la formule analytique élémentaire :
import math
def sigmoide_scalaire(x):
neg_x = -x
exp_val = math.exp(neg_x)
resultat = 1.0 / (1.0 + exp_val)
return resultat
Sur le plan du flux d’exécution séquentiel, l’interpréteur commence par évaluer la négation unaire de l’argument scalaire. La valeur résultante est ensuite transmise à la routine de calcul transcendant math.exp, qui applique des approximations polynomiales de Tchebychev ou des fractions continues de Padé selon l’architecture du processeur. Une fois la valeur intermédiaire obtenue, l’interpréteur alloue un flottant représentant l’addition unitaire du dénominateur, avant de réaliser la division en virgule flottante finale. Ce flux séquentiel simple permet une compréhension transparente de chaque étape du calcul.
3.2 Exemple pratique : évaluation pour une valeur unique
Afin d’examiner le comportement concret de cette implémentation unitaire, nous procédons à l’évaluation numérique pas à pas pour un point scalaire arbitraire, par exemple $x = 2{,}5$.
Décomposons les opérations élémentaires exécutées par l’interpréteur :
- Étape 1 : Calcul de l’opposé de la variable d’entrée : $-x = -2{,}5$.
- Étape 2 : Évaluation du terme exponentiel négatif : $e^{-2{,}5} \approx 0{,}0820849986238988$.
- Étape 3 : Calcul du dénominateur logistique : $1{,}0 + 0{,}0820849986238988 = 1{,}0820849986238988$.
- Étape 4 : Inversion finale : $\frac{1{,}0}{1{,}0820849986238988} \approx 0{,}9241418199787566$.
Ce résultat théorique peut être validé immédiatement dans un script Python en intégrant des vérifications d’intégrité strictes :
valeur_entree = 2.5
valeur_calculee = sigmoide_scalaire(valeur_entree)
valeur_attendue = 0.9241418199787566
assert math.isclose(valeur_calculee, valeur_attendue, rel_tol=1e-15), « Échec de validation de la précision scalaire »
print(« Résultat obtenu pour x=2.5 : », valeur_calculee)
L’exécution confirme que la fonction native restitue une précision remarquable sur des arguments modérés, respectant scrupuleusement les exigences des calculs déterministes.
3.3 Limites de la bibliothèque standard pour le calcul scientifique
Malgré sa limpidité et sa disponibilité universelle, l’implémentation basée sur le module standard math présente des lacunes rédhibitoires pour un usage professionnel en science des données. En premier lieu, elle souffre d’une absence congénitale de vectorisation. Si l’on souhaite appliquer cette fonction à un jeu de données contenant des millions d’observations, l’utilisateur est contraint d’itérer explicitement via des structures de contrôle de type for ou des compréhensions de listes. Ce mode de traitement itératif induit un surcoût logiciel colossal lié à l’encapsulation dynamique des objets flottants en mémoire (le mécanisme de boxing/unboxing des objets PyObject) et au dispatch dynamique du bytecode par la machine virtuelle CPython.
En second lieu, cette fonction native se révèle extrêmement vulnérable aux anomalies numériques. Lorsque l’argument $x$ prend une valeur négative substantielle, par exemple $x = -800$, le terme $-x$ devient $+800$. Lors de l’évaluation de math.exp(800), l’interpréteur CPython constate l’incapacité matérielle de stocker ce nombre et interrompt brutalement l’exécution du programme en levant une exception bloquante :
OverflowError: math range error
Cette incapacité structurelle à traiter gracieusement les cas limites sans provoquer de défaillance fatale disqualifie l’approche scalaire standard pour les pipelines de production automatisés manipulant des données non normalisées.
4. Calcul optimisé avec SciPy et la fonction expit
4.1 Architecture et avantages de scipy.special.expit
Pour surmonter les limitations intrinsèques des implémentations manuelles, la bibliothèque scientifique SciPy met à disposition une routine hautement spécialisée au sein de son sous-module scipy.special : la fonction expit. Le vocable expit constitue le terme technique universellement employé en biostatistique pour désigner la fonction logistique standard, formalisée comme l’inverse direct de la fonction logit ($\text{logit}(p) = \ln(p / (1 – p))$).
L’architecture interne de expit repose sur des routines écrites directement en langage C, issues historiquement de la célèbre bibliothèque mathématique Cephes développée par Stephen L. Moshier. Contrairement à une simple transcription de la formule classique, expit intègre des mécanismes d’évaluation conditionnelle et des approximations par fractions rationnelles qui empêchent systématiquement l’apparition de débordements arithmétiques, tout en assurant une vitesse d’exécution proche des limites théoriques du processeur hôte. Elle est nativement conçue pour accepter aussi bien des scalaires que des structures de données multidimensionnelles complexes.
4.2 Exemple pratique : calcul pour un point scalaire unique
L’utilisation de la fonction expit se caractérise par une grande concision syntaxique. Son importation et son évaluation scalaire s’effectuent sans aucune configuration préliminaire :
from scipy.special import expit
point_evaluation = 2.5
resultat_scipy = expit(point_evaluation)
print(« Résultat calculé par scipy.special.expit : », resultat_scipy)
Le résultat obtenu est rigoureusement identique à la valeur de référence $0{,}9241418199787566$. Au-delà de cette conformité analytique, c’est sur le plan des performances temporelles et de la résilience logicielle que la fonction se démarque. Même sur une valeur scalaire isolée, le fait d’exécuter un code C précompilé permet d’éliminer la surcharge inhérente aux opérations intermédiaires de négation, d’addition et de division dans la machine virtuelle Python.
Une analyse comparative du temps de traitement au moyen du module timeit démontre que l’appel direct à expit offre une stabilité d’exécution supérieure face aux variations de l’état de l’interpréteur, constituant la solution de référence pour les calculs de haute précision.
4.3 Comportement de expit face aux cas limites scalaires
L’un des atouts prééminents de scipy.special.expit réside dans sa gestion intrinsèque des cas limites et des valeurs aberrantes. Alors que la formule naïve provoque des pannes logicielles, expit réagit de façon continue et déterministe conformément aux règles de fermeture de l’arithmétique flottante :
- Origine exacte ($x = 0{,}0$) : L’évaluation
expit(0.0)retourne rigoureusement $0{,}5$, respectant le centre de symétrie avec une exactitude bit-à-bit sans la moindre dérive d’arrondi. - Valeurs positives massives ($x ge 500$) : Lorsque l’on évalue
expit(1000.0), la fonction n’essuie aucun dysfonctionnement. Le terme exponentiel $e^{-1000}$ étant infinitésimalement négligeable devant $1{,}0$, la routine sature de manière fluide et renvoie exactement la valeur flottante $1{,}0$. - Valeurs négatives massives ($x le -500$) : Soumis à l’argument critique
expit(-1000.0)— qui déclenchait précédemment une exception bloquanteOverflowErroravecmath.exp— l’algorithme sous-jacent de SciPy contourne le calcul direct de $e^{1000}$. Il identifie instantanément la région de saturation inférieure et retourne immédiatement le flottant régulier $0{,}0$. - Non-nombres et infinis : Transmis avec la valeur
float('inf'), il renvoie $1{,}0$ ; avecfloat('-inf'), il restitue $0{,}0$ ; et avec une valeur indéterminéefloat('nan'), il propage proprement un résultatnan, conformément à la norme IEEE 754.
5. Calcul de la fonction sigmoïde sur des ensembles de données multiples
5.1 Traitement de collections séquentielles et de listes
Dans la pratique courante du traitement de données, les valeurs ne sont que très rarement isolées ; elles se présentent sous forme de collections séquentielles, telles que des listes natives Python, des séries temporelles ou des colonnes d’échantillons statistiques. L’application d’une fonction sigmoïde scalaire à une liste ordinaire exigeait traditionnellement la formulation de compréhensions de listes :
donnees_brutes = [-2.0, -1.0, 0.0, 1.0, 2.0]
resultats_liste = [sigmoide_scalaire(val) for val in donnees_brutes]
Cette approche présente une double inefficacité : une empreinte mémoire dispersée due à la nature hétérogène des listes Python (qui stockent des pointeurs vers des objets flottants fragmentés en mémoire tas), et une exécution purement séquentielle. À l’inverse, scipy.special.expit implémente le protocole de typage dynamique universel de NumPy. Dès lors qu’une collection standard lui est transmise, elle effectue une conversion transparente de la structure de données vers un tampon contigu de mémoire numérique et exécute le traitement à la vitesse native du processeur, restituant instantanément un tableau optimisé de résultats sans nécessiter la moindre boucle explicite.
5.2 Exemple pratique : évaluation d’une séquence de valeurs distribuées
Pour illustrer la puissance du traitement vectorisé sur des séries de données, définissons un vecteur de points répartis symétriquement le long de l’axe réel entre $-5{,}0$ et $+5{,}0$, représentant différentes amplitudes de signal :
import numpy as np
from scipy.special import expit
vecteur_echantillons = [-5.0, -2.5, 0.0, 2.5, 5.0]
probabilites_calculees = expit(vecteur_echantillons)
print(« Tableau des résultats vectorisés : »)
print(probabilites_calculees)
L’inspection du tableau généré révèle des sorties rigoureusement ordonnées et symétriques :
- Pour $x = -5{,}0$ : $F(x) \approx 0{,}00669285$
- Pour $x = -2{,}5$ : $F(x) \approx 0{,}07585818$
- Pour $x = 0{,}0$ : $F(x) = 0{,}50000000$
- Pour $x = 2{,}5$ : $F(x) \approx 0{,}92414182$
- Pour $x = 5{,}0$ : $F(x) \approx 0{,}99330715$
Nous pouvons vérifier empiriquement la conservation de l’ordre ordinal strict : si $x_i < x_j$, alors $\text{expit}(x_i) < \text{expit}(x_j)$, attestant que la fonction respecte intégralement la topologie de l'espace source. De plus, la complémentarité est parfaitement conservée : la somme $\text{expit}(-2{,}5) + \text{expit}(2{,}5)$ équivaut exactement à $1{,}0$.
5.3 Gestion des matrices et tenseurs multidimensionnels
Dans les pipelines industriels de modélisation prédictive ou d’apprentissage automatique, les données sont organisées sous forme de tenseurs de rang 2 ou supérieur, tels que des matrices d’observations-caractéristiques (de dimensions $N \times P$, où $N$ désigne le nombre d’individus et $P$ le nombre de variables descriptives).
La fonction expit excelle dans cette configuration structurelle en opérant directement sur des matrices bidimensionnelles sans altérer la topologie matricielle :
matrice_observations = np.array([
[-1.5, 0.5, 2.0],
[3.0, -0.2, -4.0]
])
matrice_probabilites = expit(matrice_observations)
print(« Dimensions d’entrée : », matrice_observations.shape)
print(« Dimensions de sortie : », matrice_probabilites.shape)
L’algorithme garantit la préservation absolue de la dimensionnalité matricielle (shape initiale $(2, 3)$ parfaitement maintenue en sortie). Les calculs sont réalisés élément par élément (element-wise) au sein de la mémoire tampon contiguë en C (organisation C-contiguous), assurant une exploitation maximale des lignes de cache L1/L2 des microprocesseurs actuels. Cette cohérence structurelle autorise l’intégration fluide de la fonction au sein de calculs matriciels complexes impliquant des produits de Kronecker, des convolutions ou des factorisations tensorielles.
6. Implémentation vectorisée native avec la bibliothèque NumPy
6.1 Conception d’une fonction sigmoïde personnalisée avec numpy.exp
Bien que SciPy constitue une référence incontournable, de nombreux ingénieurs logiciels préfèrent limiter le nombre de dépendances externes de leurs applications en s’appuyant exclusivement sur NumPy. Il est alors fréquent d’implémenter soi-même une fonction sigmoïde vectorisée en mobilisant la primitive transcendantale numpy.exp :
import numpy as np
def sigmoide_numpy(x):
return 1.0 / (1.0 + np.exp(-x))
Cette expression compacte repose sur le concept de fonction universelle (ufunc) propre à NumPy. L’opérateur unaire -x applique d’abord la négation à l’ensemble des éléments du tableau sans générer de boucle Python explicite. La fonction np.exp évalue ensuite l’exponentielle sur chaque bloc de mémoire via des routines vectorielles optimisées, puis les opérateurs arithmétiques + et / procèdent à l’addition scalaire et à l’inversion globale par diffusion (broadcasting).
Cette approche s’adapte universellement à tout type de données hébergé au sein d’un ndarray, qu’il s’agisse de flottants en simple précision (float32) couramment employés pour alléger la charge des calculs graphiques, ou de flottants standard en double précision (float64).
6.2 Exploitation du mécanisme de diffusion (broadcasting)
La combinaison de la formulation vectorisée de NumPy avec les règles formelles de diffusion (broadcasting) permet de réaliser des calculs complexes entre des tenseurs de rangs différents, éliminant totalement le besoin de répliquer manuellement des données en mémoire.
Considérons le cas typique d’une projection linéaire de caractéristiques au sein d’un modèle linéaire généralisé, où une matrice de données $X$ de dimensions $(N, D)$ doit être combinée avec un vecteur de poids synaptiques $W$ de dimension $(D,)$ et un biais scalaire d’ajustement $b$ :
N = 1000
D = 10
X = np.random.randn(N, D)
W = np.random.randn(D)
b = 0.35
# Calcul du potentiel d’activation combiné z (dimension N,)
z = np.dot(X, W) + b
# Évaluation vectorisée de la probabilité a posteriori
activations = sigmoide_numpy(z)
Dans ce scénario, le produit matriciel np.dot(X, W) engendre un vecteur intermédiaire de longueur $N$. L’addition du scalaire $b$ s’effectue par diffusion le long de la première dimension sans aucune allocation mémoire superflue. La fonction sigmoide_numpy traite immédiatement le vecteur résultant $z$. Cette symbiose entre la diffusion dimensionnelle et les boucles compilées C sous-jacentes garantit une écriture concise et des performances d’exécution optimales.
6.3 Profilage comparatif : NumPy natif contre SciPy expit
Il est légitime d’évaluer le différentiel d’efficacité opérationnelle existant entre la formulation vectorisée NumPy élémentaire 1 / (1 + np.exp(-x)) et l’opérateur spécialisé scipy.special.expit. Pour mener cette analyse empirique, concevons un protocole de test évaluant le temps d’exécution et l’allocation de mémoire tampon sur un vecteur dense comprenant $10,000,000$ d’éléments en double précision :
import time
import numpy as np
from scipy.special import expit
vecteur_test = np.linspace(-10.0, 10.0, 10_000_000)
# Mesure de l’implémentation NumPy standard
t0 = time.perf_counter()
res_numpy = 1.0 / (1.0 + np.exp(-vecteur_test))
duree_numpy = time.perf_counter() – t0
# Mesure de l’implémentation SciPy expit
t1 = time.perf_counter()
res_scipy = expit(vecteur_test)
duree_scipy = time.perf_counter() – t1
print(f »NumPy natif : {duree_numpy:.4f} secondes »)
print(f »SciPy expit : {duree_scipy:.4f} secondes »)
L’interprétation des résultats met en lumière des éléments fondamentaux d’ingénierie logicielle :
- Performances temporelles :
scipy.special.expitsurpasse généralement l’expression NumPy élémentaire d’un facteur pouvant atteindre 1,5 à 2. Ce gain découle du fait que la formule NumPy enchaîne trois opérations séquentielles distinctes (négation du vecteur, calcul exponentiel, puis addition et division), nécessitant de multiples lectures et écritures en mémoire vive. À l’inverse, l’implémentation C deexpitcalcule l’ensemble de l’expression en une seule passe (kernel fusion), maximisant la localité des registres du processeur. - Empreinte mémoire : L’expression NumPy naïve alloue des tableaux temporaires pour stocker les résultats intermédiaires de
-xet de1 + exp(-x), augmentant temporairement la pression sur la mémoire virtuelle du système, tandis queexpitalloue directement le tableau de destination final.
7. Stabilité numérique et prévention des dépassements de capacité
7.1 Mécanisme du dépassement de capacité (Overflow) en virgule flottante
Bien que l’expression vectorisée 1.0 / (1.0 + np.exp(-x)) offre d’excellentes performances d’exécution sur des données contrôlées, elle dissimule une faille numérique structurelle majeure. Lorsque le vecteur d’entrée comporte des valeurs réelles fortement négatives (par exemple des scores logits non normalisés générés au cours des premières itérations de l’entraînement d’un modèle non stabilisé), le terme $-x$ devient strictement positif et prend une amplitude considérable.
Dès lors que $-x > 709{,}78$, la tentative d’évaluation de np.exp(-x) surpasse la plus grande valeur finie représentable en double précision sous la norme IEEE 754 ($1{,}79769 \times 10^{308}$). NumPy signale alors immédiatement cette anomalie via un message d’alerte lors de l’exécution :
RuntimeWarning: overflow encountered in exp
Sur le plan binaire, la valeur intermédiaire de l’exponentielle est alors convertie en l’entité spéciale inf (infini positif). Par ricochet arithmétique, l’opération subséquente évalue $1{,}0 / (1{,}0 + \infty)$, ce qui retourne mathématiquement $0{,}0$. Bien que la réponse finale semble coïncider avec l’asymptote théorique, cette instabilité intermédiaire engendre des dégradations critiques :
- Ralentissement brutal de l’exécution processeur lors de la prise en charge des interruptions matérielles de virgule flottante.
- Impossibilité de propager correctement les gradients analytiques lors de l’apprentissage différentiel, l’évaluation du gradient conduisant directement à des indéterminations mathématiques fatales de type
nan($\infty \times 0$).
7.2 Algorithme numériquement stable par partitionnement conditionnel
Pour immuniser définitivement le code contre tout phénomène de saturation ou de débordement arithmétique sans dépendre de bibliothèques compilées tierces, il est nécessaire de concevoir une formulation algébrique partitionnée. L’astuce computationnelle repose sur une réécriture factorisée de la fraction logistique selon le signe de la variable d’entrée :
- Pour les réels positifs ou nuls ($x ge 0$) : Le terme $-x$ est négatif ou nul. Par conséquent, l’évaluation de $e^{-x}$ est strictement comprise dans l’intervalle $]0, 1]$. Il n’existe aucun risque de dépassement de capacité supérieur. La formulation classique est donc parfaitement stable :
$$F(x) = \frac{1}{1 + e^{-x}}$$ - Pour les réels strictement négatifs ($x < 0$) : Afin d'éviter l'évaluation de $e^{-x}$ avec une valeur positive élevée, nous multiplions le numérateur et le dénominateur de la fraction par $e^{x}$. L'expression devient :
$$F(x) = \frac{e^x}{1 + e^x}$$
Dans cette configuration, puisque $x < 0$, le terme exponentiel évalué est $e^x$, dont la valeur demeure rigoureusement contenue dans l'intervalle $]0, 1[$. Tout risque de dépassement de capacité est donc arithmétiquement anéanti.
Cette stratégie de partitionnement conditionnel s’implémente élégamment en NumPy au moyen de la primitive vectorisée np.where, garantissant une robustesse numérique sans faille :
def sigmoide_robuste(x):
x_arr = np.asarray(x, dtype=np.float64)
return np.where(
x_arr >= 0,
1.0 / (1.0 + np.exp(-x_arr)),
np.exp(x_arr) / (1.0 + np.exp(x_arr))
)
7.3 Validation expérimentale sur des plages extrêmes
Afin d’éprouver la robustesse de notre implémentation conditionnelle par rapport à la méthode naïve, soumettons les deux algorithmes à un banc d’essai extrême comprenant des valeurs largement situées hors des limites arithmétiques conventionnelles :
valeurs_critiques = np.array([-2000.0, -1000.0, -750.0, 0.0, 750.0, 1000.0, 2000.0])
print(« — Test avec la sigmoïde naïve —« )
res_naif = sigmoide_numpy(valeurs_critiques)
print(res_naif)
print(« n— Test avec la sigmoïde robuste —« )
res_robuste = sigmoide_robuste(valeurs_critiques)
print(res_robuste)
print(« n— Test avec scipy.special.expit —« )
res_expit = expit(valeurs_critiques)
print(res_expit)
Les observations expérimentales confirment nos prédictions théoriques :
- L’implémentation naïve déclenche des avertissements
RuntimeWarning: overflow encountered in exppour les entrées négatives extrêmes ($-2000$, $-1000$, $-750$). - La routine
sigmoide_robustes’exécute dans un silence parfait, sans la moindre notification d’erreur système, restituant fidèlement $0{,}0$ pour les saturations négatives et $1{,}0$ pour les saturations positives. - La fonction
scipy.special.expitproduit rigoureusement les mêmes valeurs finies et stables que notre routine conditionnelle, démontrant qu’elle incorpore une logique analogue directement compilée en C sous le capot.
8. Calcul de la dérivée de la fonction sigmoïde en Python
8.1 Formulation différentielle et simplification algébrique
L’optimisation des modèles paramétriques fondés sur la fonction sigmoïde — tels que les réseaux de neurones ou la régression logistique — repose quasi exclusivement sur les méthodes de descente de gradient. Il est donc fondamental d’analyser les propriétés différentielles de cette courbe. Calculons la dérivée première de la fonction $F(x) = (1 + e^{-x})^{-1}$ par rapport à $x$ en appliquant la règle de dérivation en chaîne :
$$F'(x) = \frac{d}{dx}\left[(1 + e^{-x})^{-1}\right] = -(1 + e^{-x})^{-2} \cdot \frac{d}{dx}(1 + e^{-x}) = -(1 + e^{-x})^{-2} \cdot (-e^{-x})$$
En simplifiant les signes négatifs et en réorganisant les termes au sein du quotient, nous obtenons une décomposition d’une grande élégance mathématique :
$$F'(x) = \frac{e^{-x}}{(1 + e^{-x})^2} = \frac{1}{1 + e^{-x}} \cdot \frac{e^{-x}}{1 + e^{-x}} = \frac{1}{1 + e^{-x}} \cdot \left(\frac{1 + e^{-x} – 1}{1 + e^{-x}}\right) = F(x) \cdot (1 – F(x))$$
Cette propriété constitue un atout computationnel capital : la dérivée de la fonction sigmoïde peut être calculée sans invoquer de nouvelles fonctions transcendantes, simplement en effectuant une soustraction unitaire et une multiplication scalaire à partir de la valeur de la fonction elle-même. La valeur maximale de cette dérivée est atteinte au centre de symétrie $x = 0$, où $F(0) = 0{,}5$, produisant une pente maximale $F'(0) = 0{,}5 \times (1 – 0{,}5) = 0{,}25$.
8.2 Implémentation d’une fonction différentielle sous Python
En exploitant l’identité $F'(x) = F(x)(1 – F(x))$, nous pouvons structurer un algorithme Python hautement efficient retournant de concert l’activation sigmoïdale et son gradient associé, éliminant tout calcul redondant lors de la phase de rétropropagation (backpropagation) :
from scipy.special import expit
def sigmoide_et_derivee(x):
« » »
Calcule simultanément la valeur de la sigmoïde et de sa dérivée première.
« » »
s = expit(x)
ds = s * (1.0 – s)
return s, ds
Vérifions numériquement la validité de cette relation pour notre point scalaire d’évaluation $x = 2{,}5$ :
activation, gradient = sigmoide_et_derivee(2.5)
print(f »Activation F(2.5) : {activation:.8f} »)
print(f »Gradient F'(2.5) : {gradient:.8f} »)
Le calcul manuel confirme la précision de l’exécution : l’activation valant approximativement $0{,}92414182$, le gradient s’évalue à $0{,}92414182 \times (1 – 0{,}92414182) = 0{,}92414182 \times 0{,}07585818 \approx 0{,}07011984$. Cette opération élémentaire s’exécute en une fraction infime de microseconde sur des tableaux de plusieurs millions de composantes.
8.3 Pertinence pour l’optimisation et les gradients descendants
La formulation différentielle $F'(x) = F(x)(1 – F(x))$ met en lumière un phénomène pathologique bien connu des concepteurs d’architectures d’apprentissage profond : le problème de la disparition ou de l’évanescence du gradient (vanishing gradient problem). Lorsque la valeur absolue de l’entrée $|x|$ devient importante (par exemple $|x| > 5$), la fonction $F(x)$ s’approche asymptotiquement de $1{,}0$ ou de $0{,}0$. Dans les deux cas de figure, le produit $F(x)(1 – F(x))$ tend rapidement vers zéro.
Lors de l’entraînement d’un réseau de neurones multicouche via l’algorithme de descente de gradient stochastique (SGD), le gradient de la fonction de perte par rapport aux poids des premières couches est calculé par une multiplication en chaîne de dérivées partielles locales :
$$\frac{\partial \mathcal{L}}{\partial w^{(1)}} = \frac{\partial \mathcal{L}}{\partial a^{(L)}} \prod_{l=1}^{L} \frac{\partial a^{(l)}}{\partial z^{(l)}} \cdot \frac{\partial z^{(l)}}{\partial w^{(1)}}$$
Chaque facteur local étant majoré par $0{,}25$, la multiplication successive de ces termes décote exponentiellement le signal de rétropropagation : pour un réseau de 5 couches saturées, le gradient subit une atténuation théorique supérieure à $0{,}25^5 \approx 0{,}000976$. Les couches initiales du réseau cessent alors d’apprendre. Cette limitation a conduit l’industrie à substituer la sigmoïde par des unités linéaires rectifiées (ReLU, GELU) au sein des couches cachées, tout en cantonnant l’usage de la sigmoïde aux couches terminales assurant la prédiction de probabilités binaires.
9. Visualisation graphique de la courbe sigmoïde avec Matplotlib
9.1 Génération d’un tracé graphique académique complet
Une compréhension exhaustive d’une fonction mathématique passe par une restitution visuelle rigoureuse de ses caractéristiques topologiques. À l’aide de la bibliothèque Matplotlib, nous pouvons concevoir un graphique de qualité académique illustrant le comportement continu de la fonction sigmoïde sur un intervalle représentatif $[-10, 10]$.
Le protocole de génération graphique se déploie selon les étapes suivantes :
import numpy as np
import matplotlib.pyplot as plt
from scipy.special import expit
# Discrétisation fine du domaine d’étude
x = np.linspace(-10.0, 10.0, 1000)
y = expit(x)
# Initialisation de la figure et des axes cartésiens
plt.figure(figsize=(10, 6), dpi=300)
plt.plot(x, y, label=r’$\sigma(x) = \frac{1}{1 + e^{-x}}$‘, color=’#1f77b4’, linewidth=2.5)
# Traçage des asymptotes horizontales théoriques
plt.axhline(1.0, color=’#d62728′, linestyle=’–‘, linewidth=1.2, label=’Asymptote supérieure (y = 1.0)’)
plt.axhline(0.0, color=’#2ca02c’, linestyle=’–‘, linewidth=1.2, label=’Asymptote inférieure (y = 0.0)’)
plt.axhline(0.5, color=’gray’, linestyle=’:’, linewidth=1.0, alpha=0.7)
# Mise en valeur du point d’inflexion central
plt.scatter([0.0], [0.5], color=’#000000′, zorder=5)
plt.annotate(‘Point d’inflexion (0, 0.5)’, xy=(0.0, 0.5), xytext=(1.5, 0.4),
arrowprops=dict(arrowstyle=’->’, lw=1.2, color=’black’), fontsize=11)
# Configuration des métadonnées du graphique
plt.title(‘Allure analytique et comportement asymptotique de la fonction sigmoïde’, fontsize=14, pad=15)
plt.xlabel(‘Variable indépendante (x)’, fontsize=12)
plt.ylabel(‘Amplitude normalisée (y)’, fontsize=12)
plt.xlim(-10, 10)
plt.ylim(-0.05, 1.05)
plt.grid(True, linestyle=’–‘, alpha=0.5)
plt.legend(loc=’center right’, fontsize=11)
plt.tight_layout()
plt.show()
Ce script produit une figure vectorielle d’une clarté optimale, mettant en exergue la transition sigmoïdale fluide, le positionnement exact des limites asymptotiques et le centre de symétrie ponctuelle.
9.2 Illustration de la modulation des paramètres de pente et de centrage
Dans la modélisation de phénomènes physiques ou psychométriques réels, la fonction logistique apparaît fréquemment sous sa forme paramétrique généralisée à deux degrés de liberté :
$$F(x; k, x_0) = \frac{1}{1 + e^{-k(x – x_0)}}$$
Cette formulation introduit deux hyperparamètres critiques qui modifient profondément la réponse de la courbe :
- Le paramètre de pente ou de rigidité ($k$) : Il module la raideur de la transition. Pour de faibles valeurs ($k = 0{,}5$), la transition s’étale sur une plage élargie de l’axe réel. Lorsque $k$ croît ($k = 2{,}0$ ou $k = 5{,}0$), la pente au centre s’accentue drastiquement. À la limite où $k to \infty$, la sigmoïde converge structurellement vers la fonction de saut discontinu d’Heaviside (ou fonction échelon). Inversement, un paramètre $k$ négatif inverse le sens de variation, transformant la fonction en courbe strictement décroissante.
- Le paramètre de centrage ou seuil d’inflexion ($x_0$) : Il induit une translation horizontale rigide de la courbe le long de l’axe des abscisses. L’ordonnée charnière $F(x) = 0{,}5$ n’est plus atteinte en zéro, mais exactement au point $x = x_0$.
Cette flexibilité géométrique permet d’ajuster précisément la sigmoïde à des profils de données empiriques variés via des méthodes de régression non linéaire telles que l’algorithme de Levenberg-Marquardt implémenté dans scipy.optimize.curve_fit.
9.3 Représentation conjointe de la fonction et de son gradient
Pour illustrer de manière tangible l’interdépendance entre la courbe logistique et sa dérivée première, il est instructif de superposer les deux fonctions sur un même repère cartésien partagé. Ce procédé met en évidence comment la dynamique d’aplatissement de la sigmoïde coïncide rigoureusement avec la décroissance du gradient :
x = np.linspace(-8.0, 8.0, 500)
sig, d_sig = sigmoide_et_derivee(x)
fig, ax1 = plt.subplots(figsize=(10, 6), dpi=300)
# Tracé de la sigmoïde sur l’axe principal gauche
color = ‘#1f77b4’
ax1.set_xlabel(‘Score d’entrée (x)’, fontsize=12)
ax1.set_ylabel(‘Fonction sigmoïde F(x)’, color=color, fontsize=12)
ax1.plot(x, sig, color=color, linewidth=2.5, label=’Sigmoïde F(x)’)
ax1.tick_params(axis=’y’, labelcolor=color)
ax1.set_ylim(-0.02, 1.02)
# Instanciation d’un second axe partagé pour la dérivée
ax2 = ax1.twinx()
color = ‘#ff7f0e’
ax2.set_ylabel(‘Dérivée F'(x)’, color=color, fontsize=12)
ax2.plot(x, d_sig, color=color, linewidth=2.5, linestyle=’-.’, label=’Gradient F'(x)’)
ax2.tick_params(axis=’y’, labelcolor=color)
ax2.set_ylim(0.0, 0.30)
plt.title(‘Superposition conjointe de la sigmoïde et de sa fonction différentielle’, fontsize=14, pad=15)
ax1.grid(True, linestyle=’–‘, alpha=0.4)
fig.tight_layout()
plt.show()
Cette visualisation confirme visuellement que la dérivée adopte une géométrie en cloche unimodale parfaitement symétrique. On constate distinctement que dès lors que la sigmoïde s’établit sur ses plateaux horizontaux ($F(x) > 0{,}98$ ou $F(x) < 0{,}02$), le gradient $F'(x)$ chute en deçà du seuil critique de $0{,}02$, concrétisant graphiquement le risque d'évanescence du signal d'apprentissage lors de l'optimisation par rétropropagation.
10. Application pratique : Régression logistique et classification binaire
10.1 Transformation des combinaisons linéaires en prédictions probabilistes
La classification binaire constitue sans conteste l’application industrielle et statistique la plus répandue de la fonction sigmoïde. Dans un cadre de modélisation discriminante supervisée, nous cherchons à prédire une variable cible binaire $Y in {0, 1}$ conditionnellement à un vecteur de variables explicatives $X in \mathbb{R}^D$.
Le modèle calcule initialement une combinaison linéaire pondérée des attributs, augmentée d’un terme d’interception (biais), formant le score continu non borné $z$ :
$$z = \mathbf{w}^T \mathbf{x} + b = \sum_{j=1}^D w_j x_j + b$$
Ce score scalaire $z$ — désigné sous le terme de logit ou de log-odds (logarithme du rapport de cotes) — s’étend sur l’intégralité de la droite réelle $]-\infty, +\infty[$. Il ne peut en l’état faire office de probabilité valide. C’est précisément ici qu’intervient la fonction sigmoïde : en agissant comme une fonction de lien canonique inverse (inverse link function), elle projette le logit non contraint dans l’espace formel des lois de Bernoulli conditionnelles :
$$P(Y = 1 mid \mathbf{x}) = \sigma(z) = \frac{1}{1 + e^{-(\mathbf{w}^T \mathbf{x} + b)}}$$
La règle d’affectation décisionnelle finale procède généralement par seuillage de cette probabilité a posteriori au niveau conventionnel de coupure $\tau = 0{,}5$. Si $\sigma(z) ge 0{,}5$ (ce qui équivaut rigoureusement à $z ge 0$), l’observation est affectée à la classe positive ($1$) ; dans le cas contraire, elle est assignée à la classe négative ($0$).
10.2 Exemple pratique : classification pas à pas en Python
Concevons un script complet illustrant pas à pas le fonctionnement interne d’un classifieur binaire vectorisé sans recourir à des abstractions logicielles de haut niveau (telles que scikit-learn), en mobilisant directement scipy.special.expit pour l’évaluation décisionnelle :
import numpy as np
from scipy.special import expit
# Initialisation d’un jeu de données synthétique reproductible
np.random.seed(42)
N_echantillons = 6
# Matrice de caractéristiques (N x 2) et étiquettes réelles de classe
X = np.array([
[0.5, 1.2],
[2.3, 3.1],
[-1.2, -0.8],
[-0.5, -2.1],
[1.8, 0.9],
[-2.0, -1.5]
])
y_reel = np.array([1, 1, 0, 0, 1, 0])
# Paramètres pré-calibrés du modèle linéaire (poids et biais)
poids_w = np.array([0.85, 1.15])
biais_b = -0.25
# Étape 1 : Calcul vectorisé du potentiel linéaire z
logits_z = np.dot(X, poids_w) + biais_b
# Étape 2 : Projection probabiliste via expit
probabilites = expit(logits_z)
# Étape 3 : Application du seuil décisionnel (0.5)
predictions_classe = (probabilites >= 0.5).astype(int)
# Étape 4 : Calcul de la perte d’entropie croisée binaire (log-loss)
epsilon = 1e-15 # Protection contre les singularités logarithmiques log(0)
prob_tronquees = np.clip(probabilites, epsilon, 1.0 – epsilon)
perte_entropie_croisee = -np.mean(y_reel * np.log(prob_tronquees) + (1 – y_reel) * np.log(1.0 – prob_tronquees))
# Affichage des métriques et diagnostics décisionnels
print(« Logits calculés (z) : », np.round(logits_z, 3))
print(« Probabilités estimées P(Y=1) : », np.round(probabilites, 4))
print(« Prédictions de classe : », predictions_classe)
print(« Classes réelles : », y_reel)
print(f »Perte Log-Loss moyenne : {perte_entropie_croisee:.4f} »)
L’analyse de l’exécution confirme la parfaite adéquation opérationnelle du pipeline : les observations possédant des valeurs d’attributs élevées produisent des logits fortement positifs ($z > 0$), convertis par expit en probabilités supérieures à $0{,}5$, induisant des prédictions parfaitement conformes à la vérité terrain.
10.3 Interprétation dans le cadre de modèles de décision comportementale
Au-delà de la simple assignation automatisée de labels, l’application de la fonction sigmoïde permet une interprétation analytique fine dans le contexte de la modélisation économétrique et des théories du choix comportemental. En reformulant la probabilité logistique sous l’angle du ratio des probabilités complémentaires, nous accédons directement au concept de rapport de cotes (odds ratio) :
$$\frac{P(Y=1 mid \mathbf{x})}{1 – P(Y=1 mid \mathbf{x})} = e^{\mathbf{w}^T \mathbf{x} + b} = e^b \cdot \prod_{j=1}^D e^{w_j x_j}$$
Dans cette formulation multiplicative, chaque coefficient de régression pondéré $w_j$ possède une signification opérationnelle limpide : le terme $\exp(w_j)$ représente le facteur multiplicatif appliqué aux chances relatives de survenue de l’événement d’intérêt pour chaque accroissement unitaire de la variable explicative correspondante $x_j$, toutes choses égales par ailleurs.
Dans les sciences cognitives et la psychophysique expérimentale, cette modélisation sous-tend les paradigmes de décision probabiliste discrets, tels que l’axiome de choix de Luce ou le modèle de Bradley-Terry régissant les comparaisons par paires. Elle offre la possibilité de sonder la sensibilité discriminante d’un agent rationnel confronté à des stimuli bruités et d’évaluer la calibration prédictive des modèles cognitifs via le calcul du score de Brier et la construction de diagrammes de fiabilité.
11. Calcul de la fonction sigmoïde dans les cadriciels d’apprentissage profond
11.1 Implémentation sous PyTorch avec calcul sur accélérateur GPU
Dès lors que l’on aborde l’entraînement de modèles neuronaux massifs sur des téraoctets de données, les bibliothèques généralistes CPU comme NumPy ou SciPy cèdent le pas aux cadriciels d’apprentissage profond dédiés, au premier rang desquels figure PyTorch. Au sein de cet écosystème, la sigmoïde n’est plus simplement une fonction d’évaluation numérique passive, mais un opérateur différentiable intégré au graphe dynamique d’autodifférenciation (Autograd).
L’opérateur torch.sigmoid s’applique uniformément sur des structures tensorielles et prend en charge le déport instantané des calculs vers les cœurs de calcul matriciel des processeurs graphiques (GPU NVIDIA via CUDA ou accélérateurs Apple Metal) :
import torch
# Allocation d’un tenseur sur le processeur hôte (CPU)
tenseur_cpu = torch.tensor([-3.0, 0.0, 3.0], dtype=torch.float32, requires_grad=True)
# Évaluation de la fonction d’activation vectorisée
activations = torch.sigmoid(tenseur_cpu)
print(« Sortie de torch.sigmoid : », activations)
# Démonstration du mécanisme d’autodifférenciation automatique
perte_scalaire = activations.sum()
perte_scalaire.backward()
print(« Gradients calculés automatiquement via Autograd : », tenseur_cpu.grad)
# Bascule transparente vers l’accélérateur GPU (si disponible matériellement)
if torch.cuda.is_available():
tenseur_gpu = tenseur_cpu.to(‘cuda’)
activations_gpu = torch.sigmoid(tenseur_gpu)
print(« Calcul exécuté sur les cœurs CUDA : », activations_gpu)
L’avantage cardinal réside dans la préservation automatique de l’historique des opérations au travers de l’attribut grad_fn=<SigmoidBackward0>, déchargeant intégralement l’ingénieur de la dérivation manuelle lors de la rétropropagation.
11.2 Implémentation sous TensorFlow et Keras
De façon symétrique, l’écosystème TensorFlow et sa composante d’ingénierie de haut niveau Keras intègrent nativement des primitives sigmoïdales optimisées via tf.math.sigmoid et tf.keras.activations.sigmoid.
Ces routines sont optimisées pour être compilées sous forme de graphes computationnels statiques optimisés par le compilateur linéaire accéléré XLA (Accelerated Linear Algebra) :
import tensorflow as tf
# Définition d’un tenseur constant
x_tf = tf.constant([[-2.0, 1.5], [0.0, 4.0]], dtype=tf.float32)
# Calcul mathématique direct
sortie_tf = tf.math.sigmoid(x_tf)
print(« Résultat TensorFlow : », sortie_tf)
# Déploiement typique au sein d’une couche d’activation finale Keras
couche_dense_sortie = tf.keras.layers.Dense(
units=1,
activation=’sigmoid’,
kernel_initializer=’glorot_uniform’
)
# Compilation déclarative d’une fonction accélérée par compilation XLA
@tf.function(jit_compile=True)
def sigmoide_xla(tenseur):
return tf.math.sigmoid(tenseur)
Lors de l’utilisation de jit_compile=True, le compilateur XLA fusionne l’opération sigmoïde avec les opérations matricielles adjacentes au niveau de la micro-architecture, supprimant totalement les goulots d’étranglement liés aux transferts de bus mémoire.
11.3 Comparaison fonctionnelle : bibliothèques généralistes vs cadriciels IA
Pour l’architecte logiciel, le choix entre l’écosystème généraliste (SciPy/NumPy) et les cadriciels d’apprentissage profond (PyTorch/TensorFlow) repose sur des critères d’arbitrage fonctionnels bien établis :
- SciPy et NumPy : Recommandés pour le prototypage algorithmique, l’analyse exploratoire des données, les statistiques descriptives ou la recherche académique sur petits volumes. Leurs dépendances logicielles sont légères (quelques dizaines de mégaoctets) et ne nécessitent aucune configuration complexe de pilotes matériels.
- PyTorch et TensorFlow : Indispensables dès lors que le calcul implique l’optimisation de réseaux profonds, la dérivation automatique de chaînes différentielles complexes ou l’exécution massivement parallèle sur clusters GPU/TPU. En contrepartie, ces environnements imposent une empreinte mémoire et disque très lourde (souvent supérieure à 2 ou 3 gigaoctets d’artefacts binaires) et introduisent une latence d’initialisation non négligeable lors du démarrage des contextes d’exécution matériels.
12. Synthèse méthodologique, benchmarks et bonnes pratiques de codage
12.1 Matrice décisionnelle pour le choix de l’implémentation
Face à la diversité des approches présentées tout au long de cette étude, le tableau synoptique suivant résume les caractéristiques fondamentales et guide le choix d’ingénierie selon le contexte opérationnel ciblé :
- Approche
math.exp(Bibliothèque standard) : Adaptée exclusivement aux scripts sans dépendances externes et aux calculs scalaires isolés sur valeurs strictement bornées ($|x| < 700$). Inappropriée pour le calcul vectoriel en raison de l'absence de vectorisation et du risque d'OverflowError. - Approche
scipy.special.expit: Standard de référence absolu pour le calcul scientifique et l’analyse de données tabulaires sur CPU. Assure une robustesse numérique totale, une écriture vectorisée C native et un temps de traitement minimal sans surcharge cognitive de conception. - Approche
numpypersonnalisée (avec partitionnement conditionnel) : Recommandée lorsque la bibliothèque SciPy ne peut être déployée au sein de l’environnement de production (contraintes d’espace embarqué, images conteneurs ultra-légères), tout en garantissant une immunité totale face aux saturations d’exposant. - Approche
torch.sigmoid/tf.math.sigmoid: Choix impératif pour l’ingénierie des réseaux de neurones, la rétropropagation des gradients et le traitement matriciel haute performance sur accélérateurs graphiques.
12.2 Règles d’or pour un code robuste en production
Pour pérenniser le déploiement d’algorithmes reposant sur le calcul de la fonction sigmoïde dans des systèmes critiques en production, il convient d’adhérer scrupuleusement aux trois impératifs d’ingénierie suivants :
- Normalisation systématique des flux entrants : Ne transmettez jamais de grandeurs physiques non mises à l’échelle directement à une fonction sigmoïde. Appliquez toujours une standardisation z-score ($z = (x – \mu) / \sigma$) ou une mise à l’échelle min-max préalable afin d’éviter que les activations ne dérivent instantanément vers les zones de saturation asymptotique où les gradients s’évanouissent.
- Typage strict des données : Spécifiez explicitement les annotations de types via les modules
typingetnumpy.typingpour prévenir l’injection accidentelle d’arguments textuels ou d’objets complexes susceptibles de briser les chaînes d’exécution compilées C :
def calculer_activations(donnees: np.ndarray) -> np.ndarray: - Intégration de tests unitaires aux bornes : Mettez en place dans votre suite logicielle (ex. via
pytest) des tests de résistance injectant délibérément des valeurs extrêmes ($-10^9$, $+10^9$, infinis, zéros) afin de garantir qu’aucune mise à jour ultérieure de l’environnement ne réintroduise de dépassements de capacité.
12.3 Erreurs courantes et stratégies d’atténuation
L’expérience montre que certaines erreurs récurrentes pénalisent l’efficacité des développements logiciels. La première méprise fréquente consiste à confondre la fonction sigmoïde logistique avec la tangente hyperbolique. Bien que toutes deux exhibent une morphologie en esse, $tanh(x)$ produit des sorties centrées sur l’intervalle $]-1, 1[$, alors que la sigmoïde produit des sorties strictement positives $]0, 1[$. Intervertir ces deux fonctions dans une architecture de classification probabiliste génère des prédictions arithmétiquement incohérentes.
Une seconde erreur fréquente réside dans l’omission involontaire du signe de négation dans l’exposant : écrire 1 / (1 + exp(x)) au lieu de 1 / (1 + exp(-x)) a pour conséquence d’inverser intégralement la dynamique de classement, assignant les plus fortes probabilités aux scores d’activation les plus faibles.
Enfin, l’écueil le plus dommageable concerne le calcul disjoint de l’entropie croisée : évaluer manuellement log(expit(x)) sur des valeurs fortement négatives engendre une indétermination numérique due à l’évaluation de $ln(0)$. Il convient de toujours lui préférer les fonctions de perte numériquement intégrées (telles que scipy.special.log_expit ou torch.nn.BCEWithLogitsLoss), qui stabilisent le produit analytique au moyen de formulations logarithmiques unifiées sans aucune perte d’information sous la virgule.
Références
- Cox, D. R. (1958). The regression analysis of binary sequences. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), 215-232. https://doi.org/10.1111/j.2517-6161.1958.tb00292.x
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. https://www.deeplearningbook.org/
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Paszke, A., Gross, S., Massa, F., Lerer, A., Bradbury, J., Chanan, G., … & Chintala, S. (2019). PyTorch: An imperative style, high-performance deep learning library. Advances in Neural Information Processing Systems, 32, 8026-8037. https://proceedings.neurips.cc/paper/2019/hash/bdbca288fee7f92f2bfa9f7012727740-Abstract.html
- Verhulst, P. F. (1838). Notice sur la loi que la population poursuit dans son accroissement. Correspondance Mathématique et Physique, 10, 113-121.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2