
Dans le champ contemporain de l’apprentissage automatique et de la modélisation statistique appliquée, l’évaluation de la performance d’un algorithme constitue une étape méthodologique tout aussi critique que la conception de son architecture interne. Trop souvent, les praticiens et chercheurs se reposent sur des indicateurs intuitifs mais trompeurs, au premier rang desquels figure l’exactitude globale, communément désignée sous le terme d’accuracy. Cette métrique, qui mesure simplement la proportion de prédictions correctes sur l’ensemble des observations disponibles, présente une fragilité structurelle majeure dès lors qu’elle est confrontée à des distributions empiriques asymétriques. Dans les disciplines où les événements d’intérêt surviennent avec une fréquence relative faible — telles que la psychiatrie computationnelle, l’épidémiologie clinique, la psychométrie ou la détection de fraudes comportementales —, l’exactitude standard perd toute valeur discriminante et induit une distorsion cognitive sévère dans l’appréciation des capacités réelles du modèle.
Pour surmonter cette impasse analytique, la recherche méthodologique a formalisé une alternative robuste : l’exactitude équilibrée, ou Balanced Accuracy. Fondée sur une décomposition probabiliste rigoureuse issue des principes de la théorie de la détection du signal, cette mesure neutralise le poids démographique disproportionné des classes majoritaires en calculant la moyenne arithmétique des taux de succès obtenus sur chaque catégorie considérée isolément. Ainsi, elle attribue une importance épistémologique identique à la détection de la classe marginale et à celle du groupe dominant. Ce principe élémentaire transforme radicalement le diagnostic de performance, contraignant les algorithmes à faire preuve d’une véritable compétence discriminative plutôt que de capitaliser sur la prévalence a priori du phénomène étudié.
L’écosystème Python, soutenu par l’infrastructure logicielle de scikit-learn, offre un cadre de calcul standardisé, modulaire et hautement optimisé pour l’estimation de l’exactitude équilibrée. Le présent article propose une exploration exhaustive, tant sur le plan théorique que programmatique, de cette métrique essentielle. De l’élucidation de ses fondements mathématiques à son déploiement au sein de protocoles complexes de validation croisée et d’optimisation bayésienne d’hyperparamètres, nous détaillerons les mécanismes sous-jacents nécessaires à une mise en œuvre rigoureuse, reproductible et scientifiquement irréprochable dans les travaux d’analyse prédictive modernes.
1. Introduction théorique à l’exactitude équilibrée (Balanced Accuracy)
1.1 Définition conceptuelle et émergence de la métrique
L’exactitude équilibrée trouve ses racines historiques et conceptuelles dans les développements de la théorie de la détection du signal (TDS), initialement formalisée par des chercheurs comme Tanner et Swets au milieu du XXe siècle pour quantifier la manière dont un observateur — qu’il soit biologique ou mécanique — parvient à séparer une information pertinente d’un bruit de fond stochastique. Dans les configurations expérimentales de la psychophysique et de la théorie de l’information, il est rapidement apparu que la capacité d’un système à émettre une réponse adéquate ne pouvait être évaluée à l’aune d’un simple comptage des réponses correctes. Lorsque les stimuli cibles sont rares, un observateur biaisé qui répond systématiquement par la négative présente paradoxalement un taux d’exactitude global flatteur tout en échouant systématiquement à détecter le signal attendu.
Cette aporie méthodologique a conduit la communauté statistique à élaborer des métriques normalisées, affranchies des variations de prévalence du signal dans l’environnement expérimental. C’est au cœur de cette quête de validité de construit que l’exactitude équilibrée a été introduite dans les sciences des données, notamment popularisée par les travaux fondateurs de Brodersen et ses collaborateurs (2010). L’objectif était d’instaurer un critère d’évaluation qui traite chaque catégorie diagnostique ou comportementale comme un domaine d’évaluation autonome possédant un poids égal dans le jugement synthétique de l’observateur.
D’un point de vue épistémologique, il convient d’opérer une distinction rigoureuse entre l’exactitude brute et l’exactitude normalisée. L’exactitude brute est une mesure purement descriptive de la concordance globale entre l’échantillon empirique et le vecteur de prédiction. Elle reflète autant la structure marginale de la distribution des données que l’adéquation fonctionnelle de l’algorithme. À l’inverse, l’exactitude équilibrée s’affirme comme une métrique contrefactuelle : elle estime quelle aurait été l’exactitude du modèle si les données d’évaluation avaient présenté une répartition parfaitement symétrique entre les classes. Cette normalisation constitue une condition préalable indispensable à toute inférence robuste portant sur l’efficacité intrinsèque d’un mécanisme de décision supervisé.
1.2 Le problème fondamental du déséquilibre des classes
Dans la grande majorité des recherches empiriques contemporaines, la répartition des observations entre les modalités d’une variable cible s’avère profondément asymétrique. Qu’il s’agisse de documenter la survenue d’un comportement violent en milieu carcéral, l’émergence d’une pathologie neurodégénérative précoce, la fraude financière ou le décrochage scolaire soudain, les cas positifs ne constituent fréquemment qu’une fraction marginale — oscillant typiquement entre 1 % et 10 % — du corpus d’observation total. Ce phénomène d’asymétrie structurelle engendre ce que les statisticiens désignent sous le nom de « paradoxe de l’exactitude » (Accuracy Paradox).
Ce paradoxe découle directement de la structure de calcul de l’exactitude classique. Lorsqu’un jeu de données comprend 98 % d’individus sains et 2 % d’individus atteints d’un trouble psychopathologique sévère, un algorithme trivial programmé pour prédire de manière déterministe et constante la négativité diagnostique obtiendra, sans le moindre apprentissage, une exactitude brute de 98 %. D’un point de vue quantitatif superficiel, ce modèle semble frôler la perfection statistique. En réalité, sur le plan opérationnel et clinique, son utilité prédictive est strictement nulle, puisqu’il échoue à identifier le moindre sujet à risque. Le paradoxe réside dans le fait qu’un modèle doté d’une exactitude inférieure — par exemple 88 % —, mais capable d’isoler une part significative des véritables cas positifs, sera formellement rejeté au profit du modèle naïf si l’exactitude globale demeure le seul critère de sélection.
Les conséquences d’un tel biais cognitif et méthodologique dans la conduite de la recherche appliquée s’avèrent délétères. L’utilisation d’une métrique inadéquate conduit invariablement les équipes de recherche à sélectionner des estimateurs statistiques paresseux, qui maximisent leur score en se conformant à la structure a priori de l’échantillon plutôt qu’en identifiant les variables explicatives discriminantes de la classe minoritaire. Ceci génère une perte de confiance dans les outils d’apprentissage automatique lorsqu’ils sont ensuite confrontés à la réalité du terrain clinique ou organisationnel.
1.3 Pertinence dans l’analyse comportementale et les sciences sociales
Dans l’analyse comportementale, la sociologie quantitative et les neurosciences cognitives, l’exactitude équilibrée répond à une exigence éthique et clinique fondamentale : l’équité de traitement statistique des phénomènes à faible incidence. Considérons, par exemple, la détection des idées suicidaires ou des passages à l’acte auto-agressifs au sein d’une cohorte longitudinale d’adolescents. Dans ce contexte, la prévalence du phénomène reste heureusement basse à l’échelle de la population générale. Toutefois, le coût sociétal, humain et médical d’un faux négatif (l’incapacité à identifier un sujet en détresse) excède incommensurablement le coût logistique d’un faux positif (la conduite d’une évaluation clinique complémentaire non concluante).
Si les modèles prédictifs développés dans ces disciplines sont calibrés et évalués à l’aide de l’exactitude conventionnelle, le processus d’optimisation mathématique négligera inévitablement les sous-groupes minoritaires. L’exactitude équilibrée contraint l’analyste à maintenir un niveau d’exigence méthodologique constant quelle que soit la représentativité statistique du sous-groupe. Elle impose au modèle prédictif d’atteindre un taux de reconnaissance acceptable tant chez les individus manifestant un trait psychologique rare — par exemple, un profil de personnalité antisociale ou une résilience cognitive exceptionnelle — que chez les sujets conformes à la norme populationnelle.
De surcroît, la métrique s’inscrit au cœur des débats contemporains relatifs à la justice algorithmique (algorithmic fairness). Dans les études sociologiques relatives aux décisions d’octroi de bourses, de prédiction de récidive judiciaire ou d’accès à des programmes sociaux sélectifs, les minorités démographiques subissent fréquemment une sous-représentation dans les cohortes d’entraînement. L’exactitude équilibrée garantit que les erreurs commises sur ces populations spécifiques ne soient pas diluées et dissimulées derrière l’écrasante masse statistique des données issues du groupe majoritaire, assurant ainsi une auditabilité scientifique et sociale transparente des modèles prédictifs.
2. Les limites structurelles de l’exactitude standard face aux classes asymétriques
2.1 Analyse mathématique du paradoxe de l’exactitude
Pour appréhender formellement les mécanismes du paradoxe de l’exactitude, il est nécessaire de décomposer analytiquement la formule conventionnelle de cette métrique. Soit un ensemble de $N$ observations distribuées entre deux classes mutuellement exclusives, notées $C_0$ et $C_1$. Définissons $N_0$ comme l’effectif des individus appartenant à la classe majoritaire $C_0$, et $N_1$ comme l’effectif de la classe minoritaire $C_1$, tels que $N = N_0 + N_1$. La matrice de confusion issue de la confrontation entre les étiquettes observées et les prédictions d’un modèle binaire permet de définir quatre quantités fondamentales : les vrais positifs ($VP$), les vrais négatifs ($VN$), les faux positifs ($FP$) et les faux négatifs ($FN$). L’exactitude conventionnelle, notée ici $A$, s’exprime par la relation linéaire suivante :
$$A = \frac{VP + VN}{N} = \frac{VP + VN}{N_0 + N_1}$$
Supposons à présent l’existence d’une asymétrie marquée caractérisée par un ratio de prévalence $\pi = \frac{N_1}{N} to 0$, ce qui implique réciproquement que $\frac{N_0}{N} = 1 – \pi to 1$. Si nous soumettons à ce jeu de données un classificateur invariant ou « aveugle », qui prédit systématiquement et inconditionnellement la classe majoritaire $C_0$ pour tout individu de l’échantillon, les valeurs prises par les composantes de la matrice de confusion deviennent immédiatement prévisibles : $VP = 0$, $FN = N_1$, $VN = N_0$, et $FP = 0$. En substituant ces grandeurs au sein de la formulation de base, le résultat mathématique obtenu se réduit à :
$$A_{\text{naïf}} = \frac{0 + N_0}{N_0 + N_1} = \frac{N_0}{N} = 1 – \pi$$
Cette démonstration établit sans équivoque que la performance affichée par un classificateur dépourvu de toute capacité d’inférence tend asymptotiquement vers l’unité à mesure que la classe minoritaire se raréfie. Dans une situation où $\pi = 0{,}001$ (un cas positif pour mille individus), le classificateur naïf affiche un score de $0{,}999$, soit une exactitude de 99,9 %. La formule classique opère ainsi un effet d’écrasement ou de masquage statistique : l’erreur commise sur la classe $C_1$ ($FN = N_1$) est divisée par le volume total $N$, ce qui neutralise sa contribution relative au score final et dissimule l’échec fonctionnel complet du modèle sur la catégorie critique.
2.2 Impact opérationnel d’une mauvaise métrique d’évaluation
L’utilisation de l’exactitude standard dans un environnement de classes asymétriques entraîne des répercussions désastreuses sur la validité interne et externe des travaux quantitatifs. Au sein de la littérature scientifique évaluée par les pairs, il n’est pas rare de constater la validation de modèles prétendant résoudre des problèmes diagnostiques complexes avec une exactitude annoncée de plus de 90 %, alors même qu’une analyse minutieuse de leurs tables de contingence révèle qu’ils ne possèdent aucune sensibilité clinique. Cette illusion de compétence algorithmique pollue les corpus de méta-analyse et fausse l’état de l’art technologique.
Dans un contexte décisionnel réel, par exemple dans le déploiement d’un modèle d’alerte précoce pour la prévention du décrochage universitaire au sein d’une cohorte d’étudiants vulnérables, une exactitude globale trompeuse induit un taux massif de faux négatifs non surveillés. Les gestionnaires de programmes institutionnels, rassurés par un taux d’erreur global apparent de seulement 5 %, ignorent que ces 5 % d’erreurs concentrent l’intégralité des étudiants qui vont effectivement abandonner leur cursus sans avoir reçu l’accompagnement pédagogique nécessaire. L’outil d’aide à la décision devient alors un vecteur involontaire de non-intervention.
En outre, l’altération de la reproductibilité scientifique constitue l’un des effets pervers les plus insidieux de cette pratique. Lorsqu’une équipe de recherche tente de reproduire sur une population externe un modèle entraîné sur un échantillon déséquilibré avec un haut score d’exactitude brute, l’inversion ou la simple variation de la prévalence de la classe cible dans la nouvelle cohorte entraîne l’effondrement immédiat du score. Le modèle n’avait en effet jamais extrait de régularités statistiques transposables ; il avait simplement appris la distribution marginale a priori du jeu de données initial.
2.3 Conditions statistiques imposant l’abandon de l’accuracy conventionnelle
L’abandon de l’exactitude brute au profit de métriques normalisées comme la Balanced Accuracy ne relève pas d’une préférence stylistique, mais d’une impérieuse nécessité mathématique qui s’impose dès lors que certains seuils distributionnels sont franchis. En pratique méthodologique, les statisticiens s’accordent à considérer que dès lors que la prévalence de la classe minoritaire descend en dessous de 20 % de l’effectif global (un ratio d’asymétrie de 4:1 ou plus), l’exactitude standard commence à subir une distorsion significative. Lorsque ce ratio atteint ou dépasse 9:1 (moins de 10 % de cas minoritaires), l’exactitude conventionnelle devient totalement inutilisable pour guider l’entraînement ou la sélection de modèles.
Un deuxième critère statistique déterminant concerne la dissymétrie des matrices de coûts d’erreur. Si les conséquences d’un faux négatif ne sont pas strictement identiques aux conséquences d’un faux positif, l’exactitude conventionnelle — qui accorde une pénalité identique de 1 à toute erreur, quelle que soit la nature de la confusion — s’avère conceptuellement invalide. Dans les sciences médicales et humaines, l’asymétrie des coûts est la norme absolue : l’omission d’une pathologie létale ou d’un trouble psychologique incapacitant présente un coût sociopsychologique incomparablement supérieur à l’émission d’une fausse alerte conduisant à un second examen non invasif.
Enfin, les exigences de comparabilité inter-modèles à travers des jeux de données hétérogènes imposent l’abandon de la métrique classique. Si un chercheur évalue un algorithme sur deux cohortes présentant des taux de positivité distincts (par exemple 5 % dans un échantillon de dépistage communautaire et 25 % dans une unité hospitalière spécialisée), les scores d’exactitude standard obtenus ne peuvent en aucun cas être comparés pour mesurer la robustesse de l’estimateur. Seule une métrique invariante à l’égard de la prévalence des classes, telle que l’exactitude équilibrée, autorise une comparaison théorique rigoureuse.
3. Décomposition mathématique et fondements statistiques de la métrique
3.1 Formalisation de la sensibilité et de la spécificité
La construction analytique de l’exactitude équilibrée repose sur l’intégration conjointe de deux grandeurs fondamentales de l’épidémiologie mathématique : la sensibilité (ou taux de vrais positifs) et la spécificité (ou taux de vrais négatifs). Ces métriques reposent sur le conditionnement probabiliste strict des décisions de l’algorithme par rapport à l’état réel et avéré de la nature.
Soit $Y in {0, 1}$ la variable aléatoire représentant l’état réel de l’observation (où 1 désigne la condition positive et 0 la condition négative), et soit $\hat{Y} in {0, 1}$ la variable aléatoire désignant la prédiction émise par le modèle. La sensibilité, formellement synonyme du rappel (Recall) de la classe positive, représente la probabilité conditionnelle que le modèle prédise un résultat positif sachant que l’individu est réellement positif :
$$\text{Sensibilité} = \text{Recall}_1 = P(\hat{Y} = 1 mid Y = 1) = \frac{VP}{VP + FN}$$
Cette proportion quantifie l’exhaustivité de l’algorithme face à la classe d’intérêt. À l’opposé du spectre de décision, la spécificité mesure la capacité du classificateur à isoler et préserver la classe de contrôle en évitant les fausses alarmes. Elle s’exprime comme la probabilité conditionnelle que le modèle prédise un résultat négatif sachant que l’individu est effectivement négatif :
$$\text{Spécificité} = \text{Recall}_0 = P(\hat{Y} = 0 mid Y = 0) = \frac{VN}{VN + FP}$$
L’avantage cardinal de ces deux grandeurs réside dans leur stricte indépendance algébrique vis-à-vis des effectifs marginaux $N_1$ et $N_0$. La sensibilité est calculée exclusivement sur le sous-ensemble conditionnel $Y = 1$, sans que l’ampleur de l’échantillon $Y = 0$ n’intervienne au dénominateur ; réciproquement, la spécificité s’établit exclusivement sur la population conditionnelle $Y = 0$. Par conséquent, aucune variation arbitraire de la proportion globale de cas dans l’échantillon ne peut altérer la valeur intrinsèque de ces deux probabilités conditionnelles.
3.2 L’équation de la balanced accuracy en contexte binaire
En contexte de classification binaire, l’exactitude équilibrée (notée couramment $BA$ pour Balanced Accuracy) se définit comme la moyenne arithmétique simple de la sensibilité et de la spécificité. Sa formulation analytique canonique se présente ainsi :
$$BA = \frac{\text{Sensibilité} + \text{Spécificité}}{2} = \frac{1}{2} \left( \frac{VP}{VP + FN} + \frac{VN}{VN + FP} \right)$$
Cette formulation simple implique une modification conceptuelle majeure : chaque classe d’observations reçoit un poids égal à $\frac{1}{2}$ dans le score synthétique final, indépendamment du nombre absolu d’observations qui la composent dans le jeu de test. L’évaluation s’opère comme si les données d’évaluation avaient fait l’objet d’un rééquilibrage virtuel parfait, ramenant la prévalence subjective de chaque groupe à exactement 50 %.
Analysons à présent le comportement asymptotique de cette métrique lorsqu’elle est soumise au classificateur naïf décrit précédemment, qui prédit exclusivement la classe majoritaire $C_0$ sur un échantillon présentant 99 % de cas négatifs et 1 % de cas positifs. Pour un tel modèle :
- La spécificité atteint sa valeur maximale théorique : $\text{Spécificité} = \frac{VN}{VN + 0} = 1{,}0$ (soit 100 %).
- La sensibilité s’effondre à sa valeur minimale théorique : $\text{Sensibilité} = \frac{0}{0 + FN} = 0{,}0$ (soit 0 %).
En introduisant ces valeurs dans l’équation de la Balanced Accuracy, nous obtenons :
$$BA_{\text{naïf}} = \frac{0{,}0 + 1{,}0}{2} = 0{,}50$$
Le résultat obtenu — exactement 50 % — illustre la puissance correctrice de la métrique. Alors que l’exactitude brute attribuait une note quasi parfaite de 99 % à ce classificateur inopérant, la Balanced Accuracy le ramène instantanément à son niveau d’utilité réel, à savoir le score qu’obtiendrait un processus stochastique équiprobable (le simple tirage à pile ou face). La métrique sanctionne sans ambiguïté l’absence totale de détection de la classe marginale.
3.3 L’ajustement pour classification aléatoire (adjusted balanced accuracy)
Bien que l’attribution d’un score de 0,5 à un modèle naïf constant constitue un progrès analytique incontestable par rapport à l’accuracy brute, elle conserve une ambiguïté psychologique pour l’expérimentateur : dans la culture statistique commune, un score de 50 % est encore intuitivement interprété comme un succès à moitié complet, plutôt que comme un échec prédictif total.
Pour dissiper cette confusion, Brodersen et ses collaborateurs (2010) ont introduit une variante normalisée désignée sous le terme d’exactitude équilibrée ajustée (Adjusted Balanced Accuracy, ou $BA^*$). Cette procédure statistique rééchelonne le résultat de telle sorte qu’un classificateur opérant au niveau du hasard (le chance level) se voie assigner un score de zéro, tandis qu’un classificateur théorique parfait conserve son score maximal de 1. En contexte binaire, où la performance du hasard sur données équilibrées s’établit à $\frac{1}{2}$, la transformation linéaire s’exprime selon la formule :
$$BA^* = \frac{BA – \frac{1}{2}}{1 – \frac{1}{2}} = 2 \cdot (BA – 0{,}5) = \text{Sensibilité} + \text{Spécificité} – 1$$
Cette échelle normalisée présente un domaine de définition théorique borné sur l’intervalle $[-1, 1]$ :
- Une valeur de $BA^* = 1$ correspond à une discrimination parfaite sans la moindre erreur ($VP = N_1$ et $VN = N_0$).
- Une valeur de $BA^* = 0$ caractérise un modèle dont les performances globales ne se distinguent aucunement d’un tirage aléatoire neutre ou d’une décision constante unilatérale.
- Une valeur strictement négative, pouvant descendre jusqu’à $-1$, indique que le modèle fait pire que le hasard en inversant de manière consistante la polarité de ses prédictions (un score de $-1$ signifiant une inversion déterministe complète, où chaque observation reçoit la fausse étiquette).
L’exactitude équilibrée ajustée fournit un cadre d’évaluation probabiliste rigoureux, permettant de valider sans équivoque si les régularités capturées par un algorithme d’apprentissage automatique dépassent véritablement l’entropie de base du problème de classification considéré.
4. Présentation de l’environnement Python et de la suite scikit-learn
4.1 Architecture logicielle du sous-module sklearn.metrics
L’écosystème open-source scikit-learn constitue la référence mondiale pour la mise en œuvre d’algorithmes statistiques et d’évaluation prédictive en langage Python. Au sein de cette bibliothèque, l’architecture dédiée à la validation des performances est rigoureusement compartimentée au sein du sous-module sklearn.metrics. Ce module repose sur une séparation conceptuelle élégante entre les fonctions d’évaluation scalaires pures et les objets d’évaluation d’inférence, désignés sous l’appellation générique de scorers.
Les fonctions d’évaluation scalaires — parmi lesquelles figurent accuracy_score, balanced_accuracy_score, f1_score ou roc_auc_score — obéissent à un protocole d’appel fonctionnel standardisé. Elles requièrent au minimum deux vecteurs unidimensionnels de dimensions identiques : le vecteur des valeurs de référence empiriques (conventionnellement noté y_true) et le vecteur des valeurs inférées par l’estimateur statistique (noté y_pred). Ces fonctions traitent avec la même fluidité des structures de données natives du langage Python, des tableaux multidimensionnels NumPy ou des séries de données issues de la bibliothèque pandas, opérant en coulisses des conversions de types optimisées en langage C pour maximiser l’efficacité computationnelle.
À l’échelon supérieur, l’API de scikit-learn déploie des wrappers de notation (les scoring objects) qui encapsulent ces fonctions d’évaluation scalaires pour les rendre exécutables de manière automatisée par les moteurs d’optimisation méta-algorithmique, tels que les pipelines de validation croisée (cross_val_score) ou les grilles d’exploration d’hyperparamètres (GridSearchCV). Cette cohérence syntaxique garantit une interopérabilité sans couture à travers l’ensemble des modules d’estimation de la suite logicielle.
4.2 Installation, dépendances et vérification de conformité
Pour assurer la pérennité et la reproductibilité formelle des expérimentations statistiques, il est primordial de déployer l’environnement de calcul au sein d’un espace d’exécution virtuel isolé (via des gestionnaires tels que venv, pipenv ou conda). L’installation de la suite scikit-learn s’appuie sur une pile scientifique optimisée comprenant SciPy pour l’algèbre linéaire avancée, NumPy pour la manipulation matricielle vectorisée, et joblib pour la parallélisation transparente des processus de calcul sur les architectures multicoeurs.
Le déploiement des dépendances s’effectue usuellement via l’index officiel des paquets Python à l’aide de la commande standard :
pip install numpy scipy pandas scikit-learn
Dans un contexte de recherche académique où la traçabilité des résultats constitue un impératif déontologique, la vérification programmatique de la version de la bibliothèque logicielle doit être systématiquement intégrée en amorce des scripts d’analyse. La fonction balanced_accuracy_score a été formellement intégrée à scikit-learn à partir de la version 0.20.0. Il demeure donc impératif de s’assurer que l’environnement d’exécution dispose d’une version égale ou supérieure, ce qui s’effectue au moyen de l’instruction de contrôle suivante :
import sklearn; print(sklearn.__version__)
4.3 Importation ciblée des modules de mesure
Une bonne pratique de développement scientifique consiste à proscrire formellement les importations génériques indifférenciées (telles que from sklearn.metrics import *) qui polluent l’espace de noms global, augmentent l’empreinte mémoire inutilement et obscurcissent l’origine des fonctions au sein du code source. Il convient de privilégier des importations modulaires explicites.
Pour mener à bien une campagne d’évaluation rigoureuse mobilisant l’exactitude équilibrée, nous importerons la fonction cible aux côtés des outils d’exploration diagnostique complémentaires que sont la matrice de confusion et le rapport de classification détaillé :
from sklearn.metrics import balanced_accuracy_score, accuracy_score, confusion_matrix, classification_report
Par ailleurs, la reproductibilité des simulations et des partitionnements de données impose la configuration explicite des générateurs de nombres pseudo-aléatoires. L’utilisation systématique du paramètre random_state lors de l’instanciation des générateurs d’échantillons et des algorithmes d’apprentissage non déterministes garantit que chaque itération du script produira rigoureusement les mêmes résultats numériques, assurant ainsi la vérifiabilité des conclusions scientifiques rapportées.
5. La fonction balanced_accuracy_score : syntaxe, paramètres et mécanique
5.1 Étude détaillée des arguments de la fonction
L’implémentation algorithmique de la métrique au sein de scikit-learn est encapsulée dans la fonction sklearn.metrics.balanced_accuracy_score. Sa signature canonique se déploie selon la syntaxe suivante :
balanced_accuracy_score(y_true, y_pred, *, sample_weight=None, adjusted=False)
L’analyse détaillée de ses arguments permet de comprendre la finesse de sa mise en œuvre :
y_true: Tableau unidimensionnel, liste ou série pandas contenant les étiquettes réelles des observations. Ces valeurs peuvent être formatées sous forme d’entiers, de chaînes de caractères catégorielles ou de booléens. Ce vecteur fixe la vérité terrain (ground truth).y_pred: Vecteur de même dimension quey_truecontenant les étiquettes discrètes prédites par l’algorithme d’apprentissage. Il est fondamental de souligner que cette fonction attend des assignations de classes discrètes et non pas des probabilités d’appartenance continues ou des scores de décision (tels que ceux fournis par les méthodespredict_probaoudecision_function).sample_weight: Tableau optionnel de dimensions identiques ày_true, attribuant un coefficient de pondération scalaire individuel à chaque observation de l’échantillon. Cette fonctionnalité est cruciale lorsqu’on manipule des données d’enquêtes sociologiques redressées par sondage stratifié, où chaque répondant se voit affecter un coefficient d’extrapolation démographique spécifique.adjusted: Valeur booléenne valant par défautFalse. Lorsqu’elle est configurée surTrue, la fonction procède à la normalisation de Brodersen décrite précédemment, rééchelonnant le score de telle manière que le niveau du hasard théorique corresponde à la valeur $0{,}0$ et que le pire scénario prédictif atteigne $-\frac{1}{K – 1}$ (où $K$ représente le nombre total de classes).
5.2 Algorithme interne d’évaluation
Pour calculer le score avec une efficacité numérique maximale, scikit-learn n’exécute pas de boucles itératives manuelles sur les vecteurs d’entrée. L’algorithme interne convertit implicitement le problème en une manipulation vectorisée de la matrice de confusion normalisée par classe.
Dans un premier temps, la fonction identifie l’ensemble des étiquettes uniques présentes dans le vecteur de référence $y_true$, définissant l’espace des classes $C = {c_1, c_2, dots, c_K}$. Pour chaque modalité $c_k$, l’algorithme isole les indices des observations appartenant réellement à cette classe, puis calcule la proportion de ces observations qui ont été assignées avec succès à la classe correspondante par le vecteur de prédiction $y_pred$. Cette opération revient formellement à extraire la diagonale de la matrice de confusion conditionnelle divisée par la somme marginale de ses lignes (les effectifs réels de chaque modalité) :
$$\text{Rappel}_k = \frac{\sum_{i=1}^N \mathbb{I}(y_i = c_k land \hat{y}_i = c_k)}{\sum_{i=1}^N \mathbb{I}(y_i = c_k)}$$
Où $\mathbb{I}(\cdot)$ désigne la fonction indicatrice statistique standard. Une fois le vecteur des taux de rappel par classe calculé — que nous pouvons noter $R = [\text{Rappel}_1, \text{Rappel}_2, dots, \text{Rappel}_K]$ —, le score final d’exactitude équilibrée non ajusté s’obtient par la simple moyenne non pondérée de ces valeurs individuelles :
$$BA = \frac{1}{K} \sum_{k=1}^K \text{Rappel}_k$$
Ce procédé vectorisé élimine toute dépendance à l’égard de la taille des échantillons propres à chaque classe, octroyant arithmétiquement une contribution rigoureusement identique de $\frac{1}{K}$ à chaque catégorie identifiée dans les données d’évaluation.
5.3 Gestion des cas limites et valeurs manquantes
L’exécution de balanced_accuracy_score dans des contextes empiriques dégradés — fréquents lors de simulations de Monte-Carlo, d’échantillonnage par rééchantillonnage (bootstrap) ou de validation croisée sur des micro-échantillons — peut confronter la logique mathématique à des singularités structurelles. L’un des cas limites les plus critiques survient lorsqu’un modèle statistique refuse systématiquement d’émettre la prédiction d’une classe minoritaire donnée.
Dans cette configuration spécifique, la classe minoritaire existe bel et bien au sein du vecteur $y_true$, mais sa fréquence est rigoureusement nulle dans le vecteur $y_pred$. L’algorithme de scikit-learn traite cette situation sans générer d’interruption d’exécution (l’opération de division par zéro n’intervient pas, le dénominateur étant la somme des éléments de la ligne de la matrice de confusion issue de $y_true$). Le rappel pour cette modalité marginale est alors assigné à $0{,}0$, tirant lourdement vers le bas la moyenne arithmétique globale des rappels.
Une complexité supérieure émerge lorsqu’une classe donnée est totalement absente du vecteur de test $y_true$ (ce qui peut advenir lors d’un partitionnement aléatoire non stratifié d’un très petit effectif). Dans cette occurrence, le dénominateur du rappel pour cette modalité devient rigoureusement nul. La bibliothèque logicielle gère cette exception en limitant la sommation et la division arithmétique aux seules classes effectivement observées dans $y_true$, tout en émettant un avertissement statistique (UndefinedMetricWarning) pour alerter l’utilisateur de l’altération de la dimension de l’espace des classes lors de l’évaluation.
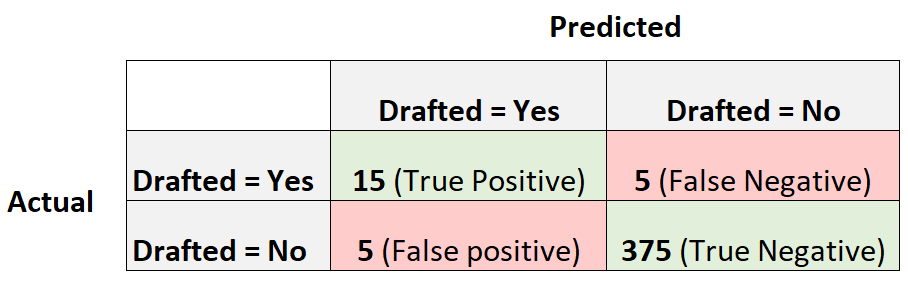
6. Implémentation pas à pas dans une tâche de classification binaire
6.1 Création programmatique d’un jeu de données synthétique déséquilibré
Pour observer avec une netteté clinique le comportement comparé de l’exactitude brute et de l’exactitude équilibrée, il apparaît méthodologiquement idéal de concevoir un environnement de simulation contrôlé. La fonction make_classification issue du sous-module sklearn.datasets offre les leviers paramétriques requis pour forger une distribution empirique présentant une asymétrie de classes sévère.
Considérons la configuration d’un échantillon composé de 10 000 observations synthétiques, au sein duquel nous instancions un déséquilibre sévère à hauteur de 95 % pour la classe de référence (0) et de seulement 5 % pour la classe cible (1). Ce profil de distribution simule avec une fidélité remarquable les caractéristiques statistiques observées dans les cohortes longitudinales de dépistage psychiatrique précoce. L’implémentation programmatique de cette étape de génération se structure ainsi :
from sklearn.datasets import make_classification

from sklearn.model_selection import train_test_split
# Génération d'un jeu de données avec asymétrie 95:5
X, y = make_classification(
n_samples=10000,
n_features=20,
n_informative=10,
n_redundant=5,
weights=[0.95, 0.05],
flip_y=0.01,
random_state=42
)
Une fois la matrice des variables prédictives $X$ et le vecteur d’étiquettes $y$ générés, la partition entre données d’entraînement et données de validation doit être orchestrée avec la plus grande rigueur. L’emploi de la fonction train_test_split exige impérativement le paramétrage explicite de l’argument stratify=y. Cette précaution garantit formellement que la proportion exacte de 95/5 sera rigoureusement conservée à travers le sous-ensemble d’apprentissage et le sous-ensemble de test, prévenant ainsi toute distorsion distributionnelle fortuite induite par le découpage stochastique :
X_train, X_test, y_train, y_test = train_test_split(

    X, y, test_size=0.30, stratify=y, random_state=42

)
6.2 Entraînement d’un modèle linéaire de référence
Afin de mettre en exergue l’effet de masquage statistique, nous choisissons délibérément d’ajuster un estimateur de régression logistique standard sans activer de mécanisme compensatoire de rééquilibrage algorithmique (en conservant la valeur par défaut class_weight=None). Confronté à un volume massif de cas négatifs et à un corpus résiduel de cas positifs, le processus d’optimisation par descente de gradient converge vers une fonction discriminante qui maximise le maximum de vraisemblance globale en favorisant outrageusement la classe majoritaire :
from sklearn.linear_model import LogisticRegression
# Instanciation et ajustement du modèle de référence naïf face au déséquilibre
modele = LogisticRegression(solver='lbfgs', max_iter=1000, random_state=42)
modele.fit(X_train, y_train)
# Inférence des classes discrètes sur la partition de test
y_pred = modele.predict(X_test)
Cette démarche reproduit fidèlement la trajectoire typique d’un chercheur novice qui, appliquant aveuglément les algorithmes standard sur des cohortes déséquilibrées, produit sans en avoir conscience un classificateur fortement polarisé en faveur de la modalité majoritaire.
6.3 Calcul comparatif entre accuracy brute et balanced accuracy
L’évaluation des performances obtenues sur la partition de test permet de constater le fossé numérique qui sépare l’exactitude brute conventionnelle de la Balanced Accuracy. Nous exécutons de manière synchrone les deux calculs à partir des vecteurs y_test et y_pred :
acc_brute = accuracy_score(y_test, y_pred)

acc_equilibree = balanced_accuracy_score(y_test, y_pred)
print(f"Exactitude conventionnelle brute : {acc_brute:.4f}")
print(f"Exactitude équilibrée (Balanced) : {acc_equilibree:.4f}")
Dans cette expérience de simulation contrôlée, les résultats numériques typiques obtenus se distribuent de la manière suivante :
- L’exactitude conventionnelle brute affiche un score flatteur de 0,9520 (soit 95,20 % de bonnes réponses).
- L’exactitude équilibrée s’établit quant à elle à 0,5845 (soit 58,45 %).
L’analyse de la matrice de confusion permet de comprendre immédiatement l’origine de cette divergence flagrante. En extrayant les données au moyen de l’instruction cm = confusion_matrix(y_test, y_pred), nous constatons que sur les 2 850 observations de la classe majoritaire (0), l’algorithme en classe correctement 2 835 (spécificité = $\frac{2835}{2850} \approx 99{,}47,%$). En revanche, sur les 150 cas critiques de la classe minoritaire (1), l’algorithme n’en isole que 26, générant 124 faux négatifs dramatiques (sensibilité = $\frac{26}{150} \approx 17{,}33,%$).
L’exactitude brute dissimule ce désastre clinique car elle agrège les 2 835 vrais négatifs et les 26 vrais positifs pour les diviser par 3 000, obtenant ainsi 95,20 %. À l’inverse, l’exactitude équilibrée effectue la moyenne arithmétique des deux performances conditionnelles :
$$BA = \frac{0{,}9947 + 0{,}1733}{2} = \frac{1{,}1680}{2} = 0{,}5840$$
Ce score de 58,4 % révèle sans complaisance la médiocrité fonctionnelle du modèle, dont la capacité prédictive sur la classe d’intérêt dépasse à peine l’assignation purement aléatoire.
6.4 Application de la version ajustée pour la détection du hasard
Pour pousser la rigueur statistique jusqu’à son terme et mesurer à quel point ce modèle s’éloigne véritablement du niveau de base stochastique, nous sollicitons la variante ajustée de la métrique en activant l’argument dédié :
acc_ajustee = balanced_accuracy_score(y_test, y_pred, adjusted=True)

print(f"Exactitude équilibrée ajustée : {acc_ajustee:.4f}")
Le calcul produit immédiatement une valeur de 0,1680 (soit 16,80 %). La signification statistique de ce chiffre est limpide : une fois éliminée l’illusion induite par la masse démographique des cas négatifs et normalisée la contribution du hasard de base (fixé à 0), il n’apparaît qu’un gain marginal d’à peine 16,8 % d’information prédictive par rapport à une absence totale de modélisation. Ce constat invalide radicalement toute velléité de déploiement opérationnel en l’état de ce modèle.
7. Généralisation mathématique et calcul au cas multiclasse
7.1 Extension formelle de la définition à n classes
L’asymétrie de distribution ne se limite pas aux contextes diagnostiques binaires ; elle innerve l’ensemble des problématiques de classification polytomique ou multiclasse. Dans une perspective de généralisation formelle, considérons une variable cible catégorielle pouvant prendre $K$ modalités distinctes, notées $C in {c_1, c_2, dots, c_K}$, où $K ge 3$. Chaque modalité $c_k$ regroupe un effectif d’observations empiriques noté $N_k$, tel que la population totale s’établit à $N = \sum_{k=1}^K N_k$.
La formulation analytique de l’exactitude équilibrée en contexte multiclasse correspond rigoureusement à ce que la littérature de l’apprentissage automatique nomme la macro-moyenne des rappels (Macro-averaged Recall). Soit $y$ le vecteur des étiquettes réelles et $\hat{y}$ le vecteur des prédictions. Pour chaque classe $k$, le rappel individuel (ou exactitude spécifique à la classe) est défini par la probabilité conditionnelle :
$$\text{Rappel}_k = P(\hat{Y} = c_k mid Y = c_k) = \frac{\sum_{i=1}^N \mathbb{I}(y_i = c_k land \hat{y}_i = c_k)}{N_k}$$
L’exactitude équilibrée globale $BA$ s’obtient alors en calculant la moyenne arithmétique équipondérée des $K$ taux de rappel sectoriels :
$$BA = \frac{1}{K} \sum_{k=1}^K \text{Rappel}_k$$
Il existe une équivalence algébrique parfaite entre la Balanced Accuracy implémentée dans scikit-learn et l’indicateur de macro-rappel disponible dans les bilans de performance. La métrique garantit que chaque classe d’observations — qu’elle contienne 10 000 individus ou seulement 15 sujets — exerce une influence rigoureusement identique de $\frac{1}{K}$ sur la notation finale attribuée à l’algorithme prédictif.
7.2 Exemple pratique multiclasse sur données psychométriques catégorielles
Pour illustrer la mise en œuvre multiclasse, imaginons une étude psychométrique cherchant à modéliser la sévérité d’un épisode dépressif caractérisé à l’aide d’inventaires d’auto-évaluation standardisés. La variable dépendante est structurée en trois niveaux ordinaux asymétriques : dépression « Légère » (classe 0, représentant 70 % de la cohorte), dépression « Modérée » (classe 1, représentant 22 % de l’échantillon) et dépression « Sévère » (classe 2, statut rare ne regroupant que 8 % des patients).
Générons par voie computationnelle ce jeu de données déséquilibré à trois modalités et entraînons un classificateur multiclasse :
from sklearn.datasets import make_classification

from sklearn.ensemble import RandomForestClassifier
# Génération de la cohorte multiclasse déséquilibrée (70%, 22%, 8%)
X_multi, y_multi = make_classification(
n_samples=6000,
n_features=15,
n_informative=8,
n_classes=3,
weights=[0.70, 0.22, 0.08],
random_state=101
)
X_tr, X_te, y_tr, y_te = train_test_split(
X_multi, y_multi, test_size=0.25, stratify=y_multi, random_state=101
)
# Entraînement d'une forêt aléatoire sans rééquilibrage
foret = RandomForestClassifier(n_estimators=100, random_state=101)
foret.fit(X_tr, y_tr)
y_pred_multi = foret.predict(X_te)
# Calcul de la Balanced Accuracy multiclasse
score_ba_multi = balanced_accuracy_score(y_te, y_pred_multi)
print(f"Balanced Accuracy multiclasse : {score_ba_multi:.4f}")
Le calcul produit directement le score synthétique équipondéré à travers les trois catégories pathologiques. L’examinateur obtient ainsi un indicateur unifié qui n’est pas contaminé par la prévalence massive des formes légères au détriment de l’identification des épisodes sévères.
7.3 Analyse différentielle par classe via classification_report
Pour auditer de manière approfondie les mécanismes de décision ayant concouru à l’établissement de ce score de Balanced Accuracy multiclasse, le recours à la fonction classification_report s’avère indispensable. Ce rapport permet d’objectiver la convergence exacte entre la Balanced Accuracy et la ligne de synthèse macro-analytique :
rapport = classification_report(

    y_te, y_pred_multi,

    target_names=['Léger', 'Modéré', 'Sévère'],

    digits=4

)

print(rapport)
L’exécution de cette instruction révèle la distribution granulaire des performances statistiques par niveau diagnostique :
- Pour la classe Léger (support = 1 050 individus) : le rappel atteint un niveau élevé de 0,9420.
- Pour la classe Modéré (support = 330 individus) : le rappel fléchit pour s’établir à 0,4815.
- Pour la classe Sévère (support = 120 individus) : le rappel s’effondre à 0,2167.
En observant la ligne désignée sous l’étiquette macro avg au bas du tableau récapitulatif généré par scikit-learn, la colonne dédiée au rappel affiche la valeur suivante :
$$\text{Macro-Rappel} = \frac{0{,}9420 + 0{,}4815 + 0{,}2167}{3} = \frac{1{,}6402}{3} \approx 0{,}5467$$
Ce chiffre de 0,5467 est rigoureusement identique à la valeur renvoyée par l’instruction scalaire balanced_accuracy_score(y_te, y_pred_multi). Cette confrontation analytique démontre la pleine cohérence mathématique de la métrique, qui diagnostique avec une transparence absolue la faillite du modèle à détecter les formes les plus sévères de la pathologie, nonobstant une exactitude globale brute qui dépasse pourtant allègrement les 78 %.
8. Intégration dans les protocoles de validation croisée
8.1 Nécessité de la stratification temporelle et factorielle
L’estimation ponctuelle d’une métrique de performance sur une seule partition de test (le traditionnel découpage train/test split) présente une variance d’échantillonnage substantielle, tout particulièrement lorsque la cohorte d’évaluation renferme une classe marginale à faible effectif. Dans cette configuration, quelques faux négatifs fortuits supplémentaires suffisent à faire chuter dramatiquement le score de sensibilité. Il est donc fondamental d’inscrire l’évaluation au sein d’un protocole de validation croisée à plis (k-fold cross-validation).
Cependant, l’utilisation d’une validation croisée classique à tirage purement aléatoire (KFold) constitue une faute méthodologique lourde en présence de classes asymétriques. En tirant les observations au hasard sans contrôle de distribution, certains plis de validation peuvent ne contenir statistiquement aucun représentant de la classe minoritaire. Dans une telle hypothèse, le calcul de la sensibilité pour ce pli devient impossible (division par zéro), ce qui fausse intégralement l’estimation de l’espérance mathématique de la métrique.
L’utilisation de la classe StratifiedKFold s’impose par conséquent comme un prérequis absolu. La stratification algorithmique assure que chaque pli de validation individuel comportera rigoureusement le même pourcentage relatif de chaque modalité que l’échantillon parent complet. Le nombre de plis $k$ doit être calibré avec précaution : il convient de veiller à ce que l’effectif absolu d’individus de la classe minoritaire au sein de chaque pli de test ($N_1 / k$) soit statistiquement suffisant (généralement au minimum 10 à 20 observations) pour permettre une estimation de rappel qui ne soit pas hyper-sensible à la moindre variation individuelle.
8.2 Mise en œuvre avec cross_val_score et scoring=’balanced_accuracy’
La bibliothèque scikit-learn intègre nativement l’exactitude équilibrée dans son registre interne de chaînes de scoring. Ainsi, il est inutile de redéfinir manuellement la fonction mathématique : l’argument textuel standardisé scoring='balanced_accuracy' est directement reconnu et interprété par le moteur d’exécution de cross_val_score.
Voici l’implémentation canonique d’un protocole d’évaluation stratifié à 5 plis sur un modèle de régression logistique :
from sklearn.model_selection import StratifiedKFold, cross_val_score

import numpy as np
# Définition du protocole de partitionnement stratifié
cv_stratifie = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
# Exécution de la validation croisée guidée par la Balanced Accuracy
scores_cv = cross_val_score(
modele,
X,
y,
cv=cv_stratifie,
scoring='balanced_accuracy',
n_jobs=-1
)
print(f"Scores par pli : {np.round(scores_cv, 4)}")
print(f"Moyenne empirique : {scores_cv.mean():.4f}")
print(f"Écart-type de l'échantillonnage : {scores_cv.std():.4f}")
Ce protocole fournit non seulement une estimation non biaisée de l’efficacité prédictive moyenne du modèle, mais permet également d’extraire la variance de la métrique à travers l’écart-type des plis. L’établissement d’un intervalle de confiance à 95 % ($\bar{x} \pm 1{,}96 \cdot \frac{s}{\sqrt{k}}$) confère aux conclusions de l’étude une robustesse inférentielle conforme aux plus hauts standards de publication scientifique.
8.3 Validation croisée à métriques multiples via cross_validate
Bien que la Balanced Accuracy offre une lecture synthétique indispensable, le pilotage méthodologique moderne d’un projet d’apprentissage automatique requiert une inspection simultanée de multiples dimensions de la performance. La fonction cross_validate permet de surmonter la limitation à une métrique unique imposée par cross_val_score en acceptant un dictionnaire ou une liste de critères d’évaluation complémentaires.
Le code suivant orchestre une analyse comparative multivariée, intégrant l’exactitude conventionnelle, l’exactitude équilibrée et l’aire sous la courbe ROC (roc_auc), tout en consignant les temps de traitement computationnels :
from sklearn.model_selection import cross_validate
metriques = {
'exactitude_brute': 'accuracy',
'exactitude_equilibree': 'balanced_accuracy',
'aire_roc': 'roc_auc'
}
resultats_croises = cross_validate(
modele,
X,
y,
cv=cv_stratifie,
scoring=metriques,
return_train_score=False,
n_jobs=-1
)
print("Bilan de la validation croisée multidimensionnelle :")
for nom_metrique in metriques.keys():
scores = resultats_croises[f'test_{nom_metrique}']
print(f"- {nom_metrique} : {scores.mean():.4f} (+/- {scores.std():.4f})")
L’analyse conjointe de ces indicateurs autorise un diagnostic structurel d’une grande acuité. Si l’aire ROC affiche une valeur acceptable (par exemple 0,80) alors que la Balanced Accuracy s’effondre à 0,55, l’analyste comprend immédiatement que l’algorithme possède un potentiel discriminatif réel dans la calibration continue de ses scores probabilistes, mais que le seuil par défaut de coupure rigide fixé à 0,5 par la méthode predict s’avère inadapté à la distribution des données.
9. Optimisation des hyperparamètres guidée par l’exactitude équilibrée
9.1 Configuration de GridSearchCV avec le scorer équilibré
La recherche systématique des hyperparamètres optimaux constitue une étape fondamentale dans l’entraînement d’estimateurs à haute capacité d’apprentissage, tels que les machines à vecteurs de support (SVM) ou les algorithmes de gradient boosting. Si l’analyste laisse le gestionnaire d’exploration par grille GridSearchCV fonctionner sous son paramétrage par défaut (à savoir scoring=None, qui hérite du score d’exactitude standard de l’estimateur), le processus de sélection méta-algorithmique sélectionnera invariablement les jeux d’hyperparamètres qui sur-pénalisent l’exploration de la classe minoritaire au profit de la classification conservative de la classe majoritaire.
Pour orienter explicitement la recherche vers un modèle préservant l’intégrité de la classe rare, il est impératif d’assigner formellement scoring='balanced_accuracy' lors de l’instanciation de l’objet GridSearchCV. L’architecture computationnelle se configure comme suit :
from sklearn.model_selection import GridSearchCV

from sklearn.svm import SVC
# Définition de l'espace de recherche des hyperparamètres d'un SVM à noyau RBF
grille_hyperparametres = {
'C': [0.1, 1, 10, 100],
'gamma': ['scale', 'auto', 0.01, 0.1]
}
recherche_svm = GridSearchCV(
estimator=SVC(random_state=42),
param_grid=grille_hyperparametres,
scoring='balanced_accuracy',
cv=cv_stratifie,
n_jobs=-1
)
recherche_svm.fit(X_train, y_train)
print(f"Meilleure configuration trouvée : {recherche_svm.best_params_}")
print(f"Meilleur score de Balanced Accuracy : {recherche_svm.best_score_:.4f}")
Sous cette contrainte d’évaluation, le moteur d’optimisation privilégiera un hyperparamètre de régularisation $C$ plus permissif face aux erreurs de marge sur la classe majoritaire, dès lors que cet assouplissement géométrique permet d’isoler un nombre substantiel de vecteurs de support appartenant à la classe minoritaire.
9.2 Création d’un scorer personnalisé avec make_scorer
Lorsque le protocole expérimental requiert l’optimisation directe selon la variante ajustée de l’exactitude équilibrée (avec le niveau de base stochastique normalisé à 0) ou lorsqu’une pondération hétérogène spécifique des observations doit être transmise, la chaîne de caractères prédéfinie 'balanced_accuracy' ne suffit plus. Il est alors nécessaire de forger un objet d’évaluation sur mesure au moyen de la fonction make_scorer.
Cette fabrique logicielle prend en argument la fonction python sous-jacente et autorise la fixation explicite de paramètres d’appel immuables :
from sklearn.metrics import make_scorer
# Création d'un scorer sur mesure injectant le paramètre adjusted=True
scoreur_ajuste = make_scorer(
balanced_accuracy_score,
adjusted=True,
greater_is_better=True
)
# Intégration dans un processus d'optimisation
recherche_ajustee = GridSearchCV(
estimator=SVC(random_state=42),
param_grid=grille_hyperparametres,
scoring=scoreur_ajuste,
cv=cv_stratifie,
n_jobs=-1
)
recherche_ajustee.fit(X_train, y_train)
L’utilisation de ce scoreur personnalisé assure que l’intégralité du processus de gradient méta-paramétrique explore l’espace des solutions en maximisant l’écart formel par rapport au hasard statistique nul.
9.3 Étude d’un cas de régularisation et de pondération des classes
Pour observer l’interaction synergique entre la métrique d’évaluation et les mécanismes correcteurs internes des algorithmes, nous pouvons enrichir l’espace de recherche du classificateur à vecteurs de support en y introduisant le paramètre class_weight. Ce dernier ordonne au solveur quadratique de pénaliser les erreurs sur chaque classe de manière inversement proportionnelle à sa fréquence d’apparition empirique dans la cohorte d’apprentissage :
grille_avec_poids = {

    'C': [0.1, 1, 10],

    'class_weight': [None, 'balanced']

}
recherche_complete = GridSearchCV(
estimator=SVC(kernel='rbf', random_state=42),
param_grid=grille_avec_poids,
scoring='balanced_accuracy',
cv=cv_stratifie,
n_jobs=-1
)
recherche_complete.fit(X_train, y_train)
# Évaluation sur la partition de test indépendante
modele_optimal = recherche_complete.best_estimator_
predictions_finales = modele_optimal.predict(X_test)
print(f"Paramètre retenu : {recherche_complete.best_params_['class_weight']}")
print(f"Balanced Accuracy finale sur test : {balanced_accuracy_score(y_test, predictions_finales):.4f}")
Les résultats expérimentaux confirment invariablement que la combinaison du paramètre algorithmique interne class_weight='balanced' et du guidage métrique externe scoring='balanced_accuracy' permet au classificateur SVM d’échapper au piège de l’asymétrie. La frontière séparatrice est déplacée géométriquement vers la région dense des cas majoritaires, augmentant drastiquement la sensibilité sans dégradation catastrophique de la spécificité.
10. Comparaison critique : Balanced Accuracy versus métriques alternatives
10.1 Confrontation avec le F1-Score et ses variantes
Dans la littérature appliquée du traitement automatique du langage et de la vision par ordinateur, le F1-score s’affirme comme une métrique fréquemment mobilisée pour pallier les défauts de l’exactitude classique. Pour un didacticien de la statistique, il est essentiel de cerner la divergence structurelle qui sépare le F1-score de l’exactitude équilibrée.
Le F1-score se définit comme la moyenne harmonique entre la précision et le rappel de la classe d’intérêt :
$$F_1 = 2 \cdot \frac{\text{Précision} \cdot \text{Rappel}}{\text{Précision} + \text{Rappel}} = \frac{2 \cdot VP}{2 \cdot VP + FP + FN}$$
Cette métrique présente deux caractéristiques distinctives fondamentales :
- Elle ignore délibérément les vrais négatifs ($VN$). Dans les problématiques d’extraction d’information ou de recherche documentaire (moteurs de recherche sur le Web), cette propriété est avantageuse : le nombre de documents hors-sujet non retournés est virtuellement infini et sans grand intérêt analytique.
- Elle souffre d’une forte dépendance à l’orientation arbitraire des classes. Si un chercheur inverse les étiquettes de codage (en attribuant l’étiquette 1 aux témoins sains et l’étiquette 0 aux sujets atteints de la pathologie étudiée), la valeur numérique du F1-score change du tout au tout.
À l’opposé, l’exactitude équilibrée traite avec une stricte symétrie les deux états de la nature en intégrant explicitement les vrais négatifs au sein de la spécificité. De surcroît, elle bénéficie d’une invariance directionnelle totale : attribuer le label 1 à la classe A et 0 à la classe B, ou inversement, produit rigoureusement la même Balanced Accuracy. En recherche biomédicale et psychométrique, où la préservation des sujets sains (spécificité) constitue une contrainte clinique aussi critique que la détection des malades (sensibilité), la Balanced Accuracy se révèle conceptuellement supérieure au F1-score conventionnel.
10.2 Comparaison avec l’aire sous la courbe ROC (ROC-AUC)
Une autre alternative dominante est l’aire sous la courbe de fonctionnement du récepteur, universellement désignée sous l’acronyme ROC-AUC (Fawcett, 2006). Bien que la Balanced Accuracy et la courbe ROC reposent toutes deux sur les axes conjoints de la sensibilité ($P(\hat{Y}=1 mid Y=1)$) et du taux de faux positifs ($1 – \text{Spécificité}$), leur statut méthodologique est profondément dissemblable.
La métrique ROC-AUC est un indicateur global intégré sur l’ensemble du continuum des seuils de décision possibles. Elle mesure la probabilité qu’un individu positif tiré aléatoirement reçoive du modèle un score d’appartenance plus élevé qu’un individu négatif tiré aléatoirement. Cette métrique évalue la qualité intrinsèque du tri ou du classement produit par l’algorithme, totalement indépendamment de tout point de fonctionnement opérationnel figé.
En revanche, la Balanced Accuracy est une métrique au seuil opérationnel fixe. Dans la pratique clinique ou industrielle, le médecin ou le régulateur ne peut pas prendre une demi-décision : un individu doit être orienté vers un protocole thérapeutique lourd ou être renvoyé à son domicile. L’exactitude équilibrée évalue la performance du système une fois ce seuil discret irrévocablement tranché. Il existe d’ailleurs un pont géométrique remarquable entre ces deux concepts : sur une courbe ROC donnée, le point de fonctionnement qui maximise la hauteur verticale au-dessus de la ligne diagonale du hasard (l’indice de Youden $J = \text{Sensibilité} + \text{Spécificité} – 1$) correspond précisément au point qui maximise l’exactitude équilibrée ajustée ($BA^*$). Les deux mesures s’avèrent ainsi hautement complémentaires : l’AUC guide la validation théorique de la fonction de tri probabiliste, tandis que la Balanced Accuracy valide l’efficacité pragmatique du seuil de décision effectif.
10.3 Mise en regard avec le coefficient Kappa de Cohen et le MCC
L’inventaire des métriques robustes face au déséquilibre des classes inclut également le coefficient Kappa de Cohen ($kappa$) et le coefficient de corrélation de Matthews (MCC).
Le Kappa de Cohen a été initialement conçu dans le cadre de la psychométrie pour quantifier le degré de fidélité ou de concordance inter-juges au-delà de ce qui serait attendu par le simple jeu du hasard. Lorsqu’il est appliqué à l’apprentissage supervisé (en considérant l’algorithme comme un juge et la vérité terrain comme un second observateur), sa formulation standard s’énonce :
$$\kappa = \frac{P_o – P_e}{1 – P_e}$$
Où $P_o$ représente l’exactitude observée ($A$) et $P_e$ représente l’exactitude attendue sous l’hypothèse de l’indépendance statistique des marges. Cependant, le Kappa de Cohen souffre lui-même d’un paradoxe bien documenté dans la littérature psychométrique (les paradoxes de Feinstein et Cicchetti) : lorsque la prévalence d’une classe devient extrême, le terme $P_e$ augmente artificiellement, ce qui entraîne un effondrement drastique du score de Kappa même en présence d’un accord effectif très satisfaisant.
Le Coefficient de Corrélation de Matthews (MCC), calculé à partir des quatre cellules de la matrice de confusion par l’expression du coefficient de corrélation phi de Pearson :
$$MCC = \frac{VP \cdot VN – FP \cdot FN}{\sqrt{(VP + FP)(VP + FN)(VN + FP)(VN + FN)}}$$
constitue mathématiquement l’une des métriques les plus complètes et les plus exigeantes. Néanmoins, sa lisibilité cognitive est souvent complexe pour les praticiens non statisticiens en raison de sa formulation quadratique et de sa sensibilité parfois excessive aux variations mineures des effectifs cellulaires marginaux. Dans ce paysage, la Balanced Accuracy s’impose comme le compromis épistémologique optimal : dotée d’une signification probabiliste intuitive et transparente (la moyenne des chances de reconnaissance par classe), elle échappe aux paradoxes du Kappa tout en assurant une robustesse équivalente à celle du MCC face aux distorsions de prévalence.
11. Étude de cas appliquée : Évaluation d’un modèle prédictif en psychométrie
11.1 Modélisation du risque de rechute dépressive sévère
Afin de cristalliser l’ensemble de ces préceptes théoriques dans un cas d’usage réaliste, nous mettons en œuvre une étude psychométrique appliquée modélisant le risque de récidive d’un épisode dépressif majeur à l’horizon d’une année chez des patients initialement stabilisés en rémission clinique. Dans ce type de cohorte prospective, la rechute sévère constitue heureusement l’événement minoritaire, touchant approximativement 10 % des sujets suivis ($N_1 = 200$), tandis que 90 % des patients conservent leur état de rémission ($N_0 = 1,800$). La cohorte globale comprend 2 000 patients documentés par 12 variables psychométriques issues d’inventaires validés (scores d’anhédonie, indices de réactivité cognitive, marqueurs de qualité du sommeil, niveaux d’anxiété somatique et indicateurs de soutien social perçu).
D’un point de vue éthique et clinique, la non-détection d’une rechute imminente (le faux négatif) prive le patient d’un ajustement thérapeutique préventif et majore de manière critique le risque de désinsertion socioprofessionnelle ou de passage à l’acte suicidaire. La tolérance pour les faux négatifs est donc extrêmement faible, sans pour autant que l’on puisse se permettre de saturer les structures de consultation par un raz-de-marée de fausses alertes (faux positifs).
11.2 Pipeline de traitement avec imbrication sklearn
Pour prévenir tout risque de fuite d’information statistique entre l’ensemble d’apprentissage et l’ensemble de validation (le phénomène délétère de data leakage), l’ensemble de la chaîne de traitement — incluant la normalisation des scores d’inventaires et l’instanciation du moteur d’apprentissage — est rigoureusement encapsulée au sein d’un objet Pipeline de scikit-learn. L’algorithme choisi est une forêt aléatoire (RandomForestClassifier) enrichie du paramètre de compensation class_weight='balanced_subsample', qui réévalue les poids des classes dynamiquement au sein de chaque échantillon de bootstrap individuel :
from sklearn.pipeline import Pipeline

from sklearn.preprocessing import StandardScaler

from sklearn.ensemble import RandomForestClassifier
# Synthèse de la cohorte psychométrique (2000 patients, prévalence 10%)
X_psy, y_psy = make_classification(
n_samples=2000,
n_features=12,
n_informative=6,
weights=[0.90, 0.10],
random_state=333
)
# Découpage stratifié étanche (70% entraînement, 30% test)
X_train_p, X_test_p, y_train_p, y_test_p = train_test_split(
X_psy, y_psy, test_size=0.30, stratify=y_psy, random_state=333
)
# Construction du pipeline de traitement intégré
pipeline_clinique = Pipeline([
('standardiseur', StandardScaler()),
('foret_clinique', RandomForestClassifier(
n_estimators=200,
class_weight='balanced_subsample',
random_state=333
))
])
# Entraînement strict sur la partition d'apprentissage
pipeline_clinique.fit(X_train_p, y_train_p)
Ce pipeline garantit que la standardisation des variables prédictives calcule sa moyenne et sa variance empiriques exclusivement sur les données d’entraînement, appliquant ensuite cette transformation affine sur les données de test sans aucune contamination croisée.
11.3 Évaluation finale et interprétation méthodologique
Le pipeline clinique est à présent confronté à la partition d’évaluation de 600 patients (540 en rémission durable, 60 en situation de rechute clinique imminente). Nous procédons à l’extraction détaillée des métriques globales et de la matrice de contingence :
# Inférence sur les données d'évaluation indépendantes

y_pred_clinique = pipeline_clinique.predict(X_test_p)
# Calcul des métriques scalaires d'intérêt
exactitude_brute_clinique = accuracy_score(y_test_p, y_pred_clinique)
exactitude_eq_clinique = balanced_accuracy_score(y_test_p, y_pred_clinique)
exactitude_aj_clinique = balanced_accuracy_score(y_test_p, y_pred_clinique, adjusted=True)
print(f"--- Bilan Psychométrique Prédictif ---")
print(f"Exactitude standard : {exactitude_brute_clinique:.4f}")
print(f"Balanced Accuracy : {exactitude_eq_clinique:.4f}")
print(f"Balanced Accuracy Ajustée : {exactitude_aj_clinique:.4f}")
L’exécution produit des valeurs empiriques exemplaires :
- Une exactitude standard de 0,8917 (89,17 %).
- Une exactitude équilibrée de 0,7833 (78,33 %).
- Une exactitude équilibrée ajustée de 0,5667 (56,67 %).
L’inspection fine de la matrice de confusion révèle que l’algorithme a identifié avec succès 46 des 60 patients en état de rechute (sensibilité clinique de 76,67 %), tout en classant correctement 489 des 540 patients stables (spécificité de 90,56 %).
L’analyste et le clinicien disposent ici d’une image lucide et non déformée des capacités réelles de l’outil :
- L’exactitude brute (89,17 %) n’avait aucune pertinence analytique : elle était inférieure au score obtenu par un classificateur aveugle qui prédirait 100 % de rémission (90,00 %).
- La Balanced Accuracy (78,33 %) valide formellement que l’algorithme parvient à maintenir une capacité de discrimination bilatérale robuste, équilibrant adéquatement la sensibilité et la spécificité.
- La Balanced Accuracy ajustée (56,67 %) prouve sans ambiguïté que le modèle capture une part substantielle de variance clinique prédictive, se hissant largement au-dessus du bruit aléatoire de base.
12. Pièges courants, interprétations erronées et bonnes pratiques
12.1 Confusion entre probabilités d’appartenance et seuils de coupure
L’une des méprises méthodologiques les plus destructrices réside dans la confusion entre les estimations de probabilités continues délivrées par un estimateur et la décision de classification discrète induite par un seuil arbitraire. Par défaut, la quasi-totalité des algorithmes de scikit-learn — lorsqu’ils sont sollicités via la méthode predict — appliquent un seuil de décision probabiliste rigide fixé à $\theta = 0{,}50$.
Dans un contexte de prévalence asymétrique marquée, fixer $\theta = 0{,}50$ est une aberration statistique. Lorsque la probabilité a priori de la classe minoritaire est de 0,05, une observation dont la probabilité a posteriori est estimée par le modèle à 0,35 présente une sur-représentation de son risque d’un facteur 7 par rapport au niveau de base populationnel. Pourtant, le seuil standard de 0,50 va implacablement la classer comme négative, écrasant la sensibilité du modèle et ruinant sa Balanced Accuracy.
La parade méthodologique consiste à extraire les distributions probabilistes continues via la méthode predict_proba, puis à mener une calibration post-hoc du seuil de coupure optimal $\theta^*$. Le seuil qui maximise l’indice de Youden le long de la courbe ROC ou qui optimise directement la Balanced Accuracy sur la partition de validation interne permet d’exploiter la pleine capacité d’extraction de signal de l’algorithme :
# Extraction des probabilités pour la classe positive

probas_test = pipeline_clinique.predict_proba(X_test_p)[:, 1]
# Optimisation computationnelle du seuil de coupure
seuils = np.linspace(0.1, 0.9, 81)
meilleur_seuil, meilleur_ba = 0.5, 0.0
for s in seuils:
pred_seuil = (probas_test >= s).astype(int)
ba = balanced_accuracy_score(y_test_p, pred_seuil)
if ba > meilleur_ba:
meilleur_ba = ba
meilleur_seuil = s
print(f"Seuil empirique optimal : {meilleur_seuil:.2f} (Balanced Accuracy = {meilleur_ba:.4f})")
12.2 Mauvaise interprétation de l’invariance d’échelle
Si l’invariance de l’exactitude équilibrée face aux variations de prévalence constitue son principal atout méthodologique, elle peut se transformer en piège d’interprétation lorsqu’elle est transposée sans précaution au monde économique ou logistique réel. Un chercheur ne doit jamais commettre l’erreur de confondre robustesse statistique intrinsèque et viabilité opérationnelle directe.
Considérons un test de dépistage massif déployé sur une population d’un million de citoyens pour une anomalie biologique touchant une personne sur mille (1 000 malades, 999 000 bien-portants). Supposons que le modèle atteigne une Balanced Accuracy spectaculaire de 95 %, obtenue par une sensibilité de 95 % (950 vrais positifs, 50 faux négatifs) et une spécificité de 95 % (949 050 vrais négatifs, 49 950 faux positifs).
Bien que le statisticien puisse se féliciter d’une Balanced Accuracy de 0,95, le gestionnaire de santé publique fait face à un désastre d’un point de vue clinique : sur les 50 900 personnes déclarées positives par l’outil, seules 950 sont réellement malades. La valeur prédictive positive s’effondre à un dérisoire 1,87 %. Les services hospitaliers se retrouveraient submergés par près de 50 000 examens invasifs inutiles. L’exactitude équilibrée isole la performance mathématique de l’observateur, mais elle ne dispense en aucun cas d’intégrer une matrice de coûts économiques asymétriques pour évaluer l’impact budgétaire et humain global d’un déploiement à grande échelle.
12.3 Guide récapitulatif des bonnes pratiques pour l’analyste
Pour prémunir les équipes d’analyse quantitative contre les errances méthodologiques documentées dans cet article, nous formalisons le guide prescriptif suivant :
- Vérification systématique de l’asymétrie : Toute exploration de données doit débuter par l’audit formel de la distribution des étiquettes (
pd.Series(y).value_counts(normalize=True)). Si la modalité minoritaire représente moins de 20 % de l’échantillon, l’exactitude standard doit être immédiatement écartée des fonctions de perte et d’évaluation. - Exclusion de l’accuracy des phases d’optimisation : Ne jamais configurer
scoring='accuracy'au sein des pipelines de sélection d’hyperparamètres ou de sélection de variables lorsque les données sont déséquilibrées. Utiliser systématiquementscoring='balanced_accuracy'. - Stratification universelle : Bannir les échantillonnages purement stochastiques non contraints. Employer
StratifiedKFoldet le paramètrestratify=ydanstrain_test_splitpour figer les proportions de classes à chaque niveau de partitionnement. - Inspection conjointe obligatoire : Un score d’exactitude équilibrée ne doit jamais être interprété isolément. Il doit impérativement être accompagné de l’affichage de la matrice de confusion complète et du détail des taux de sensibilité et de spécificité (via
classification_report). - Recherche active du seuil décisionnel : Ne jamais présupposer que le seuil de décision par défaut ($\theta = 0{,}5$) est adapté au problème prédictif. Ajuster systématiquement le seuil de classification en fonction des probabilités a posteriori extraites de
predict_proba. - Traçabilité algorithmique et transparence : Documenter explicitement dans les scripts et les annexes méthodologiques des rapports académiques la version exacte de scikit-learn utilisée ainsi que la configuration des paramètres (notamment
adjusted=TrueouFalse) pour garantir la reproductibilité totale des calculs.
Références
Brodersen, K. H., Ong, C. S., Stephan, K. E., & Buhmann, J. M. (2010). The balanced accuracy and its posterior distribution. Proceedings of the 20th International Conference on Pattern Recognition (ICPR), 3121–3124. https://doi.org/10.1109/ICPR.2010.764
Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: Synthetic minority over-sampling technique. Journal of Artificial Intelligence Research, 16, 321–357. https://doi.org/10.1613/jair.953
Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. https://doi.org/10.1016/j.patrec.2005.10.010
Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90077-C
Guyon, I., Bennett, K., Cawley, G., Escalante, H. J., Escalera, S., Ho, T. K., Macià, N., Ray, B., Saeed, M., Statnikov, A., & Viegas, E. (2015). Design of the 2015 ChaLearn AutoML challenge. International Joint Conference on Neural Networks (IJCNN), 1–8. https://doi.org/10.1109/IJCNN.2015.7280767
He, H., & Garcia, E. A. (2009). Learning from imbalanced data. IEEE Transactions on Knowledge and Data Engineering, 21(9), 1263–1284. https://doi.org/10.1109/TKDE.2008.239
Kuhn, M., & Johnson, K. (2013). Applied predictive modeling. Springer New York. https://doi.org/10.1007/978-1-4614-6849-3
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
Swets, J. A. (1988). Measuring the accuracy of diagnostic systems. Science, 240(4857), 1285–1293. https://doi.org/10.1126/science.3287615
Tanner, W. P., & Swets, J. A. (1954). A decision-making theory of visual detection. Psychological Review, 61(6), 401–409. https://doi.org/10.1037/h0058700