
Dans le domaine de l’analyse quantitative appliquée aux sciences humaines, comportementales et économiques, la modélisation des relations non linéaires constitue une exigence méthodologique récurrente. Bien que le modèle linéaire classique représente le point d’ancrage fondamental de l’économétrie et de la psychométrie, les dynamiques observables dans le monde réel s’affranchissent fréquemment d’une proportionnalité directe et constante. En psychologie expérimentale, en ergonomie cognitive et en neurosciences, de nombreux phénomènes d’assimilation, d’apprentissage ou de perception sensorielle présentent une phase initiale de croissance fulgurante suivie d’une décélération progressive, convergeant vers un seuil de saturation ou un effet de plateau. Face à de telles trajectoires, contraindre les données dans un cadre strictement affine biaise l’estimation des paramètres fondamentaux et produit des erreurs résiduelles systématiques.
La régression logarithmique s’impose comme une réponse analytique particulièrement élégante et robuste pour formaliser ces processus à rendements marginaux décroissants. En postulant que la variable dépendante varie de manière proportionnelle aux variations relatives — et non absolues — de la variable prédictive, ce modèle offre une flexibilité géométrique remarquable tout en préservant l’intelligibilité des paramètres estimés. Dès lors que le chercheur ou le statisticien cherche à capturer la décroissance continue d’un taux de variation, la transformation semi-logarithmique permet de convertir un tracé curviligne en une relation linéaire manipulable selon les principes universels de la méthode des moindres carrés ordinaires (MCO).
Si des environnements de programmation statistique dédiés tels que R, Python ou SPSS sont fréquemment mobilisés pour ces calculs, le tableur Microsoft Excel demeure un vecteur d’investigation privilégié dans les laboratoires de recherche, les cabinets d’études et les contextes pédagogiques en raison de son omniprésence et de son interactivité graphique directe. Cependant, déployer une régression logarithmique rigoureuse dans Excel requiert bien plus que l’insertion superficielle d’une courbe de tendance sur un nuage de points. Cette démarche exige une compréhension formelle des transformations mathématiques sous-jacentes, une configuration scrupuleuse des modules analytiques du tableur, une maîtrise des fonctions matricielles et une interprétation éclairée des indicateurs inférentiels. Ce guide exhaustif détaille pas à pas l’ensemble du protocole d’implémentation, depuis les axiomes mathématiques jusqu’au diagnostic des résidus et à la communication scientifique des résultats.
1. Fondements mathématiques et pertinence en psychologie quantitative
1.1 Nature mathématique de l’équation logarithmique
L’équation de régression logarithmique simple s’énonce classiquement sous la forme canonique :
y = a + b × ln(x)
Dans cette formulation, y représente la variable dépendante ou variable réponse, x désigne la variable indépendante ou prédicteur continu (strictement assujettie à la condition x > 0), et ln symbolise le logarithme népérien, dont la base mathématique correspondante est la constante d’Euler (e ≈ 2,71828). Les constantes a et b constituent les paramètres du modèle : a désigne l’ordonnée à l’origine, correspondant à la valeur prédite de y lorsque la variable explicative x est égale à 1 (puisque ln(1) = 0), tandis que b figure la pente logarithmique, régulant l’amplitude et la direction de la courbure.
La caractéristique fondamentale de cette équation réside dans sa concavité continue pour les valeurs positives du coefficient b, ou sa convexité continue lorsque b est négatif. La dérivée première de la fonction par rapport à x, donnée par l’expression dy/dx = b / x, met en lumière une propriété capitale : l’impact marginal de la variable indépendante sur la variable dépendante est inversement proportionnel à la grandeur absolue de x. Autrement dit, plus x croît, plus l’effet unitaire d’un incrément absolu d’une unité sur y s’amenuise. Cette dynamique géométrique traduit le principe fondamental des rendements marginaux décroissants, où chaque incrément supplémentaire de la variable prédictive produit un changement de plus en plus marginal sur la réponse observée.
Il convient de distinguer formellement la régression logarithmique de deux autres modèles non linéaires fréquents : la régression exponentielle et la régression de puissance. Alors que le modèle exponentiel obéit à la structure y = a × exp(b × x) — impliquant une accélération continue de la croissance — et que le modèle de puissance suit l’équation y = a × xb (qui linéarise les deux axes via une double transformation logarithmique ln(y) = ln(a) + b × ln(x)), le modèle logarithmique n’opère une transformation mathématique que sur l’axe des abscisses. Cette asymétrie structurale, qualifiée de modèle semi-logarithmique lin-log, en fait un instrument d’une remarquable simplicité interprétative : une variation relative constante de la variable x génère une variation absolue constante de la variable y.
1.2 Applications empiriques dans la recherche psychologique
En psychologie quantitative et en sciences cognitives, la régression logarithmique ne constitue pas un simple artifice d’ajustement géométrique, mais matérialise l’expression formelle de lois théoriques majeures. L’exemple paradigmatique demeure la loi psychophysique formulée par Gustav Theodor Fechner en 1860, développant les travaux pionniers d’Ernst Heinrich Weber. La loi de Weber-Fechner postule que l’intensité de la sensation psychologique perçue (S) est proportionnelle au logarithme de l’intensité physique du stimulus objectif (I), soit S = k × ln(I / I0). Cette relation formalise l’observation selon laquelle le système sensoriel humain comprime les plages dynamiques extrêmes de stimulations lumineuses, acoustiques ou tactiles afin de prévenir la saturation des récepteurs périphériques.
Un deuxième champ d’application crucial concerne la mémoire humaine et les processus d’amnésie naturelle, initialement théorisés par Hermann Ebbinghaus à la fin du XIXe siècle. La célèbre courbe de l’oubli met en évidence une chute drastique du rappel mémoriel dans les premières heures ou minutes suivant la phase d’apprentissage initial, suivie d’une stabilisation asymptotique relative à mesure que le temps s’écoule. La rétention mémorielle peut être appréhendée empiriquement au moyen d’un modèle logarithmique négatif liant le pourcentage d’éléments retenus au temps écoulé, traduisant la décélération constante du taux d’attrition cognitive au fil de la consolidation cérébrale.
Parallèlement, l’analyse des compétences motrices et cognitives fait intensivement appel aux courbes d’apprentissage log-linéaires. Face à une tâche perceptivo-motrice complexe, les progrès initiaux d’un individu s’avèrent massifs lors des premiers essais d’entraînement, avant que la vitesse d’amélioration ne ralentisse inexorablement vers un plafond asymptotique dicté par les limites neurobiologiques et attentionnelles du sujet. Enfin, l’étude des temps de réaction face à des batteries de stimuli répétitifs illustre cette même dynamique de saturation : la familiarisation sensorielle comprime la latence de réponse nerveuse selon un profil logarithmique prononcé, rendant l’équation y = a + b × ln(x) incontournable pour les chercheurs soucieux d’ancrer leurs analyses empiriques dans une modélisation mathématiquement cohérente.
2. Préalables méthodologiques et postulats statistiques
2.1 Hypothèses fondamentales de la régression linéaire généralisée
Bien que l’équation logarithmique décrive une trajectoire non linéaire dans l’espace cartésien originel (x, y), elle appartient pleinement au champ de la régression linéaire dès lors qu’elle est formulée dans l’espace transformé (ln(x), y). Le modèle est dit linéaire dans ses paramètres, car les coefficients d’intérêt a et b interviennent sous forme d’une combinaison linéaire directe. De ce fait, la validité des inférences statistiques issues de son estimation repose scrupuleusement sur le respect des postulats du théorème de Gauss-Markov et du cadre des modèles linéaires par moindres carrés ordinaires.
Le premier postulat réside dans la stricte linéarité de la relation après transformation : il est impératif que l’espérance conditionnelle des résidus soit nulle pour toute valeur de la variable indépendante transformée, ce qui s’exprime par E(εi | ln(xi)) = 0. Toute déviation systématique de cette condition indique que la structure logarithmique ne capte pas fidèlement la dynamique du phénomène et requiert un modèle polynomial ou logistique alternatif. Le second postulat impose la normalité des résidus d’estimation : les termes d’erreur εi doivent suivre une distribution normale de moyenne nulle et de variance constante, particulièrement lorsque la taille de l’échantillon est restreinte, afin de garantir la validité des tests de Student et de Fisher.
Le troisième postulat fondamental est l’homoscédasticité, qui exige que la variance des termes d’erreur demeure rigoureusement invariante sur l’ensemble du continuum de prédiction (Var(εi | ln(xi)) = σ2). Si l’amplitude de dispersion des réponses comportementales s’accroît ou se contracte à mesure que le stimulus physique augmente, le modèle bascule en situation d’hétéroscédasticité, ce qui n’invalide pas la non-biaicité des coefficients estimés mais fausse considérablement le calcul de leurs erreurs-types. Enfin, l’indépendance des observations — excluant toute autocorrélation résiduelle entre participants ou à travers les mesures sérielles temporelles — s’avère indispensable pour éviter une inflation artificielle des seuils de significativité statistique.
2.2 Gestion des contraintes de positivité stricte
L’implémentation opérationnelle du logarithme népérien se heurte à une frontière analytique incontournable : le domaine de définition de la fonction f(x) = ln(x) est strictement restreint à l’intervalle réel positif ouvert ]0, +∞[. La fonction logarithmique tend asymptotiquement vers l’infini négatif lorsque l’argument tend vers zéro, et s’avère rigoureusement indéfinie pour toute valeur négative dans l’ensemble des récents réels. En psychologie empirique, cette restriction pose un défi immédiat, car les variables prédictives peuvent comporter des zéros structurels — par exemple, un temps de mesure initial à t = 0, une intensité lumineuse nulle en condition de contrôle, ou une absence totale d’essais préalables.
Pour surmonter cette impossibilité mathématique sans corrompre arbitrairement la structure des données, les méthodologistes recourent couramment à une translation arithmétique de la variable indépendante via l’adjonction d’une constante de décalage c. Le modèle estimé devient alors :
y = a + b × ln(x + c)
Le choix de la constante c est critique. Dans de nombreuses applications, une constante unitaire (c = 1) est privilégiée, car elle assure que pour la condition initiale x = 0, l’argument du logarithme vaut ln(0 + 1) = 0, ce qui confère au paramètre a une signification psychométrique directe : le niveau de base observé au point de départ absolu de l’expérimentation. Cependant, si les valeurs positives de x sont microscopiques (par exemple des fractions de millisecondes comprises entre 0,01 et 0,05), l’adjonction d’une constante c = 1 écraserait la variance relative du prédicteur. Il convient dès lors de sélectionner une constante minimale proportionnée à l’ordre de grandeur des données ou d’utiliser des procédures d’optimisation non linéaire pour estimer simultanément c.
Parallèlement, la détection des valeurs aberrantes prend une dimension particulière sous le prisme de la transformation logarithmique. En raison de la forte courbure de la fonction au voisinage de zéro, toute observation excessivement proche du seuil plancher subit une dilatation mathématique extrême lors de la conversion semi-logarithmique, lui conférant un effet de levier disproportionné sur la pente de régression. Un audit rigoureux des queues de distribution s’impose impérativement avant toute estimation paramétrique sous Excel.
3. Configuration et optimisation de l’environnement de calcul dans Excel
3.1 Activation et vérification de l’Utilitaire d’analyse
Bien que Microsoft Excel offre des fonctions de feuille de calcul autonomes pour la manipulation statistique de base, l’exploitation exhaustive des métriques inférentielles associées à la régression requiert le déploiement de l’Utilitaire d’analyse (Analysis ToolPak). Ce module complémentaire natif, intégré à l’architecture logicielle d’Excel mais désactivé par défaut lors des installations standard, embarque des algorithmes d’analyse multivariée, des décompositions de variance et des tableaux d’inférence conformes aux standards académiques internationaux.
Pour activer ce composant stratégique, la procédure suit un cheminement précis au sein des options du logiciel. Il convient d’accéder au menu Fichier situé dans l’angle supérieur gauche du ruban applicatif, puis de cliquer sur la commande Options logée au bas de l’arborescence. Dans la boîte de dialogue contextuelle qui se déploie, l’utilisateur sélectionne la catégorie Compléments dans le volet latéral gauche. En partie inférieure de la zone principale, le champ déroulant intitulé Gérer doit afficher la mention Compléments Excel, validée par un clic sur le bouton Atteindre….
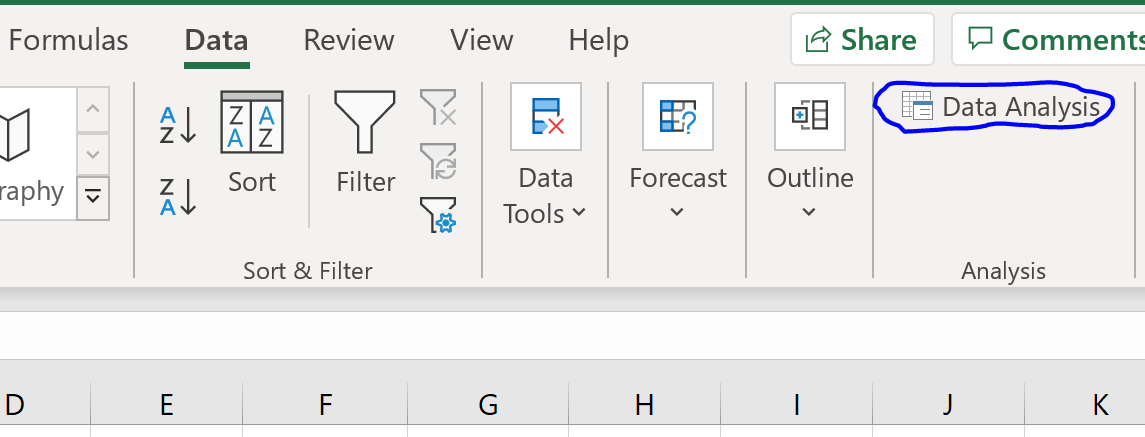
Une nouvelle interface restreinte apparaît à l’écran, listant les modules disponibles. Il est indispensable de cocher avec précision la case libellée Utilitaire d’analyse (il est inutile d’activer la variante Utilitaire d’analyse – VBA sauf en cas d’automatisation programmée via des macros). Après confirmation par le bouton OK, Excel procède au chargement dynamique de la bibliothèque mathématique. Pour certifier l’accessibilité de l’outil, il suffit de naviguer vers l’onglet Données du ruban principal : à l’extrême droite, au sein du groupe Analyse, le module fonctionnel Utilitaire d’analyse (ou Analyse de données selon les versions linguistiques) est désormais visible et opérationnel.
3.2 Paramétrage des tolérances et du formatage numérique
L’exactitude des calculs statistiques appliqués à des séries transformées par des fonctions transcendantes comme le logarithme népérien est intimement liée à la gestion de la précision arithmétique d’Excel. Bien que le moteur de calcul interne traite les nombres à virgule flottante selon la norme IEEE 754 en double précision (soit environ 15 chiffres significatifs), un formatage visuel restrictif de l’interface graphique est susceptible d’induire en erreur le praticien lors de la retranscription manuelle de constantes intermédiaires.
Il est vivement conseillé d’accéder aux Options avancées d’Excel et de s’assurer que la case à cocher Définir le calcul avec la précision affichée demeure scrupuleusement désactivée. L’activation intempestive de cette option tronquerait irréversiblement les valeurs sous-jacentes des cellules aux seuls chiffres visibles à l’écran, générant des biais d’arrondi substantiels qui se propageraient en cascade lors de l’estimation des sommes de carrés et du coefficient de détermination R².
Un autre point de vigilance critique concerne la configuration régionale des séparateurs numériques. Les systèmes d’exploitation francophones exploitent traditionnellement la virgule comme délimiteur décimal, tandis que la littérature scientifique et les bases de données anglo-saxonnes recourent universellement au point. Si des données importées comportent des points décimaux au sein d’un environnement Excel configuré à la française, ces données seront automatiquement interprétées comme des chaînes textuelles arbitraires. Cette discordance neutralise les algorithmes statistiques, renvoyant des erreurs explicites de type #VALEUR! ou ignorant silencieusement les observations critiques lors des calculs d’agrégation matricielle.
4. Étape 1 : Structuration et saisie des données psychométriques
4.1 Organisation rigoureuse de la matrice de données
La structuration rigoureuse de la feuille de calcul conditionne la reproductibilité de l’analyse et prévient les erreurs de pointage d’adresses cellulaires. Une architecture tabulaire propre impose une matrice rectangulaire standardisée où chaque ligne correspond univoquement à une unité d’observation (un participant, une session temporelle, un essai expérimental) et chaque colonne à une variable opérationnelle bien délimitée.
Dans la conception de notre classeur d’analyse, il est hautement recommandé d’attribuer la colonne A aux identifiants des sujets ou aux index sériels. La colonne B accueille la variable indépendante continue x, qui dans notre champ d’investigation correspondra par exemple à la durée d’exposition perceptive, à la dose de renforcement administrée ou à l’intervalle temporel écoulé depuis l’apprentissage. La colonne C est dédiée à la variable dépendante continue y, quantifiant la mesure comportementale brute : intensité perçue, pourcentage de mémorisation, exactitude de réponse ou temps de réaction motrice.
Les cellules de la ligne supérieure (Ligne 1) doivent impérativement être réservées aux en-têtes explicites, par exemple Sujet_ID, Temps_Secondes, et Score_Rappel. L’utilisation d’étiquettes univoques, rédigées sans caractères spéciaux prohibés ni espaces superflus, garantit une lisibilité parfaite lors de la sélection des plages dans les boîtes de dialogue des modules de régression, où l’option Intitulés simplifie considérablement la configuration matricielle.
4.2 Audit préliminaire et inspection descriptive
Préalablement à toute démarche de modélisation non linéaire, un contrôle de qualité strict des vecteurs de données brutes s’avère impératif. Ce diagnostic préliminaire vise à certifier la conformité de la série avec le domaine mathématique du logarithme et à brosser un tableau d’ensemble de la dispersion univariée des grandeurs mesurées.
L’implémentation de formules descriptives de base dans une zone d’information latérale de la feuille permet de vérifier instantanément ces paramètres :
- Calcul de la taille d’échantillon effectif :
=NB(B2:B101) - Détermination de la borne minimale du prédicteur :
=MIN(B2:B101) - Détermination de la borne maximale du prédicteur :
=MAX(B2:B101) - Moyenne arithmétique et dispersion de la variable y :
=MOYENNE(C2:C101)et=ECARTYPE.STANDARD(C2:C101)
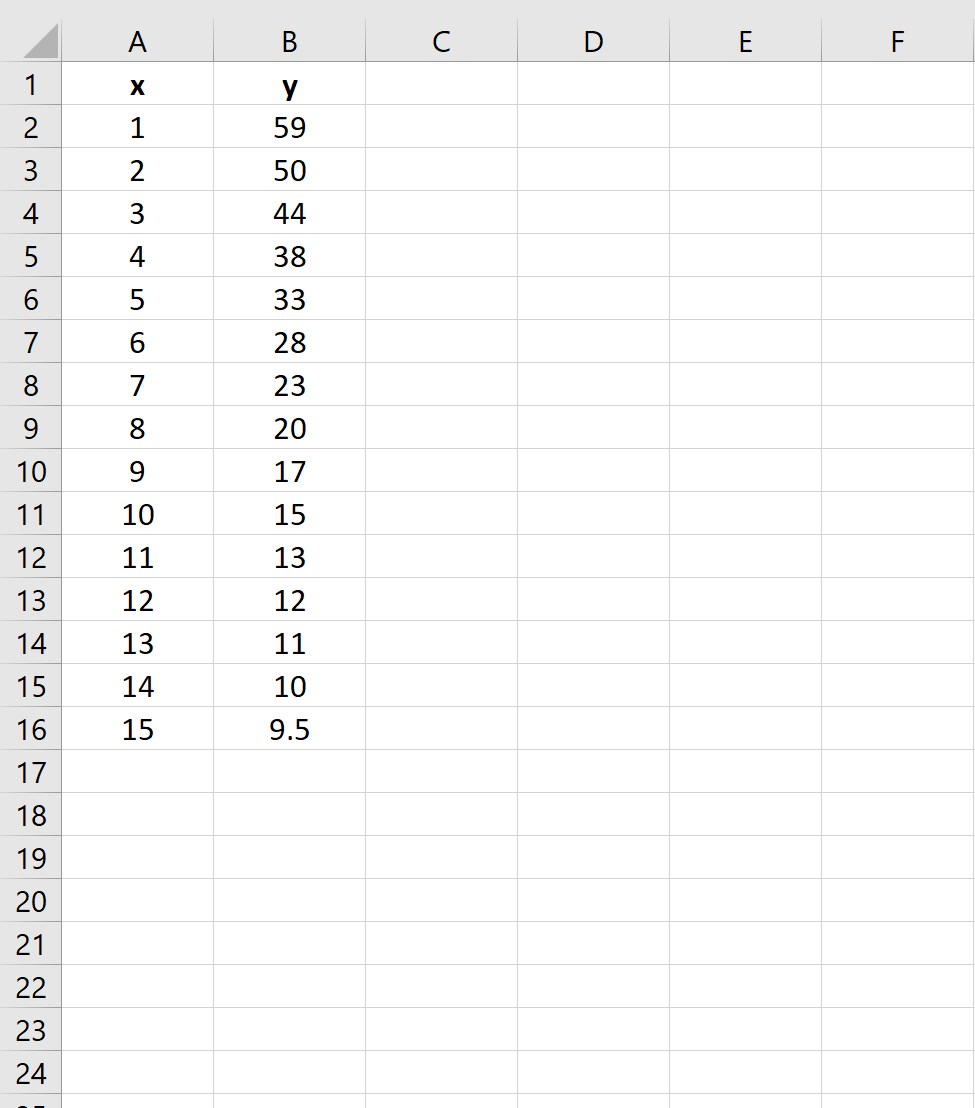
L’examen scrupuleux de la valeur renvoyée par la fonction MIN sur la colonne x constitue une barrière de sécurité non négociable : si cette valeur est inférieure ou égale à zéro, l’analyse logarithmique directe échouera inéluctablement. La mise en œuvre d’une règle de mise en forme conditionnelle sur cette colonne — surlignant en rouge toute cellule dont la valeur est ≤ 0 — offre une visualisation immédiate des anomalies de saisie, permettant au chercheur d’appliquer la correction par translation arithmétique (décrite en section 2.2) avant d’engager le calcul analytique.
5. Étape 2 : Linéarisation par transformation logarithmique
5.1 Application de la fonction mathématique LN
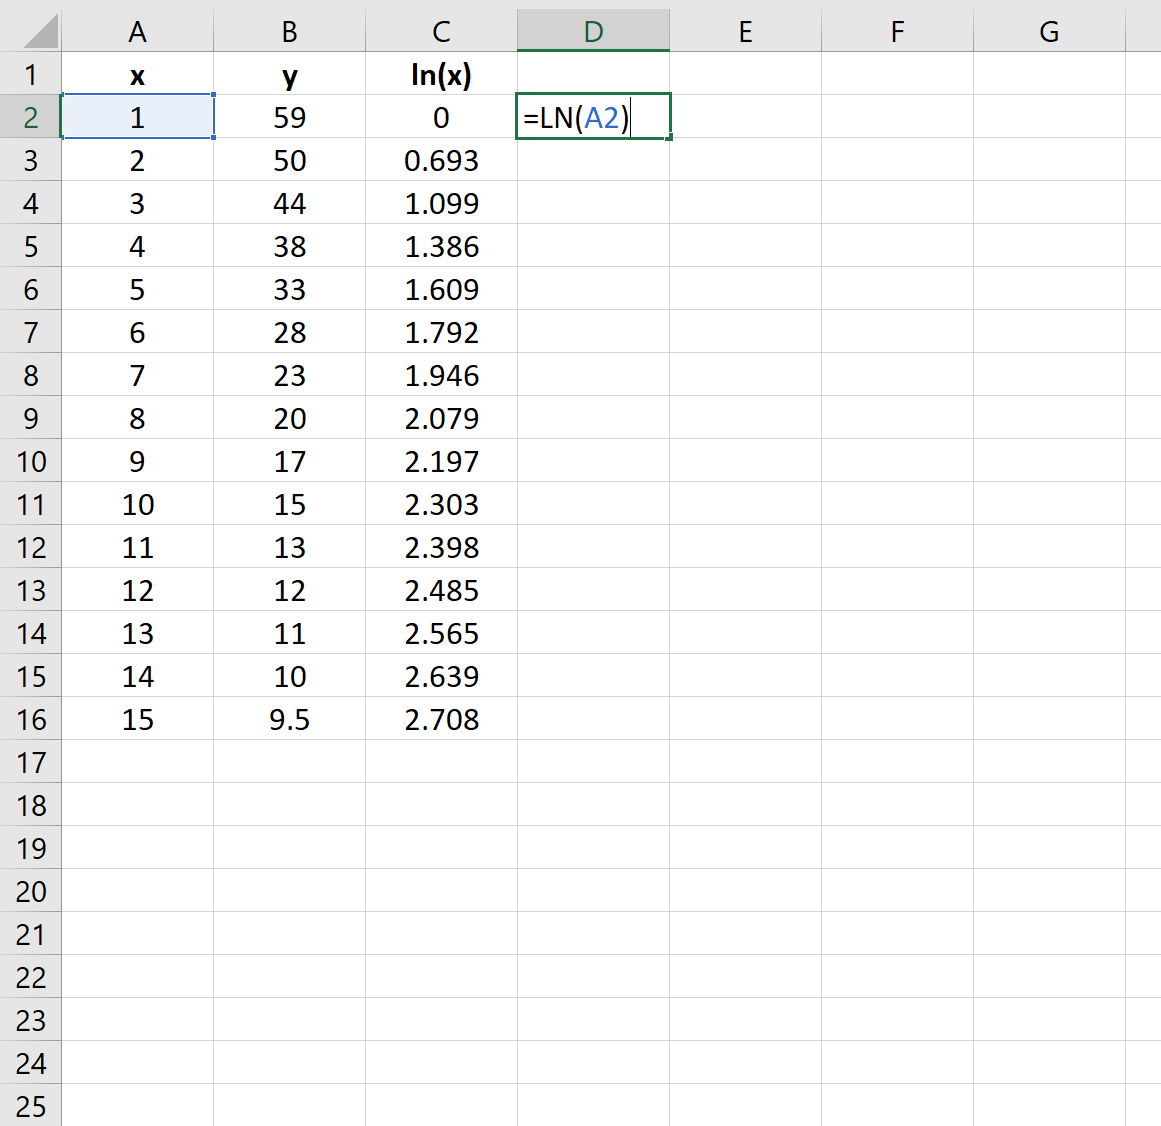
Pour exploiter les outils d’inférence linéaire standard d’Excel dans le cadre d’un modèle logarithmique, la démarche méthodologique la plus transparente et la plus rigoureuse consiste à créer une variable intermédiaire linéarisée. Cette étape consiste à projeter la variable indépendante x dans l’espace des logarithmes népériens par le biais d’une transformation fonctionnelle explicite au sein de la matrice de données.
Dans la colonne D de la feuille de calcul, que l’on intitule judicieusement LN_x ou Ln_Temps en cellule D1, on implémente la fonction mathématique fondamentale d’Excel dédiée au logarithme en base e. En cellule D2, on saisit l’expression suivante :
=LN(B2)
Il est capital d’éviter toute confusion avec la fonction alternative LOG10, qui calcule le logarithme décimal en base 10, ou avec la fonction générique LOG(cellule; [base]). Bien qu’une base logarithmique différente n’altère pas la qualité de l’ajustement géométrique global (le R² demeurant strictement identique), elle modifie l’échelle d’estimation du coefficient de pente b, rendant sa comparaison caduque avec les équations de référence de la littérature psychologique qui reposent universellement sur la base népérienne.
Une fois la formule validée en D2, son extension sur l’ensemble des lignes expérimentales s’effectue avec rapidité en double-cliquant sur la poignée de recopie située dans le coin inférieur droit de la cellule sélectionnée. Excel propage alors la transformation de manière dynamique jusqu’à la dernière ligne adjacente renseignée, constituant ainsi le vecteur linéarisé ln(xi) qui servira d’entrée opérationnelle aux modules de régression multiple et aux calculs matriciels avancés.
5.2 Vérification exploratoire de la linéarisation
Une fois le vecteur logarithmique constitué, une inspection graphique intermédiaire s’avère hautement recommandée pour évaluer empiriquement l’efficacité de la linéarisation. L’objectif consiste à confronter visuellement la variable transformée LN_x à la variable réponse non modifiée y.
En sélectionnant la colonne D (contenant les logarithmes) simultanément avec la colonne C (contenant la variable y), l’analyste insère un graphique de dispersion basique. Alors que le nuage de points initial (x, y) devait manifester une incurvation marquée caractéristique d’un phénomène de saturation ou de décélération, le nuage de points projeté (ln(x), y) doit idéalement s’aligner le long d’un corridor rectiligne homogène.
Cette étape exploratoire permet également d’identifier précocement d’éventuelles violations flagrantes du modèle. Si le tracé (ln(x), y) continue d’exhiber une courbure résiduelle prononcée en U ou en S inversé, cela indique formellement que la dynamique sous-jacente du phénomène psychologique n’est pas logarithmique simple, mais relève d’une cinétique logistique, sigmoïdale ou polynomiale. De surcroît, une dispersion des points s’évasant de façon disproportionnée à mesure que ln(x) progresse signale une hétéroscédasticité naissante qui devra être prise en compte lors du diagnostic approfondi des résidus.
6. Étape 3 : Estimation graphique directe par courbe de tendance
6.1 Création et paramétrage du nuage de points
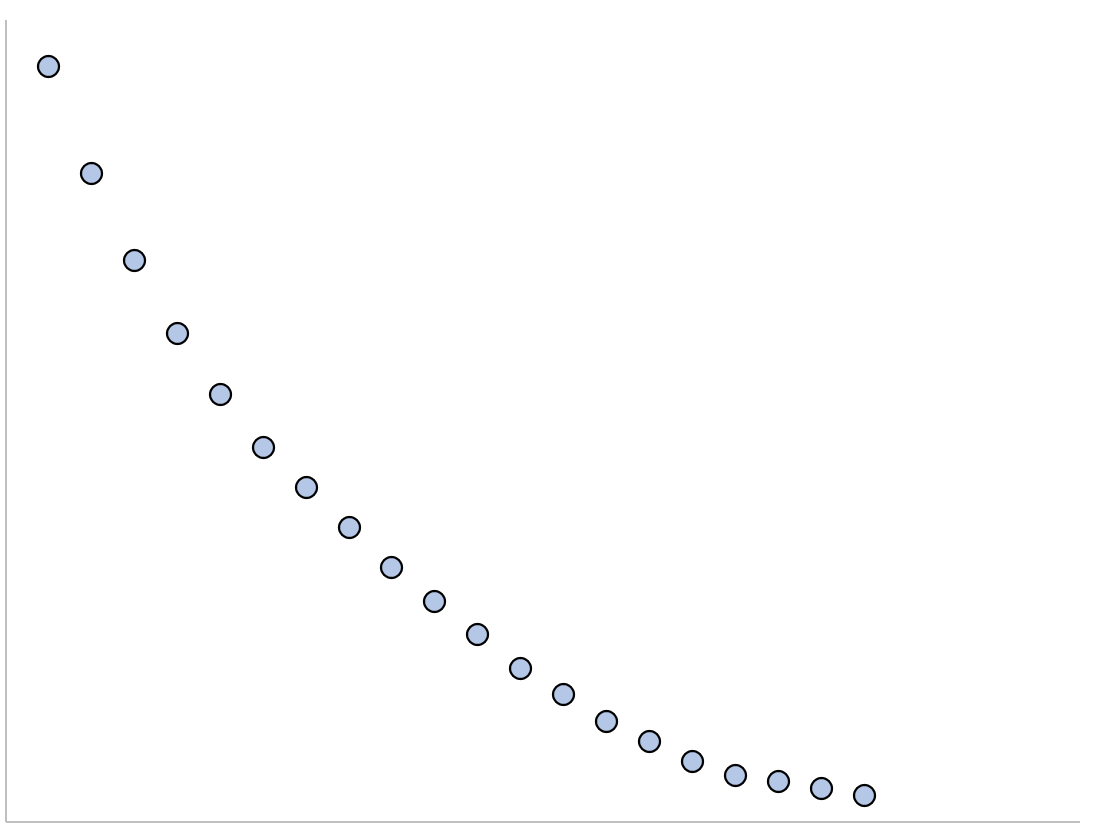
L’une des fonctionnalités les plus intuitives de Microsoft Excel réside dans sa capacité à ajuster directement des modèles de régression non linéaires sur des représentations graphiques, sans nécessiter d’étape intermédiaire de calcul matriciel. Cette approche visuelle offre une validation immédiate de la concordance empirique entre la courbe mathématique postulée et la distribution réelle des observations.
La première phase opérationnelle consiste à sélectionner rigoureusement les deux colonnes de données originales non transformées : la colonne B hébergeant la variable explicative x et la colonne C contenant la variable dépendante y. Il est préférable de ne pas inclure les lignes d’en-tête textuelles lors de cette sélection manuelle afin d’éviter tout conflit de typage dans certains moteurs graphiques anciens d’Excel. L’utilisateur se rend ensuite dans l’onglet Insertion du ruban principal, repère le groupe d’outils Graphiques, puis sélectionne l’icône Insérer un graphique en nuage de points (X, Y), en optant impérativement pour la variante Nuage de points avec marqueurs uniquement (aucun segment de liaison direct ne doit relier les points expérimentaux).
Une fois le tracé inséré sur le plan de travail, il est indispensable d’ajuster l’échelle des axes afin d’optimiser l’occupation visuelle de l’espace graphique. Par défaut, Excel initialise fréquemment l’origine des axes à zéro avec des marges excessives. En effectuant un clic droit sur l’axe horizontal, puis en sélectionnant Format de l’axe…, le chercheur peut fixer les bornes minimale et maximale au plus près des grandeurs réelles mesurées, éliminant les zones vides préjudiciables à la clarté sémiologique du graphique.
6.2 Intégration de la courbe de tendance logarithmique
Le nuage de points étant correctement calibré, l’insertion du modèle de régression s’exécute directement depuis l’interface graphique. En effectuant un clic droit sur l’un des marqueurs de données au sein du graphique, l’utilisateur sélectionne l’option Ajouter une courbe de tendance… dans le menu contextuel. Cette action déploie instantanément le panneau de configuration latérale intitulé Format de la courbe de tendance.
Au sein de la section Options de la courbe de tendance, Excel présente une typologie de six modèles mathématiques d’ajustement : Linéaire, Exponentielle, Logarithmique, Polynomiale, Puissance et Moyenne mobile. Il convient de cocher sans équivoque le bouton radio Logarithmique. On remarquera que si la série expérimentale comporte la moindre valeur négative ou nulle sur l’axe des abscisses, l’option Logarithmique apparaît grisée et demeure inaccessible, illustrant concrètement l’impératif de positivité explicité dans les sections précédentes.
Pour finaliser l’exploitation graphique du modèle, il est impératif de faire défiler le panneau latéral vers le bas et de cocher systématiquement deux cases stratégiques :
- Afficher l’équation sur le graphique : intègre directement la formule analytique calibrée y = a + b × ln(x) dans une zone de texte superposée.
- Afficher le coefficient de détermination (R²) sur le graphique : affiche la métrique d’ajustement statistique caractérisant la qualité de la modélisation.
6.3 Interprétation graphique rapide
L’équation textuelle générée automatiquement par Excel adopte généralement une notation standard où les coefficients estimés sont présentés sous forme décimale, par exemple :
y = -14,258 ln(x) + 89,412 R² = 0,9418
Dans cet exemple paradigmatique, le nombre multipliant l’expression ln(x) représente la pente logarithmique b = -14,258, tandis que la constante additive isolée correspond à l’ordonnée à l’origine a = 89,412. Notons qu’Excel permute fréquemment l’ordre d’affichage conventionnel en positionnant la composante logarithmique avant la constante additive.
La valeur du coefficient de détermination R² offre une première jauge globale de l’efficacité du modèle : un R² de 0,9418 signifie que 94,18 % de la variance totale observée dans la variable dépendante y est rigoureusement imputable à la relation logarithmique entretenue avec la variable explicative x. Cependant, cette lecture purement graphique présente des limites méthodologiques sévères : elle ne fournit aucune indication sur l’erreur-type des paramètres, ne permet pas de tester la significativité statistique de la pente par une p-value formalisée, et arrondit souvent drastiquement les décimales des coefficients, risquant de compromettre la précision de prédictions manuelles ultérieures basées sur ces valeurs tronquées.
7. Étape 4 : Modélisation par l’Utilitaire d’analyse statistique
7.1 Configuration de la boîte de dialogue de régression
Pour obtenir un compte-rendu inférentiel exhaustif répondant aux canons académiques internationaux de la recherche scientifique, il est impératif de solliciter le module de régression multivariée de l’Utilitaire d’analyse statistique. Contrairement à la courbe de tendance graphique qui opère la transformation logarithmique en tâche de fond de manière opaque, ce module requiert l’utilisation explicite de la colonne préalablement linéarisée LN_x.
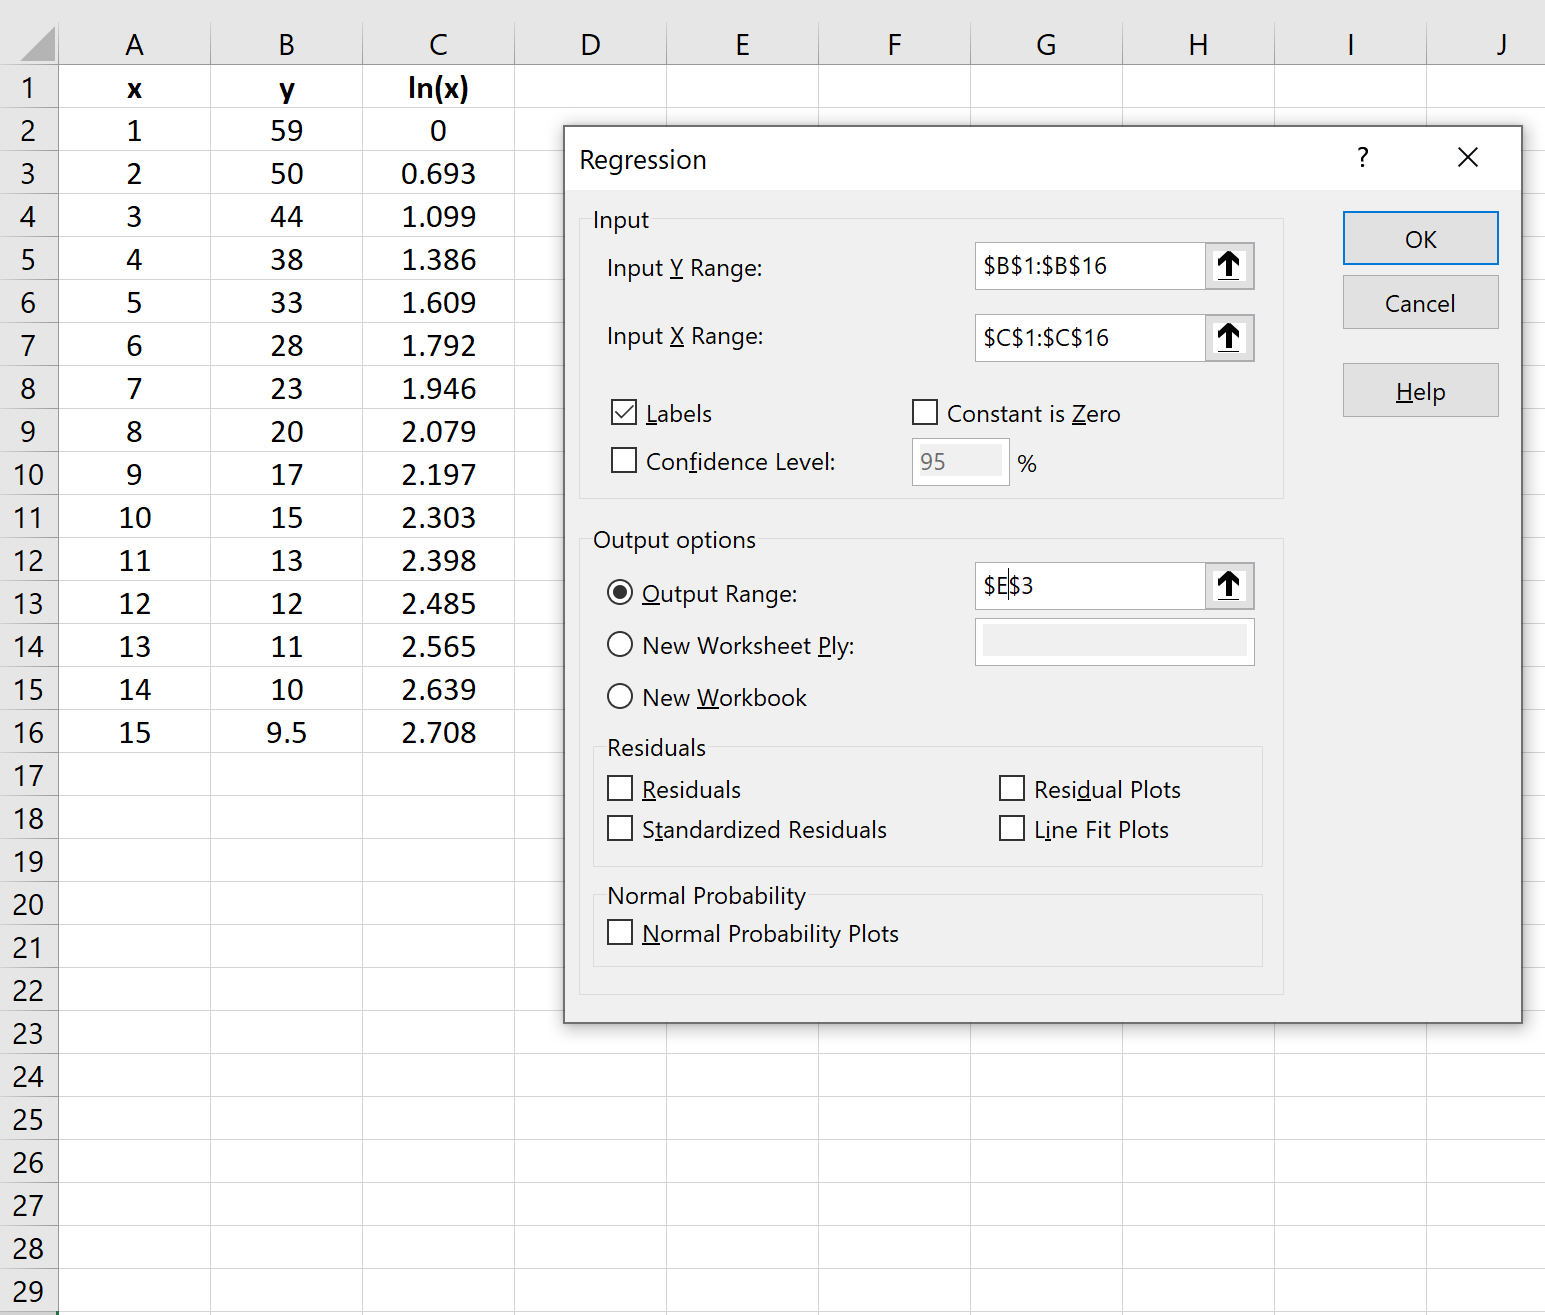
Le praticien accède à l’onglet Données, puis clique sur l’icône Utilitaire d’analyse. Dans la liste alphabétique des macro-fonctions statistiques proposées, il sélectionne Régression et confirme par un clic sur OK. La boîte de dialogue de configuration requiert alors une paramétrisation méthodique de plusieurs champs sensibles :
- Plage d’entrée Y : on sélectionne la référence de la plage hébergeant la variable dépendante d’origine (par exemple
$C$1:$C$101), en incluant expressément la cellule d’en-tête textuelle. - Plage d’entrée X : on cible exclusivement la plage contenant la variable indépendante transformée (par exemple
$D$1:$D$101contenant LN_x), en intégrant également l’étiquette supérieure. Il ne faut en aucun cas sélectionner la colonne des données brutes x, sous peine d’estimer un modèle linéaire simple non logarithmique. - Intitulés : cette case à cocher doit impérativement être validée dès lors que les plages d’entrée englobent la première ligne textuelle, garantissant que les sorties tabulaires porteront le libellé exact des variables.
- Niveau de confiance : coché par défaut à 95 %, il peut être ajusté à 99 % si les exigences du protocole expérimental imposent une rigueur probabiliste supérieure (α = 0,01).
- Constante égale à zéro : cette option doit impérativement rester DÉCOCHÉE. Forcer la constante a à zéro reviendrait à imposer arbitrairement que y = 0 lorsque x = 1, une hypothèse psychométriquement erronée dans la quasi-totalité des situations concrètes.
- Résidus : il est judicieux de cocher les options Résidus et Résidus normalisés pour autoriser la génération ultérieure des métriques diagnostiques.
7.2 Génération et organisation de la feuille de synthèse
Dans la section réservée aux options de sortie de la boîte de dialogue, il est fortement préconisé de cocher l’alternative Nouvelle feuille de calcul et de lui attribuer un libellé évocateur tel que Sortie_Regression_Log. La validation par le bouton OK déclenche instantanément le calcul matriciel des moindres carrés et la génération d’un rapport synthétique structuré en trois grands blocs normalisés.
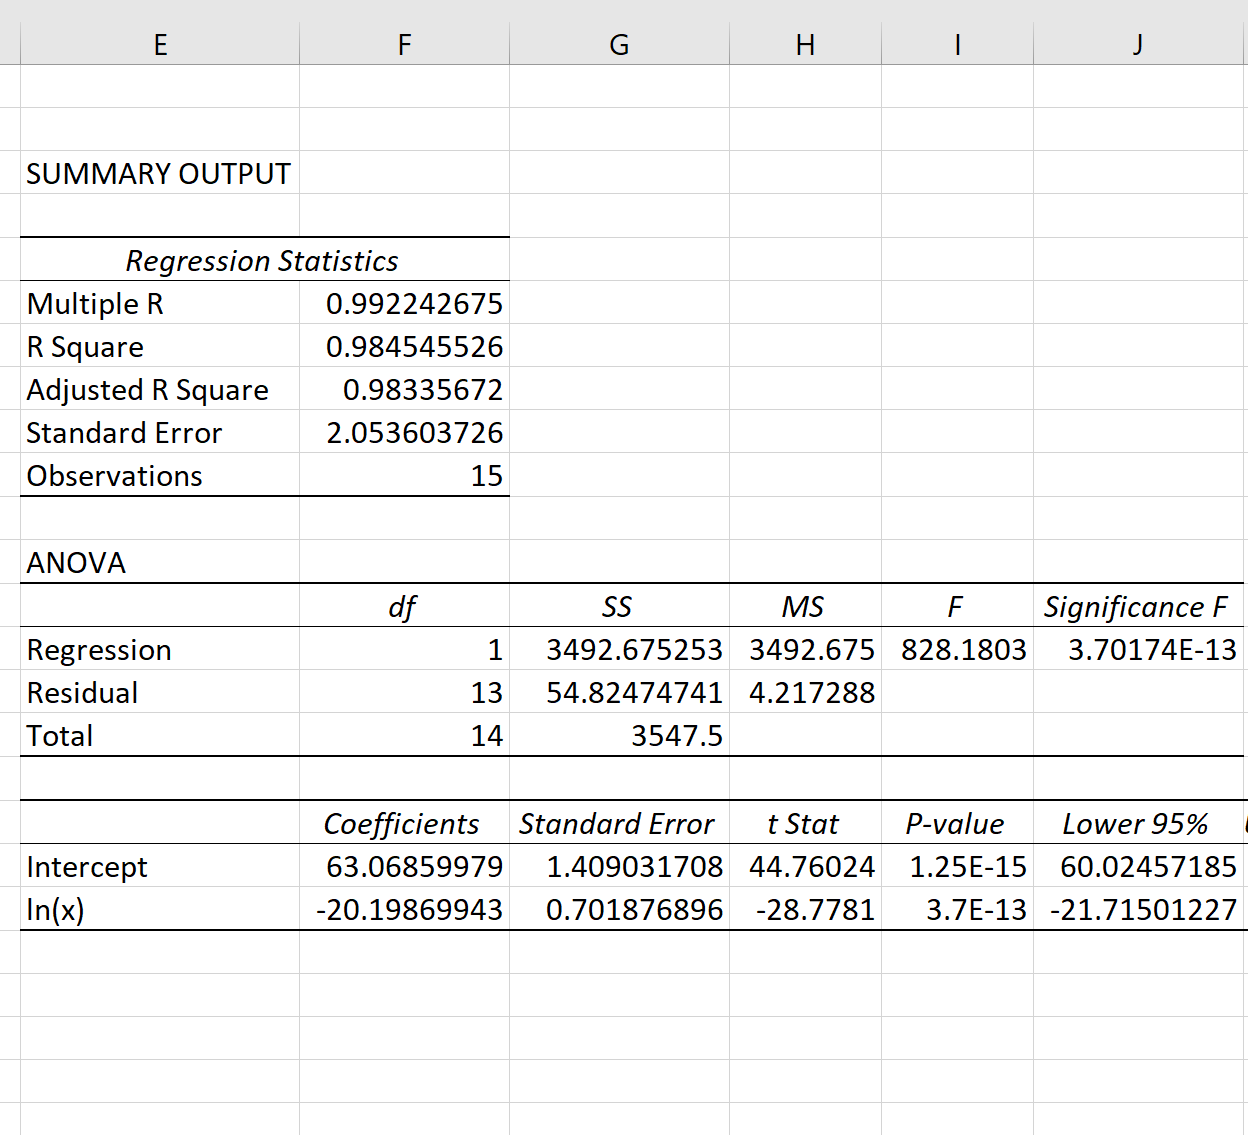
Le premier bloc regroupe les Statistiques de la régression, récapitulant les corrélations multiples, le coefficient de détermination R², le R² corrigé et l’erreur-type globale de l’estimation. Le second bloc présente le tableau de l’ANOVA (Analyse de la variance), ventilant la somme des carrés totale entre la variabilité imputable au modèle de régression et la dispersion résiduelle non expliquée, complétée par la statistique globale F de Fisher-Snedecor et sa significativité associée.
Le troisième bloc tabulaire constitue le cœur analytique du rapport, listant les lignes respectives pour l’Ordonnée à l’origine (paramètre a) et la variable explicative transformée LN_x (dont le coefficient correspond au paramètre b). Pour chaque coefficient, Excel fournit l’estimation ponctuelle, l’erreur-type, la statistique t de Student, la valeur-p (p-value) bilatérale ainsi que les bornes inférieure et supérieure de l’intervalle de confiance à 95 %. Ces grandeurs statistiques offrent l’ensemble des éléments requis pour valider formellement la robustesse de l’ajustement empirique.
8. Étape 5 : Estimation algorithmique par fonctions matricielles
8.1 Syntaxe et exécution de la fonction DROITEREG
L’utilisation de l’Utilitaire d’analyse, bien qu’exhaustive, présente une limite structurelle majeure au sein d’un classeur vivant : ses résultats sont statiques. Si une valeur brute est corrigée ou si de nouvelles données psychométriques sont ajoutées, le tableau d’analyse ne s’actualise pas dynamiquement. Pour instaurer une chaîne de modélisation logarithmique pleinement réactive et dynamique, le recours à la fonction matricielle native DROITEREG (ou LINEST dans les versions anglophones) constitue la démarche d’excellence.
La fonction DROITEREG calcule les paramètres d’une régression linéaire par moindres carrés en exploitant la variable transformée. Sa signature syntaxique globale s’articule comme suit :
=DROITEREG(y_connus; [x_connus]; [constante]; [statistiques])
Pour l’appliquer à notre modèle logarithmique, le premier argument y_connus pointe vers la plage des scores comportementaux (ex. C2:C101), tandis que le second argument x_connus pointe impérativement vers le vecteur logarithmique (ex. D2:D101). Le troisième argument est fixé au booléen VRAI pour autoriser le calcul standard de l’ordonnée à l’origine a. Le quatrième argument doit être renseigné à VRAI pour ordonner à l’algorithme de restituer la matrice complète des statistiques d’ajustement (incluant erreurs-types, R², statistique F et degrés de liberté).
Sous les versions modernes de Microsoft 365 bénéficiant du moteur de matrices dynamiques, il suffit de valider la formule par la touche Entrée en une seule cellule (ex. F2) : le tableau de sortie se déploie instantanément sur une grille standard de 5 lignes sur 2 colonnes. Sur les versions patrimoniales antérieures d’Excel, l’exécution impose de sélectionner manuellement à la souris une plage matricielle vierge de 5 lignes et 2 colonnes (de F2 à G6), de saisir rigoureusement l’expression textuelle dans la barre de formules, puis d’exécuter la combinaison triadique de touches Ctrl + Maj + Entrée pour contraindre la validation matricielle.
La topologie de distribution de la matrice retournée par DROITEREG suit un ordre codifié strict :
- Ligne 1 : Pente logarithmique b (colonne F) | Ordonnée à l’origine a (colonne G)
- Ligne 2 : Erreur-type de b (colonne F) | Erreur-type de a (colonne G)
- Ligne 3 : Coefficient de détermination R² (colonne F) | Erreur-type de l’estimation de y (colonne G)
- Ligne 4 : Statistique F de Fisher (colonne F) | Degrés de liberté résiduels (colonne G)
- Ligne 5 : Somme des carrés de régression (colonne F) | Somme des carrés résiduels (colonne G)
8.2 Calcul direct des paramètres par formules isolées
Dans de nombreuses situations d’ingénierie de reporting ou de confection de tableaux de bord, il n’est pas nécessaire de manipuler un bloc matriciel étendu. Excel dispose de fonctions statistiques scalaires ciblées permettant de rapatrier individuellement chaque paramètre au sein d’une cellule isolée, tout en maintenant une réactivité dynamique totale aux mises à jour des données sources.
Ces fonctions exploitent conjointement le vecteur dépendant y et le vecteur transformé ln(x) :
- Calcul immédiat de la pente logarithmique b :
=PENTE(C2:C101; D2:D101) - Calcul spécifique de l’ordonnée à l’origine a :
=ORDONNEE.ORIGINE(C2:C101; D2:D101) - Calcul direct du coefficient de détermination R² :
=COEFFICIENT.DETERMINATION(C2:C101; D2:D101) - Calcul de l’erreur-type standard des résidus :
=ERREUR.TYPE.PE(C2:C101; D2:D101)
La stricte concordance numérique entre les valeurs issues de ces fonctions scalaires, les paramètres issus de la fonction matricielle DROITEREG, les estimations textuelles de la courbe de tendance graphique et les résultats de l’Utilitaire d’analyse permet d’attester l’intégrité de l’environnement de calcul et l’absence totale de biais d’adressage cellulaire dans la modélisation.
9. Interprétation psychométrique des métriques de sortie
9.1 Évaluation de la variance expliquée
L’interprétation statistique des grandeurs numériques produites par Excel dépasse la simple observation des magnitudes mathématiques : elle exige une traduction méthodologique rigoureuse dans le contexte des construits psychologiques étudiés. Le coefficient de détermination, universally noté R², mesure la fraction proportionnelle de la variance de la variable réponse qui est statistiquement expliquée ou absorbée par le modèle logarithmique.
Dans le cadre des recherches en psychologie comportementale, où la variance interindividuelle et le bruit de mesure biologique sont intrinsèquement élevés, un R² excédant 0,50 traduit généralement un ajustement substantiel, tandis que des valeurs supérieures à 0,80 indiquent une adéquation remarquable entre la fonction logarithmique et les données de laboratoire. Toutefois, le statisticien avisé se doit d’examiner prioritairement le R² corrigé (ou Adjusted R-squared). Contrairement au R² ordinaire qui augmente mécaniquement dès qu’un prédicteur supplémentaire est injecté dans le modèle — même s’il ne s’agit que de pur bruit blanc —, le R² corrigé pénalise l’intégration de degrés de liberté additionnels selon l’équation de correction classique :
R²adj = 1 – [(1 – R²) × (n – 1) / (n – k – 1)]
où n est l’effectif total et k le nombre de variables indépendantes. Bien que dans une régression simple (k = 1) la divergence entre les deux métriques soit ténue pour des échantillons de taille respectable, le R² corrigé constitue une estimation non biaisée de la variance expliquée dans la population parente.
Complémentairement, l’Erreur-type de l’estimation (Standard Error) fournit une quantification absolue de la dispersion résiduelle. Exprimée dans la même unité métrique que la variable dépendante y, elle indique l’écart-type des écarts verticaux séparant les observations individuelles de la courbe d’ajustement logarithmique. Un modèle affichant un R² élevé peut néanmoins s’avérer insuffisant sur le plan clinique si son erreur-type résiduelle excède le seuil de significativité opérationnelle défini par le protocole expérimental.
9.2 Tests d’hypothèse et inférence statistique
La lecture du tableau d’analyse de variance ANOVA et des lignes de coefficients permet de formaliser la démarche de test d’hypothèses statistiques. Le test F global évalue l’hypothèse nulle (H0) selon laquelle le modèle logarithmique n’apporte aucune réduction significative de la dispersion par rapport à un modèle simpliste se limitant à la simple moyenne arithmétique de y (ce qui équivaut à postuler b = 0). Si la statistique F critique (correspondant à la p-value associée à la distribution de Fisher sous 1 et n – 2 degrés de liberté) est inférieure au seuil conventionnel de significativité α = 0,05, l’hypothèse nulle est formellement rejetée.
Au niveau de la ligne relative au coefficient LN_x, le test t de Student individualise cette inférence en testant spécifiquement si la pente logarithmique diffère statistiquement de zéro. La statistique t est obtenue en divisant l’estimation du paramètre b par son erreur-type d’échantillonnage : t = b / SEb. La colonne adjacente Probabilité (ou p-value) indique le risque d’erreur de première espèce associé au rejet de l’hypothèse nulle d’absence d’effet logarithmique. Une valeur p < 0,001 indique une certitude probabiliste très élevée quant à la non-nullité de la pente.
Enfin, l’analyse des intervalles de confiance à 95 % délimite la plage théorique au sein de laquelle le véritable paramètre populationnel possède 95 % de chances de se situer en cas de réplications expérimentales indépendantes. Si l’intervalle de confiance délimité par les bornes inférieure et supérieure n’englobe pas la valeur zéro, l’effet de décélération ou d’atténuation logarithmique est certifié statistiquement conforme aux canons méthodologiques de l’American Psychological Association (APA).
9.3 Traduction sémantique de l’équation du modèle
L’interprétation sémantique des paramètres calibrés constitue une étape où de nombreux praticiens commettent des contresens analytiques majeurs, par confusion entre modèles linéaires absolus et modèles semi-logarithmiques lin-log. L’ordonnée à l’origine a ne représente aucunement la valeur de y lorsque la variable originale est nulle (puisque ln(0) est mathématiquement indéfini). a correspond strictement à la valeur prédite de y lorsque la variable explicative originale x est égale à exactement 1 unité d’échelle expérimentale (car ln(1) = 0).
Le paramètre de pente logarithmique b ne s’interprète pas comme l’incrément de y par incrément unitaire absolu de x. Dans un modèle semi-logarithmique lin-log du type y = a + b × ln(x), le paramètre b régit la réponse de y face à des variations relatives proportionnelles de x. Deux règles de dérivation analytique permettent d’en extraire le sens clinique et théorique :
- Règle de l’incrément par le facteur d’Euler (e ≈ 2,718) : Chaque fois que la variable prédictive x est multipliée par la constante naturelle e (soit une augmentation d’environ 171,8 %), la variable dépendante y varie d’une quantité absolue rigoureusement égale à b unités de son échelle de mesure.
- Règle de l’élasticité semi-logarithmique à 1 % : Pour une petite variation en pourcentage de la variable x, l’impact sur y est obtenu par l’approximation différentielle : une augmentation de 1 % de la variable x induit une variation absolue moyenne de la variable réponse y d’environ b / 100 unités.
- Règle du doublement (facteur 2) : Chaque fois que la grandeur de la stimulation physique x double (augmentation de 100 %), la réponse psychologique y change d’une magnitude constante égale à b × ln(2) ≈ 0,69315 × b unités.
Cette formalisation mathématique illustre avec éclat le principe de compression perceptive : si b = 10, passer d’une stimulation de 1 à 2 unités physiques augmente la sensation de 6,93 unités, mais pour obtenir le même gain perceptif ultérieur de 6,93 unités, il faudra doubler à nouveau le stimulus, passant de 2 à 4 unités, puis de 4 à 8 unités, caractérisant une dynamique d’élasticité décroissante typique des systèmes neuronaux récepteurs.
10. Analyse diagnostique des résidus et validation du modèle
10.1 Inspection de la structure d’erreur
L’obtention d’un coefficient de détermination R² exceptionnellement élevé et de p-values infinitésimales ne suffit aucunement à garantir la validité scientifique d’un modèle logarithmique. Une modélisation erronée peut afficher des métriques globales séduisantes tout en violant grossièrement les postulats gaussiens fondamentaux. L’analyse diagnostique de la structure des résidus constitue le filtre méthodologique ultime pour discriminer un ajustement réel d’un artefact computationnel.
Le résidu individuel ei représente la divergence verticale entre la valeur comportementale empiriquement mesurée yi et la valeur théorique projetée par le modèle logarithmique ajusté ŷi = a + b × ln(xi) :
ei = yi – ŷi
Pour auditer ces termes d’erreur sous Excel, l’analyste exploite les colonnes générées automatiquement lors de l’exécution de l’Utilitaire d’analyse statistique : la colonne des Valeurs prédites et celle des Résidus ordinaires ou Résidus standardisés.
L’outil diagnostique par excellence est le Graphique des résidus en fonction des valeurs prédites. Il s’obtient en sélectionnant les valeurs projetées ŷ sur l’axe des abscisses et les résidus e sur l’axe des ordonnées au sein d’un nuage de points cartésien. Un modèle mathématiquement sain et valide doit produire une distribution résiduelle se présentant sous l’aspect d’un « nuage informe » de points gravitant de manière purement aléatoire et symétrique autour de la ligne horizontale d’ordonnée zéro. Si l’on discerne au contraire une forme en entonnoir — la dispersion s’évasant ou se rétrécissant le long de l’axe horizontal —, le postulat d’homoscédasticité est violé. De même, la présence d’une structure curviligne résiduelle en arc ou en sinusoïde trahit immédiatement une spécification fonctionnelle inadéquate, signalant que la véritable cinétique n’est pas logarithmique simple.
10.2 Validation de la normalité des résidus
L’exactitude des inférences statistiques déduites des tests t et F repose impérativement sur l’hypothèse de distribution gaussienne des erreurs résiduelles dans la population. Si cette normalité n’est pas respectée, les probabilités critiques rapportées dans les feuilles de calcul d’Excel risquent d’être substantiellement biaisées, exposant l’analyste à des décisions erronées de rejet ou d’acceptation de ses hypothèses théoriques.
Bien qu’Excel ne dispose pas en natif d’un test formel automatisé de normalité comme le test de Shapiro-Wilk ou de Kolmogorov-Smirnov, il permet de caractériser précisément la forme de distribution des résidus via deux métriques de moments d’ordre supérieur :
- Le coefficient d’asymétrie statistique (Skewness) : calculable par la formule
=COEFFICIENT.ASYMETRIE(plage_residus). Une valeur proche de zéro atteste une symétrie satisfaisante des erreurs, tandis qu’une valeur s’écartant au-delà de l’intervalle [-1 ; +1] signale une distorsion asymétrique prononcée. - Le coefficient d’aplatissement (Kurtosis) : calculable par la formule
=KURTOSIS(plage_residus), qui correspond au kurtosis excessif. Une distribution gaussienne standard renvoie une valeur voisine de 0. Des écarts marqués (> 2) indiquent une leptocurticité avec des queues de distribution anormalement lourdes et une vulnérabilité accrue aux résidus extrêmes.
Pour une inspection graphique rigoureuse, la confection d’un diagramme quantile-quantile d’approximation (Q-Q Plot) peut être érigée dans Excel. Elle consiste à trier les résidus standardisés par ordre croissant, à calculer leur rang percentile empirique théorique à l’aide de la formule =(RANG - 0,5) / N, à dériver les quantiles théoriques d’une loi normale centrée réduite correspondants via la fonction =LOI.NORMALE.STANDARD.INVERSE(percentile), puis à projeter ces quantiles théoriques contre les résidus réels. Tout alignement linéaire strict le long de la diagonale confirme empiriquement le postulat de normalité résiduelle.
10.3 Détection des observations à fort levier
L’estimation par la méthode des moindres carrés ordinaires possède une sensibilité reconnue aux points singuliers de données. Dans le contexte de la régression logarithmique, un point aberrant peut exercer une distorsion disproportionnée sur la trajectoire de la courbe d’ajustement s’il se positionne aux extrémités extrêmes du continuum de mesure, générant un effet de levier (leverage) mathématique substantiel.
L’identification de ces observations influentes repose initialement sur l’examen des résidus standardisés. Par convention en psychométrie, toute observation dont le résidu standardisé excède une valeur absolue de 2,5 ou 3 écarts-types (|e*i| > 3) doit être isolée et documentée en tant que valeur aberrante potentielle. Plus fondamentalement, un point localisé à l’extrême limite inférieure du prédicteur x (proche de zéro) subit une projection logarithmique très négative, ce qui le distancie considérablement du centre de gravité des données dans l’espace linéarisé.
L’analyste doit opérer une analyse de sensibilité méthodique sous Excel :
Il convient d’estimer les paramètres du modèle sur l’échantillon complet, puis de réitérer le calcul après exclusion ciblée de l’observation suspectée. Si la suppression de ce point individuel modifie drastiquement l’amplitude du coefficient de pente b (par exemple de plus de 15 %) ou transforme un résultat non statistiquement significatif en un résultat significatif, l’observation est qualifiée de point à fort levier d’influence. La règle épistémologique stricte interdit l’élimination arbitraire d’un point au seul motif qu’il dessert l’ajustement statistique ; son retrait ne peut être justifié que par l’identification formelle d’une anomalie expérimentale avérée (défaillance d’enregistrement, inattention documentée du participant) et doit impérativement être consigné de manière transparente dans les publications de recherche.
11. Étude de cas : Modélisation de la courbe de rétention mémorielle
11.1 Contexte expérimental et données brutes
Pour illustrer de manière tangible l’ensemble du protocole d’ingénierie statistique exposé jusqu’ici, développons une étude de cas empirique complète inspirée des protocoles de mémorisation verbale à long terme. Soit un protocole expérimental mené sur une cohorte de 60 participants soumis à l’apprentissage standardisé d’une liste de 30 trigrammes de lettres sans signification. La restitution du matériel mémorisé est mesurée à différents intervalles chronométriques post-acquisition, échelonnés de 5 minutes à 48 heures (2 880 minutes).
La variable indépendante x correspond à l’intervalle de rétention temporelle écoulé (exprimé en minutes). La variable dépendante y correspond au pourcentage moyen d’éléments correctement restitués sans indiçage lors de l’épreuve de rappel. Les observations consolidées issues du laboratoire s’établissent comme suit :
- Point 1 : x = 5 min → y = 78,4 %
- Point 2 : x = 15 min → y = 65,2 %
- Point 3 : x = 30 min → y = 57,8 %
- Point 4 : x = 60 min (1 h) → y = 49,1 %
- Point 5 : x = 180 min (3 h) → y = 41,3 %
- Point 6 : x = 360 min (6 h) → y = 35,6 %
- Point 7 : x = 720 min (12 h) → y = 29,8 %
- Point 8 : x = 1440 min (24 h) → y = 26,1 %
- Point 9 : x = 2880 min (48 h) → y = 21,4 %
L’inspection qualitative brute des données met en exergue l’essence même de l’amnésie naturelle postulée par Ebbinghaus : la perte d’information s’avère particulièrement foudroyante au cours de la première heure (chute de près de 30 points de pourcentage), avant de ralentir progressivement, une durée supplémentaire de 24 heures (entre 1 440 et 2 880 minutes) ne provoquant plus qu’un effritement marginal de 4,7 points de rétention.
11.2 Implémentation complète sous Excel
L’implémentation opérationnelle de cette étude de cas dans Microsoft Excel s’organise selon la séquence analytique suivante :
Dans un classeur neuf, on dispose les en-têtes textuels sur la ligne 1 : cellule A1 = Session, B1 = Temps_Min, C1 = Rappel_Pct, et D1 = LN_Temps. Les valeurs d’intervalles sont reportées dans les cellules B2 à B10, et les scores de restitution dans les cellules C2 à C10. En cellule D2, on saisit l’expression de linéarisation logarithmique :
=LN(B2)
qui renvoie pour la première ligne ln(5) = 1,6094. On propage la formule jusqu’en cellule D10, qui renvoie pour le terme temporel ultime ln(2880) = 7,9655.
Pour extraire les paramètres dynamiques sans recourir à des menus statiques, on sélectionne une cellule dégagée, par exemple F2, et l’on implémente le calcul de la pente via :
=PENTE(C2:C10; D2:D10)
Le moteur de calcul d’Excel renvoie précisément la valeur : b = -8,8378. En cellule F3, on calcule l’ordonnée à l’origine avec la formule :
=ORDONNEE.ORIGINE(C2:C10; D2:D10)
ce qui produit : a = 93,5221. Enfin, la qualité de l’ajustement évaluée en cellule F4 par la fonction =COEFFICIENT.DETERMINATION(C2:C10; D2:D10) affiche un remarquable R² = 0,9902.
Le modèle calibré d’oubli cognitif pour cette cohorte s’établit donc mathématiquement sous l’expression :
Rappel_Prédit (%) = 93,5221 – 8,8378 × ln(Temps_Min)
11.3 Synthèse des résultats et projection théorique
L’adéquation entre le modèle mathématique et les observations expérimentales apparaît exceptionnelle avec plus de 99 % de la variance temporelle du rappel mémoriel capturée par l’équation logarithmique. À titre comparatif, si nous ajustions un modèle strictement linéaire classique y = a + b × x sur cette même série de données sous Excel, le R² s’effondrerait à 0,612, produisant des prédictions aberrantes telles que des pourcentages de mémorisation négatifs dès que l’intervalle dépasse quelques jours.
La puissance du modèle réside dans sa capacité de simulation prédictive. Si le protocole expérimental nécessite d’anticiper le taux de rappel attendu à un horizon temporel intermédiaire non mesuré empiriquement — par exemple à 120 minutes (2 heures) —, il suffit d’appliquer l’équation paramétrée dans une cellule Excel :
=93,5221 - 8,8378 * LN(120)
ce qui livre une prédiction probabiliste de 51,21 % de rétention mémorielle.
Cependant, l’analyste se doit d’intégrer une mise en garde épistémologique fondamentale relative à l’extrapolation mathématique lointaine. Par nature, la fonction logarithmique à pente négative ne possède pas d’asymptote horizontale inférieure : elle tend continuellement vers l’infini négatif lorsque x → +∞. Si l’on applique mécaniquement l’équation pour simuler le rappel mémoriel à un horizon de 90 jours (129 600 minutes), l’équation produit : 93,5221 – 8,8378 × ln(129600) = -10,51 %. Or, un score de rétention inférieur à zéro est un non-sens biologique absolu. Cet écueil illustre les frontières de validité écologique des modèles semi-logarithmiques : ils constituent de formidables approximations locales et régionales de processus à rendements décroissants, mais ne sauraient remplacer des modèles logistiques à asymptotes fixes bornées [0, 100] pour des extrapolations temporelles massives.
12. Erreurs courantes, limites méthodologiques et bonnes pratiques
12.1 Biais analytiques fréquents dans Excel
La simplicité apparente de manipulation des outils graphiques et des fonctions statistiques d’Excel dissimule plusieurs pièges techniques susceptibles d’invalider les conclusions des analystes les plus rigoureux. L’erreur la plus prévalente réside dans la confusion récurrente entre la courbe de tendance logarithmique et la courbe de tendance de puissance. De nombreux praticiens sélectionnent par inadvertance l’option Puissance au sein de la boîte de dialogue graphique. Bien que visuellement ces deux courbes exhibent une décélération de croissance superficiellement similaire, leurs structures mathématiques sous-jacentes sont radicalement divergentes : le modèle de puissance comprime logarithmiquement les deux axes ln(y) = a + b × ln(x), tandis que le modèle logarithmique ne transforme que l’abscisse. Confondre ces deux approches corrompt irrévocablement le cadre d’interprétation des coefficients.
Une seconde erreur méthodologique fréquente découle de l’oubli d’actualisation manuelle de l’Utilitaire d’analyse. Un chercheur modifiant les observations d’un sujet dans sa matrice de données brutes verra immédiatement son graphique de nuage de points et ses courbes de tendance s’actualiser en temps réel, mais les tableaux inférentiels statiques générés par le complément Analyse de données demeureront figés sur les valeurs obsolètes, générant des discordances flagrantes entre les graphiques publiés et les valeurs textuelles rapportées dans les manuscrits scientifiques.
Enfin, l’omission de vérification des zéros structurels avant l’appel des macro-commandes statistiques produit des dysfonctionnements silencieux. Si une série expérimentale contient des zéros que l’utilisateur n’a pas préalablement traités par translation unitaire, Excel peut soit refuser d’exécuter la fonction matricielle (renvoyant une cellule vide ou l’erreur #NOMBRE!), soit exclure unilatéralement les observations litigieuses de l’estimation sans en informer explicitement l’opérateur, réduisant la puissance statistique de l’échantillon à l’insu du chercheur.
12.2 Limites inhérentes à la modélisation sous tableur
Si Microsoft Excel s’affirme comme un environnement d’analyse statistique exceptionnel pour l’exploration pédagogique et le prototypage rapide, il accuse des limites intrinsèques dès lors que la recherche quantitative requiert des modélisations hautement sophistiquées. L’absence d’algorithmes formels intégrés de correction d’hétéroscédasticité — tels que l’estimation des erreurs-types cohérentes de Huber-White — contraint l’utilisateur à accepter les erreurs-types standards des moindres carrés ordinaires, vulnérables en cas d’inégalité des variances résiduelles.
Plus fondamentalement, Excel est nativement inadapté à la gestion des structures de données hiérarchiques, longitudinales ou imbriquées (mesures répétées au sein des mêmes sujets avec corrélations intrasujets). Dans de telles configurations psychométriques, ajuster une simple régression logarithmique par moindres carrés ordinaires en agrégeant l’ensemble des points d’observation viole gravement le postulat d’indépendance des erreurs, gonflant dramatiquement le risque de faux positifs statistiques (erreur de type I). Ces architectures de données requièrent l’implémentation de modèles linéaires mixtes (ou modèles multiniveaux), où les ordonnées à l’origine et les pentes logarithmiques sont modélisées en tant qu’effets aléatoires variant d’un individu à un autre, une capacité qui outrepasse les compétences standards du tableur et justifie le basculement vers des écosystèmes statistiques spécialisés tels que R (packages lme4 ou nlme), Python (statsmodels), SPSS ou SAS.
12.3 Recommandations pour la communication scientifique
La publication de résultats issus d’une régression logarithmique exige le respect scrupuleux de standards de restitution normalisés, tels que dictés par les directives stylistiques de l’American Psychological Association (APA, 7e édition). Lors de la rédaction du corps textuel d’un manuscrit empirique, il ne suffit pas d’affirmer qu’une relation logarithmique a été observée : chaque métrique clé doit être rapportée avec ses degrés de liberté et son niveau d’incertitude associé.
La formulation canonique privilégie une structure rédactionnelle de ce type :
« L’analyse de régression semi-logarithmique indique que l’intervalle de rétention temporelle prédit significativement le pourcentage de rappel mémoriel, b = -8,84, SE = 0,33, t(7) = -26,67, p < 0,001. Le modèle explique 99,0 % de la variance totale de restitution cognitive (R² = 0,990, R²adj = 0,989, F(1, 7) = 711,28, p < 0,001). L’ordonnée à l’origine s’établit à a = 93,52, IC 95 % [91,24 ; 95,80]. »
Sur le plan de l’illustration graphique, les tracés bruts générés par défaut par Microsoft Excel ne doivent jamais être incorporés tels quels dans des rapports institutionnels ou des articles soumis à évaluation par les pairs. Il est impératif d’en épurer l’habillage visuel : suppression des quadrillages grisâtres superflus d’arrière-plan, application d’une typographie académique uniforme (Times New Roman, Arial ou Calibri), délimitation franche des axes en noir avec graduation orientée vers l’extérieur, dimensionnement adéquat des marqueurs de points expérimentaux et traçage continu de la courbe d’ajustement logarithmique. De surcroît, le principe de reproductibilité de la science ouverte (Open Science) impose d’archiver le classeur Excel dans un référentiel public pérenne (tel que l’Open Science Framework), en documentant explicitement les cellules de transformation et en séparant sans ambiguïté les données originales brutes des vecteurs de calcul dérivés.
Références
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
Ebbinghaus, H. (1913). Memory: A contribution to experimental psychology (H. A. Ruger & C. E. Bussenius, Trans.). Teachers College, Columbia University. (Original work published 1885). https://doi.org/10.1037/10011-000
Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
Microsoft Corporation. (2024). Documentation de l’Utilitaire d’analyse Excel et des fonctions statistiques. Support Microsoft Office. https://support.microsoft.com/fr-fr/excel
National Institute of Standards and Technology. (2023). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153–181. https://doi.org/10.1037/h0046162
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.