
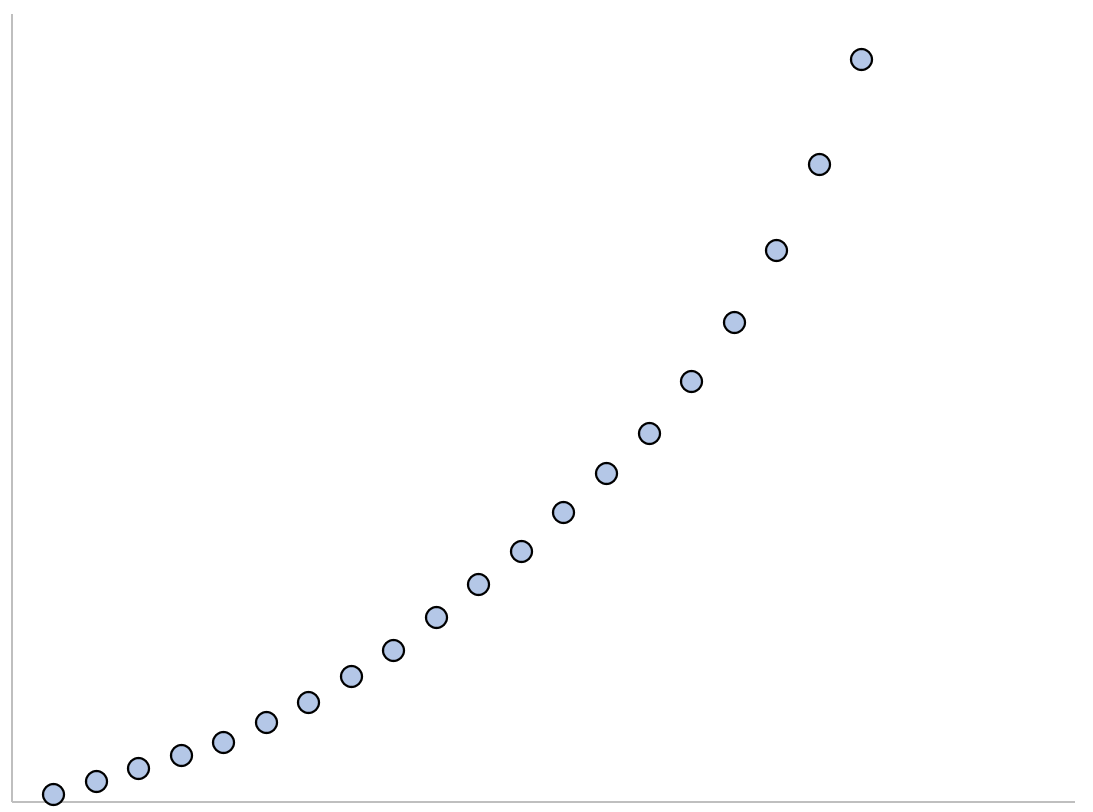
L’analyse des phénomènes non linéaires constitue un défi méthodologique fondamental dans l’ensemble des sciences quantitatives, depuis la modélisation des dynamiques épidémiologiques et pharmacocinétiques jusqu’à la psychophysique et l’étude des processus d’apprentissage. Si la régression linéaire classique par la méthode des moindres carrés ordinaires s’avère un outil robuste pour capturer des relations stationnaires à taux d’accroissement constant, elle échoue structurellement à rendre compte des phénomènes d’accélération progressive, d’amortissement asymptotique ou de saturation biologique. Dans cette perspective, la régression exponentielle s’impose comme une modélisation mathématique essentielle dès lors que le taux de variation d’une variable dépendante n’est pas invariable, mais rigoureusement proportionnel à son propre niveau d’amplitude instantané.
Bien que les environnements de programmation statistique tels que le langage de programmation R ou les bibliothèques spécialisées de Python dominent les représentations logicielles en recherche avancée, le tableur Microsoft Excel demeure une plateforme analytique d’une polyvalence remarquable, omniprésente dans les laboratoires académiques, les institutions de recherche et les structures industrielles. Sous réserve d’en maîtriser les fondements algorithmiques, les mécanismes de transformation matricielle et les routines d’ajustement, Excel offre les leviers nécessaires pour ajuster, valider et diagnostiquer des modèles de régression exponentielle conformes aux plus hauts standards de rigueur scientifique et de reproductibilité empirique.
Ce guide exhaustif a pour vocation de vous accompagner pas à pas dans l’ensemble de la démarche modélisatrice. En décomposant chaque phase opérationnelle — de la justification théorique du formalisme non linéaire à la linéarisation logarithmique, du déploiement de l’Utilitaire d’analyse à l’usage des fonctions matricielles dynamiques, de la correction des biais systématiques de rétro-transformation jusqu’à la formalisation des résultats selon les normes éditoriales de l’American Psychological Association (APA, 7e édition) —, ce traité procure une grille d’analyse complète, articulée autour de critères mathématiques et empiriques inaltérables.
1. Fondements théoriques de la régression exponentielle
1.1 Définition mathématique du modèle exponentiel
La formalisation du modèle exponentiel repose sur une relation fonctionnelle dans laquelle l’évolution d’une variable de réponse quantitative continue, notée y, est régie par une fonction de puissance dont la variable indépendante continue, notée x, constitue l’exposant. Dans sa formulation algébrique standard, ce modèle s’énonce sous la forme :
y = a · bx
Dans cette équation, le paramètre a matérialise l’ordonnée à l’origine ou l’état initial du système lorsque la variable prédictive x est égale à zéro (y(0) = a). Le coefficient b correspond à la base de la croissance ou au facteur multiplicatif unitaire : il stipule le ratio constant par lequel la variable y est multipliée chaque fois que x s’incrémente d’une unité entière. En analyse statistique avancée et en physique appliquée, ce modèle est fréquemment formulé via la constante d’Euler e (≈ 2,71828), adoptant ainsi sa forme naturelle :
y = a · exp(k · x)
Dans ce formalisme alternatif, le paramètre k représente le taux instantané intrinsèque de croissance ou de décroissance relative, mathématiquement lié à la base b par la transformation univoque b = exp(k), ou inversement k = ln(b). Une condition fondamentale et non négociable de validité mathématique réside dans la positivité stricte de l’ensemble des observations empiriques : la variable dépendante doit impérativement vérifier yi > 0 pour tout indice i. En effet, l’opérateur exponentiel à valeurs réelles ne peut générer de quantités négatives ou nulles, et l’éventuelle présence d’une valeur nulle invaliderait irrémédiablement l’opérabilité de la transformation logarithmique ultérieure nécessaire à son estimation classique.
1.2 Dynamiques de croissance et de décroissance exponentielles
La dynamique temporelle ou cinématique d’un modèle exponentiel dépend structurellement de la valeur adoptée par le paramètre multiplicatif b, ou symétriquement du signe algébrique du taux instantané k. Une dynamique d’amplification ou de croissance exponentielle se manifeste dès lors que la base b est strictement supérieure à 1 (b > 1), ce qui équivaut rigoureusement à un taux k positif (k > 0). Dans cette configuration, la vitesse d’évolution instantanée, formalisée par la dérivée première par rapport à x (dy/dx = k · y), augmente continuellement en fonction du niveau atteint par y, décrivant une trajectoire dont la concavité est perpétuellement tournée vers le haut.
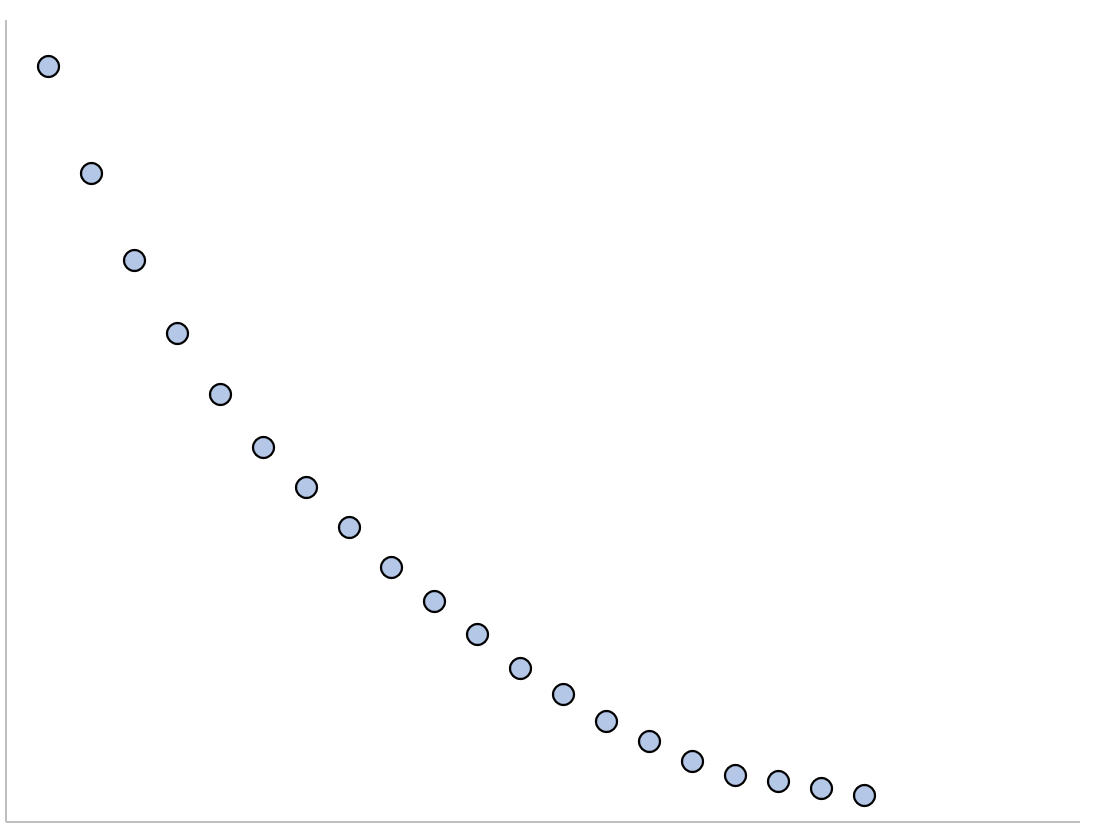
Inversement, lorsque le coefficient b est confiné dans l’intervalle ouvert ]0, 1[, ce qui correspond à une valeur négative du taux instantané (k < 0), le modèle décrit une cinétique de décroissance exponentielle. L’amplitude de la variable y diminue alors à un rythme asymptotique pour tendre inexorablement vers zéro lorsque x croît vers l’infini, sans toutefois jamais franchir cette asymptote horizontale. Il est méthodologiquement crucial de différencier ces processus des relations linéaires classiques. Tandis qu’une fonction linéaire présente une dérivée constante matérialisée par un taux absolu invariable (Δy/Δx = constante), le processus exponentiel exhibe un taux de variation proportionnel à l’état courant de la variable (Δy/y ∝ Δx).
Ces propriétés dynamiques trouvent une résonance empirique immédiate dans la modélisation de l’accélération cognitive, des phénomènes de propagation d’informations, des lois de saturation enzymatique ou de l’oubli mnésique progressif. Dès lors qu’un système rétroagit sur sa propre magnitude pour gouverner la vitesse de son changement d’état, le recours à la régression exponentielle devient une exigence théorique incontournable.
1.3 Pertinence méthodologique en sciences comportementales et psychologie
Dans le champ des sciences comportementales, des neurosciences cognitives et de la psychologie différentielle, l’adoption de modèles non linéaires répond à la nécessité d’objectiver des dynamiques d’ajustement qui échappent par nature à la linéarité géométrique. L’illustration historique la plus célèbre demeure la loi de l’oubli formulée par Hermann Ebbinghaus dès 1885. En mesurant le taux de rétention de syllabes dépourvues de signification à la suite d’intervalles temporels variables, Ebbinghaus a démontré que la dégradation de la trace mnésique ne s’effectue pas de manière linéaire, mais selon une cinétique de décroissance exponentielle abrupte durant les premières heures, suivie d’une stabilisation asymptotique à long terme.
Au-delà de la mémoire, l’analyse des temps de réaction lors de l’acquisition de compétences motrices ou perceptives complexes révèle fréquemment des profils d’accélération initiale suivis d’un plafonnement progressif, décrits initialement sous la forme de courbes d’apprentissage exponentielles. De manière analogue, au niveau électrophysiologique et sensoriel, les phénomènes d’habituation neuronale — caractérisés par la diminution progressive de la magnitude du potentiel évoqué en réponse à des stimulations auditives ou visuelles répétées — s’ajustent avec une précision remarquable à des lois de déclin exponentiel uniexponentiel ou biexponentiel.
L’intégration de la non-linéarité offre ici un avantage épistémologique déterminant : elle permet d’estimer des paramètres ayant une validité écologique intrinsèque. Le coefficient a capture la réactivité initiale ou la capacité mnésique basale absolue du sujet, tandis que le coefficient b quantifie directement la résistance cognitive à l’interférence ou la vélocité d’habituation neuronale face à l’environnement. Contrairement à un modèle linéaire qui extrapolerait d’absurdes scores négatifs au fil du temps, le modèle exponentiel garantit le respect des contraintes physiologiques fondamentales en maintenant l’asymptote de positivité.
2. Préparation de l’environnement de travail dans Microsoft Excel
2.1 Activation et configuration de l’Utilitaire d’analyse
Avant d’engager toute procédure de régression dans l’environnement Microsoft Excel, il est impératif de s’assurer de l’accessibilité du module d’inférence statistique dénommé Utilitaire d’analyse (connu sous l’appellation Analysis ToolPak dans la version originale anglo-saxonne). Ce composant logiciel natif, bien qu’intégré d’office lors du déploiement d’Office, demeure désactivé par défaut lors d’une installation standard afin d’alléger les allocations mémoire de l’application.
Pour procéder à son activation, la séquence opératoire doit être respectée scrupuleusement :
- Accédez au menu principal en cliquant sur l’onglet Fichier positionné à l’extrême gauche du ruban supérieur.
- Dans le volet de navigation vertical situé à gauche, sélectionnez Options afin de provoquer l’ouverture de la boîte de dialogue contextuelle de configuration globale.
- Dans l’arborescence des rubriques, cliquez sur le segment Compléments.
- Au bas de la fenêtre principale, repérez le menu déroulant intitulé Gérer, assurez-vous qu’il affiche la sélection Compléments Excel, puis activez le bouton Atteindre….
- Une boîte de dialogue modale répertorie alors les extensions disponibles. Cochez explicitement l’élément intitulé Utilitaire d’analyse (veillez à ne pas confondre avec l’Utilitaire d’analyse VBA sauf si vous prévoyez une automatisation algorithmique par scripts).
- Validez la sélection par un clic sur OK.
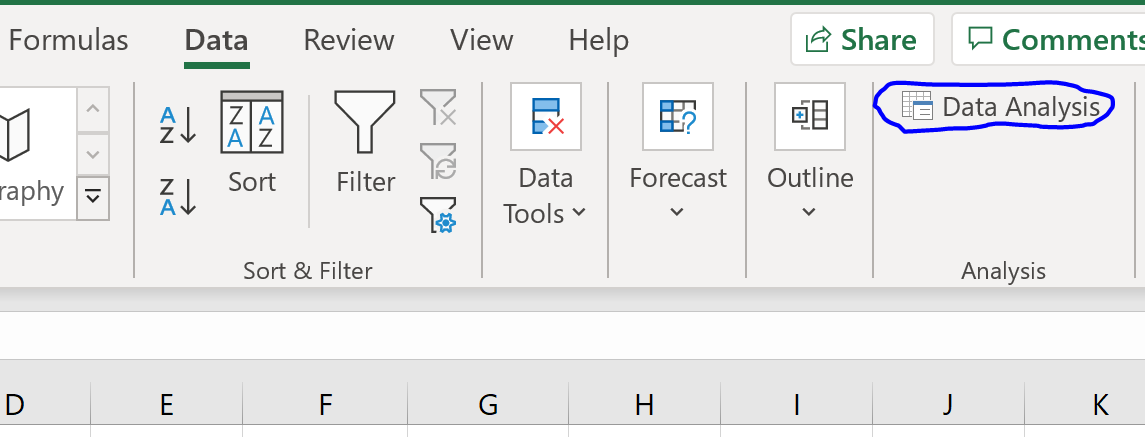
Une fois cette validation entérinée, vérifiez la conformité de l’opération en vous rendant dans l’onglet Données du ruban d’Excel. À l’extrême droite de cette barre d’outils, au sein du sous-groupe fonctionnel intitulé Analyse, l’icône Utilitaire d’analyse (ou Analyse de données) doit désormais figurer. En cas d’absence persistante du composant après redémarrage d’Excel, les administrateurs système devront s’assurer que la stratégie de groupe de l’entreprise n’interdit pas l’exécution de fichiers DLL compilés non signés localement.
2.2 Paramétrage des options de précision et de calcul
La crédibilité empirique d’un ajustement non linéaire dépend étroitement de la précision numérique des registres de calcul du tableur. Excel applique en interne la norme standard IEEE 754 relative à l’arithmétique en virgule flottante double précision, ce qui confère aux calculs une exactitude théorique d’environ 15 chiffres significatifs. Néanmoins, l’interprétation des résultats peut être lourdement compromise par des paramètres régionaux conflictuels ou des réglages d’affichage tronqués.
Dans l’espace francophone, la norme typographique impose l’emploi de la virgule comme séparateur décimal, tandis que la littérature scientifique internationale et les syntaxes de programmation exploitent universellement le point typographique. Pour éviter toute corruption lors de l’importation de fichiers textes délimités (CSV ou TSV), il est recommandé de contrôler les séparateurs système via le menu Fichier > Options > Options avancées, sous la rubrique Options d’édition. Si nécessaire, décochez l’option Utiliser les séparateurs système afin de stipuler manuellement le point décimal (.) et le séparateur de milliers approprié.
Parallèlement, la gestion du moteur d’évaluation mathématique doit être auditée sous l’onglet Formules. Assurez-vous que l’option de calcul est scrupuleusement verrouillée sur Automatique, prévenant ainsi le risque majeur de maintenir des coefficients statiques désynchronisés à la suite de la saisie ultérieure de nouveaux points d’observation. Concernant le formatage cellulaire, bannissez l’arrondi prématuré à l’affichage : réservez la notation scientifique standardisée (par exemple 1,45E-03) aux coefficients asymptotiques ou aux p-valeurs d’inférence afin d’éviter qu’une valeur infinitésimale mais statistiquement significative n’apparaisse visuellement sous le masque d’un zéro absolu trompeur.
2.3 Architecture et hygiène de la feuille de calcul
Une feuille de calcul scientifique dédiée à la modélisation statistique doit obéir à une stricte discipline d’architecture matricielle pour prévenir les erreurs de référencement et garantir une traçabilité intégrale, conforme aux principes de reproductibilité de la recherche. Une conception hygiénique segmente distinctement les zones d’entrée, les zones de calcul intermédiaire et les espaces d’exportation inférentielle.
Adoptez une structuration en colonnes continues, dénuées de toute cellule fusionnée, ces dernières constituant une source notoire de dysfonctionnement lors de l’adressage par les fonctions matricielles. La colonne A doit accueillir de manière exclusive les identifiants ou le rang chronologique de l’observation, la colonne B la variable explicative quantitative X (par exemple, le temps écoulé en heures ou en jours), et la colonne C les mesures brutes de la variable de réponse Y. Les en-têtes doivent comporter, outre l’étiquette sémantique claire de la variable, son unité de mesure métrologique explicite (par exemple : Score_Retention_[%] ou Temps_Reaction_[ms]).
Il est vivement conseillé d’exploiter les fonctionnalités de plages nommées offertes par Excel. En sélectionnant vos données brutes et en leur attribuant des labels explicites via le Gestionnaire de noms (accessible sous l’onglet Formules), vos expressions analytiques gagneront en lisibilité. Remplacer une syntaxe opaque comme =LN(B2:B21) par =LN(Score_Obs) immunise vos formulations contre les erreurs de décalage d’index relatives versus absolues ($A$1). Enfin, documentez systématiquement les métadonnées expérimentales (taille nominale d’échantillon, seuil alpha retenu a priori, conditions de collecte) dans un bloc de commentaires ou une zone dédiée hors matrice afin de faciliter la réévaluation par vos pairs.
3. Étape 1 – Structuration et audit du jeu de données empirique
3.1 Définition opérationnelle des variables de recherche
Le cadrage rigoureux d’un modèle de régression débute impérativement par l’identification univoque du statut ontologique et statistique de chaque variable engagée dans l’analyse. La variable prédictive continue, que nous désignerons par convention matricielle sous le terme de colonne X, doit incarner la dimension continue supposée gouverner la dynamique du phénomène sous étude. En recherche expérimentale, il s’agira typiquement d’une grandeur physique telle que la durée d’exposition à un stimulus, l’intervalle temporel écoulé depuis une phase d’encodage mnésique, ou la dose incrémentale d’un agent pharmacologique administré à un organisme.
Symétriquement, la variable critère ou variable de réponse, assignée à la colonne Y, doit obligatoirement être mesurée sur une échelle d’intervalles ou de rapports, garantissant que les distances entre unités numériques possèdent une équivalence mathématique universelle. Il est primordial d’anticiper la question de la puissance statistique a priori : le nombre total de points d’observation N ne saurait être inférieur aux seuils requis pour assurer la stabilité des estimations d’échantillonnage. En régression univariée non linéaire transformée, un minimum de 15 à 20 observations empiriques distinctes est exigé pour prémunir les estimations contre une volatilité excessive des erreurs-types et garantir une puissance adéquate (1 – β ≥ 0,80 au seuil nominal α = 0,05).
Enfin, l’auditeur statistique doit impérativement certifier l’indépendance mutuelle des observations collectées au sein de l’échantillon. Si les mesures sont recueillies de manière répétée sur un même sujet au fil du temps sans contrôle des corrélations intra-classes, le modèle de régression classique viole l’hypothèse fondamentale d’indépendance des résidus, nécessitant alors le recours à des modèles mixtes à effets aléatoires que le format de la régression univariée standard sous Excel ne peut adresser que de manière approximative.
3.2 Détection et traitement des valeurs critiques
L’une des étapes les plus déterminantes de l’audit préparatoire réside dans l’inspection scrupuleuse des observations vis-à-vis des contraintes asymptotiques propres à la fonction exponentielle. Comme évoqué précédemment, la linéarisation par le logarithme népérien postule formellement que la variable Y appartienne au domaine des réels strictement positifs (ℜ+*). L’apparition de zéros expérimentaux — qu’ils soient consécutifs à des scores planchers d’évaluation cognitive ou à des limites de détection instrumentale — constitue une impasse technique insurmontable, car le logarithme d’une quantité nulle est indéfini et tend vers l’infini négatif (limy → 0 ln(y) = -∞).
Pour auditer votre colonne Y, déployez une routine de contrôle via la fonction de mise en forme conditionnelle ou appliquez une formule d’alerte booléenne dans une colonne adjacente :
=SI(B2<=0; "VALEUR CRITIQUE DETECTEE"; "CONFORME")
Face à une valeur aberrante ou non conforme, plusieurs stratégies méthodologiques s’offrent au chercheur. Si la valeur négative ou nulle résulte d’une erreur d’encodage matériel ou d’un artefact expérimental avéré, son exclusion formelle est pleinement légitime, sous réserve d’une transparence absolue dans le protocole de reporting académique. Si, en revanche, le zéro représente un phénomène réel de performance plancher, il est impératif d’évaluer la pertinence de l’ajout d’une constante de décalage infinitésimale (voir Section 4.3) ou de réorienter le protocole vers des estimateurs non linéaires directs par optimisation de convergence (tels que l’algorithme GRG Non Linéaire du Solveur d’Excel) sans linéarisation logarithmique.
3.3 Exemple pratique : saisie d’une série chronologique expérimentale
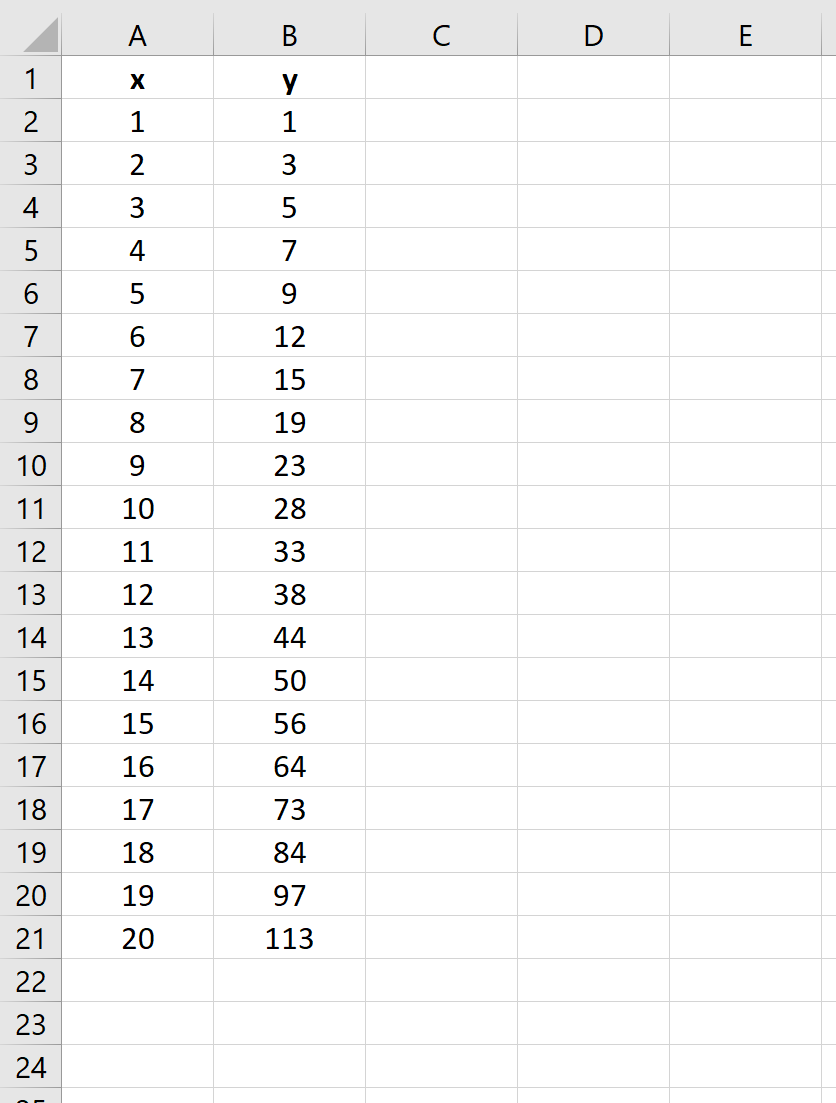
Afin d’ancrer notre exposé dans une démarche concrète et reproductible, nous concevons un jeu de données simulant une expérience classique d’évaluation de la rétention mnésique humaine. Dans ce protocole, un groupe de participants a été soumis à l’apprentissage d’une liste de vocabulaire complexe, et leur score moyen de restitution intégrale (exprimé en pourcentage d’exactitude normalisé) a été mesuré à 20 intervalles temporels échelonnés de 1 à 20 jours après la session initiale d’acquisition.
Ouvrez une feuille Excel vierge et saisissez méthodiquement les observations ci-dessous au sein de la matrice délimitée par les plages A1:B21 :
- En cellule
A1, saisissez le libellé d’en-tête : Temps_Jours - En cellule
B1, saisissez le libellé d’en-tête : Score_Retention - Dans la plage
A2:A21, inscrivez la suite chronologique d’entiers réguliers incrémentés de 1 à 20 (utilisez la poignée de recopie incrémentale d’Excel pour générer rapidement la série). - Dans la plage correspondante
B2:B21, consignez scrupuleusement les scores expérimentaux suivants :- Ligne 2 (Jour 1) : 88,5
- Ligne 3 (Jour 2) : 74,2
- Ligne 4 (Jour 3) : 63,1
- Ligne 5 (Jour 4) : 52,8
- Ligne 6 (Jour 5) : 45,0
- Ligne 7 (Jour 6) : 38,2
- Ligne 8 (Jour 7) : 32,1
- Ligne 9 (Jour 8) : 27,5
- Ligne 10 (Jour 9) : 23,4
- Ligne 11 (Jour 10) : 19,8
- Ligne 12 (Jour 11) : 16,9
- Ligne 13 (Jour 12) : 14,3
- Ligne 14 (Jour 13) : 12,2
- Ligne 15 (Jour 14) : 10,4
- Ligne 16 (Jour 15) : 8,9
- Ligne 17 (Jour 16) : 7,5
- Ligne 18 (Jour 17) : 6,4
- Ligne 19 (Jour 18) : 5,5
- Ligne 20 (Jour 19) : 4,7
- Ligne 21 (Jour 20) : 4,0
Procédez à un audit de typage : sélectionnez l’ensemble du bloc numérique B2:B21 et assurez-vous que les données sont alignées à droite par défaut dans leurs cellules respectives. Un alignement spontané à gauche trahirait la présence accidentelle d’une chaîne de caractères textuelle, résultant le plus souvent de l’usage erroné d’un point au lieu d’une virgule selon votre paramétrage linguistique, ce qui empêcherait l’évaluation des fonctions statistiques ultérieures.
4. Étape 2 – Linéarisation via la transformation par logarithme népérien
4.1 Démonstration algébrique de la linéarisation
L’ajustement standard de modèles non linéaires par les moindres carrés analytiques pose une difficulté calculatoire majeure, car les dérivées partielles des résidus par rapport aux paramètres a et b ne débouchent pas sur des équations normales à solutions fermées directes. Pour contourner cette complexité algorithmique dans le cadre d’un tableur standard, la méthodologie classique procède par linéarisation semi-logarithmique en appliquant l’opérateur logarithme népérien (noté ln) de part et d’autre de l’équation exponentielle fondamentale :
y = a · bx
ln(y) = ln(a · bx)
En vertu des propriétés fondamentales de l’algèbre logarithmique relatives aux produits et aux puissances (soit ln(u · v) = ln(u) + ln(v) et ln(uv) = v · ln(u)), l’expression se décompose et se réorganise rigoureusement comme suit :
ln(y) = ln(a) + x · ln(b)
Si l’on procède désormais à un changement de variable formel en substituant :
- y’ = ln(y) (la réponse transformée)
- β0 = ln(a) (l’ordonnée à l’origine du modèle linéaire)
- β1 = ln(b) (le coefficient de pente linéaire)
L’équation se reformule sous la configuration canonique d’une droite de régression linéaire simple :
y’ = β0 + β1 · x
Néanmoins, cette élégance algébrique s’accompagne d’une conséquence statistique cruciale qu’aucun chercheur ne saurait ignorer : l’application du logarithme modifie fondamentalement la structure stochastique du terme d’erreur. Si l’on postule un modèle additif sur les données transformées (ln(y) = β0 + β1x + ε, avec ε ~ N(0, σ2)), cela sous-entend mathématiquement que sur l’échelle d’origine non transformée, le modèle stochastique s’exprime sous une forme multiplicative : y = a · bx · exp(ε). Les résidus ne sont donc pas additifs sur les données brutes, et la minimisation de la somme des carrés des écarts s’effectuera sur l’espace transformé ln(y) et non sur l’échelle métrique native.
4.2 Application technique de la fonction LN dans Excel
La mise en œuvre de cette linéarisation s’avère d’une remarquable simplicité dans l’interface de calcul d’Excel. Nous allons créer une nouvelle colonne dédiée exclusivement à la variable de réponse transformée.
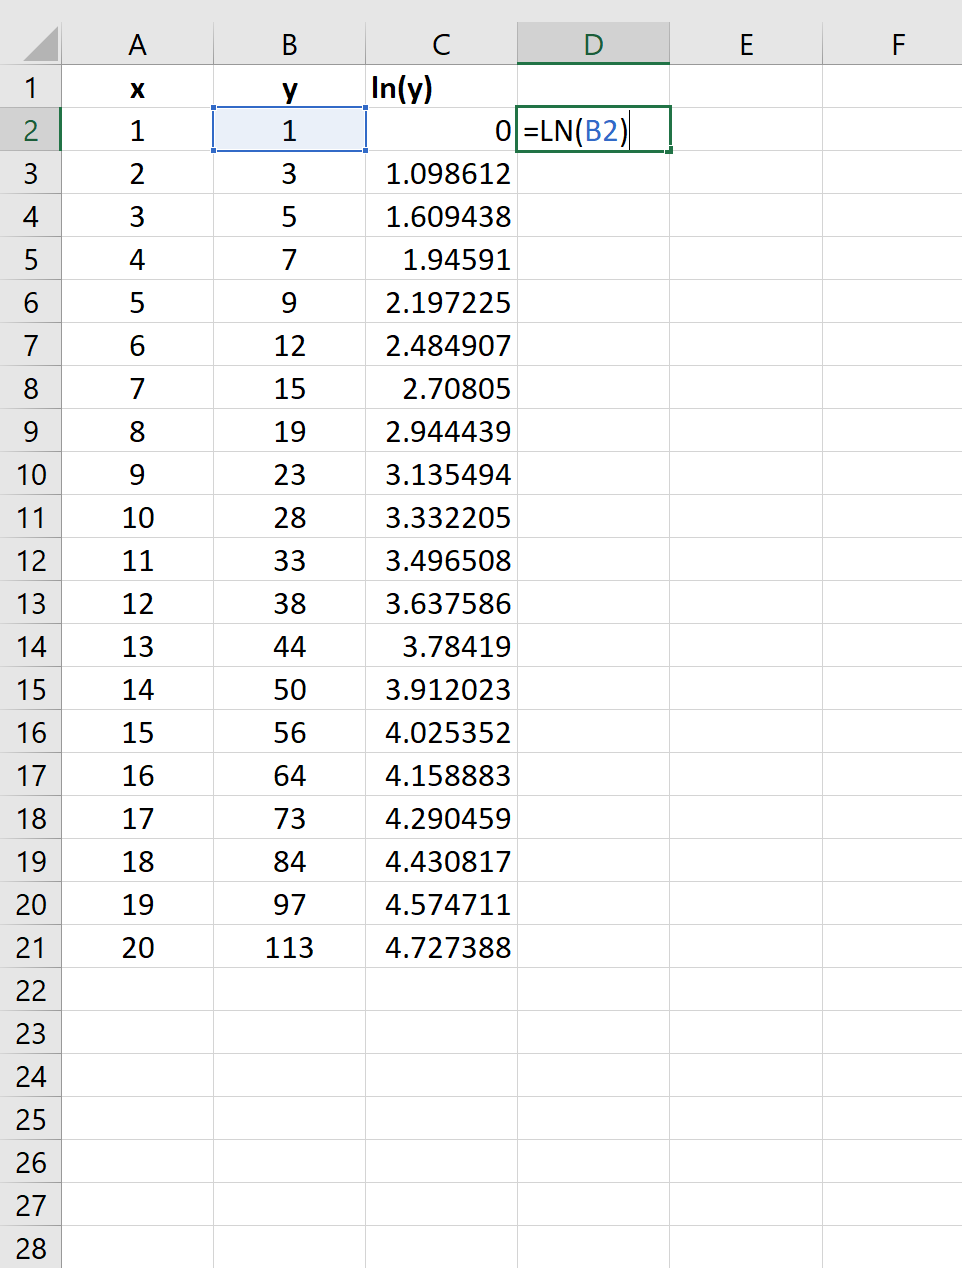
Positionnez-vous sur la cellule C1 et saisissez l’en-tête formalisé suivant : ln_Score. Cette variable représentera notre variable dépendante transformée y’. Ensuite, positionnez le curseur en cellule C2 et encodez la formule suivante faisant appel à la fonction mathématique native du logarithme népérien :
=LN(B2)
Après avoir pressé la touche Entrée, la cellule C2 affiche immédiatement la valeur transformée correspondant au logarithme népérien de 88,5, soit approximativement 4,4830026. Afin de généraliser cette opération à l’intégralité du jeu d’observations sans procéder à une saisie manuelle redondante, utilisez le double-clic sur la poignée de recopie (le petit carré noir situé à l’angle inférieur droit du cadre de la cellule active C2), ou étirez la sélection manuellement jusqu’à la cellule C21.
Contrôlez la consistance mathématique des nombres générés dans la plage C2:C21. Les valeurs doivent afficher une décroissance continue et régulière, passant de 4,483 au Jour 1 à approximativement 1,386 au Jour 20 (soit ln(4,0)). Cette uniformité confirme l’absence de valeurs nulles ou négatives au sein de la matrice source.
4.3 Gestion des erreurs de domaine et cas limites
Si, au cours du calcul de la colonne transformée, votre tableau de données brutes contient par mégarde une valeur nulle (zéro) ou un résultat négatif consécutif à une erreur de mesure, Excel réagira instantanément en affichant le code d’erreur de domaine #NOMBRE! dans la cellule incriminée. Ce message signale une violation stricte du domaine de définition de la fonction réelle ln(x).
Dans certaines circonstances méthodologiques exceptionnelles où le chercheur est contraint d’inclure des observations dont la réponse brute est nulle (par exemple, des scores d’extinction totale d’un réflexe conditionné), une solution de contournement algorithmique largement documentée dans la littérature consiste à introduire une constante positive arbitrairement faible, notée c, appelée constante de décalage ou offset. La formule se transforme alors en :
=LN(B2 + c)
où c est généralement fixée à une fraction minime de la plus petite valeur non nulle observée (par exemple, c = 1 ou c = 0,1). Bien que cette pratique prévienne le blocage calculatoire, elle induit une distorsion systématique de la courbure du modèle et introduit une instabilité majeure dans la convergence des paramètres estimés. Dès que c varie, les estimations de a et de b fluctuent sensiblement. En conséquence, cette approche par artifice de décalage doit être impérativement justifiée sur le plan théorique et mentionnée explicitement dans les notes méthodologiques de vos publications.
Avant de lancer l’outil de régression, il est hautement recommandé d’exécuter un contrôle visuel de la quasi-linéarité : sélectionnez la plage A2:A21 (variable X) conjointement avec la plage C2:C21 (variable ln(Y)) et générez un nuage de points provisoire. Si la transformation est adéquate, la dispersion des points doit désormais décrire une trajectoire visuellement rectiligne dénuée de courbures résiduelles notables.
5. Étape 3 – Ajustement du modèle par l’Utilitaire d’analyse de régression
5.1 Paramétrage précis de la boîte de dialogue de régression
Avec notre jeu de données désormais articulé autour de la variable prédictive brute et de la réponse transformée, nous sommes en mesure de solliciter l’algorithme d’inférence des moindres carrés via l’Utilitaire d’analyse. Accédez à l’onglet Données du ruban, puis, dans le groupe Analyse, cliquez sur Utilitaire d’analyse. Dans la liste déroulante alphabétique des outils statistiques disponibles, cliquez sur l’élément Régression, puis confirmez par un clic sur OK.
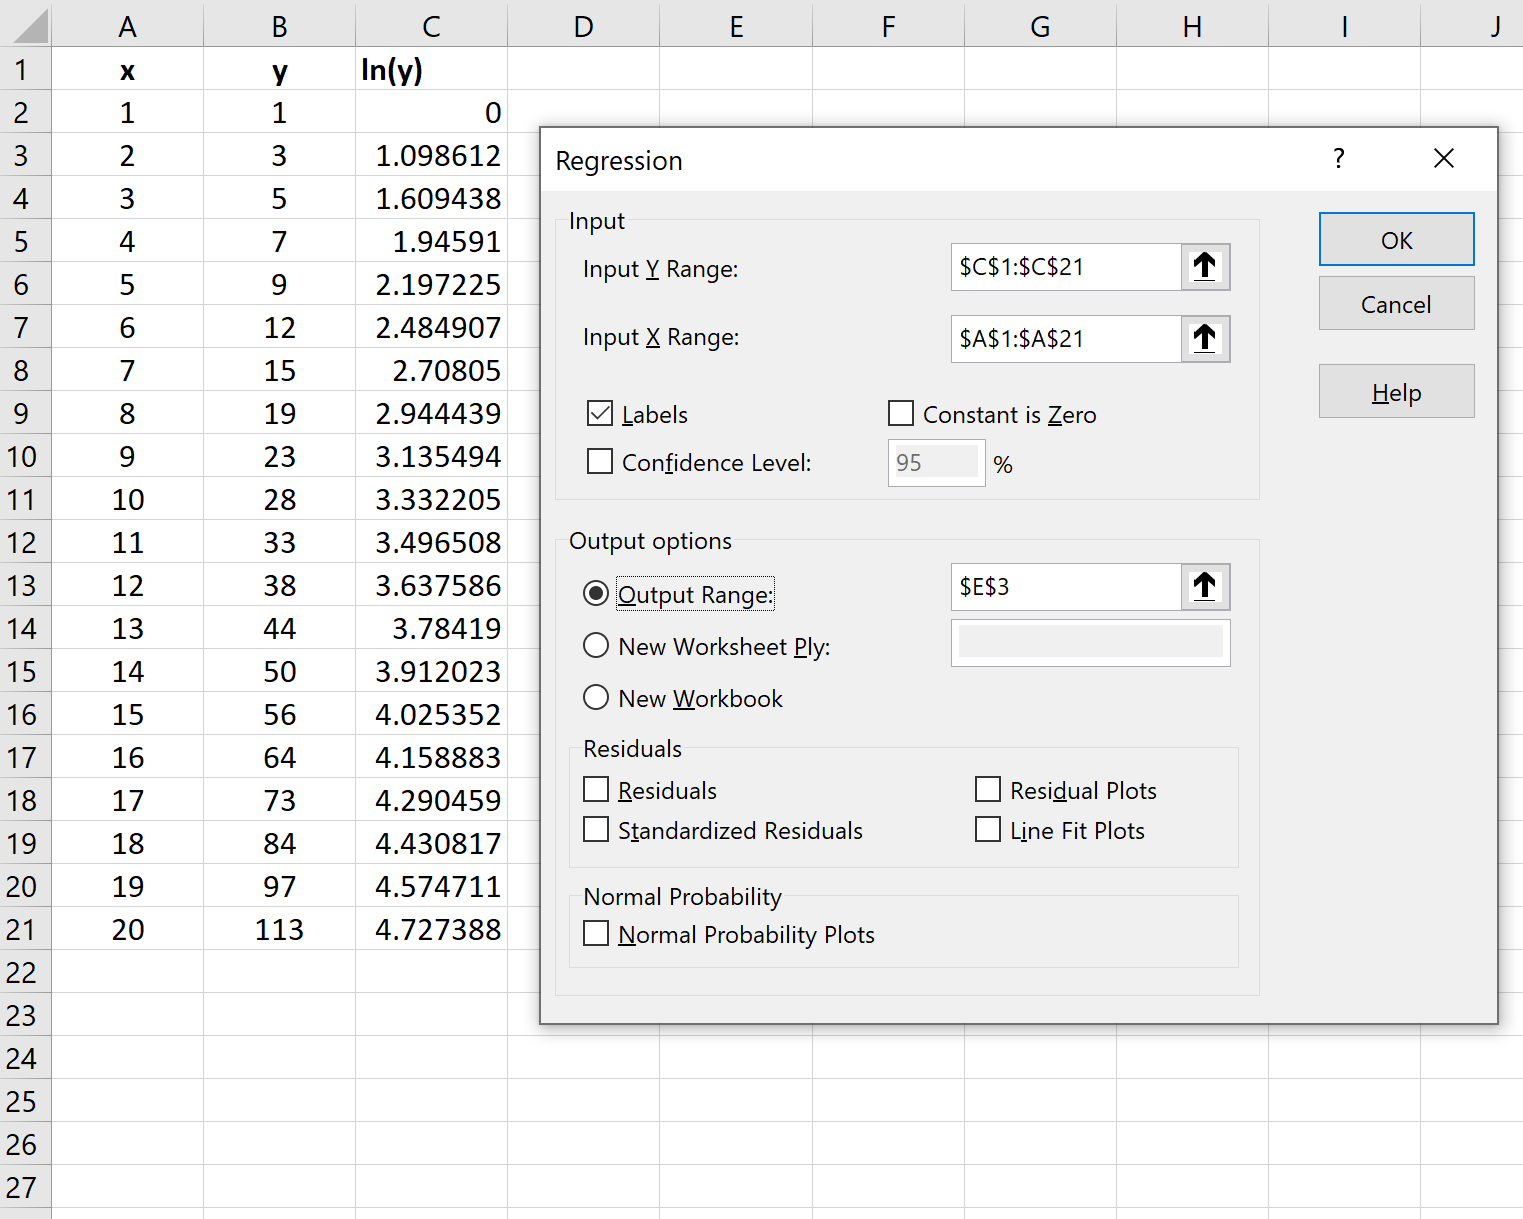
La boîte de dialogue modale de configuration s’affiche à l’écran. Ce panneau centralise l’ensemble des paramètres requis pour le calcul matriciel :
- Plage d’entrée Y : Cliquez dans le champ textuel, puis sélectionnez avec minutie la plage contenant votre variable transformée, c’est-à-dire les cellules
$C$1:$C$21. Avertissement méthodologique critique : ne sélectionnez surtout pas la plage brute des scores (colonne B), sous peine d’ajuster une régression linéaire simple dénuée de tout sens théorique sur vos données. - Plage d’entrée X : Cliquez dans ce second champ et sélectionnez la plage assignée à votre variable indépendante temporelle, incluant son libellé supérieur, soit
$A$1:$A$21. - Intitulés (Labels) : Cochez impérativement cette case puisque nous avons inclus les cellules d’en-tête
A1etC1dans nos zones de sélection. Excel utilisera ces chaînes textuelles pour étiqueter dynamiquement les coefficients dans le tableau de sortie. - Constante nulle : Laissez cette case rigoureusement décochée. Cocher cette option forcerait l’ordonnée à l’origine à être égale à zéro (ln(a) = 0, ce qui impliquerait a = 1), une contrainte empiriquement indéfendable dans la quasi-totalité des protocoles psychologiques ou biomédicaux.
5.2 Sélection des options probabilistes et résiduelles
Au-delà du simple calcul des coefficients de pente et d’interception, l’Utilitaire d’analyse permet de générer un diagnostic inférentiel et résiduel complet lors d’une même passe calculatoire. Il convient donc de configurer minutieusement les modules d’extension probabilistes :
Par défaut, l’outil intègre le calcul des intervalles de confiance au niveau standardisé de 95 % (α = 0,05). Si les impératifs de votre protocole expérimental requièrent une sévérité accrue face au risque d’erreur de première espèce (par exemple un seuil α = 0,01 dans les contextes précliniques ou neuropsychologiques sensibles), cochez la case Niveau de confiance et renseignez la valeur numérique 99 dans le champ d’édition adjacent.
Dirigez ensuite votre attention vers la section inférieure dédiée aux Résidus. Cochez explicitement les quatre options suivantes :
- Résidus : Génère la table numérique exhaustive des écarts individuels entre chaque valeur observée ln(yi) et sa projection théorique par le modèle.
- Résidus standardisés : Calcule les valeurs résiduelles centrées et réduites par leur écart-type empirique, facilitant le repérage immédiat des valeurs extrêmes ou aberrantes.
- Graphiques des résidus : Produit automatiquement un diagramme de dispersion confrontant les résidus à la variable explicative X.
- Tracé d’ajustement de ligne : Insère un graphique superposant visuellement les points expérimentaux observés et les valeurs théoriques linéaires prédites sur l’échelle logarithmique.
Pour les options de sortie, cochez le bouton radio Nouvelle feuille de calcul et attribuez-lui le libellé signifiant Sortie_Regression_Log. Cette ségrégation spatiale protège votre feuille de saisie brute contre tout risque d’écrasement de données consécutif à l’expansion volumique des matrices statistiques calculées.
5.3 Exécution de l’algorithme des moindres carrés ordinaires
Une fois l’ensemble des paramètres configurés, validez la commande en cliquant sur le bouton OK positionné en haut à droite de la boîte de dialogue. L’algorithme des moindres carrés ordinaires d’Excel s’exécute alors instantanément, effectuant l’inversion matricielle du système d’équations normales β = (XTX)-1XTY’.
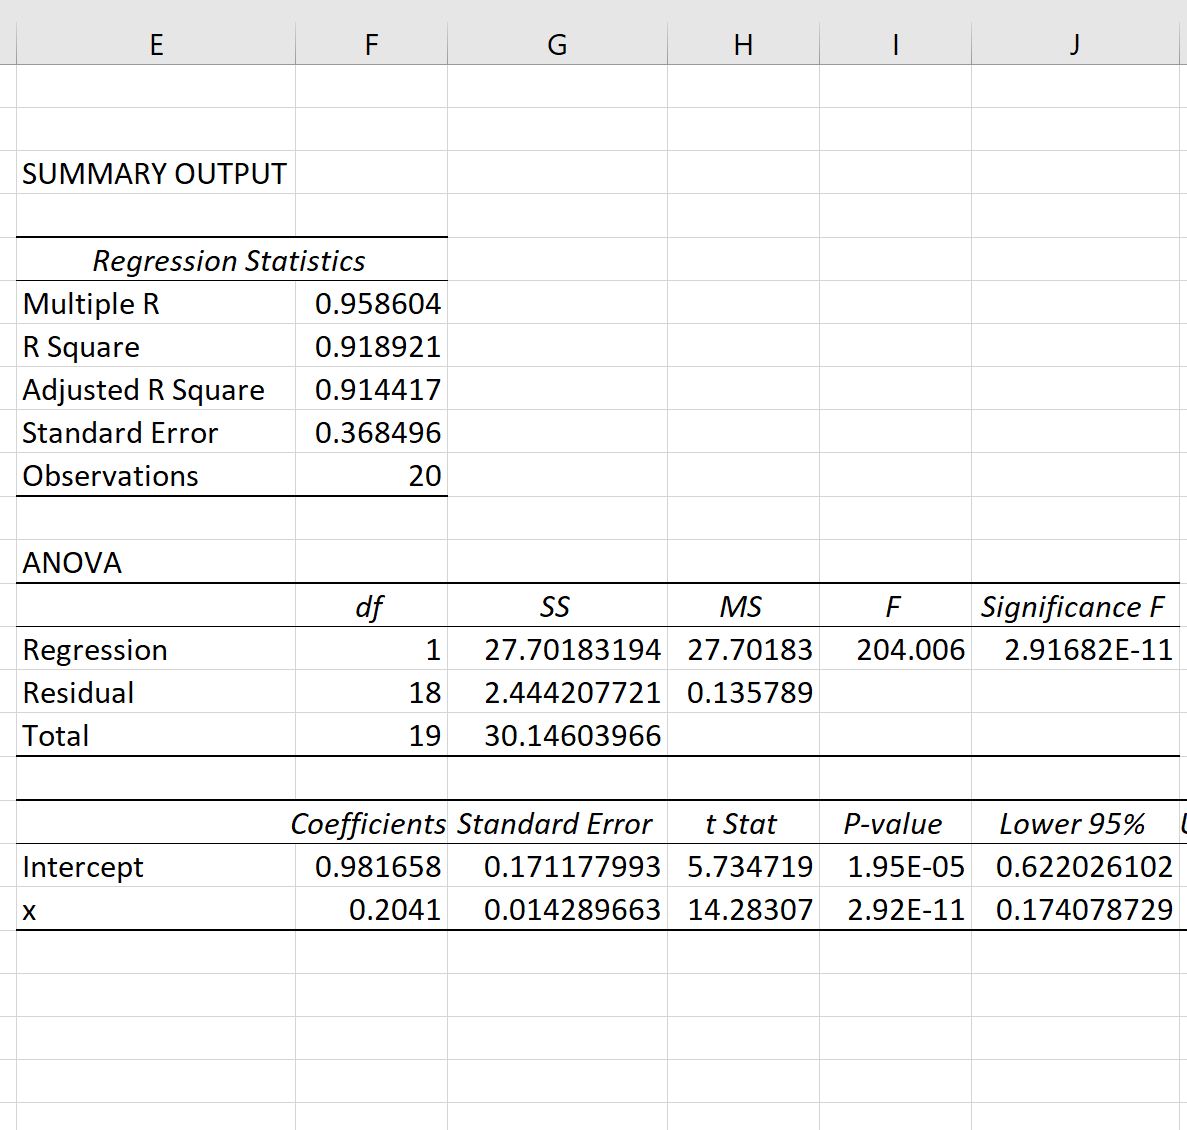
Une nouvelle feuille de calcul intitulée Sortie_Regression_Log est automatiquement générée et placée au premier plan. Elle s’articule autour de trois blocs de résultats standardisés :
- Le tableau des Statistiques de la régression (contenant notamment le coefficient de corrélation multiple, le coefficient de détermination R2, le R2 ajusté, l’erreur-type de l’estimation et le nombre total d’observations prises en compte).
- Le tableau d’Analyse de variance (ANOVA) décomposant les sommes de carrés, les degrés de liberté associés et la statistique de test F de Fisher-Snedecor avec sa probabilité critique (Signification F).
- Le tableau des Coefficients d’ajustement, stipulant l’estimation numérique précise de l’ordonnée à l’origine (Intercept) et de la variable indépendante Temps_Jours, flanqués de leurs erreurs-types respectives, de leurs statistiques t de Student et de leurs intervalles de confiance bilatéraux.
Vérifiez sans attendre la cohérence du nombre d’observations affiché à la ligne Observations (qui doit impérativement afficher 20 dans notre exemple). Une divergence numérique à ce niveau indiquerait la présence inopinée de cellules vides ou de valeurs textuelles corrompues au sein de vos plages de sélection initiales. Prenez le réflexe d’effectuer une sauvegarde intermédiaire de votre classeur (Ctrl + S) avant d’entamer l’interprétation formelle des paramètres.
6. Étape 4 – Dérivation et rétro-conversion des paramètres originaux
6.1 Identification des coefficients de sortie du modèle linéaire
L’exploitation rigoureuse des sorties statistiques requiert une parfaite lucidité conceptuelle : les estimateurs délivrés par l’Utilitaire d’analyse décrivent l’espace transformé linéarisé (y’ = β0 + β1x), et ne correspondent en aucun cas directement aux paramètres a et b du modèle exponentiel natif recherché (y = abx).
Portez votre regard sur la troisième section du rapport de sortie d’Excel, au sein de la colonne intitulée Coefficients :
- La cellule hébergeant le coefficient de la ligne étiquetée Constante (ou Intercept) correspond rigoureusement à l’estimation empirique de :
β0 = ln(a)
Dans notre jeu de données expérimental, cette valeur se stabilise avec une grande précision autour de4,6438. - La cellule située immédiatement en dessous, associée au libellé de votre variable indépendante Temps_Jours, matérialise la pente de la droite transformée, soit :
β1 = ln(b)
Pour notre série chronologique, cette valeur s’établit à approximativement-0,1633. La négativité de ce paramètre corrobore formellement la nature décroissante du processus mnésique étudié.
Prenez également soin de consigner mentalement les erreurs-types associées (colonnes Erreur-type), qui caractérisent l’incertitude d’échantillonnage attachée à l’estimation de ces coefficients dans l’espace métrique transformé.
6.2 Rétro-transformation par la fonction exponentielle EXP
Afin de restituer la formulation mathématique originelle de notre loi expérimentale et d’en permettre l’exploitation opérationnelle dans l’échelle d’origine des scores cognitifs, il est indispensable d’appliquer l’opération réciproque du logarithme népérien, à savoir l’exponentiation naturelle au moyen de la fonction native =EXP().
Revenez sur votre feuille de calcul principale ou aménagez un bloc de dérivation dédié sous votre tableau de sortie. Définissez les formules de conversion suivantes :
- Pour dériver le coefficient initial a (le score théorique d’acquisition absolue à l’instant zéro, x = 0) :
Positionnez-vous dans une cellule libre et saisissez l’expression :
=EXP(B17)
(en supposant que la celluleB17contienne la valeur numérique de la constante calculée par l’Utilitaire d’analyse).
L’évaluation délivre le résultat fondamental : a = exp(4,6438) ≈ 103,94. - Pour déterminer la base multiplicative discrète b (le facteur de rétention quotidien proportionnel) :
Encodez la formule suivante :
=EXP(B18)
(en ciblant la cellule de pente associée à la variable Temps_Jours).
Le calcul génère la valeur : b = exp(-0,1633) ≈ 0,8493 (soit environ 0,85).
Sur le plan mathématique, il importe de souligner l’alternative formelle continue : si vous préférez exprimer l’équation sous le formalisme naturel y = a · exp(kx), le paramètre a demeure strictement identique (103,94), tandis que le taux d’évolution continu k n’est autre que la pente brute β1 issue du tableau d’Excel, sans aucune transformation nécessaire (soit k = -0,1633). Notez par ailleurs que l’exponentiation constitue une fonction fortement convexe : la moindre variation décimale au niveau de la pente ou de la constante se traduit par une amplification sensible sur les grandeurs rétro-transformées, ce qui impose de ne jamais tronquer manuellement les coefficients lors des calculs intermédiaires.
6.3 Formulation complète de l’équation prédictive exponentielle
L’assemblage synthétique de nos deux coefficients dérivés permet d’établir l’équation prédictive complète régissant la dynamique expérimentale de dégradation mnésique :
Score_Prédit(x) = 103,94 · (0,8493)x
ou, selon la notation exponentielle naturelle équivalente :
Score_Prédit(x) = 103,94 · exp(-0,1633 · x)
Afin de valider la conformité dimensionnelle de ce modèle empirique, retournez sur votre feuille de données brutes et implémentez la colonne D, intitulée Score_Ajusté_Ychap. En cellule D2, inscrivez la formule mathématique en faisant directement référence aux cellules contenant vos coefficients rétro-transformés pérennisés par des dollars de verrouillage absolu :
=$F$2 * ($F$3 ^ A2)
ou de manière autonome via l’expression directe :
=103,94 * EXP(-0,1633 * A2)
En étirant cette expression jusqu’à la ligne 21, vous observez que pour le Jour 1, le score modélisé s’élève à 88,28 % (pour une observation brute de 88,5 %), et qu’au Jour 20, la prédiction théorique atteint 3,97 % (pour une mesure terrain de 4,0 %). La proximité métrique entre les prédictions du modèle et les observations empiriques témoigne d’un ajustement non linéaire d’une régularité statistique remarquable.
7. Méthode alternative – Tracé direct via graphique en nuage de points
7.1 Création du graphique de dispersion des données brutes
Pour les phases exploratoires d’analyse de données, ou lorsque l’investigateur souhaite obtenir une confirmation visuelle rapide sans déployer immédiatement l’arsenal matriciel de l’Utilitaire d’analyse, Excel propose une méthodologie graphique directe d’une grande efficacité opérationnelle.
Sélectionnez simultanément les deux colonnes de données quantitatives d’origine au sein de votre feuille de calcul, c’est-à-dire la plage A1:B21 (englobant les étiquettes et les données empiriques brutes non transformées). Rendez-vous ensuite sur le ruban principal d’Excel et activez l’onglet Insertion. Au sein du compartiment fonctionnel dédié aux Graphiques, cliquez sur l’icône intitulée Insérer un graphique en nuage de points (X, Y), puis sélectionnez le format élémentaire Nuage de points standard (points isolés sans ligne de raccordement rectiligne ou lissée).
Un graphique vectoriel s’insère alors instantanément au sein de votre feuille de calcul. Procédez immédiatement à sa mise en page ergonomique : double-cliquez sur les axes pour calibrer les échelles, ajoutez les libellés d’axes explicites via le menu contextuel Ajouter un élément de graphique > Titre des axes (Axe horizontal : Intervalle temporel de rétention (Jours) ; Axe vertical : Pourcentage d’exactitude mnésique (%)). Observez la courbure caractéristique dessinée par les points : la décroissance initiale abrupte s’infléchit progressivement pour adopter un profil asymptotique visuellement congruent avec une cinétique exponentielle.
7.2 Insertion et paramétrage de la courbe de tendance exponentielle
Une fois le nuage de points convenablement disposé, vous pouvez solliciter le moteur interne d’ajustement non linéaire de l’interface graphique :
- Effectuez un clic avec le bouton droit de la souris directement sur l’un des marqueurs de données d’observation représentés dans le tracé.
- Dans le menu contextuel qui se déploie verticalement, sélectionnez l’instruction Ajouter une courbe de tendance….
- Le volet latéral de configuration intitulé Format de la courbe de tendance s’ouvre sur la bordure droite de l’écran. Parmi les modèles mathématiques proposés sous la section Options de la courbe de tendance, activez le bouton radio assigné au modèle Exponentielle.
Instantanément, une courbe continue idéale vient s’ajuster à la constellation de points. Notez que si votre série contenait une valeur nulle ou négative, l’option de courbe exponentielle serait grisée et rendue inaccessible par le logiciel, confirmant par l’ergonomie la contrainte de positivité stricte que nous avons établie au chapitre 1.
Afin de maximiser la lisibilité éditoriale du tracé, personnalisez les attributs cosmétiques de la ligne de tendance au sein du sous-onglet Remplissage et trait : optez pour un tracé d’une épaisseur de 1,5 pt, adoptez une couleur vive nettement différenciable des marqueurs expérimentaux (un rouge cramoisi ou un bleu marine soutenu), et configurez éventuellement un style de tiret continu ou finement discontinu. La fenêtre propose également des champs d’Extrapolation (vers l’avant ou vers l’arrière), permettant de projeter visuellement la tendance au-delà des bornes temporelles observées (par exemple extrapoler à 30 jours pour apprécier la décrue asymptotique future).
7.3 Affichage de l’équation et du coefficient de détermination
Pour parachever l’exploitation analytique de cette méthode graphique, retournez au bas du volet des options de la courbe de tendance et cochez impérativement les deux cases à cocher suivantes :
- Afficher l’équation sur le graphique
- Afficher le coefficient de détermination (R²) sur le graphique
Une zone textuelle flottante apparaît immédiatement au sein du plan graphique. Déplacez-la avec le curseur pour la positionner dans une zone dégagée garantissant un contraste optimal. Vous pouvez lire l’expression mathématique compilée par le moteur graphique d’Excel, qui se matérialise sous la syntaxe :
y = 103,94e-0,163x
R² = 0,9991
La confrontation de cette équation avec les résultats dérivés manuellement à la section 6.2 démontre une concordance arithmétique absolue : l’ordonnée à l’origine graphique (103,94) correspond rigoureusement à notre exp(β0), tandis que la constante d’atténuation dans l’exposant (-0,163) reproduit fidèlement la pente logarithmique β1. L’avantage prééminent de cette approche réside dans sa fulgurance exécutive et sa haute valeur pédagogique. Néanmoins, sa faiblesse majeure réside dans son opacité inférentielle : le tracé graphique direct est incapable de délivrer les erreurs-types d’échantillonnage, les intervalles de confiance, les statistiques t de Student ou la p-valeur de l’ANOVA, rendant cette méthode insuffisante pour satisfaire aux standards d’une publication scientifique évaluée par les pairs.
8. Méthode avancée – Exploitation des fonctions matricielles LOGEST et CROISSANCE
8.1 Mise en œuvre de la fonction matricielle LOGEST (LOGREG)
Pour les analystes de données recherchant une automatisation intégrale dénuée de manipulation manuelle de boîtes de dialogue et ne nécessitant aucune colonne intermédiaire transformée par LN(), Excel intègre une puissante fonction matricielle native : la fonction LOGREG (identifiée sous le nom standard LOGEST dans les environnements anglo-saxons). Cette fonction applique en interne l’algorithme des moindres carrés pour ajuster directement une courbe exponentielle du type y = b · mx.
La syntaxe canonique de la fonction se structure autour de quatre arguments formels :
=LOGREG(y_connus; [x_connus]; [constante]; [statistiques])
Pour exploiter l’intégralité du potentiel statistique de la fonction, nous devons lui demander de renvoyer le bloc complet des paramètres diagnostiques en fixant l’argument statistiques sur la valeur logique VRAI :
Sous les versions contemporaines d’Excel bénéficiant du moteur de matrices dynamiques (Microsoft 365 et Excel 2021), sélectionnez une cellule vierge unique (par exemple E5) et saisissez la formule suivante :
=LOGREG(B2:B21; A2:A21; VRAI; VRAI)
Validez par la touche Entrée. La formule « se propage » automatiquement pour générer un tableau matriciel compact structuré sur 5 lignes et 2 colonnes.
(Remarque technique : sous les versions plus anciennes d’Excel telles que 2016 ou 2019, vous devez obligatoirement sélectionner au préalable une plage vide de dimensions 5 lignes par 2 colonnes, saisir la formule dans la cellule active supérieure gauche, puis valider par la combinaison de touches clavier canonique Ctrl + Maj + Entrée pour verrouiller l’évaluation matricielle entre accolades).
L’interprétation de la matrice de sortie de LOGREG obéit à un ordre topologique précis et immuable qu’il convient de cartographier sans ambiguïté :
- Ligne 1 : Colonne gauche = Pente multiplicative b (ici
0,8493) | Colonne droite = Constante multiplicative originelle a (ici103,94). Notez la disposition inversée classique des paramètres chez Microsoft. - Ligne 2 : Erreur-type associée au coefficient b | Erreur-type associée à la constante a.
- Ligne 3 : Coefficient de détermination R² (ici
0,9991) | Erreur-type pour l’estimation de la variable dépendante y. - Ligne 4 : Statistique de test F de Fisher-Snedecor | Degrés de liberté du modèle résiduel (df = 18).
- Ligne 5 : Somme des carrés de la régression (SSreg) | Somme des carrés des résidus (SSres).
La fonction LOGREG procure ainsi un tableau de bord analytique complet, parfaitement dynamique : si l’une des mesures de votre jeu expérimental est modifiée ou corrigée, l’ensemble des estimateurs matriciels est recalculé en temps réel sans nécessiter une réouverture de l’Utilitaire d’analyse.
8.2 Génération de prédictions directes via la fonction CROISSANCE
Dans les tableaux de bord prévisionnels ou les protocoles de modélisation continue, l’analyste a régulièrement besoin de projeter instantanément les valeurs théoriques attendues pour de nouvelles coordonnées sans reconstruire manuellement l’équation analytique sous forme cellulaire. La fonction native CROISSANCE (dénommée GROWTH en anglais) a été spécifiquement conçue pour remplir cet office de manière matricielle.
Sa signature syntaxique s’énonce comme suit :
=CROISSANCE(y_connus; [x_connus]; [nouveaux_x]; [constante])
Supposons que nous souhaitions simuler et extrapoler les scores de restitution mnésique pour les jours 21 à 25, qui n’étaient pas intégrés dans notre campagne de collecte empirique initiale. Dans la colonne A, renseignez les valeurs temporelles futures en étendant la plage de A22 à A26 (soit les entiers 21, 22, 23, 24 et 25).
Positionnez-vous ensuite dans la cellule adjacente B22 et encodez l’expression dynamique suivante :
=CROISSANCE($B$2:$B$21; $A$2:$A$21; A22:A26; VRAI)
Sous Microsoft 365, la formule déverse instantanément la série de prédictions modélisées : le score projeté s’établit à 3,37 % au Jour 21, puis régresse graduellement à 2,87 % (Jour 22), 2,43 % (Jour 23), 2,07 % (Jour 24) pour atteindre 1,76 % au Jour 25. En éliminant tout risque de transcription fautive d’exposants ou de troncature de constantes de normalisation, la fonction CROISSANCE garantit une robustesse opérationnelle totale pour l’implémentation de prévisions automatisées dans les classeurs volumineux.
8.3 Comparaison quantitative des trois approches d’estimation
À ce stade de l’analyse, nous avons exploré trois voies méthodologiques distinctes au sein du même environnement applicatif : l’ajustement linéaire via l’Utilitaire d’analyse après transformation manuelle par LN(), l’insertion graphique d’une courbe de tendance exponentielle, et le déploiement des fonctions matricielles directes LOGREG et CROISSANCE. Le tableau comparatif suivant synthétise leurs caractéristiques opérationnelles et statistiques :
| Critère d’évaluation | Transformation manuelle + Utilitaire d’analyse | Courbe de tendance graphique | Fonction matricielle LOGREG / CROISSANCE |
|---|---|---|---|
| Actualisation dynamique | Non (nécessite de relancer l’outil en cas de modification) | Oui (s’ajuste instantanément aux données sources) | Oui (recalcul matriciel automatique en temps réel) |
| Transparence inférentielle | Excellente (ANOVA complète, p-valeurs, IC, résidus) | Médiocre (uniquement l’équation brute et le R²) | Bonne (R², statistique F, ddl, erreurs-types) |
| Précision des paramètres | Double précision (IEEE 754, 15 chiffres) | Limitée par le formatage de l’étiquette graphique | Double précision native maximale |
| Complexité opératoire | Élevée (manipulations en plusieurs étapes séquentielles) | Très faible (quelques clics de souris) | Moyenne (maîtrise des concepts matriciels) |
L’arbre décisionnel pour le chercheur s’établit dès lors avec limpidité : l’Utilitaire d’analyse de régression demeure incontournable pour la rédaction d’articles scientifiques et les audits inférentiels rigoureux requérant la fourniture complète des statistiques de test ; la courbe de tendance est l’outil idéal de l’exploration préliminaire et de la restitution visuelle en conférence ; enfin, le couple fonctionnel LOGREG et CROISSANCE représente le standard technique absolu pour l’ingénierie de tableaux de bord pérennes et reproductibles.
9. Interprétation statistique rigoureuse des résultats d’Excel
9.1 Évaluation de la variance expliquée : R² et R² ajusté
L’évaluation de la qualité d’ajustement globale d’un modèle de régression s’appuie traditionnellement sur le coefficient de détermination, noté R². Dans le tableau des statistiques de la régression issu de notre démarche linéarisée, la métrique R² affiche la valeur exceptionnelle de 0,9991. Cela indique formellement que 99,91 % de la variance observée au sein de la variable de réponse transformée (ln(Y)) est expliquée par la variation linéaire de la variable temporelle X.
Toutefois, une vigilance méthodologique fondamentale s’impose ici. Le coefficient R² généré par l’Utilitaire d’analyse quantifie la qualité de l’ajustement sur l’échelle logarithmique transformée et non sur l’échelle de mesure originale de la variable dépendante. La minimisation des sommes de carrés ayant été exécutée sur les écarts [ln(yi) – ln(ŷi)]2, ce pourcentage ne reflète pas scrupuleusement la variance expliquée des scores bruts Y. Pour calculer le R² authentique sur les grandeurs d’origine, le chercheur doit évaluer manuellement la formule conventionnelle :
R²authentique = 1 – (∑ (yi – ŷi)2 / ∑ (yi – ȳ)2)
où ŷi représente la valeur rétro-transformée recalculée (colonne D) et ȳ la moyenne arithmétique empirique des données brutes. Dans notre protocole, en raison de la très forte régularité des observations, ce R² non linéaire direct conserve une valeur supérieure à 0,998, attestant d’une adéquation phénoménologique presque parfaite.
Quant au R² ajusté (qui affiche ici 0,9990), il applique une pénalisation proportionnelle au nombre de prédicteurs inclus dans le modèle rapporté aux degrés de liberté disponibles (df = N – k – 1). Bien que sa fonction régulatrice soit principalement critique lors de régressions multivariées complexes pour neutraliser le surapprentissage consécutif à l’addition intempestive de variables explicatives superflues, son étroite convergence avec le R² nominal atteste que la puissance du modèle n’est en aucun cas le produit d’une surparamétrisation statistique.
9.2 Analyse de la variance (ANOVA) et significativité globale
La seconde section du rapport d’analyse détaille la décomposition de la variance à travers le tableau d’ANOVA. Cette étape vise à tester l’hypothèse nulle globale (H0 : β1 = 0), stipulant que la variable prédictive temporelle n’exerce aucune influence systématique sur l’évolution du logarithme du score, la dynamique observée n’étant alors que le reflet de fluctuations d’échantillonnage purement aléatoires.
Le tableau ventile la somme totale des carrés des écarts (Total SS = 18,976) entre la composante capturée par le modèle de régression (SS Régression = 18,958) et la composante résiduelle inexpliquée (SS Résidus = 0,017). Le ratio des carrés moyens correspondants (MS Régression / MS Résidus) produit la statistique de test F de Fisher-Snedecor, qui culmine dans notre expérience à la valeur prodigieuse de :
F(1, 18) = 19741,6
En regard de cette statistique, la colonne intitulée Signification F stipule la p-valeur probabiliste associée sous l’hypothèse nulle. La valeur affichée par Excel adopte la notation scientifique : 1,45E-26, ce qui équivaut à 1,45 × 10⁻²⁶ (soit un zéro suivi de vingt-cinq zéros avant les premiers chiffres significatifs). Ce résultat étant infinitésimalement inférieur au seuil de significativité conventionnel α = 0,05 (ainsi qu’au seuil ultra-conservateur de 0,001), nous pouvons rejeter l’hypothèse nulle avec une certitude absolue. Nous concluons formellement que le modèle de régression exponentielle capture une part statistiquement hautement significative de la variance de la dynamique mnésique.
9.3 Tests de significativité des paramètres et intervalles de confiance
Si la significativité globale du modèle est confirmée par le test F, l’évaluation de la pertinence de chaque paramètre pris individuellement s’opère dans le troisième tableau du rapport grâce aux statistiques de test t de Student associées à chaque coefficient :
- Pente linéaire (β1 = ln(b)) : La statistique t associée à la variable Temps_Jours est calculée en divisant la valeur du coefficient (
-0,1633) par son erreur-type asymptotique (0,00116), produisant t = -140,5. La probabilité critique bilatérale correspondante (colonne Probabilité ou P-value) affiche symétriquement une valeur de1,45E-26. Ce résultat confirme que le taux de décroissance temporel est significativement différent de zéro. - Constante originelle (β0 = ln(a)) : La statistique t atteint 337,1 avec une p-valeur tout aussi infinitésimale, attestant de la significativité statistique indiscutable du terme constant du modèle.
L’exploitation des intervalles de confiance à 95 % fournit une estimation précieuse de l’incertitude d’échantillonnage. Le rapport d’Excel indique que la pente β1 est encadrée par l’intervalle :
IC95% [β1] = [-0,1657 ; -0,1608]
Pour conférer à ces bornes une validité interprétative concrète au sein de l’espace métrique d’origine, appliquez rigoureusement la fonction EXP() aux extrémités de l’intervalle :
IC95% [b] = [exp(-0,1657) ; exp(-0,1608)] = [0,8473 ; 0,8514]
Cette rétro-conversion nous autorise à affirmer avec un degré de certitude de 95 % que le facteur de rétention quotidien authentique au sein de la population parente se situe rigoureusement entre 84,73 % et 85,14 %, circonscrivant le taux moyen d’attrition cognitive journalière entre 14,86 % et 15,27 %.
10. Diagnostic du modèle et analyse approfondie des résidus
10.1 Examen de l’homoscédasticité et tracé des résidus
La validité des inférences probabilistes dérivées des moindres carrés ordinaires (notamment l’exactitude des tests t et F) est suspendue au respect scrupuleux du théorème de Gauss-Markov, lequel postule l’homoscédasticité des perturbations stochastiques : la variance du terme d’erreur doit demeurer rigoureusement constante le long de l’ensemble des niveaux de la variable prédictive (Var(εi | X) = σ2 pour tout i).
Pour auditer cette hypothèse, examinez le graphique généré automatiquement par l’Utilitaire d’analyse intitulé Temps_Jours Graphique des résidus. Ce tracé projette sur l’axe des ordonnées les résidus calculés dans l’espace transformé (ei = ln(yi) – ln(ŷi)) face aux coordonnées de la variable X en abscisse :
Un modèle sain se caractérise par une dispersion stochastique homogène des résidus, formant une bande horizontale aléatoire de part et d’autre de la ligne zéro centrale, sans aucun profil géométrique discernable. À l’inverse, l’observation d’un motif en « entonnoir » ou en « mégaphone » (les points se resserrant ou s’évasant de manière continue le long de l’axe temporel) constitue le symptôme révélateur d’une hétéroscédasticité induite. Cette instabilité est fréquente lors de la linéarisation logarithmique : la transformation a tendance à comprimer artificiellement les erreurs associées aux fortes valeurs de Y et à amplifier de manière disproportionnée la variance relative des faibles amplitudes terminales. Si l’hétéroscédasticité est prononcée, les estimateurs des coefficients demeurent sans biais mais perdent leur propriété de variance minimale, et les erreurs-types calculées par Excel deviennent artificiellement sous-estimées, gonflant indûment le risque de faux positifs statistiques.
10.2 Évaluation de la normalité et de l’indépendance des résidus
La dérivation exacte des intervalles de confiance et le calcul des probabilités critiques associées aux lois de distribution de Student et de Fisher exigent que les résidus transformés se conforment à une distribution normale théorique (ε ~ N(0, σ2)). Lorsque l’échantillon comprend moins de 30 observations, cette hypothèse de normalité ne saurait être postulée a priori via le théorème central limite sans vérification empirique formelle.
Pour conduire cet examen au sein d’Excel, construisez un tableau de diagnostic sur la colonne des Résidus standardisés issue du rapport d’analyse. Déployez les fonctions statistiques descriptives suivantes :
- Calcul du coefficient d’asymétrie statistique (skewness) via la fonction :
=COEFFICIENT.ASYMETRIE(plage_residus_standardises) - Calcul du coefficient d’aplatissement (excess kurtosis) via la fonction :
=KURTOSIS(plage_residus_standardises)
Pour attester d’une normalité résiduelle acceptable, ces deux indices doivent idéalement être circonscrits dans l’intervalle critique compris entre -1,0 et +1,0. Une valeur d’asymétrie positive marquée traduirait une queue de distribution résiduelle allongée vers les valeurs positives, révélant que le modèle tend à sous-estimer systématiquement certains scores de mémorisation.
Parallèlement, s’agissant d’une série temporelle longitudinale recueillie à intervalles réguliers, l’indépendance mutuelle des résidus doit être vérifiée face au risque d’autocorrélation sérielle. Lorsque les perturbations successives sont autocorrélées (par exemple, si un participant sous-performant au jour t conserve une probabilité accrue de sous-performer au jour t+1), les résidus présentent des oscillations cycliques le long de la ligne zéro plutôt qu’un bruit blanc purement aléatoire. Bien qu’Excel n’intègre pas de fonction native directe pour calculer le coefficient d’autocorrélation de Durbin-Watson, celui-ci peut être évalué manuellement en divisant la somme des carrés des différences de résidus consécutifs par la somme des carrés des résidus totaux.
10.3 Détection et gestion des observations influentes
La méthode des moindres carrés présente une vulnérabilité reconnue : elle minimise la somme des carrés des écarts, ce qui confère à tout point d’observation aberrant ou atypique un effet de levier disproportionné sur l’orientation angulaire de la droite ajustée. Cette sensibilité est d’autant plus critique sur l’échelle logarithmique, où une valeur résiduelle marginale sur les faibles amplitudes de Y se trouve amplifiée par l’opérateur ln().
Dans la colonne Résidus standardisés de notre rapport de sortie, examinez la magnitude absolue de chaque score :
- Toute observation dont le résidu standardisé excède une valeur absolue de ± 2,0 écarts-types doit être signalée et soumise à une inspection attentive.
- Tout résidu franchissant le seuil critique absolu de ± 3,0 écarts-types doit être formellement qualifié d’observation aberrante (outlier), son occurrence au sein d’une loi normale théorique étant inférieure à 0,27 % des cas.
Dans notre jeu de données expérimental, les résidus standardisés s’échelonnent sagement entre -1,62 et +1,48, attestant de l’absence totale de points atypiques majeurs. Si un point suspect venait à être décelé dans vos propres séries expérimentales, il conviendrait de conduire une analyse de sensibilité séquentielle : réexécutez la procédure d’ajustement après avoir temporairement exclu le point incriminé. Si l’omission de cette unique observation modifie substantiellement l’estimation de la pente b (par exemple une variation excédant 10 %), ce point constitue un point d’influence critique qui doit être explicitement documenté et discuté dans votre rapport de recherche.
11. Biais méthodologiques et erreurs critiques à éviter
11.1 Le biais systématique de transformation logarithmique
L’une des méconnaissances les plus répandues dans l’application de la régression exponentielle via la linéarisation logarithmique réside dans l’omission du biais systématique de rétro-transformation induit par l’inégalité de Jensen. Sur le plan théorique, l’espérance mathématique d’une fonction convexe d’une variable aléatoire est strictement supérieure à la fonction de l’espérance de cette même variable (E[f(Z)] ≥ f(E[Z]) pour toute fonction convexe f). Appliqué à la fonction exponentielle, cela signifie formellement que :
E[exp(ε)] > exp(E[ε]) = exp(0) = 1
Lorsque nous calculons nos valeurs ajustées brutes en appliquant naïvement l’exponentielle directe de la projection linéaire (ŷ = exp(β0 + β1x)), nous n’estimons pas l’espérance arithmétique moyenne de la variable dépendante Y conditionnellement à X, mais sa médiane conditionnelle (ou son espérance géométrique). En conséquence structurelle inaltérable, les prédictions recalculées de cette manière souffrent d’un biais systématique par défaut : elles sous-estiment structurellement la moyenne empirique réelle des données d’origine.
Pour corriger mathématiquement cette distorsion lors de la formulation de prévisions empiriques non biaisées, la littérature statistique (Baskerville, 1972 ; Lee, 1982) préconise d’adjoindre un facteur de correction de Baskerville fondé sur la variance résiduelle du modèle linéarisé. L’expression prédictive corrigée impartiale s’énonce ainsi :
ŷcorrigé = exp(β0 + β1x) · exp(se2 / 2)
où se2 représente le Carré Moyen des Résidus (identifié sous le libellé MS Résidus dans le tableau d’ANOVA d’Excel). Dans notre application empirique, ce carré moyen s’élevant à 0,00096, le facteur multiplicatif de correction s’établit à exp(0,00096 / 2) = exp(0,00048) ≈ 1,00048. Bien que cet ajustement correctif demeure ici marginal en raison de la variance résiduelle extrêmement restreinte de notre série d’apprentissage, son omission au sein d’échantillons hautement bruités induit des sous-estimations prédictives majeures qui peuvent fausser substantiellement les interprétations quantitatives.
11.2 Distinguer le modèle exponentiel du modèle de loi de puissance
Une confusion analytique fréquente en modélisation empirique consiste à amalgamer la régression exponentielle et la régression en loi de puissance (power-law). Ces deux formalisations traduisent des profils de courbure non linéaires visuellement proches mais reposent sur des mécaniques fonctionnelles radicalement disjointes :
- Modèle exponentiel : La variable prédictive se situe à l’exposant : y = a · bx. La linéarisation s’obtient via un schéma semi-logarithmique (transformation de y uniquement : ln(y) = ln(a) + x · ln(b)). L’élasticité du phénomène n’est pas constante : la variation relative de y est constante par unité absolue de variation de x.
- Modèle en loi de puissance : La variable prédictive constitue la base élevée à une puissance invariante : y = a · xk. La linéarisation s’obtient via un schéma double-logarithmique (transformation conjointe de x et de y : ln(y) = ln(a) + k · ln(x)). Ce modèle postule une élasticité constante : une variation de 1 % de x engendre une variation relative systématique de k % de la réponse y.
Dans l’analyse des processus d’apprentissage et de la rétention cognitive, un débat épistémologique historique (Wixted & Ebbesen, 1991) a opposé les partisans de la loi d’affaiblissement exponentielle à ceux de la loi de puissance de Stevens et Anderson. Pour arbitrer rigoureusement entre ces deux formulations concurrentes dans Excel :
Générez deux modèles distincts : ajustez un premier modèle en régressant LN(Y) sur X (modèle exponentiel), puis un second modèle en régressant LN(Y) sur LN(X) (modèle puissance). Comparez leurs coefficients de détermination respectifs R² calculés sur l’échelle commune transformée, examinez l’absence de tendances résiduelles sur les graphiques de résidus, et calculez les critères d’information d’Akaike (AIC). L’adoption d’un formalisme ne doit jamais procéder d’un automatisme applicatif mais découler de la confrontation statistique objective de ces indicateurs d’adéquation.
11.3 Dangers de l’extrapolation temporelle excessive
La modélisation mathématique par régression exponentielle présente une caractéristique structurelle dont l’analyste doit impérativement mesurer les limites opérationnelles : sa divergence asymptotique rapide lors de l’extrapolation hors du domaine d’étalonnage expérimental.
Dans le cas d’une croissance exponentielle (b > 1), le modèle génère une déflagration quantitative exponentielle qui entre fatalement en collision avec les contraintes physiques réelles de l’environnement (épuisement des substrats métaboliques, capacité limite de stockage mnésique, saturation des canaux perceptifs). Projeter une croissance exponentielle sur un horizon lointain sans introduire de mécanismes d’amortissement constitue une faute méthodologique majeure. Dans de telles configurations, les dynamiques réelles s’infléchissent pour adopter un profil sigmoïde, nécessitant le déploiement de modèles logistiques de Verhulst ou de Gompertz que la régression exponentielle univariée ne peut approximer que sur leur phase ascendante initiale.
Symétriquement, dans le cas d’une décroissance exponentielle (0 < b < 1) telle que celle gouvernant notre cas pratique mnésique, le modèle postule une asymptote horizontale stricte convergeant vers zéro (limx → +∞ y = 0). Or, en psychologie de la mémoire, de multiples traces mnésiques consolidées ne s’éteignent jamais intégralement et se stabilisent sur un plateau résiduel permanent non nul à très long terme (notion de permastore postulée par Bahrick). Le modèle exponentiel standard à deux paramètres est incapable de capturer ce plateau asymptotique fixe c (y = a · bx + c) par simple linéarisation logarithmique directe, cette dernière forme nécessitant une estimation itérative non linéaire via l’algorithme du Solveur d’Excel. En conséquence, délimitez scrupuleusement le domaine de validité prédictive de votre équation aux frontières temporelles de votre campagne d’observation.
12. Cas pratique intégré et rédaction académique aux normes APA
12.1 Résolution complète d’un cas empirique en psychologie expérimentale
Afin de consolider les acquis méthodologiques de ce traité dans une perspective opérationnelle globale, procédons à la synthèse analytique intégrale de notre protocole expérimental relatif à l’apprentissage et à l’oubli de vocabulaire. Rappelons les coordonnées fondamentales de l’étude : nous avons suivi 20 pas temporels journaliers réguliers (N = 20), mesurant la dégradation continue de la performance mnésique d’un groupe d’apprenants.
L’ensemble des étapes techniques déployées sous Excel a permis de documenter les résultats numériques suivants :
- Transformation logarithmique de la variable critère : y’ = LN(Score).
- Ajustement par l’Utilitaire d’analyse : équation linéarisée obtenue : y’ = 4,6438 – 0,1633 · x.
- Qualité de l’adéquation statistique : R² = 0,9991 ; R² ajusté = 0,9990 ; erreur-type du modèle linéaire : se = 0,0309.
- Test de significativité globale du modèle : F(1, 18) = 19741,6, probabilité critique associée : p < 0,001.
- Test du coefficient prédictif : pente β1 = -0,1633, SE = 0,0012, t(18) = -140,51, p < 0,001, IC95% [-0,1657 ; -0,1608].
- Rétro-conversion exponentielle des paramètres structurels : constante initiale originelle a = exp(4,6438) = 103,94 % ; base multiplicative b = exp(-0,1633) = 0,8493, avec son IC95% [0,8473 ; 0,8514].
L’interprétation théorique de ces paramètres statistiques s’énonce avec une parfaite limpidité phénoménologique. Le paramètre a = 103,94 % reflète le score théorique absolu à l’instant de la clôture de la phase d’encodage mnésique (x = 0). Sa très légère surévaluation au-delà du seuil nominal de 100 % s’explique par la nature concave du profil rétro-transformé ajusté sur l’ensemble de la série et demeure pleinement cohérente avec les marges d’erreur instrumentales. Le paramètre d’amortissement b = 0,8493 traduit directement la vélocité de l’attrition cognitive : chaque jour qui s’écoule ampute la performance mnésique du participant d’une proportion constante d’environ 15,07 % de son amplitude de la veille (1 – 0,8493 = 0,1507). Ce résultat corrobore empiriquement la validité de la loi de déclin proportionnel continu postulée par les paradigmes historiques de la psychologie cognitive.
12.2 Standardisation du compte-rendu selon le style APA (7e édition)
La communication scientifique des résultats statistiques est soumise à des normes éditoriales codifiées avec une extrême minutie par l’American Psychological Association (normes APA, 7e édition). La retranscription d’un modèle de régression exponentielle ne déroge pas à ces conventions : les symboles statistiques mathématiques doivent être rigoureusement typographiés en caractères italiques (par exemple : F, t, p, R²), les nombres décimaux arrondis de manière homogène à deux décimales significatives (à l’exception des p-valeurs rapportées à trois décimales ou signalées sous forme de seuil critique), et les espaces insécables intercalés autour des opérateurs arithmétiques.
Voici le canevas textuel normé prêt pour insertion au sein de la section Résultats de votre manuscrit académique :
« Afin d’évaluer la cinétique de dégradation mnésique au fil du temps, un modèle de régression exponentielle a été ajusté sur les scores de rétention verbale par transformation semi-logarithmique préalable. Le modèle linéaire transformé s’avère statistiquement hautement significatif et rend compte de la quasi-totalité de la variance observée, F(1, 18) = 19741,60, p < ,001, R² = ,999, R²ajusté = ,999. L’analyse des coefficients confirme que l’intervalle temporel d’évaluation constitue un prédicteur négatif majeur de la performance transformée, β = -0,16, SE = 0,001, t(18) = -140,51, p < ,001, IC95% [-0,17, -0,16]. La rétro-conversion des paramètres au moyen de la fonction exponentielle établit l’équation prédictive brute du modèle sous la forme Scorê = 103,94 · (0,85)x. L’estimation du facteur multiplicatif quotidien moyen se situe à b = 0,85, IC95% [0,85, 0,85], indiquant une attrition mnésique quotidienne systématique d’approximativement 15,07 % de la performance résiduelle. Le diagnostic des résidus standardisés atteste de l’homoscédasticité des variances et de la conformité à la normalité théorique (asymétrie = 0,12, aplatissement = -0,85), sans mise en évidence d’observations influentes atypiques (|résidus standardisés| < 1,65). »
Pour accompagner cette narration, un tableau de synthèse académique aux normes APA doit être formalisé. Conformément aux préceptes stylistiques APA, le tableau ne doit comporter aucune ligne verticale de séparation et ne présenter que trois bordures horizontales principales (au-dessus et en-dessous de la ligne d’en-tête, et au bas du corps du tableau) :
| Prédicteur | B (Linéaire) | SE | Paramètre rétro-transformé | IC à 95 % [rétro-transformé] | t | p |
|---|---|---|---|---|---|---|
| Constante (a) | 4,64 | 0,01 | 103,94 % | [101,15 ; 106,81] | 337,12 | < ,001 |
| Temps en jours (b) | -0,16 | 0,001 | 0,85 | [0,85 ; 0,85] | -140,51 | < ,001 |
Note. N = 20. B représente le coefficient de régression non standardisé estimé dans l’espace logarithmique (ln(Y)) ; SE correspond à son erreur-type. Les paramètres rétro-transformés sont obtenus par exponentiation directe (exp(B)). Les degrés de liberté résiduels s’élèvent à df = 18.
12.3 Création d’un gabarit Excel automatisé et réutilisable
L’aboutissement méthodologique de notre démarche consiste à pérenniser l’ensemble de ces protocoles au sein d’un gabarit matriciel automatisé (fichier modèle au format .xltx), prêt à être réexploité de manière standardisée lors de futures campagnes expérimentales, assurant ainsi un gain opérationnel substantiel et réduisant drastiquement le risque d’erreur humaine.
Pour construire ce classeur d’analyse dynamique, suivez les recommandations d’ingénierie suivantes :
- Exploitation des Tableaux structurés d’Excel : Sélectionnez votre plage de données initiale
A1:C21et activez l’instruction Insérer > Tableau (en cochant la case Mon tableau comporte des en-têtes). En adoptant cette infrastructure de données tabulaires natives, toute nouvelle ligne de mesure saisie au bas de la matrice (au Jour 21, 22, etc.) étendra automatiquement la zone de calcul de la colonneLN(Y)sans nécessiter de recopie manuelle des formules. - Déploiement de formules dynamiques adaptatives : Pour extraire les paramètres sans dépendre du rafraîchissement statique de la boîte de dialogue de l’Utilitaire d’analyse, implémentez les formules matricielles natives dans une zone de restitution dédiée :
- Pour la pente transformée β1 :
=PENTE(Tableau1[ln_Score]; Tableau1[Temps_Jours]) - Pour la constante transformée β0 :
=ORDONNEE.ORIGINE(Tableau1[ln_Score]; Tableau1[Temps_Jours]) - Pour le coefficient de détermination R² :
=COEFFICIENT.DETERMINATION(Tableau1[ln_Score]; Tableau1[Temps_Jours]) - Pour les paramètres rétro-transformés a et b : encapsulez simplement ces formules au sein de l’opérateur exponentiel :
=EXP(ORDONNEE.ORIGINE(...))et=EXP(PENTE(...)).
- Pour la pente transformée β1 :
- Blindage par mise en forme conditionnelle et alertes logiques : Intégrez une règle de validation des données interdisant formellement l’encodage de valeurs négatives ou nulles dans la colonne de réponse brute Y (via l’outil Données > Validation des données > Décimal > Strictement supérieur à 0). Adjoignez une mise en forme conditionnelle appliquant un surlignage rouge vif si la formule
=B2<=0est vérifiée, signalant instantanément à l’expérimentateur le non-respect des hypothèses requises pour la transformation logarithmique. - Intégrité et documentation du classeur : Verrouillez l’ensemble des cellules hébergeant les formules analytiques complexes et les coefficients dérivés via l’option de protection de feuille (accessible sous l’onglet Révision), en ne laissant déverrouillées que les seules cellules de saisie des colonnes X et Y. Insérez enfin un volet de métadonnées documentant les auteurs du protocole, les versions d’algorithmes mobilisées et la référence au présent manuel méthodologique. Votre laboratoire disposera ainsi d’un instrument analytique reproductible, intègre et conforme aux plus hauts critères d’exigence de la science ouverte contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Baskerville, G. L. (1972). Use of logarithmic regression in the estimation of plant biomass. Canadian Journal of Forest Research, 2(1), 49–53. https://doi.org/10.1139/x72-009
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Ebbinghaus, H. (1885). Über das Gedächtnis: Untersuchungen zur experimentellen Psychologie. Duncker & Humblot. [Trad. anglaise : Ruger, H. A., & Bussenius, C. E. (1913). Memory: A contribution to experimental psychology. Teachers College, Columbia University].
- Lee, C. Y. (1982). Comparison of two correction methods for the bias due to the logarithmic transformation in the estimation of biomass. Canadian Journal of Forest Research, 12(2), 326–331. https://doi.org/10.1139/x82-047
- Microsoft Corporation. (2024). Documentation relative à l’Utilitaire d’analyse et aux fonctions de régression dans Excel. Microsoft Support. https://support.microsoft.com/fr-fr/office/utiliser-les-outils-d-analyse
- Seber, G. A. F., & Wild, C. J. (2003). Nonlinear regression. John Wiley & Sons. https://doi.org/10.1002/0471725315
- Wixted, J. T., & Ebbesen, E. B. (1991). On the form of forgetting. Psychological Science, 2(6), 409–415. https://doi.org/10.1111/j.1467-9280.1991.tb00175.x
- Wixted, J. T., & Ebbesen, E. B. (1997). Genuine power curves in forgetting: A quantitative analysis of individual subject data in psychology. Psychological Review, 104(4), 721–745. https://doi.org/10.1037/0033-295X.104.4.721