
La modélisation statistique des cinétiques non linéaires constitue l’un des piliers méthodologiques les plus décisifs de la recherche empirique moderne. Dans les sciences comportementales, cognitives, biologiques et socio-économiques, l’hypothèse d’une relation strictement proportionnelle ou linéaire entre variables s’avère fréquemment insuffisante pour rendre compte de la complexité intrinsèque des mécanismes sous-jacents. De l’érosion progressive des traces mnésiques au fil du temps jusqu’à l’accélération brutale des processus de contagion sociale, les chercheurs sont constamment confrontés à des dynamiques caractérisées par des taux de variation proportionnels à l’état instantané du système. Face à de tels phénomènes, l’analyse par régression exponentielle s’impose non pas comme une simple alternative de convenance mathématique, mais comme une nécessité théorique fondamentale permettant de capturer l’essence multiplicative des processus générateurs de données.
Au sein de l’écosystème open-source The R Project for Statistical Computing, la mise en œuvre de la régression exponentielle bénéficie d’un environnement computationnel d’une puissance et d’une flexibilité remarquables. Loin de se limiter à une procédure algorithmique monolithique, R offre une double perspective d’estimation statistique : d’une part, l’approche par linéarisation logarithmique au moyen des modèles linéaires généraux et ordinaires, et d’autre part, l’estimation non linéaire directe via l’optimisation par moindres carrés non linéaires itératifs. Maîtriser ces deux paradigmes analytiques requiert une compréhension fine de leurs hypothèses de distribution sous-jacentes, de la structure stochastique de leurs termes d’erreur résiduels, ainsi que des implications mathématiques de la transformation des échelles de mesure.
Ce traité méthodologique approfondi a pour vocation de guider les chercheurs quantitatifs, les analystes de données et les étudiants gradués à travers toutes les étapes de la régression exponentielle dans R. En articulant rigueur mathématique, considérations épistémologiques et implémentation pratique détaillée, nous explorerons les fondements théoriques des dynamiques exponentielles, la configuration des environnements d’analyse, l’exploration graphique préliminaire, l’ajustement des modèles, la correction des biais systématiques induits par la rétro-transformation, le diagnostic résiduel approfondi et la restitution visuelle de niveau publication académique. Deux cas d’études détaillés issus des sciences psychologiques illustreront pas à pas la supériorité d’une démarche statistique rigoureuse face aux pièges courants de l’inférence non linéaire.
1. Cadre théorique et conceptuel de la régression exponentielle en sciences quantitatives
1.1 Définition et morphologie des phénomènes exponentiels
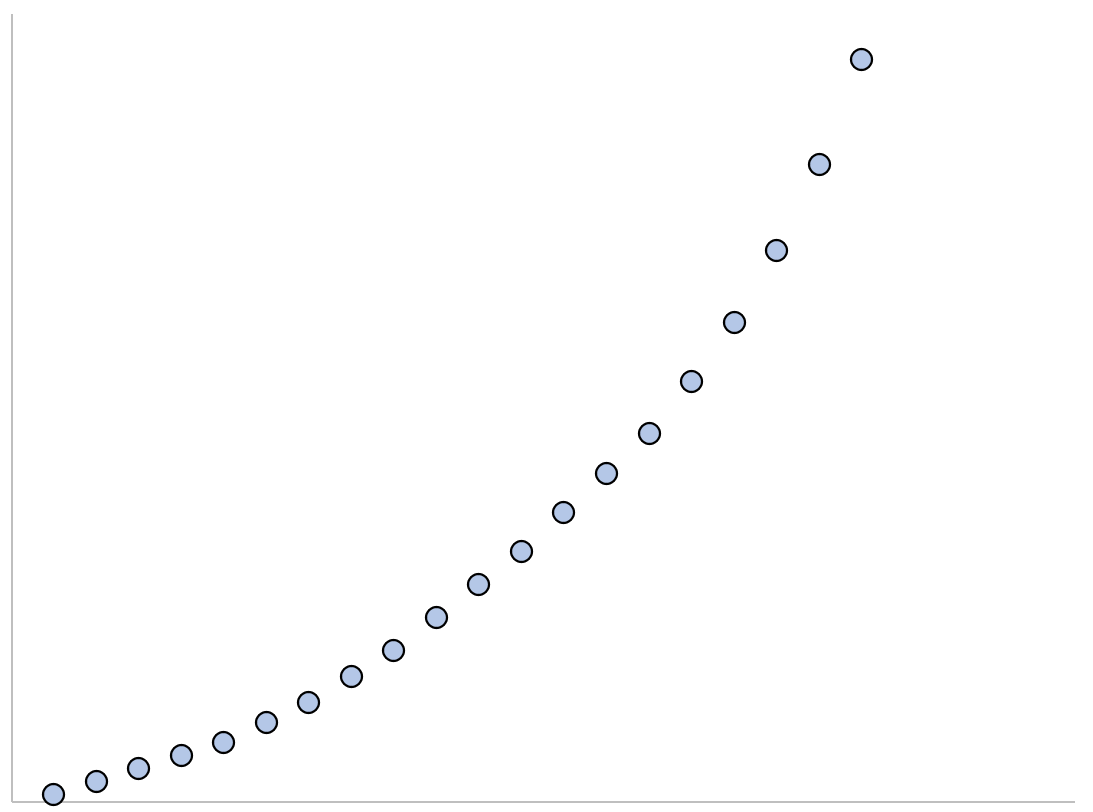
La distinction conceptuelle entre relations linéaires, polynomiales et cinétiques exponentielles repose sur la nature fondamentale du taux de variation qui régit l’évolution de la variable dépendante par rapport à la variable explicative. Dans un cadre linéaire classique régi par une équation affine, la dérivée première est constante : pour chaque accroissement unitaire de la variable prédictive, la variable de réponse varie d’une quantité absolue fixe et invariante. Les approximations polynomiales, bien qu’offrant une flexibilité accrue par l’ajout de puissances entières de la variable indépendante, conservent une logique additive locale qui peut s’avérer incapable d’extrapoler fidèlement des mécanismes physiques ou biologiques sous-jacents, générant fréquemment des oscillations artificielles ou des divergences non physiques en dehors du domaine d’interpolation.
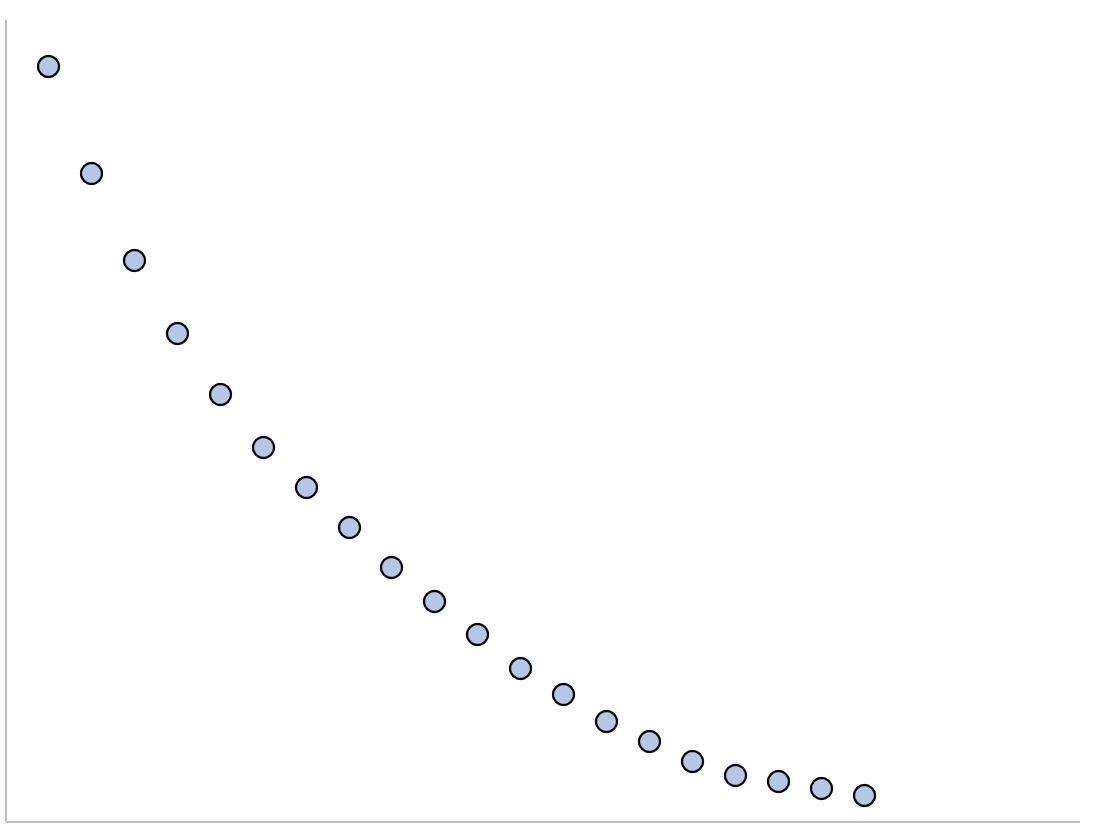
À l’inverse, les phénomènes exponentiels sont caractérisés par une dynamique multiplicative intrinsèque dans laquelle la vitesse instantanée de changement est directement proportionnelle à la magnitude courante de la variable dépendante elle-même. Mathématiquement, cela se traduit par une équation différentielle ordinaire où le taux de variation temporel est égal au produit d’une constante scalaire et de la quantité présente. Cette morphologie engendre deux régimes distincts : d’une part, la croissance accélérée sans borne, où le système s’emballe de manière explosive lorsque le taux est strictement positif, et d’autre part, la décroissance exponentielle rapide lorsque le taux est négatif, induisant une dissipation abrupte qui s’amortit progressivement pour tendre de façon asymptotique vers zéro sans jamais théoriquement l’atteindre sur un horizon temporel fini.
Dans l’analyse des processus longitudinaux et dynamiques, la pertinence du cadre exponentiel tient à son adéquation avec les lois de conservation et de dissipation de l’énergie, de l’information et des flux. Tandis que les modèles linéaires supposent implicitement un réservoir infini insensible à l’état du système, le modèle exponentiel formalise l’idée que chaque modification dépend des ressources restantes ou de la densité instantanée des interactions. Dès lors, substituer une régression linéaire à une dynamique fondamentalement multiplicative ne constitue pas un compromis acceptable, mais une erreur d’architecture théorique altérant profondément l’interprétation des mécanismes causaux régissant les données empiriques.
1.2 Pertinence empirique en psychologie quantitative et sciences comportementales
En psychologie quantitative et en neurosciences cognitives, les fonctions exponentielles occupent une place historique et paradigmatique prééminente. L’illustration la plus emblématique réside sans conteste dans les travaux pionniers d’Hermann Ebbinghaus sur la cinétique du déclin de la mémoire de travail et de la mémoire épisodique. La formulation mathématique de la courbe de l’oubli a démontré que la dégradation de la rétention mnésique ne s’opère pas à un rythme constant : la perte d’informations est vertigineuse durant les premières minutes ou heures suivant la phase initiale d’apprentissage, avant de décélérer pour se stabiliser le long d’une asymptote résiduelle correspondant aux traces consolidées à long terme au sein des réseaux neuronaux corticaux.
De manière symétrique, la modélisation de l’acquisition des compétences motrices et cognitives s’appuie fréquemment sur des trajectoires exponentielles négatives inversées, communément désignées sous l’appellation de courbes d’apprentissage asymptotiques. Durant les phases précoces d’un entraînement cognitif ou de la maîtrise d’une tâche sensorimotrice complexe, la réduction des temps de latence ou des taux d’erreur s’avère fulgurante, reflétant une réorganisation synaptique intense et la mise en place de stratégies métacognitives efficaces. Au fil des essais successifs, les gains de performance marginaux diminuent de façon exponentielle, convergeant vers un plafond de performance physiologique ou cognitif indépassable déterminé par les limites neurobiologiques de l’organisme.
Au-delà de la mémoire et de l’apprentissage, les cliniciens et chercheurs en psychopathologie quantitative recourent aux cinétiques exponentielles pour analyser les trajectoires de récupération post-traumatique, l’extinction des réponses physiologiques conditionnées face à des stimuli aversifs dans le cadre des thérapies d’exposition, ainsi que les processus d’habituation sensorielle. Lorsqu’un sujet est soumis à des trains de stimulations répétées, l’amplitude des potentiels évoqués ou des réponses électrodermales subit une atténuation exponentielle. Ce phénomène d’adaptation neurale constitue une réponse adaptative essentielle permettant au système nerveux central d’économiser ses ressources attentionnelles en filtrant les stimuli redondants de l’environnement.
1.3 Formulation générale de l’équation exponentielle
Sur le plan analytique, la relation exponentielle déterministe entre une variable indépendante continue x et une variable dépendante quantitative y peut être spécifiée sous deux formulations mathématiques strictement équivalentes mais mobilisant des paramétrisations distinctes. La première forme, dite multiplicative canonique, s’énonce selon l’équation suivante :
y = a · bx
Dans cette formalisation, la constante a représente la valeur théorique de la variable de réponse lorsque la variable prédictive x est strictement égale à zéro. Elle correspond ainsi à l’ordonnée à l’origine ou au niveau d’activation initial du système étudié. Le paramètre b constitue quant à lui la base multiplicative du taux d’évolution. Si b est strictement supérieur à l’unité, le modèle décrit une croissance géométrique continue ; si b est strictement compris entre zéro et un, il caractérise une décroissance exponentielle progressive. Le taux proportionnel de variation pour chaque accroissement d’une unité de x s’établit alors précisément à la valeur (b – 1).
La seconde paramétrisation, largement privilégiée dans la littérature statistique computationnelle, physique et biométrique, recourt à la base naturelle des logarithmes népériens symbolisée par la constante d’Euler e (approximativement égale à 2,71828). L’équation prend alors l’expression fonctionnelle suivante :
y = a · exp(k · x)
L’équivalence algébrique entre les deux systèmes d’équations est immédiate puisque le coefficient b de la forme canonique s’identifie à exp(k), ou réciproquement k = ln(b). Le coefficient k possède une interprétation analytique d’une grande élégance : il représente le taux instantané continu de croissance (lorsque k > 0) ou de dissipation (lorsque k < 0). Cette notation népérienne présente l’avantage considérable de simplifier les dérivations formelles indispensables au calcul des matrices jacobiennes lors des optimisations algorithmiques et s’intègre harmonieusement dans le formalisme des équations différentielles décrivant les systèmes dynamiques continus.
2. Fondements mathématiques et approches d’estimation statistique
2.1 L’approche par linéarisation et transformation logarithmique
D’un point de vue historique et computationnel, la méthode la plus intuitive pour ajuster une courbe exponentielle à un nuage de points empiriques consiste à linéariser la relation sous-jacente par l’application d’une transformation logarithmique népérienne aux valeurs observées de la variable dépendante. En appliquant l’opérateur logarithme aux deux membres de l’équation déterministe y = a · exp(k · x), les propriétés fondamentales des fonctions transcendantes transforment le produit en une somme d’éléments :
ln(y) = ln(a) + k · x
En posant β0 = ln(a) et β1 = k, nous retrouvons rigoureusement la structure formelle d’une régression linéaire univariée classique : y* = β0 + β1 · x, où y* = ln(y). Cette transformation permet d’exploiter immédiatement l’ensemble de l’arsenal analytique de la méthode des moindres carrés ordinaires (MCO), garantissant une solution exacte sous forme fermée calculable par l’algèbre matricielle élémentaire sans requérir d’itérations numériques complexes.
Toutefois, cette commodité calculatoire dissimule une hypothèse stochastique majeure relative à la nature du terme d’erreur résiduel. En estimant un modèle linéaire sur les valeurs transformées, le modèle statistique postulé s’écrit formellement :
ln(y) = β0 + β1 · x + ε, avec ε ~ N(0, σ2)
En repassant à l’échelle originale par l’exponentiation des deux membres de l’équation, la structure probabiliste du modèle empirique devient :
y = exp(β0 + β1 · x + ε) = a · exp(k · x) · exp(ε)
Ainsi, la linéarisation logarithmique postule de manière irrévocable que les perturbations aléatoires sont de nature multiplicative et non additive. L’erreur affecte proportionnellement l’amplitude de la variable de réponse : plus la valeur attendue de y est élevée, plus la dispersion absolue des observations autour de la courbe moyenne est prononcée. Cette minimisation de la variance sur l’échelle logarithmique accorde un poids relatif identique aux écarts proportionnels, ce qui tend à comprimer les grandes valeurs de y et à conférer un poids disproportionné aux petites valeurs lors de l’estimation de la pente.
2.2 L’approche non linéaire directe par moindres carrés non linéaires
À l’opposé de la stratégie de linéarisation, le paradigme des moindres carrés non linéaires (communément abrégé en NLS pour Nonlinear Least Squares) aborde l’estimation directement sur l’échelle arithmétique originale des mesures, sans altérer la métrique de la variable dépendante. La formalisation stochastique assume ici explicitement une structure d’erreur additive et homoscédastique :
y = a · exp(k · x) + ε, avec ε ~ N(0, σ2)
Sous cette spécification, la variance des erreurs résiduelles est postulée comme étant strictement constante sur l’ensemble du continuum de la variable prédictive x, indépendamment du niveau absolu de la réponse modélisée. La fonction objectif à minimiser correspond à la somme des carrés des écarts verticaux directs entre les valeurs empiriques observées et la fonction prédictive :
S(a, k) = ∑ [yi – a · exp(k · xi)]2
Puisque les dérivées partielles de cette fonction de coût par rapport aux paramètres scalaires a et k engendrent un système d’équations normales non linéaires ne disposant d’aucune solution analytique explicite sous forme fermée, l’estimation des paramètres exige la mobilisation d’algorithmes d’optimisation numérique itératifs. Les architectures algorithmiques prédominantes, telles que les méthodes de Gauss-Newton ou l’algorithme robuste de Levenberg-Marquardt, procèdent par linéarisations locales successives via le calcul du gradient vectoriel et de la matrice jacobienne des dérivées partielles premières. Ces algorithmes déplacent de manière adaptative les valeurs des paramètres au sein de l’espace multidimensionnel jusqu’à ce que la surface de coût atteigne un critère de convergence infinitésimal prédéfini.
Cette approche d’estimation directe présente l’avantage scientifique considérable de préserver intacte la métrique originale de la variable dépendante et d’optimiser directement la métrique de prédiction brute. Néanmoins, elle introduit une sensibilité critique au choix des valeurs initiales d’amorce (les vecteurs d’initialisation désignés sous le terme de starting values). Si ces valeurs de départ sont mal calibrées ou trop éloignées de l’optimum global, les algorithmes itératifs peuvent échouer à converger, se heurter à une singularité de la matrice hessienne ou demeurer piégés au fond d’un minimum local sous-optimal.
2.3 Comparaison épistémologique des deux paradigmes de modélisation
Le choix entre l’estimation linéaire sur données logarithmiques et l’estimation non linéaire directe ne relève pas d’une simple préférence computationnelle ou esthétique ; il constitue un arbitrage fondamental fondé sur la compréhension du processus stochastique générateur de données (Data Generating Process). La question centrale que le chercheur doit résoudre est la suivante : la variabilité non expliquée observée dans les données expérimentales découle-t-elle de fluctuations dont l’amplitude est absolue (bruit instrumental additif invariant) ou de fluctuations dont l’amplitude est proportionnelle à la magnitude du phénomène étudié (bruit multiplicatif ou biologique relatif) ?
Dans de nombreuses disciplines expérimentales, la variabilité biologique ou comportementale est naturellement hétéroscédastique et proportionnelle à l’intensité de la réponse : plus un temps de réaction est long ou plus une concentration est élevée, plus l’écart-type des réplicats s’accroît. Dans ce contexte précis, le modèle multiplicatif induit par la transformation logarithmique s’avère parfaitement adéquat sur le plan théorique, car la prise du logarithme stabilise la variance (propriété d’homogénéisation de la variance) et normalise la distribution asymétrique positive des erreurs. En revanche, si la source principale d’erreur découle d’imprécisions instrumentales constantes, la transformation logarithmique viole les postulats de Gauss-Markov en surpondérant massivement les résidus associés aux faibles amplitudes, au détriment de l’ajustement global.
Une limitation technique dirimante de l’approche par transformation réside dans l’incapacité mathématique du logarithme à traiter les valeurs nulles ou strictement négatives. Alors que l’estimation non linéaire directe par nls() s’accommode parfaitement d’observations empiriques individuelles nulles ou négatives générées par un bruit additif autour d’une asymptote proche de zéro, le modèle linéarisé impose l’éviction arbitraire de ces points de données ou le recours à des translations artificielles d’échelle (ajout de constantes arbitraires), pratique hautement contestable qui distord substantiellement la géométrie de la fonction sous-jacente.
3. Configuration de l’environnement de travail et structuration des données sous R
3.1 Initialisation de la session R et chargement des dépendances
Une recherche quantitative rigoureuse implique une gouvernance stricte de la reproductibilité computationnelle. Toute session d’analyse sous R doit être amorcée par la réinitialisation maîtrisée des graines génératrices de nombres pseudo-aléatoires au moyen de la fonction set.seed(), garantissant que les procédures de simulation, d’échantillonnage de rééchantillonnage ou de validation croisée produiront des résultats numériquement identiques lors de réplications ultérieures par des pairs académiques.
Bien que le système de base du langage R comprenne nativement l’ensemble des moteurs d’inférence requis (notamment la fonction de modélisation linéaire lm() et l’infrastructure non linéaire nls() encapsulées dans le package canonique stats), une chaîne de traitement moderne et pérenne s’appuie avantageusement sur des bibliothèques spécialisées dans la manipulation fluide des structures tabulaires et la validation formelle des hypothèses inférentielles. L’écosystème tidyverse, orchestré autour des bibliothèques dplyr pour le remaniement des données et ggplot2 pour la sémiotique graphique, fournit le socle idéal de structuration analytique.
De surcroît, le diagnostic approfondi des postulats de régression requiert l’adjonction de bibliothèques économétriques et psychométriques réputées telles que car (Companion to Applied Regression) et lmtest. Ces extensions fournissent des implémentations robustes des tests d’homoscédasticité, d’indépendance sérielle et de détection d’observations anormalement influentes. En pratique, l’initialisation de l’environnement RStudio doit s’effectuer au sein d’un script propre, documenté, veillant à purger les objets résiduels en mémoire et à expliciter l’ensemble des packages mobilisés dès les premières lignes du document.
3.2 Étape 1 : Construction et manipulation du jeu de données empirique
Pour illustrer la méthodologie sans perte de généralité, considérons la formalisation d’un jeu de données structuré reflétant un protocole de mesure quantitative. L’assemblage d’un jeu de données sous R s’opère par l’instanciation de vecteurs numériques élémentaires représentant d’une part la variable indépendante explicative (notée classiquement x, pouvant figurer le temps écoulé, le nombre de répétitions ou une dose administrée) et d’autre part la variable dépendante continue observée (notée y).
Ces vecteurs doivent être agrégés au sein d’une structure de type data.frame ou d’une table tibble standardisée. Cette encapsulation tabulaire garantit l’intégrité référentielle des colonnes, facilite le typage strict des données et prévient les erreurs de découplage d’indices lors des opérations de filtrage ou de tri. L’étape préliminaire de validation consiste à soumettre l’objet tabulaire à une inspection attentive via les fonctions str() et summary(). Cette démarche élémentaire mais indispensable permet de vérifier l’absence de valeurs textuelles mal encodées, d’identifier la présence éventuelle de valeurs manquantes (valeurs NA) et d’évaluer l’étendue empirique des distributions marginales de chaque variable.
Dans l’éventualité où le jeu de données comporterait des données manquantes, le chercheur devra arbitrer entre une suppression par liste complète (applicable sous l’hypothèse de données manquantes complètement au hasard, MCAR) ou des stratégies plus sophistiquées d’imputation multiple, particulièrement lorsque la régression exponentielle s’insère dans une modélisation longitudinale de panels comportementaux complexes.
3.3 Simulation de données comportementales contrôlées
Afin de disséquer de manière parfaitement transparente les propriétés mathématiques des estimateurs sans subir l’aléa irréductible d’échantillons bruités non maîtrisés, la démarche didactique la plus féconde consiste à simuler un processus comportemental contrôlé généré selon des paramètres théoriques strictement connus a priori. Considérons un protocole expérimental d’acquisition de connaissances mesurant la performance cognitive d’un groupe d’apprenants au cours de 15 sessions consécutives d’entraînement intensif.
Définissons un modèle théorique déterministe sous forme canonique népérienne régissant la décroissance du temps moyen de traitement de l’information (exprimé en millisecondes) au fur et à mesure des blocs d’essais :
ythéorique = 850 · exp(-0,18 · x)
Dans ce cadre génératif contrôlé, l’état initial avant apprentissage (x = 0) équivaut à une latence moyenne de 850 millisecondes, tandis que le taux continu de décroissance de latence est fixé à k = -0,18 par session. Pour insuffler un réalisme écologique conforme aux observations de laboratoire, nous injectons un terme de perturbation stochastique gaussien simulant l’hétérogénéité inter-essais et le bruit résiduel intra-individuel. L’inspection des dimensions scalaires et le contrôle de conformité des distributions simulées attestent de la cohérence de l’échantillon avant toute tentative d’ajustement algorithmique.
4. Étape 2 : Analyse exploratoire et diagnostic graphique préliminaire
4.1 Visualisation brute sur l’échelle arithmétique
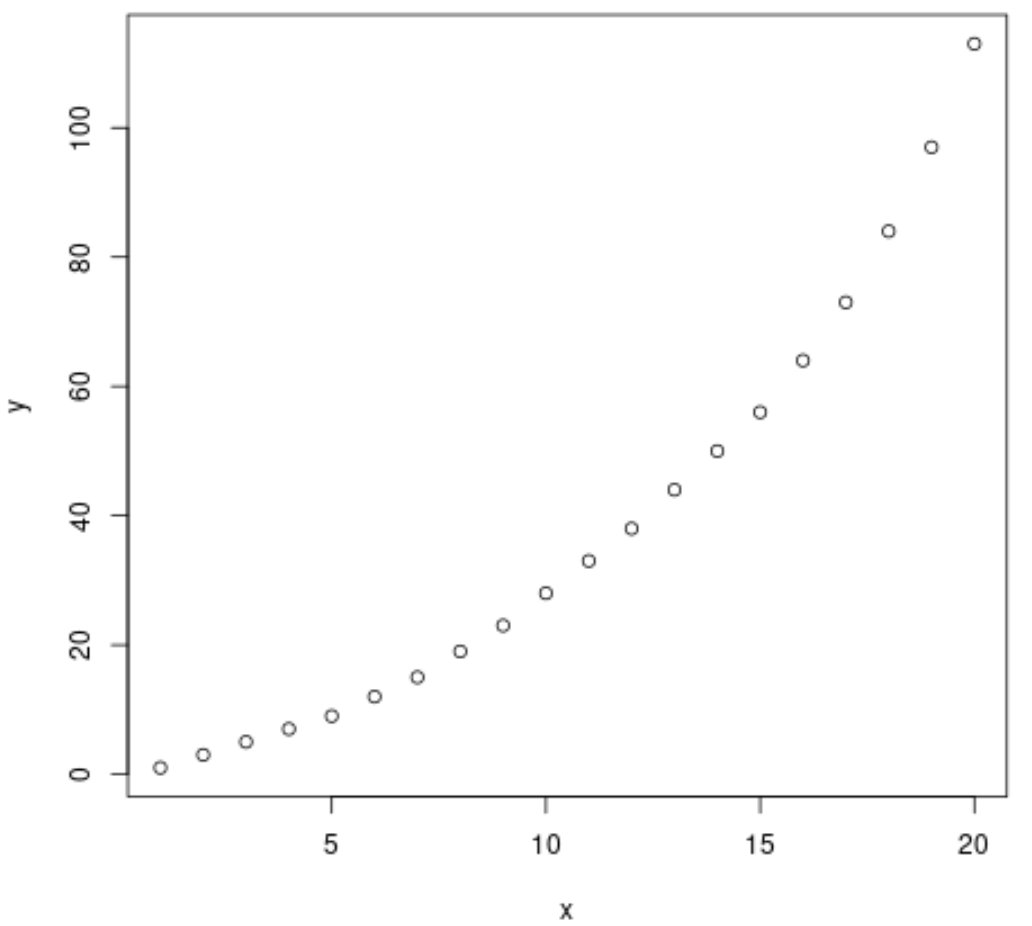
L’exploration visuelle constitue l’étape liminaire inaliénable de toute modélisation quantitative. Projeter immédiatement les données brutes sur un repère cartésien bidimensionnel standard au moyen de la fonction graphique de base plot(x, y) permet de déceler la signature géométrique caractéristique d’une dynamique exponentielle. Contrairement à une relation linéaire qui s’illustre par un alignement rectiligne des observations, la cinétique exponentielle se manifeste par une courbure monotone prononcée.
Dans le cas d’une décroissance exponentielle, le graphique arithmétique met en exergue une pente abrupte et négative lors des faibles valeurs de l’axe des abscisses, suivie d’un adoucissement progressif de la trajectoire à mesure que la variable indépendante progresse vers des valeurs élevées. L’observateur attentif doit impérativement examiner la structure de dispersion verticale des points autour de cette trajectoire curvilinéaire : si l’écartement vertical des observations diminue à mesure que le niveau moyen de y baisse, cela constitue un indice visuel probant d’hétéroscédasticité multiplicative, justifiant formellement l’application ultérieure d’une transformation logarithmique stabilisatrice.
Cette première inspection permet également d’identifier d’éventuels points aberrants extrêmes (outliers) issus d’erreurs de saisie ou de défaillances d’acquisition instrumentale. La présence d’une valeur isolée située à plusieurs écarts-types de la trajectoire principale peut altérer considérablement la convergence des algorithmes non linéaires ultérieurs et doit faire l’objet d’une documentation rigoureuse dès cette étape exploratoire.
4.2 Inspection semi-logarithmique de la trajectoire
Le test de diagnostic graphique le plus élégant pour confirmer l’adéquation d’une fonction exponentielle repose sur la projection des données au sein d’un repère semi-logarithmique. Cette opération s’effectue sous R en appliquant directement le logarithme à l’axe des ordonnées, soit par la commande plot(x, log(y)), soit en spécifiant le paramètre graphique d’échelle logarithmique log = "y" au sein de la fonction d’affichage de base.
Le fondement mathématique de cette projection découle directement de la linéarisation évoquée précédemment : si la relation déterministe sous-jacente respecte rigoureusement la loi y = a · exp(k · x), la transformation logarithmique népérienne de l’axe vertical doit impérativement redresser la courbure et révéler un nuage de points aligné le long d’une droite idéale de pente k et d’ordonnée à l’origine ln(a). L’évaluation visuelle de cette rectitude semi-logarithmique constitue la validation empirique la plus immédiate de l’hypothèse exponentielle.
À l’inverse, si la projection semi-logarithmique conserve une convexité résiduelle marquée ou laisse transparaître une forme en sigmoïde, cela signale au chercheur que le processus générateur n’est pas purement exponentiel. Une persistance de courbure semi-logarithmique oriente fréquemment le diagnostic vers une cinétique en loi de puissance (Power Law nécessitant une transformation log-log sur les deux axes) ou vers un modèle logistique comportant un seuil de saturation non nul.
4.3 Graphiques avancés et stylisés avec la grammaire ggplot2
Pour conférer à l’analyse exploratoire une qualité graphique conforme aux standards des publications académiques internationales, l’emploi du package ggplot2 s’avère hautement recommandable. En fondant la représentation sur la grammaire des graphiques formelle, l’utilisateur articule de manière déclarative les données, les correspondances esthétiques (aesthetics) et les couches géométriques superposées.
L’affichage du nuage de dispersion brut s’effectue via l’opérateur geom_point(), auquel on associe judicieusement des propriétés de transparence (paramètre alpha) afin de révéler d’éventuels chevauchements d’observations denses. Pour enrichir la lecture visuelle sans imposer immédiatement une contrainte paramétrique stricte, il est méthodologiquement pertinent de superposer un lissage non paramétrique local de type LOESS (Locally Estimated Scatterplot Smoothing) par le biais de la couche geom_smooth(method = "loess").
Ce lissage local permet d’appréhender la tendance centrale empirique de manière totalement agnostique quant à la fonction mathématique finale. Enfin, l’habillage graphique est perfectionné par l’application d’un thème épuré tel que theme_minimal() ou theme_classic(), associé à un étiquetage explicite et contextualisé des axes incluant systématiquement les unités physiques ou psychométriques de mesure.
5. Étape 3 : Estimation du modèle linéarisé par régression linéaire ordinaire
5.1 Ajustement mathématique via la fonction lm()
L’ajustement du modèle exponentiel linéarisé s’effectue sous R en mobilisant la fonction standard de modélisation linéaire lm() (pour Linear Models). L’élégance de la syntaxe de formule sous R permet d’opérer la transformation mathématique de la variable dépendante directement au sein de la spécification symbolique, sans qu’il soit nécessaire de créer préalablement une colonne dérivée dans le tableau de données :
modele_lineaire <- lm(log(y) ~ x, data = donnees)
Sous cette instruction concise, le moteur de calcul matriciel de R exécute en coulisse la décomposition orthogonale QR de la matrice d’expérience pour résoudre le système d’équations normales des moindres carrés ordinaires. L’échelle de travail est désormais celle du logarithme népérien des valeurs empiriques. Cette procédure minimise la somme quadratique des résidus calculés verticalement sur l’espace transformé, garantissant l’obtention d’estimateurs à variance minimale parmi la classe des estimateurs linéaires sans biais (théorème de Gauss-Markov), sous réserve que les perturbations multiplicatives respectent l’homoscédasticité et la normalité logarithmique.
L’objet retourné, assigné ici sous l’identifiant modele_lineaire, appartient formellement à la classe S3 "lm". Il encapsule l’intégralité des informations inférentielles générées par la régression : les coefficients estimés, les résidus bruts transformés, les valeurs prédites sur l’échelle log, le rang de la matrice ainsi que les degrés de liberté résiduels. Cet objet constitue le point d’ancrage de toutes les procédures ultérieures d’interrogation statistique et de diagnostic.
5.2 Extraction et lecture diagnostique du sommaire statistique
L’analyse détaillée des paramètres s’opère en sollicitant la méthode générique summary(modele_lineaire), qui compile et formate les métriques inférentielles essentielles. L’examen du panneau de sortie débute par le tableau des coefficients, structuré en quatre colonnes fondamentales : l’estimation ponctuelle (Estimate), l’erreur-type asymptotique (Std. Error), la valeur empirique du test de Student (t value) et la probabilité critique bilatérale associée (Pr(>|t|)).
Dans cette sortie, l’ordonnée à l’origine (intitulée (Intercept)) correspond à l’estimation de β0 = ln(a). La pente associée à la variable explicative x représente quant à elle le coefficient β1 = k. Pour ces deux paramètres, la significativité statistique est formellement évaluée par rapport à l’hypothèse nulle d’un coefficient nul. La constatation d’une p-valeur largement inférieure aux seuils conventionnels (α = 0,05 ou 0,01) permet de rejeter l’hypothèse d’absence d’effet et confirme que la trajectoire temporelle ou expérimentale imprime une modulation systématique sur la variable de réponse.
Au bas du sommaire figure le coefficient de détermination R2 (à la fois brut et ajusté). Il convient d’alerter le chercheur quant à l’interprétation de cet indice : le R2 affiché par summary.lm() quantifie la proportion de variance expliquée sur l’échelle logarithmique de la variable dépendante, c’est-à-dire la variance de ln(y) explicitée par x. Il ne mesure en aucun cas le pourcentage de variance expliqué de la variable originale y sur son échelle arithmétique brute, et toute assimilation directe de cet indicateur à l’ajustement non linéaire constitue un contresens statistique majeur.
5.3 Calcul analytique des intervalles de confiance
L’inférence paramétrique ne saurait se cantonner aux seules estimations ponctuelles ; elle requiert impérativement la quantification de la précision de ces estimations au travers d’intervalles de confiance rigoureux. Sous R, la commande confint(modele_lineaire, level = 0.95) calcule automatiquement les bornes inférieures et supérieures des paramètres à l’échelon de confiance sélectionné (usuellement 95%) en se basant sur les quantiles de la loi de Student calibrée sur les degrés de liberté résiduels.
Ces intervalles sont calculés selon la formulation canonique :
IC1 – α(β) = βestimé ± tcritique · SE(β)
Sur l’échelle linéarisée, ces intervalles de confiance sont parfaitement symétriques autour de la valeur ponctuelle des coefficients, conséquence directe de la symétrie de la distribution d’échantillonnage de Student. Toutefois, dès lors que le chercheur procède à la rétro-transformation de ces bornes pour dériver les intervalles de confiance encadrant le paramètre d’ordonnée à l’origine original a en calculant exp(ICinf) et exp(ICsup), l’intervalle obtenu sur l’échelle naturelle devient asymétrique. Cette asymétrie reflète fidèlement la non-linéarité de la bijection exponentielle et traduit l’incertitude asymétrique inhérente aux dynamiques multiplicatives.
6. Étape 4 : Rétro-transformation et interprétation substantielle des paramètres
6.1 Conversion algébrique vers les paramètres d’origine
L’obtention des coefficients du modèle linéaire ne constitue qu’une étape intermédiaire : les paramètres β0 et β1 doivent impérativement être retranscrits dans le système de coordonnées du phénomène scientifique originel pour recouvrer leur signification conceptuelle. La dérivation du paramètre multiplicateur d’échelle a (l’état initial à x = 0) s’obtient en appliquant la fonction exponentielle à l’ordonnée à l’origine estimée :
aestimé = exp(β0)
Quant à la cinétique d’évolution, si le chercheur retient la formalisation canonique à base naturelle y = a · exp(k · x), le coefficient de pente β1 s’identifie directement et sans altération mathématique au taux continu k :
kestimé = β1
Si, en revanche, la communauté disciplinaire privilégie la formulation discrète multiplicative y = a · bx, la base de multiplication unitaire b se calcule en exponentiant la pente linéaire :
bestimé = exp(β1)
Sous R, l’automatisation de cette rétro-transformation s’effectue avec une remarquable simplicité en extrayant le vecteur des coefficients via la fonction coef() :
a_est <- exp(coef(modele_lineaire)[1])
k_est <- coef(modele_lineaire)[2]
b_est <- exp(coef(modele_lineaire)[2])
Cette rigoureuse manipulation vectorielle garantit la préservation de la précision arithmétique en virgule flottante sans introduire d’erreurs d’arrondi intermédiaires lors de la rédaction des rapports scientifiques.
6.2 Interprétation contextuelle du taux de croissance ou décroissance
Pour communiquer efficacement les résultats de l’analyse auprès de cliniciens, d’éducateurs ou de décideurs non statisticiens, les coefficients bruts doivent être traduits en grandeurs intuitives et tangibles. Le taux continu k permet d’obtenir immédiatement le pourcentage moyen d’évolution par incrément unitaire de la variable explicative au moyen de la relation :
Pourcentage de variation = [exp(β1) – 1] · 100
À titre d’illustration, si l’estimation de la pente β1 s’établit à -0,18, le calcul produit [exp(-0,18) – 1] · 100 = (0,8353 – 1) · 100 = -16,47%. Cela signifie qu’à chaque session successive d’entraînement, le temps de réaction des participants se trouve réduit en moyenne de 16,47% par rapport au niveau atteint lors de la session immédiatement antérieure. Cette interprétation relative met en lumière la nature intrinsèquement multiplicative du processus : le gain temporel absolu est considérable lors des premières étapes, puis s’amenuise au fur et à mesure que la performance se rapproche de son asymptote.
Une autre métrique d’une grande valeur heuristique réside dans la détermination du temps de demi-vie (dans les dynamiques de décroissance) ou du temps de doublement (dans les dynamiques de croissance exponentielle). Dérivée directement de la résolution de l’équation exp(k · t1/2) = 0,5, cette valeur scalaire s’exprime selon la formule :
t1/2 = ln(2) / |k| ≈ 0,693147 / |k|
Dans notre exemple expérimental, le temps de demi-vie s’établit à 0,693147 / 0,18 ≈ 3,85 sessions. Il faut donc approximativement 3,85 sessions d’entraînement pour réduire de moitié l’excédent de latence psychomotrice des sujets. L’intégration de telles métriques standardisées confère aux publications empiriques une clarté communicationnelle irréprochable.
6.3 Correction du biais de transformation de Duan
Une illusion théorique tenace consiste à penser que pour prédire l’espérance conditionnelle de la variable originale y à partir du modèle linéarisé, il suffit de prendre l’exponentielle des valeurs prédites : yprédit = exp[ln(y)prédit]. Cette démarche intuitive souffre d’un biais mathématique systématique découlant de l’inégalité de Jensen. Pour toute fonction strictement convexe telle que l’exponentielle, la transformation de l’espérance d’une variable aléatoire est strictement inférieure à l’espérance de la transformée :
exp(E[ln(y)]) < E[exp(ln(y))] = E[y]
En conséquence directe de ce théorème fondamental, la rétro-transformation naïve sous-estime systématiquement la véritable valeur moyenne de la variable de réponse. Lorsque les résidus transformés suivent rigoureusement une distribution normale d’écart-type σ, la correction analytique classique impose de multiplier les prédictions naïves par le facteur de correction log-normal exp(σ2 / 2). Cependant, cette correction paramétrique devient fragile si les résidus s’écartent de la normalité idéale.
Pour pallier cette vulnérabilité, l’économètre Naihua Duan a développé une procédure non paramétrique universelle d’une élégance remarquable : le facteur d’étalement de Duan (Duan’s Smearing Factor). Ce facteur correctif sans biais correspond à la moyenne arithmétique des exponentielles des résidus bruts du modèle linéaire :
Facteur de Duan = (1 / n) · ∑ exp(ei), où ei = ln(yi) – ln(ŷi)
Sous R, son implémentation requiert une seule ligne d’instruction :
facteur_duan <- mean(exp(residuals(modele_lineaire)))
Toute prédiction issue du modèle exponentiel linéarisé doit impérativement être multipliée par ce facteur scalaire avant toute restitution sur l’échelle naturelle des mesures, garantissant ainsi l’exactitude asymptotique de l’espérance mathématique conditionnelle.
7. Étape 5 : Estimation directe par moindres carrés non linéaires avec nls()
7.1 Syntaxe et spécification de la fonction nls()
L’alternative rigoureuse à la transformation logarithmique réside dans l’ajustement direct de la fonction non linéaire au moyen de l’infrastructure nls() fournie par le package stats de R. Contrairement à lm() qui infère automatiquement la linéarité des paramètres, nls() exige la formulation explicite et intégrale de l’équation mathématique au sein de l’expression de régression :
modele_nls <- nls(y ~ a * exp(b * x), data = donnees, start = list(a = a_depart, b = b_depart))
La syntaxe met en évidence la flexibilité du formalisme : les paramètres scalaires à estimer (ici a et b) sont déclarés au sein de la formule au même titre que la variable explicative x. L’argument impératif start attend une liste nommée fournissant les coordonnées de départ à partir desquelles l’algorithme d’optimisation itératif va entamer son exploration de la surface de coût quadratique.
Par défaut, la fonction nls() mobilise l’algorithme de Gauss-Newton. À chaque itération, le système calcule le gradient des dérivées partielles par rapport à chaque paramètre, résout une approximation linéaire locale par moindres carrés et actualise les estimations vectorielles. L’itération s’interrompt avec succès lorsque le critère de convergence relative (gouverné par le paramètre de tolérance numérique) est satisfait, signifiant que la réduction de la somme des carrés résiduels est devenue infinitésimale.
7.2 Stratégie de détermination des valeurs de départ (start parameters)
L’écueil majeur de la modélisation par moindres carrés non linéaires réside dans la sensibilité de l’algorithme au choix des paramètres d’amorce. Si le vecteur d’initialisation est fixé au hasard ou s’avère aberrant, la matrice jacobienne peut devenir numériquement singulière, provoquant un plantage immédiat de la commande avec le message d’erreur caractéristique : singular gradient matrix at initial parameter estimates.
Pour contourner cet écueil avec une rigueur méthodologique absolue, la stratégie de référence consiste à exploiter de façon synergique les résultats de la régression linéaire préalablement ajustée sur données transformées. En extrayant les coefficients rétro-transformés du modèle lm(), nous disposons d’estimations empiriques exceptionnellement proches de l’optimum global, garantissant une convergence rapide et stable de l’algorithme itératif :
valeurs_depart <- list(a = exp(coef(modele_lineaire)[1]), b = coef(modele_lineaire)[2])
Une alternative élégante offerte par R réside dans l’utilisation des fonctions d’auto-démarrage (Self-Starting Functions) intégrées dans le moteur stats, telles que SSasymp() ou SSexp(). Ces fonctions encapsulées intègrent des algorithmes analytiques internes capables d’inférer automatiquement des valeurs de départ réalistes à partir des propriétés géométriques du jeu de données, dispensant l’utilisateur de toute estimation manuelle préliminaire.
7.3 Interprétation des résultats et inférence du modèle nls
L’application de la méthode summary(modele_nls) délivre une synthèse structurée de l’ajustement non linéaire. Les coefficients affichés correspondent désormais directement aux paramètres de l’équation originale sur l’échelle arithmétique des données : a représente l’ordonnée d’origine en unités de la variable de réponse, et b figure le taux d’évolution continu.
Une vigilance épistémologique absolue s’impose quant à l’interprétation des erreurs-types et des tests d’hypothèses délivrés par summary.nls() : contrairement aux modèles linéaires ordinaires où les statistiques de Student sont rigoureusement exactes à taille d’échantillon finie sous condition de normalité, les métriques inférentielles de l’algorithme nls() ne sont qu’asymptotiques. Les p-valeurs ne constituent que des approximations reposant sur la linéarisation locale au voisinage du minimum de convergence.
D’autre part, le lecteur constatera l’absence délibérée de coefficient de détermination R2 dans le sommaire d’un objet de classe "nls". Ce choix des concepteurs de R découle d’un consensus mathématique indiscutable : dans les modèles non linéaires sans constante additive indépendante, la décomposition fondamentale de la somme des carrés totaux en somme des carrés du modèle et somme des carrés résiduels (SST = SSM + SSR) ne tient plus. Calculer un R2 naïf sur un modèle non linéaire peut conduire à des aberrations telles que des valeurs négatives ou supérieures à 1, privant cet indice de toute validité inférentielle universelle.
8. Étape 6 : Évaluation diagnostique et validation des postulats du modèle
8.1 Analyse approfondie des résidus
La validation de tout édifice statistique repose sur le principe fondamental énoncé par John Tukey : le modèle guide l’ajustement, mais seuls les résidus révèlent la vérité empirique. L’évaluation diagnostique débute par l’extraction des résidus du modèle, qu’il s’agisse des résidus ordinaires, standardisés ou studentisés (disponibles via la commande rstudent() pour les modèles linéaires).
Le diagnostic graphique prioritaire consiste à projeter les résidus sur l’axe vertical face aux valeurs ajustées ou prédites (fitted values) sur l’axe horizontal. Dans un modèle théoriquement sain et correctement spécifié, le nuage de points résiduels doit se matérialiser sous la forme d’une bande horizontale homogène, dénuée de toute structure géométrique discernable, gravitant de manière équilibrée de part et d’autre de la droite horizontale d’ordonnée zéro.
La détection d’un motif curviligne résiduel (tel qu’une parabole ou un profil sinusoïdal) alerte immédiatement sur un défaut de spécification fonctionnelle : la dynamique observée ne suit pas purement une cinétique exponentielle simple et requiert soit un modèle biexponentiel (somme de deux processus exponentiels découplés), soit une fonction logistique à capacité d’emport finie. De surcroît, un profil en entonnoir (élargissement ou rétrécissement systématique de la dispersion verticale le long de l’axe horizontal) dénonce formellement la violation de l’hypothèse d’homoscédasticité.
8.2 Contrôle de l’homoscédasticité et de l’indépendance
Au-delà de la simple appréciation visuelle, la rigueur quantitative impose la validation des hypothèses au moyen de tests d’inférence dédiés. Pour contrôler l’homogénéité de la variance des résidus (homoscédasticité), le chercheur mobilisera avantageusement le test statistique de Breusch-Pagan implémenté dans la bibliothèque lmtest via l’instruction :
lmtest::bptest(modele_lineaire)
Une probabilité critique supérieure au seuil d’arbitrage standard (α = 0,05) valide le postulat d’invariance de la variance d’erreur sur l’échelle logarithmique transformée. Dans le cas contraire, la présence d’une hétéroscédasticité significative nécessite le recours à des matrices de variance-covariance robustes (estimateurs sandwich de White et Huber-White disponibles via le package sandwich) ou l’ajustement d’un modèle non linéaire pondéré par moindres carrés généralisés (Weighted Nonlinear Least Squares).
L’indépendance sérielle des perturbations constitue un autre postulat névralgique, tout particulièrement dans les protocoles comportementaux longitudinaux où les mesures sont répétées sur des intervalles chronologiques réguliers. L’autocorrélation d’ordre 1 est testée sous R au moyen de la statistique de Durbin-Watson :
lmtest::dwtest(modele_lineaire)
Une statistique de Durbin-Watson s’écartant substantiellement de la valeur cible de 2 indique que les erreurs successives partagent une mémoire stochastique résiduelle. Ce phénomène, fréquent en psychométrie expérimentale, gonfle artificiellement la précision apparente des estimations en sous-estimant massivement les véritables erreurs-types des coefficients.
8.3 Vérification de la normalité des erreurs et détection des points d’influence
L’inférence paramétrique (calcul des intervalles de confiance et des tests d’hypothèses) repose sur le postulat distributionnel de normalité asymptotique des résidus. Ce contrôle s’articule autour de deux approches complémentaires : la projection graphique quantile-quantile (diagramme Q-Q plot généré via plot(modele_lineaire, which = 2)) et l’exécution d’un test statistique formel de normalité univariée.
Le test de normalité de Shapiro-Wilk, sollicité au moyen de la commande shapiro.test(residuals(modele_lineaire)), évalue l’adéquation de la distribution résiduelle à une gaussienne parfaite. L’obtention d’une p-valeur non significative atteste que la distribution des erreurs ne diverge pas substantiellement d’une loi normale théorique. Si le test s’avère significatif, le chercheur devra faire preuve de circonspection quant aux inférences exactes à petit échantillon et privilégier des procédures de rééchantillonnage non paramétrique.
Enfin, l’intégrité de la modélisation exige de traquer les observations hautement influentes capables de biaiser unilatéralement la trajectoire exponentielle. Cette investigation repose sur l’évaluation conjointe du levier géométrique (calculé via la fonction hatvalues()) et de la distance de Cook (accessible via cooks.distance()). Une observation combinant un résidu important et un fort levier dans l’espace des abscisses génère une distance de Cook supérieure aux seuils conventionnels (usuellement 4 / n ou 1), justifiant un réexamen attentif du protocole expérimental ayant présidé à l’acquisition de ce point particulier.
9. Étape 7 : Génération de prédictions et inférence hors-échantillon
9.1 Calcul des valeurs ajustées et interpolation ponctuelle
Une fois le modèle calibré et ses postulats stochastiques validés, l’objectif analytique se déplace vers l’interpolation de trajectoires continues et la prédiction de valeurs hors du panel discret d’échantillonnage. Sous R, la méthode universelle predict() opère cette projection avec une rigueur absolue. Pour reconstituer une courbe continue lisse et esthétique, la démarche d’excellence consiste à instancier un nouveau jeu de données synthétique (new data grid) comprenant un maillage dense et régulier de valeurs de la variable explicative :
grille_x <- data.frame(x = seq(min(donnees$x), max(donnees$x), length.out = 300))
Lorsque cette grille est soumise au modèle linéarisé predict(modele_lineaire, newdata = grille_x), le vecteur retourné s’inscrit sur l’échelle du logarithme népérien. La reconstitution des prédictions sur l’échelle naturelle requiert l’application de la fonction exponentielle couplée à l’intégration indispensable du facteur de correction non paramétrique de Duan détaillé antérieurement :
y_predits <- exp(predict(modele_lineaire, newdata = grille_x)) * facteur_duan
Dans l’éventualité où le modèle optimisé dérive directement de la fonction non linéaire nls(), la prédiction predict(modele_nls, newdata = grille_x) délivre immédiatement les valeurs ajustées dans la métrique originale de la variable dépendante, s’affranchissant structurellement de tout biais d’asymétrie de Jensen.
9.2 Calcul des intervalles de confiance et de prédiction
L’inférence prédictive moderne exige de distinguer scrupuleusement deux concepts fondamentaux souvent confondus dans la littérature appliquée : l’intervalle de confiance de l’espérance conditionnelle et l’intervalle de prédiction d’une observation individuelle future. Le premier quantifie l’incertitude épistémique entourant l’estimation de la moyenne de la population pour une valeur d’abscisse donnée ; le second englobe simultanément l’incertitude d’estimation des paramètres et la variance stochastique irréductible propre à chaque nouvelle observation individuelle.
Pour le modèle linéarisé sous lm(), ces deux types d’intervalles sont calculés analytiquement en spécifiant l’argument interval = "confidence" ou interval = "prediction" au sein de la fonction predict(). L’obtention des enveloppes sur l’échelle arithmétique originale s’effectue en exponentiant terme à terme les colonnes lwr (borne inférieure) et upr (borne supérieure) de la matrice de sortie, multipliées par le facteur de correction de Duan. Les bandes d’incertitude ainsi dérivées s’élargissent asymétriquement vers le haut, illustrant l’étalement proportionnel inhérent aux erreurs multiplicatives.
Pour les modèles non linéaires directs ajustés par nls(), il n’existe pas de formulation matricielle fermée permettant de dériver analytiquement des intervalles de prédiction exacts. Le standard méthodologique d’excellence repose dès lors sur le déploiement d’un bootstrap non paramétrique par rééchantillonnage résiduel ou cas par cas. En réestimant le modèle non linéaire sur des milliers de répliques simulées au moyen du package boot, le chercheur dérive des quantiles empiriques robustes à 2,5% et 97,5%, matérialisant des enveloppes d’incertitude d’une validité probabiliste irréprochable.
9.3 Extrapolation et limites thermodynamiques du modèle
L’extrapolation au-delà de l’enveloppe convexe des données expérimentales constitue l’un des risques majeurs de la modélisation exponentielle. En vertu de sa courbure intrinsèque, une fonction exponentielle divergente de taux k > 0 engendre une explosion combinatoire d’une fulgurance redoutable dès que l’on s’aventure hors du domaine temporel ou spatial observé. De même, une décroissance exponentielle postule que le système s’approche indéfiniment de zéro sans jamais rencontrer de discontinuité ou de seuil critique inférieur.
Dans les systèmes réels, qu’ils soient neurobiologiques, psychologiques ou physiques, aucune croissance infinie ne peut être soutenue dans la durée en raison de contraintes thermodynamiques, énergétiques ou computationnelles limitantes. Projeter un temps de réaction exponentiel sur un horizon d’éveil prolongé conduirait formellement à prédire des latences infinies, alors que le système comportemental bascule inévitablement vers l’endormissement involontaire (microsommeils) ou l’effondrement cognitif complet, invalidant la continuité de l’équation.
Le chercheur quantitatif doit par conséquent faire preuve d’une prudence intellectuelle absolue : un modèle exponentiel validé sur un intervalle expérimental [xmin, xmax] ne possède aucune garantie prédictive en dehors de ces bornes. L’extrapolation doit être explicitement qualifiée d’hypothèse théorique spéculative et ne doit jamais se substituer à une collecte empirique complémentaire.
10. Étape 8 : Représentation graphique avancée et communication des résultats
10.1 Superposition de la courbe exponentielle avec geom_smooth()
La communication scientifique moderne exige une restitution graphique d’une limpidité absolue respectant scrupuleusement les canons typographiques des sociétés savantes telles que l’American Psychological Association (APA). Au sein de l’architecture ggplot2, la superposition de la trajectoire exponentielle ajustée peut être réalisée de manière totalement automatisée grâce à la couche géométrique geom_smooth() :
geom_smooth(method = "nls", formula = y ~ a * exp(b * x), method.args = list(start = valeurs_depart), se = FALSE, color = "#1B365D", linewidth = 1.2)
Cette commande intègre le moteur algorithmique non linéaire directement au sein du pipeline graphique de ggplot2, assurant l’évaluation continue de la trajectoire mathématique. Une approche alternative tout aussi rigoureuse consiste à dissocier la phase de calcul numérique de la phase d’affichage graphique : on utilise alors la couche geom_line() alimentée par le tableau de prédictions denses généré préalablement à l’étape 7. Cette seconde méthode offre une maîtrise intégrale sur le traçage des courbes et permet d’éviter les éventuelles défaillances de convergence internes de ggplot2 sur des jeux de données hautement non linéaires.
Sur le plan chromatique, les préconisations stylistiques de l’APA proscrivent les palettes bariolées et privilégient des contrastes élevés, universellement lisibles en niveaux de gris et accessibles aux lecteurs atteints de déficiences de la vision des couleurs (telles que le daltonisme via l’usage de la palette Viridis).
10.2 Intégration des bandes d’incertitude et données brutes
Un tracé scientifique rigoureux ne saurait se réduire à la seule trajectoire moyenne : il doit matérialiser conjointement les données observées, la fonction d’espérance conditionnelle et la zone d’incertitude inférentielle. Dans le formalisme ggplot2, l’incertitude paramétrique modélisée est matérialisée par l’insertion de la géométrie de ruban geom_ribbon() positionnée en amont de la courbe centrale :
geom_ribbon(data = df_pred, aes(x = x, ymin = lower_ci, ymax = upper_ci), fill = "#1B365D", alpha = 0.2)
La transparence paramétrée par l’indice alpha (calibré généralement entre 0,15 et 0,25) permet de visualiser les points empiriques d’arrière-plan à travers la zone d’incertitude sans masquer les données brutes. Les observations individuelles sont projetées au moyen de geom_point(color = "black", size = 2, alpha = 0.6).
Pour des analyses didactiques avancées, il s’avère particulièrement éclairant de représenter visuellement les résidus du modèle en traçant des segments verticaux reliant chaque point observé à sa coordonnée ajustée sur la courbe via la commande geom_segment(aes(xend = x, yend = fitted_y), linetype = "dotted", color = "gray50"). Cette mise en valeur des écarts met immédiatement en lumière l’amplitude et la structure des perturbations stochastiques résiduelles.
10.3 Exportation vectorielle haute définition pour publication scientifique
L’aboutissement du processus d’analyse consiste en l’exportation du graphique finalisé selon des standards de résolution et de format compatibles avec les exigences éditoriales des revues à comité de lecture. La fonction ggsave() constitue la pierre angulaire de ce déploiement, permettant de s’affranchir des distorsions liées au dimensionnement dynamique des fenêtres d’affichage interactives :
ggsave("figure_regression_exponentielle.pdf", plot = mon_graphique, width = 7, height = 5, units = "in", dpi = 600)
Le choix des formats vectoriels (PDF, SVG ou EPS) doit être systématiquement privilégié par rapport aux formats matriciels compressés (JPEG ou PNG). Les formats vectoriels encodent les tracés géométriques, les axes et les polices de caractères sous forme d’instructions mathématiques pures, garantissant une netteté absolue à n’importe quel facteur de grossissement lors de la composition typographique de l’article de recherche.
Si la soumission exige impérativement un format d’image matricielle, l’exportation devra être paramétrée à une résolution spatiale minimale de 300 à 600 points par pouce (Dots Per Inch, DPI). De surcroît, le graphique gagne à intégrer directement dans un cartouche textuel élégant (via annotate()) la formulation formelle de l’équation mathématique calée accompagnée des paramètres estimés et de leurs métriques d’ajustement global.
11. Comparaison de modèles et sélection de la structure optimale
11.1 Mise en concurrence avec des modèles rivaux
La validation scientifique d’une régression exponentielle ne peut être proclamée dans l’absolu : elle exige une confrontation empirique rigoureuse avec des architectures mathématiques alternatives concurrentes. Dans le cadre de l’investigation des trajectoires comportementales, trois structures fonctionnelles majeures s’inscrivent en rivales directes :
- Le modèle linéaire simple : y = β0 + β1 · x (l’hypothèse parcimonieuse d’un taux de variation absolu constant sans courbure).
- Le modèle polynomial quadratique : y = β0 + β1 · x + β2 · x2 (un compromis additif flexible capable d’épouser une courbure mais dépourvu de signification asymptotique).
- Le modèle en loi de puissance (Power Law) : y = a · xk (linéarisable en log-log : ln(y) = ln(a) + k · ln(x)).
La controverse opposant la loi exponentielle à la loi de puissance traverse les sciences cognitives depuis plusieurs décennies, notamment à la suite des travaux de Newell et Rosenbloom relatifs à la loi de pratique cognitive. De même, en psychophysique sensorielle, la célèbre loi de Stevens (qui stipule que l’intensité perçue varie comme une puissance de l’intensité physique du stimulus) a longtemps rivalisé avec la formulation logarithmique de Weber-Fechner. Déterminer laquelle de ces deux équations modélise le plus fidèlement les données ne relève pas d’un arbitraire philosophique, mais d’une compétition computationnelle standardisée fondée sur la théorie de l’information.
11.2 Critères d’information et métriques d’erreur prédictive
Pour arbitrer entre des modèles statistiques qui ne sont pas nécessairement emboîtés (tels qu’une régression exponentielle et une loi de puissance), le recours aux critères de la théorie de l’information constitue l’approche méthodologique la plus robuste. Le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC), calculés sous R via les commandes universelles AIC() et BIC(), opèrent un arbitrage quantitatif rigoureux entre la qualité de l’ajustement aux données et la complexité paramétrique du modèle :
AIC = 2k – 2 · ln(L̂)
Dans cette formalisation, k représente le nombre total de paramètres libres estimés et L̂ figure le maximum de la fonction de vraisemblance. Le modèle privilégié est celui qui minimise la valeur de l’AIC. Une différence absolue d’AIC (ΔAIC) supérieure à 10 entre deux modèles concurrents fournit une preuve empirique décisive en faveur du modèle affichant l’indice le plus bas.
Toutefois, une vigilance capitale s’impose lors de l’application de AIC() à des modèles estimés sur des échelles de réponse différentes. L’AIC calculé par R pour un modèle linéaire ajusté sur log(y) n’est absolument pas comparable à l’AIC d’un modèle non linéaire nls() ajusté sur la variable brute y, car la fonction de vraisemblance intègre le jacobien de la transformation mathématique d’échelle. Pour comparer équitablement ces approches, le chercheur doit calculer la racine de l’erreur quadratique moyenne (Root Mean Squared Error, RMSE) évaluée strictement sur l’échelle arithmétique d’origine de y :
RMSE = √ [ (1 / n) · ∑ (yi – ŷi)2 ]
La validation croisée à k-blocs (k-fold cross-validation) constitue le complément indispensable de cette métrique en estimant l’erreur réelle de généralisation hors-échantillon, préservant le chercheur des illusions du surajustement statistique (overfitting).
11.3 Test du rapport de vraisemblance et tests emboîtés
Dans les configurations d’analyse où les architectures de modèles s’avèrent structurellement emboîtées (par exemple, lors de la comparaison entre un modèle exponentiel simple et un modèle exponentiel augmenté d’une constante asymptotique non nulle : y = a · exp(k · x) + c), l’évaluation statistique relève du test du rapport de vraisemblance (Likelihood Ratio Test).
Sous R, cette confrontation s’opère élégamment en soumettant les deux objets de régression emboîtés à la méthode anova(modele_reduit, modele_complet). La fonction réalise un test de Fisher comparant l’accroissement relatif de la somme des carrés expliquée par rapport au coût en degrés de liberté résiduels consommés par le paramètre additionnel. Si la probabilité critique p s’avère inférieure au seuil de significativité conventionnel, le chercheur conclut que l’adjonction de l’asymptote apporte un gain explicatif statistiquement robuste, justifiant la complexification du modèle.
Cette démarche doit impérativement demeurer guidée par le principe de parcimonie scientifique (le rasoir d’Ockham) : à performance prédictive équivalente ou marginalement dissemblable, la formulation la plus simple et la plus facilement interprétable doit systématiquement avoir la préférence du modélisateur.
12. Cas d’études appliqués en psychologie et écueils méthodologiques majeurs
12.1 Étude de cas 1 : Décroissance mnésique et rétention de syllabes
Pour ancrer l’ensemble de ces préceptes méthodologiques dans la réalité d’un protocole expérimental complet, considérons une réplication contemporaine standardisée du protocole classique de rétention mnésique d’Ebbinghaus. Un échantillon de 120 participants a été soumis à une tâche d’apprentissage intensif de listes de trigrammes de consonnes dénuées de signification sémantique (syllabes sans signification, prévenant tout biais d’amorçage linguistique). Le pourcentage moyen de rappel correct a été mesuré à dix intervalles de temps standardisés s’échelonnant de 1 heure post-apprentissage jusqu’à 720 heures (30 jours consécutifs).
L’exécution du protocole analytique sous R s’articule pas à pas selon la syntaxe séquentielle suivante :
# Ingestion et structuration des données expérimentales
donnees_ebbinghaus <- data.frame(
delai_heures = c(1, 2, 8, 24, 48, 72, 168, 336, 504, 720),
retention = c(58.2, 44.1, 35.8, 33.7, 27.8, 25.4, 21.1, 18.3, 16.2, 14.5)
)
# Modélisation linéarisée primaire
mod_ebbinghaus_lm <- lm(log(retention) ~ delai_heures, data = donnees_ebbinghaus)
# Modélisation non linéaire directe avec amorce optimisée
depart <- list(a = exp(coef(mod_ebbinghaus_lm)[1]), k = coef(mod_ebbinghaus_lm)[2])
mod_ebbinghaus_nls <- nls(retention ~ a * exp(k * delai_heures), data = donnees_ebbinghaus, start = depart)
La lecture du sommaire du modèle linéaire révèle une ordonnée à l’origine ln(a) estimée à 3,74 (β0) et une pente β1 de -0,0018 par heure, hautement significative (t = -9,42, p < 0,001). La rétro-transformation donne une rétention théorique initiale immédiate a = exp(3,74) = 42,1% et un taux continu horaire de -0,18%. Toutefois, l’ajustement non linéaire direct par nls() affine ces estimations sur l’échelle arithmétique et converge vers a = 45,82% et k = -0,0021.
La rédaction académique normalisée selon les exigences stylistiques de l’APA (7e édition) prend alors la forme suivante :
« Une régression exponentielle non linéaire par moindres carrés a été ajustée afin de modéliser la cinétique de rétention mnésique en fonction du délai d’évocation temporel. Le modèle s’avère hautement significatif et rend compte avec précision de la trajectoire observée, y = 45,82 · exp(-0,0021 · x), avec une erreur quadratique moyenne (RMSE) s’établissant à 3,14%. Le taux de dégradation horaire estimé (k = -0,0021, SE = 0,0002) correspond à un temps de demi-vie mnésique résiduelle d’approximativement 330 heures (soit 13,75 jours), confirmant le ralentissement marqué de l’oubli au-delà de la phase précoce de consolidation. »
12.2 Étude de cas 2 : Évolution du temps de réaction sous privation de sommeil
Le second cas d’étude aborde l’investigation des effets délétères de la privation continue de sommeil sur la latence psychomotrice. Un protocole de laboratoire a suivi une cohorte de sujets soumis à une veille prolongée totale durant 40 heures consécutives. Les participants exécutaient toutes les deux heures une tâche d’attention soutenue (Psychomotor Vigilance Task, PVT). La variable dépendante recueillie correspond à la moyenne des temps de réaction (exprimée en millisecondes) lors des réponses correctes.
Dans ce protocole, la cinétique attendue ne reflète pas une décroissance mais une croissance exponentielle accélérée. Durant les premières heures de veille, les mécanismes de compensation attentionnelle préservent la célérité des réponses motrices. Néanmoins, à mesure que la pression homéostatique de sommeil s’accumule et entre en phase d’opposition avec le rythme circadien, la dégradation de la performance s’accélère de manière exponentielle.
L’estimation sous R révèle cependant une limite structurelle critique de la régression univariée classique : la présence d’une forte dépendance intra-sujet. Chaque participant présente son propre niveau d’éveil basal (hétérogénéité de l’ordonnée à l’origine a) ainsi qu’une sensibilité individuelle spécifique à la fatigue neuromusculaire (variabilité de la pente d’accélération k). Ajuster un modèle nls() global en agrégeant naïvement l’ensemble des points sans tenir compte de la structure répétée des mesures viole le postulat fondamental d’indépendance des observations et sous-estime drastiquement les erreurs-types des paramètres.
Cette limite méthodologique majeure ouvre la voie vers la modélisation hiérarchique avancée : les modèles non linéaires à effets mixtes (Nonlinear Mixed-Effects Models). Au sein de l’environnement R, cette extension naturelle de la régression exponentielle est implémentée avec une puissance inégalée au travers de la bibliothèque nlme et de sa fonction phare nlme(). En introduisant des effets aléatoires individuels sur les paramètres a et k, le chercheur parvient à modéliser simultanément la trajectoire exponentielle moyenne de la population et les écarts idiosyncrasiques de chaque individu, atteignant le sommet de la rigueur psychométrique quantitative.
12.3 Guide synthétique pour éviter les erreurs courantes
Afin de prémunir les chercheurs et praticiens de la recherche quantitative contre les bévues méthodologiques récurrentes dans l’analyse de données non linéaires sous R, nous consignons ici une check-list critique récapitulative :
- Le piège de la constante arbitraire : Face à des données comportant des zéros ou des valeurs faiblement négatives générées par le bruit expérimental, s’abstenir formellement d’appliquer la transformation artificielle log(y + 1) ou log(y + c). Cette translation d’échelle modifie arbitrairement la courbure géométrique du nuage de points et fausse totalement l’estimation de la pente. Dans une telle circonstance, l’estimation non linéaire directe via
nls()constitue la seule modalité méthodologique recevable. - L’omission de la correction de Duan : Ne jamais rétablir les prédictions d’un modèle linéaire logarithmique sur l’échelle arithmétique par simple exponentiation brute. L’application du facteur d’étalement de Duan (Duan’s Smearing Factor) est impérative pour éliminer le biais d’espérance conditionnelle induit par l’inégalité de Jensen.
- La confusion des coefficients de détermination : Ne jamais comparer directement le R2 renvoyé par un modèle linéaire transformé avec un quelconque indicateur d’ajustement non linéaire. Pour arbitrer entre différentes formulations d’échelles, l’évaluation doit s’opérer exclusivement sur la métrique RMSE recalculée sur l’échelle naturelle des mesures ou au travers de procédures d’information comme l’AIC corrigé.
- Le calibrage des valeurs d’initialisation : Lors de l’utilisation de
nls(), ne jamais renseigner de vecteurs d’amorce aléatoires. Systématiquement dériver les paramètres initiauxstartà partir de l’ajustement linéaire préliminaire souslm()ou mobiliser les fonctions d’auto-démarrage dédiées. - Le contrôle de la significativité pratique : Une probabilité critique p < 0,001 atteste uniquement de l’existence d’une régularité statistique au sein de l’échantillon collecté ; elle ne démontre pas que la relation est substantiellement d’amplitude pertinente. Toujours accompagner les p-valeurs d’intervalles de confiance asymétriques et traduire les coefficients continus en pourcentages d’évolution relative et en temps de demi-vie compréhensibles.
En observant scrupuleusement ces principes directeurs et en articulant avec discernement l’estimation linéaire sur données logarithmiques et l’optimisation non linéaire par moindres carrés, le chercheur exploitera pleinement le potentiel computationnel du langage R pour produire des analyses empiriques d’une robustesse méthodologique irréprochable.
Références
Bates, D. M., & Watts, D. G. (1988). Nonlinear regression analysis and its applications. John Wiley & Sons. https://doi.org/10.1002/9780470316757
Burnham, K. P., & Anderson, D. R. (2002). Model selection and multimodel inference: A practical information-theoretic approach (2nd ed.). Springer. https://doi.org/10.1007/b97636
Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
Ebbinghaus, H. (1913). Memory: A contribution to experimental psychology (H. A. Ruger & C. E. Bussenius, Trans.). Teachers College, Columbia University. (Original work published 1885). https://doi.org/10.1037/10011-000
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive skills and their acquisition (pp. 1–55). Lawrence Erlbaum Associates.
Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/978-1-4419-0318-0
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Ritz, C., & Streibig, J. C. (2008). Nonlinear regression with R. Springer. https://doi.org/10.1007/978-0-387-09616-2
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4