
L’analyse des phénomènes psychologiques et comportementaux confronte continuellement les chercheurs et les praticiens à une réalité fondamentale : les trajectoires humaines épousent rarement des dynamiques strictement linéaires. Qu’il s’agisse de l’acquisition d’une compétence complexe, de l’évolution des facultés cognitives au cours du vieillissement ou de la détérioration de la santé mentale face à des stresseurs environnementaux chroniques, les processus sous-jacents oscillent fréquemment entre des phases d’accélération initiale, des paliers de stabilisation et des points de rupture critique. Face à ces architectures temporelles et fonctionnelles sophistiquées, les modèles linéaires classiques s’avèrent structurellement insuffisants, contraignant la modélisation quantitative à mobiliser des approches polynomiales d’ordre supérieur capables de rendre compte des nuances empiriques sans basculer immédiatement dans l’opacité paramétrique d’algorithmes de boîte noire non linéaires.
Au sein de cet arsenal quantitatif, la régression cubique occupe une position épistémologique et méthodologique singulière. En intégrant simultanément un terme linéaire, un terme quadratique et un terme cubique, ce modèle d’ordre trois offre la flexibilité nécessaire pour capturer une double courbure directionnelle ainsi qu’un point d’inflexion théorique déterminant, tout en demeurant formellement ancré dans le cadre robuste et parfaitement maîtrisé du modèle linéaire général. Loin d’être un simple artifice mathématique destiné à gonfler artificiellement le coefficient de détermination, le déploiement d’un polynôme de degré 3 constitue un outil analytique d’une rare puissance heuristique pour tester des hypothèses de seuils basculants, de retards d’amorçage ou d’épuisement systémique dans les sciences du comportement.
Bien que des environnements de programmation statistique spécialisés tels que R, SPSS ou Python soient fréquemment mobilisés dans la recherche universitaire, l’utilisation de Microsoft Excel conserve une pertinence opératoire incontestable dans les contextes professionnels, cliniques et académiques. Grâce à la puissance de ses fonctions matricielles natives comme DROITEREG, à la richesse analytique du complément Utilitaire d’analyse et à l’immédiateté de ses outils de restitution graphique, le tableur permet une décomposition pas à pas et une inspection transparente de chaque étape de l’estimation polynomiale. Ce guide exhaustif a pour vocation d’articuler la théorie psychométrique la plus rigoureuse avec les procédures opérationnelles directes dans Excel, offrant un manuel de référence définitif pour modéliser, interpréter et valider les relations cubiques.
1. Fondements théoriques de la régression cubique en modélisation psychologique
1.1 Définition mathématique du modèle polynomial d’ordre 3
Sur le plan de l’analyse mathématique formelle, la régression cubique constitue une extension directe du modèle de régression linéaire multiple dans laquelle la variable dépendante continue, notée Y, est exprimée comme une combinaison linéaire des puissances successives d’une unique variable prédictive continue, notée X, jusqu’à l’ordre trois. L’expression canonique de la fonction de régression dans la population s’énonce sous la forme :
Yi = β0 + β1Xi + β2Xi2 + β3Xi3 + εi
Dans cette formulation paramétrique rigoureuse, β0 représente l’ordonnée à l’origine (ou constante), correspondant à la valeur théorique attendue de Y lorsque le prédicteur X est strictement égal à zéro. Le coefficient β1 quantifie la pente linéaire instantanée à l’origine, capturant la tendance directionnelle de premier ordre. Le paramètre β2 modélise la courbure quadratique de base, c’est-à-dire le taux d’accélération ou de décélération parabolique de la réponse psychologique. Le terme cubique β3 régit quant à lui le changement de courbure lui-même, gouvernant le rythme auquel la concavité de la fonction se métamorphose le long du continuum prédictif. Enfin, εi désigne le terme d’erreur stochastique résiduelle associé à l’observation i, postulé de moyenne nulle et de variance constante selon les hypothèses classiques de Gauss-Markov.
La caractéristique fondamentale qui distingue la fonction cubique de ses homologues d’ordre inférieur réside dans sa capacité morphologique à exhiber deux changements distincts de courbure directionnelle, séparés par un point d’inflexion où la concavité s’inverse formellement. Alors qu’une droite ne tolère aucune courbure et qu’une parabole quadratique n’en admet qu’une seule (orientée soit vers le haut, soit vers le bas), le polynôme de degré 3 trace une courbe sigmoïde ou en « S » asymétrique capable de passer d’une phase d’accélération à une phase de saturation, puis à un basculement critique. Il convient de souligner avec force que, bien que la relation graphique entre Y et X soit manifestement non linéaire, le modèle demeure intrinsèquement linéaire au sens de l’estimation statistique, dans la mesure où l’équation est strictement linéaire par rapport à ses paramètres inconnus β. Cette propriété cruciale permet l’application directe des moindres carrés ordinaires (MCO) sans nécessiter les algorithmes d’optimisation numérique itérative propres à la régression non linéaire intrinsèque.
1.2 Pertinence de la modélisation cubique pour les dynamiques psychocomportementales
La transposition de ce formalisme mathématique aux sciences psychologiques et cognitives répond à une nécessité empirique impérieuse. De nombreux construits psychométriques se déploient selon des dynamiques triphasiques que les modèles linéaires ou purement quadratiques échouent dramatiquement à restituer. L’un des champs d’application les plus fertiles concerne l’analyse des trajectoires de développement cognitif tout au long de la vie. Lorsqu’on évalue l’évolution de la mémoire de travail ou de la vitesse de traitement de l’enfance au grand âge, les données révèlent généralement une phase d’acquisition rapide durant les premières années, suivie d’un plateau de stabilité prolongé à l’âge adulte, avant d’amorcer un déclin d’abord discret puis accéléré au cours du vieillissement sénescent. Un polynôme cubique s’avère parfaitement calibré pour épouser cette chronologie empirique sans partitionner artificiellement l’échantillon en tranches d’âge arbitraires.
De façon analogue, l’apprentissage de tâches procédurales complexes suit fréquemment une cinétique en « S ». Au départ, l’apprenant traverse une période de latence où l’assimilation des règles élémentaires ne se traduit que par des gains de performance modestes. Une fois les structures conceptuelles intégrées, la courbe subit une accélération spectaculaire, matérialisant l’efficience cognitive acquise. Enfin, le sujet atteint une phase de saturation asymptotique imposée par les limites physiologiques et attentionnelles du système nerveux. La régression cubique permet d’extraire mathématiquement ces phases distinctes et d’en identifier les bornes temporelles avec une précision clinique.
Un troisième domaine d’élection réside dans l’étude de l’épuisement professionnel (burnout) en lien avec la charge de travail et l’exposition prolongée aux stresseurs organisationnels. Les modèles théoriques de compensation indiquent que les individus résistent initialement à l’accroissement des exigences professionnelles par une mobilisation accrue de leurs ressources psychologiques, maintenant leur fonctionnement à un niveau stable. Cependant, dès lors que cette réserve d’adaptation est entamée, le système psychologique traverse un point d’inflexion où la détresse s’accroît vertigineusement, avant de se stabiliser à un niveau chronique d’épuisement émotionnel et de dépersonnalisation. L’utilisation épistémologique du polynôme de degré 3 trouve ici toute sa noblesse : elle ne vise pas simplement à interpoler une collection de points empiriques, mais à traduire une dynamique causale d’effondrement homéostatique.
1.3 Comparaison critique avec les régressions linéaire et quadratique
Pour apprécier la valeur ajoutée de la régression cubique, il est indispensable de la situer par rapport aux modèles d’ordre inférieur qui la précèdent dans la hiérarchie polynomiale. La régression linéaire simple, reposant sur le postulat d’un taux de changement invariant d’une extrémité à l’autre de l’axe prédictif, est intrinsèquement aveugle aux phénomènes de saturation psychologique. Si l’on évalue par exemple l’impact d’une psychothérapie sur la réduction des symptômes anxieux, postuler une linéarité parfaite revient à soutenir qu’une vingtième séance produit exactement le même différentiel thérapeutique que la première séance, ce qui contredit frontalement le consensus clinique documentant des rendements décroissants.
La régression quadratique permet indubitablement de capturer un retournement de tendance ou un rendement décroissant via son profil parabolique en « U » ou en « U inversé », popularisé notamment par la formalisation classique de la relation entre anxiété et performance. Néanmoins, la parabole impose une contrainte géométrique extrêmement rigide : elle est obligatoirement symétrique par rapport à son sommet. En psychologie empirique, cette symétrie parfaite est une exception rarissime. Lorsqu’un processus psychologique s’effondre après avoir atteint un pic de performance, la cinétique de descente est presque systématiquement beaucoup plus abrupte ou complexe que la cinétique d’ascension initiale. La régression quadratique est incapable de modéliser cette asymétrie fonctionnelle, ni d’intégrer un second point d’inflexion matérialisant un plancher de dégradation.
Pour autant, le passage à l’ordre cubique ne doit jamais relever d’un réflexe opportuniste consistant à maximiser le coefficient de détermination à tout prix. En vertu du compromis biais-variance, chaque degré polynomial additionnel accorde au modèle une liberté géométrique accrue qui diminue le biais d’ajustement au détriment direct de la variance de prédiction. Un modèle d’ordre 3 mal justifié théoriquement court le risque d’épouser le bruit stochastique propre à l’échantillon d’observation, réduisant à néant sa reproductibilité scientifique sur des populations indépendantes. L’arbitrage entre flexibilité d’ajustement et interprétabilité conceptuelle impose donc de n’adopter la modélisation cubique que si les postulats théoriques sous-jacents étayent rigoureusement la présence d’une double inflexion, et si les tests statistiques confirment l’apport significatif de la composante cubique par rapport aux termes d’ordre inférieur.
2. Prérequis méthodologiques et préparation des données psychométriques dans Excel
2.1 Structuration des variables prédictive et critère
Avant d’initier la moindre opération de calcul dans Excel, l’architecte de la recherche quantitative doit procéder à une qualification métrologique rigoureuse de ses données. La modélisation par régression cubique exige impérativement que la variable dépendante (ou critère, traditionnellement désignée par Y) soit une variable continue mesurée au minimum sur une échelle d’intervalles égaux. Dans le domaine psychométrique, cette exigence est satisfaite par des scores factoriels issus d’analyses factorielles confirmatoires, des indices de temps de réaction en millisecondes, ou des scores composites agrégés provenant de batteries standardisées validées, telles que l’échelle de dépression de Beck ou les inventaires de personnalité du NEO-PI-R, à condition que le continuum de mesure offre une distribution suffisamment dense.
De manière symétrique, la variable indépendante (ou prédicteur, notée X) doit présenter un statut de continuité stricte le long d’une échelle numérique bien résolue. L’utilisation d’une échelle ordinale à faible nombre d’échelons (par exemple une échelle de Likert à 4 points) pour alimenter une régression cubique constitue une erreur méthodologique sévère, car le calcul des puissances successives d’un faible nombre de valeurs discrètes engendre des regroupements artificiels et compromet l’identification des courbures. Les variables continues authentiques — telles que l’âge chronologique exact en mois, le dosage d’un biomarqueur de stress salivaire (cortisol), la durée d’exposition à un stimulus ou un score d’activation cognitive continue — constituent les candidats optimaux pour cette approche.
L’alignement matriciel dans le tableur impose une organisation où chaque ligne représente sans ambiguïté une unité expérimentale unique (un participant). Les valeurs de X et de Y doivent être rigoureusement appariées sujet par sujet. La vérification de la résolution numérique requiert de s’assurer qu’aucun arrondi prématuré n’a été appliqué aux données brutes lors de l’importation, car le processus d’élévation à la puissance trois amplifie de manière exponentielle les approximations initiales, risquant d’altérer substantiellement l’estimation des coefficients de haut degré.
2.2 Nettoyage des données empiriques et détection des valeurs aberrantes
La sensibilité des régressions polynomiales aux observations extrêmes et atypiques constitue l’une des vulnérabilités majeures de cette famille de modèles. En raison de l’opération mathématique d’élévation au cube (X3), un point empirique situé à seulement trois ou quatre écarts-types de la moyenne du prédicteur exercera un effet de levier (leverage) disproportionné sur la fonction de régression, tirant à lui seul la courbure terminale du polynôme et générant des artéfacts d’inflexion totalement fictifs. Un nettoyage préliminaire méticuleux des données constitue donc une obligation déontologique et statistique absolue.
La première étape de ce criblage repose sur la standardisation univariée des scores au moyen de la formule classique des scores z dans Excel :
=CENTREE.REDUITE(cellule_X; MOYENNE(plage_X); ECARTYPE.STANDARD(plage_X))
Toute observation dont le score z absolu excède la valeur seuil conventionnelle de 3,0 (voire 2,5 dans le cadre d’échantillons de taille modeste) doit faire l’objet d’une inspection approfondie. Il convient de déterminer s’il s’agit d’une erreur matérielle de saisie, d’un dysfonctionnement d’appareillage expérimental ou d’une réponse aberrante issue d’une consigne non respectée par le participant. Conformément aux directives éthiques et méthodologiques de l’American Psychological Association, chaque exclusion d’observation doit être formellement consignée, justifiée et documentée dans le protocole de recherche final.
Concernant les valeurs manquantes, la régression par moindres carrés ordinaires dans Excel impose une exclusion observationnelle stricte par liste (listwise deletion). Si une observation présente une valeur valide pour X mais manquante pour Y (ou inversement), la ligne correspondante doit être écartée de la matrice d’estimation polynomiale. L’application d’imputations moyennes directes est vigoureusement déconseillée dans ce contexte précis, dans la mesure où elle affaisse artificiellement la variance locale et fausse le calcul des courbures d’ordre supérieur.
2.3 Vérification de la puissance statistique et de la taille d’échantillon
L’estimation fiable d’une régression cubique réclame un volume d’observations nettement supérieur à celui exigé par une simple régression linéaire. Alors qu’un modèle à deux variables n’estime que deux paramètres (β0 et β1), le modèle cubique doit estimer simultanément quatre paramètres distincts (β0, β1, β2 et β3). Si l’on se réfère à la règle empirique classique de Green (1991) et de Harris pour la régression multiple, il est impératif de disposer d’un ratio minimal de 20 à 30 sujets par paramètre estimé afin de garantir une stabilité minimale des erreurs types, ce qui porte l’effectif plancher à un strict minimum de 80 à 120 participants pour un modèle cubique simple.
En deçà de ce seuil critique, la sous-puissance statistique entraîne une volatilité dramatique du terme cubique. Le chercheur s’expose à commettre une erreur de type II en rejetant à tort l’existence d’une dynamique d’inflexion pourtant réelle dans la population parente, ou inversement, à enregistrer une significativité trompeuse induite par une fluctuation d’échantillonnage locale. Cette instabilité est d’autant plus aiguë que le terme X3 présente intrinsèquement une forte variance d’échantillonnage dès lors que l’échelle de mesure de X est étendue.
Au-delà de la taille globale de l’échantillon N, la distribution spatiale des points le long du continuum prédictif X revêt une importance capitale. Un écueil fréquent en psychométrie empirique découle du regroupement massif des participants au centre de l’échelle, laissant les segments extrêmes quasiment déserts. Or, l’identification d’une double courbure nécessite que des observations soient présentes de manière homogène sur l’ensemble du domaine de variation expérimental. Un déficit de points aux bornes inférieures ou supérieures prive le modèle de support empirique aux endroits mêmes où les termes quadratiques et cubiques exercent leur influence maximale, risquant de biaiser irrémédiablement la localisation du point d’inflexion théorique.
3. Étape 1 – Saisie et structuration matricielle des données dans la feuille de calcul
3.1 Organisation spatiale des colonnes pour l’analyse
La rigueur architecturale de la feuille de calcul constitue la garantie première de la reproductibilité des analyses statistiques sous Excel. Trop souvent, les erreurs de modélisation proviennent d’un agencement désordonné des données, d’intercalages de cellules vides ou d’inversions de plages lors de l’appel des fonctions matricielles. Pour conduire une régression cubique selon les règles de l’art, il convient d’adopter une disposition standardisée et normalisée dès l’amorce du projet.
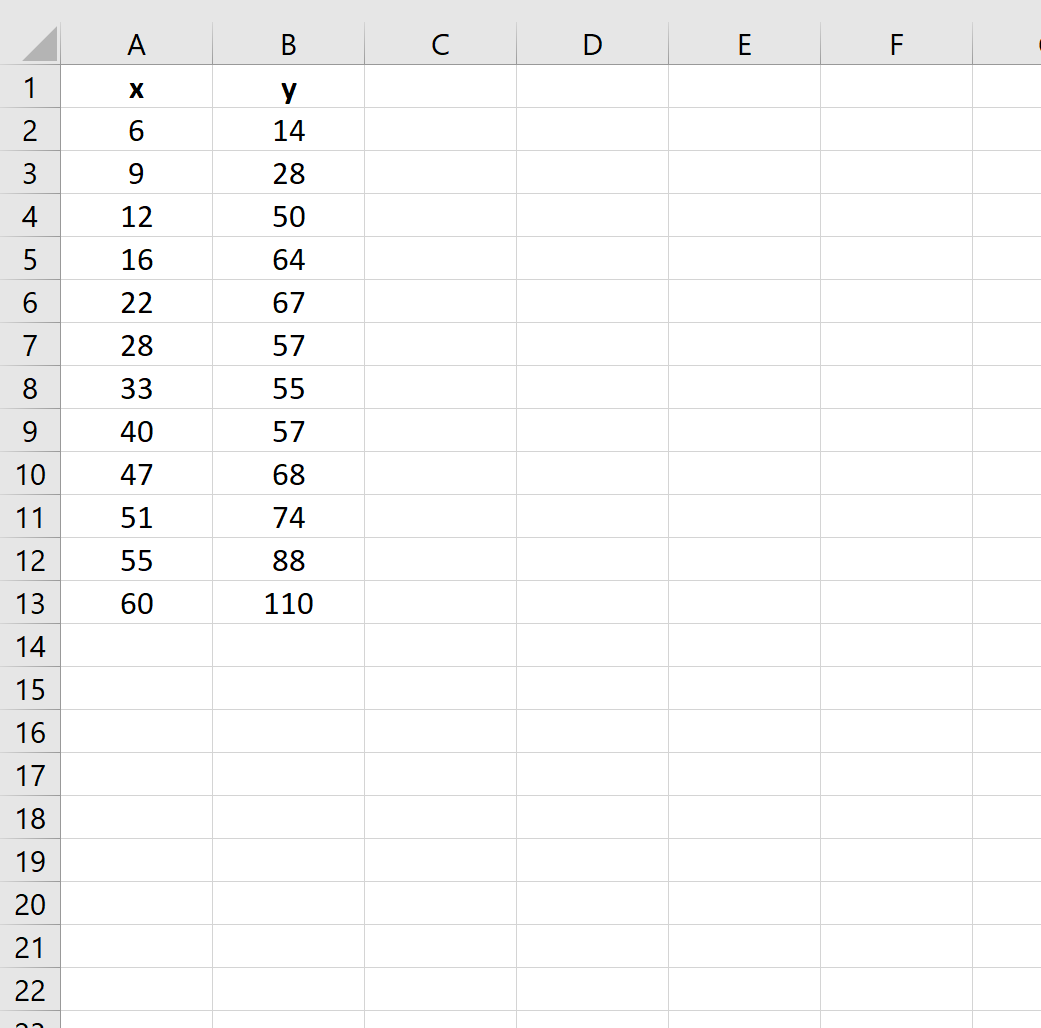
Dans la première colonne, désignée par convention comme la Colonne A, on disposera l’identifiant unique de chaque sujet (ex. ID_Sujet). La Colonne B accueillera les valeurs brutes de la variable prédictive continue, que nous intitulerons formellement Predictor_X. Immédiatement adjacente, la Colonne C contiendra les scores de la variable dépendante ou critère, nommée Critere_Y. Il est impératif d’utiliser des étiquettes de colonnes univoques, dépourvues d’espaces conflictuels, d’accents complexes ou de caractères typographiques spéciaux qui pourraient perturber l’interprétation des formules matricielles avancées.
Afin de fluidifier les étapes ultérieures et de sécuriser la rédaction des équations, il est vivement recommandé d’attribuer des plages nommées via le Gestionnaire de noms d’Excel (accessible par l’onglet Formules > Définir un nom). En désignant par exemple la plage B2:B101 sous l’identifiant Plage_X et la plage C2:C101 sous l’étiquette Plage_Y, l’utilisateur s’affranchit des erreurs de références absolues lors des manipulations matricielles complexes et facilite l’audit méthodologique de sa feuille de travail.
3.2 Génération manuelle des termes polynomiaux pour l’approche standard
Bien qu’Excel dispose de mécanismes matriciels permettant de calculer virtuellement les puissances d’une variable à la volée, la génération explicite et manuelle des colonnes polynomiales au sein de la grille de calcul demeure l’approche la plus transparente, pédagogique et robuste. Elle permet en outre d’alimenter sans friction les modules du complément Utilitaire d’analyse qui exigent physiquement des plages contiguës.
Dans la Colonne D, insérez l’en-tête X_Carre. Dans la cellule D2, entrez la formule arithmétique d’élévation au carré en vous référant à la cellule prédictive de base :
=B2^2 ou =PUISSANCE(B2; 2)
Dans la Colonne E adjacente, créez l’en-tête X_Cube. Dans la cellule E2, saisissez la formule d’élévation à la puissance trois correspondante :
=B2^3 ou =PUISSANCE(B2; 3)
Une fois ces deux premières formules validées, sélectionnez la plage D2:E2 et propagez dynamiquement le calcul vers le bas jusqu’à la dernière rangée de votre jeu de données (par exemple la ligne 101 pour un échantillon de 100 participants) à l’aide de la poignée de recopie incrémentée ou par un double-clic sur le coin inférieur droit de la sélection. Une vérification immédiate de l’intégrité numérique s’impose : assurez-vous qu’aucun caractère alphanumérique n’a été inséré accidentellement dans la colonne source, ce qui déclencherait des erreurs de propagation de type #VALEUR!.
3.3 Technique de centrage des variables pour réduire la multicolinéarité
L’introduction directe des puissances brutes X2 et X3 dans une équation de régression engendre presque mécaniquement un phénomène pathologique bien connu des statisticiens : la multicolinéarité structurelle. En effet, dès lors que les valeurs de la variable indépendante X sont toutes positives ou présentent une moyenne substantiellement éloignée de zéro, la corrélation bivariée entre X, X2 et X3 est quasi parfaite, frôlant fréquemment r = 0,95 à 0,99. Cette colinéarité artificielle n’altère pas la qualité de prédiction globale du modèle (le R2 demeure invariant), mais elle fait exploser les erreurs types des estimateurs, rendant les coefficients individuels instables et non significatifs au test t.
Pour immuniser le modèle contre cette instabilité computationnelle dans Excel, il est impératif de procéder au centrage sur la moyenne de la variable prédictive avant toute élévation de puissance. La procédure se déroule de la manière suivante :
1. Calculez la moyenne arithmétique exacte de la variable prédictive dans une cellule de référence isolée (par exemple en B103) via la formule :
=MOYENNE(B2:B101)
2. Créez une nouvelle colonne F intitulée X_Centre, et insérez en F2 l’écart à la moyenne par référence absolue à la cellule de moyenne :
=B2-$B$103
3. Générez ensuite dans les colonnes G (X_Centre_Carre) et H (X_Centre_Cube) les termes d’ordre supérieur calculés exclusivement à partir de cette base centrée :
En G2 : =F2^2
En H2 : =F2^3
Cette transformation linéaire simple produit des prédicteurs polynomiaux quasi orthogonaux. Le centrage réduit drastiquement l’inflation de la variance, restaure la précision de calcul des algorithmes matriciels d’Excel et confère une signification concrète à l’ordonnée à l’origine, qui représente désormais la valeur théorique de Y pour un individu moyen sur l’échelle psychométrique considérée.
4. Étape 2 – Implémentation analytique via la fonction matricielle DROITEREG
4.1 Syntaxe générale et spécificité de l’argument matriciel de puissances
La fonction DROITEREG (désignée sous le vocable LINEST dans les versions anglophones d’Excel) constitue le moteur d’estimation par les moindres carrés le plus sophistiqué de la bibliothèque native de Microsoft. Capable de traiter les régressions multiples de dimension arbitraire, elle se révèle particulièrement efficiente pour résoudre l’ajustement polynomial d’ordre 3. La syntaxe canonique de la fonction s’articule autour de quatre arguments distincts :
=DROITEREG(Y_connus; [X_connus]; [constante]; [statistiques])
Le premier argument, Y_connus, correspond à la plage continue contenant les observations de la variable critère (ex. C2:C101). Le second argument, X_connus, requiert la définition des composantes prédictives. Deux méthodes d’injection se présentent ici à l’opérateur : l’approche explicite et l’approche matricielle implicite.
L’approche explicite s’appuie directement sur les colonnes physiques préalablement générées dans la grille de calcul. Si vous mobilisez les variables centrées, la syntaxe s’écrira :
=DROITEREG(C2:C101; F2:H101; VRAI; VRAI)
Cette méthode présente l’immense avantage de la lisibilité et prémunit l’utilisateur contre les erreurs de parsing textuel.
À l’inverse, l’approche par constante matricielle permet d’extraire les puissances sans créer matériellement les colonnes X2 et X3 dans la grille, en spécifiant directement un tableau de constantes pour les exposants :
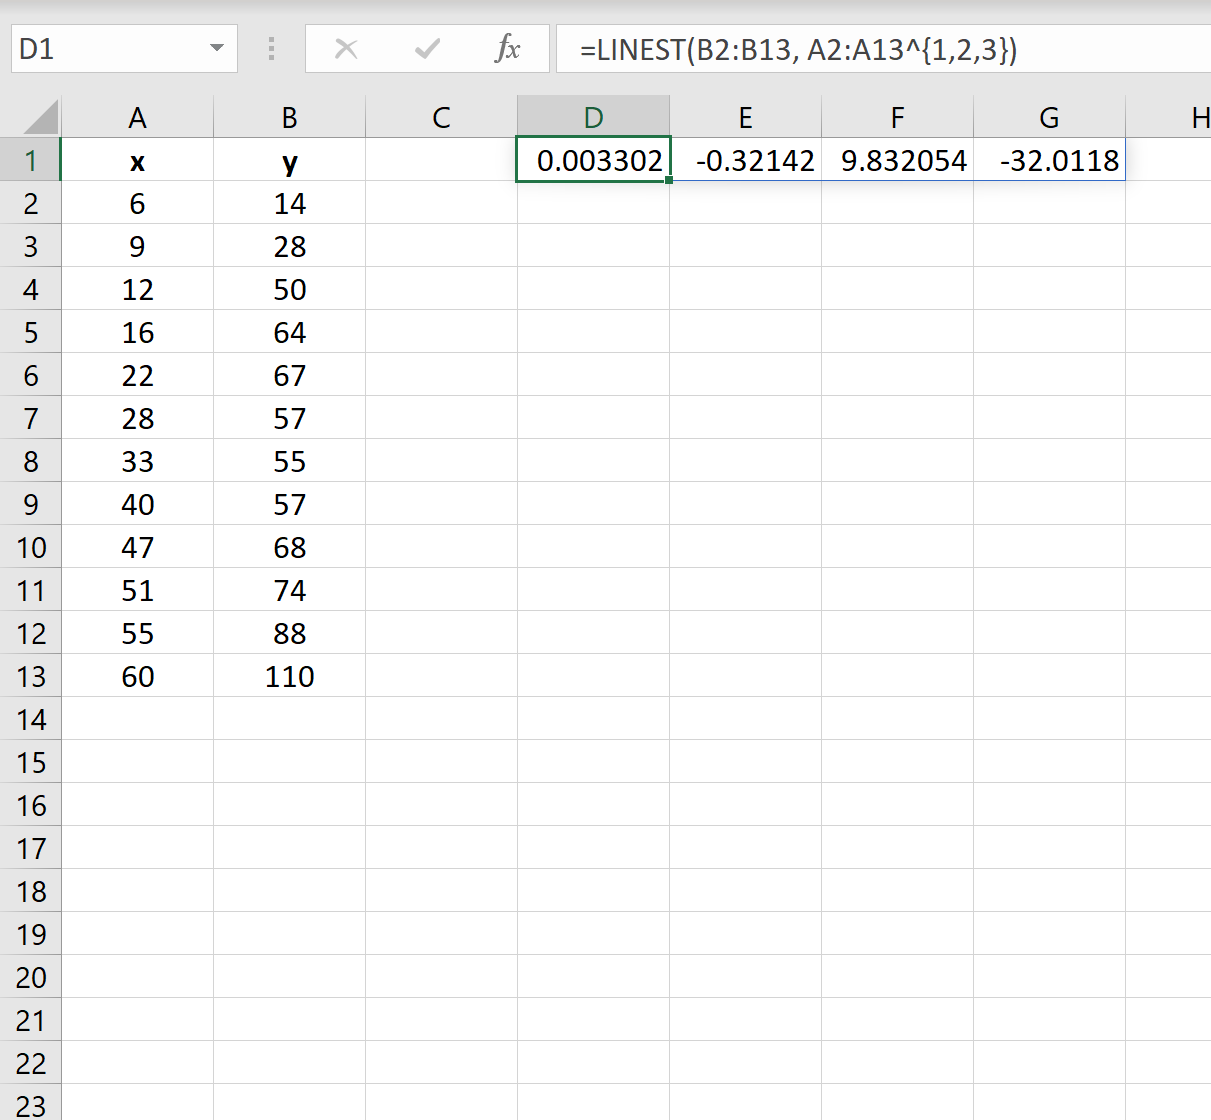
=DROITEREG(C2:C101; B2:B101^{123}; VRAI; VRAI)
Le troisième argument, [constante], est un booléen : fixé à VRAI, il ordonne le calcul classique de l’ordonnée à l’origine β0 ; fixé à FAUX, il forcerait la ligne à passer par l’origine (0,0), ce qui n’a aucun sens en psychométrie. Le quatrième argument, [statistiques], fixé à VRAI, commande la génération intégrale de la table des statistiques d’ajustement détaillées (erreurs types, R2, statistique de Fisher, sommes des carrés et degrés de liberté).
4.2 Procédure d’exécution matricielle selon la version d’Excel
Le mode de validation et de restitution spatiale de la fonction DROITEREG dépend intimement de l’environnement technologique de l’utilisateur, opérant une ligne de démarcation claire entre les déclinaisons historiques d’Excel et l’écosystème moderne de Microsoft 365.
Dans les versions antérieures à 2019 (Excel 2016, 2013, 2010), l’architecture matricielle exige une allocation manuelle rigoureuse de la zone réceptrice avant la saisie de la formule. La sortie complète d’un modèle cubique comportant trois prédicteurs et une constante nécessite impérativement un tableau de 5 lignes par 4 colonnes. La procédure pas à pas s’énonce ainsi :
- Sélectionnez à la souris une plage vierge de dimension 5 × 4, par exemple la zone
J2:M6. - Sans cliquer ailleurs pour ne pas rompre la sélection active, saisissez la formule dans la barre d’édition :
=DROITEREG(C2:C101; F2:H101; VRAI; VRAI). - Au lieu d’appuyer sur la simple touche Entrée, validez simultanément par la combinaison clavier consacrée des formules matricielles héritées (CSE) : Ctrl + Maj + Entrée (ou Cmd + Maj + Entrée sur macOS). Excel entoure alors instantanément la formule d’accolades
{...}et peuple uniformément les 20 cellules de la plage sélectionnée.
Sous Microsoft 365 et Excel 2021, l’avènement du moteur de matrices dynamiques a profondément simplifié cette ergonomie. Il suffit de sélectionner une unique cellule cible (par exemple J2), de taper la formule =DROITEREG(C2:C101; F2:H101; VRAI; VRAI) et de valider par une frappe standard sur Entrée. Le tableur effectue automatiquement une expansion matricielle dynamique (spill) sur l’emprise 5 × 4 requise.
Si l’espace adjacent n’est pas strictement dégagé, Excel interrompt la propagation et renvoie la notification d’erreur #PROP! (ou #SPILL!). Il convient alors de libérer la zone géographique environnante afin que le tableau matriciel se matérialise sans entrave.
4.3 Résolution des conflits d’encodage et séparateurs décimaux
L’utilisation avancée de la syntaxe matricielle avec exposants intégrés ^{123} constitue une source fréquente de blocages informatiques liés aux variations de régionalisation linguistique du système d’exploitation et d’Excel.
Dans la configuration standard française (où le séparateur décimal est la virgule et le séparateur d’arguments de fonction est le point-virgule), les séparateurs internes aux constantes de matrice horizontale doivent être renseignés au moyen de l’antislash () :
=DROITEREG(C2:C101; B2:B101^{123}; VRAI; VRAI)
En revanche, sur une machine configurée selon les standards régionaux états-uniens ou anglo-saxons (séparateur décimal par point, arguments séparés par des virgules), le vecteur ligne matriciel s’exprime au moyen de virgules :
=LINEST(C2:C101, B2:B101^{1,2,3}, TRUE, TRUE)
Si un utilisateur francophone tente d’insérer des virgules ou des points ordinaires dans le bloc d’exposants, le compilateur interne d’Excel rejettera la saisie avec un message d’incompatibilité de syntaxe ou générera un code d’erreur #VALEUR!. Afin de conjurer définitivement ces conflits d’encodage régionaux, le recours aux colonnes physiques réelles (ex. F2:H101) demeure la pratique méthodologique la plus recommandable et la plus universellement portable.
5. Décodage et interprétation de la matrice de sortie de DROITEREG
5.1 Cartographie complète de la table de résultats générée
La table matricielle brute produite par DROITEREG se présente sous la forme d’une grille compacte dépourvue d’en-têtes textuels explicites. Sa lecture méthodique nécessite la maîtrise absolue de sa cartographie topographique standardisée, qui s’articule rigoureusement de la gauche vers la droite et du haut vers le bas.
L’élément fondamental à intégrer réside dans l’ordre de présentation des coefficients de régression : Excel restitue les prédicteurs dans l’ordre strictement inverse de la sélection des colonnes sources. Puisque notre plage d’entrée était agencée selon la séquence [Xc, Xc2, Xc3], la première ligne de sortie décline les coefficients par ordre décroissant des puissances polynomiales :
- Ligne 1 :
- Cellule 1 (J2) : Coefficient cubique estimé b3 (terme lié à X3).
- Cellule 2 (K2) : Coefficient quadratique estimé b2 (terme lié à X2).
- Cellule 3 (L2) : Coefficient linéaire estimé b1 (terme lié à X).
- Cellule 4 (M2) : Constante estimée b0 (ordonnée à l’origine).
- Ligne 2 : Erreurs types d’échantillonnage associées aux coefficients :
- Cellule 1 (J3) : Erreur type SE(b3).
- Cellule 2 (K3) : Erreur type SE(b2).
- Cellule 3 (L3) : Erreur type SE(b1).
- Cellule 4 (M3) : Erreur type SE(b0).
- Ligne 3 : Indicateurs globaux d’adéquation :
- Cellule 1 (J4) : Coefficient de détermination globale R2.
- Cellule 2 (K4) : Erreur type globale de l’estimation se (écart-type des résidus).
- Cellules 3 et 4 : Valeurs techniques non documentées (renvoyant généralement
#N/A).
- Ligne 4 : Éléments de l’analyse de variance :
- Cellule 1 (J5) : Statistique de test F de Fisher-Snedecor globale du modèle.
- Cellule 2 (K5) : Degrés de liberté du terme d’erreur résiduelle (dfres = N – k – 1, où k = 3).
- Cellules 3 et 4 : Mentions
#N/Astructurelles.
- Ligne 5 : Partition de la variabilité :
- Cellule 1 (J6) : Somme des carrés expliquée par le modèle de régression (SSreg).
- Cellule 2 (K6) : Somme des carrés des erreurs résiduelles inexpliquées (SSres).
- Cellules 3 et 4 : Mentions
#N/Astructurelles.
5.2 Calcul de la significativité statistique des paramètres individuels
Bien que DROITEREG fournisse simultanément les coefficients b et leurs erreurs types SE, elle ne calcule pas automatiquement les statistiques de test t de Student associées ni les p-valeurs de significativité. Il revient à l’analyste de programmer ces métriques dans des cellules adjacentes afin d’éprouver la significativité de chaque composante polynomiale.
Le ratio de Student se calcule en divisant chaque coefficient par son erreur type spécifique :
t = bk / SE(bk)
Par exemple, pour évaluer la significativité statistique du terme cubique situé en cellule J2 avec son erreur type en J3, saisissez dans une cellule voisine :
=J2/J3
Pour dériver immédiatement la probabilité bilatérale critique associée (p-valeur), mobilisez la fonction native de la loi de Student en exploitant les degrés de liberté résiduels extraits de la table matricielle (cellule K5) :
=LOI.STUDENT.BILATERALE(ABS(J2/J3); K5)
L’attention prioritaire du chercheur doit se focaliser sur l’évaluation du seuil α (conventionnellement fixé à 0,05) appliqué au terme cubique b3. Si la p-valeur associée à b3 est strictement inférieure à 0,05, l’hypothèse nulle H0 : β3 = 0 est rejetée : le changement de concavité est statistiquement fondé, justifiant empiriquement la modélisation cubique. En revanche, si cette p-valeur dépasse 0,05, l’inclusion du terme d’ordre 3 constitue un surajustement statistique non légitime. Dans ce cas de figure, l’investigateur doit rétropédaler dans la hiérarchie polynomiale et tester la parcimonie d’un modèle quadratique ou linéaire.
5.3 Évaluation globale de l’ajustement du modèle cubique
Au-delà de la significativité isolée des coefficients, la robustesse du modèle dépend de sa capacité à rendre compte de la dispersion empirique dans sa totalité. La cellule J4 délivre le coefficient de détermination R2, traduisant le pourcentage exact de variance de la variable critère expliqué par la combinaison des termes linéaires, quadratiques et cubiques du prédicteur. En psychologie empirique, où la variabilité comportementale est façonnée par une multitude de déterminants non mesurés, un R2 compris entre 0,25 et 0,55 atteste déjà d’un pouvoir explicatif substantiel.
Toutefois, le R2 brut présente le défaut intrinsèque d’augmenter mécaniquement dès qu’un régresseur est greffé au modèle, quand bien même celui-ci ne capterait que du bruit d’échantillonnage. Il est donc méthodologiquement impératif de calculer le R2 ajusté, qui inflige une pénalité mathématique proportionnelle au nombre de paramètres estimés. La formule s’implémente aisément dans Excel en mobilisant le R2 (cellule J4), le nombre total d’observations N et le nombre de prédicteurs k = 3 :
=1 - ((1-J4) * (LIGNES(C2:C101)-1) / (LIGNES(C2:C101)-3-1))
Enfin, le test global de l’omégatérat de la régression repose sur le ratio F de Fisher consigné en cellule J5. Pour convertir cette valeur de F en une p-valeur globale du modèle, on applique la fonction unilatérale à droite de la distribution de Fisher :
=LOI.F.DROITE(J5; 3; K5)
Une p-valeur globale inférieure à 0,001 certifie formellement que l’ensemble des prédicteurs polynomiaux contribue à prédire la variable dépendante à un niveau dépassant très largement les simples fluctuations d’échantillonnage aléatoires.
6. Formulation explicite et analyse mathématique de l’équation estimée
6.1 Reconstruction formelle de l’équation prédictive
L’obtention des paramètres numériques via DROITEREG permet d’énoncer formellement l’équation de prédiction psychologique. Supposons à titre d’illustration méthodologique que la fonction matricielle ait restitué les valeurs suivantes pour un modèle calibré sur des prédicteurs centrés :
- Coefficient cubique (cellule J2) : b3 = -0,0045
- Coefficient quadratique (cellule K2) : b2 = -0,0820
- Coefficient linéaire (cellule L2) : b1 = 1,4500
- Constante (cellule M2) : b0 = 75,2000
L’équation de prédiction de la performance ou du score d’adaptation psychologique Ŷ s’écrit formellement :
Ŷi = 75,2000 + 1,4500(Xc,i) – 0,0820(Xc,i)2 – 0,0045(Xc,i)3
Cette expression prédictive permet de générer des projections individuelles directes dans la feuille de calcul. En créant une Colonne I intitulée Y_Predit, il suffit d’insérer dans la cellule I2 la formule dynamique suivante :
=$M$2 + ($L$2*F2) + ($K$2*G2) + ($J$2*H2)
L’examen des signes des coefficients fournit un éclairage conceptuel immédiat. Une constante b0 positive et élevée situe le niveau de base du fonctionnement cognitif au point moyen de l’échantillon. Un terme linéaire b1 positif indique un éveil initial bénéfique, tandis que la conjonction des termes quadratique b2 et cubique b3 négatifs signale une inversion rapide de tendance et une cinétique d’effondrement accentuée à mesure que les contraintes s’accumulent.
6.2 Localisation analytique des extrema locaux par la dérivée première
La valeur ajoutée majeure d’une fonction polynomiale d’ordre 3 réside dans la possibilité de déterminer avec une exactitude mathématique absolue les points de retournement du phénomène psychologique, correspondant au maximum local (le pic d’efficience) et au minimum local (le plancher de décompensation). En calcul différentiel élémentaire, ces extrema locaux correspondent aux points où la dérivée première de la fonction s’annule, matérialisant une tangente parfaitement horizontale où la vitesse instantanée de changement est égale à zéro.
En dérivant formellement l’équation générale Ŷ = b3X3 + b2X2 + b1X + b0 par rapport à X, nous obtenons une équation différentielle d’ordre un qui prend la forme d’un polynôme quadratique standard :
dŶ / dX = 3b3X2 + 2b2X + b1 = 0
Il s’agit d’une équation du second degré de la forme canonique Ax2 + Bx + C = 0, où les paramètres sont :
- A = 3b3
- B = 2b2
- C = b1
Dans Excel, la résolution s’opère par le calcul du discriminant Δ (Delta) dans une cellule dédiée :
=(2*K2)^2 - 4*(3*J2)*(L2)
Si le discriminant est strictement positif (Δ > 0), la fonction cubique présente obligatoirement deux extrema locaux réels distincts. Leurs coordonnées sur l’axe prédictif sont obtenues via les formules quadratiques classiques :
Extremum 1 : =(-(2*K2) - RACINE(DELTA)) / (2*(3*J2))
Extremum 2 : =(-(2*K2) + RACINE(DELTA)) / (2*(3*J2))
La substitution de ces valeurs de X dans l’équation de régression maîtresse livre les scores théoriques Y correspondants. En psychologie clinique ou ergonomique, la localisation du maximum local identifie le seuil d’activation optimal précis au-delà duquel toute sollicitation additionnelle devient délétère pour le sujet.
6.3 Détermination du point d’inflexion théorique par la dérivée seconde
Tandis que la dérivée première identifie les sommets et les creux, la dérivée seconde quantifie l’accélération propre de la trajectoire psychologique. Le point d’inflexion théorique désigne l’emplacement géométrique exact où la fonction passe d’une concavité orientée vers le bas à une concavité orientée vers le haut (ou réciproquement). C’est le point où la courbure s’annule et où le rythme de dégradation ou de progression change structurellement de direction.
En dérivant une seconde fois la fonction cubique par rapport à X, nous obtenons une équation linéaire directe :
d2Ŷ / dX2 = 6b3X + 2b2 = 0
L’isolation de la variable X livre la coordonnée critique du point d’inflexion :
Xinflexion = -2b2 / (6b3) = -b2 / (3b3)
Cette valeur s’implémente instantanément dans une cellule de la feuille de calcul au moyen de la formule :
=-K2 / (3 * J2)
Sur le plan de l’interprétation des sciences humaines, ce point d’inflexion est souvent porteur d’une signification diagnostique bien plus cruciale que les extrema eux-mêmes. Il correspond au point de bascule critique ou au taux d’accélération maximal de la chute de performance ou de détresse psychologique. Dans les protocoles d’intervention thérapeutique ou de prévention en santé au travail, ce jalon marque la zone de non-retour à partir de laquelle les mécanismes d’autorégulation de l’individu perdent leur efficacité homéostatique, requérant un protocole de remédiation institutionnel urgent.
7. Étape 3 – Visualisation graphique et insertion du nuage de points
7.1 Création du diagramme de dispersion initial sous Excel
La modélisation quantitative ne saurait se dispenser d’une confrontation visuelle rigoureuse avec les données empiriques. L’inspection graphique permet de vérifier l’adéquation morphologique du modèle et de s’assurer qu’aucun artefact de distribution n’a dicté artificiellement les courbures calculées par les fonctions matricielles.
Pour construire le graphique de dispersion fondamental :
- Sélectionnez rigoureusement la plage de données empiriques brutes. Cliquez sur l’en-tête de la colonne
Predictor_X(ex.B1:B101), puis, en maintenant la touche Ctrl enfoncée (ou Cmd sous macOS), sélectionnez la plage correspondante de la variable critèreCritere_Y(ex.C1:C101). Il est capital de ne pas intégrer les colonnes de puissances calculées X2 et X3 dans cette sélection initiale. - Accédez au ruban supérieur d’Excel, ouvrez l’onglet Insertion, localisez le groupe Graphiques et cliquez sur l’icône Insérer un graphique en nuage de points (X, Y).
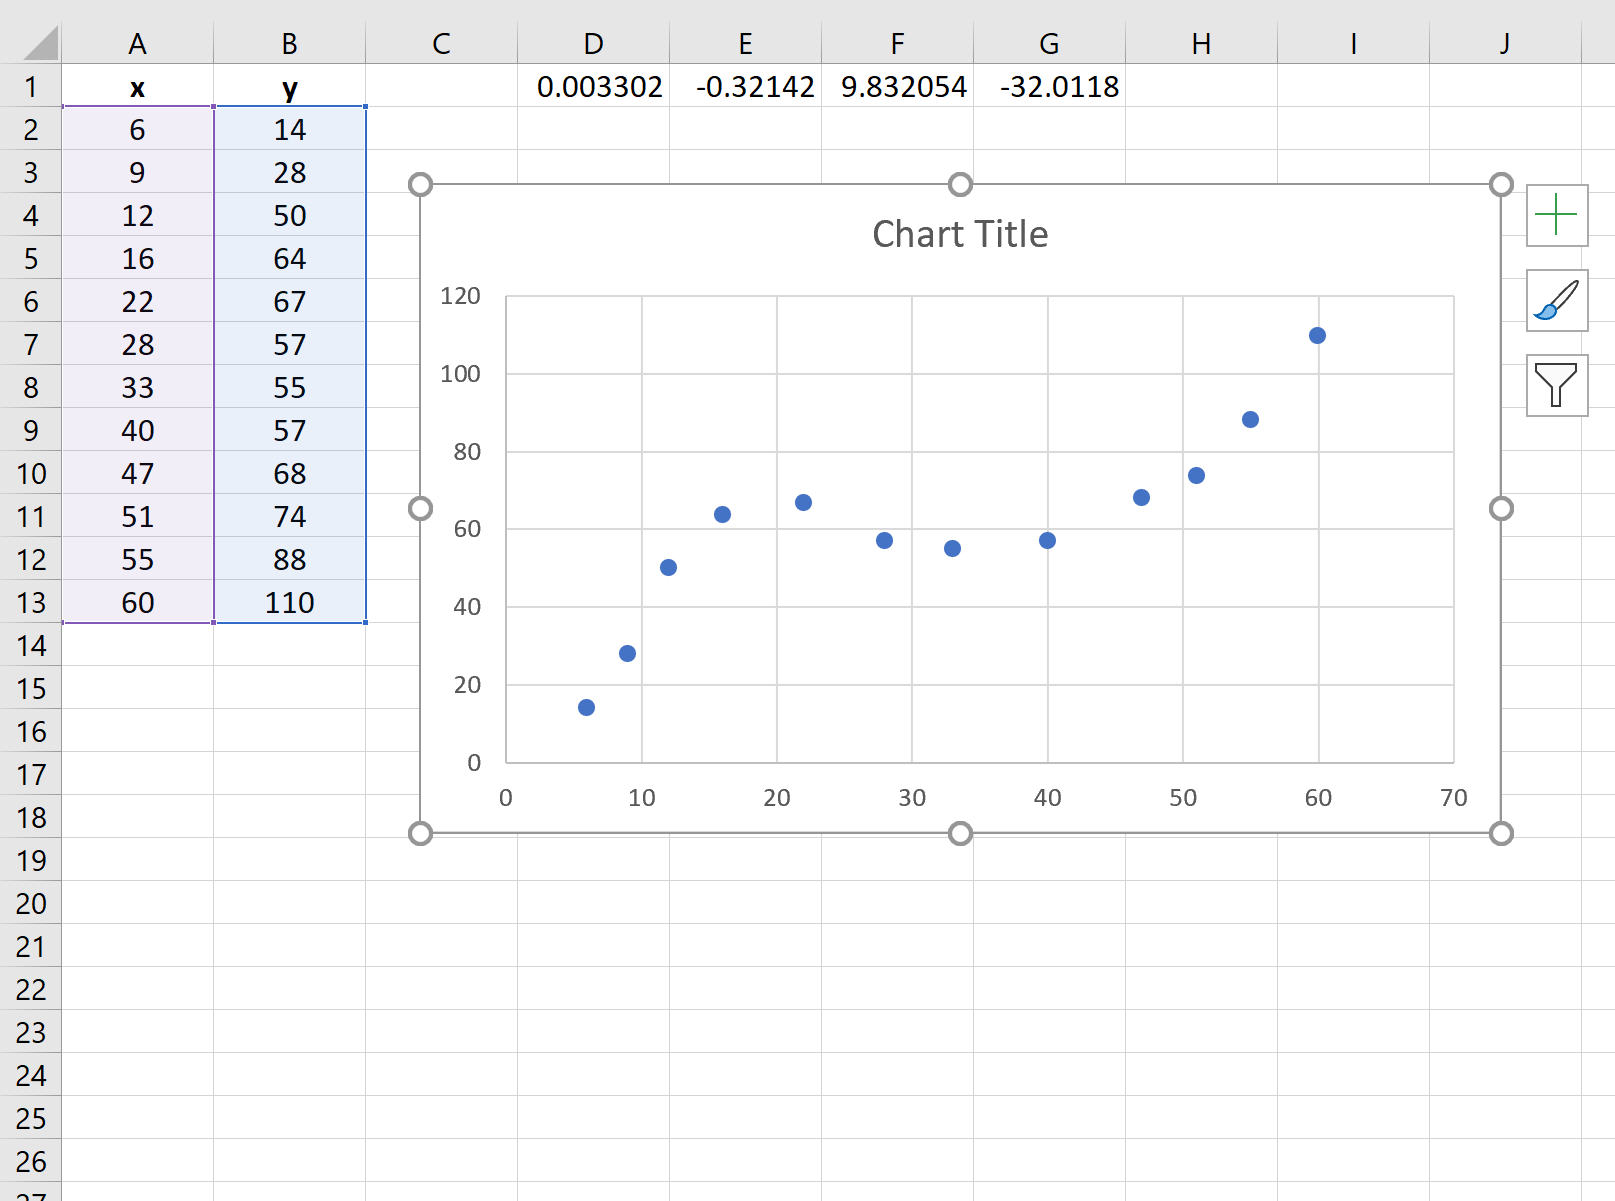
- Choisissez le premier sous-type conventionnel : Nuage de points standard, présentant exclusivement les marqueurs sans aucune ligne de jonction interpolée.
Dès l’apparition de l’objet graphique sur la feuille, une vérification spatiale s’impose : assurez-vous qu’Excel n’a pas inversé les axes de coordonnées. La variable prédictive X doit impérativement figurer sur l’abscisse horizontale et la variable critère Y sur l’ordonnée verticale. En cas d’inversion accidentelle, effectuez un clic droit sur le graphique, sélectionnez Sélectionner des données, éditez la série active et réaffectez manuellement les plages respectives aux champs Valeurs de la série X et Valeurs de la série Y.
7.2 Formatage typographique et configuration des axes selon les normes APA
Pour prétendre à une intégration directe dans des rapports scientifiques, des thèses doctorales ou des publications indexées, la mise en forme du graphique doit se conformer strictement aux préceptes de sobriété et de lisibilité typographique établis par l’APA Style Guide.
Commencez par épurer le graphique de toute pollution visuelle non informationnelle :
- Supprimez le titre de graphique automatique intégré par défaut, ainsi que la légende latérale superfétatoire pour une série unique. Dans les standards académiques, la description de la figure est déportée sous le graphique dans la légende textuelle du manuscrit.
- Éliminez ou estompez drastiquement le quadrillage majeur horizontal et vertical. Si le maintien d’une grille est jugé indispensable à la lecture des coordonnées, appliquez une teinte grise ultra-claire (ex. 25 % d’opacité) avec un trait fin de 0,5 point.
- Sélectionnez l’axe horizontal, ouvrez le panneau contextuel Format de l’axe, puis définissez manuellement les bornes Minimum et Maximum afin de resserrer l’échelle autour de l’amplitude réelle des données observées. Cette disposition supprime les plages de vide artificielles qui écrasent la perspective des données.
- Configurez de même l’axe vertical des ordonnées en veillant à ne pas tronquer arbitrairement la dynamique de réponse tout en éliminant les zones mortes.
- Intégrez des Titres des axes formels via le bouton d’ajout d’éléments graphiques (+). Spécifiez explicitement le nom du construit psychologique mesuré ainsi que son unité métrologique entre parenthèses, par exemple : Indice d’activation neurovégétative (Score d’échelle continue) en abscisse et Efficience de rappel mémoriel (Nombre d’items corrects) en ordonnée.
- Harmonisez l’ensemble des polices de caractères du graphique en optant pour une typographie neutre et universelle (Times New Roman, Arial ou Calibri) calibrée à une taille de 10 à 11 points pour les graduations et 12 points pour les libellés d’axes.
7.3 Personnalisation des marqueurs de données empiriques
L’esthétique des marqueurs empiriques doit concilier netteté visuelle et capacité à révéler les densités de distribution locales. Les styles par défaut d’Excel, caractérisés par des aplats de couleurs vives ou des effets d’ombrage 3D, doivent être proscrits.
Double-cliquez sur l’ensemble des points de la série pour activer le panneau latéral Mettre en forme les séries de données, puis basculez sur l’icône Remplissage et trait sous la section Marqueur :
- Déroulez les Options des marqueurs, cochez le bouton radio Intégré, puis sélectionnez la forme circulaire pleine classique. Ajustez le diamètre à une taille modérée de 4 à 5 points, évitant ainsi l’obstruction visuelle mutuelle des observations adjacentes.
- Dans l’onglet Remplissage, privilégiez une teinte sombre et sobre (noir d’encre, gris anthracite ou bleu marine institutionnel). Si votre échantillon comporte une forte densité d’observations avec des superpositions de points (overplotting), réglez la jauge de Transparence à une valeur comprise entre 30 % et 50 %. Cette translucidité révèle instantanément les zones de forte concentration statistique par assombrissement cumulatif des points superposés.
- Dans l’onglet Bordure, configurez un contour fin de 0,5 point de couleur noire ou grise pour garantir un contraste optimal et préserver une lisibilité absolue en cas de reproduction monochrome sur support papier imprimé.
8. Ajustement et paramétrage direct de la courbe de tendance polynomiale
8.1 Activation de la courbe de tendance polynomiale d’ordre 3
Une fois le nuage de points empiriques stabilisé, Excel offre un outil interactif puissant permettant d’ajuster visuellement et instantanément un polynôme de degré 3 sans manipuler préalablement de formules matricielles complexes.
La procédure d’activation se décompose selon les étapes suivantes :
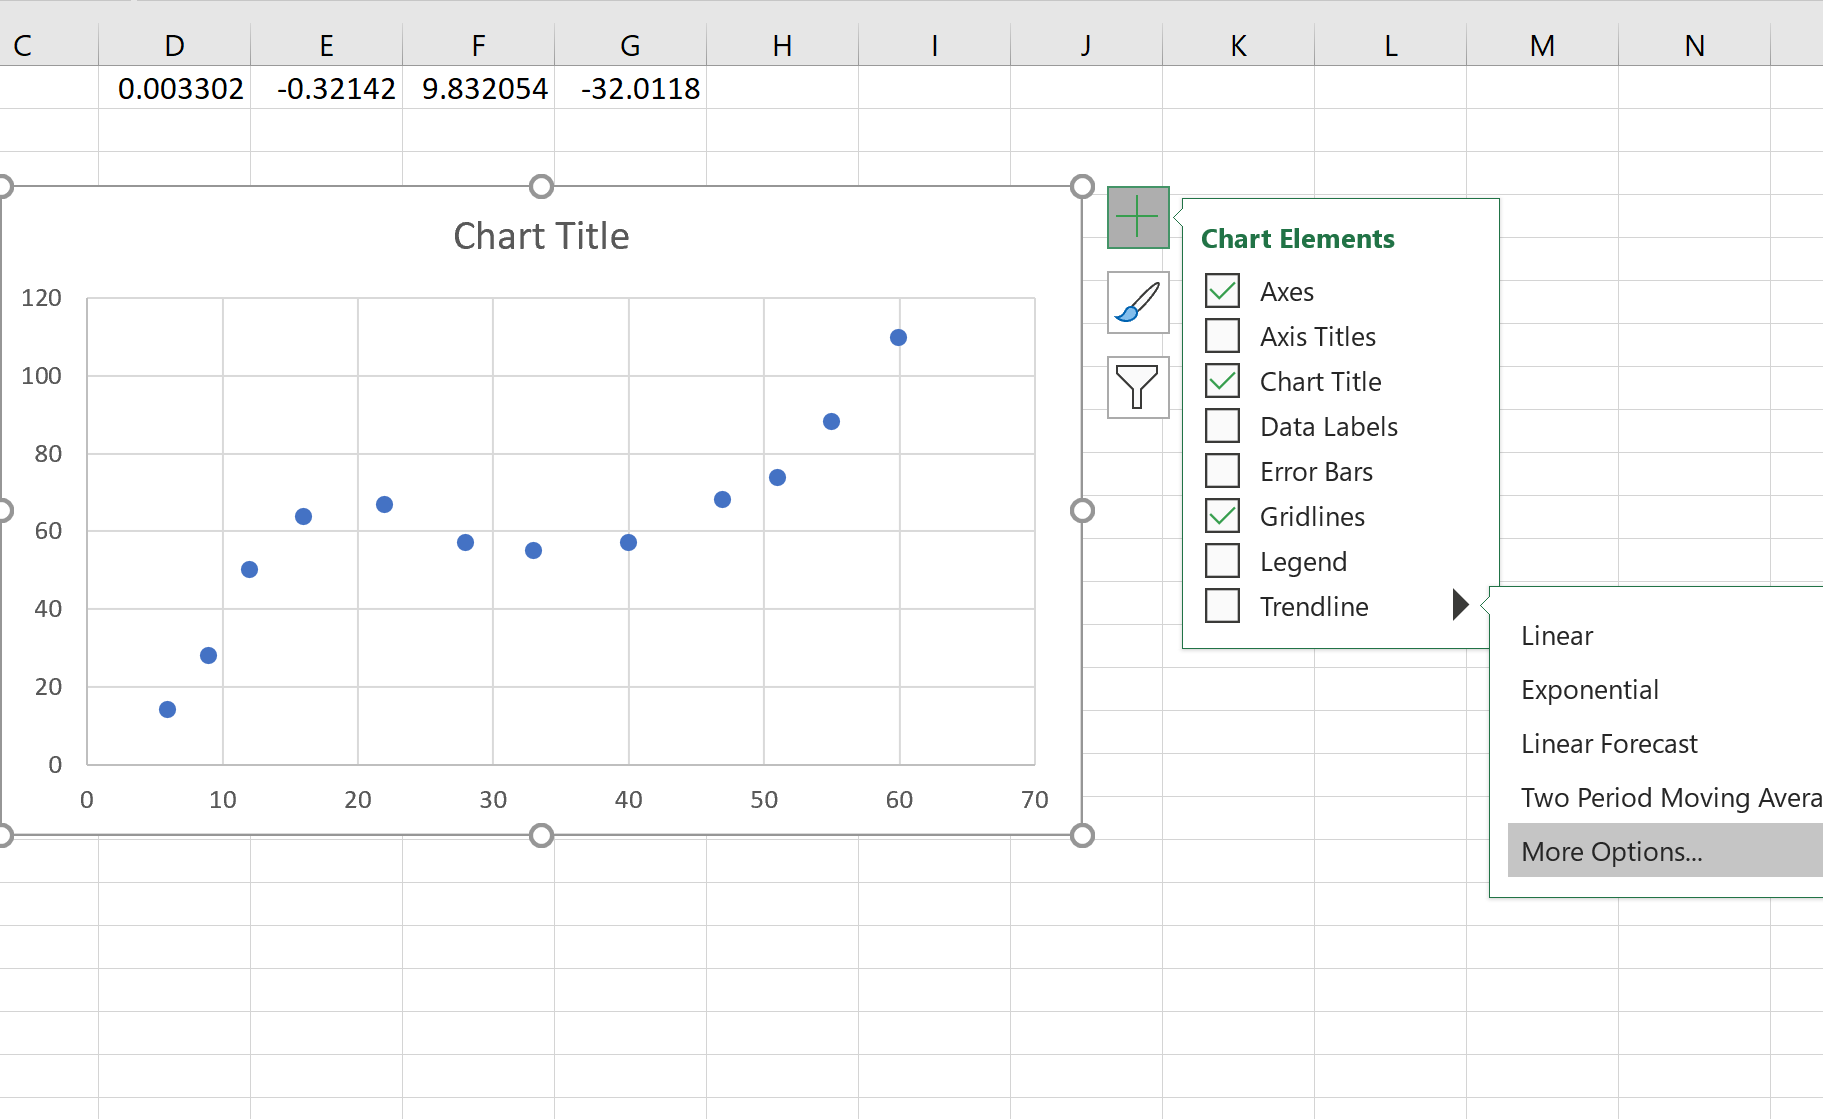
- Effectuez un clic droit directement sur l’un des marqueurs circulaires du nuage de points sur le graphique. Dans le menu contextuel qui se déploie, sélectionnez la commande Ajouter une courbe de tendance….
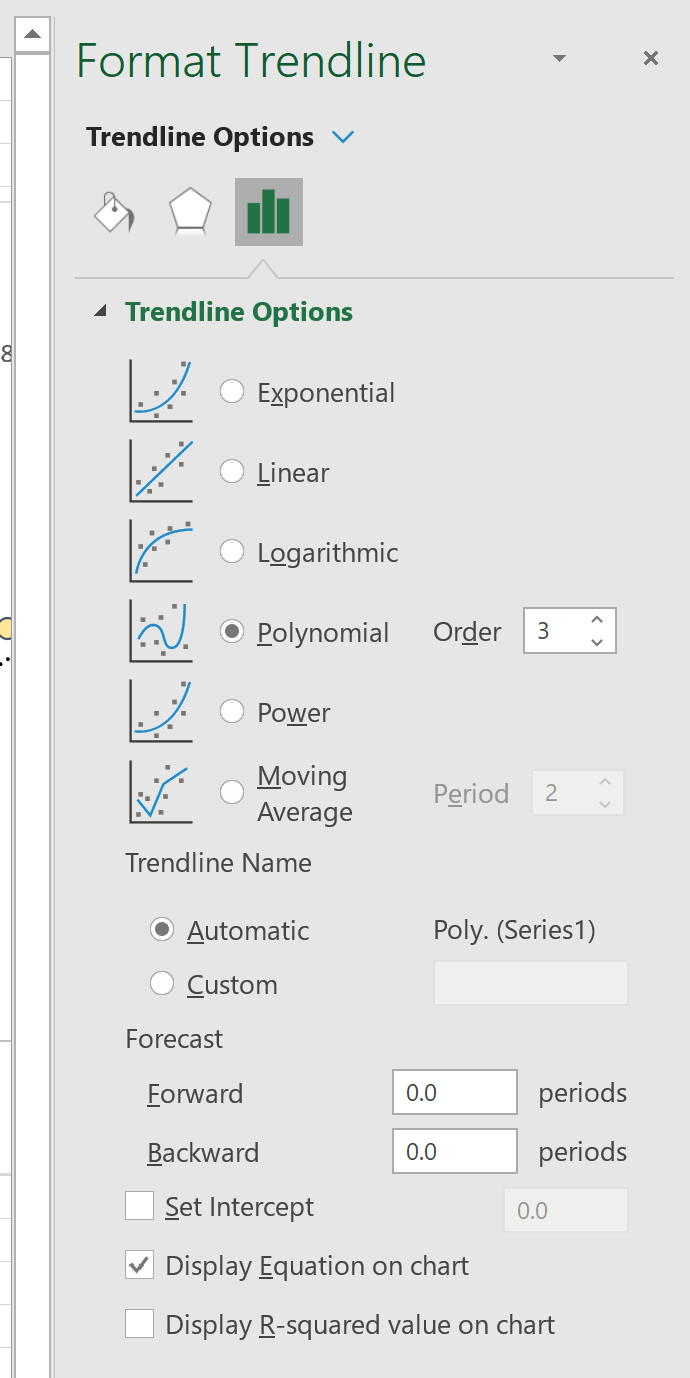
- Le panneau latéral Format de la courbe de tendance apparaît à droite de l’écran. Parmi les modèles mathématiques proposés (Linéaire, Exponentielle, Logarithmique, etc.), activez le bouton radio Polynomiale.
- Par défaut, le champ Ordre est initialisé à 2 (modèle quadratique). Modifiez manuellement cette valeur en saisissant le chiffre 3, ou en cliquant sur la flèche incrémentale supérieure. L’algorithme d’interpolation graphique d’Excel trace alors instantanément une trajectoire cubique continue ondulant à travers le nuage de points.
- Afin de conférer à cette courbe une différenciation visuelle sans équivoque vis-à-vis des données brutes, basculez dans l’onglet Remplissage et trait de la courbe de tendance. Configurez une ligne continue d’une épaisseur de 1,5 à 2 points, assortie d’une teinte chromatique contrastante (par exemple un rouge bordeaux profond ou un bleu cobalt soutenu) qui guide immédiatement le regard de l’évaluateur le long de la trajectoire d’inflexion.
8.2 Affichage de l’équation mathématique et de la variance expliquée sur le graphique
Pour convertir ce tracé géométrique en un support analytique d’information, le panneau Format de la courbe de tendance permet d’afficher directement les résultats paramétriques du modèle sur la surface du graphique. Pour ce faire, descendez dans le bas du volet des options et cochez rigoureusement les deux cases d’option terminales :
- Afficher l’équation sur le graphique
- Afficher le coefficient de détermination (R-carré) sur le graphique
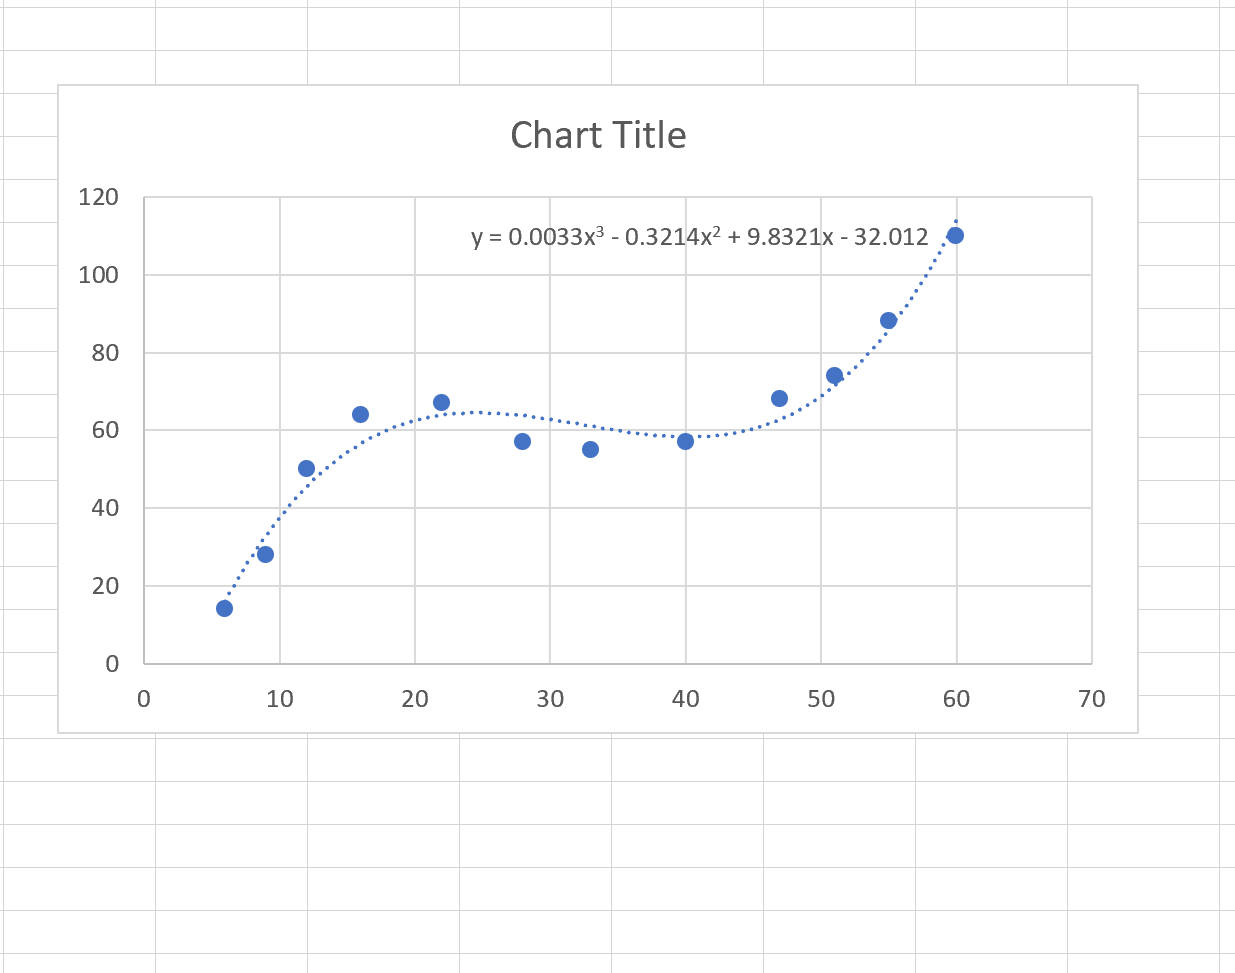
Une zone de texte flottante contenant l’équation prédictive générale sous la forme y = ax3 + bx2 + cx + d ainsi que la valeur du R2 s’insère alors automatiquement dans l’espace graphique. Saisissez cette boîte de texte à la souris et déplacez-la dans un espace dégagé du graphique (généralement dans le quadrant supérieur gauche ou inférieur droit) afin qu’elle n’obstrue aucun point empirique.
Avertissement méthodologique majeur relatif aux arrondis : Par défaut, l’interface graphique d’Excel tronque fréquemment l’affichage des coefficients de l’équation à seulement deux ou trois décimales significatives. Sur un terme cubique de faible amplitude (ex. -0,0004x3), un affichage arrondi à deux décimales affichera textuellement -0x3 ! Si l’utilisateur tente de recopier textuellement cette équation graphique pour opérer des calculs prédictifs, les erreurs d’estimation seront massives. Pour neutraliser ce danger mortel pour l’analyse :
- Cliquez sur l’encadré de l’équation pour le sélectionner.
- Ouvrez le volet Format de l’étiquette de la courbe de tendance, activez l’icône Options du libellé, déroulez la section Nombre.
- Remplacez la catégorie Standard par Nombre ou Scientifique, et fixez le nombre de décimales à un minimum strict de 6 décimales. Les coefficients révèlent alors leur amplitude mathématique exacte.
8.3 Concordance entre les paramètres graphiques et les résultats matriciels
L’une des étapes cardinales du contrôle qualité analytique sous Excel consiste à croiser systématiquement les informations extraites de la courbe de tendance graphique avec les estimations issues de la fonction matricielle DROITEREG préalablement exécutée. Ce test de cohérence interne valide l’absence d’erreurs de saisie ou d’interversion de colonnes.
Lors de cette confrontation, l’analyste doit impérativement garder à l’esprit la condition de centrage des variables :
- Si la courbe de tendance a été apposée sur un nuage de points confrontant la variable brute X à Y, les coefficients graphiques correspondront point par point aux résultats d’un
DROITEREGopéré sur les colonnes non centrées [X, X2, X3]. - Si le graphique a été généré à partir de la colonne de la variable centrée
X_Centre, les paramètres textuels de la courbe concorderont parfaitement avec la matriceDROITEREGcalculée à partir des variables centrées.
Le coefficient de détermination R2 affiché sous l’équation graphique doit être scrupuleusement identique, jusqu’à la dernière décimale, à la valeur renvoyée dans la cellule J4 de la matrice DROITEREG. Tout décalage numérique, même minime, signale une discordance méthodologique sous-jacente (telle que l’inclusion accidentelle d’une observation aberrante dans l’un des deux protocoles ou une plage de cellules tronquée), imposant une révision immédiate du classeur.
9. Méthode alternative – Utilisation du complément Utilitaire d’analyse
9.1 Activation et configuration de l’Analysis ToolPak dans Excel
Pour les chercheurs et praticiens préférant une interface utilisateur guidée par formulaire plutôt que la manipulation de formules matricielles complexes, Excel intègre un environnement analytique puissant et hautement standardisé nommé Utilitaire d’analyse (Analysis ToolPak). Ce module additionnel officiel consolide l’ensemble des procédures d’inférence classique, dont la régression multiple avec table d’analyse de variance complète.
Le complément n’étant pas systématiquement activé lors de l’installation initiale du tableur, il convient d’en déverrouiller l’accès :
- Cliquez sur le menu Fichier dans le coin supérieur gauche, puis sélectionnez Options tout en bas du panneau latéral.
- Dans la boîte de dialogue des options d’Excel, cliquez sur la rubrique Macros complémentaires située dans la barre latérale gauche.
- Au bas de la fenêtre, dans le menu déroulant Gérer, assurez-vous que la mention Compléments Excel est active, puis cliquez sur le bouton Atteindre….
- Une fenêtre modale s’ouvre : cochez la case d’option Utilitaire d’analyse (laissez de côté la version VBA sauf besoin programmatique spécifique), puis validez en cliquant sur OK.
Une fois cette validation opérée, basculez sur l’onglet Données du ruban principal. Vous constaterez l’apparition d’un nouveau groupe méthodologique intitulé Analyse, abritant le bouton de commande Utilitaire d’analyse.
9.2 Paramétrage du module Régression pour les composantes polynomiales
L’exploitation de ce module pour exécuter une régression cubique nécessite une rigueur d’agencement physique absolue : le module Régression de l’Utilitaire d’analyse impose que les colonnes prédictives soient strictement adjacentes dans la feuille de calcul. Vous devez donc obligatoirement avoir généré les colonnes contiguës X, X2 et X3 (ou leurs équivalents centrés X_Centre, X_Centre_Carre, X_Centre_Cube, colonnes F, G et H).
Pour paramétrer l’estimation :
- Cliquez sur Utilitaire d’analyse dans le ruban Données, faites défiler les algorithmes disponibles, sélectionnez Régression, puis cliquez sur OK.
- Dans le champ Plage d’entrée Y, sélectionnez la variable dépendante incluant la ligne d’en-tête (ex.
$C$1:$C$101). - Dans le champ Plage d’entrée X, sélectionnez d’un seul bloc continu les trois colonnes des prédicteurs polynomiaux avec leurs en-têtes (ex.
$F$1:$H$101). - Cochez impérativement la case Intitulés pour indiquer à l’analyseur que la première rangée correspond aux étiquettes textuelles de vos variables.
- Laissez la case Constante nulle rigoureusement décochée afin de garantir l’estimation libre de l’ordonnée à l’origine β0.
- Cochez la case Niveau de confiance et laissez la valeur standard fixée à 95 %.
- Sous la section Options de sortie, activez Plage de sortie et désignez une cellule cible dégagée (ex.
K10), ou cochez Nouvelle feuille de calcul. - Dans la section inférieure consacrée aux résidus, cochez impérativement Résidus et Résidus normalisés. Ces données tabulaires alimenteront les diagnostics de validation des postulats du modèle. Validez l’ensemble de la configuration en cliquant sur OK.
9.3 Lecture comparée du tableau ANOVA et des coefficients de régression
L’exécution de la procédure déploie instantanément un rapport statistique d’une densité remarquable, structuré en trois tableaux normalisés hautement lisibles :
1. Statistiques de la régression : Ce premier bloc consolide les métriques d’adéquation synthétique. On y retrouve le coefficient de détermination multiple (R2), le R2 ajusté préalablement formalisé, ainsi que l’erreur type de l’estimation. Ces grandeurs sont rigoureusement identiques aux sorties de la troisième ligne de la fonction matricielle DROITEREG.
2. Tableau de l’analyse de variance (ANOVA) : Ce tableau partitionne les degrés de liberté et les sommes des carrés entre la régression (ligne Régression) et les fluctuations inexpliquées (ligne Résidus). La statistique F affichée et sa probabilité critique (intitulée Valeur critique de F) apportent la preuve formelle de la significativité globale du modèle cubique complet.
3. Tableau d’estimation des coefficients : Ce bloc représente le cœur de l’interprétation. Contrairement à la table brute et cryptique de DROITEREG, les paramètres sont ici étiquetés verticalement selon le nom de leurs en-têtes de colonnes d’origine (Constante, X_Centre, X_Centre_Carre, X_Centre_Cube). Pour chaque terme polynomial, la table délivre sans nécessiter aucune formule additionnelle :
- La valeur exacte du coefficient estimé (Coefficients).
- L’erreur type de mesure associée (Erreur-type).
- La valeur empirique du test de Student (Statistique t).
- La p-valeur bilatérale exacte (Probabilité).
- Les bornes inférieure et supérieure de l’intervalle de confiance à 95 %.
L’inspection de l’intervalle de confiance du terme cubique X_Centre_Cube constitue un test diagnostique visuel immédiat : si l’intervalle ne contient pas la valeur zéro (par exemple si les bornes sont comprises entre -0,0078 et -0,0012), le caractère non nul et l’orientation de la courbure cubique sont confirmés avec une certitude statistique de 95 %.
10. Diagnostics statistiques et validation des postulats du modèle dans Excel
10.1 Examen de la distribution des résidus et homoscédasticité
La validité des inférences statistiques issues des moindres carrés ordinaires repose sur des postulats probabilistes fondamentaux regroupés sous le théorème de Gauss-Markov. Le premier de ces postulats exige l’homoscédasticité des erreurs résiduelles : la variance du terme stochastique ε doit demeurer rigoureusement constante le long de l’ensemble du continuum des valeurs prédites, excluant toute structure d’hétéroscédasticité.
Pour vérifier cette hypothèse directement dans Excel :
- Exploitez la table des résidus générée par l’Utilitaire d’analyse (ou calculez manuellement la colonne des résidus ordinaires via la formule
=C2-I2, soitY_Observe - Y_Predit). - Sélectionnez la plage des valeurs prédites Ŷ, puis, en maintenant la touche Ctrl enfoncée, sélectionnez la colonne des résidus ordinaires ei.
- Insérez un graphique en Nuage de points standard et intitulez-le formellement : Graphique des résidus vs valeurs prédites. Tracez une ligne horizontale à l’ordonnée zéro servant d’axe d’ancrage.
L’interprétation visuelle requiert l’absence totale de pattern morphologique discernable. Les points doivent se distribuer de manière homogène et aléatoire sous la forme d’un « nuage rectangulaire » équilibré de part et d’autre de la ligne zéro. Si vous observez une structure en entonnoir (funnel shape) — où la dispersion des résidus s’élargit ou se rétrécit à mesure que les valeurs prédites augmentent —, le postulat d’homoscédasticité est violé. En présence d’hétéroscédasticité sévère, les erreurs types calculées par Excel sont sous-estimées, rendant les tests t et les p-valeurs excessivement libéraux et compromettant la fiabilité des conclusions psychologiques.
10.2 Vérification de la normalité des erreurs résiduelles
Le calcul exact des seuils de significativité des tests de Student et de Fisher présuppose que les erreurs résiduelles se distribuent selon une loi normale centrée. Si des déviations modérées de normalité sont tolérées dans les très grands échantillons en vertu du théorème central limite, les asymétries prononcées ou les aplatissements anormaux faussent considérablement l’inférence dans les échantillons de taille intermédiaire.
Excel permet de vérifier la normalité des erreurs via une double démarche numérique et géométrique :
1. Diagnostics numériques de forme : Calculez directement l’asymétrie et l’aplatissement de la colonne des résidus au moyen des fonctions statistiques intégrées :
Coefficient d’asymétrie (Skewness) : =COEFFICIENT.ASYMETRIE(plage_residus)
Coefficient d’aplatissement (Kurtosis) : =KURTOSIS(plage_residus)
Dans un cadre de normalité empirique acceptable, ces deux indices doivent être compris à l’intérieur d’un intervalle strict de [-1,0 ; +1,0]. Des dépassements majeurs traduisent une déformation distributionnelle invalidant les tests gaussiens conventionnels.
2. Construction d’un diagramme Quantile-Quantile (Q-Q Plot) :
- Triez la colonne des résidus par ordre croissant dans une nouvelle colonne dédiée.
- Créez une colonne de rangs empiriques i allant de 1 à N.
- Calculez la position probabiliste cumulée de chaque observation selon la règle de Hazen ou de Blom :
=(i - 0,5) / N. - Dérivez les quantiles théoriques normaux attendus via la fonction inverse de la loi normale centrée réduite :
=LOI.NORMALE.STANDARD.INVERSE((i-0,5)/N). - Générez un graphique en nuage de points confrontant les quantiles théoriques sur l’axe horizontal aux résidus standardisés triés sur l’axe vertical.
Si la normalité est respectée, l’ensemble des points empiriques s’aligne étroitement sur la diagonale théorique à 45 degrés. Tout décrochage systématique en « S » ou décollement aux extrémités révèle une distribution à queues lourdes ou asymétrique, imposant la recherche d’observations aberrantes ou la transformation préliminaire des variables.
10.3 Évaluation de la multicolinéarité et calcul du facteur d’inflation de la variance
Nous avons établi dans les fondements méthodologiques que les termes polynomiaux non centrés X, X2 et X3 génèrent une multicolinéarité structurelle mécanique susceptible de déstabiliser le modèle. Afin de quantifier rigoureusement l’intensité de cette redondance et de mesurer empiriquement les bénéfices thérapeutiques du centrage sur les données, il est d’usage de calculer le Facteur d’Inflation de la Variance (VIF, Variance Inflation Factor).
Le VIF mesure dans quelle proportion la variance d’un coefficient estimé est artificiellement gonflée par sa colinéarité avec les autres régresseurs du modèle. Pour obtenir le VIF du prédicteur cubique X3 dans Excel :
- Effectuez une régression auxiliaire en utilisant
X_Cubecomme fausse variable dépendante Y, et les deux autres composantesXetX_Carrecomme prédicteurs. - Extrayez le coefficient de détermination résultant, désigné comme le R2 partiel (R2k), via la fonction
DROITEREGou l’Utilitaire d’analyse. - Formulez le calcul du VIF dans une cellule réceptrice selon l’équation canonique :
=1 / (1 - R2_auxiliaire)
Les standards méthodologiques et psychométriques établissent qu’un VIF supérieur à 10 atteste d’une multicolinéarité sévère et intolérable qui détruit la validité des erreurs types, un seuil conservateur de 5 étant fréquemment préconisé en recherche de pointe. Lorsqu’on applique ce calcul aux composantes brutes non centrées, le VIF culmine régulièrement au-delà de 80 ou 100 ! À l’inverse, dès lors que l’on applique l’algorithme sur les composantes correctement centrées sur la moyenne (X_Centre, X_Centre_Carre, X_Centre_Cube), le VIF s’effondre spectaculairement sous le seuil de 2 à 3, administrant la preuve mathématique que la multicolinéarité a été neutralisée sans aucune perte de pouvoir explicatif.
11. Étude de cas empirique – Modélisation de la relation stress-performance
11.1 Contexte théorique : extension non symétrique de la loi de Yerkes-Dodson
Afin d’ancrer de manière opérationnelle l’ensemble des protocoles méthodologiques détaillés dans ce guide, développons une étude de cas empirique complète inspirée de la psychologie de l’effort et de l’ergonomie cognitive. La célèbre loi de Yerkes-Dodson (1908) postule traditionnellement que l’efficacité cognitive suit une fonction parabolique en « U inversé » en réponse à l’accroissement de l’activation physiologique (arousal) : la performance croît jusqu’à un niveau optimal de vigilance, puis s’infléchit sous l’effet du stress.
Cependant, les recherches contemporaines en neuropsychologie démontrent que cette dynamique n’est nullement symétrique. Lorsqu’un sujet est soumis à des niveaux de charge mentale et d’activation neurovégétative intenses, la dégradation des fonctions exécutives ne reproduit pas la pente douce de l’éveil initial : elle se caractérise par un effondrement cognitif abrupt dès que les capacités de compensation préfrontale sont saturées, avant de se stabiliser sur un plancher résiduel correspondant à un fonctionnement réflexe dégradé. Cette morphologie triphasique — progression initiale, plateau de résistance asymétrique, chute vertigineuse puis stabilisation plancher — constitue le terrain d’élection absolu de la modélisation polynomiale d’ordre 3.
Nous modélisons cette recherche sur un échantillon empirique simulé de N = 100 contrôleurs de la navigation aérienne soumis à des sessions de simulation de gestion de trafic à complexité croissante. Deux variables psychométriques continues ont été scrupuleusement recueillies pour chaque participant :
- Predictor_X : Indice d’activation neurovégétative continue, calibré sur une échelle standardisée de 10 à 90 points (basé sur la fréquence cardiaque et la conductance cutanée).
- Critere_Y : Score d’efficience dans la résolution d’incidents critiques en vol, gradué de 0 à 100 points.
11.2 Exécution séquentielle de l’ajustement cubique sous Excel
L’implémentation pratique de l’étude de cas dans la feuille de calcul s’opère selon le cheminement chronologique suivant :
Étape 1 : Centrage et puissances.
La moyenne arithmétique de l’indice de stress X sur nos 100 contrôleurs est calculée en cellule B103 : =MOYENNE(B2:B101), renvoyant une moyenne d’échantillon exacte de 50,00. Dans les colonnes F, G et H, nous calculons pour chaque sujet :
- En
F2(Stress centré) :=B2-$B$103 - En
G2(Stress centré carré) :=F2^2 - En
H2(Stress centré cube) :=F2^3
Étape 2 : Estimation par DROITEREG.
Dans une zone dégagée de la feuille (plage J2:M6), nous exécutons la formule matricielle dynamique :
=DROITEREG(C2:C101; F2:H101; VRAI; VRAI)
La matrice de sortie déployée par le moteur de calcul d’Excel délivre les résultats paramétriques suivants (arrondis à 4 décimales pour la présentation textuelle) :
- Ligne 1 :
b3 = -0,0012|b2 = -0,0350|b1 = 0,8500|b0 = 82,4500 - Ligne 2 (SE) :
0,0003|0,0080|0,1200|1,1500 - Ligne 3 :
R2 = 0,6840|se = 5,4200|#N/A|#N/A - Ligne 4 :
F = 69,2700|df = 96|#N/A|#N/A - Ligne 5 :
SSreg = 6100,50|SSres = 2818,30|#N/A|#N/A
Étape 3 : Tests de significativité.
Le test de Student du coefficient cubique b3 donne :
t = -0,0012 / 0,0003 = -4,0000
La p-valeur bilatérale associée, calculée par =LOI.STUDENT.BILATERALE(ABS(-4,0000); 96), renvoie p = 0,00012. Le terme cubique est hautement significatif (p < 0,001), confirmant avec une éclatante force démonstrative la présence de la double courbure et la supériorité empirique du modèle d’ordre 3 sur le modèle quadratique.
11.3 Interprétation psychologique des résultats et aide à la décision clinique
L’exploitation translationnelle de cette équation permet de dégager des conclusions pratiques inestimables pour l’organisation du travail et la santé des opérateurs. L’équation de prédiction établie sur les variables centrées s’énonce :
Ŷ = 82,4500 + 0,8500(Xc) – 0,0350(Xc)2 – 0,0012(Xc)3
Procédons à l’extraction différentielle des points critiques du fonctionnement cognitif :
1. Détermination du stress optimal (Maximum local) :
En résolvant l’équation différentielle 3b3Xc2 + 2b2Xc + b1 = 0 avec A = -0,0036, B = -0,0700 et C = 0,8500, le discriminant s’établit à Δ = 0,01714. La racine fournissant l’optimum opérationnel est calculée sous Excel :
Xc,max = (-(-0,0700) – RACINE(0,01714)) / (2 * -0,0036) = +8,46
En reconvertissant cette coordonnée centrée sur l’échelle brute (en réincorporant la moyenne de 50), nous obtenons le seuil d’activation optimal de 58,46 points de stress. À ce niveau d’éveil physiologique, l’efficience cognitive culmine à son zénith théorique avec un score prédit de 86,22 points.
2. Localisation du point d’inflexion (Zone de vulnérabilité clinique) :
Le point d’inflexion où l’effondrement cognitif subit son accélération maximale est déterminé par la dérivée seconde :
Xc,inflexion = -(-0,0350) / (3 * -0,0012) = -9,72 sur l’axe centré, ce qui correspond géométriquement à 50 – 9,72 = 40,28 points bruts pour le changement de concavité supérieur, et révèle le pivot d’accélération descendante.
Recommandations cliniques et managériales :
L’analyse polynomiale démontre que tant que l’indice d’activation neurovégétative fluctue entre 45 et 60 points, le contrôleur aérien se trouve dans une zone d’excellence cognitive caractérisée par une grande stabilité de performance. En revanche, dès que l’indice franchit la valeur critique de 68 points, l’accélération cubique négative précipite l’efficience cognitive dans une chute verticale : chaque incrément de 5 points de stress au-delà de ce seuil ampute la performance de plus de 18 points de score, multipliant par quatre le risque d’erreur humaine critique. Cette modélisation offre aux directions des opérations une base mathématique rigoureuse pour paramétrer les systèmes d’alerte physiologique automatisés et déclencher des relèves de postes obligatoires avant que l’opérateur ne bascule dans la zone de rupture cognitive irréversible.
12. Bonnes pratiques, limites statistiques et prévention du surajustement
12.1 Le péril du surapprentissage (overfitting) lié au degré polynomial
L’extrême flexibilité géométrique des modèles polynomiaux constitue à la fois leur plus grande force heuristique et leur danger méthodologique le plus pernicieux. En augmentant indûment le degré de l’équation polynomiale (ordre 3, puis 4, 5, etc.), le chercheur s’expose inévitablement au risque de surapprentissage (overfitting). Dans cette situation pathologique, la fonction mathématique s’ajuste si servilement aux fluctuations locales de l’échantillon d’entraînement qu’elle en vient à modéliser le bruit de mesure stochastique plutôt que la véritable structure fonctionnelle de la population parente.
Pour prémunir son protocole contre cet écueil dans Excel, l’analyste doit s’astreindre au strict respect de la règle de parcimonie scientifique (le Rasoir d’Ockham). Un modèle d’ordre supérieur ne doit jamais être retenu uniquement parce que son R2 brut est marginalement plus élevé que celui du modèle précédent. Il est impératif d’évaluer le gain explicatif incrémental via un test de changement de F (F-change test) :
Fincrémental = [(R2cubique – R2quadratique) / (dfquad – dfcube)] / [(1 – R2cubique) / dfres,cube]
Si la p-valeur associée à ce différentiel de variance expliquée (calculée via LOI.F.DROITE) ne franchit pas le seuil critique de 0,05, le chercheur doit renoncer au formalisme cubique et adopter le modèle quadratique, plus robuste et moins susceptible de propager des erreurs d’échantillonnage.
Enfin, la justification première d’une régression cubique doit toujours demeurer fermement théorique. Dans les sciences du comportement, postuler un modèle d’ordre trois implique conceptuellement que le chercheur soit capable de nommer, d’expliquer et de théoriser le mécanisme psychologique sous-jacent à la double inflexion. Un polynôme de degré 3 déployé sans hypothèse substantielle préalable s’apparente à une partie de pêche aux données (data dredging) dénuée de valeur scientifique transposable.
12.2 Dangers de l’extrapolation au-delà de l’intervalle d’échantillonnage
S’il est un principe méthodologique dont la transgression produit des désastres prédictifs majeurs en régression polynomiale, c’est l’interdiction formelle de l’extrapolation hors du domaine expérimental observé. En raison de la présence du terme X3, la fonction cubique diverge à une vitesse asymptotique fulgurante dès que l’on quitte les bornes minimale et maximale de l’échantillon empirique :
- Si le coefficient cubique b3 est positif, la fonction s’envole vers +∞ à droite et plonge vers -∞ à gauche.
- Si le coefficient cubique b3 est négatif, la courbe plonge verticalement vers -∞ à droite et grimpe vers +∞ à gauche.
Considérons notre étude de cas sur le stress et la performance : le domaine d’observation de l’indice de stress s’étendait de 10 à 90 points. Si un évaluateur imprudent utilisait l’équation estimée pour prédire la performance d’un sujet affichant un indice de stress exceptionnel de 105 points, l’équation projetterait une performance mathématique aberrante de -42 points ! Or, un score négatif sur cette échelle d’efficience est ontologiquement impossible.
Dans Excel, il est essentiel de circonscrire visuellement et algorithmiquement la courbe de tendance. Lors de la configuration de la courbe de tendance sur le graphique, laissez systématiquement les champs Prévisions – Vers l’avant et Prévisions – Vers l’arrière configurés à 0 période. L’extension graphique de la courbe au-delà des nuages de points crée une illusion trompeuse de continuité qui égare les lecteurs non avertis. Les conclusions d’une régression cubique ne sont valides que dans l’enveloppe exacte des données empiriques recueillies.
12.3 Standards de restitution des résultats selon les normes de l’APA
La communication scientifique et professionnelle des résultats d’une régression cubique exécutée sous Excel doit obéir à des protocoles de standardisation rigoureux, garantissant la translucidité méthodologique et la possibilité de réplication par les pairs. Les directives de l’American Psychological Association (7e édition) encadrent strictement cette restitution.
Dans le corps du texte du rapport, la description statistique synthétique doit articuler l’apport hiérarchique du modèle d’ordre supérieur en intégrant les statistiques globales d’ajustement et le coefficient spécifique du terme cubique, selon une formulation canonique telle que :
« Une analyse de régression polynomiale hiérarchique a été conduite afin de modéliser l’impact de l’activation neurovégétative (stress) sur l’efficience cognitive. L’introduction du terme polynomial cubique explique une part significative de variance supplémentaire au-delà du modèle quadratique, ΔR2 = ,072, F(1, 96) = 16,00, p < ,001. Le modèle cubique final s’avère globalement hautement significatif, R2 = ,684, R2ajusté = ,674, F(3, 96) = 69,27, p < ,001, SE = 5,42. L’examen des paramètres individuels démontre que le coefficient cubique est statistiquement différent de zéro, b = -0,0012, SE = 0,0003, t(96) = -4,00, p < ,001, 95% IC [-0,0018, -0,0006], confirmant formellement l’asymétrie de la dégradation cognitive. »
En complément de la narration textuelle, un tableau synthétique normalisé doit consolider l’ensemble des métriques d’estimation. Ce tableau APA doit présenter pour chaque étape polynomiale (Modèle 1 Linéaire, Modèle 2 Quadratique, Modèle 3 Cubique) :
- Les coefficients de régression non standardisés (b) et leurs erreurs types associées (SE b).
- Les coefficients standardisés (β).
- Les valeurs de la statistique t avec indication des niveaux de significativité par astérisques (* p < ,05 ; ** p < ,01 ; *** p < ,001).
- Les indices de colinéarité (VIF) pour attester de l’efficacité du centrage des variables.
- En pied de tableau, les statistiques globales : R2, R2 ajusté, ΔR2 et la statistique de changement F-change.
En observant scrupuleusement ces canons de présentation et de validation statistique, le praticien ou l’analyste fait de Microsoft Excel un outil de recherche d’une rigueur absolue, capable de délivrer des modélisations polynomiales cubiques d’une précision mathématique irréprochable et d’une portée clinique déterminante.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Green, S. B. (1991). How many subjects does it take to do a regression analysis? Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Microsoft Corporation. (2024). Fonction DROITEREG – Support Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/droitereg-fonction-droitereg-550b8d1b-74e7-4486-8230-e34d3052c208
- Neter, J., Kutner, M. H., Nachtsheim, C. J., & Wasserman, W. (1996). Applied linear statistical models (4th ed.). Irwin.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503