
Dans le domaine de l’ingénierie des données et de l’économétrie appliquée, l’analyse des séries temporelles constitue un pilier fondamental de la modélisation prédictive et de la compréhension des dynamiques séquentielles. Qu’il s’agisse d’évaluer la persistance de chocs macroéconomiques, d’anticiper la volatilité des marchés financiers ou d’optimiser la gestion des approvisionnements logistiques, la mise en relation d’un événement contemporain avec ses manifestations antérieures est un prérequis mathématique indispensable. Cette confrontation chronologique repose sur une opération canonique : le décalage temporel, communément désigné sous l’anglicisme Lag. Au sein des environnements d’analyse spécialisés, cette opération bénéficie d’une formalisation native immédiate, permettant de dériver sans friction cognitive les observations passées.
Pourtant, au cœur des entreprises et des institutions académiques, Microsoft Excel demeure le tableur prédominant pour l’exploration, la consolidation et la communication des données chiffrées. Malgré son omniprésence et ses évolutions algorithmiques récentes, Excel se caractérise par une omission architecturale surprenante : l’absence d’une fonction native universelle et explicite nommée « LAG ». Cette lacune force les analystes, ingénieurs et chercheurs à concevoir des architectures de calcul de substitution en exploitant la géométrie matricielle des cellules, les fonctions de référence spatiale ou les moteurs de requêtage avancés. L’élaboration d’un décalage temporel rigoureux sous Excel ne relève donc pas d’une simple manipulation cosmétique, mais d’une véritable démarche d’ingénierie des formules requérant une compréhension fine des structures de données.
Le présent article constitue un traité méthodologique exhaustif visant à combler cette anomalie structurelle. À travers une progression didactique et rigoureuse, nous explorerons les fondements épistémologiques du décalage temporel, dissèquerons l’utilisation de fonctions de référence telles que DECALER et INDEX, et présenterons des solutions modernes s’appuyant sur les tableaux dynamiques et le formalisme LAMBDA d’Excel 365. De la résolution des pièges inhérents aux structures de panels stratifiés jusqu’à l’automatisation industrielle par l’intermédiaire de Power Query et de Visual Basic for Applications (VBA), ce guide fournit aux professionnels des données les protocoles nécessaires pour garantir l’intégrité référentielle, la robustesse statistique et l’efficience algorithmique de leurs classeurs.
1. Introduction théorique à la notion de décalage temporel (Lag) dans l’analyse de données sous Excel
1.1 Définition épistémologique et statistique du concept de retard temporel
D’un point de vue épistémologique, l’analyse temporelle postule que l’état d’un système à un instant $t$ donné n’est jamais entièrement spontané, mais procède au contraire d’une trajectoire historique dont la trace mémorielle s’estompe progressivement. Dans le formalisme mathématique des séries temporelles, le décalage d’ordre $k$, couramment formalisé par l’opérateur de retard $L$ (pour Lag operator) ou $B$ (pour Backshift), est défini par la transformation $L^k y_t = y_{t-k}$, où $y_t$ représente la réalisation d’une variable aléatoire mesurée à l’instant discret $t$, et $k in \mathbb{N}^*$ désigne l’amplitude discrète du recul temporel. Cet opérateur élémentaire sous-tend l’ensemble de la théorie stochastique linéaire, offrant un cadre analytique unifié pour convertir des équations différentielles continues en équations aux différences finies manipulables numériquement.
Le rôle des observations décalées s’avère central dans la modélisation des comportements passés, car il permet de formaliser les phénomènes d’inertie, d’hystérèse et de transmission retardée. En économétrie de la consommation, par exemple, la théorie du revenu permanent met en exergue l’influence des flux financiers antérieurs sur les arbitrages présents. En psychométrie et en neurosciences computationnelles, l’analyse des temps de réaction séquentiels mobilise les variables retardées pour évaluer la rémanence des stimuli antérieurs sur la prise de décision. D’un point de vue structural, il convient de distinguer avec rigueur le décalage univarié, où une variable unique est confrontée à son propre passé ($y_t$ par rapport à $y_{t-1}$), du décalage multivarié, dans lequel un vecteur de variables explicatives contemporaines est enrichi par les historiques croisés d’autres séries endogènes ou exogènes ($y_t$ modulé par $x_{t-k}$ et $z_{t-j}$).
1.2 Pertinence méthodologique des séries chronologiques et de l’autocorrélation
L’incorporation de variables retardées répond principalement à la nécessité de caractériser et de quantifier la structure de dépendance temporelle unissant les observations successives d’un processus stochastique. Contrairement aux données en coupe transversale où les unités statistiques sont traditionnellement présumées indépendantes et identiquement distribuées (hypothèse i.i.d.), les séries chronologiques violent systématiquement cette indépendance par l’introduction d’une autocorrélation sérielle. L’évaluation de cette corrélation interne à différents horizons temporels $k$ permet de déterminer la fonction d’autocorrélation empirique (ACF) et la fonction d’autocorrélation partielle (PACF), outils primordiaux pour juger de la mémoire courte ou longue d’un phénomène empirique.
Cette démarche constitue l’étape liminaire incontournable de la méthodologie de Box-Jenkins, consacrée à l’estimation des modèles autorégressifs intégrés de moyennes mobiles (ARIMA). Au-delà de la simple mesure de la persistance, l’analyse conjointe d’une série et de ses versions décalées met en lumière les composantes cycliques et saisonnières : un décalage d’ordre $k=12$ sur des observations mensuelles révèle immédiatement l’amplitude des variations infra-annuelles récurrentes. De surcroît, l’observation des ruptures brutales de corrélation temporelle permet d’identifier les bifurcations structurelles, qu’il s’agisse de changements de régime macroéconomique, de crises financières exogènes ou de modifications technologiques profondes altérant de façon irréversible les paramètres générateurs de la série.
1.3 L’absence d’une fonction native « LAG » dans Excel : Enjeux et alternatives
Dans les langages et environnements statistiques spécialisés, la manipulation temporelle rétrospective bénéficie d’implémentations hautement déclaratives et sémantiquement transparentes. En langage R, l’écosystème Tidyverse propose la commande dplyr::lag() ; au sein des systèmes de gestion de bases de données relationnelles conformes à la norme SQL, la fonction analytique de fenêtrage LAG() OVER (ORDER BY ...) résout nativement cette problématique ; quant au système SAS, il met à disposition l’opérateur LAGk() au sein du DATA step. Dans ces écosystèmes, le moteur d’exécution gère automatiquement l’ordre chronologique sous-jacent et l’allocation de la mémoire requise pour stocker les registres précédents.
Face à ces paradigmes spécialisés, Excel présente un modèle conceptuel différent, fondé sur une grille bidimensionnelle statique d’adresses absolues ou relatives. L’absence d’une fonction intrinsèque « LAG » force le praticien à conceptualiser le décalage non pas comme une translation chronologique abstraite, mais comme un déplacement spatial de coordonnées cartésiennes sur la feuille de calcul. Cette transposition spatiale peut être opérée selon trois grandes typologies de substitution : l’offsetting géométrique (principalement via la fonction DECALER), l’indexation matricielle déterministe (articulant INDEX et LIGNE) ou encore le requêtage relationnel interne via Power Query. Chacune de ces alternatives impose des contraintes distinctes en matière de coût computationnel, de volatilité du recalcul et de préservation de l’intégrité référentielle, obligeant l’analyste à adopter une rigueur formelle absolue pour prévenir toute distorsion temporelle au sein de ses classeurs.
2. Comprendre la fonction DECALER (OFFSET) : Fondement algorithmique du Lag sous Excel
2.1 Anatomie et syntaxe détaillée de la fonction DECALER
Pour reproduire le comportement d’un opérateur de décalage temporel dans l’environnement de calcul conventionnel d’Excel, la fonction DECALER (connue sous l’appellation OFFSET dans les versions anglophones du logiciel) s’impose historiquement comme l’instrument le plus immédiatement intuitif. Sur le plan de la théorie des graphes et de la géométrie analytique plane, cette fonction se comporte comme un vecteur de translation affine appliqué à une cellule ou une plage de cellules source. Sa signature algorithmique complète fait intervenir cinq paramètres ordonnés : DECALER(réf; lignes; colonnes; [hauteur]; [largeur]).
Le premier argument, réf, établit l’origine du repère, c’est-à-dire la cellule ou la plage contiguë servant de point d’ancrage absolu ou relatif à la translation. Les deuxième et troisième arguments, lignes et colonnes, constituent les grandeurs scalaires entières définissant le vecteur de déplacement. Du point de vue de l’orientation spatiale dans la grille du tableur, l’axe des ordonnées est orienté du haut vers le bas (les indices de lignes croissant vers le bas de l’écran) et l’axe des abscisses de la gauche vers la droite. Par conséquent, appliquer un décalage temporel rétrospectif vers l’instant antérieur impose impérativement de renseigner un scalaire négatif pour l’argument lignes, matérialisant une translation vers les rangs supérieurs du tableau chronologique. Lors de la phase de réévaluation par le moteur de calcul, Excel résout le pointeur mémoire vers la nouvelle coordonnée avant d’extraire la charge utile de la cellule, ce qui exige une conformité de typage rigoureuse entre la cellule source et l’environnement numérique cible.
2.2 Mécanismes de manipulation des coordonnées relatives : lignes et colonnes
L’utilisation de la fonction DECALER pour construire un lag repose sur la synchronisation harmonieuse des adresses relatives lors de la descente le long de la série chronologique. Considérons un vecteur de données disposé verticalement le long d’une colonne unique. Pour évaluer la variable retardée d’ordre un ($t-1$) à la ligne courante $i$, l’argument de translation verticale doit être fixé à $-1$, tandis que l’argument de translation horizontale doit impérativement être neutralisé par la valeur $0$, signifiant que l’opération s’exécute à abscisse constante : DECALER(Cellule_Courante; -1; 0).
Ce mécanisme exploite pleinement le principe de la translation relative propre à Excel. Lorsque la formule est propagée le long de la série temporelle par recopie incrémentielle vers le bas, la cellule de référence d’ancrage progresse simultanément d’une unité vers le bas ($i to i+1$), tandis que le vecteur de décalage soustrait invariablement un rang vertical ($(i+1) – 1 = i$). Il en résulte un suivi dynamique parfait de la trace temporelle immédiate. Toutefois, la manipulation d’indices relatifs négatifs confronte directement l’algorithme aux frontières géométriques de la feuille de calcul : si l’opérateur tente d’appliquer une translation de $-1$ sur une cellule située à la ligne 1, Excel se trouve dans l’incapacité physique d’adresser une coordonnée spatiale négative, déclenchant instantanément une interruption d’exécution matérialisée par l’erreur d’adressage référentiel critique #REF!.
2.3 Gestion des dimensions optionnelles : hauteur et largeur de la matrice renvoyée
Les quatrième et cinquième arguments de la fonction DECALER, respectivement hauteur et largeur, introduisent une capacité de redimensionnement dimensionnel de la référence restituée par l’algorithme. Lorsqu’ils sont omis par l’utilisateur, Excel attribue par défaut à ces paramètres les dimensions spatiales de la référence d’origine désignée par l’argument réf. Dans le cadre de la construction d’un décalage univarié élémentaire portant sur une cellule unique, ces paramètres demeurent non renseignés, forçant la fonction à renvoyer une valeur scalaire simple de dimension $1 \times 1$.
Néanmoins, la mobilisation délibérée de ces dimensions optionnelles déverrouille des opportunités analytiques majeures dans le traitement des séries chronologiques complexes. En renseignant par exemple une hauteur strictement supérieure à un (ou négative pour englober un intervalle d’antériorités cumulées), l’analyste peut ordonner à DECALER de renvoyer une sous-matrice contiguë de données historiques. Cette configuration s’avère particulièrement puissante lorsqu’elle est imbriquée au sein de fonctions d’agrégation statistique, telles que MOYENNE ou ECARTYPE, permettant ainsi de construire des métriques de fenêtres glissantes dynamiques sans recourir à des formules matricielles lourdes. Toutefois, il convient de souligner que la gestion de plages redimensionnées accroît considérablement la charge allouée au moteur de calcul, le stockage temporaire de matrices intermédiaires dans la mémoire vive pouvant induire une dégradation mesurable de la réactivité des classeurs volumineux.
3. Exemple pratique 1 : Implémentation pas à pas d’un Lag simple univarié (Lag t-1)
3.1 Structuration rigoureuse du jeu de données chronologiques
Pour assurer la validité scientifique et l’exactitude opérationnelle d’un calcul de décalage temporel sous Excel, l’organisation spatiale du tableau brut doit obéir à des conventions d’ingénierie des données rigoureuses. Les observations doivent être consignées au sein d’une structure tabulaire bidimensionnelle stricte où chaque enregistrement horizontal (ligne) correspond à un point temporel discret unique $t$, et chaque vecteur vertical (colonne) représente une variable mesurée. Une condition sine qua non à la cohérence de l’opération est l’ordonnancement chronologique strict et croissant de la première à la dernière ligne : les dates les plus reculées doivent impérativement occuper les lignes supérieures, tandis que les observations les plus récentes se déploient vers le bas.
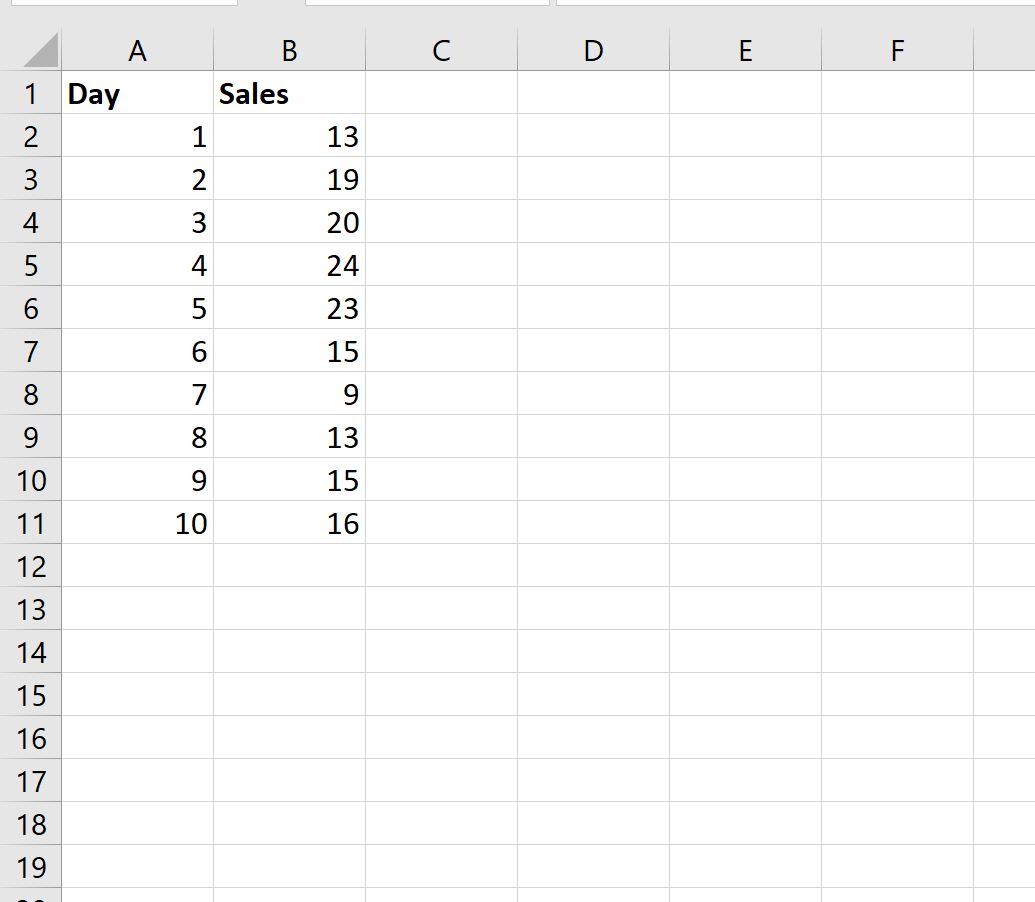
De plus, l’analyste doit vérifier l’équidistance des pas temporels (continuité chronologique). L’insertion non maîtrisée de jours fériés, de week-ends manquants dans des séries financières ou de périodes non renseignées induirait une asynchronie fondamentale, transformant un décalage formel d’un rang ($t-1$) en un décalage temporel réel hétérogène (par exemple trois jours d’intervalle entre le vendredi et le lundi). Considérons pour notre démonstration expérimentale un jeu d’essai standardisé illustrant les volumes de ventes quotidiens observés au cours de dix périodes d’observation consécutives, disposé dans les colonnes A (Période calendaire), B (Ventes constatées, exprimées en unités monétaires), la colonne C étant réservée pour la variable décalée Ventes_Lag1.
3.2 Paramétrage de la formule =DECALER(B3; -1; 0) en cellule cible
Supposons que la ligne 1 du tableau soit assignée aux en-têtes textuels de colonnes (respectivement Période, Ventes, Ventes_Lag1) et que la première observation empirique temporelle ($t=1$) prenne place sur la ligne 2. La cellule B2 héberge ainsi la première mesure scalaire, disons 13 unités de vente. À ce stade structurel, l’instant $t=1$ ne dispose d’aucun passé mesuré au sein de notre base d’observation restreinte. Par conséquent, la première instanciation possible de la variable décalée d’ordre 1 intervient obligatoirement à l’instant temporel $t=2$, matérialisé par la ligne 3 du classeur.
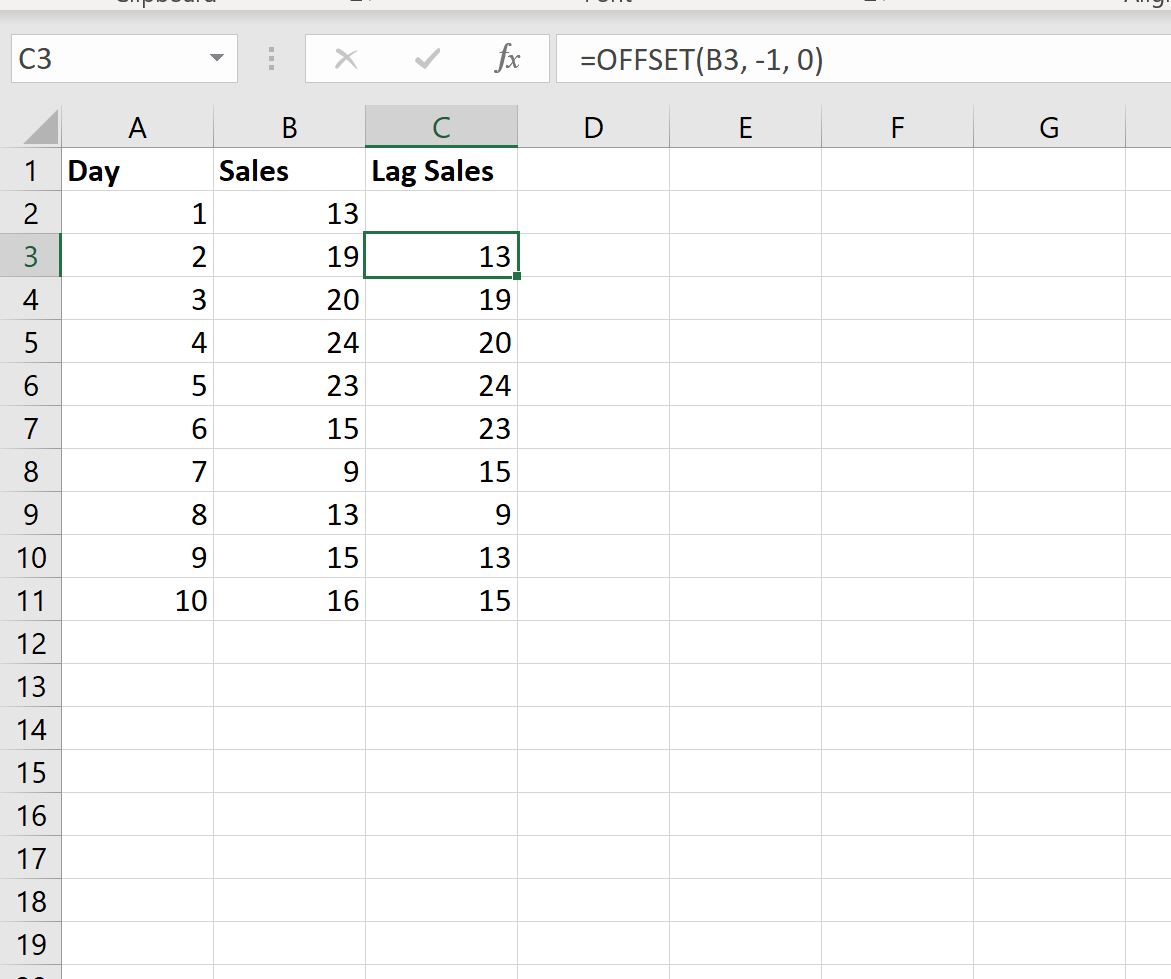
L’opérateur doit positionner le curseur d’édition directement sur la cellule C3 et y introduire rigoureusement l’expression algorithmique suivante : =DECALER(B3; -1; 0) (ou sa version internationale =OFFSET(B3, -1, 0) selon la localisation linguistique d’Office). L’ancrage est ici réalisé sur la cellule B3 représentant la valeur contemporaine à l’instant $t=2$. Le paramètre $-1$ instruit le moteur d’exécution d’effectuer une translation d’une ligne vers le sommet de la feuille, tandis que le paramètre $0$ maintient l’évaluation dans la colonne B. Lors de la validation par la touche d’entrée, Excel résout spatialement la référence vers l’adresse B2 et transvase fidèlement la valeur scalaire de 13 dans la cellule cible C3, sans aucune altération de typage.
3.3 Propagation dynamique de la formule et analyse des résultats obtenus
Dès lors que la validité de l’ancrage référentiel est certifiée en C3, la formule doit être diffusée sur l’intégralité du continuum chronologique. Cette opération s’accomplit par l’étirement vers le bas de la poignée de recopie incrémentielle, située à l’angle inférieur droit de la cellule active, ou plus rapidement par un double-clic sur cette dernière, ordonnant à Excel d’étendre automatiquement le calcul jusqu’à la dernière ligne adjacente non vide du tableau (ici la ligne 11, correspondant à la dixième période).
L’examen minutieux des valeurs transcrites dans la colonne C confirme l’exactitude de l’opérateur de retard temporel. À la ligne 4 ($t=3$, cellule C4), la formule auto-adaptée par adressage relatif devient =DECALER(B4; -1; 0) et restitue rigoureusement la valeur de la ligne 3 ($t=2$). Chaque enregistrement temporel se trouve dès lors juxtaposé horizontalement à son propre antécédent immédiat. Le tableau suivant schématise l’alignement séquentiel et la correspondance des valeurs générées par la propagation :
- Ligne 2 : Période = 1 | Ventes ($y_t$) = 13 | Ventes décalées ($y_{t-1}$) = [Non défini / Vide]
- Ligne 3 : Période = 2 | Ventes ($y_t$) = 17 | Ventes décalées ($y_{t-1}$) = 13 (report de
B2) - Ligne 4 : Période = 3 | Ventes ($y_t$) = 22 | Ventes décalées ($y_{t-1}$) = 17 (report de
B3) - Ligne 5 : Période = 4 | Ventes ($y_t$) = 19 | Ventes décalées ($y_{t-1}$) = 22 (report de
B4) - Ligne 6 : Période = 5 | Ventes ($y_t$) = 25 | Ventes décalées ($y_{t-1}$) = 19 (report de
B5)
3.4 Interprétation de la première observation et traitement des valeurs initiales
L’implémentation opérationnelle d’un décalage met en exergue une contrainte statistique fondamentale : le problème de la condition initiale à l’instant $t=1$. Si l’opérateur tente d’étendre aveuglément la formule de lag à la cellule C2 via =DECALER(B2; -1; 0), le pointeur spatial cible la cellule B1. Si celle-ci contient un en-tête textuel tel que "Ventes", la cellule C2 restituera une chaîne de caractères, générant des incohérences de type lors de calculs mathématiques ultérieurs. Dans le cas dramatique où la première observation se situerait sur la première ligne physique du classeur, la formule renverrait fatalement l’erreur d’adresse #REF!.
Sur le plan méthodologique, plusieurs postures épistémologiques peuvent être adoptées. La première, la plus rigoureuse sur le plan statistique, consiste à laisser la cellule C2 strictement vide ou à y affecter explicitement la valeur spéciale non disponible via l’expression =NA() (ou #N/A). Cette assignation informe formellement les algorithmes subséquents que l’information n’existe pas dans le référentiel d’observation. Dans certains contextes comptables ou de contrôle de gestion, une initialisation par zéro est parfois tolérée, bien qu’elle introduise une distorsion majeure en faisant passer un manque d’observation pour un niveau d’activité nul. Il importe de documenter rigoureusement que la création d’une variable décalée d’ordre un consomme inévitablement un degré de liberté, amputant l’échantillon analysable d’exactement une unité temporelle ($N – 1$).
4. Généralisation aux décalages d’ordre supérieur : Calcul des Lags t-k (k > 1)
4.1 Paramétrage systématique pour un décalage d’ordre k (Lag t-2, Lag t-3, Lag t-n)
La compréhension des phénomènes dynamiques complexes exige fréquemment de remonter au-delà de la période immédiatement précédente. Dans les analyses macroéconomiques ou industrielles, la capture des cycles d’investissement ou des retards de diffusion monétaire nécessite la formulation de décalages temporels d’ordre supérieur $k in {2, 3, dots, n}$. L’adaptation de l’algorithme sous Excel s’opère de façon déterministe en modifiant la constante entière de translation négative introduite dans le deuxième argument de la fonction DECALER.
Pour instancier un décalage temporel d’ordre deux ($t-2$, Lag 2) au sein de la colonne D, la cellule d’évaluation initiale se décale nécessairement à la ligne 4 ($t=3$), où la formule s’écrit =DECALER(B4; -2; 0), restituant l’observation consignée en B2. De manière analogue, un décalage d’ordre trois ($t-3$, Lag 3) consigné en colonne E débute à la ligne 5 ($t=4$) via la saisie de =DECALER(B5; -3; 0) pointant toujours vers cette même cellule d’ancrage primitive B2. La construction simultanée de ces colonnes successives matérialise sur la feuille de calcul une structure triangulaire supérieure de cellules non renseignées, visualisation spatiale directe de la perte graduelle d’observations historiques au fur et à mesure que l’horizon mémoriel s’élargit.
4.2 Dynamisation du paramètre de décalage via une référence de cellule variable
L’encodage en dur de la valeur de décalage $k$ sous forme de constante numérique dans les formules (par exemple $-1$, $-2$, $-3$) représente une vulnérabilité majeure en matière de gouvernance et de flexibilité des modèles financiers. Une conception logicielle rigoureuse préconise de séparer distinctement la logique algorithmique des paramètres de configuration. Il s’avère hautement préférable de lier dynamiquement le paramètre de saut à une cellule de contrôle externe isolée au sein du classeur, par exemple une cellule d’entrée nommée Ordre_K ou référencée de manière absolue en $E$1.
Dans ce cadre paramétrique, la syntaxe universelle inscrite en cellule C3 s’exprime comme suit : =DECALER(B3; -$E$1; 0). L’utilisation du signe négatif unitaire adossé à l’adressage absolu $E$1 assure que la conversion vectorielle négative reste pérenne lors de la recopie incrémentielle, tout en conférant au modèle une réactivité instantanée. Si un utilisateur modifie la valeur contenue en $E$1, la faisant passer de 1 à 4 pour scruter l’impact d’un décalage trimestriel, l’ensemble de la colonne recalcule immédiatement ses pointages temporels sans nécessiter la moindre retouche textuelle dans les formules. Pour parfaire la robustesse structurelle de l’interface, la cellule de paramètre gagne à être verrouillée au moyen d’une règle de validation des données, restreignant les entrées aux entiers strictement positifs inférieurs au nombre total d’observations disponibles.
4.3 Analyse de l’impact de l’accroissement de k sur l’échantillon tronqué
L’accroissement délibéré de l’ordre de décalage $k$ exerce une influence directe sur la dimension effective de l’espace échantillonnal exploitable par les méthodes d’inférence statistique. D’un point de vue quantitatif strict, une série initiale comportant $N$ observations temporelles ne permet d’extraire qu’un sous-ensemble de taille $N – k$ couples ordonnés complets $(y_t, y_{t-k})$. Cette troncature mécanique du jeu de données engendre une réduction mécanique de la puissance statistique des tests d’hypothèse ultérieurs, augmentant le risque d’erreur de type II (non-rejet d’une hypothèse nulle fausse).
Sur les échantillons restreints typiques des séries macroéconomiques annuelles, l’effet d’une troncature élevée peut introduire des biais d’échantillonnage substantiels. Par exemple, retenir un lag $k=5$ sur une série de $N=20$ observations amputera un quart de l’échantillon total. Dès lors, si l’analyste se propose de comparer les performances prédictives de différents modèles autorégressifs d’ordres variables (par exemple un modèle AR(1) contre un modèle AR(4)), il est impératif d’harmoniser formellement l’échantillon d’estimation. Les métriques d’information telles que les critères d’Akaike (AIC) ou de Schwarz (BIC) ne sont comparables que si elles sont calculées sur un échantillon strictement identique, ce qui impose d’amputer artificiellement le modèle AR(1) des $k_{\max}$ premières observations pour calquer sa fenêtre d’ajustement sur celle du modèle le plus contraignant.
5. Exemple pratique 2 : Calcul de valeurs décalées par groupe ou sous-population
5.1 Problématique du débordement inter-groupes lors de séries segmentées
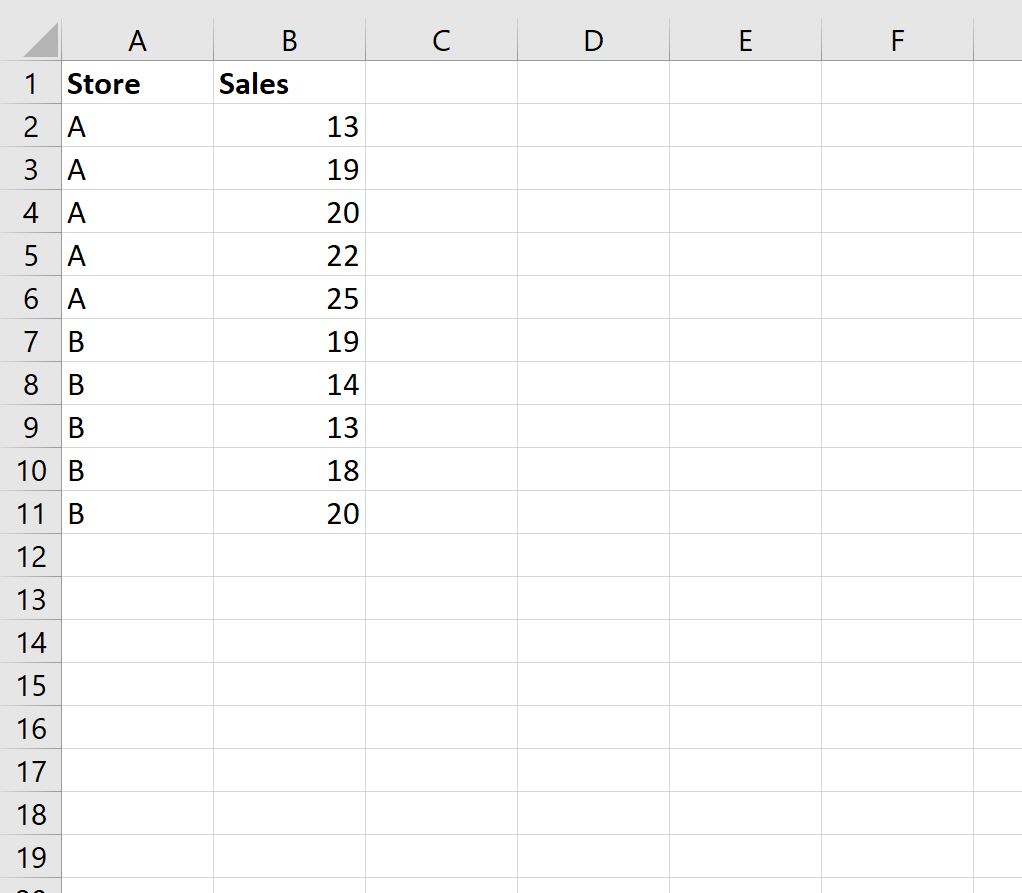
L’une des erreurs les plus fréquentes et méthodologiquement destructrices dans la manipulation des données sous tableur réside dans l’application aveugle d’un décalage temporel vertical sur des données de panel non consolidées ou stratifiées par groupes. Les données de panel, ou séries temporelles empilées, regroupent les trajectoires chronologiques de multiples entités statistiques distinctes (unités commerciales, filiales géographiques, patients d’un essai clinique ou instruments boursiers) au sein d’une table unique ordonnée successivement par identifiant d’entité puis par date.
Si l’analyste applique la formule élémentaire =DECALER(B3; -1; 0) le long de la colonne sans distinction logique, un phénomène pernicieux de contamination croisée inter-groupes survient inéluctablement à chaque transition d’unité statistique. Lors de la première observation chronologique de l’entité $B$, la formule remontera chercher par translation spatiale la dernière observation chronologique de l’entité $A$, assignant ainsi un passé factice issu d’une entité totalement étrangère. Ce débordement contamine de manière invisible les estimations économétriques, faussant les régressions à effets fixes ou aléatoires et générant des corrélations fallacieuses d’autant plus insidieuses qu’aucune erreur logicielle apparente n’est émise par le tableur.
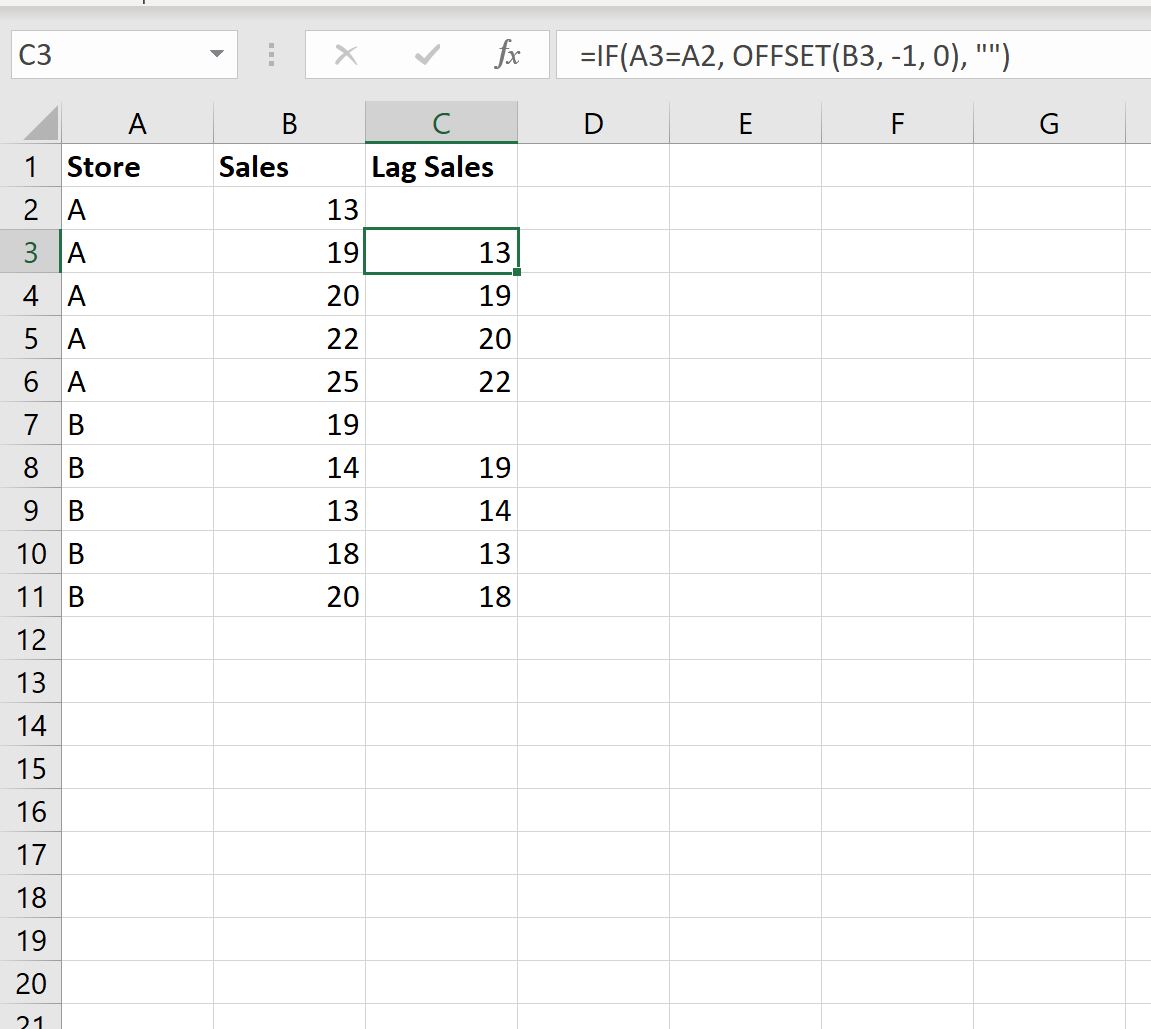
5.2 Imbrication logique conditionnelle : Utilisation de la structure =SI(A3=A2; DECALER(B3; -1; 0); « »)
Pour immuniser l’architecture de calcul contre ce risque de contagion spatiale, il est obligatoire d’assujettir l’exécution du décalage à un test de cohérence taxonomique au moyen de la fonction logique SI. L’algorithme doit préalablement vérifier que l’identifiant de groupe associé à la ligne courante est strictement superposable à l’identifiant de groupe situé sur la ligne immédiatement supérieure. Si et seulement si cette égalité fondamentale est validée, l’opération de translation temporelle est formellement autorisée.
Imaginons une structure de données où la colonne A consigne l’identifiant textuel du magasin (par exemple "Magasin_Nord" pour les cinq premières lignes, puis "Magasin_Sud" pour les suivantes), la colonne B répertorie la période chronologique, et la colonne C contient les chiffres d’affaires correspondants. Dans la colonne D, destinée à recevoir le décalage conditionnel, la formule canonique inscrite en cellule D3 s’énonce comme suit :
=SI(A3=A2; DECALER(C3; -1; 0); "")
Dans ce montage logique, lorsque la cellule active inspecte une ligne de transition (le premier point temporel du Magasin_Sud), le prédicat A3=A2 renvoie l’état booléen FAUX. L’évaluation court-circuite alors l’appel à la fonction DECALER et affecte immédiatement le résultat alternatif, à savoir une chaîne de caractères vide matérialisée par les guillemets jumelés "". La frontière entre sous-populations est ainsi hermétiquement préservée.
5.3 Traitement des discontinuités de groupe et initialisation des sous-séries
L’utilisation de la chaîne textuelle vide "" comme valeur sentinelle lors des transitions de cohortes présente l’avantage d’une clarté visuelle immédiate, isolant nettement les blocs de données dans la feuille de calcul. Toutefois, cette approche engendre des contraintes computationnelles en aval. Dans le modèle de données interne d’Excel, une cellule contenant "" n’est pas traitée comme une cellule numérique vide, mais comme un type chaîne de longueur nulle. Si une cellule subordonnée tente d’effectuer une opération arithmétique directe sur cette valeur (par exemple le calcul d’une variation relative du type =(C3-D3)/D3), le moteur d’évaluation lèvera instantanément une erreur bloquante de discordance de type #VALEUR!.
Afin de concilier propreté conceptuelle et robustesse mathématique, les standards d’ingénierie préconisent de remplacer la chaîne vide par la fonction standardisée d’indisponibilité statistique : =SI(A3=A2; DECALER(C3; -1; 0); NA()). Bien que l’affichage de l’erreur formelle #N/A dans les cellules de rupture puisse sembler inesthétique, il présente l’immense mérite d’être nativement interprété par les fonctions d’agrégation numérique, qui ignorent ou propagent rigoureusement cette non-disponibilité selon des règles statistiques strictes. Lors des phases ultérieures d’ajustement économétrique ou de modélisation par régression linéaire, un simple filtre automatique écartant les lignes marquées par #N/A permet d’extraire un échantillon de panel sans résidu textuel perturbateur.
5.4 Extension aux critères multi-factoriels via les opérateurs booléens
Dans les contextes d’ingénierie épidémiologique, de recherche agronomique ou de modélisation financière à haute granularité, l’appartenance à un groupe ne se limite pas à un prédicat univarié simple. Les observations de panel sont couramment stratifiées selon plusieurs facteurs orthogonaux : par exemple le code sujet, le numéro de protocole expérimental et le type de traitement administré. Pour étendre le calcul du décalage à ces structures complexes, le test d’appartenance doit synthétiser l’ensemble des dimensions classificatoires en une expression booléenne conjointe au moyen de la fonction ET.
Considérons un tableau où la colonne A consigne l’identifiant du patient, la colonne B la modalité thérapeutique ("Placebo" ou "Traitement_A"), et la colonne C la variable clinique d’intérêt mesurée au fil des visites. La conditionnalité du décalage en ligne 3 s’articulera formellement selon la formule suivante : =SI(ET(A3=A2; B3=B2); DECALER(C3; -1; 0); NA()). Une règle de gouvernance absolue gouverne l’application de ces méthodes : la validité des tests logiques repose sur l’hypothèse d’un tri préalable rigoureux et stable. Avant toute injection de formules décalées conditionnelles, le jeu de données doit impérativement subir un tri multi-niveaux exhaustif portant successivement sur l’ensemble des clés d’identification de groupe, la variable temporelle chronologique constituant impérativement le critère de tri terminal.
6. Méthodes alternatives sans DECALER : Approches par références directes et matricielles
6.1 La référence relative directe simple (=B2) : Avantages et vulnérabilités structurelles
L’approche la plus rudimentaire et la plus couramment adoptée pour reproduire un décalage temporel consiste à renoncer totalement aux fonctions de recherche spatiale pour recourir au pointage d’adresse direct. Dans cette configuration, l’analyste se positionne sur la cellule C3 et saisit simplement la syntaxe =B2, avant de recopier cette affectation le long du tableau. Cette méthode bénéficie d’une simplicité cognitive absolue et d’un coût de traitement computationnel nul, le moteur d’Excel se contentant de résoudre un lien de dépendance direct au sein de son graphe de calcul sans exécuter d’algorithme sous-jacent.
Cependant, cette économie apparente dissimule une fragilité structurelle critique qui proscrit son usage au sein des modèles d’entreprise pérennes. Le pointage direct par référence relative est particulièrement vulnérable aux manipulations physiques de la grille : si un utilisateur insère, déplace ou supprime par inadvertance une ligne au milieu de la série temporelle, la chaîne de dépendances est instantanément rompue. La suppression d’une ligne intermédiaire génère immédiatement des cascades d’erreurs #REF! destructrices sur les cellules sous-jacentes. Plus dangereux encore, l’exécution d’un tri automatique sur une plage de données contenant des références relatives simples corrompt silencieusement l’ordre des liens sans générer le moindre avertissement logiciel, détruisant l’intégrité temporelle du classeur de manière irrémédiable.
6.2 Combinaison INDEX et LIGNE : Une alternative non volatile et robuste
Pour pallier les vulnérabilités du pointage direct tout en évitant les surcoûts des fonctions dynamiques complexes, l’association des fonctions primitives INDEX et LIGNE constitue la solution d’ingénierie de référence. La fonction INDEX permet de renvoyer le contenu d’un scalaire situé à l’intersection d’une ligne et d’une colonne au sein d’une matrice bornée immuable. En couplant cette capacité d’extraction matricielle à la fonction LIGNE(), qui restitue dynamiquement l’indice numérique de la ligne de la cellule courante, on formule une expression déterministe d’une robustesse exceptionnelle.
Pour évaluer le décalage univarié de la série située dans la colonne B, la syntaxe implémentée en cellule C3 se formule comme suit :
=INDEX(B:B; LIGNE()-1)
Dans ce modèle, l’expression LIGNE()-1 calcule dynamiquement l’indice de la rangée précédente indépendamment de tout déplacement spatial relatif de la cellule. Si la formule se situe physiquement à la ligne 3, elle interroge formellement la 2ème composante du vecteur B:B. Pour renforcer la sécurité du modèle contre d’éventuelles insertions d’en-têtes, il est préférable d’ancrer le calcul sur une plage explicitement bornée en calibrant l’indice par rapport à la première ligne de données : =INDEX($B$2:$B$100; LIGNE() - LIGNE($B$2:$B$100)). Cette formulation résiste remarquablement aux tris partiels et conserve son intégrité géométrique même lors d’opérations lourdes de réorganisation tabulaire.
6.3 Comparaison des performances de calcul entre DECALER et INDEX
Le choix entre DECALER et le couple INDEX/LIGNE ne relève pas d’une simple préférence esthétique, mais procède d’un arbitrage technique lié à l’architecture interne du moteur d’évaluation d’Excel. La fonction DECALER est officiellement classée dans la catégorie des fonctions volatiles. Une fonction volatile se distingue par une propriété pénalisante : elle est systématiquement recalculée lors de toute modification intervenant n’importe où dans le classeur, même si l’opération d’édition concerne une cellule totalement indépendante et située sur une feuille distincte.
Dans un classeur modeste comportant quelques dizaines de lignes, l’impact de cette volatilité demeure imperceptible. En revanche, lorsque le décalage temporel doit être déployé sur des séries financières à haute fréquence ou des bases de panel excédant 100 000 enregistrements, la présence de 100 000 instances d’une fonction volatile force le processeur à réévaluer l’intégralité du tableau à chaque frappe clavier. Cette sollicitation permanente engendre des gels d’interface récurrents et des délais de traitement massifs. À l’inverse, la fonction INDEX est rigoureusement non volatile : elle n’est réévaluée que si et seulement si l’une des cellules de sa plage d’antécédents directs subit une altération effective. Les bancs d’essai démontrent que la substitution de DECALER par INDEX sur des matrices volumineuses divise couramment le temps de recalcul global par un facteur de 10 à 50, érigeant INDEX en standard architectural absolu pour les environnements de production d’entreprise.
7. Exploitation moderne avec Excel 365 : Fonctions matricielles dynamiques et LAMBDA
7.1 Création d’une fonction personnalisée LAG via le gestionnaire de noms et LAMBDA
L’introduction du moteur de calcul matriciel dynamique et du formalisme LAMBDA dans Microsoft 365 a constitué une véritable révolution de paradigme, permettant aux analystes de concevoir leurs propres fonctions natives réutilisables sans recourir à la programmation en Visual Basic. En exploitant la fonction LAMBDA, il devient enfin possible de combler définitivement l’omission historique d’Excel en déclarant une fonction personnalisée universelle baptisée LAG dotée d’une signature logicielle claire et intuitive.
Pour implémenter cette abstraction au sein d’un classeur, l’analyste accède au Gestionnaire de noms (ruban Formules > Gestionnaire de noms) et crée une nouvelle entité nommée LAG, en y associant la définition fonctionnelle suivante :
=LAMBDA(vecteur; k; CHOISIRLIGNES(vecteur; SEQUENCE(LIGNES(vecteur)-k; 1; 1)))
Dès lors que ce nom est validé, l’utilisateur final peut invoquer directement la commande =LAG(B2:B100; 1) dans n’importe quelle cellule de la grille de calcul. Le formalisme LAMBDA encapsule intégralement la plomberie mathématique et les translations spatiales, masquant les détails d’implémentation pour n’exposer qu’une interface déclarative pure. Cette approche garantit une gouvernance centralisée : toute amélioration de l’algorithme sous-jacent au sein du gestionnaire de noms se répercute instantanément sur l’ensemble des formules du classeur, tout en éliminant les risques de divergences de syntaxe entre différents services opérationnels.
7.2 Utilisation combinée de CHOISIRLIGNES (CHOOSEROWS) et SEQUENCE
L’implémentation matricielle avancée sous Excel 365 s’appuie principalement sur la synergie entre deux fonctions dynamiques contemporaines : CHOISIRLIGNES (identifiée sous le nom CHOOSEROWS en version anglaise) et SEQUENCE. La fonction CHOISIRLIGNES permet d’extraire un sous-ensemble arbitraire d’enregistrements au sein d’une matrice source en lui transmettant un vecteur d’indices numériques ordonnés. La fonction SEQUENCE se charge quant à elle de synthétiser par calcul ce vecteur d’adresses virtuelles.
Pour matérialiser un décalage d’ordre $k$ sur une plage vectorielle continue $B$, l’objectif consiste à prélever les lignes indicées de $1$ jusqu’à $N-k$, et à les repositionner spatialement en face des périodes $1+k$ à $N$. Pour injecter élégamment les valeurs manquantes structurelles ($k$ observations initiales non définies) sans corrompre la géométrie de la matrice restituée, on mobilise conjointement la fonction PILE.V (VSTACK). L’expression complète unifiée s’articule comme suit :
=PILE.V(LAMBDA_EXP; CHOISIRLIGNES(B2:B11; SEQUENCE(LIGNES(B2:B11)-1; 1; 1)))
En remplaçant LAMBDA_EXP par une matrice de non-disponibilité générée via l’expression matricielle CHOISIRLIGNES({#N/A}; SEQUENCE(k; 1; 1; 0)), l’analyste dispose d’un opérateur vectorisé complet capable d’ajuster simultanément la tête et le corps de la série temporelle en une évaluation logique unique.
7.3 Déploiement matriciel automatique sans recopie incrémentielle
La rupture fondamentale introduite par les fonctions matricielles dynamiques réside dans le mécanisme d’extension automatique de zone, communément désigné sous le vocable technique de propagation (ou Spill). Contrairement aux démarches traditionnelles exigeant d’étirer manuellement une cellule maîtresse sur des milliers de rangs par recopie incrémentielle, l’injection d’une formule matricielle vectorisée en une cellule d’ancrage unique (par exemple C2) ordonne au moteur de calcul de déverser instantanément l’intégralité du vecteur décalé sur la hauteur requise.
Cette automatisation éradique radicalement l’un des risques opérationnels majeurs des feuilles de calcul : le syndrome de la formule tronquée, survenant lorsqu’un utilisateur omet d’étirer une formule jusqu’au terme absolu d’une base de données récemment enrichie. Toutefois, ce mécanisme de déversement introduit une contrainte stricte matérialisée par l’apparition de l’erreur d’obstruction #PROPAGATION! (ou #SPILL!). Cette anomalie se déclenche dès lors qu’une cellule quelconque située sur la trajectoire théorique d’extension de la matrice contient une donnée résiduelle, un format textuel ou même un espace invisible. La résolution de ce blocage impose le dégagement intégral de la plage sous-jacente, garantissant une restitution vectorielle fluide optimisée par le moteur multithread natif des versions contemporaines d’Excel.
8. Applications analytiques avancées des variables retardées sous Excel
8.1 Calcul des taux de croissance et variations relatives périodiques
L’application économique et financière la plus universelle des variables décalées concerne la dérivation des métriques d’évolution conjoncturelle, qu’il s’agisse de variations en niveau ou de taux de croissance relatifs. La variation absolue d’une grandeur temporelle entre deux périodes successives correspond à la première différence discrète, notée mathématiquement $\Delta y_t = y_t – y_{t-1}$. Sous Excel, une fois la colonne du décalage simple constituée en colonne C en regard des valeurs brutes de la colonne B, cette quantité s’obtient trivialement par la formulation arithmétique =B3-C3.
Pour dériver le taux de variation relative périodique, couramment mobilisé pour mesurer l’inflation, la croissance du chiffre d’affaires ou le rendement discret d’un actif coté, la formulation mathématique standardisée s’établit selon le ratio :
$$g_t = \frac{y_t – y_{t-1}}{y_{t-1}} = \frac{y_t}{y_{t-1}} – 1$$
Sous Excel, la saisie en cellule cible s’exprime sous la forme =(B3-C3)/C3. Cette formule élémentaire exige toutefois des protocoles de protection arithmétique rigoureux. Si le dénominateur $y_{t-1}$ consigné en cellule C3 est rigoureusement nul, le moteur interrompt le calcul en affichant l’erreur de division par zéro #DIV/0!. De surcroît, si la série sous-jacente admet des grandeurs financières négatives (par exemple des résultats d’exploitation en perte), l’application aveugle de ce ratio engendre des inversions de signe fallacieuses. L’analyste rigoureux sécurise dès lors l’expression au moyen d’une double garde conditionnelle : =SI(OU(C3=0; NON(ESTNUM(C3))); NA(); (B3-C3)/ABS(C3)), en appliquant un formatage de pourcentage strict sur la plage résultante.
8.2 Détection de l’autocorrélation et modélisation autorégressive (AR)
L’exploitation conjointe d’une série chronologique contemporaine et de ses versions décalées successives permet de matérialiser directement l’outil de diagnostic fondamental de l’économétrie des séries temporelles : le corrélogramme. En confrontant le vecteur de données $y_t$ à son homologue retardé $y_{t-1}$, l’analyste peut mobiliser la fonction statistique COEFFICIENT.CORRELATION (ou PEARSON) pour quantifier formellement le coefficient d’autocorrélation d’ordre un ($r_1$) :
=COEFFICIENT.CORRELATION(B3:B100; C3:C100)
En reproduisant cette opération d’estimation croisée avec les colonnes de décalage d’ordre supérieur ($t-2$, $t-3$, etc.) préalablement calculées, il devient possible de tracer un graphique à barres récapitulant les corrélations séquentielles, offrant une vue immédiate de la vitesse de résorption de la mémoire stochastique du processus.
Cette architecture sert de tremplin à l’estimation d’un modèle autorégressif d’ordre un, couramment désigné sous le sigle AR(1), dont l’équation s’énonce selon la relation linéaire $y_t = \phi_0 + \phi_1 y_{t-1} + \epsilon_t$, où $\phi_1$ caractérise le coefficient de persistance dynamique et $\epsilon_t$ représente le bruit blanc résiduel. En utilisant la fonction native d’estimation linéaire matricielle DROITEREG (ou la fonction PENTE), l’analyste évalue instantanément ce paramètre structurel par l’expression =PENTE(B3:B100; C3:C100). Si la valeur absolue du coefficient estimé $|\hat{\phi}_1|$ est strictement inférieure à l’unité, le processus satisfait aux conditions élémentaires de stationnarité au sens faible, autorisant la mise en œuvre de prévisions prospectives fiables.
8.3 Calcul de moyennes mobiles intégrant des variables décalées
Dans les démarches d’analyse technique et de lissage conjoncturel, la moyenne mobile constitue un filtre passe-bas standardisé destiné à éliminer le bruit stochastique haute fréquence pour révéler la tendance sous-jacente d’une série. Il existe cependant une confusion méthodologique fréquente entre moyennes mobiles centrées et moyennes mobiles rétrospectives strictement causales. Une moyenne mobile centrée intègre des données passées, présentes et futures ($t-1$, $t$, $t+1$), ce qui la rend impropre à toute modélisation prédictive en temps réel en raison de l’injection d’une distorsion de projection prospective.
Pour construire une moyenne mobile strictement causale et retardée d’ordre 3, l’analyste doit encapsuler les observations décalées de façon à ce que le lissage n’exploite aucune information issue du temps contemporain $t$ :
$$\bar{y}_{t-1}^{(3)} = \frac{y_{t-1} + y_{t-2} + y_{t-3}}{3}$$
Cette métrique se construit sous Excel soit par la sommation directe des colonnes de décalage préalablement établies via =MOYENNE(C4:E4), soit en exploitant de manière synthétique la capacité de redimensionnement de la fonction DECALER appliquée depuis le point contemporain : =MOYENNE(DECALER(B4; -3; 0; 3; 1)). Dans cette seconde formulation, le paramètre $-3$ remonte de trois crans dans la colonne, tandis que le paramètre de hauteur $3$ ordonne d’englober un vecteur descendant de trois cellules, capturant précisément les instants $t-3$, $t-2$ et $t-1$. Ce lissage purement rétrospectif immunise formellement l’étude contre tout biais d’anticipation temporelle (ou look-ahead bias).
9. Gestion des erreurs méthodologiques et pièges fréquents du Lag sous Excel
9.1 Résolution des erreurs de référence #REF! en début de série
L’apparition brutale de l’erreur d’adressage spatial #REF! constitue l’incident le plus récurrent lors de l’implémentation de variables retardées. Cette interruption se produit mécaniquement lorsque l’argument de translation négative appliqué à la coordonnée des ordonnées force le moteur de calcul à franchir la limite supérieure absolue de la feuille de travail, c’est-à-dire en amont de la ligne 1. Ce cas se présente typiquement lorsqu’une série chronologique est positionnée dès le sommet absolu de la grille ou lorsque l’opérateur tente d’étirer uniformément un décalage d’ordre élevé $k$ sur les $k$ premières lignes du jeu de données.
Pour éradiquer préventivement cette vulnérabilité au sein des modèles automatisés, l’architecture de calcul doit encapsuler le pointeur de recherche dans une structure de garde d’interception d’erreur via la fonction standardisée SIERREUR :
=SIERREUR(DECALER(B2; -k; 0); NA())
Cependant, l’utilisation aveugle de SIERREUR doit être opérée avec discernement épistémologique. Si elle résout élégamment l’inaccessibilité géométrique des lignes négatives, elle risque de masquer silencieusement d’autres anomalies graves, telles que des corruptions de plages induites par des suppressions accidentelles de colonnes sources. Une alternative méthodologiquement supérieure consiste à vérifier explicitement le numéro d’ordre de la ligne active avant d’autoriser l’évaluation du décalage temporel :
=SI(LIGNE() - LIGNE($B$2) >= k; DECALER(B2; -k; 0); NA())
Cette formulation déterministe prévient en amont toute tentative de lecture hors bornes sans solliciter inutilement les routines de traitement d’interruption du processeur.
9.2 Impact des opérations de tri et d’insertion de lignes sur DECALER
L’utilisation de la fonction DECALER repose sur un postulat implicite fondamental : la stricte équivalence entre l’espace métrique physique de la grille (l’ordonnancement séquentiel des numéros de lignes) et l’espace temporel logique des phénomènes modélisés. Si cette correspondance biunivoque est altérée, l’ensemble de l’édifice mathématique s’effondre. Le risque le plus critique découle de l’application désinvolte d’un tri multicritère sur un tableau de données comportant des colonnes de décalage spatiales.
Considérons un tableau trié initialement par ordre chronologique. Si un utilisateur applique soudainement un tri descendant sur la colonne des volumes de vente pour repérer les plus fortes performances commerciales, l’ordre physique des enregistrements est bouleversé. Or, la fonction DECALER(B10; -1; 0) continuera imperturbablement d’extraire la valeur située physiquement sur la ligne 9, laquelle ne correspond plus du tout à la période temporelle $t-1$, mais à une transaction de vente totalement aléatoire issue du tri. Le décalage temporel est ainsi dénaturé sans qu’aucune erreur visuelle n’apparaisse. Pour verrouiller les classeurs contre ce péril, deux bonnes pratiques s’imposent : incorporer une colonne d’index chronologique immuable (numérotée de 1 à $N$) permettant de restaurer immédiatement le tri originel, et privilégier des architectures fondées sur Power Query lorsque des manipulations de tris croisés sont nécessaires.
9.3 Volatilité de la fonction DECALER et optimisation des classeurs volumineux
Comme explicité dans les fondements algorithmiques de la section 2, DECALER appartient à la famille des fonctions volatiles du tableur. Dans des classeurs financiers d’entreprise comportant des dizaines d’onglets interconnectés et des centaines de milliers de lignes de reporting, l’omniprésence de formules volatiles induit des temps de latence majeurs. À chaque saisie d’un scalaire ou à chaque modification mineure, l’arborescence complète des calculs dépendants est invalidée, contraignant Excel à recalculer la totalité des expressions temporelles, paralysant les sessions de travail des utilisateurs.
Face à des classeurs manifestant des symptômes avérés de surcharge computationnelle, une stratégie d’ingénierie progressive doit être déployée. Le premier niveau d’optimisation consiste à convertir systématiquement les blocs de formules DECALER par leur équivalent non volatil INDEX/LIGNE. Si le modèle a atteint une phase de stabilité définitive et que les séries historiques ne sont plus sujettes à révision, le second niveau d’assainissement consiste à figer définitivement les colonnes de décalage en valeurs scalaires pures (commande Copier puis Coller en valeurs), ne conservant les formules dynamiques actives que sur la frange terminale des données récemment injectées.
9.4 Gestion des données manquantes, cellules vides et ruptures de continuité
Le traitement des lacunes d’observation constitue un défi méthodologique classique dans la manipulation des séries temporelles sous tableur. Par défaut, le comportement intrinsèque du moteur de calcul d’Excel face à une cellule source vide est source d’ambiguïté : lorsqu’une formule de type =DECALER(B3; -1; 0) pointe vers une cellule ne contenant aucune valeur, Excel convertit automatiquement cette absence en la valeur numérique zéro ($0$). Dans un contexte d’analyse statistique, cette substitution automatique est inacceptable : une absence de cotation financière ou une journée sans relevé météorologique ne sauraient être confondues avec un rendement nul ou une température de zéro degré.
Pour contourner ce biais d’interprétation, il est impératif d’intégrer une clause de vérification de vacuité au sein de la formule de décalage :
=SI(ESTVIDE(DECALER(B3; -1; 0)); NA(); DECALER(B3; -1; 0))
Une fois les cellules manquantes formellement identifiées par le marqueur standard #N/A, deux voies de traitement méthodologique s’offrent à l’analyste :
- L’interpolation linéaire : Elle consiste à estimer les valeurs absentes au prorata de l’intervalle temporel séparant les observations valides les plus proches, garantissant une transition continue de la trajectoire.
- La méthode de la dernière observation valide (LOCF) : Communément désignée sous l’acronyme anglais Last Observation Carried Forward, cette règle reporte systématiquement la dernière grandeur observée jusqu’à l’apparition d’un nouveau point de mesure, maintenant le niveau constant en palier.
10. Conception de fonctions « Lead » (décalage prospectif ou anticipation temporelle)
10.1 Principes théoriques du décalage prospectif (t+1, t+k)
Symétrique exact de l’opérateur de retard temporel, l’opérateur d’avance temporelle, conventionnellement désigné sous le vocable Lead ou opérateur d’anticipation prospective $F$ (pour Forward shift operator), est formellement défini par l’expression mathématique $F^k y_t = y_{t+k}$, où $k in \mathbb{N}^*$. Dans ce cadre, la variable courante observée à l’instant contemporain $t$ est mise en perspective avec les réalisations futures du système aux horizons $t+1$, $t+2$ ou $t+k$.
Sur le plan de l’épistémologie des données et de l’apprentissage statistique supervisé, l’usage des variables de type Lead remplit une fonction fondamentale : elles constituent les cibles prédictives d’entraînement (les labels ou variables dépendantes $y$) dans les régressions supervisées visant à calibrer des modèles projectifs à partir de descripteurs contemporains $x_t$. Cependant, la manipulation de variables prospectives impose une discipline éthique et méthodologique absolue afin d’éviter le piège dévastateur du biais de projection future (ou look-ahead bias). Ce biais cognitif survient lorsqu’une variable prospectant l’avenir est injectée par mégarde parmi les variables explicatives d’un algorithme prédictif, engendrant des performances artificiellement parfaites lors des phases de tests rétrospectifs (backtesting), mais provoquant l’effondrement intégral du modèle lors de son déploiement en conditions opérationnelles réelles.
10.2 Adaptation de la syntaxe DECALER avec arguments de lignes positifs
La transcription technique de l’opérateur d’avance prospective sous Excel s’avère particulièrement limpide. Puisque les enregistrements chronologiques progressent vers le bas de la feuille de calcul (les indices de rangs croissant à mesure que l’on s’avance dans le futur), l’application d’un décalage orienté vers l’avenir nécessite simplement d’inverser le signe arithmétique attribué au deuxième paramètre de la fonction DECALER.
Pour construire une variable prospective univariée d’ordre un ($t+1$, Lead 1) face à la série contemporaine positionnée en colonne B, la syntaxe inscrite en cellule C2 (correspondant à l’instant initial $t=1$) s’articule comme suit :
=DECALER(B2; 1; 0)
Contrairement au cas du Lag où la troncature structurelle frappe la tête de la série (premières lignes privées de passé), la mécanique du Lead déplace la frontière de non-disponibilité vers le pied absolu du tableau. Pour la dernière observation temporelle consignée sur la ligne $N$, il n’existe par définition aucun futur disponible dans l’échantillon collecté. L’extension aveugle de la formule sur cette rangée terminale pointe dès lors vers une cellule vide ou vers les bordures inférieures du tableau, imposant l’insertion de clauses conditionnelles pour sécuriser l’évaluation :
=SI(LIGNE() < LIGNE($B$11); DECALER(B2; 1; 0); NA())
10.3 Applications comparatives : Analyses prospectives versus rétrospectives
L’utilisation combinée et simultanée des colonnes de Lag et de Lead autour d’une colonne contemporaine offre un cadre d’exploration dimensionnelle particulièrement fécond pour la méthodologie des études d’événements (event studies). En économie financière, l’analyse d’un choc exogène majeur (annonce de résultats trimestriels, fusion-acquisition ou intervention d’une banque centrale) requiert d’isoler une fenêtre temporelle étroite structurée symétriquement de part et d’autre de l’instant critique $t_0$.
Dans ce canevas, les colonnes retardées quantifient la dynamique structurelle préexistante et l’ajustement ex-ante du marché, tandis que les colonnes prospectives isolent la trajectoire de réaction et de réallocation ex-post. De surcroît, la confrontation directe du ratio d’élasticité prévisionnelle unissant les variations anticipées $\frac{y_{t+1}-y_t}{y_t}$ aux variations enregistrées antérieurement $\frac{y_t-y_{t-1}}{y_{t-1}}$ permet d’estimer les indicateurs d’accélération conjoncturelle et de formaliser des oscillateurs d’inversion de tendance (momentum). L’analyste peut ainsi concevoir des visualisations graphiques avancées superposant la courbe native, son ombre passée et sa projection anticipée, offrant aux comités d’investissement une lisibilité accrue des dynamiques de transition.
11. Automatisation et industrialisation du calcul de Lag via Power Query et VBA
11.1 Génération de colonnes indexées et fusion de requêtes décalées dans Power Query
Lorsque les données chronologiques proviennent de flux externes réguliers et excèdent les capacités d’un classeur classique, l’utilisation de l’outil ETL natif Power Query constitue l’approche d’industrialisation la plus robuste. Power Query permet de manipuler les transformations vectorielles en mémoire sans inscrire la moindre formule au sein des cellules de la feuille Excel finale, éliminant ainsi toute volatilité et tout risque d’altération accidentelle par les utilisateurs.
L’algorithme de décalage sous Power Query repose sur une technique de fusion auto-relationnelle via des index désynchronisés. Le protocole s’articule selon les étapes normalisées suivantes :
- Étape 1 : Importer la table de données chronologiques dans l’éditeur Power Query et s’assurer que la colonne temporelle fait l’objet d’un tri croissant irréprochable.
- Étape 2 : Générer une première colonne d’index débutant à 0 (ruban Ajouter une colonne > Colonne d’index > À partir de 0), désignée sous le nom technique
Index_0. - Étape 3 : Générer une seconde colonne d’index débutant à 1 au sein de la même table (Ajouter une colonne > Colonne d’index > À partir de 1), nommée
Index_1. - Étape 4 : Réaliser une opération de jointure interne ou externe gauche de la requête sur elle-même (ruban Accueil > Fusionner des requêtes). La clé de jointure de la table primaire est configurée sur
Index_0, tandis que la clé de correspondance de la table secondaire fusionnée est assignée àIndex_1. - Étape 5 : Développer la colonne de table issue de la fusion en sélectionnant exclusivement la variable d’intérêt que l’on souhaite décaler. L’enregistrement contemporain de la rangée $i$ (indexé à $i$) se retrouve dès lors formellement fusionné avec l’enregistrement antérieur provenant de l’index $i-1$.
Cette méthodologie d’ingénierie relationnelle garantit un traitement ultra-performant, entièrement reproductible lors de chaque actualisation de classeur et scalable sur des millions d’enregistrements sans aucune instabilité d’affichage.
11.2 Écriture d’une macro-fonction VBA personnalisée pour un calcul Lag vectorisé
Pour les contextes où l’utilisateur final doit conserver la possibilité d’invoquer une fonction interactive au sein de la grille de calcul sur des versions historiques d’Excel ne disposant pas de la technologie matricielle dynamique 365, le recours aux fonctions personnalisées écrites en Visual Basic for Applications (VBA), communément désignées sous l’acronyme UDF (User Defined Functions), offre une flexibilité totale. Une conception optimisée impose de manipuler les données en mémoire vive sous forme de tableaux de variantes (Variant Arrays) afin de contourner l’extrême lenteur des interactions directes avec l’interface graphique de la feuille de calcul.
L’architecture algorithmique de la fonction s’implémente dans un module de code standardisé selon la structure suivante :
Function LAG_VBA(PlageSource As Range, Optional ByVal OrdreK As Long = 1) As Variant
Dim DonneesEntree As Variant
Dim MatriceSortie As Variant
Dim NbLignes As Long, i As Long
DonneesEntree = PlageSource.Value2
If Not IsArray(DonneesEntree) Then Exit Function
NbLignes = UBound(DonneesEntree, 1)
ReDim MatriceSortie(1 To NbLignes, 1 To 1)
For i = 1 To NbLignes
If i <= OrdreK Then
MatriceSortie(i, 1) = CVErr(xlErrNA)
Else
MatriceSortie(i, 1) = DonneesEntree(i - OrdreK, 1)
End If
Next i
LAG_VBA = MatriceSortie
End Function
Cette implémentation vectorisée garantit un temps d’exécution quasi-instantané : le tableau source est copié en une opération unitaire au sein du processeur, le décalage d’indice s’exécute dans une boucle itérative optimisée affectant la constante d’erreur standard CVErr(xlErrNA) sur les $k$ premières cellules, avant de restituer la matrice intégrale en sortie sans requérir la moindre fonction volatile.
11.3 Comparatif méthodologique : Formules de feuille, Power Query ou macro VBA
L’arbitrage entre les différentes stratégies d’implémentation du décalage temporel doit s’opérer au regard d’une grille de sélection multicritères évaluant la volumétrie des données, la complexité organisationnelle de l’infrastructure informatique et le profil de compétences des utilisateurs finaux :
- Formules de feuille de calcul (INDEX/LIGNE, LAMBDA 365) : Solution optimale pour les travaux d’analyse exploratoire, le prototypage rapide et les modèles financiers interactifs nécessitant une traçabilité visuelle immédiate des dépendances mathématiques. Elle offre une portabilité totale sans contrainte de sécurité liée aux macros, mais demeure soumise à la vigilance humaine face aux insertions de lignes.
- Power Query : Standard d’excellence pour l’ingénierie des données à forte volumétrie, les rapports périodiques institutionnels et les tableaux de bord décisionnels connectés à des sources de données relationnelles. Cette solution garantit une robustesse architecturale absolue, une absence totale de charge sur le processeur lors de la consultation et une reproductibilité certifiée, au détriment de l’immédiateté d’évaluation en temps réel (l’actualisation nécessitant une commande explicite).
- Macros VBA vectorisées : Outil spécialisé préconisé au sein des systèmes informatiques patrimoniaux ou des classeurs d’entreprise distribués sous d’anciennes versions d’Excel ne supportant pas les matrices dynamiques. Cette méthode allie la vitesse de calcul à la commodité de la syntaxe de cellule, mais introduit des vulnérabilités de gouvernance liées aux politiques de sécurité d’entreprise bloquant l’exécution du code macroactif (fichiers
.xlsm).
12. Protocole de validation et bonnes pratiques pour l’audit des modèles sous Excel
12.1 Procédures d’audit et de traçabilité des dépendances de cellules
La validation formelle d’un modèle incorporant des variables retardées impose l’application d’un protocole d’audit méthodique visant à certifier l’intégrité du réseau de dépendances cellulaires. Excel intègre des outils d’inspection graphique de pointe au sein du ruban Formules (groupe Audit de formules). Les commandes Repérer les antécédents et Repérer les dépendants matérialisent visuellement par des traceurs fléchés bleus la trajectoire spatiale des flux d’information.
L’analyste doit inspecter systématiquement les lignes de transition pour s’assurer de l’absence totale de dérive vectorielle : la flèche d’antécédent pointant vers un calcul de Lag doit invariablement remonter vers la rangée antérieure désignée sans divergence oblique. Un contrôle critique porte sur l’absence formelle de références circulaires accidentelles, incident survenant fréquemment lorsqu’un modèle tente de lisser un décalage en utilisant une valeur contemporaine déjà modélisée par le retard lui-même. Enfin, l’activation du mode d’affichage global des formules (via la combinaison de touches Ctrl + " ou Ctrl + Alt + ') permet d’effectuer un audit textuel panoramique sur toute la hauteur de la grille, confirmant l’homogénéité stricte de la syntaxe déployée.
12.2 Documentation des décalages et standardisation des conventions de nommage
Dans un contexte de recherche académique ou de modélisation financière soumise aux contraintes réglementaires (telles que les normes Sarbanes-Oxley ou les audits prudentiels IFRS 9), la transparence documentaire d’un classeur est aussi cruciale que son exactitude arithmétique. Une série temporelle modélisée ne doit jamais être affublée d’une étiquette ambiguë susceptible d’induire le lecteur en erreur quant à sa temporalité réelle.
L’ingénierie des modèles préconise une standardisation rigoureuse de la typographie des en-têtes de colonnes en appliquant des suffixes temporels explicites et normalisés :
NomVariable_t: Désigne exclusivement la valeur empirique mesurée à l’instant contemporain.NomVariable_t-1(ouNomVariable_Lag1) : Désigne formellement le décalage univarié d’ordre un.NomVariable_t-k: Documente sans ambiguïté l’ordre structurel $k$ appliqué à la série rétrospective.NomVariable_t+1(ouNomVariable_Lead1) : Identifie formellement la variable prospective anticipée.
De plus, chaque en-tête doit faire l’objet d’une note de cellule détaillée ou d’un commentaire permanent spécifiant la méthode de calcul mobilisée, les modalités de traitement des valeurs initiales et l’hypothèse sous-jacente quant à l’équidistance des pas temporels. Il est hautement recommandé d’ériger, au sein du classeur, une feuille d’infrastructure dédiée aux métadonnées (dictionnaire des variables), répertoriant exhaustivement les définitions mathématiques, les sources de données et les équations employées afin de faciliter l’audit indépendant par les pairs.
12.3 Vérification de l’intégrité des séries avant transmission académique ou opérationnelle
L’étape terminale de tout cycle de modélisation consiste en l’exécution d’une batterie de tests de cohérence logique et de validations croisées automatisées avant toute transmission du classeur aux instances décisionnelles ou éditoriales. L’analyste doit implanter des cellules sentinelles de contrôle logique configurées pour lever des alertes visuelles immédiates en cas d’incohérence.
La première validation porte sur le contrôle de la somme de contrôle cumulée : la somme arithmétique d’une colonne de décalage d’ordre un sur l’intervalle $[t_2, t_N]$ doit correspondre au centime près à la somme de la série originelle contemporaine évaluée sur l’intervalle $[t_1, t_{N-1}]$. Tout écart résiduel signale une distorsion de recopie ou une troncature illégitime de données intermédiaires. Le second contrôle porte sur les métriques descriptives : les moyennes statistiques, variances et extrêmes doivent exhiber une stricte concordance entre la série source et sa transposition retardée. Enfin, la pérennisation du classeur requiert le gel des droits d’édition par le verrouillage des cellules de formules et la protection de la structure des feuilles, garantissant que les protocoles de calcul de décalage temporel élaborés avec rigueur ne puissent être corrompus lors des futures phases d’exploitation opérationnelle.
Références
- Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Davidson, R., & MacKinnon, J. G. (2004). Econometric theory and methods. Oxford University Press. https://global.oup.com/academic/product/econometric-theory-and-methods-9780195123722
- Hamilton, J. D. (1994). Time series analysis. Princeton University Press. https://press.princeton.edu/books/hardcover/9780691042893/time-series-analysis
- Microsoft Corporation. (2023). Fonction DECALER (OFFSET). Support Microsoft. https://support.microsoft.com/fr-fr/office/fonction-decaler-c8de19ae-dd79-4b9b-a14e-b5d5d0421526
- Microsoft Corporation. (2023). Recalcul dans Excel et optimisation des performances. Microsoft Learn. https://learn.microsoft.com/fr-fr/office/client-developer/excel/excel-recalculation
- Microsoft Corporation. (2023). Fonction LAMBDA. Support Microsoft. https://support.microsoft.com/fr-fr/office/fonction-lambda-bd212d27-1cd1-4321-a34a-ccbf254b8b67
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning. https://www.cengage.com/c/introductory-econometrics-a-modern-approach-7e-wooldridge/9781337558860/