
L’évaluation quantitative des phénomènes psychologiques et cognitifs repose fondamentalement sur la capacité du chercheur et du praticien à situer une mesure individuelle au sein d’une distribution populationnelle de référence. Depuis les travaux fondateurs de Carl Friedrich Gauss, d’Adolphe Quetelet et de Francis Galton, la modélisation probabiliste par la courbe en cloche constitue la pierre angulaire de l’inférence statistique appliquée aux sciences humaines. Qu’il s’agisse d’évaluer l’efficience intellectuelle globale au moyen des échelles de Wechsler, de cartographier la sévérité d’un épisode dépressif majeur à travers l’inventaire de Beck, ou de mesurer le déclin cognitif via des tests neuro-psychologiques standardisés, l’assignation rigoureuse d’une probabilité conditionnelle à une performance brute conditionne la validité des diagnostics cliniques et la portée théorique des conclusions expérimentales.
Dans l’écosystème contemporain du traitement de données, si des environnements programmatiques dédiés tels que le langage R ou le logiciel SPSS dominent la recherche académique de pointe, Microsoft Excel demeure l’outil computationnel universellement déployé dans les laboratoires hospitaliers, les cabinets d’évaluation psychologique et les structures institutionnelles. Souvent perçu comme un simple tableur bureautique, le logiciel intègre pourtant un ensemble sophistiqué d’algorithmes mathématiques de haute précision permettant d’exécuter des analyses distributionnelles avancées, de déterminer des rangs centiles exacts et de modéliser des scores seuils sans recourir à une infrastructure de programmation complexe.
Ce guide exhaustif a pour vocation de déconstruire pas à pas les mécanismes sous-jacents aux calculs probabilistes régis par la loi normale sous Microsoft Excel. En articulant les axiomes théoriques de la psychométrie différentielle, l’anatomie syntaxique des fonctions modernes du tableur et des cas d’études cliniques empiriques rigoureusement contextualisés, ce traité fournit aux chercheurs, étudiants et praticiens de santé mentale les compétences techniques et analytiques indispensables pour automatiser le traitement des métriques psychométriques avec un niveau de rigueur académique sans compromis.
1. Fondements théoriques de la loi normale et pertinence en psychométrie
1.1 Propriétés mathématiques de la courbe de Gauss
La distribution normale, souvent qualifiée de distribution gaussienne ou de courbe en cloche, représente sans doute le modèle mathématique continu le plus universel en statistique théorique et appliquée. Elle est entièrement définie par sa fonction de densité de probabilité, notée f(x), dont l’expression analytique fait intervenir deux paramètres scalaires essentiels : la moyenne arithmétique ou espérance mathématique (μ), qui fixe l’ancrage central de la distribution sur l’axe des abscisses, et l’écart-type (σ), strictement positif, qui régit le degré d’étalement ou d’éparpillement des données autour de ce centre. Mathématiquement, cette fonction d’ordonnée s’articule selon l’équation classique suivante :
f(x) = (1 / (σ √(2π))) × exp(- (x – μ)² / (2σ²))
Cette formulation élégante confère à la courbe géométrique plusieurs attributs fondamentaux immuables. Le premier est une symétrie axiale parfaite par rapport à la droite verticale d’équation x = μ. Il découle de cette symétrie que la moyenne, la médiane (le point divisant la surface sous-jacente en deux moitiés égales) et le mode (le point d’ordonnée maximale ou sommet de la cloche) coïncident rigoureusement en une valeur unique. L’écart entre un score observé et la moyenne produit ainsi la même valeur de densité mathématique qu’un écart de signe opposé mais de même amplitude.
Le deuxième attribut géométrique d’importance réside dans l’existence de deux points d’inflexion cardinaux situés précisément aux abscisses x = μ – σ et x = μ + σ. En ces coordonnées exactes, la concavité de la courbe bascule : de concave vers le bas dans la région centrale péri-moyenne, elle devient convexe vers le haut à mesure que l’on progresse vers les extrémités latérales. Ces points délimitent visuellement la transition entre la zone de densité forte et les amorces des queues de distribution.
Enfin, la courbe présente un comportement asymptotique horizontal bilatéral : lorsque la variable indépendante x tend vers l’infini positif ou vers l’infini négatif, l’ordonnée f(x) décroît de manière continue et s’approche indéfiniment de zéro sans jamais l’intercepter formellement. En vertu des principes fondateurs du calcul intégral de Kolmogorov, l’intégrale définie de cette fonction de densité sur l’ensemble du domaine réel — s’étendant de moins l’infini à plus l’infini — est strictement égale à l’unité (1,00). Cette équivalence mathématique absolue établit que l’aire totale enserrée sous la courbe gaussienne incarne l’espace probabiliste universel d’un événement certain.
1.2 Le théorème central limite et la distribution des traits psychologiques
La récurrence quasi systématique de profils gaussiens lors du recueil de données en psychologie différentielle n’est pas un artifice statistique fortuit, mais l’émanation directe d’un principe fondamental de la théorie des probabilités : le théorème central limite. Selon ce théorème, la somme ou la moyenne arithmétique d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées (ou même modérément corrélées) tend asymptotiquement vers une loi normale, quelle que soit la nature distributionnelle spécifique des variables élémentaires sous-jacentes, pourvu que leur variance demeure finie.
Dans l’architecture cognitive humaine et l’organisation de la personnalité, les construits latents complexes — tels que l’efficience cognitive générale (facteur g), l’extraversion, la stabilité émotionnelle ou encore la réactivité anxieuse — ne résultent pas de l’expression isolée d’un déterminant biologique ou contextuel unitaire. Ils constituent l’aboutissement émergent d’une agrégation massive et multifactorielle : des centaines d’allèles génétiques à effet infinitésimal (modèle polygénique), combinés à une myriade d’expériences environnementales, éducatives, épigénétiques et neurobiologiques indépendantes. Par le jeu de l’addition de ces influences élémentaires multiples, la distribution phénotypique macroscopique converge inexorablement vers le gabarit d’une distribution normale au sein de la population générale.
Néanmoins, l’adhésion dogmatique à l’hypothèse de normalité requiert une vigilance méthodologique aiguë dans le domaine de la psychopathologie clinique. De nombreuses dimensions psychopathologiques ne se distribuent pas de manière symétrique dans la population non clinique. Par exemple, la symptomatologie psychotique, le risque suicidaire ou les comportements d’addiction sévère manifestent fréquemment une asymétrie positive prononcée (biais à droite), où une écrasante majorité d’individus présente un score nul ou plancher, tandis qu’une minorité clinique étire une queue leptokurtique vers les valeurs pathologiques extrêmes. Postuler a priori la normalité pour de telles métriques sans validation empirique préalable introduit des biais majeurs dans l’estimation des probabilités d’occurrence et peut compromettre l’étalonnage des dispositifs d’évaluation.
1.3 Standardisation et scores dérivés dans les tests psychométriques
L’exploitation pratique des scores bruts obtenus par un participant à un questionnaire de personnalité ou à une épreuve neuropsychologique s’avère particulièrement complexe. Un score brut — par exemple 42 points sur une épreuve de rétention mnésique ou 18 items réussis à un sous-test de raisonnement matriciel — est dénué de signification intrinsèque absolue si l’on ne dispose pas de la fonction de distribution de l’échantillon normatif d’étalonnage. Pour pallier cette incommensurabilité métrique, la psychométrie recourt à la transformation linéaire des données brutes en scores d’écart standardisés, communément désignés sous l’appellation de scores z.
Le score z exprime l’écart relatif séparant le score brut individuel x de la moyenne empirique de son groupe d’appartenance (μ), quantifié en fractions d’écart-type (σ). Sa formule canonique, z = (x – μ) / σ, projette la variable empirique sur une échelle standardisée invariante : la distribution normale centrée réduite, caractérisée de manière invariable par une moyenne de 0 et un écart-type de 1. Grâce à cette normalisation, les praticiens peuvent comparer directement des performances issues d’instruments de mesure radicalement hétérogènes.
Pour des raisons pratiques, cliniques et pédagogiques — notamment afin d’éviter la manipulation de nombres négatifs ou de décimales —, les psychométriciens dérivent des échelles secondaires par transformation linéaire du score z selon la formulation générale Score dérivé = Moyenne souhaitée + (z × Écart-type souhaité) :
- Le Quotient Intellectuel standard (QI) : ancré sur les échelles d’intelligence de David Wechsler (WAIS, WISC, WPPSI), il repose conventionnellement sur une moyenne μ = 100 et un écart-type σ = 15. Un QI de 115 correspond ainsi rigoureusement à un score z de +1,00, tandis qu’un score de 70 équivaut à z = -2,00.
- Les notes T : largement adoptées dans les inventaires de personnalité tels que le MMPI (Minnesota Multiphasic Personality Inventory) ou le NEO-PI, elles possèdent une moyenne théorique fixée à 50 et un écart-type de 10. Un score T de 65 marque traditionnellement le seuil de significativité clinique.
- Les stanines (Standard Nines) : système métrique divisant la distribution normale en neuf intervalles discrets standardisés, ayant pour moyenne 5 et pour écart-type approximatif 2.
Le calcul des probabilités cumulées sous-jacentes à ces échelles standardisées permet de convertir ces scores métriques en rangs centiles (percentiles). Un percentile indique la proportion exacte d’individus au sein de la cohorte normative qui obtiennent un score strictement inférieur ou égal à une performance donnée. Cette translation probabiliste se révèle fondamentale pour fixer des seuils cliniques diagnostiques objectifs, tels que le seuil de déficience intellectuelle (traditionnellement fixé sous le 2e centile) ou celui du haut potentiel intellectuel (positionné au-delà du 98e centile).
2. Vue d’ensemble des fonctions de distribution normale dans Microsoft Excel
2.1 Évolution historique : de NORMDIST aux fonctions contemporaines
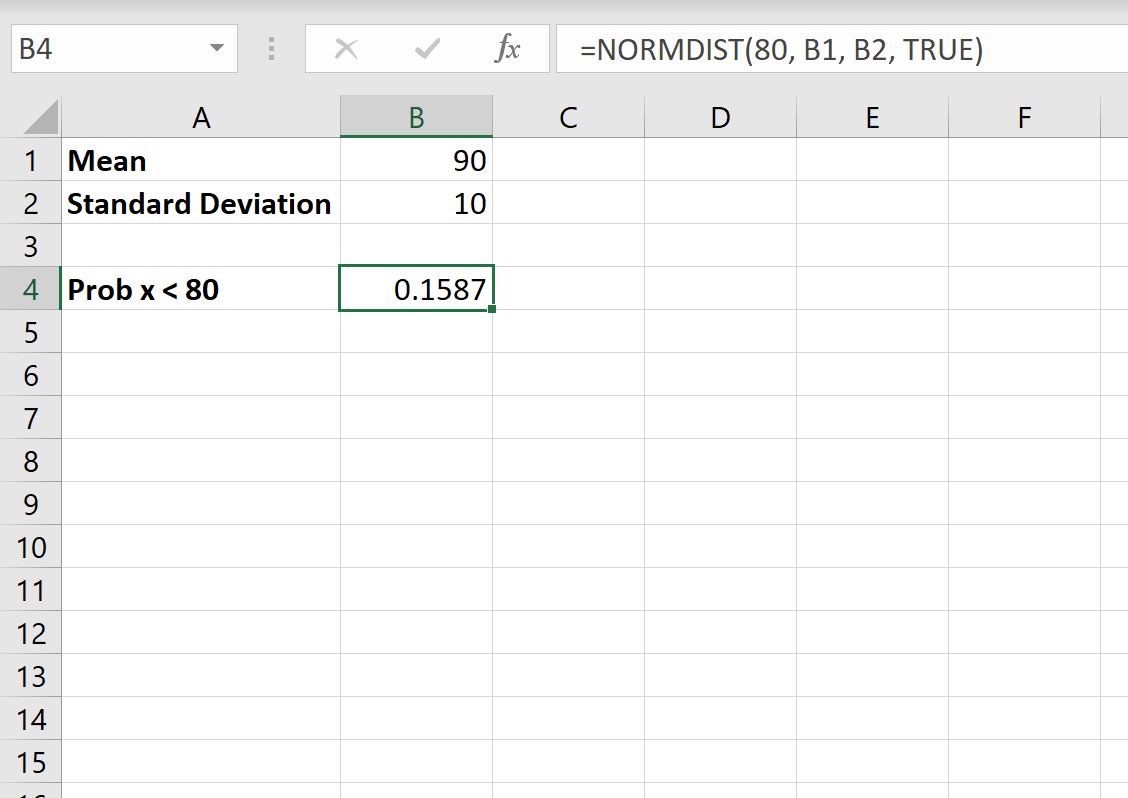
Le traitement des calculs probabilistes au sein du logiciel Microsoft Excel a connu une mutation structurelle d’envergure. Dans les versions préexistantes à Excel 2010, l’évaluation de la distribution gaussienne s’articulait principalement autour de l’instruction LOI.NORMALE (ou NORMDIST dans la nomenclature anglaise). Bien que fonctionnelle pour des opérations d’ingénierie courantes ou des enseignements d’initiation statistique, cette ancienne syntaxe souffrait de limitations numériques identifiées par les statisticiens computationnels, notamment lors de l’exploration des queues de distribution extrêmement distantes (au-delà de 4 ou 5 écarts-types de la moyenne).
À partir de la version 2010, les équipes d’ingénierie logicielle de Microsoft ont procédé à une refonte globale des librairies d’algorithmes statistiques dans le cadre d’un vaste programme d’alignement avec les standards d’exactitude définis par l’IEEE et la communauté scientifique internationale. Cette modernisation a conduit à l’introduction de nouvelles fonctions typées par des suffixes explicites, notamment le point suivi de la lettre N pour signifier l’architecture numérique révisée : LOI.NORMALE.N (traduction directe de NORM.DIST). Ces révisions reposent sur des routines d’approximation rationnelle et des méthodes d’intégration numérique polynomiales perfectionnées, garantissant une précision à double virgule flottante (15 chiffres significatifs) même aux confins des probabilités infinitésimales.
Bien qu’Excel préserve une compatibilité descendante absolue en autorisant l’exécution des classeurs exploitant encore les anciennes fonctions dites de compatibilité (symbolisées visuellement par un triangle jaune de mise en garde dans l’interface contemporaine), les meilleures pratiques méthodologiques en recherche exigent impérativement l’abandon systématique de LOI.NORMALE au profit de LOI.NORMALE.N. L’archivage pérenne des données cliniques et l’auditabilité des protocoles de recherche imposent d’adopter ces fonctions standardisées actuelles pour prévenir toute divergence d’arrondi numérique lors de transferts inter-plateformes.
2.2 Typologie des fonctions dédiées à la loi normale
Afin de manipuler les différentes facettes de la loi normale, Excel propose un quatuor de fonctions complémentaires articulées selon une taxonomie rigoureuse. Cette classification dépend de deux axes : la nature des données traitées (variables brutes non centrées avec moyenne et variance spécifiques vs variable centrée réduite standardisée) et le sens vectoriel du calcul (détermination d’une probabilité à partir d’un score seuil vs calcul d’un score quantile à partir d’un quota de probabilité donné).
Le tableau conceptuel ci-après résume cette typologie fonctionnelle moderne :
LOI.NORMALE.N(x; moyenne; ecart_type; cumulative): La fonction universelle par excellence. Elle calcule soit la densité de probabilité f(x), soit la fonction de répartition cumulée F(x) = P(X ≤ x) pour une variable aléatoire X continue suivant une loi normale générale caractérisée par des paramètres μ et σ quelconques.LOI.NORMALE.STANDARD.N(z; cumulative): Version simplifiée et computationnellement optimisée de la précédente, calibrée spécifiquement pour la distribution normale standard (μ = 0, σ = 1). Elle requiert uniquement le score z et le sélecteur d’intégration cumulée.LOI.NORMALE.INVERSE.N(probabilité; moyenne; ecart_type): L’opérateur réciproque ou fonction quantile de la loi normale générale. Étant donné un niveau de probabilité cumulée unilatérale inférieure compris strictement dans l’intervalle ouvert ]0 ; 1[, elle restitue la valeur exacte de l’abscisse x telle que P(X ≤ x) = probabilité.LOI.NORMALE.STANDARD.INVERSE.N(probabilité): L’inverse quantile dédié à la loi normale centrée réduite. Elle retourne le score z critique correspondant à l’aire cumulée sous-jacente spécifiée en paramètre.
Le choix de l’instruction idoine repose sur l’état de structuration de votre feuille de travail. Si les données empiriques ont préalablement subi une réduction mathématique en scores z dans une colonne distincte, les fonctions dotées du qualificatif STANDARD sont à privilégier pour leur concision syntaxique. Si, à l’inverse, l’analyse porte directement sur les échelles natives d’un test (notes brutes à une batterie neuro-psychologique sans phase de transformation intermédiaire), l’emploi direct de LOI.NORMALE.N élimine les étapes de calcul transitoires et réduit le risque d’erreurs humaines de recopie.
3. Anatomie détaillée de la fonction LOI.NORMALE.N
3.1 Décryptage des arguments de la fonction
L’implémentation opérationnelle de la fonction LOI.NORMALE.N requiert une compréhension exhaustive de ses quatre paramètres formels. Tout manquement dans la saisie ou la typologie de ces arguments compromet irrémédiablement le résultat ou génère des anomalies logiques difficilement décelables lors de traitements statistiques automatisés sur de volumineuses cohortes cliniques.
Le premier argument, noté x, correspond à la valeur empirique scalaire dont l’analyste cherche à évaluer le positionnement probabiliste. Il s’agit du score seuil, de la performance observée chez un patient donné ou de la borne d’intérêt sur l’axe continu de la métrique psychologique (par exemple, un score brut de 85 au test du QI). Cet argument peut être injecté sous la forme d’une constante numérique littérale, du résultat d’une sous-formule arithmétique ou, de manière bien plus préconisée, d’une référence cellulaire dynamique (comme B2).
Le deuxième argument, désigné par moyenne, matérialise l’espérance mathématique μ de la population de calibrage. Il reflète l’ancrage central du modèle théorique de référence. En contexte psychométrique, cette moyenne est issue de tables normatives validées scientifiquement ou déduite de l’échantillon d’étalonnage via la fonction d’agrégation arithmétique MOYENNE(). Sa valeur conditionne le centre de symétrie de la fonction intégrée.
Le troisième argument, ecart_type, représente la valeur σ quantifiant la dispersion intrinsèque des scores autour du paramètre central. Sur le plan formel, la théorie mathématique des densités continues impose une contrainte catégorique : l’écart-type doit être strictement positif (σ > 0). L’introduction d’un écart-type égal à zéro — qui anéantirait toute dispersion et réduirait la variable à une constante dégénérée — ou a fortiori d’une valeur négative provoque une interruption du calcul sous Excel et le renvoi d’une alerte d’erreur de domaine numérique.
3.2 L’argument booléen ‘cumulative’ : VRAI contre FAUX
Le quatrième et dernier paramètre de la fonction constitue sans doute la source la plus fréquente de contresens méthodologiques chez les néophytes de la modélisation statistique sous tableur. Cet argument logique accepte exclusivement deux valeurs d’entrée : le booléen VRAI (ou le chiffre 1 dans l’algèbre booléenne d’Excel) et le booléen FAUX (ou le chiffre 0).
Lorsque le paramètre prend la valeur VRAI, la fonction instruit le moteur de calcul d’évaluer la fonction de répartition cumulative, notée formellement F(x) dans la littérature probabiliste. Dans cette configuration, Excel procède à l’intégration numérique de l’aire sous la courbe de Gauss comprise entre moins l’infini (-∞) et la borne supérieure fixée par x :
F(x) = ∫-∞x f(t) dt = P(X ≤ x)
La valeur retournée représente authentiquement une probabilité géométrique, comprise rigoureusement dans l’intervalle [0 ; 1]. Elle s’interprète directement en termes de proportion de population ou de probabilité d’occurrence pour une observation aléatoire.
À l’inverse, l’affectation de l’argument à FAUX intime à Excel le calcul de l’ordonnée stricte de la fonction de densité de probabilité au point d’abscisse x, c’est-à-dire l’évaluation directe de l’équation f(x) exposée au chapitre 1.1. Une mise en garde fondamentale doit être posée ici : pour une variable aléatoire strictement continue, la probabilité d’observer de manière infinitésimale une valeur ponctuelle isolée est mathématiquement nulle (P(X = x) = 0). L’ordonnée fournie par l’argument FAUX ne constitue donc en aucun cas une probabilité ! Elle exprime simplement la hauteur relative de la courbe en cloche en ce point. Ce mode est quasi exclusivement réservé au traçage graphique des courbes gaussiennes sous Excel, et ne doit jamais être mobilisé pour des tests d’hypothèses probabilistes ou des diagnostics centiles sous peine d’aboutir à des conclusions statistiques fallacieuses.
3.3 Structure syntaxique et référencement cellulaire optimal
Pour exploiter pleinement la puissance du tableur dans le traitement de jeux de données psychométriques exhaustifs, l’écriture de la formule doit respecter des principes rigoureux d’architecture cellulaire. L’écriture canonique directe s’énonce comme suit :
=LOI.NORMALE.N(x; moyenne; ecart_type; VRAI)
Dans un contexte d’analyse clinique appliquée impliquant une cohorte de patients, les scores bruts sont classiquement consignés le long d’une colonne (par exemple, de la cellule A2 à A150). Les paramètres de distribution populationnels (la moyenne et l’écart-type étalonnés du test) sont, quant à eux, avantageusement déportés dans des cellules de référence dédiées (par exemple, D1 pour la moyenne μ et D2 pour l’écart-type σ).
Pour permettre l’extension automatisée de la formule par incrémentation verticale (double-clic ou glisser-déposer de la poignée de recopie) sans altérer la cohérence des paramètres théoriques, l’analyste doit impérativement employer le référencement absolu au moyen de l’opérateur dollar ($). La formule matricielle de base, saisie en cellule B2 pour évaluer le premier sujet, s’articule ainsi :
=LOI.NORMALE.N(A2; $D$1; $D$2; VRAI)
Tandis que l’adresse relative A2 bascule automatiquement vers A3, A4, etc., les coordonnées $D$1 et $D$2 demeurent immuablement verrouillées sur les paramètres d’étalonnage. Enfin, pour garantir la lisibilité et l’élégance scientifique du rendu, les cellules d’accueil des probabilités résultantes doivent être formatées au standard de pourcentage avec deux décimales significatives, évitant ainsi la lecture ardue de valeurs décimales brutes telles que 0,02275.
4. Calcul de la probabilité cumulée unilatérale inférieure
4.1 Modélisation de P(X < x) dans le cadre d’évaluations cognitives
L’estimation de la probabilité cumulée unilatérale inférieure — formalisée par l’expression P(X < x) ou indifféremment P(X ≤ x) en vertu de la continuité mathématique de la distribution où la masse d’un point isolé est nulle — représente le problème le plus élémentaire et le plus récurrent en évaluation psychologique. Ce calcul correspond à la quantification de la surface sous la courbe s’étalant depuis l’extrémité négative asymptotique jusqu’à la limite supérieure représentée par le score empirique x.
Dans la pratique neuro-cognitive et psychologique, ce calcul intervient systématiquement dès lors que l’évaluateur cherche à identifier une défaillance, un déficit fonctionnel ou une atypie par le bas. Prenons l’exemple d’un protocole d’investigation des fonctions exécutives ou de l’attention sélective chez des enfants scolarisés, évalué par une tâche de flexibilité mentale. Le score final reflète le nombre d’erreurs de persévération ou le temps nécessaire à la complétion. L’objectif diagnostique consiste à déterminer la rareté relative d’un score inhabituellement bas, afin de qualifier un potentiel trouble du déficit de l’attention.
Sur le plan métrologique, la probabilité cumulée unilatérale inférieure calculée par LOI.NORMALE.N(x; moyenne; ecart_type; VRAI) s’assimile immédiatement au concept de rang centile ou percentile. Si le résultat numérique retourné par le logiciel s’établit à 0,05, la déduction clinique est immédiate : précisément 5 % des individus de la population générale de référence obtiennent une note égale ou inférieure à celle du participant évalué. Les 95 % restants réalisent une performance supérieure.
4.2 Exemple pratique pas à pas : analyse d’un score de test psychométrique
Afin de matérialiser ce protocole computationnel, considérons le cadre standardisé des échelles d’intelligence de Wechsler pour adultes (WAIS-IV). Par convention internationale solidement ancrée, les indices composites et le Quotient Intellectuel Total (QIT) obéissent à un étalonnage normatif rigoureusement calibré sur une moyenne théorique μ = 100 et un écart-type σ = 15.
Supposons qu’un praticien examine un patient présentant des difficultés substantielles d’insertion socioprofessionnelle et obtienne, au terme de la passation de la batterie complète, un score de QIT brut de 85. La question clinique fondamentale posée est la suivante : quelle est la proportion exacte d’individus dans la population générale qui obtient une performance intellectuelle globale inférieure à cette marque ?
Le cheminement opératoire sous Excel s’articule comme suit :
- Dans la cellule
A1, saisir l’étiquette de variable :Score QIT. EnB1, consigner la valeur empirique du sujet :85. - Dans les cellules
A2etA3, définir respectivement les paramètres normatifs :MoyenneenA2associée à100enB2, etÉcart-typeenA3associé à15enB3. - Sélectionner la cellule d’évaluation
B4, et inscrire la formule de répartition cumulée :
=LOI.NORMALE.N(B1; B2; B3; VRAI)
Le moteur d’évaluation numérique d’Excel compile immédiatement l’expression et restitue la grandeur scalaire : 0,15865526. En appliquant à la cellule B4 un format de type Pourcentage à deux décimales, la valeur se convertit élégamment en 15,87 %.
L’analyse psychométrique et l’interprétation diagnostique de cette valeur chiffrée s’énoncent avec une clarté totale : le score de 85 se situe exactement à une distance de moins un écart-type de la moyenne populationnelle (z = (85 – 100) / 15 = -1,00). En vertu des caractéristiques invariantes de l’intégrale gaussienne, approximativement 15,87 % de la cohorte normative se situe sous cette borne. Le patient se positionne donc précisément au 16e rang centile de l’intelligence générale. Sur le plan de la nosographie clinique, une telle mesure demeure dans les marges de la normalité basse standard (communément bornée entre les scores 85 et 115) et ne saurait justifier à elle seule le diagnostic d’un déficit intellectuel pathologique, lequel exigerait une déviation statistique bien plus substantielle (sous les deux écarts-types, soit un QIT inférieur à 70).
5. Calcul de la probabilité unilatérale supérieure
5.1 Application de la règle du complément : P(X > x) = 1 – P(X < x)
Si la fonction LOI.NORMALE.N avec l’argument cumulatif VRAI résout avec une simplicité déconcertante le calcul des aires unilatérales inférieures, de nombreuses investigations scientifiques s’intéressent prioritairement à la problématique symétrique : estimer la probabilité qu’une observation franchisse un niveau d’excellence ou dépasse un seuil d’alerte critique vers les valeurs élevées, ce que l’on formalise par P(X > x).
L’environnement algorithmique d’Excel ne comporte pas de fonction native directe spécifiquement intitulée « LOI.NORMALE.DROITE ». Néanmoins, la solution mathématique s’impose d’elle-même par l’application rigoureuse du troisième axiome de la théorie des probabilités : l’axiome de la probabilité totale ou règle du complément. L’aire intégrale sous la courbe en cloche étant strictement égale à 1 (ou 100 %), la probabilité que la variable aléatoire excède une valeur x donnée équivaut précisément au complémentaire à 1 de la probabilité qu’elle ne l’atteigne pas. La relation fonctionnelle s’établit selon l’identité immuable :
P(X > x) = 1 – P(X ≤ x)
Dès lors, l’implémentation opérationnelle sous Microsoft Excel pour capturer l’aire unilatérale droite prend la structure syntaxique suivante :
=1 - LOI.NORMALE.N(x; moyenne; ecart_type; VRAI)
Sur le plan algorithmique, cette soustraction arithmétique simple opère remarquablement bien pour la quasi-totalité des seuils cliniques usités en psychométrie. Toutefois, le praticien averti doit conserver à l’esprit une contrainte technique liée à l’arithmétique en virgule flottante d’Excel. Lorsque le score x atteint des valeurs extraordinairement atypiques (situées au-delà de 7 ou 8 écarts-types au-dessus de la moyenne), la valeur de probabilité cumulée inférieure s’approche de manière si ténue du chiffre 1 que le processeur, saturant ses 15 chiffres significatifs de mantisse, peut renvoyer 1, aboutissant après soustraction à un zéro absolu. Pour les recherches psychologiques ciblant des cohortes d’une représentativité phénoménologique standard, cette limite numérique demeure néanmoins sans conséquence pratique.
5.2 Étude de cas : détection du haut potentiel intellectuel
La détection de l’efficience cognitive supérieure, fréquemment désignée sous l’appellation de haut potentiel intellectuel (HPI) ou douance cognitive, fournit une illustration paradigmatique de la probabilité unilatérale supérieure en psychométrie. Dans la nomenclature diagnostique prévalente (notamment celle de l’Organisation Mondiale de la Santé et des manuels psychométriques internationaux), le critère statistique opératoire requis pour postuler une douance intellectuelle générale s’établit à une performance supérieure ou égale à deux écarts-types stricts au-dessus de la moyenne générale d’étalonnage.
Sur l’échelle de Wechsler dotée des paramètres conventionnels μ = 100 et σ = 15, ce seuil de bascule correspond mathématiquement à un score de Quotient Intellectuel de 130 (x = 100 + 2 × 15 = 130). Pour un chercheur pilotant un programme d’identification d’enfants intellectuellement précoces ou pour un neuropsychologue clinicien restituant un bilan d’évaluation approfondi, la question centrale consiste à déterminer la prévalence théorique exacte d’un tel profil au sein de la population générale.
L’implémentation dans la cellule de travail Excel s’exécute par la formule :
=1 - LOI.NORMALE.N(130; 100; 15; VRAI)
L’exécution de la formule engendre un résultat brut de 0,02275013, qui, traduit en format de pourcentage calibré à deux décimales, s’établit avec netteté à 2,28 %.
Cette quantification probabiliste recèle des répercussions empiriques et logistiques profondes pour la recherche et la pratique institutionnelle :
- Dans un groupe aléatoire et représentatif de 10 000 individus scolarisés, l’espérance mathématique du nombre d’enfants répondant strictement au critère psychométrique de QI ≥ 130 s’élève théoriquement à 228 individus.
- Toute revendication empirique proclamant une prévalence significativement plus volumineuse (par exemple 5 % ou 10 % d’enfants surdoués dans une cohorte scolaire générale) trahit soit un biais d’échantillonnage substantiel lors du recrutement des sujets, soit une altération méthodologique de l’étalonnage du test psychologique employé (effet Flynn non compensé, saturation de l’instrument ou violation de la standardisation).
6. Évaluation des probabilités pour un intervalle défini
6.1 Calcul de probabilité entre deux bornes : P(a < X < b)
Au-delà des probabilités unilatérales orientées vers les queues extrêmes, la caractérisation statistique d’un échantillon psychologique exige constamment l’évaluation de zones centrales ou d’intervalles intermédiaires. L’analyste se trouve régulièrement confronté à l’obligation de chiffrer la proportion d’individus dont le score se situe entre une borne inférieure désignée a et une borne supérieure notée b, soit formellement : P(a ≤ X ≤ b).
Sur le plan fondamental du calcul d’intégration, l’aire enserrée entre les abscisses a et b sous la courbe de densité s’obtient en soustrayant l’aire cumulée s’étendant jusqu’à la borne inférieure a de l’aire cumulée s’étirant jusqu’à la borne supérieure b. Cette démonstration découle directement de la propriété d’additivité des intégrales définies sur des intervalles contigus (relation de Chasles) :
P(a ≤ X ≤ b) = ∫ab f(x) dx = ∫-∞b f(x) dx – ∫-∞a f(x) dx = F(b) – F(a)
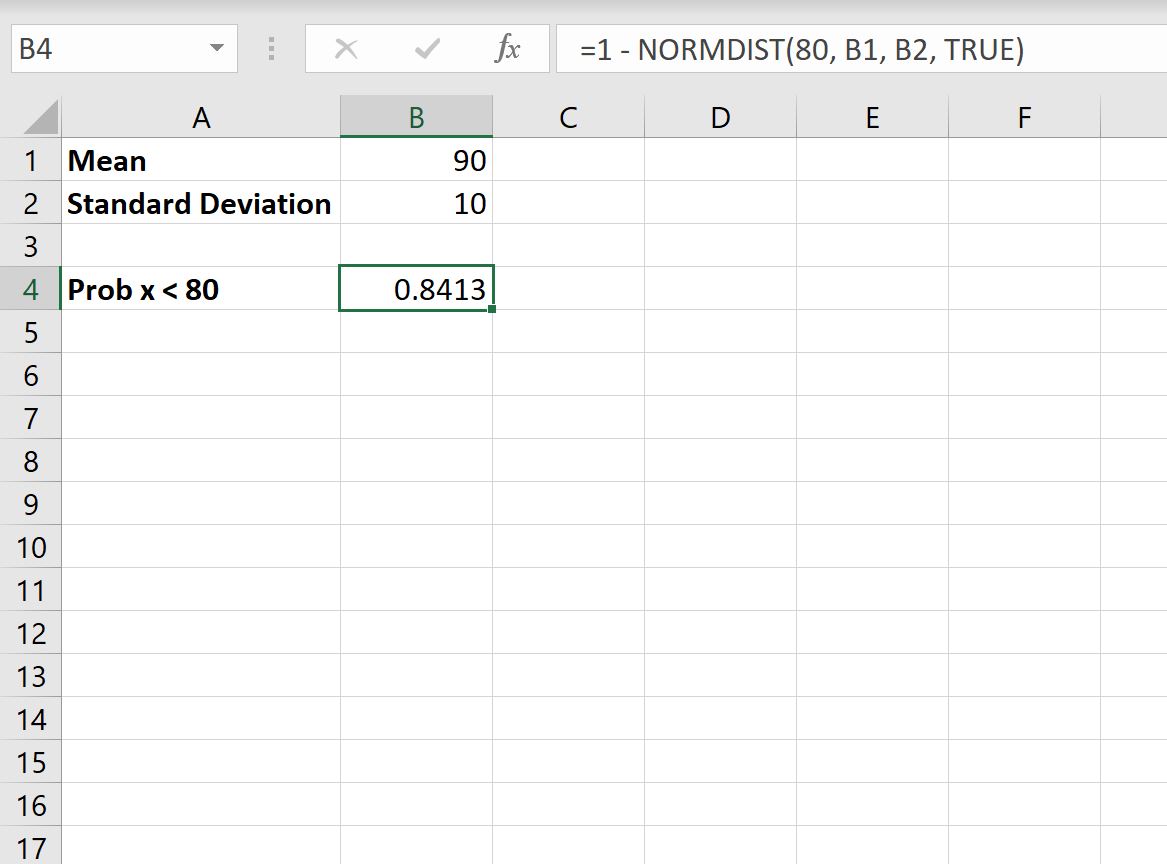
Dans l’environnement de calcul d’Excel, la modélisation de cette opération ne sollicite aucun module complémentaire, mais s’exécute par la construction d’une formule composite effectuant la différence vectorielle directe entre deux appels conjoints de la fonction LOI.NORMALE.N :
=LOI.NORMALE.N(b; moyenne; ecart_type; VRAI) - LOI.NORMALE.N(a; moyenne; ecart_type; VRAI)
Il est capital, pour la validité logique de cette formule composite, de vérifier la cohérence directionnelle des entrées : la borne supérieure b doit impérativement être plus grande que la borne inférieure a (b > a). Une interversion accidentelle de ces arguments dans la formule d’Excel conduirait inévitablement à un résultat numérique strictement négatif, ce qui constituerait une aberration conceptuelle absolue au regard des axiomes élémentaires de Kolmogorov régissant les espaces de probabilité.
6.2 La règle empirique 68-95-99,7 vérifiée sous Excel
L’un des enseignements théoriques les plus illustres de la statistique paramétrique réside dans la célèbre règle empirique des trois sigmas, universellement désignée sous l’appellation mnémotechnique de règle 68-95-99,7. Ce postulat théorique quantifie avec une précision mathématique la dispersion cumulée des observations au sein d’une distribution gaussienne non biaisée en fonction d’écarts-types discrets mesurés autour de la moyenne.
Microsoft Excel permet d’établir une démonstration expérimentale immédiate de ces proportions en formulant les calculs d’intervalles canoniques sur une loi normale centrée sur 100 et dotée d’une dispersion de 15 :
- Intervalle d’un écart-type [μ – 1σ ; μ + 1σ] (scores 85 à 115) :
Formule :=LOI.NORMALE.N(115; 100; 15; VRAI) - LOI.NORMALE.N(85; 100; 15; VRAI)
Le résultat généré s’élève rigoureusement à 0,682689, soit 68,27 %. Plus de deux tiers d’une cohorte humaine se concentrent donc spontanément à l’intérieur de cette fenêtre centrale immédiate. - Intervalle de deux écarts-types [μ – 2σ ; μ + 2σ] (scores 70 à 130) :
Formule :=LOI.NORMALE.N(130; 100; 15; VRAI) - LOI.NORMALE.N(70; 100; 15; VRAI)
La convergence numérique livre précisément 0,954499, c’est-à-dire 95,45 %. Cet intervalle délimite la zone de normalité statistique au sens large. En dehors de cette frontière se situent les anomalies fonctionnelles ou les dons exceptionnels. - Intervalle de trois écarts-types [μ – 3σ ; μ + 3σ] (scores 55 à 145) :
Formule :=LOI.NORMALE.N(145; 100; 15; VRAI) - LOI.NORMALE.N(55; 100; 15; VRAI)
L’évaluation statistique retourne 0,997300, équivalant à 99,73 % de l’espace distributionnel global. La probabilité d’observer un individu dont le score s’émancipe de cette marge n’est que de 0,27 %, soit environ un individu sur 370.
6.3 Application : calibrage des zones de performance moyenne dans une cohorte
L’exploitation pratique de cette analyse par intervalle trouve son prolongement direct dans le calibrage institutionnel des grilles d’évaluation psychologique. Considérons un protocole de recherche universitaire au cours duquel une équipe de chercheurs examine un groupe de 500 étudiants soumis à un test standardisé d’anxiété situationnelle (normalisé sur une moyenne populationnelle de 50 points et un écart-type de 10 points). La commission scientifique souhaite identifier la proportion théorique d’étudiants dont le niveau de réactivité affective est strictement qualifié de « moyen supérieur », défini arbitrairement par la tranche de scores s’étalant de 55 à 65 points.
L’implémentation algorithmique s’exécute directement dans le tableau de bord Excel via la formule composite :
=LOI.NORMALE.N(65; 50; 10; VRAI) - LOI.NORMALE.N(55; 50; 10; VRAI)
L’analyse informatique dégage immédiatement une proportion théorique de 0,2417 (soit 24,17 %). Multipliée par l’effectif de la cohorte (500), cette proportion indique que les investigateurs doivent s’attendre à recenser environ 121 étudiants au sein de cette catégorie diagnostique précise si les données empiriques se conforment parfaitement au modèle gaussien.
Pour confronter cette attente théorique aux observations de terrain directement dans Excel, l’analyste peut déployer une formule matricielle croisée mobilisant l’opérateur de comptage conditionnel NB.SI.ENS. Si les scores bruts observés de l’échantillon sont indexés dans la plage cellulaire A2:A501, le comptage empirique direct s’écrit :
=NB.SI.ENS(A2:A501; ">=55"; A2:A501; "<=65") / 500
La comparaison immédiate entre le pourcentage théorique issu de la loi normale (24,17 %) et la proportion empirique extraite de la cohorte via NB.SI.ENS offre un puissant test diagnostique préliminaire : une divergence notable entre ces deux indicateurs (par exemple une fréquence réelle de 38 % versus 24 % théorique) avertit instantanément le statisticien d’un écart substantiel à la normalité ou de la présence d’un facteur d’échantillonnage biaisant la représentativité du groupe expérimental.
7. La distribution normale centrée réduite : LOI.NORMALE.STANDARD.N
7.1 Utilité de la standardisation préalable des variables
Dans de multiples architectures de recherche en psychologie clinique et en neuro-imagerie comportementale, les scientifiques ne manipulent pas une variable métrique unique et isolée, mais de vastes batteries de tests administrant simultanément des dizaines d’instruments hétéroclites. Un patient peut ainsi compléter un test de vitesse de traitement cognitif chronométré en secondes, un inventaire de dépression gradué de 0 à 63 points, et une tâche de mémoire spatiale comptabilisée en nombre d’items restitués. Dans une telle configuration, maintenir le traitement computationnel sur les échelles d’unités brutes engendre une complexité algorithmique démesurée et interdit les croisements statistiques multidimensionnels directs.
La réduction préalable des variables empiriques via leur transformation en scores z résout cette impasse méthodologique en éliminant intégralement les unités de mesure physiques pour projeter toutes les distributions sur une métrique d’écart standardisé adimensionnelle. Microsoft Excel simplifie cette transition vectorielle grâce à une fonction dédiée particulièrement utile : CENTREE.REDUITE (correspondant à l’instruction anglophone STANDARDIZE). Sa syntaxe d’appel se déploie selon le formalisme suivant :
=CENTREE.REDUITE(x; moyenne; ecart_type)
Cette fonction implémente rigoureusement l’algorithme arithmétique z = (x – μ) / σ. En insérant cette formule au sommet d’une colonne de données brutes et en exploitant des références absolues pour désigner la moyenne et l’écart-type de référence, le chercheur convertit instantanément l’intégralité d’une cohorte hétérogène en un tableau d’écarts standardisés directement comparables entre eux et immédiatement exploitables dans des calculs multivariés.
7.2 Mise en œuvre de LOI.NORMALE.STANDARD.N
Dès lors qu’une variable continue a été réduite à sa métrique standardisée z, l’obligation d’injecter manuellement les paramètres théoriques μ et σ dans les formules probabilistes devient caduque. L’analyste se tourne alors vers l’instruction computationnellement optimisée : LOI.NORMALE.STANDARD.N (retranscription de NORM.S.DIST).
La syntaxe de cette fonction est resserrée à sa plus simple expression :
=LOI.NORMALE.STANDARD.N(z; cumulative)
Le premier argument, z, accueille le score centré réduit (positif ou négatif). Le second argument, cumulative, conserve le même comportement booléen dichotomique : la saisie de VRAI restitue la probabilité cumulée unilatérale inférieure Φ(z) = P(Z ≤ z), tandis que FAUX génère l’ordonnée de la densité gaussienne standardisée.
Il existe une identité mathématique absolue entre les deux fonctions du tableur. Supposons un score de QI x = 115 issu d’une population caractérisée par μ = 100 et σ = 15. Le score standardisé correspondant est z = (115 – 100) / 15 = 1,00. L’évaluation comparative sous Excel révèle une convergence numérique parfaite au millionième :
=LOI.NORMALE.N(115; 100; 15; VRAI)→ 0,84134474=LOI.NORMALE.STANDARD.N(1; VRAI)→ 0,84134474
L’exploitation de LOI.NORMALE.STANDARD.N fluidifie de surcroît l’évaluation des probabilités bilatérales fondées sur les principes de parité symétrique de la fonction. En statistique inférentielle, tester l’hypothèse nulle bidirectionnelle au seuil alpha α = 0,05 exige de vérifier si la valeur absolue du score z calculé excède la valeur critique bilatérale (traditionnellement 1,96). La probabilité bilatérale globale associée à un écart absolu |z| s’exécute de manière élégante et compacte en exploitant la fonction de valeur absolue ABS selon la formulation :
=2 * (1 - LOI.NORMALE.STANDARD.N(ABS(z); VRAI))
Cette écriture synthétique multiplie par deux l’aire résiduelle confinée dans la queue de distribution supérieure de la valeur absolue du score, fournissant instantanément la valeur-p (p-value) bilatérale exacte indispensable à l’approbation ou au rejet d’une hypothèse de recherche.
8. Calcul inverse des probabilités : détermination des scores seuils
8.1 La fonction LOI.NORMALE.INVERSE.N : principe et usage
L’ensemble des développements explorés jusqu’à présent cheminait selon une causalité vectorielle descendante : partant d’un score empirique x ou z connu, le tableur en déduisait la probabilité cumulée sous-jacente P. Cependant, la démarche psychométrique impose très fréquemment une trajectoire conceptuelle strictement inverse. L’investigateur, le législateur ou le clinicien fixe à l’avance une proportion critique — par exemple déterminer un quota de 5 % d’échec scolaire, isoler les 10 % d’employés manifestant le niveau de stress professionnel le plus aigu, ou calibrer un seuil d’éligibilité pour une prise en charge médicale spécialisée — et cherche à connaître la valeur métrique exacte x qui délimite rigoureusement ce groupe dans la distribution.
Cette opération mathématique s’appuie sur la fonction quantile ou fonction de répartition inverse de la loi normale, formalisée par F-1(p). Dans l’arsenal fonctionnel contemporain d’Excel, cet opérateur est exécuté par la fonction LOI.NORMALE.INVERSE.N (correspondant au standard international NORM.INV). Sa syntaxe d’appel se structure selon l’ordonnancement de trois paramètres obligatoires :
=LOI.NORMALE.INVERSE.N(probabilité; moyenne; ecart_type)
L’argument central probabilité requiert impérativement un scalaire décimal compris strictement dans l’intervalle ouvert ]0 ; 1[. Il incarne l’aire unilatérale cumulative inférieure requise. Si l’utilisateur introduit par mégarde une probabilité égale ou inférieure à 0, ou égale ou supérieure à 1, le moteur de calcul d’Excel suspend son évaluation et renvoie l’erreur d’argument invalide #NOMBRE!. Si le chercheur travaille sur une distribution préalablement standardisée, il emploiera avec profit la version spécialisée :
=LOI.NORMALE.STANDARD.INVERSE.N(probabilité)
8.2 Détermination des seuils de coupure clinique
La modélisation de seuils de coupure clinique à travers LOI.NORMALE.INVERSE.N constitue un levier déterminant pour l’étalonnage des inventaires de psychopathologie. Illustrons cette méthodologie à l’aide de deux cas concrets issus des protocoles d’évaluation standardisés.
Premier cas : Isolement des 5 % les plus symptomatiques à un inventaire d’anxiété.
Considérons une échelle clinique d’anxiété dont l’étalonnage national indique une moyenne de population générale μ = 50 points et un écart-type σ = 8 points. Un protocole de recherche médicale ambitionne de sélectionner exclusivement les 5 % d’individus les plus sévèrement anxieux de la cohorte pour les intégrer à un essai thérapeutique pharmacologique.
La prudence méthodologique impose de bien conceptualiser l’orientation du quantile : les 5 % les plus sévères se situent dans la queue supérieure droite de la distribution. Par conséquent, l’aire cumulative inférieure s’étirant depuis l’origine jusqu’au seuil de coupure est égale à 1 – 0,05 = 0,95 (ou 95e rang centile). La saisie opérationnelle dans la cellule Excel s’établit ainsi :
=LOI.NORMALE.INVERSE.N(0,95; 50; 8)
Le logiciel restitue instantanément la valeur métrique : 63,1587. Le protocole clinique pourra ainsi fixer avec une rigueur statistique infaillible son critère d’inclusion d’éligibilité à un score brut arrondi à 64 points ou plus au questionnaire.
Deuxième cas : Partitionnement des quartiles pour les facettes du NEO-PI.
Dans l’usage des échelles de personnalité de type NEO-PI-R mesurant les cinq grands facteurs fondamentaux (Big Five), les scores bruts sont fréquemment convertis en notes T (μ = 50, σ = 10). Pour bâtir une typologie descriptive catégorisant les répondants en « Bas », « Moyen-Bas », « Moyen-Haut » et « Élevé », les psychologues exploitent la partition en quartiles (25e, 50e et 75e centiles). Les scores de coupure se génèrent automatiquement sous Excel par les commandes :
- Premier quartile (Q1, 25 % inférieurs) :
=LOI.NORMALE.INVERSE.N(0,25; 50; 10)→ 43,26 - Deuxième quartile (Q2, médiane, 50 %) :
=LOI.NORMALE.INVERSE.N(0,50; 50; 10)→ 50,00 - Troisième quartile (Q3, 75 % inférieurs) :
=LOI.NORMALE.INVERSE.N(0,75; 50; 10)→ 56,74
Cette approche inverse assure un partitionnement objectif des classes d’individus, rigoureusement arrimé aux propriétés structurelles de la courbe de Gauss.
9. Applications empiriques en recherche psychologique et neuropsychologie
9.1 Étude de cas 1 : Évaluation de la détérioration cognitive
L’évaluation neuropsychologique du vieillissement pathologique et des démences neuro-dégénératives (telle que la maladie d’Alzheimer) offre un terrain d’application privilégié pour la modélisation gaussienne sous Excel. L’outil de dépistage rapide le plus diffusé à l’échelle planétaire demeure le Mini-Mental State Examination (MMSE), calibré sur une échelle ordinale globale bornée de 0 à 30 points. Toutefois, l’interprétation d’un score brut au MMSE sans ajustement sociodémographique s’avère hautement erronée : un score de 24 peut s’avérer normal pour une personne de 85 ans non diplômée, mais pathologiquement bas pour un ancien universitaire de 60 ans.
Les tables normatives avancées (telles que les normes françaises du GRECO ou les normes internationales de Crum et al.) fournissent la moyenne μ et l’écart-type σ attendus pour chaque strate combinant classe d’âge et niveau d’études. Considérons un protocole hospitalier consignant les scores de patients suivis en consultation mémoire au sein d’un tableau Excel :
- Colonne A : Identifiant du patient (ex.
PAT_042) - Colonne B : Score brut observé au MMSE (ex.
22) - Colonne C : Moyenne normative ajustée selon la strate d’âge et d’études (ex.
27,4) - Colonne D : Écart-type normatif de la même strate (ex.
1,8)
L’objectif clinique consiste à déterminer si le déclin cognitif observé chez le patient PAT_042 présente un caractère statistiquement pathologique en évaluant la probabilité d’obtenir une telle performance par le simple fait de la fluctuation d’échantillonnage aléatoire d’une population saine. En colonne E, l’analyste implémente la formule d’inférence cumulée unilatérale inférieure :
=LOI.NORMALE.N(B2; C2; D2; VRAI)
L’évaluation computationnelle retourne le résultat : 0,00135, soit un rang centile alarmant de 0,14 %. Sur le plan de la décision clinique, ce résultat est confronté au seuil alpha critique unilatéral de 0,05 (ou plus conservateur de 0,01). La probabilité étant largement inférieure à α = 0,01, le clinicien rejette l’hypothèse nulle d’un fonctionnement cognitif préservé : le score du patient dévie de z = (22 – 27,4) / 1,8 = -3,00 écarts-types sous sa moyenne de référence démographique, confirmant un profil d’altération neuro-cognitive sévère justifiant des investigations d’imagerie cérébrale complémentaires.
9.2 Étude de cas 2 : Dépistage de la dépression via des inventaires standardisés
Dans l’investigation épidémiologique des troubles de l’humeur au sein de cohortes universitaires ou en milieu d’entreprise, l’utilisation de l’Inventaire de Dépression de Beck dans sa seconde révision (BDI-II) est particulièrement courante. Composé de 21 items cotés de 0 à 3, l’instrument dégage un score global variant de 0 à 63. Bien que les manuels cliniques établissent des bornes empiriques semi-arbitraires (ex. 0-11 : dépression minime, 12-19 : légère, 20-27 : modérée, 28-63 : sévère), la modélisation probabiliste continue sous Excel affine substantiellement l’analyse de dépistage à grande échelle.
Lors d’une campagne de dépistage portant sur 1 200 salariés d’une grande entreprise, la distribution des scores au BDI-II peut être modélisée sous hypothèse de normalité asymptotique (par exemple μ = 9,2 points et σ = 5,4 points pour un effectif global en bonne santé au travail). L’équipe médicale souhaite segmenter précisément la cohorte pour organiser des entretiens de soutien individualisés, en priorisant les salariés dont la probabilité d’appartenance à la population saine est inférieure à 1 % par le haut.
Pour calculer individuellement cette probabilité conditionnelle d’atypie clinique, l’analyste insère en colonne de droite la formule unilatérale supérieure :
=1 - LOI.NORMALE.N(A2; $G$1; $G$2; VRAI)
où A2 contient le score individuel de la personne évaluée, $G$1 la moyenne (9,2) et $G$2 l’écart-type (5,4). Un employé présentant un score de 22 points reçoit une probabilité résiduelle calculée de 0,0088 (soit 0,88 %). Se situant sous la barre critique du centile supérieur (P < 0,01), il est immédiatement classifié en priorité de dépistage médicale.
Toutefois, la manipulation rigoureuse de ces probabilités exige d’intégrer les problématiques de faux positifs et de faux négatifs. Si le seuil probabiliste est positionné de façon trop restrictive (par exemple un seuil α = 0,001), l’entreprise s’assure que tout individu ciblé souffre indiscutablement d’une détresse majeure, mais laisse échapper une cohorte substantielle d’employés modérément déprimés qui ne recevront aucune intervention préventive. La modulation dynamique du seuil d’exclusion dans Excel via des formules conditionnelles interactives permet aux épidémiologistes de trouver l’équilibre opérationnel idoine selon les capacités de prise en charge du système médical.
9.3 Étude de cas 3 : Temps de réaction en psychologie cognitive expérimentale
L’expérimentation en psychologie cognitive du traitement de l’information (tâches de type Stroop, amorçage sémantique, paradigmes d’écoute dichotique) mesure quasi invariablement des temps de réaction chronométriques exprimés en millisecondes. Les chercheurs inexpérimentés commettent régulièrement l’erreur d’appliquer immédiatement les fonctions LOI.NORMALE.N à ces latences motrices brutes. Or, les temps de réaction constituent l’exemple d’école d’une métrique réfractaire à l’hypothèse pure de normalité gaussienne :
- Ils sont physiologiquement bornés à gauche par un seuil plancher incompressible imposé par la conduction synaptique et la transmission nerveuse neuromusculaire (environ 150 à 180 ms pour une réponse motrice simple).
- Leur distribution empirique est structurellement asymétrique positive, se modélisant fidèlement par une distribution ex-gaussienne (convolution d’une composante normale et d’une loi exponentielle traduisant les décrochages attentionnels).
Face à cette réalité expérimentale, la rigueur scientifique exige d’opérer une transformation préalable stabilisatrice de variance et réductrice d’asymétrie avant tout calcul probabiliste dans le tableur. La transformation mathématique la plus robuste pour ce type de traceur cognitif est la transformation logarithmique népérienne (Log-transformation). Le flux de travail sous Excel s’articule alors en trois temps opératoires :
- En colonne B, convertir chaque temps de réaction brut de la colonne A (ex.
A2 = 450 ms) via la fonction logarithme :=LN(A2). - Calculer les paramètres centraux sur la nouvelle variable transformée : moyenne
μlnen$D$1via=MOYENNE(B2:B500)et écart-typeσlnen$D$2via=ECARTYPE.STANDARD(B2:B500). - Déterminer les probabilités d’occurrence d’essais ultra-rapides aberrants — caractéristiques d’anticipations motrices impulsives non fondées sur l’analyse du stimulus — pour identifier les observations à purger avant l’analyse finale de variance (ANOVA). Pour évaluer la probabilité qu’un temps de réaction soit inférieur à 200 ms, l’analyste interroge la fonction de répartition cumulée en utilisant le logarithme de la borne :
=LOI.NORMALE.N(LN(200); $D$1; $D$2; VRAI)
Cette méthodologie hybride restaure l’intégrité de l’hypothèse de normalité et autorise une exploitation scientifiquement irréprochable des algorithmes gaussiens d’Excel sur des variables chronométriques hautement asymétriques.
10. Représentation graphique et visualisation des aires probabilistes sous Excel
10.1 Génération des données pour la courbe gaussienne théorique
La compréhension et la communication des résultats statistiques en milieu clinique ou lors de soutenances universitaires gagnent une force démonstrative majeure lorsqu’elles s’adossent à une visualisation graphique de haute précision. Microsoft Excel permet de construire un tracé rigoureusement proportionné de la cloche de Gauss théorique, libéré de toute déformation visuelle.
La génération du tracé requiert la discrétisation ordonnée d’un segment d’abscisses continu. Pour restituer l’intégralité visuelle de la cloche, l’intervalle d’échantillonnage doit balayer une amplitude s’étendant d’au moins quatre écarts-types en deçà de la moyenne (μ – 4σ) jusqu’à quatre écarts-types au-delà (μ + 4σ), ce qui embrasse plus de 99,99 % de l’aire sous-jacente.
Considérons à nouveau l’étalonnage standard du QI (μ = 100, σ = 15). La fenêtre de visualisation couvrira l’intervalle [40 ; 160]. Pour obtenir un tracé lisse dénué de toute angularité polygonale, il convient de générer au minimum 120 à 200 points d’interpolation réguliers :
- Dans la colonne A (étiquetée
Score X), initialiser la celluleA2à la valeur40. Dans la celluleA3, inscrire la formule d’incrémentation fine d’un demi-point :=A2 + 0,5. Recopier cette formule vers le bas jusqu’à atteindre la valeur de160en celluleA242. - Dans la colonne B (étiquetée
Densité f(X)), configurer le calcul de l’ordonnée de la fonction de densité gaussienne. Saisir enB2la formule mobilisant le paramètre FAUX :
=LOI.NORMALE.N(A2; 100; 15; FAUX) - Étendre cette formule par double-clic jusqu’au bas de la colonne. La cellule correspondant au sommet de la cloche (
x = 100) affichera son pic d’ordonnée maximal absolu égal à 1 / (15 × √(2π)) ≈ 0,026596. - Sélectionner l’intégralité du tableau
A1:B242, naviguer dans le ruban Insertion, et choisir dans le menu des diagrammes statistiques le type : Graphique en nuage de points avec lignes lisses (sans marqueurs).
Le tableur restitue instantanément une courbe de Gauss d’une pureté géométrique parfaite, reflétant l’exactitude de la fonction de densité théorique.
10.2 Coloration dynamique de l’aire sous la courbe correspondant à une probabilité
Si la courbe squelettique offre une appréciation esthétique évidente, l’objectif didactique ultime consiste à colorer dynamiquement l’aire sous la courbe matérialisant la probabilité associée à une région critique spécifique — par exemple, l’ombrage en bleu de la queue supérieure isolant les hauts potentiels (scores ≥ 130). Cette prouesse de mise en page statistique s’exécute sous Excel en combinant harmonieusement un tracé en nuage de points et une série en aires superposées pilotée par des instructions conditionnelles logiques.
Le protocole de montage se déroule selon la démarche méthodique suivante :
- Définir dans une cellule indépendante le score seuil visé, par exemple la cellule
E1initialisée à130. - Créer une troisième colonne en C, intitulée
Aire Probabiliste. Saisir enC2une formule conditionnelle évaluant si l’abscisse correspondante se situe dans la zone d’intérêt unilatérale droite :
=SI(A2>=$E$1; B2; 0) - Dupliquer cette instruction jusqu’à la fin de la série. Ainsi, pour tout score inférieur à 130, la valeur retournée est un zéro rigoureux ; dès que l’abscisse franchit le seuil de 130, la colonne C capture fidèlement la valeur de hauteur de densité de la colonne B.
- Faire un clic droit sur le graphique préalablement créé, cliquer sur Sélectionner des données, et ajouter une nouvelle série dont les valeurs de l’axe X proviennent de la colonne A et les valeurs de l’axe Y sont extraites de la nouvelle colonne C.
- Modifier le type de graphique pour cette série secondaire en optant pour un Graphique en aires (ou graphique combiné Ligne / Aire).
- Ajuster la mise en forme graphique conformément aux exigences rigoureuses des publications scientifiques de l’American Psychological Association (APA) : supprimer le quadrillage d’arrière-plan superflu, colorer la ligne principale de densité en noir dense d’une épaisseur de 1,5 pt, formater l’aire sous la courbe avec un remplissage monochrome bleu acier doté d’une transparence de 40 %, et étiqueter formellement les axes avec la taille de police adéquate (abscisse : Score de QI standardisé ; ordonnée : Densité de probabilité).
Grâce à ce montage paramétrique, toute modification de la valeur seuil inscrite en cellule E1 (par exemple en la rétrogradant à 120 ou en la portant à 135) actualise instantanément et automatiquement l’étendue de l’aire ombrée sur le graphique sans requérir aucune ressaisie manuelle.
11. Diagnostic des anomalies, validation des hypothèses et gestion des erreurs
11.1 Vérification préalable de la normalité des distributions empiriques
L’utilisation scrupuleuse des fonctions LOI.NORMALE.N repose sur une prémisse mathématique non négociable : la variable mesurée doit raisonnablement se conformer à un modèle gaussien au sein de la population cible. Appliquer ces algorithmes à des séries de données violant gravement cette hypothèse — comme des variables fortement asymétriques, plurimodales ou tronquées — expose le chercheur à des erreurs d’interprétation massives, générant des taux d’attribution centile totalement factices.
Dans un protocole d’analyse rigoureux, le déploiement du calcul des probabilités doit toujours être précédé d’un contrôle de distribution par l’extraction des deux coefficients d’évaluation de forme universels :
1. Le coefficient d’asymétrie (Skewness) :
Calculé sous Excel via l’instruction statistique =COEFFICIENT.ASYMETRIE(plage_donnees) (ou SKEW), il quantifie le degré d’écart à la symétrie axiale. Une distribution parfaitement normale présente un coefficient d’asymétrie théorique nul de 0. Une valeur positive indique un étirement anormal de la queue de distribution vers les scores élevés (asymétrie droite), tandis qu’une valeur négative dénote une prédominance de scores agglutinés au plafond avec une traîne vers les valeurs faibles (asymétrie gauche).
2. Le coefficient d’aplatissement (Kurtosis) :
Évalué dans le tableur par la fonction =KURTOSIS(plage_donnees) (ou KURT), il mesure l’épaisseur des queues de distribution et la hauteur relative de la pointe centrale par rapport à la courbe gaussienne standard (le tableur calcule conventionnellement l’excès de kurtosis, où la référence normale équivaut à 0). Une valeur positive indique une distribution leptokurtique (pic acéré et queues épaisses propices aux observations extrêmes aberrantes) ; une valeur négative signale un profil platykurtique (aplatissement de la cloche avec sous-représentation des queues).
Sur le plan des critères décisionnels admis dans la littérature psychométrique contemporaine — notamment d’après les directives méthodologiques largement citées de George et Mallery —, les tolérances requises pour autoriser l’exploitation des statistiques paramétriques univariées s’établissent comme suit :
- Une valeur d’asymétrie (Skewness) confinée entre -1,00 et +1,00 est jugée excellente pour postuler une quasi-normalité. Des écarts tolérés entre -2,00 et +2,00 demeurent acceptables pour de grands échantillons (N > 100). Au-delà de ±2,00, l’hypothèse de normalité doit être révoquée.
- De même, un excès de Kurtosis contenu entre -2,00 et +2,00 atteste d’une morphologie compatible avec le modèle théorique. Des excursions excédant ces limites révèlent la présence d’outliers pathologiques ou de contraintes d’échelle exigeant un traitement correcteur d’urgence (transformation de variable ou passage à des modélisations non-paramétriques par rangs).
Pour parachever ce contrôle d’intégrité sans acquérir des logiciels statistiques dispendieux, l’analyste peut élaborer un diagramme Quantile-Quantile (Q-Q plot) directement sous Excel. Il suffit d’ordonner la série empirique par ordre croissant, de calculer les quantiles théoriques attendus correspondants au moyen de l’instruction LOI.NORMALE.STANDARD.INVERSE.N((RANG - 0,5) / EFFECTIF_TOTAL), puis de projeter ces coordonnées dans un nuage de points croisant scores observés et quantiles théoriques. Tout alignement linéaire strict le long de la diagonale confirme empiriquement l’adéquation distributionnelle à la loi normale.
11.2 Résolution des codes d’erreur courants dans Excel
La pratique quotidienne de la modélisation sous tableur expose inévitablement les chercheurs et gestionnaires de bases de données à des messages d’anomalie générés par le moteur de calcul. Maîtriser l’étiologie précise de ces codes d’alerte et leur procédure de rectification constitue un impératif pour garantir la robustesse des chaînes de traitement statistique.
Le code d’erreur le plus emblématique rencontré lors de l’usage des fonctions de loi normale est l’alerte #NOMBRE!. Ce message signifie que le calcul mathématique sous-jacent est insoluble dans le corps des nombres réels en raison d’une violation formelle des bornes de validité des paramètres. Deux sources fondamentales sont régulièrement diagnostiquées :
- Un écart-type négatif ou nul : Dans les fonctions
LOI.NORMALE.NouLOI.NORMALE.INVERSE.N, si le paramètreecart_typefait référence à une cellule contenant0, un nombre négatif ou une case vide (interprétée implicitement comme 0 par Excel), l’algorithme génère instantanément l’erreur#NOMBRE!. La formule doit être sécurisée en imbriquant un test de validation logique, par exemple :
=SI(D2>0; LOI.NORMALE.N(A2; D1; D2; VRAI); "Écart-type invalide") - Une probabilité hors limites : Lors de l’exploitation de la fonction réciproque
LOI.NORMALE.INVERSE.N(p; moyenne; ecart_type), l’injection d’une valeur de probabilité en dehors du domaine ouvert ]0 ; 1[ — par exemple saisir-0,05,0,1ou1,02— conduit systématiquement à l’erreur#NOMBRE!. L’analyste doit vérifier que ses pourcentages sont saisis sous forme de fractions décimales (ex.0,05et non5pour 5 %).
Le second dysfonctionnement fréquent réside dans l’apparition du code #VALEUR!. Cette alerte sanctionne l’incompatibilité de nature d’un argument qui exigeait un scalaire arithmétique mais reçoit une chaîne de caractères textuelle. En psychométrie empirique, cette anomalie émerge massivement lors de deux scénarios typiques :
- La contamination par des chaînes qualitatives de codage d’absence : Lors du recueil de données, la présence d’acronymes alphanumériques signalant des données manquantes (tels que
"NA","ABS","REFUS"ou un point isolé".") au milieu d’une colonne de scores numériques interrompt l’exécution de la formule et produit l’erreur#VALEUR!. - Le conflit international des séparateurs décimaux : Dans les systèmes paramétrés selon les normes francophones, le séparateur décimal officiel est la virgule (
,). L’importation brute de fichiers issus de plateformes d’évaluation anglophones configurées avec un point décimal (., ex.100.5) conduit Excel à interpréter le nombre comme un texte pur, neutralisant tout calcul mathématique subséquent.
Pour purifier méthodiquement les bases de données psychométriques massives, il est recommandé de sanctuariser l’intégrité des entrées cellulaires en combinant les fonctions de validation ESTNUM et de conversion VALEUR, ou en filtrant les données via l’instruction moderne SI.NON.DISP ou SI.ERREUR :
=SI.ERREUR(LOI.NORMALE.N(VALEUR(A2); $D$1; $D$2; VRAI); "Donnée à auditer")
12. Automatisation, modélisation dynamique et bonnes pratiques pour l’analyste
12.1 Création d’un calculateur dynamique de probabilités interactif
L’optimisation des flux de travail au sein d’un laboratoire de recherche comportementale ou d’un cabinet neuropsychologique passe avantageusement par la construction d’un tableau de bord de modélisation probabiliste interactif. L’objectif est de concevoir une interface épurée permettant à un clinicien de sélectionner le test administré dans un menu déroulant, de renseigner le score brut observé chez le patient, et de voir s’actualiser instantanément les rangs centiles, les probabilités unilatérales et le diagnostic textuel d’interprétation clinique.
La structure architecturale d’un tel outil interactif sous Excel se conçoit selon l’agencement suivant :
- Création d’un référentiel normatif sécurisé : Sur un onglet dédié baptisé
Normes_Tests, construire une table répertoriant les batteries psychométriques couramment administrées. Par exemple :- Ligne 1 : WAIS-IV (QIT) | Moyenne : 100 | Écart-type : 15
- Ligne 2 : MMPI-2 (Note T) | Moyenne : 50 | Écart-type : 10
- Ligne 3 : WMS (Mémoire) | Moyenne : 100 | Écart-type : 15
- Ligne 4 : BDI-II (Dépression) | Moyenne : 9,2 | Écart-type : 5,4
- Configuration des cellules d’interrogation sur l’interface principale :
- Cellule
B2: Menu déroulant de sélection de l’épreuve psychologique, configuré via l’outil Validation des données (paramétré sur une liste ciblant les noms des tests de l’onglet de référence). - Cellule
B3: Saisie libre du score brut du sujet (associée à une règle de validation limitant les entrées à des nombres réels positifs). - Cellules
B4etB5: Rapatriement automatisé des paramètres d’étalonnage via la fonction de recherche moderneXLOOKUP(ouRECHERCHEX) :
Pour la moyenne :=RECHERCHEX(B2; Normes_Tests!A:A; Normes_Tests!B:B)
Pour l’écart-type :=RECHERCHEX(B2; Normes_Tests!A:A; Normes_Tests!C:C)
- Cellule
- Déploiement des métriques probabilistes automatisées :
- Cellule
B7(Score z standardisé) :=(B3 - B4) / B5 - Cellule
B8(Rang centile unilatéral inférieur) :=LOI.NORMALE.N(B3; B4; B5; VRAI)(au format Pourcentage) - Cellule
B9(Probabilité d’excéder ce niveau) :=1 - B8
- Cellule
- Restitution diagnostique qualitative automatisée : Dans la cellule
B11, une formule logique imbriquée génère une qualification narrative immédiate de la performance pour éclairer la rédaction du compte rendu clinique :
=SI(B8<0,0228; "Déficit très significatif (< -2 σ)"; SI(B8<0,1587; "Zone limite inférieure [-2 σ ; -1 σ]"; SI(B8<=0,8413; "Performance dans la moyenne normale [± 1 σ]"; SI(B8<=0,9772; "Zone supérieure [+1 σ ; +2 σ]"; "Niveau exceptionnellement élevé (> +2 σ)"))))
Ce calculateur automatisé éradique le risque d’erreur humaine d’assignation normative et fluidifie considérablement la restitution diagnostique quotidienne.
12.2 Optimisation des processus d’analyse pour les bases de données psychométriques massives
Lorsque la démarche analytique franchit le stade de l’évaluation clinique unitaire pour s’attaquer au traitement de cohortes épidémiologiques massives — intégrant plusieurs dizaines de milliers d’enregistrements psychométriques —, la gestion classique de la feuille de calcul montre ses limites opérationnelles. L’emploi de plages cellulaires figées et de recopies manuelles devient un vecteur majeur d’incohérences de calcul. L’analyste chevronné doit faire évoluer ses méthodes computationnelles vers des architectures contemporaines robustes.
Le premier impératif méthodologique réside dans la conversion immédiate de tout registre de données empiriques en Tableau structuré Excel (via la commande Insertion > Tableau ou le raccourci Ctrl + L). Cette opération confère à la base une structure dynamique où les colonnes adoptent des identifiants sémantiques explicites. L’application d’un calcul de probabilité au sein d’un tableau structuré élimine le besoin d’étendre manuellement les formules vers le bas : la saisie de l’équation dans la première cellule déclenche le calcul immédiat et automatique pour l’ensemble de la colonne, y compris pour les futures lignes qui viendraient enrichir la cohorte ultérieurement. La syntaxe prend une clarté remarquable :
=LOI.NORMALE.N([@[Score_Brut]]; [@[Norme_Moyenne]]; [@[Norme_EcartType]]; VRAI)
Le deuxième palier d’optimisation concerne l’exploitation des fonctions matricielles dynamiques (disponibles sous Excel 365 et Excel 2021). Grâce au mécanisme de déversement automatique (Spill range), une formule unique inscrite en tête de tableau peut projeter instantanément des milliers de calculs de distribution sans alourdir la mémoire de travail de la machine. Par exemple, pour obtenir les scores standardisés d’une colonne entière sans étendre une formule classique, il suffit de poser :
=(A2:A10000 - MOYENNE(A2:A10000)) / ECARTYPE.STANDARD(A2:A10000)
Enfin, la gouvernance des données psychométriques impose des exigences éthiques et légales strictes (notamment sous le cadre du Règlement Général sur la Protection des Données ou RGPD). Tout protocole automatisé exploitant des scores psychologiques nominatifs doit intégrer une stricte séparation entre les variables directement identifiantes (nom, prénom, numéro de sécurité sociale) — cantonnées dans des répertoires cryptés — et les identifiants de recherche anonymisés (pseudonymisation). L’auditabilité complète des formules de calcul, l’absence de constantes numériques directement écrites dans les formules (les « magic numbers » non documentés), et la documentation exhaustive des tables normatives de calibrage représentent les prérequis absolus d’une analyse quantitative intègre, transparente et reproductible.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation.
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Crum, R. M., Anthony, J. C., Bassett, S. S., & Folstein, M. F. (1993). Population-based norms for the Mini-Mental State Examination by age and educational level. JAMA, 269(18), 2386-2391. https://doi.org/10.1001/jama.1993.03500180078038
George, D., & Mallery, P. (2019). IBM SPSS Statistics 26 step by step: A simple guide and reference (16th ed.). Routledge. https://doi.org/10.4324/9780429056765
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Microsoft Corporation. (2023). Documentation des fonctions de feuille de calcul Excel : LOI.NORMALE.N et LOI.NORMALE.STANDARD.N. Microsoft Learn. https://support.microsoft.com/fr-fr/office/
Wechsler, D. (2008). Wechsler Adult Intelligence Scale – Fourth Edition (WAIS-IV) Administration and Scoring Manual. Psychological Corporation.