
Dans le domaine de l’expérimentation scientifique, qu’il s’agisse des essais cliniques biomédicaux, des investigations en psychologie cognitive ou des évaluations d’interventions comportementales, la rigueur de l’inférence causale repose fondamentalement sur la qualité de l’attribution des traitements. Sans une méthode robuste d’assignation, les biais systématiques s’immiscent insidieusement dans les données, corrompant la comparabilité des groupes et réduisant à néant des mois de collecte laborieuse. Si la randomisation simple apparaît intuitivement comme la solution la plus démocratique et la plus pure pour distribuer le hasard, la pratique révèle rapidement ses défaillances criantes, particulièrement lorsque la taille de la cohorte est modeste ou que le recrutement s’échelonne sur de longues périodes temporelles.
Face à l’écueil des déséquilibres numériques majeurs et aux dérives temporelles inhérentes aux flux continus de participants, les méthodologistes et biostatisticiens ont développé des procédures d’allocation restreinte hautement sophistiquées. Au cœur de cet arsenal méthodologique figure la randomisation par blocs permutés (permuted block randomization). Cette technique ingénieuse concilie le respect scrupuleux du hasard probabiliste avec une contrainte déterministe périodique, assurant qu’à intervalles réguliers et prédéterminés, un équilibre parfait ou strictement proportionnel soit maintenu entre les différentes modalités d’intervention d’une étude.
Le présent article propose une exploration approfondie, exhaustive et mathématiquement rigoureuse de la randomisation par blocs permutés. À travers l’examen de ses fondements théoriques, de ses propriétés combinatoires, de ses protocoles de déploiement empirique et de ses vulnérabilités face aux biais de sélection, ce guide s’adresse aux chercheurs, cliniciens et statisticiens désireux d’optimiser la validité interne de leurs devis expérimentaux, tout en se conformant aux standards internationaux les plus rigoureux tels que les directives CONSORT.
1. Introduction et fondements conceptuels de la randomisation par blocs permutés
1.1 Le rôle fondamental de la randomisation dans la recherche expérimentale
L’attribution aléatoire constitue la pierre angulaire de l’inférence causale moderne, telle que conceptualisée par le statisticien Ronald A. Fisher et formalisée ultérieurement dans le modèle causal de Rubin. Dans tout protocole expérimental visant à comparer l’effet d’une variable indépendante manipulée — qu’il s’agisse d’un composé pharmacologique novateur, d’une thérapie comportementale ou d’une tâche d’apprentissage cognitif — sur une variable dépendante, l’objectif fondamental réside dans l’élimination des variables confusionnelles, tant observées qu’inobservées. Sans allocation aléatoire, les caractéristiques intrinsèques des participants risquent d’orienter systématiquement leur affectation, introduisant un biais de sélection fatal pour la validité de l’étude.
En assignant les sujets aux groupes de traitement et de contrôle selon un mécanisme strictement stochastique, la randomisation garantit l’équivalence probabiliste initiale entre les cohortes. Cela signifie que la distribution de toutes les covariables potentielles — l’âge, le genre, les prédispositions génétiques, le statut socio-économique, la sévérité basale de la pathologie ou même les traits de personnalité latents — ne présente aucune différence systématique entre les bras expérimentaux avant l’application de la moindre intervention. Par conséquent, toute divergence statistiquement significative observée sur les critères de jugement à l’issue de l’expérimentation peut être attribuée, avec un niveau de confiance mathématiquement quantifiable, à l’intervention testée elle-même plutôt qu’à un artéfact d’échantillonnage.
Toutefois, la randomisation simple — qui s’apparente conceptuellement au lancer répété d’une pièce de monnaie équilibrée pour chaque participant consécutif — présente des vulnérabilités critiques, en particulier au sein des échantillons de taille modeste ou moyenne (inférieurs à quelques centaines d’individus). La loi des grands nombres ne garantit une convergence vers la parité parfaite qu’à la limite asymptotique d’un échantillon infini. Sur des cohortes réduites, la randomisation simple génère avec une probabilité non négligeable des déséquilibres majeurs dans les effectifs des bras expérimentaux. Un tel déséquilibre entraîne une érosion substantielle de la puissance statistique des tests d’hypothèse et compromet dramatiquement l’analyse contrefactuelle, justifiant ainsi le recours impérieux à des techniques de randomisation restreinte.
1.2 Origine et définition opérationnelle du bloc permuté
Pour pallier les faiblesses structurelles de la randomisation non contrainte, les biostatisticiens ont conçu la randomisation restreinte, dont la forme la plus canonique et universellement adoptée est la randomisation par blocs permutés. Sur le plan opérationnel, cette technique consiste à segmenter la séquence globale d’inclusion des participants en sous-ensembles discrets et successifs de taille prédéterminée, désignés sous le terme de « blocs ». Chaque bloc agit comme une unité microscopique d’équilibrage structurel et temporel au sein du protocole expérimental global, assurant le respect des proportions théoriques d’allocation au sein de chaque sous-groupe.
Le concept de bloc repose sur une combinatoire stricte : si l’on évalue deux traitements alternatifs notés $A$ et $B$ selon un ratio d’allocation équiprobable de 1:1, un bloc de taille $b$ contiendra obligatoirement $b/2$ assignations pour la condition $A$ et $b/2$ assignations pour la condition $B$. La « permutation » intervient dans l’ordonnancement interne des traitements au sein du bloc : toutes les configurations séquentielles répondant à cette contrainte d’égalité numérique sont identifiées, puis l’une de ces configurations est sélectionnée au hasard selon une distribution uniforme pour guider l’attribution séquentielle des sujets appartenant à cette tranche de recrutement.
Cette approche se distingue nettement de la randomisation systématique et de la randomisation simple. Contrairement à la randomisation simple, où la probabilité d’attribution à chaque étape est rigoureusement indépendante des assignations antérieures, la randomisation par blocs introduit une dépendance conditionnelle contrôlée afin d’interdire toute déviation excessive par rapport au ratio cible. À l’opposé de l’alternance systématique (par exemple, attribuer invariablement $A, B, A, B, A, B$), qui supprime tout aléa et autorise une prédictibilité absolue exposant l’essai aux pires biais de sélection, le bloc permuté maintient un niveau stochastique suffisant pour préserver l’imprévisibilité de l’assignation tout en garantissant un équilibre périodique parfait dès qu’un bloc est intégralement complété.
1.3 Pertinence spécifique pour les sciences psychologiques et comportementales
L’application de la randomisation par blocs permutés revêt une acuité méthodologique toute particulière dans les sciences psychologiques, cognitives, psychiatriques et comportementales. Dans ces disciplines, les protocoles expérimentaux et cliniques ne bénéficient que très rarement d’un recrutement massif, instantané et homogène. L’inclusion des participants s’opère typiquement sous la forme d’un flux continu, s’étalant fréquemment sur des trimestres, voire des années entières. Durant ces longues périodes, l’environnement expérimental et institutionnel est soumis à d’inévitables fluctuations contextuelles : variations saisonnières des symptômes affectifs, changements subtils dans les critères diagnostiques appliqués par l’équipe clinique, renouvellement du personnel de recherche, ou encore effets d’apprentissage des psychologues évaluateurs.
Si une randomisation simple était mise en œuvre sous un tel régime de recrutement étalé, des agrégats fortuits (« clusters ») de participants affectés à la même condition thérapeutique pourraient se constituer au cours d’une période temporelle spécifique. Si, par exemple, une vague disproportionnée de sujets assignés au groupe contrôle était recrutée au cœur de l’hiver — période traditionnellement associée à une exacerbation de la dépression saisonnière — tandis que le bras expérimental recevrait une majorité de sujets au printemps, le différentiel d’efficacité mesuré serait irrémédiablement confondu avec la cyclicité temporelle de la symptomatologie. La randomisation par blocs prévient structurellement ce biais en forçant une distribution homogène et proportionnelle des interventions à travers chaque fenêtre temporelle successive représentée par un bloc.
En outre, les interventions psychothérapeutiques et comportementales se heurtent chroniquement à des taux d’attrition différentielle élevés, les participants interrompant fréquemment leur suivi en cours d’expérimentation en raison de la lourdeur des protocoles ou d’une intolérance psychique perçue. L’usage des blocs permutés garantit que, même en cas d’interruption prématurée du recrutement en raison de contraintes budgétaires ou d’abandons massifs imprévus, l’échantillon effectivement constitué jusqu’au dernier bloc achevé demeure rigoureusement équilibré sur le plan des effectifs, autorisant ainsi des analyses statistiques valides selon le paradigme de l’intention de traiter sans perte catastrophique de puissance.
2. Cadre mathématique et combinatoire de la méthode
2.1 Formulation mathématique du nombre d’arrangements possibles
L’architecture formelle de la randomisation par blocs permutés procède directement de la combinatoire discrète. Considérons un essai clinique ou une expérience factorielle comportant deux modalités d’intervention distinctes, notées $A$ et $B$, pour lesquelles le chercheur impose un ratio d’allocation équiprobable (1:1). Soit $b$ la taille globale d’un bloc donné. Par nécessité arithmétique élémentaire, afin de permettre une distribution entière et équilibrée entre les deux groupes, la taille du bloc $b$ doit obligatoirement être un nombre entier pair ($b in {2, 4, 6, 8, dots}$). Le nombre d’assignations destinées à la condition $A$ est donc $n_A = b/2$, et le nombre d’assignations dévolues à la condition $B$ est identiquement $n_B = b/2$, avec la contrainte $n_A + n_B = b$.
Le nombre total d’arrangements distincts — c’est-à-dire de permutations uniques permettant d’agencer $b/2$ éléments de type $A$ et $b/2$ éléments de type $B$ le long d’une séquence ordonnée de longueur $b$ — est déterminé par le coefficient binomial standard des permutations avec répétitions. L’équation formelle s’exprime comme suit :
$$N = \binom{b}{b/2} = \frac{b!}{(b/2)! \times (b/2)!} = \frac{b!}{((b/2)!)^2}$$
L’évaluation numérique de cette formule combinatoire met en lumière la croissance factorielle de l’espace des solutions à mesure que la taille du bloc augmente. Pour un micro-bloc de taille $b = 2$, l’espace permutationnel est minimal : $\binom{2}{1} = 2$ configurations distinctes, à savoir ${AB, BA}$. Pour un bloc de dimension intermédiaire $b = 4$, le nombre de permutations s’élève à $\binom{4}{2} = \frac{24}{4} = 6$ arrangements, précisément ${AABB, ABAB, ABBA, BAAB, BABA, BBAA}$. Si la taille du bloc est portée à $b = 6$, l’espace combinatoire s’élargit substantiellement pour atteindre $\binom{6}{3} = \frac{720}{36} = 20$ permutations uniques. Enfin, pour un bloc large de $b = 8$, nous obtenons $\binom{8}{4} = \frac{40320}{576} = 70$ séquences possibles.
Dans les schémas expérimentaux plus complexes impliquant $k$ conditions d’intervention ($k ge 3$), notées $T_1, T_2, dots, T_k$, avec une volonté d’équipartition stricte, la taille du bloc $b$ doit impérativement être un multiple entier de $k$, de telle sorte que chaque condition apparaisse exactement $m = b/k$ fois au sein de l’arrangement. La formulation mathématique s’étend alors naturellement sous la forme d’un coefficient multinomial :
$$N = \binom{b}{m, m, dots, m} = \frac{b!}{(m!)^k} = \frac{b!}{((b/k)!)^k}$$
Ainsi, pour une étude psychologique évaluant trois modalités d’entraînement cognitif ($k = 3$) au sein de blocs de taille $b = 6$, chaque modalité apparaissant $m = 2$ fois, le nombre de permutations possibles s’établit à $\frac{6!}{(2! \times 2! \times 2!)} = \frac{720}{8} = 90$ agencements séquentiels distincts. Cette richesse combinatoire est déterminante : plus le nombre d’arrangements est élevé, plus l’incertitude quant à l’ordre précis des attributions est préservée, renforçant la sécurité méthodologique du protocole.
2.2 Structure probabiliste des séquences générées
D’un point de vue probabiliste, la randomisation par blocs permutés repose sur une double structure : une équiprobabilité stricte au moment de la sélection du bloc complet, couplée à une distribution conditionnelle évolutive pour chaque participant individuel à mesure que le bloc se remplit séquentiellement. Lors de l’initialisation d’un bloc de taille $b$ contenant $N$ permutations possibles, le processus algorithmique effectue un tirage aléatoire uniforme au sein de cet espace discret. Chaque configuration théorique possède donc une probabilité ex ante d’activation rigoureusement identique, définie par :
$$P(\text{Configuration}_i) = \frac{1}{N} = \frac{1}{\binom{b}{b/2}}$$
Cependant, si l’on examine le processus d’allocation du point de vue d’un participant individuel occupant le rang $j$ ($1 le j le b$) à l’intérieur d’un bloc en cours de constitution, la probabilité d’assignation au traitement $A$ ou $B$ ne demeure pas invariablement fixée à 0,5. Elle est rigoureusement conditionnée par l’historique des allocations déjà consommées au sein de ce même bloc. Soient $n_A(j-1)$ et $n_B(j-1)$ les nombres respectifs de sujets déjà affectés aux bras $A$ et $B$ parmi les $j-1$ participants précédents. La probabilité conditionnelle que le $j$-ième participant reçoive le traitement $A$ s’établit formellement selon la distribution hypergéométrique sous-jacente :
$$P(T_j = A mid n_A(j-1)) = \frac{\frac{b}{2} – n_A(j-1)}{b – (j – 1)}$$
Cette formulation révèle les conséquences statistiques cruciales de la non-indépendance conditionnelle. Tant que les quotas d’assignation ne sont pas épuisés, la probabilité oscille autour de la valeur centrale. En revanche, dès que l’un des bras expérimentaux atteint son quota maximal ($b/2$), la probabilité d’assignation pour ce groupe s’effondre instantanément à zéro, tandis que la probabilité d’assignation au groupe complémentaire culmine de manière déterministe à 1,0. Au tout dernier rang du bloc ($j = b$), le résultat de la randomisation ne présente plus aucun aléa intrinsèque : il est intégralement prédéterminé par les $b-1$ tirages antérieurs. Cette propriété mathématique inaliénable constitue la principale vulnérabilité de la méthode, car elle expose l’expérimentateur à la possibilité de déduire avec certitude la prochaine assignation si l’insu est rompu.
2.3 Rapport d’allocation et configurations asymétriques
Bien que la parité numérique 1:1 constitue le standard d’efficience statistique maximale dans la majorité des essais comparatifs, des impératifs éthiques, logistiques ou économiques dictent parfois l’adoption de rapports d’allocation asymétriques, tels que 2:1, 3:1, ou plus rarement 3:2. Un ratio 2:1 en faveur d’un nouveau traitement est fréquemment plébiscité en recherche clinique et psychiatrique afin de maximiser le recrutement des patients, ces derniers étant statistiquement plus enclins à consentir à une étude s’ils possèdent deux fois plus de chances de recevoir la thérapie innovante que le placebo ou le traitement standard.
Pour adapter le modèle des blocs permutés à un ratio d’allocation non équilibré de forme $r_A : r_B$ (où $r_A$ et $r_B$ sont des entiers premiers entre eux), la taille minimale absolue du bloc, désignée par $b_{\min}$, est strictement contrainte par la somme arithmétique de ces coefficients :
$$b_{\min} = r_A + r_B$$
Par voie de conséquence, toute taille de bloc valide $b$ doit obligatoirement être un multiple entier strictement positif de cette taille unitaire fondamentale : $b = c \times (r_A + r_B)$, avec $c in \mathbb{N}^*$. Pour un ratio d’allocation asymétrique 2:1, la taille minimale possible d’un bloc est de $b_{\min} = 2 + 1 = 3$. Les blocs admissibles dans le protocole doivent donc présenter des longueurs appartenant à la suite ${3, 6, 9, 12, dots}$. Au sein d’un bloc de taille $b$ respectant ce ratio, le nombre d’assignations réservées au traitement $A$ sera rigoureusement $n_A = c \times r_A = \frac{b \times r_A}{r_A + r_B}$, et pour le traitement $B$, $n_B = c \times r_B = \frac{b \times r_B}{r_A + r_B}$.
Le calcul combinatoire du nombre d’arrangements possibles pour ces configurations asymétriques s’effectue au moyen du coefficient binomial asymétrique :
$$N_{\text{asym}} = \binom{b}{n_A} = \frac{b!}{n_A! \times (b – n_A)!} = \frac{b!}{\left(\frac{b \cdot r_A}{r_A + r_B}\right)! \times \left(\frac{b \cdot r_B}{r_A + r_B}\right)!}$$
Considérons à titre d’illustration méthodologique un essai clinique adoptant un ratio 2:1 structuré en blocs de taille $b = 6$. Dans chaque bloc, quatre participants recevront le traitement $A$ ($n_A = \frac{6 \times 2}{3} = 4$) et deux participants recevront le traitement $B$ ($n_B = \frac{6 \times 1}{3} = 2$). Le nombre total d’arrangements permutationnels distincts s’élève alors à :
$$\binom{6}{4} = \frac{6!}{4! \times 2!} = \frac{720}{24 \times 2} = 15$$
La mise en œuvre de ratios asymétriques altère profondément la trajectoire des probabilités conditionnelles au sein du bloc. L’épuisement des allocations pour le bras minoritaire $B$ intervient généralement plus précocement le long de la séquence, ce qui accroît mathématiquement la période durant laquelle l’assignation au groupe majoritaire devient déterministe, renforçant la nécessité d’occulter rigoureusement la longueur exacte des blocs auprès des investigateurs de terrain.
3. Avantages méthodologiques et justifications scientifiques
3.1 Équilibre numérique garanti à intervalles réguliers
L’atout méthodologique prééminent de la randomisation par blocs permutés réside dans l’endiguement absolu des disparités d’effectifs entre les bras expérimentaux au fil de l’avancement de l’étude. Dans le cadre d’une randomisation simple portant sur une cohorte de 60 sujets répartis en deux conditions à probabilité égale ($p = 0,5$), la distribution d’échantillonnage de la taille du groupe expérimental suit une loi binomiale $B(60, 0.5)$. Les lois de la probabilité indiquent qu’il existe un risque cumulé supérieur à 15 % d’observer un déséquilibre égal ou pire que 36 sujets contre 24, une dissymétrie qui dégrade considérablement l’efficience statistique sans qu’aucun événement anormal ne soit survenu dans le protocole.
À l’inverse, l’implémentation de blocs permutés de taille $b$ impose une contrainte déterministe qui borne de façon absolue le déséquilibre numérique maximal potentiel à n’importe quel instant de l’expérimentation. À l’achèvement de chaque bloc unitaire, le déséquilibre net entre les groupes $A$ et $B$ est rigoureusement nul. Au point le plus défavorable — c’est-à-dire au point médian d’un bloc de taille $b$ non encore achevé où tous les premiers tirages se trouveraient être attribués au même bras — le déséquilibre instantané maximal ne peut en aucun cas excéder $b/2$ sujets. Pour des blocs de taille 4, le différentiel entre les bras ne dépassera jamais 2 participants, quelle que soit la date à laquelle on inspecte l’état d’avancement de l’inclusion.
Cette régulation périodique confère une protection méthodologique majeure en cas de survenue d’événements imprévus imposant l’interruption prématurée de l’essai clinique. Qu’une étude doive être arrêtée de manière anticipée sur recommandation d’un comité indépendant de surveillance et de suivi des données (Data Safety and Monitoring Board — DSMB) pour cause de toxicité aiguë inacceptable, d’efficacité hautement supérieure franchissant les bornes d’arrêt d’O’Brien-Fleming, ou simplement en raison d’un assèchement imprévu des subsides de recherche, le corpus de données accumulé demeure parfaitement équilibré jusqu’au dernier bloc achevé. De surcroît, cette propriété optimise grandement la validité des analyses intermédiaires planifiées, en garantissant que chaque coupe transversale des données respecte rigoureusement la structure d’allocation prévue par le protocole.
3.2 Contrôle des effets de cohorte et de dérive temporelle
Au-delà de la simple égalité arithmétique globale, la randomisation par blocs neutralise de façon très efficace les effets de dérive temporelle séculaires qui corrompent insidieusement les expérimentations s’étendant sur des échelles de temps longues. Ces dérives proviennent d’une multiplicité de sources endogènes et exogènes : maturation progressive de l’expertise des équipes soignantes ou des expérimentateurs, modifications climatiques ou calendaires influençant l’humeur des participants, campagnes d’information médiatiques modifiant la perception publique d’une pathologie, ou encore glissement insensible des critères de sélection au fil de la baisse d’enthousiasme du recrutement.
Si une cohorte est recrutée sur douze mois selon une randomisation simple présentant par hasard une concentration d’allocations au traitement $A$ durant le premier semestre et une concentration au traitement $B$ durant le second, l’estimation de l’effet thérapeutique sera indémêlablement contaminée par l’effet de cohorte temporel. Les participants recrutés tardivement peuvent présenter des caractéristiques sociodémographiques ou une sévérité clinique sous-jacente divergentes de ceux inclus au tout début de l’investigation. En imposant un rééquilibrage systématique tous les $b$ sujets, la randomisation par blocs contraint chaque phase chronologique de l’expérimentation à comporter une représentation rigoureusement proportionnelle des différentes interventions.
Ce mécanisme garantit une invariance temporelle de la composition des groupes. Les effets d’apprentissage des évaluateurs — qui ont tendance à administrer les échelles psychométriques avec une précision et une sensibilité accrues au fur et à mesure que l’essai progresse — se trouvent uniformément distribués entre les groupes expérimentaux. De même, les phénomènes de lassitude ou d’épuisement professionnel (« burnout ») des thérapeutes intervenant dans les essais psychologiques ouverts se répartissent équitablement sur l’ensemble des bras comparatifs, empêchant qu’un groupe d’intervention ne pâtisse systématiquement d’un encadrement clinique dégradé par rapport à un autre.
3.3 Optimisation de la puissance statistique
D’un point de vue inférentiel, la préservation d’un équilibre strict des effectifs entre les bras d’une étude constitue la configuration la plus robuste pour maximiser la puissance statistique d’un contraste bilatéral sous contrainte d’un effectif total $N$ donné. En statistique inférentielle classique, l’erreur standard de la différence entre deux moyennes indépendantes $\bar{Y}_A – \bar{Y}_B$ s’exprime par la relation fondamentale :
$$SE(\bar{Y}_A – \bar{Y}_B) = \sigma \sqrt{\frac{1}{n_A} + \frac{1}{n_B}}$$
où $\sigma$ désigne l’écart-type résiduel supposé commun sous l’hypothèse d’homosパdasticité. Il s’agit d’une propriété mathématique élémentaire que, sous la contrainte $n_A + n_B = N$, la somme arithmétique $\frac{1}{n_A} + \frac{1}{n_B}$ atteint son minimum théorique absolu si et seulement si les deux effectifs sont rigoureusement égaux, c’est-à-dire lorsque $n_A = n_B = N/2$. Tout écart par rapport à cette égalité se traduit inéluctablement par un gonflement de l’erreur standard de l’estimateur, élargissant les intervalles de confiance et affaiblissant la capacité du test d’hypothèse (tel que le test $t$ de Student ou l’analyse de variance univariée) à rejeter l’hypothèse nulle d’absence d’effet en présence d’une différence réelle.
Bien que des procédures correctrices a posteriori ou des ajustements par régression multivariée puissent atténuer les distorsions induites par des disparités d’effectifs, elles ne sauraient reconstituer l’information perdue due au sous-dimensionnement de l’un des bras. En maintenant une parité numérique quasi parfaite tout au long de l’étude, la randomisation par blocs protège la configuration d’échantillonnage optimale, garantissant que la puissance a priori calculée lors de la phase de conception du protocole soit effectivement concrétisée lors de l’analyse primaire des données.
4. Protocole méthodologique d’implémentation en recherche empirique
4.1 Étape 1 : Définition des paramètres initiaux du protocole
L’élaboration concrète d’une procédure de randomisation par blocs débute impérativement par une explicitation a priori des paramètres cardinaux de l’essai au sein du protocole d’investigation formel, préalablement à toute inclusion du premier participant. Le méthodologiste doit déterminer avec exactitude la taille globale de l’échantillon cible ($N$), issue d’un calcul rigoureux de puissance statistique prenant en considération la taille d’effet minimale cliniquement pertinente (exprimée par exemple sous forme de $d$ de Cohen ou de rapport de cotes), le risque d’erreur de première espèce ($\alpha$, conventionnellement fixé à 0,05) et la puissance souhaitée ($1 – \beta$, typiquement établie à 0,80 ou 0,90).
L’étape critique consiste ensuite à sélectionner la taille du bloc ($b$). Ce choix procède d’un arbitrage délicat entre deux exigences contradictoires : maximiser la fréquence du rééquilibrage numérique (ce qui plaide pour des blocs réduits, $b = 2$ ou $b = 4$) et minimiser la prédictibilité des attributions pour préserver l’insu (ce qui requiert des blocs plus volumineux, $b ge 6$ ou $b = 8$). La taille choisie doit obligatoirement être un diviseur exact de la taille de l’échantillon total si l’on souhaite que le dernier bloc de l’étude s’achève sur une égalité mathématique absolue, bien que cela ne soit pas une condition invalidante en pratique clinique courante si l’effectif final s’arrête en cours de bloc.
Enfin, le chercheur doit identifier les éventuelles variables pronostiques majeures susceptibles d’interagir fortement avec le traitement — telles que le stade pathologique, la tranche d’âge ou le centre investigateur dans un cadre multicentrique. Si de telles covariables existent, elles devront servir de base à une stratification conjointe, chaque strate hébergeant sa propre séquence autonome de blocs permutés, comme nous le détaillerons dans les sections ultérieures de ce travail.
4.2 Étape 2 : Énumération et génération de l’espace des permutations
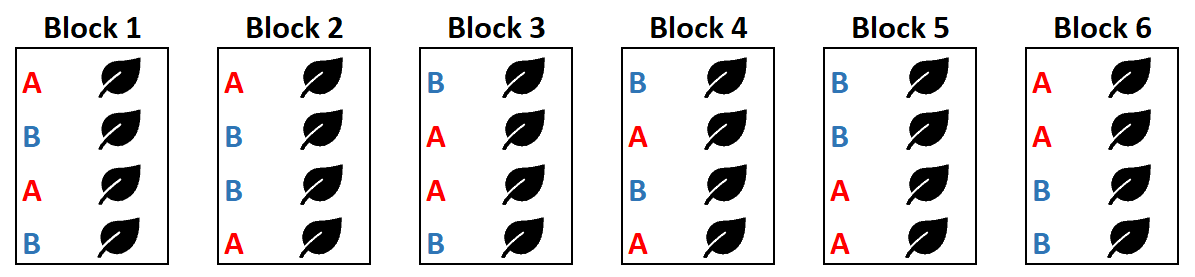
Une fois la taille du bloc fixée, la seconde phase méthodologique consiste à cartographier exhaustivement et systématiquement l’ensemble de l’espace combinatoire des permutations admissibles répondant aux contraintes du ratio d’allocation. Considérons l’évaluation de deux interventions $A$ et $B$ dans un schéma équiprobable avec des blocs de taille $b = 4$. Comme démontré précédemment par le calcul binomial $\binom{4}{2} = 6$, l’espace permutationnel complet comporte exactement six agencements distincts, qu’il convient d’indexer formellement dans une table de référence :
- Configuration 1 : A — A — B — B
- Configuration 2 : A — B — A — B
- Configuration 3 : A — B — B — A
- Configuration 4 : B — A — A — B
- Configuration 5 : B — A — B — A
- Configuration 6 : B — B — A — A
Toute configuration violant la parité stricte (telle que $A-A-A-B$ ou $B-B-B-B$) est rigoureusement exclue du domaine d’éligibilité combinatoire. Dans les situations où la dimension du bloc est plus substantielle ($b = 6$ ou $b = 8$), l’énumération manuelle devient fastidieuse et source d’erreurs humaines ; elle est donc systématiquement déléguée à des algorithmes combinatoires déterministes implantés dans des logiciels statistiques certifiés, capables de générer la liste exhaustive des vecteurs d’allocation conformes sans la moindre omission.
4.3 Étape 3 : Tirage aléatoire et assignation séquentielle
La troisième phase opérationnelle concrétise l’aléa scientifique en sélectionnant stochastiquement la séquence des blocs successifs qui guidera l’attribution effective des participants au fil de leur recrutement. Cette sélection ne doit en aucun cas reposer sur des mécanismes artisanaux non contrôlés (tels que le mélange manuel de jetons ou l’usage de dés physiques), mais doit impérativement faire appel à un générateur de nombres pseudo-aléatoires (PRNG — Pseudo-Random Number Generator) cryptographiquement sécurisé ou certifié pour les applications biomédicales (tel que l’algorithme de Mersenne Twister).
Le système tire successivement des nombres entiers compris dans l’intervalle d’indexation des permutations disponibles (dans notre exemple, des entiers aléatoires uniformes entre 1 et 6) jusqu’à couvrir l’intégralité de l’effectif planifié. Si l’étude cible 48 participants structurés en blocs de 4, l’algorithme procède au tirage de 12 blocs successifs. Si la suite de nombres aléatoires tirée est ${3, 1, 6, 2, 5, dots}$, la séquence maîtresse d’assignation se déploiera en concaténant les vecteurs correspondants : le premier bloc appliquera la configuration 3 ($ABBA$), le deuxième la configuration 1 ($AABB$), le troisième la configuration 6 ($BBAA$), et ainsi de suite jusqu’à l’atteinte du 48-ième sujet.
Une fois générée dans son intégralité, la table d’assignation globale doit faire l’objet d’un archivage cryptographique immédiat et inaltérable. La « graine » (seed) du générateur aléatoire est scrupuleusement documentée dans le dossier permanent de l’essai afin de garantir une reproductibilité auditable totale du tirage. La liste maîtresse est alors verrouillée et placée sous la responsabilité exclusive d’un biostatisticien indépendant non impliqué dans le recrutement clinique, afin d’interdire tout accès prématuré ou modification rétroactive de la séquence.
5. Exemple pratique 1 : Étude de laboratoire en psychologie cognitive
5.1 Mise en situation et hypothèses expérimentales
Afin d’illustrer la matérialisation empirique de cette méthodologie, considérons une recherche fondamentale en psychologie cognitive menée en environnement de laboratoire contrôlé. L’équipe d’investigation s’intéresse à l’impact d’une charge de stress aigu d’origine psychosociale sur l’efficience de la mémoire de travail exécutive, évaluée au moyen d’une tâche de n-back informatisée complexe. Le protocole comporte deux conditions expérimentales indépendantes : le groupe contrôle, noté condition $A$, dans lequel les sujets effectuent une tâche verbale neutre dénuée de pression évaluative ; et le groupe expérimental, noté condition $B$, exposé au protocole de stress standardisé de Trèves (Trier Social Stress Test — TSST), impliquant une prise de parole publique impromptue devant un panel d’évaluateurs neutres suivie d’un test d’arithmétique mentale accéléré.
Le calcul de dimensionnement a priori préconise un échantillon cible de $N = 48$ étudiants volontaires sains. En raison des contraintes logistiques du laboratoire et du temps requis pour la passation individuelle (environ 90 minutes par sujet), le recrutement et les tests doivent s’échelonner sur une période globale de trois mois civils, à raison de 4 passations hebdomadaires regroupées sur des plages horaires fixes. Dans ce contexte expérimental, l’heure de passation (matin versus fin d’après-midi, en raison des fluctuations circadiennes du cortisol salivaire) et la période du semestre universitaire (proximité des examens terminaux générant un stress résiduel parasitaire) constituent d’évidentes variables de confusion temporelles.
Afin de prémunir l’étude contre ces interférences temporelles et de s’assurer qu’au terme de chaque semaine de travail (composée de 4 créneaux de laboratoire), les conditions expérimentales soient rigoureusement équilibrées, le protocole opte pour une randomisation par blocs permutés de taille fixe $b = 4$. L’effectif total de 48 participants sera donc distribué le long d’une chaîne séquentielle rigoureuse de 12 blocs successifs comportant chacun 2 sujets en condition neutre ($A$) et 2 sujets en condition de stress ($B$).
5.2 Dérivation analytique des séquences d’interventions
La cartographie de l’espace combinatoire pour des blocs de taille $b = 4$ avec deux modalités équiprobables correspond exactement aux six permutations canoniques identifiées à la section précédente. Le biostatisticien associé au laboratoire exécute un script R initialisé avec une graine aléatoire fixée arbitrairement (par exemple, set.seed(4210)) pour sélectionner aléatoirement une chaîne de 12 entiers compris entre 1 et 6 avec remise. Supposons que le tirage stochastique produise la séquence ordonnée d’indices de blocs suivante :
$$\text{Séquence des blocs} = {4, 2, 1, 5, 3, 6, 2, 4, 3, 1, 5, 6}$$
En remplaçant chaque indice par la configuration vectorielle correspondante, l’ordonnancement exact de l’allocation pour les 48 participants se structure selon la grille d’implémentation chronologique suivante :
- Bloc 1 (Config. 4) : Sujets 01 à 04 → B — A — A — B
- Bloc 2 (Config. 2) : Sujets 05 à 08 → A — B — A — B
- Bloc 3 (Config. 1) : Sujets 09 à 12 → A — A — B — B
- Bloc 4 (Config. 5) : Sujets 13 à 16 → B — A — B — A
- Bloc 5 (Config. 3) : Sujets 17 à 20 → A — B — B — A
- Bloc 6 (Config. 6) : Sujets 21 à 24 → B — B — A — A
- Bloc 7 (Config. 2) : Sujets 25 à 28 → A — B — A — B
- Bloc 8 (Config. 4) : Sujets 29 à 32 → B — A — A — B
- Bloc 9 (Config. 3) : Sujets 33 à 36 → A — B — B — A
- Bloc 10 (Config. 1) : Sujets 37 à 40 → A — A — B — B
- Bloc 11 (Config. 5) : Sujets 41 à 44 → B — A — B — A
- Bloc 12 (Config. 6) : Sujets 45 à 48 → B — B — A — A
Dans la pratique du laboratoire, dès qu’un étudiant franchit la porte pour sa session d’expérimentation, l’assistant de recherche consulte l’assignation correspondant strictement à son numéro d’inclusion séquentiel et applique le protocole correspondant, sans aucune possibilité discrétionnaire d’intervertir les passages ou de sélectionner la condition selon l’état apparent de fatigue ou d’anxiété du sujet.
5.3 Analyse des résultats et vérification de l’équilibre expérimental
Au terme des trois mois d’expérimentation, l’analyse descriptive confirme la parfaite parité de l’échantillon global : exactement 24 participants ont été évalués sous la condition neutre $A$ et 24 sous la condition de stress aigu $B$. Plus important encore, l’analyse diagnostique de la distribution temporelle démontre l’efficacité protectrice du dispositif : à l’issue de chaque semaine de travail (chaque tranche de 4 sujets correspondant à un bloc complet), le ratio de participants entre les conditions $A$ et $B$ a été rigoureusement égal à 2 contre 2.
Une régression linéaire multiple menée sur le critère d’exactitude à la tâche de n-back, intégrant la condition expérimentale et le numéro d’ordre séquentiel d’inclusion (de 1 à 48) comme covariable continue, atteste de l’absence totale de corrélation entre le rang temporial d’inclusion et la performance cognitive résiduelle ($r = 0,03, p = 0,84$). De surcroît, le contrôle strict des créneaux horaires a permis d’éliminer tout biais d’interaction entre l’élévation du cortisol salivaire et le moment de la journée.
Grâce à cette invariance temporelle garantie par la structure des blocs permutés, les chercheurs ont pu confirmer avec une rigueur méthodologique irréprochable l’hypothèse d’une réduction spécifique de la capacité de mise à jour exécutive sous l’effet du stress aigu psychosocial ($t(46) = 2,87, p = 0,006, d = 0,83$), en ayant l’absolue certitude empirique que ce résultat ne saurait être imputé à un déséquilibre numérique fortuit ou à une concentration asymétrique des conditions d’intervention à des périodes d’examen universitaire plus propices au stress environnemental.
6. Exemple pratique 2 : Essai clinique contrôlé en psychothérapie
6.1 Contexte clinique et allocation de patients dépressifs
Considérons à présent un cadre méthodologique aux exigences encore plus complexes : un essai clinique contrôlé randomisé (ECR) mené en milieu hospitalier psychiatrique ambulatoire, visant à comparer l’efficacité relative d’une Thérapie Cognitive et Comportementale structurée (TCC, notée condition $A$) à celle d’un programme de Réduction du Stress Basée sur la Pleine Conscience (MBSR, notée condition $B$) chez des patients présentant un Épisode Dépressif Majeur unipolaire modéré à sévère. L’intervention s’organise non pas sous forme de séances individuelles isolées, mais dans le cadre d’ateliers de psychothérapie de groupe comprenant chacun 3 patients suivis simultanément par deux cliniciens seniors pendant 8 semaines consécutives.
L’objectif de recrutement est de $N = 60$ patients ambulatoires, inclus au fil de l’eau dès confirmation des critères diagnostiques par l’entrevue clinique structurée DSM-5. La contrainte opérationnelle est particulièrement drastique : pour démarrer les cycles thérapeutiques sans imposer aux patients des délais d’attente prolongés — ce qui serait éthiquement indéfendable et majorerait le risque d’aggravation suicidaire —, l’équipe clinique doit impérativement constituer des cohortes de traitement dès que 6 nouveaux patients ont été randomisés. À chaque franchissement de ce palier d’inclusion de 6 participants, l’équipe doit pouvoir ouvrir un groupe de TCC ($n = 3$) et un groupe de MBSR ($n = 3$).
Dans ce scénario clinique, le recours à la randomisation simple est totalement prohibé : elle risquerait de produire, par exemple, 5 patients assignés à la TCC et seulement 1 à la MBSR sur une vague d’inclusion donnée, rendant impossible l’ouverture du groupe de pleine conscience et saturant la capacité d’accueil du groupe TCC. Seule la randomisation par blocs permet de garantir mathématiquement que chaque contingent de 6 patients consécutifs fournira exactement l’effectif requis pour alimenter les deux modalités d’ateliers collectifs de manière parfaitement synchronisée.
6.2 Construction de la grille de randomisation par blocs
L’architecte méthodologique de l’essai conçoit une randomisation articulée autour de 10 blocs consécutifs de taille fixe $b = 6$ respectant un ratio d’allocation équiprobable 1:1. Pour chaque bloc, la contrainte impose la présence de 3 patients en TCC ($n_A = 3$) et 3 patients en MBSR ($n_B = 3$). L’espace combinatoire unitaire correspond au coefficient binomial $\binom{6}{3} = \frac{720}{6 \times 6} = 20$ permutations possibles. Ces 20 configurations sont formellement indexées de 1 à 20 ($1 = AAABBB, 2 = AABABB, dots, 20 = BBBAAA$).
Pour matérialiser cette séquence dans l’environnement hospitalier tout en prévenant les biais de sélection de la part des psychiatres recruteurs, la pharmacie centrale de l’établissement met en œuvre un dispositif d’enveloppes scellées, opaques et numérotées séquentiellement (procédure SNOE — Sequentially Numbered, Opaque, Sealed Envelopes). À partir de la liste maîtresse générée par ordinateur associant les 10 blocs de 6 permutations tirés au sort, des cartons d’assignation contenant la mention exclusive du traitement attribué sont insérés dans 60 enveloppes sécurisées. Du papier aluminium doublant l’intérieur des enveloppes interdit toute lecture par translucidité sur négatoscope ou source lumineuse puissante.
Les enveloppes sont scellées à l’aide d’un adhésif de sécurité inviolable et numérotées chronologiquement de 01 à 60 sur leur face externe. Les cliniciens investigateurs n’ont aucun accès à la liste globale ni à la taille des blocs. Lorsqu’un patient signe le consentement éclairé et valide l’intégralité des critères d’admissibilité, le médecin ouvre solennellement, devant témoin, l’enveloppe portant le numéro séquentiel immédiatement disponible, consigne le nom du patient et l’horodatage sur le registre d’inclusion, et oriente le sujet vers le programme thérapeutique désigné sur le carton scellé.
6.3 Gestion des abandons et analyse en intention de traiter
Dans tout essai psychothérapeutique d’envergure, l’attrition des participants représente un défi méthodologique colossal. Dans notre cohorte de 60 patients, 7 abandons de protocole prématurés surviennent au cours des 8 semaines de thérapie (4 dans le bras TCC, 3 dans le bras MBSR), motivés par des effets secondaires perçus, des déménagements géographiques ou une perte de motivation. Cette réalité soulève immédiatement la question de l’intégrité des blocs d’allocation et de la validité de l’analyse inférentielle finale.
D’un point de vue statistique, la randomisation par blocs garantit que ces sorties d’essai s’opèrent sur une matrice d’inclusion originellement et périodiquement équilibrée. Conformément aux standards internationaux de l’analyse en intention de traiter (ITT — Intention-to-Treat), l’intégrité de la structure randomisée initiale est préservée de manière absolue. Tous les 60 patients randomisés sont maintenus dans leur groupe d’affectation originel au sein du modèle statistique final, indépendamment de leur assiduité aux séances ou de leur retrait hâtif. La gestion des données manquantes consécutives aux abandons est traitée au moyen de modèles mixtes linéaires à effets aléatoires (LMM) et de techniques d’imputation multiple par équations chaînées (MICE), qui respectent la variance d’échantillonnage conditionnelle sous l’hypothèse de données manquantes au hasard (MAR — Missing At Random).
L’existence des blocs permutés a également conféré un avantage managérial et analytique inestimable lors des bilans trimestriels intermédiaires transmis au comité de pilotage hospitalier : à chaque revue de projet, le volume de données colligé présentait un équilibre thérapeutique quasi chirurgical, sans qu’aucun bras ne souffre d’un déficit systématique de puissance ou d’une surexposition clinique déstabilisante pour les ressources humaines du département de psychiatrie.
7. La sélection de la taille des blocs : Enjeux statistiques et compromis
7.1 Implications méthodologiques des blocs de petite taille
La détermination de la dimension métrique des blocs d’allocation ne relève pas d’une simple convention technique secondaire, mais engage profondément l’équilibre entre la rigueur de l’alignement numérique et la vulnérabilité épistémologique de l’essai face aux biais humains. L’adoption de blocs de dimensions très réduites — spécifiquement de taille $b = 2$ ou $b = 4$ pour une comparaison binaire — maximise avec une précision chirurgicale l’équilibre des bras expérimentaux. Avec des blocs de taille 2, le déséquilibre numérique maximal entre les groupes ne peut en aucun cas excéder un unique individu à n’importe quelle étape du protocole.
Toutefois, ce bénéfice d’équilibrage quasi continu s’accompagne d’un coût méthodologique potentiellement rédhibitoire : une hyper-prédictibilité de l’allocation séquentielle. Dans un bloc de taille 2, il n’existe mathématiquement que deux permutations admissibles : ${AB}$ ou ${BA}$. Par conséquent, dès que le premier sujet d’un bloc a reçu son assignation (par exemple $A$), la probabilité que le second sujet reçoive le traitement complémentaire ($B$) n’est plus aléatoire : elle culmine de manière déterministe à 1,0 ($P = 100%$). Même au sein d’un bloc de taille 4, dès que deux participants ont été consécutivement assignés à la même modalité (par exemple $A-A$), l’expérimentateur sait avec une certitude absolue que les deux sujets suivants recevront sans équivoque le traitement $B$.
Cette prédictibilité s’avère particulièrement toxique dans les essais cliniques en ouvert (open-label) ou dans ceux où le double aveugle parfait est illusoire en raison des effets secondaires manifestes ou de la nature évidente de l’intervention (comme en psychothérapie ou en chirurgie). Les cliniciens ou évaluateurs qui devinent — consciemment ou inconsciemment — l’assignation du sujet à venir peuvent être tentés de différer l’inclusion d’un patient complexe ou fragile pour le réserver au traitement qu’ils estiment subjectivement le plus profitable, induisant ainsi un biais d’allocation désastreux qui anéantit l’équivalence initiale postulée par le modèle causal.
7.2 Propriétés et inconvénients des blocs de grande dimension
À l’autre extrémité du spectre méthodologique, le recours à des blocs de grande dimension (par exemple $b = 12, 16$ ou $20$) pulvérise l’horizon de prédictibilité de l’expérimentateur. Au sein d’un bloc de taille $b = 16$ avec un ratio 1:1, l’espace combinatoire totalise $\binom{16}{8} = 12,870$ permutations distinctes. Face à une combinatoire d’une telle magnitude, l’intuition humaine et les calculs mentaux de probabilités conditionnelles s’avèrent totalement inopérants pour anticiper avec une quelconque précision l’assignation séquentielle des participants, préservant ainsi de façon remarquable l’intégrité de la dissimulation de l’allocation.
Néanmoins, l’adoption exclusive de blocs volumineux réintroduit insidieusement les vulnérabilités majeures propres à la randomisation simple non restreinte. Au cours du déroulement interne d’un grand bloc, des écarts numériques temporaires substantiels peuvent se manifester sur de longues périodes de recrutement. Il est mathématiquement tout à fait concevable, au sein d’un bloc de taille 16 débutant par la séquence ${A, A, A, A, A, B, A, A}$, d’observer un différentiel cumulé de 7 sujets dans un groupe contre un seul dans l’autre sur une durée de plusieurs semaines ou mois de recrutement clinique.
De surcroît, si l’expérimentation doit être interrompue de façon inopinée — que ce soit pour des motifs éthiques, logistiques ou sécuritaires — alors que le recrutement se situe en plein milieu d’un grand bloc, l’étude s’achève sur un déséquilibre d’effectifs potentiellement massif qui grève lourdement la puissance statistique finale. De même, si le rythme d’inclusion est particulièrement lent, l’incapacité d’un grand bloc à assurer un rééquilibrage fréquent expose l’essai aux effets de dérive temporelle et de cohorte saisonnière, annulant précisément l’un des bénéfices premiers ayant motivé l’abandon de la randomisation simple.
7.3 Directives pour le choix optimal selon le contexte expérimental
Le calibrage idéal de la dimension des blocs ne saurait donc résulter du hasard ; il doit impérativement s’adosser à une analyse multidimensionnelle des contraintes contextuelles du protocole expérimental. Les biostatisticiens s’accordent sur un ensemble de directives pragmatiques formalisées pour guider ce choix stratégique :
- Cadence et volume de l’échantillon : Pour les études à inclusion très rapide et à large cohorte ($N > 500$), des blocs plus volumineux ($b = 8, 10$ ou $12$) sont recommandés car les déséquilibres transitoires sont rapidement résorbés sans menacer l’intégrité de l’étude. Pour les petites cohortes ($N < 80$) ou les recrutements particulièrement léthargiques, des blocs de taille $b = 4$ ou $b = 6$ constituent un compromis d'équilibre optimal.
- Niveau de préservation de l’aveuglement : En présence d’un double aveugle pharmacologique absolu et rigoureux (placebo indiscernable en goût, couleur, texture et profil d’effets secondaires), le risque de déduction déterministe est fortement atténué, autorisant l’usage de blocs de taille modeste ($b = 4$). Dans les essais ouverts ou psycho-comportementaux sans aveuglement possible, la dimension du bloc doit obligatoirement être accrue ($b ge 6$) et impérativement dissimulée aux investigateurs.
- Règle empirique de dimensionnement : Une heuristique biostatistique classique stipule que la taille du bloc ne devrait jamais excéder environ 10 % à 15 % de la taille globale de la cohorte finale ciblée, sous peine de rendre l’équilibrage périodique purement symbolique et de s’exposer à des pertes d’efficience sévères si le protocole venait à avorter prématurément.
8. Technique avancée : La randomisation par blocs de taille variable
8.1 Principe de l’alternance aléatoire de la taille des blocs
Pour résoudre l’antagonisme apparemment insoluble entre l’exigence d’un rééquilibrage fréquent et la nécessité impérieuse de supprimer toute prévisibilité déterministe, les méthodologistes ont conçu une variante méthodologique supérieure : la randomisation par blocs de taille variable (variable block randomization). Le principe fondamental de cette technique consiste à bannir la dimension fixe unique au profit d’un mélange aléatoire et imprévisible de blocs de calibres hétérogènes le long de la séquence d’attribution.
Dans ce cadre sophistiqué, le biostatisticien définit a priori un ensemble discret de tailles de blocs admissibles, toutes compatibles avec le ratio d’allocation cible. Pour une comparaison binaire 1:1, une sélection canonique associe par exemple des blocs de taille 4, de taille 6 et de taille 8. Le processus de génération comporte alors une double couche stochastique :
- Aléa de premier niveau (macro-niveau) : L’algorithme sélectionne au hasard, selon une distribution de probabilité discrète (le plus souvent uniforme), la taille du prochain bloc à instancier (par exemple, tirer aléatoirement entre $b in {4, 6, 8}$).
- Aléa de second niveau (micro-niveau) : Une fois la taille du bloc déterminée par le premier tirage, l’algorithme tire au sort une permutation spécifique parmi l’espace combinatoire propre à cette dimension précise (1 parmi 6 pour un bloc de 4, 1 parmi 20 pour un bloc de 6, ou 1 parmi 70 pour un bloc de 8).
Cette alternance stochastique supprime radicalement le caractère déterministe lié à l’épuisement des blocs. Dès lors que l’investigateur ignore non seulement la configuration interne des allocations mais également la longueur même du bloc en cours d’exécution, il se trouve dans l’incapacité mathématique de déduire si une alternance observée clôture un cycle d’équilibrage ou si elle ne constitue qu’une étape intermédiaire au sein d’un bloc plus large.
8.2 Protection contre les biais de sélection et de prédiction
L’introduction de la variabilité dimensionnelle constitue le rempart méthodologique le plus étanche contre les mécanismes de déduction prédictive développés par les évaluateurs sur le terrain. Considérons un investigateur qui — dans un protocole à blocs fixes de 4 — observe que sur une tranche récente de trois patients consécutifs, deux ont été assignés au traitement $A$ et un au traitement $B$. Dans un schéma à taille fixe, il sait avec une certitude absolue ($P = 1,0$) que le quatrième patient recevra obligatoirement le traitement $B$.
Dans un protocole à blocs variables mélangeant des tailles de 4 et de 6, l’esprit de l’investigateur est plongé dans une incertitude probabiliste permanente. Face à la même séquence partielle ${A, A, B}$, deux hypothèses concurrentes et indémêlables s’affrontent :
- Soit le système opère actuellement au sein d’un bloc de taille 4 : dans ce cas de figure, le prochain sujet sera certes assigné au traitement $B$ avec une probabilité conditionnelle de 1,0.
- Soit le système déroule un bloc de taille 6 : dans cette configuration, il reste encore 3 places à attribuer (un traitement $A$ et deux traitements $B$), ce qui ramène la probabilité conditionnelle que le prochain sujet reçoive l’intervention $A$ à $1/3$ ($P \approx 33,3%$) et celle de recevoir $B$ à $2/3$ ($P \approx 66,7%$).
En agrégeant les probabilités de ces deux états latents pondérées par la probabilité d’occurrence de chaque taille de bloc, la probabilité a posteriori demeure strictement comprise entre les extrêmes, interdisant tout déterminisme absolu. Le principe cardinal de la dissimulation de l’allocation (allocation concealment) — exigé sans concession par les directives méthodologiques internationales telles que le manuel Cochrane pour les revues systématiques d’interventions — s’en trouve puissamment consolidé, assurant une conformité exemplaire avec les standards régulateurs des agences d’évaluation médicale (EMA, FDA).
8.3 Exemple d’ordonnancement avec blocs mixtes
Pour appréhender la mécanique intime d’un tel dispositif, examinons la planification concrète d’une cohorte de $N = 40$ participants assignés selon un ratio 1:1, utilisant une combinaison stochastique de blocs de dimensions 4 et 6. La génération algorithmique commence par tirer aléatoirement la succession des tailles de blocs requises pour atteindre l’effectif cible de 40 individus. Une réalisation stochastique valide pourrait produire la partition suivante :
$$\text{Séquence des blocs} = {\text{Bloc}_1: b=4, \text{Bloc}_2: b=6, \text{Bloc}_3: b=6, \text{Bloc}_4: b=4, \text{Bloc}_5: b=4, \text{Bloc}_6: b=6, \text{Bloc}_7: b=4, \text{Bloc}_8: b=6}$$
On constate que la somme des capacités ($4 + 6 + 6 + 4 + 4 + 6 + 4 + 6 = 40$) coïncide rigoureusement avec la cible d’échantillonnage. Dans un deuxième temps, pour chacun de ces blocs instanciés, l’ordinateur tire au sort une permutation conforme parmi les configurations autorisées pour la dimension considérée. La séquence maîtresse d’assignation se déploie alors de manière totalement opaque pour les expérimentateurs :
- Bloc 1 ($b=4$) : $A — B — B — A$ (Sujets 01 à 04)
- Bloc 2 ($b=6$) : $B — A — A — B — A — B$ (Sujets 05 à 10)
- Bloc 3 ($b=6$) : $A — B — B — A — A — B$ (Sujets 11 à 16)
- Bloc 4 ($b=4$) : $B — A — A — B$ (Sujets 17 à 20)
- Bloc 5 ($b=4$) : $A — A — B — B$ (Sujets 21 à 24)
- Bloc 6 ($b=6$) : $B — B — A — B — A — A$ (Sujets 25 à 30)
- Bloc 7 ($b=4$) : $B — A — B — A$ (Sujets 31 à 34)
- Bloc 8 ($b=6$) : $A — A — B — B — B — A$ (Sujets 35 à 40)
Des simulations informatiques répétées démontrent que l’introduction de cette variabilité abaisse de plus de 75 % l’exactitude des tentatives de déduction empirique de l’assignation formulées par les investigateurs sur le terrain, neutralisant quasiment l’ensemble du biais de sélection attribuable à l’anticipation cognitive de la séquence.
9. Combinaison avec la stratification : Randomisation par blocs stratifiés
9.1 Fondements théoriques de la stratification pronostique
Bien que la randomisation par blocs garantisse un équilibre quantitatif sans faille entre les effectifs bruts des groupes comparatifs, elle ne saurait prémunir totalement contre le risque de déséquilibres qualitatifs fortuits concernant des covariables fondamentales ayant un pouvoir pronostique majeur sur l’issue clinique. Si, par exemple, dans un essai sur la maladie d’Alzheimer, l’âge supérieur à 75 ans ou le port de l’allèle ApoE4 constituent des facteurs déterminants de déclin cognitif rapide, une surreprésentation accidentelle de ces profils dans l’un des bras thérapeutiques risquerait de masquer l’efficacité réelle de l’intervention ou d’engendrer un effet faussement positif.
Pour parer à cette menace, les chercheurs conjuguent la méthode des blocs permutés avec la randomisation stratifiée (stratified permuted block randomization). Le fondement théorique de cette approche conjointe consiste à subdiviser la population globale des participants éligibles en sous-groupes homogènes et mutuellement exclusifs, désignés sous le terme de « strates », sur la base d’une ou plusieurs variables pronostiques catégorielles identifiées a priori comme hautement critiques.
D’un point de vue opérationnel, une séquence de randomisation par blocs permutés totalement indépendante et autonome est alors générée au sein de chaque strate pronostique distincte. Dès qu’un patient intègre le protocole, son profil clinique est évalué afin de le rattacher à la strate correspondante. Son attribution au traitement est alors gouvernée par la liste de blocs spécifiquement allouée à cette strate. Cette stratégie garantit simultanément deux niveaux de contrôle méthodologique : un équilibre parfait des effectifs au sein de chaque sous-groupe pronostique et, par sommation mathématique, un équilibre parfait des covariables d’intérêt à l’échelle globale de l’étude.
9.2 Mise en œuvre concrète sur un schéma multicentrique
L’illustration la plus exemplaire et la plus indispensable de la randomisation par blocs stratifiés s’incarne dans les essais cliniques multicentriques, au sein desquels les patients sont recrutés à travers plusieurs établissements hospitaliers ou centres de recherche géographiquement distants. Dans un tel schéma, le centre investigateur lui-même constitue invariablement une variable de stratification pronostique non négociable, en raison de l’hétérogénéité des populations locales de patients, des variations dans les pratiques médicales de routine et des divergences de compétences des équipes locales.
Imaginons un essai clinique multicentrique en neuropsychologie évaluant une intervention de remédiation cognitive versus prise en charge habituelle chez des patients victimes d’un accident vasculaire cérébral (AVC). L’étude implique trois centres hospitaliers universitaires distincts (Centre 1 : Paris, Centre 2 : Lyon, Centre 3 : Bordeaux) et s’intéresse à une covariable pronostique binaire majeure : la sévérité initiale du déficit moteur et cognitif (Stade modéré versus Stade sévère). Le croisement de ces variables génère une matrice factorielle composée de $3 \times 2 = 6$ strates mutuellement exclusives :
- Strate 1 : Centre 1 (Paris) — Déficit modéré
- Strate 2 : Centre 1 (Paris) — Déficit sévère
- Strate 3 : Centre 2 (Lyon) — Déficit modéré
- Strate 4 : Centre 2 (Lyon) — Déficit sévère
- Strate 5 : Centre 3 (Bordeaux) — Déficit modéré
- Strate 6 : Centre 3 (Bordeaux) — Déficit sévère
Le biostatisticien central génère six listes de randomisation par blocs distinctes et étanches, comportant chacune des blocs permutés de taille variable (par exemple, des blocs de 4 et 6). Chaque site hospitalier dispose d’un accès sécurisé — généralement via une plateforme web cryptée — aux deux seules listes correspondant à ses strates de sévérité locales. De cette manière, même si le Centre 3 de Bordeaux recrute deux fois moins vite que le Centre 1 de Paris, l’équilibre des traitements est rigoureusement maintenu au sein de chaque hôpital et pour chaque niveau de sévérité clinique, empêchant que le facteur « centre » ne vienne biaiser l’estimation globale de l’effet d’intervention.
9.3 Le piège de la sur-stratification
Bien que la stratification apparaisse conceptuellement séduisante, son implémentation débridée expose le protocole expérimental à un piège méthodologique pernicieux désigné sous le terme de sur-stratification (over-stratification). Le nombre global de strates résultant du produit multiplicatif du nombre de modalités de chaque variable retenue, l’espace des cellules de randomisation croît à une vitesse exponentielle sous l’effet de ce que les mathématiciens qualifient de malédiction de la dimensionnalité.
Si un investigateur souhaite imprudemment stratifier son essai clinique selon le centre (4 hôpitaux), le sexe (2 modalités), la tranche d’âge (3 catégories : jeune, moyen, âgé) et le stade clinique de la maladie (3 niveaux), le modèle génère immédiatement $4 \times 2 \times 3 \times 3 = 72$ strates hermétiques distinctes. Si l’échantillon total planifié pour l’étude n’est que de $N = 144$ participants, la moyenne théorique d’inclusion par cellule de stratification s’établit à seulement 2 patients par strate ($144 / 72 = 2$).
La conséquence méthodologique d’un tel morcellement est dramatique : la grande majorité des strates abriteront des blocs permutés commencés mais jamais achevés à la clôture de l’essai. Si l’on déploie des blocs de taille 4 sur 72 strates et que le recrutement s’arrête alors que chaque strate ne compte que 1, 2 ou 3 sujets, la propriété fondamentale d’équilibrage des blocs est totalement annihilée. Le déséquilibre résiduel cumulé sur l’ensemble des strates incomplètes peut alors dépasser très largement le déséquilibre qu’aurait naturellement généré une simple randomisation pure non stratifiée.
Pour éviter cette dérive, une directive biostatistique universelle prescrit de limiter rigoureusement le nombre total de variables de stratification à deux ou trois facteurs au grand maximum, et de s’assurer que le ratio entre l’effectif global planifié ($N$) et le nombre total de cellules de stratification ($S$) respecte au minimum la condition empirique $N / S ge 3 \times b$, où $b$ désigne la taille moyenne du bloc utilisé.
10. Risques de prévisibilité, biais d’allocation et maintien de l’insu
10.1 Mécanisme du biais de sélection par déduction déterministe
L’écueil épistémologique majeur inhérent à la randomisation par blocs réside dans le biais de sélection par prédiction déterministe. Ce biais ne résulte pas d’une défaillance des équations combinatoires, mais de l’interaction perverse entre la structure mathématique de la méthode et la psychologie cognitive des chercheurs et soignants impliqués dans la sélection des participants sur le terrain. Lorsque l’investigateur clinique connaît la taille des blocs (ou parvient à la déduire empiriquement au fil de l’inclusion), la liberté stochastique s’amenuise à mesure que le bloc se remplit.
Le processus psychologique menant au biais s’articule selon une chaîne décisionnelle bien identifiée :
- L’investigateur observe les assignations des sujets précédents au sein du bloc en cours (par exemple, dans un bloc de taille 4, il a constaté l’attribution de $A$, puis de $B$, puis de nouveau de $A$).
- Il applique mentalement la contrainte de fermeture combinatoire et déduit avec certitude que la prochaine assignation sera obligatoirement $B$.
- Inconsciemment ou consciemment influencé par ses préférences cliniques, son empathie médicale ou ses préjugés quant à l’efficacité relative des traitements, il altère son comportement d’inclusion pour le patient suivant qui se présente à la consultation.
Si le soignant est convaincu de la supériorité de la nouvelle thérapie $B$ et qu’il sait de façon déterministe que le prochain billet de randomisation délivrera $B$, il sera inconsciemment plus incitatif à faire signer le consentement éclairé à un patient gravement atteint qu’il désire ardemment « sauver ». À l’inverse, s’il déduit que la prochaine assignation sera le placebo $A$, il pourra trouver un prétexte clinique marginal pour juger un patient sévère inéligible et différer son inclusion, le préservant ainsi de l’exposition au groupe témoin.
Cette sélection pervertit irréversiblement l’équivalence initiale des groupes. Les patients les plus gravement atteints se retrouvent concentrés dans un bras spécifique, faussant l’estimation du traitement. Des démonstrations mathématiques formelles ont prouvé que cette déduction systématique de l’insu peut faire enfler le taux d’erreur de première espèce ($\alpha$) de son seuil nominal de 5 % jusqu’à des niveaux atteignant 15 % ou 20 %, conduisant la communauté scientifique à déclarer comme « efficaces » des thérapies en réalité inopérantes ou dangereuses.
10.2 Stratégies méthodologiques pour préserver l’insu
Face à la gravité du risque de déduction déterministe, la communauté des méthodologistes et les agences réglementaires ont standardisé un ensemble de protocoles de sécurité visant à rendre inviolable la dissimulation de l’affectation (allocation concealment) :
- Centralisation automatisée de la randomisation : L’époque des listes papier consultables dans les tiroirs hospitaliers est définitivement révolue. L’attribution des traitements doit être confiée à des systèmes informatisés centraux distants et sécurisés, accessibles par interface web cryptée (IWRS — Interactive Web Response System) ou serveurs vocaux interactifs (IVRS). Le médecin n’obtient l’attribution aléatoire qu’après avoir définitivement validé et téléversé dans la base de données auditable les données d’admissibilité et de consentement non modifiables du patient.
- Masquage absolu des paramètres de blocs : La taille des blocs, leur caractère fixe ou variable et la séquence d’alternance doivent impérativement demeurer secrets. Cette information constitue une donnée confidentielle hautement sensible, détenue exclusivement par le biostatisticien indépendant en charge de la génération. Le protocole clinique soumis aux investigateurs de terrain doit formellement stipuler que l’essai utilise des blocs permutés sans jamais en divulguer les dimensions précises.
- Ségrégation stricte des rôles : Dans les essais nécessitant une manipulation physique de l’intervention (comme en ergothérapie, kinésithérapie ou psychothérapie), une dichotomie hermétique doit être instaurée entre les professionnels administrant le traitement et les cliniciens évaluateurs indépendants chargés de mesurer les critères de jugement de l’étude. Ces derniers doivent rester rigoureusement aveugles à l’histoire thérapeutique des participants et aux assignations passées.
10.3 Audit statistique de l’intégrité de la randomisation
L’intégrité de l’attribution aléatoire ne doit pas être postulée sur la simple foi déclarative des investigateurs ; elle doit pouvoir faire l’objet de vérifications métrologiques a posteriori au moyen d’audits statistiques spécialisés. Le biostatisticien de contrôle dispose d’outils analytiques sophistiqués capables d’identifier si la randomisation par blocs a subi des distorsions illégitimes sur le terrain au cours du recrutement.
Le test le plus emblématique de cette démarche de contrôle est le test de Berger pour la détection du biais de sélection (Berger’s Selection Bias Test). Ce test non paramétrique évalue formellement s’il existe une corrélation statistiquement anormale entre l’état de prévisibilité déterministe d’une assignation (quantifié par le différentiel d’allocation cumulé au sein du bloc au moment où le sujet franchit l’inclusion) et les caractéristiques pronostiques de base ou les scores d’efficacité observés chez les participants inclus sous ces créneaux à haute prédictibilité.
Si l’analyse diagnostique révèle que les sujets inclus précisément aux positions terminales de blocs prédictibles présentent des profils cliniques systématiquement plus sévères ou plus favorables que ceux inclus aux positions initiales purement aléatoires, la rupture de l’insu est formellement démontrée sur le plan statistique. Les agences d’homologation telles que l’EMA ou la FDA procèdent régulièrement à de telles analyses forensiques lors des audits d’essais pivots, rejetant sans appel les demandes d’autorisation de mise sur le marché dès lors qu’un biais d’inclusion substantiel est mis en évidence au sein des séquences d’assignation.
11. Implémentation computationnelle et programmation statistique
11.1 Génération de blocs permutés avec le langage R
Dans l’écosystème de la recherche académique et biopharmaceutique, le langage environnemental R s’impose comme la référence méthodologique pour concevoir des séquences de randomisation conformes aux exigences réglementaires. Le package spécialisé blockrand, développé spécifiquement pour les essais cliniques et biomédicaux, offre des fonctionnalités éprouvées pour paramétrer des blocs fixes ou variables associés à des identifiants uniques de participants.
Le déploiement algorithmique s’articule autour de la fonction homonyme blockrand(), qui nécessite la spécification explicite de la taille d’échantillon souhaitée (n), du nombre de traitements à comparer (num.levels), des libellés nominaux des bras d’intervention (levels), et de l’amplitude vectorielle des blocs admissibles (block.sizes). Il est impératif d’initialiser formellement le générateur avec une graine pseudo-aléatoire reproductible via la commande set.seed(). La syntaxe R permet également d’introduire des variables de stratification en répétant l’appel de fonction à travers une boucle ou en utilisant les arguments de stratification dédiés.
Le script génère en sortie un objet de type data.frame exhaustif, comportant pour chaque sujet son identifiant séquentiel anonymisé, le numéro du bloc d’appartenance, la taille du bloc spécifique dans lequel il a été capturé, et son assignation thérapeutique définitive. Cette matrice peut ensuite être exportée dans des formats tabulaires sécurisés ou directement transmise sous forme de fichiers cryptés aux services de pharmacie centrale pour le conditionnement en aveugle des unités thérapeutiques.
11.2 Scripts et modules équivalents en langage Python
Dans les environnements d’ingénierie de données et au sein des plateformes de santé numériques, Python constitue une alternative de premier plan grâce à sa robustesse de déploiement et à la richesse de ses bibliothèques de calcul scientifique telles que numpy et pandas. La conception d’un algorithme de blocs permutés sous Python ne requiert pas nécessairement de bibliothèques tierces opaques ; elle peut être programmée de manière transparente en exploitant les générateurs combinatoires du module standard itertools.
Le cœur algorithmique repose sur la construction d’une fonction génératrice qui détermine l’ensemble des permutations uniques au moyen de la méthode itertools.permutations() appliquée sur un vecteur d’allocation équilibré (par exemple une liste contenant deux fois le libellé de l’intervention A et deux fois le libellé de l’intervention B pour un bloc de 4). L’élimination des doublons s’opère par conversion en structure de données set. Le moteur pseudo-aléatoire numpy.random.default_rng() est ensuite instancié avec une graine cryptographique pour effectuer des tirages avec remise au sein de cette bibliothèque de configurations conformes jusqu’à saturation de l’effectif planifié.
La structure résultante est alors encapsulée dans un tableau pandas.DataFrame, enrichi d’horodatages d’audit conformes aux exigences du titre 21 du Code of Federal Regulations (CFR Part 11) de la FDA. Ce pipeline Pythonisé peut être directement interfacé avec des API web pour alimenter en temps réel des systèmes de randomisation centralisée sécurisés, garantissant une étanchéité absolue entre la génération du code et l’investigateur clinique.
11.3 Procédures sous SPSS et logiciels dédiés aux essais cliniques
Pour les chercheurs évoluant principalement sous l’interface d’environnements statistiques généralistes tels qu’IBM SPSS Statistics, la génération de blocs permutés s’effectue via des syntaxes spécialisées combinant les commandes de manipulation matricielle et le générateur de nombres aléatoires interne (accessible par les instructions SET SEED et RV.UNIFORM). SPSS autorise la création de grilles d’assignation structurées, bien que sa flexibilité algorithmique pour gérer des blocs de taille variable et des stratifications multifactorielles complexes soit sensiblement plus rigide que celle offerte par R ou Python.
Dans le cadre professionnel des essais pivots menés par l’industrie pharmaceutique et les organismes de recherche sous contrat (CRO), la génération des listes maîtresse d’assignation s’affranchit totalement des scripts statistiques locaux de bureau pour s’intégrer directement au sein de solutions logicielles d’acquisition de données électroniques (EDC — Electronic Data Capture) validées et dédiées, telles que Medidata Rave RTSM, REDCap (Research Electronic Data Capture) ou Oracle Clinical. Ces environnements intégrés garantissent une traçabilité inviolable (audit trail), consignant de façon immuable l’identité de l’opérateur, la date et l’heure exactes de chaque allocation, tout en verrouillant l’accès aux tables de blocs permutés sous des couches d’authentification biométrique et cryptographique hautement sécurisées.
12. Synthèse critique, normes CONSORT et recommandations pratiques
12.1 Conformité avec les exigences de la déclaration CONSORT
La publication des résultats d’un essai clinique randomisé au sein des revues biomédicales et psychologiques à comité de lecture les plus exigeantes est strictement conditionnée par le respect de la déclaration CONSORT (Consolidated Standards of Reporting Trials). Cette directive méthodologique internationale impose une transparence absolue et sans compromis concernant la conceptualisation, l’implémentation et la divulgation des mécanismes de randomisation au sein du manuscrit académique.
Plusieurs items cruciaux de la grille de contrôle CONSORT ciblent directement la méthodologie des blocs permutés :
- Item 8a (Génération de la séquence) : Le texte doit expliciter en détail la méthode précise utilisée pour générer la séquence d’allocation aléatoire. Si des blocs ont été employés, les auteurs doivent formellement spécifier la nature de ces blocs : blocs de taille fixe ou blocs de taille variable, et détailler les dimensions exactes utilisées dans le protocole.
- Item 8b (Type de randomisation) : Si une restriction a été appliquée (comme la stratification selon des facteurs pronostiques ou des centres hospitaliers), celle-ci doit être explicitée avec clarté, en énumérant l’intégralité des variables de stratification et le nombre total de strates résultantes.
- Item 9 (Mécanisme de dissimulation de l’affectation) : Le manuscrit doit décrire minutieusement le mode opératoire déployé pour masquer la séquence d’attribution jusqu’à l’assignation effective du traitement (ex. serveurs web centraux sécurisés, enveloppes opaques numérotées), garantissant aux relecteurs que les investigateurs de terrain ne pouvaient anticiper l’ordre des interventions.
- Item 10 (Mise en œuvre) : Il est impératif de documenter précisément la répartition des tâches opérationnelles : qui a généré la séquence d’allocation aléatoire, qui a enrôlé les participants sur le terrain, et qui a formellement assigné les interventions aux participants, attestant d’une dissociation stricte entre ces intervenants.
12.2 Arbre de décision : Quand privilégier la randomisation par blocs permutés ?
L’adoption de la randomisation par blocs permutés ne constitue pas une décision universelle applicable indistinctement à toutes les problématiques expérimentales. Le choix du dispositif d’allocation doit découler d’un arbitrage raisonné, guidé par les caractéristiques structurelles de l’étude :
La randomisation simple non restreinte demeure parfaitement acceptable — et même méthodologiquement préférable en raison de son imprévisibilité intrinsèque absolue — exclusivement dans les études observationnelles ou interventionnelles portant sur de très grandes cohortes de participants ($N > 1,000$), où les lois asymptotiques de la probabilité garantissent spontanément l’équivalence numérique sans nécessiter la moindre contrainte déterministe.
La randomisation par blocs permutés s’impose en revanche comme la référence méthodologique incontournable lorsque l’essai présente un effectif total modeste à intermédiaire ($N < 200$), que le recrutement est étalé dans le temps avec un risque d'effet de cohorte ou de dérive temporelle, lorsque des analyses intermédiaires planifiées nécessitent des coupes transversales équilibrées, ou lorsque l'administration des traitements exige la constitution de cohortes de taille homogène (comme dans les thérapies de groupe ou les programmes d'ateliers comportementaux).
Enfin, lorsque le protocole exige d’équilibrer un nombre substantiel de variables pronostiques critiques au sein d’une petite cohorte — situation où la sur-stratification des blocs permutés deviendrait désastreuse —, le chercheur devra délaisser les blocs au profit d’algorithmes de randomisation dynamique adaptative, au premier rang desquels figure la procédure de minimisation de Pocock-Simon (Pocock-Simon dynamic minimization), capable de minimiser le déséquilibre global marginal sans fragmenter l’échantillon en micro-strates fermées.
12.3 Synthèse des dix commandements méthodologiques pour le chercheur
Pour clore ce traité méthodologique exhaustif, nous synthétisons sous forme de dix commandements opérationnels les directives fondamentales que tout investigateur rigoureux doit impérativement respecter lors du déploiement de la randomisation par blocs permutés :
- Planifier a priori : La taille des blocs et le protocole d’assignation doivent être intégralement gravés dans le protocole formel avant l’inclusion du premier sujet expérimental.
- Privilégier la variabilité dimensionnelle : Banish les blocs de taille fixe unique dans les essais ouverts ; privilégier systématiquement l’alternance aléatoire de blocs de longueurs différentes (ex. 4, 6 et 8).
- Sceller le secret des blocs : Ne jamais divulguer la taille des blocs aux investigateurs, aux cliniciens de terrain ni aux évaluateurs de critères de jugement.
- Automatiser et centraliser : Utiliser impérativement des générateurs d’assignation distants informatisés (IWRS/EDC) plutôt que des supports papier locaux vulnérables aux manipulations.
- Préserver l’insu absolu : S’assurer que le carton d’assignation n’est accessible qu’après la validation formelle et irrévocable de l’admissibilité du participant.
- Éviter la sur-stratification : Limiter la stratification conjointe à un ou deux facteurs pronostiques suprêmes pour empêcher la prolifération de blocs résiduels incomplets.
- Documenter la reproductibilité : Archiver la graine (seed) du générateur pseudo-aléatoire et l’algorithme combinatoire source dans le dossier réglementaire permanent de l’essai.
- Analyser en intention de traiter : Maintenir impérativement chaque participant dans son groupe d’assignation théorique initiale lors des analyses inférentielles finales.
- Auditer les biais potentiels : Exécuter des tests statistiques de contrôle de sélection (tels que le test de Berger) pour attester formellement de l’absence de déduction de l’insu.
- Respecter les normes de publication : Décrire en toute transparence l’intégralité du processus de randomisation conformément aux items obligatoires de la déclaration CONSORT.
Références
Berger, V. W. (2005). Selection bias and covariate imbalances in randomized clinical trials. John Wiley & Sons. https://doi.org/10.1002/0470863640
Beller, E. M., Gebski, V., & Keech, A. C. (2002). Randomisation in clinical trials. Medical Journal of Australia, 177(10), 565-567. https://doi.org/10.5694/j.1326-5377.2002.tb04955.x
Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
Kernan, W. N., Viscoli, C. M., Makuch, R. W., & Brass, L. M. (1999). Stratified randomization for clinical trials. Journal of Clinical Epidemiology, 52(1), 19-26. https://doi.org/10.1016/S0895-4356(98)00138-3
Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c869. https://doi.org/10.1136/bmj.c869
Pocock, S. J. (1983). Clinical trials: A practical approach. John Wiley & Sons.
Pocock, S. J., & Simon, R. (1975). Sequential treatment assignment with balancing for prognostic factors in the controlled clinical trial. Biometrics, 31(1), 103-115. https://doi.org/10.2307/2529712
Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688-701. https://doi.org/10.1037/h0037350
Schulz, K. F., & Grimes, D. A. (2002). Generation of allocation sequences in randomised trials: Chance, not choice. The Lancet, 359(9305), 515-519. https://doi.org/10.1016/S0140-6736(02)07683-3
Schulz, K. F., & Grimes, D. A. (2002). Allocation concealment in randomised trials: Defending against deciphering. The Lancet, 359(9306), 614-618. https://doi.org/10.1016/S0140-6736(02)07750-4
Snowdon, C., Elbourne, D., & Garcia, J. (1999). Zelen randomization: Attitudes of parents and clinicians in a neonatal trial. Lancet, 353(9169), 2073-2074. https://doi.org/10.1016/S0140-6736(05)75440-2
Zelen, M. (1974). The randomization and stratification of patients to clinical trials. Journal of Chronic Diseases, 27(7-8), 365-375. https://doi.org/10.1016/0021-9681(74)90015-0