
Dans le paysage contemporain de la recherche quantitative en sciences humaines, cognitives et comportementales, la modélisation statistique linéaire s’impose comme une pierre angulaire de l’investigation empirique. Qu’il s’agisse d’évaluer l’impact combiné de traits de personnalité sur la propension au stress, de décrypter les déterminants environnementaux et génétiques du quotient intellectuel, ou d’estimer l’efficacité relative d’interventions thérapeutiques ciblées, la régression multiple constitue l’outil analytique le plus massivement déployé. Au cœur de cette méthodologie reposent deux indicateurs omniprésents, pourtant fréquemment confondus par les praticiens et les étudiants : le coefficient de corrélation multiple (désigné par la lettre majuscule R) et le coefficient de détermination (noté R² ou R-carré).
Bien que mathématiquement articulés de manière directe, l’élévation au carré de l’un produisant rigoureusement la valeur de l’autre, ces deux paramètres véhiculent des significations conceptuelles et des fonctions épistémologiques profondément distinctes. Le R multiple formalise la magnitude brute de l’association linéaire globale unissant une combinaison optimale de variables prédictrices à un critère observé. À l’inverse, le R-carré opère une quantification de la variance partagée, traduisant la fraction proportionnelle de dispersion du phénomène étudié qui se trouve absorbée et explicitée par l’architecture du modèle. Cette divergence d’échelle — d’une métrique de distance et d’alignement vectoriel vers une métrique de proportionnalité d’énergie dispersée — engendre régulièrement des distorsions d’interprétation notables au sein de la littérature scientifique.
Le présent article propose un examen exhaustif, théorique et appliqué des divergences, convergences et subtilités méthodologiques liant le R multiple au R-carré. En explorant leurs soubassements algébriques matriciels, leurs dynamiques face au bruit d’échantillonnage, la correction impérative apportée par l’ajustement aux degrés de liberté, ainsi que les protocoles de restitution conformes aux exigences éditoriales les plus strictes de l’American Psychological Association (APA), cette analyse vise à doter les chercheurs d’un cadre conceptuel rigoureux pour transcender la simple lecture automatisée des sorties logicielles.
1. Introduction aux métriques de régression en psychologie : genèse du R multiple et du R-carré
1.1 Le rôle fondamental des modèles de régression en recherche psychologique
L’avènement de la psychologie scientifique à la fin du XIXe siècle, sous l’impulsion conjointe de figures telles que Francis Galton, Karl Pearson et Charles Spearman, s’est intrinsèquement noué à l’élaboration d’instruments quantitatifs capables d’objectiver l’invisible. La psychométrie, en cherchant à mesurer des entités non directement observables — les traits latents, l’intelligence générale, l’anxiété état ou l’estime de soi —, a rapidement buté sur la complexité multifactorielle des conduites humaines. Aucun phénomène psychologique d’envergure ne saurait être réduit à une dynamique univariée ou à une relation causale linéaire simple entre un stimulus unique et une réponse isolée. Dès lors, le recours à l’analyse de régression s’est imposé non seulement comme une nécessité statistique, mais comme un impératif ontologique.
L’évaluation de la qualité de l’ajustement prédictif des variables comportementales pose un défi de taille : comment condenser, au sein d’un indice parcimonieux et standardisé, la capacité d’une constellation hétérogène de prédicteurs (allant d’échelles de personnalité ordonnées à des biomarqueurs continus) à rendre compte des variations d’un critère clinique ou cognitif ? La modélisation linéaire permet de projeter ces prédicteurs dans un espace géométrique multidimensionnel afin de générer une équation prédictive dont l’ajustement aux observations empiriques doit être quantifié avec une précision millimétrique. Il devient alors indispensable d’opérer une césure nette entre la simple corrélation bivariée de Pearson (r), confinée à la covariation symétrique entre deux grandeurs isolées, et la régression multivariée, qui orchestre une synthèse asymétrique de multiples sources d’information pour prédire une variable dépendante unique.
Dans ce cadre complexe, l’estimation de la qualité d’ajustement ne se limite pas à un contrôle de conformité mathématique. Elle constitue le fondement même sur lequel repose la validité de construit des théories psychologiques. Un modèle prédictif dont on ne peut apprécier rigoureusement la force d’ajustement empêche toute distinction entre une régularité comportementale robuste et une coïncidence imputable aux fluctuations stochastiques du recueil de données.
1.2 Origine des coefficients dans les logiciels d’analyse statistique
Avec la démocratisation informatique des années 1970 et l’hégémonie subséquente d’environnements d’analyse tels que IBM SPSS Statistics, puis plus récemment d’outils modernes et ouverts comme le langage de programmation R ou les interfaces graphiques dédiées aux sciences sociales telles que Jamovi et JASP, les calculs matriciels complexes sont devenus instantanés. Cette automatisation a toutefois engendré un effet pervers : la banalisation des tableaux de sortie standardisés, au sein desquels les indices R, R-carré (R²) et R-carré ajusté figurent côte à côte dans une même ligne de résumé de modèle sans que l’utilisateur n’en saisisse toujours la portée différentielle.
Une confusion chronique s’est ainsi installée dans les laboratoires de recherche et la rédaction d’articles empiriques. Trop fréquemment, la force de l’association globale (incarnée par le R multiple) est interchangée avec la proportion de variance expliquée (incarnée par le R²). Cette approximation sémantique dissimule des disparités arithmétiques majeures. Alors que le R multiple évolue sur une échelle dimensionnelle linéaire équivalente à celle d’une corrélation d’ordre zéro, le R² représente une surface géométrique ou une fraction d’énergie statistique. Confondre ces deux métriques conduit à des distorsions cognitives majeures dans l’appréciation des effets : un chercheur peut juger une relation impressionnante à la lecture d’un R multiple de 0,40, tout en omettant de réaliser que le modèle ne parvient en réalité à expliquer que 16 % des disparités interindividuelles.
L’objectif cardinal de cet article est de dissiper méthodiquement ces ambiguïtés. Il s’agit de fournir aux chercheurs, cliniciens et analystes du comportement les repères analytiques indispensables pour décoder la mécanique sous-jacente à ces métriques, identifier leurs domaines de pertinence respectifs et déjouer les pièges interprétatifs inhérents à la modélisation statistique avancée.
2. Définition théorique et fondements mathématiques du R multiple
2.1 Nature du coefficient de corrélation multiple
Sur le plan de la théorie statistique fondamentale, le coefficient de corrélation multiple, désigné par convention typographique par la lettre majuscule R, se définit très précisément comme la corrélation linéaire simple de Pearson établie entre les valeurs réelles observées de la variable dépendante (notées Y) et les valeurs composites théoriques prédites par l’équation de régression (notées Ŷ ou Y-chapeau). En d’autres termes, si l’on calcule le score prédit pour chaque participant d’un échantillon à partir de la combinaison optimale de ses scores aux prédicteurs, la corrélation bivariée entre cette nouvelle colonne de scores estimés et la colonne des scores réellement mesurés est strictement égale au R multiple du modèle.
Cette définition entraîne des propriétés mathématiques spécifiques. La plus remarquable réside dans son intervalle de variation : alors que le coefficient de corrélation classique de Pearson bivarié (r) oscille entre -1,00 et +1,00, le coefficient de corrélation multiple R est, par construction axiomatique, strictement borné au domaine continu allant de 0,00 à 1,00. Il ne peut jamais prendre de valeur négative. Cette contrainte découle du principe même d’optimisation par la méthode des moindres carrés ordinaires (MCO / OLS). L’algorithme d’ajustement est conçu pour orienter les poids de régression partiels de manière à maximiser systématiquement l’accord linéaire entre les prédictions et les critères réels.
En conséquence directe, l’apparition de coefficients de régression partiels négatifs (les coefficients bêta standardisés ou B non standardisés) au sein du modèle n’induit aucunement un R négatif. Si, par exemple, un niveau accru d’anxiété prédit négativement la performance mnésique, l’algorithme affecte simplement une pondération négative à l’anxiété. L’accord global entre la projection combinée et la mesure réelle demeure dans une dynamique de covariation positive maximale, excluant structurellement toute négativité du R multiple global.
2.2 Formulation algébrique et calcul matriciel
D’un point de vue algébrique et computationnel, le R multiple ne s’obtient pas par une simple moyenne ou somme pondérée des corrélations individuelles. Son calcul exige l’intégration matricielle des relations unissant l’ensemble des variables du système. Considérons un système d’analyse prédictive composé d’un vecteur de corrélations simples entre chaque prédicteur Xi et le critère Y, noté ryx, et de la matrice carrée symétrique inversible des corrélations inter-prédicteurs, désignée par Rxx. Le carré du coefficient de corrélation multiple s’exprime alors par le produit matriciel suivant :
R² = r‘yx × Rxx-1 × ryx
Le R multiple correspond à la racine carrée positive de cette forme quadratique scalaire. Cette formulation met en exergue le rôle pivot joué par la matrice inverse Rxx-1. Cette inversion opère un ajustement rigoureux pour toutes les redondances informatives existant au sein de la batterie de prédicteurs. Si deux tests psychologiques mesurent des facettes très proches d’un même construit intellectuel, leur forte corrélation mutuelle gonfle les termes de la matrice Rxx, ce qui, via l’inversion, atténue la contribution incrémentale de la seconde variable au R global.
D’un point de vue géométrique, dans l’espace vectoriel euclidien à n dimensions (où n représente le nombre total d’observations ou de participants), la variable dépendante Y est représentée par un vecteur partant de l’origine. L’ensemble des k variables prédictrices engendre un sous-espace vectoriel appelé hyperplan. Dans cette perspective spatiale, le vecteur des valeurs prédites Ŷ est l’exacte projection orthogonale du vecteur Y sur l’hyperplan formé par les prédicteurs. Le coefficient de corrélation multiple R correspond alors géométriquement au cosinus de l’angle vectoriel (noté thêta) séparant le vecteur observé Y de sa projection orthogonale Ŷ. Plus l’angle est aigu, plus le cosinus tend vers 1,00, signifiant une proximité vectorielle quasi parfaite entre l’observation empirique et la prédiction théorique.
2.3 Signification conceptuelle en psychométrie
Transposé au champ opérationnel de la psychométrie contemporaine, le coefficient R multiple trouve son application la plus noble dans l’évaluation de la validité critère composite. Lorsqu’une équipe de psychologues conçoit une batterie d’évaluations cliniques ou de sélection professionnelle, l’objectif n’est presque jamais d’utiliser un test isolé, mais de combiner plusieurs épreuves pour appréhender une réalité complexe (le risque de rechute dépressive, l’aptitude au commandement, le rendement académique ultérieur). Le R multiple synthétise en un indicateur scalaire unique le plafond de performance prédictive que cette batterie optimisée peut théoriquement atteindre.
Le R multiple agit comme une mesure de validité concurrente ou prédictive globale. Il indique jusqu’à quel point la combinaison pondérée idéale des scores aux sous-échelles réplique les différences observées sur le critère externe. C’est un indicateur de calibrage brut de l’instrument composé. Dès lors qu’un clinicien s’interroge sur l’opportunité d’ajouter un troisième inventaire de personnalité à une évaluation déjà chronophage, l’augmentation marginale du R multiple informe immédiatement sur le gain d’alignement empirique rendu possible par cet ajout.
Cependant, la sensibilité du R multiple aux artefacts de multicolinéarité impose une vigilance méthodologique constante. Si des items ou des échelles partagent une variance résiduelle massive sans apporter d’information nouvelle sur le critère, l’estimation du R peut être artificiellement stabilisée ou faussée par des problèmes d’instabilité numérique lors de l’inversion matricielle. Le R multiple offre une vision holistique de l’association, mais demeure totalement muet quant à l’indépendance fonctionnelle des éléments qui le composent.
3. Définition et interprétation fondamentale du coefficient de détermination (R-carré)
3.1 Dérivation du R-carré à partir du R multiple
Si le R multiple quantifie une corrélation vectorielle, le coefficient de détermination — quasi universellement désigné sous le terme de R-carré (R²) — s’obtient algébriquement en élevant le R multiple au carré. Cette opération arithmétique, en apparence élémentaire, transforme radicalement la nature mathématique et la portée interprétative de l’indice. En élevant au carré un nombre décimal compris entre 0 et 1, on opère une translation dimensionnelle : on passe d’une unité de mesure linéaire à une unité de surface ou de variance proportionnelle.
Cette transformation élimine toute dépendance résiduelle aux unités de mesure métriques d’origine des variables considérées. Le R² est un ratio adimensionnel, rigoureusement standardisé entre 0,00 (absence totale de relation explicative au sein du modèle) et 1,00 (détermination déterministe parfaite, où chaque point de données coïncide rigoureusement avec la droite ou l’hyperplan de régression). Cette standardisation universelle confère au R-carré un statut privilégié au sein des sciences empiriques. Il sert d’étalon commun permettant de confronter directement des recherches investiguant des construits psychologiques disparates, mesurés via des méthodologies divergentes (par exemple, comparer la prédictibilité d’une mesure chronométrique de temps de réaction face à celle d’une échelle ordinale de dépression de Beck).
Dans la recherche contemporaine, et plus singulièrement au sein des synthèses quantitatives et des méta-analyses, la stabilité d’échelle du R² offre une unité commune d’évaluation de la magnitude des effets. Les chercheurs peuvent agréger les fractions de variance expliquée issues de multiples laboratoires internationaux afin d’estimer avec précision la consistance d’un paradigme théorique donné.
3.2 Décomposition de la variance : somme des carrés
L’assise conceptuelle fondamentale du R-carré réside dans le grand théorème de partitionnement de la variabilité au sein du modèle linéaire généralisé. Toute la variabilité observée chez les sujets autour de la moyenne arithmétique globale de la variable dépendante peut être décomposée en deux composantes mutuellement exclusives et parfaitement additives. Ce découpage repose sur la décomposition de la somme des carrés totale (Sum of Squares Total ou SST) :
SST = SSR + SSE
Dans cette formulation axiomatique, la somme des carrés totale (SST) formalise la dispersion brute des observations individuelles par rapport à la moyenne du groupe. La somme des carrés de la régression (Sum of Squares Regression ou SSR, parfois appelée somme des carrés expliquée) quantifie la dispersion des valeurs prédites Ŷ par rapport à cette même moyenne globale. Enfin, la somme des carrés des résidus ou de l’erreur (Sum of Squares Error ou SSE) représente l’agglomération quadratique des écarts d’ajustement, c’est-à-dire les erreurs de prédiction individuelles résiduelles (Y – Ŷ) que l’ensemble des prédicteurs s’est révélé incapable de capturer.
À partir de cette partition fondamentale, le coefficient de détermination se formule rigoureusement comme le ratio exact de la somme des carrés expliquée sur la somme des carrés totale :
R² = SSR / SST = 1 – (SSE / SST)
Cette relation établit indubitablement le R² comme la proportion exacte de variance totale du critère imputable statistiquement à l’action combinée des variables indépendantes du modèle. Sur le plan heuristique, ce phénomène est fréquemment schématisé à l’aide de diagrammes de Venn ensemblistes. L’aire circulaire globale représentant la dispersion totale de la variable critère est partiellement recouverte par les cercles figurant les prédicteurs. La surface de superposition consolidée de ces prédicteurs sur le disque de la variable dépendante correspond rigoureusement à la proportion formulée par le R².
3.3 Interprétation contextuelle de la variance expliquée
La simplicité séduisante de l’expression « pourcentage de variance expliquée » masque des enjeux épistémologiques cruciaux qu’il convient de délimiter rigoureusement. Tout d’abord, une distinction conceptuelle nette doit être maintenue entre la prédiction individuelle concrète et l’explication de la variance agrégée. Obtenir un R² de 0,36 au sein d’une cohorte clinique atteste qu’un peu plus d’un tiers de l’hétérogénéité globale de la gravité symptomatique est aligné avec les variations des prédicteurs. Cela n’implique absolument pas que l’erreur de prédiction clinique pour un patient pris individuellement sera réduite de 36 % dans tous les contextes d’application.
De surcroît, le terme « expliqué » doit être appréhendé sous une acception strictement statistique et comptable, et non comme une validation de liens de causalité ontologique. Dans les devis de recherche non expérimentaux ou transversaux — qui prédominent largement en psychologie sociale et du développement —, le R² enregistre une pure covariation empirique. Affirmer qu’un modèle combinant le perfectionnisme parental et la pression académique « explique » 28 % de la variance de l’épuisement scolaire ne confère aucune certitude sur la nature causale de cette dynamique. Des variables tierces non intégrées, une causalité inverse ou des rétroactions complexes peuvent être à l’origine de cette covariation partagée.
Enfin, l’interprétabilité du R-carré se heurte à des limites méthodologiques sévères dès lors que les hypothèses sous-jacentes de la régression linéaire sont bafouées. Si la distribution des résidus s’éloigne notablement de la normalité multivariée, ou si l’hétéroscédasticité — l’inégalité de la variance de l’erreur à travers les différents niveaux des prédicteurs — corrompt les données, le R² perd sa qualité d’estimateur neutre. L’énergie statistique résiduelle ne se distribue plus de manière homogène, rendant illusoire l’attribution d’un ratio constant de variance à l’échelle de l’espace d’échantillonnage.
4. Analyse comparative directe : R multiple versus R-carré
4.1 Comparaison dimensionnelle et propriétés d’échelle
La distinction technique entre le R multiple et le R-carré s’ancre dans une disparité dimensionnelle fondamentale qui induit des biais de jugement fréquents chez les chercheurs. Le R multiple se déploie sur une métrique unidimensionnelle de corrélation, régie par des variations linéaires directes. En miroir, le R-carré évolue sur une métrique quadratique, bidimensionnelle, assimilable à une aire de surface ou à une fraction énergétique.
L’élévation au carré génère un écrasement non linéaire asymétrique particulièrement prononcé dans la moitié inférieure de la distribution des coefficients. Cette dynamique mathématique explique pourquoi l’esprit humain, intuitivement habitué aux relations de proportionnalité directe, a tendance à surestimer massivement la portée pratique d’un R multiple moyen. Le tableau sous-jacent illustre sans équivoque cette perte d’amplitude mécanique :
Considérons un modèle de régression affichant un R multiple de 0,50. Un observateur non averti y verra souvent un modèle d’une efficacité médiane (atteignant 50 % d’une cible théorique). Or, la conversion en variance partagée (0,50 au carré) révèle que ce modèle n’explique en vérité que 0,25, soit très exactement 25 % de la variance totale du comportement évalué. Les 75 % restants demeurent totalement assignés à la variance résiduelle, aux facteurs non mesurés et aux erreurs d’échantillonnage. Pour atteindre le seuil où la moitié exacte de la variance comportementale est maîtrisée (R² = 0,50), le R multiple doit s’élever à une valeur minimale de 0,707. Le seuil psychologique d’un R à 0,30, fréquent dans les études exploratoires, n’élucide quant à lui que 9 % de la variance d’un trouble ou d’une performance.
4.2 Utilisations respectives selon les objectifs scientifiques
Le choix de privilégier le R multiple ou le R-carré dans les écrits académiques découle directement des finalités épistémiques et techniques assignées à la recherche. Le recours au R multiple se révèle particulièrement pertinent dès lors que l’analyste se focalise sur l’efficacité prédictive d’un score composite opérationnel. Dans les domaines du diagnostic neuropsychologique, de l’orientation scolaire ou du recrutement organisationnel, l’enjeu clinique consiste à évaluer avec quelle précision un agencement pondéré de tests s’aligne avec le comportement futur observable. Le R multiple, en tant que corrélation directe entre la projection algorithmique et la réalité de terrain, renseigne sur l’exactitude de cet ordonnancement individuel.
À l’opposé, lorsque l’investigation s’inscrit dans un paradigme explicatif, de validation théorique ou de comparaison de modèles concurrents, le R-carré s’impose sans rival. C’est le R² qui permet de déterminer quelle proportion de la variabilité humaine un modèle théorique donné parvient à structurer par rapport à une formalisation alternative. Lors de l’utilisation de protocoles de régression hiérarchique, c’est l’accroissement spécifique du R-carré (noté Delta R²) qui sert de juge de paix méthodologique pour attester qu’une nouvelle théorie apporte un gain explicatif substantiel au-delà des facteurs déjà établis dans la littérature.
Ce partitionnement est également indispensable pour l’appréciation globale des tailles d’effet. Là où le R multiple conserve une connotation descriptive d’association, le R-carré autorise une décomposition fine des parts d’influence relatives des différents blocs de variables, matérialisant la part d’inconnu qui résiste encore aux hypothèses scientifiques posées.
4.3 Tableau comparatif exhaustif des caractéristiques statistiques
Pour ancrer de manière synthétique et didactique les divergences théoriques, algébriques et opérationnelles qui caractérisent ces deux indices, le tableau analytique ci-dessous structure les paramètres fondamentaux régissant leur comportement respectif au sein des architectures de régression :
| Critères d’analyse | Coefficient de corrélation multiple (R) | Coefficient de détermination (R-carré / R²) |
|---|---|---|
| Nature mathématique | Indice linéaire de corrélation bivariée entre Y et Ŷ | Ratio de variance proportionnelle (forme quadratique) |
| Bornes de variation | Strictement fixé entre 0,00 et +1,00 | Strictement fixé entre 0,00 et +1,00 |
| Sensibilité de signe | Toujours positif par construction moindres carrés | Toujours positif par élévation au carré |
| Formulation matricielle | (r‘yx × Rxx-1 × ryx)1/2 | r‘yx × Rxx-1 × ryx ou SSR / SST |
| Sensibilité aux prédicteurs non corrélés | Augmente asymptotiquement par captation du bruit | Augmente systématiquement avec l’ajout de variables |
| Transformations linéaires des X | Invariant face aux changements d’échelle linéaires | Invariant face aux changements d’échelle linéaires |
| Interprétation principale | Validité critère et précision d’alignement prédictif | Proportion de variance du critère expliquée par le modèle |
| Utilisation en méta-analyse | Requiert la transformation en z de Fisher | Comparaison et agrégation proportionnelle directe |
| Statut face à l’échantillonnage | Estimateur biaisé positivement de la population | Estimateur biaisé vers le haut (surestimation systématique) |
5. Interprétation des grandeurs d’effet en recherche psychologique et comportementale
5.1 Les repères conventionnels de Jacob Cohen
L’évaluation quantitative des résultats en psychologie a été profondément façonnée par les contributions pionnières du statisticien et psychologue Jacob Cohen. Dans ses travaux fondateurs sur l’analyse de puissance statistique pour les sciences du comportement (notamment l’ouvrage de référence publié en 1988), Cohen s’est efforcé de fournir des repères opérationnels aux chercheurs désireux de traduire des coefficients statistiques en grandeurs d’effet concrètes. Pour le coefficient de détermination R², Cohen a formalisé trois seuils heuristiques demeurés célèbres : un effet est qualifié de faible à partir d’un R² de 0,02 (soit 2 % de variance expliquée), de moyen à 0,13 (13 % de variance expliquée) et de fort lorsqu’il atteint ou dépasse 0,26 (26 % de variance expliquée).
Ces jalons numériques se traduisent directement en termes de R multiple. Un R² de 0,02 équivaut à un R multiple d’environ 0,14 ; un R² de 0,13 renvoie à un R de 0,36 ; et un R² de 0,26 correspond à une corrélation globale de 0,51. De surcroît, Cohen a dérivé du R-carré une métrique d’effet indispensable pour les calculs de puissance statistique a priori ou post hoc : l’indice f-carré (f²). Formellement défini par le rapport R² / (1 – R²), cet indice quantifie le rapport de la variance expliquée sur la variance non expliquée. Les seuils de Cohen pour f² sont fixés conventionnellement à 0,02 (effet minime), 0,15 (effet intermédiaire) et 0,35 (effet large).
Cependant, la communauté méthodologique contemporaine formule des critiques de plus en plus acerbes contre l’application aveugle et dogmatique de ces repères conventionnels. Décontextualisées des contraintes propres à un champ de recherche spécifique, ces grilles de lecture figées occultent le fait que l’ampleur d’un effet statistique dépend intrinsèquement de la nature des phénomènes analysés, de leur niveau de distalité causale et des conditions de mesure sur le terrain.
5.2 Spécificités des variables psychologiques latentes
Les sciences psychologiques se heurtent à une contrainte métrologique majeure que ne connaissent pas les sciences physiques fondamentales : l’inévitabilité de l’erreur de mesure aléatoire et systématique au sein des instruments psychométriques. Tout score observé X est la sommation d’un score vrai V et d’une composante d’erreur stochastique E, conformément aux préceptes de la théorie classique des tests. Cette imperméabilité des outils aux construits purs induit un phénomène d’atténuation artificielle des coefficients de régression et, par corollaire direct, des valeurs de R multiple et de R².
L’impact de la fidélité des instruments (souvent estimée par l’alpha de Cronbach ou le coefficient oméga de McDonald) sur les coefficients est impitoyable : la corrélation observable maximale entre deux variables est bornée supérieurement par la racine carrée du produit de leurs fidélités respectives. Si un questionnaire d’impulsivité possède une fidélité de 0,70 et qu’un critère comportemental d’agressivité affiche une fidélité de 0,60, le plafond théorique de la corrélation bivariée ne peut excéder la racine de 0,42, soit 0,648, même dans l’hypothèse où les traits latents sous-jacents seraient rigoureusement isomorphes (corrélation unitaire). Ce plafond structurel bride mécaniquement les valeurs de R² observées, les maintenant souvent à des niveaux jugés modestes au regard des critères de Cohen.
Pour cette raison, l’application d’une formule de correction pour atténuation s’avère parfois requise dans les cadres métathéoriques ou lors de l’usage de la modélisation par équations structurelles (SEM). En séparant l’erreur de mesure de la variance du construit latent, les modèles en variables latentes permettent d’estimer un R multiple désatténué, reflétant la puissance explicative intrinsèque des construits indépendamment des imperfections instrumentales.
Il en résulte qu’un R² semblant modeste (compris par exemple entre 0,05 et 0,10) peut revêtir une portée théorique majeure et une signification clinique déterminante, dès lors qu’il implique des variables complexes, multifactorielles et grevées de bruit métrologique.
5.3 Contextualisation écologique des résultats empiriques
L’évaluation de la pertinence pratique d’un R-carré ne doit jamais s’opérer dans le vide méthodologique, mais s’inscrire dans une perspective d’écologie scientifique comparée. Un modèle de laboratoire ultra-contrôlé mesurant des réactions cognitives élémentaires peut exiger un R² élevé (par exemple 0,40 ou plus) pour être jugé informatif, car l’environnement expérimental neutralise délibérément les interférences externes. À l’inverse, dans les études longitudinales ou les protocoles épidémiologiques menés en milieu naturel sur de très larges cohortes, prédire ne serait-ce que 4 % de la variance (R² = 0,04 ; R = 0,20) de comportements tels que la délinquance juvénile, le suicide ou la récidive addictologique constitue un accomplissement de premier ordre pour l’action publique et la prévention clinique.
Le design temporel de l’étude module également de façon drastique l’amplitude attendue de ces coefficients. Les designs transversaux présentent régulièrement une inflation artificielle de la variance expliquée imputable au biais de méthode commune (common method variance), notamment lorsque toutes les données proviennent d’auto-questionnaires remplis simultanément par les mêmes répondants. En revanche, dans un schéma prospectif s’étendant sur plusieurs années, les décalages temporels érodent inévitablement les corrélations brutes, rendant tout R² résiduel significatif particulièrement robuste d’un point de vue heuristique.
Pour les praticiens prenant des décisions d’orientation thérapeutique ou éducative, la valeur d’un coefficient s’évalue à l’aune du rapport coût-bénéfice. Si un modèle exploitant trois indicateurs simples et peu coûteux permet d’expliquer 8 % de la variance d’un échec thérapeutique futur, ce résultat autorise un ciblage précoce susceptible d’éviter des détresses humaines et d’optimiser l’allocation de ressources médico-sociales, démontrant qu’une statistique modeste peut porter en elle une utilité sociale immense.
6. Le problème de l’inflation mécanique du R-carré lors de l’ajout de prédicteurs
6.1 Démonstration du phénomène d’inflation artificielle
L’une des vulnérabilités mathématiques les plus insidieuses du coefficient de détermination ordinaire (R²) réside dans sa relation unilatérale face à l’adjonction de variables au sein de l’équation de régression. Il est une loi algébrique immuable de l’estimation par moindres carrés : l’introduction d’un nouveau prédicteur dans un modèle existant ne peut en aucun cas faire baisser la valeur du R-carré. La valeur de R² soit augmentera, soit, dans le scénario le plus improbable où le nouveau prédicteur est rigoureusement orthogonal au critère et à toutes les variables déjà présentes, demeurera strictement stationnaire.
Cette propriété découle directement de la méthode mathématique de minimisation de la somme des carrés des erreurs (SSE). Lorsqu’une variable supplémentaire est insérée, l’algorithme dispose d’un degré de liberté additionnel pour ajuster les pondérations. Même si la variable ajoutée n’entretient absolument aucun lien théorique ou biologique avec la variable dépendante — s’il s’agit, par exemple, d’une suite de chiffres aléatoires générée par un algorithme stochastique —, cette variable présentera presque toujours, par pure fluctuation d’échantillonnage, une corrélation non rigoureusement nulle (par exemple, r = 0,06) avec le critère dans l’échantillon analysé. Le modèle linéaire capitalise immédiatement sur ce bruit stochastique pour minimiser la SSE et accroître la SSR.
Ce phénomène porte le nom de capitalisation sur le hasard (capitalization on chance). Plus le nombre de prédicteurs k s’accroît et s’approche de la taille de l’échantillon n, plus le R² conventionnel grimpe artificiellement. Dans la situation limite absolue où le nombre de paramètres estimés est égal au nombre d’observations moins un (k = n – 1), le R-carré atteindra mathématiquement la valeur parfaite de 1,00 (100 % de variance expliquée), quand bien même les variables ne contiendraient que du bruit aléatoire pur. Cette inflation structurelle conduit tout droit à l’écueil majeur de la modélisation statistique : le surapprentissage (ou overfitting).
6.2 Conséquences délétères pour la reproductibilité en psychologie
Le surapprentissage provoqué par l’inflation mécanique du R² constitue l’un des moteurs silencieux de la crise de la reproductibilité qui secoue la psychologie et les neurosciences cognitives depuis le début des années 2010. Lorsqu’un modèle ajuste ses coefficients aux singularités stochastiques d’un jeu de données particulier, il perd toute capacité de généralisation à d’autres cohortes issues de la même population parente. L’équation devient une description hyper-spécifique du bruit de l’échantillon initial, plutôt qu’une modélisation de la véritable dynamique comportementale sous-jacente.
Cette faiblesse méthodologique favorise l’essor de pratiques de recherche contestables (connues sous l’acronyme de QRPs pour Questionable Research Practices), au premier rang desquelles figure le p-hacking ou l’extraction opportuniste de données (data dredging). Des chercheurs peu scrupuleux ou insuffisamment formés peuvent être tentés d’intégrer une multitude de covariables secondaires au gré de régressions successives dans l’unique but de gonfler le R² global ou de forcer un seuil d’adéquation prédictive, publiant ensuite des modèles artificiellement flatteurs mais intrinsèquement caducs.
Ce faisant, ce réductionnisme méthodologique viole frontalement le principe cardinal de parcimonie épistémologique, connu sous le nom de rasoir d’Ockham : entre deux modèles offrant des descriptions comparables d’une réalité, le plus sobre doit toujours être préféré. Un modèle mobilisant vingt prédicteurs pour afficher un R² de 0,35 est scientifiquement et théoriquement inférieur à un modèle n’en convoquant que deux pour atteindre un R² de 0,30. Le premier dissimule son inanité derrière une inflation stochastique, tandis que le second dégage des régularités universelles potentiellement exploitables dans la recherche appliquée.
7. La solution du R-carré ajusté : modélisation et pénalisation mathématique
7.1 Formulation théorique du R-carré ajusté
Pour neutraliser l’optimisme trompeur du R-carré conventionnel et endiguer la capitalisation sur le hasard, les statisticiens — sous l’impulsion originelle de Robert Wherry et Henri Theil — ont élaboré une version corrigée de l’indice, universellement désignée sous le nom de R-carré ajusté (noté R̄² ou Adj. R²). L’objectif explicite de cette métrique est de fournir un estimateur non biaisé de la variance expliquée par le modèle dans la population parente, et non plus simplement au sein de l’échantillon empirique particulier soumis à l’analyse.
La formulation algébrique canonique du R-carré ajusté opère un réajustement proportionnel basé sur la répartition des degrés de liberté du système :
R̄² = 1 – [(1 – R²) × (n – 1) / (n – k – 1)]
Dans cette équation structurelle, n représente la taille globale de l’échantillon d’observations (le nombre total de participants inclus dans la modélisation), tandis que k désigne le nombre de variables prédictrices introduites dans le système de régression. Le ratio (n – 1) / (n – k – 1) joue le rôle exact d’un multiplicateur de pénalité. Les degrés de liberté associés à la variance résiduelle (n – k – 1) diminuent à mesure que l’on introduit des prédicteurs supplémentaires, ce qui augmente le coefficient multiplicateur appliqué au résidu non expliqué (1 – R²).
Sur le plan computationnel, cette formulation revient à substituer le ratio de la moyenne des carrés de l’erreur (Mean Square Error ou MSE) sur la moyenne des carrés totaux (Mean Square Total ou MST) au simple ratio de sommes de carrés non pondérées par leurs degrés de liberté. Comme la MSE et la MST sont des estimateurs sans biais des variances résiduelles et totales de la population, le R² ajusté opère une correction probabiliste de la déviation stochastique induite par la taille du jeu de données.
7.2 Comportement dynamique selon le rapport prédicteurs/participants
L’introduction de ce terme pénalisateur modifie radicalement la dynamique du coefficient lors des modifications de l’architecture du modèle. Contrairement au R² classique, le R² ajusté ne garantit nullement une augmentation monotone lors de l’adjonction de variables. En réalité, une condition arithmétique précise régit son évolution : le R-carré ajusté n’augmentera lors de l’insertion d’un nouveau prédicteur que si et seulement si la valeur absolue de la statistique t de Student associée au coefficient de régression de cette nouvelle variable (ou la valeur de la statistique F de son apport incrémental) est strictement supérieure à 1,00. Si l’apport informatif du prédicteur est marginal et génère une statistique F inférieure à l’unité, le R² ajusté diminuera, pénalisant immédiatement le modèle pour son manque de parcimonie.
Ce mécanisme engendre une propriété surprenante et méconnue de nombreux chercheurs : le R² ajusté peut théoriquement prendre des valeurs négatives. Si un modèle de régression incorpore un ensemble de prédicteurs dont l’association globale avec la variable dépendante est quasi inexistante (R² empirique proche de zéro) et que le rapport entre le nombre de prédicteurs k et l’effectif n est déséquilibré, la fraction pénalisatrice excède la valeur 1,00, projetant le résultat final dans le domaine négatif. Sur le plan de l’interprétation clinique ou scientifique, un R² ajusté négatif ne signifie aucunement une « variance inversée » ; il doit être interprété sans détour comme l’indicateur d’un modèle d’ajustement structurellement nul, incapable d’extraire le moindre signal hors du bruit statistique ambiant, suggérant que la moyenne arithmétique brute constitue un estimateur supérieur au modèle testé.
Cette sensibilité dynamique s’exprime avec une acuité particulière dans les protocoles neuropsychologiques ou psychiatriques impliquant des cohortes restreintes (par exemple, des études cliniques pionnières sur l’imagerie cérébrale portant sur 20 à 30 patients). Dans ces contextes où n est faible, chaque prédicteur supplémentaire induit une amputation substantielle des degrés de liberté résiduels, déclenchant une chute drastique du R² ajusté si la variable n’apporte pas un saut qualitatif majeur à la modélisation.
7.3 Distinction formelle : R multiple, R² conventionnel et R² ajusté
La distinction entre ces trois métriques forme le socle sur lequel doit s’édifier toute sélection raisonnée de modèles en sciences empiriques. Le R multiple formalise la liaison linéaire empirique maximale instantanée observée sur l’échantillon de travail. Le R² conventionnel quantifie l’énergie comptable brute captée dans ce même échantillon. Le R² ajusté, quant à lui, estime la capacité prédictive reproductible dans la population mère dont cet échantillon n’est qu’une émanation temporelle.
Bien que le R² ajusté surpasse largement le R² ordinaire pour arbitrer la pertinence de l’ajout de prédicteurs, il n’échappe pas à certaines limitations inhérentes aux méthodes d’estimation linéaire. Le R² ajusté n’est pas un estimateur strictement sans biais du paramètre théorique sous-jacent (le R² de population, noté rho-carré), même s’il atténue considérablement la surestimation. De surcroît, il n’intègre pas de pénalisation logarithmique aussi agressive que les critères issus de la théorie de l’information contemporaine.
C’est pourquoi la statistique moderne associe fréquemment le R² ajusté à des critères de sélection alternatifs tels que le critère d’information d’Akaike (Akaike Information Criterion ou AIC) et le critère d’information bayésien (Bayesian Information Criterion ou BIC). Ces derniers intègrent des pénalités asymétriques pour chaque paramètre additionnel, évaluant la perte d’information relative d’un modèle avec une sévérité accrue lors des analyses menées sur de vastes ensembles de données.
8. Applications pratiques dans les logiciels d’analyse statistique (SPSS, R, Jamovi)
8.1 Extraction et lecture des tableaux de sortie sous SPSS
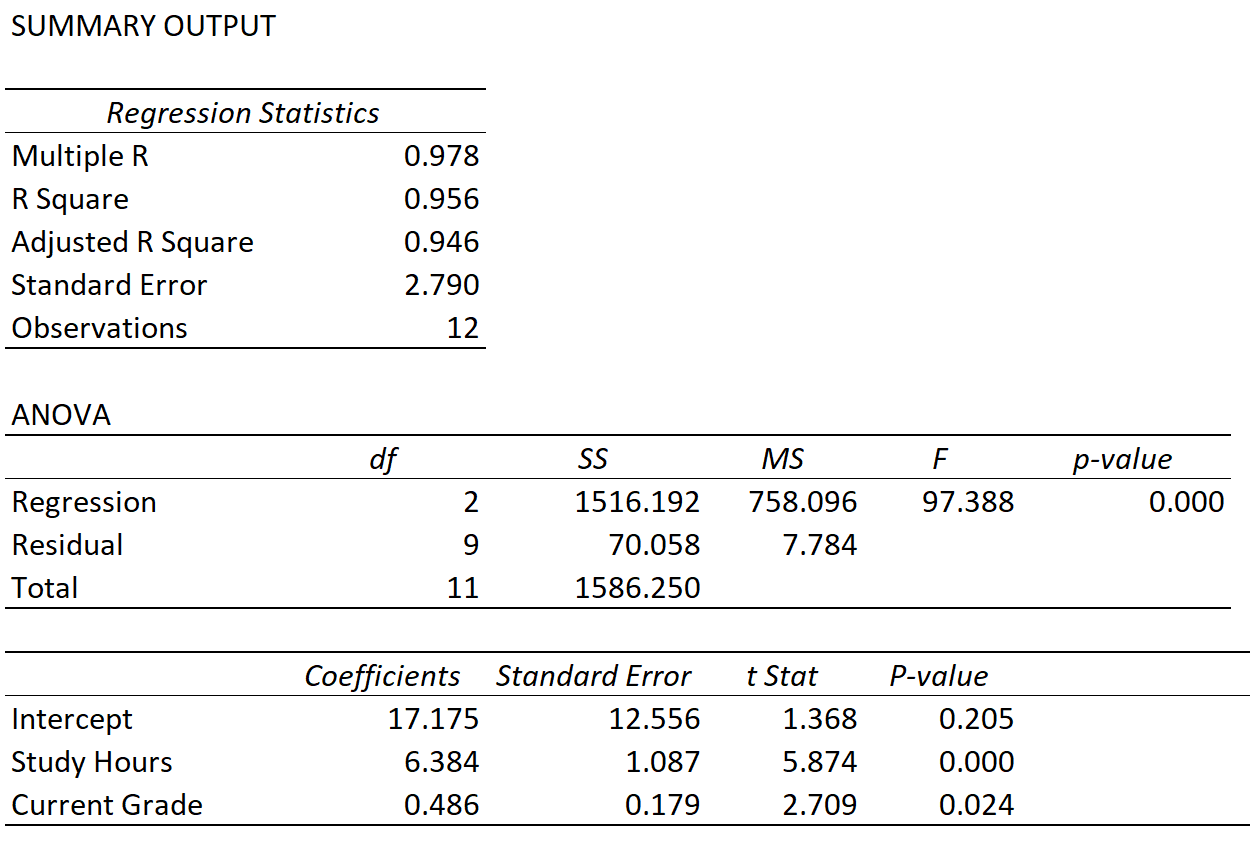
Dans l’environnement SPSS, l’exécution d’une procédure de régression linéaire multiple via le menu Analyser > Régression > Linéaire génère une série de blocs tabulaires dont l’un des plus importants s’intitule conventionnellement « Récapitulatif des modèles » (Model Summary). Ce tableau se compose d’une ligne récapitulative structurée en colonnes standardisées : la colonne « R » présente le coefficient de corrélation multiple, suivie de la colonne « R-deux » (R Square), puis de la colonne « R-deux ajusté » (Adjusted R Square) et enfin de « Erreur standard de l’estimation ».
La lecture analytique de ce tableau requiert une interprétation séquentielle et rigoureuse. L’analyste doit d’abord porter son regard sur l’écart arithmétique séparant le R-deux et le R-deux ajusté. Un différentiel restreint (par exemple un R² de 0,38 face à un R² ajusté de 0,36) atteste que l’échantillon est d’une taille suffisante au regard du nombre de prédicteurs inclus, validant la robustesse du modèle face au risque de surapprentissage. À l’inverse, un fossé béant (par exemple un R² de 0,42 chutant à un R² ajusté de 0,18) constitue un signal d’alarme immédiat, révélant un modèle artificiellement surchargé d’informations redondantes ou appliqué à une cohorte trop restreinte.
Lorsque le chercheur utilise l’approche par blocs hiérarchiques (méthode de régression pas-à-pas ou régression hiérarchique théorique), SPSS intègre une section complémentaire intitulée « Statistiques de changement ». Cette zone affiche le changement de R-deux (R Square Change), qui mesure la contribution unique apportée par le nouveau bloc de prédicteurs, assorti de la statistique de test F de changement (F Change) et de sa significativité stochastique (Sig. F Change). Cette lecture croisée permet d’authentifier si l’élévation du R multiple et du R-carré traduit un gain théorique substantiel ou un simple artefact numérique.
8.2 Implémentation et extraction sous R syntaxique
Dans l’environnement de programmation statistique R, l’approche syntaxique offre une flexibilité conceptuelle inégalée pour décomposer et extraire ces métriques. L’ajustement d’un modèle linéaire repose classiquement sur l’opérateur fondamental lm(). L’appel de la fonction générique summary() sur l’objet de régression résultant compile l’ensemble des indices d’adéquation dans les lignes finales de la sortie console, sous les termes Multiple R-squared et Adjusted R-squared.
Il est révélateur de constater que l’objet summary.lm sous R n’affiche pas explicitement le R multiple de base. Ce choix n’est pas anodin : les concepteurs du langage ont délibérément privilégié l’indicateur d’énergie de variance (R²) sur l’indicateur d’association brute (R). Néanmoins, pour le praticien désireux d’extraire la valeur du R multiple, la syntaxe R permet une dérivation directe :
modele <- lm(Y ~ X1 + X2 + X3, data = donnees)
res <- summary(modele)
r_multiple <- sqrt(res$r.squared)
r_carre <- res$r.squared
r_carre_ajuste <- res$adj.r.squared
Pour approfondir les analyses psychométriques, les chercheurs mobilisent régulièrement des écosystèmes de packages spécialisés. Le package psych, développé par William Revelle, offre des fonctions dédiées au calcul de la matrice de corrélations corrigées et au partitionnement hiérarchique. Le package car (Companion to Applied Regression) fournit des tests diagnostiques indispensables pour traquer l’hétéroscédasticité ou la colinéarité, tandis que le package moderne performance permet d’extraire, via la fonction model_performance(), l’intégralité des métriques d’ajustement (R², R² ajusté, AIC, BIC, RMSE) au sein d’un tableau d’une clarté optimale.
8.3 Vérification sous Jamovi et JASP pour les sciences du comportement
Conçus spécifiquement pour allier la rigueur calculatoire du moteur R sous-jacent à l’intuitivité d’une interface graphique moderne, les logiciels Jamovi et JASP sont devenus incontournables dans l’enseignement et la recherche en psychologie internationale. L’analyse de régression multiple s’y déploie de manière dynamique et réactive en temps réel.
Dans le menu de régression linéaire de Jamovi, l’utilisateur coche simplement les options situées dans l’onglet « Ajustement du modèle » (Model Fit). Le logiciel génère instantanément un tableau d’ajustement affichant simultanément R, R² et R² ajusté. La force ergonomique de ces outils réside dans la possibilité de superposer des contrôles visuels directs : graphiques de dispersion des résidus standardisés face aux valeurs prédites, tracés Q-Q de normalité résiduelle et estimations instantanées des coefficients d’inflation de la variance (VIF).
De surcroît, Jamovi et JASP intègrent une passerelle d’exportation native permettant de copier directement les tableaux récapitulatifs au format de mise en page standardisé APA 7. Cette fonctionnalité réduit considérablement les erreurs humaines de retranscription manuelle qui polluent historiquement les rapports de laboratoire, sécurisant ainsi le passage de l’analyse brute à la rédaction scientifique finalisée.
9. Étude de cas psychologique : modélisation prédictive de l’épuisement professionnel (Burnout)
9.1 Présentation du protocole de recherche et des variables
Afin d’ancrer ces concepts statistiques fondamentaux dans une réalité empirique concrète, analysons une étude méthodologique dédiée à la modélisation de l’épuisement professionnel (burnout) chez le personnel soignant. Les données sont issues d’une cohorte clinique standardisée de n = 250 soignants (infirmiers, aides-soignants, médecins urgentistes) exerçant au sein d’un centre hospitalier universitaire à haute tension opérationnelle.
La variable dépendante (critère Y) est constituée par le score continu standardisé à la dimension « Épuisement Émotionnel » de l’inventaire d’épuisement professionnel de Maslach (Maslach Burnout Inventory ou MBI), échelle psychométrique de référence dont le score varie continûment de 0 à 54 points. Pour prédire ce construit clinique majeur, l’équipe de recherche introduit initialement deux prédicteurs théoriquement légitimés par la littérature sur la psychologie de la santé au travail :
1. La charge de travail perçue (variable X1), mesurée via l’échelle d’évaluation de la charge cognitive et temporelle (score de 10 à 50).
2. Le manque perçu de soutien organisationnel et hiérarchique (variable X2), documenté par le questionnaire de soutien social de Karasek (score inversé de 8 à 32).
9.2 Étape 1 : Modèle bivarié puis ajout de prédicteurs psychologiques
Dans une première phase exploratoire, les chercheurs introduisent uniquement la charge de travail perçue (X1) dans l’équation de régression bivariée simple. L’estimation linéaire produit les résultats suivants :
Le coefficient de corrélation bivarié (qui est strictement équivalent au R multiple dans un cadre à prédicteur unique) ressort à R = 0,45. En élevant cette valeur au carré, nous obtenons le coefficient de détermination : R² = 0,2025 (soit 20,25 % de la variance de l’épuisement émotionnel expliquée par la charge de travail isolée). Le calcul du R² ajusté donne :
R̄² = 1 – [(1 – 0,2025) × (250 – 1) / (250 – 1 – 1)] = 1 – [0,7975 × 249 / 248] = 0,1993 (soit 19,93 %).
Dans la seconde étape de la modélisation hiérarchique, les chercheurs intègrent le second prédicteur théorique : le manque de soutien organisationnel (X2). Le réajustement de la matrice de régression opère un saut qualitatif. Le nouveau R multiple grimpe à R = 0,58. L’élévation au carré de cette association globale révèle que le nouveau R² atteint désormais 0,3364 (soit 33,64 % de variance expliquée). Le calcul du R² ajusté actualisé produit :
R̄² = 1 – [(1 – 0,3364) × (249) / (250 – 2 – 1)] = 1 – [0,6636 × 249 / 247] = 0,3310 (soit 33,10 %).
Le gain incrémental de variance (Delta R²) s’établit à 0,1339 (un apport de 13,39 % de variance additionnelle explicative). Le test F de changement s’avère hautement significatif (p < 0,001). Le R multiple et le R-carré ajusté progressent de concert, attestant que le soutien organisationnel constitue un prédicteur théorique solide qui apporte une information unique non redondante avec la charge de travail.
9.3 Étape 2 : Ajout de prédicteurs bruits et observation de la pénalisation
Pour mettre en lumière la vulnérabilité différentielle des indices face à la capitalisation sur le hasard, les chercheurs introduisent délibérément dans un troisième bloc une variable théoriquement absurde et méthodologiquement dénuée de tout lien causal avec la santé mentale : la couleur du bureau de travail du soignant, codée numériquement sur une échelle arbitraire de teintes (variable bruit X3).
Par pure fluctuation d’échantillonnage stochastique au sein de ce groupe de 250 soignants, cette variable bruit présente une corrélation marginale et non significative avec le score d’épuisement (r = 0,035). L’algorithme de moindres carrés intègre immédiatement cette infime covariation pour minimiser l’erreur résiduelle. Les sorties logicielles révèlent l’évolution suivante des coefficients :
Le R multiple passe de 0,5800 à 0,5808. Le R² conventionnel enregistre une hausse mécanique, passant de 0,3364 à 0,3373 (soit une augmentation apparente de près de 0,1 % de variance expliquée). Un chercheur focalisé uniquement sur le R² classique conclurait à une légère amélioration du modèle.
Cependant, l’examen du R-carré ajusté rétablit la vérité méthodologique :
R̄² = 1 – [(1 – 0,3373) × (249) / (250 – 3 – 1)] = 1 – [0,6627 × 249 / 246] = 0,3292 (soit 32,92 %).
Au lieu de progresser, le R-carré ajusté a chuté, passant de 33,10 % à 32,92 %. Parce que la statistique t associée à ce prédicteur bruit est largement inférieure à 1,00 (t = 0,57, p = 0,569), la pénalité imposée par la perte d’un degré de liberté résiduel (le dénominateur passant de 247 à 246) dépasse le gain stochastique infinitésimal capté par l’algorithme. Cette démonstration empirique illustre la supériorité diagnostique du R² ajusté, qui protège l’analyste contre l’illusion prédictive et garantit le respect de la parcimonie scientifique.
10. Limites méthodologiques, multicolinéarité et pièges d’interprétation
10.1 Le piège de la multicolinéarité entre prédicteurs psychométriques
L’interprétation conjointe du R multiple et du R-carré se complique considérablement en présence d’une pathologie statistique fréquente en psychométrie : la multicolinéarité. Cette distorsion survient lorsque deux ou plusieurs variables prédictrices au sein de l’équation de régression partagent des niveaux d’intercorrélation très élevés, traduisant une redondance conceptuelle ou métrologique substantielle.
Dans une telle configuration, l’inversion de la matrice de corrélation Rxx devient computationnellement instable en raison d’un déterminant proche de zéro. Les conséquences sur le modèle sont paradoxales et fréquemment mal comprises : le R multiple global et le R-carré associé demeurent extrêmement élevés et statistiquement significatifs à un seuil critique (attestant que le bloc global de prédicteurs capture une part massive de variance), tandis que l’ensemble des coefficients de régression partiels standardisés (les bêtas) voient leur erreur standard exploser, devenant individuellement non significatifs (valeurs de p > 0,05).
Pour diagnostiquer et circonscrire ce piège, les chercheurs doivent surveiller deux indicateurs interdépendants : l’indice de tolérance (Tolerance = 1 – R²i, où R²i est la variance du prédicteur i expliquée par tous les autres prédicteurs) et le facteur d’inflation de la variance (Variance Inflation Factor ou VIF = 1 / Tolérance). Une valeur de VIF supérieure à 5 (ou une tolérance inférieure à 0,20) signale un danger de multicolinéarité sévère. Dans cette situation, un R-carré élevé donne une impression trompeuse de maîtrise du phénomène, alors même qu’il est impossible de délimiter l’apport théorique spécifique de chaque composante.
10.2 Effets de suppression en régression multiple
Un autre phénomène méthodologique susceptible de fausser radicalement la lecture du R multiple et du R-carré est l’effet de suppression (ou variable suppressive). En psychologie différentielle et sociale, une variable suppressive se définit comme un prédicteur qui, bien qu’affichant une corrélation bivariée quasiment nulle, voire non significative avec le critère Y, induit une augmentation substantielle et paradoxale du R² global lorsqu’il est introduit dans l’équation de régression.
La littérature distingue trois variantes principales de suppressors :
- La suppression classique : la variable prédictrice X2 n’a aucune corrélation avec Y (ry,x2 = 0), mais est corrélée avec le prédicteur X1. En entrant dans le modèle, X2 « purge » ou « nettoie » X1 de sa variance résiduelle non pertinente pour la prédiction de Y, décuplant ainsi le coefficient bêta de X1 et propulsant le R² à un niveau inattendu.
- La suppression nette : les deux prédicteurs sont corrélés positivement avec le critère, mais présentent une relation mutuelle si forte que l’un des coefficients bêta change de signe algébrique (devenant négatif), amplifiant artificiellement la valeur absolue de l’autre coefficient et le R² global.
- La suppression coopérative (ou réciproque) : deux prédicteurs corrélés négativement entre eux s’épaulent pour prédire positivement le critère, induisant une explosion conjointe de leurs bêtas et une élévation spectaculaire de la variance expliquée consolidée.
L’occurrence d’un effet de suppression peut être source de graves méprises épistémologiques. Les analystes inexpérimentés ont tendance à interpréter l’accroissement massif du R² comme la révélation d’une mécanique causale nouvelle, alors qu’il ne s’agit bien souvent que d’une redistribution géométrique d’erreur de mesure au sein de l’espace vectoriel des prédicteurs.
10.3 Hétérogénéité de l’échantillon et restriction de l’étendue
La robustesse descriptive du R multiple et du coefficient de détermination repose sur l’hypothèse sous-jacente que l’échantillon analysé est représentatif de la dispersion réelle de la population cible. Deux distorsions méthodologiques majeures d’échantillonnage viennent régulièrement biaiser ces métriques : la restriction de variance et l’hétérogénéité non contrôlée.
Le phénomène de restriction d’étendue (range restriction) survient lorsqu’un protocole d’échantillonnage tronque délibérément ou accidentellement la variabilité des sujets sur les prédicteurs ou le critère. C’est le cas classique des études de validité prédictive conduites au sein d’universités ultra-sélectives : si l’on cherche à prédire la réussite aux examens finaux à partir d’un test d’aptitude générale chez des étudiants ayant tous été sélectionnés parmi les 2 % les plus brillants au concours d’entrée, la variance du test d’aptitude est drastiquement comprimée. Cette contraction mathématique entraîne une sous-estimation systématique et sévère du R multiple et du R², qui peuvent paraître dérisoires (par exemple R² = 0,04) alors que dans la population générale, le même modèle afficherait un R² supérieur à 0,35.
Parallèlement, l’existence de sous-groupes cliniques cachés au sein d’un échantillon global peut générer des distorsions complexes, dont la manifestation la plus spectaculaire est le paradoxe de Simpson. Une corrélation multiple globale peut paraître forte (R = 0,55) sous l’effet de l’écartement des moyennes entre sous-groupes, alors que l’association interne au sein de chaque sous-groupe pris individuellement est rigoureusement inexistante, voire orientée en sens inverse. Les chercheurs doivent impérativement s’assurer de l’homogénéité structurale de leurs données avant de faire du R² le résumé unique de leur démarche explicative.
11. Bonnes pratiques de reporting selon les normes APA (7e édition)
11.1 Normes textuelles et tabulaires de présentation
La diffusion rigoureuse des travaux en psychologie et en sciences sociales est strictement encadrée par les directives du Publication Manual of the American Psychological Association (7e édition). La restitution du R multiple et du R-carré obéit à des conventions typographiques et grammaticales standardisées qu’il convient de respecter à la lettre.
Sur le plan typographique fondamental, tous les symboles statistiques désignés par des lettres latines doivent impérativement être composés en italique : R, R², F, t, p. De surcroît, une règle spécifique régit l’affichage des zéros initiaux : pour toute statistique dont la borne supérieure ne peut théoriquement jamais dépasser la valeur 1,00, il ne faut jamais insérer de zéro avant la virgule ou le point décimal. En conséquence, les coefficients de détermination s’écrivent obligatoirement sous la forme R² = .34 (et non 0.34), le R² ajusté devient R̄² = .31, et les niveaux de probabilité s’énoncent p < .001.
Dans le corps du texte, une formulation canonique conforme aux standards internationaux pour rendre compte d’un modèle de régression multiple s’articule ainsi :
« L’analyse de régression multiple indique que l’ensemble des prédicteurs explique une part significative de la variance de l’épuisement émotionnel, F(3, 246) = 41.72, p < .001, R = .58, R² = .34, R² ajusté = .33. »
Lors de l’élaboration d’un tableau synthétique pour une régression hiérarchique, les normes APA préconisent une organisation verticale standardisée intégrant les colonnes suivantes pour chaque bloc de variables : coefficients non standardisés (B) avec leur erreur standard (SE), coefficients standardisés (β), valeur du test t associée, complétées en bas de tableau par les indices globaux du modèle : R, R², R² ajusté, ainsi que le changement de variance : Delta R² (ΔR²), la statistique F de changement et le seuil de significativité associé.
11.2 Transparence statistique et science ouverte (Open Science)
Le tournant épistémologique vers la science ouverte (Open Science) a profondément redéfini les exigences entourant la communication des métriques d’ajustement. Présenter une simple estimation ponctuelle du R² est désormais considéré comme insuffisant par les comités éditoriaux des revues scientifiques de premier plan. La pratique contemporaine impose de rapporter systématiquement l’intervalle de confiance à 95 % entourant le R-carré (noté 95 % IC [.xx, .yy]). L’estimation de cet intervalle ne reposant pas sur une distribution normale symétrique élémentaire, elle exige le recours à des distributions d’échantillonnage non centrales ou à des techniques non paramétriques de rééchantillonnage par bootstrap (facilement exécutables via les packages R dédiés).
Dans cette dynamique d’intégrité scientifique, le pré-enregistrement des protocoles (notamment sur des registres publics certifiés comme l’Open Science Framework) s’affirme comme le rempart le plus efficace contre l’inflation stochastique du R multiple. En figeant à l’avance le nombre exact de prédicteurs, l’ordre d’entrée des blocs hiérarchiques et les règles strictes d’exclusion des données aberrantes, le pré-enregistrement interdit toute forme de data fishing visant à maximiser artificiellement le R-carré publié.
Enfin, les revues encouragent ou rendent obligatoire le dépôt en libre accès des données brutes anonymisées ou, à tout le moins, de la matrice complète des covariances et corrélations inter-items. Ce partage autorise une réanalyse indépendante par la communauté des chercheurs, garantissant la reproductibilité computationnelle stricte des formes quadratiques matricielles qui sous-tendent les valeurs déclarées de R multiple et de R-carré.
12. Synthèse critique et arbre de décision pour les chercheurs en sciences cognitives et sociales
12.1 Arbre décisionnel pour le choix des métriques de reporting
Face à la pluralité des indices générés lors d’une analyse de régression linéaire, les chercheurs sont fréquemment confrontés à un arbitrage méthodologique : quelle métrique privilégier dans les synthèses textuelles, les discussions théoriques et les résumés d’articles ? Pour formaliser ce choix de manière pragmatique et reproductible, l’arbre de décision heuristique suivant explicite les voies à privilégier selon les objectifs de l’investigation :
1. L’objectif premier est-il l’étalonnage ou la validation opérationnelle d’un outil composite de mesure/diagnostic ?
Si OUI → Privilégier le R multiple. Il matérialise directement la corrélation d’alignement empirique entre le score composite généré par l’outil et le critère réel observable sur le terrain, permettant de statuer sur la validité critère directe de l’instrument.
2. L’objectif premier est-il de tester un modèle explicatif théorique ou d’évaluer la proportion de dispersion humaine captée ?
Si OUI → Déployer le R-carré conventionnel (R²) comme indicateur de variance partagée, systématiquement accompagné de son intervalle de confiance à 95 %. Il permet la comparaison standardisée de théories concurrentes au sein d’une échelle proportionnelle universelle.
3. Le modèle incorpore-t-il plus d’un prédicteur (k > 1) et/ou la taille de l’échantillon est-elle limitée (n modéré à faible) ?
Si OUI → Le rapportage du R-carré ajusté (R̄²) devient un impératif méthodologique catégorique. Il neutralise la capitalisation stochastique, pénalise l’introduction de variables non parcimonieuses et fournit une estimation réaliste de la validité reproductible dans la population.
4. L’analyse s’inscrit-elle dans une sélection de modèles concurrents emboîtés ou non emboîtés ?
Si OUI → Compléter obligatoirement les indices linéaires par les critères d’information (AIC, BIC) afin d’évaluer la perte relative d’information selon les principes de la théorie statistique de la décision.
12.2 Perspectives avancées au-delà des modèles linéaires classiques
Si la dichotomie entre R multiple et R-carré trouve son cadre naturel dans la modélisation linéaire des moindres carrés ordinaires, la recherche psychologique contemporaine recourt fréquemment à des architectures statistiques non linéaires ou multiniveaux, au sein desquelles ces métriques traditionnelles cessent de s’appliquer sous leur forme canonique.
En régression logistique binaire ou multinomiale (déployée lorsque le critère est une variable qualitative, telle que le diagnostic de présence/absence d’un trouble), le calcul d’une somme des carrés exacte devient impossible. Les statisticiens ont développé des substituts conceptuels désignés sous le terme générique de pseudo-R². Parmi les plus répandus figurent le R² de Cox & Snell, le R² de Nagelkerke (qui corrige le précédent pour lui permettre d’atteindre la borne maximale théorique de 1,00) et le pseudo-R² de McFadden fondé sur le ratio des log-vraisemblances. Ces indices émulent le comportement du R-carré en termes de gain d’ajustement relatif, bien qu’ils ne correspondent plus à une décomposition pure de variance euclidienne.
Parallèlement, l’essor des modèles linéaires mixtes ou hiérarchiques à effets aléatoires (Linear Mixed Models ou LMM), incontournables dans l’analyse de données écologiques longitudinales (Experience Sampling Method) ou d’écoliers imbriqués au sein de classes scolaires, a nécessité l’émergence d’une nouvelle métrologie de la détermination. Les travaux de référence de Nakagawa et Schielzeth ont formalisé la décomposition en un R² marginal (quantifiant la part de variance expliquée uniquement par les effets fixes de l’expérience) et un R² conditionnel (reflétant la variance globale expliquée conjointe des effets fixes et des effets aléatoires assignés aux groupes ou aux individus).
L’évaluation de la qualité d’ajustement d’un modèle psychologique ne peut se cantonner à l’examen passif et isolé d’un coefficient unique extrait d’un logiciel. Qu’il s’agisse du R multiple, du R-carré conventionnel ou de sa version ajustée, ces indicateurs constituent des abstractions mathématiques dont la valeur heuristique dépend de la rigueur théorique, de la représentativité de l’échantillonnage et de la transparence des pratiques de recherche.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Darlington, R. B., & Hayes, A. F. (2017). Regression analysis and linear models: Concepts, applications, and implementation. The Guilford Press.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R² from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
- Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research (R package version 2.3.6). Northwestern University. https://cran.r-project.org/package=psych
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wherry, R. J. (1931). A new formula for predicting the shrinkage of the coefficient of multiple correlation. The Annals of Mathematical Statistics, 2(4), 440–457. https://doi.org/10.1214/aoms/1177732951