
Dans l’écosystème contemporain de l’apprentissage automatique et de la science des données, l’évaluation de la performance des modèles prédictifs constitue une étape méthodologique déterminante. Trop souvent réduite à des approximations empiriques ou à des raccourcis industriels, cette démarche conditionne pourtant la viabilité scientifique, économique et éthique des systèmes d’intelligence artificielle déployés dans le monde réel. Parmi le panthéon des métriques d’évaluation de la classification binaire ou multi-classes, le score F1 s’est imposé comme une référence incontournable, régulièrement brandi comme le garant ultime de la robustesse face aux données asymétriques. Pourtant, une interrogation fondamentale persiste et divise praticiens et théoriciens : qu’est-ce qui constitue véritablement un « bon » score F1 ?
Répondre de façon péremptoire par un seuil universel — tel que 0,80 ou 0,90 — relève d’une illusion méthodologique dangereuse. Le score F1, par sa construction mathématique intrinsèque, synthétise deux exigences divergentes : la précision, qui mesure la pertinence des détections positives, et le rappel, qui quantifie la capacité d’exhaustivité du système. Juger de l’excellence ou de la médiocrité d’une valeur numérique sans sonder la topologie sous-jacente des données, le taux de prévalence du phénomène étudié, les asymétries de coûts entre erreurs de type I et de type II, ainsi que les contraintes réglementaires du domaine considéré, expose l’ingénieur à des déconvenues opérationnelles majeures. Un score F1 jugé médiocre dans un cadre d’extraction d’information peut s’avérer exceptionnel dans la détection précoce de signaux faibles en oncologie ou dans l’identification de fraudes massives au sein de flux transactionnels haute fréquence.
Le présent article propose une déconstruction épistémologique, mathématique et pragmatique approfondie du score F1. En explorant ses fondements analytiques, sa relativité contextuelle à travers divers champs disciplinaires — de la médecine translationnelle à la cybersécurité et aux sciences cognitives —, ainsi que les pathologies statistiques susceptibles d’en fausser l’interprétation, nous établirons une grille d’analyse rigoureuse. L’objectif n’est pas de fournir une réponse dogmatique, mais d’armer les chercheurs, ingénieurs et décideurs d’un cadre normatif éclairé permettant de déterminer avec précision si un score obtenu répond aux impératifs d’utilité décisionnelle et de performance minimale viable.
1. Fondements mathématiques et conceptuels du score F1
1.1 Définition formelle et moyenne harmonique
D’un point de vue strictement formel, le score F1 est défini comme la moyenne harmonique de la précision (ou valeur prédictive positive) et du rappel (ou sensibilité). Contrairement à la moyenne arithmétique élémentaire, qui attribue un poids strictement linéaire à chacune de ses composantes, la moyenne harmonique impose une structure mathématique spécifique qui pénalise de manière draconienne les disparités extrêmes entre les deux métriques. Formulée initialement dans le champ de la recherche d’information par C. J. van Rijsbergen en 1979, cette mesure s’exprime analytiquement selon l’équation suivante :
F1 = 2 × (Précision × Rappel) / (Précision + Rappel)
Cette formulation révèle immédiatement la propriété fondamentale de la moyenne harmonique : elle est dominée par la valeur la plus faible. Si un modèle de classification affiche une précision parfaite de 1,0 mais un rappel infinitésimal tendant vers zéro, la moyenne arithmétique classique suggérerait une performance globale flatteuse de 0,50. À l’inverse, le score F1 s’effondre irrémédiablement vers zéro. Ce comportement asymptotique traduit une posture épistémologique stricte : un système prédictif ne peut être qualifié d’efficace s’il sacrifie entièrement l’un des deux piliers de l’évaluation au profit de l’autre.
La pénalisation structurelle des déséquilibres découle directement de la relation d’inégalité générale entre moyennes : pour tout ensemble de réels strictement positifs, la moyenne harmonique est toujours inférieure ou égale à la moyenne géométrique, elle-même inférieure ou égale à la moyenne arithmétique. L’égalité parfaite n’est atteinte que dans le cas singulier où la précision et le rappel sont strictement identiques. Dès lors que l’une des composantes diverge de l’autre, le score F1 agit comme un régulateur impitoyable, tirant le score final vers le bas et forçant l’algorithme à maintenir un équilibre fonctionnel entre la rigueur de ses prédictions positives et son exhaustivité.
1.2 Articulation entre précision et rappel
Pour appréhender la substance du score F1, il convient de disséquer minutieusement la dynamique antagoniste qui régit la précision et le rappel. La précision quantifie la pureté des alertes déclenchées par l’algorithme : sur l’ensemble des instances classées positivement, quelle proportion correspond véritablement à des cas avérés ? Le rappel, quant à lui, évalue la complétude ou la sensibilité du dépistage : sur la totalité des instances réellement positives présentes dans le jeu de données, quelle fraction a été correctement interceptée par le système ?
Ces deux grandeurs entretiennent une relation dialectique d’opposition intrinsèque, modulée par le seuil de discrimination bayésien ou probabiliste fixé par l’opérateur. Si l’on durcit le seuil de décision pour n’émettre une prédiction positive que face à un degré d’incertitude quasi nul, la précision s’élève tendanciellement vers l’unité, au détriment direct du rappel qui s’atrophie, laissant échapper de nombreux cas positifs réels. Inversement, si le système abaisse son seuil pour capturer le moindre signal diffus, le rappel croît de manière spectaculaire, mais au prix d’une contamination massive par de fausses alertes, laminant ainsi la précision.
Le grand mérite conceptuel de l’articulation opérée par le score F1 réside dans sa capacité à neutraliser le biais de prévalence inhérent à l’exactitude globale (accuracy). L’exactitude mesure la proportion totale de prédictions correctes parmi l’ensemble des prédictions effectuées. Or, dans des contextes réels caractérisés par une asymétrie de classe marquée, l’exactitude devient une métrique aveugle et trompeuse. Le score F1, en se focalisant exclusivement sur les prédictions positives et les omissions critiques, ignore délibérément le volume massif des vrais négatifs, fournissant ainsi une évaluation réaliste de la capacité du modèle à extraire le signal pertinent du bruit de fond.
1.3 Illustration empirique à travers la matrice de confusion
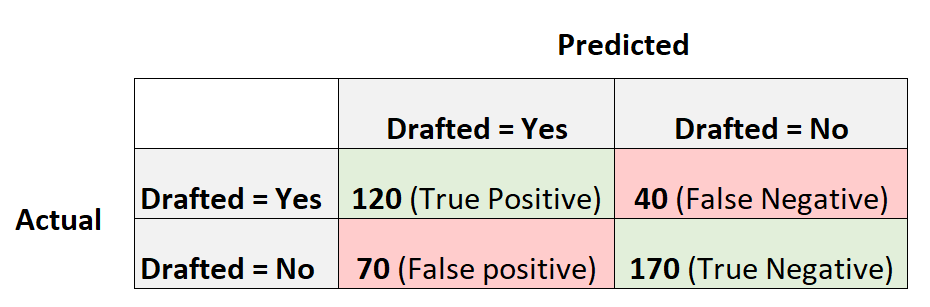
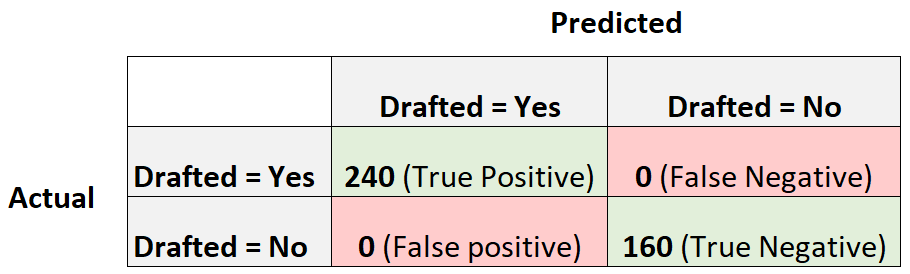
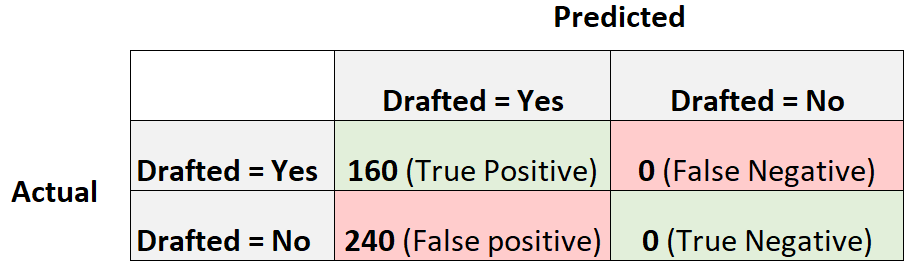
L’assise empirique du score F1 se cristallise au sein de la matrice de confusion binaire, structure matricielle fondamentale croisant la réalité du terrain avec les assignations prédictives du modèle. Cette matrice partitionne l’espace des données en quatre contingents mutuellement exclusifs : les vrais positifs (VP), les faux positifs (FP, ou erreurs de type I), les vrais négatifs (VN) et les faux négatifs (FN, ou erreurs de type II). À partir de cette typologie élémentaire, la précision se définit par le ratio VP / (VP + FP), tandis que le rappel correspond au ratio VP / (VP + FN).
En injectant ces grandeurs au sein de la formule de la moyenne harmonique, le score F1 se condense sous une expression algébrique unifiée, particulièrement révélatrice de sa mécanique interne :
F1 = 2 VP / (2 VP + FP + FN)
Cette équation met en lumière la symétrie exacte avec laquelle les faux positifs et les faux négatifs sont pénalisés au dénominateur. Chaque erreur de classification, qu’il s’agisse d’une fausse alerte ou d’une omission non détectée, contribue avec un coefficient strictement unitaire à dégrader le score global, tandis que chaque succès sur la classe positive (VP) est pondéré par un facteur multiplicateur de deux au numérateur et au dénominateur. Il apparaît ainsi clairement que le contingent des vrais négatifs (VN) brille par son absence totale dans ce calcul.
Cette absence des VN explique la grande sensibilité du score F1 face aux variations d’échantillonnage de la classe positive. Considérons une cohorte de 10 000 patients comprenant 100 individus malades. Un modèle qui isole 80 malades réels mais génère 120 faux positifs obtiendra une précision de 80 / 200 = 0,40 et un rappel de 80 / 100 = 0,80. Le score F1 qui en découle sera de (2 × 0,40 × 0,80) / (0,40 + 0,80) = 0,533. Si un second modèle, testé sur la même cohorte, détecte 90 malades mais génère 300 faux positifs, sa précision chute à 90 / 390 ≈ 0,231 tandis que son rappel atteint 0,90 ; son score F1 s’établira alors à 0,367. La matrice de confusion met ainsi à nu la rigueur avec laquelle l’inflation de faux positifs vient saborder le score global, contraignant le data scientist à optimiser chirurgicalement chaque point d’arbitrage.
2. L’interprétation absolue du score F1 : Repères théoriques et heuristiques
2.1 Le spectre théorique de zéro à un
À l’instar des probabilités élémentaires, le score F1 est borné dans un intervalle fermé s’étendant rigoureusement de 0 à 1. Chacune de ces bornes extrêmes incarne une réalité théorique bien définie dans l’espace des modèles formels. L’atteinte d’un score F1 de 0 signifie l’échec total et absolu de la tâche de classification. Cet état de faillite opérationnelle survient soit lorsque le nombre de vrais positifs est strictement nul (le système échoue à détecter ne serait-ce qu’une seule instance de la classe cible), soit lorsque la précision ou le rappel est mathématiquement indéfini en raison d’une absence totale de prédictions positives conjuguée à une absence de détection effective.
À l’autre extrémité du continuum, le score F1 parfait de 1,0 représente l’idéal inaccessible de la séparabilité déterministe pure. Atteindre un tel score implique simultanément un rappel de 1,0 (zéro faux négatif) et une précision de 1,0 (zéro faux positif). Dans cette situation idyllique, le modèle a totalement résolu le problème de classification : chaque instance positive a été interceptée sans la moindre contamination par des bruits de fond ou des cas négatifs résiduels.
Cependant, en dehors de ces points d’ancrage asymptotiques, le score F1 ne suit aucune distribution normale ou canonique standardisée qui permettrait une conversion probabiliste immédiate en rangs centiles. Un score de 0,75 ne signifie pas que le modèle est supérieur à 75 % des modèles envisageables, ni qu’il possède une probabilité de prédiction correcte de 75 %. L’assignation de qualificatifs simplistes tels que « faible », « médiocre », « satisfaisant » ou « excellent » sur la base de tranches arithmétiques abstraites constitue un contresens méthodologique que la recherche académique rejette fermement.
2.2 Les seuils heuristiques conventionnels dans la littérature académique
En dépit des réserves formulées ci-dessus, la littérature empirique et les revues systématiques de la recherche en intelligence artificielle ont forgé, par consensus tacite, certaines lignes directrices heuristiques destinées à calibrer les attentes initiales. Ces repères statistiques permettent d’établir un premier niveau de filtrage technique lors du prototypage algorithmique :
- Scores inférieurs à 0,50 : Généralement considérés comme non viables pour une exploitation directe. Un tel niveau traduit le fait que le modèle produit soit une majorité écrasante de faux positifs, soit un taux d’omission inacceptable. Il indique fréquemment que l’architecture sélectionnée ne parvient pas à extraire de structures sous-jacentes cohérentes ou que le niveau de bruit des variables explicatives noie le signal informatif.
- Plage de 0,50 à 0,70 : Représente le seuil typique des modèles préliminaires ou exploratoires, particulièrement dans des contextes complexes où les données sont intrinsèquement bruitées ou fortement asymétriques. Dans les tâches d’analyse des sentiments, d’extraction d’opinions ou de détection de signaux faibles, franchir la barre des 0,60 est souvent salué comme une avancée méthodologique majeure par rapport aux heuristiques aléatoires ou majoritaires.
- Plage de 0,70 à 0,90 : Constitue la zone standard d’efficacité requise pour envisager un passage à l’échelle industrielle ou un déploiement opérationnel dans des processus d’automatisation assistée. Un modèle gravitant autour de 0,80 offre généralement un équilibre robuste et prévisible entre la détection des cas d’intérêt et la limitation des fausses alertes, autorisant une intégration fluide au sein des flux de travail humains.
- Scores supérieurs à 0,90 : Qualifiés d’excellents, ces résultats reflètent une séparabilité quasi optimale des représentations latentes. Toutefois, en environnement non contrôlé, l’obtention immédiate d’un score F1 dépassant 0,95 déclenche systématiquement chez le méthodologiste chevronné une suspicion de pathologie d’évaluation, notamment un surapprentissage massif ou une fuite d’information insidieuse (data leakage).
2.3 Déconstruction critique des échelles normatives universelles
Il est impératif de souligner avec gravité les périls associés à la transposition mécanique de ces échelles heuristiques d’un domaine d’application à un autre. Considérer qu’un score F1 de 0,85 est universellement supérieur à un score de 0,65 revient à occulter la dimension fondamentale de la complexité intrinsèque de la tâche (task difficulty) et la nature de l’espace topologique des données.
Classifier des documents textuels structurés en deux catégories thématiques étanches (telles que le sport et l’astrophysique) constitue un problème trivial où un score F1 inférieur à 0,95 traduirait une défaillance méthodologique flagrante du modèle. À l’inverse, prédire la survenue d’un infarctus du myocarde dans les quarante-huit heures à venir à partir de séries temporelles physiologiques bruitées est une tâche d’une complexité stochastique inouïe. Dans un tel environnement hautement incertain, un modèle atteignant un score F1 de 0,58 peut surpasser l’expertise humaine combinée des meilleurs collèges de praticiens et sauver des centaines de vies, constituant ainsi un triomphe scientifique éclatant.
La distinction entre la performance statistique brute et l’utilité clinique ou décisionnelle réelle s’avère ici capitale. La valeur numérique d’un score F1 ne prend son sens qu’une fois mise en regard de la fonction de perte sociétale, humaine ou financière associée au processus décisionnel. Une norme universelle et décontextualisée n’est qu’un mirage rassurant qui anesthésie l’esprit critique de l’évaluateur.
3. La relativité contextuelle : Définir l’excellence selon le domaine d’application
3.1 Le secteur médical et diagnostique : Priorité au rappel
Dans le domaine de l’informatique médicale et de l’aide au diagnostic algorithmique, la qualification d’un « bon » score F1 est entièrement subordonnée aux conséquences cliniques et vitales des erreurs de classification. Lorsqu’un algorithme est destiné au dépistage précoce de pathologies létales à évolution rapide — telles que le glioblastome ou le mélanome malin —, le coût humain d’une erreur de type II (faux négatif) est infiniment supérieur à celui d’une erreur de type I (faux positif).
Un patient victime d’un faux négatif est renvoyé chez lui avec un faux sentiment de sécurité, ce qui retarde irrémédiablement la prise en charge thérapeutique et réduit drastiquement ses chances de survie. À l’inverse, un faux positif génère certes un stress psychologique transitoire et des coûts économiques liés à des examens complémentaires (biopsies, imageries métaboliques), mais ne compromet pas directement le pronostic vital immédiat. Dans ces conditions, les systèmes de santé acceptent volontiers d’opérer avec des modèles affichant une précision modeste — par exemple 0,35 — pourvu que le rappel s’élève à 0,98 ou 0,99.
Par la mécanique de la moyenne harmonique, cette asymétrie dégrade inévitablement la valeur absolue du score F1, qui pourra plafonner péniblement autour de 0,52. Pourtant, ce score de 0,52 sera qualifié d’exceptionnel et de hautement conforme aux exigences réglementaires de sécurité sanitaire, car il aura maximisé l’extraction du risque tout en maintenant un contingent de fausses alertes supportable pour l’infrastructure hospitalière. Les instances normatives, telles que la Food and Drug Administration (FDA) aux États-Unis ou l’Agence européenne des médicaments (EMA), n’évaluent jamais un score F1 de manière isolée, mais scrutent rigoureusement les marges de sensibilité sous-jacentes.
3.2 La détection de fraude et la cybersécurité : Gestion des volumes extrêmes
Le paradigme opérationnel s’inverse radicalement lorsque l’on franchit les frontières de la cybersécurité ou de la détection de fraudes au sein des infrastructures bancaires et financières mondiales. Dans ces écosystèmes, les volumes de données traités quotidiennement atteignent des échelles vertigineuses : plusieurs centaines de millions de transactions financières par tranche de vingt-quatre heures, ou des milliards de paquets réseau transitant par les routeurs dorsaux.
Dans ce contexte de déluge informationnel, même un taux marginal de faux positifs de seulement 0,5 % se traduit par la génération instantanée de dizaines de milliers d’alertes infondées par jour. Or, chaque alerte requiert une intervention humaine d’investigation menée par des analystes spécialisés au sein des centres d’opérations de sécurité (SOC). La surcharge cognitive et logistique induite par une trop grande proportion de fausses alertes paralyse le fonctionnement opérationnel et dilue l’attention des équipes face aux menaces authentiques (phénomène d’anesthésie aux alarmes).
Par conséquent, les institutions bancaires exigent des modèles d’une précision chirurgicale, souvent supérieure à 0,90, quitte à tolérer un rappel substantiellement plus dégradé, oscillant entre 0,45 et 0,55. Dans un tel environnement, la capture d’une fraction substantielle des fraudes majeures sans engorger les cellules de remédiation constitue la cible de rentabilité ultime. Un score F1 se situant à 0,60 est alors fréquemment célébré comme un succès économique et technologique magistral, permettant de bloquer des millions d’euros de préjudices criminels tout en maintenant les coûts d’exploitation opérationnels sous contrôle strict.
3.3 Le traitement automatique du langage naturel et la recherche d’information
Le traitement automatique du langage naturel (NLP) et la recherche d’information (IR) constituent le berceau historique du score F1. Qu’il s’agisse de la reconnaissance d’entités nommées (NER), de la classification de documents juridiques complexes ou de la modélisation de relations sémantiques, les praticiens sont confrontés à l’ambiguïté polymorphe et à la subjectivité inhérentes au langage humain. Contrairement aux signaux physiques rigides, un énoncé linguistique peut prêter à de multiples interprétations valides selon le contexte pragmatique.
Dans ce cadre, la performance d’un modèle de fondation ou d’un grand modèle de langage (LLM) est systématiquement ventilée selon deux optiques de calcul distinctes : le F1-micro et le F1-macro. Le score F1-micro agrège l’ensemble des vrais positifs, faux positifs et faux négatifs à l’échelle globale de toutes les catégories, favorisant mathématiquement les classes textuelles dominantes. Le score F1-macro calcule le score F1 de façon indépendante pour chaque entité sémantique avant d’en opérer la moyenne arithmétique simple, accordant ainsi un pouvoir de sanction égal aux classes rares et aux classes majoritaires.
Pour des tâches industrielles de routage automatique de réclamations clients, un F1-macro de 0,78 est généralement jugé pleinement admissible pour l’autonomie applicative. En revanche, pour des applications critiques d’extraction d’arguments juridiques au sein de corpus contractuels multilingues, où la moindre clause manquée peut emporter des conséquences financières désastreuses, les seuils d’acceptabilité technique sont relevés au-delà de 0,88. La nature de la cible textuelle dicte ainsi la frontière exacte entre performance opérationnelle et insuffisance méthodologique.
4. L’impact critique du déséquilibre des classes sur la qualification du score
4.1 L’illusion de l’exactitude globale (accuracy paradox)
Pour saisir toute la pertinence du score F1 et la rigueur de sa qualification, il est indispensable de comprendre le piège statistique désigné sous le nom de « paradoxe de l’exactitude » (accuracy paradox). Considérons un cas d’école emblématique : la détection d’une cyber-attaque sophistiquée au sein d’un flux de données où la classe malveillante ne représente que 0,1 % des événements observés (soit 10 occurrences sur 10 000 paquets).
Un algorithme naïf et totalement inopérant, programmé pour prédire systématiquement la classe majoritaire (« trafic légitime ») sans jamais analyser le contenu des données, affichera une exactitude globale spectaculaire de 99,9 %. Un observateur superficiel pourrait conclure à la perfection du modèle. Pourtant, son utilité opérationnelle est rigoureusement nulle : l’ensemble des cyber-attaques passe inaperçu, exposant le réseau à une compromission totale.
Face à ce classificateur aveugle, le score F1 démasque instantanément la supercherie statistique. Avec 0 vrai positif, 0 faux positif et 10 faux négatifs, la précision est mathématiquement indéterminée ou nulle, et le rappel s’établit à 0. Le score F1 qui en résulte est sans appel : 0,00. Cette propriété intrinsèque d’immunité face à la masse passive des vrais négatifs confère au score F1 sa supériorité absolue pour appréhender la valeur réelle d’un algorithme opérant sur des distributions déséquilibrées.
4.2 La performance face à des taux de prévalence infinitésimaux
Lorsque la prévalence d’un phénomène chute à des niveaux infinitésimaux (par exemple 0,01 % ou moins, ce qui est la règle dans le dépistage de maladies ultra-rares ou l’interception de signaux terroristes), les propriétés mathématiques du score F1 subissent une tension structurelle extrême. En raison de la règle bayésienne d’actualisation des probabilités, même une spécificité phénoménale de 99,9 % engendre inévitablement un volume de faux positifs largement supérieur à l’effectif réel des vrais positifs.
Dans un tel scénario, la précision subit une chute mécanique vertigineuse. Pour un jeu de données comptant 10 cas positifs sur 100 000 observations, un modèle hautement performant qui parvient à intercepter 9 des 10 cibles (rappel = 0,90) tout en maintenant le nombre de fausses alertes à seulement 50 verra sa précision plafonner à :
9 / (9 + 50) = 9 / 59 ≈ 0,1525
Le score F1 qui en découle sera alors de :
(2 × 0,1525 × 0,90) / (0,1525 + 0,90) ≈ 0,2745 / 1,0525 ≈ 0,2608
Un data scientist non averti jugerait ce score de 0,26 comme lamentable et disqualifierait le modèle. Pourtant, d’un point de vue scientifique et probabiliste, ce résultat constitue un tour de force d’une rareté absolue : l’algorithme a multiplié par plus de 1 500 la concentration du phénomène cible au sein de l’échantillon sélectionné par rapport à sa distribution naturelle dans la population générale. Dans les contextes de prévalence ultra-faible, un score F1 de 0,25 ou 0,35 doit ainsi être interprété comme une percée technologique majeure, pulvérisant les limites statistiques classiques.
4.3 Stratégies d’ajustement : Rééchantillonnage et seuillage
Pour optimiser le score F1 sur des ensembles de données asymétriques, les ingénieurs recourent fréquemment à des stratégies d’ingénierie de données telles que le suréchantillonnage de la classe minoritaire par génération de données synthétiques (notamment via l’algorithme SMOTE – Synthetic Minority Over-sampling Technique) ou le sous-échantillonnage aléatoire de la classe majoritaire. Bien que ces approches modifient la surface de décision du classificateur durant la phase d’apprentissage, elles introduisent un risque méthodologique majeur lors de l’évaluation finale.
Si l’on évalue un modèle sur un jeu de test dont la distribution des classes a été artificiellement équilibrée (50 % de positifs et 50 % de négatifs), le score F1 obtenu sera colossalement gonflé et perdra toute pertinence prédictive pour le monde réel. La seule rigueur admissible consiste à préserver rigoureusement la prévalence naturelle et non manipulée au sein de l’ensemble de test (hold-out test set). Les techniques d’échantillonnage ne doivent gouverner que l’espace d’entraînement.
Parallèlement, la maximisation du score F1 ne doit pas être subie passivement à travers le seuil probabiliste standard arbitraire de 0,50 hérité des fonctions logistiques. En faisant glisser de façon systématique le seuil de discrimination le long de la courbe d’étalonnage probabiliste, il devient possible d’identifier le point d’inflexion optimal qui maximise précisément la métrique cible sur un ensemble de validation distinct, ajustant le modèle aux exigences spécifiques du cas d’usage réel.
5. Au-delà de la symétrie : Quand le score F-bêta redéfinit ce qui est « bon »
5.1 Limites de la pondération égale entre précision et rappel
L’une des critiques épistémologiques les plus acérées formulées à l’encontre du score F1 standard concerne son postulat implicite d’équivalence absolue entre précision et rappel. En attribuant un poids rigoureusement identique de 1 aux deux composantes, le score F1 postule que le coût sociétal, économique ou éthique d’une fausse alerte équivaut point par point au coût d’une omission non détectée.
Dans la quasi-totalité des systèmes décisionnels réels régis par la théorie mathématique de la décision rationnelle, cette hypothèse de symétrie parfaite est invalidée par les faits. Rares sont les situations où la perte engendrée par un faux positif coïncide au centime près ou à la même unité de souffrance humaine avec celle d’un faux négatif. Le choix du coefficient 1 s’apparente ainsi à une convention arbitraire plutôt qu’à une nécessité fonctionnelle. Dès lors que les asymétries de coûts deviennent prononcées, juger de la pertinence d’un système à l’aune du seul score F1 symétrique devient non seulement erroné, mais contre-productif d’un point de vue décisionnel.
5.2 Le score F2 : Privilégier la sensibilité et la détection
Pour répondre formellement à cette asymétrie lorsque le coût de l’omission supplante largement celui de la fausse alerte, la littérature statistique a généralisé le score F1 sous la forme du score F-bêta (Fβ), dont la formulation s’établit comme suit :
Fβ = (1 + β2) × (Précision × Rappel) / (β2 × Précision + Rappel)
Le paramètre β sert de curseur d’arbitrage : il quantifie l’importance relative accordée au rappel par rapport à la précision. Lorsque l’on fixe β = 2, on obtient le score F2, une formulation analytique qui confère un poids deux fois supérieur au rappel par rapport à la précision. Au dénominateur, la précision se trouve multipliée par β2 = 4, ce qui signifie que toute baisse du rappel pénalise le résultat final quatre fois plus sévèrement qu’une dégradation équivalente de la précision.
Le score F2 s’impose ainsi comme l’étalon de référence incontournable dans la détection des pannes catastrophiques dans les réacteurs industriels, l’alerte aux tsunamis ou le dépistage médical d’urgence. Un modèle affichant un score F1 modeste de 0,65 peut voir son score F2 grimper à 0,85 s’il a été sciemment optimisé pour intercepter la quasi-totalité des occurrences critiques. Dans ces conditions opératoires, c’est bien la valeur du score F2 qui détermine si le modèle est qualifié de « bon », reléguant le F1 symétrique au rang de simple indicateur secondaire.
5.3 Le score F0.5 : Priorité à la certitude prédictive
À l’inverse symétrique, certaines architectures applicatives ne peuvent sous aucun prétexte tolérer un débordement de faux positifs, sous peine d’engager la responsabilité juridique de l’organisation ou de détruire irrémédiablement la confiance de l’utilisateur final. Dans de telles configurations, c’est le score F0.5 (β = 0,5) qui prend le relais de l’évaluation.
En fixant β = 0,5, la formule élève le poids relatif de la précision au double de celui du rappel. Tout faux positif est lourdement sanctionné mathématiquement, accordant une prime prépondérante à la fiabilité absolue des détections positives au détriment de l’exhaustivité de la couverture. Les cas d’usage typiques incluent les systèmes de filtrage automatique de contenus illicites avec blocage immédiat de comptes utilisateurs, les mécanismes d’attribution automatisée de subventions publiques hautement réglementées, ou encore les algorithmes générateurs de diagnostics d’inculpation juridique.
Dans cet univers opérationnel, un modèle qui sacrifierait sa précision pour aller chercher des points marginaux de rappel verrait son score F0.5 s’effondrer brutalement. Un système affichant un score F0.5 de 0,85 sera qualifié d’excellent, même si son score F1 ne franchit pas 0,72 en raison d’un rappel volontairement bridé à des fins de sécurité juridique.
6. L’établissement de modèles de référence (Baselines) et scores de hasard
6.1 Calcul du score F1 d’un classificateur purement aléatoire
L’une des illusions les plus profondément ancrées chez les praticiens débutants consiste à croire que, dans un problème de classification binaire, les performances d’un modèle aléatoire correspondent systématiquement à un score de 0,50. Si cette intuition est exacte pour l’exactitude globale (dans une situation d’équilibre de classes parfait), elle est rigoureusement fausse pour le score F1.
Considérons un classificateur aléatoire stochastique qui émet une prédiction positive avec une probabilité fixe p sur un ensemble de données où la prévalence réelle de la classe positive est notée π. Par les lois fondamentales de la probabilité combinatoire, la précision espérée de ce classificateur coïncide purement et simplement avec le taux de prévalence : E(Précision) = π. Parallèlement, le rappel espéré correspond à la probabilité de déclenchement du modèle : E(Rappel) = p. En réinjectant ces espérances mathématiques dans la formule du score F1, on démontre que pour un modèle aléatoire uniforme tirant à pile ou face (p = 0,5) sur un jeu de données déséquilibré où π = 0,05, le score F1 espéré ne vaut nullement 0,50, mais :
E(F1) = 2 × (0,05 × 0,50) / (0,05 + 0,50) = 0,05 / 0,55 ≈ 0,0909
Si la stratégie de tirage aléatoire est proportionnelle (le modèle tire positivement avec une probabilité égale à la prévalence observée π), le score F1 espéré s’effondre directement à la valeur exacte de la prévalence, soit 0,05. Ainsi, pour prétendre attester d’un apprentissage effectif et non trivial, un modèle doit impérativement afficher un score F1 significativement supérieur à la prévalence de sa classe cible. Dans un contexte où π = 0,01, un modèle atteignant un F1 de 0,20 n’est pas médiocre : il surpasse de 2 000 % le niveau de bruit aléatoire.
6.2 Comparaison avec des modèles heuristiques déterministes
Déterminer si un score F1 est « bon » exige impérativement de confronter les résultats obtenus à des modèles de référence (baselines) heuristiques déterministes. Avant de déployer un réseau de neurones profond complexe comptant plusieurs millions de paramètres, la rigueur scientifique impose d’évaluer la performance de règles métier simples fondées sur un ou deux attributs majeurs.
Il arrive régulièrement dans la pratique industrielle qu’un arbre de décision rudimentaire fondé sur une variable explicative dominante atteigne un score F1 de 0,74 avec un temps de calcul de quelques millisecondes et une explicabilité parfaite. Si un modèle de type gradient boosting hautement calibré ou un transformeur ne parvient qu’à hisser ce score à 0,76 au prix d’une infrastructure coûteuse et d’une opacité algorithmique complète, ce gain marginal de deux points ne saurait qualifier le score de 0,76 de « succès ». Le principe de parcimonie scientifique (rasoir d’Ockham) impose de considérer ce résultat comme insuffisant pour justifier le déploiement de la solution lourde.
6.3 L’état de l’art scientifique comme mètre étalon
Le jugement qualitatif porté sur un score F1 dépend intimement de l’état de l’art mondial consigné dans la littérature scientifique de pointe sur des jeux de données de référence partagés (benchmarks standardisés tels que Papers with Code, GLUE ou ImageNet). Être capable d’extraire un score F1 de 0,82 sur un jeu de données public où la communauté scientifique internationale plafonne historiquement à 0,79 constitue une performance de tout premier plan qui fera l’objet d’une publication académique majeure.
Il convient néanmoins d’exercer une vigilance épistémologique constante face au biais de publication qui sature la littérature savante. Les équipes de recherche ont structurellement tendance à ne publier que des architectures présentant des scores flatteurs obtenus sur des découpages de données parfois optimisés. La transposition de ces performances théoriques au sein d’environnements industriels réels se solde presque invariablement par une dégradation substantielle du score, liée à l’hétérogénéité des données de production.
7. La perspective psychométrique : Évaluation des diagnostics cognitifs et comportementaux
7.1 Validation des outils de dépistage en santé mentale
L’introduction des algorithmes d’apprentissage supervisé dans les sciences psychologiques et psychiatriques renouvelle en profondeur la question de la validité métrologique. Dans le dépistage automatisé du trouble dépressif majeur, de l’anxiété généralisée ou du risque suicidaire imminent à partir d’écrits numériques ou de signaux vocaux, l’évaluation du score F1 s’inscrit au cœur de dilemmes moraux et thérapeutiques insolubles.
La psychométrie classique s’articule traditionnellement autour des concepts de fidélité et de validité, étroitement liés aux métriques de sensibilité (rappel) et de valeur prédictive positive (précision). Dans l’évaluation du risque suicidaire aigu, le coût moral et sociétal d’un faux négatif est infini : il équivaut à la perte irréparable d’une vie humaine qui aurait pu être sauvée par une intervention de crise. Toutefois, l’inflation incontrôlée de faux positifs engendre un traumatisme iatrogène sévère, des hospitalisations sous contrainte injustifiées et une stigmatisation sociale destructrice pour le patient.
Dans ce contexte éthique d’une gravité exceptionnelle, un score F1 de 0,55 — qui pourrait sembler médiocre aux yeux d’un informaticien néophyte — constitue souvent le seuil d’utilité clinique le plus élevé jamais atteint par des échelles psychométriques traditionnelles, matérialisant un progrès diagnostique substantiel par rapport aux entretiens non standardisés.
7.2 Évaluation cognitive et phénotypage numérique
Le phénotypage numérique (digital phenotyping) exploite les flux continus de données issues des capteurs de téléphones intelligents et d’objets connectés (latence de frappe au clavier, actimétrie, variabilité des patterns de mobilité GPS) pour inférer des états cognitifs altérés. L’un des chantiers les plus novateurs concerne la détection précoce du déclin cognitif léger (MCI – Mild Cognitive Impairment), précurseur potentiel de la maladie d’Alzheimer.
L’évaluation des modèles dans cette discipline se heurte à une variabilité interindividuelle et intra-individuelle considérable. Les rythmes circadiens, le niveau de fatigue ponctuel ou les événements de vie stressants introduisent un bruit de mesure continu qui contamine la pureté des séries temporelles. Les algorithmes de classification prédictive se situent généralement dans des zones de score F1 comprises entre 0,62 et 0,75.
Ce niveau de performance est jugé pleinement suffisant dès lors que le modèle n’a pas pour vocation d’émettre un diagnostic médical contraignant, mais de fonctionner comme un système d’alerte passive de première ligne, incitant le patient à consulter un neurologue pour un bilan neuropsychologique complet standardisé.
7.3 Fiabilité des étiquettes diagnostiques de vérité terrain
Un verrou épistémologique central dans l’évaluation psychométrique du score F1 réside dans la fragilité de la vérité terrain (ground truth). En vision par ordinateur, identifier un véhicule sur une image constitue une tâche où l’accord entre observateurs humains approche 100 %. En santé mentale et en sciences comportementales, l’étiquette cible découle des critères du DSM-5 ou de la CIM-11, dont la fiabilité inter-juges est notoirement imparfaite.
Le coefficient Kappa d’accord diagnostique entre deux psychiatres chevronnés évaluant le même patient dépasse rarement 0,60 à 0,70 pour de nombreuses pathologies psychiatriques complexes. Mathématiquement, un algorithme d’apprentissage automatique ne peut pas dépasser la cohérence intrinsèque des données qui ont servi à l’entraîner. Si l’étalon-or humain comporte une marge d’incertitude structurelle de 30 %, exiger d’un algorithme un score F1 de 0,90 est une absurdité conceptuelle. Dans ce cadre, un modèle affichant un score F1 de 0,68 aligné sur le consensus moyen d’experts humains doit être considéré comme ayant atteint le plafond théorique de séparabilité statistique admissible.
8. Les pathologies de l’évaluation : Risques associés à un score F1 anormalement élevé
8.1 Le piège du surapprentissage (Overfitting)
L’obtention d’un score F1 exceptionnellement élevé — par exemple 0,98 ou 0,99 — ne doit pas susciter un enthousiasme naïf, mais éveiller immédiatement une profonde méfiance méthodologique. Le phénomène de surapprentissage constitue la pathologie la plus récurrente de l’ingénierie prédictive moderne. Lorsqu’un modèle à haute capacité (tel qu’un réseau neuronal profond ou un ensemble d’arbres à forte profondeur) possède un trop grand nombre de degrés de liberté par rapport au volume d’exemples disponibles, il finit par mémoriser le bruit stochastique propre à l’échantillon d’entraînement au lieu d’apprendre des régularités généralisables.
Le diagnostic de cette pathologie se manifeste par une divergence critique entre les métriques observées en phase d’apprentissage et celles relevées sur l’échantillon de test indépendant. Un modèle qui affiche un F1 de 0,99 à l’entraînement mais s’effondre à 0,62 sur des données non vues est un modèle défaillant, inapte à toute extrapolation. La préservation d’une capacité de généralisation saine requiert la mise en œuvre de techniques strictes de régularisation mathématique (pénalités L1/L2, dropout, arrêt précoce) et une évaluation impérative sur des cohortes géographiquement ou temporellement indépendantes.
8.2 Fuite de données (Data Leakage) et contamination
Une cause encore plus pernicieuse d’inflation artificielle du score F1 est la fuite d’information ou fuite de données (data leakage). Cette anomalie survient lorsqu’une variable explicative incorporée dans le modèle contient directement ou indirectement des informations sur l’étiquette cible qui ne seraient pas disponibles au moment de la prédiction en conditions réelles.
Un exemple classique réside dans l’analyse prédictive hospitalière, où l’inclusion du code de facturation d’un médicament administré uniquement en soins intensifs permet au modèle de prédire la mortalité d’un patient avec un F1 stupéfiant de 0,97. En réalité, le modèle n’anticipe rien : il constate simplement un traitement administré a posteriori. De même, une fuite peut résulter d’une erreur d’ingénierie logicielle élémentaire, comme la normalisation statistique des données (centrage et réduction) appliquée à l’ensemble du jeu de données avant sa partition en jeux d’entraînement et de test. Lors du déploiement en conditions réelles où ces données futures disparaissent, le score F1 s’effondre de manière spectaculaire, invalidant totalement le système.
8.3 Biais de représentativité et validité externe
Un score F1 peut briller d’un éclat trompeur s’il a été mesuré sur un échantillon expérimental caractérisé par un biais de sélection sévère. Dans la recherche en santé et en reconnaissance faciale, il a été abondamment démontré que des modèles affichant des scores F1 globaux de 0,92 sur des banques de données académiques souffraient de performances catastrophiques dès lors qu’ils étaient confrontés à des sous-populations marginalisées ou sous-représentées au sein du jeu d’entraînement initial.
Ce phénomène détruit la validité externe du modèle. Un score F1 moyen flatteur masque fréquemment des disparités scandaleuses entre sous-groupes démographiques ou opérationnels : le modèle peut afficher un F1 de 0,95 sur les segments majoritaires mais s’effondrer à 0,30 sur les minorités vulnérables. L’évaluation de l’excellence d’un score ne peut donc plus s’opérer de manière holistique : elle exige une désagrégation systématique des scores F1 à travers les différentes strates pour garantir l’équité algorithmique et l’invariance structurelle de la performance.
9. Métriques complémentaires indispensables pour contextualiser le score F1
9.1 Le coefficient de corrélation de Matthews (MCC)
Bien que le score F1 soit largement supérieur à l’exactitude brute sur les jeux de données déséquilibrés, il souffre d’une limitation théorique majeure : son incapacité structurelle à prendre en compte les vrais négatifs. Face à cette lacune, de nombreux biostatisticiens et théoriciens de l’information recommandent de compléter systématiquement l’analyse par le coefficient de corrélation de Matthews (MCC).
Le MCC intègre formellement les quatre quadrants de la matrice de confusion dans son calcul analytique :
MCC = (VP × VN – FP × FN) / √((VP + FP)(VP + FN)(VN + FP)(VN + FN))
Variant sur une échelle continue de -1 à +1, le MCC s’interprète rigoureusement comme un coefficient de corrélation de Pearson entre les classes réelles et les classes prédites. Une valeur de +1 reflète une classification parfaite, 0 caractérise une performance strictement équivalente à un tirage au sort aléatoire, et -1 traduit un désaccord systématique et complet. L’un des atouts déterminants du MCC est son invariance absolue par rapport à la désignation conventionnelle de la classe « positive » ou « négative ». Lorsque le score F1 et le MCC divergent significativement, il convient de faire preuve d’une prudence extrême : une envolée du F1 masquant souvent une mauvaise gestion de la classe négative.
9.2 Courbes ROC et PR : Analyse de la dynamique des seuils
Le score F1 présente la rigidité d’être une métrique ponctuelle : il fige l’évaluation du modèle à un seuil de discrimination unique et prédéterminé (traditionnellement fixé à 0,50). Or, les modèles probabilistes modernes émettent des scores continus qu’il convient d’analyser dans leur trajectoire dynamique globale.
Pour appréhender cette plasticité décisionnelle, l’utilisation conjointe des courbes ROC (Receiver Operating Characteristic) et des courbes Précision-Rappel (PRC) est indispensable. Si l’aire sous la courbe ROC (AUC-ROC) est universellement mobilisée, les statisticiens ont prouvé qu’elle demeure excessivement optimiste et trompeuse face à des distributions hautement déséquilibrées, précisément parce que son axe des abscisses (taux de faux positifs) intègre la masse écrasante des vrais négatifs à son dénominateur. L’aire sous la courbe Précision-Rappel (AUC-PR) fournit à l’inverse une vision fidèle et incorruptible de la qualité de séparation du modèle sur les zones rares. Le score F1 représente alors le sommet maximal atteignable sur cette courbe PR, et ne doit être interprété qu’au regard de cette enveloppe de performance globale.
9.3 Indice Kappa de Cohen et métriques de concordance
Issu des sciences comportementales, l’indice Kappa de Cohen quantifie le degré de concordance entre deux évaluateurs (en l’occurrence, le classificateur algorithmique et la vérité terrain étiquetée par l’humain), tout en retranchant explicitement l’accord qui pourrait survenir par le pur hasard statistique :
κ = (Po – Pe) / (1 – Pe)
Où Po représente l’accord observé empiriquement et Pe l’accord théorique espéré sous l’hypothèse d’indépendance stochastique complète. L’intégration conjointe du Kappa de Cohen et du score F1 au sein des dossiers de validation algorithmique permet de sécuriser le processus décisionnel. Un modèle affichant un score F1 substantiel couplé à un indice Kappa effondré indique immédiatement que le succès numérique apparent est imputable à des coïncidences statistiques sur les marges marginales plutôt qu’à une compétence prédictive authentique.
10. Méthodologies de validation statistique pour fiabiliser le score F1
10.1 Validation croisée stratifiée à K blocs (K-Fold)
Affirmer la qualité intrinsèque d’un score F1 à l’issue d’une simple partition aléatoire unique entre ensemble d’entraînement et ensemble de test constitue une négligence méthodologique coupable. Une telle estimation ponctuelle est tributaire des fluctuations d’échantillonnage et peut surestimer ou sous-estimer dramatiquement la valeur réelle du modèle.
Le standard méthodologique minimal repose sur l’application rigoureuse d’une validation croisée stratifiée à K blocs (Stratified K-Fold Cross-Validation). La stratification garantit que le ratio de prévalence exacte de la classe positive est préservé de manière millimétrique au sein de chacun des K sous-ensembles de validation. À l’issue des K itérations, l’évaluateur ne consigne pas simplement une valeur moyenne unique, mais documente l’écart-type empirique du score F1. Un modèle affichant un score F1 moyen de 0,82 avec un écart-type de ± 0,02 inspire une confiance opérationnelle infiniment supérieure à un modèle concurrent affichant un F1 moyen flatteur de 0,86 mais grevé d’une volatilité erratique de ± 0,12, révélant une instabilité structurelle aiguë face aux perturbations de l’échantillon.
10.2 Intervalles de confiance par rééchantillonnage Bootstrap
Pour franchir un degré supplémentaire de rigueur scientifique, l’estimation du score F1 doit s’accompagner d’un intervalle de confiance statistique probabiliste. Dans la mesure où la distribution mathématique exacte de la moyenne harmonique de ratios n’admet pas de forme analytique paramétrique simple, la méthode computationnelle du rééchantillonnage non paramétrique (Bootstrap) s’impose comme la solution de référence.
En tirant avec remise des milliers d’échantillons bootstrapés à partir de la population de test, on reconstruit empiriquement la véritable distribution d’échantillonnage du score F1. Il devient alors aisé d’en extraire un intervalle de confiance percentile à 95 %. Communiquer un résultat sous la forme scientifique : « Le modèle présente un score F1 de 0,78 (IC 95 % : [0,74 – 0,82]) » transforme radicalement la portée du diagnostic technique. Cela permet aux instances d’arbitrage de quantifier précisément le risque de queue (tail risk) et de vérifier que, même dans l’hypothèse de la borne basse la plus défavorable, le système respecte encore le cahier des charges opérationnel.
10.3 Tests de signification statistique entre modèles concurrents
Lorsque deux architectures algorithmiques sont en compétition pour un déploiement et qu’un modèle A présente un score F1 de 0,84 tandis qu’un modèle B affiche 0,86, conclure d’emblée à la supériorité du second modèle relève de l’illusion numérique. Ce modeste écart de deux points peut parfaitement résulter du hasard de l’échantillonnage ou d’artefacts stochastiques résiduels.
La validation scientifique de cette supériorité exige la mise en œuvre de tests d’hypothèse statistique formels adaptés aux classifications dépendantes. Le test non paramétrique de McNemar, appliqué directement sur les discordances croisées de la matrice de contingence des deux algorithmes, permet de réfuter rigoureusement l’hypothèse nulle d’équivalence prédictive. Dans le cadre de validations croisées répétées, l’application de tests t appariés corrigés de Nadeau et Bengio garantit que le dépassement du score F1 est statistiquement significatif au seuil α = 0,05, protégeant ainsi l’équipe de développement contre le risque d’erreur de type I lors du choix du modèle définitif.
11. Études de cas empiriques : Analyse critique de scores F1 réels
11.1 Dépistage du risque suicidaire par analyse textuelle
Afin de concrétiser notre propos, examinons une étude clinique réelle consacrée à la détection des idéations suicidaires au sein des forums de discussion et des réseaux sociaux à l’aide de modèles d’apprentissage profond de traitement du langage naturel. Dans cette recherche, la prévalence du risque suicidaire imminent au sein des messages analysés était extrêmement faible, évaluée à environ 1,2 %.
Le système prédictif entraîné par l’équipe a atteint, après calibrage fin, un score F1 de 0,55, résultant d’une sensibilité (rappel) de 0,82 et d’une précision de 0,42. Dans une perspective technologique conventionnelle, un score F1 de 0,55 serait dédaigneusement qualifié d’insuffisant ou de médiocre. Pourtant, l’intégration de ce système aux consoles de veille des lignes d’écoute psychologique a constitué une avancée humaine majeure.
Auparavant, les intervenants humains étaient submergés par des millions de messages et n’intervenaient qu’au hasard ou sur signalement tardif. Grâce au modèle, pour 100 alertes transmises aux écoutants professionnels, 42 concernaient effectivement des individus au bord du passage à l’acte suicidaire, tandis que 82 % des détresse vitales disséminées sur la plateforme étaient interceptées. En transformant un bruit de fond chaotique en une file d’attente hautement concentrée, ce score F1 de 0,55 a permis de sauver des dizaines de vies humaines, illustrant de manière éclatante la totale déconnexion entre la modestie d’une valeur numérique absolue et sa valeur d’usage opérationnelle.
11.2 Diagnostic de la maladie d’Alzheimer à partir de l’IRM
Le second cas empirique porte sur la neuro-imagerie computationnelle dédiée au diagnostic automatisé des stades précoces de la maladie d’Alzheimer à partir d’acquisitions IRM structurelles 3D pondérées en T1. Un modèle de réseau convolutif tridimensionnel (3D-CNN) a atteint, lors des phases d’évaluation finale, un score F1 remarquable de 0,88, combinant un rappel de 0,90 et une précision de 0,86.
Avant d’entériner la supériorité de ce modèle, les chercheurs ont déployé des cartes de saillance anatomique fondées sur l’algorithme Grad-CAM pour cartographier les zones cérébrales ayant activé les décisions du réseau de neurones. L’audit d’interprétabilité a révélé que les activations coïncidaient rigoureusement avec les zones hippocampiques et le cortex entorhinal, régions universellement reconnues par la science neurologique comme le siège de l’atrophie neurodégénérative initiale. Le score F1 de 0,88 a ainsi pu être validé cliniquement par des comités d’experts médicaux, non seulement pour sa valeur statistique élevée, mais pour sa parfaite cohérence physiopathologique.
11.3 Prédiction du décrochage universitaire en ligne
Le troisième cas d’école concerne l’enseignement supérieur numérique et la prévention précoce du décrochage au sein des cours en ligne ouverts et massifs (MOOC). Face à un taux d’abandon naturel historiquement proche de 85 %, une université de premier plan a développé un algorithme de suivi prédictif analysant la régularité des connexions et la complétion des exercices hebdomadaires.
Le modèle a convergé vers un score F1 de 0,72, matérialisé par une précision de 0,78 et un rappel de 0,67. L’équipe de direction pédagogique disposait d’un budget restreint permettant de financer un contingent limité d’heures de tutorat humain personnalisé d’urgence. Avec un seuil de précision de près de 80 %, chaque intervention d’un tuteur ciblait un étudiant dont la probabilité de décrochage était quasi certaine, évitant ainsi le gaspillage des deniers publics alloués au programme de remédiation.
En ajustant dynamiquement le seuil de risque du modèle selon les capacités d’accueil variables des tuteurs au fil des semestres, l’institution a réussi à pérenniser son taux de rétention d’inscriptions. Le score F1 de 0,72 a constitué dans cette configuration la trajectoire de rentabilité optimale entre l’exhaustivité du dépistage et les contraintes économiques structurelles de l’établissement.
12. Cadre décisionnel normatif : Fixer le seuil d’acceptabilité d’un bon score F1
12.1 Étape 1 : Cartographie de la matrice des coûts et gains
Pour affranchir l’ingénieur de données de la subjectivité stérile et lui permettre de décréter en toute objectivité si un score F1 est satisfaisant, la première démarche méthodologique consiste à élaborer une matrice formalisée des coûts et des gains financiers, éthiques et organisationnels. Cette démarche impose d’associer étroitement les experts métiers, les juristes et les data scientists au sein d’une commission d’arbitrage interdisciplinaire.
Chaque quadrant de la matrice de confusion doit se voir assigner une valeur d’utilité ou de perte explicite :
- Gain économique ou sociétal associé à un vrai positif (CVP)
- Coût induit par l’interception et le traitement d’une fausse alerte (CFP)
- Coût pénal, éthique ou vital associé à la non-détection d’une occurrence critique (CFN)
- Bénéfice ou neutralité attaché à l’absence légitime d’alerte sur un cas négatif (CVN)
Une fois cette fonction d’utilité espérée U = ∑ (Cij × Nij) rigoureusement modélisée, il devient possible de calculer mathématiquement le seuil exact de score F1 (et l’arbitrage F-bêta correspondant) en deçà duquel le système détruit de la valeur nette par rapport au statu quo manuel. Dès cet instant, le qualificatif de « bon » score s’arrache à l’arbitraire pour s’inscrire dans une rentabilité objectivement mesurable.
12.2 Étape 2 : Évaluation des contraintes réglementaires et éthiques
L’intelligence artificielle contemporaine opère désormais au cœur d’un environnement juridique de plus en plus contraignant. Le déploiement opérationnel d’un système prédictif au sein de l’Union européenne est désormais strictement encadré par le Règlement sur l’intelligence artificielle (AI Act), particulièrement pour les architectures qualifiées de « systèmes à haut risque » (santé, gestion des infrastructures critiques, recrutement, maintien de l’ordre).
Ces cadres réglementaires imposent des exigences d’auditabilité publique, de reproductibilité scientifique et de non-discrimination statistique entre sous-groupes démographiques. Même un modèle affichant un score F1 phénoménal de 0,93 se verra légalement refuser toute autorisation de mise sur le marché s’il est prouvé que cette performance globale a été obtenue en sacrifiant l’équité de traitement sur une catégorie démographique protégée. Un « bon » score F1 au XXIe siècle est un score qui résiste à l’épreuve de la conformité juridique et de l’auditabilité éthique institutionnelle.
12.3 Étape 3 : Définition du contrat de performance minimale viable (PMV)
L’ultime jalon consiste à formaliser un contrat de performance minimale viable (PMV) engageant conjointement l’équipe d’ingénierie et la direction métier avant toute mise en production. Ce document contractuel stipule les critères stricts de recevabilité et les protocoles de contingence :
- Le seuil plancher critique : La valeur du score F1 (ou F-bêta) mesurée en validation croisée stratifiée en dessous de laquelle le système ne recevra en aucun cas l’autorisation de déploiement opérationnel.
- Le protocole de débrayage humain : Les conditions précises dans lesquelles le modèle doit automatiquement céder la main à une expertise humaine manuelle lorsque la confiance probabiliste de ses prédictions passe sous un seuil d’entropie déterminé.
- Les indicateurs d’alerte de dérive (data drift) : La surveillance en temps réel de l’évolution du score F1 au fil des semaines d’exploitation industrielle. Dès lors que la dérive distributionnelle des données d’entrée dégrade le score F1 de plus de 5 % par rapport à sa référence de validation, un protocole de réentraînement d’urgence doit être automatiquement déclenché.
En dernière analyse, il apparaît évident qu’il n’existe pas de « bon » score F1 gravé dans l’absolu mathématique. Un score F1 ne saurait être qualifié de bon que s’il surpasse significativement les modèles de hasard et les heuristiques triviales, s’il maximise la fonction d’utilité spécifique de son écosystème en respectant l’asymétrie des coûts, et s’il assure un ratio d’amélioration opérationnelle démontrable supérieur aux risques inhérents à son déploiement dans le monde réel.
Références
Chinchor, N. (1992). MUC-4 MUC-4 evaluation metrics. In Proceedings of the 4th Conference on Message Understanding (pp. 22-29). Association for Computational Linguistics. https://doi.org/10.3115/1072064.1072067
Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: Synthetic minority over-sampling technique. Journal of Artificial Intelligence Research, 16, 321-357. https://doi.org/10.1613/jair.953
Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21(1), Article 6. https://doi.org/10.1186/s12864-019-6413-7
Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37-46. https://doi.org/10.1177/001316446002000104
Hand, D. J., & Christen, P. (2018). A note on using the F-measure for evaluating information retrieval performance. Statistics and Computing, 28(3), 539-546. https://doi.org/10.1007/s11222-017-9746-6
Nadeau, C., & Bengio, Y. (2003). Inference for the generalization error. Machine Learning, 52(3), 239-281. https://doi.org/10.1023/A:1024068612657
Powers, D. M. (2011). Evaluation: from precision, recall and F-measure to ROC, informedness, markedness and correlation. Journal of Machine Learning Technologies, 2(1), 37-63. https://hdl.handle.net/2328/27165
Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432
van Rijsbergen, C. J. (1979). Information Retrieval (2nd ed.). Butterworth-Heinemann. https://dl.acm.org/doi/book/10.5555/539927