
L’essor fulgurant de l’apprentissage automatique (machine learning) et de l’intelligence artificielle au cours des dernières décennies a profondément bouleversé le traitement des données et la prise de décision automatisée. De la reconnaissance biométrique aux diagnostics médicaux assistés par ordinateur, en passant par la prédiction des marchés financiers et la modélisation climatique, les algorithmes prédictifs se sont imposés comme des outils d’une puissance sans précédent. Toutefois, cette puissance de calcul et cette capacité d’ajustement algorithmique dissimulent une vulnérabilité épistémologique et technique majeure. En effet, la quête d’une précision absolue sur les données observées conduit fréquemment les concepteurs de modèles dans un piège pernicieux : la confusion entre l’apprentissage réel de lois sous-jacentes et la simple mémorisation mécanique des fluctuations statistiques propres à l’échantillon d’entraînement.
Ce phénomène d’illusion statistique porte un nom bien connu de tous les praticiens de la science des données : le surapprentissage, couramment désigné par le terme anglo-saxon d’overfitting. Loin de constituer une simple anomalie mineure ou un artefact de calcul négligeable, le surapprentissage représente l’un des défis théoriques et pratiques les plus cruciaux et persistants de la modélisation prédictive contemporaine. Lorsqu’un modèle statistique ou un réseau de neurones surapprend, il produit des résultats spectaculaires sur les données ayant servi à calibrer ses paramètres internes, affichant parfois une précision de cent pour cent. Cependant, dès qu’il est confronté à des données inédites issues du monde réel, ses prédictions s’effondrent lamentablement, révélant son incapacité totale à généraliser ce qu’il prétendait avoir compris.
Comprendre en profondeur le surapprentissage exige une déconstruction rigoureuse des paradigmes de l’inférence statistique, une analyse fine de la décomposition mathématique de l’erreur, ainsi qu’une exploration des mécanismes par lesquels les algorithmes modernes capturent le bruit stochastique au détriment du signal utile. Cet article encyclopédique propose une immersion exhaustive au cœur de cette pathologie algorithmique. À travers l’étude de ses fondements mathématiques, l’examen détaillé d’une étude de cas empirique, l’analyse des facteurs causaux et la présentation des stratégies d’atténuation les plus avancées, ce guide s’adresse aux chercheurs, ingénieurs et étudiants désireux de maîtriser les subtilités de la robustesse algorithmique et de concevoir des systèmes prédictifs viables, fiables et véritablement généralisables.
1. Introduction aux fondements de l’apprentissage automatique et de la modélisation prédictive
1.1 Le paradigme de l’inférence statistique et prédictive
L’apprentissage automatique supervisé repose fondamentalement sur l’hypothèse qu’il existe une relation fonctionnelle déterministe ou probabiliste entre un ensemble de variables prédictives, communément appelées caractéristiques ou features, et une variable cible d’intérêt, souvent notée Y. Dans ce cadre formel, l’objectif du statisticien ou du data scientist ne consiste pas à redéfinir les règles du système physique ou économique sous-jacent, mais plutôt à approximer au mieux une fonction cible inconnue f telle que Y = f(X) + ε, où ε représente un terme d’erreur aléatoire irréductible de moyenne nulle.
Il convient d’opérer une distinction méthodologique fondamentale entre l’inférence descriptive, l’inférence explicative et la pure prédiction. L’inférence descriptive cherche à résumer et condenser l’information contenue dans un ensemble de données historiques, sans nécessairement prétendre à l’universalité temporelle. L’inférence explicative, traditionnellement valorisée en économétrie et en biostatistique, vise à identifier les liens de causalité et à quantifier avec certitude l’impact marginal d’une variable indépendante sur la variable dépendante, en s’appuyant sur des tests d’hypothèses rigoureux comme le test de Student ou le test de Fisher. En revanche, le paradigme prédictif moderne privilégie l’exactitude de la projection : peu importe la complexité interne de la fonction f̂ estimée, pourvu qu’elle fournisse une estimation précise de la cible face à un nouveau vecteur de variables d’entrée.
C’est précisément dans cette transition vers la prédiction pure que réside l’exigence critique de la capacité de généralisation. Un algorithme prédictif ne tire pas sa valeur opérationnelle de son aptitude à répéter ce qu’il a déjà observé, mais de sa performance face à des observations non observées lors de la phase d’apprentissage. Si la cartographie opérée par le modèle capture des configurations contingentes propres aux données passées au lieu d’appréhender les invariants structurels du système, la fonction approximée échouera inexorablement lorsqu’elle sera déployée dans des conditions réelles de production.
1.2 La métrique de performance : l’erreur quadratique moyenne (MSE)
Pour évaluer la qualité d’une fonction d’approximation f̂ au sein d’une tâche de régression, la communauté mathématique recourt classiquement à des fonctions de coût permettant de quantifier l’écart entre la réalité observée et la valeur prédite. Parmi ces métriques, l’erreur quadratique moyenne (couramment désignée sous l’acronyme MSE, pour Mean Squared Error) occupe une place hégémonique. Sa formulation mathématique rigoureuse sur un ensemble d’apprentissage constitué de n observations s’exprime comme suit :
MSE = (1 / n) × ∑i=1..n (yi – f̂(xi))²
D’un point de vue géométrique et statistique, l’élévation au carré des résidus (les écarts yi – f̂(xi)) induit une propriété déterminante : elle confère un poids disproportionné aux grandes erreurs de prédiction. Une déviation résiduelle de dix unités génère une pénalité de cent dans la fonction de coût, tandis qu’une déviation d’une unité ne contribue qu’à hauteur de un. Cette pénalisation non linéaire force le processus d’optimisation algorithmique à concentrer ses efforts sur la résorption des prédictions hautement déviantes.
Néanmoins, une ambiguïté fondamentale persiste entre la valeur du MSE calculée sur l’échantillon d’entraînement (notée MSEtrain) et celle calculée sur un ensemble indépendant de données de validation ou de test (notée MSEtest). L’optimisation aveugle d’une fonction de perte sur le seul corpus initial constitue un biais d’évaluation majeur. En forçant la minimisation absolue du MSE sur les observations d’entraînement, les algorithmes de gradient descendant ajustent leurs paramètres internes pour réduire à la fois le signal prédictif et les perturbations aléatoires contenues dans l’échantillon d’apprentissage, ouvrant ainsi la voie à une détérioration rapide de la métrique sur des données indépendantes.
1.3 L’illusion de la performance parfaite à l’entraînement
Dans la pratique de la modélisation statistique, l’obtention d’une erreur d’entraînement tendant vers zéro constitue rarement le signe d’un triomphe méthodologique ; il s’agit, au contraire, du symptôme clinique le plus manifeste d’une pathologie d’ajustement. Ce constat renvoie à un piège cognitif fréquent chez les développeurs débutants, qui tendent à assimiler la convergence parfaite d’une fonction de perte à une compréhension exhaustive de la réalité par le modèle mathématique.
Il existe une frontière ontologique entre la mémorisation passive des données et l’extraction de lois structurelles. Considérons un modèle doté d’un nombre excessif de degrés de liberté par rapport au volume d’observations fournies : un tel système n’a nullement besoin d’identifier des corrélations sous-jacentes plausibles pour annuler son erreur empirique. Il lui suffit d’attribuer une combinaison paramétrique unique à chaque point de données, agissant de facto comme une table de consultation (lookup table) géante. Le modèle retient que l’observation numéro quarante-deux possède la valeur cible cent quatre, sans comprendre quelles propriétés fondamentales des caractéristiques justifient cette valeur.
Les conséquences d’une telle fidélité aux singularités de l’échantillon de calibration s’avèrent catastrophiques. L’échantillon d’entraînement est inévitablement corrompu par des bruits de mesure, des imprécisions d’arrondi, des biais de sélection et des coïncidences purement aléatoires. En voulant ajuster sa courbe à la moindre aspérité de ce corpus historique, le modèle sacrifie sa robustesse structurelle. Il s’enferme dans une rigidité topologique qui le rend totalement inopérant dès lors qu’il rencontre une observation dont les coordonnées spatiales diffèrent, ne serait-ce que marginalement, des coordonnées mémorisées.
2. Définition conceptuelle et théorique du surapprentissage (Overfitting)
2.1 Caractérisation théorique du phénomène de surapprentissage
Le surapprentissage se définit formellement comme une situation pathologique d’optimisation dans laquelle l’amélioration continue de la performance d’un modèle sur les données d’entraînement s’accompagne d’une dégradation systématique de sa performance sur des données de validation indépendantes. En d’autres termes, il existe un point de rupture critique à partir duquel la corrélation positive attendue entre la réduction de la perte d’entraînement et la réduction de la perte de généralisation s’inverse de manière destructrice.
Sur le plan informationnel, le modèle commence par assimiler le signal déterministe utile contenu dans l’échantillon — c’est-à-dire la véritable fonction génératrice des données. Cependant, au fur et à mesure que la complexité de l’espace d’hypothèses croît ou que l’entraînement se prolonge de manière déraisonnable, l’algorithme se met à traiter le bruit stochastique comme s’il s’agissait d’une composante essentielle du signal. Le bruit statistique, par définition imprévisible et non reproductible d’un échantillon à un autre, est alors encodé de façon indélébile dans les coefficients ou les poids du modèle.
Cette dynamique devient particulièrement virulente au sein des architectures algorithmiques modernes sur-paramétrées, telles que les réseaux neuronaux convolutifs profonds ou les transformeurs, où le nombre de paramètres libres dépasse parfois de plusieurs ordres de grandeur le nombre d’observations disponibles. Dès lors que l’espace d’hypothèses fonctionnelles devient suffisamment vaste pour interpoler n’importe quelle configuration arbitraire de points, la frontière mathématique entre la complexité nécessaire à la capture du problème et la redondance paramétrique s’estompe, plongeant le système dans un régime de surajustement structurel.
2.2 Divergence entre risque empirique et risque réel
L’analyse théorique de l’apprentissage statistique, formalisée par Vladimir Vapnik et Alexey Chervonenkis à travers la théorie VC, fournit le cadre formel indispensable à la compréhension du surapprentissage. Dans ce cadre, on distingue le risque empirique (la perte moyenne subie sur l’échantillon d’entraînement) du risque réel (l’espérance mathématique de la perte sur l’ensemble de la distribution de probabilité conjointe sous-jacente des données).
Le paradigme standard de l’apprentissage repose sur le principe de minimisation du risque empirique (ERM, pour Empirical Risk Minimization). Puisque la véritable distribution sous-jacente P(X, Y) demeure inconnue, l’algorithme présume que la minimisation de la perte sur l’échantillon fini disponible constitue un substitut raisonnable à la minimisation du risque réel. Or, la théorie démontre que la convergence du risque empirique vers le risque réel n’est garantie que si la complexité de la classe de fonctions considérée est strictement bornée.
Lorsque cette condition de régularité est violée, il apparaît ce que les théoriciens désignent sous le terme de generalization gap ou écart de généralisation :
Δgen = | R(f̂) – Remp(f̂) |
La dimension VC d’un ensemble de fonctions mesure sa capacité à pulvériser (c’est-à-dire à séparer arbitrairement) un ensemble de points. Si la dimension VC de l’espace d’hypothèses est infinie ou excessivement élevée comparativement à la taille de l’échantillon n, les bornes de généralisation théoriques garantissant la proximité entre le risque empirique et le risque réel deviennent triviales et inopérantes. Le risque empirique peut alors s’annuler tandis que le risque réel diverge vers des valeurs infinies, matérialisant de facto la faillite prédictive totale induite par le surapprentissage.
2.3 Le surapprentissage opposé au sous-apprentissage (Underfitting)
Pour appréhender le surapprentissage dans toute sa complexité systémique, il est indispensable de le confronter à sa pathologie symétrique : le sous-apprentissage (ou underfitting). Si le surapprentissage découle d’un excès de flexibilité algorithmique, le sous-apprentissage résulte quant à lui d’une incapacité structurelle du modèle à capturer la géométrie intrinsèque des données.
Le sous-apprentissage survient typiquement lorsque la classe de fonctions sélectionnée a priori est trop restrictive pour embrasser la complexité du phénomène observé. L’exemple classique consiste à ajuster une droite de régression linéaire rigide sur une distribution de points répondant manifestement à une dynamique exponentielle ou oscillatoire sinusoïdale. Dans cette configuration, le modèle se heurte à un plafond de verre : tant sur les données d’entraînement que sur les données de test, l’erreur quadratique demeure très élevée. Le modèle ne parvient pas à extraire le signal déterministe primaire.
Cette opposition binaire structure l’ensemble de l’évaluation prédictive :
- Sous-apprentissage (Underfitting) : Caractérisé par un biais élevé et une faible variance. Le modèle commet des erreurs massives et systématiques sur le jeu d’entraînement comme sur le jeu de test, par manque de capacité expressive.
- Ajustement optimal (Sweet Spot) : Équilibre subtil où le modèle capte la véritable courbure du signal sans intégrer le bruit stochastique, assurant un niveau d’erreur faible et homogène sur tous les sous-ensembles de données.
- Surapprentissage (Overfitting) : Caractérisé par un biais extrêmement faible et une variance démesurée. Le modèle excelle de façon trompeuse sur le jeu d’entraînement mais s’avère incapable de maintenir sa cohérence prédictive sur de nouvelles observations.
3. Le compromis fondamental entre biais et variance (Bias-Variance Tradeoff)
3.1 Décomposition analytique de l’erreur quadratique attendue
Le compromis entre biais et variance représente sans doute l’un des théorèmes informels les plus universels et élégants de la théorie de l’apprentissage statistique. Il démontre rigoureusement que l’erreur quadratique moyenne de prédiction d’un modèle ne relève pas du hasard, mais résulte d’une décomposition analytique exacte en trois composantes mathématiquement distinctes.
Supposons que nous cherchions à estimer une variable cible Y = f(X) + ε, où l’espérance du bruit conditionnel est nulle (E[ε] = 0) et sa variance est constante et égale à σ². Si nous ajustons un estimateur f̂(X) sur différents ensembles d’apprentissage aléatoires indépendants issus de la même distribution globale, l’erreur quadratique attendue sur une observation arbitraire x0 se décompose formellement selon l’identité suivante :
E[(Y – f̂(x0))²] = (Biais[f̂(x0)])² + Var[f̂(x0)] + σ²
Le premier terme, le Biais au carré, correspond à l’écart entre la prédiction moyenne théorique de notre algorithme (calculée sur une infinité d’entraînements distincts) et la véritable valeur de la fonction cible f(x0) :
Biais[f̂(x0)] = E[f̂(x0)] – f(x0)
Un biais élevé indique que le modèle effectue des hypothèses simplificatrices trop rigides, passant systématiquement à côté de la structure fondamentale des données.
Le second terme, la Variance de l’estimateur, quantifie la variabilité de la prédiction du modèle autour de sa propre espérance lorsque l’on change d’échantillon d’entraînement :
Var[f̂(x0)] = E[(f̂(x0) – E[f̂(x0)])²]
Une variance élevée signifie que les paramètres estimés du modèle sont excessivement tributaires des particularismes de l’échantillon d’entraînement utilisé pour la calibration. Enfin, le troisième terme, σ², désigne le bruit irréductible. Il reflète l’entropie intrinsèque du système physique mesuré, les variables explicatives non observées et les imperfections métrologiques. Aucun modèle, quelle que soit sa sophistication algorithmique théorique, ne peut abaisser l’erreur globale en deçà de ce seuil de bruit incompressible.
3.2 Comportement dynamique de la variance en fonction de la complexité
La compréhension du comportement dynamique de la composante de variance en réponse aux modifications de la complexité structurelle du modèle permet de saisir l’essence même du surapprentissage. Dès lors qu’un algorithme acquiert une grande liberté paramétrique — qu’il s’agisse de coefficients polynomiaux d’ordre élevé, de branches arborescentes profondes ou de millions de connexions synaptiques —, son instabilité statistique augmente de manière quasi exponentielle.
Cette instabilité se traduit par une vulnérabilité extrême aux micro-variations présentes dans les corpus d’entraînement. Imaginons deux échantillons d’apprentissage de même taille, prélevés sur une même population mais différant par de légères fluctuations aléatoires. Un modèle à faible variance (comme une régression linéaire standard) ajustera deux droites presque confondues sur ces deux jeux de données distincts. À l’inverse, un modèle à haute complexité (comme un arbre de décision non élagué ou un polynôme de degré élevé) produira deux fonctions d’approximation aux géométries radicalement divergentes.
En présence d’une variance excessive, l’estimateur devient hyper-sensible aux valeurs aberrantes (outliers). Une seule observation anormale, générée par une faute de frappe ou une anomalie instrumentale, peut déformer la frontière de décision ou faire osciller violemment la surface de réponse dans l’espace multidimensionnel. La quête de l’optimum opérationnel (le sweet spot) consiste donc précisément à naviguer le long de cette frontière d’arbitrage : il faut injecter juste assez de complexité architecturale pour réduire le biais sans pour autant déclencher l’explosion de la variance paramétrique.
3.3 Visualisation graphique de la frontière de compromis
Sur le plan géométrique, l’analyse conjointe des trajectoires des courbes de perte d’entraînement et de test en fonction de la complexité algorithmique constitue la signature graphique universelle de l’apprentissage statistique. Lorsque la complexité est représentée sur l’axe des abscisses (allant des modèles les plus rigides aux architectures les plus flexibles) et l’erreur d’estimation sur l’axe des ordonnées, deux trajectoires aux dynamiques contrastées émergent immédiatement :
La courbe d’erreur d’entraînement décroît de manière monotone et continue. Plus le modèle possède de paramètres et de degrés de liberté, plus il dispose de la flexibilité nécessaire pour épouser les données fournies, jusqu’à atteindre asymptotiquement une erreur nulle lorsque la dimension du modèle égale ou dépasse le nombre d’observations à ajuster.
En revanche, la courbe d’erreur de validation ou de test adopte une trajectoire en « U » caractéristique :
- Dans la phase initiale de faible complexité, l’erreur de test est élevée, dominée par la composante de biais : le modèle est trop simpliste pour appréhender la dynamique réelle (zone de sous-apprentissage).
- Au fur et à mesure que la complexité augmente, le biais s’effondre plus rapidement que la variance n’augmente, ce qui fait chuter l’erreur de test globale jusqu’à un extremum local minimal. C’est le point d’équilibre optimal.
- Au-delà de ce point d’inflexion critique, toute augmentation supplémentaire de la complexité entraîne une croissance quadratique de la variance qui surcompense la diminution infinitésimale du biais restant. L’erreur de test s’envole de manière spectaculaire, tandis que l’erreur d’entraînement continue de plonger vers zéro. Ce décrochage net et irréversible matérialise l’entrée dans la zone franche du surapprentissage.
4. Étude de cas détaillée : Prédiction des scores académiques à l’ACT
4.1 Présentation du cadre expérimental et des variables
Afin de concrétiser ces principes mathématiques au sein d’une problématique appliquée accessible et rigoureuse, examinons une étude empirique consacrée à la prédiction des résultats académiques. L’American College Testing (ACT) constitue un test standardisé largement utilisé aux États-Unis pour évaluer l’admissibilité des élèves de l’enseignement secondaire à l’entrée à l’université. Le score global oscille traditionnellement entre un minimum de 1 et un maximum théorique de 36 points.
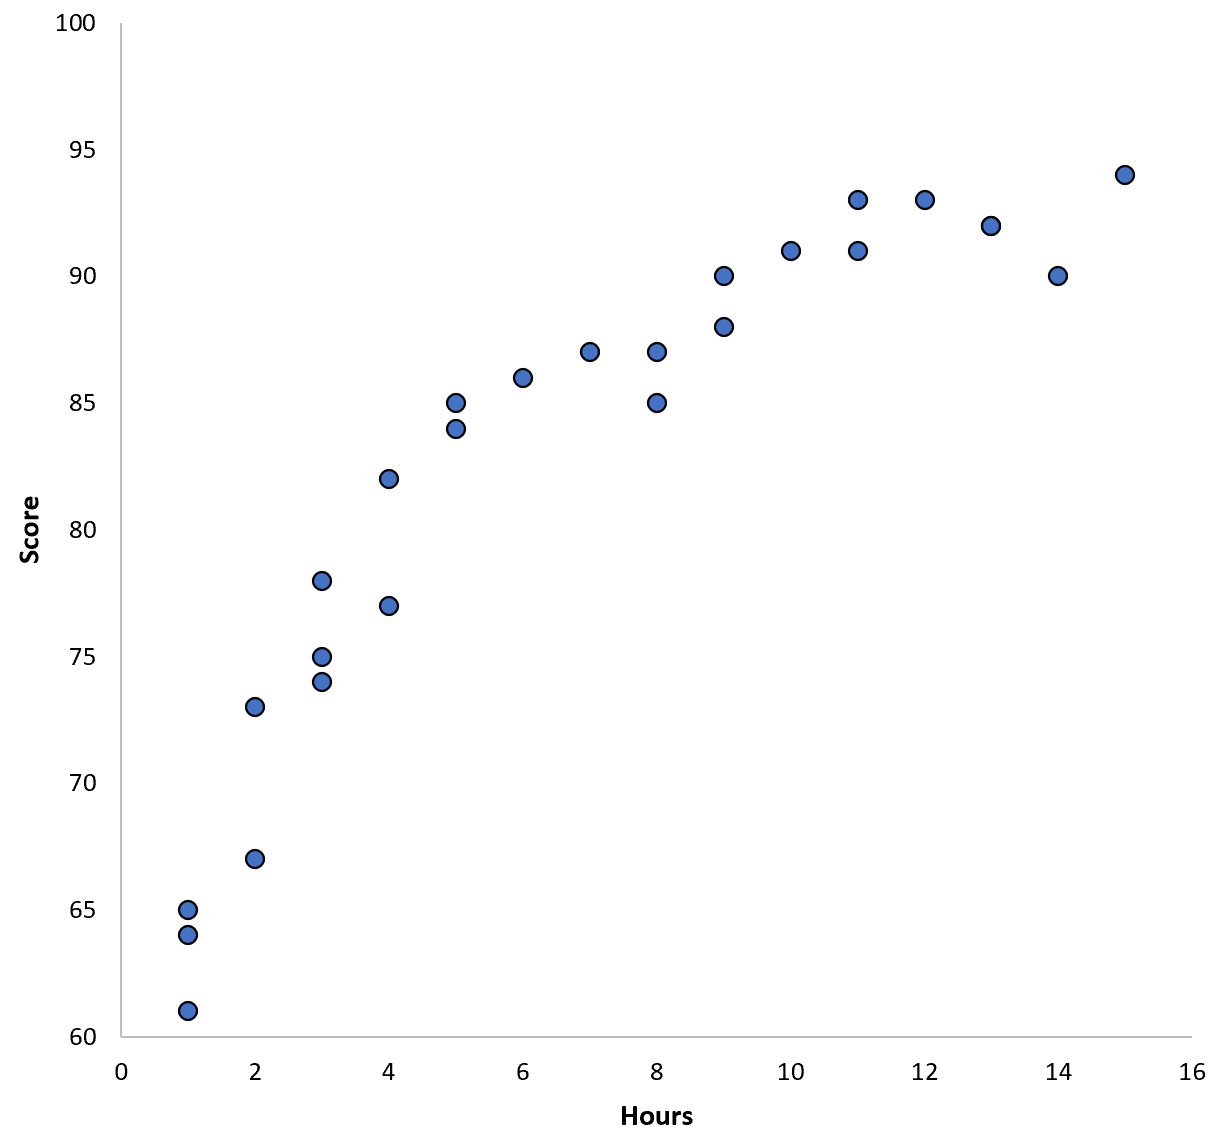
Imaginons une équipe de chercheurs en sciences de l’éducation cherchant à modéliser la relation fonctionnelle entre le volume hebdomadaire moyen d’heures consacrées à l’étude autonome (la variable prédictive X, exprimée en heures par semaine) et le score final obtenu à l’examen standardisé de l’ACT (la variable cible Y). Les chercheurs collectent un échantillon initial restreint composé de n = 15 élèves issus d’un même district scolaire public.
La réalité psychométrique de cette relation présente des caractéristiques statistiques bien identifiées. D’une part, le rendement marginal des heures d’étude est typiquement décroissant : passer de zéro à cinq heures de travail hebdomadaire produit un impact structurel majeur sur la compréhension des notions, alors que passer de quarante à quarante-cinq heures engendre un gain cognitif marginal, potentiellement altéré par l’épuisement mental. D’autre part, la distribution des données comporte une part inhérente d’hétéroscédasticité et de variabilité stochastique : des élèves à mémoire exceptionnelle peuvent obtenir d’excellents scores avec peu d’efforts, tandis que des candidats souffrant d’anxiété de performance lors des examens peuvent sous-performer en dépit d’un travail préparatoire massif.
4.2 Régression linéaire simple versus régression polynomiale de haut degré
Face à cet échantillon d’entraînement de quinze élèves, les chercheurs comparent plusieurs approches de modélisation par régression. Ils débutent leur analyse par l’ajustement d’un modèle de régression linéaire standard d’ordre 1 :
Y = β0 + β1 × X + ε
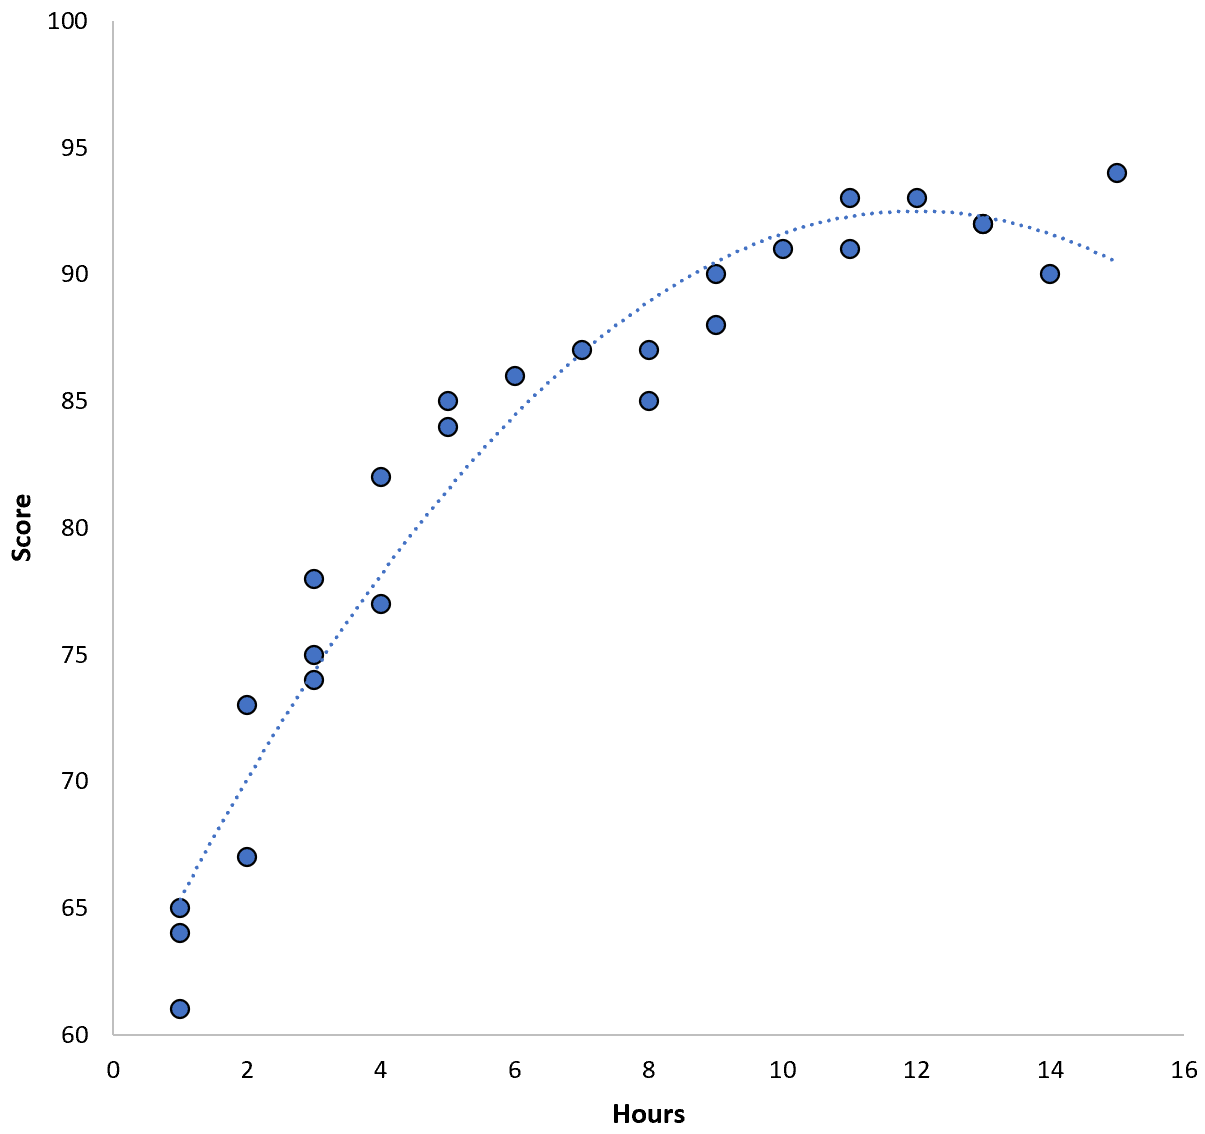
La droite obtenue capture adéquatement la tendance générale ascendante : plus un élève travaille, plus son score prédit progresse. Cependant, la rigidité de cette droite est évidente : elle ne permet pas de restituer l’effet de saturation progressive des heures d’étude aux valeurs extrêmes. L’erreur quadratique moyenne calculée sur ce jeu d’entraînement (MSEtrain) affiche une valeur modérée mais non nulle, témoignant d’un résidu de biais structurel.
Désireux d’améliorer la performance apparente de leur algorithme, les modélisateurs décident d’accroître la capacité d’ajustement en adoptant une formulation de régression polynomiale. Ils testent successivement des ordres polynomiaux croissants : degré 2, degré 5, puis degré 9, et enfin un polynôme complet de degré 14 :
Y = β0 + β1 X + β2 X² + … + β14 X¹⁴ + ε
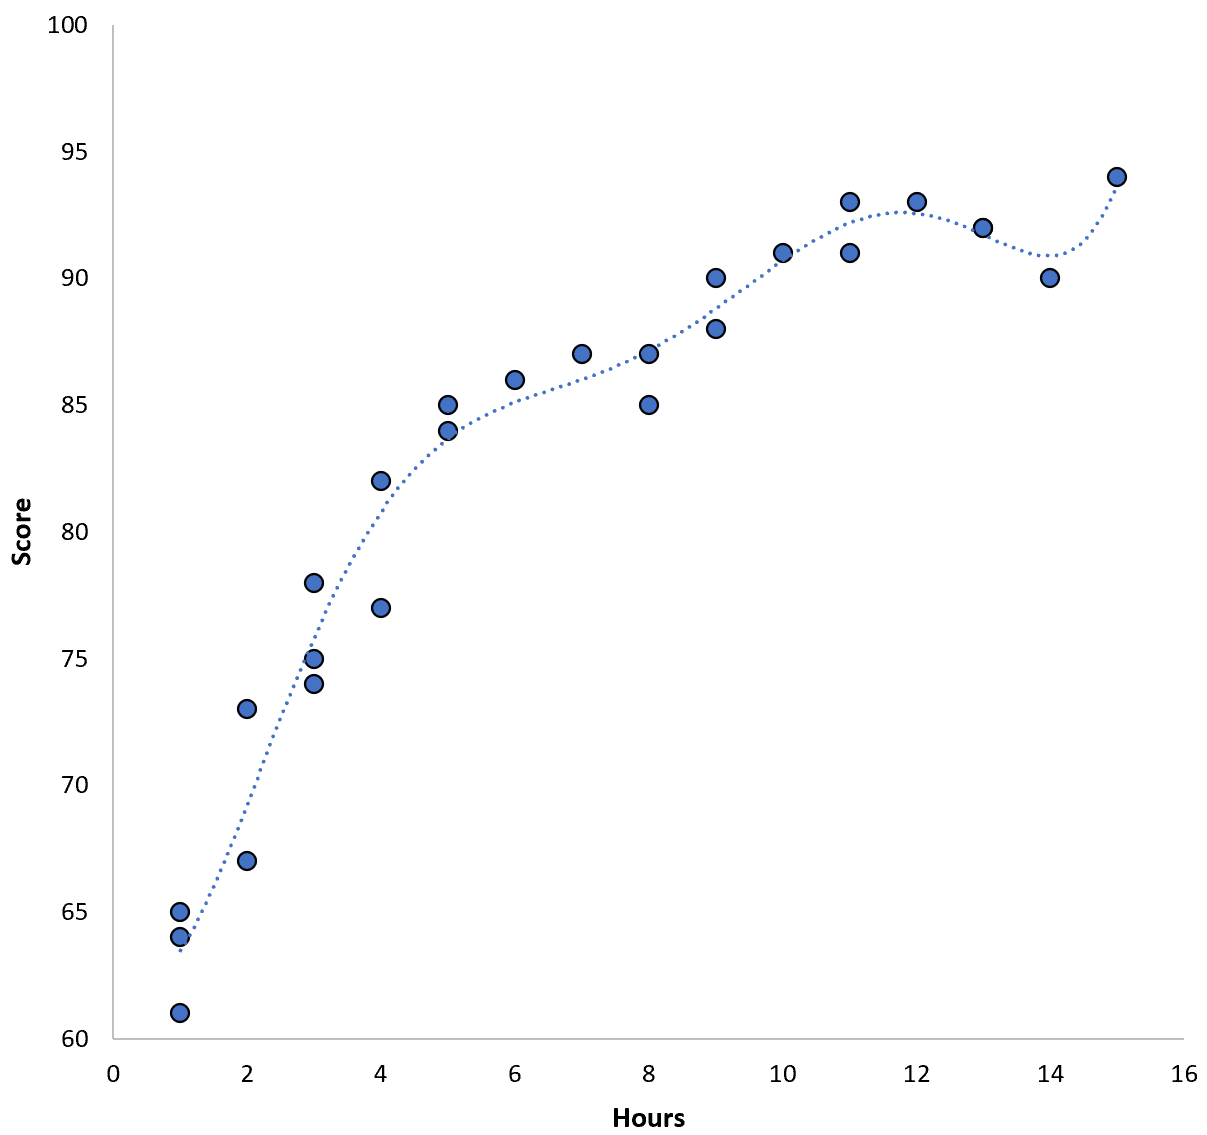
En atteignant le degré 14 pour un jeu de données comptant exactement quinze observations, le système mathématique sous-jacent dispose d’un nombre de paramètres libres strictement équivalent au nombre de contraintes indépendantes imposées par les points observés. Le théorème d’interpolation polynomiale garantit alors l’existence d’une courbe continue unique passant rigoureusement par chacun des quinze points de données sans la moindre exception. Le MSEtrain s’effondre instantanément à une valeur rigoureusement égale à zéro.
Toutefois, la visualisation graphique de cette fonction interpolante révèle une anomalie géométrique déconcertante : le phénomène de Runge. Entre les points observés, et singulièrement à proximité des extrémités de l’intervalle d’étude, la courbe polynomiale de degré 14 ne se contente pas d’osciller légèrement ; elle plonge vers des valeurs négatives absurdes (prédiant par exemple un score ACT de -18 pour un élève étudiant 3,2 heures) avant de s’élever vertigineusement à plus de 90 pour un élève étudiant 18 heures, défiant ainsi les limites physiques et réglementaires de l’examen.
4.3 Évaluation sur la cohorte de validation et faillite de la généralisation
L’illusion d’une adéquation parfaite vole irrémédiablement en éclats lorsque les chercheurs confrontent leurs deux modèles concurrents — la modeste droite linéaire de degré 1 et le complexe polynôme de degré 14 — à une cohorte de validation indépendante composée de cinquante nouveaux élèves issus d’un district voisin présentant des profils sociodémographiques analogues.
Le calcul du MSEtest produit un verdict statistique saisissant et sans équivoque :
- Pour la régression linéaire (degré 1), le MSEtest ressort à 14,8, une valeur tout à fait comparable et cohérente avec son erreur d’entraînement initiale (MSEtrain = 13,2). La droite ne modélise pas parfaitement la saturation, mais elle préserve une approximation globale robuste et raisonnablement stable.
- Pour la régression polynomiale (degré 14), le MSEtest subit une explosion cataclysmique, dépassant une valeur de 84 000. L’immense majorité des nouveaux élèves tombent précisément dans les intervalles d’oscillation sauvage induits par le phénomène de Runge. Pour ces élèves, le modèle interpolant produit des prédictions délirantes, déconnectées de toute réalité empirique.
Cette débâcle prédictive met en lumière le coût décisionnel dramatique d’une modélisation trompeuse en contexte institutionnel ou scolaire. Si un administrateur universitaire s’était fondé sur le modèle de degré 14 pour allouer des bourses d’études au mérite ou orienter des tutorats d’urgence sur la base des heures de révision déclarées, les décisions adoptées auraient été totalement erronées et profondément inéquitables, privant des élèves méritants de soutiens cruciaux en raison d’artefacts algorithmiques non maîtrisés.
5. Facteurs causaux favorisant le développement du surapprentissage
5.1 La taille restreinte et le manque de représentativité de l’échantillon
La propension fondamentale d’un modèle statistique à développer un surapprentissage dépend au premier chef de la quantité et de la qualité des données mises à sa disposition lors de sa calibration. L’un des indicateurs les plus fiables de cette vulnérabilité réside dans le ratio critique entre le nombre d’observations indépendantes (N) et le nombre de variables explicatives ou paramètres libres (P), souvent théorisé sous l’angle du problème P ≫ N.
Lorsque le volume d’échantillons est réduit, la densité de l’espace des descripteurs devient extrêmement clairsemée — un état de fait formalisé sous le terme de fléau de la dimensionnalité (curse of dimensionality). Dans un espace à plusieurs dizaines ou centaines de dimensions, des points de données réels se retrouvent isolés à des distances euclidiennes immenses les uns des autres. Dans ces zones de vide géométrique, un algorithme d’optimisation peut choisir une infinité de séparateurs ou de surfaces d’ajustement sans subir la moindre contrainte probabiliste contraignante.
De surcroît, les petits corpus souffrent presque invariablement de biais d’échantillonnage sévères. Si l’échantillon d’entraînement n’est pas rigoureusement représentatif de la variabilité globale de la population cible, le modèle calibré s’adaptera à des particularismes régionaux, démographiques ou temporels qui ne se reproduiront jamais plus à l’avenir. Dès lors que la distribution sous-jacente des données subit une non-stationnarité ou un glissement conceptuel (concept drift), l’ajustement aux coïncidences de l’échantillon initial transforme la modélisation en un système d’extrapolation purement aléatoire.
5.2 Le bruit de mesure et les valeurs aberrantes (outliers)
Le second carburant structurel du surapprentissage réside dans l’incapacité intrinsèque des algorithmes d’optimisation numérique à distinguer a priori le signal informatif pérenne du bruit stochastique parasite. Tout processus de collecte de données dans le monde réel est inévitablement entaché d’imperfections métrologiques : erreurs de calibration d’un capteur télémétrique, fautes de frappe d’un opérateur humain, imprécisions de catégorisation ou perturbations environnementales aléatoires.
Lorsqu’un modèle doté d’une grande flexibilité paramétrique traite ces observations frelatées, sa fonction de perte l’enjoint à courber sa frontière prédictive pour englober ces valeurs aberrantes (outliers). Par exemple, si dans une base de données médicale un patient de vingt ans sans pathologie cardiovasculaire est enregistré par erreur comme ayant subi un infarctus massif du myocarde, un algorithme d’arbre décisionnel profond créera une ramification dédiée, isolant ce patient particulier via des combinaisons invraisemblables de variables auxiliaires (telles que son heure d’admission et son groupe sanguin).
Ce faisant, le modèle érige une anomalie statistique sporadique en règle prédictive universelle. En assimilant ce bruit de mesure à de la causalité pure, l’algorithme perd sa robustesse géométrique globale. Il applique désormais une pénalité ou un bonus probabiliste injustifié à toute observation future présentant par coïncidence ces mêmes attributs secondaires, dégradant substantiellement sa fiabilité globale au nom d’un conformisme naïf envers ses données d’entraînement.
5.3 La complexité architecturale disproportionnée
Le troisième vecteur causal majeur du surapprentissage relève directement des choix de conception architecturale opérés par le praticien de l’intelligence artificielle. Face à une problématique prédictive donnée, le recours systématique et non justifié aux architectures algorithmiques les plus massives et expressives disponibles constitue une pratique d’ingénierie fréquemment contre-productive.
La capacité d’un modèle correspond à l’éventail de fonctions mathématiques qu’il est en mesure d’approximer sans contrainte. Qu’il s’agisse de modèles paramétriques (comme les réseaux neuronaux denses dotés de multiples couches cachées) ou non-paramétriques (comme les régressions par processus gaussiens ou les forêts d’arbres décisionnels), une capacité disproportionnée par rapport à la complexité intrinsèque de la fonction cible conduit inéluctablement au surajustement.
Ce phénomène est souvent amplifié par deux travers méthodologiques concomitants :
- La prolifération de caractéristiques corrélées ou redondantes. L’inclusion effrénée de variables prédictives non sélectionnées multiplie artificiellement la dimensionnalité de l’espace d’hypothèses, offrant au modèle d’infinies opportunités de forger des combinaisons linéaires fallacieuses pour annuler son erreur d’apprentissage.
- L’entraînement excessif dans le temps. Dans les architectures itératives optimisées par des variantes de descente de gradient stochastique, poursuivre le cycle d’apprentissage au-delà du point de convergence du signal pousse le modèle à explorer les micro-bassins d’attraction de la surface de perte. Il cesse alors d’affiner ses représentations générales pour s’adonner à une mémorisation minutieuse des résidus spécifiques au corpus d’entraînement.
6. Manifestations du surapprentissage à travers diverses familles d’algorithmes
6.1 Le surapprentissage dans les arbres de décision
Les arbres de décision non paramétriques (tels que ceux construits par les algorithmes historiques ID3, C4.5 ou CART) offrent une illustration saisissante de la dynamique géométrique du surapprentissage. Le principe opératoire de ces algorithmes repose sur une segmentation récursive de l’espace des caractéristiques en hyper-rectangles orthogonaux alignés sur les axes, dans le but d’isoler des groupes d’observations affichant la plus grande pureté possible au sens de l’impureté de Gini ou de l’entropie de Shannon.
Si aucune contrainte d’arrêt structurelle n’est imposée à l’algorithme de partitionnement, la construction récursive de l’arbre se poursuit jusqu’à ce que chaque feuille terminale ne contienne plus qu’une unique observation isolée, ou un ensemble infime d’observations rigoureusement identiques. D’un point de vue quantitatif, l’erreur de classification ou de régression sur l’échantillon d’entraînement s’annule totalement. Cependant, sur le plan topologique, la frontière de décision se morcelle en une myriade d’îlots rectangulaires microscopiques, spécifiquement façonnés pour capturer des points individuels isolés au sein de classes concurrentes.
Ce fractionnement extrême de l’espace décisionnel ruine l’interprétabilité naturelle de l’arbre et annihile sa robustesse. La moindre fluctuation marginale sur la valeur d’une coordonnée continue peut faire basculer une nouvelle observation d’un îlot à un autre, provoquant des sauts qualitatifs de prédiction erronés. Pour endiguer cette dérive, il est impératif d’imposer des bornes de régularisation structurelles, notamment en plafonnant la profondeur maximale de l’arbre (max_depth) ou en fixant un seuil plancher au nombre d’échantillons nécessaires pour autoriser une scission (min_samples_split) ou constituer une feuille terminale (min_samples_leaf).
6.2 Le surapprentissage dans les réseaux de neurones profonds
Dans l’univers de l’apprentissage profond (Deep Learning), la problématique du surapprentissage prend une dimension mathématique paradoxale qui a profondément remodelé les théories computationnelles contemporaines. Les réseaux de neurones profonds modernes comptent couramment des dizaines de millions, voire des centaines de milliards de paramètres ajustables, ce qui excède très largement la taille des corpus d’apprentissage disponibles.
Dans un article fondateur publié en 2017 sous le titre Understanding deep learning requires rethinking generalization, Zhang et ses collaborateurs ont démontré de manière empirique qu’une architecture neuronale convolutive standard (telle qu’Inception) était parfaitement capable d’atteindre une précision d’entraînement de 100 % sur un ensemble d’images dont les étiquettes de classe avaient été préalablement permutées de façon totalement aléatoire. Ce résultat spectaculaire a prouvé que la capacité expressive brute de ces réseaux profonds est suffisante pour mémoriser par cœur des millions d’associations purement bruitées et arbitraires, défiant les bornes traditionnelles de la complexité statistique de Rademacher.
Dès lors, pourquoi les réseaux de neurones profonds généralisent-ils si brillamment dans la pratique lorsqu’ils sont entraînés sur des données réelles ? Cette énigme s’explique par ce que les théoriciens appellent la régularisation implicite induite par les algorithmes d’optimisation eux-mêmes, à l’instar de la descente de gradient stochastique (SGD). L’injection de bruit d’échantillonnage lors du traitement par mini-lots oriente implicitement la trajectoire des poids vers des minima locaux larges et plats de la surface de perte, lesquels favorisent empiriquement la généralisation, au détriment des minima étroits et escarpés propices à la mémorisation pure.
6.3 Le surapprentissage dans les machines à vecteurs de support (SVM)
Les machines à vecteurs de support (Support Vector Machines ou SVM) abordent la classification via une optimisation convexe rigoureuse visant à déterminer l’hyperplan linéaire maximisant la marge géométrique entre deux classes distinctes d’observations au sein d’un espace vectoriel de grande dimension. Néanmoins, l’introduction de mécanismes de transformation non linéaire — par le biais de l’astuce du noyau (kernel trick) — et de relaxations par variables d’écart (slack variables) réintroduit le risque de surapprentissage sous des formes géométriques très singulières.
Deux hyperparamètres majeurs régissent l’équilibre entre marge et surapprentissage au sein d’une SVM à marge souple dotée d’un noyau gaussien à base de fonctions radiales (RBF) :
- Le paramètre de pénalisation C : Il arbitre le compromis entre la maximisation de la largeur de la marge séparatrice et la minimisation du nombre de violations d’entraînement. Si C est configuré à une valeur excessivement élevée, l’optimiseur applique un coût prohibitif à toute erreur de classification sur le corpus d’entraînement. Le modèle préférera contorsionner la marge pour intégrer la moindre observation isolée plutôt que d’accepter une marge élargie mais imparfaite, menant directement au surajustement.
- Le paramètre γ (gamma) du noyau RBF : Il détermine le rayon d’influence de chaque vecteur de support individuel. Lorsque le coefficient γ est trop élevé, la cloche gaussienne associée à chaque point de données devient extrêmement pointue et resserrée. La fonction de décision dégénère alors en une série d’îlots décisionnels étroits centrés exclusivement sur les observations d’entraînement. Toute observation de test tombant en dehors de ces capsules microscopiques est arbitrairement attribuée à la classe majoritaire par défaut.
7. Méthodes de détection et diagnostic empirique du surapprentissage
7.1 Analyse rigoureuse des courbes d’apprentissage (Learning Curves)
Le diagnostic empirique du surapprentissage constitue une phase incontournable du flux de travail d’ingénierie en science des données. L’outil analytique le plus puissant et direct pour révéler cette défaillance réside dans le tracé et l’interprétation méthodique des courbes d’apprentissage (learning curves). Ces graphiques visualisent l’évolution conjointe de la fonction de perte ou de la métrique de performance en fonction de deux axes distincts : le volume de données d’apprentissage d’une part, et le nombre d’itérations d’optimisation d’autre part.
Lorsque l’on trace l’erreur en fonction de la taille progressive de l’échantillon d’entraînement N, un diagnostic sans équivoque peut être posé :
Dans un régime de fonctionnement sain et robuste, à mesure que N grandit, l’erreur d’entraînement tend à progresser légèrement (car il devient plus difficile d’interpoler parfaitement un nombre accru de contraintes), tandis que l’erreur de validation s’effondre de façon continue, les deux courbes convergeant asymptotiquement vers un plateau commun proche de l’erreur Bayesienne optimale.
À l’inverse, dans un scénario de surapprentissage pathologique caractérisé par une variance dominante, un décrochage asymptotique net persiste : la courbe d’erreur d’entraînement demeure plaquée au plancher à un niveau quasi nul, alors que la courbe d’erreur de validation stagne sur un plateau d’erreur significativement plus élevé, sans jamais converger. Cette distance résiduelle inextinguible entre les deux courbes matérialise visuellement l’ampleur du fossé de généralisation. Si l’augmentation exponentielle du volume de données ne parvient pas à combler cette brèche, le diagnostic d’un espace d’hypothèses sur-dimensionné est formellement confirmé.
7.2 Surveillance des fonctions de perte au cours des époques
Dans le contexte spécifique des modèles itératifs paramétriques, tels que les réseaux de neurones ou les algorithmes de gradient boosting (comme XGBoost ou LightGBM), le surapprentissage s’observe à travers la dynamique temporelle du vecteur de paramètres au fil des époques d’entraînement (une époque représentant un passage complet de l’ensemble du corpus d’apprentissage à travers l’optimiseur).
Au début de l’entraînement, les gradients calculés sur les données d’apprentissage permettent une réduction simultanée et rapide de la fonction de perte (par exemple l’entropie croisée ou le MSE) tant sur le corpus d’entraînement que sur un ensemble de validation gelé en amont. C’est la phase d’apprentissage utile du signal. Toutefois, à partir d’un moment temporel précis appelé point de divergence, les deux dynamiques se dissocient brutalement :
- La perte d’entraînement continue de décliner tranquillement vers zéro, traduisant une minimisation purement mécanique des résidus de calibration.
- La perte de validation, quant à elle, cesse de décroître, atteint son extremum plancher, puis commence à remonter de manière graduelle ou explosive au fil des époques subséquentes.
Cette remontée de la perte de validation indique formellement que les ajustements paramétriques supplémentaires calculés par la rétropropagation du gradient ne captent plus des invariants statistiques généraux, mais modélisent des corrélations fallacieuses spécifiques au sous-ensemble d’entraînement. La surveillance en temps réel de cette dérivée temporelle de la perte de validation constitue la clé de voûte des protocoles d’arrêt précoce.
7.3 Matrices de confusion et dérive des métriques de classification
Au-delà des simples fonctions de coût globales scalaires, le surapprentissage altère de manière hétérogène et asymétrique les métriques de classification multiclasses, ce qui impose un audit attentif des matrices de confusion et des scores de probabilité calibrés.
Dans de nombreuses applications réelles caractérisées par des données asymétriques (par exemple, la détection de fraudes bancaires ou le diagnostic de maladies orphelines), un modèle surajusté manifeste fréquemment une chute sélective de ses métriques de rappel (recall) ou de précision sur les classes minoritaires hors échantillon. À l’entraînement, le modèle aura mémorisé des motifs ad-hoc pour identifier sans faille les quelques exemples positifs disponibles. Mais confronté à de nouvelles données de test, il échouera totalement à reconnaître ces mêmes profils anormaux dès lors qu’ils diffèrent marginalement des cas mémorisés.
Un autre symptôme pernicieux et moins visible réside dans la sur-confiance probabiliste. Les fonctions d’activation terminales de type Softmax tendent, dans les architectures neuronales profondes sur-paramétrées, à délivrer des distributions de probabilité d’une certitude écrasante (affichant des scores de confiance de 0,999 pour une classe donnée), même lorsque la prédiction sous-jacente est factuellement erronée. Pour traquer cette distorsion statistique, le calcul de métriques d’évaluation probabiliste comme le score de Brier ou l’analyse des diagrammes de fiabilité (calibration plots) permet de vérifier si les probabilités annoncées correspondent effectivement aux fréquences empiriques de succès observées.
8. Techniques de régularisation mathématique
8.1 Régularisation L2 (Régression Ridge / Décroissance du poids)
Pour contrecarrer mathématiquement l’explosion de la variance paramétrique sans renoncer à la flexibilité fonctionnelle du modèle, l’approche la plus formelle consiste à introduire une pénalité au sein de la fonction de perte originelle. Cette technique est connue sous le nom générique de régularisation mathématique. La première grande variante historique est la régression Ridge (ou régularisation de Tikhonov), équivalente au concept de décroissance du poids (weight decay) en apprentissage profond.
Le principe de la régularisation L2 repose sur l’ajout, à la fonction de perte standard L(θ), d’un terme proportionnel au carré de la norme euclidienne du vecteur des coefficients :
LRidge(θ) = L(θ) + λ × ∑j=1..p (θj)² = L(θ) + λ ||θ||2²
L’hyperparamètre λ ≥ 0 gouverne directement l’intensité de la pénalisation. Sur le plan de l’optimisation, cette pénalité quadratique impose un coût marginal croissant à l’ampleur des coefficients. Pour que l’algorithme consente à attribuer un coefficient important à une variable donnée, il faut que cette dernière apporte une contribution prédictive substantielle capable de compenser l’alourdissement de la pénalité L2.
L’effet géométrique fondamental de la pénalité Ridge est la contraction des poids (shrinkage) vers zéro, sans pour autant annuler rigoureusement aucun d’entre eux. Sur le plan analytique dans le cadre de la régression linéaire ordinaire, l’estimateur Ridge résout l’équation suivante :
β̂Ridge = (XTX + λI)-1 XTY
Cette formulation permet d’injecter une constante λ sur la diagonale de la matrice de covariance empirique XTX, garantissant que la matrice résultante soit toujours strictement inversible et bien conditionnée, même en présence d’une forte multicolinéarité entre prédicteurs ou lorsque le nombre de variables excède le volume d’observations.
8.2 Régularisation L1 (Régression Lasso)
La seconde grande formulation de régularisation paramétrique est la méthode Lasso (Least Absolute Shrinkage and Selection Operator), théorisée par Robert Tibshirani en 1996. Contrairement à l’approche Ridge qui utilise la norme quadratique, le Lasso pénalise la somme des valeurs absolues des coefficients d’ajustement, ce qui correspond à la norme vectorielle L1 :
LLasso(θ) = L(θ) + λ × ∑j=1..p |θj| = L(θ) + λ ||θ||1
Cette divergence mathématique en apparence minime induit des propriétés structurelles fondamentalement différentes. En vertu de la non-dérivabilité de la fonction valeur absolue au point zéro, la contrainte géométrique imposée par la norme L1 prend la forme d’un polytope convexe aux arêtes pointues (un losange dans un plan à deux dimensions, ou un hyper-octaèdre en dimension supérieure).
Lorsque les courbes de niveau ellipsoïdales de la fonction de perte des moindres carrés entrent en contact tangentiel avec l’espace de contrainte en losange du Lasso, ce point de contact se produit très fréquemment sur l’un des sommets ou le long des arêtes de la contrainte, où l’une ou plusieurs coordonnées s’annulent exactement. Par conséquent, la régularisation L1 ne se contente pas de contracter les poids : elle possède une propriété intrinsèque de sélection automatique de variables (sparsity). Le Lasso élimine purement et simplement les caractéristiques redondantes ou non informatives en fixant leurs coefficients rigoureusement à zéro, générant des modèles explicatifs épurés et hautement parcimonieux.
8.3 Régularisation combinée : L’ElasticNet
Bien que les approches Ridge et Lasso offrent des réponses théoriques élégantes aux manifestations de surapprentissage, chacune comporte des limites pratiques inhérentes. Le Lasso présente une instabilité notable lorsque l’on traite un groupe de variables prédictives fortement corrélées entre elles (par exemple, des capteurs mesurant des températures similaires en différents points d’un moteur) : il tend à sélectionner arbitrairement une seule variable du groupe et à annuler sans nuance les coefficients de toutes les autres. De plus, lorsque p > n, le Lasso ne peut sélectionner au maximum que n variables actives.
Pour surmonter ces contraintes, Zou et Hastie ont introduit en 2005 la régularisation combinée baptisée ElasticNet. L’architecture de cette méthode consiste à intégrer simultanément une pénalité L1 et une pénalité L2 au sein d’une même équation d’optimisation unifiée :
LElasticNet(θ) = L(θ) + λ1 ||θ||1 + λ2 ||θ||2²
Dans la pratique logicielle standard (notamment au sein de la bibliothèque Python scikit-learn), cette formulation est généralement reparamétrée à l’aide de deux hyperparamètres intuitifs : la force de pénalité globale α et le ratio de mélange L1 noté l1_ratio (ou ρ), oscillant rigoureusement entre 0 et 1 :
Pénalité = α [ ρ ||θ||1 + (1 – ρ) / 2 × ||θ||2² ]
Grâce à cette configuration hybride, l’ElasticNet tire parti du meilleur des deux paradigmes : la composante L1 assure la mise à zéro des variables totalement dénuées d’intérêt prédictif (sélection de variables), tandis que la courbure quadratique de la composante L2 stabilise l’inversion matricielle et permet la préservation groupée des variables fortement corrélées, offrant ainsi un rempart exceptionnel contre le surapprentissage sur des données tabulaires complexes.
9. Protocoles de partitionnement et de validation croisée
9.1 Le cloisonnement strict : entraînement, validation et test
Aucune technique algorithmique de régularisation ne saurait pallier une faille méthodologique fondamentale dans le protocole de partitionnement des données. Pour prévenir, diagnostiquer et contrer efficacement le surapprentissage, la séparation rigoureuse du corpus de données en sous-ensembles hermétiques et mutuellement exclusifs constitue un impératif déontologique absolu en apprentissage automatique.
Le standard méthodologique universel impose de scinder les données disponibles en trois partitions distinctes :
- L’ensemble d’entraînement (Training set) : Constituant traditionnellement 60 à 80 % du corpus disponible, il est exclusivement utilisé pour ajuster les paramètres libres du modèle (les poids synaptiques d’un réseau ou les coefficients d’une régression) via les algorithmes d’optimisation mathématique.
- L’ensemble de validation (Validation set) : Représentant typiquement 10 à 20 % des données, il sert de banc d’essai neutre pour arbitrer les choix d’architecture, régler les hyperparamètres (comme la valeur de λ en régularisation ou la profondeur d’un arbre) et décider de l’arrêt de l’apprentissage.
- L’ensemble de test (Test set) : Sanctuarisé de manière absolue dès le premier jour du projet, ce sous-ensemble terminal (10 à 20 %) ne doit intervenir qu’une seule et unique fois à la toute fin de la chaîne d’ingénierie, dans le but d’estimer de manière impartiale l’erreur de généralisation dans le monde réel.
L’infraction la plus grave à ce protocole est la fuite de données (data leakage). Cette distorsion survient lorsque des informations issues de l’ensemble de test ou de validation contaminent, de manière explicite ou insidieuse, la phase d’apprentissage. Un cas d’école consiste à normaliser l’ensemble des données (calcul de la moyenne et de l’écart-type) avant d’opérer la scission entre entraînement et test : le modèle bénéficie alors d’une connaissance implicite des propriétés statistiques de l’ensemble de test, conduisant à des scores de performance artificiellement élevés qui masquent un surapprentissage latent certain.
9.2 La validation croisée k-fold et ses variantes
Lorsque le volume d’échantillons total est restreint, sacrifier une fraction significative des données pour constituer un ensemble de validation figé peut s’avérer sous-optimal et introduire une forte instabilité statistique d’échantillonnage. Dans ce cas de figure, le recours au protocole de validation croisée à k blocs (k-fold cross-validation) représente la méthodologie de référence.
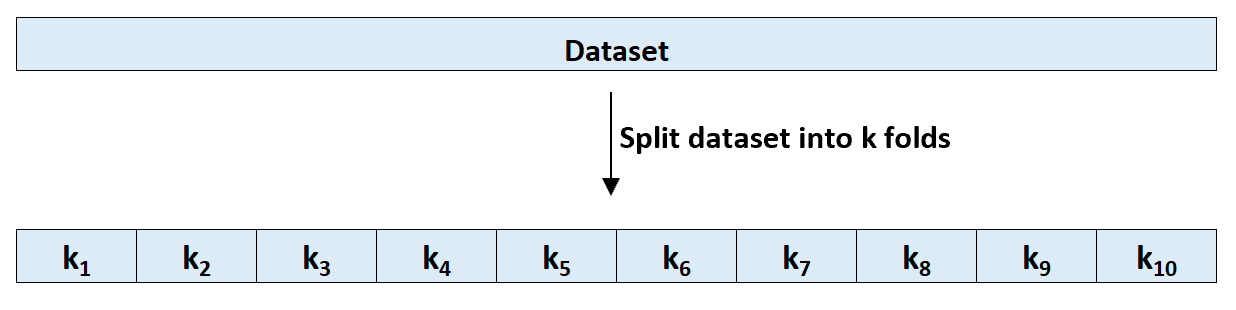
Le principe de la validation croisée k-fold consiste à partitionner pseudo-aléatoirement l’échantillon d’entraînement en k sous-ensembles de taille égale, appelés « blocs » ou « plis » (folds). L’algorithme d’apprentissage est ensuite entraîné k fois de manière itérative : lors de chaque itération i (pour i ∈ {1, …, k}), le i-ème pli est réservé comme ensemble de validation indépendant, tandis que les k – 1 plis restants sont mutualisés pour former le jeu d’apprentissage effectif.
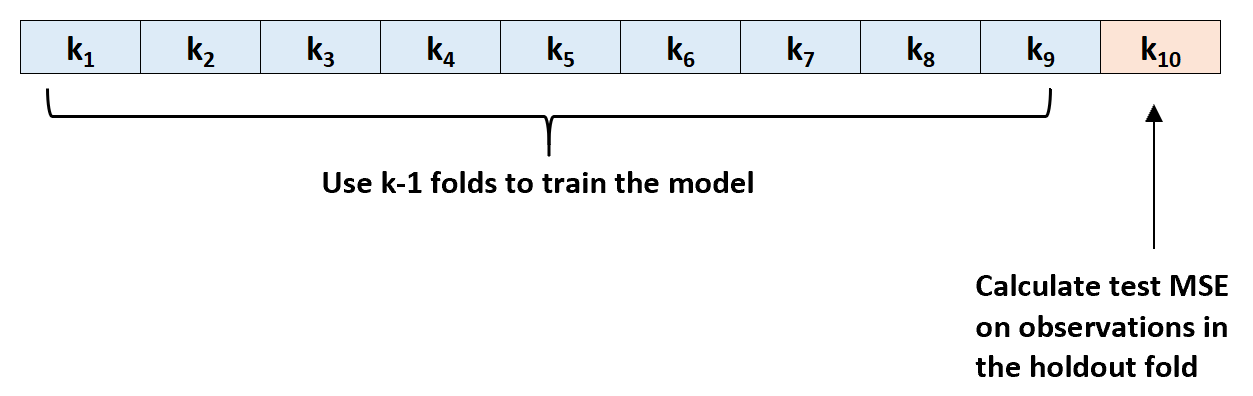
La performance finale de généralisation est calculée en effectuant la moyenne arithmétique des scores de validation enregistrés sur les k itérations. Ce mécanisme assure que chaque point de données du jeu global est utilisé exactement une fois pour l’évaluation et k – 1 fois pour l’apprentissage, maximisant ainsi l’efficience informationnelle du corpus tout en fournissant un intervalle de confiance robuste quant à la stabilité du modèle.
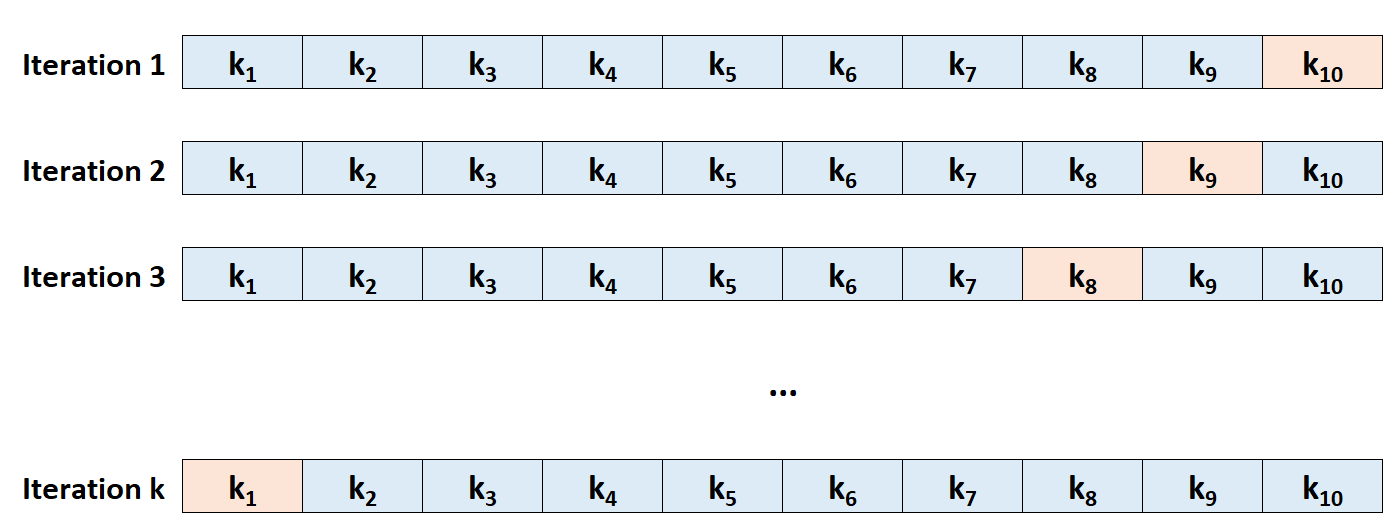
Plusieurs déclinaisons spécialisées permettent de s’adapter aux particularités des distributions sous-jacentes :
- Validation croisée stratifiée (Stratified k-fold) : Indispensable pour les problèmes de classification déséquilibrée, elle garantit que chaque pli préserve rigoureusement la proportion relative de chaque classe cible observée dans la population totale.
- Validation croisée imbriquée (Nested cross-validation) : Comportant une boucle d’optimisation interne dédiée à la sélection fine des hyperparamètres et une boucle externe réservée à l’estimation de l’erreur de généralisation, elle empêche tout surapprentissage d’hyperparamètres sur de petits ensembles de données.
- Validation temporelle par blocs glissants (Time Series Split) : Obligatoire pour les séries chronologiques dépendantes, elle interdit formellement tout mélange aléatoire rétroactif afin de respecter scrupuleusement la flèche du temps et d’éviter que le passé ne soit prédit à l’aide d’informations issues du futur.
10. Stratégies algorithmiques modernes pour prévenir le surapprentissage
10.1 L’arrêt précoce (Early Stopping)
L’arrêt précoce, couramment désigné par le terme anglophone d’early stopping, constitue sans doute l’une des stratégies de régularisation algorithmique les plus intuitives, efficientes et universellement adoptées pour les modèles entraînés par descente de gradient itérative, tels que les réseaux neuronaux profonds et les systèmes de gradient boosting.
Le principe opérationnel repose sur l’observation continue et en temps réel de la fonction de perte calculée sur un ensemble de validation indépendant tout au long des cycles itératifs d’apprentissage. Tant que la perte de validation décroît, l’algorithme poursuit sa trajectoire d’optimisation paramétrique. Dès l’instant où cette courbe atteint son point bas et commence à dériver vers le haut — signalant indubitablement que le modèle quitte la capture du signal pour s’enfermer dans l’interpolation du bruit —, le processus d’entraînement est immédiatement interrompu.
Pour immuniser ce mécanisme contre les micro-oscillations stochastiques et les plateaux temporaires inhérents aux dynamiques de gradient, les praticiens intègrent un hyperparamètre fondamental appelé patience. La patience définit le nombre d’époques consécutives tolérées au cours desquelles aucune amélioration de la perte de validation n’est observée avant de déclencher l’arrêt définitif des calculs. À la clôture de l’exécution, le système procède à la restauration automatique de l’état des poids correspondant rigoureusement à l’époque ayant produit l’erreur de validation la plus basse de tout l’historique de calcul.
10.2 La désactivation aléatoire des neurones (Dropout)
Introduite en 2014 par Nitish Srivastava et al. au sein de l’équipe de Geoffrey Hinton à l’Université de Toronto, la technique de la désactivation aléatoire ou dropout constitue l’une des innovations les plus déterminantes dans la régularisation des réseaux de neurones profonds.
Au cours de chaque passe avant (forward pass) et rétropropagation subséquente de l’entraînement, le dropout force l’inhibition stochastique temporaire d’une fraction aléatoire p de neurones (typiquement fixée entre 0,2 et 0,5) au sein des couches cachées sélectionnées. Les connexions afférentes et efférentes de ces unités sont provisoirement neutralisées, empêchant toute transmission d’activation ou de gradient pour le lot de données en cours de traitement.
L’effet théorique du dropout s’avère doublement puissant :
- Il brise les co-adaptations complexes et fragiles entre neurones adjacents. Dans un réseau profond classique, certains neurones compensent mutuellement les erreurs systématiques de leurs pairs, formant des chaînes de dépendance hyper-spécifiques aux singularités de l’échantillon d’entraînement. En désactivant continuellement les neurones de manière imprévisible, chaque nœud est contraint d’apprendre des représentations autonomes et robustes du signal d’entrée.
- Il équivaut mathématiquement à l’entraînement implicite d’un méta-ensemble géant de sous-réseaux clairsemés partageant leurs poids. Lors de la phase d’inférence ou de test, tous les neurones sont réactivés simultanément et leurs pondérations sont simplement mises à l’échelle en les multipliant par la probabilité de survie (1 – p), réalisant ainsi une approximation probabiliste remarquablement efficace d’un vote d’ensemble.
10.3 L’augmentation synthétique de données (Data Augmentation)
Puisque la taille limitée et le manque de diversité des corpus d’apprentissage constituent l’un des premiers vecteurs causaux du surapprentissage, une réponse d’ingénierie directe consiste à amplifier artificiellement la volumétrie des données d’entraînement : c’est le paradigme de l’augmentation synthétique de données (data augmentation).
Cette approche est particulièrement intuitive et productive dans le domaine du traitement d’images et de la vision par ordinateur. À partir d’un ensemble restreint de clichés authentiques, il est aisé de générer des centaines de variantes synthétiques photoréalistes en appliquant des transformations géométriques et photométriques qui préservent scrupuleusement l’invariance sémantique de la cible : rotations légères, translations spatiales, recadrages aléatoires, inversions horizontales (horizontal flips), altérations de contraste, et injections de bruit gaussien aléatoire.
Dans le domaine des données tabulaires et du traitement automatique du langage naturel (NLP), l’augmentation synthétique s’effectue par des techniques telles que la rétro-traduction (back-translation), le masquage contextuel de mots via des modèles de langage de type BERT, ou l’algorithme SMOTE pour synthétiser par interpolation des observations au sein de classes minoritaires. En exposant continuellement l’algorithme à des variations combinatoires infinies du corpus d’apprentissage, l’augmentation synthétique interdit la mémorisation exacte des pixels ou des coordonnées, forçant le modèle à extraire des descripteurs universels véritablement robustes.
10.4 Les méthodes d’ensemble : Bagging et Forêts Aléatoires
L’ingénierie algorithmique contemporaine offre un remède mathématique élégant contre le surapprentissage par le biais des méthodes d’ensemble, et tout particulièrement de la famille du Bagging (acronyme de Bootstrap Aggregating), magnifiquement incarnée par les Forêts Aléatoires (Random Forests) conceptualisées par Leo Breiman en 2001.
Le fondement théorique du Bagging repose sur la loi statistique stipulant que la moyenne d’un ensemble de variables aléatoires indépendantes possède une variance strictement inférieure à celle de chacun de ses membres constitutifs, tout en préservant rigoureusement leur espérance mathématique (leur biais). Ainsi, si nous disposons de B estimateurs indépendants affichant chacun une variance σ², la variance de leur prédiction agrégée moyenne tombe à σ² / B.
Pour concrétiser cette réduction théorique de la variance en pratique :
- L’algorithme génère de multiples sous-échantillons d’apprentissage distincts par tirage aléatoire avec remise (bootstrap sampling) au sein du corpus initial.
- Sur chaque réplique bootstrap, un arbre de décision profond et très instable (présentant un fort surapprentissage individuel, un biais très faible et une variance élevée) est entraîné de manière totalement indépendante.
- Les Forêts Aléatoires introduisent une dé-corrélation supplémentaire cruciale : lors de chaque scission de nœud, l’arbre n’est autorisé à considérer qu’un sous-ensemble restreint et tiré au sort de variables explicatives candidates (typiquement √P pour la classification). Cette contrainte empêche une variable dominante d’uniformiser la structure de tous les arbres de la forêt.
L’agrégation finale des prédictions individuelles — par vote majoritaire pour la classification ou par moyenne arithmétique pour la régression — élimine de façon mécanique les fluctuations erratiques propres aux arbres individuels. La variance globale s’effondre sans que le faible biais ne soit altéré, conférant aux Forêts Aléatoires une immunité naturelle remarquable face au surapprentissage comparativement aux arbres de décision isolés.
11. Parallèle épistémologique et cognitif : Le surapprentissage dans la pensée humaine
11.1 Le sur-ajustement des modèles mentaux aux expériences vécues
Loin d’être l’apanage exclusif des systèmes informatiques et des architectures numériques, le phénomène de surapprentissage offre une grille de lecture saisissante pour analyser les dysfonctionnements et les rigidités de la cognition humaine. L’esprit humain opère, lui aussi, comme une machine prédictive cherchant continuellement à concevoir des modèles internes du monde afin d’anticiper les périls environnementaux et d’orienter les prises de décision futures.
Toutefois, la psychologie cognitive contemporaine démontre que nos systèmes neuronaux biologiques sont particulièrement enclins à sur-ajuster leurs modèles mentaux sous l’impact d’expériences vécues singulières, particulièrement lorsque celles-ci présentent une forte charge émotionnelle ou traumatique. Un individu ayant été victime d’un accident lors d’un vol commercial ou d’une morsure de chien durant son enfance aura une propension psychologique intense à forger une règle cognitive universelle et péremptoire : « tous les avions sont dangereux » ou « tous les chiens sont agressifs ».
Sur le plan statistique, cette généralisation abusive correspond précisément à une allocation de variance démesurée à un échantillon unique composé d’un seul point de données (N = 1). Le cerveau humain, sous l’effet du biais d’ancrage et de l’hyper-réactivité de l’amygdale, traite cette anomalie environnementale locale comme une loi physique générale, sacrifiant toute rationalité probabiliste globale au profit d’un réflexe de mémorisation protecteur mais profondément inadapté à la réalité statistique moyenne.
11.2 L’apophénie et le biais de confirmation sous l’angle du Machine Learning
Dans cette perspective interdisciplinaire, deux travers majeurs de la pensée humaine s’éclairent d’un jour nouveau lorsqu’on les modélise à travers le prisme de l’apprentissage automatique : l’apophénie et le biais de confirmation.
L’apophénie désigne la disposition psychologique universelle qui consiste à percevoir des motifs signifiants, des connexions causales ou des visages anthropomorphes au sein de configurations perceptuelles totalement fortuites ou d’un signal purement aléatoire (comme déceler des prédictions boursières dans des alignements de chiffres ou voir des animaux dans les nuages). En termes d’apprentissage machine, l’apophénie n’est rien d’autre que l’encodage du bruit blanc stochastique sous forme de prédicteurs déterministes au sein d’un système cognitif doté d’une capacité d’hypothèses trop vaste et insuffisamment régularisée.
Le biais de confirmation, pour sa part, agit comme un terme de régularisation excessivement asymétrique et biaisé vers une fonction d’évaluation préexistante. Lorsqu’un être humain soutient une hypothèse idéologique ou politique, son cerveau filtre activement les flux d’informations entrants : il élimine impitoyablement les faits contradictoires (considérés à tort comme du bruit non pertinent) tout en sur-pondérant les rares données qui corroborent sa conviction initiale. Face à une surabondance informationnelle contemporaine non hiérarchisée, l’esprit humain surapprend de façon spectaculaire en construisant des systèmes de croyances hermétiques et totalement imperméables aux nouvelles observations de validation du monde réel.
11.3 La simplification heuristique comme mécanisme de survie adaptatif
Pour survivre au sein d’un environnement naturel hostile et caractérisé par des ressources énergétiques et temporelles rigoureusement limitées, l’évolution biologique n’a pas sélectionné un système cognitif cherchant à optimiser le risque empirique jusqu’au centième de décimale. Au contraire, le cerveau de l’Homo sapiens a privilégié le recours systématique aux heuristiques de jugement : des raccourcis cognitifs délibérément simplificateurs.
Cette réalité biologique fait écho direct au vénérable principe philosophique du rasoir d’Ockham : parmi plusieurs hypothèses concurrentes capables d’expliquer un même phénomène, la formulation la plus épurée et parcimonieuse est presque toujours la plus judicieuse et la plus robuste. Dans l’écologie cognitive d’un hominidé confronté au bruissement suspect d’un buisson dans la savane, adopter l’hypothèse simpliste et hautement biaisée de la présence imminente d’un fauve dangereux constitue une stratégie de survie infiniment supérieure à l’analyse minutieuse et exhaustive de toutes les variables physiques et météorologiques en jeu.
En acceptant délibérément une certaine dose de biais heuristique, l’intelligence naturelle parvient à limiter drastiquement sa propre variance cognitive, prévenant ainsi la paralysie décisionnelle face à l’inconnu. Ce grand enseignement de la cognition évolutive rappelle avec force aux concepteurs d’algorithmes artificiels que la perfection apparente de l’ajustement aux données passées est bien souvent l’ennemie jurée de l’adaptabilité, de la robustesse opérationnelle et de la véritable intelligence face à l’inattendu.
12. Guide méthodologique et bonnes pratiques pour concevoir des modèles robustes
12.1 Protocole systématique de conception de modèles
L’immunisation d’un projet d’apprentissage automatique contre le surapprentissage ne s’improvise pas à l’issue de la modélisation ; elle exige l’application d’un protocole méthodologique systématique et incrémental dès l’initialisation de la démarche d’ingénierie logicielle et statistique.
La règle cardinale de tout scientifique des données rigoureux consiste à débuter systématiquement par la conception et l’évaluation d’un modèle de référence naïf (baseline model). Ce modèle initial doit être le plus transparent et le plus simple possible : une simple moyenne constante pour la régression, un classifieur aléatoire stratifié pour la classification, ou au maximum une régression logistique standard sans ingénierie de variables complexe. Cette baseline définit le plancher absolu de performance qu’aucune architecture ultérieure ne pourra revendiquer sans démontrer une plus-value statistique tangible.
Dans un second temps, l’accroissement de la complexité architecturale ne doit être autorisé qu’au compte-gouttes, en fournissant à chaque étape une justification empirique rigoureuse basée sur l’évolution de la perte de validation croisée. Chaque paramètre supplémentaire, chaque couche neuronale additionnelle et chaque transformation non linéaire doit prouver formellement sa capacité à faire reculer le risque réel sans creuser le fossé de généralisation. Tout projet sérieux doit documenter méthodiquement, via des tableaux de suivi standardisés (à l’aide d’outils comme MLflow ou Weights & Biases), la trajectoire conjointe des métriques de validation et de test afin de détecter immédiatement l’émergence du premier point d’inflexion.
12.2 Sélection et ingénierie rigoureuse des caractéristiques
L’ingénierie et la sélection des caractéristiques (feature engineering & selection) représentent la ligne de défense préventive la plus efficace pour préserver les modèles de la malédiction de la grande dimensionnalité et de l’absorption du bruit métrologique.
Le nettoyage de l’espace d’hypothèses doit obéir à un ensemble de filtres séquentiels rigoureux :
- L’élimination immédiate des variables affichant une variance quasi nulle ou une proportion rédhibitoire de valeurs manquantes non informatives, lesquelles n’apportent aucun pouvoir séparateur réel mais complexifient inutilement les calculs.
- Le filtrage impitoyable de la multicolinéarité par l’analyse des matrices de corrélation de Pearson ou de Spearman et le calcul du facteur d’inflation de la variance (VIF). Si deux prédicteurs présentent une corrélation supérieure à 0,85 ou 0,90, l’un d’eux doit être impérativement retiré ou fusionné avec l’autre via une opération de réduction synthétique.
- L’application raisonnée de techniques de réduction de dimensionnalité non supervisées, telles que l’Analyse en Composantes Principales (ACP) ou des techniques non linéaires comme UMAP, permettant de projeter l’espace des données dans un sous-espace orthogonal de dimension très réduite concentrant l’immense majorité de l’information utile.
- La primauté incontournable accordée à l’expertise métier dans la sélection initiale des variables candidates. Aucun algorithme automatique de filtrage ne remplacera jamais le discernement d’un médecin, d’un géologue ou d’un actuaire pour attester de la plausibilité causale fondamentale d’un prédicteur avant d’autoriser un modèle mathématique à s’en emparer.
12.3 Check-list opérationnelle de validation avant déploiement
Avant d’autoriser le déploiement d’un modèle algorithmique au sein d’une infrastructure décisionnelle en production, il est impératif de soumettre le système candidat à une validation de robustesse finale formalisée par une check-list opérationnelle stricte :
Premièrement, procéder à un audit de sanctuarisation temporelle et spatiale : certifier de façon irréfutable qu’aucune fuite d’information (data leakage) n’a eu lieu au cours du pipeline de prétraitement (imputation des valeurs manquantes, encodage des étiquettes, normalisation) et que l’ensemble de test a été strictement isolé jusqu’à cette étape d’évaluation terminale.
Deuxièmement, exécuter des stress-tests de robustesse par injection de bruit artificiel. En altérant légèrement les données de test avec du bruit blanc gaussien ou en introduisant des variations contrôlées sur les variables d’entrée les plus influentes, on évalue la sensibilité différentielle du modèle : une variation infinitésimale d’une variable continue ne doit en aucun cas induire un basculement cataclysmique de la prédiction finale.
Troisièmement, déployer un système de monitoring continu de la dérive des données (data drift & concept drift) en production. Même le modèle le mieux régularisé finira par développer des symptômes assimilables au surapprentissage si la réalité du monde réel évolue tandis que ses paramètres internes demeurent figés. L’implémentation de tests d’hypothèse d’homogénéité distributionnelle (tels que le test de Kolmogorov-Smirnov ou la divergence de Kullback-Leibler) sur les flux de requêtes opérationnels garantit que toute distorsion entre les données de production et les corpus d’entraînement initiaux sera immédiatement repérée, déclenchant ainsi un réentraînement préventif contrôlé avant que les conséquences de l’obsolescence ne se matérialisent.
Références
Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. https://www.microsoft.com/en-us/research/publication/pattern-recognition-and-machine-learning/
Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5-32. https://doi.org/10.1023/A:1010933404324
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., & Salakhutdinov, R. (2014). Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(56), 1929-1958. https://jmlr.org/papers/v15/srivastava14a.html
Tibshirani, R. (1996). Regression shrinkage and selection via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
Vapnik, V. N. (1998). Statistical Learning Theory. Wiley-Interscience.
Zhang, C., Bengio, S., Hardt, M., Recht, B., & Vinyals, O. (2017). Understanding deep learning requires rethinking generalization. International Conference on Learning Representations (ICLR). https://arxiv.org/abs/1611.03530
Zou, H., & Hastie, T. (2005). Regularization and variable selection via the Elastic Net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301-320. https://doi.org/10.1111/j.1467-9868.2005.00503.x