
Dans le champ de l’apprentissage automatique et de la science des données contemporaine, l’estimation rigoureuse de la performance prédictive constitue la pierre angulaire de toute démarche scientifique crédible. L’édification d’un modèle statistique ne saurait se résumer à la seule minimisation d’une fonction de coût sur un échantillon d’observations ; elle exige d’apporter la preuve formelle que les régularités apprises possèdent une portée universelle au sein de la distribution sous-jacente des données. Pourtant, une confusion épistémologique et méthodologique pernicieuse persiste tant dans les cercles académiques que dans les applications industrielles : l’assimilation erronée, ou l’usage interchangeable, des notions d’ensemble de validation et d’ensemble de test.
Cette imprécision conceptuelle ne représente pas une simple querelle sémantique réservée aux théoriciens de l’optimisation. Elle induit des biais d’optimisme majeurs, fausse l’estimation de l’erreur de généralisation et engendre, lors du déploiement en conditions réelles, des défaillances systémiques aux répercussions économiques, techniques et sociétales considérables. Si l’ensemble d’entraînement matérialise le substrat empirique sur lequel s’ajustent les poids synaptiques ou les coefficients structurels d’un algorithme, l’arbitrage entre les ensembles de validation et de test détermine la frontière exacte entre l’ingénierie itérative du modèle et son audit terminal impartial.
L’objectif de cet article est de disséquer de manière exhaustive la dynamique opérationnelle, statistique et méthodologique qui régit le partitionnement des données. En explorant les fondements du compromis biais-variance, les mécanismes insidieux de fuite d’information (data leakage), les protocoles avancés de rééchantillonnage et les singularités imposées par les structures non indépendantes, nous établirons les démarcations formelles indispensables à la conduite d’expérimentations reproductibles, robustes et conformes aux standards les plus stricts de la modélisation prédictive.
1. Introduction aux partitions de données en apprentissage automatique
1.1 Le triptyque fondamental : entraînement, validation et test
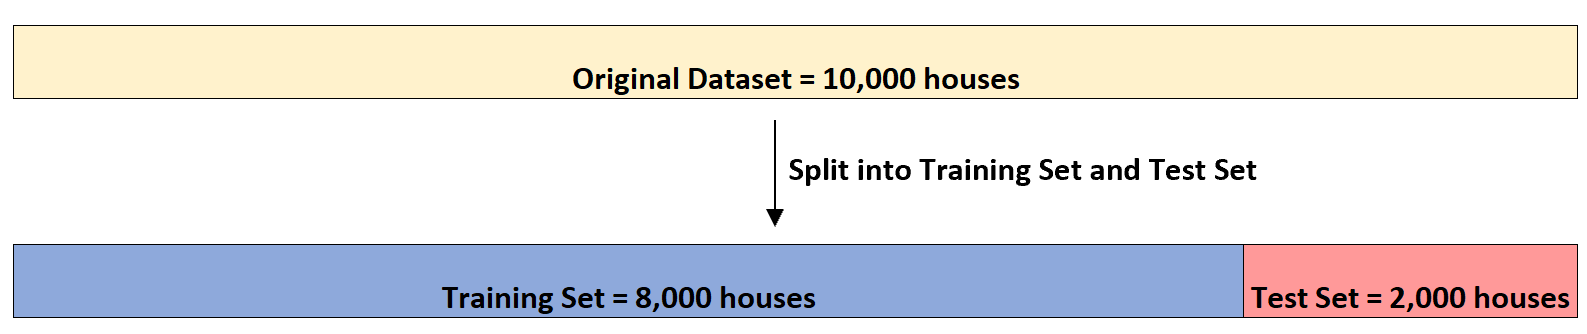
La théorie de l’apprentissage statistique, formalisée notamment dans le cadre de la théorie de Vapnik-Chervonenkis et de l’apprentissage probablement approximativement correct (Probably Approximately Correct ou PAC Learning), postule qu’un algorithme ne peut attester de sa capacité inductive à partir des seules données ayant servi à contraindre ses paramètres libres. Pour contourner l’écueil tautologique de l’auto-évaluation, la pratique fondamentale exige la décomposition stricte du corpus d’observations disponible en trois sous-ensembles fonctionnels mutuellement exclusifs : l’ensemble d’entraînement (training set), l’ensemble de validation (validation set) et l’ensemble de test (test set).
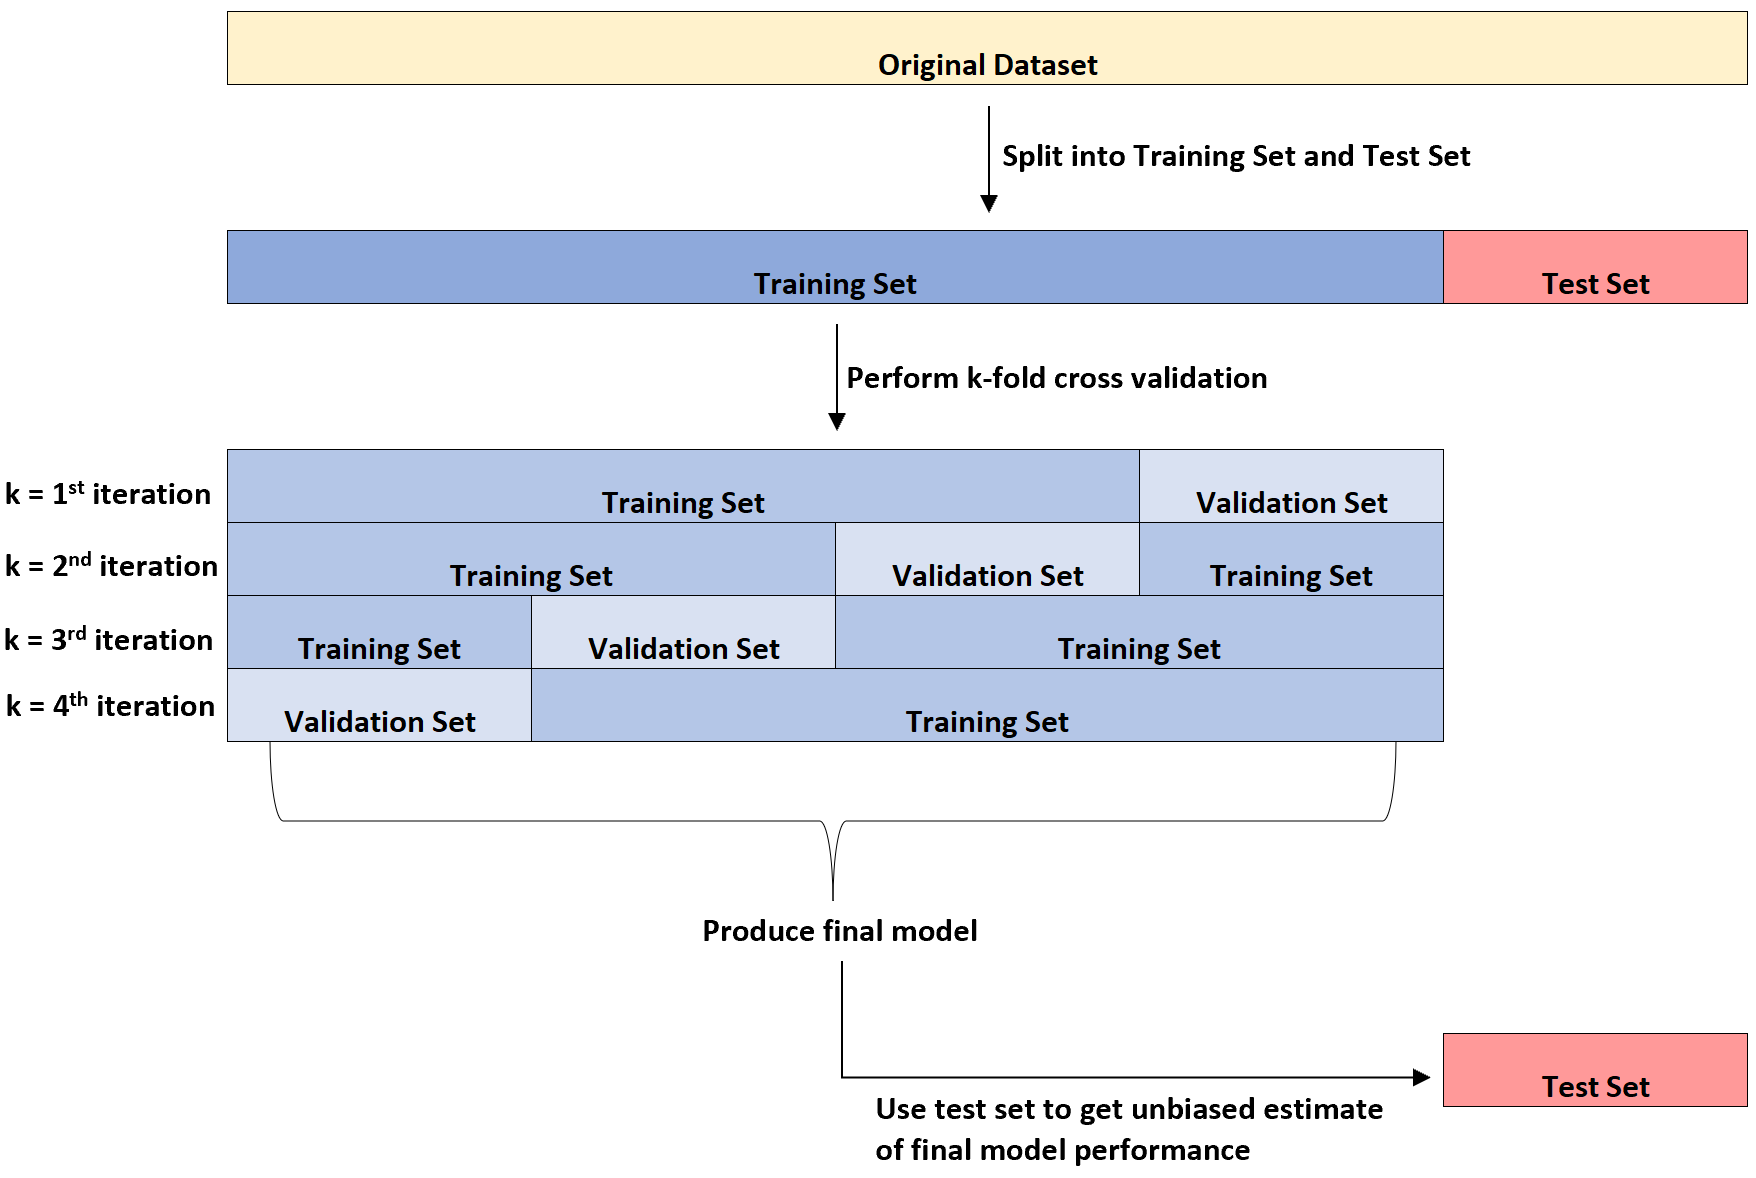
L’ensemble d’entraînement constitue le laboratoire d’apprentissage au sein duquel l’optimiseur numérique minimise la perte empirique. L’ensemble de validation intervient comme un arbitre intermédiaire, guidant l’expérimentateur dans les choix méta-architecturaux : sélection des algorithmes compétiteurs, réglage fin des hyperparamètres, et mise en œuvre de contre-mesures face au surajustement. Enfin, l’ensemble de test représente la cour de cassation statistique : totalement hermétique au processus de modélisation, il est sollicité une unique fois pour délivrer une mesure non biaisée du risque réel.
La rupture d’étanchéité entre ces compartiments vicie irrémédiablement la démarche scientifique. Dès lors qu’un échantillon dédié à l’évaluation finale participe, directement ou par capillarité statistique, à la trajectoire d’optimisation, les métriques obtenues perdent leur validité asymptotique, transformant une inférence prédictive en une mémorisation sophistiquée.
1.2 Les enjeux méthodologiques du partitionnement des données
Le partitionnement d’un ensemble de données ne se réduit pas à une simple segmentation arithmétique de lignes matricielles. Il soulève des problématiques méthodologiques aiguës quant à la préservation des propriétés distributionnelles du phénomène étudié. La première exigence réside dans la représentativité statistique : chaque sous-ensemble doit refléter fidèlement l’hétérogénéité, la dispersion, la structure de covariance et les déséquilibres éventuels de la variable cible inhérents à la population mère.
Une mauvaise stratégie de scission peut introduire une dérive distributionnelle artificielle (covariate shift induit), où la partition d’évaluation présente des caractéristiques marginales divergentes de la partition d’entraînement, faussant dramatiquement le comportement du modèle. Par ailleurs, la gestion des dépendances latentes constitue un défi critique. Si des observations corrélées — telles que des mesures répétées sur un même patient ou des séries spatialement contiguës — sont réparties indistinctement de part et d’autre d’une frontière de partition, une fuite informationnelle substantielle se produit.
Enfin, le choix des proportions allouées à chaque bloc opérationnel conditionne directement l’arbitrage entre l’erreur empirique et l’erreur structurelle. Réduire excessivement l’ensemble d’entraînement pénalise l’estimation des paramètres complexes en amplifiant le biais d’estimation, tandis que comprimer démesurément l’ensemble de test dégrade la puissance statistique des tests de comparaison d’hypothèses, augmentant dramatiquement la variance d’estimation de l’erreur généralisée.
1.3 La confusion récurrente entre validation et test
Dans la littérature appliquée et la pratique industrielle, une ambiguïté linguistique tenace conduit fréquemment les praticiens à employer indifféremment les termes « validation » et « test ». Cette interchangeabilité erronée puise son origine dans les architectures logicielles historiques qui ne proposaient qu’une dichotomie binaire : apprentissage et test. Dans ce schéma obsolète, le jeu de test était fréquemment réquisitionné pour sélectionner la complexité polynomiale ou ajuster le coefficient de pénalisation L2 (Tikhonov), annihilant ainsi sa nature d’évaluateur neutre.
Sur le plan épistémologique, confondre ces deux entités revient à confondre l’optimisation itérative avec l’évaluation terminale impartiale. Lorsqu’un jeu de données guide le moindre choix de configuration — qu’il s’agisse de l’élagage d’un arbre de décision, de la profondeur d’un réseau convolutif ou du seuil de discrimination bayésien —, il subit une contamination informationnelle. Les décisions de l’analyste deviennent corrélées aux fluctuations stochastiques propres à cet échantillon précis.
Distinguer explicitement la validation du test permet de restaurer la rigueur de la méthode hypothético-déductive en intelligence artificielle. L’ensemble de validation appartient au domaine du développement exploratoire et de l’ingénierie des modèles ; l’ensemble de test relève exclusivement du protocole de vérification externe, garantissant que les inférences tirées ne sont pas des mirages statistiques induits par la multiplicité des tests d’hypothèses.
2. L’ensemble d’entraînement : fondation de l’apprentissage des paramètres
2.1 Rôle et mécanisme d’ajustement des paramètres internes
L’ensemble d’entraînement, souvent désigné sous l’anglicisme training set, constitue le corpus empirique exclusif à partir duquel l’algorithme déduit ses structures internes. Dans un cadre formel, soit un espace d’entrée $\mathcal{X}$ et un espace de sortie $\mathcal{Y}$, le jeu d’entraînement est constitué d’un échantillon $\mathcal{S}_{train} = {(x_i, y_i)}_{i=1}^{n}$ tiré de manière indépendante et identiquement distribuée (i.i.d.) selon une loi conjointe inconnue $P(X, Y)$. La vocation de l’ensemble d’entraînement est de permettre la résolution numérique du principe de minimisation du risque empirique (Empirical Risk Minimization ou ERM).
Au cours de cette phase, le modèle ajuste ce que la statistique désigne comme les paramètres internes : les matrices de poids et les biais dans les réseaux neuronaux profonds, les coefficients directeurs dans les régressions linéaires ou logistiques, ou encore les seuils de coupure optimaux aux nœuds des forêts aléatoires. Ce processus d’apprentissage repose sur des algorithmes d’optimisation mathématique continue ou combinatoire, tels que la descente de gradient stochastique (SGD), l’optimiseur Adam ou l’algorithme glouton CART.
La convergence de ces optimiseurs dépend directement du volume, de la variété et de la qualité de cet ensemble initial. L’algorithme y calcule le gradient de la fonction de perte locale par rapport aux paramètres modélisables afin de mettre à jour pas à pas l’état interne du système. Ce sous-ensemble absorbe la quasi-totalité de l’effort computationnel du cycle de vie du modèle, servant de substrat mathématique à la formation des représentations sémantiques ou géométriques de la tâche à accomplir.
2.2 Le risque intrinsèque de surapprentissage (overfitting)
L’optimisation des paramètres internes sur l’ensemble d’entraînement comporte une vulnérabilité mathématique inhérente : le surapprentissage ou overfitting. En vertu du théorème de non-existence de repas gratuit (No Free Lunch Theorem), un modèle doté d’une capacité paramétrique suffisante peut minimiser sa perte empirique jusqu’à zéro en mémorisant point par point les observations de l’ensemble d’apprentissage, sans pour autant extraire la moindre loi sous-jacente transposable.
Ce phénomène se produit lorsque l’algorithme modélise non seulement la fonction de régression sous-jacente $f(x) = \mathbb{E}[Y|X=x]$, mais incorpore également le bruit aléatoire irréductible $\epsilon_i$ propre à l’échantillon $\mathcal{S}_{train}$. Il en résulte une distorsion géométrique de la frontière de décision, caractérisée par une complexité excessive et des oscillations de haute fréquence. L’écart entre la perte d’entraînement, artificiellement basse, et la perte sur toute distribution non observée se creuse alors de façon exponentielle.
Le paradoxe fondamental réside dans le fait que l’ensemble d’entraînement est intrinsèquement aveugle à son propre égarement. Plus l’algorithme s’adapte aux idiosyncrasies de l’échantillon d’apprentissage, plus la métrique de perte calculée sur ce même échantillon s’améliore. Cette dynamique circulaire interdit toute auto-évaluation de la robustesse : un modèle sur-ajusté affichera sur ses données d’entraînement une confiance absolue et des indices de corrélation parfaits, tout en se révélant intégralement dysfonctionnel face au monde réel.
2.3 Limites de l’évaluation exclusive sur les données d’entraînement
L’évaluation des performances d’un système prédictif restreinte à son seul ensemble d’entraînement induit un biais d’optimisme statistique majeur, qualifié dans la littérature de biais de resubstitution. Ce biais découle de l’utilisation conjointe des mêmes données pour concevoir la règle de décision et pour quantifier son efficacité. La théorie statistique démontre que l’erreur apparente sous-estime structurellement l’erreur réelle de prédiction d’une quantité proportionnelle au rapport entre la dimension de Vapnik-Chervonenkis du modèle et la taille de l’échantillon.
Cette carence méthodologique prive l’analyste de tout renseignement quantitatif sur la capacité d’extrapolation de son architecture. Dans les espaces de grande dimension, l’écueil de la malédiction de la dimensionnalité (curse of dimensionality) accentue ce phénomène : les données y sont naturellement éparses, permettant à des classifieurs linéaires ou non linéaires de scinder parfaitement des classes par pur artefact combinatoire sans capturer aucune relation de causalité ou de corrélation généralisable.
Pour prévenir cette dérive, l’introduction d’un tiers arbitre s’avère mathématiquement impérative. Sans une référence externe déconnectée de la mise à jour des gradients, il est impossible de doser la régularisation requise, de déterminer l’intensité d’une pénalité de parcimonie (telle que la norme L1 Lasso) ou d’interrompre l’apprentissage avant l’incorporation délétère du bruit stochastique. L’évaluation exclusive sur les données d’entraînement représente une impasse épistémologique qui invalide toute prétention prédictive.
3. L’ensemble de validation : définition et finalités opérationnelles
3.1 Optimisation des hyperparamètres et réglage fin
L’ensemble de validation s’érige comme le réceptacle opérationnel dédié au pilotage des méta-décisions de modélisation. Contrairement aux paramètres internes mis à jour de manière continue par la machinerie d’optimisation mathématique sur le jeu d’entraînement, les hyperparamètres sont des grandeurs exogènes qui gouvernent le comportement global de l’algorithme et sa capacité de représentation. Parmi ces éléments figurent le taux d’apprentissage initial, le nombre de couches dissimulées dans un perceptron multicouche, la profondeur maximale d’un arbre d’amplification de gradient (gradient boosting) ou encore le paramètre de marge douce $C$ d’une machine à vecteurs de support (SVM).
L’ensemble de validation intervient lors de l’exploration de l’espace des hyperparamètres, que celle-ci s’opère par recherche exhaustive sur grille (grid search), par échantillonnage aléatoire (random search) ou par optimisation bayésienne à base de processus gaussiens. L’analyste évalue les performances d’un ensemble de configurations concurrentes sur cet échantillon étanche à l’apprentissage primaire. La configuration qui maximise la métrique d’intérêt sur le jeu de validation est retenue comme la configuration optimale du modèle.
Cette approche permet de calibrer précisément le compromis entre biais et variance. En observant la réaction de la métrique de validation face à la complexification graduelle de la structure prédictive, le praticien localise le point d’inflexion où l’augmentation de la capacité modélisatrice cesse de réduire l’erreur structurelle pour commencer à amplifier l’erreur d’estimation. L’ensemble de validation sert ainsi d’instrument de navigation empirique pour guider le choix de la complexité algorithmique optimale.
3.2 Sélection d’architecture et comparaison de modèles
Au-delà du simple ajustement numérique d’hyperparamètres au sein d’une même famille d’algorithmes, l’ensemble de validation constitue l’arène impartiale permettant d’arbitrer entre des paradigmes d’apprentissage fondamentalement hétérogènes. Face à une problématique de classification tabulaire, l’analyste peut hésiter entre une régression logistique pénalisée par elastic net, une forêt aléatoire, un modèle de gradient boosting extrême (XGBoost ou LightGBM) et un réseau neuronal profond pour données tabulaires. L’ensemble de validation offre une base empirique strictement équitable pour les départager.
Cette sélection architecturale obéit au principe de parcimonie scientifique ou rasoir d’Ockham : à performance prédictive équivalente ou marginalement distincte sur l’ensemble de validation, le modèle présentant la variance la plus faible et la complexité structurelle la plus réduite doit systématiquement être privilégié. Le jeu de validation permet de mesurer si le gain marginal de précision apporté par une architecture hautement non linéaire compense la perte d’explicabilité et le surcoût computationnel induits.
Il importe de souligner que ce processus de sélection comparative expose l’ensemble de validation à un risque d’usure statistique. À mesure que l’analyste évalue un nombre croissant de modèles sur ce même échantillon, la probabilité qu’un modèle surpasse les autres par pur hasard d’échantillonnage s’accroît de façon exponentielle. L’ensemble de validation filtre efficacement les architectures inadaptées, mais accumule une variance de sélection qui justifie, à terme, l’intervention d’une validation externe définitive.
3.3 Arrêt précoce (early stopping) et régularisation
L’arrêt précoce, universellement désigné sous le terme anglais d’early stopping, incarne l’une des techniques de régularisation algorithmique les plus efficientes et élégantes en apprentissage profond et dans les méthodes ensemblistes itératives. Son principe fondamental repose sur la surveillance continue de la perte calculée sur l’ensemble de validation à la clôture de chaque époque ou itération d’apprentissage.
Au cours des premières phases de l’optimisation numérique, la fonction de perte décroît simultanément sur l’échantillon d’entraînement et sur l’échantillon de validation, traduisant l’acquisition des structures statistiques fondamentales des données. Toutefois, passé un certain seuil d’itérations, la trajectoire bifurque : tandis que la perte d’entraînement poursuit sa décroissance asymptotique vers des valeurs infinitésimales, la perte de validation atteint un minimum local ou global, s’aplatit, puis entame une remontée inexorable. Cette divergence signale la genèse précise du surapprentissage.
L’algorithme d’arrêt précoce implémente des critères d’interruption automatique fondés sur la patience (patience), interrompant l’entraînement si la perte de validation ne s’améliore plus d’une marge $\delta$ prédéterminée pendant un nombre consécutif $k$ d’époques. Les poids du réseau ou les arbres d’amplification sont alors restaurés à l’état précis correspondant au minimum historique de la perte de validation. Cette technique contraint la capacité effective du modèle sans altérer formellement son espace d’hypothèses, agissant comme un mécanisme de régularisation implicite hautement performant.
4. L’ensemble de test : le garant de l’impartialité prédictive
4.1 Évaluation non biaisée de la performance finale
L’ensemble de test constitue le garant ultime de l’intégrité scientifique d’une démarche d’apprentissage automatique. Sa mission exclusive est de fournir une estimation asymptotiquement non biaisée du risque de généralisation d’un modèle finalisé, c’est-à-dire de son comportement espéré lorsqu’il sera confronté à de nouvelles observations générées par la distribution stationnaire sous-jacente $P(X,Y)$. Dans le formalisme statistique, si $\hat{f}$ représente le prédicteur définitif issu des phases d’entraînement et de sélection par validation, l’erreur de test est définie par :
$$\hat{\mathcal{R}}_{test}(\hat{f}) = \frac{1}{n_{test}} \sum_{i=1}^{n_{test}} \mathcal{L}(\hat{f}(x_i), y_i)$$
Pour que cette quantité représente un estimateur convergent et non biaisé de l’erreur réelle $\mathcal{R}(\hat{f}) = \mathbb{E}[\mathcal{L}(\hat{f}(X), Y)]$, il est rigoureusement impératif que le modèle $\hat{f}$ n’ait subi aucune influence, directe ou indirecte, de la part des données de test. Cela implique que l’ensemble de test ne doit intervenir ni dans le calcul des gradients des paramètres, ni dans la sélection des hyperparamètres, ni dans le choix des variables explicatives, ni dans la détermination des seuils de convergence de l’arrêt précoce.
L’ensemble de test confère une valeur probante aux métriques publiées dans la recherche académique ou aux engagements de service (SLA) contractuels dans les déploiements industriels. Contrairement aux résultats issus de la validation, qui conservent un biais d’optimisme résiduel lié aux arbitrages de l’analyste, le score obtenu sur l’ensemble de test reflète la véritable valeur ajoutée prédictive de la solution logicielle élaborée.
4.2 Simulation du déploiement en conditions opérationnelles
Au-delà de la confirmation théorique, l’ensemble de test agit comme un banc d’essai réaliste simulant les conditions rigoureuses d’une mise en production industrielle. Dans les architectures opérationnelles réelles, les flux d’inférence en temps réel soumettent le modèle à des distributions empiriques qui ne bénéficient jamais du moindre retour rétroactif vers les paramètres de l’algorithme. L’ensemble de test matérialise cette altérité radicale.
Cette simulation permet de mesurer la résilience du modèle face aux fluctuations stochastiques d’échantillonnage. Même sous l’hypothèse de stationnarité des processus générateurs, les sous-populations d’échantillonnage présentent des micro-variations. L’ensemble de test permet de vérifier si les prédictions du modèle demeurent stables et calibrées en probabilité lorsqu’il traite des cas limites n’ayant jamais croisé le pipeline d’ingénierie des caractéristiques ou d’optimisation.
De plus, cette étape permet d’auditer les aspects non fonctionnels du modèle en situation quasi-opérationnelle : la latence d’inférence par observation, la consommation de mémoire vive lors de l’exécution matricielle, et le comportement du système en présence de données faiblement dégradées ou de valeurs atypiques. L’ensemble de test constitue ainsi la dernière ligne de défense technique avant l’exposition du système algorithmique aux utilisateurs finaux ou aux processus critiques de l’organisation.
4.3 La règle d’or : l’accès unique et terminal aux données de test
Le statut épistémologique de l’ensemble de test repose sur un principe déontologique et mathématique absolu que l’on nomme « la règle d’or de l’évaluation » : l’accès aux données de test doit être strictement unique et terminal. Tout protocole qui déroge à cette exigence compromet irrémédiablement l’indépendance de la mesure statistique.
Dès lors qu’un ingénieur ou un chercheur prend connaissance du score obtenu sur l’ensemble de test et s’en sert d’argument pour réajuster la structure du modèle — par exemple en modifiant la topologie du réseau, en modifiant la sélection des caractéristiques ou en augmentant le coefficient de régularisation —, l’ensemble de test perd instantanément son statut de validateur neutre. Par ce geste de rétroaction, de l’information s’infiltre à rebours dans le système modélisateur. L’ensemble de test se transmute de facto en un second ensemble de validation, altéré et affaibli.
En pratique industrielle avancée, cette séparation est matérialisée par un verrouillage cryptographique ou une gouvernance stricte des droits d’accès. L’ensemble de test est isolé sur des serveurs sécurisés, inaccessible aux équipes de science des données pendant la phase de recherche et développement. Seul un script de test automatisé, déclenché une fois que l’artefact de modélisation est définitivement gelé (frozen) et versionné, est autorisé à exécuter l’inférence terminale et à consigner les résultats dans un registre immuable.
5. Fuite de données (Data Leakage) et contamination du jeu de test
5.1 Mécanismes subtils d’infiltration de l’information
La fuite de données, ou data leakage, représente l’un des fléaux méthodologiques les plus insidieux en apprentissage automatique. Elle se manifeste lorsque des informations exogènes à la partition d’entraînement, issues de la validation ou du test, contaminent le processus d’ajustement du modèle. L’un des vecteurs les plus fréquents de fuite survient lors de la phase de prétraitement des données, lorsque des transformations statistiques sont exécutées sur l’intégralité de la matrice globale avant toute scission opérationnelle.
Considérons l’opération banale de standardisation des variables centrée-réduite :
$$z = \frac{x – \mu}{\sigma}$$
Si la moyenne empirique $\mu$ et l’écart-type $\sigma$ sont calculés sur l’ensemble du jeu de données agrégé (entraînement + validation + test) avant l’échantillonnage, la distribution intrinsèque des données d’évaluation s’infiltre insidieusement dans chaque valeur transformée du jeu d’entraînement. Le modèle apprend dès lors sur un espace d’entrée qui intègre implicitement la variance et l’espérance de données qu’il n’est théoriquement pas censé connaître.
Ce mécanisme s’avère plus désastreux encore lors d’étapes sophistiquées telles que l’imputation de valeurs manquantes par des algorithmes itératifs (K-plus proches voisins ou MICE), l’encodage de variables catégorielles à haute cardinalité par la moyenne de la cible (target encoding), ou la sélection non supervisée de variables par analyse en composantes principales (ACP). Si ces transformations synthétisent l’information globale de l’échantillon complet, les sous-ensembles de validation et de test sont contaminés dès la racine méthodologique.
5.2 L’optimisation indirecte sur les données de test
Une modalité tout aussi destructrice de fuite d’information relève de l’optimisation indirecte orchestrée par l’analyste lui-même, souvent de manière inconsciente. Ce phénomène survient lorsque le praticien, constatant des performances décevantes sur l’ensemble de test, réintègre le processus d’expérimentation pour modifier manuellement des paramètres de modélisation, supprimer des observations jugées rétroactivement « aberrantes », ou modifier la fenêtre temporelle d’apprentissage.
Ce comportement équivaut à utiliser le cerveau de l’ingénieur comme un optimiseur externe non traçable. L’analyste devient une composante algorithmique de l’apprentissage qui minimise manuellement la fonction de perte sur le jeu de test. Dès lors, les performances publiées ou documentées subissent une inflation artificielle, ne reflétant aucunement la capacité réelle de généralisation face à des observations futures.
Le résultat inéluctable de cette contamination se révèle lors de l’application pratique sur le terrain : le modèle subit une chute brutale et inexpliquée de ses scores d’exactitude ou de rappel. L’organisation découvre a posteriori que l’efficacité mirobolante promise par les tests internes n’était qu’un artifice d’optimisation induit par une perméabilité informationnelle continue entre les étapes de conception et d’audit.
5.3 Protocoles stricts d’isolation des jeux de données
L’éradication systématique du risque de fuite de données requiert l’implémentation de protocoles d’ingénierie logicielle rigoureux. Le principe fondamental d’architecture impose d’exécuter la scission des données au tout début de la chaîne de traitement (pipeline), avant toute inspection exploratoire, nettoyage ou transformation matricielle. Rien ne doit franchir la frontière de partition en amont de l’entraînement.
Dans les environnements modernes de programmation scientifique comme Python ou R, cette étanchéité s’opérationnalise par l’encapsulation des étapes de transformation au sein de pipelines hermétiques, tels que l’objet Pipeline de la bibliothèque scikit-learn. Dans cette configuration, les estimateurs de prétraitement (calcul des moyennes, imputeurs, extracteurs de caractéristiques) n’exécutent leur méthode d’ajustement (fit) que sur le jeu d’entraînement strict. Le jeu de validation ou de test n’est soumis qu’à l’application passive de la transformation calculée (transform), interdisant mathématiquement tout transfert d’information rétrograde.
Sur le plan organisationnel, les structures matures mettent en œuvre des audits systématiques de révision de code (code review) axés sur la traçabilité des variables. Elles créent également des environnements d’évaluation physiquement disjoints où les données de test sont entreposées dans des répertoires aux autorisations de lecture restreintes, empêchant matériellement les équipes de modélisation de charger accidentellement ces vecteurs d’observations au cours de leurs notebooks d’exploration préliminaire.
6. Validation croisée vs ensemble de validation fixe
6.1 Principes et mise en œuvre de la validation croisée k-fold
L’arbitrage entre l’usage d’un ensemble de validation fixe et le déploiement d’une validation croisée (cross-validation) constitue une décision stratégique conditionnée par la volumétrie des données et les ressources de calcul disponibles. L’approche standard par validation croisée à $k$ blocs (k-fold cross-validation) consiste à partitionner l’ensemble disponible (hors test terminal) en $k$ sous-ensembles disjoints d’égale envergure, le plus souvent fixés à $k=5$ ou $k=10$.
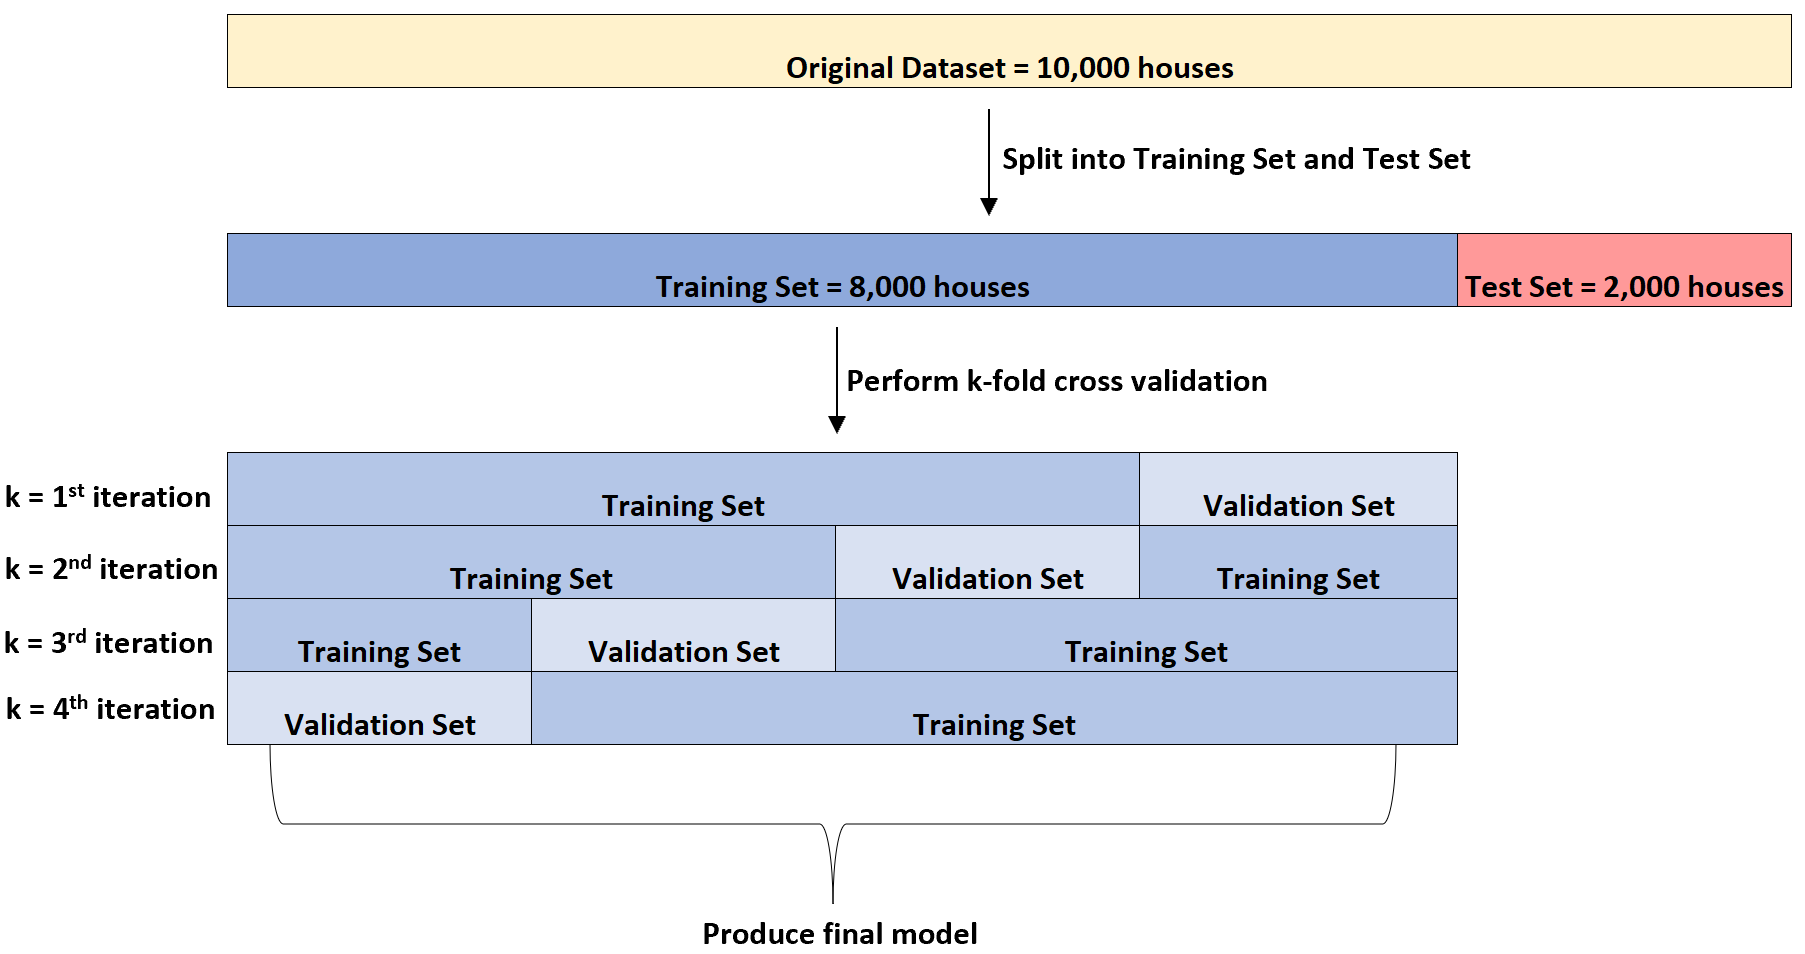
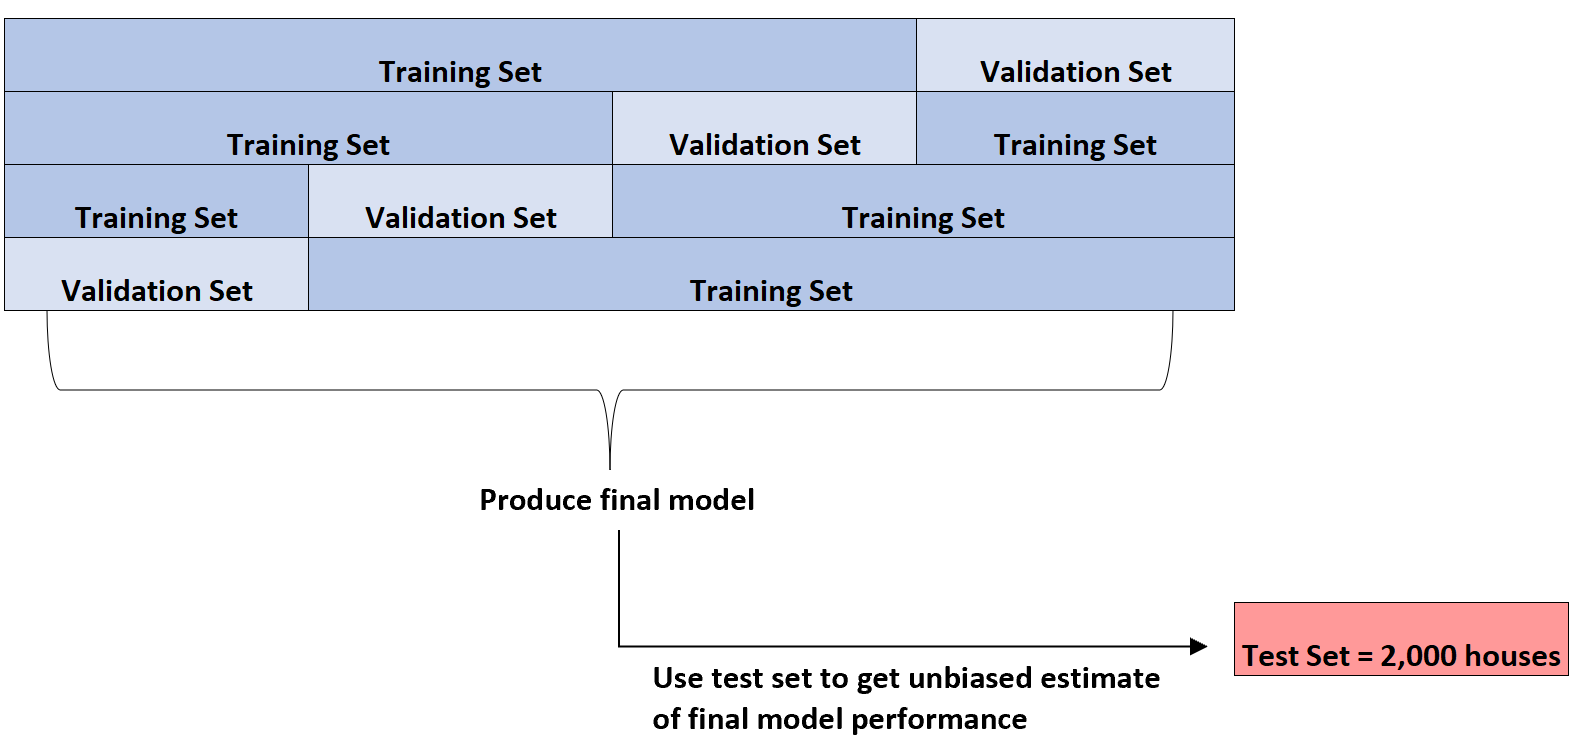
Le processus itère ensuite $k$ fois : à chaque itération, un bloc distinct est réservé pour la validation, tandis que les $k-1$ blocs restants sont fusionnés pour constituer l’ensemble d’apprentissage temporaire. Le modèle est réentraîné intégralement sur cette base, puis ses performances sont évaluées sur le bloc exclu. La métrique de performance finale correspond à la moyenne empirique des scores obtenus sur les $k$ itérations, assortie de son écart-type :
$$\hat{\mu}_{CV} = \frac{1}{k} \sum_{j=1}^{k} \text{Score}_j, \quad \hat{\sigma}_{CV} = \sqrt{\frac{1}{k-1}\sum_{j=1}^{k} (\text{Score}_j – \hat{\mu}_{CV})^2}$$
L’avantage cardinal de cette approche réside dans l’optimisation maximale de l’information disponible. Chaque observation participe à la fois à l’entraînement et, une unique fois, à la validation. En outre, le calcul de la dispersion des scores offre une mesure directe de la stabilité structurelle de l’algorithme face aux perturbations de l’échantillonnage, réduisant considérablement la variance d’estimation inhérente à un ensemble de validation fixe unique, lequel peut être fortuitement favorable ou défavorable par simple aléa d’échantillonnage.
6.2 Sous-estimation potentielle de l’erreur généralisée
Malgré sa robustesse théorique largement saluée, la validation croisée standard à $k$ blocs n’est pas exempte de biais statistiques. L’un des pièges les plus insidieux réside dans sa propension à sous-estimer l’erreur généralisée dès lors qu’elle est utilisée simultanément pour le réglage des hyperparamètres et pour rapporter l’estimation finale de la performance du système. Cette faiblesse découle de l’effet de sélection cumulative des meilleurs résultats au fil des itérations d’optimisation.
Lorsqu’un chercheur explore des milliers de combinaisons d’hyperparamètres en utilisant le score moyen de la validation croisée comme fonction d’objectif, il finit inévitablement par sélectionner une configuration qui sur-ajuste l’échantillon global de validation croisée. Même si chaque pli isole ses données lors de l’apprentissage local, le processus méta-heuristique d’optimisation inspecte la totalité des données à travers la moyenne globale. Il s’ensuit un biais d’optimisme statistique parfaitement documenté dans la littérature probabiliste.
Il en découle une règle méthodologique impérative : la validation croisée $k$-fold standard ne saurait se substituer à un ensemble de test externe indépendant. Elle remplace très efficacement l’ensemble de validation fixe pour guider le choix architectural et la régularisation, mais elle ne délivre pas une mesure définitive et non biaisée de la capacité d’extrapolation en production si elle a servi de critère de tri sélectif.
6.3 La validation croisée imbriquée (Nested Cross-Validation)
Dans les contextes où la volumétrie globale des données s’avère particulièrement restreinte — rendant l’isolation définitive d’un ensemble de test fixe prohibitif pour la puissance d’apprentissage —, la validation croisée imbriquée (nested cross-validation) s’impose comme l’étalon-or méthodologique. Cette architecture d’évaluation repose sur l’articulation hiérarchique de deux boucles de rééchantillonnage imbriquées : une boucle externe et une boucle interne.
La boucle externe est dédiée à l’estimation non biaisée de l’erreur de généralisation, jouant le rôle fonctionnel d’un ensemble de test tournant. Pour chaque itération de la boucle externe, les données sont divisées en un sous-ensemble d’entraînement-validation et un sous-ensemble de test externe. C’est à l’intérieur de ce sous-ensemble d’entraînement-validation qu’intervient la boucle interne : celle-ci exécute une seconde validation croisée complète pour sélectionner les hyperparamètres optimaux. Une fois la meilleure configuration identifiée par la boucle interne, le modèle est réentraîné sur l’ensemble complet d’entraînement-validation et évalué sur le pli de test externe.
Ce protocole garantit une étanchéité absolue entre la sélection des hyperparamètres et l’évaluation finale, supprimant tout biais de sélection cumulative. Bien que son coût computationnel soit élevé — nécessitant l’entraînement d’un nombre de modèles égal au produit des facteurs $K_{externe} \times K_{interne} \times N_{configurations}$ —, la validation croisée imbriquée constitue la réponse mathématique la plus rigoureuse pour les études biomédicales ou économétriques fondées sur de faibles effectifs d’échantillons.
7. Étude de cas comparatif : Analyse pas à pas de la modélisation
7.1 Définition du cadre expérimental et des variables
Afin de matérialiser ces concepts théoriques au sein d’une mise en œuvre concrète, considérons un cas d’usage portant sur la prédiction de l’attrition client (churn prediction) au sein d’une institution financière. Le corpus empirique est constitué d’un échantillon tabulaire de 100 000 observations individuelles, comportant 45 variables explicatives (données sociodémographiques, volumétrie des transactions bancaires, réclamations au support et historique de navigation applicative) et une variable binaire cible $Y in {0, 1}$ indiquant si le client a résilié ses services au trimestre suivant.
Le protocole expérimental s’ouvre par la partition initiale de la base de données selon un ratio stratifié rigoureux de 70/15/15. Cette opération génère trois partitions étanches : l’ensemble d’entraînement ($\mathcal{S}_{train}$, 70 000 observations), l’ensemble de validation ($\mathcal{S}_{val}$, 15 000 observations) et l’ensemble de test terminal ($\mathcal{S}_{test}$, 15 000 observations). La stratification garantit que la prévalence de la classe positive, fixée à 8% dans la population source, soit rigoureusement répliquée à hauteur de 8% au sein de chacun des trois sous-ensembles.
Immédiatement après cette scission initiale, l’ensemble de test $\mathcal{S}_{test}$ est sérialisé sous forme chiffrée sur un stockage distant isolé, sans qu’aucune analyse statistique univariée ou bivariée ne lui soit appliquée. Toutes les opérations de prétraitement — telles que l’imputation par médiane des soldes bancaires manquants et la normalisation robuste des distributions de montants de transaction — sont apprises exclusivement sur $\mathcal{S}_{train}$ et appliquées consécutivement sur $\mathcal{S}_{val}$ sans réestimation des paramètres distributionnels.
7.2 Phase de réglage itératif sur le jeu de validation
La seconde étape du protocole met en concurrence trois familles d’algorithmes aux propriétés inductives divergentes : une régression logistique régularisée (L1/L2 ElasticNet), un classifieur de forêts aléatoires (Random Forest) et un algorithme de gradient boosting basé sur des arbres de régression (XGBoost). Chaque architecture fait l’objet d’une exploration d’hyperparamètres orientée par la maximisation de l’aire sous la courbe de précision-rappel (PR-AUC) mesurée exclusivement sur $\mathcal{S}_{val}$.
Pour le modèle XGBoost, la profondeur maximale des arbres varie de 3 à 9, le taux d’apprentissage de 0,01 à 0,2, et le ratio de sous-échantillonnage stochastique des colonnes de 0,5 à 1,0. Au fil des époques de renforcement, les métriques sont relevées. L’observateur note qu’avec une profondeur d’arbre de 8 et un taux d’apprentissage de 0,1, le score PR-AUC d’entraînement atteint 0,98 au bout de 400 arbres, mais la métrique sur $\mathcal{S}_{val}$ plafonne à 0,68 dès le 120e arbre avant de régresser continuellement vers 0,61 à la 400e itération.
Le mécanisme d’arrêt précoce intervient alors, restaurant la structure du modèle à l’état correspondant au 120e arbre. Après confrontation sur $\mathcal{S}_{val}$, les scores PR-AUC maximaux s’établissent à 0,52 pour l’ElasticNet, 0,65 pour la Forêt Aléatoire et 0,68 pour le modèle XGBoost. L’algorithme XGBoost est donc formellement retenu comme le vainqueur de la phase d’optimisation par validation, et ses hyperparamètres optimaux sont définitivement fixés.
7.3 Évaluation finale et confirmation sur le jeu de test
La phase terminale du protocole expérimental scelle le cycle de développement. Le modèle XGBoost, configuré avec les hyperparamètres victorieux obtenus lors de l’étape précédente, est optionnellement réentraîné sur l’agrégation de l’ensemble d’entraînement et de validation ($\mathcal{S}_{train} \cup \mathcal{S}_{val}$, soit 85 000 observations) en conservant strictement le nombre d’arbres calibré par l’arrêt précoce. L’ensemble de test $\mathcal{S}_{test}$ est alors extrait de son coffre-fort numérique pour une passe d’inférence unique.
Les métriques de performance sont calculées sans aucun réajustement ultérieur des seuils décisionnels. Le score PR-AUC obtenu sur le jeu de test ressort à 0,673, affichant une infime variation par rapport au score de validation (0,680). La courbe ROC affiche quant à elle un indice de 0,86 sur le jeu de test, en adéquation étroite avec les 0,87 mesurés lors de la validation. Cette proximité statistique confirme l’absence de surapprentissage structurel sur l’ensemble de validation et valide l’étanchéité méthodologique du pipeline.
Si l’analyste avait mesuré un score PR-AUC de test s’effondrant à 0,45 face aux 0,68 de la validation, un tel décrochage aurait immédiatement sonné l’alerte méthodologique. Il aurait révélé, au choix, une fuite de données pernicieuse lors des étapes de pré-filtrage, une instabilité majeure causée par un sur-ajustement de la recherche d’hyperparamètres sur l’échantillon $\mathcal{S}_{val}$, ou une dérive temporelle insidieuse de la distribution des caractéristiques bancaires.
8. Biais cognitifs et psychologie de l’analyste dans l’évaluation
8.1 Le biais de confirmation face aux résultats empiriques
L’évaluation rigoureuse des modèles prédictifs se heurte continuellement aux écueils psychologiques et heuristiques cognitives qui influencent l’esprit humain. Parmi ces distorsions, le biais de confirmation exerce une pression déstabilisatrice majeure sur l’objectivité de l’analyste de données. Lorsque les performances obtenues sur l’ensemble de test coïncident avec les anticipations théoriques ou les souhaits hiérarchiques, l’expérimentateur a tendance à valider le pipeline sans le moindre examen critique.
Inversement, lorsque le score délivré par l’ensemble de test se révèle substantiellement inférieur aux espérances, une asymétrie de scepticisme s’installe. L’analyste se met immédiatement en quête d’anomalies techniques : il remet en cause la représentativité de l’échantillon de test, postule la présence d’aberrations statistiques ou incrimine la malchance probabiliste. Ce réflexe conduit trop souvent à invalider rétrospectivement l’ensemble de test pour justifier un nouveau découpage des données jusqu’à l’obtention d’un résultat aligné sur les préjugés du chercheur.
Cette rationalisation a posteriori constitue la négation même de la démarche expérimentale. En acceptant aveuglément les réussites tout en refusant systématiquement d’assumer les échecs révélés par le jeu de test, la communauté des praticiens s’expose à la production d’artefacts algorithmiques illusoires, incapables de survivre à l’épreuve de l’environnement opérationnel non contrôlé.
8.2 La tentation du p-hacking algorithmique et de la réévaluation
Dans la recherche scientifique et la compétition d’ingénierie prédictive, la quête d’une métrique supérieure engendre fréquemment des comportements analogues au p-hacking identifié en inférence statistique classique. Cette dérive, que l’on pourrait qualifier de « sur-optimisation opportuniste de test », survient dès lors qu’un protocole permet l’interrogation récurrente du jeu de test sous prétexte de « simples ajustements marginaux ».
Chaque fois qu’un praticien teste un modèle sur les données de test, modifie la valeur d’un hyperparamètre de régularisation pour tenter d’améliorer le résultat, puis réexécute l’inférence terminale, il prélève un échantillon d’information dans le réservoir d’indépendance de l’échantillon. Répétée des dizaines de fois, cette procédure transforme le test en un moteur d’apprentissage implicite. L’analyste capitalise sur les fluctuations du bruit aléatoire propres au jeu de test, augmentant le risque d’erreur de type I (faux positif quant à la supériorité du modèle).
Ce phénomène se situe au cœur de la crise contemporaine de la reproductibilité qui secoue l’intelligence artificielle appliquée à la médecine, à la finance quantitative et aux sciences sociales. Des centaines d’articles prétendent surpasser l’état de l’art sur des corpus de données ouverts (benchmarks de référence) simplement parce que les chercheurs ont itéré de façon cumulative sur les mêmes ensembles de test, exploitant sans vergogne la variance de l’échantillon jusqu’à afficher des gains statistiques totalement fictifs.
8.3 Discipline épistémique et protocoles préenregistrés
Pour neutraliser ces dérives cognitives et restaurer la solidité méthodologique des évaluations, le déploiement de règles de gouvernance inspirées des sciences biomédicales s’avère indispensable. La démarche la plus efficace réside dans l’adoption de plans d’analyse pré-spécifiés et préenregistrés (preregistration). Dans ce cadre, la fonction de perte, les métriques d’audit, la grille exacte d’hyperparamètres et les critères stricts d’arbitrage sont formalisés contractuellement avant toute manipulation des données.
Une autre réponse structurelle majeure consiste en la séparation institutionnelle des responsabilités au sein des organisations technologiques. Les équipes de recherche et développement chargées de concevoir les modèles ne doivent pas posséder les habilitations informatiques requises pour accéder aux données d’audit terminal. Ce rôle échoit à une cellule indépendante d’assurance qualité algorithmique (Model Risk Management) qui applique les conteneurs d’inférence sur un ensemble de test détenu sous séquestre cryptographique.
Enfin, une éducation approfondie à la discipline épistémique s’impose. La publication transparente de résultats de test négatifs ou décevants doit être reconnue comme un acte de valeur scientifique supérieure à l’optimisation compulsive de métriques illusoires. L’acceptation de l’échec empirique constitue le seul vecteur garantissant que les modèles déclarés performants le sont véritablement par la grâce de leur capacité inductive, et non par la sophistication de leur contamination méthodologique.
9. Métriques d’évaluation : divergences entre validation et test
9.1 Analyse des écarts de métriques critiques
La disparité empirique constatée entre la performance mesurée sur l’ensemble de validation et celle consignée sur l’ensemble de test représente un indicateur diagnostique fondamental de la santé méthodologique du projet. Dans une configuration théorique saine, si les deux sous-ensembles sont générés de manière i.i.d. à partir du même processus stochastique, la performance sur l’ensemble de test doit être marginalement inférieure ou égale à celle de la validation, respectant la relation d’ordre :
$$\mathcal{L}_{train} le \mathcal{L}_{val} less\sim \mathcal{L}_{test}$$
L’observation d’un léger fléchissement des scores entre la validation et le test — par exemple une baisse de 1 à 2 points de pourcentage sur l’indice de l’aire sous la courbe ROC (ROC-AUC) ou sur le F1-Score pondéré — relève de la simple variance d’échantillonnage et de la dissipation naturelle du biais d’optimisme lié à la sélection des hyperparamètres sur le jeu de validation.
En revanche, une divergence prononcée — telle qu’une amplification soudaine de l’erreur quadratique moyenne (RMSE) de plus de 15% ou un effondrement drastique de la précision à rappel constant — constitue un signal d’alerte critique. Une telle dégradation ne peut être balayée comme un aléa statistique standard ; elle trahit une anomalie structurelle dans le processus de construction ou d’évaluation du modèle qu’il convient d’isoler méthodiquement.
9.2 Détection du surapprentissage sur l’ensemble de validation
Le premier suspect technique lors d’une divergence aiguë entre les métriques de validation et de test réside dans le surapprentissage spécifique à l’ensemble de validation (overfitting to the validation set). Bien que les algorithmes ne rétropropagent pas directement d’erreurs sur ces observations, le choix continu d’architectures et d’hyperparamètres sur ce sous-échantillon finit par sur-ajuster le modèle aux particularités statistiques de cette fraction de données.
Ce phénomène survient fréquemment lorsque l’espace d’exploration des hyperparamètres est vaste (plusieurs milliers de configurations évaluées par des méthodes d’optimisation génétique ou bayésienne) et que la taille de l’ensemble de validation est modeste. L’optimiseur retient des combinaisons d’hyperparamètres qui exploitent fortuitement le bruit d’échantillonnage du jeu de validation pour maximiser la métrique cible.
Pour confirmer ce diagnostic, l’analyste doit inspecter l’évolution de la métrique en fonction de la complexité des configurations explorées. Si le modèle sélectionné affiche une perte de régularité ou d’invariance géométrique (par exemple une sensibilité extrême à des micro-variations de variables d’entrée), l’hypothèse d’un surapprentissage de validation est confirmée. La remédiation exige l’augmentation substantielle des contraintes de régularisation globale, la réduction drastique du nombre d’itérations d’exploration ou la substitution de l’ensemble de validation fixe par un protocole de validation croisée imbriquée.
9.3 Interprétation des divergences inattendues sur le test
Si l’hypothèse du surapprentissage de validation est écartée, la défaillance des scores de test peut résulter d’un décalage structurel de distribution entre les ensembles, brisant le postulat fondamental de distributions indépendantes et identiquement distribuées. Deux dynamiques causales majeures doivent être investiguées : le décalage des covariables (covariate shift) et la dérive de concept (concept drift).
Le décalage des covariables survient lorsque la distribution des variables explicatives $P(X)$ diffère entre la validation et le test, bien que la relation fonctionnelle conditionnelle $P(Y|X)$ demeure inchangée. L’application d’un test d’adéquation multivarié, tel que le test d’énergie statistique ou l’entraînement d’un classifieur adversarial visant à distinguer si une observation provient de la validation ou du test, permet de détecter formellement cette divergence distributionnelle.
Si le classifieur adversarial parvient à discriminer les ensembles avec une exactitude nettement supérieure au hasard (AUC > 0,5), cela démontre que la scission des données n’a pas produit des sous-ensembles statistiquement interchangeables. L’origine réside le plus souvent dans une partition non stratifiée, un biais de sélection temporel involontaire ou une ségrégation spatiale incontrôlée lors de la collecte initiale des données. La résolution de ce problème impose de revoir intégralement la stratégie d’échantillonnage originelle.
10. Stratégies de répartition des données et proportions optimales
10.1 Ratios conventionnels selon la taille du corpus
La détermination des fractions quantitatives allouées respectivement à l’entraînement, à la validation et au test ne saurait obéir à une formule magique universelle. Cette répartition dépend fondamentalement du volume global d’observations ($N$) et de la complexité intrinsèque de l’architecture prédictive envisagée. Dans le régime traditionnel de l’apprentissage automatique sur des volumes de données faibles à modérés (typiquement de quelques centaines à quelques dizaines de milliers d’observations), les ratios empiriques conventionnels se sont historiquement fixés à 70/15/15 ou 60/20/20.
Ces proportions garantissent que la fraction d’apprentissage conserve une masse critique suffisante pour permettre l’estimation des coefficients sans sombrer dans une variance d’estimation prohibitive, tout en allouant des volumes viables aux compartiments d’évaluation pour préserver la significativité statistique des métriques.
À l’ère des données massives (Big Data) et de l’apprentissage profond (Deep Learning), où les jeux de données englobent des dizaines de millions d’observations (corpus textuels pour modèles de fondation, imagerie satellitaire globale), ces ratios historiques deviennent obsolètes et contre-productifs. Dans un ensemble comprenant 10 000 000 d’enregistrements, réserver 20% pour le test mobiliserait 2 000 000 d’exemples, ce qui représente une surallocation massive et injustifiée de puissance statistique pour évaluer une métrique scalaire.
Dans ce contexte de massivité, la distribution bascule vers des configurations asymétriques du type 98/1/1, voire 99/0,5/0,5. Un échantillon de test de 1% sur un ensemble de dix millions d’exemples contient 100 000 observations, ce qui procure une puissance statistique exceptionnelle pour borner les intervalles de confiance à des fractions de pourcentages infimes, tout en laissant 98% des données disponibles pour maximiser l’extraction des motifs profonds lors de l’apprentissage des poids synaptiques.
10.2 Stratification et préservation de l’équilibre des classes
L’échantillonnage purement aléatoire (simple random sampling) est fréquemment tenu pour garant de l’impartialité statistique. Pourtant, face à des distributions empiriques hautement déséquilibrées, cette approche peut s’avérer destructrice pour la validité méthodologique. Dans les applications critiques telles que la détection de fraudes bancaires, le diagnostic de maladies orphelines ou la prédiction d’intrusion réseau, la classe d’intérêt (positive) ne représente souvent qu’une fraction infime du corpus global (par exemple 0,1% ou 0,01%).
Dans ce scénario, une scission purement stochastique risque, par simple déviation d’échantillonnage, de concentrer la quasi-totalité des occurrences positives au sein de l’ensemble d’entraînement, privant l’ensemble de validation ou de test d’un nombre suffisant d’événements pour calculer des métriques discriminantes fiables telles que le rappel ou l’aire sous la courbe précision-rappel. Dans le pire des cas, une partition d’évaluation peut se retrouver totalement dépourvue de la classe minoritaire, rendant le calcul de la métrique mathématiquement indéfini.
L’obligation méthodologique impose alors le recours à l’échantillonnage stratifié (stratified sampling). Cette technique opère un partitionnement contrôlé qui contraint la distribution de la variable cible — ou d’un ensemble de combinaisons de variables catégorielles critiques — à demeurer strictement identique dans chacun des trois sous-ensembles. En garantissant que chaque strate soit représentée à hauteur exacte de sa proportion dans la population d’origine, la stratification élimine la variance inter-partitions et préserve la comparabilité mathématique directe des fonctions de perte.
10.3 Échantillonnage en présence de regroupements (Clustering)
L’un des écueils les plus pernicieux lors du découpage des données survient lorsque les observations présentent une structure hiérarchique ou des dépendances groupées sous-jacentes. Cette configuration se rencontre fréquemment dans les études médicales (où un même patient fait l’objet de dizaines d’examens d’imagerie au cours du temps), dans l’analyse de documents textuels (plusieurs paragraphes provenant d’un même ouvrage) ou dans les plateformes de commerce électronique (multiples transactions initiées par un même profil d’utilisateur).
Si la partition des données est exécutée de manière agnostique au niveau des lignes individuelles, les observations associées à une même entité génératrice (le même individu) se trouvent inévitablement disséminées simultanément dans l’ensemble d’entraînement, de validation et de test. Le modèle se trouve alors en position de mémoriser les signatures biométriques ou idiosyncrasiques propres à l’individu lors de l’entraînement, et de « reconnaître » ce même individu lors de la phase de test. L’erreur ainsi mesurée ne reflète nullement la capacité à généraliser vers de nouveaux patients, mais simplement la capacité de ré-identification au sein d’un groupe connu.
Pour prévenir cette défaillance de validité écologique, l’application d’un échantillonnage groupé (group-aware splitting ou GroupKFold) est indispensable. Ce protocole impose que l’unité de partitionnement ne soit pas l’observation unitaire, mais l’identifiant du groupe (le patient, l’auteur, l’appareil source). Toutes les données afférentes à un groupe donné sont impérativement assignées dans leur globalité à un seul et unique sous-ensemble. Ce dispositif garantit que l’ensemble de test évalue la véritable capacité d’extrapolation envers des cohortes totalement inédites, condition sine qua non à la certification de tout système d’intelligence artificielle clinique ou critique.
11. Spécificités temporelles, spatiales et données non indépendantes
11.1 Partitionnement temporel et séries chronologiques
L’hypothèse selon laquelle les données sont générées de manière indépendante et identiquement distribuée ($i.i.d.$) constitue la simplification mathématique la plus commode de l’apprentissage statistique. Néanmoins, cette hypothèse s’effondre frontalement dès lors que les données s’inscrivent dans une dynamique temporelle continue, comme c’est le cas des séries chronologiques financières, des relevés météorologiques ou des journaux d’événements industriels (logs). Dans ce contexte, l’échantillonnage aléatoire classique représente une faute méthodologique rédhibitoire.
L’application d’un découpage aléatoire au sein d’une série temporelle engendre une forme gravissime de fuite d’information bidirectionnelle : la fuite vers le futur (lookahead bias). Un tel partitionnement autorise l’algorithme à utiliser des observations capturées à l’instant $t+1$ pour prédire des événements survenus à l’instant $t$. Les corrélations temporelles de haute fréquence et l’autorégression intrinsèque des processus procurent au modèle une clairvoyance anormale, gonflant artificiellement ses résultats d’évaluation.
La modélisation de séries chronologiques exige impérativement un partitionnement temporel contraint, strictement ordonné le long de la flèche du temps (out-of-time validation). L’architecture canonique requiert que :
- L’ensemble d’entraînement occupe la période chronologique la plus ancienne : $[t_0, t_1]$
- L’ensemble de validation s’étende sur la période intermédiaire consécutive : $]t_1, t_2]$
- L’ensemble de test soit exclusivement confiné à la période terminale la plus récente : $]t_2, t_3]$
Ce partitionnement linéaire peut être décliné sous forme de fenêtres glissantes ou expansives (rolling/expanding window backtesting), mais le principe sous-jacent demeure intangible : le futur ne doit jamais être accessible pour prédire le passé.
11.2 Dépendances spatiales et autocorrélation
À l’instar de la temporalité, la dimension spatiale viole structurellement l’hypothèse d’indépendance des observations. Selon la première loi de la géographie formulée par Waldo Tobler, « tout interagit avec tout, mais deux objets proches ont plus de chances d’interagir que deux objets éloignés ». Cette autocorrélation spatiale induit une redondance informationnelle majeure entre points géographiquement adjacents.
Si un chercheur modélisant la biomasse forestière ou les concentrations de polluants atmosphériques partitionne ses mesures de terrain par tirage aléatoire des coordonnées géographiques, des parcelles distantes de seulement quelques mètres se retrouveront réparties entre l’entraînement et le test. Les prédicteurs environnementaux (type de sol, microclimat, hygrométrie) étant quasi-identiques à cette échelle spatiale, l’erreur de test mesurera simplement la capacité d’interpolation spatiale locale (krigeage implicite) plutôt que la capacité du modèle à extrapoler ses prédictions vers des zones écologiques non échantillonnées.
Pour neutraliser l’effet trompeur de l’autocorrélation spatiale, la méthodologie prescrit le recours à la validation croisée spatiale par blocs disjoints (spatial block cross-validation). Cette technique divise le domaine géographique en quadrats ou bassins hydrographiques distants, séparés par des zones tampons (buffer zones) au sein desquelles aucune donnée n’est prélevée. Cette séparation physique élimine l’influence des corrélations spatiales de courte portée, forçant le modèle à extraire des lois fonctionnelles véritables plutôt que de se reposer sur la contiguïté topologique des observations.
11.3 Dérive des concepts (Concept Drift) entre validation et test
Dans les environnements physiques ou économiques réels, la distribution génératrice des données n’est presque jamais parfaitement stationnaire. Les transformations structurelles de l’environnement génèrent ce que la littérature théorique désigne sous le terme de dérive de concept ou concept drift : l’altération progressive ou brutale de la relation probabiliste conjointe entre les variables d’entrée $X$ et la variable cible $Y$ au cours du temps :
$$P_{t_1}(X, Y) \neq P_{t_2}(X, Y)$$
Ce phénomène introduit une divergence naturelle entre les performances observées sur l’ensemble de validation et celles relevées sur l’ensemble de test, lorsque ce dernier est positionné sur une fenêtre temporelle ultérieure. Par exemple, l’irruption d’une crise macroéconomique, la modification soudaine d’un cadre réglementaire ou l’apparition d’un événement épidémique modifie substantiellement le comportement des agents économiques.
L’observation d’une telle détérioration des métriques de test ne traduit pas une faille de conception de l’algorithme, mais reflète la dégradation inévitable de l’hypothèse de stationnarité. L’analyse différentielle des erreurs entre la validation (passé récent) et le test (présent opérationnel) permet de quantifier précisément le taux de dépréciation temporelle du pouvoir prédictif du modèle. Ces informations permettent de calibrer la périodicité requise pour le réentraînement périodique du système et d’élaborer des mécanismes d’adaptation dynamique des seuils d’inférence en environnement perturbé.
12. Synthèse méthodologique et guide des meilleures pratiques
12.1 Tableau récapitulatif des distinctions conceptuelles
Afin de clore définitivement toute ambiguïté terminologique et opérationnelle, le tableau suivant synthétise les propriétés mathématiques, les finalités algorithmiques et les contraintes de gouvernance associées à chacune des trois partitions canoniques du paradigme de l’apprentissage automatique :
| Dimension d’analyse | Ensemble d’entraînement | Ensemble de validation | Ensemble de test |
|---|---|---|---|
| Finalité primaire | Ajustement direct des paramètres internes (poids, coefficients, seuils de coupure). | Optimisation des hyperparamètres, sélection d’architectures, arrêt précoce. | Estimation finale non biaisée du risque de généralisation en conditions réelles. |
| Visibilité algorithmique | Accès direct et exhaustif par les fonctions de perte et optimiseurs numériques. | Accès indirect via les boucles de méta-optimisation pilotées par l’analyste. | Occultation totale jusqu’au gel définitif du pipeline de prédiction. |
| Fréquence d’accès | Continue et récurrente au fil de millions d’époques ou itérations de calcul. | Itérative et périodique au terme des époques d’apprentissage exploratoires. | Unique et terminale, réservée à l’audit définitif pré-déploiement. |
| Statut statistique | Biais d’optimisme maximal (erreur apparente / resubstitution empirique). | Biais d’optimisme modéré (variance cumulée due à la sélection d’hypothèses). | Estimateur asymptotiquement non biaisé de l’erreur réelle de prédiction. |
| Actions autorisées après évaluation | Calcul des gradients, mise à jour des représentations matricielles. | Modification des hyperparamètres, élagage, changement d’algorithme. | Aucune modification du modèle autorisée (audit d’acceptation passif). |
12.2 Liste de contrôle opérationnelle pour les praticiens
L’implémentation industrielle d’un pipeline de modélisation exige une discipline d’ingénierie rigoureuse. Avant de déclarer un modèle prêt pour l’intégration opérationnelle ou la publication de ses résultats de performance, l’analyste doit valider formellement la conformité de sa méthodologie avec les points de contrôle cardinaux suivants :
- Séparation primordiale des données : Le découpage entre entraînement, validation et test a-t-il été effectué dès l’acquisition initiale, avant toute normalisation, imputation ou filtrage ?
- Confinement strict des estimateurs de transformation : Les paramètres de centrage-réduction, de discrétisation ou de réduction de dimension ont-ils été ajustés (
fit) uniquement sur l’ensemble d’entraînement ? - Préservation de l’équilibre distributionnel : La méthode de partitionnement intègre-t-elle une stratification systématique sur la variable cible si celle-ci présente un déséquilibre marqué de prévalence ?
- Respect des dépendances de groupe : Si le jeu de données comporte des mesures longitudinales ou répétées, les observations provenant d’une même entité sont-elles strictement confinées au sein d’une seule et même partition (Group Split) ?
- Respect de l’orientation chronologique : En présence d’une composante temporelle, la partition respecte-t-elle l’alignement passé (entraînement) $to$ présent (validation) $to$ futur (test), sans contamination rétrograde ?
- Isolement physique de l’ensemble de test : Les données de test sont-elles entreposées dans un environnement étanche, non consultables lors des phases exploratoires et du réglage fin ?
- Invariance terminale : Les hyperparamètres et la structure du modèle ont-ils été définitivement gelés avant le calcul de l’erreur sur l’ensemble de test ? Aucune modification n’a-t-elle été consentie post-évaluation ?
12.3 Perspectives futures de la validation en intelligence artificielle
L’avènement des modèles de fondation préentraînés sur des corpus quasi-exhaustifs de l’Internet public et l’essor de l’apprentissage auto-supervisé transforment en profondeur les frontières méthodologiques traditionnelles du partitionnement de données. La notion même d’ensemble d’entraînement étanche vacille lorsque les données de préentraînement englobent l’intégralité des benchmarks de référence académiques, provoquant une forme de contamination globale et involontaire du web (web-scale benchmark contamination).
Face à ce défi contemporain, la communauté scientifique réoriente ses protocoles d’audit vers des tests d’invariance fonctionnelle, d’interventions causales et de robustesse adversariale. L’évaluation ne saurait plus se contenter d’un score scalaire statique obtenu sur un jeu de test figé. Elle adopte des méthodologies d’évaluation continue (continuous evaluation) post-déploiement, associées à des batteries d’échantillons générés dynamiquement par des approches contrefactuelles (stress testing algorithmique).
Parallèlement, la certification des systèmes autonomes critiques impose désormais l’adoption d’audits formels de conformité statistique, tels que la prédiction conforme (conformal prediction), qui substitue aux simples prédictions ponctuelles des ensembles de confiance dont le taux de couverture est mathématiquement garanti sans hypothèse distributionnelle forte. L’ensemble de validation s’y métamorphose en ensemble d’étalonnage (calibration set), illustrant l’évolution continue des techniques de validation statistique face aux exigences d’explicabilité, de sûreté et de fiabilité du monde contemporain.
Références
- Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. https://www.microsoft.com/en-us/research/publication/pattern-recognition-and-machine-learning/
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. https://www.deeplearningbook.org/
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://link.springer.com/book/10.1007/978-0-387-84858-7
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- Kohavi, R. (1995). A study of cross-validation and bootstrap for accuracy estimation and model selection. In Proceedings of the 14th International Joint Conference on Artificial Intelligence (IJCAI), 2, 1137–1143. https://www.ijcai.org/Proceedings/95-2/Papers/016.pdf
- Roberts, D. R., Bahn, V., Ciuti, S., Boyce, M. S., Elith, J., Guillera-Arroita, G., Hauenstein, S., Lahoz-Monfort, J. J., Schröder, B., Thuiller, W., Warton, D. I., Wintle, B. A., Hartig, F., & Dormann, C. F. (2017). Cross-validation strategies for data with temporal, spatial or phylogenetic structure. Ecography, 40(8), 913–929. https://doi.org/10.1111/ecog.02881
- Vapnik, V. N. (1998). Statistical Learning Theory. Wiley. https://www.wiley.com/en-us/Statistical+Learning+Theory-p-9780471030034
- Shafer, G., & Vovk, V. (2008). A tutorial on conformal prediction. Journal of Machine Learning Research, 9, 371–421. https://www.jmlr.org/papers/v9/shafer08a.html