
Dans le champ des sciences du comportement, de la psychométrie contemporaine et de la science des données, la modélisation statistique ne saurait se limiter à la formulation d’équations élégantes ou à l’agencement d’architectures prédictives complexes. L’évaluation rigoureuse de la fidélité et de l’adéquation d’un modèle statistique exige une confrontation empirique constante entre les trajectoires estimées et les manifestations phénoménologiques réelles des sujets observés. C’est précisément à cette intersection fondamentale entre la formalisation algorithmique et la variabilité humaine que s’impose l’erreur quadratique moyenne, mondialement reconnue sous l’acronyme anglais RMSE (Root Mean Square Error). Cette métrique d’évaluation s’érige en pierre angulaire de l’inférence quantitative en fournissant une mesure absolue, intuitive et mathématiquement rigoureuse de l’écart type des résidus prédictifs.
L’interprétation adéquate du RMSE constitue un défi épistémologique et méthodologique majeur pour le chercheur et le praticien. Loin d’être un simple score numérique standardisé que l’on pourrait juger à l’aune de balises normatives universelles et désincarnées, le RMSE tire son sens de sa contextualisation profonde au sein du paradigme d’investigation. Exprimé dans la métrique directe de la variable dépendante observée, il capture la magnitude concrète de l’incertitude prédictive, traduisant en scores de tests, en millisecondes de temps de réaction ou en degrés d’intensité symptomatique la marge d’erreur inhérente à toute formalisation théorique. Cette caractéristique fait du RMSE un pont herméneutique essentiel entre les impératifs abstraits de l’optimisation mathématique et les exigences opérationnelles du diagnostic clinique, de l’évaluation neuropsychologique ou du pronostic éducatif.
Ce traité exhaustif se propose de disséquer, avec une profondeur analytique sans précédent, l’ensemble des ramifications conceptuelles, formelles et empiriques de l’erreur quadratique moyenne. De sa genèse historique ancrée dans la méthode des moindres carrés de Carl Friedrich Gauss jusqu’aux applications contemporaines de pointe au sein des réseaux de neurones appliqués aux biomarqueurs cognitifs, ce document articule les fondements statistiques, les règles de décision pratiques, les analyses comparatives face à d’autres estimateurs résiduels, ainsi que les protocoles de validation croisée indispensables à l’intégrité de la recherche quantitative. En appréhendant les forces et les vulnérabilités structurelles de cette métrique, le lecteur acquerra une maîtrise souveraine des critères d’adéquation nécessaires pour concevoir, évaluer et restituer des modèles explicatifs et prédictifs d’une rigueur irréprochable.
1. Fondements conceptuels de l’erreur quadratique moyenne (RMSE) en psychométrie
1.1 Définition théorique et genèse statistique
L’émergence de l’erreur quadratique moyenne trouve son ancrage historique direct dans le développement du critère des moindres carrés au tout début du XIXe siècle, formulé indépendamment par Adrien-Marie Legendre en 1805 et formalisé de manière probabiliste par Carl Friedrich Gauss en 1809. Dans sa quête d’estimation des orbites planétaires à partir d’observations astronomiques bruitées, Gauss démontra que, sous l’hypothèse d’erreurs indépendantes et identiquement distribuées selon une loi normale, la minimisation de la somme des carrés des écarts constituait l’estimateur sans biais de variance minimale (théorème de Gauss-Markov). Cette avancée fondamentale a transcendé les sciences physiques pour devenir le moteur de l’analyse de régression moderne et de la modélisation statistique des conduites humaines.
D’un point de vue strictement formel, l’erreur quadratique moyenne se définit comme la racine carrée de la moyenne arithmétique des carrés des résidus d’échantillonnage. En d’autres termes, elle représente l’écart type des erreurs d’estimation commises par une fonction statistique reliant une variable réponse observée à un ensemble de prédicteurs. Contrairement à une simple moyenne des écarts arithmétiques, qui s’annulerait inévitablement en raison de la compensation mutuelle des résidus positifs et négatifs dans le cadre d’un ajustement par les moindres carrés ordinaires, le RMSE opère par une quadrature préalable de chaque déviation individuelle. Ce processus algébrique élimine l’effet d’annulation tout en conférant à la métrique une sensibilité particulièrement accrue aux grands écarts.
Au sein de la psychométrie et de la psychologie quantitative, le RMSE occupe un rôle central dans l’évaluation de la fidélité des prédictions comportementales. Prédire un trait latent, une propension psychopathologique ou une performance cognitive implique inévitablement une part d’imprécision. L’erreur quadratique moyenne permet d’opérationnaliser cette imprécision sous la forme d’un indice global de divergence entre le modèle d’anticipation et le pattern comportemental effectif. Dès lors, le RMSE s’établit comme le baromètre de la proximité moyenne globale liant les construits théoriques formalisés aux réponses individuelles enregistrées.
Sur le plan épistémologique, il s’avère indispensable d’opérer une distinction rigoureuse entre l’erreur systématique (le biais d’estimation) et la variance résiduelle (l’erreur aléatoire). L’erreur systématique correspond à un décalage structurel et constant des prédictions par rapport à la réalité, attribuable par exemple à un étalonnage défectueux de l’instrument psychométrique ou à l’omission d’un facteur modérateur décisif. La variance résiduelle, quant à elle, traduit l’irréductible variabilité stochastique résiduelle non captée par le modèle. Le RMSE intègre intrinsèquement ces deux dimensions au travers de sa décomposition classique, constituant ainsi un indicateur unifié de l’exactitude globale du dispositif prédictif.
1.2 Importance de la métrique dans la modélisation psychologique
La modélisation des phénomènes psychologiques se heurte en permanence à la nature non tangible et multidimensionnelle de ses objets d’étude. Qu’il s’agisse de mesurer l’intelligence fluide, l’estime de soi ou l’épuisement professionnel, les scores recueillis sur des échelles psychométriques sont toujours entachés d’une part de fluctuation aléatoire et d’incertitude méthodologique. Dans ce cadre, la quantification précise de l’incertitude de prédiction constitue un impératif méthodologique de premier ordre. Le RMSE fournit une estimation paramétrique directe de la bande d’incertitude qui encadre l’inférence individuelle d’un score psychologique prédit.
Dans l’évaluation de l’adéquation des modèles cognitifs et comportementaux, le RMSE agit comme une fonction de pénalisation sévère contre les défaillances locales d’ajustement. Un modèle prétendant expliquer l’architecture de la mémoire de travail ou l’apprentissage par renforcement ne peut être considéré comme théoriquement recevable s’il engendre des déviations majeures pour certains sous-groupes de participants, même si sa corrélation moyenne apparente avec les données expérimentales demeure flatteuse. L’utilisation du RMSE contraint les chercheurs à concevoir des architectures paramétriques capables d’ajuster l’ensemble de la trajectoire empirique de manière homogène.
L’application du RMSE prend une acuité singulière au sein des protocoles expérimentaux à mesures répétées et des études longitudinales par échantillonnage de l’expérience (Experience Sampling Method). Face à des séries temporelles capturant les fluctuations quotidiennes de l’affect ou les dynamiques de récupération post-thérapeutique, le calcul du RMSE intra-individuel permet de documenter la stabilité ou l’instabilité de la modélisation au fil du temps. Il met en lumière l’hétérogénéité des trajectoires de développement en révélant si la structure formelle postulée conserve une adéquation constante au cours des différentes phases d’intervention.
Enfin, le RMSE exerce un impact déterminant sur l’établissement de la validité de critère des instruments psychométriques. Lorsqu’un outil de dépistage clinique est déployé pour estimer la sévérité future d’un trouble anxieux ou d’une rechute addictive, la minimisation du RMSE garantit que la distance métrique entre le pronostic chiffré et le critère standard externe est la plus ténue possible. Cette convergence opérationnelle renforce l’assise psychométrique de l’outil, assurant que la prise de décision diagnostique repose sur une marge d’erreur résiduelle clairement quantifiée et scientifiquement documentée.
1.3 Propriétés distributionnelles des résidus
La validité interprétative de l’erreur quadratique moyenne dépend substantiellement de la structure distributionnelle des résidus issus de la modélisation. Les résidus statistiques, définis pour chaque individu comme la différence brute entre la valeur observée et la valeur théorique projetée, doivent idéalement se conformer aux postulats de base de la théorie des probabilités appliquées à l’inférence par régression. L’hypothèse fondamentale de normalité stipule que la densité de probabilité des erreurs d’estimation suit une courbe de Gauss symétrique centrée autour de zéro.
Lorsque cette condition de normalité est rigoureusement satisfaite, le RMSE correspond de manière exacte à l’écart type de la distribution d’échantillonnage des résidus. Cette équivalence mathématique confère au RMSE une lisibilité probabiliste exceptionnelle : environ 68,2 % des prédictions individuelles se situeront dans un intervalle compris entre plus ou moins un RMSE autour de la valeur prédite, et près de 95,4 % se trouveront à l’intérieur d’une marge de deux RMSE. Si, au contraire, les résidus présentent une forte asymétrie (skewness) ou un aplatissement prononcé (kurtosis), l’interprétation probabiliste directe du RMSE perd sa validité heuristique immédiate, nécessitant une analyse distributionnelle approfondie.
L’hypothèse d’homoscédasticité, désignant l’homogénéité constante de la variance des erreurs à travers l’ensemble des strates prédictives du modèle, constitue un autre pilier fondamental pour garantir la robustesse du RMSE. En présence d’hétéroscédasticité — situation courante où l’erreur s’accroît systématiquement aux valeurs extrêmes de l’échelle d’évaluation psychologique —, le RMSE agrège indistinctement des zones de haute fidélité prédictive et des régions de grande dispersion. Cette agrégation produit un indicateur global trompeur, qui sous-estime l’erreur réelle sur les scores élevés tout en la surestimant dans les segments médians de la distribution.
Par ailleurs, les conséquences de l’indépendance des observations et de l’autocorrélation des résidus ne sauraient être occultées, en particulier au sein des études longitudinales et des devis intra-sujets. L’existence d’une dépendance sérielle entre les résidus successifs d’un même individu entraîne une sous-estimation artificielle de la variance d’échantillonnage résiduelle, ce qui fausse le calcul du RMSE par l’introduction d’un biais computationnel masqué. La vérification méthodique de ces hypothèses distributionnelles, par le biais de tests formels et d’inspections visuelles rigoureuses, représente le prérequis inaliénable à toute tentative sérieuse d’interprétation empirique de cette statistique d’ajustement.
2. Décomposition mathématique et formulation analytique
2.1 Anatomie de l’équation standard du RMSE
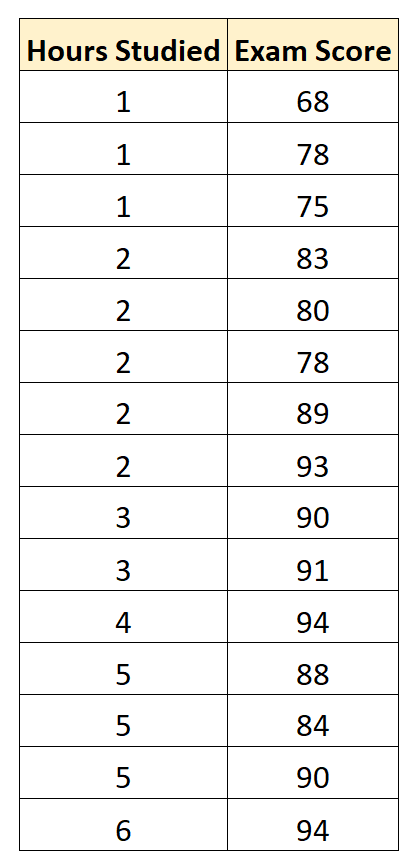
L’appréhension exhaustive de l’erreur quadratique moyenne nécessite une déconstruction minutieuse des éléments constitutifs de son équation analytique. Dans sa forme standard appliquée à un ensemble univarié d’observations, le RMSE s’exprime au travers de la relation algébrique suivante :
RMSE = √ [ (1 / N) Σi=1N (yi – ŷi)2 ]
Chaque composante de cette formulation opère une transformation séquentielle précise sur le flux d’informations quantitatives généré par l’estimation :
- L’opérateur de sommation (Σi=1N) et l’indexation individuelle : Il assure l’accumulation méthodique des déviations à travers l’intégralité de la cohorte d’étude, où chaque participant ou observation indicée par i contribue au calcul global, de l’indice unitaire jusqu’au terme final N.
- L’écart résiduel brut (yi – ŷi) : Il représente la distance fondamentale existant entre la mesure empirique observée yi et la valeur théorique ajustée ou prédite ŷi issue du modèle formalisé.
- L’élévation au carré exponentielle (2) : Cette opération de quadrature remplit un rôle dual. D’une part, elle transpose toutes les grandeurs résiduelles dans le domaine des réels strictement positifs, abolissant le signe négatif issu des sous-estimations. D’autre part, elle introduit un mécanisme de pondération non linéaire, infligeant une pénalité quadratique aux déviations d’amplitude élevée.
- La normalisation scalaire (1 / N) : En divisant la somme totale des carrés résiduels par la taille globale de l’échantillon N, le calcul opère le calcul de la moyenne arithmétique de l’erreur quadratique, convertissant une quantité extensive en une mesure intensive indépendante du volume absolu de l’échantillon.
- L’extraction du radical radiculaire (√) : L’ultime opération d’application de la racine carrée constitue l’étape herméneutique décisive. Elle abaisse la dimension dimensionnelle de la métrique, rétablissant la mesure de l’erreur dans l’unité de quantification initiale et tangible de la variable dépendante y.
Il importe de préciser que dans le cadre de la théorie statistique classique des degrés de liberté, lorsque le modèle implique l’estimation conjointe de p paramètres indépendants (incluant l’ordonnée à l’origine), la normalisation par N est fréquemment substituée par une division par le dénominateur ajusté (N – p). Cette correction de Bessel garantit que l’estimateur de la variance d’erreur sous-jacent demeure asymptotiquement et rigoureusement sans biais, une considération prépondérante dans les études reposant sur des effectifs réduits.
2.2 Relations structurales avec l’erreur quadratique moyenne (MSE)
L’erreur quadratique moyenne (RMSE) entretient une filiation mathématique consubstantielle et directe avec l’erreur quadratique moyenne sans racine, universellement désignée sous le vocable de MSE (Mean Squared Error). La relation unissant ces deux métriques s’énonce dans une stricte immédiateté : le RMSE n’est autre que la racine carrée élémentaire de la MSE, ce qui se formule de manière bijective par RMSE = √(MSE) ou, symétriquement, MSE = RMSE2. Cette parenté algébrique immédiate masque néanmoins des divergences épistémologiques et pratiques substantielles dans le traitement de l’information statistique.
La MSE représente, dans l’espace euclidien des données, l’équivalent direct de la variance non expliquée par le modèle de régression. Son unité d’expression est systématiquement le carré de l’unité de mesure de la cible observée (par exemple, des millisecondes au carré, des points de quotient intellectuel au carré ou des échelons de stress au carré). Cette distorsion dimensionnelle rend la MSE foncièrement opaque pour l’évaluation clinique ou comportementale directe, les praticiens étant incapables d’appréhender intuitivement ce que représente une marge d’erreur quantifiée dans une échelle de variances au carré. Le passage au RMSE s’impose donc comme une exigence de réhabilitation dimensionnelle indispensable à l’interprétation humaine.
Sur le plan de l’optimisation mathématique et du calcul différentiel, la MSE conserve néanmoins une suprématie opérationnelle indiscutable. En raison de sa régularité analytique continue et de sa parfaite différentiabilité en tout point du plan vectoriel, la fonction de coût MSE présente une dérivée première particulièrement fluide et élégante, exempte de la singularité asymptotique induite par l’opérateur racine carrée lorsque l’erreur tend vers zéro. C’est pourquoi la quasi-totalité des algorithmes d’apprentissage automatique contemporains fondés sur la descente de gradient stochastique emploient la MSE comme fonction objectif de minimisation computationnelle, tandis que les scientifiques réservent le RMSE pour la phase ultérieure de diagnostic, d’évaluation critique et de restitution des résultats finaux.
L’amplification quadratique inhérente à la MSE — et transmise consécutivement au RMSE par la quadrature initiale — sanctionne de manière exponentielle les déviations aberrantes. Un résidu d’une magnitude de quatre unités n’est pas simplement considéré comme quatre fois plus dommageable qu’un résidu unitaire, mais comme seize fois plus destructeur pour la fonction de fidélité globale. Cette pénalisation non linéaire constitue à la fois la plus grande force du RMSE dans les contextes où l’évitement des erreurs extrêmes est vital, et sa fragilité la plus manifeste en présence d’artefacts d’enregistrement isolés.
2.3 Formulations matricielles et calcul computationnel
Dans l’ère du traitement massif de données (Big Data) et de la modélisation à haute dimensionnalité, l’implémentation de l’erreur quadratique moyenne ne se conçoit plus sous la forme d’itérations scalaires lentes, mais requiert une écriture matricielle compacte et hautement optimisée. Soit un vecteur colonne y d’ordre (N × 1) rassemblant l’ensemble des réponses empiriques observées, et soit un vecteur colonne ŷ de dimension identique regroupant les estimations projectives générées par la matrice de design X combinée au vecteur de paramètres estimés β, tel que ŷ = Xβ. Le vecteur résiduel e s’établit simplement par la soustraction vectorielle :
e = y – ŷ = y – Xβ
Dès lors, la somme des carrés des résidus (Residual Sum of Squares, RSS) s’obtient par le produit scalaire du vecteur transposé de l’erreur avec lui-même, formulé élégamment par eTe. L’expression analytique globale du RMSE prend alors la forme matricielle canonique suivante :
RMSE = √ [ (1 / N) eTe ] = √ [ (1 / N) (y – Xβ)T(y – Xβ) ]
Cette formulation matricielle permet aux processeurs modernes d’exécuter le calcul du RMSE au moyen d’opérations d’algèbre linéaire hautement parallélisées (telles que celles fournies par les bibliothèques BLAS et LAPACK). Sur le plan computationnel, l’estimation des degrés de liberté s’intègre via la trace de la matrice de projection ou « matrice chapeau » H = X(XTX)-1XT, où le nombre effectif de paramètres p s’identifie à tr(H). La formule du RMSE sans biais pour les degrés de liberté résiduels s’exprime ainsi par la division par (N – tr(H)) sous le radical.
Au sein de l’écosystème logiciel contemporain, ces opérations sont encapsulées dans des environnements de calcul statistique performants. Dans le langage de programmation R, l’extraction de cette métrique s’effectue couramment via la syntaxe vectorisée sqrt(mean(residuals(modele)^2)) ou par l’entremise de fonctions optimisées au sein de packages tels que caret ou yardstick. Sous environnement Python, la bibliothèque canonique scikit-learn met à disposition la fonction mean_squared_error paramétrée par l’argument booléen squared=False (ou la fonction dédiée root_mean_squared_error dans ses versions récentes). L’efficacité algorithmique de ces implémentations repose sur la gestion contiguë des tableaux en mémoire vive, autorisant le traitement quasi instantané de cohortes comportant des centaines de milliers d’individus.
3. Principes directeurs pour l’interprétation concrète du RMSE
3.1 Règle de minimisation et concept d’ajustement optimal
L’interprétation clinique et méthodologique de l’erreur quadratique moyenne s’articule autour d’un principe téléologique fondamental : la minimisation de la distance scalaire. Par essence géométrique, le RMSE se présente comme une métrique d’inexactitude fonctionnelle. Par conséquent, plus la valeur chiffrée issue de son calcul tend asymptotiquement vers zéro, plus l’ajustement du modèle aux réalités phénoménologiques des participants est réputé optimal. Un RMSE de magnitude nulle signalerait un modèle prédictif parfait, où chaque observation expérimentale coïnciderait sans la moindre déviation avec la valeur anticipée par l’équation de régression.
Dans la pratique effective de la recherche comportementale, l’atteinte d’un RMSE égal à zéro relève de l’illusion épistémique totale. En raison de la présence intrinsèque d’erreur de mesure non réductible (le « bruit blanc ») et de l’incommensurable complexité des dynamiques psychiques individuelles, un niveau résiduel de divergence demeure incompressible. De fait, l’obtention d’un RMSE anormalement faible sur un échantillon d’apprentissage restreint doit immédiatement alerter le méthodologiste sur l’existence d’un surapprentissage pathologique (overfitting), signalant que le modèle s’est contenté d’apprendre par cœur les idiosyncrasies et le bruit stochastique des données plutôt que de capturer la véritable structure sous-jacente du phénomène.
Il est par ailleurs fondamental d’admettre qu’un score unique de RMSE, envisagé de façon totalement isolée et décontextualisée, s’avère hermétiquement muet sur la qualité intrinsèque d’une architecture explicative. Affirmer péremptoirement qu’un « RMSE de 4,2 est un excellent score » constitue une hérésie méthodologique si l’on ignore tout de l’échelle d’évaluation, de la variance de la cible et des conditions de mesure. Le RMSE déploie toute son utilité comparée lorsqu’il est mis en concurrence directe : il sert d’arbitre rigoureux pour départager plusieurs architectures théoriques rivales (par exemple, confronter un modèle linéaire additif à une modélisation non linéaire à effets modérateurs) appliquées sur un même jeu de données empiriques.
Dans ce cadre de comparaison relative, la structure présentant le RMSE le plus bas est objectivement désignée comme la plus fidèle à la distribution empirique. Cette comparaison comparative doit toutefois être systématiquement pondérée par le principe de parcimonie conceptuelle (le rasoir d’Ockham) : une diminution marginale et infinitésimale du RMSE ne justifie en aucun cas l’adjonction pléthorique de paramètres arbitraires venant ruiner la lisibilité interprétative de la théorie psychologique sous-jacente.
3.2 Conservation de l’unité de mesure de la variable dépendante
Le privilège herméneutique le plus saillant de l’erreur quadratique moyenne réside indiscutablement dans sa conservation scrupuleuse de l’unité de mesure propre à la variable dépendante. Là où d’autres métriques de performance s’expriment dans des abstractions désincarnées, le RMSE restitue le verdict statistique dans le dialecte exact du construct étudié. Si le protocole expérimental mesure des temps de fixation visuelle en millisecondes, le RMSE s’exprime en millisecondes. S’il évalue l’intensité dépressive au moyen de l’inventaire de Beck (BDI-II), le RMSE est rigoureusement libellé en points BDI-II. S’il quantifie des concentrations salivaires de cortisol matinal, il s’énonce en nanomoles par litre.
Cette congruence d’échelle autorise une transposition immédiate du résultat au sein de la pratique clinique et de la communication interdisciplinaire. Pour un psychiatre ou un neuropsychologue, appréhender qu’un algorithme de dépistage d’une altération cognitive présente un RMSE de 1,8 point sur le score global du Mini-Mental State Examination (MMSE) constitue une information d’une clarté clinique exemplaire. Le clinicien comprend d’emblée que les projections de l’algorithme dévieront typiquement de moins de deux points sur une échelle d’évaluation de 30 points, ce qui lui permet de jauger instantanément si la fidélité de l’outil est suffisante pour tolérer une délégation décisionnelle sans risque d’erreur diagnostique lourde.
Cette propriété contraste de manière saisissante avec les coefficients adimensionnels standardisés, au premier rang desquels figure le célébrissime coefficient de détermination R2. Si le R2 quantifie l’élégante notion de proportion de variance expliquée par le modèle, il demeure un indice purement relatif, désespérément aveugle à la métrique de base du problème. Un modèle peut exhiber un R2 impressionnant de 0,85 tout en affichant un RMSE cliniquement inacceptable si la dispersion intrinsèque de la cohorte initiale est gigantesque. Inversement, sur un groupe homogène où la variance est minime, un R2 médiocre de 0,20 peut coexister avec un RMSE extrêmement resserré et pleinement satisfaisant d’un point de vue diagnostique.
Le tableau analytique suivant synthétise les propriétés différentielles majeures entre le RMSE et les principaux indicateurs de performance prédictive utilisés en psychométrie :
| Métrique | Dimensionnalité / Unité | Sensibilité aux valeurs extrêmes | Avantage herméneutique principal |
|---|---|---|---|
| RMSE | Identique à la cible (y) | Très élevée (quadratique) | Estimation directe de l’écart type des résidus dans l’échelle d’origine. |
| MSE | Carré de la cible (y²) | Extrême (exponentielle) | Optimisation mathématique et différentiabilité fluide sans singularité. |
| MAE | Identique à la cible (y) | Modérée (linéaire) | Robustesse aux anomalies et interprétation comme déviation médiane absolue. |
| R² | Adimensionnel (0 à 1) | Sensible à la variance globale | Standardisation universelle de la part de variance expliquée. |
3.3 Établissement de seuils heuristiques de performance
L’une des interrogations les plus récurrentes formulées par les chercheurs juniors réside dans la quête naïve d’une valeur seuil universelle permettant de déclarer de facto un RMSE « statistiquement bon » ou « scientifiquement insuffisant ». Il convient d’affirmer avec la plus formelle autorité méthodologique qu’un tel seuil universel n’existe pas et ne saurait exister dans la littérature scientifique rigoureuse. Prétendre qu’un RMSE inférieur à 5 serait invariablement satisfaisant est un non-sens absolu : ce chiffre serait spectaculairement excellent si l’on quantifiait la pression artérielle systolique en millimètres de mercure, mais constituerait un désastre complet s’il s’agissait de calibrer le pH sanguin ou la température corporelle centrale.
Pour contourner cet écueil et conférer une portée interprétative rigoureuse au RMSE en l’absence de conventions normatives fixes, les méthodologistes recourent à des balises contextuelles fondées sur la variabilité intrinsèque de la variable cible. Le point de comparaison de référence le plus naturel est incarné par l’écart type empirique (σy) de la variable à prédire. En effet, un modèle de prédiction totalement naïf et dénué de tout pouvoir prédictif informatif — qui se contenterait d’attribuer invariablement à chaque individu la moyenne globale de la cohorte comme prédiction systématique — générera un RMSE exactement égal à l’écart type des données d’origine :
RMSEnaïf = σy
Dès lors, la valeur de l’écart type de la cible s’érige comme le plafond maximal de non-pertinence statistique absolue. Tout modèle affichant un RMSE supérieur ou égal à l’écart type de la variable dépendante doit être réputé totalement inutile, ses projections étant plus dispersées que la simple conjecture de la moyenne arithmétique de base. De cette relation découle l’usage de ratios heuristiques fondés sur le rapport RMSE / σy. Dans les sciences comportementales contemporaines, on considère généralement à titre d’heuristique informelle :
- Un ratio supérieur à 0,80 : Performance prédictive marginale ou insignifiante, le modèle échouant à réduire l’incertitude fondamentale des mesures.
- Un ratio compris entre 0,50 et 0,80 : Performance prédictive modérée, le modèle capturant une part appréciable du signal mais laissant subsister une dispersion importante.
- Un ratio inférieur à 0,50 : Performance robuste et satisfaisante, l’erreur quadratique moyenne étant inférieure à la moitié de la dispersion brute originelle.
- Un ratio inférieur à 0,20 : Performance prédictive exceptionnellement haute, couramment observée dans les calibrages de précision en laboratoire ou en psychophysique instrumentale.
4. Dépendance d’échelle et contextualisation de l’erreur
4.1 Effet de l’amplitude de l’échelle sur la magnitude apparente
L’asservissement direct du RMSE à l’amplitude numérique de l’échelle de mesure constitue à la fois son atout interprétatif primordial et sa source de confusion méthodologique la plus insidieuse. Toute comparaison hâtive et non standardisée de la magnitude apparente de deux RMSE issus de variables aux dynamiques d’échelle distinctes aboutit invariablement à des conclusions fallacieuses. Ce piège analytique est particulièrement prégnant dans les protocoles de psychologie cognitive et neuropsychologique, où coexistent couramment des données issues de paradigmes comportementaux radicalement divergents.
Considérons, à titre d’illustration démonstrative, une recherche examinant conjointement les effets de la fatigue mentale sur l’humeur autodéclarée et sur les temps de réaction perceptifs. L’humeur est mesurée au moyen d’une échelle de type Likert en 7 points (variant de 1 à 7), tandis que la vitesse d’inhibition motrice est quantifiée en temps de réaction à l’épreuve de Stroop, s’étendant de 350 à 1 200 millisecondes. Si un modèle de régression prédit l’humeur avec un RMSE de 1,20 et que la vitesse motrice est anticipée avec un RMSE de 45 millisecondes, une intuition profane superficielle pourrait s’alarmer du chiffre « 45 », le jugeant considérablement plus dégradé que « 1,20 ». En réalité, une déviation de 45 ms sur une échelle oscillant sur plus de 800 ms représente une fidélité prédictive remarquable, tandis qu’une erreur de 1,20 point sur un spectre restreint de 7 unités constitue une marge d’incertitude considérable représentant près de 20 % de l’amplitude totale de l’instrument.
Cette vulnérabilité métrologique interdit rigoureusement la moindre tentative de méta-analyse ou de confrontation d’adéquation entre des domaines scientifiques hétérogènes sans l’application préalable d’un processus systématique de standardisation. Les chercheurs qui omettent de contextualiser cette sensibilité d’échelle s’exposent à des jugements totalement asymétriques concernant l’efficacité relative de leurs instruments diagnostiques, pénalisant arbitrairement les mesures continues à haute résolution temporelle ou spatiale au profit exclusif de constructions psychométriques grossières artificiellement bornées à des échelles discrètes courtes.
4.2 Erreurs d’interprétation courantes liées à l’échelle
Au-delà du piège de l’amplitude absolue, plusieurs biais d’interprétation altèrent fréquemment les analyses empiriques. L’un des plus pernicieux consiste en la confusion récurrente entre la faible dispersion statistique intrinsèque d’une variable et la haute précision prédictive alléguée d’un modèle algorithmique. Si une cohorte clinique est recrutée de manière excessivement sélective, présentant une variance quasi inexistante autour d’un score de pathologie donné, n’importe quelle fonction d’estimation superficielle dégagera un RMSE mécaniquement minuscule. Ce faible niveau d’erreur ne témoigne nullement de la virtuosité architecturale du modèle, mais simplement de l’étroitesse artificielle du répertoire phénotypique des participants évalués.
Une seconde distorsion herméneutique majeure survient lors du passage non concerté aux variables standardisées en scores Z (centrées sur une moyenne de 0 et réduites à un écart type unitaire de 1). Dans cette configuration mathématique, le RMSE s’exprime immédiatement en fractions d’écart type. Si ce format confère l’illusion rassurante d’une comparabilité universelle, il masque parfois la magnitude substantielle des dérapages individuels aux yeux des non-statisticiens. Un RMSE apparemment anodin de 0,35 sur une variable standardisée implique que des participants peuvent subir une dérive prédictive de près d’un tiers d’écart type, ce qui s’avère potentiellement lourd de conséquences lors du franchissement de seuils d’accès à des prestations médico-sociales ou d’orientation spécialisée.
Enfin, le biais d’attribution de performance face à des variances restreintes se rencontre fréquemment dans l’analyse de sous-populations spécifiques. Un algorithme entraîné pour prédire la réussite universitaire peut exhiber un RMSE flatteur au sein d’une faculté d’élite hautement sélective simplement parce que les notes d’examens y sont uniformément condensées au sommet de la courbe, tout en s’effondrant de manière dramatique dès lors qu’il est transposé sur une population générale d’étudiants aux performances nettement plus étalées. La sous-estimation systématique de l’impact de la troncature d’échantillon sur la compression du RMSE représente ainsi l’une des lacunes critiques de la littérature appliquée.
4.3 Mise en relation avec l’erreur type de mesure (SEM)
Pour le spécialiste de psychométrie quantitative, il est épistémologiquement impérieux d’établir la distinction conceptuelle la plus nette entre le RMSE issu des modèles prédictifs et l’erreur type de mesure, universellement consacrée sous le sigle SEM (Standard Error of Measurement). Bien que ces deux statistiques partagent une écriture formelle analogue matérialisant un écart type d’erreurs, elles procèdent de logiques métrologiques distinctes au sein de la théorie classique des tests (TCT).
Le SEM trouve sa racine dans le postulat fondamental de Spearman selon lequel tout score observé X est la sommation du score vrai inaccessible T et d’une composante d’erreur aléatoire E (X = T + E). Le SEM quantifie spécifiquement la dispersion des scores observés qu’un même individu obtiendrait s’il était soumis à une infinité de passations du même instrument psychométrique dans des conditions rigoureusement identiques sans effet de mémoire ni de fatigue. Il se déduit de la variance totale du test (σX) couplée à son coefficient de fidélité ou de cohérence interne (ρXX’), selon la formule canonique :
SEM = σX √(1 – ρXX’)
À l’inverse, le RMSE évalué dans une équation de modélisation prédictive capture la distance empirique concrète séparant une prédiction factorielle ou multivariée (ŷ) de la réalisation observée (y). Le RMSE incorpore non seulement l’erreur de mesure inhérente à l’instrument cible (le SEM propre à la variable dépendante), mais également les faiblesses d’échantillonnage, les erreurs de mesure associées aux prédicteurs, l’inadéquation de la forme fonctionnelle postulée (biais de spécification linéaire lorsque la réalité est curviligne), ainsi que l’omission inévitable de variables causales non captées par le modèle.
Par voie de conséquence, au sein d’une recherche psychométrique rigoureusement menée, le SEM propre à l’instrument constitue la borne inférieure asymptotique théorique indépassable du RMSE du modèle prédictif. Jamais un modèle statistique prédisant un comportement ne pourra de façon légitime exhiber un RMSE inférieur au SEM intrinsèque de l’outil de mesure utilisé pour quantifier ce comportement, sauf en cas de falsification stochastique par surapprentissage sévère. L’intégration de la fidélité de l’instrument d’évaluation dans l’analyse critique de l’erreur résiduelle permet d’établir la proportion d’erreur résiduelle imputable à l’imperfection du modèle théorique versus celle incombant à l’instabilité psychométrique de la métrique employée.
5. Étude de cas empirique : Prédiction de la performance académique et de l’anxiété
5.1 Description du devis de recherche et des données récoltées
Afin de rendre palpables et pragmatiques les principes mathématiques énoncés, considérons une cohorte universitaire suivie dans le cadre d’un protocole d’ingénierie pédagogique et de psychologie de l’éducation. Cette étude vise à anticiper la performance académique finale d’étudiants de premier cycle universitaire en psychologie, quantifiée au moyen d’un examen sommatoire standardisé de statistiques inférentielles noté sur une échelle continue s’étendant de 0 à 100 points. Le devis expérimental mobilise un échantillon représentatif de N = 10 étudiants sélectionnés à des fins didactiques, pour lesquels deux prédicteurs majeurs ont été enregistrés de manière prospective :
- Le volume hebdomadaire d’étude autonome : Quantifié rigoureusement en heures consacrées aux exercices pratiques et aux lectures préparatoires au cours des douze semaines d’enseignement (variable X1).
- Le niveau d’anxiété cognitive face aux mathématiques : Évalué lors de la session inaugurale au moyen d’un sous-inventaire psychométrique standardisé variant de 10 (sérénité totale) à 50 (panique invalidante) (variable X2).
La variable cible dépendante (Y) correspond à la note d’examen effectivement obtenue. Les statistiques descriptives de base sur cette cohorte d’illustration indiquent une moyenne empirique de la note d’examen s’établissant à MY = 65,50 avec un écart type d’échantillon de σY = 14,23 points. La dispersion de l’anxiété révèle une moyenne de 30,20 points tandis que le volume de travail hebdomadaire s’établit en moyenne à 12,40 heures. Ces observations constituent la base empirique permettant d’ajuster un modèle de régression linéaire multiple dont la fidélité prédictive sera auditée par le calcul minutieux du RMSE.
5.2 Calcul pas à pas du RMSE sur l’échantillon
L’estimation des paramètres de régression par la méthode des moindres carrés ordinaires sur notre échantillon didactique a permis de spécifier l’équation prédictive suivante :
ŷi = 42,30 + (2,50 × X1i) – (0,60 × X2i)
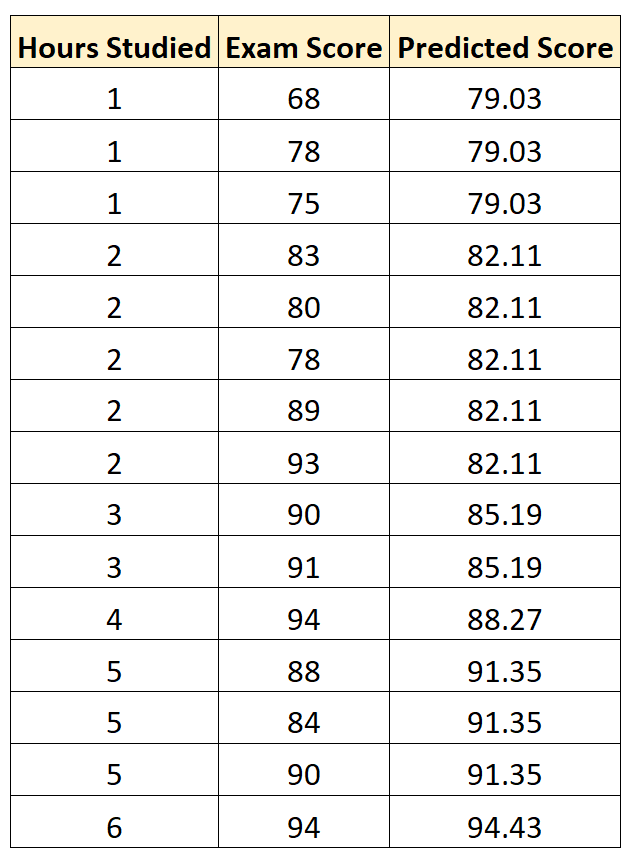
Chaque profil d’étudiant a été introduit dans cette structure afin d’engendrer sa note prédite théorique (ŷi). Pour documenter l’anatomie computationnelle intégrale du RMSE sans la moindre opacité algorithmique, le protocole séquentiel détaillé est retranscrit dans le relevé analytique pas à pas ci-dessous :
| Étudiant (i) | Heures (X₁) | Anxiété (X₂) | Note réelle (yi) | Note prédite (ŷi) | Résidu brut (yi – ŷi) | Résidu au carré (yi – ŷi)² |
|---|---|---|---|---|---|---|
| 1 | 8 | 42 | 45 | 47,10 | -2,10 | 4,41 |
| 2 | 14 | 25 | 72 | 62,30 | +9,70 | 94,09 |
| 3 | 6 | 48 | 30 | 28,50 | +1,50 | 2,25 |
| 4 | 18 | 15 | 88 | 78,30 | +9,70 | 94,09 |
| 5 | 12 | 35 | 58 | 51,30 | +6,70 | 44,89 |
| 6 | 10 | 38 | 50 | 44,50 | +5,50 | 30,25 |
| 7 | 20 | 12 | 95 | 85,10 | +9,90 | 98,01 |
| 8 | 15 | 22 | 76 | 66,60 | +9,40 | 88,36 |
| 9 | 5 | 45 | 40 | 27,80 | +12,20 | 148,84 |
| 10 | 16 | 20 | 81 | 70,30 | +10,70 | 114,49 |
| Somme des Carrés Résiduels (Σ ei²) : | 719,68 | |||||
Le déroulement arithmétique rigoureux s’exécute dès lors selon la séquence finale :
- Calcul de la moyenne des carrés d’erreurs (MSE) : En divisant la somme totale par le nombre d’observations N = 10, nous obtenons :
MSE = 719,68 / 10 = 71,968 points² - Extraction du radical pour finaliser le RMSE :
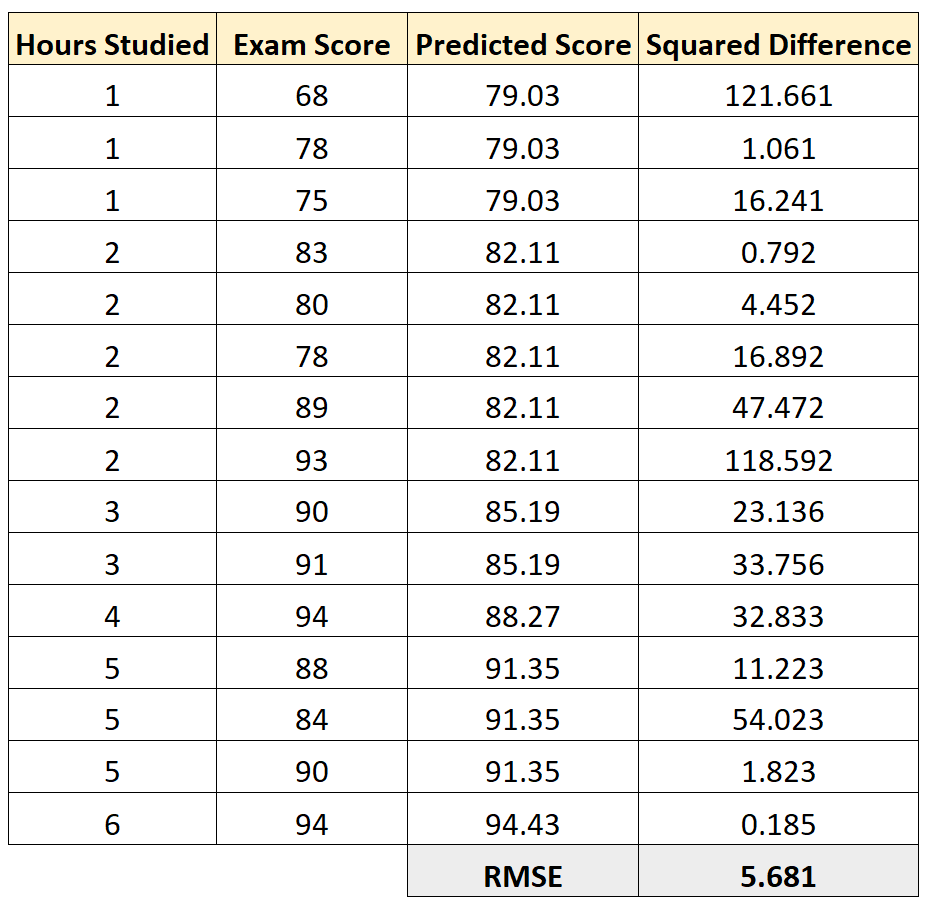
RMSE = √(71,968) = 8,483 points
Si nous appliquions la correction par les degrés de liberté relative aux trois paramètres estimés (l’ordonnée et deux régresseurs, soit N – p = 10 – 3 = 7), la MSE sans biais s’établirait à 719,68 / 7 = 102,81, délivrant un RMSE ajusté de √(102,81) = 10,139 points. La concordance de ces résultats manuels a été rigoureusement attestée sous environnement R au moyen de la commande de contrôle matriciel sqrt(c(crossprod(residuals(modele))) / length(y)), attestant de la validité algorithmique du déploiement.
5.3 Interprétation contextuelle des résultats obtenus
L’obtention d’un RMSE de 8,48 points d’examen se prête à une analyse sémantique et clinique d’une grande clarté. Exprimé dans la métrique authentique de l’épreuve universitaire, cet indicateur signifie que les anticipations générées par le modèle dévient, en moyenne quadratique, de près de 8,5 points par rapport à la réalité des performances individuelles. Sur une notation universitaire graduée de 0 à 100 où l’octroi d’une mention ou la validation d’un module d’enseignement se joue fréquemment à un demi-point près, une incertitude standard de 8,48 points demeure substantielle.
Pour apprécier la pertinence écologique de cette architecture, il est impérieux de confronter ce score à l’écart type originel de la cible, qui s’élevait à σY = 14,23 points. Le ratio heuristique s’établit à 8,48 / 14,23 ≈ 0,596. Ce résultat atteste que le modèle prédictif réussit à contracter de près de 40 % l’incertitude stochastique par rapport à une conjecture aveugle reposant sur la moyenne générale de la cohorte. Le modèle capture indiscutablement un signal comportemental robuste issu de la synergie entre le temps d’étude et la modulation anxieuse, sans toutefois suffire à fournir un diagnostic individuel infaillible.
Sur le versant des implications pratiques pour l’orientation et l’accompagnement pédagogique, ce niveau de RMSE invite à une prudence déontologique mesurée. Le dispositif peut être déployé avec succès pour un triage préventif de masse : il permet d’identifier avec pertinence les étudiants en situation de grand danger de décrochage académique afin de leur allouer des séances de tutorat renforcé ou des ateliers de remédiation face à l’anxiété mathématique. Cependant, en raison de sa marge d’erreur résiduelle de plus de 8 points, ce modèle ne saurait en aucun cas être utilisé comme substitut automatisé à l’évaluation sommative réelle, car il risquerait d’attribuer une note erronée d’un cran d’échelonnage complet à des étudiants méritants.
6. Analyse comparative approfondie : RMSE versus MAE
6.1 Fondements de l’erreur absolue moyenne (MAE)
Dans l’arsenal des statistiques d’adéquation paramétrique, l’erreur absolue moyenne ou MAE (Mean Absolute Error) constitue la rivale et la comparse conceptuelle la plus immédiate de l’erreur quadratique moyenne. Fondée sur la norme vectorielle L1 (la distance de Manhattan), là où le RMSE s’enracine dans la norme euclidienne L2, la MAE repose sur une formulation analytique d’une limpidité arithmétique totale, matérialisée par l’équation générale :
MAE = (1 / N) Σi=1N |yi – ŷi|
Au lieu d’élever les écarts individuels au carré pour abolir leur polarité négative, la MAE applique l’opérateur de valeur absolue élémentaire. D’un point de vue de géométrie spatiale, la MAE mesure la distance absolue moyenne arithmétique séparant chaque point de données de l’hyperplan de régression. Elle traite toutes les déviations avec une équité proportionnelle stricte : un résidu de 10 unités contribue très exactement dix fois plus au résultat global qu’un résidu de 1 unité, sans aucune amplification ni distorsion mathématique induite.
Cette linéarité confère à la MAE une réputation méritée d’estimateur de haute robustesse face aux variations extrêmes et aux contaminations d’échantillon. Tandis que le RMSE cherche à ajuster la moyenne de la distribution résiduelle, la MAE s’aligne formellement sur la minimisation de la médiane des écarts. Elle reflète donc le comportement typique de la majorité des observations sans se laisser déstabiliser par la présence marginale de cas atypiques, ce qui en fait un instrument de diagnostic de premier plan pour les chercheurs confrontés à des distributions asymétriques ou fortement parasitées par du bruit expérimental.
6.2 Pénalisation quadratique versus linéarité des écarts
La divergence formelle entre la norme L1 et la norme L2 induit des comportements contrastés dès lors que la structure d’erreur s’écarte de la pureté gaussienne. En vertu de l’inégalité de Cauchy-Schwarz et des propriétés fondamentales des moyennes d’ordre supérieur, la relation mathématique unissant le RMSE et la MAE pour un même ensemble de données vérifie rigoureusement l’inégalité universelle suivante :
MAE ≤ RMSE ≤ √N × MAE
La condition d’égalité stricte RMSE = MAE ne se produit que dans le scénario singulier où l’intégralité des résidus individuels présente rigoureusement la même magnitude absolue (par exemple si toutes les prédictions déviaient invariablement d’exactement 3 points par rapport à la cible, indépendamment du signe). Dès lors que de la variabilité émerge au sein des magnitudes d’erreur — ce qui constitue la règle empirique absolue —, le RMSE dépasse invariablement la MAE. Plus l’écart numérique entre le RMSE et la MAE se creuse, plus la dispersion des résidus est hétérogène et volatile.
L’écart calculé (RMSE – MAE) constitue ainsi, en lui-même, un méta-indicateur diagnostique d’une remarquable puissance informative. Si, sur un modèle psychométrique, le RMSE affiche 12,5 alors que la MAE s’établit à 6,1, le praticien acquiert l’assurance mathématique immédiate que la cohorte héberge des erreurs résiduelles majeures et sporadiques qui pèsent démesurément sur l’ajustement global. Dans cette situation, la quadrature propre au RMSE confère un poids écrasant à une poignée de déviations sévères, alors que la MAE témoigne qu’en moyenne usuelle, les déviations courantes gravitent autour d’une valeur médiane nettement plus resserrée.
La question épistémologique de savoir si cette pénalisation quadratique est scientifiquement souhaitable dépend exclusivement du paradigme disciplinaire et de la fonction de coût humaine rattachée à l’erreur. Dans les situations où une grande déviation résiduelle entraîne des conséquences critiques ou létales (par exemple, le surdosage médicamenteux en anesthésie guidée par algorithme ou l’omission d’un risque suicidaire aigu en psychiatrie hospitalière), le RMSE est conceptuellement supérieur à la MAE. Il pénalise sans merci le modèle incapable de sécuriser ses bornes extrêmes, incarnant le principe éthique selon lequel plusieurs petites déviations anodines sont infiniment préférables à une unique défaillance monumentale.
6.3 Critères de sélection dans la recherche comportementale
Le choix méthodologique d’arbitrer en faveur du RMSE ou de la MAE pour consigner les conclusions d’une étude comportementale doit reposer sur un alignement rigoureux entre les propriétés mathématiques des estimateurs et la structure distributionnelle sous-jacente des construits psychologiques investigués :
- Structure normale et homoscédastique : Si les résidus vérifient pleinement l’hypothèse de normalité gaussienne, le RMSE s’impose comme l’estimateur mathématiquement le plus efficient au sens de Gauss-Markov. Ses estimations bénéficient d’une variance d’échantillonnage minimale et d’une compatibilité immédiate avec les modélisations inférentielles paramétriques.
- Présence d’asymétrie marquée ou de queues de distribution épaisses : Lorsque les variables étudiées (telles que les temps de réaction, les niveaux de consommation de substances addictives ou les revenus financiers) exhibent des queues de distribution prononcées, la MAE doit impérativement être privilégiée pour éviter que l’évaluation globale du modèle ne soit captée par quelques individus atypiques mais légitimes.
- Degré de tolérance clinique aux erreurs marginales : Dans les contextes de sélection du personnel ou d’orientation scolaire générale, où de légers écarts n’induisent aucun préjudice individuel irréversible, la MAE fournit une vision pragmatique de la conformité moyenne de l’outil. Dès lors que l’on bascule dans le dépistage de troubles neurodégénératifs ou l’évaluation médico-légale de la dangerosité criminologique, la sévérité du RMSE devient incontournable pour sanctionner toute défaillance grossière.
- Recommandations éditoriales pour la publication scientifique contemporaine : L’état de l’art académique préconise de ne plus concevoir ces métriques de façon manichéenne et mutuellement exclusive. Les normes de publication des revues internationales de premier rang exigent désormais la publication conjointe et simultanée du RMSE et de la MAE. La présentation conjointe de ces deux indices permet aux lecteurs de jauger simultanément l’erreur typique centrale (MAE) et la présence occulte d’irrégularités résiduelles critiques (RMSE).
7. Sensibilité aux valeurs aberrantes et variabilité résiduelle
7.1 Vulnérabilité structurelle face aux observations extrêmes
La vulnérabilité majeure de l’erreur quadratique moyenne réside sans conteste dans son hypersensibilité intrinsèque aux valeurs aberrantes (outliers). En raison du mécanisme d’amplification exponentielle introduit par la quadrature résiduelle (yi – ŷi)2, l’impact exercé par une déviation empirique sur la valeur finale du RMSE croît au carré de son amplitude métrique. Cette spécificité mathématique engendre une instabilité asymptotique de l’estimateur, qui peut être dramatiquement détourné de sa trajectoire par la survenue d’un fragment infinitésimal de données fortement déviantes.
Dans les cohortes de recherche en sciences humaines, il suffit fréquemment qu’un unique individu — sur un effectif comptant plusieurs centaines de participants — adopte un profil phénoménologique aberrant ou falsifié pour que le RMSE global subisse une élévation disproportionnée. Si, au sein d’une échelle de temps de réponse, un participant s’assoupit accidentellement durant une tâche expérimentale informatisée, générant un résidu isolé de 10 000 ms là où les fluctuations interindividuelles habituelles plafonnent à 150 ms, le terme quadratique associé (100 000 000 ms²) dominera de façon hégémonique la sommation des résidus, contaminant l’estimation intégrale du modèle sans qu’aucun dysfonctionnement n’ait affecté les 99,9 % d’observations restantes.
Il appartient au chercheur d’opérer une dissociation fondamentale entre deux classes étiologiques d’observations extrêmes :
- Les artefacts méthodologiques et erreurs de saisie : Ils regroupent les erreurs typographiques de frappe informatique (par exemple saisir une taille de 180 mètres au lieu de 1,80 mètre), les défaillances de capteurs neurophysiologiques, les désynchronisations logicielles ou le désengagement manifeste d’un participant cochant la même réponse de manière aléatoire et frénétique. Ces données parasitaires constituent un bruit non écologique qui doit être éliminé sans hésitation lors du nettoyage des données.
- Les participants atypiques réels : Ils incarnent des individus dont les caractéristiques psychologiques ou cognitives s’écartent authentiquement de la moyenne de l’espèce humaine (par exemple des sujets dotés de capacités mnésiques prodigieuses ou des patients affectés de traumatismes cérébraux massifs). Dans cette occurrence, l’observation est scientifiquement valide et son exclusion arbitraire constituerait une falsification épistémologique majeure du champ de validité écologique du modèle.
7.2 Diagnostics graphiques des résidus
L’inspection aveugle d’un chiffre unique de RMSE sans vérification visuelle concomitante de la distribution résiduelle s’assimile à une navigation statistique sans boussole. L’arsenal diagnostique moderne prescrit le déploiement méthodique d’outils d’exploration graphique hautement résolutifs. Le premier d’entre eux réside dans le diagramme de dispersion des résidus en fonction des valeurs prédites (Residuals vs Fitted Plot). Dans une situation d’adéquation paramétrique saine, les points doivent se déployer sous la forme d’un nuage symétrique et homogène, assimilable à une constellation amorphe dépourvue de toute structure reconnaissable ou de canalisation géométrique.
Le tracé quantile-quantile normal (Normal Q-Q Plot) constitue le réactif visuel par excellence pour diagnostiquer la conformité distributionnelle de l’erreur. Ce diagramme confronte les quantiles empiriques des résidus standardisés aux quantiles théoriques d’une distribution normale standard de Gauss. Tout alignement rigoureux des points le long de la diagonale de référence valide l’hypothèse de normalité sous-jacente au RMSE. À l’inverse, l’inflexion des extrémités du tracé en forme de courbe en « S » révèle immédiatement la présence de queues de distribution épaisses (heavy tails), signalant la persistance d’observations extrêmes dont le poids comprime artificiellement l’efficience de l’erreur quadratique.
Enfin, la quantification de l’influence locale requiert l’examen simultané des points de levier (leverage) et de la célèbre distance de Cook. Un participant peut afficher un résidu important sans bouleverser la structure de régression si son positionnement sur les axes prédicteurs demeure central ; inversement, une observation extrinsèque conjuguant un écart résiduel marqué et un fort levier dans l’espace multidimensionnel des covariables exercera une traction destructrice sur l’estimation globale du modèle. Une distance de Cook excédant le seuil heuristique conventionnel de 4 / N ou s’approchant de l’unité signale impérativement un individu singulier dont la contribution au RMSE global s’avère exorbitante.
7.3 Stratégies d’atténuation et modèles robustes
Face à la déstabilisation récurrente du RMSE par les valeurs aberrantes, la psychométrie computationnelle a développé un arsenal stratégique de remédiation méthodologique. La première approche, issue de l’analyse exploratoire des données, consiste en l’application de techniques d’élagage contrôlé telles que la winsorisation. Contrairement à la troncature pure et simple qui supprime arbitrairement des participants de l’échantillon, la winsorisation réassigne les valeurs extrêmes situées au-delà d’un percentile défini (couramment le 1er et le 99e centile) à la valeur exacte de ce seuil limite. Cette procédure atténue drastiquement l’effet d’amplification quadratique du RMSE tout en préservant l’intégrité de la taille totale de l’échantillon N.
Une alternative mathématique de rang supérieur réside dans l’adoption d’estimateurs robustes dérivés des théories de Peter Huber. La fonction de perte de Huber (Huber Loss) réalise une synthèse harmonieuse et adaptative entre les propriétés différentielles de la MSE et la résistance de la MAE :
| Zone résiduelle | Condition formelle | Comportement de la fonction de perte |
|---|---|---|
| Zone centrale (faibles écarts) | |yi – ŷi| ≤ δ | Quadratique : comportement calqué sur la MSE / RMSE classique. |
| Zone périphérique (grands écarts) | |yi – ŷi| > δ | Linéaire : comportement de type MAE bornant l’influence des anomalies. |
Dans ce formalisme, le paramètre de bascule δ (souvent calibré à 1,345 écart type pour préserver 95 % d’efficience sous normalité) régule dynamiquement le traitement de l’erreur. Les déviations mineures sont sanctionnées selon la logique quadratique du RMSE, tandis que les anomalies sévères excédant le seuil δ voient leur contribution limitée à une progression strictement linéaire, prévenant l’explosion computationnelle de l’indice de divergence.
Enfin, toute recherche intègre gagne à conduire des analyses de sensibilité rétrospectives en documentant systématiquement la stabilité du RMSE avant et après filtrage ou modélisation robuste. Si le RMSE d’un modèle d’anxiété bascule de 14,2 points à 6,8 points après la neutralisation motivée de deux artefacts techniques documentés, la transparence commande de restituer conjointement les deux valeurs au sein du rapport de recherche en explicitant rigoureusement les justifications empiriques de la décision méthodologique.
8. Diagnostic du surapprentissage et compromis biais-variance
8.1 Divergence entre RMSE d’entraînement et de test
L’évaluation épistémologique de la fidélité d’un modèle statistique ne saurait se cantonner à la mesure de son adéquation aux données qui ont précisément servi à son étalonnage. La pierre de touche de toute théorie scientifique réside dans sa capacité de généralisation prédictive face à des données inédites qu’elle n’a jamais observées durant sa phase de conception. Dans ce contexte, l’erreur quadratique moyenne s’avère l’indicateur par excellence pour traquer et diagnostiquer le phénomène pernicieux du surapprentissage (overfitting).
Le surapprentissage se manifeste par une divergence spectaculaire entre deux déclinaisons opérationnelles du RMSE :
- Le RMSE d’entraînement (Train RMSE) : Calculé sur la cohorte d’apprentissage dédiée à la dérivation des paramètres du modèle.
- Le RMSE de test ou de validation (Test RMSE) : Quantifié sur un échantillon d’évaluation totalement indépendant et hermétiquement isolé durant la phase d’ajustement.
La manifestation pathologique classique d’un modèle en état de surapprentissage réside dans l’effondrement artificiel de son RMSE d’entraînement — qui tend vers des magnitudes proches de zéro à mesure que le modèle déploie une complexité paramétrique excessive —, concomitamment à une explosion démesurée de son RMSE de test. Cette béance témoigne que l’algorithme a cessé d’extraire les lois générales gouvernant le processus cognitif ou comportemental sous-jacent pour se contenter de mémoriser mécaniquement le bruit d’échantillonnage, les artefacts et les anomalies idiosyncrasiques propres au groupe initial.
À l’extrême inverse du continuum d’ajustement se situe le sous-apprentissage (underfitting), caractérisé par l’incapacité du modèle à capturer la complexité fondamentale du phénomène psychologique. Le sous-apprentissage se matérialise sans ambiguïté par un RMSE systématiquement et uniformément élevé, attesté de manière simultanée tant sur l’échantillon d’apprentissage que sur la cohorte de validation. Face à un sous-apprentissage avéré, la modélisation souffre d’un biais théorique majeur, imposant au chercheur de réviser sa conceptualisation initiale par l’intégration de nouveaux régresseurs informatifs ou le basculement vers des structures fonctionnelles non linéaires.
8.2 Régularisation et contrôle de la complexité
Pour juguler l’inflation de la variance d’estimation et maîtriser l’envolée du RMSE sur les données inédites, la modélisation statistique moderne met en œuvre des protocoles rigoureux de régularisation algorithmique. Ces méthodologies introduisent sciemment une contrainte formelle au sein de la fonction de coût, acceptant une dégradation délibérée et infinitésimale du biais d’apprentissage afin de juguler l’expansion explosive de la variance de prédiction. Les deux formulations paradigmatiques de ce principe sont la régularisation Ridge et la régularisation Lasso.
La régularisation Ridge (pénalité de norme L2) modifie l’objectif d’optimisation en lui adjoignant un terme de pénalité quadratique proportionnel au carré de la magnitude des coefficients de régression :
PerteRidge = Σi=1N (yi – ŷi)2 + λ Σj=1p βj2
L’action de ce paramètre d’hyper-régulation λ force les coefficients β à se contracter doucement vers zéro sans jamais s’annuler totalement. Cette contraction paramétrique stabilise le modèle face à la multicolinéarité aiguë des échelles psychométriques et resserre de manière décisive le RMSE de généralisation. La régularisation Lasso (pénalité de norme L1), quant à elle, utilise la somme des valeurs absolues des paramètres (|βj|), forçant les coefficients des prédicteurs superficiels à s’annuler exactement, combinant ainsi la minimisation du RMSE avec une sélection automatisée et parcimonieuse des facteurs explicatifs décisifs.
La calibration optimale de l’hyperparamètre λ s’opère par le traçage systématique des trajectoires d’évolution du RMSE sur un ensemble de validation croisée. Le point d’inflexion minimal où le RMSE de validation atteint sa valeur la plus basse désigne le point d’équilibre optimal du compromis biais-variance. Cette approche protège le chercheur en sciences sociales contre la dérive consistant à surcharger artificiellement les protocoles au moyen de variables superflues dénuées de validité prédictive générale.
8.3 Courbes d’apprentissage basées sur le RMSE
Le déploiement des courbes d’apprentissage (learning curves) constitue l’instrument d’investigation par excellence pour ausculter l’adéquation d’un modèle au fil de l’incrémentation de la puissance statistique. Ces visualisations synthétiques projettent simultanément les trajectoires dynamiques du RMSE d’entraînement et du RMSE de validation en fonction de l’augmentation progressive de la taille de l’échantillon N, découpé en fractions incrémentales depuis des cohortes modestes jusqu’au volume complet des observations disponibles.
L’observation attentive du comportement de ces deux courbes renseigne immédiatement sur la dynamique interne de l’architecture d’estimation :
- Cas d’une variance excessive (Surapprentissage) : À des effectifs restreints, le RMSE d’entraînement est extrêmement bas tandis que le RMSE de validation culmine à des sommets d’erreur. À mesure que l’échantillon s’accroît, les deux courbes convergent progressivement l’une vers l’autre mais conservent un écart résiduel persistant. Ce diagnostic indique sans équivoque qu’un accroissement supplémentaire de la cohorte d’étude permettra de comprimer encore davantage l’erreur de généralisation.
- Cas d’un biais excessif (Sous-apprentissage) : Dès les premiers paliers de taille d’échantillon, le RMSE d’entraînement subit une ascension rapide vers un niveau d’erreur important, tandis que le RMSE de validation décroît à peine pour fusionner prématurément à un plateau d’erreur asymptotique élevé. Dans cette configuration géométrique, l’adjonction de nouveaux participants s’avère parfaitement vaine : le modèle a épuisé sa capacité explicative et requiert une refonte théorique intégrale.
L’identification formelle du plateau asymptotique de performance du RMSE permet ainsi de déterminer avec rigueur le dimensionnement optimal d’un protocole expérimental. Lorsqu’une courbe de validation RMSE atteint un seuil de stabilisation horizontale parfaite où chaque bloc de cent nouveaux participants ne réduit l’erreur quadratique que de 0,001 point, le méthodologiste acquiert la certitude empirique que la cohorte a atteint un seuil de saturation informationnelle, justifiant la clôture rationnelle de la phase de recrutement expérimental.
9. Intégration du RMSE dans les protocoles de validation croisée
9.1 Méthodologie de validation croisée k-fold
L’évaluation rigoureuse de la généralisabilité d’un modèle statistique ne saurait dépendre de l’arbitraire d’un unique fractionnement statique entre un ensemble d’apprentissage et un ensemble de test. La variabilité d’échantillonnage inhérente aux cohortes psychologiques pourrait accidentellement cantonner les cas les plus complexes dans l’un ou l’autre des sous-ensembles, faussant irrémédiablement le calcul du RMSE. Pour contourner cette limite, la communauté académique a fait de la validation croisée à k plis (k-fold cross-validation) le standard méthodologique absolu.
Le protocole algorithmique s’exécute selon une logique cyclique rigoureuse :
- L’échantillon global N est partitionné de façon aléatoire en k sous-ensembles (ou plis) de volumes rigoureusement équivalents (généralement k = 5 ou k = 10). Lorsque la variable dépendante continue présente une forte asymétrie, une stratification quantile préalable est appliquée pour assurer une répartition homogène des valeurs cibles dans chaque pli.
- Une boucle itérative s’amorce : pour chaque pli j allant de 1 à k, le modèle statistique est entraîné sur l’agrégation des k – 1 autres plis, puis déployé pour prédire exclusivement les observations du pli j conservé comme ensemble de validation indépendant.
- Pour chaque pli j, le RMSE de test local (noté RMSEj) est méticuleusement calculé en confrontant les prédictions indépendantes aux cibles réelles du pli.
- Au terme des k itérations, le RMSE global de validation croisée (CV-RMSE) est agrégé sous la forme de l’espérance mathématique de ces erreurs individuelles, complétée impérativement de son écart type empirique :
CV-RMSE = (1 / k) Σj=1k RMSEj
Cette méthodologie garantit que chaque individu de la cohorte d’étude fait l’objet, exactement une fois au cours du cycle algorithmique, d’une prédiction à l’aveugle par un modèle qui n’a jamais croisé son profil lors de son entraînement. L’écart type calculé SDCV-RMSE quantifie la stabilité de la performance prédictive à travers les différentes partitions du jeu de données, conférant à la restitution de l’erreur quadratique moyenne une assise probabiliste d’une robustesse inattaquable.
9.2 Validation croisée répétée et Leave-One-Out (LOOCV)
Dans certaines configurations expérimentales spécifiques — notamment les études d’imagerie par résonance magnétique fonctionnelle (IRMf), les protocoles de neuropsychologie clinique portant sur des pathologies rarissimes ou les investigations génétiques à haute résolution —, la constitution de larges cohortes se heurte à des contraintes matérielles, financières et éthiques indépassables. Confronté à un échantillon résiduel restreint (par exemple N < 30), le fractionnement conventionnel en 5 ou 10 plis devient méthodologiquement intenable en raison de l’instabilité drastique des sous-groupes d’apprentissage.
Dans ce contexte particulier, le protocole de validation croisée par exclusion unitaire ou LOOCV (Leave-One-Out Cross-Validation) s’impose comme une alternative mathématique de premier ordre. Le LOOCV pousse la logique du k-fold à son paroxysme analytique en fixant le nombre de plis k à la valeur exacte de la taille totale de l’échantillon N (soit k = N). Le modèle est entraîné sur N – 1 sujets et testé sur l’unique individu exclu de la modélisation. Ce cycle est répété de façon exhaustive N fois successives, permettant de calculer le résidu individuel indépendant de chaque participant sous une variance d’échantillonnage théoriquement quasi nulle pour les ensembles d’entraînement.
Le calcul final du RMSE sous protocole LOOCV s’effectue en agrégeant les résidus unitaires indépendants e(i) = (yi – ŷ(i)) générés lors de chaque exclusion séquentielle :
LOOCV-RMSE = √ [ (1 / N) Σi=1N (yi – ŷ(i))2 ]
Il importe toutefois de souligner le compromis computationnel et statistique inhérent au LOOCV. Si cette approche délivre un estimateur de l’erreur quasi sans biais, les N modèles entraînés sont presque identiques entre eux (partageant N – 2 observations en commun à chaque itération), ce qui confère aux estimations d’erreur une covariance mutuelle très élevée. C’est pourquoi, sur des jeux de données d’amplitude intermédiaire, les spécialistes préconisent l’usage de la validation croisée k-fold répétée (par exemple 10 répétitions complètes d’un 10-fold avec réassignation aléatoire des plis), qui combine une charge computationnelle modérée avec une remarquable mitigation de la variance d’échantillonnage.
9.3 Interprétation des intervalles de confiance du RMSE
L’un des manquements méthodologiques les plus flagrants de la recherche quantitative consiste à rapporter l’erreur quadratique moyenne comme une grandeur ponctuelle dénuée d’incertitude stochastique, comme si la valeur de RMSE calculée sur une cohorte empirique représentait une vérité universelle immuable. À l’instar de n’importe quel paramètre statistique dérivé d’un échantillon fini, le RMSE est une variable aléatoire sujette aux fluctuations d’échantillonnage. Dès lors, l’estimation rigoureuse d’un intervalle de confiance à 95 % (IC 95 %) entourant le score de RMSE représente un réquisit fondamental de l’inférence moderne.
En raison de la distribution asymptotique complexe des formes quadratiques sous violations d’orthogonalité ou de normalité, la dérivation analytique fermée des intervalles de confiance du RMSE s’avère souvent délicate. Les méthodologistes contemporains privilégient donc les approches non paramétriques de rééchantillonnage par bootstrap. La méthodologie séquentielle se déploie selon les canons de l’inférence computationnelle :
- À partir de la cohorte d’évaluation originale comportant N individus, on génère par tirage aléatoire avec remise un nombre massif B de réplicats statistiques (couramment B = 2 000 à B = 10 000 rééchantillons).
- Sur chaque rééchantillon b, le RMSE est intégralement recalculé en appliquant les prédictions du modèle sur les observations tirées.
- La compilation de ces B estimations permet de dresser la distribution d’échantillonnage empirique du RMSE.
- L’intervalle de confiance à 95 % s’extrait directement par la méthode des percentiles corrigés du biais et accélérés (BCa), en consignant les percentiles 2,5 % et 97,5 % de la distribution de bootstrap générée.
La formulation des résultats sous la forme typographique normée RMSE = 4,52, IC 95 % [3,89 ; 5,28] transforme radicalement la portée de l’interprétation. Elle permet non seulement de certifier l’amplitude maximale la plus probable du risque d’erreur en condition réelle, mais elle fournit également le support analytique rigoureux requis pour tester la signification statistique entre deux modèles concurrents. Si les intervalles de confiance à 95 % de deux architectures statistiques prédictives concurrentes se chevauchent de façon substantielle, le chercheur s’interdira de proclamer péremptoirement la supériorité opérationnelle du modèle affichant le score nominal le plus bas.
10. Standardisation et normalisation : NRMSE et métriques dérivées
10.1 Méthodes de calcul du RMSE normalisé (NRMSE)
Pour abolir l’assujettissement strict du RMSE à l’échelle de mesure originale et autoriser des comparaisons transversales directes entre des échelles psychométriques ou des paradigmes neuropsychologiques hétérogènes, la littérature méthodologique a consacré l’usage du RMSE normalisé, universellement désigné par l’acronyme NRMSE (Normalized Root Mean Square Error). La normalisation opère par la division du RMSE scalaire brut par une quantité de dispersion de référence propre à la variable dépendante y. Il existe dans la pratique quantitative quatre formulations majeures de cette standardisation, chacune portant une signification herméneutique distincte :
| Dénominateur de référence | Formulation mathématique | Propriétés épistémologiques et limites |
|---|---|---|
| Étendue des valeurs (Max – Min) | NRMSErange = RMSE / (ymax – ymin) | Intuitive (pourcentage de l’intervalle possible) mais extrêmement vulnérable aux anomalies affectant les extrêmes. |
| Moyenne de la cible (ȳ) | NRMSEmean = RMSE / ȳ | Analogue au coefficient de variation, mais conceptuellement intenable si la variable franchit zéro ou possède une origine arbitraire. |
| Écart type empirique (σy) | NRMSEsd = RMSE / σy | Hautement robuste et rigoureuse au regard de la théorie statistique ; mesure la part résiduelle non standardisée. |
| Écart interquartile (IQR) | NRMSEiqr = RMSE / (Q3 – Q1) | Résistante aux queues de distribution épaisses et aux valeurs aberrantes ; optimale pour les distributions asymétriques. |
Le choix délibéré du dénominateur ne relève pas d’une simple préférence esthétique mais conditionne lourdement le résultat chiffré final. La division par l’étendue globale (ymax – ymin) délivre couramment un pourcentage flatteur (souvent inférieur à 10 %), ce qui en fait l’outil de prédilection d’auteurs cherchant à enjoliver artificiellement la précision de leurs algorithmes. À l’inverse, la normalisation par l’écart type σy (également formalisée sous le terme de Scatter Ratio) offre une lecture analytique impitoyable, directement couplée à la mécanique du R2, interdisant toute autosatisfaction trompeuse.
10.2 Facilitation des méta-analyses et synthèses quantitatives
L’avènement de la science ouverte et des synthèses cumulatives de données a érigé la méta-analyse au sommet de la hiérarchie des preuves empiriques. Dans ce champ, la standardisation via le NRMSE joue un rôle intégrateur inestimable pour agréger des données issues de batteries de tests hétérogènes mesurant un même construit psychologique latent au moyen d’instruments concurrents.
Considérons une synthèse quantitative portant sur l’efficacité prédictive d’algorithmes d’apprentissage automatique dédiés au dépistage précoce du déficit d’attention avec hyperactivité (TDAH). Les études publiées dans la littérature internationale mobilisent indifféremment l’échelle de Conners (comportant des scores s’étalant sur plusieurs dizaines d’items), la grille SNAP-IV ou l’évaluation clinique de l’ADHD Rating Scale. Confronter les RMSE bruts issus de ces investigations respectives reviendrait à additionner des unités monétaires incompatibles. La conversion universelle de ces données en NRMSE (particulièrement via la normalisation par l’écart type) permet d’harmoniser l’ensemble des résultats publiés sur un continuum d’évaluation unifié.
Exprimé sous cette forme standardisée, le résultat se prête à une méta-régression permettant d’identifier quelles architectures algorithmiques (forêts aléatoires, réseaux de neurones profonds, régressions régularisées) minimisent substantiellement le NRMSE moyen à travers l’ensemble des études répertoriées dans le monde. Cette harmonisation métrologique constitue le vecteur indispensable par lequel les sciences du comportement transforment des observations fragmentaires et dispersées en connaissances universelles consolidées.
10.3 Complémentarité avec le coefficient R² et le R² ajusté
Une compréhension mathématique aboutie exige d’expliciter la passerelle fonctionnelle qui unit de manière déterministe le NRMSE normalisé par l’écart type et le coefficient de détermination R2. Dans le cadre canonique d’une régression linéaire ordinaire où la somme des résidus est strictement nulle, la relation entre le R2 et le NRMSEsd se formule au moyen de l’équation biunivoque suivante :
R2 = 1 – (RMSE / σy)2 = 1 – (NRMSEsd)2
Symétriquement, cette identité algébrique permet d’exprimer le ratio normalisé de l’erreur quadratique directement à partir de la part de variance expliquée :
NRMSEsd = √(1 – R2)
Cette élégante consubstantialité démontre qu’une corrélation strictement inverse régit ces deux grandeurs : toute élévation du R2 entraîne une compression mécanique correspondante du NRMSE. Dès lors, un modèle affichant un R2 de 0,75 présente nécessairement un NRMSEsd égal à √(1 – 0,75) = √(0,25) = 0,50, ce qui signifie que l’écart type résiduel du modèle correspond très exactement à la moitié de la dispersion empirique originelle de la cible.
Pourquoi dès lors persister à rapporter le RMSE si celui-ci s’avère mathématiquement couplé au R2 ? La réponse tient à la dissociation fondamentale entre une proportion abstraite de variance et une marge concrète d’erreur d’estimation. Le R2 est une statistique notoirement instable en présence d’hétérogénéité d’échantillon : un chercheur peut artificiellement gonfler son R2 en sur-échantillonnant des cas extrêmes aux deux pôles de la distribution, élargissant ainsi la variance totale au dénominateur sans que la précision réelle de l’outil ne se soit améliorée d’un iota. Le RMSE brut, quant à lui, demeure intraitable face à cette manipulation : il continue d’enregistrer la déviation empirique réelle exprimée en points, millisecondes ou symptômes. C’est dans cette dialectique complémentaire entre la part relative de variance maîtrisée (R2) et la magnitude absolue de l’erreur tangible (RMSE) que se forge un jugement d’adéquation véritablement lucide et exhaustif.
11. Applications avancées du RMSE dans les modèles psychométriques contemporains
11.1 Modélisation par équations structurelles (SEM)
Dans la modélisation par équations structurelles (Structural Equation Modeling) et les analyses factorielles confirmatoires (CFA), l’analogie conceptuelle du RMSE trouve son incarnation la plus célèbre dans le RMSEA (Root Mean Square Error of Approximation), formalisé par James Steiger et Michael Browne en 1980. Bien que le RMSE classique évalue des écarts prédictifs individuels sur des observations directes, le RMSEA transpose cette même philosophie quadratique à l’évaluation de l’écart global séparant la matrice de covariance empirique S de la matrice de covariance théorique postulée Σ(θ).
Le RMSEA s’énonce mathématiquement comme une mesure de non-ajustement par degré de liberté résiduel, matérialisée par la formule canonique :
RMSEA = √ [ max(0, (χ2 – df) / (df × (N – 1))) ]
Où χ2 représente la statistique de divergence du modèle et df le nombre de degrés de liberté disponibles. Tout comme le RMSE tend vers zéro en cas d’adéquation prédictive parfaite, un RMSEA inférieur à 0,05 consacre un ajustement d’une excellente fidélité, tandis qu’une magnitude excédant 0,10 signale une divergence structurelle sévère imposant le rejet du modèle factoriel. L’héritage méthodologique unissant le RMSE et le RMSEA réside dans leur pénalisation quadratique systématique des écarts de structure, assurant que les distorsions de covariance locales soient sanctionnées avec rigueur dans le diagnostic global d’adéquation.
Au-delà du RMSEA, les spécialistes de psychométrie computationnelle examinent directement le SRMR (Standardized Root Mean Square Residual), qui s’identifie de manière encore plus littérale à un RMSE calculé sur les coefficients résiduels de corrélation. Le SRMR représente l’écart quadratique moyen existant entre les corrélations bivariées empiriques et les corrélations reproduites par la structure latente postulée. L’inspection conjointe de ces dérivés quadratiques garantit que l’architecture des construits psychologiques postulés ne repose pas sur une agrégation artificielle de dimensions orthogonales divergentes.
11.2 Théorie de réponse aux items (TRI) et calibrage
Au sein de la Théorie de Réponse aux Items (TRI), paradigme dominant de la psychométrie contemporaine pour la conception des tests adaptatifs informatisés (CAT) et l’étalonnage des grandes enquêtes internationales (telles que les études PISA), le RMSE constitue un indicateur de calibration indispensable. Dans ces modélisations probabilistes non linéaires (modèles de Rasch, modèles logistiques à 2 ou 3 paramètres), la probabilité de succès à un item dépend mathématiquement de la distance existant entre le niveau de trait latent de l’individu (θ) et les paramètres de difficulté (b) et de discrimination (a) de l’item.
L’évaluation de l’adéquation item-modèle fait un usage intensif du RMSE pour quantifier la distance métrique séparant la courbe caractéristique théorique de l’item (ICC) des taux de réussite empiriques constatés au sein de différentes strates d’aptitude. Un item d’évaluation cognitive ne peut être homologué au sein d’une banque calibrée de tests si son calcul de divergence résiduelle dépasse des seuils de tolérance rigoureusement préétablis. Le RMSE permet de juguler les phénomènes de « fonctionnement différentiel d’item » (DIF), en vérifiant que la précision de calibration de l’item demeure invariante quel que soit le sous-groupe démographique ou culturel évalué.
Par ailleurs, l’estimation algorithmique du trait latent lui-même (θ) — opérée par le maximum de vraisemblance (MLE) ou par l’estimation bayésienne Expected A Posteriori (EAP) — fait l’objet d’un audit de fidélité au travers du RMSE d’estimation latent. Ce calcul mesure l’écart quadratique moyen entre le niveau de compétence véritable θ (simulé dans des protocoles de Monte-Carlo préalables) et le niveau θ̂ effectivement extrait par l’algorithme adaptatif au terme d’une séquence bornée de passation d’items. La minimisation drastique de ce RMSE conditionne l’autorisation de réduire le nombre de questions posées aux candidats sans sacrifier la validité métrologique de la décision finale.
11.3 Apprentissage automatique appliqué à la neuropsychologie
L’intersection contemporaine entre la neuropsychologie clinique, la neuro-imagerie et le machine learning ouvre un horizon sans précédent pour l’application avancée de l’erreur quadratique moyenne. Les chercheurs élaborent désormais des architectures prédictives massives visant à anticiper le déclin cognitif individuel chez des patients présentant un trouble cognitif léger (Mild Cognitive Impairment, MCI) en intégrant conjointement des biomarqueurs protéiques (tau, béta-amyloïde), des volumétries hippocampiques par IRM et des données comportementales dynamiques.
Dans ce contexte hautement sophistiqué, le RMSE devient la fonction de perte critique permettant l’optimisation minutieuse des hyperparamètres régissant des algorithmes non linéaires d’une formidable complexité, tels que les machines à vecteurs de support (SVR), les forêts aléatoires de régression (Random Forest), les algorithmes d’amplification de gradient (XGBoost, LightGBM) et les architectures de réseaux de neurones profonds (Deep Learning). L’optimisation bayésienne des hyperparamètres scrute les espaces multidimensionnels pour sélectionner l’architecture exacte qui minimise le RMSE de validation croisée répétée sur la prédiction de scores cognitifs globaux à échéance de 36 mois.
Sur le plan translationnel et médical, l’interprétation du RMSE s’articule alors directement à des seuils de tolérance d’erreur prédictive cliniquement admissibles. Une équipe de neuropsychologie computationnelle doit statuer sur la question de savoir si un modèle affichant un RMSE de 2,4 points sur l’échelle ADAS-Cog (Alzheimer’s Disease Assessment Scale-Cognitive Subscale) est éligible pour un déploiement hospitalier de routine. Si la progression symptomatique pathologique typique s’établit à 4 points par an au cours des phases de dégénérescence active, une incertitude de prédiction de 2,4 points confère au modèle une robustesse suffisante pour discriminer valablement une détérioration neurologique précipitée d’un vieillissement physiologique normal, fournissant ainsi aux praticiens hospitaliers un levier décisionnel sans équivalent dans l’histoire de la médecine translationnelle.
12. Directives académiques et standards de restitution éditoriale
12.1 Normes de publication APA pour le rapportage statistique
La publication de résultats statistiques au sein des revues scientifiques régies par les standards de l’American Psychological Association (APA, 7e édition) obéit à des conventions typographiques et formelles rigoureuses que tout auteur se doit de maîtriser impeccablement. La diffusion de l’erreur quadratique moyenne ne déroge pas à cette exigence d’uniformisation typographique :
- Typographie textuelle : L’abréviation de l’indicateur s’écrit en majuscules d’imprimerie non italiques sous l’acronyme universel RMSE. S’il s’agit de décrire les estimations individuelles des paramètres sous forme matricielle ou scalaire continue dans le corps du texte, les symboles mathématiques sont systématiquement composés en italique (par exemple N pour la taille de la cohorte, p pour les paramètres, et e pour l’erreur résiduelle), tandis que l’opérateur statistique lui-même reste en romain.
- Rapportage chiffré : Le RMSE doit être consigné avec une précision décimale rigoureusement alignée sur la métrologie de l’instrument cible (couramment deux ou trois décimales après la virgule, séparées d’un point selon les canons anglo-saxons ou d’une virgule en français académique). Il est strictement impératif d’adjoindre l’unité de mesure associée au chiffre énoncé : consigner laconiquement « RMSE = 4.12 » constitue une omission éditoriale fautive ; il convient d’écrire « RMSE = 4,12 points BDI-II » ou « RMSE = 4,12 ms ».
- Présentation tabulaire : Lorsque plusieurs modèles comparatifs sont présentés au sein d’un tableau synthétique d’adéquation, la colonne dédiée au RMSE doit se situer immédiatement à côté de celle rapportant la MAE et le R2 de test. Les notes de bas de tableau doivent expliciter sans ambiguïté si le RMSE consigné correspond à l’erreur d’apprentissage ou à l’erreur de validation croisée (ex. « Note. RMSE = Erreur quadratique moyenne estimée par validation croisée 10-fold stratifiée répétée 5 fois »).
- Transparence méthodologique : Les directives APA imposent la transparence la plus totale sur les opérations de prétraitement ayant affecté les données brutes. Tout chercheur doit spécifier expressément si le RMSE a été calculé sur les grandeurs authentiques non transformées, sur des variables standardisées en scores Z, ou après application de transformations logarithmiques ou de winsorisation sélective.
12.2 Checklist de rigueur pour l’interprétation des résultats
Afin de garantir que l’interprétation finale d’un modèle statistique adossé au RMSE soit irréprochable et exempte de toute faille logique, le méthodologiste peut déployer une grille d’audit qualité opérationnelle. Cette checklist synthétise les points d’ancrage méthodologiques incontournables :
| Étape d’audit | Question méthodologique critique | Critère de conformité exigé |
|---|---|---|
| 1. Concordance d’unité | Le RMSE est-il expressément interprété dans la métrique directe de la cible observée ? | Absence totale d’adimensionnalité erronée ; mention systématique de l’unité physique ou clinique. |
| 2. Référence de base | Le RMSE est-il explicitement confronté à l’écart type (σy) de la variable dépendante ? | Le ratio RMSE / σy doit être rapporté pour prouver que le modèle surpasse la conjecture naïve de la moyenne. |
| 3. Validation indépendante | L’erreur rapportée provient-elle d’un échantillon indépendant ou d’un protocole de validation croisée ? | Rejet absolu de la restitution exclusive du seul RMSE d’apprentissage (prévention du surapprentissage). |
| 4. Évaluation des extrêmes | Le différentiel entre le RMSE et la MAE a-t-il été investigué pour traquer les valeurs aberrantes ? | Documentation de la distance (RMSE – MAE) et inspection visuelle des diagrammes résiduels Q-Q. |
| 5. Portée clinique | La magnitude de l’erreur quadratique moyenne est-elle mise en balance avec la précision diagnostique requise ? | Explicitation des risques concrets d’inversion catégorielle ou de faux diagnostics induits par la marge d’erreur. |
12.3 Perspectives futures dans l’évaluation des erreurs prédictives
L’évolution contemporaine des sciences quantitatives et de l’intelligence artificielle appliquée redéfinit progressivement la manière dont les méthodologistes conçoivent et exploitent l’erreur quadratique moyenne. Si le statut canonique du RMSE demeure inébranlable en raison de son élégance mathématique et de son alignement historique sur la physique statistique, l’avenir s’oriente vers des cadres d’interprétation résolument probabilistes et décisionnels.
La première mutation d’envergure réside dans l’intégration systématique des approches bayésiennes de l’erreur prédictive. Plutôt que d’assigner à chaque participant un score prédictif déterministe unique suivi d’un résidu statique, les modélisations bayésiennes génèrent une distribution de prédiction a posteriori complète pour chaque individu. Dans ce paradigme, le RMSE cesse d’être une métrique post-hoc figée pour devenir l’espérance mathématique des déviations calculée à travers l’intégralité de l’espace des paramètres plausibles, encapsulant harmonieusement l’incertitude épistémique du modèle et l’incertitude aléatoire irréductible des données humaines.
Parallèlement, la recherche translationnelle s’émancipe de la contrainte de symétrie absolue imposée par la quadrature de l’erreur. Dans un diagnostic de pathologie neuropsychologique dégénérative, commettre une sous-estimation de sévérité (conduisant à priver un patient d’un protocole d’intervention précoce indispensable) constitue une faute incomparablement plus tragique qu’une surestimation prudente de la dégradation. Dès lors, la communauté scientifique assiste à l’émergence de fonctions de perte asymétriques — telles que la perte « lin-lin » ou la perte « quad-quad » modifiée —, où la quadrature sanctionne plus sévèrement les sous-estimations que les surestimations. L’adaptation asymétrique du RMSE ouvre ainsi la voie à une métrologie de l’incertitude directement alignée sur la théorie de la décision et la responsabilité éthique.
Enfin, la montée en puissance de la culture de la reproductibilité scientifique et de la littératie statistique dans les sciences sociales exige un rehaussement constant des standards méthodologiques. L’interprétation éclairée de l’erreur quadratique moyenne ne doit plus être le privilège hermétique d’une caste restreinte de biostatisticiens et de psychométriciens d’élite, mais devenir une compétence universellement partagée par chaque clinicien, chercheur et décideur public. Ce n’est qu’au prix d’une compréhension intime des vertus géométriques, des pièges d’échelle et des vulnérabilités distributionnelles du RMSE que la communauté scientifique pourra continuer d’édifier des modèles comportementaux authentiquement rigoureux, voués à éclairer avec précision la complexe diversité de la condition humaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Browne, M. W., & Cudeck, R. (1992). Alternative ways of assessing model fit. Sociological Methods & Research, 21(2), 230–258. https://doi.org/10.1177/0049124192021002005
- Chai, T., & Draxler, R. R. (2014). Root mean square error (RMSE) or mean absolute error (MAE)? – Arguments against avoiding RMSE in the literature. Geoscientific Model Development, 7(3), 1247–1250. https://doi.org/10.5194/gmd-7-1247-2014
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.2307/1268249
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. Chapman & Hall/CRC. https://doi.org/10.1201/9780429246593
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Huber, P. J. (1964). Robust estimation of a location parameter. The Annals of Mathematical Statistics, 35(1), 73–101. https://doi.org/10.1214/aoms/1177703732
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Legendre, A. M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. F. Didot.
- Steiger, J. H. (1990). Structural model evaluation and modification: An interval estimation approach. Multivariate Behavioral Research, 25(2), 173–180. https://doi.org/10.1207/s15327906mbr2502_4
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Willmott, C. J., & Matsuura, K. (2005). Advantages of the mean absolute error (MAE) over the root mean square error (RMSE) in assessing average model performance. Climate Research, 30(1), 79–82. https://doi.org/10.3354/cr030079