
L’apprentissage automatique contemporain repose sur une promesse fondamentale : celle d’extraire des lois sous-jacentes à partir d’observations empiriques finies afin d’inférer avec exactitude des propriétés sur des données non encore observées. Cependant, cette quête d’extrapolation se heurte d’emblée à une tension mathématique et conceptuelle universelle. Tout modèle prédictif, qu’il s’agisse d’une humble régression linéaire univariée ou d’un réseau neuronal profond comportant des centaines de milliards de paramètres, se trouve inexorablement contraint par le compromis biais-variance. Ce théorème informel, dérivé de la théorie de l’estimation statistique, formalise l’équilibre précaire entre l’incapacité d’un algorithme à saisir la complexité d’un phénomène (le biais) et sa vulnérabilité excessive face aux fluctuations aléatoires de l’échantillon d’apprentissage (la variance).
Dans l’histoire des sciences computationnelles, la modélisation statistique a souvent oscillé entre le piège de la simplification réductrice et celui de l’illusion mimétique. D’un côté, un modèle trop rigide impose des a priori dogmatiques sur la structure de la réalité, ignorant des signaux critiques et condamnant le système à un sous-apprentissage systématique. De l’autre, un modèle doté d’une expressivité démesurée mémorise le bruit stochastique propre à son jeu de données d’entraînement, perdant toute robustesse dès lors qu’il est confronté à la moindre perturbation empirique. Entre cette cécité structurelle et cette instabilité hystérique s’établit la frontière subtile de la généralisation, véritable pierre de touche de toute l’ingénierie algorithmique moderne.
Comprendre en profondeur la nature de cette dichotomie nécessite d’articuler une analyse mathématique rigoureuse de la décomposition de l’erreur quadratique avec une réflexion épistémologique sur la nature même de l’induction. L’objectif de cette étude exhaustive est de disséquer le compromis biais-variance sous tous ses angles : depuis ses fondements probabilistes au sein de la théorie de Vapnik-Chervonenkis jusqu’à ses manifestations pratiques dans les architectures modernes, en passant par le phénomène récent et fascinant de la double descente, qui redéfinit les frontières théoriques de la surparamétrisation dans l’apprentissage profond.
1. Introduction épistémologique et théorique au compromis biais-variance
1.1 Définition fondamentale de l’erreur de généralisation
La finalité ultime de l’apprentissage supervisé ne réside jamais dans la simple restitution d’une mémoire statistique des faits passés, mais dans l’acquisition d’un pouvoir prédictif sur des états de nature inconnus. Cette exigence impose une distinction méthodologique fondamentale entre la performance mesurée sur l’échantillon d’entraînement, souvent qualifiée d’erreur empirique, et l’erreur de généralisation, définie comme l’espérance de la perte subie sur l’ensemble de la distribution conjointe sous-jacente des données. L’erreur empirique n’est rien d’autre que la moyenne arithmétique des pertes observées sur un ensemble d’apprentissage fini, tandis que l’erreur de généralisation correspond à l’intégrale de la fonction de perte pondérée par la véritable densité de probabilité génératrice des données.
Dans le cadre de la théorie statistique de l’apprentissage développée par Vladimir Vapnik et Alexey Chervonenkis, cette opposition s’exprime par le fossé conceptuel séparant le principe de minimisation du risque empirique du risque théorique réel. La théorie de Vapnik-Chervonenkis (VC) démontre mathématiquement que la convergence du risque empirique vers le risque réel est régie par la capacité expressive de la classe d’hypothèses explorée, mesurée notamment par la dimension VC. Lorsque cette dimension est infinie ou disproportionnée par rapport au nombre d’observations indépendantes et identiquement distribuées disponibles, la minimisation aveugle du risque empirique conduit à une illusion d’apprentissage : le modèle minimise sa perte sur l’échantillon connu sans restreindre son risque sur l’espace d’extrapolation.
Ainsi, l’objectif cardinal de l’apprentissage automatique est de construire un estimateur dont l’erreur d’extrapolation reste bornée et minimale. Cette ambition contraint le modélisateur à ne jamais confondre l’optimisation mathématique sur un échantillon donné avec l’apprentissage statistique proprement dit. Un algorithme performant n’est pas celui qui annule l’erreur sur les données dont il a la garde, mais celui qui parvient à extraire un invariant structurel capable de résister à la variabilité inhérente aux futures observations tirées de la même loi de probabilité.
1.2 La dualité entre représentativité et adaptabilité
L’acte d’apprentissage repose sur un paradoxe épistémologique persistant : comment modéliser fidèlement la tendance générale d’un phénomène physique ou social sans en intégrer les perturbations accidentelles ? Ce paradoxe de l’approximation soulève une tension directe entre la flexibilité structurelle d’une fonction mathématique et le principe de parcimonie, souvent associé au rasoir d’Ockham. Un modèle doté d’une grande adaptabilité possède un espace d’hypothèses vaste au sein duquel il peut théoriquement trouver une solution approchant n’importe quel ensemble discret de points. Toutefois, cette liberté morphologique devient son talon d’Achille lorsqu’il s’agit de distinguer le signal déterministe du bruit aléatoire additif.
Cette dialectique s’exacerbe considérablement sous l’effet de la rareté des données ou du fléau de la haute dimensionnalité, conceptualisé par Richard Bellman. Lorsque le nombre de caractéristiques descriptives (la dimension de l’espace d’entrée) dépasse ou approche l’ordre de grandeur du nombre d’observations empiriques, l’espace vectoriel devient dramatiquement clairsemé. Dans cette géométrie de haute dimension, tous les points d’apprentissage deviennent mutuellement distants et périphériques. L’adaptabilité d’un modèle non contraint conduit alors à une interpolation locale qui épouse des artefacts d’échantillonnage plutôt qu’une régularité phénoménologique.
À l’inverse, l’excès de représentativité contrainte — incarné par des modèles rigides comme les régressions affines — protège l’analyste contre l’explosion combinatoire de la dimensionnalité, mais au détriment de l’expressivité. Si la véritable variété différentiable qui sous-tend les données présente une courbure complexe ou des discontinuités intrinsèques, une hypothèse trop parcimonieuse projettera la réalité dans un sous-espace réducteur, éliminant arbitrairement l’information pertinente au nom de la stabilité statistique.
1.3 Importance stratégique de la décomposition de l’erreur de test
L’évaluation naïve d’un modèle prédictif repose fréquemment sur l’observation globale de l’erreur de test, calculée sur un jeu de données disjoint de l’entraînement. Pourtant, cette valeur scalaire unique dissimule des dynamiques antagonistes fondamentales. L’erreur d’entraînement s’avère un estimateur structurellement optimiste de l’erreur réelle en raison du processus d’ajustement qui exploite opportunistement les corrélations fortuites de l’échantillon. Il devient donc impératif de disséquer analytiquement l’erreur de test globale pour comprendre les forces contradictoires qui la composent et orienter rationnellement le cycle d’ingénierie.
La décomposition formelle de l’erreur d’extrapolation isole des composantes d’origines radicalement distinctes : une composante systématique liée aux postulats du modèle, une composante stochastique liée à la variabilité de l’échantillon, et une fraction incompressible liée à la nature probabiliste du monde. Identifier précisément la proportion de chacune de ces forces au sein de l’erreur totale transforme un processus d’optimisation empirique aléatoire en une démarche scientifique méthodique. Sans ce diagnostic, l’ingénieur risque d’appliquer des remèdes inadaptés, par exemple en augmentant la taille de l’échantillon pour corriger un modèle structurellement incapable de formuler la bonne solution.
Cette taxonomie de l’erreur est enfin la clé de voûte guidant la sélection des familles algorithmiques. Selon les contraintes de volume, le niveau de bruit capteur ou environnemental, et la géométrie des données, l’analyste doit arbitrer en toute connaissance de cause entre des familles à forte contrainte inductive, comme les modèles linéaires régularisés, et des familles universellement expressives, à l’instar des arbres de décision profonds ou des réseaux de neurones non paramétriques.
2. Formalisation mathématique : Décomposition analytique de l’erreur quadratique moyenne
2.1 Dérivation analytique de l’espérance de l’erreur quadratique
Afin d’établir formellement le compromis biais-variance, il convient de définir un cadre probabiliste rigoureux pour l’apprentissage supervisé en régression. Considérons une variable explicative vectorielle $x in \mathbb{R}^d$ et une variable cible scalaire continue $y in \mathbb{R}$. La relation réelle et inconnue entre ces deux grandeurs est gouvernée par une fonction déterministe $f$ corrompue par un bruit blanc additif stochastique $epsilon$ :
$$y = f(x) + \epsilon$$
On postule que le bruit aléatoire $epsilon$ satisfait les conditions classiques d’espérance conditionnelle nulle et d’homoscédasticité, soit $\mathbb{E}[\epsilon | x] = 0$ et $\mathbb{E}[\epsilon^2 | x] = \sigma^2$, ce qui implique immédiatement que $\mathbb{E}[y | x] = f(x)$ et que la variance conditionnelle de la cible vaut $\text{Var}(y | x) = \sigma^2$. Soit désormais un jeu de données d’apprentissage $\mathcal{D} = {(x_1, y_1), dots, (x_n, y_n)}$, extrait de manière indépendante et identiquement distribuée selon la loi conjointe de $(x, y)$. Un algorithme d’apprentissage applique une règle d’inférence sur $\mathcal{D}$ pour produire un estimateur fonctionnel $\hat{f}_{\mathcal{D}}(x)$. Comme le jeu de données $\mathcal{D}$ est lui-même une réalisation aléatoire parmi l’infinité des ensembles d’entraînement possibles de taille $n$, l’estimateur $\hat{f}_{\mathcal{D}}(x)$ est une variable aléatoire pour tout point fixe $x$.
Pour évaluer la qualité de cet estimateur en un point donné $x$, on mobilise la fonction de perte quadratique. L’erreur quadratique moyenne attendue, calculée conjointement sur la distribution des cibles $y$ et sur l’ensemble des réalisations possibles du jeu d’entraînement $\mathcal{D}$, s’écrit formellement :
$$\mathbb{E}_{\mathcal{D}, y}\left[ (y – \hat{f}_{\mathcal{D}}(x))^2 \right]$$
Pour simplifier les notations, posons $\hat{f} = \hat{f}_{\mathcal{D}}(x)$ et dénotons son espérance sur toutes les réalisations possibles de $\mathcal{D}$ par $\mathbb{E}[\hat{f}]$. Développons algébriquement l’expression intérieure en ajoutant et en soustrayant simultanément les termes $f(x)$ et $\mathbb{E}[\hat{f}]$ :
$$y – \hat{f} = (y – f(x)) + (f(x) – \mathbb{E}[\hat{f}]) + (\mathbb{E}[\hat{f}] – \hat{f})$$
En élevant ce trinôme au carré et en appliquant l’opérateur d’espérance mathématique conditionnelle à $x$, nous obtenons la somme des espérances des trois carrés et des trois doubles produits croisés. Analysons rigoureusement ces termes croisés. Le premier double produit s’énonce :
$$2 \mathbb{E}_{\mathcal{D}, y}\left[ (y – f(x))(f(x) – \mathbb{E}[\hat{f}]) \right]$$
Puisque par définition $y – f(x) = epsilon$, et que le terme $(f(x) – \mathbb{E}[\hat{f}])$ est totalement indépendant du bruit présent dans la nouvelle cible $y$ au point de test, l’espérance se factorise. Sachant que $\mathbb{E}[\epsilon] = 0$, ce terme s’annule purement et simplement. Il en va rigoureusement de même pour le deuxième double produit impliquant $(y – f(x))(\mathbb{E}[\hat{f}] – \hat{f})$. Enfin, considérons le troisième produit croisé :
$$2 \mathbb{E}_{\mathcal{D}}\left[ (f(x) – \mathbb{E}[\hat{f}])(\mathbb{E}[\hat{f}] – \hat{f}) \right]$$
Ici, la quantité $(f(x) – \mathbb{E}[\hat{f}])$ est une constante déterministe par rapport à la distribution de $\mathcal{D}$. Elle peut donc être sortie de l’opérateur d’espérance :
$$2 (f(x) – \mathbb{E}[\hat{f}]) \mathbb{E}_{\mathcal{D}}\left[ \mathbb{E}[\hat{f}] – \hat{f} \right] = 2 (f(x) – \mathbb{E}[\hat{f}]) (\mathbb{E}[\hat{f}] – \mathbb{E}[\hat{f}]) = 0$$
Tous les termes de covariance croisée s’annulant de manière irrévocable, il ne subsiste que les espérances des trois grandeurs élevées au carré :
$$\mathbb{E}_{\mathcal{D}, y}\left[ (y – \hat{f})^2 \right] = \mathbb{E}_y\left[ (y – f(x))^2 \right] + (f(x) – \mathbb{E}_{\mathcal{D}}[\hat{f}])^2 + \mathbb{E}_{\mathcal{D}}\left[ (\hat{f} – \mathbb{E}_{\mathcal{D}}[\hat{f}])^2 \right]$$
Cette égalité fondamentale constitue la décomposition analytique exacte de l’erreur quadratique moyenne en apprentissage supervisé. Elle révèle que l’erreur totale se scinde strictement en trois composantes orthogonales et additives : le biais au carré, la variance d’estimation, et le bruit irréductible.
2.2 Le biais statistique au carré
Le deuxième terme de notre décomposition fondamentale représente le biais statistique au carré de l’estimateur fonctionnel :
$$\text{Biais}^2(\hat{f}(x)) = \left( \mathbb{E}_{\mathcal{D}}[\hat{f}_{\mathcal{D}}(x)] – f(x) \right)^2$$
Mathématiquement, le biais quantifie l’écart absolu entre la valeur moyenne que l’algorithme prédit lorsqu’on intègre l’ensemble infini des univers d’entraînement possibles, et la véritable fonction sous-jacente évaluée en ce même point. Il ne s’agit donc pas d’une erreur d’échantillonnage ponctuelle, mais d’une erreur structurelle, déterministe et systématique inhérente à l’architecture même de l’algorithme.
Sur le plan géométrique, le biais capture l’inadéquation morphologique entre l’espace d’hypothèses $\mathcal{H}$ imposé par le concepteur du modèle et la géométrie intrinsèque de la réalité $f$. Si l’on choisit de restreindre $\mathcal{H}$ à des hyperplans affines alors que la véritable fonction génératrice possède une topologie quadratique ou sinusoïdale, aucun jeu de données, quelle que soit son abondance, ne permettra à l’espérance de l’estimateur de coïncider avec $f(x)$. Le biais traduit l’ensemble des hypothèses simplificatrices formulées a priori pour rendre l’inférence computationnellement traitable.
Une propriété remarquable du biais réside dans son comportement asymptotique. Si l’espace des hypothèses $\mathcal{H}$ est trop contraint, l’erreur de biais ne s’évanouit pas lorsque la taille $n$ de l’échantillon d’apprentissage tend vers l’infini. Le modèle convergera avec une certitude absolue vers la meilleure projection de $f$ sur son sous-espace rigide, conservant un biais résiduel strictement positif. Ce n’est que si la classe de fonctions considérée est universellement dense (comme dans le cas des splines de degré libre ou des réseaux neuronaux profonds non restreints) que le biais asymptotique peut théoriquement converger vers zéro lorsque le volume de données devient illimité.
2.3 La variance d’estimation
Le troisième terme issu de notre dérivation formelle capture la variance d’estimation de l’algorithme :
$$\text{Var}(\hat{f}(x)) = \mathbb{E}_{\mathcal{D}}\left[ \left( \hat{f}_{\mathcal{D}}(x) – \mathbb{E}_{\mathcal{D}}[\hat{f}_{\mathcal{D}}(x)] \right)^2 \right]$$
Ce terme formalise la dispersion quadratique moyenne des prédictions du modèle autour de leur propre espérance mathématique, sous l’effet du tirage aléatoire de l’échantillon d’apprentissage $\mathcal{D}$. La variance mesure l’instabilité statistique de la procédure d’ajustement. Un modèle à forte variance produira des fonctions prédictives radicalement dissemblables selon les variations aléatoires microscopiques présentes dans les données qui lui ont été fournies lors de son initialisation ou de son optimisation.
L’origine de la variance réside dans la sur-réactivité de l’estimateur face aux spécificités de l’échantillon fini. Au lieu de n’extraire que les invariants structurels pérennes régis par la fonction $f$, un modèle d’une grande flexibilité ajuste ses paramètres de manière à annuler les résidus locaux, confondant ainsi les singularités accidentelles de $\mathcal{D}$ avec la règle de décision générale. Cela se traduit par une sensibilité critique au rééchantillonnage : si l’on supprimait ne serait-ce qu’une fraction marginale des points de $\mathcal{D}$ pour les remplacer par de nouvelles mesures issues du même processus stochastique, la surface de réponse $\hat{f}(x)$ subirait de violentes déformations topologiques.
Contrairement au biais structurel, la variance d’estimation possède la propriété d’être une fonction inversement proportionnelle au volume d’observations d’entraînement. À architecture et flexibilité fixées, l’augmentation du cardinal $n$ de $\mathcal{D}$ comprime l’espace de dispersion de l’estimateur. Toutefois, à volume de données constant, toute élévation non régulée des degrés de liberté du modèle provoque une dérive asymptotique de cette variance vers des valeurs critiques, ruinant la capacité de prédiction hors échantillon.
2.4 L’erreur irréductible
Le premier terme isolé lors du développement analytique correspond à la variance du bruit intrinsèque :
$$\mathbb{E}_y\left[ (y – f(x))^2 \right] = \mathbb{E}_{\epsilon}[\epsilon^2] = \sigma^2$$
Ce résidu constant est qualifié d’erreur irréductible. Il formalise la limite asymptotique absolue de précision que tout algorithme d’apprentissage supervisé peut théoriquement espérer atteindre sur les données considérées, quand bien même il disposerait d’une infinité d’observations et d’une architecture mathématiquement parfaite capable d’annihiler simultanément le biais et la variance d’estimation.
L’erreur irréductible trouve sa genèse dans deux facteurs physiques et conceptuels majeurs. D’une part, elle incarne le bruit stochastique pur inhérent aux systèmes de mesure, aux fluctuations thermiques des capteurs ou aux incertitudes fondamentales du domaine étudié. D’autre part, et de manière bien plus prépondérante dans les applications réelles, $\sigma^2$ découle de l’existence de variables explicatives non mesurées ou inobservables. Si la variable cible $y$ dépend d’un jeu de descripteurs $(x, z)$, mais que le protocole expérimental ne fournit que le vecteur partiel $x$, l’influence du vecteur omis $z$ se retrouve mathématiquement projetée dans la composante de perturbation stochastique $epsilon$.
Dès lors, il apparaît évident que l’effort algorithmique doit se concentrer exclusivement sur la somme réductible $\text{Biais}^2 + \text{Var}$. Chercher à forcer l’erreur globale en deçà du plancher $\sigma^2$ constitue une impasse théorique absolue. Toute tentative d’un modèle pour faire passer son erreur d’apprentissage sous ce seuil thermodynamique de l’information signifie inéluctablement qu’il modélise la composante stochastique $epsilon$, transférant artificiellement l’erreur irréductible vers la variance de l’estimateur.
3. Le concept de biais : Hypothèses simplificatrices et sous-apprentissage
3.1 Origine structurelle du biais algorithmique
Le biais statistique ne doit pas être interprété comme une erreur méthodologique ou une défaillance de conception, mais plutôt comme la conséquence inévitable de ce que Tom Mitchell a défini comme le biais inductif (inductive bias). Pour qu’un système computationnel puisse généraliser à partir d’un ensemble discret de points vers un continuum indéfini de situations futures, il doit impérativement adopter un ensemble d’hypothèses et d’a priori sur la nature du monde. Sans ces postulats restrictifs fondamentaux, le problème de l’induction est formellement sous-déterminé : pour tout ensemble fini de points d’apprentissage, il existe une infinité indénombrable de fonctions mathématiques interpolatrices parfaites qui adoptent des comportements arbitraires en dehors de ces points.
Le biais algorithmique naît de la nature géométrique de ces contraintes inductives. Lorsqu’un praticien sélectionne une classe de modèles, il restreint délibérément l’espace de recherche $\mathcal{H}$ à des topologies spécifiques. Par exemple, choisir un modèle linéaire équivaut à formuler l’hypothèse ontologique rigide que les effets des covariables sont strictement additifs et proportionnels, sans interactions croisées complexes. Si cette conjecture s’avère grossièrement dissonante avec le mécanisme physique générateur des données, le modèle se trouve structurellement bridé.
Le biais inductif est donc à la fois la condition de possibilité de l’apprentissage et sa première limitation. Il agit comme un filtre qui élimine la majorité des fonctions possibles pour ne conserver que celles respectant certaines régularités (linéarité, continuité, parcimonie, invariance par translation). Si ces a priori sont trop sévères, ils aveuglent l’algorithme, l’empêchant d’enregistrer des structures empiriques pourtant hautement significatives contenues dans les signaux d’entrée.
3.2 Manifestations concrètes du sous-apprentissage (Underfitting)
L’expression pratique d’un biais algorithmique prédominant est le phénomène de sous-apprentissage (underfitting). La signature empirique la plus limpide de cette pathologie réside dans la stagnation précoce des performances : le modèle converge vers une erreur élevée tant sur les données d’entraînement que sur les données d’évaluation hors échantillon. Contrairement à un algorithme surajusté qui brille artificiellement sur sa base d’apprentissage avant de s’effondrer en production, le modèle souffrant d’un biais excessif échoue de manière flagrante dès la phase d’optimisation.
Cette incapacité se traduit par une insensibilité notoire aux motifs non linéaires et aux dynamiques d’interaction d’ordre supérieur. Face à des distributions de points présentant des frontières de décision sinueuses ou des relations de seuil critiques, le modèle sous-dimensionné trace des lignes ou des plans sécants qui regroupent indûment des populations hétérogènes. Les résidus issus de ces estimations ne se comportent pas comme un bruit blanc gaussien centré, mais manifestent une structure géométrique déterministe évidente, preuve irréfutable que le modèle laisse échapper une part substantielle de l’information explicative disponible.
De surcroît, le sous-apprentissage engendre une rigidité fonctionnelle extrême. Face à des modifications des variables d’entrée, les prédictions d’un tel système restent ancrées dans leur trajectoire monotone imposée. Les métriques de performance telles que le coefficient de détermination $R^2$ en régression ou l’aire sous la courbe ROC en classification se plafonnent à des valeurs médiocres que nulle prolongation de la phase d’optimisation ni nulle régularisation ne saurait rehausser.
3.3 Typologie des modèles à biais élevé
Certains algorithmes emblématiques de l’histoire de la science des données sont intrinsèquement porteurs d’un biais élevé en raison de la nature simplificatrice de leurs postulats structurels fondateurs :
- La régression linéaire simple et la régression logistique canonique : Ces modèles contraignent la surface de décision ou la relation d’espérance à être un hyperplan affine dans l’espace des descripteurs. Toute courbure, effet d’accélération ou couplage non linéaire entre variables est irrémédiablement ignoré à moins d’être manuellement encodé par l’ingénieur via des transformations explicites.
- Les souches de décision (decision stumps) : Constitués d’un arbre de décision limité à une profondeur unitaire, ces estimateurs n’autorisent qu’une unique scission orthogonale le long d’un axe unique de l’espace. Ils traitent l’ensemble de la complexité multivariée à travers le prisme d’une unique question binaire, induisant une caricature extrême des dynamiques sous-jacentes.
- Le classificateur Bayésien Naïf (Naive Bayes) : Cet algorithme repose sur le postulat d’indépendance conditionnelle forte de toutes les caractéristiques explicatives sachant la classe cible. Bien que remarquablement robuste et rapide computationnellement, ce postulat est presque toujours violé dans le monde physique réel où les corrélations partielles abondent, infligeant au modèle un biais intrinsèque indélébile sur les probabilités a posteriori.
Ces familles d’algorithmes ne manquent pas de valeur opérationnelle ; elles constituent souvent d’excellentes références initiales (baselines) en raison de leur prodigieuse stabilité statistique. Cependant, leur déploiement sur des systèmes régis par des lois physiques, économiques ou biologiques denses les condamne fréquemment à des performances sous-optimales imputables à la tyrannie de leur biais structurel.
4. Le concept de variance : Complexité excessive et sensibilité aux données
4.1 Mécanique sous-jacente de l’instabilité statistique
À l’exact opposé du biais simplificateur se déploie la variance d’estimation, dont le moteur dynamique est la complexité expressive démesurée. Lorsqu’un algorithme dispose d’une classe d’hypothèses $\mathcal{H}$ trop riche au regard de la densité de l’échantillon d’apprentissage, il acquiert la capacité d’interpoler une infinité de configurations de points. Dès lors, le processus d’optimisation numérique ne se borne plus à capturer le vecteur moyen $\mathbb{E}[y | x]$, mais commence à exploiter les alignements accidentels de points causés par le tirage stochastique du bruit $epsilon$.
Cette dynamique engendre une mémorisation passive du bruit aléatoire, que l’algorithme assimile indûment à un signal déterministe prédictif. L’instabilité mathématique qui en résulte est flagrante : deux jeux de données $\mathcal{D}_1$ et $\mathcal{D}_2$, bien qu’extraits de la même distribution fondamentale, contiendront des bruits résiduels dissemblables. Un modèle trop expressif s’adaptera si intimement à $\mathcal{D}_1$ que ses paramètres prendront des configurations hautement divergentes de celles induites par un entraînement sur $\mathcal{D}_2$.
Sur le plan vectoriel et paramétrique, la variance se manifeste par une explosion de l’amplitude des poids ou coefficients du modèle. Pour parvenir à faire coïncider sa surface de prédiction avec chaque observation empirique, le système génère des gradients vertigineux et des oscillations morphologiques erratiques entre les points de données. En dehors des coordonnées spatiales exactes de l’échantillon d’apprentissage, la fonction estimée fluctue de manière chaotique, ruinant toute possibilité d’interpolation fluide et a fortiori d’extrapolation valide.
4.2 Pathologie du surapprentissage (Overfitting)
La manifestation empirique universelle d’une variance débridée est le surapprentissage (overfitting). Cette pathologie classique de l’apprentissage automatique s’identifie immédiatement à la lecture croisée des performances d’optimisation et d’évaluation : l’erreur calculée sur le jeu d’entraînement s’effondre jusqu’à avoisiner le zéro absolu, tandis que l’erreur mesurée sur le jeu de test indépendant explose de manière exponentielle. L’analyste se trouve face à une dichotomie trompeuse, où un modèle apparemment omniscient en laboratoire se révèle totalement incapable de naviguer dans des conditions réelles non contrôlées.
Ce divorce statistique entraîne une destruction complète de la propriété d’invariance du système. Un modèle robuste doit demeurer insensible à de légères perturbations infinitésimales appliquées sur ses entrées vectorielles. En situation de surapprentissage critique, une variation infime de la variable $x$ — souvent imperceptible à l’œil nu ou inférieure à la résolution du capteur — peut provoquer un basculement radical de la prédiction émise, le modèle oscillant brutalement d’un sous-espace de décision à un autre pour satisfaire les aspérités de sa surface mémorisée.
En outre, le surapprentissage dégrade drastiquement la calibration probabiliste des modèles de classification. Les systèmes surajustés ont tendance à émettre des prédictions affectées d’indices de confiance extrêmement élevés, proches de la certitude absolue ($p \approx 1.0$), même lorsqu’ils commettent des erreurs grossières. Cette défaillance de calibration, particulièrement documentée dans les réseaux de neurones profonds modernes formés sans régularisation adéquate, représente un danger opérationnel majeur pour les systèmes critiques tels que le diagnostic médical ou le guidage autonome.
4.3 Typologie des modèles à variance élevée
Certains modèles se distinguent par leur propension quasi-illimitée à absorber le bruit dès lors qu’ils ne sont pas assujettis à des mécanismes de contention explicites :
- Les arbres de décision profonds entièrement développés : Lorsqu’un arbre CART ou C4.5 est autorisé à scinder l’espace récursivement sans limitation de profondeur minimale par feuille ni élagage, il continue son partitionnement jusqu’à isoler chaque observation dans sa propre région terminale. L’erreur d’apprentissage s’annule, mais la structure fractale des cellules de décision produit une variance asymptotique ingérable.
- L’algorithme des $k$ plus proches voisins ($k$-NN) avec $k=1$ : En affectant à chaque point de l’espace la valeur exacte de son plus proche voisin empirique immédiat, le 1-NN engendre une mosaïque de Voronoï complexe autour de chaque observation, y compris autour des points aberrants corrompus par le bruit. La variance de cet estimateur est maximale, ne bénéficiant d’aucun effet de moyenne locale.
- Les réseaux de neurones profonds sans régularisation : Dotés de millions ou de milliards de paramètres configurables, les perceptrons multicouches profonds disposent d’une capacité d’approximation universelle. En l’absence de régularisation, ils atteignent une interpolation totale des données en intégrant aussi bien les signaux de fond que les singularités stochastiques des pixels ou des tokens textuels.
Ces architectures possèdent une puissance expressive formidable, indispensable à la résolution des problèmes perceptuels complexes comme la vision par ordinateur ou le traitement du langage naturel. Néanmoins, leur exploitation impose la maîtrise d’outils statistiques avancés de contrôle de la variance pour canaliser leur formidable capacité d’adaptation empirique.
5. La dynamique du compromis : Analyse géométrique de la courbe en U
5.1 Évolution conjointe des composantes de l’erreur
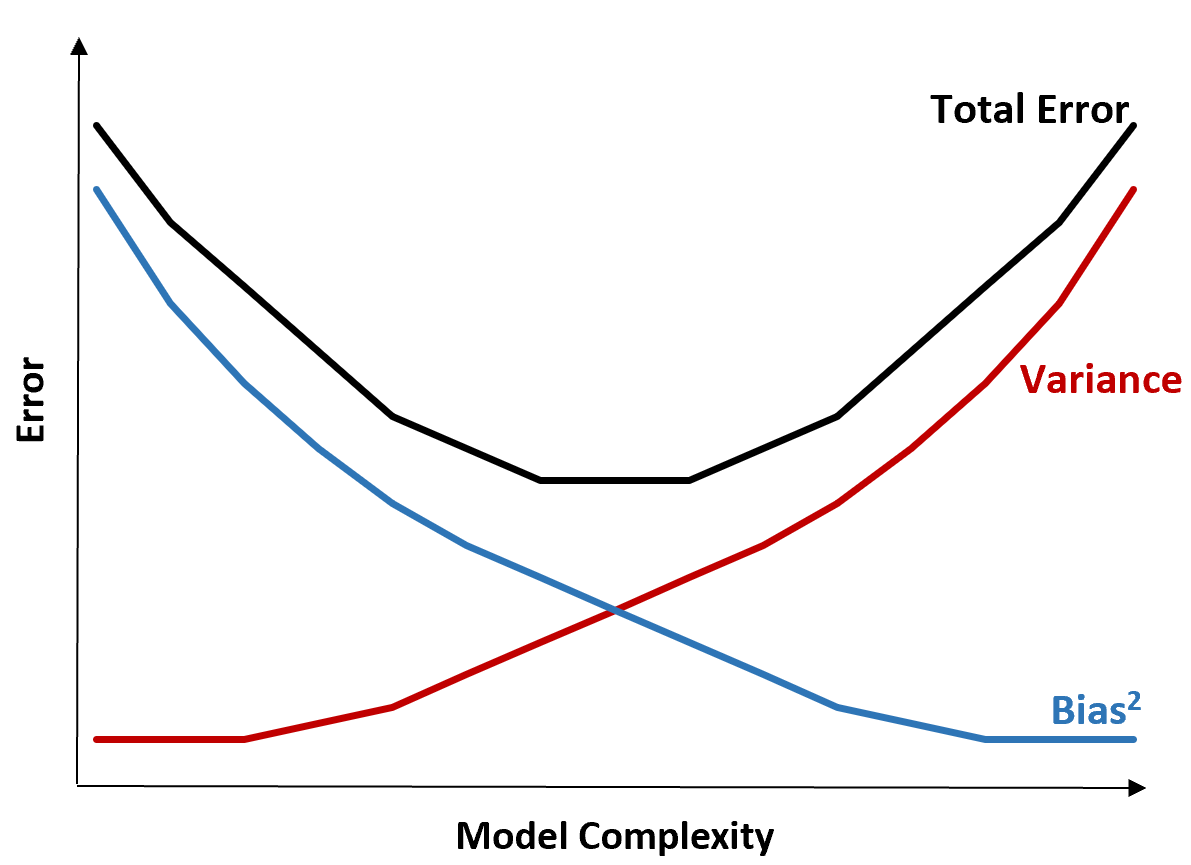
L’interaction entre le biais et la variance présente une structure dynamique fondamentalement antagoniste lorsqu’elle est indexée sur l’axe de la complexité du modèle. Cette complexité peut être conceptualisée de multiples façons : le degré d’un polynôme d’ajustement, le nombre de variables prédictives intégrées dans une régression, la profondeur maximale autorisée pour un arbre de décision, ou le nombre de paramètres ajustables d’un réseau dense.
Lorsque la complexité croît depuis un état minimal (modèle trivial constant) vers un état maximal (modèle totalement interpolateur), les composantes analytiques de l’erreur quadratique moyenne suivent des trajectoires strictement divergentes mais prévisibles. Le biais au carré $\text{Biais}^2(\hat{f}(x))$ est une fonction monotone décroissante de la complexité. Plus le modèle gagne en liberté structurelle, plus son espace d’hypothèses s’élargit, lui permettant d’épouser fidèlement la topologie sous-jacente de la fonction cible déterministe $f(x)$ et d’éliminer progressivement l’erreur d’approximation.
À l’opposé, la variance d’estimation $\text{Var}(\hat{f}(x))$ se comporte comme une fonction monotone strictement croissante de cette même complexité. À mesure que les contraintes paramétriques se relâchent, l’estimateur devient excessivement réactif à l’échantillon d’apprentissage particulier utilisé, amplifiant sa dispersion spatiale. En sommant ces deux fonctions monotones de pentes opposées avec la constante incompressible du bruit $\sigma^2$, l’erreur de test globale $\text{Err}(x)$ adopte mathématiquement la forme d’une courbe convexe asymétrique, traditionnellement immortalisée sous le nom de courbe en U.
5.2 Localisation du point de fonctionnement optimal
L’analyse mathématique de cette courbe en U révèle l’existence d’un optimum unique régissant l’apprentissage statistique classique. Le point de fonctionnement optimal correspond au minimum global de la fonctionnelle d’erreur totale :
$$\mathcal{C}^* = arg\min_{\mathcal{C}} \left( \text{Biais}^2(\mathcal{C}) + \text{Var}(\mathcal{C}) + \sigma^2 \right)$$
En dérivant cette somme par rapport à la variable continue de complexité $\mathcal{C}$, la condition d’optimalité du premier ordre impose que :
$$\frac{\partial}{\partial \mathcal{C}}\left( \text{Biais}^2(\mathcal{C}) \right) + \frac{\partial}{\partial \mathcal{C}}\left( \text{Var}(\mathcal{C}) \right) = 0 iff -\frac{\partial}{\partial \mathcal{C}}\left( \text{Biais}^2(\mathcal{C}) \right) = \frac{\partial}{\partial \mathcal{C}}\left( \text{Var}(\mathcal{C}) \right)$$
Le point optimal est donc rigoureusement atteint lorsque le taux marginal de réduction du biais sous l’effet de la complexité équilibre exactement le taux marginal d’accroissement de la variance. Tout déplacement vers la gauche de cet optimum plonge l’algorithme dans la zone de sous-apprentissage, où le gain de stabilité statistique ne compense pas la perte brutale de représentativité du phénomène. À l’inverse, tout déplacement vers la droite précipite le modèle dans la zone de surapprentissage, où les gains infinitésimaux d’approximation structurelle sont balayés par l’explosion de l’instabilité face au bruit stochastique.
Cet équilibre illustre magnifiquement le critère d’optimalité parcimonieuse : le meilleur modèle n’est pas le plus sophistiqué mathématiquement, mais le modèle le plus simple capable de capturer l’intégralité du signal exploitable présent dans les données.
5.3 Facteurs modulateurs de la forme de la courbe
Si la courbe en U constitue un invariant topologique du cadre d’apprentissage classique, sa morphologie précise, son acuité et la position de son minimum dépendent directement des propriétés fondamentales de l’échantillon d’apprentissage et de l’environnement informationnel. Le facteur modulateur le plus puissant est sans conteste le volume d’entraînement $n$.
Lorsque la taille d’échantillon augmente de plusieurs ordres de grandeur, l’effet d’échantillonnage s’amortit. Selon les théorèmes limites fondamentaux de la statistique, la variance d’estimation pour une classe d’hypothèses de dimension finie décroît typiquement selon un taux en $\mathcal{O}(d/n)$, où $d$ représente le nombre de degrés de liberté du modèle. Par conséquent, une expansion massive du volume de données $n$ a pour effet géométrique d’écraser la courbe de variance vers l’axe des abscisses. Cet affaissement translate mécaniquement le point d’inflexion optimal vers des zones de complexité structurelle beaucoup plus élevées. C’est précisément cette dynamique qui explique la viabilité empirique contemporaine des modèles géants : la surabondance de données permet d’exploiter des architectures ultra-complexes sans subir l’explosion théorique de la variance qui surviendrait en environnement restreint.
Inversement, le ratio entre la dimensionnalité $p$ et la taille $n$ ($p/n$) agit comme un amplificateur d’instabilité. Dans les contextes de haute dimension où $p gg n$ (comme en génomique ou en traitement de données spectrales), la courbe de variance monte avec une pente vertigineuse dès les plus faibles niveaux de complexité. L’optimum se trouve alors violemment repoussé vers des architectures à très fort biais inductif, forçant le mathématicien à imposer des contraintes drastiques pour prévenir l’effondrement immédiat du pouvoir de généralisation.
6. Méthodes empiriques de diagnostic : Identifier la source prédominante de l’erreur
6.1 Interprétation avancée des courbes d’apprentissage
Dans la pratique de l’ingénierie statistique, la quantification théorique du biais et de la variance est rendue complexe par l’inaccessibilité de la vraie fonction déterministe $f$ et de l’erreur irréductible $\sigma^2$. L’instrument empirique privilégié pour diagnostiquer l’équilibre d’un modèle reste l’analyse des courbes d’apprentissage (learning curves), qui tracent l’évolution conjointe de l’erreur d’entraînement et de l’erreur de validation en fonction du nombre d’exemples d’entraînement $m$ alloués au système.
La morphologie de ces trajectoires fournit une signature clinique sans équivoque de l’état de l’estimateur :
- La signature du biais prédominant (sous-apprentissage) : Lorsque le modèle est trop contraint, l’erreur d’entraînement commence à un niveau bas pour des échantillons minuscules, puis augmente rapidement à mesure que de nouvelles contraintes empiriques sont imposées, convergeant très précocement vers un plateau asymptotique élevé. Parallèlement, l’erreur de validation décroît légèrement pour venir se calquer presque immédiatement sur l’erreur d’entraînement, scellant un écart (generalization gap) extrêmement ténu mais un niveau de perte global inacceptable. L’ajout de nouvelles données d’entraînement s’avère ici strictement inutile, le modèle ayant atteint sa limite d’absorption structurelle.
- La signature de la variance prédominante (surapprentissage) : Lorsque l’instabilité domine, l’erreur d’entraînement demeure confinée à des niveaux artificiellement bas, voire nuls, le modèle parvenant sans peine à surajuster les données qui lui sont soumises. À l’opposé, l’erreur de validation stagne à des niveaux considérablement plus élevés, maintenant un fossé volumineux et persistant entre les deux courbes. Ce différentiel massif indique que l’algorithme ne capture que des régularités locales. Dans cette configuration, la pente de la courbe de validation montre généralement qu’un apport substantiel de nouvelles observations d’entraînement permettra de combler l’écart et de faire converger l’estimateur vers des zones de risque acceptables.
L’observation attentive de ces asymptotes constitue ainsi le premier acte méthodologique permettant de décider s’il convient de modifier la complexité de l’architecture ou d’investir dans l’expansion du jeu d’apprentissage.
6.2 Protocoles de validation croisée rigoureux
L’évaluation rigoureuse de la variance d’un algorithme requiert des protocoles empiriques capables de simuler le rééchantillonnage de la population sous-jacente sans biaiser l’estimation par des fuites d’information (data leakage). La méthode de référence demeure la validation croisée à $k$ blocs ($k$-fold cross-validation). Le jeu de données initial est partitionné en $k$ sous-ensembles orthogonaux d’égale envergure. De manière itérative, $k-1$ blocs sont dévolus à l’apprentissage tandis que le bloc résiduel sert à évaluer l’erreur d’extrapolation.
Au-delà de la moyenne empirique de l’erreur, la distribution statistique des $k$ scores obtenus constitue un révélateur direct de la variance de l’estimateur. Un modèle affecté d’une forte variance produira des performances violemment fluctuantes d’un pli à l’autre, reflétant son hypersensibilité aux données d’apprentissage qui lui ont été présentées. Dans les contextes de classification déséquilibrée, l’emploi de la validation croisée stratifiée s’impose afin de préserver les proportions exactes des classes au sein de chaque bloc et d’éviter que des variations stochastiques d’échantillonnage ne viennent polluer l’estimation de la variance.
Lorsque la sélection d’hyperparamètres s’effectue sur le même jeu de données, le risque d’introduire un surapprentissage par sélection devient critique. Pour pallier cet écueil, la communauté statistique a institué la validation croisée imbriquée (nested cross-validation). Une boucle interne est exclusivement consacrée au balayage des hyperparamètres et à l’arbitrage biais-variance sur un pli temporaire, tandis qu’une boucle externe estime de manière impartiale l’erreur de généralisation du modèle sélectionné. Ce protocole hermétique garantit que l’évaluation finale demeure totalement aveugle aux décisions architecturales d’optimisation.
6.3 Techniques de rééchantillonnage bootstrap
Théorisé par Bradley Efron, le bootstrap non paramétrique constitue l’une des armes statistiques les plus élégantes pour estimer empiriquement les composantes formelles de la décomposition biais-variance sans faire appel à des hypothèses de distribution trop rigides. Le protocole consiste à générer $B$ pseudo-échantillons d’apprentissage distincts $\mathcal{D}^{*1}, \mathcal{D}^{*2}, dots, \mathcal{D}^{*B}$ de taille $n$, chacun étant formé par tirage avec remise (tirage uniforme probabiliste) au sein de la base d’apprentissage originelle.
L’algorithme sous examen est ensuite ajusté indépendamment sur chacun de ces $B$ pseudo-échantillons, engendrant une famille d’estimateurs ${\hat{f}^{*b}(x)}_{b=1}^B$. Pour chaque point d’un jeu de validation dédié non altéré par les tirages, on calcule l’espérance de prédiction empirique par la moyenne arithmétique simple :
$$\bar{f}(x) = \frac{1}{B} \sum_{b=1}^B \hat{f}^{*b}(x)$$
À partir de cet opérateur empirique, la variance d’estimation du modèle en ce point s’estime directement par la dispersion quadratique :
$$\widehat{\text{Var}}(x) = \frac{1}{B-1} \sum_{b=1}^B \left( \hat{f}^{*b}(x) – \bar{f}(x) \right)^2$$
De façon analogue, si l’on suppose que la cible observée sur ce jeu de validation fournit une approximation satisfaisante du signal réel, le biais empirique au carré peut être quantifié par la distance euclidienne $(\bar{f}(x) – y)^2$, déduction faite de l’estimation locale du bruit de fond. Cette méthode offre une cartographie granulaire remarquable de la décomposition de l’erreur dans l’espace des descripteurs, révélant des hétérogénéités spatiales où un modèle peut s’avérer localement dominé par la variance tout en restant contraint par le biais sur d’autres régions de la variété.
7. Stratégies algorithmiques de réduction du biais
7.1 Ingénierie et enrichissement de l’espace des caractéristiques
La méthode la plus immédiate pour extraire un algorithme de l’ornière du sous-apprentissage consiste à intervenir en amont sur la géométrie de l’espace de description vectoriel. Si une classe de modèles simples souffre d’un biais élevé, cela tient à l’inadéquation morphologique entre ses hyperplans de séparation et la topologie des données. En projetant les variables d’entrée primitives dans un espace fonctionnel de dimension supérieure au moyen d’une fonction de transformation non linéaire $\phi : \mathbb{R}^d to \mathbb{R}^D$ (avec $D gg d$), on accorde au modèle la liberté expressive nécessaire pour résoudre des séparations complexes.
Cette approche s’opérationnalise concrètement par la génération de caractéristiques polynomiales d’ordre supérieur, incorporant non seulement les puissances des variables individuelles ($x_i^2, x_i^3$), mais surtout leurs termes de couplage et d’interactions croisées ($x_i x_j, x_i x_j x_k$). Ces extensions permettent à un simple estimateur linéaire d’émuler des surfaces de réponse hyperboliques, elliptiques ou paraboliques sans altérer la convexité de son problème d’optimisation sous-jacent. Des transformations analytiques non linéaires ciblées — telles que l’application de fonctions logarithmiques pour corriger les asymétries de distribution, de fonctions sigmoïdes ou d’expansions en splines cubiques régularisées — autorisent une capture souple des régularités locales.
Dans les domaines de pointe, cette ingénierie prend la forme d’extractions sémantiques profondes : représentations fréquentielles par ondelettes (wavelets), descripteurs de textures ou plongements vectoriels pré-entraînés (embeddings). En fournissant au modèle des concepts dérivés riches plutôt que des signaux bruts, l’ingénieur décharge l’algorithme d’une partie de sa charge de déduction géométrique, réduisant d’autant son biais inductif initial.
7.2 Augmentation de la complexité architecturale
Lorsque la structure du modèle est paramétrique ou modulaire, la réduction systématique du biais passe par l’extension délibérée de sa capacité computationnelle interne. Dans le champ des réseaux de neurones, cette intervention se matérialise par l’amplification de la profondeur (le nombre de couches successives) et de la largeur (le nombre de neurones ou canaux par couche). Conformément au théorème d’approximation universelle, un réseau doté d’une profondeur adéquate et de non-linéarités continues peut approximer n’importe quelle fonction borélienne sur un compact avec une précision arbitraire, écrasant le biais structurel vers des valeurs asymptotiquement nulles.
Pour les algorithmes d’arbres de décision, la réduction du biais implique de desserrer les contraintes morphologiques limitant l’expansion des nœuds. Autoriser une profondeur maximale accrue ($\max_depth to \infty$) et diminuer le seuil critique d’échantillons nécessaires pour autoriser une scission ($\min_samples_split to 2$) permet à l’arbre de diviser l’espace en hyper-rectangles de plus en plus fins, épousant fidèlement les variations les plus abruptes de la variable cible.
Dans le domaine des machines à vecteurs de support (SVM), le recours aux méthodes à noyaux (kernel trick) permet de projeter implicitement les données dans des espaces de Hilbert de dimension infinie, comme c’est le cas avec le noyau gaussien à base radiale (RBF) :
$$K(x, x’) = \exp\left(-\gamma |x – x’|^2\right)$$
En ajustant le paramètre d’échelle $\gamma$ vers des valeurs élevées, le rayon d’influence de chaque point support se contracte, permettant à la surface de décision d’épouser n’importe quelle géométrie complexe et éliminant ainsi toute trace de biais inductif linéaire.
7.3 Assouplissement des pénalités structurelles
Une cause fréquente de sous-apprentissage dans les systèmes modernes réside dans l’application excessive de contraintes de régularisation paramétrique. Si les termes de pénalisation ont pour vocation noble de contenir l’explosion de la variance, un dosage disproportionné bride la flexibilité expressive du modèle et réintroduit subrepticement un biais structurel massif. La correction de ce biais passe donc par un desserrage méthodique de ces contraintes.
Dans le cadre des régressions régularisées de type Tikhonov ou Lasso, cette démarche s’incarne dans la diminution drastique du coefficient scalaire d’hyperparamètre $lambda$ régissant la force de la pénalité dans la fonction de coût :
$$\mathcal{L}_{\text{total}}(\theta) = \mathcal{L}_{\text{empirique}}(\theta) + \lambda , \Omega(\theta)$$
En faisant tendre $lambda$ vers zéro, la fonction de perte redonne la primauté absolue à la fidélité empirique aux données, permettant aux paramètres $\theta$ d’atteindre les amplitudes requises pour modéliser des pentes raides et des séparations franches.
De même, sur le plan des topologies modernes comme les réseaux de neurones profonds, l’assouplissement structurel peut être soutenu par l’intégration d’architectures résiduelles (ResNets). En autorisant des connexions de saut (skip connections) qui court-circuitent les couches d’opérations non linéaires, on élimine le phénomène d’évanescence de gradient. Cette innovation architecturale permet d’entraîner des réseaux de plusieurs centaines de couches sans subir la dégradation de la performance d’entraînement, assurant une convergence efficace vers un régime à très faible biais.
8. Stratégies de réduction de la variance et régularisation
8.1 Régularisations analytiques paramétriques
Pour juguler une variance d’estimation excessive, la théorie statistique a formulé des approches analytiques élégantes consistant à contraindre l’espace des solutions admissibles au sein de la fonctionnelle de coût. La plus célèbre est la régularisation de Tikhonov, universellement connue en apprentissage sous le nom de régression Ridge. Elle pénalise la norme euclidienne ($L_2$) du vecteur de paramètres :
$$\mathcal{L}_{\text{Ridge}}(\beta) = |y – Xbeta|_2^2 + \lambda |beta|_2^2$$
D’un point de vue analytique, la solution fermée de cette optimisation s’écrit $\hat{\beta}_{\text{Ridge}} = (X^T X + \lambda I)^{-1} X^T y$. L’introduction du terme diagonal $lambda I$ modifie le spectre des valeurs propres de la matrice de Gram $X^T X$, empêchant son conditionnement pathologique d’amplifier les fluctuations stochastiques des données. L’effet géométrique est une contraction isotrope continue (shrinkage) de tous les coefficients vers l’origine. Cette contraction sacrifie une fraction infinitésimale de biais pour obtenir un effondrement spectaculaire de la variance des coefficients estimés.
À cette pénalisation s’ajoute l’approche Lasso (Least Absolute Shrinkage and Selection Operator), théorisée par Robert Tibshirani, qui applique une pénalité fondée sur la norme de Manhattan ($L_1$) :
$$\mathcal{L}_{\text{Lasso}}(\beta) = |y – Xbeta|_2^2 + \lambda |beta|_1$$
En vertu de la géométrie polyédrique de la boule unitaire $L_1$ dont les sommets coïncident avec les axes de coordonnées, le Lasso force un nombre substantiel de coefficients à s’annuler exactement lorsque $lambda$ s’accroît. Il réalise ainsi une sélection de caractéristiques parcimonieuse (sparsity). En éliminant purement et simplement les variables explicatives redondantes ou non informatives qui ne font qu’injecter du bruit dans l’inférence, le Lasso compresse drastiquement la dimensionnalité effective du système et élimine les sources diffuses de variance d’estimation.
La synthèse de ces deux paradigmes s’incarne dans le modèle ElasticNet développé par Hui Zou et Trevor Hastie. En combinant linéairement les pénalités $L_1$ et $L_2$ au travers de deux hyperparamètres $\lambda_1$ et $\lambda_2$, ElasticNet parvient à surmonter les limitations du Lasso face aux groupes de variables fortement colinéaires, réalisant simultanément une sélection parcimonieuse et un effet de groupement stabilisateur qui protège l’inférence contre l’instabilité induite par la colinéarité.
8.2 Contraintes structurelles et arrêt précoce
Outre les pénalités analytiques incorporées aux fonctions de perte, le contrôle de la variance repose sur l’imposition de contraintes topologiques rigides sur la morphologie des modèles computationnels. Dans les arbres de décision, l’arme méthodologique fondamentale est l’élagage pour complexité de coût (cost-complexity pruning). L’arbre est d’abord développé jusqu’à sa profondeur maximale pour minimiser le biais, puis une pénalité proportionnelle au nombre terminal de feuilles $|\mathcal{T}|$ est introduite :
$$R_\alpha(\mathcal{T}) = R(\mathcal{T}) + \alpha |\mathcal{T}|$$
En faisant croître le coefficient $\alpha$, les branches de l’arbre qui n’apportent qu’une réduction marginale de l’impureté (mesurée par l’entropie ou l’indice de Gini) sont récursivement amputées. L’algorithme élimine ainsi les cellules terminales microscopiques surajustées au bruit pour ne conserver que les séparations macroscopiques statistiquement fiables.
Dans l’optimisation des architectures itératives telles que les réseaux de neurones ou les algorithmes de gradient boosting, la technique d’arrêt précoce (early stopping) constitue une régularisation implicite redoutablement efficiente. Bien que l’espace d’hypothèses théorique du modèle soit immense, le processus d’optimisation par descente de gradient explore cet espace de manière progressive en partant d’une initialisation aléatoire proche de zéro. Les premières itérations d’entraînement permettent de capturer les composantes spectrales principales et les invariants macroscopiques des données. Ce n’est qu’au fil des époques avancées que l’optimiseur commence à adapter les poids aux singularités du bruit.
En surveillant l’erreur d’extrapolation sur un jeu de validation disjoint à chaque époque, on observe typiquement que cette perte de validation atteint un minimum avant de remonter, marquant l’instant précis où l’accroissement de la variance surpasse le gain de réduction du biais. Interrompre l’apprentissage à cet instant exact fige le système dans son état d’équilibre optimal sans nécessiter de modification algébrique de la fonction de perte.
8.3 Stochasticité et augmentation de données
Le contrôle de l’instabilité s’opère également par l’injection méthodique d’aléas au sein des phases d’apprentissage et par la diversification forcée de l’information empirique. Dans les réseaux profonds, la technique du Dropout introduite par Srivastava et al. représente une rupture conceptuelle majeure. À chaque itération de la descente de gradient, chaque unité neuronale (à l’exception de la couche de sortie) est temporairement désactivée avec une probabilité fixe $p$ (typiquement fixée à 0.5) :
Cette mutilation stochastique empêche les unités du réseau d’élaborer des co-adaptations complexes et fragiles, où un neurone viendrait silencieusement compenser les erreurs d’un autre sur un artefact particulier des données d’entraînement. Chaque neurone est contraint d’extraire des descripteurs utiles et robustes de manière autonome, en présence d’un contexte d’activation partiellement dégradé. Sur le plan théorique, le Dropout s’apparente à l’entraînement simultané d’un ensemble exponentiel d’architectures sous-échantillonnées partageant leurs poids, dont l’inférence finale constitue une moyenne géométrique régularisatrice.
Parallèlement, la variance peut être combattue à la source par l’expansion artificielle du jeu de données grâce à l’augmentation de données (data augmentation). En soumettant les données existantes à des transformations préservant l’invariance sémantique (rotations, translations, étirements, injection de bruit gaussien sur les pixels, masquage de portions lexicales), on enrichit massivement l’espace des phases exploré par le modèle. Cette pratique contraint l’estimateur à devenir insensible aux variations topologiques mineures et comble les zones d’ombre de l’espace des caractéristiques, abaissant mécaniquement la variance d’extrapolation par simulation empirique d’un échantillon d’apprentissage plus vaste.
9. Le rôle déterminant de l’apprentissage ensembliste
9.1 Le Bagging et les Forêts Aléatoires pour terrasser la variance
L’apprentissage ensembliste (ensemble learning) a apporté l’une des réponses mathématiques les plus péremptoires et élégantes au compromis biais-variance. La première grande famille de méthodes ensemblistes, le Bagging (acronyme de Bootstrap Aggregating), conçu par Leo Breiman, s’attaque de front à l’élimination de la variance statistique sans altérer le niveau de biais intrinsèque des modèles individuels sous-jacents.
Le fondement probabiliste du Bagging s’enracine dans le théorème central limite et la variance d’une moyenne de variables aléatoires. Soit un ensemble de $B$ estimateurs $\hat{f}_1(x), dots, \hat{f}_B(x)$ entraînés chacun sur un pseudo-échantillon bootstrap indépendant issu de la base initiale. Supposons que chaque estimateur présente un biais individuel identique $\mathbb{E}[\hat{f}_b(x)] – f(x) = \text{Biais}$, une variance individuelle $\text{Var}(\hat{f}_b(x)) = \sigma^2_f$, et qu’ils manifestent une corrélation mutuelle moyenne positive mesurée par le coefficient $rho in [0, 1]$. L’estimateur agrégé formé par la moyenne arithmétique simple :
$$\hat{f}_{\text{Bag}}(x) = \frac{1}{B} \sum_{b=1}^B \hat{f}_b(x)$$
possède une espérance mathématique strictement égale à celle des modèles constitutifs individuels :
$$\mathbb{E}[\hat{f}_{\text{Bag}}(x)] = \frac{1}{B} \sum_{b=1}^B \mathbb{E}[\hat{f}_b(x)] implies \text{Biais}(\hat{f}_{\text{Bag}}) = \text{Biais}(\hat{f}_b)$$
Le biais demeure donc rigoureusement invariant par l’opération de moyennage. En revanche, l’algèbre de la variance d’une somme de variables aléatoires corrélées révèle une transformation spectaculaire :
$$\text{Var}(\hat{f}_{\text{Bag}}(x)) = \rho , \sigma^2_f + \frac{1 – \rho}{B} , \sigma^2_f$$
Cette équation fondamentale éclaire magnifiquement la dynamique du Bagging. Lorsque le nombre d’arbres ou d’estimateurs $B$ tend vers l’infini, le deuxième terme s’annule asymptotiquement. La variance de l’ensemble ne dépend plus alors que du niveau de corrélation intrinsèque $rho$ entre les estimateurs. Si les estimateurs étaient parfaitement décorrélés ($rho = 0$), la variance totale s’effondrerait vers zéro à mesure que $B to \infty$.
C’est précisément cette intuition fondamentale qui a conduit Breiman à formaliser l’algorithme des Forêts Aléatoires (Random Forests). Pour forcer le coefficient $rho$ à décroître vers ses planchers théoriques, les forêts aléatoires injectent une seconde source de stochasticité : lors de chaque scission au sein de chaque arbre de décision non élagué (donc à très faible biais mais à très forte variance), l’algorithme ne cherche plus la meilleure séparation parmi l’ensemble des $p$ caractéristiques disponibles, mais restreint arbitrairement son choix à un sous-espace aléatoire de $m \approx \sqrt{p}$ variables (technique du random feature subspace). Ce sous-échantillonnage structurel interdit aux variables ultra-dominantes de saturer la racine de tous les arbres, décorrélant puissamment les prédicteurs individuels et permettant à la variance collective de s’effondrer sans dégrader l’excellent niveau de biais obtenu par l’absence d’élagage.
9.2 Le Boosting séquentiel pour corriger systématiquement le biais
Tandis que le Bagging agit comme un compresseur de variance opérant en parallèle sur des estimateurs décorrélés, la famille du Boosting — initiée par l’algorithme AdaBoost de Yoav Freund et Robert Schapire, puis sublimée par le Gradient Boosting de Jerome Friedman — adopte une philosophie algorithmique séquentielle diamétralement opposée : transformer une collection d’apprenants faibles (weak learners), caractérisés par un biais élevé et une faible complexité individuelle, en un ensemble prédictif souverain à très faible biais.
Le Boosting ne procède pas par tirages bootstrap indépendants mais organise une dynamique corrective récursive. Chaque nouvel estimateur introduit dans l’ensemble est spécifiquement entraîné pour modéliser les défaillances, les résidus ou les erreurs commises par l’agrégation de tous les modèles qui l’ont précédé. Dans le cas d’AdaBoost, cette focalisation s’opère par une repondération adaptative des observations d’entraînement : les exemples mal classés reçoivent un poids statistique accru lors de l’itération suivante, contraignant le nouvel apprenant à focaliser son énergie d’ajustement sur les zones d’ombre du domaine de décision.
Dans le Gradient Tree Boosting (incarné aujourd’hui par des bibliothèques hautement optimisées telles que XGBoost, LightGBM ou CatBoost), le processus s’interprète formellement comme une descente de gradient dans l’espace des fonctions. À chaque pas temporel $t$, le nouvel arbre $\hat{h}_t(x)$ est ajusté directement sur les pseudo-résidus de la fonction de perte différentiable $\mathcal{L}$, ces résidus n’étant rien d’autre que l’opposé du gradient par rapport aux prédictions actuelles :
$$r_{it} = – \left[ \frac{\partial \mathcal{L}(y_i, F(x_i))}{\partial F(x_i)} \right]_{F(x) = F_{t-1}(x)}$$
Le modèle global se construit ainsi par sommation itérative pondérée d’arbres de faible profondeur :
$$F_t(x) = F_{t-1}(x) + \eta , \hat{h}_t(x)$$
Grâce à cette accumulation méthodique de corrections locales, le biais algorithmique est progressivement comprimé vers le zéro absolu. Toutefois, cette puissance corrective s’accompagne d’une vulnérabilité intrinsèque : le paramètre de taux d’apprentissage (learning rate) $eta$ et le nombre total d’itérations $T$ doivent être minutieusement calibrés. Si l’on prolonge l’itération du Boosting au-delà du seuil de convergence optimal sans amortir l’apprentissage par un coefficient $eta$ suffisamment petit, l’algorithme commence à modéliser les singularités du bruit résiduel $epsilon$, basculant brutalement d’un état d’excellent compromis vers une pathologie d’explosion de variance.
9.3 L’empilement généralisé (Stacking)
La troisième voie majeure de l’ingénierie ensembliste réside dans l’empilement généralisé (Stacking), théorisé à l’origine par David Wolpert sous l’appellation d’apprentissage empilé (stacked generalization). Contrairement au Bagging et au Boosting qui mobilisent généralement des apprenants homogènes (arbres de décision), le Stacking organise la collaboration hétérogène de classes algorithmiques fondamentalement divergentes afin de neutraliser mutuellement leurs angles morts respectifs en matière de biais et de variance.
L’architecture opérationnelle du Stacking s’articule sur deux niveaux hiérarchiques distincts :
- Les modèles de niveau 0 (Base Learners) : Un panel diversifié d’estimateurs de nature mathématique distincte — par exemple une régression linéaire fortement régularisée (modèle à fort biais, faible variance), un modèle de plus proches voisins non paramétrique (modèle à géométrie locale), une machine à vecteurs de support à noyau RBF, et une forêt aléatoire profonde — est entraîné sur l’échantillon initial.
- Le méta-modèle de niveau 1 (Meta-Learner) : Au lieu d’agréger les prédictions de ces modèles hétérogènes par un vote majoritaire naïf ou une moyenne équipondérée, un méta-modèle prédictif (généralement une régression logistique ou un modèle linéaire contraint à des poids positifs) est entraîné pour apprendre la combinaison pondérée optimale de leurs sorties.
Pour prévenir tout surapprentissage critique lors de cette étape d’intégration, les données servant à alimenter le méta-modèle doivent impérativement être générées selon une procédure de prédictions hors-échantillon (out-of-fold predictions) calquée sur une validation croisée rigoureuse. De cette manière, le méta-modèle évalue les propensions empiriques de chaque famille algorithmique à se tromper dans certaines régions de l’espace des données.
Le Stacking réalise ainsi une conciliation mathématique remarquable : les déficiences structurelles d’un algorithme à fort biais sur une zone non linéaire sont automatiquement compensées par les prédictions des modèles non paramétriques, tandis que l’instabilité locale d’un estimateur à forte variance est lissée par la rigidité stabilisatrice des composants linéaires régularisés. Il en résulte un système d’apprentissage dont l’erreur quadratique moyenne finale s’avère fréquemment inférieure à celle de n’importe lequel de ses constituants isolés.
10. La remise en question moderne : Le phénomène de « double descente »
10.1 Les limites du paradigme classique face aux réseaux de neurones
Durant plusieurs décennies, le compromis biais-variance traditionnel incarné par la courbe en U a été érigé en dogme intangible au sein de la communauté statistique. Selon cette perspective historique, tout assouplissement de la complexité au-delà du point d’interpolation — c’est-à-dire le seuil critique où le nombre de paramètres ajustables du modèle égale exactement le nombre de points d’apprentissage — conduit inéluctablement à une explosion catastrophique de la variance et à l’effondrement de la capacité de généralisation.
Pourtant, le déploiement spectaculaire de l’apprentissage profond (Deep Learning) au cours des années 2010 a confronté la théorie classique à un paradoxe empirique flagrant. Des architectures massives telles que les transformeurs (comme la série des modèles GPT) ou les réseaux convolutionnels modernes (comme les variantes géantes de ResNet) comportent fréquemment des dizaines ou des centaines de milliards de poids synaptiques pour des jeux de données d’entraînement ne comptant « que » quelques millions ou milliards d’exemples. Ces systèmes opèrent en régime d’interpolation parfaite : leur erreur d’entraînement est rigoureusement nulle, ce qui signifie qu’ils ont la capacité théorique d’apprendre par cœur chaque élément d’information du corpus, y compris d’éventuelles étiquettes totalement corrompues par du bruit blanc.
Or, selon le schéma classique de la courbe en U, ces architectures surdimensionnées devraient manifester une variance d’estimation hyperbolique et une erreur de test proche du hasard complet. La réalité expérimentale démontre l’exact opposé : ces modèles hautement surparamétrés surpassent systématiquement leurs homologues plus parcimonieux, exhibant des performances de généralisation exceptionnelles qui ont défié pendant plusieurs années les cadres analytiques hérités de la statistique du XXe siècle.
10.2 Mécanismes théoriques du régime surparamétré
La résolution théorique de cette apparente contradiction a été formalisée à partir de 2019 par les travaux pionniers de Mikhail Belkin, Daniel Hsu, Siyuan Ma et Soumik Mandal, qui ont introduit le concept unificateur de double descente (double descent). Ce cadre conceptuel démontre que la courbe d’erreur de généralisation ne s’arrête pas au point d’ajustement exact, mais s’étend à travers deux régimes d’apprentissage qualitativement distincts, séparés par un pic de singularité critique :
Le premier régime correspond au domaine classique sous-paramétré, où la complexité est inférieure à la taille de l’échantillon ($p < n$). Dans cette zone, la courbe de test obéit fidèlement à la dynamique traditionnelle en U : l’erreur décroît d’abord sous l’effet de l’abaissement du biais, atteint son minimum classique, puis remonte violemment à mesure qu’elle approche du seuil d’interpolation ($p \approx n$). À ce seuil précis, le système est contraint de mobiliser l’intégralité de ses rares degrés de liberté pour faire passer sa surface de prédiction par chaque point d’apprentissage, ce qui produit des oscillations spatiales vertigineuses et provoque une divergence asymptotique de la variance d’estimation.
Cependant, dès lors que la complexité franchit ce goulet d’étranglement pour pénétrer dans le régime surparamétré ($p gg n$), un phénomène d’une nature mathématique radicalement neuve émerge : la seconde descente. Dans cette région où les paramètres sont surabondants par rapport aux données, le problème d’optimisation admet désormais une infinité continue d’interpolateurs parfaits annulant l’erreur d’entraînement. L’algorithme d’optimisation (généralement la descente de gradient stochastique, SGD) cesse d’être un simple minimiseur de perte empirique pour devenir un opérateur de sélection implicite.
Les recherches théoriques sur la régression linéaire surparamétrée et les modèles à noyaux d’interpolation de norme minimale ont démontré que les algorithmes basés sur le gradient convergent spontanément vers la solution qui possède la plus petite norme euclidienne de paramètres $|theta|_2$ parmi toutes les solutions interpolantes possibles. Ce biais inductif implicite agit comme un mécanisme de lissage géométrique global : au lieu de générer des oscillations locales erratiques pour raccorder les points de données, l’excès massif de dimensions permet à la fonction d’interpoler les observations par les trajectoires les plus douces et les plus parcimonieuses possibles dans l’espace de Hilbert sous-jacent. Dès lors, la variance d’estimation se remet à décroître de façon monotone au fur et à mesure que le degré de surparamétrisation s’amplifie, conduisant à une performance d’extrapolation souvent bien supérieure à l’optimum du régime classique sous-paramétré.
10.3 Réconciliation théorique entre statistique classique et apprentissage moderne
L’avènement de la double descente n’invalide nullement la pertinence de la décomposition analytique biais-variance établie au deuxième chapitre ; elle en renouvelle profondément l’interprétation épistémologique. La décomposition $\text{MSE} = \text{Biais}^2 + \text{Var} + \sigma^2$ demeure rigoureusement exacte à chaque point du continuum de complexité. Ce qui a été fondamentalement bouleversé est la compréhension de la métrique régissant la complexité effective d’un système computationnel.
Dans la théorie statistique classique, la complexité d’un modèle était quasi-exclusivement assimilée au comptage brut de ses paramètres libres ou à la dimension combinatoire de Vapnik-Chervonenkis. Or, dans le régime surparamétré moderne, le nombre volumétrique de paramètres cesse d’être un indicateur fidèle de la flexibilité effective. La véritable complexité se trouve désormais régulée par des grandeurs géométriques intrinsèques : la norme des opérateurs de projection, la régularité lipschitzienne de la fonction apprise, et le spectre des valeurs propres des matrices de covariance associées au noyau tangent neuronal (Neural Tangent Kernel).
Le compromis biais-variance se trouve ainsi unifié dans un cadre théorique élargi. Dans le monde des données tabulaires restreintes où l’on déploie des modèles traditionnels sous-paramétrés (arbres de décision, régressions régularisées), la maîtrise du compromis classique via la courbe en U demeure la règle d’ingénierie cardinale. En revanche, dans le monde des architectures perceptuelles géantes où les données sont massives et l’espace vectoriel sursaturé de paramètres, le praticien opère en aval du pic d’interpolation, exploitant les propriétés de régularisation implicite de la surparamétrisation pour écraser simultanément le biais d’approximation et la variance géométrique.
11. Perspectives épistémologiques et cognitives sur le compromis
11.1 Heuristiques cognitives et architecture à biais élevé
Le compromis biais-variance dépasse largement le périmètre technique des mathématiques computationnelles pour toucher aux fondements de l’épistémologie et des sciences cognitives comparées. Dans ses travaux sur la rationalité écologique, le psychologue cognitiviste Gerd Gigerenzer a formalisé un lien direct entre les mécanismes heuristiques de l’esprit humain et les modèles statistiques à fort biais inductif.
Dans des environnements naturels caractérisés par une incertitude radicale, un niveau élevé de bruit stochastique et une rareté chronique des observations, chercher à élaborer une représentation exhaustive et multiparamétrique du réel mène inévitablement à un surapprentissage comportemental létal. Les heuristiques de jugement rapides et frugales mobilisées par le cerveau biologique — telles que la règle du « Take The Best », qui fonde une décision binaire sur un unique indice discriminant en ignorant délibérément tous les autres — fonctionnent exactement comme des souches de décision (decision stumps) ou des modèles linéaires ultra-contraints. Elles assument délibérément un biais d’approximation substantiel pour immuniser l’organisme contre une variance prédictive dévastatrice.
Gigerenzer a formulé ce principe sous le paradoxe du « less is more » : il existe des conditions écologiques formellement identifiables où un modèle mathématiquement fruste et délibérément incomplet prédit les comportements futurs avec une exactitude systématiquement supérieure à celle d’un système d’optimisation exhaustif incorporant toutes les variables contextuelles disponibles. La survie adaptative a forgé dans l’architecture cognitive biologique une disposition sélective pour des a priori rigides et protecteurs contre la volatilité de l’échantillon phénoménologique.
11.2 Surinterprétation cognitive et variance comportementale
À l’inverse, l’analyse des biais cognitifs humains révèle des pathologies qui s’apparentent de manière frappante aux dérives algorithmiques d’une variance excessive. Le phénomène de l’apophénie — défini comme la propension psychologique universelle à percevoir des motifs significatifs, des régularités intentionnelles ou des visages anthropomorphes au sein de configurations stochastiques dénuées de sens — constitue l’incarnation même du surapprentissage de la variance : le système perceptuel accorde une confiance aveugle au bruit ambiant et ajuste ses paramètres cognitifs sur des coïncidences fortuites.
De même, le biais de confirmation opère comme un surapprentissage localisé sur un sous-ensemble biaisé de l’expérience vécue. L’esprit humain, confronté à une surabondance d’informations contradictoires dans un monde hyper-complexe, sélectionne préférentiellement les données confortant sa structure d’attente antérieure, mémorisant les exceptions confirmatoires et rejetant les signaux d’invalidation. Cette hyper-spécificité génère une rigidité psychologique face à la nouveauté qui rappelle les faillites d’extrapolation d’un arbre de décision excessivement profond face à un glissement de distribution.
Le coût comportemental d’une variance cognitive débridée est immense : il condamne l’agent à une hyper-réactivité permanente face à des stimuli environnementaux éphémères et anecdotiques, épuisant ses ressources attentionnelles et ruinant sa capacité à formuler des stratégies temporelles de long terme fondées sur des invariants stables.
11.3 L’apprentissage biologique comme modèle d’équilibrage dynamique
Le cerveau des mammifères supérieurs offre un modèle d’ingénierie biologique fascinant quant à la résolution dynamique du compromis biais-variance au cours de l’existence. Durant les premières phases du développement ontogénétique, le système nerveux fait preuve d’une plasticité synaptique phénoménale, caractérisée par une synaptogenèse massive qui dote l’encéphale d’une capacité computationnelle surdimensionnée, prête à intégrer n’importe quelle structure linguistique, culturelle ou sensorielle. Cette phase initiale, caractérisée par une forte expressivité, est rapidement relayée par un processus massif d’élagage synaptique (synaptic pruning) au cours duquel les connexions neuronales redondantes, sous-utilisées ou associées au bruit de fond sont impitoyablement détruites.
Cet élagage biologique est le pendant direct du cost-complexity pruning des algorithmes d’apprentissage : il réduit la complexité structurelle globale du réseau pour ancrer la stabilité de la mémoire à long terme et prévenir le surajustement perceptuel. Parallèlement, le cycle circadien alternant sommeil à ondes lentes et sommeil paradoxal opère une régularisation continue indispensable. Les théories contemporaines de neurobiologie computationnelle suggèrent que la consolidation mnésique nocturne s’apparente à une injection de bruit thermique et à une compression vectorielle, éliminant les détails anecdotiques de la journée pour n’intégrer dans le cortex que les régularités structurelles pérennes.
Cette dynamique trouve son expression formelle la plus aboutie dans la théorie du cerveau bayésien et du codage prédictif (predictive coding), théorisée notamment par Karl Friston. Le système nerveux y est conceptualisé comme une machine d’inférence hiérarchique permanente qui arbitre à chaque milliseconde entre ses modèles a priori descendants (top-down priors, porteurs de biais stabilisateur) et les erreurs de prédiction sensorielles ascendantes (bottom-up prediction errors, porteuses de variance adaptative). La modulation de la précision relative accordée à ces flux informationnels concurrents permet au cerveau d’ajuster dynamiquement son point d’équilibre sur la courbe biais-variance en fonction du degré de volatilité perçu de l’environnement physique.
12. Guide pratique et méthodologique pour l’optimisation en environnement réel
12.1 Protocole systématique de diagnostic d’erreur
Pour l’ingénieur de données ou le chercheur confronté à des performances insatisfaisantes sur un modèle en production, l’arbitrage biais-variance ne doit pas s’effectuer à tâtons mais obéir à un protocole clinique standardisé. Inspiré par les méthodologies formalisées par Andrew Ng, ce processus d’audit s’articule en trois étapes séquentielles intangibles :
- Établissement d’une ligne de base de référence (Human-level performance / Bayes Optimal Error) : Avant d’interpréter un score brut, il est indispensable de quantifier l’erreur théorique incompressible $\sigma^2$ du cas d’usage. Sur des tâches de perception (vision, parole, traduction), la performance d’un consensus d’experts humains chevronnés sert d’approximation de référence de l’erreur bayésienne. Sur des données tabulaires industrielles, cette référence peut être établie par des analyses physiques ou des régressions non paramétriques saturées. Sans cette base, il est impossible de savoir si une erreur de 10 % relève d’un défaut du modèle ou de la présence d’un bruit irréductible infranchissable.
- Quantification du biais évitable : Cette composante s’évalue en calculant la différence absolue entre l’erreur obtenue sur le jeu d’entraînement et la ligne de base de Bayes :
$$\text{Biais Évitable} = \text{Erreur d’Entraînement} – \text{Erreur de Bayes}$$
Si cette quantité est substantielle, l’algorithme est formellement diagnostiqué en état de sous-apprentissage. Il échoue à capturer le signal disponible, et aucun effort de collecte de données supplémentaires n’aura d’impact tangible tant que cette fracture ne sera pas résorbée. - Quantification de la variance d’estimation : Cette seconde grandeur se mesure en calculant le fossé séparant l’erreur du jeu de validation de l’erreur d’entraînement :
$$\text{Variance Évitable} = \text{Erreur de Validation} – \text{Erreur d’Entraînement}$$
Si ce différentiel est prépondérant, le modèle est catégorisé en état de surapprentissage. L’effort technique doit alors basculer prioritairement sur des techniques de contention de l’instabilité statistique.
12.2 Matrice décisionnelle d’intervention technique
Une fois le diagnostic chiffré établi avec rigueur, le praticien doit appliquer une matrice de remédiation technique sans équivoque, interdisant toute intervention désordonnée qui risquerait de déstabiliser simultanément les deux fronts du compromis :
- Traitements prioritaires si le BIAIS domine :
- Accroître l’expressivité structurelle du modèle (augmenter la profondeur des réseaux ou des arbres, élargir les couches denses).
- Enrichir l’espace d’entrée par de l’ingénierie de variables (générer des caractéristiques polynomiales, des termes d’interactions non linéaires).
- Atténuer ou supprimer les pénalités de régularisation (réduire les coefficients $lambda$ de Ridge/Lasso, baisser le taux de Dropout).
- Basculer vers une classe algorithmique plus puissante (remplacer une régression logistique par un gradient boosting ou un réseau profond).
- Traitements prioritaires si la VARIANCE domine :
- Accroître le volume des données d’entraînement (collecter de nouvelles observations, appliquer des stratégies massives de data augmentation).
- Intensifier les régularisations analytiques (accroître drastiquement les pénalités $L_1$ ou $L_2$, renforcer les coefficients de Dropout).
- Restreindre les hyperparamètres topologiques du modèle (imposer un élagage strict des arbres, contraindre la profondeur maximale, fixer des seuils d’échantillons minimaux par feuille).
- Opérer une sélection drastique de caractéristiques pour éliminer le bruit en haute dimension (utilisation d’approches Lasso ou de méthodes de filtrage par information mutuelle).
- Mobiliser des méthodes ensemblistes de moyennage (transformer le modèle isolé en une Forêt Aléatoire ou un ensemble Bagging).
Il est impératif d’adopter un principe d’orthogonalité opérationnelle : ajuster un levier ciblant le biais, réévaluer les métriques d’entraînement, puis seulement stabiliser la variance par une régularisation ciblée, plutôt que de manipuler simultanément des hyperparamètres aux dynamiques opposées.
12.3 Gouvernance et pérennité des modèles en production
L’optimisation du compromis biais-variance ne s’achève jamais avec le déploiement d’un artefact algorithmique sur une infrastructure de production. Dans les écosystèmes réels, les processus physiques, sociaux ou financiers générateurs de données ne sont presque jamais stationnaires dans le temps. Ce phénomène universel d’altération temporelle des distributions statistiques se décompose classiquement en dérive des données (data drift, variation de la distribution marginale $P(x)$) et en dérive conceptuelle (concept drift, variation de la distribution conditionnelle $P(y|x)$).
L’impact de ces dérives sur l’équilibre biais-variance est asymétrique et pernicieux. Lorsqu’un modèle a été optimisé à l’extrême limite de sa variance pour un échantillon d’apprentissage donné, la moindre translation de la distribution réelle en production peut provoquer une rupture silencieuse du système. Un modèle hautement calibré sur une topologie passée verra son erreur exploser de manière imprévisible face à de nouveaux régimes macroéconomiques, comportementaux ou environnementaux, révélant une hypersensibilité résiduelle catastrophique.
La gouvernance pérenne d’un système d’apprentissage automatique impose donc la mise en œuvre d’une surveillance télémétrique continue des résidus en production. Cette démarche implique de tester régulièrement la robustesse hors distribution (out-of-distribution robustness) par des tests de stress stochastiques (fuzzing d’entrée, injection de bruit adversarial). Un système résilient en environnement industriel est souvent un modèle délibérément sous-ajusté d’une fraction marginale sur ses performances théoriques de test au laboratoire, afin de conserver un matelas de biais inductif protecteur lui permettant d’absorber les futures oscillations stochastiques d’un monde en perpétuelle métamorphose.
Références
- Belkin, M., Hsu, D., Ma, S., & Mandal, S. (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. Proceedings of the National Academy of Sciences, 116(32), 15849-15854. https://doi.org/10.1073/pnas.1903070116
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123-140. https://doi.org/10.1007/BF00058655
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5-32. https://doi.org/10.1023/A:1010933404324
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press.
- Freund, Y., & Schapire, R. E. (1997). A decision-theoretic generalization of on-line learning and an application to boosting. Journal of Computer and System Sciences, 55(1), 119-139. https://doi.org/10.1006/jcss.1997.1504
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189-1232. https://doi.org/10.1214/aos/1013203451
- Geman, S., Bienenstock, E., & Doursat, R. (1992). Neural networks and the bias/variance dilemma. Neural Computation, 4(1), 1-58. https://doi.org/10.1162/neco.1992.4.1.1
- Gigerenzer, G., & Brighton, H. (2009). Homo heuristicus: Why biased minds make better inferences. Topics in Cognitive Science, 1(1), 107-143. https://doi.org/10.1111/j.1756-8765.2008.01006.x
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Mitchell, T. M. (1980). The need for biases in learning generalizations (Technical Report CBM-TR-117). Rutgers University.
- Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., & Salakhutdinov, R. (2014). Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(56), 1929-1958. http://jmlr.org/papers/v15/srivastava14a.html
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Vapnik, V. N. (1998). Statistical learning theory. John Wiley & Sons.
- Wolpert, D. H. (1992). Stacked generalization. Neural Networks, 5(2), 241-259. https://doi.org/10.1016/S0893-6080(05)80023-1
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301-320. https://doi.org/10.1111/j.1467-9868.2005.00503.x