
L’apprentissage automatique contemporain et la statistique computationnelle ont profondément transformé la manière dont les chercheurs et les praticiens appréhendent la modélisation prédictive au sein de corpus de données complexes. Historiquement tributaires de modèles paramétriques linéaires dont la validité repose sur des hypothèses distributionnelles souvent violées par les données empiriques réelles, les analystes se tournent désormais vers des estimateurs non paramétriques capables de capturer de manière endogène des relations non linéaires et des interactions d’ordre élevé. Parmi ces méthodologies, les arbres de décision binaire, popularisés notamment par les travaux fondateurs de Breiman, Friedman, Olshen et Stone relatifs à la classification et la régression arborescentes (CART), occupent une place centrale en raison de leur flexibilité conceptuelle et de leur lisibilité heuristique immédiate.
Cependant, la contrepartie majeure de cette remarquable adaptabilité réside dans une instabilité structurelle intrinsèque, formalisée mathématiquement par une variance d’échantillonnage disproportionnée. Une infime perturbation au sein du jeu de données d’apprentissage est susceptible d’induire une modification radicale de la topologie de l’arbre, conduisant à des prédictions hautement volatiles dès lors que le modèle est confronté à des observations inédites. Pour surmonter cet écueil fondamental sans sacrifier la puissance descriptive des structures arborescentes, Leo Breiman a introduit au milieu des années 1990 le concept révolutionnaire de Bootstrap Aggregating, universellement contracté sous l’acronyme de bagging. Cette approche méta-algorithmique exploite la puissance du rééchantillonnage bootstrap afin de générer une multiplicité d’estimateurs perturbés dont l’agrégation finale produit une réduction drastique de la variance globale.
Le présent article constitue un guide exhaustif, théorique et appliqué, dédié à l’implémentation rigoureuse du bagging sous l’environnement statistique R. En articulant les fondements de la théorie de l’apprentissage statistique avec les exigences méthodologiques de la modélisation quantitative appliquée aux sciences comportementales et à la psychométrie, ce document expose de manière détaillée chaque étape du processus analytique. Depuis le prétraitement méthodique des cohortes jusqu’à l’évaluation diagnostique de l’erreur out-of-bag (OOB) et l’estimation de l’importance des covariables, ce protocole fournit aux analystes de données, psychométriciens et biostatisticiens les leviers techniques nécessaires au déploiement de modèles prédictifs à la fois robustes, reproductibles et scientifiquement irréprochables.
1. Fondements théoriques : de l’arbre décisionnel simple à l’ensemble bootstrap
1.1 Limites structurelles et variance élevée de l’arbre unique
Pour appréhender l’utilité du bagging, il convient d’analyser la dynamique d’ajustement d’un arbre de décision standardisé, qu’il soit déployé dans un contexte de régression ou de classification supervisée. Le paradigme algorithmique sous-jacent repose sur une partition récursive gloutonne de l’espace des prédicteurs. À chaque nœud interne, l’algorithme inspecte de manière exhaustive l’ensemble des descripteurs disponibles et évalue toutes les scissions binaires envisageables afin de maximiser l’homogénéité des nœuds enfants, mesurée classiquement par la réduction de la variance résiduelle pour les variables continues ou par le gain d’information issu de l’impureté de Gini pour les variables qualitatives. Cette approche purement myope ne garantit nullement l’optimalité globale de l’arborescence, mais optimise localement un critère d’ajustement immédiat.
Cette logique récursive engendre une sensibilité pathologique aux fluctuations stochastiques de l’échantillon d’apprentissage. En vertu de la décomposition théorique de l’erreur quadratique moyenne en termes de biais, de variance et de bruit irréductible, un arbre de décision profond non élagué présente un biais asymptotiquement faible, car il possède la capacité d’épouser les frontières de décision les plus sinueuses au sein de l’espace vectoriel d’entraînement. En revanche, sa composante de variance explose : la suppression, l’ajout ou la simple modification d’une poignée d’individus dans l’échantillon initial peut réorienter le choix de la variable de scission au niveau du nœud racine. Une telle modification inaugurale propage en cascade des altérations topologiques majeures le long de toutes les branches subséquentes, aboutissant à une surface prédictive entièrement dissemblable.
Face à des jeux de données bruités, caractérisés par un ratio signal sur bruit défavorable ou par une colinéarité prononcée entre variables explicatives, l’arbre unique souffre de surapprentissage systématique. Il mémorise les artefacts d’échantillonnage, le bruit idiosyncratique et les valeurs aberrantes au lieu d’extraire la véritable structure latente sous-jacente génératrice des données. L’élagage par complexité de coût constitue une tentative d’atténuer cette dérive en tronquant les ramifications terminales superfétatoires. Cependant, cet arbitrage biais-variance s’opère nécessairement au détriment de la résolution fine des interactions locales, limitant substantiellement l’efficacité prédictive globale de l’estimateur individuel.
1.2 Mécanisme fondamental du bootstrap aggregating
Le Bootstrap Aggregating transcende cette aporie en modifiant radicalement la posture épistémologique du modélisateur : au lieu de rechercher un arbre unique optimal introuvable, l’algorithme construit un ensemble démocratique d’arbres instables mais décorrélés par perturbation statistique. Le socle théorique de cette démarche repose sur le principe du bootstrap non paramétrique formulé par Bradley Efron. Soit un échantillon d’apprentissage constitué de N observations indépendantes et identiquement distribuées selon une loi de probabilité inconnue. L’algorithme tire avec remise B échantillons dits bootstrap, chacun comprenant exactement N observations.
En vertu des propriétés combinatoires du tirage uniforme avec remise, chaque échantillon bootstrap contient en moyenne approximativement 63,2 % d’observations uniques issues du jeu d’entraînement initial, les données restantes étant constituées de duplications stochastiques. Sur chacun de ces B sous-ensembles, un arbre de décision complet est ajusté sans faire l’objet d’aucun élagage limitatif. Ces estimateurs individuels conservent donc individuellement un biais d’ajustement extrêmement faible, mais manifestent chacun une variance empirique marquée. La prédiction finale de l’ensemble d’arbres pour une nouvelle observation est ensuite obtenue par agrégation uniforme : calcul de la moyenne arithmétique des prédictions continues en régression, ou vote à la majorité simple des assignations de classes en classification.
La justification analytique de cette convergence réside dans le théorème statistique de réduction de variance d’une moyenne de variables aléatoires. Si l’on dispose de B estimateurs identiquement distribués présentant chacun une variance individuelle $\sigma^2$ et une corrélation moyenne inter-arbres notée $rho$, la variance de la prédiction moyenne agrégée s’établit formellement comme la somme de deux composantes distinctes : $\rho \sigma^2 + \frac{1 – \rho}{B} \sigma^2$. Lorsque le nombre d’arbres bootstrap B croît vers l’infini, le second terme s’annule asymptotiquement. La variance totale converge alors vers un plancher structurel défini par $\rho \sigma^2$. Dès lors que la corrélation $rho$ demeure inférieure à l’unité, le bagging garantit une réduction mathématique stricte de la variance d’estimation sans pénaliser le biais intrinsèque des arbres individuels.
1.3 Distinction formelle entre bagging, boosting et forêts aléatoires
Dans la nomenclature des méthodes ensemblistes (ensemble learning), le bagging doit être rigoureusement distingué d’autres approches algorithmiques majeures, singulièrement le boosting et les forêts aléatoires, avec lesquelles des confusions conceptuelles persistent fréquemment. Le bagging repose sur un paradigme de parallélisme strict : l’ensemble des B arbres décisionnels sont entraînés de façon totalement indépendante les uns des autres, sur des répliques bootstrap autonomes, sans qu’aucune communication inter-arbres n’intervienne au cours de la phase d’apprentissage. Cette architecture favorise une parallélisation computationnelle massive sur des environnements de calcul distribué ou multi-cœurs.
À l’opposé, les algorithmes de boosting (tels que le gradient boosting ou AdaBoost) opèrent selon une logique séquentielle déterministe et adaptative. Chaque nouvel arbre introduit dans le modèle a pour mandat explicite de corriger les erreurs résiduelles ou de compenser les gradients de perte générés par la chaîne d’estimateurs qui le précèdent. Alors que le bagging s’applique prioritairement à des apprenants de base complexes à faible biais et forte variance (arbres profonds non élagués) dans l’optique exclusive d’en amortir la variance, le boosting mobilise traditionnellement des apprenants dits faibles présentant un biais élevé et une faible variance (arbres très peu profonds, souvent restreints à une scission unique nommée moignon ou stump) afin de comprimer méthodiquement le biais global.
Quant aux forêts aléatoires (Random Forests), théorisées formellement par Leo Breiman en 2001, elles constituent une extension directe et un raffinement structurel du bagging standard. Dans le bagging conventionnel appliqué aux arbres, chaque scission examine systématiquement l’intégralité du vecteur des prédicteurs disponibles. Dans une forêt aléatoire, un sous-ensemble aléatoire de prédicteurs de taille réduite est échantillonné indépendamment à chaque scission binaire de chaque nœud. Cette restriction délibérée interdit aux prédicteurs ultra-dominants d’accaparer les premiers niveaux de scission de tous les arbres bootstrap, ce qui induit une baisse drastique de la corrélation inter-arbres $rho$. Par conséquent, le bagging standard préserve intégralement la topologie de l’espace des descripteurs originaux à chaque nœud, tandis que la forêt aléatoire force une décorrélation artificielle supplémentaire au sein de l’espace des variables explicatives.
2. Pertinence du bagging en modélisation quantitative et psychométrie
2.1 Gestion de l’hétérogénéité et du bruit dans les données psychologiques
L’application du bagging aux disciplines quantitatives traitant du comportement humain, notamment la psychométrie computationnelle, les sciences cognitives et l’épidémiologie psychiatrique, répond à des défis méthodologiques singuliers. Les métriques psychologiques issues d’échelles auto-rapportées, d’inventaires de personnalité ou d’évaluations cliniques se caractérisent par un ratio bruit sur signal particulièrement substantiel. Les erreurs de mesure inhérentes à la fidélité imparfaite des instruments psychométriques, les biais de réponse d’acquiescement, ainsi que la variabilité intra-individuelle transitoire introduisent une quantité phénoménale de perturbations stochastiques dans les matrices d’observations empiriques.
Face à de telles matrices de données, un modèle arborescent unique a tendance à surinterpréter les réponses atypiques d’individus isolés, considérant des configurations extrêmes ou aberrantes comme des points de rupture véridiques de traits latents. L’agrégation par bootstrap agit comme un mécanisme de filtrage robuste : un individu atypique n’apparaissant que dans un sous-ensemble fini d’itérations bootstrap, son potentiel de déformation des frontières décisionnelles est neutralisé par le vote démocratique des arbres issus des tirages dont il a été exclu. Les scores d’échelles composites et les diagnostics différentiels gagnent ainsi une stabilité structurelle remarquable, assurant que les inférences comportementales reposent sur des régularités phénotypiques généralisables plutôt que sur des fluctuations accidentelles d’échantillonnage.
De surcroît, les seuils de coupure clinique définis empiriquement le long de continuums de détresse psychologique ou de capacités cognitives souffrent fréquemment d’un manque de réplicabilité lorsqu’ils sont extraits par régression logistique classique ou par un arbre binaire isolé. Le bagging atténue considérablement cette instabilité de seuillage. En lissant les discontinuités de surface inhérentes aux fonctions en escalier des arbres individuels, le processus d’agrégation génère des estimations de probabilités a posteriori continues et hautement étalonnées, fournissant aux cliniciens et aux chercheurs des indicateurs pronostiques d’une bien meilleure validité écologique.
2.2 Équilibre entre capacité prédictive et parcimonie explicative
L’histoire de la psychométrie a longtemps été dominée par une exigence exclusive de parcimonie explicative, incarnée par les modèles d’équations structurelles, l’analyse factorielle confirmatoire et les modèles de régression linéaire généralisée. Si ces méthodologies demeurent incomparables pour évaluer la conformité théorique de construits hypothétiques formalisés à l’avance, elles s’avèrent structurellement impuissantes lorsqu’il s’agit de découvrir des interactions d’ordre élevé non spécifiées a priori. Les dynamiques psychologiques et comportementales obéissent rarement à des lois purement additives : des effets de modération complexes, des phénomènes de compensation cognitive ou des effets de seuil conditionnels structurent fréquemment les trajectoires cliniques.
Le recours aux modèles ensemblistes fondés sur le bagging permet d’opérer un basculement pragmatique vers la maximisation de l’exactitude prédictive, tout en conservant une traçabilité globale de l’espace des covariables. Contrairement aux approches par réduction de dimension linéaire qui fusionnent ou projettent les variables explicatives au sein d’espaces orthogonaux abstraits, le bagging conserve l’intégrité nominale de chaque item, variable démographique ou marqueur comportemental. La multiplicité des découpages arborescents permet de capturer simultanément des réseaux d’interactions non linéaires de dimension arbitraire sans contraindre le chercheur à formaliser manuellement des produits croisés polynomiaux.
Ce gain prédictif s’accompagne d’une préservation de la validité de contenu des instruments d’évaluation. En sciences du comportement, l’identification précise des prédicteurs dominants à travers des métriques d’importance agrégées offre une perspective diagnostique de premier plan. Le bagging réconcilie ainsi la rigueur inductive de l’apprentissage automatique non paramétrique et la nécessité explicative des disciplines comportementales, fournissant des prédictions généralisables dont la robustesse outrepasse systématiquement celle des modèles linéaires rigides confrontés à des données comportementales hautement corrélées et multivariées.
3. Étape 1 : Configuration de l’environnement R et chargement des dépendances
3.1 Sélection et installation des bibliothèques spécialisées
La mise en œuvre professionnelle du bagging au sein du langage R requiert la sélection méticuleuse d’un écosystème de paquetages optimisés, éprouvés pour leur efficience computationnelle et leur rigueur numérique. Le cœur fonctionnel du bagging d’arbres décisionnels repose historiquement sur le package ipred (Improved Predictors), développé par Andrea Peters et Torsten Hothorn. Ce module fournit une implémentation directe, concise et hautement paramétrable de l’algorithme original de Breiman via la fonction dédiée au calcul bootstrap. En synergie directe avec ipred, le package fondamental rpart (Recursive Partitioning and Regression Trees) de Terry Therneau et Beth Atkinson constitue le moteur algorithmique sous-jacent chargé de construire les arbres CART individuels.
Pour unifier le pipeline de modélisation, standardiser les procédures de rééchantillonnage et évaluer sans biais la généralisabilité des prédicteurs, l’intégration du méta-package caret (Classification and REgression Training), conçu par Max Kuhn, est impérative. Ce framework structure l’intégralité du cycle de vie des modèles prédictifs, automatisant le partitionnement des données, le prétraitement des prédicteurs, l’optimisation des hyperparamètres et la génération de métriques de validation croisée. En complément de ces bibliothèques de modélisation, le recours aux extensions de manipulation vectorielle dplyr et tidyr issues de l’écosystème tidyverse garantit une manipulation expressive et fluide des structures tabulaires matricielles.
Compte tenu de la charge computationnelle substantielle induite par l’ajustement sériel de plusieurs centaines d’arbres de décision profonds, la mise en place d’un environnement de calcul parallèle est indispensable pour une pratique quantitative efficace. L’installation des packages foreach et doParallel permet de lier l’architecture logicielle de R aux capacités physiques du microprocesseur hôte. Ce dispositif technique autorise la distribution asynchrone des itérations de rééchantillonnage bootstrap à travers les différents cœurs physiques de calcul disponibles, écourtant ainsi drastiquement les temps d’exécution requis pour la convergence des modèles ensemblistes volumineux.
3.2 Initialisation de la reproductibilité scientifique
La validité d’une démarche d’apprentissage statistique repose de manière inconditionnelle sur sa stricte reproductibilité expérimentale. Le processus de bagging faisant un usage intensif de générateurs de nombres pseudo-aléatoires pour exécuter le tirage uniforme avec remise des répliques bootstrap, deux exécutions successives d’un même script analytique sur une même machine produiraient sans précaution des résultats divergents au niveau des prédictions individuelles et des estimations d’erreurs. Il est par conséquent primordial de fixer l’état interne du générateur pseudo-aléatoire dès l’initialisation de la session de travail à l’aide de l’instruction canonique set.seed(), en consignant expressément la graine numérique choisie dans le protocole de recherche.
Au-delà de la graine aléatoire, la robustesse de la traçabilité scientifique impose une consignation formelle de l’état complet du système d’exploitation et des versions logicielles mobilisées. L’exécution de la commande intégrée sessionInfo() permet d’archiver la version exacte de l’interpréteur R, l’architecture processeur sous-jacente, les paramètres de localisation linguistique et l’ensemble exhaustif des versions des paquetages chargés dans l’espace de noms global. Cette traçabilité prévient les altérations méthodologiques insidieuses induites par les évolutions futures d’implémentations d’algorithmes tiers ou les modifications de valeurs par défaut dans les bibliothèques d’appoint.
Parallèlement, la configuration du calcul distribué multi-cœurs requiert une initialisation prudente de l’infrastructure logicielle via les primitives de parallel::makeCluster() et registerDoParallel(). Le chercheur doit explicitement définir le contingent de processeurs logiques alloués à la tâche, en veillant scrupuleusement à réserver au minimum un cœur de traitement pour la gestion des processus système résidents. Cette discipline d’architecture logicielle prévient les goulots d’étranglement de mémoire vive et les instabilités de mémoire partagée lors de la transmission des sous-matrices bootstrap aux différents sous-processus de calcul distribué.
4. Étape 2 : Préparation, partitionnement et inspection des données
4.1 Contrôle qualité et imputation des données manquantes
L’étape préliminaire de conditionnement des données détermine directement la validité asymptotique de l’estimateur par bagging. En dépit de leur résilience supérieure comparativement aux modèles linéaires classiques, les arbres décisionnels non paramétriques demeurent sensibles aux données manquantes non informatives ainsi qu’aux incohérences d’encodage de variables catégorielles. Dans le cadre spécifique de bases de données psychométriques ou comportementales, la présence de cellules vides ou de patrons d’incomplétude univariés ou multivariés (manquants complètement aléatoires MCAR, ou manquants aléatoires MAR) requiert une intervention méthodique avant le déploiement du rééchantillonnage.
Le diagnostic exploratoire préliminaire évalue la proportion et la distribution spatiale des valeurs manquantes à travers l’ensemble de la cohorte d’observations. Lorsqu’une imputation s’avère méthodologiquement soutenable, plusieurs stratégies s’offrent au praticien. L’imputation naïve par la médiane ou la moyenne arithmétique globale des séries continues doit être proscrite pour les variables fortement corrélées, sous peine de compresser artificiellement la variance et d’oblitérer les corrélations bivariées fondamentales. On privilégiera systématiquement des algorithmes d’imputation multivariée basés sur les k-plus proches voisins (k-NN) ou sur des décompositions arborescentes itératives, capables de restaurer la vraisemblance distributionnelle conditionnelle en exploitant l’information latente des prédicteurs auxiliaires.
Le formatage des covariables exige également un encodage sémantique rigoureux. Les prédicteurs qualitatifs ordinaux ou nominaux doivent être impérativement convertis en facteurs R natifs (factors) dotés de niveaux clairement labellisés, garantissant ainsi que l’algorithme rpart sous-jacent segmente judicieusement les catégories en sous-ensembles de modalités non ordonnées plutôt qu’en variables continues artificielles. En revanche, le bagging d’arbres CART présente l’avantage théorique fondamental de s’affranchir de toute contrainte de normalisation, de standardisation ou de transformation monotone des variables continues : les scissions binaires étant invariantes par transformation strictement croissante des descripteurs, l’échelle d’observation originale des inventaires psychologiques demeure préservée.
4.2 Stratification et division de l’échantillon empirique
L’évaluation sans compromis de la performance prédictive réelle d’un estimateur méta-algorithmique requiert une séparation étanche entre la phase d’apprentissage et la phase d’évaluation sommative finale. Cette règle méthodologique cardinale prévient l’introduction involontaire de fuites de données (data leakage) au sein du pipeline expérimental. La population échantillonnale globale doit être scindée de manière irrévocable en deux sous-cohortes mutuellement exclusives : une fraction substantielle dédiée exclusivement à l’apprentissage du modèle (typiquement 70 % à 80 % des individus disponibles) et une fraction résiduelle préservée pour le test terminal (20 % à 30 %).
Dans les contextes applicatifs où la variable dépendante d’intérêt est une variable catégorielle binaire ou multinomiale présentant un déséquilibre d’effectifs modéré à sévère — situation ubiquitaire en diagnostic psychiatrique où la prévalence d’un trouble pathologique au sein de la cohorte est nettement inférieure à celle des témoins sains —, le découpage de l’échantillon doit être strictement stratifié. L’utilisation de la fonction createDataPartition() intégrée au package caret garantit que les proportions relatives des différentes classes diagnostiques au sein de la variable cible soient reproduites à l’identique dans le jeu d’entraînement et dans le jeu de test.
Une fois le partitionnement stratifié exécuté de façon contrôlée, le jeu de données de test indépendant doit être immédiatement séquestré dans l’environnement R. Il est impératif d’interdire formellement toute manipulation, imputation dépendante ou inspection de distribution sur ce corpus de validation avant l’étape ultime de confrontation empirique. Toute statistique descriptive, imputation de valeur manquante ou diagnostic de centrage calculé sur l’ensemble global avant partitionnement contaminerait le processus d’apprentissage par une transmission d’informations futures, biaisant irrémédiablement vers l’optimisme les estimations de performance ultérieures.
5. Étape 3 : Construction du modèle de bagging avec le package ipred
5.1 Syntaxe formelle et appel de la fonction bagging()
L’instanciation programmatique du bagging au moyen du paquetage canonique ipred s’effectue via la fonction éponyme bagging(). Cette fonction implémente une interface symbolique formulée selon le paradigme classique des modèles statistiques R, reliant formellement le descripteur dépendant cible au vecteur des prédicteurs comportementaux explicatifs par le biais d’un opérateur tilde. La compacité de cette syntaxe ne doit pas dissimuler la richesse des mécanismes sous-jacents configurables par l’analyste, particulièrement les paramètres contrôlant la morphologie des sous-arbres et le nombre d’itérations rééchantillonnées.
Le paramètre nominal nbagg régit directement le cardinal de l’ensemble d’arbres générés au fil des tirages bootstrap non paramétriques. Par défaut, certaines implémentations restreignent cette valeur à un seuil historique modeste de 25 arbres, un contingent manifestement sous-dimensionné pour la plupart des matrices empiriques modernes caractérisées par une haute dimensionnalité ou un bruit résiduel substantiel. L’analyste rigoureux veillera à expliciter ce paramètre pour l’élever à des ordres de grandeur statistiquement pertinents, compris généralement entre 100 et 500 unités selon la complexité intrinsèque de l’espace des descripteurs.
Le contrôle de la topologie géométrique des arbres constitutifs de l’ensemble s’effectue par l’injection d’un objet de contrôle spécialisé issu de la fonction rpart.control() via l’argument dédié control. Conformément à la théorie formelle du bagging édictée par Breiman, les apprenants individuels doivent exhiber un biais minimal, ce qui exige la suppression des pénalisations d’élagage conventionnelles. Il convient ainsi d’assigner au paramètre de complexité de coût (cp) une valeur nulle ou infinitésimale (par exemple, cp = 0) et d’abaisser le seuil minimal d’individus requis pour autoriser une scission terminale (minsplit) à un effectif restreint, garantissant l’épanouissement complet de chaque arbre jusqu’à une homogénéité quasi totale de ses feuilles terminales.
5.2 Optimisation du nombre d’arbres agrégés (nbagg)
L’arbitrage relatif au dimensionnement optimal de la collection arborescente induit un examen approfondi de la trajectoire asymptotique de l’erreur empirique globale. Contrairement aux algorithmes d’apprentissage séquentiel compétitifs tels que le gradient boosting, pour lesquels un nombre disproportionné d’itérations finit inévitablement par surajuster l’espace résiduel et dégrader la généralisabilité du système, le bagging possède la propriété remarquable d’être théoriquement immunisé contre le surapprentissage induit par l’augmentation de la taille de l’ensemble. L’agrégation démocratique d’arbres bootstrap converge asymptotiquement vers une limite d’espérance stable sans amplification parasitaire de la variance.
Dès lors, l’augmentation du paramètre nbagg ne comporte aucun risque mathématique de surapprentissage. En revanche, elle impose un compromis direct entre le gain marginal de stabilité statistique et la saturation progressive des ressources computationnelles de la station de travail. Passer de 50 à 200 arbres entraîne fréquemment une décroissance visible et significative de l’erreur moyenne quadratique ou du taux d’erreur de mauvaise classification, lissant les aspérités de la surface de réponse globale. Cependant, au-delà d’un certain palier empirique propre à chaque matrice de données — souvent observé entre 150 et 300 estimateurs —, les gains résiduels de performance deviennent asymptotiquement microscopiques et ne justifient plus le décuplement des durées de calcul et de la charge mémoire requise.
L’optimisation de cette dimension s’opère rigoureusement en documentant la courbe d’erreur empirique en fonction d’une grille discrète de valeurs progressives du paramètre nbagg. L’analyste suit la décroissance monotone de l’erreur résiduelle jusqu’à observer la formation d’un plateau horizontal distinct marquant le seuil de saturation fonctionnelle. Dès que la variance résiduelle de prédiction se stabilise dans une plage de tolérance arbitrairement étroite (inférieure à un centième d’écart-type d’estimation), l’hyperparamètre est figé à ce palier optimal, ce qui garantit un arbitrage irréprochable entre parcimonie des cycles d’horloge processeur et stabilité probabiliste des estimations ensemblistes finales.
6. Étape 4 : Évaluation de l’erreur out-of-bag (OOB)
6.1 Démonstration théorique de la probabilité de sélection OOB
L’un des atouts théoriques et computationnels les plus spectaculaires du bagging réside dans la présence intrinsèque d’un mécanisme d’auto-évaluation interne impartial dispensant l’utilisateur de recourir systématiquement à une procédure itérative et coûteuse de validation croisée externe au cours du calibrage : l’évaluation out-of-bag (hors-sac ou OOB). La légitimité formelle de cet estimateur repose sur les fondements combinatoires du tirage uniforme avec remise d’un échantillon de cardinal N au sein d’une population finie de taille identique N.
Considérons une observation spécifique désignée arbitrairement parmi les N individus du jeu d’apprentissage. À chaque tirage stochastique élémentaire composant la constitution d’une réplique bootstrap, la probabilité que cette observation particulière ne soit pas sélectionnée s’établit exactement à :
$$P(\text{non-sélection}) = 1 – \frac{1}{N}$$
Sachant qu’un échantillon bootstrap valide requiert la répétition rigoureusement indépendante de ce tirage élémentaire exactement N fois successives, la probabilité conjointe que cette observation donnée soit totalement omise de l’intégralité de la constitution de l’échantillon bootstrap considéré s’exprime par le produit probabiliste :
$$P(\text{omission globale}) = \left(1 – \frac{1}{N}\right)^N$$
En mobilisant la définition analytique fondamentale de la constante d’Euler comme limite exponentielle remarquable, lorsque la taille échantillonnale N s’accroît vers l’infini, cette expression converge de façon déterministe vers la valeur limite :
$$\lim_{N to \infty} \left(1 – \frac{1}{N}\right)^N = e^{-1} = \frac{1}{e} \approx 0{,}36787944…$$
Ainsi, lors de la génération de n’importe quel sous-ensemble bootstrap, environ 36,8 % de l’ensemble des observations matricielles initiales sont délaissées par le processus de tirage et n’interviennent sous aucune modalité dans l’édification de l’arbre décisionnel correspondant. Ces observations sont formellement désignées comme out-of-bag vis-à-vis de cet estimateur spécifique.
La conséquence méthodologique de cette propriété combinatoire est immense : pour chaque individu de l’échantillon d’apprentissage, il existe mécaniquement un sous-ensemble d’arbres — représentant approximativement un tiers de la forêt globale — qui ne l’ont jamais rencontré au cours de leur phase d’ajustement. L’agrégation sélective des prédictions émises exclusivement par ces arbres hors-sac spécifiques fournit une prédiction rigoureusement indépendante pour cet individu. L’agrégation de ces prédictions sur l’intégralité de la cohorte constitue l’estimateur d’erreur OOB, dont la neutralité asymptotique rivalise directement avec celle d’une validation croisée d’ordre K, sans requérir le réentraînement complet de multiples méta-modèles distincts.
6.2 Extraction et suivi de l’erreur OOB dans R
Dans l’écosystème algorithmique de ipred, l’estimation systématique de cette métrique non biaisée s’active par l’intermédiaire du paramètre logique coob = TRUE au sein de l’appel d’exécution de la fonction bagging(). Lorsque cette condition est formellement requise par le statisticien, le paquetage déclenche automatiquement en arrière-plan la conservation de la table d’appartenance des individus aux sous-échantillons bootstrap respectifs. Dès l’achèvement de la phase d’entraînement, l’algorithme isole pour chaque observation la partition d’arbres pour laquelle l’observation était absente du tirage, collecte les prédictions indépendantes issues de cette sous-collection et calcule la métrique globale de disparité.
Dans le cadre d’une modélisation de régression, l’estimateur extrait l’erreur quadratique moyenne out-of-bag (OOB-MSE) ou sa racine carrée (OOB-RMSE), quantifiant l’écart-type empirique des résidus hors-sac. Dans le périmètre de la classification d’états psychopathologiques ou de catégories diagnostiques, l’algorithme compile le taux global de mauvais classement OOB ainsi que la matrice d’attribution correspondante. L’inspection formelle de l’objet de classe R retourné permet d’extraire directement ces grandeurs diagnostiques à travers les champs descriptifs de l’estimateur sans nécessiter la moindre écriture de boucles itératives manuelles chronophages.
Le monitoring longitudinal de l’erreur OOB en fonction de l’accroissement graduel du volume nbagg fournit l’outil visuel le plus probant pour attester de la stabilisation fonctionnelle de l’ensemble. En traçant graphiquement l’évolution de la perte OOB face au nombre d’arbres générés, l’analyste visualise précisément l’amortissement initial rapide des fluctuations résiduelles jusqu’à l’aplanissement définitif de la courbe d’erreur. Cette stabilisation constitue la preuve tangible que la variance d’échantillonnage de l’ensemble a atteint son minimum structurel incompressible, attestant de la complétude optimale de la phase d’entraînement.
7. Étape 5 : Implémentation standardisée via le framework caret
7.1 Paramétrage du contrôle d’entraînement avec trainControl()
Bien que le recours direct au module ipred présente une clarté didactique indéniable pour l’analyse fondamentale de l’algorithme, la standardisation des flux d’ingénierie statistique contemporains s’appuie préférentiellement sur des structures d’abstraction de plus haut niveau. Le méta-package caret s’impose à cet égard comme le standard industriel le plus robuste en R, encapsulant les modules de calcul sous-jacents au sein d’une interface prédictive harmonisée, hautement reproductible et sécurisée contre les erreurs méthodologiques d’évaluation.
L’ossature centrale de tout protocole développé sous caret réside dans l’instanciation préalable de la fonction de contrôle trainControl(). Cet opérateur formalise avec une précision chirurgicale l’architecture du protocole de rééchantillonnage interne destiné à calibrer et évaluer la structure prédictive. Dans un cadre de validation robuste, il est particulièrement préconisé de configurer l’argument method selon la modalité de validation croisée répétée (repeatedcv), couplée à la spécification conjointe du nombre de partitions (number = 10 pour un K-fold conventionnel) et de l’effectif des réplications indépendantes complètes (repeats = 5 ou 10).
Au-delà de la topologie de partitionnement, trainControl() gouverne les modalités d’évaluation des métriques d’ajustement. Lorsque la modélisation traite de variables catégorielles binomiales ou multinomiales, il est indispensable d’activer l’indicateur classProbs = TRUE afin de contraindre les sous-modèles arborescents à émettre l’estimation des probabilités continues d’appartenance de classe plutôt que de simples labels déterministes. Concomitamment, l’adjonction de l’argument summaryFunction = twoClassSummary (dans un contexte binaire) ordonne l’extraction automatique de l’aire sous la courbe ROC, de la sensibilité clinique et de la spécificité, métriques infiniment plus informatives que le simple taux de reconnaissance global (Accuracy) face à des distributions empiriques asymétriques.
7.2 Entraînement avec la méthode treebag
L’orchestration opérationnelle du bagging s’articule ensuite autour de l’appel à la fonction directrice caret::train(), en configurant explicitement l’argument de sélection d’algorithme sous la chaîne de caractères method = « treebag ». Cette instruction indique au framework de mobiliser sous le capot les bibliothèques ipred et rpart tout en les intégrant de façon totalement transparente dans l’architecture de contrôle, de standardisation et d’évaluation préalablement circonscrite par trainControl().
Cette encapsulation fonctionnelle apporte des bénéfices substantiels sur le plan méthodologique :
- Standardisation et prétraitement intégrés : L’argument preProcess permet de déclencher à la volée des imputations par médianes ou k-NN, des transformations de Box-Cox ou des filtrages de prédicteurs à variance nulle (nearZeroVar), sans aucun risque de fuite de données entre les plis de validation croisée.
- Harmonisation des hyperparamètres : Bien que le bagging standard d’arbres CART ne requière formellement aucun paramètre de régularisation obligatoire, le framework applique des configurations rigoureuses par défaut (par exemple, nbagg = 50 ou personnalisé via trainControl) tout en unifiant l’interface de contrôle des splits arborescents.
- Agrégation rigoureuse des estimations : Les métriques de performance affichées en sortie représentent la moyenne et l’écart-type empiriques des performances mesurées sur l’intégralité des plis de rééchantillonnage, fournissant un intervalle de confiance empirique de l’exactitude de l’ensemble.
L’exécution de la méthode treebag garantit ainsi que chaque pli de la validation croisée répétée exécute en toute autonomie un bagging complet d’arbres, préservant la stricte indépendance statistique requise pour garantir que les métriques d’erreur rapportées constituent des estimateurs irréprochables de l’erreur de généralisation future de la procédure globale.
8. Étape 6 : Évaluation des performances prédictives sur le jeu de test
8.1 Application du modèle aux données non vues
Dès lors que le modèle de bagging a été ajusté et consolidé au sein de l’espace d’entraînement, l’attention méthodologique se focalise sur l’étape de validation sommative : la projection de l’opérateur ensembliste sur le jeu de test indépendant, rigoureusement préservé de toute exposition algorithmique depuis le partitionnement initial. L’exécution de cette inférence s’effectue au moyen de l’implémentation générique de la méthode predict(), prenant comme arguments le conteneur du modèle baggé finalisé et le sous-ensemble matriciel réservé aux tests.
Dans les problèmes d’assignation diagnostique ou de classification supervisée, la méthode predict() offre deux modalités de sortie distinctes qu’il convient de manier avec discernement selon les impératifs analytiques visés. Par défaut, la méthode extrait le label d’appartenance catégorielle finale issu du scrutin à la majorité démocratique absolue des arbres individuels (argument type = « raw » sous caret). Cependant, pour toute démarche de calibration probabiliste fine ou d’analyse décisionnelle clinique à seuil d’utilité modulable, il est méthodologiquement recommandé d’extraire la distribution continue des probabilités a posteriori attribuées à chaque classe (argument type = « prob »), offrant une vision granulaire de la certitude de prédiction de l’ensemble.
Cette étape d’inférence s’accompagne d’une inspection rigoureuse de la plausibilité distributionnelle des prédictions générées. L’analyste examine avec acuité la dispersion empirique des scores projetés, recherchant d’éventuelles saturations extrêmes ou des déviations inattendues. Dans les modèles de régression prédisant des grandeurs psychométriques continues, la visualisation bivariée des résidus (valeurs observées versus valeurs prédites) permet d’attester de l’homosパdasticité des résidus de test et de vérifier l’absence d’aberrations de prédiction le long des extrémités supérieures et inférieures de l’échelle d’évaluation.
8.2 Calcul exhaustif des métriques de précision
L’évaluation quantitative des modèles de régression et de classification ne peut en aucun cas s’appuyer sur un indice unique, sous peine de masquer des déficits d’ajustement structurels. Pour les variables dépendantes continues modélisées par bagging de régression, la quantification des performances s’articule autour d’un triptyque d’indices complémentaires :
- La racine de l’erreur quadratique moyenne (RMSE) : Mesurant l’écart-type géométrique des résidus d’estimation dans l’unité de mesure originale de la variable dépendante, le RMSE pénalise sévèrement les déviations résiduelles majeures et constitue la métrique standard d’erreur de prédiction.
- L’erreur absolue moyenne (MAE) : Moins sensible que le RMSE à la présence d’écarts sporadiques extrêmes, le MAE offre une interprétation intuitive directe de la magnitude moyenne des erreurs de déviation unitaire.
- Le coefficient de détermination empirique ($R^2$) : Représentant la proportion de variance du descripteur de test fidèlement capturée et restituée par l’ensemble ensembliste, calculé comme le carré de la corrélation de Pearson entre prédictions et observations réelles.
Lorsque le bagging est déployé à des fins de classification catégorielle, le standard méthodologique repose sur la compilation de la matrice de confusion exhaustive via la fonction caret::confusionMatrix(). Cette routine calcule instantanément le taux de précision global (Accuracy), l’indice Kappa de Cohen — qui pondère rigoureusement l’accord observé en soustrayant la probabilité d’accord purement aléatoire —, ainsi que les taux d’erreur spécifiques déclinés en sensibilité (taux de vrais positifs cliniques) et spécificité (taux de vrais négatifs témoins).
Enfin, pour s’affranchir de l’arbitraire d’un seuil de coupure dichotomique unique fixé classiquement à 0,5, l’élaboration de la courbe Receiver Operating Characteristic (ROC) au moyen de bibliothèques spécialisées comme pROC est indispensable. Le calcul de l’aire sous la courbe (Area Under the Curve ou AUC) fournit une mesure synthétique invariante par rapport au seuil décisionnel, évaluant la capacité discriminante intrinsèque du bagging à travers l’ensemble du spectre des sensibilités et spécificités possibles.
9. Étape 7 : Interprétabilité et estimation de l’importance des variables
9.1 Surmonter l’opacité relative de l’agrégation de modèles
Si le bagging permet de juguler de façon spectaculaire la variance structurelle des estimateurs arborescents uniques, cette supériorité statistique se paye d’un tribut épistémologique substantiel : l’oblitération de l’interprétabilité graphique immédiate. Un arbre de décision unique présente l’atout heuristique incomparable d’être visuellement traduisible sous la forme d’un organigramme décisionnel déterministe limpide, au sein duquel chaque cheminement conditionnel peut être inspecté et assimilé sans ambiguïté par les praticiens de terrain ou les autorités de régulation clinique.
À l’inverse, dès lors que le modèle procède de l’agrégation conjointe de 100, 300 ou 500 arborescences structurellement divergentes, l’accès direct aux règles de déduction individuelles s’effondre. Le système se transforme en une quasi « boîte noire » ou plus exactement en une structure d’ensemble dont la complexité combinatoire dépasse l’appréhension cognitive directe. Or, dans les disciplines académiques telles que la psychologie quantitative ou l’épidémiologie clinique, prédire fidèlement un critère phénotypique sans être en mesure de cartographier la contribution respective des covariables explicatives constitue une limite scientifique majeure.
Pour dépasser cette opacité sans renoncer aux gains de variance du bagging, la statistique computationnelle a développé des méthodologies indirectes d’interprétation globale fondées sur l’estimation post-hoc de l’importance relative des variables (Variable Importance Measures). Le fondement théorique de cette décomposition repose sur le calcul de la réduction cumulative d’impureté apportée par chaque descripteur à travers l’ensemble des ramifications de tous les arbres constituant la collection. Chaque fois qu’une variable explicative donnée est sélectionnée pour scinder un nœud, la diminution correspondante de l’indice de Gini (en classification) ou de la somme des carrés des résidus (en régression) est comptabilisée et attribuée à cette variable, puis sommée et moyennée sur l’ensemble de la forêt bootstrap.
9.2 Extraction programmatique avec varImp()
L’implémentation logicielle de cette extraction s’avère remarquablement directe sous R grâce à l’interfaçage unifié offert par la fonction varImp() issue du package caret. Lorsqu’elle est appliquée à un objet de modèle préalablement entraîné via la méthode treebag, cette méthode extrait les métriques d’importance cumulée calculées au niveau des moteurs rpart sous-jacents et les rééchelonne de manière transparente sur une échelle standardisée normalisée de 0 à 100.
Sur le plan de la restitution graphique, l’application de la méthode générique plot() sur l’objet d’importance extrait génère instantanément un diagramme à barres horizontales ordonné, mettant immédiatement en exergue la hiérarchie fonctionnelle des descripteurs les plus discriminants du modèle.
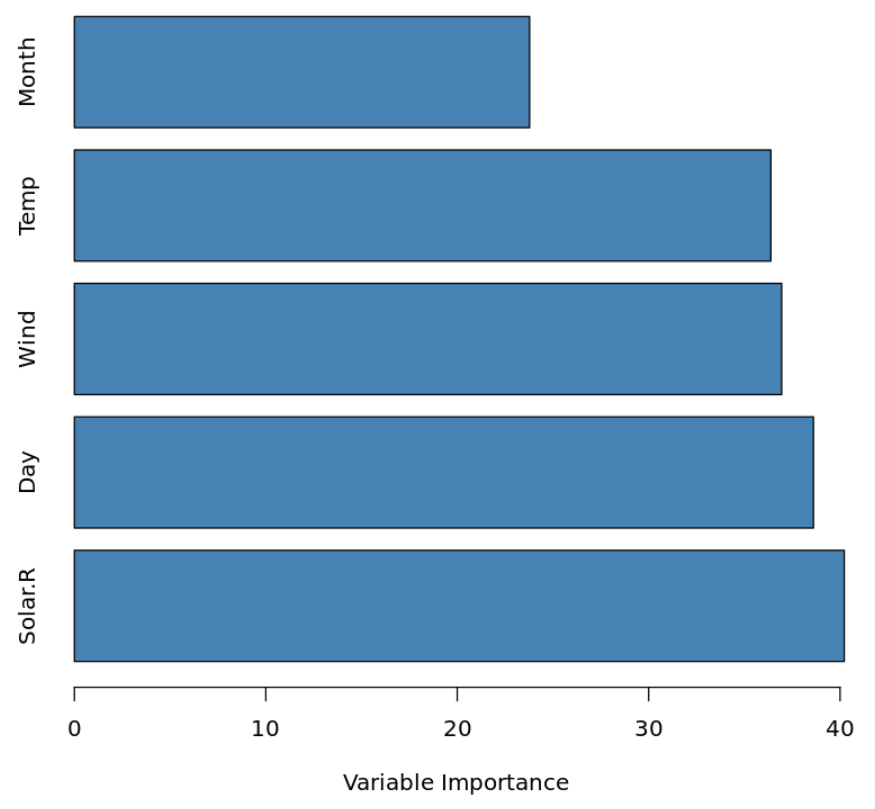
Cette représentation permet de distinguer sans ambiguïté les prédicteurs à haute valeur informative des variables accessoires ou redondantes dont la contribution marginale à l’épuration de la variance globale s’avère insignifiante. Dans un contexte de validation d’échelles de personnalité ou d’identification de biomarqueurs comportementaux, ce classement permet d’orienter prioritairement les investigations qualitatives ou de concevoir des protocoles expérimentaux allégés en éludant les variables à contribution négligeable.
L’interprétation de ces métriques doit toutefois être conduite avec discernement scientifique. L’indice d’importance fondé sur l’impureté de Gini manifeste un biais structurel bien documenté en faveur des descripteurs continus présentant un large spectre de modalités ou des variables qualitatives possédant un nombre élevé de catégories. Ce biais favorise mécaniquement leur sélection statistique lors des scissions arborescentes locales au détriment de prédicteurs binaires pourtant potentiellement plus spécifiques mais offrant moins d’options combinatoires de découpage.
10. Comparaison empirique : Arbre décisionnel simple contre Bagging
10.1 Mise en œuvre du modèle de référence rpart
Afin de quantifier de façon rigoureuse et irréfutable l’amplitude des gains prédictifs obtenus par le passage au méta-algorithme de bagging, il est méthodologiquement impératif de construire un modèle de référence rigoureux (baseline) reposant sur un arbre décisionnel simple unique, ajusté sur le même sous-ensemble d’apprentissage et évalué sur le même jeu de test indépendant. La bibliothèque canonique rpart offre l’infrastructure idoine pour calibrer cet estimateur unitaire selon les règles de l’art académique.
La procédure d’ajustement d’un arbre CART isolé requiert une séquence méthodique en deux étapes fondamentales :
- Croissance maximale de l’arbre initial : L’arbre est d’abord développé de manière extensive en spécifiant un paramètre de complexité nul (cp = 0), autorisant l’algorithme à subdiviser l’espace jusqu’à un seuil de saturation proche du surapprentissage total sur les données d’entraînement.
- Élagage par complexité de coût : L’arbre surdimensionné fait ensuite l’objet d’une sélection de son point d’élagage optimal au moyen de la validation croisée intégrée dans rpart. L’analyste inspecte la table de complexité numérique (cptable) et sélectionne la valeur minimale du paramètre cp satisfaisant au critère de l’erreur minimale ou à la règle heuristique standard de « l’écart-type 1 » (1-SE rule), qui sélectionne le sous-arbre le plus parcimonieux dont l’erreur résiduelle demeure à moins d’un écart-type de l’erreur minimale absolue observée.
L’arbre ainsi élagué représente l’expression la plus pure et la mieux régularisée de ce qu’un estimateur décisionnel binaire unique est capable d’extraire de la matrice d’apprentissage sans sombrer dans un surajustement caricatural.
10.2 Quantification chiffrée du différentiel de variance
La confrontation empirique directe entre les prédictions délivrées sur le jeu de test par l’arbre CART unique élagué et celles issues de l’ensemble méta-algorithmique de bagging met quasi systématiquement en évidence un différentiel de performance massif et statistiquement documenté. Dans les applications quantitatives portant sur des cohortes cliniques ou psychosociales réelles, le bagging produit une compression spectaculaire de l’erreur quadratique moyenne de test (RMSE), s’établissant couramment dans une fourchette de réduction comprise entre 15 % et 40 % par rapport à l’arbre unitaire de référence.
Sur le plan géométrique, l’analyse comparative des surfaces de décision tracées à travers des projections bidimensionnelles de prédicteurs illustre avec une clarté remarquable la source mathématique de ce différentiel empirique. La frontière décisionnelle déployée par un arbre unique se caractérise par des discontinuités anguleuses abruptes, matérialisées par des découpages orthogonaux rigides épousant mécaniquement les artefacts de positionnement des données d’entraînement. Toute nouvelle observation tombant de façon marginale de part et d’autre de ces fractures linéaires se voit assigner des valeurs radicalement disparates, témoignant de la variance d’estimation aiguë de la structure arborescente isolée.
À l’inverse, l’opération de moyennage ou de vote pluraliste inhérente au bagging opère un lissage spatial continu de ces frontières décisionnelles. Les découpages orthogonaux désordonnés et décorrélés issus des multiples tirages bootstrap se superposent et se pondèrent mutuellement, transformant l’escalier discontinu en une surface de réponse remarquablement fluide et curviligne. Cette régularité géométrique accrue restitue fidèlement la transition progressive des probabilités d’appartenance de classe ou des continuums de traits latents, garantissant que les prédictions interpolées bénéficient d’une stabilité et d’une résilience phénoménologique largement supérieures.
11. Diagnostic des limites intrinsèques du bagging
11.1 Le problème de corrélation entre arbres induit par des prédicteurs dominants
Nonobstant ses mérites statistiques indéniables, le bagging souffre d’une limitation théorique structurelle inhérente à sa dépendance stricte envers la topologie de l’espace des descripteurs disponibles : la sensibilité pernicieuse à la présence de prédicteurs ultra-dominants présentant un ratio signal/bruit disproportionné. Ce phénomène fragilise directement l’hypothèse de décorrélation inter-arbres qui conditionne pourtant l’efficacité asymptotique de l’agrégation.
Lorsqu’un prédicteur comportemental, cognitif ou clinique exerce un impact causal ou corrélationnel massif sur la variable cible, l’algorithme CART standard — qui inspecte rigoureusement l’ensemble de tous les prédicteurs à chaque embranchement — sélectionnera invariablement ce même descripteur hégémonique pour orchestrer la première scission binaire au niveau du nœud racine de la quasi-totalité des B arbres bootstrap. Les répliques d’entraînement bootstrap auront beau différer par leur composition stochastique, la force du signal de cette variable dominante écrasera toute variation résiduelle, contraignant tous les sous-arbres à adopter une charpente topologique primaire rigoureusement identique.
Sous l’angle analytique explicité précédemment, ce conditionnement unilatéral induit une élévation drastique du coefficient de corrélation positive inter-arbres $rho$. Or, dès lors que $rho$ tend vers des valeurs élevées, le terme résiduel $\rho \sigma^2$ plafonne la décroissance théorique de la variance globale de l’ensemble, interdisant au bagging d’exploiter pleinement le potentiel de réduction offert par l’accroissement du nombre d’itérations bootstrap B. C’est précisément l’identification formelle de ce goulot d’étranglement structurel qui a historiquement motivé Breiman à théoriser les Random Forests, lesquelles introduisent une décorrélation forcée supplémentaire en contraignant chaque nœud à n’évaluer qu’un sous-ensemble aléatoire restreint de prédicteurs (paramètre mtry), brisant ainsi mécaniquement l’hégémonie de scission des prédicteurs dominants.
11.2 Coût computationnel et contraintes de mémoire vive
L’autre écueil inhérent au déploiement du bagging réside dans son empreinte computationnelle et sa consommation exponentielle de ressources de mémoire vive (RAM), singulièrement au sein de l’environnement de programmation R. Contrairement à des langages compilés de bas niveau manipulant des pointeurs dynamiques légers, R gère les objets d’arbres sous la forme de structures de listes hiérarchiques particulièrement verbeuses contenant des métadonnées étendues relatives aux effectifs de nœuds, aux seuils de partition, aux labels et aux résidus intermédiaires.
Par conséquent, la constitution d’un objet ensembliste amalgamant plusieurs centaines d’arbres CART profonds et non élagués ajustés sur des corpus volumineux (par exemple, des dizaines de milliers d’observations cliniques croisées avec des centaines de descripteurs psychométriques ou génomiques) génère un objet R dont le poids en mémoire vive peut rapidement saturer l’espace d’adressage standard. Cette contrainte physique complique la manipulation interactive des sessions de travail et interdit le stockage sériel d’un grand nombre de variantes de modèles dans l’environnement global.
De surcroît, si la phase d’entraînement peut être considérablement accélérée par l’exploitation des architectures multi-cœurs via doParallel, l’inférence prédictive en temps réel sur des flux massifs de données subit une latence incompressible. Chaque prédiction unitaire exigeant la traversée séquentielle descendante de chaque observation à travers l’intégralité des centaines d’arbres constituants avant de procéder à l’opération de calcul de moyenne arithmétique ou de scrutin électoral, la cadence de restitution prédictive s’avère nettement plus lente que celle d’un modèle de régression logistique régularisée (de type Elastic Net) ou d’un réseau neuronal artificiel compact, dont l’inférence se résume à une suite de multiplications matricielles vectorisées hautement optimisées.
12. Bonnes pratiques méthodologiques et directives de reproductibilité
12.1 Protocole de validation pour publications scientifiques
L’intégration de modèles prédictifs fondés sur le bagging au sein d’articles scientifiques soumis à l’évaluation par les pairs au sein de revues biomédicales ou psychologiques internationales requiert le respect scrupuleux d’un protocole méthodologique standardisé. Les exigences de rigueur empirique interdisent désormais formellement de rapporter de simples métriques d’exactitude calculées sur des échantillons d’apprentissage bruts ou via des schémas de validation naïfs perméables aux fuites d’information prédictive.
Le chercheur doit consigner de manière transparente et documentée les dispositions suivantes :
- Sanctuarisation de la chaîne de prétraitement : Toutes les étapes de conditionnement des données — incluant l’imputation des valeurs manquantes, l’encodage des facteurs, l’élimination des prédicteurs invariants et la sélection éventuelle de caractéristiques — doivent être encapsulées à l’intérieur des boucles de validation croisée externe ou appliquées exclusivement au jeu d’entraînement avant projection sur le test. La mise à disposition publique des scripts de réplication R au format Markdown ou via des dépôts pérennes (Zenodo, OSF) constitue désormais un standard déontologique incontournable.
- Rapports d’intervalles de dispersion stochastique : Les performances mesurées (RMSE, AUC, F1-Score) ne doivent pas être résumées à de simples estimations ponctuelles isolées. L’analyste doit formellement adjoindre les intervalles de confiance empiriques dérivés des réplications de la validation croisée répétée ou des quantiles bootstrap d’évaluation de test.
- Documentation logicielle exhaustive : En annexe méthodologique, l’auteur consignera la graine pseudo-aléatoire originelle (set.seed), les numéros de version précis de l’interpréteur R et des paquetages mobilisés (caret, ipred, rpart), ainsi que la déclaration explicite des hyperparamètres structurants fixés (valeur de nbagg, paramètres de complexité et de scission de rpart.control).
Cette transparence procédurale conditionne la réplicabilité des conclusions quantitatives, immunisant l’étude contre les critiques relatives à la sur-optimisation opportuniste d’algorithmes complexes.
12.2 Recommandations pour l’application aux cohortes cliniques et comportementales
L’exploitation pratique des méta-algorithmes d’arbres décisionnels agrégés auprès de cohortes d’évaluation humaine impose une prudence épistémologique accrue quant à l’interprétation des inférences dégagées. S’il est désormais établi que le bagging délivre une capacité de discrimination et d’étalonnage probabiliste nettement supérieure aux régressions paramétriques rigides face à des relations non linéaires subtiles, il demeure impératif de ne jamais assimiler aveuglément les indices d’importance relative des variables à des relations de causalité étiologique directe.
La métrique d’importance issue de la réduction d’impureté reflète exclusivement la capacité statistique prédictive conditionnelle d’un descripteur au sein d’un espace vectoriel d’observation spécifique. En présence de colinéarité prononcée entre plusieurs variables psychologiques ou biomédicales — situation omniprésente dans les inventaires psychopathologiques où des symptômes distincts covarient fortement en vertu de traits de détresse générale sous-jacents —, le modèle peut arbitrairement privilégier l’une des variables au détriment des autres lors des scissions arborescentes, masquant artificiellement la pertinence conceptuelle des covariables concurrentes non sélectionnées au niveau des nœuds primaires.
En synthèse opérationnelle, le bagging s’impose comme une méthodologie quantitative d’une élégance et d’une efficacité remarquables au sein de l’environnement de calcul R. En apportant une réponse algorithmique formelle et élégante à l’instabilité congénitale des arbres de décision uniques de type CART, il permet aux statisticiens et aux chercheurs en sciences comportementales de déployer des modèles prédictifs hautement étalonnés, capables d’absorber le bruit stochastique empirique et de stabiliser les frontières de classification diagnostique. Intégré de manière disciplinée au sein du framework standardisé caret, couplé à une validation étanche sur des cohortes indépendantes et interprété avec la réserve causale qui s’impose, le bagging constitue l’un des piliers méthodologiques les plus robustes de la statistique d’apprentissage moderne.
Références
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123–140. https://doi.org/10.1007/BF00058655
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/A:1010933404324
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and Regression Trees. Wadsworth & Brooks/Cole Advanced Books & Software.
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hothorn, T., & Peters, A. (2021). ipred: Improved Predictors (R package version 0.9-12). CRAN. https://CRAN.R-project.org/package=ipred
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- Kuhn, M. (2008). Building predictive models in R using the caret package. Journal of Statistical Software, 28(5), 1–26. https://doi.org/10.18637/jss.v028.i05
- Kuhn, M., & Johnson, K. (2013). Applied Predictive Modeling. Springer. https://doi.org/10.1007/978-1-4614-6849-3
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Therneau, T., & Atkinson, B. (2023). rpart: Recursive Partitioning and Regression Trees (R package version 4.1.19). CRAN. https://CRAN.R-project.org/package=rpart