
Dans le vaste champ de la modélisation statistique, de l’économétrie et de la psychométrie contemporaine, la quête fondamentale de tout chercheur consiste à distinguer la régularité du chaos, l’ordre intelligible des fluctuations fortuites, ou, selon l’expression consacrée, le signal informationnel du bruit stochastique. Toute démarche scientifique d’analyse empirique repose sur la formulation de modèles mathématiques qui tentent d’expliquer les variations observées au sein d’un phénomène complexe par le biais d’un ensemble de prédicteurs théoriquement motivés. Cependant, la réalité phénoménologique se dérobe presque systématiquement à une prédiction déterministe parfaite. C’est précisément dans cet interstice entre la valeur mesurée sur le terrain et la valeur prédite par l’appareil formel que s’enracine le concept cardinal de variance résiduelle.
Loin de constituer un simple déchet algorithmique ou un aveu d’échec méthodologique, la variance résiduelle, souvent qualifiée de variance inexpliquée ou de variance d’erreur, représente un pilier fondamental de l’inférence statistique moderne. Elle quantifie avec une précision chirurgicale l’ampleur de notre ignorance relative face aux dynamiques sous-jacentes d’un système. Qu’il s’agisse d’évaluer la trajectoire d’une rémission clinique sous psychothérapie, de décrypter les déterminants cognitifs de la réussite académique ou d’analyser les mécanismes neurobiologiques de la mémoire de travail, l’estimation rigoureuse de cette dispersion résiduelle conditionne directement la validité des conclusions, la puissance des tests d’hypothèses et la réplicabilité des découvertes scientifiques.
Le présent article propose une exploration exhaustive, rigoureuse et multidimensionnelle de la variance résiduelle. En partant de ses fondements épistémologiques et de ses définitions mathématiques fondamentales, nous parcourrons ses manifestations concrètes au sein des modèles de régression linéaire, des analyses de variance (ANOVA) et des architectures statistiques avancées, telles que la modélisation par équations structurelles et les approches multiniveaux. À travers des exemples appliqués détaillés et des démonstrations méthodologiques pas à pas, ce guide vise à doter les chercheurs, analystes et étudiants d’une compréhension profonde de cet indicateur incontournable, transformant ce qui n’apparaît initialement que comme une « erreur » en un instrument diagnostique d’une fécondité scientifique exceptionnelle.
1. Introduction et fondements conceptuels de la variance résiduelle
1.1 Émergence du concept en psychométrie et modélisation statistique
L’histoire de la quantification de l’incertitude dans l’étude des comportements humains trouve ses racines dans les travaux pionniers de l’astronomie et de la géodésie du début du XIXe siècle, notamment portés par Carl Friedrich Gauss et Adrien-Marie Legendre, avant d’être transposée avec brio aux sciences du vivant par Sir Francis Galton et Karl Pearson. Lorsque la psychologie scientifique et la psychométrie ont entrepris de mesurer des construits latents non observables directement, tels que l’intelligence générale, les traits de personnalité ou l’intensité des états affectifs, les méthodologistes se sont heurtés à une barrière ontologique majeure : la variabilité inhérente aux systèmes vivants. Contrairement aux systèmes mécaniques déterministes, deux individus partageant des scores rigoureusement identiques sur un ensemble de variables prédictives présenteront invariablement des réponses distinctes face à une situation donnée.
Cette réalité a imposé l’émergence d’une distinction conceptuelle nette entre le signal théorique mesurable et le bruit aléatoire inhérent à l’échantillonnage et à la mesure. Dans les premiers travaux de l’American Psychological Association et les élaborations de Charles Spearman sur la théorie classique des tests, l’erreur n’a plus été perçue comme une simple maladresse de l’expérimentateur, mais comme une variable aléatoire dotée de propriétés statistiques intrinsèques. La nécessité de quantifier formellement cette composante non déterministe a mené à l’élaboration de la variance d’erreur, pierre angulaire sur laquelle repose l’évaluation de la robustesse de tout modèle psychologique. Dès lors, estimer la consistance d’un modèle n’impliquait plus l’élimination utopique de l’aléa, mais l’évaluation mathématique de sa dispersion autour de la trajectoire structurelle prévue par la théorie.
Dans le paradigme contemporain de la psychométrie computationnelle, la variance résiduelle occupe ainsi une place régulatrice indispensable. Elle permet de circonscrire précisément la frontière au-delà de laquelle nos théories explicatives cessent d’opérer, conférant aux sciences empiriques un ancrage probabiliste indispensable. Sans cette prise en compte formalisée de l’aléa, les chercheurs s’exposeraient à confondre des variations fortuites d’échantillonnage avec des dynamiques psychologiques universelles, compromettant de fait la validité interne et externe des modèles comportementaux.
1.2 Définition fondamentale de la variance inexpliquée
Sur le plan conceptuel, la variance résiduelle, communément appelée variance inexpliquée, se définit comme la proportion ou la quantité absolue de variabilité observée dans une variable dépendante qui ne peut pas être imputée linéairement ou structurellement aux variables indépendantes incluses dans un modèle analytique donné. Lorsqu’un modèle mathématique formule une prédiction pour un individu ou une observation, il applique une fonction systématique déterminée par les coefficients estimés. L’écart existant entre la valeur véritablement observée pour cet individu et la valeur estimée par la fonction constitue le résidu. La dispersion de l’ensemble de ces écarts individuels autour de leur valeur centrale définit la variance résiduelle.
Il est fondamental de comprendre ce que recouvre substantiellement cette dispersion inexpliquée. D’un point de vue phénoménologique, elle agrège trois sources distinctes de non-détermination. En premier lieu, elle englobe l’impact de l’ensemble des facteurs déterminants omis dans la spécification du modèle : qu’il s’agisse de variables psychologiques non mesurées, d’événements contextuels récents propres à chaque participant, d’influences épigénétiques ou de fluctuations d’humeur transitoires. En second lieu, elle incorpore l’imprécision inévitable des instruments de mesure psychométriques, incluant les biais de désirabilité sociale, la fatigue cognitive du répondant lors de la passation ou les ambiguïtés sémantiques des items d’un questionnaire. En troisième lieu, elle reflète les fluctuations purement stochastiques inhérentes aux processus neurobiologiques et décisionnels humains.
Il existe, de ce fait, une relation inverse fondamentale entre la magnitude de la variance résiduelle et le pouvoir explicatif global du modèle considéré. Plus la variance résiduelle d’un modèle statistique est restreinte par rapport à la variance totale du phénomène étudié, plus le faisceau de prédicteurs retenu se rapproche d’une explication exhaustive de la variance de sortie. Inversement, une variance résiduelle massive indique que l’essentiel de la dynamique sous-jacente échappe aux hypothèses formulées par le chercheur, soulignant soit une mauvaise spécification théorique du modèle, soit l’intervention prépondérante d’un bruit de mesure déstabilisateur.
1.3 Rôle épistémologique dans la validation des théories scientifiques
Sur le plan de l’épistémologie des sciences comportementales et sociales, la variance résiduelle incarne le champ d’application direct du principe de parcimonie scientifique, traditionnellement formulé sous le nom de rasoir d’Ockham. La modélisation statistique ne cherche pas à reproduire la complexité infinie du monde réel, mais à en fournir une abstraction simplifiée, intelligible et prédictive. Dès lors, le chercheur se trouve confronté à un arbitrage permanent entre la complexité de son architecture formelle — mesurée par le nombre de paramètres et de prédicteurs introduits — et l’ampleur des résidus subséquents. Tolérer une certaine quantité de variance résiduelle constitue le coût nécessaire pour préserver la généralisabilité d’une théorie et prévenir le phénomène de sur-ajustement statistique.
L’adéquation empirique d’un paradigme théorique donné s’évalue précisément au regard de cette composante non expliquée. Si, en dépit de l’introduction de construits hypothétiques majeurs, la variance résiduelle demeure excessivement dominante, la communauté scientifique est contrainte de s’interroger sur la validité même du paradigme. À l’inverse, une réduction drastique de la variance résiduelle au fur et à mesure des raffinements théoriques successifs fournit un indice puissant de progrès scientifique cumulatif. La confrontation empirique prend ainsi la forme d’un dialogue continu où la variance résiduelle joue le rôle d’un indicateur de falsifiabilité poppérienne.
Enfin, la maîtrise et l’évaluation lucide de la variance résiduelle ont un impact direct sur la crise contemporaine de la réplicabilité qui traverse la psychologie et les sciences sociales. Lorsqu’un modèle affiche une variance résiduelle colossale mais que des tests d’inférence atteignent artificiellement le seuil de significativité statistique en raison d’échantillons surdimensionnés, les conclusions tirées reposent sur des effets structurels minuscules noyés dans un océan d’incertitude. Reconnaître, décomposer et publier en toute transparence la variance résiduelle constitue l’un des remparts méthodologiques les plus efficaces contre la publication de faux positifs et de théories éphémères.
2. Définition mathématique et formulation théorique de l’erreur résiduelle
2.1 Le résidu individuel comme écart direct à la prédiction
Pour appréhender la variance résiduelle dans toute sa rigueur mathématique, il convient d’en examiner les constituants élémentaires au niveau de l’unité d’observation individuelle. Considérons un échantillon composé de $n$ individus indépendants, pour lesquels on mesure une variable dépendante quantitative continue $Y$. Pour chaque observation indicée $i$ (avec $i in {1, 2, dots, n}$), la valeur empirique constatée est désignée par $y_i$. Lorsque nous appliquons un modèle statistique à ces données, ce dernier produit une estimation, ou valeur prédite, notée $\hat{y}_i$. Le résidu individuel empirique, universellement désigné par le symbole $e_i$, est défini par la différence algébrique stricte entre l’observation mesurée et la prédiction du modèle :
$$e_i = y_i – \hat{y}_i$$
Il est impératif d’établir une distinction théorique fondamentale, trop souvent négligée, entre l’erreur populationnelle théorique (notée $\varepsilon_i$) et le résidu échantillonnal empirique ($e_i$). L’erreur populationnelle $\varepsilon_i$ est une entité probabiliste inobservable issue du modèle théorique sous-jacent qui relie les variables dans l’ensemble de la population cible. Elle correspond à l’écart entre la valeur observée et l’espérance conditionnelle théorique régie par les vrais paramètres inconnus de la population. En revanche, le résidu $e_i$ est une quantité calculée sur un échantillon empirique fini, obtenue en utilisant des estimateurs d’échantillonnage pour paramétrer la fonction de prédiction.
Dans le cadre de l’estimation par la méthode classique des moindres carrés ordinaires (OLS pour Ordinary Least Squares), les équations normales imposent des contraintes algébriques rigides sur ces résidus. Sous réserve que le modèle intègre une constante (ordonnée à l’origine), la somme algébrique des résidus individuels est obligatoirement égale à zéro, ce qui entraîne mécaniquement que leur moyenne arithmétique est strictement nulle :
$$\sum_{i=1}^n e_i = 0 \quad implies \quad \bar{e} = \frac{1}{n}\sum_{i=1}^n e_i = 0$$
Cette propriété de centrage signifie que les déviations positives et négatives se compensent parfaitement par construction mathématique, illustrant le fait que la droite ou l’hyperplan de régression traverse le centre de gravité multidimensionnel des données observées.
2.2 La somme des carrés des erreurs (SSE)
Puisque la somme simple des résidus est algébriquement contrainte à s’annuler, elle ne peut en aucun cas servir d’indice pour quantifier la dispersion de l’erreur globale du modèle. Pour contourner cette compensation des signes opposés, la démarche mathématique standard consiste à élever chaque écart résiduel individuel au carré avant de procéder à leur sommation. Cette opération fondamentale donne naissance à la Somme des Carrés des Erreurs, traditionnellement désignée par l’acronyme anglais SSE (Sum of Squared Errors) ou SSR (Sum of Squared Residuals), que nous noterons ici $SS_{res}$ :
$$SS_{res} = \sum_{i=1}^n e_i^2 = \sum_{i=1}^n (y_i – \hat{y}_i)^2$$
L’utilisation de la fonction quadratique remplit un double rôle conceptuel et méthodologique de premier ordre. D’une part, en élevant les écarts au carré, toutes les valeurs deviennent strictement positives, ce qui permet d’agréger l’ensemble des écarts sans annulation réciproque. D’autre part, la pénalisation quadratique accorde un poids disproportionnellement plus lourd aux déviations majeures comparativement aux fluctuations mineures. Ainsi, un résidu de 4 unités génère une pénalité de 16, soit quatre fois supérieure à celle d’un résidu de 2 unités qui ne génère qu’une valeur de 4. Cette caractéristique confère à la méthode des moindres carrés sa sensibilité légendaire aux observations extrêmes.
Sur le plan fonctionnel, $SS_{res}$ constitue précisément la fonction de coût, ou fonction d’erreur, que l’algorithme des moindres carrés cherche à minimiser. L’optimisation différentielle résout le système d’équations en annulant les dérivées partielles de $SS_{res}$ par rapport à chacun des paramètres du modèle. Par voie de conséquence, la valeur finale de $SS_{res}$ reflète l’erreur globale minimale résiduelle accessible sous la structure linéaire postulée. Elle demeure toutefois une métrique brute, directement dépendante de la taille de l’échantillon $n$ et de l’échelle métrique dans laquelle la variable $Y$ est mesurée.
2.3 Degrés de liberté et calcul du carré moyen de l’erreur (MSE)
La somme des carrés résiduels $SS_{res}$ présente une lacune majeure si elle est utilisée isolément pour quantifier la variance : elle augmente mécaniquement de manière monotone à mesure que l’on ajoute des observations à l’échantillon, indépendamment de la qualité intrinsèque du modèle. Pour convertir cette grandeur additive en une véritable mesure de variance non biaisée, il est indispensable de la normaliser non pas simplement par la taille de l’échantillon $n$, mais par les degrés de liberté associés au terme d’erreur.
Les degrés de liberté résiduels représentent le nombre d’informations indépendantes restant disponibles dans le vecteur de données après l’estimation des paramètres du modèle. Si nous ajustons un modèle comprenant $p$ prédicteurs ainsi qu’une ordonnée à l’origine, nous estimons au total $k = p + 1$ paramètres à partir des données. Chacun de ces paramètres estimés impose une contrainte linéaire stricte sur les résidus, réduisant d’autant leur liberté de variation. Le nombre de degrés de liberté résiduels, noté $df_{res}$, s’établit donc formellement selon l’équation :
$$df_{res} = n – p – 1 = n – k$$
La variance résiduelle de l’échantillon, notée de manière standard $\hat{\sigma}^2_e$ ou $MS_{res}$ (pour Mean Square of Residuals ou Carré Moyen de l’Erreur, MSE), est obtenue en divisant la somme des carrés des résidus par ses degrés de liberté correspondants :
$$MS_{res} = \hat{\sigma}^2_e = \frac{SS_{res}}{df_{res}} = \frac{\sum_{i=1}^n (y_i – \hat{y}_i)^2}{n – p – 1}$$
Cette formulation mathématique garantit que $\hat{\sigma}^2_e$ est un estimateur non biaisé de la variance populationnelle de l’erreur $\sigma^2_\varepsilon$, satisfaisant ainsi la condition d’espérance mathématique $E(\hat{\sigma}^2_e) = \sigma^2_\varepsilon$. En extrayant la racine carrée positive de ce carré moyen résiduel, on obtient une métrique d’une utilité clinique et interprétative exceptionnelle : l’erreur standard de l’estimation (notée $s_e$ ou $SEE$ pour Standard Error of the Estimate). Exprimée dans la même unité de mesure originale que la variable dépendante $Y$, cette valeur caractérise l’écart-type de la distribution des résidus autour de l’hyperplan de régression, fournissant une jauge immédiate de l’incertitude prédictive qui pèse sur chaque estimation individuelle.
3. Décomposition de la variance totale : Modèle additif de Fisher
3.1 Le principe fondamental de partitionnement de la somme des carrés
L’un des apports méthodologiques les plus profonds de Sir Ronald Aylmer Fisher à la statistique contemporaine réside dans le développement de l’analyse de variance et dans la démonstration géométrique de la décomposition orthogonale de la variabilité totale. Dans tout ensemble de données univariées, la variabilité globale observée pour la variable $Y$ autour de sa propre moyenne arithmétique globale $\bar{y}$ est mesurée par la Somme Totale des Carrés, notée $SS_{tot}$ (ou $SST$) :
$$SS_{tot} = \sum_{i=1}^n (y_i – \bar{y})^2$$
Le théorème fondamental de la décomposition de la variance stipule que cet écart total peut être scindé de manière rigoureusement additive en deux composantes mutuellement exclusives et orthogonales au sens vectoriel de l’espace euclidien :
$$y_i – \bar{y} = (\hat{y}_i – \bar{y}) + (y_i – \hat{y}_i)$$
En élevant cette égalité au carré et en sommant sur l’intégralité des $n$ observations, le terme de double produit croisé $2 \sum (\hat{y}_i – \bar{y})(y_i – \hat{y}_i)$ s’annule obligatoirement dès lors que les paramètres sont estimés par les moindres carrés ordinaires. L’équation maîtresse de la décomposition de Fisher se déploie alors dans toute son élégance formelle :
$$SS_{tot} = SS_{reg} + SS_{res}$$
Où $SS_{reg} = \sum_{i=1}^n (\hat{y}_i – \bar{y})^2$ représente la Somme des Carrés expliquée par le modèle de régression (composante déterministe et systématique capturée par les prédicteurs), et $SS_{res} = \sum_{i=1}^n (y_i – \hat{y}_i)^2$ représente la Somme des Carrés résiduelle (composante stochastique ou inexpliquée). Cette orthogonalité fondamentale garantit qu’aucune fraction d’information n’est comptabilisée deux fois : la dispersion des scores psychométriques se divise sans ambiguïté entre ce qui est compris au travers du filtre théorique du modèle et ce qui demeure impénétré à ce stade de l’investigation.
3.2 Le coefficient de détermination et son articulation avec les résidus
Cette décomposition additive offre une assise directe pour définir le coefficient le plus célèbre de la statistique appliquée : le coefficient de détermination, universellement noté $R^2$. Par définition, le $R^2$ représente la proportion de la variance totale de la variable d’intérêt qui est expliquée ou prédite par la combinaison des variables explicatives incluses dans le modèle. Son expression canonique découle directement du ratio des sommes des carrés :
$$R^2 = \frac{SS_{reg}}{SS_{tot}} = 1 – \frac{SS_{res}}{SS_{tot}}$$
Cette formulation met en lumière la complémentarité mathématique absolue qui unit le succès prédictif et l’erreur résiduelle. Le ratio $\frac{SS_{res}}{SS_{tot}}$, parfois qualifié de coefficient de non-détermination ou d’aliénation au carré, représente exactement la part relative de la variance résiduelle. Par conséquent, minimiser la variance résiduelle équivaut strictement à maximiser le coefficient de détermination. Si la variance résiduelle est égale à zéro ($SS_{res} = 0$), alors $R^2 = 1$, ce qui décrit une situation déterministe idéale où chaque point empirique repose exactement sur la surface de régression. À l’inverse, si le modèle n’apporte aucune information prédictive valide, la prédiction optimale pour chaque sujet se résume à la moyenne générale $\bar{y}$ ; il en résulte que $SS_{reg} = 0$, que $SS_{res} = SS_{tot}$, et que $R^2 = 0$.
Néanmoins, le $R^2$ brut souffre d’un biais mathématique sévère : l’adjonction de n’importe quel prédicteur supplémentaire dans une équation de régression — même s’il ne s’agit que d’une suite de nombres purement aléatoires générée par un algorithme — entraîne mécaniquement une diminution infinitésimale ou substantielle de $SS_{res}$, augmentant artificiellement le $R^2$. Pour corriger cette inflation trompeuse, les statisticiens recourent au $R^2$ ajusté ($R^2_{adj}$), qui substitue les sommes des carrés par leurs carrés moyens respectifs, intégrant ainsi une pénalisation stricte liée à la consommation de degrés de liberté :
$$R^2_{adj} = 1 – \frac{MS_{res}}{MS_{tot}} = 1 – \left[ \frac{\frac{SS_{res}}{n – p – 1}}{\frac{SS_{tot}}{n – 1}} \right] = 1 – (1 – R^2)\left( \frac{n – 1}{n – p – 1} \right)$$
Grâce à cette pondération mathématique rigoureuse, si un nouveau prédicteur introduit dans l’analyse ne réduit pas la variance résiduelle au-delà de ce que le simple hasard statistique produirait, le $R^2$ ajusté diminue, protégeant ainsi l’analyste contre l’illusion de performance prédictive.
3.3 Interprétation contextuelle : Variabilité interindividuelle et bruit de mesure
L’interprétation de la variance résiduelle ne saurait se cantonner à une manipulation algébrique désincarnée ; elle requiert une immersion contextualisée dans le domaine substantiel étudié, tout particulièrement en psychologie différentielle et en sciences médicales. Face à une variance inexpliquée résiduelle substantielle, le chercheur doit mener une analyse critique visant à dissocier la variabilité interindividuelle authentique du bruit de mesure instrumentale.
La fidélité d’un instrument, évaluée par exemple via le coefficient alpha de Cronbach ou les coefficients de fidélité composite de McDonald, impose un plafond absolu à la part de variance qu’il est théoriquement possible d’expliquer. En vertu des axiomes de la théorie classique des scores vrais formalisée par Lord et Novick, la variance totale d’une mesure observée $\sigma^2_Y$ est égale à la somme de la variance du score vrai $\sigma^2_T$ et de la variance de l’erreur de mesure pure $\sigma^2_E$. Dès lors, si une échelle d’évaluation clinique possède un coefficient de fidélité de 0,80, cela signifie par construction que 20 % de sa variance totale est constituée d’une erreur de mesure purement stochastique. Aucun modèle statistique, aussi complexe et pertinent soit-il, ne pourra jamais expliquer ces 20 % d’aléa instrumental. Cette fraction de l’erreur résiduelle est incompressible sans une refonte intégrale de la métrologie utilisée.
À l’opposé, la fraction restante de la variance résiduelle relève de la variance structurelle non capturée. Elle traduit l’hétérogénéité biologique, les trajectoires de vie uniques, les micro-environnements non modélisés et les dynamiques adaptatives propres à chaque sujet. En psychologie différentielle, cette variabilité n’est pas une nuisance mais l’essence même de l’objet d’étude. Rejeter un modèle ou le juger prématurément indigent sous prétexte qu’il ne parvient à expliquer que 35 % de la variance d’un comportement complexe (laissant 65 % de variance résiduelle) relève d’une méconnaissance profonde des systèmes ouverts et multi-déterminés qui caractérisent le fonctionnement psychologique humain.
4. La variance résiduelle dans les modèles de régression linéaire
4.1 Mécanique résiduelle en régression simple
Dans le cadre élémentaire d’un modèle de régression linéaire simple, nous cherchons à rendre compte des variations d’une variable réponse quantitative $Y$ au moyen d’un prédicteur unique continu $X$. La relation probabiliste postulée s’écrit formellement sous la forme :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
Où $\beta_0$ représente l’ordonnée à l’origine (constante structurelle), $\beta_1$ correspond à la pente de régression (taux de variation attendu de $Y$ pour une élévation unitaire de $X$), et $\varepsilon_i$ est le terme d’erreur stochastique non observable. Sur le plan géométrique, l’estimation des paramètres par la méthode des moindres carrés ordinaires consiste à projeter les observations sur un plan à deux dimensions et à faire pivoter la droite d’estimation jusqu’à ce que la somme des distances verticales quadratiques séparant chaque point empirique $(x_i, y_i)$ de son homologue modélisé $(x_i, \hat{y}_i)$ atteigne son minimum absolu.
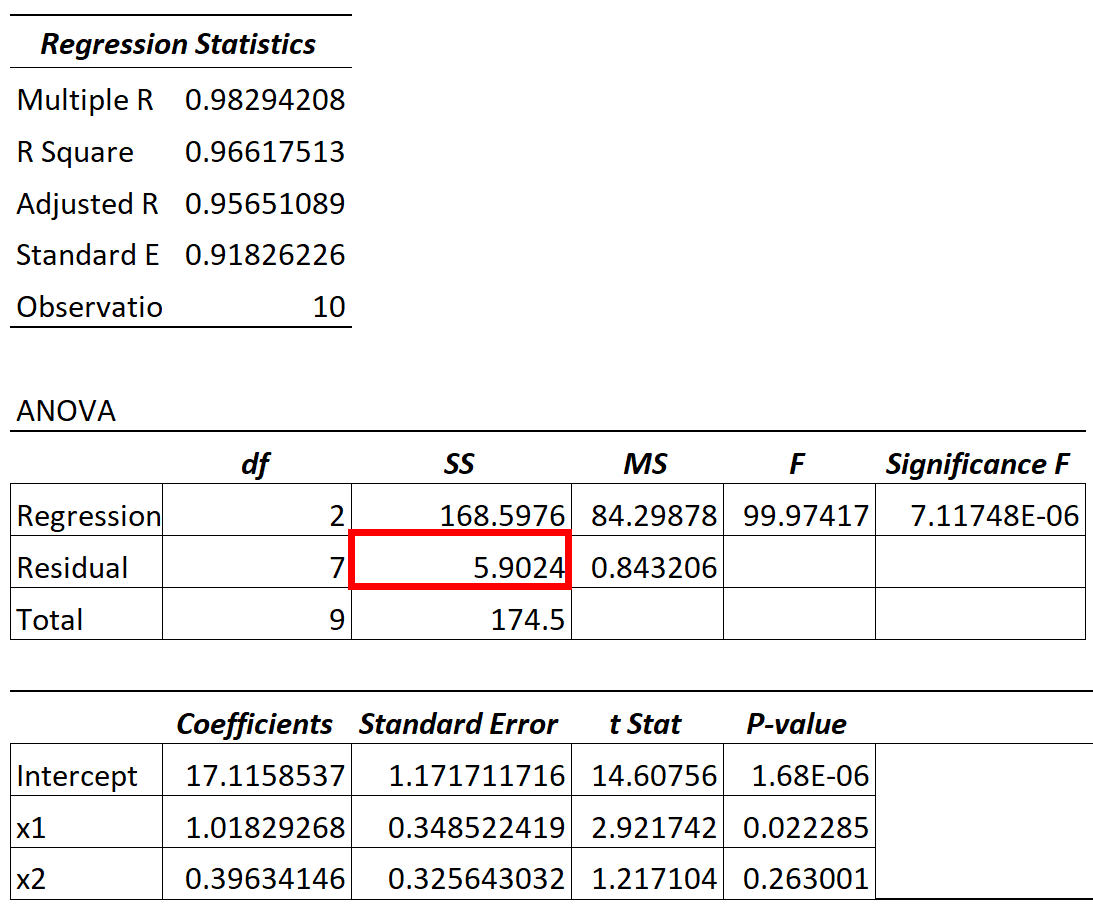
La variance résiduelle $\hat{\sigma}^2_e$ représente dans ce cadre l’épaisseur de dispersion des observations autour de cette droite. Si l’on trace deux bandes parallèles à une distance verticale de $\pm 1,96 , s_e$ de part et d’autre de la droite de régression, on délimite un intervalle dans lequel environ 95 % des observations individuelles doivent théoriquement se situer, sous réserve de la normalité des résidus. Cette variance résiduelle conditionne directement la précision de l’estimation de la pente elle-même. En effet, l’erreur type de l’estimateur de la pente, notée $SE(\hat{\beta}_1)$, est mathématiquement proportionnelle à la racine de la variance résiduelle :
$$SE(\hat{\beta}_1) = \sqrt{\frac{MS_{res}}{\sum_{i=1}^n (x_i – \bar{x})^2}} = \frac{\hat{\sigma}_e}{\sqrt{SS_X}}$$
Cette relation démontre avec clarté que plus la variance résiduelle est volumineuse, plus l’incertitude pesant sur l’orientation de la droite de régression s’accroît, ce qui se traduit par des intervalles de confiance élargis autour du coefficient et par une érosion proportionnelle de la statistique $t$ de Student associée au test de significativité.
4.2 Extension aux modèles de régression linéaire multiple
La transition vers la régression linéaire multiple implique l’introduction conjointe de plusieurs prédicteurs $X_1, X_2, dots, X_p$. La structure mathématique s’élève alors dans un hyperespace vectoriel où la prédiction n’est plus une ligne univariée mais un hyperplan à $p$ dimensions. L’équation matricielle générale prend la forme compacte :
$$Y = X\beta + \varepsilon$$
Le vecteur des résidus observés s’obtient alors via la matrice chapeau (hat matrix) $H = X(X^TX)^{-1}X^T$, qui projette orthogonalement les observations de $Y$ sur le sous-espace vectoriel engendré par les colonnes de la matrice des régresseurs $X$. Le calcul vectoriel s’exprime alors simplement : $e = (I – H)Y$, où $I$ est la matrice identité de dimension $n \times n$.
La dynamique de la variance résiduelle dans un environnement multivarié est intimement modulée par la structure de covariance existant entre les prédicteurs eux-mêmes. Lorsqu’on intègre de nouvelles variables explicatives fortement corrélées entre elles — un scénario d’une extrême banalité en psychologie où les traits de personnalité ou les symptômes psychopathologiques s’entrecroisent constamment —, le phénomène de multicolinéarité émerge. La multicolinéarité n’augmente pas la variance résiduelle globale $MS_{res}$ du modèle complet ; au contraire, l’ajout de prédicteurs maintient ou diminue toujours $SS_{res}$. Cependant, elle provoque une inflation massive des erreurs types associées aux coefficients de régression individuels en raison de l’instabilité de l’inversion de la matrice $(X^TX)$.
D’autre part, la régression multiple expose l’analyste au dilemme classique opposant le sous-ajustement (underfitting) et le sur-ajustement (overfitting). Dans une configuration de sous-ajustement, le modèle exclut des prédicteurs critiques ou omet des termes non linéaires nécessaires : la variance résiduelle est alors gonflée de manière artificielle et contient une structure systématique non aléatoire. Dans une configuration d’overfitting, l’introduction inconsidérée d’un nombre excessif de prédicteurs par rapport à la taille de l’échantillon force le modèle à mémoriser les fluctuations d’échantillonnage singulières du jeu de données. Bien que la variance résiduelle calculée sur l’échantillon d’apprentissage chute drastiquement vers des niveaux artificiellement optimistes, la variance résiduelle évaluée sur de nouvelles données indépendantes (erreur de généralisation hors échantillon) explose littéralement.
4.3 Interprétation standardisée : Résidus semi-étudiantisés et studentisés
L’examen direct des résidus bruts $e_i = y_i – \hat{y}_i$ présente des limites techniques évidentes. D’une part, ils dépendent entièrement de l’échelle d’origine de la variable dépendante, ce qui empêche toute comparaison rigoureuse entre des modèles évaluant des indicateurs cliniques distincts. D’autre part, les résidus bruts issus d’un ajustement par les moindres carrés n’ont pas la même variance en tous les points de l’espace des données : la variance mathématique d’un résidu dépend de la distance de l’observation au centre des variables explicatives, distance capturée par l’élément diagonal correspondant $h_{ii}$ de la matrice chapeau (valeur de levier ou leverage) :
$$Var(e_i) = \sigma^2 (1 – h_{ii})$$
Pour remédier à cette hétérogénéité intrinsèque, plusieurs protocoles de normalisation ont été développés. La première transformation élémentaire consiste à diviser le résidu brut par l’erreur standard de l’estimation du modèle complet, produisant ce que la littérature nomme les résidus semi-étudiantisés ou résidus standardisés basiques :
$$e_i^* = \frac{e_i}{\hat{\sigma}_e}$$
Toutefois, pour corriger rigoureusement l’impact du levier de chaque point sur sa propre variance résiduelle, on recourt préférentiellement aux résidus studentisés internes (internally studentized residuals) :
$$r_i = \frac{e_i}{\hat{\sigma}_e \sqrt{1 – h_{ii}}}$$
Enfin, l’outil le plus puissant pour la détection clinique et statistique d’anomalies prédictives est constitué par le résidu studentisé externe ou résidu supprimé (jackknife residual ou externally studentized residual), noté $t_i$. Dans ce calcul, la variance d’erreur est estimée en réajustant le modèle sur les données en ayant pris le soin d’exclure préalablement la $i$-ème observation :
$$t_i = \frac{e_i}{\hat{\sigma}_{e(-i)} \sqrt{1 – h_{ii}}}$$
Sous les hypothèses de normalité standard, ce résidu studentisé externe suit rigoureusement une loi de Student à $(n – p – 2)$ degrés de liberté. En pratique diagnostique, une valeur absolue excédant le seuil critique de 2 ou 3 signale immédiatement un cas hautement atypique : il s’agit d’un individu dont la trajectoire psychologique ou clinique défie radicalement l’équation générale du modèle, exigeant une inspection qualitative approfondie.
5. Exemple pratique en psychologie : Régression appliquée aux symptômes dépressifs
5.1 Présentation du cadre de recherche et variables mesurées
Afin de rendre ces formulations parfaitement tangibles, examinons une étude empirique fictive mais représentative, menée dans une clinique spécialisée dans la prise en charge des troubles de l’humeur. Une équipe de chercheurs souhaite quantifier dans quelle mesure l’intensité de la symptomatologie anxieuse peut prédire la sévérité des manifestations dépressives. Le protocole implique l’administration de deux échelles psychométriques validées auprès d’une cohorte de 10 patients admis consécutivement : l’Inventaire d’Anxiété de Beck (BAI, pour Beck Anxiety Inventory), qui constitue notre variable indépendante quantitative $X$, et l’Inventaire de Dépression de Beck (BDI-II, pour Beck Depression Inventory-II), qui constitue notre variable dépendante continue $Y$.
L’échantillon présente une distribution clinique typique de sévérité modérée à sévère. Les scores collectés pour les dix participants sont rigoureusement répertoriés ci-dessous :
- Patient 1 : BAI ($X$) = 12, BDI-II ($Y$) = 18
- Patient 2 : BAI ($X$) = 15, BDI-II ($Y$) = 20
- Patient 3 : BAI ($X$) = 18, BDI-II ($Y$) = 22
- Patient 4 : BAI ($X$) = 20, BDI-II ($Y$) = 28
- Patient 5 : BAI ($X$) = 24, BDI-II ($Y$) = 27
- Patient 6 : BAI ($X$) = 28, BDI-II ($Y$) = 35
- Patient 7 : BAI ($X$) = 30, BDI-II ($Y$) = 32
- Patient 8 : BAI ($X$) = 34, BDI-II ($Y$) = 42
- Patient 9 : BAI ($X$) = 38, BDI-II ($Y$) = 40
- Patient 10 : BAI ($X$) = 41, BDI-II ($Y$) = 46
À partir de ces données brutes, les calculs descriptifs préliminaires établissent la moyenne de la variable anxiété à $\bar{x} = 26,0$ et la moyenne de la dépression à $\bar{y} = 31,0$. En appliquant les formules d’estimation des moindres carrés ordinaires pour la pente ($\hat{\beta}_1 = \frac{\sum (x_i – \bar{x})(y_i – \bar{y})}{\sum (x_i – \bar{x})^2}$) et l’ordonnée à l’origine ($\hat{\beta}_0 = \bar{y} – \hat{\beta}_1 \bar{x}$), nous obtenons une pente $\hat{\beta}_1 \approx 0,9339$ et une constante $\hat{\beta}_0 \approx 6,7186$. L’équation de régression linéaire empirique reliant l’anxiété à la sévérité dépressive s’écrit par conséquent :
$$\widehat{\text{BDI}}_i = 6,7186 + 0,9339 \times \text{BAI}_i$$
5.2 Calcul pas à pas des résidus et de la variance inexpliquée
Pour calculer la variance résiduelle exacte du modèle, nous devons décomposer méticuleusement chaque étape, en calculant la prédiction théorique $\hat{y}_i$, le résidu brut $e_i$, et le carré de cet écart $e_i^2$ pour l’intégralité des sujets de la cohorte :
- Patient 1 : $X_1 = 12$, $Y_1 = 18$. Prédiction : $\hat{y}_1 = 6,7186 + (0,9339 \times 12) = 17,925$. Résidu : $e_1 = 18 – 17,925 = +0,075$. Résidu au carré : $e_1^2 \approx 0,0056$.
- Patient 2 : $X_2 = 15$, $Y_2 = 20$. Prédiction : $\hat{y}_2 = 6,7186 + (0,9339 \times 15) = 20,727$. Résidu : $e_2 = 20 – 20,727 = -0,727$. Résidu au carré : $e_2^2 \approx 0,5285$.
- Patient 3 : $X_3 = 18$, $Y_3 = 22$. Prédiction : $\hat{y}_3 = 6,7186 + (0,9339 \times 18) = 23,529$. Résidu : $e_3 = 22 – 23,529 = -1,529$. Résidu au carré : $e_3^2 \approx 2,3378$.
- Patient 4 : $X_4 = 20$, $Y_4 = 28$. Prédiction : $\hat{y}_4 = 6,7186 + (0,9339 \times 20) = 25,397$. Résidu : $e_4 = 28 – 25,397 = +2,603$. Résidu au carré : $e_4^2 \approx 6,7756$.
- Patient 5 : $X_5 = 24$, $Y_5 = 27$. Prédiction : $\hat{y}_5 = 6,7186 + (0,9339 \times 24) = 29,132$. Résidu : $e_5 = 27 – 29,132 = -2,132$. Résidu au carré : $e_5^2 \approx 4,5454$.
- Patient 6 : $X_6 = 28$, $Y_6 = 35$. Prédiction : $\hat{y}_6 = 6,7186 + (0,9339 \times 28) = 32,868$. Résidu : $e_6 = 35 – 32,868 = +2,132$. Résidu au carré : $e_6^2 \approx 4,5454$.
- Patient 7 : $X_7 = 30$, $Y_7 = 32$. Prédiction : $\hat{y}_7 = 6,7186 + (0,9339 \times 30) = 34,736$. Résidu : $e_7 = 32 – 34,736 = -2,736$. Résidu au carré : $e_7^2 \approx 7,4857$.
- Patient 8 : $X_8 = 34$, $Y_8 = 42$. Prédiction : $\hat{y}_8 = 6,7186 + (0,9339 \times 34) = 38,471$. Résidu : $e_8 = 42 – 38,471 = +3,529$. Résidu au carré : $e_8^2 \approx 12,4538$.
- Patient 9 : $X_9 = 38$, $Y_9 = 40$. Prédiction : $\hat{y}_9 = 6,7186 + (0,9339 \times 38) = 42,207$. Résidu : $e_9 = 40 – 42,207 = -2,207$. Résidu au carré : $e_9^2 \approx 4,8708$.
- Patient 10 : $X_{10} = 41$, $Y_{10} = 46$. Prédiction : $\hat{y}_{10} = 6,7186 + (0,9339 \times 41) = 45,009$. Résidu : $e_{10} = 46 – 45,009 = +0,991$. Résidu au carré : $e_{10}^2 \approx 0,9821$.
En agrégeant l’ensemble de ces déviations quadratiques, nous parvenons à la Somme des Carrés Résiduelle :
$$SS_{res} = \sum_{i=1}^{10} e_i^2 = 0,0056 + 0,5285 + 2,3378 + 6,7756 + 4,5454 + 4,5454 + 7,4857 + 12,4538 + 4,8708 + 0,9821 = 44,5307$$
L’échantillon comprenant $n = 10$ sujets et le modèle ayant estimé $k = 2$ paramètres ($\beta_0$ et $\beta_1$), le nombre de degrés de liberté résiduels est de $df_{res} = 10 – 2 = 8$. La variance résiduelle se déduit alors avec exactitude :
$$MS_{res} = \hat{\sigma}^2_e = \frac{SS_{res}}{df_{res}} = \frac{44,5307}{8} \approx 5,5663$$
L’erreur type d’estimation s’obtient par extraction de la racine carrée : $s_e = \sqrt{5,5663} \approx 2,359$. Parallèlement, la somme totale des carrés de $Y$ s’élève à $SS_{tot} = \sum (y_i – 31)^2 = 852$. Le modèle explique ainsi $SS_{reg} = 852 – 44,5307 = 807,4693$, ce qui génère un $R^2 = \frac{807,4693}{852} \approx 0,9477$, soit 94,77 % de variance expliquée et seulement 5,23 % de variance résiduelle relative.
5.3 Interprétation clinique des résultats et prise de décision
L’erreur standard de l’estimation de 2,359 points à l’échelle BDI-II revêt une signification clinique directe. Elle indique que, dans le cadre de ce modèle, la prédiction du score dépressif basée exclusivement sur le niveau d’anxiété s’accompagne d’une marge d’incertitude typique d’environ deux points et demi. Pour un patient se présentant avec un score BAI de 30 (prédiction de 34,7 points), l’intervalle de prédiction individuel approximatif à 95 % s’étendra sur une plage allant approximativement de $34,7 – (2 \times 2,359)$ à $34,7 + (2 \times 2,359)$, c’est-à-dire de 30,0 à 39,4 points.
Bien que le score d’anxiété explique une part écrasante de la variance (plus de 94 %), la variance résiduelle de 5,57 n’est pas insignifiante. Sur le plan psychiatrique et psychologique, cette dispersion inexpliquée rappelle que deux patients affichant une anxiété rigoureusement superposable peuvent présenter des intensités dépressives divergentes. Cette différence résiduelle trouve son origine théorique dans des variables cliniques non mesurées dans cette régression simple : les perturbations du cycle du sommeil (insomnie terminale versus hypersomnie), le sentiment d’auto-efficacité, la qualité perçue du soutien social intrafamilial ou la charge génétique associée aux troubles affectifs.
En conséquence, sur le plan de la décision thérapeutique, le clinicien ne saurait extrapoler mécaniquement la sévérité d’un état dépressif à partir du seul inventaire d’anxiété. La variance résiduelle matérialise l’espace clinique irréductible qui justifie une évaluation diagnostique complète et personnalisée, prévenant toute dérive algorithmique déterministe qui mépriserait la singularité du tableau symptomatique individuel.
6. La variance résiduelle dans l’analyse de variance (ANOVA)
6.1 Conceptualisation de la variance intra-groupe (Within-Group)
L’Analyse de Variance (ANOVA), initialement conçue par Fisher pour dissocier les effets génétiques et environnementaux dans les essais agronomiques, constitue un cadre conceptuel au sein duquel la variance résiduelle trouve une formalisation remarquable. Dans un modèle ANOVA univarié à plan simple (à un facteur fixe), une variable dépendante quantitative continue $Y$ est mesurée à travers plusieurs groupes indépendants correspondant aux modalités d’un facteur catégoriel. L’équation formelle s’exprime selon :
$$Y_{ij} = \mu + \alpha_j + \varepsilon_{ij}$$
Où $Y_{ij}$ est le score de l’individu $i$ dans le groupe $j$, $\mu$ est la moyenne générale de l’ensemble de la population, $\alpha_j$ représente l’effet différentiel du groupe thérapeutique ou expérimental $j$, et $\varepsilon_{ij}$ symbolise l’erreur résiduelle stochastique individuelle.
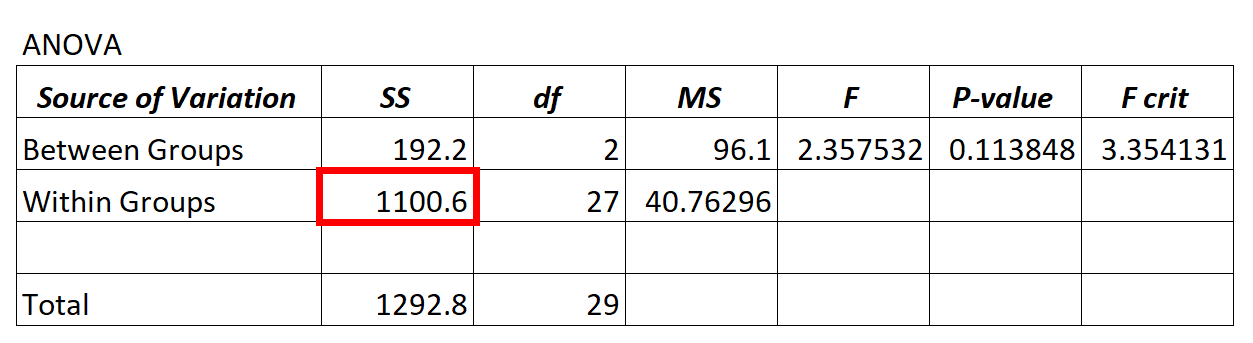
Dans ce contexte expérimental, la variance résiduelle se matérialise rigoureusement sous la forme de la variance intra-groupe (souvent désignée par la terminologie anglo-saxonne Within-Group Variance ou Error Variance). Alors que la variance inter-groupes (Between-Group Variance) mesure l’espacement mutuel entre les moyennes de chaque condition, la variance intra-groupe mesure la façon dont les sujets placés sous une condition de traitement strictement identique divergent néanmoins les uns des autres. Puisque tous les individus d’un groupe donné reçoivent le même protocole, toute variation observée à l’intérieur de ce groupe ne peut en aucun cas être attribuée à l’intervention expérimentale : elle constitue par excellence la variance résiduelle, reflet de la variabilité biologique, cognitive et dispositionnelle propre à la condition humaine.
Un prérequis fondamental de l’ANOVA classique réside dans le postulat d’homogénéité des variances ou homoscédasticité. Ce postulat stipule que la variance résiduelle théorique intra-groupe doit demeurer invariante à travers toutes les modalités du facteur étudié : $\sigma_1^2 = \sigma_2^2 = dots = \sigma_J^2 = \sigma^2_\varepsilon$. Si cette hypothèse n’est pas vérifiée, la notion même d’une variance résiduelle unique et commune décrivant l’ensemble du processus s’effondre, faussant radicalement le calcul des probabilités critiques associées.
6.2 Algorithme de calcul de la somme des carrés de l’erreur
L’algorithme de partitionnement de la somme des carrés en ANOVA sépare l’écart d’un score individuel à la moyenne générale $(y_{ij} – \bar{y}_{bulletbullet})$ en deux termes : l’écart de la moyenne du groupe à la moyenne générale $(\bar{y}_{bullet j} – \bar{y}_{bulletbullet})$ et l’écart du score individuel à la moyenne de son propre groupe $(y_{ij} – \bar{y}_{bullet j})$. La Somme des Carrés de l’Erreur ou Somme des Carrés Intra-groupe, notée indifféremment $SS_{error}$, $SS_{within}$ ou $SS_{res}$, se calcule en sommant les carrés des distances de chaque sujet à la moyenne arithmétique de sa condition :
$$SS_{within} = SS_{res} = \sum_{j=1}^J \sum_{i=1}^{n_j} (y_{ij} – \bar{y}_{bullet j})^2$$
Cette sommation peut être avantageusement appréhendée comme l’agrégation directe des sommes des carrés calculées isolément au sein de chaque groupe :
$$SS_{res} = SS_1 + SS_2 + dots + SS_J$$
Pour déterminer le Carré Moyen Résiduel (le $MS_{within}$ ou $MS_{error}$), il convient de rapporter cette somme des carrés à ses degrés de liberté propres. Si l’expérience dénombre $J$ groupes distincts et un effectif global cumulé de $N = \sum n_j$ observations, chaque groupe utilise un degré de liberté pour fixer sa moyenne conditionnelle locale. Le nombre total de degrés de liberté résiduels équivaut donc à la différence entre l’effectif global et le nombre de groupes :
$$df_{within} = df_{res} = \sum_{j=1}^J (n_j – 1) = N – J$$
Le carré moyen de l’erreur, incarnation rigoureuse de la variance résiduelle globale de l’expérience, se définit alors formellement comme la moyenne pondérée des variances échantillonnales de chaque condition :
$$MS_{error} = \hat{\sigma}^2_\varepsilon = \frac{SS_{within}}{N – J} = \frac{\sum_{j=1}^J (n_j – 1)s_j^2}{N – J}$$
Ce résultat démontre la continuité conceptuelle absolue entre la régression linéaire et l’ANOVA : le carré moyen intra-groupe d’une ANOVA n’est autre que la variance résiduelle d’un modèle linéaire général dans lequel les variables explicatives sont des variables indicatrices (muettes ou dummy variables) codant l’appartenance aux différentes conditions expérimentales.
6.3 Le ratio F de Snedecor comme balance entre signal et bruit
L’aboutissement de l’analyse de variance réside dans le calcul de la statistique de test $F$, formulée par George Snedecor en hommage à Ronald Fisher. Ce ratio statistique constitue une balance d’une élégance conceptuelle parfaite, opposant la dispersion induite par les traitements expérimentaux à la dispersion inexpliquée résiduelle :
$$F = \frac{MS_{between}}{MS_{within}} = \frac{\text{Signal (Variance expliquée par l’effet traitement)}}{\text{Bruit (Variance résiduelle intra-groupe)}}$$
Dans cette architecture inférentielle, la variance résiduelle $MS_{within}$ remplit le rôle d’étalon de mesure du bruit de fond. L’espérance mathématique du carré moyen inter-groupes $MS_{between}$ est égale à la variance résiduelle pure additionnée d’une quantité proportionnelle à la véritable amplitude de l’effet de traitement dans la population :
$$E(MS_{between}) = \sigma^2_\varepsilon + \frac{\sum n_j \alpha_j^2}{J – 1}$$
Tandis que l’espérance mathématique du carré moyen intra-groupes ne contient que l’aléa : $E(MS_{within}) = \sigma^2_\varepsilon$. Sous l’hypothèse nulle ($H_0$) d’une stricte absence d’effet des différentes conditions expérimentales (c’est-à-dire tous les $\alpha_j = 0$), $E(MS_{between}) = E(MS_{within}) = \sigma^2_\varepsilon$, ce qui entraîne que le ratio $F$ oscille autour de la valeur 1. Si les traitements engendrent une différenciation réelle des moyennes, le numérateur croît par rapport au dénominateur, faisant progresser le ratio $F$ vers des valeurs critiques associées à une probabilité de rejet de $H_0$.
Cette relation fondamentale met en lumière l’impact dévastateur d’une variance résiduelle boursouflée sur la puissance statistique. Si une expérimentation souffre d’un protocole laxiste ou d’instruments instables, le dénominateur de la fraction explose. Dès lors, même en présence d’une thérapie ou d’un médicament hautement efficace capable de déplacer substantiellement les moyennes, le ratio $F$ demeure contenu à un niveau médiocre en raison de la force du bruit sous-jacent. L’inflation de la variance résiduelle constitue ainsi la cause première de l’erreur statistique de type II (non-rejet à tort de l’hypothèse nulle), conduisant fréquemment les chercheurs à abandonner des interventions thérapeutiques prometteuses simplement parce que leur dispositif expérimental s’est révélé incapable de museler la variance inexpliquée.
7. Exemple pratique en psychologie : Modèle ANOVA d’interventions thérapeutiques
7.1 Contexte expérimental : Comparaison de protocoles psychothérapeutiques
Illustrons la dynamique de la variance intra-groupe à travers un essai contrôlé randomisé conduit auprès d’une patientèle présentant un trouble d’anxiété généralisée. L’investigation se propose de comparer l’efficacité de trois protocoles cliniques distincts d’une durée de douze semaines :
- Groupe 1 : Thérapie Cognitive et Comportementale classique (TCC), axée sur la restructuration cognitive et l’exposition intéroceptive graduelle.
- Groupe 2 : Programme de Réduction du Stress Basée sur la Pleine Conscience (MBSR, Mindfulness-Based Stress Reduction), mobilisant la méditation formelle et la défocalisation attentionnelle.
- Groupe 3 : Groupe Contrôle sur liste d’attente avec suivi psychologique non directif minimal.
La variable dépendante retenue est l’évaluation de la régulation émotionnelle globale mesurée à l’issue des douze semaines par l’Échelle de Difficultés de Régulation Émotionnelle (DERS, pour Difficulties in Emotion Regulation Scale). Pour cet exemple didactique, chaque condition accueille $n_j = 5$ patients affectés de manière purement aléatoire, portant l’effectif global de l’essai clinique à $N = 15$. Les scores post-traitement obtenus par les participants sont les suivants (un score bas témoignant d’une meilleure régulation émotionnelle) :
- Groupe 1 (TCC) : 42, 45, 39, 48, 41 (Moyenne du groupe : $\bar{y}_1 = 43,0$)
- Groupe 2 (Pleine Conscience) : 49, 53, 46, 55, 52 (Moyenne du groupe : $\bar{y}_2 = 51,0$)
- Groupe 3 (Contrôle) : 62, 68, 59, 65, 66 (Moyenne du groupe : $\bar{y}_3 = 64,0$)
La moyenne arithmétique globale de l’ensemble des 15 participants s’établit à :
$$\bar{y}_{bulletbullet} = \frac{43,0 + 51,0 + 64,0}{3} = \frac{158,0}{3} \approx 52,667$$
L’hypothèse nulle postulée stipule qu’aucun traitement ne surpasse les autres en population générale ($\mu_1 = \mu_2 = \mu_3$). Notre objectif consiste à déterminer formellement la variance résiduelle intra-groupe afin de tester la significativité de ces écarts thérapeutiques.
7.2 Construction détaillée de la table d’ANOVA empirique
Procédons au partitionnement rigoureux des différentes sommes des carrés. Nous entamons la démarche par l’évaluation de la Somme des Carrés Inter-groupes ($SS_{between}$), laquelle mesure l’effet direct des protocoles thérapeutiques :
$$SS_{between} = \sum_{j=1}^3 n_j (\bar{y}_j – \bar{y}_{bulletbullet})^2 = 5 \times (43 – 52,667)^2 + 5 \times (51 – 52,667)^2 + 5 \times (64 – 52,667)^2$$
$$SS_{between} = 5 \times (-9,667)^2 + 5 \times (-1,667)^2 + 5 \times (11,333)^2 = 5 \times 93,451 + 5 \times 2,779 + 5 \times 128,437$$
$$SS_{between} = 467,255 + 13,895 + 642,185 = 1123,335$$
Calculons ensuite pas à pas la Somme des Carrés Intra-groupes ($SS_{within}$ ou $SS_{res}$), qui matérialise l’écartement des patients par rapport à la moyenne de leur propre condition :
- Pour le Groupe 1 (TCC) :
$$SS_1 = (42-43)^2 + (45-43)^2 + (39-43)^2 + (48-43)^2 + (41-43)^2 = (-1)^2 + 2^2 + (-4)^2 + 5^2 + (-2)^2 = 1 + 4 + 16 + 25 + 4 = 50$$ - Pour le Groupe 2 (Pleine Conscience) :
$$SS_2 = (49-51)^2 + (53-51)^2 + (46-51)^2 + (55-51)^2 + (52-51)^2 = (-2)^2 + 2^2 + (-5)^2 + 4^2 + 1^2 = 4 + 4 + 25 + 16 + 1 = 50$$ - Pour le Groupe 3 (Contrôle) :
$$SS_3 = (62-64)^2 + (68-64)^2 + (59-64)^2 + (65-64)^2 + (66-64)^2 = (-2)^2 + 4^2 + (-5)^2 + 1^2 + 2^2 = 4 + 16 + 25 + 1 + 4 = 50$$
La Somme des Carrés Résiduelle totale est la somme directe de ces déviations intra-groupes :
$$SS_{res} = SS_{within} = 50 + 50 + 50 = 150$$
Déterminons à présent les degrés de liberté associés. Pour l’effet inter-groupes, $df_{between} = J – 1 = 3 – 1 = 2$. Pour le terme d’erreur résiduel, $df_{res} = df_{within} = N – J = 15 – 3 = 12$. Nous pouvons alors calculer les carrés moyens respectifs :
$$MS_{between} = \frac{SS_{between}}{df_{between}} = \frac{1123,335}{2} = 561,668$$
$$MS_{res} = MS_{within} = \frac{SS_{within}}{df_{within}} = \frac{150}{12} = 12,50$$
La variance résiduelle de notre modèle expérimental est donc rigoureusement égale à 12,50. Le ratio statistique de Fisher s’établit dès lors à :
$$F = \frac{MS_{between}}{MS_{within}} = \frac{561,668}{12,50} \approx 44,93$$
En consultant la distribution de $F$ à 2 et 12 degrés de liberté, la valeur critique au seuil de signification $\alpha = 0,001$ est de 12,97. La statistique observée ($44,93$) surpassant très largement ce seuil critique ($p < 0,0001$), nous rejetons catégoriquement l'hypothèse nulle d'égalité des moyennes thérapeutiques.
7.3 Analyse substantielle de la variance intra-groupe obtenue
L’obtention d’une variance résiduelle $MS_{within}$ de 12,50 — ce qui équivaut à un écart-type résiduel intra-groupe $s_e = \sqrt{12,50} \approx 3,54$ points sur l’échelle DERS — livre des enseignements substantiels cruciaux. Cette valeur de 12,50 représente l’hétérogénéité résiduelle de réponse des sujets soumis à un même traitement. Même sous l’égide standardisée d’une thérapie cognitive et comportementale menée par des cliniciens chevronnés, certains patients obtiennent un score de 39 tandis que d’autres atteignent 48. Cette divergence intra-condition ne peut être attribuée aux modules de la TCC, mais reflète l’influence de facteurs internes aux sujets (tels que la flexibilité neurocognitive initiale, le tempérament anxieux sous-jacent, l’alliance thérapeutique établie avec le soignant ou des stresseurs de vie survenus en cours d’essai).
Pour pondérer l’importance relative de la variance résiduelle face à l’effet thérapeutique global, le calcul de la taille d’effet par le coefficient éta-carré ($\eta^2$) est indispensable :
$$\eta^2 = \frac{SS_{between}}{SS_{tot}} = \frac{SS_{between}}{SS_{between} + SS_{within}} = \frac{1123,335}{1123,335 + 150} = \frac{1123,335}{1273,335} \approx 0,8822$$
Ce résultat démontre que 88,22 % de la variabilité globale de la régulation émotionnelle des participants est gouvernée par le type de thérapie reçue, tandis que seulement 11,78 % de cette variabilité constitue de la variance résiduelle inexpliquée au sein des groupes. Dans les essais cliniques psychothérapeutiques réels, les tailles d’effet atteignent rarement une telle pureté ; la variance résiduelle absorbe couramment de 60 à 80 % de la variance totale, reflétant la grande complexité inhérente à la subjectivité et au changement psychothérapeutique.
Pour les futurs protocoles expérimentaux, ces données incitent à raffiner le modèle. Si un chercheur désire réduire encore cette variance intra-groupe de 12,50 afin d’accroître la puissance statistique pour détecter des différences plus subtiles entre la TCC et la Pleine Conscience, il pourra envisager l’intégration d’une covariable d’évaluation initiale (ANCOVA) ou adopter un plan factoriel croisé isolant les styles d’attachement des patients.
8. Hypothèses statistiques fondamentales régissant les résidus
8.1 Postulat de normalité distributionnelle des erreurs
L’inférence statistique classique — qu’il s’agisse des tests d’hypothèses d’adéquation globale (test $F$), des tests de significativité des paramètres individuels (tests $t$) ou de la construction des intervalles de confiance et de prédiction — repose formellement sur une série d’hypothèses rigoureuses concernant la distribution probabiliste du terme d’erreur stochastique $\varepsilon_i$. Le premier de ces postulats exige que les erreurs résiduelles de la population soient distribuées selon une loi normale à moyenne nulle :
$$\varepsilon_i \overset{i.i.d.}{\sim} \mathcal{N}(0, \sigma^2)$$
Il est primordial de dissiper une confusion théorique omniprésente dans la littérature appliquée : la régression linéaire et l’ANOVA n’exigent en aucun cas que la variable dépendante $Y$ ni que les prédicteurs $X$ soient individuellement distribués selon une loi normale. Le postulat de normalité s’applique de manière exclusive à la distribution des erreurs résiduelles conditionnelles. Une variable dépendante peut afficher une distribution empirique bimodale ou asymétrique à l’échelle globale ; si cette non-normalité apparente est entièrement résorbée par l’influence des groupes ou des prédicteurs, les résidus conditionnels se répartiront selon une loi normale canonique, respectant scrupuleusement l’hypothèse sous-jacente.
Lorsque la distribution des résidus s’écarte sévèrement de la normalité — en affichant une asymétrie marquée (skewness) ou des queues de distribution épaisses générées par une leptocurticité prononcée (kurtosis excessif) —, les estimateurs des moindres carrés conservent leur propriété d’être non biaisés en vertu du théorème de Gauss-Markov. En revanche, l’estimation de leur variance d’échantillonnage et, par voie de conséquence, les distributions théoriques des statistiques de Student et de Fisher perdent leur validité exacte. Sur des échantillons de taille modeste, une distorsion de la normalité peut fausser gravement les probabilités critiques (valeurs de $p$), augmentant le taux d’erreur de première ou de deuxième espèce.
Certes, le théorème central limite offre un bouclier mathématique réconfortant : lorsque la taille d’échantillon $n$ devient suffisamment large (usuellement $n > 100$), les estimateurs des coefficients convergent asymptotiquement vers une loi normale, conférant au modèle linéaire une robustesse relative face aux déviations de normalité résiduelle. Néanmoins, en matière d’estimation des intervalles de prédiction individuels pour un cas clinique singulier, l’hypothèse de normalité exacte demeure incontournable, même sur de très grands échantillons.
8.2 Homoscédasticité et invariance de la dispersion résiduelle
La seconde hypothèse cardinale régissant le modèle linéaire général est celle de l’homoscédasticité, étymologiquement issue du grec signifiant « même dispersion ». Elle impose que la variance d’erreur résiduelle demeure strictement uniforme et constante le long de toutes les valeurs possibles des variables prédictives, ou à travers toutes les strates de l’espace dimensionnel considéré :
$$Var(\varepsilon_i mid X) = \sigma^2 \quad \forall i$$
La violation de cette hypothèse engendre la condition pathologique inverse désignée sous le vocable d’hétéroscédasticité. Dans un contexte hétéroscédastique, l’amplitude de la variance résiduelle se contracte ou se dilate en fonction du niveau des valeurs prédites. Ce phénomène est fréquent dans les évaluations psychométriques. Par exemple, lors de l’étude de l’anxiété de performance chez des musiciens en fonction de leur temps d’entraînement, les novices affichent généralement une variance de performance considérable (variance résiduelle massive), tandis que les musiciens d’élite s’entraînant intensivement convergent tous vers des scores presque uniformément parfaits (variance résiduelle compressée).
L’hétéroscédasticité n’altère pas le caractère sans biais des estimateurs des coefficients de régression $\hat{\beta}$ : la droite ou l’hyperplan de régression demeure bien centré au milieu des points. En revanche, elle ruine complètement l’estimation de la matrice de variance-covariance des coefficients. En présence d’hétéroscédasticité, la formule classique de l’erreur type $SE(\hat{\beta})$ sous-estime ou surestime drastiquement l’incertitude réelle. Le chercheur s’expose alors à des tests $t$ artificiellement gonflés, conduisant à identifier des liens statistiques prétendument significatifs qui ne sont que de purs artefacts méthodologiques issus d’un gradient de variance résiduelle non maîtrisé.
8.3 Indépendance mutuelle et absence d’autocorrélation
La troisième exigence structurelle fondamentale stipule que les résidus doivent être mutuellement indépendants les uns des autres. En termes probabilistes formels, la covariance entre l’erreur résiduelle associée à une observation $i$ et l’erreur résiduelle attachée à une observation $j$ doit être rigoureusement nulle pour toute paire d’observations distinctes ($i \neq j$) :
$$Cov(\varepsilon_i, \varepsilon_j) = 0 \quad \forall i \neq j$$
Cette condition signifie que la connaissance de la déviation résiduelle d’un sujet particulier ne procure strictement aucune information prédictive quant à la direction ou à l’amplitude de l’écart d’un autre sujet. Or, dans la pratique empirique des sciences humaines et de la santé, cette indépendance conditionnelle est fréquemment enfreinte par la structure même des protocoles de recueil de données. Les deux formes les plus courantes de violation de ce postulat sont l’autocorrélation temporelle et la dépendance contextuelle (données en grappes ou clustered data).
L’autocorrélation temporelle ou sérielle émerge systématiquement lorsque les mesures sont répétées dans le temps sur les mêmes unités expérimentales, comme dans les devis longitudinaux ou les protocoles à cas unique (Single-Case Experimental Designs). L’humeur, la douleur ou la performance d’un patient à l’instant $t$ est presque inévitablement corrélée à son niveau à l’instant $t-1$. Quant à la dépendance contextuelle, elle se manifeste dès lors que les sujets sont recrutés au sein d’unités écologiques partagées : élèves au sein d’une même classe d’école, patients traités par un même thérapeute ou membres d’une même famille. Les individus partagent un micro-environnement invariant, ce qui induit une covariance résiduelle positive entre leurs scores.
L’impact de l’autocorrélation positive sur le modèle linéaire standard est destructeur : elle provoque une sous-estimation substantielle de la variance d’échantillonnage réelle. Les tests statistiques standard fondés sur l’OLS opèrent sous l’illusion d’une quantité d’information indépendante supérieure à celle réellement disponible. Il en découle une explosion spectaculaire du taux d’erreur de type I, pouvant atteindre des niveaux où des résultats prétendument significatifs à $p < 0,001$ ne correspondent en réalité qu'à des fluctuations aléatoires auto-corrélées.
9. Diagnostic approfondi des résidus et détection des anomalies de modélisation
9.1 Outils d’exploration graphique de la variance résiduelle
Face à la complexité des dynamiques résiduelles, la simple lecture de métriques scalaires globales (telles que le $R^2$ ou le $MS_{res}$) se révèle incapable de déceler des violations structurales majeures. Une modélisation statistique rigoureuse implique nécessairement une inspection visuelle exploratoire de la distribution spatiale des résidus à travers une batterie graphique normalisée.
Le premier outil diagnostique fondamental est le graphique des résidus studentisés en fonction des valeurs prédites (Residuals vs Fitted Plot). Dans une situation idéale où toutes les hypothèses du modèle linéaire sont satisfaites, les points doivent se distribuer de manière homogène et aléatoire à l’intérieur d’une bande horizontale symétrique centrée sur l’axe d’ordonnée zéro, sans afficher la moindre trajectoire reconnaissable. Si ce nuage de points adopte une silhouette parabolique ou curviligne, le diagnostic est sans appel : la relation sous-jacente entre les variables est non linéaire, et le modèle souffre d’une erreur de spécification fonctionnelle. Si le nuage dessine une forme d’entonnoir (expansion ou contraction latérale de la dispersion le long de l’axe horizontal), l’existence d’une hétéroscédasticité est mise en évidence.
Le second graphique d’inspection indispensable est le diagramme quantile-quantile normal (Normal Q-Q Plot). Ce tracé confronte les quantiles empiriques de la distribution des résidus standardisés aux quantiles théoriques attendus sous une loi normale idéale. Si le postulat de normalité est rigoureusement vérifié, l’ensemble des points empiriques s’aligne fidèlement sur la diagonale d’identité à 45 degrés. Une courbure en forme de « S » indique des queues de distribution excessivement épaisses ou fines (anomalies d’aplatissement ou de kurtosis), tandis qu’une incurvation unilatérale vers le haut ou vers le bas trahit une asymétrie distributionnelle prononcée.
Enfin, le graphique d’échelle-localisation (Scale-Location Plot), qui met en relation la racine carrée des résidus standardisés absolus ($\sqrt{|r_i|}$) avec les valeurs ajustées $\hat{y}_i$, constitue le dispositif visuel le plus sensible pour isoler les gradients d’hétéroscédasticité. En éliminant le signe du résidu, toute variation tendancielle de la droite de lissage non paramétrique (comme une régression LOWESS) met en lumière une instabilité de la variance résiduelle conditionnelle.
9.2 Batterie de tests d’inférence pour la conformité des postulats
L’exploration visuelle doit être corroborée par une batterie de tests d’inférence formels destinés à quantifier le risque de rejet des postulats du modèle d’erreur. Pour éprouver l’hypothèse de normalité des résidus, les méthodologistes mobilisent préférentiellement le test de Shapiro-Wilk (sur des effectifs restreints ou modérés, $n < 50$) ou le test de Kolmogorov-Smirnov avec correction de Lilliefors, ainsi que le test de Jarque-Bera fondé sur les coefficients conjoints d'asymétrie et d'aplatissement. Une probabilité critique inférieure au seuil alpha conventionnel ($\alpha = 0,05$) contraint le chercheur à rejeter le postulat de normalité des erreurs.
L’homoscédasticité fait l’objet de vérifications spécifiques adaptées à la nature de la modélisation. Dans le cadre de la régression multiple, on déploie le test de Breusch-Pagan, qui régresse les carrés des résidus bruts sur l’ensemble des prédicteurs d’origine pour vérifier si une part systématique de la variance résiduelle dépend des variables indépendantes. Sa variante robuste, le test de Koenker, est employée lorsque l’hypothèse de normalité sous-jacente est elle-même fragile. Dans le champ de l’ANOVA, on privilégie le test de Levene (fondé sur l’écart à la médiane pour garantir une robustesse optimale) ou le test de Bartlett (plus puissant mais extrêmement vulnérable aux déviations de la normalité).
Pour déceler la présence pernicieuse d’une autocorrélation d’ordre un dans les séries temporelles ou séquentielles, la statistique de Durbin-Watson demeure la référence canonique. Sa valeur oscille structurellement entre 0 et 4. Une valeur proche de 2 témoigne d’une absence complète d’autocorrélation sérielle des résidus ; une valeur chutant significativement vers 0 révèle une autocorrélation positive majeure, tandis qu’une valeur se hissant vers 4 indique une autocorrélation sérielle négative. En complément, le test de Breusch-Godfrey permet d’explorer des dépendances résiduelles d’ordres temporels supérieurs ($p > 1$).
9.3 Identification des observations influentes et résidus atypiques
Un résidu individuel massif ne doit jamais être interprété isolément sans considérer son positionnement dans l’espace multidimensionnel des variables prédictives. La méthodologie moderne impose de distinguer formellement trois concepts interdépendants mais théoriquement distincts : la valeur aberrante (outlier), le point de levier (high leverage point) et l’observation influente (influential case).
Une observation constitue un outlier si son résidu studentisé externe $t_i$ est excessivement grand, signifiant que le modèle échoue dramatiquement à prédire sa valeur $Y$. Un point affiche un fort levier ($h_{ii}$) si ses valeurs sur les prédicteurs $X$ sont singulièrement éloignées du centroïde de l’échantillon, même si son résidu est minuscule. Enfin, une observation est qualifiée d’influente si son inclusion ou son retrait du jeu de données altère substantiellement les estimations numériques des coefficients de régression $\hat{\beta}$ ou modifie fondamentalement la variance résiduelle globale.
L’outil le plus célèbre pour synthétiser cette dynamique est la distance de Cook ($D_i$). Cette mesure agrège simultanément la grandeur du résidu studentisé interne et le poids du levier de l’observation :
$$D_i = \frac{r_i^2}{p + 1} \left( \frac{h_{ii}}{1 – h_{ii}} \right)$$
Une règle empirique usuelle suggère qu’une distance de Cook supérieure à 1,0 (ou excédant le seuil de $\frac{4}{n – p – 1}$) signale une observation hautement déstabilisatrice. En complément, les diagnostics fins mobilisent les statistiques DFBETAS (qui évaluent le glissement spécifique induit sur chaque paramètre pris individuellement) et le ratio COVRATIO, lequel évalue l’impact direct du retrait de l’observation sur la précision globale de la matrice de variance-covariance des résidus.
Face à un résidu atypique extrême déstabilisant le modèle, le chercheur ne doit jamais céder à la tentation méthodologique d’une suppression aveugle dictée par la seule quête d’un ajustement flatteur. Un arbre décisionnel rigoureux s’impose :
- Vérifier s’il s’agit d’une erreur matérielle d’encodage ou de saisie des données cliniques, auquel cas la correction immédiate s’impose.
- Déterminer si le sujet appartient bien à la population cible définie par les critères d’inclusion (par exemple, un participant ayant répondu sous l’emprise d’une substance psychotrope non déclarée).
- Si l’observation est authentique et valide, analyser si sa présence trahit l’omission d’une interaction majeure ou d’un terme non linéaire dans le modèle théorique.
- En dernière instance, si le cas s’avère être une idiosyncrasie clinique authentique mais isolée, rapporter systématiquement les modèles avec et sans l’observation influente afin de garantir la transparence scientifique la plus totale.
10. Méthodes pour réduire et maîtriser la variance résiduelle en recherche
10.1 Optimisation des protocoles et fidélité instrumentale
La première stratégie pour maîtriser la variance résiduelle ne relève pas de la manipulation statistique rétrospective, mais de la rigueur prophylactique déployée lors de la phase de conception empirique. L’incompressibilité théorique d’une partie de la variance résiduelle provient, comme nous l’avons établi, des erreurs de mesure stochastiques inhérentes aux outils d’évaluation. Il existe une relation mathématique inverse stricte entre la fidélité d’une échelle de mesure ($r_{xx}$) et la variance de son erreur :
$$\sigma_E^2 = \sigma_Y^2 (1 – r_{xx})$$
Par conséquent, substituer un questionnaire exploratoire peu consistant (par exemple affichant un alpha de Cronbach modeste de 0,65) par un instrument psychométrique étalonné, éprouvé et bénéficiant d’une excellente consistance interne et d’une fidélité test-retest irréprochable ($r_{xx} > 0,90$), comprime mécaniquement la variance d’erreur pure de plus de 70 %. L’agrégation multi-indicateurs — consistant à utiliser des échelles composites plutôt que des items uniques — constitue le moyen le plus sûr d’épurer les scores observés du bruit résiduel aléatoire.
Parallèlement, la standardisation impitoyable des conditions d’administration expérimentale endigue l’intrusion de variances parasites non contrôlées. Contrôler l’éclairage ambiant, le moment de la journée, le niveau d’insonorisation des cabines d’évaluation, formuler des consignes rigoureusement informatisées pour neutraliser les effets d’attente de l’expérimentateur (effet Pygmalion/Rosenthal), et utiliser des dispositifs d’enregistrement automatisés constituent les piliers de cette hygiène méthodologique. Chaque source de variation contextuelle éliminée à la source se traduit par une soustraction directe au sein du terme de variance résiduelle du modèle final.
10.2 Intégration de covariables pertinentes (Modèles ANCOVA)
Lorsqu’une source substantielle de variance interindividuelle ne peut être physiquement éliminée par le protocole expérimental, la stratégie de prédilection consiste à la neutraliser mathématiquement par l’Analyse de Covariance (ANCOVA). L’ANCOVA combine les principes de l’ANOVA et de la régression linéaire multiple en introduisant dans le modèle une ou plusieurs variables quantitatives continues concomitantes (covariables), corrélées avec la variable dépendante mais idéalement indépendantes des facteurs de traitement expérimentaux.
Le mécanisme sous-jacent repose sur l’épuration du terme d’erreur. Si une covariable $C$ explique une fraction substantielle de la variabilité du score de sortie $Y$, l’inclusion de $C$ permet de soustraire la variance qui lui est propre directement de la somme des carrés résiduelle intra-groupe $SS_{within}$. Le nouveau terme d’erreur ajusté, noté $SS’_{within}$, est expurgé de l’influence de cette covariable :
$$SS’_{within} = SS_{within} (1 – r_{YC}^2)$$
Où $r_{YC}$ désigne la corrélation intra-classe groupée reliant la covariable à la réponse. Bien que l’introduction de la covariable consomme un degré de liberté résiduel supplémentaire ($df’_{within} = N – J – 1$), la diminution de la somme des carrés de l’erreur est généralement si substantielle que le carré moyen résiduel $MS’_{error}$ subit une contraction massive. Le dénominateur du ratio $F$ de Snedecor s’en trouvant drastiquement réduit, la puissance statistique du test de comparaison des groupes expérimentaux connaît une élévation spectaculaire. L’ANCOVA permet ainsi d’extraire la signature véritable d’une intervention clinique qui serait autrement restée masquée sous le poids de la variance résiduelle interindividuelle préexistante.
10.3 Plans expérimentaux à mesures répétées et devis intra-sujets
L’approche architecturale la plus radicale pour terrasser la variance résiduelle liée aux divergences interindividuelles consiste à employer des devis expérimentaux intra-sujets (ou plans à mesures répétées). Dans un plan inter-sujets traditionnel, chaque participant n’est soumis qu’à une seule condition expérimentale ; la variance résiduelle intra-groupe agrège donc inévitablement toutes les différences stables séparant les participants (patrimoine génétique, intelligence fluide, histoire développementale, traits de personnalité).
Dans un plan à mesures répétées, chaque sujet devient son propre témoin en traversant consécutivement l’ensemble des modalités du traitement. Dès lors, le partitionnement de la somme des carrés franchit un niveau supérieur de décomposition analytique. La variabilité globale n’est plus simplement séparée en composantes inter-groupes et intra-groupes ; la variabilité interindividuelle stable fait l’objet d’une extraction explicite sous la forme de la « Somme des Carrés Sujets » ($SS_{sujets}$) :
$$SS_{tot} = SS_{traitements} + SS_{sujets} + SS_{residu}$$
La variance résiduelle pure ($MS_{residu}$), qui servira désormais d’étalon au dénominateur du test $F$, n’est plus polluée par les variations dispositionnelles stables entre les individus. Elle est réduite à l’interaction stochastique « Sujets $\times$ Traitements », c’est-à-dire à l’inconsistance temporelle intra-individuelle de la réponse et aux micro-fluctuations d’erreur de mesure. Cette contraction titanesque du terme d’erreur résiduelle confère aux plans intra-sujets une sensibilité expérimentale sans équivalent, permettant d’identifier des effets d’une subtilité extrême sur des cohortes d’une taille modérée.
Ce bénéfice statistique incontestable s’accompagne toutefois d’un arbitrage méthodologique complexe. Les plans à mesures répétées exposent l’expérimentateur à des menaces sévères de validité interne : effets d’ordre, effets de report (carryover effects), fatigue cognitive ou apprentissage procédural des épreuves. La mise en œuvre rigoureuse de techniques de contrebalancement parfait ou de plans en carré latin s’avère impérative pour éviter que ces artefacts ne viennent réintroduire une variance résiduelle systématique masquée au sein de l’expérience.
11. La variance résiduelle dans les modélisations statistiques avancées
11.1 Modèles linéaires mixtes et approches multiniveaux
L’avènement des Modèles Linéaires Mixtes (LMM) et de la modélisation hiérarchique multiniveau (HLM) a révolutionné le traitement contemporain de la variance résiduelle en s’affranchissant du carcan de l’erreur résiduelle unique et monolithique. Dans de nombreuses disciplines appliquées, les données présentent une structure intrinsèquement imbriquée : des patients imbriqués au sein de thérapeutes ou de centres hospitaliers, des élèves au sein d’écoles, ou des évaluations longitudinales répétées au fil des semaines au sein de chaque patient.
Dans ces configurations imbriquées, le postulat d’indépendance des résidus régissant les moindres carrés est irrémédiablement violé. La modélisation multiniveau résout cette impasse en scindant la variance résiduelle en composantes hiérarchiques distinctes opérant à des niveaux d’analyse spécifiques. Pour un modèle à deux niveaux élémentaire, la réponse d’un individu $i$ appartenant au groupe $j$ se formalise ainsi :
$$Y_{ij} = \beta_{0j} + \beta_1 X_{ij} + e_{ij}$$
Où l’ordonnée à l’origine du groupe $\beta_{0j}$ est elle-même modélisée comme une fonction d’une moyenne générale $\gamma_{00}$ et d’une déviation aléatoire propre au groupe $u_{0j}$ :
$$\beta_{0j} = \gamma_{00} + u_{0j}$$
Ce qui donne, par substitution :
$$Y_{ij} = \gamma_{00} + \beta_1 X_{ij} + (u_{0j} + e_{ij})$$
Dans cette équation structurelle, la variance résiduelle globale se subdivise formellement en deux composantes de variance aléatoire :
- La variance résiduelle de Niveau 2 ($\tau_{00} = Var(u_{0j})$), qui quantifie l’hétérogénéité résiduelle inexpliquée existant entre les différents centres cliniques ou thérapeutes.
- La variance résiduelle de Niveau 1 ($\sigma^2 = Var(e_{ij})$), qui capture la dispersion des individus au sein d’un même centre après avoir contrôlé les prédicteurs individuels.
Cette distinction permet de calculer avec exactitude le Coefficient de Corrélation Intra-classe (ICC) :
$$\rho = \frac{\tau_{00}}{\tau_{00} + \sigma^2}$$
Ce ratio évalue la part de variance résiduelle totale directement imputable à l’agrégation contextuelle. Grâce à cette décomposition multiniveau, les erreurs types des estimations ne subissent plus les biais dévastateurs de la dépendance en grappes, et le chercheur peut explorer explicitement des prédicteurs capables d’éteindre sélectivement la variance de niveau 1 ou celle de niveau 2.
11.2 Modélisation par équations structurelles (SEM)
La Modélisation par Équations Structurelles (SEM, pour Structural Equation Modeling) représente l’aboutissement méthodologique de la fusion entre l’analyse factorielle confirmatoire et la régression multivariée sur variables latentes. Au sein de ce cadre analytique d’une puissance formelle exceptionnelle, la variance résiduelle est dédoublée de manière rigoureuse entre le modèle de mesure et le modèle structurel.
Dans le modèle de mesure, chaque variable observée $X_k$ ou $Y_k$ sert d’indicateur empirique imparfait d’un construit latent hypothétique sous-jacent $xi$ ou $eta$. L’équation de mesure classique s’écrit :
$$Y_k = \lambda_k \eta + \epsilon_k$$
Où $\lambda_k$ représente la charge factorielle (saturation) reliant le concept théorique à sa manifestation empirique, et $\epsilon_k$ désigne la variance résiduelle de l’indicateur, désignée en psychométrie sous le nom de variance d’unicité (uniqueness). Cette variance d’unicité agrège à la fois l’erreur de mesure aléatoire pure de l’item et sa variance spécifique (la composante systématique propre à cet item particulier qui ne participe pas au construit latent partagé). En fixant ces résidus de mesure, la SEM purifie les variables latentes de tout bruit métrologique.
Une fois le bruit instrumental ainsi isolé, le modèle structurel relie les variables latentes épurées entre elles au moyen d’équations de trajectoire (path analysis) :
$$\eta = \beta \xi + \zeta$$
Ici, le terme résiduel $zeta$ (zêta) ne représente plus une imprécision d’évaluation instrumentale ; il incarne la perturbation structurelle pure, c’est-à-dire la part de variabilité de la variable latente dépendante qui n’est pas prédite par les variables latentes indépendantes du système théorique. De surcroît, la SEM autorise le chercheur à tester l’indépendance locale de ses indicateurs en modélisant, si la théorie l’impose, des covariances entre erreurs résiduelles ($Cov(\epsilon_j, \epsilon_k)$), matérialisant des similarités de formulation lexicale ou des méthodologies de recueil partagées entre des items spécifiques.
11.3 Régression robuste et traitement de l’hétéroscédasticité persistante
Lorsque les vérifications diagnostiques révèlent une hétéroscédasticité substantielle ou la présence d’observations aberrantes impossibles à régulariser par les transformations conventionnelles de variables (telles que les fonctions logarithmiques ou les transformations de Box-Cox), l’analyste doit abandonner les moindres carrés ordinaires au profit d’approches statistiques robustes spécialement forgées pour modéliser adéquatement la variance d’erreur.
La première solution consiste à employer les estimateurs de variance-covariance consistants face à l’hétéroscédasticité (estimateurs HC, ou matrice de correction de White-Huber). Sans altérer les coefficients de régression $\hat{\beta}$ originels, cette formulation « sandwich » corrige la matrice de covariance en introduisant les carrés des résidus individuels directement dans le produit vectoriel :
$$\Sigma_{\hat{\beta}} = (X^TX)^{-1} \left( \sum_{i=1}^n e_i^2 x_i x_i^T \right) (X^TX)^{-1}$$
Des déclinaisons perfectionnées, telles que les corrections HC3 ou HC4, intègrent des facteurs de pénalisation plus agressifs sur les leviers $h_{ii}$, restaurant des erreurs types fiables et des intervalles de confiance non faussés, même face à des structures hétéroscédastiques sévères sur des échantillons de taille restreinte.
La seconde alternative repose sur la régression quantile développée par Roger Koenker. Contrairement au modèle linéaire classique qui estime l’espérance conditionnelle moyenne $E(Y mid X)$ en minimisant la somme des carrés résiduels, la régression quantile modélise la médiane conditionnelle ou n’importe quel autre quantile spécifique ($tau in ]0, 1[$) de la distribution de réponse en minimisant une somme d’écarts absolus asymétriquement pondérés. Si la variance résiduelle se dilate à mesure que les scores croissent, la régression quantile révélera que la pente associée au 90e percentile est radicalement différente de celle du 10e percentile. Cette méthodologie transforme l’hétéroscédasticité, autrefois perçue comme une pathologie analytique rédhibitoire, en une source d’information clinique substantielle décrivant l’hétérogénéité des sous-populations.
Enfin, les méthodes computationnelles non paramétriques fondées sur le rééchantillonnage de type bootstrap offrent un recours pour estimer la distribution empirique de la variance résiduelle sans imposer le moindre a priori formel quant à sa normalité théorique. Par des tirages aléatoires successifs avec remise au sein des observations originales ou des résidus, le bootstrap reconstruit la variabilité d’échantillonnage de façon empirique, fournissant des inférences statistiques intègres même dans des configurations de variance d’erreur particulièrement réfractaires aux approches paramétriques.
12. Synthèse méthodologique et recommandations de rédaction selon les normes APA
12.1 Ce que la variance résiduelle révèle sur les limites scientifiques
Au terme de cette exploration statistique, il convient d’adopter une posture de lucidité épistémologique quant à la signification profonde de la variance inexpliquée. Toute modélisation quantitative, aussi sophistiquée soit son architecture mathématique, procède par réduction schématique de la phénoménologie réelle. La variance résiduelle constitue le rappel tangible de la finitude de nos appareils théoriques face à la complexité de l’appareil psychique et des conduites humaines. Loin de représenter un défaut méthodologique indésirable, elle matérialise l’espace de liberté stochastique, la singularité individuelle et l’inépuisable contingence des systèmes écologiques ouverts.
Un écueil classique guette le chercheur novice : celui de la sur-interprétation ou du sur-ajustement complaisant. Une recherche affichant un modèle dont la variance résiduelle serait anormalement minuscule (par exemple un $R^2 > 0,98$ sur un phénomène complexe comme la dépression ou l’anxiété sociale) ne constitue que très exceptionnellement une percée scientifique majeure ; elle signale presque systématiquement un artefact méthodologique pernicieux :
- Une quasi-tautologie sémantique entre les items du prédicteur et ceux de la variable dépendante (recouvrement conceptuel évident).
- Une contamination des données par fuite d’information entre l’échantillon d’entraînement et de validation.
- Un phénomène sévère de sur-apprentissage (overfitting) où le modèle mémorise le bruit d’échantillonnage, le rendant incapable d’assurer la moindre réplication sur une cohorte indépendante.
L’attitude scientifique rigoureuse consiste à envisager la variance résiduelle comme un vecteur programmatique d’investigations ultérieures. Chaque unité de variance inexpliquée identifiée aujourd’hui constitue une invitation pour les chercheurs de demain à postuler de nouvelles variables médiatrices, à explorer des modérateurs contextuels négligés, ou à concevoir des métrologies psychométriques plus raffinées.
12.2 Normes de rapport statistique et transparence académique
La communication des résultats statistiques au sein des revues scientifiques internationales exige une conformité rigoureuse aux standards de transparence méthodologique, au premier rang desquels figurent les directives du manuel de publication de l’American Psychological Association (actuellement dans sa 7e édition). Trop souvent, les publications se limitent à mentionner un coefficient de corrélation ou une valeur de $p$, dissimulant l’ampleur exacte de l’erreur résiduelle sous-jacente.
Selon les normes académiques strictes, tout modèle de régression linéaire doit obligatoirement s’accompagner du rapport explicite :
- Du coefficient de détermination brut ($R^2$) et de sa déclinaison ajustée ($R^2_{adj}$).
- Du test de significativité global avec ses degrés de liberté précis : $F(df_{reg}, df_{res}) = dots$, $p = dots$.
- De l’erreur standard de l’estimation ($s_e$), qui est la racine carrée directe de la variance résiduelle ($MS_{res}$), permettant au lecteur de contextualiser la marge d’erreur dans l’unité de mesure native de la variable de réponse.
- Des coefficients de régression non standardisés ($B$) avec leurs erreurs types associées ($SE$), lesquelles dérivent directement du carré moyen de l’erreur.
De même, pour l’Analyse de Variance, l’ensemble des composantes du tableau source doit être décliné : les sommes des carrés ($SS$), les degrés de liberté respectifs, et de façon incontournable, le Carré Moyen de l’Erreur ($MS_{error}$ ou $MS_{within}$), accompagné systématiquement d’une mesure de taille d’effet standardisée comme l’éta-carré partiel ($\eta_p^2$) ou l’oméga-carré ($\omega^2$), ce dernier offrant une estimation moins biaisée de l’effet dans la population en soustrayant l’impact de la variance d’erreur.
Enfin, dans le sillage du mouvement contemporain pour la science ouverte (Open Science), la transparence exige la mention formelle de la vérification des hypothèses distributionnelles régissant les résidus. Il incombe aux auteurs de spécifier les tests et diagnostics déployés (normalité, homoscédasticité, détection des points influents) et de déposer sur des plateformes ouvertes (telles que le Centre pour la Science Ouverte, OSF) les scripts de traitement computationnel (code R, Python ou syntaxe SPSS) et les matrices de données brutes. Ce niveau d’exigence permet à la communauté internationale de vérifier la conformité des dynamiques résiduelles rapportées.
12.3 Guide récapitulatif pour l’évaluation critique d’une publication
Pour outiller le clinicien, l’enseignant ou le chercheur dans l’évaluation critique de la littérature scientifique, nous proposons une grille de lecture synthétique et séquentielle sous forme de check-list méthodologique, destinée à jauger la crédibilité et la solidité de la modélisation de la variance résiduelle au sein d’un article scientifique :
- Examen de la plausibilité de l’ajustement global : L’ampleur de la variance résiduelle rapportée est-elle théoriquement cohérente avec la complexité du phénomène étudié ? Un modèle affichant des résidus quasi inexistants dans l’étude d’un processus comportemental complexe doit immédiatement éveiller le soupçon d’un sur-ajustement ou d’un biais méthodologique dissimulé.
- Rapport formel de l’étalon de l’erreur : L’auteur fournit-il l’erreur standard d’estimation ou le carré moyen résiduel ? Une publication qui omet délibérément de rapporter ces indices d’erreur pour ne se concentrer que sur des probabilités critiques ($p$-values) prive le lecteur de la métrique essentielle permettant d’évaluer la précision clinique réelle des estimations.
- Contrôle et diagnostic explicite des hypothèses sur les résidus : Le manuscrit atteste-t-il formellement de la vérification de la normalité, de l’absence d’hétéroscédasticité et de l’indépendance mutuelle des erreurs ? Des diagnostics visuels (diagrammes Q-Q, résidus versus prédictions) ou des tests formels sont-ils cités ? L’absence totale de ces diagnostics constitue une carence méthodologique majeure.
- Traitement des données aberrantes et influentes : Les auteurs ont-ils documenté la présence éventuelle d’observations exerçant un effet de levier excessif ou affichant des distances de Cook critiques ? La prise en charge de ces cas atypiques est-elle justifiée sur le plan théorique et clinique, ou procède-t-elle d’une élimination arbitraire non transparente ?
- Préservation des degrés de liberté : Le ratio entre le nombre total de sujets analysés ($n$) et le nombre de prédicteurs ou de conditions ($p$) est-il suffisant pour garantir une estimation stable de la variance résiduelle ? Un nombre de degrés de liberté résiduels étriqué fragilise toute la portée inférentielle de l’étude.
- Adéquation de l’architecture formelle : Si les données présentent une structure hiérarchique, longitudinale ou nichée, le modèle a-t-il procédé à une partition multiniveau de la variance résiduelle, ou s’est-il contenté d’un modèle OLS standard dont les tests statistiques sont notoirement invalidés par l’autocorrélation résiduelle ?
En mobilisant cette grille d’analyse rigoureuse, le lecteur averti est en mesure de porter un jugement critique impartial sur les publications scientifiques contemporaines, en reconnaissant que la valeur d’une démonstration empirique ne se mesure pas seulement à la séduction conceptuelle de ses variables explicatives, mais tout autant à l’honnêteté, à la précision et à la rigueur méthodologique avec lesquelles elle a su apprivoiser et quantifier sa variance résiduelle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://doi.org/10.1037/t00742-000
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409–428. https://doi.org/10.2307/2332388
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Gelman, A., & Hill, J. (2007). Data analysis using regression and multilevel/hierarchical models. Cambridge University Press. https://doi.org/10.1017/CBO9780511790942
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934