
L’évaluation psychologique et psychométrique contemporaine repose sur une exigence fondamentale : la capacité des instruments de mesure à fournir des informations fiables, stables et théoriquement fondées sur les conduites humaines. Parmi l’ensemble des critères métrologiques mobilisés pour attester de la pertinence d’un test, la notion de validité occupe incontestablement une place prépondérante. Si mesurer un attribut latent constitue un défi épistémologique majeur, la faculté d’un score à anticiper avec précision des comportements, des performances ou des événements futurs représente le véritable étalon d’or de l’évaluation appliquée. C’est précisément dans cet interstice entre la mesure instantanée et la projection temporelle que s’ancre la validité prédictive.
Historiquement développée pour répondre à des impératifs sociétaux pressants, qu’il s’agisse de la sélection militaire, du recrutement professionnel ou de l’orientation académique, la validité prédictive interroge la valeur pragmatique des scores. Elle ne s’arrête pas à la conformité interne d’un questionnaire ou à son ancrage théorique abstrait ; elle éprouve empiriquement sa portée opérationnelle dans le monde réel. Lorsqu’un recruteur utilise une épreuve d’aptitude cognitive, lorsqu’une université sélectionne ses futurs étudiants sur la base d’un examen standardisé, ou lorsqu’un clinicien évalue le risque de récidive d’un patient médicolégal, une même question structure leur démarche : dans quelle mesure le résultat présent permet-il d’estimer avec exactitude la trajectoire future d’un individu ?
Cet article propose une exploration approfondie et rigoureuse de la validité prédictive à travers ses dimensions conceptuelles, mathématiques, méthodologiques et éthiques. En articulant les fondements théoriques classiques issus de la psychométrie avec les avancées contemporaines en modélisation statistique, nous examinerons comment s’élabore, se quantifie et s’interprète cet indicateur d’efficacité. À travers des exemples emblématiques puisés dans l’éducation, les organisations et la clinique, nous mettrons en lumière les apports décisifs de la démarche prédictive tout en analysant minutieusement les biais méthodologiques susceptibles d’en altérer la portée.
1. Introduction fondamentale à la validité prédictive
1.1 Émergence et pertinence en psychométrie
L’histoire de la psychométrie moderne est intimement liée à la nécessité sociétale d’anticiper les conduites humaines. Dès la fin du dix-neuvième siècle, sous l’impulsion de pionniers tels que Francis Galton et Alfred Binet, l’ambition d’objectiver les facultés individuelles s’est rapidement heurtée à une exigence d’utilité concrète. La conception par Binet et Théodore Simon de la première échelle métrique de l’intelligence ne visait pas une pure spéculation philosophique, mais répondait à une commande publique précise : identifier les élèves en difficulté nécessitant un enseignement adapté. Dès lors, le score obtenu à un test n’était plus une fin en soi, mais un levier opérationnel orienté vers le devenir de l’individu.
Le développement massif des épreuves d’aptitude lors de la Première Guerre mondiale avec les tests Army Alpha et Beta a accéléré l’institutionnalisation de la prédiction comme critère de validation empirique. Dans les contextes éducatifs, professionnels et cliniques, la légitimité des instruments de mesure dépend de leur pouvoir de projection. La démarche scientifique exige de transcender la simple observation du présent : un test d’aptitude n’est jugé scientifiquement solide que s’il démontre un lien statistique vérifiable avec une performance ultérieure, qu’il s’agisse du succès dans un cursus d’études ou de l’efficacité sur un poste de travail.
Cette perspective impose une distinction épistémologique stricte entre la description d’un état psychologique présent et la prévision d’un critère ultérieur. Un instrument purement descriptif vise à cartographier les compétences, l’humeur ou les dispositions d’un individu à un instant précis (t), sans présumer des variations futures. En revanche, un test à vocation prédictive postule que les structures mesurées à l’instant t constituent des précurseurs stables et explicatifs d’un comportement mesurable à un instant ultérieur (t + k). Cette dialectique entre le constat synchronique et la conjecture diachronique fonde l’ensemble de la démarche prédictive.
1.2 Définition conceptuelle de la validité prédictive
D’un point de vue conceptuel, la validité prédictive désigne le degré d’efficacité avec lequel un score obtenu à un instrument d’évaluation permet d’estimer avec précision un résultat, un comportement ou un événement survenant dans le futur. Elle constitue une déclinaison majeure de la validité liée au critère. Au cœur de cette définition réside la notion d’inférence valide : le praticien ne s’intéresse pas uniquement au score brut en tant qu’entité abstraite, mais à la signification prévisionnelle de ce score au regard d’un comportement observable dans l’environnement réel de l’individu.
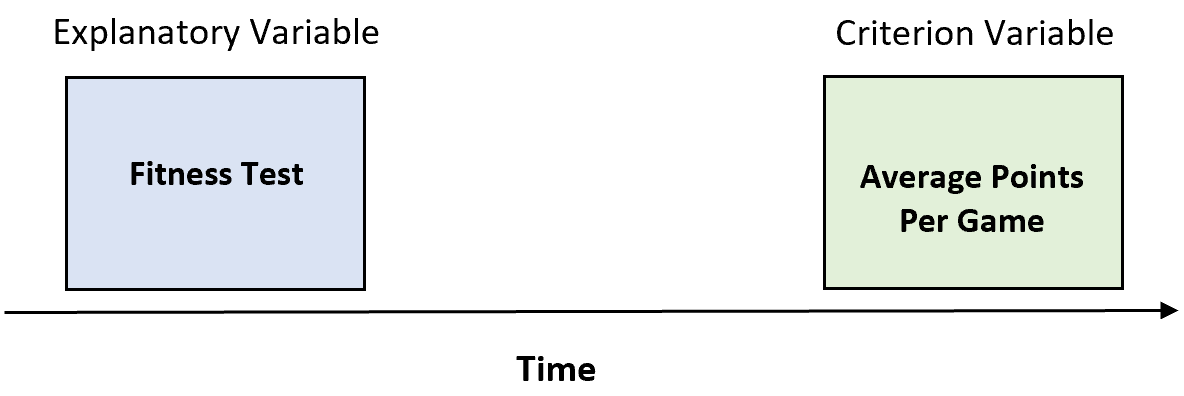
La caractéristique fondamentale de la validité prédictive est l’existence d’une relation temporelle asymétrique et différée. L’administration du prédicteur (le test initial, qu’il s’agisse d’un test cognitif, d’un inventaire de personnalité ou d’une épreuve de mise en situation) s’effectue au temps initial t₀. L’évaluation de la variable critère (la note scolaire, le rendement au travail, l’absence de récidive, la stabilité émotionnelle post-traitement) intervient après un intervalle de temps déterminé t₁. Ce délai temporel peut varier de quelques semaines à plusieurs années, selon la nature du phénomène étudié et la portée des décisions à prendre.
Les Standards for Educational and Psychological Testing, élaborés conjointement par l’AERA, l’APA et le NCME, rappellent que la validité n’est pas une propriété intrinsèque d’un test, mais plutôt la force des preuves empiriques et des arguments théoriques soutenant l’adéquation des inférences tirées des scores. Dans le cadre prédictif, l’argumentation repose sur la démonstration d’un lien systématique, quantifiable et réplicable entre le prédicteur et le critère externe.
1.3 Importance de la validité prédictive dans la prise de décision
L’enjeu pragmatique de la validité prédictive se cristallise dans la prise de décision humaine. Dans tout processus de sélection ou d’orientation, les décideurs opèrent sous un régime d’incertitude. L’absence d’outils métrologiquement éprouvés contraint les organisations et les praticiens à s’en remettre à des intuitions, des impressions subjectives ou des critères arbitraires, générant un nombre considérable d’erreurs d’appréciation. La validité prédictive fournit une base probabiliste rationnelle, réduisant de manière substantielle les décisions erronées telles que les faux positifs (individus sélectionnés mais échouant par la suite) et les faux négatifs (individus rejetés qui auraient pourtant réussi).
Au-delà de la sélection, cet indicateur est central pour l’optimisation des ressources pédagogiques et thérapeutiques. Dans les dispositifs éducatifs, la capacité à anticiper avec justesse les risques de décrochage scolaire ou de difficultés d’apprentissage permet de déployer des plans de remédiation préventifs avant que les lacunes ne deviennent structurelles. De même, en santé mentale, prévoir la probabilité d’observance d’un traitement ou le risque de rechute guide l’intensité et la nature du suivi clinique, garantissant une affectation plus efficiente des moyens matériels et humains.
Sur le plan déontologique et juridique, la validité prédictive constitue le rempart indispensable contre l’arbitraire et la discrimination. L’utilisation d’épreuves standardisées pour l’accès à l’emploi ou aux grandes filières académiques impose de prouver que l’instrument mesure bel et bien des compétences prédictives de la réussite future sur le poste ou dans la formation visée. L’absence de preuves formelles de validité prédictive expose les institutions à des contestations judiciaires pour discrimination indirecte, tout en sapant la confiance du public envers les sciences psychologiques et managériales.
2. Cadre théorique et articulation avec la validité de critère
2.1 La taxonomie tripartite de la validité
L’appréhension moderne de la validité s’enracine dans la classification tripartite établie au milieu du vingtième siècle par les commissions techniques de l’APA. Ce modèle canonique distinguait classiquement trois formes fondamentales de validité : la validité de contenu, la validité de construit et la validité liée au critère. La validité de contenu s’assure que les items du test représentent fidèlement l’ensemble du domaine conceptuel à explorer. La validité de construit examine si le test mesure effectivement le concept théorique hypothétique qu’il prétend évaluer.
La validité liée au critère, quant à elle, s’émancipe de l’analyse interne pour confronter le score à une mesure de performance externe. Contrairement à la validité de construit qui requiert une élucidation des processus mentaux sous-jacents, l’approche par critère adopte une posture éminemment pragmatique : elle s’intéresse à l’efficacité empirique avec laquelle l’outil prédit ou reflète un indicateur de la vie réelle. Cette performance externe sert de pierre de touche à l’utilité du test dans un environnement donné.
L’évolution épistémologique portée par Samuel Messick a ultérieurement promu une vision unifiée de la validité, stipulant que toute forme de validation converge vers la validité de construit. Toutefois, même au sein de ce cadre holistique, la validation par critère conserve une spécificité opérationnelle irremplaçable. Elle constitue l’ancrage écologique du test, la preuve irréfutable que la métrologie psychologique produit des conséquences observables et pertinentes au-delà des murs du laboratoire ou de la salle d’examen.
2.2 Distinction cruciale entre validité prédictive et validité concomitante
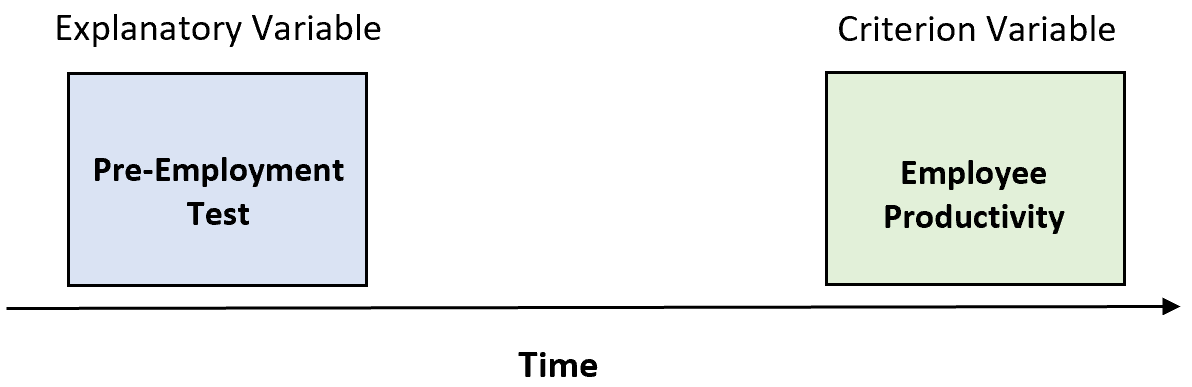
La validité liée au critère se décline en deux sous-catégories majeures qu’il convient de distinguer rigoureusement : la validité prédictive et la validité concomitante (souvent qualifiée de concurrente). L’élément discriminant cardinal entre ces deux approches réside dans la gestion de la variable temporelle. Dans un devis de validité concomitante, le prédicteur et le critère sont recueillis de manière quasi simultanée. On administre par exemple un nouveau test de diagnostic de la dépression à des patients hospitalisés tout en évaluant simultanément leur état à l’aide d’un entretien clinique standardisé.
La validité concomitante offre indéniablement des avantages méthodologiques et logistiques, notamment la réduction des coûts, l’absence de mortalité expérimentale et l’immédiateté des résultats. Cependant, elle ne saurait être assimilée sans précaution à une validité prédictive. Dans une étude prédictive, le délai temporel différé expose le sujet aux aléas de la vie quotidienne, aux apprentissages ultérieurs et aux événements transitionnels. Prédire le rendement au travail de candidats à l’embauche (validité prédictive) est une tâche autrement plus complexe que de corréler le score d’employés déjà en poste avec leur évaluation annuelle actuelle (validité concomitante).
De surcroît, les devis concomitants sont sujets à des biais d’échantillonnage majeurs, tels que l’effet du travailleur sain ou la sélection naturelle des effectifs en poste, qui tronquent la variabilité des données. Le risque de contamination du critère est également accru lorsque l’évaluation du critère coïncide temporellement avec la passation du test. Dès lors, substituer hâtivement un coefficient concomitant à un coefficient prédictif constitue une imprudence méthodologique susceptible d’induire en erreur les praticiens quant à la réelle capacité prévisionnelle de leur outil.
2.3 Le concept de variable critère en psychologie
La validité d’une démarche prédictive ne dépend pas uniquement de l’élégance psychométrique du test prédicteur ; elle est tributaire de la rigueur avec laquelle la variable critère est conceptualisée et mesurée. En psychologie et en sciences de l’éducation, un bon critère doit impérativement posséder trois propriétés fondamentales : la pertinence théorique (le critère doit refléter les aspects cardinaux du succès ou de l’inadaptation que l’on cherche à cerner), la fidélité de mesure (la mesure du critère doit être exempte de fluctuations aléatoires) et l’absence de biais systématiques.
La recherche se heurte fréquemment au défi du critère ultime versus le critère intermédiaire ou opérationnel. Le critère ultime représente l’idéal théorique abstrait, c’est-à-dire l’ensemble complet des comportements déterminant l’accomplissement réussi d’une fonction (par exemple, être un « excellent enseignant » ou un « citoyen équilibré »). Ce critère ultime étant par essence complexe et souvent inaccessible dans sa globalité, le chercheur doit recourir à des critères opérationnels intermédiaires, tels que l’évaluation des compétences pédagogiques par des inspecteurs ou le taux de rétention des élèves.
Ce décalage engendre deux pathologies métrologiques majeures : la déficience du critère et la contamination du critère. La déficience se produit lorsque la mesure opérationnelle omet des pans entiers du domaine de performance pertinent (par exemple, évaluer l’efficacité d’un cadre uniquement à travers le chiffre d’affaires généré, en ignorant le climat social de son équipe). Inversement, la contamination intervient lorsque le critère intègre des facteurs étrangers à la performance réelle de l’individu, tels que des biais d’évaluation managériale, des effets de favoritisme ou des contraintes matérielles contextuelles indépendantes de sa volonté.
3. Fondements statistiques et modélisation de la validité prédictive
3.1 Le coefficient de corrélation comme indice d’association
L’estimation empirique de la validité prédictive repose au premier chef sur l’analyse de la liaison statistique entre la variable prédictive (notée X) et la variable critère (notée Y). Lorsque les deux variables sont continues et quantitativement ordonnées, l’indice d’association privilégié est le coefficient de corrélation linéaire de Pearson (r_{xy}). Ce paramètre standardisé mesure l’intensité et le sens de la relation linéaire reliant les scores initiaux aux performances futures, variant sur un intervalle théorique de -1,00 à +1,00.
Dans l’univers des sciences humaines et de la psychologie appliquée, la magnitude des coefficients de validité prédictive diffère notablement des standards rencontrés en physique ou en ingénierie. Un coefficient de validité prédictive oscillant entre 0,30 et 0,40 est fréquemment considéré comme modéré à substantiel, tandis qu’une valeur dépassant 0,50 témoigne d’un pouvoir prédictif exceptionnellement élevé. Cette échelle d’interprétation découle de la multidétermination des conduites humaines : aucun test isolé ne saurait rendre compte de la totalité des facteurs intervenant dans la réussite académique ou professionnelle d’un individu.
Le calcul valide du coefficient de Pearson présuppose le respect strict de plusieurs postulats mathématiques : la normalité de la distribution univariée et bivariée des scores, l’existence d’une relation strictement linéaire entre X et Y, et l’homoscédasticité, c’est-à-dire la constance de la variance des résidus pour chaque niveau du prédicteur. La violation de ces hypothèses, notamment l’existence d’une non-linéarité (relation curvilinéaire) ou d’une hétéroscédasticité prononcée, conduit inexorablement à une sous-estimation ou à une déformation du coefficient d’association réel.
3.2 Modèles de régression linéaire et équations prédictives
Au-delà de la quantification d’une corrélation descriptive, la validité prédictive prend toute sa dimension opérationnelle à travers les modèles de régression linéaire simple ou multiple. L’équation de régression linéaire univariée classique s’énonce sous la forme :
Ŷ = bX + a
où Ŷ représente la valeur estimée ou prédite du critère futur, b symbolise la pente de régression (coefficient non standardisé reflétant le taux de variation attendu sur le critère pour chaque unité supplémentaire sur le prédicteur), et a constitue la constante d’ordonnée à l’origine. Ce formalisme permet de transformer directement un score obtenu au test en une espérance concrète de performance sur le critère.
L’adéquation globale du modèle est sanctionnée par le coefficient de détermination (R²). Dans une régression univariée, ce paramètre correspond simplement au carré du coefficient de corrélation de Pearson (r_{xy}²). Le R² quantifie la proportion exacte de la variance de la variable critère qui est directement expliquée ou partagée par le prédicteur. Une corrélation de validité de 0,40 implique que 16 % de la variance des performances futures est rendue prévisible par l’instrument initial, les 84 % résiduels relevant de facteurs non mesurés, d’erreurs d’échantillonnage ou d’aléas conjoncturels.
Pour appréhender l’incertitude inhérente à toute prévision individuelle, les statisticiens calculent l’erreur standard d’estimation (SE_est). Cet indice s’exprime mathématiquement par la formule :
SE_est = s_y × √(1 – r_{xy}²)
où s_y représente l’écart-type du critère. L’erreur standard d’estimation permet d’établir des intervalles de confiance autour de chaque prédiction individuelle Ŷ, rappelant avec rigueur que la prévision psychologique ne relève jamais de la certitude absolue mais d’une distribution probabiliste de résultats plausibles.
3.3 Analyse de sensibilité, spécificité et courbes ROC pour critères dichotomiques
Dans de nombreuses situations pratiques, notamment en psychopathologie, en criminologie clinique ou lors de sélections binaires strictes, le critère d’intérêt n’est pas continu mais dichotomique : échec versus réussite, récidive versus non-récidive, développement d’un trouble psychiatrique versus maintien de l’homéostasie. Dans ce contexte, la régression logistique binaire et les outils d’épidémiologie clinique se substituent à la régression linéaire pour modéliser la validité prédictive.
L’instrument prédictif est alors évalué au regard de sa capacité de classification catégorielle, résumée par une matrice de confusion qui croise les décisions du test avec la réalité future du critère. Quatre dénouements sont possibles :
- Vrais positifs (VP) : Les individus identifiés comme à risque ou admissibles qui réalisent effectivement l’événement sur le critère.
- Faux positifs (FP) : Les individus signalés positivement par le prédicteur mais pour lesquels le comportement critique ne se produit pas ultérieurement.
- Vrais négatifs (VN) : Les individus classés négativement par l’outil et qui n’expérimentent effectivement aucun événement défavorable.
- Faux négatifs (FN) : Les individus déclarés hors de danger ou inaptes qui manifestent pourtant le comportement critère attendu.
La sensibilité traduit la probabilité pour un test de détecter correctement un cas avéré (taux de vrais positifs : VP / [VP + FN]), tandis que la spécificité mesure son aptitude à exclure les sujets sains ou non concernés (taux de vrais négatifs : VN / [VN + FP]). Pour s’affranchir du caractère arbitraire du seuil de coupure choisi, les chercheurs tracent la courbe ROC (Receiver Operating Characteristic), qui visualise le taux de sensibilité en fonction de 1 – spécificité pour l’ensemble des seuils possibles. L’aire sous la courbe (AUC, pour Area Under the Curve) constitue alors l’indice synthétique d’exactitude prédictive : une AUC de 0,50 équivaut au hasard absolu, tandis qu’une AUC s’élevant à 1,00 consacre un pouvoir discriminant infaillible.
4. Protocole méthodologique pour établir la validité prédictive
4.1 Étape 1 : Administration standardisée du prédicteur
L’établissement d’une preuve de validité prédictive débute impérativement par une collecte initiale de données méticuleusement contrôlée. La première exigence réside dans l’échantillonnage : la cohorte d’individus soumise au test prédicteur doit présenter une représentativité parfaite de la population cible à laquelle le test sera destiné ultérieurement. Tout biais de sélection initial (surreprésentation d’un genre, homogénéité anormale des niveaux d’instruction) compromet gravement l’extrapolabilité des résultats métrologiques futurs.
La passation de l’instrument requiert une standardisation absolue des conditions expérimentales. Consignes de passation, temps alloué, ambiance physique de la salle d’examen, clarté des interfaces informatiques : chaque variable d’environnement doit être strictement calibrée pour éradiquer les sources d’erreur de mesure aléatoire ou systématique. Si les conditions d’administration fluctuent d’un individu à un autre, la variance des scores reflétera des bruits parasites plutôt que l’attribut latent mesuré, dégradant mécaniquement la corrélation prédictive avec le critère ultérieur.
Enfin, la qualité psychométrique intrinsèque de l’outil doit faire l’objet d’une documentation exhaustive préalable. Un test ne peut prédire avec efficience un critère externe s’il ne bénéficie pas lui-même d’une consistance interne élevée (mesurée par exemple par l’alpha de Cronbach ou le coefficient oméga de McDonald) et d’une fidélité test-retest irréprochable. L’erreur de mesure grevant le prédicteur agit comme un plafond limitant la relation observable entre les variables.
4.2 Étape 2 : Gestion de l’intervalle temporel et suivi longitudinal
La deuxième étape méthodologique implique la conduite d’un devis longitudinal rigoureux. La détermination de la durée de l’intervalle séparant l’administration du prédicteur et le recueil du critère constitue un arbitrage théorique décisif. Un intervalle trop restreint risque de transformer artificiellement l’étude en un devis de validité quasi-concomitante, masquant l’impact des variations temporelles réelles. Inversement, un délai démesuré expose l’étude à l’intervention d’une multitude de variables modératrices exogènes (changements économiques, trajectoires de vie imprévisibles, formations complémentaires) qui diluent la trace prédictive originelle.
Durant cette période d’incubation temporelle, le chercheur doit exercer une vigilance méthodologique continue face au phénomène de mortalité expérimentale ou d’attrition des participants. Les pertes de vue au cours du suivi ne sont que rarement réparties de manière aléatoire : les sujets en grande difficulté académique, professionnelle ou médicale ont une probabilité accrue de décrocher ou de refuser de participer aux évaluations de suivi. Une telle attrition sélective produit un biais d’échantillonnage qui tronque la variance du critère et fausse la modélisation statistique.
Il est par ailleurs impératif d’identifier et de documenter les interventions parasites susceptibles de modifier substantiellement la dynamique naturelle du phénomène étudié. Si, entre l’administration d’un test prédictif d’aptitude en entreprise et la mesure annuelle de performance, un sous-groupe d’employés bénéficie d’un programme de tutorat individualisé intensif, l’effet propre de ce traitement pédagogique externe viendra altérer la relation prédictive brute. La traçabilité méticuleuse des événements de vie intercurrents représente donc une condition de rigueur indispensable.
4.3 Étape 3 : Mesure indépendante du critère et analyse statistique
L’ultime phase du protocole consiste à évaluer la variable critère avec une objectivité irréprochable. La règle méthodologique cardinale de cette étape est le respect absolu du principe de double insu ou d’aveuglement des évaluateurs. Les personnes chargées de mesurer ou de noter la performance future des sujets (qu’il s’agisse d’enseignants attribuant des notes, de superviseurs hiérarchiques ou de cliniciens posant un diagnostic d’évolution) ne doivent sous aucun prétexte avoir accès aux scores initiaux obtenus par les sujets au test prédicteur.
La rupture de cette indépendance déclenche inévitablement un biais de contamination du critère d’origine humaine : la connaissance préalable du statut prédit incite l’évaluateur, consciemment ou non, à conformer son jugement ultérieur aux attentes générées par le score initial (phénomène de prophétie autoréalisatrice ou biais de confirmation). L’évaluation du critère doit donc être menée de façon hermétique, idéalement à l’aide d’indicateurs standardisés et multiples pour garantir une fidélité optimale de la mesure d’aboutissement.
Une fois les données collectées, le traitement statistique s’attache à produire des coefficients de corrélation et des paramètres de régression bruts, accompagnés de leurs intervalles de confiance à 95 %. Des corrections statistiques appropriées, telles que l’ajustement pour l’erreur de mesure ou la restriction de l’étendue, sont ensuite appliquées pour estimer les paramètres réels au sein de la population. Les conclusions tirées doivent explicitement formuler les limites de transférabilité de l’instrument à d’autres contextes organisationnels ou culturels.
5. Applications et exemples en psychologie de l’éducation
5.1 Examens d’admission universitaire et réussite académique
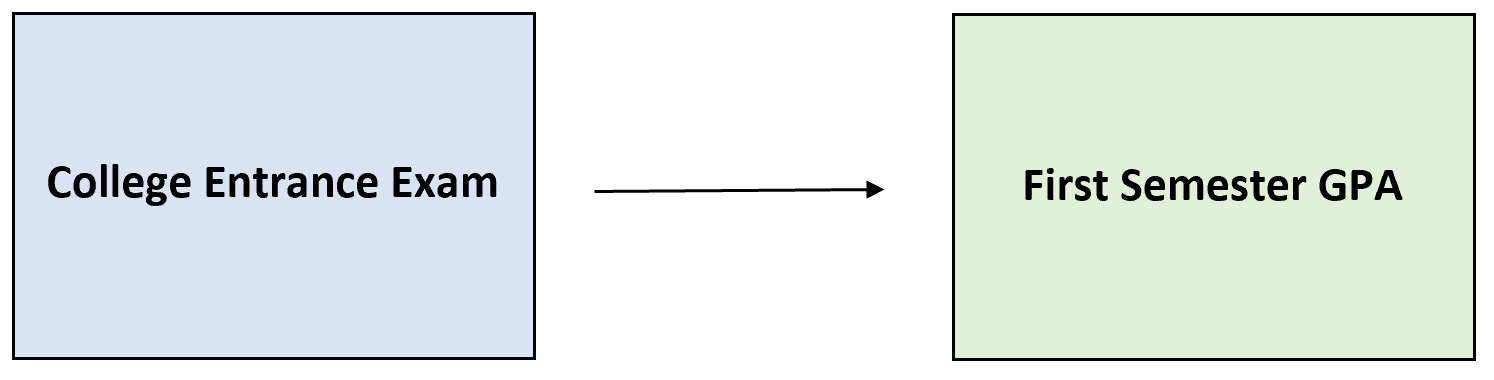
L’enseignement supérieur représente le champ historique d’application des instruments à forte validité prédictive. Aux États-Unis et dans de nombreux systèmes éducatifs mondiaux, les commissions d’admission s’appuient massivement sur des épreuves standardisées de raisonnement verbal et quantitatif, telles que le SAT ou l’ACT, pour sélectionner les candidats aux filières universitaires sélectives. L’objectif avoué est d’anticiper la performance académique des étudiants, mesurée traditionnellement par la moyenne générale obtenue à l’issue de la première année d’études universitaires (le First-Year Grade Point Average ou FYGPA).
Les méta-analyses conduites sur plusieurs décennies par des chercheurs spécialisés attestent d’une validité prédictive robuste et systématique de ces tests. La corrélation brute entre les scores au SAT et la moyenne de première année gravite généralement autour de 0,35 à 0,45. Lorsque ce score est associé aux résultats scolaires antérieurs obtenus dans le secondaire (le dossier du lycée), le coefficient de corrélation multiple s’élève fréquemment au-delà de 0,55, démontrant l’efficacité remarquable de cette combinaison prédictive pour discriminer les profils d’étudiants susceptibles de réussir.
Néanmoins, les études longitudinales révèlent un phénomène d’érosion progressive de la validité prédictive de ces tests standardisés au fur et à mesure que l’étudiant avance dans son cursus. Si le test prédit avec précision l’adaptation académique immédiate en première année, son pouvoir explicatif s’amenuise en troisième ou quatrième année. Cette atténuation s’explique par la spécialisation croissante des disciplines, l’intervention massive de la motivation intrinsèque, le travail personnel et l’engagement méthodologique, des dimensions non cognitives qui finissent par supplanter les seules aptitudes de raisonnement général.
5.2 Tests de préparation à la lecture en petite enfance
Dans l’enseignement primaire, la validité prédictive s’érige en outil indispensable de dépistage précoce des troubles spécifiques de l’apprentissage. Les épreuves évaluant la conscience phonologique, la dénomination rapide automatisée et la connaissance des lettres administrées en grande section de maternelle démontrent une valeur prédictive éclatante quant aux compétences futures en lecture et en décodage textuel mesurées au cours préparatoire (CP) et au cours élémentaire (CE1).
Les enfants présentant des déficits marqués dans la manipulation métaphonologique des sons du langage oral dès l’âge de cinq ans manifestent une probabilité statistique très élevée d’échouer dans l’acquisition du principe alphabétique au cours des années subséquentes. La corrélation longitudinale entre ces mesures phonologiques précoces et l’exactitude de lecture deux ans plus tard oscille régulièrement entre 0,50 et 0,65 selon les études d’intervention développementale. Cette force d’association confère à ces instruments une sensibilité clinique exceptionnelle pour identifier la dyslexie développementale avant même que l’apprentissage formel de l’écrit ne commence.
L’intérêt ultime de cette démarche réside dans la fenêtre d’opportunité thérapeutique qu’elle offre aux pédagogues. En fondant la prise en charge sur des scores dotés d’une validité prédictive avérée, l’école peut introduire des protocoles d’entraînement phonologique intensifs bien avant la cristallisation de l’échec scolaire. L’efficacité prédictive de ces batteries constitue ainsi le levier direct d’une pédagogie différenciée et préventive.
5.3 Évaluation du potentiel d’apprentissage versus tests d’acquis
Une controverse fondamentale en psychologie scolaire oppose l’usage des épreuves d’intelligence fluide et de potentiel d’apprentissage aux examens d’acquis académiques standardisés pour prédire les trajectoires scolaires ultérieures. Les tests de raisonnement fluide non verbal (comme les matrices progressives de Raven) évaluent la capacité de déduction logique face à des situations inédites, indépendamment de la maîtrise explicite d’un corpus de connaissances culturelles, tandis que les examens disciplinaires quantifient la rétention de contenus pédagogiques préalablement dispensés.
D’un point de vue purement statistique, les examens d’acquis scolaires antérieurs présentent souvent un coefficient de validité prédictive immédiate supérieur à celui des épreuves d’intelligence fluide pour anticiper les notes scolaires à court terme, la corrélation s’expliquant par le recouvrement direct des matières évaluées. En revanche, le potentiel d’apprentissage présente une validité prédictive particulièrement robuste et stable lors des transitions éducatives majeures (passage de l’école primaire au collège, puis aux filières techniques ou supérieures), où l’élève est soudainement confronté à des exigences cognitives qualitativement neuves.
La recherche souligne également le rôle modérateur critique joué par le statut socio-économique dans cette équation. Les tests d’acquis sont fortement sensibles au capital culturel familial et aux opportunités éducatives formelles, ce qui peut pénaliser des élèves défavorisés mais dotés de capacités d’abstraction remarquables. Les tests de potentiel d’apprentissage, en conservant une excellente validité prédictive indépendamment de l’origine sociale, permettent de repérer des talents académiques inexploités et de contourner les biais de reproduction sociale.
6. Applications et exemples en psychologie du travail et des organisations
6.1 Sélection du personnel et performance professionnelle
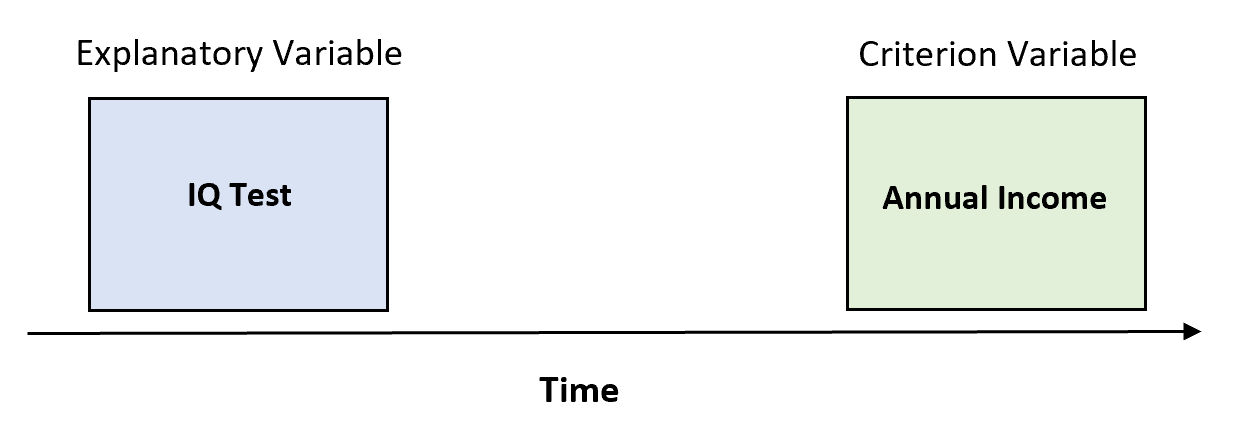
La psychologie du travail et des organisations a consacré un siècle de recherches empiriques à quantifier la validité prédictive des méthodes de sélection du personnel. Les méta-analyses historiques initiées par Frank Schmidt et John Hunter ont révolutionné le domaine en agrégeant les données issues de centaines d’études englobant des dizaines de milliers de travailleurs dans une diversité immense de secteurs professionnels. Leurs constats convergent de façon univoque : l’aptitude cognitive générale (souvent assimilée au facteur g de l’intelligence) s’impose comme le prédicteur univarié le plus puissant de la performance professionnelle globale.
Après correction statistique pour la restriction de l’étendue et l’infidélité des mesures, la validité prédictive de l’aptitude cognitive s’établit à un coefficient moyen d’environ 0,51 pour des postes de complexité moyenne, et dépasse 0,60 pour les emplois à haute complexité analytique (ingénieurs, cadres supérieurs, scientifiques). Cette efficacité découle du fait que le facteur g conditionne directement la vitesse d’apprentissage des compétences requises sur le poste, la capacité d’adaptation à des situations professionnelles ambiguës et la pertinence de la prise de décision stratégique en temps réel.
Parallèlement, la comparaison méthodique des dispositifs d’évaluation a permis de discréditer scientifiquement des pratiques de recrutement encore trop répandues. L’entretien de recrutement non structuré, caractérisé par un échange informel et l’absence de critères d’évaluation normalisés, affiche une validité prédictive notoirement faible, oscillant entre 0,15 et 0,20. À l’inverse, l’entretien hautement structuré, fondé sur des questions comportementales ou situationnelles dérivées d’une analyse rigoureuse des exigences du poste, atteint un coefficient de validité prédictive remarquable avoisinant 0,45 à 0,51, rivalisant directement avec les meilleurs tests cognitifs.
6.2 Tests de personnalité et comportements organisationnels
L’intégration des modèles factoriels de la personnalité, et tout particulièrement du modèle en cinq facteurs (le Big Five), a profondément affiné la prédiction des conduites professionnelles. Parmi les dimensions fondamentales que sont l’Ouverture, la Conscience, l’Extraversion, l’Agréabilité et le Névrosisme, le trait « Conscience » (Conscientiousness) se distingue par une validité prédictive universelle à travers la quasi-totalité des familles de métiers.
Caractérisée par le sens du devoir, la rigueur organisationnelle, la persévérance et le perfectionnisme, la Conscience affiche une corrélation méta-analytique corrigée d’environ 0,22 à 0,28 avec le rendement global au travail. Si cette magnitude est inférieure à celle du facteur cognitif, son apport est capital pour expliquer la dimension motivationnelle et l’effort continu fourni sur le long terme. Les autres traits du modèle Big Five manifestent une validité prédictive contingente et spécialisée : l’Extraversion prédit avec brio le succès des commerciaux et des managers de proximité, tandis que l’Agréabilité anticipe la performance au sein des équipes collaboratives et des métiers d’aide.
Par ailleurs, les tests d’intégrité organisationnelle constituent une application éclatante de la validité prédictive orientée vers les comportements contre-productifs au travail (CWB). Ces instruments prédisent avec une acuité surprenante (coefficients de validité de 0,30 à 0,40) la probabilité d’occurrences délétères telles que l’absentéisme non justifié, les vols de matériel, les dégradations d’équipements ou les fraudes internes. L’évaluation de la personnalité dépasse donc le cadre de la performance technique pour englober la viabilité éthique et socioculturelle de l’organisation.
6.3 Mises en situation et centres d’évaluation (Assessment Centers)
Les centres d’évaluation, ou Assessment Centers, représentent une méthodologie d’évaluation multimodale intensive particulièrement prisée pour la sélection et le développement des cadres dirigeants. Ce dispositif combine des épreuves psychométriques classiques avec des simulations professionnelles directes : exercices de corbeille d’arrivée (in-basket), jeux de rôle conflictuels, études de cas managériales et débats de groupe sans leader désigné. Les candidats sont observés et évalués par un panel d’assesseurs entraînés sur une grille de compétences comportementales standardisée.
Les études empiriques confirment la solide validité prédictive des Assessment Centers, affichant des corrélations moyennes corrigées situées entre 0,35 et 0,45 pour prédire la réussite managériale globale, les promotions hiérarchiques futures et la progression salariale à long terme sur des horizons de 5 à 15 ans. La force prédictive de ce protocole découle de la fidélité écologique de ses épreuves : le comportement manifesté au cours d’une simulation complexe est une réplique quasi parfaite des exigences quotidiennes du rôle managérial futur.
Toutefois, la mise en œuvre d’un centre d’évaluation engendre des investissements logistiques et financiers colossaux. L’arbitrage managérial exige une analyse rigoureuse du ratio coût-efficacité prédictif : le gain substantiel de précision décisionnelle justifie-t-il les dépenses engagées par rapport à l’administration conjointe d’un test cognitif informatisé et d’un inventaire de personnalité ? Dans les postes à très haut niveau de responsabilité, où le coût d’une erreur d’embauche peut compromettre la trajectoire d’une entreprise, l’investissement dans un Assessment Center se révèle hautement rentable d’un point de vue actuariel.
7. Applications et exemples en psychologie clinique et médico-légale
7.1 Évaluation du risque de récidive criminelle et de violence
Le champ de la psychologie légale et psychiatrique incarne l’un des environnements où les décisions fondées sur la validité prédictive emportent les conséquences sociétales les plus graves. L’évaluation de la dangerosité et du risque de récidive violente chez des personnes incarcérées ou hospitalisées sous contrainte a longtemps reposé sur l’impression clinique intuitive non structurée des experts psychiatres et psychologues. Or, des décennies de confrontation empirique ont formellement démontré l’incurie prédictive du jugement clinique pur, dont le taux d’exactitude dépasse à peine le niveau du hasard.
Cette faillite méthodologique a suscité l’avènement des échelles actuarielles de prédiction du risque, telles que le VRAG (Violence Risk Appraisal Guide) ou le protocole de jugement clinique structuré HCR-20 (Historical Clinical Risk-20). Ces instruments intègrent des variables empiriquement corrélées à la violence future : antécédents judiciaires précoces, toxicomanie, psychopathie, instabilité relationnelle et conformité aux règles institutionnelles. Les coefficients de validité prédictive de ces instruments, exprimés en termes d’AUC, oscillent de façon constante entre 0,70 et 0,82 pour des fenêtres de prévision post-libération s’étendant de 2 à 10 ans.
La supériorité de l’évaluation actuarielle et structurée réside dans son insensibilité aux biais cognitifs individuels des praticiens (biais de disponibilité, ancrage affectif, clémence déplacée ou sévérité punitive). En substituant une équation probabiliste standardisée à l’intuition impressionniste, la validité prédictive des outils médico-légaux optimise l’équilibre complexe entre la protection de la sécurité publique et la préservation des libertés individuelles des justiciables.
7.2 Échelles pronostiques et risque suicidaire
L’anticipation du geste suicidaire représente le défi clinique le plus angoissant et complexe auquel font face les professionnels de la santé mentale. De nombreux questionnaires et échelles standardisées, à l’instar de la Beck Scale for Suicide Ideation (BSS) ou de l’échelle d’évaluation du risque suicidaire de Columbia (C-SSRS), ont été développés dans l’espoir de fournir aux praticiens des signaux d’alerte prédictifs fiables pour prévenir les passages à l’acte fatals.
Cependant, ce domaine met en lumière une contrainte mathématique implacable qui altère la portée pratique de la validité prédictive : le problème du très faible taux de base (base rate). Bien que le suicide constitue un problème de santé publique majeur, la survenue d’un passage à l’acte fatal au sein d’une population de patients psychiatriques demeure un événement statistiquement rare à court terme. Même en présence d’un instrument doté d’une excellente sensibilité (ex. : 85 %) et d’une spécificité respectable (ex. : 80 %), la valeur prédictive positive d’une échelle de risque suicidaire demeure dérisoire (souvent inférieure à 5 %). Cela implique que pour 100 alertes déclenchées par l’outil, plus de 95 représentent de faux positifs.
Ces limites structurelles imposent une extrême prudence déontologique. Les chercheurs s’attachent aujourd’hui à dépasser la simple administration transversale d’échelles autorapportées pour concevoir des modèles prédictifs multimodaux. Ces derniers croisent les données psychométriques avec des marqueurs comportementaux en vie réelle (évaluation écologique momentanée par smartphone, suivi des fluctuations du sommeil) et des indicateurs neurobiologiques, afin de capter la dynamique prédictive aiguë qui précède la crise suicidaire.
7.3 Dépistage précoce du déclin cognitif et neurodégénérescence
Dans le domaine de la neuropsychologie du vieillissement, l’exigence de validité prédictive s’avère décisive pour identifier les prodromes des pathologies neurodégénératives, au premier rang desquelles figure la maladie d’Alzheimer. Le diagnostic d’atteinte cognitive légère (Mild Cognitive Impairment ou MCI) place les cliniciens face à une incertitude : le patient va-t-il demeurer stable, régresser vers un état normal ou basculer vers un tableau démentiel sévère ?
Les épreuves neuropsychologiques standardisées ciblant la mémoire épisodique à long terme — notamment le test de rappel libre et indicé à 16 items de Grober et Buschke — déploient une validité prédictive remarquable. L’incapacité d’un patient à consolider de nouvelles informations et l’échec de l’indiçage sémantique permettent de prédire la conversion du MCI vers une démence formelle sur un horizon temporel de 3 à 5 ans avec une sensibilité et une spécificité excédant régulièrement 80 % (AUC supérieure à 0,85).
Cette acuité prédictive est aujourd’hui amplifiée par la convergence des métriques psychométriques et des biomarqueurs paracliniques (mesure des dépôts amyloïdes par tomographie par émission de positons, dosages plasmatiques de la protéine p-tau217, imagerie volumétrique de l’hippocampe). Ce mariage de la psychométrie fine et de la neurologie moléculaire ouvre la voie à des diagnostics prédictifs ultra-précoces, indispensables pour initier des thérapies modificatrices de la maladie avant l’installation de destructions neuronales irréversibles.
8. Facteurs méthodologiques atténuant ou altérant la validité prédictive
8.1 Le phénomène de restriction de l’étendue (Range Restriction)
L’un des écueils statistiques les plus insidieux entravant l’estimation de la validité prédictive est le phénomène de restriction de l’étendue (range restriction). Cette déformation se produit systématiquement dès lors que le chercheur ou le praticien n’a accès à la mesure du critère que pour un sous-groupe sélectionné d’individus, plutôt que pour l’échantillon complet ayant initialement passé le prédicteur. En contexte de recrutement, une entreprise administre un test à 1 000 postulants mais n’embauche que les 50 meilleurs scores : la performance ultérieure au travail (le critère) ne pourra jamais être mesurée chez les 950 candidats rejetés.
Cette sélection tronque drastiquement la variabilité du prédicteur. Or, les formules mathématiques de covariance et de corrélation de Pearson dépendent directement de la dispersion des scores : lorsque la variance d’une variable est comprimée artificiellement, le coefficient de corrélation empirique observé s’effondre de façon spectaculaire. Un test possédant une validité prédictive réelle de 0,60 dans la population générale peut ainsi voir son coefficient apparent chuter à 0,20 au sein du sous-groupe hyper-sélectionné.
On distingue classiquement la restriction d’étendue directe (la sélection s’est opérée explicitement sur le test prédicteur analysé) de la restriction d’étendue indirecte (la sélection s’est effectuée sur une tierce variable corrélée au test, comme des entretiens préalables ou des diplômes). Pour corriger cette distorsion et rétablir le coefficient de validité réel dans la population parente, les psychométriciens mobilisent les formules mathématiques de correction de Thorndike (Cas 2 pour la restriction directe, Cas 3 pour la restriction indirecte), rétablissant la comparabilité des instruments.
8.2 L’infidélité de mesure du prédicteur et du critère
Toute mesure en sciences humaines est affectée d’une certaine marge d’erreur aléatoire. Selon les postulats de la théorie classique des tests, un score observé X est composé de la somme du score vrai théorique V et d’une composante d’erreur aléatoire E. L’impact direct de ces erreurs de mesure non corrélées est d’atténuer la force des associations statistiques entre variables : c’est le phénomène universel de l’atténuation de la corrélation.
Le coefficient de validité prédictive observé entre un prédicteur X et un critère Y dépend non seulement de la force de leur lien conceptuel, mais également de la fidélité de chacun des deux instruments. Mathématiquement, la corrélation observable est bornée par la racine carrée du produit des indices de fidélité respectifs des mesures :
r_{X(obs)Y(obs)} ≤ r_{XY(vrai)} × √(r_{xx} × r_{yy})
où r_{xx} représente la fidélité du prédicteur et r_{yy} la fidélité du critère. Si l’un des deux instruments souffre d’un manque de cohérence ou d’instabilité temporelle, le coefficient de validité prédictive apparaîtra artificiellement faible.
Si les concepteurs de tests accordent généralement un soin méticuleux à optimiser la fidélité du prédicteur, ils manifestent fréquemment une négligence coupable à l’égard de la fidélité de la variable critère. Dans le milieu professionnel, les évaluations annuelles de performance réalisées par des managers présentent souvent une fidélité inter-juges déplorable (souvent inférieure à 0,50). Pour estimer la validité théorique maximale d’une relation débarrassée des scories instrumentales, Charles Spearman a formulé la correction pour氲atténuation complète :
r_{XY(vrai)} = r_{XY(obs)} / √(r_{xx} × r_{yy})
Cette correction permet de juger de la pertinence de l’architecture conceptuelle sous-jacente.
8.3 La contamination et le biais d’évaluation du critère
Même lorsque la fidélité statistique est démontrée, la présence de biais de mesure systématiques dans le recueil du critère constitue un poison méthodologique qui fausse irrémédiablement la validité prédictive. L’une des contaminations les plus pernicieuses survient par le biais d’évaluation humaine, au premier rang desquels figure le biais de halo. Ce phénomène cognitif pousse un examinateur à évaluer globalement un individu de manière positive (ou négative) sur la base d’une seule caractéristique saillante non pertinente pour la performance réelle.
Une altération majeure découle de la violation de la procédure de double insu évoquée précédemment. Si des professeurs ou des managers sont informés en amont des scores stratosphériques ou médiocres obtenus par des sujets à un test d’aptitude, cette connaissance modifie leur regard évaluatif. L’observateur cherche inconsciemment à valider le pronostic annoncé, attribuant de meilleures notes aux sujets labellisés « à haut potentiel » indépendamment de leur production factuelle. Cette prophétie autoréalisatrice gonfle artificiellement le coefficient de corrélation, trompant le chercheur sur l’efficacité autonome de l’outil.
Enfin, le critère peut être contaminé par des facteurs contextuels d’iniquité situationnelle. Dans une étude portant sur la prédiction du chiffre d’affaires généré par des vendeurs, si les candidats sélectionnés sont affectés à des zones géographiques aux potentiels économiques drastiquement asymétriques, la performance brute finale reflétera la richesse du secteur commercial bien plus que les compétences intrinsèques de négociation prévues par le test. La neutralisation de ces contaminations requiert la mise en place de variables de contrôle contextuelles et une standardisation absolue des métriques de sortie.
9. Validité prédictive incrémentielle : l’optimisation des batteries de tests
9.1 Concept et utilité de la validité incrémentielle
Dans la pratique clinique, académique ou organisationnelle, les décisions ne reposent que très rarement sur l’administration d’un instrument univarié unique. Les professionnels déploient le plus souvent des batteries d’évaluations combinant plusieurs tests de nature variée. Dès lors émerge une interrogation économique et scientifique fondamentale : que nous apporte réellement l’adjonction d’un second ou d’un troisième outil d’évaluation par rapport à la capacité prédictive déjà assurée par le premier ? C’est précisément l’objet de la validité prédictive incrémentielle.
La validité incrémentielle se définit comme le gain net en pouvoir explicatif et prédictif (traduit par l’augmentation de la variance expliquée du critère) généré par l’introduction d’un nouvel instrument d’évaluation dans un modèle décisionnel préexistant. Ce principe opérationnalise le rasoir d’Ockham en métrologie : il est inutile de multiplier les épreuves coûteuses et chronophages si ces dernières ne font que dupliquer l’information déjà captée par les outils initiaux.
L’optimisation du rapport coût-bénéfice constitue l’un des piliers cardinaux de l’approche incrémentielle. L’administration d’un test psychologique ou d’une session d’entretien mobilise du temps pour le candidat et des ressources substantielles pour l’institution. Démontrer empiriquement qu’un questionnaire de personnalité de vingt minutes apporte une contribution incrémentielle significative à côté d’un examen cognitif de trois heures permet de justifier rationnellement la complexification du protocole diagnostique.
9.2 Modélisation par régression hiérarchique
L’approche statistique classique pour démontrer l’existence d’une validité incrémentielle repose sur la régression linéaire multiple hiérarchique (ou par blocs). Cette procédure méthodologique consiste à entrer séquentiellement les variables prédictives dans l’équation mathématique selon un ordre théoriquement prédéterminé, afin d’observer la métrique d’ajustement à chaque palier.
À la première étape (Bloc 1), le chercheur introduit le prédicteur de référence, par exemple le score d’aptitude cognitive générale (X₁), et enregistre la part de variance du critère expliquée :
R²_Modèle1
À la seconde étape (Bloc 2), le nouvel instrument candidat, par exemple une échelle de Conscience (X₂), est introduit dans l’équation. Le logiciel calcule alors le changement de R², noté :
ΔR² = R²_Modèle2 – R²_Modèle1
Ce delta de R² est ensuite testé formellement à l’aide d’un test d’inférence F de Fisher. Si la valeur de p associée à ce test de changement est inférieure au seuil de significativité critique (habituellement α = 0,05), l’hypothèse de validité prédictive incrémentielle est validée.
Un enjeu majeur lors de cette modélisation concerne la gestion de la multicolinéarité. Lorsque deux instruments prédictifs sont trop fortement corrélés entre eux (partageant une variance redondante massive), l’erreur standard des coefficients de régression partiels s’accroît, rendant les estimations instables. Une variable ne peut démontrer une validité incrémentielle que si elle capte une dimension orthogonale (indépendante) du phénomène que le prédicteur principal est impuissant à mesurer.
9.3 Exemple pratique : combiner aptitude cognitive et traits de personnalité
L’illustration la plus éclatante de la validité incrémentielle dans la littérature contemporaine concerne l’articulation entre l’intelligence générale (facteur g) et les traits de personnalité du modèle Big Five pour prédire la performance au travail. Comme établi précédemment, l’intelligence générale constitue le prédicteur unitaire le plus robuste du rendement professionnel, expliquant à elle seule entre 25 % et 35 % de la variance de la performance dans les fonctions complexes (r ≈ 0,51, donc R² ≈ 0,26).
Dans un modèle de régression hiérarchique, lorsque le chercheur introduit le trait Conscience dans le second bloc après l’aptitude cognitive, les méta-analyses révèlent systématiquement un ΔR² significatif de l’ordre de 0,05 à 0,09. Cela indique que la Conscience permet de prédire 5 à 9 % de variance additionnelle de la performance au travail, totalement indépendante de l’intelligence générale. Les deux attributs mesurent en effet des dimensions psychologiques distinctes mais complémentaires : si l’intelligence détermine le niveau maximal de complexité qu’un individu est capable de traiter (« ce qu’il peut faire »), la Conscience prédit la régularité, l’effort et la probabilité qu’il déploie effectivement ce potentiel au quotidien (« ce qu’il fera sur la durée »).
En couplant judicieusement ces deux outils au sein d’une équation de régression pondérée, les praticiens parviennent à un coefficient de corrélation multiple (R) approchant 0,65, maximisant l’exactitude de leurs décisions d’affectation et d’embauche. Cet exemple parfait démontre que la recherche de validité incrémentielle évite l’écueil de la redondance tout en optimisant le discernement diagnostique global.
10. Analyse comparative : validité prédictive face aux autres formes de validité
10.1 Validité prédictive versus validité de construit
L’articulation entre validité prédictive et validité de construit relève d’une divergence téléologique majeure au sein de la théorie psychométrique. La validité de construit s’intéresse à l’élucidation de l’attribut latent sous-jacent : le test mesure-t-il bien l’entité théorique abstraite (l’anxiété, la mémoire de travail, l’extraversion) définie par les modèles conceptuels ? Sa vocation première est explicative et compréhensive. La validité prédictive, quant à elle, poursuit une fin éminemment pragmatique et fonctionnelle : son objectif n’est pas tant de disséquer le fonctionnement intime de l’esprit que d’anticiper avec exactitude une conduite factuelle future.
Cette distinction engendre une situation paradoxale : il est théoriquement possible d’observer une excellente validité prédictive sans pour autant posséder une compréhension théorique limpide du construit mesuré. Une régression empirique boîte noire peut s’avérer capable de prédire un critère avec une précision chirurgicale, sans que le praticien ne comprenne les mécanismes causaux régissant l’association. Historiquement, de nombreuses échelles empiriques ont démontré un pouvoir de sélection remarquable avant même que les sciences cognitives ne décodent les facteurs psychologiques effectivement sollicités.
Cependant, l’épistémologie contemporaine sous l’égide de Cronbach et Messick refuse de dissocier durablement ces approches. La validité prédictive est aujourd’hui intégrée comme l’un des volets empiriques cardinaux de la validation de construit. L’adéquation des prédictions générées par un instrument sert à corroborer ou à falsifier le réseau nomologique qui entoure le construit théorique : si une échelle conçue pour évaluer l’optimisme est incapable de prédire la résilience post-traumatique ultérieure, c’est la validité du construit lui-même qui s’en trouve théoriquement fragilisée.
10.2 Validité prédictive versus validité de contenu
L’opposition entre validité de contenu et validité prédictive illustre le contraste fondamental entre l’exploration synchronique d’un domaine d’acquis et la projection prospective dans un contexte dynamique. La validité de contenu garantit que les items ou les exercices qui composent un examen constituent un échantillonnage représentatif et fidèle de l’ensemble des connaissances, des habiletés ou des tâches définissant un domaine précis (par exemple, le programme officiel de mathématiques d’un niveau scolaire donné ou les gestes techniques indispensables à un chirurgien-dentiste).
Une erreur fréquente consiste à présumer qu’un instrument pourvu d’une parfaite validité de contenu possédera automatiquement une solide validité prédictive. Or, il n’en est rien : un test d’acquis mesurant avec une exactitude irréprochable les connaissances de fin de formation peut s’avérer singulièrement inefficace pour prédire la réussite ultérieure sur le terrain réel. La performance future est soumise à des stress situationnels, des exigences relationnelles, des imprévus environnementaux et des mécanismes d’adaptation comportementale que l’examen de contenu n’intègre pas dans son format standardisé.
La complémentarité entre ces deux formes de validité demeure néanmoins indispensable, notamment lors de la conception d’épreuves professionnelles ou de certifications d’aptitude. Alors que la validité de contenu assure la légitimité juridique et formelle de l’évaluation (en démontrant que l’examen interroge effectivement les éléments constitutifs du métier), la validité prédictive apporte la preuve empirique que la maîtrise de ce contenu à un instant t garantit l’efficacité du praticien lors de son exercice futur.
10.3 Validité convergente et discriminante
Pour parachever l’examen structural des propriétés métrologiques d’un prédicteur, il convient d’analyser son positionnement au sein de la matrice multi-traits multi-méthodes (MTMM) conceptualisée par Donald Campbell et Donald Fiske. Cette approche examine conjointement la validité convergente et la validité discriminante. La validité convergente postule qu’un instrument doit corréler fortement avec d’autres mesures alternatives évaluant le même construit théorique, y compris lorsque des méthodes de passation dissemblables sont employées.
Dans l’analyse prédictive, la validité discriminante joue un rôle régulateur fondamental. Un instrument d’évaluation ne doit pas prédire indifféremment n’importe quel critère externe de manière floue et ubiquitaire ; il doit impérativement manifester une spécificité relationnelle. Si un test d’aptitude mathématique prédit avec la même force la performance future en algèbre et les compétences futures en expression poétique orale, son manque de validité discriminante suggère qu’il mesure en réalité un artefact méthodologique global (comme la compréhension générale des consignes ou la conformité sociale) plutôt que l’habileté computationnelle revendiquée.
L’analyse fine de la validité prédictive exige donc que le chercheur formule des hypothèses d’association spécifiques : le prédicteur doit démontrer une forte relation avec le critère théoriquement congruent (validité prédictive convergente) et une absence de corrélation (ou une corrélation négligeable) avec des critères conceptuellement étrangers (validité prédictive discriminante). C’est à ce prix que l’instrument conquiert sa pleine crédibilité scientifique.
11. Considérations éthiques, diversité et limites déontologiques
11.1 Le biais prédictif et l’impact disparate sur les sous-groupes
L’utilisation d’épreuves standardisées pour des décisions à fort enjeu (accès aux universités, embauches de cadres, promotions militaires) soulève la question complexe de l’équité de traitement à l’égard des minorités ethniques, socioculturelles ou de genre. Dans ce débat, il est primordial de distinguer rigoureusement la notion sociologique d’impact disparate de la notion psychométrique de biais prédictif.
L’existence d’un impact disparate — c’est-à-dire une différence statistiquement significative dans les moyennes obtenues par différents groupes démographiques à un test — ne constitue pas en soi une preuve irréfutable de biais du test. Selon le modèle classique de Cleary, universellement adopté en psychométrie, un instrument d’évaluation est réputé non biaisé pour la prédiction d’un critère si les droites de régression calculées séparément pour chaque sous-groupe possèdent des pentes identiques et des ordonnées à l’origine confondues. En d’autres termes, pour un score donné au prédicteur, l’espérance de performance future sur le critère doit être mathématiquement identique, quelle que soit l’appartenance groupale de l’individu.
Si la droite de régression d’un sous-groupe minoritaire présente une pente plus faible (biais de pente) ou une ordonnée à l’origine systématiquement inférieure (biais d’interception), l’équation unifiée pénalise structurellement ce groupe en sous-estimant ou surévaluant ses compétences futures réelles. Détecter le fonctionnement différentiel des items (DIF) et garantir l’invariance de mesure de l’équation prédictive constitue une exigence légale et éthique absolue pour prémunir les organisations contre la discrimination indirecte involontaire.
11.2 Le danger du déterminisme psychologique et des prophéties autoréalisatrices
Sur le versant déontologique et sociétal, l’usage immodéré de la validité prédictive véhicule le péril insidieux du réductionnisme et du fatalisme psychologique. Transformer une probabilité statistique collective en un pronostic catégorique individuel est une dérive méthodologique majeure : aucun coefficient de corrélation, aussi élevé soit-il, n’autorise à déclarer qu’un individu précis est irrémédiablement condamné à l’échec ou voué au triomphe. L’être humain est un système dynamique et résilient, capable d’apprentissages métacognitifs et de ruptures de trajectoire qui échappent aux équations linéaires statiques.
Cette tentation déterministe génère des effets pervers majeurs au travers du mécanisme sociocognitif de la prophétie autoréalisatrice ou effet Pygmalion. Lorsqu’un score prédictif est communiqué à des éducateurs, des tuteurs ou des superviseurs, cette étiquette modifie implicitement le climat relationnel, le niveau d’exigence et le soutien accordé à l’apprenant. Les individus catalogués comme « peu prédisposés au succès » finissent par intérioriser ce renvoi négatif (menace du stéréotype), ce qui détériore leur engagement et aboutit à l’échec effectivement prédit, non pas en raison de la clairvoyance intrinsèque du test, mais par l’effet toxique de l’attente générée par sa divulgation.
Les codes déontologiques internationaux imposent donc aux psychologues et évaluateurs de toujours formuler les résultats des démarches prédictives sous forme de probabilités conditionnelles modulables par l’environnement et de proscrire tout fatalisme réducteur qui enfermerait les personnes dans une trajectoire immuable.
11.3 Transparence, consentement éclairé et utilisation responsable
L’administration d’outils à visée prédictive impose des obligations éthiques et juridiques strictes en matière de protection des personnes évaluées. La première exigence repose sur le consentement éclairé : les participants doivent être préalablement informés, dans un langage clair et intelligible, de la nature de l’évaluation, des finalités précises pour lesquelles leurs scores seront exploités, et de la nature des décisions individuelles susceptibles d’en découler.
La question de la validité temporelle et de l’archivage des scores prédictifs s’avère particulièrement sensible dans l’ère du traitement massif de données et des profils numériques. Un score d’aptitude ou de personnalité n’a pas une durée de vie éternelle ; son pouvoir de prédiction s’estompe naturellement avec le passage des années, la maturation psychologique des personnes et l’évolution des contextes sociotechniques. Les organisations ont l’obligation déontologique de définir des politiques de péremption des données psychométriques afin d’éviter qu’un résultat obsolète ne vienne entraver arbitrairement le parcours futur d’un candidat.
Enfin, la restitution des résultats représente un droit inaliénable de l’évalué. Tout candidat ou patient ayant consenti à un protocole de sélection ou de diagnostic prédictif doit pouvoir bénéficier d’un retour explicatif individualisé et constructif. Ce retour doit contextualiser les conclusions de l’évaluation, expliciter les zones d’incertitude inhérentes aux modèles probabilistes, et offrir des voies de développement ou des possibilités de recours légitimes si l’intéressé conteste l’équité des conditions de passation.
12. Directives méthodologiques et bonnes pratiques pour les chercheurs et praticiens
12.1 Protocoles de validation croisée et réplicabilité
Dans l’élaboration de tout modèle prédictif complexe, le chercheur affronte une tentation statistique classique : le phénomène de surapprentissage ou surajustement (overfitting). Lorsqu’une équation de régression multiple est calibrée sur un échantillon empirique d’investigation, l’algorithme mathématique maximise l’ajustement en tirant profit non seulement des relations conceptuelles vraies, mais également de toutes les variations d’échantillonnage accidentelles et idiosyncrasiques propres à cet échantillon spécifique. Si le modèle est ensuite appliqué tel quel à une cohorte distincte, son coefficient de prédiction effectif s’effondre de manière drastique (phénomène de contraction ou shrinkage).
Pour immuniser les équations prédictives contre cette fragilité, la mise en œuvre d’un protocole rigoureux de validation croisée (cross-validation) s’impose comme une norme de bonne pratique scientifique incontournable. La méthode classique consiste à scinder l’échantillon global en deux sous-groupes indépendants : un échantillon d’étalonnage (derivation sample) servant à calculer les coefficients de pondération des variables, et un échantillon de validation (validation sample) sur lequel l’équation préalablement figée est testée pour mesurer sa résistance réelle.
L’utilisation de techniques computationnelles de rééchantillonnage intensif, telles que la validation croisée par blocs (k-fold cross-validation) et le rééchantillonnage par réinjection (bootstrapping), offre des estimations extrêmement robustes des intervalles de confiance associés aux coefficients prédictifs. Ces garde-fous garantissent aux praticiens que l’instrument conservera sa valeur prévisionnelle opérationnelle lorsqu’il sera déployé en vie réelle auprès de nouvelles cohortes de candidats ou de patients.
12.2 Conformité aux standards internationaux de publication psychométrique
L’exercice responsable de la psychométrie appliquée exige une adhésion indéfectible aux directives internationales formalisées dans les Standards for Educational and Psychological Testing rédigés par le consortium APA/AERA/NCME, ainsi qu’aux recommandations de l’International Test Commission (ITC). Ces corpus normatifs dictent avec précision les exigences méthodologiques applicables à la publication de tout test psychologique commercial ou scientifique.
Le rapportage d’une étude de validité prédictive ne saurait se satisfaire de la communication laconique d’un coefficient de corrélation ponctuel. Les auteurs et éditeurs sont tenus de publier les intervalles de confiance à 95 % autour de chaque paramètre estimé, de fournir une description exhaustive et sociodémographiquement transparente de la cohorte d’échantillonnage, et de renseigner en toute honnêteté le taux de mortalité expérimentale survenu au cours du suivi longitudinal. Les sources potentielles de contamination du critère et les stratégies déployées pour les neutraliser doivent être documentées de façon traçable.
En outre, les concepteurs doivent publier les matrices complètes d’intercorrélations entre l’ensemble des prédicteurs et des critères opérationnels retenus, ainsi que les indices de fidélité respectifs calculés sur l’échantillon d’étude. Ce niveau d’exigence éditoriale et de transparence scientifique constitue la seule digue efficace contre la prolifération de tests pseudo-scientifiques aux prétentions prédictives miraculeuses mais dénués de tout fondement empirique vérifiable.
12.3 Recommandations pragmatiques pour la sélection d’un outil prédictif
Face à la multiplicité des outils d’évaluation disponibles sur le marché du conseil, de l’éducation et des ressources humaines, les professionnels et décideurs doivent adopter une méthodologie d’analyse critique rigoureuse avant de choisir et déployer un instrument prédictif. Cette démarche passe impérativement par l’examen minutieux du manuel technique du test (test manual), qui doit détailler les preuves de validation empirique accumulées.
Une grille d’évaluation pragmatique doit intégrer les points de contrôle cardinaux suivants :
- Examen des critères empiriques : La variable critère prédite dans les études de validation est-elle directement congruente avec le problème décisionnel spécifique que l’organisation cherche à résoudre (ex. : prédiction de la performance réelle sur le poste plutôt qu’une simple évaluation de fin de stage) ?
- Généralisation de la validité : Les études attestant de la validité prédictive ont-elles été conduites dans des contextes organisationnels ou culturels suffisamment proches de celui dans lequel l’outil sera utilisé, ou s’agit-il d’une extrapolation géographique hasardeuse ?
- Récence et pertinence des données : Les normes psychométriques et les équations prédictives ont-elles fait l’objet d’une actualisation régulière pour intégrer les mutations technologiques des métiers et les évolutions démographiques des populations cibles ?
- Indépendance des validations : Existe-t-il des études de réplication indépendantes menées par des laboratoires universitaires ou des chercheurs n’ayant aucun lien d’intérêt commercial avec l’éditeur du test ?
En abordant l’évaluation psychologique et la validité prédictive sous cet angle d’exigence métrologique et de vigilance éthique, les psychologues, pédagogues et gestionnaires de talents s’assurent que leurs décisions ne reposent pas sur des illusions spéculatives, mais sur une science humaine rigoureuse, soucieuse de justice sociale et d’efficacité collective.
Références
American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.apa.org/science/programs/testing/standards
Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
Cleary, T. A. (1968). Test bias: Prediction of grades of Negro and white students in integrated colleges. Journal of Educational Measurement, 5(2), 115–124. https://doi.org/10.1111/j.1745-3984.1968.tb00618.x
Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957
Grober, E., & Buschke, H. (1987). Genuine memory deficits in dementia. Developmental Neuropsychology, 3(1), 13–36. https://doi.org/10.1080/87565648709540361
Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741–749. https://doi.org/10.1037/0003-066X.50.9.741
Schmidt, F. L., & Hunter, J. E. (1998). The validity and utility of selection methods in personnel psychology: Practical and theoretical implications of 85 years of research findings. Psychological Bulletin, 124(2), 262–274. https://doi.org/10.1037/0033-2909.124.2.262
Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.
Webster, C. D., Douglas, K. S., Eaves, D., & Hart, S. D. (1997). HCR-20: Assessing risk for violence (Version 2). Mental Health, Law, and Policy Institute, Simon Fraser University.