
Dans le champ de l’analyse quantitative appliquée aux sciences humaines, sociales et comportementales, l’investigation empirique repose traditionnellement sur le postulat d’une relation strictement proportionnelle entre les phénomènes observés. Pourtant, la complexité intrinsèque de l’appareil psychique, des comportements interpersonnels et des dynamiques biologiques s’accommode rarement d’une trajectoire rectiligne immuable. Les processus d’adaptation, les mécanismes d’apprentissage, la réactivité émotionnelle au stress ou encore l’épuisement professionnel manifestent presque systématiquement des seuils de bascule, des effets d’accélération, des plateaux de saturation ou des régressions fonctionnelles. Réduire ces dynamiques à une droite de régression univariée classique constitue souvent une simplification abusive qui altère la validité écologique et épistémologique des conclusions scientifiques.
La régression curvilinéaire, principalement incarnée par les extensions de la modélisation polynomiale, apporte une réponse méthodologique rigoureuse à cette limitation structurelle. En permettant à la fonction d’estimation d’épouser les courbures, les inflexions et les changements de direction inhérents aux données empiriques, cette approche statistique offre aux chercheurs un cadre formel pour tester des hypothèses théoriques sophistiquées. Loin d’être un simple artifice d’ajustement géométrique guidé par l’empirisme aveugle, elle permet d’opérationnaliser des concepts fondamentaux tels que l’optimum motivationnel, le déclin cognitif non linéaire ou les dynamiques d’équilibre homéostatique au sein des systèmes vivants.
Le présent article propose une exploration exhaustive, théorique et appliquée de la régression curvilinéaire. À travers l’analyse détaillée de ses fondements mathématiques, de ses manifestations canoniques — notamment les modèles quadratiques et cubiques —, de ses pièges méthodologiques comme la multicolinéarité structurelle, ainsi que de ses protocoles diagnostiques et logiciels, ce guide vise à doter les étudiants, cliniciens et chercheurs d’une grille de lecture approfondie pour comprendre, exécuter et interpréter des modélisations polynomiales dans le respect des standards scientifiques les plus exigeants.
1. Introduction et fondements conceptuels de la régression curvilinéaire
1.1 Définition formelle et nature non linéaire des relations
La régression curvilinéaire désigne une classe de modèles statistiques au sein de laquelle la relation fonctionnelle unissant une ou plusieurs variables explicatives indépendantes à une variable critère dépendante est représentée par une ligne courbe plutôt que par une trajectoire rectiligne. Dans l’espace géométrique défini par le produit cartésien des variables observées, l’espérance conditionnelle de la variable réponse ne varie plus à un taux constant par unité d’incrément de la variable prédictive. Cette approche mathématique traduit le fait que l’effet marginal d’un facteur dépend intrinsèquement du niveau déjà atteint par ce même facteur ou par d’autres dimensions du système étudié.
Il convient d’établir une différenciation fondamentale, au cœur de l’analyse matricielle, entre la linéarité des paramètres et la non-linéarité des variables. Sur le plan statistique, la régression polynomiale demeure un cas particulier du modèle linéaire général. L’équation est qualifiée de linéaire non pas parce qu’elle trace une ligne droite sur un graphique à deux dimensions, mais parce que les coefficients d’estimation inconnus — les paramètres bêta — sont combinés de manière purement linéaire, c’est-à-dire sans être élevés à des puissances, intégrés dans des fonctions transcendantes ou multipliés entre eux. C’est la variable explicative qui subit des transformations d’élévation à des puissances entières successives, conférant ainsi au modèle sa flexibilité curvilinéaire tout en conservant les propriétés mathématiques tractables des moindres carrés.
L’émergence historique de la modélisation curvilinéaire dans les sciences quantitatives remonte aux travaux pionniers de la biométrie et de la psychophysique à la fin du dix-neuvième et au début du vingtième siècle. Des pionniers tels que Francis Galton et Karl Pearson ont rapidement constaté que les lois de transmission héréditaire et les corrélations morphologiques présentaient des asymétries notables. Plus tard, avec le développement de la psychométrie, les chercheurs ont réalisé que les dynamiques comportementales humaines répondent rarement à des lois purement proportionnelles. La modélisation de trajectoires asymétriques ou non monotones s’est imposée comme une nécessité pour capturer la réalité des phénomènes psychiques où l’impact d’une cause s’amplifie, s’atténue ou s’inverse selon le contexte de son déploiement.
Dans la recherche contemporaine, l’importance accordée à la capture des dynamiques comportementales asymétriques est primordiale. Les processus psychologiques sont régis par des contraintes biologiques, environnementales et structurelles qui imposent des limites physiques aux réponses individuelles. L’analyse curvilinéaire permet d’éviter l’écueil d’une linéarisation forcée qui aplatirait artificiellement les variations critiques survenant aux extrémités de la distribution d’échantillonnage, fournissant ainsi une représentation fidèle des seuils adaptatifs propres au fonctionnement humain.
1.2 Pertinence méthodologique en sciences psychologiques
Sur le plan épistémologique, l’hypothèse de linéarité stricte constitue souvent une pétition de principe injustifiée dans l’étude des processus mentaux. Postuler qu’une augmentation unitaire d’un agent stresseur ou d’une stimulation incitative produit exactement la même variation de performance psychologique, quel que soit le niveau de départ de l’individu, contredit les observations les plus élémentaires de la psychologie cognitive et de la neurophysiologie. Les fonctions cérébrales fonctionnent selon des principes de rétroaction dynamique, d’épuisement des neurotransmetteurs et de régulation homéostatique qui génèrent structurellement des réponses curvilinéaires.
La modélisation des seuils de saturation cognitive et des effets de plafond psychologique représente l’une des applications les plus probantes de cette pertinence méthodologique. Dans le cadre de l’apprentissage ou du traitement de l’information sous contrainte temporelle, l’architecture de la mémoire de travail impose une limite supérieure infranchissable à l’efficacité du traitement. Dès lors qu’un individu s’approche de sa capacité maximale de charge mentale, le rendement marginal des ressources attentionnelles investies diminue drastiquement avant de s’annuler, voire de provoquer une désorganisation cognitive totale. Une fonction curvilinéaire concave permet de mathématiser précisément ce point de rendement décroissant et cette asymptote comportementale.
Dès lors, l’ajustement de fonctions polynomiales devient une nécessité méthodologique incontournable pour tester des théories psychologiques complexes qui prédisent explicitement des relations non monotones. Qu’il s’agisse de mesurer la vulnérabilité différentielle face au traumatisme, d’évaluer la transition entre affect normal et pathologique, ou d’explorer les conflits organisationnels, les modèles polynomiaux offrent un banc d’essai formel. Ils permettent aux chercheurs de dépasser la simple confirmation de corrélation pour vérifier si la courbure observée correspond aux prédictions déduites des paradigmes théoriques établis.
2. Formalisation mathématique et structure des modèles polynomiaux
2.1 L’équation générale des modèles de régression polynomiale
La formalisation mathématique de la régression polynomiale univariée d’ordre supérieur s’exprime à travers une équation générale dans laquelle la variable dépendante quantitative continue est exprimée comme une somme pondérée de la variable prédictive élevée à des puissances entières successives, jusqu’à un degré fini noté k. L’équation théorique pour une observation individuelle i prend la forme canonique suivante :
Yi = β0 + β1Xi + β2Xi2 + β3Xi3 + … + βkXik + εi
Dans cette formulation rigoureuse, le paramètre β0 représente la constante ou l’ordonnée à l’origine, correspondant à l’espérance conditionnelle de Y lorsque le prédicteur X est rigoureusement égal à zéro. Le coefficient β1 reflète la composante linéaire de premier ordre, laquelle traduit la pente locale instantanée de la courbe au point précis d’abscisse zéro. Les paramètres d’ordre supérieur, β2 à βk, sont les coefficients partiels de régression associés aux termes de puissance respective ; ils quantifient la magnitude, la direction et la complexité géométrique de la courbure du modèle.
Le terme d’erreur stochastique, noté εi, encapsule l’ensemble des variations de la variable critère qui ne sont pas expliquées par la trajectoire polynomiale déterministe. Dans le cadre de l’inférence statistique classique, ce résidu est soumis aux hypothèses rigoureuses de Gauss-Markov étendues : les erreurs doivent être identiquement et indépendamment distribuées selon une loi normale d’espérance nulle et de variance constante (homoscédasticité), et ne présenter aucune autocorrélation entre les observations :
εi ~ N(0, σ2)
Cette structure univariée peut être étendue au cadre multivarié où plusieurs prédicteurs coexistent. Dans une telle configuration, l’expansion polynomiale n’incorpore pas seulement les puissances pures de chaque variable explicative, mais également leurs termes croisés multiplicatifs. Ces derniers permettent d’estimer simultanément les interactions non linéaires et les courbures multidimensionnelles, transformant la ligne d’ajustement en une surface de réponse complexe au sein d’un espace vectoriel à plusieurs dimensions.
2.2 Propriétés statistiques de la linéarité dans les paramètres
L’une des caractéristiques les plus fondamentales et pourtant fréquemment mal comprises de la régression curvilinéaire polynomiale réside dans son statut de modèle intrinsèquement linéaire. Bien que la courbe résultante tracée dans le plan euclidien soit non linéaire, le modèle d’estimation demeure mathématiquement linéaire par rapport à ses paramètres inconnus β. Cela signifie que la dérivée partielle de la fonction de régression par rapport à n’importe lequel de ses coefficients ne dépend d’aucun autre paramètre inconnu du modèle :
∂Y / ∂βj = Xj
Cette propriété structurelle est d’une portée pratique considérable : elle garantit l’applicabilité directe de la méthode des moindres carrés ordinaires (MCO) pour l’estimation analytique du vecteur des paramètres. En posant de nouvelles variables vectorielles telles que Z1 = X, Z2 = X2, …, Zk = Xk, le modèle polynomial se transforme formellement en une régression linéaire multiple standard dans un espace vectoriel augmenté. L’estimation des coefficients s’obtient donc via l’équation matricielle classique bien connue :
β = (X’X)-1X’Y
Il est dès lors impératif de tracer une frontière épistémologique stricte entre ces modèles d’ordre polynomial et les modèles intrinsèquement non linéaires. Ces derniers, illustrés par les équations logistiques à quatre paramètres, les fonctions de puissance exponentielles ou les modèles de Michaelis-Menten, ne peuvent en aucun cas être linéarisés par transformation directe des prédicteurs. Leur résolution numérique exige l’abandon des moindres carrés analytiques au profit d’algorithmes itératifs d’optimisation non linéaire, tels que l’algorithme de Gauss-Newton ou de Levenberg-Marquardt, qui posent des défis distincts en matière de convergence et de pièges des minima locaux.
3. La régression quadratique : modélisation des courbes en U et en U inversé
3.1 Formulation et propriétés géométriques du modèle d’ordre deux
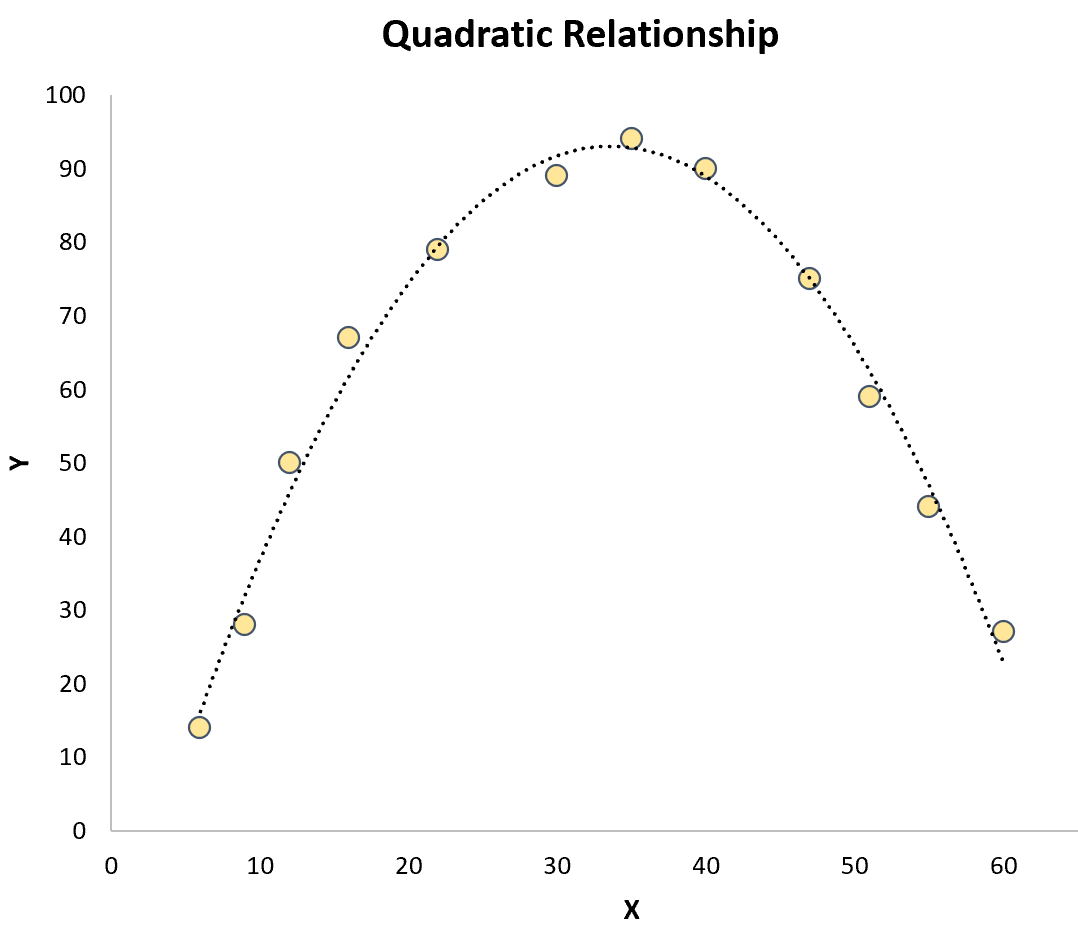
La régression quadratique, correspondant à un polynôme de degré deux (k = 2), constitue la forme la plus élémentaire et la plus fréquemment déployée de modélisation curvilinéaire. Son expression formelle se réduit à l’équation :
Yi = β0 + β1Xi + β2Xi2 + εi
Sur le plan de la topologie géométrique, cette fonction décrit une parabole parfaite dont l’orientation spatiale et l’ouverture sont gouvernées par le signe et l’amplitude du coefficient quadratique β2. Si β2 < 0, la parabole présente une concavité dirigée vers le bas, traçant une courbe en U inversé qui atteint un sommet théorique maximal avant de redescendre. À l’inverse, lorsque β2 > 0, la courbure est convexe, dessinant une morphologie en U qui plonge vers un minimum absolu avant de remonter de façon symétrique.
L’intérêt analytique majeur de ce modèle réside dans la détermination exacte de l’extremum local, qu’il s’agisse d’un pic adaptatif ou d’un nadir critique. Par le calcul différentiel élémentaire, l’annulation de la dérivée première de la fonction d’estimation par rapport à la variable indépendante permet d’identifier l’abscisse précise du point stationnaire, notée Xopt :
dY / dX = β1 + 2β2X = 0 ⟹ Xopt = – β1 / (2β2)
Cette dérivation met en exergue une réalité dynamique essentielle : le taux de changement instantané de Y par rapport à X n’est pas constant, mais varie de façon continue le long du continuum de la variable explicative. À des valeurs de X nettement inférieures à l’extremum, l’effet de levier marginal est fortement prononcé ; il s’atténue progressivement à mesure que l’on se rapproche du point critique où la pente s’annule, puis inverse sa directionnalité au-delà de cette frontière critique.
3.2 Illustration théorique : la loi de Yerkes-Dodson
L’illustration historique et conceptuelle la plus célèbre de la dynamique quadratique en psychologie est sans conteste la loi de Yerkes-Dodson, formulée initialement en 1908. Ce postulat psychophysiologique formalise la relation empirique entre le niveau d’éveil cortical, ou stress biologique, et l’efficacité de la performance cognitive ou motrice lors de l’exécution de tâches d’apprentissage complexes.
Modélisée par une fonction en U inversé caractérisée par un coefficient β2 négatif et statistiquement significatif, cette loi démontre qu’un état d’hypo-activation physiologique se traduit par de l’apathie, un déficit attentionnel et des performances dégradées. À mesure que l’activation neurovégétative croît, la vigilance, l’acuité perceptive et la concentration s’optimisent jusqu’à un point d’activation idéal, précisément identifié par l’apex mathématique de la parabole. Toutefois, si la stimulation dépasse ce seuil optimal pour basculer dans l’hyper-activation émotionnelle, l’anxiété aiguë désorganise le traitement de l’information et entraîne un effondrement de la performance.
Cette loi illustre avec éclat les dangers méthodologiques d’une spécification linéaire erronée. Si un expérimentateur contraignait les données d’une telle étude à travers une régression linéaire simple, la pente globale β1 résultante serait approximativement égale à zéro si l’échantillon couvre l’ensemble du spectre d’activation de manière équilibrée. Le chercheur conclurait alors, de façon dramatiquement fausse, à l’absence totale d’effet de l’éveil sur la performance (erreur de type II). Seule l’incorporation formelle du terme quadratique permet de rejeter l’hypothèse nulle et de dévoiler la puissante régulation homéostatique sous-jacente.
3.3 Exemples en psychologie de la santé et du bien-être
Au-delà de la psychophysiologie classique, les modèles quadratiques trouvent un terrain d’application fertile dans l’étude des comportements de santé contemporains. Un exemple paradigmatique concerne l’impact du temps d’écran quotidien sur le bien-être psychologique des adolescents, objet de débats sociétaux majeurs. Plusieurs enquêtes épidémiologiques d’envergure démontrent que cette relation ne suit pas une détérioration linéaire simple, mais plutôt une trajectoire en U inversé conforme à « l’hypothèse Boucles d’or » (Goldilocks hypothesis). Une privation numérique complète est associée à un score de bien-être sous-optimal, souvent lié à l’isolement social par rapport au groupe de pairs ; un usage modéré constitue un espace d’intégration relationnelle maximisant l’ajustement psychosocial ; enfin, un usage excessif au-delà du seuil critique précipite le désengagement scolaire et l’altération de l’humeur.
Dans le domaine de la personnalité et de la psychopathologie, la dynamique du perfectionnisme névrotique répond à des mécanismes similaires. À des niveaux faibles à modérés, certaines dimensions perfectionnistes d’exigence personnelle soutiennent l’effort, la méticulosité et le sentiment d’auto-efficacité, favorisant une bonne adaptation psychologique. Cependant, dès lors que ces traits franchissent un seuil critique pour se muer en préoccupations évaluatives obsessionnelles et en peur paralysante de l’échec, le modèle bascule brutalement vers la détresse psychologique, favorisant l’émergence d’épisodes dépressifs majeurs.
Enfin, en psychologie du travail, l’engagement professionnel illustre avec acuité cette dynamique non linéaire. L’implication active et le dévouement envers l’organisation sont corrélés positivement à l’épanouissement personnel et à la vitalité au travail jusqu’à un plafond spécifique. Lorsque l’engagement se transforme en surinvestissement compulsif (workaholism), l’incapacité à se détacher mentalement des contraintes professionnelles déclenche une surconsommation des ressources énergétiques, précipitant le travailleur vers l’épuisement émotionnel et le burn-out.
4. La régression cubique : dynamique des points d’inflexion multiples
4.1 Structure mathématique et double courbure
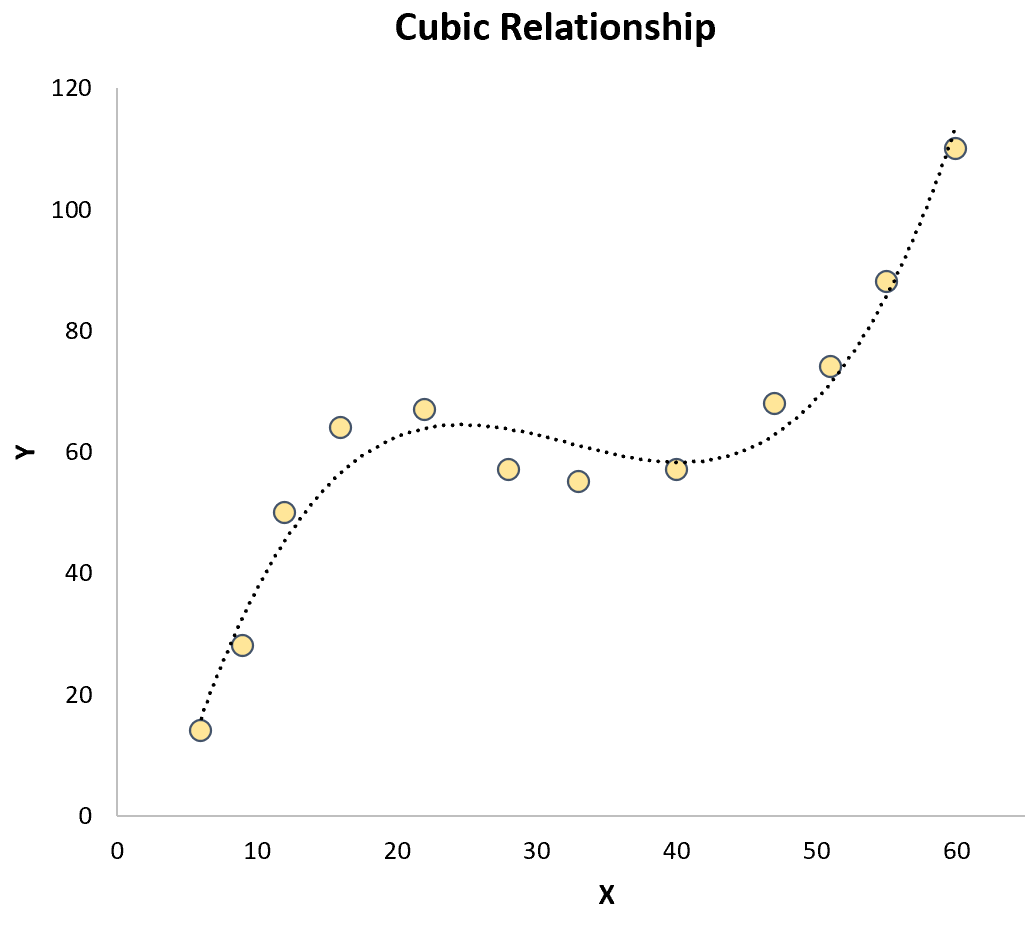
Lorsque la complexité théorique du phénomène dépasse la symétrie parabolique simple d’un modèle d’ordre deux, l’analyse polynomiale recourt à la régression cubique, correspondant à un polynôme d’ordre trois. Son équation mathématique intègre une composante d’élévation à la puissance trois :
Yi = β0 + β1Xi + β2Xi2 + β3Xi3 + εi
L’adjonction du terme cubique confère à la courbe une flexibilité géométrique substantielle : elle permet de modéliser des trajectoires asymétriques, des fonctions sigmoïdes en forme de S ou des doubles oscillations présentant à la fois un maximum local et un minimum local. L’analyse des propriétés différentielles du modèle d’ordre trois révèle sa dynamique interne :
dY / dX = β1 + 2β2X + 3β3X2
La résolution de cette équation quadratique permet d’identifier jusqu’à deux extremums stationnaires réels, à la condition stricte que le discriminant algébrique Δ = (2β2)2 – 4(3β3)(β1) soit strictement positif. Parallèlement, l’annulation de la dérivée seconde de la fonction met en évidence l’existence d’un point d’inflexion central, déterminé par :
d2Y / dX2 = 2β2 + 6β3X = 0 ⟹ Xinflexion = – β2 / (3β3)
Ce point d’inflexion signale le moment précis où la fonction modifie sa courbure intrinsèque, basculant de la concavité à la convexité, ou inversement. Cependant, l’usage des polynômes cubiques impose une vigilance statistique extrême. Le terme X3 présente une sensibilité exponentielle aux valeurs extrêmes ou aux observations atypiques situées aux marges de la distribution. Une seule valeur aberrante à fort levier peut contraindre artificiellement l’estimation de β3, créant l’illusion d’une double courbure là où n’existe en réalité qu’un artefact d’échantillonnage. Le principe de parcimonie scientifique (le rasoir d’Ockham) impose donc que l’introduction d’un degré trois soit rigoureusement étayée par un modèle théorique solide et des indices statistiques sans équivoque.
4.2 Applications en psychologie du développement et vieillissement cognitif
La trajectoire développementale des fonctions exécutives au cours de l’existence humaine constitue un domaine d’élection de la régression cubique. L’évolution de dimensions telles que le contrôle inhibiteur, la flexibilité cognitive et la vitesse de traitement de l’information ne peut être appréhendée par un modèle parabolique symétrique. La cinétique empirique suit une trajectoire triphasique asymétrique : une phase initiale de croissance rapide durant l’enfance et l’adolescence, suivie d’un plateau prolongé de relative stabilité à l’âge adulte, puis d’une inflexion menant à un déclin progressif lors du vieillissement avancé.
Dans les stades initiaux du développement de l’enfant, l’acquisition du vocabulaire lexical illustre également cette cinétique d’ordre trois. Les premiers mois d’apprentissage du langage oral sont caractérisés par une phase de latence où l’accumulation de nouveaux mots est lente et laborieuse. Aux alentours de dix-huit à vingt-quatre mois survient un point d’inflexion spectaculaire, traditionnellement désigné sous le terme d’explosion lexicale, où le taux d’acquisition subit une accélération exponentielle. Enfin, au fur et à mesure que les structures grammaticales se consolident, la courbe tend à décélérer vers un taux d’apprentissage plus stable, dessinant une courbe en S sigmoïdale que la régression cubique capture avec précision.
On retrouve ces dynamiques au sein des courbes d’apprentissage complexe chez l’adulte confronté à l’acquisition de compétences motrices ou cognitives de haut niveau, comme le pilotage aéronautique ou la maîtrise d’un instrument de musique. Ces courbes révèlent fréquemment des plateaux intermédiaires de stagnation apparente, durant lesquels les structures cognitives se réorganisent avant qu’un nouveau palier de maîtrise supérieure ne soit franchi, invalidant d’emblée toute formalisation purement linéaire ou simplement quadratique.
5. Distinction comparative : régression linéaire simple versus régression curvilinéaire
5.1 Les risques de l’erreur de spécification fonctionnelle
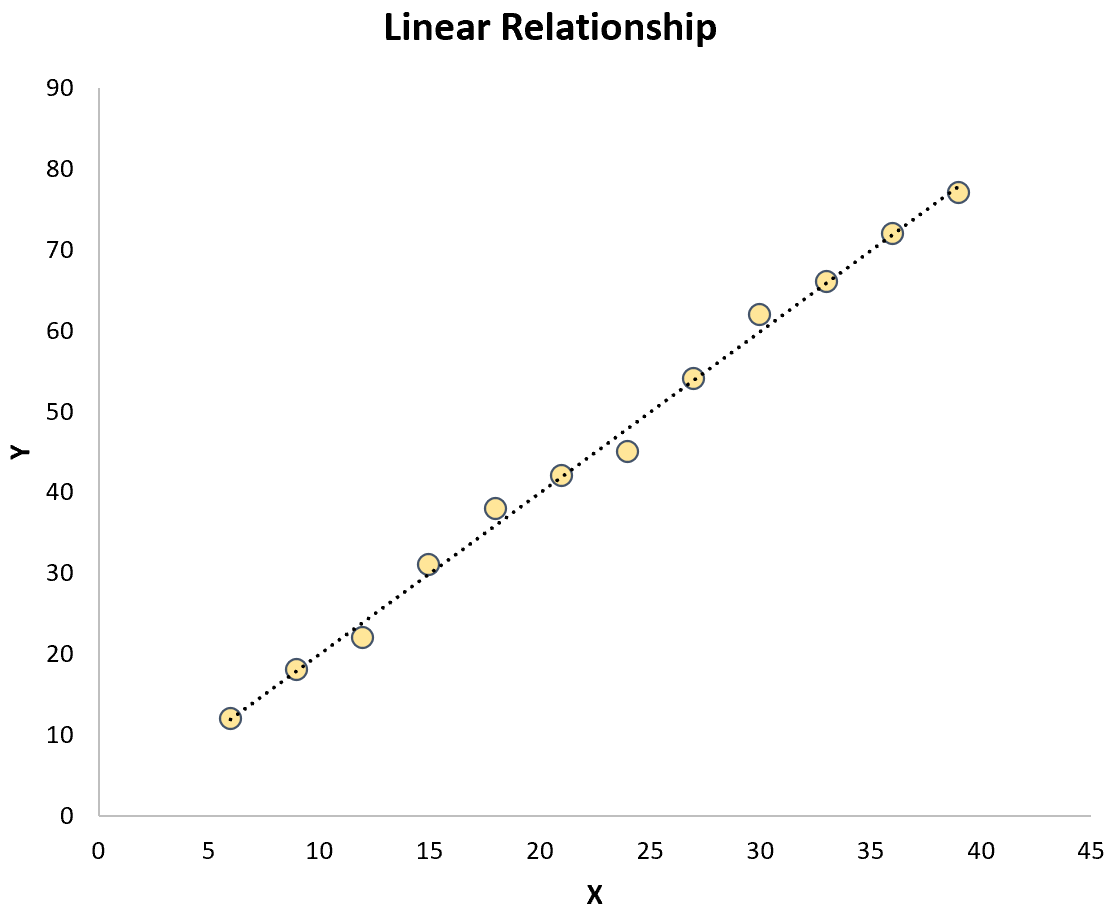
L’erreur de spécification fonctionnelle survient lorsqu’un chercheur impose une structure mathématique inadéquate aux données observées — en particulier lorsqu’il contraint une dynamique naturellement curviligne à s’exprimer sous la forme d’un modèle linéaire simple de type Y = β0 + β1X. Les conséquences de ce sous-ajustement (underfitting) sur le plan de l’inférence statistique sont dévastatrices et affectent l’intégrité même des conclusions de l’étude.
En premier lieu, le biais systématique affectant le coefficient de pente β1 est direct. Si la véritable relation est symétriquement quadratique, la pente linéaire globale convergera asymptotiquement vers zéro, conduisant à une sous-estimation massive de la force du lien unissant les variables. Même dans les configurations asymétriques où la relation est monotone mais présente une courbure prononcée, la pente linéaire moyenne échoue à refléter la variabilité locale des taux d’impact, surestimant l’effet à une extrémité de la distribution tout en le sous-estimant à l’autre.
En second lieu, cette erreur structurelle génère une perte drastique de puissance statistique. L’ensemble de la variance systématique de la variable dépendante générée par la courbure non modélisée se trouve mécaniquement transférée dans la somme des carrés des résidus d’erreur (SSE). Cette inflation artificielle de la variance d’erreur gonfle le dénominateur des tests statistiques de Student et de Fisher, diminuant d’autant la probabilité de détecter les effets réels et augmentant de manière inacceptable le risque d’erreur de type II. La validité interne de la recherche s’en trouve lourdement compromise.
5.2 Le compromis biais-variance dans l’ordre polynomial
L’alternative consistant à pallier le risque de sous-ajustement par une élévation sans frein du degré polynomial expose le chercheur à l’écueil opposé, bien connu en apprentissage statistique sous le nom de dilemme biais-variance. Si l’augmentation de l’ordre polynomial garantit mathématiquement une réduction continue de la somme des résidus au carré sur l’échantillon d’apprentissage, elle induit rapidement un phénomène délétère de surapprentissage (overfitting).
À mesure que le degré polynomial s’accroît, le modèle cesse de capturer la tendance structurelle de la population pour commencer à interpoler le bruit stochastique, les fluctuations aléatoires d’échantillonnage et les erreurs de mesure inhérentes aux protocoles psychologiques. Il en résulte un modèle d’une extrême complexité dont la variance d’estimation explose : une variation minime dans l’échantillon d’entraînement produira une configuration radicalement divergente des paramètres estimés, anéantissant toute possibilité de réplication empirique.
Ce surapprentissage culmine fréquemment dans le phénomène géométrique d’oscillation de Runge. Aux bornes du domaine expérimental, les polynômes de degré élevé ont tendance à osciller de manière violente et erratique, produisant des prédictions absurdes en dehors de la zone centrale d’observation. C’est pourquoi la sélection du degré polynomial optimal ne doit jamais résulter d’une quête algorithmique aveugle du coefficient de détermination maximal, mais doit être guidée par des considérations théoriques substantielles, en s’arrêtant presque invariablement aux degrés deux ou trois dans l’étude des processus comportementaux.
6. Protocoles de diagnostic statistique et détection de la non-linéarité
6.1 Analyse visuelle et inspection des résidus
La démarche diagnostique visant à identifier la non-linéarité commence invariablement par une analyse graphique soignée. L’outil exploratoire initial fondamental est le diagramme de dispersion bivarié, superposé d’une courbe de lissage non paramétrique locale, telle qu’une régression LOESS (Locally Estimated Scatterplot Smoothing). Ce lissage empirique, exempt d’hypothèse fonctionnelle contraignante préalable, permet à l’œil du chercheur d’entrevoir les tendances à la courbure, les changements de pente et les asymétries potentielles du nuage de points.
Toutefois, l’inspection directe des résidus d’estimation demeure le test diagnostique le plus sensible et le plus discriminant. Lorsque l’on trace le graphique des résidus standardisés en ordonnée en regard des valeurs prédites (ou des valeurs de la variable explicative) en abscisse, un modèle linéaire correctement spécifié doit afficher une distribution parfaitement homogène, aléatoire et sans structure, évoquant un nuage de points horizontal sans motif discernible. Si la relation sous-jacente est en réalité curvilinéaire mais a été forcée dans une équation linéaire, les résidus afficheront une signature géométrique systématique caractéristique, adoptant une forme en arche, en banane ou en parabole inversée.
Cette analyse graphique permet en outre d’éviter la confusion fréquente entre une véritable hétéroscédasticité et une non-linéarité non modélisée. Une structure résiduelle en éventail ou en entonnoir peut parfois n’être que le reflet d’une courbure oubliée qui projette des résidus systématiquement positifs au centre et négatifs aux extrémités. Une fois le terme polynomial d’ordre supérieur introduit dans l’équation, le motif résiduel tend à se dissoudre pour retrouver la configuration d’homoscédasticité requise par les postulats d’inférence.
6.2 Tests inférentiels de confirmation de la non-linéarité
L’appréciation visuelle des résidus, bien qu’indispensable, doit être corroborée par des procédures inférentielles formelles permettant de rejeter rigoureusement l’hypothèse de linéarité. Le test le plus largement validé pour accomplir ce diagnostic d’omission fonctionnelle est le test de Ramsey RESET (Regression Equation Specification Error Test). Ce test évalue si des puissances non linéaires des valeurs prédites par le modèle linéaire d’origine (par exemple Ŷ2 et Ŷ3) possèdent une capacité explicative statistiquement significative lorsqu’elles sont réintroduites comme prédicteurs auxiliaires dans l’équation. Si la statistique de test F associée s’avère significative, l’hypothèse nulle de spécification linéaire adéquate est formellement rejetée.
Une alternative élégante réside dans l’utilisation du test d’hypothèse emboîté fondé sur la comparaison de modèles hiérarchiques. Cette approche procède par comparaison de la somme des carrés des erreurs résiduelles entre un modèle restreint (le modèle linéaire simple) et un modèle général augmenté (le modèle polynomial quadratique ou cubique). La statistique F de changement incrémentiel de variance est définie par l’équation matricielle :
Fchangement = [(SSErestreint – SSEcomplet) / (dfrestreint – dfcomplet)] / [SSEcomplet / dfcomplet]
Si la valeur p associée à cette statistique franchit le seuil conventionnel de significativité (typiquement α = 0,05), cela prouve mathématiquement que la réduction de l’erreur d’estimation apportée par le terme quadratique ou cubique n’est pas réductible aux seules fluctuations aléatoires de l’échantillonnage. Enfin, l’observation directe du test de Student bilatéral appliqué au coefficient partiel βk du terme de puissance supérieure offre une confirmation immédiate de la contribution isolée de la courbure au sein du modèle complet.
7. Gestion des défis méthodologiques : multicolinéarité et centrage
7.1 Le problème de la corrélation structurelle entre puissances
L’implémentation pratique des régressions curvilinéaires polynomiales se heurte à un écueil technique majeur et universel : la multicolinéarité structurelle. Contrairement à la colinéarité fortuite qui résulte du hasard de l’échantillonnage de prédicteurs corrélés, la colinéarité structurelle est mathématiquement engendrée par la construction même des variables du modèle. Lorsque l’on élève une variable indépendante continue X constituée exclusivement de valeurs positives au carré (X2) ou au cube (X3), le vecteur transformé conserve une corrélation bivariée mécanique extrêmement élevée avec le vecteur source de premier ordre, cette corrélation dépassant souvent r = 0,90 ou 0,95.
L’introduction simultanée de ces deux termes fortement corrélés au sein de la matrice d’inversion des moindres carrés (X’X)-1 provoque une quasi-singularité matricielle. Les conséquences statistiques sont bien documentées : un gonflement démesuré des erreurs-types associées aux estimations des coefficients partiels, une instabilité extrême des paramètres qui peuvent changer de signe à la suite de fluctuations minimes dans l’échantillon, et un effondrement de la puissance statistique des tests de signification individuels associés aux composantes linéaire et quadratique.
Le diagnostic de cette pathologie métrologique s’établit par l’inspection conjointe de la tolérance d’échantillonnage et du facteur d’inflation de la variance (VIF). Dans les modèles polynomiaux non corrigés, il n’est pas rare d’observer des valeurs de VIF franchissant allègrement les seuils conventionnels d’alerte critique fixés à 5 ou 10, atteignant parfois des magnitudes supérieures à 50 ou 100, ce qui témoigne d’une dégénérescence presque totale de l’estimation de la pente linéaire conditionnelle.
7.2 La technique du centrage sur la moyenne
Pour neutraliser ce piège structurel sans dénaturer la qualité de l’ajustement global, la communauté méthodologique préconise quasi unanimement l’application systématique du centrage sur la moyenne préalable à toute dérivation polynomiale. Cette procédure élémentaire mais fondamentale consiste à soustraire la moyenne arithmétique de l’échantillon X̄ de chaque score individuel de la variable indépendante avant d’effectuer l’opération d’élévation à la puissance :
Xcentré = X – X̄
Y = β0* + β1*(Xcentré) + β2*(Xcentré)2 + ε
Sur le plan géométrique, si la distribution originale du prédicteur est approximativement symétrique autour de sa moyenne, le produit des termes d’écart positif et négatif se compense lors du passage au carré, conduisant à une corrélation théorique quasi nulle entre Xcentré et (Xcentré)2. Cette orthogonalisation substantielle des composantes fait s’effondrer instantanément les indices de facteur d’inflation de la variance vers des niveaux optimaux proches de l’unité, restaurant l’efficience statistique des erreurs-types.
Au-delà de la résolution de la colinéarité, le centrage opère une clarification sémantique décisive pour l’interprétation des résultats. Dans le modèle non centré, le coefficient β1 représente la pente instantanée au point d’abscisse X = 0, une valeur qui se situe fréquemment hors du domaine observable en psychologie (par exemple, un score d’intelligence ou d’âge égal à zéro) et qui n’a aucun sens théorique. Dans le modèle centré, Xcentré = 0 correspond rigoureusement à la moyenne de l’échantillon X̄. Par conséquent, le coefficient linéaire β1* se réinterprète de façon limpide comme la pente marginale moyenne du phénomène évaluée au cœur de la distribution empirique. Pour les cas exigeant une indépendance mathématique totale entre les termes de décomposition de variance, les chercheurs peuvent également recourir à la formulation par polynômes orthogonaux de Chebychev.
8. Applications en psychologie sociale et organisationnelle
8.1 Dynamique de la charge de travail et épuisement professionnel
La psychologie organisationnelle moderne a progressivement abandonné les conceptions déterministes linéaires pour embrasser des cadres conceptuels non linéaires plus aptes à capturer la complexité des milieux professionnels contemporains. L’exploration de la relation unissant les exigences professionnelles objectives (charge horaire, pression temporelle, complexité décisionnelle) et l’épuisement émotionnel des salariés en constitue une illustration paradigmatique.
Les modélisations curvilinéaires démontrent que cette relation ne s’exprime pas sous la forme d’une constante de dégradation, mais suit une trajectoire exponentielle ou quadratique convexe ascendante. À des niveaux faibles à modérés d’exigences professionnelles, les mécanismes de régulation psychologique individuelle, le sentiment d’utilité et les capacités d’adaptation absorbent l’impact de la charge sans provoquer d’altération notable de la santé mentale. Le travailleur mobilise ses ressources cognitives au sein d’une zone d’élasticité adaptative où le stress demeure gérable et parfois stimulant.
Cependant, dès lors que la charge de travail franchit un seuil de saturation fonctionnelle spécifique, la capacité tampon homéostatique se trouve brutalement débordée. Au-delà de cette frontière de rupture critique, l’augmentation marginale de la moindre contrainte temporelle ou tâche additionnelle engendre une détérioration disproportionnée du capital énergétique, précipitant l’individu vers une décompensation psychique sévère et l’épuisement professionnel. Cette constatation a des répercussions directes sur l’ergonomie et la gouvernance d’entreprise : elle invalide formellement l’hypothèse selon laquelle les augmentations de productivité peuvent être poursuivies de façon indéfinie au prix d’un coût humain marginal constant.
8.2 Leadership, autorité et cohésion d’équipe
L’étude des styles de direction en psychologie sociale contemporaine est largement structurée par la théorisation de l’effet « trop d’une bonne chose » (Too-Much-of-a-Good-Thing Effect). Ce cadre conceptuel postule que des comportements managériaux universellement reconnus comme bénéfiques peuvent, lorsqu’ils sont portés à l’extrême, devenir dysfonctionnels et engendrer des conséquences contre-productives au sein des organisations.
Le leadership directif et structurant offre un exemple parlant de cette dynamique en U inversé. À faible intensité, le manque de direction plonge les équipes dans l’ambiguïté des rôles, la confusion opérationnelle et l’inefficacité collective. Une augmentation du guidage structurel clarifie les objectifs, réduit l’anxiété organisationnelle et coordonne les flux d’action, optimisant la cohésion d’équipe. Cependant, lorsque le style de management bascule dans l’hyper-directivité ou le micro-management autoritaire, l’inflexion négative de la parabole se manifeste : l’autonomie des collaborateurs est annihilée, la motivation intrinsèque s’érode et la prise d’initiative s’effondre pour laisser place à la résignation ou au ressentiment passif-agressif.
Une configuration similaire s’observe dans l’analyse de la cohésion groupale. Alors qu’un niveau minimal de cohésion affective est une condition sine qua non de la coopération intra-équipe, une sur-cohésion extrême favorise l’émergence des pathologies de pensée de groupe (groupthink). L’impératif absolu d’harmonie interpersonnelle y étouffe l’esprit critique, inhibe l’expression des voix discordantes et détériore la qualité des décisions stratégiques du collectif, validant l’exigence d’un équilibre curvilinéaire dynamique.
9. Évaluation de la qualité de l’ajustement et sélection de modèles
9.1 Indicateurs d’ajustement global et incrémental
L’évaluation rigoureuse d’un modèle de régression curvilinéaire requiert un arbitrage subtil entre l’amélioration de la qualité d’ajustement et la pénalisation de la complexité mathématique superflue. L’indicateur conventionnel d’ajustement global demeure le coefficient de détermination R2, lequel quantifie la proportion de variance de la variable critère absorbée par le modèle. Toutefois, le R2 brut souffre d’un biais algébrique intrinsèque : son amplitude augmente de façon monotone et inconditionnelle à chaque fois qu’un terme polynomial supplémentaire est adjoint à l’équation, quand bien même ce terme ne contiendrait que du bruit stochastique résiduel.
Pour parer à cette faille, le chercheur doit obligatoirement reporter le coefficient de détermination ajusté (R2ajusté), qui intègre une correction tenant compte des degrés de liberté du modèle en regard de la taille d’échantillon :
R2ajusté = 1 – [(1 – R2) * (n – 1) / (n – k – 1)]
Si l’adjonction d’un terme quadratique ou cubique améliore l’ajustement du modèle dans une proportion inférieure à ce qui serait attendu par simple chance d’échantillonnage, le R2ajusté décroîtra, signalant immédiatement une inflation préjudiciable de la complexité. La justification du passage à un ordre supérieur s’appuie également sur le test F de changement incrémentiel de R2 (ΔR2), qui permet de quantifier rigoureusement la plus-value explicative nette isolée du terme non linéaire par rapport au modèle d’ordre immédiatement inférieur.
Cependant, le chercheur doit garder à l’esprit les limites inhérentes à l’interprétation de ces coefficients dans les disciplines comportementales. En raison des erreurs d’échantillonnage psychométrique et de l’instabilité contextuelle des mesures, l’observation d’un incrément de ΔR2 modeste — de l’ordre de 1 à 3 % — peut sembler statistiquement marginale alors qu’elle revêt une signification théorique et pratique majeure si elle reflète un basculement qualitatif du comportement humain.
9.2 Critères d’information et validation croisée
Face à la compétition entre plusieurs ordres polynomiaux concurrents (modèle linéaire contre quadratique, cubique ou quartique), l’application des critères de la théorie de l’information constitue le standard méthodologique dominant. Les deux mesures les plus robustes sont le critère d’information d’Akaike (AIC) et le critère d’information bayésien de Schwarz (BIC), formulés par les équations :
AIC = 2p – 2 ln(L̂)
BIC = p ln(n) – 2 ln(L̂)
Dans ces équations, L̂ représente le maximum de vraisemblance du modèle estimé, p le nombre total de paramètres libres incorporés et n la taille effective de l’échantillon. Ces deux critères imposent une pénalité explicite proportionnelle au nombre de paramètres introduits, le BIC appliquant une sanction plus sévère pour les grands échantillons. La règle de décision sélectionne le modèle qui minimise la valeur absolue du critère, une différence ΔAIC supérieure à 2 étant généralement considérée comme le seuil à partir duquel le modèle de valeur inférieure présente une supériorité empirique démontrée.
Pour parachever cette validation et se prémunir définitivement contre les artefacts de surapprentissage, il est recommandé de soumettre les modèles polynomiaux à des protocoles de validation croisée à k blocs (k-fold cross-validation). En scindant aléatoirement les données en sous-ensembles d’apprentissage et de test, cette technique permet de mesurer l’erreur quadratique moyenne de prédiction (RMSE) hors échantillon. Le meilleur modèle polynomial sera dès lors celui qui maximise sa capacité de généralisation prédictive sur de nouvelles observations non mobilisées pour l’étalonnage de ses paramètres.
10. Extensions et modèles non linéaires alternatifs
10.1 Modèles splines et lissage par morceaux
Malgré leur élégance mathématique et leur relative facilité de mise en œuvre, les régressions polynomiales globales partagent une limitation structurelle intrinsèque : leur caractère strictement holistique. L’estimation d’un coefficient polynomial dépend simultanément de l’intégralité des données distribuées sur l’ensemble du domaine d’observation. Dès lors, une modification locale de données survenant à une extrémité de l’échantillon peut altérer la courbure prédite à l’autre extrémité, un comportement parfois indésirable dans l’étude de trajectoires psychologiques complexes.
Pour surmonter cet obstacle, les biostatisticiens et économètres font appel aux techniques de régression par splines. Le principe fondamental d’une spline de régression consiste à segmenter le continuum de la variable prédictive en plusieurs sous-intervalles distincts, délimités par des points d’ancrage appelés nœuds (knots). À l’intérieur de chaque segment, un polynôme local d’ordre modeste (généralement cubique) est ajusté de manière indépendante, avec la contrainte mathématique rigoureuse d’assurer une continuité différentiable parfaite aux points de jonction des nœuds.
Les splines de régression s’avèrent particulièrement puissantes pour modéliser des ruptures de dynamique psychologique consécutives à un événement de vie marquant, une transition développementale aiguë ou l’exposition à un stress traumatique. Contrairement au polynôme classique qui tenterait de lisser artificiellement l’ensemble du profil au prix d’ondulations parasites, la spline permet d’épouser des virages serrés et des régimes fonctionnels radicalement hétérogènes tout en préservant une stabilité asymptotique remarquable en dehors des zones d’ancrage.
10.2 Modèles additifs généralisés et fonctions sigmoïdes
Lorsque le corpus théorique sous-jacent est insuffisant pour prescrire a priori une forme polynomiale définie (qu’elle soit de degré deux, trois ou plus), l’investigateur peut opter pour une démarche purement inductive non paramétrique en recourant aux modèles additifs généralisés (GAM). Développés initialement par Trevor Hastie et Robert Tibshirani, les GAM assouplissent le cadre du modèle linéaire en remplaçant la combinaison paramétrique rigide des termes par des fonctions de lissage non paramétriques lisses et flexibles :
Y = β0 + s(X) + ε
Dans cette formalisation, s(X) représente une fonction de lissage non paramétrique estimée directement à partir des propriétés intrinsèques des données via des algorithmes de pénalisation de rugosité (penalized splines). Les GAM permettent de « laisser parler les données » afin de découvrir la forme fonctionnelle réelle liant les variables, servant ainsi d’outil de criblage exploratoire avant d’arrêter le choix d’une spécification polynomiale définitive plus parcimonieuse.
Par ailleurs, lorsque les fondements théoriques dictent l’existence d’une dynamique strictement bornée par des asymptotes infranchissables — comme dans les épreuves psychophysiques de détection sensorielle ou les tests de saturation de l’apprentissage perceptif —, le recours à des fonctions non linéaires transcendantes pures s’avère supérieur aux approximations polynomiales. Les modèles logistiques à quatre paramètres ou les courbes de Gompertz garantissent une convergence asymptotique sans jamais présenter le risque de rechute ou d’oscillation géométrique qui affecte inévitablement les polynômes d’ordre supérieur aux limites de leur distribution.
11. Protocole d’implémentation logicielle et restitution des résultats
11.1 Mise en œuvre dans les environnements statistiques courants
L’implémentation opérationnelle de la régression polynomiale centré dans les environnements de calcul scientifique contemporains s’appuie sur des routines standardisées. Dans l’écosystème open-source R, l’opération s’exécute avec fluidité au moyen de la fonction native de modélisation linéaire. Il est méthodologiquement recommandé d’appliquer la transformation de centrage en amont, ou de faire appel à la fonction d’orthogonalisation polynomiale :
# Approche par centrage manuel préalable
data$X_centre <- scale(data$X, center = TRUE, scale = FALSE)
modele_poly <- lm(Y ~ X_centre + I(X_centre^2), data = data)
summary(modele_poly)
L’opérateur I() au sein de la syntaxe de R est impératif pour forcer l’interpréteur de formules à évaluer l’opération d’élévation à la puissance arithmétique avant son incorporation dans la matrice d’analyse. Pour exploiter la décomposition par polynômes orthogonaux exempts de multicolinéarité, la syntaxe concise lm(Y ~ poly(X, 2, raw = FALSE)) génère des coefficients non corrélés parfaits, bien que leur réinterprétation en unités brutes d’échelle exige une conversion inverse.
Dans l’environnement Python, la démarche s’articule généralement autour de la bibliothèque statsmodels pour l’inférence ou de scikit-learn pour l’apprentissage automatique prédictif. L’utilisation conjointe de StandardScaler et de PolynomialFeatures(degree=2, include_bias=False) au sein d’un pipeline séquentiel garantit que le centrage des variables et le calcul des puissances s’exécutent de façon hermétique, prévenant toute fuite de données (data leakage) lors de la validation croisée.
Au sein du logiciel IBM SPSS Statistics, l’estimation d’une trajectoire curvilinéaire peut être menée via le menu « Régression linéaire hiérarchique ». Le chercheur insère en premier bloc le terme centré de premier ordre, puis configure un second bloc contenant le terme d’ordre deux préalablement généré via la commande « Calculer la variable ». L’activation de la case « Modification de R-deux » permet d’obtenir directement le test F de significativité incrémentielle de la courbure.
11.2 Normes de présentation scientifique selon le style APA
La restitution académique des modèles de régression curvilinéaire selon les normes de l’American Psychological Association (APA, 7e édition) impose une rigueur documentaire stricte, interdisant l’omission des étapes hiérarchiques d’ajustement. Les résultats doivent être consignés au sein d’un tableau récapitulatif hiérarchique détaillant pour chaque étape d’introduction : les coefficients de régression non standardisés (B) assortis de leurs erreurs-types respectives (SE B), les coefficients standardisés (β), les valeurs des statistiques de Student (t), les degrés de signification exacte (valeurs p), ainsi que le R2 cumulé, le R2ajusté et le changement de variance ΔR2 accompagné du test F associé.
Le style APA accorde une importance critique à la visualisation graphique des effets curvilinéaires. La publication d’un modèle non linéaire doit systématiquement s’accompagner d’une représentation graphique rigoureuse illustrant la ligne de prédiction du modèle entourée de ses bandes d’intervalles de confiance à 95 %. Il est fortement préconisé d’y superposer une projection semi-transparente du nuage de points réels de l’échantillon, afin de permettre au lecteur de juger visuellement de la densité empirique appuyant la courbure et de vérifier l’absence d’artefacts générés par des valeurs aberrantes isolées.
Sur le plan de la narration scientifique, le texte doit formellement documenter la directionnalité de la courbure (concave ou convexe), la significativité du coefficient d’ordre supérieur, ainsi que les coordonnées exactes de l’extremum ou du point d’inflexion empirique déduit par calcul différentiel (ex. : « L’apex de performance a été localisé à un niveau d’activation de X = 42,3, au-delà duquel l’efficacité cognitive commence à décliner »). Enfin, le chercheur doit expressément rappeler les bornes inférieures et supérieures du domaine empirique observé au sein de l’échantillon pour prévenir toute tentative fallacieuse d’extrapolation au-delà de ces frontières.
12. Synthèse épistémologique et recommandations pratiques pour le chercheur
12.1 Guide décisionnel pour l’analyse de données non linéaires
Pour naviguer avec rigueur dans l’analyse des trajectoires non linéaires, le chercheur a intérêt à mobiliser un cadre décisionnel séquentiel, structuré en étapes de vérification méthodologique successives. Ce protocole systématique permet d’éviter tant le sous-ajustement réductionniste que le surapprentissage non contrôlé :
- Étape 1 : Justification théorique préalable. La décision d’évaluer une relation curvilinéaire ne doit jamais résulter d’un dragage de données (data dredging) fortuit. Elle doit s’enraciner dans des hypothèses substantiellement étayées par la littérature psychologique, décrivant un mécanisme d’autorégulation, de saturation ou d’inversion d’effet.
- Étape 2 : Exploration bivariée et diagnostic visuel. Tracé initial des diagrammes de dispersion accompagnés de courbes de lissage LOESS et vérification de la présence éventuelle d’observations aberrantes ou de points à fort levier (mesurés par la distance de Cook) susceptibles de biaiser artificiellement l’estimation de la courbure.
- Étape 3 : Centrage systématique des prédicteurs. Calcul des écarts à la moyenne pour la variable explicative avant toute dérivation de puissances d’ordre supérieur, afin d’éliminer la multicolinéarité structurelle et d’assurer une interprétabilité directe des termes de premier ordre.
- Étape 4 : Modélisation hiérarchique progressive. Ajustement successif du modèle linéaire (Bloc 1), puis du modèle quadratique (Bloc 2) et, le cas échéant, du modèle cubique (Bloc 3). Évaluation de la pertinence de chaque incrément via le test de changement F (ΔR2) et comparaison des critères d’information (AIC/BIC).
- Étape 5 : Audit diagnostique des résidus. Inspection approfondie des graphiques de résidus standardisés pour s’assurer que les motifs en arche ont disparu et vérifier les postulats d’homoscédasticité et de normalité des erreurs.
- Étape 6 : Interprétation différentielle et cartographie des seuils. Calcul formel de l’extremum (apex ou nadir) ou du point d’inflexion via les dérivées première et seconde, et contextualisation théorique de ces valeurs critiques par rapport à la distribution d’échantillonnage.
12.2 Perspectives futures de la modélisation curvilinéaire en psychologie
Le champ méthodologique de la modélisation non linéaire connaît actuellement une expansion sans précédent sous l’impulsion conjointe de la révolution computationnelle et du déploiement massif de nouveaux protocoles de recueil de données. L’une des frontières les plus prometteuses concerne l’intégration de la curvilinéarité au sein des modèles d’équations structurelles (SEM) et de l’analyse en variables latentes. En dépassant les limites des scores observés bruts entachés d’erreurs de mesure, les SEM non linéaires permettent d’estimer des interactions et des courbures polynomiales entre construits psychologiques latents purs, renforçant la validité écologique des théories formulées.
Parallèlement, la généralisation des méthodes d’évaluation écologique momentanée (Ecological Momentary Assessment, EMA) et des capteurs physiologiques connectés génère désormais des flux continus de données longitudinales intensives. L’analyse de ces séries temporelles à haute résolution spatio-temporelle révèle que les processus psychologiques fluctuent selon des dynamiques non linéaires complexes, caractérisées par des cycles circadiens, des phénomènes d’hystérésis et des bascules de bifurcation soudaines.
Dans ce contexte novateur, la régression curvilinéaire classique constitue le socle conceptuel indispensable à partir duquel se déploient les théories des systèmes dynamiques complexes et de la modélisation par équations différentielles appliquées à l’esprit humain. Comprendre que la réponse psychique n’est pas une simple ligne droite, mais une géométrie subtile de flux, d’inflexions et de seuils, constitue sans doute le pas épistémologique le plus déterminant franchi par la psychologie quantitative au cours des dernières décennies.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). Sage Publications.
- Grant, A. M., & Schwartz, B. (2011). Too much of a good thing: The challenge and opportunity of the inverted U. Perspectives on Psychological Science, 6(1), 61–76. https://doi.org/10.1177/1745691610393523
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized Additive Models. Chapman and Hall/CRC. https://doi.org/10.1201/9780203738788
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An introduction to statistical learning: with applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- MacCallum, R. C., & Austin, J. T. (2000). Applications of structural equation modeling in psychological research. Annual Review of Psychology, 51(1), 201–226. https://doi.org/10.1146/annurev.psych.51.1.201
- Marsh, H. W., Dowson, M., Pietsch, J., & Walker, R. (2004). Why multicollinearity matters: A reexamination of relations among self-efficacy, self-concept, and achievement. Journal of Educational Psychology, 96(3), 518–522. https://doi.org/10.1037/0022-0663.96.3.518
- Przybylski, A. K., & Weinstein, N. (2017). A large-scale test of the Goldilocks hypothesis: Quantifying the relations between digital-screen use and the mental well-being of adolescents. Psychological Science, 28(2), 204–215. https://doi.org/10.1177/0956797616678438
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503